

We zijn er niet vies van om de grenzen van de computertechnologie te verleggen, maar dit keer slaan we echt alles. Na de mijlpaal van 100 biljoen cijfers van vorig jaar, besloten we de lat nog hoger te leggen en het aantal bekende cijfers van Pi te verhogen naar 105 biljoen. Dat zijn 105,000,000,000,000 getallen na de 3. We hebben een aantal updates doorgevoerd ten opzichte van de run van vorig jaar, onderweg een paar verrassende dingen ontdekt en het een en ander geleerd – waaronder het 105 biljoenste cijfer van Pi: 6!
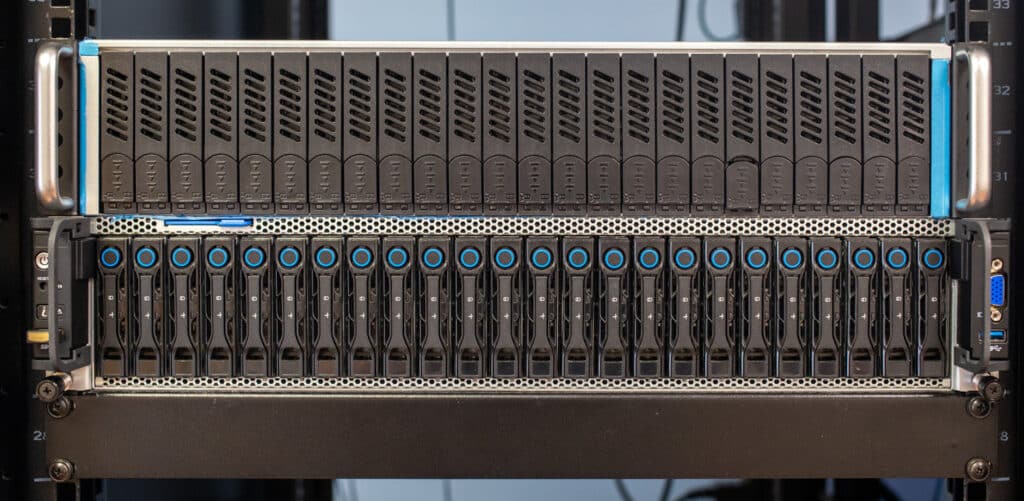
Met een wereldrecordbrekende berekening van Pi tot 105 biljoen cijfers heeft het StorageReview-lab de ongelooflijke mogelijkheden van moderne hardware onderstreept. Deze onderneming, mogelijk gemaakt door een baanbrekend 2P 128-core AMD EPYC Bergamo-systeem uitgerust met 1.5 TB DRAM en bijna een petabyte aan Solidigm QLC SSD's, vertegenwoordigt een mijlpaal op het gebied van computer- en opslagtechnologie.
De Uitdaging
In de digitale run van 100 biljoen zijn we verschillende technologische beperkingen tegengekomen. Het serverplatform ondersteunde bijvoorbeeld slechts 16 NVMe SSD's in de voorste slots. Hoewel we voldoende CPU-kracht hadden, vereiste deze berekening enorme opslagruimte tijdens het proces en aan de achterkant toen het uiteindelijke TXT-bestand werd uitgevoerd.
Om het opslagprobleem de vorige keer op te lossen, hebben we onze toevlucht genomen tot PCIe NVME-adaptersleeën om er nog eens drie SSD's in te persen. Vervolgens hadden we voor de uitvoer een HDD-opslagserver in RAID0, let wel, met een iSCSI-share terug naar de rekenbox. Deze keer wilden we wat ondernemender zijn met deze server, dus hebben we een paar vrienden erbij gehaald om te helpen. Interessant genoeg is het niet zo eenvoudig als het lijkt om een aantal NVMe SSD's aan een server toe te voegen.
De hardware
Het hart van deze monumentale taak was het dual-processor AMD EPYC 9754 Bergamo-systeem, dat elk 128 cores bood. De processors van AMD, bekend om hun uitzonderlijke prestaties bij complexe rekentaken (AI, HPC, big data-analyse) , leverden de benodigde rekenkracht. Dit werd aangevuld met 1.5 TB DRAM, wat zorgde voor snelle gegevensverwerking en -overdracht. Tegelijkertijd bood bijna een petabyte aan Solidigm QLC-opslag ongekende capaciteit en betrouwbaarheid.
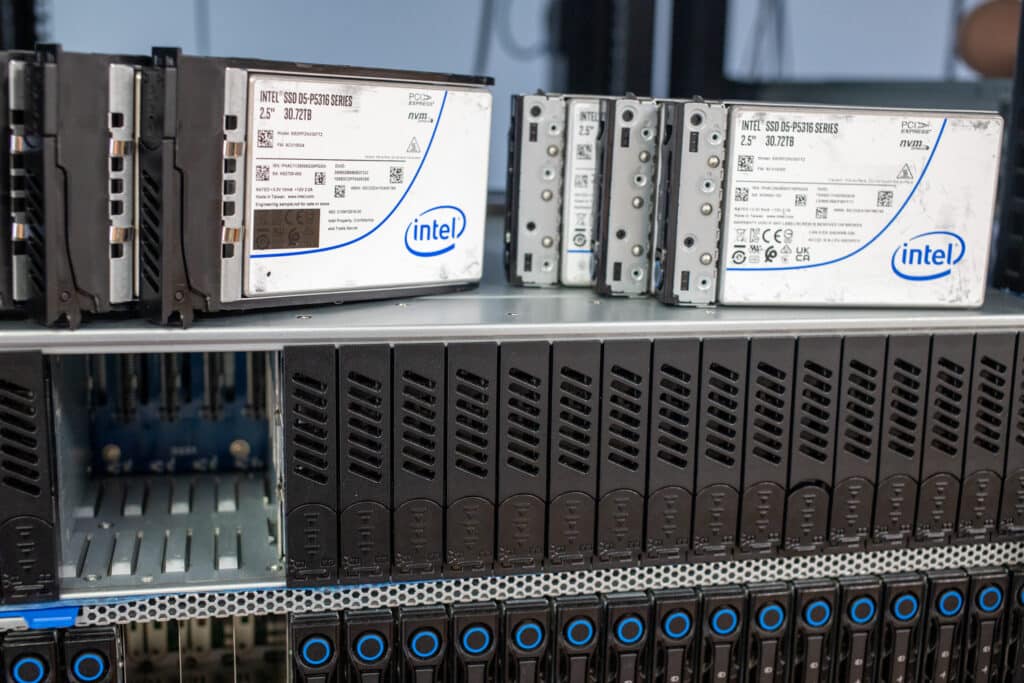
Ons basischassisplatform bleef hetzelfde als vorig jaar (een QCT-box), maar we hebben de CPU's geüpgraded naar AMD EPYC 9754 Bergamo-chips. We wilden een snelheids- en decimale verbetering nastreven en tegelijkertijd het gebruik van opslag voor de berekeningen vermijden, wat betekende dat we een beroep moesten doen op SerialCables om een JBOF te leveren. Dit bracht op zichzelf enkele uitdagingen met zich mee, die we hieronder zullen bespreken.
| Parameter | Waarde |
|---|---|
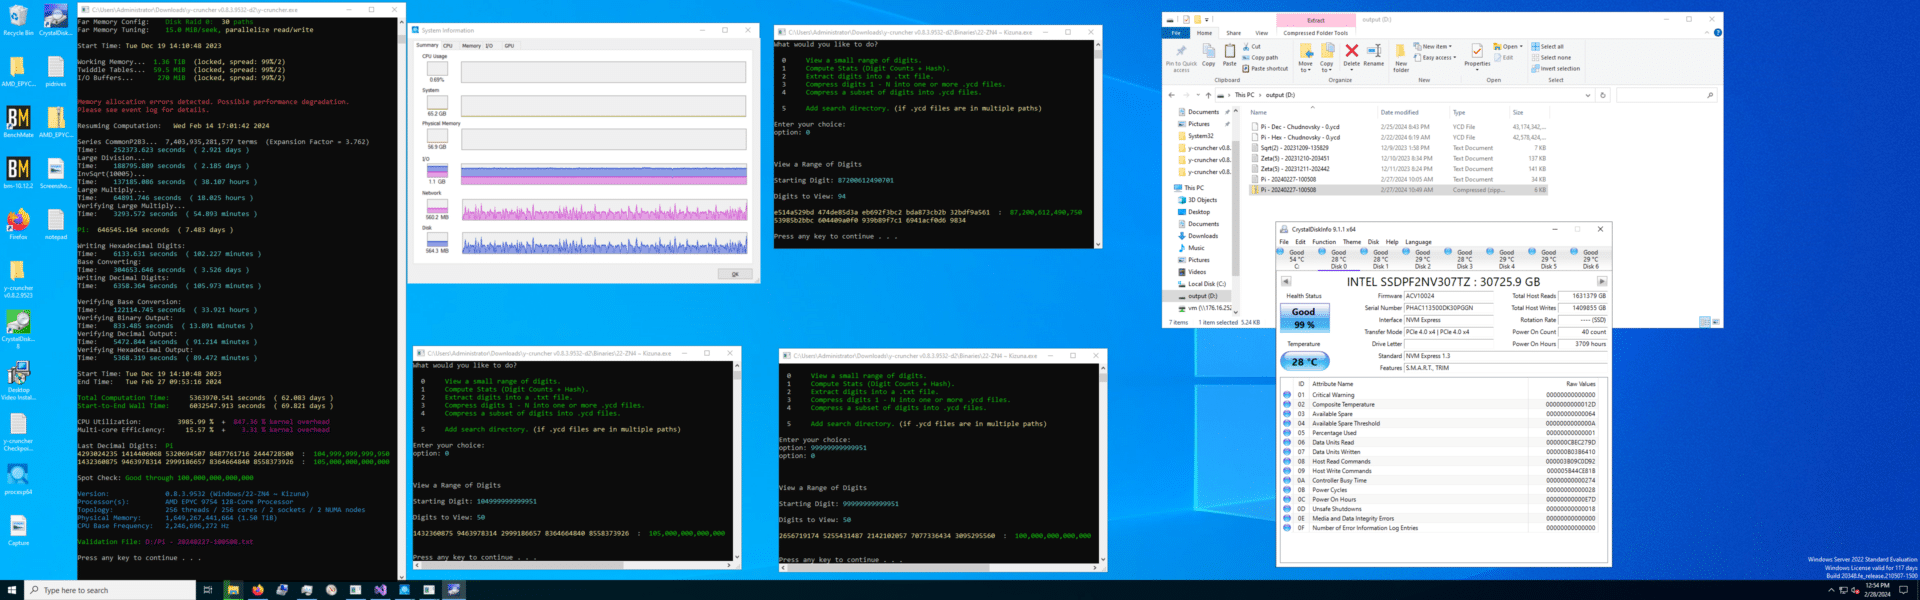
| Begin datum | di 19 dec 14:10:48 2023 |
| Einddatum | di 27 februari 09:53:16 2024 |
| Totale rekentijd | 5,363,970.541 seconden / 62.08 dagen |
| Begin-tot-eind-muurtijd | 6,032,547.913 seconden / 69.82 dagen |
Berekeningsperiode: 14 december 2023 – 27 februari 2024, een periode van 75 dagen.
- CPU: Dubbele AMD Epyc 9754 Bergamo-processors, 256 cores met gelijktijdige multithreading (SMT) uitgeschakeld in BIOS.
- Geheugen: 1.5 TB DDR5-RAM.
- Opslag: 36x 30.72 TB Solidigm D5-P5316 SSD's.
- 24x 30.72 TB Solidigm D5-P5316 SSD's in een seriële kabel-JBOF
- 12x 30.72TB Solidigm D5-P5316 SSD's in de server, direct aangesloten.
- Besturingssysteem: Windows Server 2022 (21H2).
Het pad naar 105 biljoen
| Parameter | Waarde |
|---|---|
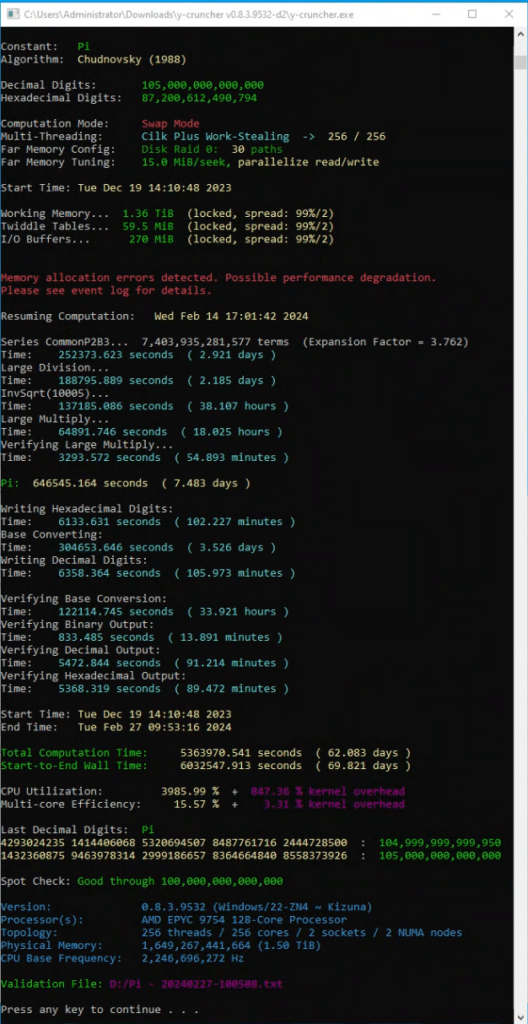
| constante | Pi |
| Algoritme | Tsjoednovski (1988) |
| Decimale cijfers | 105,000,000,000,000 |
| Hexadecimale cijfers | 87,200,612,490,794 |
| Inrijgmodus | Cilk Plus werkstelen -> 256 / 256 |
| Werkgeheugen | 1,492,670,259,968 (1.36 TiB) |
| totaal geheugen | 1,492,984,298,368 (1.36 TiB) |
| Logisch grootste controlepunt | 157,783,654,587,576 (144 TiB) |
| Logisch piekschijfgebruik | 534,615,969,510,896 (486 TiB) |
| Logische schijfbytes lezen | 44,823,456,487,834,568 (39.8 PiB) |
| Logische schijfbytes geschreven | 38,717,269,572,788,080 (34.4 PiB) |
Uitdagingen tegengekomen
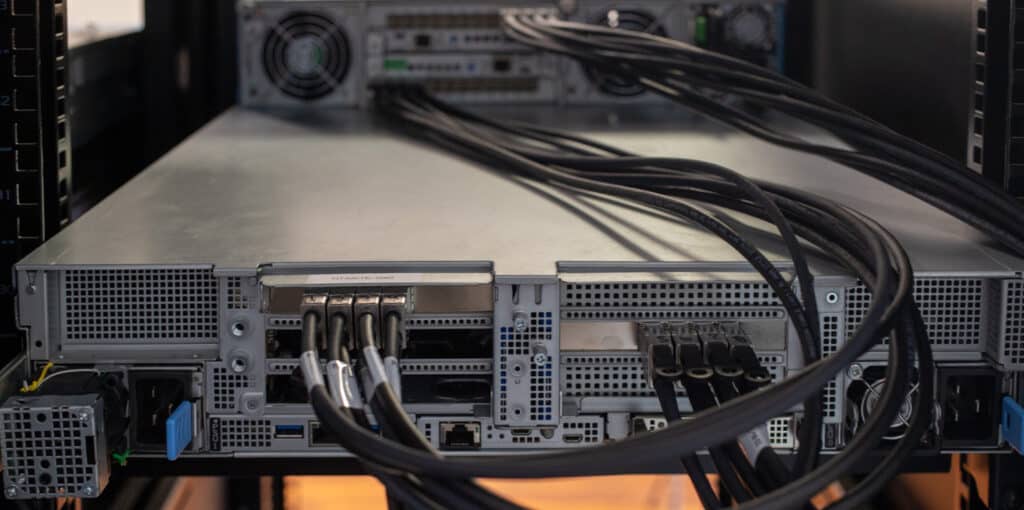
Een nieuwe component voor deze testrun, die nodig was om de beschikbare opslagruimte voor de processors uit te breiden, was de toevoeging van een NVMe JBOF. Ons testplatform bood 16 NVMe-bays, waarvan de overige acht alleen voor SATA waren bedraad. Hoewel we bij onze testrun van 100 biljoen drie interne PCIe U.2-adapters gebruikten om het aantal NVMe-schijven uit te breiden naar 19, was dit niet optimaal. Voor deze herhaling hebben we een Serial Cables 24-bay U.2 JBOF toegevoegd , wat op twee manieren aanzienlijk verbeterde: meer swap-opslag voor de rekenkracht en interne opslag voor uitvoerbestanden. Geen gekke RAID0 HDD-opslagserver meer!
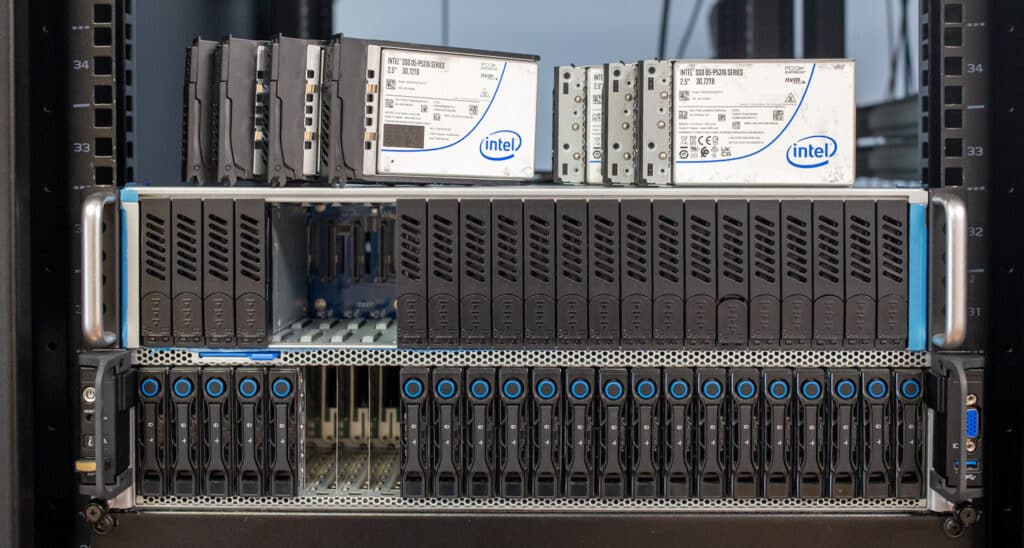
Dankzij de 24-bay JBOF met seriële kabels konden we het aantal schijven bijna verdubbelen ten opzichte van onze oorspronkelijke run. We hebben 30 schijven toegewezen aan de y-cruncher-swapruimte, waardoor er 6 SSD's overblijven voor een Storage Spaces RAID5-uitvoervolume. Een groot voordeel van die aanpak kwam tijdens de eindfase, waar we niet werden tegengehouden door de snelheid van een enkele 10Gb-verbinding, zoals bij de eerste 100T Pi-iteratie. Hoewel de JBOF het probleem van het totale aantal schijven aanpakte, introduceerde het wel één beperking: de prestaties van individuele schijven.
In een server met direct aangesloten U.2 SSD's zijn er vier PCIe-lanes per schijf. Als elke schijf rechtstreeks op het moederbord is aangesloten, komt dat neer op 96 PCIe-lanes voor 24 SSD's. De totale bandbreedte van de JBOF wordt beperkt door het aantal PCIe-lanes dat het kan verbinden met de host.
In dit geval hebben we twee PCIe-switchhostkaarten gebruikt, waardoor de JBOF in twee groepen van 12 SSD's is gesplitst. Elke groep van 12 SSD's deelde vervolgens 16 PCIe-lanes. Hoewel we nog steeds aanzienlijke voordelen boden bij het verbinden van de SSD's met onze host, hadden we wel scenario's waarin swap-drives die door de JBOF liepen, achter schijven raakten die rechtstreeks op de server waren aangesloten. Dit is niet de schuld van de JBOF. Het is slechts een technische beperking, of beter gezegd een beperking van het aantal PCIe-lanes waarmee de server kan werken.
Oplettende lezers vragen zich misschien af waarom we in deze serie zijn gestopt bij 36 SSD's in plaats van naar 40 te gaan. Het is een grappig verhaal. Adresseerbare PCIe-ruimte heeft op veel servers zijn grenzen. In ons geval nam de laatste SSD bij het aantal van 38 schijven het PCIe-adres van de USB-chipset over en verloren we de controle over de server. Om op safe te spelen, hebben we een back-up gemaakt van 36 SSD's, zodat we nog steeds naar het BIOS konden gaan of op de server konden inloggen. Het verleggen van grenzen leidt tot verrassende ontdekkingen.
Diagnostisch inzicht en oplossing
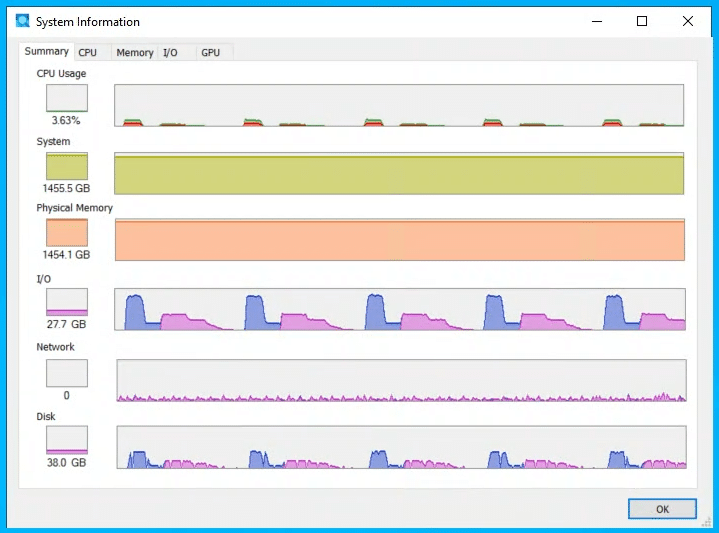
De eerste van de twee belangrijkste uitdagingen waar we tegenaan liepen, was prestatiegerelateerd. Wat we ontdekten, was de wet van Amdahl in actie. Er ontstond een merkwaardig probleem toen y-cruncher leek vast te lopen op ons 256-core AMD Bergamo-systeem tijdens grote swap-bewerkingen. Deze vastloop, gekenmerkt door een gebrek aan CPU- en schijf-I/O-activiteit, tartte de gangbare verwachtingen van softwaregedrag. Dit leidde tot een diepgaand onderzoek naar de complexiteit van parallel computing en de interactie tussen hardware.
Uit het ontdekkingsproces bleek dat het programma niet echt vastliep, maar met een zeer beperkte capaciteit werkte en single-threaded draaide over een uitgebreide 256-core opstelling. Dit ongebruikelijke gedrag leidde tot vragen over de mogelijke impact van de wet van Amdahl, vooral omdat de betrokken bewerkingen niet rekenintensief waren en geen significante vertragingen hadden mogen veroorzaken op een systeem dat was uitgerust met 1.5 TB RAM.
Het onderzoek nam een onverwachte wending toen het probleem zich voordeed op een consumenten-desktopcomputer, wat de ernstige gevolgen van de wet van Amdahl benadrukte, zelfs op minder omvangrijke systemen. Dit leidde tot een diepgaander onderzoek naar de onderliggende oorzaken, waarbij een CPU-risico werd ontdekt dat specifiek is voor de Zen4-architectuur en te maken heeft met super-alignment en de effecten daarvan op geheugentoegangspatronen.
Het probleem werd bij AMD-processors verergerd door een lus in de code die, vanwege zijn eenvoudige aard, veel sneller had moeten worden uitgevoerd dan waargenomen. De hoofdoorzaak leek een inefficiënte verwerking van geheugenaliasing door AMD's load-store-eenheid te zijn. De oplossing van dit complexe probleem vereiste zowel het beperken van het gevaar van superuitlijning door vectorisatie van de lus met behulp van AVX512 als het aanpakken van de vertraging veroorzaakt door de wet van Amdahl met verbeterd parallellisme. Deze alomvattende aanpak loste niet alleen het directe probleem op, maar leidde ook tot aanzienlijke optimalisaties in de computerprocessen van y-cruncher, waardoor een precedent werd geschapen voor het aanpakken van soortgelijke uitdagingen in krachtige computeromgevingen.
Het volgende probleem deed zich voor in de laatste stappen van de berekening, die onverwacht stopte en geen informatie opleverde over de oorzaak van de crash. Alexander Yee kreeg toegang op afstand en voor het eerst in meer dan tien jaar vereiste het voltooien van een Pi-record directe tussenkomst van de ontwikkelaar.
We waren niet betrokken bij dit diagnoseproces, maar er was een kritieke rekenfout met drijvende-komma getallen in het AVX512-codepad van het N63-vermenigvuldigingsalgoritme. Alexander kon de fout op afstand diagnosticeren , een gecorrigeerd binair bestand leveren en verdergaan vanaf een checkpoint, wat resulteerde in een succesvolle berekening na het implementeren van cruciale softwarecorrecties.
Reflecties en vooruitgaan
Dit streven illustreert de complexiteit en onvoorspelbaarheid van high-performance computing. Het oplossen van deze uitdagingen zorgde voor een nieuw Pi-berekeningsrecord en leverde waardevolle inzichten op in softwareontwikkeling en testmethodologieën. De nieuwste release van y-cruncher, v0.8.4, bevat oplossingen voor de geïdentificeerde problemen, en belooft verbeterde stabiliteit voor toekomstige berekeningen.
Het berekenen van Pi tot 105 biljoen cijfers was geen sinecure. Het ging om een nauwgezette planning, optimalisatie en uitvoering. Door gebruik te maken van een combinatie van open source en propriëtaire software optimaliseerde het team van StorageReview het algoritmische proces om de mogelijkheden van de hardware volledig te benutten, waardoor de rekentijd werd verminderd en de efficiëntie werd verbeterd.
Met PCIe Gen4 verzadigende leesprestaties en toonaangevende capaciteiten tot 61.44 TBs leveren Solidigm QLC SSD's ongelooflijke resultaten. “Stel je voor wat deze schijven mogelijk kunnen maken in krachtige computer- of AI-intensieve applicaties”, zegt Greg Matson, VP Strategic Planning en Marketing bij Solidigm. We zijn heel blij dat de SSD's van Solidigm de tweede recordbrekende poging van Storagereview om pi te berekenen kunnen ondersteunen. Hun inspanningen bewijzen de ware mogelijkheden van de opslagschijven van Solidigm en openen een wereld van mogelijkheden voor data-intensieve AI-toepassingen.”
Conclusie
De run naar 105 biljoen cijfers van Pi was veel complexer dan we hadden verwacht. Bij nader inzien hadden we moeten verwachten dat we met nieuwe problemen te maken zouden krijgen; we zijn tenslotte bezig met een berekening die nog nooit eerder is uitgevoerd. Maar nu de berekening van 100 biljoen werd aangevuld met een veel meer ‘ducttape en kippengaas’-configuratie, dachten we dat we het voor elkaar hadden. Uiteindelijk was er een gezamenlijke inspanning nodig om dit tuig over de finish te krijgen.
Terwijl we ons samen met onze partners verheugen over deze recordbrekende run, moeten we ons afvragen: “Wat betekent dit eigenlijk?” Vijf biljoen cijfers Pi zullen waarschijnlijk geen groot verschil maken voor de wiskunde. Toch kunnen we enkele lijnen trekken tussen computationele werklasten en de behoefte aan moderne onderliggende hardware om deze te ondersteunen. In wezen weerspiegelt deze oefening dat de juiste hardware het verschil maakt, of het nu gaat om een datacentercluster van een onderneming of om een grote HPC-installatie.
Voor de berekening van Pi werden we volledig beperkt door de opslagruimte. Snellere CPU's helpen de berekeningen te versnellen, maar de beperkende factor voor veel nieuwe wereldrecords is de hoeveelheid lokale opslag in het systeem. Voor deze run maken we opnieuw gebruik van de Solidigm D5-P5316 30.72 TB SSD's , waarmee we iets meer dan 1.1 PB aan ruwe flashgeheugen in het systeem krijgen. Deze SSD's zijn de enige reden dat we de vorige records konden verbreken en 105 biljoen cijfers van Pi konden bereiken.
Dit roept echter een interessante vraag op. Veel van onze volgers weten dat Solidigm SSD's van 61.44 TB in de D5-P5336-serie heeft en tot 30.72 TB in de D5-P5430 -serie, verkrijgbaar in verschillende formaten en capaciteiten. We hebben de schijven getest en veel berichten op sociale media geplaatst waarin deze verbazingwekkend compacte schijven worden getoond. Met 32 van deze SSD's die samen bijna 2 PB aan opslagruimte bieden, zou je je kunnen afvragen hoe lang die 105 biljoen cijfers van Pi nog de grootste ter wereld zullen blijven. Wij denken van niet al te lang.
Grootste bekende decimale cijfers van Pi
1432360875 9463978314 2999186657 8364664840 8558373926: Cijfers tot 105,000,000,000,000


 Amazon