

De NVIDIA RTX PRO 4500 Blackwell Server Edition is de videokaart die NVIDIA heeft ontwikkeld voor de servers die de meeste bedrijven al bezitten. Het is een single-slot, passief gekoelde kaart van 165 W met 32 GB GDDR7-geheugen en de volledige Blackwell-functionaliteit: vijfde generatie Tensor Cores met FP4, vierde generatie RT-cores, drie encoders en drie decoders, en ondersteuning voor Multi-Instance GPU's waarmee het geheugen kan worden opgesplitst in twee geïsoleerde partities van 16 GB. De kaart vervangt de L4 als instapmodel in NVIDIA's RTX PRO-serverlijn en past zonder problemen in een 2U PowerEdge, ProLiant of ThinkSystem.

NVIDIA's argument voor de kaart is 'right-sizing': de meeste bedrijven bouwen geen AI-fabrieken; ze hebben luchtgekoelde, bestaande datacenters met strikte limieten voor het stroomverbruik van de racks, en ze hebben een eerste stap in versnelde computing nodig die geen nieuwe serverklasse vereist. Of ze werken aan de rand van het netwerk, waar de RTX PRO 4500 beter aansluit bij de workloads en stroombeperkingen die doorgaans bepalen wat er ingezet kan worden.
De RTX PRO 6000 Blackwell bestrijkt de top van die markt met 96 GB en tot 600 W. De 4500 behoudt dezelfde architectuur en halveert alle andere specificaties, zodat klanten met kleinere modellen, veel kleinere taken of een budget voor schaalvergroting per dollar per watt de Blackwell-serie kunnen aanschaffen zonder te betalen voor extra capaciteit die ze niet gebruiken.
De taken voor deze klasse GPU's zijn goed bekend: inferentie van kleine taalmodellen, AI voor beeldherkenning en videoanalyse, vectorzoekopdrachten en het genereren van embeddings, transcodering en virtuele werkstations onder vGPU 20. De GPU claimt meer dan 5x de prestaties van L4 voor inferentie van kleine en middelgrote modellen en tot 10x voor Nemotron-modellen. De lanceringspartners omvatten NTT DATA voor edge-video, Pacific Biosciences voor sequencing en Nokia voor AI-RAN-basisstations. AWS heeft zijn nieuwe G7-instances erop gebouwd als vervanging voor de G6.
We hebben de kaart al getest tegen de L4 in een HPE ProLiant DL145 Gen11 in onze review van de RTX PRO 4500 edge , waar hij 2.7 keer de doorvoer van de L4 leverde. Deze review beantwoordt de vraag hoe dicht hij in de buurt komt van de 350W dual-slot L40S, die al twee jaar de standaard is voor inferentie-taken in het mainstream segment, en wat de RTX PRO 6000 daarboven toevoegt aan extra geheugen en stroom.
Om dit te achterhalen, hebben we de 4500 in een Dell PowerEdge R770 vergeleken met een L40S en een L4, de gegevens van de RTX PRO 6000 Blackwell van onze Dell Pro Max Tower T2 toegevoegd , zowel met de standaardwaarde van 600W als met een limiet van 450W die overeenkomt met wat de R770 per GPU-slot toestaat, en vLLM online serving uitgevoerd op vier modellen met twee contextlengtes.
Als korte vooruitblik: bij typische chat- en agentcontextlengtes houdt de 4500 gelijke tred met de L40S op FP8- en BF16-modellen, maar met minder dan de helft van het stroomverbruik; bij 8K-input laat de 32 GB framebuffer zijn beperkingen zien; en NVFP4, de precisie waarmee NVIDIA zijn Blackwell-aanbod presenteert, presteert in lijn met de rest van de line-up op deze vLLM-build.
Key Takeaways
- Doorvoersnelheid van de L40S bij 165W in één slot: Bij een invoer- en uitvoersnelheid van 512 tokens evenaarde of overtrof de 4500 de L40S op elk FP8- en BF16-model dat we hebben getest: 1,107 versus 995 tokens/s op de Ministral 3 14B FP8 en 2,006 versus 1,988 op de Ministral 3 3B. Dit alles met een kaart die slechts 47 procent van het vermogen van de L40S en de helft van het aantal slots heeft.
- Ongeveer drie keer zo groot als de L4 die hij vervangt: 2.8 tot 3.6 keer de uitvoerdoorvoer van de L4 bij een korte context, met 2.3 keer het stroomverbruik van de L4.
- 32 GB heeft een maximumcapaciteit: Bij een invoer van 8K bleef de 4500 17 tot 33 procent achter op de L40S, en de prestatiecurves vlakten af bij een gelijktijdigheid van 8, terwijl de L40S bleef stijgen tot 16. Deze afvlakking wordt veroorzaakt door het opraken van de KV-cache, en 32 GB is de limiet.
- NVFP4 is een softwareverhaal, op elke kaart: Op Qwen3.8-27B NVFP4 produceerde de 4500 320 tokens/s bij een gelijktijdigheid van 32, de L40S 480 zonder FP4-hardware en de RTX PRO 6000 621. Het NVFP4-pad in deze vLLM-build schaalt op geen van de kaarten mee met de geheugenbandbreedte, terwijl de MAMF-sweep laat zien dat de FP4-hardware van de 4500 568.6 TFLOPS bereikt, tegenover 280.1 in FP8.
- Wat je met de grotere kaart krijgt: Met een maximaal vermogen van 450W, het maximum dat een Dell R770 GPU-slot toelaat, presteerde de RTX PRO 6000 ongeveer twee keer zo goed als de 4500 bij korte context en 2.5 tot 3.2 keer zo goed bij 8K. Het volledige vermogen van 600W voegde daar nog eens 1 tot 2 procent aan toe bij korte context en 4 tot 9 procent bij lange context, dus het grootste verschil dat de 6000 ten opzichte van de 4500 maakt, zit hem in het geheugen.
Specificaties van de NVIDIA RTX PRO 4500 Blackwell Server Edition
Er bestaan twee videokaarten met de naam RTX PRO 4500 Blackwell, die weliswaar op elkaar lijken, maar niet identiek zijn. De Workstation Edition, aangekondigd op GTC 2025, is een 200W dual-slot kaart met actieve koeling, vier DisplayPort-uitgangen en een geheugenbandbreedte van 896 GB/s. De Server Edition, die we hier bespreken, werd gepresenteerd op GTC 2026 als een 165W single-slot, passieve, headless kaart met een bandbreedte van 800 GB/s. Deze versie ruilt de DisplayPort-uitgangen en wat extra kloksnelheid in voor de datacenterfunctionaliteit: MIG, vertrouwelijke computing, een derde NVENC- en NVDEC-chip en vGPU 20-ondersteuning. Onder de motorkap beschikken beide kaarten over dezelfde GPU met 10,496 cores en 32 GB GDDR7-geheugen met ECC.
Volgens de gegevens van NVIDIA bevat de chip 45.6 miljard transistors op 378 mm² TSMC 4nm custom silicon met 82 RT-cores van de vierde generatie, wat neerkomt op 82 SM's en 328 Tensor Cores. Dit zijn GB203-cijfers, dezelfde chipfamilie als de RTX 5080, maar dan iets lager. De Tensor-cijfers hieronder zijn de pieken van NVIDIA met sparse optimalisatie; met dense optimalisatie is dit de helft, wat NVIDIA's eigen peakTOPS-programma bevestigt met 805 TFLOPS FP8 en 403 TFLOPS FP16, gemeten op deze kaart.
| Specificaties | RTX PRO 4500 Blackwell SE | L4 | L40S | RTX PRO 6000 Blackwell SE |
|---|---|---|---|---|
| Platformoverzicht | ||||
| Architectuur | NVIDIA Blackwell | NVIDIA Ada Lovelace | NVIDIA Ada Lovelace | NVIDIA Blackwell |
| CUDA-kernen | 10,496 | 7,424 | 18,176 | 24,064 |
| RT Cores | 82 (4e generatie) | 58 (3e generatie) | 142 (3e generatie) | 188 (4e generatie) |
| GPU-geheugen | 32 GB GDDR7 met ECC | 24GB GDDR6 | 48 GB GDDR6 met ECC | 96 GB GDDR7 met ECC |
| Geheugeninterface | 256-bit | 192-bit | 384-bit | 512-bit |
| Geheugenbandbreedte | 800GB / s | 300GB / s | 864GB / s | 1,597GB / s |
| Prestaties (NVIDIA piekcijfers, Tensor-snelheden met spaarzaamheid) | ||||
| FP32 | 51 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS | 120 TFLOPS |
| FP16 / BF16 Tensor | 406 TFLOPS | 242 TFLOPS | 733 TFLOPS | 1 PFLOPS |
| FP8-tensor | 811 TFLOPS | 485 TFLOPS | 1,466 TFLOPS | 2 PFLOPS |
| FP4-tensor | 1.6 PFLOPS | Niet ondersteund | Niet ondersteund | 4 PFLOPS |
| RT-kernprestaties | 154 TFLOPS | Niet op de lijst | 209 TFLOPS | 355 TFLOPS |
| Vermogen en vormfactor | ||||
| Max Board Power | 165W | 72W | 350W | Tot 600 W (configureerbaar) |
| Form Factor | Enkelvoudige sleuf, FHFL 4.4 "x 10.5" |
Enkelvoudige sleuf, HHHL | Dubbele sleuf, FHFL 4.4 "x 10.5" |
Dubbele sleuf, FHFL (lucht) Enkelvoudige sleuf, FHXL (vloeistof) |
| Warmte- | Passieve | Passieve | Passieve | Passief (lucht) of vloeistof |
| Stekker | 1x PCIe CEM5 16-pins | Slot-aangedreven | 1x 16-pin | 1x PCIe CEM5 16-pins |
| interconnect | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| Gewicht | 1,055g | Niet op de lijst | Niet op de lijst | Niet op de lijst |
| Kenmerken | ||||
| GPU met meerdere instanties | Tot 2x 16GB | Nee | Nee | Tot 4x 24GB |
| NVENC/NVDEC | 3x / 3x | 2x / 4x | 3x / 3x | 4x / 4x |
| Vertrouwelijk computergebruik | ondersteunde | Nee | Nee | ondersteunde |
| vGPU-ondersteuning | Ja (vGPU 20) | Ja | Ja | Ja |
Ontwerp en bouw
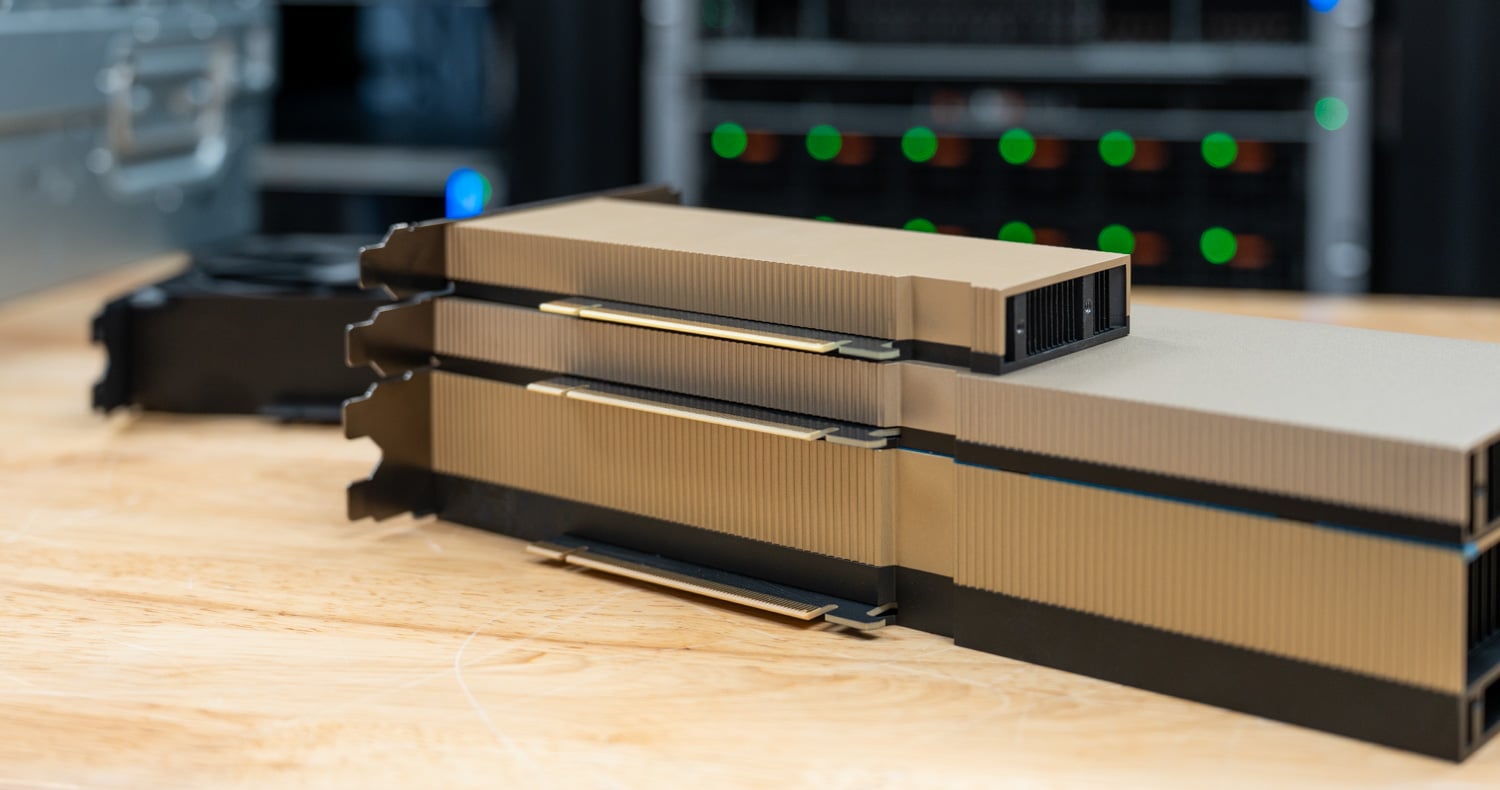
De 4500 Server Edition is een full-height, full-length kaart, 4.4 inch hoog en 10.5 inch lang, en vult één slot. Dat is een belangrijke verandering ten opzichte van de L4, die een half-height, half-length kaart was. De L4 dient nog steeds als referentiepunt voor de benchmarks, maar de formfactor is veranderd naar FHFL (full-height, full-length) om ruimte te maken voor het geheugen, de 16-pins voedingsaansluiting en een koelblok dat met alleen de luchtstroom in de behuizing 165W aan vermogen kan afvoeren.

Die vormfactor is het enige echte verschil met de L4, die in elk HHHL-slot paste en zijn 72W uit het slot haalde, waardoor hij in 1U-servers en kleine edge-boxen werd gebruikt. De 4500 is volledig van hoogte en lengte en vereist een 16-pins kabel. De gangbare 1U-servers waarmee we werken, waaronder de huidige 1U PowerEdge-lijn van Dell, ondersteunen maximaal HHHL- of FHHL-kaarten zonder die connector.
In de praktijk is dit een 2U-kaart, of een kaart voor de weinige 1U-chassis die zonder sleuf zijn gebouwd en FHFL-sleuven hebben. Een winkel die L4's heeft gekocht voor 1U- of edge-behuizingen krijgt dus geen direct vervangingsonderdeel.
Als de L40S zijdelings op elkaar gestapeld wordt, met de L40S erboven en de L40S eronder, heeft de 4500 één slot nodig waar de L40S er twee nodig heeft. Daarom kan een 2U-server die vier dubbelbrede kaarten accepteert, er acht van deze kaarten bevatten, en daarom kunnen AWS G7-instances tot acht van deze kaarten per host draaien.
De stroomvoorziening verloopt via een enkele PCIe CEM5 16-pins connector, dezelfde connector als de RTX PRO 6000, zonder extra 8-pins aansluiting. De koeling is volledig passief, waardoor de kaart afhankelijk is van de ventilatoren van de server en de prestaties zullen worden teruggeschroefd in een behuizing die geen luchtcirculatie mogelijk maakt. Dit is normaal voor deze klasse, en alle andere GPU's hebben dezelfde vereisten.
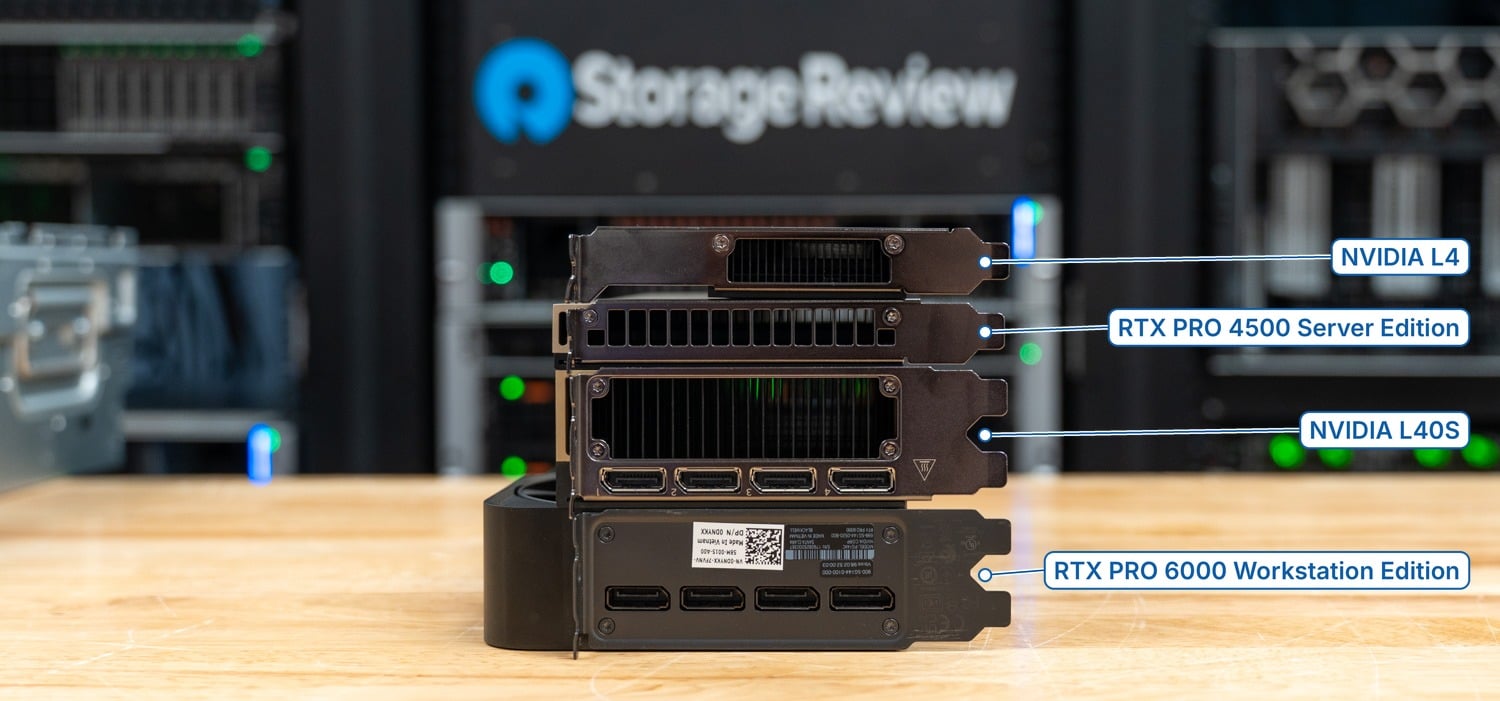
De kaart heeft geen video-uitgangen, dus grafische taken, of het nu gaat om virtuele vGPU-werkstations of rendering, verlopen via het netwerk. De bracket is daarom geventileerd. De drie NVENC-engines van de negende generatie en de drie NVDEC-engines van de zesde generatie bieden 4:2:2 H.264- en HEVC-codering en -decodering ten opzichte van de L4-generatie. NVIDIA claimt een tweemaal zo hoge H.264-decodeersnelheid per NVDEC-engine vergeleken met de L4. De onderstaande afbeelding van de bracket maakt het verschil duidelijk: de L4 en de 4500 hebben alleen ventilatieopeningen, terwijl de L40S en de RTX PRO 6000 Workstation Edition elk vier DisplayPort-uitgangen hebben.
Waar past de RTX PRO 4500 Blackwell Server Edition?
NVIDIA presenteert de kaart als een kaart met de volgende kernwaarde: "De combinatie van AI, rekenkracht, grafische mogelijkheden en videoversnelling in een passief ontwerp met één slot en een stroomverbruik van 165 W." De kaart is ontworpen voor servers "waar rackdichtheid, stroomverbruik en koeling de belangrijkste implementatiebeperkingen zijn." De kaart bevindt zich in wat NVIDIA het mainstream datacenter- en edge-segment van het RTX PRO-serverportfolio noemt, onder de RTX PRO 6000 Blackwell Server Edition en boven niets; het is het instapmodel van de Blackwell-serverlijn.
NVIDIA claimt ten opzichte van de L4-processor tot wel 10x sneller te werken met de Nemotron Nano-modellen voor inferentie met kleine modellen (NVFP4 op de 4500 versus FP8 op de L4), tot 4x sneller voor videosamenvatting met Cosmos Reason 2, 1.9x sneller met SPECviewperf 15 in 4K en 1.8x sneller met streaming. Ten opzichte van CPU's claimt NVIDIA tot wel 50x sneller te werken met vectordatabases met cuVS CAGRA in Milvus en tot wel 100x sneller met AI voor computervisie, beide gemeten op 4500-servers met acht videokaarten versus dual-socket EPYC 9654-systemen.
Het serverteam van Dell vertelde ons dat ze de 4500 in reguliere serverracks verwachten, omdat drie 32GB 4500's ongeveer evenveel kosten als één 96GB 6000, en in dat geval wint de grotere kaart meestal. Deze kaart is bedoeld voor een server die anders geen GPU of L4-geheugen zou hebben, en is niet optimaal voor een server die ontworpen is voor één of meer 6000's.
Test Setup
We hebben de 4500, de L40S en de L4 geïnstalleerd in onze Dell PowerEdge R770, geconfigureerd met twee Intel Xeon 6787P-processors (elk 86 cores) en 2 TB DDR5-6400 verdeeld over 32 DIMM's, met NVIDIA-driver 595.71.05. De tests maakten gebruik van de NGC vLLM 26.08-py3-container, die vLLM 0.27.1 op CUDA 13.4.1 bevat, waardoor de softwarestack voor alle kaarten identiek is. Elke kaart werd afzonderlijk getest op de standaard stroomlimiet, en de R770 levert elke kaart het volledige vermogen: Dell geeft voor de L4 een vermogen van 72 W, voor de 4500 165 W en voor de L40S 350 W in die behuizing op.
De RTX PRO 6000 Blackwell is de workstation-kaart in onze Dell Pro Max Tower T2, in dezelfde behuizing en met dezelfde driver. NVIDIA geeft voor de workstation- en serverversies een identiek vermogen van 600W aan, en in onze tests presteren ze ook hetzelfde, dus deze kaart fungeert als vervanging voor de serverkaart. Overigens hebben we ook een review van de RTX PRO 6000 Server -kaarten in een XE7740, mocht u meer willen weten over de schaalbaarheid van deze kaarten.
We hebben de 6000 twee keer getest: één keer met de standaardwaarde van 600W en één keer met een geverifieerde limiet van 450W via nvidia-smi. Dit komt omdat 450W het maximale vermogen is dat de R770 aan een 6000 in een GPU-slot kan leveren, en dit is het cijfer waarmee een koper die moet kiezen tussen een 4500 en een 6000 voor een typische 2U-server, rekening moet houden. Het hostplatform verschilt voor de 6000, maar bij deze GPU-intensieve serverbelastingen hebben de CPU en de PCIe-topologie een veel kleiner effect dan de vermogenslimiet.
We gebruikten de online serving benchmark van vLLM met gelijktijdigheidsniveaus van 1, 2, 4, 8, 16 en 32 en twee aanvraagvormen: 512 invoertokens en 512 uitvoertokens, wat overeenkomt met chat en korte agentbeurten, en 8,192 invoertokens met 1,024 uitvoertokens, wat overeenkomt met RAG- en documentverwerking waarbij prefill dominant is en de KV-cache wordt gevuld. De modellen werden zo gekozen dat ze, waar mogelijk, op de kleinste kaart in de groep pasten, dus de 24 GB van de L4 vormt de ondergrens: Ministral 3 3B Reasoning en Ministral 3 8B Reasoning in BF16, Ministral 3 14B Instruct in FP8 en Qwen3.8-27B in NVFP4, die op kaarten van 32 GB en groter past, maar niet op de L4.
We rapporteren de doorvoer van uitvoertokens op elk niveau van gelijktijdigheid en vermelden de totale doorvoer, inclusief vooraf ingevulde tokens, waar dit het beeld verandert.
Wat hier niet aanwezig is: grotere modellen die alleen kaarten van 48 GB en groter aankunnen, MIG-partitionering, vGPU, videotranscodering, stroomverbruik met meter, de configuratie met twee 4500-kaarten en de datacenterkaarten van een hogere klasse.
Maximaal haalbare Matmul FLOPS (MAMF)
MAMF is een aanhoudende, intensieve GEMM-test die de hoogste matrixvermenigvuldigingsdoorvoer rapporteert die een kaart in elke precisie behaalt. Dit maakt het de eenvoudigste manier om te controleren of de FP4-hardware werkt zodra de serverstack buiten beeld is. De 4500 behaalde 135.9 TFLOPS in BF16, 280.1 in FP8 en 568.6 in NVFP4, waarbij elke stap naar een lagere precisie de doorvoer bijna verdubbelde. Vergeleken met NVIDIA's pieken van 202, 406 en 811 TFLOPS, is dat 67% tot 70% van de piek in elke precisie, en het komt overeen met NVIDIA's eigen cuBLAS-cijfers voor de kaart van 133, 275 en 534.
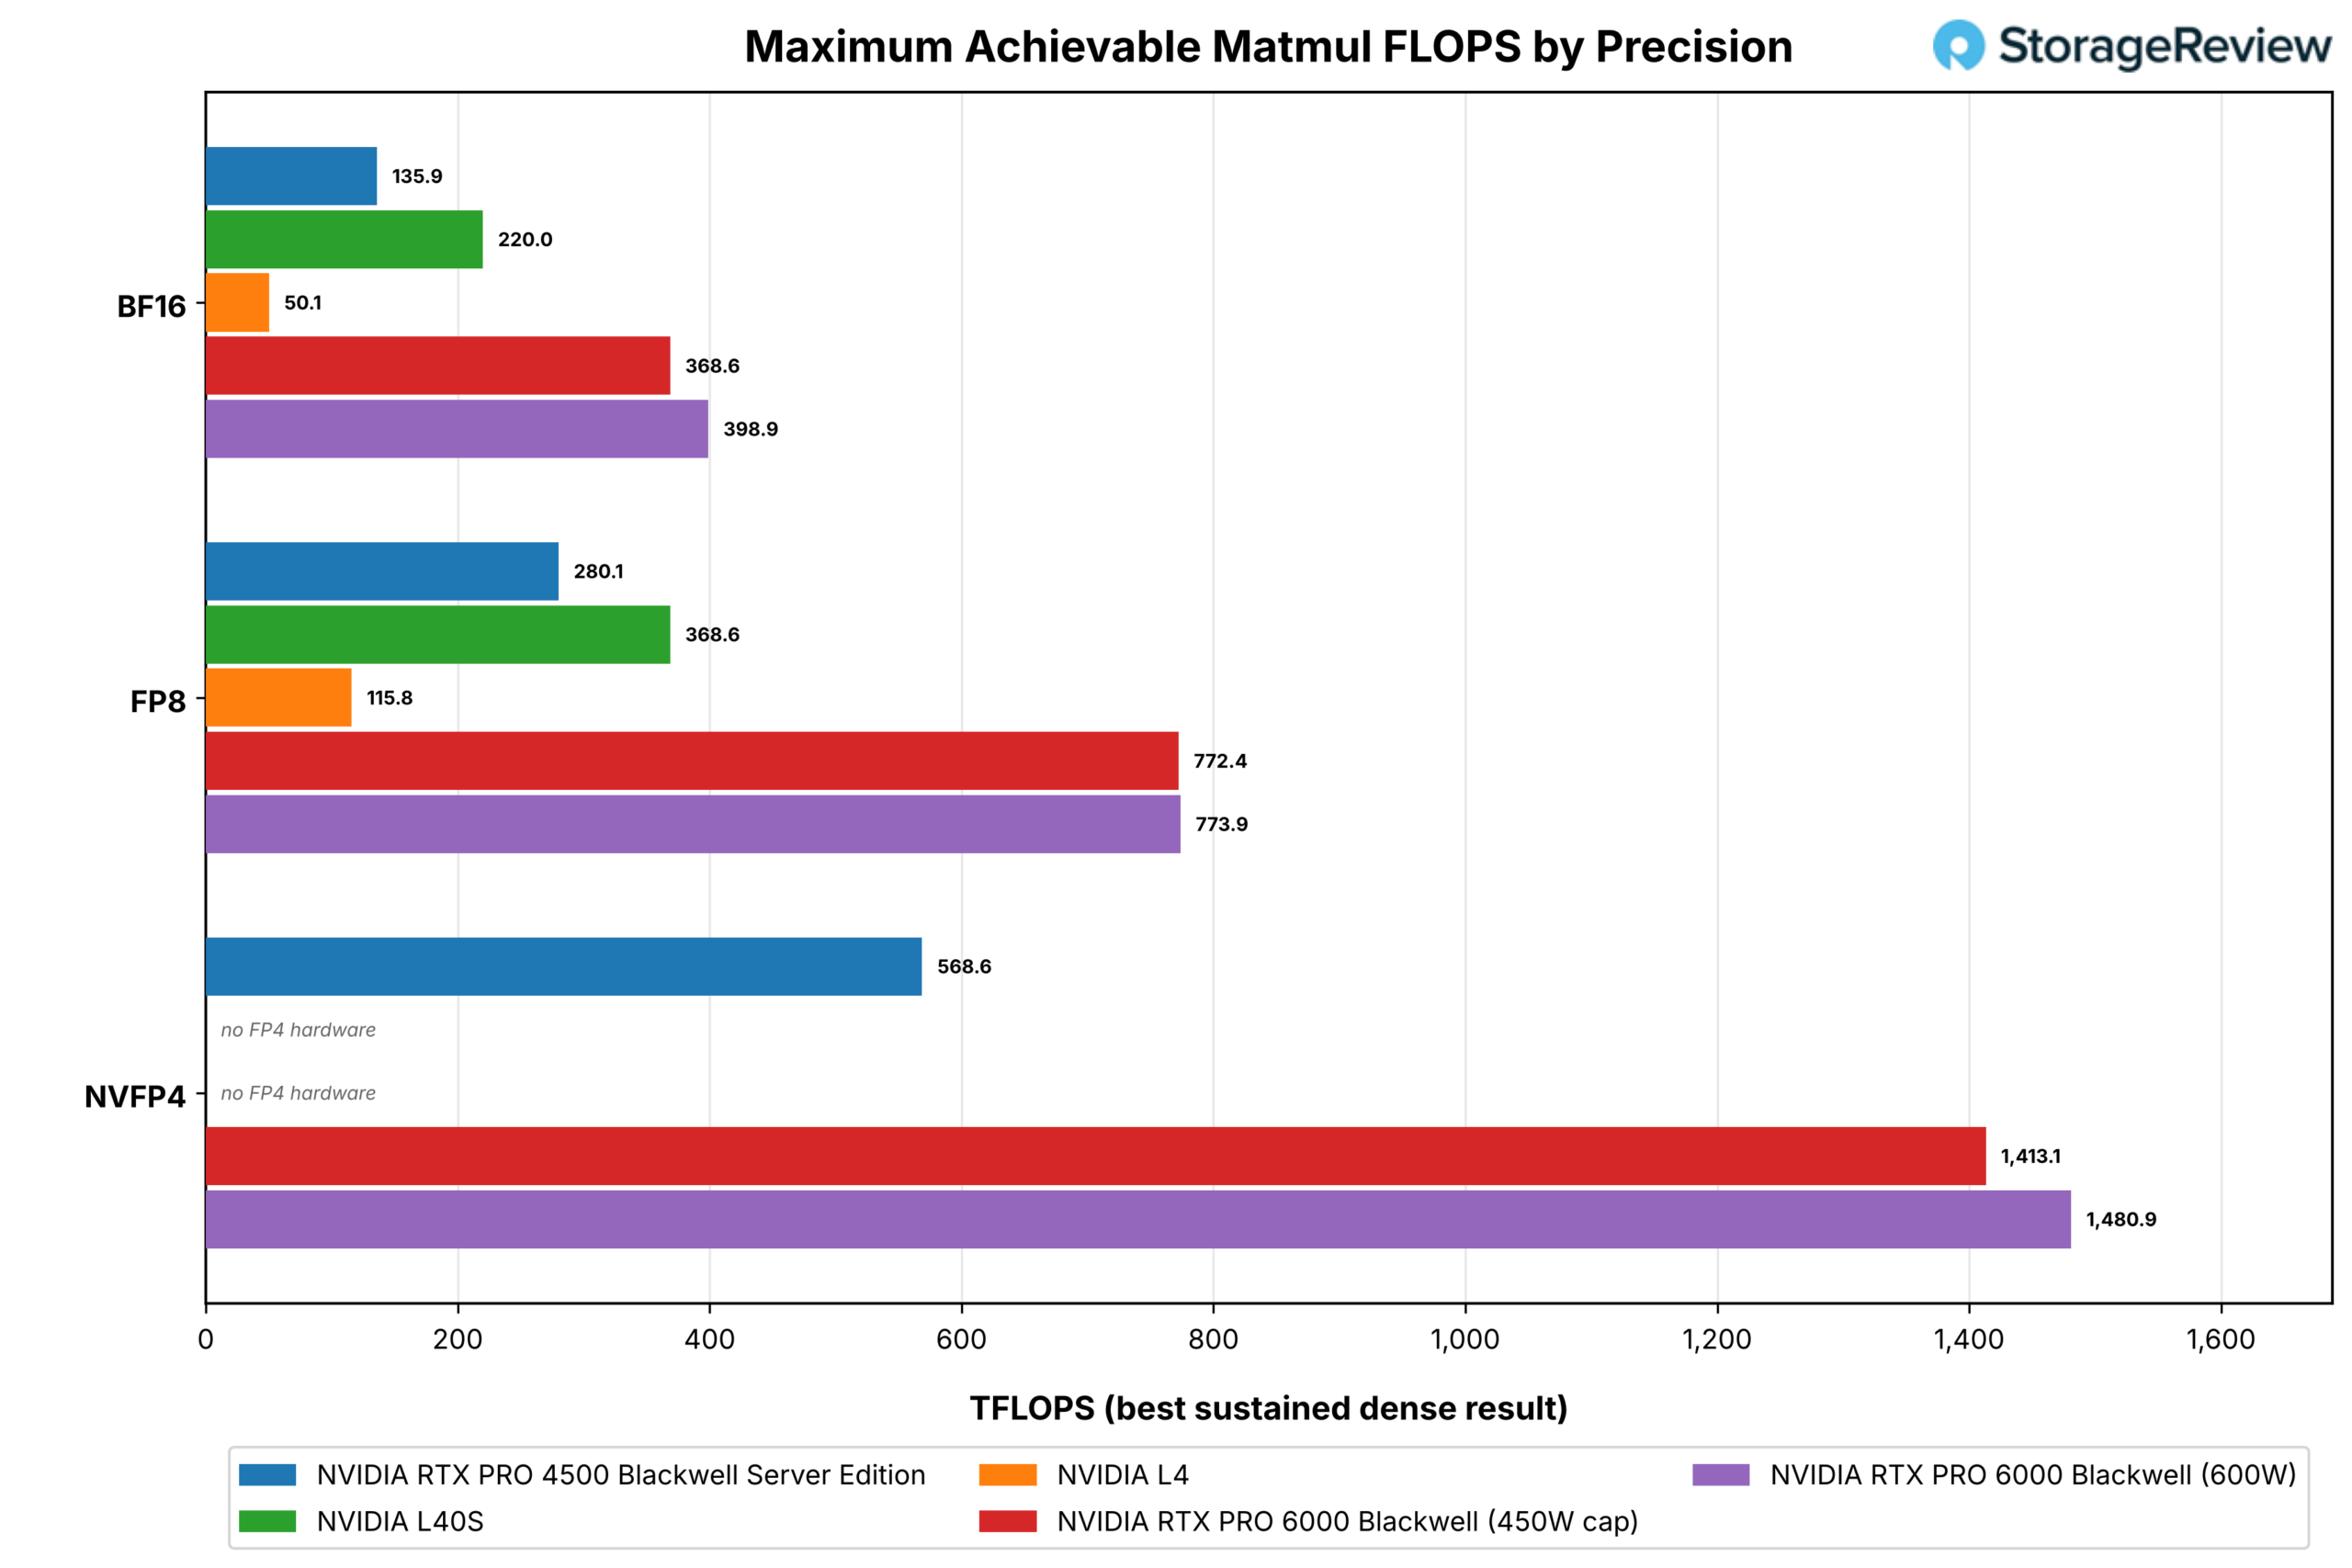
De RTX PRO 6000 schaalde op vergelijkbare wijze en bereikte 398.9, 773.9 en 1,480.9 TFLOPS bij 600W, 2.6 tot 2.9 keer de 4500 over de drie precisies, wat overeenkomt met wat de chipgrootte en het stroombudget voorspellen. Bij de maximale belasting van 450W bereikte de kaart 368.6, 772.4 en 1,413.1 TFLOPS: FP8 bleef gelijk, BF16 verloor 8 procent en NVFP4 verloor 5 procent, wat aangeeft dat het FP8-tensorpad van de 6000 onder de 450W blijft tijdens deze test, en de andere twee precisies slechts de limiet benaderen. De L40S bereikte 220.0 en 368.6 TFLOPS in BF16 en FP8, en de L4 bereikte 50.1 en 115.8 TFLOPS; Geen van beide Ada-kaarten beschikt over FP4 Tensor-hardware.
Een nuttige vergelijking is het NVFP4-resultaat van de 4500 ten opzichte van de FP8-resultaten van alle andere kaarten: 568.6 TFLOPS is 1.5 keer het FP8-plafond van de L40S en 74% van het gelimiteerde FP8-plafond van de 6000, en dat met een kaart van 165W. Dat is het FP4-voordeel, en dat is merkbaar op GEMM-niveau. De vLLM-servingresultaten die volgen, laten zien dat het in deze configuratie de servingstack nog niet heeft bereikt, en het MAMF-resultaat suggereert dat de servingcijfers zullen blijven groeien naarmate de NVFP4-kernels de achterstand inhalen.
vLLM Online Serving: Korte context (512/512)
Kort samengevat, de 4500 bewijst zijn waarde: op de drie FP8- en BF16-modellen bedroeg de uitvoerdoorvoer bij 32 gelijktijdige verwerkingen 1,107 tokens/s op de Ministral 3 14B tegenover 995 voor de L40S, 1,017 tegenover 1,005 op de Ministral 3 8B en 2,006 tegenover 1,988 op de Ministral 3 3B. Elk van deze kaarten is een Blackwell-kaart met een stroomverbruik van 165W, die een Ada-kaart met 350W evenaart of overtreft. Bovendien liggen de curves van gelijktijdige verwerking 1 tot en met 32 dicht bij elkaar, dus dit is geen resultaat dat alleen de piekwaarde weergeeft. De L4 behaalde 364, 279 en 704 op dezelfde modellen, wat de 4500 2.8 tot 3.6 keer sneller maakt dan zijn voorganger.

De RTX PRO 6000 laat zien wat de rest van het Blackwell-budget te bieden heeft. Met een maximaal vermogen van 450W behaalde hij 2,161, 2,042 en 4,069 tokens/s op dezelfde drie modellen, 1.95 tot 2.03 keer zoveel als de 4500; op zijn volle vermogen van 600W behaalde hij 2,283, 2,139 en 4,155 tokens/s, wat een toename van 2.06 tot 2.1 keer is. De twee 6000-curves liggen tot en met concurrency 16 op elk model vrijwel gelijk en verschillen slechts 2 tot 5 procent bij concurrency 32, dus op korte termijn maakt de laatste 150W weinig verschil. Vergeleken met de 4500 is dat een verdubbeling van de doorvoer van een kaart met drie keer zoveel geheugen en, in het geval van de R770, 2.7 keer zoveel vermogen.

De totale doorvoer, inclusief de 512 prefill-tokens per verzoek, volgt dezelfde volgorde: 2,215 tokens/s voor de 4500 op het 14B-model, tegenover 1,990 voor de L40S en 727 voor de L4. De 6000 haalt maximaal 4,323 tokens en de 600W-versie 4,566 tokens. Het verschil met de L4 is het grootst bij het 8B-model (3.6x) en het kleinst bij het 3B-model (2.8x). Het verschil met de L40S bedraagt nooit meer dan 12 procent in het voordeel van de 4500.

vLLM Online Serving: Lange context (8K/1K)
Bij 8,192 invoertokens verandert het beeld, en de reden hiervoor is zichtbaar in de vorm van de curves. Op Ministral 3 14B FP8 volgt de 4500 de L40S tot een gelijktijdigheid van 8, waarna de snelheid afvlakt op ongeveer 180 tokens/s, terwijl de L40S doorgaat tot 230 bij een gelijktijdigheid van 16 en daar blijft. Het 8B-model doet hetzelfde: 185 tokens/s voor de 4500 bij 32, tegenover 277 voor de L40S, waarbij de 4500 stabiliseert bij 8 en de L40S bij 16. Op het 3B-model stabiliseren beide kaarten bij 16, respectievelijk 384 en 475.

De reden hiervoor is de capaciteit van de KV-cache: elke gelijktijdige 8K-aanvraag vereist dat de context op de kaart aanwezig is, en zodra de gewichten geladen zijn, kan een framebuffer van 32 GB er minder bevatten dan een van 48 GB. Wanneer vLLM geen KV-ruimte meer heeft, stopt het met het toevoegen van nuttige gelijktijdige verwerking en vlakt de doorvoerlijn af. De 4500 levert om die reden alleen al 17 tot 33 procent minder op dan de L40S bij een gelijktijdigheid van 32 op deze modellen; de rekenkracht is niet het knelpunt, zoals de resultaten met een korte context laten zien. De L4, met 24 GB en 300 GB/s, presteert vanaf een gelijktijdigheid van 4 op elk model vlak, met 34 tot 130 tokens/s.

De 96 GB van de 6000-serie komt in deze test nooit tekort en de prestaties blijven oplopen tot 32 tokens per seconde bij elk model. Bij een maximaal vermogen van 450 W bereikte de kaart 552, 589 en 973 tokens per seconde, 2.5 tot 3.2 keer zoveel als de 4500-serie; bij 600 W bereikte hij 608, 639 en 1,033 tokens per seconde, oftewel 2.7 tot 3.5 keer zoveel. Dit is het enige punt waar de vermogenslimiet merkbaar wordt: prefill met een lange context zorgt ervoor dat de 6000-serie langer rekenintensief blijft, waardoor de kaart met de maximale vermogenslimiet 4 tot 9 procent minder presteert bij 16 en 32 gelijktijdige processen, tegenover 2 tot 5 procent bij een korte context. In beide gevallen neemt de prestatie ten opzichte van de 4500-serie toe van 2 tot ongeveer 3 keer, en het geheugen is hier meer de oorzaak van dan het vermogen.

Als uw werklast bestaat uit document-Q&A, RAG over lange contexten of agents die grote tooloutputs verwerken, is geheugen de belangrijkste specificatie en vormt de 32 GB van de 4500 een beperking voor gelijktijdige verwerking. Bij chat, classificatie of korte agentbeurten is dit niet het geval. De totale doorvoer bij 8K/1K wordt gedomineerd door prefill en vertoont dezelfde volgorde: 1,713 tokens/s voor de 4500 op het 14B-model, tegenover 2,070 voor de L40S en 381 voor de L4, met een maximum van 4,971 voor de 6000 en 5,474 voor de 600W.
NVFP4: Waar de software de grenzen bepaalt
De Qwen3.8-27B in NVFP4 is het enige model in de groep dat gebruikmaakt van de FP4 Tensor-hardware waarmee Blackwell toonaangevend is, en het resultaat is de meest vlakke curve in deze review. Bij een gelijktijdigheid van 32 in de short-context test produceerde de 4500 320 output tokens/s; de L40S, 480 en RTX PRO 6000 haalden respectievelijk 621 (gecapt) en 616 bij 600W. Bij een gelijktijdigheid van 1 behaalde elke kaart tussen de 17 en 22 tokens/s op een 27B-model, inclusief de 6000 met 1.6 TB/s GDDR7, waar dezelfde kaart 99 tokens/s single-stream levert op het 14B FP8-model.

De L40S heeft geen FP4 Tensor-hardware, dus vLLM voert een NVFP4-checkpoint uit door de gewichten te dequantiseren en berekeningen met hogere precisie uit te voeren. Dit is een methode die de geheugenbandbreedte beperkt, en de L40S presteert 1.5 keer beter dan de 4500. De 6000, die dezelfde FP4-hardware heeft als de 4500 en twee keer zoveel bandbreedte, presteert ongeveer twee keer zo goed als de 4500, wat de twee kaarten op alle andere vlakken van elkaar scheidt. Bovendien liggen de 450W- en 600W-runs bij elke gelijktijdigheid binnen 1 procent van elkaar, waardoor de kernel ook niet door het stroomverbruik wordt beperkt.
Het patroon in alle vier de series, met een single-stream doorvoer die niet verandert met de geheugenbandbreedte en een concurrency-32 plafond van 480 tot 621 ongeacht de onderliggende GPU, wijst erop dat het NVFP4-kernelpad in deze vLLM-build de beperkende factor is voor elke kaart.

Bij 8K/1K bereikte de 4500 153 tokens/s bij een gelijktijdigheid van 32, vergeleken met 190 voor de L40S en 402 en 425 voor de 6000 met en zonder cachelimiet. Dit zijn dezelfde door de KV-cache beperkte patronen die de FP8- en BF16-modellen lieten zien, waarbij de 96 GB van de 6000 wederom de reden is dat deze blijft stijgen terwijl de andere modellen stabiliseren.
NVIDIA behaalt met deze kaart FP4-prestaties van 1,221 tokens/s op Llama 3.1 8B bij 2K/256 en 905 tokens/s op Nemotron 3 Nano 30B A3B onder TensorRT-LLM, dus de hardware presteert goed met NVIDIA's eigen stack. De huidige data laten zien dat NVFP4 op deze kaart een softwarematig succes is dat vergelijkbaar is met vLLM, en dat dit geldt voor alle GPU's die we hebben getest. Kopers die rekenen op FP4-doorvoer, zouden hun serverstack eerst moeten testen voordat ze daarop vertrouwen.
Doorvoer per nominaal watt
We hebben in deze testronde het stroomverbruik niet gemeten, dus de beschikbare efficiëntieberekeningen zijn gebaseerd op de geteste stroomlimiet van elke kaart. Op Ministral 3 14B FP8 met 32 gelijktijdige processen levert de 4500 6.7 outputtokens/s per watt, tegenover 2.8 voor de L40S, 5.1 voor de L4, 4.8 voor de RTX PRO 6000 bij zijn maximale vermogen van 450W en 3.8 voor de 6000 bij 600W. Bij het 3B-model blijft de verhouding hetzelfde: 12.2 voor de 4500, 5.7 voor de L40S, 9.8 voor de L4, 9.0 voor de 6000 bij zijn maximale vermogen en 6.9 voor de 6000 bij 600W.
De 4500 is op basis van deze maatstaf de meest efficiënte kaart in de groep bij korte context, en alleen de 6000 met beperkte capaciteit komt in de buurt. Door het stroomverbruik van de 6000 terug te brengen naar 450W gaat 2 tot 5 procent van de doorvoer verloren, maar wordt 25 procent van het energiebudget terugverdiend. Dit verklaart waarom het efficiëntiecijfer met een kwart stijgt. De L4 blijft concurrerend op dit vlak omdat 72W een zeer kleine noemer is, maar heeft drie keer zoveel slots en servers nodig om dezelfde doorvoer te bereiken, en dat is precies de afweging die de 4500 wilde maken.
Bij 8K/1K verandert de volgorde: de 4500 haalt 1.2 tokens/s per nominaal watt op het 14B-model, de 6000 met capping haalt 1.2, en de 600W 6000 haalt 1.0, terwijl de L40S op 0.7 uitkomt. Zodra de KV-cache van de 4500 vol is, stopt de doorvoer met groeien, terwijl het vermogen niet toeneemt. Daardoor evenaart de 6000 met 450W bij een lange context de efficiëntie en levert 2.9 keer zoveel werk per slot.
Conclusie
De RTX PRO 4500 Blackwell Server Edition doet precies wat NVIDIA belooft: hij plaatst Blackwell in een slot, met een stroombudget en in een behuizingsklasse die voorheen maximaal een L4 aankon. Op de modellen die de meeste gangbare servers zullen gebruiken, met kleine en middelgrote instructie- en redeneermodellen in chatcontext, levert hij L40S-doorvoer vanuit een single-slot kaart met een stroomverbruik dat minder dan de helft is van dat van de L40S, en drie keer zoveel als de L4 kon leveren.
Er zijn natuurlijk wel beperkingen. Om te beginnen het geheugen: 32 GB is voldoende capaciteit voor de modellen waarvoor deze kaart bedoeld is, maar het beperkt de gelijktijdige verwerking bij lange contexten, waar de 48 GB van de L40S en vooral de 96 GB van de 6000 een voorsprong nemen, en waar de 6000 ongeveer drie keer zo snel presteert als de 4500 bij dezelfde aanvraagvorm, zelfs als het vermogen beperkt wordt tot wat dezelfde server toelaat.
NVFP4, de belangrijkste precisietechnologie van Blackwell, presteert in deze vLLM-configuratie vergelijkbaar met kaarten zonder FP4-hardware, hoewel de MAMF-test aantoont dat de FP4-hardware op GEMM-niveau een tweemaal zo hoge FP8-snelheid levert. Het FP4-voordeel moet dus nog op uw eigen testomgeving worden geverifieerd, maar er is duidelijk nog meer winst te behalen via software.
Iedereen met 2U-servers, of een 1U-chassis dat een FHFL-kaart ondersteunt, die inferentie, AI voor beeldverwerking, transcodering of virtuele werkstations wil toevoegen zonder de stroomvoorziening of koeling aan te tasten, zal de RTX PRO 4500 een uitstekende keuze vinden. Bovendien zal iedereen die nog steeds L4 gebruikt en de 24GB-limiet ontgroeid is, enthousiast zijn over de 4500. Voor organisaties met workloads die langdurig of multi-tenant zijn en 48GB of meer per kaart vereisen, is de RTX PRO 6000 de betere optie.
NVIDIA heeft er goed aan gedaan om twee duidelijke 'swim lanes' voor deze kaarten te creëren, en de 4500 vult het gat in de edge AI tussen de L4 en de 6000 op, terwijl hij slechts 165W verbruikt.
Klassement: De RTX PRO 4500 Blackwell Server Edition staat bovenaan als beste single-slot GPU in ons klassement van beste enterprise GPU's , waar ook de gegevens van de L40S en RTX PRO 6000 uit deze review te vinden zijn.



 Amazon