

Updated November 3, 2026: The AMD Instinct MI350P joins Also Tested from our first look at 450W, and its two-card results join Scale-Out Configurations; it ranks once it completes the Ministral 3 ladder at 600W. Published October 14, 2026. Five PCIe accelerators ranked on one vLLM container and one model set, with the H100 NVL and the MI350P in Also Tested; the H200 NVL carries a power note explained below.
Każdy akcelerator oceniony na tej stronie przeszedł przez laboratorium StorageReview jako pojedyncza karta PCIe. Rynek procesorów graficznych klasy enterprise jest podzielony między moduły HGX i OAM, które wypełniają fabryki sztucznej inteligencji, oraz karty rozszerzeń, które trafiają do serwerów 2U i 4U, które są już dostępne w większości centrów danych. Ta strona obejmuje tylko tę drugą grupę: procesory graficzne dla centrów danych, które można zamówić w konfiguratorze serwerów głównego nurtu i wmontować do posiadanej już szafy rack.
To rynek wnioskowania korporacyjnego, a wnioskowanie korporacyjne to obciążenie, na podstawie którego klasyfikowana jest każda karta. Każdy wybór jest powiązany z recenzją zawierającą dane, a ranking pochodzi z tego samego testu dla każdej karty.
Test dotyczy serwowania online vLLM, stosu, na którym działa większość wnioskowania przedsiębiorstwa, obsługiwanego przez od 1 do 32 współbieżnych strumieni na każdej karcie i do 128 na dwóch kartach Hopper, na czterech modelach w tym samym kontenerze NGC vLLM 26.08 (vLLM 0.27.1 na CUDA 13.4.1) i tym samym sterowniku 595.71.05.
Pięć z sześciu kart działało w naszym Dell PowerEdge R770 z mocą, jaką serwer dostarcza do gniazda GPU; karta RTX PRO 6000 działała w naszym Dell Pro Max Tower T2 na tym samym kontenerze i sterowniku. Kolejność, którą widzisz poniżej, obowiązywała w każdym modelu i obu testowanych przez nas konfiguracjach, więc ranking nie jest jedynie wynikiem szczytowym.
W tej klasie pamięć ma większe znaczenie niż moc obliczeniowa. Karta 24 GB lub 32 GB obsługuje modele małych i średnich rozmiarów na długich trasach i wyczerpuje pamięć podręczną KV, gdy narastają długie kolejki; karta 48 GB lub 96 GB obsługuje modele średniej wielkości z możliwością jednoczesnej obsługi wielu użytkowników, a karty HBM o pojemności 94 GB i 141 GB to modele z zakresu od 70 do 120 KB, które pozostają na jednym GPU. Wybór jest oparty na tym podziale, a sekcja FAQ na dole odpowiada na najczęściej zadawane pytania kupujących, od RTX PRO 6000 w porównaniu z H100, po porównanie mocy 450 W i 600 W w obudowie 2U.
W skrócie
Tokeny wyjściowe na sekundę pochodzą z Ministral 3 14B Instruct FP8 przy 32 współbieżnych strumieniach, co stanowi najwyższy punkt każdej ukończonej karty, w konfiguracji czatu 512 wejść/512 wyjść oraz konfiguracji dokumentu 8,192 wejść/1,024 wyjść. FP8 to maksymalny osiągalny wynik matmul MAMF w TFLOPS, stały, gęsty pomiar GEMM, a nie szczyt dostawcy.
| Kategoria | Akcelerator | Pamięć / Przepustowość | Sloty / Moc testowana | Czat 512/512 (tok/s) | Dokument 8K/1K (tok/s) | MAMF FP8 (TFLOPS) | Pełna recenzja |
|---|---|---|---|---|---|---|---|
| Najlepszy ogólny akcelerator sztucznej inteligencji PCIe | NVIDIA H200 NVL* | 141 GB HBM3e / 4.8 TB/s | Podwójne gniazdo / 450 W* | 3,435 | 1,038 | 1,262 | Recenzja ET900N G3 (dane H200 NVL) |
| Najlepszy procesor graficzny do wnioskowania korporacyjnego | NVIDIA RTX PRO 6000 Blackwell Server Edition | 96 GB GDDR7 / 1.6 TB/s | Podwójny slot / 600 W (testowany również z pojemnością 450 W) | 2,283 | 608 | 774 | Recenzja RTX PRO 6000 |
| Najlepszy procesor graficzny z jednym gniazdem | NVIDIA RTX PRO 4500 Blackwell Server Edition | 32 GB GDDR7 / 800 GB/s | Pojedynczy slot / 165 W | 1,107 | 190 | 280 | Recenzja RTX PRO 4500 SE |
| Najlepszy popularny procesor graficzny do wnioskowania wciąż w sprzedaży | NVIDIA L40S | 48 GB GDDR6 / 864 GB/s | Podwójne gniazdo / 350 W | 995 | 230 | 369 | Recenzja RTX PRO 4500 SE (dane L40S) |
| Najlepsza karta zasilana przez gniazdo do 1U i Edge | NVIDIA L4 | 24 GB GDDR6 / 300 GB/s | Pojedynczy slot HHHL / 72W | 364 | 42 | 116 | Recenzja L4 |
*Karta H200 NVL została przetestowana przy 450 W, co stanowi maksymalną wartość, jaką oferuje gniazdo GPU Dell PowerEdge R770. Karta ma moc znamionową 600 W i nie testowaliśmy jej w tym trybie, więc podane na tej stronie wartości są wartościami minimalnymi. Dane dotyczące karty RTX PRO 6000 pochodzą z wersji Workstation Edition; NVIDIA szacuje pobór mocy obu edycji na 600 W i ich profile w naszych testach są identyczne. Wersja Server Edition to pasywna karta bezgłowicowa z tym samym GPU i pamięcią.
Wybory
Najlepszy ogólny akcelerator sztucznej inteligencji PCIe: NVIDIA H200 NVL
Karta H200 NVL to najszybsza karta rozszerzeń, jaką zmierzyliśmy, i jedyna na tej stronie, która skaluje się powyżej 32 strumieni. Przy 32 współbieżnych strumieniach na Ministral 3 14B FP8, obsługiwała 3,435 tokenów wyjściowych na sekundę, w porównaniu z 3,096 dla H100 NVL i 2,283 dla RTX PRO 6000. Różnica ta pogłębiała się wraz ze wzrostem współbieżności: 7,336 tokenów na sekundę przy 128 strumieniach, gdzie karty RTX już się zatrzymały. W przypadku 8,192 tokenów w formacie dokumentu, 141 GB pamięci HBM3e nigdy nie było mniej, a karta wyprzedzała H100 NVL o 21–23 procent na każdym modelu przy identycznej współbieżności.
Przewaga nad kartą Blackwell jest większa niż sugerują arkusze specyfikacji. Przy 32 strumieniach, H200 wyprzedził o 50 do 81 procent RTX PRO 6000 w trzech modelach FP8 i BF16, a przy wejściu 8K utrzymywał 1,038 tokenów na sekundę w modelu 14B w porównaniu z 608 tokenami na karcie RTX, ponieważ 4.8 TB/s strumieni HBM dekoduje w sposób, w jaki 1.6 TB/s GDDR7 nie jest w stanie tego zrobić.
Dwie lub cztery karty łączą się przez NVLink z prędkością 900 GB/s, czego nie oferuje żadna inna karta. Nasze wyniki H200 NVL pojawiają się obok RTX PRO 6000 i stacji GB300 DGX w teście ET900N G3, gdzie stacja osiągnęła 22 041 tokenów wyjściowych na sekundę na GPT-OSS-20B przy 128 strumieniach, w porównaniu z 6,022 tokenami na sekundę dla tej karty.
Moc ma znaczenie dla nabywcy 2U: ta karta działała z mocą 450 W, na jaką pozwala gniazdo PowerEdge R770, a jej moc 600 W nie została jeszcze przetestowana w naszym laboratorium. Jedynym obciążeniem, w którym nie wykazuje żadnej przewagi, jest wersja NVFP4 karty Qwen3.8-27B, w której karta nie ma sprzętu FP4, a vLLM dekwantuje w locie, osiągając 467 tokenów na sekundę w porównaniu z 616 dla RTX PRO 6000. Warto ją kupić ze względu na pamięć i przepustowość, które są niezbędne w przypadku instalacji z 70–120 B.
Przeczytaj recenzję ASUS ET900N G3, w której znajdziesz nasze wyniki H200 NVL
Najlepszy procesor graficzny do wnioskowania korporacyjnego: NVIDIA RTX PRO 6000 Blackwell Server Edition
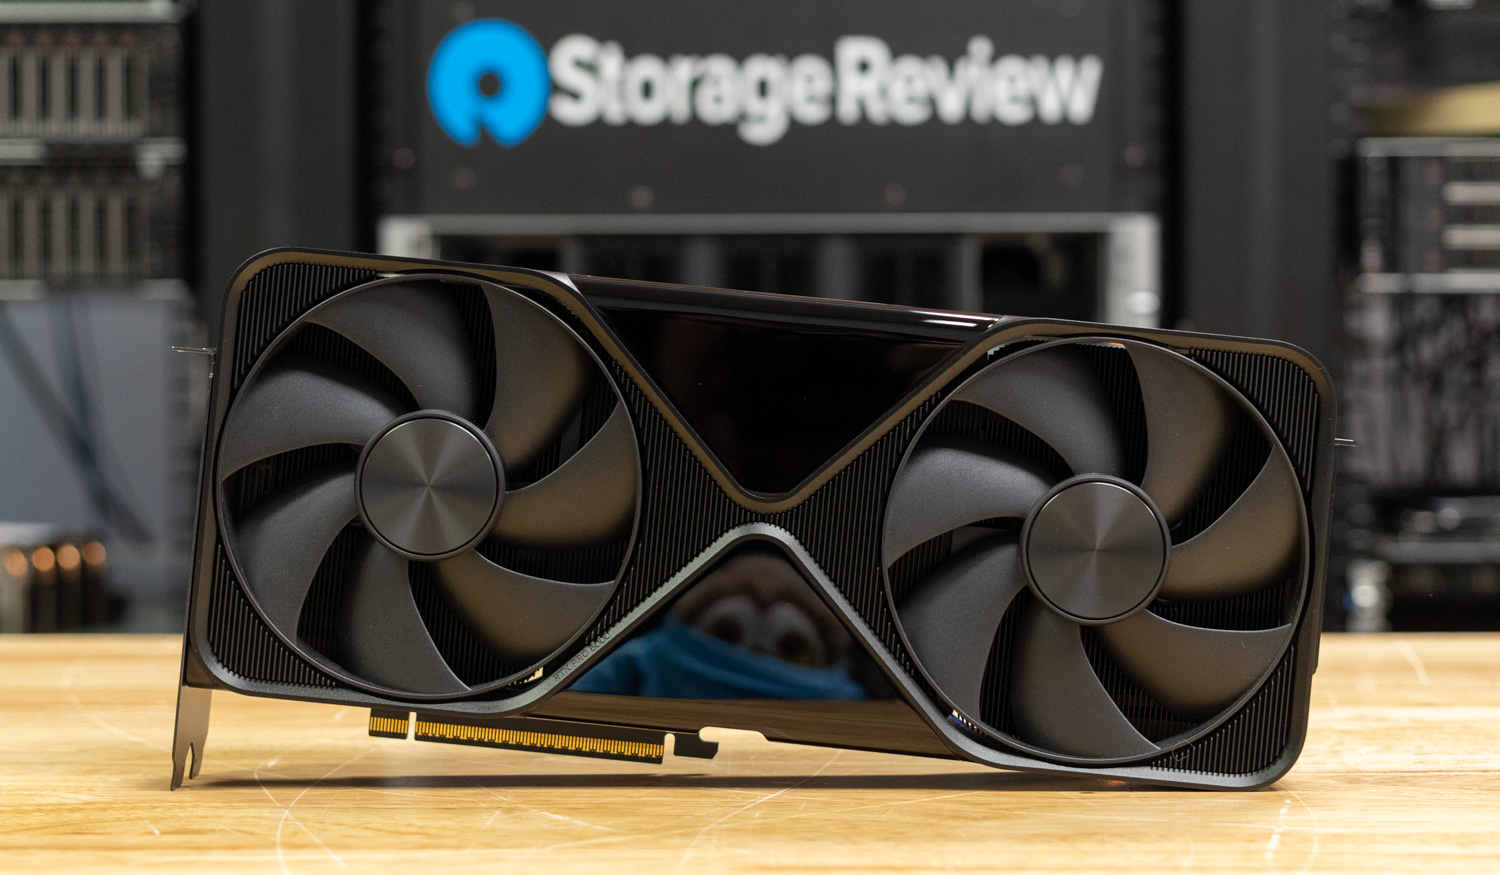
RTX PRO 6000 to korporacyjny procesor graficzny do wnioskowania przedstawiony na tej stronie. Karta Blackwell została stworzona z myślą o serwerach wnioskowania 2U i 4U, które obecnie kupują przedsiębiorstwa. Charakteryzuje się największym buforem ramki poniżej poziomu HBM i najszerszym zestawem funkcji spośród wszystkich kart dostępnych na tej stronie. Przy mocy 600 W karta obsługiwała 2,283 tokeny wyjściowe na sekundę przy 32 strumieniach na Ministral 3 14B FP8, 2,139 na modelu 8B i 4,155 na modelu 3B, czyli mniej więcej dwukrotnie więcej niż RTX PRO 4500 przy krótkim kontekście i od 2.7x do 3.5x przy wejściu 8K, gdzie jej 96 GB stopniowo zwiększało się do 32 strumieni, podczas gdy karty 32 GB i 48 GB ulegały spłaszczeniu.
W MAMF osiągnięto 774 TFLOPS w FP8 i 1,481 w NVFP4, co jest najwyższą wartością dla FP4 na stronie.
Kondensator 450 W informuje nabywcę 2U, ile warte jest ostatnie 150 W. Przy mocy 450 W, maksymalnej mocy oferowanej przez gniazdo PowerEdge R770, karta traciła od 2 do 5 procent przy krótkim kontekście i od 4 do 9 procent przy długim kontekście, a jej wynik FP8 MAMF nie uległ zmianie. Przy tym kondensacie zapewnia 4.8 tokenów wyjściowych na sekundę na wat mocy znamionowej w modelu 14B w porównaniu z 3.8 przy 600 W, dlatego nabywca 2U niewiele traci, stosując go w tym trybie.
Jest to również jedyna karta na tej stronie z rdzeniami RT, czterema enkoderami i dekoderami oraz wyjściami wyświetlacza, więc serwer, który łączy wnioskowanie z renderowaniem, transkodowaniem lub wirtualnymi stacjami roboczymi w oparciu o vGPU, otrzymuje jedną kartę do wszystkich tych zadań. Nasze dane pochodzą z wersji Workstation Edition w obudowie Dell Pro Max Tower T2; NVIDIA szacuje pobór mocy obu edycji na 600 W, ich profile w naszych testach są identyczne, a wersja Server Edition to pasywna, bezgłowa wersja z tym samym GPU GB202 i 96 GB pamięci GDDR7 z korekcją ECC.
Również w naszym laboratorium: cztery karty Server Edition w HPE ProLiant DL380a Gen12 , dwie i cztery karty w Dell PowerEdge XE7740 w teście ET900N G3 , pojedyncza karta w obudowie Dell Pro Max Tower T2 , która osiągnęła powyższe wyniki, obie karty Max-Q 300 W i 600 W w Dell Pro Precision 9 T2 , gdzie karta 600 W kosztowała procesor Xeon od 4 do 5 procent w przypadku pracy z procesorem all-core, osiem kart i 768 GB w Comino Grando oraz dwie karty Max-Q w Dell Precision 7875 i HP Z8 Fury G6i.
Przeczytaj pełną recenzję karty NVIDIA RTX PRO 6000
Najlepsza karta graficzna jednogniazdowa: NVIDIA RTX PRO 4500 Blackwell Server Edition

Karta RTX PRO 4500 Server Edition zapewnia przepustowość L40S z jednogniazdowej karty o mocy 165 W, co jest rozwiązaniem, na które czekała większość popularnych serwerów. Przy 32 strumieniach na czacie, karta dorównywała lub przewyższała L40S na każdym modelu FP8 i BF16: 1,107 w porównaniu z 995 tokenami na sekundę na Ministral 3 14B FP8 i 2,006 w porównaniu z 1,988 na modelu 3B, z karty o mocy 47% mocy L40S i o połowę mniejszej od niej liczby slotów. W porównaniu z L4, którą zastępuje, karta działała od 2.8 do 3.6 razy szybciej, zużywając 2.3 razy więcej mocy niż karta, a obudowa 2U mieszcząca cztery karty dwugniazdowe mieści osiem z nich.
Limit wynosi 32 GB: przy 8,192 tokenach wejściowych karta pozostawała w tyle za L40S o 17 do 33 procent, a jej krzywe spłaszczyły się przy ośmiu strumieniach, gdzie karta 48 GB nadal rosła do 16, ponieważ wyczerpała się pamięć podręczna KV, a nie moc obliczeniowa. Jest to również płytka o pełnej wysokości i pełnej długości z 16-pinowym złączem, więc obudowy L4 o wysokości 1U i połowie wysokości nie zmieszczą się bez obudowy przeznaczonej dla kart FHFL.
NVFP4 to kolejne zastrzeżenie, wspólne dla wszystkich kart testowanych w tej konfiguracji vLLM: w Qwen 3.8-27B, karta 4500 generowała 320 tokenów na sekundę przy 32 strumieniach, podczas gdy jej sprzęt FP4 osiągnął 569 TFLOPS w trybie MAMF, co oznacza, że przewaga FP4 istnieje na poziomie GEMM i nie dotarła jeszcze do stosu obsługującego. Dwie partycje MIG o pojemności 16 GB, poufne przetwarzanie i vGPU 20 uzupełniają zestaw funkcji centrum danych, którego nie ma w wersji Workstation Edition tej samej karty.
Również w naszym laboratorium: ta sama karta porównana z kartą L4 wewnątrz serwera HPE ProLiant DL145 Gen11 , recenzji serwera brzegowego poprzedzającej tę recenzję.
Przeczytaj pełną recenzję karty NVIDIA RTX PRO 4500 Blackwell Server Edition
Najlepszy procesor graficzny do wnioskowania głównego nurtu, który wciąż jest dostępny: NVIDIA L40S

Karta L40S była przez dwa lata standardową kartą wnioskowania statystycznego, a pojemność 48 GB sprawiła, że nadal zasługuje na miejsce na stronie z czasów Blackwella. Jeśli chodzi o kształt czatu, obsłużył 995 tokenów wyjściowych na sekundę przy 32 strumieniach na Ministral 3 14B FP8, 1,005 na modelu 8B i 1,988 na 3B.
To wynik o 12 procent gorszy od RTX PRO 4500 we wszystkich kategoriach, a nawet lepszy w przypadku formatu pliku 8K: 230 w porównaniu ze 190 w modelu 14B, 277 w porównaniu ze 185 w modelu 8B i 475 w porównaniu ze 384 w modelu 3B. Jego krzywe rosną do 16 strumieni w długim kontekście, podczas gdy karta 32 GB zatrzymuje się na ośmiu.
Koszt tej pamięci to 350-watowa, dwuslotowa płyta z interfejsem PCIe 4.0 i bez sprzętu FP4; w konfiguracji NVFP4 procesora Qwen3.8-27B osiągnęła ona 480 tokenów na sekundę dzięki dekwantyzacji, co przewyższyło 4500 o 1.5 raza w tej konfiguracji oprogramowania. Jej maksymalne wartości MAMF wynoszą 220 TFLOPS w BF16 i 369 w FP8, czyli nieco mniej niż połowa RTX PRO 6000. Dla floty, która już działa na L40S i której obciążenia dotyczą długiego kontekstu, nie jest to jeszcze karta do zastąpienia; w przypadku nowej obudowy 2U, jednoslotowa karta 4500 wykonuje tę samą pracę na długości czatu, przy połowie liczby slotów i poborze mocy.
Również w naszym laboratorium: pojedyncza karta L40S w komputerze Lenovo ThinkSystem SR650 V4 oraz karta graficzna w naszym egzemplarzu L40S dla Omniverse.
Przeczytaj nasze wyniki L40S w recenzji RTX PRO 4500 Server Edition
Najlepsza karta z zasilaniem slotowym do 1U i Edge: NVIDIA L4
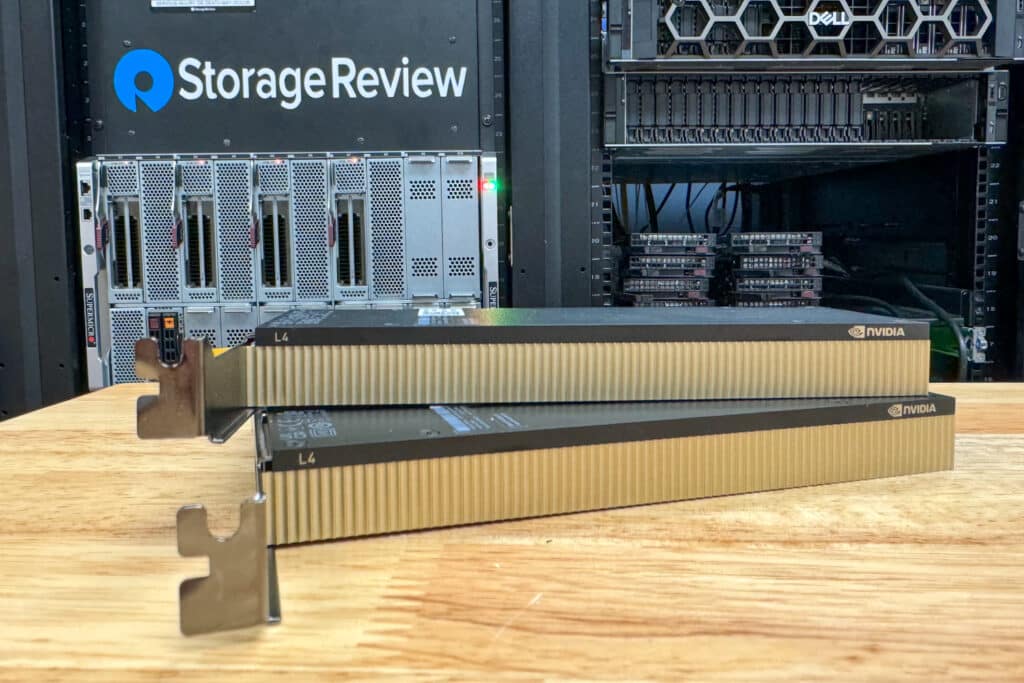
Karta L4 jest jedyną na tej stronie, która pobiera zasilanie ze slotu i pasuje do zatoki o połowie wysokości, dzięki czemu mieści się w serwerach 1U i urządzeniach typu edge, do których nie zmieści się żadna nowsza karta. Przy mocy 72 W karta obsłużyła 364 tokeny wyjściowe na sekundę przy 32 strumieniach na Ministral 3 14B FP8, 279 na modelu 8B i 704 na 3B, a jej 5.1 tokenów wyjściowych na sekundę na wat znamionowy w modelu 14B przewyższa wynik L40S z wynikiem 2.8 i RTX PRO 6000 z wynikiem 600 W z wynikiem 3.8.
Maksymalne wartości MAMF wynoszące 50 TFLOPS w BF16 i 116 w FP8 są najniższe w tym przypadku. Ponadto nie ma on ścieżki FP4, więc model 27B NVFP4 nie zmieścił swojej pamięci 24 GB.
Kontekst jest na tym, gdzie się kończy: przy konfiguracji 8,192 tokenów, L4 był płaski z czterech strumieni w każdym modelu, z prędkością od 34 do 130 tokenów na sekundę, ponieważ 24 GB i 300 GB/s obsługują bardzo niewiele kontekstów 8K jednocześnie. RTX PRO 4500 Server Edition działa od 2.8 do 3.6 razy szybciej, ale wymaga gniazda FHFL i 16-pinowego kabla, więc flota L4 w obudowie 1U lub o połowie wysokości nie ma możliwości natychmiastowego zastąpienia. W naszej recenzji RTX PRO 4500 Edge zmierzyliśmy obie karty w serwerze HPE ProLiant DL145 Gen11, gdzie model 4500 zapewnił 2.7-krotnie większą wydajność niż L4.
Również w naszym laboratorium: karta L4 na krawędzi w serwerze Dell PowerEdge XR7620 , cztery karty L4 w serwerze Dell PowerEdge T560 i karta w porównaniu z kartą RTX PRO 4500 w serwerze HPE ProLiant DL145 Gen11.
Przeczytaj pełną recenzję NVIDIA L4
Również przetestowane
NVIDIA H100 NVL
Model H100 NVL był montowany na tej samej drabinie w tym samym modelu R770 i znajduje się w kategorii „Testy również przetestowane” tylko dlatego, że na tej stronie nie ma odpowiednika modelu Hopper, z którym można by porównać tę kategorię. Generację temu karta ta była nadal od 36 do 61 procent szybsza niż RTX PRO 6000 przy tej samej współbieżności w testowanych przez nas modelach FP8 i BF16.
W tym samym R770, na tym samym kontenerze, obsłużył 3,096 tokenów wyjściowych na sekundę przy 32 strumieniach na Ministral 3 14B FP8, 3,449 w modelu wnioskowania 8B i 5,873 w modelu 3B, a następnie, podobnie jak jego następca, skalował się do 128 strumieni, osiągając 6,038 w modelu 14B. Jego wynik MAMF wynoszący 1,047 TFLOPS w FP8 jest o 35 procent wyższy niż 774 TFLOPS w przypadku RTX PRO 6000.
Powodem tego jest 94 GB pamięci HBM3 o przepustowości 3.9 TB/s. W przypadku modelu 14B, karta ta obsługuje 859 tokenów na sekundę przy 32 strumieniach, o 41% więcej niż RTX PRO 6000 o mocy 600 W, przy tym samym kształcie krzywej, co karta H200, o wysokości od 21 do 23 procent niższej. Dwie karty łączą się przez NVLink z prędkością 600 GB/s, co pokrywa konfiguracja objęta naszą recenzją Comino Grando H100, a karta pobiera od 350 do 400 W, co można skonfigurować w dwugniazdowej obudowie pasywnej, która pasuje do tych samych riserów co L40S.
W tym samym miejscu, w którym zawodzi H200: w punktach kontrolnych NVFP4 nie ma odpowiedniego sprzętu. Dla kupującego, który potrzebuje pojemności HBM i ma w ręku ofertę na H100 NVL, dane wskazują, że pozostaje ona drugą najszybszą kartą rozszerzeń, jaką testowaliśmy, ustępując jedynie wspomnianej H200 NVL.
Również w naszym laboratorium: ta sama para kart H100 NVL, która była zamontowana w naszym R770, posłużyła do przeprowadzenia testów Graid SupremeRAID AE GPU Direct Storage.
Przeczytaj pełną recenzję Comino Grando H100
AMD Instinct MI350P

The MI350P is AMD’s first new PCIe Instinct card in four years, and it sits in Also Tested because it has not yet run the ranking ladder above. That ladder uses the NGC container and the Ministral 3 model set; our first look ran the card on stock vLLM for ROCm at 450W in a 2U PowerEdge R7725, against a 600W rating. It carries 144GB of HBM3E at 4TB/s, the most memory of any PCIe accelerator we have tested, 3GB above the H200 NVL.
On the tests that overlap, it lands between the two NVIDIA cards. MAMF reached 1,120 TFLOPS in FP8 and 2,228 in block-scaled FP4 at 450W, 36 to 38 percent above the 600W RTX PRO 6000 at every precision in that review’s runs and behind the H200 NVL in BF16 and FP8. On GPT-OSS-120B at 128 streams on the chat shape, one card served 5,057 output tokens per second against 3,064 for the RTX PRO 6000 and 3,376 for the H200 NVL, and on 512-token prompts it beat the RTX PRO 6000 by 35 to 65 percent on every FP8, BF16, and GPT-OSS model.
The H200 NVL stays 4 to 18 percent ahead on the dense FP8 and BF16 models at 128 streams on chat prompts, and on 8,192-token prompts the MI350P trails it by 25 to 58 percent on the same models and flattens by 16 streams on Llama 3.1 8B and MiniMax M2.7. Its two-card results, where a pair holds MXFP4 builds of MiniMax M3 and GLM-5.2 that take four RTX PRO 6000s, ran on ROCm 7.2.3 and appear under Scale-Out Configurations.
It ranks once it completes the Ministral 3 ladder at 600W in a PowerEdge XE7745, which Dell supports with eight MI350Ps. Until then, for a buyer whose models sit between 96GB and 144GB, it is one of two PCIe cards that keep them on a single GPU, and the only one past 141GB.
Read the AMD Instinct MI350P first look
Konfiguracje skalowalne
Karta uzyskuje swoją rangę na tej stronie jako pojedyncza karta. Wyniki dla wielu kart są tutaj prezentowane jako konfiguracje, nierankingowane, ponieważ korzystają z różnych zestawów modeli i stosów oprogramowania i nie można ich uszeregować względem siebie ani względem drabinki pojedynczych kart powyżej. Każdy wiersz zawiera zmierzony wynik i recenzję, z której pochodzi.
| Konfiguracja | Gospodarz | Wynik pomiaru | Stos | Źródło |
|---|---|---|---|---|
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | Dell PowerEdge XE7740 | MiniMax M3 NVFP4: 1,181 tokenów wyjściowych/s przy 16 strumieniach, 759 przy 32 (512/512) | NGC vLLM 26.08, dekodowanie spekulatywne MTP | Recenzja ET900N G3 |
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | HPE ProLiant DL380a Gen12 | GPT-OSS-120B NVFP4, TP4: 4,016 tokenów/s w sumie w partii 64, 3,956 w partii 32; Llama 3.2 90B Vision: 1,372 tokenów/s w sumie w partii 128 | Usługi online vLLM | Recenzja DL380a Gen12 |
| 2x NVIDIA RTX PRO 6000 Blackwell Server Edition (192 GB) | Dell PowerEdge XE7740 | MiniMax M2.7 NVFP4: 1,932 tokenów wyjściowych/s przy 128 strumieniach (512/512), 511 przy 8K/1K | NGC vLLM 26.08 | Recenzja ET900N G3 |
| 4x Intel Gaudi 3 PCIe (512 GB HBM) | Dell PowerEdge XE7740 | Llama 3.1 70B, TP4: około 3,600 tokenów/s przy 128 równoczesnych żądaniach (1,024/1,024); ścieżki FP8 wolniejsze niż BF16 w tej kompilacji | Rozwidlenie Intel vLLM 2.7.1 na Gaudi Docker 1.22.2 | Recenzja XE7740 (sponsorowana przez firmę Dell) |
| 2x AMD Instinct MI350P (288GB), 450W per card | Dell PowerEdge R7725 | MiniMax M3 MXFP4: 998 output tokens/s at 16 streams, 1,509 at 32 (512/512); DeepSeek-V4-Flash FP8: 1,081 output tokens/s at 32 streams (512/512), 621 on 8K/1K | vLLM on ROCm 7.2.3 | MI350P First Look |
W czasie testów fork Intel vLLM nie zoptymalizował jeszcze ścieżek FP8, a FP8 działał wolniej niż BF16. Wynik MiniMax M3 pokazuje maksymalny poziom skalowalności PCIe w modelu, który ledwo mieści 384 GB, gdzie cztery karty wyprzedzały pojedynczą stację GB300 DGX przy 16 strumieniach i spadały do 32, ponieważ długie monity zużywały pamięć podręczną.
Poza szczeliną
Model, który przekracza 141 GB na jednej karcie, lub obciążenie wymagające kilkudziesięciu strumieni na punkcie kontrolnym klasy 400B, zniknęły z rynku kart rozszerzeń. Klasa GB300 DGX Station została sklasyfikowana w naszym rankingu najlepszych komputerów stacjonarnych do lokalnej sztucznej inteligencji , gdzie pojedyncza karta graficzna Blackwell Ultra z 252 GB pamięci HBM3e znajduje się obok H200 NVL w tych samych zestawieniach, a systemy HGX B200 i AMD Instinct MI350X z naszych recenzji Supermicro JumpStart należą do najlepszych serwerów . Systemy te są oceniane jako systemy, a nie jako karty, i nie są tutaj klasyfikowane.
Jak oceniamy
W każdym rankingu StorageReview obowiązują trzy zasady. Pierwsza z nich to, że klasyfikowane są tylko karty testowane laboratoryjnie: wszystko, czego nie testowaliśmy, może być wymienione, ale nie może być przypisane do żadnej kategorii. Po drugie, karty są testowane jako pojedyncze karty w hostach, które je obsługują, z mocą dostarczaną przez hosta, a moc ta jest podana przy każdym wpisie; powyższa notatka NVL H200 to jedyny przypadek, w którym ocena i testowana moc różnią się.
Po trzecie, karty do stacji roboczych nie są uwzględniane na tej stronie, z jednym podanym wyjątkiem: jeśli NVIDIA sprzedaje ten sam układ scalony jako część serwerową i oba profile są identyczne, karta do stacji roboczej jest traktowana jako część składowa i o tym informuje wpis.
Rankingi wynikają z przepustowości wyjściowej serwera online vLLM, obciążenia wnioskowania przedsiębiorstwa, przy dopasowanej współbieżności na współdzielonym zestawie modeli, przy czym kształt dokumentu z 8,192 tokenami i wyniki obliczeń MAMF rozstrzygają remisy, a pojemność pamięci określa poziom wykonalności. Dostawcy nie widzą rankingów przed publikacją, umieszczenie na tej stronie nie jest płatne, a w przypadku cytowania artykułu sponsorowanego jest on odpowiednio identyfikowany. Nowe karty są wprowadzane w miarę ukończenia tego samego testu w tym samym kontenerze, a rejestr zmian na górze strony rejestruje każdą zmianę.
Software stacks change every few weeks, so each figure on this page comes from the run that set the ranking, and later reviews may report newer runs of the same card. We re-rank when a newer run changes the order, not when a number moves.
Często zadawane pytania dotyczące procesorów graficznych dla przedsiębiorstw
Jaki procesor GPU jest najlepszy do wnioskowania w przedsiębiorstwie?
W przypadku serwerów inferencyjnych 2U i 4U, które kupuje większość przedsiębiorstw, najlepszym wyborem jest RTX PRO 6000 Blackwell Server Edition, ponieważ łączy w sobie 96 GB — najwyższą moc obliczeniową FP4, jaką zmierzyliśmy w karcie PCIe — MIG, vGPU oraz silniki graficzne i wideo na karcie, która traci zaledwie od 2 do 9 procent swojej przepustowości przy 450 W oferowanym przez standardowe gniazdo.
Karta H200 NVL jest szybsza, gdy pamięć i przepustowość decydują o obciążeniu, i była szybsza w każdym testowanym przez nas modelu, więc wdrożenie oparte na modelach 70–120 B z wysoką współbieżnością powinno się rozpocząć od niej. RTX PRO 4500 Server Edition to najlepszy wybór, gdy slot ma pojedynczą szerokość lub budżet mocy wynosi 165 W.
RTX PRO 6000 vs H100 NVL: który jest szybszy w przypadku wnioskowania?
Karta H100 NVL jest od 36 do 61 procent szybsza przy dopasowanej współbieżności w modelach FP8 i BF16, które uruchomiliśmy w tym samym kontenerze vLLM, oraz od 41 do 52 procent szybsza w przypadku struktury dokumentu 8,192-tokenowego, ponieważ 94 GB pamięci HBM3 z przepustowością 3.9 TB/s dekoduje dane szybciej niż 96 GB pamięci GDDR7 z przepustowością 1.6 TB/s. Karta RTX PRO 6000 wygrywa w punktach kontrolnych NVFP4, gdzie karta H100 nie posiada sprzętu FP4 i jako jedyna z tych dwóch oferuje obsługę grafiki, wideo i wyświetlania. Kup kartę H100 NVL ze względu na przepustowość w modelach FP8 i BF16; kup kartę RTX PRO 6000 do obciążeń mieszanych lub w ramach planu działania FP4.
H100 NVL vs H200 NVL: czy warto dokonać modernizacji?
Moduł H200 NVL uzyskał od 10 do 12 procent przewagi nad modułem H100 NVL przy 32 strumieniach w formacie czatu i od 21 do 23 procent przewagi przy 128 strumieniach i formacie dokumentu 8,192 tokenów, z 141 GB pamięci w porównaniu do 94 GB i przepustowością 4.8 TB/s w porównaniu do 3.9 TB/s. Dane te pochodzą z modułu H200 o mocy 450 W, co stanowi maksymalną moc oferowaną przez gniazdo R770 2U. Jego moc znamionowa 600 W nie została przetestowana w naszym laboratorium, więc różnica jest minimalna. Różnica w pojemności jest decydująca dla większości kupujących: model klasy 120B w FP8, który mieści 141 GB, wymaga dwóch modułów H100 NVL.
L40S kontra RTX PRO 6000: co można kupić za większą kartę?
W skrócie, RTX PRO 6000 oferował przepustowość wyjściową od 2.1x do 2.3x większą niż L40S przy 32 strumieniach na zestawie Ministral, a przy 8,192 tokenach wejściowych stosunek ten wzrósł do 2.2x do 2.6x, ponieważ karta 48 GB wyczerpała pamięć podręczną KV przy 16 strumieniach, podczas gdy karta 96 GB nadal się skalowała. 6000 oferuje również sprzęt FP4, PCIe 5.0 i MIG z czterema partycjami 24 GB, przy poborze mocy 600 W w porównaniu do 350 W. Do pracy z długim kontekstem lub wieloma dzierżawcami jest to lepszy zakup; do obsługi długich rozmów z mocą L40S, bardziej odpowiednim wyborem jest jednogniazdowa karta RTX PRO 4500.
L4 kontra RTX PRO 4500: czy warto modernizować flotę L4?
Karta RTX PRO 4500 Server Edition osiągnęła przepustowość od 2.8 do 3.6 razy większą niż L4 w krótkim kontekście w naszym serwerze R770 i 2.7 razy większą w serwerze HPE ProLiant DL145 Gen11, przy 165 W w porównaniu z 72 W oraz z 32 GB w porównaniu z 24 GB. Problem tkwi w fizyce: karta 4500 to karta o pełnej wysokości i pełnej długości z 16-pinowym złączem, a karta L4 to karta o połowie wysokości zasilana przez gniazdo, więc serwery 1U i małe urządzenia brzegowe zbudowane wokół L4 nie obsługują karty 4500. W przypadku, gdy obudowa ma gniazdo FHFL, należy dokonać modernizacji; L4 należy zachować tam, gdzie go nie ma.
RTX PRO 6000 Server Edition vs Workstation Edition: jaka jest różnica?
Ten sam procesor graficzny GB202, 96 GB pamięci GDDR7 z korekcją ECC i moc 600 W; NVIDIA ocenia je identycznie i mają takie same parametry w naszych testach, dlatego dane z wersji Workstation Edition zastępują na tej stronie wersję Server Edition. Wersja Server Edition jest pasywna i bezgłowa, zaprojektowana z myślą o przepływie powietrza w obudowie, z zestawem funkcji dla centrów danych, takich jak MIG, poufne przetwarzanie i vGPU; wersja Workstation Edition jest aktywnie chłodzona za pomocą czterech wyjść DisplayPort. Nabywca serwera chce wybrać wersję Server Edition; parametry w obu przypadkach są takie same.
Jaka jest różnica pomiędzy kartą graficzną PCIe a modułem SXM lub HGX?
Akcelerator PCIe to karta rozszerzeń, którą podłącza się do standardowego gniazda i pobiera od 72 W do 600 W. Dzięki temu pasuje do serwerów 2U i 4U już zainstalowanych w szafie rack, a komunikacja między wieloma kartami odbywa się przez PCIe lub mostek NVLink. Moduły SXM i OAM są lutowane do płyty głównej w specjalnie zaprojektowanych systemach, takich jak platformy HGX B200 lub MI350X, pracują z mocą od 700 W do 1,400 W na GPU i łączą się za pomocą pełnej siatki NVLink lub Infinity Fabric. Ta strona przedstawia pierwszy rodzaj; drugi jest omówiony na naszych płytach głównych do serwerów i komputerów stacjonarnych z lokalnym AI.
Ile pamięci GPU potrzebuje serwer inferencyjny?
Zależy to od modelu i kontekstu. Na tej stronie karty 24 GB i 32 GB wygodnie obsługiwały modele od 3B do 14B przy długości czatu i spłaszczały się o cztery do ośmiu strumieni przy wejściu 8,192 tokenów; 48 GB stale rosło do 16 strumieni, 96 GB nigdy nie brakowało w tych samych modelach, a karta H200 NVL o pojemności 141 GB obsługiwała GPT-OSS-120B na jednej karcie w naszych testach ET900N G3. Najpierw zaplanuj wagi, a następnie pamięć podręczną KV dla oczekiwanej współbieżności i traktuj pracę z długim kontekstem lub wieloma dzierżawcami jako wymaganie 48 GB lub więcej.
Czy ma znaczenie, czy 450 W czy 600 W jest istotne w przypadku serwera 2U?
Less than the rating gap suggests, on the one card we have measured both ways. Capped to 450W, the most a PowerEdge R770 slot delivers, the RTX PRO 6000 gave up 2 to 5 percent of output throughput at short context and 4 to 9 percent at long context, and its FP8 MAMF result did not change, which returned 25 percent of its power budget for a 2 to 9 percent cost. The H200 NVL on this page was tested at 450W for the same reason, and its full 600W result has not yet been measured. The AMD Instinct MI350P in our first look also ran at 450W in a 2U PowerEdge R7725, against a 600W rating, and we will measure the difference in a PowerEdge XE7745.


 Amazon