

Podczas wydarzenia Advancing AI w San Jose, AMD zaprezentowało serię Instinct MI350, najnowszą generację procesorów graficznych, a także ambitny plan rozwoju przyszłych platform akceleratorów AI. Zbudowana w oparciu o zaawansowaną architekturę CDNA4, seria MI350 obiecuje znaczny wzrost wydajności w wymagających zastosowaniach AI. Ogłoszenie obejmowało również zapowiedź przyszłej linii Instinct, podkreślając zaangażowanie AMD w ciągłe innowacje w sprzęcie AI.
Seria AMD Instinct MI350
Seria AMD Instinct MI350 , oparta na nowej architekturze CDNA4, stanowi znaczący krok naprzód w obliczeniach AI. Zaprojektowana specjalnie z myślą o obciążeniach AI, architektura CDNA4 wprowadza ulepszone silniki macierzowe, obsługę nowych formatów danych oraz istotne udoskonalenia w zakresie efektywności energetycznej.
Zaawansowane pakowanie i architektura chipletów: podstawy MI350
Seria MI350 powstała w oparciu o zaawansowaną technologię pakowania chipletów 3D firmy AMD, stanowiącą rozwinięcie serii MI300 i wzbogaconą o kluczowe udoskonalenia.
Projektowanie i produkcja chipletów
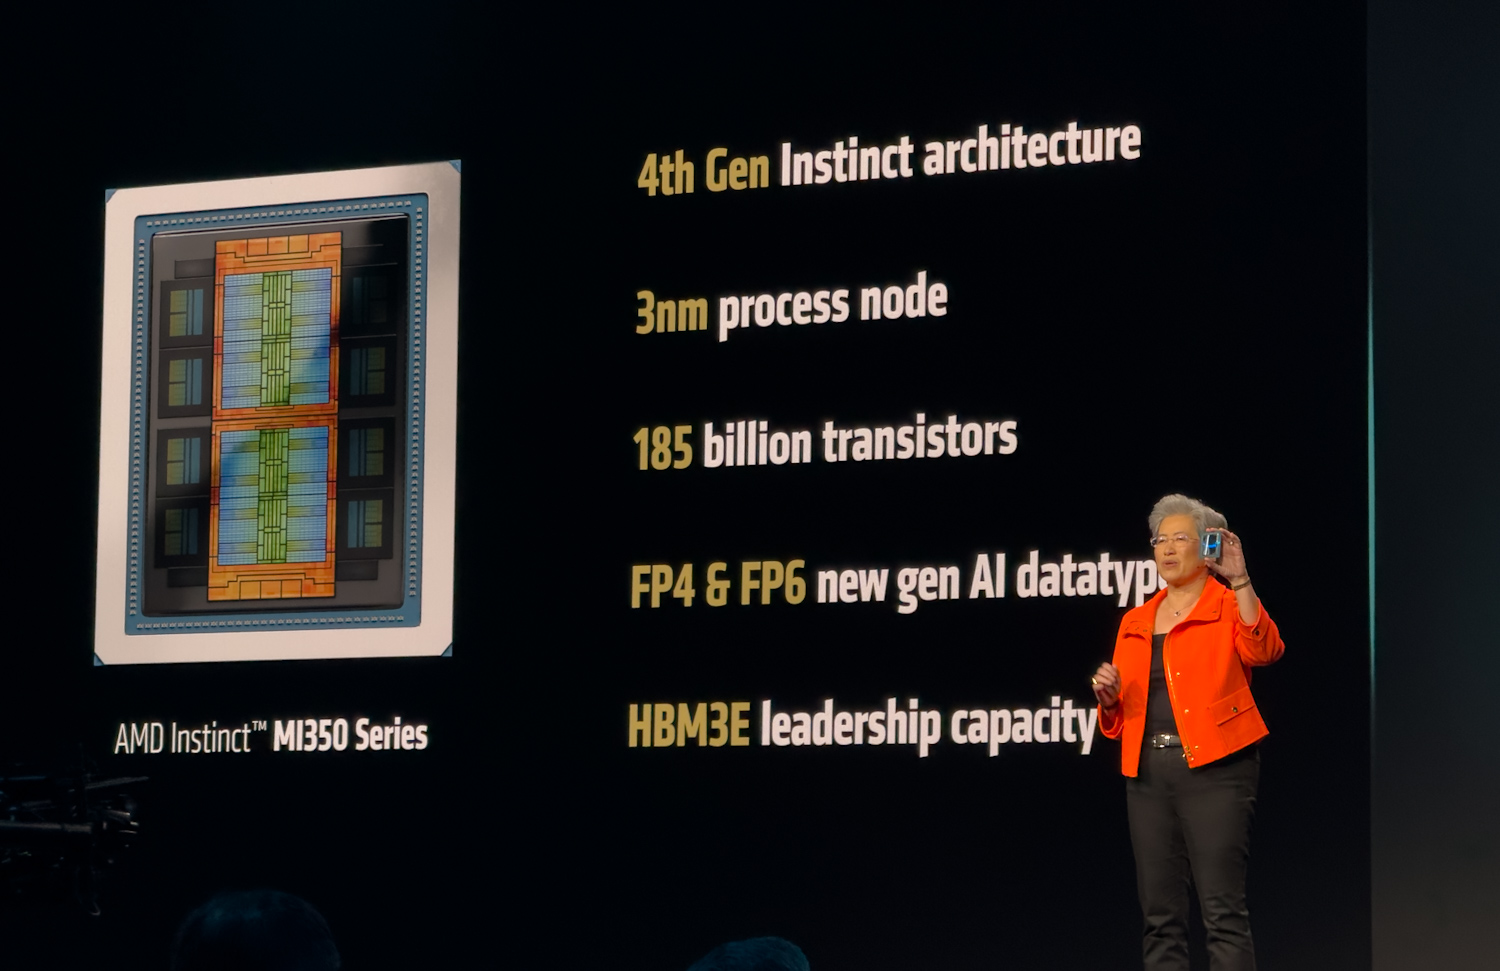
W swojej istocie pakiet GPU zawiera osiem chipletów akceleratora obliczeniowego (XCD), stanowiących główne silniki obliczeniowe. Chiplety XCD są wytwarzane w zaawansowanym procesie technologicznym Node 3+ 3 nm, będącym ulepszeniem technologii 5 nm stosowanej w serii MI300, co znacząco przyczynia się do poprawy efektywności energetycznej. Każdy XCD zawiera cztery silniki shaderów, z których każdy zawiera osiem aktywnych jednostek obliczeniowych CDNA4, co daje łącznie 32 jednostki CU na XCD i 256 jednostek CU dla akceleratora.

Uzupełnieniem układów XCD są dwie matryce IO (IOD), co stanowi redukcję w porównaniu z czterema matrycami IOD w serii MI300. Te matryce IOD, produkowane w procesie technologicznym 6 nm, obsługują dostęp do pamięci, operacje wejścia/wyjścia oraz komunikację między chipletami. Ta uproszczona konstrukcja z dwoma matrycami IOD, w połączeniu z szerszymi wewnętrznymi połączeniami, utrzymuje docelową przepustowość przy jednoczesnym zmniejszeniu zużycia energii.
Integracja fizyczna i jedność logiczna
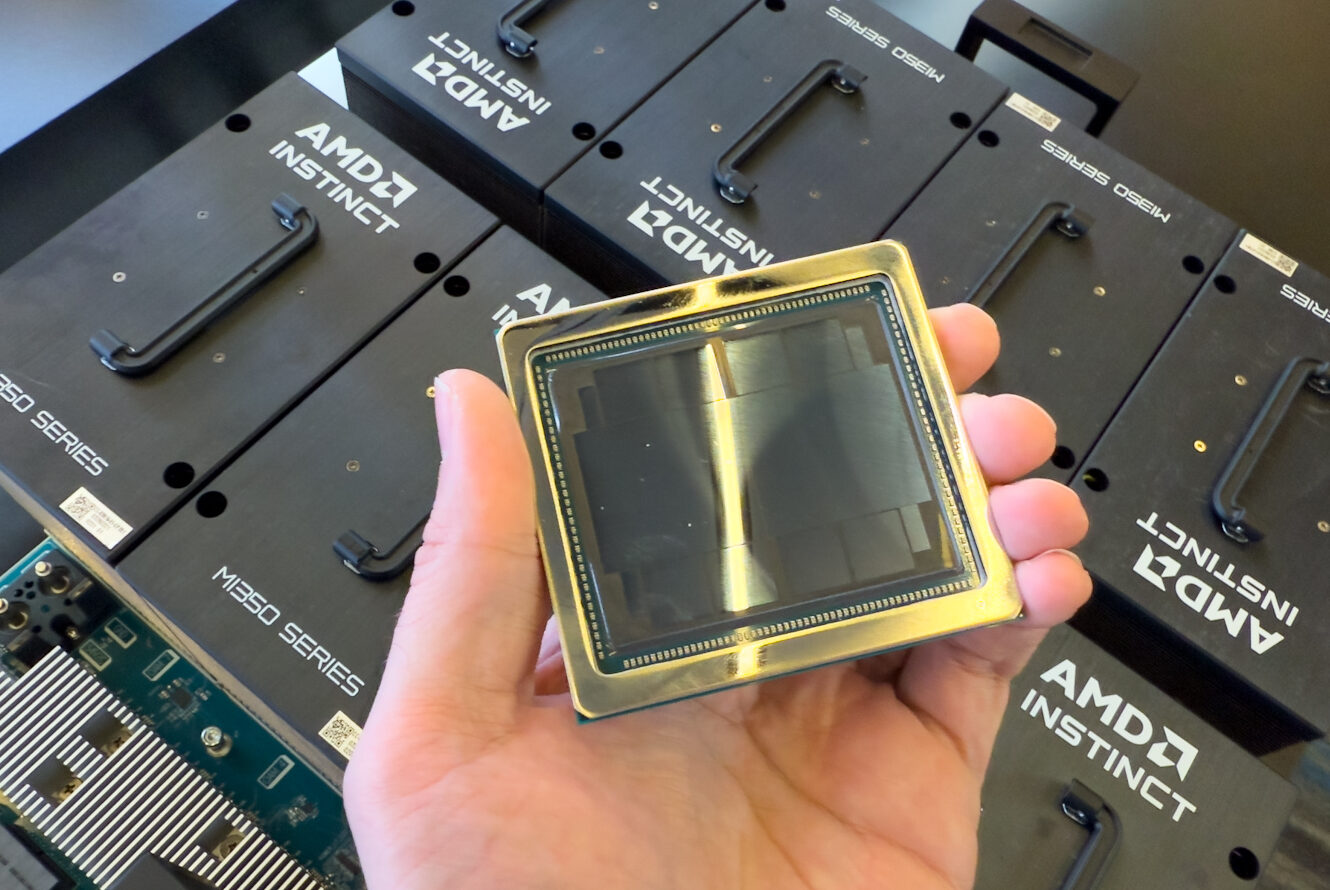
Montaż fizyczny obejmuje montaż stosów pamięci XCD i HBM3E na interposerze typu „chip-on-wafer-on-substrate” (COOS). Kluczowym aspektem tej konstrukcji jest hybrydowe połączenie XCD z umieszczonymi pod nimi modułami IOD. Ta technika hybrydowego połączenia 3D tworzy wyjątkowo gęste połączenia o wysokiej przepustowości między chipletami obliczeniowymi a chipletami wejścia/wyjścia, znacznie przewyższając tradycyjne konstrukcje 2.5D, co jest niezbędne do wydajnego dostarczania danych do energochłonnych układów XCD. Co więcej, ta zaawansowana integracja 3D przyczynia się do zmniejszenia całkowitej powierzchni zajmowanej przez procesor graficzny (GPU), co może zwiększyć wydajność produkcji i niezawodność operacyjną.
Pomimo złożonej konstrukcji chipletu, MI350 logicznie funkcjonuje jako pojedynczy, zunifikowany procesor graficzny (GPU). Każdy XCD stanowi kompleks obliczeniowy akceleratora, wyposażony w zasoby globalne, w tym procesor poleceń i 4 MB pamięci podręcznej L2.
Ulepszony podsystem pamięci
Aby zapewnić odpowiednie zasilanie wydajnych rdzeni CDNA4, seria MI350 została wyposażona w znacząco ulepszony podsystem pamięci. Wyposażono ją w osiem stosów pamięci HBM3E, co zapewnia łączną pojemność 288 GB na każdy procesor graficzny. Każdy stos o pojemności 36 GB, złożony z 12 urządzeń o pojemności 24 Gb/s, działa z pełną prędkością transmisji pinów HBM3E, wynoszącą 8 Gb/s na pin.
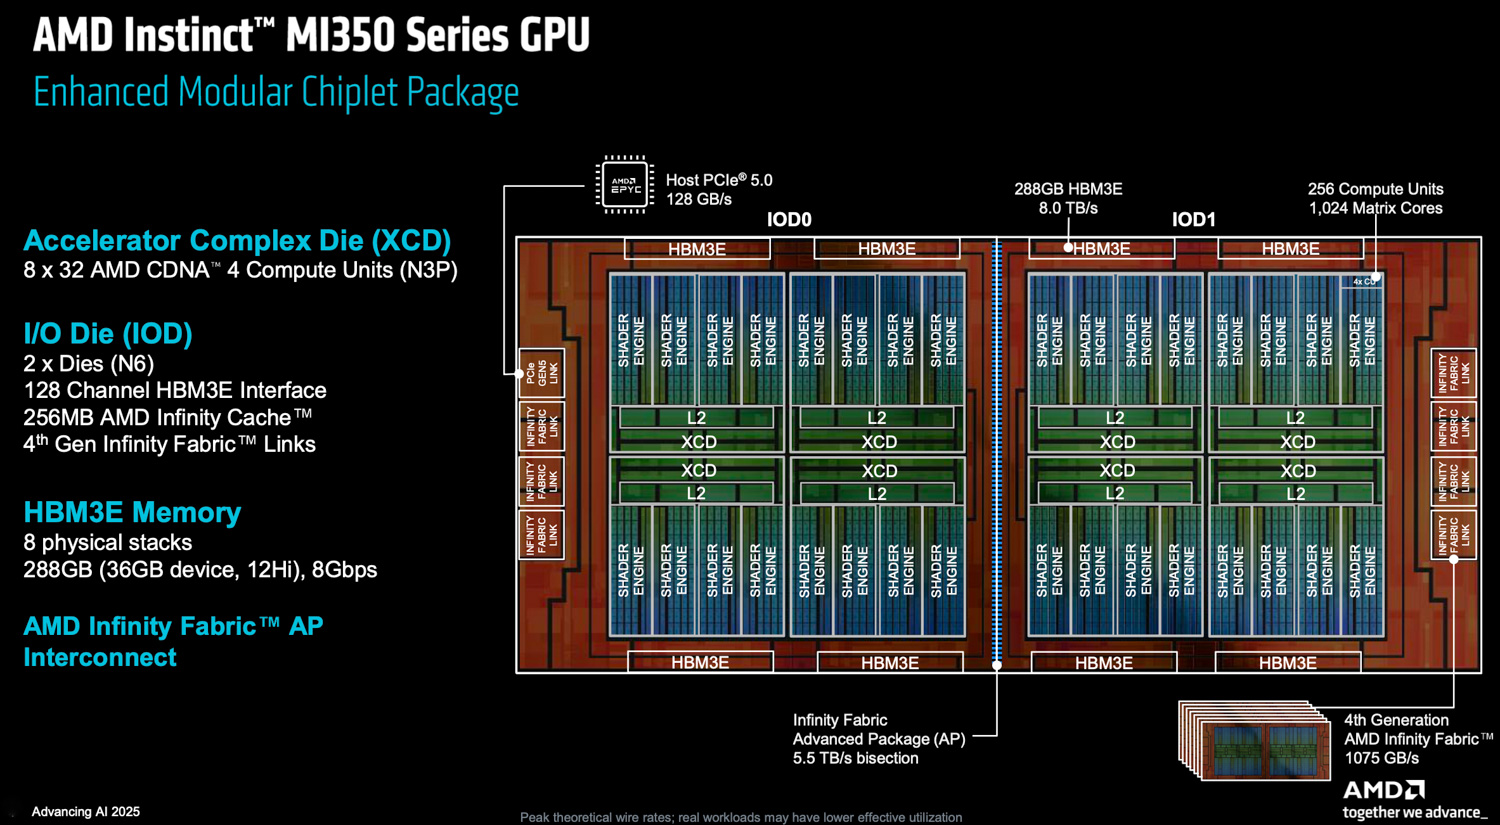
Architektura zachowuje również pamięć podręczną AMD Infinity Cache, kluczową pamięć podręczną po stronie pamięci, umieszczoną pomiędzy HBM a pamięcią podręczną Infinity Fabric/L2. Pamięć ta składa się ze 128 kanałów, z których każdy jest wspierany przez 2 MB pamięci podręcznej, co daje łącznie 256 MB dla GPU. Aby zwiększyć efektywność dostarczania przepustowości przy niższym poborze mocy, AMD poszerzyło magistrale sieciowe w modułach IOD i obsługuje je przy obniżonym napięciu. Ta optymalizacja zmniejsza zużycie energii na bit, umożliwiając serii MI350 osiągnięcie około 1.3-krotnie wyższej przepustowości pamięci na wat w porównaniu z poprzednią serią MI300.
Co więcej, aby skutecznie zarządzać rozległą pamięcią fizyczną o pojemności 288 GB, znacząco udoskonalono uniwersalne bufory tłumaczeń (UTC), analogiczne do buforów TLB (CPU Translation Lookaside Buffers). Seria MI350 wprowadza bardziej szczegółową kontrolę rozmiaru stron zarówno w UTC L1, jak i L2, a także zwiększoną pojemność. Te udoskonalenia zapewniają większy zasięg buforów TLB i efektywniejsze zarządzanie pamięcią wirtualną.
Ulepszenia tkaniny Infinity
Technologia AMD Infinity Fabric pozostaje kluczowa dla skalowalności i wydajności komunikacji między procesorami graficznymi MI350. Dwusekcyjna przepustowość łącza Infinity Fabric AP łączącego dwa urządzenia IOD została znacząco zwiększona do 5.5 TB/s, co ułatwia efektywne przesyłanie danych między dwiema połówkami procesora graficznego.
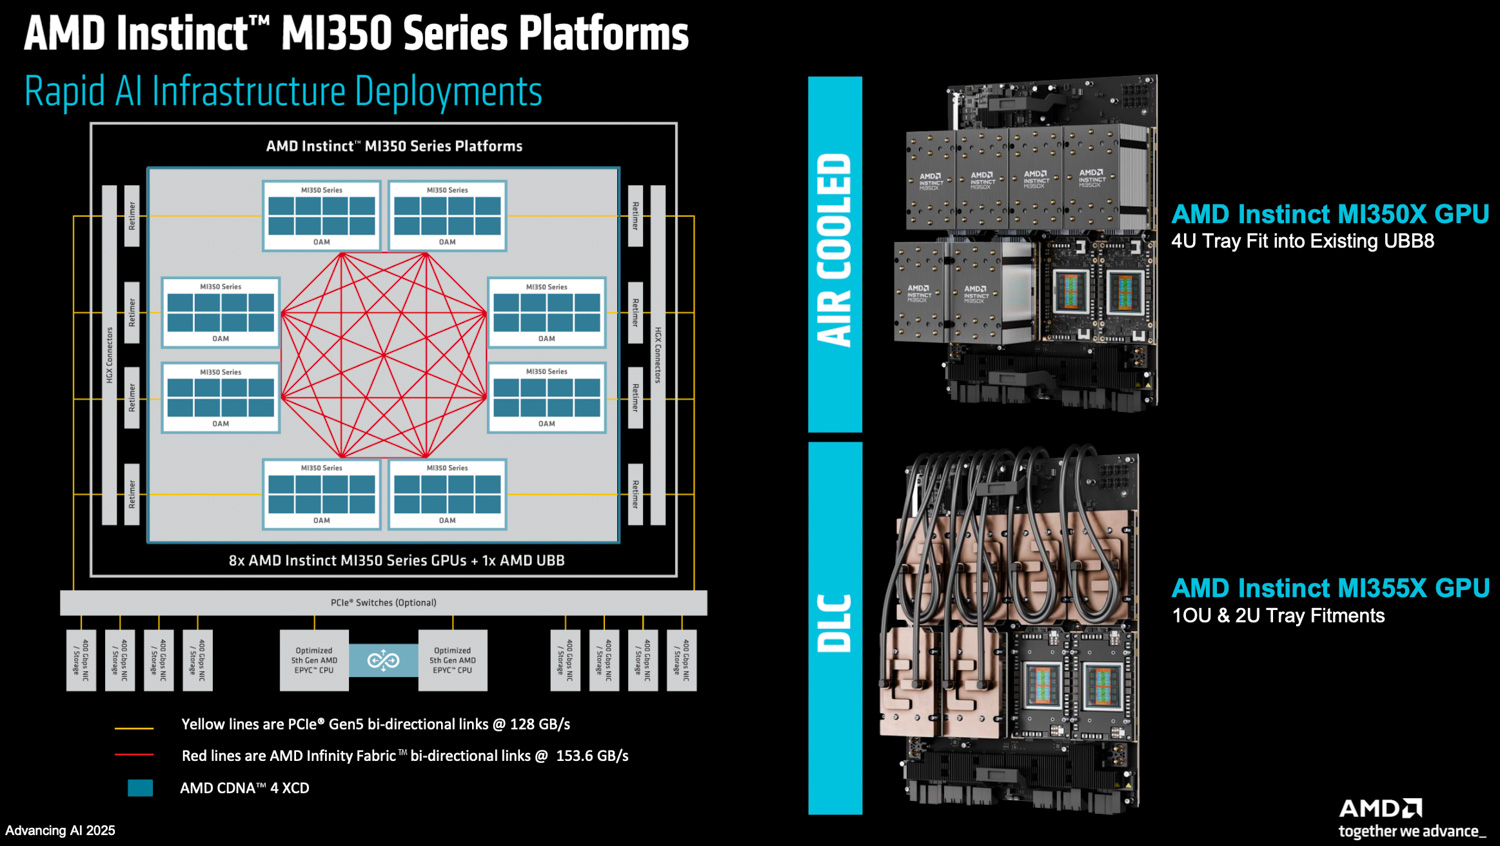
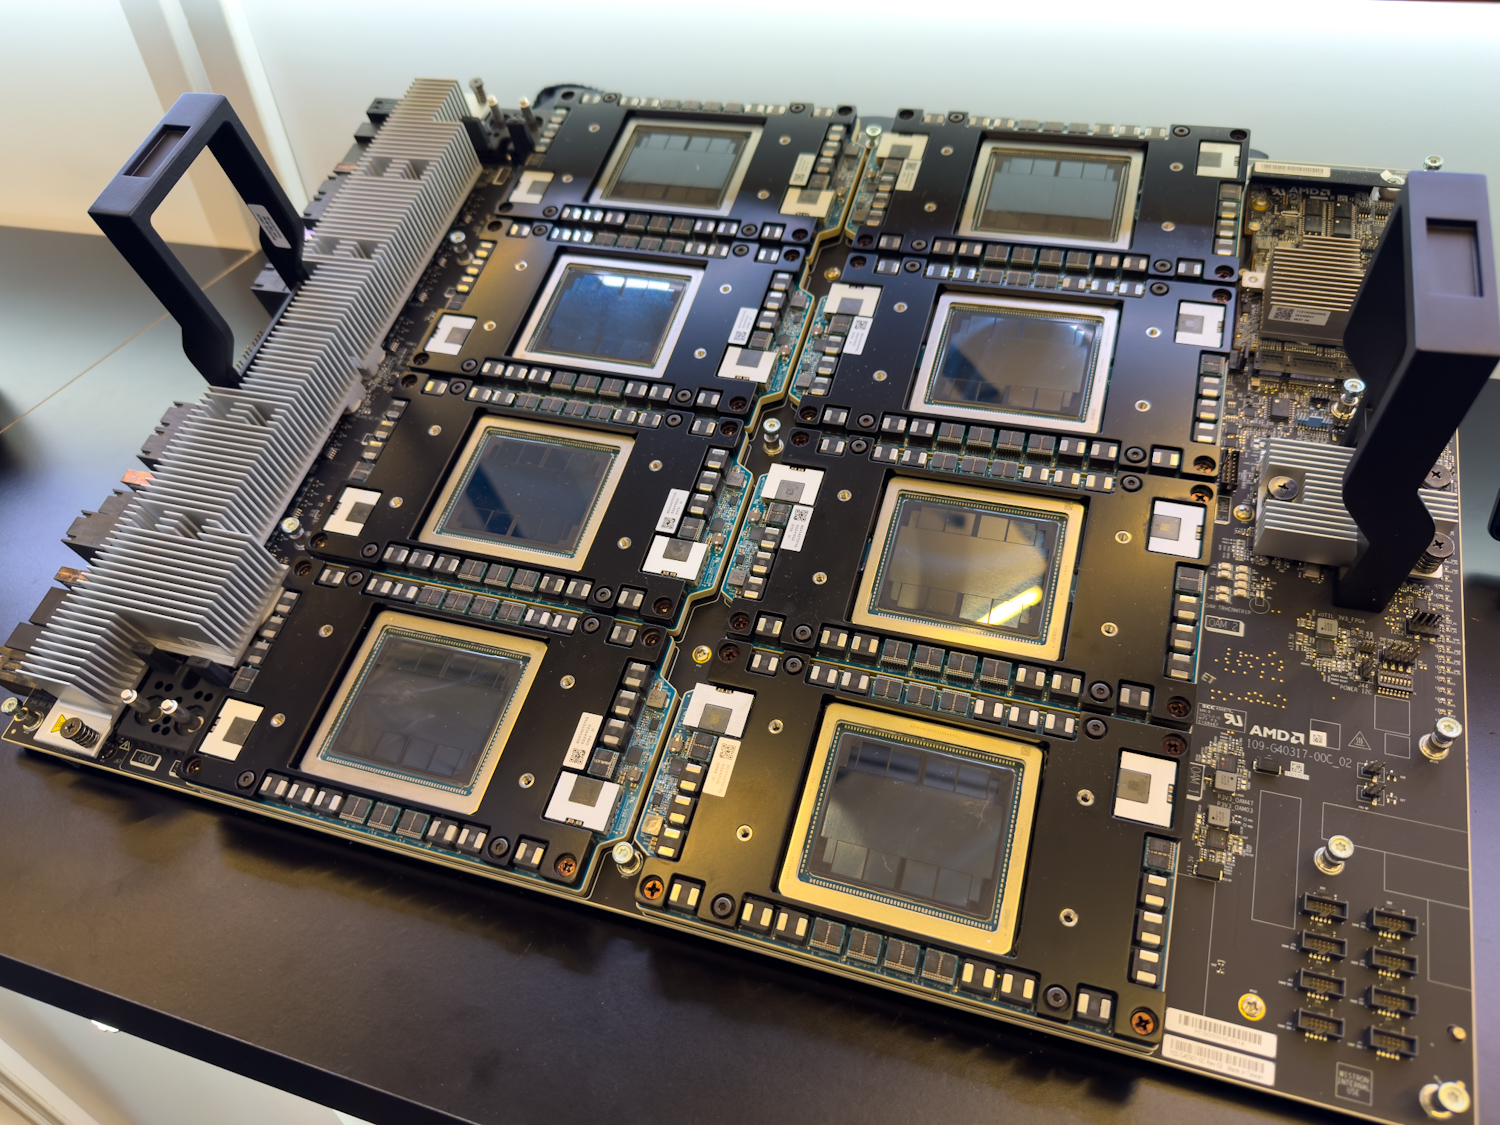
Do komunikacji zewnętrznej każdy procesor graficzny MI350 oferuje siedem łączy Infinity Fabric, umożliwiając bezpośrednią łączność między procesorami graficznymi w konfiguracjach takich jak platforma UBB 2.0 z 8 procesorami graficznymi. Łącza te działają z szybkością 38.4 Gb/s na pin. W konfiguracji OAM z 8 procesorami graficznymi, konfiguracja ta zapewnia dwusekcyjną przepustowość wynoszącą około 153.6 GB/s w każdym kierunku na łącze. AMD udoskonaliło również techniki pakowania i kompresji danych w tych łączach zewnętrznych, aby zwiększyć efektywną dostarczaną przepustowość. Wewnętrznie Infinity Fabric zapewnia wszystkim modułom XCD pełny, drobnoziarnisty, przeplatany dostęp do całej przestrzeni pamięci HBM3E w obu interfejsach IOD, prezentując pamięć jako pojedynczy, płaski, zunifikowany zasób dla jednostek obliczeniowych.
Architektura rdzenia obliczeniowego CDNA4
Sercem mocy obliczeniowej komputera MI350 jest jednostka obliczeniowa CDNA4 , która przeszła znaczącą przebudowę pod kątem sztucznej inteligencji.
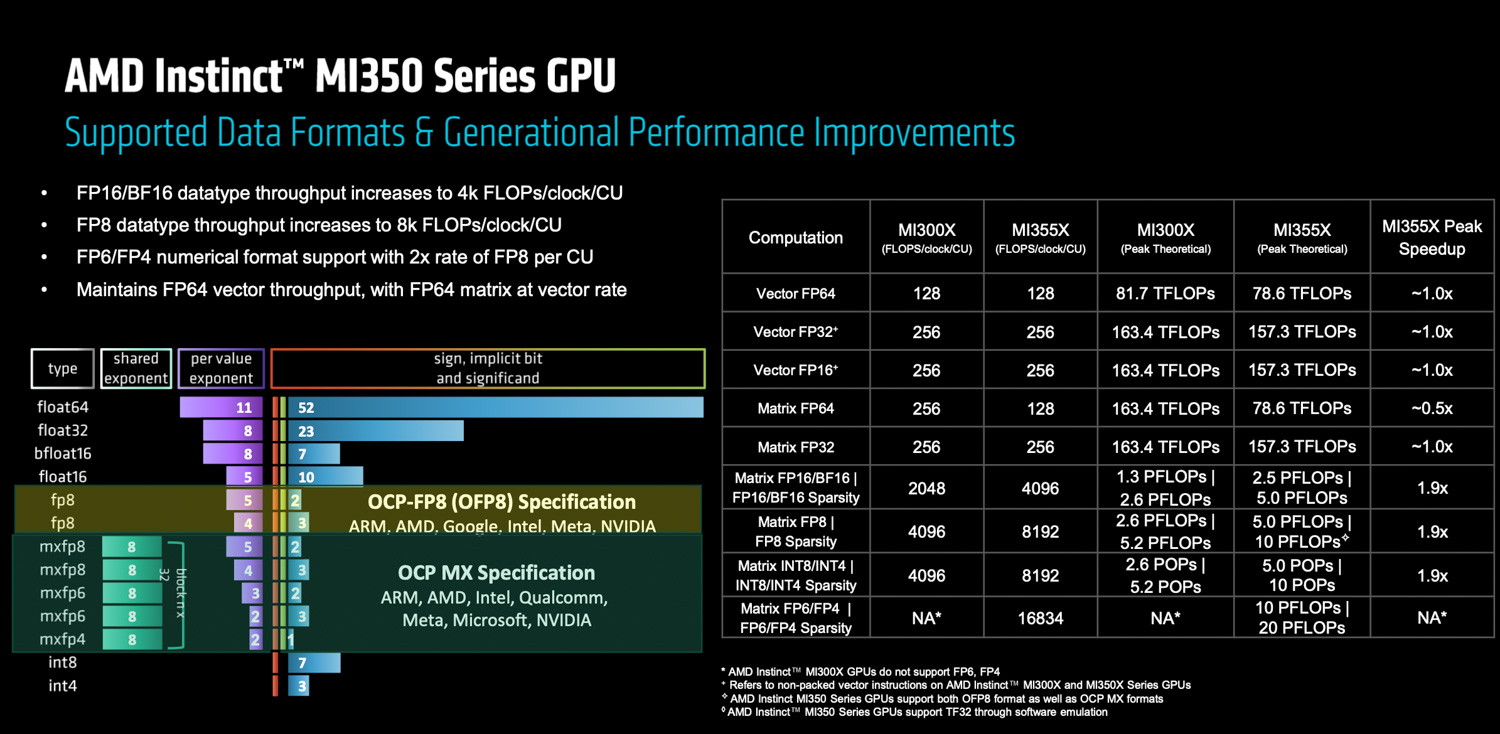
Możliwości matematyki macierzowej znacznie wzrosły: jednostki CU MI350 zapewniają dwukrotny wzrost przepustowości na jednostkę CU dla operacji 16-bitowych (BF16, FP16) i 8-bitowych (FP8, INT8) w porównaniu do odpowiedników MI300. Seria MI350 wprowadza również sprzętowe wsparcie dla formatów mikroskali określonych przez OCP MX, w szczególności FP6 i FP4, które skalują się proporcjonalnie od FP8. Co godne uwagi, implementacja AMD umożliwia FP6 działanie z tą samą szybkością obliczeniową co FP4. Ta strategiczna decyzja pozycjonuje AMD na pozycji lidera w FP6, wschodzącym formacie z potencjałem do szkolenia AI. Ponadto dodano nową wektorową jednostkę ALU, obsługującą operacje 2-bitowe i zdolną do gromadzenia wyników BF16 w FP32, zwiększając w ten sposób przepustowość dla niektórych operacji wektorowych o niskiej precyzji.
Aby obsłużyć te zwiększone przepustowości tensorów, zwiększono rozmiar lokalnego udziału danych (LDS) na jednostkę CU, a nowe możliwości zwiększają przepustowość ładowania danych z pamięci globalnej do LDS. Rozpoznając potencjalne wąskie gardła w operacjach takich jak softmax i mechanizmy uwagi, zwiększono również przepustowość funkcji transcendentalnych, co szło w parze z ulepszeniami rdzenia tensora.
Na wydajność i elastyczność wpływa szereg innych udoskonaleń architektonicznych:
- Sprzętowo obsługiwane zaokrąglanie stochastyczne: zmniejsza odchylenia przy rzutowaniu w dół z FP32 do formatów o niższej precyzji poprzez wstrzykiwanie entropii.
- Instrukcja operatora logicznego 3 (LUT3): Oferuje programistom większą elastyczność w implementacji niestandardowych operacji logicznych dla trzech wejść.
- Nowi operatorzy Min-Max: umożliwiają programistom kontrolowanie propagacji NaN podczas porównań, umożliwiając im propagowanie wartości NaN lub wybieranie liczb zmiennoprzecinkowych innych niż NaN, co wspomaga sprawne zarządzanie danymi AI.
Choć głównym celem jest sztuczna inteligencja, seria MI350 nadal obsługuje 64-bitowe operacje zmiennoprzecinkowe (FP64) zarówno w jednostkach wektorowych, jak i macierzowych. Kluczową różnicą w porównaniu z MI300 jest jednak to, że w MI350 operacje macierzowe FP64 działają z taką samą szybkością, jak w jednostkach wektorowych FP64, czyli efektywnie o połowę szybciej niż w MI300.
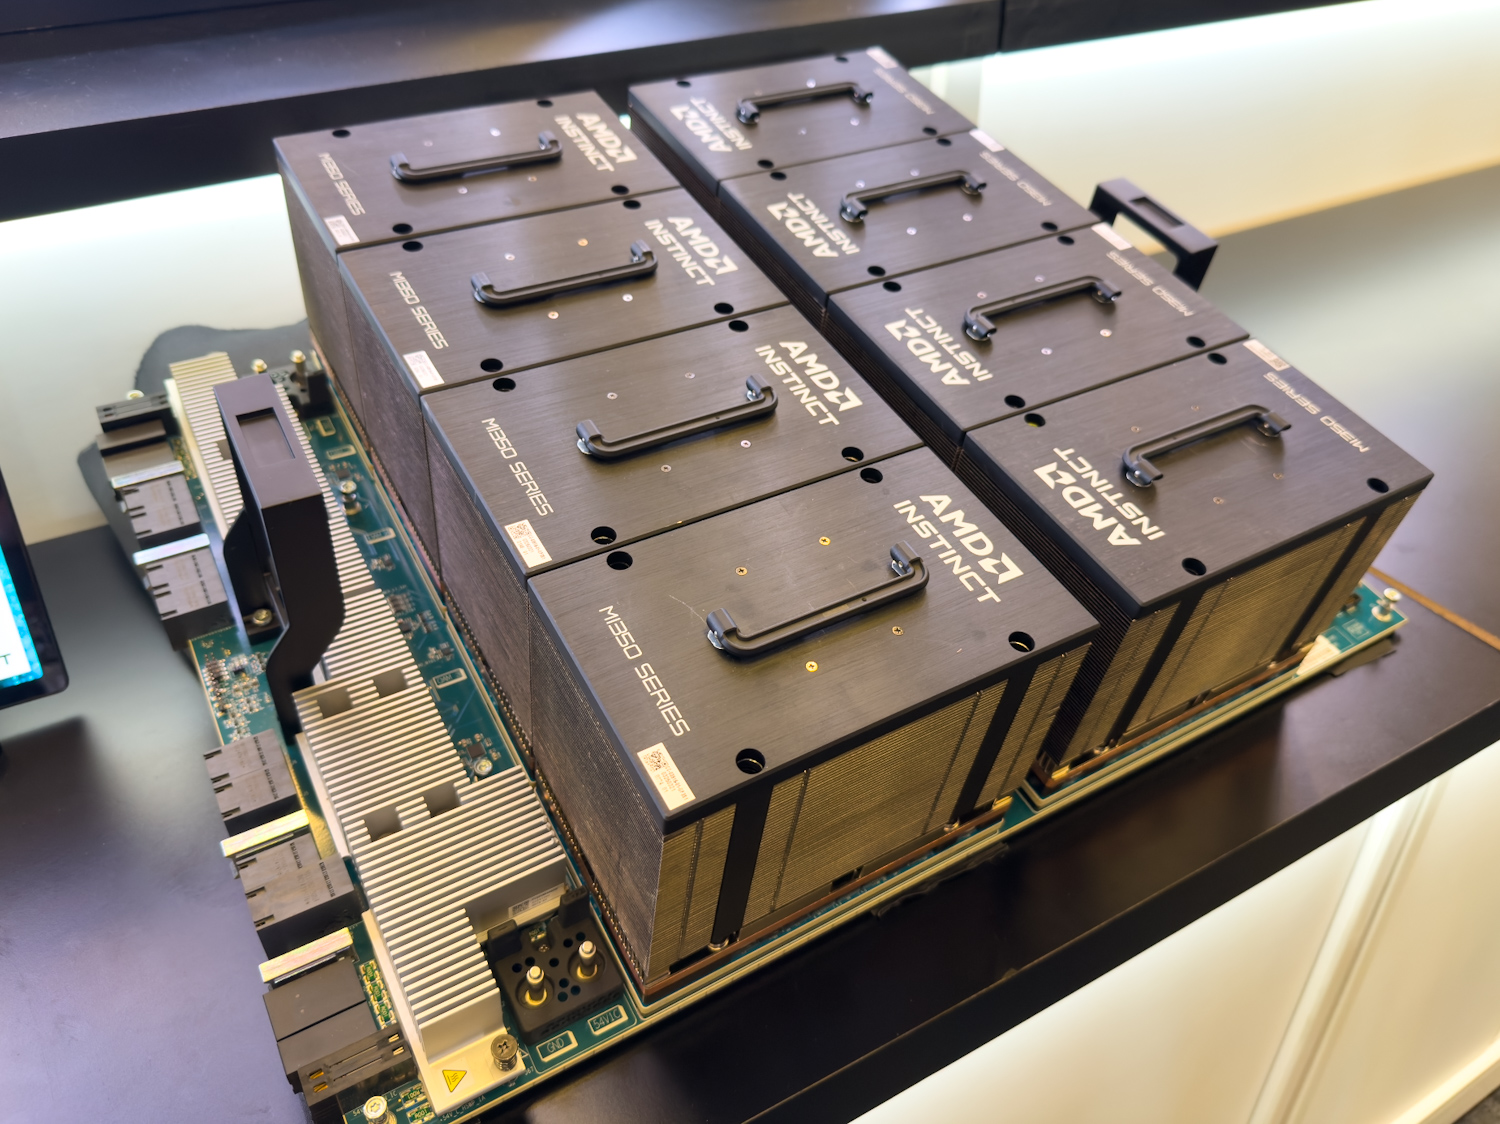
Wreszcie, połączenie wyższej przepustowości HBM3E i nieznacznie zmniejszonej liczby jednostek CU (256 w MI350X/355X w porównaniu z 304 w MI300X) oznacza, że każda jednostka CU w serii MI350 korzysta ze zwiększonej globalnej przepustowości pamięci na cykl zegara. Jest to kluczowe dla przyspieszenia zarówno operacji wymagających dużej przepustowości (mnożenie macierzy ogólnej), jak i arytmetyki wektorowej o ograniczonej przepustowości.
Partycjonowanie dla elastyczności: partycjonowanie NPS i obliczeniowe
Seria AMD MI350 charakteryzuje się udoskonalonymi możliwościami partycjonowania, oferując niezwykle elastyczną alokację znacznych zasobów w celu maksymalizacji wykorzystania i efektywności w przypadku różnorodnych obciążeń.
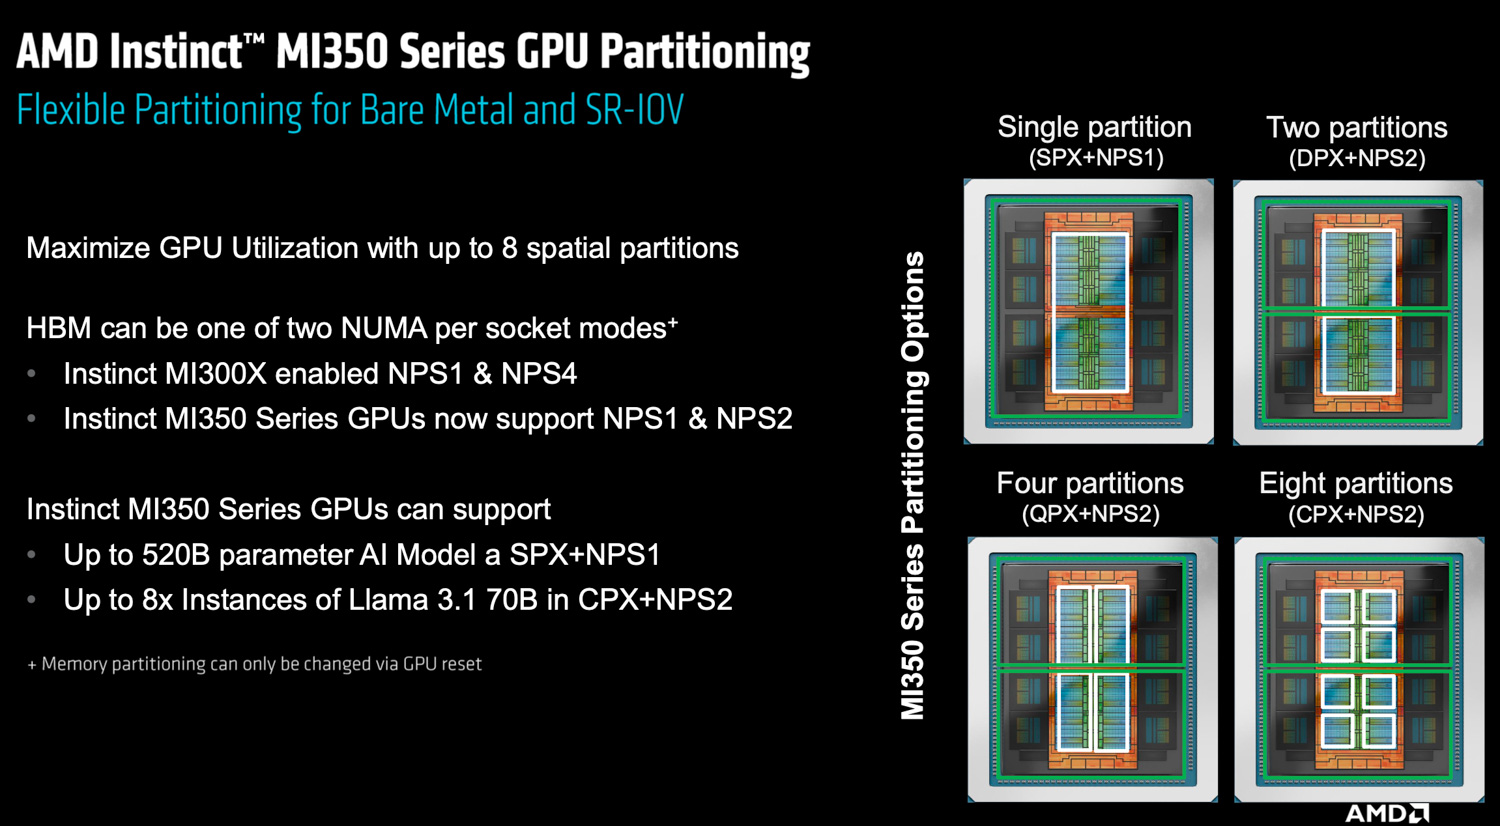
W zakresie zarządzania pamięcią MI350 udostępnia dwa podstawowe tryby NUMA (Non-Uniform Memory Access):
- NPS1: traktuje całą pamięć HBM3E o pojemności 288 GB jako pojedynczą, zunifikowaną domenę NUMA, przeplatając dostęp do danych we wszystkich ośmiu stosach HBM.
- NPS2: Dzieli pamięć na dwie oddzielne domeny NUMA, z których każda odpowiada jednemu z dwóch urządzeń IOD i czterem powiązanym z nim stosom HBM. Podczas gdy dostęp do pamięci w obrębie każdego urządzenia IOD w trybie NPS2 pozostaje drobnoziarnisty i przeplatany, staje się gruboziarnisty w obrębie urządzeń IOD. Ten tryb, szczególnie w połączeniu z partycjonowaniem obliczeniowym, umożliwia optymalizację pod kątem lokalności przestrzennej.
Warto zauważyć, że AMD zdecydowało się nie obsługiwać trybu NPS4 w modelu MI350 (który był dostępny w modelu MI300). Decyzja ta wynika z ściślejszego powiązania pamięci w każdym z dwóch interfejsów IOD w nowszej architekturze, co zmniejszyło potencjalne korzyści wydajnościowe wynikające z dalszego podziału pamięci.
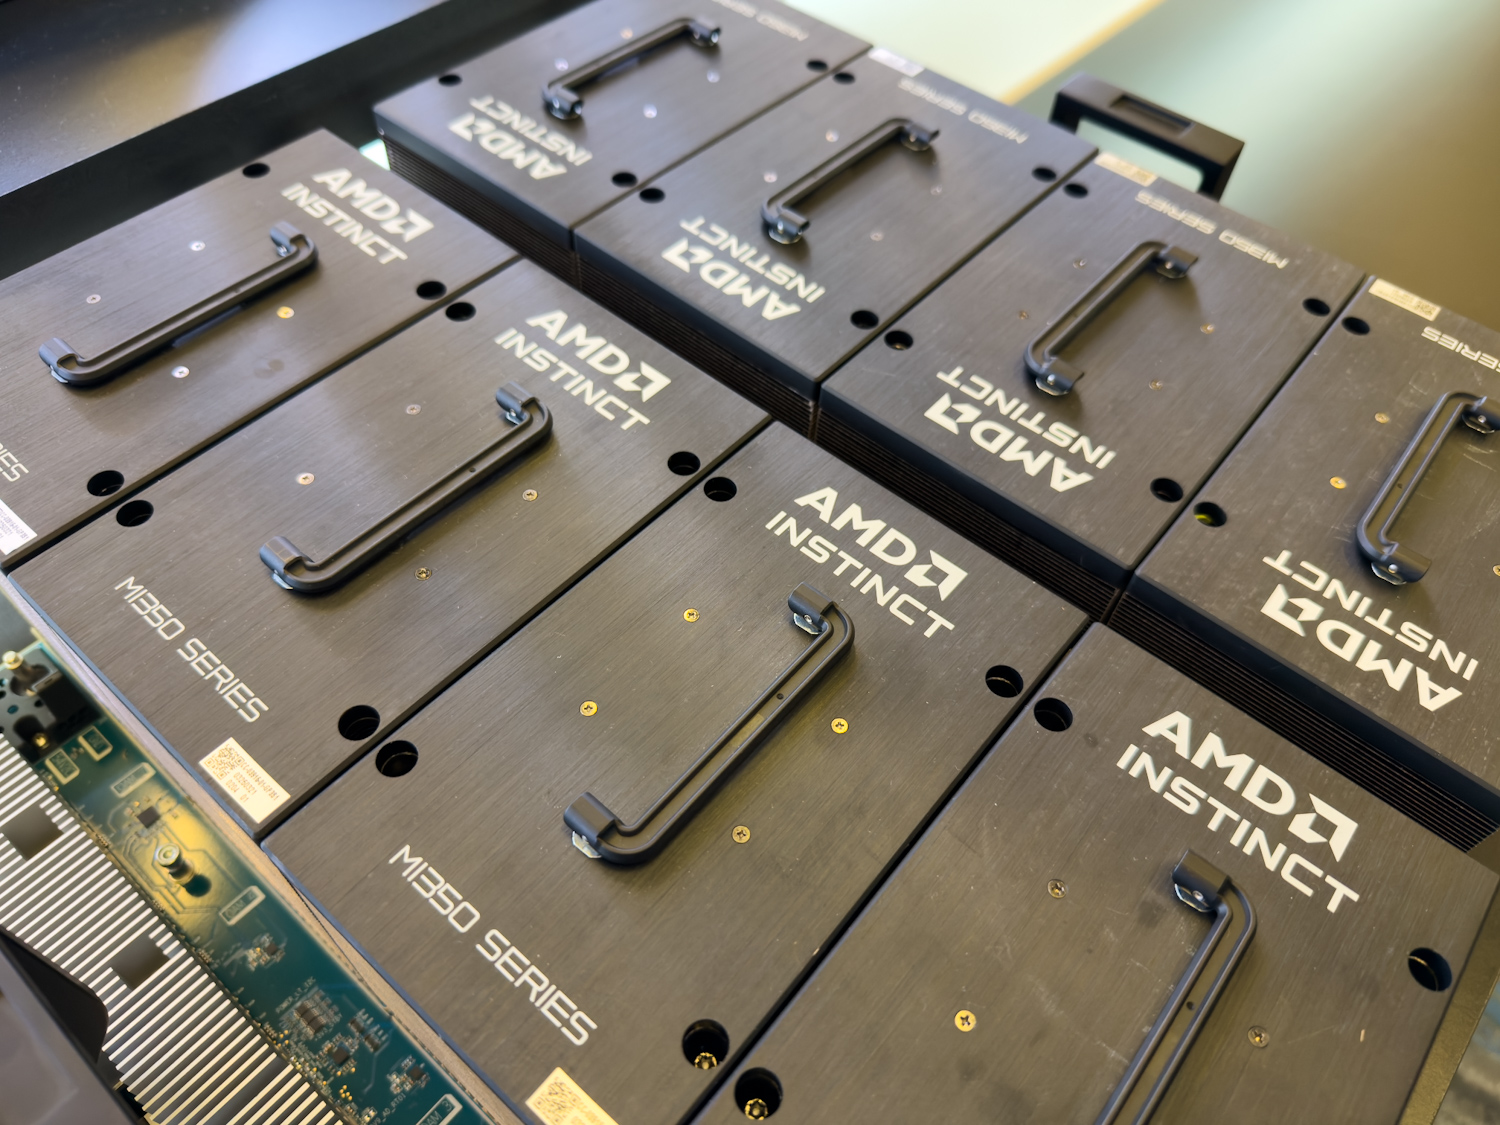
Po stronie obliczeniowej procesor graficzny można skonfigurować tak, aby działał w kilku trybach:
- SPX (Single Partition Execution): Procesor GPU działa jako pojedynczy, wydajny silnik, zwykle używany w trybie pamięci NPS1.
- DPX, QPX, OPX (wykonywanie partycji podwójnych, poczwórnych, ósemkowych): Procesor GPU można podzielić odpowiednio na dwie, cztery lub nawet osiem niezależnych partycji obliczeniowych.
Te partycje obliczeniowe można sparować z konfiguracjami pamięci NPS1 lub NPS2, pod warunkiem, że granularność partycji obliczeniowej musi być co najmniej tak samo dokładna jak granularność partycji pamięci lub większa (np. tryb SPX jest niezgodny z partycjonowaniem pamięci NPS2).
Te wszechstronne opcje partycjonowania są obsługiwane zarówno we wdrożeniach bare-metal, jak i poprzez SR-IOV (Single Root I/O Virtualization), co czyni je idealnymi dla zwirtualizowanych środowisk wielodostępnych. Na przykład, w środowisku chmury lub centrum danych, pojedynczy procesor graficzny MI350 może zostać logicznie podzielony na segmenty, aby obsługiwać wielu użytkowników lub aplikacje jednocześnie. Każdy użytkownik otrzymuje dedykowany wycinek pamięci i zasobów obliczeniowych, co gwarantuje jakość usług i bezpieczeństwo, co jest szczególnie cenne w scenariuszach, w których różne maszyny wirtualne wymagają izolowanego dostępu do sprzętu GPU.
MI350X kontra MI355X: dostosowane do różnych wdrożeń
Seria MI350 została wprowadzona w dwóch głównych wariantach, dostosowanych do różnych potrzeb wdrożeniowych i typów osłon termicznych:
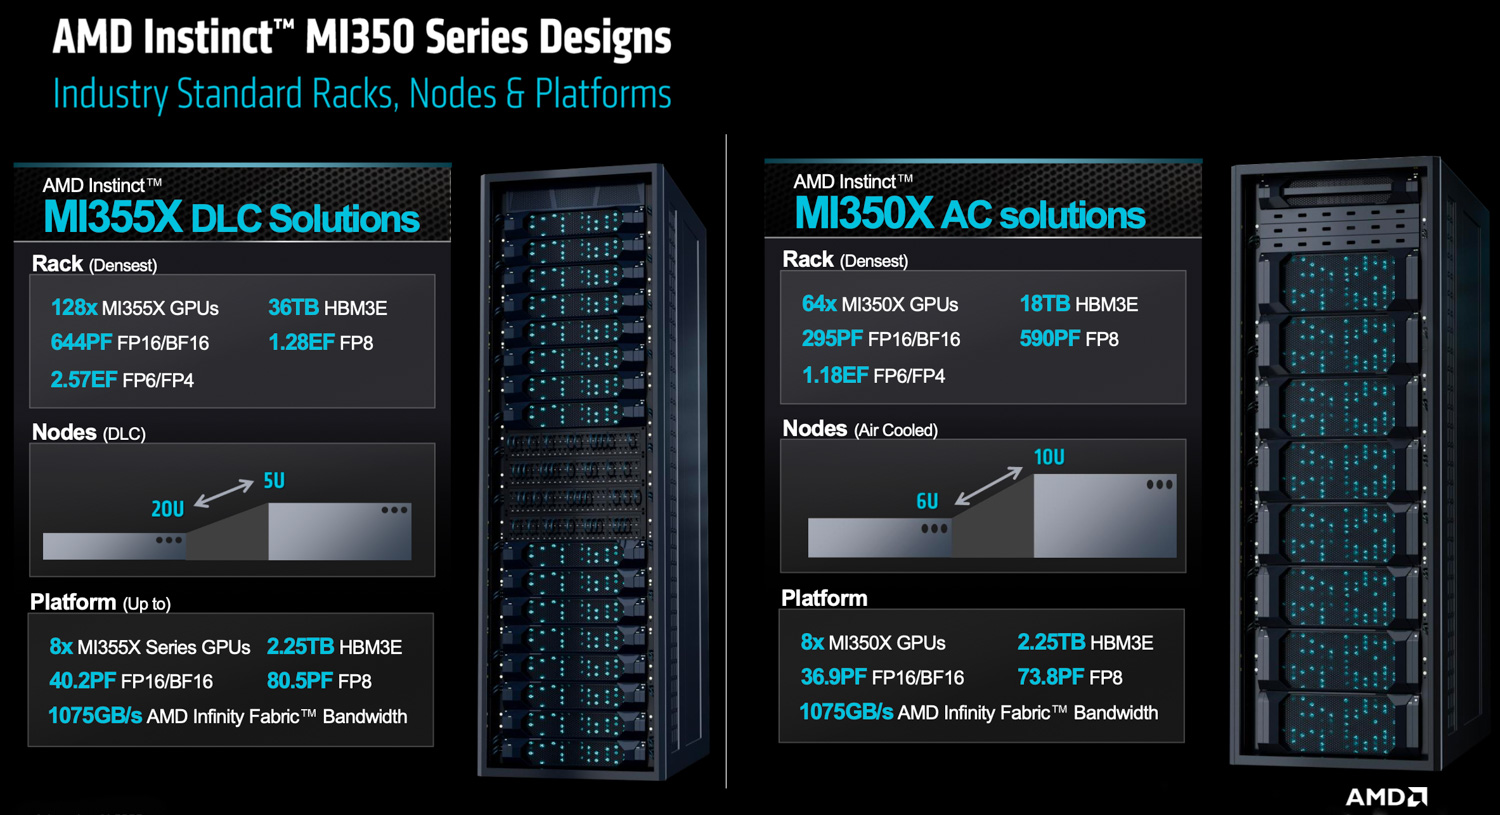
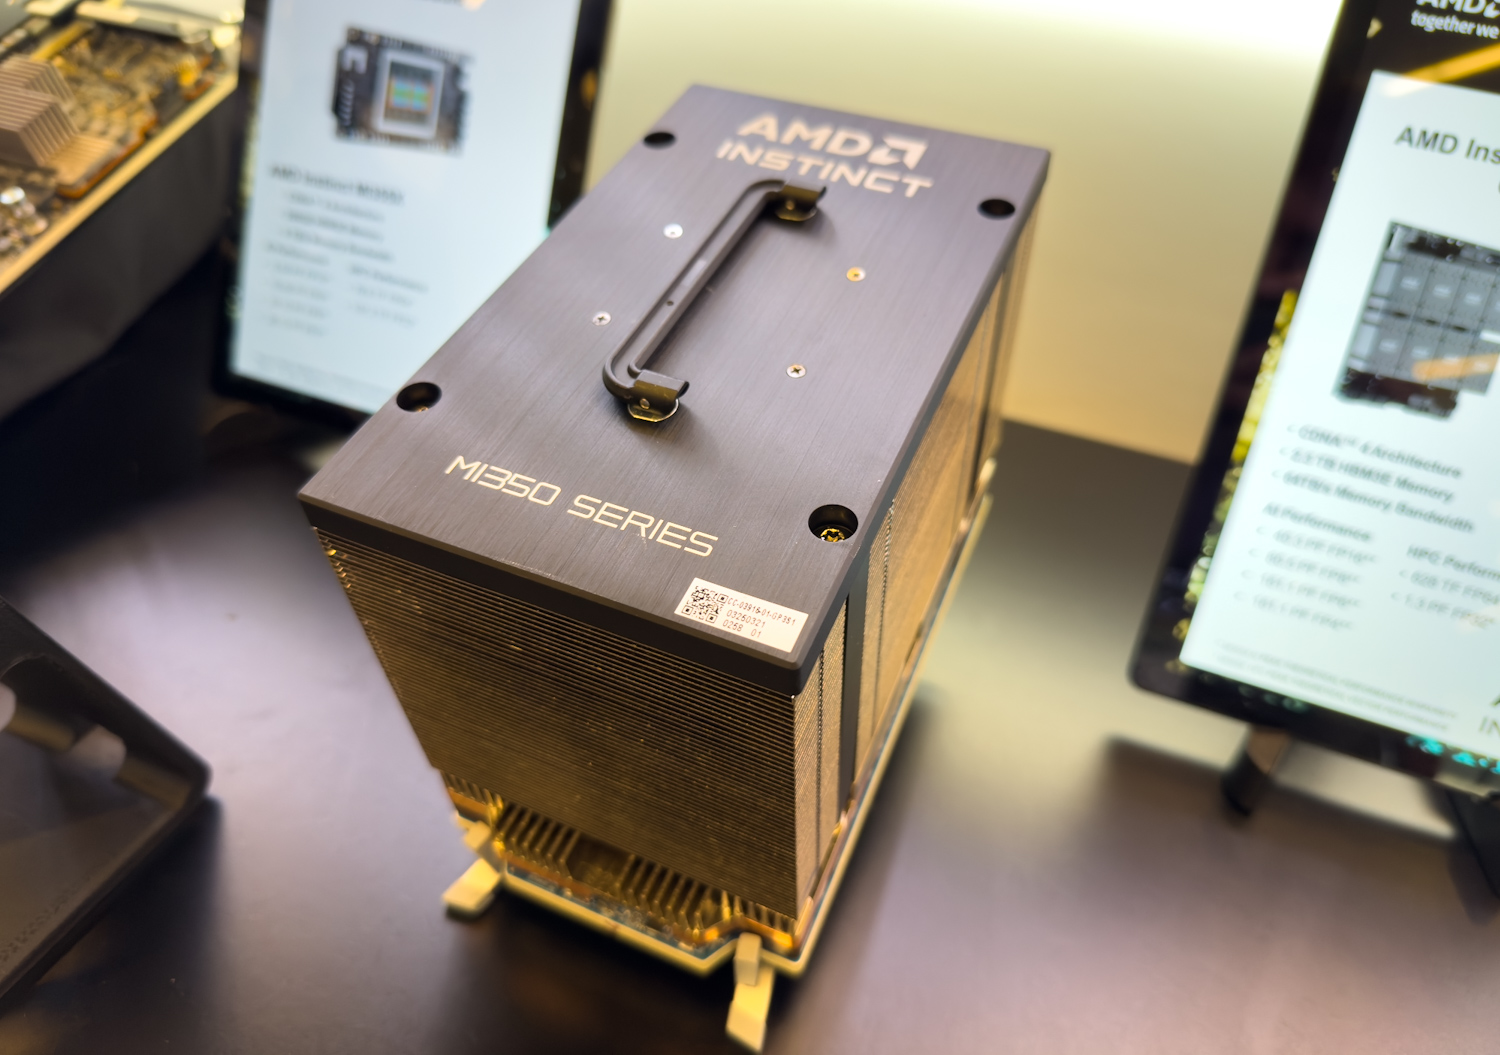
- MI350X: Ten wariant został zaprojektowany z myślą o niższym zużyciu energii, z mocą obliczeniową termiczną (TDP) do jednego kilowata. Obsługuje wdrożenia chłodzone powietrzem, oferując szerszą kompatybilność z istniejącą infrastrukturą centrów danych.
- MI355X: Pracując z wyższą mocą systemową TDP, sięgającą nawet 1.4 kilowata, MI355X jest przeznaczony przede wszystkim do wdrożeń wymagających chłodzenia cieczą, co pozwala mu osiągać maksymalną wydajność.
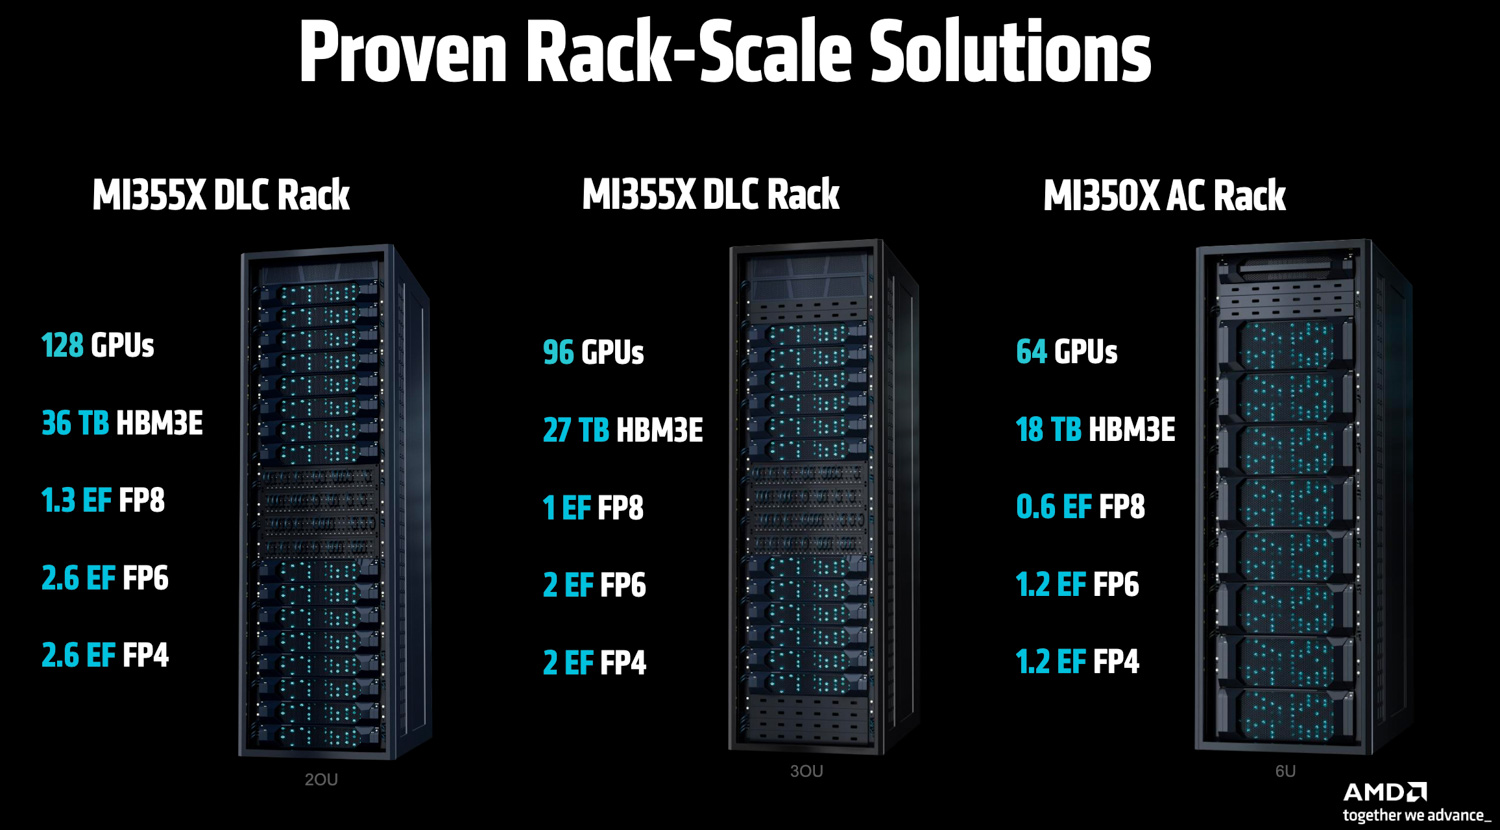
Chociaż oba warianty bazują na tym samym podstawowym sprzęcie, wyższa moc robocza MI355X pozwala na utrzymanie wyższych częstotliwości taktowania. Przekłada się to na około 20% wzrost wydajności w rzeczywistych, kompleksowych obciążeniach w porównaniu z MI350X. Są one dostępne w trzech sprawdzonych konfiguracjach rack.
Sieć AMD Pensando Pollara
Oprócz nowych procesorów graficznych, AMD przedstawiło dogłębną analizę swoich rozwiązań sieciowych Pollara, prezentując znaczące postępy w architekturze, mające na celu sprostanie rosnącym wymaganiom systemów sztucznej inteligencji na dużą skalę. Karta sieciowa Pollara 400 AI NIC, oparta na technologii uzyskanej dzięki przejęciu Pensando przez AMD, wprowadza nowy poziom programowalności i inteligencji do struktur sieciowych AI.

Istotą innowacyjności Pollary jest jej programowalna architektura. W przeciwieństwie do sprzętu o stałej funkcjonalności, karta sieciowa Pollara wykorzystuje programowalny rdzeń MPU P4. Taka konstrukcja jest kluczowa, ponieważ wymagania sieciowe AI podlegają ciągłym zmianom, a nowe protokoły, mechanizmy transportu i potrzeby telemetryczne szybko się pojawiają. Programowalność umożliwia karcie sieciowej Pollara adaptację poprzez aktualizacje oprogramowania, co pozwala na wdrażanie niestandardowych schematów zarządzania ruchem, nowatorskich algorytmów równoważenia obciążenia i dostosowanych mechanizmów kontroli przeciążenia bez konieczności wymiany sprzętu. Ta elastyczność jest kluczowa dla przyszłościowego przygotowania centrów danych AI i szybkiego reagowania na zmieniającą się charakterystykę obciążeń.
Rozwiązując typowe wąskie gardła sieciowe, Pollara wprowadza multicast. W przypadku komunikacji między procesorami graficznymi (GPU) dane z jednego połączenia mogą być dystrybuowane jednocześnie do wielu fizycznych łączy sieciowych. Takie podejście zwiększa ogólne wykorzystanie sieci i przepustowość, zapobiegając przeciążeniom na pojedynczej ścieżce. Sama karta sieciowa zarządza złożonością tej dystrybucji, w tym zmianą kolejności pakietów, które mogą dotrzeć do celu w niewłaściwej kolejności.
Wydajność sieci jest zwiększana dzięki selektywnemu potwierdzaniu retransmisji. W tradycyjnych sieciach utrata pojedynczego pakietu może spowodować retransmisję rozległej sekwencji danych. Pollara implementuje również bardziej precyzyjną metodę, w której ponownie wysyłane są tylko utracone pakiety. To znacznie redukuje nadmiarowość danych w sieci, poprawiając efektywną przepustowość. Rozwiązanie sieciowe Pollara zostało również zaprojektowane z myślą o niezawodnej pracy w zróżnicowanych środowiskach sieciowych, w tym w tych ze stratnymi połączeniami. Zawiera ono zaawansowaną, programowalną i uwzględniającą ścieżkę kontrolę przeciążenia. Ta funkcja zmniejsza zależność od idealnie bezstratnych struktur sieciowych, których wdrożenie i utrzymanie może być skomplikowane i kosztowne w przypadku ogromnej skali wymaganej przez nowoczesne klastry AI.

AMD aktywnie uczestniczy również w Ultra Ethernet Consortium, współtworząc i wdrażając jego standardy. Celem UEC jest zdefiniowanie Ethernetu nowej generacji zoptymalizowanego pod kątem sztucznej inteligencji, koncentrując się na efektywnym równoważeniu obciążenia, zwiększonej niezawodności i kontroli przeciążenia specyficznej dla sztucznej inteligencji. Przestrzeganie tych otwartych standardów promuje interoperacyjność i sprzyja szerszemu ekosystemowi.
Technologia Pollara została zaprojektowana z myślą o synergii działania w ramach szerszej platformy AMD, umożliwiając współtworzenie innowacji między komponentami CPU, GPU i kart sieciowych. Obejmuje to takie funkcje, jak kolektywne odciążanie operacyjne, gdzie karta sieciowa obsługuje określone zadania komunikacyjne intensywnie obciążające sieć (te, które nie wymagają obliczeń GPU). Uwalnia to zasoby GPU do ich głównych zadań obliczeniowych.
ROCm 7: Otwarty ekosystem oprogramowania dla zaawansowanej sztucznej inteligencji
Podstawą tych innowacji sprzętowych jest zapowiedź ROCm 7, najnowszej wersji otwartej platformy programowej AMD, zaprojektowanej z myślą o maksymalizacji wydajności i dostępności. Zaplanowana na dziś publiczna prezentacja przed pełną premierą w sierpniu, AMD informuje, że ROCm 7 oferuje oszałamiającą, 3- do 3.5-krotną poprawę wydajności wnioskowania i uczenia na istniejącym sprzęcie w porównaniu z poprzednikiem.
Dla klientów korporacyjnych AMD wprowadza ROCm AI Enterprise, kompleksowy pakiet oferujący zarządzanie klastrami, MLOps oraz narzędzia do tworzenia aplikacji na potrzeby wdrożeń na dużą skalę. Jednocześnie AMD umożliwia indywidualnym deweloperom dostęp do nowej chmury deweloperskiej, wraz z darmowymi kredytami GPU, aby zachęcić do eksperymentowania. Ten nacisk na dostępność idzie jeszcze dalej, ponieważ ROCm 7 oficjalnie rozszerza obsługę urządzeń klienckich, w tym laptopów i stacji roboczych z systemem Windows, zapewniając deweloperom możliwość płynnego tworzenia i testowania aplikacji AI w całym ekosystemie AMD.
Droga przed nami
Firma AMD stawia na szybki, roczny cykl innowacji, a plan rozwoju produktów wykracza poza serię MI350.

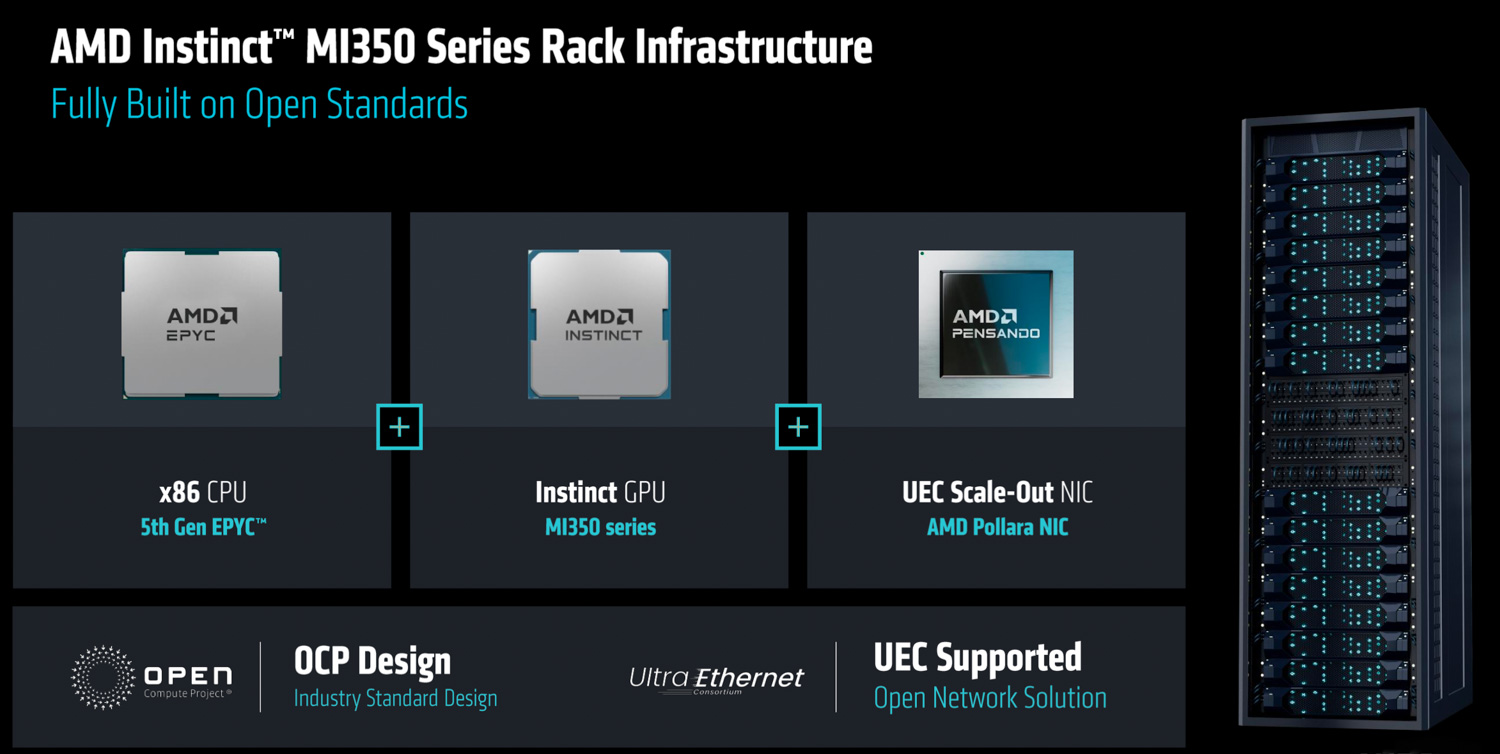
Z myślą o planowanym wprowadzeniu na rynek w 2026 roku, AMD opracowuje serię MI400, która będzie stanowić rdzeń w pełni zintegrowanego rozwiązania o skali rackowej o nazwie kodowej Helios. Platforma ta jest projektowana specjalnie w celu trenowania najnowocześniejszych modeli AI i zarządzania rozproszonymi zadaniami wnioskowania na dużą skalę. System Helios będzie zintegrowaną platformą AMD, obejmującą przyszłe procesory EPYC o nazwie kodowej Venice, procesory graficzne Instinct MI400 oraz sieci Pensando nowej generacji, w szczególności kartę sieciową Vulcano 800G AI. Kompleksowy stos oprogramowania ROCm, w tym dedykowany menedżer Fabric Manager do automatycznego wdrażania i zarządzania, będzie również częścią tego rozwiązania. Kładąc nacisk na otwarte standardy, szafa Helios będzie zgodna ze specyfikacjami OCP. Będzie wykorzystywać technologię Ultra Ethernet (UEC) do skalowania sieci między szafami oraz wprowadzać technologię Ultra Accelerator Link (UAL 1.0) do skalowania komunikacji w ramach pojedynczej szafy.

Sam procesor graficzny Instinct MI400 został zaprojektowany specjalnie z myślą o ekstremalnie skalowalnych aplikacjach AI. Wstępne specyfikacje wskazują na imponujące możliwości, w tym 40 PetaFLOPS wydajności FP4 i 20 PetaFLOPS wydajności FP8. Każdy procesor graficzny ma posiadać 432 gigabajty pamięci HBM, zapewniając przepustowość pamięci HBM około 20 TB/s i oferując skalowalną przepustowość 300 gigabitów na sekundę. Uzupełnieniem procesora graficznego będzie karta sieciowa Vulcano 800G AI NIC, gotowa do obsługi UEC i obsługująca UAL wraz z PCIe Gen6, przy czym UAL zapewnia dwukrotnie większą przepustowość niż PCIe Gen6. Przewiduje się, że ta karta sieciowa zapewni do ośmiu razy większą skalowalną przepustowość na procesor graficzny w porównaniu z wcześniejszą generacją Polara. AMD ma ambitne cele wydajnościowe dla rozwiązania Helios rack, prognozując, że zapewni ono do dziesięciu razy większą wydajność AI w najbardziej zaawansowanych modelach frontier w porównaniu z MI355. W rywalizacji z Verą Rubin w 2026 r. Helios zamierza zaoferować konkurencyjne FLOPS-y, o 50% większą pojemność HBM, o 50% większą przepustowość pamięci HBM i do 50% większą przepustowość skalowania poziomego.
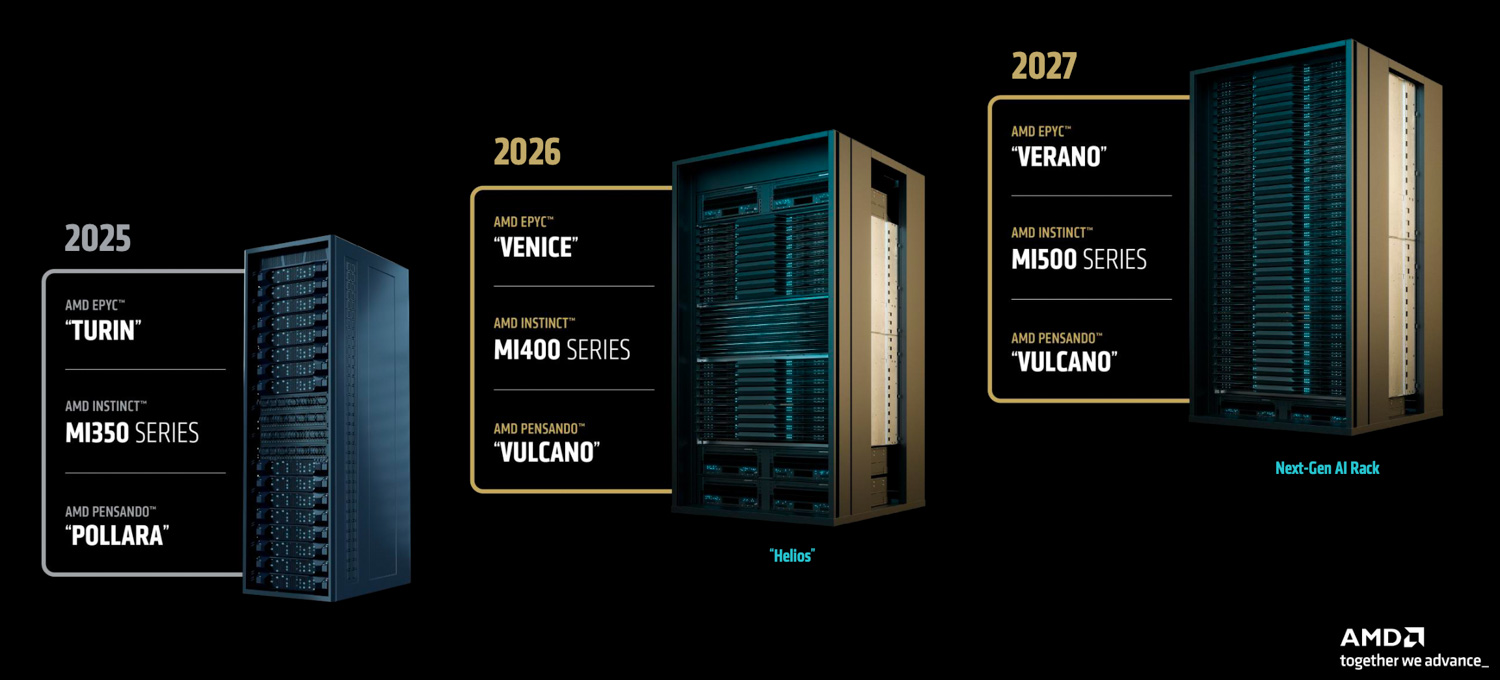
Plany AMD sięgają jeszcze dalej, ponieważ prace nad serią MI500 i kolejnymi architekturami rackowymi są już w toku i planowane na rok 2027 i kolejne lata. Te przyszłe platformy będą integrować serię MI500, procesory EPYC nowej generacji o nazwie kodowej Verano oraz dalsze udoskonalenia technologii sieciowej Pensando. Jednak podczas wydarzenia nie ujawniono żadnych dodatkowych informacji.


 Amazon