

Firma Meta przedstawiła szybki rozwój swojego programu Meta Training and Inference Accelerator (MTIA). Opisano w nim cztery generacje układów scalonych, które powstały w ciągu około dwóch lat. Układy te rozwiązują kluczowy problem infrastrukturalny, który Meta uważa za kluczowy dla światowej sztucznej inteligencji: szybkie dostosowywanie się do ewoluujących architektur modeli przy niskich kosztach, bez konieczności długich cykli rozwoju układów scalonych. MTIA jest częścią szerszej strategii dotyczącej układów scalonych, a Meta potwierdziła współpracę z firmą Broadcom w zakresie rozwoju tych układów.
Według Meta, firma wdrożyła już setki tysięcy urządzeń MTIA w produkcji i zintegrowała kilka modeli wewnętrznych. Prace walidacyjne obejmują testowanie dużych modeli językowych, takich jak Llama. Firma opublikowała wcześniej szczegóły techniczne dotyczące dwóch pierwszych generacji MTIA, MTIA 100 i MTIA 200, w artykułach badawczych ISCA. Obecnie rozszerza platformę o MTIA 300, 400, 450 i 500. Te nowe komponenty rozszerzają zakres od wnioskowania rankingowego i rekomendacyjnego (R&R) po szkolenie R&R, a coraz częściej także na ogólne obciążenia GenAI, zwłaszcza wnioskowanie. Wdrożenia są w toku lub planowane na lata 2026 i 2027.
Iteracja jako zasada projektowania
Kluczowym tematem jest rytm. Meta argumentuje, że ewolucja modelu jest szybsza niż w przypadku tradycyjnego rozwoju układów scalonych, który może trwać 2 lata od projektu do produkcji. Meta buduje układy MTIA w oparciu o architekturę open source RISC-V, a ich produkcją zajmuje się Taiwan Semiconductor Manufacturing Corporation (TSMC). Odpowiedzią na to jest iteracyjne, modułowe podejście do projektowania. Każda generacja opiera się na chipletach wielokrotnego użytku i jest dopracowywana z wykorzystaniem najnowszych danych dotyczących operatorów i obsługi. Firma podkreśliła również znaczenie ponownego wykorzystania wykraczające poza sam układ. Układy MTIA 400, 450 i 500 korzystają z tej samej obudowy, szafy i infrastruktury sieciowej. Pozwala to na szybkie aktualizacje, skracając czas od gotowości krzemowej do wdrożenia w centrum danych.
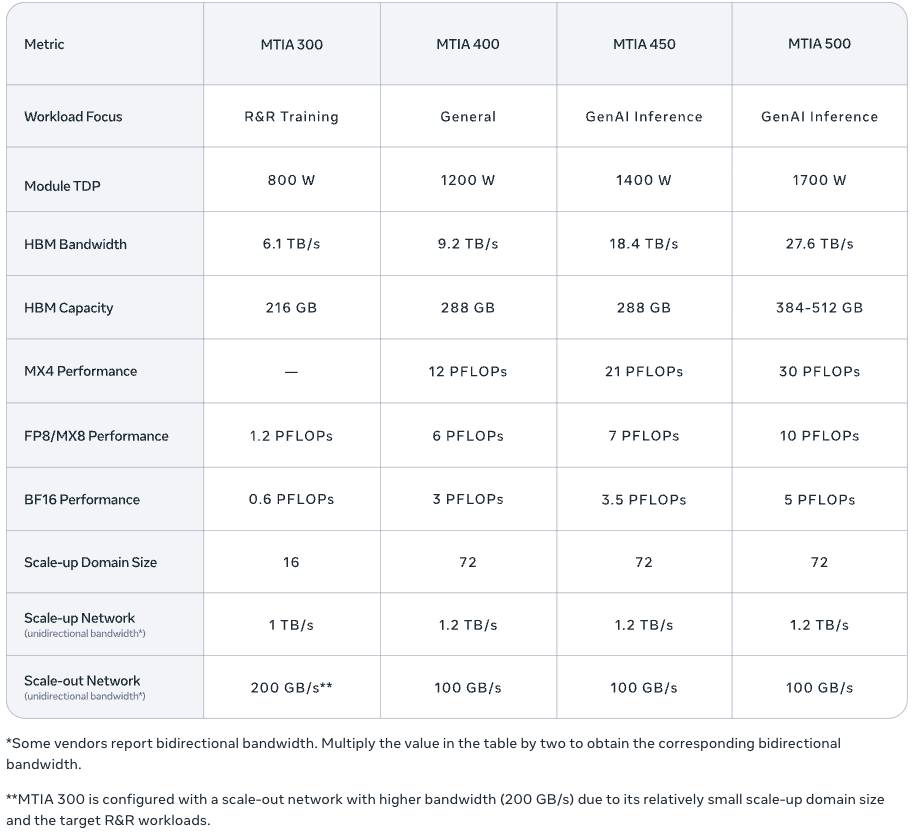
MTIA 300: Sieci i kolektywy wbudowane w krzem
MTIA 300 stanowi podstawę nowego planu działania. Początkowo był on zoptymalizowany pod kątem treningu R&R, głównego obciążenia Meta przed pojawieniem się GenAI. Architektura obejmuje wbudowane chiplety sieciowe, dedykowane silniki komunikatów dla wydajnej komunikacji zbiorczej oraz przetwarzanie w bliskiej pamięci (near-memory computing), aby zmniejszyć obciążenie operacji zbiorczych. Chociaż skoncentrowano się na R&R, te komponenty komunikacyjne wspierają również trening GenAI i wydajność wnioskowania w późniejszych wersjach.
Na poziomie bloków Meta opisał MTIA 300 jako konstrukcję wielochipletową, składającą się z jednego chipletu obliczeniowego, dwóch chipletów sieciowych i wielu stosów HBM. Blok obliczeniowy jest zorganizowany jako siatka elementów przetwarzających (PE), z dodatkowymi PE w celu zwiększenia wydajności. Każdy PE zawiera dwa rdzenie wektorowe RISC-V, silnik iloczynu skalarnego do operacji macierzowych, wyspecjalizowaną jednostkę funkcyjną do aktywacji i operacji na elementach, silnik redukujący do akumulacji i komunikacji PE-PE oraz silnik DMA do lokalnego transferu danych.
MTIA 400: Zwrot w stronę GenAI z konkurencyjnymi deklaracjami przepustowości
MTIA 400 to udoskonalenie MTIA 300, które zapewnia lepszą obsługę GenAI przy jednoczesnym zachowaniu możliwości R&R. Meta opisuje MTIA 400 jako znaczącą aktualizację, zgłaszając o 400% wyższą wydajność FP8 FLOPS i o 51% wyższą przepustowość HBM niż MTIA 300. Pod względem architektury, MTIA 400 łączy dwa chiplety obliczeniowe, aby zwiększyć gęstość obliczeniową, i dodaje obsługę ulepszonych formatów MX8 i MX4 o niskiej precyzji, które Meta uważa za niezbędne do wydajnego wnioskowania GenAI.

Projektowanie systemu pozostaje kluczowym zagadnieniem. Meta opisała wdrożenie w skali rack, w którym 72 urządzenia MTIA 400 łączą się za pośrednictwem przełączanej płyty głównej, tworząc jedną skalowalną domenę. W przypadku elastycznych wdrożeń, Meta wspomniała o rackach z chłodzeniem cieczą wspomaganym powietrzem (AALC), które przyspieszają konfigurację w istniejących centrach danych. Firma zauważyła również, że platforma może obsługiwać rozwiązania chłodzenia cieczą.
MTIA 450: Optymalizacja wnioskowania GenAI zaczyna się od przepustowości pamięci
MTIA 450 to ulepszona wersja MTIA 400, skoncentrowana na wnioskowaniu i napędzana rosnącym zapotrzebowaniem na wnioskowanie GenAI. Meta zidentyfikowała przepustowość HBM jako główny czynnik ograniczający wydajność wnioskowania i podwoiła ją z MTIA 400 do MTIA 450. Firma odnotowała również 75% wzrost liczby flopsów MX4, co usprawniło obliczenia z wykorzystaniem mieszanych ekspertów, a także akcelerację sprzętową w celu zmniejszenia typowych wąskich gardeł w operacjach uwagi i sprzężenia zwrotnego, szczególnie w działaniu funkcji Softmax i FlashAttention.
Firma Meta podkreśliła swoją pracę nad typami danych jako istotny czynnik. MTIA 450 wykracza poza FP8 i MX8, osiągając przepustowość MX4, sześciokrotnie większą niż FP16/BF16. Układ obsługuje mieszane obliczenia o niskiej precyzji bez konieczności konwersji oprogramowania. Zawiera niestandardowe innowacje dla typów danych, zaprojektowane w celu zachowania jakości modelu przy jednoczesnym zwiększeniu liczby FLOPS przy minimalnym wpływie na powierzchnię. Masowe wdrożenie MTIA 450 planowane jest na początek 2027 roku.
MTIA 500: Większa przepustowość, większa pojemność, dalsza dekompozycja chipletów
MTIA 500 nadal koncentruje się na inferencji, wprowadzając dalsze ulepszenia pamięci i mocy obliczeniowej. Meta stwierdził, że MTIA 500 zwiększa przepustowość HBM o 50% w porównaniu z MTIA 450, wydajność HBM nawet o 80% i wydajność MX4 FLOPS o 43%. Projekt chipletów został udoskonalony dzięki konfiguracji 2×2 mniejszych chipletów obliczeniowych, otoczonych wieloma stosami HBM i dwoma chipletami sieciowymi. Zawiera on również chiplet System-on-Chip (SoC) do łączności PCIe z procesorem hosta i kartami sieciowymi skalowalnymi w poziomie. Meta wspomniał o dodatkowym przyspieszeniu sprzętowym i zmianach typów danych w celu wyeliminowania wąskich gardeł inferencji.
Masowe wdrożenie MTIA 500 planowane jest na rok 2027.
Łatwa adopcja
Meta dostosowuje MTIA do celu łatwej adopcji, kładąc nacisk na standardowe narzędzia branżowe, a nie na wyspecjalizowane ramy. Firma opisuje MTIA jako natywne dla PyTorch, płynnie współpracujące z procesami kompilacji PyTorch 2.x i obsługujące zarówno wykonywanie grafów, jak i wykonywanie grafów. W trybie grafów programiści mogą używać torch.compile i torch.export do optymalizacji grafów bez konieczności przepisywania modeli specyficznych dla MTIA, co umożliwia równoległe wdrażanie na GPU i MTIA.
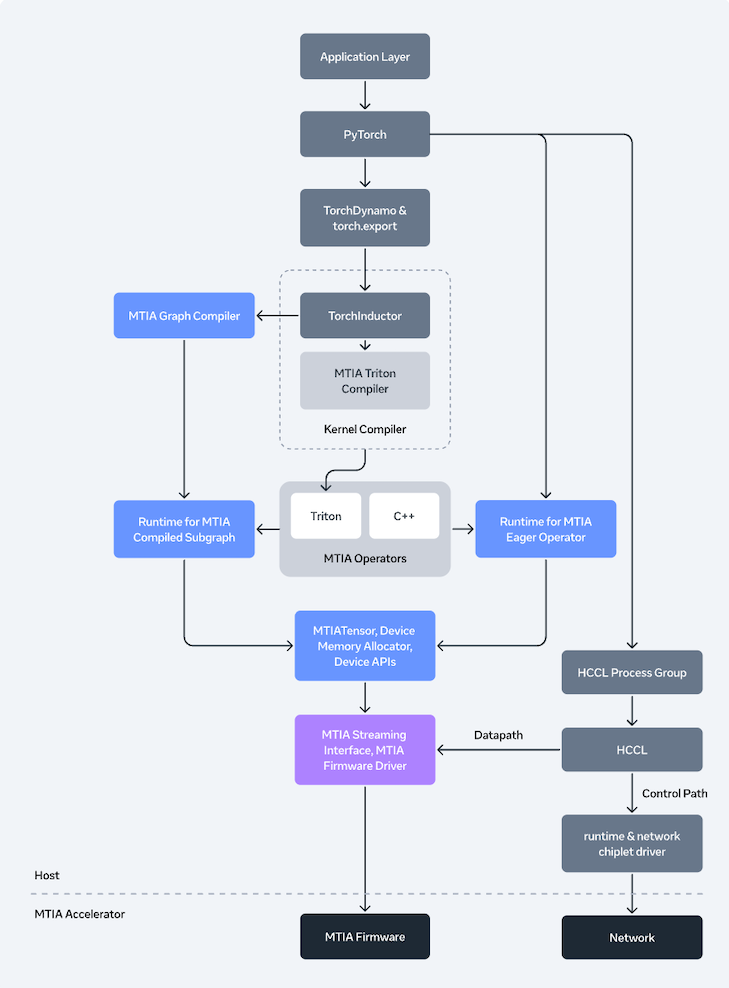
Meta szczegółowo opisał stos kompilatorów MTIA zbudowanych na Torch FX IR i TorchInductor. Niższe warstwy wykorzystują Triton, MLIR i LLVM, a także optymalizacje specyficzne dla MTIA, w tym ulepszenia fuzji jądra i rozszerzenia dla elementów krytycznych pod względem wydajności. Automatyczne dostrajanie jest kluczową funkcją umożliwiającą wybór spośród różnych strategii kompilacji.
Do obsługi zadań rozproszonych Meta wprowadziła bibliotekę Hoot Collective Communications Library (HCCL). Biblioteka ta jest podobna do stosów zbiorczych GPU, ale zoptymalizowana pod kątem wbudowanych chipletów sieciowych i silników komunikatów MTIA. Wykorzystuje obliczenia bliskiej pamięci (near-memory computing), aby przyspieszyć operacje redukcji. Meta obsługuje również fuzję obliczeń zbiorczych w celu zmniejszenia opóźnień i posiada stos transportowy zaprojektowany do zarządzania ścieżką danych i redukcji obciążenia hosta.
W czasie wykonywania Meta zademonstrowała środowisko wykonawcze urządzenia, które zarządza pamięcią, harmonogramowaniem i koordynacją w trybach chętnym i graficznym. Wprowadzono również sterownik przestrzeni użytkownika oparty na Rust, odchodząc od tradycyjnego sterownika Linuksa w jądrze. Oprogramowanie układowe jest napisane w języku Rust, kładąc nacisk na niskie opóźnienia i bezpieczeństwo.
W przypadku GenAI, Meta opisała integrację vLLM za pomocą systemu wtyczek. Zastępuje on kluczowe operatory, takie jak FlashAttention i połączony LayerNorm, jądrami specyficznymi dla MTIA. Umożliwia również tryb grafu za pomocą niestandardowego backendu torch.compile. Ponadto Meta wspomniała o narzędziach do zarządzania dużymi wdrożeniami MTIA, w tym o monitorowaniu, profilowaniu, debugowaniu i możliwości obserwacji na hostach i urządzeniach.
Co dalej
Zaktualizowany plan działania MTIA firmy Meta kładzie nacisk na ekonomikę wnioskowania GenAI, podkreślając przepustowość HBM i formaty o niskiej precyzji jako kluczowe czynniki. Jeśli Meta dotrzyma terminów wdrożenia, MTIA 450 i 500 posłużą jako pierwsze testy na dużą skalę mające na celu ustalenie, czy strategia akceleratora zorientowanego na wnioskowanie, oparta na szybkich iteracjach chipletów i znormalizowanym oprogramowaniu, może utrzymać przewagę nad popularnymi platformami GPU w dostarczaniu usług GenAI.


 Amazon