

LPU, czyli Language Processing Unit, to niestandardowy akcelerator wnioskowania AI zaprojektowany i zbudowany przez Groq, Inc. Założony w 2016 roku przez Jonathana Rossa, byłego inżyniera Google, uznawanego za jednego z pierwotnych wynalazców TPU, Groq spędził lata na opracowywaniu od podstaw deterministycznej, programowo definiowanej architektury procesora. W przeciwieństwie do procesorów graficznych (GPU), które opierają się na dynamicznym harmonogramowaniu sprzętowym i wielopoziomowych hierarchiach pamięci podręcznej, LPU stosuje radykalnie inne podejście: eliminuje wszystkie reaktywne komponenty sprzętowe i umieszcza całą płaszczyznę sterowania w kompilatorze, umożliwiając w pełni przewidywalne wykonywanie z dokładnością do cyklu zegara.
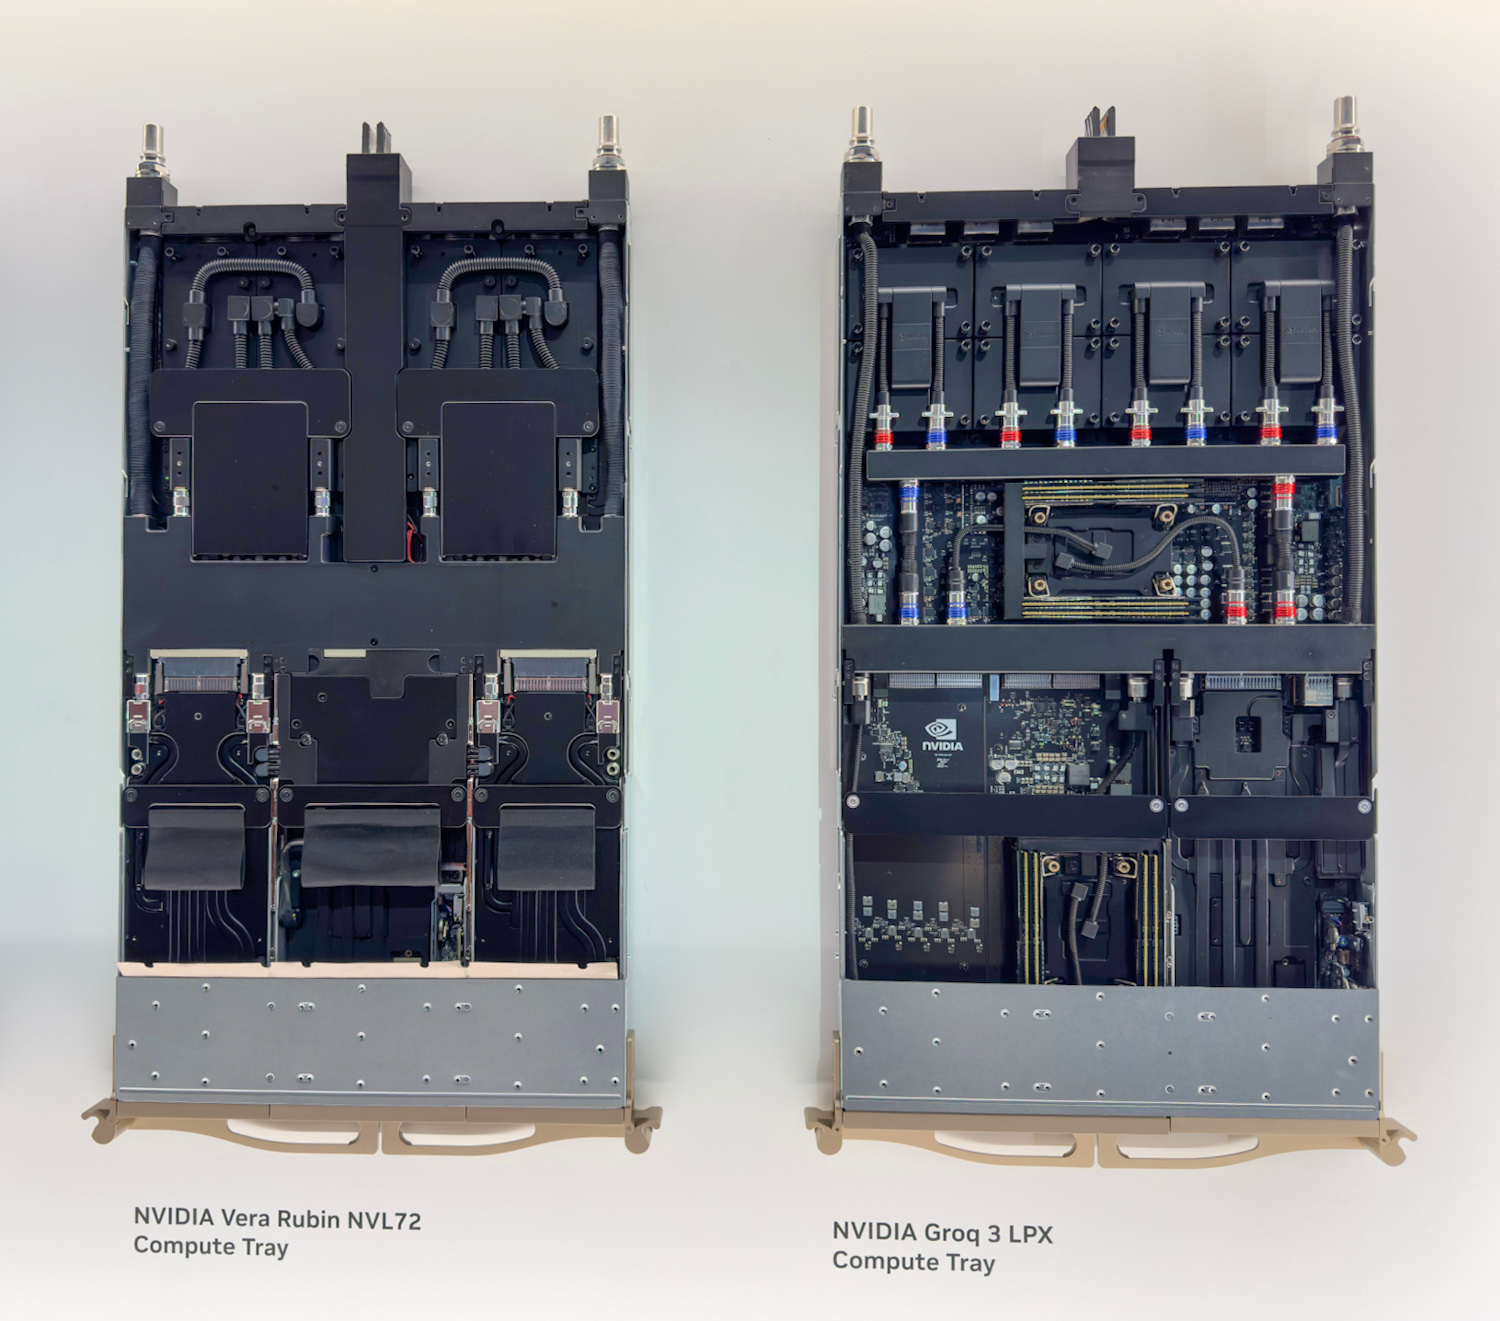
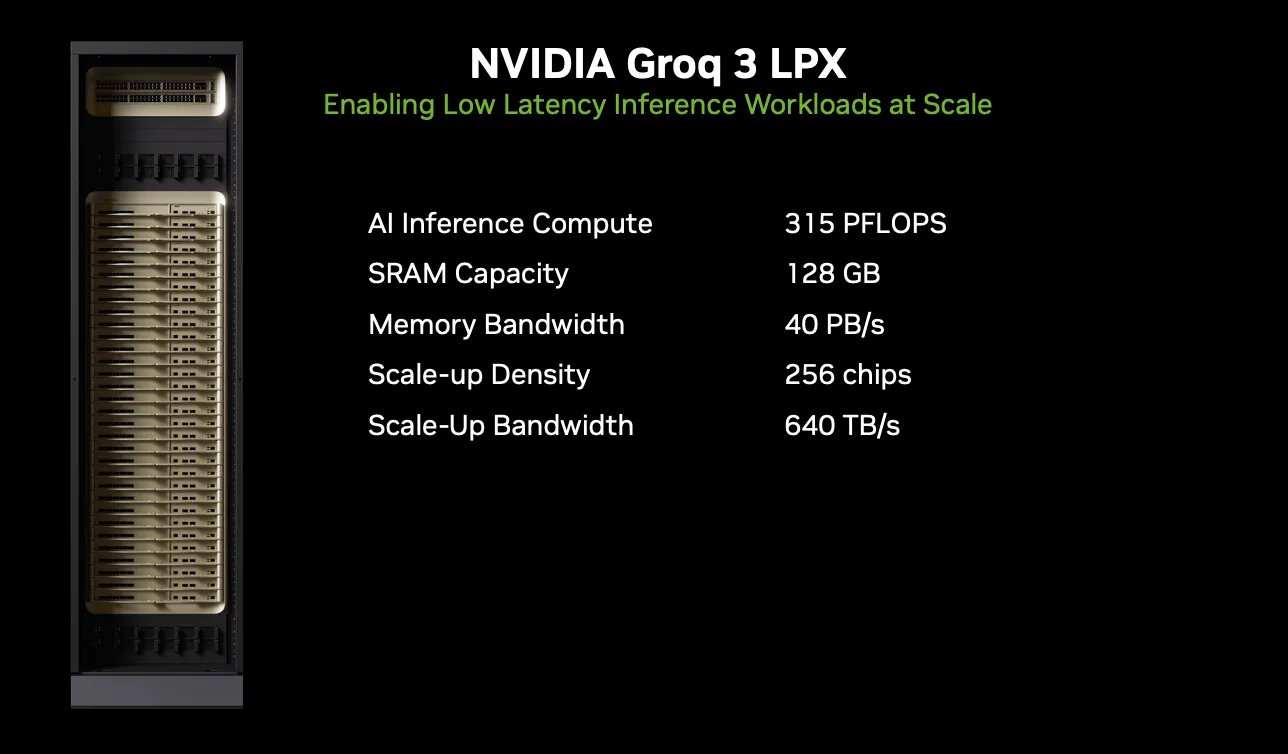
W grudniu ubiegłego roku NVIDIA przejęła Groq, wprowadzając architekturę LPU pod swoje skrzydła. Przejęcie to spotkało się z ogromnym zainteresowaniem w branży i wywołało natychmiastowe spekulacje na temat tego, jak NVIDIA zintegruje technologię Groq ze swoim ekosystemem centrów danych. Odpowiedzi na te pytania ostatecznie uzyskano podczas targów GTC 2026, gdzie NVIDIA zaprezentowała Groq 3 LPX – siódmy układ platformy Vera Rubin, łączący 256 akceleratorów LPU w systemie rackowym wraz z Vera Rubin NVL72.
Co się stało z CPX?
W zeszłym roku, podczas konferencji AI Infra Summit, NVIDIA ogłosiła również szafę CPX w kilku konfiguracjach zaprojektowanych do przyspieszania zapytań wnioskowania długokontekstowego. Po naszym pierwszym omówieniu tej zapowiedzi, pojawiło się kilka pytań dotyczących faktycznej funkcji CPX. Na pierwszy rzut oka, choć była to interesująca koncepcja architektoniczna, CPX nie oferował niczego istotnego poza samym procesorem graficznym Rubin, poza ewentualnym dodatkowym przyspieszeniem operacji związanych z koncentracją uwagi. Następnie nastąpiło przejęcie Groq, które wywołało spekulacje na temat tego, jak NVIDIA zintegruje technologię LPU Groq z szerszą platformą Vera Rubin.
NVIDIA wyjaśniła sytuację na targach GTC 2026, ogłaszając LPX. Z tego, co zaprezentowano, wynika, że koncepcja stelaża CPX ewoluowała w kierunku stelaża Groq 3 LPX, gdzie pierwotne skupienie CPX na przetwarzaniu kontekstu ustąpiło miejsca fundamentalnie innej architekturze dekodowania i przyspieszania, zbudowanej na krzemie Groq. Stelaż LPX jest w pełni chłodzony cieczą, oparty na infrastrukturze MGX i będzie dostępny w drugiej połowie 2026 roku, równolegle z szerszą premierą Vera Rubin. NVIDIA deklaruje nawet 35-krotnie wyższą przepustowość wnioskowania na megawat i nawet 10-krotnie większe możliwości generowania przychodów dla modeli bilionowych parametrów dzięki temu nowemu rozwiązaniu.
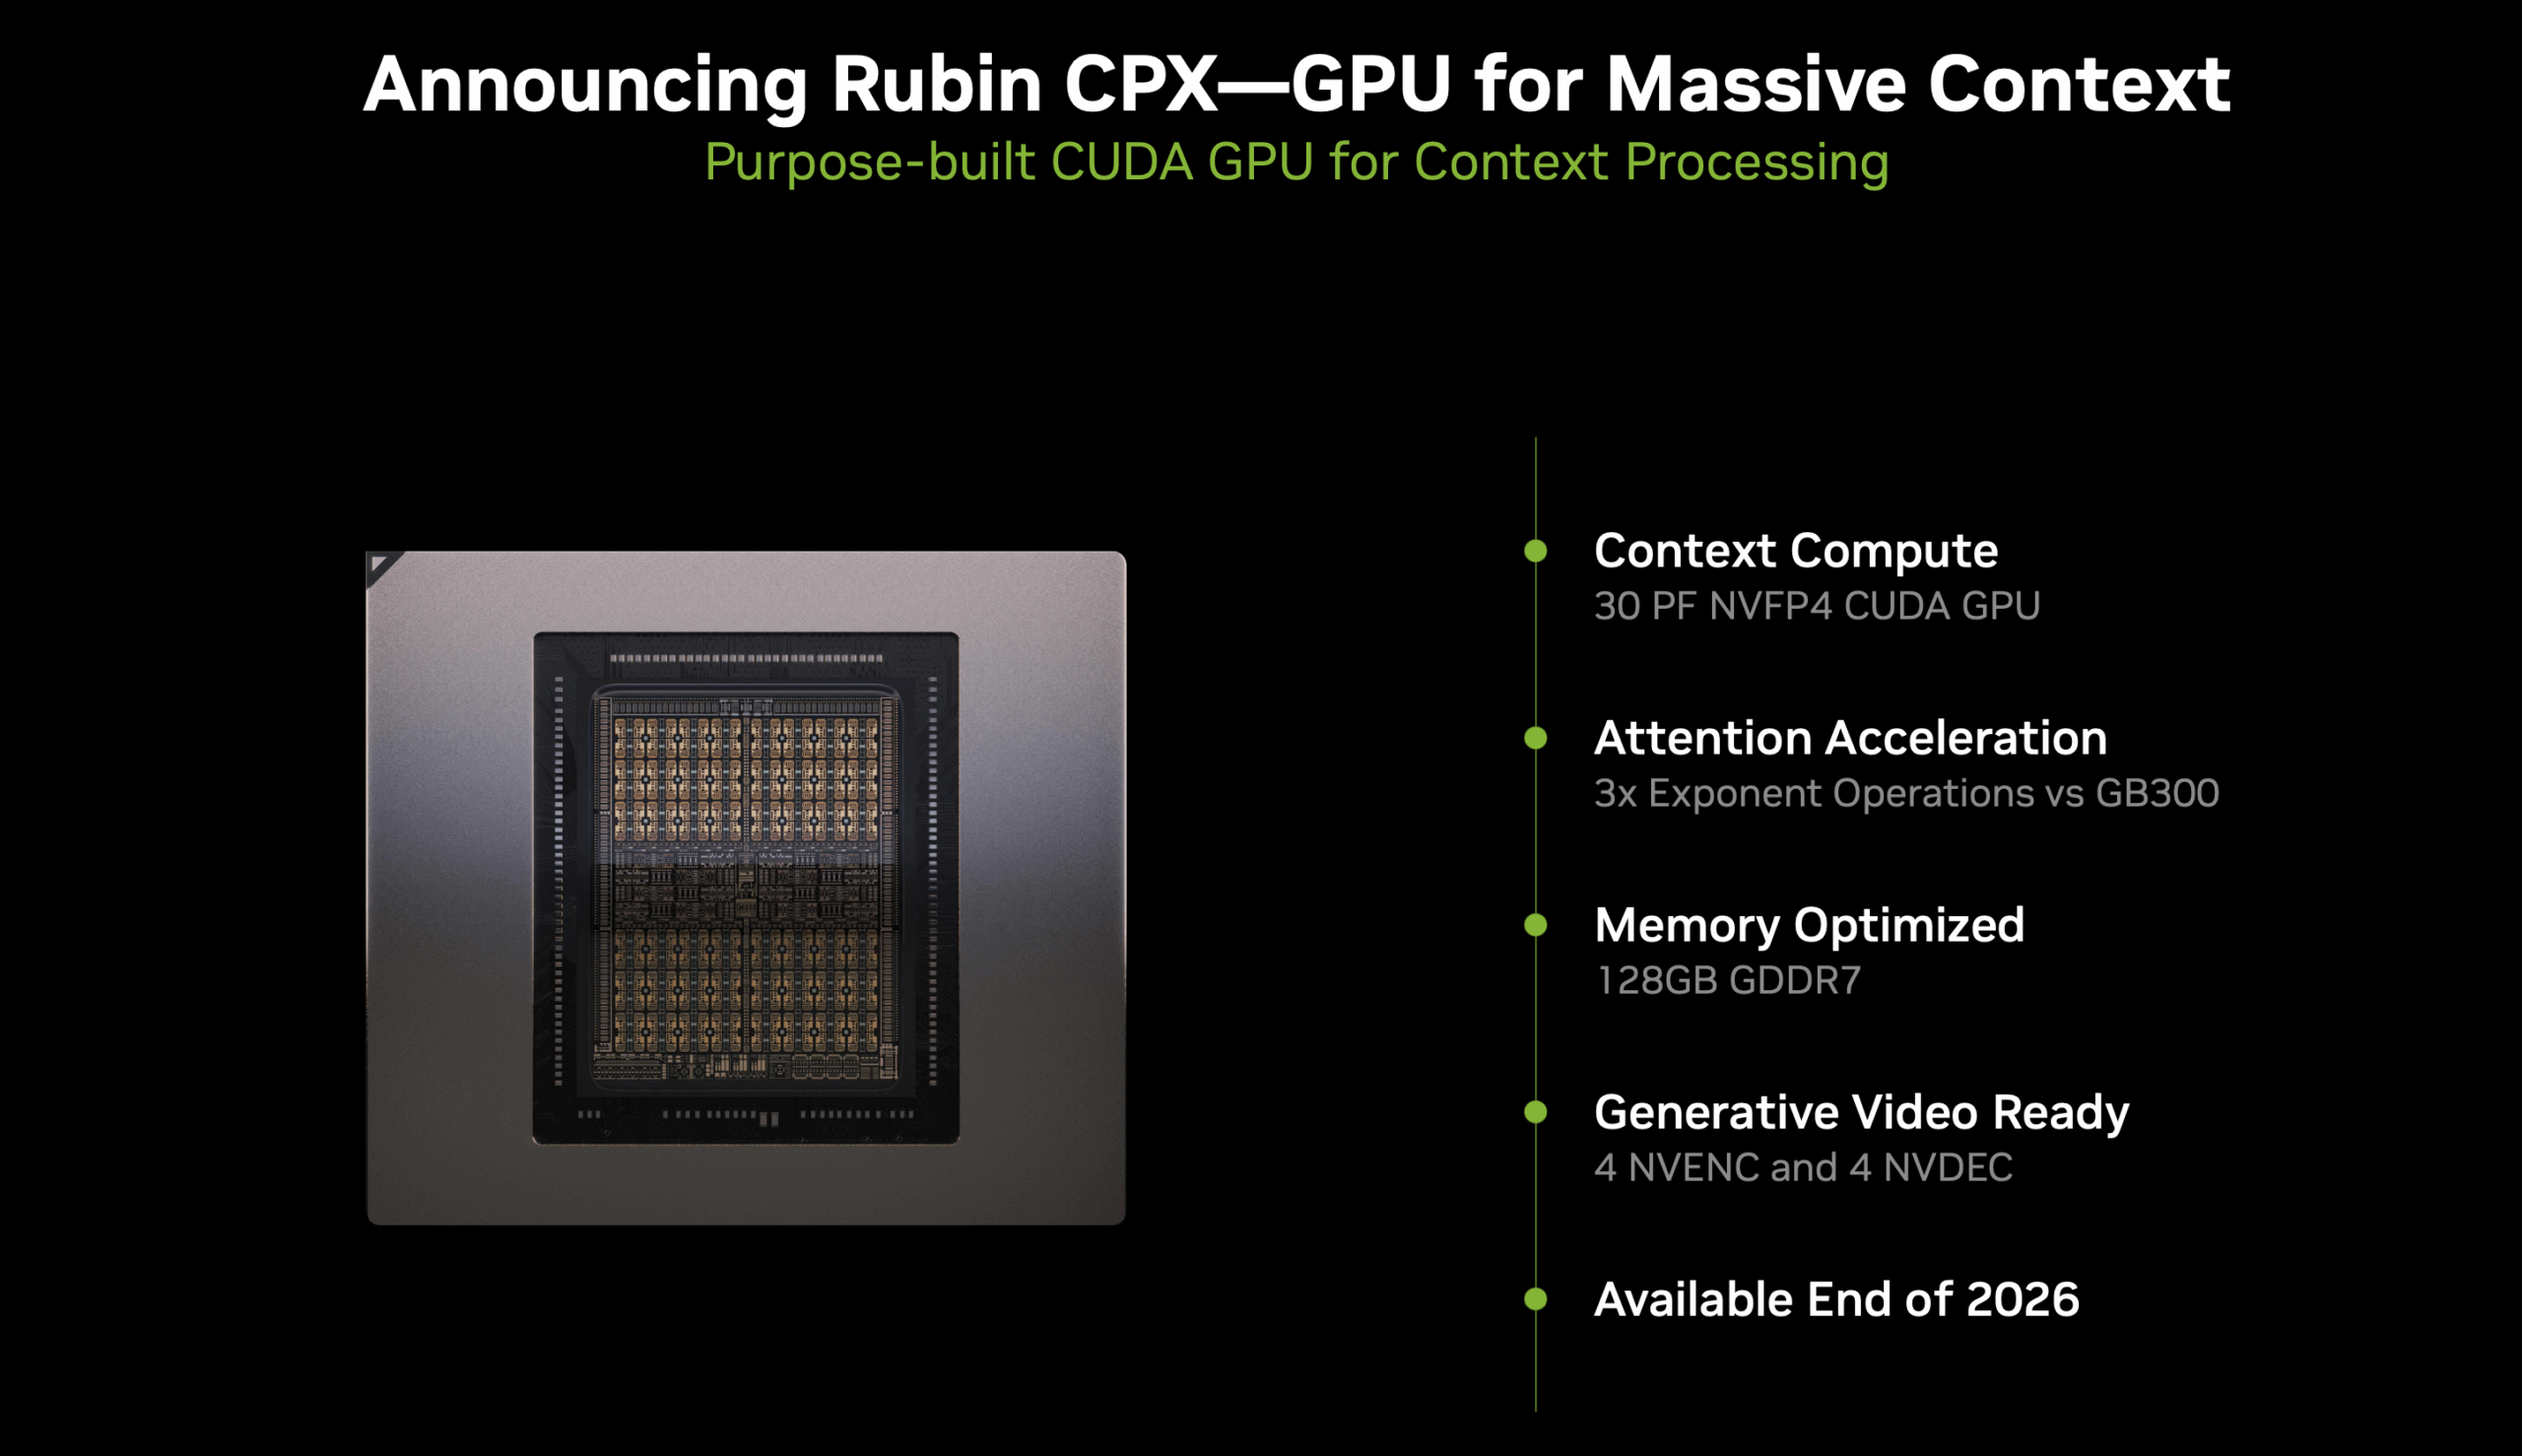
Co ważniejsze, NVIDIA potwierdziła, że LPU działa jako akcelerator w ramach istniejącego stosu CUDA działającego na platformach Vera i NVL72, a obliczenia są odciążane transparentnie, w zależności od tokena. Podczas sesji pytań i odpowiedzi GTC, NVIDIA opisała LPU jako „wzmacniacz modelu dekodowania” i wyjaśniła, że będzie ściśle współpracować z laboratoriami sztucznej inteligencji i twórcami modeli pionierskich, wdrażając modele o bilionach parametrów, aby umożliwić wdrożenie kolejnej generacji modeli premium.
Po rozstrzygnięciu kwestii CPX naturalnym pytaniem jest: czym właściwie jest ten LPU, wokół którego NVIDIA buduje cały system wielkości stojaka?
Co to jest LPU?
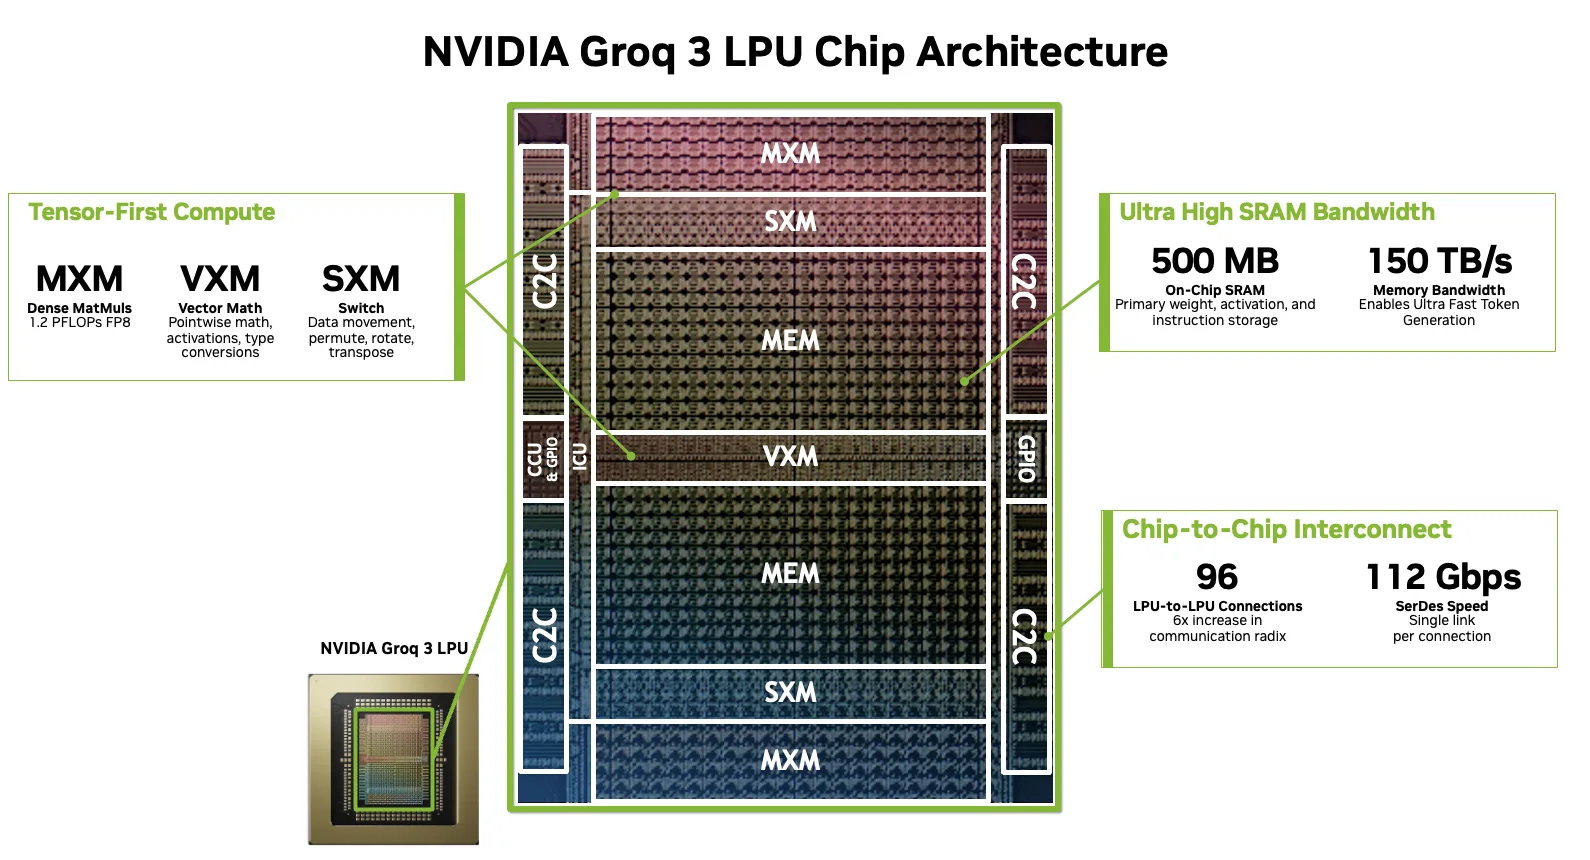
W swojej istocie LPU to bardzo duży procesor wektorowy. Podstawową jednostką obliczeniową i komunikacyjną jest 320-elementowy wektor, składający się z 320 bajtów w INT8 i 640 bajtów w FP16. Każda operacja na chipie, czy to arytmetyczna, dostęp do pamięci, przekształcanie danych, czy transfer między chipami, działa na tych wektorach o stałym rozmiarze.
Źródło: Nvidia
Architektura zbudowana jest z jednego podstawowego bloku: jednostki funkcjonalnej SIMD połączonej z lekką jednostką dystrybucji instrukcji. Groq traktuje to jako klasę bazową, która jest specjalizowana w cztery odrębne typy, każdy zoptymalizowany pod kątem określonej kategorii operacji:
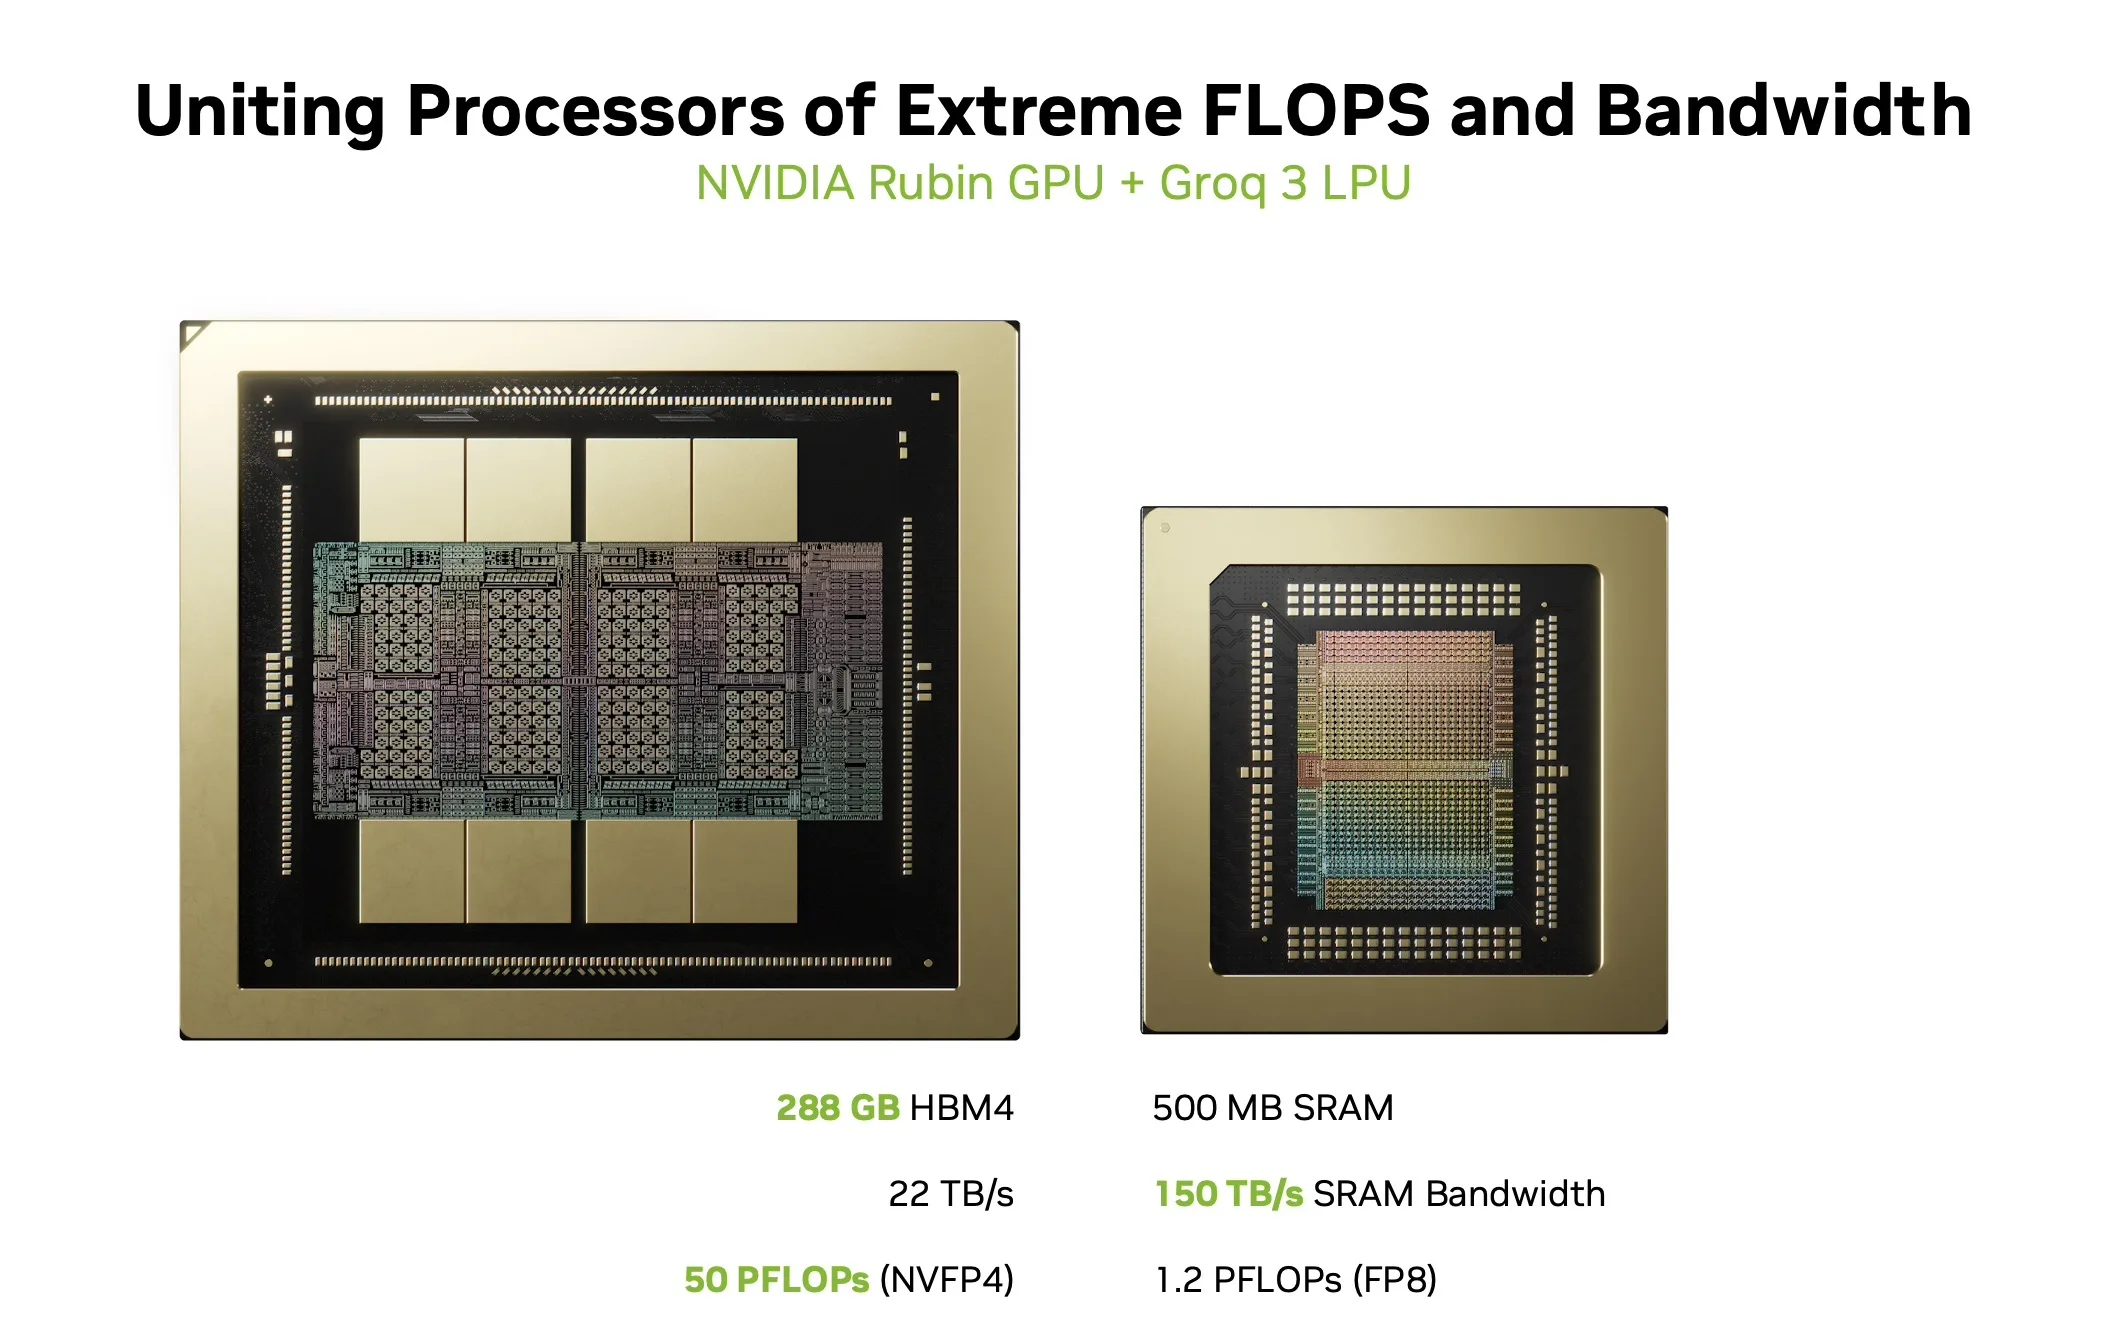
Moduły wykonawcze macierzy (MXM): główny „koń obliczeniowy”, zapewniający gęste możliwości mnożenia i akumulacji dla operacji macierz-wektor i macierz-macierz. Każdy z 8 układów Groq 3 LP30 w szafie LPX firmy NVIDIA zapewnia 1.2 PFLOPS obliczeń FP8 na układ, co daje łącznie 9.6 PLOPS obliczeń FP8 na tackę LPX.
Moduły wykonawcze wektorów (VXM): obsługują arytmetykę punktową, operacje logiczne, konwersje typów i funkcje aktywacji. VXM zawiera tablicę jednostek ALU, które kompilator automatycznie łączy w łańcuchy, tworząc operacje złożone (na przykład redukcja, a następnie dodawanie biasu, aktywacja, a następnie rzutowanie typu) w jednym przebiegu.
Moduły wykonawcze przełącznika (SXM): wykonują ustrukturyzowane przemieszczanie danych, w tym permutację, rotację, dystrybucję i transpozycję wektorów.
Jednostki pamięci (MEM): Płaska architektura pamięci SRAM, oparta na pamięci podręcznej, bez hierarchii i bez możliwości pominięcia pamięci podręcznej. Groq 3 LP30 oferuje 500 MB wbudowanej pamięci SRAM o przepustowości 150 TB/s. Kompilator bezpośrednio adresuje fizyczne lokalizacje banków, znając dokładne położenie wszystkich danych w trakcie wykonywania programu.
Wiele kopii każdego typu jednostki funkcjonalnej jest wytłoczonych na całej długości poziomej powierzchni układu scalonego. Instrukcje płyną z góry i dołu do środka, podczas gdy strumienie danych płyną ze wschodu na zachód, przecinając jednostki funkcjonalne w celu wykonywania operacji.
Połączenie 1D, rejestry strumieniowe i determinizm
Rejestry strumieniowe i połączenie 1D
Komunikacja między jednostkami funkcjonalnymi w LPU odbywa się za pośrednictwem rejestrów strumieniowych, celowo prostego, jednowymiarowego połączenia. Istnieją dwie ścieżki komunikacyjne, jedna biegnąca na wschód, a druga na zachód, przy czym każdy rejestr strumieniowy reprezentuje jeden przeskok. Dane przesyłane są z dokładnością do jednego przeskoku na cykl zegara, co oznacza, że kompilator może oszacować czas podróży między dowolnymi dwiema jednostkami funkcjonalnymi, wykonując proste dodawanie lub odejmowanie na podstawie ich fizycznego położenia na układzie scalonym.
W ramach połączenia międzysystemowego nie ma kolejek ani mechanizmów rywalizacji. To upraszcza problem harmonogramowania ze złożonego, dwuwymiarowego problemu pakowania pakietów do znacznie bardziej prostego problemu jednowymiarowego. Igor Arsovski, główny architekt Groq, opisuje to najlepiej: kompilator dokładnie wie, gdzie dany fragment danych znajdzie się za 10 cykli, ponieważ będzie on oddalony o dokładnie 10 przeskoków. Nie ma tu niejasności, spekulacji ani sprzętu podejmującego niezależne decyzje dotyczące routingu.
Determinizm
Cechą charakterystyczną LPU jest determinizm. W przeciwieństwie do konwencjonalnych procesorów, w których dynamiczne planowanie, zachowanie pamięci podręcznej i rywalizacja o dostęp do pamięci powodują zmienność w czasie wykonania, LPU działają z zerową zmiennością, a każda jednostka funkcjonalna działa w synchronizacji.
Ten determinizm osiąga się poprzez usunięcie takich funkcji jak blokady sprzętowe i przeniesienie całego procesu decyzyjnego do kompilatora; sprzęt po prostu wykonuje powstały harmonogram. Inną zaletą tego podejścia jest to, że wszystko działa z dokładnie tym samym opóźnieniem, a nawet zużycie energii jest przewidywalne w każdym momencie.
Determinizm rozciąga się również na dziedzinę numeryczną dzięki technologii TruePoint, którą Groq nazywa technologią TruePoint. Gwarantowana przez architekturę kolejność operacji umożliwia dokładność na poziomie FP32 z danych wejściowych FP16 za pomocą 320-elementowego, połączonego iloczynu skalarnego z jednym krokiem zaokrąglenia. Szczegółowe informacje na temat znaczenia determinizmu numerycznego dla wnioskowania LLM i przyczyn, dla których niedeterministyczny sprzęt generuje subtelnie różne wyniki w różnych przebiegach, zostały dogłębnie omówione w dokumencie roboczym Thinking Lab „Defeating Nondeterminism in LLM Inference” . Nie jest to tematem niniejszego artykułu, ale czytelnicy zainteresowani implikacjami dla dokładności numerycznej znajdą odpowiednią analizę w dokumentacji technicznej TruePoint firmy Groq, do której link znajduje się na końcu.
Jak łączą się jednostki LPU: RealScale, linia montażowa i topologia stojaka
Linia montażowa: jak przemieszczają się dane
W najprostszym ujęciu, ruch danych pomiędzy jednostkami LPU działa jak linia montażowa. Gdy model jest kompilowany dla systemu, kompilator dzieli go na etapy i przestrzennie odwzorowuje każdy etap na grupę układów LPU. Każda grupa przechowuje potrzebne parametry wagowe w lokalnej pamięci SRAM na chipie. Podczas wnioskowania, jedynymi danymi, które przemieszczają się między grupami układów, są pośrednie dane wyjściowe aktywacji z poprzedniego etapu. Dane przepływają z układu do układu jak produkt poruszający się po taśmie produkcyjnej, przy czym każda stacja wykonuje przypisane obliczenia i przekazuje wynik do następnej. Różni się to zasadniczo od układów GPU, gdzie każdy etap obliczeniowy wymaga pobrania pełnego zestawu wag z pamięci HBM poza układem i zapisania wyników. W LPU wagi są już rezydujące w pamięci SRAM na każdej stacji; przemieszczają się tylko tensory aktywacji.
Uwaga dotycząca łączy C2C: RealScale, nie NVIDIA C2C
Zanim przejdziemy do szczegółów topologii, ważne jest wyjaśnienie potencjalnego źródła nieporozumień. Łącza C2C (chip-to-chip) używane w całym systemie LPX to połączenia międzyukładowe RealScale C2C firmy Groq. Nie są one takie same jak technologia C2C firmy NVIDIA, wykorzystywana w innych obszarach ekosystemu NVIDIA. Te dwie technologie różnią się pod względem architektury:
- NVIDIA C2C to spójny pod względem pamięci podręcznej interfejs zaprojektowany do łączenia dwóch różnych typów układów scalonych w ściśle powiązanym module, takim jak łącze CPU-GPU. Wykorzystuje on spójny protokół z szybszym SerDes i jest przeznaczony do heterogenicznej komunikacji między układami scalonymi w ramach jednego pakietu lub modułu.
- Groq RealScale C2C to programowo planowany, deterministyczny interfejs typu punkt-punkt. Połączenia sieciowe są jawnie kontrolowane przepływem przez kompilator i planowane jako jednostki funkcjonalne pierwszej klasy, podobnie jak jednostki obliczeniowe MXM lub VXM. Nie ma arbitrażu sprzętowego ani routingu adaptacyjnego, a pakiety nie przenoszą nagłówków źródłowych ani docelowych. Połączenia są wyrównane fazowo i działają jak przewody o dużej przepustowości i stałym opóźnieniu między układami scalonymi. Protokół plezjochroniczny uwzględnia deterministycznie naturalny dryft zegara między układami scalonymi, udostępniając kompilatorowi jedną wspólną domenę czasu w całej sieci.
Każde połączenie C2C w szafie LPX, czy to w obrębie tacy, przez półki przez szkielet, czy między szafami przez porty na panelu przednim, wykorzystuje technologię RealScale. Jest to ta sama fundamentalna technologia połączeń, którą Groq stosował od czasu oryginalnego GroqNode, ze zwiększoną prędkością łącza (z 30 Gb/s do 112 Gb/s na tor), ale bez zmian architektonicznych.
Uwaga: następna sekcja objaśniająca łączność opiera się na naszej wiedzy na temat architektury bazującej na dokumentacji Groq (link na końcu), wpisie na blogu firmy NVIDIA i objaśnieniach dotyczących stojaka udostępnionych nam na stoisku GTC:
- Łącza C2C używane przez jednostki rackowe LPX są technologią firmy Groq i nie są takie same jak łącza C2C używane w innych systemach rackowych firmy NVIDIA
- Cztery łącza C2C z przodu każdej jednostki rack LPX służą do łączenia się z sąsiednimi jednostkami rack na tym samym poziomie
- W obrębie szafy istnieje komunikacja typu „wszystko do wszystkiego” pomiędzy jednostkami LPU
- Procesor w szafie LPX to x86
Łączność wewnątrz tacy
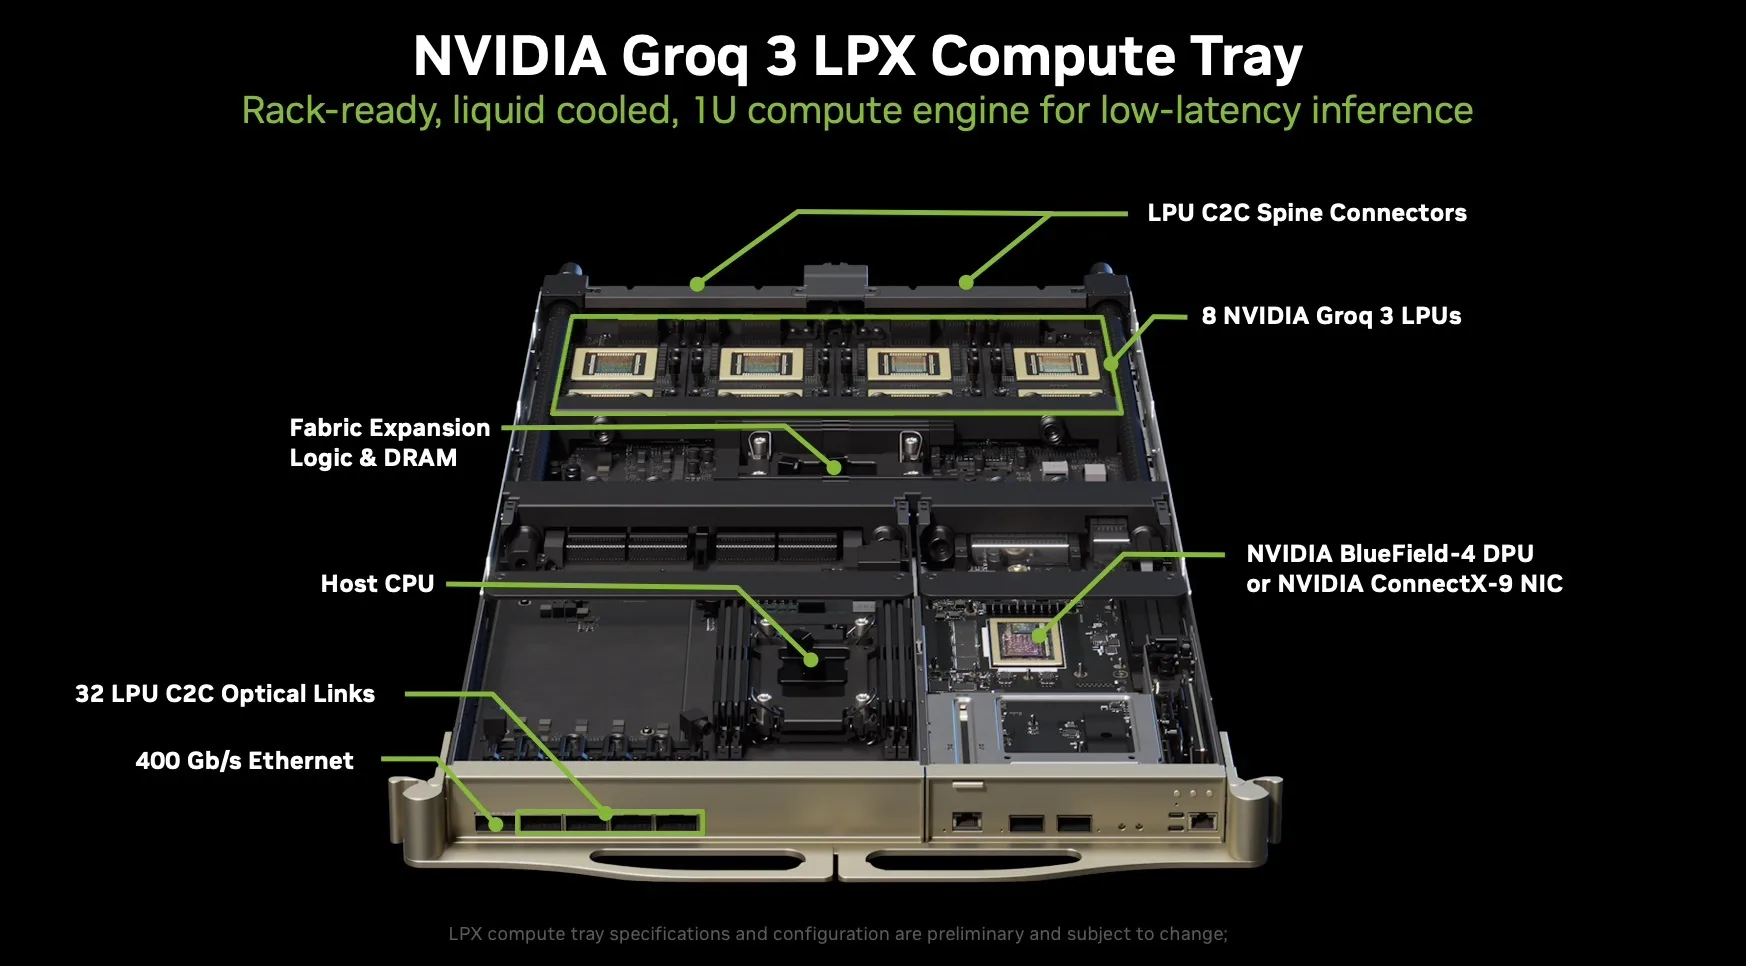
Podstawowy element topologii sieci Groq nie zmienił się od oryginalnego GroqNode do NVIDIA Groq 3 LPX. Każda tacka obliczeniowa 1U zawiera dokładnie osiem układów LP30, gęsto połączonych w grafie pełnym (wszystko ze wszystkim), gdzie każdy układ może bezpośrednio komunikować się z każdym innym układem z tą samą szybkością.
Źródło: Nvidia
Każdy układ LP30 ma 96 łączy C2C, każde o przepustowości 112 Gb/s, zapewniając 2.5 TB/s dwukierunkowej przepustowości na układ. Na pełnym grafie 8 układów, każdy układ ma 7 sąsiadów. Liczba unikalnych krawędzi między układami w obrębie tacy wynosi C(8,2) = 28. Pewna część z 96 łączy każdego układu jest dedykowana tym wewnątrztacowym połączeniom typu „wszystko do wszystkiego”, a pozostałe łącza są kierowane do płyty montażowej (do szkieletu szafy) i panelu przedniego (do połączeń między szafami). Opublikowana specyfikacja firmy NVIDIA podaje 20 TB/s całkowitej przepustowości skalowania na tacę, co reprezentuje łączną przepustowość wewnątrztacki i szkieletu. Możemy to zweryfikować: każda taca ma 8 układów × 96 łączy = 768 łączy w sumie. Odejmując 32 linie międzyszafowe na panelu przednim, pozostaje 736 łączy do skalowania. Przy 112 Gb/s na łącze, czyli 736 × 112 Gb/s = 82 432 Gb/s, czyli około 10.3 TB/s w każdym kierunku, co daje około 20.6 TB/s w obu kierunkach. Jest to zgodne z deklarowanymi przez firmę NVIDIA wartościami 20 TB/s na tackę.
Ta 8-chipowa grupa typu „wszystko do wszystkiego” tworzy „grupę lokalną” w topologii sieci Dragonfly. Oryginalny GroqChip 1 posiadał 11 łączy C2C na kartę, każde o przepustowości 30 Gb/s na kanał (cztery łącza na łącze), co daje łącznie 330 GB/s na kartę. 96 łączy Groq 3 LP30 o przepustowości 112 Gb/s stanowi ogromny skok generacyjny w przepustowości wejścia/wyjścia na chip, przy jednoczesnym zachowaniu tej samej struktury topologicznej.
Łączność wewnątrz szafy
W pojedynczej szafie LPX 32 tace obliczeniowe (łącznie 256 chipów) są połączone za pomocą czterech rdzeni ETL w płycie montażowej. Te rdzenie przenoszą ruch RealScale C2C między tackami, tworząc domenę skalowania w górę w skali szafy. Łączna przepustowość skalowania w górę w całej szafie wynosi 640 TB/s (32 tace × 20 TB/s na tacę). Podzielona na cztery rdzenie, każda z nich przenosi około 160 TB/s dwukierunkowej przepustowości.
Łączność między regałami
Każda tacka obliczeniowa 1U udostępnia cztery porty QSFP C2C na panelu przednim, zapewniając łącznie 32 linie (8 linii na port) do komunikacji między szafami. Porty te łączą się z sąsiednimi szafami w układzie symetrycznym: dwa porty (16 linii) łączą się z lewą sąsiednią szafą, a dwa porty (16 linii) łączą się z prawą sąsiednią szafą. Każda pozycja U łączy się z odpowiadającą jej pozycją U w sąsiedniej szafie (pierwsza pozycja U w szafie A łączy się z pierwszą pozycją U w szafie B, druga z drugą itd.).
Źródło: Nvidia
Przy przepustowości 112 Gb/s na tor, 32 tory międzyszafkowe każdej tacki zapewniają przepustowość 32 × 112 Gb/s = 3,584 Gb/s, czyli około 448 GB/s w każdym kierunku na tackę. W całej szafie, 32 tacki zapewniają przepustowość 32 × 32 = 1,024 torów międzyszafkowych. Daje to 1,024 × 112 Gb/s = 114 688 Gb/s, czyli około 14.3 TB/s w każdym kierunku do każdej sąsiedniej szafy (podzielone równo: ~7.2 TB/s w każdym kierunku do sąsiedniego urządzenia z lewej strony i ~7.2 TB/s w każdym kierunku do sąsiedniego urządzenia z prawej strony).
Ta przepustowość między szafami jest z założenia mniejsza niż przepustowość wewnątrz szafy. Wewnątrz szafy, domena skalowania 640 TB/s zapewnia gęstą, bezpośrednią dostępność poprzez szkielet. Pomiędzy szafami, łącza na panelu przednim zapewniają rzadsze połączenia globalne w topologii Dragonfly. Jest to ten sam schemat architektoniczny, co w oryginalnym GroqRack, gdzie cztery zewnętrzne łącza C2C na chip łączyły grupy lokalne (węzły), tworząc systemy wieloszafowe o małej średnicy sieci (maksymalnie trzy przeskoki w konfiguracji 264-chipowej).
Łącząc to wszystko: ta sama architektura, czterokrotnie większa gęstość
Pierwotne wdrożenie GroqRack w czterech szafach obejmowało 264 procesory GroqChip. Pojedyncza szafa LPX mieści 256 układów LP30 w jednej szafie MGX ETL, co stanowi około czterokrotnie większą gęstość układów, a jednocześnie pozwala na zastosowanie pojedynczej szafy z chłodzeniem cieczowym i bezprzewodową płytą główną. 8-procesorowa lokalna grupa all-to-all, topologia Dragonfly oraz paradygmat routingu programowanego programowo zostały zachowane w niezmienionej formie. Podstawowa technologia sieciowa Groq nie uległa zmianie; została ona rozbudowana.
W przypadku modeli, których pojemność pamięci SRAM przekracza pojemność pojedynczego racka (łącznie 128 GB w 256 układach), wiele racków LPX lub rzędów racków można połączyć ze sobą za pomocą portów C2C na panelu przednim, co pozwala na dalsze wydłużenie linii montażowej. Więcej informacji na temat rzeczywistych rozmiarów modeli znajduje się w następnej sekcji.
Dlaczego warstwy FFN? Zrozumienie, co NVIDIA odciąża
Dlaczego Decode staje się coraz trudniejszy w obsłudze
Zanim zagłębimy się w szczegóły dotyczące tego, co NVIDIA przekazuje do LPX i dlaczego, warto zrozumieć szersze trendy, jak wskazuje NVIDIA, które uzasadniają konieczność podjęcia tej decyzji architektonicznej. Wnioskowanie AI nie jest pojedynczym, jednorodnym obciążeniem. W ramach jednego żądania, faza wstępnego wypełniania (pobieranie komunikatu i budowanie pamięci podręcznej KV) oraz faza dekodowania (generowanie tokenów po jednym) stawiają zupełnie inne wymagania sprzętowe, a wymagania te zmieniają się wraz z rozmiarem partii, długością kontekstu i strukturą modelu.
W miarę jak modele generują dłuższe wyniki rozumowania i wieloetapowe łańcuchy myślowe, coraz większa część każdego żądania przechodzi do fazy sekwencyjnego dekodowania. Jednocześnie techniki takie jak buforowanie prefiksów zmniejszają koszt wstępnego wypełniania poprzez ponowne wykorzystanie współdzielonego stanu monitu w różnych żądaniach, co tylko zwiększa względny koszt dekodowania. Okna kontekstowe również rozrastają się do setek tysięcy tokenów, wywierając coraz większą presję na przepustowość pamięci podczas obliczeń uwagi. W przepływach pracy z agentami opóźnienia kumulują się w wielu wywołaniach modeli, interakcjach z narzędziami i pętlach weryfikacji. W efekcie opóźnienia dekodowania stają się coraz bardziej wąskim gardłem, odczuwanym przez użytkowników, a sprzęt zoptymalizowany wyłącznie pod kątem maksymalnej łącznej przepustowości nie zawsze jest najlepszym rozwiązaniem dla obciążeń wymagających szybkiego i przewidywalnego generowania tokenów dla każdego indywidualnego żądania.
Ponadto, jak widać po wydaniu trybu Fast Mode firmy Anthropic , niższe opóźnienia i większa przepustowość tokenów przekładają się na wyższe przychody, przy czym usługa szybkiego wnioskowania firmy Anthropic kosztuje 6 razy więcej niż zwykłe żądania.
Dzięki ogłoszeniu LPX wiemy, że NVIDIA chce odciążyć jednostki LPU, które stanowią największe wąskie gardło dekodowania: warstwy sieciowe typu feed-forward (FFN). Aby zrozumieć, dlaczego FFN jest celem i docenić skalę tego, co to oznacza, przeanalizowaliśmy liczbę parametrów FFN dla najpopularniejszych obecnie modeli open source.
Czym są warstwy FFN i dlaczego są dominujące?
Każda warstwa Transformera składa się z dwóch głównych bloków: bloku uwagi i bloku sprzężenia zwrotnego (FFN). Blok uwagi pozwala tokenom przeglądać i mieszać informacje z innych tokenów w sekwencji. Blok FFN działa na każdym tokenie niezależnie: rzutuje jego reprezentację w górę do przestrzeni wielowymiarowej, stosuje nieliniowość i rzutuje ją z powrotem w dół. Można go traktować jako magazyn wiedzy modelu, w którym przechowywane są skojarzenia faktów i wyuczone transformacje.
Architektura MoE lub Mixture of Experts stała się dominującą architekturą wśród wiodących współczesnych modeli języków programowania typu open source: DeepSeek R1, Kimi K2, Qwen3-235B, GLM-5, MiniMax M2.5 i OpenAI's GPT-OSS 120B.
W tych modelach MoE to właśnie blok FFN jest replikowany do setek mniejszych, niezależnych kopii zwanych ekspertami, podczas gdy uwaga pozostaje współdzielona. Lekka, wyuczona funkcja routingu dynamicznie wybiera niewielki podzbiór ekspertów do aktywacji dla każdego tokena. Rezultatem jest model, który przechowuje ogromną łączną liczbę parametrów, ale aktywuje tylko ułamek dla każdego tokena, uzyskując korzyści jakościowe wynikające ze skali bez proporcjonalnych kosztów obliczeniowych.
Jednak, jak zapewne zauważyłeś, stwarza to kolejne wyzwanie: warstwy FFN odpowiadają za większość wag modelu. W przypadku modeli MoE może to stanowić nawet 90% wag modelu.
Wewnątrz DeepSeek R1: praktyczny przykład
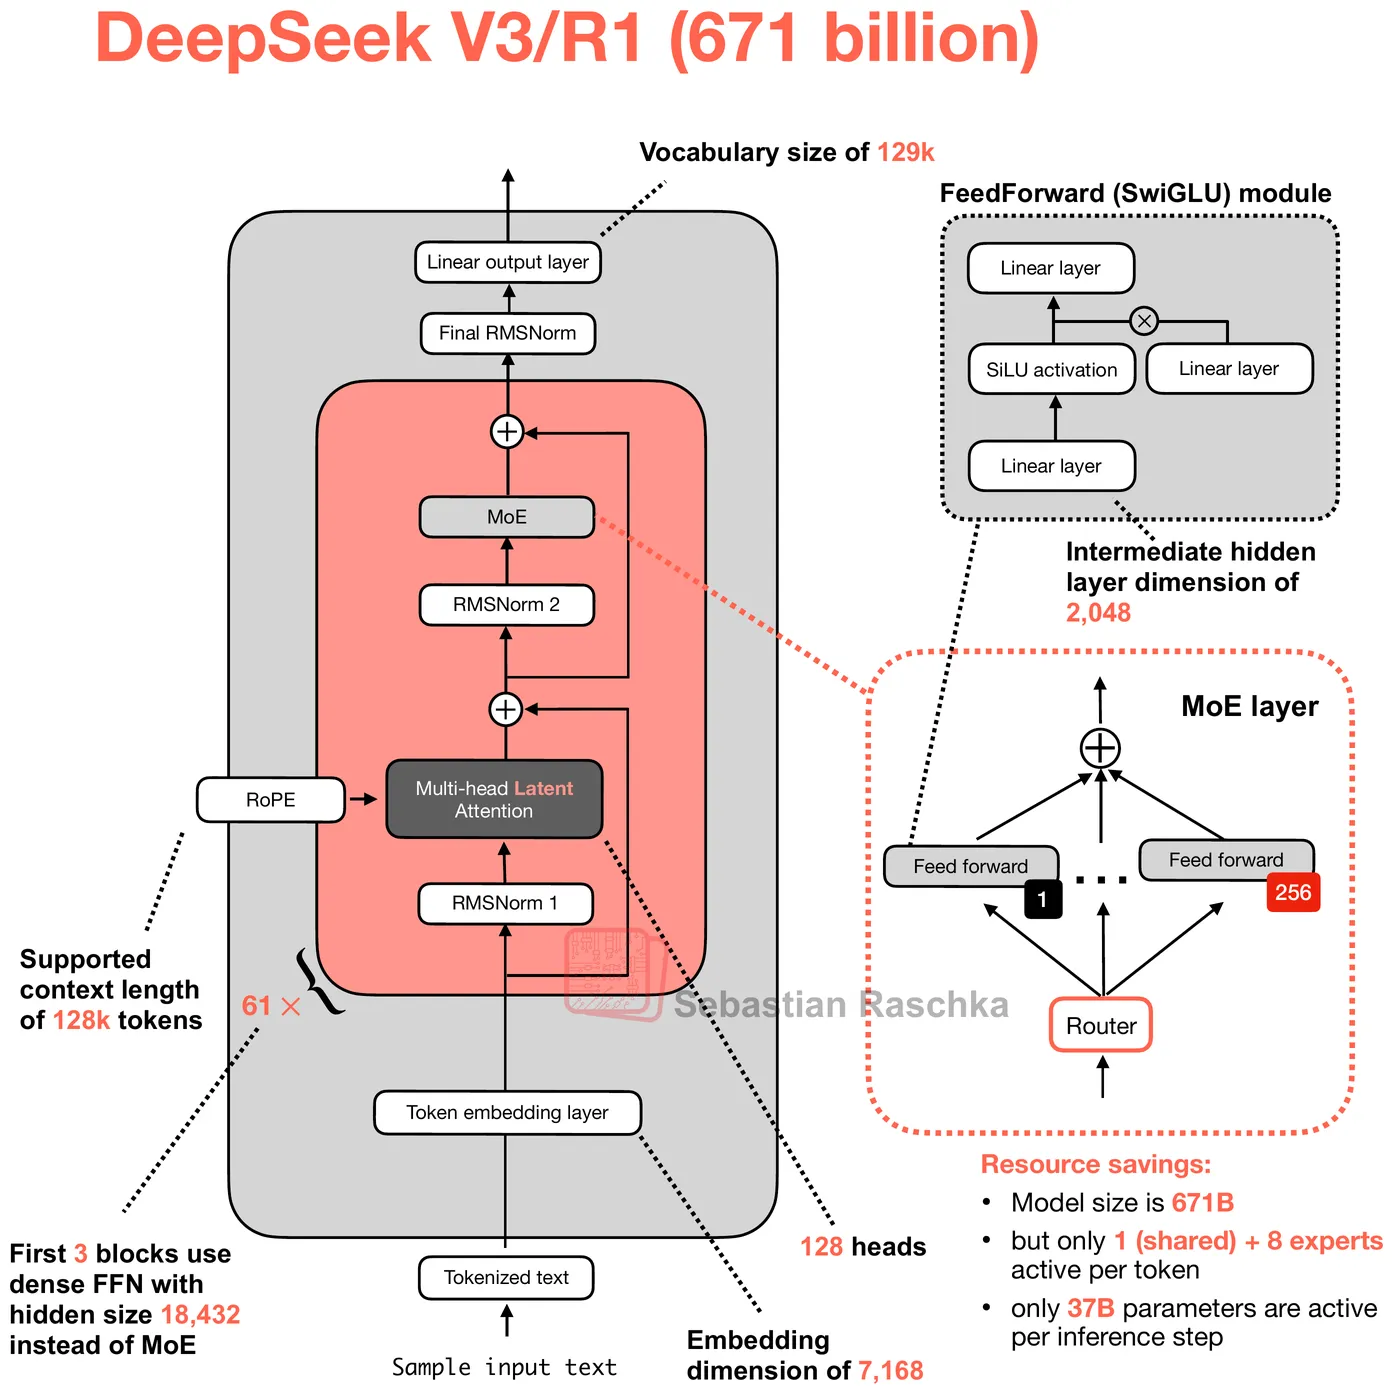
Aby to zilustrować, przyjrzyjmy się DeepSeek R1. Model ma 61 warstw Transformer z ukrytym wymiarem (H) wynoszącym 7,168. Pierwsze 3 warstwy używają standardowego gęstego FFN, podczas gdy pozostałych 58 używa MoE (plus 1 dodatkowa warstwa MTP z własnymi ekspertami, co daje łącznie 59 warstw MoE). Nowoczesne LLM używają wariantu o nazwie SwiGLU, który ma trzy macierze wag zamiast dwóch. Przejście do przodu oblicza w2(SiLU(w1(x)) ⊙ w3(x)), gdzie w1 (projekcja bramkowa) i w3 (projekcja w górę) rozszerzają ukryty wymiar z H do rozmiaru pośredniego I, a w2 (projekcja w dół) kompresuje go z powrotem. ⊙ jest mnożeniem elementarnym między ścieżkami bramkowanymi i niebramkowanymi. Żadna z tych macierzy nie ma wyrazów bias, więc każdy blok FFN SwiGLU zawiera dokładnie 3 × H × I parametrów.
Źródło: Sebastian Raschka
Dla gęstych warstw DeepSeek R1 (pierwszych 3) wymiar pośredni wynosi 1.8 432, co daje 3 × 7,168 × 18 432 = 396.4 miliona parametrów na warstwę. W przypadku warstw MoE każdy z 256 ekspertów trasowanych stanowi kompletny blok SwiGLU z mniejszym wymiarem pośrednim wynoszącym 2,048, więc każdy ekspert ma 3 × 7,168 × 2,048 = 44.0 miliona parametrów. Pomnóż przez 256 ekspertów, a otrzymasz 11.27 miliarda parametrów w samych ekspertach trasowanych na warstwę. Co więcej, każda warstwa MoE ma jednego współdzielonego eksperta (ten sam blok SwiGLU o 44 MB parametrów, zawsze aktywowany dla każdego tokena), bramkę routera (liniową projekcję kształtu [256, 7168] = 1,8 MB parametrów) i mały wektor odchylenia 256 wartości FP32 używany do równoważenia obciążenia podczas routingu.
Pełna pamięć FFN ma około 669.1 miliarda parametrów. W formacie FP8 E4M3 (1 bajt na wagę) odpowiada to około 623.1 GB danych FFN. Stanowi to 97.7% szacowanego całkowitego rozmiaru modelu na dysku. Pozostałe ~2.3% to wagi uwagi, osadzenia, głowica wyjściowa, normy warstw i metadane skali FP8.
Dekodowanie dezagregacji
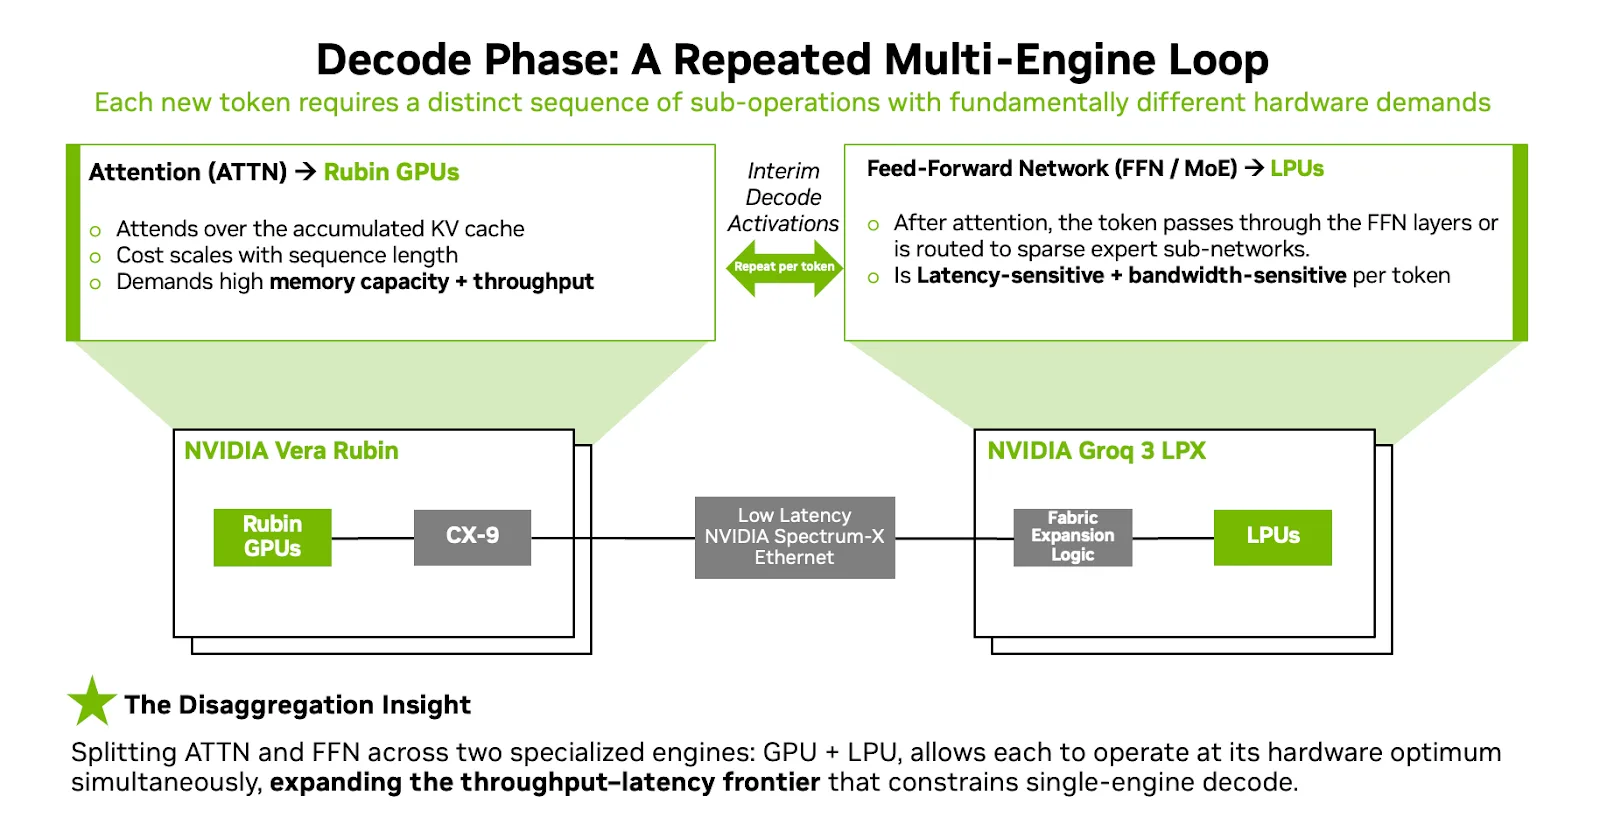
NVIDIA postrzega teraz fazę dekodowania nie jako operację monolityczną, lecz jako powtarzalną pętlę dla każdego tokena, w której różne części obciążają różne wąskie gardła sprzętowe. Faza wstępnego wypełniania jest zdominowana przez przetwarzanie dużych danych wejściowych i budowanie pamięci podręcznej KV – obciążenia, które korzysta z gęstych obliczeń równoległych i dużej pojemności pamięci. Vera Rubin NVL72 radzi sobie z tym sprawnie, szczególnie w przypadku obciążeń o długim kontekście, gdzie monit może być ogromny i bardzo zmienny.
Źródło: Nvidia
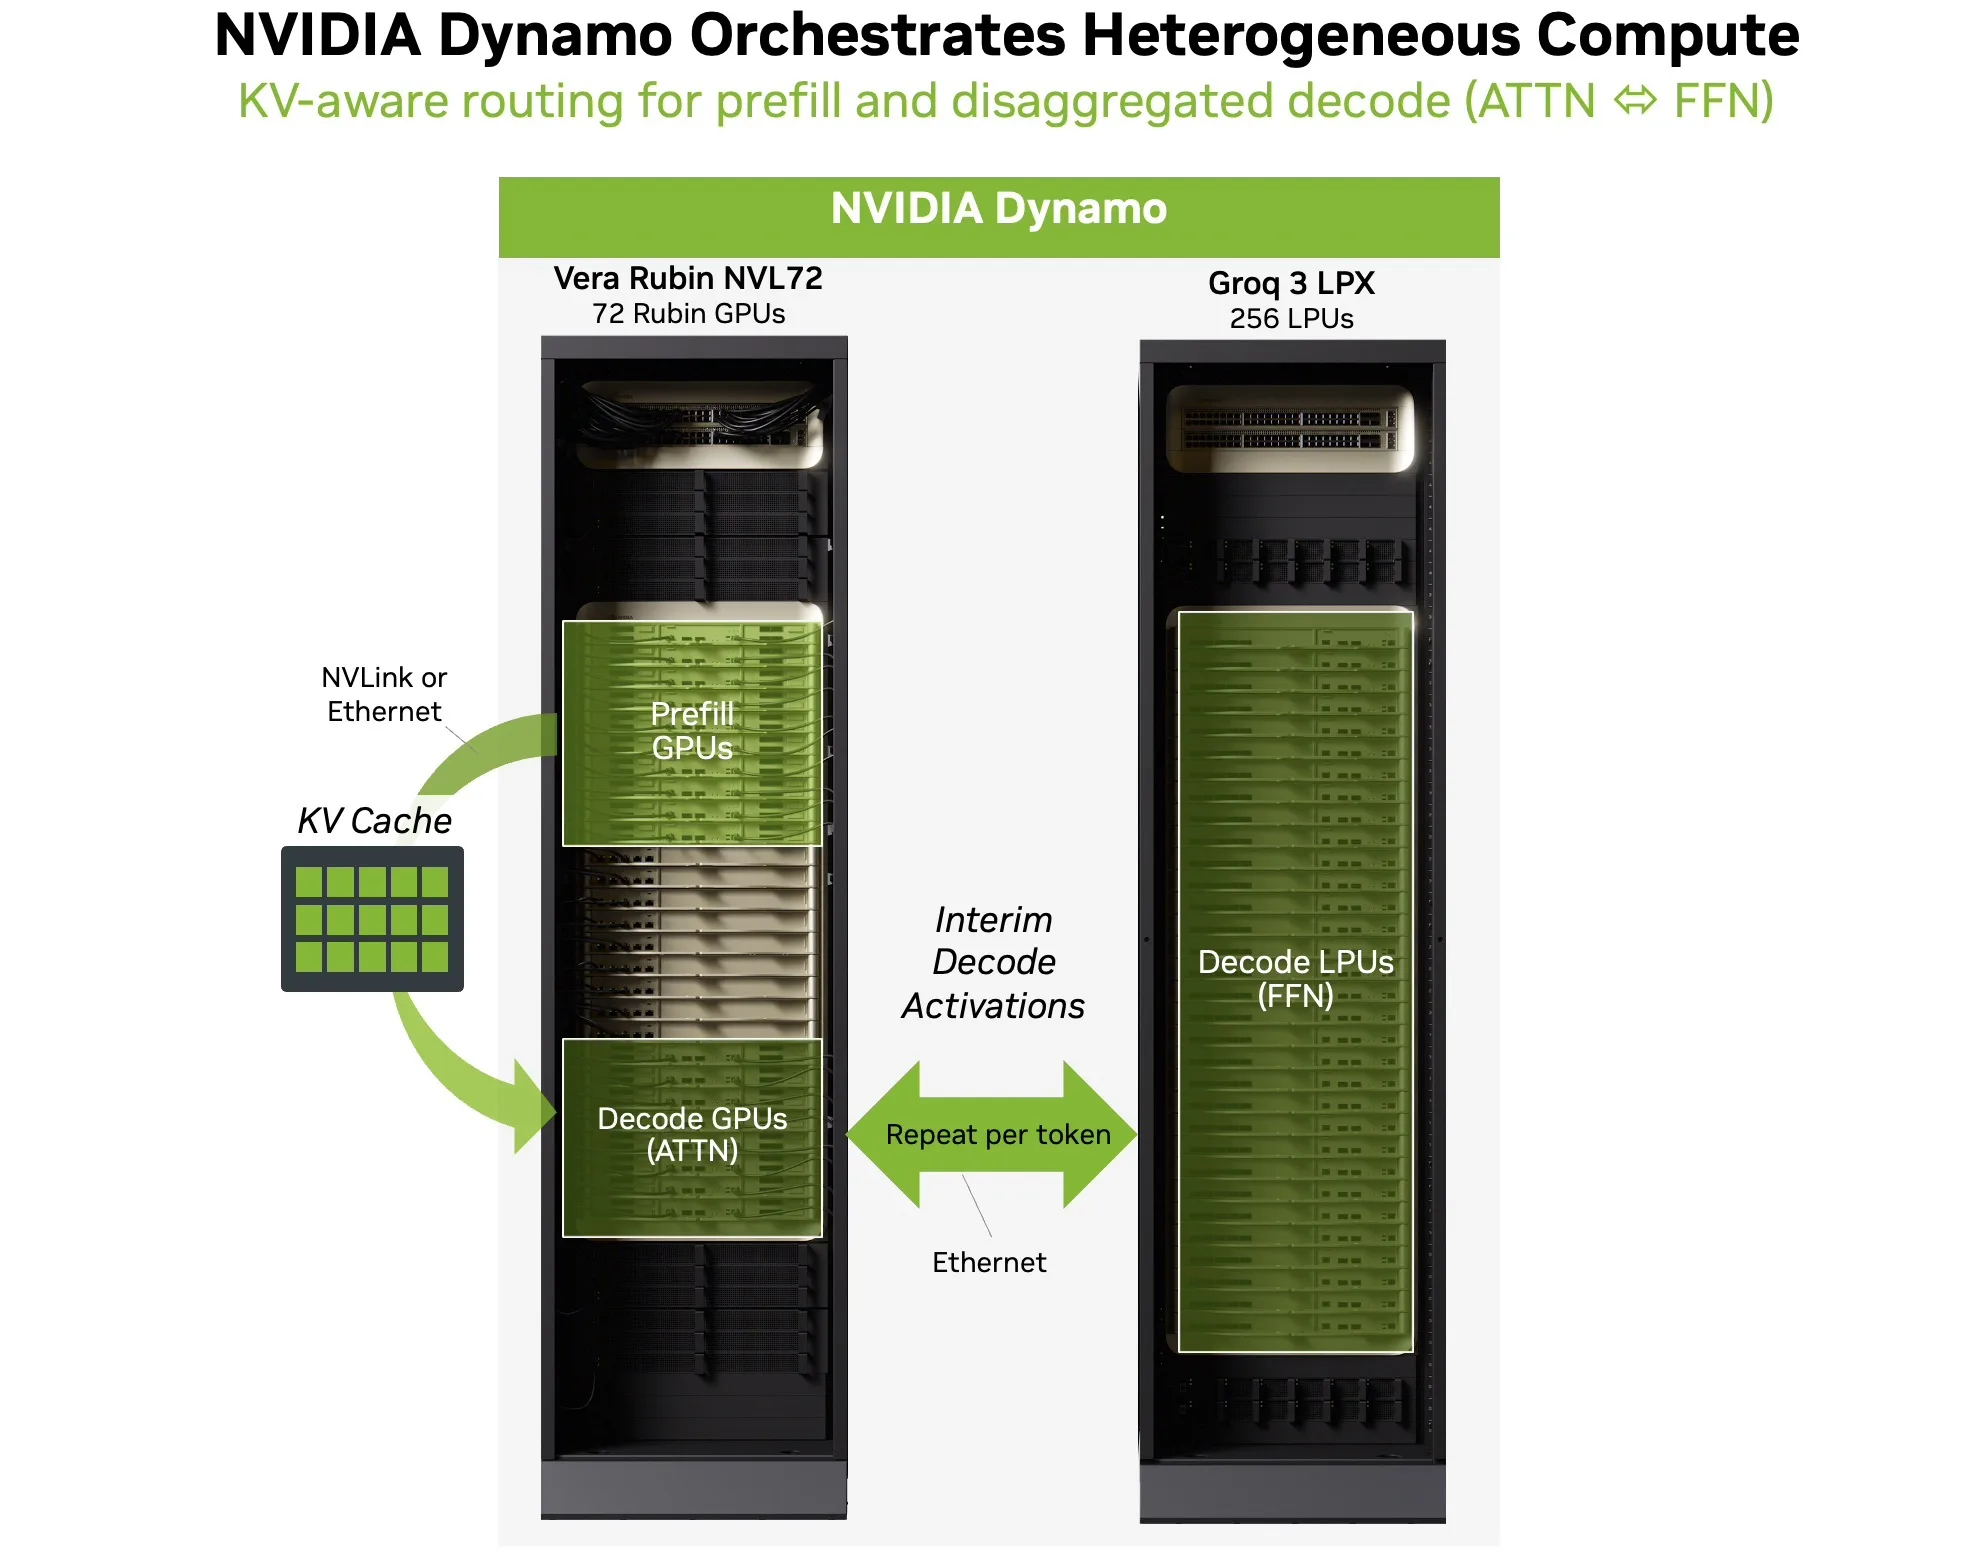
Dekodowanie jest inne. Dla każdego nowego tokena system musi wykonać obliczenia uwagi na całej zakumulowanej pamięci podręcznej KV, a następnie uruchomić obliczenia FFN/MoE na wyjściu uwagi. W architekturze Attention-FFN Disaggregation (AFD) firmy NVIDIA te dwa kroki są rozdzielone między dwa silniki. Procesory graficzne Rubin obsługują dekodowanie uwagi: odczytują pamięć podręczną KV z HBM, obliczają wyniki uwagi i generują aktywację pośrednią. Ten tensor aktywacji (który NVIDIA nazywa „stanem tensora pośredniego”) jest następnie przekazywany do procesora LPX, który uruchamia obliczenia eksperckie FFN lub MoE przy ekstremalnej przepustowości i deterministycznym opóźnieniu, a następnie zwraca wynik do procesora graficznego, aby kontynuować generowanie tokenów.
To przekazanie ma miejsce dla każdego pojedynczego tokena. Tensory aktywacji wymieniane między GPU a LPU są niewielkie w stosunku do danych o wagach, co jest właśnie tym obszarem, w którym sieć LPU o niemal zerowym narzucie działa znakomicie. Podział ten odpowiada fundamentalnym zaletom każdego procesora: GPU zapewniają wydajność HBM i elastyczne wykonywanie niezbędne do obsługi uwagi o zmiennej długości w dużych pamięciach podręcznych KV, podczas gdy LPU zapewniają przepustowość pamięci SRAM i deterministyczne harmonogramowanie niezbędne do statycznie harmonogramowanych, ograniczonych przepustowością wag FFN.
Źródło: Nvidia
Warto tu zwrócić uwagę na subtelną, ale ważną właściwość skalowania. Wraz ze wzrostem długości kontekstu, rosną również wymagania obliczeniowe i pamięciowe operacji uwagi: pamięć podręczna KV rozszerza się liniowo z każdym dodatkowym tokenem kontekstu, a każdy nowy krok dekodowania musi obsłużyć całą zgromadzoną pamięć podręczną. FFN jednak w ogóle nie rośnie wraz z kontekstem. Macierze wag FFN (w1, w2, w3 w SwiGLU) są stałymi stałymi architektury modelu. Mają one ten sam rozmiar niezależnie od tego, czy kontekst liczy 1,000, czy 1 000 000 tokenów, a każdy token przechodzi przez nie niezależnie. Oznacza to, że w architekturze AFD, wraz ze wzrostem okien kontekstowych, strona GPU absorbuje rosnące koszty (więcej HBM dla pamięci podręcznej KV, więcej obliczeń dla uwagi), podczas gdy strona LPX pozostaje całkowicie statyczna. Liczba szaf LPX wymaganych do obsługi FFN modelu jest w całości określana przez architekturę modelu, a nie przez długość kontekstu konfiguracji obsługującej. To zgrabnie rozwiązuje jedno z największych wyzwań dla akceleratorów opartych wyłącznie na pamięci SRAM: rosnące wymagania kontekstowe ostatecznie przewyższają stałą pojemność pamięci na chipie. W podziale AFD zadania zależne od kontekstu pozostają na sprzęcie z rozszerzalną pamięcią HBM, a jednostka LPU obsługuje tylko zadania niezależne od kontekstu, które naturalnie mieszczą się w stałej pamięci SRAM.
NVIDIA Dynamo umożliwia działanie heterogenicznego dekodowania
Aby ta dwusilnikowa pętla działała w środowisku produkcyjnym, potrzeba czegoś więcej niż tylko sprzętu. Warstwa orkiestracji Dynamo firmy NVIDIA sprawia, że heterogeniczne dekodowanie jest praktyczne. Dynamo koordynuje rozproszone serwowanie w zapleczu GPU i LPU, obsługując klasyfikację per token, routing i transfer aktywacji wymagany przez AFD.
Źródło: Nvidia
W praktyce Dynamo kieruje prefill do procesorów GPU w celu przetworzenia danych wejściowych i utworzenia pamięci podręcznej KV. Podczas dekodowania Dynamo koordynuje pętlę AFD: procesory GPU przetwarzają zgromadzoną pamięć podręczną KV, aktywacje pośrednie są przekazywane do jednostek LPU w celu wykonania FFN/MoE, a dane wyjściowe wracają do procesorów GPU w celu kontynuacji generowania tokenów. W rezultacie powstaje pojedyncza, spójna ścieżka obsługi zamiast dwóch rozłączonych systemów.
Dynamo oferuje również routing z uwzględnieniem KV (dzięki czemu żądania trafiają do instancji roboczych, które już posiadają odpowiednią pamięć podręczną KV), harmonogramowanie oparte na opóźnieniu (dzięki czemu sesje interaktywne nie trafiają do długich kolejek) oraz zarządzanie transferem o niskim narzucie. Te możliwości są istotne, ponieważ w rzeczywistym ruchu produkcyjnym ze zmienną długością kontekstu, mieszanymi typami żądań i dynamiczną współbieżnością, warstwa orkiestracji utrzymuje stabilność opóźnienia końcowego i zapobiega pogorszeniu jakości obsługi przez użytkowników, wynikającemu z jittera między dzierżawcami.
Rozmiary FFN we wszystkich głównych modelach open source i rozmiary LPX
Skoro rozumiemy już, jak działa LPX i co próbuje rozwiązać, przyjrzyjmy się bliżej jego wymaganiom sprzętowym.
Obliczyliśmy liczbę parametrów i rozmiar FFN na dysku dla popularnych modeli przy użyciu plików config.json i model.safetensors.index.json dostępnych na Huggingface.
| Model | Parametry FFN | Rozmiar FFN (na dysku) | FFN % | Typ D | . |
|---|---|---|---|---|---|
| DeepSeek R1 i DeepSeek V3.2 | 669.1B | 623.1 GB | 97.7% | FP8 | 256 |
| Kimi K2 | 1.02T | 948.0 GB | 98.9% | FP8 | 384 |
| Kimi K2.5 | 1.02T | 474.0 GB | 98.5% | INT4 | 384 |
| MiniMax M2.5 | 224.7B | 209.3 GB | 97.7% | FP8 | 256 |
| OpenAI GPT-OSS 120B | 114.7B | 53.4 GB | 95.4% | MXFP4 | 128 |
| GLM 5 | 738.1B | 1,374.8 GB | 98.0% | BF16 | 256 |
| Qwen3 235B-A22B | 227.2B | 423.1 GB | 96.6% | BF16 | 128 |
Ten wzorzec potwierdza to, co badaliśmy wcześniej: w każdym modelu w tej analizie parametry FFN stanowią od 95% do 99% całkowitego rozmiaru modelu na dysku. Kimi K2 to najbardziej ekstremalny przypadek, z 384 trasowanymi ekspertami na warstwę, co zwiększa FFN do ponad biliona parametrów i prawie 99% całości. Nawet najmniejszy model w zestawie, GPT-OSS 120B OpenAI ze 128 ekspertami przechowywanymi w MXFP4, nadal ma FFN reprezentujące 95.4% całości. Rozmiary na dysku wahają się od skromnych 53 GB dla GPT-OSS 120B (dzięki kwantyzacji 4-bitowej) do prawie 1.4 TB dla GLM 5 (przechowywane w BF16 bez kwantyzacji).
Te liczby pomagają nam zrozumieć rozmiary LPX. Pojedyncza szafa LPX zapewnia łącznie 128 GB pamięci SRAM w 256 układach. W przypadku modelu takiego jak OpenAI GPT-OSS 120B z 53 GB FFN, wagi FFN mieszczą się bez problemu w jednej szafie, a nawet pozostawiają sporo miejsca. DeepSeek R1 z 623 GB pamięci wymagałby około pięciu szaf LPX, podczas gdy GLM 5 z 1.4 TB w BF16 wymagałby ponad dziesięciu (choć kwantyzacja do FP8 zmniejszyłaby tę liczbę mniej więcej o połowę). Właśnie dlatego potrzebne są międzyszafkowe porty C2C na przednim panelu: umożliwiają one łączenie wielu szaf LPX, wydłużając linię montażową i umożliwiając montaż większych modeli.
Przyspieszanie dekodowania spekulatywnego za pomocą LPX
Oprócz pętli dekodowania AFD, NVIDIA wskazuje na drugi ważny przypadek zastosowania LPX: wykorzystanie go jako silnika generowania projektów w dekodowaniu spekulatywnym.
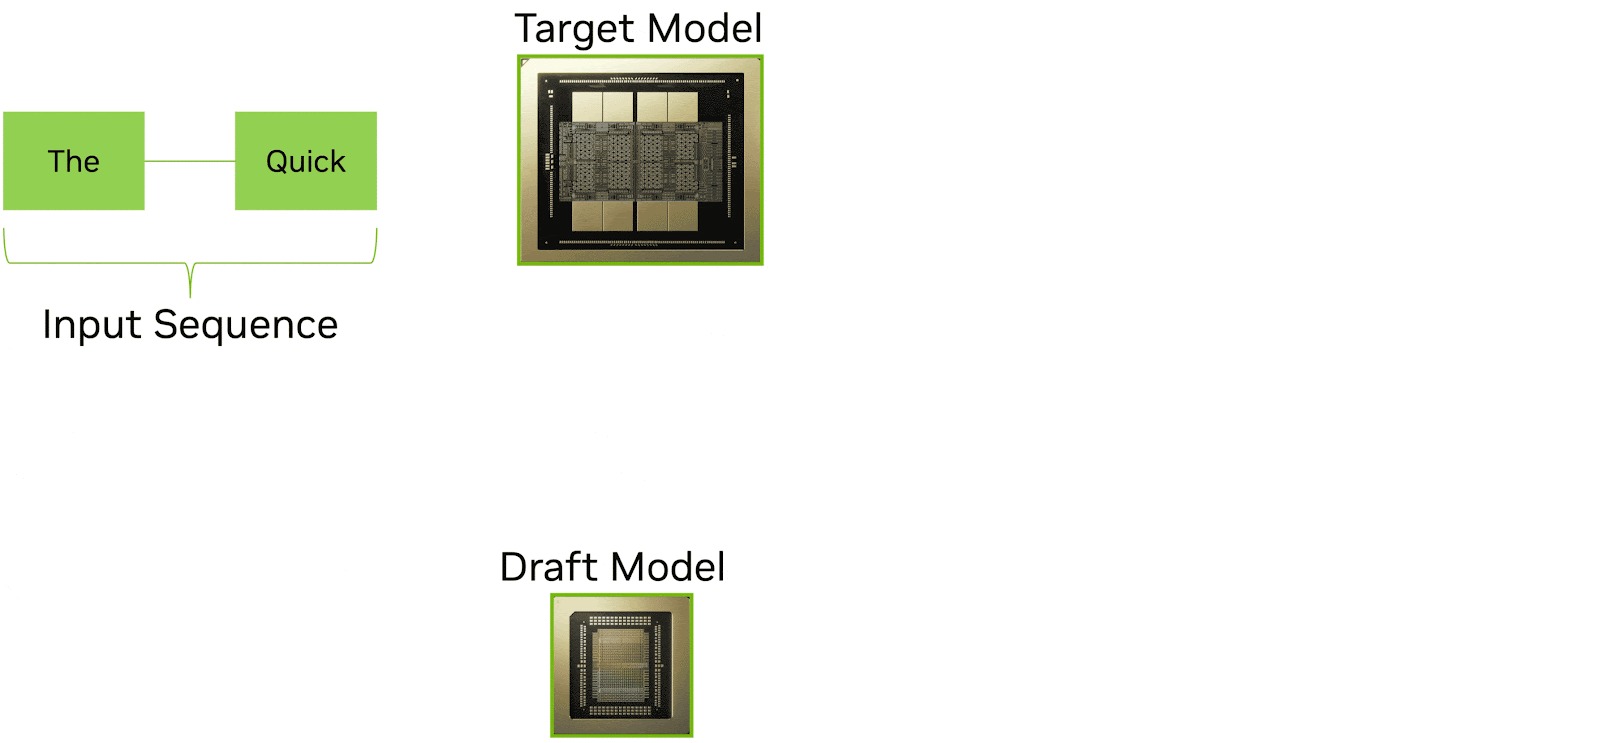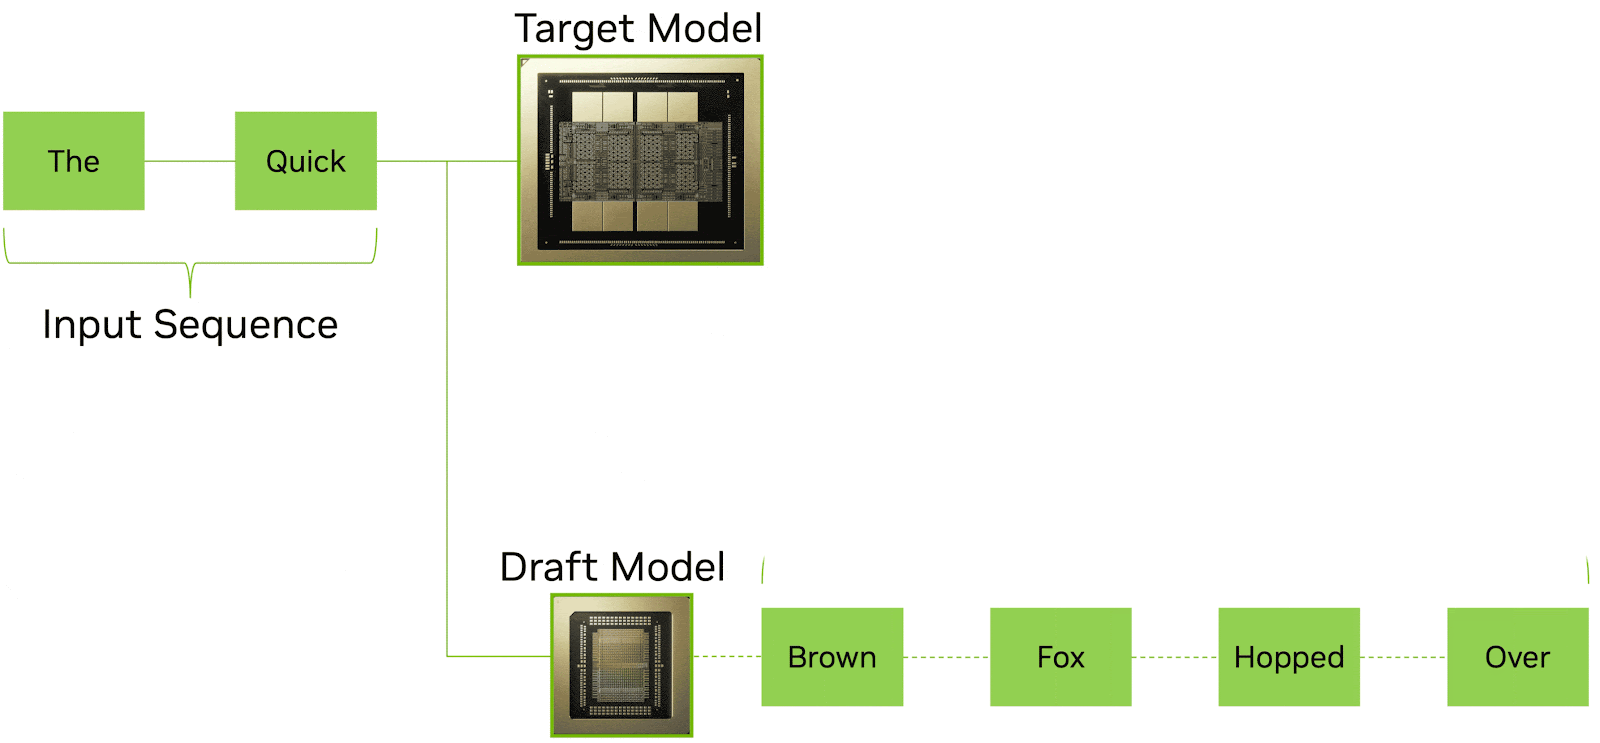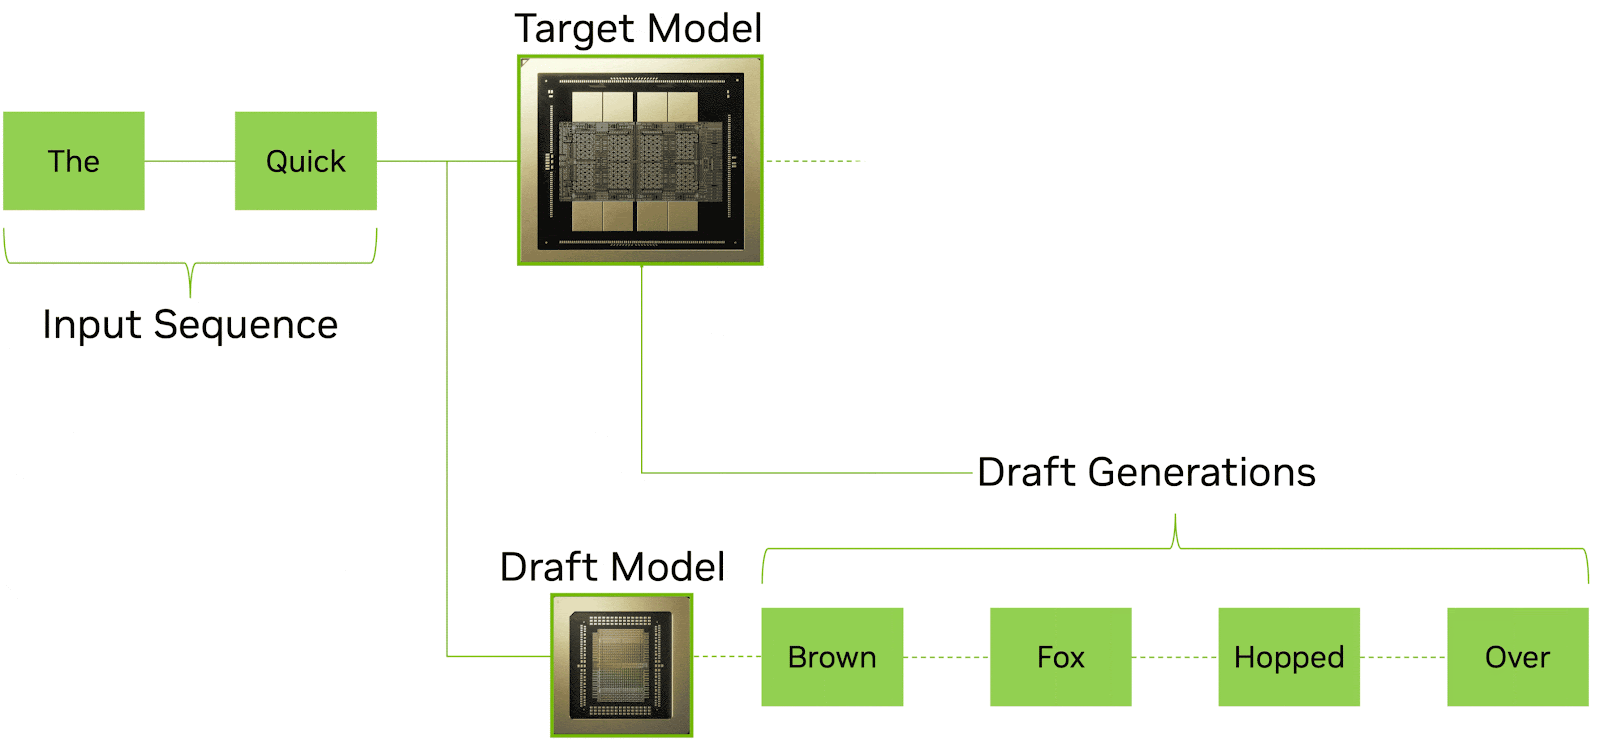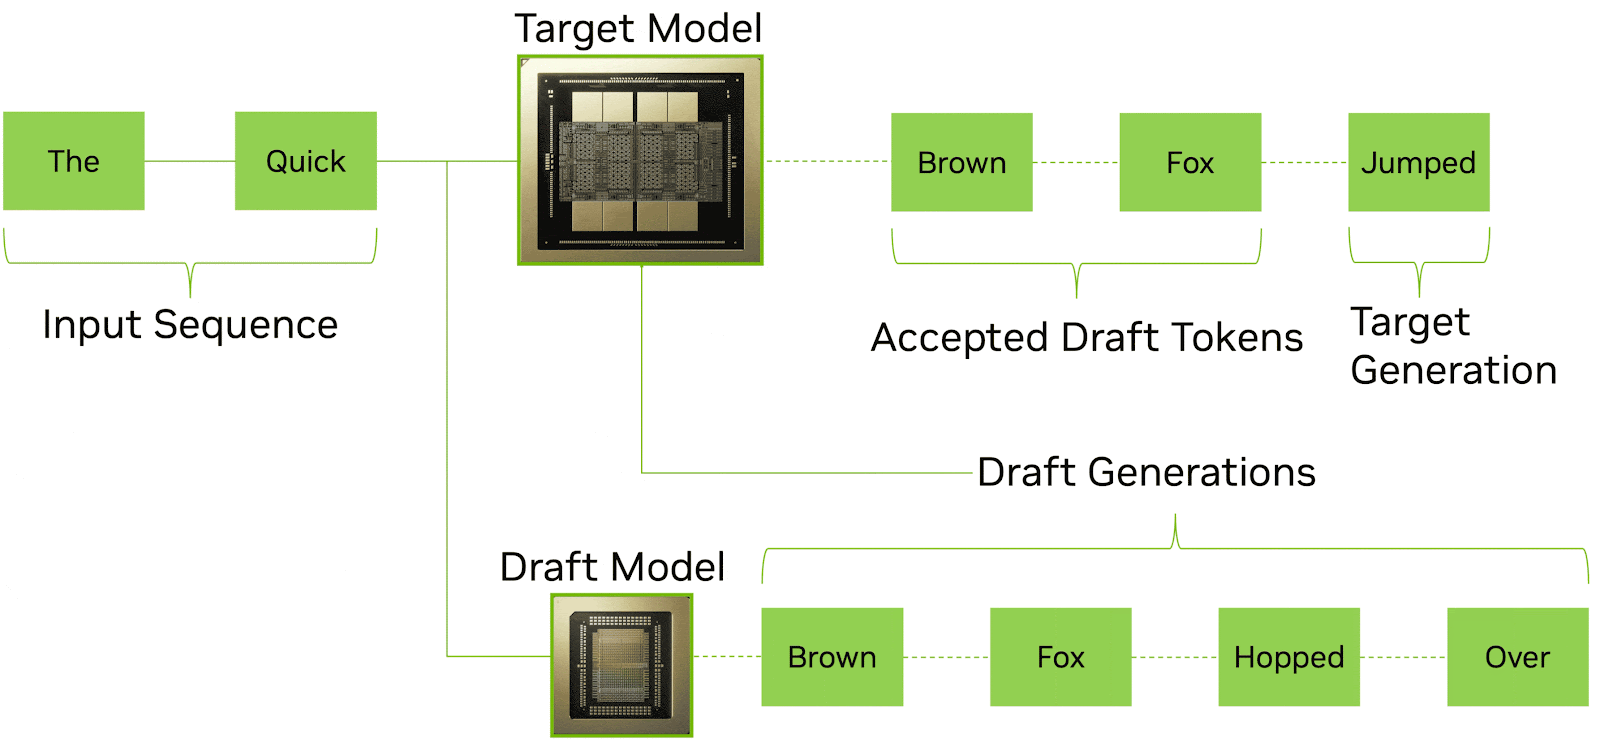
Dekodowanie spekulatywne to coraz ważniejsza technika redukcji opóźnień w wnioskowaniu LLM. Idea jest prosta: mniejszy, szybszy model roboczy generuje wiele tokenów kandydujących z wyprzedzeniem, podczas gdy większy model docelowy weryfikuje je i akceptuje równolegle. Gdy przewidywania modelu roboczego są poprawne (co często ma miejsce w przypadku rutynowego tekstu), wiele tokenów może zostać zatwierdzonych jednocześnie w jednym kroku weryfikacji. Rezultatem jest znacznie wyższa liczba efektywnych tokenów na sekundę i niższe odczuwalne opóźnienie dla użytkownika końcowego.
Źródło: Nvidia
Wyzwaniem jest to, że dekodowanie spekulatywne wymaga ekstremalnie szybkiego działania modelu roboczego. Każda milisekunda, jaką model roboczy spędza na generowaniu kandydatów, to milisekunda oczekiwania weryfikatora. W konwencjonalnej konfiguracji opartej wyłącznie na GPU, zarówno model roboczy, jak i model docelowy konkurują o te same zasoby sprzętowe, a prędkość modelu roboczego jest ograniczona przez te same ograniczenia przepustowości HBM, które wpływają na wszystkie inne elementy.
LPX doskonale nadaje się do tej roli. Deterministyczny model wykonania i ekstremalna przepustowość pamięci SRAM w układzie LP30 umożliwiają bardzo szybkie i przewidywalne generowanie tokenów roboczych. Mniejszy model roboczy mieści się wygodnie w pamięci SRAM pojedynczej tacki LPX lub niewielkiej liczby tacek, a deterministyczne harmonogramowanie zapewnia, że generowanie robocze przebiega ze stałą, przewidywalną prędkością, bez odchyleń, które utrudniałyby potokowanie z weryfikatorem.
W tej konfiguracji system łączy oba procesory, pełniąc uzupełniające się role: LPX szybko generuje tokeny robocze, wykorzystując architekturę o niskim opóźnieniu, podczas gdy procesory graficzne Rubin weryfikują i finalizują tokeny efektywnie, wykorzystując swoją wysoką przepustowość obliczeniową i dużą moc obliczeniową HBM. Ta separacja pozwala na wykonywanie dekodowania spekulatywnego na heterogenicznych procesorach, zamiast wymagać, aby oba modele współużytkowały jeden procesor graficzny, co potencjalnie zwiększa szybkość tworzenia tokenów roboczych i przepustowość weryfikacji w porównaniu z jednorodną konfiguracją.
NVIDIA wskazała dekodowanie spekulatywne, obok AFD, jako kluczowe obciążenie dla LPX, sugerując, że postrzega je jako istotny element wartości systemu. Wraz z rozwojem modeli granicznych i wydłużaniem się łańcuchów wnioskowania, możliwość równoległego generowania i weryfikowania tokenów na specjalistycznym sprzęcie może stać się ważnym czynnikiem utrzymania responsywności interaktywnej.
Podsumowanie: ekstremalne współprojektowanie sprzętu i oprogramowania
Jedną z rzeczy, która wyróżnia podejście firmy NVIDIA do platformy Vera Rubin i LPX, jest precyzja każdego komponentu. W sektorze konsumenckim regularnie spotykamy się z produktami, które próbują rozwiązywać problemy, których nikt tak naprawdę nie ma, pochodzącymi od firm, które nie do końca rozumieją potrzeby swoich klientów. Strategia firmy NVIDIA w tym przypadku stanowi jaskrawy kontrast. Jest wręcz oczywiste, że rozumieją problemy związane z procesem wnioskowania na niezwykle szczegółowym poziomie i optymalizują każdy jego segment, aby pomóc swoim klientom zmaksymalizować zwrot z inwestycji w sprzęt.
Dezagregacja uwagi/FFN nie jest koncepcją marketingową. To bezpośrednia odpowiedź na zmierzony profil wąskiego gardła w obsłudze modelu MoE o bilionach parametrów. Decyzja o odciążeniu konkretnie FFN (a nie uwagi) i przekształceniu szafy CPX w szafę LPX odzwierciedla precyzyjne zrozumienie tego, które operacje są ograniczone przepustowością, a które pojemnością, które są statycznie harmonogramowalne, a które dynamicznie zmienne, oraz która architektura procesora jest najlepiej dopasowana do każdego z nich. Warstwa orkiestracji Dynamo, transparentna integracja CUDA i bezkablowa konstrukcja szafy MGX wskazują na zespół inżynierów, który przemyślał cały cykl wdrożenia.
Wciąż wiele niewiadomych dotyczy nowych, pionierskich produktów LPX i NVIDIA. Jednym z najważniejszych pytań, które wciąż nas nurtują, jest cel „Fabric Expansion Logic and DRAM”, rodzaj krzemu, który jest w nim użyty. Jak już zauważyliśmy, gniazdo x86, biorąc pod uwagę inwestycje w Intela w zeszłym roku i konstrukcję radiatora, prawdopodobnie jest to procesor Intela, ale jaka część wciąż pozostaje wielką niewiadomą.
Wdrożenie LPX będzie początkowo koncentrować się na twórcach modeli i dostawcach usług, a nie na szerokiej dostępności. Rzeczywista wydajność w warunkach produkcyjnych, ze zmienną długością kontekstu, mieszanymi typami żądań i dynamiczną współbieżnością, a także efektywność energetyczna, wymagają jeszcze niezależnej weryfikacji. Z niecierpliwością czekamy na uzyskanie dostępu do tych systemów w celu przeprowadzenia niezależnych testów.
Źródła cytowane:
Groq: Czym jest jednostka przetwarzania języka?
Groq: Groq LPU, technologia wnioskowania AI, zapewnia większą efektywność energetyczną…
Groq: Technologia połączeń między układami scalonymi RealScale
Groq: Determinizm i procesor strumieniowy tensorowy
Nvidia: Wewnątrz Nvidia Groq 3 LPX…


 Amazon