

Konferencja NVIDIA GPU Technology Conference (GTC) powraca na scenę po wielu latach wyłącznie wirtualnej formy wydarzenia. To fantastyczne wydarzenie dla innowatorów, badaczy, naukowców i entuzjastów technologii, którzy chcą zapoznać się z najnowszymi rozwiązaniami tego giganta technologicznego. Tegoroczna konferencja NVIDIA GTC 2024, długo oczekiwana w społeczności technologicznej, prezentuje najnowsze przełomy w dziedzinie sztucznej inteligencji, głębokiego uczenia, pojazdów autonomicznych i nowej architektury Blackwell.
Oto najważniejsze wydarzenia z poniedziałkowego wystąpienia prezesa firmy NVIDIA, Jensena Huanga. Dotyczyło ono nowej architektury Blackwell firmy NVIDIA, sieci, postępów w dziedzinie obliczeń kwantowych oraz aktualizacji stosu oprogramowania.
NVIDIA Blackwell
Sześć przełomowych technologii, które mają na nowo zdefiniować akcelerowane obliczenia, leży u podstaw innowacji Blackwell. Od usprawnienia przetwarzania danych, przez rewolucję w projektowaniu leków, po wiele innych aspektów – NVIDIA wyznacza nowe standardy. Znani użytkownicy, tacy jak Amazon i Microsoft, już ustawiają się w kolejce, oczekując na rewolucyjny potencjał Blackwell.
Przyjrzyjmy się bliżej cudowi inżynierii, którego dokonała firma NVIDIA. Procesory graficzne Blackwell zawierają aż 208 miliardów tranzystorów w dwóch chipach, co jest możliwe dzięki wykorzystaniu procesu 4NP TSMC z limitem dwóch siatek. To podejście przekracza granice produkcji półprzewodników i wprowadza nowatorski sposób łączenia chipów z interfejsem o imponującej przepustowości 10 TB/s. Ten krok w kierunku projektów chipletów odzwierciedla ambicje firmy NVIDIA, by przekraczać tradycyjne granice.
| Specyfikacja | H100 | B100 | B200 |
| Maksymalna pamięć | 80GB HBM3 | 192 GB HBM3e | 192 GB HBM3e |
| Przepustowość pamięci | 3.35 TB/s | 8 TB/s | 8 TB/s |
| FP4 | - | 14 PFLOPS | 18 PFLOPS |
| FP6 | - | 7 PFLOPS | 9 PFLOPS |
| FP8/INT8 | 3.958 PFLOPS/POPS | 7 PFLOPS/POPS | 9 PFLOPS/POPS |
| FP16/BF16 | X TFTPS | 3.5 PFLOPS | 4.5 PFLOPS |
| TF32 | X TFTPS | 1.8 PFLOPS | 2.2 PFLOPS |
| FP64 | X TFTPS | X TFTPS | X TFTPS |
| Maksymalny pobór mocy | 700W | 700W | 1000W |
Uwaga: Wszystkie podane liczby przedstawiają wydajność obliczeń na macierzach rzadkich.
Nie chodzi tylko o upakowanie większej liczby tranzystorów. Wprowadzenie możliwości obliczeniowych FP4 i FP6 wprowadza nowy poziom efektywnego trenowania modeli, aczkolwiek z niewielkim kompromisem w wydajności modelu. Ten kompromis jest niuansem platformy, odzwierciedlającym złożoną równowagę między wydajnością a precyzją.
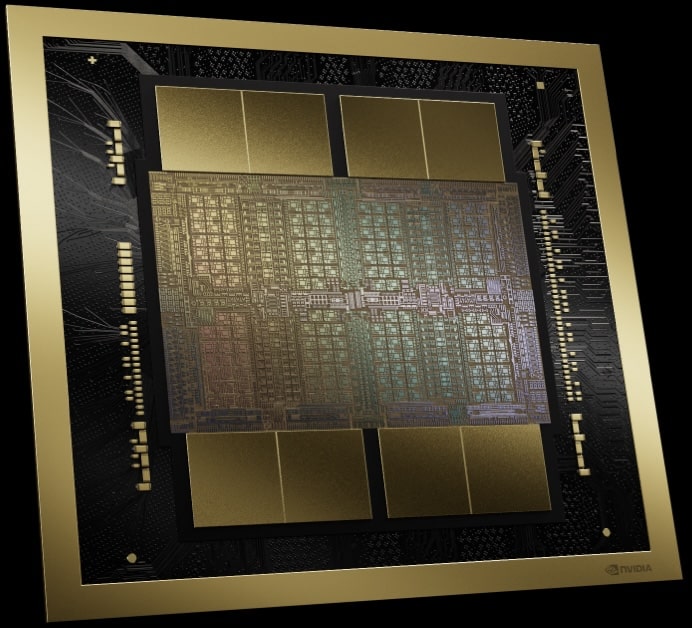
Silnik transformatorowy drugiej generacji w Blackwell umożliwia skokowy wzrost mocy obliczeniowej, przepustowości i możliwości rozmiaru modelu podczas korzystania z FP4, wprowadzając ulepszenia niezbędne dla przyszłości rozwoju sztucznej inteligencji. Co więcej, integracja PCIe Gen6 i nowej technologii pamięci HBM3e zapewnia znaczny wzrost przepustowości, która w połączeniu z NVLink piątej generacji podwaja przepustowość w porównaniu z poprzednią generacją do oszałamiających 1.8 TB/s.
Jednym z bardziej intrygujących rozwiązań jest silnik RAS, który zwiększa niezawodność, dostępność i łatwość obsługi w przypadku masowych wdrożeń AI. Ta innowacja może znacząco poprawić wykorzystanie błędów modeli, rozwiązując jedno z kluczowych wyzwań w skalowaniu aplikacji AI.
Dzięki technologii Blackwell, NVIDIA wprowadza nowe możliwości przetwarzania poufnego, w tym pierwszy w branży procesor graficzny obsługujący środowisko TEE (Trusted Execution Environment) i wejścia/wyjścia (I/O), rozszerzając możliwości TEE poza procesory CPU na procesory graficzne. Zapewnia to bezpieczne i szybkie przetwarzanie danych prywatnych, kluczowe dla szkolenia generatywnej sztucznej inteligencji (AI). Ta innowacja jest szczególnie istotna dla branż, w których obowiązują przepisy dotyczące prywatności lub informacje zastrzeżone. Technologia przetwarzania poufnego NVIDIA Blackwell zapewnia niezrównane bezpieczeństwo bez obniżania wydajności, oferując niemal identyczną przepustowość jak w trybach nieszyfrowanych. Ten postęp nie tylko zabezpiecza duże modele AI, ale także umożliwia poufne szkolenie AI i uczenie federacyjne, chroniąc własność intelektualną w dziedzinie AI.
Silnik dekompresji w NVIDIA Blackwell to znaczący krok naprzód w dziedzinie analityki danych i przepływów pracy w bazach danych. Silnik ten może dekompresować dane z imponującą szybkością do 800 GB/s, znacząco zwiększając wydajność analityki danych i skracając czas uzyskiwania analiz. W połączeniu z pamięcią HBM3e o przepustowości 8 TB/s i szybkim połączeniem NVLink-C2C, przyspiesza on zapytania do baz danych, czyniąc Blackwell 18 razy szybszym niż procesory CPU i 6 razy szybszym niż poprzednie procesory GPU NVIDIA w testach porównawczych zapytań. Technologia ta obsługuje najnowsze formaty kompresji i pozycjonuje NVIDIA Blackwell jako potęgę w dziedzinie analityki danych i badań naukowych, radykalnie przyspieszając kompleksowy proces analityczny.
Pomimo technicznych cudów, twierdzenie firmy NVIDIA o zmniejszeniu kosztów operacyjnych i zużycia energii w procesie wnioskowania LLM nawet o 25x budzi wątpliwości, zwłaszcza biorąc pod uwagę brak szczegółowych danych o zużyciu energii. Twierdzenie to, choć godne uwagi, może wymagać dalszych wyjaśnień, aby w pełni ocenić jego wpływ.
Podsumowując, platforma Blackwell firmy NVIDIA jest świadectwem nieustannego dążenia firmy do poszerzania granic możliwości w dziedzinie sztucznej inteligencji i informatyki. Dzięki rewolucyjnym technologiom i ambitnym celom, Blackwell to nie tylko krok naprzód, ale gigantyczny skok naprzód, obiecujący stymulację rozwoju w różnych branżach. W miarę jak zagłębiamy się w erę akcelerowanych obliczeń i generatywnej sztucznej inteligencji, innowacje firmy NVIDIA mogą stać się katalizatorem kolejnej rewolucji przemysłowej.
NVIDIA Blackwell HGX
Wdrażając architekturę Blackwell, NVIDIA odświeżyła serię serwerów i płyt bazowych HGX. Ta znacząca ewolucja w stosunku do poprzednich modeli przynosi istotną zmianę, w szczególności obniżając całkowity koszt posiadania (TCO) przy jednoczesnym imponującym wzroście wydajności. Porównanie jest uderzające – porównując FP8 z FP4, można zauważyć znaczący, 4.5-krotny wzrost wydajności. Nawet porównując FP8 z poprzednikiem, wydajność jest niemal dwukrotnie wyższa. Nie chodzi tu tylko o samą prędkość; to skok w wydajności pamięci, prezentujący 8-krotny wzrost łącznej przepustowości pamięci.
| Specyfikacja | HGX H100 | HGX H200 | HGXB100 | HGXB200 |
| Maksymalna pamięć | 640GB HBM3 | 1.1TB HBM3e | 1.5TB HBM3e | 1.5TB HBM3e |
| Przepustowość pamięci | 7.2 TB/s | 7.2 TB/s | 8 TB/s | 8 TB / s |
| FP4 | - | - | 112 PFLOPS | 144 PFLOPS |
| FP6 | - | - | 56 PFLOPS | 72 PFLOPS |
| FP8/INT8 | 32 PFLOPS/POPS | 32 PFLOPS/POPS | 56 PFLOPS/POPS | 72 PFLOPS/POPS |
| FP16/BF16 | 16 PFLOPS | 16 PFLOPS | 28 PFLOPS | 36 PFLOPS |
NVIDIA Grace-Blackwell SuperChip
Przyglądając się bliżej zawiłościom najnowszego ogłoszenia firmy NVIDIA, skupiamy się na GB200, kamieniu węgielnym arsenału platformy Blackwell. NVIDIA nieustannie przesuwa granice w dziedzinie obliczeń o wysokiej wydajności, a GB200 stanowi znaczącą ewolucję w ofercie procesorów graficznych, łącząc najnowocześniejszą technologię ze strategicznymi postępami w zakresie łączności i skalowalności. GB200 zawiera dwa procesory graficzne B200; ta konfiguracja różni się od poprzedniej generacji GH200, która charakteryzowała się połączeniem typu jeden do jednego między procesorem graficznym a procesorem Grace. Tym razem oba procesory graficzne B200 są połączone z tym samym procesorem Grace za pomocą łącza C2C (chip-to-chip) o przepustowości 900 GB/s.
| Specyfikacja | GH200 | GB200 |
| Maksymalna pamięć | 144 GB HBM3e | 384 GB HBM3e |
| Przepustowość pamięci | 8 TB/s | 16 TB/s (łącznie) |
| FP4 | - | 40 PFLOPS |
| FP6 | - | 20 PFLOPS |
| FP8/INT8 | 3.958 PFLOPS/POPS | 20 PFLOPS |
| FP16/BF16 | X TFTPS | 10 PFLOPS |
| TF32 | X TFTPS | 5 PFLOPS |
| FP64 | X TFTPS | X TFTPS |
| Porty PCIe | 4x PCIe Gen 5 x16 | 2x PCIe Gen 6 x16 |
| Maksymalny pobór mocy | 1000W | 2700W |
# Uwaga: Wszystkie podane liczby przedstawiają wydajność obliczeń na macierzach rzadkich.
Na pierwszy rzut oka decyzja o zachowaniu łącza C2C o przepustowości 900 GB/s z poprzedniej generacji może wydawać się ograniczeniem. Jednak ten wybór konstrukcyjny podkreśla przemyślaną strategię wykorzystania istniejących technologii, torując jednocześnie drogę do nowych poziomów skalowalności. Architektura GB200 pozwala mu komunikować się z maksymalnie 576 procesorami graficznymi z prędkością 1.8 TB/s, dzięki technologii NVLink piątej generacji. Ten poziom łączności jest kluczowy dla budowy masowo równoległych środowisk obliczeniowych niezbędnych do szkolenia i wdrażania największych i najbardziej złożonych modeli sztucznej inteligencji.
Aktualizacja stosu sieciowego NVIDIA
Integracja GB200 z najnowszymi technologiami sieciowymi firmy NVIDIA, platformy Quantum-X800 InfiniBand i Spectrum-X800 Ethernet rodzą interesujące pytania dotyczące łączności i przepustowości. Wzmianka o możliwościach 800 Gb/s sugeruje, że NVIDIA bada korzyści, jakie może przynieść PCIe Gen6.
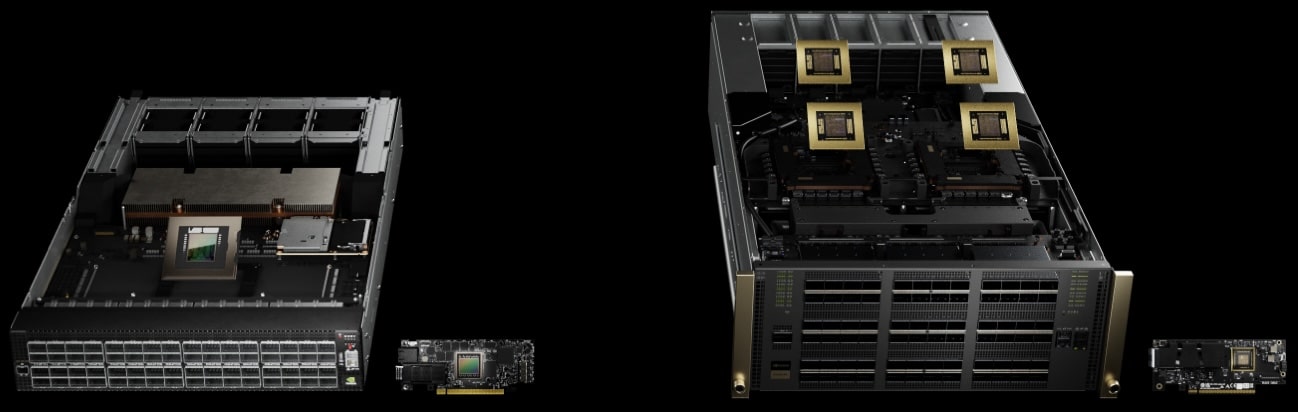
Konfiguracja GB200, z dwoma procesorami graficznymi i zaawansowanymi opcjami sieciowymi, odzwierciedla wizję firmy NVIDIA dotyczącą przyszłości technologii HPC. Wizja ta nie dotyczy wyłącznie mocy obliczeniowej poszczególnych komponentów, ale sposobu ich koordynacji w spójny, skalowalny system. Umożliwiając wyższy poziom łączności i zachowując równowagę między mocą obliczeniową a szybkością przesyłu danych, NVIDIA stawia czoła jednym z najważniejszych wyzwań w badaniach i rozwoju sztucznej inteligencji, w szczególności w zakresie obsługi wykładniczo rosnących rozmiarów modeli i wymagań obliczeniowych.
Przełączniki NVLink i NVLink piątej generacji firmy NVIDIA
NVLink piątej generacji to kamień milowy w dziedzinie obliczeń o wysokiej wydajności i sztucznej inteligencji. Technologia ta zwiększa możliwości łączenia się i komunikacji między procesorami graficznymi, co jest kluczowym aspektem dla szybko zmieniających się wymagań modeli fundamentalnych w sztucznej inteligencji.
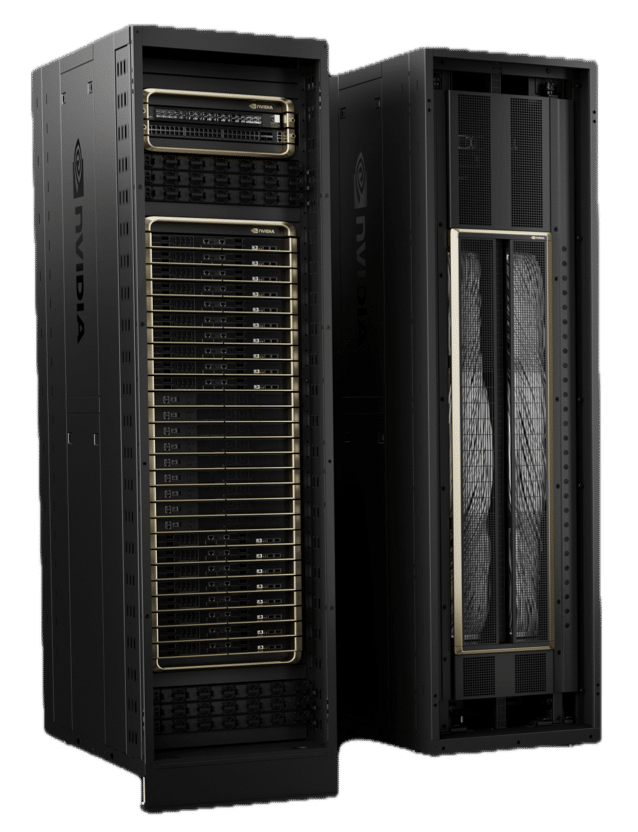
Piąta generacja NVLink zwiększa przepustowość połączeń GPU do 576, co stanowi znaczny wzrost w porównaniu z poprzednim limitem 256 GPU. To rozszerzenie łączy się z podwojeniem przepustowości w porównaniu z poprzednikiem, co ma kluczowe znaczenie dla wydajności coraz bardziej złożonych modeli bazowych AI.
Każde łącze GPU Blackwell oferuje dwie szybkie pary różnicowe, podobnie jak GPU Hopper, ale osiąga efektywną przepustowość na łącze wynoszącą 50 GB/s w każdym kierunku. Te GPU są wyposażone w 18 łączy NVLink piątej generacji, co zapewnia imponującą całkowitą przepustowość 1.8 TB/s. Ta przepustowość jest ponad 14 razy większa niż w przypadku obecnego PCIe Gen 5.
Kolejną godną uwagi cechą jest przełącznik NVIDIA NVLink, który obsługuje przepustowość GPU 130 TB/s w pojedynczej domenie 72 GPU NVLink (NVL72), co jest kluczowe dla paralelizmu modeli. Przełącznik ten zapewnia również czterokrotny wzrost wydajności przepustowości dzięki obsłudze nowego protokołu NVIDIA Scalable Hierarchical Aggregation and Reduction Protocol (SHARP) FP8.
Ponadto NVIDIA Unified Fabric Manager (UFM) uzupełnia przełącznik NVLink, zapewniając solidne i sprawdzone zarządzanie infrastrukturą obliczeniową NVLink.
Obliczenia eksaskalowe w szafie rack
Bazując na solidnym fundamencie swojego poprzednika, GraceHopper GH200 NVL32, DGX GB200 NVL72 to nie tylko ulepszenie; to kamień milowy w rozwoju, który poszerza możliwości w zakresie mocy obliczeniowej i wydajności. Platforma DGX GB200 NVL72 prezentuje zdumiewające postępy w każdym obszarze. Każdy system DGX GB200 NVL72 składa się z 18 węzłów GB200 SuperChip, z których każdy zawiera 2 węzły GB200.
Platforma ta ponad dwukrotnie zwiększa liczbę procesorów graficznych (GPU) z 32 do 72 i nieznacznie zwiększa liczbę procesorów (CPU) z 32 do 36. Jednak skok w zakresie pamięci jest znaczący – z 19.5 TB do imponujących 30 TB. To rozszerzenie nie dotyczy jedynie większych liczb, ale także umożliwienia nowego poziomu możliwości obliczeniowych, szczególnie w obsłudze najbardziej złożonych modeli i symulacji sztucznej inteligencji.
Jednym z najbardziej oszałamiających ulepszeń jest skok w wydajności obliczeniowej. Platforma skacze ze 127 PetaFLOPS do 1.4 ExaFLOPS w porównaniu z wydajnością FP4, co oznacza wzrost około 11-krotny. To porównanie pokazuje zaangażowanie firmy NVIDIA w przekraczanie granic precyzji i szybkości, szczególnie w dziedzinie sztucznej inteligencji i uczenia maszynowego. Jednak nawet porównując FP8 z FP8, platforma osiąga wzrost 5.6-krotny, ze 127 PF do 720 PF, co podkreśla znaczący postęp w zakresie wydajności i mocy obliczeniowej.
Zaangażowanie w utrzymanie systemu w pełni chłodzonego wodą odzwierciedla dążenie firmy NVIDIA do zrównoważonego rozwoju i optymalizacji wydajności. Takie podejście zwiększa wydajność operacyjną systemu i wpisuje się w szersze trendy branżowe w kierunku bardziej przyjaznych dla środowiska technologii centrów danych.
NVIDIA DGX SuperPOD z superchipami NVIDIA GB200 Grace Blackwell
Firma NVIDIA ogłosiła również swój superkomputer AI nowej generacji, DGX SuperPOD, wyposażony w 8 systemów NVIDIA GB200 NVL72 Grace Blackwell. Ta potężna konfiguracja została zaprojektowana do obsługi modeli o bilionach parametrów i oferuje 11.5 eksaflopów mocy obliczeniowej AI z precyzją FP4 w swojej chłodzonej cieczą architekturze rackowej. Każdy system GB200 NVL72 zawiera 36 superchipów NVIDIA GB200, co gwarantuje 30-krotny wzrost wydajności w porównaniu z poprzednikami H100 w przypadku obciążeń związanych z wnioskowaniem dużych modeli językowych.
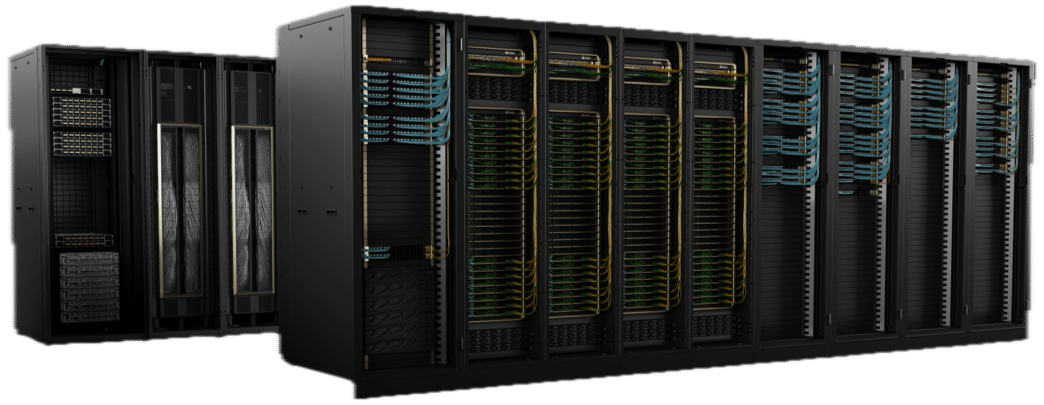
Według Jensena Huanga, dyrektora generalnego firmy NVIDIA, DGX SuperPOD ma stać się „fabryką rewolucji przemysłowej w dziedzinie sztucznej inteligencji”.
Chmura symulacji kwantowej
Firma NVIDIA zaprezentowała również usługę Quantum Simulation Cloud, umożliwiającą badaczom eksplorację obliczeń kwantowych w różnych dziedzinach nauki. Oparta na platformie open source CUDA-Q, usługa ta oferuje potężne narzędzia i integracje do tworzenia i testowania algorytmów i aplikacji kwantowych. Współpraca z Uniwersytetem w Toronto oraz firmami takimi jak Classiq i QC Ware podkreśla dążenie firmy NVIDIA do przyspieszenia innowacji w dziedzinie obliczeń kwantowych.
Stos oprogramowania NVIDIA NIM
Kolejnym ważnym ogłoszeniem była premiera stosu oprogramowania NVIDIA NIM, oferującego dziesiątki generatywnych mikrousług AI klasy korporacyjnej. Usługi te umożliwiają firmom tworzenie i wdrażanie niestandardowych aplikacji na swoich platformach, optymalizując wnioskowanie na popularnych modelach AI i usprawniając rozwój dzięki mikrousługom NVIDIA CUDA-X dla szerokiej gamy aplikacji. Jensen Huang podkreślił potencjał tych mikrousług w przekształcaniu przedsiębiorstw z różnych branż w podmioty oparte na sztucznej inteligencji.
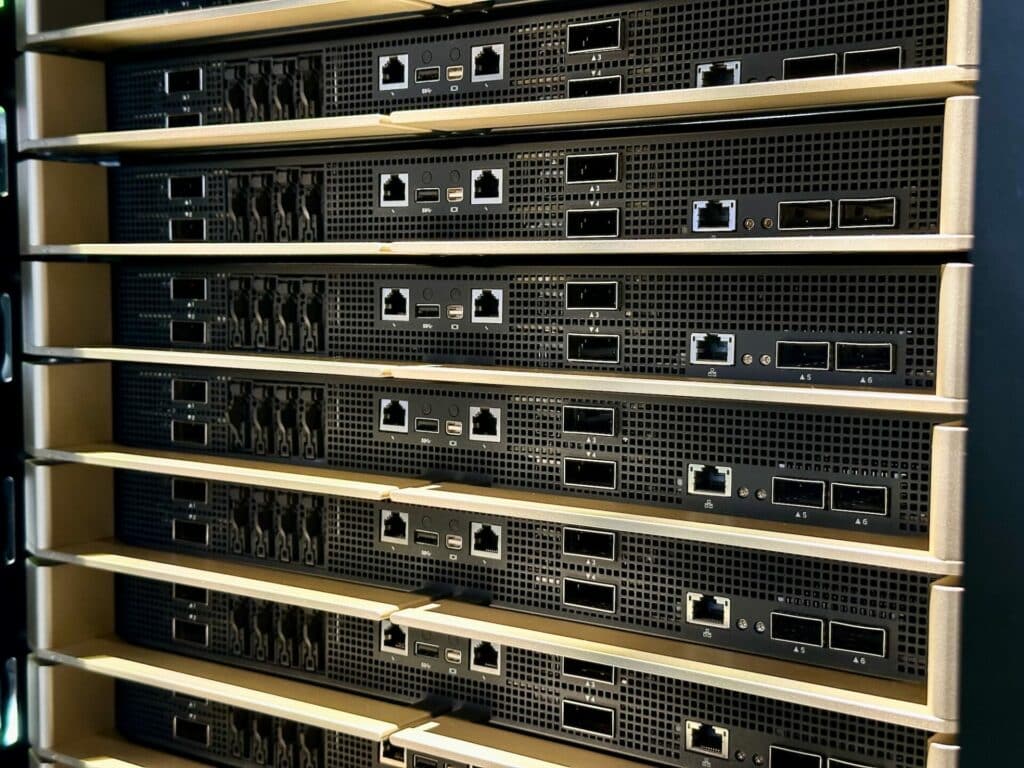
Systemy komputerowe OVX
W odpowiedzi na szybki rozwój generatywnej sztucznej inteligencji (AI) w różnych branżach, NVIDIA wprowadziła systemy obliczeniowe OVX – rozwiązanie zaprojektowane z myślą o usprawnieniu złożonych zadań AI i intensywnych graficznie. Uznając kluczową rolę wydajnej pamięci masowej we wdrożeniach AI, NVIDIA zainicjowała program walidacji partnerów w zakresie pamięci masowej z udziałem wiodących partnerów, takich jak DDN, Dell PowerScale , NetApp, Pure Storage i WEKA.
Nowy program standaryzuje proces walidacji urządzeń pamięci masowej przez partnerów, zapewniając optymalną wydajność i skalowalność dla obciążeń AI w przedsiębiorstwach. Dzięki rygorystycznym testom firmy NVIDIA, systemy pamięci masowej są weryfikowane pod kątem zróżnicowanych parametrów, odzwierciedlających wysokie wymagania aplikacji AI.
Co więcej, certyfikowane przez firmę NVIDIA serwery OVX, oparte na procesorach graficznych NVIDIA L40S i zintegrowane z kompleksowymi rozwiązaniami programowymi i sieciowymi, oferują elastyczną architekturę, która pasuje do zróżnicowanych środowisk centrów danych. Takie podejście nie tylko przyspiesza obliczenia tam, gdzie znajdują się dane, ale także zaspokaja specyficzne potrzeby generatywnej sztucznej inteligencji, zapewniając wydajność i opłacalność. Serwery NVIDIA OVX są wyposażone w solidne procesory graficzne, oferujące zwiększone możliwości obliczeniowe, szybki dostęp do pamięci masowej i niskie opóźnienia sieciowe. Jest to szczególnie istotne w przypadku wymagających aplikacji, takich jak chatboty i narzędzia wyszukiwania, które wymagają intensywnego przetwarzania danych.
Serwery OVX z certyfikatem NVIDIA, obecnie dostępne u globalnych dostawców, takich jak GIGABYTE, Hewlett Packard Enterprise, Lenovo i Supermicro, stanowią znaczący krok naprzód w obsłudze złożonych obciążeń związanych ze sztuczną inteligencją, gwarantując wydajność, bezpieczeństwo i skalowalność klasy korporacyjnej.
Myśli końcowe
Ponadto, pojawiły się ogłoszenia z branży motoryzacyjnej, robotyki, opieki zdrowotnej i generatywnej sztucznej inteligencji (AI). Wszystkie te zapowiedzi świadczą o nieustannym dążeniu firmy NVIDIA do innowacji, oferując zaawansowane narzędzia i platformy, które napędzają przyszłość sztucznej inteligencji i informatyki w wielu dziedzinach. Wszystkie są wysoce techniczne i charakteryzują się wieloma złożonościami, szczególnie w przypadku komputerów kwantowych i nowych wersji oprogramowania. Bądź na bieżąco z analizą zapowiedzi, ponieważ będziemy otrzymywać więcej informacji na temat każdej z tych nowości.


 Amazon