

Konferencja NVIDIA GTC 2023 rozpoczęła się od prezentacji nowych produktów, partnerów, innowacji i oprogramowania. Aby dać Państwu wyobrażenie o szerokim zakresie zapowiedzi, prezentacja trwała 78 minut. Zaprezentowano cztery nowe platformy, z których każda została zoptymalizowana pod kątem konkretnego obciążenia generatywnego wnioskowania AI oraz specjalistycznego oprogramowania.
Platformy łączą pełen pakiet oprogramowania inferencyjnego firmy NVIDIA z najnowszymi procesorami NVIDIA Ada, Hopper i Grace Hopper. Dziś wprowadzono na rynek dwa nowe procesory graficzne: NVIDIA L4 Tensor Core i H100 NVL.
NVIDIA L4 for AI Video zapewnia 120 razy większą wydajność wideo z wykorzystaniem sztucznej inteligencji niż procesory CPU, a także o 99% lepszą efektywność energetyczną. L4 pełni funkcję uniwersalnego procesora graficznego do praktycznie każdego obciążenia, oferując ulepszone możliwości dekodowania i transkodowania wideo, strumieniowanie wideo, rozszerzoną rzeczywistość, generatywne wideo AI i wiele więcej.
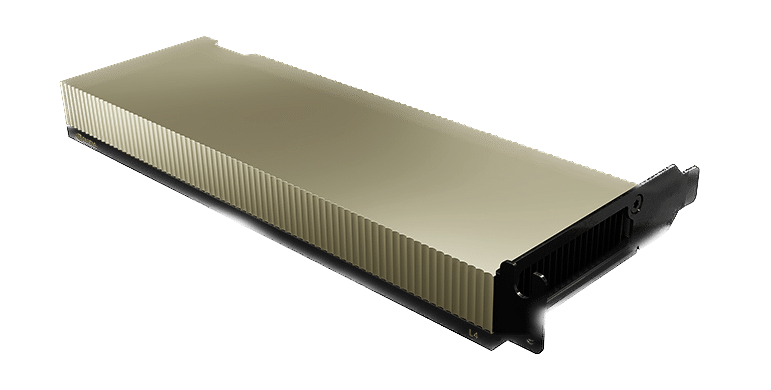
Procesor graficzny NVIDIA Ada Lovelace L4 Tensor Core zapewnia uniwersalną akcelerację i energooszczędność w aplikacjach wideo, sztucznej inteligencji, wirtualnych pulpitach i aplikacjach graficznych w przedsiębiorstwach, w chmurze i na brzegu sieci. Dzięki platformie AI i pełnemu stosowi NVIDIA
Podejście L4 jest zoptymalizowane pod kątem wnioskowania na dużą skalę w szerokim zakresie zastosowań sztucznej inteligencji, w tym rekomendacji, asystentów awatarów AI opartych na głosie, sztucznej inteligencji generatywnej, wyszukiwania wizualnego i automatyzacji centrów kontaktowych.
L4 to najwydajniejszy akcelerator NVIDIA do zastosowań ogólnych, a serwery wyposażone w L4 zapewniają nawet 120-krotnie wyższą wydajność wideo AI i 2.7-krotnie wyższą wydajność generatywnej AI w porównaniu z rozwiązaniami CPU, a także ponad 4-krotnie wyższą wydajność graficzną niż poprzednia generacja GPU. NVIDIA L4 to wszechstronny, energooszczędny, jednogniazdowy, niskoprofilowy akcelerator, idealny do dużych wdrożeń i lokalizacji brzegowych.
Procesor NVIDIA L40 do generowania obrazu jest zoptymalizowany pod kątem grafiki i generowania obrazów 2D, wideo i 3D z wykorzystaniem sztucznej inteligencji. Platforma L40 stanowi silnik NVIDIA Omniverse, platformy do tworzenia i obsługi aplikacji metaverse w centrum danych, zapewniając siedmiokrotnie wyższą wydajność wnioskowania dla funkcji Stable Diffusion i dwunastokrotnie wyższą wydajność Omniverse w porównaniu z poprzednią generacją.
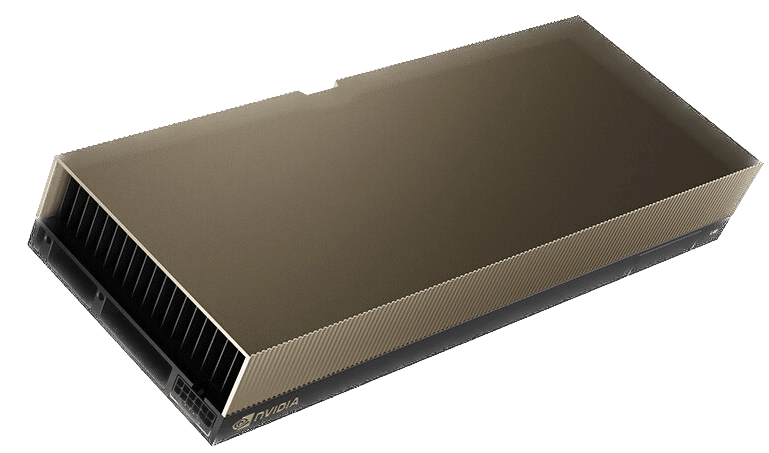
Procesor graficzny NVIDIA L40 zapewnia wysoką wydajność obliczeń wizualnych dla centrów danych, oferując możliwości grafiki, obliczeń i sztucznej inteligencji nowej generacji. Zbudowany w oparciu o architekturę NVIDIA Ada Lovelace, procesor L40 wykorzystuje moc rdzeni RT, Tensor i CUDA najnowszej generacji, aby zapewnić wydajność wizualizacji i obliczeń dla wymagających obciążeń centrów danych.
Procesor L40 oferuje zwiększoną przepustowość oraz jednoczesne funkcje śledzenia promieni i cieniowania, które poprawiają wydajność śledzenia promieni i przyspieszają renderowanie w procesach projektowania i architektury produktów, inżynierii i budownictwa. Procesor graficzny L40 zapewnia sprzętowe wsparcie dla rzadkości strukturalnej i zoptymalizowany format TF32, co pozwala na natychmiastowy wzrost wydajności, co przekłada się na szybsze trenowanie modeli sztucznej inteligencji i analizy danych. Przyspieszone możliwości graficzne wspomagane przez sztuczną inteligencję, w tym DLSS, zapewniają wyższą rozdzielczość i lepszą wydajność w wybranych aplikacjach.
Duża pamięć GPU komputera L40 obsługuje aplikacje i obciążenia wymagające dużej ilości pamięci, takie jak analiza danych, symulacje, modelowanie 3D i renderowanie, dzięki 48 GB ultraszybkiej pamięci GDDR6. Pamięć jest przydzielana wielu użytkownikom za pomocą oprogramowania vGPU, co pozwala na rozdzielenie dużych obciążeń między zespoły kreatywne, zajmujące się analizą danych i projektowaniem.
Zaprojektowana z myślą o całodobowej pracy w centrach danych przedsiębiorstw, z energooszczędnym sprzętem i komponentami, karta NVIDIA L40 jest zoptymalizowana pod kątem skalowalnego wdrażania i zapewniania maksymalnej wydajności dla zróżnicowanych obciążeń w centrach danych. L40 oferuje funkcję bezpiecznego rozruchu z technologią Root of Trust, zapewniającą dodatkową warstwę bezpieczeństwa, oraz jest zgodna z normami NEBS poziomu 3, co gwarantuje zgodność ze standardami centrów danych.
Rozwiązanie NVIDIA H100 NVL do wdrażania dużych modeli językowych (LLM) idealnie nadaje się do wdrażania dużych systemów LLM, takich jak ChatGPT, na dużą skalę. Nowe rozwiązanie H100 NVL jest wyposażone w 94 GB pamięci z akceleracją Transformer Engine i zapewnia do 12 razy szybszą wydajność wnioskowania w GPT-3 w porównaniu z poprzednią generacją A100 w skali centrum danych.
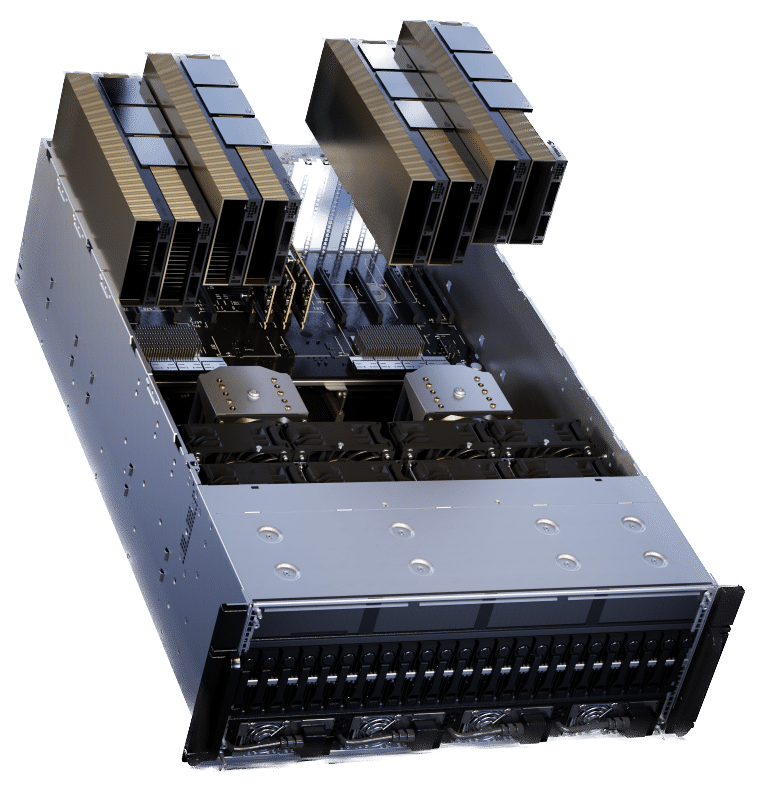
Oparty na PCIe układ H100 NVL z mostkiem NVLink wykorzystuje technologię Transformer Engine, NVLink i 188 GB pamięci HBM3, aby zapewnić optymalną wydajność i skalowalność w centrach danych. H100 NVL obsługuje modele LLM (Language Language Models) o maksymalnej liczbie parametrów 175 miliardów. Serwery wyposażone w procesory graficzne H100 NVL zwiększają wydajność modelu GPT-175B nawet 12-krotnie w porównaniu z systemami NVIDIA DGX A100, zachowując jednocześnie niskie opóźnienia w środowiskach centrów danych o ograniczonym zużyciu energii.
NVIDIA Grace Hopper for Recommendation Models idealnie nadaje się do grafowych modeli rekomendacyjnych, wektorowych baz danych i grafowych sieci neuronowych. Dzięki połączeniu NVLink-C2C o przepustowości 900 GB/s między procesorem a kartą graficzną, Grace Hopper zapewnia 7-krotnie szybszy transfer danych i obsługę zapytań niż PCIe Gen 5.
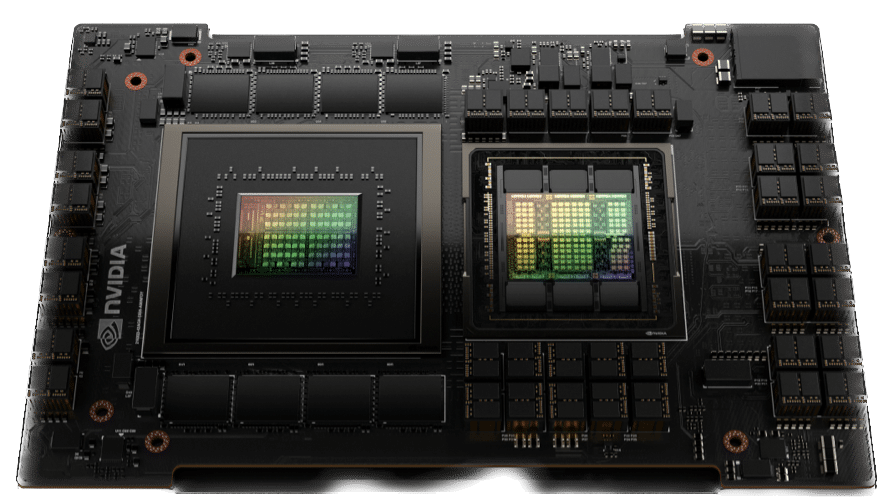
NVIDIA Grace Hopper Superchip to przełomowy akcelerowany procesor zaprojektowany od podstaw z myślą o gigantycznych zastosowaniach sztucznej inteligencji (AI) i obliczeniach o wysokiej wydajności (HPC). Superchip zapewni nawet 10-krotnie wyższą wydajność w aplikacjach przetwarzających terabajty danych, umożliwiając naukowcom i badaczom osiąganie bezprecedensowych rozwiązań najbardziej złożonych problemów na świecie.
Układ NVIDIA Grace Hopper Superchip łączy architektury Grace i Hopper, wykorzystując technologię NVIDIA NVLink-C2C, aby zapewnić spójny model pamięci CPU+GPU dla akcelerowanych aplikacji AI i HPC. Grace Hopper oferuje spójny interfejs o przepustowości 900 gigabajtów na sekundę (GB/s), jest 7 razy szybszy niż PCIe Gen5 i zapewnia 30-krotnie wyższą łączną przepustowość pamięci systemowej dla GPU w porównaniu z NVIDIA DGX A100. Co więcej, obsługuje wszystkie stosy oprogramowania i platformy NVIDIA, w tym NVIDIA HPC SDK, NVIDIA AI i NVIDIA Omniverse.
Nowoczesne modele systemów rekomendacji wymagają znacznych ilości pamięci do przechowywania tabel osadzania. Tabele osadzania zawierają semantyczne reprezentacje elementów i cech użytkowników, co pomaga w dostarczaniu konsumentom lepszych rekomendacji.
Zasadniczo te osadzenia stosują rozkład potęgowy częstotliwości użycia, ponieważ niektóre wektory osadzenia są używane częściej niż inne. NVIDIA Grace Hopper umożliwia tworzenie potoków systemów rekomendacji o wysokiej przepustowości, które
Przechowują najczęściej używane wektory osadzania w pamięci HBM3, a pozostałe wektory osadzania w pamięci LPDDR5X o większej pojemności. Połączenie NVLink C2C zapewnia procesorom graficznym Hopper dostęp o wysokiej przepustowości do lokalnej pamięci LPDDR5X. Jednocześnie system przełączania NVLink rozszerza tę funkcjonalność, zapewniając procesorom graficznym Hopper dostęp o wysokiej przepustowości do całej pamięci LPDDR5X wszystkich superchipów Grace Hopper w sieci NVLink.


 Amazon