

Duże modele językowe oferują niesamowite nowe możliwości, poszerzając granice możliwości sztucznej inteligencji. Jednak ich duży rozmiar i unikalne cechy wykonawcze mogą utrudniać ich ekonomiczne wykorzystanie. Oprogramowanie NVIDIA TensorRT-LLM zostało udostępnione jako oprogramowanie open source, aby przyspieszyć rozwój modeli LLM.
Czym jest NVIDIA TensorRT-LLM?
NVIDIA ściśle współpracuje z wiodącymi firmami, m.in. Meta, AnyScale, Cohere, Deci, Grammarly, Mistral AI, MosaicML (obecnie część Databricks), OctoML, Tabnine i Together AI, aby przyspieszyć i zoptymalizować wnioskowanie LLM.
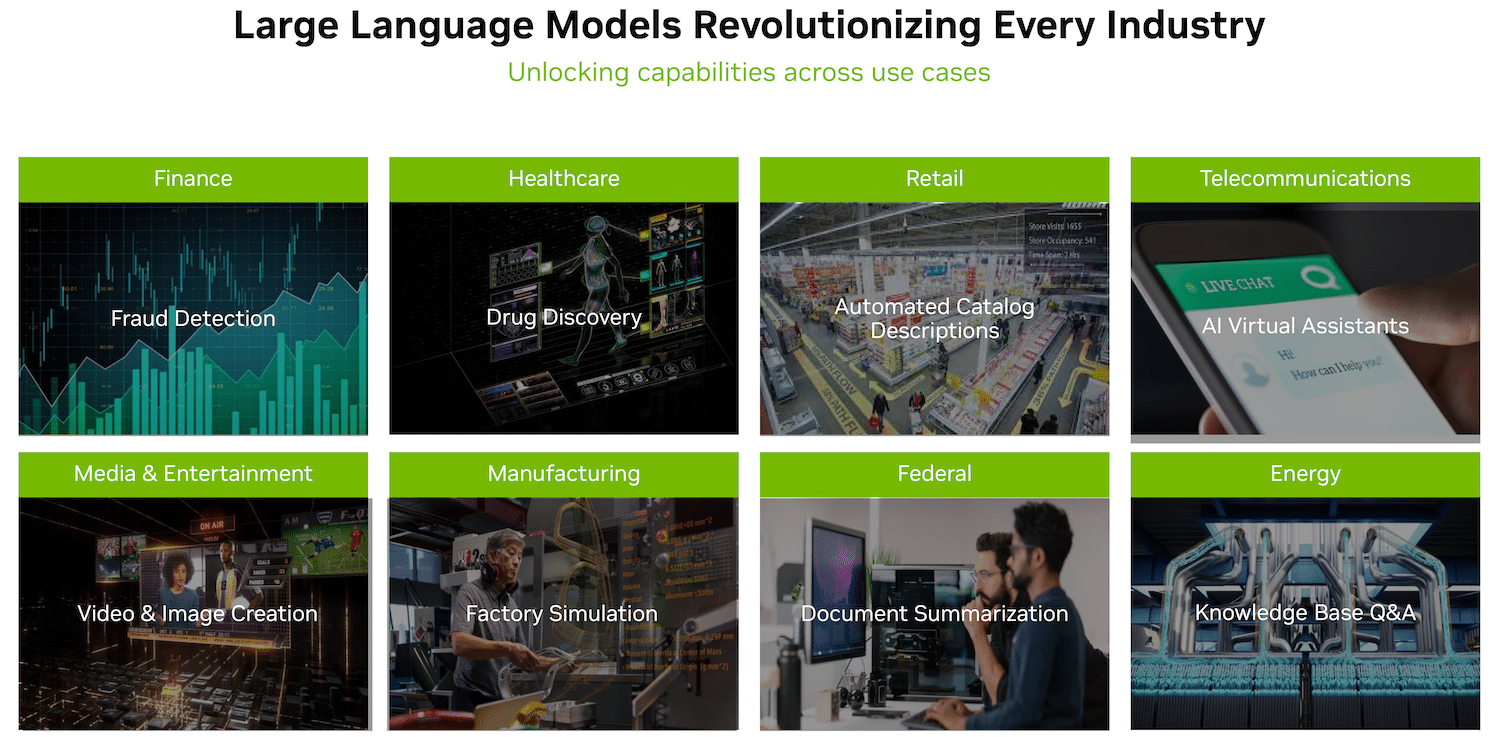
Te innowacje zostały zintegrowane z oprogramowaniem open source NVIDIA TensorRT-LLM , którego premiera planowana jest w nadchodzących tygodniach. TensorRT-LLM składa się z kompilatora głębokiego uczenia TensorRT i zawiera zoptymalizowane jądra, kroki przetwarzania wstępnego i końcowego oraz prymitywy komunikacji wieloprocesorowej/wielowęzłowej, zapewniające przełomową wydajność na procesorach graficznych NVIDIA. Umożliwia ono programistom eksperymentowanie z nowymi LLM, oferując najwyższą wydajność i możliwości szybkiej personalizacji bez konieczności dogłębnej znajomości języka C++ lub NVIDIA CUDA.
TensorRT-LLM charakteryzuje się łatwością użytkowania i rozszerzalnością dzięki modułowemu interfejsowi API typu open source w języku Python, który umożliwia definiowanie, optymalizowanie i wdrażanie nowych architektur i udoskonaleń w miarę rozwoju programów LLM i umożliwia łatwą personalizację.
Na przykład MosaicML płynnie dodał konkretne, potrzebne mu funkcje do TensorRT-LLM i zintegrował je z istniejącym stosem usług. Naveen Rao, wiceprezes ds. inżynierii w Databricks, zauważa, że „to była absolutna bułka z masłem”.
Wydajność NVIDIA TensorRT-LLM
Podsumowywanie artykułów to tylko jedno z wielu zastosowań LLM . Poniższe testy wydajności pokazują poprawę wydajności dzięki TensorRT-LLM w najnowszej architekturze NVIDIA Hopper.
Poniższe rysunki przedstawiają podsumowanie artykułu wykonane przy użyciu NVIDIA A100 i NVIDIA H100 z CNN/Daily Mail, znanym zestawem danych służącym do oceny wydajności podsumowywania.
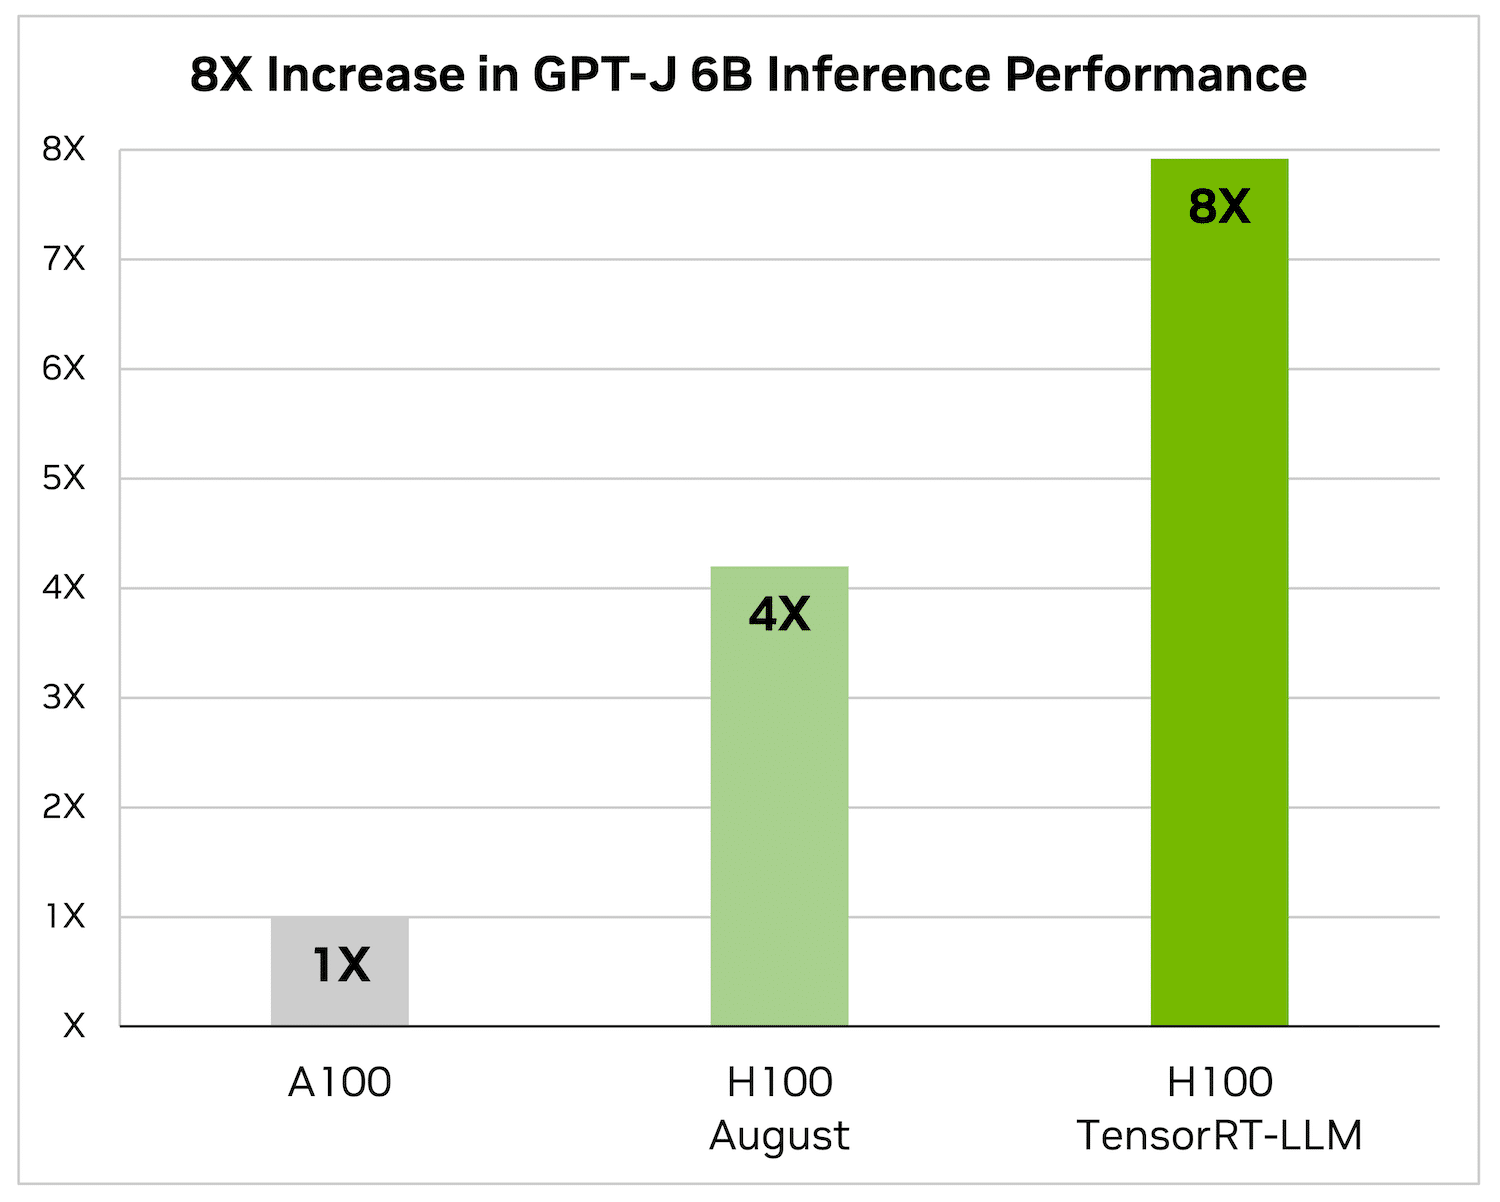
Sam H100 jest 4 razy szybszy niż A100. Dodanie TensorRT-LLM i jego zalet, w tym przetwarzania wsadowego w trakcie pracy, skutkuje 8-krotnym wzrostem i zapewnia najwyższą przepustowość.
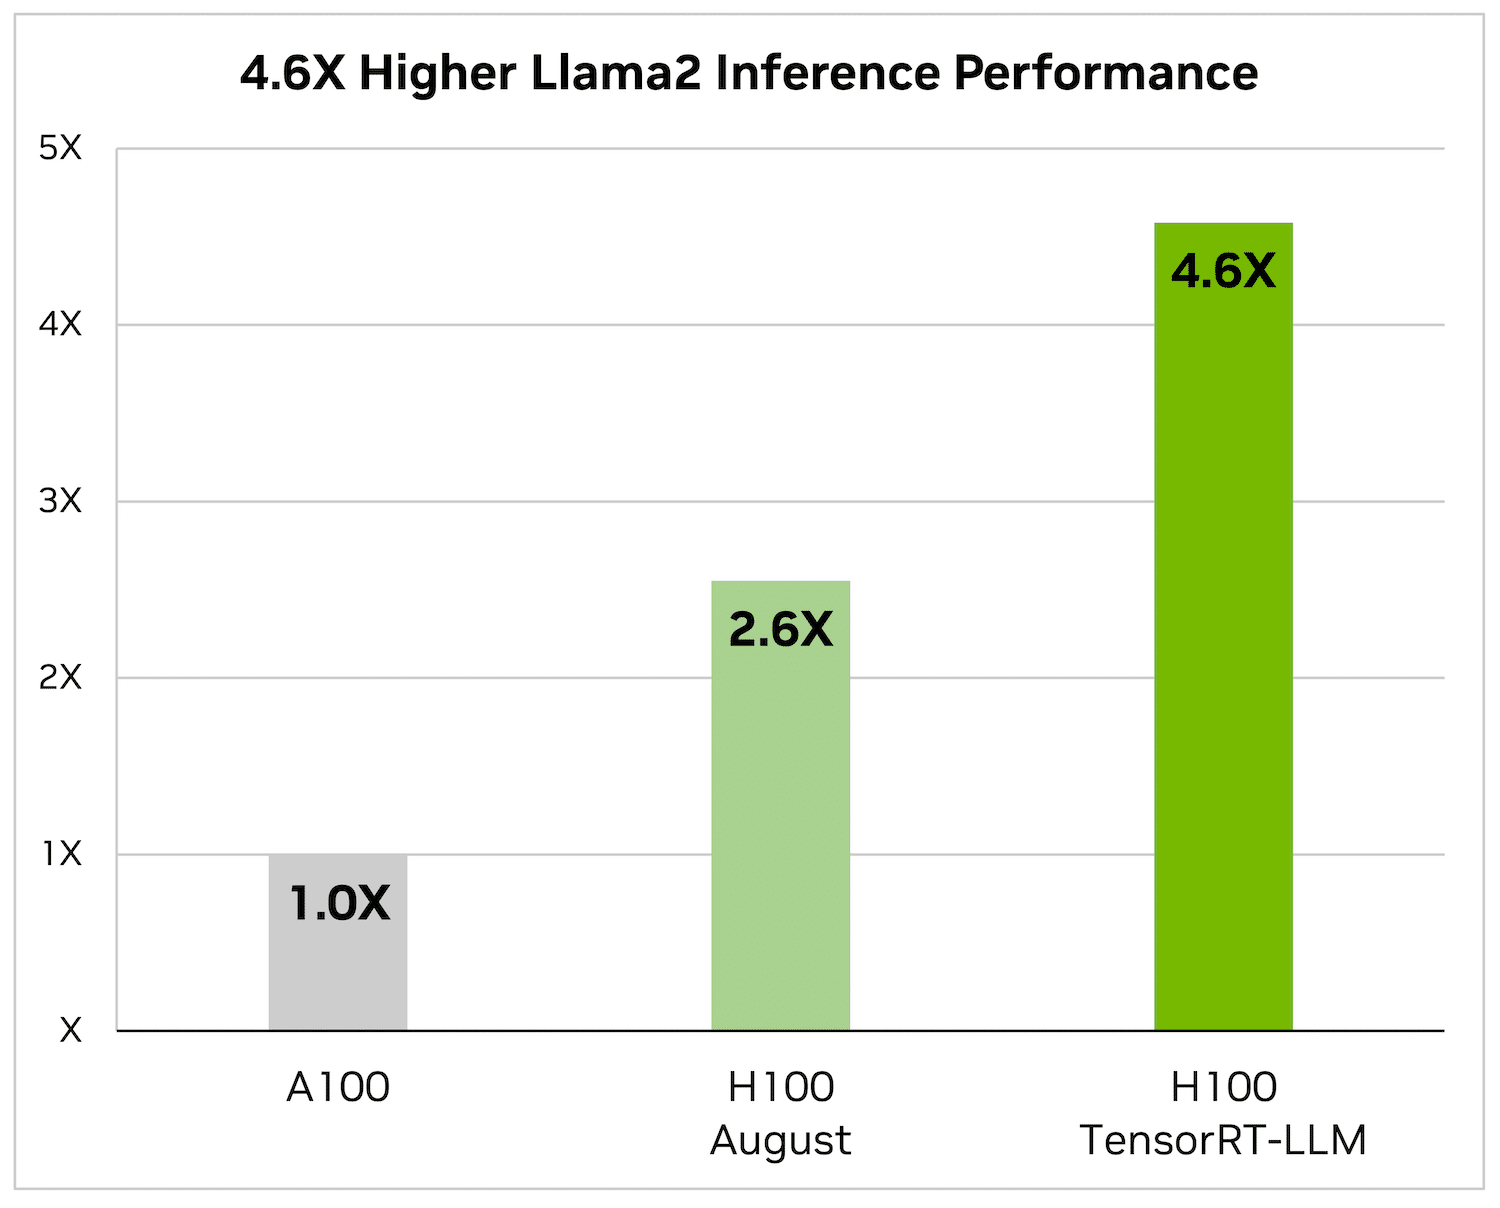
W przypadku Llama 2 — popularnego modelu językowego niedawno wydanego przez Meta i szeroko stosowanego przez organizacje planujące wdrożenie sztucznej inteligencji generatywnej — TensorRT-LLM może przyspieszyć wydajność wnioskowania o 4.6 raza w porównaniu z procesorami graficznymi A100.
Innowacje ekosystemu LLM rozwijają się szybko
Ekosystem LLM (Large Language Model) dynamicznie ewoluuje, dając początek różnorodnym architekturom modeli o rozbudowanych możliwościach. Niektóre z największych i najbardziej zaawansowanych LLM, takie jak Llama 2 firmy Meta o 70 miliardach parametrów, wymagają wielu procesorów GPU do zapewnienia odpowiedzi w czasie rzeczywistym. Wcześniej optymalizacja wnioskowania LLM pod kątem maksymalnej wydajności wymagała złożonych zadań, takich jak ręczny podział modeli AI i koordynacja wykonywania obliczeń na GPU.
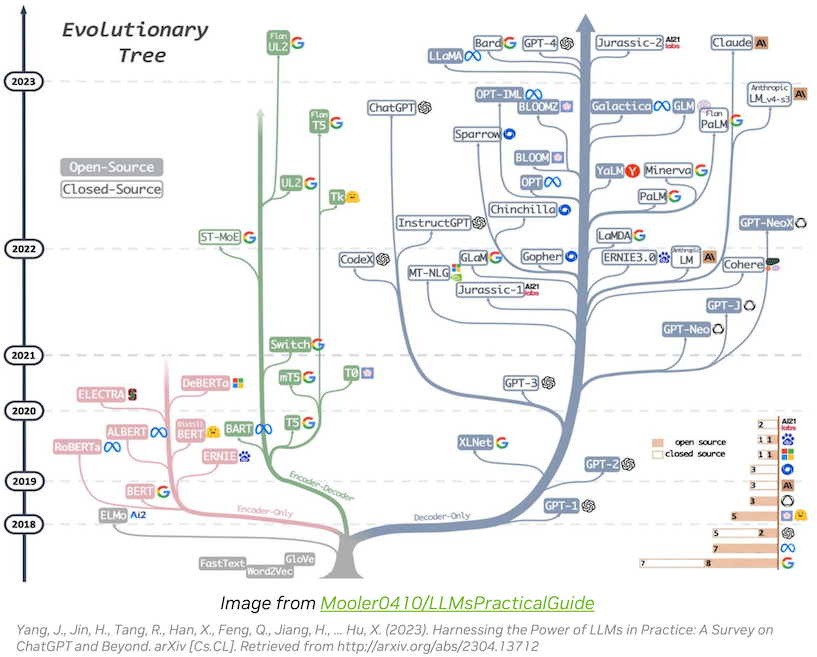
TensorRT-LLM upraszcza ten proces, wykorzystując paralelizm tensorowy – formę paralelizmu modeli, która rozprowadza macierze wag pomiędzy urządzeniami. To podejście umożliwia efektywne wnioskowanie skalowalne w poziomie na wielu procesorach graficznych połączonych za pomocą NVLink i wielu serwerach, bez ingerencji programisty ani modyfikacji modelu.
W miarę pojawiania się nowych modeli LLM i architektur modeli deweloperzy mogą optymalizować swoje modele, wykorzystując najnowsze jądra sztucznej inteligencji NVIDIA dostępne w pakiecie TensorRT-LLM, w tym najnowocześniejsze implementacje, takie jak FlashAttention i maskowana uwaga wielogłowicowa.
Ponadto TensorRT-LLM zawiera wstępnie zoptymalizowane wersje powszechnie używanych programów LLM, takich jak Meta Llama 2, OpenAI GPT-2, GPT-3, Falcon, Mosaic MPT, BLOOM i inne. Można je łatwo wdrożyć za pomocą przyjaznego dla użytkownika interfejsu API języka Python dla TensorRT-LLM, umożliwiając programistom tworzenie niestandardowych programów LLM dostosowanych do różnych branż.
Aby sprostać dynamicznemu charakterowi obciążeń LLM, TensorRT-LLM wprowadza przetwarzanie wsadowe w trakcie realizacji (in-flight), optymalizując harmonogramowanie żądań. Ta technika zwiększa wykorzystanie GPU i niemal podwaja przepustowość rzeczywistych żądań LLM, obniżając całkowity koszt posiadania (TCO).
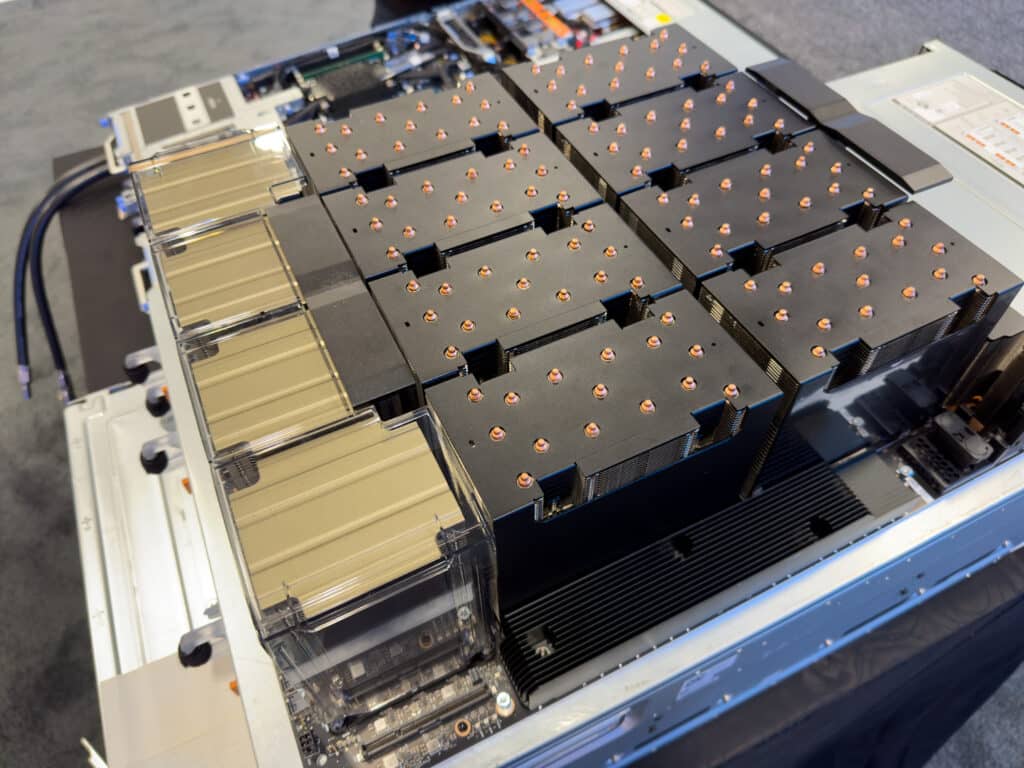
Blok GPU Dell XE9680
Dodatkowo, TensorRT-LLM wykorzystuje techniki kwantyzacji do reprezentacji wag i aktywacji modeli z niższą precyzją (np. FP8). Zmniejsza to zużycie pamięci, umożliwiając wydajne działanie większych modeli na tym samym sprzęcie, minimalizując jednocześnie obciążenie pamięci podczas wykonywania.
Ekosystem LLM dynamicznie się rozwija, oferując coraz większe możliwości i zastosowania w różnych branżach. TensorRT-LLM usprawnia wnioskowanie LLM, zwiększając wydajność i obniżając całkowity koszt posiadania (TCO). Umożliwia programistom łatwą i efektywną optymalizację modeli. Aby uzyskać dostęp do TensorRT-LLM, programiści i badacze mogą wziąć udział w programie wczesnego dostępu za pośrednictwem platformy NVIDIA NeMo lub serwisu GitHub, pod warunkiem rejestracji w programie NVIDIA Developer Program z adresem e-mail organizacji.
Myśli końcowe
Od dawna zauważamy w The Lab, że stos oprogramowania nie wykorzystuje w pełni dostępnych zasobów narzutowych, a TensorRT-LLM jasno pokazuje, że ponowne skupienie się na optymalizacjach, a nie tylko na innowacjach, może być niezwykle cenne. Kontynuując lokalne eksperymenty z różnymi frameworkami i najnowocześniejszymi technologiami, planujemy niezależnie testować i weryfikować korzyści płynące z ulepszonych wersji bibliotek i SDK.
Firma NVIDIA ewidentnie poświęca czas i zasoby na rozwój, aby wycisnąć z urządzeń ostatnią kroplę wydajności, umacniając tym samym swoją pozycję lidera branży i kontynuując swój wkład w rozwój społeczności oraz demokratyzację sztucznej inteligencji, utrzymując otwartoźródłowy charakter swoich narzędzi.


 Amazon