

Firma NVIDIA wprowadziła technologię Helix Parallelism, nową metodę opracowaną dla architektury GPU Blackwell, mającą na celu poprawę wydajności sztucznej inteligencji w czasie rzeczywistym w przypadku bardzo dużych zbiorów danych. Technika ta odpowiada na rosnące zapotrzebowanie na przetwarzanie kontekstów wielomilionowych tokenów przez systemy LLM. NVIDIA demonstruje, że to podejście może zwiększyć prędkość przetwarzania nawet 32-krotnie w porównaniu z metodami konwencjonalnymi, umożliwiając tworzenie bardziej złożonych i responsywnych aplikacji AI.
Wyzwanie miliona tokenów: dlaczego sztuczna inteligencja potrzebowała nowego podejścia
Granica sztucznej inteligencji (AI) wykroczyła poza proste zapytania, wkraczając w obszar złożonego, długoterminowego rozumowania. Zaawansowane aplikacje wymagają niezwykle szerokiego kontekstu, aby działać skutecznie. Asystent AI, który pamięta miesiące rozmów, narzędzie prawne analizujące gigabajty orzecznictwa za jednym zamachem, czy partner programistyczny, który rozumie całe repozytorium. Te zadania wymagają przetwarzania milionów tokenów.
Jednak skalowanie do tego poziomu ujawnia dwa podstawowe wąskie gardła.
- Wąskie gardło pamięci podręcznej KV: Podczas autoregresyjnego generowania tokenów modele obliczają uwagę na wcześniej wygenerowanych tokenach, aby uniknąć kwadratowego współczynnika skalowania. Aby to osiągnąć, wcześniej wygenerowane tokeny są buforowane – proces ten znany jest jako pamięć podręczna KV. W przypadku kontekstów wielomilionowych tokenów pamięć podręczna staje się ogromna, nasycając przepustowość pamięci GPU i drastycznie wydłużając czas reakcji.
- Wąskie gardło wagi FFN: Każdy nowy token generowany przez model musi załadować z pamięci ogromne wagi sieci Feed-Forward (FFN). W interaktywnych aplikacjach o niskim opóźnieniu ten ciągły proces ładowania staje się głównym źródłem opóźnień.
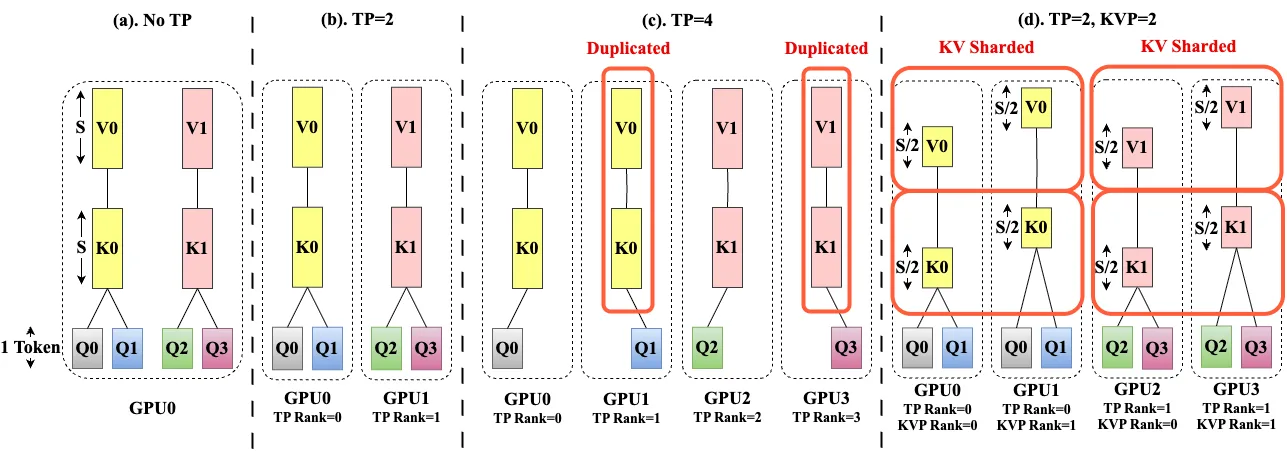
Obecnie opieramy się na metodach takich jak paralelizm tensorów, które rozdzielają tensory modelu, a tym samym zapotrzebowanie na pamięć i obliczenia, na wiele procesorów GPU. Choć skuteczne w przypadku niektórych zadań, korzyści z nich maleją wraz z nowszymi mechanizmami uwagi. W mechanizmach uwagi, takich jak GQA (Grouped Query Attention) lub MLA (Multi-Latent Attention), aby zmniejszyć zużycie pamięci, wiele głowic zapytań współdzieli mniejszy zestaw głowic KV. Jednak gdy rozmiar paralelizmu tensorów przekracza liczbę głowic KV, konieczne jest duplikowanie głowic KV ze względu na znaczne opóźnienie wprowadzane przez komunikację między procesorami GPU na każdym kroku. To duplikowanie niweluje niektóre korzyści płynące z paralelizmu tensorów.
Paralelizm helisy
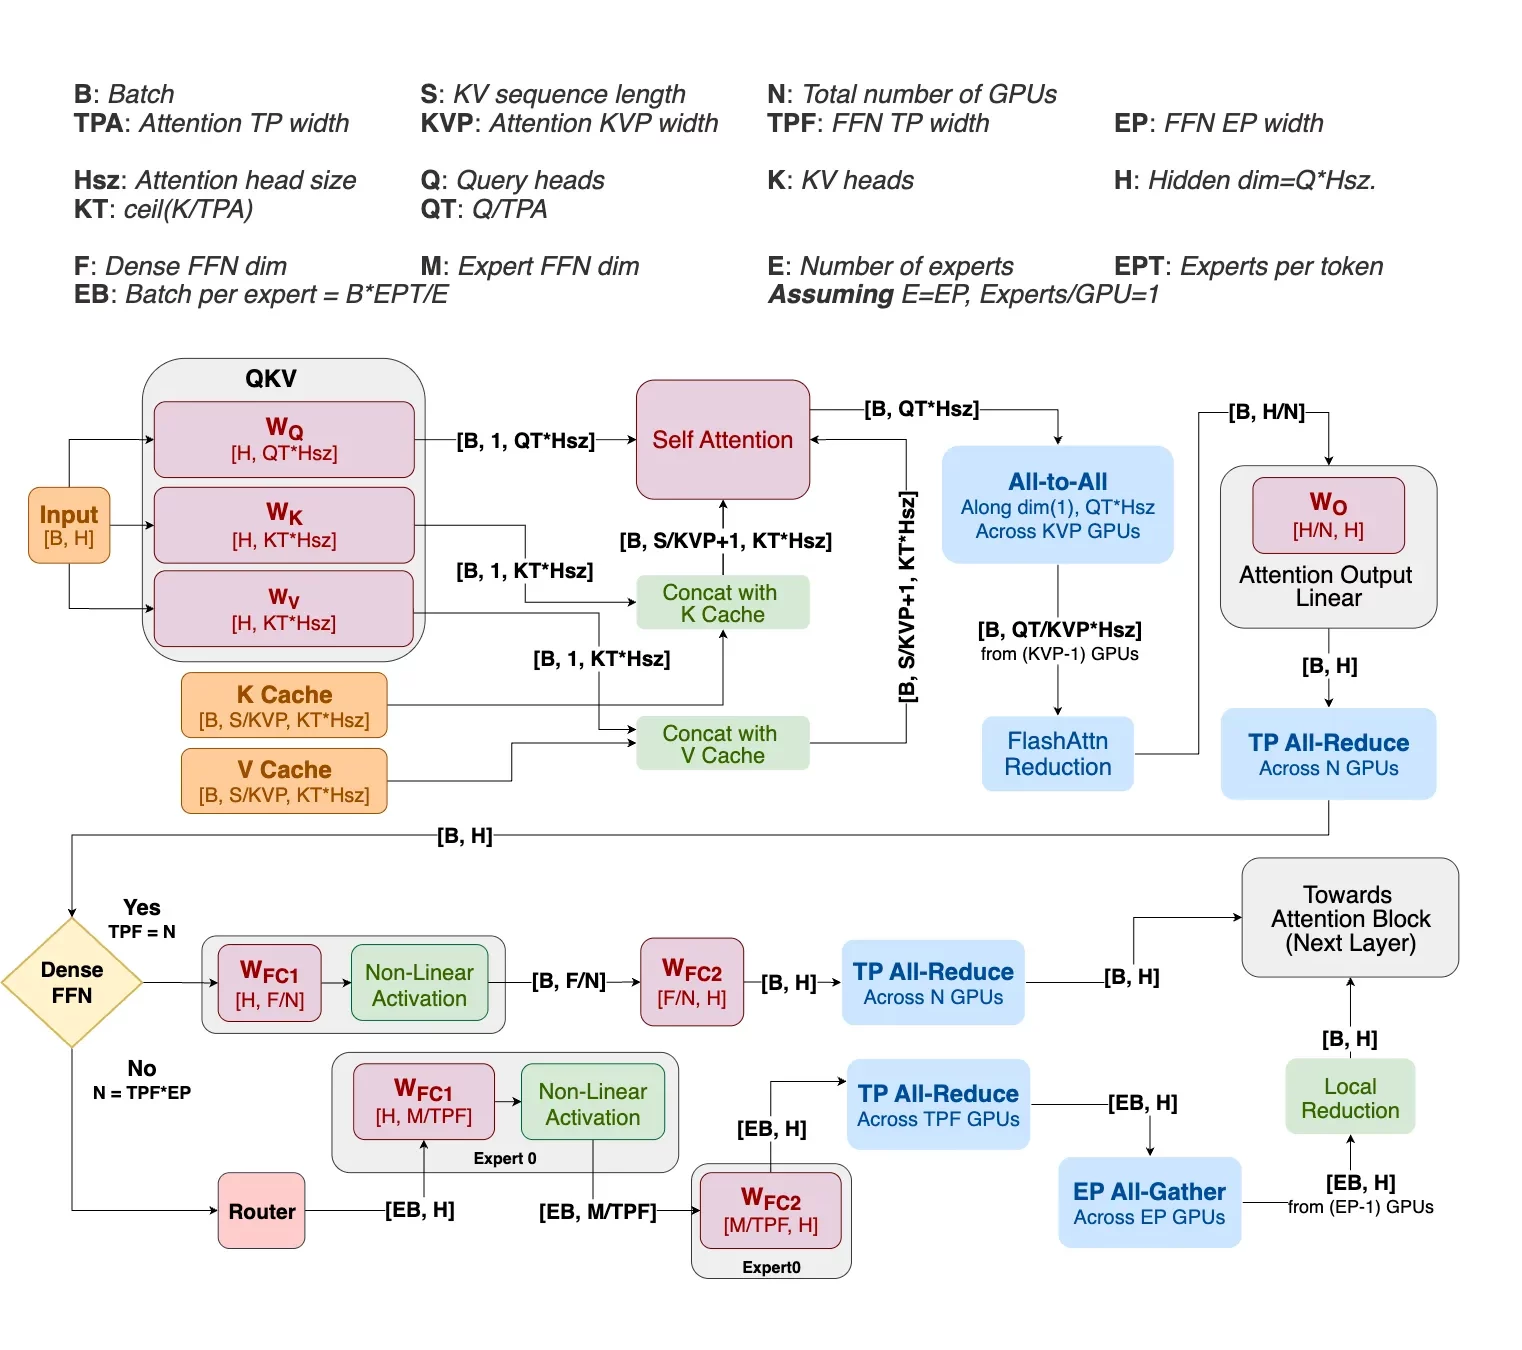
Aby rozwiązać tę zagadkę, technologia Helix Parallelism firmy NVIDIA wprowadza hybrydową strategię, która traktuje te dwa wąskie gardła jako oddzielne problemy, które należy rozwiązać w płynnym, temporalnym procesie. Zamiast stosować pojedynczą metodę paralelizmu dla całego procesu, Helix dynamicznie rekonfiguruje tę samą pulę procesorów graficznych, aby zastosować optymalną strategię dla każdego etapu obliczeń.
Proces można podzielić na dwie główne fazy dla każdej warstwy modelu.
Faza 1: Faza uwagi (zajmowanie się pamięcią podręczną KV)
Helix bezpośrednio rozwiązuje problem wąskiego gardła pamięci podręcznej KV, łącząc dwie formy paralelizmu. Po pierwsze, stosuje paralelizm KV, który rozdziela pamięć podręczną KV na wiele procesorów GPU wzdłuż wymiaru sekwencji. Oznacza to, że każdy procesor GPU przechowuje tylko część całego kontekstu, zmniejszając obciążenie pamięci.
Jednocześnie wykorzystuje paralelizm tensorowy do podziału punktów uwagi, zapewniając, że liczba podziałów nie przekracza liczby punktów KV. To połączenie pozwala uniknąć duplikacji pamięci podręcznej, która jest plagą tradycyjnego paralelizmu tensorowego. Rezultatem jest dwuwymiarowa siatka procesorów graficznych (GPU), które mogą efektywnie obliczać uwagę w rozległym kontekście, bez przeciążania żadnego z nich. Komunikacja między tymi procesorami graficznymi jest obsługiwana przez pojedynczą, wydajną wymianę typu „wszyscy do wszystkich”, której koszt jest niezależny od długości kontekstu, co zapewnia wysoką skalowalność.
Faza 2: Faza FFN (zajmowanie się ciężarami FFN)
Komunikacja typu „wszystko ze wszystkim” na końcu fazy uwagi również rozdziela dane wyjściowe pomiędzy procesory GPU. Oznacza to, że dane są już idealnie uporządkowane, aby obliczenia FFN mogły rozpocząć się natychmiast.
Ta sama pula procesorów GPU jest ponownie alokowana w dużą grupę paralelizmu tensorowego. Ponieważ dane są wstępnie partycjonowane, każdy procesor GPU może wykonać lokalne mnożenie macierzy, wykorzystując swój fragment masywnych wag FFN. To początkowe obliczenie odbywa się równolegle, bez komunikacji między procesorami GPU, co maksymalizuje prędkość. Dopiero po tym etapie obliczeń lokalnych procesory GPU uczestniczą w wydajnej komunikacji all-reduce, aby połączyć swoje częściowe wyniki w ostateczny wynik.
Ostatnim elementem układanki jest sposób, w jaki Helix zarządza pamięcią podręczną KV w miarę jej wzrostu. W miarę jak model generuje nowe tokeny, muszą one być dodawane do pamięci podręcznej. Naiwne podejście mogłoby stworzyć hotspot pamięci, zapisując wszystkie nowe tokeny na jednym GPU. Helix zapobiega temu dzięki sprytnemu systemowi aktualizacji typu round-robin. Na przykład, pierwszy blok nowych tokenów może trafić do GPU 0, kolejny blok do GPU 1 i tak dalej. To stopniowe podejście zapewnia równomierny wzrost wykorzystania pamięci na wszystkich GPU w grupie paralelizmu KV, utrzymując zrównoważoną wydajność i spójną przepustowość niezależnie od rozmiaru kontekstu.
Nowa granica wydajności na Blackwell
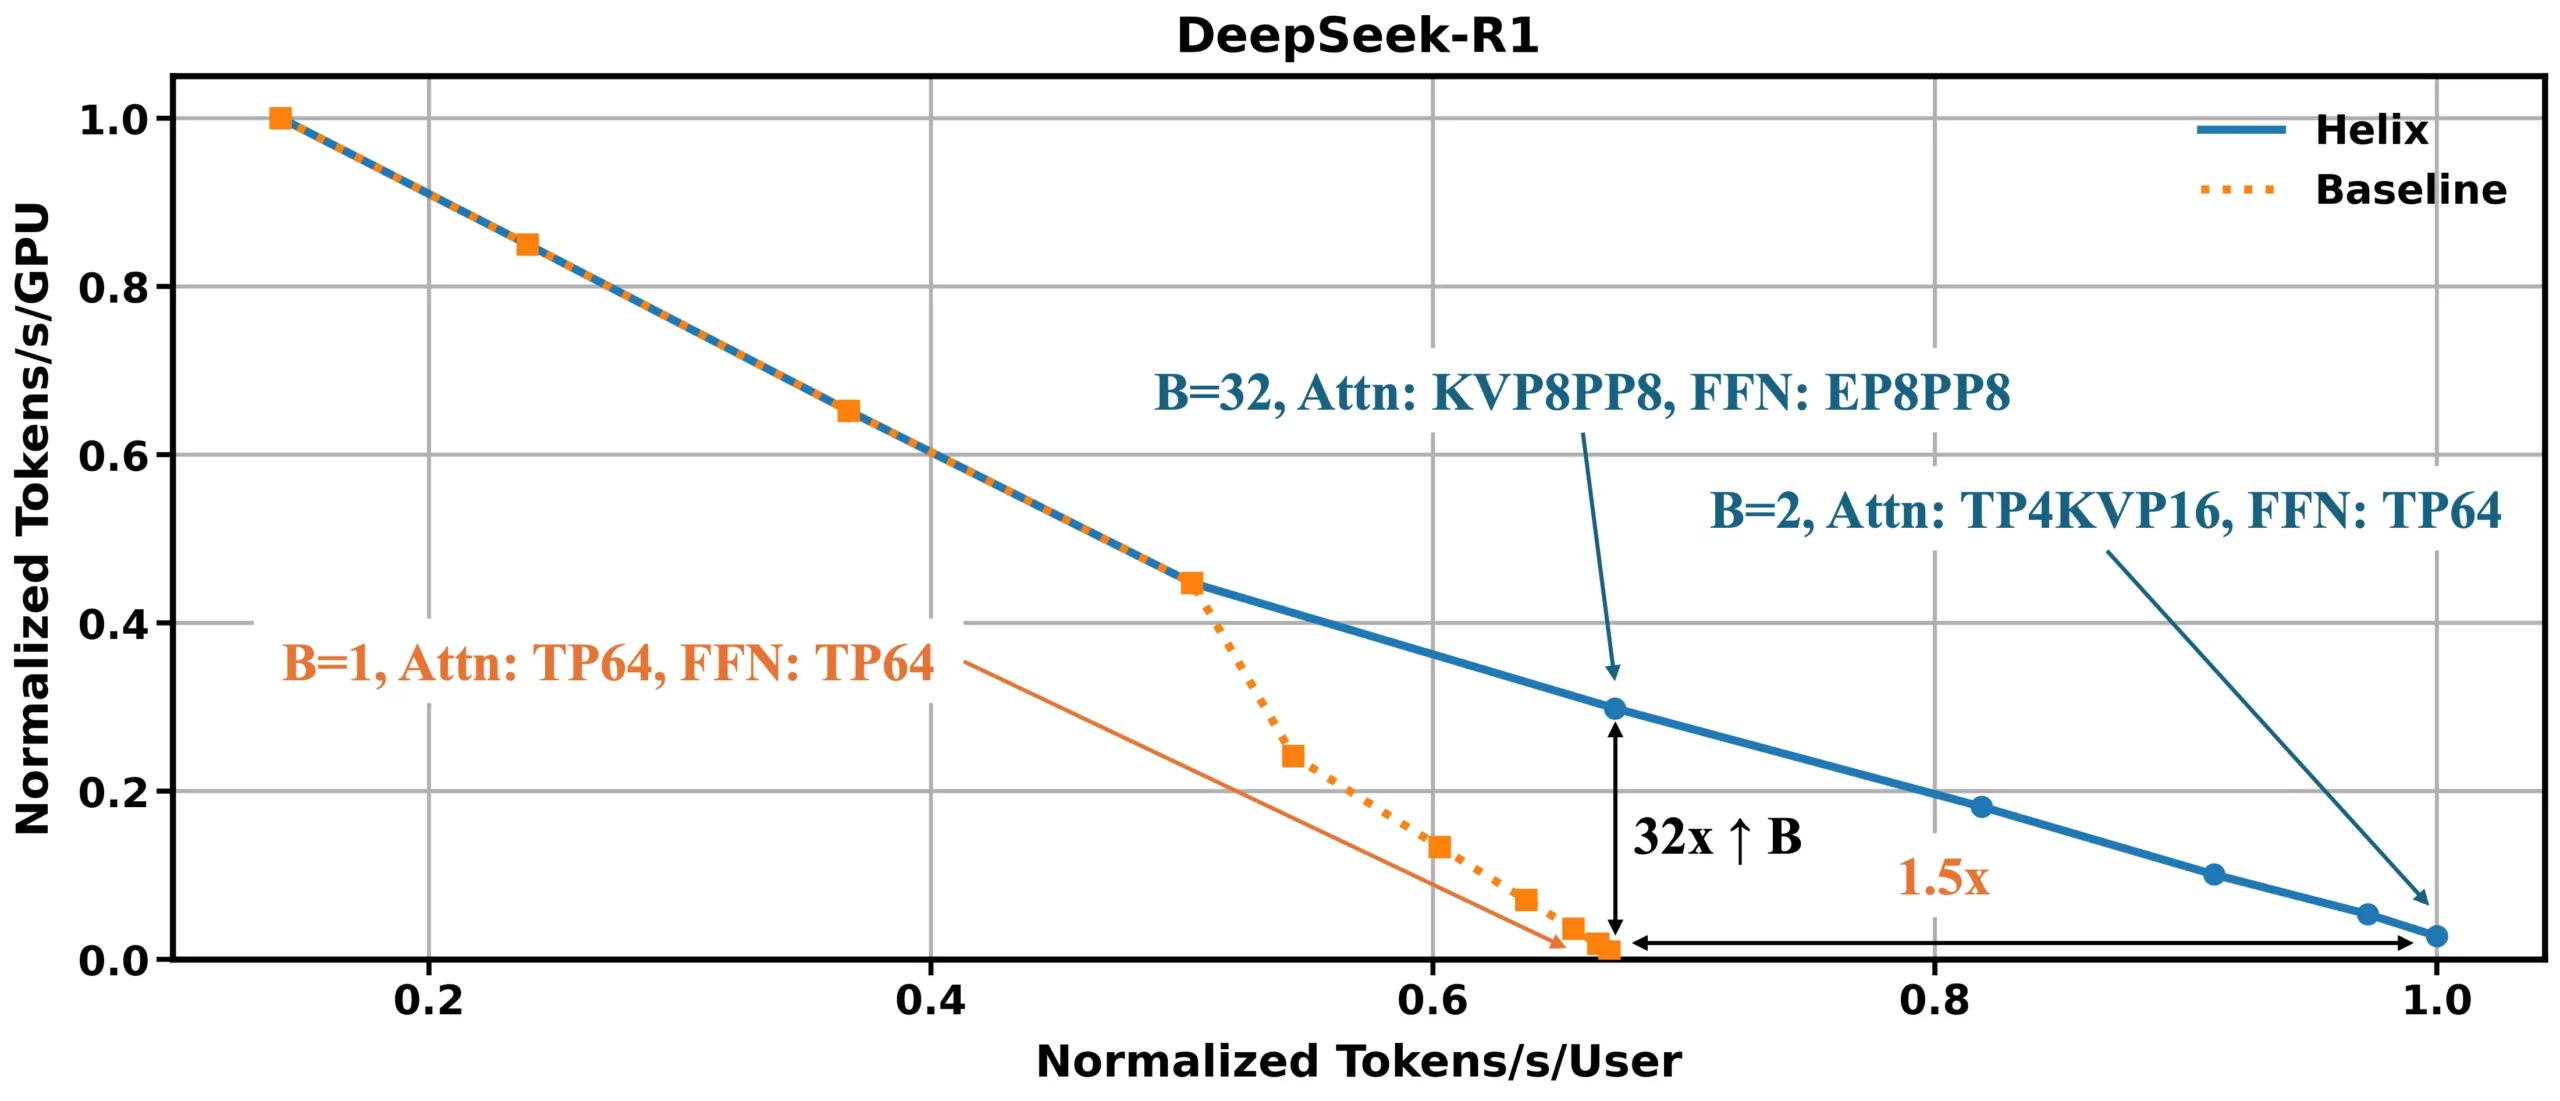
Helix wyznacza nowy standard wydajności dla dekodowania LLM w długim kontekście. Wyniki oparte są na wyczerpującej symulacji na procesorze Blackwell NVL72 z wykorzystaniem modelu parametrów DeepSeek R1 671B (FP4) z hipotetycznym kontekstem miliona tokenów, systematycznie zmieniając strategie partycjonowania i rozmiary wsadów w celu znalezienia najlepszego kompromisu między przepustowością a opóźnieniem. W aplikacjach wymagających dużej skalowalności, takich jak obsługa wielu użytkowników jednocześnie, Helix może zwiększyć liczbę równoczesnych użytkowników nawet 32-krotnie przy danym budżecie opóźnienia. W środowiskach o niskiej współbieżności, gdzie kluczowe znaczenie ma responsywność pojedynczego użytkownika, technika ta może poprawić interaktywność użytkownika nawet 1.5-krotnie poprzez zmniejszenie minimalnego osiągalnego opóźnienia między tokenami. Korzyści te są możliwe dzięki partycjonowaniu pamięci podręcznej KV i wag FFN na wszystkich dostępnych urządzeniach, co radykalnie zmniejsza obciążenie pamięci DRAM i poprawia wydajność obliczeniową.
Aby zapoznać się ze szczegółami technicznymi metodologii i wyników symulacji, podajemy link do pełnego raportu.


 Amazon