

Firma Pliops ogłosiła strategiczne partnerstwo z vLLM Production Stack , referencyjną implementacją open source dla całego klastra, zaprojektowaną w celu optymalizacji obciążeń wnioskowania w dużych modelach językowych (LLM). Partnerstwo to ma kluczowe znaczenie w kontekście przygotowań społeczności AI do konferencji GTC 2025. Łącząc zaawansowane zaplecze pamięci masowej opartej na wartościach kluczowych (KV) firmy Pliops z solidną architekturą vLLM Production Stack, współpraca wyznacza nowy standard wydajności, efektywności i skalowalności AI.
Junchen Jiang, kierownik laboratorium LMCache na Uniwersytecie Chicagowskim, podkreślił potencjał współpracy, podkreślając jej zdolność do zwiększenia efektywności i wydajności wnioskowania LLM. Wspólne rozwiązanie oferuje zaawansowane możliwości wyszukiwania i pobierania wektorów poprzez wprowadzenie nowej, petabajtowej warstwy pamięci poniżej pamięci o dużej przepustowości (HBM). Obliczone pamięci podręczne KV są efektywnie przechowywane i pobierane za pomocą rozproszonej, inteligentnej pamięci masowej, co przyspiesza wnioskowanie vLLM.
Więcej informacji na temat Pliops znajdziesz w naszym szczegółowym artykule.
O tym KVCache
Większość dużych modeli językowych wykorzystuje architektury transformatorowe, które opierają się na mechanizmach uwagi obejmujących macierze zapytań, kluczy i wartości. Podczas sekwencyjnego generowania tokenów, transformatory wielokrotnie obliczają uwagę, co wymaga ponownego obliczenia poprzednich macierzy kluczy i wartości (KV), co prowadzi do wzrostu kosztów obliczeniowych. Buforowanie KV rozwiązuje ten problem, przechowując wcześniej obliczone macierze KV, co umożliwia ich ponowne wykorzystanie w kolejnych predykcjach tokenów, znacząco zwiększając wydajność i przepustowość generowania.
Wiąże się to jednak z nowymi wyzwaniami. Pamięci podręczne KV mogą być dość duże, szczególnie podczas długich generacji lub wnioskowania wsadowego z typowymi rozmiarami partii wynoszącymi 32, ostatecznie przekraczając dostępną pamięć. Aby rozwiązać ten problem, niezbędne staje się zaplecze pamięci podręcznej KV.
Pliops XDP LightningAI
Wdrożenie platformy XDP LightningAI firmy Pliops w centrach danych stanowi zmianę paradygmatu w zakresie opłacalności, zapewniając znaczne oszczędności w porównaniu z tradycyjnymi architekturami. Dodając dedykowane serwery XDP LightningAI do istniejącej infrastruktury, organizacje mogą osiągnąć znaczne oszczędności, w tym optymalizację przestrzeni w szafach rack o 67%, redukcję zużycia energii o 66%, roczne oszczędności na wydatkach operacyjnych o 58% oraz obniżenie początkowych kosztów inwestycyjnych o 69%.
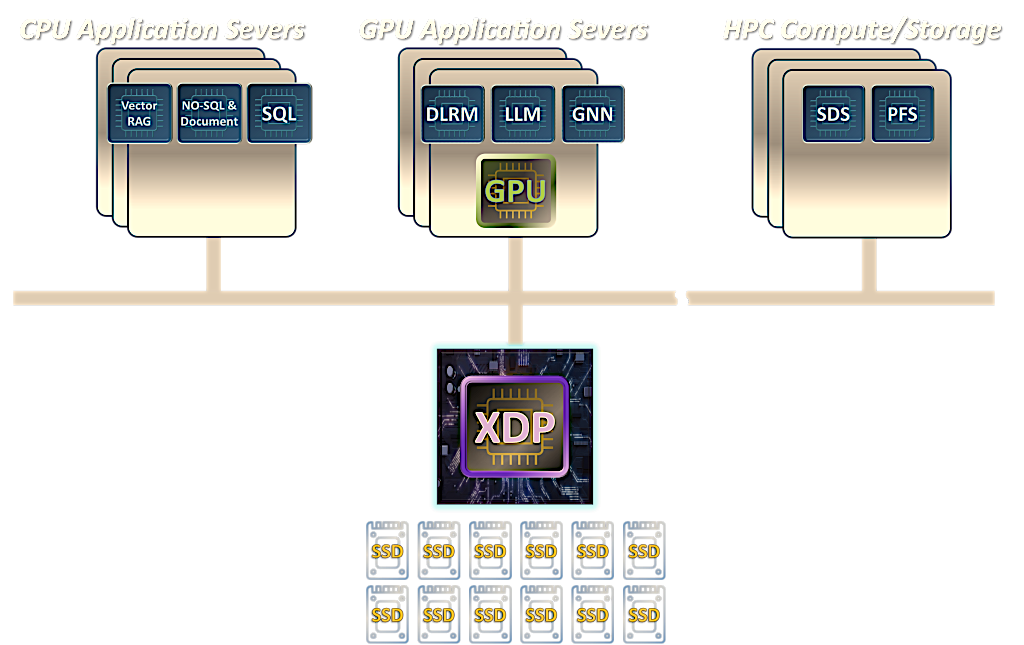
Firma Pliops stale rozwija swój procesor Extreme Data Processor (XDP), układ XDP-PRO ASIC, uzupełniony o kompleksowy stos oprogramowania AI i węzły rozproszone. Wykorzystując interfejs wejścia/wyjścia Key-Value inicjowany przez GPU, to rozwiązanie zapewnia niespotykaną dotąd skalowalność i wydajność. Rozwiązanie XDP LightningAI firmy Pliops zapewnia znaczną poprawę wydajności, osiągając nawet 8-krotny wzrost wydajności w zakresie wnioskowania vLLM, co znacząco przyspiesza obciążenia generatywnej sztucznej inteligencji (GenAI). Dzięki integracji najnowocześniejszych trendów branżowych, takich jak DeepSeek, Pliops zapewnia solidną adaptację do przyszłych rozwiązań AI.
Pliops zaprezentował te postępy na konferencji AI DevWorld, podkreślając, jak XDP LightningAI rewolucjonizuje wydajność LLM poprzez znaczną redukcję mocy obliczeniowej i kosztów. Ta demonstracja zilustrowała zaangażowanie Pliops w zapewnianie zrównoważonych innowacji w zakresie sztucznej inteligencji na skalę przedsiębiorstw.
Ciągła współpraca
Pliops pomaga organizacjom maksymalnie wykorzystać potencjał analiz opartych na sztucznej inteligencji i utrzymać przewagę konkurencyjną w szybko zmieniającym się środowisku technologicznym, zapewniając natychmiastowy dostęp do przydatnych danych i gwarantując płynną ścieżkę integracji.
Przyszły plan współpracy obejmuje zasadniczą integrację stosu KV-IO firmy Pliops ze stosem produkcyjnym, co przełoży się na zaawansowane możliwości, takie jak szybkie buforowanie konwersacji wieloobrotowych, skalowalne odciążanie pamięci podręcznej KV i usprawnione strategie routingu.


 Amazon