

ASUS ExpertCenter Pro ET900N G3 to druga stacja GB300 DGX, którą testowaliśmy, i pierwsza, którą mieliśmy okazję przetestować w laboratorium; testy MSI XpertStation WS300 przeprowadziliśmy zdalnie. Wykorzystuje ona ten sam układ NVIDIA, który testowaliśmy w MSI XpertStation WS300: układ Grace Blackwell Ultra Desktop Superchip z 72 rdzeniami Grace, procesor graficzny B300, 252 GB pamięci HBM3e, 496 GB pamięci LPDDR5X oraz kartę sieciową ConnectX-8 SuperNIC z dwoma portami 400 GbE. ASUS umieścił tę platformę rdzeni w schludnej obudowie typu tower, zaprojektowanej z myślą o sztucznej inteligencji przy biurku, dodając kilka udoskonaleń, których nie ma w WS300: dwa uchwyty do przenoszenia na górze, dedykowany wentylator skierowany na klatki z optyką ConnectX-8 oraz zasilacz o mocy 1,600 W z certyfikatem 80 PLUS Titanium.
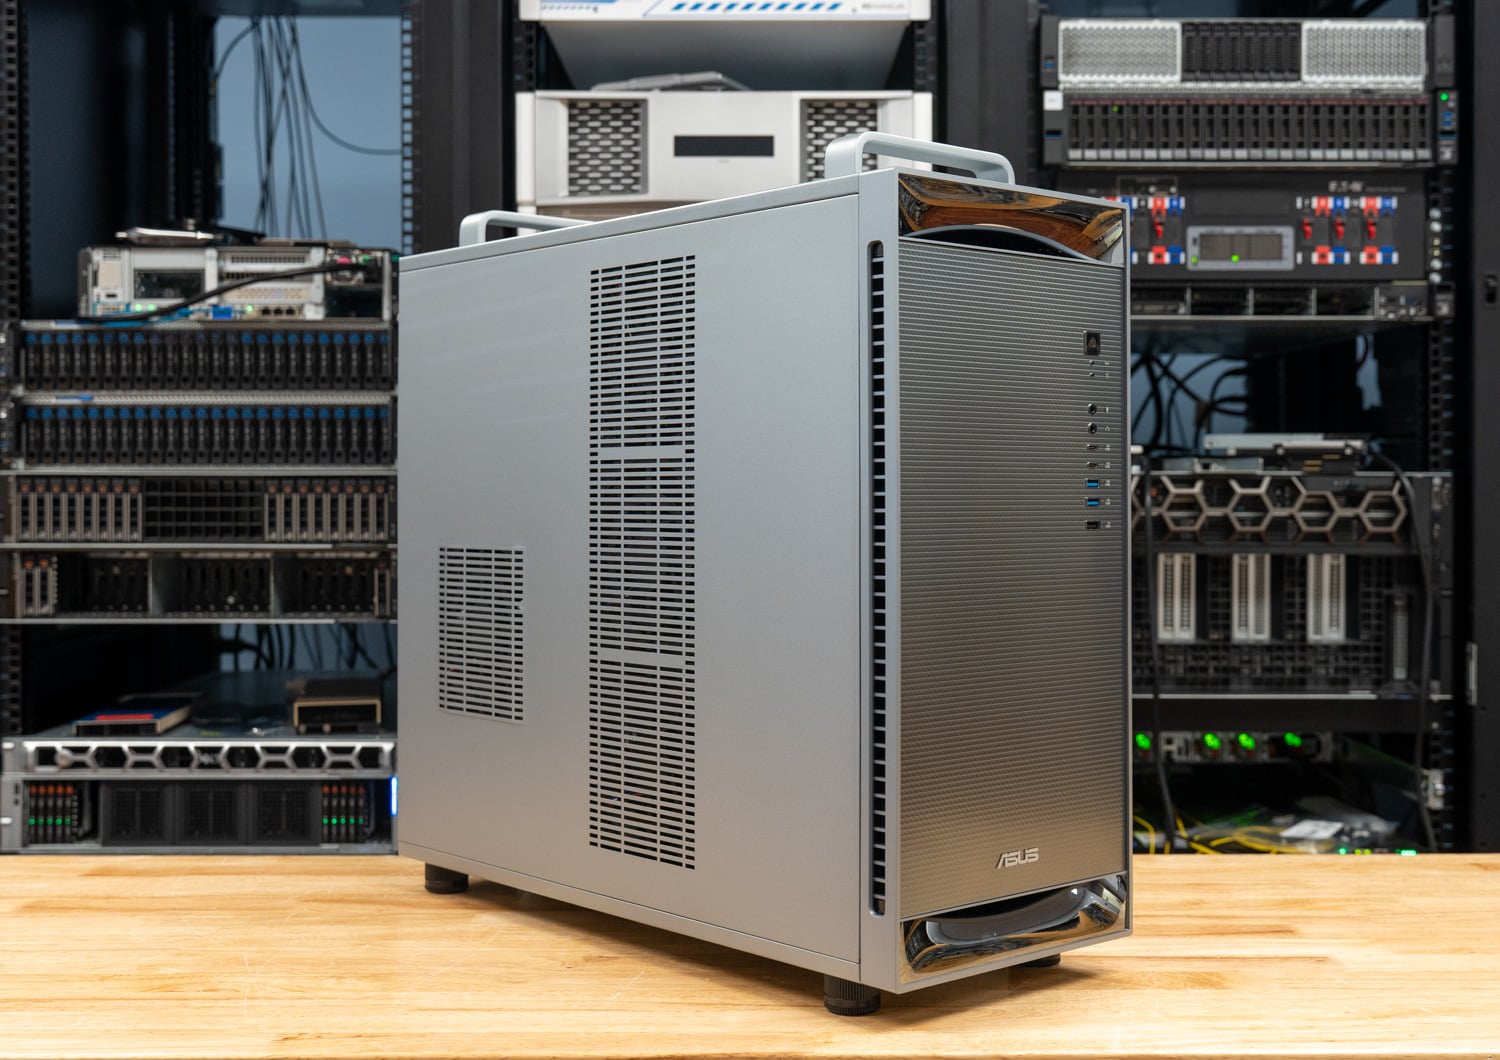
ASUS wysłał ET900N G3 do laboratorium na około tydzień testów porównawczych, sesji zdjęciowych i testów fizycznych z zainstalowaną kartą RTX PRO 2000. Jeśli chodzi o samą platformę, B300, Grace, NVLink-C2C, MIG i do czego służy stacja DGX, recenzja WS300 omawia te zagadnienia. Niniejsza recenzja dotyczy tego, co ASUS zbudował wokół Superchipa i czy wyniki wypadają dobrze w porównaniu z pierwszą testowaną przez nas wieżą GB300.
Specyfikacja ASUS ExpertCenter Pro ET900N G3
| Specyfikacja | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| Omówienie platformy | |
| Superchip | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| CPU | NVIDIA Grace, 72-ramienne rdzenie Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra (B300), do 20 PFLOPS NVFP4 z rozrzedzeniem |
| Połączenie CPU-GPU | NVLink-C2C, 900 GB/s dwukierunkowy |
| Pamięć | |
| Pamięć koherentna | 748GB |
| Pamięć GPU | 252 GB HBM3e, 7.1 TB/s |
| Pamięć procesora | 496 GB LPDDR5X, 396 GB/s, 4x SOCAMM |
| Dyski | |
| Dyski rozruchowe | 2x M.2 2280 PCIe 5.0 x4 (klucz M), wypełnione 2x 2TB NVMe w RAID 1 |
| Napędy rozszerzeń | 2x M.2 2280 (klucz M), PCIe 6.0 x4 według ASUS, otwarte fabrycznie |
| Sieci | |
| SuperNIC | NVIDIA ConnectX-8, 2x QSFP112 400GbE |
| Ethernet | 1x Marvell 10GbE 1x Realtek 1GbE (BMC) |
| Ekspansja | |
| Sloty PCIe | 1x PCIe 5.0 x16 2x PCIe 5.0 x16 (sygnały x8) |
| Dodatkowy procesor graficzny | Do jednej karty NVIDIA RTX PRO Blackwell; egzemplarz testowy dostarczany z kartą RTX PRO 2000 Blackwell |
| I / O | |
| Przód | 2x USB 10 Gb/s typu C 2x USB 10 Gb/s typu A 1x USB 2.0 Gniazda słuchawkowe i mikrofonowe |
| Tył | 4x USB 10 Gb/s typu A 1x Micro-USB COM (konsola szeregowa BMC) 1x Mini DisplayPort (BMC) 3x gniazda audio |
| Zarządzanie i bezpieczeństwo | |
| BMC | ASPEED AST2600 z oprogramowaniem układowym AMI MegaRAC, IPMI i Redfish |
| Ochrona | Wbudowany moduł TPM 2.0 |
| Zasilanie i chłodzenie | |
| Zasilacz laboratoryjny | 1x 1,600 W ATX, 80 PLUS Titanium |
| Chłodzenie | Zamknięty obieg chłodzenia cieczą AIO (według firmy ASUS) z płytkami chłodzącymi na płytach GB300, SOCAMM i ConnectX-8; radiatory z przodu i z góry, wentylator z tyłu obudowy, dedykowany wentylator nad klatkami QSFP112 |
| temperatura robocza | 10C do 35C |
| Oprogramowanie i współczynnik kształtu | |
| System operacyjny | Ubuntu z narzędziami programistycznymi NVIDIA AI; ASUS twierdzi, że planowane jest wsparcie rozwoju AI w systemie Windows |
| Wymiary | 584 x 232 x 565 mm (23.0 x 9.1 x 22.3 cala), zgodnie z deklaracją firmy ASUS |
| Waga | 27 kg netto, 32 kg brutto |
Zaprojektuj i zbuduj
ASUS ubiera ET900N G3 jako biznesową stację roboczą, ze szczotkowaną srebrną obudową, ciemną siatką z przodu, chromowaną nasadką i stopką oraz nisko umieszczonym logo ASUS z przodu. Proporcje są takie, jakie dyktuje platforma: 584 x 232 x 565 mm według specyfikacji ASUS, co jest nieco wyższe i węższe niż WS300 o wysokości 529 mm, głębokości 570 mm i szerokości 246 mm. Przy wadze 27 kg nie jest to system, który ktokolwiek przenosi swobodnie, i to właśnie tutaj wchodzi w grę pierwsza decyzja specyficzna dla ASUS-a. Dwa metalowe uchwyty na górnej krawędzi, jeden z przodu i jeden z tyłu, pozwalają dwóm osobom podnieść wieżę na biurko lub wózek bez chwytania za panele. Wyglądają nieco nie na miejscu na maszynie biurowej, dopóki nie trzeba będzie przenieść wieży GB300 przez laboratorium.
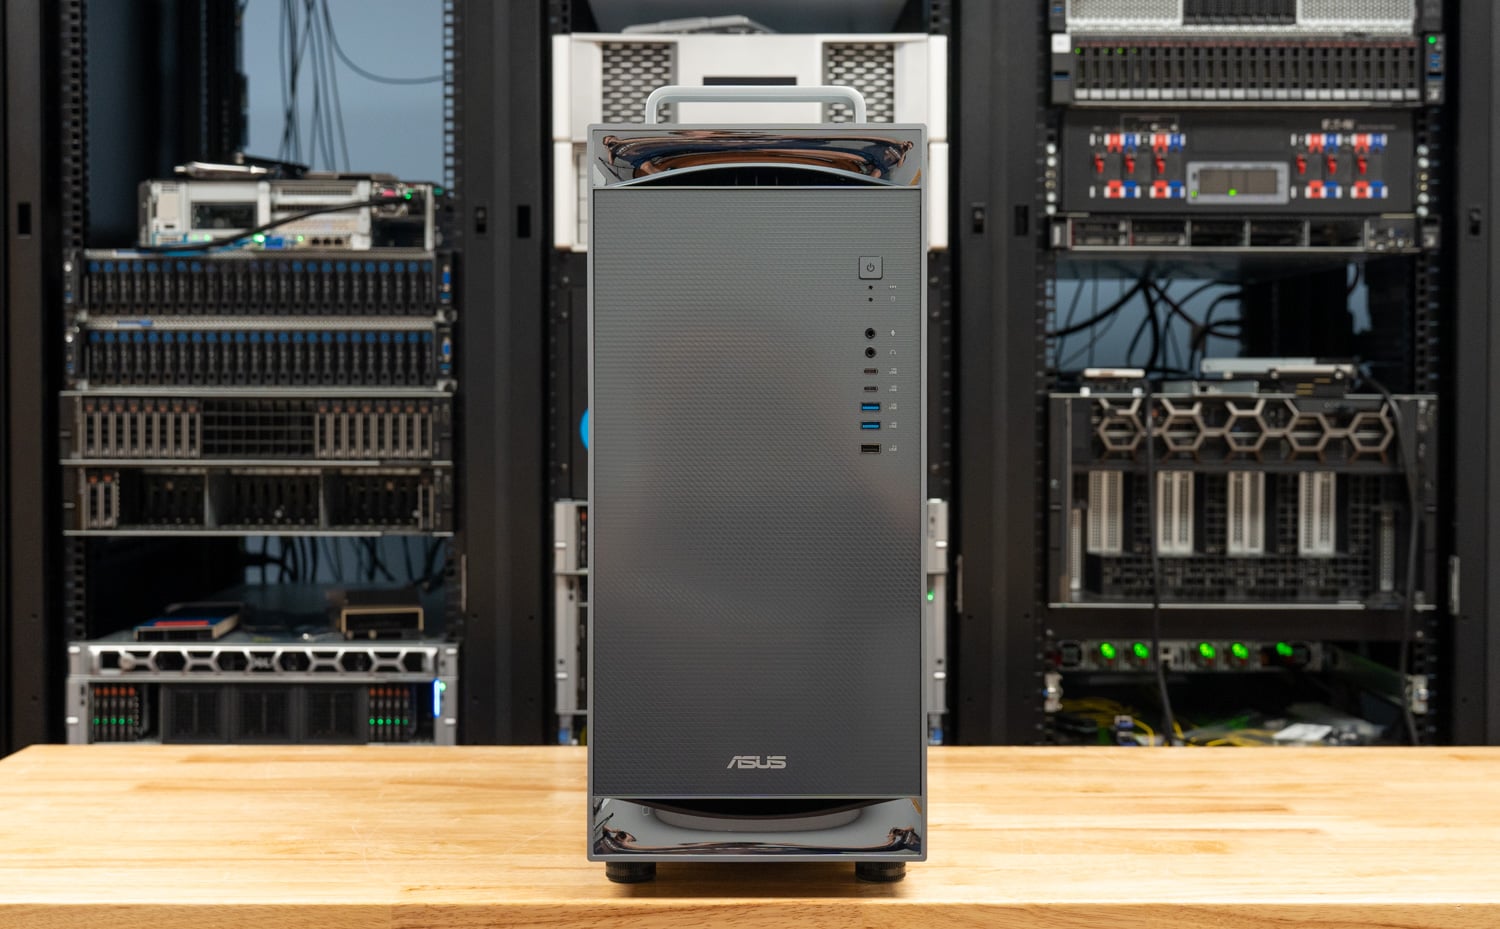
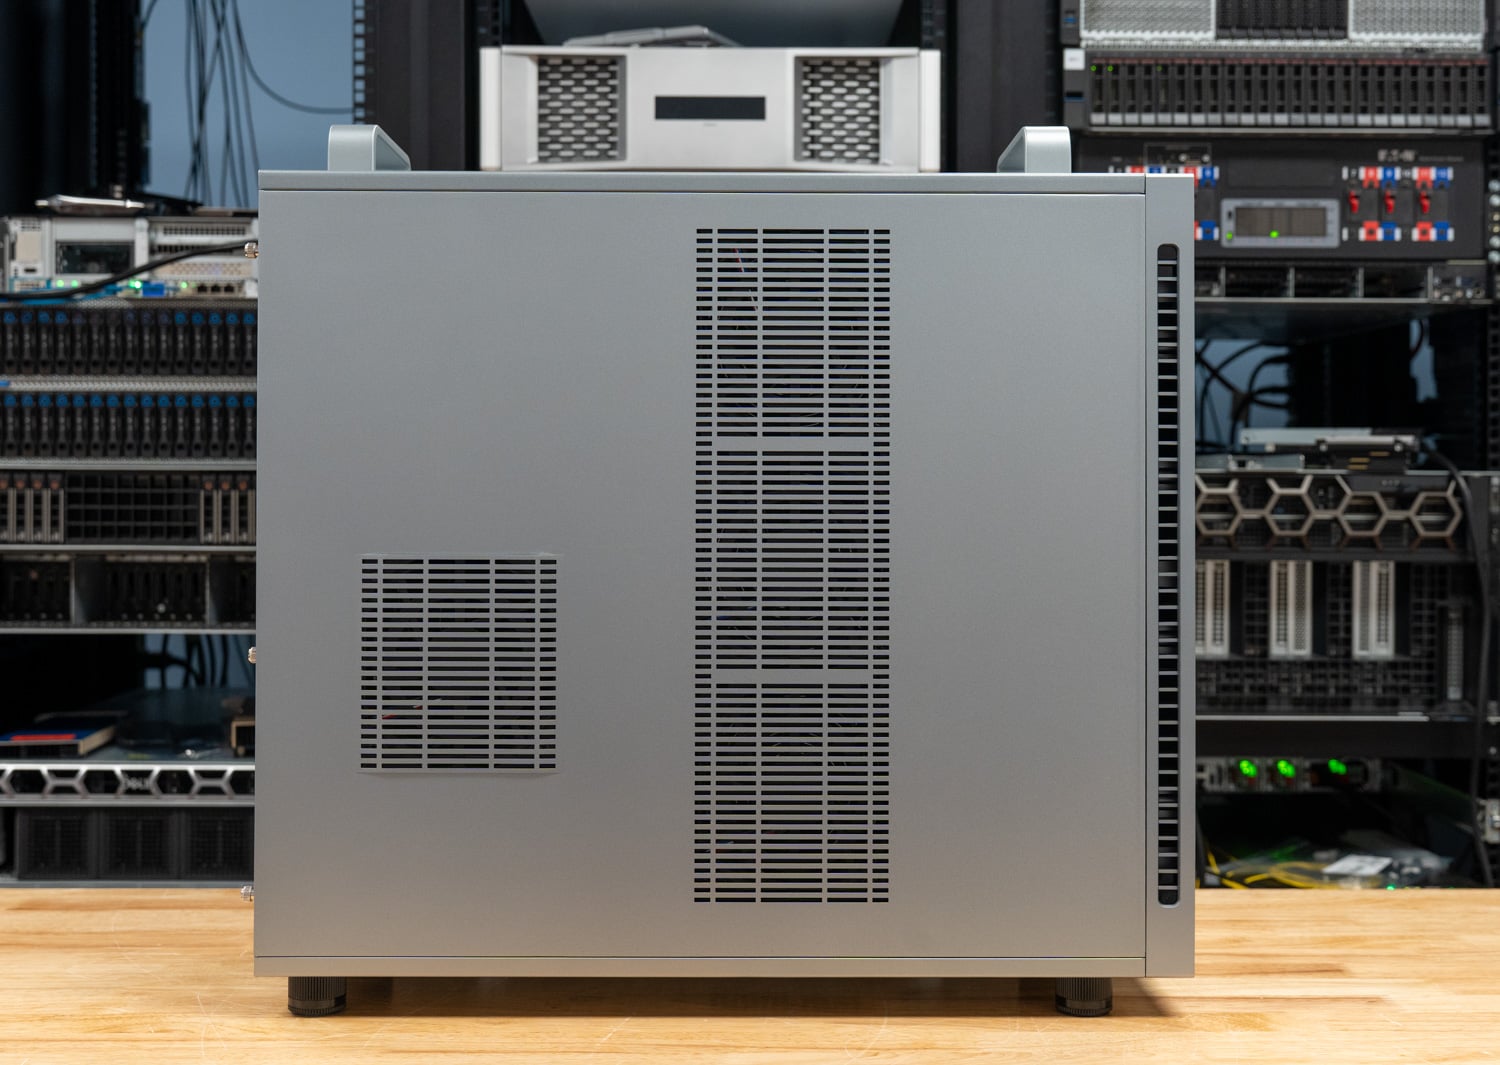
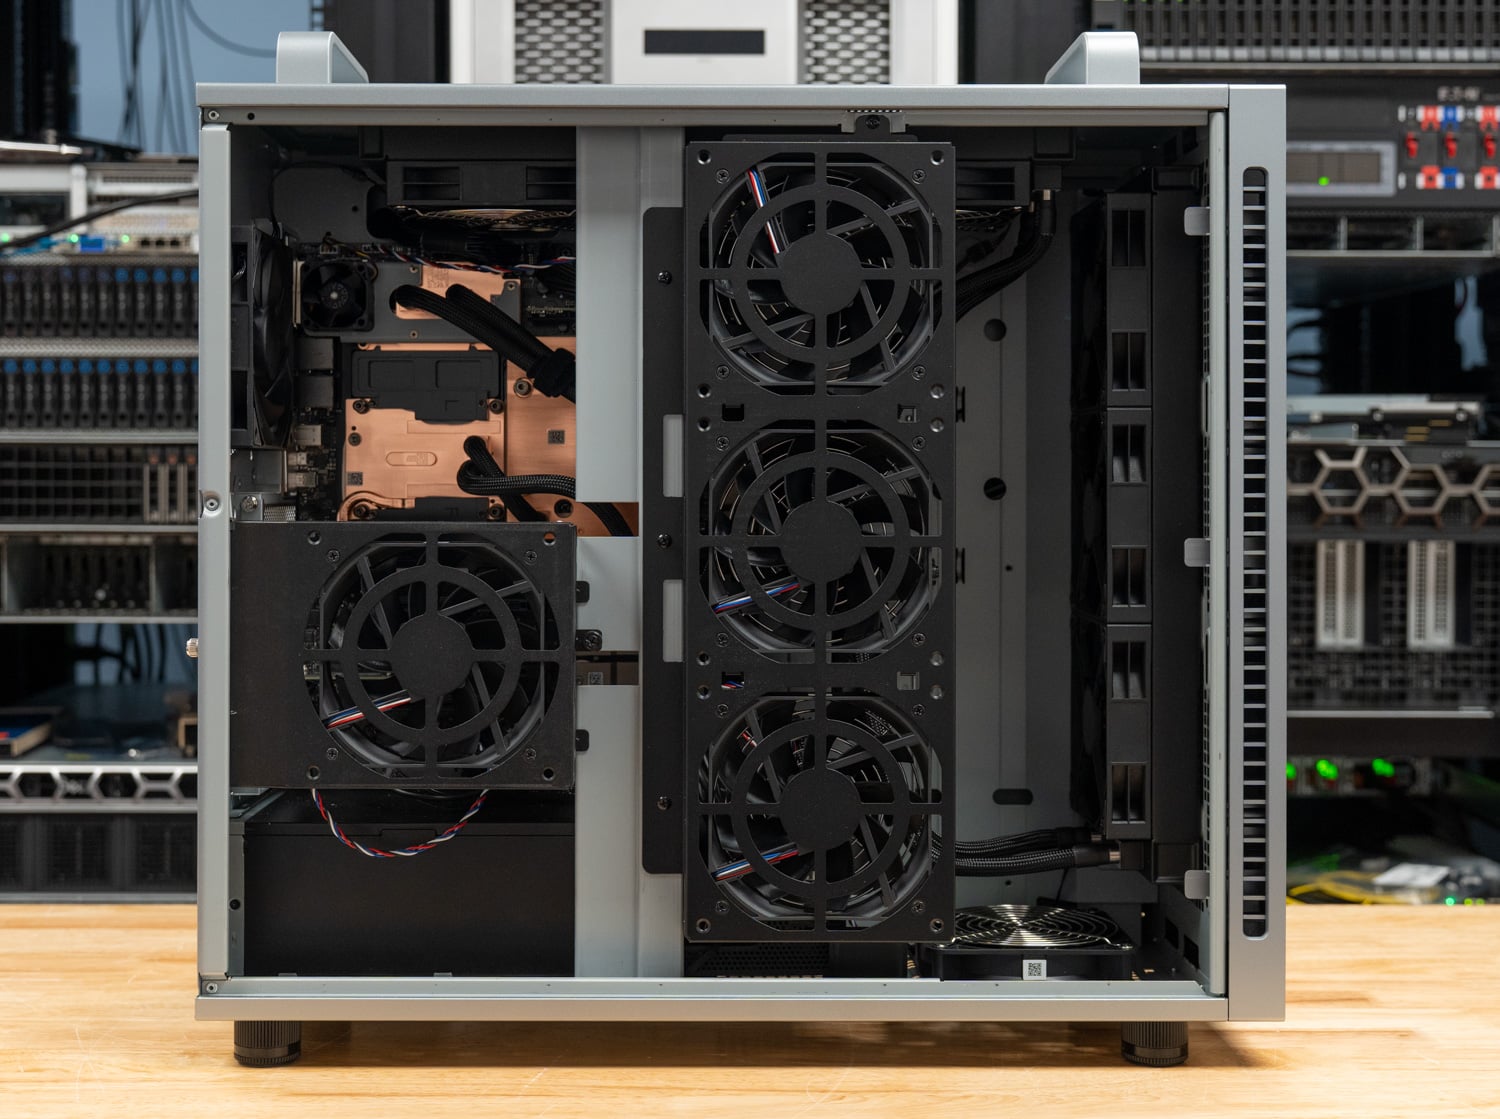
Na przednim panelu znajdują się przycisk zasilania, dwa porty USB typu A 10 Gb/s, dwa porty USB typu C 10 Gb/s, port USB 2.0 oraz oddzielne gniazda słuchawkowe i mikrofonowe, ułożone w pionowym pasku w prawym górnym rogu siatki. Panel boczny to duża, wentylowana płyta z długą, perforowaną kolumną z przodu, służącą do wlotu powietrza do chłodnicy, oraz mniejszą, kwadratową kratką z tyłu, która jest ustawiona w linii z wentylatorami systemowymi. Brakuje okna i oświetlenia, co odpowiada docelowemu klientowi.
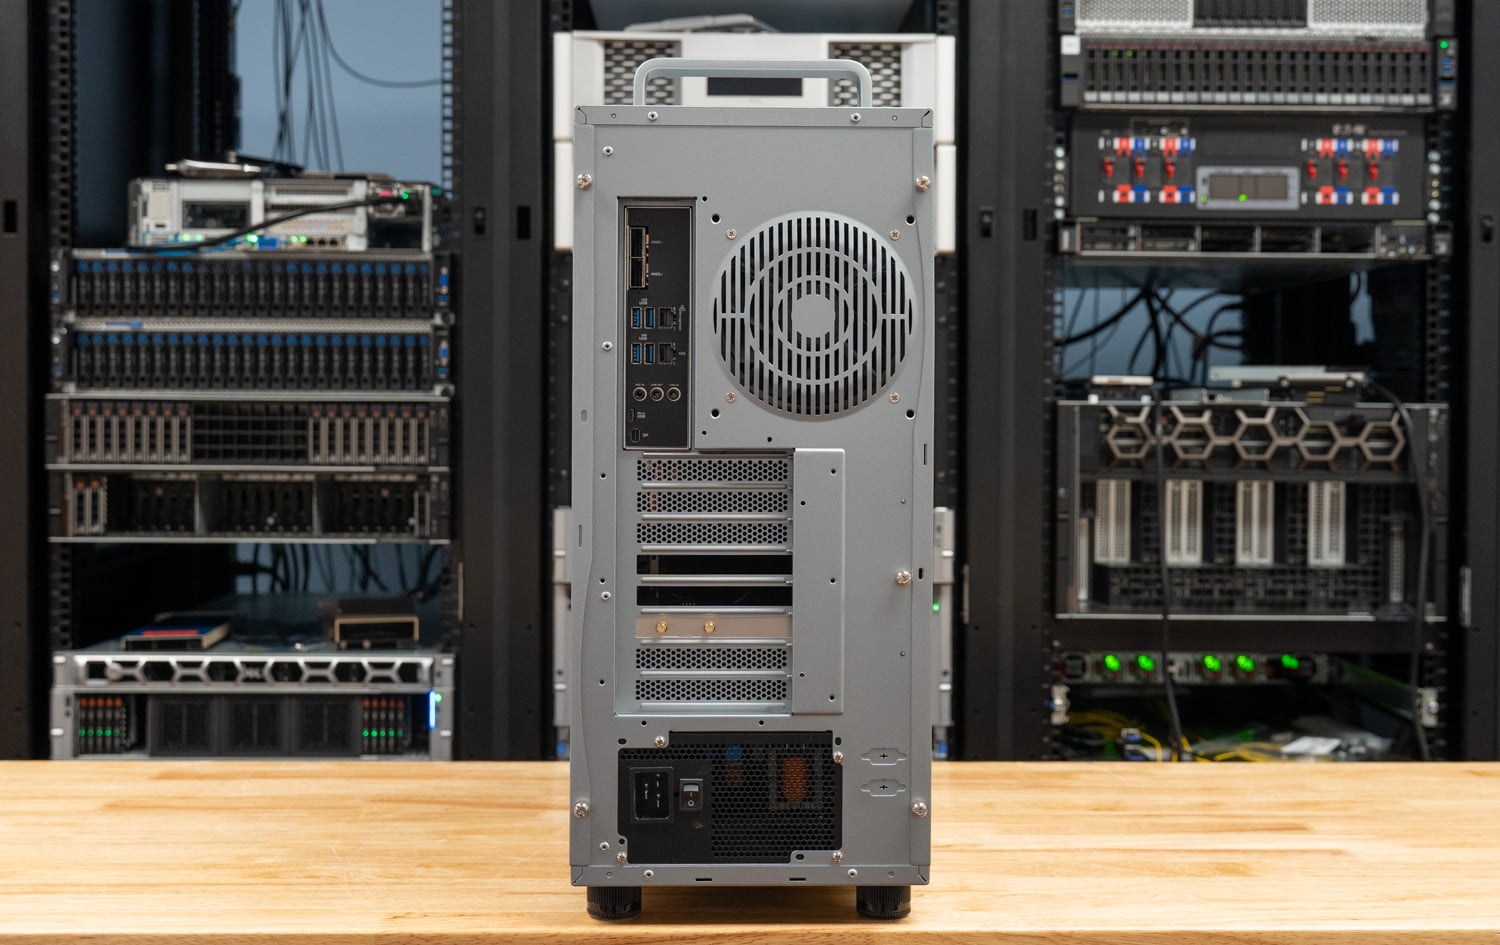
Z tyłu, układ oddziela porty wejścia/wyjścia stacji roboczej od sprzętu serwerowego znajdującego się pod spodem. Górny klaster zawiera cztery porty USB typu A 10 Gb/s, gniazda RJ45 10 GbE i 1 GbE, trzy gniazda audio, port konsoli Micro-USB BMC oraz port Mini DisplayPort, który BMC obsługuje w celach konfiguracyjnych. Dwie klatki QSFP112 dla ConnectX-8 znajdują się u góry osłony portów wejścia/wyjścia; obok nich znajduje się wentylator wyciągowy; pośrodku biegną trzy pokrywy gniazd rozszerzeń; a zasilacz z wejściem C19 znajduje się u dołu. Podobnie jak w modelu WS300, port Mini DisplayPort jest wyjściem BMC do wstępnej konfiguracji i rozwiązywania problemów; każdy, kto chce mieć komputer stacjonarny na tym komputerze, potrzebuje karty RTX PRO.
Wewnątrz ET900N G3
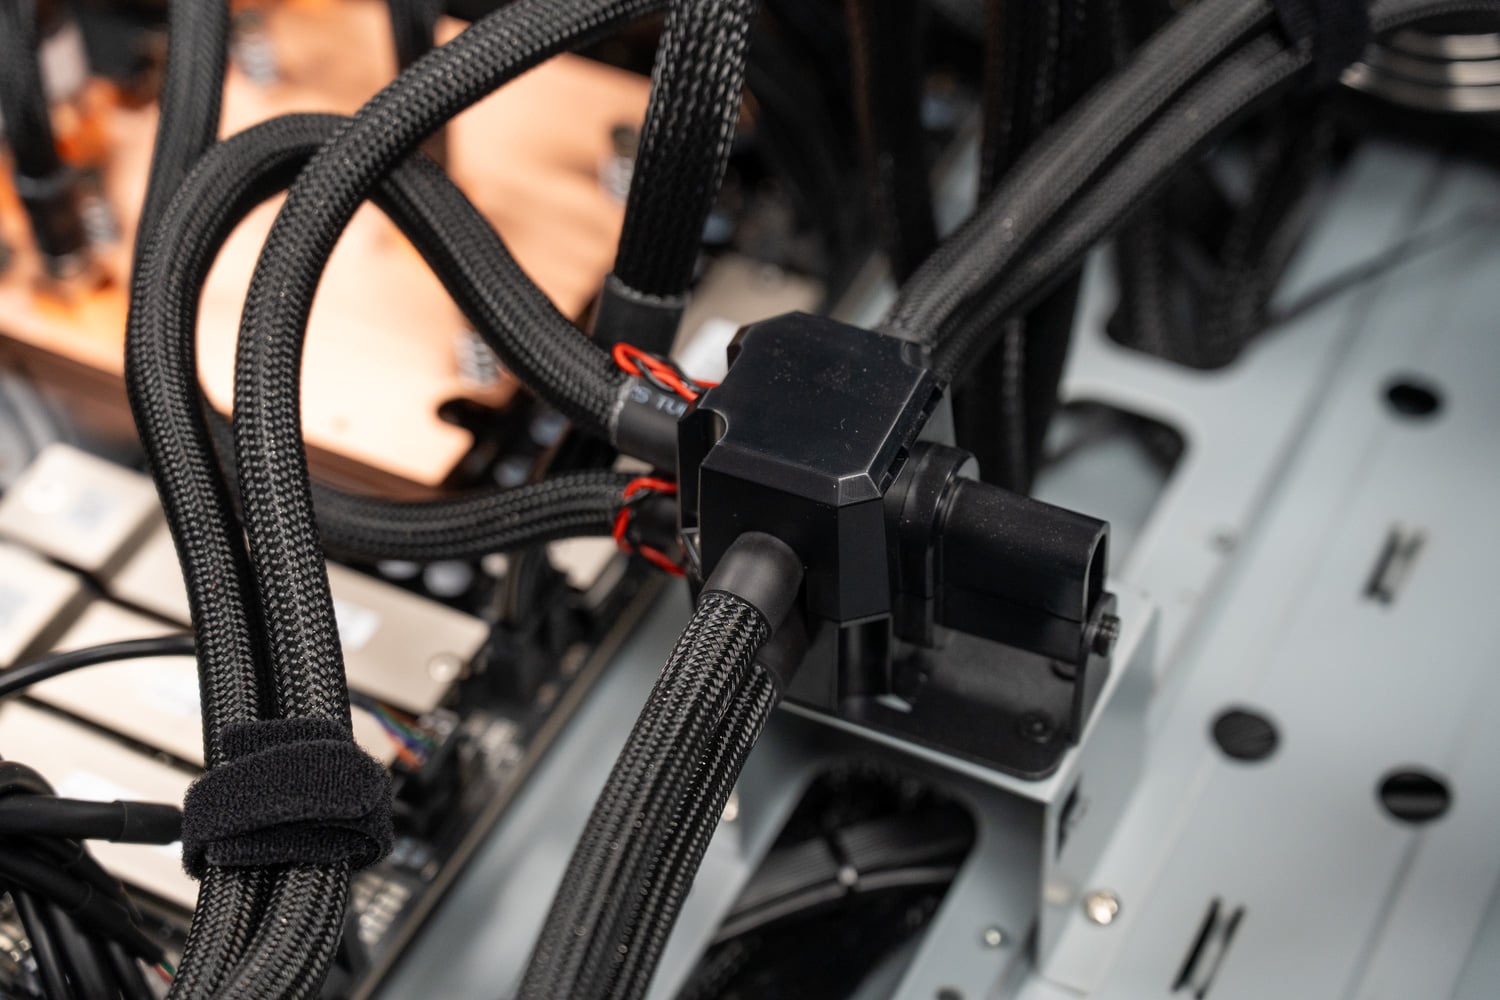
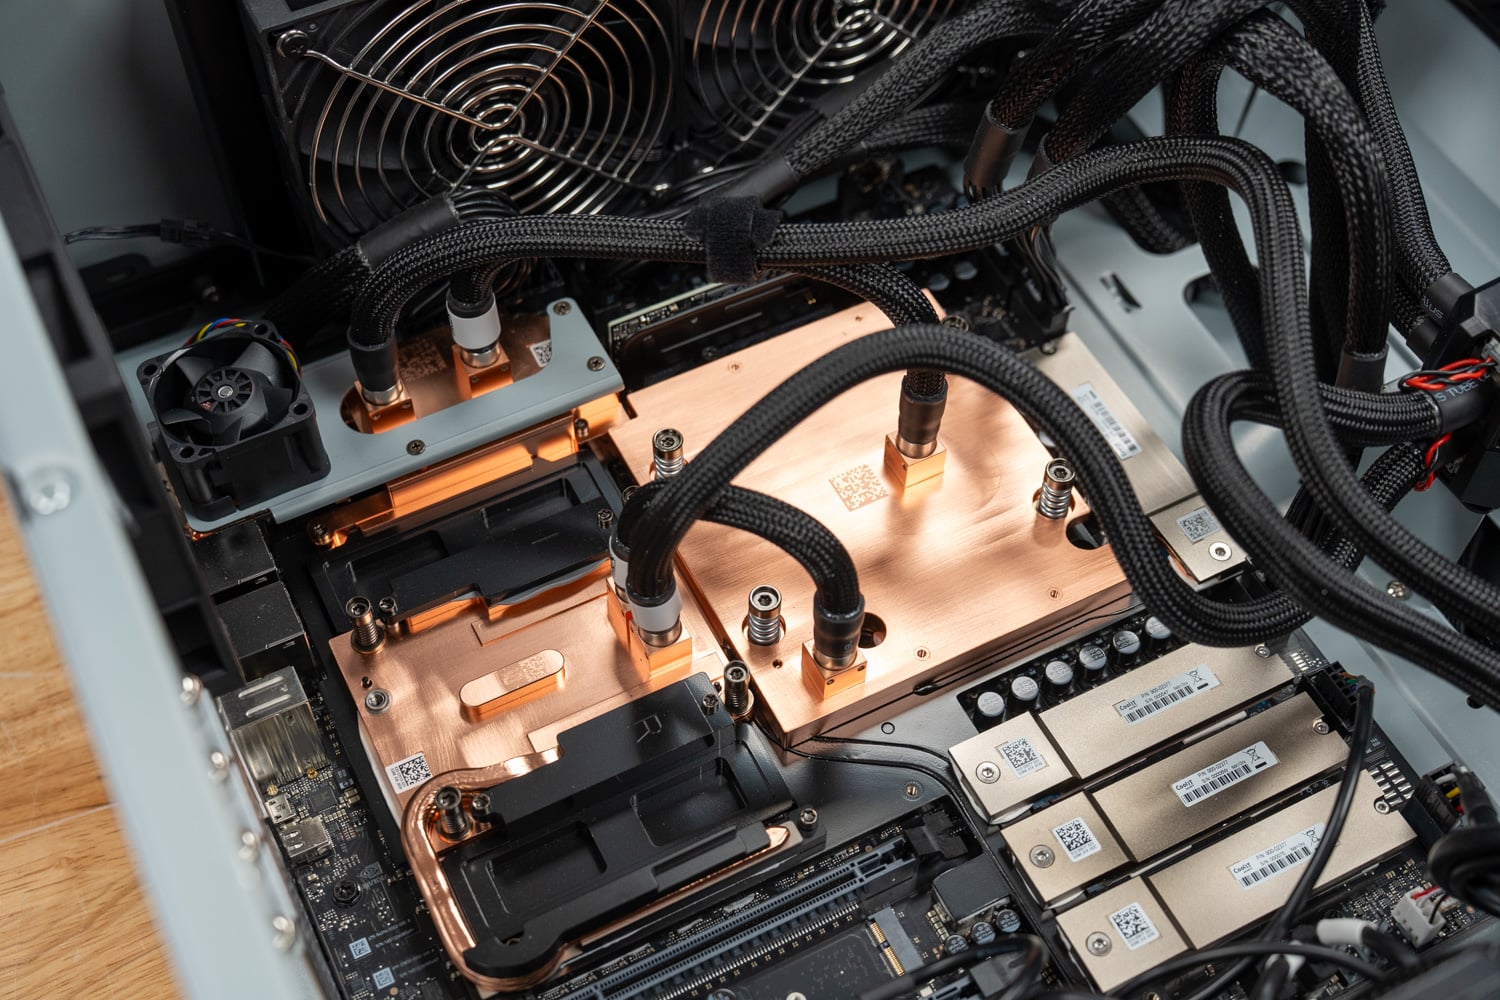
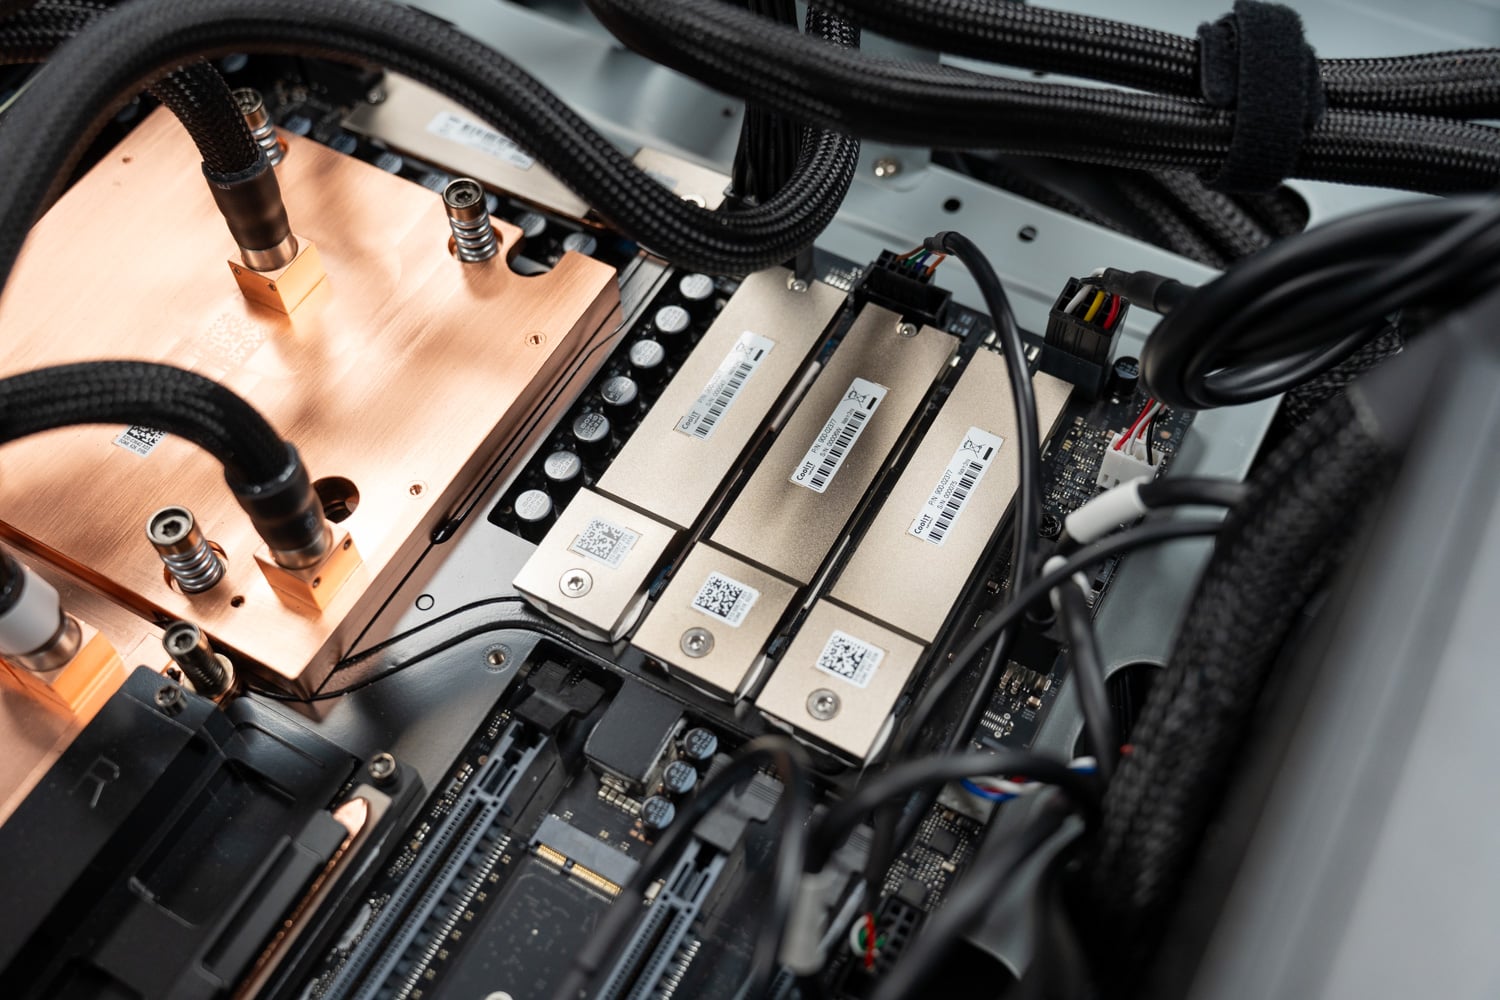
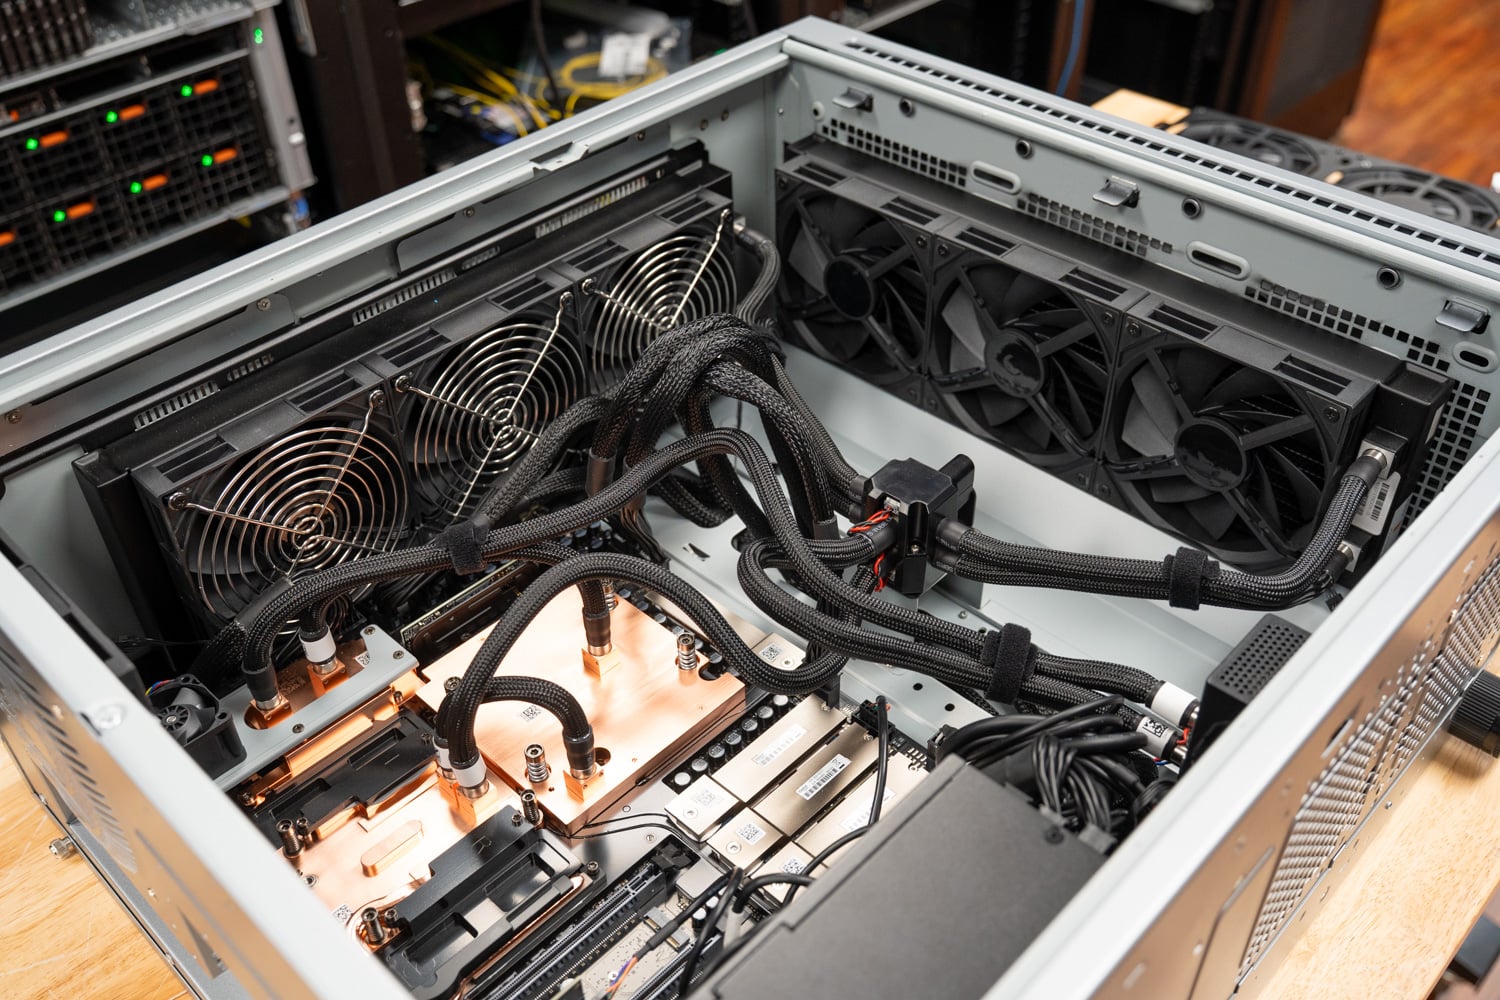
Po zdjęciu panelu bocznego, ET900N G3 wydaje się być bliskim krewnym WS300, co jest zrozumiałe, biorąc pod uwagę, że oba korzystają z tej samej płyty głównej NVIDIA. Układ GB300 Superchip znajduje się pod miedzianą płytą chłodzącą po lewej stronie obudowy, moduły SOCAMM pod własnymi miedzianymi płytami obok niego, a ConnectX-8 pod trzecim blokiem w pobliżu tylnego panelu I/O. Oplot rurowy biegnie od bloków do kolektora rozdzielczego zamontowanego na belce poprzecznej obudowy, a stamtąd do radiatorów. Trzy pełnowymiarowe gniazda PCIe znajdują się pod układem Superchip, zasilacz zajmuje dolny przedni narożnik, a metalowa osłona zakrywa ścieżkę kablową wzdłuż dolnej krawędzi.
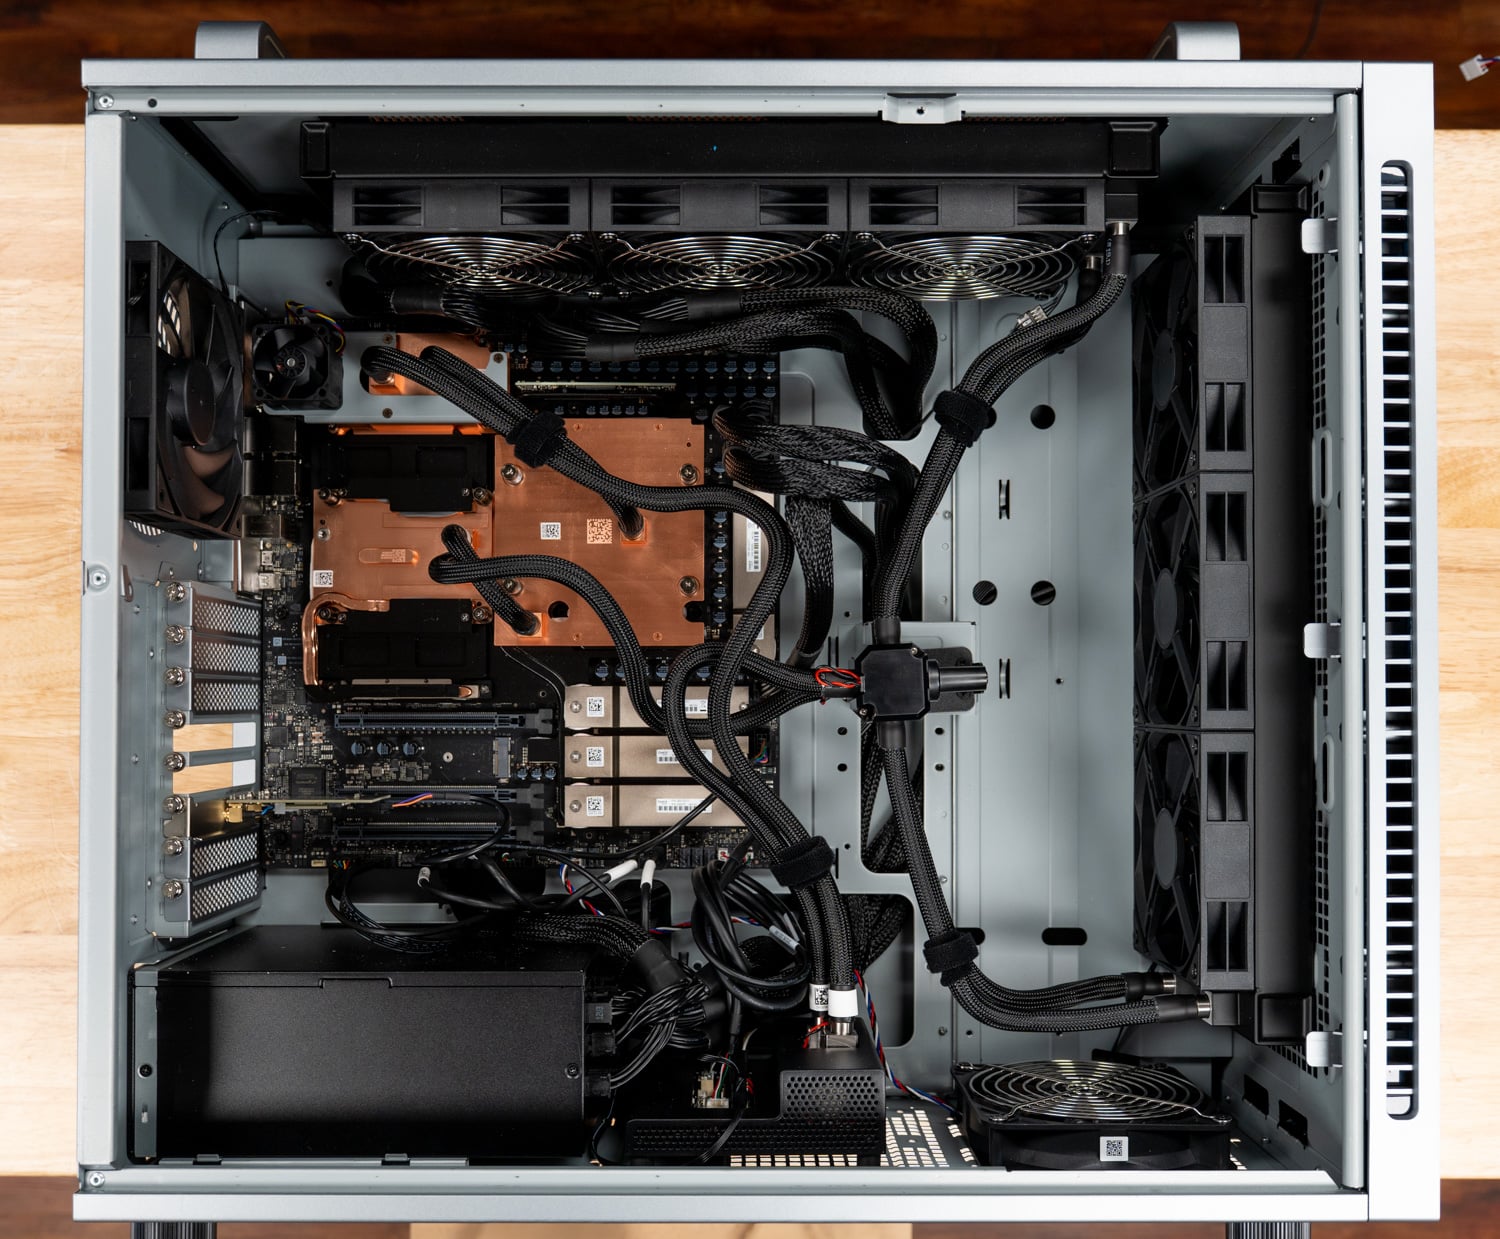
Układ wnętrza jest taki sam jak w modelu WS300: jedna chłodnica zamontowana pionowo za przednią siatką i druga u góry, każda z rzędem wentylatorów, plus wentylator podwozia z tyłu. Przewody płynu chłodzącego są osłonięte i przymocowane do belki poprzecznej za pomocą pasów na rzepy, a kolektor konsoliduje przewody z czterech płyt chłodzących, tak że do każdej chłodnicy docierają tylko dwa przewody.
Wentylator optyczny
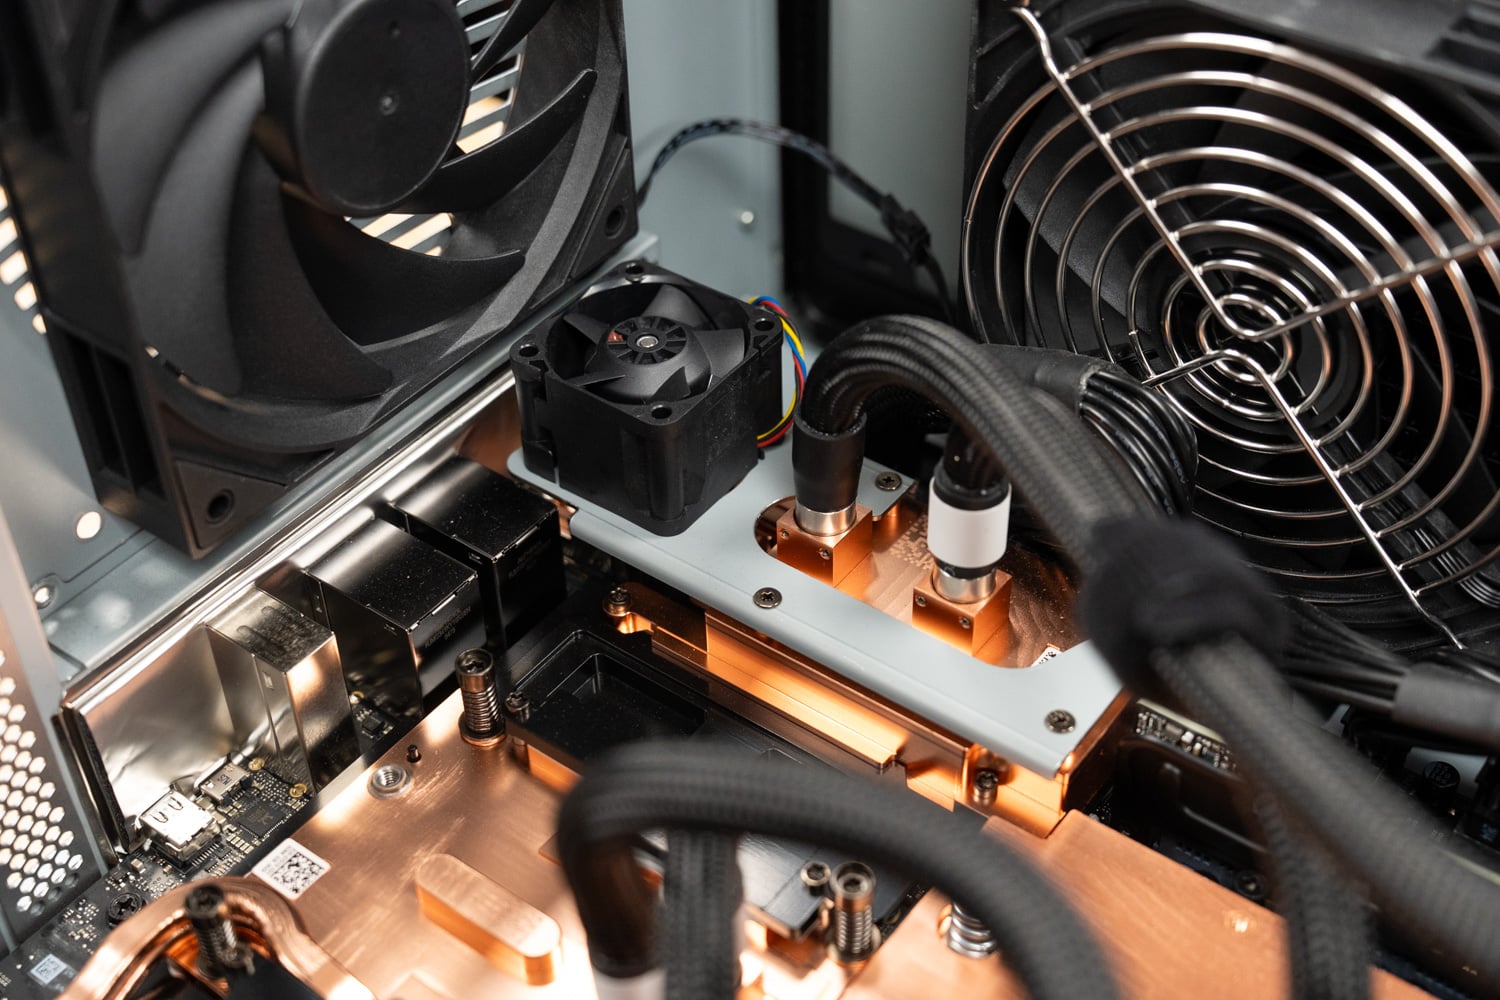
Jedynym elementem chłodzącym, który nie ma odpowiednika w WS300, jest mały wentylator zamontowany na wsporniku nad płytą chłodzącą ConnectX-8, skierowany na klatki QSFP112. Pętla cieczowa obsługuje sam krzem SuperNIC, ale transceivery optyczne 400G generują własne ciepło i są umieszczone w metalowych klatkach, do których płytka chłodząca może dotrzeć tylko poprzez przewodzenie. W innych testach zauważyliśmy, że ConnectX-8 nagrzewa się pod stałym obciążeniem, a sama optyka może się nagrzewać, więc dedykowana ścieżka przepływu powietrza przez klatki jest dobrym elementem konstrukcyjnym dla każdego, kto planuje uruchamiać ET900N G3 na światłowodzie przez wiele godzin. Z przetwornikami cyfrowo-analogowymi (DAC), którymi podłączyliśmy go do drugiej stacji GB300 w ramach dogłębnego badania z wykorzystaniem klastrów, które wciąż trwa, wentylator ma mniej zadań.
Przechowywanie, rozbudowa i zasilanie
ASUS dostarczył model ET900N G3 z pojedynczym dyskiem NVMe o pojemności 2 TB na system operacyjny i oprogramowanie NVIDIA, umieszczonym w dwóch gniazdach M.2 2280 podłączonych do płyty Grace przez PCIe 5.0 x4. Druga para gniazd jest przymocowana do zintegrowanego przełącznika PCIe ConnectX-8 i dostarczana jest pusta.
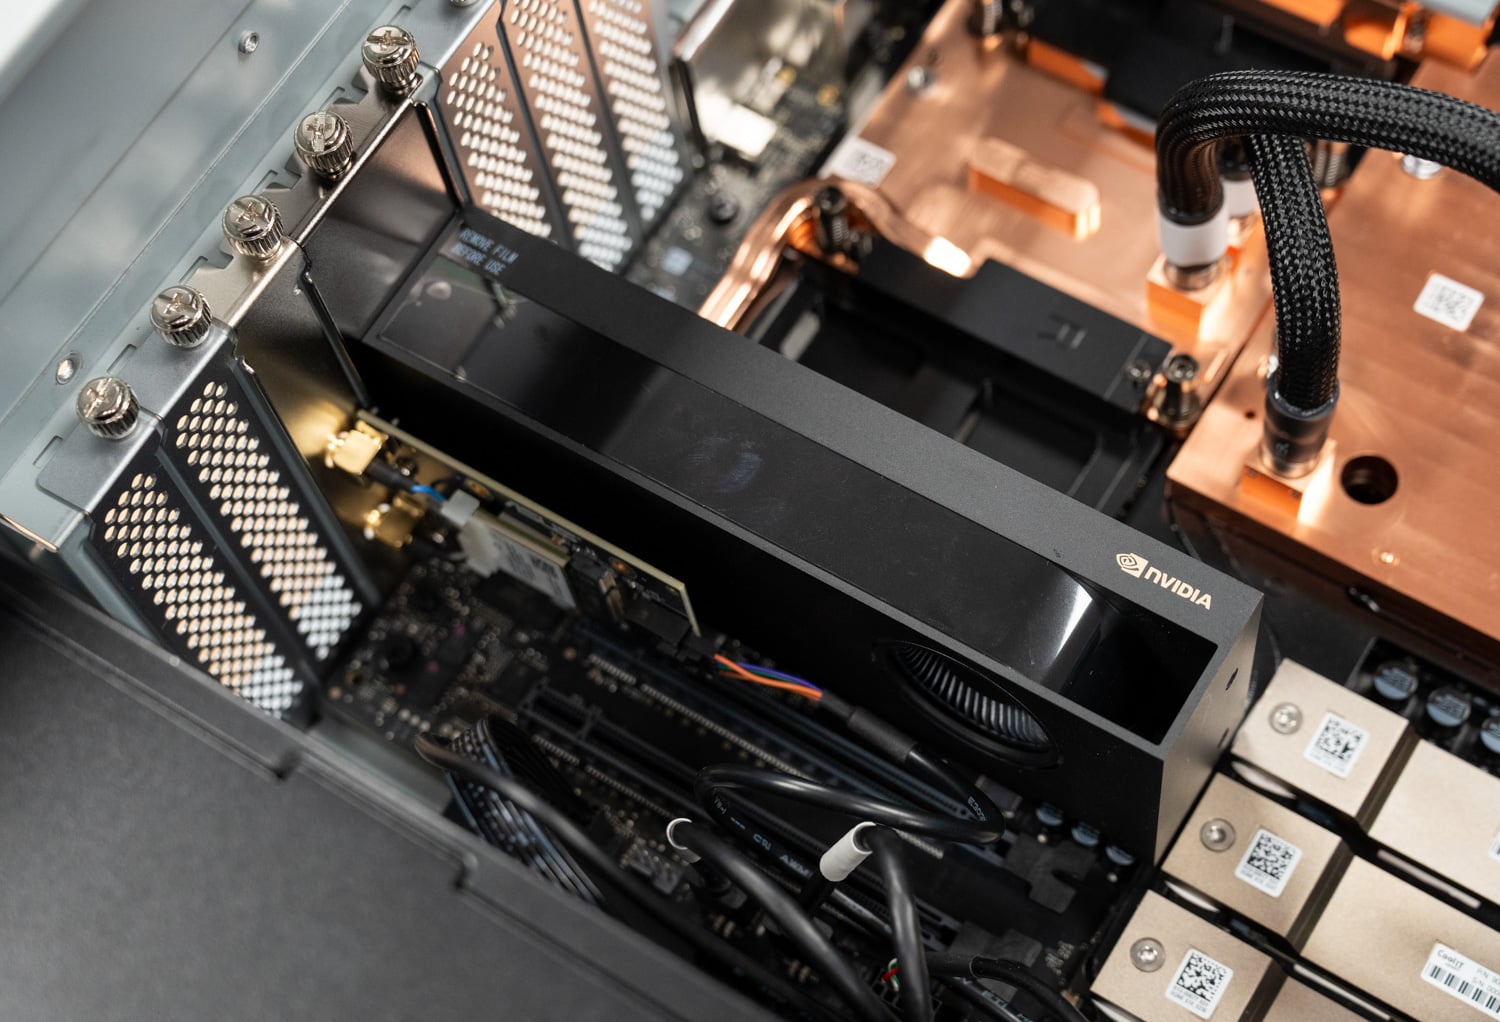
Nasz egzemplarz testowy został wyposażony w kartę graficzną NVIDIA RTX PRO 2000 Blackwell w gnieździe PCIe 5.0 x16, co jest jedną z konfiguracji wymienionych przez ASUS. Karta zapewnia wyjście wideo bez znaczącego obciążenia budżetu mocy GB300, a ASUS twierdzi, że obudowa pomieści nawet jedną kartę RTX PRO Blackwell. Przed testem porównawczym wyjęliśmy kartę RTX PRO 2000, aby Superchip miał pełny budżet akceleratora, podobnie jak w przypadku WS300. Nie testowaliśmy również karty RTX PRO o dużej mocy w tej obudowie; ta ścieżka i jej wpływ na współdzielony budżet mocy zostaną omówione w nadchodzącej recenzji stacji GB300.
Zasilacz to jednostka ATX o mocy 1,600 W, którą ASUS ocenia na 80 PLUS Titanium, poziom wyżej niż jednostkę Platinum w WS300. Titanium wymaga 94% sprawności przy 50% obciążeniu przy wejściu 115 V w porównaniu z 92% dla Platinum i jest to jedyny poziom, który ustala dolną granicę obciążenia na 10%, więc ET900N G3 powinien marnować kilkadziesiąt watów mniej na ścianie przy pełnym obciążeniu GB300. Budżet jest nadal wspólny: Grace, B300, pompy, wentylatory, pamięć masowa i dowolna karta RTX PRO pobierają z tych samych 1,600 W, a usługa vsloshd firmy NVIDIA przesuwa margines mocy między Superchipem a dodatkowym GPU w miarę zmiany ich poboru, bez ustalonego limitu dla żadnego z nich. Recenzja WS300 omawia tę politykę i tutaj pozostaje ona niezmieniona. Dedykowany obwód 20 A pozostaje wymogiem dla instalacji w Ameryce Północnej.
Łączność
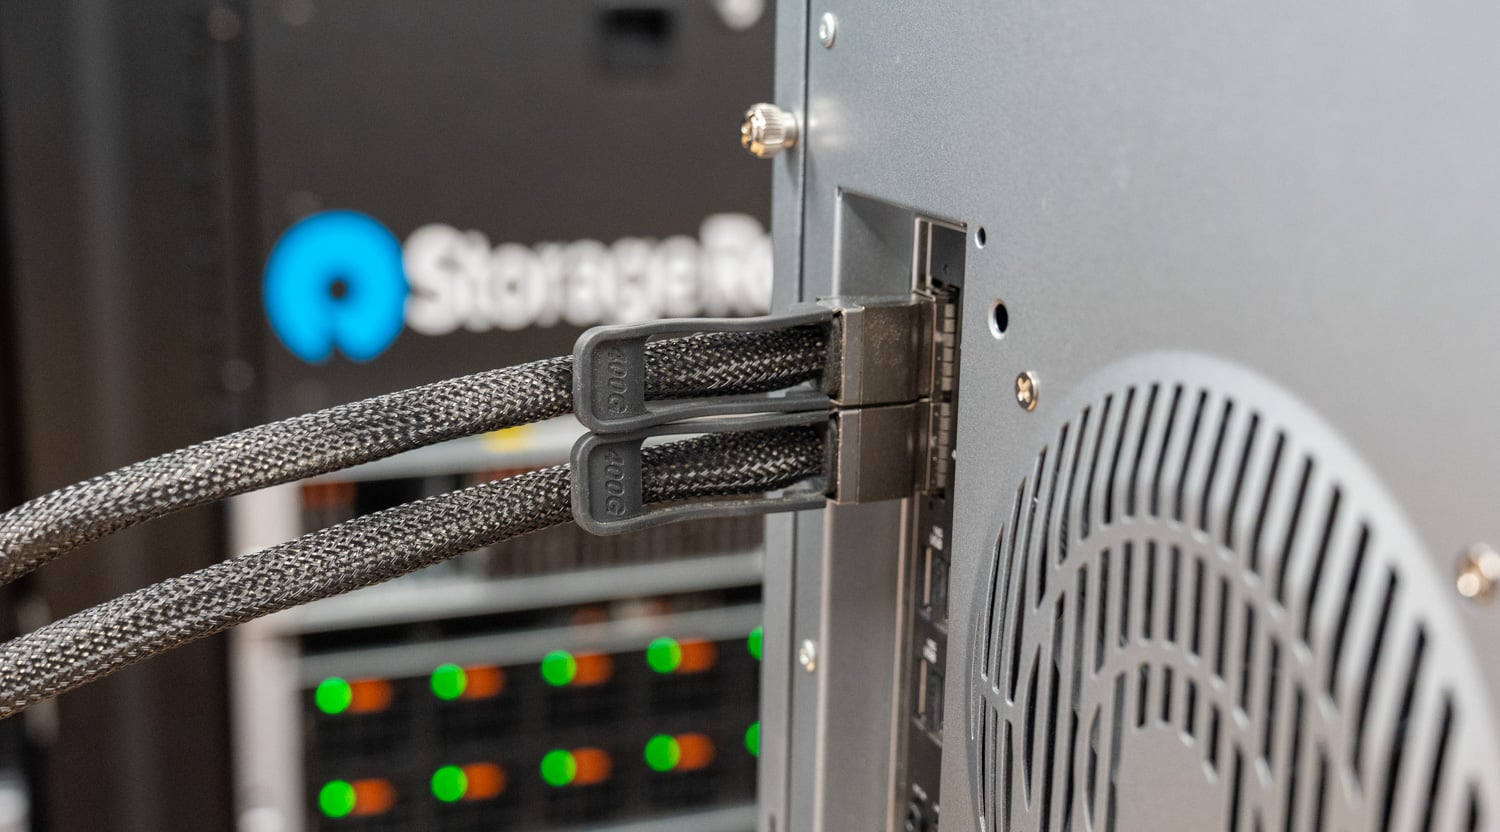
Dwa porty QSFP112 w ConnectX-8 stanowią łącznik ET900N G3 ze wszystkim innym: pamięcią masową, drugą stacją DGX lub strukturą klastra. Porty te są już używane w laboratorium, a ET900N G3 jest podłączony do drugiej stacji GB300 za pośrednictwem przetworników DAC 400G, co pozwala na dogłębną analizę wnioskowania klastrowego, którą opublikujemy osobno. Port Marvell 10GbE obsługuje standardowy ruch hosta, a port Realtek 1GbE jest dedykowany dla kontrolera BMC.
Notatki testowe
Wszystkie wyniki w tej recenzji pochodzą z urządzenia dostarczonego przez firmę ASUS do naszego laboratorium, w konfiguracji z pamięcią fabryczną, z 252 GB pamięci HBM3e i 496 GB pamięci LPDDR5X. System działał bez zainstalowanej karty RTX PRO, więc układ GB300 Superchip miał pełny budżet mocy akceleratora, co odpowiadało warunkom naszych testów WS300. Stos oprogramowania, konfiguracja vLLM, profile obciążeń i analiza współbieżności są takie same jak te, których użyliśmy w przypadku WS300, więc obie obudowy można bezpośrednio porównać. Niniejsza recenzja dotyczy wyłącznie wydajności; nie wykonywaliśmy pomiarów poboru mocy ani temperatury w tym urządzeniu.
Obciążenia to te same dwa profile wnioskowania na żywo vLLM, które uruchamiamy w każdym lokalnym systemie AI: równe obciążenie z 512 tokenami wejściowymi i 512 tokenami wyjściowymi oraz obciążenie z dużym wstępnym wypełnianiem z 8,192 tokenami wejściowymi i 1,024 tokenami wyjściowymi, przemiatanymi od jednego do 128 współbieżnych strumieni. W przypadku modeli o skali granicznej porównujemy je z serwerem GPU Dell PowerEdge XE7740 wyposażonym w dwie lub cztery karty RTX PRO 6000 , najbliższą alternatywą w jednym pudełku dla tych punktów kontrolnych. W przypadku mniejszych modeli porównujemy je z pojedynczą kartą RTX PRO 6000 w tej samej obudowie XE7740, pojedynczą kartą H200 NVL w obudowie Dell PowerEdge R770 oraz kartą GB10 DGX Spark reprezentowaną przez kartę Acer Veriton GN100 , tę samą kartę Spark, której użyliśmy w przeglądzie modelu WS300. Podane poniżej wartości dla ET900N G3 to dokładne wartości z dzienników uruchomień; wartości porównawcze pochodzą z naszych wykresów wyników.
Wydajność wnioskowania
Modele graniczne w puli pamięci koherentnej
Powodem istnienia GB300 jest obsługa modeli po obu stronach granicy 252 GB pamięci HBM3e B300, dlatego zaczynamy od czterech punktów kontrolnych, które ją obejmują: pamięć Flash DeepSeek V4 i MiniMax M2.7 mieszczą się w pamięci HBM z zapasem miejsca, MiniMax M3 ledwo się mieści i przenosi część swoich zasobów do pamięci Grace, a GLM-5.2 odciąża mniej więcej połowę swojej wagi. Po drugiej stronie każdego wykresu znajduje się najbliższa alternatywa w jednym pudełku: karty RTX PRO 6000 razem w obudowie PowerEdge XE7740, z odciążeniem zasobów eksperckich, aby pomieścić pamięć tam, gdzie jest potrzebna.
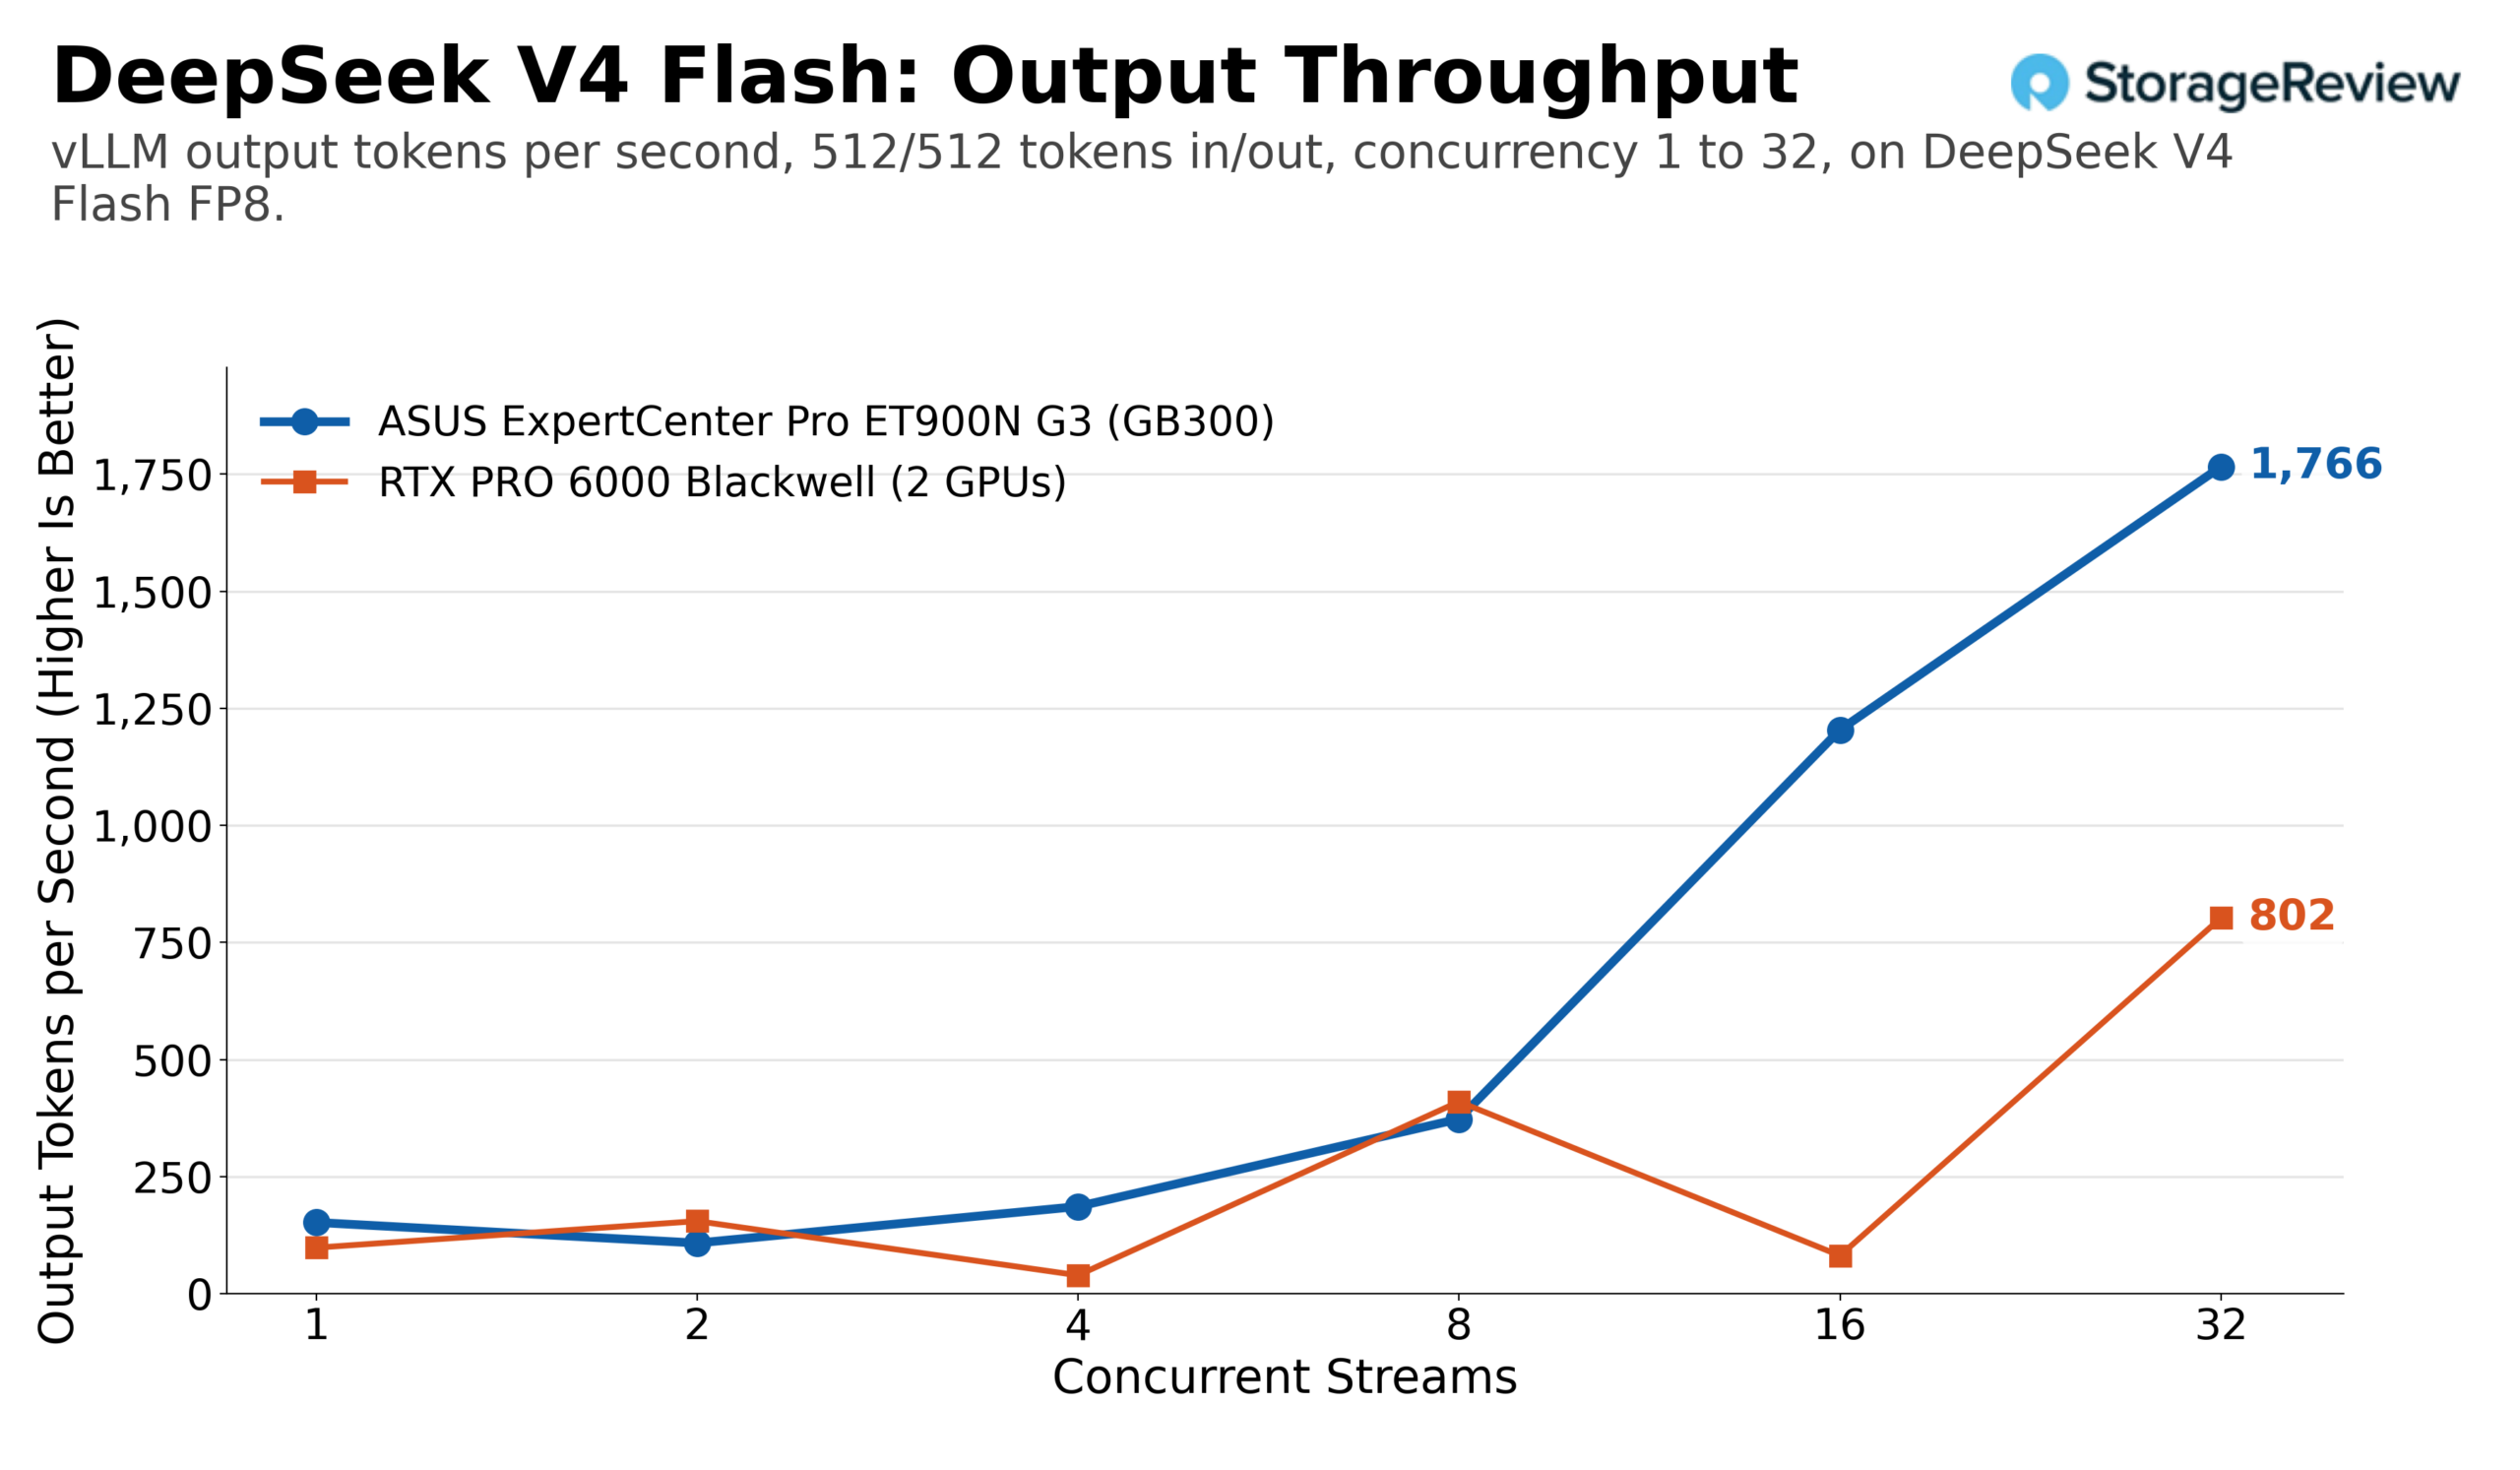
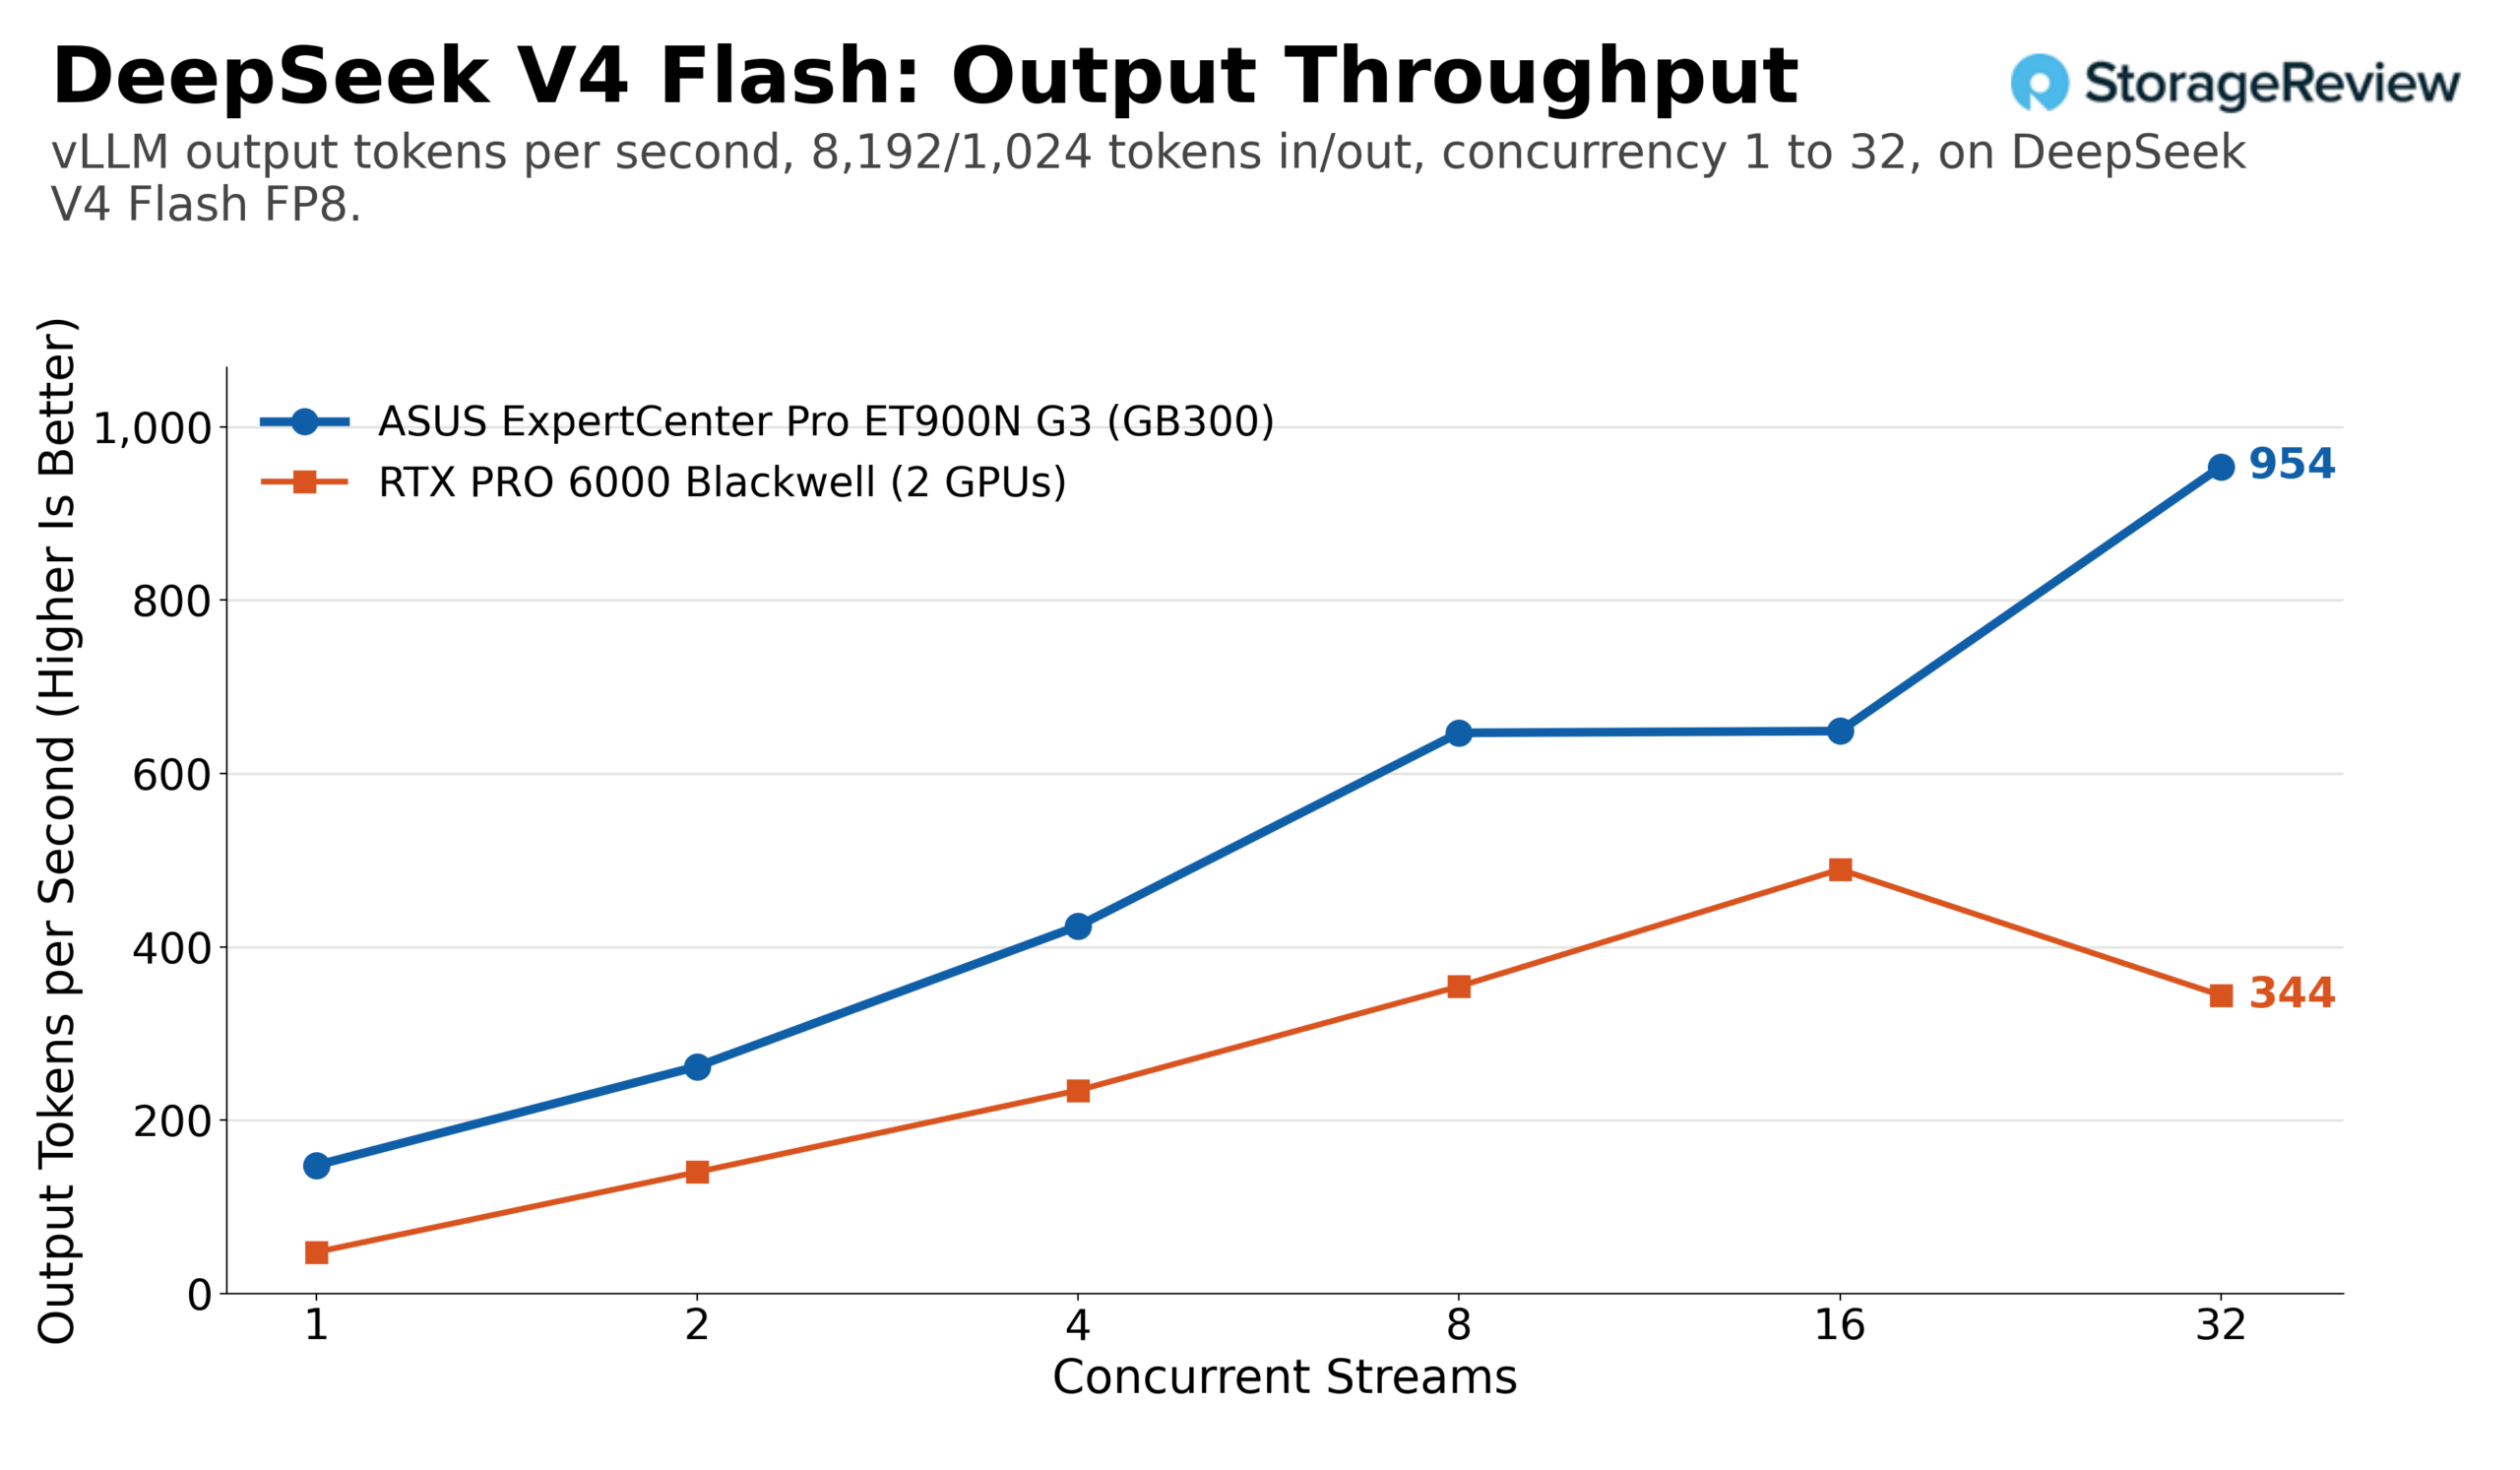
DeepSeek V4 Flash to prosty przypadek: natywny punkt kontrolny FP8 o rozmiarze około 20 GB, który B300 obsługuje bezproblemowo. Przepustowość wyjściowa przy tym samym obciążeniu wzrosła ze 152 tokenów na sekundę przy 1 strumieniu do 1,766 przy 32 strumieniach, co daje łączną przepustowość tokenów do 3,532. W profilu z dużym obciążeniem wstępnym, ET900N G3 zwiększył przepustowość tokenów wyjściowych ze 148 do 954 tokenów wyjściowych na sekundę, osiągając łącznie 8,587 tokenów. Para kart RTX PRO 6000 osiągnęła szczytową wartość blisko 800 tokenów wyjściowych na sekundę przy tym samym obciążeniu i około 490 przy długich monitach, z nierównomierną krzywą przy niskiej współbieżności.
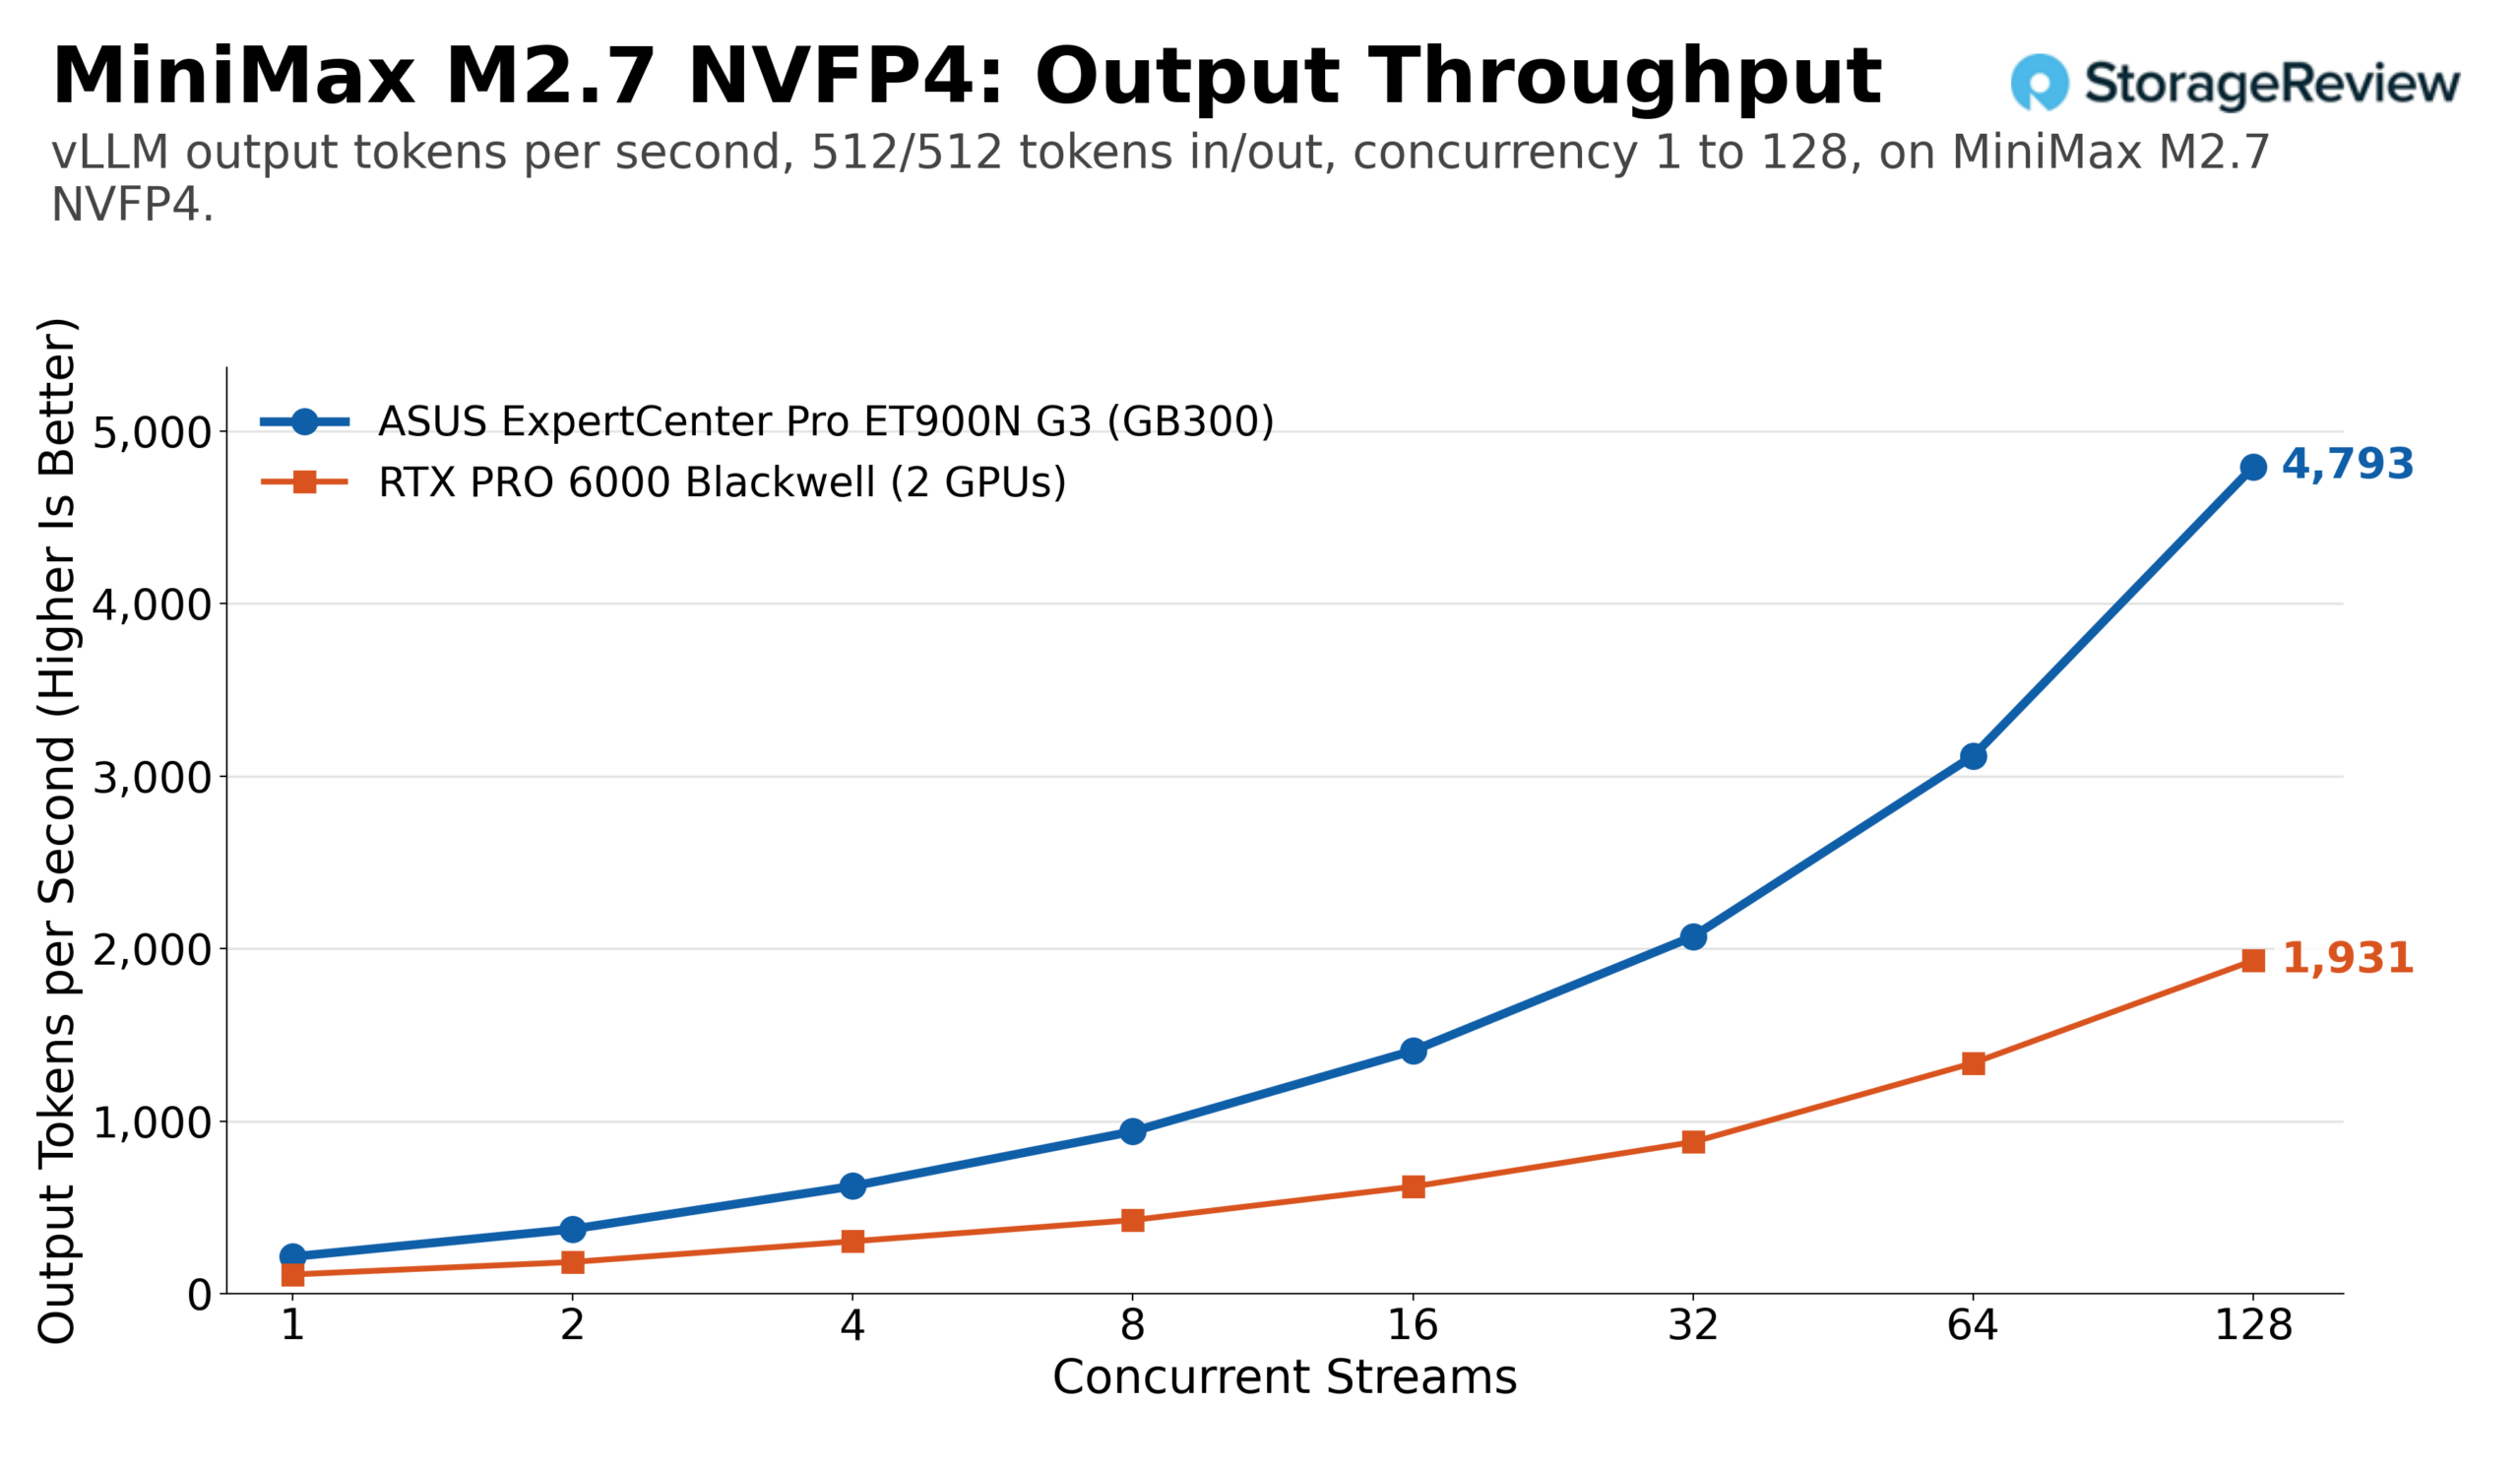
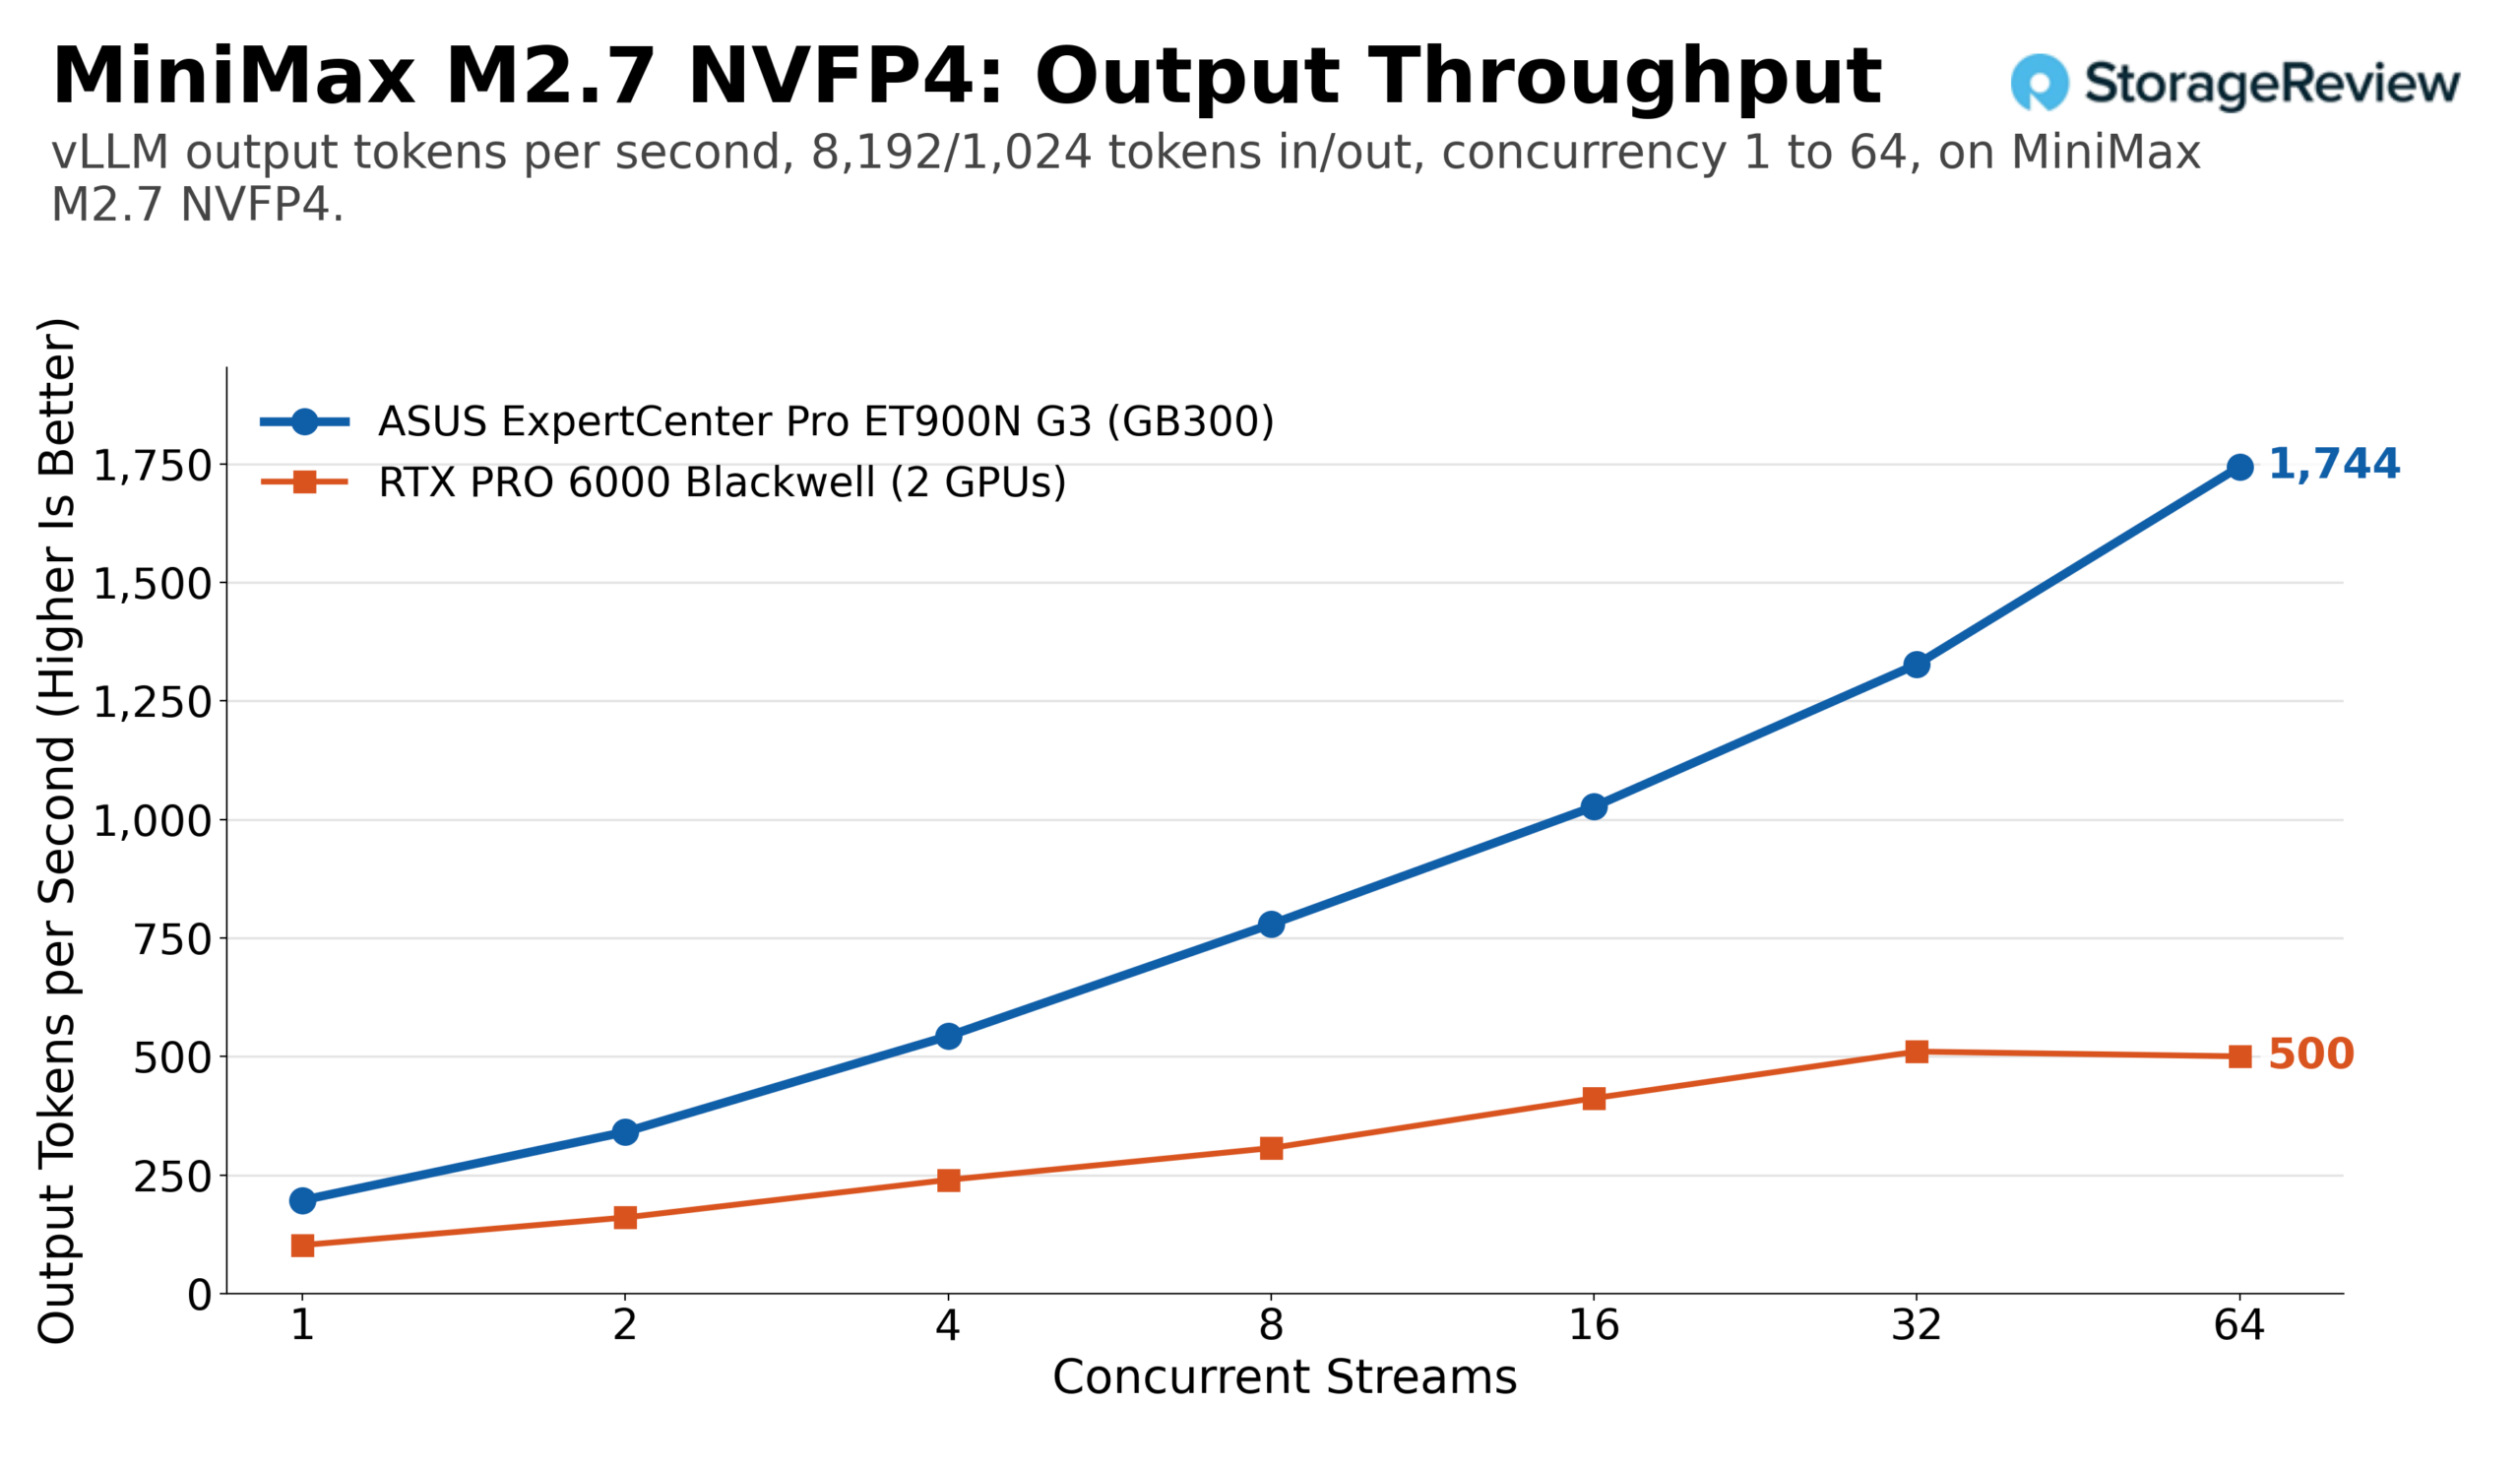
Karta MiniMax M2.7 w kwantyzacji NVFP4 firmy NVIDIA zajmuje około 125 GB pamięci HBM i skaluje się najmocniej spośród czterech. Równe obciążenie wzrosło z 214 tokenów wyjściowych na sekundę dla jednego strumienia do 4,793 dla 128 strumieni, a całkowita przepustowość osiągnęła 9,586. Przebieg z dużą ilością prefillu skalował się do 1,744 tokenów wyjściowych na sekundę i 15 700 tokenów na sekundę przy 64 strumieniach. Dwie karty RTX PRO 6000 podążały za tym samym kształtem, ale o mniej niż połowę niższej wysokości, osiągając maksymalnie 1,930 tokenów wyjściowych na sekundę przy równym obciążeniu i około 510 dla długich monitów.
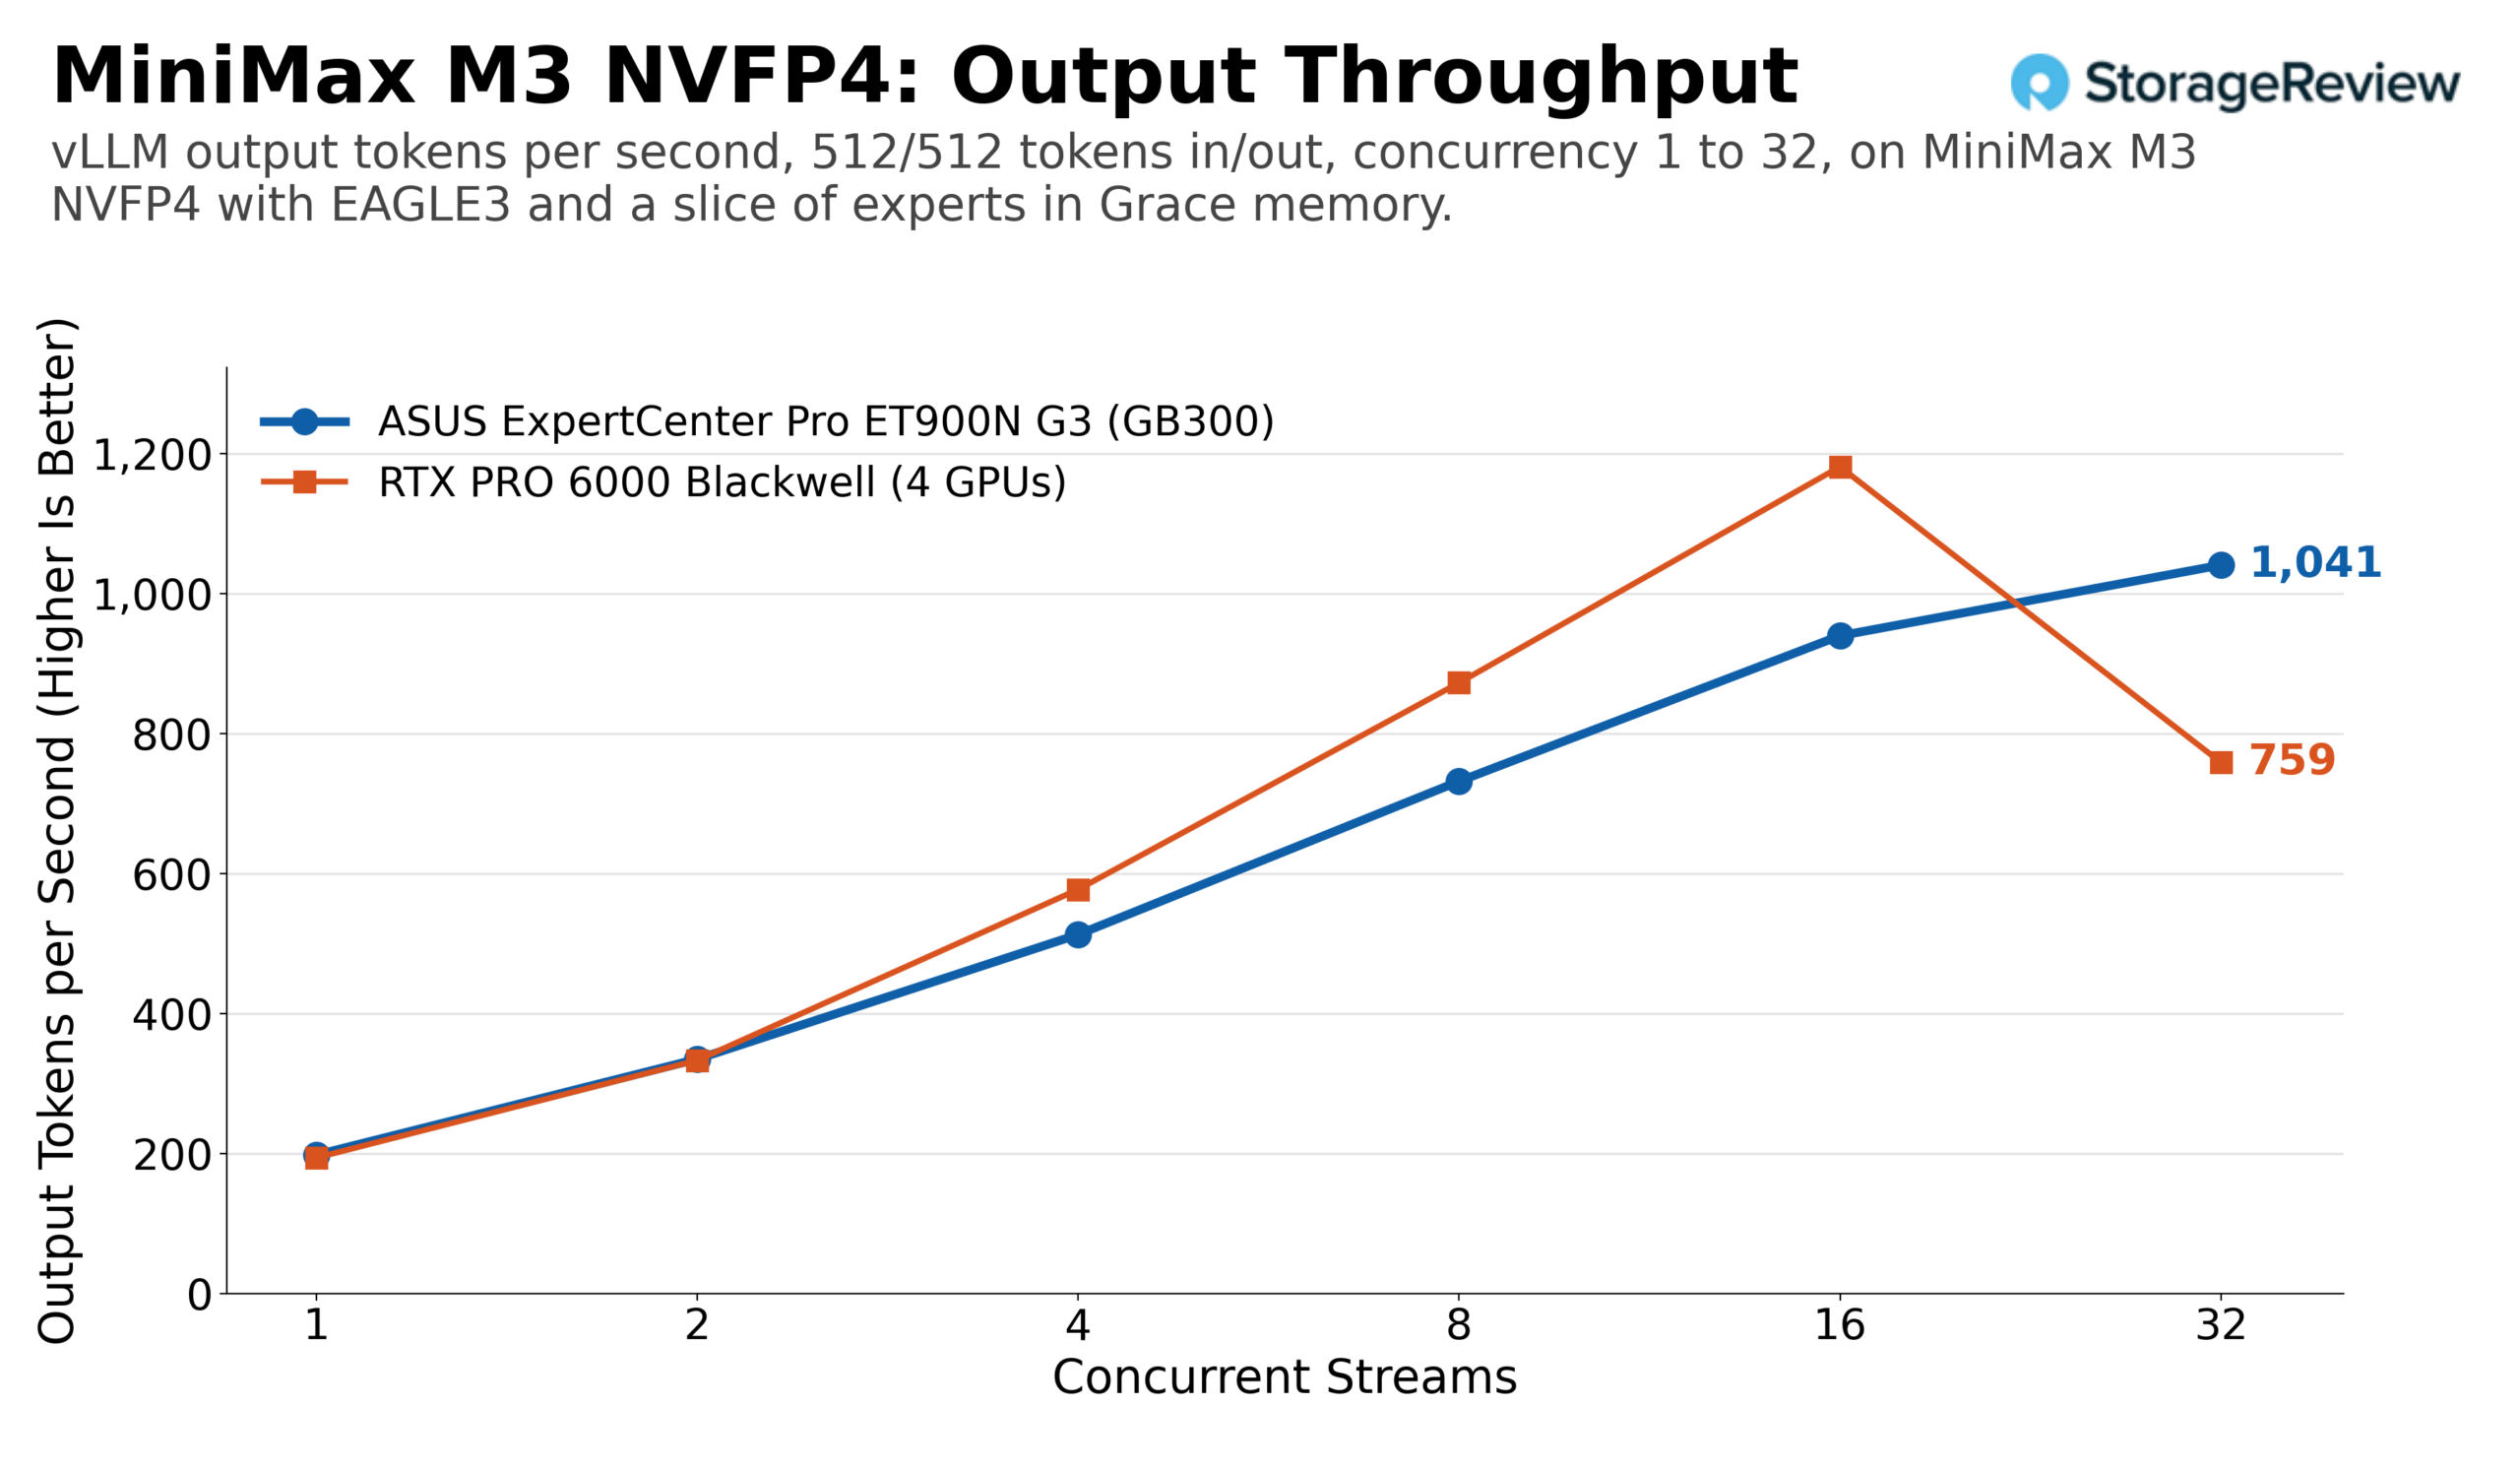
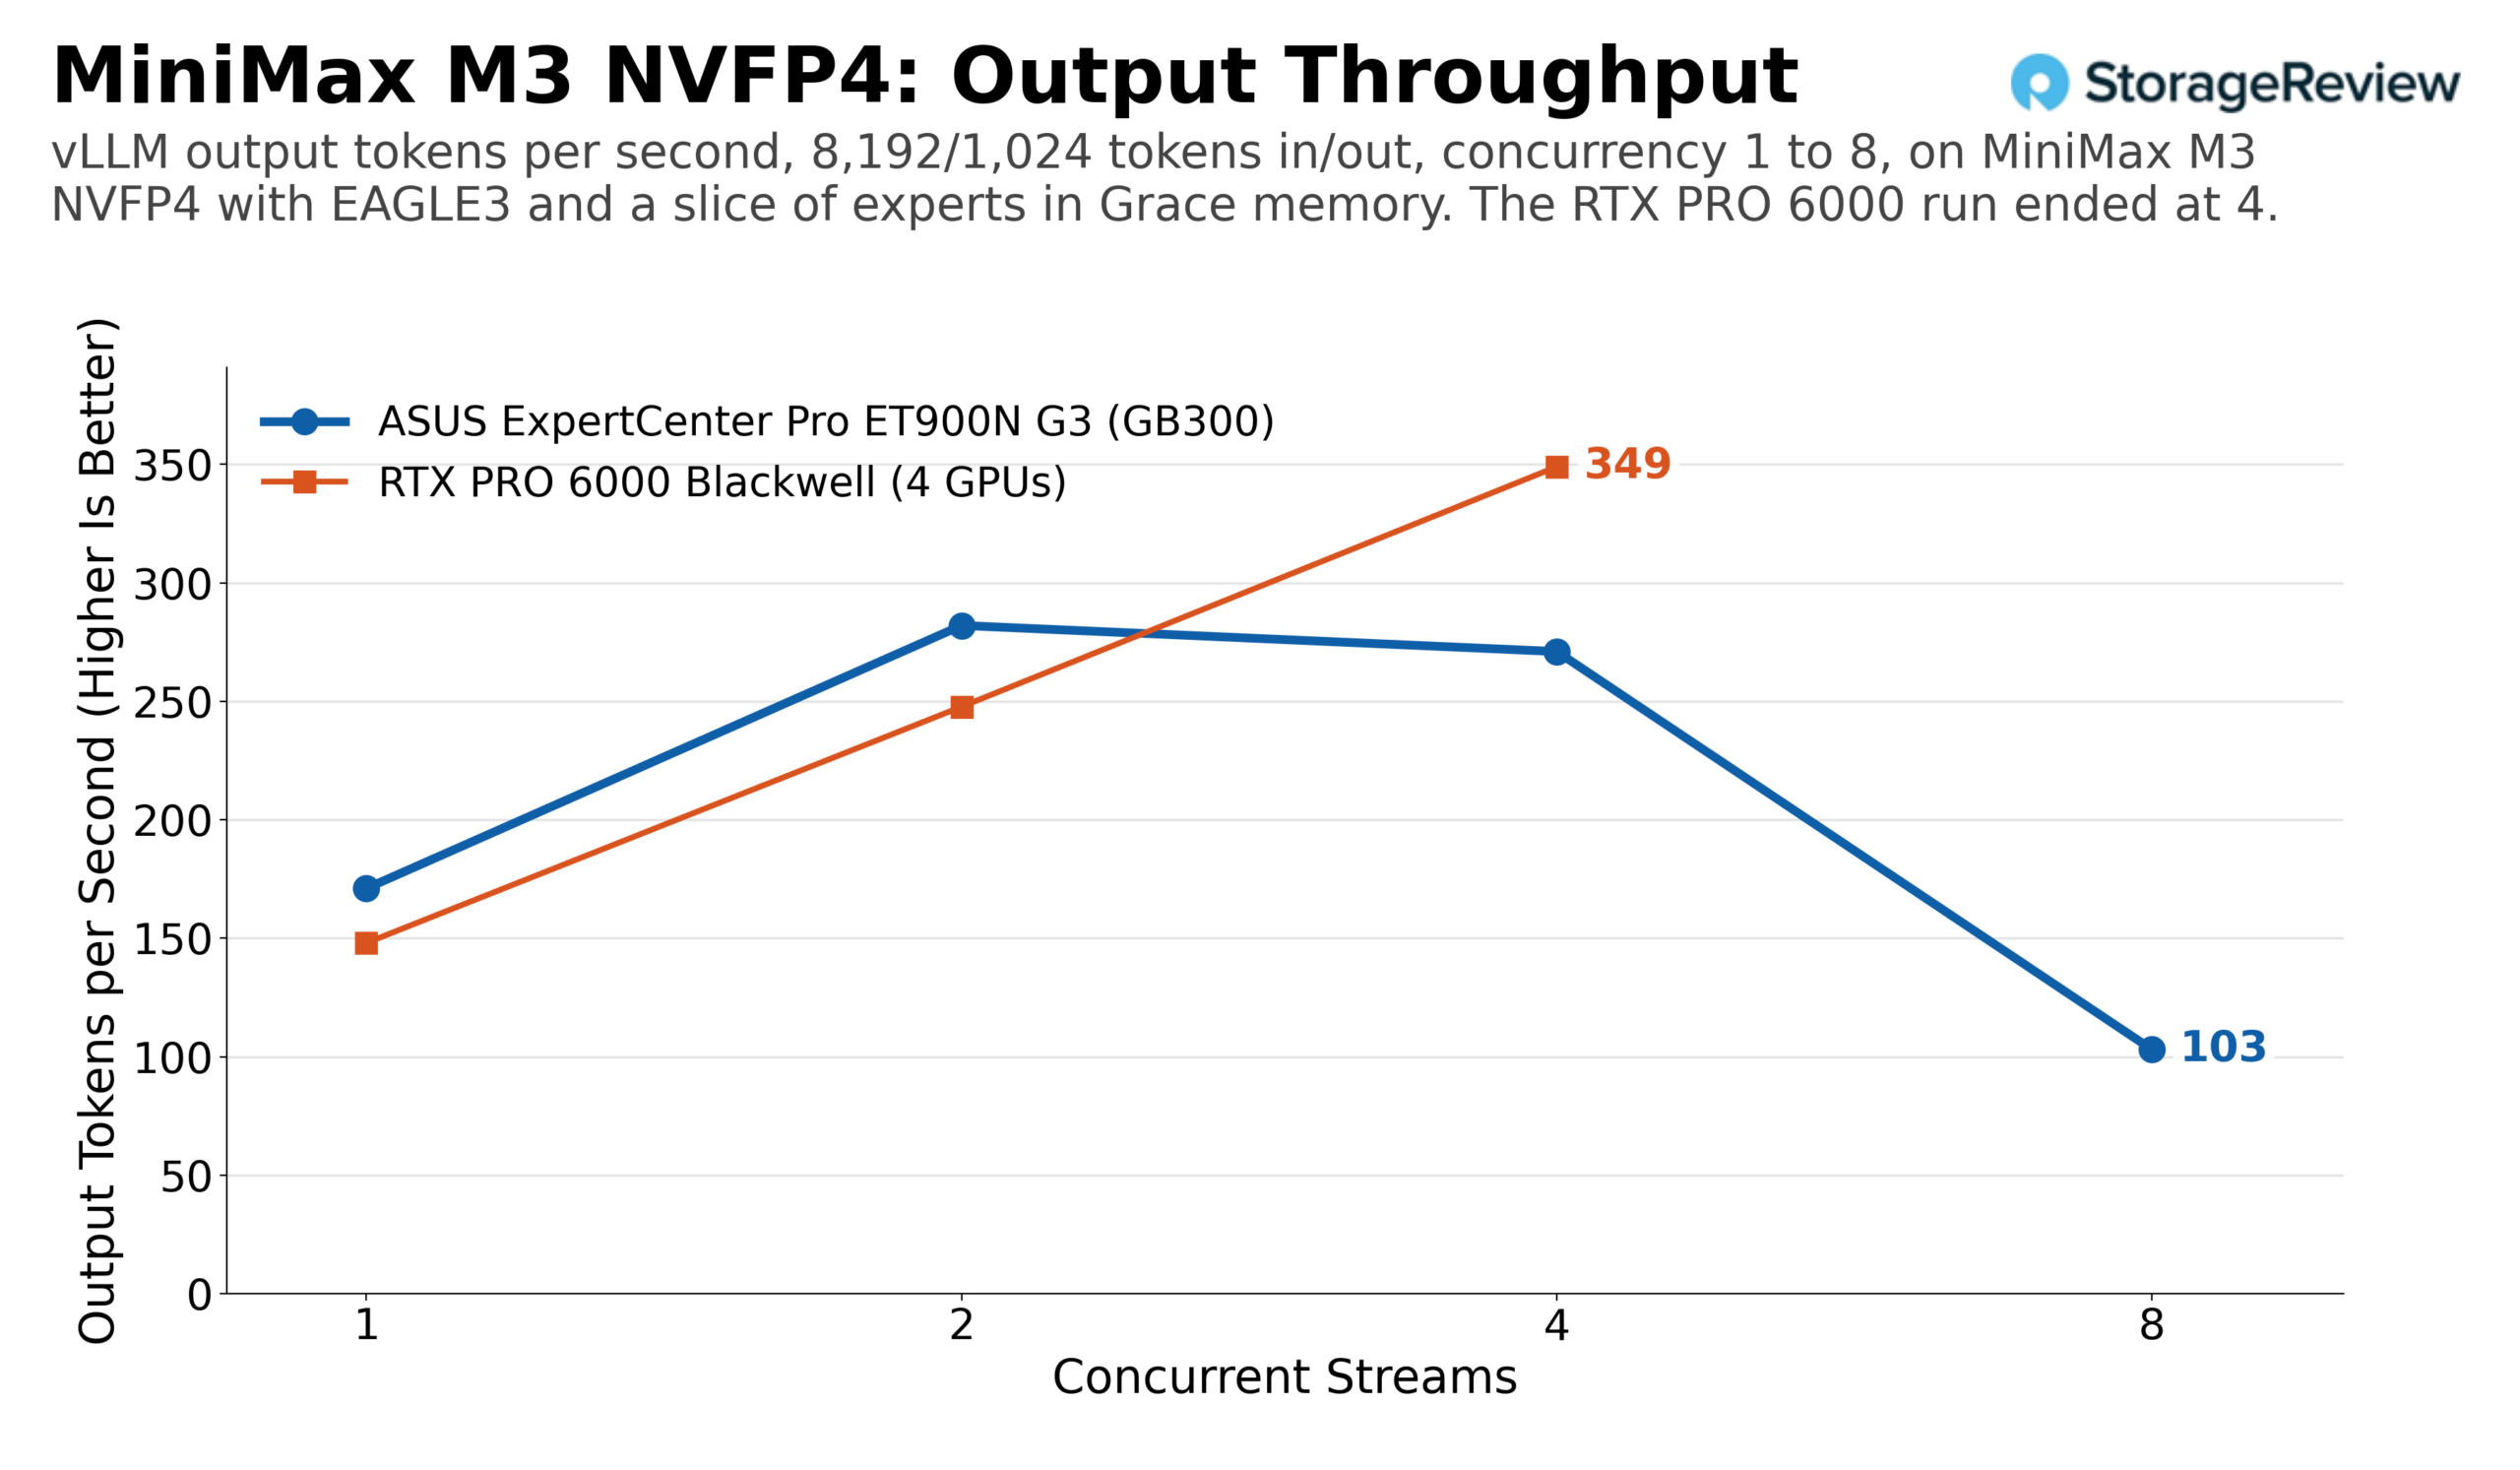
MiniMax M3 pokazuje, jak trudno zmieścić się w pamięci. Punkt kontrolny NVFP4 jest mniejszy niż 252 GB, ale pamięć podręczna środowiska wykonawczego i KV również wymagają przestrzeni, dlatego część ekspertów znajduje się w pamięci Grace, a każdy krok dekodowania, który ich dotyka, przechodzi przez NVLink-C2C. Dzięki dekodowaniu spekulatywnemu EAGLE3, ET900N G3 osiągnął 1,041 tokenów wyjściowych na sekundę przy 32 strumieniach i równym obciążeniu. Profil z dużym obciążeniem wstępnym osiągnął szczyt na poziomie 282 przy dwóch strumieniach, utrzymał się na poziomie 271 przy czterech i spadł do 103 przy ośmiu, gdy długie monity zużywały pozostałą pamięć podręczną. Cztery karty RTX PRO 6000 z tym samym dekoderem spekulatywnym dotrzymywały kroku przy ośmiu strumieniach i wyprzedziły przy 16 strumieniach z około 1,180 tokenami wyjściowymi na sekundę, a następnie spadły do około 760 przy 32 strumieniach. W profilu z dużym udziałem wstępnego wypełniania, czterokartowe pudełko mieściło około 349 tokenów wyjściowych na sekundę przy czterech strumieniach w porównaniu do 271 tokenów stacji. Model znajdujący się na granicy HBM to jedyne miejsce w tym zestawie, w którym 384 GB pamięci VRAM na czterech kartach konkuruje z 252 GB pamięci HBM plus odciążenie.
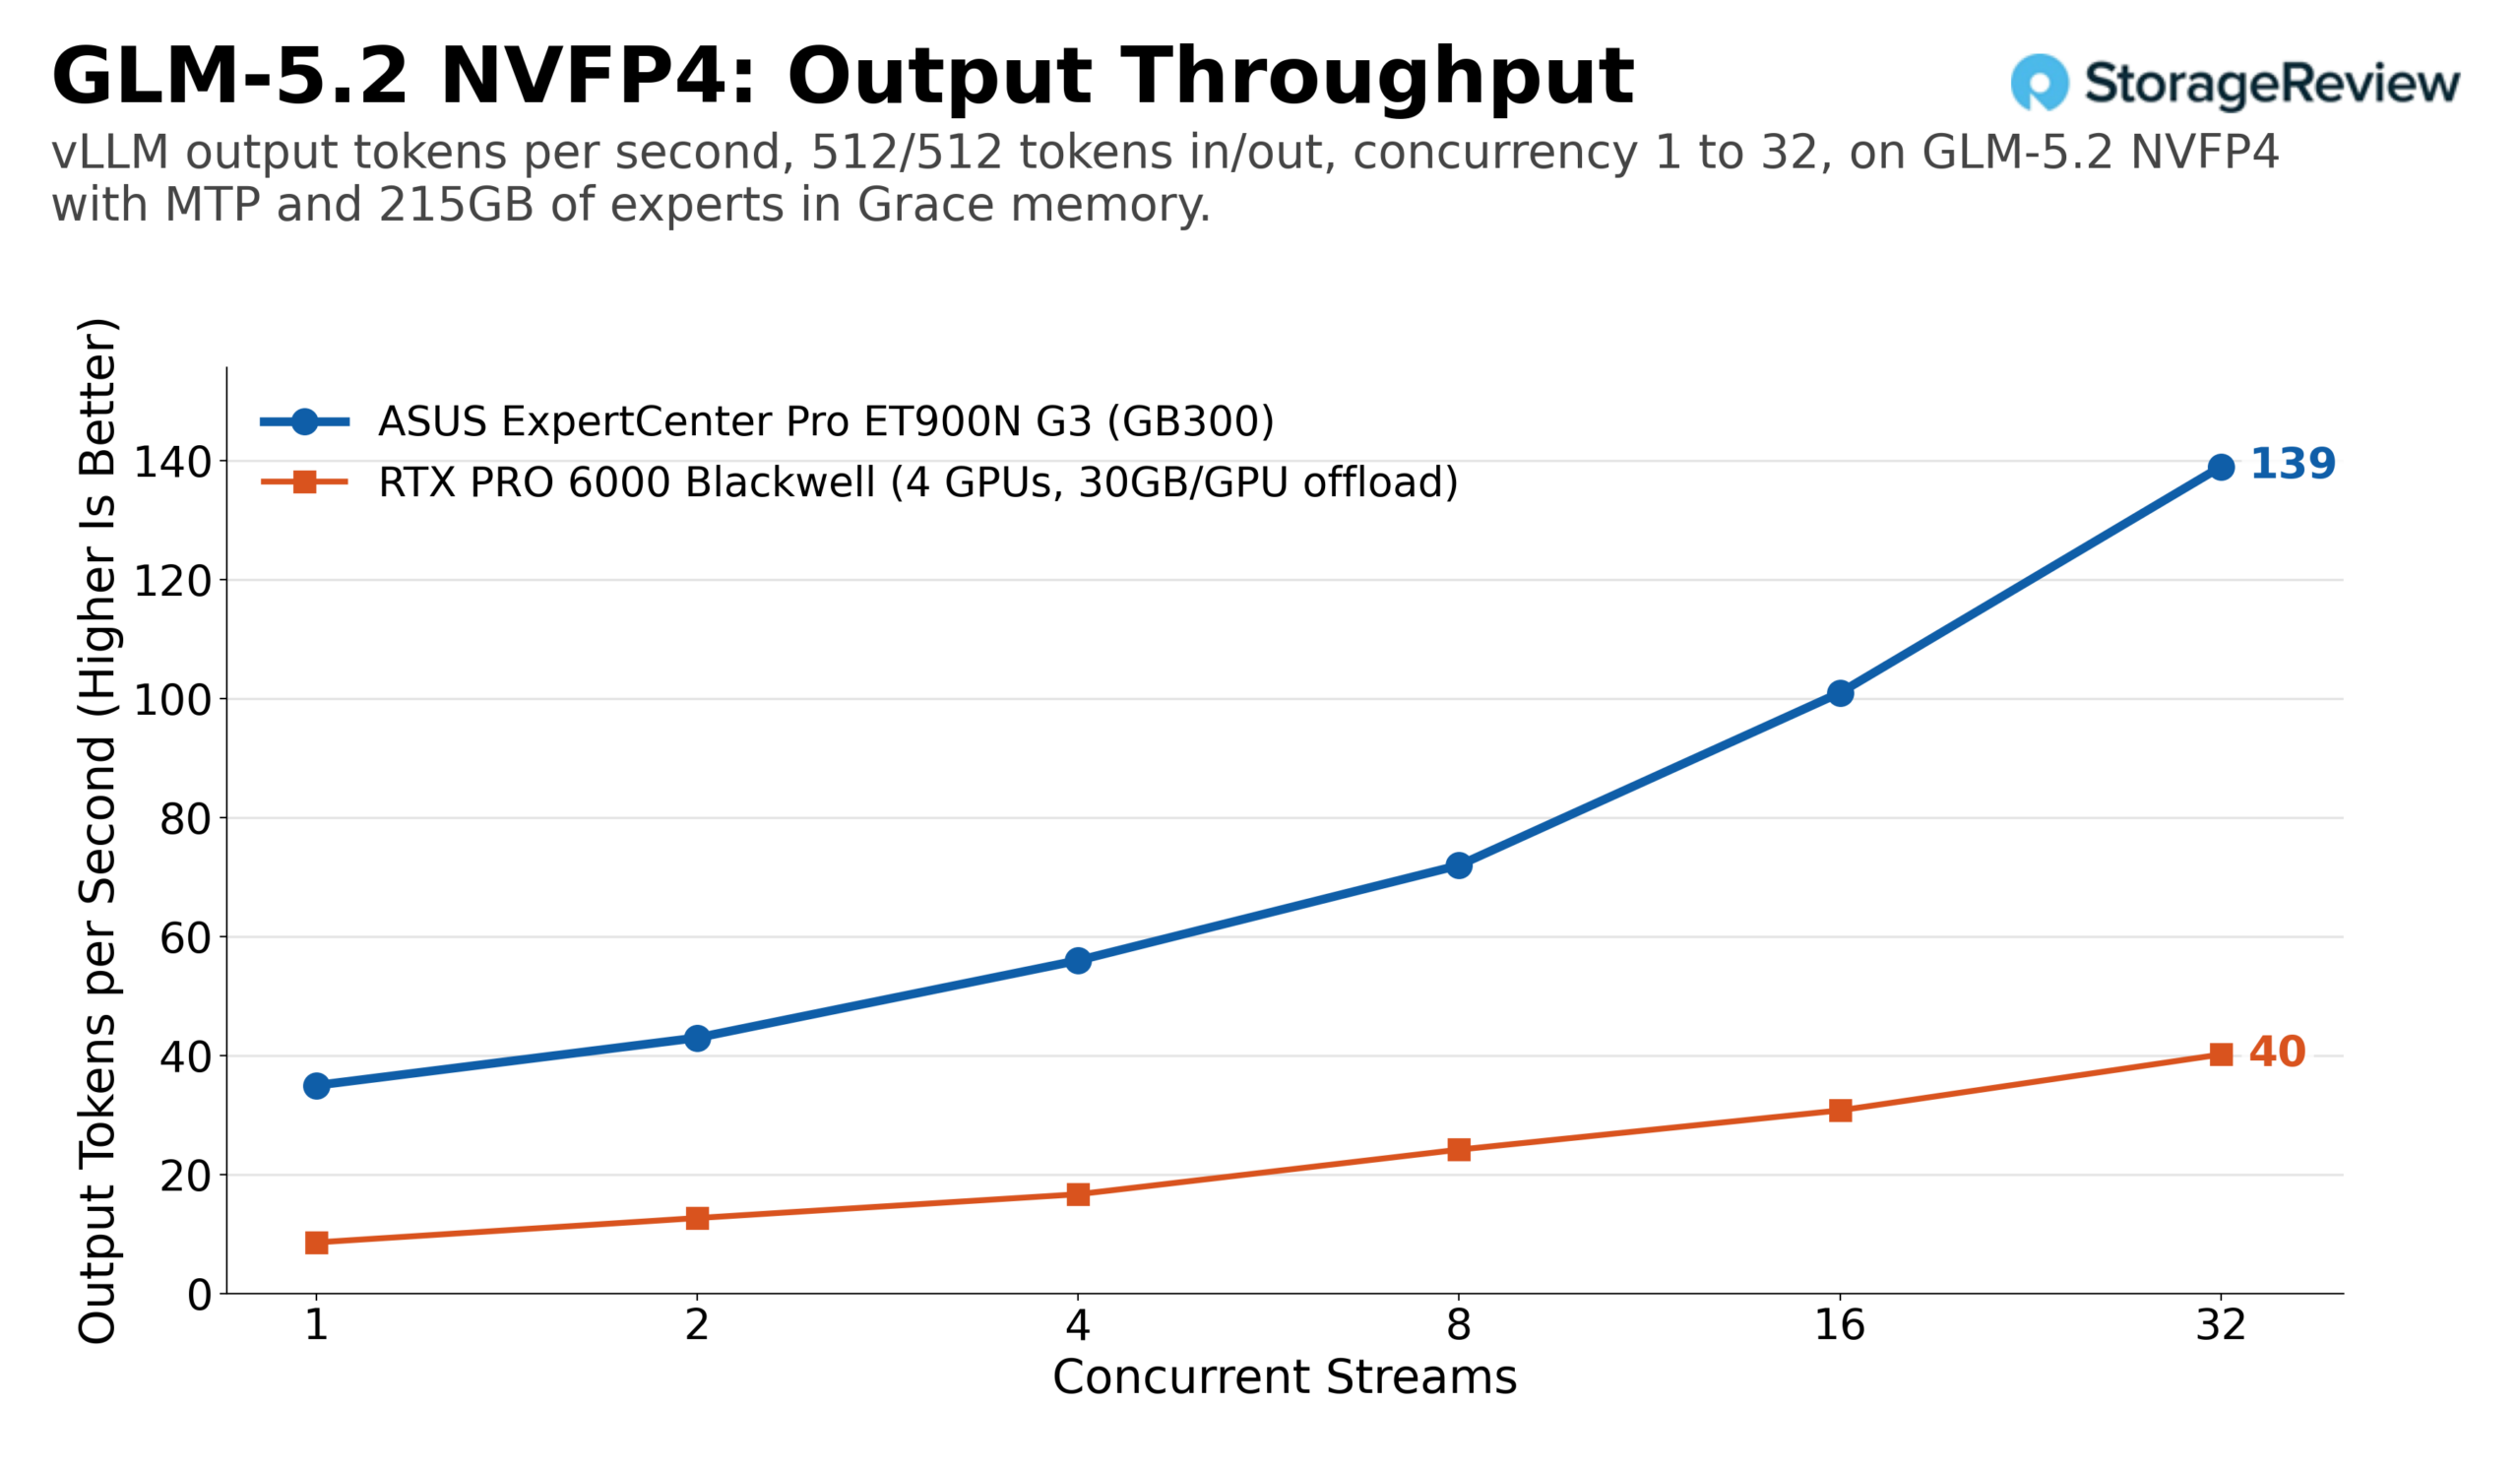
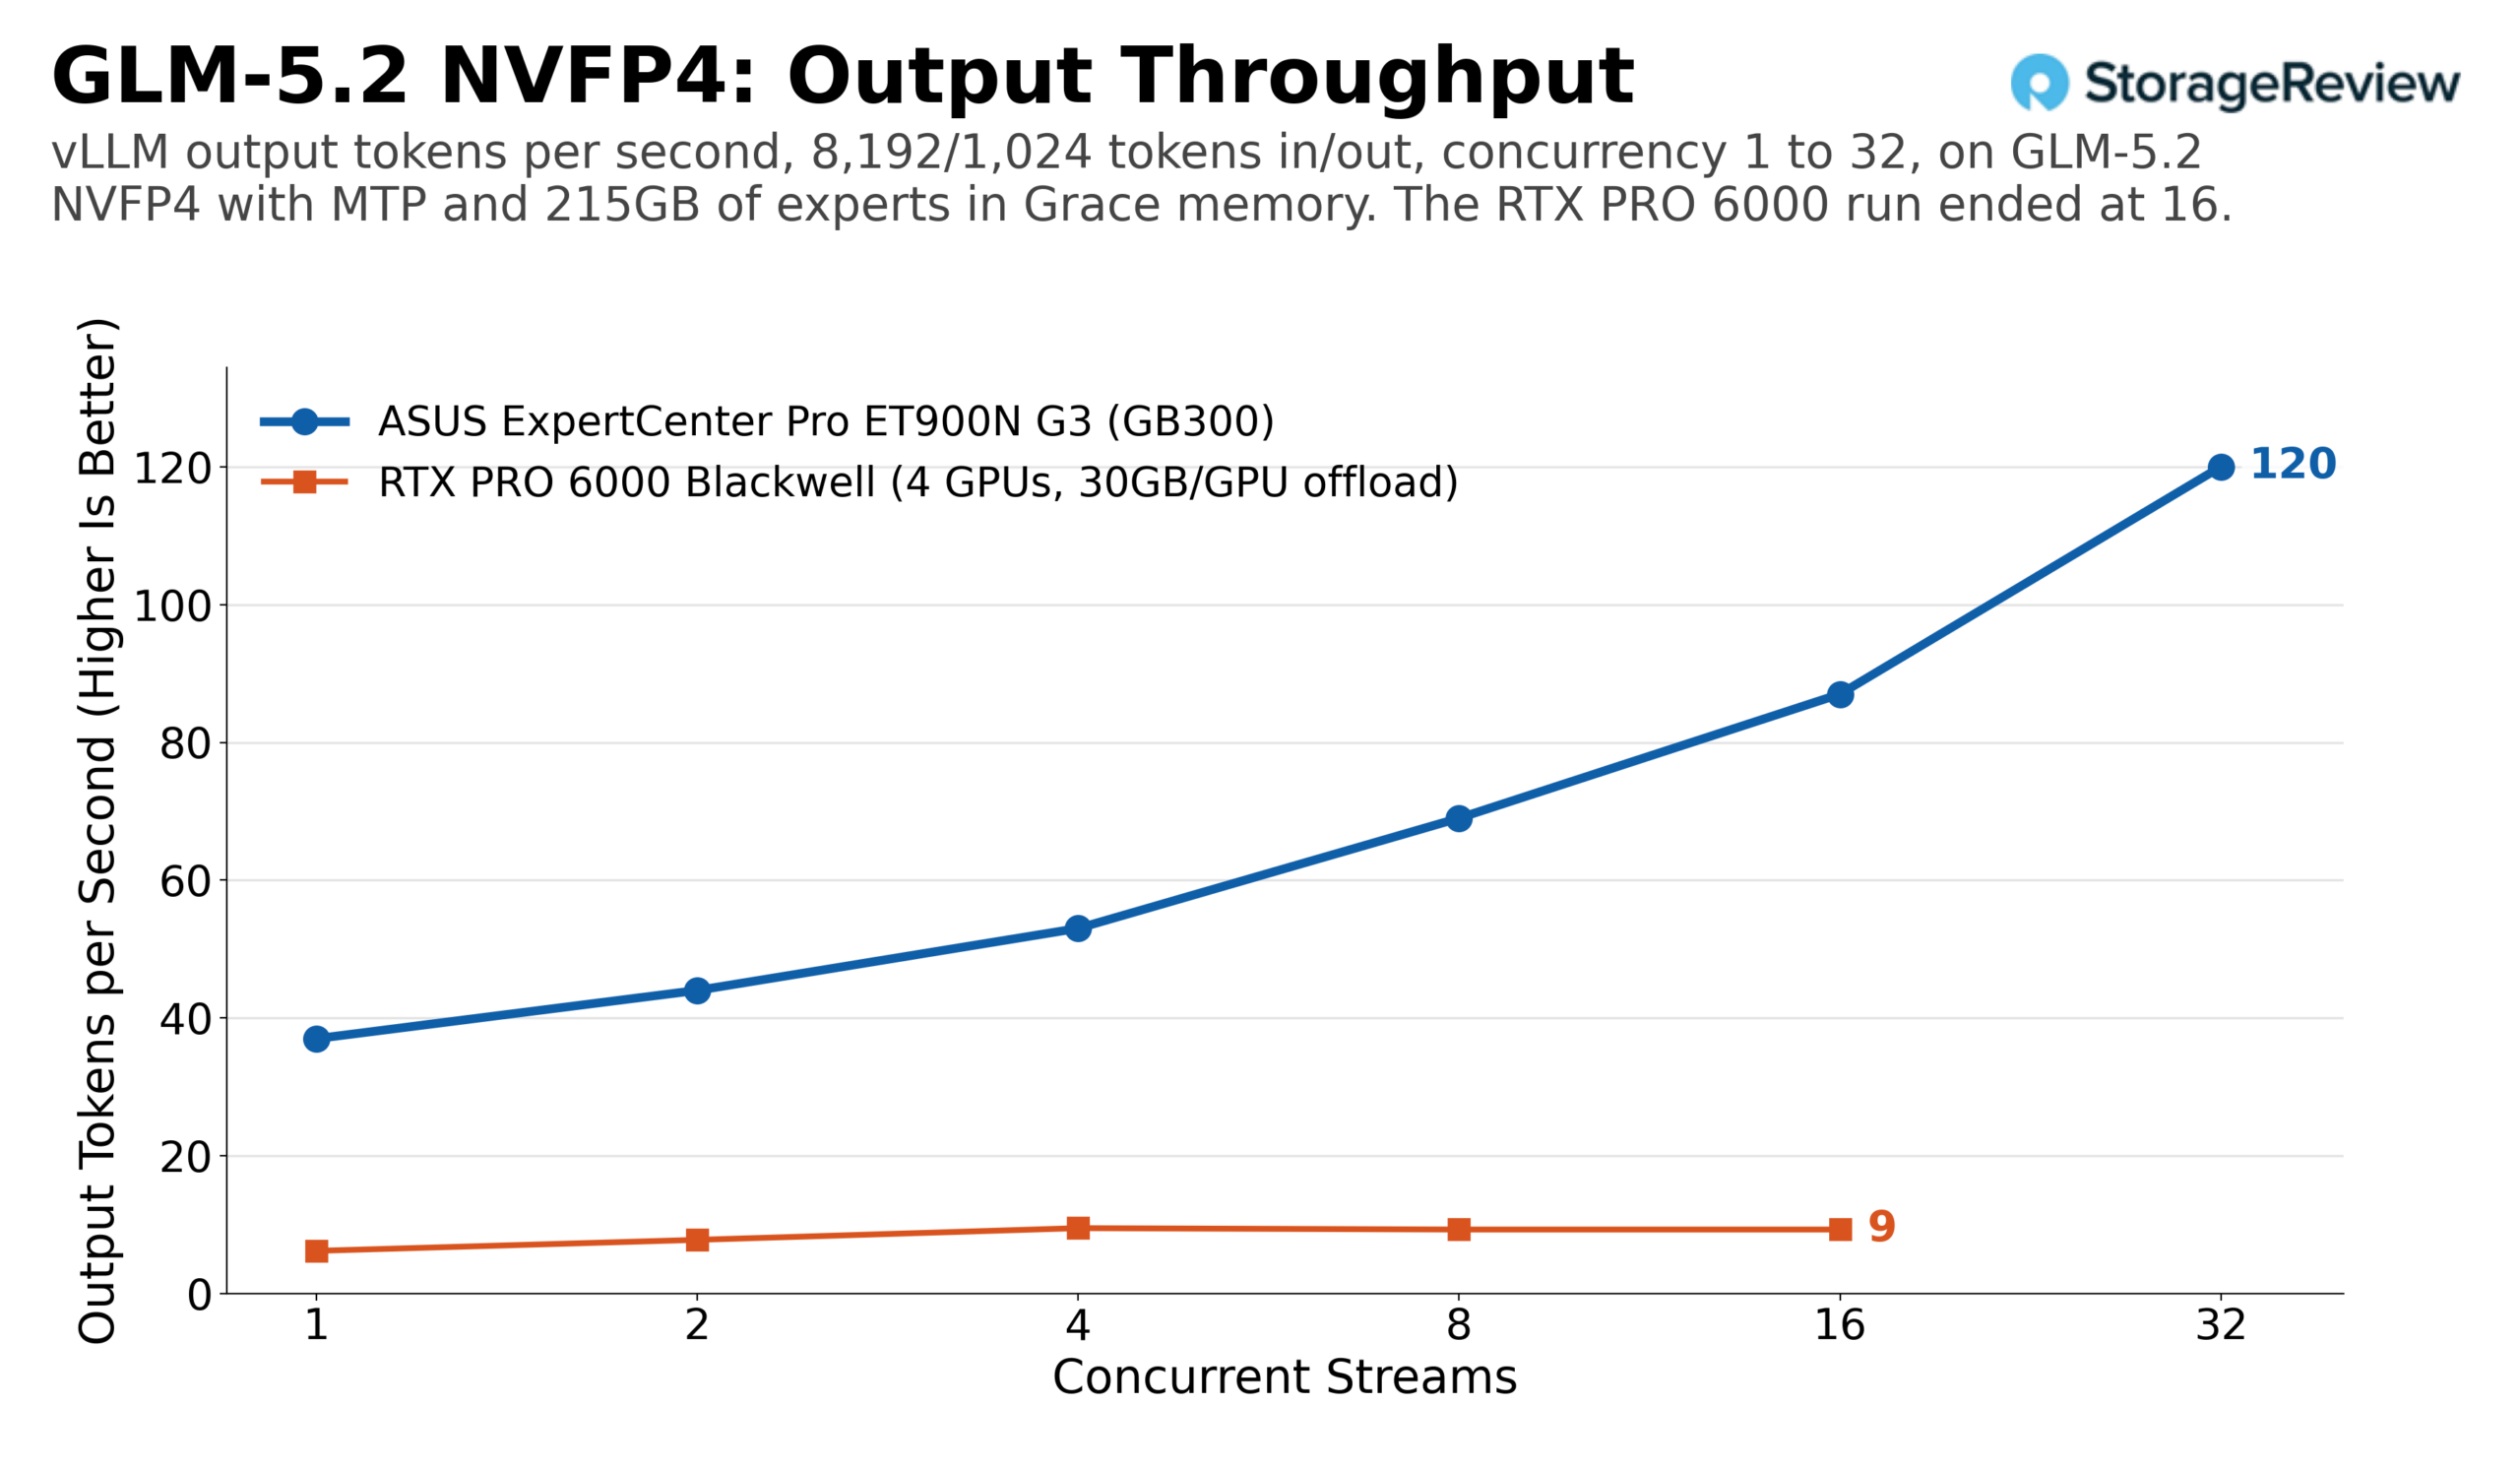
GLM-5.2 to przypadek użycia, który jest możliwy tylko dzięki puli koherentnej. Punkt kontrolny NVFP4 przechowuje około 215 GB wag eksperckich w pamięci Grace z dekodowaniem spekulatywnym MTP, a ET900N G3 obsłużył go z prędkością 35 tokenów wyjściowych na sekundę dla jednego strumienia i 139 dla 32 strumieni przy równym obciążeniu, a całkowita przepustowość osiągnęła 277. W profilu z dużym obciążeniem wstępnym, przeszukiwanie objęło 32 strumienie, osiągając 120 tokenów wyjściowych na sekundę i łącznie 1,079 tokenów. Cztery karty RTX PRO 6000, z których każda odciążała pamięć hosta z około 30 GB, obsłużyły około 40 tokenów wyjściowych na sekundę przy 32 strumieniach, spłaszczając tę wartość do około 9-10 przy długich monitach od czterech strumieni w górę. Żaden z systemów nie sprawia wrażenia szybkiego modelu 433 GB, ale GB300 oferuje przepustowość 396 GB/s LPDDR5X i 900 GB/s NVLink-C2C, co pozwala ekspertom w dziedzinie odciążania pamięci, a jednocześnie oferuje skalowalność na poziomie, na jakim kończy się pamięć hosta podłączona przez PCIe na czterech kartach.
W porównaniu z MSI WS300, wyniki modelu granicznego ET900N G3 mieszczą się w granicach około 1% w każdym porównywalnym punkcie: 1,766 tokenów wyjściowych na sekundę na DeepSeek V4 Flash przy 32 strumieniach na obu wieżach, 4,793 w porównaniu z 4,801 na MiniMax M2.7 przy 128, 1,041 na MiniMax M3 przy 32 strumieniach na obu i 139 na GLM-5.2 przy 32 strumieniach na obu.
Modele współdzielone dla RTX PRO 6000, H200 NVL i DGX Spark
Druga część benchmarku wykorzystuje modele na tyle małe, że obsługuje je każdy system: GPT-OSS-20B i 120B w natywnym MXFP4; Llama 3.1 8B w BF16 i FP8; Mistral Small 24B w BF16 i FP8; oraz Qwen3 Coder 30B w BF16 i FP8. Nowością od czasu testu WS300 jest pojedyncza karta H200 NVL, karta Hopper firmy NVIDIA o pojemności 141 GB, co pozwala na porównanie z akceleratorem centrów danych o jedną generację wstecz.
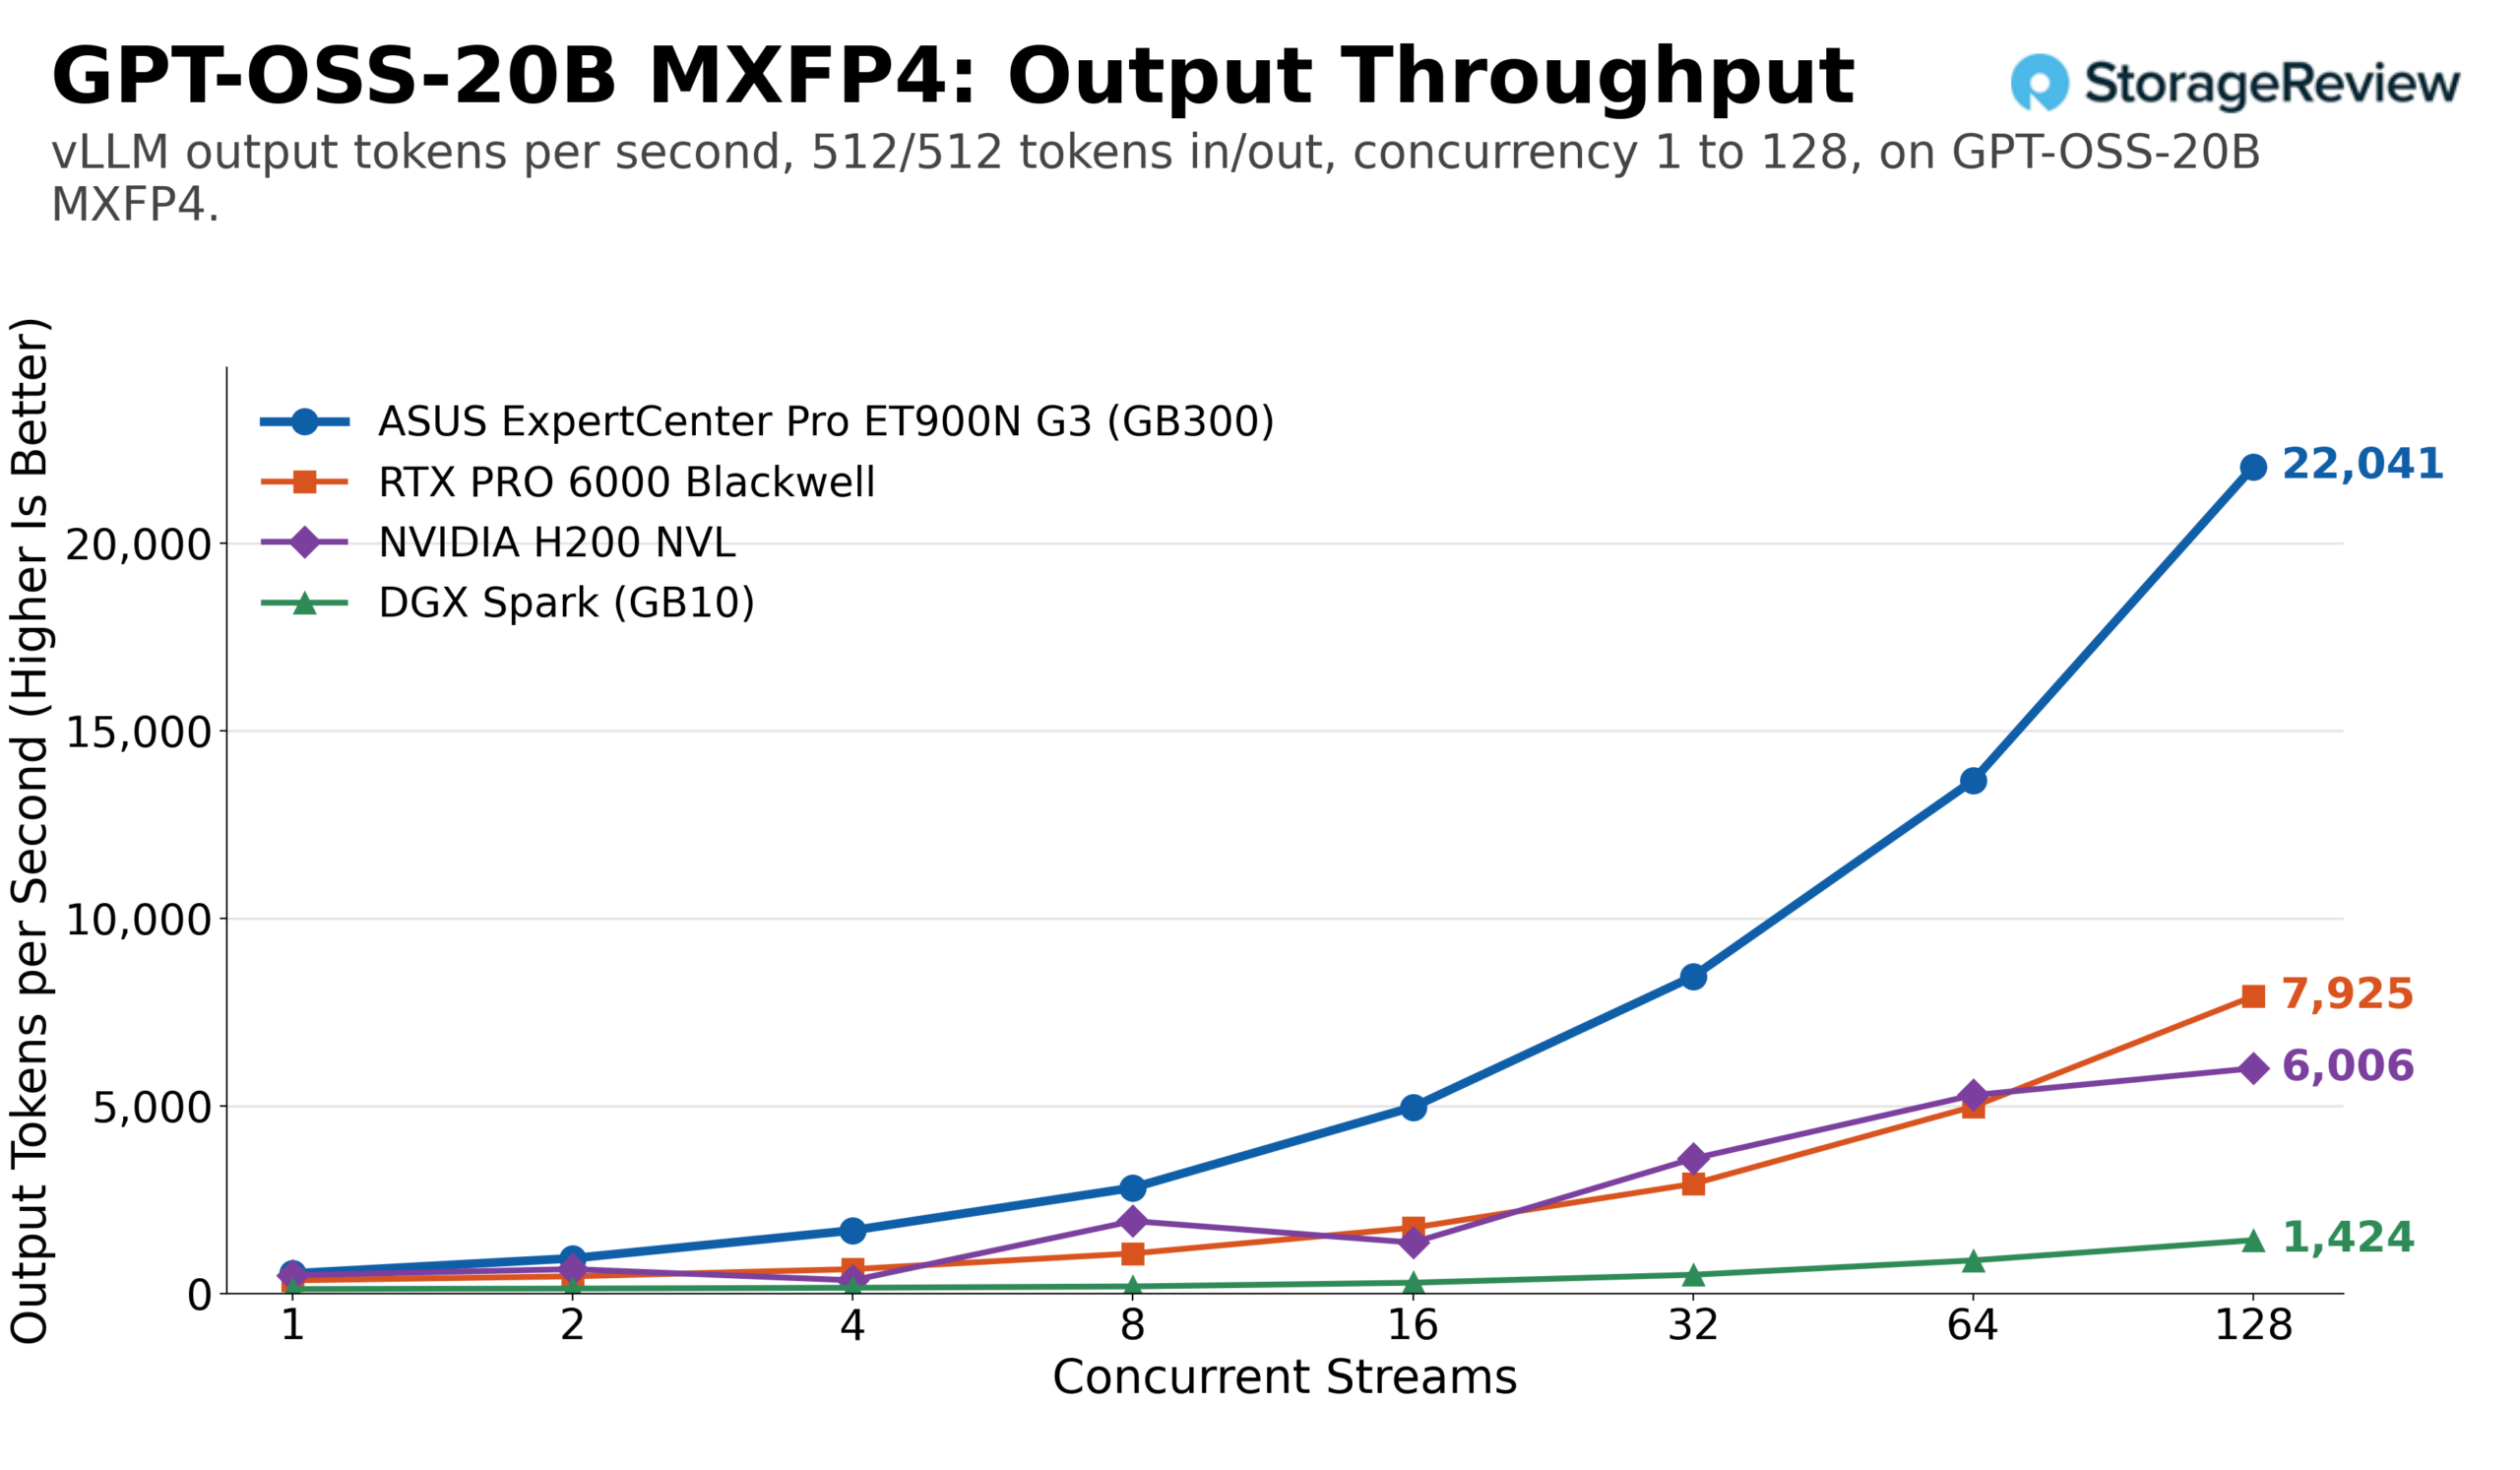
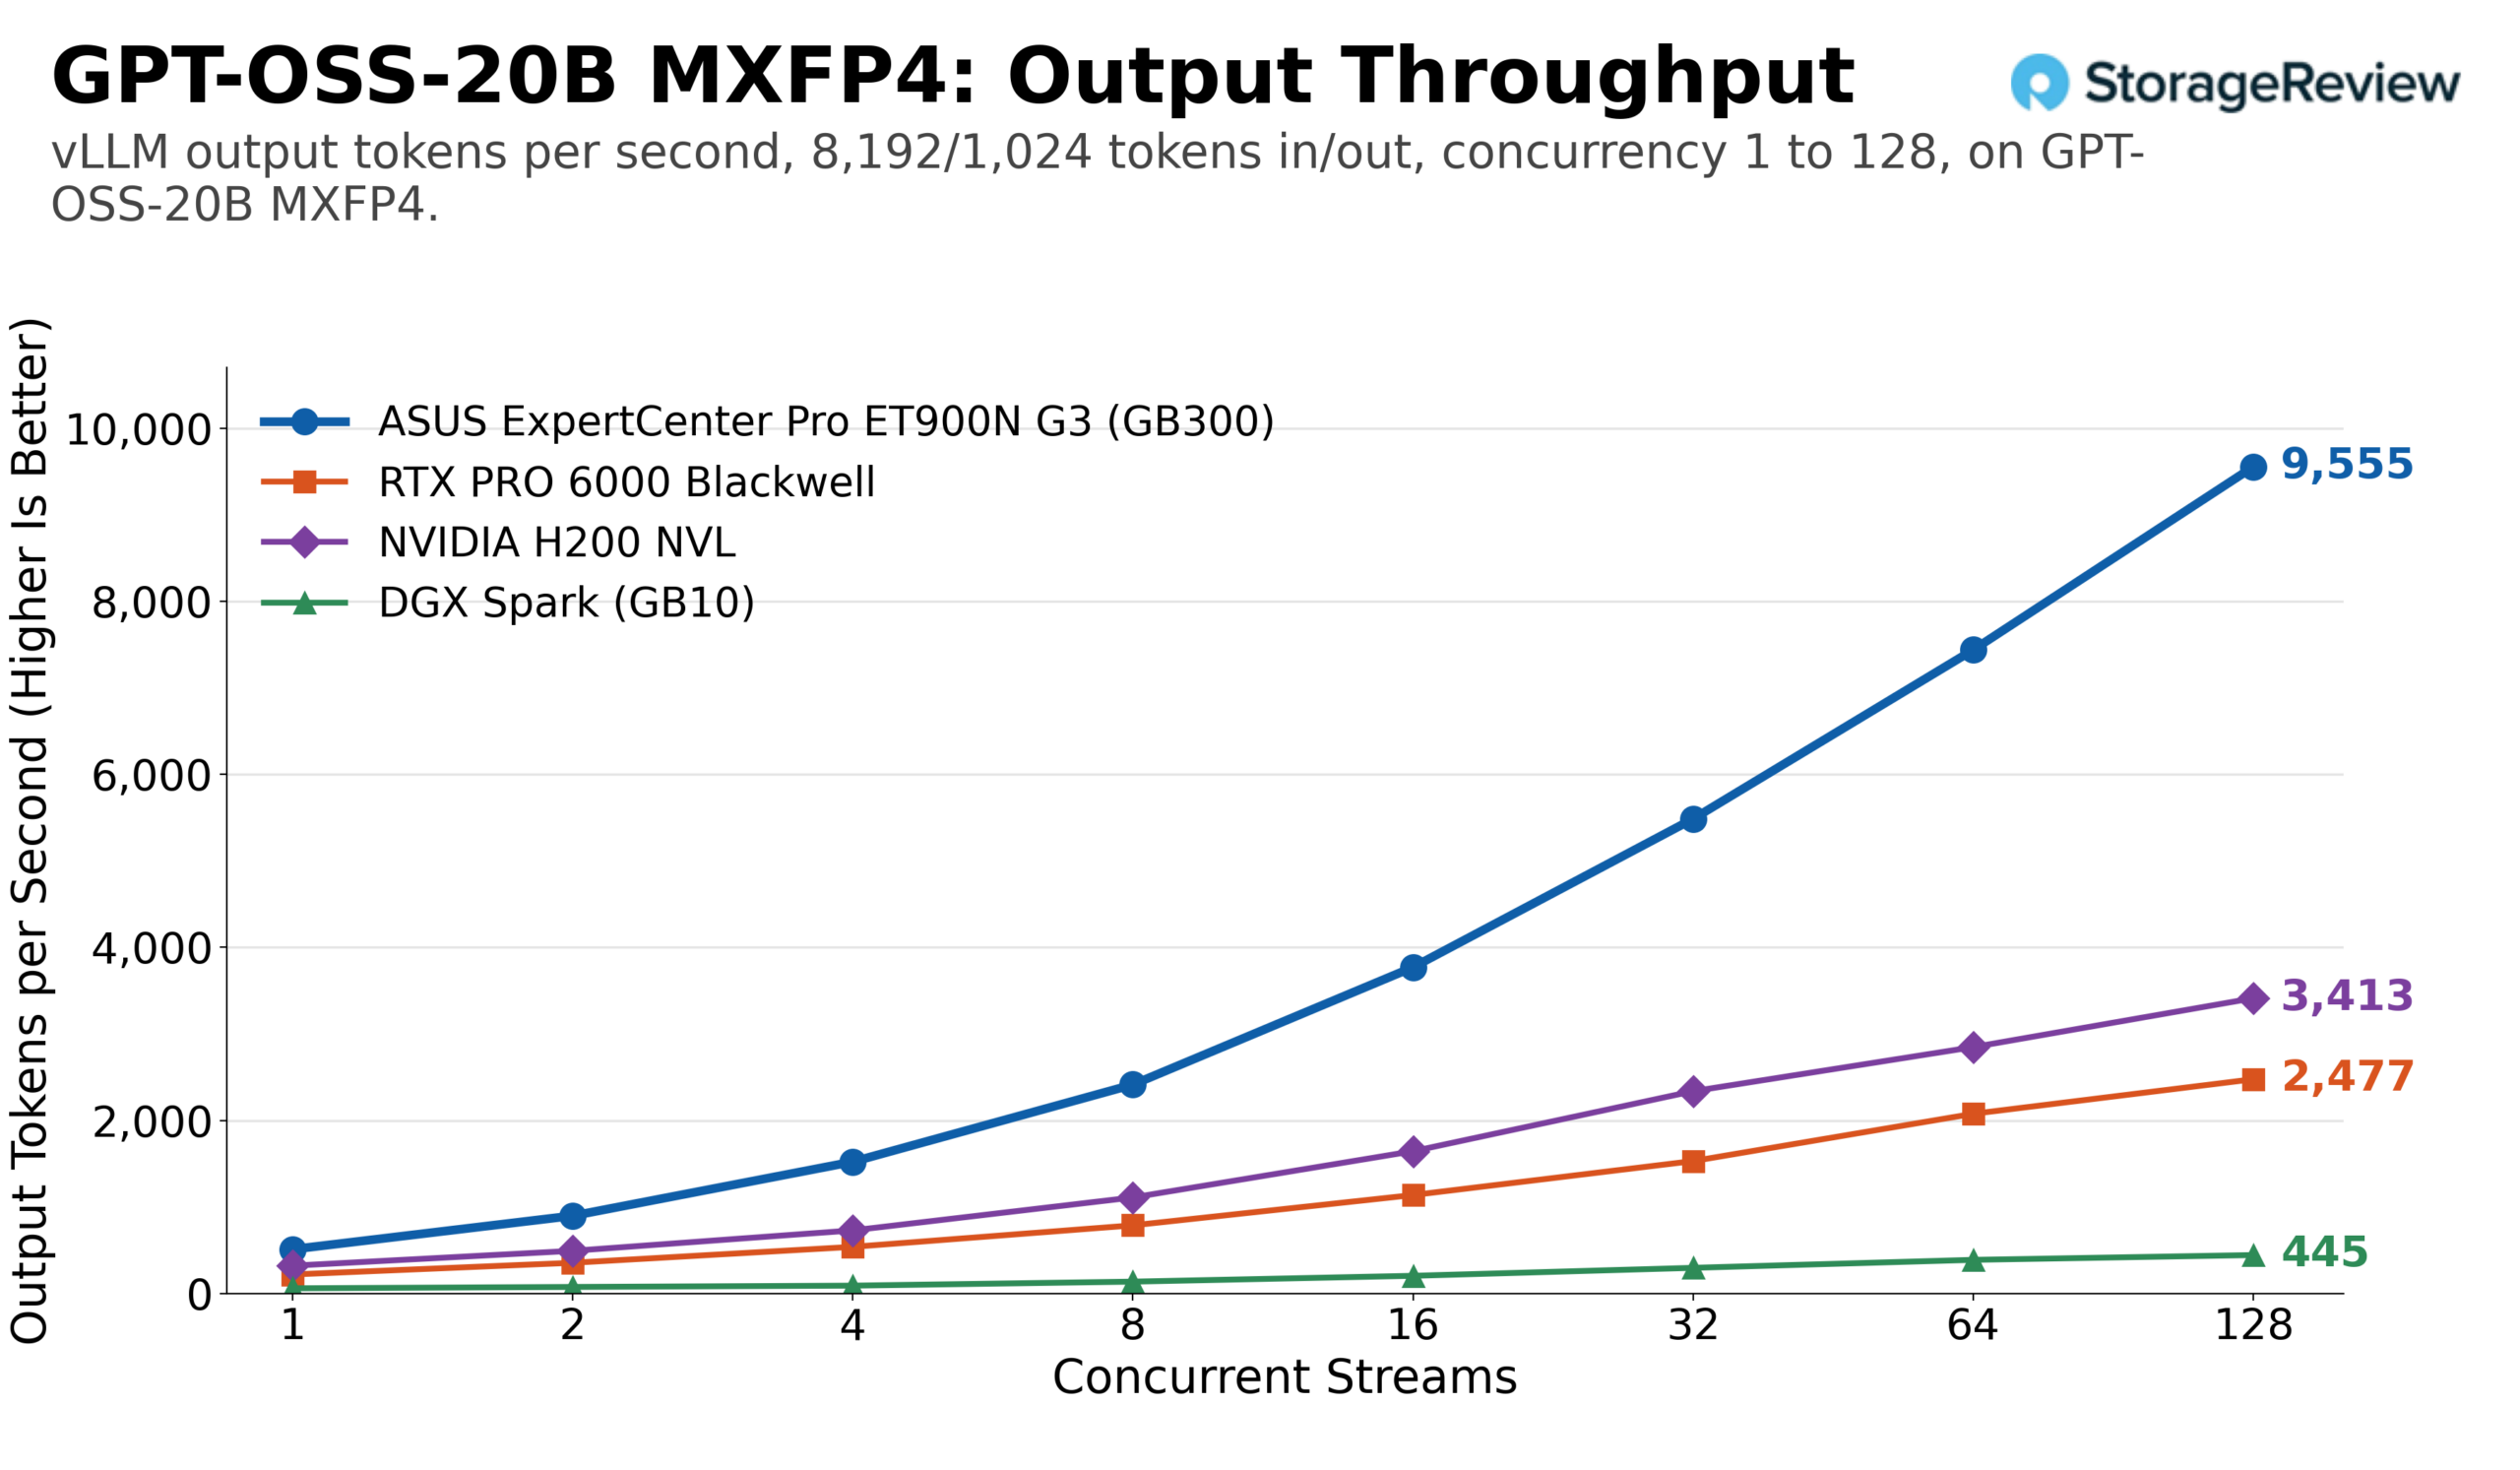
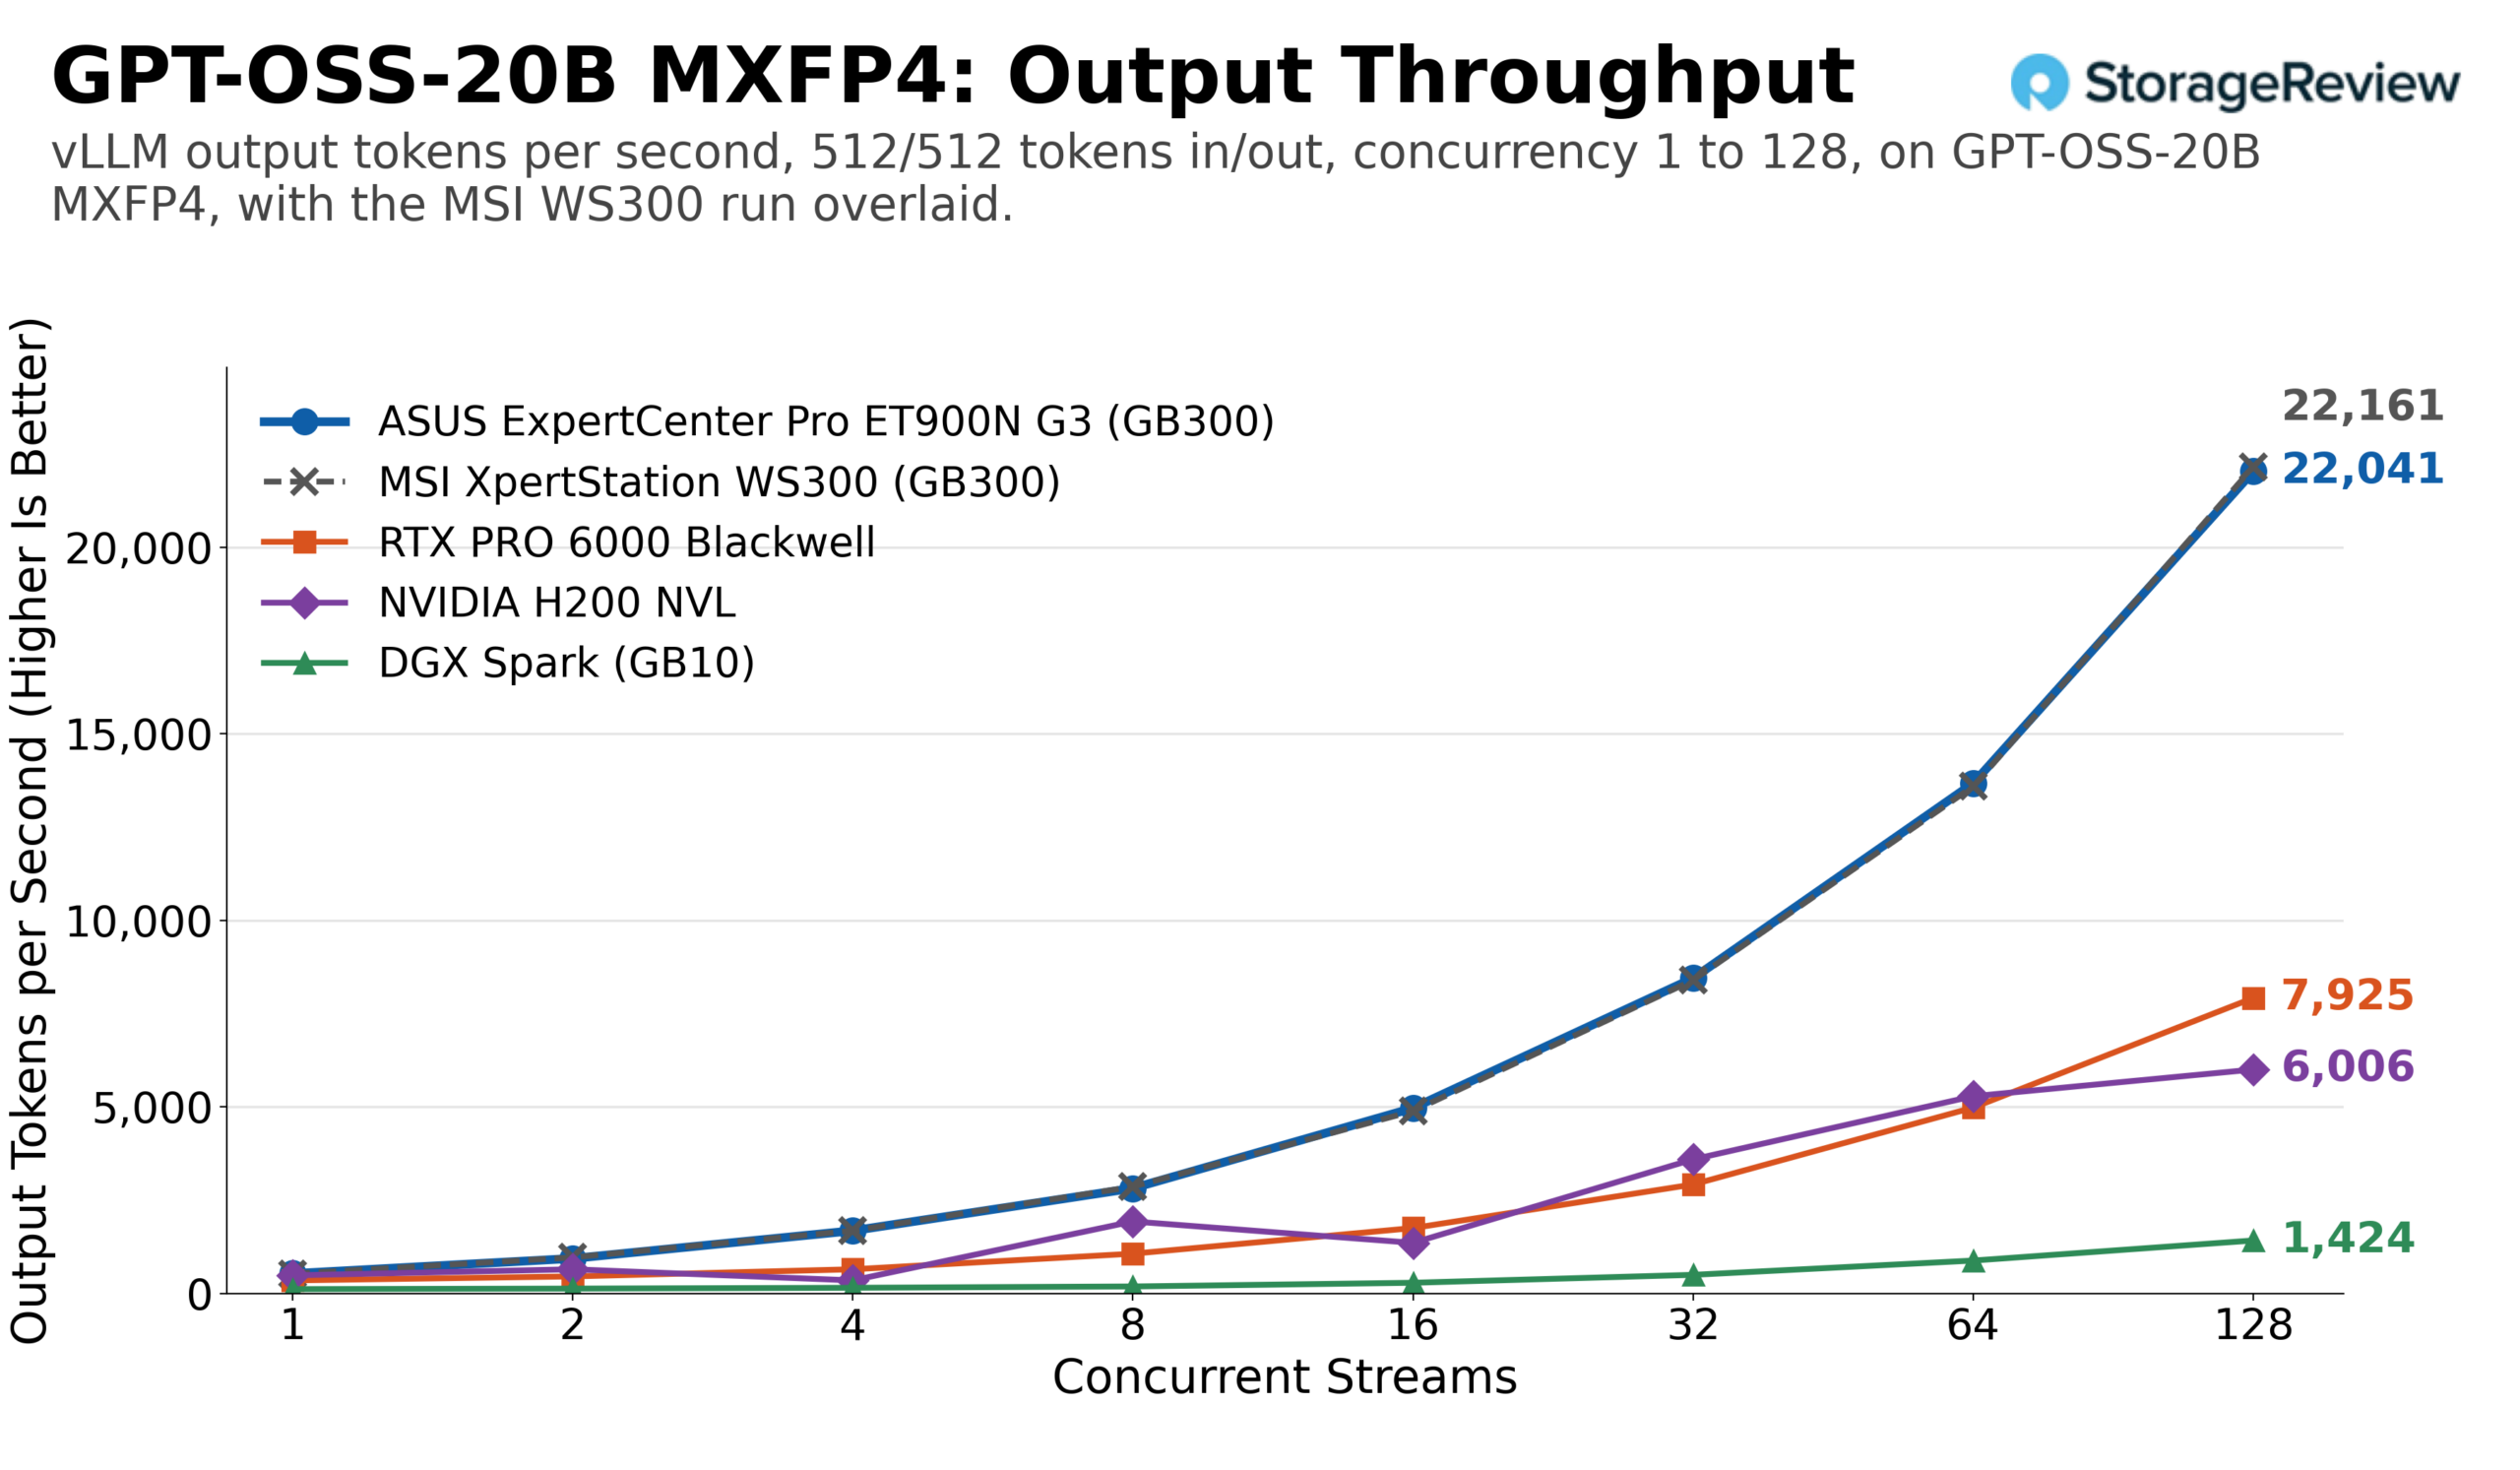
GPT-OSS-20B to najłatwiejszy test w zestawie, punkt kontrolny, który każdy system bez problemu przechodzi. Przy takim samym obciążeniu ET900N G3 osiągnął 22 041 tokenów wyjściowych na sekundę przy 128 strumieniach, czyli łącznie 44 082, w porównaniu do około 7,920 dla RTX PRO 6000, 6,010 dla H200 NVL i 1,420 dla DGX Spark. W trybie pojedynczego strumienia, Stacja produkowała 536 tokenów wyjściowych na sekundę, w porównaniu do 354 kart, 489 kart H200 i 120 kart Spark. Profil z dużą ilością wstępnego wypełniania pogłębił tę różnicę: 9,555 tokenów wyjściowych na sekundę i łącznie 85 994 przy 128 strumieniach dla Stacji, przy czym RTX PRO 6000 produkował około 2,480 tokenów, H200 NVL — 3,410, a Spark — 445.
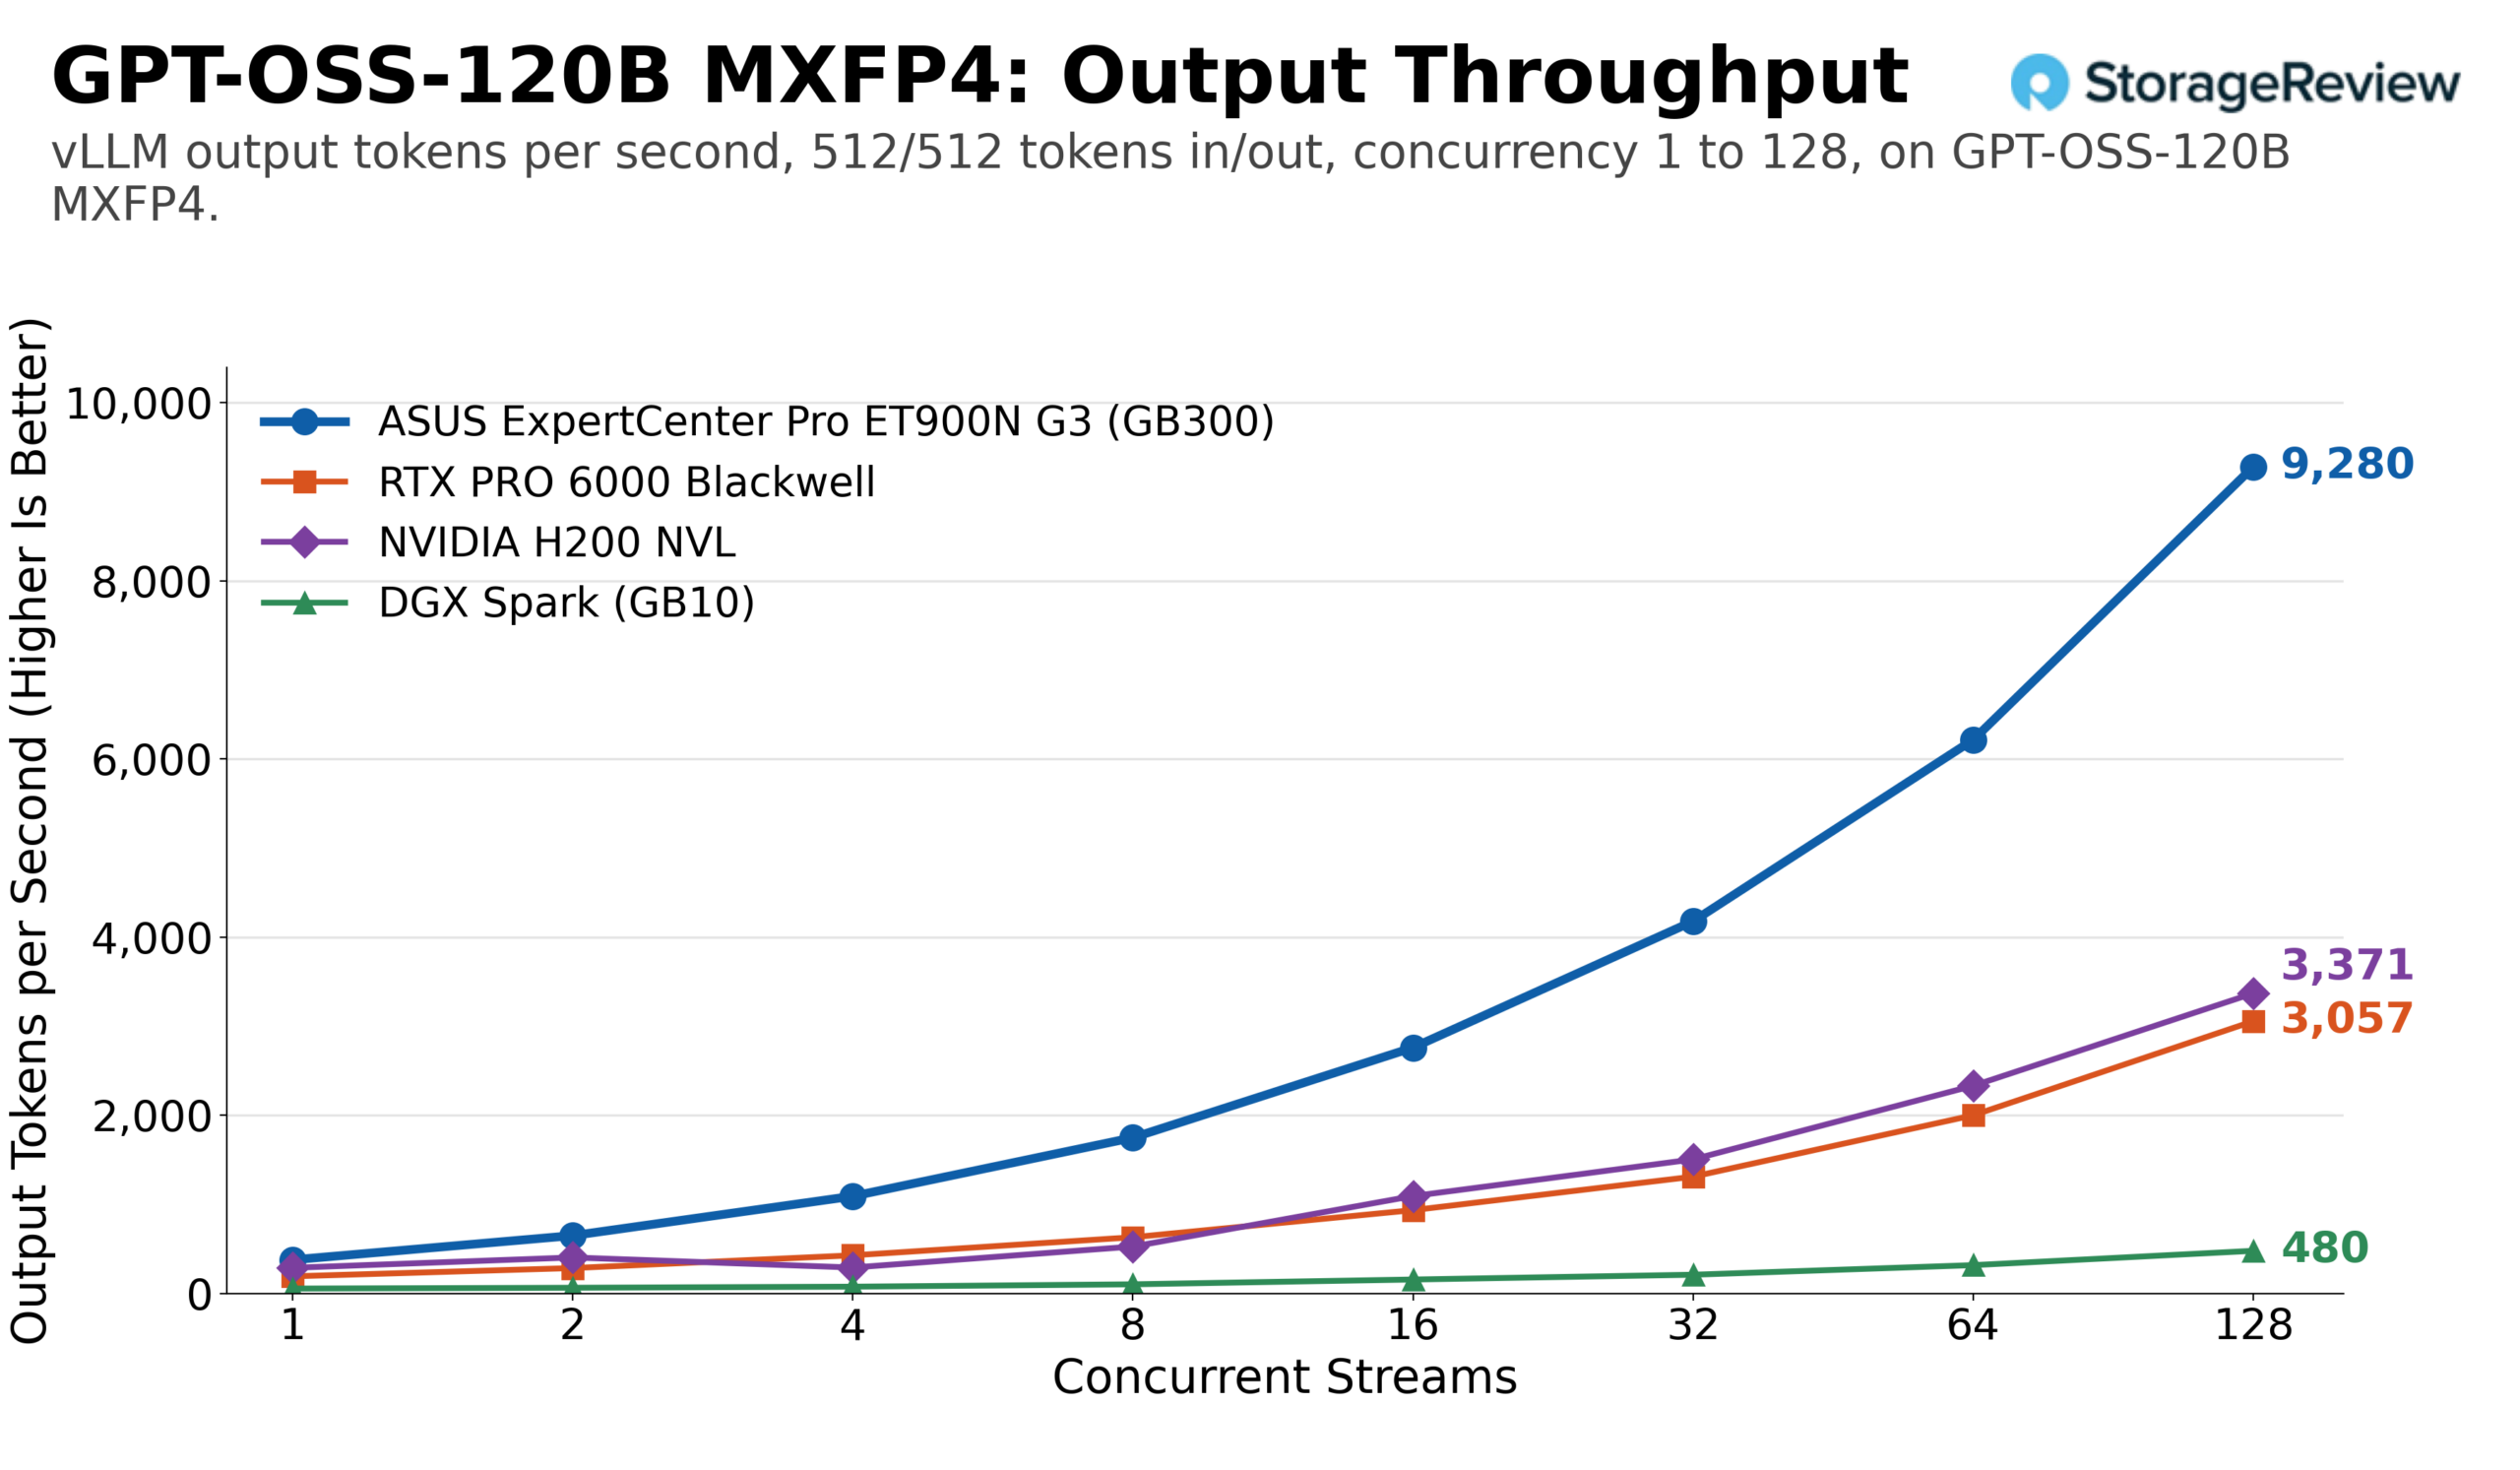
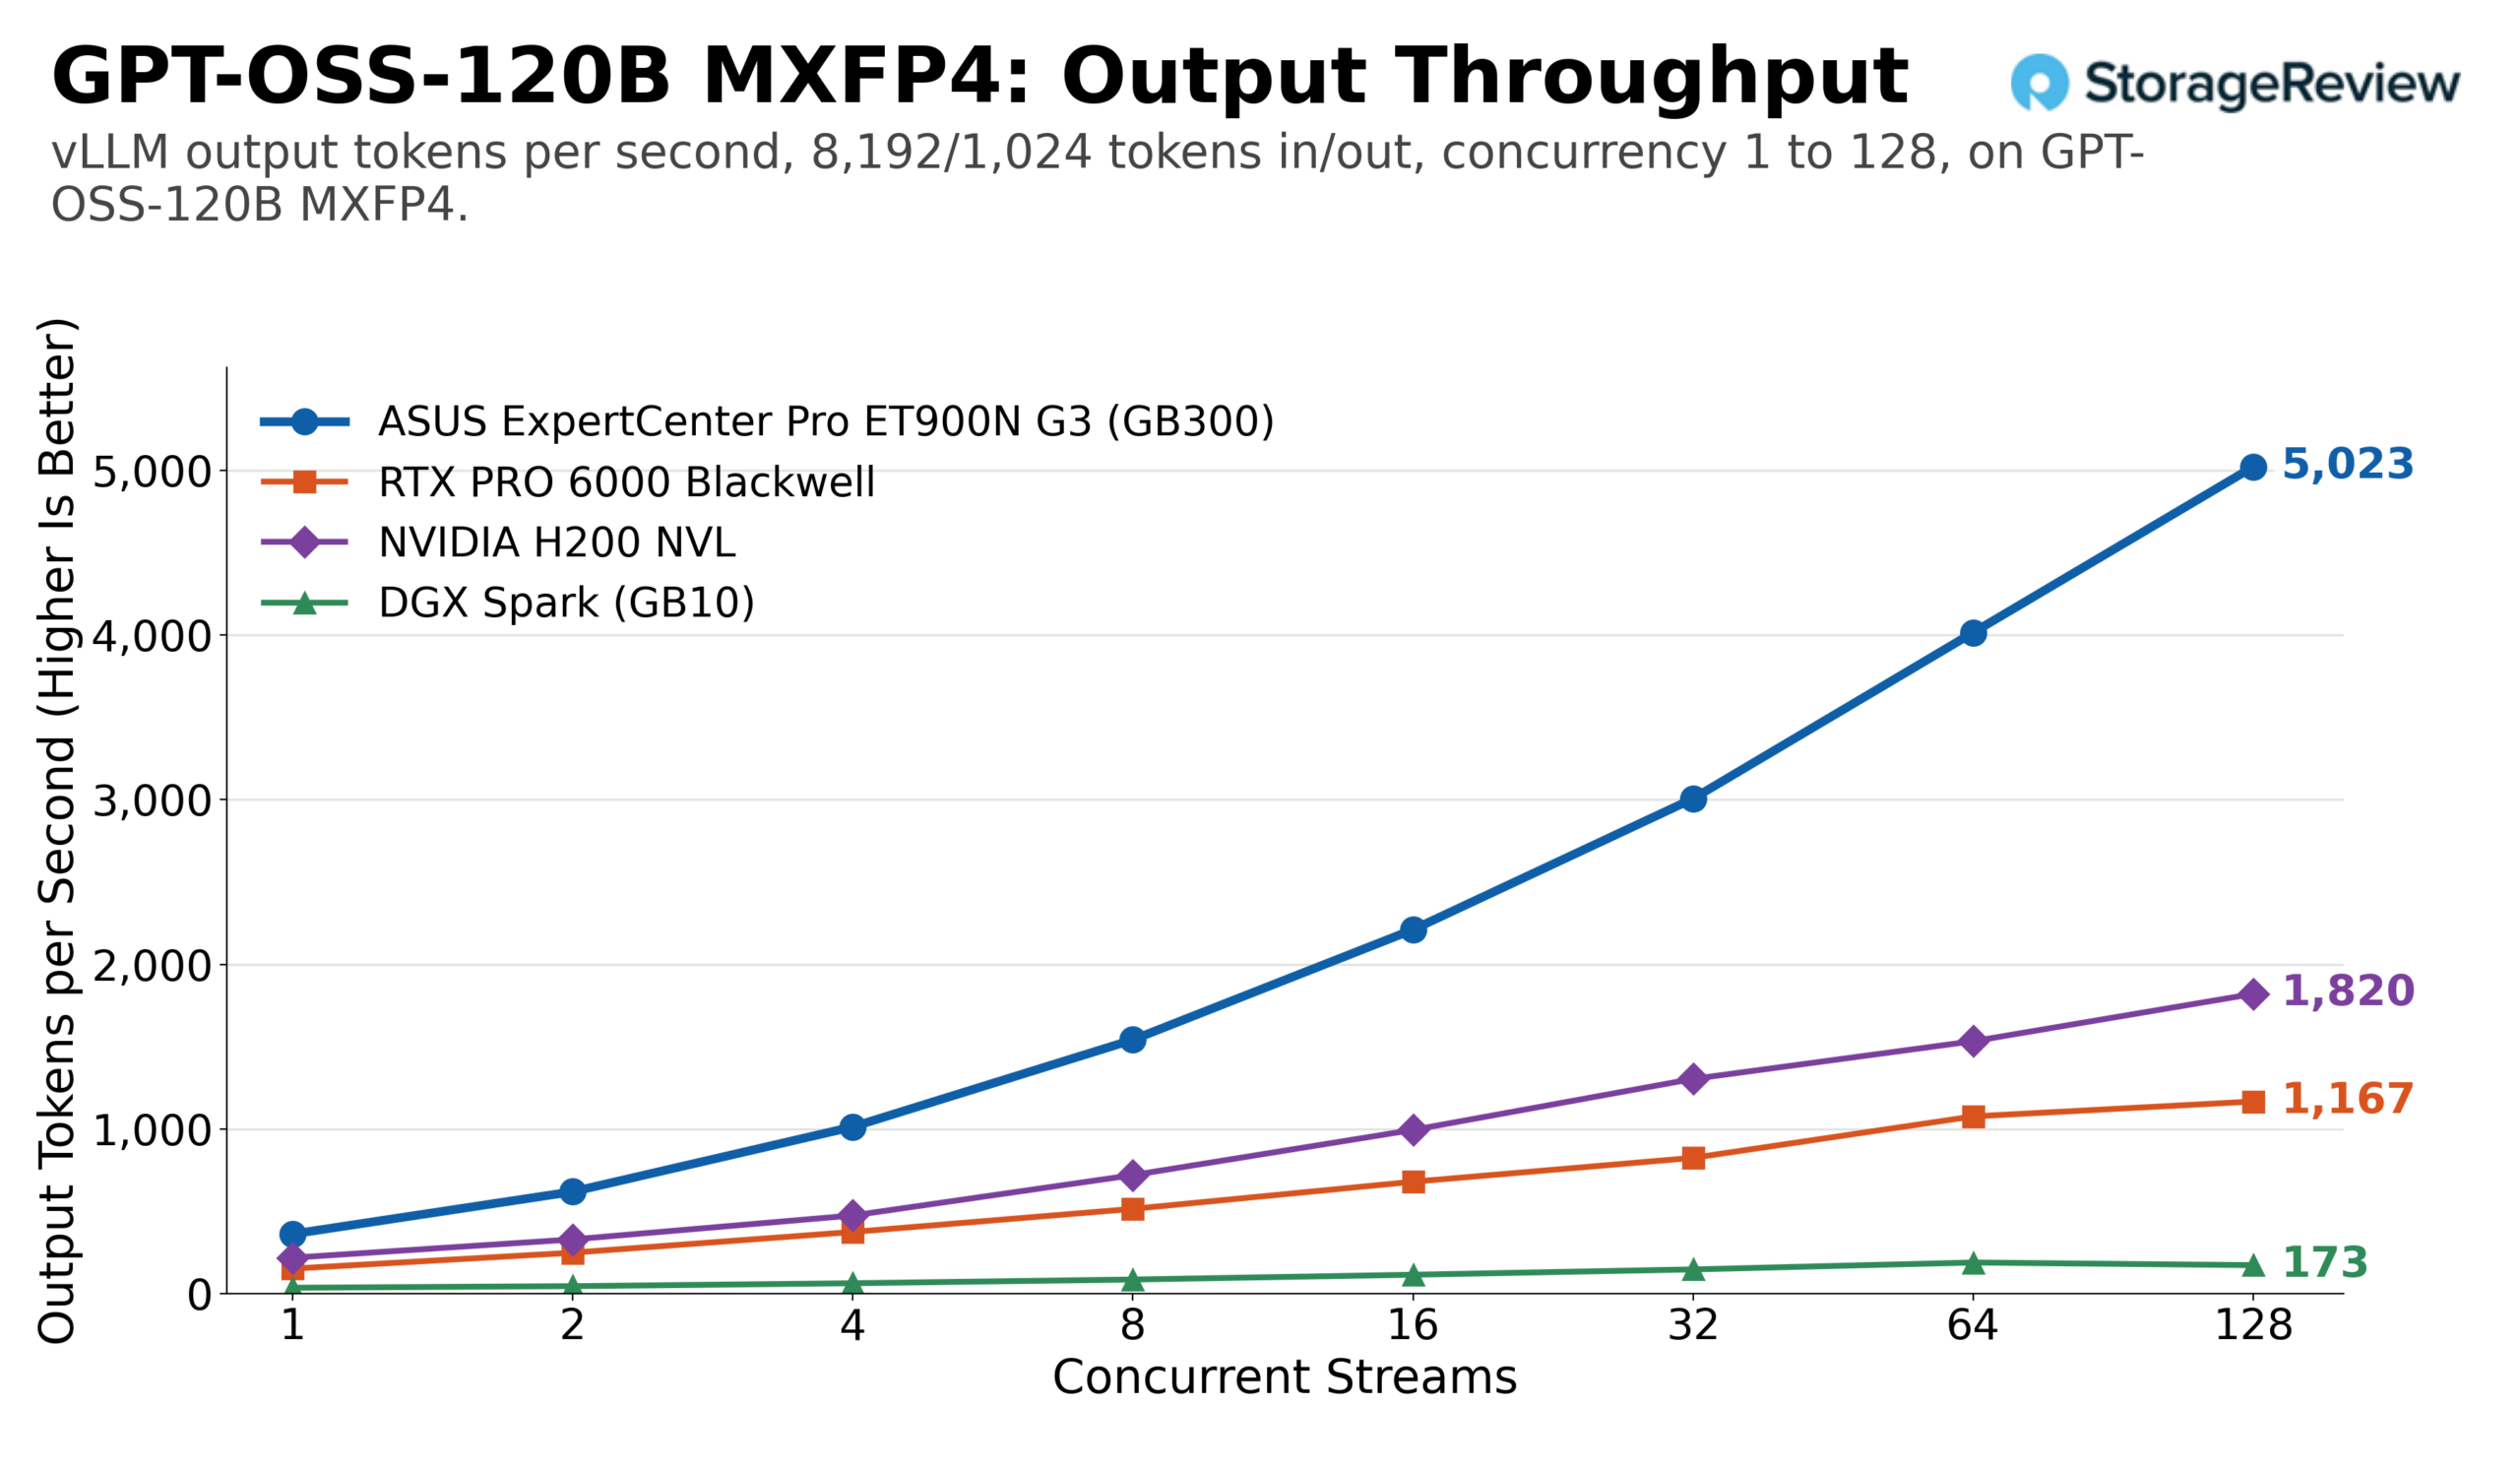
GPT-OSS-120B to miejsce, w którym pamięć zaczyna porządkować pole. ET900N G3 osiągnął 9,280 tokenów wyjściowych na sekundę przy tym samym obciążeniu i 128 strumieniach, czyli około trzy razy więcej niż RTX PRO 6000 (3,060), 2.8 razy więcej niż H200 NVL (3,370) i ponad 19 razy więcej niż Spark (480). Przy długich monitach mniejsze systemy szybko wyczerpały zapas pamięci podręcznej KV: RTX PRO 6000 osiągnął szczyt na poziomie około 1,170 tokenów wyjściowych na sekundę, a H200 NVL prawie 1,820, podczas gdy stacja wciąż rosła, osiągając 128 strumieni i kończąc na poziomie 5,023, z całkowitą przepustowością 45 205 tokenów na sekundę.
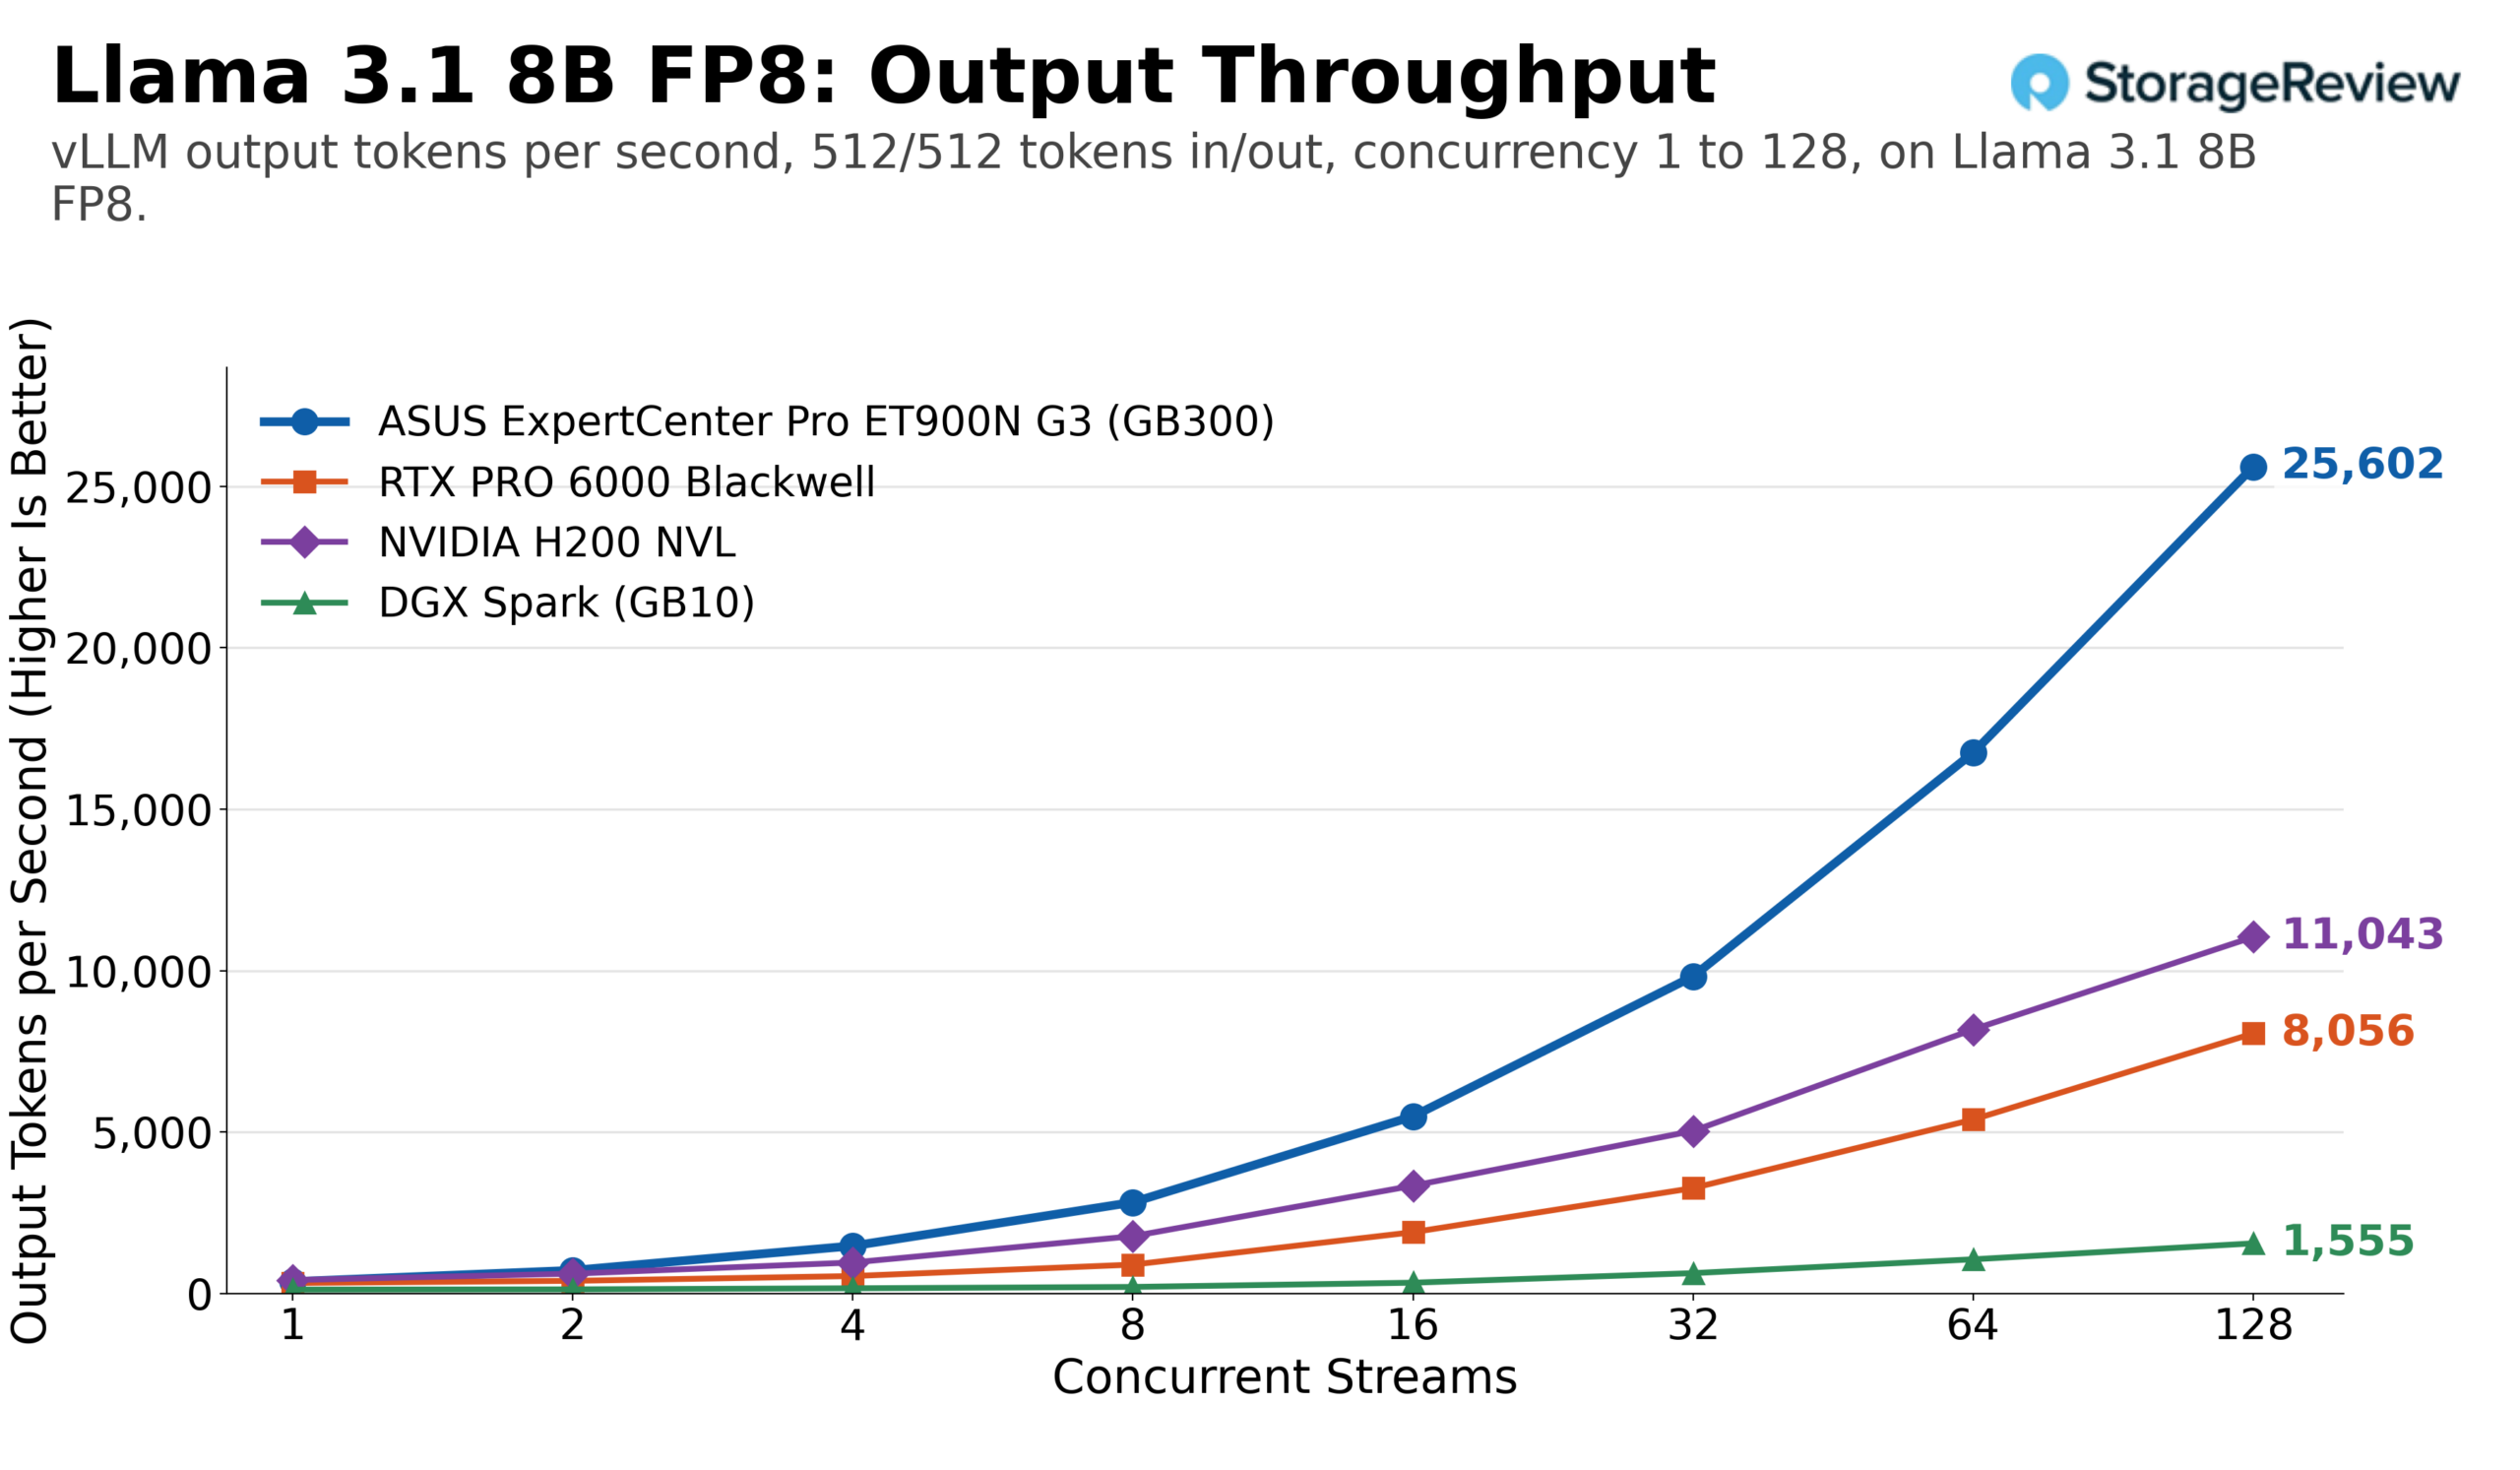
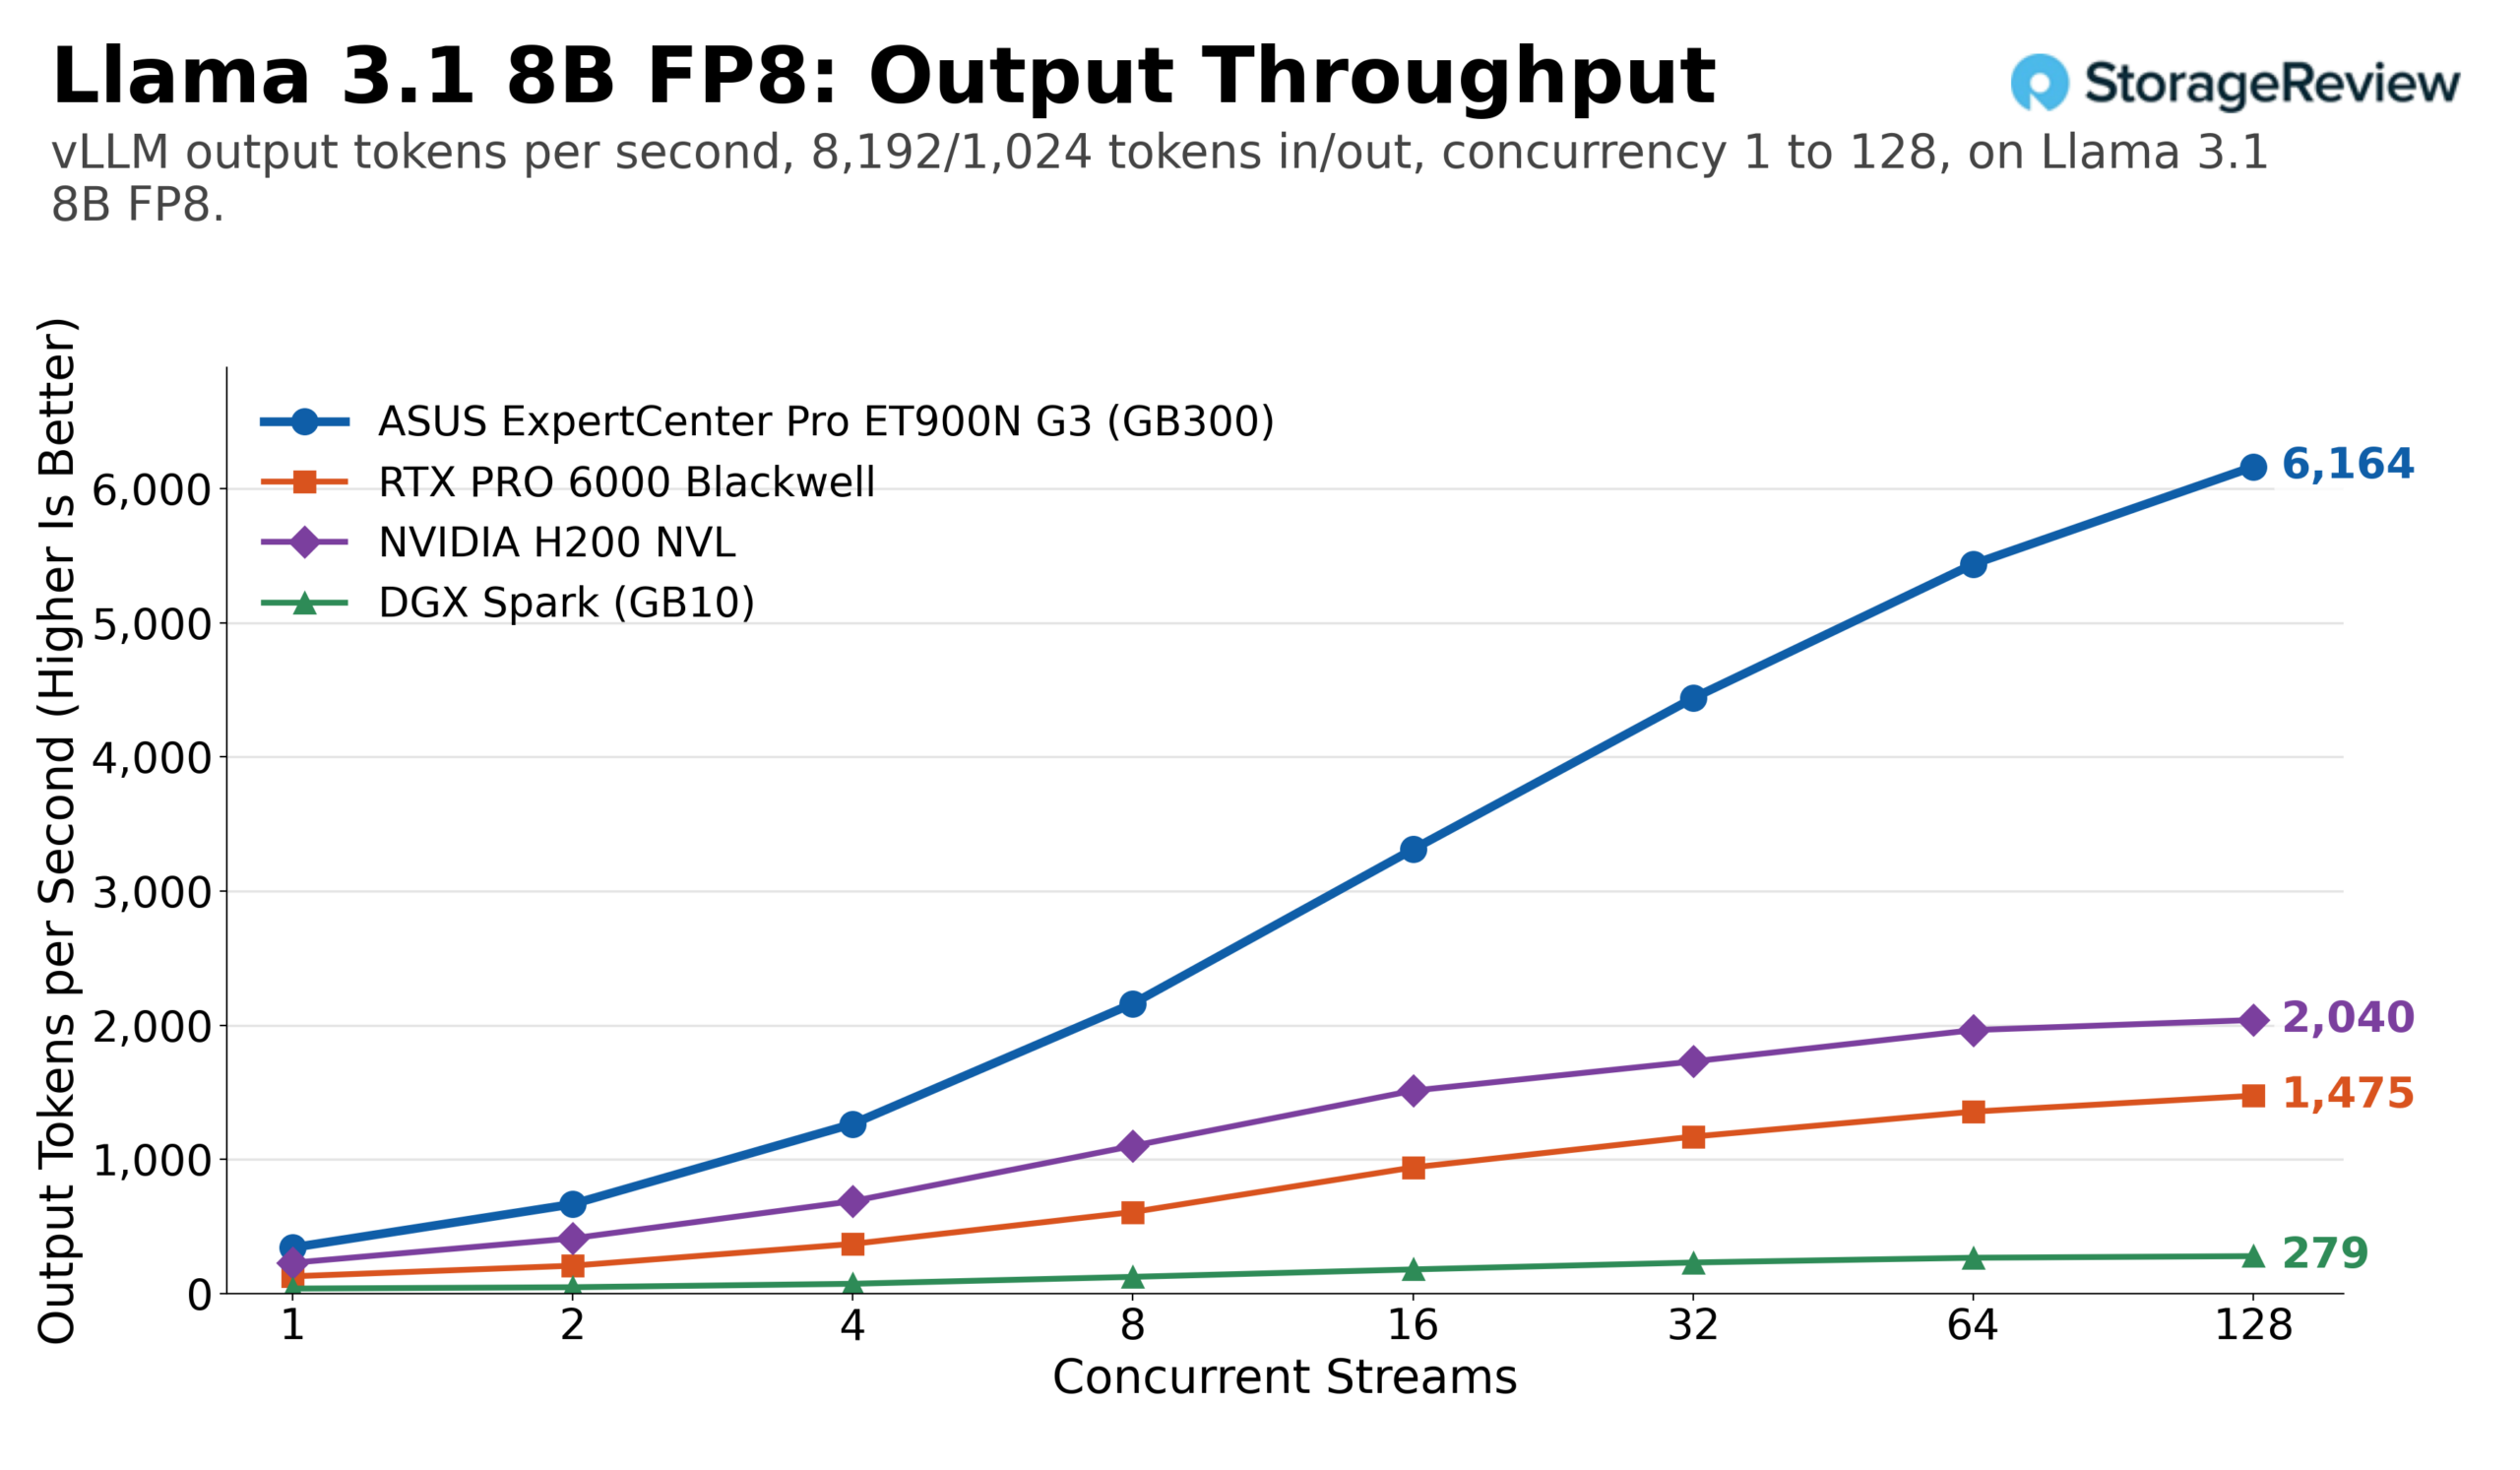
Llama 3.1 8B z FP8 to najwyższa wartość w zestawie. Karta ET900N G3 przesłała 25 602 tokeny wyjściowe na sekundę w 128 strumieniach przy tym samym obciążeniu, łącznie 51 205, w porównaniu z około 8,060 dla RTX PRO 6000 i 11 040 dla H200 NVL. Przejście z BF16 do FP8 podniosło wydajność Stacji o około 50% (z 17 074 do 25 602), podczas gdy RTX PRO 6000 zyskał około 70%, a H200 NVL około 37% dzięki tej samej zmianie. Profil z dużą ilością tokenów prefill skompresował wszystko: Stacja osiągnęła 6,164 tokeny wyjściowe na sekundę, karta 1,480, a H200 2,040.
Mistral Small 24B podczas FP8 osiągnął najwyższe wskaźniki. ET900N G3 osiągnął szczytową wydajność 11 075 tokenów wyjściowych na sekundę przy tym samym obciążeniu, 3.4 razy więcej niż RTX PRO 6000 (3,240), 2.4 razy więcej niż H200 NVL (4,610) i prawie 20 razy więcej niż Spark (559). Przy długich promptach RTX PRO 6000 osiągnął szczytową wydajność 32 strumieni i około 480 tokenów wyjściowych na sekundę, po czym nastąpił spadek; H200 NVL osiągnął szczytową wydajność około 854, a Stacja osiągnęła 2,302 przy 128 strumieniach.


Qwen3 Coder 30B, model łączący w sobie ekspertów i małą liczbę aktywnych parametrów, to miejsce, w którym różnica między pojedynczym strumieniem się zawęża. Przy jednym strumieniu i równym obciążeniu, RTX PRO 6000 dostarczył około 232 tokeny wyjściowe na sekundę do 319 tokenów wyjściowych w Stacji i 308 tokenów NVL w H200. Przetwarzanie wsadowe przywraca porządek: przy 128 strumieniach, ET900N G3 osiągnął 12 439 tokenów wyjściowych na sekundę w FP8, 3.1 razy więcej niż karta (3,990) i 1.7 razy więcej niż H200 NVL (7,450). W profilu z dużą ilością prefill, Stacja osiągnęła 3,837 tokenów wyjściowych na sekundę, podczas gdy RTX PRO 6000 osiągnął szczyt na poziomie około 880 tokenów wyjściowych na sekundę przy 64 strumieniach, a H200 NVL na poziomie około 1,820.


Wśród współdzielonych modeli, ET900N G3 uzyskał wyniki od 2.8 do 3.4 razy lepsze od pojedynczego RTX PRO 6000 i od 1.7 do 3.7 razy lepsze od H200 NVL przy pełnej współbieżności, przy czym przewaga nad nimi rosła w przypadku długich monitów, gdy ich zapas pamięci podręcznej KV się wyczerpał. W porównaniu z WS300, te cztery modele ponownie plasują się w granicach 1%: 22 041 w porównaniu z 22 161 na GPT-OSS-20B, 9,280 w porównaniu z 9,294 na GPT-OSS-120B, 11 075 w porównaniu z 11 157 na Mistral Small FP8 i 12 439 w porównaniu z 12 425 na Qwen3 Coder FP8. Pełne porównanie 14 modeli, w tym trzech modeli z większymi różnicami, znajduje się w następnej sekcji.
Dwie wieże, jedna płyta główna: ASUS ET900N G3 kontra MSI WS300
ET900N G3 i MSI XpertStation WS300 to ta sama płyta bazowa NVIDIA GB300 DGX Station w dwóch obudowach OEM. Obie zostały sprawdzone na tych samych 14 modelach, tych samych dwóch obciążeniach i tym samym cyklu współbieżności w tej samej konfiguracji vLLM. Poniższy wykres porównuje szczytową przepustowość wyjściową ET900N G3 we wszystkich modelach z WS300.
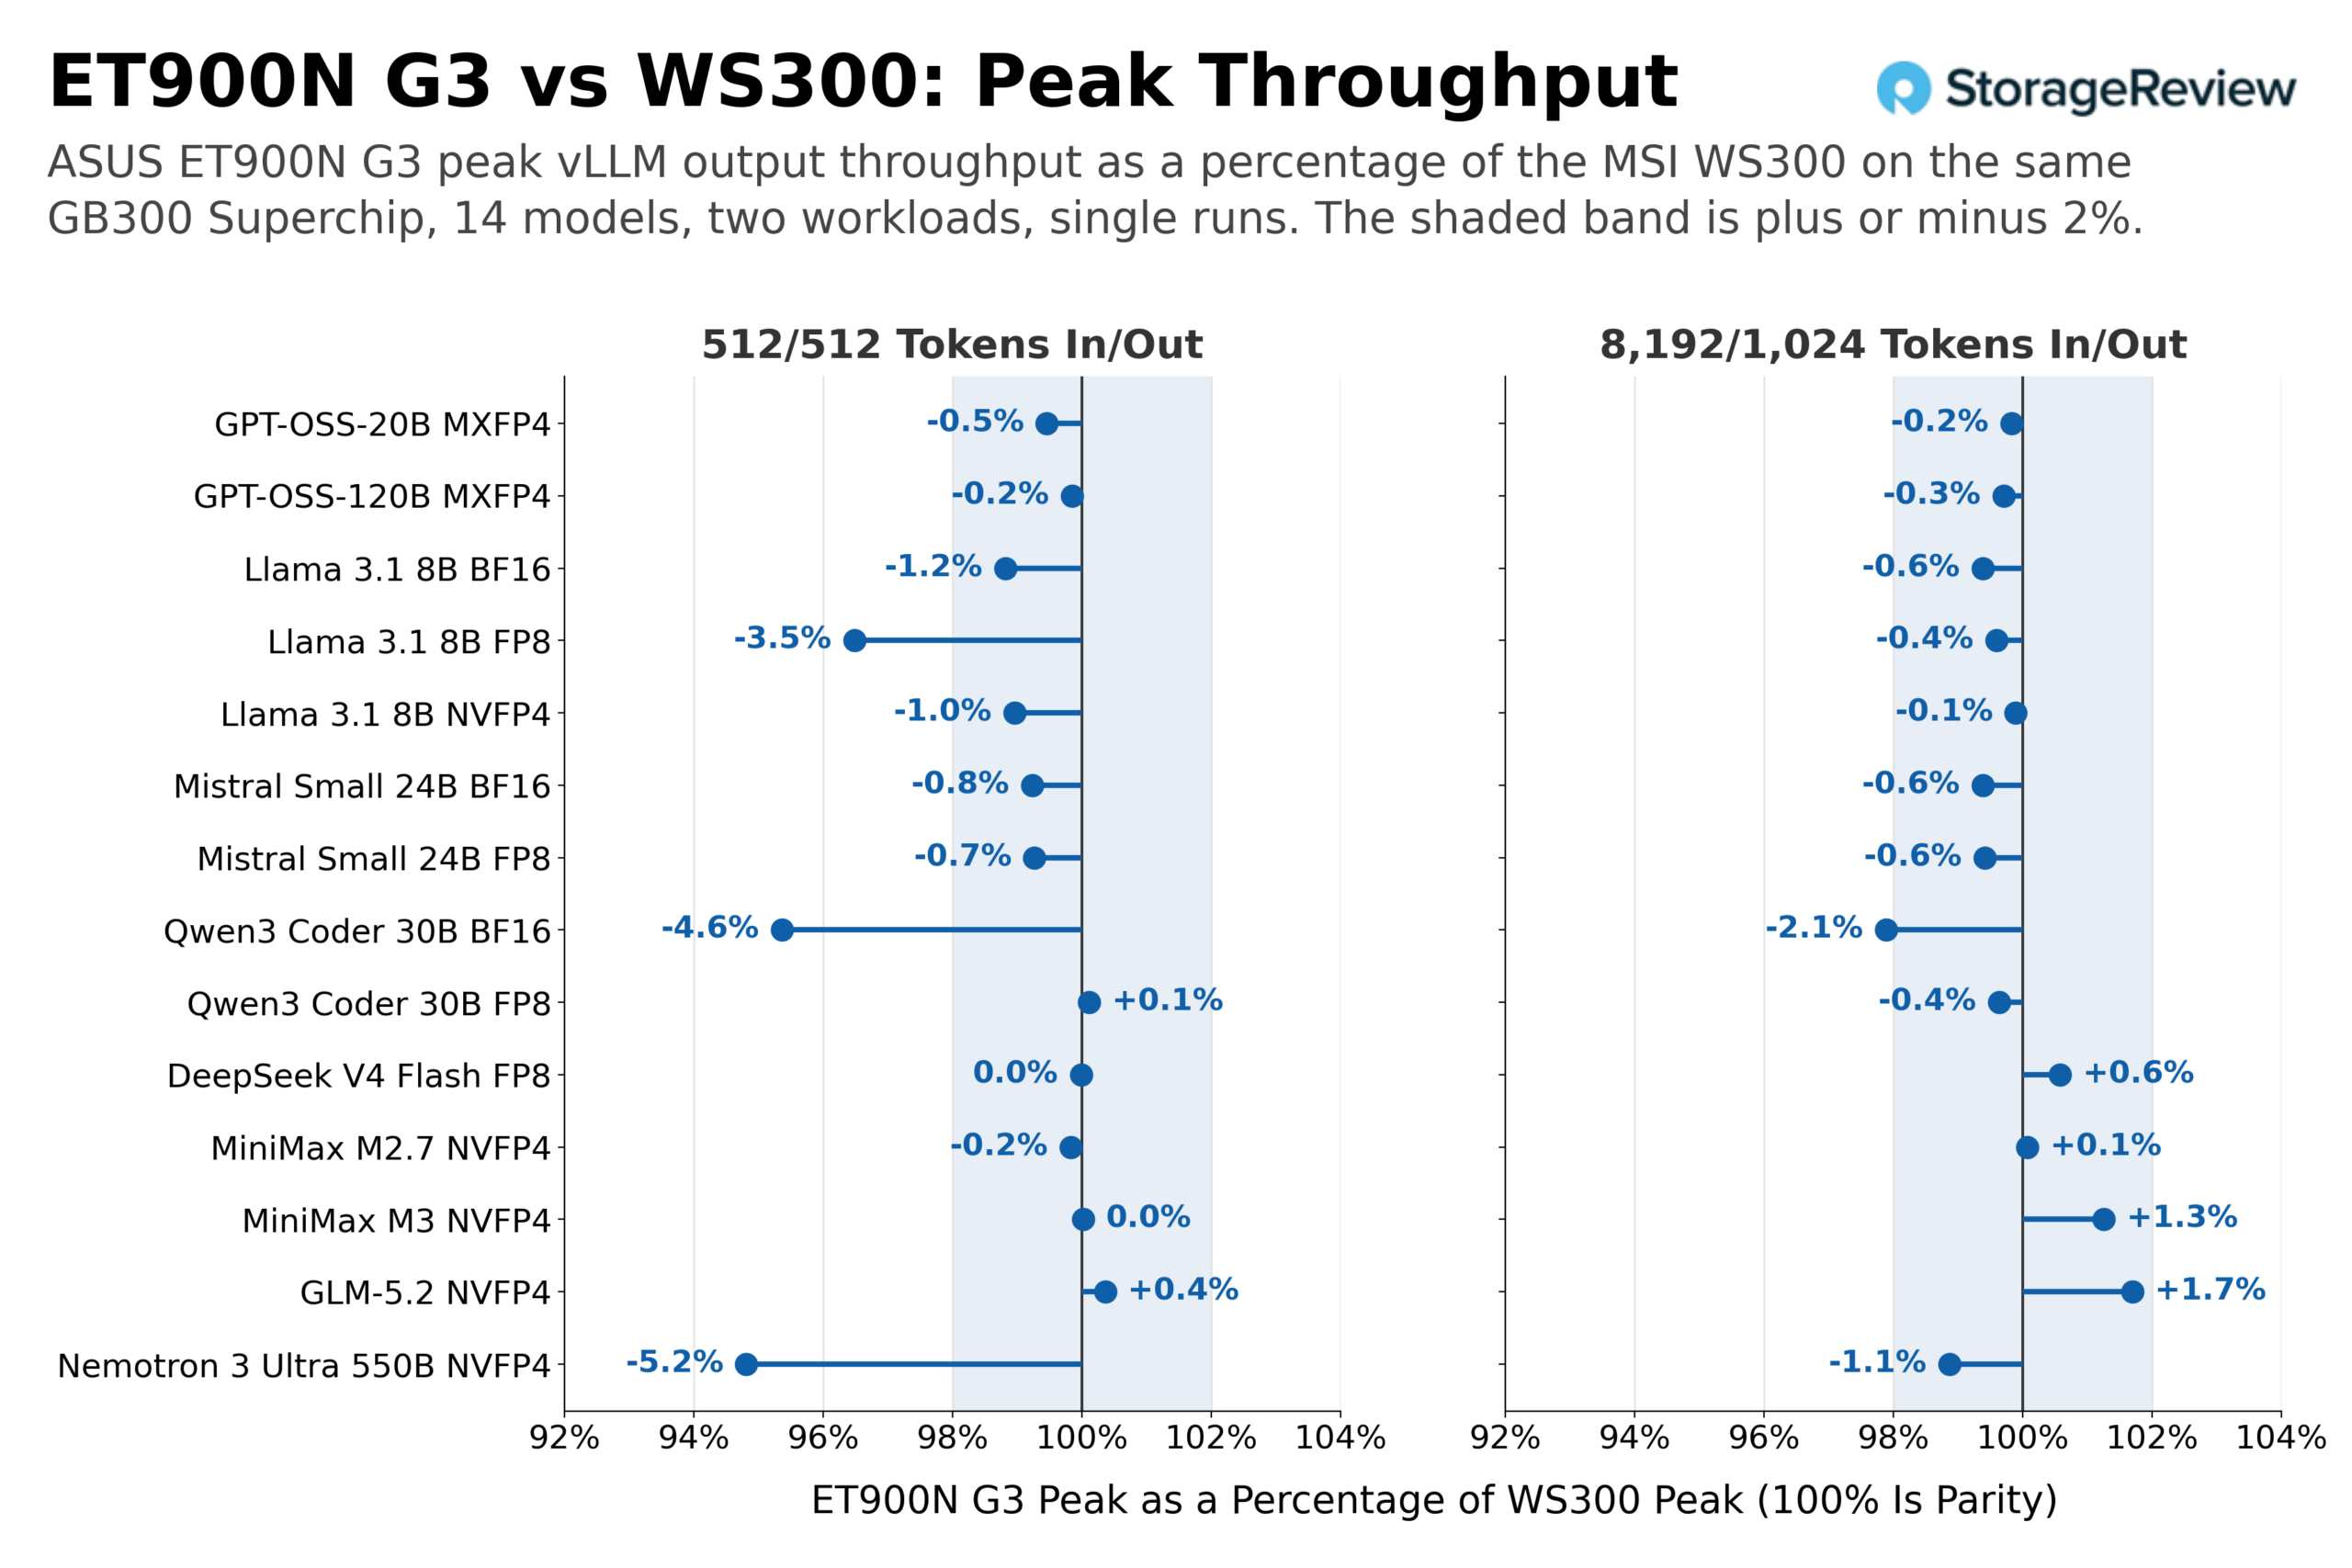
Spośród 28 par model-obciążenie, 24 mieszczą się w zakresie 2% od siebie, a większość z nich stanowi ułamek procenta na korzyść WS300. Cztery znajdują się poza tym zakresem, trzy z nich przy równym obciążeniu: Llama 3.1 8B FP8 ze spadkiem o 3.5% w stosunku do WS300 (25 602 w porównaniu do 26 536 tokenów wyjściowych na sekundę), Qwen3 Coder 30B BF16 ze spadkiem o 4.6% w stosunku do WS300 (10 000 w porównaniu do 10 486) i Nemotron 3 Ultra 550B ze spadkiem o 5.2% w stosunku do (159 w porównaniu do 168), plus Qwen3 Coder 30B BF16 ponownie ze spadkiem o 2.1% w stosunku do długich monitów. Każda wartość tutaj to pojedynczy przebieg dla każdej wieży, więc różnica od 2 do 5% między trzema modelami z 14 nie jest czymś, co przypiszemy obudowie; Po prostu notujemy dane i różnicę między nimi. Modele korzystające z puli pamięci koherentnej, MiniMax M3 i GLM-5.2, osiągają parzystość lub wyższą w obu obciążeniach; to wynik, który naszym zdaniem ma największe znaczenie dla platformy: ścieżka odciążania Grace działa tak samo w obudowach ASUS-a, jak i MSI.
| Model | WS300 512/512 | ET900N G3 512/512 | Delta | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| Lama 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Lama 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Lama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| Mistral Small 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| Mistral Small 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Koder Qwen3 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Koder Qwen3 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 Flash FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
GPT-OSS-20B, przypadek o najwyższej przepustowości i GLM-5.2, przypadek odciążenia, pokazują nakładanie się bez współczynnika: w obu przypadkach przebieg WS300 śledzi punkt po punkcie układ ET900N G3.
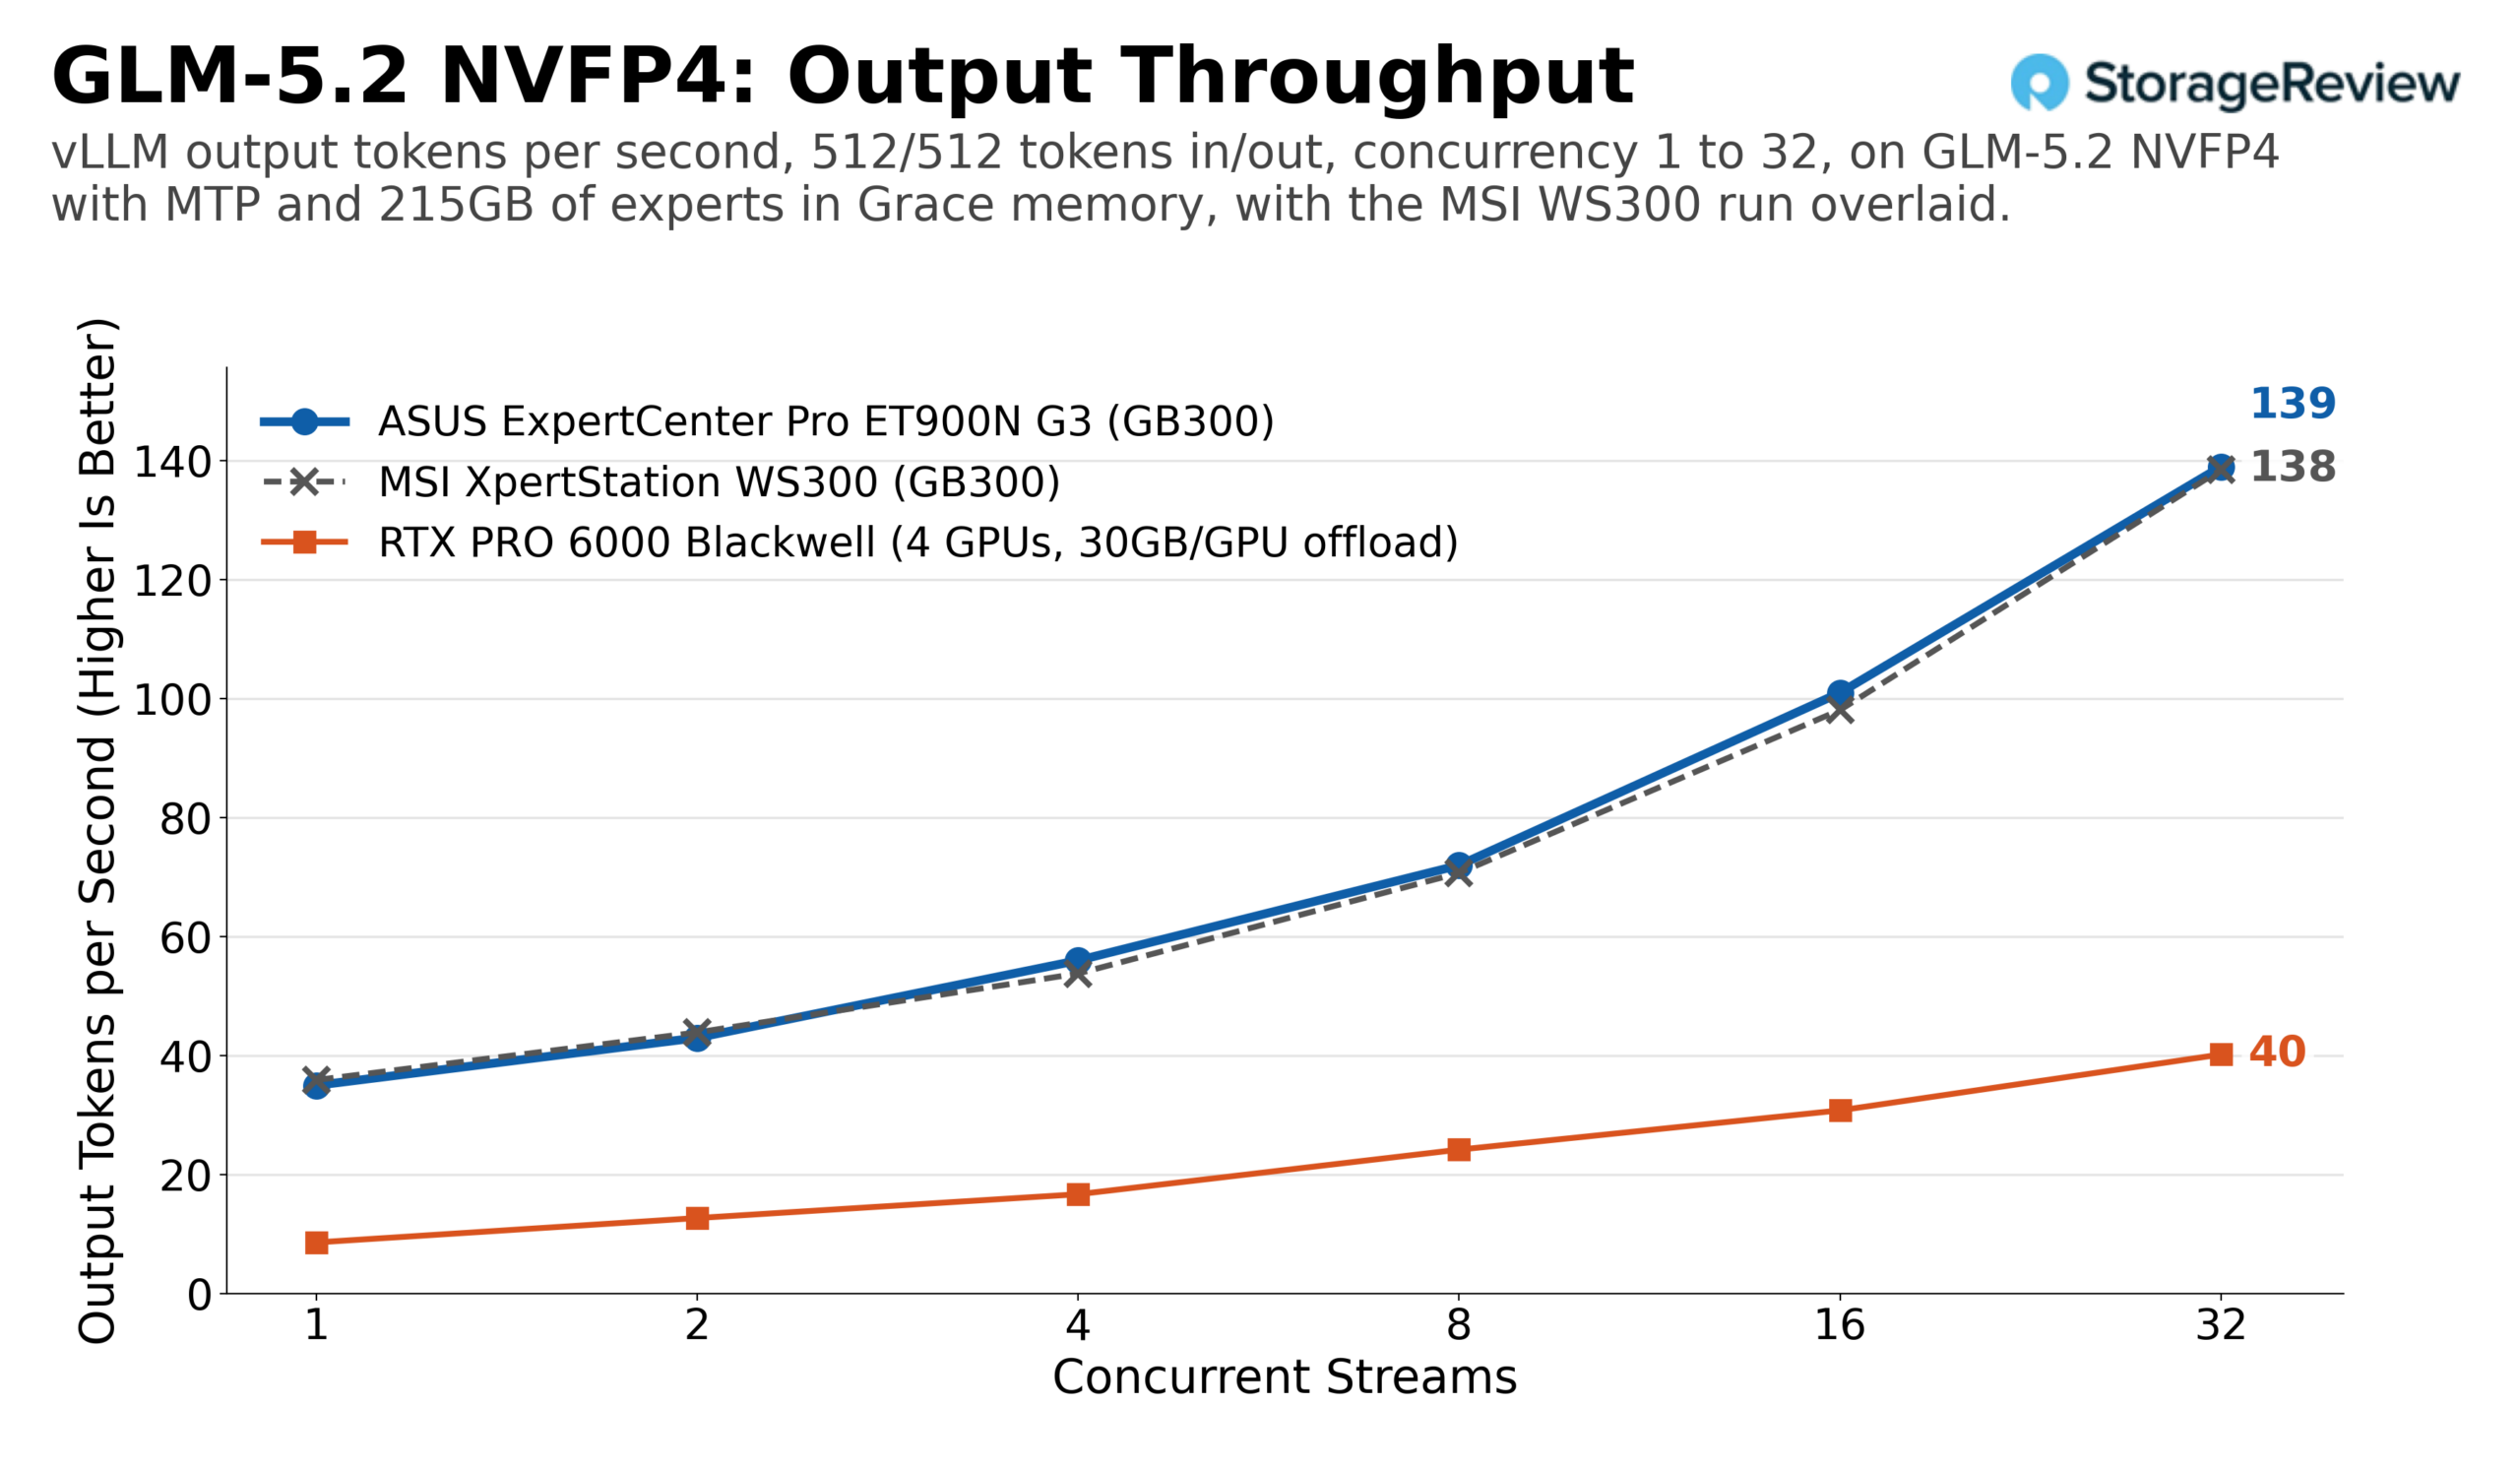
To porównanie będziemy rozwijać, gdy kolejne wieże GB300 przejdą przez laboratorium. Następny jest HP ZGX, a po nim kolejne, a każdy z nich przechodzi przez ten sam cykl, więc wszelkie różnice między implementacjami OEM będą widoczne tutaj, na oddzielnym wykresie dla każdej wieży, a wykresy modeli będą zawierały surowe krzywe.
Wniosek
ASUS ExpertCenter Pro ET900N G3 robi to, co powinna druga implementacja platformy referencyjnej: potwierdza pierwszą. W 14 modelach i dwóch obciążeniach, jego szczytowa przepustowość vLLM mieściła się w granicach 2% przepustowości MSI XpertStation WS300 w 24 z 28 porównań, od 1,766 tokenów wyjściowych na sekundę w DeepSeek V4 Flash do 22 041 w GPT-OSS-20B, z czterema pojedynczymi wartościami odstającymi od normy, od 2 do 5% poniżej, i obsługiwał GLM-5.2 z 215 GB pamięci ekspertów w pamięci Grace z szybkością, której nie były w stanie osiągnąć cztery karty RTX PRO 6000. Superchip GB300 wyznacza nowy poziom, a ASUS wykonał dobrą robotę.
ASUS dodaje coś praktycznego: uchwyty sprawiają, że wieża o wadze 27 kg staje się czymś, co dwie osoby mogą przenosić bez chwytania za panele, wentylator nad klatkami QSFP112 rozwiązuje potencjalny problem dla każdego, kto korzysta z optyki 400G przez wiele godzin, a zasilacz Titanium oszczędza kilka watów mocy pobieranej z gniazdka ściennego. Host ARM, obwód 20 A, wyjście wyświetlacza tylko dla BMC i współdzielony budżet 1,600 W po zainstalowaniu dużej karty to cechy platformy, które dotyczą w równym stopniu obu wież.
Stacja GB300 DGX pozostaje najwydajniejszym urządzeniem, jakie kiedykolwiek umieściliśmy na biurku, a firma ASUS sprawiła, że jej wersja jest świetną okazją do jej zakupu.
Na naszym Najlepsze komputery stacjonarne dla lokalnej sztucznej inteligencji leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon