

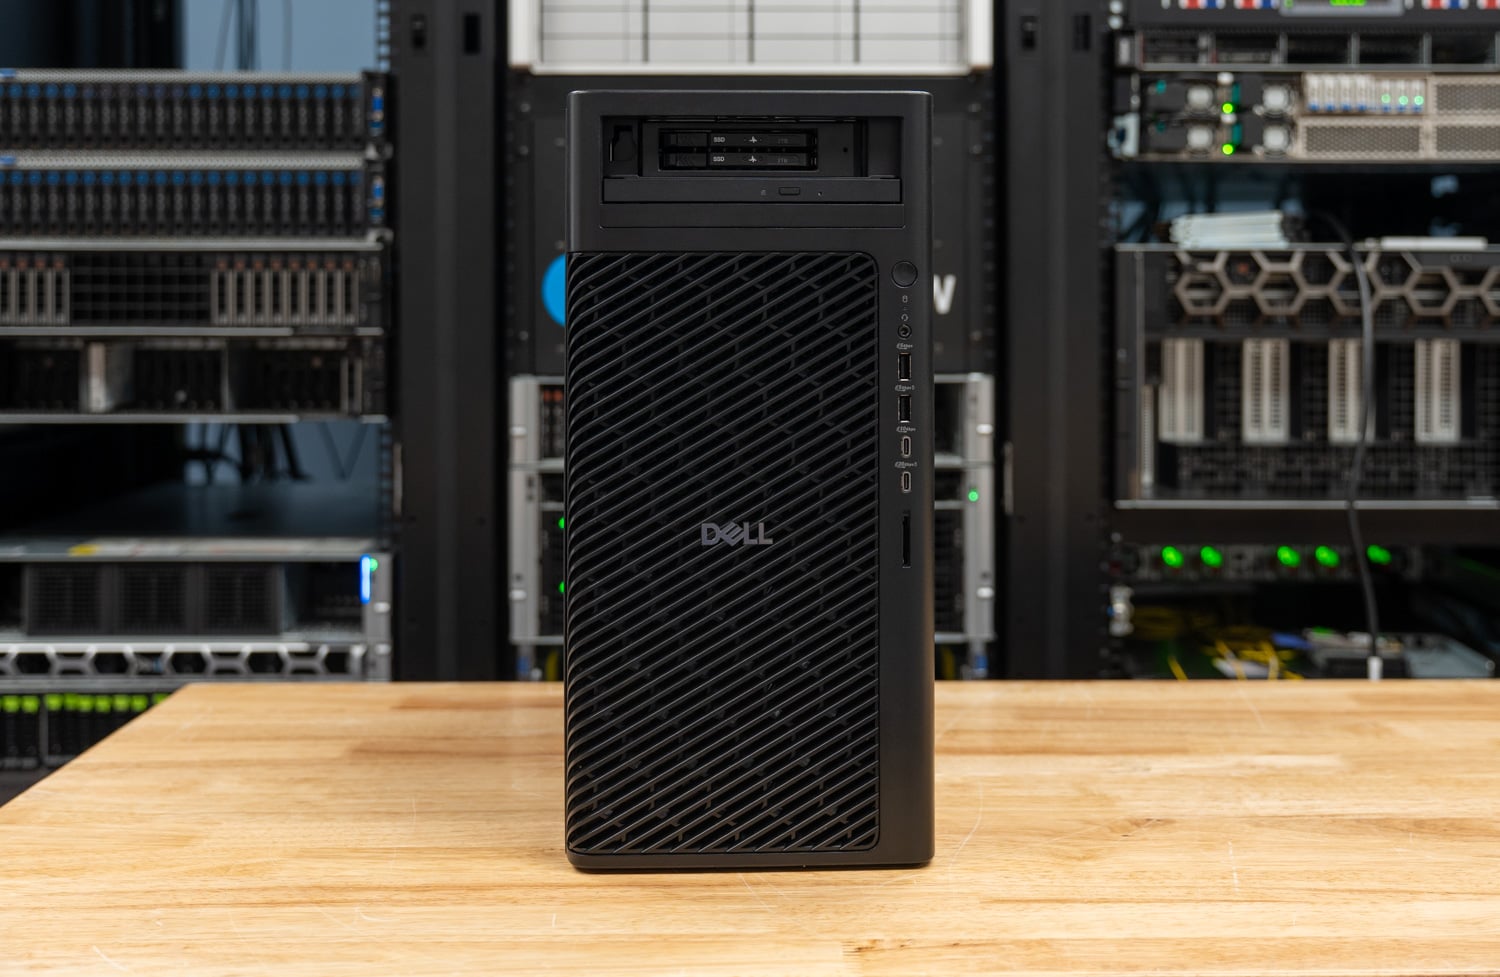
Dell Pro Precision 9 T2 to wersja z procesorem Xeon, którą testowaliśmy rok temu jako Dell Pro Max Tower T2 , i pojawia się z dwiema zmianami naraz: nową nazwą (Dell powraca do sprzedaży stacji roboczych pod marką Precision) oraz nową platformą, gdzie procesor Intel Xeon 6 zastępuje procesor Core Ultra 9 285K w tej samej 32-litrowej obudowie. Nasz egzemplarz został dostarczony z 24-rdzeniowym procesorem Xeon 658X, 128 GB pamięci DDR5-6400 RDIMM ECC, kartą graficzną RTX PRO 6000 Blackwell Max-Q o mocy 300 W oraz dwoma dyskami twardymi E3.S Gen5 o pojemności 2 TB umieszczonymi w przedniej wnęce FlexBay. Skonfigurowany w ten sam sposób na stronie Dell.com, kosztuje około 28 300 dolarów.
Przetestowaliśmy go jako macierz: Pro Precision 9 T2 uruchomił cały nasz pakiet z kartą Max-Q dołączoną do zestawu, a także z kartą graficzną RTX PRO 6000 Blackwell o mocy 600 W, wyjętą z naszego Pro Max Tower T2. T2 z procesorem Core uruchomił również obie karty, więc wszystkie poniższe wyniki mają cztery kolumny, a każda para izoluje jedną zmienną: platformę procesora lub limit mocy GPU. Pakiet jest taki sam, jak ten, który działał na notebookach RTX Spark z zeszłego tygodnia , z kilkoma dodatkami, które debiutują tutaj.
Xeon zapewnia przepustowość i redukuje opóźnienia. Procesor Pro Precision 9 T2 uzyskał 12 322 punkty w wielordzeniowym teście Cinebench 2026 w porównaniu z 8,856 punktami Core T2, zbudował LLVM w 140.2 sekundy w porównaniu ze 182.5 sekundy i odczytał 122 233 MB/s w STREAM Triad w porównaniu z 33 003 punktami, podczas gdy jego wynik w teście jednordzeniowym Cinebench wynoszący 454.1 sekundy ustępuje 564.4 punktom 285K, a wynik Speedometer wynoszący 36.8 sekundy ustępuje 46.3 punktom. Karta o mocy 600 W zwiększa wydajność dekodowania LLM o około 7 do 20 procent i o 20 do 39 procent w szybkim przetwarzaniu i rozsyłaniu danych w obu obudowach, a w obudowie Xeon obciąża procesor o 4 do 5 procent w przypadku pracy na wszystkich rdzeniach.
Na wynos
- Xeon 6 to platforma przepustowości w obudowie jednogniazdowej: 12 322 w wielordzeniowym teście Cinebench 2026, o 39 procent więcej niż Core Ultra 9 285K w tej samej obudowie, 289.6 GIPS w 7-Zip w porównaniu do 174.8, DGEMM na poziomie 1,638 GFLOPS w porównaniu do 768 oraz 3.7-krotnie większa przepustowość pamięci z czterech kanałów DDR5-6400.
- 285K nadal zapewnia prędkość na wątek: Xeon traci 20 procent w teście Cinebench dla jednego rdzenia, 21 procent w teście Speedometer i od 20 do 31 procent w teście Python dla jednego wątku, przy opóźnieniu między rdzeniami wynoszącym 56.2 ns w porównaniu do 38.1 ns.
- Procesor graficzny decyduje o wynikach sztucznej inteligencji, a karta o mocy 600 W pobiera moc na podstawie monitów: MLPerf Llama 3.1 8B generuje 230.9 tokenów na sekundę z kartą Max-Q i 252.8 z kartą 600W, podczas gdy czas otrzymania pierwszego tokena spada z 0.082 do 0.059 sekundy, a Qwen-Image 20B renderuje obraz o rozdzielczości 1024×1024 w 19.7 sekundy w porównaniu do 26.1.
- Karta o mocy 600 W obciąża procesor Xeon o 4 do 5 procent: Wyniki testu wielordzeniowego Cinebench spadły z 12 322 do 11 705, a wyniki testu pętli 30-minutowej z 12 328 do 11 764, przy czym taktowanie w stanie ustalonym spadło z 4,274 do 4,178 MHz; ta sama zamiana nie zmieniła niczego w przypadku Core T2.
- E3.S w FlexBay, paski VROC od Graid: Przednia zatoka mieści dwa dyski E3.S Gen5, co jest pierwszym tego typu rozwiązaniem w stacji roboczej typu tower w naszym laboratorium. Opcja rozruchu RAID0 firmy Dell pozwala na utworzenie woluminu o pojemności 4,097 GB z technologią VROC firmy Graid. Prędkość odczytu z paska wynosi 9,332 MB/s sekwencyjnie, a maksymalna wartość IOPS to 840.1 tys. przy losowych odczytach 4K, w porównaniu z 1.78 mln IOPS pojedynczego dysku Gen5 M.2 w obudowie Core T2.
Od Pro Max do Pro Precision
Dell wycofał nazwę Precision na początku 2025 roku, kiedy wszystkie stacje robocze stały się Dell Pro Max, a teraz ją przywrócił. 7 października Dell zmienił nazwy swoich komputerów stacjonarnych GB10 i GB300 z Dell Pro Max na Dell Pro Precision, a na stronie Dell.com Pro Precision 9 T2 jest wymieniany obok nowych modeli T4 i T6 pod tą samą marką. Pro Max pozostaje w przypadku komputerów z procesorami Core, więc recenzowany w zeszłym roku model Core Ultra Tower nadal jest sprzedawany jako Dell Pro Max Tower T2, a recenzowany tutaj model Xeon Tower to Dell Pro Precision 9 T2, model PW9T2260.
Modele T4 i T6 przeszły na procesory Xeon 6, zmieniając nazwę, a Dell pozycjonuje trzy wieże w kolejności rozbudowy. Model Pro Precision 9 T4 (PW9T4260) działa na tej samej liście procesorów, aż do 86-rdzeniowego Xeona 698X, posiada 16 gniazd DIMM, do 4 TB pamięci DDR5-6400 na wszystkich ośmiu kanałach pamięci, a także obsługuje pojedynczą kartę graficzną RTX PRO 6000 o mocy 600 W lub dwie karty Max-Q na zasilaczu 1500 W, z opcjonalną obudową o mocy 2400 W.
Pro Precision 9 T6 (PW9T6260) to topowy model z tej serii, z sześcioma gniazdami, zasilaczem 2400 W i miejscem na dwie karty RTX PRO 6000 o mocy 600 W, trzy karty Max-Q lub maksymalnie pięć kart RTX PRO 5000. T2 to czterokanałowy, podstawowy model z rodziny, wyposażony w jeden procesor graficzny.
Dokładność nazewnictwa ma znaczenie, ponieważ obie obudowy są identyczne z zewnątrz – mają tę samą 32-litrową obudowę o wymiarach 387 x 187.7 x 438 mm, tę samą ramkę i przednią wnękę FlexBay oraz te same opcje karty graficznej RTX PRO 6000 Blackwell w konfiguratorze Della. Różnica tkwi w płycie głównej. Podczas gdy Pro Max Tower T2 łączy 24-rdzeniowy procesor Core Ultra 9 285K z czterema gniazdami DIMM niebuforowanej pamięci DDR5, Pro Precision 9 T2 korzysta z procesora Intel Xeon 6 do stacji roboczych – platformy Granite Rapids-WS , którą testowaliśmy na płycie głównej w czerwcu, z zarejestrowaną pamięcią ECC, większą liczbą linii PCIe i procesorem 250 W w najwyższej konfiguracji.

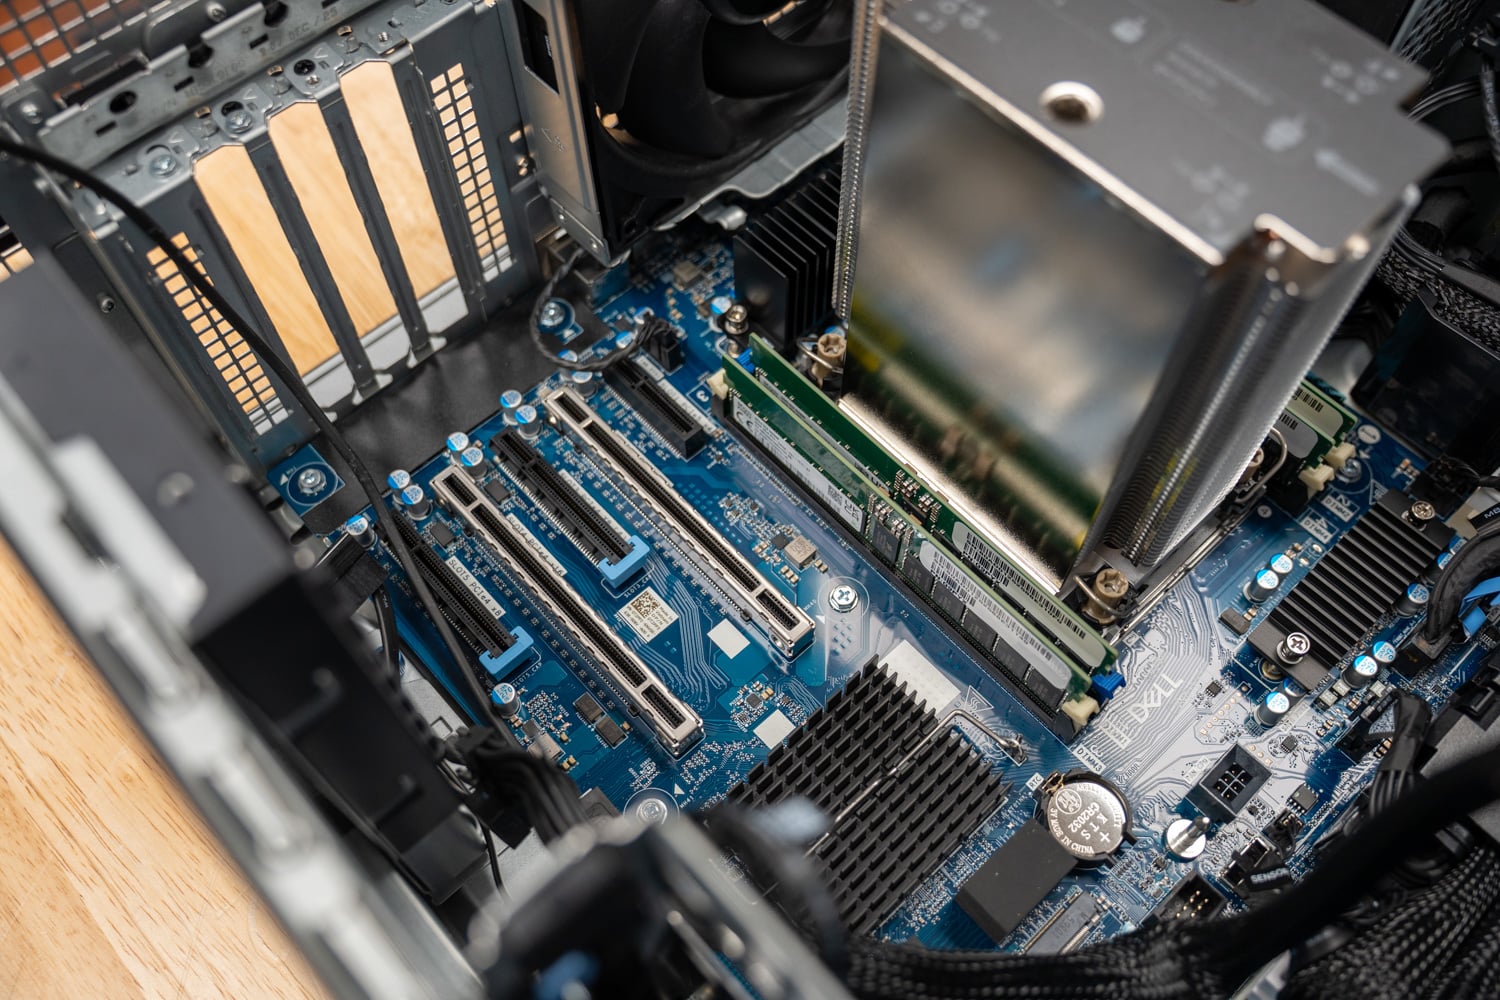
Dell oferuje sześć procesorów Xeon 6 w modelu Pro Precision 9 T2, od 12-rdzeniowego Xeona 634 o mocy 150 W do 24-rdzeniowego 658X o mocy 250 W w naszym modelu. Przejście z 634 na 658X to opcja kosztująca 1,560 dolarów. Model 658X obsługuje 24 rdzenie i 48 wątków z częstotliwością bazową 3.0 GHz i turbo 4.9 GHz, ze 144 MB pamięci L3, trzykrotnie większą niż 36 MB w modelu 285K, i obsługuje standardy AVX-512 i AMX, których 285K nie obsługuje. Układ obsługuje osiem kanałów DDR5-6400 i 128 linii Gen5; T2 udostępnia cztery gniazda DIMM i pięć gniazd rozszerzeń, a większe T4 i T6 odsłaniają resztę.
| Platforma | Dell Pro Precision 9 T2 (testowany) | Dell Pro Max Tower T2 (testowany) |
|---|---|---|
| Procesor | Intel Xeon 658X, 24 rdzenie / 48 wątków, 3.0 do 4.9 GHz, 144 MB L3, 250 W | Intel Core Ultra 9 285K, 24 rdzenie / 24 wątki (8P + 16E), do 5.7 GHz, 36 MB L3, 125 W |
| Zestawy instrukcji | AVX-512, AMX | AVX2 (bez AVX-512), Intel AI Boost NPU |
| Pamięć | 4 x 32 GB DDR5-6400 RDIMM ECC (cztery kanały; maksymalnie 1 TB) | 4 x 32 GB DDR5-4400 ECC UDIMM |
| Ekspansja | Gen5 x16, Gen5 x4, Gen4 x16, dwa Gen4 x8 (jeden x4 elektryczny) | Gen5 x16, jeden Gen4 x4 i dwa Gen3 x4 |
| Przechowywanie w bagażniku po przetestowaniu | 2 x 2TB E3.S Gen5 NVMe w przedniej kieszeni FlexBay, RAID0 (VROC firmy Graid Technology), 4,097 GB | 2TB SK hynix PCB01 M.2 Gen5 (pojedynczy dysk) |
| Wewnętrzny M.2 | 3 x M.2 2280 Gen5 | 1 x Gen5 i 2 x Gen4 M.2 |
| Zasilanie | Standardowo 750 W; opcjonalnie 500 W lub 1500 W (testowane 1500 W) | 360 W, 500 W lub 1500 W (80 Plus Platinum) |
| Grafika testowana | RTX PRO 6000 Blackwell Max-Q (300 W) w stanie dostawy; przetestowano również kartę o mocy 600 W | RTX PRO 6000 Blackwell (600 W) w stanie dostawy; przetestowano również kartę Max-Q |
| Podwozie | 387 x 187.7 x 438 mm, od 11.6 do 21.8 kg | 387 x 187.7 x 438 mm, od 8.17 do 23 kg |
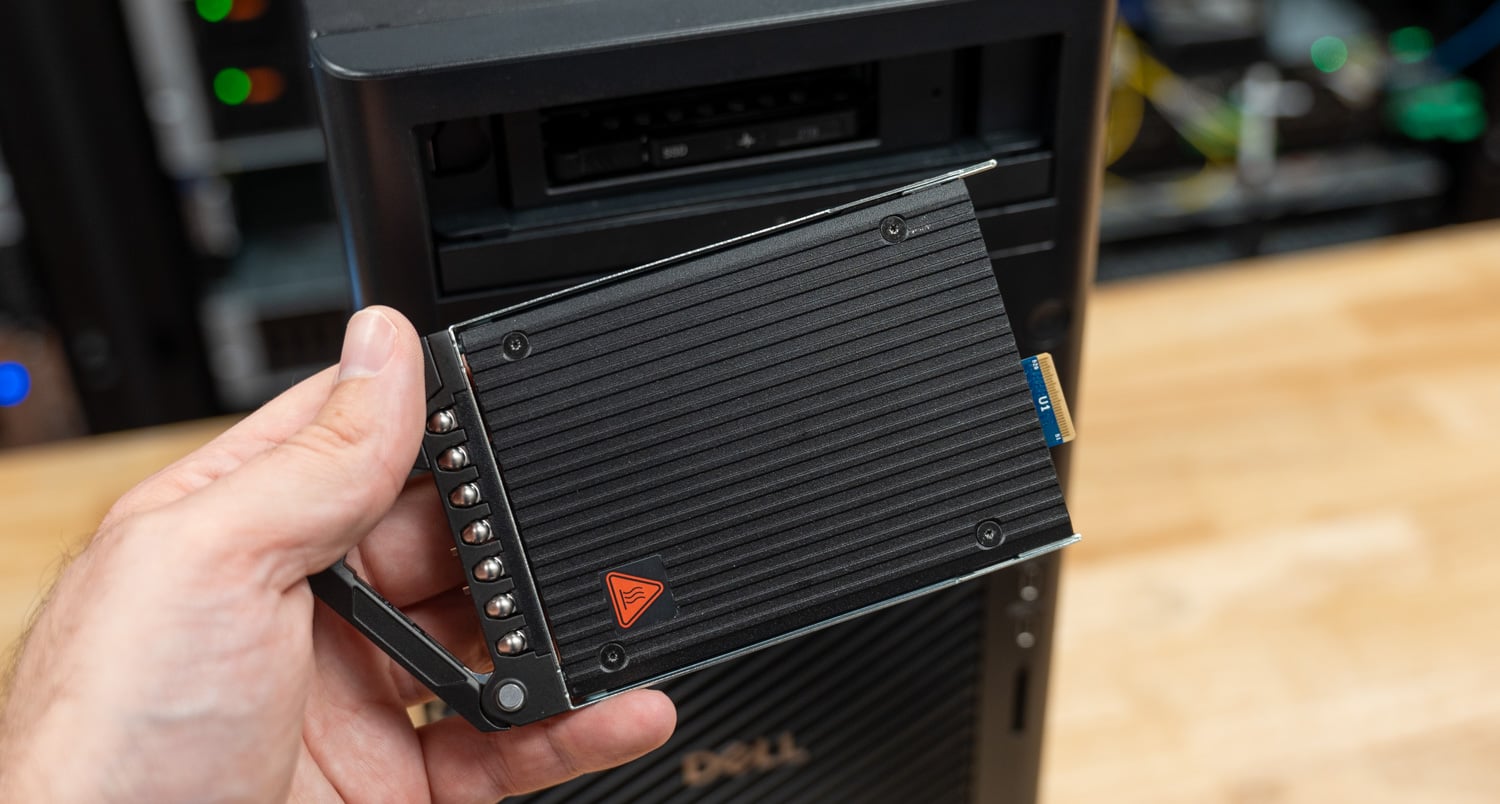
Core T2 uruchamiał się z pojedynczego dysku M.2, podczas gdy nasz Pro Precision 9 T2 został wyposażony w konfigurację rozruchową Dell FlexBay NVMe: dwa podłączane w trakcie pracy dyski E3.S Gen5 za przednią ramką, połączone w jeden wolumin o pojemności 4,097 GB za pomocą opcji rozruchu RAID0. E3.S to format korporacyjny, o który prosiliśmy dostawców obudów typu tower, ponieważ znacznie przewyższa on limit pojemności M.2, a dyski można wyjąć z przodu bez otwierania obudowy. Warstwa RAID to VROC firmy Graid Technology , kod Intel VROC, który Graid przejął w zeszłym roku i ponownie wprowadził na rynek na targach Computex. To pierwsza stacja robocza w naszym laboratorium, która została wyposażona w tę technologię.

Karta 600 W potrzebuje trochę więcej miejsca, Max-Q nie. Nasz egzemplarz został dostarczony z dwuportowym adapterem Intel E810-XXV 25 GbE w slocie obok GPU, a aby zainstalować kartę RTX PRO 6000 600 W, musieliśmy go zdemontować; chłodzenie karty zajmuje miejsce w sąsiednim slocie, a także zasilanie. Klienci, którzy chcą mieć kartę o pełnej mocy i szybką kartę sieciową, powinni zaplanować układ slotów przed złożeniem zamówienia, a zasilacz 1500 W to jedyne rozsądne rozwiązanie; nasz egzemplarz miał opcję 1500 W, co stanowiło 40 dolarów więcej niż standardowy zasilacz 750 W.
Budowa i projektowanie
Model Pro Precision 9 T2 wykorzystuje tę samą, beznarzędziową obudowę, co wersja Pro Max, z pełnowymiarową siatkową osłoną wlotu powietrza, bocznym zatrzaskiem i śrubą mocującą panel boczny, a także wnęką FlexBay i opcjonalnym, smukłym napędem optycznym za dolną ramką. Dell podaje, że pusta obudowa waży 11.6 kg, a skonfigurowana do 21.8 kg. Nasza, z zasilaczem 1500 W, chłodzeniem 658X i dwuslotowym procesorem graficznym, plasuje się w czołówce tego przedziału.

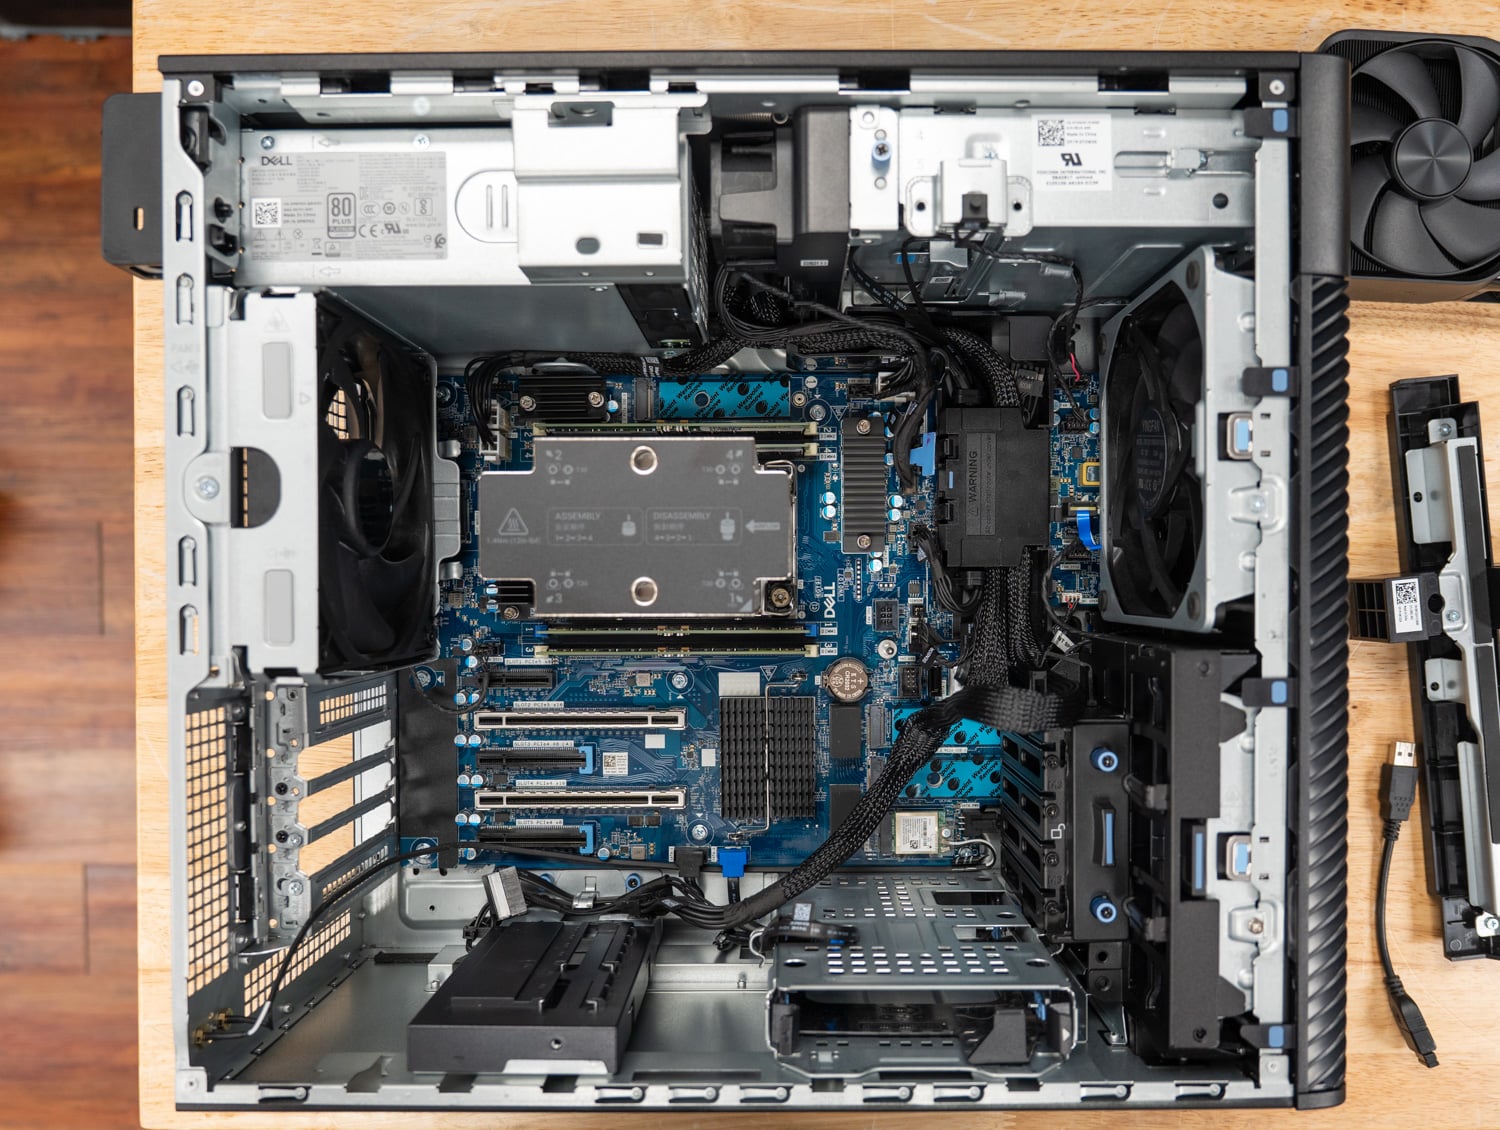
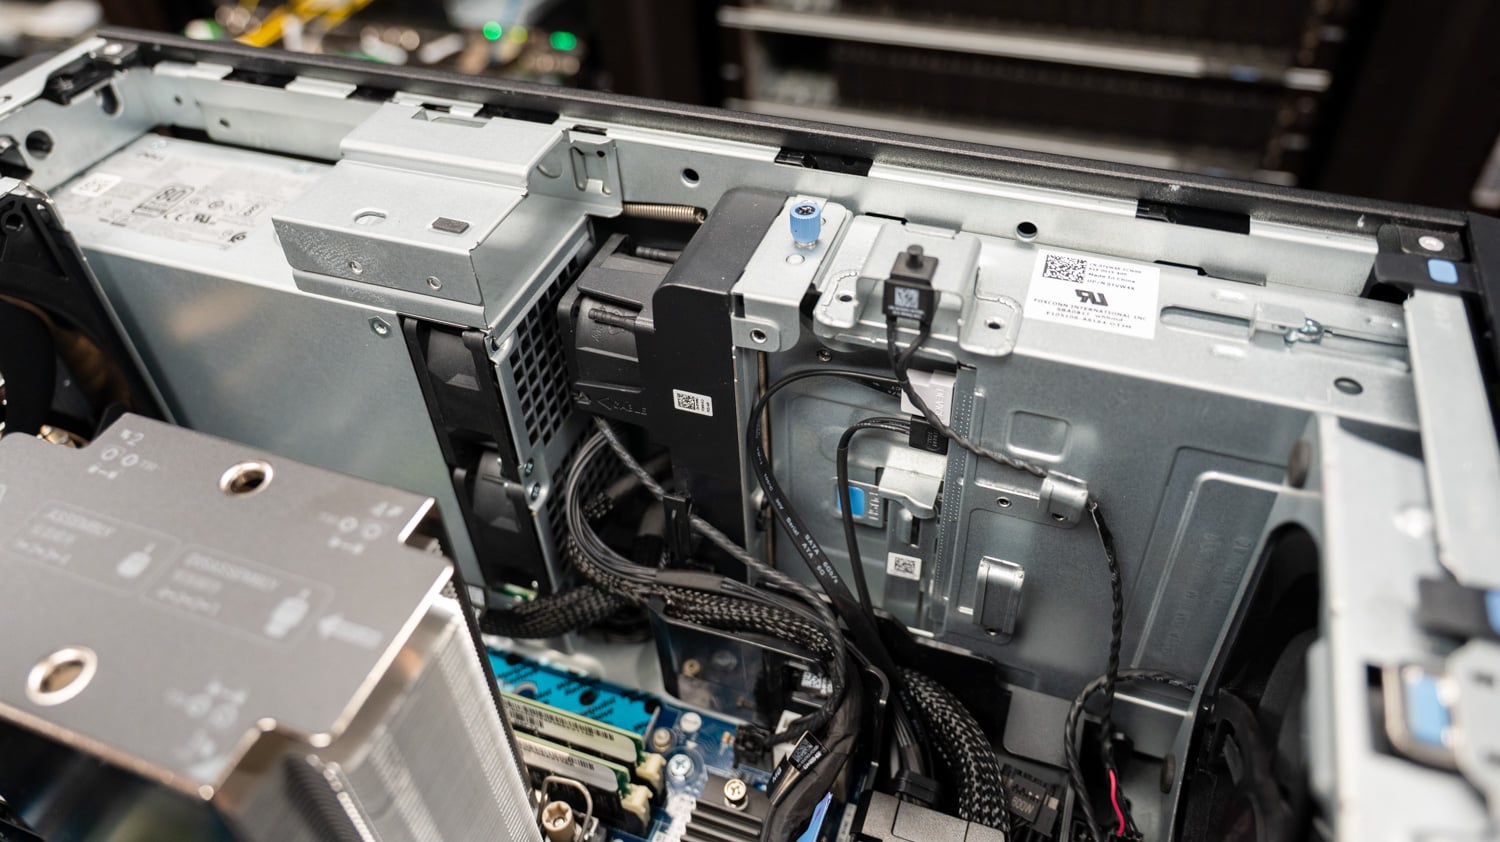
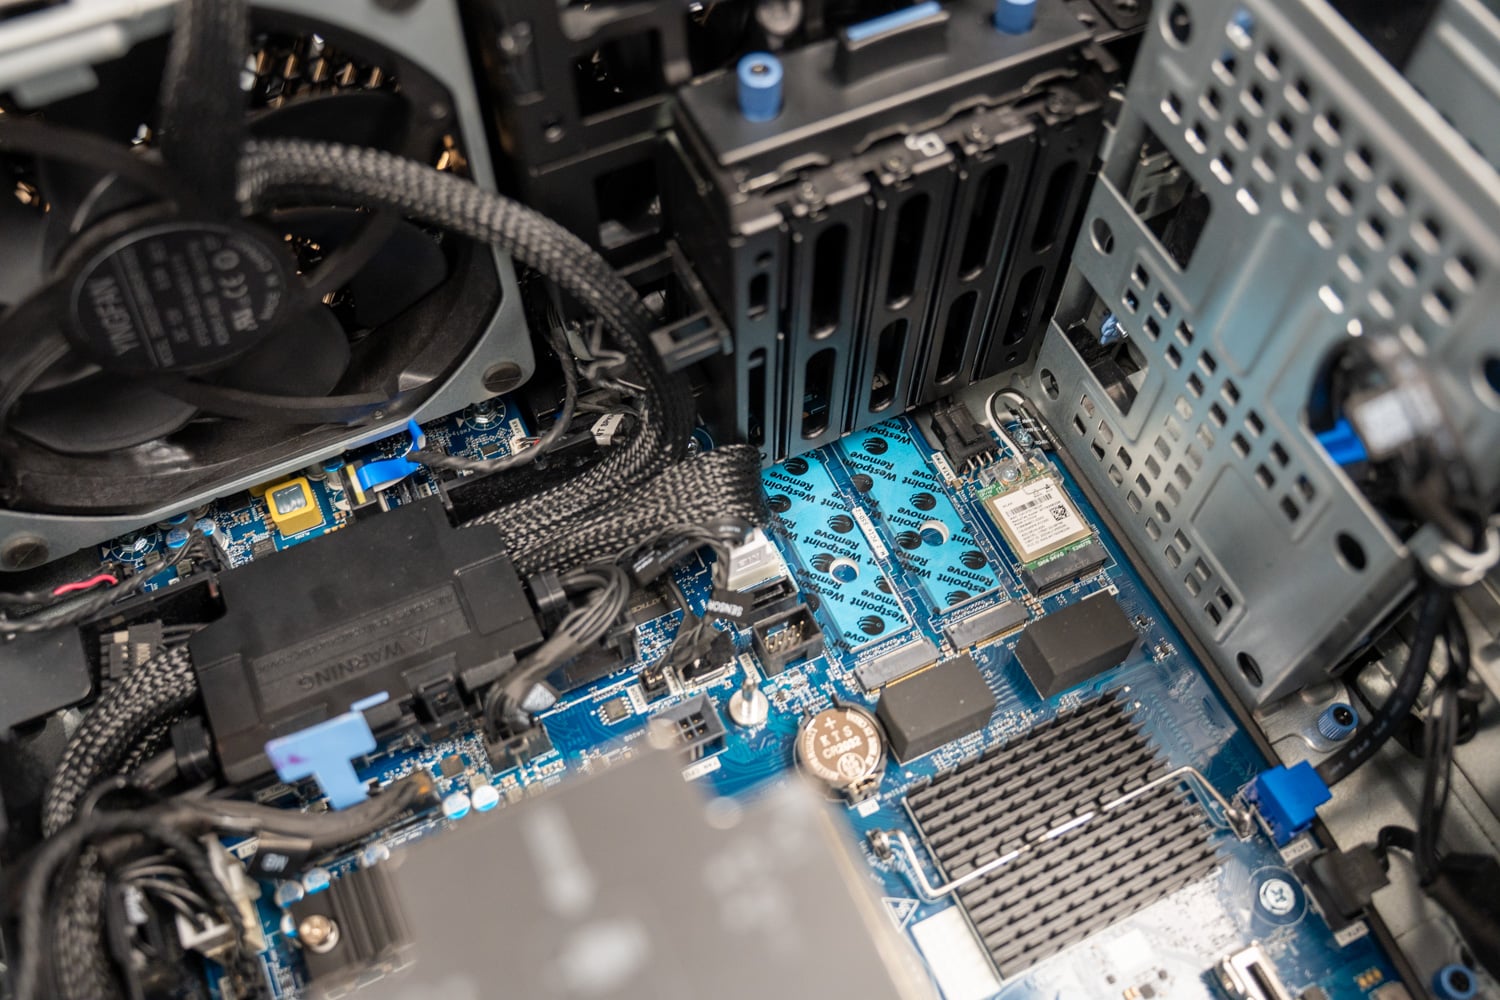
Wnętrze obudowy zostało zaprojektowane z myślą o przepływie powietrza, a Dell kieruje je dokładnie tam, gdzie jest potrzebne. Duża osłona chłodząca, która chłodzi moduły DIMM i odprowadza gorące powietrze z procesora bezpośrednio z obudowy, posiada wentylator zintegrowany z samą osłoną. Po otwarciu obudowy można zobaczyć, jak osłona wpasowuje się w strukturę obudowy, opierając dolną krawędź o wspornik karty graficznej i ściśle przylegając do pokrywy bocznej.
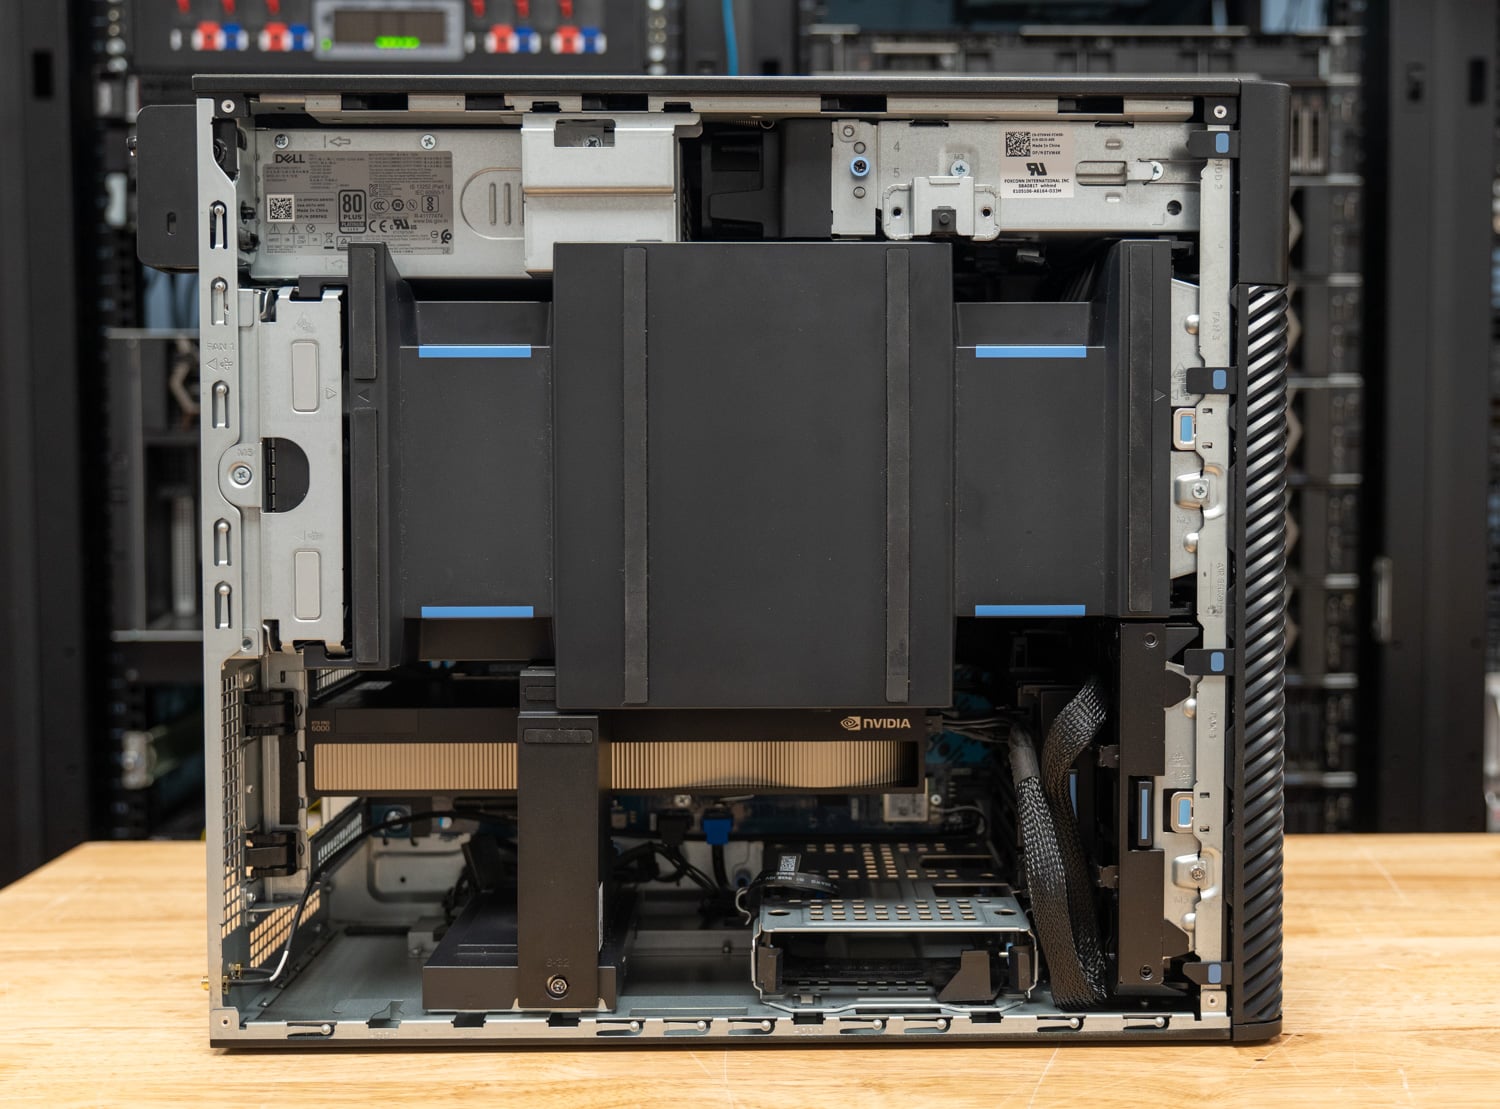
Wnętrze obudowy Pro Max Tower charakteryzuje się układem: procesor i cztery gniazda DIMM znajdują się nad obszarem rozszerzeń, karta graficzna w gnieździe Gen5 x16 jest podparta na jego drugim końcu wspornikiem mocującym, a zasilacz montuje się z tyłu za pomocą uchwytu, co umożliwia demontaż bez użycia narzędzi. Wszystkie pięć gniazd ma pełną wysokość: gniazdo 2 to Gen5 x16 dla karty graficznej, gniazdo 1 to Gen5 x4, a pozostałe trzy to Gen4, jedno x16 i dwa otwarte x8, przeznaczone na kartę sieciową, kartę pamięci lub drugą kartę graficzną. Trzy wewnętrzne gniazda M.2 2280 Gen5 i dwie 3.5-calowe wnęki SATA znajdują się za przednią wnęką E3.S.
Przedni panel I/O to gniazdo słuchawkowe, port USB-C 20 Gb/s z funkcją PowerShare, port USB-C 10 Gb/s, dwa porty USB-A oraz opcjonalne gniazdo kart SD. Z tyłu znajdują się wyjście liniowe audio, porty USB-C 20 Gb/s i 10 Gb/s, dwa porty USB 2.0 z funkcją SmartPower, dwa porty USB-A 5 Gb/s, port 1 Gb/s, gniazdo opcjonalnego modułu obsługujące kartę sieciową 5 Gb/s lub dwa dodatkowe porty USB-A oraz opcjonalny port szeregowy starszego typu. Nasz model posiada kartę Wi-Fi 7 MediaTek MT7925 w wewnętrznym gnieździe M.2 2230 oraz kartę Intel E810-XXV 25 Gb/s, przeznaczoną dla procesora graficznego o mocy 600 W.

Specyfikacja Dell Pro Precision 9 T2
| Specyfikacja | Dell Pro Precision 9 T2 (PW9T2260) |
|---|---|
| Omówienie platformy | |
| Opcje procesora | Intel Xeon 634 (12 rdzeni, 150 W), 636 (12 rdzeni, 170 W), 638 (16 rdzeni, 180 W), 654 (18 rdzeni, 200 W), 656 (20 rdzeni, 210 W), 658X (24 rdzenie / 48 wątków, 144 MB L3, 250 W) Xeon 658X w testach |
| Pamięć | DDR5 RDIMM ECC, 5600 lub 6400 MT/s, cztery gniazda, do 1 TB (4 x 256 GB) 128 GB (4 x 32 GB) DDR5-6400, jak testowano |
| Opcje graficzne | NVIDIA RTX A400, A1000, RTX PRO 2000 / 4000 / 4500 / 5000 / 6000 Blackwell (600 W) / 6000 Blackwell Max-Q (300 W), A800 Active; AMD Radeon Pro W7400; konfiguracje podwójne i potrójne na wybranych kartach RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7, testowany |
| Dyski | Przednia kieszeń FlexBay: do dwóch dysków E3.S/NVMe plus opcjonalny napęd ODD o smukłej konstrukcji lub jedna kieszeń SATA 3.5 cala Wewnętrzne: 3 x M.2 2280 Gen5 NVMe, 2 x 3.5-calowy SATA RAID: Intel VMD z VROC firmy Graid Technology (rozruch RAID0, wewnętrzny RAID0) 2 x 2TB E3.S Gen5 NVMe w RAID0 (4,097 GB) zgodnie z testem |
| Ekspansja | Gniazdo 1: Gen5 x4; Gniazdo 2: Gen5 x16; Gniazdo 3: Gen4 x8 (x4 elektryczne, otwarte); Gniazdo 4: Gen4 x16; Gniazdo 5: Gen4 x8 (otwarte); M.2 2230 dla Wi-Fi |
| I / O | |
| Porty przednie | 1 x USB-C 20 Gb/s z funkcją PowerShare, 1 x USB-C 10 Gb/s, 1 x USB-A 5 Gb/s z funkcją PowerShare, 1 x USB-A 5 Gb/s, gniazdo słuchawkowe, opcjonalne gniazdo SD |
| Porty tylne | 1 x USB-C 20 Gb/s, 1 x USB-C 10 Gb/s, 2 x USB 2.0 (SmartPower), 2 x USB-A 5 Gb/s, wyjście liniowe audio, 1 x RJ45 1 GbE, opcjonalny moduł 5 GbE lub podwójny USB-A, opcjonalny port szeregowy |
| Sieć przetestowana | Karta graficzna Intel E810-XXV DA2 dual-port 25GbE SFP28 (usunięta w przypadku procesorów graficznych o mocy 600 W); MediaTek MT7925 Wi-Fi 7, Bluetooth 5.4 |
| Moc i Fizyczność | |
| Zasilanie | Standardowo 750 W; opcjonalnie 500 W lub 1500 W; 1500 W po testach |
| Wymiary | 387 x 187.7 x 438 mm (15.23 x 7.38 x 17.24 cala) |
| Waga | Od 11.6 kg (25.57 funta) minimum do 21.8 kg (48.06 funta maksimum |
| System operacyjny | Windows 11 Pro for Workstations (testowany) lub Ubuntu Linux 24.04 LTS |
| Zarządzanie i bezpieczeństwo | Intel vPro, TPM 2.0, czujnik otwarcia obudowy, opcje blokowanej ramki, gniazdo Kensington |
| Cena | Dell.com konfiguracja podstawowa 3,978 USD (Xeon 634, 16 GB, RTX A400, 256 GB, 750 W); około 28 300 USD po testach (Xeon 658X, 128 GB DDR5-6400, RTX PRO 6000 Max-Q, 2 dyski 2 TB Gen5 FlexBay w RAID0, 1500 W, 25 GbE, Wi-Fi 7), ceny na Dell.com z 19 października 2026 r. |
Cena ta wiąże się z dwoma zastrzeżeniami. Konfigurator Dell.com wymienia dyski FlexBay jako moduły M.2 2280 Gen5 o pojemności 2 TB w cenie 1,700 USD za sztukę, podczas gdy dyski w naszym zestawie to E3.S, a my zapytaliśmy firmę Dell, kiedy opcja E3.S pojawi się w sieci. Dell szczerze przyznaje, że niewiele stacji roboczych dla firm jest kupowanych w cenach internetowych, więc traktuj kwotę 28 300 USD jako pułap, poniżej którego mieszczą się ceny hurtowe i kontraktowe. Pamięć i karta graficzna stanowią 19 090 USD z tej kwoty, a opcja z kartą GPU kosztuje tyle samo, niezależnie od tego, czy wybierzesz kartę 300 W, czy 600 W.
Firma Dell wyceniła testowany egzemplarz na 31 700 dolarów. W cenie tego egzemplarza uwzględniono kartę sieciową E810-XXV 25 GbE, moduł Wi-Fi 7, napęd optyczny i trzy lata usługi ProSupport.
Konfiguracja i metodologia testów
Wszystkie wyniki w tej recenzji pochodzą z sr-client 1.2, naszego skryptowego pakietu testowego dla klientów Windows, w pełnym profilu uruchomienia, wykorzystującego fabryczny obraz systemu Windows firmy Dell ze sterownikami Dell i sterownikiem NVIDIA 596.71 we wszystkich czterech konfiguracjach. Pakiet stosuje wszędzie te same ustawienia: tryb zasilania systemu Windows ustawiony na najlepszą wydajność, wszystkie timery uśpienia i wyłączenia ekranu wyłączone, Zapora systemu Windows i monity UAC wyłączone, VBS i integralność pamięci pozostawione w stanie domyślnym. Każdy wynik to mediana z wielokrotnych przebiegów, a pakiet ponownie uruchamia test, którego rozrzut przekracza 2%, zanim go zaakceptuje.
Cztery poniższe konfiguracje to dwie wieże i dwa procesory graficzne (GPU). Komputer Pro Precision 9 T2 obsługiwał pełen pakiet z kartą Max-Q, a następnie z kartą graficzną RTX PRO 6000 Blackwell o mocy 600 W z naszego komputera Pro Max Tower T2, a komputer Pro Max Tower T2 obsługiwał obie karty naraz. Zatem kolumny GPU w obudowie różnią się tylko kartą, a kolumny w obudowie GPU różnią się tylko platformą. Dysk w komputerze Core T2 to pojedynczy dysk Gen5 M.2 o pojemności 2 TB, z którym był dostarczany, a w komputerze Xeon T2 to dwudyskowy dysk E3.S Stripe. W związku z tym wiersze pamięci masowej i ładowania modelu są identyczne w konfiguracji.
| Konfiguracja | CPU | Pamięć | GPU | Dysk rozruchowy | System operacyjny i tryb zasilania |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T2 (PW9T2260), Max-Q | Intel Xeon 658X, 24 rdzenie / 48 wątków, 250 W | 128 GB pamięci DDR5-6400 RDIMM ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300 W, 96 GB | 2 x 2TB E3.S Gen5 NVMe, VROC RAID0 (wolumin rozruchowy 4,097 GB) | Windows 11 Pro dla stacji roboczych 25H2, najlepsza wydajność |
| Dell Pro Precision 9 T2 (PW9T2260), 600 W | Intel Xeon 658X, 24 rdzenie / 48 wątków, 250 W | 128 GB pamięci DDR5-6400 RDIMM ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600 W, 96 GB | 2 x 2TB E3.S Gen5 NVMe, VROC RAID0 (wolumin rozruchowy 4,097 GB) | Windows 11 Pro dla stacji roboczych 25H2, najlepsza wydajność |
| Dell Pro Max Tower T2 (FCT2250), Max-Q | Intel Core Ultra 9 285K, 24 rdzenie / 24 wątki, 125 W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300 W, 96 GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, najlepsza wydajność |
| Dell Pro Max Tower T2 (FCT2250), 600 W | Intel Core Ultra 9 285K, 24 rdzenie / 24 wątki, 125 W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600 W, 96 GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, najlepsza wydajność |
Debiutują tutaj różne testy, zaczynając od LLM, który uruchamia serwer llama z czterema modelami i analizuje współbieżność od jednego żądania do maksymalnego, jakie mieści się w pamięci GPU, raportując przepustowość całkowitą i na użytkownika, czas do pierwszego tokena i czas na token wyjściowy. Test generowania obrazu renderuje obrazy 1024×1024 za pomocą FLUX.2 Klein 4B, Z-Image Turbo 6B i Qwen-Image 20B z wagami Q4_0, Q8_0 i BF16, a następnie ocenia skwantyzowane wyjścia względem BF16 za pomocą PSNR i SSIM, dzięki czemu szybkość i dokładność są ze sobą powiązane. Test agenta kodującego działa teraz na platformie Crush, a test agenta obok użytkownika wykorzystuje zmodyfikowaną metodę, która ogranicza benchmark przeglądarki do trzech pełnych przebiegów.
W tabelach powtarzają się trzy etykiety, zaczynające się od N/A, co oznacza, że test nie dotyczy sprzętu: SMT jednordzeniowy na 285K, który nie ma SMT, oraz wiersze OpenBLAS z najwyższymi rdzeniami na Xeon, którego 24 rdzenie należą do jednej klasy. „Partial” oznacza wynik zaakceptowany przez pakiet z adnotacją, najczęściej w warstwie agenta kodowania, gdzie jeden z trzech przebiegów nie przeszedł testów. Ani komputer stacjonarny, ani temperatura procesora nie były narażone na działanie czujników pakietu, dlatego w tej recenzji zamiast tabeli termicznej podawana jest średnia wartość taktowania procesora na test.
Lokalna wydajność sztucznej inteligencji
Z 96 GB pamięci GDDR7 w każdej konfiguracji, pojemność modelu jest oczywista, a każdy poziom naszego lokalnego pakietu AI działa na wszystkich czterech. Wyniki rozkładają się zatem według limitu mocy GPU: tam, gdzie test jest ograniczony przepustowością pamięci, karty Max-Q i 600 W działają blisko siebie, a tam, gdzie jest on ograniczony mocą obliczeniową, karta 600 W wyprzedza. Platforma procesora rzadko ma znaczenie, a tam, gdzie ma, kierunek jest wart uwagi.
Klient MLPerf w wersji 2.0
Klient MLPerf uruchamia Llamę 3.1 8B i Phi-4-mini w pięciu kategoriach komunikatów i raportuje czas do pierwszego tokena oraz częstotliwość tokenów po nim, jako średnią geometryczną dla wszystkich kategorii, z silnikiem llama.cpp na CUDA w każdej konfiguracji. Scenariusze agentowe uruchamiają Llamę 3.1 8B jako agenta analityka danych i agenta inżynierii oprogramowania, którzy wywołują narzędzia w wielu turach.

| Klient MLPerf w wersji 2.0 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Llama 3.1 8B, czas do pierwszego tokena, średnia geograficzna (s, im niższy tym lepszy) | 0.082 | 0.059 | 0.082 | 0.060 |
| Llama 3.1 8B, token rate, geomean (tok/s) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini, czas do pierwszego żetonu, średnia geograficzna (s, im niższy tym lepszy) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini, stawka tokena, średnia geograficzna (tok/s) | 345.9 | 379.0 | 351.0 | 374.3 |
| Agent analityka danych, kompleksowy (s, im niższy tym lepszy) | 17.5 | 15.7 | 16.2 | 14.4 |
| Agent analityka danych, stawka tokena (tok/s) | 202.9 | 223.9 | 202.3 | 218.4 |
| Agent SWE, end-to-end (s, im niższy tym lepszy) | 16.2 | 14.9 | 14.6 | 13.5 |
| Agent SWE, stawka tokena (tok/s) | 197.5 | 214.6 | 195.5 | 210.2 |
Karta Max-Q generowała Llama 3.1 8B z prędkością 230.9 tokenów na sekundę w obudowie Xeon Tower i 230.0 tokenów na sekundę w obudowie Core Tower, a Phi-4-mini z prędkością 345.9 tokenów na sekundę i 351.0 tokenów na sekundę, co oznacza ten sam układ GPU wykonujący tę samą pracę. Karta 600 W podniosła te wartości do 252.8 tokenów na sekundę w obudowie Xeon Tower, co stanowi wzrost o około 9 procent, a czas potrzebny na wygenerowanie pierwszego tokena w Llama skrócił się z 0.082 do 0.059 sekundy, czyli o 28 procent. Szybkie przetwarzanie jest ograniczone mocą obliczeniową, a dekodowanie – przepustowością. Obie karty korzystają z tej samej pamięci, więc limit mocy jest znacznie bardziej widoczny w przypadku pierwszego tokena niż w kolejnych.
Scenariusze agentowe to scenariusze, w których pojawia się platforma CPU. Agent analityka danych zakończył działanie w 16.2 sekundy na procesorze Core T2 z kartą Max-Q i 17.5 sekundy na procesorze Xeon T2, a agent SWE w 14.6 sekundy w porównaniu z 16.2 sekundy, przy czym fazy wywołań narzędzi Xeon trwały o około 1.5 sekundy dłużej w każdej z nich. Szybkości tokenów pokrywają się z dokładnością do 1 procenta, więc różnica polega na tym, że narzędzia działają na procesorze między wywołaniami modelu, gdzie szybsze rdzenie procesora 285K kończą działanie szybciej.
Ładowanie modelu
Ten test mierzy czas odczytu lokalnego modelu w Ollama z dysku do pierwszego wygenerowanego tokena, zimnego (z opróżnioną pamięcią podręczną pliku) i ciepłego (plik już w pamięci), a także raportuje, jak szybko dysk został odczytany podczas zimnego obciążenia, kiedy wagi dotarły do pamięci GPU, a także podaje wartość wydajności obciążenia, która porównuje szybkość odczytu podczas obciążenia z sekwencyjnym limitem 1 MB dysku. Przy 96 GB pamięci VRAM wszystkie trzy poziomy działają: gpt-oss:20b przy 12.8 GB, Qwen3.6-35B-A3B przy 21.1 GB i gpt-oss:120b przy 60.9 GB.

| Ładowanie modelu (włączone mapowanie pamięci) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| gpt-oss:20b, zimne ładowanie do pierwszego tokena (s, im niższy tym lepszy) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b, ciepłe ładowanie do pierwszego tokena (s, im niższy tym lepszy) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b, przybycie do pamięci GPU, zimno (s, im mniej tym lepiej) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B, zimne ładowanie do pierwszego tokena (s, im niższy tym lepszy) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B, ciepłe ładowanie do pierwszego tokena (s, im niższy tym lepiej) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b, zimne ładowanie do pierwszego tokena (s, im niższy tym lepszy) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b, ciepłe ładowanie do pierwszego tokena (s, im niższy tym lepszy) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b, przepustowość odczytu podczas ładowania na zimno (MB/s) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b, przybycie do pamięci GPU, zimno (s, im mniej tym lepiej) | 11.33 | 11.57 | 7.74 | 7.63 |
| obciążenie gpt-oss:120b po zamianie z gpt-oss:20b (s, im niższy tym lepszy) | 14.30 | 13.97 | 11.89 | 11.93 |
| Maksymalna prędkość napędu, DiskSpd 1 MB, odczyt sekwencyjny (MB/s) | 11,306 | 11,296 | 11,563 | 11,646 |
Procesor Core T2 ładuje każdy model szybciej, a to zasługa właśnie tego dysku. gpt-oss:120b osiągnął swój pierwszy token w 28.54 sekundy na Core T2, w porównaniu z 32.06 sekundy na Xeon T2, a 61 GB danych dotarło do pamięci GPU w 7.74 sekundy w porównaniu z 11.33 sekundy. Pojedynczy moduł PCB01 obciążał go z prędkością 11 633 MB/s, dokładnie przy swoim limicie prędkości dysku 11 563 MB/s, podczas gdy moduł E3.S obsługiwał go z prędkością 9,875 MB/s, przy własnym limicie 11 306 MB/s. Wolumin RAID odczytuje duże bloki niemal tak szybko, jak pojedynczy dysk, ale nie utrzymuje tej prędkości w mapowanej pamięci ścieżce ładowania Ollama.
Ciepłe ładowanie skraca czas ładowania do sekundy lub dwóch, ponieważ plik jest już w pamięci systemowej, a pozostaje jedynie transfer do pamięci VRAM i konfiguracja llama.cpp: 27.18 sekundy na Xeonie T2 w porównaniu z 25.58 dla gpt-oss:120b oraz 7.52 sekundy w porównaniu z 6.60 dla gpt-oss:20b. Limit mocy GPU nie ma znaczącego wpływu na obciążenie, jak oczekiwano.
Agent kodujący
Crush, agent kodujący terminal, steruje lokalnym modelem obsługiwanym przez Ollamę poprzez stałe zadanie kodowania w przypiętym repozytorium, z maksymalnie trzema rundami, aby zaliczyć 11 testów w repozytorium; raportujemy medianę czasu ściany dla trzech przebiegów, liczbę udanych przebiegów oraz tempo generowania. Czas ściany zależy od liczby wywołań narzędzi i tokenów, które model zdecyduje się wydać, co różni się w zależności od przebiegu, więc tempo generowania jest bardziej przejrzystym porównaniem sprzętowym. Test agent-obok-użytkownika uruchamia agenta i Speedometer jednocześnie i raportuje, o ile każdy z nich spowalnia działanie drugiego.

| Agent kodujący Crush | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Poziom S, gpt-oss:20b, kontekst 64K | ||||
| Czas na ścianie, mediana (s, im niższy tym lepiej) | 55.1 | 99.8 | 57.2 | 43.2 |
| Sukcesy (z 3) | 3 | 2 | 3 | 2 |
| Szybkość generacji (tok/s) | 214.1 | 237.9 | 218.0 | 237.7 |
| Poziom M, Qwen3.6-35B-A3B, kontekst 64K | ||||
| Czas na ścianie, mediana (s, im niższy tym lepiej) | 35.2 | 27.0 | 86.7 | 32.1 |
| Sukcesy (z 3) | 3 | 3 | 3 | 3 |
| Szybkość generacji (tok/s) | 234.5 | 242.9 | 223.3 | 245.8 |
| Poziom L, Qwen3.6-35B-A3B, kontekst 128K | ||||
| Czas na ścianie, mediana (s, im niższy tym lepiej) | 38.1 | 30.6 | 74.1 | 58.8 |
| Sukcesy (z 3) | 3 | 3 | 3 | 3 |
| Szybkość generacji (tok/s) | 222.9 | 237.0 | 231.1 | 252.8 |
| Poziom W, gpt-oss:120b, kontekst 128K | ||||
| Czas na ścianie, mediana (s, im niższy tym lepiej) | 49.1 | 37.9 | 56.6 | 30.8 |
| Sukcesy (z 3) | 3 | 3 | 3 | 3 |
| Szybkość generacji (tok/s) | 160.9 | 177.1 | 158.5 | 174.4 |
| Agent obok użytkownika (gpt-oss:20b i Speedometer razem) | ||||
| Prędkościomierz obok agenta (wynik) | 36.6 | 36.7 | 43.2 | 45.2 |
| Spowolnienie prędkościomierza (x, im mniej tym lepiej) | 1.005 | 1.011 | 1.053 | 1.044 |
| Szybkość generowania agentów obok prędkościomierza (tok/s) | 218.2 | 231.6 | 212.4 | 229.2 |
| Spowolnienie agenta (x, im mniej tym lepiej) | 1.006 | 1.009 | 1.023 | 0.998 |
Każda konfiguracja ukończyła wszystkie trzy przebiegi zadania warstwy W z gpt-oss:120b, największym modelem w zestawie, generując od 160.9 do 177.1 tokenów na sekundę w obudowie Xeon i od 158.5 do 174.4 tokenów na sekundę w obudowie Core, przy czym karta 600W stanowiła około 10 procent w każdym z nich. Zadania Qwen3.6 również ukończyły trzy z trzech przebiegów w każdym przypadku, z prędkością od 223 do 253 tokenów na sekundę. gpt-oss:20b to model, który zawiódł: zadanie warstwy S przegrało jeden z trzech przebiegów w dwóch z czterech konfiguracji, a jego zadanie warstwy M o kontekście 128 KB (niepokazane) przegrało co najmniej jeden przebieg w każdym przypadku, co jest zachowaniem modelu, którego sprzęt nie zmienia.
Jednoczesne uruchomienie agenta i benchmarku przeglądarki kosztuje praktycznie nic w przypadku komputera z oddzielną kartą graficzną i 24 rdzeniami. Speedometer zwolnił o 1.005x na Xeon T2 i 1.053x na Core T2 z uruchomionym agentem, a tempo generowania agenta w każdym przypadku wzrosło o 2% lub mniej. Wynik Speedometera Xeon T2 wynoszący 36.6 przy uruchomionym agencie jest niższy niż 43.2 Core T2 z tego samego powodu, dla którego jest niższy: z powodu szybkości na rdzeń procesora 285K.
Generacja rozszerzona o odzyskiwanie
Nasz test RAG osadza 20 963 fragmenty SQuAD v1.1 za pomocą nomic-embed-text, pobiera pięć najlepszych fragmentów dla każdego z 2,000 pytań i odpowiada na 400 z nich za pomocą Phi-4-mini, uzyskując wynik dokładnego dopasowania i F1 w stosunku do odpowiedzi referencyjnych. Modele są małe, więc test mierzy cały proces, w tym wyszukiwanie wektorowe po stronie procesora między fazami GPU.

| RAG | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Czas wchłaniania na ścianie, 20 963 przejścia (s, im mniej tym lepiej) | 128.5 | 125.5 | 108.1 | 103.0 |
| Szybkość osadzania (tok/s) | 29,875 | 30,592 | 35,165 | 37,508 |
| Czas zapytania pobierania, p50 (ms, im niższy, tym lepiej) | 30.6 | 27.2 | 23.4 | 18.7 |
| Odpowiedź: czas Phi-4-mini do pierwszego żetonu, p50 (s, im niższy tym lepszy) | 0.099 | 0.087 | 0.089 | 0.083 |
| Odpowiedź, szybkie przetwarzanie (tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| Odpowiedź, szybkość generacji (tok/s) | 296.4 | 337.8 | 324.3 | 344.1 |
| Pytanie do odpowiedzi, p50 (s, im niżej tym lepiej) | 0.152 | 0.133 | 0.130 | 0.120 |
| Przypomnienie@5 (%) | 82.7 | 82.7 | 82.7 | 82.7 |
| Odpowiedź F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
Procesor Core T2 działa szybciej dzięki temu procesowi. Pobierał dane w 108.1 sekundy (w porównaniu do 128.5 sekundy na procesorze Xeon T2 z tą samą kartą Max-Q), pobierał dane w 23.4 ms (w porównaniu do 30.6 sekundy przy medianie) i odpowiadał na pytanie w 0.130 sekundy (w porównaniu do 0.152 sekundy). Zarówno osadzanie, jak i pobieranie danych mają etapy ograniczone przez procesor, co faworyzuje procesor 285K. Karta 600 W przyspieszyła przetwarzanie danych o 25–30 procent na obu platformach, z 20 318 do 26 549 tokenów na sekundę na procesorze Xeon T2, a dokładność była identyczna we wszystkich czterech konfiguracjach, co jest typowe dla tych samych modeli w temperaturze 0.
Obsługa LLM
Test obsługi uruchamia serwer llama z Ministral 3 3B i 8B (4,096 tokenów zachęty, 1,024 tokeny wyjścia), Qwen3.8 27B i gpt-oss 120B (8,192 tokeny zachęty), przydziela tyle slotów, ile mieści się w pamięci GPU po uwzględnieniu wag, a następnie analizuje współbieżność od jednego żądania do tego limitu. Raportujemy całkowitą przepustowość (łącznie tokeny zachęty i wyjścia), przepustowość wyjścia, czas do pierwszego tokena i czas na token wyjścia jako medianę. Na karcie 96 GB, gpt-oss 120B obsługuje 64 sloty z 22.5 GB pamięci podręcznej KV, Qwen3.8 27B obsługuje osiem, a dwa modele Ministral obsługują cztery w swoim kontekście.

| llama-server, gpt-oss 120B, 8,192-tokeny-monity, 1,024-tokeny-wyjścia | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| 1 współbieżna: przepustowość wyjściowa (tok/s) | 160.6 | 182.7 | 158.4 | 179.0 |
| 1 współbieżne: czas do pierwszego tokena, mediana (ms, im niższy tym lepiej) | 1,241 | 918 | 1,238 | 923 |
| 1 współbieżne: czas na token wyjściowy, mediana (ms, im niższy, tym lepiej) | 5.03 | 4.58 | 5.11 | 4.70 |
| 8 współbieżne: całkowita przepustowość (tok/s) | 2,088 | 2,460 | 2,154 | 2,534 |
| 8 współbieżne: wyjście na użytkownika (tok/s) | 29.0 | 34.2 | 29.9 | 35.2 |
| 8 współbieżne: czas do pierwszego tokena, mediana (ms, im niższy tym lepiej) | 2,847 | 2,152 | 2,856 | 2,121 |
| 64 współbieżne: całkowita przepustowość (tok/s) | 3,296 | 3,805 | 3,531 | 4,220 |
| 64 współbieżne: wyjście na użytkownika (tok/s) | 5.7 | 6.6 | 6.1 | 7.3 |
| 64 współbieżne: czas do pierwszego tokena, mediana (ms, im niższy tym lepiej) | 4,315 | 3,491 | 4,607 | 3,622 |
| 64 współbieżne: czas na token wyjściowy, mediana (ms, im niższy, tym lepiej) | 163.0 | 141.3 | 152.7 | 126.3 |
Pojedynczy użytkownik otrzymuje pakiet gpt-oss 120B z szybkością 160.6 tokenów na sekundę na karcie Max-Q i 182.7 na karcie 600W, przy czym pierwszy token dociera w 1,241 i 918 ms po monicie o 8,192 tokeny. Obciążenie karty 64 równoczesnymi żądaniami zwiększyło całkowitą przepustowość do 3,296 tokenów na sekundę na karcie Max-Q i 3,805 na karcie 600W, kosztem 5.7 i 6.6 tokenów na sekundę na użytkownika i pierwszych tokenów w 4.3 i 3.5 sekundy. Krzywa spłaszcza się między 4 a 32 równoczesnymi żądaniami, a następnie ponownie skacze przy 64, gdzie partia w końcu amortyzuje długie monity.

| llama-server, przepustowość wyjściowa przy najwyższej współbieżności, jaka pasuje (tok/s) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Ministerial 3 3B Rozumowanie, 4 jednoczesne | 562.5 | 600.4 | 576.8 | 625.3 |
| Ministerial 3 8B Rozumowanie, 4 jednoczesne | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B, 8 współbieżnych | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B, 64 współbieżne | 366.3 | 422.8 | 392.3 | 468.9 |
| Przepustowość wyjściowa pojedynczego żądania (tok/s) | ||||
| Ministral 3 3B Rozumowanie | 232.1 | 241.8 | 232.1 | 246.0 |
| Ministral 3 8B Rozumowanie | 165.0 | 183.3 | 164.1 | 180.4 |
| Qwen3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
Gęsta karta Qwen3.8 27B jest najwolniejszym modelem dla pojedynczego użytkownika, osiągając 54.0 tokenów na sekundę na Max-Q, ponieważ każdy token przetwarza wszystkie 27 miliardów parametrów, podczas gdy mieszanka ekspertów gpt-oss 120B działa 3.0 razy szybciej, pomimo czterokrotnie większego rozmiaru dysku. Przewaga karty 600 W jest największa w modelu gęstym, 24 procent przy ośmiu równoczesnych żądaniach, a najmniejsza w Ministral 3B, wynosząca około 7 procent. Obie wieże plasują się w przedziale około 3 procent wszędzie, z wyjątkiem przypadku gpt-oss z 64 żądaniami, gdzie Core T2 prowadził o 7 do 11 procent z każdą z kart, więc obciążenie procesora serwera przy tej wielkości wsadu faworyzuje szybsze rdzenie.
Generowanie obrazu
Test generowania obrazu renderuje obrazy o rozdzielczości 1024×1024 z trzema modelami dyfuzji i trzema precyzjami wag, podając czas na obraz, szybkość odszumiania oraz pamięć GPU zajmowaną przez wagi. Renderuje również to samo ziarno w BF16 i porównuje z nim wyniki Q4_0 i Q8_0 za pomocą PSNR i SSIM, co określa koszt kwantyzacji na obrazie.

| Generowanie obrazu, 1024×1024 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| FLUX.2 klein 4B, 4 kroki | ||||
| Q8_0: sekund na obraz (im mniej, tym lepiej) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0: obrazów na minutę | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16: sekundy na obraz (im mniej, tym lepiej) | 1.60 | 1.34 | 1.55 | 1.27 |
| Z-Image Turbo 6B, 8 kroków | ||||
| Q8_0: sekund na obraz (im mniej, tym lepiej) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0: obrazów na minutę | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16: sekundy na obraz (im mniej, tym lepiej) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Image 20B, 20 kroków | ||||
| Q4_0: sekund na obraz (im mniej, tym lepiej) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0: sekund na obraz (im mniej, tym lepiej) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16: sekundy na obraz (im mniej, tym lepiej) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0: obrazów na minutę | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16: Pamięć GPU dla wag (GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
Dyfuzja jest ograniczona przez moc obliczeniową, co pokazuje karta 600 W: Qwen-Image 20B w Q8_0 potrzebował 26.1 sekundy na obraz na Max-Q i 19.7 sekundy na karcie 600 W w obudowie Xeon Tower, co oznacza wzrost o 33% w liczbie obrazów na minutę, podczas gdy Z-Image Turbo zyskał 32%, a FLUX.2 Klein 21%. Platforma procesora nie ma tu znaczenia, ponieważ obie obudowy osiągają wynik w granicach 1% w każdym wierszu, z wyjątkiem startu serwera, gdzie wolumin RAID Xeon T2 potrzebuje kilku sekund dłużej na załadowanie wag.
| Wierność kwantyzacji w porównaniu z BF16 (to samo ziarno) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| PSNR (dB, im wyższa wartość, tym lepiej) / SSIM (im wyższa wartość, tym lepiej) | ||||
| FLUX.2 klein 4B, Q4_0 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| FLUX.2 klein 4B, Q8_0 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Z-Image Turbo 6B, Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Z-Image Turbo 6B, Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Qwen-Image 20B, Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Qwen-Image 20B, Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
Wiersze wierności są identyczne we wszystkich czterech konfiguracjach, ponieważ wynik zależy od wag, a nie od sprzętu. Q8_0 odtwarza obraz BF16 z SSIM od 0.938 do 0.987 i PSNR od 28 do 36 dB, podczas gdy Q4_0 obniża się do 0.75 do 0.79 SSIM i 18 do 22 dB, co przedstawia zupełnie inny obraz. Na karcie 96 GB nie ma powodu, aby uruchamiać te modele poniżej Q8_0; wagi BF16 firmy Qwen-Image mieszczą się przy 45.3 GB, a BF16 renderuje się tak samo szybko jak Q8_0 lub nieco szybciej we wszystkich trzech modelach, ponieważ ścieżka Q8_0 poświęca czas na dekwantyzację.
Wydajność procesora
Dwa procesory dzielą nasz zestaw CPU w sposób przejrzysty. W teście wykorzystującym wszystkie rdzenie, Xeon 658X wygrywa z przewagą od 27 do 150 procent w większości przypadków, a im szersze wektory i większy ruch pamięci, tym większa przewaga. W teście przeprowadzanym na jednym lub kilku wątkach, Core Ultra 9 285K wygrywa z przewagą od 13 do 31 procent, dzięki rdzeniowi P 5.7 GHz, w porównaniu z rdzeniem Xeon 4.9 GHz o wyższej pamięci podręcznej i opóźnieniu pamięci. Wpływ procesora graficznego o mocy 600 W na wyniki wszystkich rdzeni Xeona jest omówiony w każdej tabeli i podsumowany w sekcji poświęconej taktowaniu.
Cinebench 2026 i obciążenie ciągłe
Cinebench 2026 renderuje scenę z silnikiem Redshift firmy Maxon na procesorze i ocenia przepustowość dla pojedynczego rdzenia, pojedynczego rdzenia SMT (dwa wątki na jednym rdzeniu fizycznym) oraz wielu rdzeni. Następnie przeprowadzamy pętlę, która powtarza przebieg wielordzeniowy przez około 30 minut i porównuje stan ustalony z pierwszym przebiegiem.

| Cinebench 2026 (punkty, im więcej tym lepiej) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Pojedynczy rdzeń | 454.1 | 455.6 | 564.4 | 564.5 |
| SMT pojedynczy rdzeń | 599.1 | 601.0 | N/A (brak SMT) | N/A (brak SMT) |
| Wielordzeniowy | 12,322 | 11,705 | 8,856 | 8,838 |
| Pętla podtrzymywana, pierwsze przejście | 12,201 | 11,731 | 8,717 | 8,788 |
| Pętla podtrzymywana, stan ustalony | 12,328 | 11,764 | 8,825 | 8,844 |
| Stan stacjonarny / pierwsze przejście | 1.010 | 1.003 | 1.012 | 1.006 |
| Pętla podtrzymująca, ustalony zegar procesora (MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
Procesor 658X uzyskał 12 322 wyniki w teście wielowątkowym z zainstalowaną kartą Max-Q, o 39 procent więcej niż 8,856 punktów procesora 285K, i utrzymał 12 328 punktów w 30-minutowej pętli, co stanowi wynik stabilny o 1 procent wyższy niż w pierwszym przejściu. W przypadku jednego rdzenia kolejność się odwraca: 285K uzyskał 564.4 punktów w porównaniu z 454.1 punktów procesora Xeon, a do przebicia wyniku 285K w teście jednowątkowym potrzebne są dwa wątki na jednym rdzeniu Xeon, z wynikiem 599.1.
Po zamontowaniu karty 600 W wynik wielordzeniowy procesora Xeon wyniósł 11 705, a w stanie ustalonym 11 764, czyli o 5 procent mniej, przy taktowaniu w stanie ustalonym obniżonym z 4,274 do 4,178 MHz. Core T2 nie wykazał takiej zmiany, z wynikami 8,856 i 8,838. Pakiet nie rejestrował temperatur procesora ani karty graficznej w żadnej obudowie, więc nie możemy stwierdzić, czy procesor 250 W traci na cieple karty 600 W, czy na współdzielonym budżecie mocy. Wiemy jedynie, że traci od 4 do 5 procent w każdym teście na wszystkich rdzeniach z większą kartą w obudowie.
7-Zip
Wbudowany test porównawczy 7-Zip raportuje przepustowość kompresji i dekompresji LZMA w gigainstrukcjach na sekundę, raz dla każdego wątku i po przypięciu do pojedynczego rdzenia. LZMA opiera się na przepustowości całkowitoliczbowej, przewidywaniu rozgałęzień oraz opóźnieniu pamięci podręcznej i pamięci, dlatego bardziej ceni liczbę rdzeni i szybką ścieżkę pamięci niż szerokość wektora.

| 7-Zip (GIPS, im wyższy tym lepszy) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Wszystkie wątki | ||||
| Cena produktu z VAT: | 289.6 | 288.9 | 174.8 | 175.7 |
| Kompresować | 276.4 | 273.5 | 151.5 | 151.9 |
| Rozprężać | 303.0 | 304.4 | 198.1 | 199.4 |
| Jeden wątek | ||||
| Cena produktu z VAT: | 8.74 | 8.05 | 10.82 | 10.83 |
| Kompresować | 8.66 | 7.80 | 9.31 | 9.31 |
| Rozprężać | 8.83 | 8.30 | 12.33 | 12.34 |
Na 48 wątkach Xeon uzyskał wynik 289.6 GIPS, podczas gdy 285K uzyskał 174.8 na 24, co daje 66-procentową przewagę, przy czym kompresja wyprzedziła go o 82 procent, a dekompresja o 53. Na jednym wątku 285K prowadził z wynikiem 10.82 GIPS wobec 8.74, a różnica ta powiększyła się wraz z kartą 600W w obudowie Xeon, osiągając 8.05, co było zgodne z niższymi taktowaniami tej konfiguracji.
Blender, HandBrake i LLVM
Blender 4.5 renderuje sceny Monster, Junkshop i Classroom za pomocą Cycles na procesorze. HandBrake koduje programowo 60 sekund klipu 4K60 z kodekiem x265 (HEVC, ustawienie średnie, jakość 22) i SVT-AV1 (ustawienie 8, jakość 30). Test LLVM kompiluje pełne drzewo LLVM 21.1.4 z Clang i Ninja, co stanowi najdłuższe obciążenie wszystkich rdzeni w pakiecie.

| Testowanie | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Blender 4.5 Monster (próbek/min, im więcej tym lepiej) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 Junkshop (próbki/min) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender 4.5 Classroom (próbki/min) | 187.2 | 169.2 | 132.5 | 132.3 |
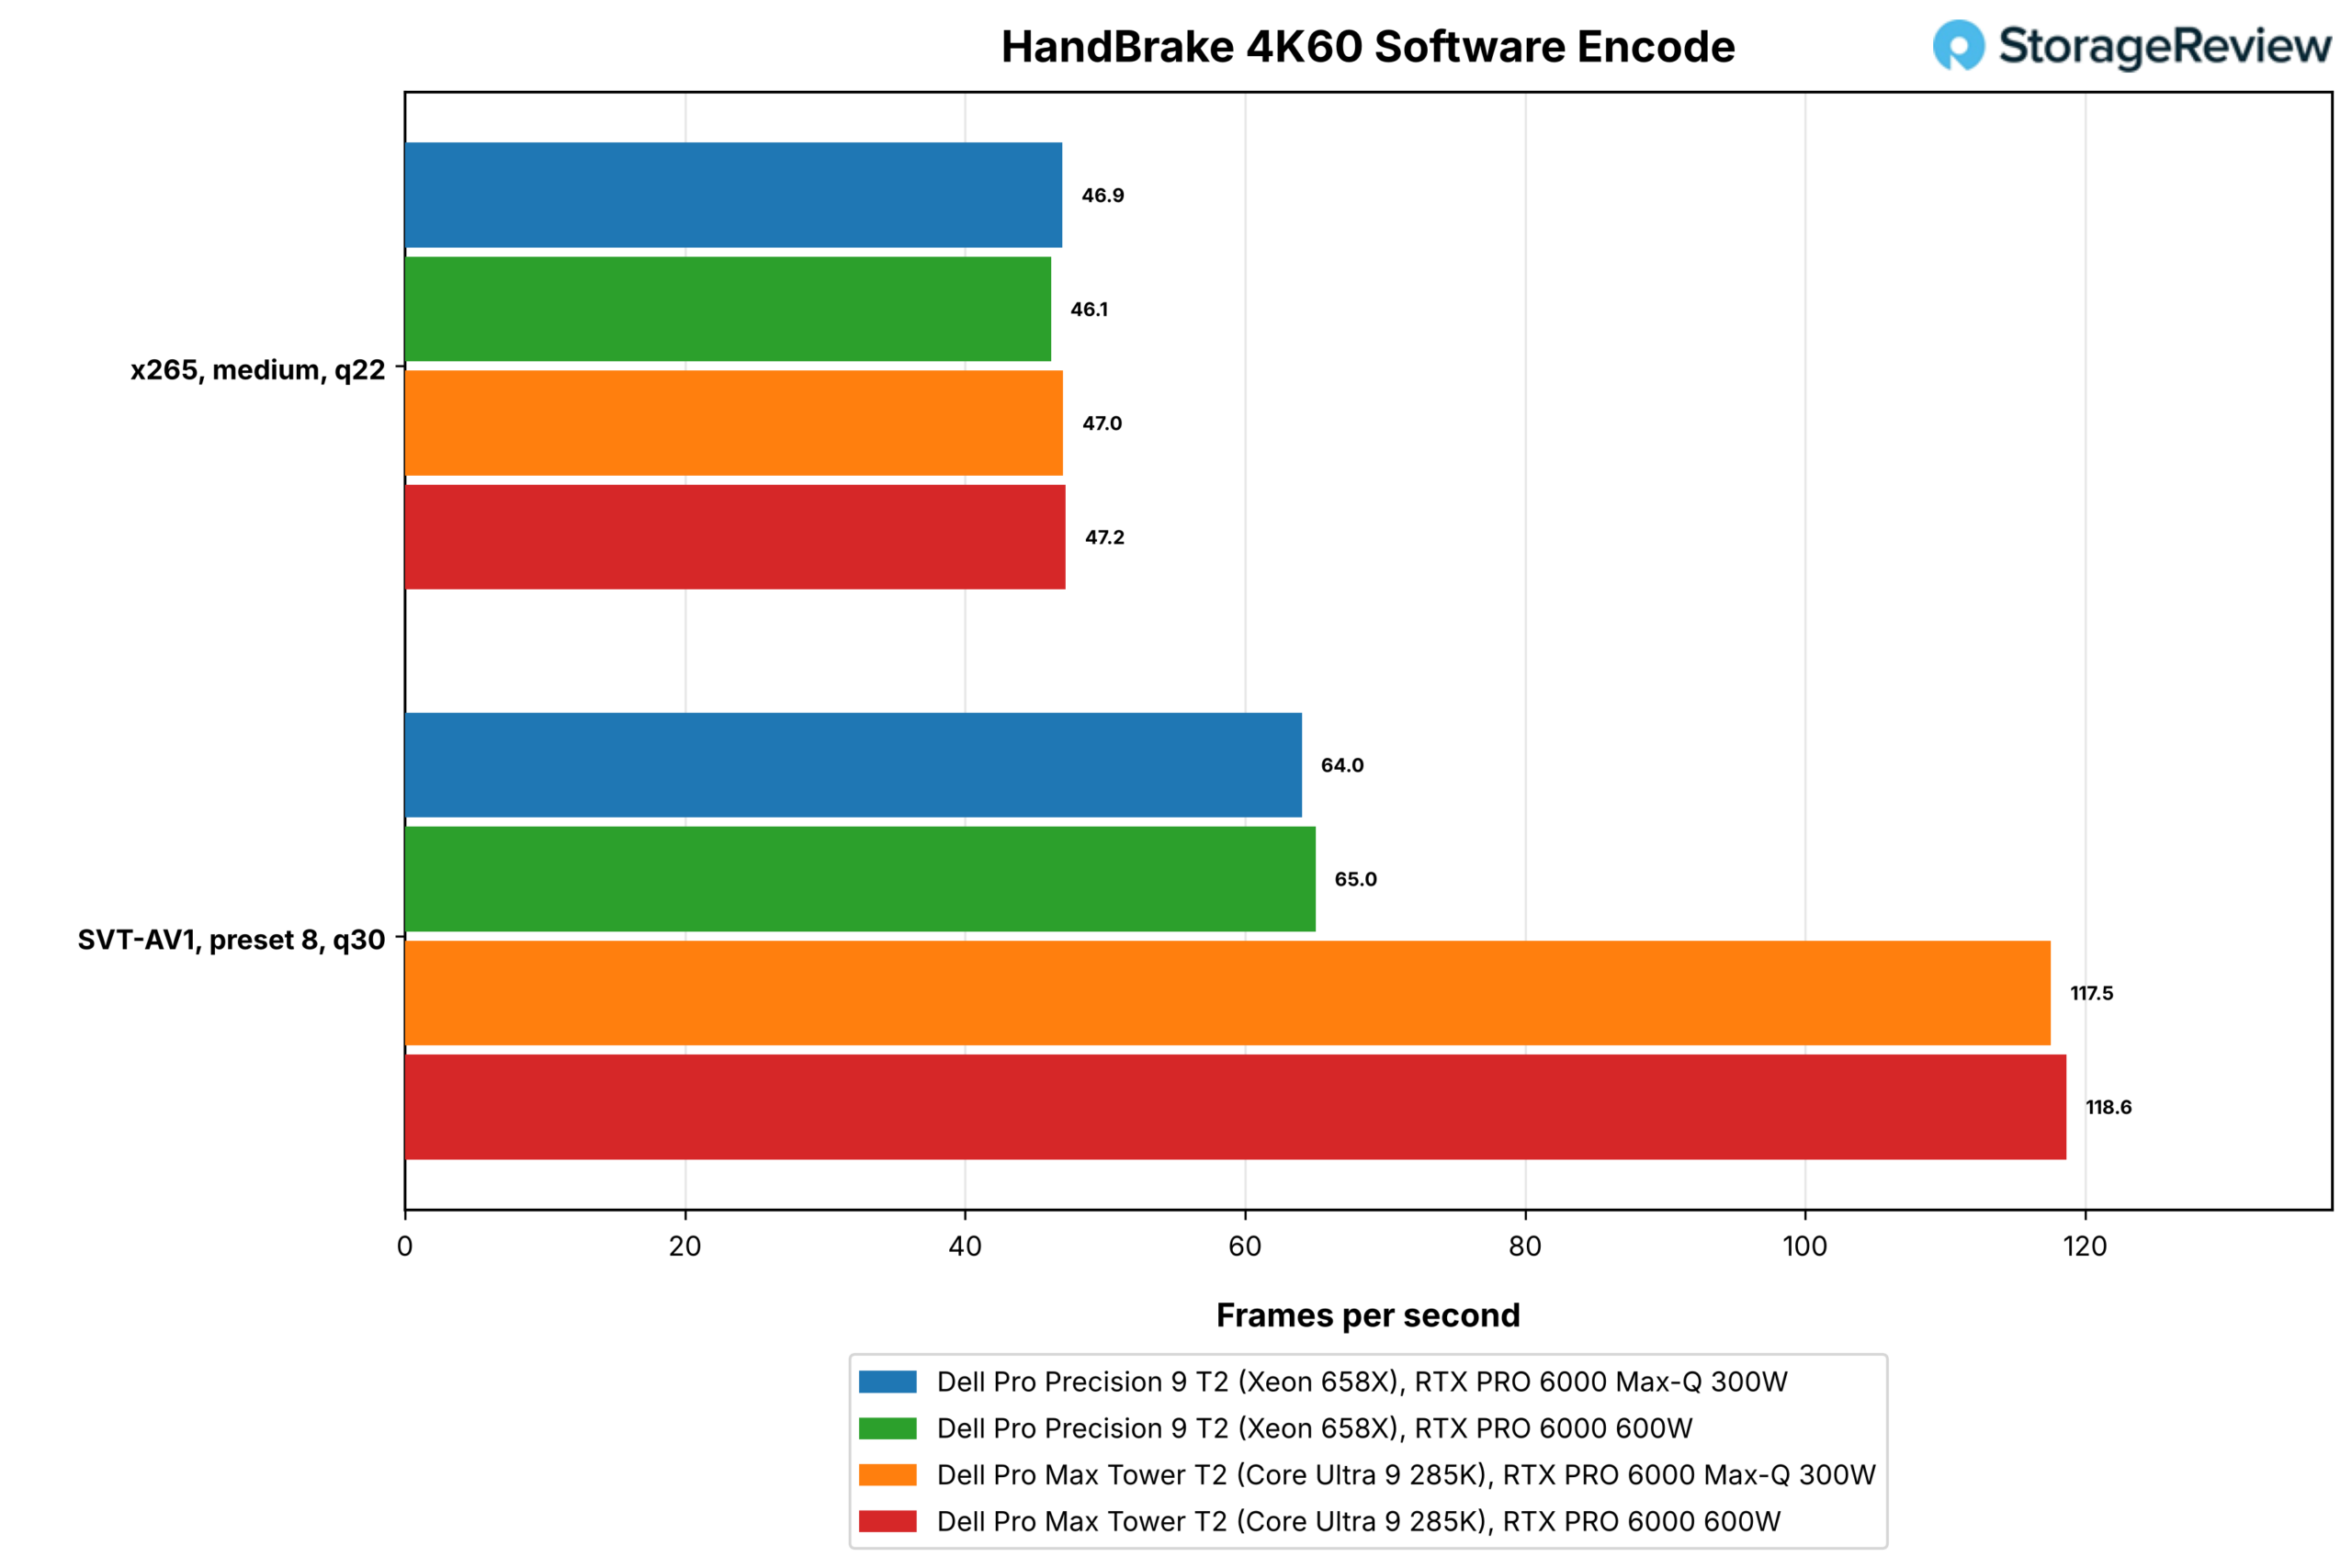
| HandBrake x265, średni, q22 (fps, im wyższa tym lepiej) | 46.9 | 46.1 | 47.0 | 47.2 |
| HandBrake SVT-AV1, preset 8, q30 (fps) | 64.0 | 65.0 | 117.5 | 118.6 |
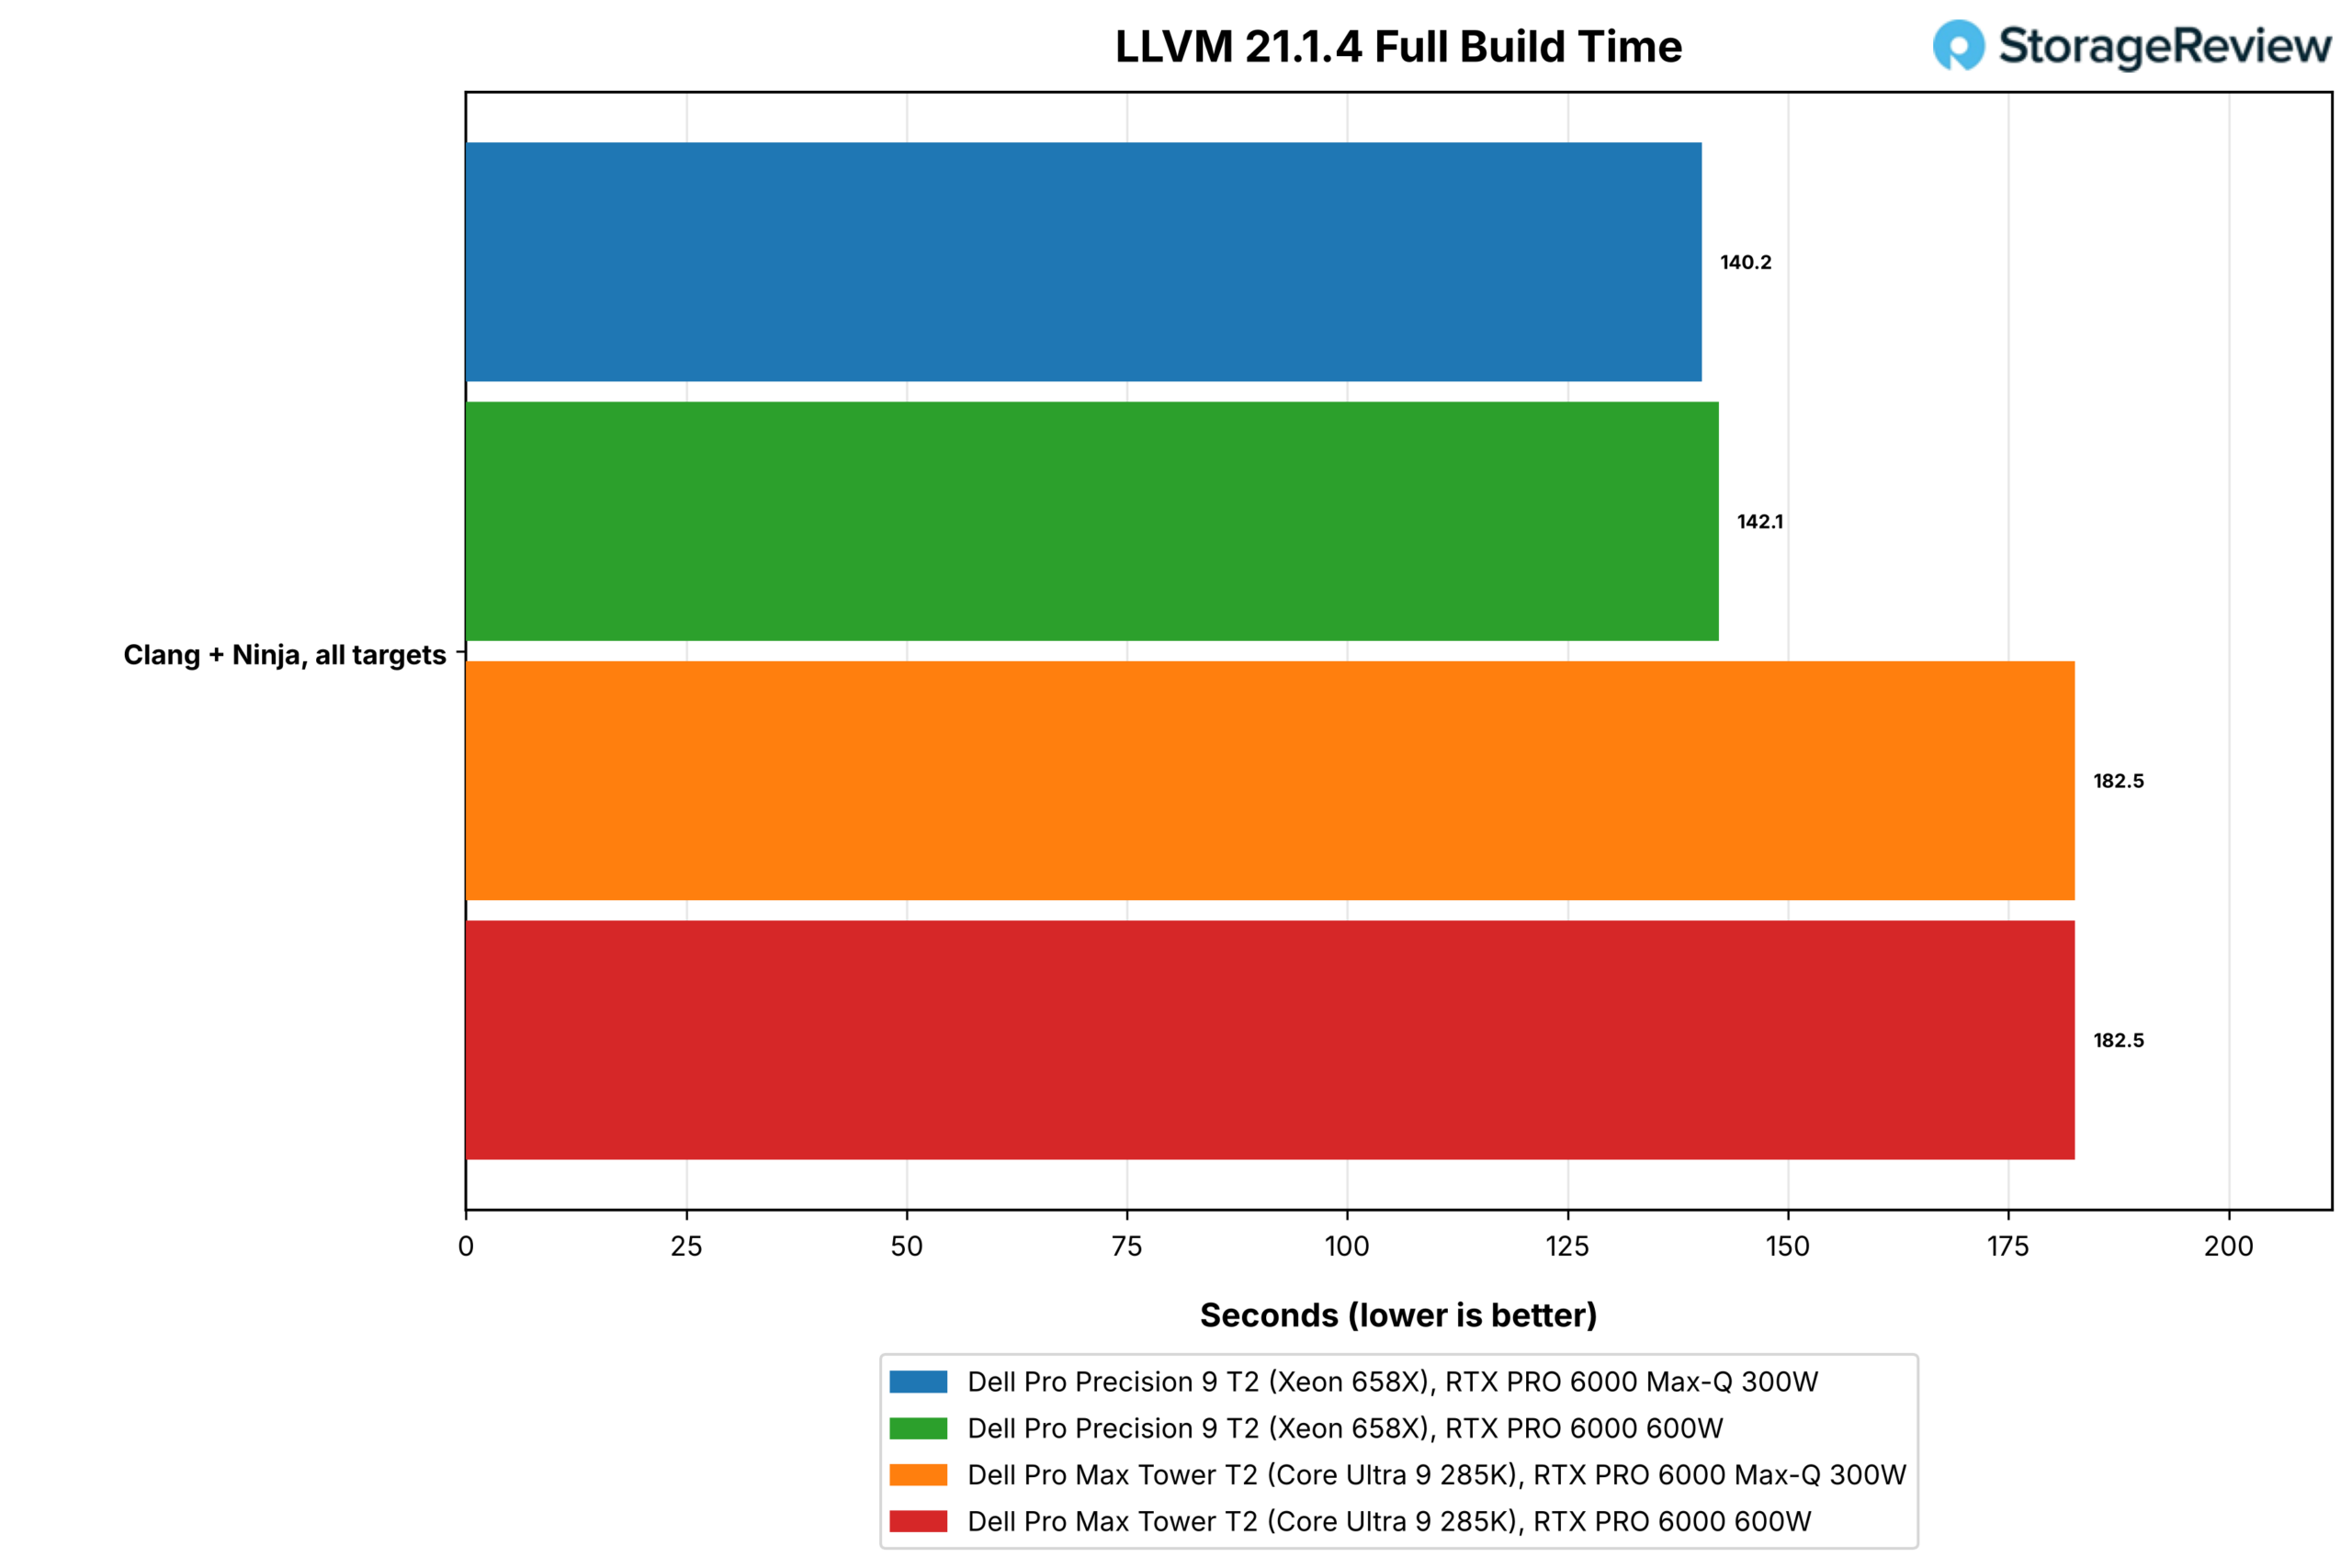
| Kompilacja LLVM 21.1.4 (s, im niższa tym lepsza) | 140.2 | 142.1 | 182.5 | 182.5 |
Xeon renderował obraz Monster z szybkością 366.2 próbek na minutę w porównaniu z 259.6 na 285K, co daje 41-procentową przewagę i utrzymuje się w granicach dwóch punktów we wszystkich trzech scenach, a LLVM zbudował w 140.2 sekundy w porównaniu ze 182.5, czyli o 23 procent szybciej. Po zainstalowaniu karty 600 W wyniki Xeona w Blenderze spadły o 7 do 10 procent, co stanowi najwyższy koszt tej karty w zestawie procesorów.
HandBrake podzielił się według linii enkodera: x265 przy średnim ustawieniu osiągnął 46.9 fps na Xeonie i 47.0 na 285K, co stanowi remis, podczas gdy SVT-AV1 przy ustawieniu 8 osiągnął 64.0 fps na Xeonie w porównaniu do 117.5 na 285K.
Poświęciliśmy popołudnie na tę przerwę i jest to wynik dla każdego wątku. Przy tym ustawieniu koder osiąga poziom 6 i zajmuje pracę około dziewięciu procesorów logicznych na Xeonie; wymuszenie jąder AVX2 zamiast AVX-512 nic nie zmieniło (63.8 w porównaniu do 63.9 kl./s), a przypisanie go do jednego wątku na rdzeń fizyczny spowodowało spowolnienie o 2 procent (62.6 kl./s), więc ani ścieżka wektorowa, ani harmonogramowanie SMT nie są przyczyną. Pozostaje sam rdzeń Xeona i siatka między rdzeniami, którą koder potokowy oczekujący na przekazanie między etapami odczuwa w każdej klatce.
Stockfish, sito główne, Python i przeglądarka
Wbudowana funkcja Stockfish raportuje prędkość wyszukiwania w szachach w milionach węzłów na sekundę. Primesieve zlicza liczby pierwsze poniżej 10^12 we wszystkich wątkach i poniżej 10^11 w jednym wątku. PyPerformance uruchamia trzy testy porównawcze CPython (go, nbody i regex_compile) przypisane do jednego szybkiego rdzenia, a Speedometer 3.1 mierzy responsywność aplikacji internetowych w przeglądarce Microsoft Edge.
| Testowanie | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Ławka do stockfisha, wszystkie wątki (Mnps, im wyżej tym lepiej) | 40.87 | 39.17 | 30.10 | 30.63 |
| Ławka do stockfisha, jeden wątek (Mnps, im wyżej tym lepiej) | 1.65 | 1.60 | 1.99 | 1.99 |
| primesieve 1e12, wszystkie wątki (s, im niższy tym lepszy) | 7.69 | 7.51 | 6.77 | 6.84 |
| sito główne 1e11, jednonitkowe (s, im niżej, tym lepiej) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance go (ms, im niższy tym lepiej) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody (ms, im mniej tym lepiej) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance regex_compile (ms, im mniej tym lepiej) | 88.6 | 90.5 | 61.1 | 61.2 |
| Prędkościomierz 3.1, Edge (wynik, im wyższy tym lepiej) | 36.8 | 37.3 | 46.3 | 46.5 |
Stockfish na 48 wątkach osiągnął 40.87 Mnps na Xeonie w porównaniu z 30.10 na 285K, a na jednym wątku 285K prowadził z wynikiem 1.99 w porównaniu z 1.65. Primesieve to jedyny test wielowątkowy, w którym 285K wygrywa, z wynikiem 6.77 sekundy w porównaniu z 7.69, ponieważ jego „sieve” mieści się w pamięci podręcznej i skaluje się z zegarem tak samo, jak z rdzeniami. Wszystkie wiersze jednowątkowe osiągają wynik 285K w stosunku od 13 do 31 procent: PyPerformance osiąga 64.8 ms w porównaniu z 91.4, regex_compile 61.1 w porównaniu z 88.6, a Speedometer 46.3 w porównaniu z 36.8.
Ten wynik przeglądarki to ten, który kupujący odczuwa przy biurku. Wynik Speedometer na poziomie 36.8 jest nadal szybki w wartościach bezwzględnych, ale o jedną piątą niższy niż w przypadku procesorów Core Tower w tej samej obudowie. Każdy, kto wybierze Xeona ze względu na jego wydajność, powinien spodziewać się, że interaktywna strona urządzenia będzie o krok wolniejsza niż komputer stacjonarny Core Ultra.
GROMACS, OpenBLAS i pamięć
GROMACS uruchamia przypadek dynamiki molekularnej benchMEM na 16 rdzeniach w czterech układach rangowo-wątkowych i raportuje nanosekundy symulowanego czasu na dzień dla najlepszego układu. Nasz test OpenBLAS uruchamia rozwiązanie LU podwójnej precyzji w stylu HPL dla trzech rozmiarów problemu oraz mnożenie macierzy DGEMM na wszystkich rdzeniach, a także na 285K ponownie na jego ośmiu rdzeniach P; 24 rdzenie Xeona należą do jednej klasy, więc te wiersze nie mają zastosowania. STREAM mierzy stałą przepustowość pamięci, a wiersze opóźnień mierzą pojedynczy dostęp do pamięci i między rdzeniami.

| Test (im wyżej tym lepiej) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| GROMACS benchMEM, najlepszy układ (ns/dzień) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000, wszystkie rdzenie (GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000, wszystkie rdzenie (GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000, wszystkie rdzenie (GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000, tylko rdzenie P (GFLOPS) | N/A (jedna klasa podstawowa) | N/A (jedna klasa podstawowa) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000, wszystkie rdzenie (GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000, tylko rdzenie P (GFLOPS) | N/A (jedna klasa podstawowa) | N/A (jedna klasa podstawowa) | 565.3 | 566.5 |
Tutaj AVX-512, 144 MB pamięci L3 i cztery kanały DDR5-6400 łączą się. DGEMM osiągnął 1,638 GFLOPS na Xeonie w porównaniu z 768 na 285K, a rozwiązanie LU N=40000, które przesyła 11.9 GB pamięci, osiągnęło 1,659 w porównaniu z 668 GFLOPS, 2.5-krotnie więcej niż w przypadku procesora Core Tower. Wynik 285K ledwo zmienia się z N=20000 do N=40000, ponieważ jest on wtedy ograniczony przepustowością, podczas gdy Xeon nadal się skaluje. GROMACS na 16 rdzeniach faworyzował Xeona o 27 procent, osiągając 47.39 ns/dzień.

| Testowanie | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Kopiowanie strumieniowe (MB/s, im wyższa prędkość, tym lepiej) | 106,698 | 106,512 | 39,477 | 39,426 |
| Skala STREAM (MB/s) | 105,368 | 105,180 | 39,788 | 39,801 |
| STREAM Dodaj (MB/s) | 119,520 | 119,332 | 36,324 | 36,306 |
| STREAM Triad (MB/s) | 122,233 | 122,135 | 33,003 | 33,014 |
| Opóźnienie pamięci, bufor 1GiB, strony 4KiB (ns, im mniej, tym lepiej) | 148.3 | 147.8 | 135.2 | 135.4 |
| Opóźnienie między rdzeniami, średnia wszystkich par (ns, im niższe, tym lepiej) | 56.2 | 56.0 | 38.1 | 38.2 |
| Opóźnienie między rdzeniami, minimalna para (ns) | 4.6 | 4.6 | 18.6 | 18.6 |
| Opóźnienie między rdzeniami, maksymalna para (ns) | 65.7 | 66.8 | 44.7 | 44.5 |
STREAM Triad osiągnął prędkość 122 233 MB/s na procesorze Xeon T2 i 33 003 MB/s na procesorze Core T2, co stanowi 3.7-krotnie większą przepustowość, z czterech kanałów pamięci DDR5-6400 RDIMM w porównaniu z czterema kanałami DDR5-4400 UDIMM na platformie, która nie nadąża za modułami DIMM. Kosztem jest opóźnienie: 148.3 ns do pamięci na procesorze Xeon w porównaniu ze 135.2 ns na procesorze 285K i 56.2 ns między rdzeniami średnio w porównaniu z 38.1 ns. Minimalne opóźnienie 4.6 ns w procesorze Xeon to para rdzeni SMT na jednym rdzeniu, a maksymalne 65.7 ns to przesunięcie w poprzek siatki.
Gry
SuperTuxKart 1.5 uruchamia wbudowany test porównawczy w rozdzielczości 1080p na pełnym ekranie, z najwyższą predefiniowaną rozdzielczością i wyłączoną synchronizacją pionową, a my raportujemy średnią i stałą liczbę klatek na sekundę. Przy tej rozdzielczości GPU ma zapas mocy obliczeniowej, więc wynik jest zgodny z CPU, a test zastępuje wiele profesjonalnych okienek podglądu, które są ograniczone w ten sam sposób. Przebieg NVENC w naszym teście kodowania nie został ukończony na tych systemach i został pominięty.

| SuperTuxKart 1.5, 1080p Ultra, wyłączony vsync (fps, im więcej tym lepiej) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Średni | 304.6 | 323.2 | 359.1 | 383.5 |
| Typowy | 304 | 322 | 354 | 376 |
| Stały | 161 | 174 | 122 | 135 |
Core T2 osiągnął średnio 359.1 kl./s z kartą Max-Q w porównaniu z 304.6 kl./s z Xeon T2, co ponownie stanowiło różnicę w liczbie klatek na sekundę. Z kolei wieża Xeon utrzymała wyższą, stabilną liczbę klatek na sekundę, wynoszącą 161 kl./s w porównaniu ze 122, z mniejszą liczbą spadków. Karta 600 W zwiększyła średnią o około 6 procent w obu wieżach.
Zegary pod obciążeniem
Żadna z obudów nie raportowała temperatury procesora ani karty graficznej za pośrednictwem ścieżki czujników w obudowie, dlatego tabela termiczna, którą zazwyczaj publikujemy, jest tutaj zastąpiona średnim taktowaniem procesora podczas każdego testu, czyli wartością wyjaśniającą wpływ karty 600 W na Xeona. Z zainstalowanym modułem Max-Q, 658X utrzymywał taktowanie 4,269 MHz w 30-minutowej pętli i od 4,040 do 4,480 MHz w krótszych testach na wszystkich rdzeniach. Z kartą 600 W w obudowie, większość testów przebiegała z niższym taktowaniem, nawet o 300 MHz, i wszystkie uzyskały niższe wyniki.
| Średnie taktowanie procesora podczas testu (MHz) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Cinebench 2026 | 4,477 | 4,470 | 4,789 | 4,786 |
| Pętla podtrzymywana | 4,269 | 4,182 | 4,663 | 4,682 |
| 7-Zip | 4,414 | 4,307 | 4,854 | 4,837 |
| Sztokfisz | 4,291 | 3,995 | 4,749 | 4,741 |
| mikser | 4,258 | 4,253 | 4,582 | 4,552 |
| Hamulec ręczny | 4,188 | 4,180 | 4,601 | 4,622 |
| Kompilacja LLVM | 4,202 | 4,258 | 4,582 | 4,585 |
| GROMACS | 4,288 | 4,290 | 4,664 | 4,694 |
| OtwórzBLAS | 4,039 | 3,979 | 4,766 | 4,761 |
| STRUMIEŃ | 4,321 | 4,326 | 4,687 | 4,676 |
| premier | 4,441 | 4,268 | 4,814 | 4,810 |
| Klient MLPerf | 4,191 | 4,138 | 3,814 | 3,686 |
| Agent kodujący | 4,134 | 4,100 | 4,239 | 4,213 |
| Obsługa LLM | 4,261 | 4,169 | 4,229 | 4,209 |
| Generowanie obrazu | 4,044 | 4,008 | 3,702 | 3,837 |
| RAG | 4,178 | 4,197 | 4,172 | 4,108 |
| Super Tux Kart | 4,239 | 4,211 | 4,637 | 4,649 |
Częstotliwość Stockfish spadła z 4,291 do 3,995 MHz, primesieve z 4,441 do 4,268, 7-Zip z 4,414 do 4,307, a częstotliwość pętli ciągłej z 4,269 do 4,182, podczas gdy 285K działał w granicach 20 MHz w każdym teście wszystkich rdzeni, niezależnie od karty.
Średnia częstotliwość taktowania to nie wszystko. Cinebench i Blender uśredniły taktowanie w granicach 10 MHz w stosunku do wyników Max-Q, a mimo to straciły od 5 do 10 procent, co wskazuje na krótkie skoki częstotliwości, które średnia dla każdego testu wygładza. Karta 658X pobiera do 250 W, karta 600 W kolejne 600 W, a obie karty odprowadzają moc do tej samej, 32-litrowej objętości za jednym przednim wlotem powietrza; czy ograniczeniem jest zapas mocy procesora, czy też limit mocy platformy, to pytanie, które odpowie nasza kolejna próba z zewnętrznym rejestrowaniem zasilania i temperatury. Na razie kupujący korzystający z procesorów all-core powinni wiedzieć, że konfiguracja Max-Q jest szybsza po stronie procesora.
Wydajność pamięci masowej
Nasz test pamięci masowej polega na uruchomieniu systemu Fio Four Corners na dysku rozruchowym o pojemności 5 GB i 25 GB, przez system plików i ponownie na urządzeniu surowym, a wyniki dla 25 GB są tutaj prezentowane. W Core T2 dysk rozruchowy to pojedynczy dysk SK Hynix PCB01 o pojemności 2 TB na Gen5 x4; w Pro Precision 9 T2 to dwa dyski E3.S Gen5 w FlexBay, połączone w wolumen RAID0 o pojemności 4,097 GB przez VROC firmy Graid Technology. BitLocker był wyłączony we wszystkich czterech konfiguracjach, więc wiersze systemu plików mierzą NTFS i warstwę RAID, a nie szyfrowanie.


| fio, 25 GB pamięci, QD32 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Wieża Pro Max T2, 600 W |
|---|---|---|---|---|
| Odczyt sekwencyjny 128 KB, system plików (MB/s) | 9,332 | 9,255 | 11,377 | 11,406 |
| Odczyt sekwencyjny 128 KB, surowe urządzenie (MB/s) | 10,782 | 10,675 | 11,186 | 11,444 |
| Zapis sekwencyjny 128 KB (MB/s) | 6,507 | 6,496 | 7,401 | 7,371 |
| 1 MB odczytu wstępnego, QD32 (MB/s) | 4,617 | 4,679 | 6,440 | 6,346 |
| Losowy odczyt 4K, system plików, szczyt (IOPS) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| Losowy odczyt 4K, surowe urządzenie, szczyt (IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| Losowy zapis 4K, szczyt (IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| Surowy/losowy odczyt systemu plików | 1.32x | 1.31x | 1.29x | 1.31x |
| Losowy odczyt 4K, 4 zadania, opóźnienie p99 (w USA, im niższe, tym lepiej) | 506 | 485 | 183 | 185 |
| Losowy odczyt 4K, 16 zadania, opóźnienie p99.99 (w USA, im niższe, tym lepiej) | 15,270 | 23,462 | 676 | 676 |
| Losowy zapis 4K, 4 zadania, opóźnienie p99 (w USA, im niższe, tym lepiej) | 610 | 594 | 228 | 228 |
| Temperatura napędu, maksymalna (C) | N/A (za RAID-em) | N/A (za RAID-em) | 50 | 57 |
Pasek nie jest szybszy od pojedynczego dysku, a w przypadku małych bloków znacznie go ustępuje. Dwa dyski E3.S odczytały sekwencyjnie 9,332 MB/s przez NTFS i 10 782 z woluminu surowego, w porównaniu z 11 377 i 11 186 dla PCB01, a zapisały 6,507 MB/s w porównaniu z 7,401. Podczas losowych odczytów 4K wolumin osiągnął szczyt na poziomie 840.1 K IOPS przez system plików i 1.11 MB surowego, w porównaniu z 1.78 MB i 2.30 MB dla pojedynczego dysku, a losowe zapisy wyniosły 557.5 K IOPS w porównaniu z 957.5 KB. Stosunek surowego do systemu plików wynosi około 1.3x w obu przypadkach, więc koszty systemu NTFS są takie same; różnicą jest warstwa VROC znajdująca się pod obiema ścieżkami.
Opóźnienie ogonowe jest następujące: przy 16 zadaniach, najwolniejsze 0.01% losowych odczytów zajęło 15.3 ms na woluminie w porównaniu z 0.68 ms na pojedynczym dysku, a opóźnienie odczytu p99 dla 4 zadań wyniosło 506 μs w porównaniu ze 183 μs. RAID programowy na dwóch urządzeniach NVMe dodaje przeskok procesora do każdego wejścia/wyjścia, co pokazują odczyty procesora fio: 80% dla przejść sekwencyjnych w porównaniu z 40% dla rdzenia T2. Wolumin ukrywa również dane SMART dysków, więc pakiet nie mógł rejestrować ich temperatury.
Nic z tego nie czyni FlexBay złym wyborem. Zapewnia on dyski T2 z obsługą od przodu i funkcją hot-plug, w formacie skalowalnym do pojemności nieosiągalnych dla M.2, a wolumin rozruchowy o pojemności 4 TB z dwóch dysków jest wygodny. Oznacza to, że kupujący, którego obciążeniem są losowe operacje wejścia/wyjścia małych bloków, lokalna baza danych lub mocno buforowany katalog modelu, powinien rozważyć pojedynczy dysk E3.S bez stripe'a lub wewnętrzne gniazda M.2, gdzie wyniki Core T2 pokazują, co potrafi jeden dysk Gen5 w tej obudowie.
Wniosek
Dell Pro Precision 9 T2 to Pro Max Tower T2 z wbudowanym procesorem do stacji roboczych, a dane z recenzji wskazują, że właśnie tego powinni oczekiwać kupujący. W tej samej 32-litrowej obudowie, Xeon 658X oferuje o 39 procent większą przepustowość wielordzeniową w Cinebench, 3.7 razy większą przepustowość pamięci, dwukrotnie większą szybkość DGEMM oraz 24-rdzeniowy, 48-wątkowy procesor z obsługą AVX-512, AMX, zarejestrowaną pamięcią ECC i ścieżką do 1 TB. W przypadku zadań jednowątkowych, od Primesieve po Pythona, oszczędza od 13 do 31 procent, co zauważą kupujący spędzający dzień w oknie podglądu lub terminalu.
Ta recenzja ma pomóc kupującym zrozumieć decyzję dotyczącą GPU. Karty Max-Q i 600W RTX PRO 6000 współdzielą 96 GB pamięci i dekodują dane z różnicą od 7 do 20 procent, a karta 600W zyskuje swoją moc dzięki szybkiemu przetwarzaniu, gdzie czas do pierwszego tokena spada o jedną trzecią lub więcej, oraz rozproszeniu, gdzie obrazy docierają o 20 do 34 procent szybciej.
W obudowie Xeon Tower karta 600 W również obciąża procesor o 4 do 5 procent w przypadku pracy na wszystkich rdzeniach i wymaga gniazda obok, co w naszym przypadku oznaczało usunięcie adaptera 25 GbE. W przypadku obudowy, której właściciel korzysta z renderowania i symulacji na procesorze, a także z modeli lokalnych, karta Max-Q firmy Dell stanowi zrównoważony wybór; w przypadku obudowy, która obsługuje modele dla zespołu lub renderuje obrazy przez cały dzień, karta 600 W jest warta gniazda i zasilacza 1500 W.
Dysk E3.S w obudowie FlexBay to format, którego od lat szukaliśmy w obudowie typu tower; VROC firmy Graid Technology to solidne połączenie dla stosu RAID. Jest wolniejszy w przypadku małych losowych operacji wejścia/wyjścia niż pojedynczy dysk M.2 w Core T2, o około połowę wolniejszy w przypadku odczytów i zapisów 4K, a kupujący, który nie potrzebuje woluminu rozruchowego RAID, może rozważyć jeden dysk E3.S lub wewnętrzne gniazda M.2.
Z drugiej strony, dzięki dyskom SSD E3.S o pojemności przekraczającej 60 TB, użytkownicy wykorzystujący dane w ekstremalnych celach uzyskują dostęp do zupełnie nowego świata, który wcześniej wiązał się z koniecznością stosowania zewnętrznych obudów lub montażu współdzielonego woluminu pamięci masowej, a praktyczną granicą była cena pamięci flash.
W cenie około 28 300 dolarów (w konfiguracji na Dell.com), przed cenami hurtowymi, z którymi spotyka się większość klientów biznesowych, Pro Precision 9 T2 jest o około 4,500 dolarów droższy od Pro Max Tower T2 skonfigurowanego w ten sam sposób: z 285 KB, 128 GB pamięci DDR5-4400 ECC, kartą graficzną RTX PRO 6000, dyskiem 2 TB Gen5 i zasilaczem 1500 W, cena wynosi około 23 800 dolarów, a opcje GPU i pamięci w obu obudowach różnią się o 900 dolarów. Drugi dysk FlexBay kosztuje 1,700 dolarów mniej, a reszta to platforma Xeon.
W zamian otrzymujemy wieżę z jednym gniazdem, która zachowuje się jak mały serwer przy obciążeniu wszystkich rdzeni i ma takie same wymiary jak komputer stacjonarny. Tak jest w przypadku powrotu marki Precision.
Tabela wyników: Dell Pro Precision 9 T2 został uznany za najlepszą stację roboczą w rankingu najlepszych stacji roboczych , a wyniki RTX PRO 6000 znalazły się również na liście najlepszych procesorów graficznych dla przedsiębiorstw.



 Amazon