

Scaled Sysbench to ostateczny test wydajności węzła all-flash EMC ScaleIO VxRack skonfigurowanego w HCI. W trybie dwuwarstwowym wykorzystaliśmy system do 99.2% wydajności i zaobserwowaliśmy fenomenalną przepustowość, gdy cztery serwery Dell działały jako generatory obciążenia. Tym razem, z mocą obliczeniową i pamięcią masową w obudowie 2U, przeprowadziliśmy te same testy, aby sprawdzić, co się stanie. Spodziewalibyśmy się, że czynnikiem ograniczającym będzie większe obciążenie procesorów, ponieważ system ma więcej pracy, ale jak dotąd w testach HCI ScaleIO okazało się niezwykle wydajne i lekkie pod względem narzutu, co zazwyczaj ma miejsce w innych rozwiązaniach HCI.
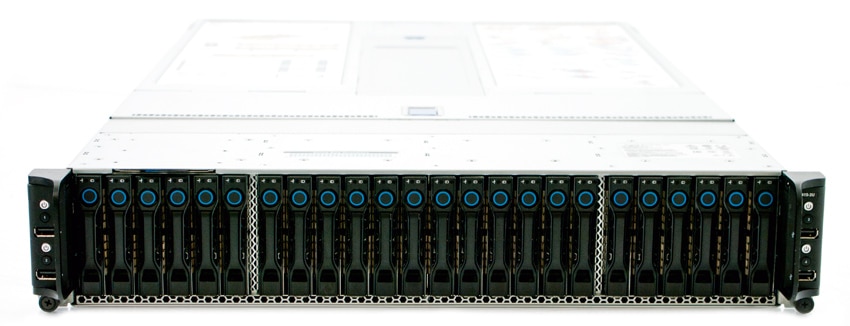
Specyfikacje węzła VCE VxRack (Performance Compute All Flash PF100)
- Podwozie – liczba węzłów: 2U-4 węzły
- Procesory na węzeł: dwa Intel E5-2680 V3, 12 rdzeni, 2.5 GHz
- Chipset: Intel 610
- Pamięć DDR4 na węzeł: 512 GB (16 x 32 GB)
- Wbudowana karta sieciowa na węzeł: dwa porty Ethernet 1 Gb/s + 1 port zarządzania 10/100
- Kontroler RAID na węzeł: 1x LSI 3008
- Dyski SSD na węzeł: 4.8 TB (6 dysków 2.5 cala 800 GB eMLC)
- SATADOM na węzeł: 32 GBSLC
- Port 10GbE na węzeł: 4 porty 10Gbps SFP+
- Zasilanie: Podwójny platynowy zasilacz AC o mocy 1600 W
- Router: Cisco Nexus C3164Q-40GE
Wydajność Sysbench
Zastosowaliśmy tę samą konfigurację do naszego testu VxRack Node HCI, co w przypadku konfiguracji dwuwarstwowej, z wyjątkiem miejsca, w którym działały maszyny wirtualne. W konfiguracji dwuwarstwowej hostowaliśmy pamięć masową na węźle VxRack, ale obliczenia były dostarczane przez cztery do ośmiu serwerów Dell PowerEdge R730 13G. W tej iteracji testów same węzły VxRack obsługiwały obciążenia. W pewnym momencie, niezależnie od szybkości ScaleIO, zobaczymy kompromis między konfiguracją dwuwarstwową a HCI, gdzie zabraknie cykli procesora z powodu dodatkowej wagi maszyn wirtualnych obliczeniowych w konfiguracji HCI i rozbieżności w wydajności procesora. W przypadku HCI mamy osiem procesorów Intel E5-2680 v3. W konfiguracji dwuwarstwowej skalowaliśmy do ośmiu serwerów na najwyższym poziomie, obsługując szesnaście procesorów Intel E5-2690 v3. Dla porównania, przy maksymalnym obciążeniu różnica wynosi 240 GHz w porównaniu do 499.2 GHz.
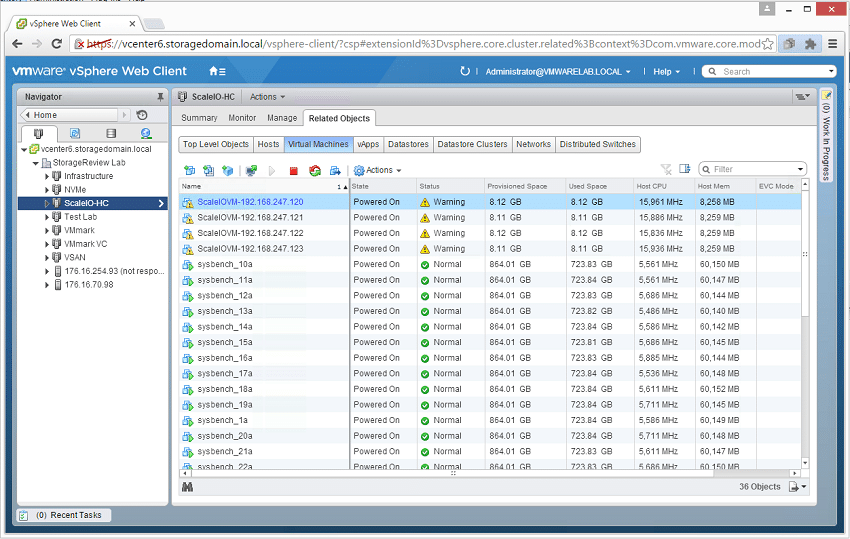
Konfiguracja testów Sysbench (na maszynę wirtualną)
- CentOS 6.3 64-bit
- Zajęta przestrzeń dyskowa: 1 TB, wykorzystane 800 GB
- Percona XtraDB 5.5.30-rel30.1
- Tabele bazy danych: 100
- Rozmiar bazy danych: 10 000 000
- Wątki bazy danych: 32
- Bufor RAM: 24 GB
- Długość testu: 3 godziny
- 2 godziny wstępnego kondycjonowania 32 wątków
- 1 godzina 32 wątki
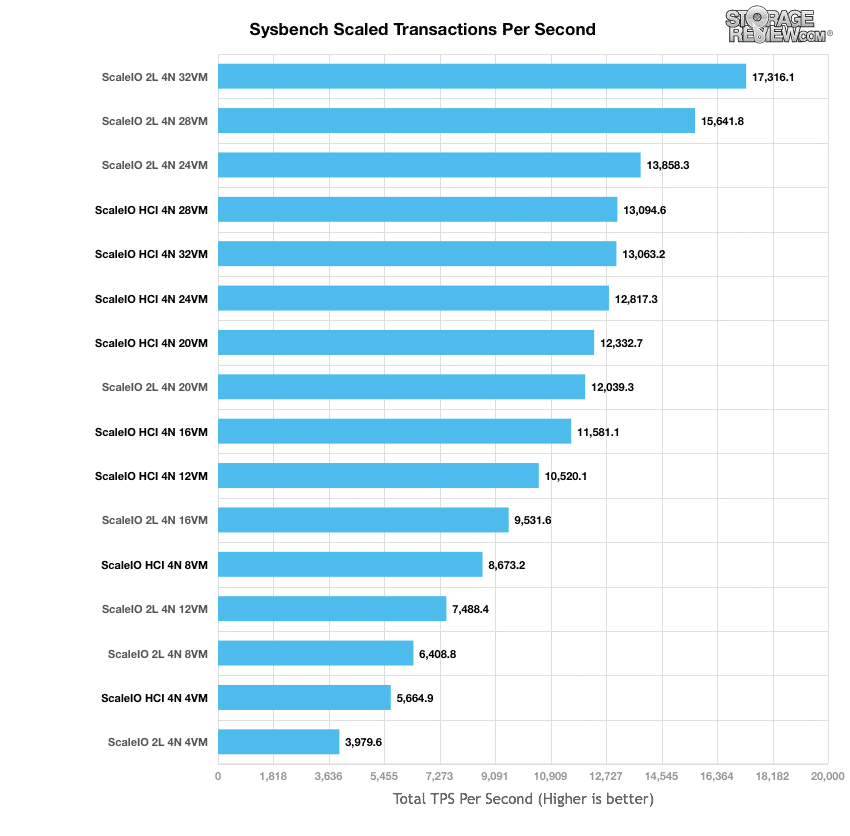
Porównamy węzeł EMC VxRack w HCI z węzłem EMC VxRack w konfiguracji dwuwarstwowej, nazywając wyniki odpowiednio HCI i 2L. Przy 4 maszynach wirtualnych HCI zapewnił nam 5,664.9 TPS w porównaniu z 3,979.4 TPS dla węzła 2L. W miarę skalowania, HCI utrzymywał przewagę nad węzłem 2L, aż do osiągnięcia 24 maszyn wirtualnych; w tym przypadku HCI zapewnił nam 12,817.3 TPS, a węzeł 2L – 13,858.3 TPS. Chociaż konfiguracja HCI nadal nieznacznie zwiększała ogólną wydajność, po 20 maszynach wirtualnych wydajność zaczęła spadać, a po 32 maszynach wirtualnych zaobserwowaliśmy spadek wydajności. Był to sygnał, że procesory osiągnęły punkt krytyczny.
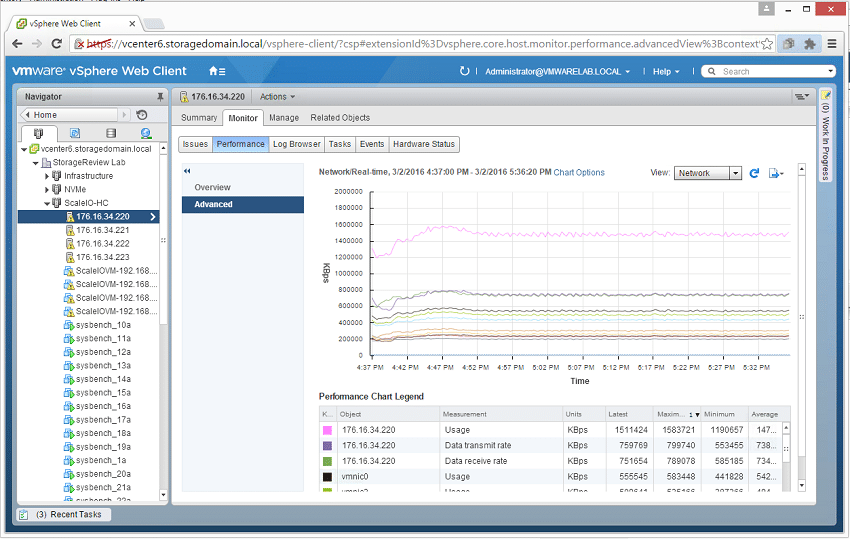
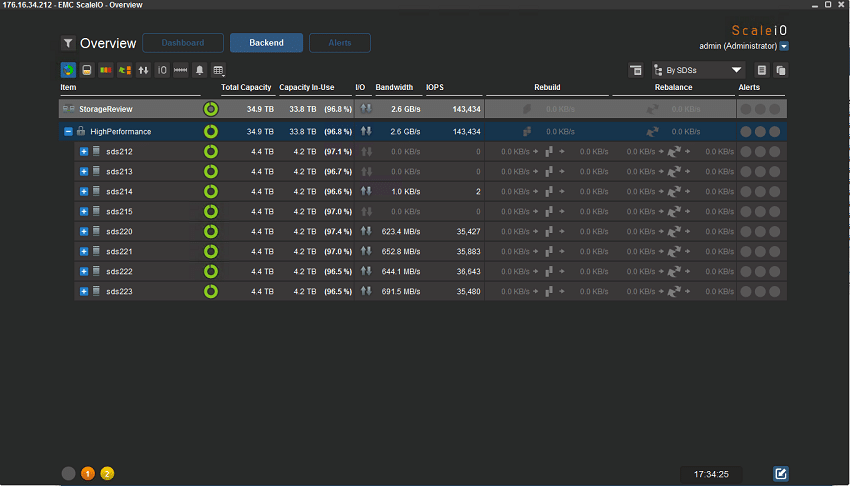
Analizując wpływ na pamięć masową za pomocą graficznego interfejsu użytkownika ScaleIO przy 32 maszynach wirtualnych, widzimy ruch na poziomie około 2.6 GB/s i nieco ponad 143 tys. operacji wejścia/wyjścia na sekundę na poziomie systemu.
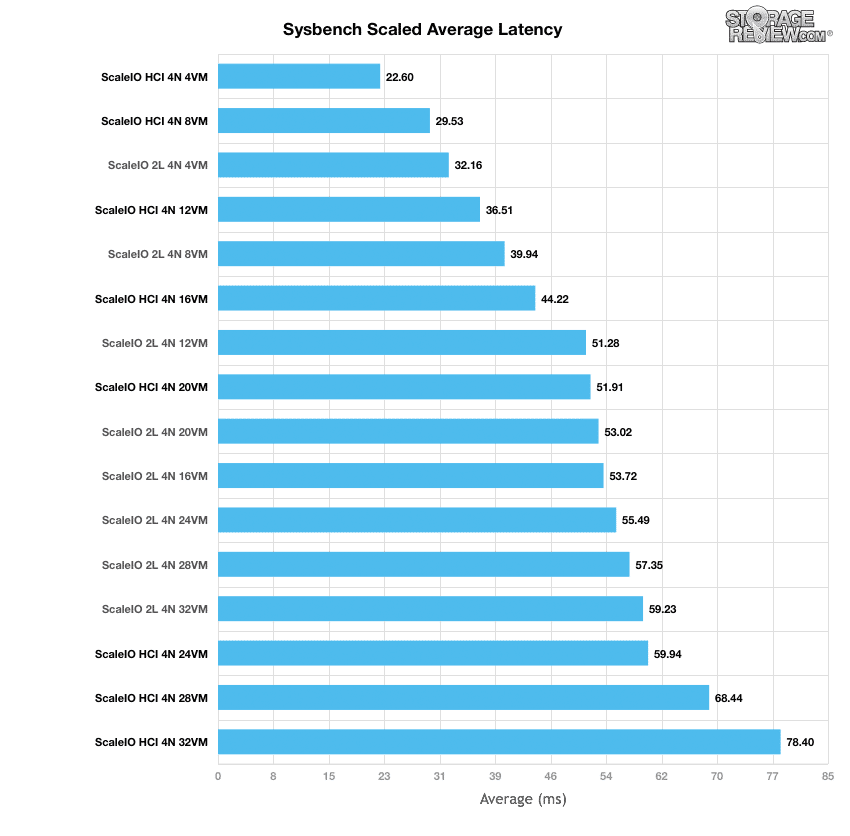
Skalowane średnie opóźnienie przedstawia nieco podobny obraz – początkowo HCI wykazywał niższe opóźnienie niż 2L. Przy 4 maszynach wirtualnych (VM) HCI miał opóźnienie wynoszące zaledwie 22.6 ms, w porównaniu z 32.16 ms w 2L. W miarę skalowania, sytuacja powoli się zmieniała – 2L miał niższe opóźnienie od 24 maszyn wirtualnych w górę. Jednak przy 32 maszynach wirtualnych (VM) HCI miał średnie opóźnienie wynoszące zaledwie 78.4 ms.
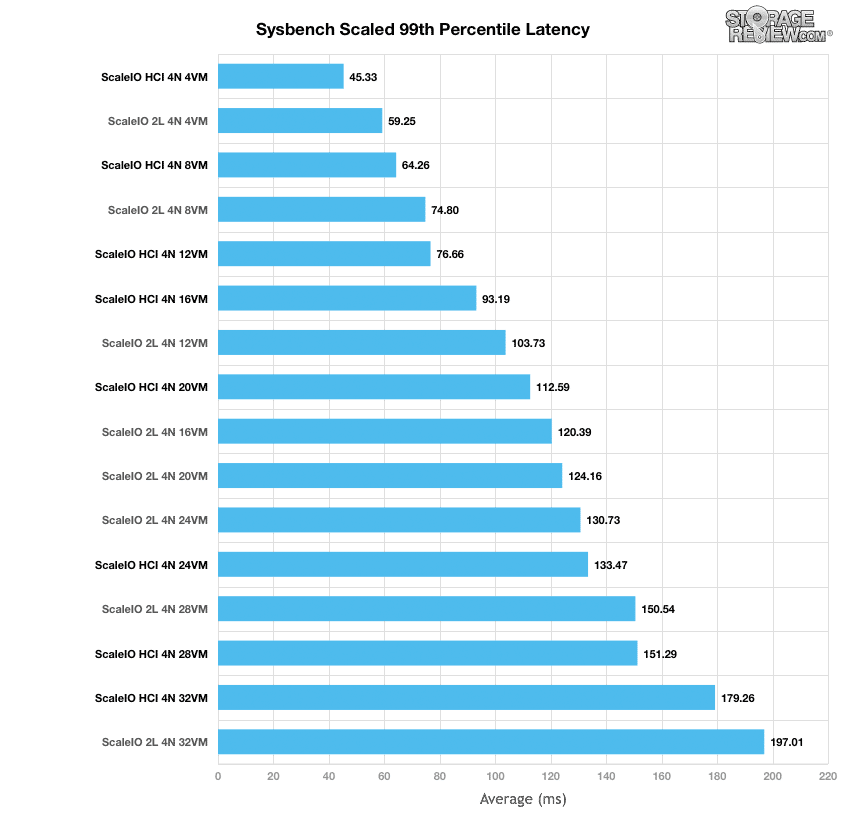
Przenosząc naszą uwagę na profile maksymalnych opóźnień z 99. percentylem, HCI rozpoczął z niższym opóźnieniem (45.33 ms przy 4 maszynach wirtualnych) i ponownie stracił zwycięską pozycję na rzecz 2L przy 24 maszynach wirtualnych. Jednak po osiągnięciu 32 maszyn wirtualnych, HCI osiągnął opóźnienie 179.26 ms, przewyższając 197.01 ms 2L.
Wniosek
Ponownie, węzeł EMC VxRack wypadł znakomicie w tych testach. Chociaż spodziewalibyśmy się pewnego obciążenia administracyjnego w konfiguracji HCI, tak naprawdę nie zaobserwowaliśmy żadnego negatywnego wpływu. W rzeczywistości konfiguracja HCI przewyższała konfigurację dwuwarstwową do momentu, w którym czynnikiem ograniczającym staje się procesor. Znajduje to również odzwierciedlenie w naszym niedawnym artykule na temat testów SQL Server uruchomionych w HCI, gdzie przewyższyła konfigurację dwuwarstwową, osiągając niższe wskaźniki opóźnień. Tak czy inaczej, wydajność była doskonała, co po raz kolejny dowodzi, że ScaleIO jest wiodącym rozwiązaniem definiowanym programowo na rynku pod względem wydajności i elastyczności.
Zagłębiając się w szczegóły, ScaleIO bez problemu zrównoważyło obciążenie serwera SDS działającego w tym samym systemie co obciążenia MySQL. Dzięki niższej częstotliwości taktowania platformy w porównaniu z naszymi testami dwuwarstwowymi (2.5 GHz vs. 2.6 GHz) zaobserwowaliśmy poprawę opóźnień i wyższą wydajność transakcyjną w środowisku HCI, gdzie obciążenia znajdowały się bliżej samej pamięci masowej. Choć na pierwszy rzut oka może się to wydawać intuicyjne, nigdy nie widzieliśmy takiego efektu w żadnym innym środowisku HCI, ponieważ zawsze były one wolniejsze niż zewnętrzna macierz pamięci masowej podłączona do dedykowanych serwerów obliczeniowych. Punkt krytyczny nastąpił, gdy nasi pracownicy Sysbench zużyli wszystkie dostępne zasoby procesora w klastrze, tracąc przewagę przy 20 maszynach wirtualnych uruchomionych w porównaniu z dwuwarstwowym.
Warto jednak zwrócić uwagę na fakt, że nadal istniały niewykorzystane wejścia/wyjścia pamięci masowej, które nadal można prezentować poza klastrem ScaleIO HCI. Oznacza to, że oprócz obciążenia HCI, można również współdzielić pamięć masową w trybie dwuwarstwowym. Jest to fundamentalne dla propozycji wartości oferowanej przez ScaleIO, która pozwala organizacji dostosować system do swoich potrzeb. Będąc tak elastycznym i wydajnym, ScaleIO nigdy nie wykazało żadnych słabości poza wyczerpaniem pojemności lub wyczerpaniem dostępnych cykli procesora na samych hostach.
Recenzja węzła EMC VxRack: przegląd
Węzeł EMC VxRack oparty na technologii ScaleIO: Skalowany przegląd wydajności Sysbench OLTP (2-warstwowy)
Węzeł EMC VxRack oparty na technologii ScaleIO: przegląd wydajności serwera SQL (2-warstwowy)
Węzeł EMC VxRack oparty na technologii ScaleIO: syntetyczny przegląd wydajności (2-warstwowy)
Recenzja węzła EMC VxRack opartego na technologii ScaleIO: syntetyczny przegląd wydajności (HCI)
Węzeł EMC VxRack oparty na technologii ScaleIO: przegląd wydajności serwera SQL (HCI)
Węzeł EMC VxRack oparty na technologii ScaleIO: przegląd wydajności VMmark (HCI)


 Amazon