

Firma Fungible zmienia sposób projektowania platform pamięci masowej, usuwając ograniczenia istniejących architektur pamięci masowej dzięki wprowadzeniu klastra pamięci masowej Fungible Storage Cluster, węzła pamięci masowej o wysokiej wydajności FSC 1600. Klaster pamięci masowej Fungible Storage Cluster oferuje wydajne, nisko-opóźnieniowe, rozproszone rozwiązanie pamięci masowej NVMe/TCP, w pełni transparentne dla aplikacji wysokiego poziomu. Oparty na procesorze Fungible DPU™, klaster pamięci masowej Fungible Storage Cluster (FSC) to wydajna, bezpieczna, skalowalna, rozproszona platforma pamięci masowej all-flash.
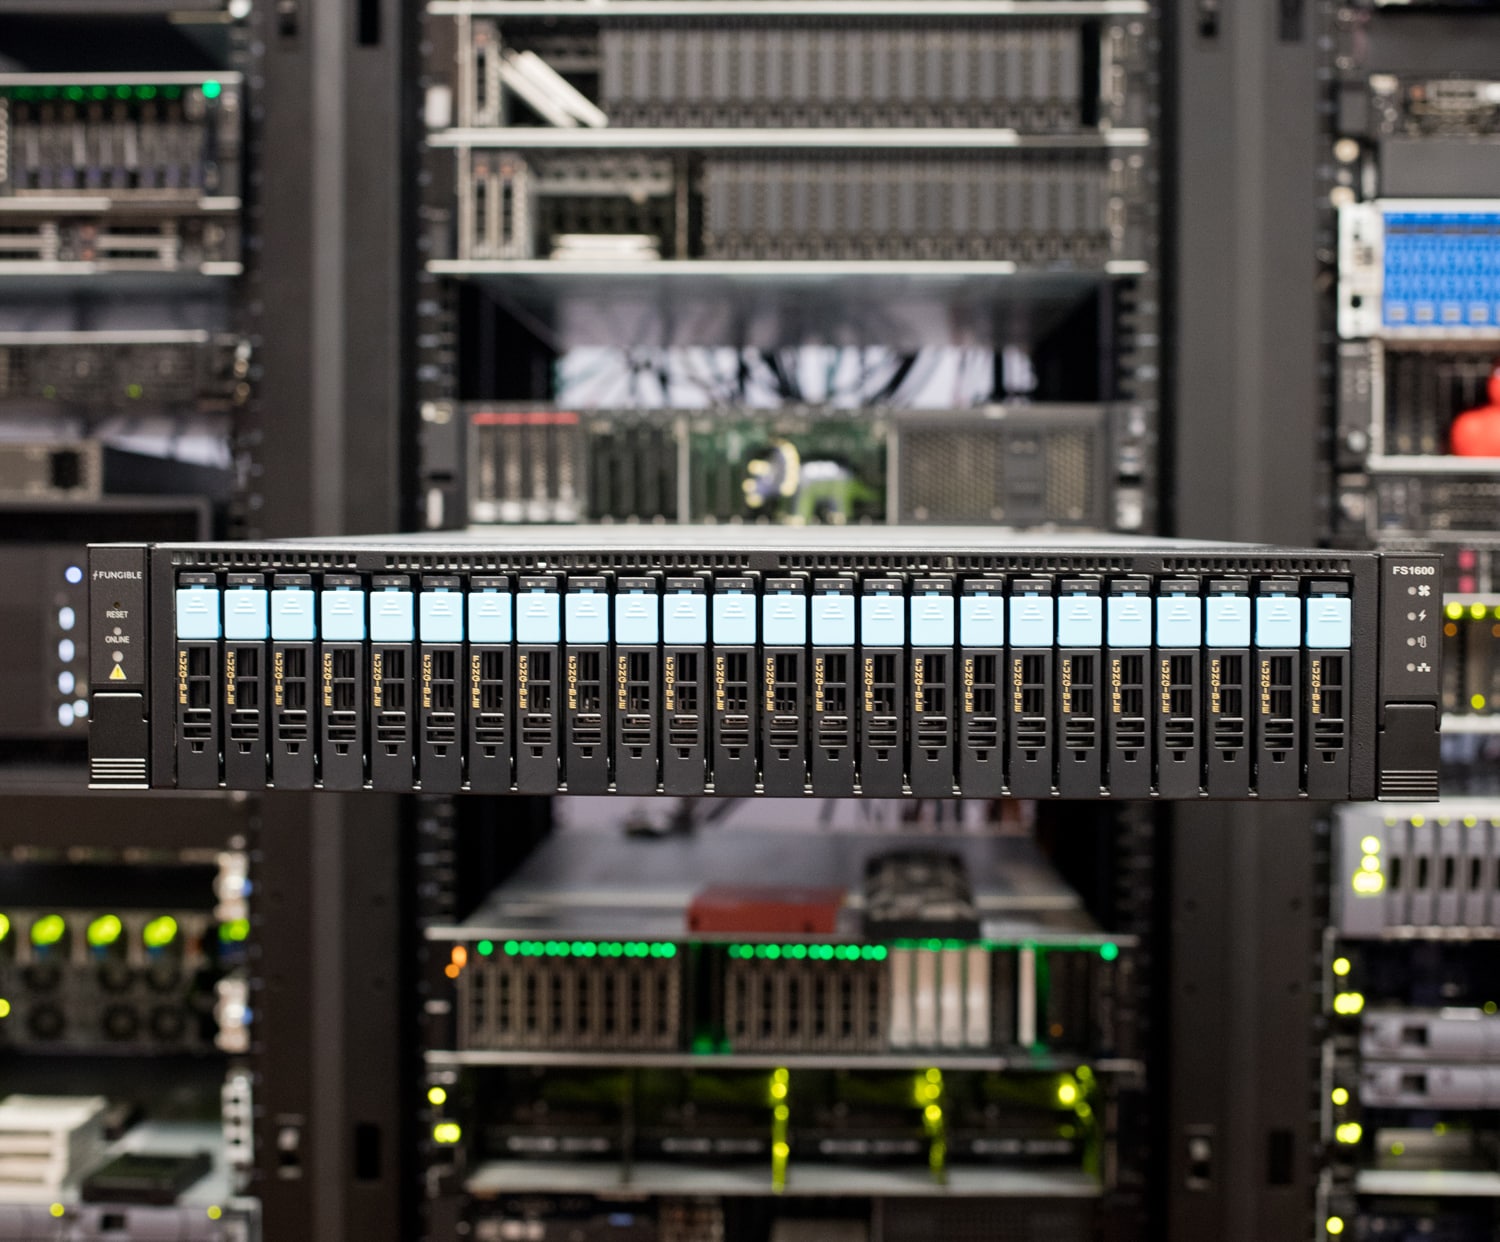
Zamienna macierz flash FS1600
Jednostka przetwarzania danych (DPU) to w zasadzie system na chipie. Zazwyczaj DPU składa się z wielordzeniowego mikroprocesora, interfejsu sieciowego i silników akceleracyjnych, które odciążają zadania związane z danymi, takie jak obsługa sieci, pamięci masowej, wirtualizacja, bezpieczeństwo i funkcje analityczne. Jednostki DPU i karty SmartNIC zyskują na popularności w centrach danych przedsiębiorstw i dostawców usług chmurowych.
Zamienny FSC1600 Klaster pamięci masowej
FS1600 jest zasilany przez dwie jednostki przetwarzania danych Fungible. Jednostka DPU, będąca unikalną innowacją Fungible, reprezentuje nową klasę mikroprocesorów zaprojektowanych od podstaw z myślą o zapewnieniu niezrównanej wydajności i efektywności w obsłudze usług infrastrukturalnych.
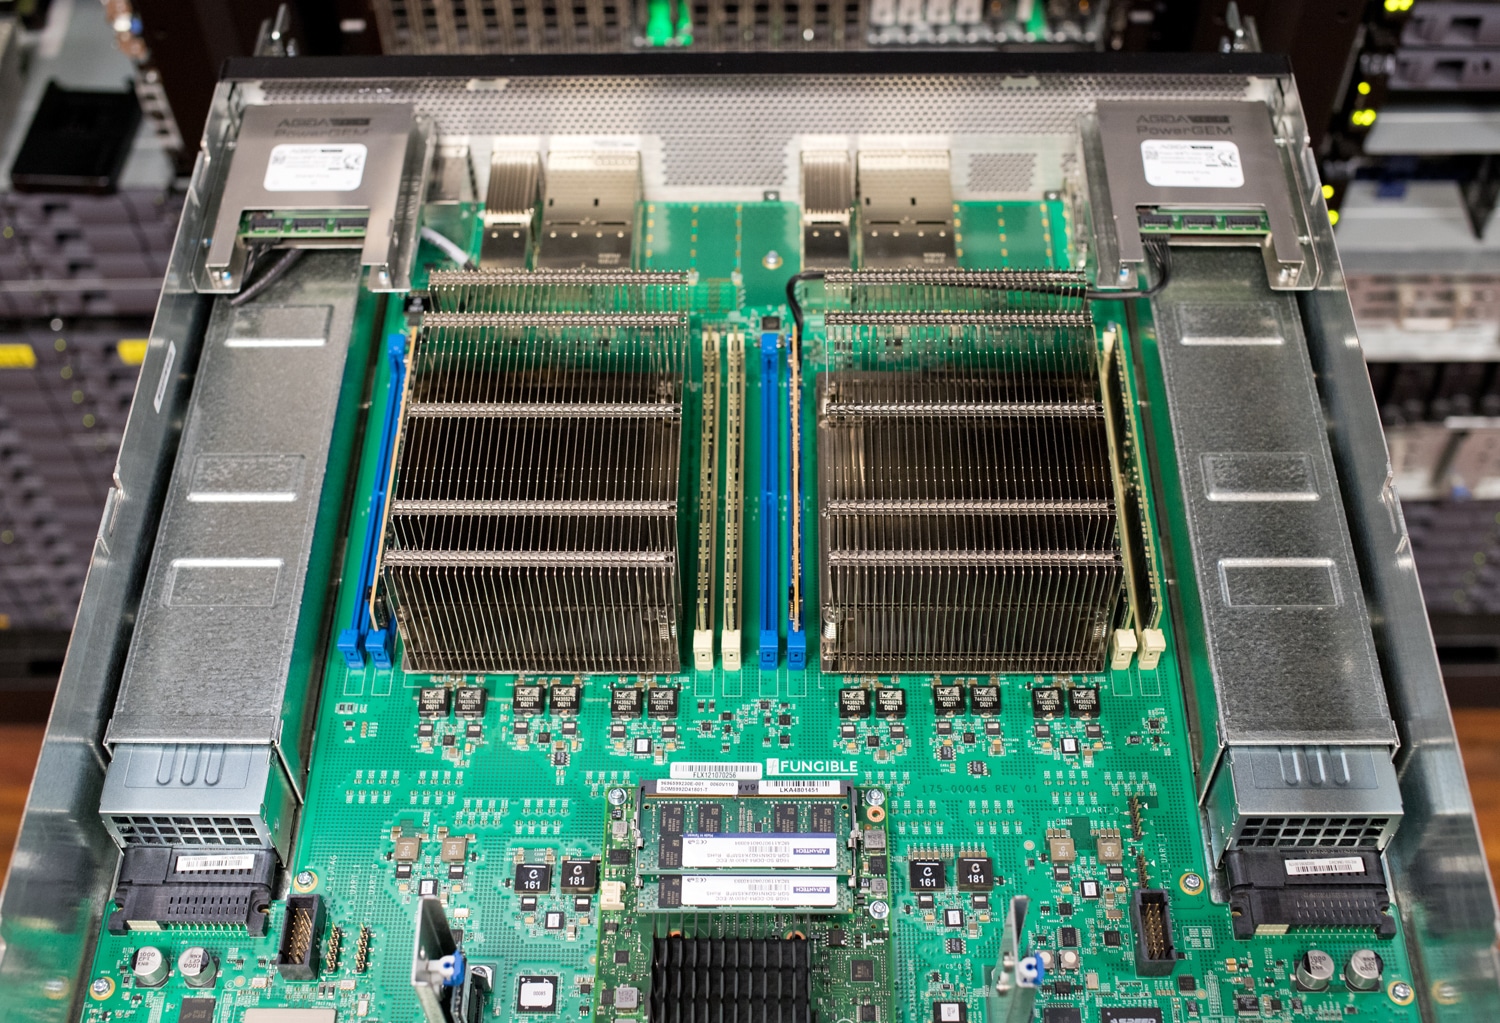
Zamienne elementy wewnętrzne FS1600
Podczas gdy większość platform pamięci masowej bazuje na architekturze x86, FS1600 opiera się na fundamentalnej technologii Fungible DPU. Zaprojektowany specjalnie do wydajniejszego przetwarzania obciążeń zorientowanych na dane niż procesory, DPU umożliwia FS1600 osiągnięcie wyższej wydajności. FS1600 charakteryzuje się losową szybkością odczytu 13 milionów IOPS (4 KB), przepustowością 75 GB/s na węzeł i opóźnieniami odczytu na poziomie +10 μs, co zapewnia znacznie wyższą wydajność niż systemy pamięci masowej podłączonej bezpośrednio (DAS), zapewniając 96.5% wskaźnika efektywności wydajności (PEP).
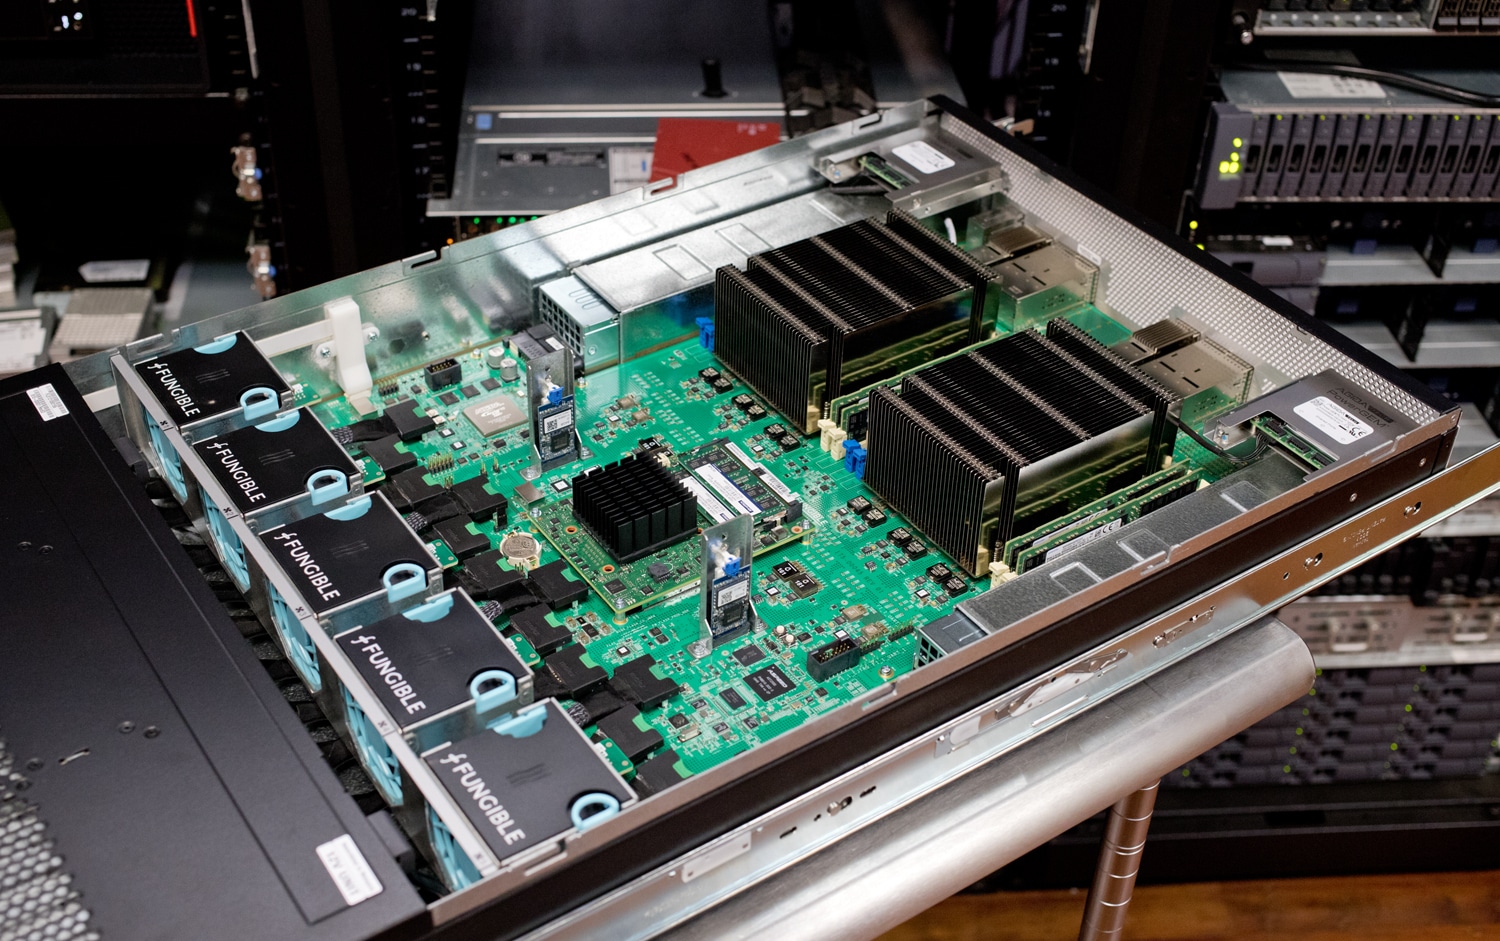
Sprzętowe akceleratory DPU obejmują kompresję, kodowanie erasure, szyfrowanie, wyrażenia regularne, głęboką inspekcję pakietów i DMA, działając z przepustowością łącza 800 Gb/s. Dzięki kodowaniu erasure, w przypadku awarii węzła dane są odbudowywane z wykorzystaniem parzystości i fragmentów danych z innych węzłów, a host zapewnia alternatywną ścieżkę dostępu do danych poprzez wielościeżkowość. FS1600, zgodny z NVMe/TCP i oprogramowaniem zarządzającym poprzez Container Storage Interface (CSI) dla Kubernetes i Openstack dla maszyn wirtualnych, może być natychmiastowym zamiennikiem istniejących systemów pamięci masowej. Nie ma wymagań dotyczących specjalnych agentów wykorzystujących zasoby procesora hosta; wymagany jest jedynie standardowy sterownik NVMe/TCP. Istniejące aplikacje nie wymagają żadnych zmian.
Modele S1 i F1 DPU
Dostępne są dwa modele procesorów DPU Fungible: S1 DPU i F1 DPU. Rodzina procesorów Fungible wykorzystuje tę samą konstrukcję sprzętową i programową oraz ten sam model programowania. Podczas gdy procesor F1 DPU został zaprojektowany z myślą o wydajnych, samodzielnych urządzeniach, takich jak serwery pamięci masowej, bezpieczeństwa, sztucznej inteligencji i analityczne, model S1 DPU maksymalizuje wydajność w ramach standardowej karty PCIe o wymiarach i mocy.
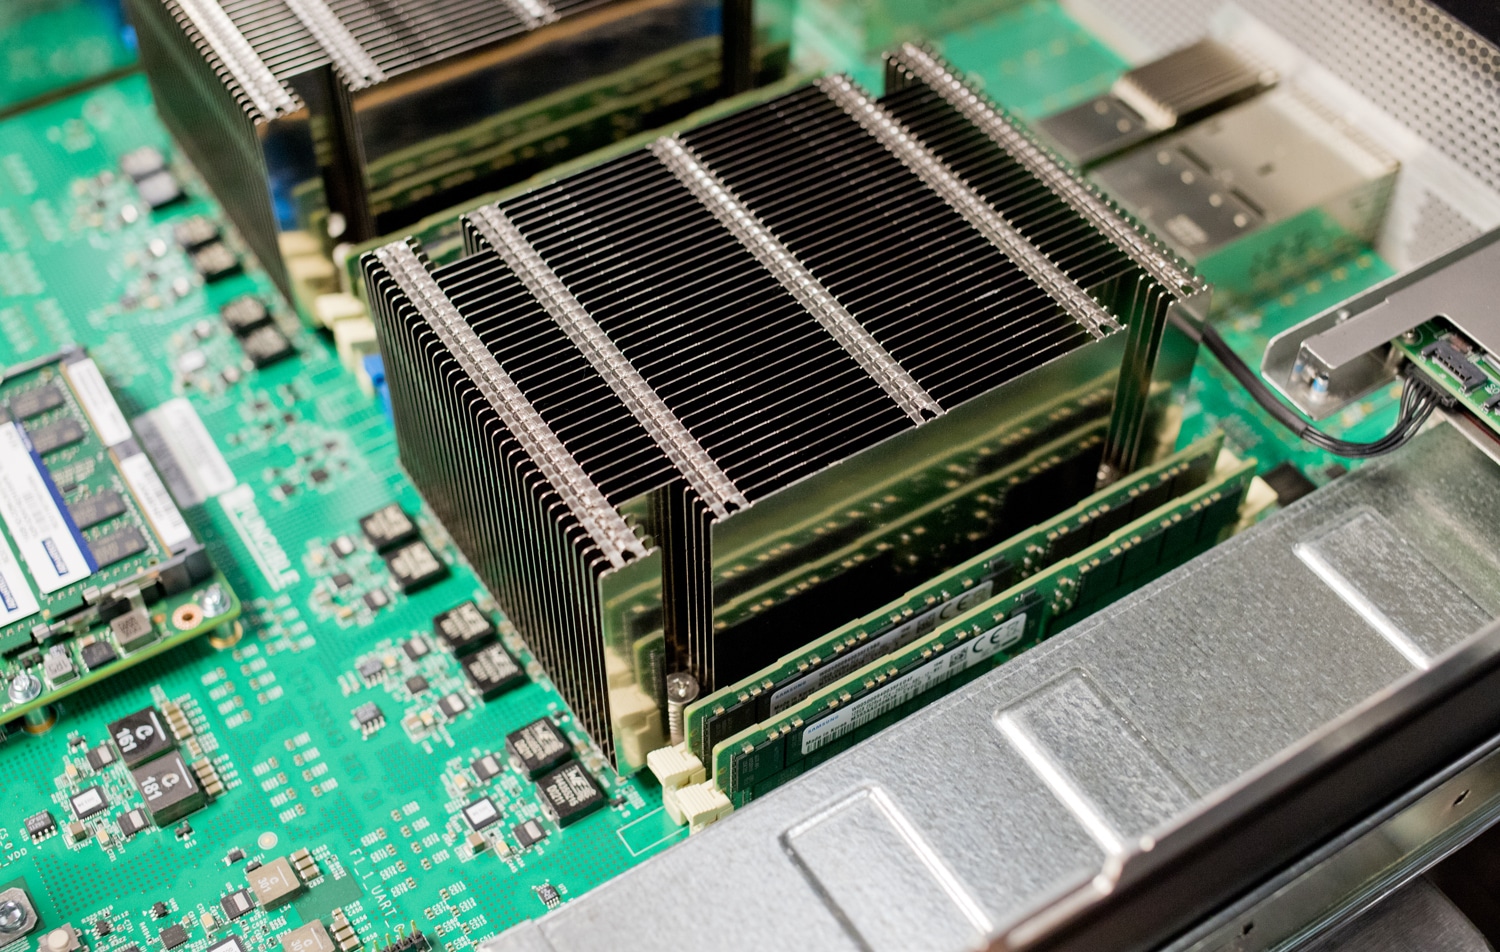
Jednostka DPU Fungible S1 jest zoptymalizowana pod kątem łączenia obliczeń zorientowanych na dane w węzłach serwerowych i efektywnego przesyłania danych między węzłami. Obliczenia zorientowane na dane charakteryzują się przetwarzaniem strumieni danych z zachowaniem stanu i dużą szybkością, zazwyczaj za pomocą stosów sieciowych, zabezpieczeń i pamięci masowej.
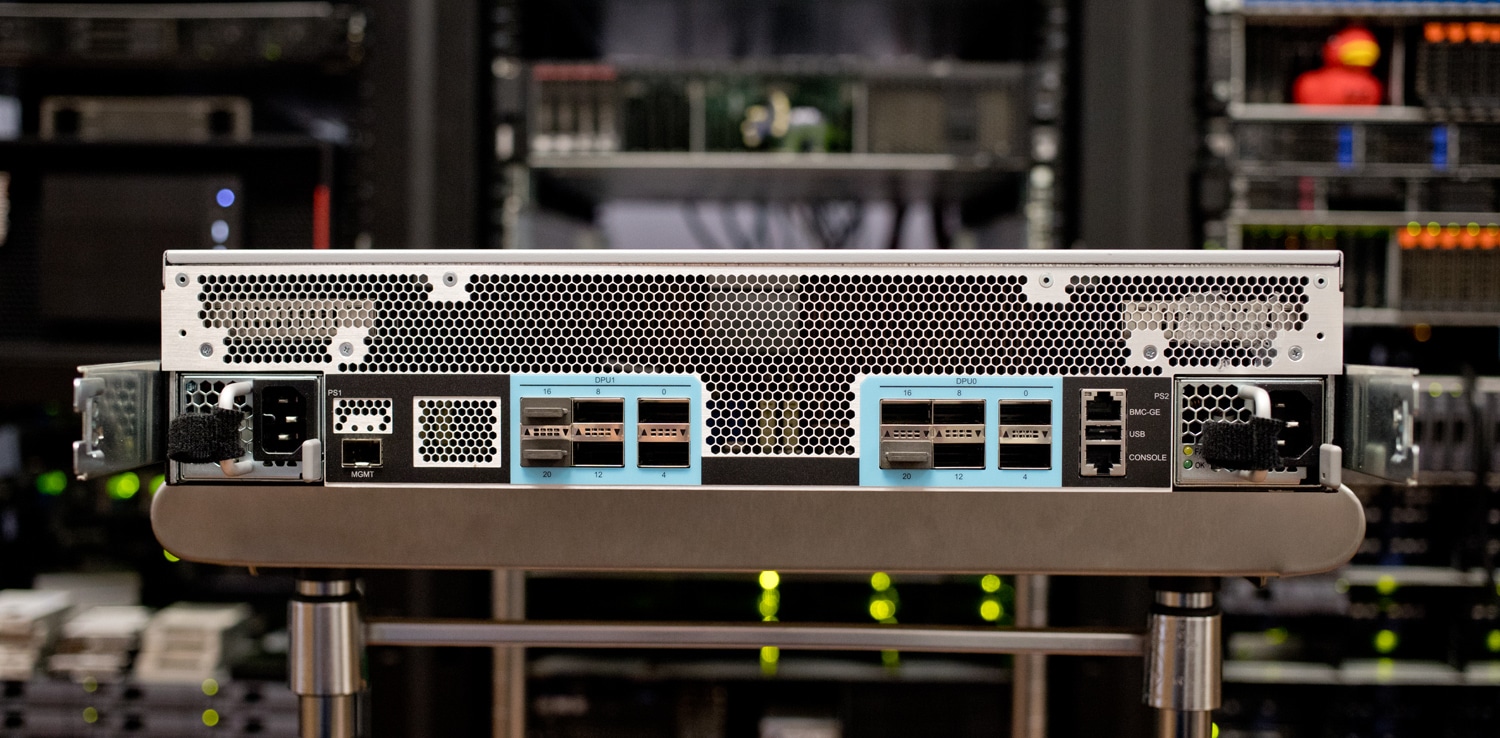
Zamienne tylne porty FS1600
Jednostka DPU S1 ułatwia wymianę danych między węzłami serwerów dzięki technologii TrueFabric™. TrueFabric to protokół IP-over-Ethernet na dużą skalę, zapewniający całkowitą przepustowość sieciową z niskimi średnimi i końcowymi opóźnieniami, kompleksową jakość usług (QoS), łączność bez przeciążeń oraz bezpieczeństwo między węzłami serwerów. Protokół TrueFabric jest w pełni zgodny ze standardami i interoperacyjny z TCP/IP przez Ethernet, co umożliwia budowę sieci Spine-Leaf w centrum danych przy użyciu standardowych, gotowych przełączników Ethernet.
FunOS
Płaszczyzna danych dla jednostek DPU S1 i F1 obsługuje FunOS™, specjalnie zaprojektowany system operacyjny napisany w językach programowania wysokiego poziomu (ANSI-C). FunOS obsługuje stosy sieciowe, pamięci masowej, zabezpieczeń, wirtualizacji i analityki. Płaszczyzna sterowania działa pod kontrolą standardowego systemu operacyjnego (np. Linux) i zawiera agenty, które umożliwiają zarządzanie, kontrolowanie i monitorowanie klastra jednostek DPU S1 i F1 za pomocą zestawu interfejsów API REST. Te interfejsy API REST można zintegrować ze standardowymi lub zewnętrznymi systemami orkiestracji, takimi jak wtyczki Kubernetes CSI, OpenStack, OpenShift itp.
Łącząc te kluczowe możliwości w jednym rozwiązaniu, rodzina procesorów Fungible DPU umożliwia hiper-dezagregację i łączenie zasobów obliczeniowych i pamięci masowej, zapewniając wydajną, niezwykle skalowalną, komponowalną infrastrukturę dla centrów danych nowej generacji!
Co tworzy klaster
FSC™ składa się z klastra składającego się z dwóch lub więcej docelowych węzłów pamięci masowej Fungible FS1600 oraz trzech węzłów Fungible Composer. Oprogramowanie Fungible Composer zarządza płaszczyzną sterowania (Control Plane), scentralizowanym rozwiązaniem do zarządzania, które konfiguruje, zarządza, koordynuje, kontroluje i wdraża klaster pamięci masowej Fungible. Węzły Composer zapewniają usługi takie jak pamięć masowa, zarządzanie siecią, telemetria, zarządzanie węzłami w celu gromadzenia logów oraz bramka API zapewniająca zewnętrzny dostęp do usług świadczonych przez Fungible Composer.
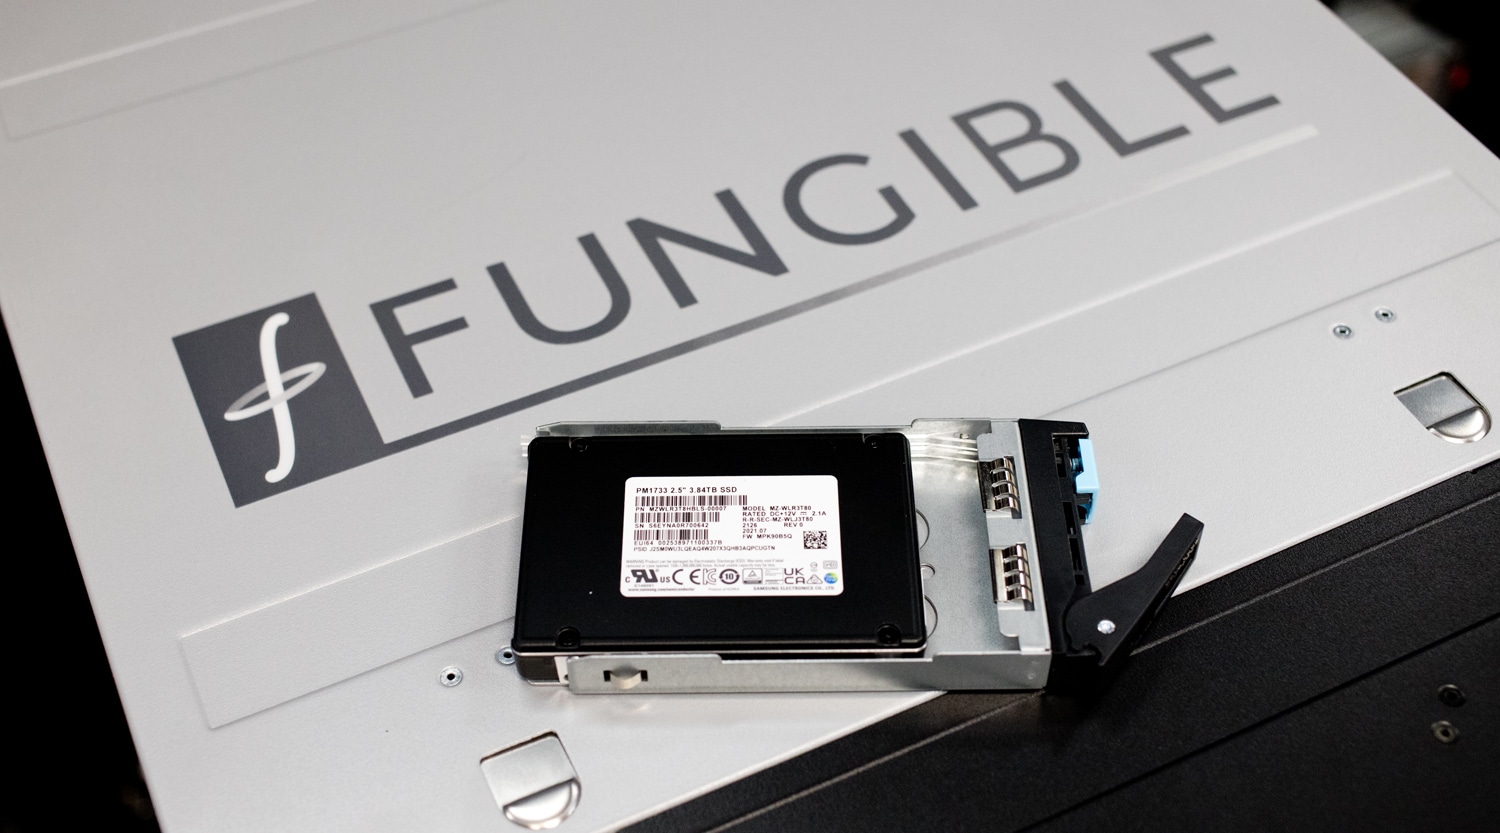
Klaster pamięci masowej Fungible Storage Cluster oferuje wydajne, nisko-opóźnieniowe, rozproszone rozwiązanie pamięci masowej NVMe/TCP, w pełni transparentne dla aplikacji wysokiego poziomu. Każdy FS1600 obsługuje do 24 dysków SSD U.2 NVMe/TCP, a wydajność skaluje się liniowo od pojemności zaledwie 70 TB do wielu PB.
Przypadków użycia
Natywna pamięć masowa w chmurze z funkcją hiperdezagregacji : FSC oferuje dostawcom usług chmurowych alternatywę dla konwencjonalnych pamięci masowych. Dzięki dezagregacji pamięci masowej, FSC umożliwia niezależne skalowanie mocy obliczeniowej i pamięci masowej, zwiększone wykorzystanie, redukcję liczby jednostek magazynowych (SKU) serwerów, zmniejszenie złożoności zarządzania i zwiększenie elastyczności.
Sztuczna inteligencja / uczenie maszynowe: Nowoczesne obciążenia AI/ML zazwyczaj wymagają ogromnej paralelizacji wydajności, niskich opóźnień i dużej pojemności. FSC w połączeniu z wysoce skalowalnymi, równoległymi systemami plików eliminuje wąskie gardła w pamięci masowej, zapewniając bezprecedensową wydajność, opóźnienia i efektywność dla tych nowoczesnych obciążeń.
Wysokowydajne bazy danych w chmurze : Wiele współczesnych, wysokowydajnych, skalowalnych baz danych wdraża DAS, aby sprostać wymaganiom dotyczącym opóźnień. Takie bazy danych zazwyczaj zapewniają trwałość dzięki klastrowym schematom redundancji, takim jak zestawy replik lub konfiguracje główny-pomocniczy. W przypadku awarii serwera dane są zachowywane na innym serwerze. FSC zachowuje opóźnienia typowe dla DAS, oferując jednocześnie lepsze wykorzystanie pamięci masowej i klastrową redundancję, ale przy niższym narzucie pojemności.
Uproszczone zarządzanie IT
Oprócz wszystkich korzyści w zakresie wydajności, jakie oferują FS1600 i jednostki DPU Fungible, dostępne jest również uproszczone podejście do zarządzania. Fungible oferuje narzędzie do zarządzania wielodostępnymi, bezpiecznymi centrami danych z poziomu jednego panelu. Panel Fungible Composer usprawni pracę administratora IT i dostarczy informacji niezbędnych do efektywnego zarządzania codziennymi funkcjami centrum danych.
Zamienny kompozytor
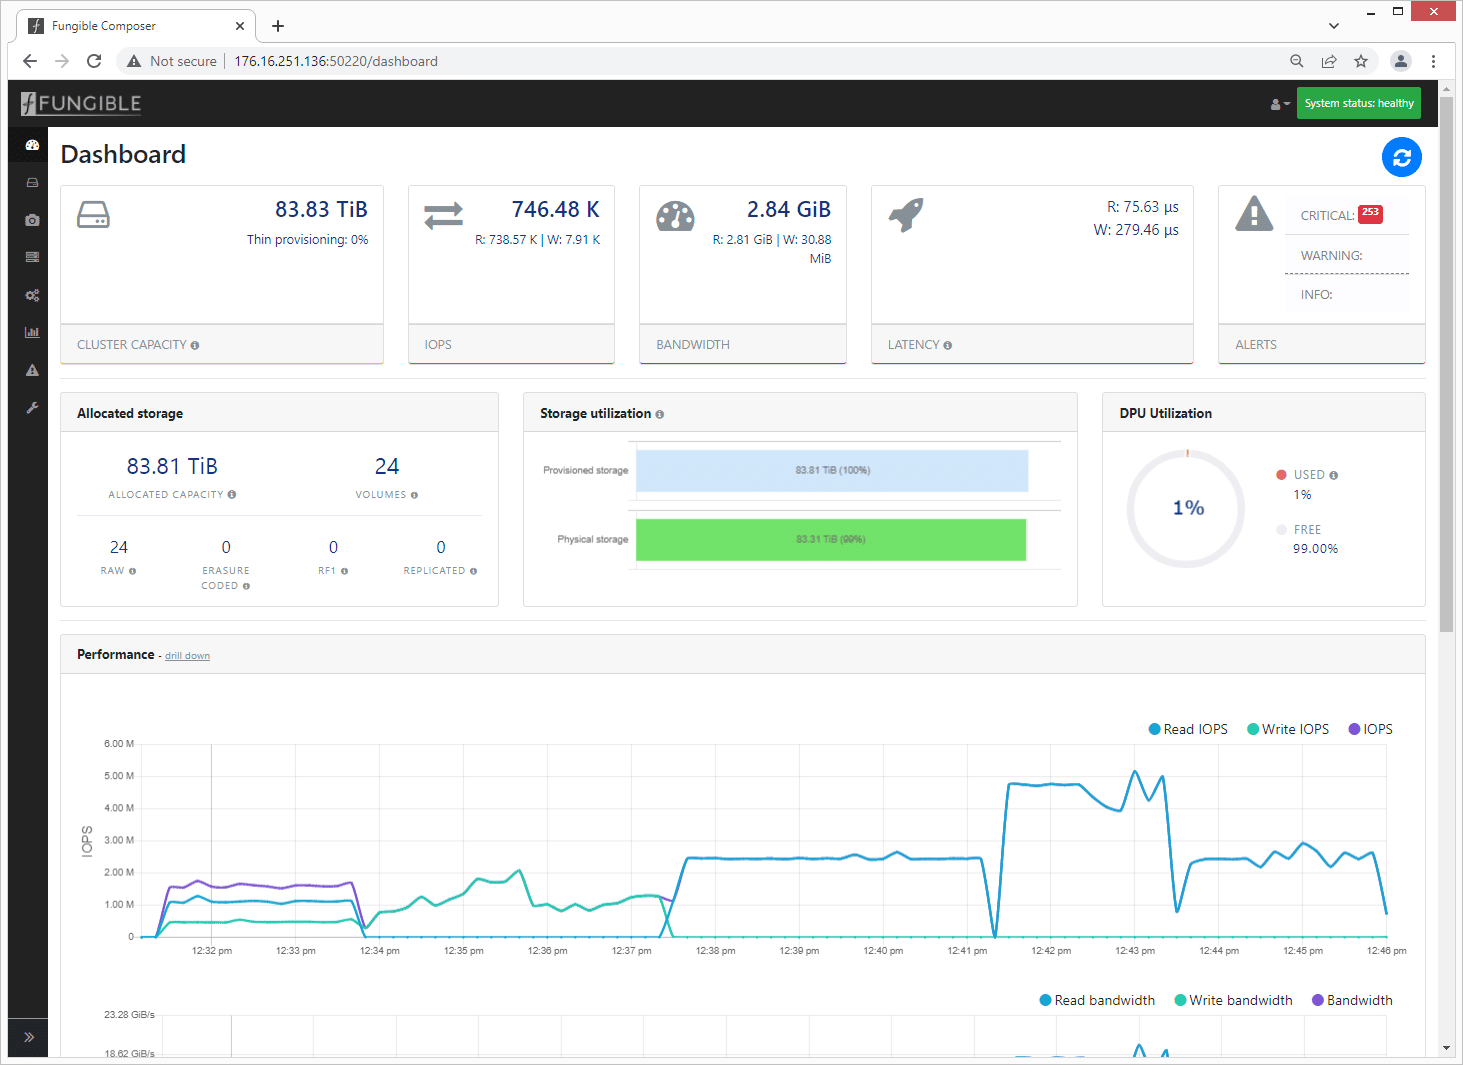
Panel Fungible Composer jest prosty w obsłudze i oferuje mnóstwo szczegółowych informacji do śledzenia, zarządzania, konfiguracji i monitorowania wydajności. Górna zakładka wskazuje podłączony system, wyświetlając szczegółowe informacje o klastrze, IOPS, dane dotyczące pamięci masowej, a także wszelkie alarmy wymagające uwagi.
Ikony po lewej stronie ekranu umożliwiają natychmiastowy dostęp do określonych narzędzi zarządzania.
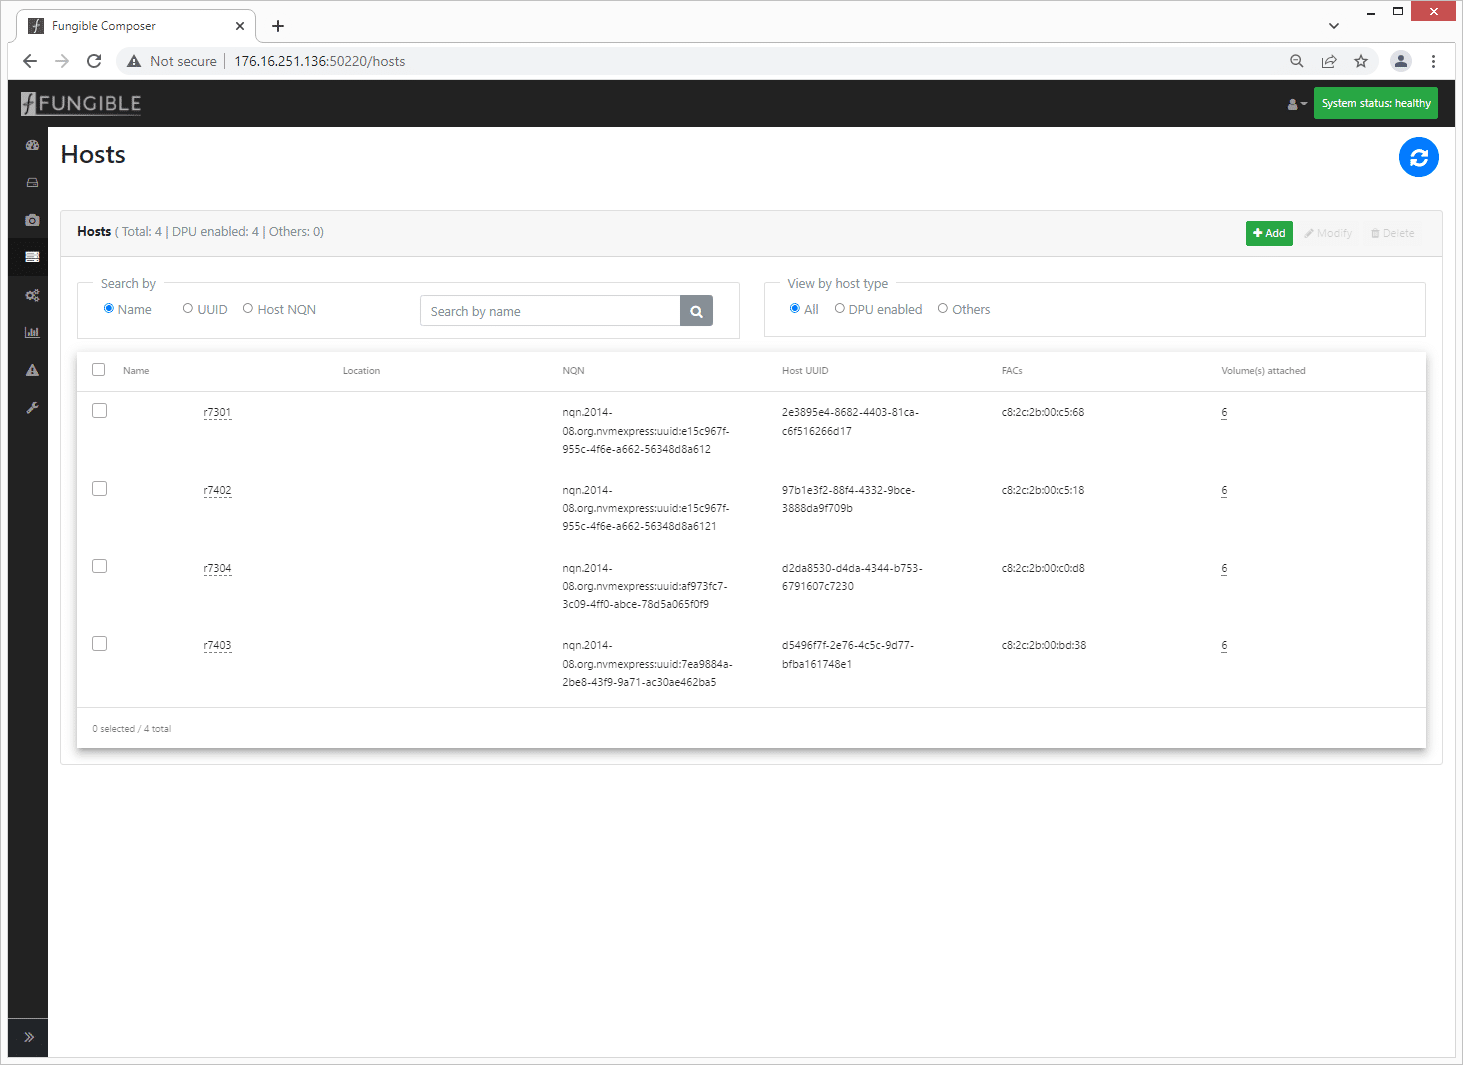
W zależności od szczegółów podanych podczas wdrażania urządzeń zamiennych, tabela hostów umożliwi administratorowi szybki podgląd podłączonych hostów z opcją przejścia do konkretnego hosta.
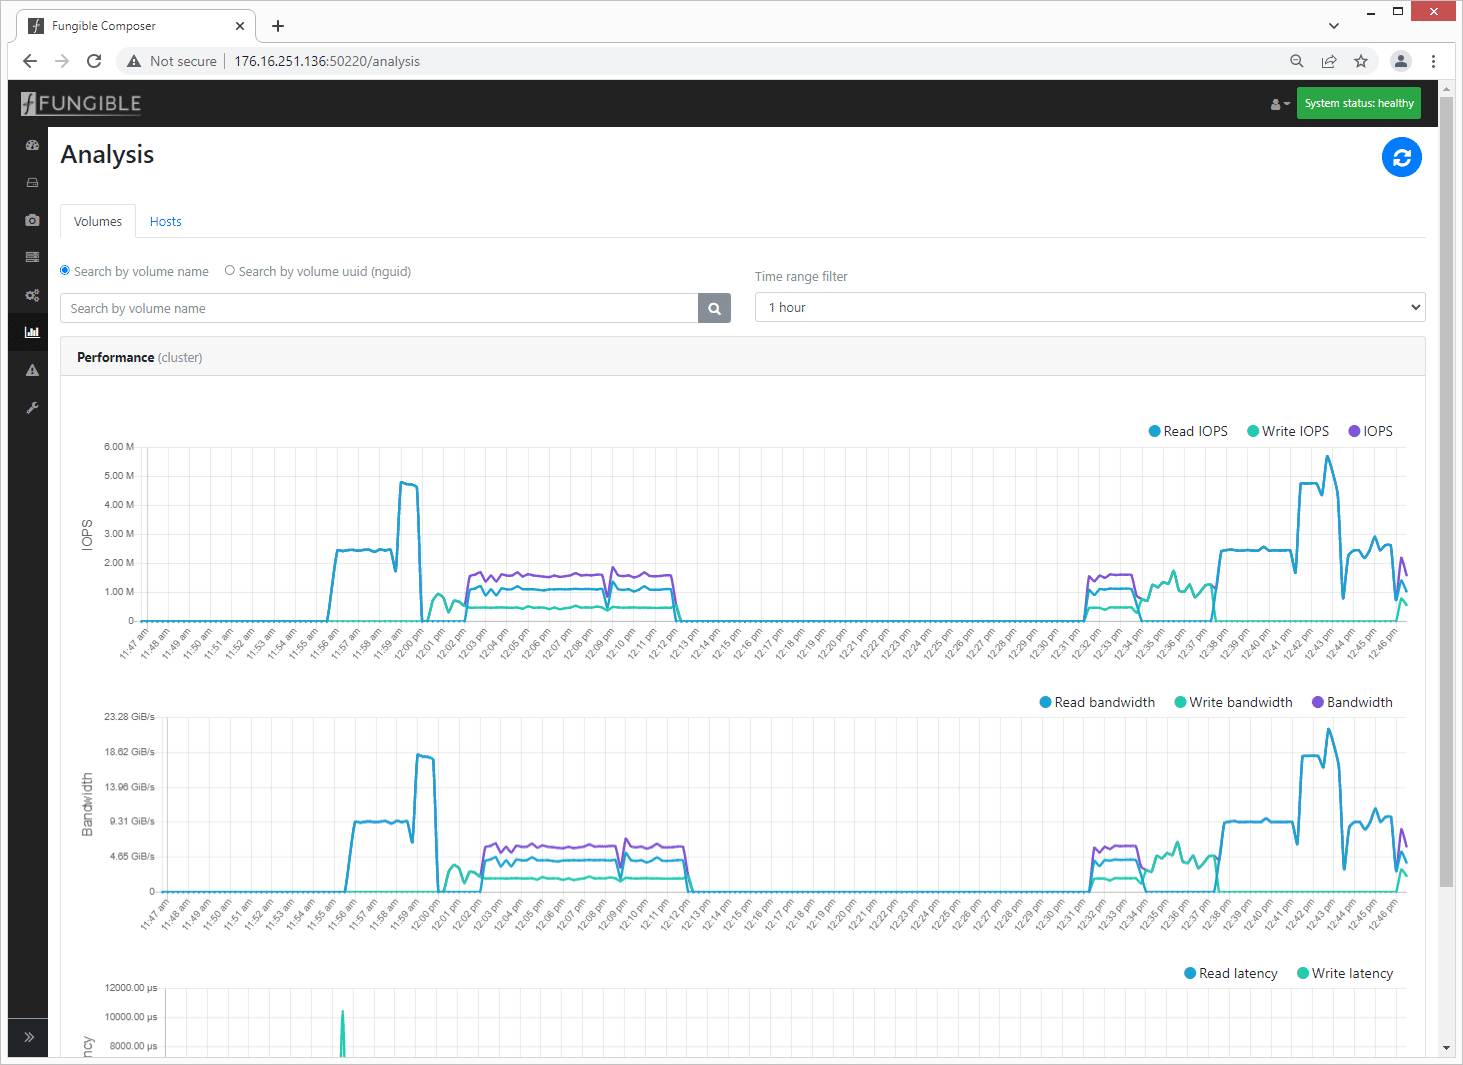
Aby uzyskać dane dotyczące wydajności, po wybraniu ikony analizy na ekranie pojawią się szczegóły dotyczące wydajności klastra, umożliwiające szybki podgląd danych dotyczących operacji wejścia/wyjścia na sekundę (IOPS), przepustowości i opóźnień.
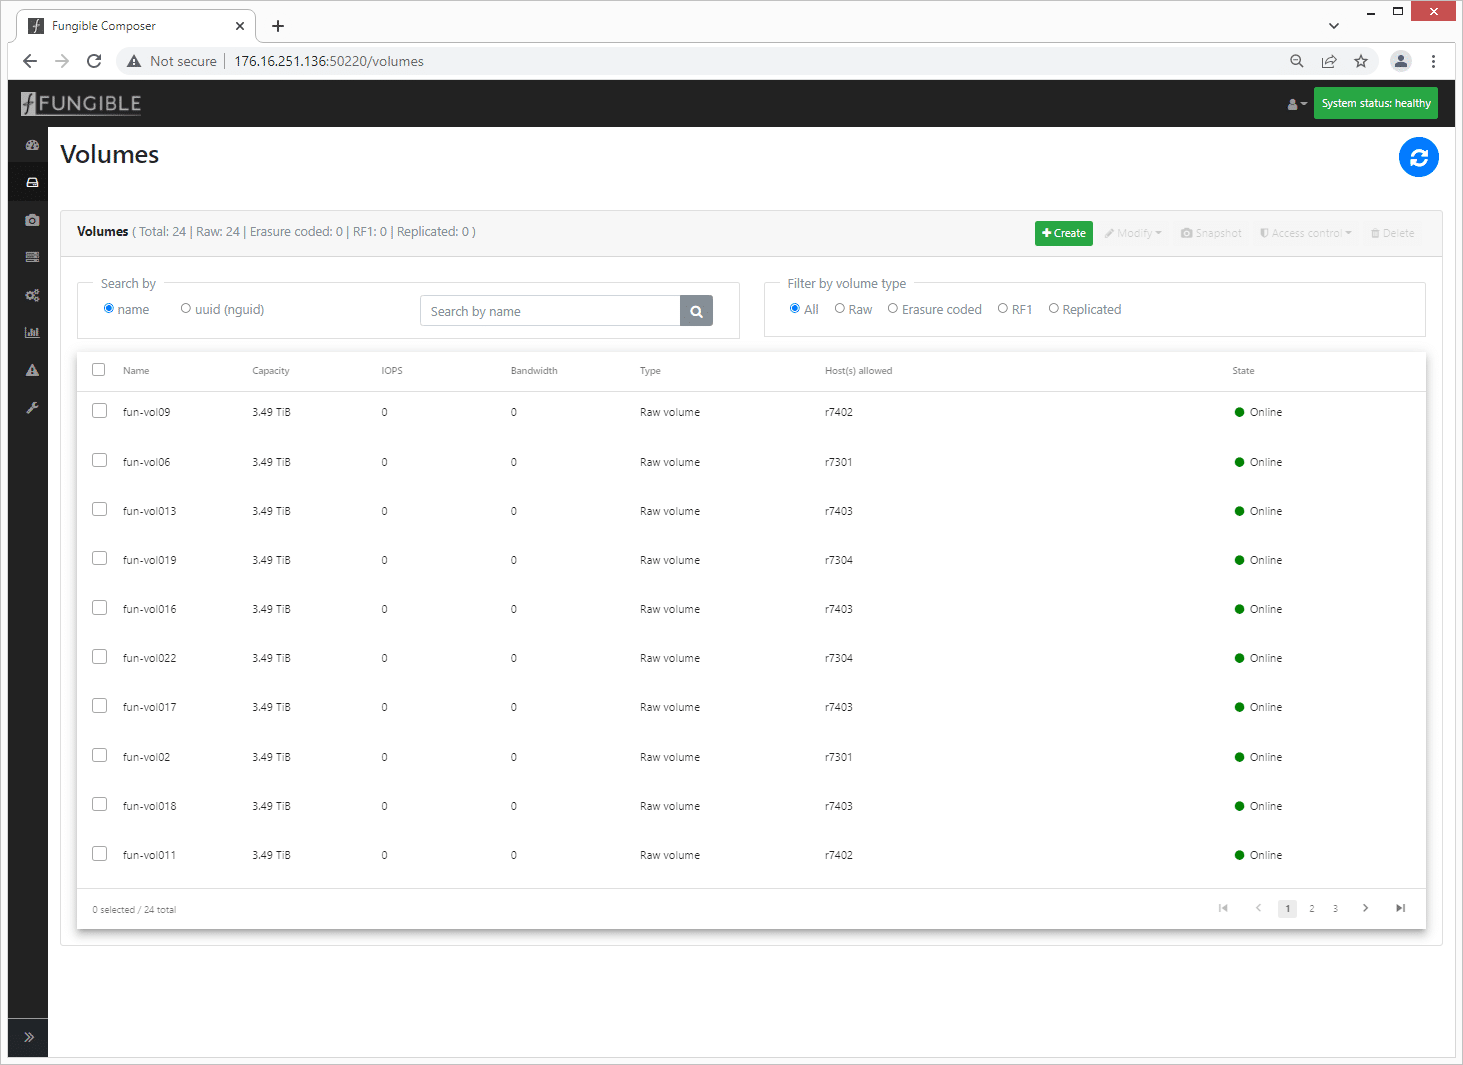
Szczegóły woluminu zapewniają szybki przegląd stanu każdego woluminu. Z tego miejsca możesz przejść do poszczególnych woluminów, aby uzyskać więcej szczegółów.
Szczegóły wdrożenia
1 x Zamienny FSC1600
- 8 połączeń 100GbE
- 24 urządzenia NVME o pojemności 3.84 TB
4 x Dell R740xd
- 1 x Zamienny FC200
- 1 połączenie 100GbE
- 1 x NVIDIA ConnectX-5
- 1 połączenie 100GbE
- 2 procesory Intel Xeon Gold 6130 o taktowaniu 2.10 GHz
- 1 256 GB pamięci DRAM
Volumes
- Łącznie 192 wolumeny 100G RAW
- 16 x 4K woluminów RAW na hosta
- 16 x 8K woluminów RAW na hosta
- 16 x 16K woluminów RAW na hosta
Proces testowania
Przygotowanie do testów obejmowało wstępne przygotowanie wszystkich woluminów obciążeniem zapisu w celu ich wypełnienia przed zainicjowaniem obciążeń testowych. Rozmiary woluminów dopasowano do rozmiaru bloku zastosowanego obciążenia. Do testów wykorzystano woluminy o pojemności 4 KB, 8 KB i 16 KB odpowiednio dla losowych obciążeń 4 KB, losowych 8 KB i sekwencyjnych obciążeń 64 KB. Wykorzystaliśmy protokół NVMe przez TCP, a pamięć masową testowano z jednym węzłem bez schematu zabezpieczeń.
Każda iteracja FIO między wymiennymi jednostkami DPU lub kartami sieciowymi 100 GbE była równoważona, aby zapewnić podobny profil opóźnień. Następnie zwiększono obciążenie karty sieciowej 100 GbE, aby uzyskać wyższą wydajność, co przełożyło się na większe opóźnienia i wykorzystanie procesora.
Na wstępnym etapie testów zadania FIO były połączone z węzłem NUMA, w którym zainstalowano karty. Między testami zamieniano jednostki DPU lub NIC i umieszczano je w tym samym gnieździe PCIe. Na poziomie serwera nie było potrzeby przeprowadzania żadnych specjalnych dostrajań poza ustawieniem profilu BIOS serwera na „Wydajność”. Dla każdego loadgena zainstalowaliśmy Ubuntu 20.04.2 Live Server.
Zamienny FS1600 Podsumowanie wyników wydajności
Zamienny FC200 IOPS
| Obciążenie pracą | Gospodarz 1 | Gospodarz 2 | Gospodarz 3 | Gospodarz 4 |
| 4 tys. odczytów | 2019k | 2015k | 2016k | 2012k |
| 4 tys. zapisów | 2244k | 2020k | 2280k | 2203k |
| 64 czyta | 167k | 166k | 166k | 166k |
| 64 tys. zapisów | 161k | 168k | 164k | 186k |
| 8k 70r/30w | 1118k / 479k | 1105k / 474k | 1075k / 461k | 1117k / 479k |
Zamienna przepustowość FC200
| Obciążenie pracą | Gospodarz 1 | Gospodarz 2 | Gospodarz 3 | Gospodarz 4 |
| 4 tys. odczytów | 7886 MiB/s | 7871 MiB/s | 7873 MiB/s | 7858 MiB/s |
| 4 tys. zapisów | 8766 MiB/s | 7890 MiB/s | 8905 MiB/s | 8606 MiB/s |
| 64 czyta | 9.80 Gb/s | 10.1 Gb/s | 10.2 Gb/s | 10.1 Gb/s |
| 64 tys. zapisów | 8732 MiB/s | 10.2 Gb/s | 11.3 Gb/s | 11.4 Gb/s |
| 8k 70r/30w | 8732 MiB /3743 MiB/s | 8632 MiB/3699 MiB/s | 8395 MiB/3598 MiB/s | 8729 MiB /3741 MiB/s |
100GbE IOPS karty sieciowej
| Obciążenie pracą | Gospodarz 1 | Host 1 Ramped | Gospodarz 2 | Gospodarz 3 | Gospodarz 4 |
| 4 tys. odczytów | 980k | 2019k | 1108k | 1102k | 1120k |
| 4 tys. zapisów | 968k | 2776k | 494k | 1025k | 1011k |
| 64 czyta | 140k | 118k | 125k | 141k | 140k |
| 64 tys. zapisów | 72.5k | 179k | 40.1k | 100k | 47.0k |
| 8k 70r/30w | 498k / 213k | 1147k / 491k | 597k / 256k | 567k / 243k | 595k / 255k |
Przepustowość karty sieciowej 100 GbE
| Obciążenie pracą | Gospodarz 1 | Host 1 Ramped | Gospodarz 2 | Gospodarz 3 | Gospodarz 4 |
| 4 tys. odczytów |
3828 MiB/s | 7887 MiB/s | 4330 MiB/s | 4303 MiB/s | 4374 MiB/s |
| 4K Zapis |
3783 MiB/s | 10.6 Gb/s | 1931 MiB/s | 4005 MiB/s | 3950 MiB/s |
| 64 tys. odczytów | 8761 MiB/s | 7269 MiB/s | 7804 MiB/s | 8832 MiB/s | 8753 MiB/s |
| 64K Zapis |
4529 MiB/s | 10.9 Gb/s | 2505 MiB/s | 6251 MiB/s | 3000 MiB/s |
| 8K 70R/30W | 3889 MiB/1667 MiB/s | 8958 MiB/3839 MiB/s | 4663 MiB/1998 MiB/s | 4427 MiB/1897 MiB/s | 4646 MiB/1991 MiB/s |
Zamienny FS1600 jest wykonawcą
Już na początku recenzji wiedzieliśmy, że Fungible FS1600 jest szybki; nie mieliśmy co do tego wątpliwości. Chociaż poszczególne karty w każdym hoście były mocno obciążone, w tym DPU i NIC, macierz wciąż miała zapas wydajności. Głównym celem było porównanie kart sieciowych i DPU w przypadku obciążeń NVMe/TCP wykorzystujących tę samą macierz pamięci masowej i podobnych scenariuszy testowych. Jednostki DPU przyniosły niesamowite korzyści rynkowi pamięci masowej. Mogą one odciążyć procesor, uwalniając go do obsługi innych zadań, takich jak obciążenia aplikacji, wykorzystujące te wejścia/wyjścia lub przepustowość. Skupiając się na pojedynczym hoście, dostrzegamy te korzyści.
Zamienny DPU
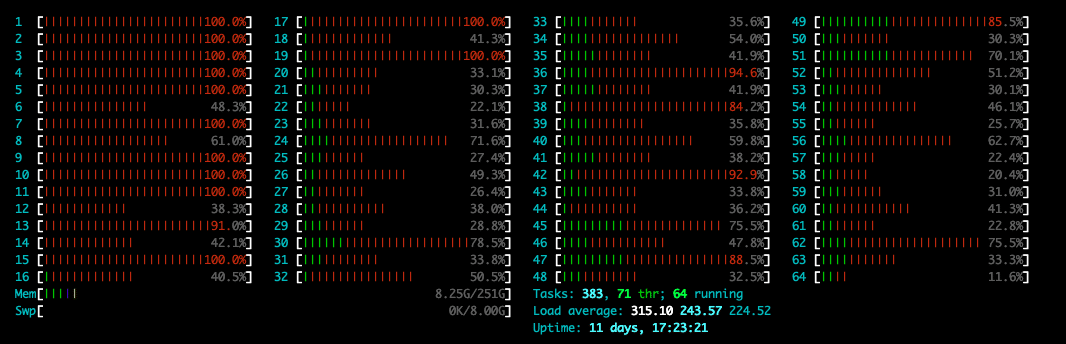
Na początek, jeśli średnie opóźnienie każdego obciążenia będzie zbliżone, widać, że jednostka DPU może zapewnić około dwukrotnie większą wydajność niż karta sieciowa. W tym przypadku zmierzyliśmy 2.02 mln IOPS dla losowego odczytu 4K z jednostki DPU Fungible, przy średnim opóźnieniu 0.474 ms. Analizując użycie procesora w czasie rzeczywistym podczas tego obciążenia, widać, że obciążenie ogranicza się do rdzeni procesora określonych w obciążeniu FIO.
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –iodepth=5 –numjobs=12 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=25,27,29,31,33,35,37,39,41,43,45,47,49,51,53,55,57,59,61,63 –randrepeat=0
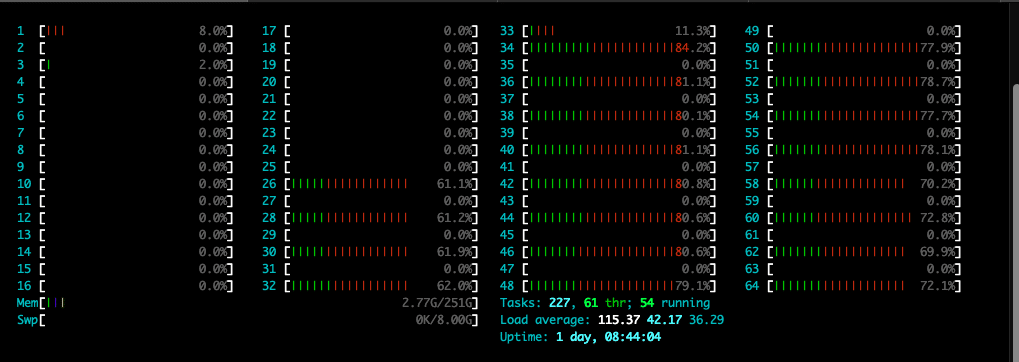
Karta sieciowa 100GbE
Następnie przeszliśmy do karty sieciowej 100 GbE, która jest w stanie obsłużyć 980 tys. operacji wejścia/wyjścia na sekundę (IOPS) przy średnim opóźnieniu 0.39 ms. Głębokość operacji wejścia/wyjścia (IO) i liczba zadań zostały zmniejszone przez DPU, aby utrzymać opóźnienia pod kontrolą, ale patrząc na obciążenie procesora, szybko widać korzyści płynące z DPU. Chociaż karcie sieciowej przypisano te same rdzenie procesora w zadaniu FIO, miała ona znacznie szersze wykorzystanie systemu. Istnieje kompromis między wykorzystaniem procesora przez procesy zaplecza (karty sieciowe, adaptery itp.) na serwerze produkcyjnym a procesami front-end, takimi jak obciążenia aplikacji. W tym przypadku widzimy, że sterownik karty sieciowej zużywa cykle procesora, podczas gdy DPU pozostaje internalizowane.
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –iodepth=4 –numjobs=6 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=25,27,29,31,33,35,37,39,41,43,45,47,49,51,53,55,57,59,61,63 –randrepeat=0
Karta sieciowa 100GbE z rampą
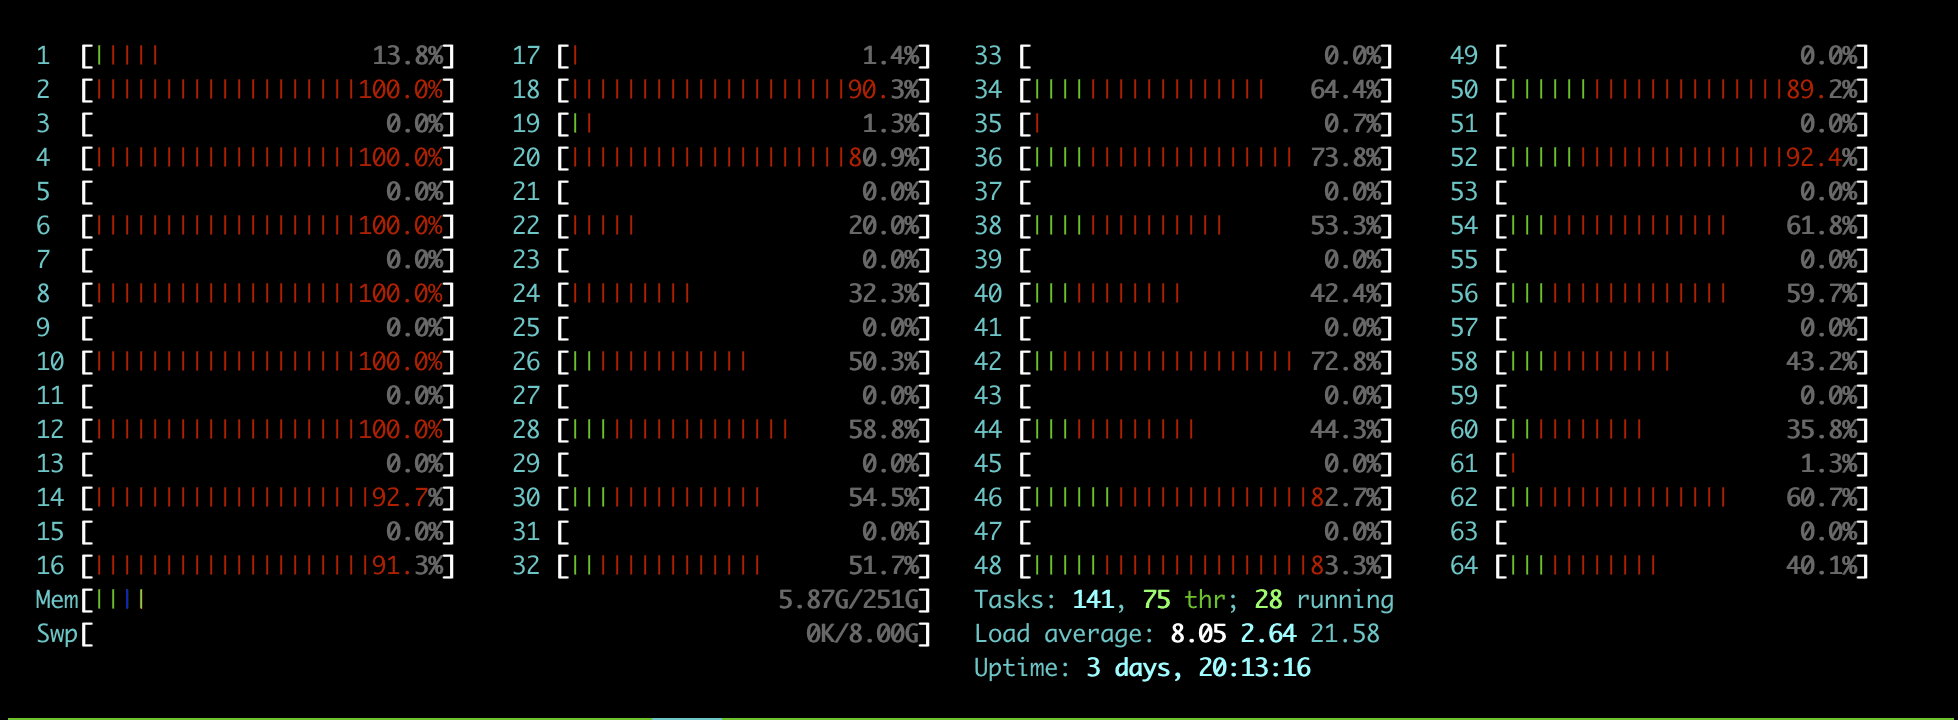
Wreszcie, przeszliśmy na dostrojone obciążenie karty sieciowej 100 GbE, które mogło osiągnąć ten sam poziom wydajności co DPU, czyli około 2.02 mln IOPS. Kosztem tej wyższej prędkości jest jednak opóźnienie, które znacznie wzrosło do 2.6 ms i wyższe opóźnienie szczytowe. Wynikało to ze skalowania głębokości operacji wejścia/wyjścia (IOdepth) z 4 do 16 oraz liczby zadań z 6 do 20. Chociaż uwaga skupia się na zwiększonym opóźnieniu, patrząc na obciążenie procesora, widać, że prawie wszystkie zasoby systemowe są skoncentrowane na aktywności wejścia/wyjścia, nie pozostawiając wiele dla innych procesów. Firmy starające się zwiększyć gęstość i wydajność swoich wdrożeń serwerów, łatwo zauważyć, że nie wszystkie operacje wejścia/wyjścia są sobie równe i jak szybko jednostki DPU zmieniają rynek pamięci masowej.
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –iodepth=16 –numjobs=20 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=14-63 –randrepeat=0
Ostatnie słowa
Pracujemy z Fungible FS1600 i jego jednostkami DPU od kilku tygodni. Chociaż sama macierz nie wymaga skomplikowanego okablowania ani zmian, chcieliśmy przeprowadzić dogłębną analizę, aby dogłębnie zrozumieć wpływ jednostek DPU. Nie chodzi o to, że same jednostki DPU są czymś nowym, ale w końcu stają się dostępne komercyjnie w rozwiązaniach klasy korporacyjnej, a nie tylko w projektach naukowych. I żeby było jasne, implementacje jednostek DPU nie są takie same, dlatego zrozumienie wpływu infrastruktury i wydajności na decyzje projektowe ma kluczowe znaczenie.
W świecie DPU, Fungible wyróżnia się jako firma wyjątkowa. Postanowili wdrożyć niestandardowe rozwiązanie, gdy firma zaczynała w 2015 roku, przeznaczając znaczne środki na rozbudowę firmy pod koniec 2016 roku. To właśnie wtedy Mellanox ogłosił swoją pierwszą wersję DPU o nazwie BlueField. Chociaż można argumentować, że Fungible dobrze by zrobiło, wdrażając BlueField, pójście własną drogą zapewniło firmie znaczącą przewagę technologiczną i wiodącą pozycję. Fungible ma pełną kontrolę nad swoim stosem i może z łatwością wykorzystywać DPU zarówno u klienta, jak i u celu. Albo nie, decyzja należy do klientów. Jednak nasze testy wskazują na znaczące korzyści z wdrożenia kompleksowego rozwiązania Fungible.
Wprowadzenie technologii Fungible z jednostkami DPU wykorzystanymi w macierzy pamięci masowej i hoście dopełnia obraz, który oferuje ogromne korzyści pod względem wydajności. Jednostki DPU odciążają zasoby, które w przeciwnym razie byłyby przypisane do procesora systemowego, co stanowi interesującą kombinację w przypadku obu stron równania. Wykorzystanie Fungible FC200 zamiast tradycyjnej karty sieciowej (NIC) pozwala na uzyskanie znacznych korzyści w zakresie szybkości wejścia/wyjścia, a także mniejszego obciążenia procesora. Patrząc na nasz losowy transfer danych 4K, FC200 był w stanie osiągnąć ponad 2 mln IOPS przy opóźnieniu 0.474 ms, podczas gdy karta sieciowa osiągnęła około 1 mln IOPS przy opóźnieniu 0.39 ms. Zwiększenie wydajności karty sieciowej do 2 mln IOPS było możliwe, ale wiązało się ze znacznym kosztem opóźnienia i zasobów systemowych.
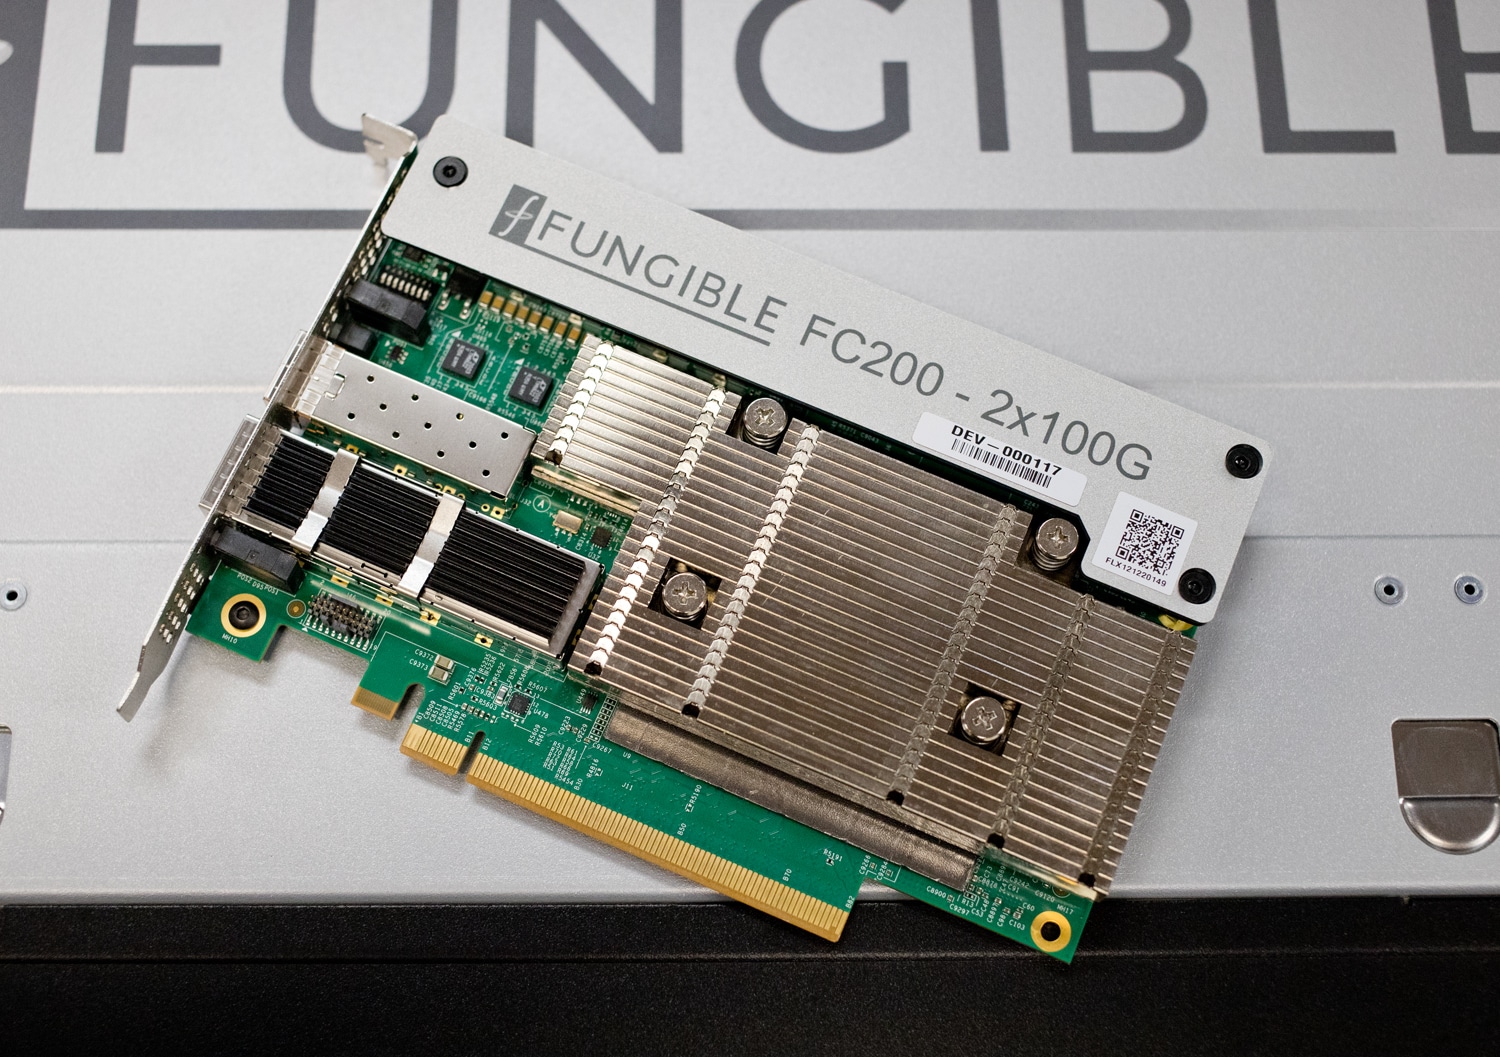
Zamienny FC200 DPU
Jednostki DPU jako klasa mają ogromny potencjał, jeśli chodzi o odblokowanie natywnej wydajności dostępnej w pamięciach flash. Chociaż jest to już dziś prawdą, matematyka staje się jeszcze bardziej korzystna dla jednostek DPU, gdy na rynku pojawiają się technologie takie jak dyski SSD Gen5 i szybsze połączenia. Płacenie dodatkowej opłaty za x86 za zarządzanie liniami PCIe po prostu nie ma sensu w przypadku aplikacji, które mogą wykorzystać te komponenty, a starsze architektury po prostu nie są tak skalowalne.
Fungible oferuje atrakcyjne rozwiązania sprzętowe i programowe, takie jak węzeł pamięci masowej FS1600 i karty akceleracyjne. Niedawno firma skupiła się również na dezagregacji procesorów graficznych (GPU) , oferując klientom bardziej kompletny stos dla obciążeń HPC i AI. W szybko rozwijającym się segmencie DPU będzie wielu zwycięzców, ale Fungible z pewnością jest jednym z tych, na których warto zwrócić uwagę. Organizacje, które potrzebują jak najwięcej z pamięci masowej, zdecydowanie powinny wypróbować FS1600.


 Amazon