

Wraz z premierą platformy DGX Spark firmy NVIDIA, obserwujemy, jak różni dostawcy pakują podstawę GB10 Grace Blackwell do własnych kompaktowych komputerów stacjonarnych. Choć płyta główna i układ scalony pozostają standardowe, pojawiają się różnice w konstrukcji obudowy, sposobie chłodzenia, konfiguracji pamięci masowej i ogólnym działaniu. W tej recenzji skupiamy się na implementacji GIGABYTE z procesorem AI TOP ATOM.
Wewnątrz znajduje się ten sam układ GB10 Superchip, łączący 20-rdzeniowy procesor ARM z akceleracją Blackwell AI i 128 GB zunifikowanej pamięci LPDDR5X. Ta baza obsługuje do 1 petaflopa mocy obliczeniowej FP4 i modeluje do 200 miliardów parametrów, co plasuje go zdecydowanie w czołówce rozwiązań AI klasy stacji roboczych.
AI TOP ATOM mieści się w kompaktowej, 1-litrowej obudowie o wymiarach 150 x 150 x 50.5 mm i jest zasilany zewnętrznym zasilaczem o mocy 240 W. Chociaż rdzeń obliczeniowy jest identyczny jak w innych systemach Spark, sprawdzamy, jak rozwiązania konstrukcyjne GIGABYTE wpływają na temperaturę, zachowanie przy stałym obciążeniu, wydajność pamięci masowej i codzienną użyteczność.
Opcje pamięci masowej skalują się do 4 TB pamięci NVMe Gen5, a system jest dostarczany z systemem operacyjnym NVIDIA DGX opartym na Ubuntu, co czyni go gotowym do obsługi zadań AI od razu po instalacji. Krótko mówiąc, choć rdzeń sprzętowy pozostaje identyczny jak w innych systemach klasy Spark, to wrażenia użytkownika, parametry termiczne, akustyka i ogólna prezentacja sprowadzają się do tego, co oferuje GIGABYTE w swojej kompaktowej obudowie.
W tej recenzji sprawdzimy, jak rozwiązanie GIGABYTE na platformie Spark wypada pod względem stałych obciążeń, sposobu chłodzenia i codziennej użyteczności, a także czy kompaktowy format wiąże się z jakimiś zauważalnymi kompromisami.
| Specyfikacja | GIGABYTE AI TOP ATOM (GB10) |
|---|---|
| Wymiary i waga | |
| Wysokość | 2 w |
| Szerokość | 5.9 w |
| Głębokość | 5.9 w |
| Waga | 2.64 lb |
| Procesor | |
| Typ procesora | NVIDIA GB10 (Grace Blackwell Superchip) (20 rdzeni) |
| Zintegrowana karta graficzna | Procesor graficzny NVIDIA Blackwell (zintegrowany) |
| Pamięć | |
| Typ pamięci | LPDDR5x (zunifikowana pamięć systemowa) |
| Konfiguracja pamięci | 128 GB LPDDR5x, ujednolicona pamięć systemowa |
| Przepustowość pamięci | 273 GB/s (8533 MT/s) |
| System operacyjny | |
| obsługiwane systemy operacyjne | System operacyjny NVIDIA DGX |
| Zewnętrzne porty i gniazda | |
| Porty sieciowe | Jedno złącze RJ45 (10GbE) Karta sieciowa NVIDIA ConnectX-7 (200 Gb × 2 QSFP) |
| Porty USB | Trzy porty USB 3.2 Gen 2×2 typu C (20 Gb/s) Jeden port USB 3.2 Gen 2×2 typu C z wejściem PD |
| Port(y) wideo | Jedno złącze HDMI 2.1a |
| Port zasilacza | USB typu C (PD IN) |
| Gniazdo bezpieczeństwa | żaden |
| Bezprzewodowy | |
| WiFi | Wi-Fi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Dyski | |
| Opcje bagażu | Do 4 TB Gen5 NVMe (obsługa samoszyfrującego) |
| Zasilacz | |
| Typ | Zasilacz zewnętrzny 240 W (USB typu C) |
Projekt i budowa GIGABYTE AI TOP ATOM
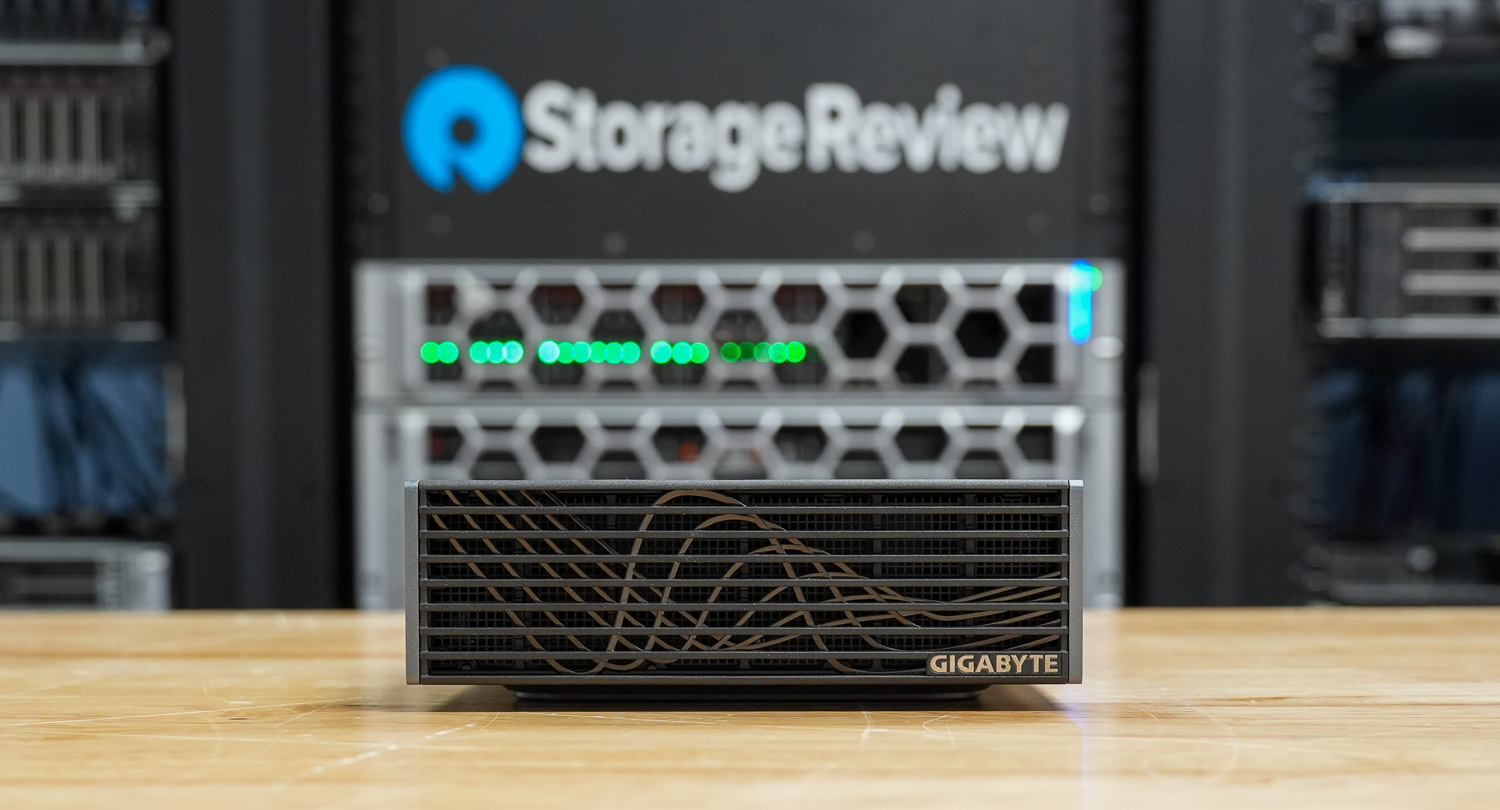
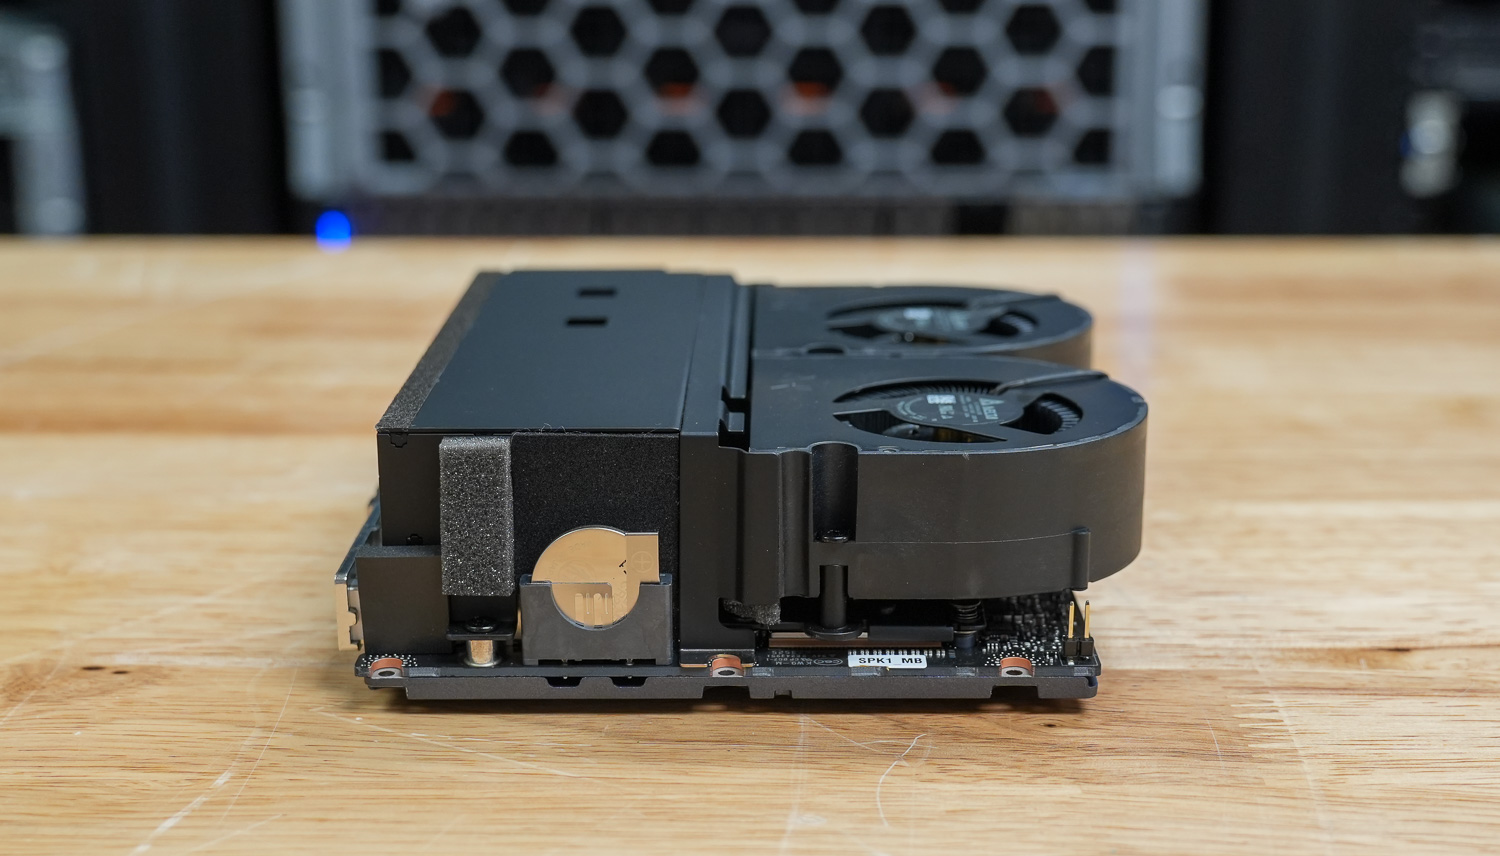
GIGABYTE AI TOP ATOM zachowuje znane nam wymiary 150 x 150 mm, znane z systemów opartych na platformie Spark, mierząc 50.5 mm wysokości i ważąc 1.2 kg. Jest na tyle kompaktowy, że zmieści się na biurku, ale po podniesieniu wydaje się gęsty i solidny. Wykończenie ma ciemny, matowy kolor, który nadaje mu bardziej charakter stacji roboczej.
Zamiast prostej, płaskiej maskownicy na przednim panelu, cała powierzchnia obudowy pokryta jest poziomymi listwami i subtelnym, falistym wzorem, który nadaje jej głębi i faktury, patrząc z różnych kątów. To konstrukcja skoncentrowana na chłodzeniu. Logo GIGABYTE znajduje się w dolnym rogu, a z przodu nie ma portów danych ani przycisku zasilania, dzięki czemu powierzchnia pozostaje czysta i zapewnia swobodny przepływ powietrza.
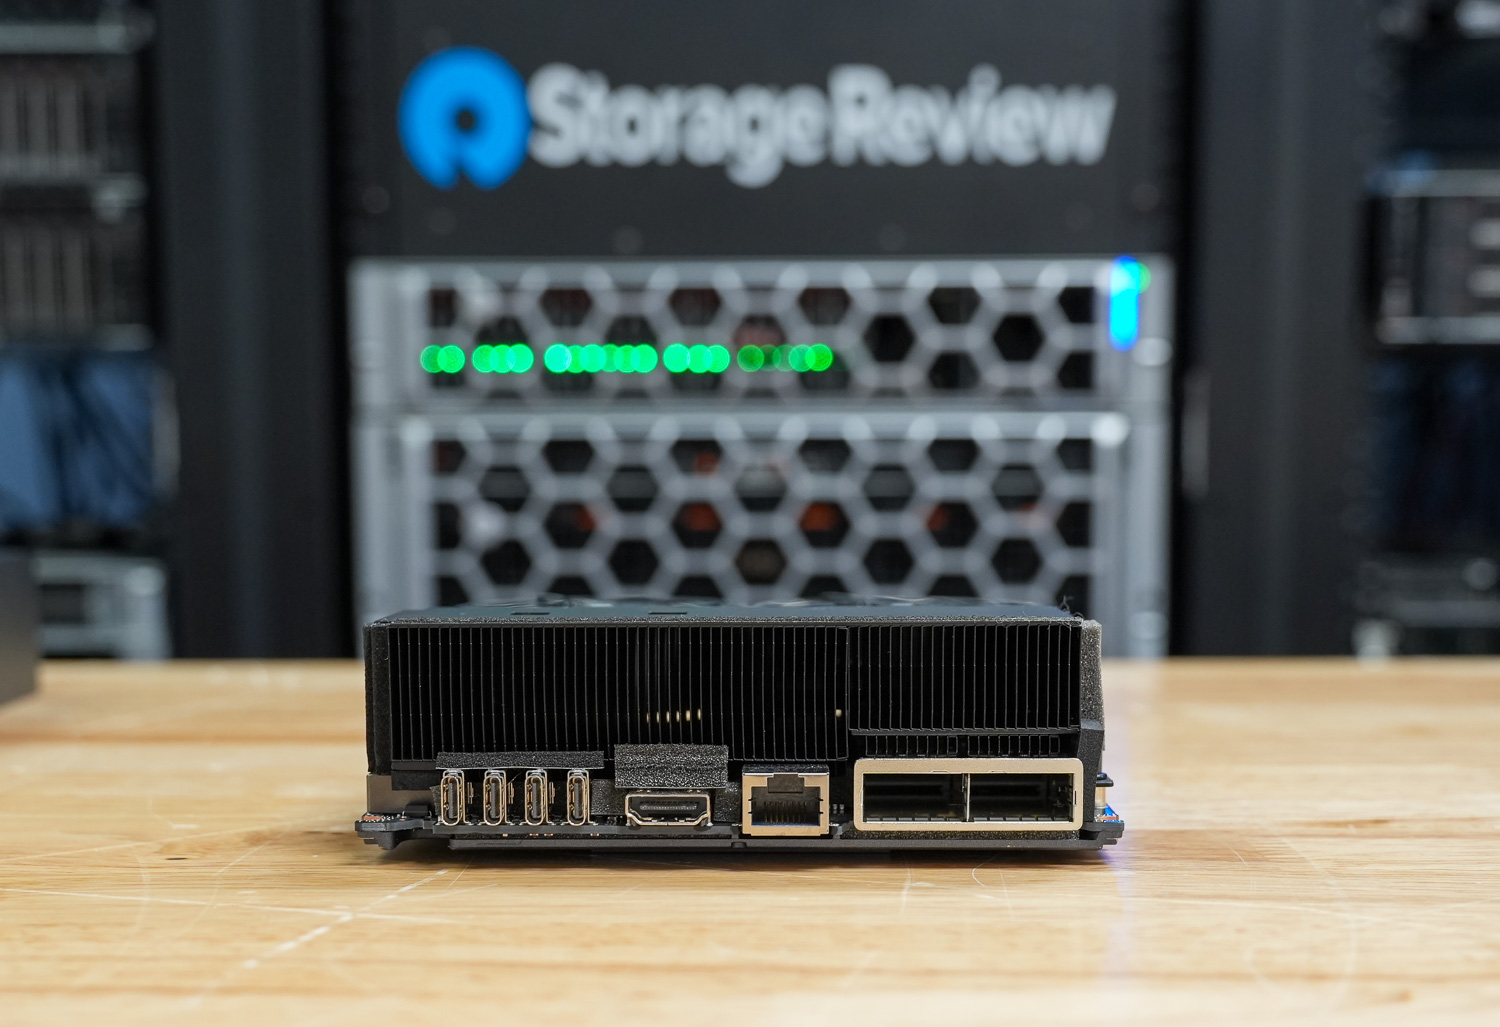
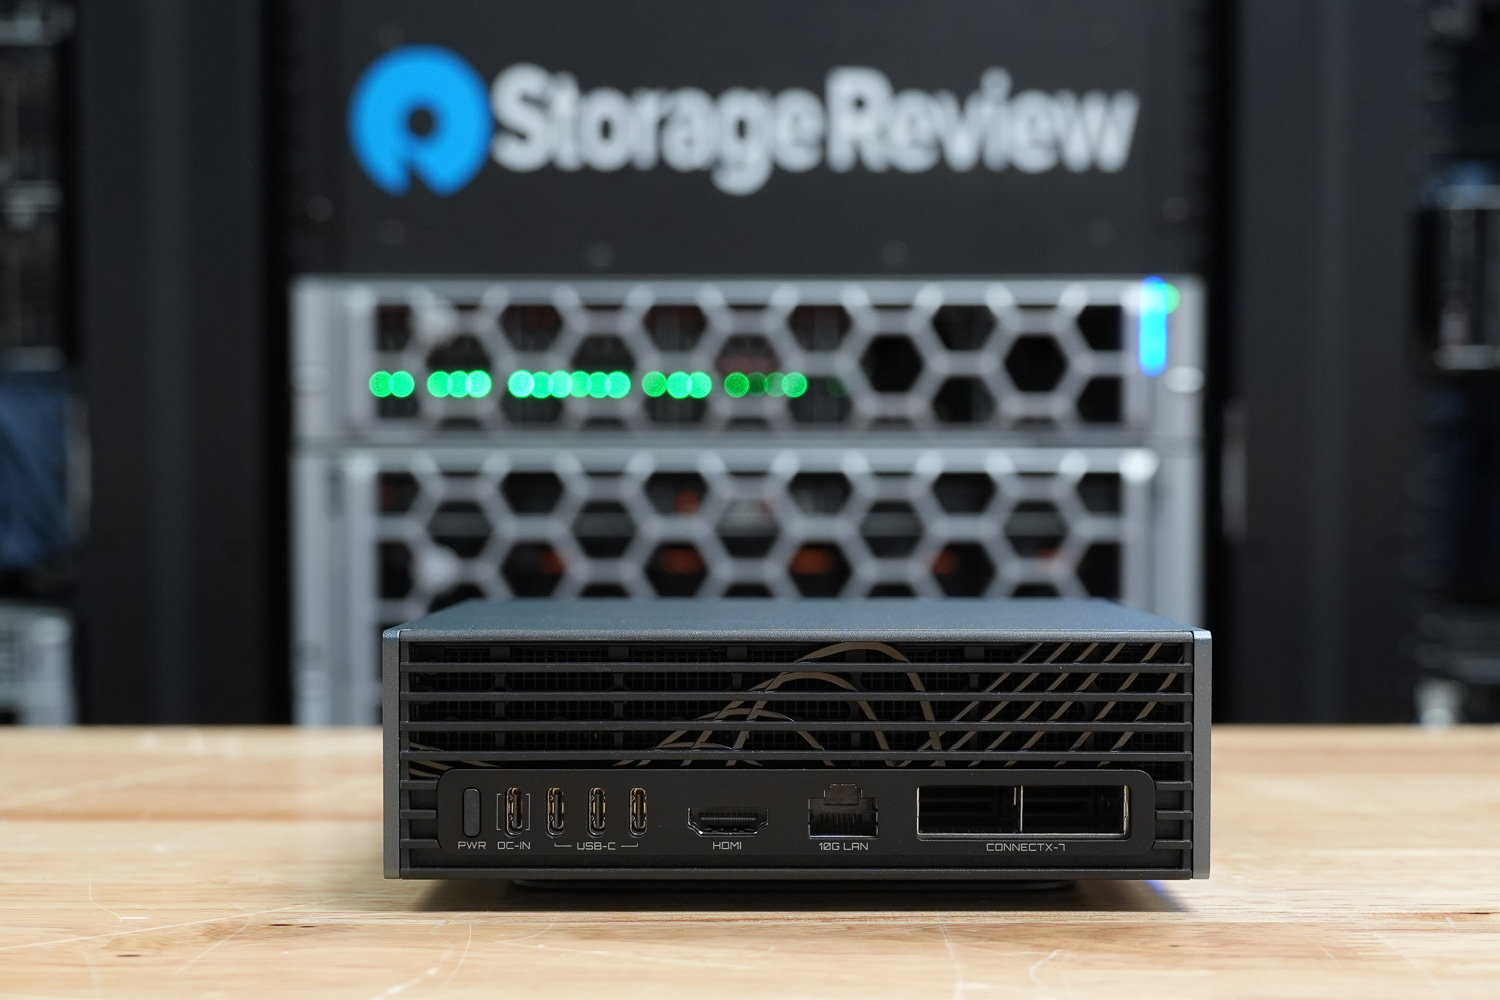
Wszystkie złącza znajdują się na tylnym panelu. Znajdują się tam trzy porty USB 3.2 Gen 2×2 typu C o przepustowości do 20 Gb/s oraz czwarty port USB typu C przeznaczony do zasilania. Do podłączenia monitora dostępny jest pojedynczy port HDMI 2.1a. Sieć oferuje port RJ-45 10 GbE oraz kartę sieciową NVIDIA ConnectX-7 SmartNIC, która obsługuje szybki transfer danych i umożliwia łączenie wielu systemów, co pozwala na rozbudowę konfiguracji. Na panelu bocznym GIGABYTE znajduje się gniazdo blokady Kensington Nano.
Wewnątrz AI TOP ATOM działa na układzie scalonym GB10 Grace Blackwell Superchip firmy NVIDIA, łączącym 20-rdzeniowy procesor ARM z zintegrowaną kartą graficzną Blackwell. System jest wspierany przez 128 GB zunifikowanej pamięci LPDDR5x z 256-bitowym interfejsem, zapewniając przepustowość do 273 GB/s. Podobnie jak w innych systemach GB10, procesor i karta graficzna korzystają z tej samej puli pamięci, co jest kluczowe dla sposobu, w jaki te maszyny są zaprojektowane do obsługi obciążeń związanych ze sztuczną inteligencją.
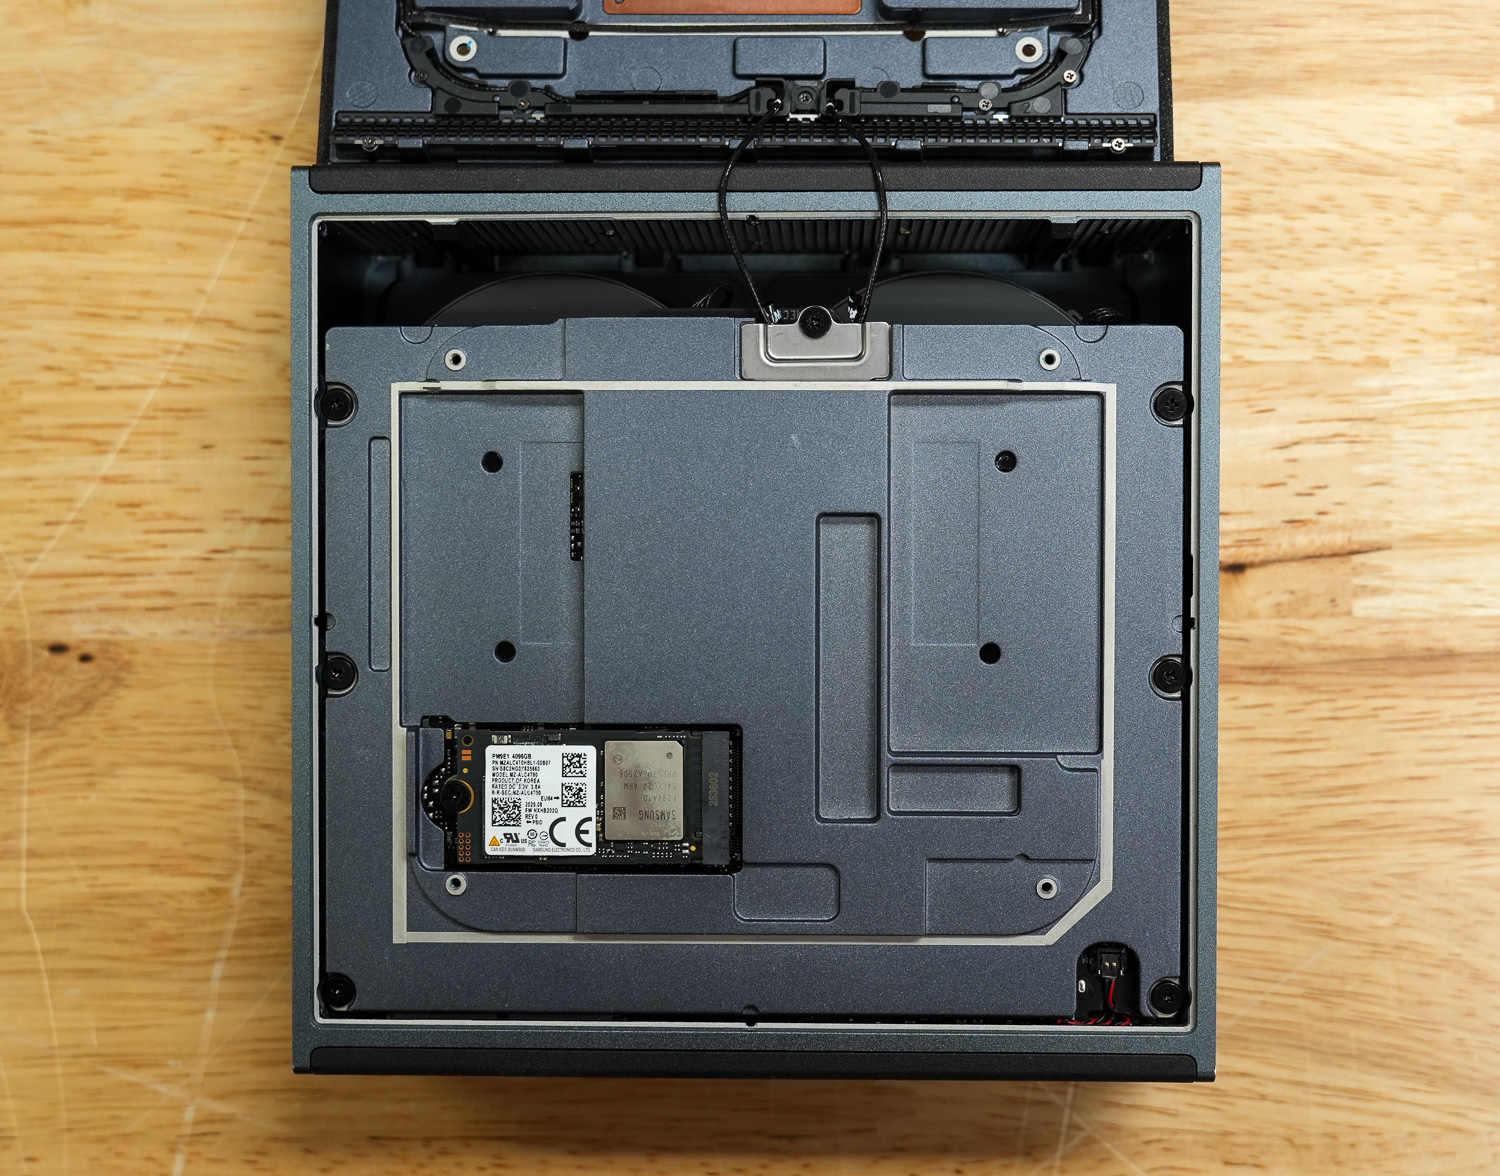
W zależności od konfiguracji, obsługa pamięci masowej obejmuje dysk SSD NVMe Gen5 o pojemności do 4 TB, a zasilanie odbywa się za pośrednictwem zewnętrznego zasilacza o mocy 240 W. Łączność bezprzewodowa obejmuje Wi-Fi 7 i Bluetooth 5.4, a także zintegrowaną sieć 10 GbE zapewniającą wydajność przewodową.
Testy termiczne GIGABYTE AI TOP ATOM
Aby przetestować parametry termiczne podzespołów GIGABYTE AI TOP ATOM, porównaliśmy je z podzespołami Founders Edition oraz producentami OEM, takimi jak Asus, Acer i Dell. Zagłębiliśmy się w ten temat w naszym artykule „Spark Thermal Testing”.
Monitorowaliśmy komponenty w całym stosie w określonym przedziale czasowym, z 3 etapami obciążenia, zwiększając wykorzystanie w ciągu około godziny. Pozwoliło nam to zobaczyć urządzenie w trakcie intensywnego użytkowania i na różnych etapach obciążenia. Monitorowaliśmy temperatury procesora, karty graficznej, sieci, dysków NVMe oraz całkowite zużycie energii.
Temperatura procesora
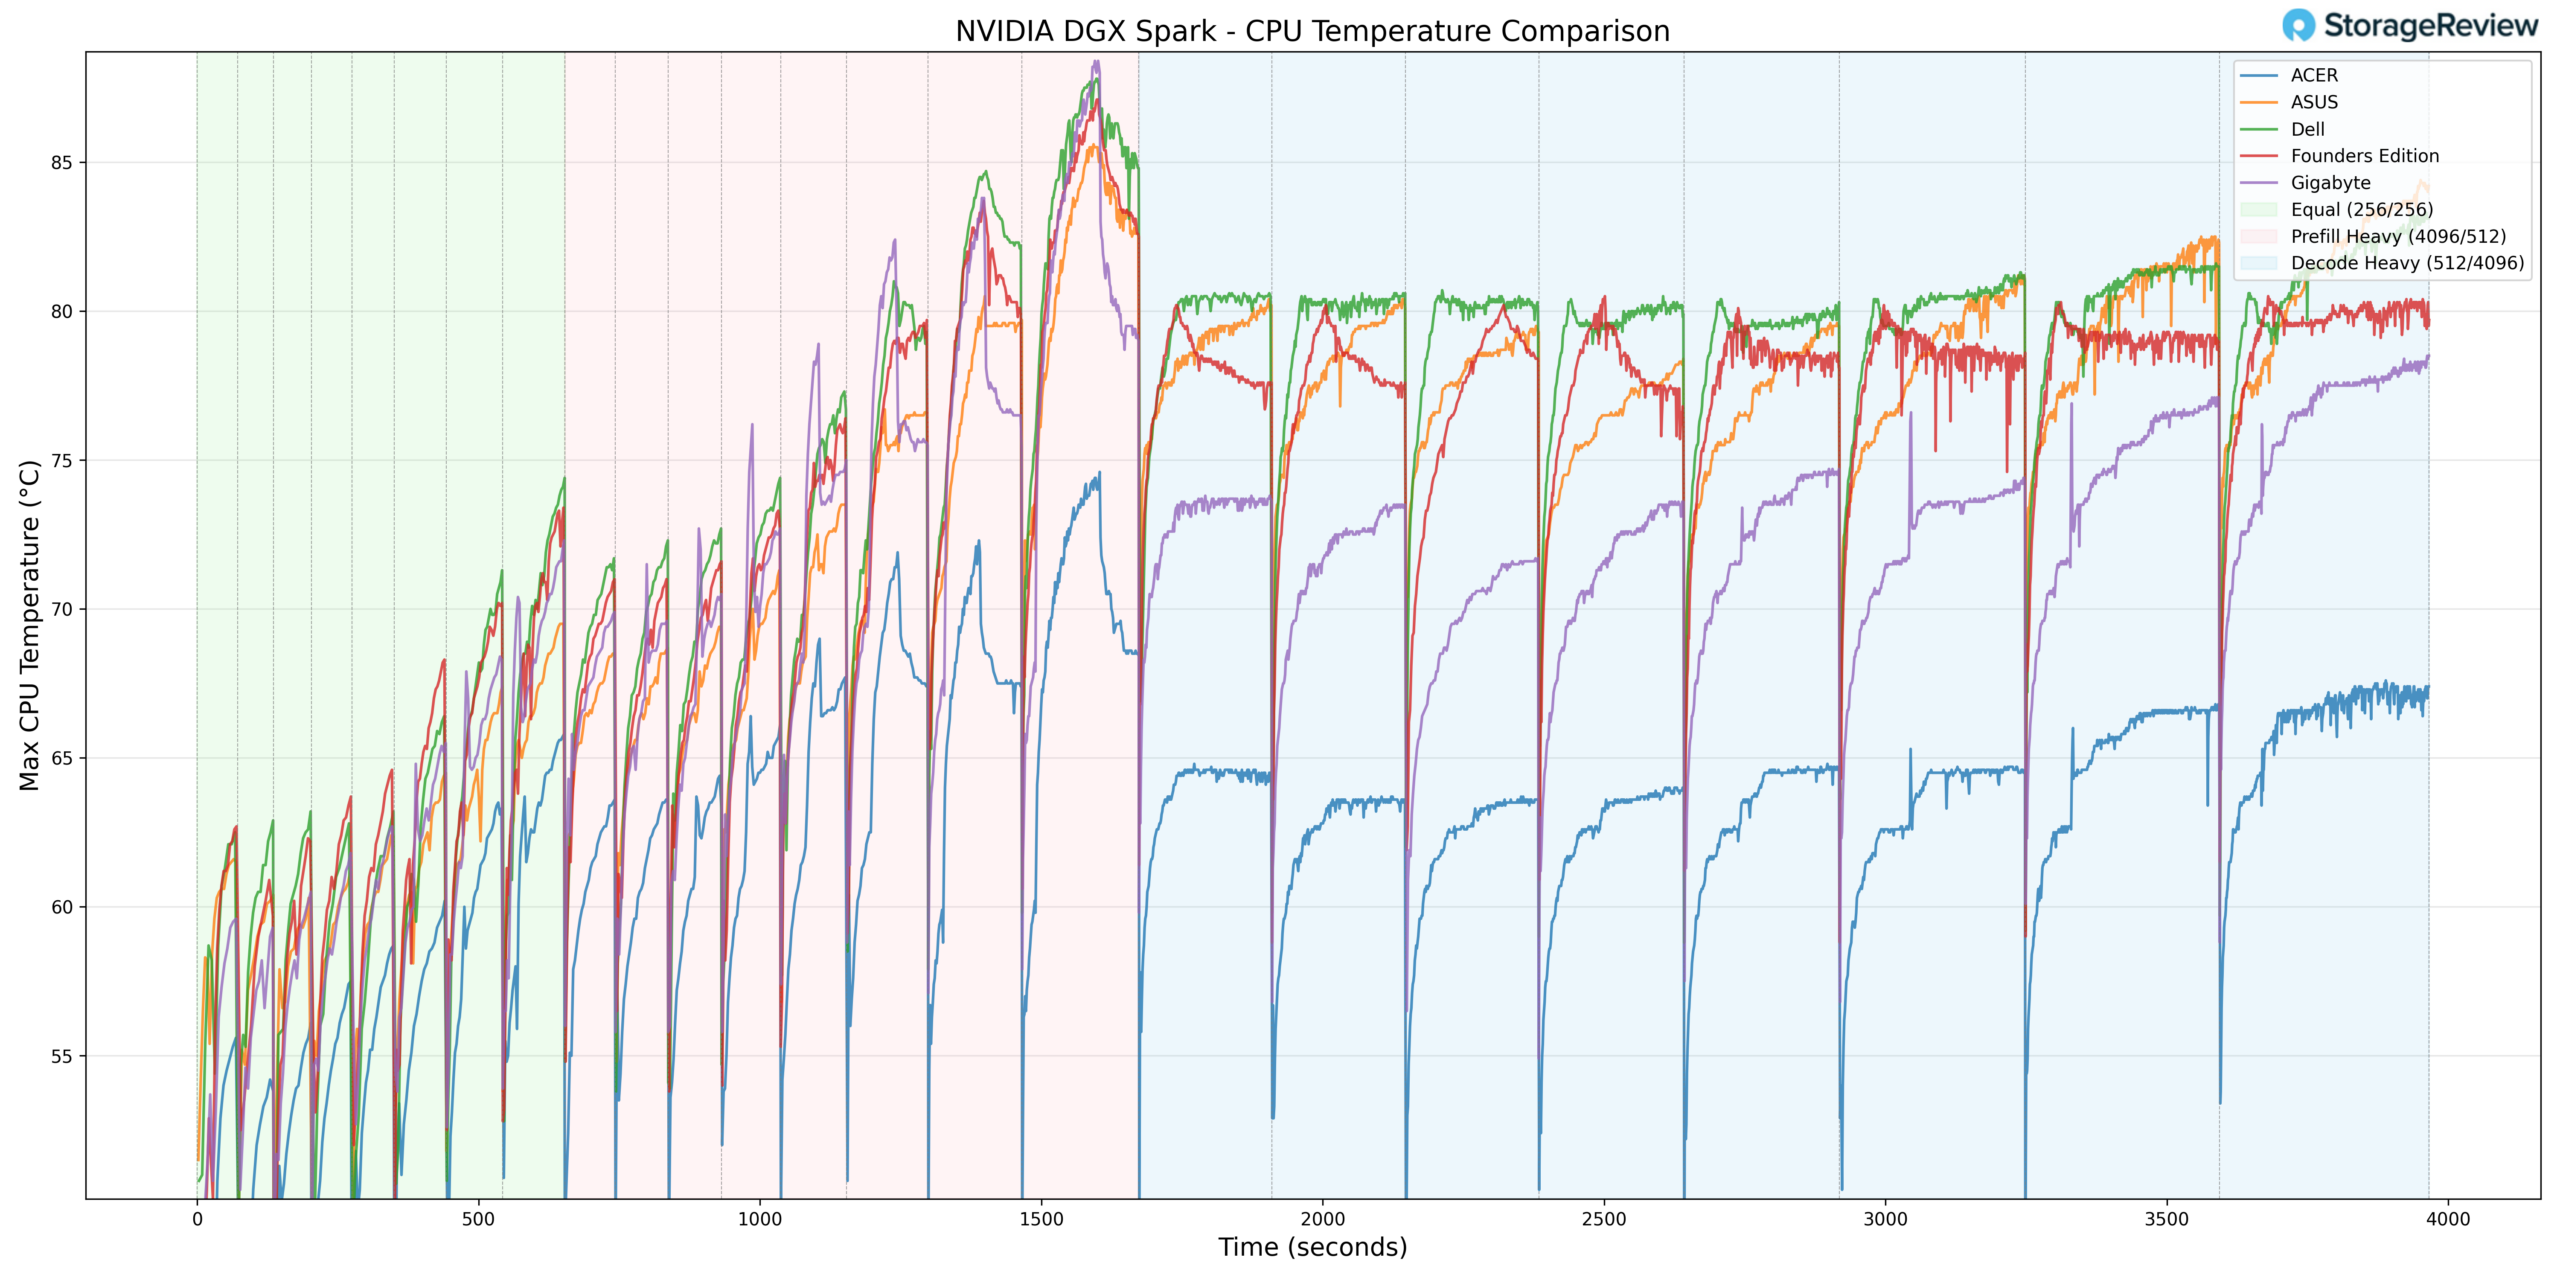
Podczas testów termicznych procesora, system GIGABYTE osiągnął szczytową temperaturę 90°C podczas intensywnych przejść Prefill. To plasuje go w górnej granicy obserwowanych szczytów obciążenia procesora w grupie porównawczej podczas agresywnego wzrostu obciążenia.
Po przejściu na tryb Equal ISL/OSL i ostatecznie na obciążenia Decode Heavy, krzywa temperatury ustabilizowała się, zamiast nadal rosnąć. Przy stałym obciążeniu procesor utrzymywał się w kontrolowanym paśmie temperaturowym, co dowodzi, że wyższy szczyt był związany z krótkotrwałą aktywnością narastającą, a nie z niewystarczającą wydajnością chłodzenia w dłuższej perspektywie.
W dolnym zakresie, procesor odnotował minimalną temperaturę 38.7°C w stanie spoczynku lub przy niewielkim obciążeniu. Ta niska wartość bazowa odzwierciedla efektywne odprowadzanie ciepła w stanie spoczynku i wskazuje, że rozwiązanie chłodzące zapewnia wystarczającą rezerwę mocy poza fazami gwałtownego wzrostu.
Ogólnie rzecz biorąc, GIGABYTE wykazywał wyższe temperatury procesora, ale utrzymywał stabilne zachowanie po normalizacji obciążenia.
Temperatura GPU
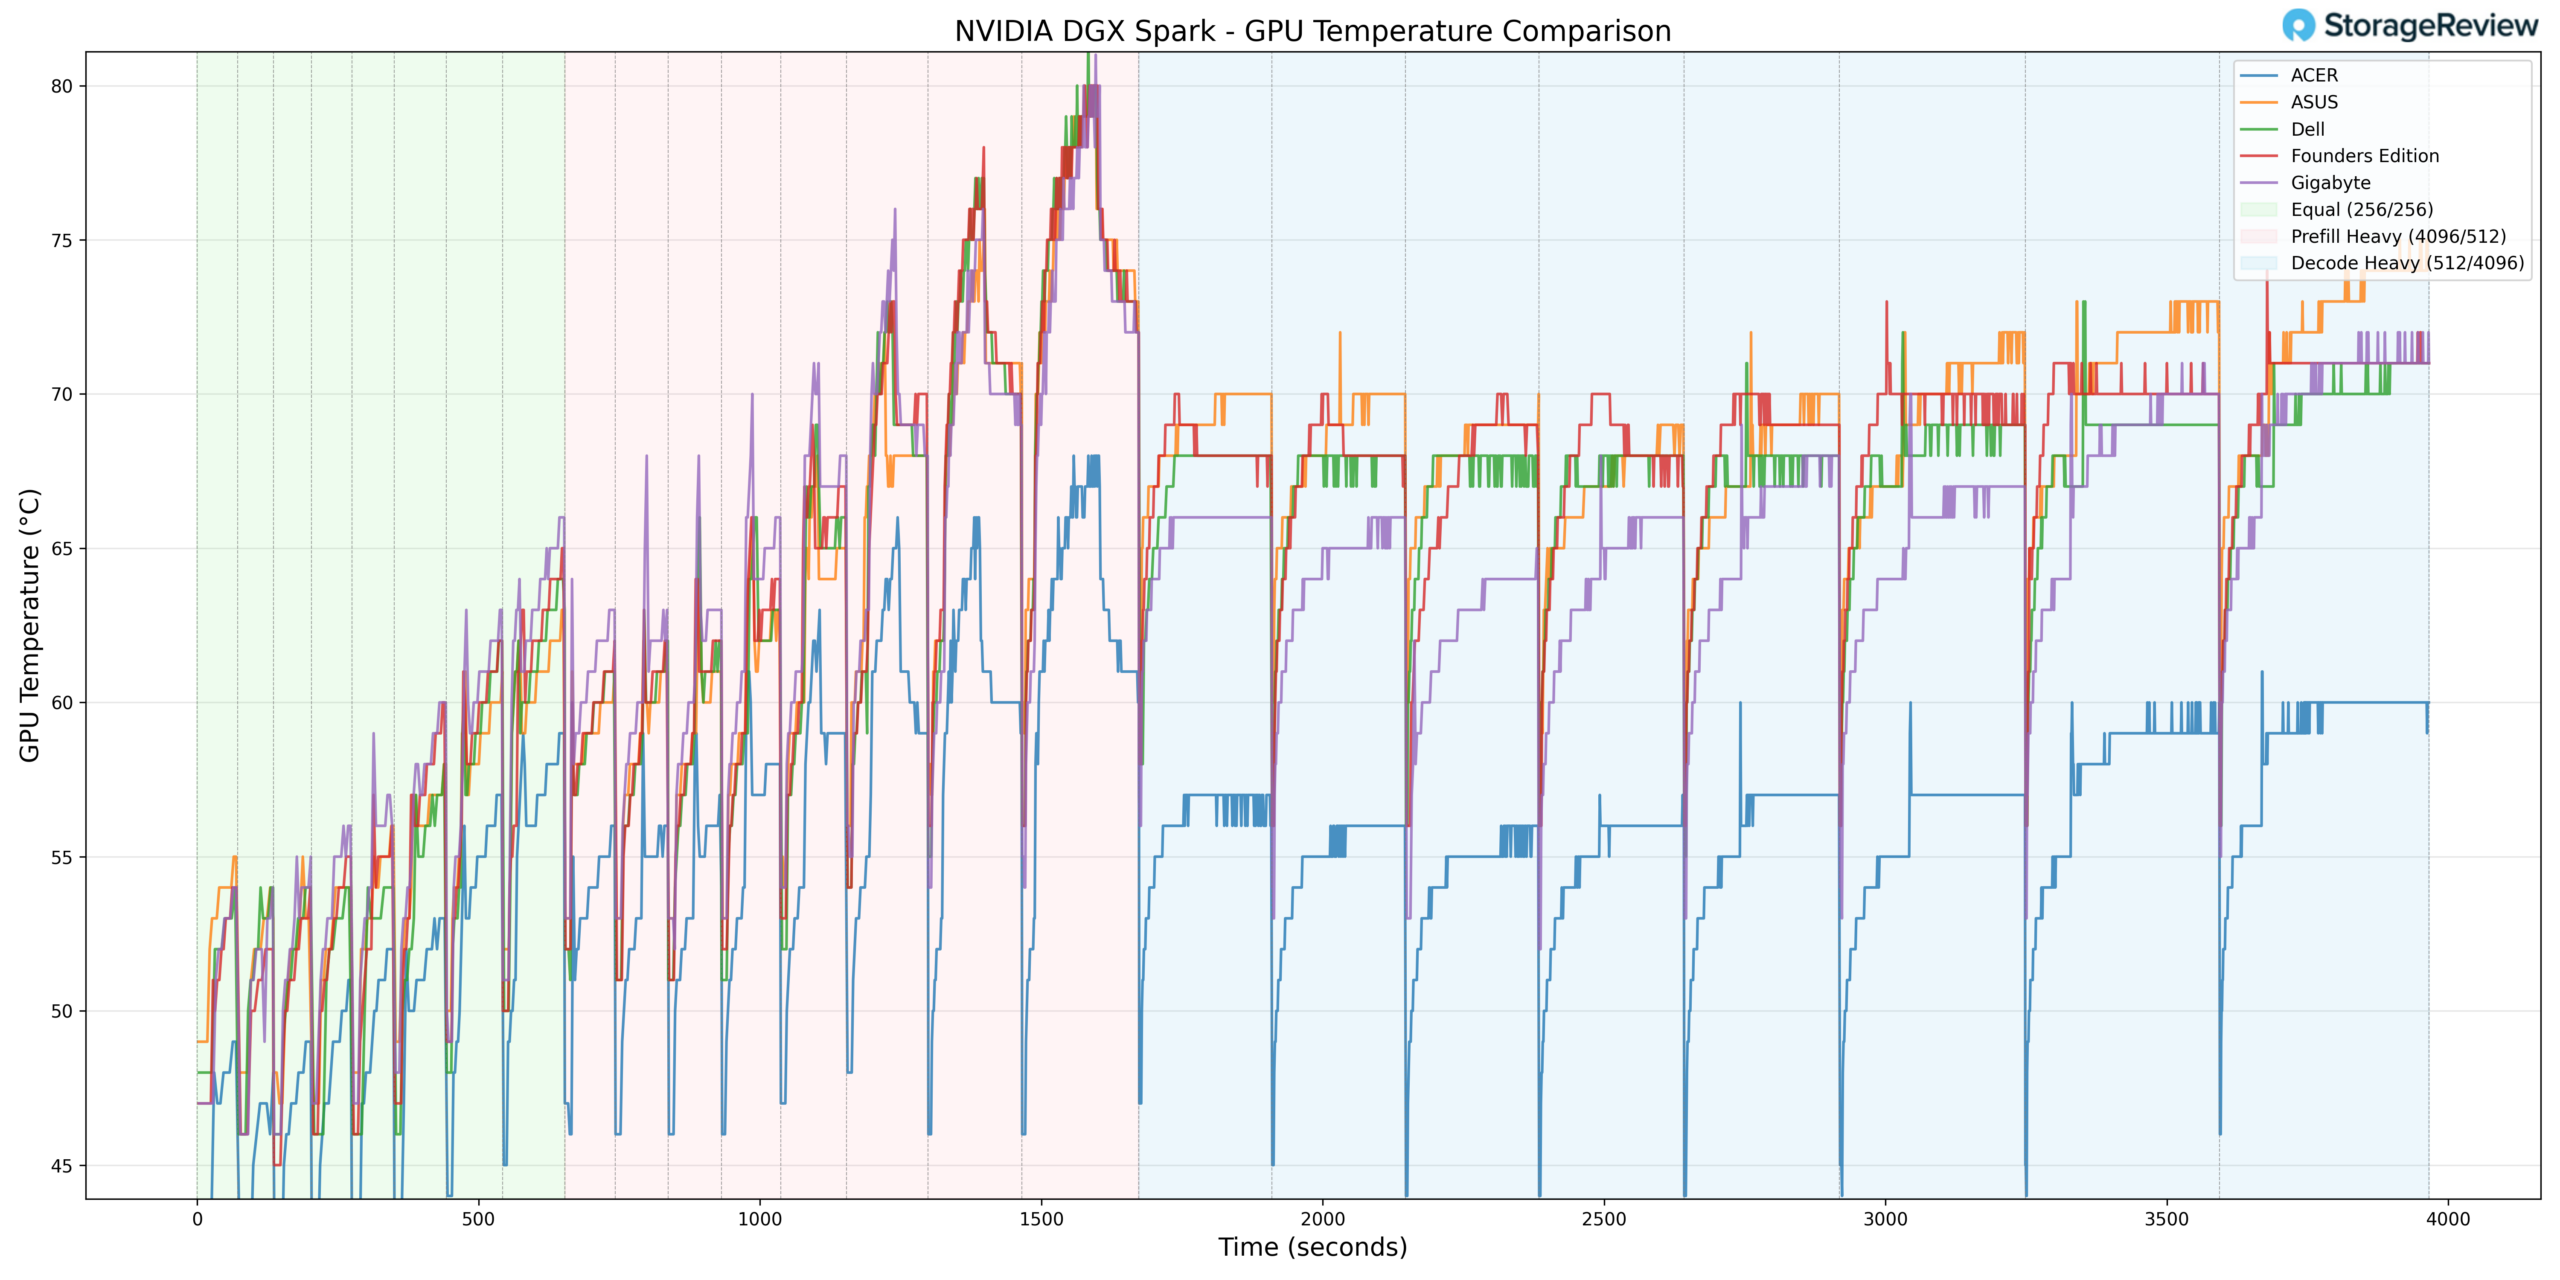
Podobny przebieg miała temperatura GPU. Podczas intensywnego działania Prefill, GPU osiągnął maksymalną temperaturę 81°C. To plasuje go w cieplejszej części grupy podczas intensywnego przyspieszania, ale nadal mieści się w oczekiwanych parametrach operacyjnych platformy GB10.
Gdy obciążenie przeszło w fazy Equal ISL/OSL i Decode Heavy, temperatura procesora graficznego ustabilizowała się, zamiast nadal rosnąć.
W stanie spoczynku lub przy niskim obciążeniu procesor graficzny odnotował temperaturę minimalną 37°C, co wskazuje na dobrą kontrolę temperatury w warunkach, gdy system nie jest obciążony obliczeniami.
Podsumowując, zachowanie procesora graficznego GIGABYTE odzwierciedla agresywne wykorzystanie mocy w połączeniu ze stabilną temperaturą.
Temperatura NVMe
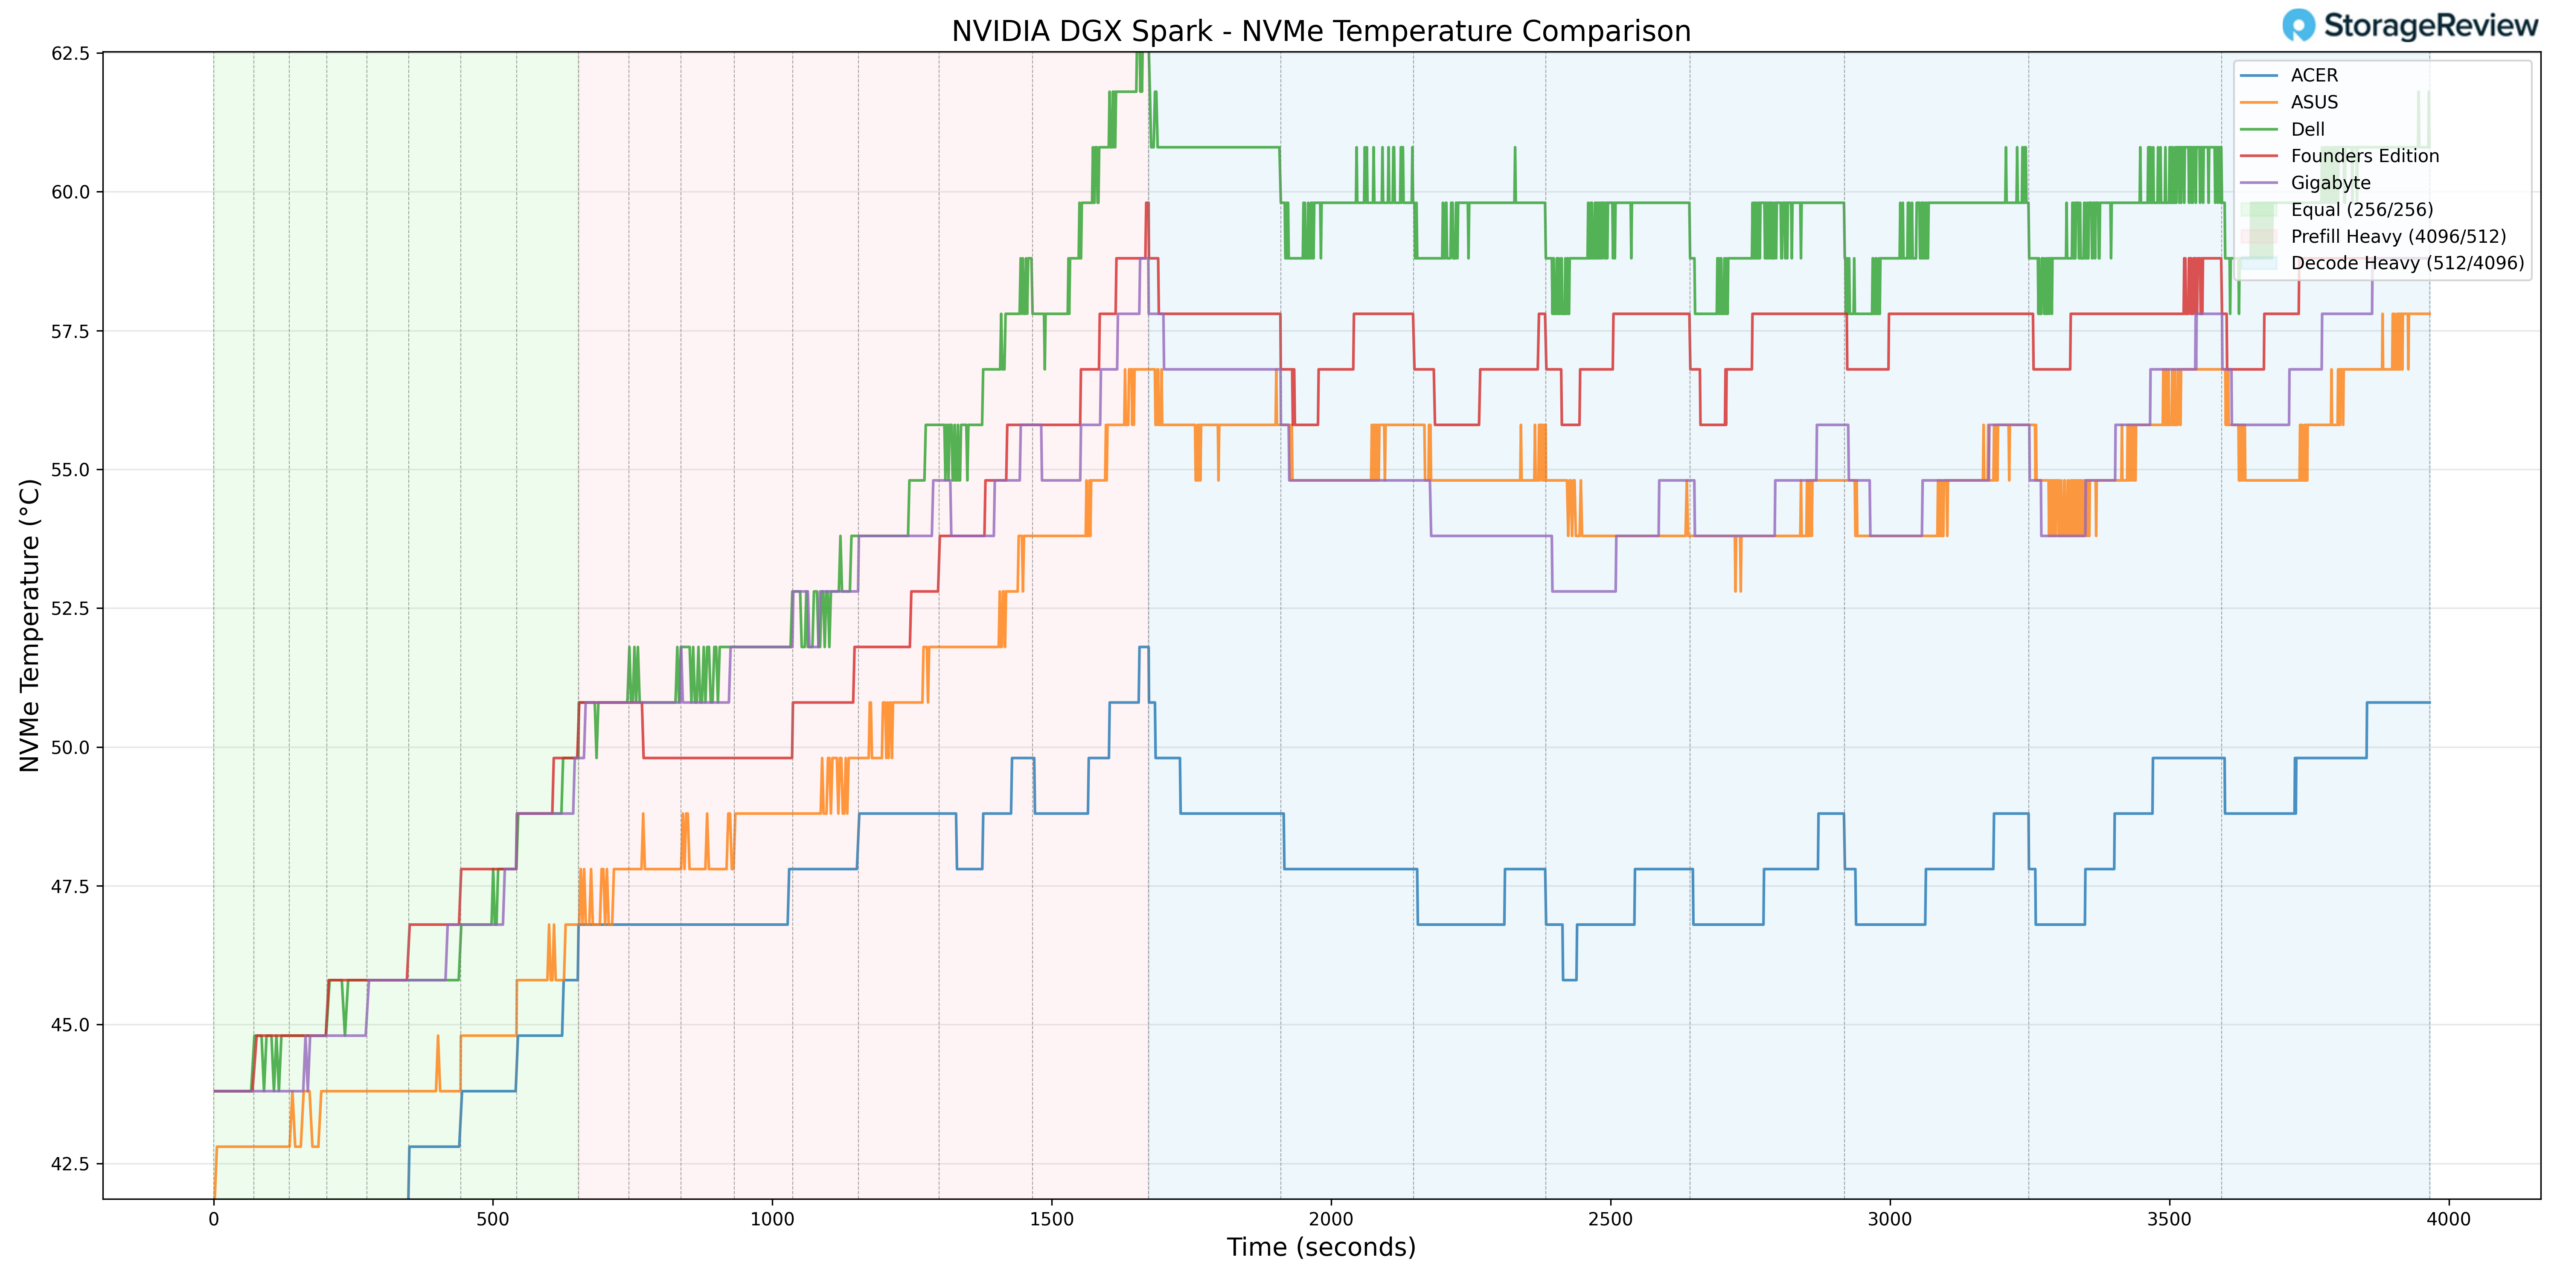
Temperatura pamięci masowej pozostawała pod dobrą kontrolą przez cały czas testów. Dysk NVMe odnotował maksymalną temperaturę 59.8°C podczas faz intensywnej pracy. Ten szczyt utrzymywał się znacznie poniżej typowych progów dławienia, co sugeruje odpowiedni przepływ powietrza lub korzystne rozmieszczenie napędu w obudowie.
W fazach mniejszego obciążenia temperatura dysku NVMe spadła do minimum 37.8°C, co potwierdza, że parametry termiczne pamięci masowej w stanie spoczynku nie są ograniczone.
W porównaniu do niektórych kompaktowych rozwiązań zorientowanych na komputery stacjonarne, utrzymanie temperatury poniżej 60°C pod obciążeniem świadczy o dobrym zarządzaniu temperaturą pamięci masowej.
Temperatura karty sieciowej
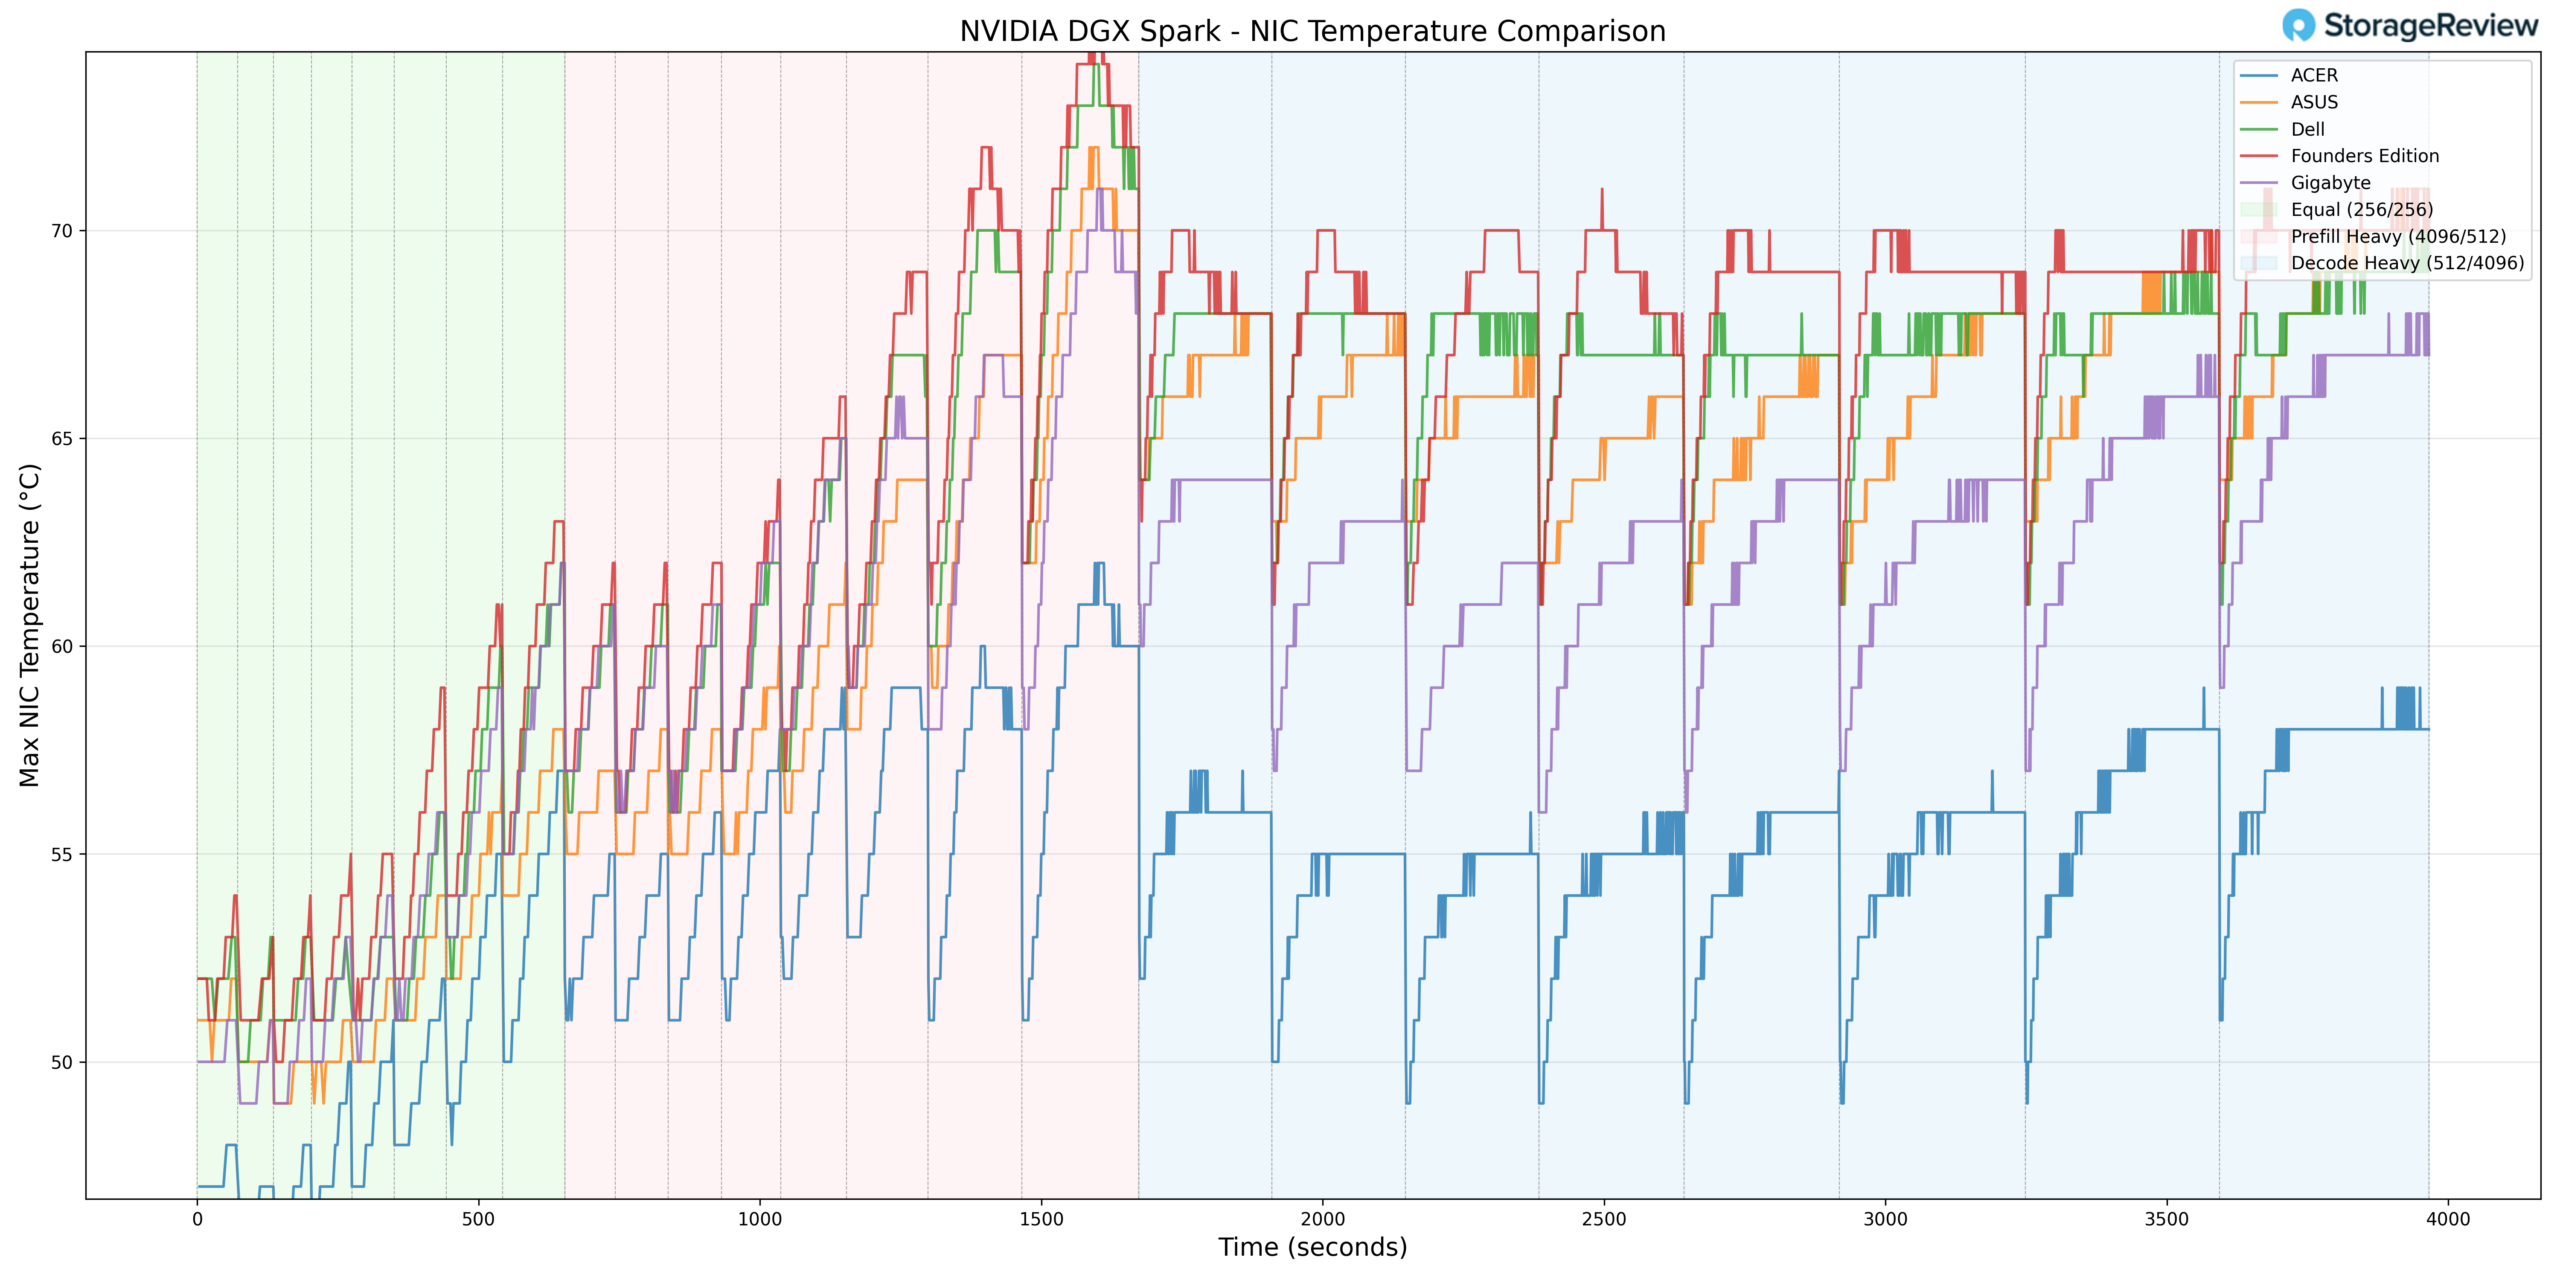
Temperatura karty sieciowej osiągnęła szczyt 72°C podczas faz większego obciążenia, co odpowiadało podwyższonej przepustowości podczas przejść Prefill i Decode. Chociaż umieszczało to kontroler sieciowy w cieplejszej połowie stosu podczas szczytowej aktywności, temperatura mieściła się w granicach tolerancji operacyjnej i nie wykazywała skoków.
Minimalna zarejestrowana temperatura NIC wyniosła 41°C, co odzwierciedla normalne zachowanie się temperatury bazowej w lżejszych fazach.
Ogólnie rzecz biorąc, karta sieciowa przewidywalnie dostosowywała się do ogólnego obciążenia systemu i nie wykazywała nienormalnej skalowalności.
Pobór mocy GPU
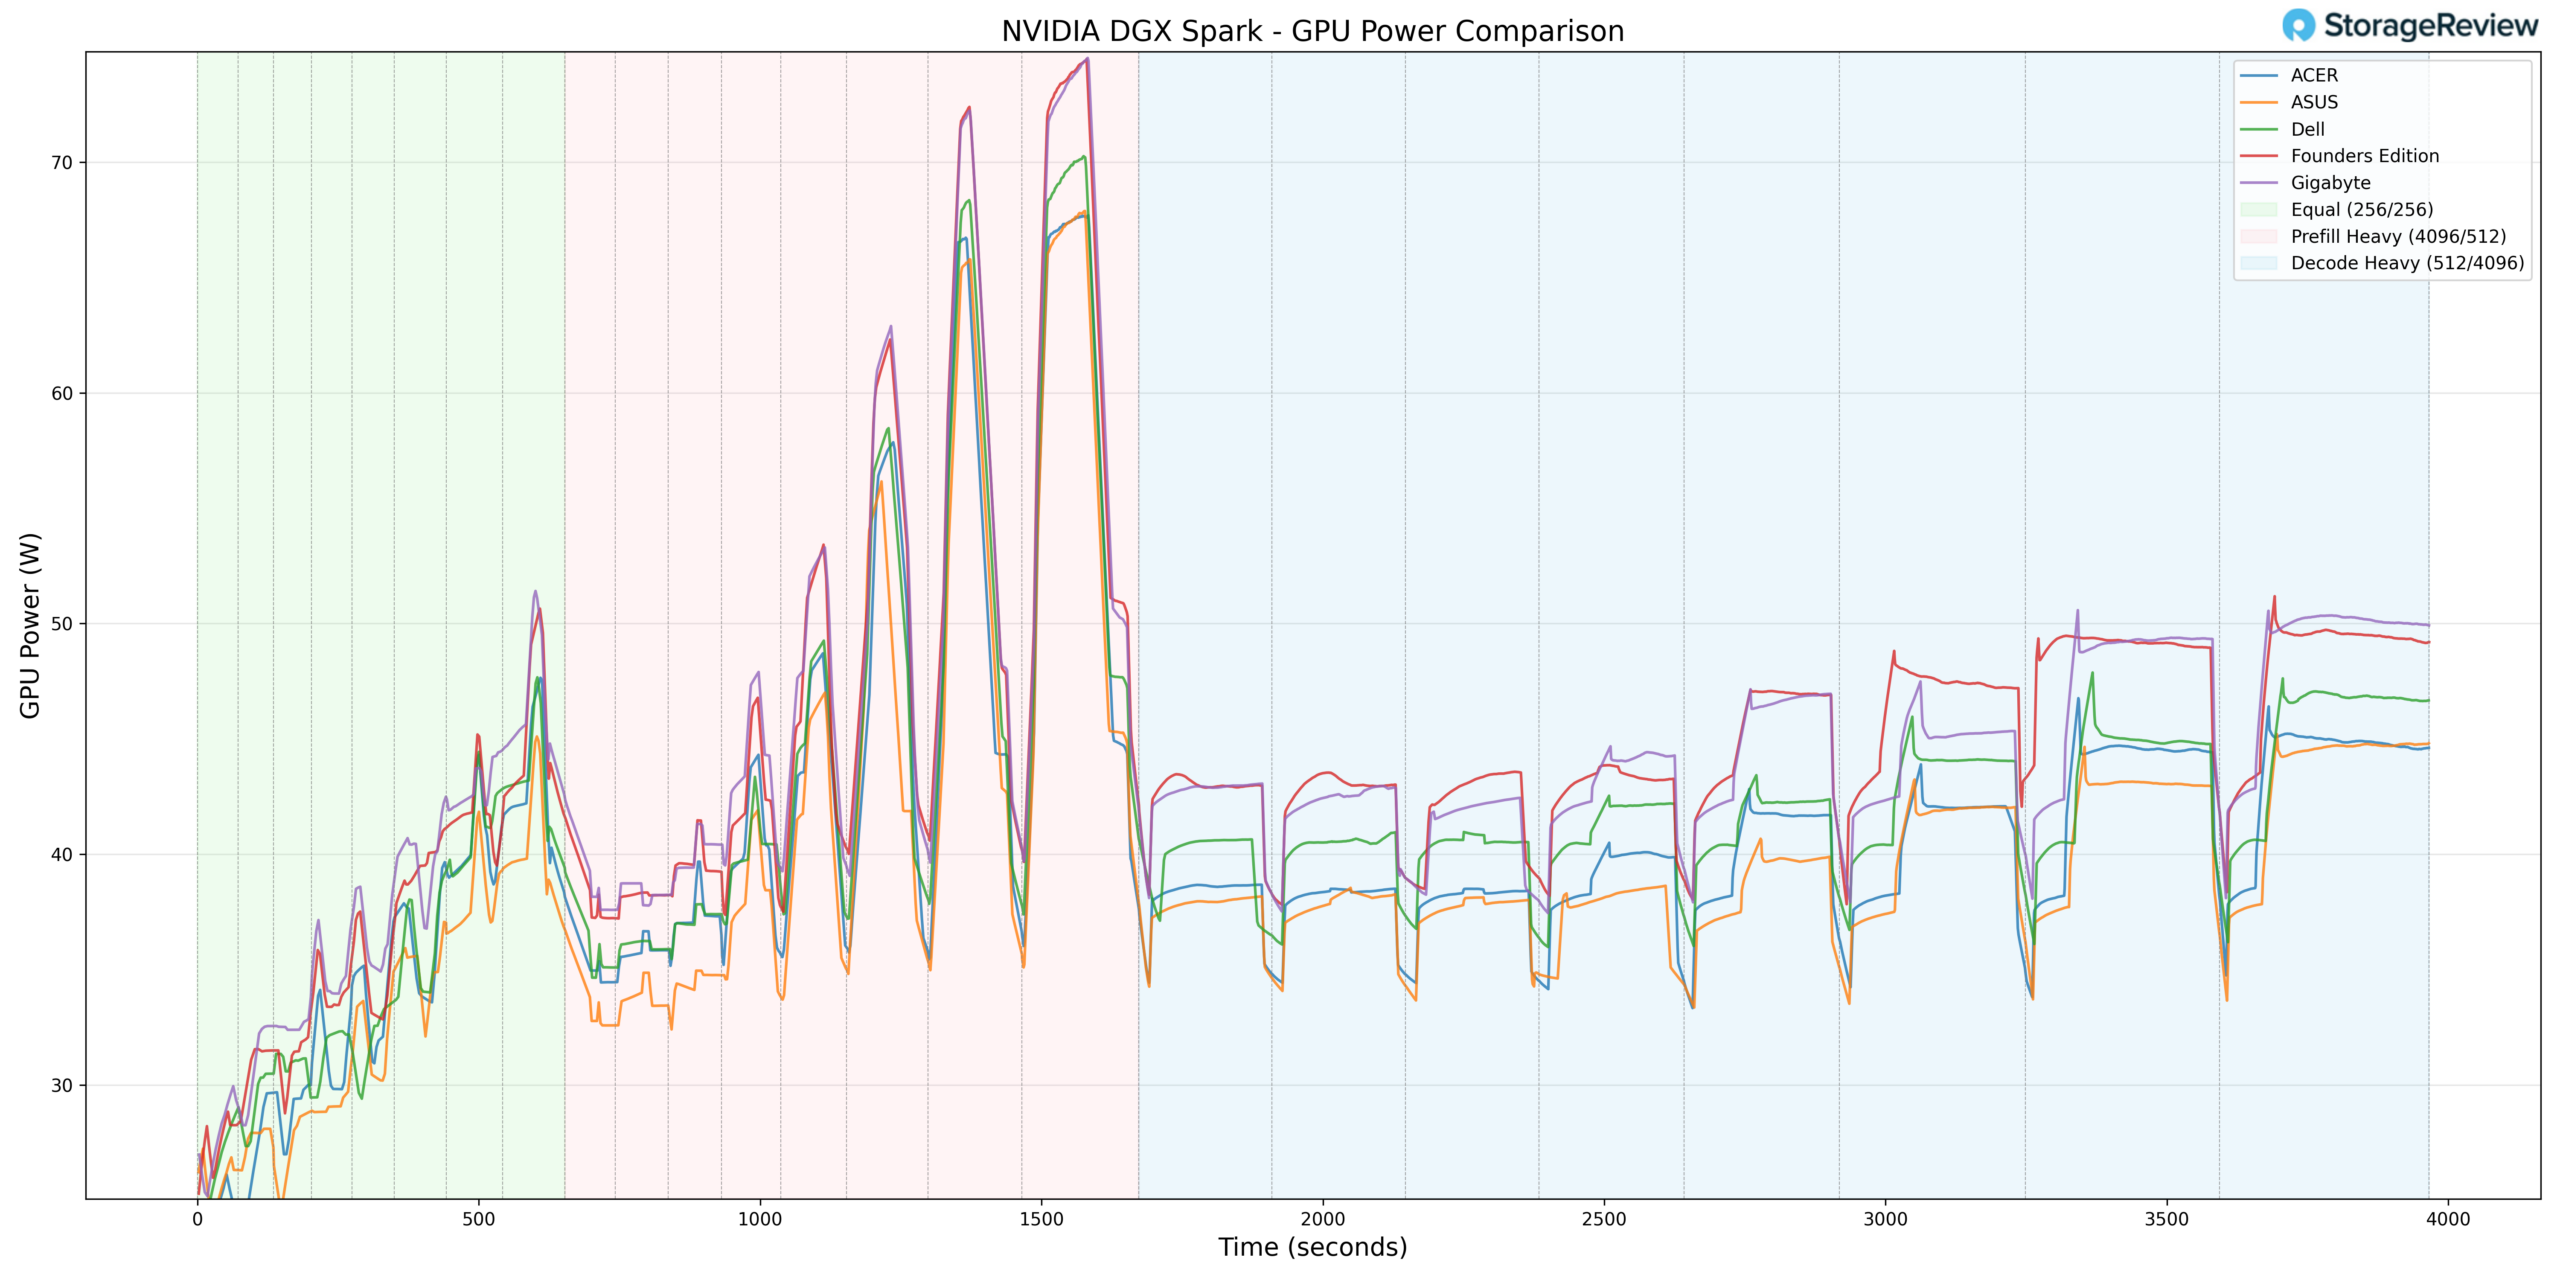
Zachowanie poboru mocy przez GPU pomaga w odpowiednim kontekście podwyższonych temperatur szczytowych. GIGABYTE osiągnął szczytowy pobór mocy GPU na poziomie 75.54 W podczas przejść z trybem Prefill High. To plasuje go w górnej granicy obserwowanych wartości poboru mocy wśród testowanych jednostek GB10.
Zamiast sztucznie ograniczać moc GPU, GIGABYTE wydaje się dopuszczać okresy szczytowego obciążenia, które korelują bezpośrednio z wyższymi temperaturami szczytowymi GPU. Wraz z przejściem obciążeń w fazy dekodowania, pobór mocy odpowiednio się stabilizował.
Z punktu widzenia poboru mocy, system GIGABYTE nie wydaje się nadmiernie przeciążony. Przeciwnie, jego wyższe szczytowe temperatury w fazach burstu wynikają z decyzji o alokacji mocy nastawionych na wydajność, a nie z niekontrolowanej konstrukcji termicznej.
Podsumowanie termiczne
Monitorując procesor, kartę graficzną, dysk NVMe i kartę sieciową, dysk GIGABYTE GB10 pracował z konkurencyjnymi parametrami termicznymi w stanie spoczynku i wyższymi szczytowymi wartościami napięcia podczas intensywnych przejść z funkcją Prefill. Temperatura procesora CPU osiągnęła 90°C, a karty graficznej 81°C podczas szczytowego przyspieszenia, podczas gdy temperatura NVMe utrzymywała się poniżej 60°C, a karty sieciowej 72°C. Pobór mocy przez kartę graficzną osiągnął szczyt 75.54 W, co wskazuje na szczytowe wartości szczytowe.
Przy stałym obciążeniu Decode temperatura ustabilizowała się bez dalszego wzrostu, co wskazuje, że GIGABYTE, choć dopuszcza agresywną wydajność w krótkim czasie, utrzymuje przewidywalne, kontrolowane parametry termiczne podczas dłuższej pracy.
Testy wydajności GIGABYTE AI TOP ATOM
Aby ocenić GIGABYTE AI TOP ATOM, przetestowaliśmy jednostki Spark za pomocą testu porównawczego vLLM Online Serving, najpopularniejszego silnika wnioskowania i obsługi o wysokiej przepustowości dla dużych modeli językowych. Test porównawczy vLLM Online Serving symuluje rzeczywiste obciążenia produkcyjne poprzez wysyłanie współbieżnych żądań do działającego serwera vLLM, mierząc kluczowe wskaźniki, takie jak całkowita przepustowość tokenów (liczba tokenów na sekundę), czas do pierwszego tokena i czas na token wyjściowy, w zmiennych warunkach obciążenia.
Nasze testy obejmowały szereg modeli, od gęstych architektur po mikroskalowe typy danych. Ocenialiśmy wydajność w trzech scenariuszach obciążenia: Equal ISL/OSL, Prefill Heavy i Decode Heavy. Scenariusze te odzwierciedlają różne wzorce obsługi w świecie rzeczywistym, od zrównoważonych obciążeń wejścia i wyjścia, przez intensywne obliczeniowo przetwarzanie natychmiastowe, po generowanie tokenów z ograniczoną przepustowością pamięci.
Oprócz GIGABYTE AI TOP ATOM, przeprowadziliśmy testy wydajności NVIDIA Founders Edition Spark jako punktu odniesienia, obok systemów OEM firm Asus, Acer i Dell. Pozwoliło nam to umiejscowić wyniki GIGABYTE w szerszym kontekście konkurencji i zrozumieć, gdzie przoduje, dotrzymuje kroku, a gdzie pozostaje w tyle w porównaniu z różnymi modelami i typami obciążeń.
GPT-OSS-120B
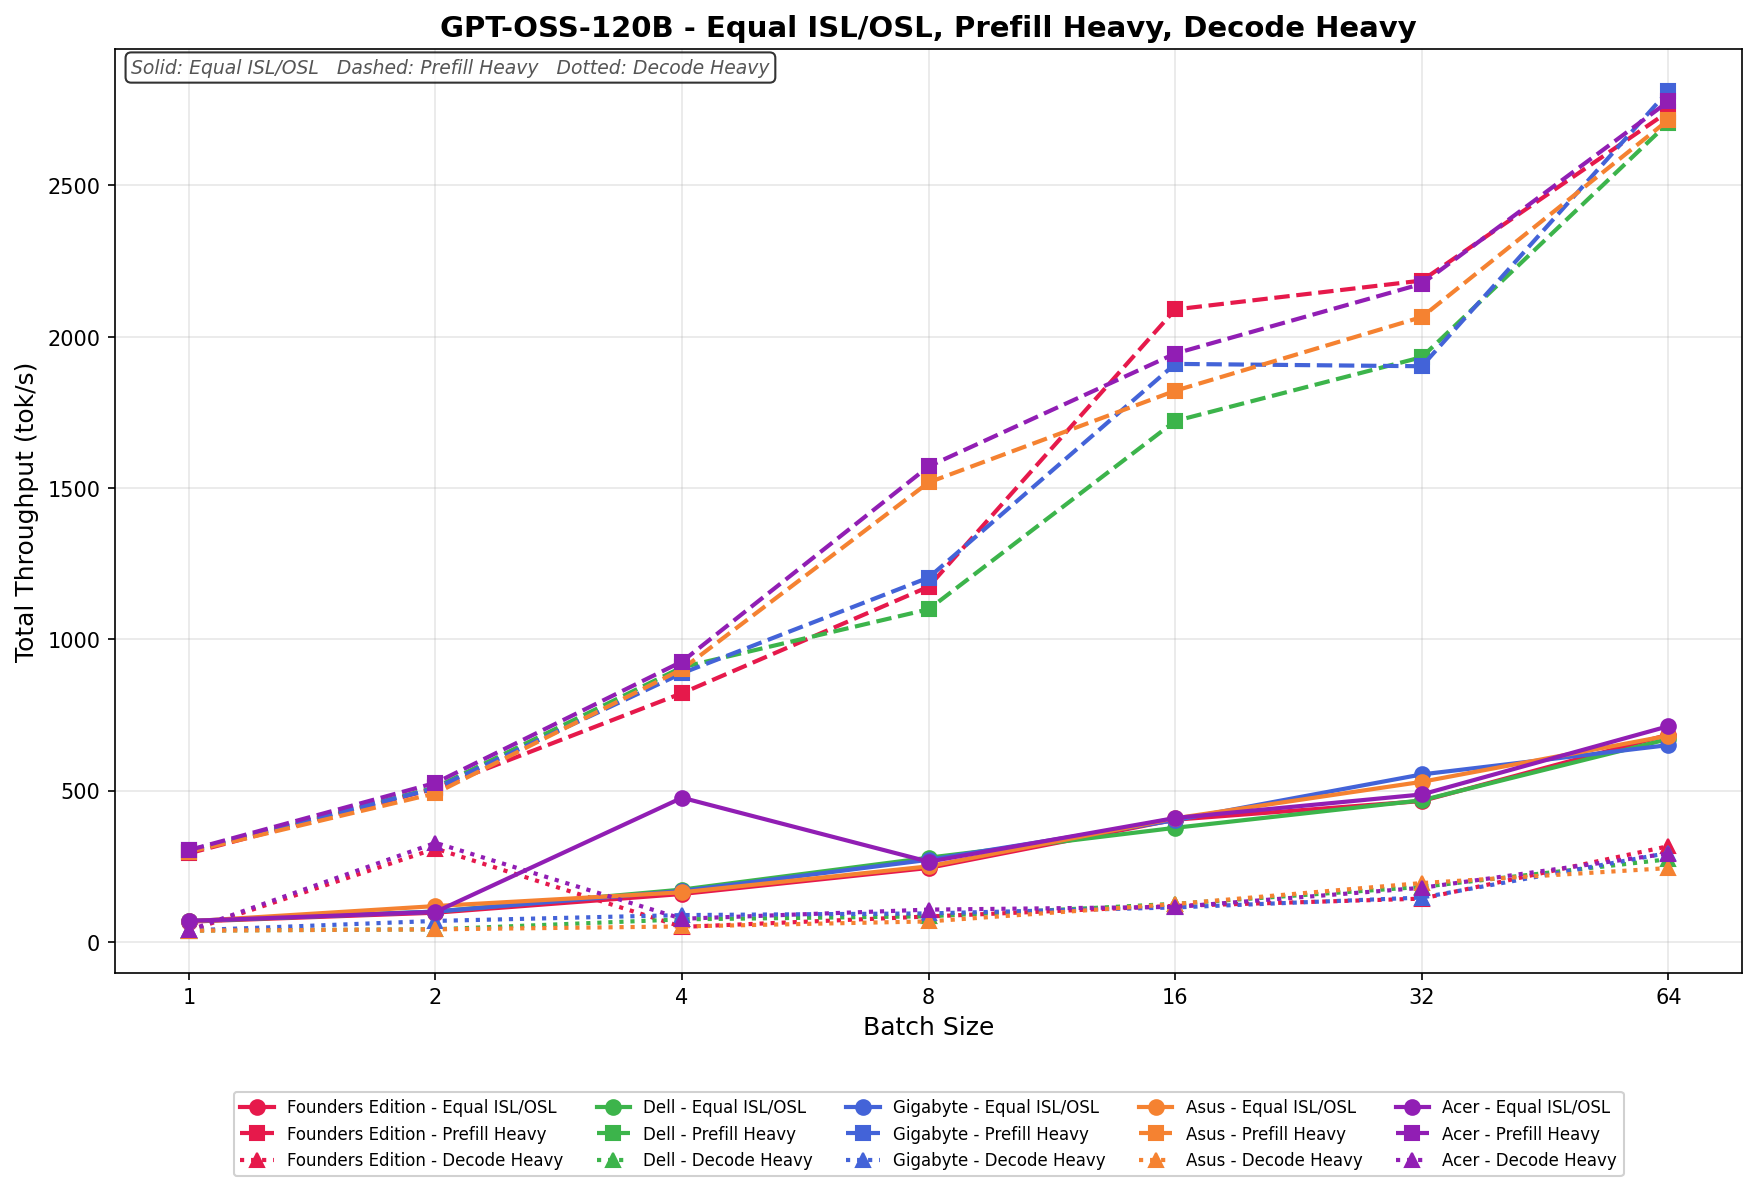
W teście Equal ISL/OSL, GIGABYTE skaluje się od 60.71 do 649.62 tok/s, plasując się konsekwentnie w środku stawki i ściśle dorównując wynikom Dell i Asus przy większych partiach. Skalowanie jest stabilne i liniowe w partii 32, z ciągłym wzrostem w partii 64, choć nie dorównuje w pełni najlepszym procesorom w górnym zakresie.
Prefill Heavy rozpoczyna się od 304.63 tok/s i rośnie do 2,771.38 tok/s przy wielkości partii 64. Wzrost jest silny do partii 16, gdzie GIGABYTE na krótko zajmuje trzecie miejsce od góry, zanim zrówna się z szerszą grupą przy większych wielkościach partii. Ogólnie skalowanie jest agresywne i konkurencyjne, szczególnie w przypadku partii o średniej wielkości.
Decode Heavy ma zakres od 47.01 do 299.41 tok/s, ze stopniowym i spójnym skalowaniem w całym cyklu przetwarzania wsadowego.
GPT-OSS-20B
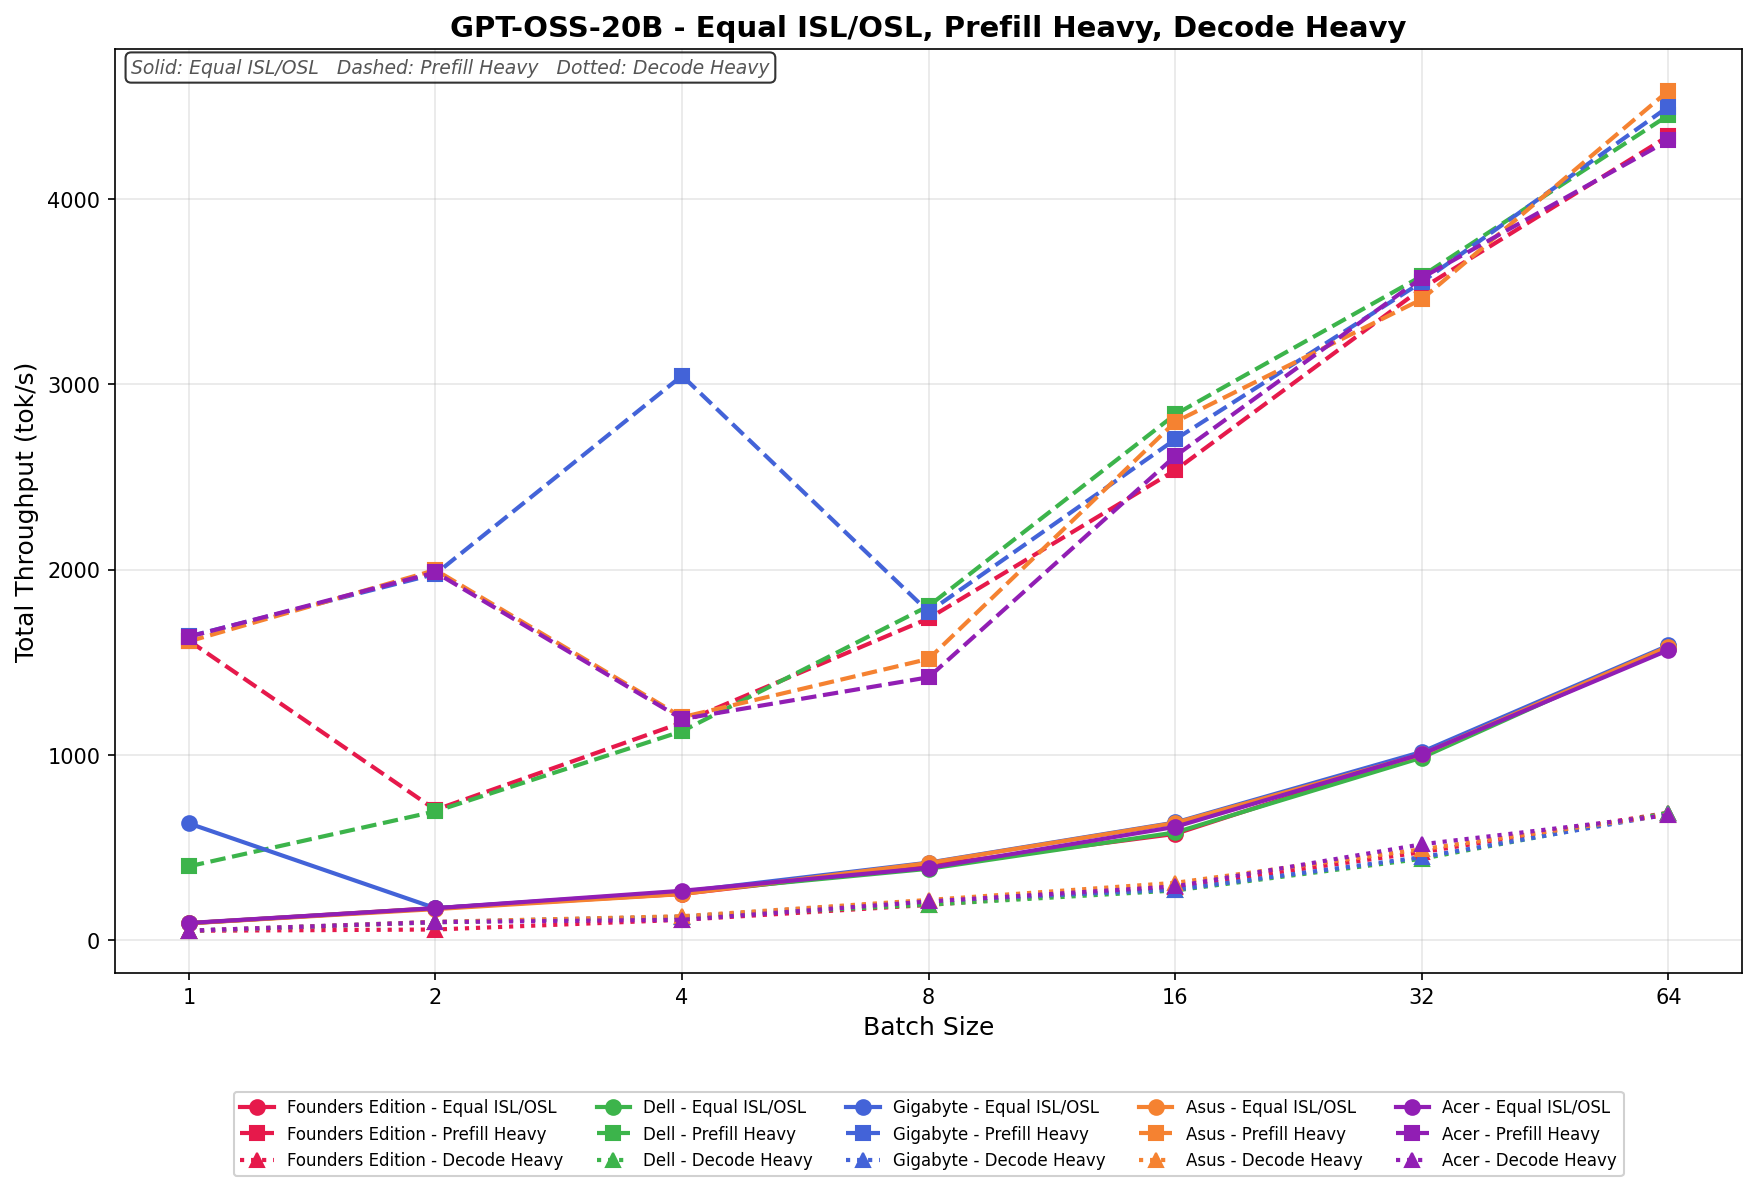
W Equal ISL/OSL, GIGABYTE skaluje się od 641.73 do 1,587.62 tok/s, zaczynając mocno od partii 1, po czym spadając w partii 2, a następnie stopniowo zwiększając się wraz z kolejnymi partiami. Od partii 8 skalowanie normalizuje się i ściśle dorównuje reszcie stawki, kończąc w pobliżu szczytu w partii 64.
Prefill Heavy rozpoczyna się od 1,650.32 tok/s i osiąga szczyt na poziomie 4,401.27 tok/s przy rozmiarze partii 64. Od partii 16 skalowanie jest spójne i konkurencyjne, dotrzymując kroku firmom Dell i Asus w przypadku większych rozmiarów partii.
Przepustowość Decode Heavy waha się od 63.18 do 688.44 tok/s, z czystym, liniowym skalowaniem w całym zakresie. Zyski są przyrostowe, ale spójne, ściśle dopasowane do innych platform i odzwierciedlają bardziej ograniczone skalowanie typowe dla obciążeń intensywnie dekodujących.
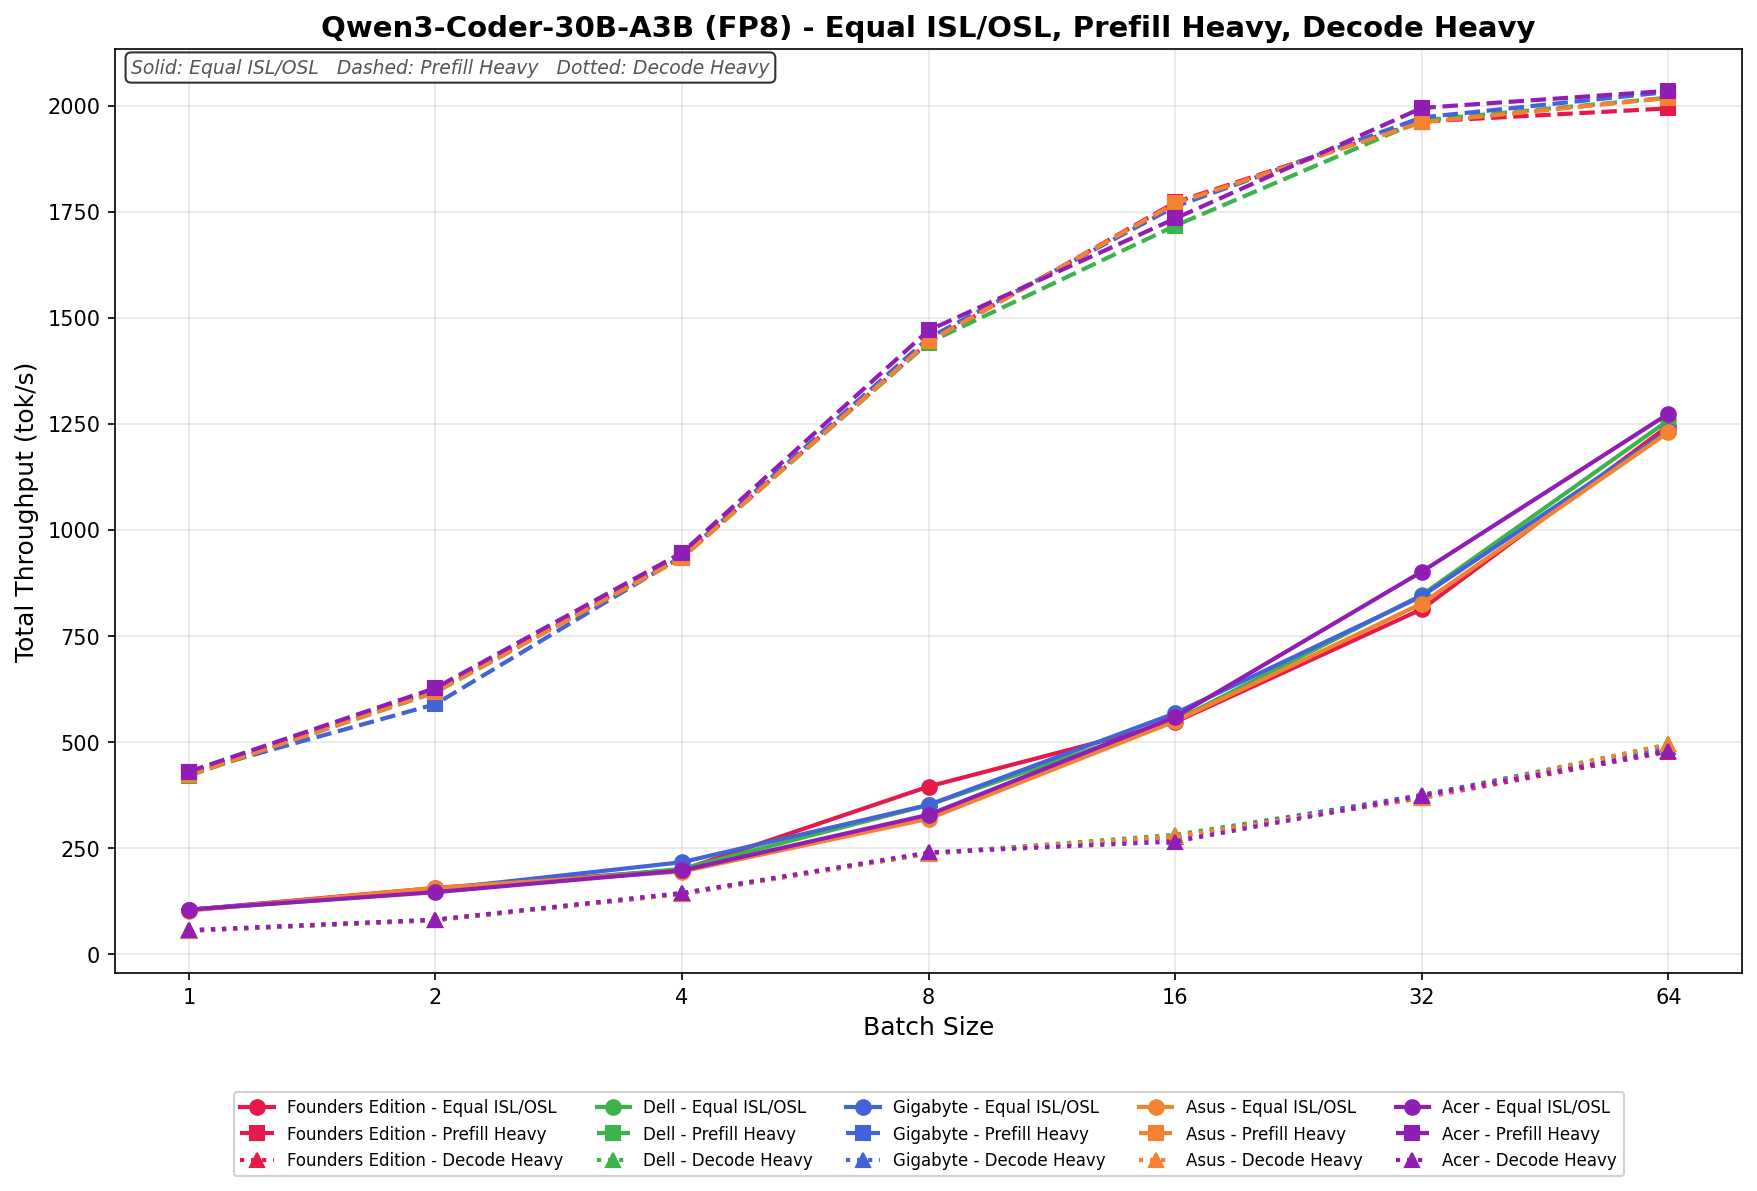
Koder Qwen3 30B A3B FB8
W Equal ISL/OSL, GIGABYTE skaluje się od 101.27 do 1,251.84 tok/s, wykazując stały, liniowy wzrost w całym cyklu przetwarzania partii. Wydajność jest porównywalna z wydajnością Dell i Asus do partii 16, a następnie kontynuuje wyraźny wzrost do partii 64, plasując się blisko górnej granicy bez zauważalnych anomalii skalowania.
Prefill Heavy rozpoczyna się od 428.66 tok/s i skaluje się do 2,026.94 tok/s wraz ze wzrostem rozmiaru partii do 64. Wzrost jest płynny i spójny dla wszystkich rozmiarów partii, przy czym GIGABYTE pozostaje blisko grupy z szerszym polem działania.
Zakres Decode Heavy mieści się w przedziale od 61.18 do 482.73 tok/s, a wraz ze wzrostem rozmiarów partii można przewidywać przyrosty.
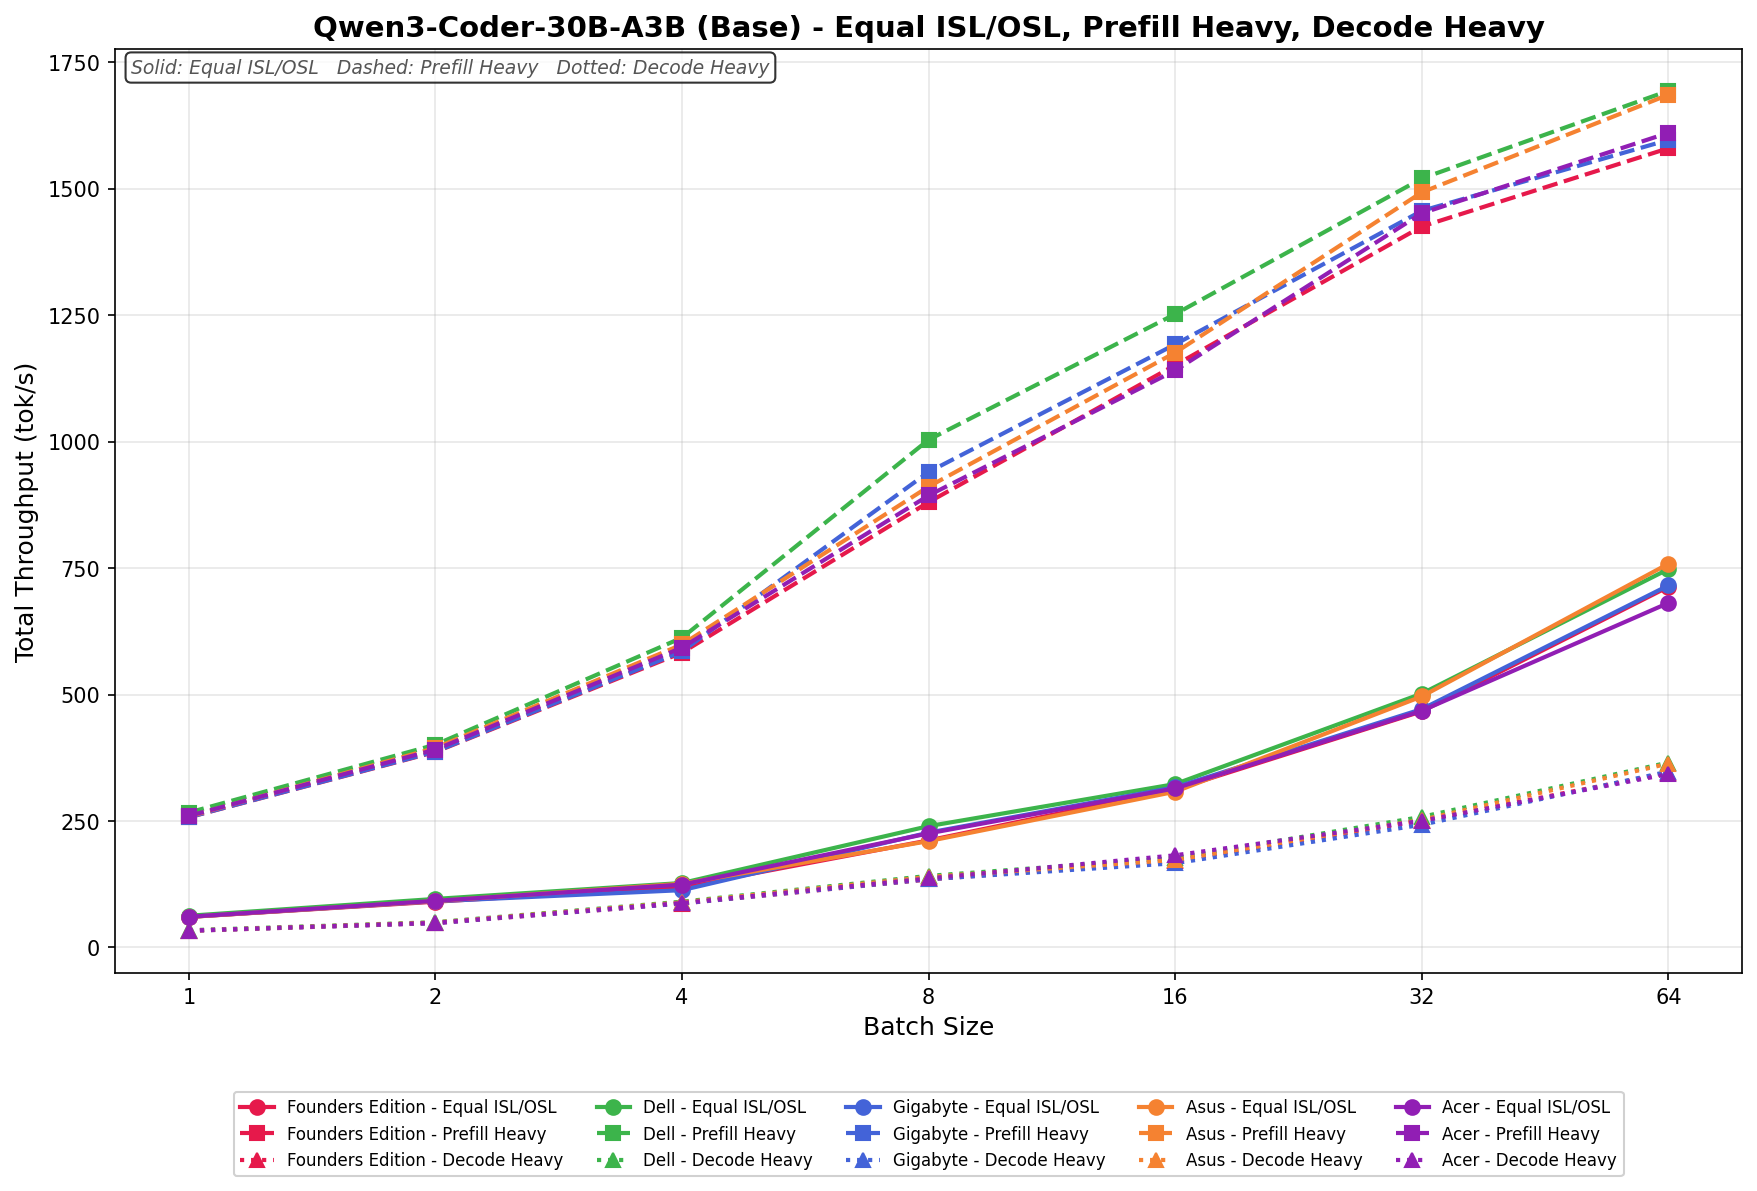
Koder Qwen3 30B A3B Base
W teście Equal ISL/OSL, wydajność GIGABYTE'a skaluje się od 63.42 do 721.08 tok/s, stale rosnąc w całym zakresie partii. Wydajność w tym przypadku jest porównywalna z wynikami w całej grupie aż do partii 16 i utrzymuje się na stałym poziomie aż do partii 64, kończąc na konkurencyjnym poziomie bez zauważalnych odchyleń od liniowego zachowania.
Prefill Heavy rozpoczyna się od 258.11 tok/s i wzrasta do 1,603.74 tok/s przy rozmiarze partii 64.
Decode Heavy ma zakres od 33.57 do 349.82 tok/s, ze stopniowym, liniowym skalowaniem w całym zakresie.
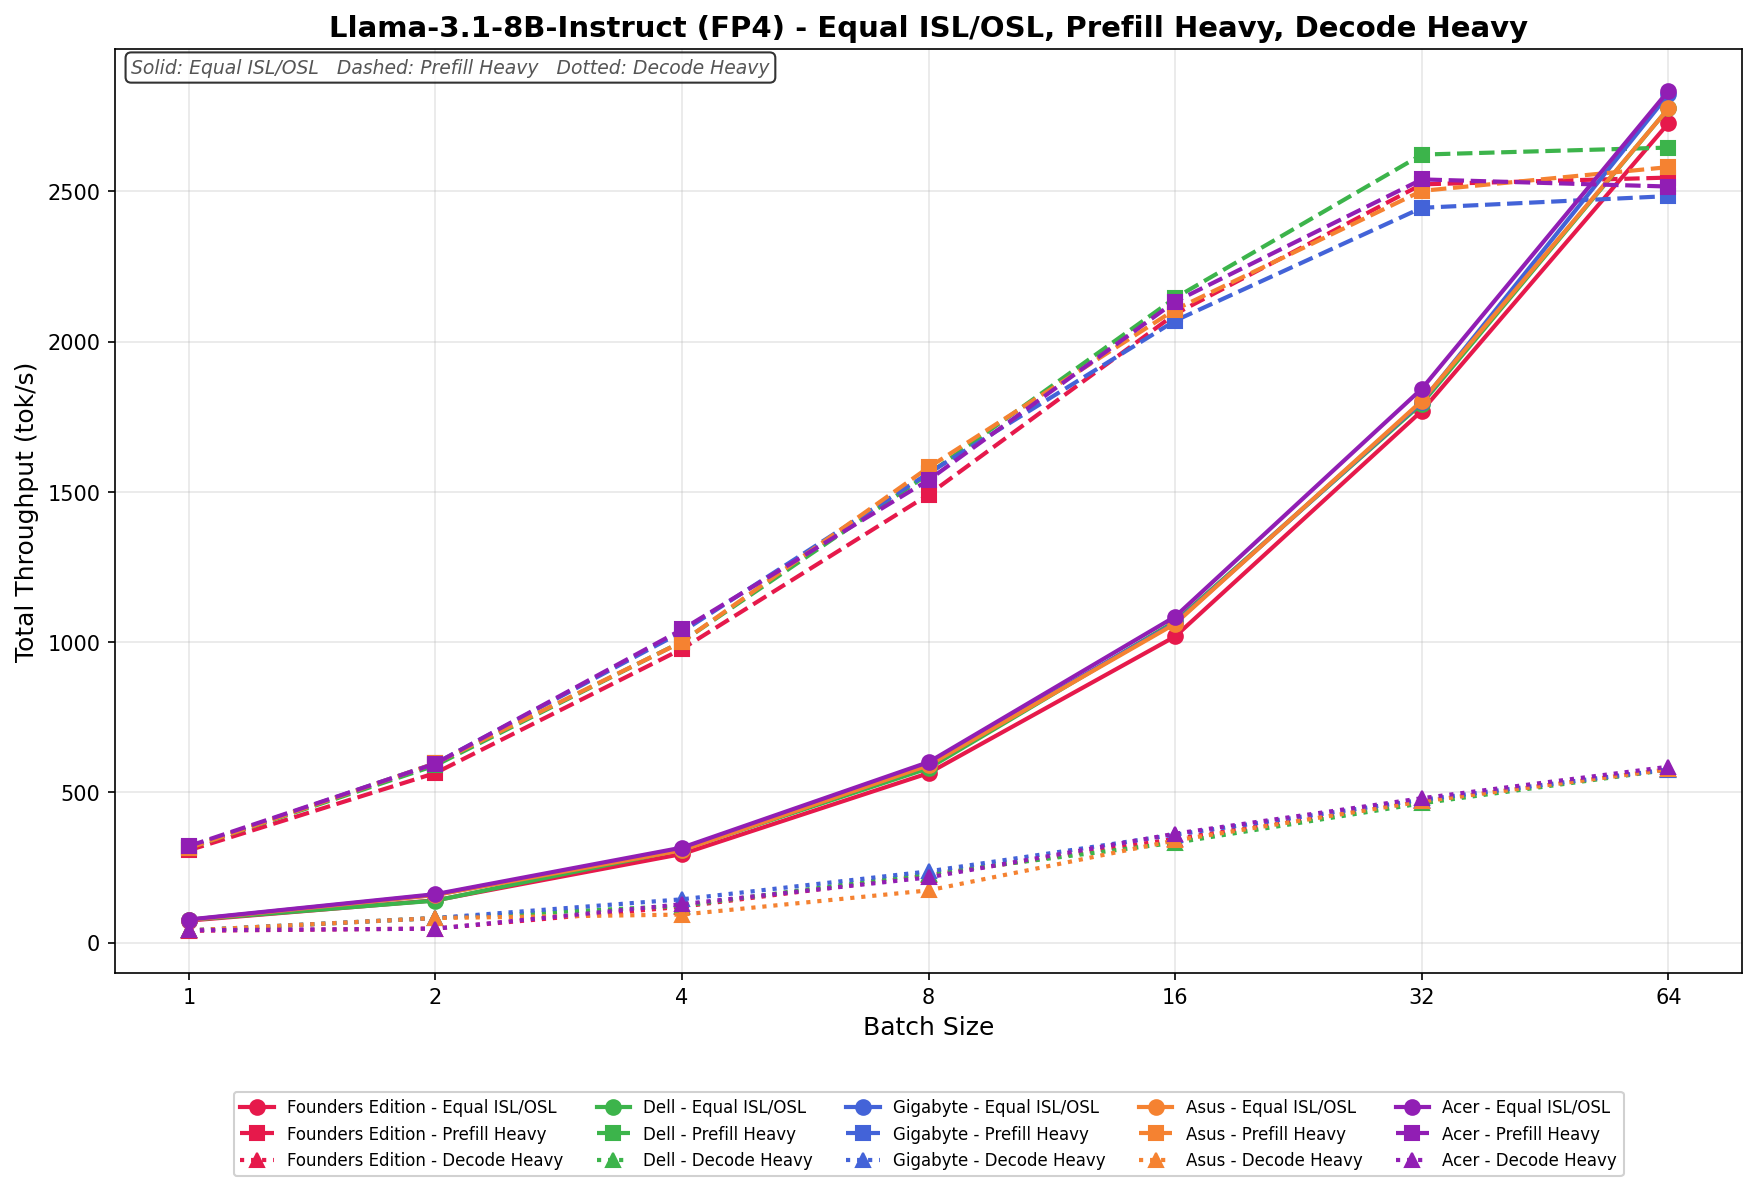
Llama 3.1 8B Instrukcja FP4
W Equal ISL/OSL, przepustowość GIGABYTE wzrasta z 69.84 do 2,756.91 tok/s w całym cyklu przetwarzania wsadowego. Skalowanie jest progresywne i dobrze wyważone w cyklu przetwarzania wsadowego 32, gdzie przepustowość zbliża się do najwyższego poziomu, a następnie następuje znaczny skok w cyklu przetwarzania wsadowego 64, co plasuje go wśród wiodących systemów o wyższych poziomach współbieżności.
Prefill Heavy zaczyna się od 321.67 tok/s i osiąga 2,493.52 tok/s przy wielkości partii 64. Wzrost jest stabilny do partii 16, a następnie zaczyna nieznacznie spadać przy większych wielkościach partii w porównaniu do najlepszego urządzenia, co wskazuje na solidną, ale nie dominującą wydajność skalowania dużych partii.
Zakres Decode Heavy wynosi od 48.92 do 575.84 tok/s, przy czym wraz ze wzrostem rozmiaru partii następuje stały przyrost zysków.
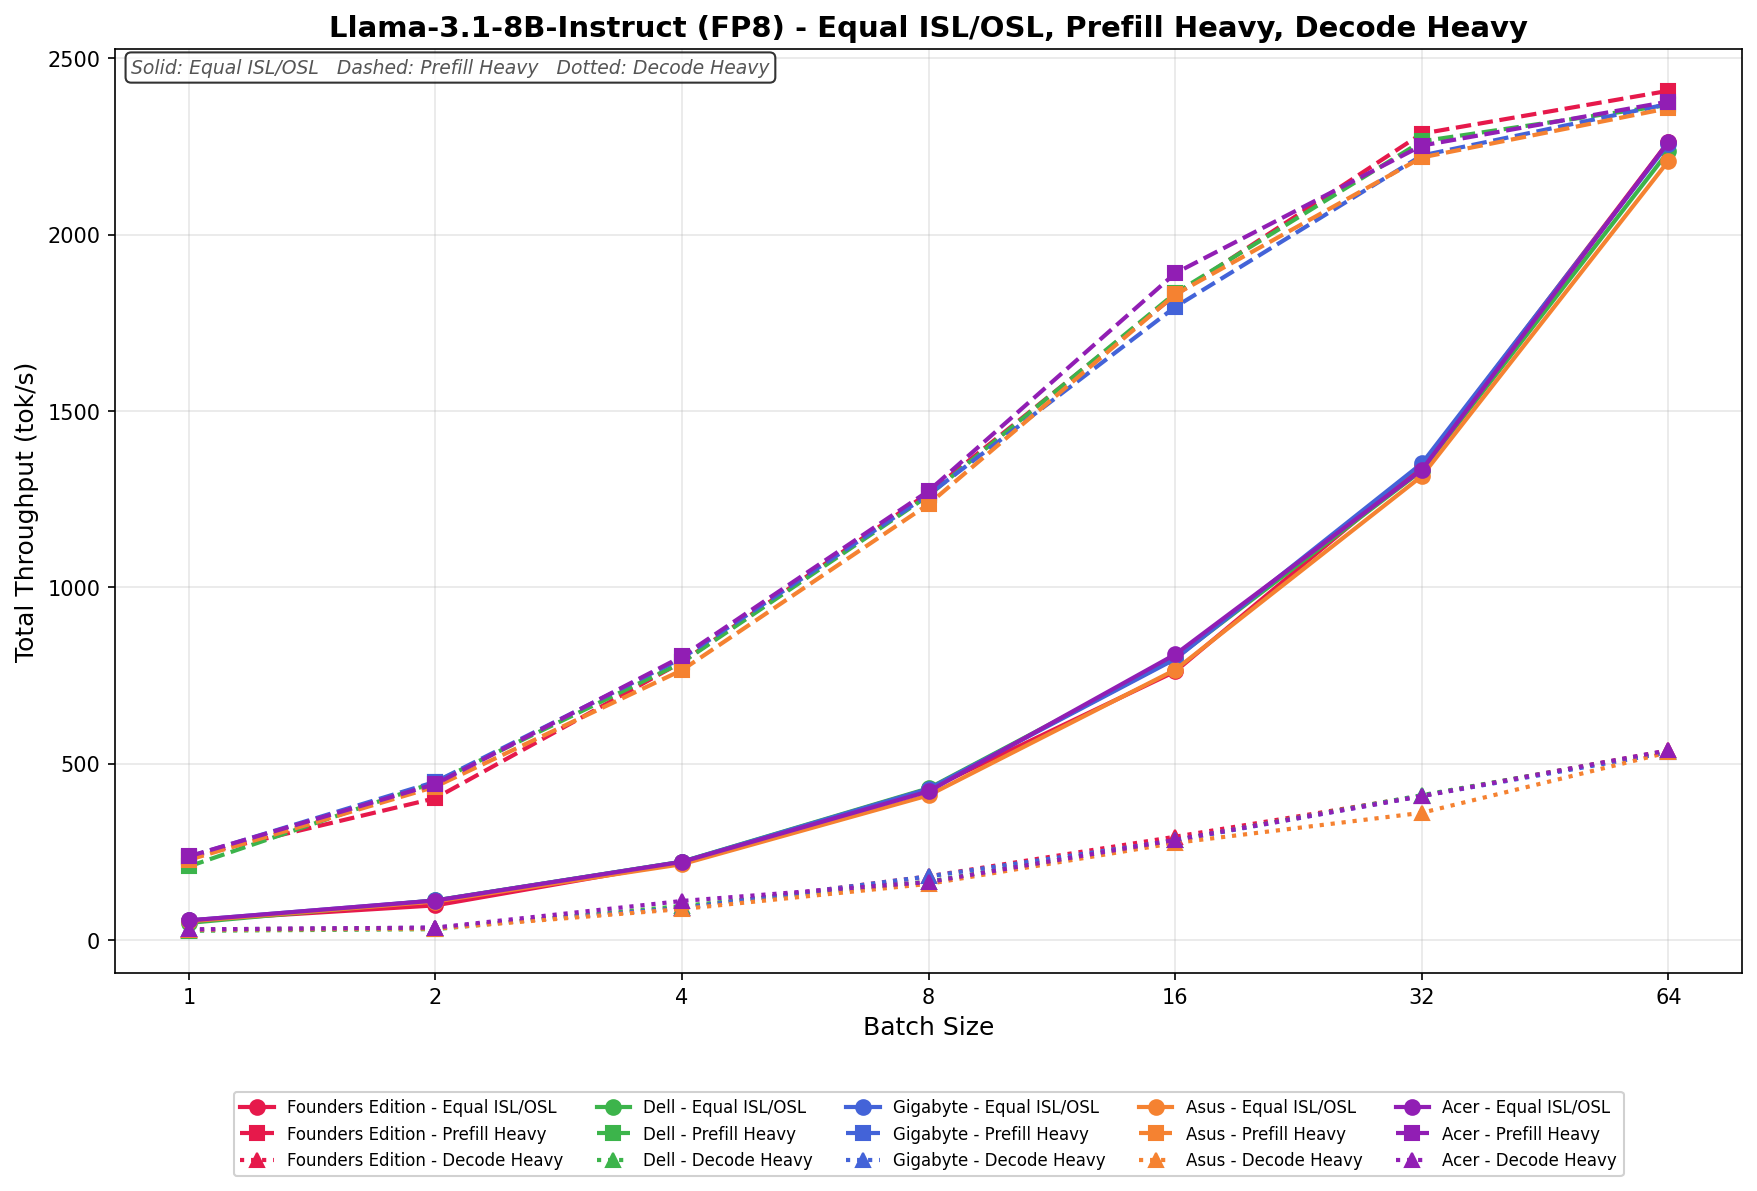
Llama 3.1 8B Instrukcja FP8
W Equal ISL/OSL wydajność GIGABYTE skaluje się od 54.12 do 2,314.87 tok/s, wykazując płynny, liniowy wzrost w partii 32 i silne przyspieszenie w partii 64, co pozwala firmie zachować konkurencyjność przy wyższych poziomach współbieżności.
Prefill Heavy zaczyna się od 226.43 tok/s i osiąga 2,332.19 tok/s przy wielkości partii 64. Skalowanie jest spójne w całym zakresie, ściśle zgodne z szerszym polem i utrzymuje solidną wydajność przy większych wielkościach partii.
Przepustowość Decode Heavy waha się od 32.88 do 522.41 tok/s, ze stałym wzrostem przyrostowym wraz ze wzrostem rozmiaru partii. Zgodnie z oczekiwaniami, skalowanie pozostaje bardziej ograniczone w porównaniu z obciążeniami Equal i Prefill.
Bezpośrednie przechowywanie GPU
Jednym z testów, jakie przeprowadziliśmy na Sparku, był test MagnumIO GPU Direct Storage (GDS). GDS to funkcja opracowana przez firmę NVIDIA, która pozwala procesorom graficznym ominąć procesor główny (CPU) podczas uzyskiwania dostępu do danych przechowywanych na dyskach NVMe lub innych szybkich urządzeniach pamięci masowej. Zamiast kierować dane przez procesor i pamięć systemową, GDS umożliwia bezpośrednią komunikację między procesorem graficznym a urządzeniem pamięci masowej, znacznie redukując opóźnienia i poprawiając przepustowość danych.
Gigabyte wykorzystuje 4-terabajtowy dysk SSD Samsung PM9E1 Gen5 w obudowie AI TOP ATOM, który jak dotąd jest najszybszym dyskiem M.2 o pojemności 2242, jaki widzieliśmy na rynku. To ten sam dysk SSD, który widzieliśmy w laptopach FE Spark i Acer Veriton GN100.
Jak działa bezpośrednie przechowywanie danych GPU
Tradycyjnie, gdy procesor graficzny (GPU) przetwarza dane przechowywane na dysku NVMe, dane muszą najpierw przejść przez procesor (CPU) i pamięć systemową, zanim dotrą do procesora graficznego (GPU). Proces ten wprowadza wąskie gardła, ponieważ procesor (CPU) działa jako pośrednik, zwiększając opóźnienia i zużywając cenne zasoby systemowe. Technologia GPU Direct Storage eliminuje ten problem, umożliwiając procesorowi graficznemu bezpośredni dostęp do danych z urządzenia pamięci masowej za pośrednictwem magistrali PCIe. Ta bezpośrednia ścieżka zmniejsza obciążenie związane z przesyłaniem danych, umożliwiając szybsze i bardziej wydajne przesyłanie danych.
Obciążenia sztucznej inteligencji, zwłaszcza te wykorzystujące uczenie głębokie, charakteryzują się wysoką intensywnością przetwarzania danych. Trenowanie dużych sieci neuronowych wymaga przetwarzania terabajtów danych, a każde opóźnienie w transferze danych może prowadzić do niewykorzystania procesorów graficznych (GPU) i wydłużenia czasu trenowania. Technologia GPU Direct Storage rozwiązuje ten problem, zapewniając jak najszybsze dostarczanie danych do procesora graficznego (GPU), minimalizując czas przestoju i maksymalizując wydajność obliczeniową.
Ponadto GDS jest szczególnie przydatny w przypadku obciążeń wymagających strumieniowego przesyłania dużych zbiorów danych, takich jak przetwarzanie wideo, przetwarzanie języka naturalnego czy wnioskowanie w czasie rzeczywistym. Zmniejszając zależność od procesora, GDS przyspiesza przesyłanie danych i uwalnia zasoby procesora do innych zadań, co dodatkowo zwiększa ogólną wydajność systemu.
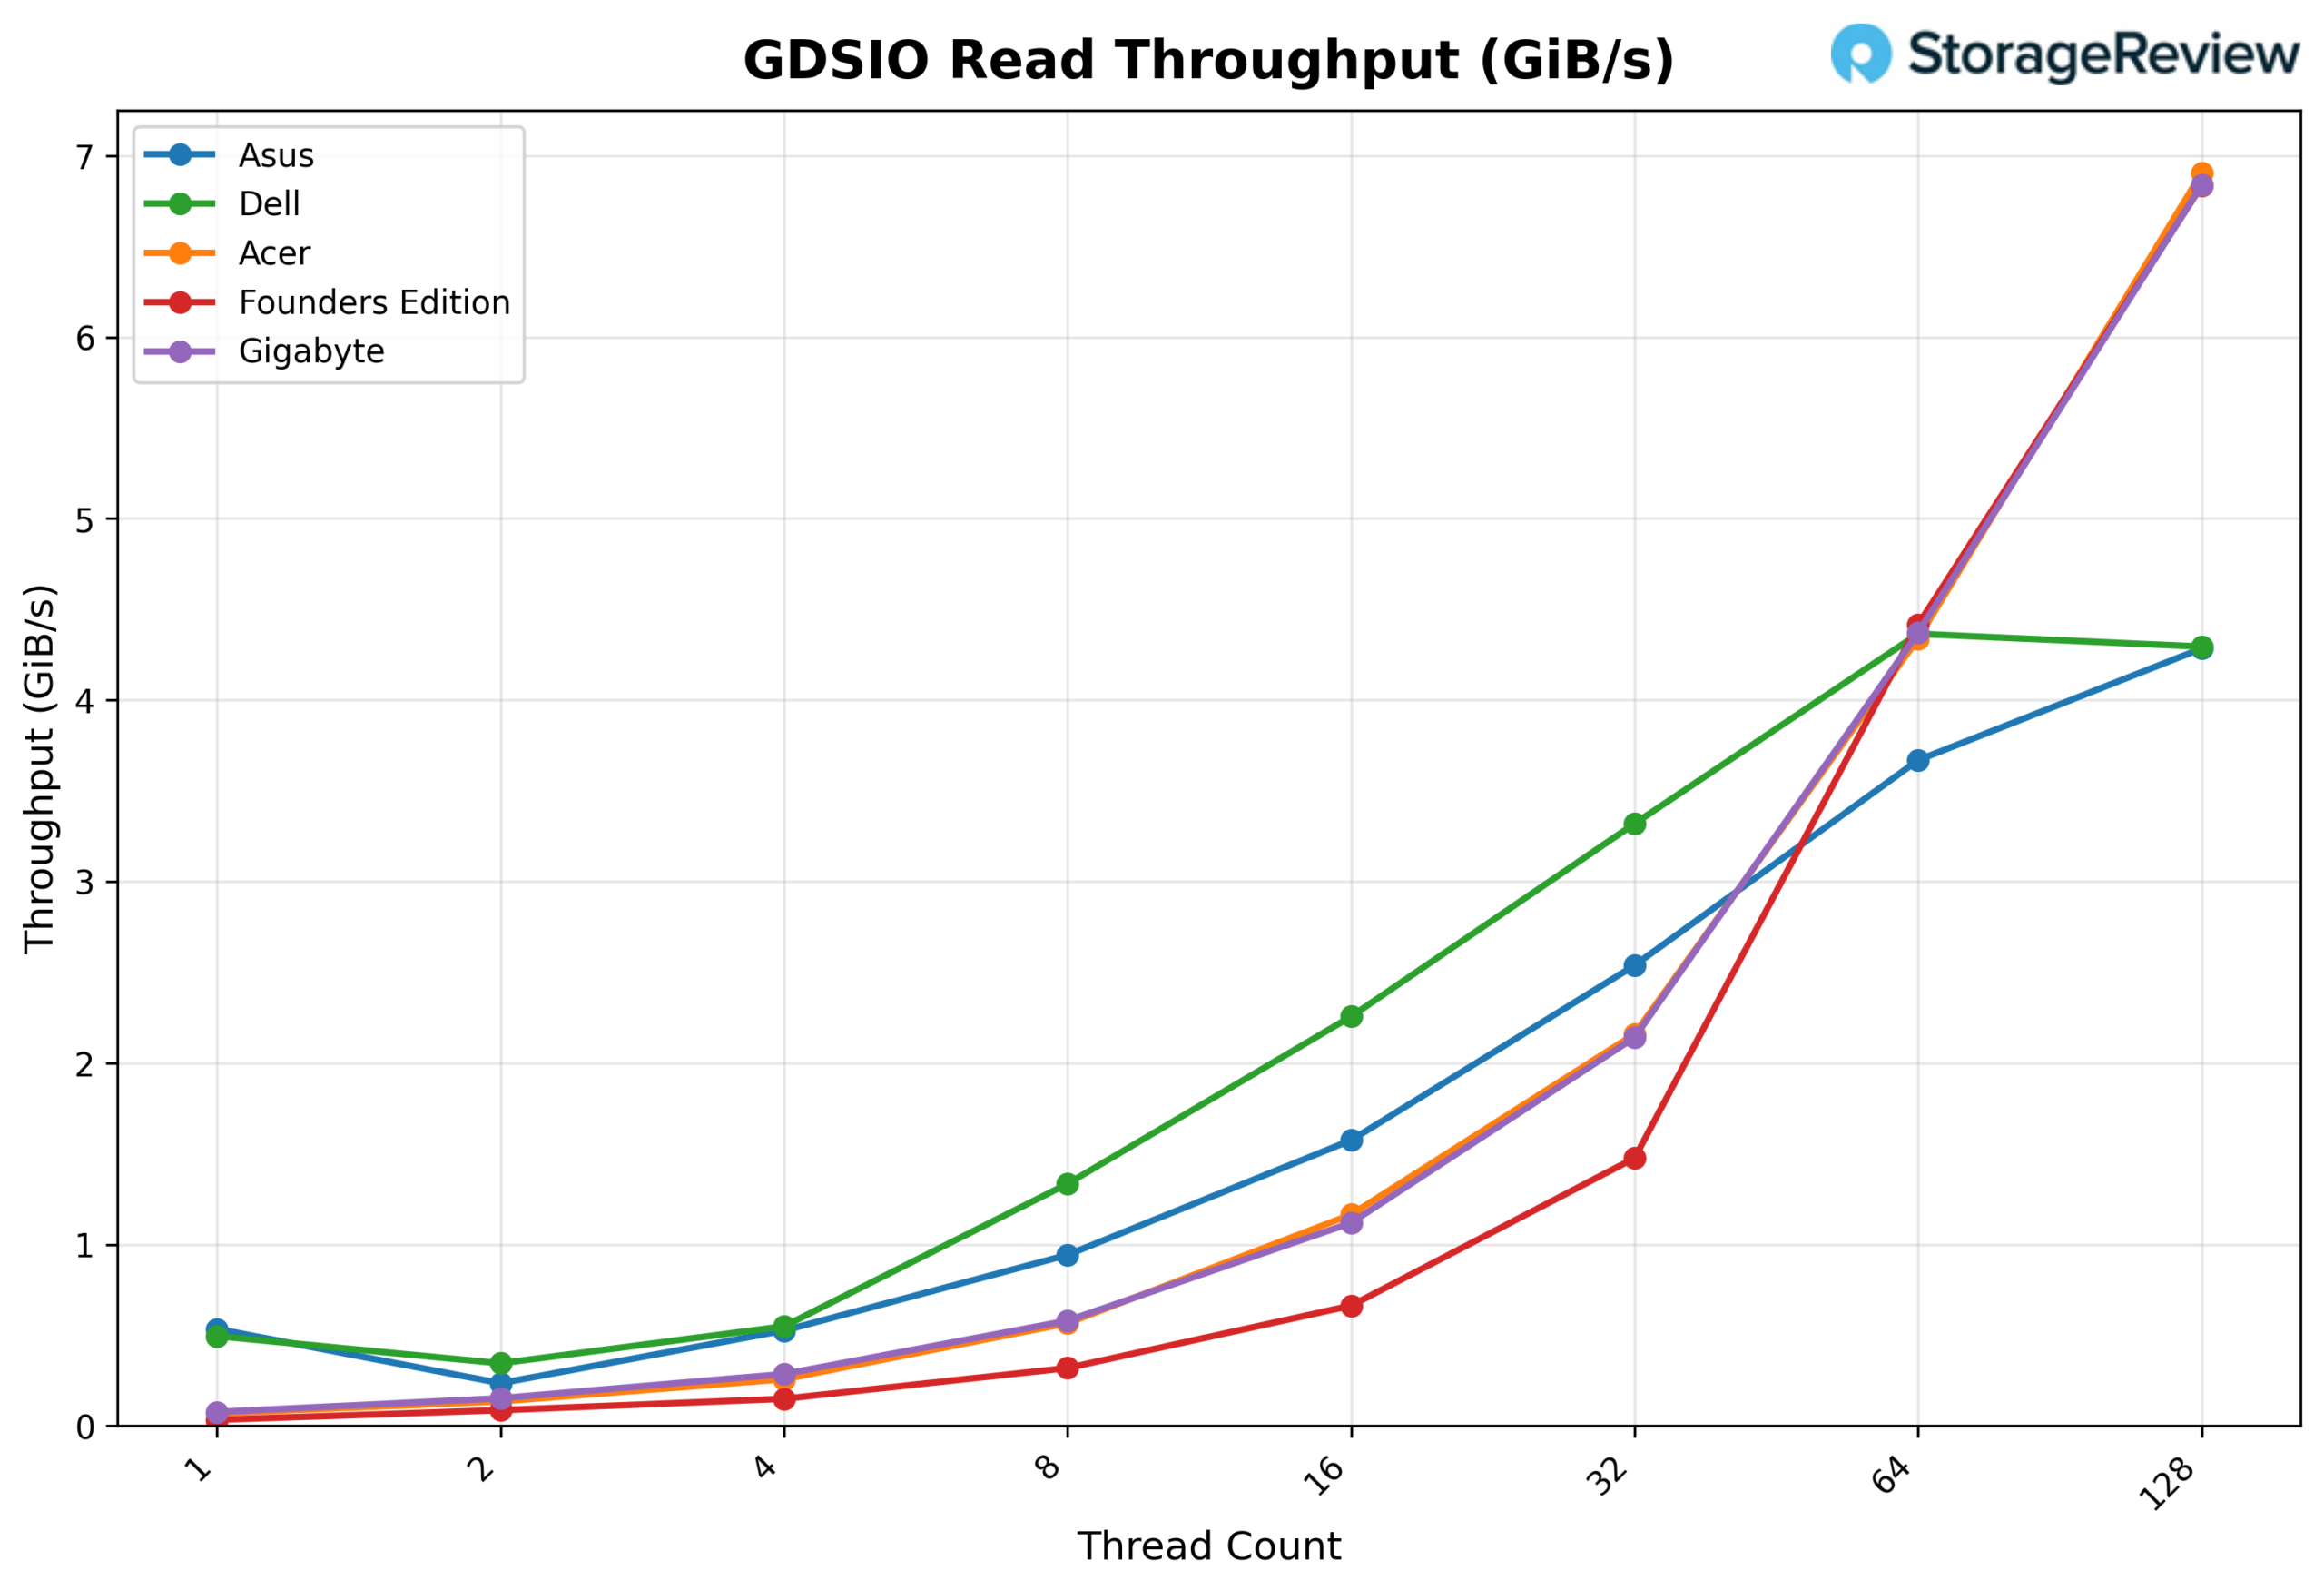
Przepustowość odczytu GDSIO 16k
Patrząc na przepustowość odczytu GDSIO 16 KB, GIGABYTE zaczyna od około 0.08 GiB/s przy 1 wątku i wzrasta do 0.58 GiB/s przy 8 wątkach. Następnie kontynuuje skalowanie czysto przy 16 wątkach (1.12 GiB/s) i 32 wątkach (2.14 GiB/s), po czym gwałtownie rośnie przy 64 wątkach do 4.37 GiB/s. Przy 128 wątkach GIGABYTE kontynuuje skalowanie do 6.84 GiB/s, nie wykazując oznak stabilizacji w górnym zakresie wątków.
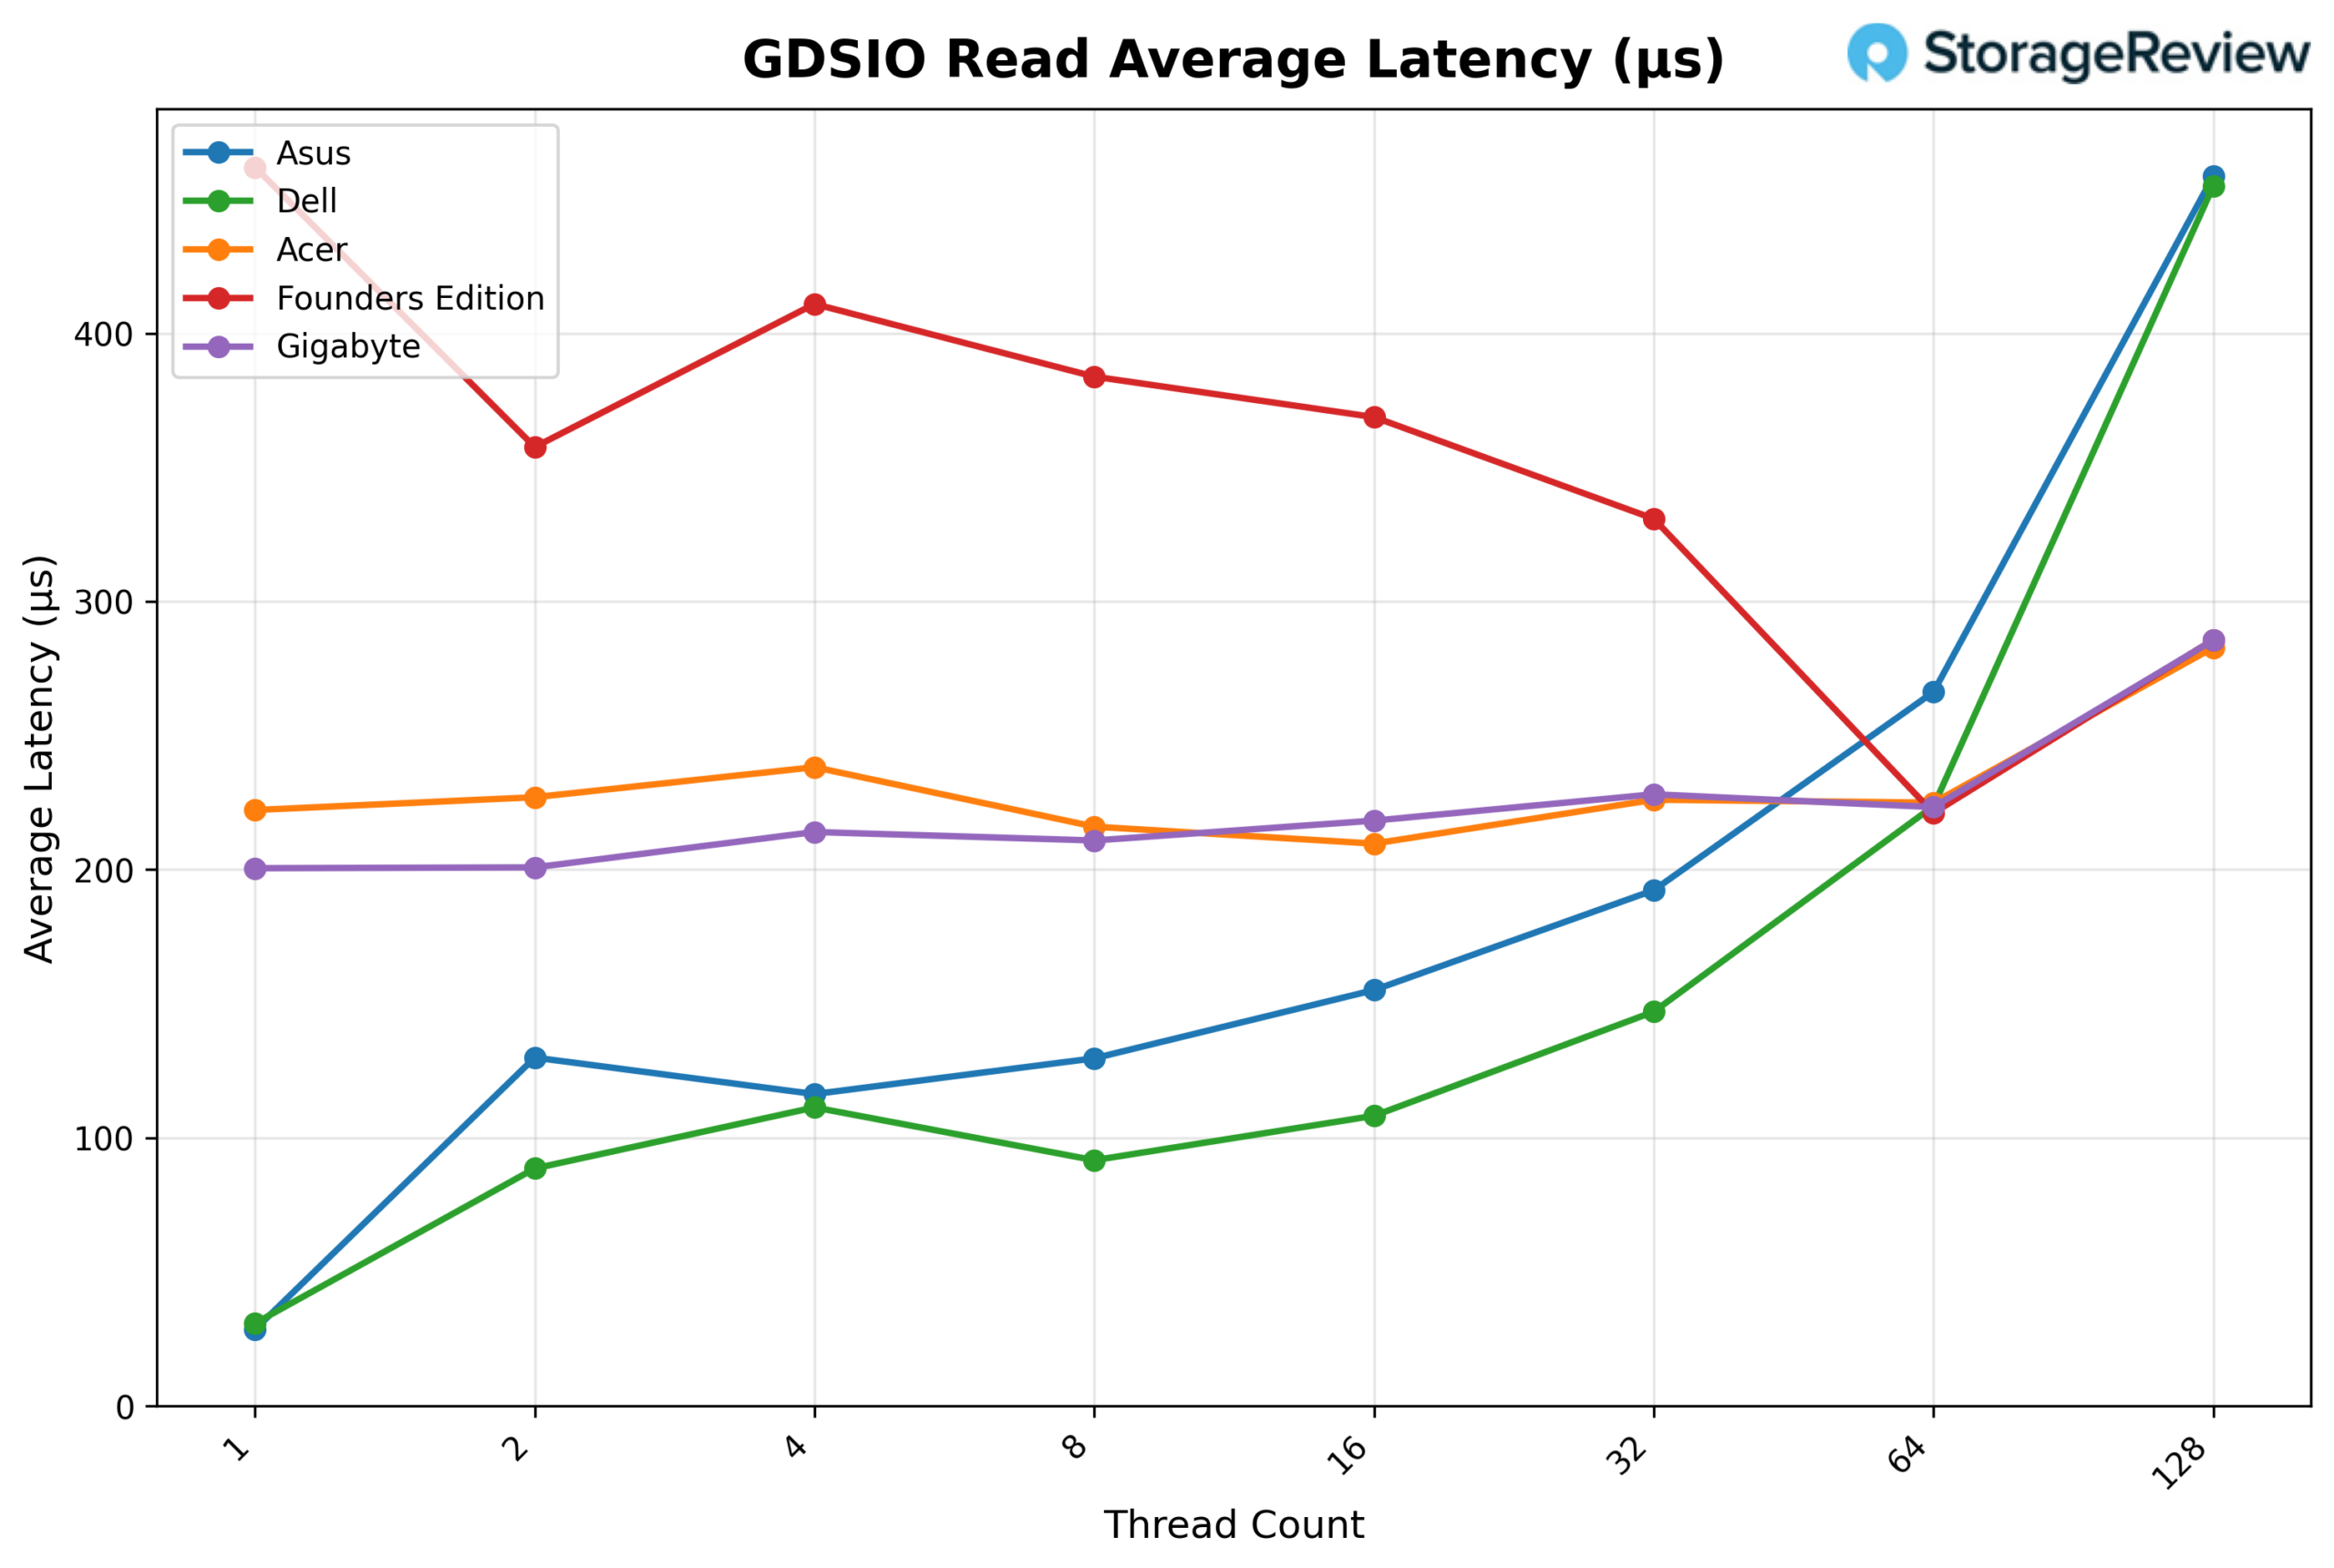
Średnie opóźnienie odczytu GDSIO 16K
Patrząc na średnie opóźnienie odczytu GDSIO (16 KB), GIGABYTE utrzymuje bardzo stabilne opóźnienie na większości krzywej. Zaczyna się ono od około 0.201 ms dla 1 wątku i pozostaje ściśle zgrupowane w zakresie ~0.21–0.23 ms dla 2 wątków do 64 wątków (np. 0.211 ms dla 8 wątków, 0.218 ms dla 16 wątków, 0.228 ms dla 32 wątków i 0.223 ms dla 64 wątków). Dopiero przy 128 wątkach opóźnienie wzrasta zauważalnie do około 0.286 ms, a przepustowość nadal rośnie.
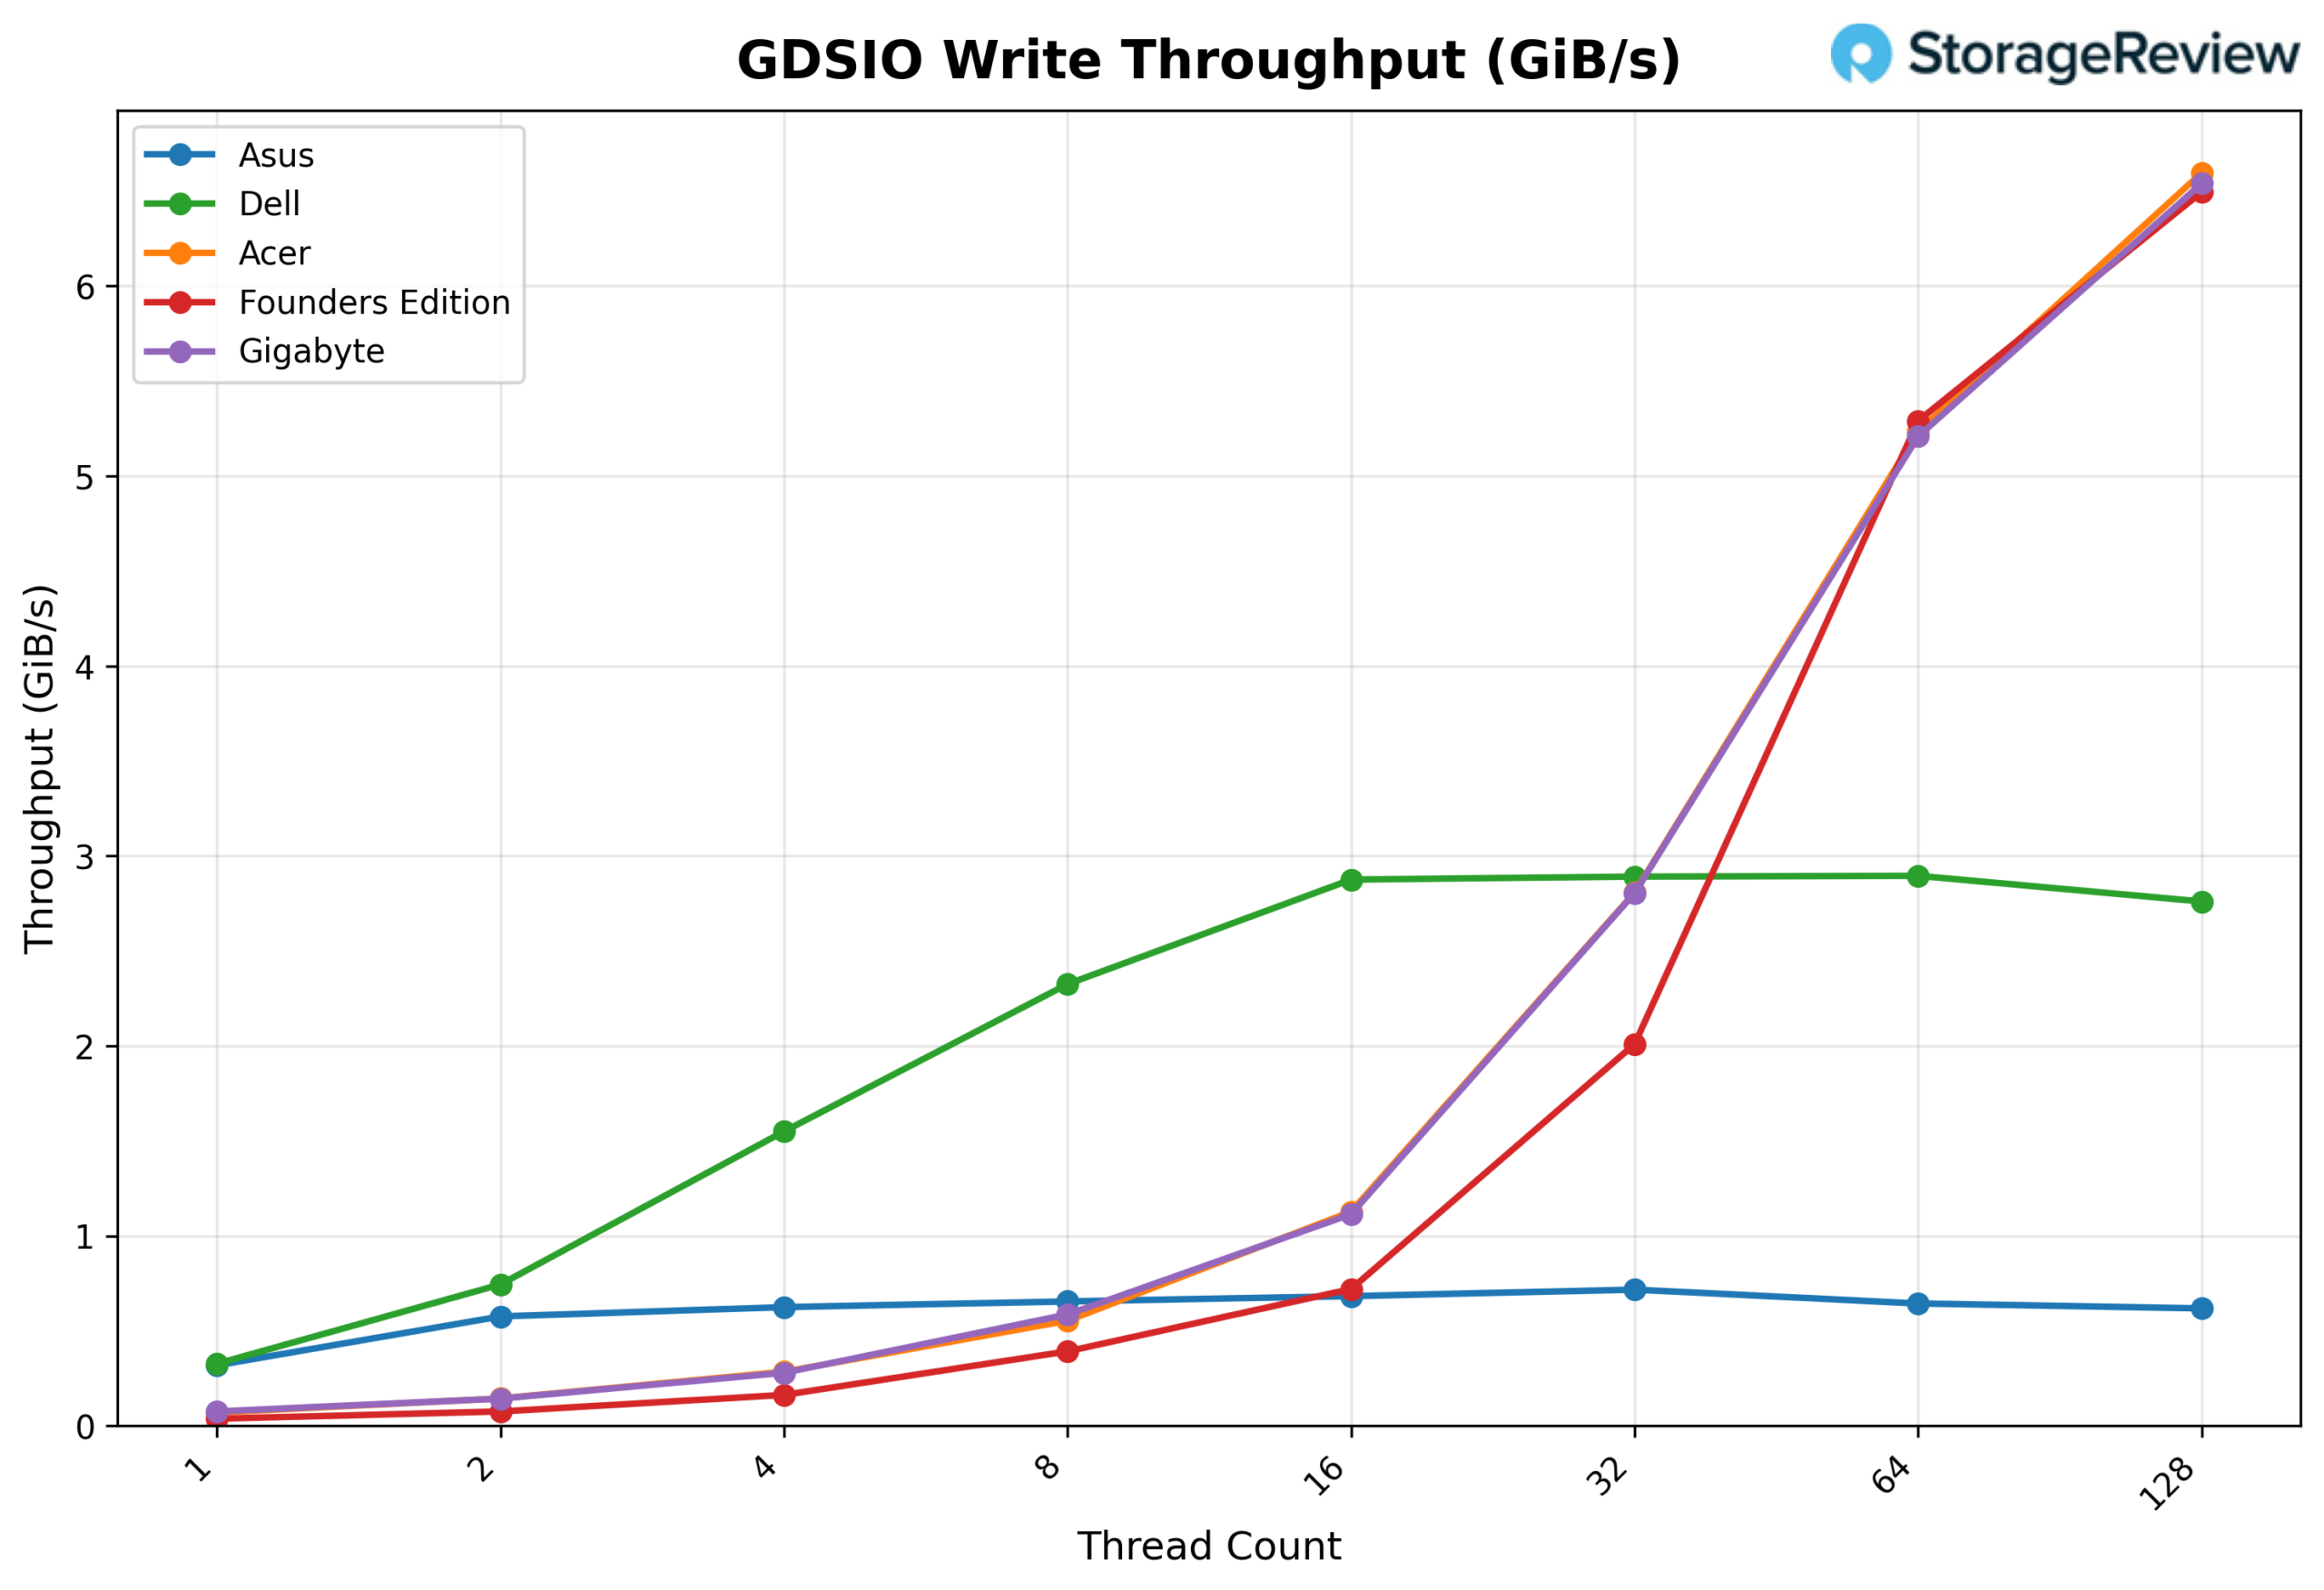
Przepustowość zapisu GSDIO 16K
Patrząc na przepustowość zapisu GDSIO 16K, GIGABYTE zaczyna od około 0.08 GiB/s przy 1 wątku, skaluje się stabilnie do 0.14 GiB/s przy 2 wątkach i 0.28 GiB/s przy 4 wątkach. Wydajność nadal rośnie czysto przy 8 wątkach (0.59 GiB/s) i 16 wątkach (1.11 GiB/s), a następnie gwałtownie rośnie przy 32 wątkach (2.80 GiB/s). Skalowanie utrzymuje się na wysokim poziomie przy 64 wątkach (5.21 GiB/s) i osiąga szczyt na poziomie 6.54 GiB/s przy 128 wątkach, co wskazuje na ciągły wzrost bez wcześniejszego plateau.
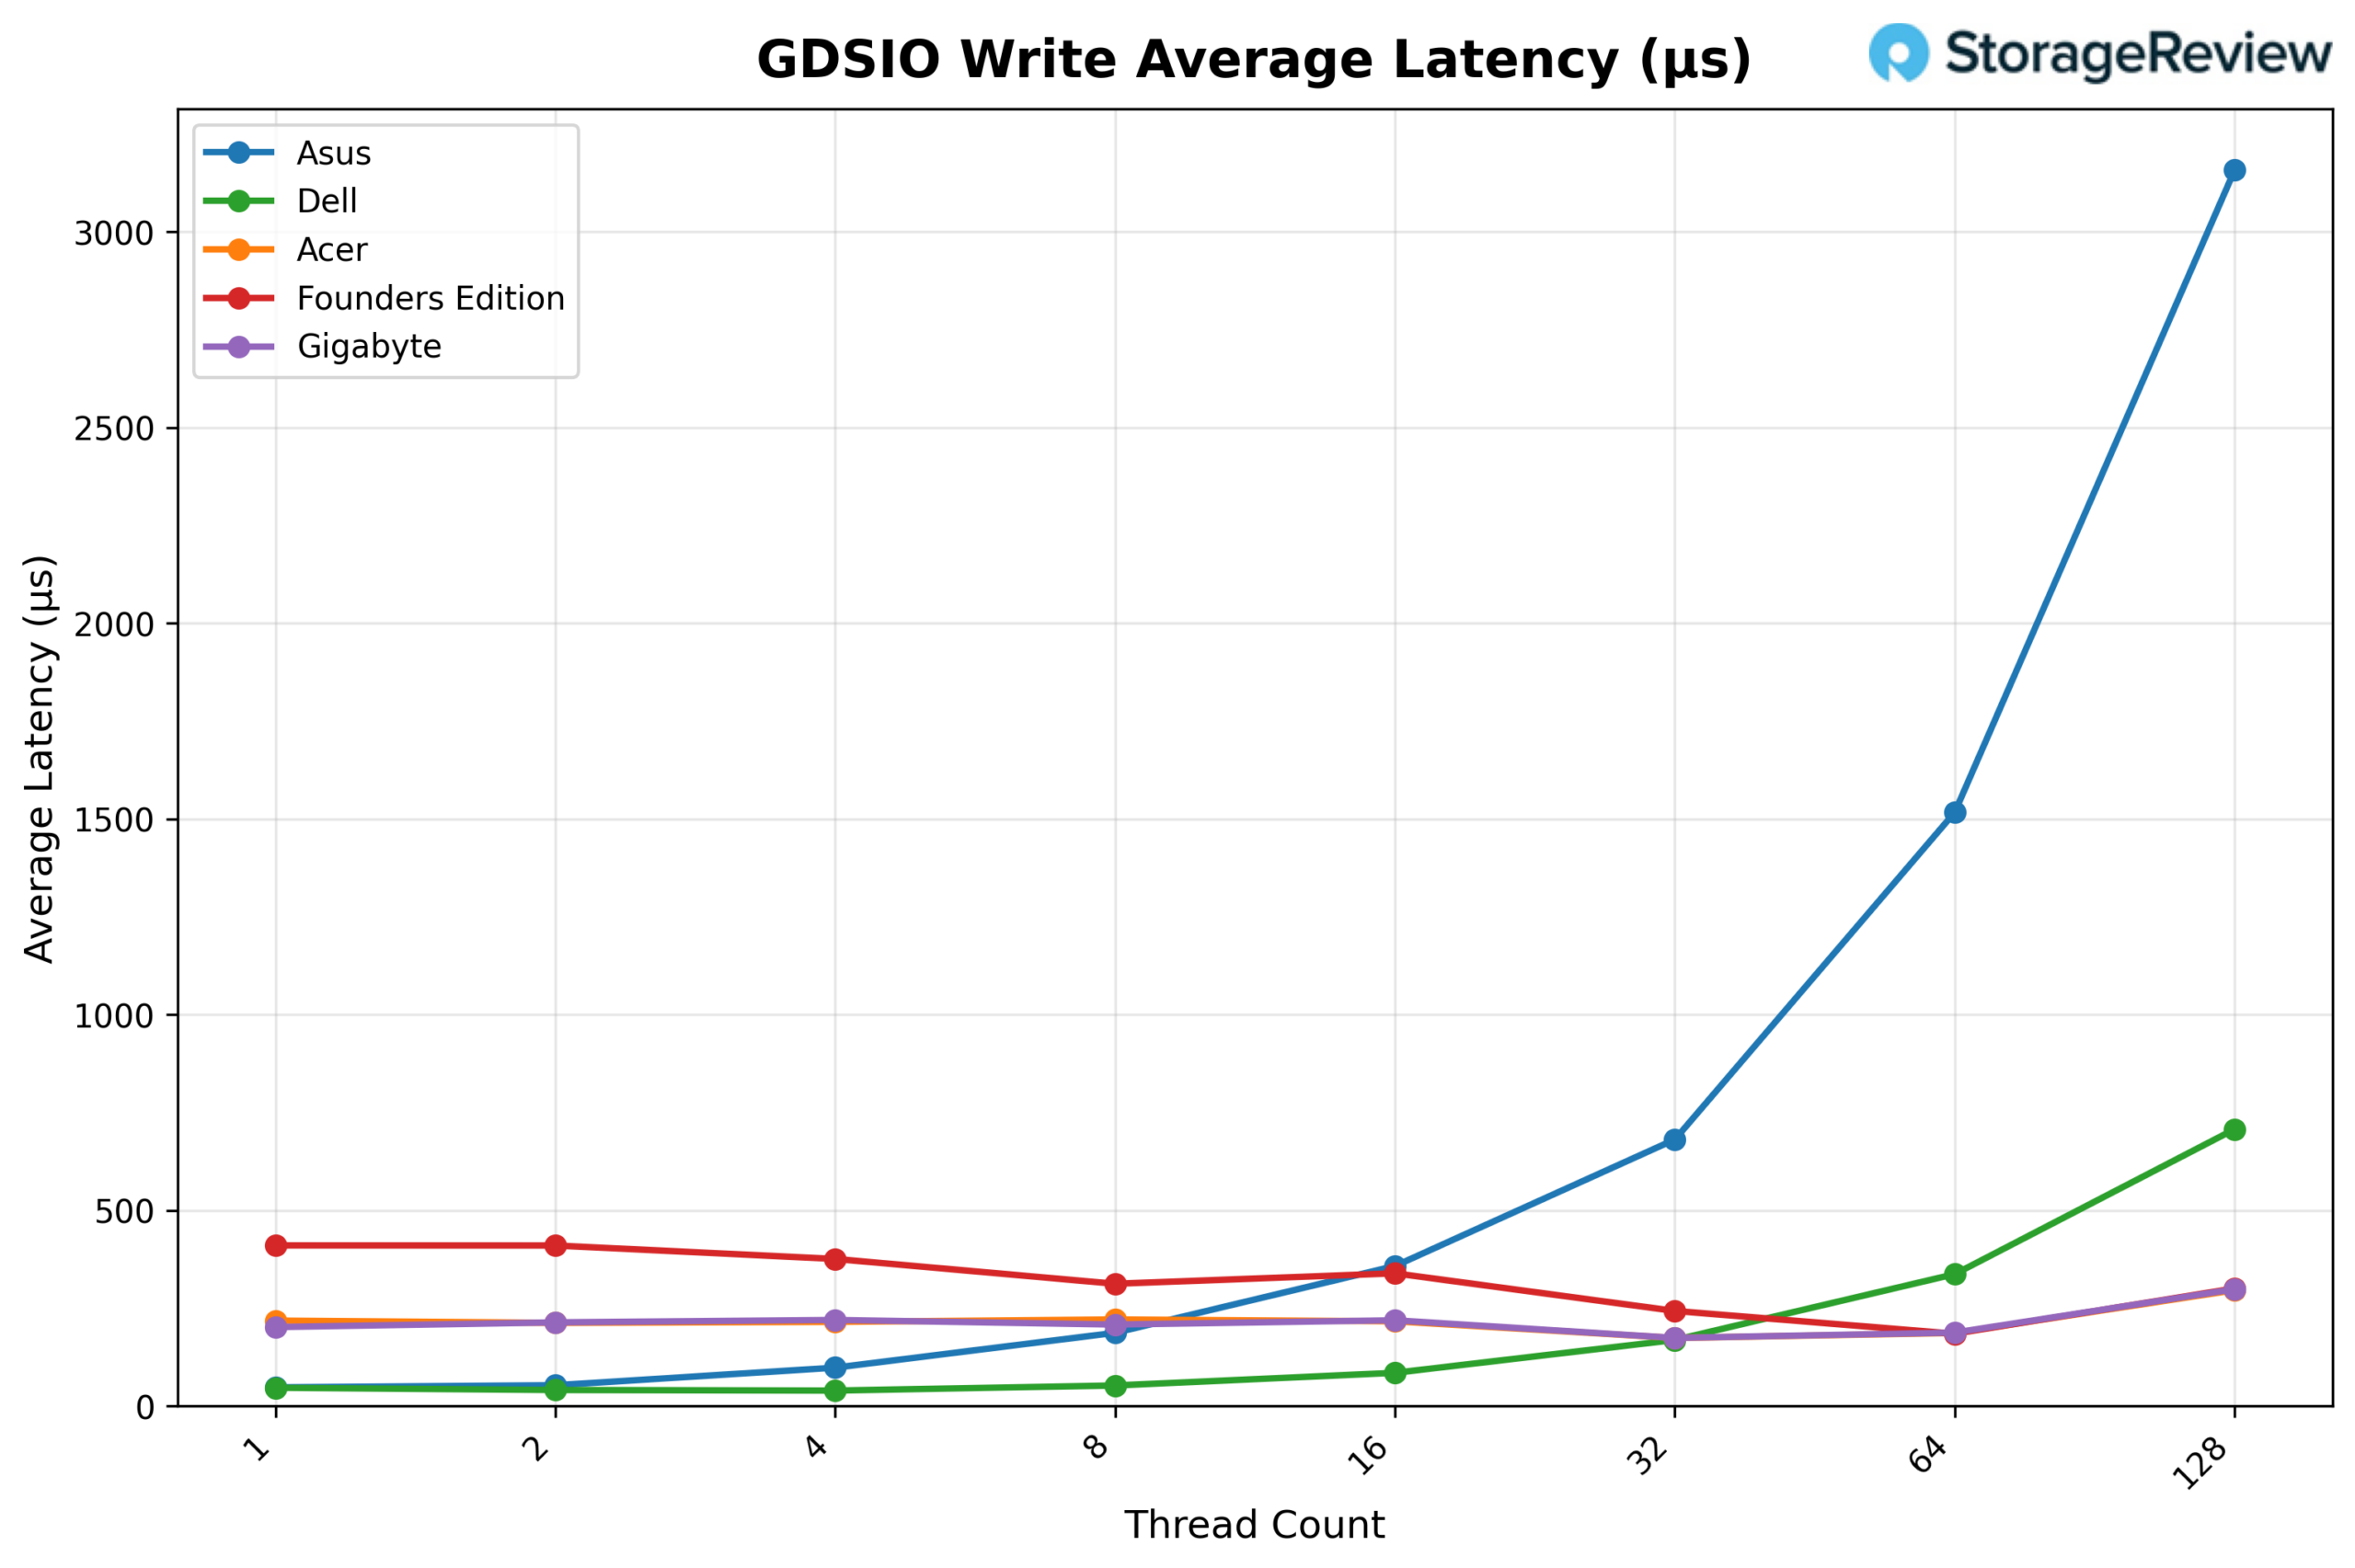
Średnie opóźnienie zapisu GDSIO 16 tys.
Patrząc na średnie opóźnienie zapisu GDSIO (16 KB), GIGABYTE utrzymuje stosunkowo stabilne opóźnienie na większości krzywej. Zaczyna się ono od około 0.20 ms przy 1 wątku i utrzymuje się w zakresie ~0.21–0.22 ms przy 16 wątkach. Przy 32 wątkach opóźnienie nieznacznie spada do około 0.17 ms, a następnie nieznacznie wzrasta przy 64 wątkach (0.19 ms). Dopiero przy 128 wątkach opóźnienie zauważalnie wzrasta do około 0.30 ms, co odpowiada najwyższemu poziomowi przepustowości.
Przepustowość odczytu GDSIO 1M
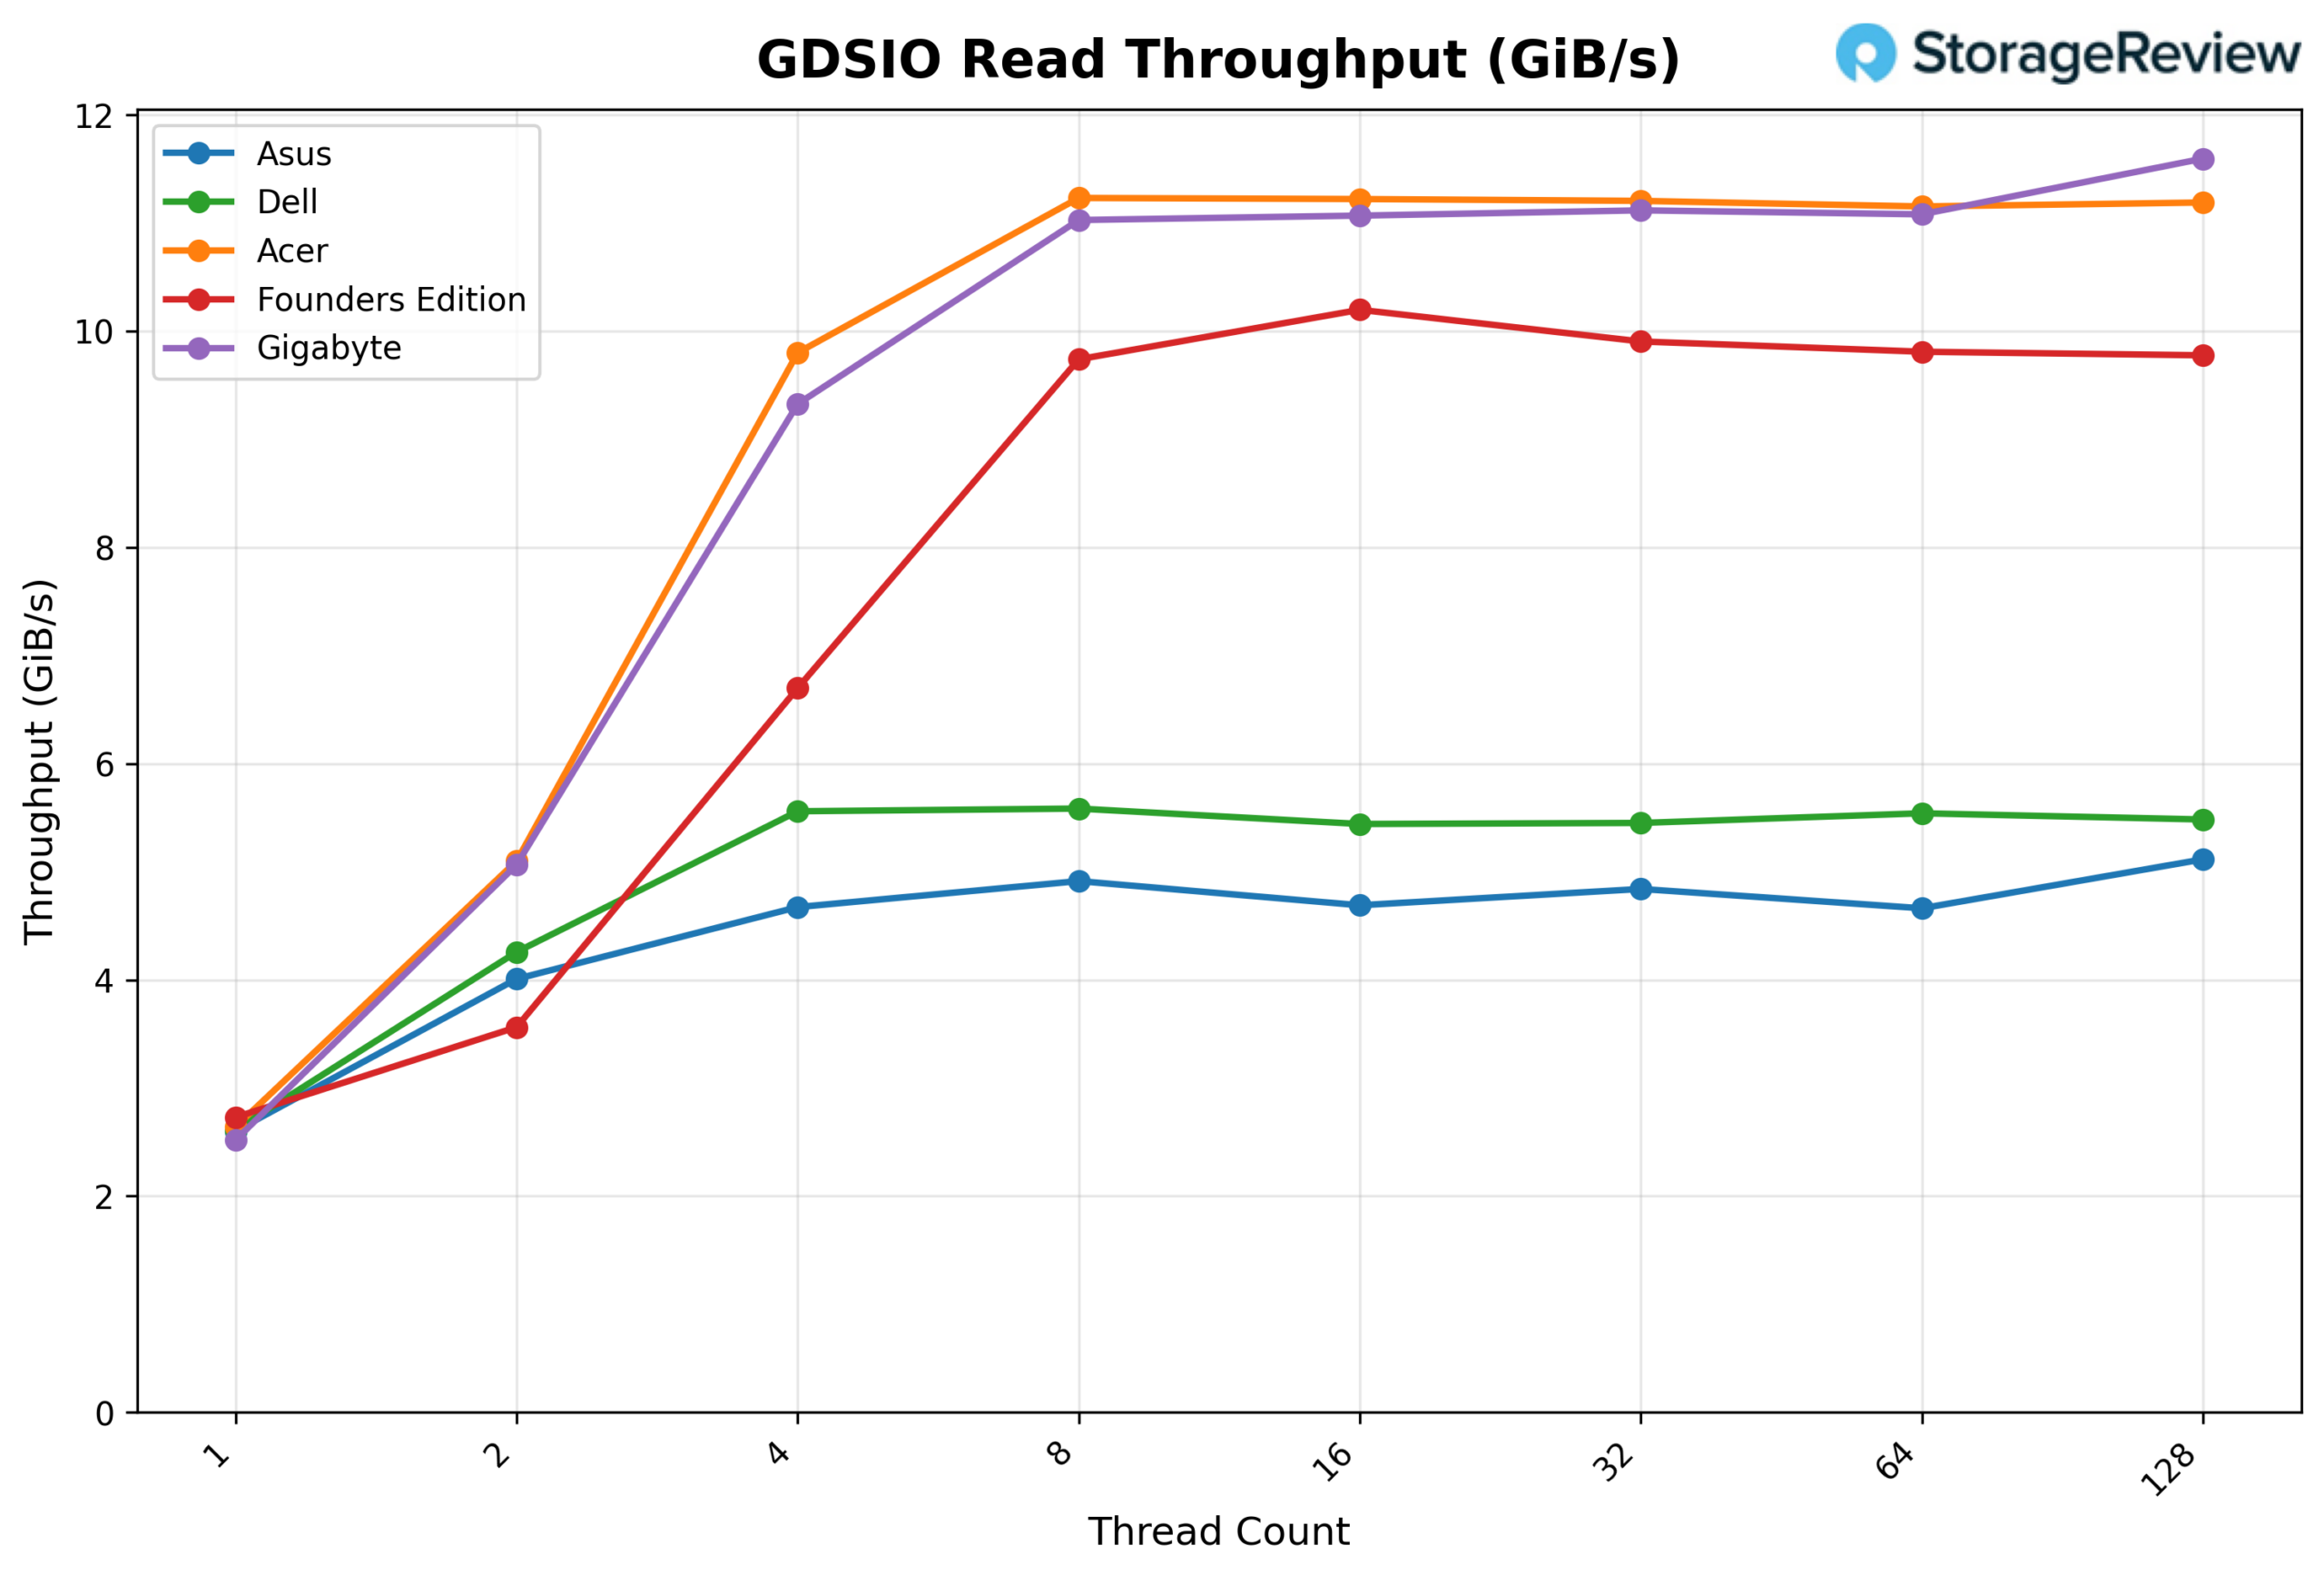
Patrząc na przepustowość odczytu GDSIO 1M, GIGABYTE rozpoczyna od 2.52 GiB/s przy 1 wątku i skaluje się do 5.07 GiB/s przy 2 wątkach i 9.33 GiB/s przy 4 wątkach. Przy 8 wątkach przepustowość osiąga 11.03 GiB/s, po czym platforma skutecznie się nasyca. Wydajność pozostaje stabilna przy 16 wątkach (11.07 GiB/s), 32 wątkach (11.12 GiB/s) i 64 wątkach (11.08 GiB/s), wykazując stabilny plateau. Przy 128 wątkach przepustowość nieznacznie wzrasta do 11.60 GiB/s, co stanowi najwyższy zaobserwowany wynik w tym cyklu.
Średnie opóźnienie odczytu GDSIO: 1M
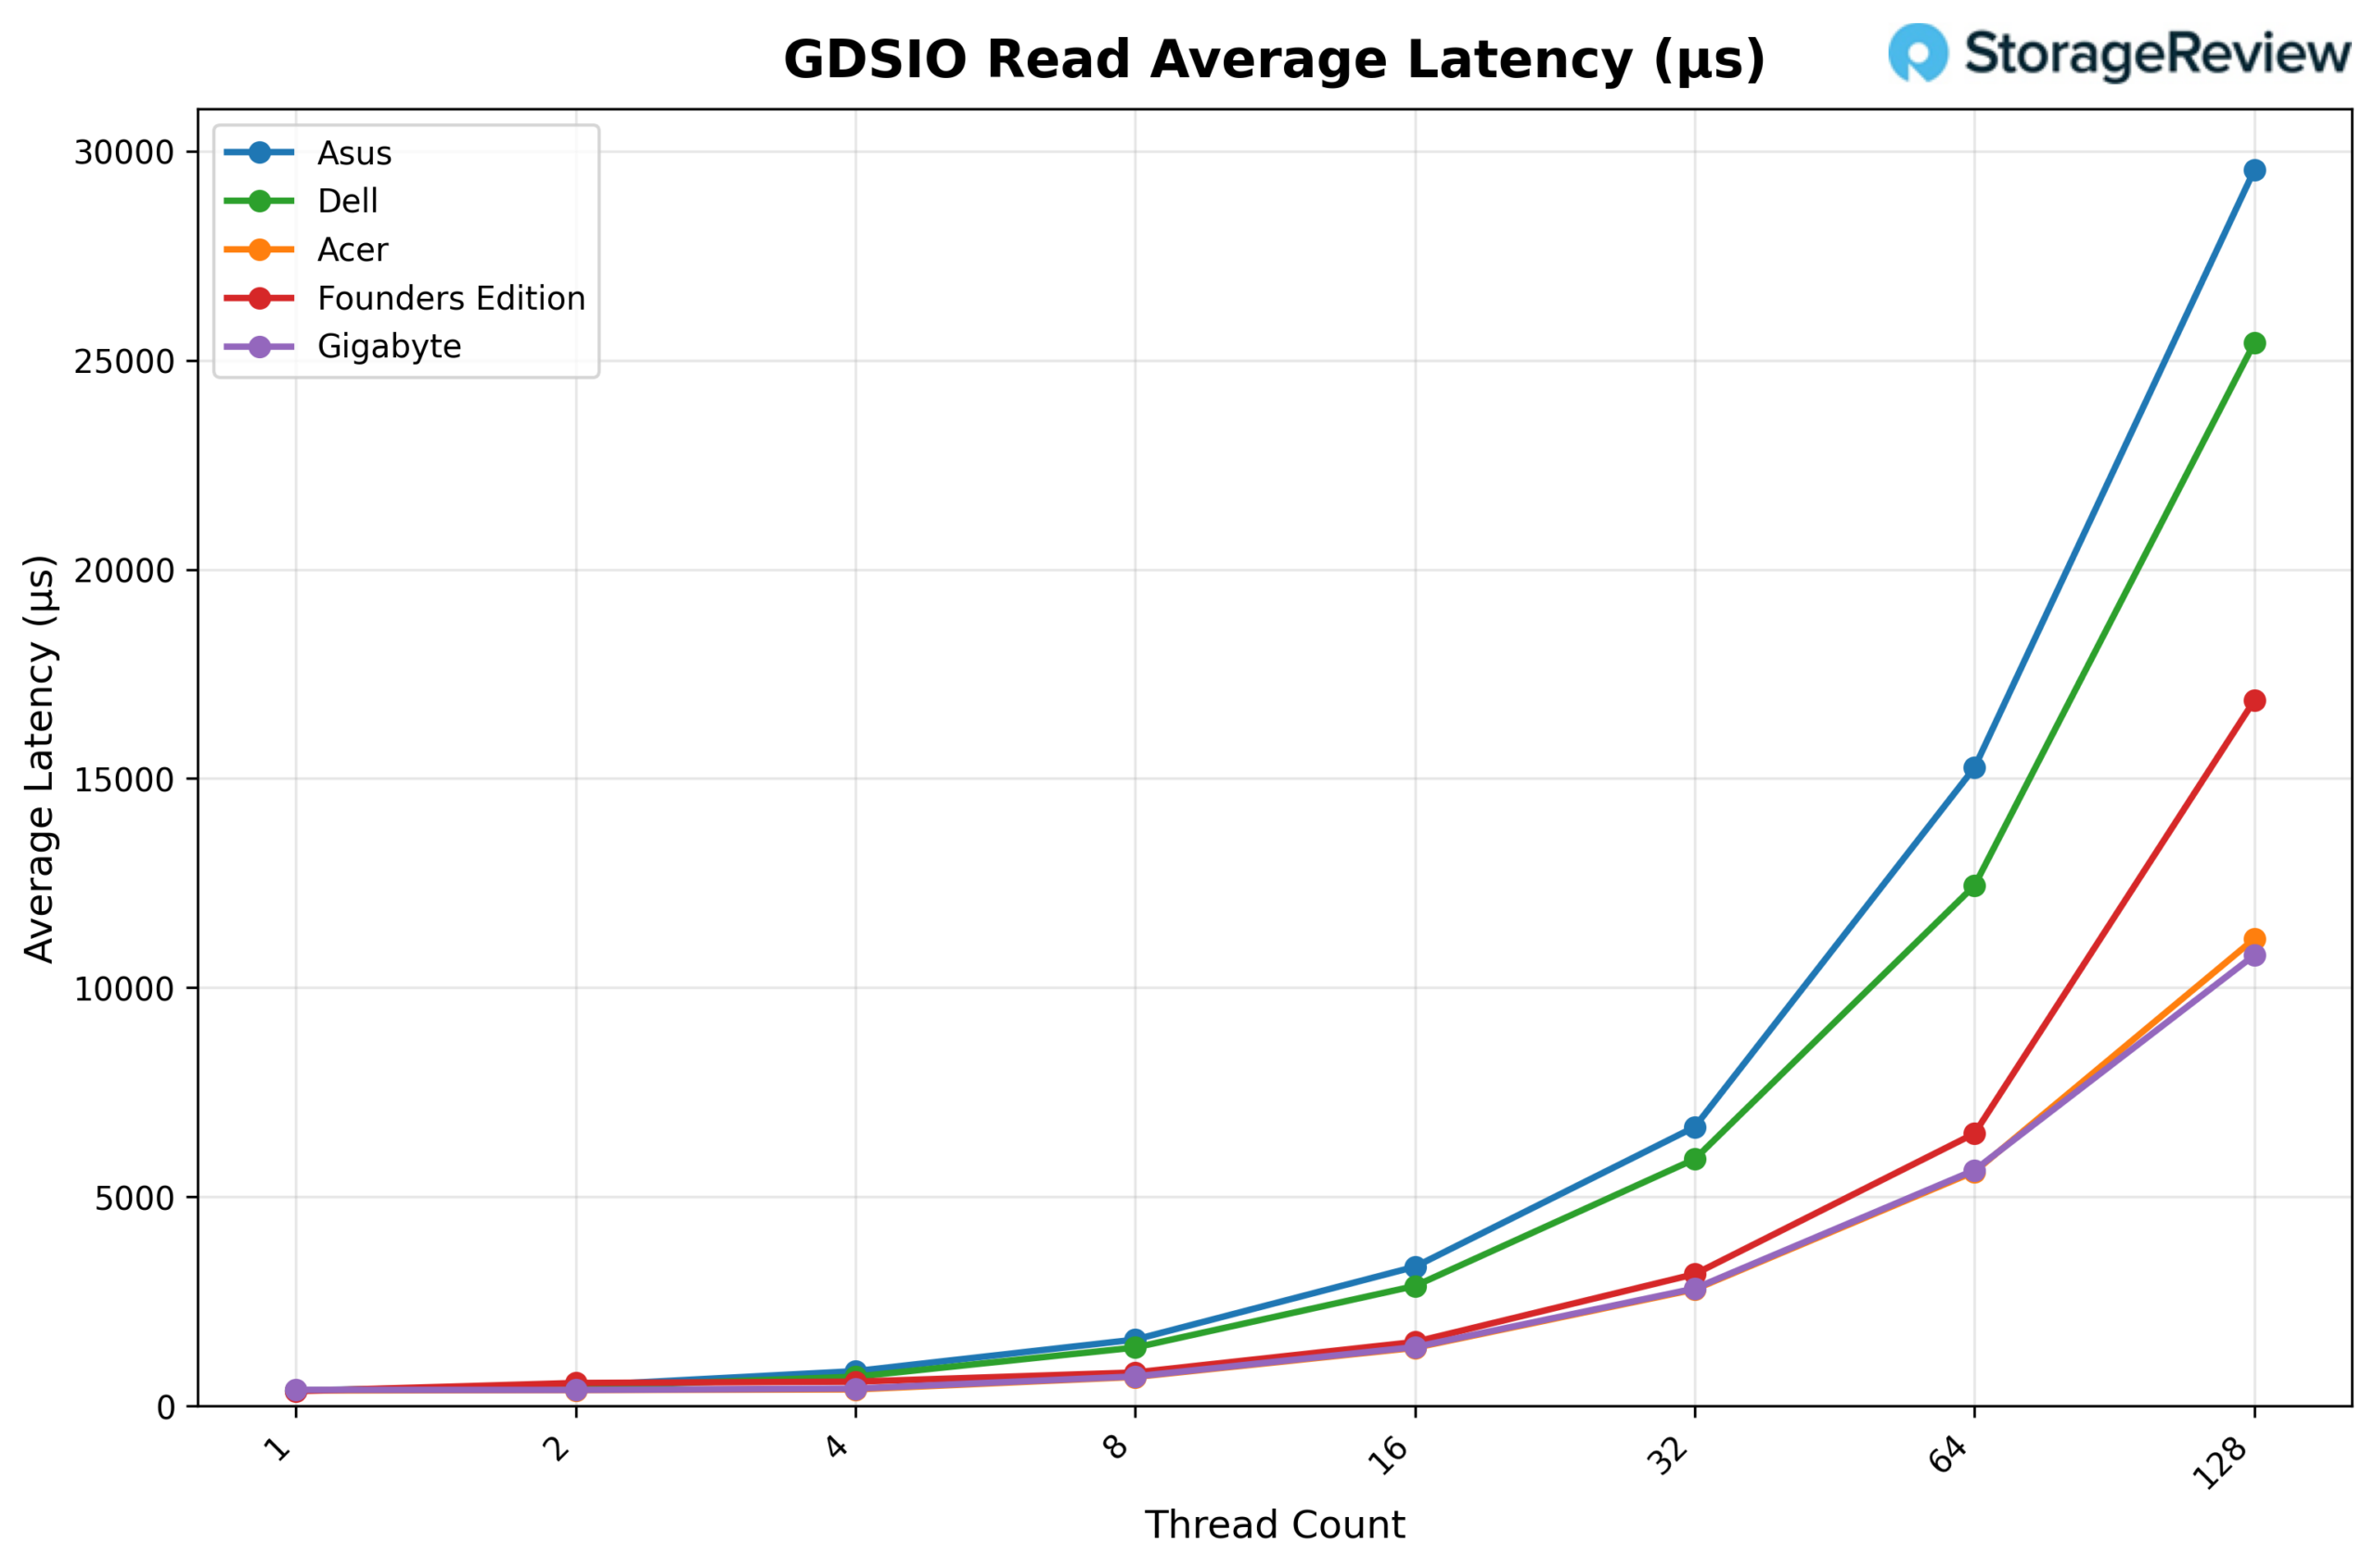
Patrząc na średnie opóźnienie odczytu GDSIO (1M), GIGABYTE zaczyna od około 0.39 ms przy 1 wątku i utrzymuje się na podobnym poziomie przy 2 wątkach (0.39 ms) i 4 wątkach (0.42 ms). Opóźnienie rośnie wraz ze wzrostem współbieżności, osiągając 0.71 ms przy 8 wątkach, 1.41 ms przy 16 wątkach i 2.81 ms przy 32 wątkach. Trend wzrostowy utrzymuje się przy 64 wątkach (5.64 ms) i osiąga 10.78 ms przy 128 wątkach, co odpowiada szczytowym poziomom współbieżności, a przepustowość pozostaje w dużej mierze stabilna.
Przepustowość zapisu GDSIO 1M
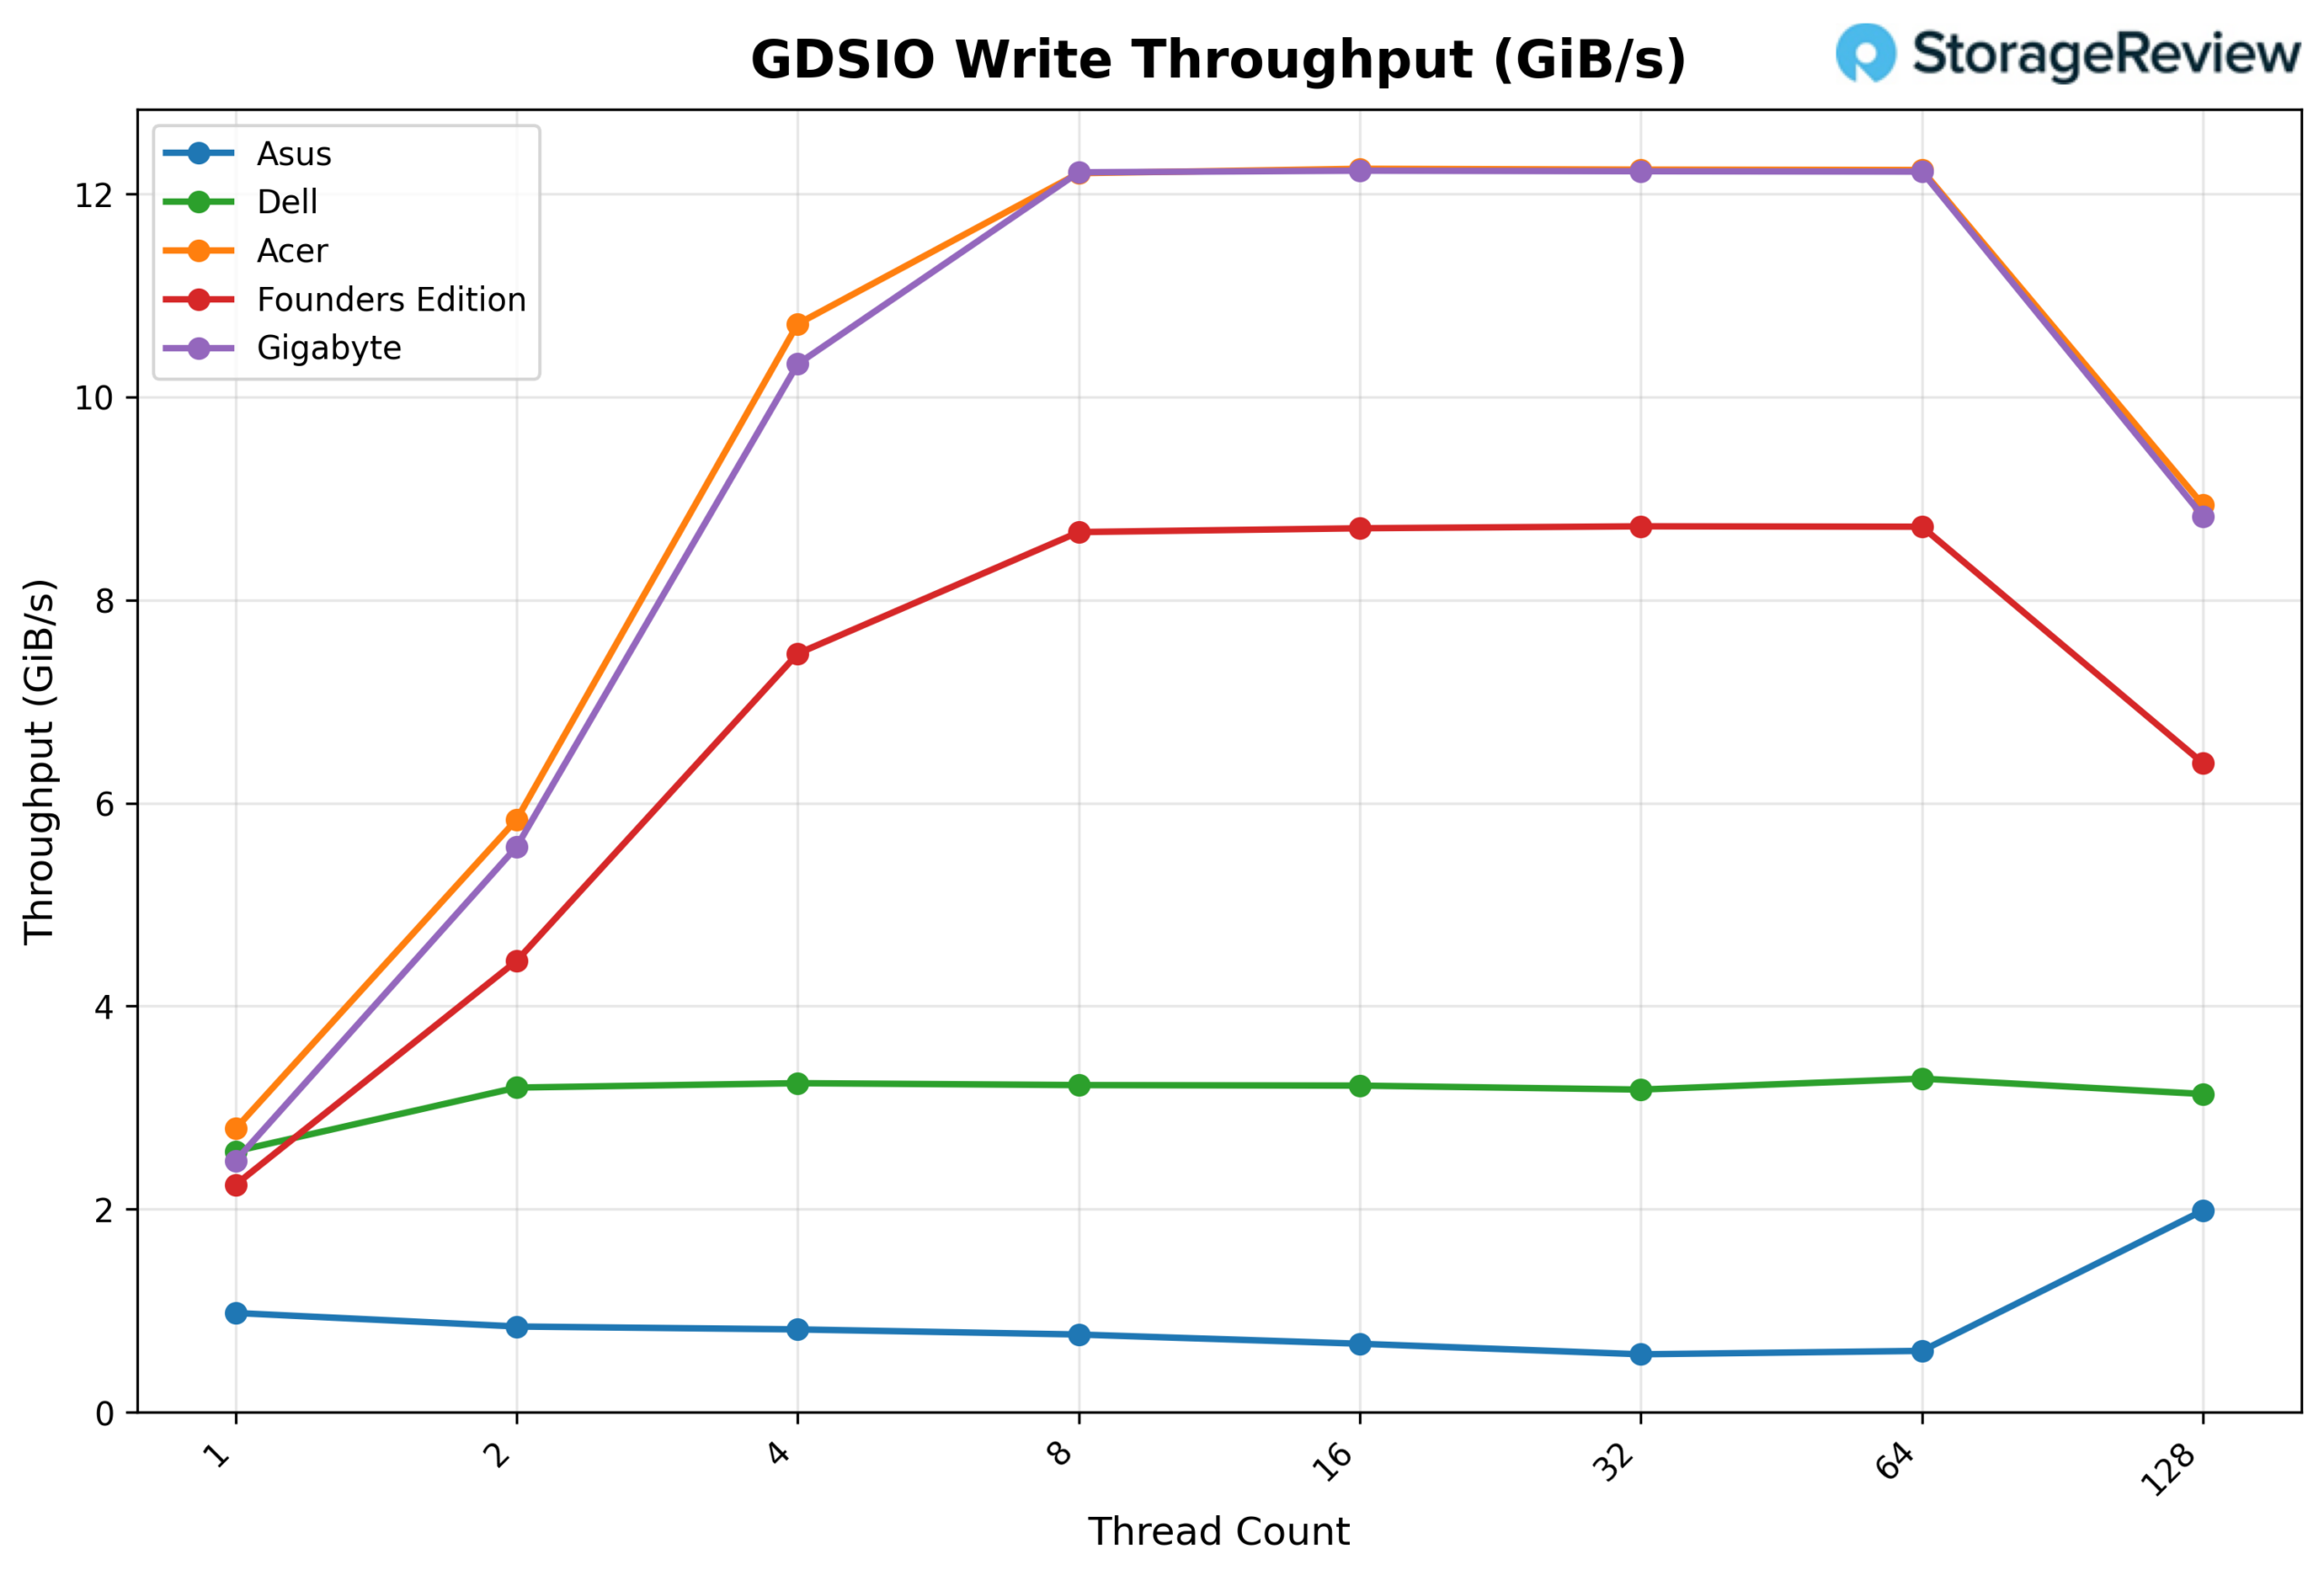
Patrząc na przepustowość zapisu GDSIO 1M, GIGABYTE zaczyna od 2.48 GiB/s przy 1 wątku i gwałtownie skaluje do 5.57 GiB/s przy 2 wątkach i 10.32 GiB/s przy 4 wątkach. Przy 8 wątkach przepustowość osiąga 12.21 GiB/s, skutecznie nasycając platformę. Wydajność pozostaje stabilna przy 16 wątkach (12.23 GiB/s), 32 wątkach (12.22 GiB/s) i 64 wątkach (12.22 GiB/s), co wskazuje na wczesne osiągnięcie plateau. Przy 128 wątkach przepustowość spada do 8.82 GiB/s, co sugeruje, że system przekroczył optymalny zakres współbieżności.
Średnie opóźnienie zapisu GDSIO 1M
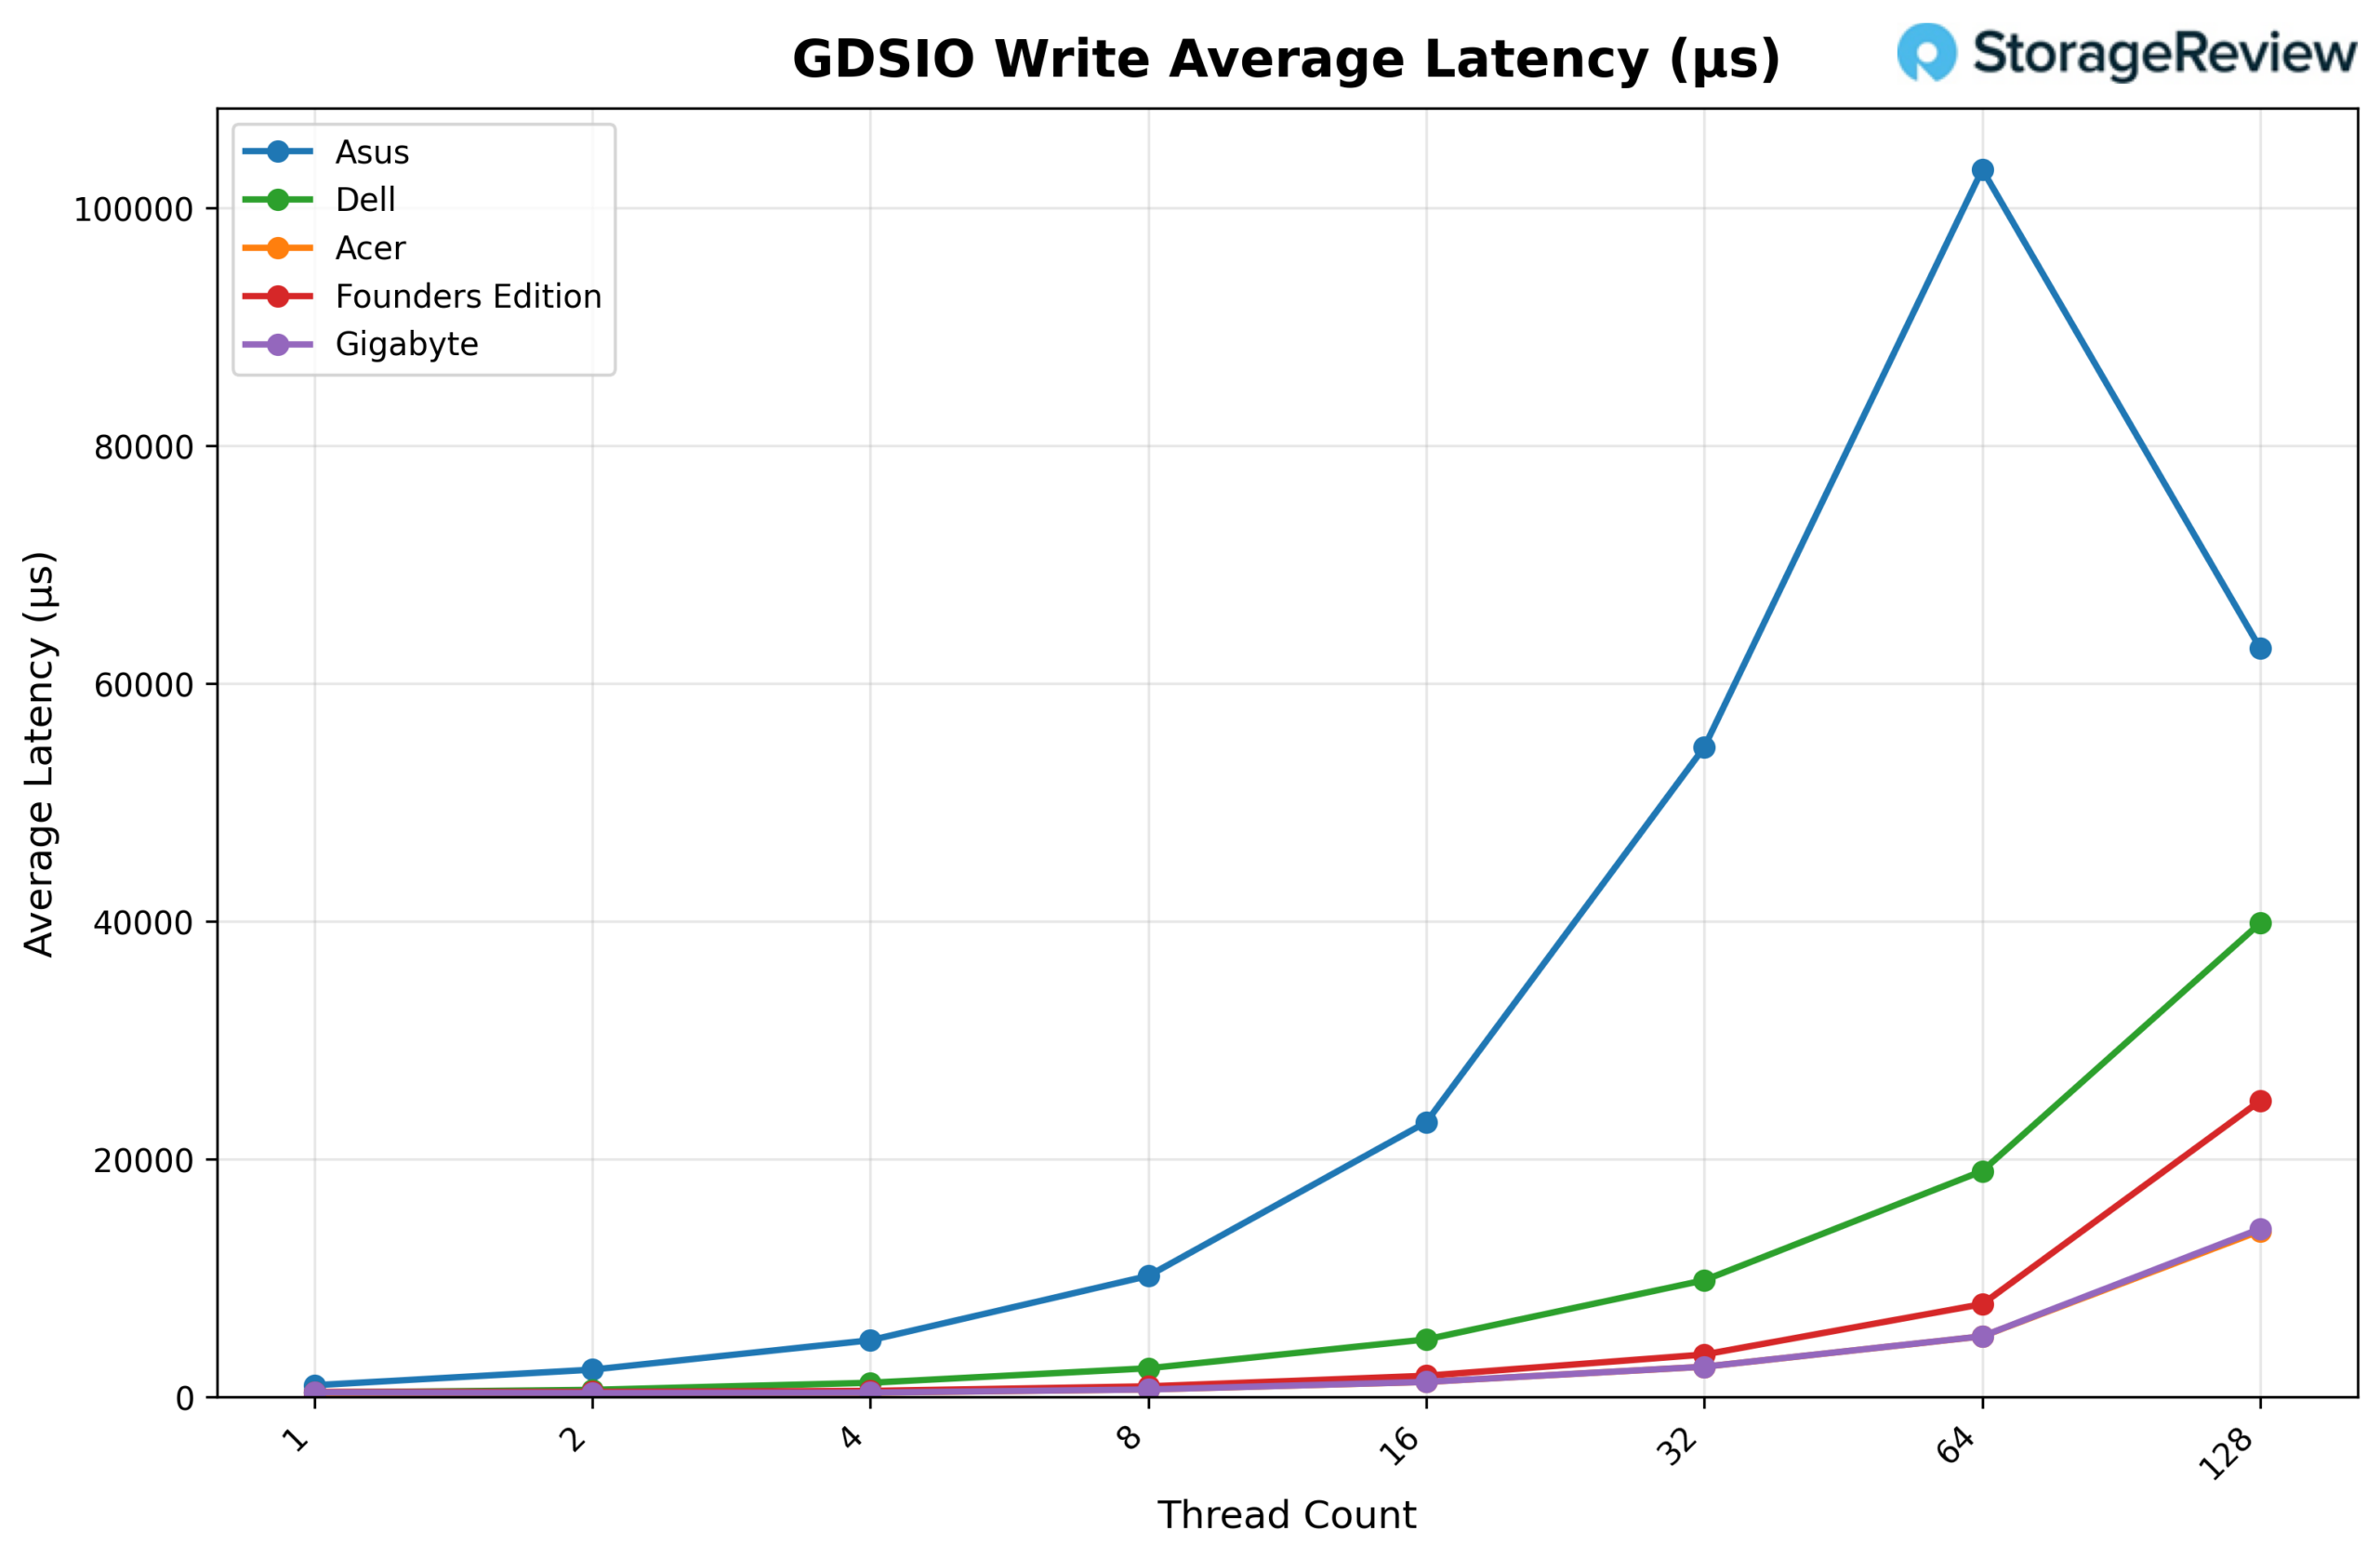
Patrząc na średnie opóźnienie zapisu GDSIO (1M), GIGABYTE rozpoczyna od około 0.39 ms przy 1 wątku i utrzymuje się na stosunkowo niskim poziomie przy 2 wątkach (0.35 ms) i 4 wątkach (0.38 ms). Opóźnienie wzrasta zauważalnie przy większej liczbie wątków, osiągając 0.64 ms przy 8 wątkach, 1.28 ms przy 16 wątkach i 2.56 ms przy 32 wątkach. Trend ten utrzymuje się przy 64 wątkach (5.11 ms), a następnie gwałtownie wzrasta przy 128 wątkach do 14.16 ms, co jest zgodne z obserwowanym spadkiem przepustowości przy najwyższym poziomie współbieżności.
Wniosek
GIGABYTE AI TOP ATOM to kolejna implementacja platformy Spark firmy NVIDIA opartej na architekturze GB10, zbudowana na tej samej płycie głównej i układzie scalonym, które testowaliśmy w całej ofercie. Zgodnie z oczekiwaniami, wydajność obliczeniowa rdzeni w vLLM jest porównywalna z resztą rynku. W modelach GPT-OSS, Qwen3-Coder i Llama 3.1 skalowanie pozostało przewidywalne, z wysoką przepustowością prefill i stabilną wydajnością Equal i Decode wraz ze wzrostem współbieżności.
Pod względem termicznym GIGABYTE dopuszczał nieco bardziej agresywne zachowanie w trybie burst. Podczas przejść z dużą intensywnością prefill, procesor CPU osiągał szczytową temperaturę 90°C, a GPU 81°C, a pobór mocy GPU sięgał 75.54 W. Po normalizacji obciążeń, temperatury ustabilizowały się bez oznak trwałego dławienia. W praktyce wyższe wartości szczytowe odzwierciedlają raczej krótkotrwałe decyzje dotyczące alokacji mocy niż niestabilność.
To urządzenie wyraźnie wyróżnia się pod względem pamięci masowej. Dzięki dyskowi Samsung PM9E1 Gen5 o pojemności 4 TB, GIGABYTE osiągnął jedne z najlepszych wyników GDSIO w grupie Spark. Przepustowość odczytu i zapisu skalowała się płynnie zarówno przy obciążeniach 16 tys., jak i 1 mln, z wczesnym nasyceniem przy oczekiwanych poziomach współbieżności i wzrostem opóźnień głównie przy największej liczbie wątków.
Ponieważ wszystkie systemy Spark korzystają z tego samego fundamentu GB10, różnica w benchmarkach w wnioskowaniu AI pozostaje niewielka. Wybór w warunkach rzeczywistych sprowadza się do konstrukcji obudowy, zachowania termicznego, konfiguracji pamięci masowej i dopasowania do dostawcy, a nie do fundamentalnych różnic w obliczeniach.
Strona produktu – GIGABYTE AI TOP ATOM
Tabela wyników: GIGABYTE AI TOP ATOM znajduje się w czołówce sprawdzonych komputerów w naszej tabeli najlepszych komputerów stacjonarnych dla lokalnej sztucznej inteligencji.


 Amazon