

Projekt Battlematrix firmy Intel stanowi atrakcyjną ofertę dla dostępnej infrastruktury AI, wprowadzając znaczną pojemność pamięci GPU do obudów stacji roboczych dzięki konstrukcji wieloprocesorowej. Platforma, zbudowana w oparciu o profesjonalny procesor graficzny o nazwie kodowej Battlemage Arc Pro B60, jest skierowana do organizacji, które chcą wdrażać duże modele językowe lokalnie, bez kosztów subskrypcji chmury i obaw o prywatność danych. Dzięki do 192 GB pamięci VRAM na ośmiu procesorach graficznych w jednym systemie, Battlematrix pozycjonuje się jako stosunkowo ekonomiczna alternatywa dla innych profesjonalnych ekosystemów GPU do zadań wnioskowania AI.
Zobacz ten post na Instagramie
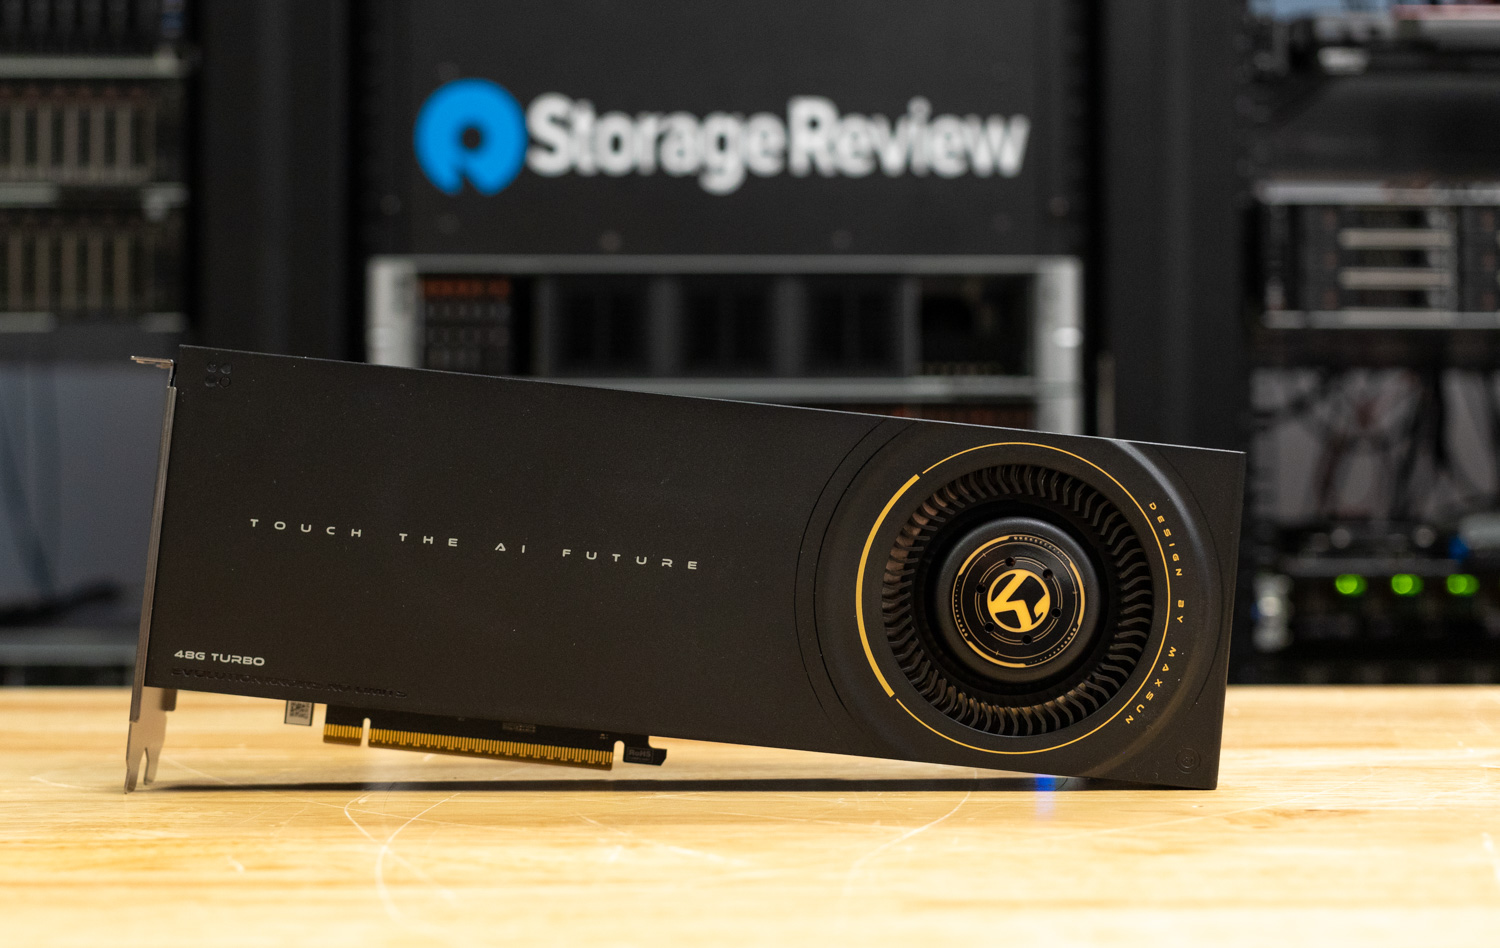
To, co wyróżnia Battlematrix na tle tradycyjnych konfiguracji stacji roboczych, to konstrukcja karty Intel z dwoma procesorami graficznymi (GPU), która umieszcza dwa pełne układy GPU B60 na jednej płytce PCB, wymagającej obsługi rozwidlenia PCIe. To zoptymalizowane pod kątem gęstości podejście umożliwia konfiguracje, które w innym przypadku wymagałyby serwerowych płyt głównych, a 24 GB pamięci GDDR6 na każdy procesor graficzny w Arc Pro B60 sprawia, że karta ta doskonale nadaje się do modeli transformatorowych o dużej pojemności pamięci. Wstępne testy ujawniają obiecujący potencjał, choć optymalizacja oprogramowania wciąż pozostaje w tyle za możliwościami sprzętu.
Ujawnienie
Testy przeprowadzono z wykorzystaniem wczesnych wersji oprogramowania i sterowników, w tym gałęzi rozwojowych Intel LLM Scaler. Ponadto nasza platforma testowa wykorzystuje procesory AMD EPYC, a nie platformę Intel Xeon. Intel pozycjonuje Battlematrix jako rozwiązanie oparte wyłącznie na procesorach Intel Xeon 6, a systemy produkcyjne z procesorami Intel mogą wykazywać wyższą wydajność niż sugerują nasze wyniki. Czytelnicy powinni traktować te wyniki jako wstępne, mając na uwadze, że dojrzałość oprogramowania i optymalizacja platformy powinny się poprawić w ciągu 2026 roku.
Specyfikacje i architektura
| Specyfikacja | Szczegół |
|---|---|
| Kolekcja produktów | Karta graficzna Intel® Arc™ Pro serii B |
| Nazwa kodowa | Mag bitewny |
| Architektura GPU | Xe2 (TSMC N5) |
| Xe-kolory | 20 |
| Renderuj plasterki | 5 |
| Jednostki śledzenia promieni | 20 |
| Silniki XMX | 160 |
| Silniki wektorowe Xe | 160 |
| Zegar graficzny | 2400 MHz |
| Zegar graficzny (tryb LP) | 2000 MHz |
| Wydajność GPU FP32 | X TFTPS |
| Szczytowe wartości GPU (INT8) | 197 |
| Całkowita moc płyty (TBP) | W 200 |
| Pamięć | 24 PL GDDR6 |
| Interfejs pamięci | 192-bit |
| Przepustowość pamięci | 456 Gb / s |
| Szybkość pamięci | 19 Gbps |
| Interfejs PCIe | PCIe 5.0 x8 |
| Obsługiwane wyświetlacze | 4 |
| Wyjście graficzne | HDMI 2.1 | DP2.1 (UHBR 13.5) | DP2.1 (UHBR 10) |
| Maksymalna rozdzielczość (HDMI) | 7680 x 4320 @ 120Hz |
| Maksymalna rozdzielczość (DP) | 7680 x 4320 @ 60Hz |
| Zmienna częstotliwość odświeżania HDMI | Tak |
| Adaptacyjna synchronizacja VESA | Tak |
| Kodowanie/dekodowanie H.264 / H.265 / AV1 | Tak |
| Obsługa Ray Tracingu | Tak |
| Wsparcie oneAPI | Tak |
| Wsparcie OpenVINO | Tak |
| Obsługa Intel IPEX | Tak |
| Obsługa Intel XeSS | Tak |
Intel Arc Pro B60 dzieli swoją krzemową podstawę z systemem skoncentrowanym na grach Intel Arc B580Oba wykorzystują tę samą matrycę, wyprodukowaną w procesie technologicznym 5 nm firmy TSMC. Ten układ o powierzchni 272 mm² zawiera 19.6 miliarda tranzystorów i integruje 20 rdzeni Xe2, które według zapewnień mają zapewnić 12.28 TFLOPS mocy obliczeniowej FP32 i 197 TOPS wydajności INT8 AI na GPU. Kluczowa różnica tkwi w konfiguracji pamięci: podczas gdy model B580 jest wyposażony w 12 GB pamięci GDDR6, model B60 podwaja jej pojemność do 24 GB.
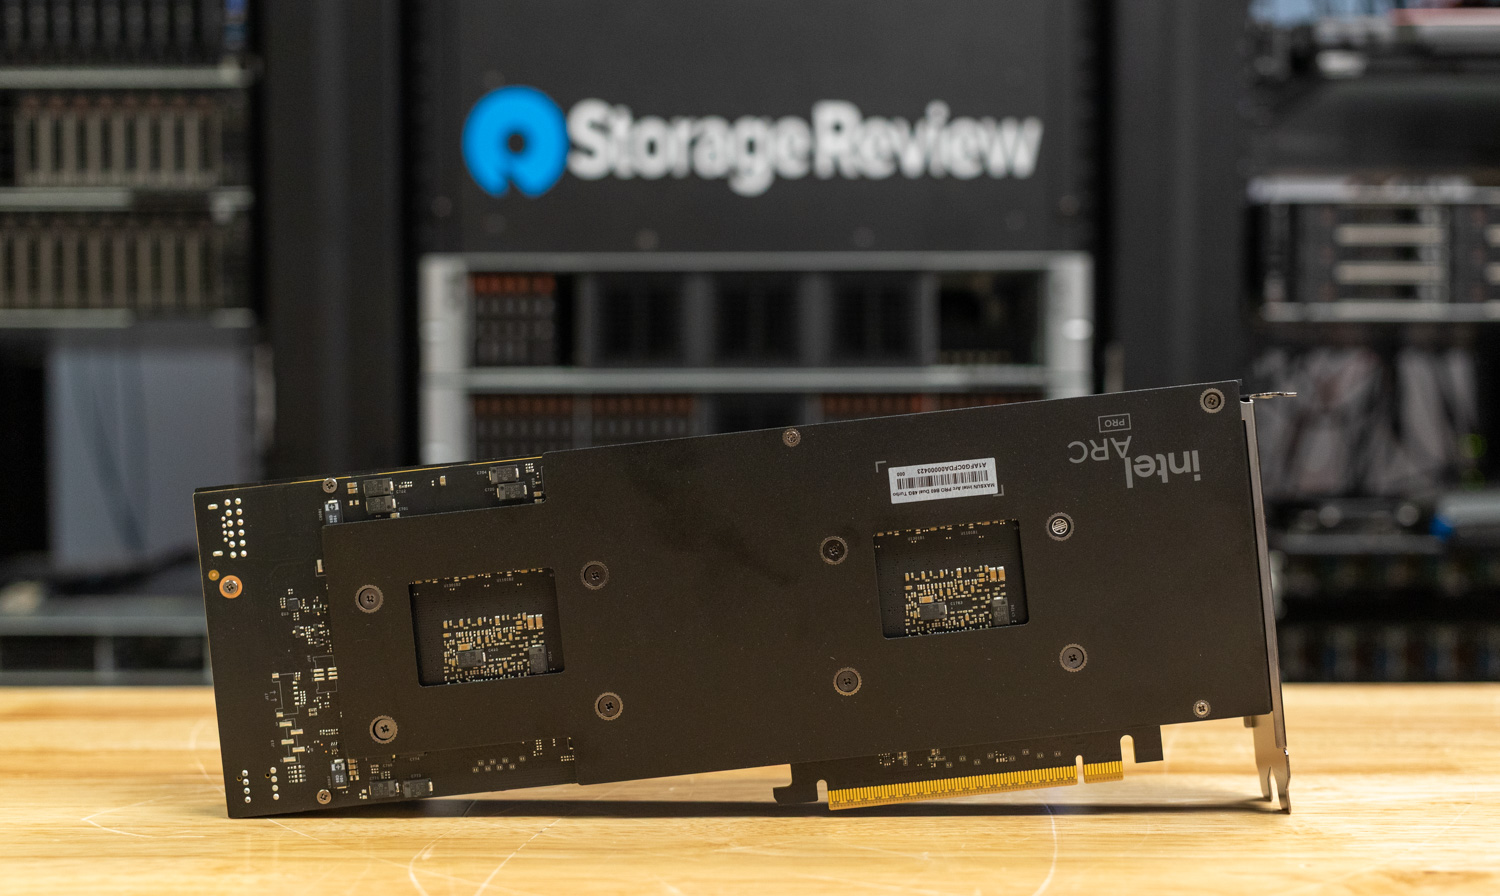
Każdy procesor graficzny B60 działa z częstotliwością 2,400 MHz na 192-bitowym interfejsie pamięci, zapewniając przepustowość 456 GB/s na procesor graficzny. Architektura obejmuje 160 silników AI XMX (Xe Matrix Extensions) na procesor graficzny, zaprojektowanych specjalnie do przyspieszenia operacji macierzowych w wnioskowaniu AI.
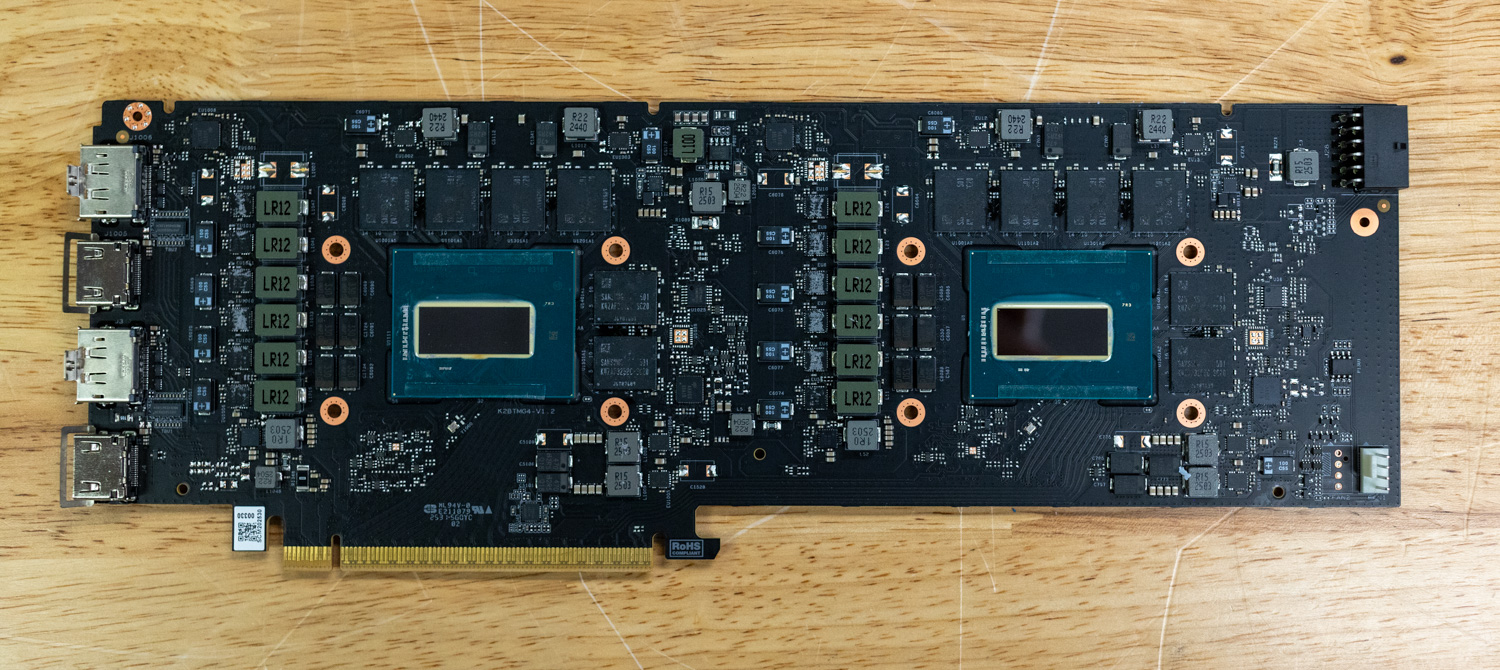
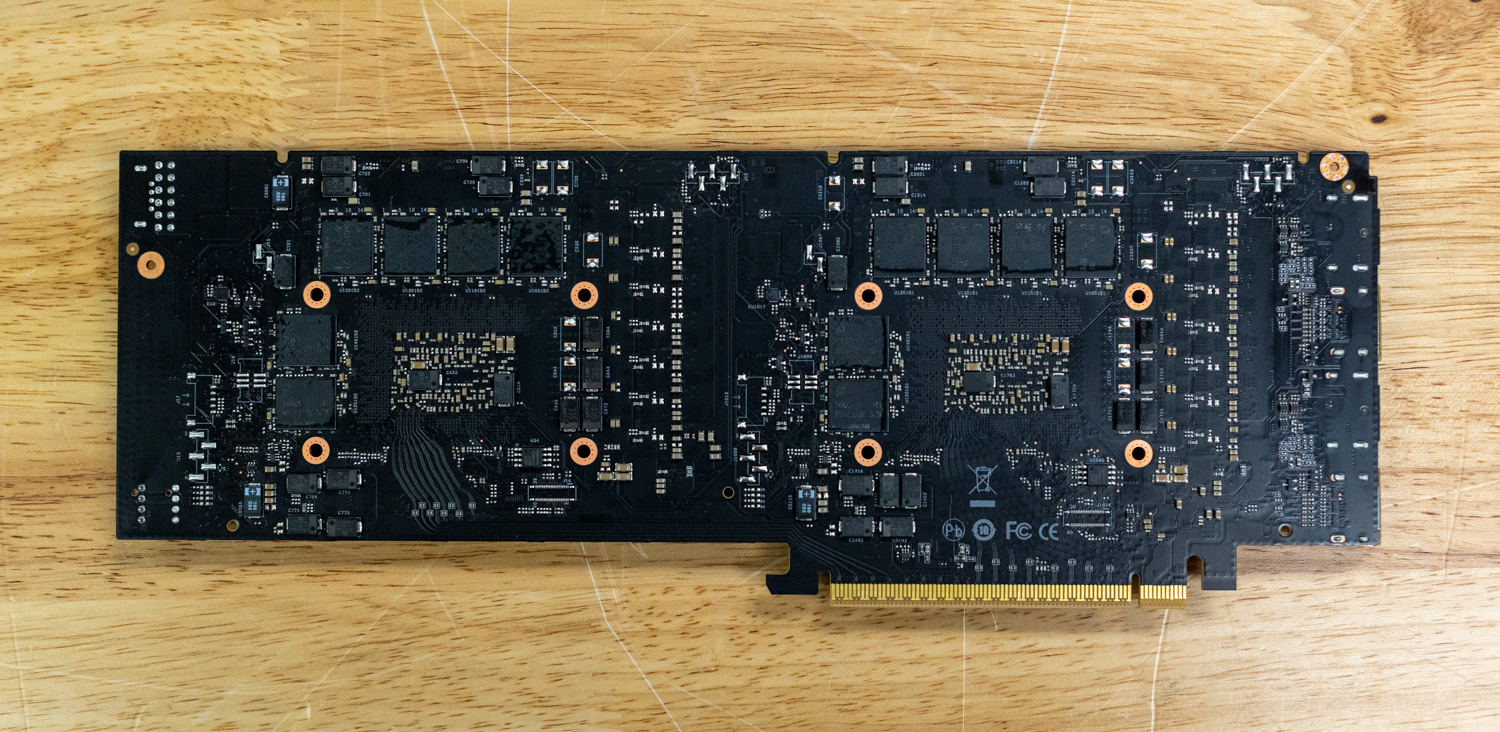
Konstrukcja z dwoma procesorami graficznymi i rozwidlenie PCIe
Karta Maxsun Arc Pro B60 Dual 48G Turbo stanowi przykład strategii firmy Intel w zakresie gęstości: dwa kompletne procesory graficzne (GPU) zamontowane na jednej karcie dwugniazdowej, połączone niezależnie interfejsami PCIe 5.0 x8. W przeciwieństwie do tradycyjnych konstrukcji z dwoma procesorami graficznymi, które łączą ze sobą układy, aby działały jako pojedynczy procesor graficzny, każdy procesor graficzny B60 jest traktowany jako oddzielne urządzenie w systemie, co wymaga obsługi przez płytę główną rozwidlenia PCIe x8/x8. Pojedynczy slot x16 dzieli się elektrycznie na dwa złącza x8, a każdy procesor graficzny otrzymuje dedykowaną przepustowość.
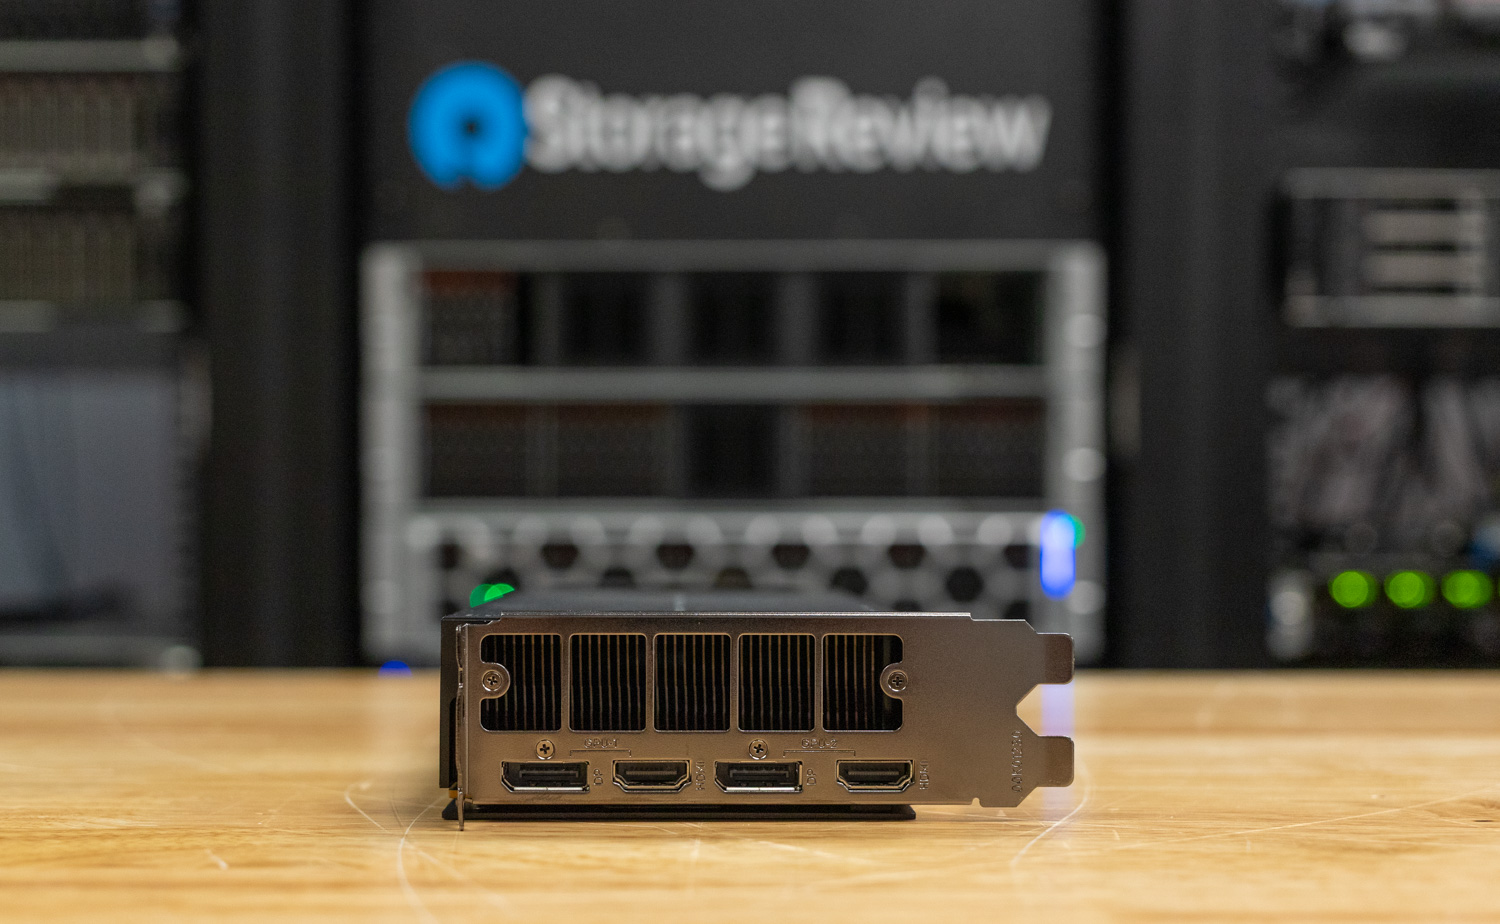
PCIe 5.0 x8 zapewnia dwukierunkową przepustowość 128 GB/s na kartę graficzną, dorównując PCIe 4.0 x16. Konfiguracja z dwiema kartami ma 300 mm długości, zajmuje dwa sloty z chłodzeniem typu blower i pobiera łącznie 400 W mocy za pośrednictwem pojedynczego złącza 12 V-2×6 o mocy 600 W.
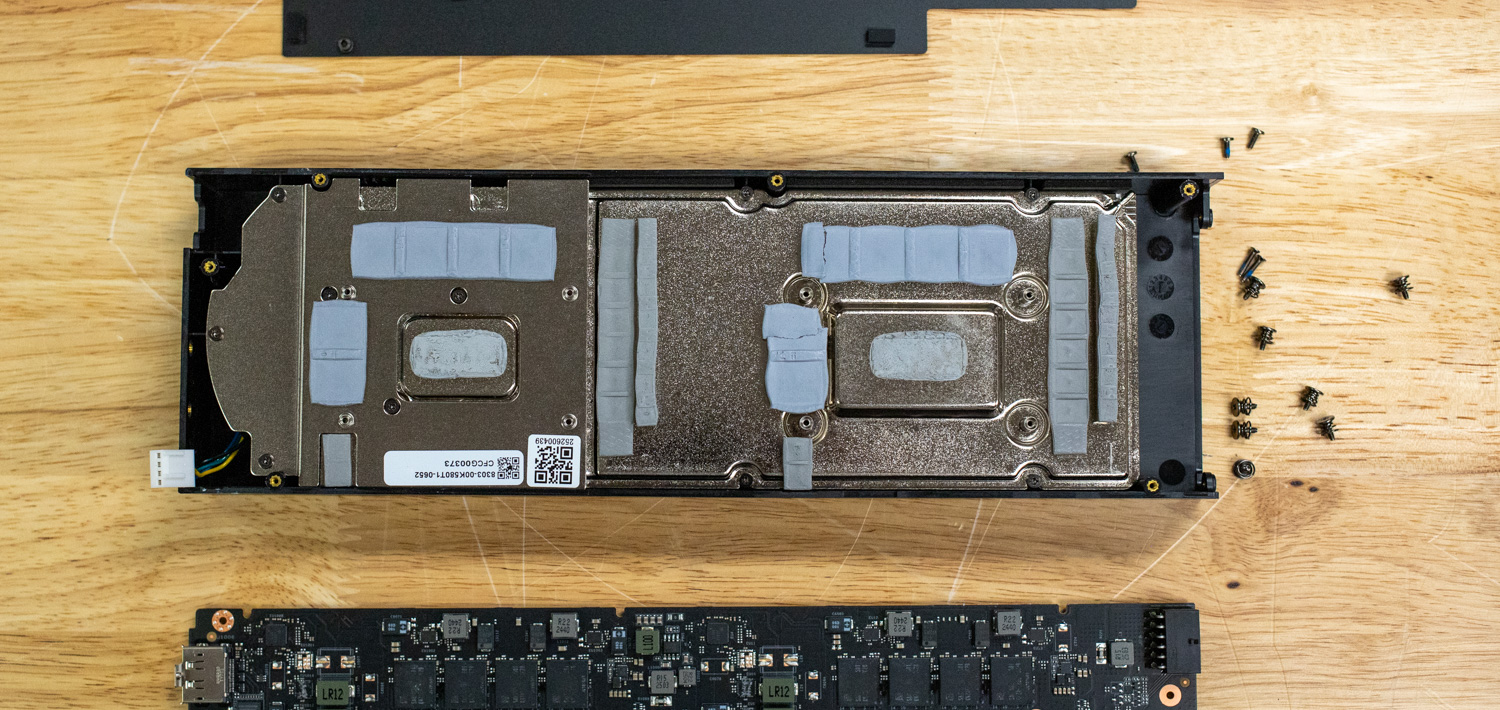
Każda podwójna karta oferuje cztery wyjścia wideo: dwa porty DisplayPort 2.1 UHBR20 i dwa porty HDMI 2.1a, po jednym na każdy procesor graficzny, co umożliwia oddzielne konfiguracje wyjścia wideo dla zwirtualizowanych środowisk desktopowych lub systemów wielodostępnych. Należy pamiętać, że dla każdego procesora graficznego można jednocześnie używać tylko jednego z dwóch wyjść wideo.
Zobacz ten post na Instagramie
Konfiguracja Battlematrix z ośmioma procesorami GPU
Referencyjna specyfikacja Intel Battlematrix obsługuje do ośmiu procesorów graficznych Arc Pro B60 w obudowie stacji roboczej, co jest możliwe dzięki zastosowaniu czterech kart z dwoma procesorami graficznymi. Ta konfiguracja zapewnia:
- 192 GB całkowitej pamięci VRAM systemu (8 × 24 GB)
- 1,280 silników XMX AI
- 1,576 TOPÓW INT8 obliczenia zbiorcze
- 3.6 TB/s łączna przepustowość pamięci
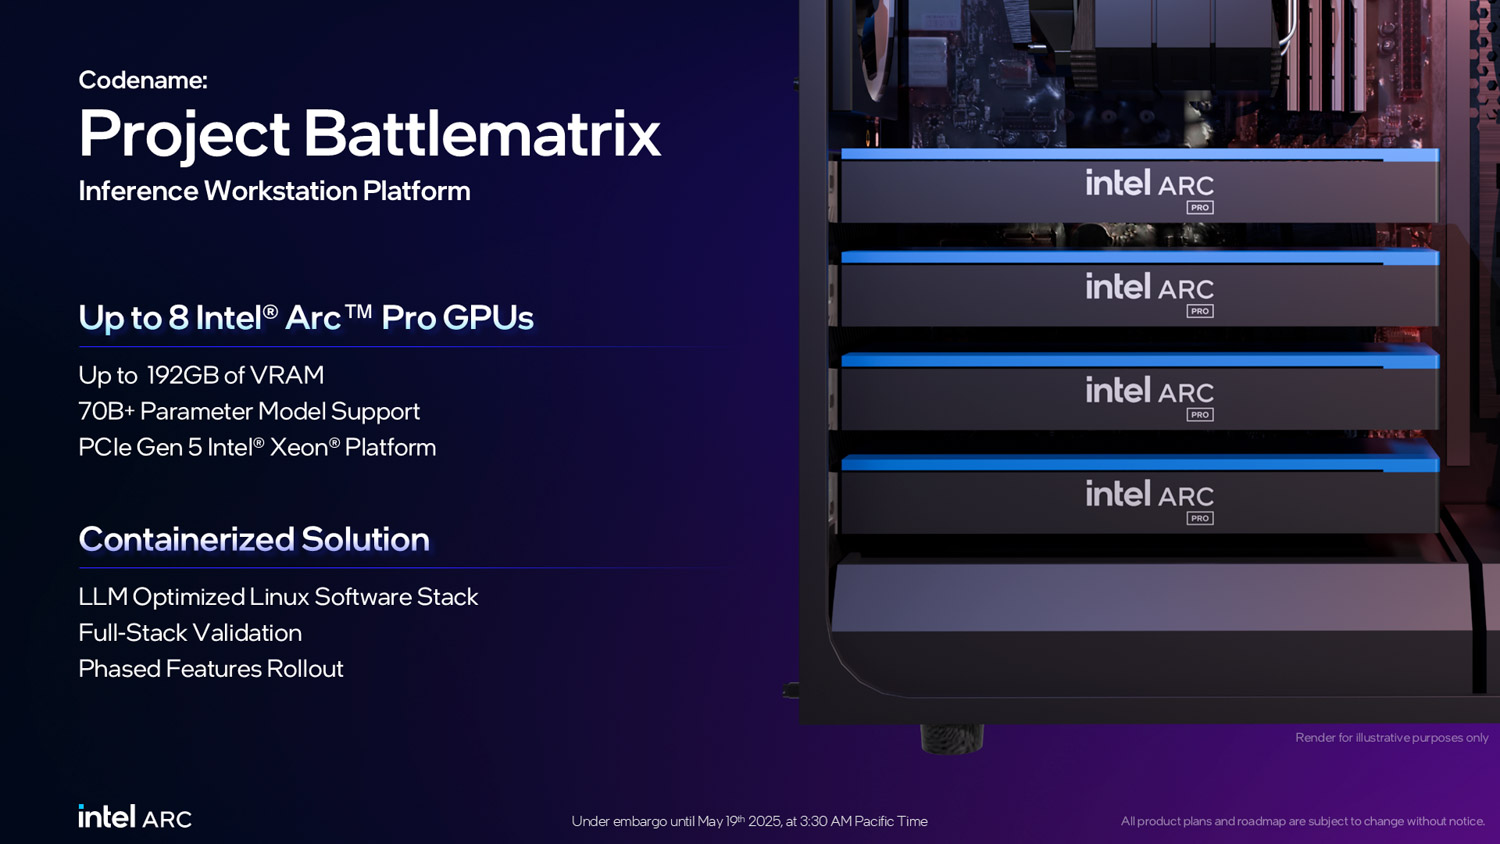
Platforma wymaga płyty głównej z czterema gniazdami PCIe 5.0 x16 obsługującymi rozwidlenie, a specyfikacja Battlematrix będzie również obejmować procesor Xeon 6. Jednak obecnie nie ma dostępnych innych informacji na temat konfiguracji Battlematrix.
Przykłady zastosowań i propozycja wartości
Grupa docelowa
Projekt Battlematrix firmy Intel jest skierowany do trzech segmentów rynku: zespołów programistów AI wymagających infrastruktury lokalnej, organizacji zajmujących się inżynierią oprogramowania wdrażających procesy wspomagane sztuczną inteligencją z wykorzystaniem wrażliwych baz kodu oraz organizacji poszukujących ekonomicznych alternatyw dla usług wnioskowania w chmurze. Podstawową wartością platformy jest suwerenność danych i przewaga całkowitego kosztu posiadania (TCO) nad wieloletnimi subskrypcjami w chmurze.
Prywatna sztuczna inteligencja i rozwój agentów
Podstawową zaletą platformy Battlematrix jest obsługa procesów rozwojowych dla dużych modeli językowych, które wymagają obszernych okien kontekstowych i znacznej liczby parametrów.
Zespoły programistyczne tworzące systemy agentowe szczególnie korzystają z dostępnej rezerwy pamięci. Implementacje agentów RAG zazwyczaj utrzymują jednocześnie wiele komponentów w pamięci GPU: model języka bazowego, modele osadzania do wyszukiwania wektorowego oraz modele rerankingu. Ponadto, przepływy pracy agentowe realizują wieloetapowe wnioskowanie, wykorzystują narzędzia i dokonują autokorekty, generując obszerne okna kontekstowe w toku iteracji. Agent kodujący analizujący dużą bazę kodu może zgromadzić ponad 100 tys. tokenów w całym cyklu operacyjnym.
Przyszłość VDI i wirtualizowane gry
Plany firmy Intel obejmują włączenie obsługi SR-IOV (Single Root I/O Virtualization) w procesorach graficznych Arc Pro B60, przekształcając sprzęt w platformę graficzną dla wielu użytkowników. SR-IOV umożliwia podział fizycznego procesora graficznego na wiele wirtualnych procesorów graficznych, z których każdy może być przypisany do oddzielnych maszyn wirtualnych z bezpośrednim dostępem do sprzętu i izolowanymi przestrzeniami pamięci.
Ta funkcja odblokowuje scenariusze infrastruktury wirtualnych pulpitów bez licencji, w których pojedynczy system Battlematrix z ośmioma GPU obsługuje dziesiątki równoczesnych użytkowników z dedykowaną akceleracją GPU do aplikacji CAD, edycji wideo lub gier o umiarkowanym natężeniu. Tradycyjne rozwiązania VDI wymagają wysokich opłat licencyjnych oprócz kosztów sprzętu, co często wiąże się z koniecznością stosowania droższych procesorów graficznych dla profesjonalistów lub centrów danych. Zaangażowanie firmy Intel w wirtualizację bez licencji eliminuje te koszty operacyjne.
Propozycja cen i wartości
Firma Intel ogłosiła, że cena procesora Arc Pro B60 wyniesie około 600 dolarów za kartę graficzną. Na potrzeby wstępnych testów i rozwoju, konfiguracje z jedną lub dwiema kartami (w cenach od 600 do 1,200 dolarów) oferują przystępne ceny. Pojedyncza karta z dwoma kartami graficznymi i 48 GB pamięci VRAM zapewnia wystarczającą pojemność dla modeli kwantyzowanych i obsługuje znaczną część popularnych aplikacji LLM typu open source.
Testowana przez nas konfiguracja Maxsun Dual Arc Pro B60 Dual 48G Turbo kosztuje bezpośrednio w Maxsun 1,200 dolarów, zgodnie z pierwotną zapowiedzią firmy Intel. Jednak ostatnie wahania cen pamięci mogą mieć na to wpływ.
Wyjątkowa wartość w cenach wejściowych
Konfiguracje z jedną i dwiema kartami oferują atrakcyjne rozwiązania ekonomiczne dla małych zespołów, indywidualnych programistów i domowych laboratorów. Przy cenie 600 dolarów za 24 GB pamięci GPU i 1,200 dolarów za 48 GB, platforma ta znacznie przewyższa profesjonalne alternatywy GPU, które zazwyczaj kosztują co najmniej dwa razy więcej.
Ta propozycja wartości jest szczególnie przydatna dla organizacji, które rozważają integrację sztucznej inteligencji bez angażowania w to budżetu korporacyjnego.
Wydajność testu porównawczego obsługi online vLLM
vLLM to najpopularniejszy silnik wnioskowania i obsługi o wysokiej przepustowości dla systemów LLM. Test porównawczy obsługi online vLLM to narzędzie do oceny wydajności, które mierzy rzeczywistą wydajność obsługi przy współbieżnych żądaniach. Symuluje obciążenia produkcyjne, wysyłając żądania do działającego serwera vLLM z konfigurowalnymi parametrami, takimi jak częstotliwość żądań, długość wejścia/wyjścia i liczba współbieżnych klientów. Test mierzy kluczowe wskaźniki, takie jak przepustowość (liczba tokenów na sekundę), czas do pierwszego tokena (TTFT) i czas na token wyjściowy (TPOT), pomagając użytkownikom zrozumieć, jak vLLM działa w różnych warunkach obciążenia.
Platforma testowa:
- serwer: Supermicro AS-4125GS-TNRT
- Procesory: AMD EPYC 9374F
- Pamięć: 512 GB Samsung 4800 MT/s DDR5
- Procesory graficzne: 4x Maxsun MS-Intel ARC Pro B60 Dual 48G Turbo
Wsparcie i ograniczenia kwantyzacji
Te procesory graficzne powinny doskonale radzić sobie z wnioskowaniem o niskiej precyzji, ukierunkowanym na kwantyzację INT4, aby zapewnić optymalną wydajność. Jednak ze względu na bardzo wczesną wersję rozwojową oprogramowania LLM Scaler firmy Intel, które testowaliśmy, tylko modele GPT OSS trenowane początkowo w formacie mikroskalowania MXFP4 działały poprawnie. Inne formaty kwantyzacji, w tym standardowe INT4, FP8 i AWQ, nie uruchomiły się całkowicie. To ograniczenie znacząco ograniczyło nasze możliwości dokładnego przetestowania tych procesorów graficznych, choć spodziewamy się szerszego wsparcia dla kwantyzacji w miarę rozwoju stosu oprogramowania.
Większość modeli przetestowaliśmy w dwóch konfiguracjach: pełnej konfiguracji Battlematrix z ośmioma GPU oraz minimalnej liczbie GPU wymaganej do umieszczenia modelu w pamięci. To porównanie ujawnia interesujące cechy skalowania, szczególnie w zakresie narzutu komunikacyjnego przy mniejszych rozmiarach partii.
Typy danych mikroskalowych
Mikroskala to zaawansowane podejście do kwantyzacji, które stosuje drobnoziarniste współczynniki skalowania do małych bloków wag, zamiast jednorodnej kwantyzacji w dużych grupach parametrów. Format MXFP4 implementuje tę technikę za pomocą blokowej reprezentacji zmiennoprzecinkowej, gdzie każdy blok mikroskali ma wspólny wykładnik jako współczynnik skalowania, co pozwala zachować precyzję numeryczną przy jednoczesnym osiągnięciu precyzji 4-bitowej. Kluczową zaletą typu danych MXFP4 jest to, że kwantyzacja modeli do INT4 nie powoduje znacznego pogorszenia jakości odpowiedzi, w przeciwieństwie do kwantyzacji z formatów o wyższej precyzji, takich jak BF16. Modele GPT OSS są uruchamiane z kwantyzacją INT4 na procesorach B60, ponieważ nie obsługują one natywnie MXFP4.
OpenAI GPT-OSS 20B
Model parametrów 20B wyraźnie ilustruje zjawisko narzutu komunikacyjnego. Przy rozmiarze partii 1, pojedynczy procesor GPU zapewnia 49.22 tok/s na użytkownika, w porównaniu z zaledwie 22.83 tok/s po rozłożeniu na wszystkie osiem procesorów GPU. Konfiguracja z jednym procesorem GPU przewyższa go ponad dwukrotnie. Jednak konfiguracja z ośmioma procesorami GPU wyróżnia się przy wyższej współbieżności, osiągając całkowitą przepustowość 511.99 tok/s przy rozmiarze partii 16.
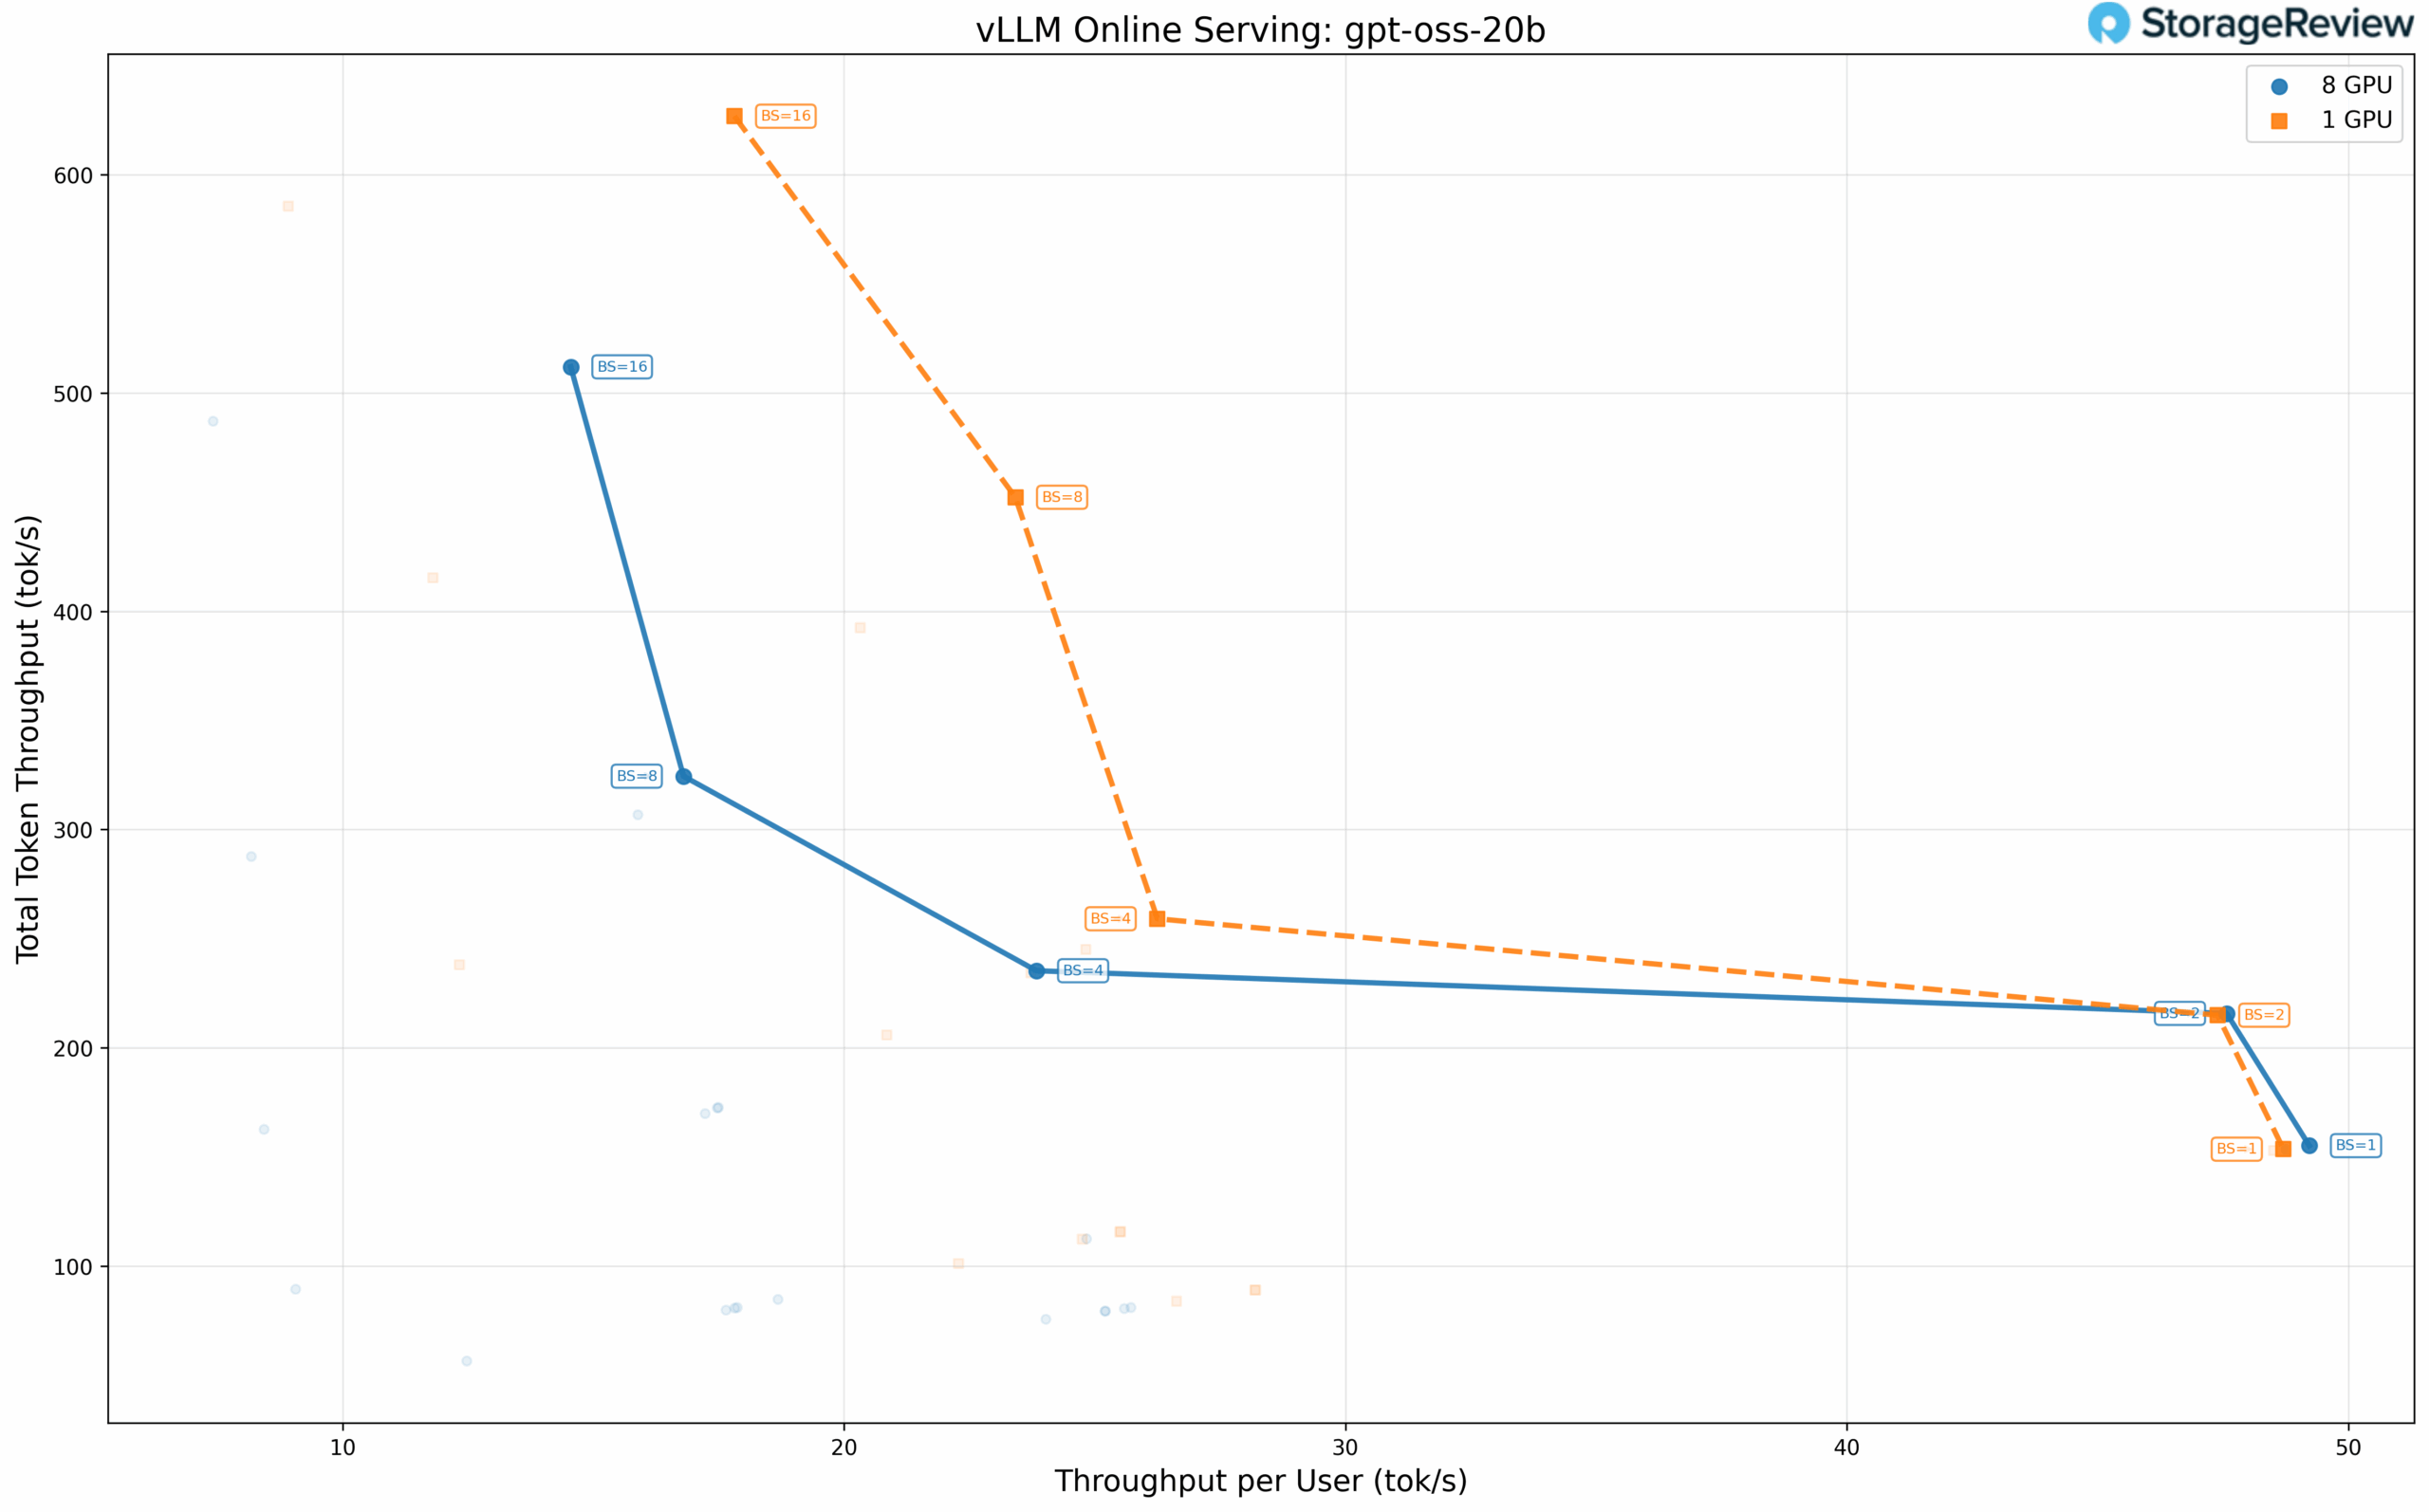 Minimalna konfiguracja GPU faktycznie zapewnia wyższą całkowitą przepustowość przy rozmiarze partii 16: 626.84 tok/s przy TP=4 w porównaniu z 511.99 tok/s przy TP=8. Ten sprzeczny z intuicją wynik podkreśla, że w przypadku modeli i długości kontekstu, które wygodnie mieszczą się na mniejszej liczbie GPU, dodanie większej ilości sprzętu wprowadza narzut komunikacyjny bez proporcjonalnego wzrostu wydajności.
OpenAI GPT-OSS 120B
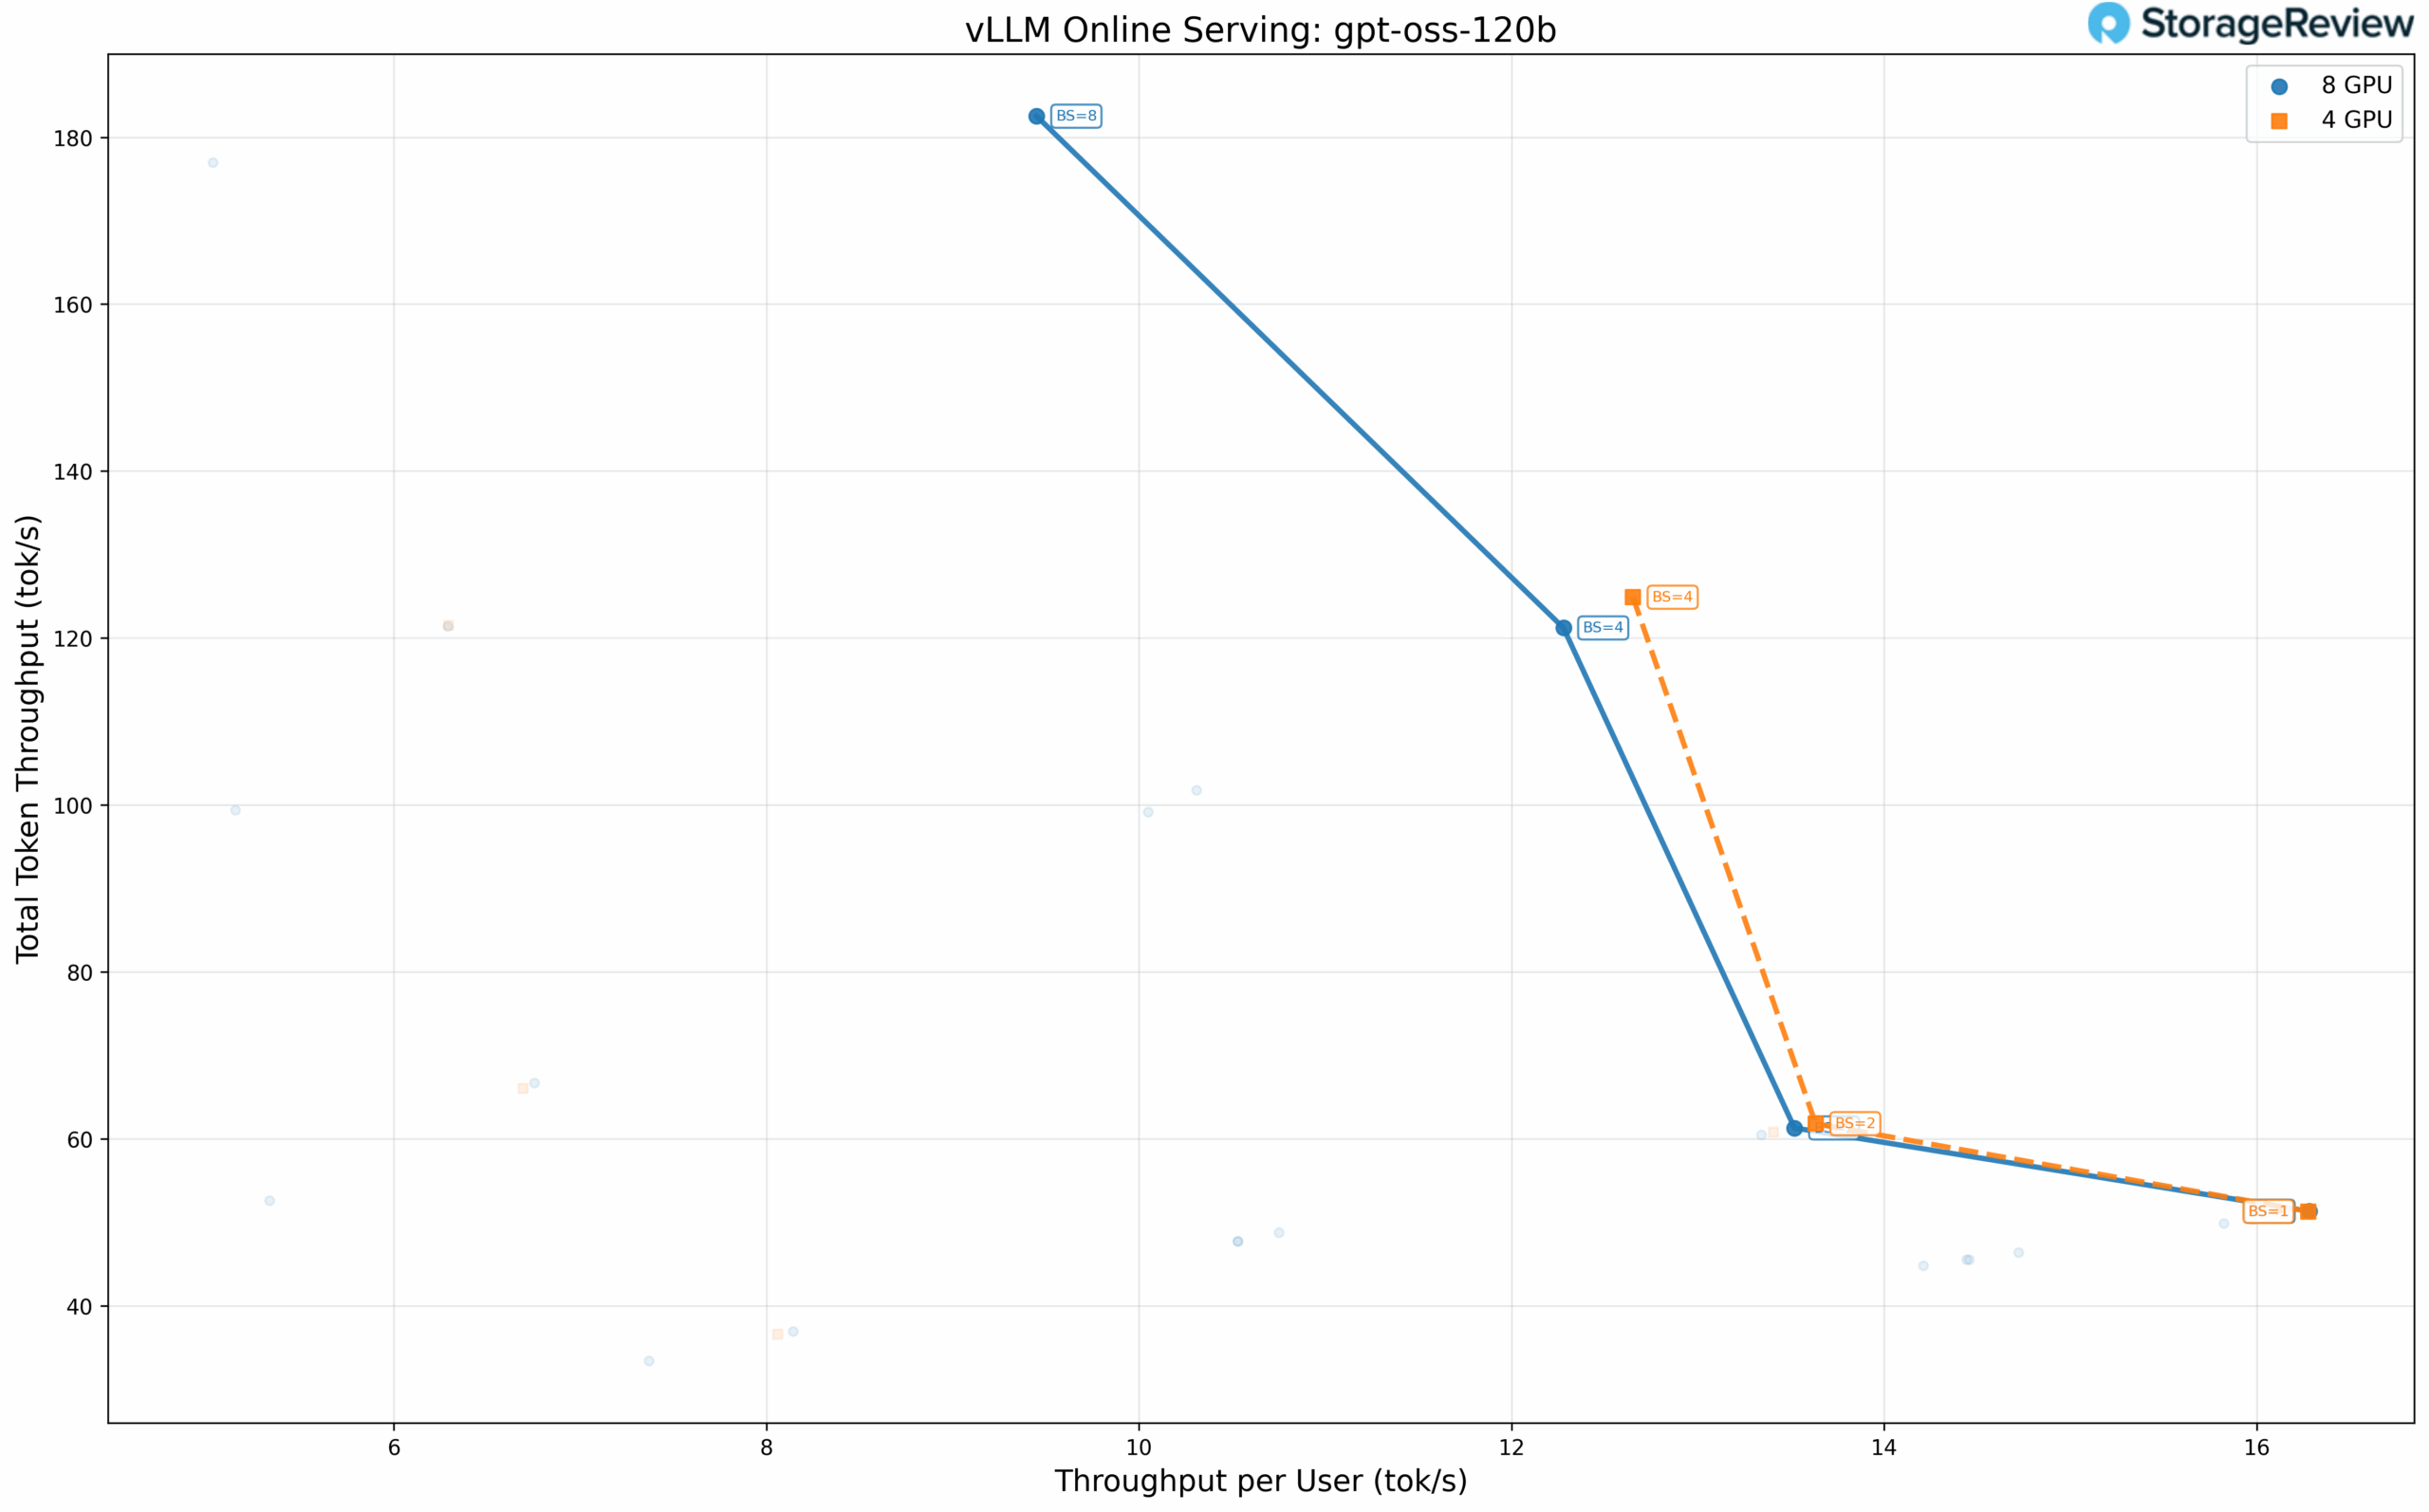
Większy model 120B wymaga co najmniej 4 procesorów GPU, co eliminuje konieczność porównywania z jednym GPU. Wydajność między konfiguracjami z czterema a ośmioma GPU jest bardziej zbliżona, a przepustowość na użytkownika jest niemal identyczna przy rozmiarze partii 1 (16.28 tok/s dla obu). Konfiguracja z ośmioma GPU zapewnia niewielkie korzyści przy większych rozmiarach partii dzięki paralelizmowi danych.
Mieszanka ekspertów: Qwen3 Coder 30B-A3B
Rozrzedzone architektury MoE utrzymują dużą liczbę parametrów, aktywując jednocześnie tylko ich podzbiór podczas wnioskowania. Qwen3 Coder 30B-A3B aktywuje około 3 mld parametrów na token z pełnej puli 30 mld parametrów, co czyni go popularnym rozwiązaniem w przypadku wdrożeń lokalnego asystenta kodowania.
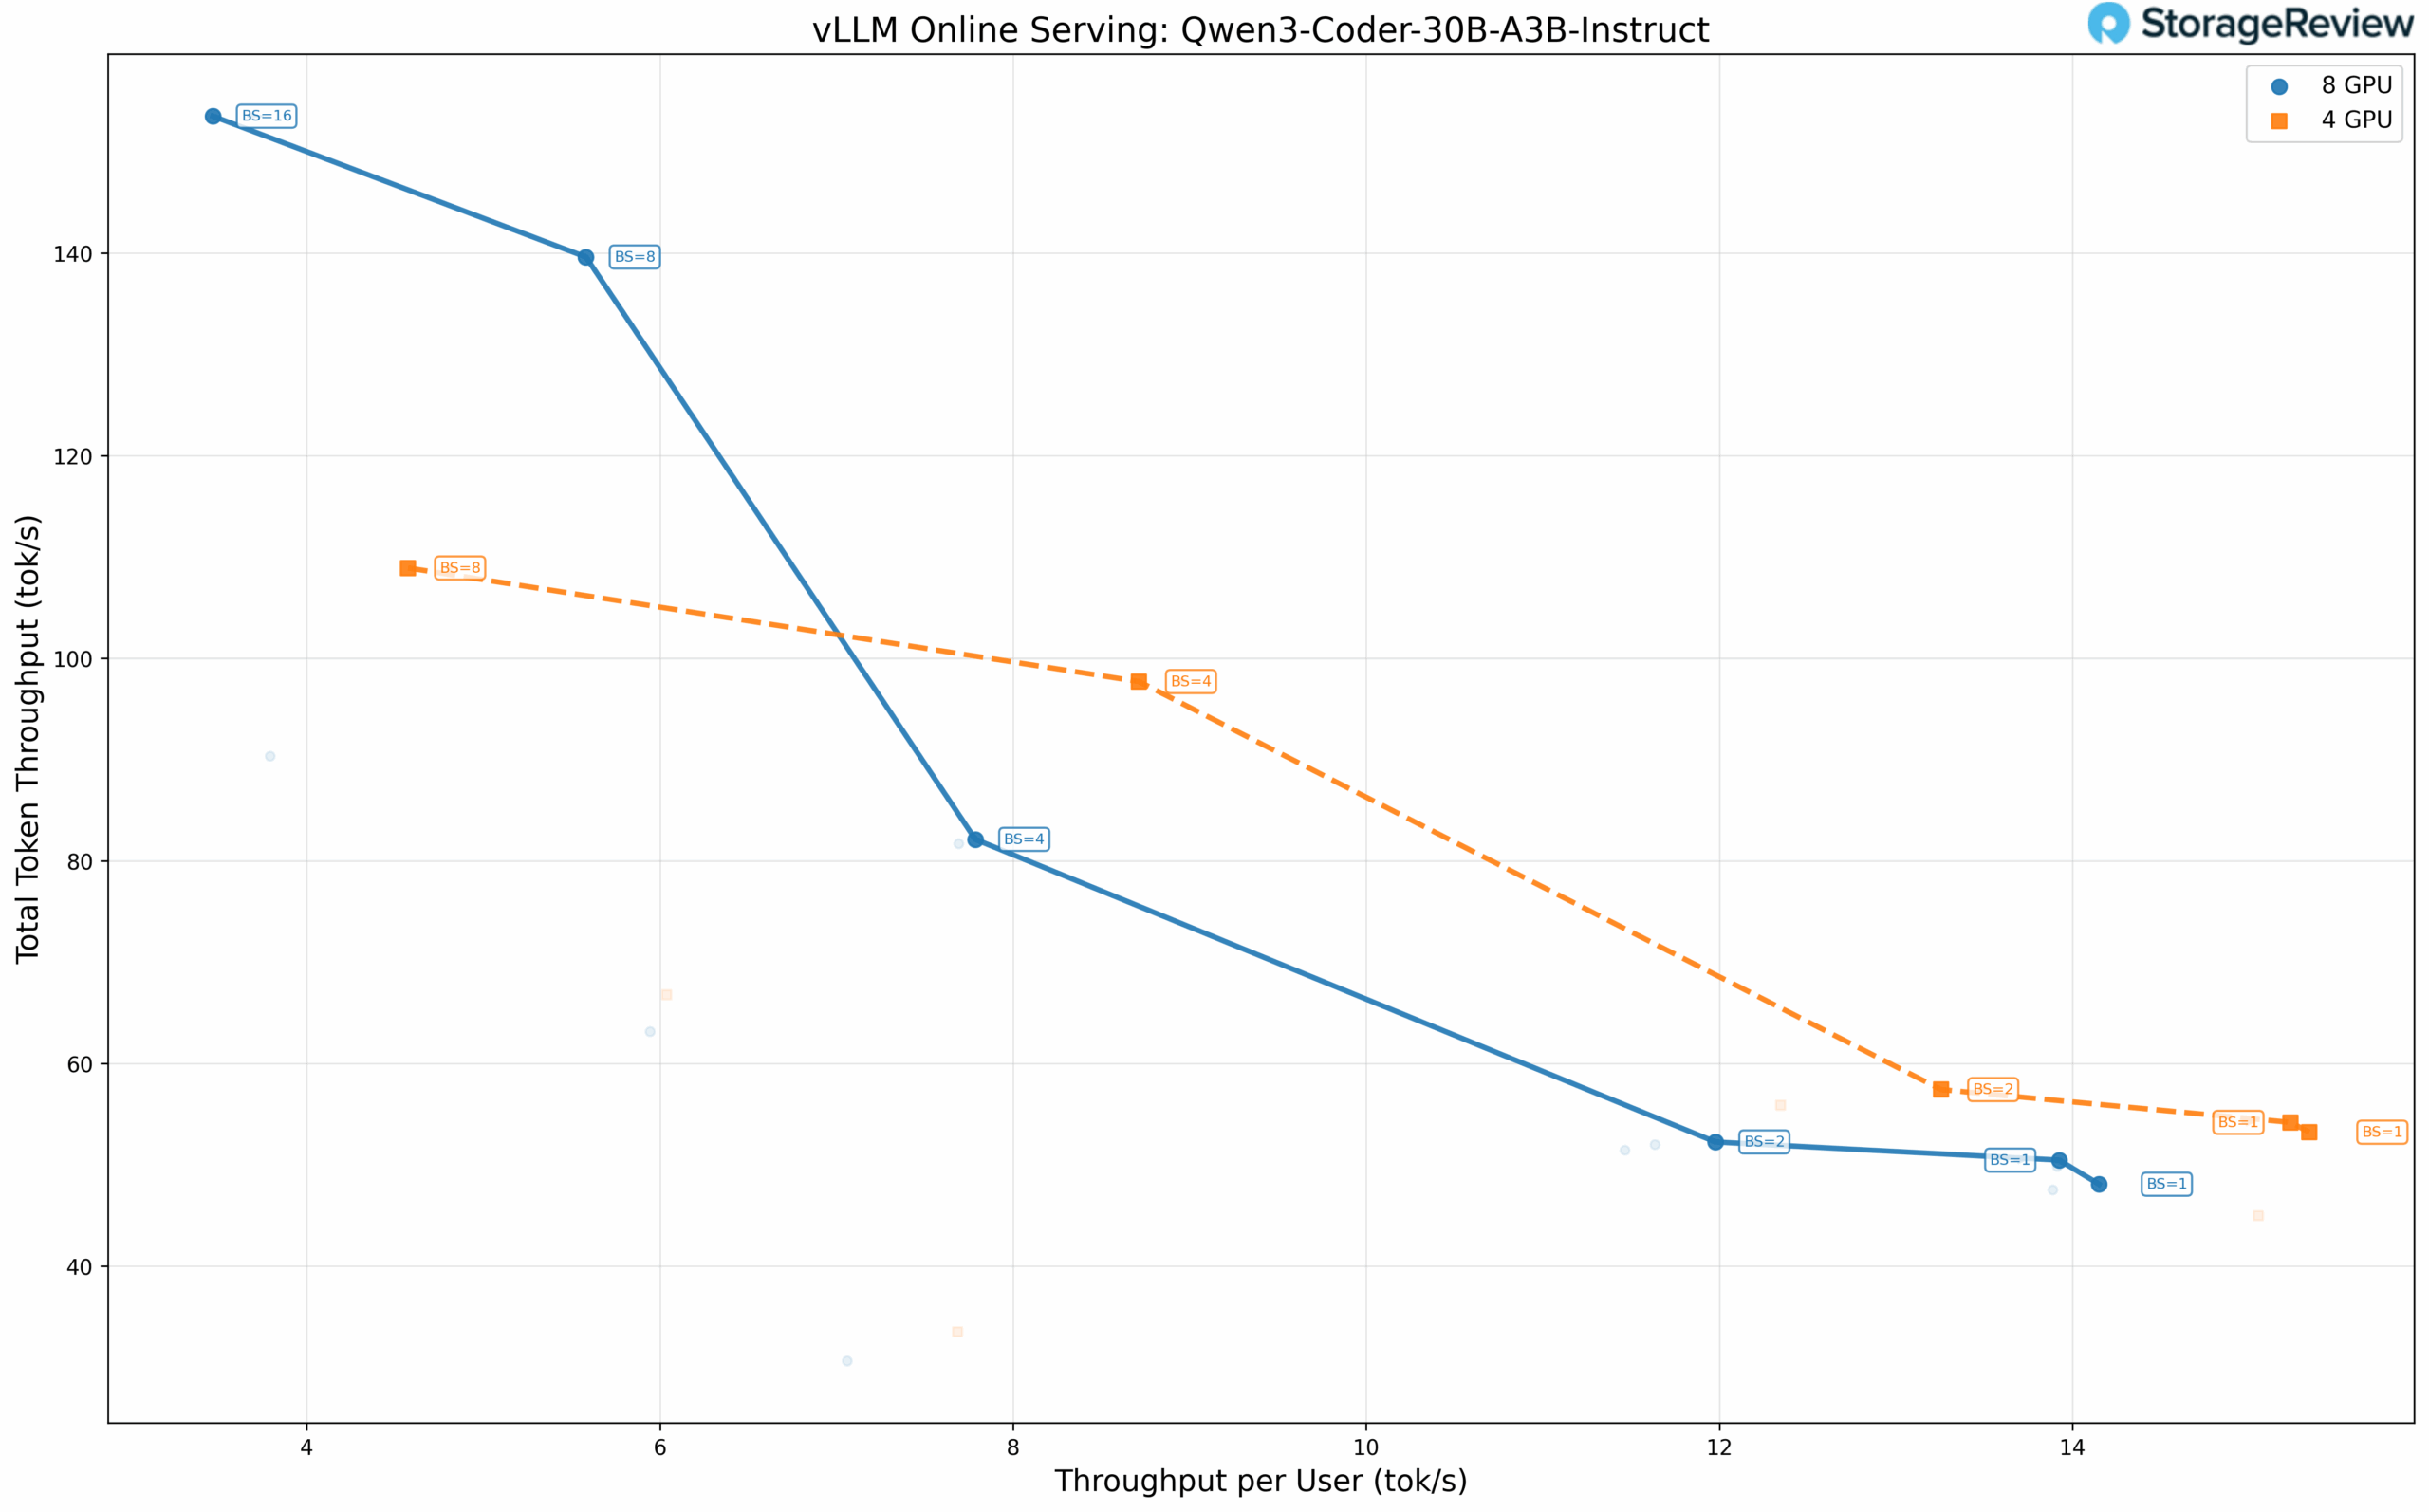
Testy z precyzją BF16 ponownie wykazały zalety konfiguracji z czterema GPU przy mniejszych rozmiarach partii. Przepustowość na użytkownika osiąga 15.34 tok/s przy TP=4, w porównaniu do 14.15 tok/s przy TP=8, przy rozmiarze partii 1.
Gęste modele
Modele gęste bazują na konwencjonalnej architekturze LLM, w której wszystkie parametry i aktywacje są wykorzystywane podczas wnioskowania, co skutkuje bardziej intensywnym obliczeniowo przetwarzaniem niż w przypadku modeli rzadkich. Bez kwantyzacji INT4 w trakcie naszych testów, modele te działały z precyzją BF16.
Lama 3.1 8B Instruktaż
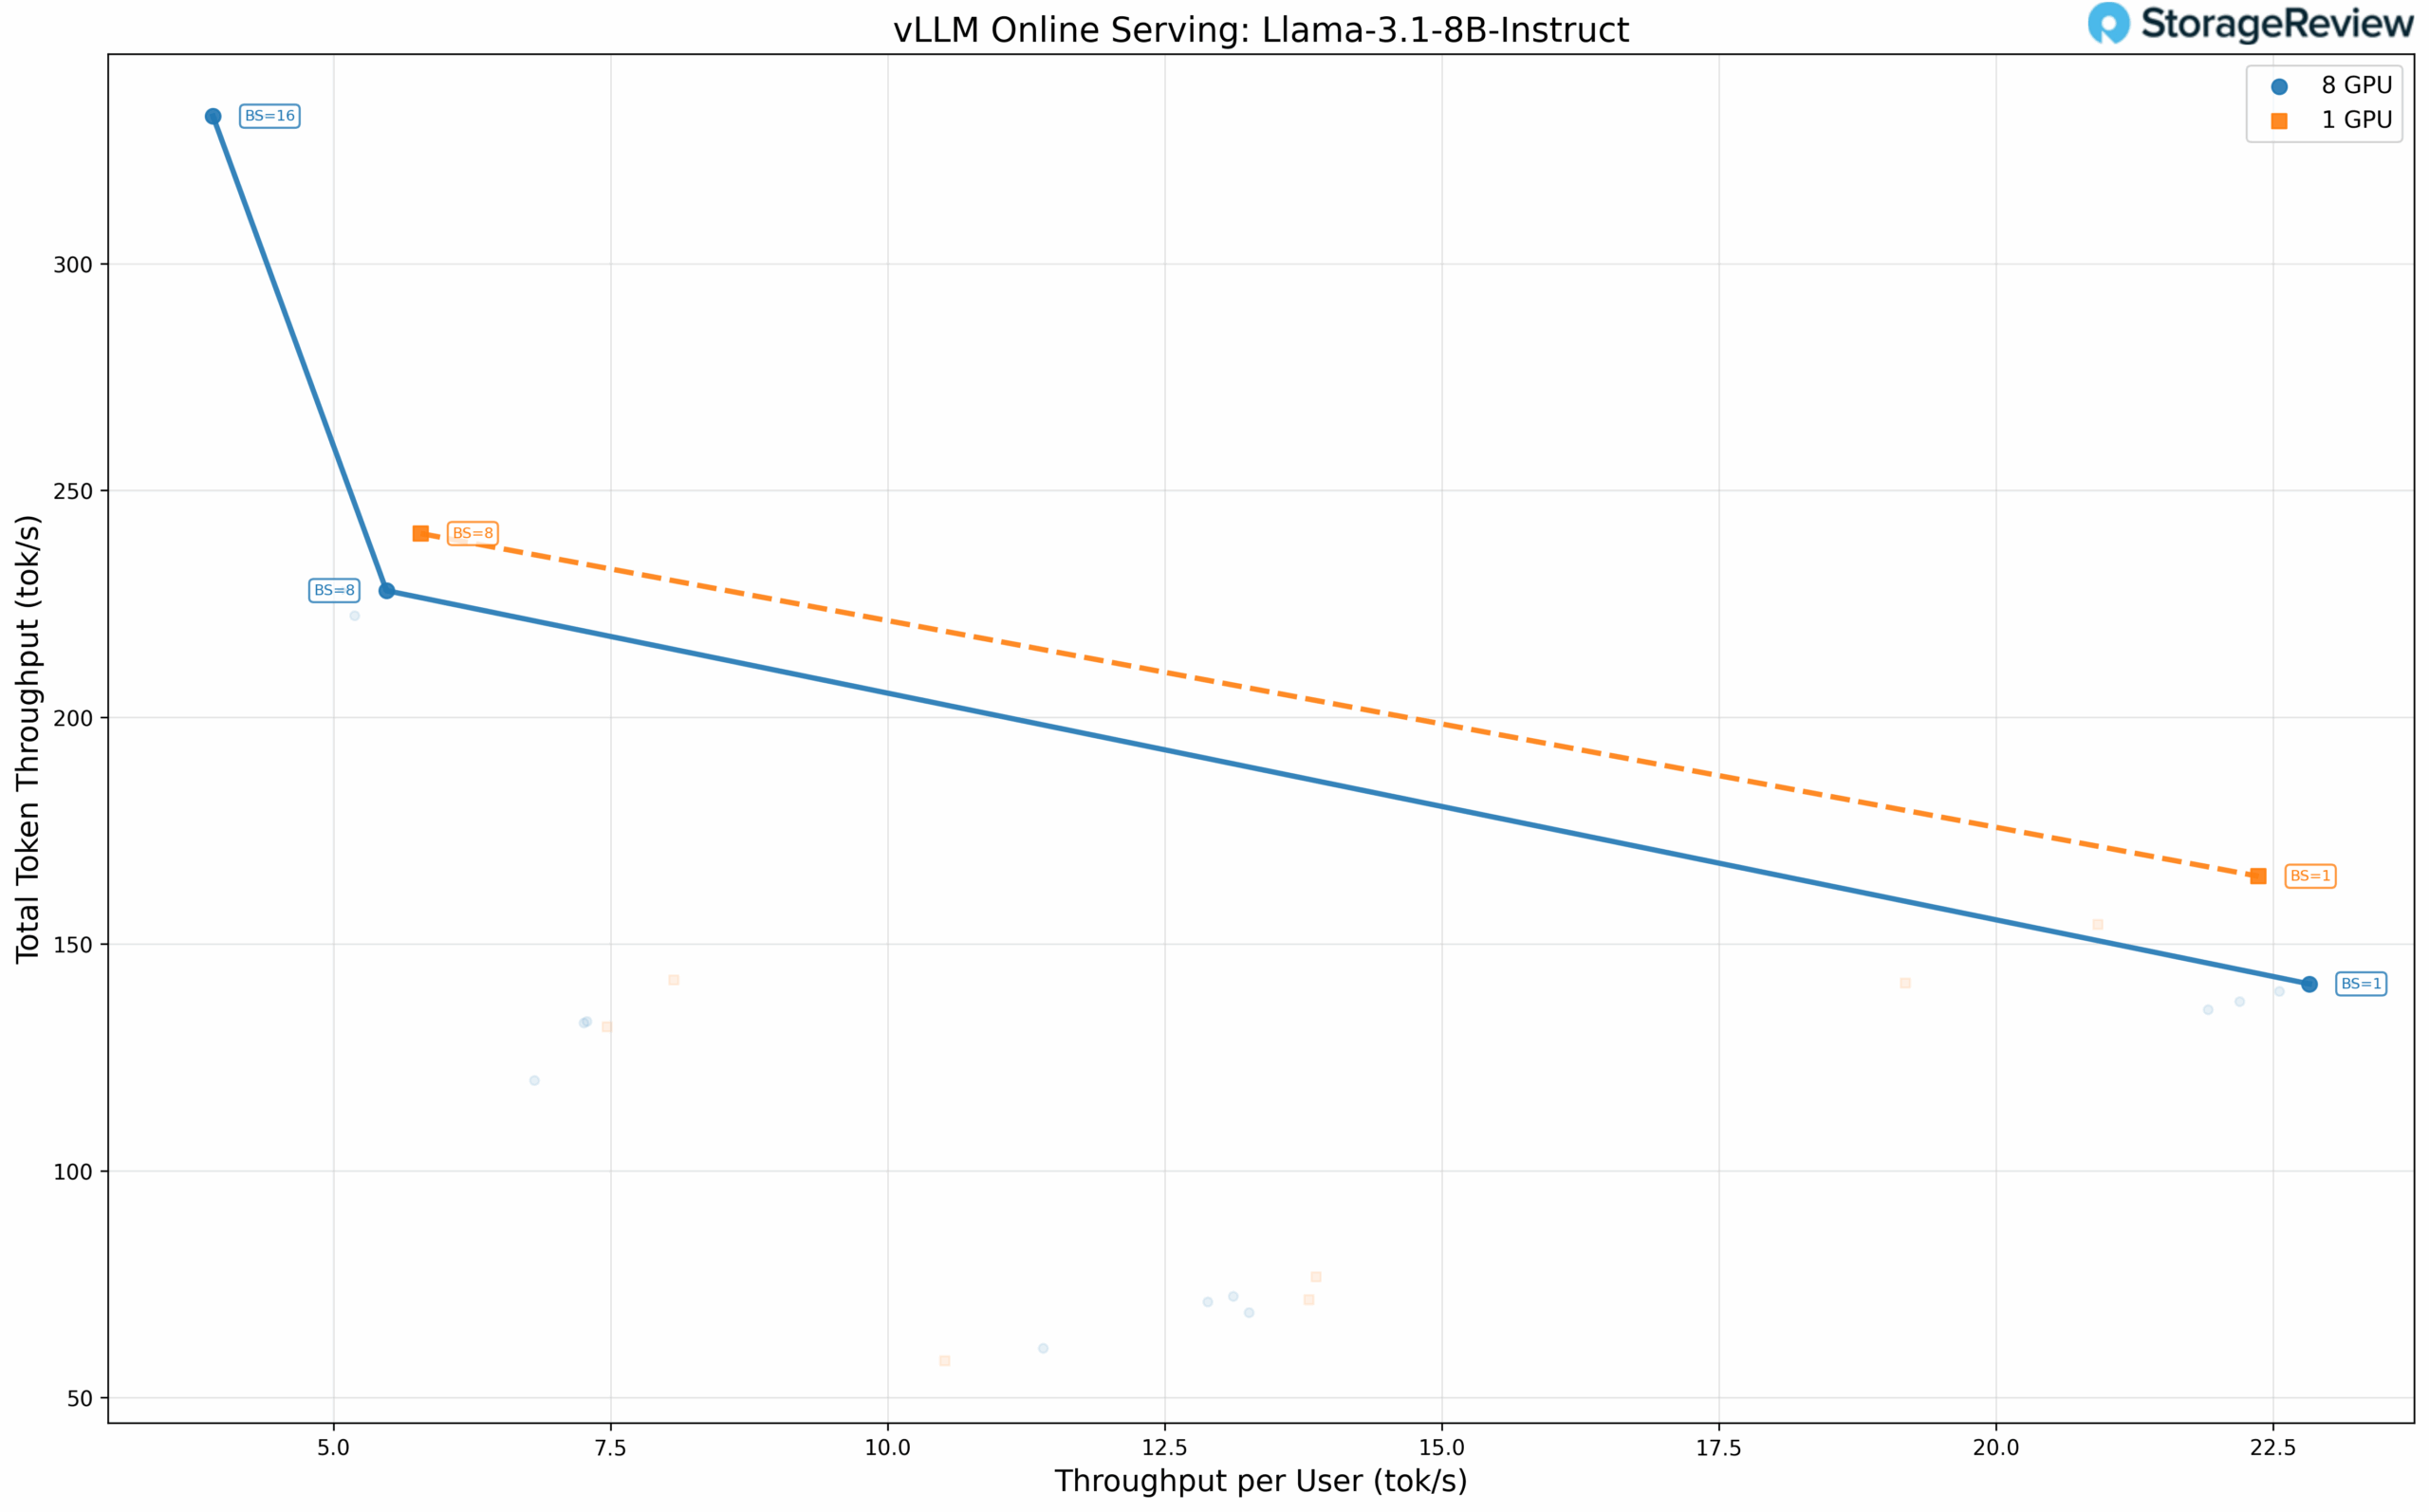
Kompaktowy model 8B mieści się wygodnie na jednym GPU, ale został przetestowany w różnych konfiguracjach, aby scharakteryzować zachowanie skalowalności. Wyniki potwierdzają ten schemat: cztery GPU zapewniają całkowitą przepustowość 240.48 tok/s przy rozmiarze partii 8 w porównaniu do 227.90 tok/s przy ośmiu GPU przy tym samym rozmiarze partii. Przepustowość na użytkownika przy rozmiarze partii 1 pozostaje niemal identyczna (22.37 tok/s w porównaniu do 22.83 tok/s).
Mistral Small 3.1 24B Instrukcja
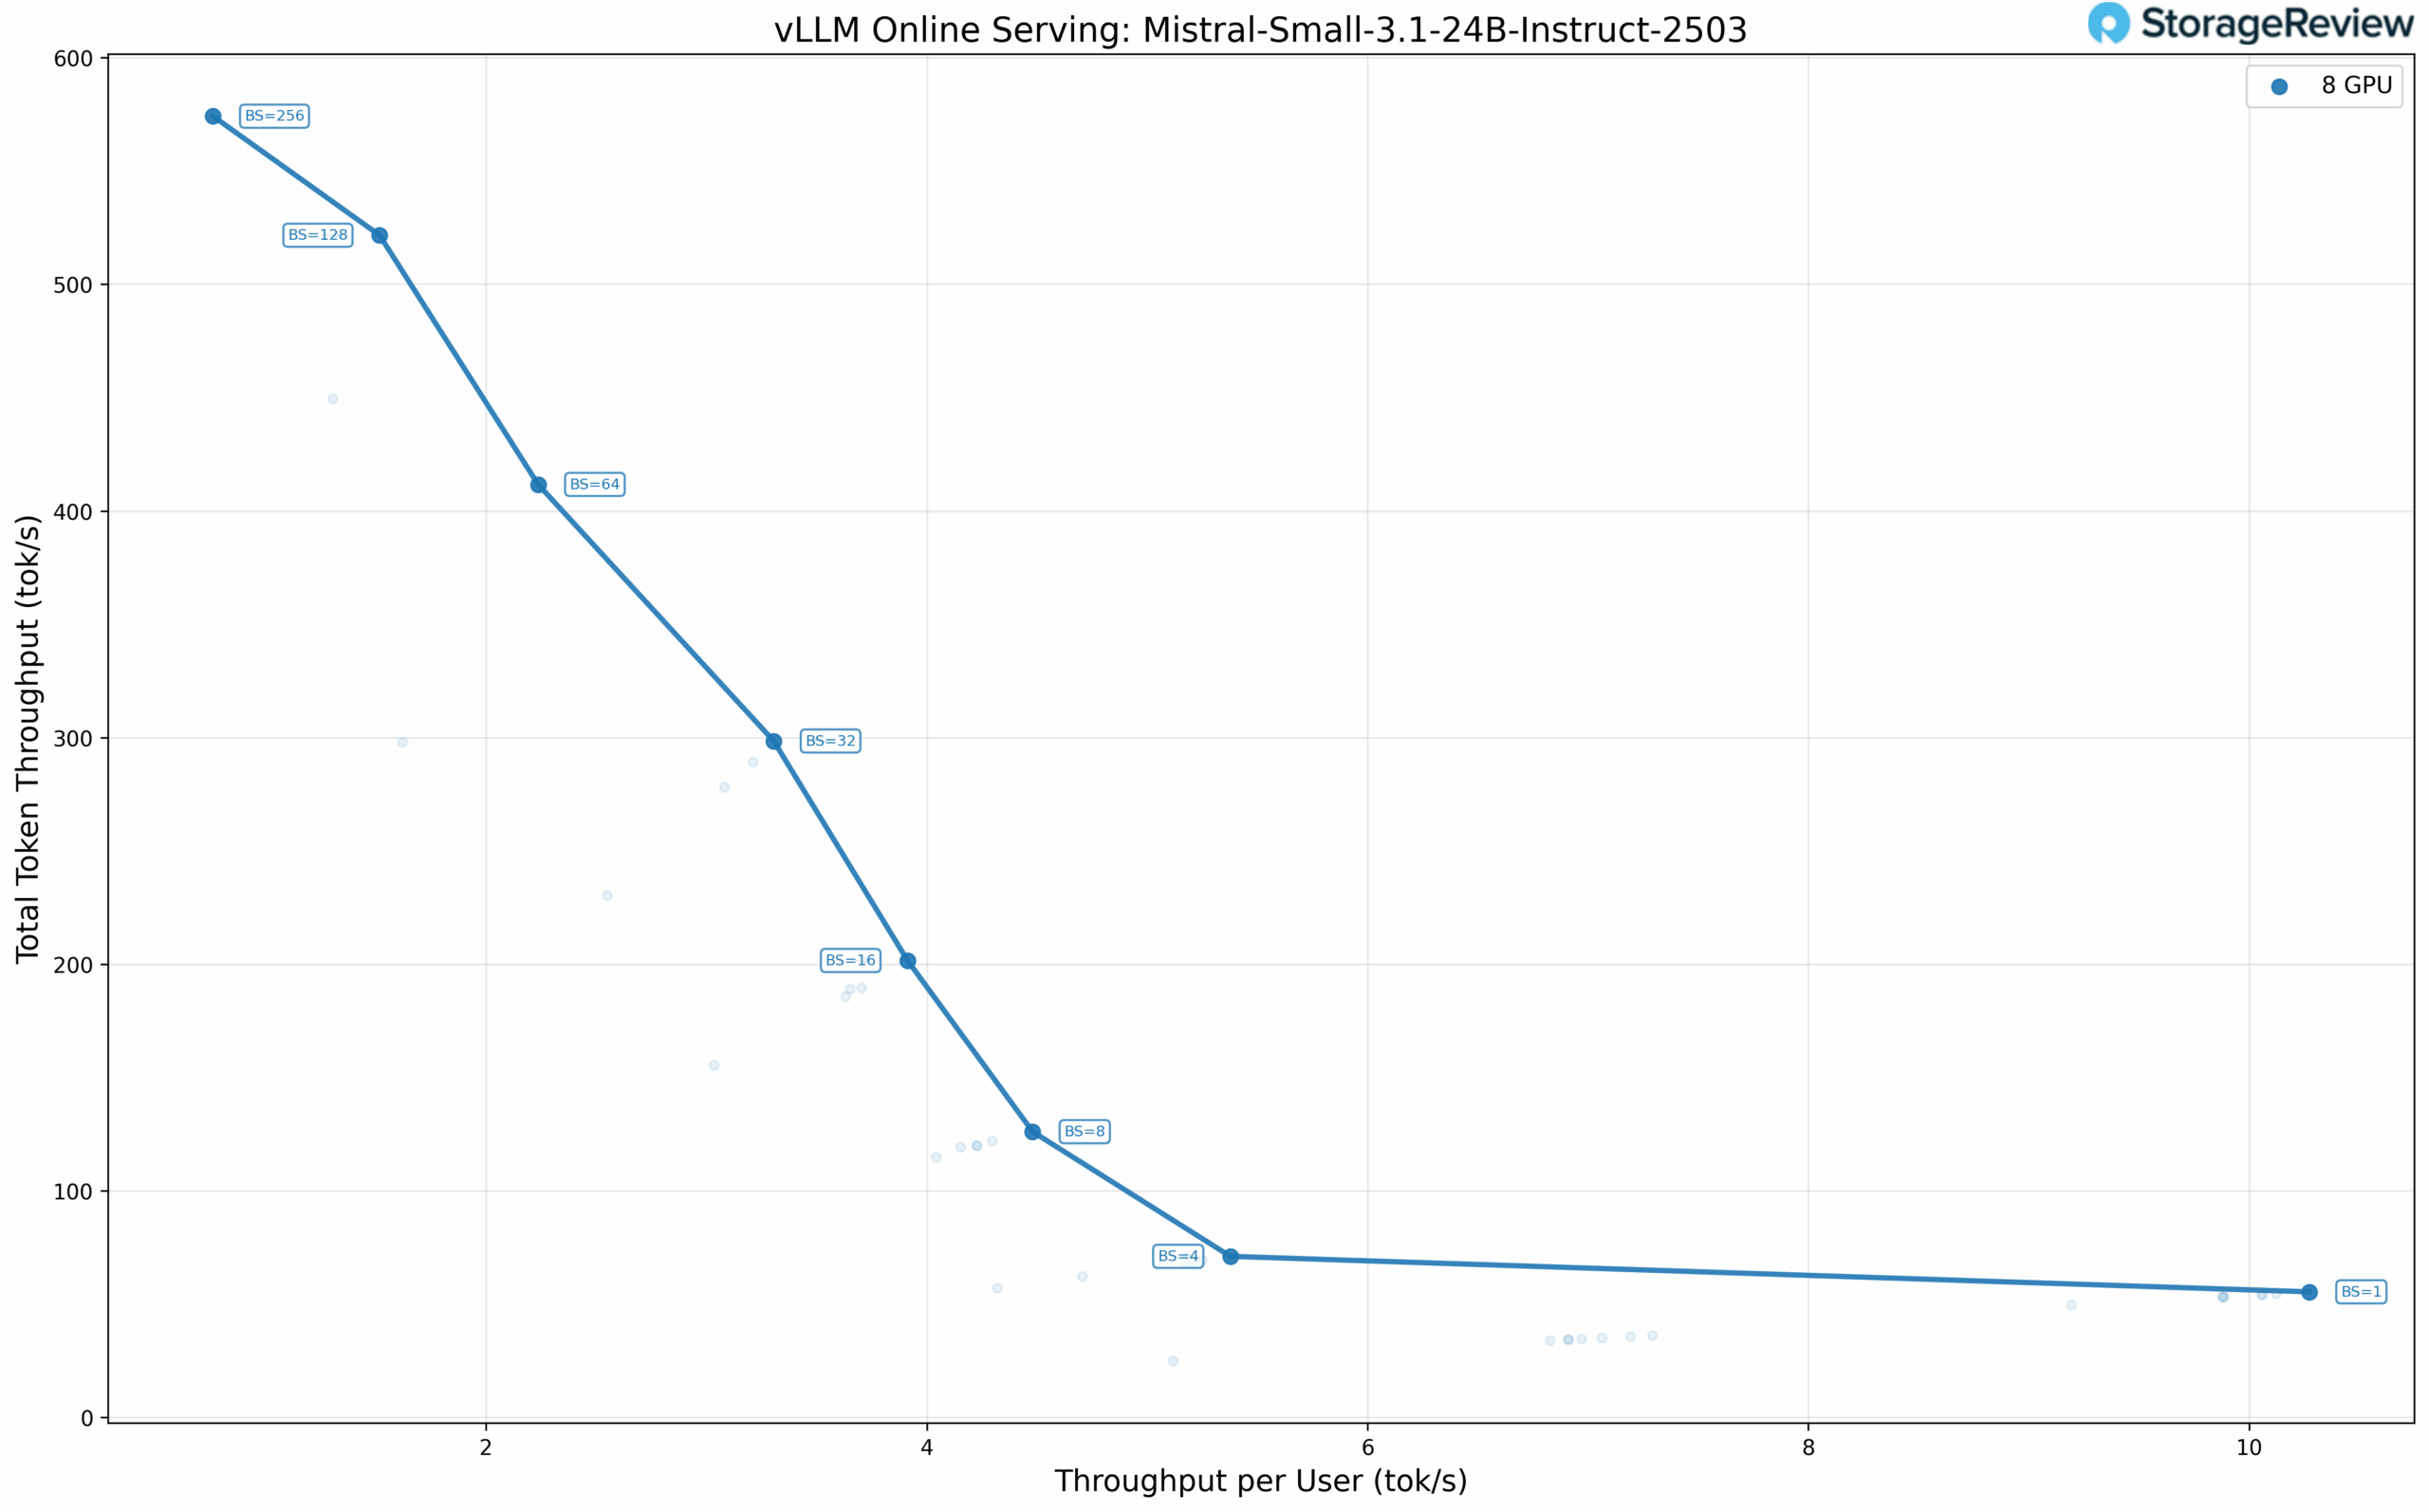
Model Mistral o parametrach 24B reprezentuje bardziej wymagające obciążenie. Przy precyzji BF16 model osiąga wysoką skalowalność przepustowości przy większych rozmiarach partii, osiągając 574.16 tok/s przy rozmiarze partii 256 na wszystkich ośmiu GPU.
Ustalenia
We wszystkich testowanych modelach pojawia się spójny schemat: przy małych rozmiarach partii danych z naszą konfiguracją 256 tokenów wejścia/wyjścia, użycie minimalnej liczby GPU wymaganej do dopasowania modelu zapewnia lepszą wydajność dla każdego użytkownika niż dystrybucja na wszystkie osiem GPU . Narzut związany z komunikacją między GPU przez PCIe, nawet przy prędkościach PCIe 5.0, wprowadza opóźnienia przewyższające korzyści płynące z paralelizacji w scenariuszach z jednym użytkownikiem lub niską współbieżnością.
To odkrycie ma praktyczne implikacje dla planowania wdrożeń. Organizacje korzystające z asystentów kodowania dla pojedynczego użytkownika lub przepływów pracy agentów o niskiej współbieżności mogą zadowolić się mniejszymi konfiguracjami GPU i nadal uzyskać akceptowalną wydajność. Pełna konfiguracja Battlematrix z ośmioma GPU jest najbardziej korzystna w przypadku obciążeń związanych z wnioskowaniem wsadowym, generowaniem danych syntetycznych lub scenariuszy obsługi o wysokiej współbieżności, gdzie całkowita przepustowość ma większe znaczenie niż opóźnienie na żądanie, zwłaszcza w przypadku korzystania z większych modeli wymagających większej ilości pamięci.
Doświadczenie z Arc Pro B60s
W ograniczonych testach, które przeprowadziliśmy, doświadczenie było niezwykle bezproblemowe. Uruchomienie kart było proste, a konfiguracja LLM-Scaler, gałęzi rozwojowej vLLM ze wsparciem Battlemage, okazała się równie prosta. Oprogramowanie jest jednak wciąż na bardzo wczesnym etapie rozwoju. Na początku testów nie byliśmy w stanie pobrać żadnych statystyk GPU, a poza paralelizmem tensorowym, nie udało nam się zastosować innych strategii paralelizmu, takich jak paralelizm ekspercki czy paralelizm potokowy, do skalowania w wielu systemach. Mimo to spodziewaliśmy się tych ograniczeń, biorąc pod uwagę stan stosu oprogramowania przed jego wydaniem.
Chłodzenie wywołało ożywioną dyskusję po naszym pierwszym krótkim filmie na YouTube , a wielu komentujących wyraziło obawy, że karty mogą się przegrzewać na otwartym polu testowym. Z powodu braku możliwości monitorowania temperatury, ostatecznie przenieśliśmy karty do obudowy serwera, aby zapewnić odpowiedni przepływ powietrza. Zamierzamy przetestować wydajność chłodzenia w konfiguracji stacji roboczej na potrzeby pełnej recenzji, ponieważ w finalnej wersji Battlematrix, jak widać na powyższych renderach marketingowych Intela, karty te umieszczono w obudowie stacji roboczej ustawionej blisko siebie.
Jeśli chodzi o format, karty te są nieco dłuższe niż standardowe procesory graficzne do stacji roboczych, co może stwarzać problemy z kompatybilnością z obudową. Pasują jednak bez problemu do obudów serwerów, ponieważ większość obudów serwerowych zapewnia dodatkową przestrzeń w pobliżu przedniej krawędzi karty na wsporniki.
Przyszłe plany testowe
Planujemy ponownie przeanalizować Intel Battlematrix i przeprowadzić bardziej szczegółową analizę po pełnej premierze i powszechnej dostępności procesorów B60. Ocenimy wydajność inferencji LLM poprzez dodatkowe testy vLLM w szerokiej gamie modeli i konfiguracji wdrożeniowych. Chociaż nie zostało to ukazane w tej wersji zapoznawczej, zaobserwowaliśmy, że te procesory GPU, w obecnym stanie oprogramowania, działają lepiej podczas operacji wstępnego wypełniania niż podczas dekodowania. Pełna analiza będzie bardziej szczegółowo analizować obciążenia inferencyjne z dużą ilością wstępnego wypełniania i dekodowania, aby scharakteryzować to zachowanie.
Społeczność homelab wyraziła zainteresowanie wykorzystaniem tych procesorów graficznych do jednego z najpopularniejszych obciążeń domowych: serwerów multimediów. Chcemy przetestować je z Plex i ewentualnie Jellyfin z użytkownikami na naszym Discordzie . W kręgu naszych zainteresowań znajdują się również obciążenia profesjonalne, w tym SolidWorks i Autodesk do testowania wydajności CAD. Planujemy również przyjrzeć się technologii SR-IOV z Proxmox, aby wdrożyć wielodostępny serwer VDI dla użytkowników Discorda w celu oceny gęstości współbieżnych pulpitów i gier w chmurze.
Wniosek
Intel Arc Pro B60 Battlematrix to ekscytująca platforma, która udostępnia pamięć GPU o dużej pojemności w cenach stacji roboczych. Konstrukcja z dwoma GPU zaspokaja ograniczenia gęstości, alokacja 24 GB na GPU odpowiada obciążeniom wnioskowania LLM, a struktura cenowa tworzy atrakcyjną alternatywę dla uznanych, profesjonalnych ekosystemów GPU. Platforma ta jest warta rozważenia dla organizacji, dla których suwerenność danych i efektywność kosztowa są ważniejsze niż najnowocześniejsza wydajność.
Dojrzałość oprogramowania pozostaje głównym ograniczeniem. Inwestycja Intela w optymalizację infrastruktury za pomocą LLM Scaler i ciągłe udoskonalanie sterowników świadczą o zaangażowaniu w utrzymanie linii procesorów graficznych Arc jako znaczącej wartości.
Nie wiadomo, jak popularna będzie konfiguracja z ośmioma procesorami graficznymi (GPU) w porównaniu z niesamowitą wydajnością oferowaną przez NVIDIA DGX Spark . Prawdziwym problemem mogą być konfiguracje z jedną i dwiema kartami, gdzie cena wejścia wynosząca 600–1,200 dolarów znacząco obniża bariery dla prywatnej infrastruktury AI.
Będziemy rozszerzać nasze testy w miarę pojawiania się aktualizacji sterowników i rozwoju frameworków oprogramowania. Jeśli chcesz wypróbować je samodzielnie, dołącz do naszego serwera Discord , gdzie mamy serwer społecznościowy z ograniczonym dostępem do B60.


 Amazon