

Chociaż wokół gęstych serwerów GPU dla AI narosło sporo szumu – i słusznie – w rzeczywistości większość projektów szkoleniowych AI rozpoczyna się na stacjach roboczych. Chociaż obecnie możemy zmieścić do czterech procesorów graficznych NVIDIA A6000 Ada w jednej stacji roboczej, trudniejszym wyzwaniem jest zapewnienie solidnej pamięci masowej w tych obudowach AI. Przeanalizowaliśmy ten problem i opracowaliśmy plan, który pozwoli nam najlepiej wyposażyć kilka stacji roboczych AI w szybką pamięć masową. Współpracowaliśmy z firmami Supermicro i KIOXIA, aby zapełnić serwer 24 dyskami SSD NVMe serii XD7P o pojemności 7.68 TB i stworzyć niezwykle wydajny serwer pamięci masowej 1U z inferencyjnym asem w rękawie.
Wiemy, o czym myślisz: jak zamierzasz połączyć platformę serwerową z dyskami SSD E1.S, stacje robocze trenujące modele AI i wnioskowanie na tym samym serwerze pamięci masowej? Pozwól na odrobinę swobody, aby to wyjaśnić.
Stacje robocze AI nie muszą znajdować się pod biurkiem
Z kilkoma wyjątkami, wydajne stacje robocze AI z drogimi procesorami GPU prawdopodobnie nie powinny być rozprowadzane na obrzeżach sieci, a nawet w obrębie budynku biurowego. Problemów jest wiele. Przede wszystkim te punkty końcowe są narażone na wysokie ryzyko zagrożeń bezpieczeństwa i wycieku danych, a co ważniejsze, cierpią z powodu niedostatecznego wykorzystania. Większość specjalistów AI nie ma dostępu do ogromnej ilości danych potrzebnych do trenowania swoich modeli z powodu nieodpowiedniej konfiguracji sieci LAN.
Z drugiej strony, gdybyśmy umieścili te wydajne stacje robocze w centrum danych, zyskalibyśmy kilka korzyści. Po pierwsze, bezpieczeństwo fizyczne zostałoby rozwiązane, a problemy z dostępem zdalnym można by złagodzić dzięki cienkim klientom lub dostępowi, który przesyła jedynie piksele, a nie dane przez sieć. W tym scenariuszu dane znajdują się na serwerze, a nie na stacji roboczej. Po drugie, tworzenie kopii zapasowych tych systemów w centrum danych jest szybsze, a nawet łatwiejsze. Po trzecie, dzięki inteligentnemu provisionowaniu możemy zwiększyć wykorzystanie zasobów w całej firmie, udostępniając te systemy rozproszonemu zespołowi specjalistów ds. sztucznej inteligencji. Po trzecie, obecność w centrum danych daje nam dostęp do najcenniejszego zasobu sztucznej inteligencji: danych.
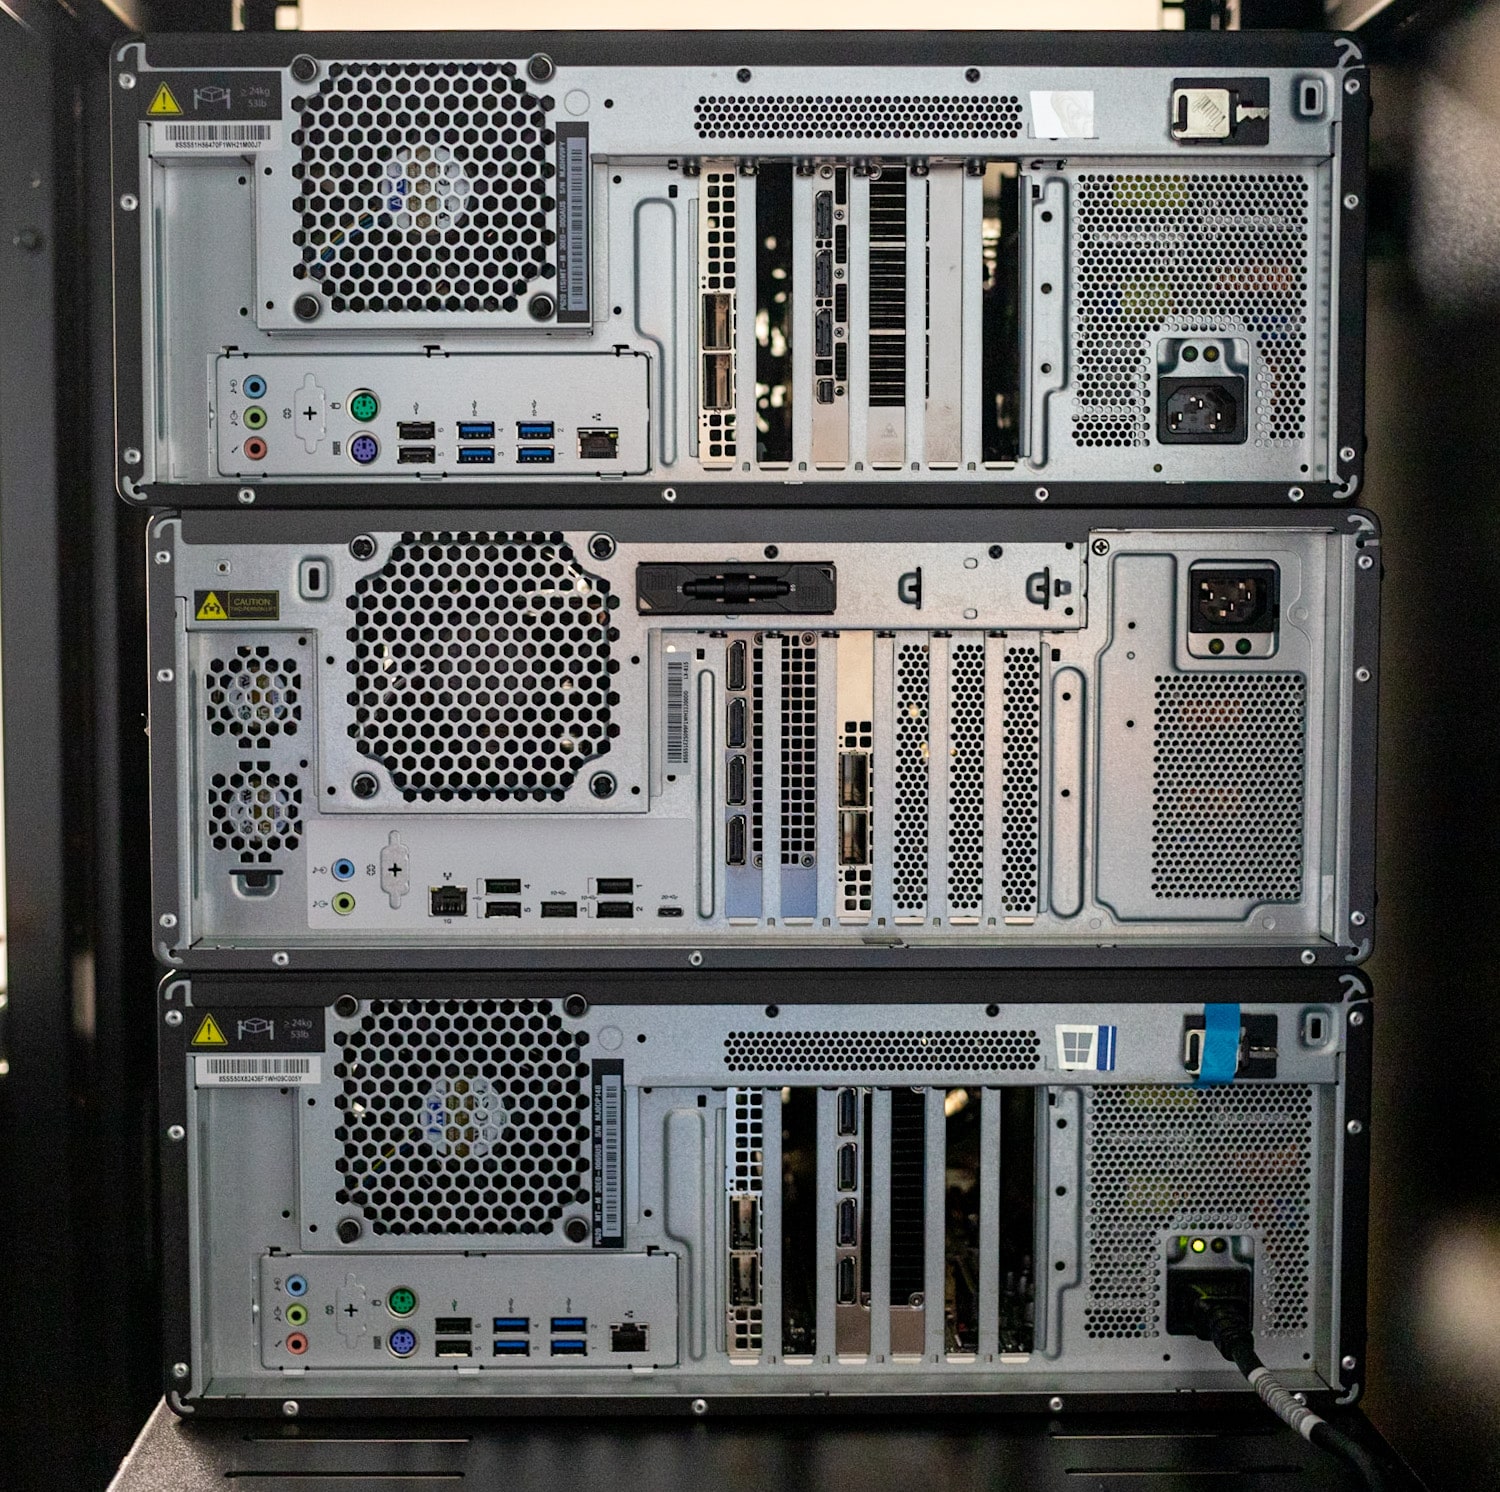
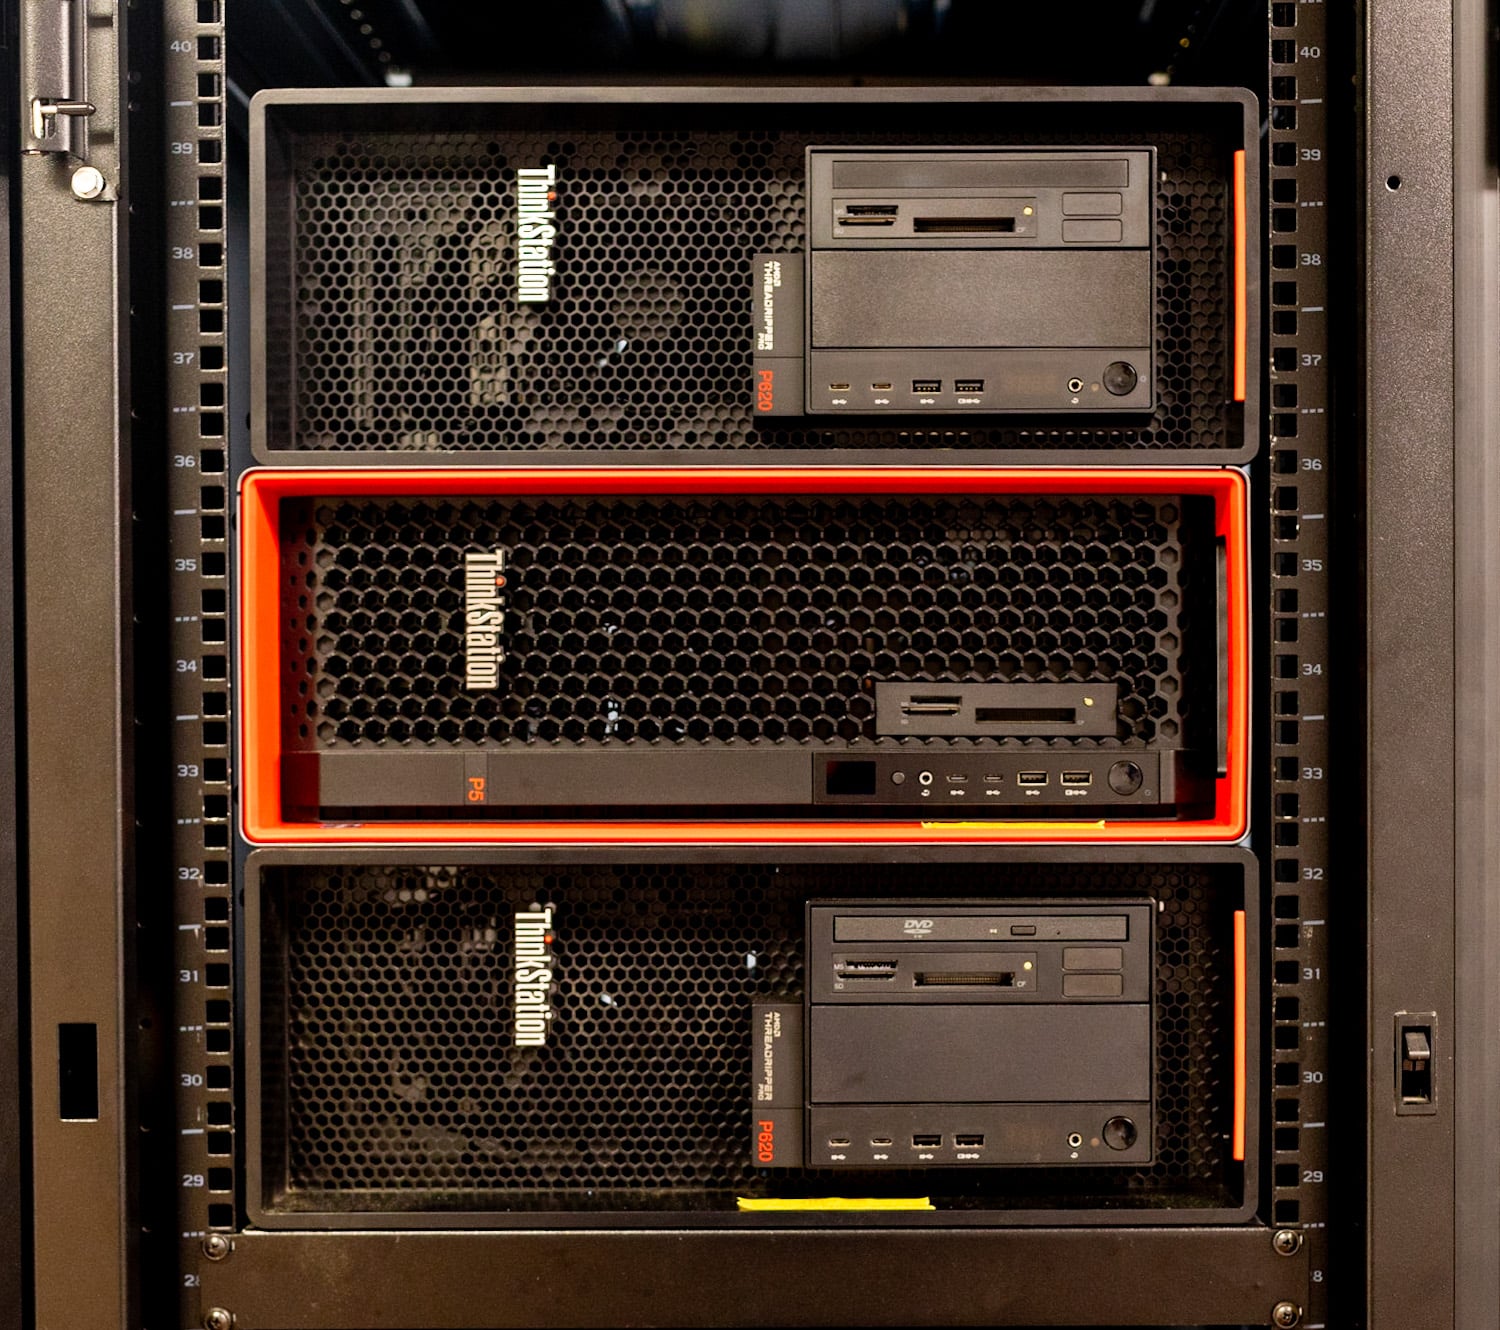
Do tych prac udostępniliśmy trzy stacje robocze Lenovo, które mieliśmy w laboratorium. Każda z nich jest skonfigurowana nieco inaczej, wykorzystując zarówno procesory graficzne AMD, jak i NVIDIA, co zapewnia elastyczność, ponieważ niektóre modele mogą działać lepiej na różnych akceleratorach. W każdym systemie zainstalowano kartę NVIDIA ConnectX-6 100 GbE, która jest kluczowa dla zapewnienia tym systemom szybkiego dostępu do pamięci masowej. Następnie każdy system łączy się z przełącznikiem Dell Z9100 100 GbE, do którego również podłączona jest usługa pamięci masowej.
| Część | Stanowisko robocze 1 | Stanowisko robocze 2 | Stanowisko robocze 3 |
| Model | Lenovo P620 | Lenovo P620 | Lenovo P5 |
| CPU | AMD Ryzen Threadripper PRO 5995WX | AMD Ryzen Threadripper PRO 3995WX | Intel Xeon w7-2495X |
| Pamięć | 128GB DDR4 3200 | 32GB DDR4 3200 | 32 GB pamięci DDR5 4800 MHz |
| GPU | AMD Radeon PRO W7900 | Nvidii RTX A6000 | Nvidii RTX A4500 |
Szybkie przechowywanie danych AI z dyskami SSD serii KIOXIA XD7P
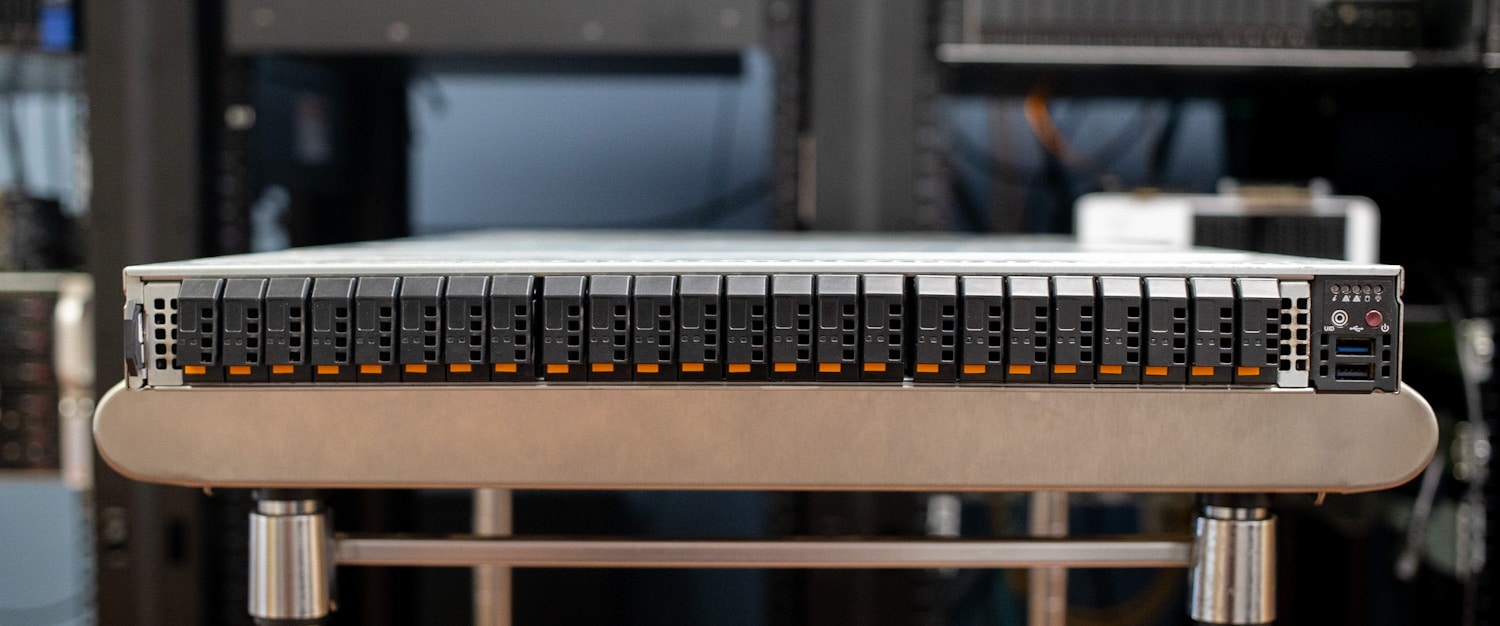
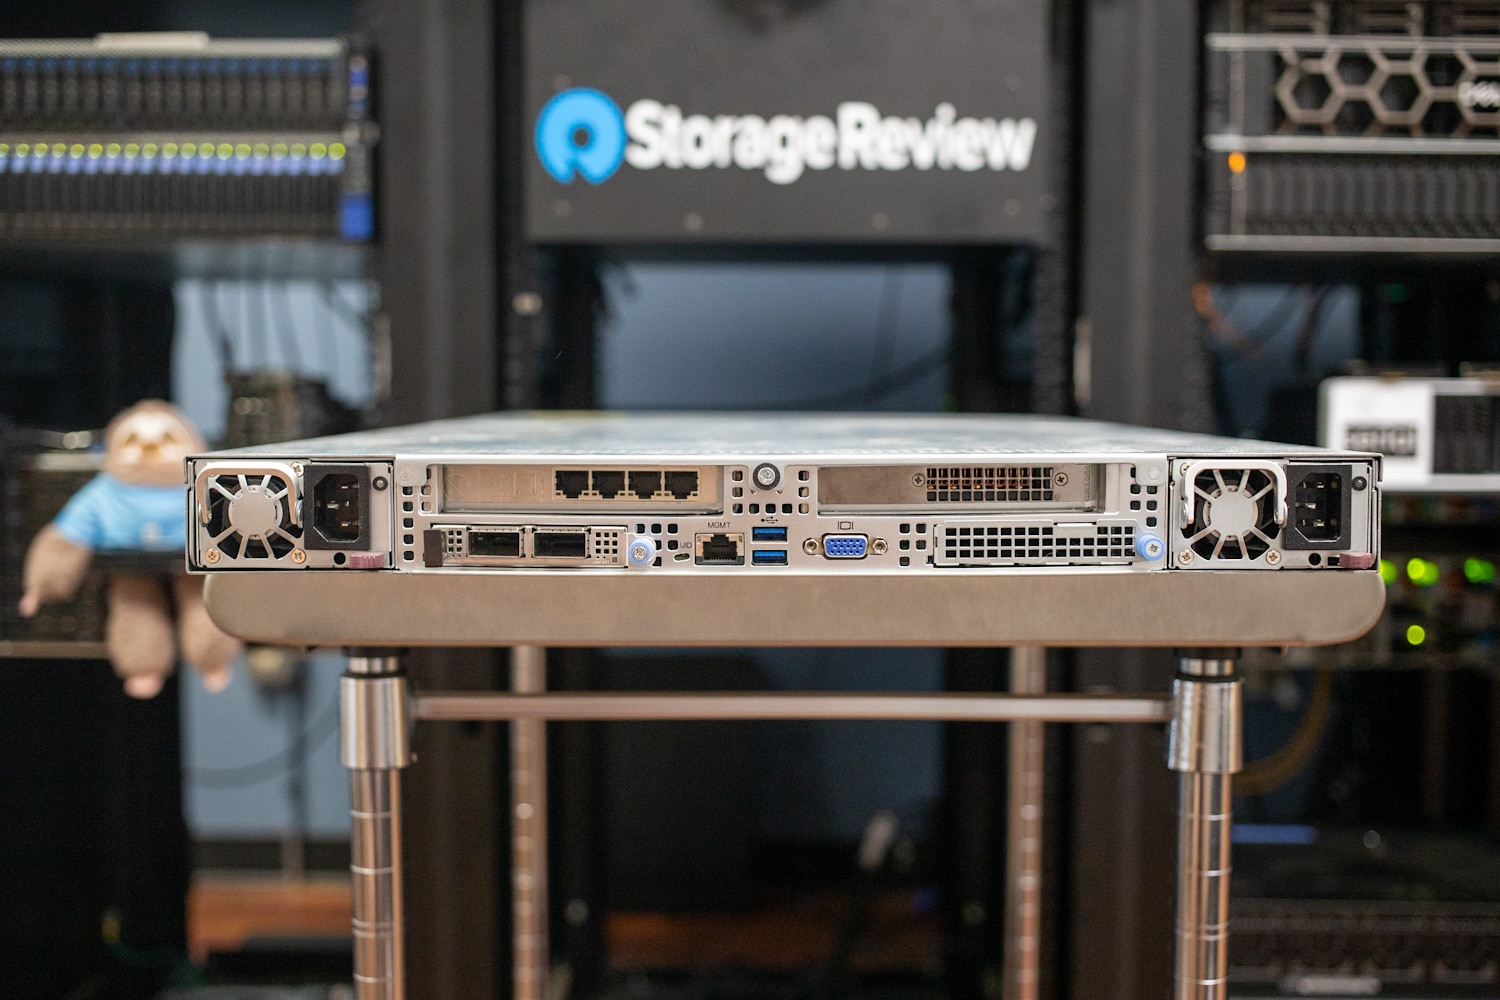
Mając przygotowane stanowisko testowe dla stacji roboczej AI, przechodzimy do serwera pamięci masowej. W tym przypadku używamy Supermicro Storage SuperServer SSG-121E-NES24R . Ten serwer 1U ma dwa procesory Intel Xeon Platinum 8450H z 28 rdzeniami i 56 wątkami o częstotliwości bazowej 2.00 GHz. Procesory 8450H mogą osiągnąć maksymalną częstotliwość turbo 3.50 GHz, przy czym mają pamięć podręczną 75 MB i TDP 250 W. 512 GB pamięci RAM DDR5 to stosunkowo skromna ilość pamięci RAM. Serwer korzysta z tej samej karty sieciowej NVIDIA ConnectX-6 100GbE co stacje robocze do łączności. Zainstalowaliśmy również procesor graficzny NVIDIA A2 do wnioskowania.
Przechodząc do kwestii pamięci masowej, firma KIOXIA przesłała nam 24 dyski SSD NVMe serii XD7P do centrów danych. Dyski SSD E1.S serii XD7P firmy KIOXIA zostały zaprojektowane specjalnie z myślą o potrzebach aplikacji o dużej skali, spotykanych w nowoczesnych centrach danych, w szczególności w zakresie wydajności, energooszczędności i wymagań termicznych, zgodnie ze specyfikacją Open Compute Project (OCP) Datacenter NVMe SSD.
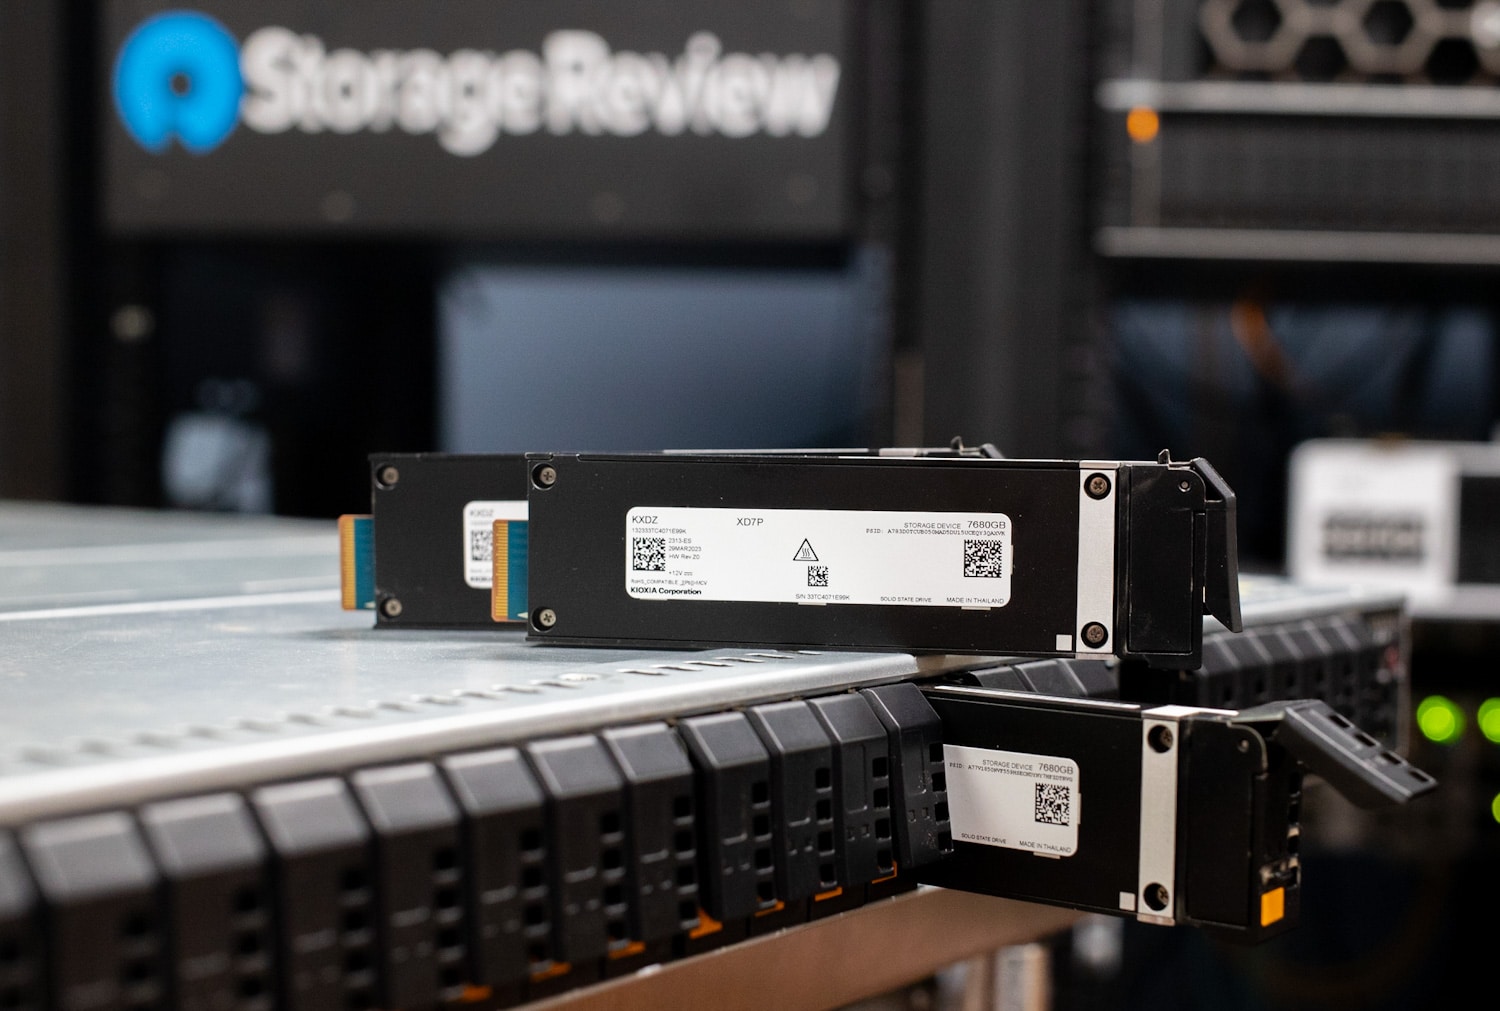
Te dyski SSD są dostępne w wersjach E1.S o grubości 9.5 mm i 15 mm, przy czym ta druga jest wyposażona w radiator poprawiający odprowadzanie ciepła. Opatentowana przez KIOXIA architektura dysku XD7P, obejmująca kontroler, oprogramowanie układowe i pamięć BiCS FLASH™ piątej generacji , przyczynia się do ogólnej wydajności, niezawodności i wydajności. Nowa seria jest oferowana w pojemnościach od 1.92 TB do 7.68 TB, aby sprostać zróżnicowanym potrzebom w zakresie pamięci masowej.
Do kluczowych funkcji należą ochrona przed utratą zasilania (PLP) i kompleksowa ochrona danych, które są kluczowe dla zachowania integralności danych w przypadku nieoczekiwanej utraty zasilania. Dodatkowo, dostępność technologii dysków samoszyfrujących (SED) zapewnia dodatkową warstwę bezpieczeństwa danych.
Jeśli chodzi o wydajność, dyski SSD serii KIOXIA XD7P oferują imponujące potencjalne wartości w różnych pojemnościach. Dzięki stałym prędkościom odczytu sekwencyjnego do 7,200 MB/s i sekwencyjnym prędkościom zapisu do 4,800 MB/s w przypadku większych pojemności, dyski te zostały zaprojektowane z myślą o wydajnej obsłudze zadań wymagających dużej ilości danych. Dodatkowo, stałe prędkości odczytu i zapisu losowego, odpowiednio do 1,650 tys. operacji wejścia/wyjścia na sekundę (IOPS) i 200 tys. operacji wejścia/wyjścia na sekundę (IOPS), sprawiają, że dyski te nadają się do zadań wymagających dużej liczby operacji wejścia/wyjścia.
XD7P wykorzystuje format E1.S, aby osiągnąć unikalną równowagę między wydajnością a gęstością. Dzięki temu nowe dyski stanowią przyszłościowe rozwiązanie dla pamięci flash w chmurze i hiperskalowych centrach danych, spełniając zmieniające się wymagania tych wymagających środowisk. Standardowy rozmiar i wbudowane radiatory XD7P zapewniają wydajne rozwiązanie do montażu 24 dysków montowanych z przodu w obudowie 1U SuperServer SSG-121E-NES24R, znacząco zwiększając gęstość serwera. Co więcej, możliwość wymiany dysków E1.S podczas pracy, w połączeniu z możliwością obsługi obciążeń o wysokiej wydajności bez obaw o przegrzanie, pozycjonuje je jako praktyczny zamiennik złącza M.2 w centrach danych, oferując zwiększoną wydajność i efektywność w rozwiązaniach pamięci masowej, takich jak centra danych.
XD7P obsługuje linie PCIe Gen4 x4. Dysk dobrze współpracuje z płytami głównymi Gen4 i Gen5.
Krótkie specyfikacje serii KIOXIA XD7P
| Pojemność | 7,680 GB | 3,840 GB | 1,920 GB | 7,680 GB | 3,840 GB | 1,920 GB |
| Podstawowe dane techniczne | ||||||
| Form Factor | E1.S 15mm | E1.S 9.5mm | ||||
| Interfejs | PCIe 5.0, NVMe 2.0 | |||||
| Typ pamięci Flash | BiCS FLASH TLC | |||||
| Wydajność (do) | ||||||
| Utrzymany sekwencyjny odczyt 128 KiB | 7,200MB / s | |||||
| Utrzymany zapis sekwencyjny 128 KiB | 4,800MB / s | 3,100MB / s | 4,800MB / s | 3,100MB / s | ||
| Utrzymany losowy odczyt 4 KiB | 1,550K IOPS | 1,650K IOPS | 1,500K IOPS | 1,550K IOPS | 1,650K IOPS | 1,500K IOPS |
| Utrzymany losowy zapis 4 KiB | 200K IOPS | 180K IOPS | 95K IOPS | 200K IOPS | 180K IOPS | 95K IOPS |
| Wymagania dotyczące zasilania | ||||||
| Napięcie zasilające | 12 V ± 10% | |||||
| Pobór mocy (aktywny) | Typowo 20 W. | Typowo 20 W. | Typowo 16 W. | Typowo 20 W. | Typowo 20 W. | Typowo 16 W. |
| Pobór mocy (tryb gotowości) | Typowo 5 W. | |||||
| Niezawodność | ||||||
| MTTF | 2,000,000 godzin | |||||
| DWPD | 1 | |||||
Wydajność serwera pamięci masowej z dyskami SSD serii KIOXIA XD7P
Aby lepiej zrozumieć, jak dobrze działa ta kombinacja, zaczęliśmy od sprawdzenia wydajności serwera pamięci masowej za pomocą wewnętrznych testów. Analizując wydajność serwera pamięci masowej, skupiliśmy się na pełnej wydajności w konfiguracji JBOD w systemie Ubuntu Linux, aby określić możliwości pamięci masowej.
Przeanalizowaliśmy przepustowość szczytową przy losowym obciążeniu 4K, a następnie przepustowość szczytową przy sekwencyjnym obciążeniu 64K. Testy te przeprowadzono z wykorzystaniem VDbench w środowisku Ubuntu 22.04.
| Obciążenie pracą | Czytaj | Pisać |
|---|---|---|
| 64K sekwencyjne, ładowanie 64 wątków | 158GB / s | 64.1GB / s |
| 4K losowo, obciążenie 512 wątków | 4.09 mln operacji wejścia/wyjścia na sekundę (IOPS), 16 GB/s | 4.5 mln operacji wejścia/wyjścia na sekundę (IOPS), 17.7 GB/s |
W naszej konfiguracji eksperymentalnej zdecydowaliśmy się na wykorzystanie funkcji Windows Storage Spaces w połączeniu z protokołem SMB3, aby wykorzystać szybkie dyski KIOXIA. Wykorzystując funkcję Storage Spaces do utworzenia odpornej, lustrzanej puli pamięci masowej, mogliśmy zapewnić integralność danych i zoptymalizować wydajność wejścia/wyjścia.
Ulepszone funkcje protokołu SMB3, takie jak obsługa wielu kanałów i trwałe uchwyty, umożliwiają bezpośrednie strumieniowanie dużych fragmentów danych z wysoką przepustowością do wielu stacji roboczych GPU, omijając tradycyjne wąskie gardła często związane z wolniejszą, obciążającą procesor pamięcią. Taka konfiguracja miała podwójną zaletę: umożliwiała szybkie pobieranie danych, a jednocześnie pozwalała wielu stacjom roboczym na jednoczesny dostęp do danych i ich ładowanie do i z naszej współdzielonej pamięci masowej opartej na technologii KIOXIA.
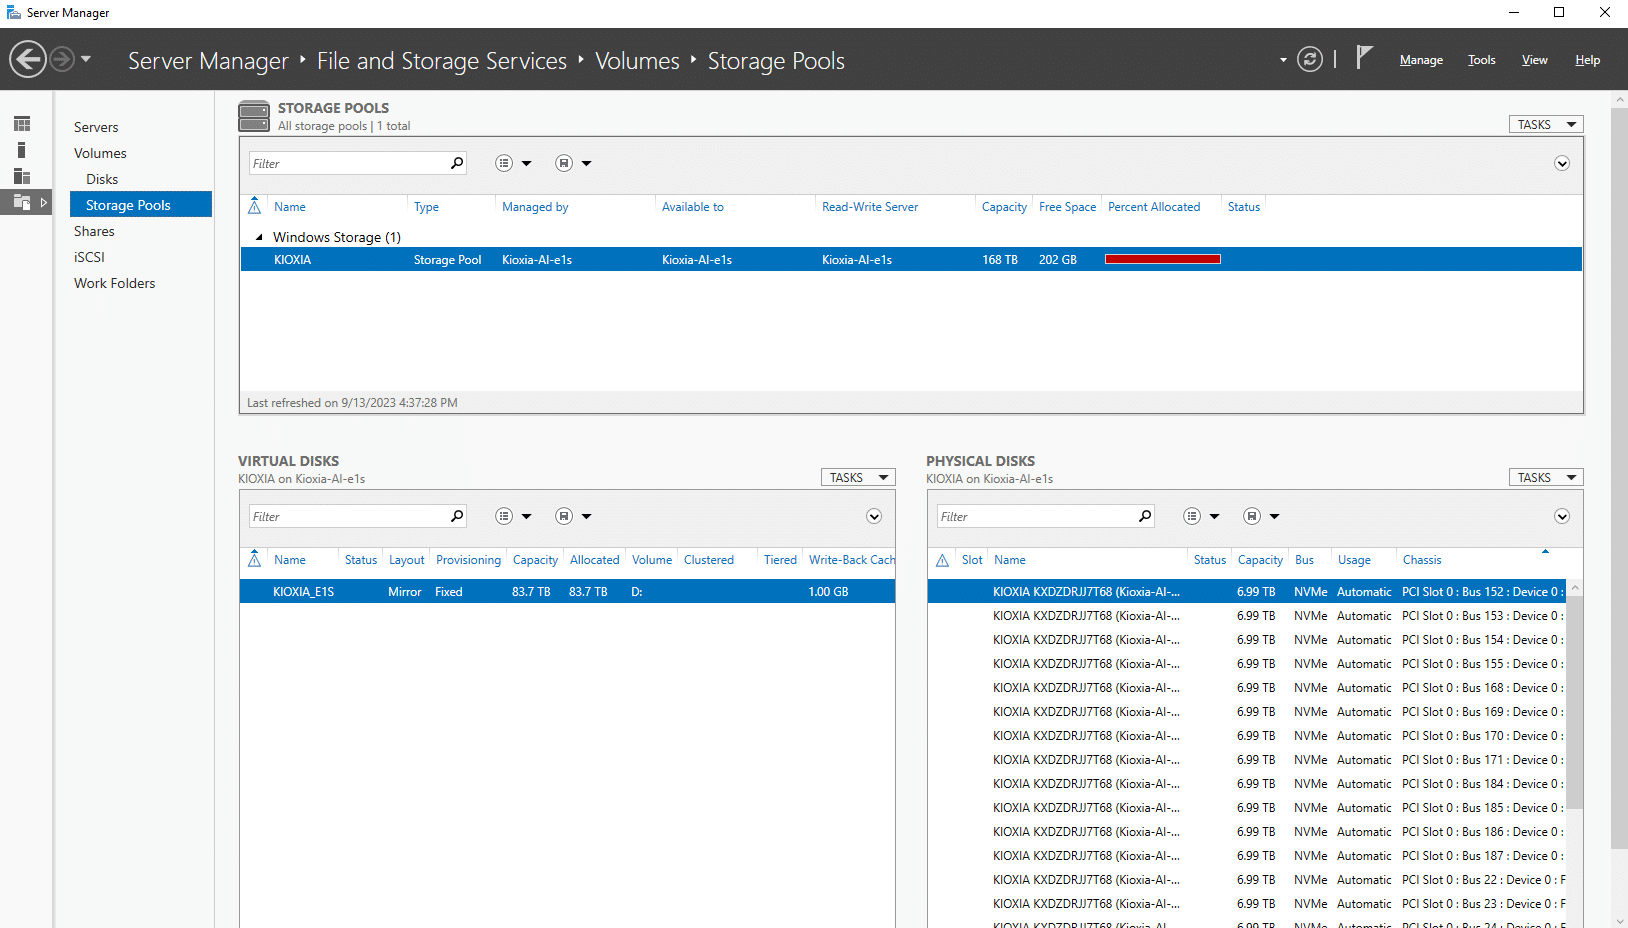
Podczas gdy nasze poprzednie testy mierzyły wydajność dysków SSD serii KIOXIA XD7P bez zainstalowanego systemu plików, ponownie przyjrzeliśmy się wydajności w środowisku Windows Server 2022. W tej konfiguracji, z lustrzanym dyskiem wirtualnym w naszej dużej puli pamięci masowej, użyliśmy systemu plików NTFS.
Aby potwierdzić wysoką wydajność w naszym lustrzanym woluminie, wykorzystaliśmy lokalnie na serwerze program CrystalDiskMark. Test ten został skonfigurowany tak, aby zmierzyć wydajność sekwencyjnego odczytu i zapisu przy rozmiarze transferu 1 MB oraz losowych prędkościach transferu 4 KB. W tym przypadku, przy rozmiarze pliku 64 GB, zmierzyliśmy prędkość odczytu 87.4 GB/s i zapisu ponad 18.4 GB/s.
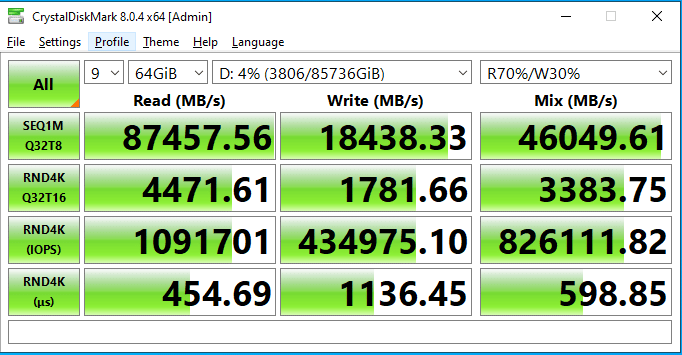
W tym artykule analizujemy ogólne możliwości całego rozwiązania AI, więc choć taki profil wydajności jest imponujący, KIOXIA wyraźnie oferuje nam więcej, niż potrzebujemy. To dobra wiadomość, ponieważ oznacza, że możemy łatwo zwiększyć liczbę stacji roboczych AI lub przypisać serwerowi pamięci masowej dodatkowe zadania, czy to czyszczenie i czyszczenie danych, czy coś zupełnie innego.
Dostarczanie stacjom roboczym AI dużej ilości pamięci masowej o dużej szybkości
Po umieszczeniu naszych stacji roboczych GPU w szafie laboratoryjnej, połączonych siecią 100 GbE z naszym serwerem plików all-flash 1U opartym na architekturze KIOXIA i skonfigurowaniu zasobów, postanowiliśmy przetestować to w praktyce. W naszej konfiguracji testowej zdecydowaliśmy się na podstawowe, pojedyncze łącze 100 GbE z każdej stacji roboczej do naszego przełącznika Dell Z9100 100 GbE, który następnie łączył się z serwerem pamięci masowej za pomocą kolejnego łącza 100 GbE.
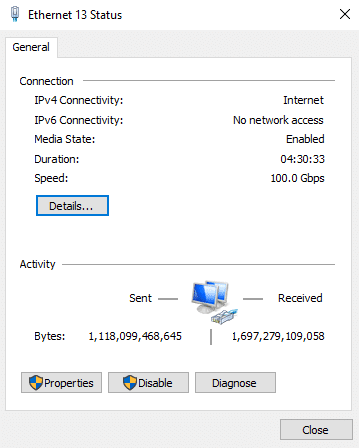
Tutaj udało nam się zmierzyć imponujące wyniki odczytu i zapisu na poziomie 11.4 GB/s dla udostępnionego pliku Windows na naszym serwerze pamięci masowej KIOXIA.
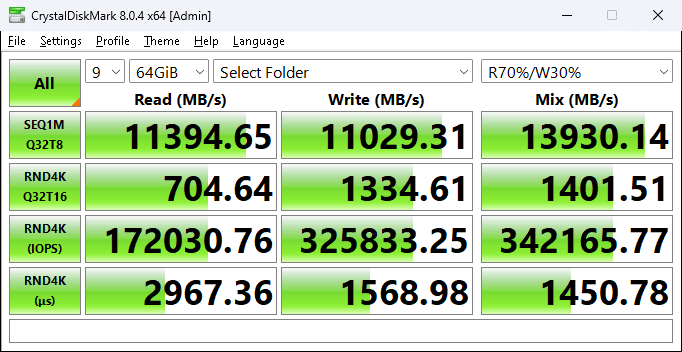
Ten poziom wydajności i gęstości transmisji danych przez sieć do stacji roboczych AI zapewni ogromną wartość. Zamiast wypełniać stacje robocze AI lokalną pamięcią masową, możemy udostępniać jeszcze wydajniejszą pamięć masową o przepustowości 100 GbE, która ma praktycznie nieograniczoną pojemność.
GenAI w praktyce – zestawy danych szkoleniowych LLM
Duże Modele Językowe (LLM) to obecnie najpopularniejsze tematy w branży IT. Ich szkolenie i dostrajanie to ogromne przedsięwzięcie, wymagające ogromnych zbiorów danych i jeszcze większej mocy obliczeniowej GPU do ich przetwarzania. Aby wykorzystać potencjał kilku stacji roboczych z GPU i przeprowadzić testy w warunkach rzeczywistych, zrzuciliśmy wszystkie teksty i komentarze przesłane na Reddicie w latach 2012–2021, wraz z pewnymi modyfikacjami, a także zbiór danych szkoleniowych Stanford Alpaca , do modelu LLaMa w celu przeprowadzenia wielokrotnych prób dostrajania. Celem była ocena wydajności, dokładności i wykonalności modelu LLaMa w warunkach rzeczywistych, w których został on poddany działaniu dużych zbiorów danych.
Na platformie Windows Server 2022 24 dyski SSD KIOXIA XD7P zgrupowano w pulę o pojemności 168 TB, a następnie w lustrzany wolumin o pojemności 83.7 TB. Wolumin ten udostępniono następnie w sieci 100 GbE z udziałem plików dla każdej z trzech stacji roboczych, aby wykorzystać jego potencjał. Serwer pamięci masowej Supermicro Superserver może obsłużyć rozmiar danych, który zapełniłby cały wolumin o pojemności 84 TB, bez wpływu na wydajność. Obecnie używany rozmiar danych wynosi 5.6 TB, ale wolumin może obsłużyć znacznie większy rozmiar.
Każda stacja robocza GPU została skonfigurowana nieco inaczej, aby zapewnić zróżnicowane środowisko. Traktowaliśmy każdą maszynę tak, jakby była indywidualnym programistą pracującym z różnymi modelami na wspólnym zestawie danych i nie prowadziliśmy żadnego szkolenia. Wybór systemu Windows w tym kontekście miał na celu naśladowanie wczesnego scenariusza badań lub rozwoju.
Dla porównania, jeśli chodzi o skalę danych, z którymi mamy do czynienia, nasze zbiory danych dla tego testu obejmowały 16 372 pliki danych treningowych LLM, zajmujące 3.7 TB miejsca na dysku, oraz kolejne 8,501 plików danych treningowych dla obrazów, zajmujące 1.9 TB. Łącznie pracowaliśmy z 24 873 plikami o łącznej pojemności 5.6 TB. Należy zauważyć, że celowo ograniczyliśmy rozmiar naszych zbiorów danych i nie wykorzystaliśmy całej pojemności pamięci masowej na potrzeby tych eksperymentów; w przeciwnym razie proces szkolenia lub dostrajania byłby zbyt czasochłonny dla tego projektu. Dzięki tej konfiguracji wszystkie stacje robocze mogły współdzielić zbiory danych oraz zapisywać punkty kontrolne i fragmenty na serwerze w celu współpracy.
| Akta | Rozmiar na dysku | |
| Dane szkoleniowe LLM | 16,372 | 3.7TB |
| Dane treningowe obrazu | 8,501 | 1.9TB |
| Cena produktu z VAT: | 24,873 | 5.6TB |
Stos oprogramowania dla obu naszych eksperymentów charakteryzował się prostą konfiguracją, a my wykorzystaliśmy potencjał Anacondy i podsystemu Windows dla systemu Linux (WSL). Anaconda zapewnia solidne środowisko do zarządzania naszymi bibliotekami uczenia maszynowego i zależnościami opartymi na Pythonie, umożliwiając modułową i łatwą do powielenia konfigurację na naszych stacjach roboczych z procesorami graficznymi. WSL pomaga wypełnić lukę między narzędziami opartymi na systemie Windows i Linuksie, oferując elastyczność i możliwość płynnego uruchamiania specyficznych dla systemu Linux narzędzi do manipulacji danymi i orkiestracji na naszych stacjach roboczych z systemem Windows. Mogliśmy uruchamiać skrypty powłoki do wstępnego przetwarzania danych i uruchamiać zadania szkoleniowe oparte na Pythonie w ramach ujednoliconego przepływu pracy. Jednym z powodów, dla których wybraliśmy tę drogę, była nie tylko łatwość konfiguracji, ale także wyrównanie szans w naszym mieszanym środowisku GPU.
W trakcie szkolenia poczyniono kilka kluczowych obserwacji:
- Różnorodność danych: Połączenie zgłoszeń i komentarzy z Reddita, obejmujących prawie dekadę, stworzyło model z eklektyczną mieszanką tematów, leksykonów i kontekstów konwersacyjnych. Ta bogata różnorodność zapewniła kompleksową platformę, na której model mógł zrozumieć i dostosować się do różnych niuansów, nastrojów i zmian kulturowych na przestrzeni lat.
- Skalowalność modelu: Obsługa tak ogromnej ilości danych była testem skalowalności modelu LLaMa. Stwierdziliśmy, że wraz z wydłużaniem się epok treningowych, zdolność modelu do przewidywania i generowania trafnych odpowiedzi znacznie się poprawiła, co wskazuje na jego potencjał w zastosowaniach na dużą skalę. Przeuczenie było problemem po około pół tuzinie, ale niekoniecznie w tym teście, ponieważ celem było obciążenie naszych procesorów graficznych i udziału sieciowego bardziej niż stworzenie ogólnego modelu LLM.
- Optymalizacja zasobów: Biorąc pod uwagę ogromną moc obliczeniową GPU, kluczowe było zapewnienie efektywnego wykorzystania zasobów obliczeniowych. Aby zapewnić optymalną wydajność, zastosowano dynamiczne równoważenie obciążenia, okresowe punkty kontrolne oraz techniki błyskawicznego zwiększania ilości danych.
- Potencjał transferu wiedzy: Wykorzystanie zbioru danych szkoleniowych Stanford Alpaca w połączeniu z danymi z Reddita odegrało kluczową rolę w ocenie możliwości transferu wiedzy modelu. Struktura i akademicki charakter zbioru danych Alpaca, w zestawieniu z nieformalną i zróżnicowaną naturą danych z Reddita, stanowiły ekscytujące wyzwanie. Wyniki wskazały, że LLaMa może płynnie integrować wiedzę z różnych źródeł, co czyni ją wszechstronną i elastyczną.
- Kwestie etyczne: Chociaż ogromny zbiór danych Reddita oferuje skarbnicę informacji, kluczowe jest zapewnienie, że dane osobowe nie będą ujawniane, a dane będą wykorzystywane w sposób etyczny i odpowiedzialny. Aby chronić prywatność użytkowników, publikacja modelu wymagałaby wdrożenia rygorystycznych procesów czyszczenia i anonimizacji danych.
To ćwiczenie podkreśliło kluczową rolę, jaką dyski KIOXIA o wysokiej gęstości odegrały w zwiększeniu wydajności naszego treningu. Biorąc pod uwagę kolosalny rozmiar zbiorów danych i iteracyjny charakter treningu modelu, prędkość i pojemność pamięci masowej często stanowią wąskie gardła w tego typu eksperymentach. Dzięki dyskom KIOXIA mogliśmy sobie pozwolić na przechowywanie wielu instancji zbioru danych, pośrednich wag modeli i dziesiątek precyzyjnie dostrojonych punktów kontrolnych. Ich wysokie prędkości odczytu i zapisu ułatwiły szybkie pobieranie danych, umożliwiając nam równoległe przetwarzanie wielu iteracji precyzyjnego dostrajania z różnymi hiperparametrami, jak pokazano poniżej.
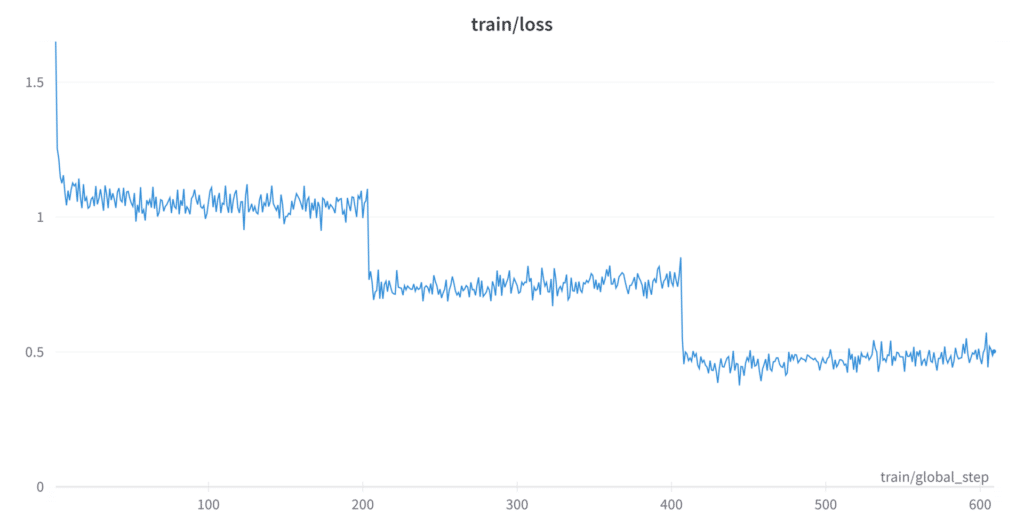
Miało to kluczowe znaczenie w naszych dążeniach do zidentyfikowania optymalnego punktu kontrolnego. Dzięki nowo zbudowanemu serwerowi pamięci masowej opartemu na architekturze KIOXIA mogliśmy skupić się na udoskonalaniu modelu, modyfikowaniu parametrów i ocenie wyników, zamiast ograniczać się do ograniczeń pojemności pamięci masowej. Dyski o wysokiej gęstości były zatem nie tylko rozwiązaniem pamięci masowej, ale kluczowym atutem, który znacznie przyspieszył naszą fazę eksperymentów. Umożliwiło to dokładniejsze i efektywniejsze zbadanie potencjału modelu LLaMa i pozwoliło nam opracować własną, nowatorską splotową sieć neuronową (CNN).
Dla niewtajemniczonych , splotowa sieć neuronowa (CNN) to wyspecjalizowany typ architektury głębokiego uczenia, stosowany głównie w przetwarzaniu obrazu i zadaniach z zakresu wizji komputerowej. Jej charakterystyczną cechą są warstwy splotowe, które automatycznie i adaptacyjnie uczą się hierarchii przestrzennych cech z obrazów wejściowych. W przeciwieństwie do tradycyjnych sieci neuronowych, które opierają się na w pełni połączonych warstwach, CNN wykorzystują strukturę przestrzenną danych, stosując filtry splotowe, które przetwarzają dane wejściowe w małych fragmentach lub polach recepcyjnych. W rezultacie powstaje sieć, która może wykrywać złożone wzorce, takie jak krawędzie, tekstury i bardziej złożone struktury, budując je z prostszych. W miarę jak dane wnikają głębiej w sieć, wzorce te stają się bardziej abstrakcyjne, umożliwiając CNN rozpoznawanie i klasyfikowanie różnorodnych i często zawiłych jednostek wizualnych hierarchicznie.
Dzięki licznym próbom dopracowania, model udowodnił swoją zdolność do wydajnego przetwarzania ogromnych zbiorów danych i podkreślił swój potencjał w zakresie generowania trafnych, kontekstowych i zniuansowanych wyników. Wraz z rosnącą popularnością modeli LLM, takie eksperymenty dostarczają cennych spostrzeżeń na temat ich praktycznych zastosowań i ograniczeń, torując drogę dla bardziej zaawansowanych i zorientowanych na użytkownika rozwiązań AI w przyszłości.
Możliwości wnioskowania serwera
Wykonywanie operacji wnioskowania na tym samym zbiorze danych zapewnia uproszczoną strukturę, upraszczając zawiłości zarządzania danymi. Nasz serwer to nie tylko narzędzie do przechowywania danych – jest on wyposażony w funkcje związane z wnioskowaniem, w tym pobieranie i przygotowywanie danych.
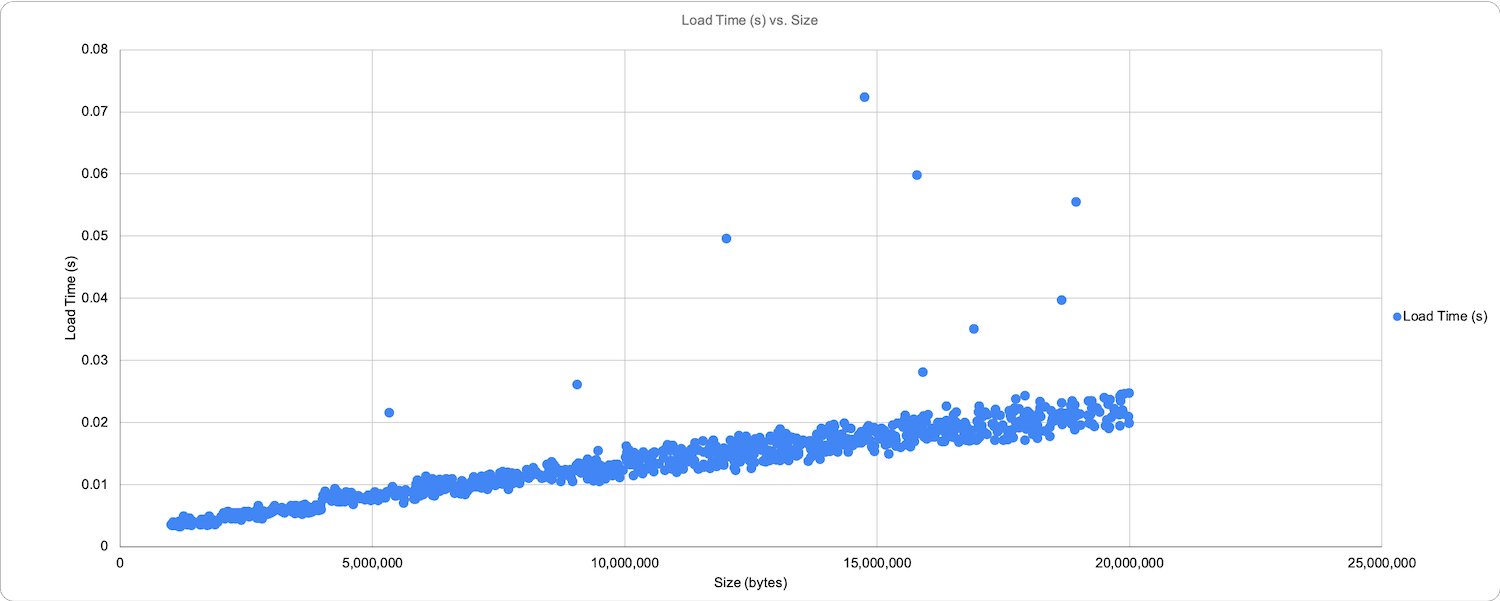
Aby przetestować wnioskowanie na większych zbiorach danych, wybraliśmy zestaw obrazów astrofotograficznych o rozmiarze od około 1 MB do 20 MB i uruchomiliśmy na nich nową sieć CNN, nad którą pracujemy. W naszym scenariuszu model jest ładowany do GPU, a następnie ładowany jest obraz lub seria obrazów do przetworzenia przez sieć neuronową.
To szerszy profil zajmowanej przestrzeni dyskowej niż ten, który można spotkać w przypadku klasyfikacji obiektów wizji komputerowej ze standardowej kamery. Mimo to, ilustruje on elastyczność i spójność działania platformy. Na poniższym wykresie, posortowanym według rozmiaru, a nie kolejności ładowania (z wyjątkiem kilku wartości odstających), czasy odczytu i zapisu są odpowiednio skalowane.
Należy pamiętać, że wykres ten jest posortowany od najmniejszego do największego, aby zilustrować liniową wydajność dysków i serwera. Rzeczywisty przebieg i zbiór danych były losowe, więc mógł zostać odczytany i zapisany plik o rozmiarze 1 MB, a następnie bezpośrednio po nim plik o rozmiarze 20 MB. Kolejność przetwarzania nie była określona. Czasy odczytu wahały się od 10 ms do 25 ms, z wartościami odstającymi sięgającymi ponad 70 ms.
Poniższy wykres ilustruje zapisywanie podobnie liniowej progresji z mniejszymi odchyleniami i pokazuje czasy zapisu tych samych plików od 12 ms do 118 ms.
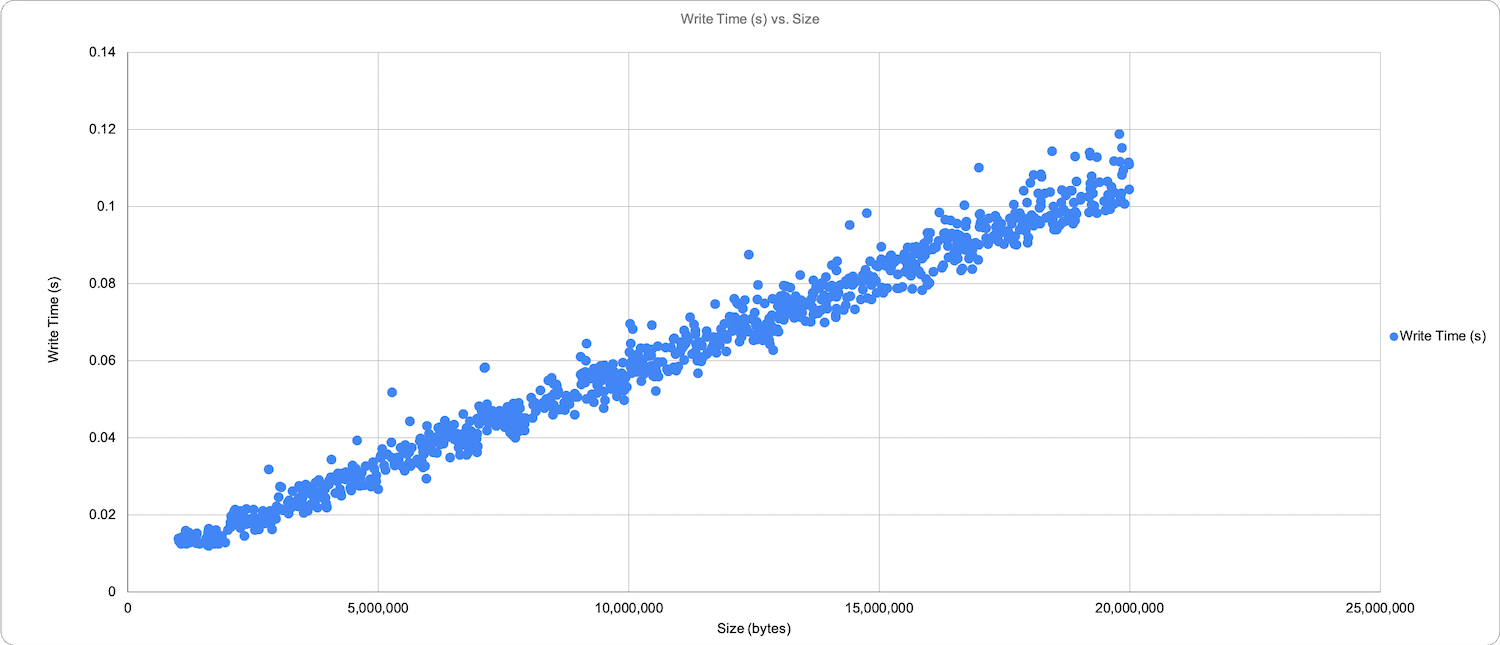
Kolejną istotną informacją, o której należy pamiętać, jest to, że wykres ten jest agregatem danych uzyskanych ze śledzenia na trzech stacjach roboczych GPU, które jednocześnie przeprowadzały wnioskowanie na tym samym zbiorze danych. Dyski KIOXIA były w stanie obsłużyć i zapisać imponujące 10.5 GB danych na trzech stacjach roboczych GPU, które przeprowadzały wnioskowanie na losowym zbiorze danych 1000 obrazów, z wyłączeniem przetwarzania serializowanego wykorzystywanego przez model. Cały proces odczytu i zapisu pojedynczego obrazu zajął zaledwie 59.62 sekundy, czyli 59 ms.
Kilka opcji mogłoby poprawić szybkość i opóźnienia, ponieważ projekt ten skaluje się do wielu stacji roboczych lub serwerów GPU. Implementacja technologii NVIDIA GPUDirect Storage w połączeniu z protokołem RDMA (Remote Direct Memory Access) umożliwiłaby płynne przenoszenie danych z współdzielonej pamięci masowej o wysokiej gęstości bezpośrednio do pamięci GPU. Takie podejście skutecznie ominęłoby wąskie gardła procesora i pamięci systemowej. Wykorzystując technologię NVMe w architekturze Fabric i sprzęt sieciowy NVIDIA, duże wolumeny danych mogą być wstępnie ładowane do pamięci GPU w czasie niemal rzeczywistym. Byłoby to szczególnie korzystne w przypadku systemów LLM, biorąc pod uwagę ich duże zbiory danych i wymagania obliczeniowe. Taka możliwość mogłaby wyeliminować potrzebę buforowania danych i umożliwiłaby wielu stacjom roboczym jednoczesne odczytywanie i pobieranie danych z puli współdzielonej pamięci masowej.
Uwagi końcowe
Rozwiązanie problemu wąskiego gardła wejścia/wyjścia w większych modelach ma kluczowe znaczenie dla dalszego rozwoju uczenia maszynowego, szczególnie w przypadku rozległych zbiorów danych. Scentralizowany, szybki współdzielony dostęp sieciowy oferuje potrójną przewagę nad tradycyjnym, lokalnym magazynem danych.
- Po pierwsze, usprawnia operacje, eliminując potrzebę migracji ogromnych zbiorów danych na poszczególne stacje robocze w celu szkolenia. To bezpośrednio eliminuje wąskie gardła wejścia/wyjścia, które mogą sparaliżować projekty uczenia maszynowego, zwłaszcza te obejmujące modele głębokiego uczenia.
- Po drugie, wybierając podejście scentralizowane, unikasz przeciążania cennych linii PCIe stacji roboczej nadmierną lub wręcz nieosiągalną ilością lokalnej pamięci masowej. Dzięki szybkiemu połączeniu może to umożliwić większej liczbie procesorów graficznych wydajniejsze, równoległe przetwarzanie danych, usprawniając i zwiększając elastyczność operacji uczenia maszynowego.
- Po trzecie, scentralizowane przechowywanie danych z natury zapewnia lepsze zabezpieczenia. Gdy dane są przechowywane w bezpiecznym, jednym miejscu, łatwiej jest zarządzać kontrolą dostępu i wdrażać protokoły bezpieczeństwa, zmniejszając ryzyko wycieków danych, zagrożeń fizycznych lub nieautoryzowanego dostępu.
Ponadto centralizacja danych zapewnia lepszą spójność danych i dodatkową warstwę redundancji danych. Stacje robocze uzyskują dostęp do najbardziej aktualnych danych z jednego źródła, minimalizując rozbieżności w wynikach spowodowane nieaktualnymi lub niespójnymi danymi szkoleniowymi lub dostrajającymi bądź punktami kontrolnymi modelu. Upraszcza to również zarządzanie danymi i oszczędza miejsce na dysku.
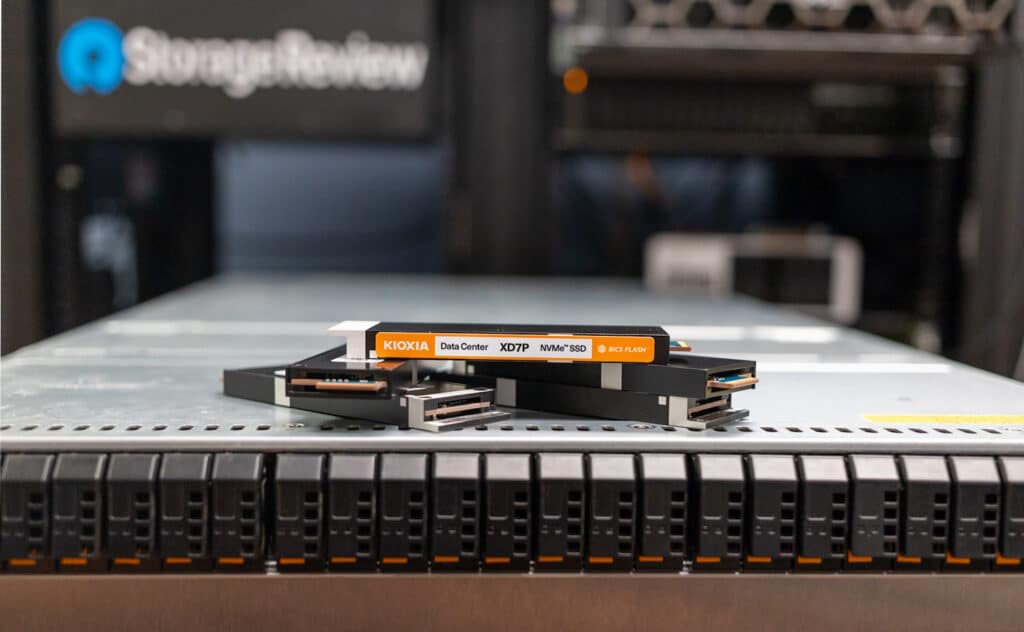
W miarę jak skalowalność, wydajność i bezpieczeństwo stają się coraz ważniejsze w hipersonicznie ewoluującym środowisku sztucznej inteligencji i uczenia maszynowego, przejście na scentralizowaną, gęstą i szybką pamięć masową, oferowaną przez technologie takie jak platforma KIOXIA E1.S, stanowi przekonujący argument. Ma to kluczowe znaczenie nie tylko dla zwiększenia wydajności, ale także dla fundamentalnej transformacji naszego podejścia do zarządzania danymi i trenowania modeli.
Karta specyfikacji centrum danych KIOXIA XD7P serii E1.S NVMe
Niniejszy raport jest sponsorowany przez KIOXIA America, Inc. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej ocenie rozpatrywanego produktu(ów).


 Amazon