

Lenovo ThinkSystem SR650 V4 to elastyczny i wydajny serwer rackowy z 2 gniazdami i wysokością 2U, zaprojektowany z myślą o potrzebach takich branż jak usługi chmurowe, telekomunikacja i obliczenia o wysokiej wydajności (HPC). Niezależnie od tego, czy chodzi o optymalizację pod kątem skalowalnych obciążeń, czy o zabezpieczenie centrum danych przed przyszłymi wyzwaniami dzięki dużej gęstości mocy obliczeniowej, SR650 V4 oferuje znaczące ulepszenia w porównaniu ze swoim poprzednikiem, SR650 V3.

Różnice między Lenovo SR650 V4 i SR650 V3
Procesory
Możliwości procesora stanowią jedną z ważniejszych modernizacji w modelu SR650 V4. Podczas gdy SR650 V3 bazował na procesorach Intel Xeon Scalable czwartej generacji, SR650 V4 wprowadza platformę Intel Xeon 6 (wcześniej o nazwie kodowej „Granite Rapids”). Nasza recenzja koncentruje się na architekturze rdzeni P (Performance-core), zaprojektowanej specjalnie z myślą o obciążeniach wymagających dużej mocy obliczeniowej. Model V4 obsługuje jeden lub dwa procesory z maksymalnie 86 rdzeniami P na gniazdo (do 172 wątków), zapewniając wyższą częstotliwość taktowania rdzeni (do 4 GHz) i TDP do 350 W.
To przejście pozwala organizacjom obsługiwać bardziej wymagające aplikacje na serwer, zmniejszając ich fizyczną powierzchnię. Architektura ta tworzy solidną podstawę dla wirtualizacji i intensywnych operacji bazodanowych. Dodatkowo, architektura V4 obsługuje ogromną przepustowość PCIe, z maksymalnie 88 liniami PCIe 5.0 na procesor, co jest niezbędne do obsługi nowoczesnych, szybkich kart sieciowych i macierzy pamięci masowej NVMe bez wąskich gardeł.
| Model procesora | Rdzenie / nici | Częstotliwość podstawowa | Max Turbo | L3 Cache | TDP |
|---|---|---|---|---|---|
| 6787P | 86 / 172 | 2.0 GHz | 3.8 GHz | 336 MB | W 350 |
| 6781P | 80 / 160 | 2.0 GHz | 3.8 GHz | 336 MB | W 350 |
| 6767P | 64 / 128 | 2.4 GHz | 3.9 GHz | 336 MB | W 350 |
| 6761P | 64 / 128 | 2.5 GHz | 3.9 GHz | 336 MB | W 350 |
| 6760P | 64 / 128 | 2.2 GHz | 3.8 GHz | 320 MB | W 330 |
| 6747P | 48 / 96 | 2.7 GHz | 3.9 GHz | 288 MB | W 330 |
| 6745P | 32 / 64 | 3.1 GHz | 4.3 GHz | 336 MB | W 300 |
| 6741P | 48 / 96 | 2.5 GHz | 3.8 GHz | 288 MB | W 300 |
| 6740P | 48 / 96 | 2.1 GHz | 3.8 GHz | 288 MB | W 270 |
| 6737P | 32 / 64 | 2.9 GHz | 4.0 GHz | 144 MB | W 270 |
| 6736P | 36 / 72 | 2.0 GHz | 4.1 GHz | 144 MB | W 205 |
| 6732P | 32 / 64 | 3.8 GHz | 4.3 GHz | 144 MB | W 350 |
| 6731P | 32 / 64 | 2.5 GHz | 4.1 GHz | 144 MB | W 245 |
| 6730P | 32 / 64 | 2.5 GHz | 3.8 GHz | 288 MB | W 250 |
| 6724P | 16 / 32 | 3.6 GHz | 4.3 GHz | 72 MB | W 210 |
| 6714P | 8 / 16 | 4.0 GHz | 4.3 GHz | 48 MB | W 165 |
| 6530P | 32 / 64 | 2.3 GHz | 4.1 GHz | 144 MB | W 225 |
| 6527P | 24 / 48 | 3.0 GHz | 4.2 GHz | 144 MB | W 255 |
| 6521P | 24 / 48 | 2.6 GHz | 4.1 GHz | 144 MB | W 225 |
| 6520P | 24 / 48 | 2.4 GHz | 4.0 GHz | 144 MB | W 210 |
| 6517P | 16 / 32 | 3.2 GHz | 4.2 GHz | 72 MB | W 190 |
| 6515P | 16 / 32 | 2.3 GHz | 3.8 GHz | 72 MB | W 150 |
| 6511P | 16 / 32 | 2.3 GHz | 4.2 GHz | 72 MB | W 150 |
| 6507P | 8 / 16 | 3.5 GHz | 4.3 GHz | 48 MB | W 150 |
| 6505P | 12 / 24 | 2.2 GHz | 4.1 GHz | 48 MB | W 150 |
Pamięć
Jeśli chodzi o pamięć, SR650 V4 znacznie przewyższa możliwości V3, maksymalizując wydajność podsystemu. Obsługuje pamięci DDR5 o częstotliwości do 6400 MHz (1 moduł DIMM na kanał), co stanowi znaczny wzrost w porównaniu z limitem 4800 MHz w poprzedniej generacji. System oferuje 32 gniazda DIMM (16 na procesor) rozmieszczone w ośmiu kanałach pamięci na procesor. Obsługuje standardowe moduły RDIMM, 3DS RDIMM oraz nowe moduły Multiplexed Rank DIMM (MRDIMM), które mogą pracować z częstotliwością do 8000 MHz w aplikacjach wymagających dużej przepustowości. Dzięki 256 GB modułom 3DS RDIMM serwer obsługuje aż 8 TB całkowitej pamięci systemowej.

Ponadto, V4 wprowadza obsługę rozszerzenia pamięci CXL 2.0 (Compute Express Link). Administratorzy mogą zainstalować do 12 modułów pamięci CXL w zatokach dysków E3.S (w szczególności w formacie E3.S 2T). Pozwala to systemowi skalować pojemność pamięci i przepustowość poza tradycyjne ograniczenia związane z podłączonym procesorem, zmniejszając opóźnienia obliczeniowe w przypadku obciążeń nowej generacji i obniżając całkowity koszt posiadania (TCO) dzięki mniejszej liczbie niewykorzystanych pamięci.
Dyski
Możliwości pamięci masowej Lenovo SR650 V4 odzwierciedlają przejście w kierunku wydajnej gęstości NVMe i elastycznych formatów. Obsługując starsze dyski 3.5-calowe i 2.5-calowe, V4 wprowadza szeroką obsługę formatu E3.S NVMe. System może pomieścić do 32 dysków E3.S 1T lub 12 dysków E3.S 2T, zapewniając większą gęstość i lepsze zarządzanie temperaturą w porównaniu z tradycyjnymi dyskami SSD U.2.

Co najważniejsze, V4 obsługuje bezpośrednią łączność NVMe bez nadsubskrypcji (1:1), co gwarantuje, że szybka pamięć masowa nie będzie ograniczana przez współdzielone linie PCIe. Dodanie opcji dysków rozruchowych M.2 z możliwością wymiany na gorąco dodatkowo zwiększa łatwość serwisowania.
Sieci
Do obsługi sieci, SR650 V4 oferuje dwa dedykowane gniazda OCP 3.0, oba obsługujące PCIe Gen 5 x16. To kluczowa modernizacja, która umożliwia redundantną, szybką sieć (np. dwuportową 200 GbE lub jednoportową 400 GbE) bez zajmowania standardowych gniazd nośnych PCIe. Przejście na PCIe 5.0 podwaja teoretyczną przepustowość (32 GT/s w porównaniu z 16 GT/s), dzięki czemu V4 jest w stanie obsłużyć najbardziej wymagający ruch sieciowy w chmurze i AI.

Zasilanie i chłodzenie
SR650 V4 oferuje ulepszone opcje zasilania, od 800 W do 3200 W, dostępne w wersjach o sprawności Titanium i Platinum. System obsługuje również zasilanie prądem stałym -48 V oraz opcje HVAC/HVDC, aby spełnić specyficzne wymagania centrów danych.

Aby zarządzać ciepłem wytwarzanym przez procesory i pamięć o wysokim TDP, Lenovo wprowadza opcję chłodzenia cieczą Neptune. Moduł „Compute Complex Neptune Core Module” wykorzystuje chłodzenie cieczą w obiegu otwartym, aby odprowadzać ciepło z procesorów, pamięci i regulatorów napięcia, co pozwala na odprowadzenie ponad 80% ciepła z serwera i znaczące obniżenie kosztów chłodzenia centrum danych.
Ogólnie rzecz biorąc, SR650 V4 to duży krok naprzód pod względem wydajności, gęstości i efektywności cieplnej w nowoczesnych środowiskach korporacyjnych.
Dane techniczne Lenovo ThinkSystem SR650 V4
| Specyfikacja | Szczegóły |
|---|---|
| Specyfikacja systemu | |
| Form Factor | Szafa 2U |
| Procesor | Do 2 procesorów Intel Xeon serii 6700/6400 (rdzenie P); do 86 rdzeni na procesor; TDP do 350 W |
| Pamięć | 32 gniazda DIMM (16 na procesor); obsługa modułów TruDDR5 RDIMM do 6400 MHz i MRDIMM do 8000 MHz |
| Rozszerzenie pamięci | Obsługuje moduły pamięci CXL 2.0 w formacie E3.S 2T (do 12 modułów DIMM) |
| Maksymalna pamięć | Do 8 TB pamięci systemowej (przy użyciu modułów 3DS RDIMM o pojemności 256 GB) |
| Zatoki dysków twardych | Z przodu: Do 24 dysków 2.5″ NVMe/SAS/SATA, 16 dysków 3.5″ SAS/SATA lub 32 dysków E3.S NVMe Środek: Do 8 gniazd 2.5″ z możliwością łatwej wymiany Tylny: Do 8 dysków 2.5″ lub 4 dysków 3.5″ z możliwością wymiany na gorąco |
| Kontroler pamięci masowej | Do 36 wbudowanych portów NVMe (łączność 1:1); obsługa RAID/HBA |
| Interfejsy sieciowe | Dwa gniazda OCP 3.0 SFF z interfejsem hosta PCIe 5.0 x16 |
| Gniazda rozszerzeń PCI | Do 10 gniazd PCIe 5.0 (z tyłu); opcjonalne gniazda PCIe z przodu |
| Obsługa GPU | Do 10 procesorów graficznych o pojedynczej szerokości lub 2 procesory graficzne o podwójnej szerokości |
| porty | Z przodu: Zewnętrzny port diagnostyczny, opcjonalnie USB i Mini-DP Tylny: 2x USB 3.0, 1x VGA, 1x zarządzanie RJ-45, opcjonalnie port szeregowy |
| Chłodzenie | Do 6 wentylatorów z możliwością wymiany na gorąco (redundancja N+1); opcjonalne moduły chłodzenia cieczą Neptune |
| Zasilacz laboratoryjny | Do dwóch redundantnych zasilaczy AC/DC z możliwością wymiany na gorąco (800–3200 W) |
| systemy zarządzania | Kontroler XClarity 3 (XCC3); opcjonalny XCC3 Premier |
| Funkcje zabezpieczeń | TPM 2.0, PFR Root of Trust (NIST SP800-193), ochrona przed otwarciem obudowy, blokowana ramka |
| Systemy operacyjne | Microsoft Windows Server, RHEL, SLES, Ubuntu Server |
| Gwarancja | 3-letnia gwarancja podstawowa (konfigurowalna) |
| Wymiary | 87 mm (3.4 cala) wys. x 440 mm (17.3 cala) szer. x 800 mm (31.5 cala) gł. |
| Waga | Maksymalna waga: 38.8 kg (85.5 funta) |
Projekt i budowa Lenovo ThinkSystem SR650 V4
Lenovo ThinkSystem SR650 V4 to standardowa platforma 2U, która efektywnie wykorzystuje swoją fizyczną obudowę, łącząc gęstość komponentów z przepływem powietrza i łatwością serwisowania. Obudowa ma 3.4 cala wysokości, 17.3 cala szerokości i 31.5 cala głębokości, a jej maksymalna waga wynosi 85.5 funta (ok. 38 kg). Te wymiary plasują ją w samym centrum rynku serwerów korporacyjnych 2U, zapewniając jednocześnie wystarczającą głębokość dla wydajnych procesorów, gęstych konfiguracji pamięci i elastycznych płyt głównych pamięci masowej.
Uznany, przemysłowy design ThinkSystem firmy Lenovo jest natychmiast rozpoznawalny dzięki sztywnej, stalowej obudowie i czytelnym, funkcjonalnym oznaczeniom. Wnętrze jest przejrzyste i funkcjonalne, z naciskiem na bezpośredni przepływ powietrza, modułowe strefy podzespołów oraz beznarzędziowy dostęp do rutynowych czynności serwisowych. Konstrukcja sprawia wrażenie solidnej i dobrze zaprojektowanej, odzwierciedlając platformę zaprojektowaną do ciągłej pracy w centrach danych, a nie walory estetyczne.
Przedni panel
Panel przedni jest wysoce konfigurowalny. Nasz system testowy jest wyposażony w 8-zatokową płytę montażową dla dysków 2.5 cala, ale obudowę można łatwo skalować do 16, a nawet 24 zatok przy minimalnym wysiłku. Klienci mogą również wybrać zatoki 3.5 cala o większej pojemności lub nowsze opcje płyty montażowej E3.S o wysokiej wydajności i gęstości NVMe. Obsługa AnyBay umożliwia współistnienie dysków SAS, SATA i NVMe w tej samej klatce dyskowej, co zapewnia znaczną elastyczność w przypadku wdrożeń z mieszanymi pamięciami masowymi.

Na panelu przednim znajdują się niezbędne elementy sterujące dla operatora: przycisk zasilania, przycisk ID oraz diody LED informujące o stanie systemu i aktywności sieci. Wysuwana zakładka informacyjna zapewnia szybki dostęp do etykiety dostępu do sieci XCC i numeru seryjnego. Opcjonalne złącza lokalne obejmują porty Mini DisplayPort i USB do obsługi kart awaryjnych, co jest nieocenione podczas rozwiązywania problemów w centrach danych z awariami.
Panel tylny
Tylna część obudowy została zaprojektowana z myślą o maksymalnej gęstości wejść/wyjść. W zależności od konfiguracji riserów, może pomieścić do 10 gniazd PCIe Gen 5. Dzięki dwóm gniazdom OCP 3.0 standardowe risery PCIe można wykorzystać do podłączenia innych kart rozszerzeń, takich jak karty graficzne czy kontrolery pamięci masowej.
Oprócz portów rozszerzeń, tylny panel zawiera wbudowany port sieciowy zarządzania BMC, dwa porty USB-A oraz wyjście VGA do lokalnego dostępu do konsoli. Z tyłu zamontowano dwa zasilacze z możliwością wymiany w trakcie pracy, co zapewnia łatwą obsługę bez zakłócania przepływu powietrza i możliwości rozbudowy.
Wewnętrzne
Wnętrze jest schludne i zoptymalizowane pod kątem przepływu powietrza. 32 gniazda DIMM sąsiadują z dwoma gniazdami procesora, rozmieszczonymi tak, aby zapewnić niezakłócone chłodzenie od przodu do tyłu dzięki sześciu wydajnym wentylatorom hot-swap umieszczonym z przodu obudowy. Wentylatory są całkowicie beznarzędziowe i łatwe w wymianie, a cała tacka wentylatorów jest demontowalna bez użycia narzędzi. Demontaż tacy zapewnia swobodny, bezpośredni dostęp do przestrzeni dyskowej AnyBay, co upraszcza serwisowanie, modernizację i wymianę płyty głównej.

Okablowanie pamięci masowej jest starannie poprowadzone wzdłuż boków obudowy, aby nie blokować przepływu powietrza do procesorów i pamięci. W konfiguracjach z modułami chłodzenia cieczą Neptune, układ wewnętrzny ulega niewielkim zmianom, aby dostosować się do pętli chłodzenia, ale łatwość serwisowania rdzenia pozostaje wysoka. Moduł dysku rozruchowego M.2 jest zamontowany na przegrodzie powietrznej lub klatce dysków, co umożliwia łatwy dostęp bez konieczności demontażu innych komponentów.
Kontroler XClarity 3
Serwer SR650 V4 jest wyposażony w nowy kontroler XClarity Controller 3 (XCC3). Ten moduł zarządzający oferuje znaczną poprawę wydajności w porównaniu z poprzednimi generacjami, oferując krótszy czas rozruchu i bardziej responsywny interfejs HTML5. Menedżer zasobów platformy zapewnia szczegółowe dane telemetryczne dotyczące stanu zasilania i temperatury, pomagając administratorom optymalizować wydajność centrum danych.
XCC3 obsługuje szeroki zakres funkcji zdalnego zarządzania, w tym zdalne sterowanie (KVM), montowanie nośników wirtualnych i aktualizacje oprogramowania sprzętowego. Interfejs jest intuicyjny i zapewnia podgląd stanu systemu, aktywnych zdarzeń i inwentaryzacji sprzętu w formie pulpitu nawigacyjnego. W celu automatyzacji, XCC3 w pełni obsługuje interfejsy API REST Redfish.
Wydajność Lenovo ThinkSystem SR650 V4
W tej sekcji przeanalizowano wyniki testów porównawczych z programów Blender, y-cruncher, vLLM i Phoronix. Wstępne testy przeprowadzono na systemie Lenovo ThinkSystem SR650 V4 wyposażonym w procesory Intel Xeon 6740P, co pozwoliło nam ocenić architekturę rdzeni P zorientowaną na wydajność oraz ogólną przepustowość platformy przy obciążeniach obciążających procesor. W trakcie testu dostosowaliśmy konfigurację systemu, aby umożliwić testy z akceleracją GPU. Przejście było proste, wspomagane przez zestaw Lenovo do rozbudowy GPU, który zawiera wydajne wentylatory, ulepszone radiatory, zmodyfikowaną osłonę przepływu powietrza oraz risery obsługujące GPU, zaprojektowane do obsługi akceleratorów o wyższej mocy. Instalacja nie wymagała znaczących zmian w obudowie i idealnie zintegrowała się z istniejącym układem systemu.
Po zainstalowaniu ulepszonych komponentów chłodzenia i przepływu powietrza, dodaliśmy do platformy pojedynczy procesor graficzny NVIDIA L40S. Pozwoliło nam to rozszerzyć testy o obciążenia akcelerowane przez GPU, takie jak renderowanie GPU w Blenderze i testy porównawcze skoncentrowane na wnioskowaniu, przy jednoczesnym zachowaniu stabilnych parametrów termicznych i spójnego działania systemu. Modułowy charakter modernizacji podkreśla elastyczność SR650 V4, umożliwiając łatwe przejście z konfiguracji CPU zorientowanej na wydajność do zrównoważonej platformy CPU+GPU, odpowiedniej do mieszanych obciążeń obliczeniowych.
Konfiguracja Lenovo ThinkSystem SR650 V4:
- PROCESOR: 2x Intel Xeon 6740P
- Pamięć: 1TB pamięci RAM
- Przechowywanie: 4 dyski SSD 960 GB
- GPU: NVIDIA L40S
Blender 4.5
Blender to aplikacja do modelowania 3D o otwartym kodzie źródłowym. Ten test porównawczy został przeprowadzony za pomocą narzędzia Blender Benchmark. Wynik jest mierzony w próbkach na minutę, a wyższe wartości oznaczają lepszą wydajność.
W teście wydajności procesora Blendera, Lenovo ThinkSystem SR650 V4 zapewnia solidną wydajność renderowania we wszystkich scenach, uzyskując 1136.99 próbek na minutę w trybie Monster, 707.60 w trybie Junkshop i 562.53 w trybie Classroom. Wyniki odzwierciedlają silne skalowanie wielowątkowe dwóch procesorów Intel Xeon 6740P, z stabilną wydajnością przy rosnącej złożoności scen.
| Procesor Blendera (liczba próbek na minutę; im wyższa wartość, tym lepiej) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1TB RAM) |
|---|---|
| Potwór | 1136.99 |
| Sklep ze złomem | 707.60 |
| Sala szkoleniowa | 562.53 |
W teście Blender CPU bez SMT, SR650 V4 wykazuje znaczny wzrost przepustowości renderowania, osiągając 4686.40 próbek na minutę w trybie Monster, 2223.96 w trybie Junkshop i 2385.98 w trybie Classroom. Wyniki GPU podkreślają zdolność systemu do przyspieszania złożonych obciążeń renderujących, zapewniając znacznie wyższą przepustowość w porównaniu z renderowaniem wyłącznie z wykorzystaniem procesora.
| Procesor Blendera (bez SMT) (liczba próbek na minutę; im wyższa, tym lepiej) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1TB RAM) |
|---|---|
| Potwór | 4686.40 |
| Sklep ze złomem | 2223.96 |
| Sala szkoleniowa | 2385.98 |
y-cruncher
y-cruncher to wielowątkowy, skalowalny program, który oblicza liczbę Pi i inne stałe matematyczne z dokładnością do bilionów cyfr. Od momentu premiery w 2009 roku, stał się popularną aplikacją do benchmarkingu i testów obciążeniowych dla overclockerów i entuzjastów sprzętu.
W y-cruncherze Lenovo skaluje się płynnie wraz ze wzrostem rozmiaru problemu, co podkreśla wysoką wydajność wielowątkowych obliczeń i przepustowość pamięci platformy. Dzięki dwóm procesorom Intel Xeon 6740P i 1 TB pamięci RAM system wykonuje obliczenia Pi o długości 1 mld cyfr w nieco ponad 20 sekund i utrzymuje stałą wydajność do 25 mld cyfr, co zajmuje 362 sekundy. Wyniki pokazują przewidywalne skalowanie przy stałym obciążeniu procesora i pamięci, dzięki czemu SR650 V4 doskonale nadaje się do dużych obciążeń matematycznych i scenariuszy testów obciążeniowych.
| Y-Cruncher (całkowity czas obliczeń) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1TB RAM) |
|---|---|
| 1 Billion | 20.715 s |
| 2.5 Billion | 44.412 s |
| 5 Billion | 81.937 s |
| 10 Billion | 152.743 |
| 25 Billion | 362.566 |
vLLM Online Serving Wydajność wnioskowania LLM
vLLM to najpopularniejszy silnik wnioskowania i obsługi o wysokiej przepustowości dla systemów LLM. Test porównawczy obsługi online vLLM to narzędzie do oceny wydajności, które mierzy rzeczywiste możliwości obsługi tego silnika wnioskowania przy współbieżnych żądaniach. Symuluje obciążenia produkcyjne, wysyłając żądania do działającego serwera vLLM z konfigurowalnymi parametrami, takimi jak częstotliwość żądań, długość wejścia/wyjścia i liczba współbieżnych klientów. Test mierzy kluczowe wskaźniki, takie jak przepustowość (liczba tokenów na sekundę), czas do pierwszego tokena i czas na token wyjściowy (TPOT), pomagając użytkownikom zrozumieć, jak vLLM działa w różnych warunkach obciążenia.
Przetestowaliśmy wydajność wnioskowania w ramach kompleksowego zestawu modeli obejmujących różne architektury, skale parametrów i strategie kwantyzacji, a także oceniliśmy przepustowość przy różnych profilach współbieżności.
Wydajność gęstego modelu
Modele gęste bazują na konwencjonalnej architekturze LLM, w której wszystkie parametry i aktywacje są wykorzystywane podczas wnioskowania, co skutkuje bardziej intensywnym obliczeniowo przetwarzaniem niż w przypadku modeli rzadkich. Aby kompleksowo ocenić charakterystykę wydajności w różnych skalach modeli i strategiach kwantyzacji, przeprowadziliśmy testy porównawcze wielu konfiguracji modeli gęstych z rodziny Llama 3.1 8B.
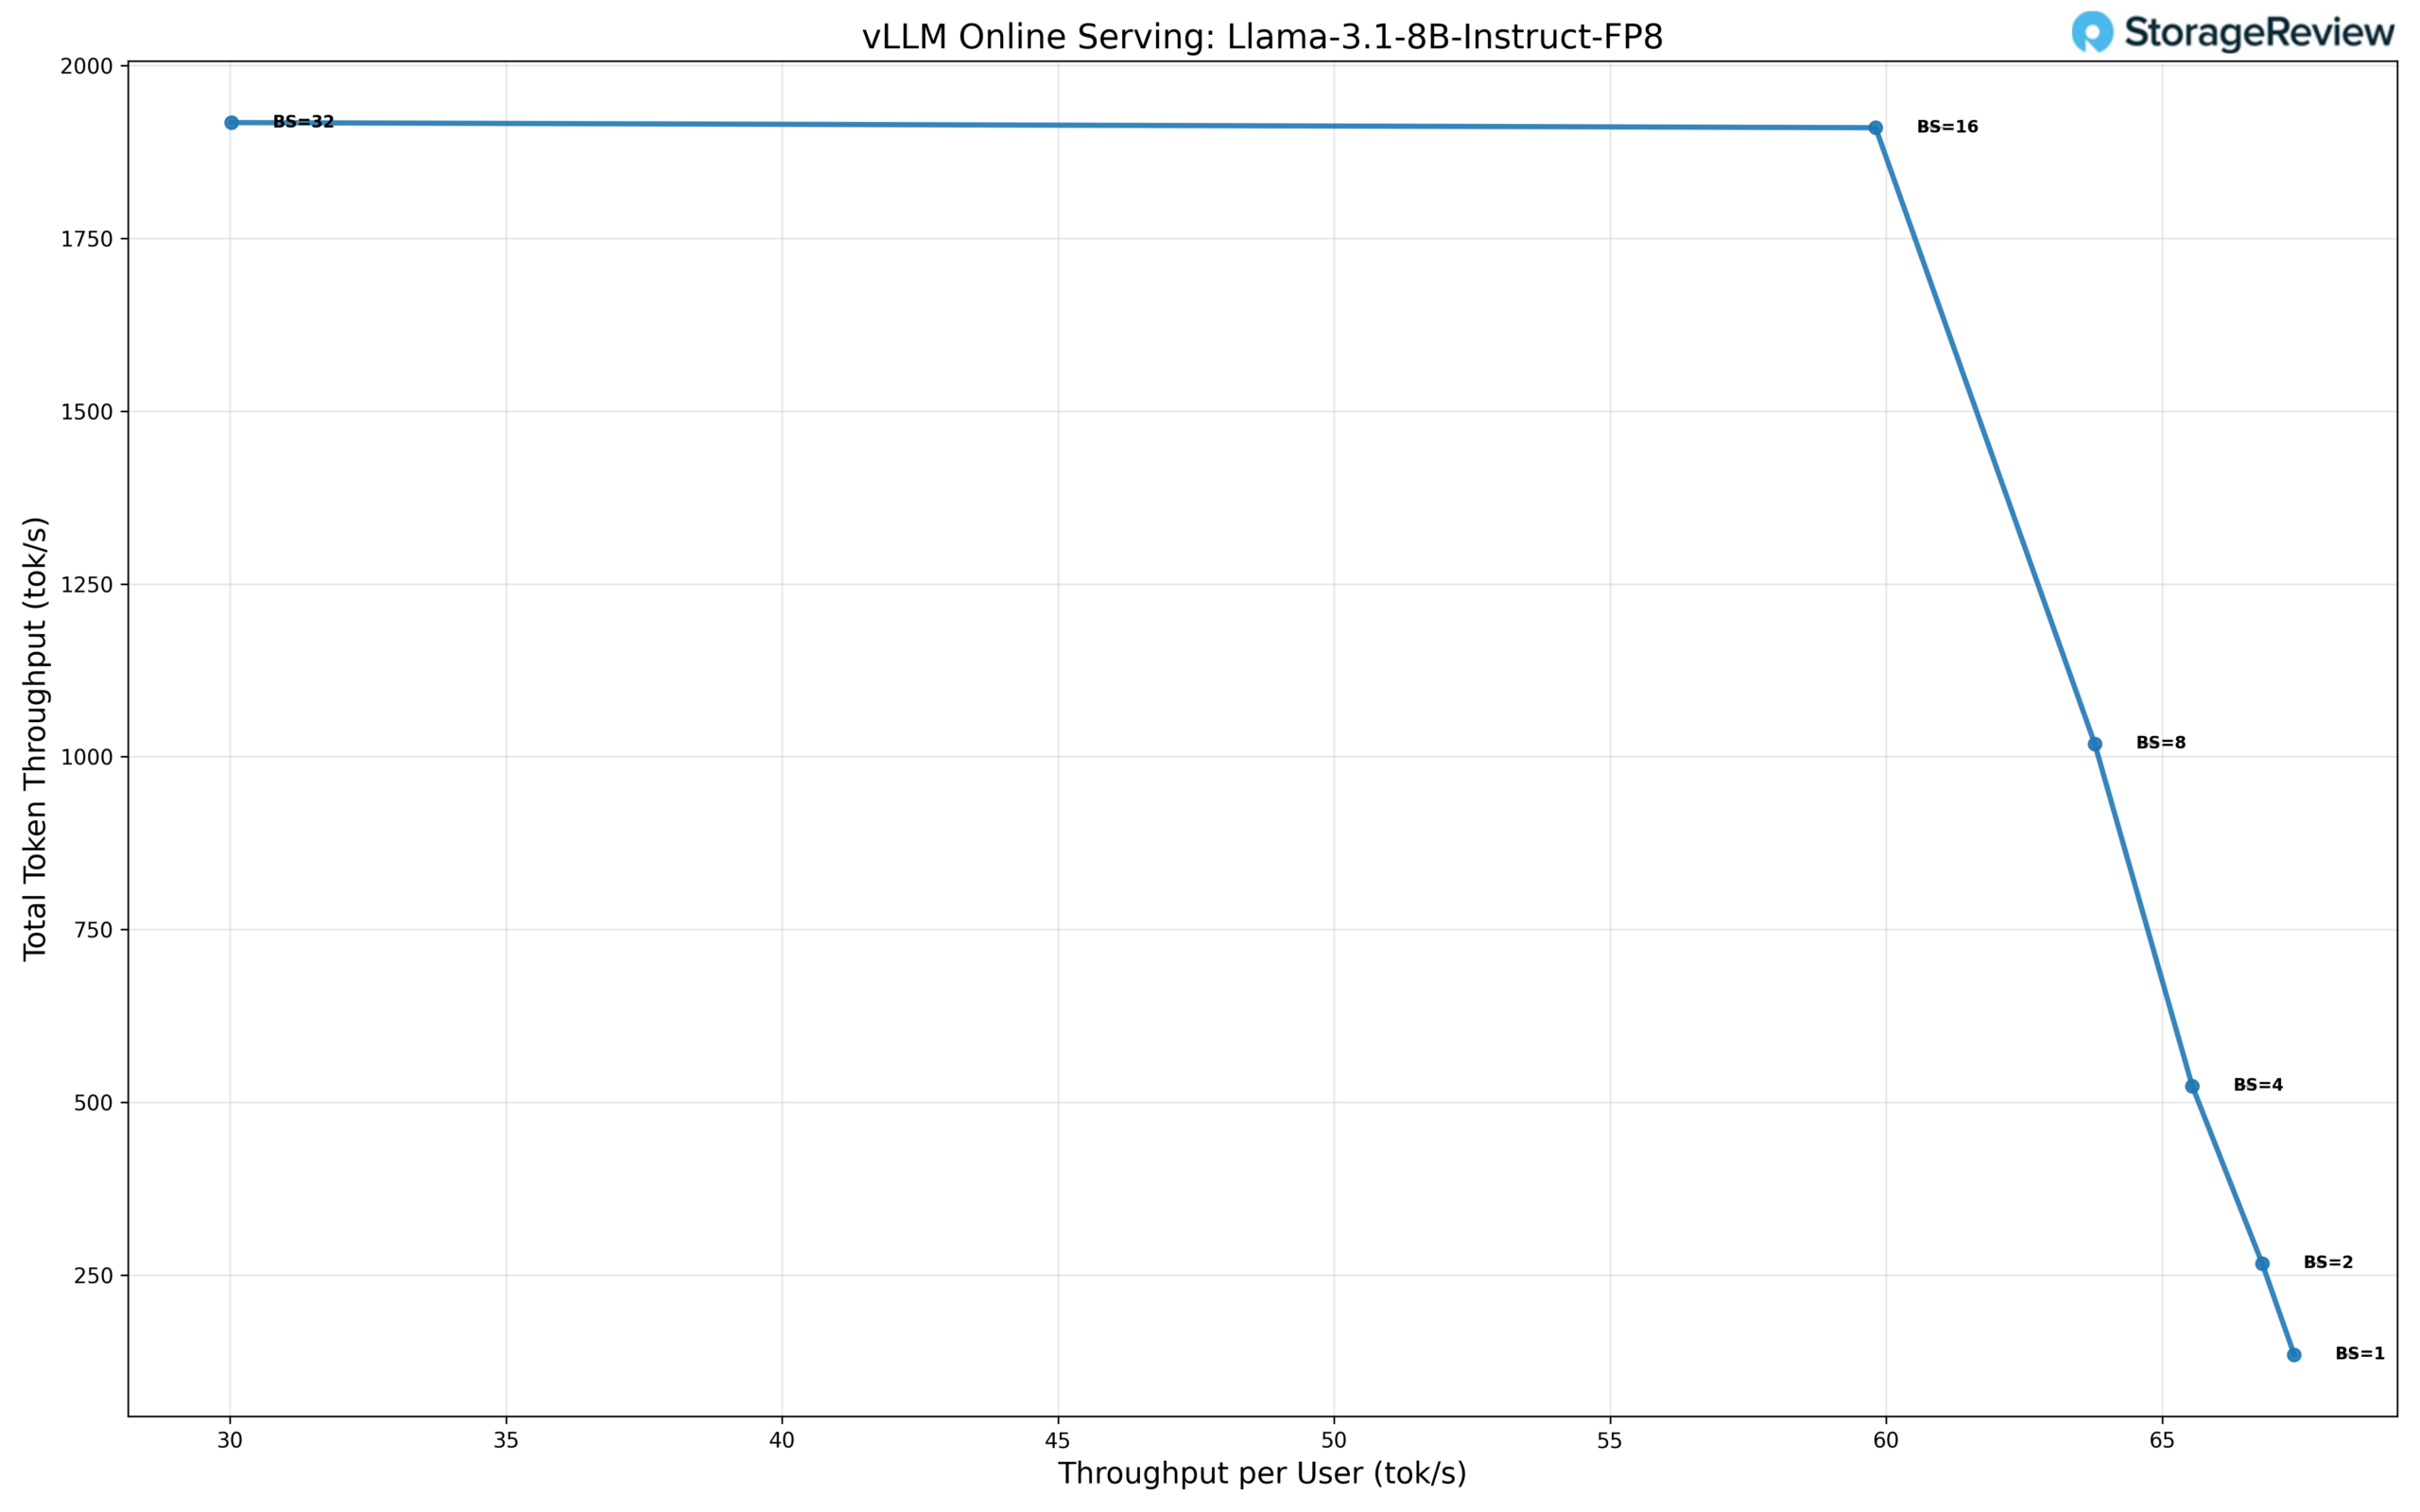
Lama 3.1 8B Precision FP8
Model Llama 3.1 8B działający z precyzją FP8 charakteryzuje się innym profilem skalowania niż konfiguracja o standardowej precyzji, priorytetyzując wydajność przy umiarkowanych poziomach współbieżności, jednocześnie redukując przepustowość poza szczytem przy większych rozmiarach wsadów. Przy współbieżności pojedynczego użytkownika (BS=1) model zapewnia 67.8 tok/s na użytkownika, przy całkowitej przepustowości 135.6 tok/s i TPOT około 3.1 ms, co stanowi niższą bazę dla pojedynczego strumienia w porównaniu z pełną precyzją.
Wraz ze wzrostem rozmiaru partii, całkowita przepustowość szybko rośnie, podczas gdy przepustowość na użytkownika spada w kontrolowany sposób. Przy BS=2 przepustowość wzrasta do 271 tok/s, przy 66.8 tok/s na użytkownika. Przy BS=4 całkowita przepustowość osiąga 523 tok/s, a przy BS=8 model zapewnia 1,017 tok/s, przy 63.6 tok/s na użytkownika. Opóźnienie pozostaje stabilne przy tych niższych poziomach współbieżności, co sprawia, że FP8 doskonale nadaje się do prostych scenariuszy wnioskowania z wieloma użytkownikami.
Skalowanie jest kontynuowane do BS=16, gdzie model utrzymuje całkowitą przepustowość na poziomie 1,918 tok/s, przy 60.0 tok/s na użytkownika. Przy BS=32 całkowita przepustowość osiąga plateau na poziomie około 1,920 tok/s, a przepustowość na użytkownika spada do 30.0 tok/s. To plateau wskazuje, że konfiguracja FP8 osiąga punkt nasycenia wcześniej niż standardowa precyzja, faworyzując wydajność i przewidywalność nad maksymalną łączną przepustowością.
Ogólnie rzecz biorąc, FP8 osiąga około 14-krotny wzrost całkowitej przepustowości od BS=1 do szczytu BS=16-32. Opóźnienie pozostaje stałe do BS=16, a następnie stabilizuje się wraz z przepustowością przy wyższej współbieżności, co podkreśla, że FP8 jest praktycznym wyborem dla zrównoważonych, wrażliwych na opóźnienia obciążeń wnioskowania, a nie dla ekstremalnego skalowania wsadowego.
Lama 3.1 8B Standardowa precyzja
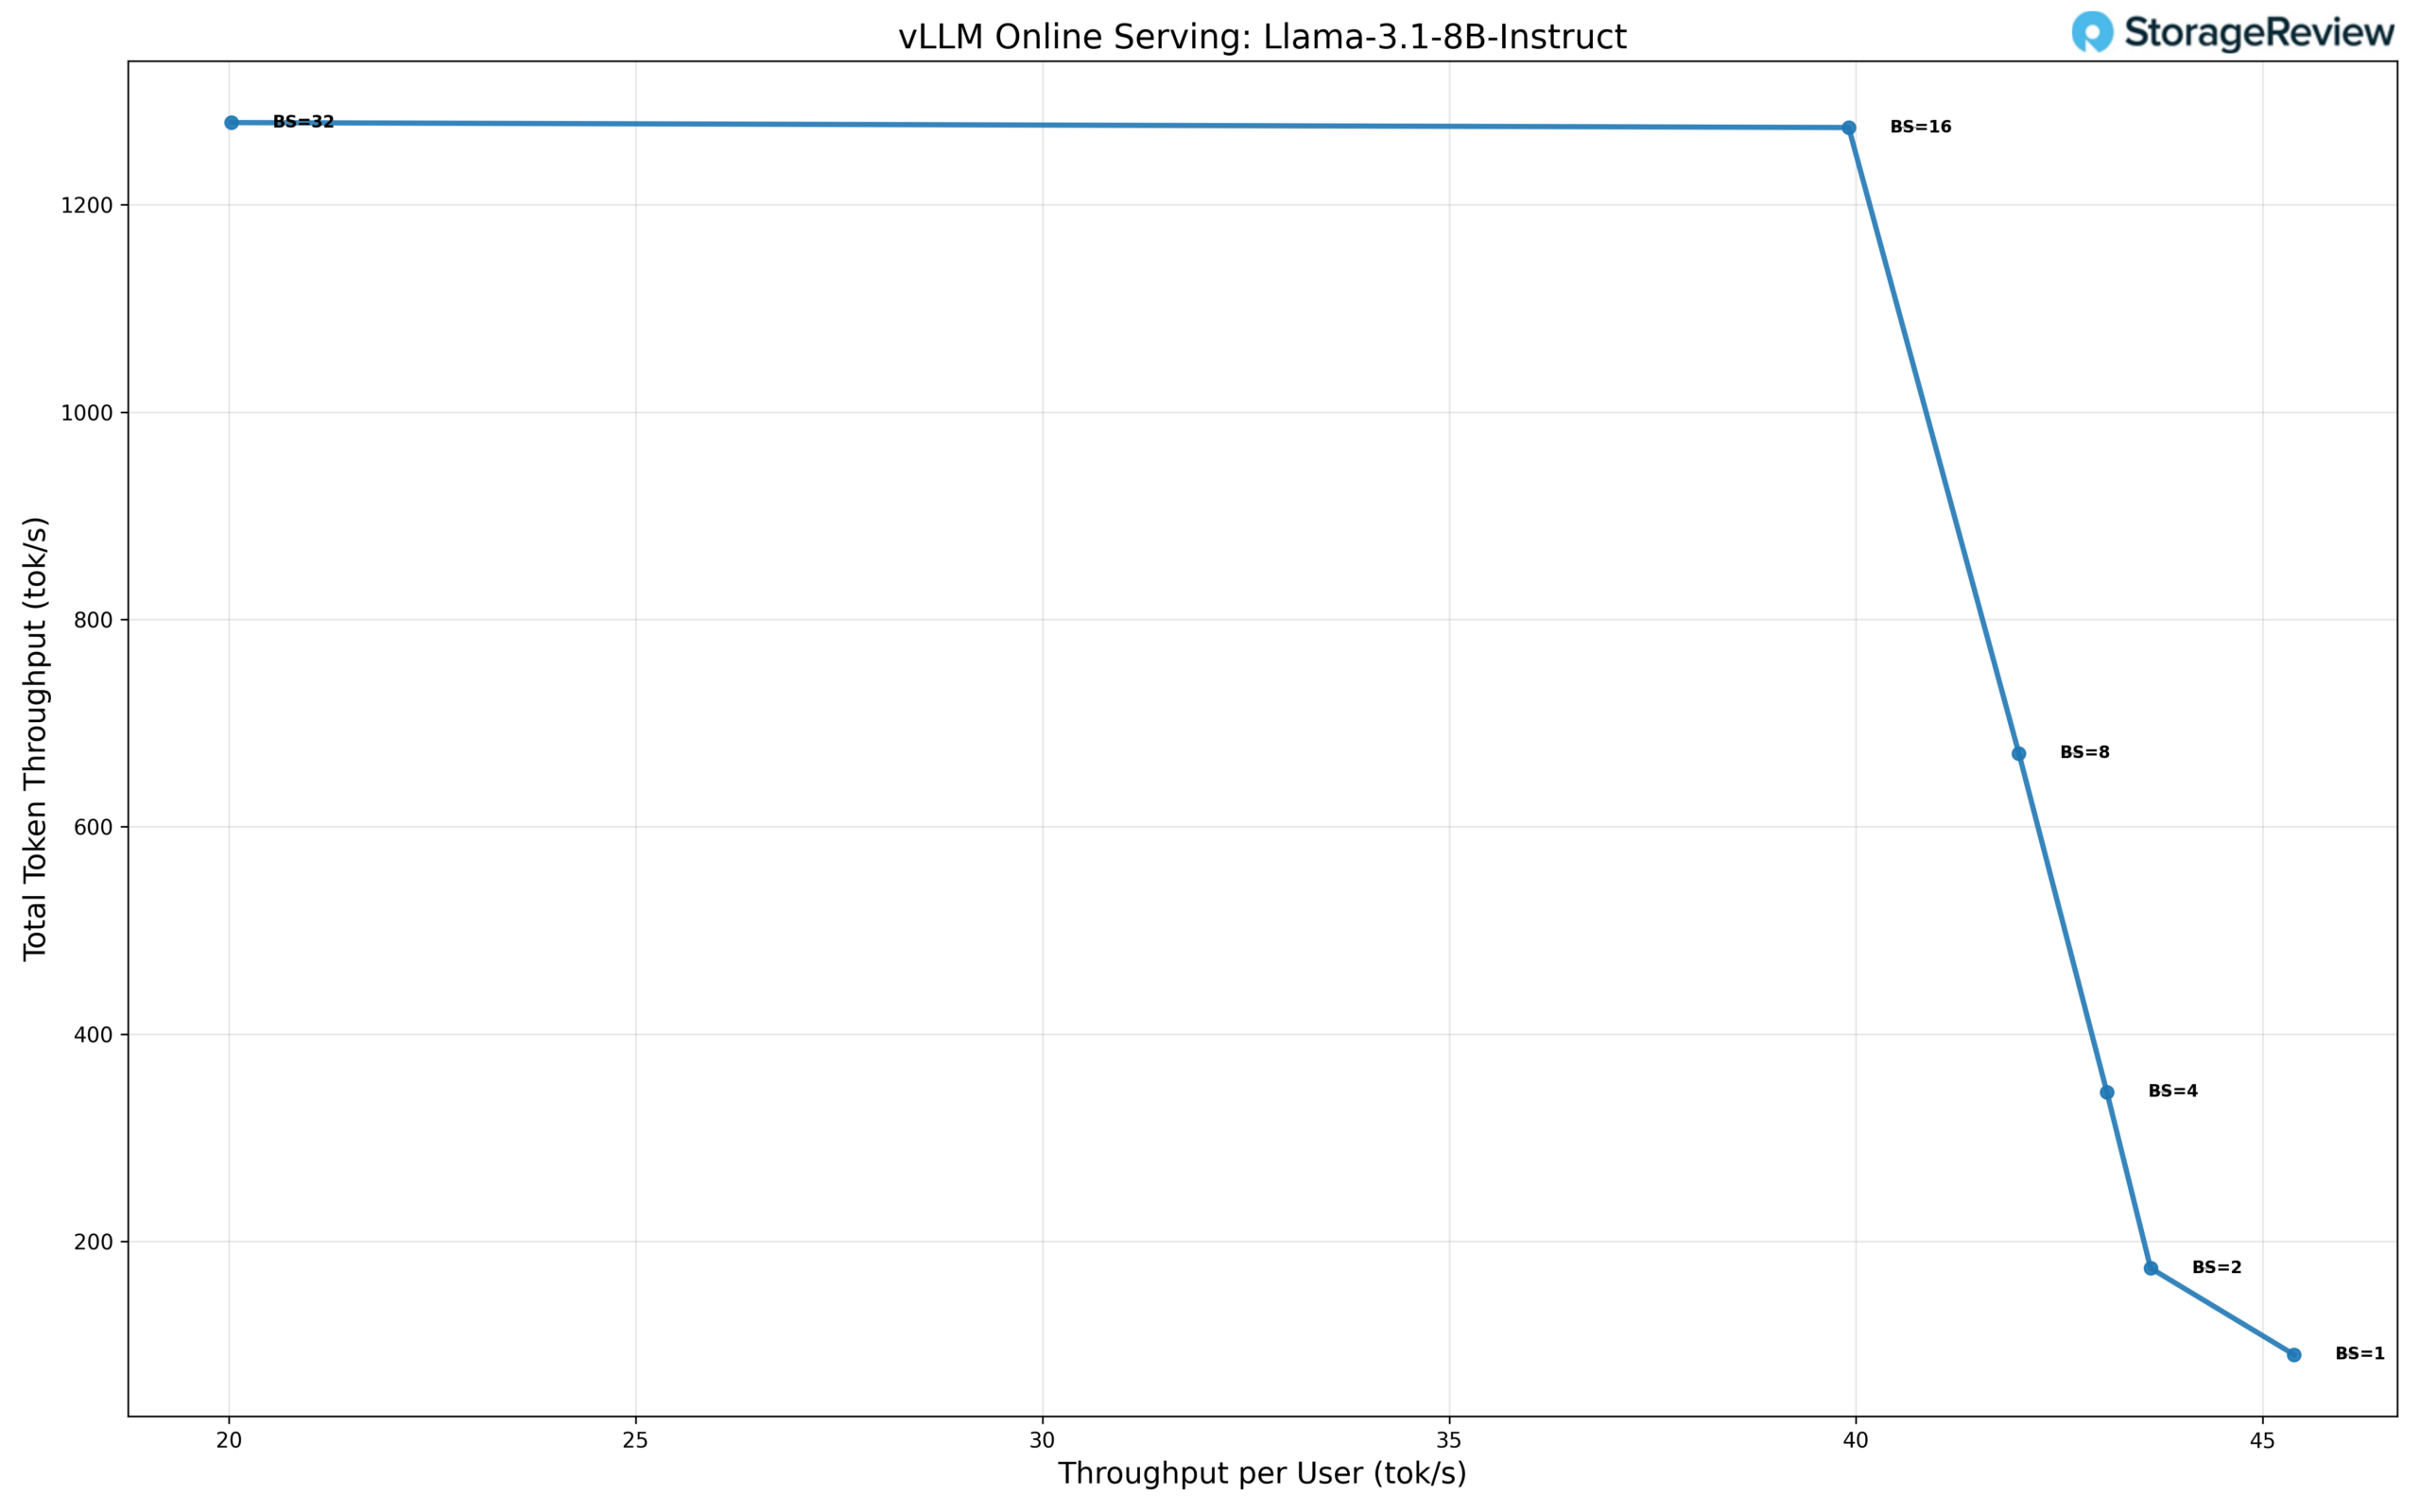
Przy standardowej precyzji model Llama 3.1 8B wykazuje przewidywalne zachowanie skalowania przy niższych poziomach współbieżności, z wysoką wydajnością na użytkownika przy małych rozmiarach wsadów i stale rosnącą łączną przepustowością wraz ze wzrostem współbieżności. W trybie pojedynczego użytkownika (BS=1) model zapewnia około 45.8 tok/s na użytkownika, co daje całkowitą przepustowość 91.6 tok/s i stanowi solidny punkt odniesienia dla obciążeń wrażliwych na opóźnienia.
Wraz ze wzrostem współbieżności, całkowita przepustowość skaluje się efektywnie, podczas gdy przepustowość na użytkownika stopniowo spada. Przy BS=2 całkowita przepustowość wzrasta do 176 tok/s, przy 44.0 tok/s na użytkownika, a przy BS=4 osiąga 344 tok/s, przy 43.0 tok/s na użytkownika. To zachowanie utrzymuje się do BS=8, gdzie model utrzymuje całkowitą przepustowość na poziomie 672 tok/s, przy 42.0 tok/s na użytkownika, co wskazuje na dobre wykorzystanie bez znaczącego spadku wydajności na użytkownika.
Skalowanie trwa do BS=16, gdzie całkowita przepustowość osiąga szczyt na poziomie około 1,280 tok/s, przy 40.0 tok/s na użytkownika. Przy BS=32 całkowita przepustowość pozostaje praktycznie płaska na poziomie około 1,280 tok/s, podczas gdy przepustowość na użytkownika spada do 20.0 tok/s, sygnalizując nasycenie potoku wykonawczego. To plateau sugeruje, że przy standardowej precyzji model osiąga optymalny punkt działania około BS=16, równoważąc przepustowość i responsywność.
Ogólnie rzecz biorąc, standardowa precyzja pozwala na około 14-krotny wzrost całkowitej przepustowości z BS=1 do wartości szczytowej, przy stabilnej wydajności dla każdego użytkownika i umiarkowanych poziomach współbieżności. Ten profil sprawia, że standardowa precyzja doskonale sprawdza się we wdrożeniach, w których priorytetem są stałe opóźnienia i przewidywalne skalowanie, a nie agresywna rozbudowa wsadowa.
Wydajność modelu rzadkiego
Modele rzadkie, a w szczególności architektury Mixture of Experts (MoE), to nowe podejście do efektywnego skalowania modeli językowych. Architektury te utrzymują wysoką całkowitą liczbę parametrów, aktywując jednocześnie tylko podzbiór parametrów na token, co potencjalnie oferuje lepszą wydajność w przeliczeniu na aktywny parametr.
Wydajność Qwen3-Coder-30B-A3B FP8
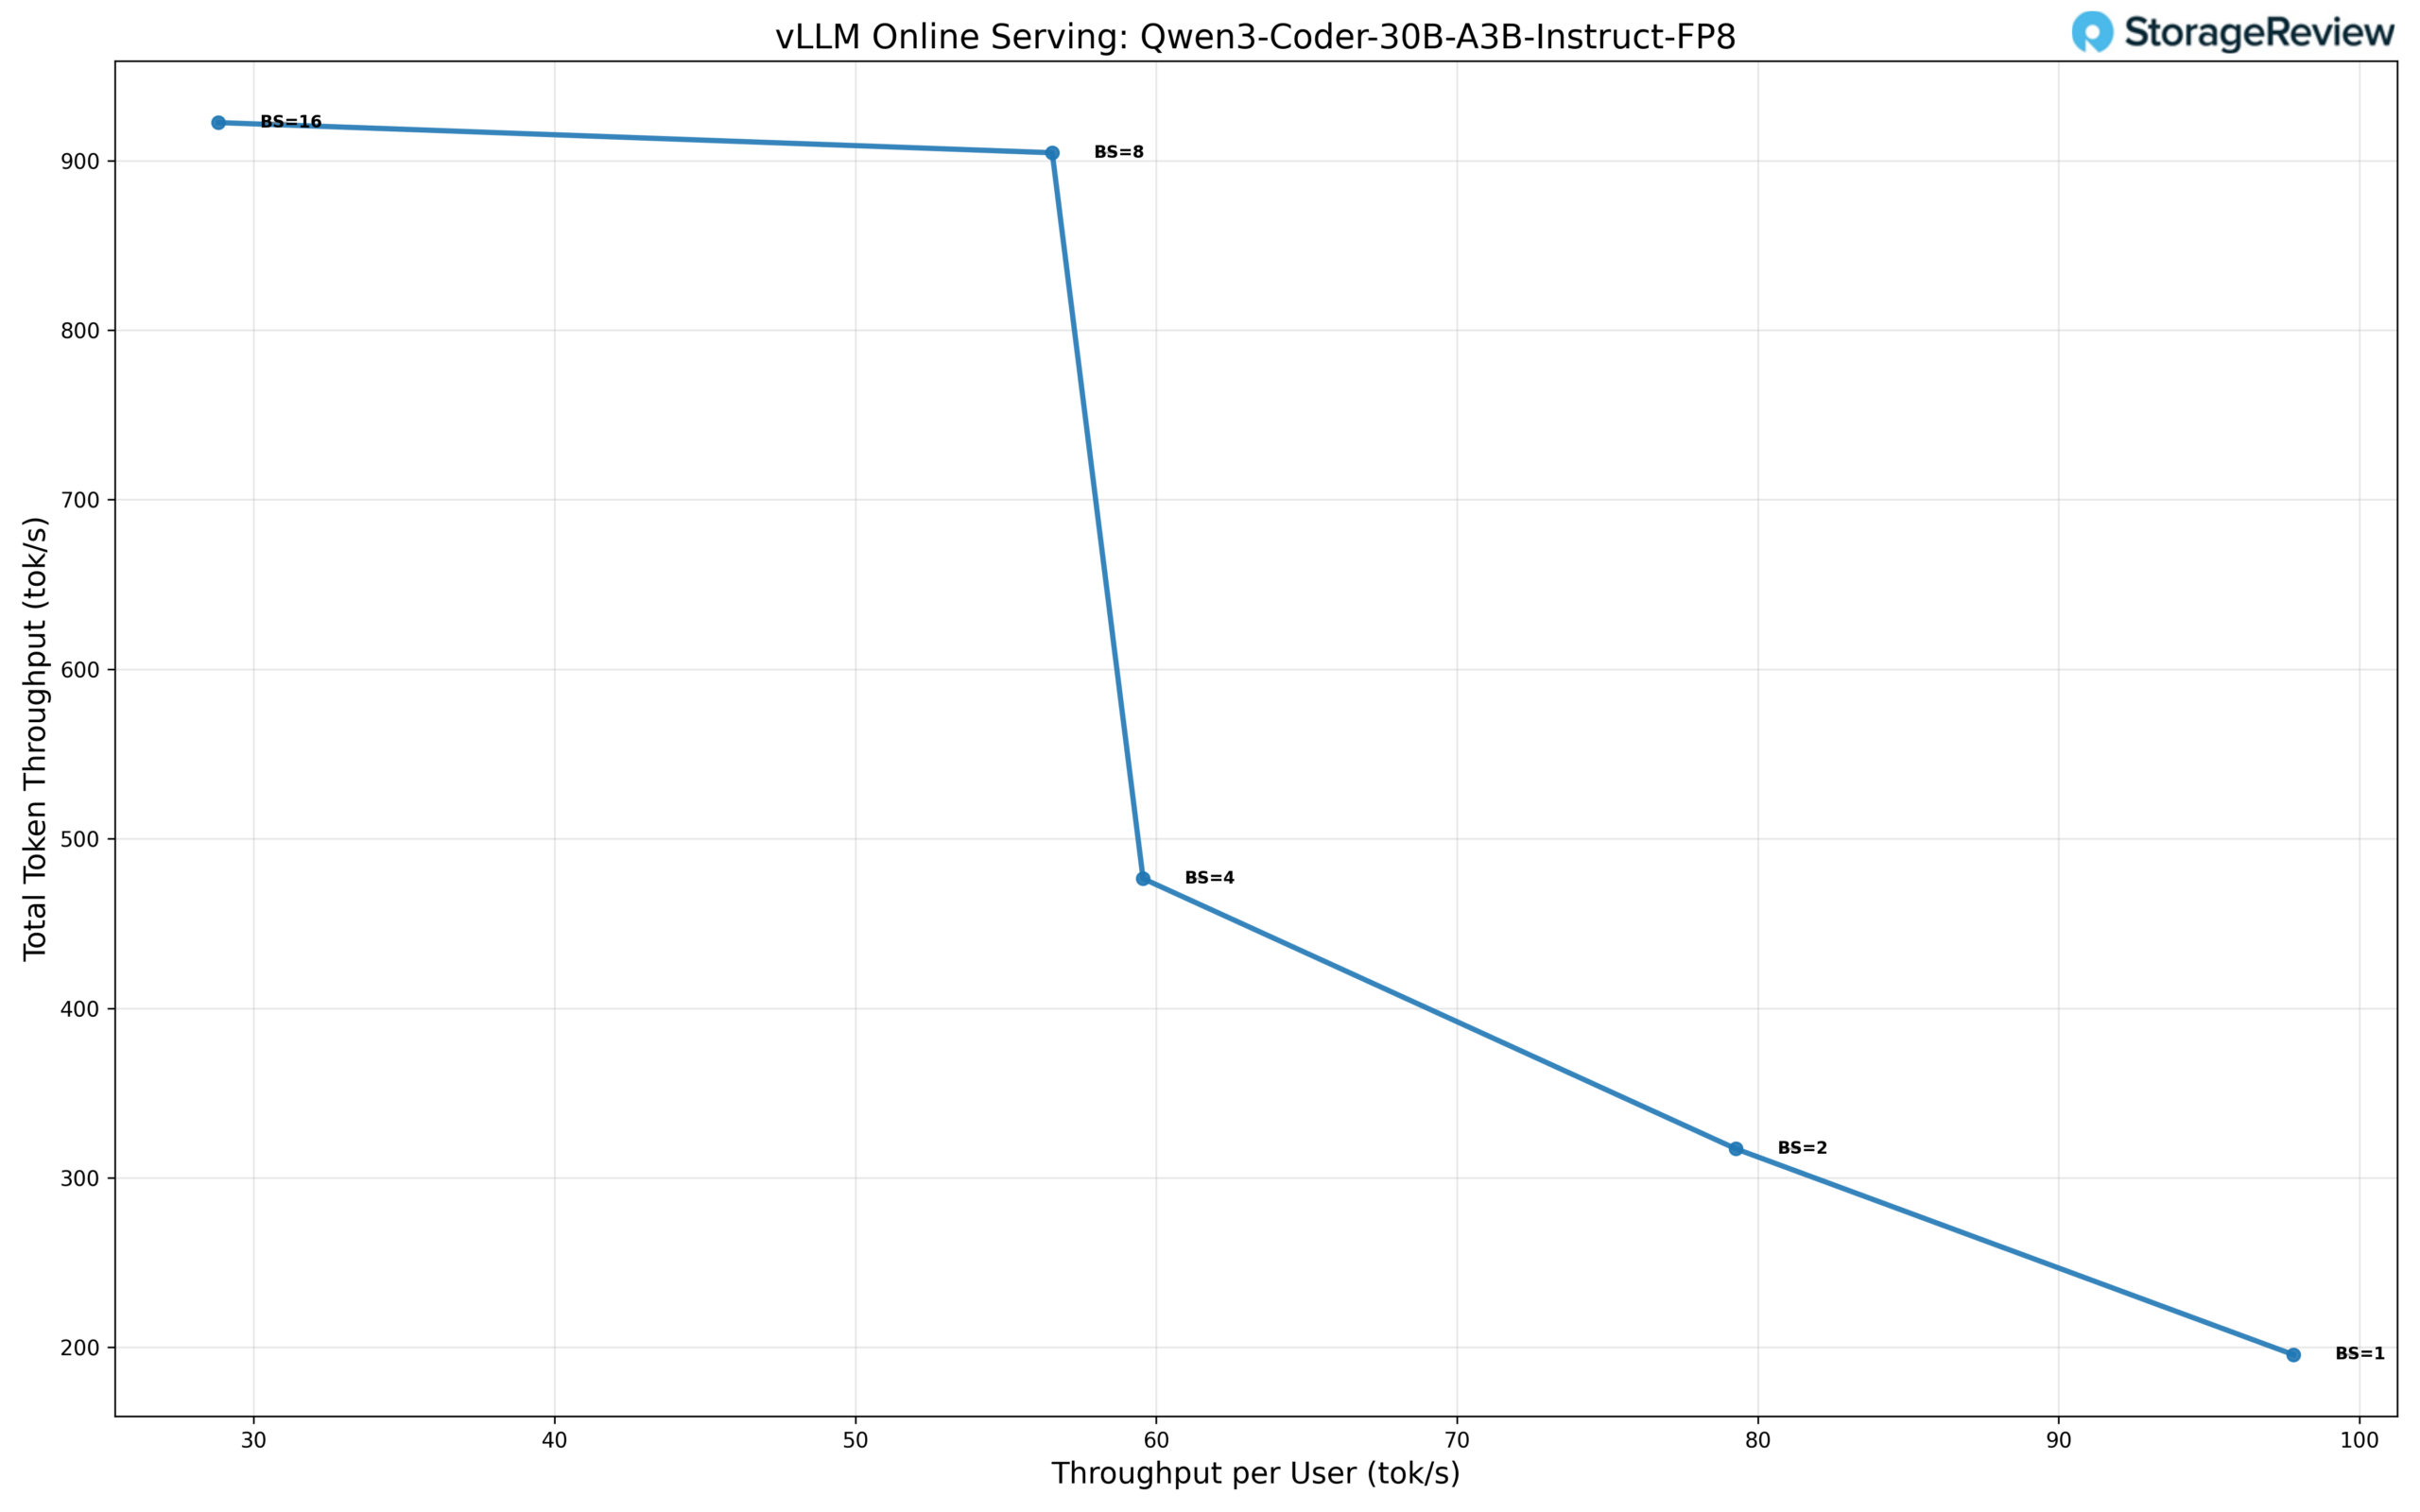
Model Qwen3-Coder-30B-A3B działający z precyzją FP8 charakteryzuje się profilem skalowania zoptymalizowanym pod kątem umiarkowanej współbieżności, zapewniając wysoką wydajność na użytkownika i osiągając nasycenie wcześniej niż mniejsze modele. W trybie pojedynczego użytkownika (BS=1) model osiąga około 98 tok/s na użytkownika, przy całkowitej przepustowości 196 tok/s, co stanowi wysoką bazę dla pojedynczego strumienia, odzwierciedlającą optymalizację modelu pod kątem obciążeń związanych z generowaniem kodu.
Wraz ze wzrostem współbieżności, całkowita przepustowość skaluje się efektywnie, podczas gdy przepustowość na użytkownika spada w kontrolowany sposób. Przy BS=2 całkowita przepustowość wzrasta do 317 tok/s, przy 79 tok/s na użytkownika, a przy BS=4 model zapewnia całkowitą przepustowość 477 tok/s przy 59 tok/s na użytkownika. Wyniki te pokazują efektywne wykorzystanie dostępnych zasobów obliczeniowych dzięki niskiemu lub umiarkowanemu przetwarzaniu wsadowemu, bez gwałtownego spadku responsywności na użytkownika.
Model osiąga szczytową łączną przepustowość przy BS=8, utrzymując całkowitą przepustowość na poziomie około 905 tok/s, z czego 56 tok/s na użytkownika. Skalowanie jest kontynuowane marginalnie do BS=16, gdzie całkowita przepustowość nieznacznie wzrasta do 920 tok/s, a przepustowość na użytkownika spada do 29 tok/s, co wskazuje na nasycenie potoku wnioskowania. Powyżej tego punktu dodatkowa współbieżność zapewnia minimalny wzrost całkowitej przepustowości, a jednocześnie znacząco wpływa na wydajność na użytkownika.
Ogólnie rzecz biorąc, Qwen3-Coder-30B-A3B FP8 zapewnia około 4.7-krotny wzrost całkowitej przepustowości z BS=1 do szczytowej wartości BS=16. Charakterystyka opóźnień i przepustowości sugeruje, że ta konfiguracja najlepiej nadaje się do umiarkowanych obciążeń kodowania wielodostępnego, wymagających wysokiej wydajności na żądanie. Jednak ekstremalne skalowanie wsadowe nie jest głównym celem.
Wydajność typów danych w mikroskali
Mikroskalanie to zaawansowane podejście do kwantyzacji, które stosuje drobnoziarniste współczynniki skalowania do małych bloków wag, zamiast jednorodnej kwantyzacji w dużych grupach parametrów. Format NVFP4 firmy NVIDIA implementuje tę technikę poprzez blokową reprezentację zmiennoprzecinkową, gdzie każdy mikroblok o wartościach od 8 do 32 ma wspólny wykładnik jako współczynnik skalowania. To granularne podejście zachowuje precyzję numeryczną, jednocześnie osiągając 4-bitową reprezentację, utrzymując zakres dynamiczny krytyczny dla architektur transformatorowych. Format integruje się z architekturą Tensor Core firmy NVIDIA, umożliwiając wydajne obliczenia o mieszanej precyzji z dekompresją „w locie” podczas operacji na macierzach.
Wydajność GPT-OSS-20b
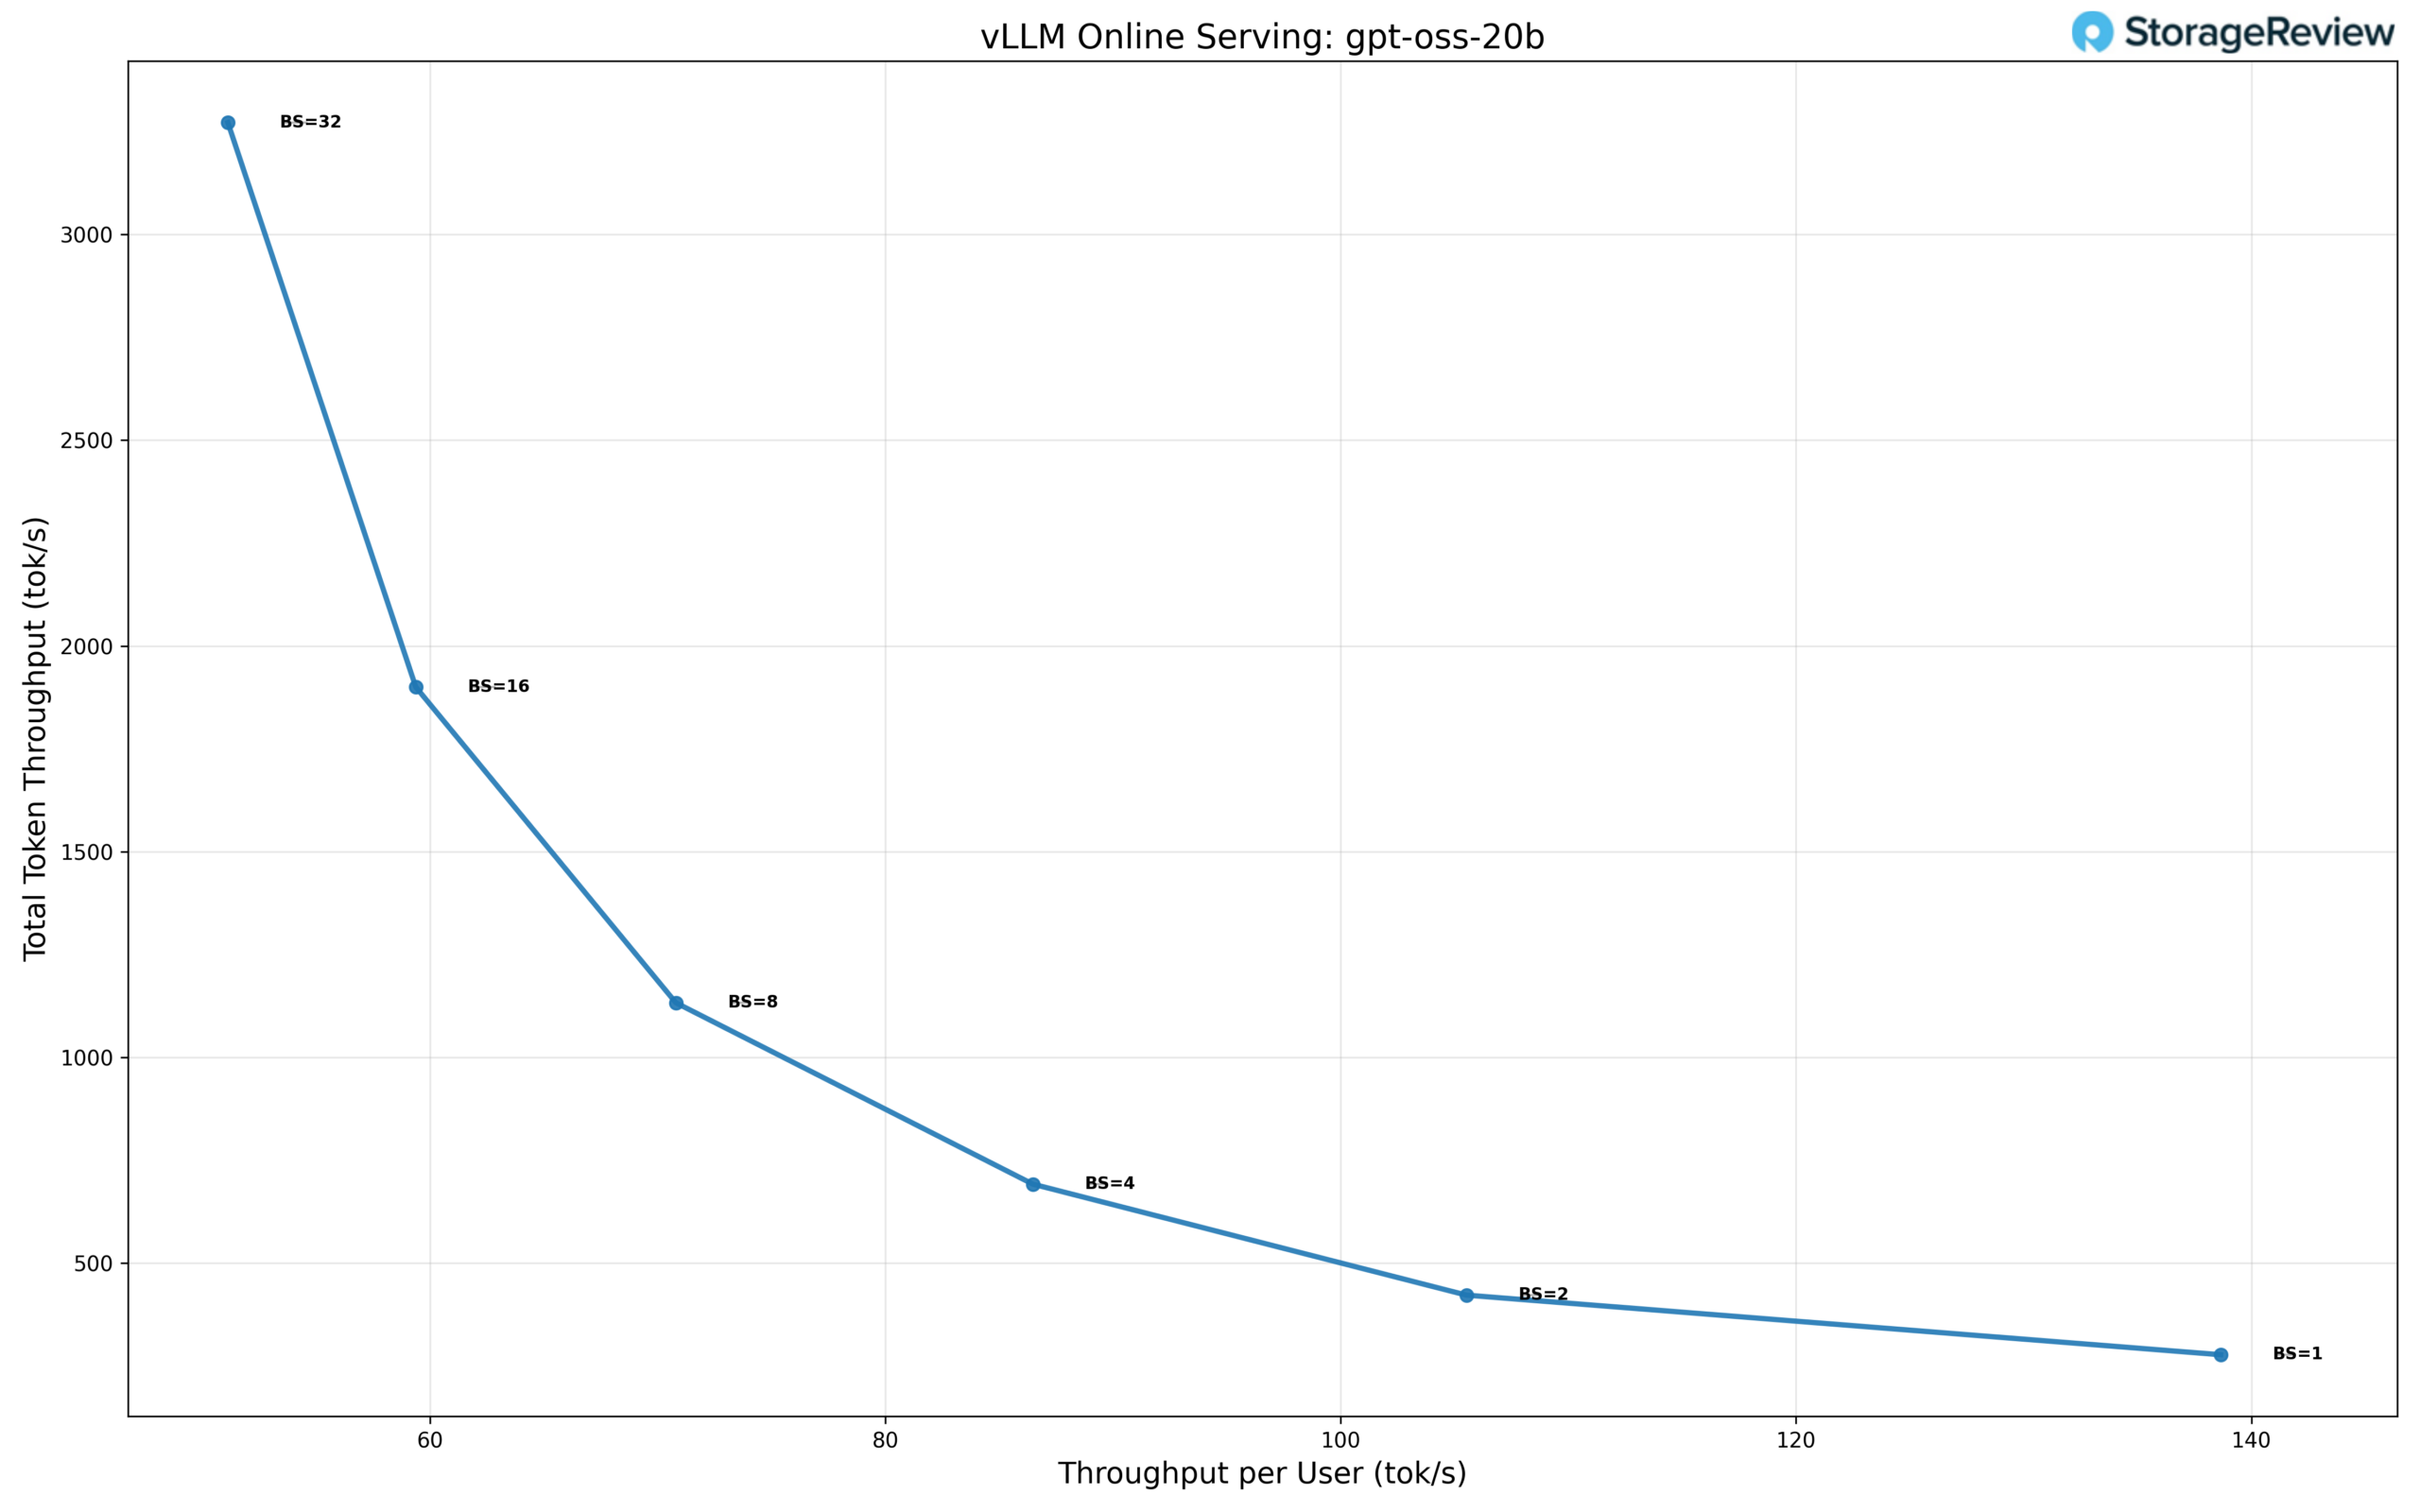
Model gpt-oss-20b charakteryzuje się wysoką skalowalnością przy rosnących poziomach współbieżności, ze szczególnie wysoką łączną przepustowością przy większych rozmiarach wsadów. Przy współbieżności pojedynczego użytkownika (BS=1) model zapewnia około 138 tok/s na użytkownika, co daje całkowitą przepustowość 276 tok/s, co stanowi solidny punkt odniesienia dla wnioskowania jednostrumieniowego.
Wraz ze wzrostem współbieżności, całkowita przepustowość dynamicznie się skaluje, podczas gdy przepustowość na użytkownika spada, zgodnie z oczekiwaniami. Przy BS=2 całkowita przepustowość wzrasta do 420 tok/s, przy 105 tok/s na użytkownika, a przy BS=4 osiąga 690 tok/s, przy 86 tok/s na użytkownika. Ten stały wzrost wskazuje na efektywne wykorzystanie dostępnych zasobów obliczeniowych poprzez przetwarzanie wsadowe na niskim lub średnim poziomie.
Skalowanie jest kontynuowane do BS=8, gdzie model osiąga całkowitą przepustowość około 1,120 tok/s przy 70 tok/s na użytkownika, oraz BS=16, gdzie całkowita przepustowość wzrasta do 1,900 tok/s przy 60 tok/s na użytkownika. Wyniki te pokazują, że gpt-oss-20b utrzymuje stosunkowo wysoką wydajność na użytkownika, nawet przy wzroście współbieżności, co czyni go dobrze przystosowanym do scenariuszy obsługi wielu użytkowników.
Model osiąga szczytową łączną przepustowość przy BS=32, zapewniając całkowitą przepustowość około 3,250 tok/s, przy czym przepustowość na użytkownika spada do 50 tok/s. Stanowi to 11.8-krotny wzrost całkowitej przepustowości w porównaniu z wydajnością pojedynczego użytkownika. Chociaż przepustowość na użytkownika nadal spada przy większych rozmiarach partii, ogólna wydajność skalowania pozostaje wysoka, co wskazuje, że model korzysta z wyższej współbieżności bez osiągania punktu wczesnego nasycenia.
Ogólnie rzecz biorąc, gpt-oss-20b charakteryzuje się zrównoważonym profilem skalowania, łącząc wysoką wydajność pojedynczego użytkownika z wydajnym skalowaniem wsadowym. To sprawia, że jest to atrakcyjna opcja dla wdrożeń wymagających zarówno responsywnego wnioskowania indywidualnego, jak i wysokiej przepustowości łącznej przy większym obciążeniu wielu użytkowników.
Testy porównawcze Phoronix
Phoronix Test Suite to zautomatyzowana platforma testowa typu open source, która obsługuje ponad 450 profili testowych i ponad 100 pakietów testowych za pośrednictwem OpenBenchmarking.org. Obsługuje wszystko, od instalowania zależności, przez uruchamianie testów, po zbieranie wyników, co czyni ją idealną do porównywania wydajności, walidacji sprzętu i ciągłej integracji.
Przepustowość pamięci strumieniowej
Model SR650 V4 zapewnił przepustowość pamięci na poziomie 369.6 GB/s, co świadczy o wysokiej przepustowości w przypadku obciążeń intensywnie przetwarzających dane i potwierdza dobrą wydajność pamięci wielokanałowej.
Kompresja 7-Zip
Dzięki 584 499 MIPS system osiągnął znakomitą wydajność kompresji i dekompresji, co odzwierciedla solidną wydajność wielordzeniową i duże możliwości obliczeń całkowitoliczbowych.
Kompilacja jądra
Serwer ukończył kompilację jądra allmod w 256.175 sekund, co jest imponującym wynikiem, który podkreśla jego zdolność do wydajnej obsługi kompilacji równoległej i przepływów pracy programistów.
Apache Web Server
Osiągając prędkość 61 654 R/s, SR650 V4 wykazał się wysoką wydajnością podczas obsługi stron internetowych, utrzymując wysoką przepustowość żądań, odpowiednią dla hostingu front-end lub lekkich stosów wirtualizacji.
Weryfikacja OpenSSL
Osiągając wydajność 712.6 miliarda bajtów na sekundę, platforma wykazała się solidną wydajnością weryfikacji kryptograficznej, co potwierdziło zdolność procesora do wykonywania bezpiecznych operacji wymagających dużej ilości certyfikatów.
| Testy porównawcze Phoronix | Lenovo ThinkSystem SR650 V4 |
|---|---|
| Strumień | 369,58.3 MB / s |
| 7-zip | 584,499 MIPS |
| Kompilacja jądra (allmod) | Sekundy 256.175 |
| Apache (liczba żądań na sekundę) | 48 729,63 R/s |
| Otwórz SSL | 712 633 776 990 bajtów/s |
Wniosek
ThinkSystem SR650 V4 to odświeżenie platformy, które ma znaczenie, ponieważ nie polega jedynie na wymianie procesora. Lenovo wykorzystało tę generację do wprowadzenia znaczących ulepszeń w obszarach, które ograniczają rzeczywiste wdrożenia: przepustowości pamięci, dostępności linii PCIe, gęstości pamięci masowej i możliwości adaptacji konfiguracji do zmieniających się potrzeb. Przejście na procesor Intel Xeon 6 zapewnia więcej opcji rdzeni i większą przestrzeń we/wy na gniazdo, a współpraca z platformą, w tym szybsza pamięć DDR5 z obsługą MRDIMM i opcjonalną rozbudową CXL, daje SR650 V4 możliwość utrzymania aktualności w miarę wzrostu zapotrzebowania na pamięć.
Jeśli chodzi o pamięć masową, pomimo ograniczonej konfiguracji testowej z U.2, Lenovo stawia na E3.S, oferując wyższą gęstość NVMe z łącznością 1:1 i bardziej płynną charakterystyką termiczną, co jest zgodne ze sposobem budowy nowoczesnej infrastruktury, szczególnie w przypadku stosów wirtualizacji wymagających większej ilości lokalnej pamięci flash, a także w przypadku potoków przetwarzania danych w środowisku AI, gdzie zasilanie GPU jest równie ważne, co przetwarzanie surowe. Dwa gniazda OCP 3.0 Gen5 x16 to również praktyczne ulepszenie: można wdrożyć zaawansowane rozwiązania sieciowe bez poświęcania gniazd PCIe, które wolałbyś zarezerwować dla akceleratorów, pamięci masowej lub specjalistycznych adapterów.
Jeśli korzystasz z SR650 V3 i odczuwasz ograniczenia związane z szybkością pamięci, zapasem PCIe lub gęstością NVMe, SR650 V4 to przekonujący krok naprzód. Zachowuje on funkcjonalność i konfigurowalność, które zapewniły popularność serii SR650, a jednocześnie oferuje platformę uruchomieniową, która pomaga zespołom IT uniknąć sytuacji bez wyjścia. Niezależnie od tego, czy budujesz klaster wirtualizacji, modernizujesz usługi skalowalne poziomo, czy montujesz zbalansowany węzeł CPU/GPU, SR650 V4 spełnia wszystkie wymagania i pozostawia miejsce na to, co przyniesie przyszłość.


 Amazon