

Klienci poszukujący wydajnej macierzy pamięci masowej all-flash z pewnością docenią NetApp AFF A800. Ta kompleksowa macierz NVMe zapewnia ogromną wydajność i pochodzi z bogatej linii macierzy AFF firmy NetApp. Wcześniej testowaliśmy macierz A800 przez Fibre Channel i uznaliśmy ją za bestię, zdobywając nagrodę Editor's Choice. W tej recenzji testujemy tę samą macierz, tym razem wykorzystującą technologię NVMe over Fabrics (NVMeOF).
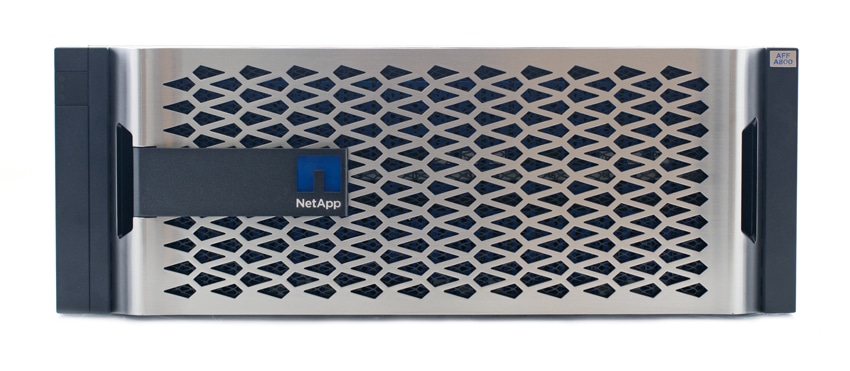
Ponieważ jest to recenzja uzupełniająca, nie będziemy zagłębiać się w kwestie takie jak projektowanie i budowa, specyfikacje czy zarządzanie. Nasza wstępna recenzja skupia się na każdym z tych obszarów. Konfiguracja w tej recenzji jest zasadniczo taka sama, z innym interfejsem sieciowym, aby zobaczyć różnicę w wydajności. Należy zauważyć, że nie jest to dokładne porównanie. Macierz oferuje różne opcje łączności, dostosowane do potrzeb różnych użytkowników, a my recenzujemy różne typy, aby dać im wyobrażenie o tym, czego mogą się spodziewać po poszczególnych opcjach łączności.
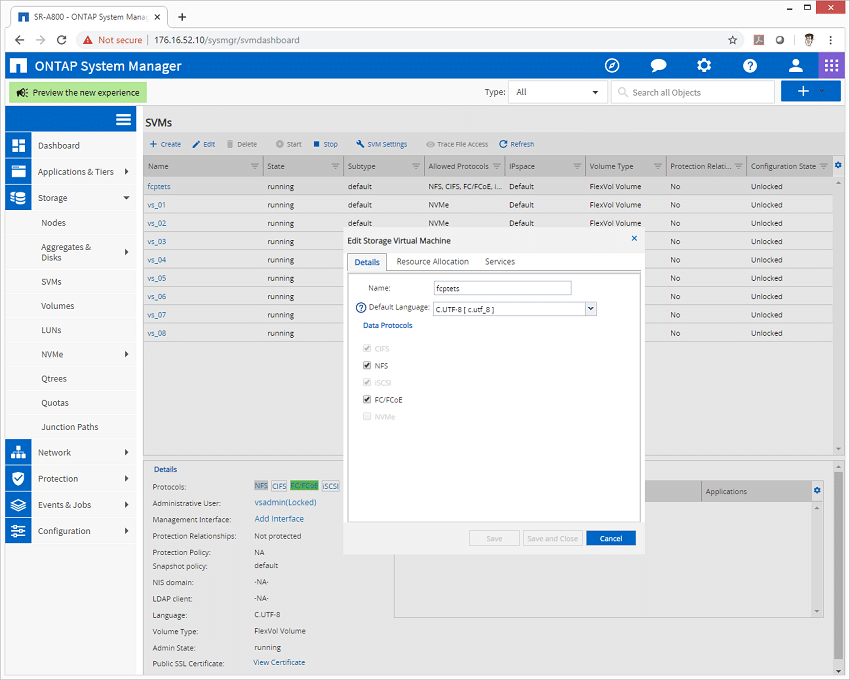
Po raz pierwszy wprowadzony w 2014 roku, NVMeOF to koncepcja wykorzystania protokołu transportowego w sieci, a nie tylko wykorzystania urządzeń NVMe poprzez magistralę PCIe. Firma NVM Express, Inc. opublikowała standard NVMeOF w 2016 roku. NVMeOF umożliwia hostowi NVMe połączenie z docelową pamięcią masową NVMe przy jednoczesnym zachowaniu niskiego opóźnienia. Ogólnym zamysłem jest uzyskanie większej wydajności bez znaczącego zwiększenia opóźnienia. Do tej pory istniało wiele podejść różnych dostawców dotyczących obsługiwanego protokołu lub możliwości jego jednoczesnej pracy w wielu trybach. Wyposażony w ONTAP AFF A800 może obsługiwać jednocześnie CIFS, NFS, iSCSI, FCP i FC NVMeOF, a wszystko to bez najmniejszego wysiłku. Nie wszystkie platformy są zbudowane w ten sposób – nawet NetApp EF600 (zaprojektowany z myślą o nieco innych celach) może działać w trybie FCP lub FC NVMeOF, ale nie w obu jednocześnie.
Konfiguracja wydajności
Konfiguracja naszej macierzy NetApp AFF A800 obejmowała 8 portów FC 32 Gb/s z 24 zainstalowanymi dyskami SSD NVMe o pojemności 1.92 TB. Spośród 24 dysków SSD 1.92 TB zainstalowanych w naszej macierzy A800, podzieliliśmy je na dwa agregaty RAID-DP, z czego efektywnie 23 dyski SSD są w użyciu, a dwie połówki partycji stanowią zapasowe dyski. Połowa każdego dysku SSD jest przypisana do obu kontrolerów, dzięki czemu każdy kontroler może wykorzystać wydajność wszystkich zainstalowanych dysków SSD. Macierz została podłączona 32 Gb/s przez dwa przełączniki Brocade G620, które następnie miały 16 łączy 32 Gb/s do 12 serwerów Dell PowerEdge R740xd z systemem SLES 12 SP4.
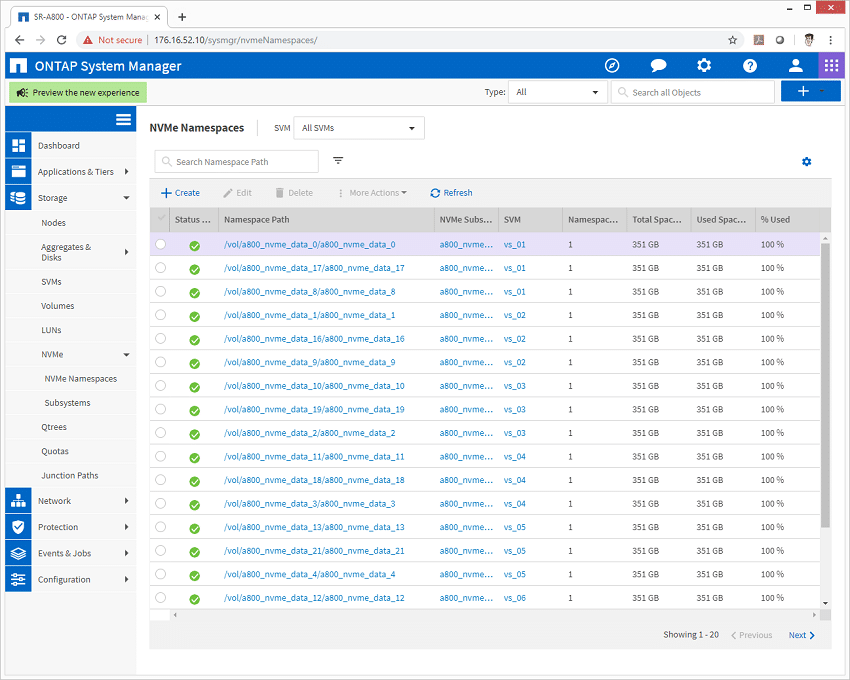
Każdy serwer wyposażono w 2 dyski LUN o pojemności 350 GB, co łącznie dało 8.4 TB przestrzeni dyskowej.
Wydajność
W przypadku testów porównawczych macierzy pamięci masowej, testy aplikacji są najlepsze, a testy syntetyczne plasują się na drugim miejscu. Chociaż nie odzwierciedlają one idealnie rzeczywistych obciążeń, testy syntetyczne pomagają w ustaleniu punktu odniesienia dla urządzeń pamięci masowej, zapewniając powtarzalność, która ułatwia bezpośrednie porównanie konkurencyjnych rozwiązań. Obciążenia te oferują szereg różnych profili testowych, od testów „czterech kątów”, przez testy rozmiaru transferu baz danych, po przechwytywanie śladów z różnych środowisk VDI. Wszystkie te testy wykorzystują generator obciążeń vdBench z silnikiem skryptowym do automatyzacji i przechwytywania wyników w dużym klastrze obliczeniowym. Pozwala to na powtarzanie tych samych obciążeń dla szerokiej gamy urządzeń pamięci masowej, w tym macierzy flash i pojedynczych urządzeń pamięci masowej.
Profile:
- Losowy odczyt 4K: 100% odczytu, 128 wątków, 0-120% ioratu
- 4K losowy zapis: 100% zapisu, 64 wątki, 0-120% ioracji
- 64K Sekwencyjny odczyt: 100% odczytu, 16 wątków, 0-120% ioracji
- 64K Sekwencyjny zapis: 100% zapisu, 8 wątków, 0-120% ioratu
- Syntetyczna baza danych: SQL i Oracle
Podstawową zaletą wydajnościową NVMeOF w przypadku A800 jest wzrost wydajności odczytu i niższe opóźnienie. Podczas gdy nasze poprzednie testy koncentrowały się na wydajności w środowisku VMware z wykorzystaniem protokołu FCP, z dyskami VMDK podłączonymi do wielu maszyn wirtualnych, nasze testy NVMeOF koncentrują się na wydajności bare-metal. W związku z tym nie można przeprowadzić bezpośredniego porównania z naszymi istniejącymi danymi. Należy również zauważyć, że w celu zapewnienia spójności testów we wszystkich naszych macierzach pamięci masowej, zachowaliśmy tę samą liczbę wątków dla każdej macierzy. Podczas testów NVMeOF na A800 zauważyliśmy pewne obszary, w których nasz test zakończył się przed znacznym wzrostem opóźnienia. Przede wszystkim pokazuje to, że platforma działa wyjątkowo dobrze, zapewniając niskie opóźnienia przy imponujących statystykach wydajności. Wadą jest jednak to, że pewien poziom wydajności został pominięty. NetApp stwierdził, że w pewnych okolicznościach A800 może osiągnąć nawet wyższą wydajność niż ta, którą zmierzyliśmy.
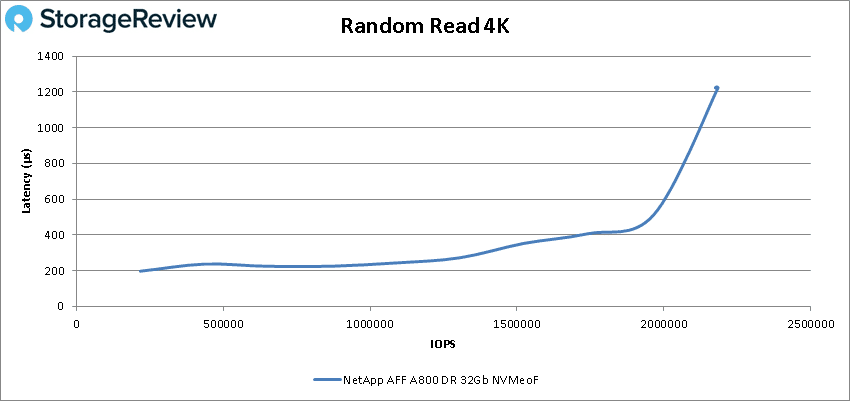
Przy odczycie 4K procesor A800 z interfejsem NVMeOF osiągnął wynik 217 460 IOPS z opóźnieniem wynoszącym zaledwie 196.8 µs, a następnie osiągnął wartość szczytową 2 184 220 IOPS z opóźnieniem wynoszącym 1.22 ms.
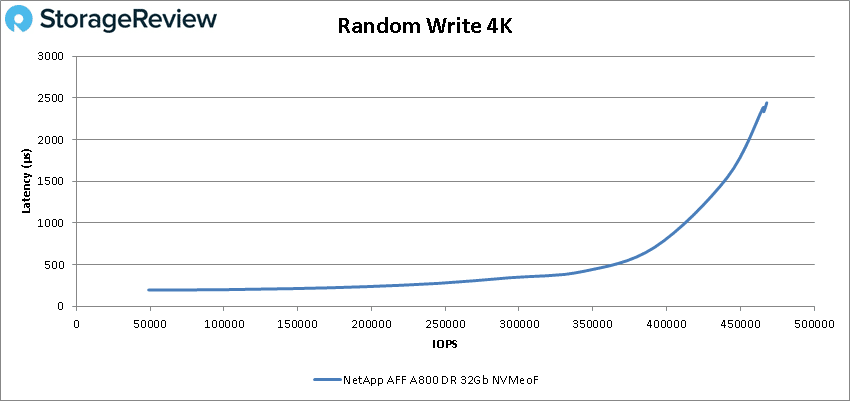
W przypadku zapisu 4K macierz wyjściowa wynosiła 48 987 IOPS, a opóźnienie 196 µs, a szczytowa wartość wyniosła 465 445 IOPS, a opóźnienie 2.44 ms.
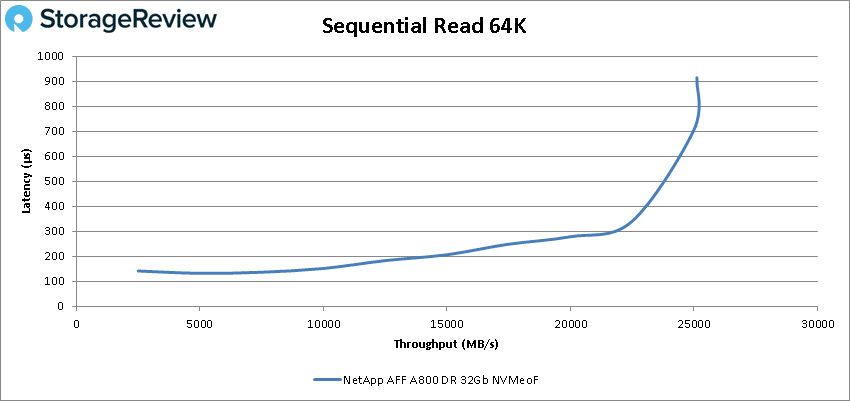
Następnie mamy nasze sekwencyjne obciążenia 64 KB. W przypadku odczytu 64 KB procesor A800 był w stanie utrzymać opóźnienie poniżej milisekundy, osiągając szczytową wydajność około 403 000 IOPS lub 25 GB/s z opóźnieniem 800 µs, po czym nastąpił niewielki spadek.
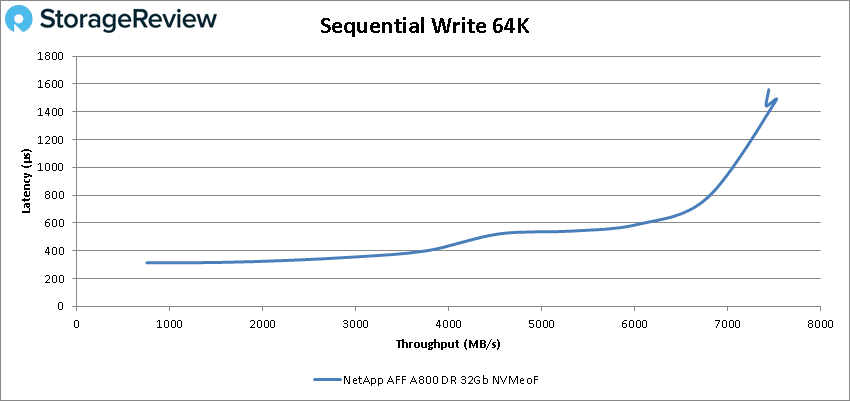
W przypadku zapisu 64 KB procesor A800 z interfejsem NVMeOF zaczął mocno i utrzymywał wynik poniżej 1 ms do momentu osiągnięcia około 110 000 IOPS (7 GB/s), a następnie osiągnął szczyt na poziomie 120 314 IOPS (7.52 GB/s) z opóźnieniem 1.48 ms.
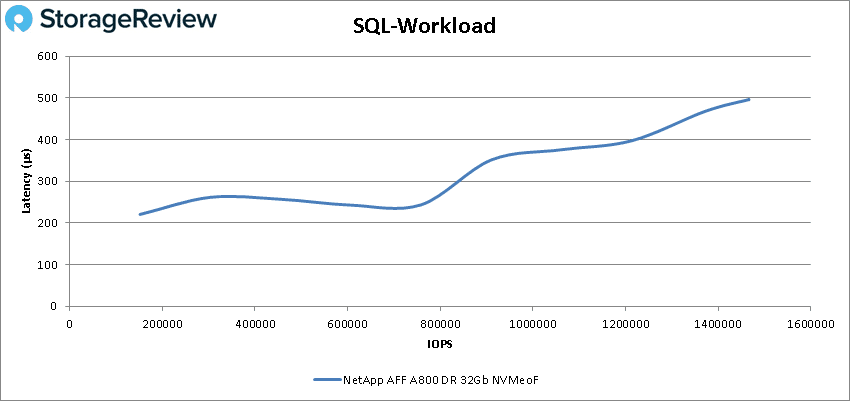
Kolejną partią testów porównawczych są testy SQL. W teście SQL A800 utrzymywał się poniżej 1 ms, osiągając imponujący szczyt 1 466 467 IOPS przy opóźnieniu zaledwie 496.6 µs.
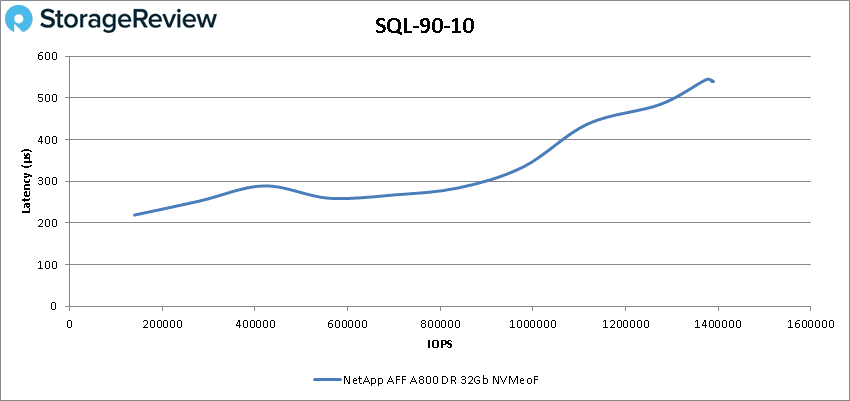
W przypadku SQL 90-10 procesor A800 z interfejsem NVMeOF zanotował kolejny imponujący wynik opóźnienia poniżej milisekundy, rozpoczynając od 139 989 IOPS i osiągając wartość szczytową 1 389 645 IOPS przy opóźnieniu wynoszącym zaledwie 539.6 µs.
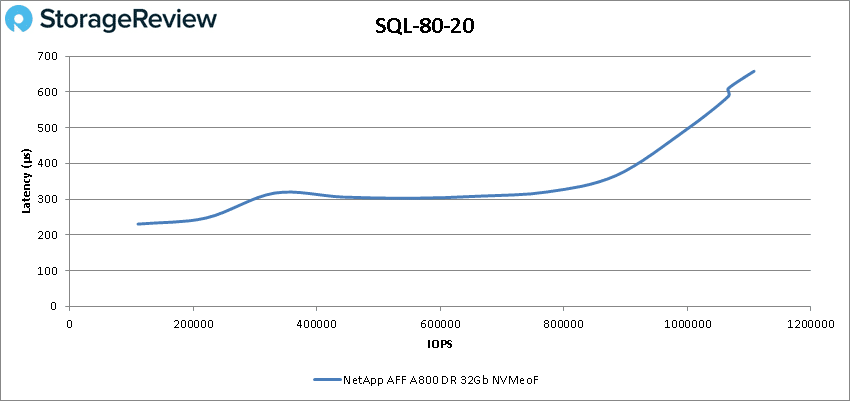
W przypadku SQL 80-20 opóźnienia znów były mniejsze od milisekundy, osiągając szczytową wartość 1 108 068 IOPS przy opóźnieniu 658 µs.
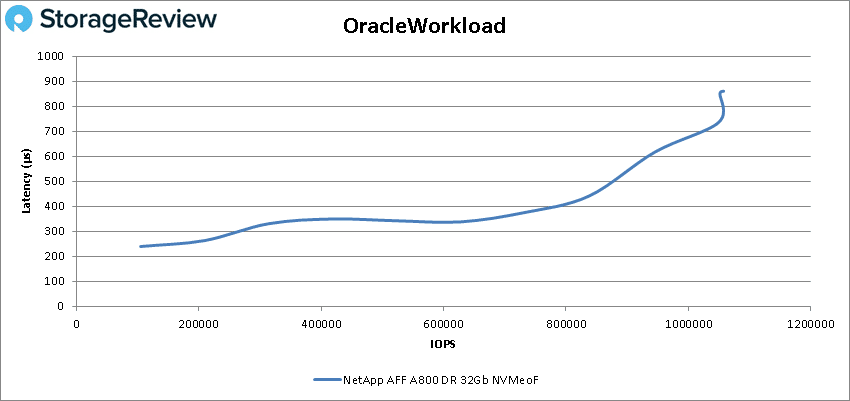
Przechodząc do naszych obciążeń Oracle, A800 z NVMeOF utrzymał wynik poniżej 1 ms, osiągając szczytowy wynik 1 057 570 IOPS przy opóźnieniu 860.4 µs.
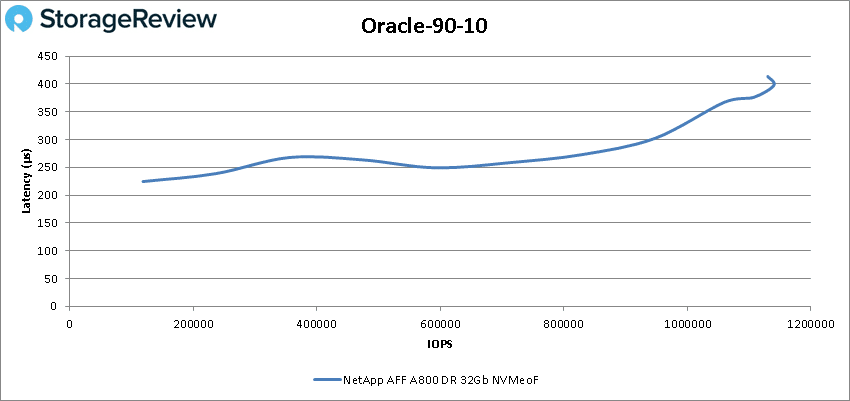
W systemie Oracle 90-10 procesor A800 początkową wartość stanowiło 118 586 IOPS, a szczytową 1 140 178 IOPS przy opóźnieniu 397.6 µs.
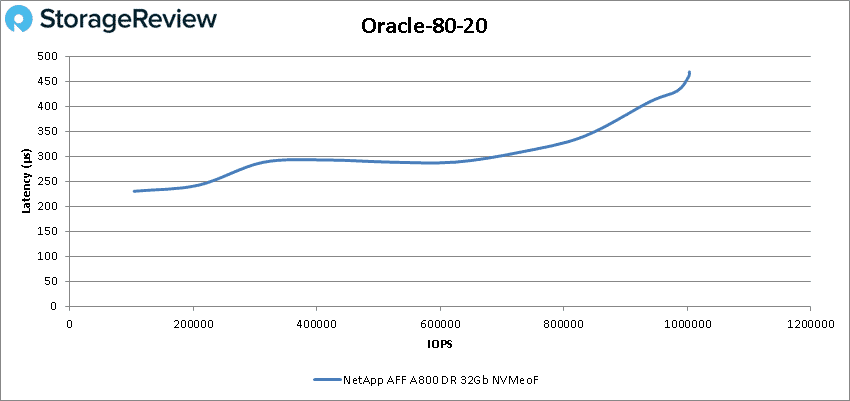
W Oracle 80-20 zobaczyliśmy, że A800 ponownie osiągnął opóźnienie mniejsze od milisekundy, zaczynając od 104 206 IOPS i osiągając szczyt na poziomie 1 003 577 IOPS przy opóźnieniu 468.8 µs.
Wniosek
NetApp AFF A800 to macierz all-flash o wysokości 4U, która obsługuje dostęp do bloków i plików, a także kompleksową obsługę technologii NVMe. Macierz A800 jest przeznaczona dla użytkowników o najbardziej wymagających obciążeniach, wymagających wysokiej wydajności i dużej pojemności pamięci masowej, o maksymalnej efektywnej pojemności 316.8 PB. Podczas gdy nasza pierwsza nagradzana recenzja dotyczyła tej macierzy w porównaniu z tradycyjnym Fibre Channel, ta recenzja wykorzystuje technologię NVMe w technologii Fabric, aby sprawdzić, jak się sprawdzi.
W przypadku obciążeń VDBench, NetApp AFF A800 zaoferował imponujący zestaw wyników we wszystkich kategoriach. W naszym podstawowym teście na czterech narożnikach zaobserwowaliśmy losową szczytową wydajność 4K na poziomie 2.2 miliona IOPS dla odczytu i 465 tysięcy IOPS dla zapisu. W sekwencyjnych obciążeniach 64K zanotowaliśmy 25 GB/s dla odczytu i 7.52 GB/s dla zapisu. W obciążeniach SQL zanotowaliśmy szczyty na poziomie 1.5 miliona IOPS, SQL 90-10 odnotował 1.4 miliona IOPS, a SQL 80-20 1.1 miliona IOPS. Nasze testy Oracle wykazały imponujące 1.1 miliona IOPS, Oracle 90-10 1.14 miliona IOPS, a Oracle 80-20 1 milion IOPS. Jeszcze bardziej imponujący był fakt, że obciążenia SQL i Oracle utrzymywały opóźnienie poniżej 1 ms.
Chociaż widzieliśmy świetne wyniki z A800 skonfigurowanym do obsługi NVMeOF, szczególnie pod względem wydajności odczytu, warto zauważyć, że system ma jeszcze wiele do zaoferowania. Podczas naszych testów serwery generujące obciążenie były oparte na hiperwizorze VMware, co dodaje kolejny poziom złożoności. Ponadto VMware nie obsługuje obecnie w pełni NVMeOF. Dla głównych przedsiębiorstw, które chcą w pełni wykorzystać potencjał NVMeOF w systemach NetApp, najlepszą wydajność zapewni system bare metal. Mimo to wiele z nich będzie chciało używać systemów NVMeOF ONTAP w konfiguracji hybrydowej, wykorzystując zarówno struktury, jak i standardową łączność Fibre Channel. W obu przypadkach NetApp nadal przoduje pod względem wdrażania technologii wiodącej generacji, aby mieć pewność, że ich macierze są gotowe na wszystko, czego potrzebują klienci, zawsze, gdy tego potrzebują. A800 radzi sobie tutaj szczególnie dobrze, dlatego przyznaliśmy mu tytuł Editor's Choice w naszej wstępnej recenzji. Technologia NVMeOF zapewnia znaczny wzrost wydajności, co powinno przypaść do gustu przedsiębiorstwom wymagającym maksymalnej przepustowości i mikrosekundowych opóźnień w przypadku aplikacji o znaczeniu krytycznym dla działalności.


 Amazon