

Firma VMware niedawno dodała NVMe over Fabric (NVMe-oF) jako opcję protokołu sieciowego pamięci masowej w vSphere 7.0. Fakt, że to najszybsze rozwiązanie współdzielonej pamięci masowej jest teraz dostępne dla najpopularniejszego na świecie oprogramowania do wirtualizacji, to prawdziwy przełom, otwierający zupełnie nowe możliwości zastosowań dla zwirtualizowanego centrum danych. Oznacza to również, że istnieją teraz aplikacje bare metal, które mogą działać na maszynach wirtualnych (VM) z obsługą NVMe-oF w vSphere. Należą do nich: sztuczna inteligencja (AI), uczenie maszynowe (ML), bazy danych w pamięci, obliczenia o wysokiej wydajności (HPC), handel wysokoczęstotliwościowy (HFT), przetwarzanie transakcji online (OLTP), a także wszelkie inne aplikacje wymagające wyjątkowo niskich opóźnień i dużej pojemności pamięci masowej.
W StorageReview.com zawsze jesteśmy zainteresowani testowaniem najnowszych technologii, aby sprawdzić, jak działają w praktyce. Biorąc pod uwagę nasze wcześniejsze doświadczenia z NVMe-oF, w pełni oczekujemy, że znacząco poprawi to wydajność aplikacji w vSphere. Aby uzyskać rzeczywisty obraz wpływu NVMe-oF na wydajność, porównamy go z iSCSI, który jest obecnie standardem dla pamięci blokowej w centrum danych vSphere. Nasze testy będą jednak miały unikalną specyfikę, ponieważ nie będziemy korzystać z wysoce wyspecjalizowanej, niszowej technologii. Zamiast tego wykorzystamy produkty powszechnie spotykane w dzisiejszych centrach danych. Testy przeprowadzimy na serwerze Dell R720XD podłączonym za pomocą dwuportowych adapterów NVIDIA ConnectX-5 z prędkością 25 GbE do macierzy Pure Storage FlashArray//X obsługującej NVMe-oF.
Zanim przejdziemy do wyników naszych testów, najpierw przedstawimy Państwu, co VMware obsługuje w zakresie NVMe-oF, a następnie przedstawimy podstawowe informacje na temat NVMe i NVMe-oF oraz wyjaśnimy, dlaczego są one wydajniejsze niż iSCSI. Omówimy również niektóre kroki, które podjęliśmy, aby skonfigurować NVMe w vSphere.
Firma VMware niedawno (w kwietniu 2020 r.) włączyła obsługę standardu NVMe-oF, chociaż został on wydany w 2016 r. Linux obsługuje go od 2018 r., a obsługa NVMe-oF w macierzach pamięci masowej jest dostępna również od kilku lat. NVMe-oF jest uważany za rozwijającą się, ale stabilną technologię. W kwietniu 2020 r. firma VMware wydała vSphere 7.0, a ta wersja zawierała obsługę NVMe-oF, umożliwiając łączność z macierzami NVMe za pomocą technologii NVMe over Fibre Channel (NVMe/FC) lub NVMe over RDMA Converged Ethernet (NVMe-RoCE, zwanej również NVMe/RDMA).
Przegląd NVMe i NVMe-oF
Do niedawna dyski SSD były de facto standardowym nośnikiem dla podłączonych pamięci masowych. Mają jednak również istotne wąskie gardło. Dyski SSD wykorzystują złącza SATA lub SAS, zaprojektowane do współpracy z dyskami twardymi, co poważnie ogranicza ich wydajność. Aby rozwiązać ten problem, w 2011 roku konsorcjum ponad 90 firm połączyło siły i opublikowało nową specyfikację, która miała umożliwić podłączenie dysków SSD do komputerów, które nie miałyby wąskiego gardła SATA. Rozwiązanie to ostatecznie stało się znane jako NVMe.
Urządzenia NVMe są szybkie. Podczas gdy dyski SSD SATA/SAS radykalnie zmieniły branżę pamięci masowych w ostatniej dekadzie, NVMe radykalnie ją zmienia w tym stuleciu. Na przykład, w naszych ostatnich testach z obciążeniem odczytu 4 KB, odkryliśmy, że dysk SATA (Kingston DC500M) mógł zapewnić nieco poniżej 80 000 IOPS, podczas gdy dysk NVMe (Kingston DC1000M) mógł osiągnąć 580 000 IOPS, co stanowi aż 7.25-krotną różnicę. Istnieje wiele technicznych powodów, dla których NVMe jest o wiele wydajniejsze niż dyski SATA, ale jednym z najważniejszych jest krótsza ścieżka danych. Poniższy diagram przedstawia uproszczoną ilustrację tego, jak ścieżka danych jest znacznie krótsza w przypadku NVMe w porównaniu z pamięciami masowymi poprzedniej generacji, takimi jak SAS.
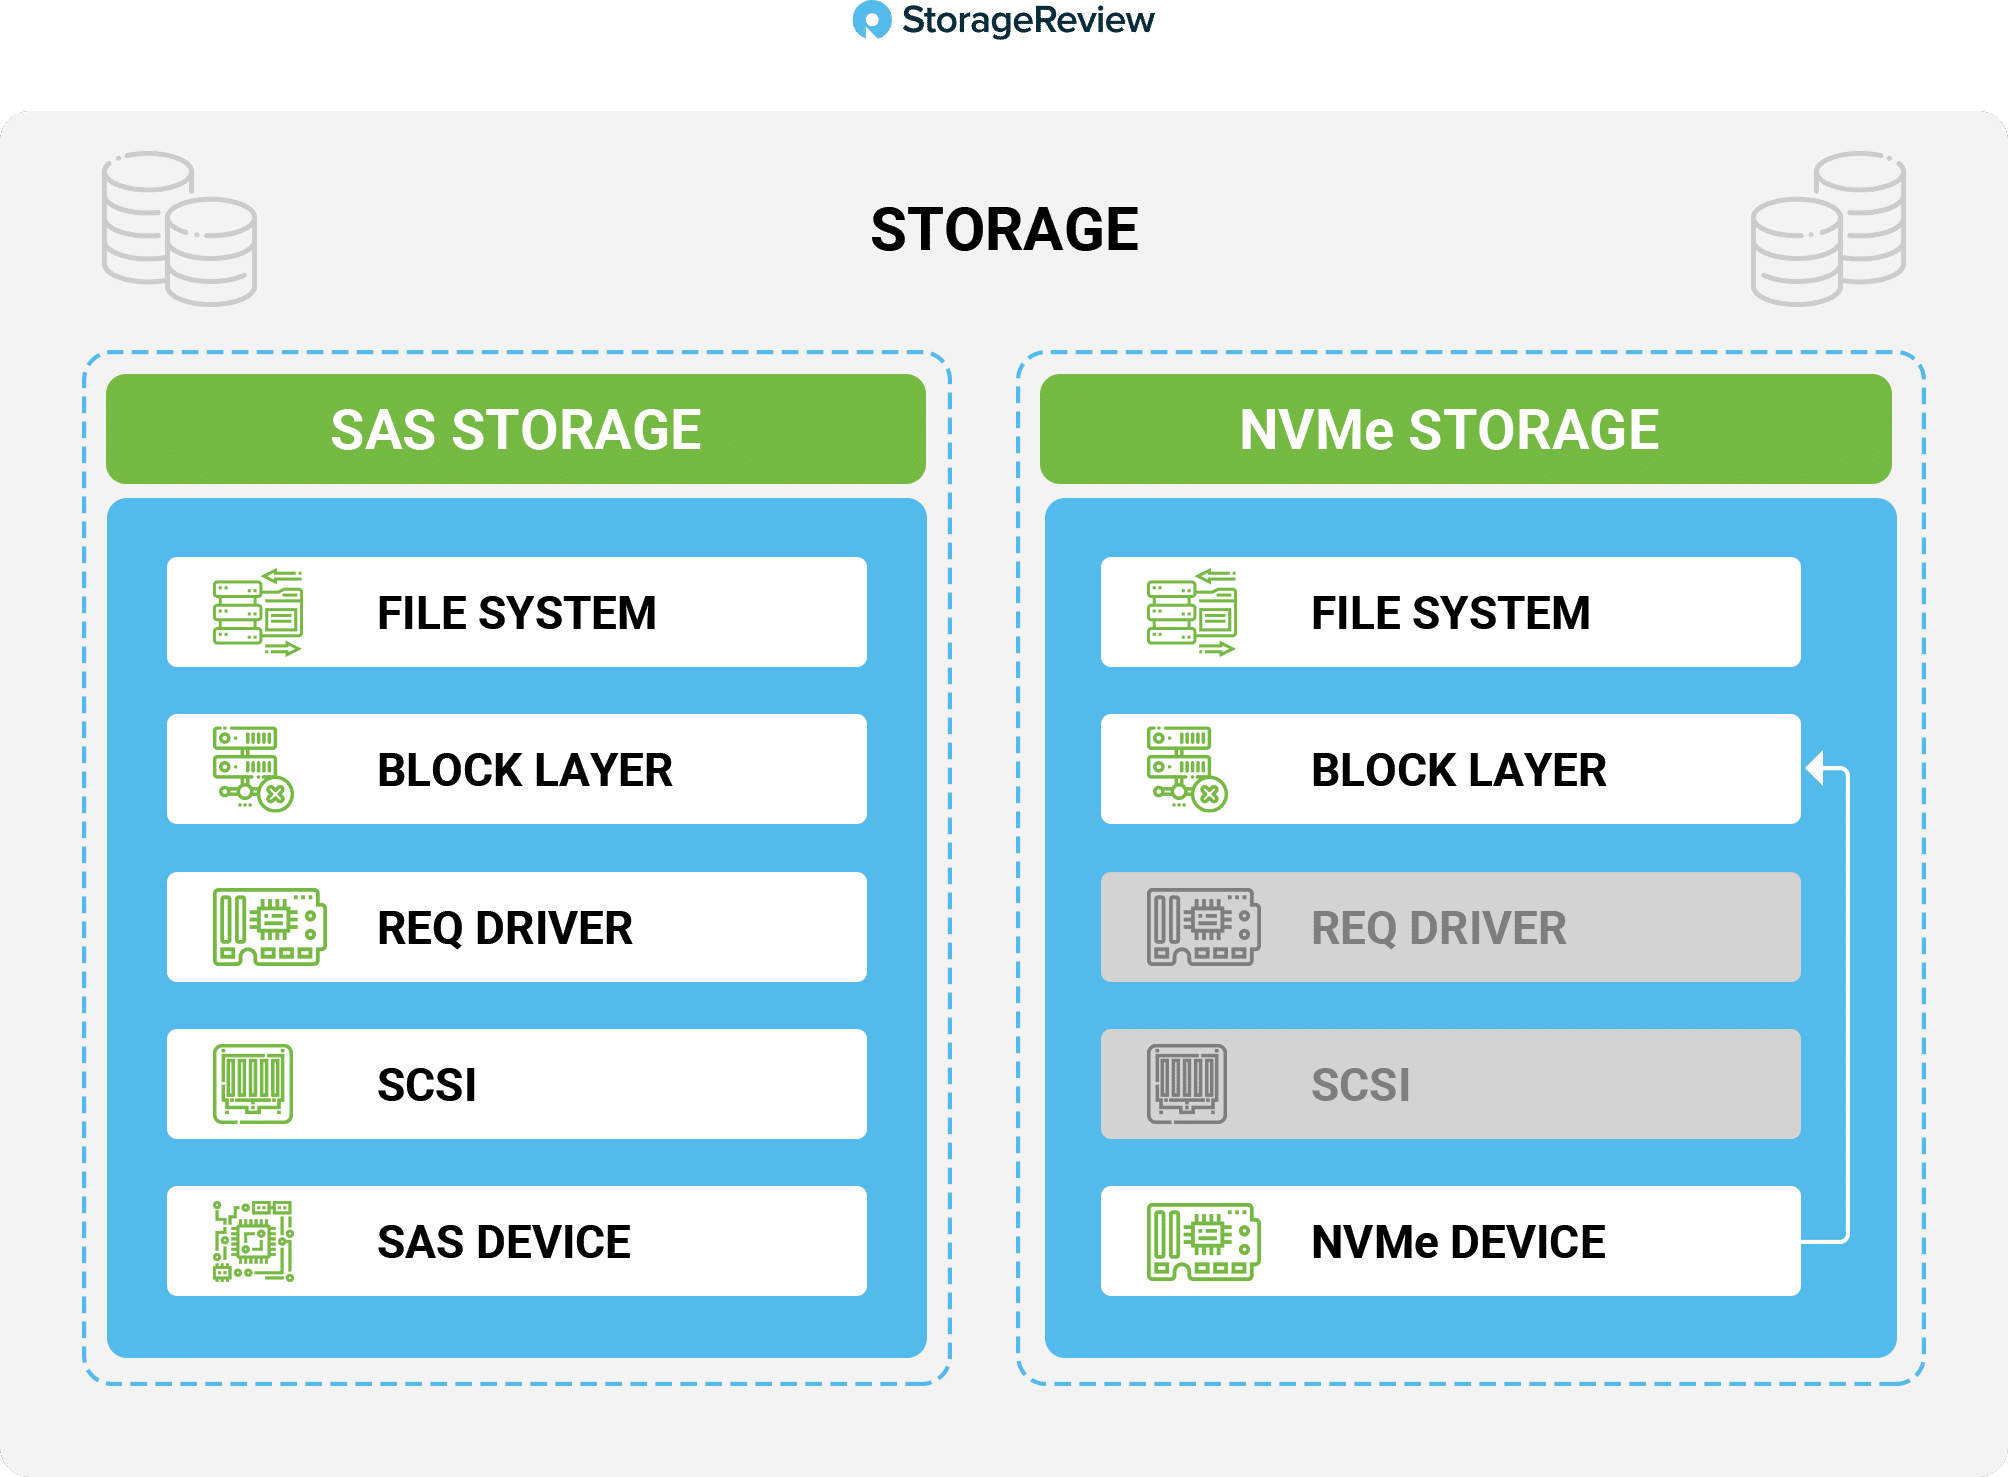 Ulepszona wydajność w połączeniu z gwałtownym spadkiem ceny sprawiły, że technologia NVMe stała się faworytem w nowoczesnych centrach danych.
Wkrótce po tym, jak dyski NVMe stały się powszechne w centrach danych, zdano sobie sprawę, że urządzenia te nie są w pełni wykorzystywane, a ich ograniczenia wynikające z bezpośredniego podłączenia do pamięci masowej stały się bardziej widoczne. Urządzenia NVMe wymagały odłączenia od serwera, dlatego inna grupa firm zebrała się i opracowała specyfikację dostarczania NVMe przez sieć. Po udostępnieniu mechanizmu transportowego dla pamięci masowej NVMe mogliśmy agregować, abstrahować i udostępniać urządzenia NVMe w systemie pamięci masowej wielu różnym systemom, w tym hostom ESXi. NVMe-oF wykorzystuje terminologię „cel/inicjator”.
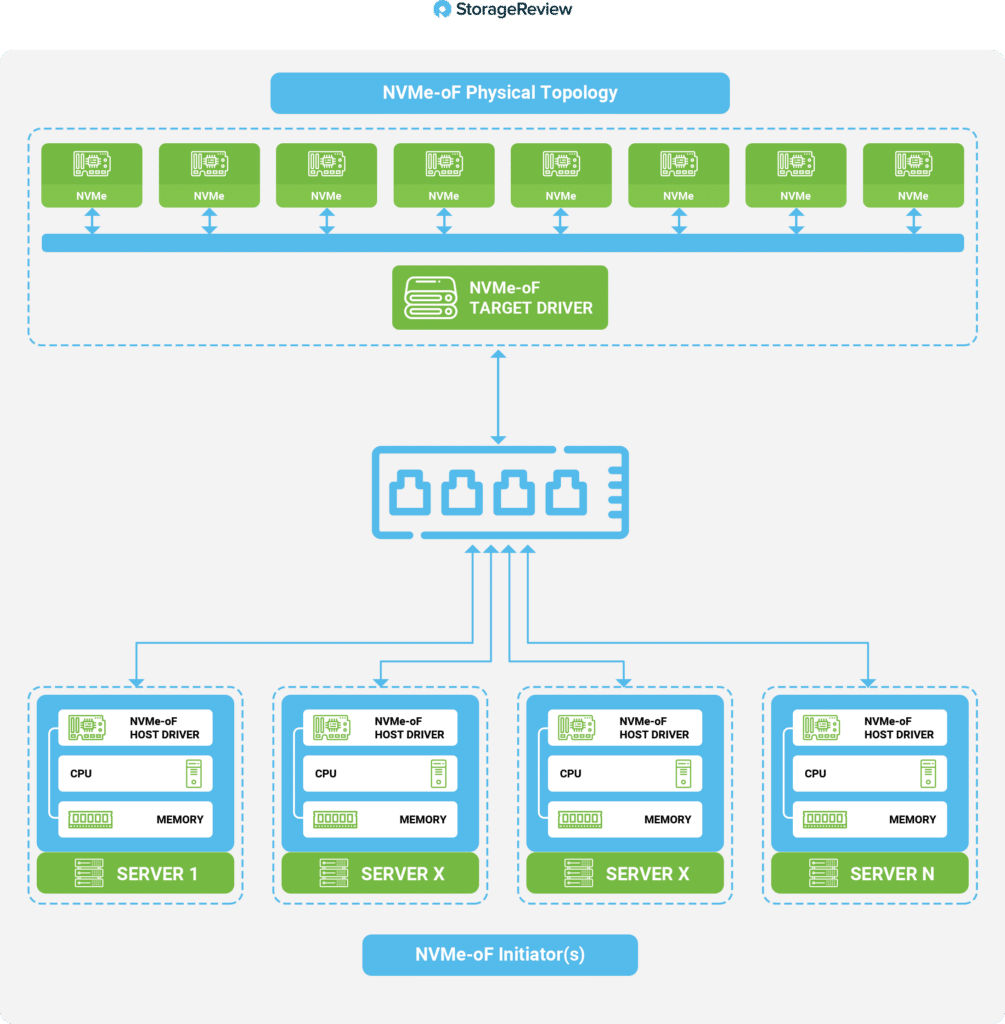
RoCE umożliwia zdalny bezpośredni dostęp do pamięci (RDMA) przez sieć Ethernet. Istnieją dwie wersje RoCE: RoCE v1 i RoCE v2. Podczas gdy RoCE v1 umożliwia komunikację między dowolnymi dwoma hostami w tej samej domenie rozgłoszeniowej Ethernet (warstwa 2), RoCE v2 działa na TCP (warstwa 3) i dlatego jest routowalny, co pozwala mu łączyć się z hostami spoza domeny rozgłoszeniowej Ethernet. Ze względu na swoje zalety i popularność w centrach danych, VMware obsługuje tylko wersję 2. W tym artykule będziemy nazywać RoCE v2 po prostu RoCE.
RoCE wymaga kontrolerów interfejsu sieciowego RDMA (rNIC) zamiast standardowych kart sieciowych. Sieci RoCE zazwyczaj wymagają konfiguracji funkcji Priority Flow Control, ale przełączniki Spectrum są zoptymalizowane pod kątem kontroli przeciążenia w połączeniu z adapterami ConnectX, co pozwala na brak konieczności konfiguracji. RoCE cieszy się dużą popularnością i posiada prężnie rozwijający się ekosystem, który dostarcza zarówno karty rNIC, jak i podsystemy NVMe-oF. Jest on obecnie wykorzystywany przez niektóre z największych na świecie centrów danych o dużej skali, co znacznie obniżyło cenę kart rNIC od momentu ich wprowadzenia.
Dzięki wykorzystaniu RDMA dane mogą być przesyłane bezpośrednio do hosta z urządzeń NVMe-oF, bez konieczności kopiowania ich do buforów pamięci, co miałoby miejsce w przypadku korzystania ze standardowego stosu Transmission Control Protocol/Internet Protocol (TCP/IP). Omijając bufory, RDMA zmniejsza obciążenie procesora na hoście i zmniejsza opóźnienie w dostępie do danych na zdalnym urządzeniu NVMe. Istnieje wiele technicznych powodów, dla których NVMe-oF jest wydajniejszy niż technologie pamięci masowej sieciowej poprzedniej generacji. Na uwagę zasługuje ogromna liczba kolejek (64 KB) obsługiwanych przez NVMe-oF, ale być może najbardziej wymowna jest ścieżka danych NVMe-oF. Poniższy diagram przedstawia uproszczoną ilustrację tego, jak ścieżka danych jest znacznie krótsza dla NVMe-oF w porównaniu z pamięcią masową iSCSI.
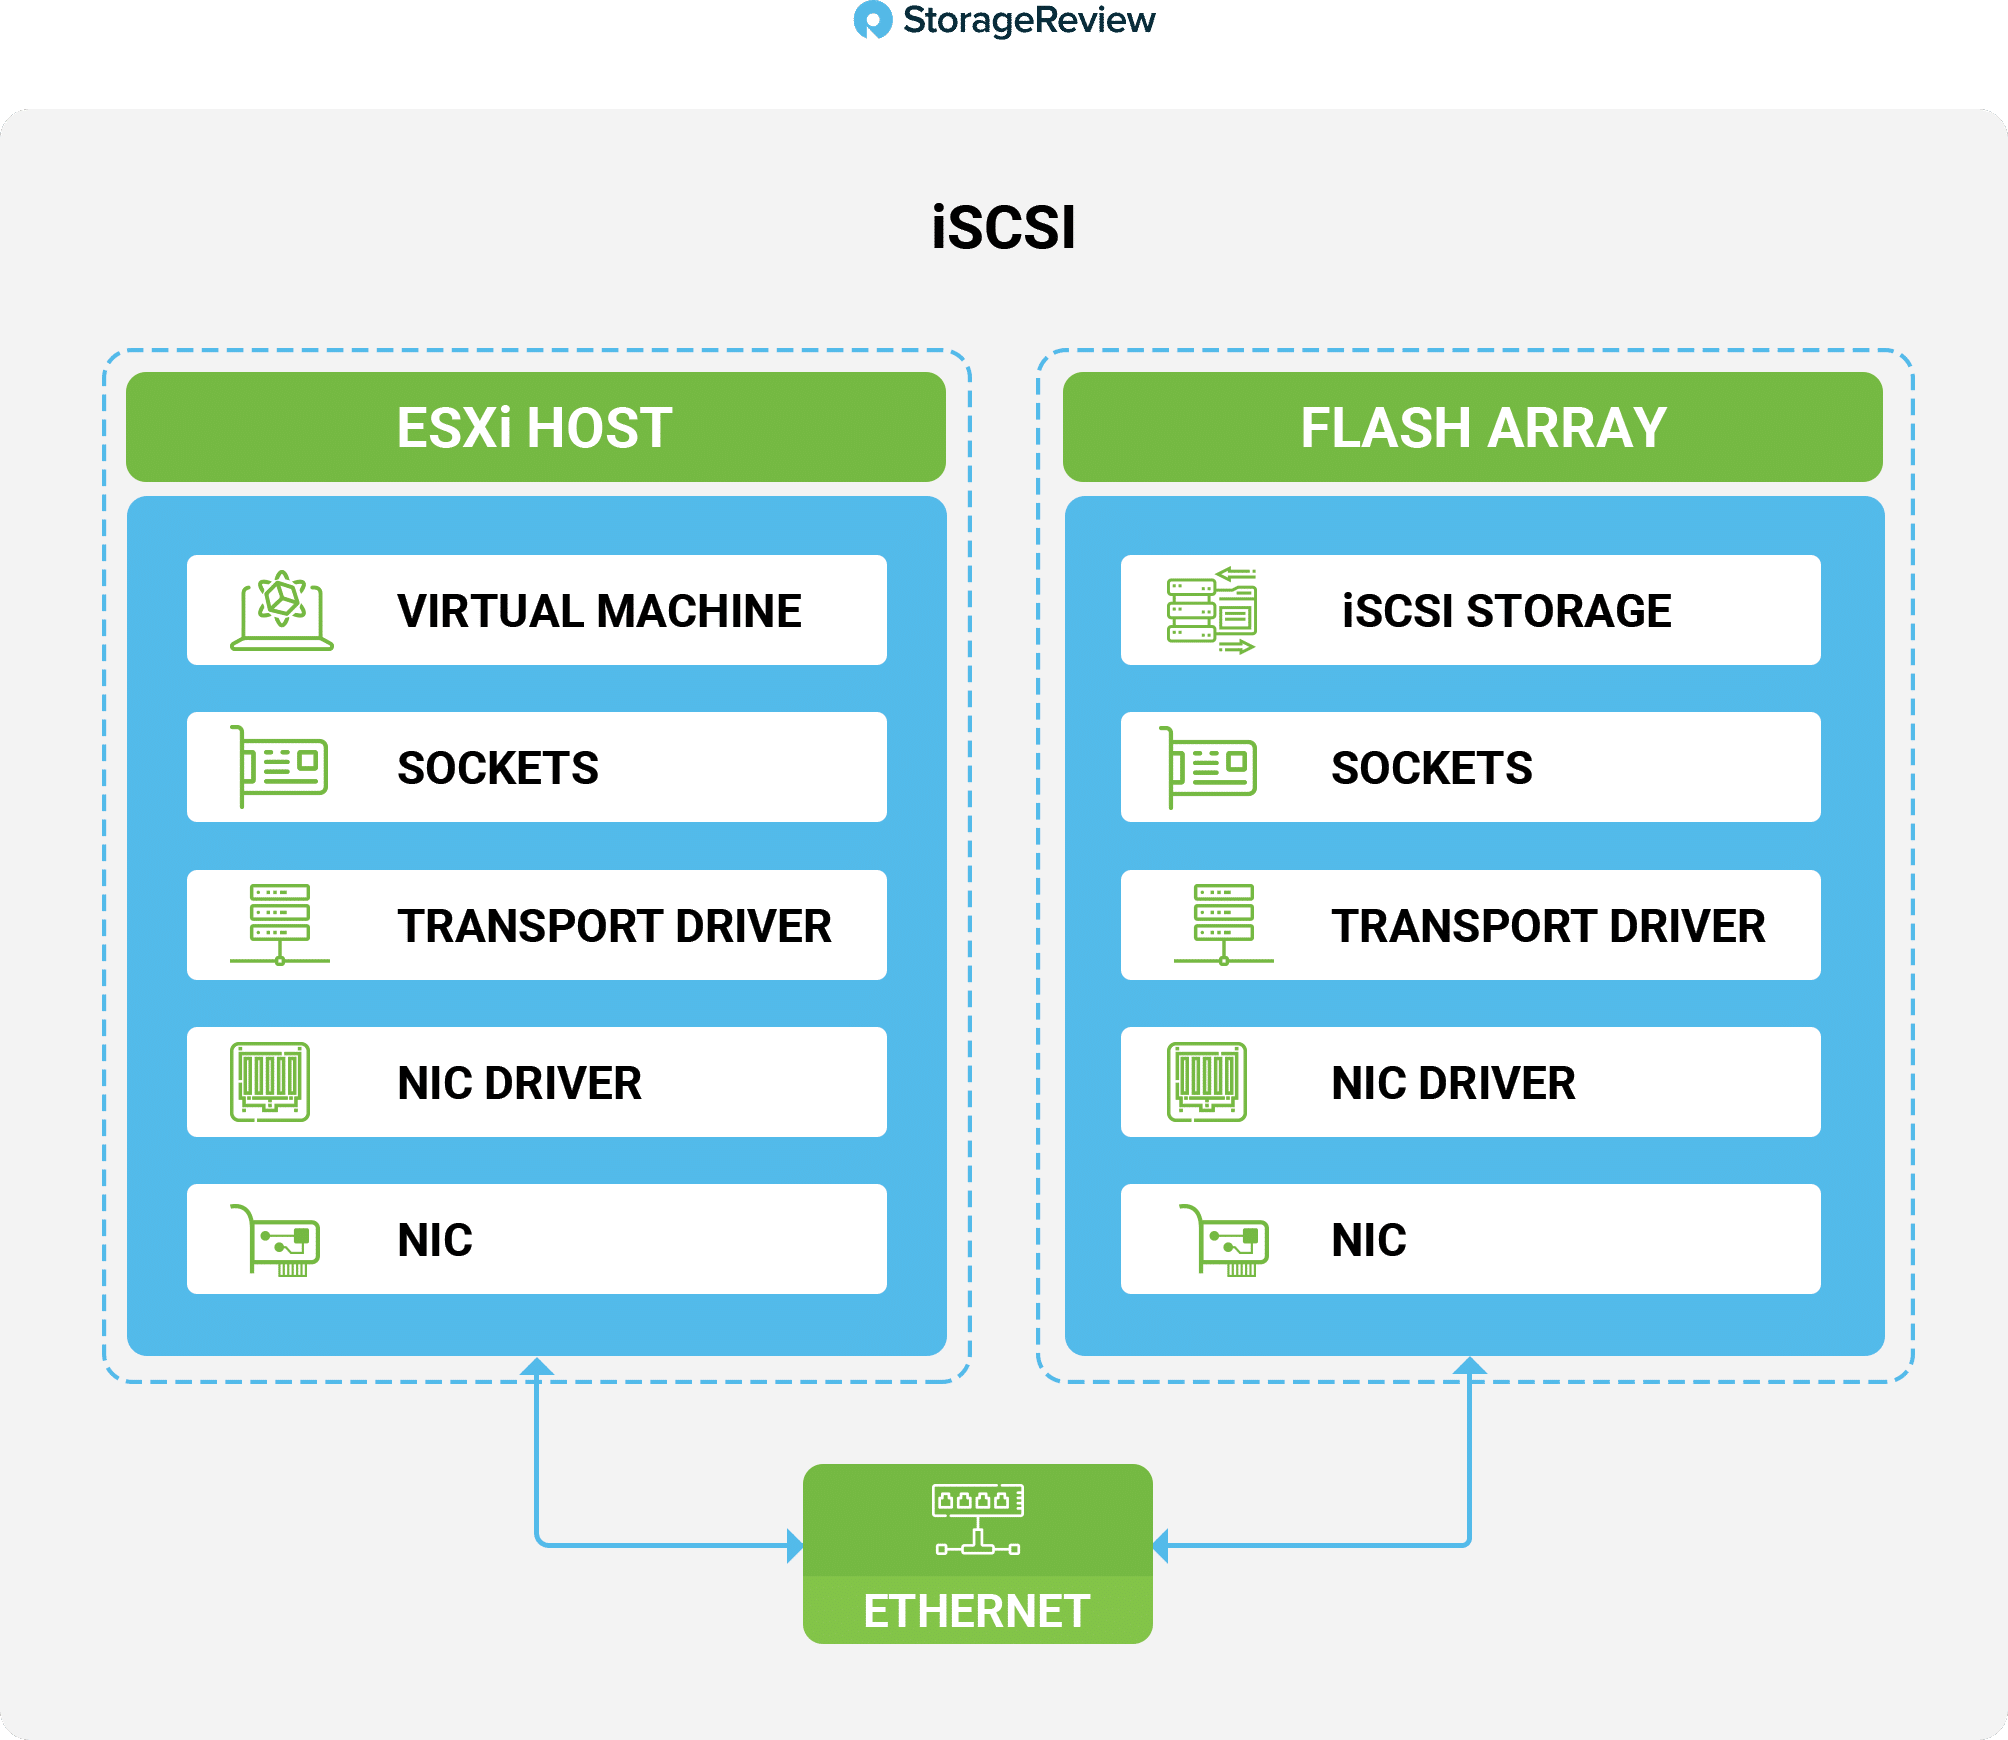
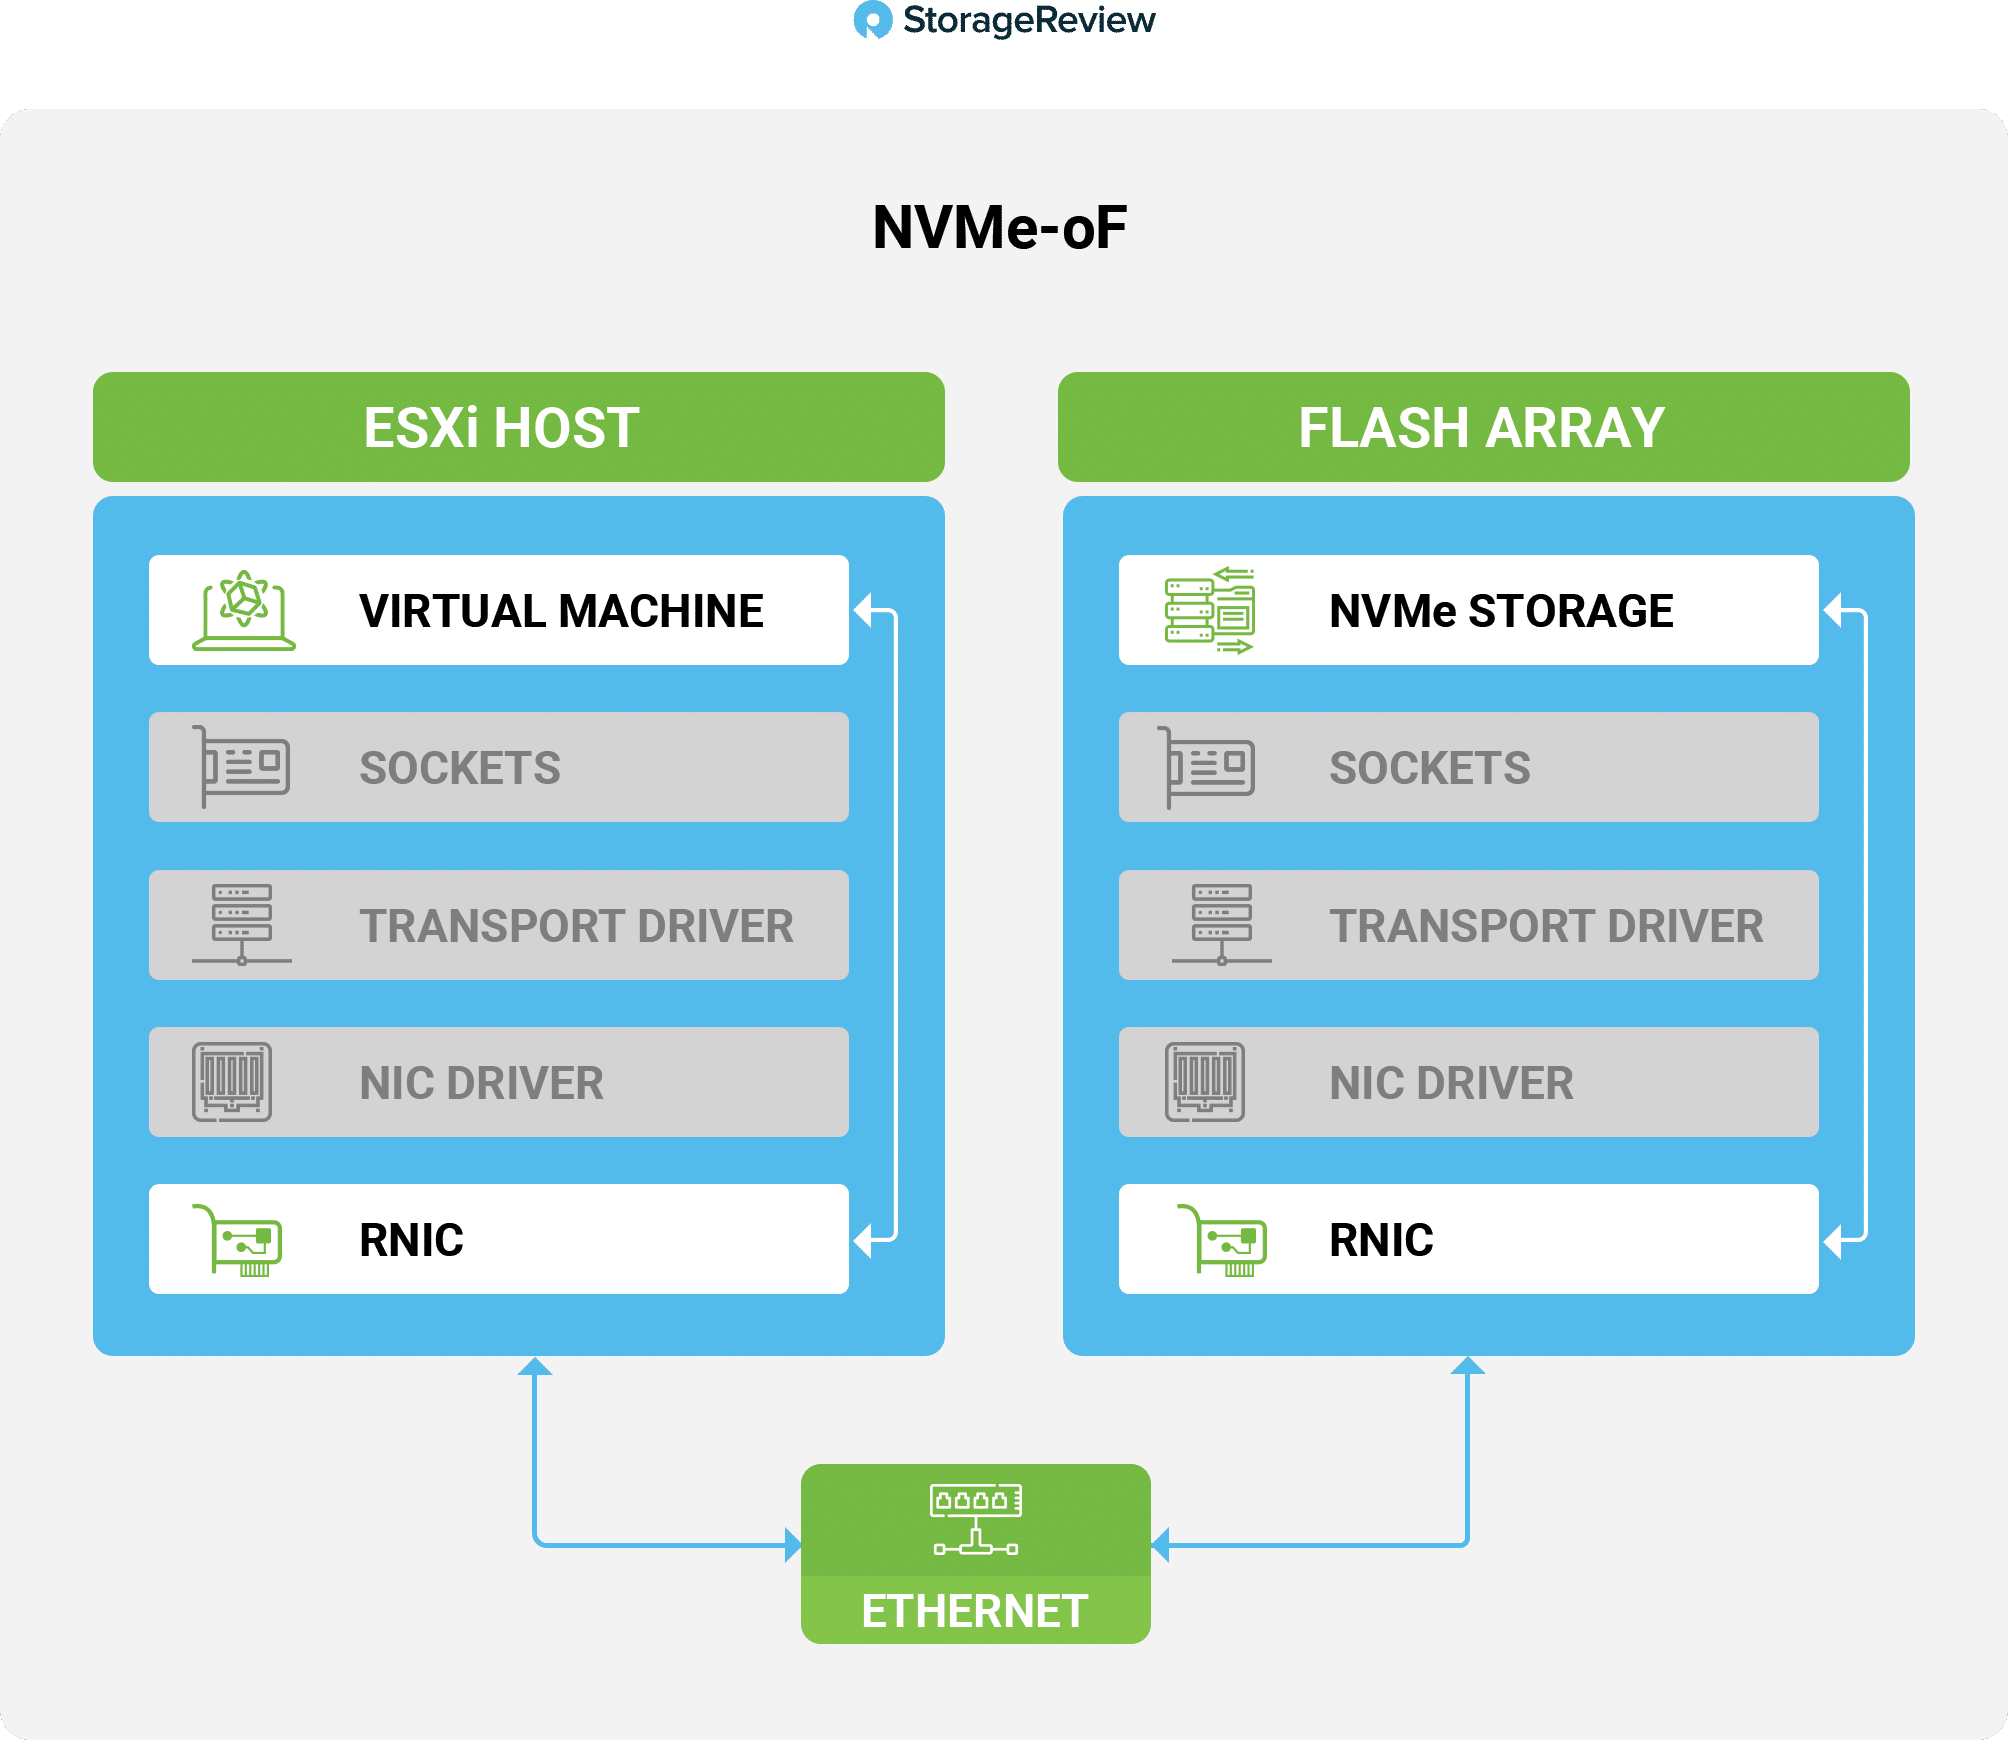
RoCE korzysta z protokołu UDP, co wpływa na wydajność, ponieważ UDP wymaga mniejszego narzutu. Jednak RoCE opiera się na pełnej kompatybilności, aby zapewnić pełną bezstratną łączność. Chociaż nowoczesne przełączniki sieciowe obsługują łączność bezstratną, należy upewnić się, że starszy przełącznik, który nie obsługuje łączności bezstratnej, nie znajduje się na ścieżce sieciowej NVMe-oF.
W rezultacie technologia NVMe-oF umożliwia dostęp do dysków NVMe w sieci tak, jakby były one lokalne dla serwera uzyskującego dostęp. Wstępne raporty wykazały, że opóźnienie dla pulowanej pamięci masowej wynosi około 100 μs, zamiast 500 μs lub więcej w przypadku macierzy pamięci masowej all-flash iSCSI.
NVMe-oF z vSphere
Wymagania dla technologii NVMe-oF z vSphere są proste:
- Macierz NVMe obsługująca transport RDMA (RoCE).
- Zgodny host ESXi
- Przełączniki Ethernet obsługujące sieć bezstratną
- Karta sieciowa obsługująca RoCE
- Oprogramowanie NVMe przez adapter RDMA
- Kontroler NVMe
- Sieć bezstratna na warstwie 2 i 3 lub sieć stratna z rozwiązaniem ZTR (Zero Touch RoCE) firmy NVIDIA
- Dedykowane łącza, VMkernele i adaptery RDMA do celów NVMe
- Dedykowana sieć VLAN warstwy 3 lub łączność warstwy 2
Ponieważ NVMe-oF jest nowością w VMware, nie wszystkie funkcje vSphere są dla niego dostępne. Kilka funkcji, których zauważyliśmy, to obsługa współdzielonych dysków VMDK, map urządzeń surowych (RDM), woluminów vVol oraz możliwość rozruchu z NVMe-oF.
Wdrażanie NVMe-oF
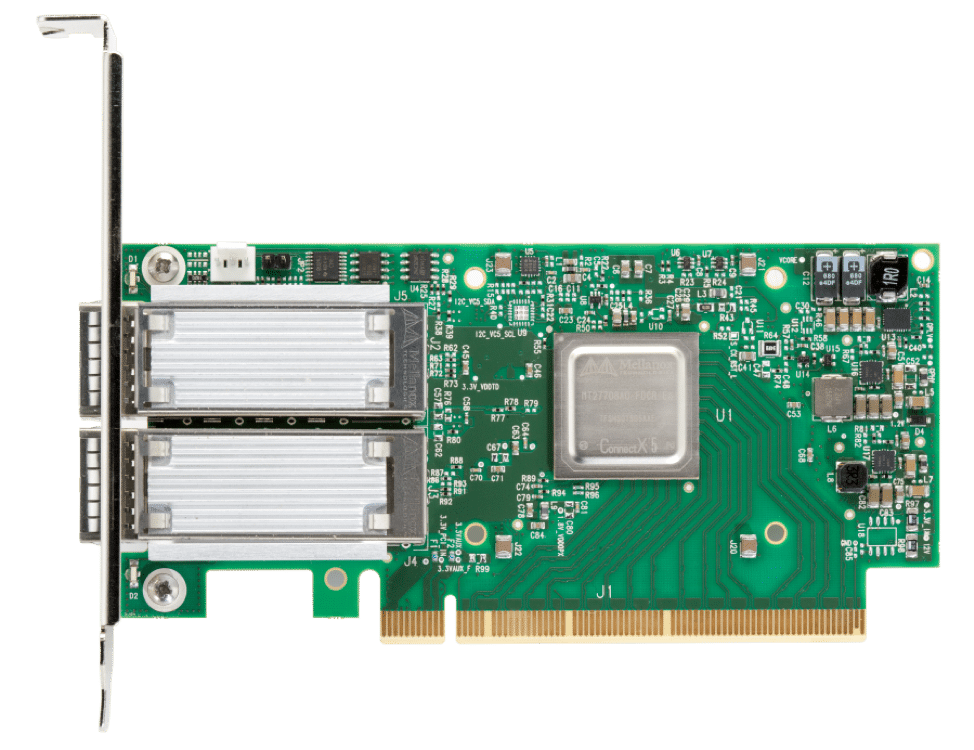
Użyliśmy kart sieciowych NVIDIA ConnectX-5 rNIC, jednej z najpopularniejszych kart w centrach danych. Karty te to jedno- lub dwuportowe adaptery sieciowe z obsługą RDMA. Są one dostępne dla serwerów PCIe Gen 3.0 i Gen 4.0 i zapewniają obsługę przepustowości 1, 10, 25, 40, 50 i 100 Gb/s. Charakteryzują się opóźnieniem 750 ns i mogą przesyłać do 200 milionów komunikatów na sekundę. W połączeniu z obciążeniami pamięci masowej obsługują szeroką gamę technologii akceleracji.
W ramach testów uruchomiliśmy karty PCIe Gen 3.0 ConnectX-5 z prędkością 25 GbE w dwóch serwerach Dell R720 połączonych siecią za pośrednictwem pary przełączników NVIDIA Spectrum SN2010 z macierzą flash Pure Storage.
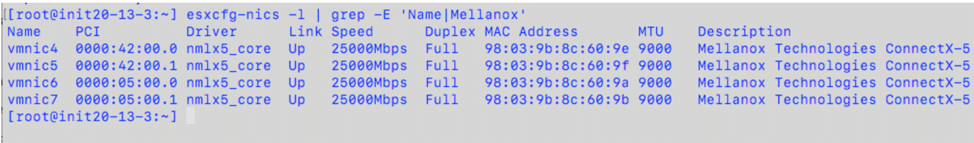
Najpierw sprawdziliśmy, czy uruchomiliśmy sterownik nmlx5_core, wpisując polecenie esxcfg -nics -l |grep -E 'Name|NVIDIA'.
Gdybyśmy uruchomili sterownik nmlx4_core, moglibyśmy włączyć dla niego RoCE z poziomu interfejsu wiersza poleceń ESXi.
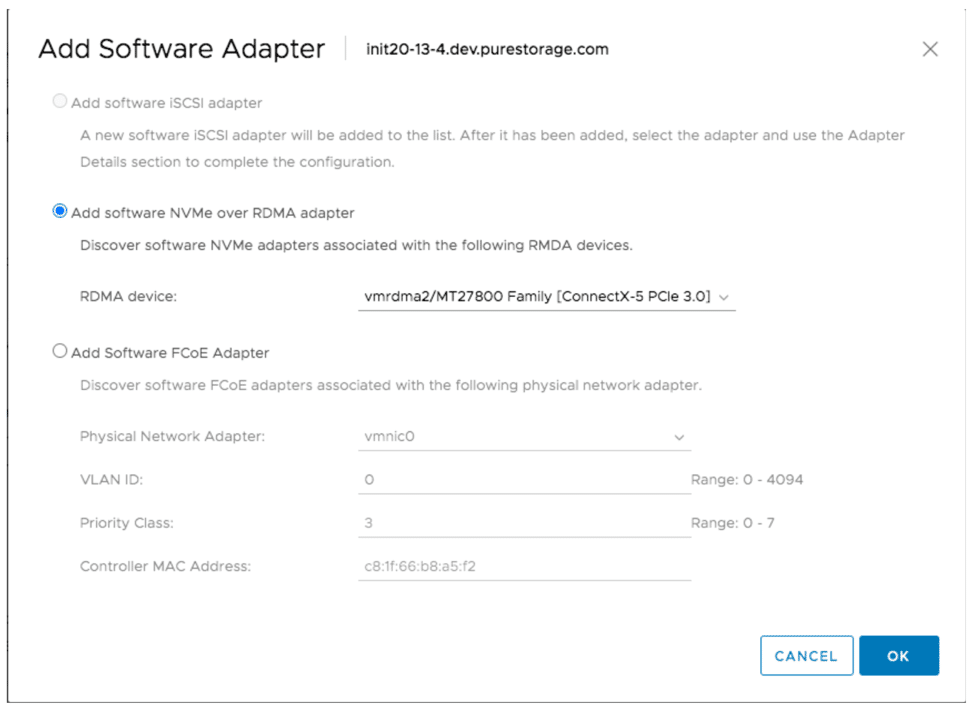
Proces włączania NVMe-oF (podobny do konfiguracji i włączania iSCSI) obejmował konfigurację przełączników wirtualnych, grup portów i portów vmkernel na hostach ESXi. Główną różnicą było to, że musieliśmy dodać co najmniej dwa programowe adaptery NVMe over RDMA do każdego hosta ESXi.
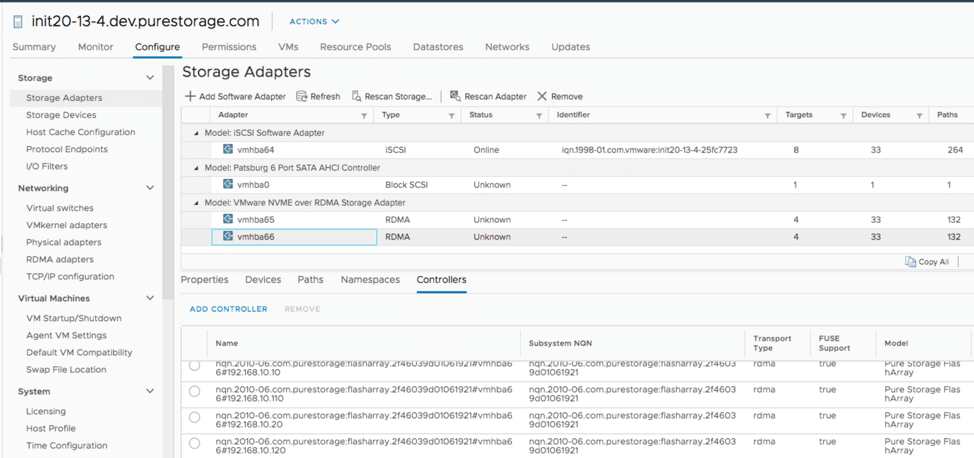
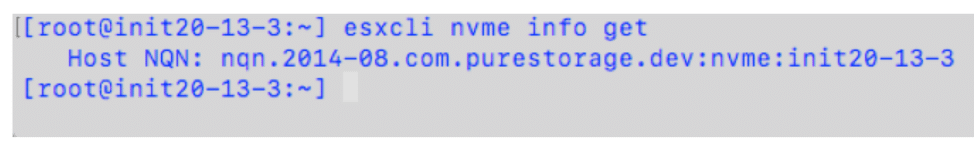
Ostatnim krokiem, który musieliśmy wykonać, było zidentyfikowanie kwalifikowanej nazwy NVMe (NQN) hosta ESXi poprzez wprowadzenie polecenia esxcli nvme info get.
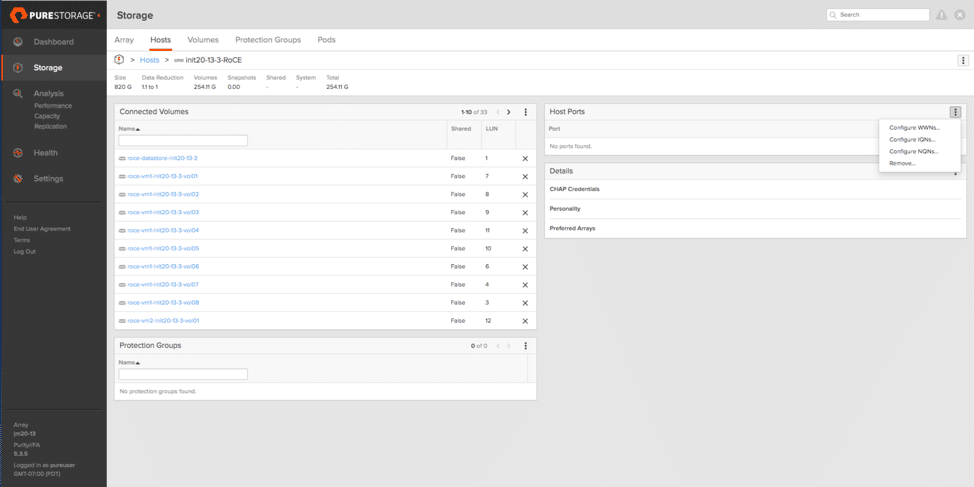
W przypadku macierzy Pure Storage proces przebiegał podobnie do konfiguracji macierzy iSCSI, z jednym dużym wyjątkiem: musieliśmy wybrać opcję „Konfiguruj NQN”.
Wyniki testów NVMe-oF z vSphere
W tym teście zachowaliśmy wszystkie parametry niezmienne, z wyjątkiem infrastruktury. Chcemy ocenić wpływ przejścia z bardziej tradycyjnego iSCSI na RoCE. Mówiąc wprost, nie jest to test porównawczy pamięci masowej, lecz badanie mające na celu sprawdzenie korzyści płynących z technologii NVMe-oF w środowisku VMware, które wymaga bardzo niewielu zmian. Użyliśmy dwóch serwerów Dell EMC PowerEdge oraz macierzy Pure FlashArray//X R2 jako zaplecza pamięci masowej.
Nasz plan testów obejmował pomiar łącznej wydajności 8 maszyn wirtualnych (4 na każdym hoście ESXi) oraz wykorzystanie vdBench do pomiaru tradycyjnych obciążeń typu „cztery rogi” i obciążeń mieszanych. Każda maszyna wirtualna zajmowała 64 GB pamięci masowej, a łączna powierzchnia zajmowana przez każde obciążenie wynosiła 512 GB, co pozwalało na porównanie zmian wydajności w miarę zmiany protokołu.
Aby zinterpretować te wyniki, należy pamiętać, że w przypadku przepustowości korzystniejsza jest poprawa, natomiast w przypadku opóźnienia korzystniejsza jest jej redukcja.
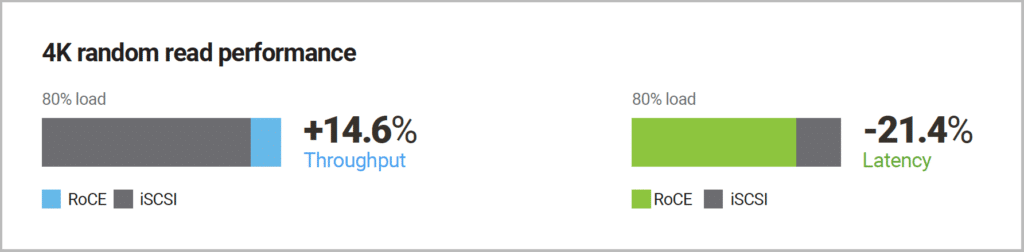 Podczas naszego pierwszego pomiaru wydajności losowego odczytu 4K przy obciążeniu 80% odnotowaliśmy wzrost przepustowości o 14.6% i spadek opóźnienia odczytu o 21.4%.
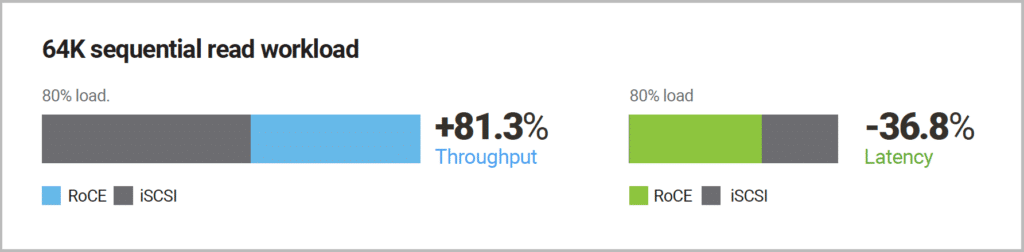 Następnie, analizując przepustowość odczytu przy obciążeniu odczytu sekwencyjnego 64K, zaobserwowaliśmy ogromny wzrost przepustowości o 81.3%, a także spadek opóźnienia o 36.8% — również przy obciążeniu 80%.
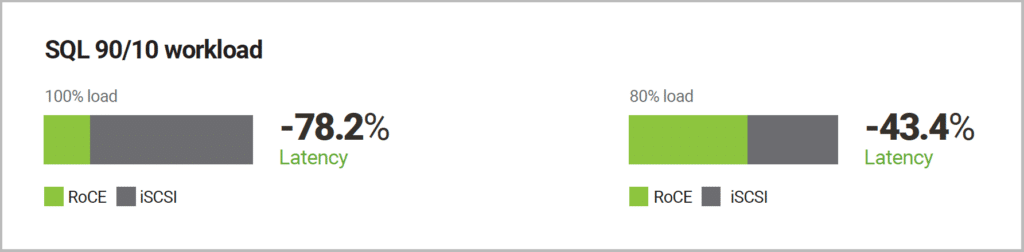 Chociaż największe wzrosty odnotowano w obciążeniach odczytu, przyjrzeliśmy się również kilku typowym obciążeniom mieszanym, z których pierwszym był SQL 90/10. W tym obciążeniu zaobserwowaliśmy spadek opóźnień nawet o 78.2% przy obciążeniu 100% i spadek opóźnień o 43.4% przy obciążeniu 80%.
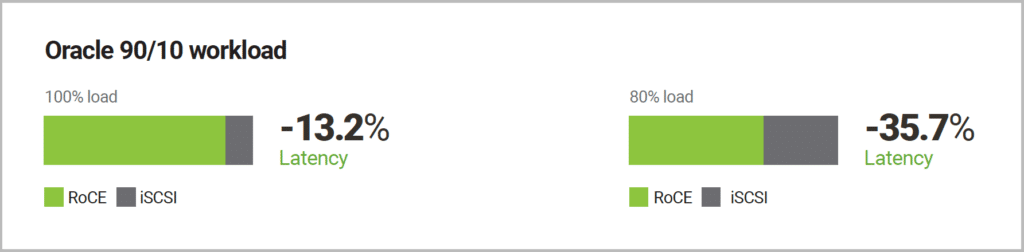 Wreszcie, w naszym obciążeniu Oracle 90/10 zaobserwowaliśmy spadek opóźnień o 13.2% przy obciążeniu 100% i spadek opóźnień o 35.7% przy obciążeniu 80%.
W testach tych wyraźnie widać, że RoCE wykazało znaczną poprawę w szerokim zakresie obciążeń powszechnie występujących w przedsiębiorstwach.
Wniosek
Nasze testy dowiodły, że NVMe-oF w praktyce to coś więcej niż tylko koncepcja. NVMe-oF może zapewnić znakomitą wydajność, wykorzystując obecny sprzęt centrum danych, taki jak serwery ze złączami PCI Gen 3.0, karty sieciowe NVIDIA ConnectX-5 oraz macierz Pure Storage FlashArray//X R2 (Pure wprowadza teraz //X R3 z jeszcze większą poprawą wydajności).
W naszych testach zaobserwowaliśmy znaczący wzrost obciążeń odczytu małych i dużych bloków. Aby ocenić rzeczywisty wpływ, skupiliśmy się na nasyceniu obciążenia mniejszym niż 100%, ponieważ większość obciążeń nie w pełni nasyca platformę pamięci masowej. W naszym teście mierzącym wydajność losowego odczytu 4K, opóźnienie spadło o 21.4% przy obciążeniu 80%. Wydajność odczytu sekwencyjnego z obciążeniem 64K odnotowała ogromny wzrost przepustowości o 81.3% przy obciążeniu 80%. Zaobserwowaliśmy również spadek opóźnień o odpowiednio 43.4% i 35.7% w obciążeniach SQL 90/10 i Oracle 90/10, również przy obciążeniu 80%. Liczby te wskazują na dodatkową możliwość przeniesienia wymagających obciążeń fizycznych do VMware.
Jesteśmy przekonani, że NVMe-oF będzie kolejnym przełomem w technologii pamięci masowej i spodziewamy się, że jego popularność w centrach danych będzie szybko rosnąć. Będziemy w czołówce tej kategorii w miarę jej rozwoju w ciągu najbliższych kilku lat i z niecierpliwością czekamy na zbadanie innych i pokrewnych technologii NVMe, gdy tylko zostaną wprowadzone na rynek.
Aby uzyskać dodatkowe informacje:
Czysta pamięć masowa FlashArray//X
Niniejszy raport jest sponsorowany przez firmę NVIDIA. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej opinii na temat rozpatrywanego produktu/produktów.


 Amazon