

Świat sztucznej inteligencji rozwija się w zawrotnym tempie – mrugnij, a przegapisz kolejny postęp. Wraz ze wzrostem rozmiarów modeli, naukowcy i programiści nieustannie poszukują sposobów na poprawę wydajności i efektywności modeli AI. Jednym z najłatwiejszych sposobów osiągnięcia tego celu jest wykorzystanie wielu procesorów graficznych (GPU) lub procesorów tensorowych (TPU, więcej na ten temat w następnym odcinku) do szkolenia i wnioskowania AI.
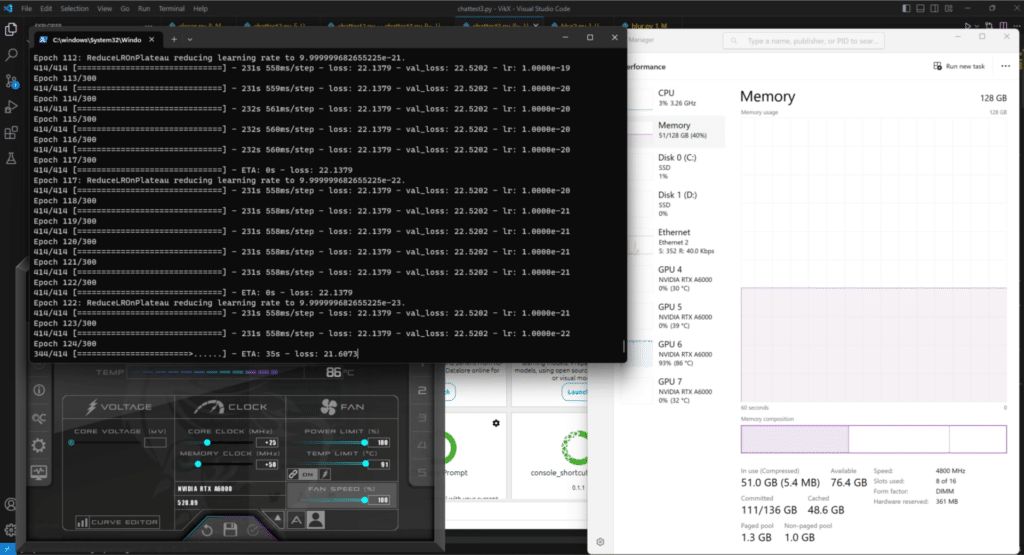
Szkolenie DNN na komputerze HP z8 G5 Fury
W ramach kontynuacji naszej ostatniej odsłony cyklu „Sztuczna inteligencja w laboratorium” dokładnie przeanalizowaliśmy i sprawdziliśmy w praktyce korzyści płynące z przejścia z używania pojedynczego procesora graficznego na stosowanie dwóch, a docelowo czterech, tych wydajnych kart w naszej stacji roboczej HP Z8 G5 Fury, ze szczególnym uwzględnieniem paralelizmu modeli PyTorch.
Siła paralelizmu modeli
Zanim przejdziemy do szczegółów, konieczne jest zrozumienie koncepcji paralelizmu. W kontekście sztucznej inteligencji (AI) paralelizm odnosi się do procesu jednoczesnego wykonywania wielu obliczeń. Jest to szczególnie przydatne w trenowaniu i wnioskowaniu sztucznej inteligencji, gdzie konieczne jest przetwarzanie dużych ilości danych. PyTorch, biblioteka uczenia maszynowego typu open source, z której korzystamy w laboratorium, oferuje paralelizm modeli, który umożliwia dystrybucję modelu AI na wielu procesorach graficznych (GPU). Prowadzi to do krótszego czasu trenowania, wydajniejszego wnioskowania oraz możliwości uruchamiania większych, bardziej złożonych modeli.
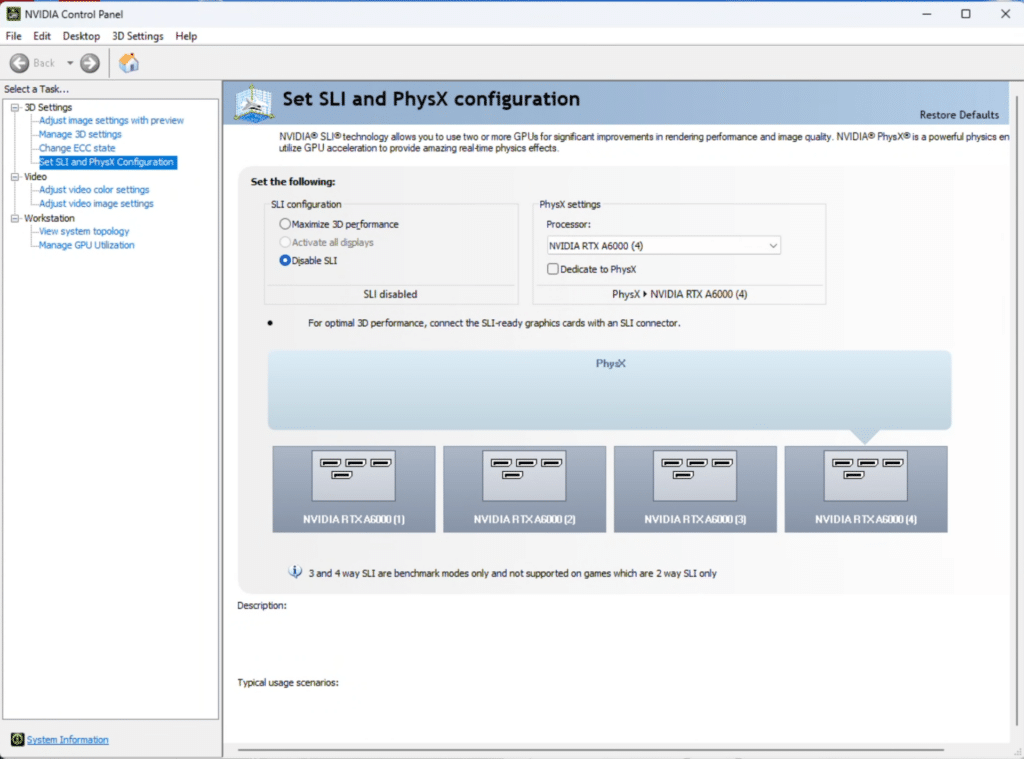
Upewnienie się, że funkcja SLI jest wyłączona, jest kluczowe
Korzyści ze skalowania
Pojedynczy GPU
Zaczynając od pojedynczego procesora graficznego (GPU), ta konfiguracja zapewnia solidną podstawę do trenowania i wnioskowania AI. Uruchomienie jednego nowoczesnego (lub nawet kilku generacji) procesora graficznego na stacji roboczej do celów programistycznych jest więcej niż wystarczające na etapie weryfikacji koncepcji (POC). Jest on w stanie obsłużyć rozsądną ilość danych i może generować zadowalające wyniki w przypadku mniejszych modeli AI. Jednak wraz ze wzrostem złożoności i rozmiaru modeli, pojedynczy procesor graficzny może szybko mieć problemy z nadążaniem, co prowadzi do wydłużenia czasu trenowania i spowolnienia wnioskowania.
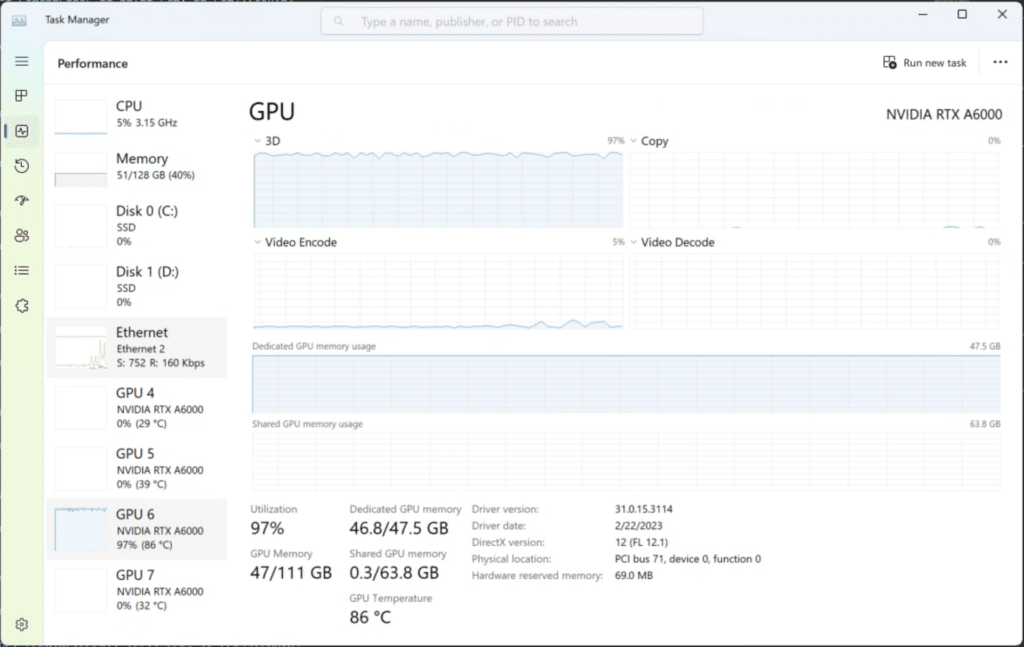
Wykorzystanie pojedynczego procesora GPU
Dwa procesory graficzne
Przejście na parę procesorów graficznych może znacząco zwiększyć wydajność modeli AI. Pomyśl tylko: dwukrotnie większa moc obliczeniowa może radykalnie skrócić czas szkolenia, torując drogę do szybszych iteracji i szybszej drogi do rezultatów.
Etap wnioskowania również odnosi korzyści, stając się bardziej wydajny i zdolny do jednoczesnego przetwarzania większych partii danych. W takim środowisku do gry wchodzi paralelizm modeli PyTorch. Efektywnie rozdziela on obciążenie między dwie jednostki, maksymalizując ich wykorzystanie. To inteligentny sposób na zapewnienie, że każdy element sprzętowy ma swoją wagę, co pozwala na osiągnięcie wysoce wydajnego działania sztucznej inteligencji.
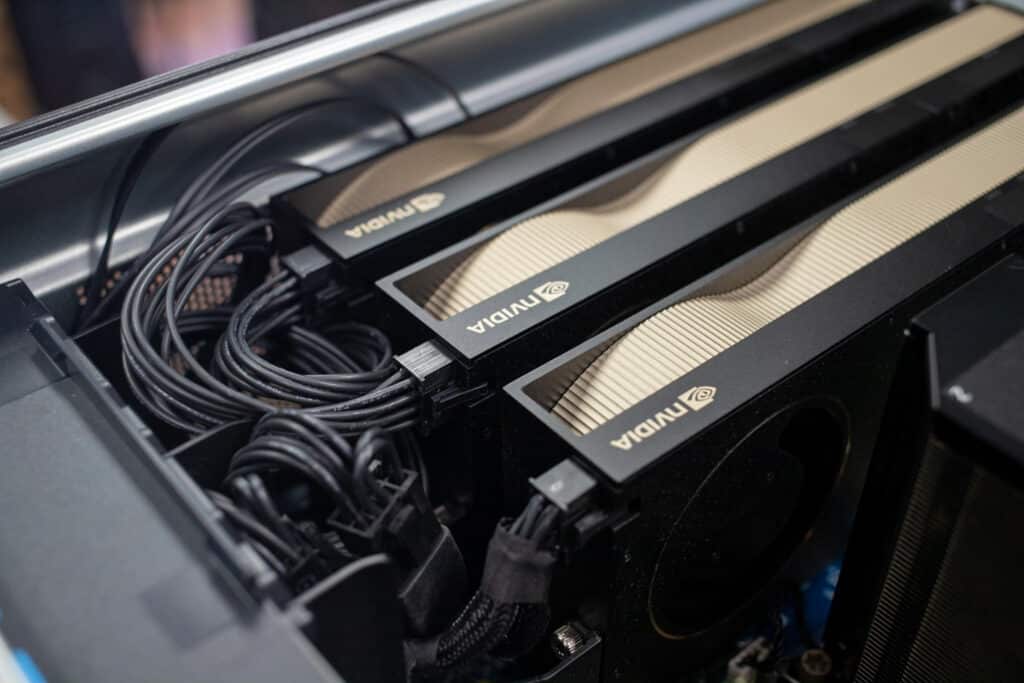
Trzy razy więcej zabawy, NVIDIA A6000
Cztery procesory graficzne
Skalowanie do czterech procesorów GPU przenosi korzyści z wykorzystania wielu procesorów GPU na zupełnie nowy poziom. Dzięki czterokrotnie większej mocy obliczeniowej, modele AI można trenować i wnioskować z niespotykaną dotąd szybkością. Taka konfiguracja jest szczególnie korzystna w przypadku dużych, złożonych modeli, wymagających znacznych zasobów obliczeniowych. Paralelizm modeli w PyTorch pozwala na rozłożenie modelu na wszystkie cztery jednostki, zapewniając optymalne wykorzystanie i wydajność.
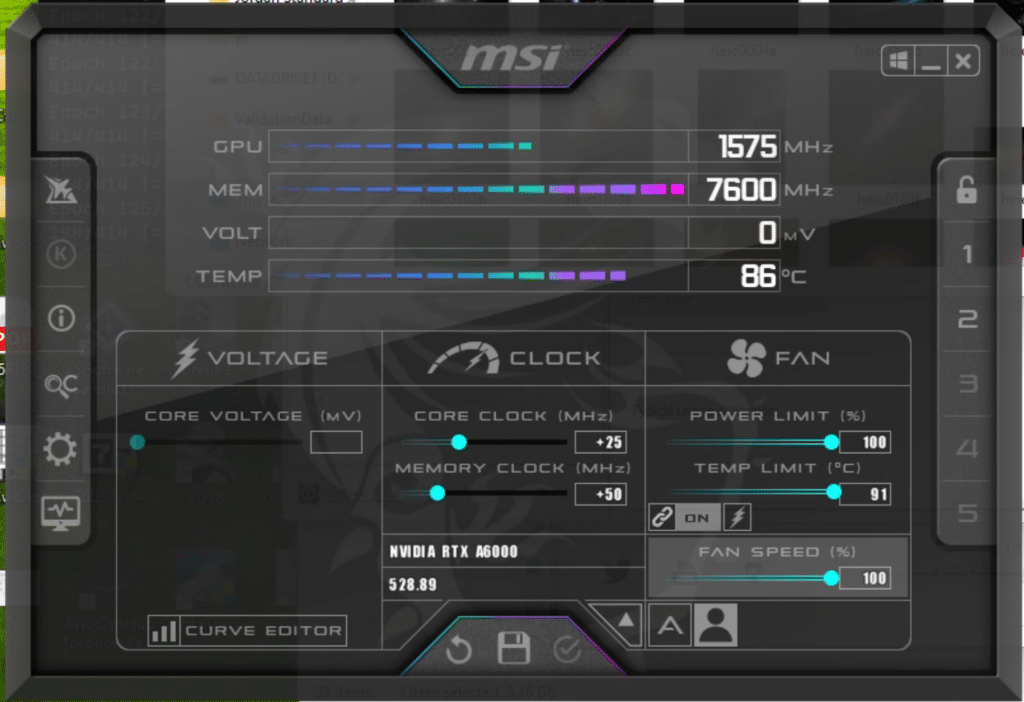
Na stanowisku roboczym ręczne wprowadzanie wartości wentylatora i zegara może również przynieść poprawę wydajności szkolenia.
Wdrożenie w laboratorium
Przejście od jednostki solo do duetu, a ostatecznie do kwartetu procesorów graficznych do szkolenia i wnioskowania AI, może przynieść znaczne korzyści. Dzięki paralelizmowi modeli w PyTorch, korzyści te można optymalnie wykorzystać, co przekłada się na szybsze i wydajniejsze modele AI.
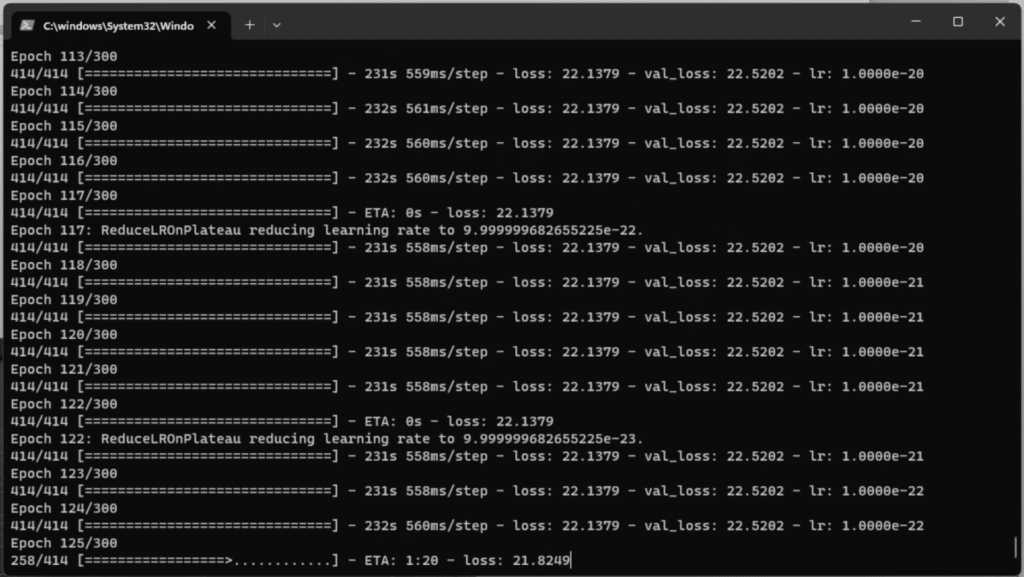
W przypadku szkoleń AI/ML/DL kluczem jest metoda prób i błędów oraz cierpliwość.
Wraz ze wzrostem naszego zapotrzebowania na bardziej złożoną i kompetentną sztuczną inteligencję, znaczenie stosowania wielu procesorów graficznych (GPU) niewątpliwie wzrośnie. W kolejnym artykule zaprezentujemy poprawę złożoności, jaką uzyskamy, dodając większą moc obliczeniową i rozdzielając ją między systemy.
Uwaga: Niniejszy artykuł opiera się na aktualnym stanie sztucznej inteligencji i platformy PyTorch z czerwca 2023 r. Aby uzyskać najbardziej aktualne informacje, zapoznaj się z naszymi najnowszymi artykułami na temat sztucznej inteligencji.


 Amazon