

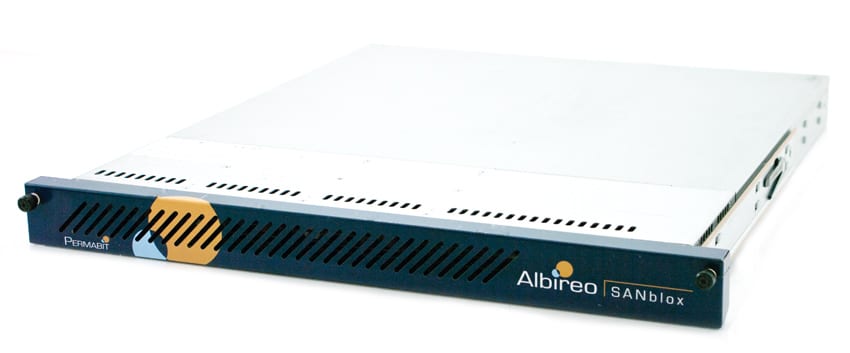
Permabit Albireo SANblox to specjalnie zaprojektowane urządzenie do redukcji danych, zaprojektowane w celu uwolnienia większej pojemności z sieci SAN Fibre Channel. Permabit szacuje, że użytkownicy odnotują co najmniej 6-krotną redukcję ilości danych przechowywanych w sieci SAN, co pozwoli inwestycjom w pamięć masową znacząco zmienić standardową ofertę wartości. SANblox oferuje deduplikację i kompresję z funkcją thin provisioning, co dodatkowo rozszerza zestaw funkcji. Cała redukcja danych odbywa się inline – urządzenie SANblox po prostu wsuwa się przed sieć SAN i wirtualizuje ją, a sieć SAN i aplikacja nie są świadome obecności rozwiązania SANblox. SANblox działa z dowolną pamięcią masową FC, niezależnie od konfiguracji dysków – dyski twarde, rozwiązania hybrydowe i all-flash odnotują taką samą redukcję ilości danych.
Sześciokrotna redukcja danych jest powszechnie uznawana za dobry wynik w przypadku standardowych, mieszanych obciążeń aplikacji korporacyjnych. Jednak w zależności od wykorzystania pamięci masowej, liczby te mogą być znacznie wyższe. Zastosowania VDI mogą znacząco zwiększyć korzyści z SANblox, a działy IT, które wykorzystują wiele kopii baz danych, na przykład do celów programistycznych, odnotują znaczną redukcję zajmowanego miejsca. W rzeczywistości, sama możliwość wyodrębnienia kopii danych do celów programistycznych może umożliwić nowe procesy biznesowe, w których koszt wdrożenia kompletnych zestawów danych mógł być wcześniej zbyt wysoki.
Firma Permabit od dawna zajmuje się deduplikacją danych. Chociaż do niedawna redukcja danych nie była szeroko popularna poza urządzeniami do tworzenia kopii zapasowych, urządzenia oparte na pamięci flash wprowadziły tę koncepcję do bardziej popularnych zastosowań. Technologia deduplikacji, na której opiera się wiele z tych urządzeń all-flash, jest najprawdopodobniej rozwiązaniem firmy Permabit. Deduplikacja nie jest jednak wszechobecna – macierze dysków twardych, a nawet większość systemów hybrydowych, po prostu nie są budowane z myślą o tej koncepcji, a nawet wiele macierzy flash oferuje ograniczony zestaw usług redukcji danych. Permabit udostępnia te usługi za pośrednictwem urządzenia SANblox, dając nowym lub istniejącym pamięciom masowym nowe możliwości.
Dysk Permabit Albireo SANblox jest już dostępny w sugerowanej cenie detalicznej, która różni się w zależności od dostawcy pamięci masowej, z którym jest sparowany, oraz od ceny promocyjnej. Oczywiście argumenty cenowe sprawdzają się najlepiej, gdy pojemność jest wystarczająco duża, aby uzyskać korzyści skali. Permabit zamieścił przykład cenowy, aby pokazać, jak tradycyjna pamięć flash wypada w porównaniu ze środowiskiem SANblox:
- Koszt 60 TB danych surowych: 720 000 USD
- Koszt po uwzględnieniu narzutu na ochronę danych: 12 USD/GB
- Koszt oszczędności pojemności SANblox 6:1: 70 000 USD
- Koszt 10 TB po uwzględnieniu kosztów ochrony danych: 120 000 USD
- Całkowity koszt przed rabatami: 190 000 USD
- Efektywny koszt za GB (pamięć masowa + sanblox) przed rabatami: 3.16 USD
- Oszczędności netto: 74%
Specyfikacje Permabit Albireo SANblox
- PROCESOR: Intel Xeon E5-1650v2
- RAM: 128 GB
- Porty FC: 4 x 16 Gb (Emulex)
- Maksymalna pojemność użytkowa: 256 TiB
- Maksymalna obsługiwana liczba jednostek LUN: 256
- Losowe wejście/wyjście (4K IOPS):
- Przeczytane: 230,000
- Napisz: 111 000
- Mieszane RW70: 180 000
- Przepustowość sekwencyjna:
- Odczyt: 1045 MB/s
- Zapis: 800 MB/s
- Minimalne opóźnienie:
- Odczyt: 300us
- Napisz: 400us
- Niezawodność: Wszystkie dane/metadane są zapisywane w pamięci masowej przed potwierdzeniem zapisu. Żadne dane nie są buforowane na serwerze SANblox.
- Dostępność: Bezproblemowa wysoka dostępność umożliwia transparentne przełączanie awaryjne w czasie krótszym niż 30 sekund.
- Łatwość serwisowania: powiadamianie SMTP i transparentne uaktualnienia oprogramowania i komponentów sprzętowych.
- Parametry fizyczne:
- Współczynnik kształtu: montaż w szafie 1U
- Szerokość: 17.2 "(437 mm)
- Waga: 38 funta (16.5 kg)
- Zasilanie:
- Napięcie: 100-240 V, 50-60 Hz
- Waty: 330
- Ampery: maks. 4.5
- Temperatura pracy: od 10°C do 35°C (od 50°F do 95°F)
- Wilgotność względna podczas pracy: od 8% do 90% (bez kondensacji)
- Dane Techniczne
- Emisje elektromagnetyczne: FCC klasa A, ICES-003, CISPR 22 klasa A, AS/NZS CISPR 22 klasa A, EN 61000-3-2/-3-3, VCCI:V-3, KN22 klasa A
- Odporność elektromagnetyczna: CISPR 24, KN 24, (EN 61000-4-2, EN 61000-4-3, EN 61000-4-4, EN 61000-4-5, EN 61000-4-6, EN 61000-4-8, EN 61000-4-11)
- Wydajność zasilacza: certyfikat 80 Plus Gold
Deduplikacja
Deduplikacja to po prostu proces zapobiegania zajmowaniu cennego miejsca w pamięci masowej przez zduplikowane dane. Różnica między zakupem urządzenia do redukcji danych przeznaczonego specjalnie do tworzenia kopii zapasowych a urządzeniem przeznaczonym do pamięci masowej może być dla niektórych kupujących myląca. Pamięć masowa z redukcją danych została zaprojektowana w celu optymalizacji wydajności w przypadku losowego dostępu do bloków danych o stałym rozmiarze. Aby osiągnąć większą wydajność, redukcja danych w pamięci masowej koncentruje się na stałych fragmentach danych, zazwyczaj na większej liczbie mniejszych bloków (jednak występują różnice w zależności od konkretnego dostawcy). Z drugiej strony urządzenie do tworzenia kopii zapasowych z deduplikacją koncentruje się bardziej na przepustowości sekwencyjnej, aby przyspieszyć procesy tworzenia kopii zapasowych i przywracania danych. Urządzenia do tworzenia kopii zapasowych z deduplikacją, dzięki swojemu sekwencyjnemu nastawieniu, są w stanie przetwarzać duże strumienie danych i zapisywać je na nośnikach o zmiennych rozmiarach fragmentów. Z jednej strony oznacza to, że urządzenie może wykorzystywać większe fragmenty, a zatem ma mniej fragmentów do śledzenia; z drugiej strony, jeśli istnieje niewielka ilość danych do odczytania, konieczne jest odczytanie całego fragmentu.
Jeśli chodzi o deduplikację, istnieją dwa główne sposoby jej przeprowadzenia: inline lub postprocessing. Deduplikacja inline oznacza po prostu, że w miarę przemieszczania się danych w kierunku celu, duplikaty są znajdowane, ale nigdy nie są zapisywane. Dzięki inline, pamięci podręczne i warstwy szybszej pamięci masowej w macierzach hybrydowych korzystają ze wzrostu efektywnej pojemności. Jest to idealne rozwiązanie zarówno pod względem oszczędności miejsca na dysku, jak i ograniczenia liczby zapisów na nośnikach flash (pamięć flash może przyjąć ograniczoną liczbę zapisów, zanim zacznie się degradować). Oprócz tych korzyści, inline umożliwia również natychmiastową replikację w celu ochrony danych. Wadą deduplikacji inline jest spadek wydajności podczas dostrajania zapisu, który jest niemal nieunikniony.
Deduplikacja poprocesowa oznacza, że proces deduplikacji rozpoczyna się po dotarciu danych do docelowego miejsca w pamięci masowej lub do pamięci podręcznej. Chociaż może to pominąć początkowy spadek wydajności w momencie zapisu, powoduje to jednak inne problemy. Po pierwsze, duplikaty, czekając na rozpoczęcie procesu deduplikacji lub na nadrobienie zaległości (jeśli proces jest stale uruchomiony), zajmują miejsce w pamięci masowej. Jeśli dane są najpierw przesyłane do pamięci podręcznej, pamięć podręczna może się szybko zapełnić. W rezultacie macierze hybrydowe mogą odnotować oszczędności pojemności tylko na najniższym poziomie. Zapisywanie wszystkiego na nośniku pamięci masowej przed deduplikacją może również znacznie obciążyć pamięć flash. I chociaż początkowy spadek wydajności może zostać pominięty, proces deduplikacji nadal będzie musiał korzystać z zasobów po rozpoczęciu przetwarzania poprocesowego.
Wydajność jest zazwyczaj największym zmartwieniem dostawców, ponieważ nie chcą oni, aby ich urządzenie działało wolniej niż konkurencyjne (mimo że będą one zużywać mniej miejsca na dysku). Spadek wydajności i ograniczenie wydajności wynikają z połączenia dostępnych zasobów, a także oprogramowania używanego w danym urządzeniu. Chociaż wydajność może również budzić obawy klientów, i to poważne, obawiają się oni również utraty danych, ponieważ proces deduplikacji zmienia sposób przechowywania danych w porównaniu z ich pierwotnym zapisem.
Gdzie zatem w tej różnicy w deduplikacji mieści się Permabit? Permabit działa przed siecią SAN i deduplikuje dane w miarę ich przemieszczania się w kierunku celu. Permabit wykorzystuje inline, wielordzeniową, skalowalną i niskonakładową metodę deduplikacji. Przyglądając się testowanemu przez nas urządzeniu, Permabit Albireo SANblox, można zauważyć, że może ono indeksować dane wymagające deduplikacji z granularnością 4K w środowisku pamięci masowej. Permabit Albireo SANblox może zatem pomieścić 256 TB przydzielonych jednostek LUN i przedstawić je jako 2.5 PB pamięci logicznej, a jednocześnie robi to w zaledwie 128 GB pamięci RAM. Pozwala to urządzeniu na zajęcie się aspektami wydajności zarówno poprzez odczytywanie mniejszych fragmentów danych, jak i mniejsze zużycie zasobów. Inną metodą rozwiązania problemu wydajności za pomocą Permabit jest osadzenie oprogramowania w urządzeniu. Permabit twierdzi, że klienci korzystający z tej metody zaobserwowali wydajność przekraczającą 600 000 IOPS.
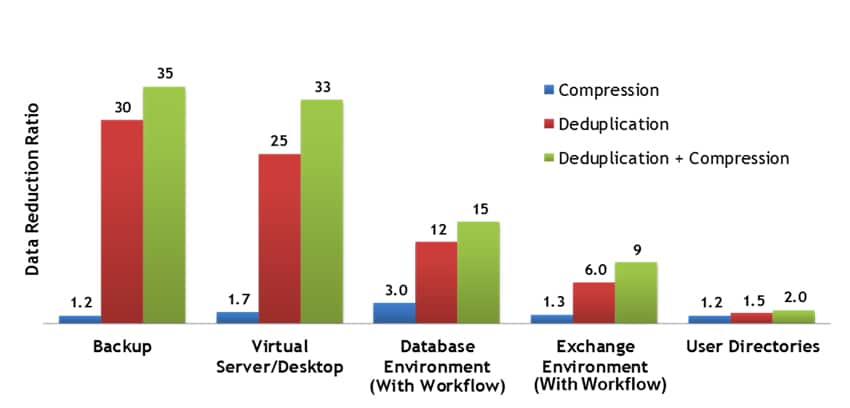
Każdej firmie łatwo jest powiedzieć, że jej urządzenie (w tym przypadku deduplikacja) jest znakomite w tym, co robi. Zawsze jednak lepiej jest przedstawić dowód w kontekście zrozumiałym dla klientów i dostawców, którzy chcą połączyć Permabit ze swoimi urządzeniami SAN. Kilka lat temu Permabit przeprowadził badanie z Enterprise Strategy Group (ESG). W badaniu przeanalizowano współczynnik redukcji danych w różnych środowiskach i porównano samą kompresję, samą deduplikację oraz kompresję i deduplikację łącznie.
Instalacja i konfiguracja
Urządzenie SANblox to serwer 1U, który zasadniczo włącza się do ścieżki danych dla jednostek LUN, przez które są kierowane. Oczywiście nie wszystkie jednostki LUN muszą przechodzić przez SANblox. Jednostki SANblox są zazwyczaj wdrażane w parach HA, a w zależności od potrzeb lub możliwości bazowej pamięci masowej, można użyć wielu par HA, aby spełnić dowolne wymagania dotyczące pamięci masowej lub wydajności.
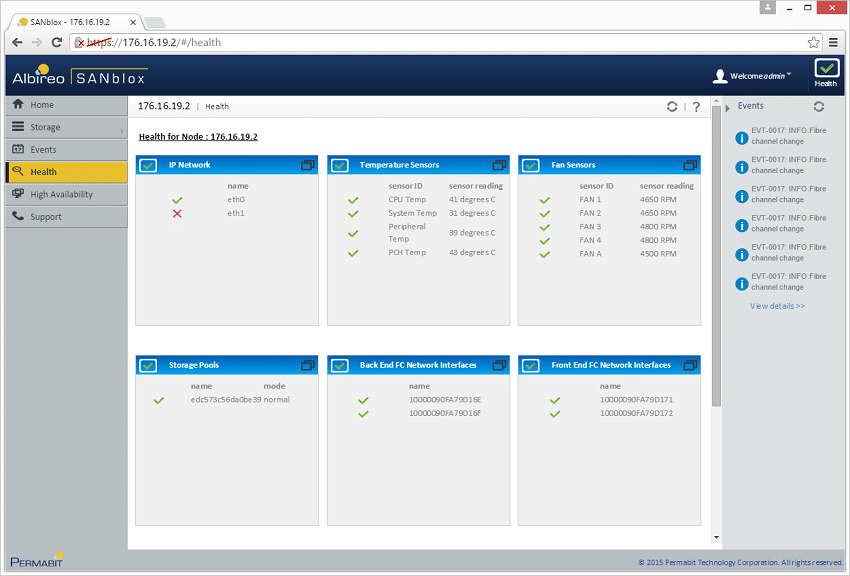
Uruchomienie SANblox jest dość szybkie i proste. Systemowi przypisuje się dwa adresy IP: jeden dla IPMI, a drugi dla interfejsu zarządzania siecią i SSH. Po uruchomieniu systemu pobiera się nazwy WWN dwóch portów FC zaplecza (tych, które będą łączyć się z systemem pamięci masowej) i używa się ich do utworzenia oddzielnej strefy FC.
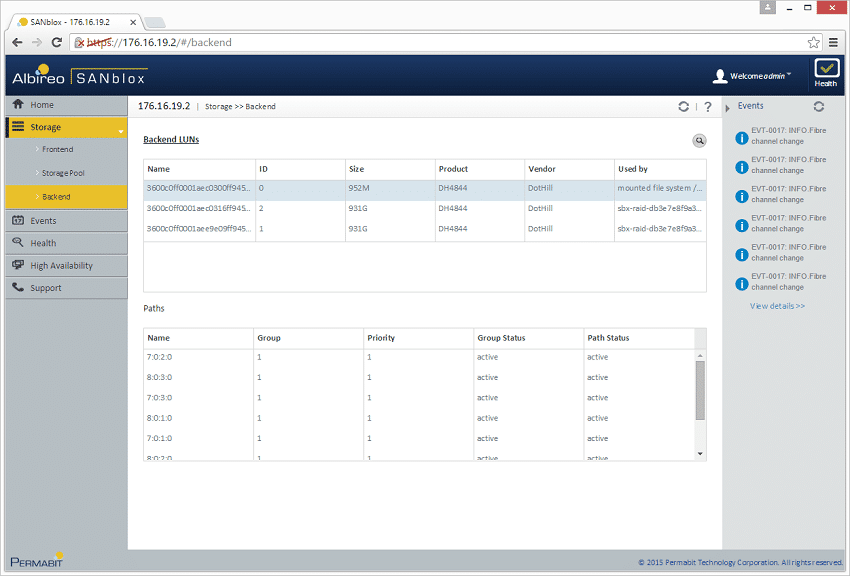
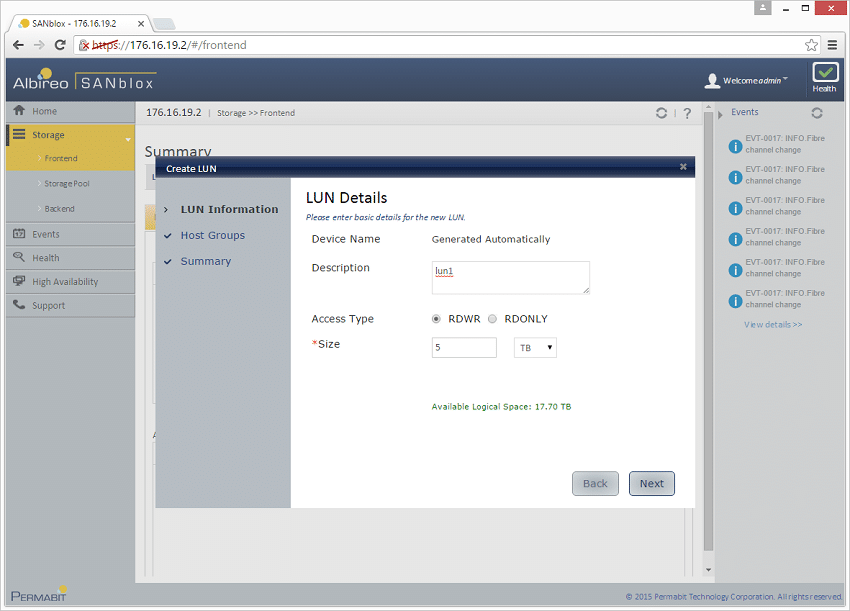
Na poziomie macierzy konfigurujesz pamięć masową, tak aby mieć jedną jednostkę LUN o pojemności 1 GB na ustawienia urządzenia i wiele jednostek LUN na główny magazyn danych. Wszystkie metadane są również przechowywane na tych woluminach. SANblox nie utrwala żadnych danych w urządzeniu, co jest możliwe dzięki jego synchronicznej, inline’owej funkcjonalności. W przykładowych zrzutach ekranu wykorzystaliśmy naszą macierz DotHill Ultra48, konfigurując jedną jednostkę LUN o pojemności 1 GB na ustawienia SANblox i dwie jednostki LUN o pojemności 1 TB na pulę pamięci masowej SANblox.
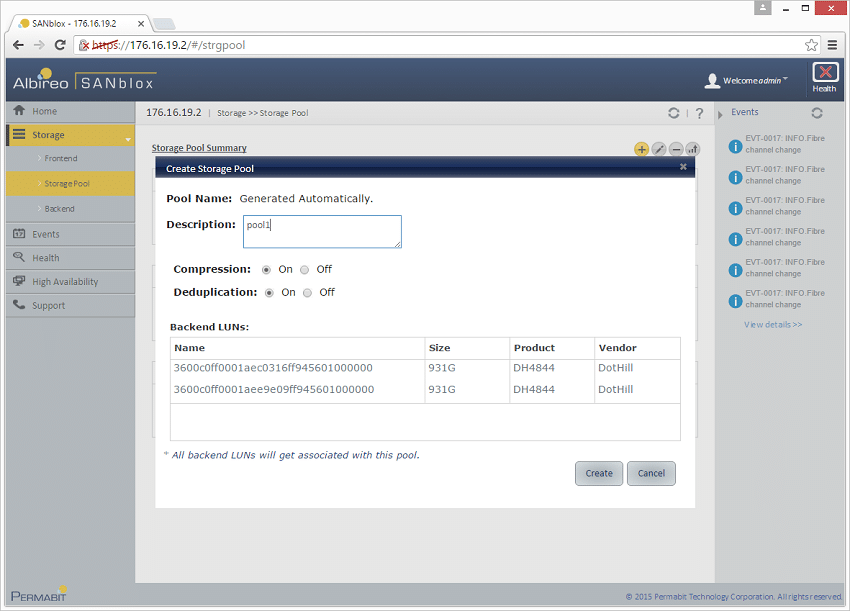
Po skonfigurowaniu pamięci masowej SANblox automatycznie wykrywa i konfiguruje się, korzystając z jednostki LUN o pojemności 1 GB do ustawień urządzenia, a także przegląda pozostałe jednostki LUN w celu utworzenia puli pamięci masowej. W tym przypadku grupuje je wszystkie podczas tworzenia puli i pozwala wybrać, czy deduplikacja ma być włączona, czy wyłączona, a także czy ma być włączona, czy wyłączona kompresja.
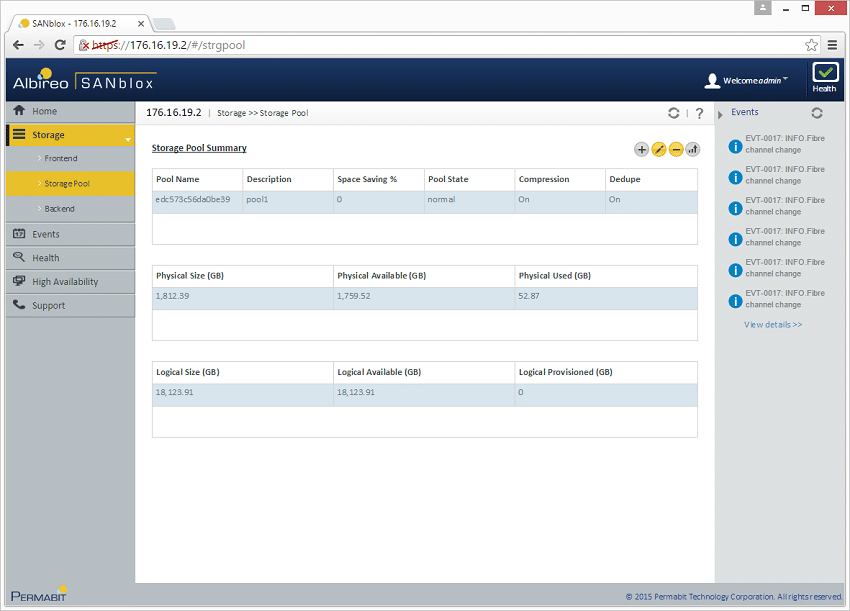
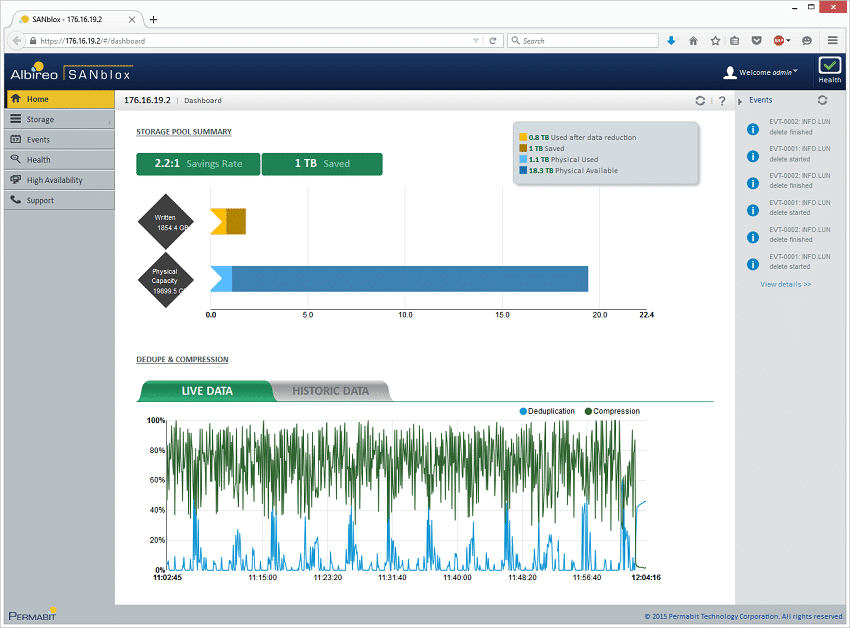
Po utworzeniu puli, Permabit SANblox domyślnie pozwala użytkownikom na adresowanie fizycznej pamięci masowej z logicznym rozmiarem adresowalnym 10:1. Zatem 1 TB przestrzeni surowej staje się 10 TB przestrzeni użytkowej podczas tworzenia woluminów. W naszym przypadku 1.8 TB przestrzeni surowej zostało zmapowane jako 18 TB przestrzeni użytkowej, którą mogliśmy przypisać.
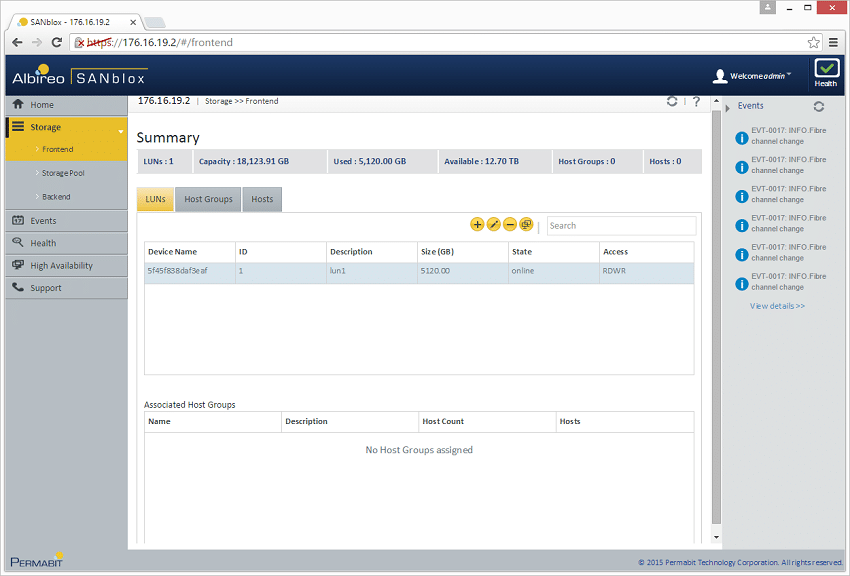
Po uporządkowaniu podstawowej pamięci masowej, reszta interfejsu działa podobnie jak w przypadku podstawowej macierzy pamięci masowej. Można tworzyć jednostki LUN, przypisywać je do hostów lub grup hostów, a także definiować reguły, takie jak dostęp tylko do odczytu lub dostęp do odczytu i zapisu.
Wydajność
Nie wszystkie wydajne pamięci masowe oferują deduplikację. Dobrym przykładem jest rodzina macierzy flash X-IO ISE G3, a niedawno testowana macierz X-IO ISE 860 została zaprojektowana głównie z myślą o wydajności. X-IO świadomie zdecydowało się nie nakładać zbyt wielu funkcji, które wymagają więcej pamięci RAM i procesora, jednocześnie zmniejszając zdolność macierzy do zapewnienia najwyższej wydajności. Należy jednak pamiętać, że istnieją przypadki użycia, w których aplikacje muszą wybierać między wydajnością a pojemnością, a przy wciąż stosunkowo wysokim koszcie pamięci flash w przeliczeniu na TB, deduplikacja może znacząco wpłynąć na ekonomikę wydajnej pamięci masowej, rozwiązując problem kosztów i zachowując wysoką wydajność. W tym kontekście wdrożyliśmy SANblox przed ISE 860, aby ocenić jego możliwości. Skupiając się na wpływie deduplikacji na wydajność aplikacji, wykorzystaliśmy nasze środowiska testowe Microsoft SQL Server, MySQL Sysbench i VMware VMmark do obciążenia pojedynczego urządzenia SANblox. Każdy z tych testów działa z wykorzystaniem wielu jednoczesnych obciążeń obciążających daną macierz pamięci masowej w tym samym czasie, co zapewnia systemowi redukcji danych, takiemu jak Permabit SANblox, fantastyczną możliwość ograniczenia rozmiaru danych wdrożonego obciążenia.
Ważnym elementem, który należy zrozumieć w kontekście deduplikacji i wydajności, jest to, że zmniejszając ilość danych, zwiększamy również obciążenie we/wy pamięci masowej back-end. Przepustowość w wielu przypadkach może zostać zmniejszona, ponieważ przesyła się znacznie mniej danych niż wcześniej, ale liczba losowych żądań we/wy dla małych bloków znacznie wzrasta. To jeden z powodów, dla których odzyskiwanie danych (DR) i pamięć flash mogą tak dobrze ze sobą współgrać, ale oznacza to również, że w pewnych scenariuszach nadal będzie można nasycić pamięć masową back-end. Na szczęście opatentowana technologia SANblox minimalizuje narzuty związane z redukcją danych, pozostawiając miejsce na skalowanie lub natywne wykorzystanie macierzy dla innych aplikacji. W przypadku dużych środowisk lub platform o dużym potencjale we/wy użytkownicy mogą skalować liczbę urządzeń SANblox w celu zwiększenia wydajności i pojemności. Chociaż otrzymaliśmy do recenzji jedno urządzenie, prawdopodobnie zaobserwowalibyśmy wyższą wydajność, gdyby dwie pary pracowały razem, a nie tylko jedno.
Protokół testowania OLTP dla Microsoft SQL Server firmy StorageReview wykorzystuje aktualną wersję roboczą testu Benchmark C (TPC-C) opracowanego przez Transaction Processing Performance Council – internetowego testu porównawczego przetwarzania transakcji, który symuluje działania występujące w złożonych środowiskach aplikacji. Test TPC-C jest bliższy niż syntetyczne testy wydajnościowe, mierząc mocne strony i wąskie gardła infrastruktury pamięci masowej w środowiskach baz danych.
W tym teście wykorzystano SQL Server 2014 działający na gościnnych maszynach wirtualnych z systemem Windows Server 2012 R2, testowany przez program Dell Benchmark Factory for Databases. Podczas gdy tradycyjnie testowaliśmy ten test w dużych bazach danych o skali 3,000 w pamięci lokalnej lub współdzielonej, w tej iteracji skupiamy się na równomiernym rozmieszczeniu czterech baz danych o skali 1,500 w naszym systemie X-IO ISE 860, aby lepiej zilustrować łączną wydajność w 4-węzłowym klastrze VMware.
Druga generacja SQL Server OLTP Benchmark Factory LoadGen Equipment
- Hosty klientów wirtualnych Dell PowerEdge R730 VMware ESXi vSphere (2)
- Cztery procesory Intel E5-2690 v3 o taktowaniu 124 GHz w klastrze (dwa na węzeł, 2.6 GHz, 12 rdzeni, pamięć podręczna 30 MB)
- 512 GB pamięci RAM (256 GB na węzeł, 16 GB x 16 DDR4, 128 GB na procesor)
- Rozruch z karty SD (Lexar 16 GB)
- 2 x adapter Mellanox ConnectX-3 InfiniBand (vSwitch dla vMotion i sieci VM)
- 2 x Karta HBA FC Emulex 16 GB z dwoma portami
- 2 x Karta sieciowa dwuportowa Emulex 10GbE
- VMware ESXi vSphere 6.0 / Enterprise Plus 4-CPU
- Klaster SQL zwirtualizowany Dell PowerEdge R730 z 4 węzłami
- Osiem procesorów Intel E5-2690 v3 o taktowaniu 249 GHz w klastrze (dwa na węzeł, 2.6 GHz, 12 rdzeni, pamięć podręczna 30 MB)
- 1 TB pamięci RAM (256 GB na węzeł, 16 GB x 16 DDR4, 128 GB na procesor)
- Rozruch z karty SD (Lexar 16 GB)
- 4 x adapter Mellanox ConnectX-3 InfiniBand (vSwitch dla vMotion i sieci VM)
- 4 x Karta HBA FC Emulex 16 GB z dwoma portami
- 4 x Karta sieciowa dwuportowa Emulex 10GbE
- VMware ESXi vSphere 6.0 / Enterprise Plus 8-CPU
Każda maszyna wirtualna SQL Server jest skonfigurowana z dwoma dyskami wirtualnymi: jednym o pojemności 100 GB do rozruchu i jednym o pojemności 500 GB na bazę danych i pliki dziennika. Z perspektywy zasobów systemowych, skonfigurowaliśmy każdą maszynę wirtualną z 16 procesorami wirtualnymi, 64 GB pamięci DRAM i wykorzystaliśmy kontroler LSI Logic SAS SCSI.
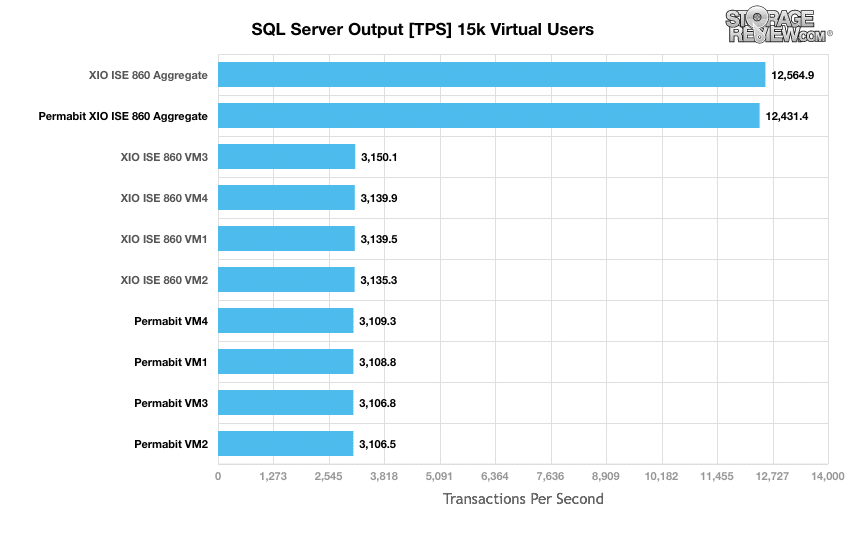
Patrząc na zmianę wydajności TPS przy uruchamianiu obciążenia SQL TPC-C na X-IO ISE 860 i na Permabit SANblox, spadek był stosunkowo niewielki i wyniósł 12 564 do 12 431 TPS.
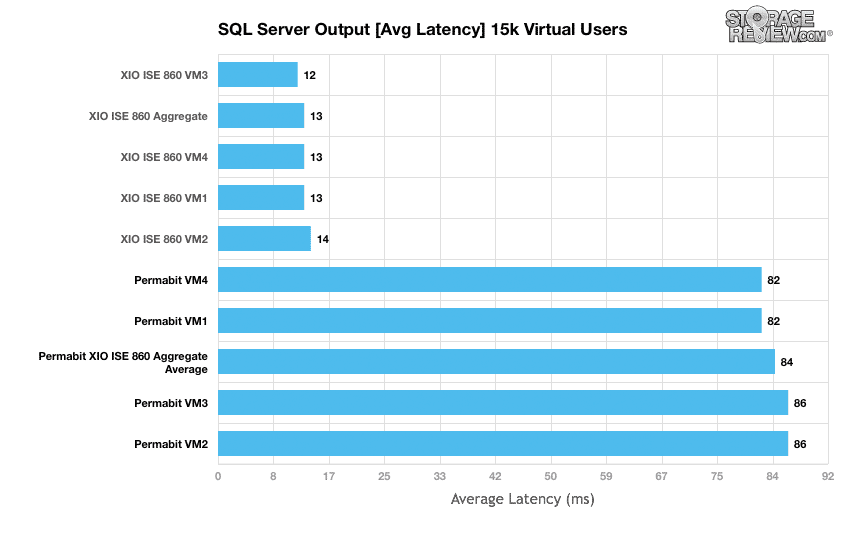
Przenosząc uwagę z wydajności transakcyjnej na opóźnienie, dostrzegamy jednak wpływ redukcji danych na nasze obciążenie. Przy obciążeniach działających przez SANblox, opóźnienie wzrosło ze średnio 13 ms do średnio 84 ms; skok nieco poniżej 5.5x. Permabit wyjaśnił, że możemy zbliżać się do maksymalnego obciążenia pojedynczej pary SANblox i że nieznaczne zmniejszenie obciążenia lub dodanie drugiego SANblox mogłoby znacząco zmniejszyć średnie opóźnienie.
Benchmark Sysbench OLTP działa na bazie Percona MySQL, wykorzystując silnik pamięci masowej InnoDB działający w instalacji CentOS. Aby dostosować nasze testy tradycyjnej sieci SAN do nowszych, hiperkonwergentnych urządzeń, przenieśliśmy wiele naszych testów do większego, rozproszonego modelu. Główna różnica polega na tym, że zamiast uruchamiać jeden test na serwerze fizycznym, uruchamiamy teraz wiele instancji tego testu w środowisku zwirtualizowanym. W tym celu wdrożyliśmy 4 i 8 maszyn wirtualnych Sysbench na platformie X-IO ISE 860, po 1-2 na węzeł, i zmierzyliśmy całkowitą wydajność klastra, działając jednocześnie. Przedstawiliśmy na wykresie, jak 4 i 8 maszyn wirtualnych działało zarówno na macierzy flash w stanie surowym, jak i za pośrednictwem Permabit SANblox.
Klaster Sysbench zwirtualizowany Dell PowerEdge R730 z 4 węzłami
- Osiem procesorów Intel E5-2690 v3 o taktowaniu 249 GHz w klastrze (dwa na węzeł, 2.6 GHz, 12 rdzeni, pamięć podręczna 30 MB)
- 1 TB pamięci RAM (256 GB na węzeł, 16 GB x 16 DDR4, 128 GB na procesor)
- Rozruch z karty SD (Lexar 16 GB)
- 4 x adapter Mellanox ConnectX-3 InfiniBand (vSwitch dla vMotion i sieci VM)
- 4 x Karta HBA FC Emulex 16 GB z dwoma portami
- 4 x Karta sieciowa dwuportowa Emulex 10GbE
- VMware ESXi vSphere 6.0 / Enterprise Plus 8-CPU
Każda maszyna wirtualna Sysbench jest skonfigurowana z trzema dyskami wirtualnymi: jednym do rozruchu (~92 GB), jednym z predefiniowaną bazą danych (~447 GB) i trzecim na bazę danych, którą będziemy testować (400 GB). Z perspektywy zasobów systemowych, każdą maszynę wirtualną skonfigurowaliśmy z 16 procesorami wirtualnymi, 64 GB pamięci DRAM i wykorzystaliśmy kontroler LSI Logic SAS SCSI.
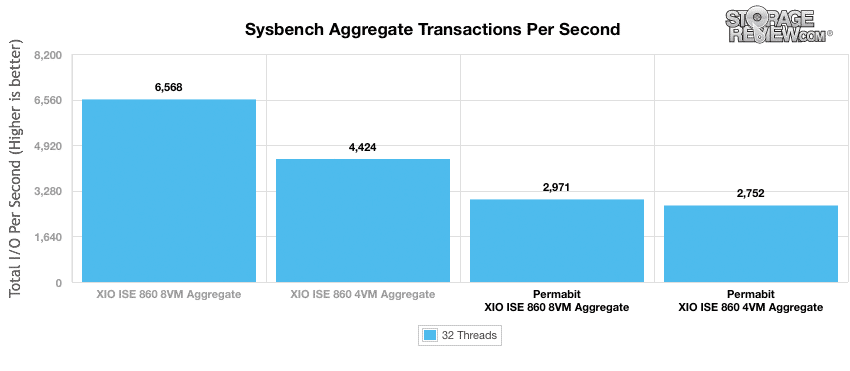
Nasz test Sysbench mierzy średnią liczbę transakcji na sekundę (TSP), średnie opóźnienie, a także średnie opóźnienie 99. percentyla przy szczytowym obciążeniu 32 wątków.
Przy natywnym uruchomieniu Sysbencha na platformie X-IO ISE 860 z obciążeniem 8 maszyn wirtualnych, zmierzyliśmy łączną wartość 6,568 TPS w całym klastrze. Po dodaniu SANblox, wartość ta spadła do 2,971 TPS. Przy obciążeniu 4 maszyn wirtualnych spadek był mniejszy – z 4,424 TPS do 2,752 TPS. W obu przypadkach obciążenie związane z obsługą urządzenia do redukcji danych stanowiło odpowiednio 55% i 38%. Jednak jednym z kluczowych aspektów jest to, że wartość ta nie wpływa bezpośrednio na jednostki LUN obsługiwane przez macierz pamięci masowej. Jako system zewnętrzny, użytkownicy mogą zdecydować się na kierowanie ruchu o wyższym priorytecie do samej macierzy, aczkolwiek bez korzyści finansowych związanych z redukcją danych.
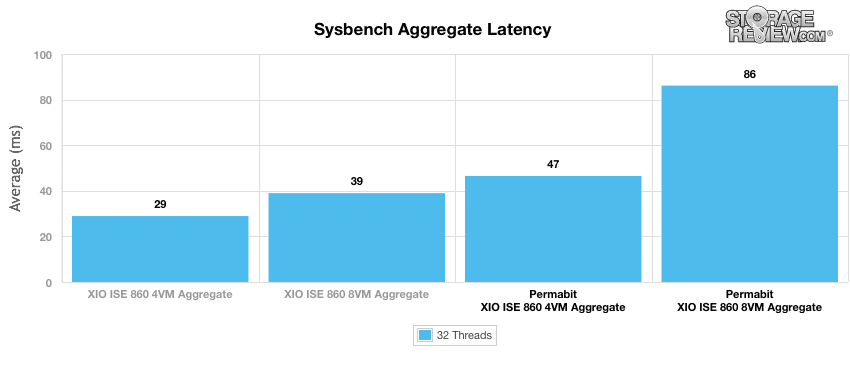
Porównując średnie opóźnienia w naszych konfiguracjach, zaobserwowaliśmy wzrost średniego opóźnienia 4 maszyn wirtualnych z 29 do 47 ms, natomiast średnie opóźnienie 8 maszyn wirtualnych zwiększyło się z 39 do 86 ms.
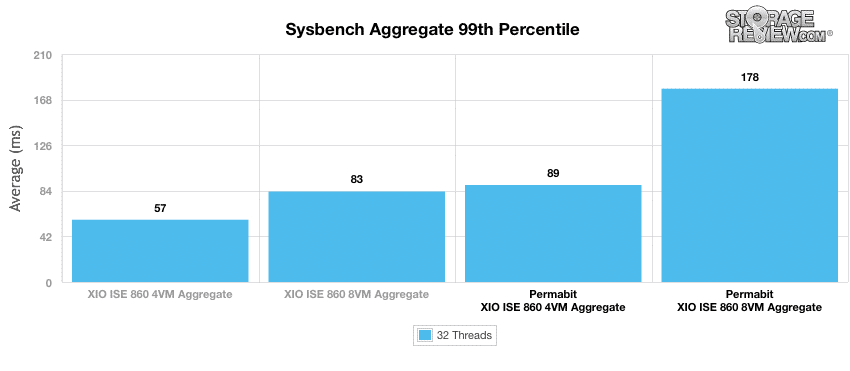
Analizując opóźnienie na poziomie 99. percentyla po dodaniu serwera SANblox do naszego środowiska, zaobserwowaliśmy wzrost z 57 do 89 ms przy 4 maszynach wirtualnych i z 83 do 178 ms przy 8 maszynach wirtualnych.
Analiza wydajności VMmark
Podobnie jak w przypadku wszystkich naszych analiz wydajności aplikacji, staramy się pokazać, jak produkty działają w rzeczywistym środowisku produkcyjnym w porównaniu z deklaracjami firmy dotyczącymi wydajności. Rozumiemy wagę oceny pamięci masowej jako elementu większych systemów, a przede wszystkim jej responsywności w interakcji z kluczowymi aplikacjami korporacyjnymi. W tym teście wykorzystujemy benchmark wirtualizacji VMmark firmy VMware w środowisku wieloserwerowym.
VMmark, ze względu na swoją konstrukcję, jest testem porównawczym o dużej intensywności zasobów, z szerokim spektrum obciążeń aplikacji opartych na maszynach wirtualnych, obciążających pamięć masową, sieć i zasoby obliczeniowe. Jeśli chodzi o testowanie wydajności wirtualizacji, nie ma praktycznie lepszego testu porównawczego, ponieważ VMmark analizuje tak wiele aspektów, obejmujących wejście/wyjście pamięci masowej, procesor, a nawet wydajność sieci w środowiskach VMware.
Specyfikacje klastra VMware VMmark 4-węzłowego Dell PowerEdge R730
- Serwery Dell PowerEdge R730 (x4)
- Procesory: osiem Intel Xeon E5-2690 v3 2.6 GHz (12 rdzeni/24 wątki)
- Pamięć: 64 x 16 GB DDR4 RDIMM
- Emulex LightPulse LPe16002B 16 Gb FC Dual-Port HBA
- Karta sieciowa Emulex OneConnect OCe14102-NX 10 Gb Ethernet Dual-Port
- VMware ESXi 6.0
ISE 860 G3 (20 dysków SSD o pojemności 1.6 TB na DataPac)
- Przed RAID-em: 51.2 TB
- Pojemność RAID 10: 22.9 TB
- Pojemność RAID 5: 36.6 TB
- Cena katalogowa: 575,000$
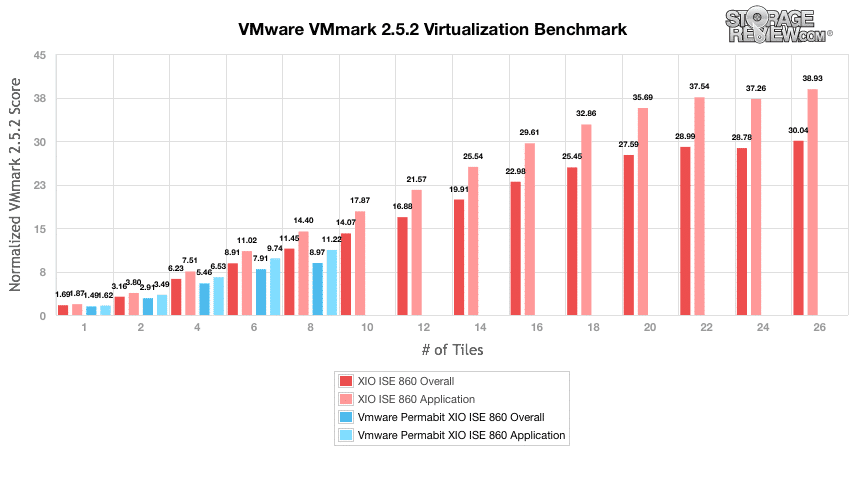
Konfigurując macierz SANblox Permabit do testów z narzędziem VMmark firmy VMware, zoptymalizowaliśmy sposób dystrybucji danych. Tradycyjnie, w przypadku danej macierzy, maszyny wirtualne są wdrażane w konfiguracji „wszystko albo nic”, co oznacza, że dane są w całości przenoszone na testowaną macierz pamięci masowej. Dzięki macierzy SANblox, jej unikalnemu umiejscowieniu przed urządzeniem pamięci masowej, mogliśmy wykorzystać ją bezpośrednio do obsługi niektórych obciążeń wymagających dużej ilości danych, a także za jej pośrednictwem do obsługi większości dysków systemu operacyjnego i obciążeń VMmark, gdzie oszczędności wynikające z deduplikacji były największe. W naszej konkretnej konfiguracji przenieśliśmy wszystkie maszyny wirtualne na macierz SANblox, z wyjątkiem indywidualnych wirtualnych dysków pocztowych Mailserver o pojemności 40 GB, które umieściliśmy bezpośrednio na platformie X-IO ISE 860.
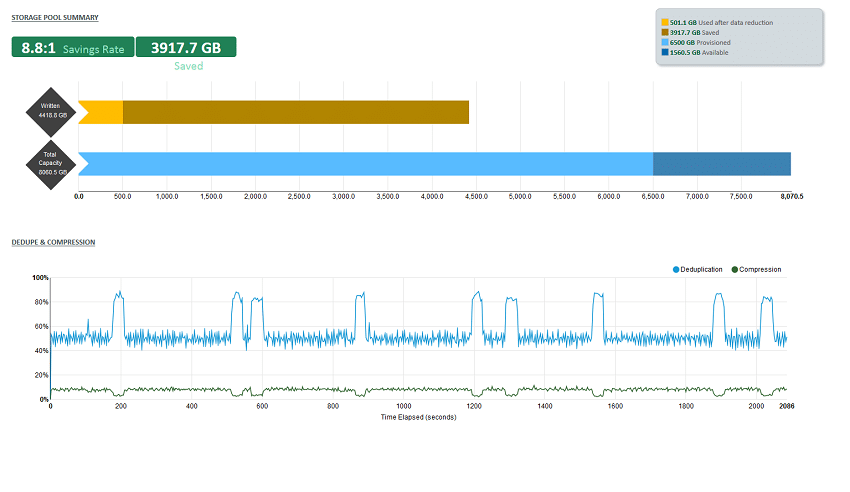
Dzięki naszej zoptymalizowanej konfiguracji udało nam się osiągnąć łącznie 8 kafelków z VMmark, wykorzystując Permabit SANblox przed X-IO ISE 860. Dla porównania, wcześniej zmierzyliśmy szczytową liczbę 26 kafelków hostowanych bezpośrednio na macierzy. Z punktu widzenia wydajności, uruchomienie naszego obciążenia przez SANblox wiązało się z narzutem na poziomie 70%. Jednak pod względem redukcji danych, zajęte miejsce pozostało na niezmienionym poziomie 1 kafelka. Migracja kolejnych kafelków do macierzy nie miała znaczącego wpływu na zajęte miejsce. Jest to jeden ze scenariuszy, w którym posiadanie drugiej pary urządzeń SANblox o wysokiej dostępności (HA) poprawiłoby ogólną wydajność.
Wniosek
Permabit Albireo SANblox to łatwe we wdrożeniu urządzenie, które oferuje ogromne korzyści, znacząco redukując ilość danych w organizacji. Permabit twierdzi, że Albireo SANblox można zainstalować przed dowolną siecią SAN Fibre Channel, co pozwala klientom zaobserwować nawet 6-krotną redukcję ilości danych. Cała redukcja danych odbywa się w trybie on-line, bez wiedzy sieci SAN o jej obecności. Oprócz typowej 6-krotnej redukcji danych, SANblox oferuje również funkcję thin provisioning i kompresję. Permabit to znana i ceniona marka w dziedzinie deduplikacji, która może pomóc klientom dostrzec potencjalne, znaczne redukcje ilości danych w zależności od obciążenia.
Na pierwszy rzut oka deduplikacja brzmi wspaniale. Organizacje mogą w pełni wykorzystać zakupioną pamięć masową, zamiast pozwolić jej zapełnić się duplikatami, a nawet starsze dyski mogą zyskać nowe życie. Fakt, że Permabit Albireo SANblox działa niezależnie od konfiguracji, to kolejny argument przemawiający za jej rozważeniem. Największą wadą deduplikacji jest spadek wydajności, który w niektórych przypadkach może być dość znaczący. Zamiast traktować to jako czynnik wykluczający, potencjalni klienci powinni zdać sobie sprawę, że chociaż wydajność w porównaniu z macierzami all-flash jest niższa, to i tak jest ona szybsza niż tradycyjne macierze dyskowe HDD z podobnej półki cenowej.
Jeśli ultrawysoka wydajność i wyjątkowo niskie opóźnienia są bardziej potrzebne niż wykorzystanie całej inwestycji w pamięć masową, należy pominąć deduplikację. Jeśli jednak przedsiębiorstwo jest w stanie znieść spadek wydajności i nadal funkcjonować w ramach zdefiniowanych parametrów, to zdecydowanie powinno rozważyć urządzenie takie jak Permabit Albireo SANblox. Istnieje również kompromis – trzecią opcją byłoby przesyłanie danych mniej krytycznych pod względem wydajności (takich jak dane programistyczne) przez SANblox, a jednocześnie przepuszczanie danych produkcyjnych bez deduplikacji. Podobne podejście należy zastosować do analizy wyników wydajności. Porównanie nie polega na „zobaczeniu, o ile lepiej działa X-IO bez SANblox”, a raczej na przedstawieniu rodzaju wydajności, jakiej można oczekiwać po zastosowaniu deduplikacji w sieci SAN.
Jak wspomniano, dodanie urządzenia do stosu pamięci masowej zależy od wielu czynników. Ostatecznie Permabit oferuje rozszerzenie pojemności pamięci masowej i jej żywotność, zwłaszcza tam, gdzie obciążenia nie wymagają dużej wydajności. W dzisiejszym środowisku IT, gdzie zadania takie jak tworzenie baz danych na potrzeby rozwoju oprogramowania stają się standardem, SANblox umożliwia to bez obciążenia danymi. Integracja z systemem przedsiębiorstwa jest również prosta, a w razie konieczności dostrojenia i dostosowania, urządzenie to umożliwia.
ZALETY
- Prosta integracja z architekturą pamięci masowej
- Zgodny z nowoczesnymi praktykami rozwoju
- Można włączać/wyłączać za pomocą LUN
Wady
- Deduplikacja wiąże się z narzutem, a aplikacje wrażliwe na opóźnienia mogą wymagać ominięcia urządzenia
Podsumowanie
Permabit Albireo SANblox łatwo integruje się z istniejącymi systemami i przeprowadza redukcję danych inline, umożliwiając organizacjom pełne wykorzystanie potencjału inwestycji w pamięć masową. Redukcję danych można włączyć lub wyłączyć, a także zastosować ją tylko do wybranych obciążeń, aby zmaksymalizować zarówno wydajność, jak i pojemność.
Strona produktu Permabit Albireo SANblox
Omów tę recenzję



 Amazon