

W listopadzie uczestniczyliśmy w Międzynarodowej Konferencji 2017 poświęconej wysokowydajnym obliczeniom, sieciom, pamięci masowej i analizie danych – lepiej znanej jako 2017 Supercomputing Conference (SC17). Co roku podczas konferencji Supercomputing Conference naukowcy i dostawcy z uczelni i przemysłu tworzą SCinet: superkomputer i infrastrukturę sieciową, która służy jako poligon doświadczalny i dowód słuszności koncepcji dla nowych technologii wysokowydajnych obliczeń, sieci i pamięci masowej. Premio jest jednym z dostawców, którzy wnieśli sprzęt i wiedzę specjalistyczną na konferencję SCinet 2017 w postaci dwóch obudów węzłów danych FlacheSAN1N4C-D4, z których każdy zapewniał stałą przepustowość odczytu do 24 GB/s (168 Gb/s) i do 3.6 mln operacji wejścia/wyjścia na sekundę (IOPS). Dzięki temu SCinet mógł przesyłać duże zbiory danych z dużą prędkością pamięci podręcznej.
Węzły Premio FlacheSAN pełniły kilka odrębnych funkcji podczas konferencji Supercomputing Conference 2017, w tym punkt testowy dla dużych projektów transferu danych, platformę dla projektów o dużym przepływie oraz eksperymentalnego dostawcę usług sieciowych odpornych na opóźnienia i zakłócenia dla konferencji SC i sieci WAN SCinet. Ta pierwsza rola jest prawdopodobnie najważniejsza dla obserwatorów branży, takich jak my, którzy w tym roku analizowali SCinet pod kątem wskazówek dotyczących przyszłości technologii transferu dużych danych.
SCinet ma ugruntowaną pozycję w zakresie demonstracji technologii sieciowych, które następnie weszły na rynek technologii informatycznych dla przedsiębiorstw, takich jak Asynchronous Transfer Mode, Fiber Distributed Data Interface oraz High Performance Parallel Interface (HiPPi). Podczas konferencji SC17 Brian Beeler, redaktor naczelny StorageReview, rozmawiał z członkami zespołu badawczego Uniwersytetu Northwestern, który pracuje z dyskiem FlacheSAN1N4C-D4. Poza samą konferencją Supercomputing Conference, dysk FlacheSAN1N4C-D4 firmy Premio jest wykorzystywany do migracji petabajtowych zbiorów danych z Wielkiego Zderzacza Hadronów w CERN, w trakcie przenoszenia danych z pierwszego poziomu CERN w Chicago w stanie Illinois do Caltech w Pasadenie w Kalifornii.
Sektor pamięci masowych dla przedsiębiorstw od lat pracuje nad tym, aby sprostać stale rosnącej ilości generowanych i przetwarzanych danych. Jednym z wyzwań, które nabiera obecnie coraz większego znaczenia, jest potrzeba szybkiego i płynnego przesyłania ogromnych ilości danych. W przyszłości coraz powszechniejsze stanie się przesyłanie dużych zbiorów danych na duże odległości geograficzne, między różnymi platformami, w sposób umożliwiający radzenie sobie z opóźnieniami i innymi zakłóceniami, które są nieodłączną cechą złożonego i masowego przesyłu danych. W tym kontekście SCinet zajmuje się obecną rzeczywistością transferu danych, z którą przedsiębiorstwa będą musiały się zmierzyć za pięć do dziesięciu lat.
Przykładem może być projekt badawczy Caltech, w którym eksperyment w ramach Wielkiego Zderzacza Hadronów (Large Hadron Collider) może z łatwością generować surowe dane z czujników o wielkości około 25 petabajtów, które następnie są przekazywane do analizy afiliowanym instytucjom badawczym na całym świecie. W rzeczywistości to ograniczenia obliczeniowe, sieciowe i pamięci masowej okazały się kluczowymi wąskimi gardłami ograniczającymi tempo przeprowadzania eksperymentów w zderzaczu, dlatego poprawa wydajności w tym obszarze jest kwestią priorytetową. W sektorze przedsiębiorstw, ostatnie postępy w dziedzinie sztucznej inteligencji i innych analiz Big Data sugerują, że przesyłanie tak ogromnych zbiorów danych wkrótce stanie się powszechne w sektorze prywatnym (pomyślmy o wszystkim, od samochodów autonomicznych po czujniki środowiskowe na terenach rekultywacyjnych po wydobyciu).
FlacheSAN1N4C-D4 jest napędzany dwoma procesorami Intel Xeon E5-2600v4/v3 Broadwell/Haswell, które zarządzają macierzą pamięci masowej złożoną z czterech dysków flash NVMe PCIe3 x8. FlacheSAN1N4C-D4 wykorzystuje technologię procesorów Intel Broadwell 14 NM, ponieważ zapewnia mniejsze zużycie energii i lepsze częstotliwości taktowania przy porównywalnym lub niższym współczynniku TDP niż jego poprzednik. FlacheSAN1N4C-D4 charakteryzuje się stałą przepustowością odczytu 24 GB/s i 3.6 mln operacji wejścia/wyjścia na sekundę (IOPS), co jest niezbędne do przesyłania ogromnych ilości danych wymaganych przez SCinet i inne najnowocześniejsze sieci obliczeniowe o wysokiej wydajności.
Specyfikacje Premio FlacheSAN1N4C-D4
- Obsługiwany procesor: Podwójny Intel Xeon E5-2600v4/v3 Broadwell/Haswell do 135 W TDP, gniazdo R3
- Chipset: chipset Intel C612
- Obsługa pamięci: 16 modułów DDR4 ECC RDIMM/LRDIMM 1600/1866/2133/2400MT/s, maks. pojemność 1TB
- Gniazda rozszerzeń: obsługa do 2x pełnej wysokości PCIe3 x16, 1x modułu IO PCIe3 x8
- Przechowywanie:
- 4x niskoprofilowe, wymienne na gorąco karty PCIe3 x8 NVMe
- 2 wewnętrzne zatoki 2.5-calowe na system operacyjny
- Networking:
- Podwójny gigabitowy procesor Intel i210
- Opcjonalny moduł FDR Infiniband QSFP+ 56 Gb/s lub Dual 40 GbE Ethernet przez wejście/wyjście
- 1x port RJ45 do zarządzania IPMI
- 2 gniazda PCIe3 x16 na inne opcjonalne karty sieciowe
- Moc: 1+1 750 W AC/DC 80 Plus Platinum Redundant PSU
- Bezpieczeństwo: technologia Intel Trusted Execution; TPM 1.2
- Obsługiwane systemy operacyjne: Windows 2012 R2, RHEL 6.5, SLES 11 SP3, Windows 208 R2, VMWare ESXi 5.5, FreeBSD 9.2, Centos 6.5
- Panel przedni: włącznik/wyłącznik zasilania z diodą LED, przełącznik resetowania, przełącznik NMI, przełącznik lokalizacji z diodą LED, 4 diody LED sieci LAN, dioda ostrzegawcza
- Tylne we / wy:
- DB15 VGA, 2x RJ45 1GbE, 1x szeregowy DB9,
- 1x RJ45 MGMT, 2x USB 3.0, 2x USB 2.0
- 1x dioda LED ID, opcjonalnie podwójny QSFP+
- Chłodzenie: 3 wentylatory chłodzące 97 mm
- Inne funkcje: Dedykowany port GbE dla IPMI 2.0
- Waga
- Masa brutto: 23 kg/50 funtów
- Waga netto: 17 kg/37.4 funta
- Wymiary systemu: 31.38” x 19” x 1.75” (dł. x szer. x wys.)
- Opakowanie: 37.8” x 24” x 9.45” (dł. x szer. x wys.)
- Kod logistyczny HTS: 8473 30 5100; ECCN: 4A994
- Temperatura pracy: od 0°C do 35°C
- Temperatura podczas przechowywania: od -20°C do 70°C
- Wilgotność: 5% do 95% bez kondensacji
- Zgodność z normami CE, FCC Klasa A, zgodność z RoHS 6/6
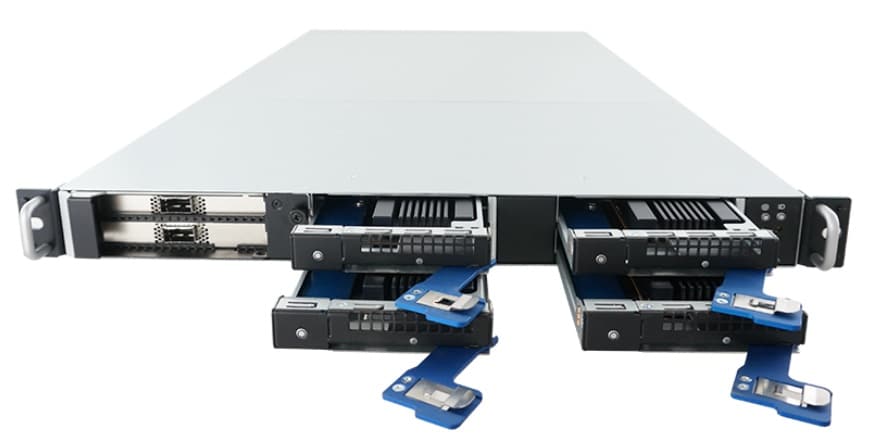
FlacheSAN1N4C-D4 zawiera cztery dostępne od przodu zatoki na niskoprofilową pamięć masową PCIe3 x8 NVMe. Gniazda NVMe stanowią pamięć masową, która jest dostępna do wykorzystania w trybie „data-in-flight” w węzłach transferu danych. Dwa wewnętrzne dyski 2.5 cala obsługują system operacyjny.
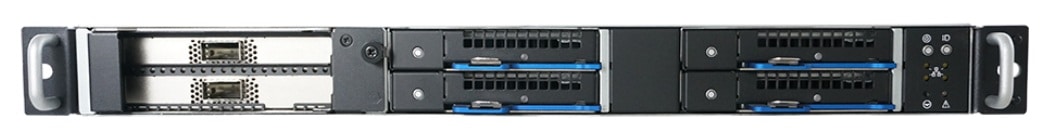
Pula pamięci masowej tej macierzy FlacheSAN jest wymienna w trybie hot-swap i posiada certyfikat do użytku z różnymi urządzeniami pamięci masowej NVMe. Premio publikuje listę zatwierdzonych dostawców na stronie z informacjami o produkcie FlacheSAN1N4C-D4, która powstała na podstawie wewnętrznych testów laboratoryjnych Premio.
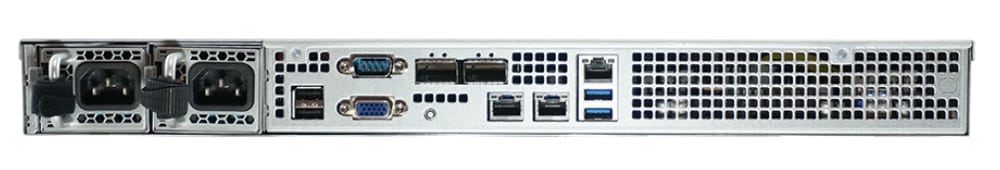
Tylna część macierzy zapewnia dostęp do zintegrowanych interfejsów Dual GbE Intel i210. Macierz można opcjonalnie skonfigurować z modułami FDR Infiniband QSFP+ 56 Gb/s lub Dual 40 Gb/s Ethernet przez I/O. Dostępny jest również port zarządzania IPMI RJ45 oraz dwa gniazda PCIe3 x16 do obsługi innych kart sieciowych.
Linia serwerów FlacheStreams firmy Premio koncentruje się na macierzach flash NVMe jako nośniku strategii eliminacji wąskich gardeł Premio „zrównoważonej architektury”, która równoważy zasoby między napędami NVMe a kartami Ethernet. Systemy FlacheStreams mogą również zapewniać bezpośredni dostęp do pamięci masowej NVMe macierzy przez sieć, co zmniejsza opóźnienia.
Bazując na doświadczeniu Premio we współpracy z Caltech w zakresie warstwowania danych eksperymentalnych z Chicago do Pasadeny, firma przekazała SCinet dwie macierze FlacheSAN1N4C-D4, które miały pełnić funkcję serwerów węzłów transferu danych (DTN). Łącznie dwie macierze DTN Premio oferowały przepustowość dysk-dysk na potrzeby demonstracji technologii, w tym zintegrowanego front-endu Jupyter do intensywnych procesów naukowych, struktur sieciowych wymagających programowalnego interfejsu API oraz interfejsu API do monitorowania DTN macierzy.
Rodzaje obciążeń obsługiwanych przez eksperymentalną sieć dystrybucji danych Wielkiego Zderzacza Hadronów, a także te modelowane przez SCinet na konferencji Supercomputer Conference, są ważnymi wyznacznikami przyszłego sposobu wdrażania technologii transferu dużych ilości danych w sektorze prywatnym. Niezależnie od tego, czy chodzi o transfer na duże odległości, czy między różnymi systemami zarządzania informacją, duże transfery danych staną się nową rzeczywistością.


 Amazon