

W 2023 roku Quantum wprowadziło na rynek nowe, nowoczesne podejście do pamięci masowej definiowanej programowo – Myriad. Pod koniec zeszłego roku przeprowadziliśmy dogłębną analizę Myriad i byliśmy pod wrażeniem jego niezwykle wydajnej i odpornej architektury. Zróżnicowany zestaw funkcji i elastyczność protokołów Myriad rozszerzają zakres jego zastosowań poza potrzeby udostępniania plików w przedsiębiorstwach. A obecnie nie ma aplikacji cieszącej się większym popytem niż sztuczna inteligencja.
Sztuczna inteligencja fundamentalnie zmienia oblicze przedsiębiorstw, dostarczając nowych spostrzeżeń w procesie podejmowania decyzji, automatyzując złożone procesy i tworząc nowe sposoby interakcji z klientami i zarządzania operacjami. Oto kilka kluczowych obszarów, w których sztuczna inteligencja ma wpływ:
Automatyzacja : Sztuczna inteligencja automatyzuje rutynowe, podatne na błędy zadania, takie jak wprowadzanie danych i obsługa klienta, za pomocą chatbotów, a nawet znajduje sposoby na optymalizację złożonych procesów, takich jak zarządzanie łańcuchem dostaw. To oszczędza czas i pozwala pracownikom skupić się na bardziej kreatywnych lub strategicznych zadaniach.
Analiza danych : Przeszukuje ogromne zbiory danych, aby znaleźć wzorce i wnioski szybciej niż zrobiłby to człowiek. Pomaga to firmom podejmować mądrzejsze decyzje, przewidywać trendy rynkowe i lepiej rozumieć swoich klientów.
Personalizacja : Firmy wykorzystują sztuczną inteligencję, aby dostosowywać swoje usługi i działania marketingowe do indywidualnych klientów, podobnie jak wyszukiwarki rekomendacji, które uczą się, co użytkownik lubi oglądać na Netflixie lub Spotify.
Zwiększone bezpieczeństwo : Sztuczna inteligencja odgrywa ważną rolę w cyberbezpieczeństwie, pomagając natychmiast wykrywać zagrożenia i reagować na nie. Zawsze jest czujna, skanując wszystko, co podejrzane.
Innowacje : Sztuczna inteligencja napędza innowacje, pomagając w opracowywaniu nowych produktów i usług – od leków po nowe materiały – poprzez symulację każdego aspektu projektu, wyglądu i działania produktu oraz jego konserwacji. Potrafi nawet przewidywać wyniki przed fizycznymi badaniami leków.
Wyzwania skalowalności i elastyczności
Starsze systemy pamięci masowej często nie są w stanie efektywnie skalować, co jest kluczowe dla aplikacji AI generujących i przetwarzających duże wolumeny danych. Tradycyjne pamięci masowe mogą wymagać znacznych przestojów lub skomplikowanych modernizacji, konfiguracji i alokacji sieci w celu zwiększenia pojemności. Nie jest to możliwe w dynamicznych środowiskach AI, które wymagają szybkiej skalowalności, braku przestojów i wdrażania modeli bez utraty wydajności.
Obciążenia AI wymagają jednocześnie wysokiej przepustowości i niskich opóźnień. Starsze systemy, zazwyczaj wyposażone w napędy mechaniczne i przestarzałe sieci, nie są w stanie sprostać tym wymaganiom, co prowadzi do wąskich gardeł, które utrudniają działanie AI. Współczesna AI korzysta w znacznym stopniu z szybszych technologii, takich jak NVMe i akceleracja GPU, które często są niekompatybilne ze starszymi systemami.
Aplikacje AI wymagają dostępu do danych w czasie rzeczywistym i analizy z różnych źródeł. Starsze systemy pamięci masowej, często wyizolowane, utrudniają integrację i migrację danych, ograniczając efektywną analizę danych i uczenie maszynowe. Starsze narzędzia do zarządzania mają również problemy ze złożonym zarządzaniem danymi i automatycznym warstwowaniem, niezbędnym dla AI.
Konserwacja i modernizacja starszych systemów pamięci masowej są również kosztowne i nieefektywne w kontekście wymagań sztucznej inteligencji, w tym wysokich kosztów operacyjnych związanych z zasilaniem, chłodzeniem i przestrzenią. Modernizacja starych systemów w celu obsługi nowych technologii jest nieopłacalna.
Sztuczna inteligencja rozwija się dzięki nowoczesnym funkcjom przechowywania danych, takim jak automatyczne warstwowanie, analityka w czasie rzeczywistym i solidne zabezpieczenia, takie jak szyfrowanie. Starsze systemy nie posiadają tych kluczowych funkcji, które są niezbędne do ochrony danych sztucznej inteligencji i spełniania norm regulacyjnych.
Modernizacja infrastruktury zarządzania danymi i pamięci masowej ma kluczowe znaczenie dla wykorzystania potencjału transformacyjnego sztucznej inteligencji. Rozwiązania pamięci masowej nowej generacji, zaprojektowane z myślą o złożoności sztucznej inteligencji, mogą znacząco poprawić wydajność, skalowalność i efektywność kosztową, wspierając innowacyjne aplikacje i modele biznesowe.
Poznaj Quantum Myriad
Quantum Myriad to wydajne, definiowane programowo rozwiązanie pamięci masowej all-flash, zaprojektowane z myślą o wymaganiach nowoczesnych aplikacji, zwłaszcza tych wymagających wysokiej przepustowości i niskich opóźnień. Dotyczy to w szczególności sztucznej inteligencji, analizy danych, efektów wizualnych i animacji. Natywna dla chmury architektura Myriad zapewnia elastyczność, łatwość wdrażania i automatyczne reagowanie na zmiany w systemie, zarówno lokalnie, jak i w środowisku chmury publicznej, takim jak AWS.
Konstrukcja Myriad koncentruje się na zapewnieniu stałego, niskiego opóźnienia i wysokiej przepustowości. Te cechy są absolutnie niezbędne w aplikacjach wymagających błyskawicznego przetwarzania danych i wydajności w czasie rzeczywistym.
Architektura Myriad jest niezwykle elastyczna i bez problemu obsługuje zarówno małe, jak i duże wdrożenia. Łatwo jest zacząć od małego systemu, a następnie rozbudować klaster Myriad. Wraz z dodawaniem kolejnych węzłów, skalowanie jest liniowe, przy jednoczesnym zachowaniu wydajności i równowagi.
Zarządzanie klastrami za pomocą Myriad jest proste. Platforma oferuje funkcje takie jak bezklikowe rozszerzanie pamięci masowej i przyjazny dla użytkownika portal zarządzania, które pomagają ograniczyć potrzebę ciągłej obsługi administracyjnej. Myriad dba o integralność danych dzięki transakcyjnemu magazynowi klucz-wartość rozproszonemu po wszystkich węzłach, a korekcja błędów jest zarządzana we wszystkich dostępnych węzłach pamięci masowej.
Myriad oferuje imponujące wsparcie sieciowe. Dzięki obsłudze protokołu RDMA over Converged Ethernet (RoCE) i integracji z istniejącymi wdrożeniami sieciowymi poprzez routing BGP, dane mogą bezproblemowo przepływać do i z klastra Myriad, wykorzystując jednocześnie zaawansowane możliwości sieciowe.
Platforma Myriad została zaprojektowana z myślą o łatwości obsługi i wymaga minimalnej liczby kroków do skonfigurowania i uruchomienia lub dodania dodatkowych lokalizacji współdzielonych. Dzięki temu idealnie nadaje się dla przedsiębiorstw, które muszą szybko dostosowywać się do zmieniających się potrzeb w zakresie pamięci masowej, zwłaszcza że rozwiązanie działa na standardowych, gotowych serwerach. Ponadto, jeśli rozważasz chmurę, Myriad doskonale współpracuje z platformami takimi jak AWS, umożliwiając rozszerzenie jej poza konfigurację lokalną.
Konfiguracja Quantum Myriad po testach
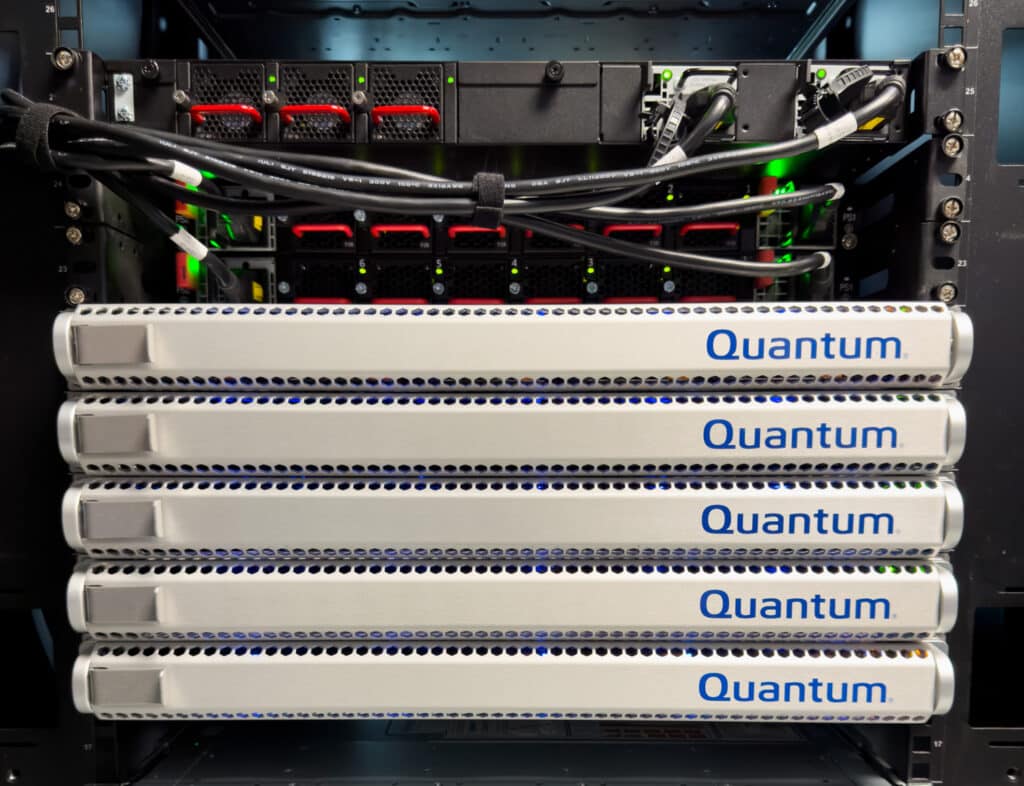
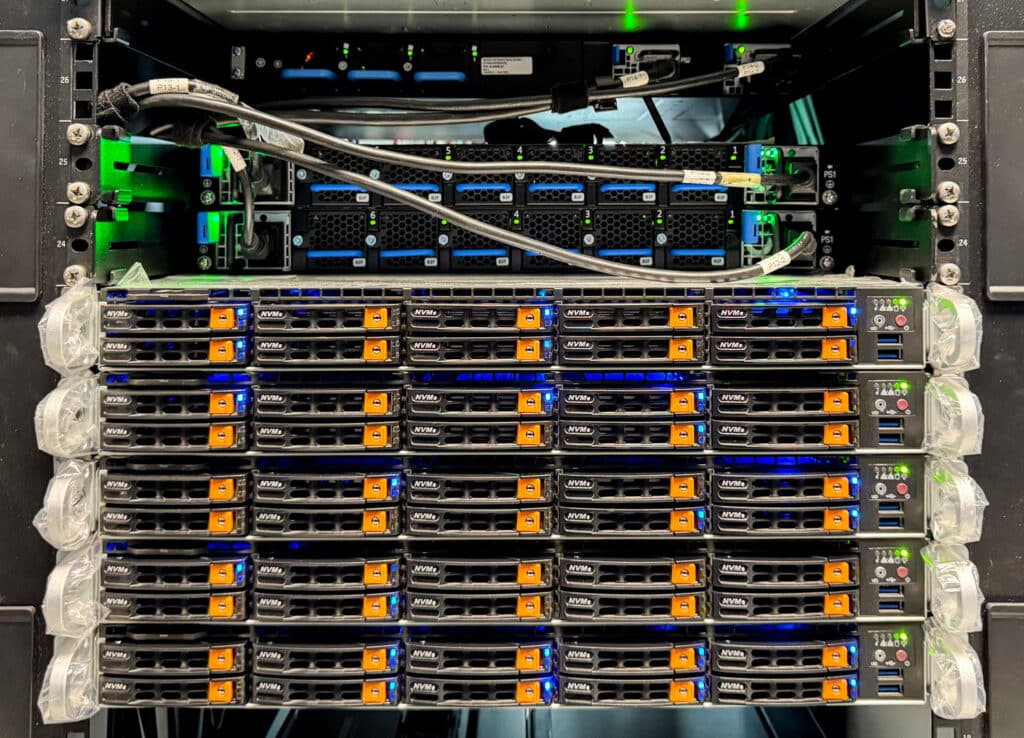
Testowany system Quantum Myriad składał się z konfiguracji bazowej składającej się z pięciu węzłów. Każdy węzeł był wyposażony w dziesięć dysków SSD o pojemności 15 TB, co łącznie zapewniało znaczną ilość pamięci masowej o szybkim dostępie w całym klastrze. Ta konfiguracja bazowa umożliwiła uzyskanie znacznej pojemności pamięci masowej przy jednoczesnym zachowaniu szybkości niezbędnej do wykonywania operacji wejścia/wyjścia i szybkiego pobierania danych – co jest niezbędne do przetwarzania w czasie rzeczywistym i obliczeń AI. Węzły pamięci masowej zostały określone i skonfigurowane przez firmę SuperMicro, a dyski NVMe są dostępne od firmy Samsung.
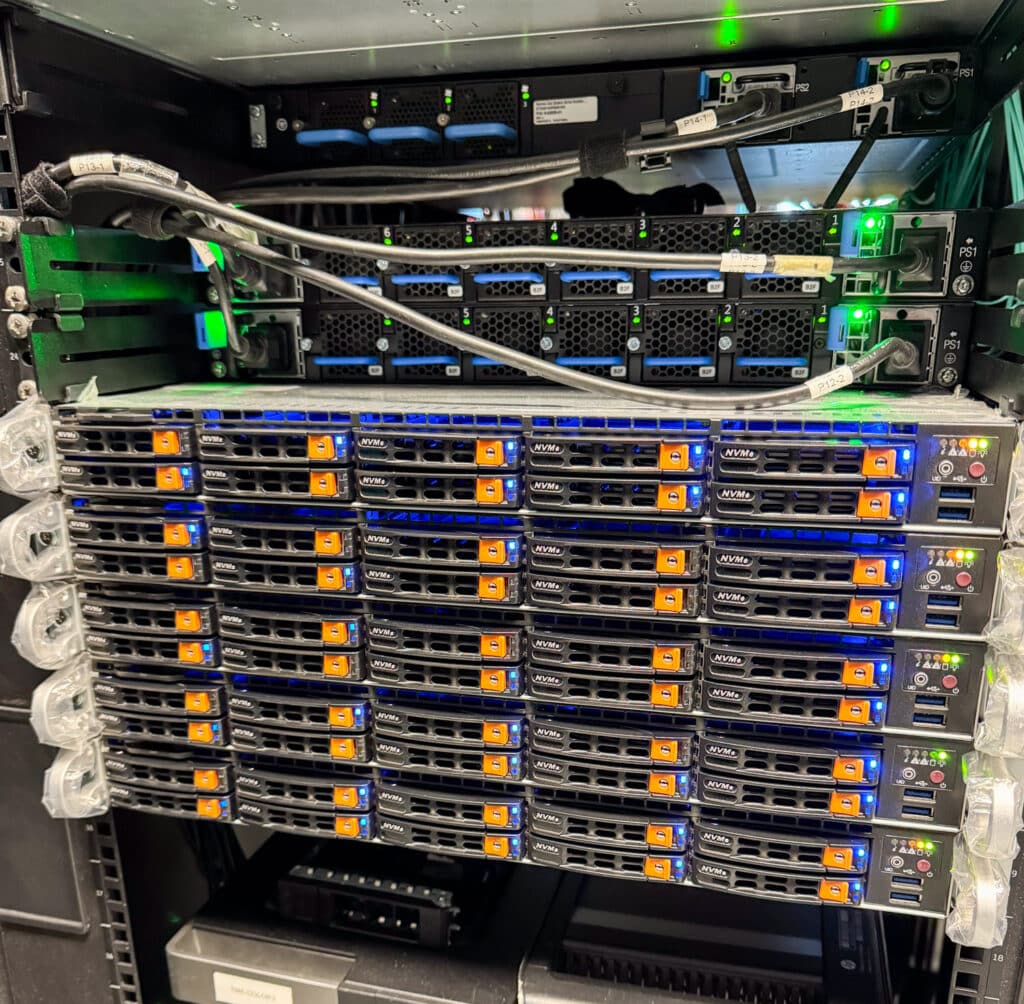
Do testów wykorzystaliśmy platformę Myriad skonfigurowaną w klastrze 5-węzłowym, z których każdy miał następujące kluczowe specyfikacje:
- Węzeł pamięci masowej Quantum Myriad N1010 z pojedynczym 64-rdzeniowym procesorem AMD EPYC
- 10 dysków NVMe TLC o pojemności 15.36 TB
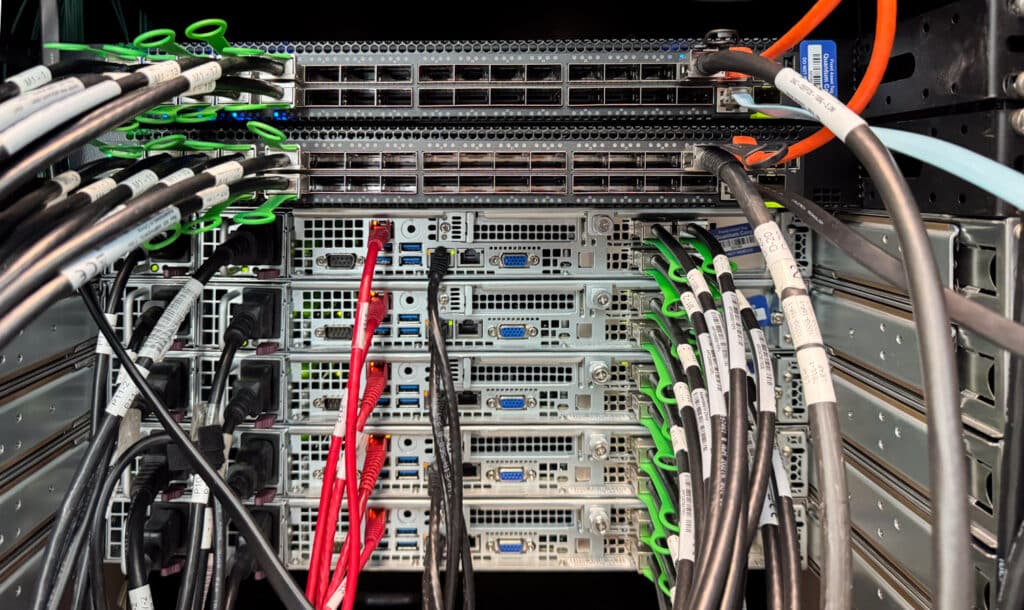
- 2 x porty Ethernet 100GbE Dual Port
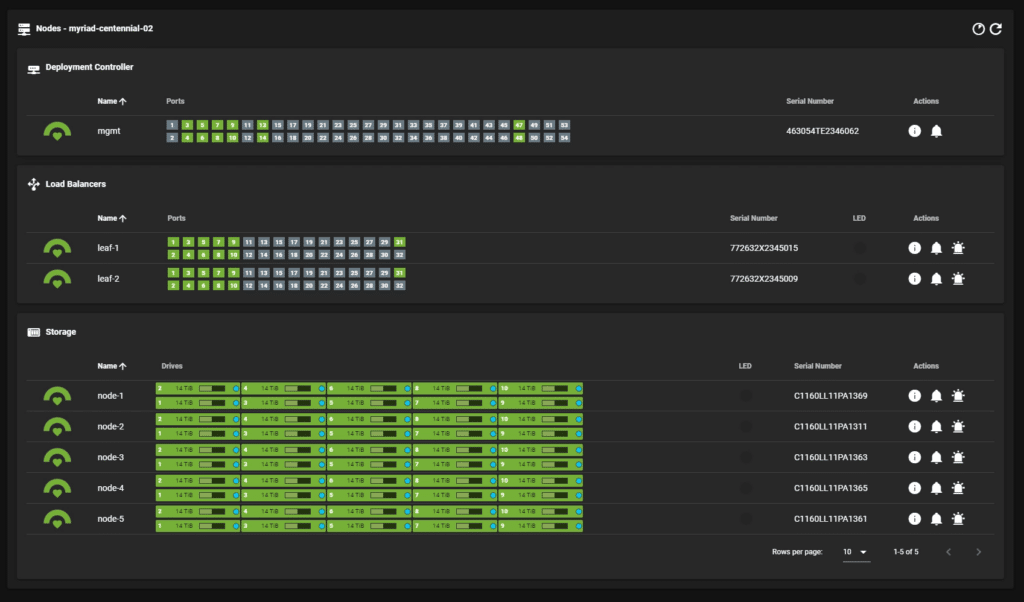
Integralną częścią Myriad są węzły równoważenia obciążenia, rozmieszczone w redundantnej parze, połączonej krzyżowo we wszystkich węzłach pamięci masowej. Odgrywają one kluczową rolę w zarządzaniu ruchem danych do i z węzłów pamięci masowej. Para modułów równoważenia obciążenia zapewnia równomierny rozkład ruchu sieciowego między węzłami pamięci masowej, zapobiegając sytuacji, w której pojedynczy węzeł stanie się wąskim gardłem. W przypadku konieczności jednoczesnego dostępu do danych i ich przetwarzania, jest to niezwykle istotne w środowiskach, w których szybkość i niezawodność dostępu do danych mogą znacząco wpłynąć na ogólną wydajność systemu.
Użycie wielu węzłów i modułów równoważenia obciążenia zwiększa wydajność oraz niezawodność i odporność systemu na błędy. Dystrybucja obciążenia pamięci masowej i sieci pozwala systemowi na wydajną pracę nawet w przypadku problemów z jednym węzłem. Taka konfiguracja jest niezbędna do utrzymania sprawności i zapewnienia integralności danych w krytycznych aplikacjach biznesowych.
Podstawowa konfiguracja jest elastyczna i można ją skalować, dodając w razie potrzeby kolejne węzły pamięci masowej. Pojemność pamięci masowej można zwiększyć, dodając kolejne węzły, stosując gęstsze dyski NVMe lub stosując oba te rozwiązania. Na przykład, można dodać nowy węzeł pamięci masowej wyposażony w dyski 30 TB do systemu, który obecnie korzysta z dysków 15 TB, lub dokonać modernizacji, wybierając gęstsze moduły dyskowe w ramach istniejącej infrastruktury. Skalowalność jest niezbędna dla firm, które spodziewają się wzrostu zapotrzebowania na dane lub doświadczają zmiennych wzorców ich wykorzystania.
Serwery Comino GPU Load Gen
Do testowania systemu Myriad i generowania testów porównawczych wykorzystaliśmy parę systemów Comino Grando. Systemy Comino Grando to wydajne, chłodzone cieczą konfiguracje zaprojektowane specjalnie w celu maksymalizacji wydajności i stabilności GPU pod obciążeniem. Są one szczególnie odpowiednie do intensywnych zadań obliczeniowych, takich jak te spotykane w aplikacjach AI, analizie danych i wymagających dużej mocy obliczeniowej. Oto podsumowanie kluczowych aspektów, które skonfigurowaliśmy na potrzeby tych testów:
| Serwer Grando | Stacja robocza Grando | |
|---|---|---|
| CPU | Threadripper Pro W5995WX | Threadripper Pro 3975WX |
| Baran | RAM 512GB | RAM 512GB |
| GPU | 2X NVIDIA A100 | 2X NVIDIA A100 |
| NIC | 4x NVIDIA ConnectX 6 200G EN/IB | 4x NVIDIA ConnectX 6 200G EN/IB |
| PSU | 4 zasilacze 1600 W | 3x 1000 SFX-L zasilacz |
| Dyski | 2 TB NVMe | 2 TB NVMe |
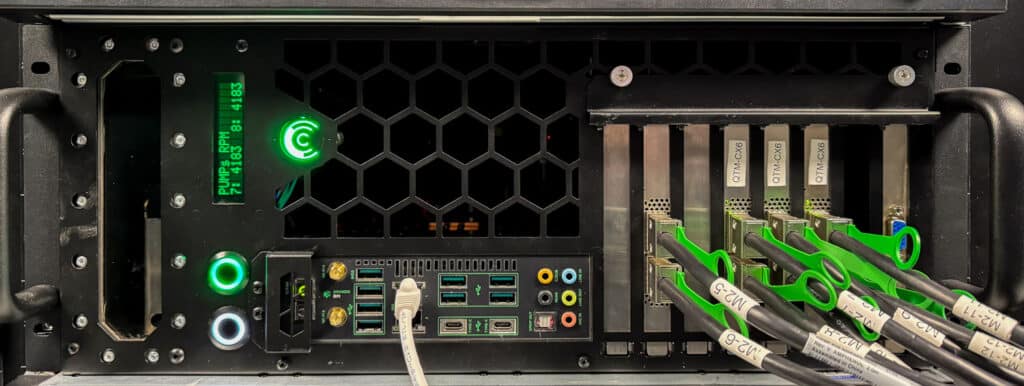
Comino Grando wykorzystuje zaawansowany system chłodzenia cieczą procesora i układów GPU, który obejmuje złącza zapobiegające kapaniu oraz duży blok dystrybucji cieczy, który efektywnie zarządza przepływem chłodziwa, zapewniając wydajność nawet przy dużym obciążeniu. Taka konfiguracja zwiększa wydajność i minimalizuje hałas.
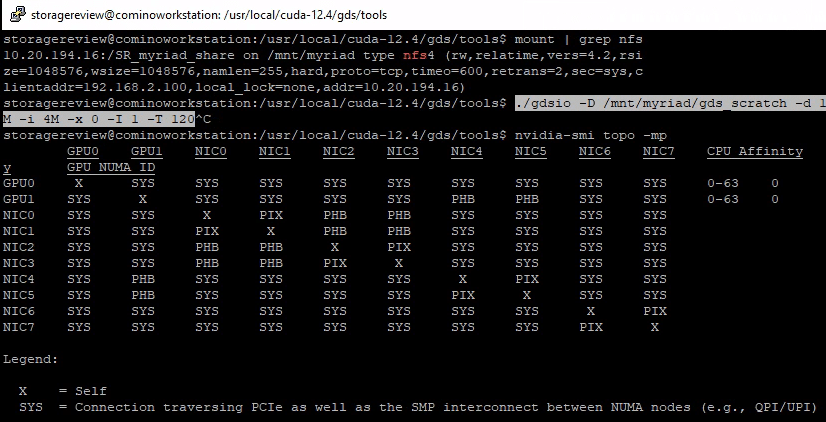
Korzystanie z nvidia-smi top -mp Polecenie wyświetla mapowanie GPU i kart sieciowych w naszym systemie oraz ścieżki, którymi muszą podążać dane. Oto legenda:
X = Samego siebie
SYS = Połączenie przechodzące przez PCIe oraz połączenie SMP między węzłami NUMA (np. QPI/UPI)
Węzeł = Połączenie przechodzące przez PCIe oraz połączenia między mostami hosta PCIe w węźle NUMA
PHB = Połączenie przechodzące przez PCIe oraz most hosta PCIe (zwykle procesor)
PXB = Połączenie przechodzące przez wiele mostów PCIe (bez przechodzenia przez most hosta PCIe)
PIX = Połączenie przechodzące przez większość pojedynczy most PCIe
Na tej podstawie możemy stwierdzić, że nie chcemy używać GPU1 z NIC4 i NIC5 dla uzyskania optymalnej wydajności, choć ma to ograniczone znaczenie w naszych testach syntetycznych.
Testowanie sztucznej inteligencji Quantum Myriad
Przeprowadziliśmy analizę techniczną, aby ocenić wydajność klastra pamięci masowej Quantum Myriad i jego wpływ na rzeczywiste obciążenia AI. Nasza analiza koncentrowała się na zdolności klastra do optymalizacji wykorzystania zasobów i efektywnego skalowania. Podczas testów wykorzystaliśmy wysokiej klasy stacje robocze Comino w obudowie rack, wyposażone w karty sieciowe NVIDIA ConnectX-6 200GbE oraz dwa procesory graficzne NVIDIA A100. Są one kluczowe, ponieważ stanowią solidne środowisko testowe, podobne do tego, które może być stosowane w projektach AI na dużą skalę.
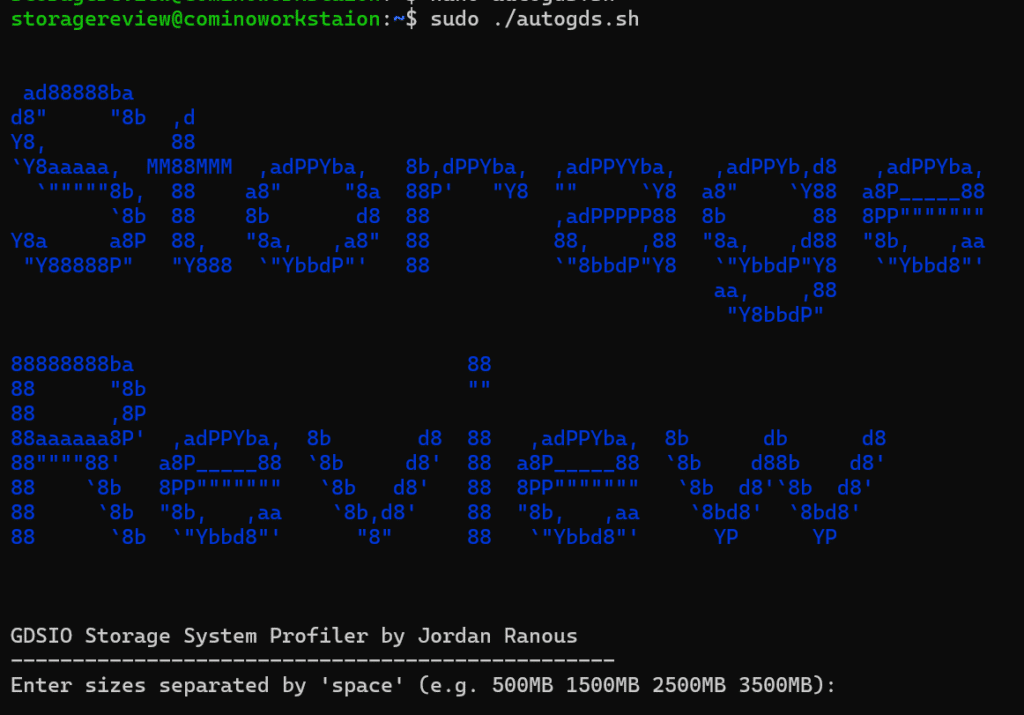
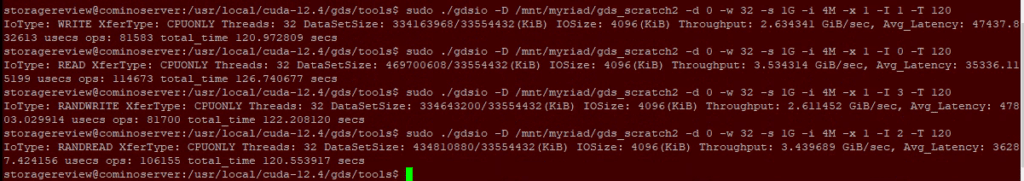
Wykorzystaliśmy prosty skrypt powłoki, aby pomóc w tworzeniu skryptów testowych GDS i analizie wyników. Grafika ASCII jako punkty stylu
Głównym celem tych testów była ocena zdolności klastra Quantum Myriad do obsługi intensywnych operacji wejścia/wyjścia (IO) oraz tego, jak dobrze radzi sobie on z przepustowością procesorów graficznych o dużej pojemności, które są kluczowe dla obliczeń AI. Biorąc pod uwagę, że obciążenia AI w dużym stopniu zależą od szybkiego przetwarzania zbiorów danych, zdolność rozwiązania pamięci masowej do dostarczania danych z prędkością odpowiadającą możliwościom przetwarzania GPU ma bezpośredni wpływ na ogólną wydajność i efektywność systemu.
Naszym głównym narzędziem testowym był NVIDIA GPUDirect Storage I/O (GDSIO). GPUDirect to kluczowa technologia zaprojektowana w celu zwiększenia efektywności transferu danych między systemami pamięci masowej a procesorami graficznymi, usprawniając przepływy pracy kluczowe w obliczeniach o wysokiej wydajności, sztucznej inteligencji i analityce dużych zbiorów danych.
Technologia ta umożliwia bezpośredni dostęp do pamięci (DMA) z pamięci masowej bezpośrednio do pamięci GPU, z pominięciem procesora. Eliminuje to zbędne kopie danych, co zmniejsza opóźnienia i poprawia przepustowość. GDSIO to syntetyczna implementacja GPUDirect i jest szczególnie reprezentatywna dla aplikacji wymagających szybkiego przetwarzania dużych zbiorów danych. Obejmuje to trenowanie modeli uczenia maszynowego lub analizę danych w czasie rzeczywistym. Zapewnia również profilowanie i dostrajanie informacji zwrotnych dla infrastruktury pamięci masowej i sieci.
W kontekście benchmarkingu pamięci masowej, GDSIO odgrywa kluczową rolę w precyzyjnej ocenie wydajności rozwiązań pamięci masowej w środowiskach intensywnie wykorzystujących procesory graficzne (GPU). Zapewniając bardziej bezpośrednią ścieżkę przesyłu danych, GDSIO umożliwia benchmarking w celu pomiaru rzeczywistego potencjału systemów pamięci masowej w obsłudze aplikacji akcelerowanych przez GPU.
Konfiguracja udostępniania AI
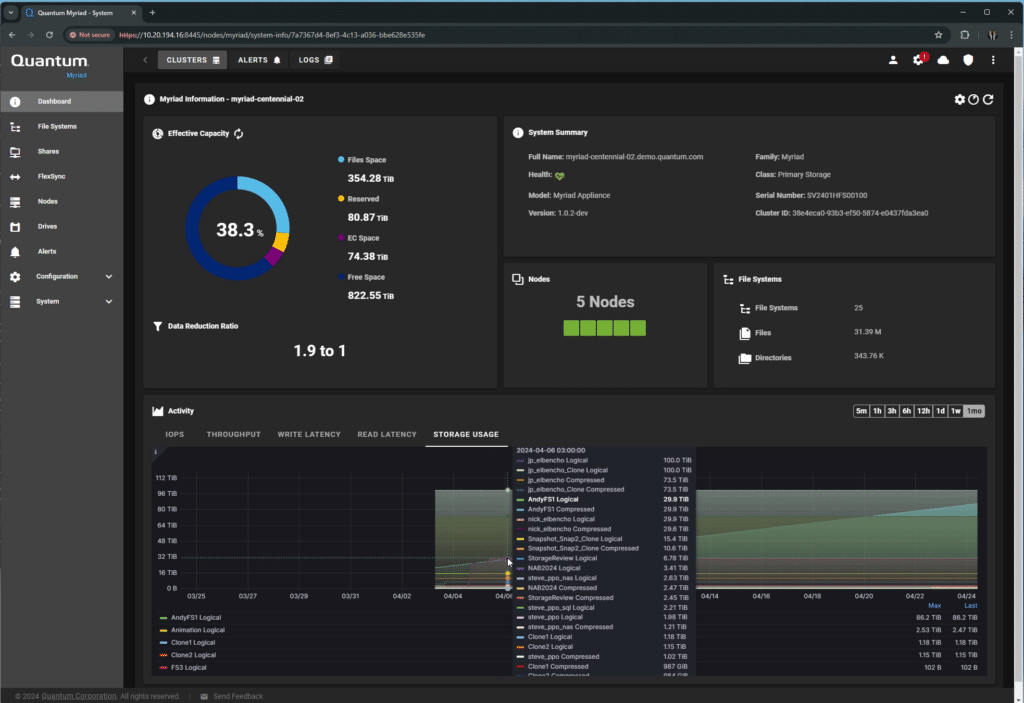
Po zalogowaniu się do Myriad użytkownikowi wyświetla się pulpit nawigacyjny, który przedstawia ogólny przegląd aktualnej wydajności i specyfikacji klastra. Użytkownicy mogą łatwo przeglądać dane telemetryczne, takie jak IOPS, przepustowość, opóźnienie i wykorzystanie.
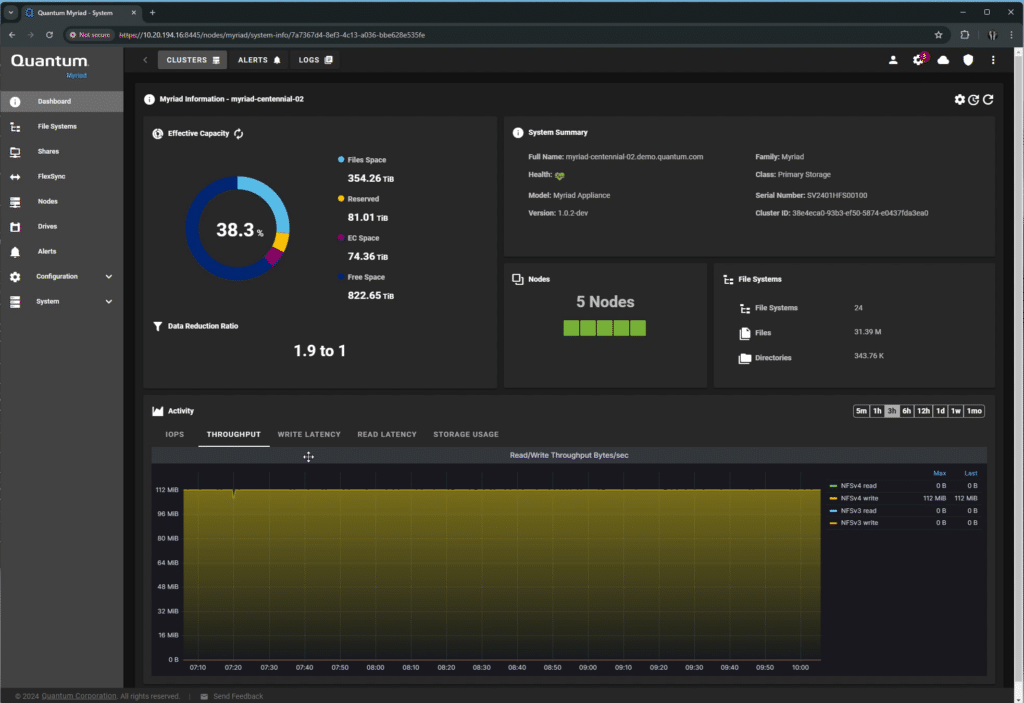
Najechanie kursorem na dowolny wykres umożliwia dostęp do szczegółowych informacji na temat wydajności.
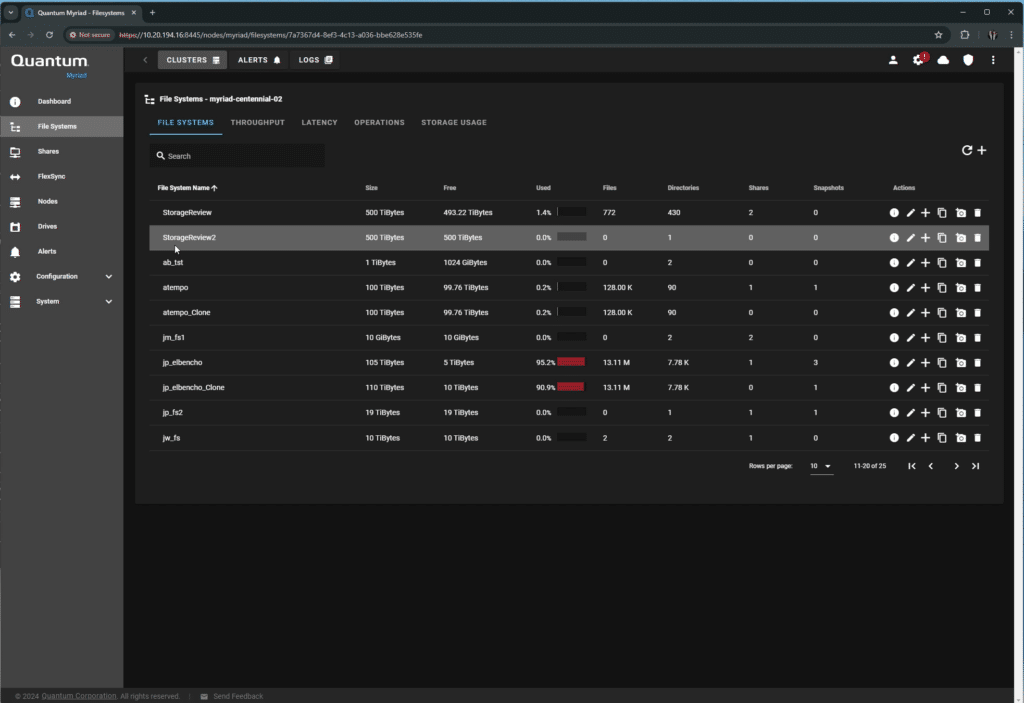
Na ekranie systemu plików można intuicyjnie przeglądać aktualnie skonfigurowane punkty montowania udziałów.
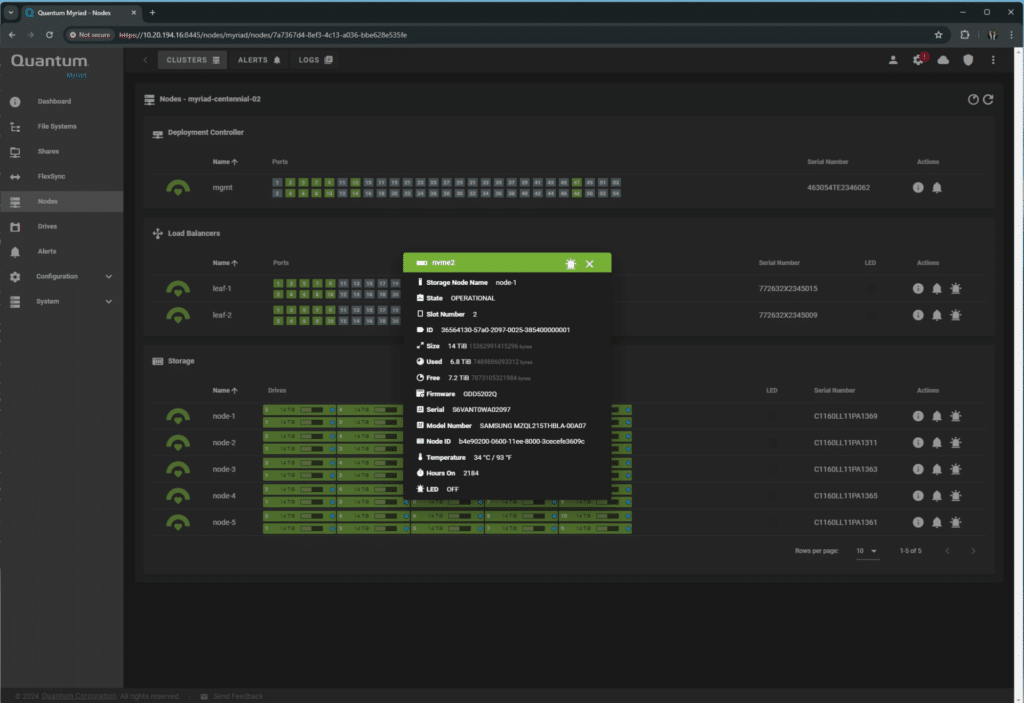
Ciekawa jest strona węzłów, na której znajduje się mapa fizyczna klastra, kontrolera i modułów równoważenia obciążenia, a także aktywność portów i dysków NVMe.
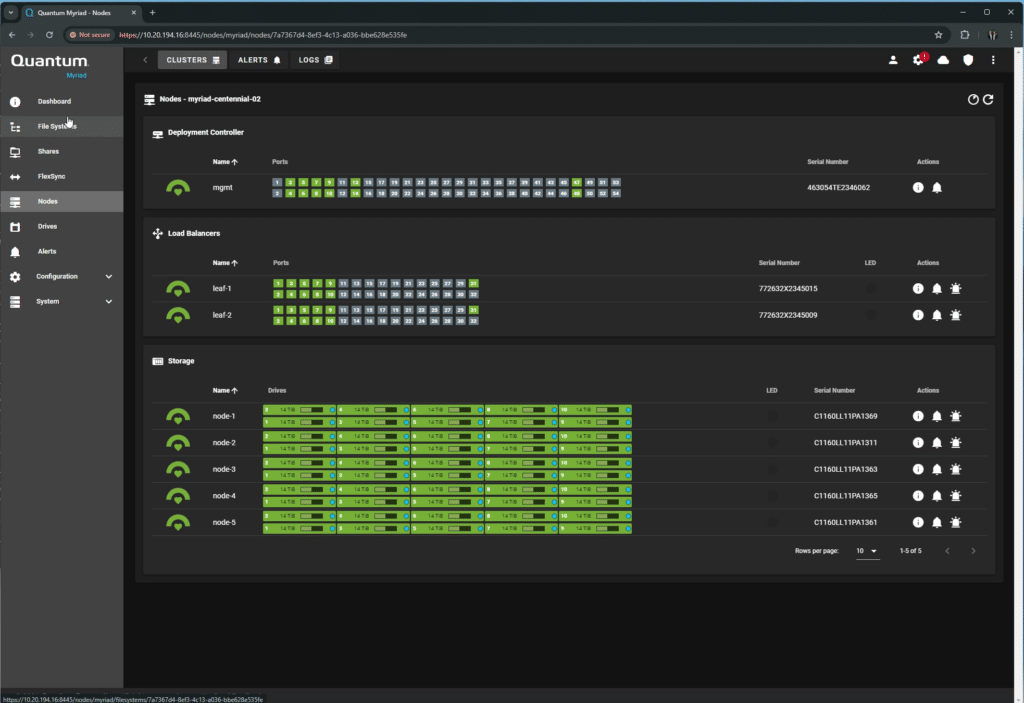
Kliknięcie dowolnego dysku wyświetla jego status zgłoszony przez hosta.
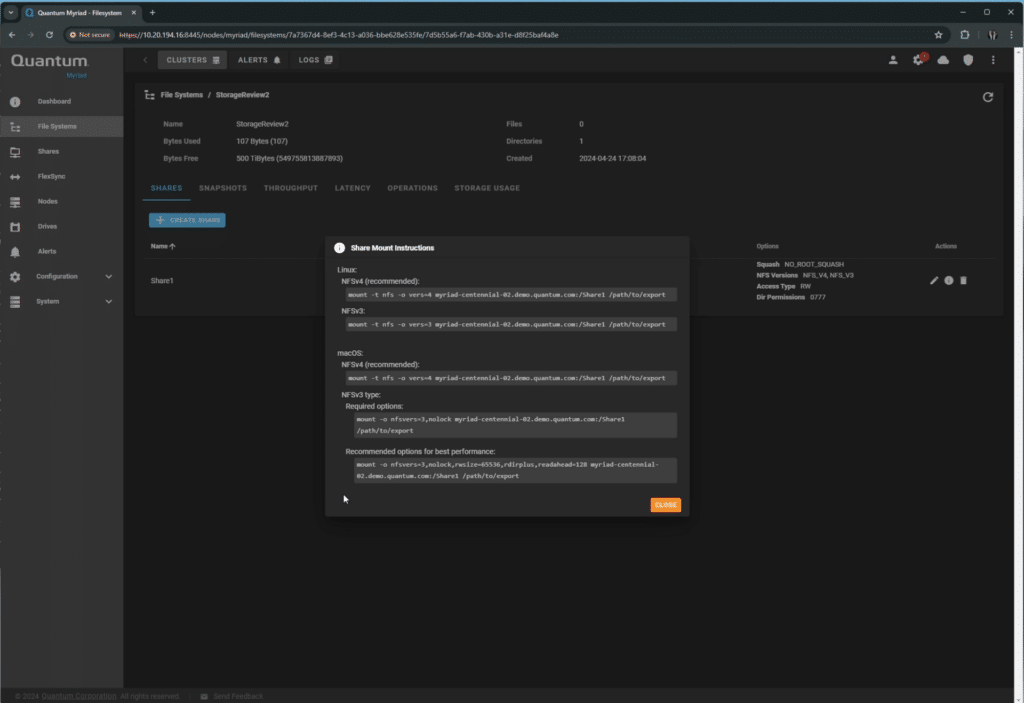
W sekcji Udostępnione zasoby użytkownicy mogą łatwo skonfigurować je według swoich potrzeb i uzyskać instrukcje dotyczące ich montowania w różnych systemach operacyjnych.
Współpracowaliśmy z Quantum, aby skonfigurować dedykowany udział NFS do naszych testów. Został on zamontowany w /mnt/myriad/
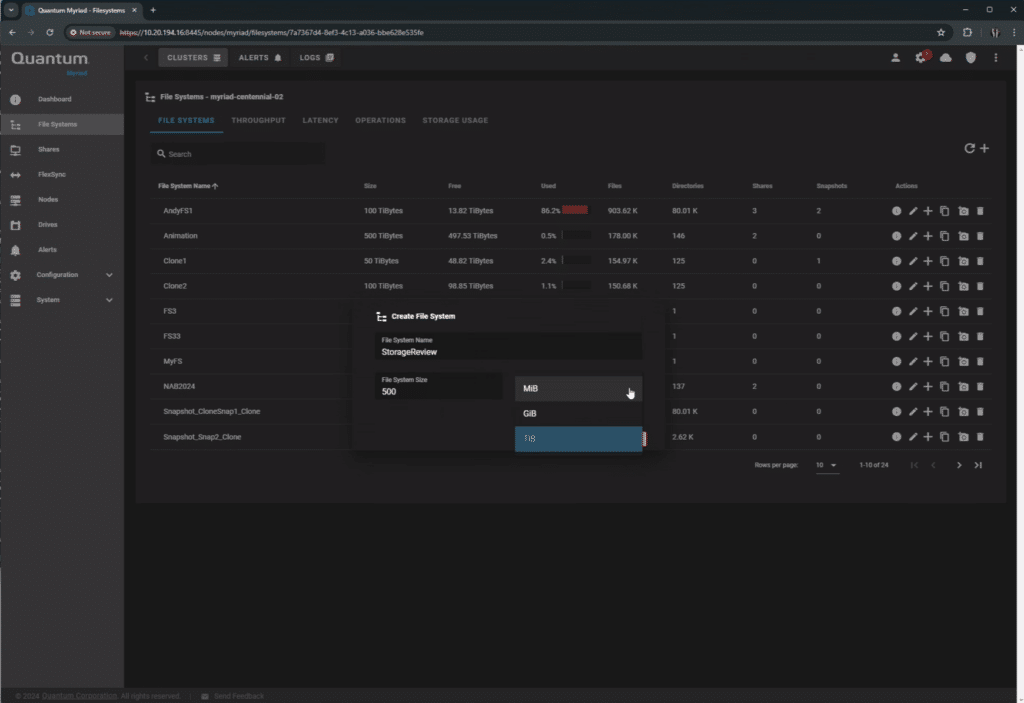
Osiągnięto to dzięki przyjaznemu dla użytkownika interfejsowi Myriad, który oferuje prostą konfigurację typu „wskaż i kliknij”. W okresie testowym opcja SMB znajdowała się w fazie wczesnego dostępu, a NFS pozostał preferowanym protokołem dla naszych maszyn z systemem Linux.
Nasz punkt montowania NFS został skonfigurowany na 500 TB przestrzeni, ale można było wykorzystać dowolną ilość miejsca, rozszerzając system plików. Można swobodnie nadakować pamięć masową bez żadnych kar, a limit rozmiaru nie jest sztywny. Staje się to bardzo interesujące, gdy weźmiemy pod uwagę kompresję danych Myriad, która zasadniczo zmniejsza rozmiar danych na dyskach SSD NVMe.
Dzięki jednemu punktowi montowania na hosta każdy procesor GPU ma swój własny podfolder i korzysta z własnej karty sieciowej, aby uniknąć ograniczeń NFSv4.
Wyniki i analiza Quantum Myriad AI
Najpierw przyjrzyjmy się ogólnej wydajności jednego z naszych przebiegów loadgen. Ten przykład z perspektywy jednego GPU w kontekście pamięci masowej przedstawia wydajność, jaką mogliśmy zaobserwować na wszystkich węzłach/GPU.
| Typ wejścia/wyjścia | Rozmiar wejścia/wyjścia (KiB) | Przepustowość (GiB/s) | Średnie opóźnienie (usecs) | Specjaliści ds. operacyjnych |
|---|---|---|---|---|
| RANDWRITE | 1024 | 2.57 | 10,087.74 | 78,820 |
| ODCZYT RANDOWY | 1024 | 6.92 | 2,277.86 | 209,319 |
| RANDWRITE | 4096 | 3.44 | 18,193.14 | 56,616 |
| ODCZYT RANDOWY | 4096 | 3.64 | 6,481.70 | 73,715 |
| RANDWRITE | 4 | 0.03 | 2,307.57 | 237,512 |
| ODCZYT RANDOWY | 4 | 0.12 | 497.05 | 941,971 |
| NAPISZ | 1024 | 2.79 | 5,609.64 | 94,017 |
| CZYTAĆ | 1024 | 3.11 | 5,021.91 | 95,556 |
| NAPISZ | 4096 | 2.77 | 22,551.26 | 31,716 |
| CZYTAĆ | 4096 | 3.50 | 17,875.32 | 31,871 |
| NAPISZ | 4 | 0.08 | 812.93 | 580,169 |
| CZYTAĆ | 4 | 0.12 | 507.34 | 926,909 |
Wyniki testów dostarczają istotnych informacji na temat wydajności Myriad w różnych operacjach wejścia/wyjścia i rozmiarach. Oto niektóre z naszych ustaleń:
- Wydajność małych i dużych bloków: Testy pokazują wyraźną różnicę w przepustowości i opóźnieniu podczas obsługi małych (4 KiB) i dużych (1024 KiB i 4096 KiB) bloków. Na przykład, operacje RANDREAD na dużych blokach o rozmiarze 4096 KiB wykazały najwyższą przepustowość, wynoszącą około 9.64 GiB/s, przy stosunkowo niższym średnim opóźnieniu wynoszącym 6,481.70 mikrosekund. Wskazuje to na doskonałą wydajność w przypadku zadań przetwarzania danych na dużą skalę, typowych dla szkoleń modeli uczenia maszynowego, gdzie często uzyskuje się dostęp do dużych zbiorów danych.
- Możliwość nasycenia GPU: Przepustowość uzyskana podczas testów dużych bloków, szczególnie w przypadku operacji RANDREAD, sugeruje, że klaster pamięci masowej Myriad jest w pełni zdolny do obsługi procesorów graficznych NVIDIA A100 w obciążeniach związanych z pobieraniem danych inferencyjnych oraz do przenoszenia punktów kontrolnych do centralnej lokalizacji podczas obciążeń szkoleniowych. Biorąc pod uwagę, że A100 może obsługiwać ogromne ilości danych w uczeniu głębokim, wysoka przepustowość jest niezbędna, aby zapewnić, że te procesory graficzne nie będą bezczynne w oczekiwaniu na dane, maksymalizując tym samym wydajność obliczeniową.
- Obsługa małych rozmiarów bloków: Z kolei, badając operacje z blokami 4 KiB, zaobserwowaliśmy gwałtowny wzrost liczby operacji i opóźnień, przy jednoczesnym znacznym spadku przepustowości. Ten scenariusz jest kluczowy dla zrozumienia wydajności w środowiskach, w których występuje wiele małych transakcji na plikach, takich jak systemy przetwarzania transakcji online lub bazy danych obsługujące wiele małych zapytań.
Ale poczekaj, jest więcej!
Skupiając się na testach 4K, sytuacja przybrała interesujący obrót, gdy załadowaliśmy Myriad kolejnymi procesorami graficznymi. Ze względu na ograniczenia protokołu montowania, odkryte podczas początkowych uruchomień w fazie testowania, Myriad zachowywał się zgodnie z oczekiwaniami, ale z zaskakującym wyjątkiem. Po jednoczesnym załadowaniu Myriad na wszystkie procesory graficzne, dzięki kilku sztuczkom skryptowym, wyniki były imponujące. Myriad zapewnił praktycznie taką samą wydajność wszystkim węzłom jednocześnie.
Rozmiar pliku 4K
Oto kompilacja pięciu jednoczesnych przebiegów obciążenia 4K:
| Node | Typ wejścia/wyjścia | Przepustowość (MiB/s) | Średnie opóźnienie (usecs) | Specjaliści ds. operacyjnych |
|---|---|---|---|---|
| 1 | ODCZYT RANDOWY | 125.73 | 497.05 | 941,971 |
| 2 | ODCZYT RANDOWY | 121.29 | 506.67 | 907,642 |
| 3 | ODCZYT RANDOWY | 128.37 | 474.73 | 906,847 |
| 4 | ODCZYT RANDOWY | 122.93 | 487.88 | 966,441 |
| Całkowita liczba losowych odczytów | 498.31 | 491.58 | 3,722,901 | |
| 1 | RANDWRITE | 27.08 | 2,307.57 | 237,512 |
| 2 | RANDWRITE | 26.88 | 2,285.62 | 231,625 |
| 3 | RANDWRITE | 26.10 | 2,406.89 | 228,983 |
| 4 | RANDWRITE | 28.27 | 2,341.65 | 245,172 |
| Całkowita liczba losowych zapisów | 108.34 | 2,335.43 | 943,292 | |
| 1 | CZYTAĆ | 123.19 | 507.34 | 926,909 |
| 2 | CZYTAĆ | 125.69 | 511.23 | 900,136 |
| 3 | CZYTAĆ | 123.90 | 502.04 | 945,949 |
| 4 | CZYTAĆ | 123.77 | 502.36 | 948,850 |
| Całkowita liczba odczytów | 496.54 | 505.74 | 3,721,844 | |
| 1 | NAPISZ | 76.87 | 812.93 | 580,169 |
| 2 | NAPISZ | 80.17 | 839.88 | 551,311 |
| 3 | NAPISZ | 78.62 | 783.24 | 556,060 |
| 4 | NAPISZ | 73.40 | 811.62 | 597,226 |
| Całkowity zapis | 309.06 | 811.92 | 2,284,766 | |
Rozmiar pliku 4 MB
| Node | Typ wejścia/wyjścia | Przepustowość (GiB/s) | Średnie opóźnienie (usecs) | Specjaliści ds. operacyjnych |
|---|---|---|---|---|
| 1 | ODCZYT RANDOWY | 3.44 | 6,481.70 | 73,715 |
| 2 | ODCZYT RANDOWY | 3.97 | 6802.17 | 75,689 |
| 3 | ODCZYT RANDOWY | 3.83 | 6498.16 | 73,277 |
| 4 | ODCZYT RANDOWY | 3.50 | 6,589.43 | 70,443 |
| Całkowita liczba losowych odczytów | 14.75 | 6,593 | 293,124 | |
| 1 | RANDWRITE | 3.44 | 18,193.14 | 56,616 |
| 2 | RANDWRITE | 3.4048 | 19090.38 | 54,725 |
| 3 | RANDWRITE | 3.4349 | 18125.25 | 56,277 |
| 4 | RANDWRITE | 3.5084 | 17018.30 | 54,397 |
| Całkowita liczba losowych zapisów | 13.78 | 18,107 | 222,015 | |
| 1 | CZYTAĆ | 3.50 | 17,875.32 | 31,871 |
| 2 | CZYTAĆ | 3.4388 | 17110.93 | 31,119 |
| 3 | CZYTAĆ | 3.5133 | 18124.53 | 31,096 |
| 4 | CZYTAĆ | 3.3035 | 17755.53 | 31,257 |
| Całkowita liczba odczytów | 13.75 | 17,717 | 125,343 | |
| 1 | NAPISZ | 2.77 | 22,551.26 | 31,716 |
| 2 | NAPISZ | 2.8845 | 23674.69 | 33,017 |
| 3 | NAPISZ | 2.7008 | 22661.31 | 30,971 |
| 4 | NAPISZ | 2.7719 | 22798.83 | 29,519 |
| Całkowity zapis | 11.13 | 22,922 | 125,223 | |
Unikalna architektura pamięci masowej Quantum Myriad zapewnia podwójną dostępność, która przynosi korzyści zarówno dla operacji GPU, jak i dla równoczesnych działań użytkowników bez utraty wydajności. Jest to szczególnie efektywne w środowiskach o dużym zapotrzebowaniu, gdzie wymagany jest jednoczesny dostęp do danych i ich przetwarzanie, podobnie jak w przypadku społeczności użytkowników korzystających z serwerów sztucznej inteligencji i uczenia maszynowego oraz dostępu analityków użytkowników końcowych. Wspierając dostępność dużych bloków danych dla GPU, a jednocześnie obsługując inne operacje użytkownika, Myriad zapewnia efektywne wykorzystanie zasobów i zapobiega powstawaniu wąskich gardeł. Ma to kluczowe znaczenie dla utrzymania wysokiej prędkości operacyjnej i dokładności danych w aplikacjach takich jak analityka w czasie rzeczywistym i trenowanie modeli sztucznej inteligencji.
Warto zauważyć, że sztuczka Quantum Myriad polega na jego zdolności do sprawnej obsługi wielu strumieni danych, aż do ograniczeń NFSv4, które mogą być łatwo przekroczone przy intensywnym obciążeniu GPU. Zaawansowane funkcje zarządzania danymi systemu zapobiegają wpływowi tych ograniczeń na ogólną wydajność platformy Myriad, zapewniając, że zadania GPU o dużym zapotrzebowaniu nie spowalniają innych operacji w tej samej sieci. Ta funkcja jest szczególnie przydatna dla branż wymagających solidnych możliwości przetwarzania danych bez utraty wydajności zadań współbieżnych, zapewniając płynny przepływ pracy dla wszystkich użytkowników.
Implikacje w świecie rzeczywistym i skalowanie
Quantum Myriad ma potencjał, aby z łatwością współpracować z rzeczywistymi aplikacjami i scenariuszami skalowania. Jego zdolność do obsługi dużych bloków przy wysokiej przepustowości i niskich opóźnieniach przynosi korzyści obciążeniom AI, w tym trenowaniu modeli głębokiego uczenia, w których duże zbiory danych są przetwarzane partiami. Wysoka przepustowość zapewnia bezzwłoczne przesyłanie danych do procesorów graficznych, co jest kluczowe dla utrzymania wysokiego poziomu wykorzystania i efektywnego uczenia.
Kolejną istotną cechą jest skalowalność. Wydajność klastra pamięci masowej Quantum Myriad w naszych testach sugeruje, że może on efektywnie obsługiwać większe konfiguracje. Wraz ze wzrostem liczby podłączonych urządzeń (np. dodatkowych procesorów GPU lub innych jednostek obliczeniowych o wysokiej wydajności) system pamięci masowej wydaje się być w stanie utrzymać wysoki poziom przesyłu danych, nie stając się wąskim gardłem.
Wydajność klastra pamięci masowej Quantum Myriad podczas operacji RANDREAD na dużych blokach była szczególnie zauważalna podczas naszych testów. Ta funkcjonalność jest kluczowa, biorąc pod uwagę potrzeby nowoczesnych platform sztucznej inteligencji i uczenia maszynowego.
Test RANDREAD, dzięki swojej znacznej przepustowości, dowodzi zdolności Myriad do szybkiego i wydajnego pobierania dużych wolumenów danych. Staje się to szczególnie istotne w kontekście obciążeń wnioskowania, gdzie szybkość dostępu do danych bezpośrednio wpływa na wydajność modeli AI w środowiskach produkcyjnych. Zadania wnioskowania, które często wymagają szybkiego dostępu do dużych zbiorów danych w celu podejmowania decyzji w czasie rzeczywistym, w ogromnym stopniu korzystają z możliwości szybkiego pobierania danych, jakie oferuje klaster Myriad. Na przykład w aplikacjach takich jak rozpoznawanie obrazu w czasie rzeczywistym czy złożone silniki decyzyjne napędzające systemy zautomatyzowane, możliwość pobierania dużych bloków danych z minimalnym opóźnieniem gwarantuje, że silniki wnioskowania mogą działać z maksymalną wydajnością bez zatrzymywania się na danych.
W fazie testów platforma Myriad wykazała się solidnością w obsłudze danych punktów kontrolnych podczas obciążeń treningowych, co jest równie ważne, jak wydajność klastra podczas operacji zapisu. Trenowanie nowoczesnych modeli sztucznej inteligencji, zwłaszcza sieci głębokiego uczenia, obejmuje procesy iteracyjne, w których punkty kontrolne odgrywają kluczową rolę. Punkty kontrolne, które reprezentują stan modelu w danej iteracji, muszą być okresowo zapisywane, aby zapobiec utracie postępów i umożliwić efektywne dostrajanie modeli bez konieczności ponownego trenowania od podstaw. Platforma Myriad skutecznie przenosi duże operacje zapisu do klastra pamięci masowej, skracając czas wejścia/wyjścia i pozwalając procesorom graficznym skupić się na obliczeniach zamiast na obsłudze danych.
Architektura Myriad gwarantuje, że wraz ze wzrostem zapotrzebowania na dane, czy to ze względu na większy rozmiar zbiorów danych, czy bardziej złożone wymagania dotyczące trenowania modeli, system może odpowiednio się skalować, bez tworzenia wąskich gardeł, przestojów czy utraty łączności z użytkownikami. Ta skalowalność jest niezbędna w erze dynamicznej ewolucji obciążeń związanych ze sztuczną inteligencją i uczeniem maszynowym, co wymaga rozwiązań pamięci masowej, które dotrzymują kroku obecnym wymaganiom i są odporne na przyszłe postępy w badaniach i rozwoju sztucznej inteligencji.
Wniosek
Klaster pamięci masowej Quantum Myriad charakteryzuje się wyjątkową wydajnością w zarządzaniu zróżnicowanymi i wymagającymi operacjami wejścia/wyjścia. To wszechstronne rozwiązanie dla tradycyjnych obciążeń biznesowych i najnowocześniejszych aplikacji AI. Dzięki wysokiej przepustowości i niskim opóźnieniom, możliwości Myriad wykraczają poza tradycyjne zadania związane z magazynowaniem danych, które są kluczowe dla utrzymania płynności działania i efektywnego pobierania danych.
Oprócz tych konwencjonalnych zastosowań, solidne parametry wydajnościowe Myriad czynią go idealnym kandydatem do bardziej wymagających zadań związanych z przepływami pracy AI. W tym przypadku klaster doskonale sprawdza się w scenariuszach wymagających szybkiego dostępu do danych i szybkiego przetwarzania, co jest kluczowe dla trenowania zaawansowanych modeli uczenia maszynowego i uruchamiania złożonych sieci neuronowych. Możliwość szybkiego odczytu i zapisu dużych, współdzielonych wolumenów danych może zwiększyć wykorzystanie GPU i zapewnić bezproblemowe wykonywanie obliczeń AI.
Te kompleksowe testy klastra Myriad stanowią kluczowy punkt odniesienia dla zrozumienia jego skalowalności i wydajności w środowiskach łączących tradycyjne potrzeby IT i biznesu z wysokimi wymaganiami badań i rozwoju w dziedzinie sztucznej inteligencji. Wyniki podkreślają techniczne możliwości Myriad i jego potencjał w zakresie realizacji wymagających aplikacji AI i projektów uczenia maszynowego, podkreślając jego zdolność adaptacji i wydajność w szerokim spektrum zadań obliczeniowych. Takie możliwości potwierdzają rolę Myriad jako fundamentalnej technologii wspierającej przedsiębiorstwa w radzeniu sobie z obecnymi potrzebami i przyszłymi wyzwaniami technologicznymi.
Strona produktu Quantum Myriad
Niniejszy raport jest sponsorowany przez Quantum. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej opinii na temat rozpatrywanego produktu/produktów.



 Amazon