

Infrastruktura sztucznej inteligencji (AI) w przedsiębiorstwach przeniosła się z optymalizacji modeli szkoleniowych na ich obsługę, co zmienia ekonomię. Szkolenie to projekt inwestycyjny z punktem końcowym. Wnioskowanie to obciążenie produkcyjne, które działa tak długo, jak usługa jest aktywna, a dane wyjściowe są mierzone w tokenach. To jest problem tokenomiki, z którym borykają się obecnie operatorzy AI: gdy procesory graficzne są już w szafach i budżet mocy jest ustalony, biznes zależy od liczby tokenów generowanych przez sprzęt.
W przypadku długich, wieloetapowych obciążeń, ten sam kontekst jest wielokrotnie przepuszczany przez model w miarę rozwoju konwersacji. Procesor graficzny (GPU) już raz zapłacił za przetworzenie tych tokenów, ale po usunięciu pamięci podręcznej KV system musi ponownie wypełnić ten kontekst. To zmusza przeciwnika do ponownego obliczenia. W dowolnej skali nie jest to błąd zaokrąglenia. To koszt zwracany w postaci energii, czasu GPU, wzrostu kolejki lub dodatkowego sprzętu.
Rozwiązaniem odruchowym jest zakup większej ilości najdroższych zasobów w szafie: więcej procesorów GPU, więcej pamięci DRAM. Ale recompute już wytworzyło coś wielokrotnego użytku. Pamięć podręczna KV to po prostu dane; można je tanio przechowywać i pobierać, wymieniając niewielki koszt przeładowania na drogie obliczenia wstępnego wypełniania, których unika. Pytanie zatem nie brzmi, czy zachować pamięć podręczną, ale gdzie ją przechowywać, a to jest w takim samym stopniu kwestia kosztów, jak i wydajności. Pamięć VRAM to najszybsza i najrzadsza warstwa; po jej nasyceniu serwer wnioskowania zaczyna usuwać pamięć podręczną. Pamięć DRAM zapewnia dużą i szybko rosnącą cenę. Pamięć flash to miejsce, w którym matematyka może się zmieniać: wolniejsza niż DRAM, z pewnością, ale znacznie tańsza w przeliczeniu na terabajt, z wystarczającą pojemnością, aby pomieścić kontekst, który szybsze warstwy są zmuszone odrzucić, co stanowi różnicę między ponownym przetworzeniem całej konwersacji a jej prostym odczytaniem.
Aby zmierzyć wpływ, zbudowaliśmy wieloetapowe obciążenie testowe z agentem na serwerze Dell PowerEdge XE7740, utrzymując model, procesory graficzne i stos serwerów na stałym poziomie. Liczbą, która ma znaczenie dla każdego, kto określa rozmiar systemu, jest to, co dzieje się po zapełnieniu warstw pamięci. Po przekroczeniu tego punktu pamięć flash utrzymywała około 30 000 tokenów na sekundę, w porównaniu z 17 000 tokenów pamięci DRAM, utrzymując 94% swojego szczytowego obciążenia, podczas gdy warstwa DRAM spadła do 42%. Obie warstwy odciążające znacznie przewyższały poziom bazowy wyłącznie pamięci VRAM w szczycie (2.9x w DRAM i 2.2x w Flash), ale szczyt przypada dokładnie na moment, w którym warstwa DRAM jest bliska wyczerpania. Najdroższa pamięć zapewnia szczyt; pamięć flash utrzymuje go, gdy kontekst rośnie.
Zanim przejdziemy do wyników, warto dokładnie wyjaśnić, czym jest pamięć podręczna KV, dlaczego się zapełnia i dlaczego wydajność wnioskowania zaczyna się pogarszać, gdy system nie ma tańszego źródła jej przechowywania.
Na wynos
- Pamięć Flash podtrzymuje to, czego pamięć DRAM nie jest w stanie: Wszystkie trzy konfiguracje działają identycznie, dopóki obciążenie pamięci nie wymusi usunięcia danych. Najpierw następuje nasycenie pamięci VRAM, a warstwa DRAM 512 GB zapełnia się po około 45 minutach od uruchomienia i rozpoczyna usuwanie danych. Po przekroczeniu tego punktu pamięć flash obsługuje łącznie około 30 000 tokenów na sekundę, w porównaniu z 17 000 tokenów pamięci DRAM, utrzymując 94% swojego maksymalnego obciążenia, podczas gdy pamięć DRAM spadła do 42%.
- Odciążenie przywraca utraconą przepustowość w celu ponownego obliczenia: W szczytowym momencie odciążenie pamięci podręcznej KV zwiększyło całkowitą przepustowość serwerów do 2.9 razy w porównaniu z bazą VRAM w warstwie DRAM i 2.2 razy w pamięci flash. Zysk wynika z pominięcia ponownego wstępnego wypełniania, ponieważ kontekst, który GPU już obliczył, jest odczytywany z warstwy odciążenia, a nie odbudowywany.
- Użytkownicy powracający odczuwają różnicę najbardziej: Najgorsze opóźnienie pierwszego tokena po wznowieniu sesji wyniosło 13.9 sekundy w przypadku samej pamięci VRAM w porównaniu z 3.2 sekundy w przypadku pamięci flash. Odciążenie to sposób na utrzymanie tego „ogonu” w granicach, w których interaktywny użytkownik będzie musiał się poruszać.
- Ruch agentów zwiększa koszty eksmisji: Tydzień ruchu Claude Code obejmował 98.16% odczytów pamięci podręcznej i zaledwie 0.02% prawdziwie zimnych danych wejściowych.
- Odciążanie KV to obciążenie wymagające dużej ilości zapisu, które wymaga dysków o dużej wytrzymałości: Każdy token generowany przez model zapisuje wpis KV, a rotacja TTL nieustannie nadpisuje warstwę. Przy naszej stałej szybkości zapisu, testowana przez nas macierz lustrzana RAID10 generuje około 3.2 zapisu dziennie na dysk, spadając do około 1.6 DWPD w trybie pasowym w RAID0, co plasuje ją w przedziale 3 DWPD pamięci D7-PS1030. Wytrzymałość, a nie pojemność czy szybkość, jest decydującym ograniczeniem warstwy flash, a ponieważ pamięć podręczna jest jednorazowa, tak intensywne korzystanie z dysku skoncentrowanego na zapisie jest akceptowalnym rozwiązaniem.
Jak działa wnioskowanie
Duże modele językowe są autoregresyjne: każdy token wyjściowy jest warunkowany każdym poprzedzającym go tokenem. Mechanizm uwagi implementuje to warunkowanie poprzez obliczenie (dla każdego tokenu w sekwencji) wektora zapytania (Q), który jest dopasowywany do wektorów klucza (K) i wartości (V) każdego poprzedniego tokenu. Wyjście uwagi to ważona kombinacja wartości, których wagi pochodzą z iloczynów skalarnych QK.
Po otrzymaniu żądania, na monit nie można odpowiedzieć, dopóki dla każdego zawartego w nim tokenu nie będą istniały tensory K i V. Pierwszym krokiem jest wstępne wypełnienie: silnik przepuszcza monit przez model w jednym równoległym przebiegu i zapisuje wynikowe tensory K i V do pamięci. Wstępne wypełnienie jest zatem ograniczone obliczeniowo, a jego opóźnienie skaluje się wraz z długością monitu.
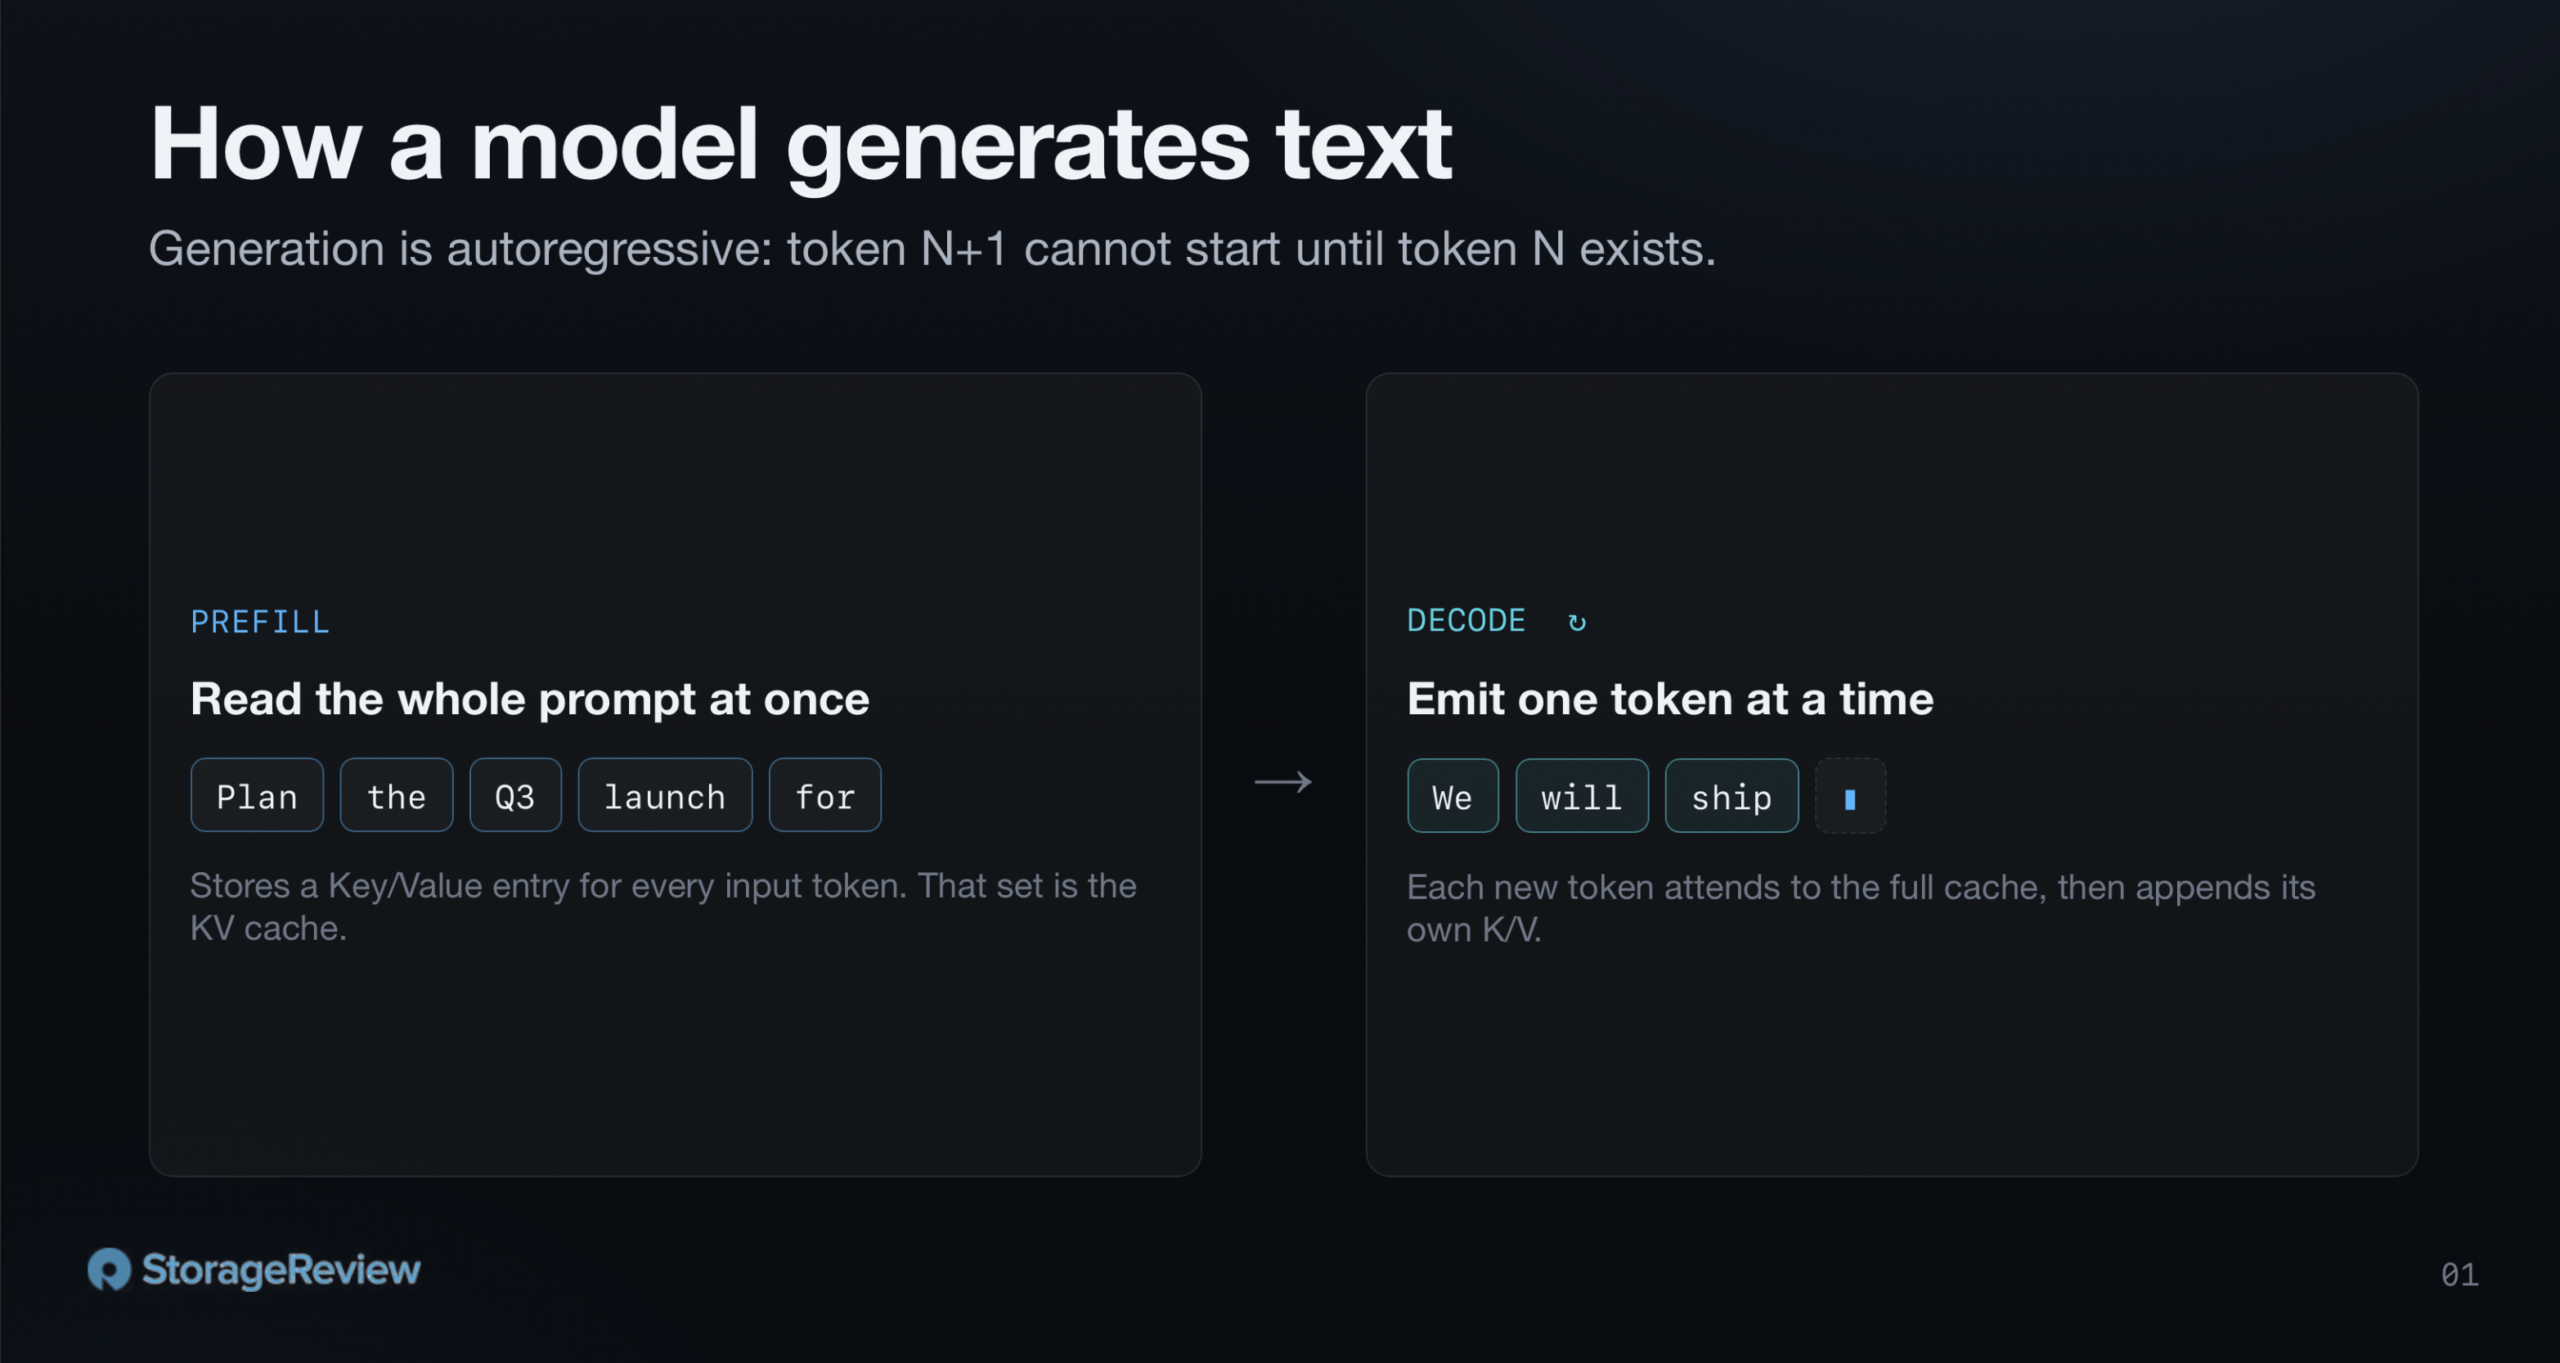
Po zakończeniu wstępnego wypełniania silnik emituje odpowiedź po jednym tokenie na raz. Każdy nowy token odczytuje wartości K i V każdego poprzedniego tokena, oblicza swój sygnał uwagi i zapisuje własne wartości K i V w pamięci na potrzeby następnego kroku. Ta druga faza to dekodowanie. Jest ona sekwencyjna i ograniczona przepustowością pamięci, ponieważ generowanie każdego tokena wymaga załadowania z pamięci podręcznej tensorów K i V dla wszystkich poprzednich tokenów i obliczenia na nich uwagi przed zapisaniem tensorów K i V nowego tokena na potrzeby kolejnych kroków.
Tensory K i V z obu faz stanowią pamięć podręczną KV. Bez nich wygenerowanie n+1. tokena skutkowałoby przeliczeniem kluczy i wartości dla wszystkich n poprzednich tokenów na każdym kroku, co jest kwadratowe pod względem złożoności obliczeniowej. Z pamięcią podręczną każdy nowy token oblicza tylko swoje własne K i V, a resztę odczytuje z pamięci, więc koszt na token pozostaje liniowy.
Jak wygląda ruch agentów
Ludzie często opisują wnioskowanie jako ograniczone przepustowością pamięci, ponieważ dekodowanie dominuje nad widoczną dla użytkownika częścią odpowiedzi. Rzeczywista równowaga między tymi dwiema fazami zależy od obciążenia. Krótki monit żądający długiego eseju jest mocno dekodowany; długi monit agenta żądający drobnej edycji JSON jest mocno wypełniany. To, która strona dominuje, decyduje o tym, co jest obciążane, gdy pamięć podręczna jest źle zarządzana.
Kształt problemu rekomputacji wynika z tej równowagi, a „agentyczność” obejmuje szeroki zakres wzorców użycia. Kodowanie agentowe jest obecnie jednym z najpopularniejszych i w rankingach OpenRouter odpowiada za znaczną część używanych tokenów. Aby skwantyfikować reprezentatywny przypadek, wyposażyliśmy Claude Code w rejestrowanie OpenTelemetry (OTEL) i wyeksportowaliśmy tygodniowe ślady do Grafany. Poniżej przedstawiono podział ruchu tokenów według typu. Uwaga: To użycie Claude Code dotyczy modelu Claude Opus 4.8 z długością kontekstu 1M, pracującego nad wieloma projektami kodowania jednocześnie.
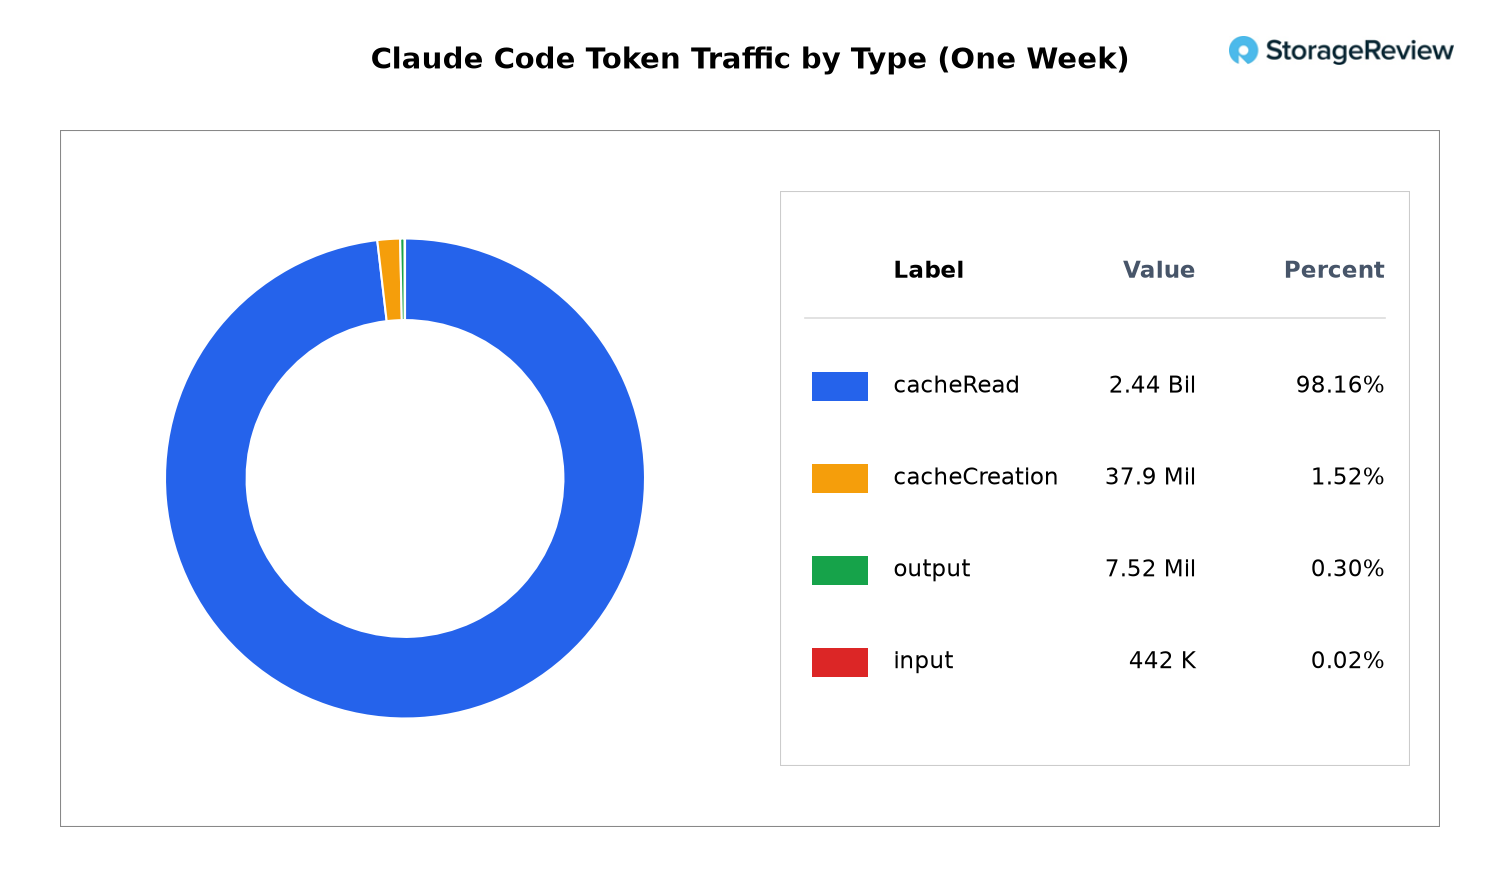
Odczyty z pamięci podręcznej stanowiły 98.16% całego ruchu tokenów. Odsetek tworzenia pamięci podręcznej (wcześniej obserwowany prefiks, który został ponownie wstępnie wypełniony z powodu wygaśnięcia wpisu) wyniósł 1.52%. Odsetek tokenów wyjściowych wyniósł 0.30%. Odsetek prawdziwie zimnych tokenów wejściowych wyniósł 0.02%.
W obciążeniu, w którym 98% ruchu to odczyty z pamięci podręcznej, usunięcie bez odciążenia oznacza ponowne wstępne wypełnienie większości zadań, które system miał wykonać. Wąskie gardło przesuwa się z przepustowości dekodowania, która jest zazwyczaj optymalizowana, na obliczenia wstępnego wypełnienia, które GPU wykonało już we wcześniejszych turach. W rzeczywistości, dość często zdarza się, że architektury obsługujące rozproszone zasoby uruchamiają więcej procesów roboczych wstępnego wypełnienia niż dekodowania w dużej skali, z tego samego powodu: wstępne wypełnienie jest fazą bramkowania.
Wartość 98% to rozkład ruchu jednego użytkownika. Obciążenie czatem w krótkich turach wskazywałoby na większy ruch „na zimno”. System z funkcją wyszukiwania, który wstawia różne dokumenty w każdej turze, również by to wykazał. Ogólny kształt utrzymuje się wszędzie tam, gdzie rozmowy są długie, prefiksy są stabilne, a użytkownicy wracają do tego samego kontekstu.
Gdzie znajduje się skrytka i co się dzieje, gdy się zapełnia
Gdzie tak naprawdę znajduje się ta pamięć podręczna i co się stanie, gdy zabraknie jej miejsca? Po załadowaniu wag modelu, pozostała pamięć VRAM staje się przestrzenią pamięci podręcznej KV, podzieloną na bloki o stałym rozmiarze, a podczas uruchamiania silnik informuje o liczbie tokenów, które może pomieścić. Ta pula to jedyne miejsce, w którym pamięć podręczna może się znajdować w standardowej konfiguracji bez odciążania KV.
Serwery GPU są drogie, a tokeny stanowią produkt, dlatego celem jest ich całodobowe zasilanie. Oznacza to utrzymywanie GPU obciążonej małą kolejką żądań oczekujących na przetworzenie, aby obliczenia nie stały bezczynnie, a jednocześnie równoważenie kolejki w celu utrzymania opóźnienia odpowiedzi w ramach celu poziomu usług (SLO). Nie każde żądanie zużywa całe okno kontekstowe, dlatego wiele ukończonych kluczy KV pozostaje w pamięci podręcznej VRAM. Jednak pod stałym obciążeniem pamięć podręczna się zapełnia, a gdy to nastąpi, starsze wpisy są usuwane, aby zrobić miejsce.
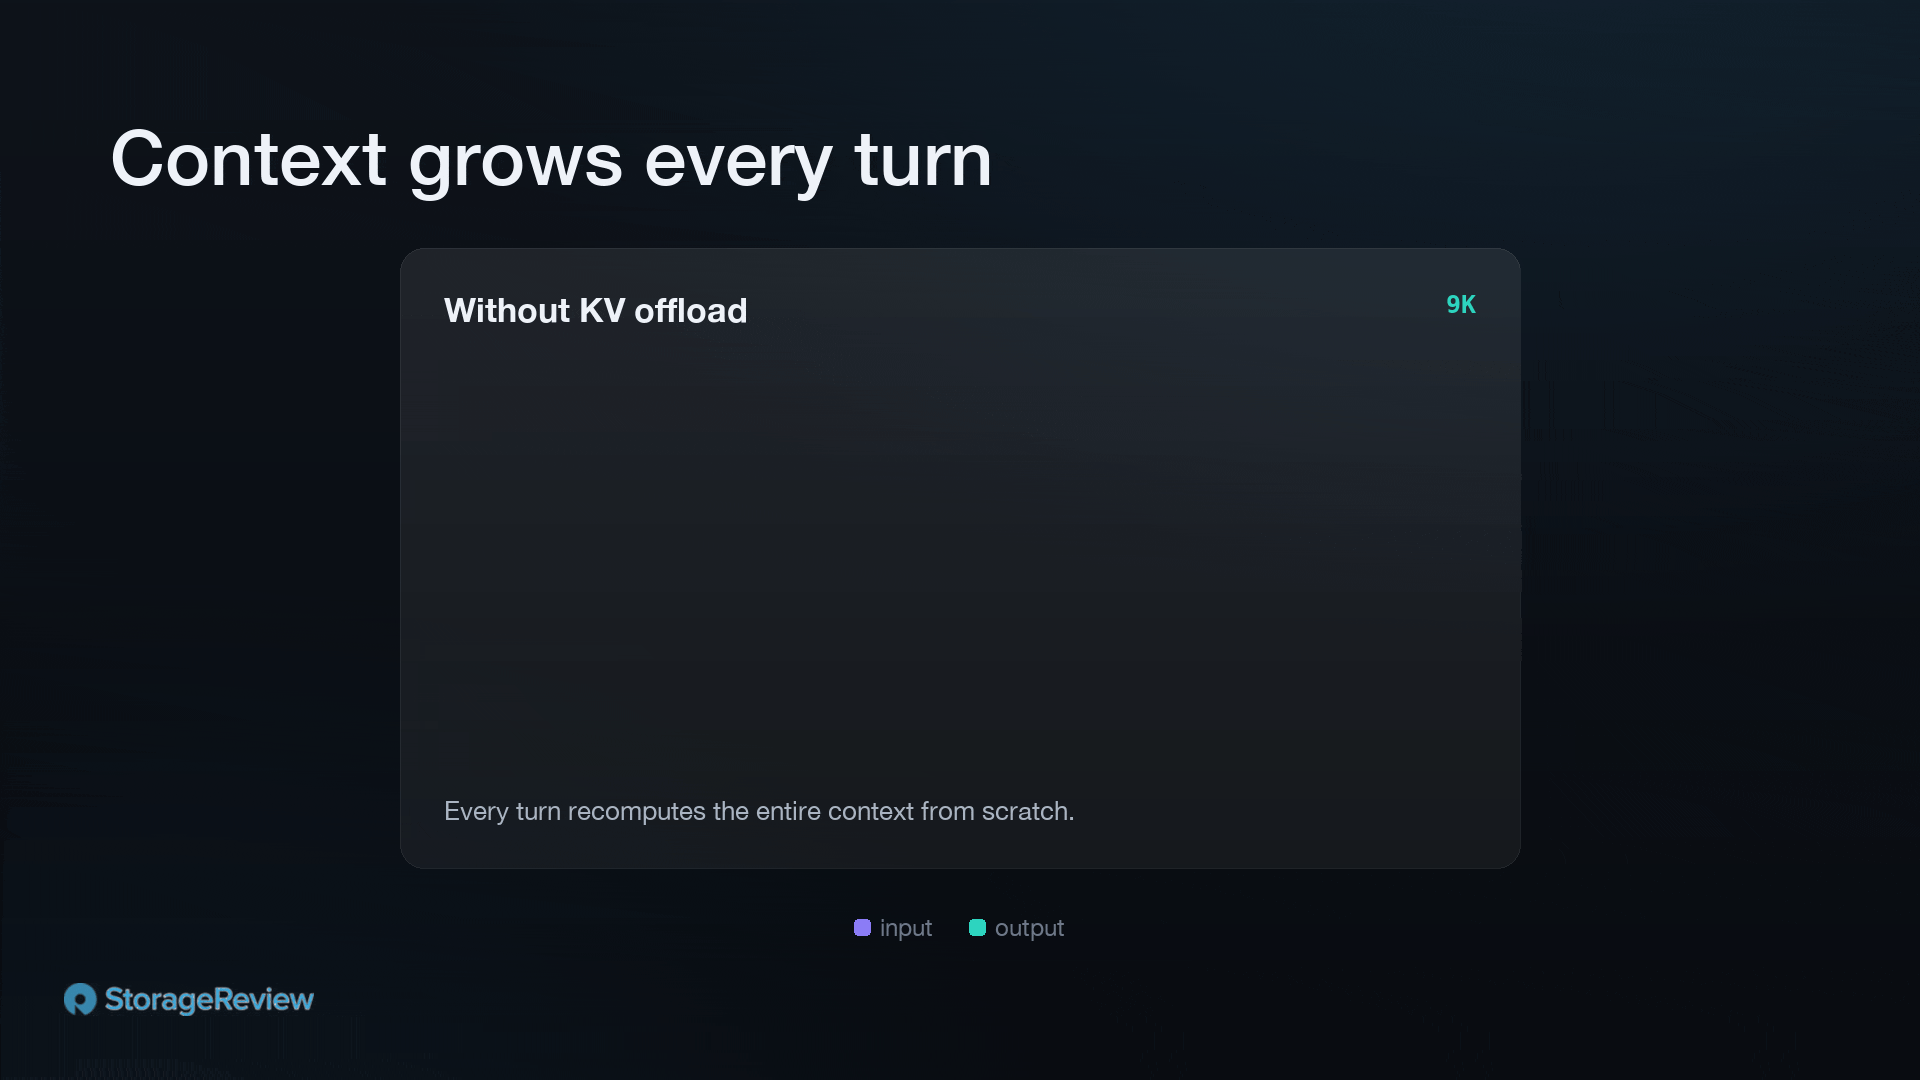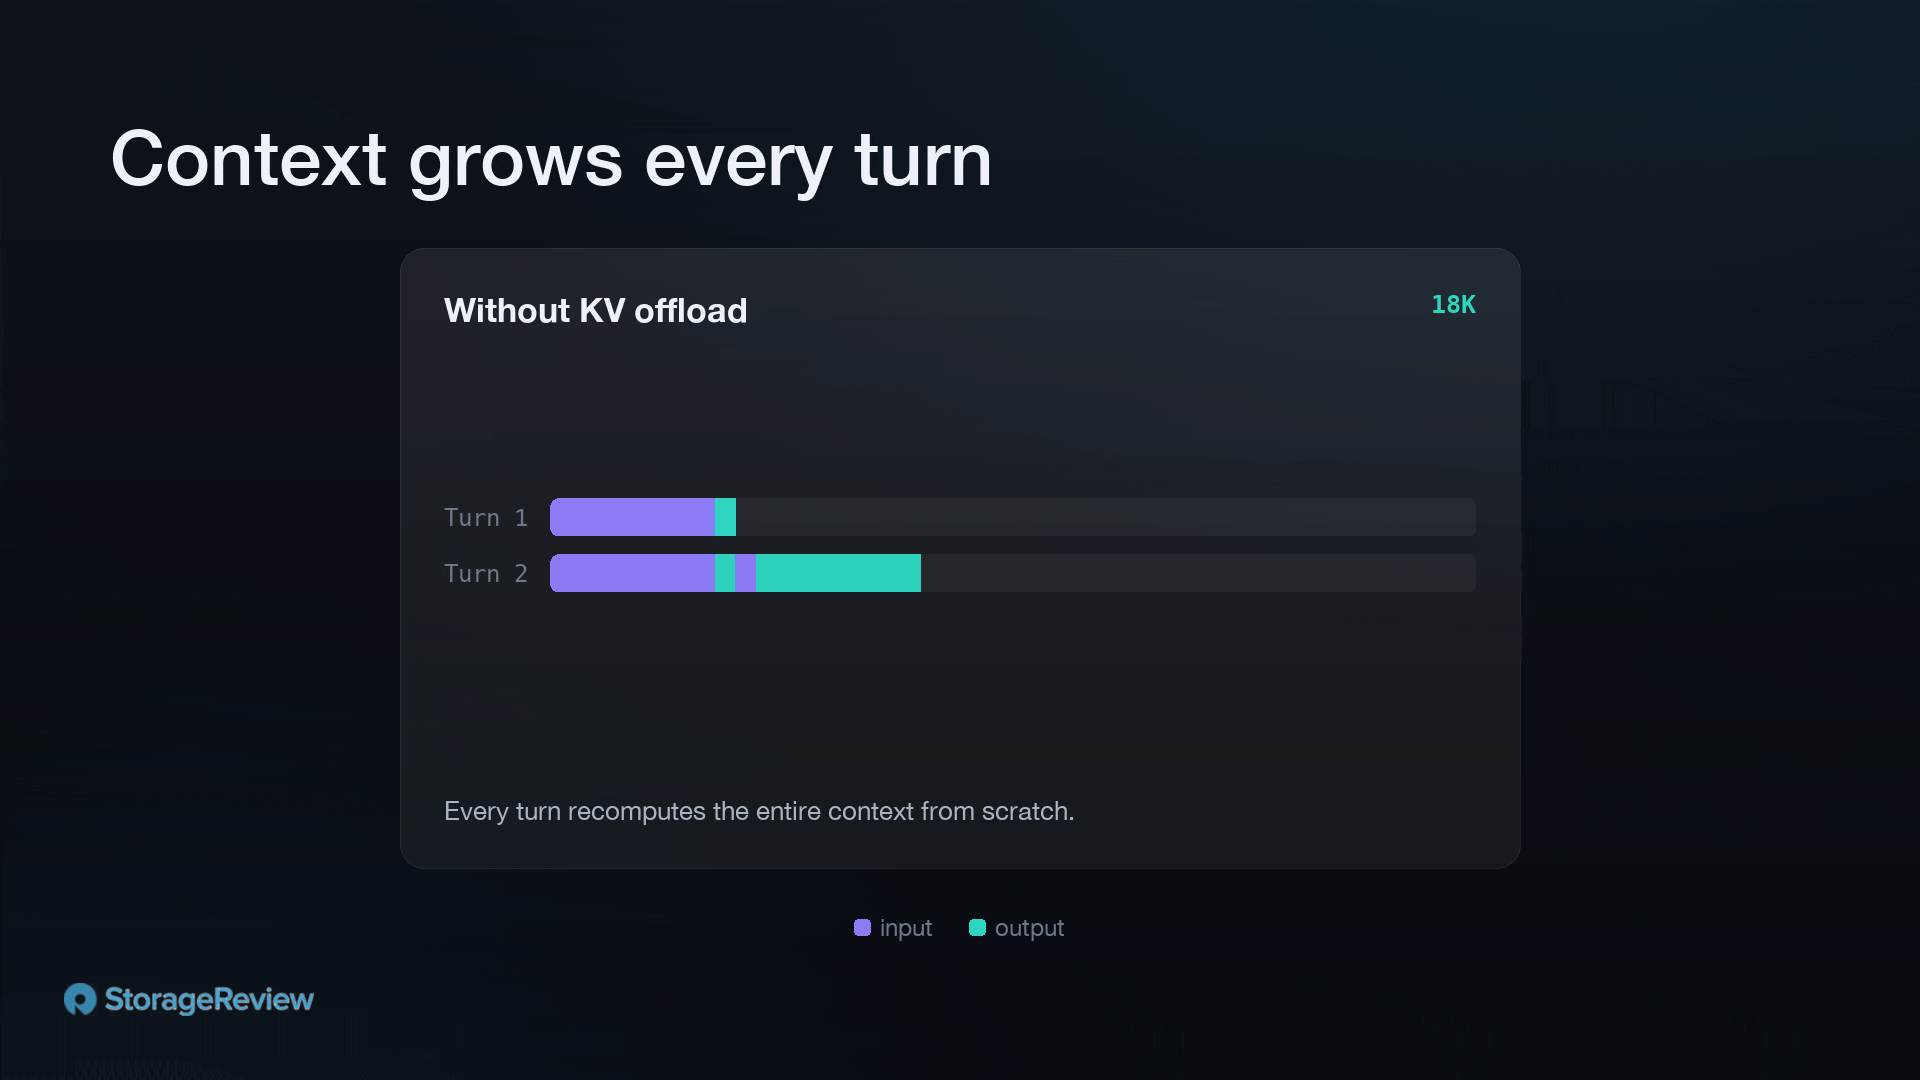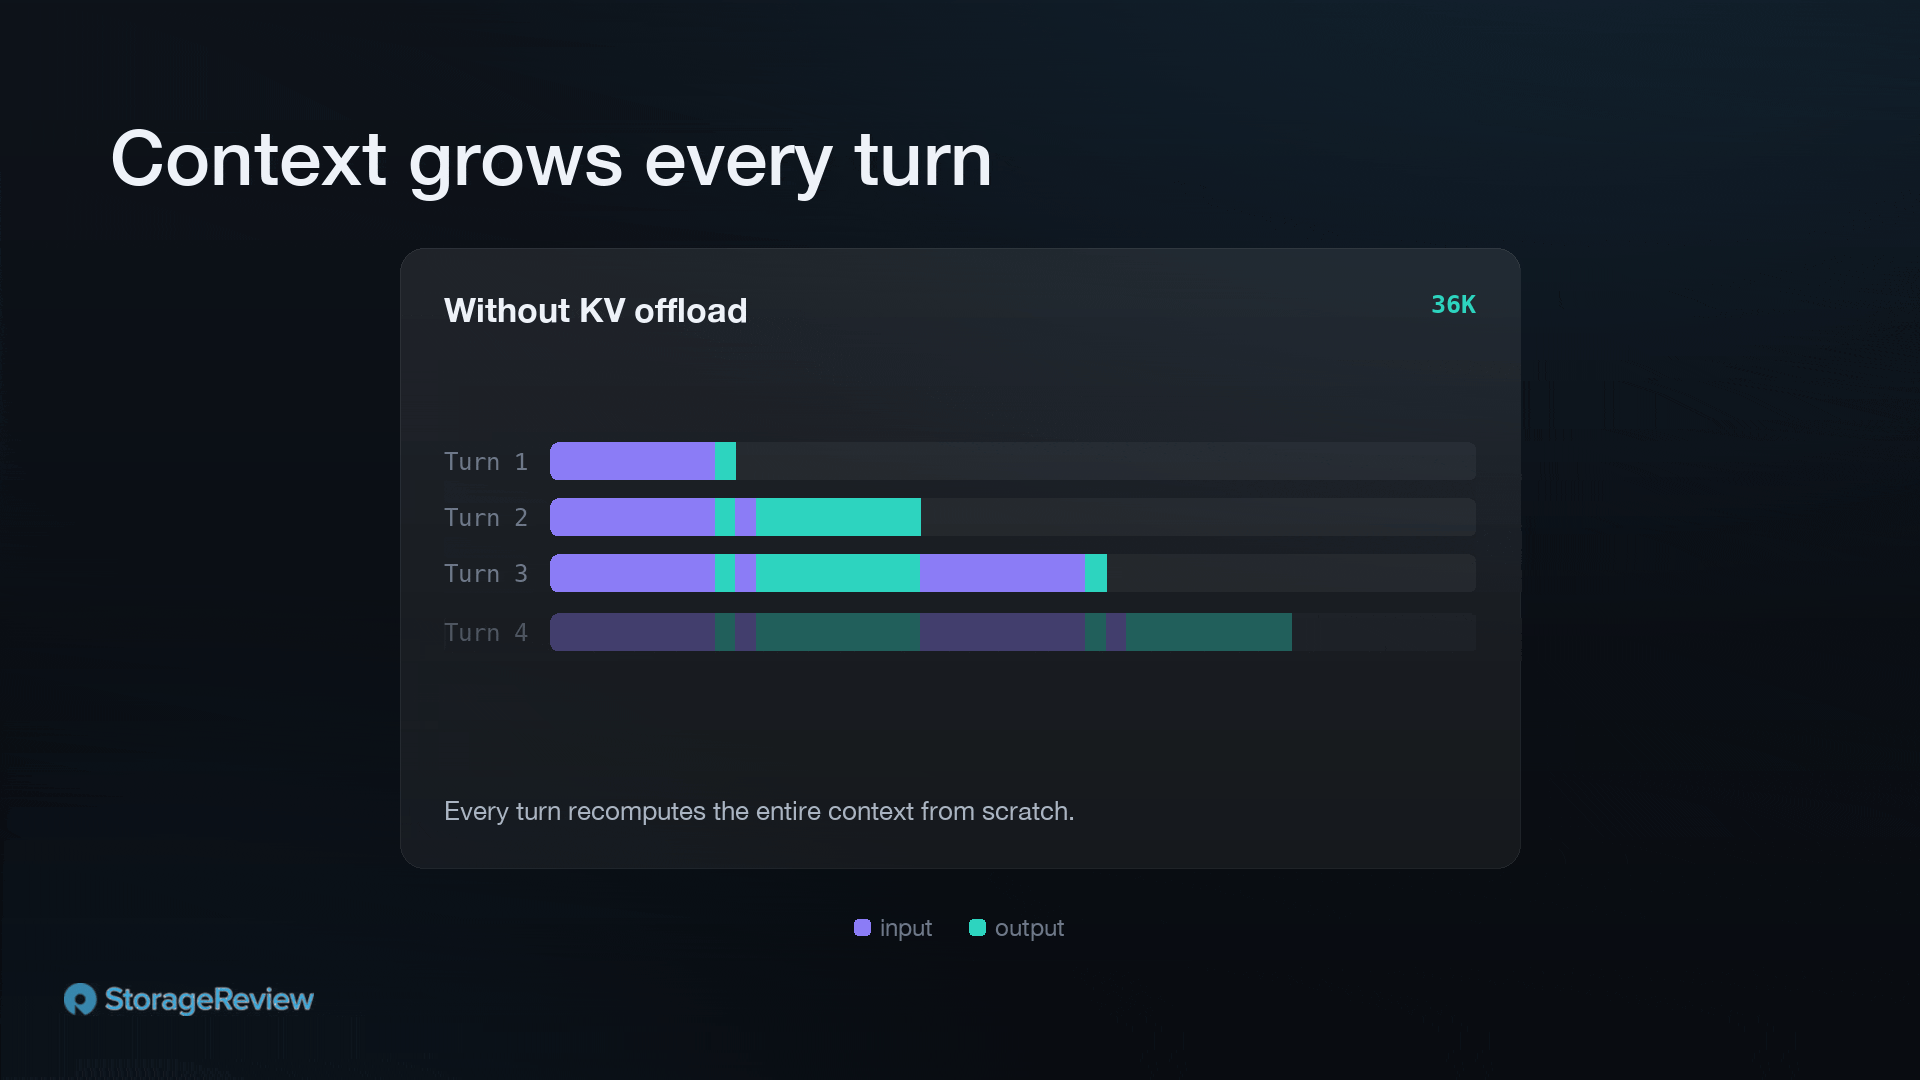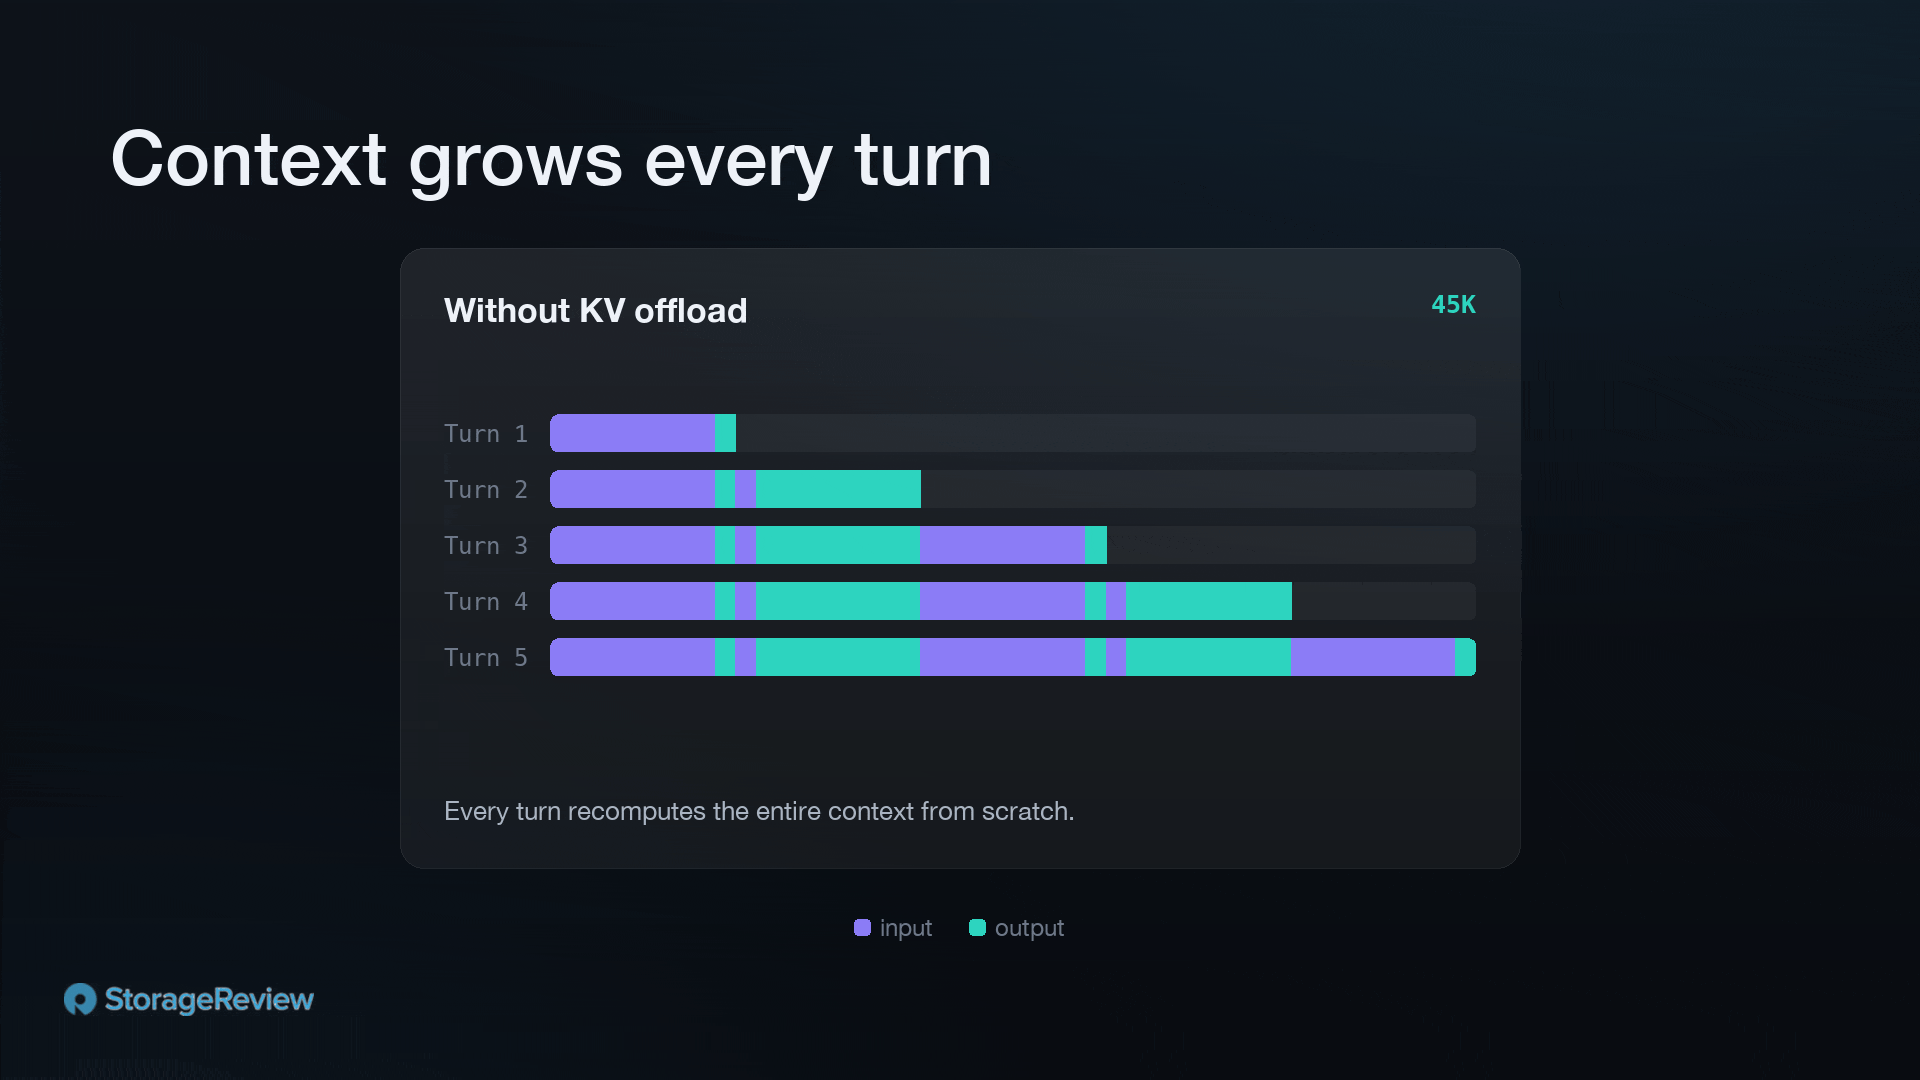
W idealnym świecie wystarczyłoby odpowiedzieć na wszystkie pytania za jednym zamachem i mieć to z głowy. Ale modele nie są jeszcze tak dobre, więc uruchamiamy pętle agentowe, przełączając się między użytkownikiem a agentami. Gdy nadchodzi kolejna tura, jeśli jej KV nie jest jeszcze zbuforowana, silnik ponownie przetwarza całą dotychczasową konwersację, w tym nowe tokeny. Kontekst każdej poprzedniej tury jest ponownie przetwarzany przez model, a obliczenia, które GPU już wykonało na tych tokenach, są opłacane drugi, trzeci i kolejny raz za każdą kolejną turę. Ta część ćwiczenia to czyste marnotrawstwo.
Co zmienia odciążenie pamięci podręcznej KV
Zamiast usuwać dane w momencie zapełnienia pamięci VRAM, odciążenie stopniowo usuwa dane z pamięci podręcznej w dół hierarchii: z pamięci VRAM do pamięci systemowej, a następnie do dysku SSD. Gorący zestaw roboczy pozostaje w pamięci VRAM; wpisy, które już się nie mieszczą, są przenoszone do pamięci systemowej, a jeśli pamięć systemowa się zapełni, są ponownie przenoszone na dysk SSD lub do sieciowej warstwy pamięci masowej. Rzeczywiste usuwanie danych staje się rzadsze, ponieważ wynika z ustawionego przez użytkownika czasu życia (TTL), a nie z obciążenia pamięci.
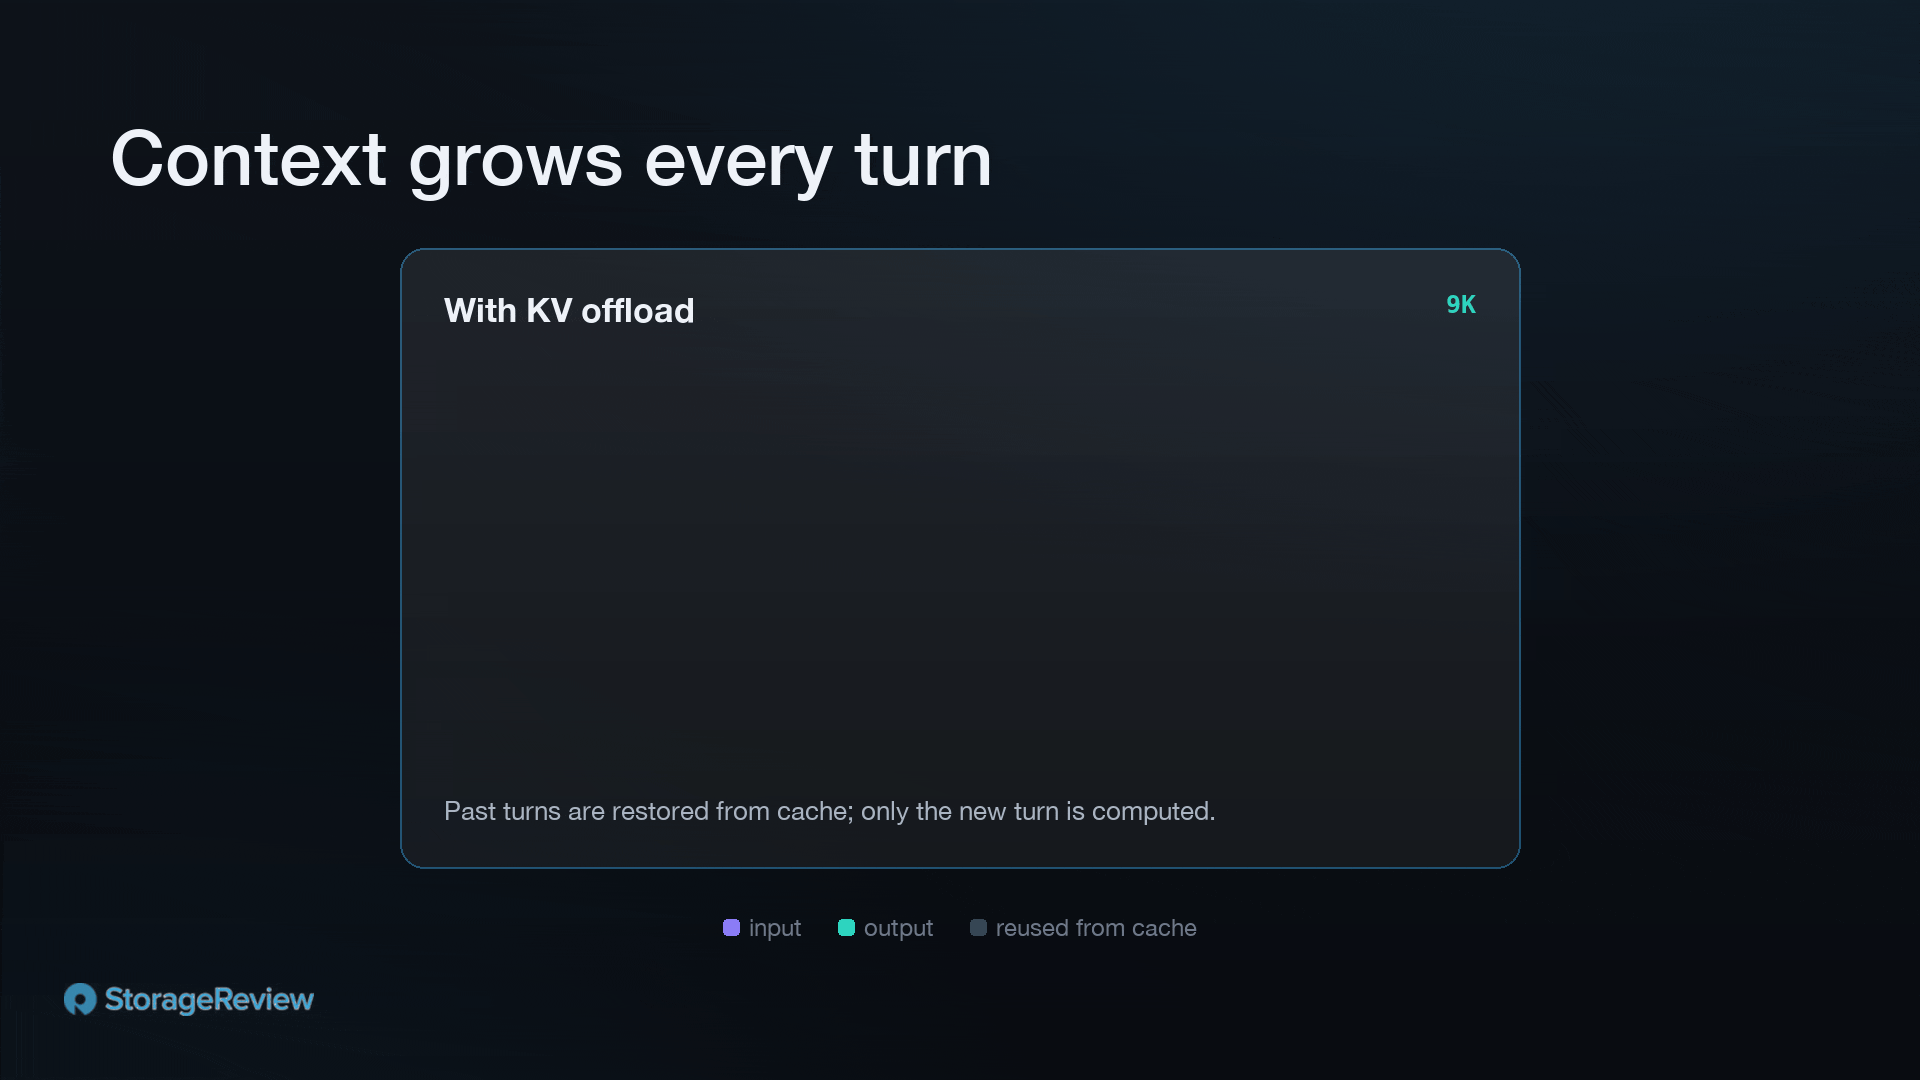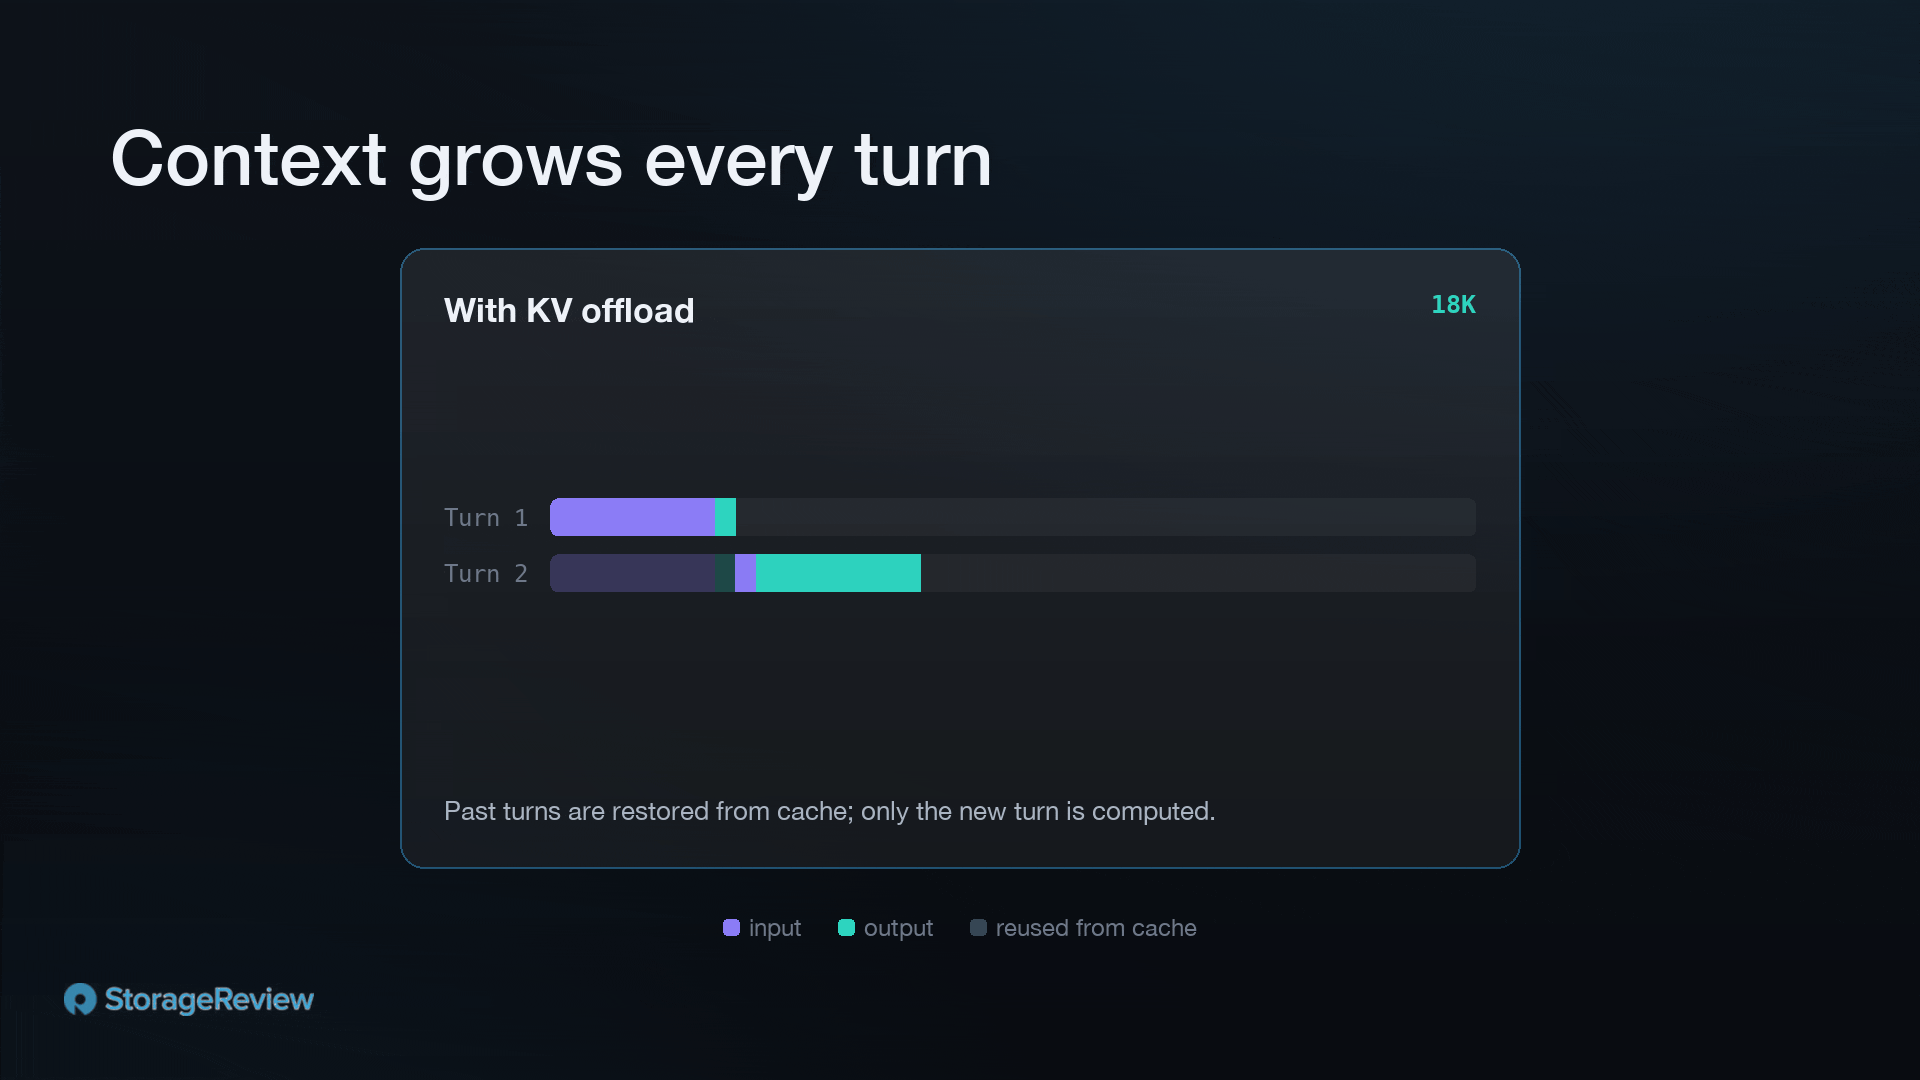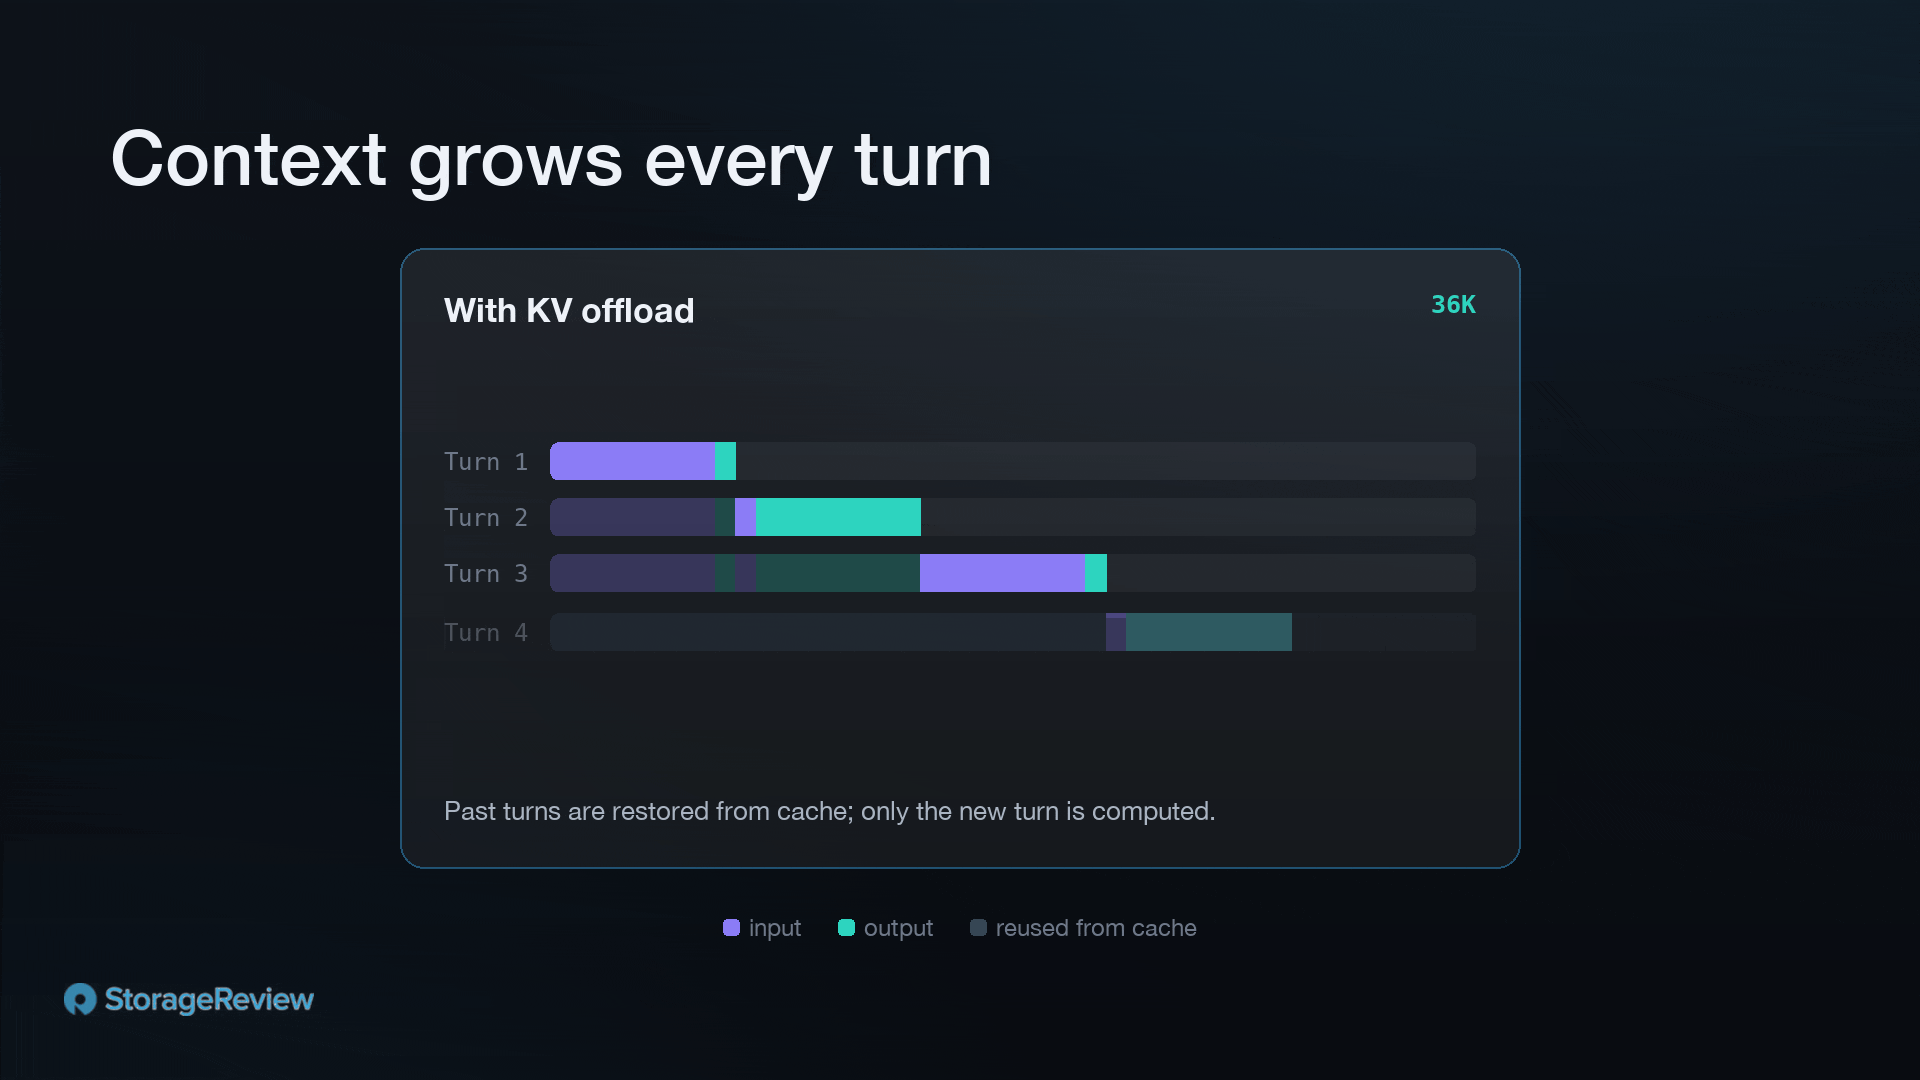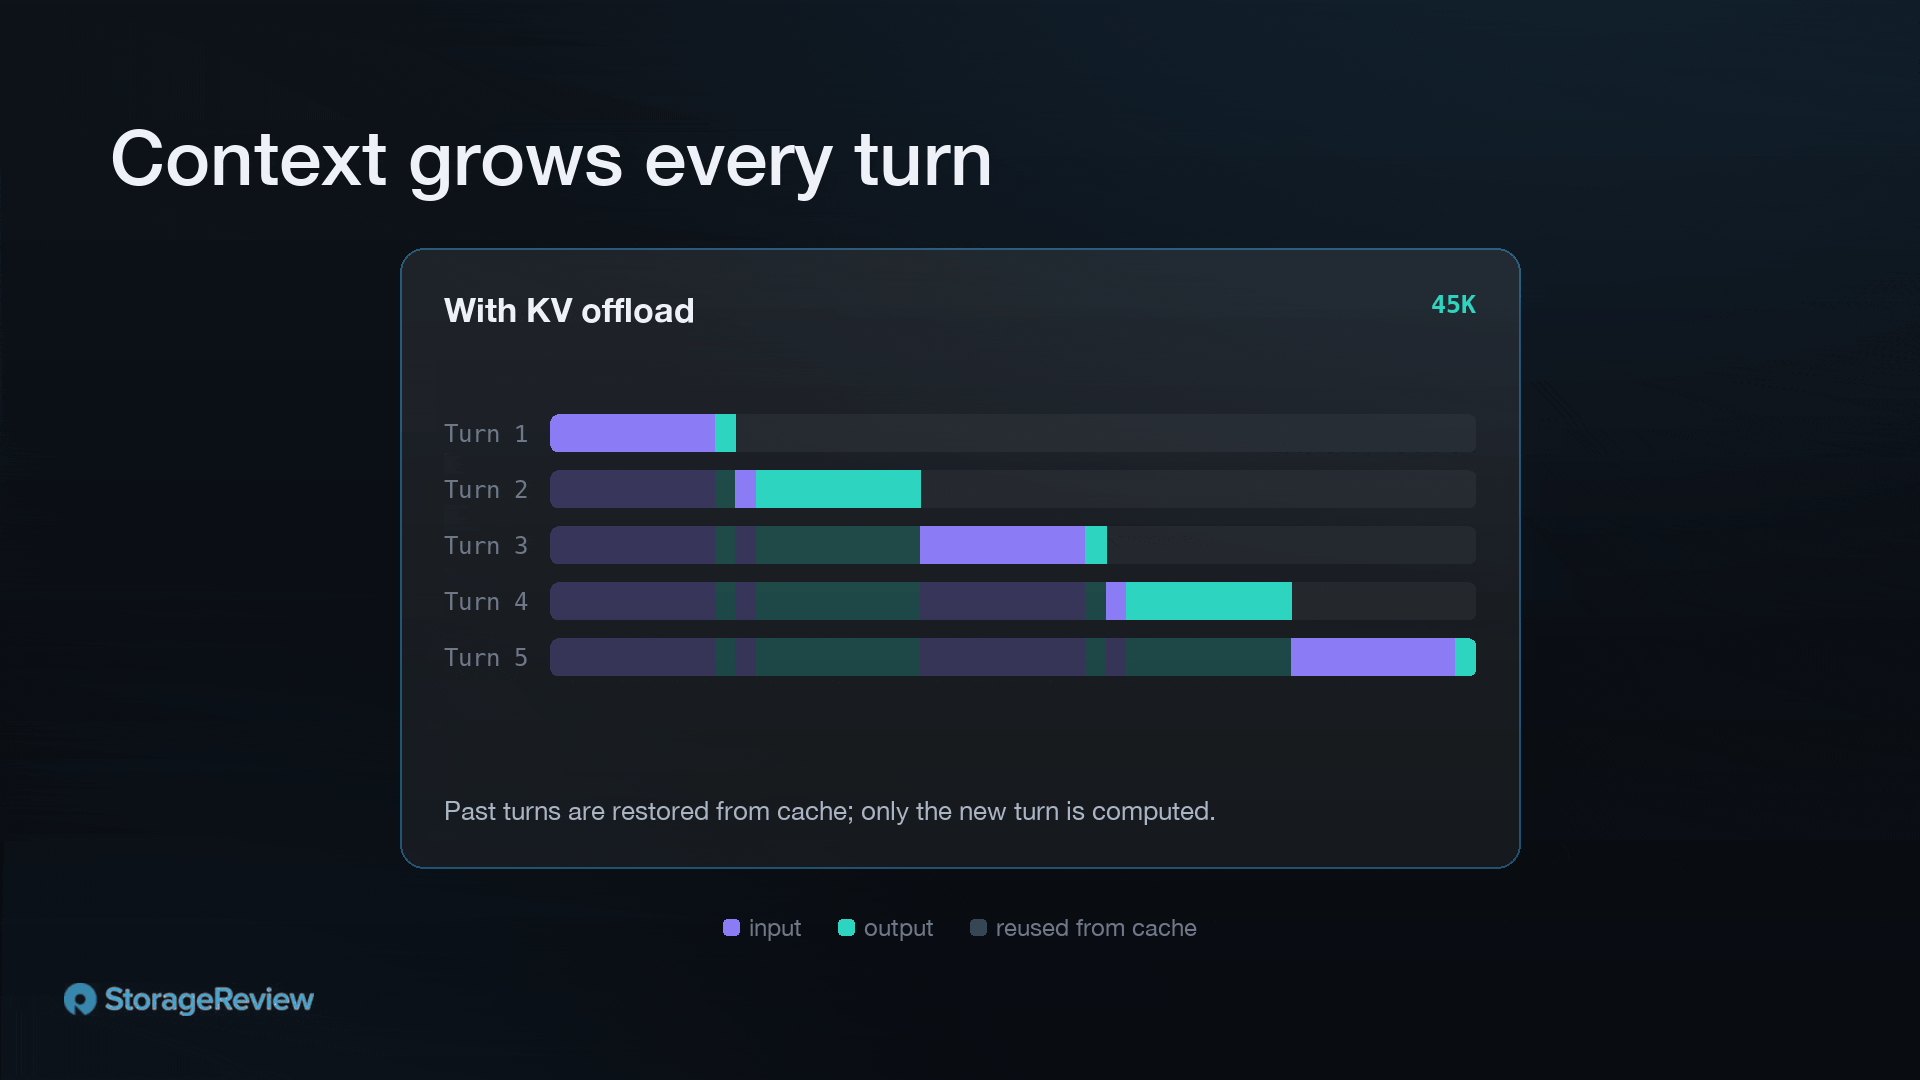
Podczas kolejnej tury, zamiast przeliczać dziesiątki tysięcy tokenów kontekstu, pobieramy KV z pamięci RAM lub pamięci flash. Przeładowanie z pamięci systemowej wiąże się z niewielkim opóźnieniem, ale jest znacznie tańsze i szybsze niż ponowne wypełnianie wstępne. Przeładowanie z pamięci NVMe jest nieco wolniejsze niż pobieranie z pamięci DRAM, ale nadal znacznie szybsze niż zastępowane przeliczenie. Pojemność pamięci masowej jest stosunkowo tania; obliczenia GPU nie, więc poświęcenie niewielkiego opóźnienia przeładowania na początku tury w celu pominięcia wielosekundowego przeliczenia jest korzystne.
Jak testowaliśmy
Przetestowaliśmy to w naszym laboratorium. Konfiguracja systemu wyglądała następująco:
- Serwer: Dell PowerEdge XE7740
- Procesory graficzne: 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (96 GB)
- Pamięć systemowa: 1TB DDR5 (16 x 64GB 5200MT/s DDR5)
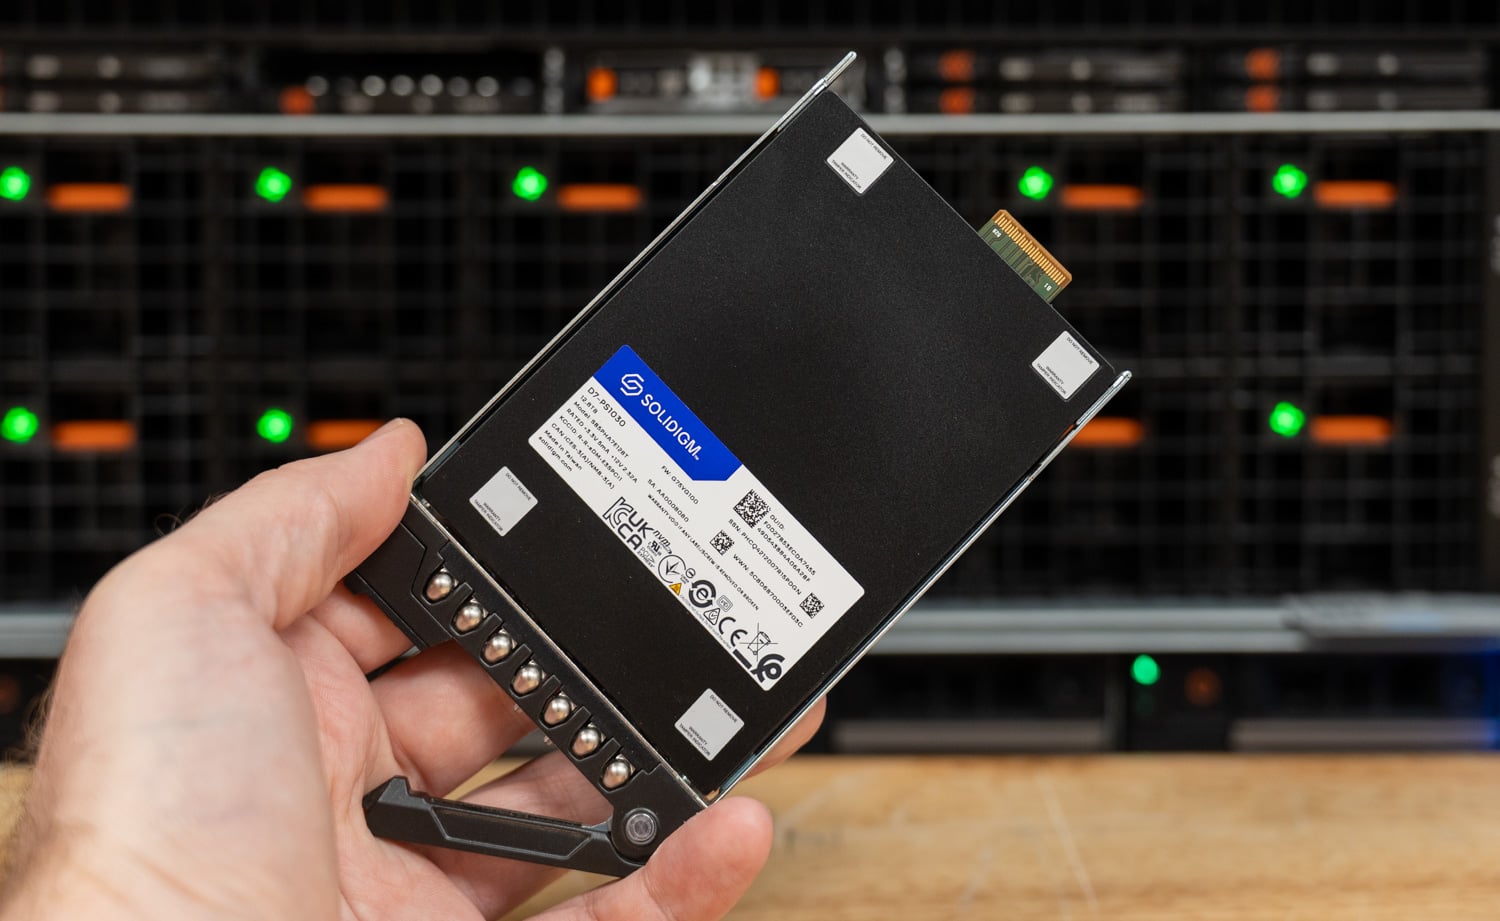
- Pamięć masowa: 8 dysków Solidigm PS1030 12.8 TB E3.S (RAID10)
- Stos obsługujący: vLLM 0.22.0 z LMCache 0.5.0
- Model: MiniMax-M2.7
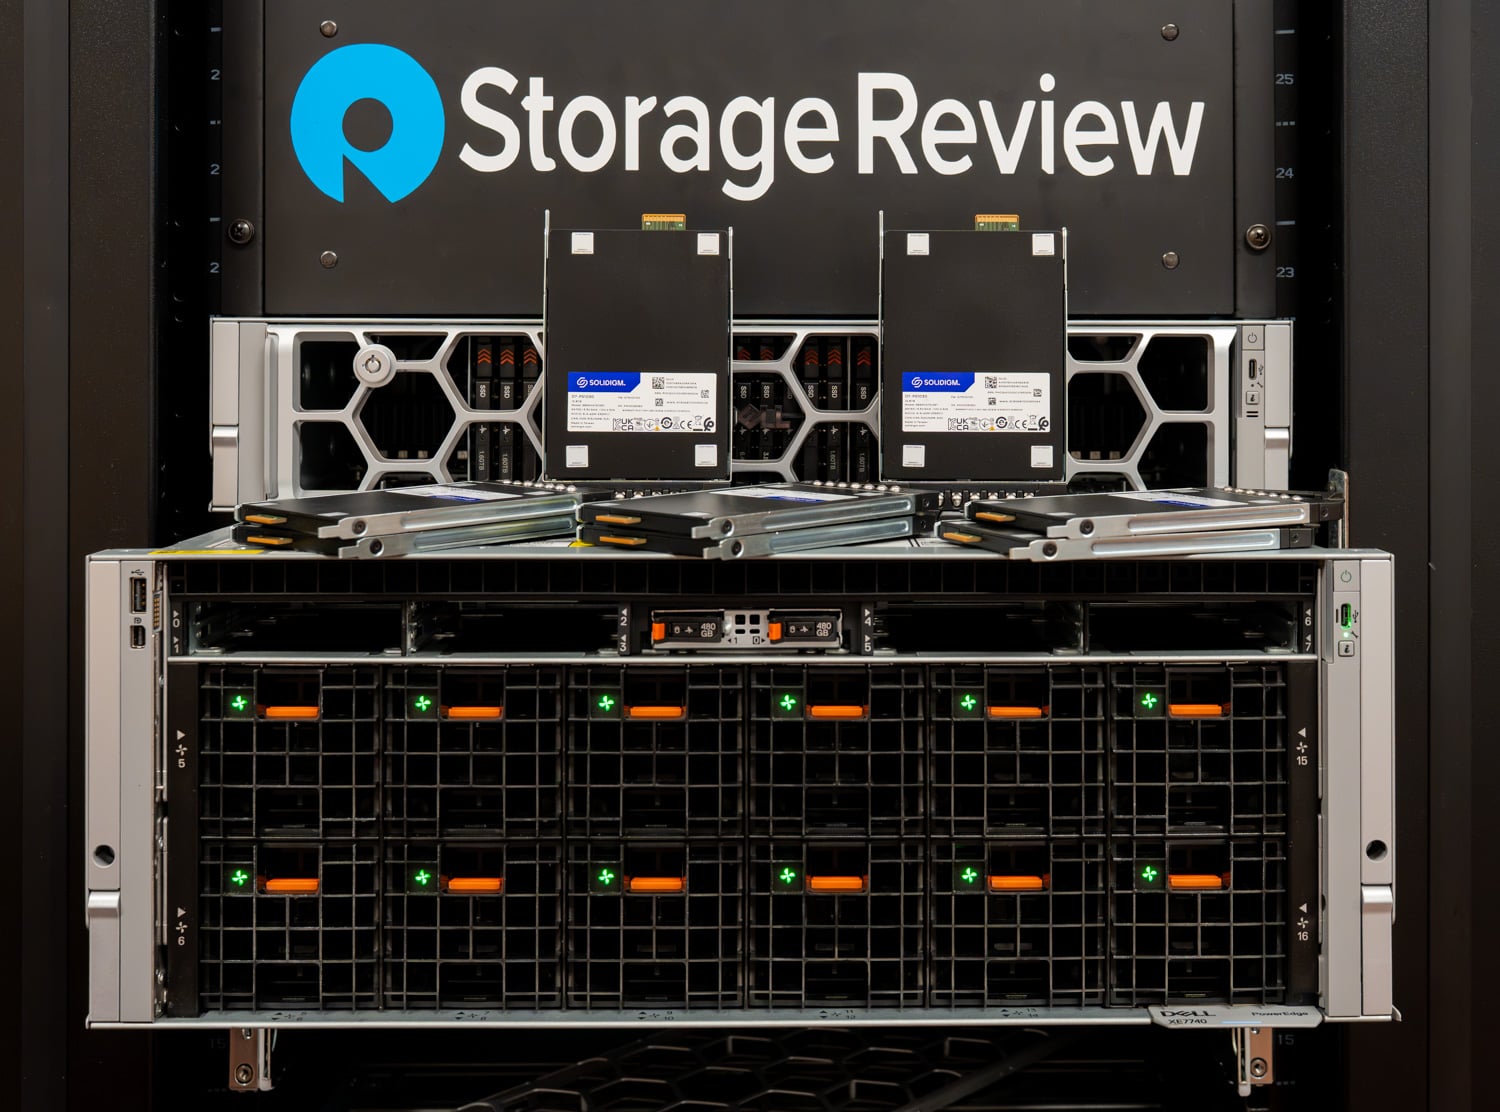
Platforma testowa idealnie nadaje się do tego obciążenia. Serwer Dell PowerEdge XE7740 został zaprojektowany specjalnie do wnioskowania AI w przedsiębiorstwach – to obudowa PCIe Gen5 obsługująca do 8 procesorów graficznych o podwójnej szerokości. Konfiguracja z czterema procesorami graficznymi, którą testowaliśmy, jest jedną z najpopularniejszych sprzedawanych konfiguracji. Zapewnia ona wystarczającą moc akceleratora dla szerokiego zakresu wdrożeń wnioskowania, pozostawiając jednocześnie miejsce na skalowanie do ośmiu w miarę wzrostu zapotrzebowania. Każda karta NVIDIA RTX PRO 6000 Blackwell Server Edition oferuje 96 GB pamięci GDDR7, więc cztery karty zapewniają pokaźną pulę pamięci VRAM, zanim pamięć podręczna będzie musiała opuścić procesor graficzny. Poniżej, warstwa odciążająca opiera się na ośmiu dyskach Solidigm D7-PS1030 o pojemności 12.8 TB w konfiguracji RAID10 – pamięci flash Gen5 o wysokiej wytrzymałości, dostosowanej do ciągłych zapisów generowanych przez warstwę pamięci podręcznej KV. I wreszcie, wybór modelu — MiniMax-M2.7 — w czasie testów był jednym z najlepszych modeli o otwartym kodowaniu, które pasowały do naszej konfiguracji z czterema procesorami graficznymi.
Przetestowaliśmy trzy konfiguracje:
- Bazowa pamięć VRAM, standardowa pamięć vLLM bez odciążania, w której wszystko, co mieści się w pamięci VRAM, jest buforowane, a wszystko inne jest usuwane.
- Odciążenie pamięci podręcznej LMCache do pamięci systemowej, przydzielone 512 GB do odciążenia.
- Odciążenie LMCache do pamięci flash, z lokalną macierzą RAID10 NVMe jako warstwą odciążenia, wspomaganą przez bufor przejściowy pamięci RAM o pojemności 64 GB.
Modelowaliśmy obciążenie na rzeczywistym ruchu kodowania agentowego, a nie na stałym, syntetycznym przemiataniu prefiksów. Ten ruch jest intensywnie wypełniany prefiksami i mało dekodowany, z rozległym ponownym wykorzystaniem prefiksów. Sesje przychodzą jako proces Poissona z szybkością λ = 2.5 sesji na minutę. Każda sesja trwa wiele tur. W każdej turze model przyjmuje krótki append, zazwyczaj wynik narzędzia lub polecenia o długości od 250 do 600 tokenów, a czasami odczyt pliku o długości od 1,500 do 3,500 tokenów. Odpowiada krótką odpowiedzią, zazwyczaj od 40 do 200 tokenów wywołań narzędzi lub krótkiego uzasadnienia, a czasami blokiem kodu o długości od 400 do 900 tokenów. Długość tur jest jitterowana o ±100 tokenów. Sesje rosną monotonicznie w kierunku pułapu kontekstu 64 tys. tokenów, co umieszcza je w reżimie głębokiego kontekstu, w którym zestaw roboczy przekracza pojemność pamięci VRAM. Na wszystkich trzech poziomach obowiązuje ten sam ładunek, przy czym każdy z nich ma 3-minutową rozgrzewkę pamięci podręcznej.
Krótka uwaga na temat konfiguracji pamięci: model XE7740 w momencie dostawy był wyposażony w 2 TB pamięci DDR5, co stanowiło konfigurację o najwyższej specyfikacji, przeznaczoną do realizacji szeregu projektów, a jego cena została ustalona przed 2026 rokiem, kiedy to wzrost zapotrzebowania na pamięć sprawił, że tak duża ilość pamięci DRAM stała się zupełnie inną pozycją. Pierwotna konfiguracja była przewymiarowana w stosunku do tego, co firma zamówiłaby dzisiaj z czterema procesorami graficznymi, więc aby była bardziej realistyczna, usunęliśmy 1 TB pamięci, pozostawiając jeden moduł DIMM na kanał, aby zachować maksymalną przepustowość pamięci.
Jedna uwaga dotycząca metodologii warstwy flash: w uruchomieniach wykorzystano lokalne zaplecze dyskowe LMCache z wymaganym buforem przejściowym RAM o pojemności 64 GB przed macierzą. Zasięg KV zachowany w pamięci flash znacznie przekroczył całkowitą pamięć DRAM hosta w trakcie uruchomienia, więc stałe wyniki odzwierciedlają obsługę dysku, a nie pamięć hosta.
Wydajność
Przepustowość pod obciążeniem
Całkowita przepustowość obsługi w trakcie cyklu, gdy zestaw roboczy KV przekracza możliwości każdej warstwy:
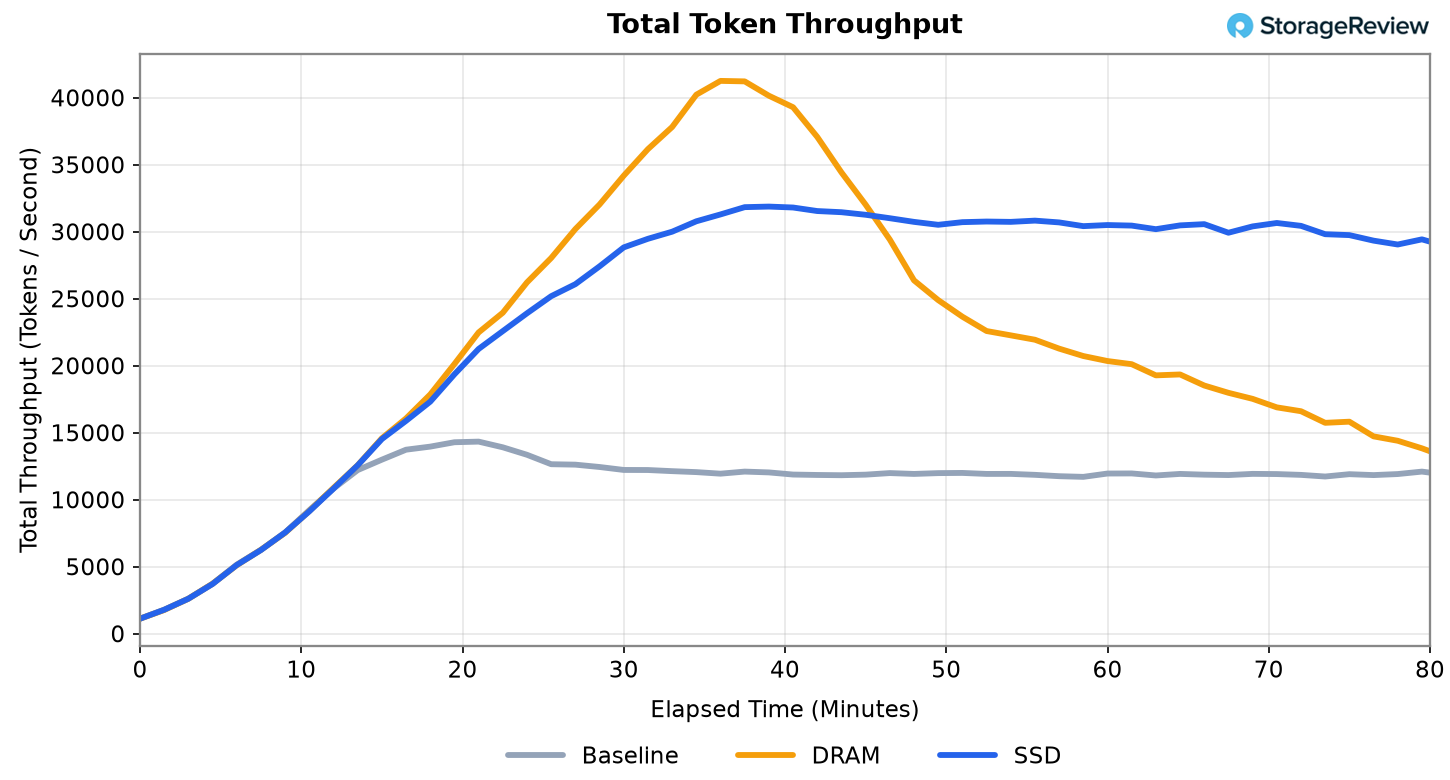
Każda warstwa pamięci działa razem przez pierwsze 10 minut, podczas gdy pamięć podręczna się zapełnia, praktycznie bez różnicy w wydajności. Następnie, w miarę zapełniania się warstw pamięci, warstwy rozdzielają się. Najpierw następuje zatrzymanie bazowej wartości VRAM: po nasyceniu VRAM, osiąga ona poziom około 12 000 tokenów na sekundę. Każda nowa sesja usuwa starszą, a przesunięta pamięć podręczna musi zostać odbudowana od nowa po powrocie sesji. W związku z tym więcej czasu poświęca się na ponowne wstępne zapełnienie, a mniej na dekodowanie.
Poziomy DRAM i SSD stale rosną, znacznie przekraczając ten pułap, ponieważ do momentu zapełnienia pamięci podręcznej obsługują niemal każdy prefiks z pamięci lub dysku, zamiast go przeliczać. Czas, który jest zużywany podczas ponownego wstępnego zapełniania, jest przeznaczany na generowanie nowych tokenów.
W szczytowym momencie odciążenie zapewniało do 2.9-krotności całkowitej przepustowości bazowej w warstwie DRAM (+188%) i 2.2-krotności w warstwie flash (+122%). Zanim zestaw roboczy przekroczy pojemność pamięci VRAM, wszystkie trzy konfiguracje osiągają różnicę procentową. Nic nie jest usuwane, więc odciążenie nie ma czego odzyskać. Korzyści pojawiają się tylko wtedy, gdy obciążenie pamięci wymusza usunięcie i rosną wraz ze stopniem obciążenia serwera.
Potrzeba większego poziomu pojawia się po zapełnieniu pamięci DRAM. Przy takim obciążeniu pamięć podręczna RAM o pojemności 512 GB ulega nasyceniu po około 45 minutach od uruchomienia i od tego momentu musi rozpocząć usuwanie danych. Zwracane prefiksy nie trafiają i są ponownie wstępnie wypełniane, co jest dokładnym przeliczeniem, którego pamięć podręczna miała uniknąć. Poziom SSD, z terabajtami zapasu, nigdy nie napotyka na tę przeszkodę. Po przejściu przez mostek, pamięć flash obsługuje około 30 000 tokenów na sekundę, w porównaniu z około 17 000 tokenów pamięci DRAM, co daje 75% przewagę w przepustowości dysku SSD po wyczerpaniu się pamięci RAM. Innymi słowy, po nasyceniu, poziom DRAM zapewnił zaledwie 42% swojej szczytowej przepustowości, podczas gdy poziom SSD zapewnił 94% swojej własnej. To jest drabina pojemności, na której opiera się całe ćwiczenie: pamięć VRAM kończy się pierwsza, pamięć DRAM 512 GB kończy się później, a pamięć pamięci masowej mierzona w terabajtach, a nie gigabajtach, w praktyce nigdy się nie kończy, dzięki czemu kontekst jest nadal udostępniany na długo po tym, jak szybsze pamięci będą musiały zacząć go usuwać.
Jedno zastrzeżenie dotyczące odczytu tej wartości całkowitej przepustowości: dziesiątki tysięcy tokenów na sekundę, które raportuje, nie odzwierciedlają szybkości, z jaką GPU oblicza tokeny; w dużej mierze odzwierciedlają one szybkość obsługi warstwy odciążenia. Całkowita przepustowość obejmuje każdy wejściowy token prefill oraz każdy wyjściowy token decode przesyłany przez każde żądanie. Jednak dzięki pamięci podręcznej, trafienie ładuje wartość KV prefiksu z pamięci DRAM lub flash zamiast ponownie wstępnie wypełniać ją na GPU.
Ograniczenie liczby tokenów wyjściowych, czyli części przepustowości, na którą użytkownik faktycznie czeka, daje bardziej przejrzysty obraz:
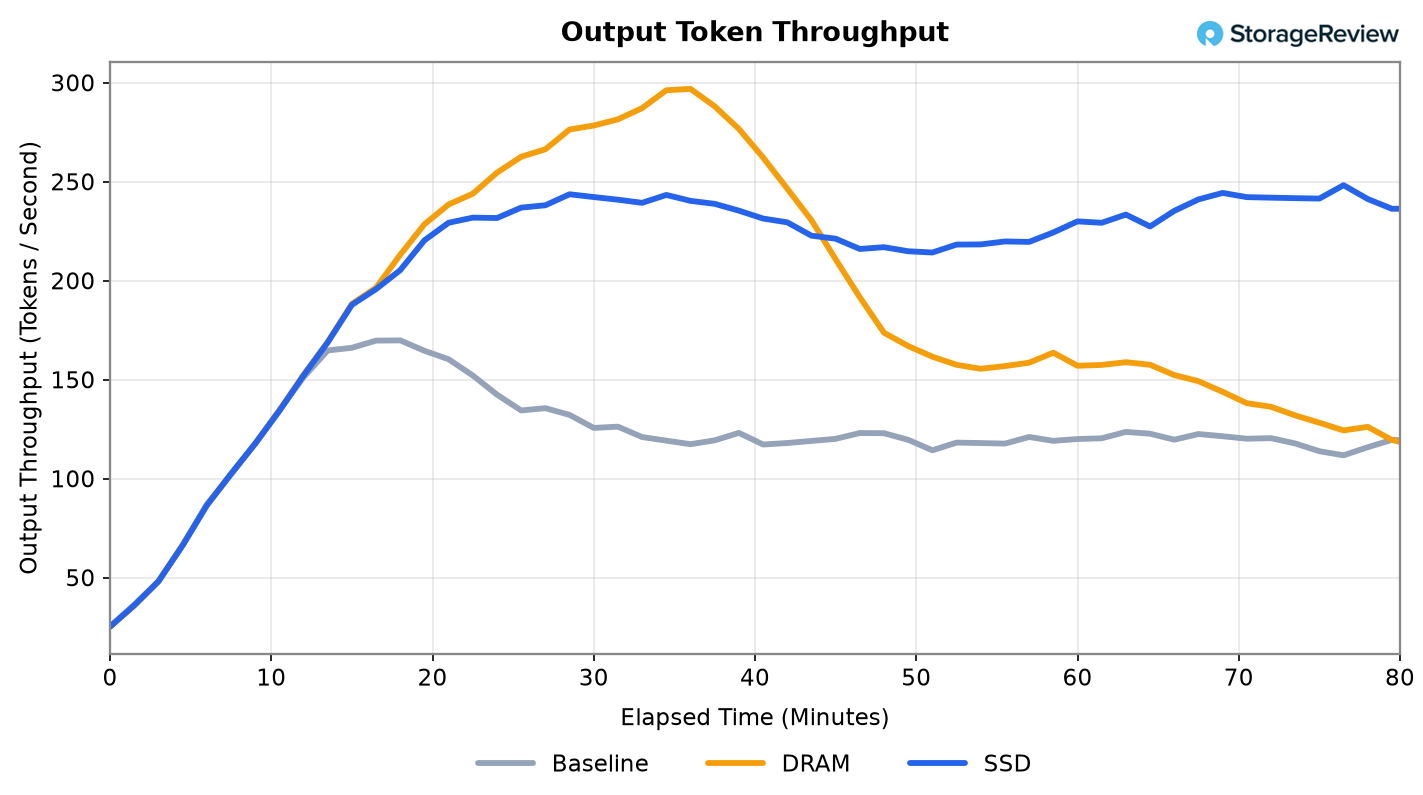
W przypadku tokenów wyjściowych, trzy warstwy ponownie śledzą się, gdy pamięć podręczna się zapełnia, a następnie rozdzielają się w punkcie przecięcia. Warstwa DRAM osiąga szczyt blisko 300 tokenów na sekundę, co stanowi wzrost o 75% w stosunku do wartości bazowej, i spada, gdy zaczyna się wycofywać; pamięć flash utrzymuje się na poziomie blisko 250 tokenów przez resztę cyklu, co stanowi wzrost o 46% w stosunku do wartości bazowej. Linie RAM i SSD utrzymują się w odległości około 10% od siebie, aż do momentu nasycenia pamięci DRAM; po tym czasie różnica się powiększa.
Opóźnienie pierwszego tokena: na co czeka użytkownik
Przepustowość mierzy łączną produkcję tokenów. Czas do pierwszego tokena mierzy to, co widzi indywidualny użytkownik: czas oczekiwania od wysłania do otrzymania pierwszego tokena. Przedstawiamy go w trakcie realizacji, na medianie, w miarę rozrastania się zestawu roboczego i zapełniania kolejnych poziomów.
Dopóki pamięć podręczna jest aktywna, wszystkie trzy warstwy zwracają pierwszy token w około pół sekundy. Następnie rozchodzą się, w tej samej kolejności, co ich przepustowość. Najpierw załamuje się linia bazowa: na początku testu przekracza 10 sekund, podczas gdy warstwa DRAM utrzymuje się poniżej 1-sekundowego czasu TTFT znacznie dłużej, aż do zapełnienia 512 GB około 45 minuty. Następnie opóźnienie gwałtownie spada, gdy rozpoczyna się usuwanie danych i ponowne przetwarzanie. Warstwa SSD degraduje się najłagodniej i utrzymuje najniższy ogon z trzech w drugiej połowie testu.
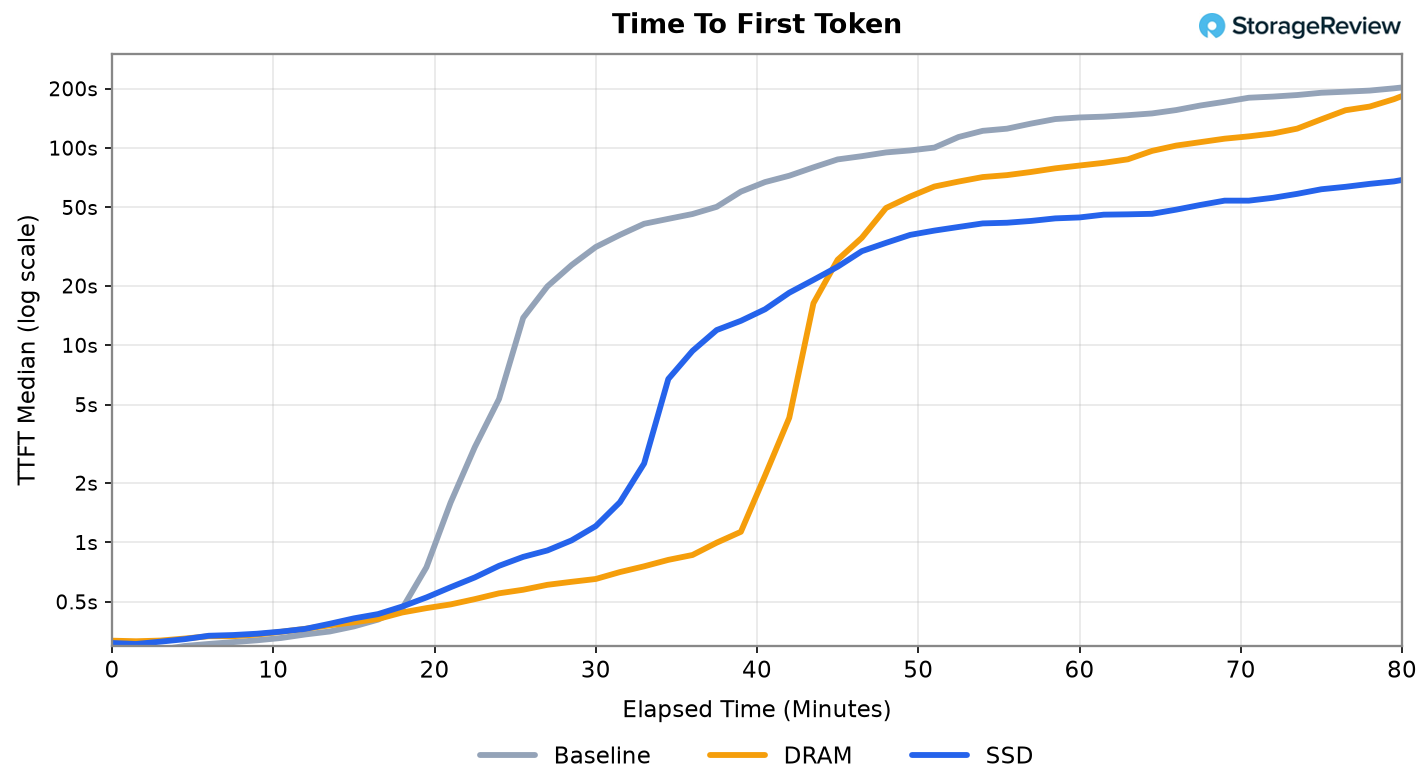
To odwrócenie jest miniaturowym argumentem o warstwowaniu. Pamięć DRAM wygrywa pod względem opóźnień, gdy zestaw roboczy mieści się w tej warstwie; pamięć flash wygrywa pod względem opóźnień, gdy nie mieści się w tej warstwie, ponieważ nadal zachowuje kontekst, który warstwa DRAM zaczęła usuwać.
Problem powracającego użytkownika
Podane powyżej wartości opóźnień obejmują tury w ramach ciągłej sesji. Przypadek powracającego użytkownika jest inny: sesja wstrzymuje się w połowie rozmowy, pozostaje bezczynna przez około piętnaście minut, a następnie wznawia się od miejsca, w którym została przerwana. Modelowaliśmy to z kohortą, która przeszła w stan uśpienia po około 20 turach i została przywrócona 15 minut później, wystarczająco długo, aby obciążony serwer mógł w tym czasie przepuścić inny ruch przez swoje pamięci podręczne. Jedenaście takich przywróceń wylądowało w oknie pomiarowym każdego poziomu, a ponieważ obciążenie jest identycznie rozłożone we wszystkich poziomach, te same jedenaście sesji zostało przywróconych w każdym przebiegu, dając porównanie tury wznowienia dla podobnych wartości. Poniższy wykres przedstawia medianę czasu pierwszego tokena dla każdego poziomu w normalnej turze w porównaniu z turą wznowienia, przy czym wąs oznacza najgorsze wznowienie w próbie.
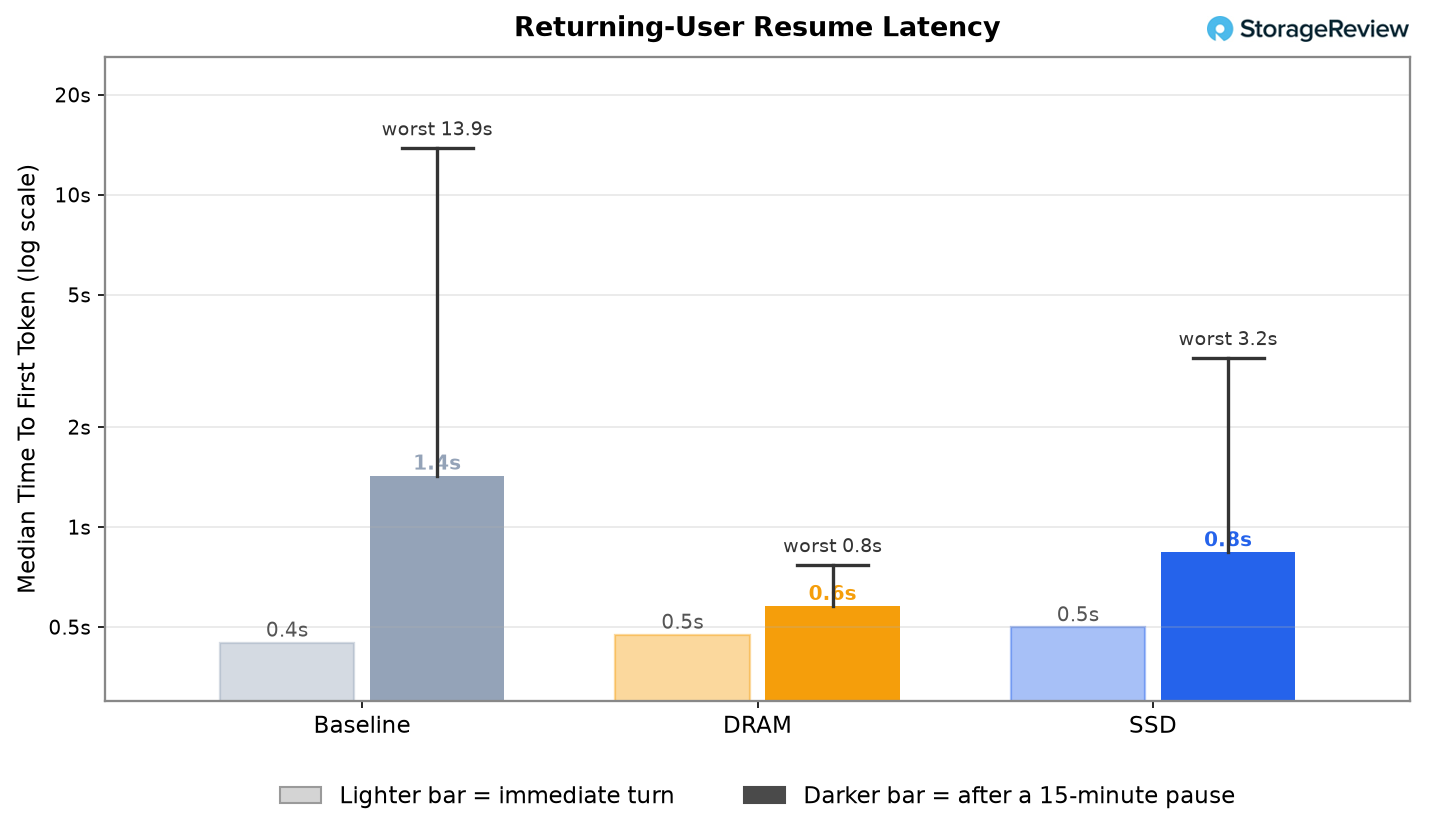
Na medianie liczby jedynie potwierdzają przewidywania mechaniki, a poziomy pojawiają się w oczekiwanej kolejności. DRAM prowadzi: uśpiona sesja wznawia się po 0.6 sekundy, niewiele szybciej niż 0.5 sekundy w przypadku normalnej tury. Drugie miejsce zajmuje dysk SSD z czasem 0.8 sekundy; wiemy, że pobieranie danych z NVMe jest wolniejsze niż pobieranie danych z DRAM i to właśnie widać. Bazowy czas dla samej pamięci VRAM jest najwolniejszy i wynosi 1.4 sekundy; bez możliwości odciążenia, prefiks bezczynnej sesji został usunięty z pamięci GPU dla aktywnego ruchu, a pierwszy powrót musi go ponownie obliczyć. W najlepszym przypadku, cały rozrzut wynosi zaledwie około sekundy.
Najlepszym przypadkiem nie jest ten, w którym dokonuje się wyboru. Najgorszy z jedenastu odrodzeń w każdym poziomie to: 0.8 sekundy na DRAM, 3.2 sekundy na SSD i 13.9 sekundy na poziomie bazowym. To, czy czternastosekundowe oczekiwanie na pierwszy token jest akceptowalne, czy stanowi poważne naruszenie SLO, zależy od usługi, ale w przypadku wszystkiego, co interaktywne, jest to to drugie, a jedynie poziomy odciążenia utrzymują ten ogon w granicach, które użytkownik będzie w stanie przeczekać. Poszerza się on również w kontekście, ponieważ koszt ponownego obliczenia skaluje się wraz z ilością historii zgromadzonej przez powracającego użytkownika: w głębszych kontekstach testu przepustowości, ogon bazowy przekracza 14 sekund, podczas gdy DRAM i SSD nadal podlegają jedynie ograniczonemu przeładowaniu.
Wybór i rozmiar pamięci podręcznej KV
Oba poziomy odciążenia znacznie przewyższają poziom bazowy VRAM i plasują się blisko siebie na tej drodze. Różnica jest niewielka, ponieważ zysk w przepustowości wynika jedynie ze zwolnienia pamięci VRAM, a ta sama ilość pamięci zostaje zwolniona niezależnie od tego, czy usunięta pamięć podręczna trafi do DRAM, czy na dysk SSD. Przepustowość nie ma znaczenia, z którego poziomu pamięci podręcznej pochodzi. Opóźnienie ma znaczenie, ponieważ pobieranie danych z DRAM jest szybsze niż pobieranie danych z NVMe, ale oba są tanie w porównaniu z ponownym obliczeniem tej samej wartości KV od podstaw.
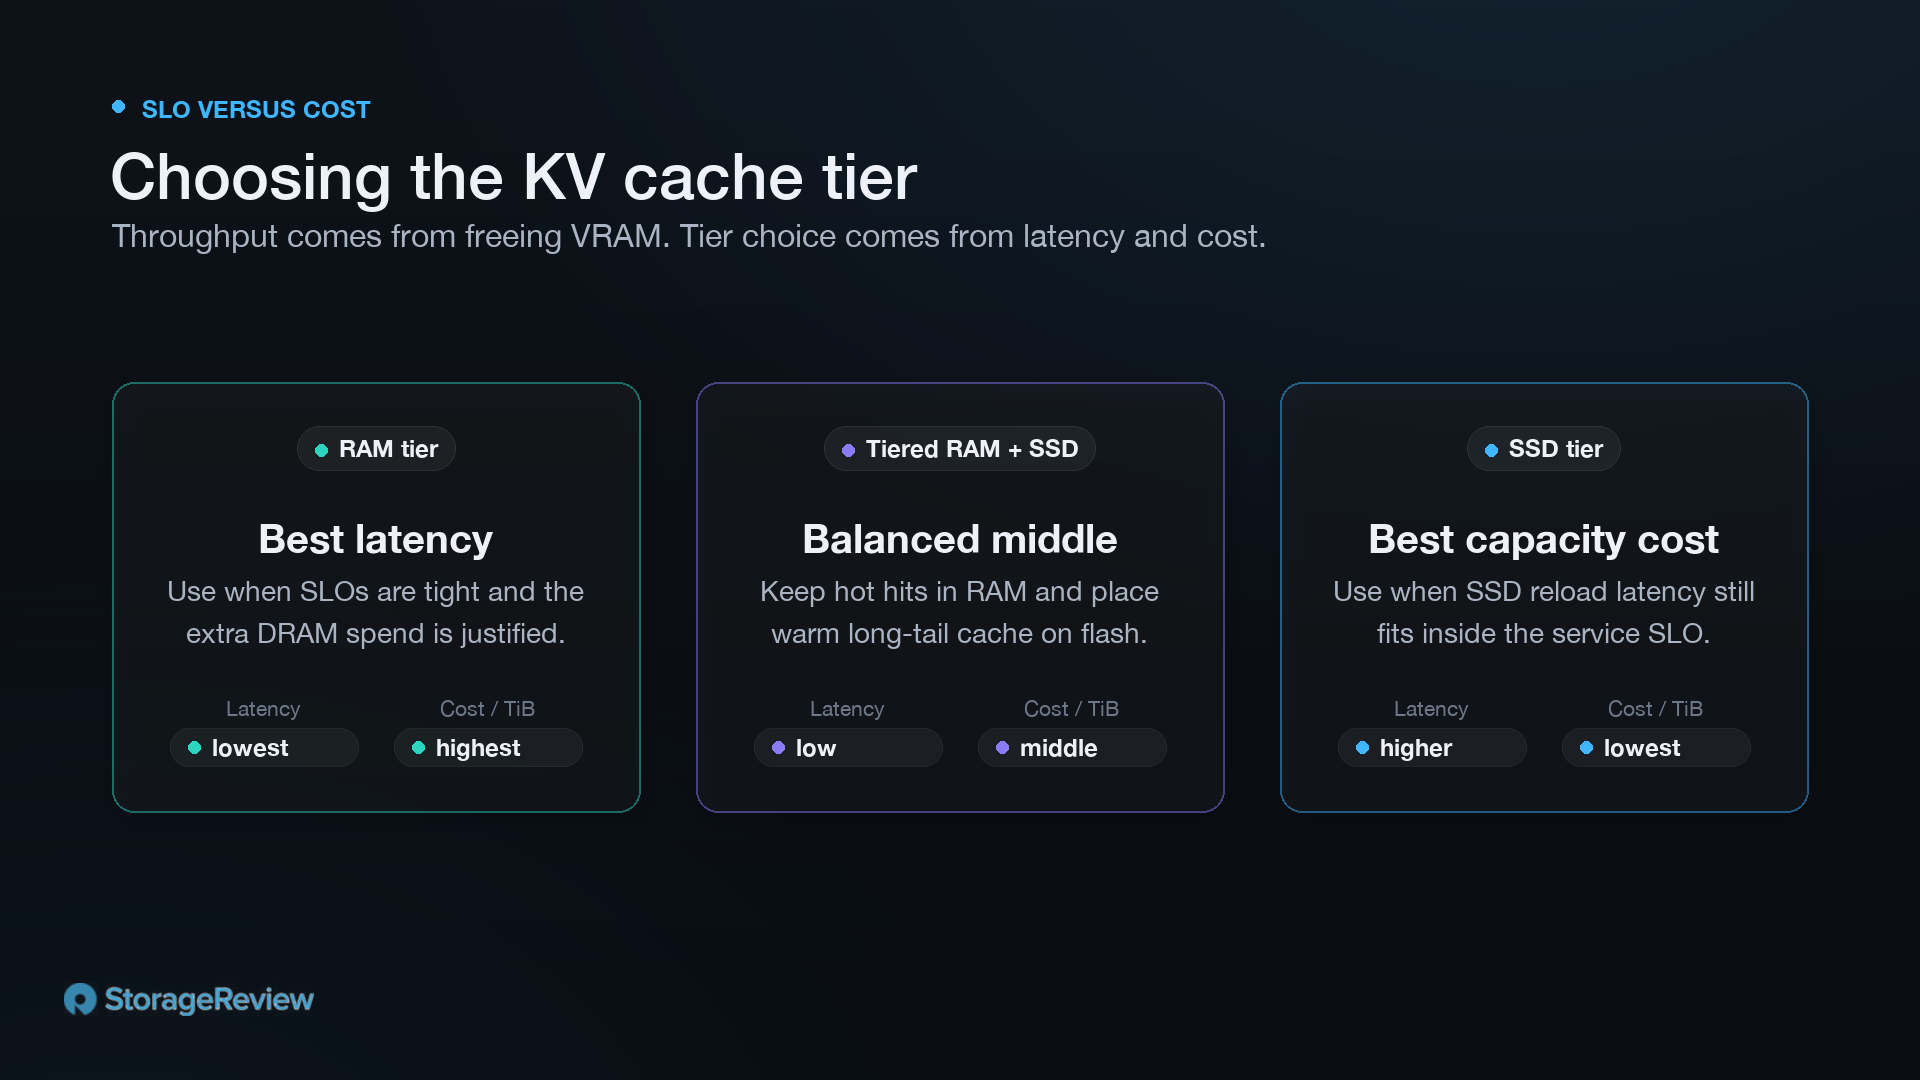
Wybór między nimi to kompromis między SLO a kosztami, który zależy od optymalizacji operatora. Utrzymanie całej odciążonej pamięci podręcznej w pamięci RAM zapewnia najlepsze opóźnienie, ale wiąże się z dużymi nakładami inwestycyjnymi (CAPEX) przy stosunkowo niewielkim wzroście opóźnienia w porównaniu z pamięcią flash. Tiering to rozwiązanie pośrednie: mniejsza warstwa pamięci RAM, która absorbuje krytyczne dla opóźnień uderzenia tam, gdzie są one istotne, a za nią znajduje się warstwa pamięci masowej, która przechowuje cieplejsze, długie pamięci podręczne, które nie muszą być zwracane w ciągu kilkuset milisekund.
Innym sposobem myślenia o pamięciach podręcznych KV jest ich rozmiar. Rozmiar warstwy pamięci masowej sprowadza się do maksymalnej przepustowości tokenów, jaką system może utrzymać. Zasięg pamięci podręcznej KV, jaki musi utrzymać system, to iloczyn przepustowości i czasu TTL wpisów w pamięci podręcznej. Każdy wygenerowany token zapisuje wpis KV, więc wynik to po prostu szybkość, z jaką tokeny docierają, i czas ich przechowywania. Dwa domyślne czasy TTL w środowisku produkcyjnym to pięć minut i jedna godzina.
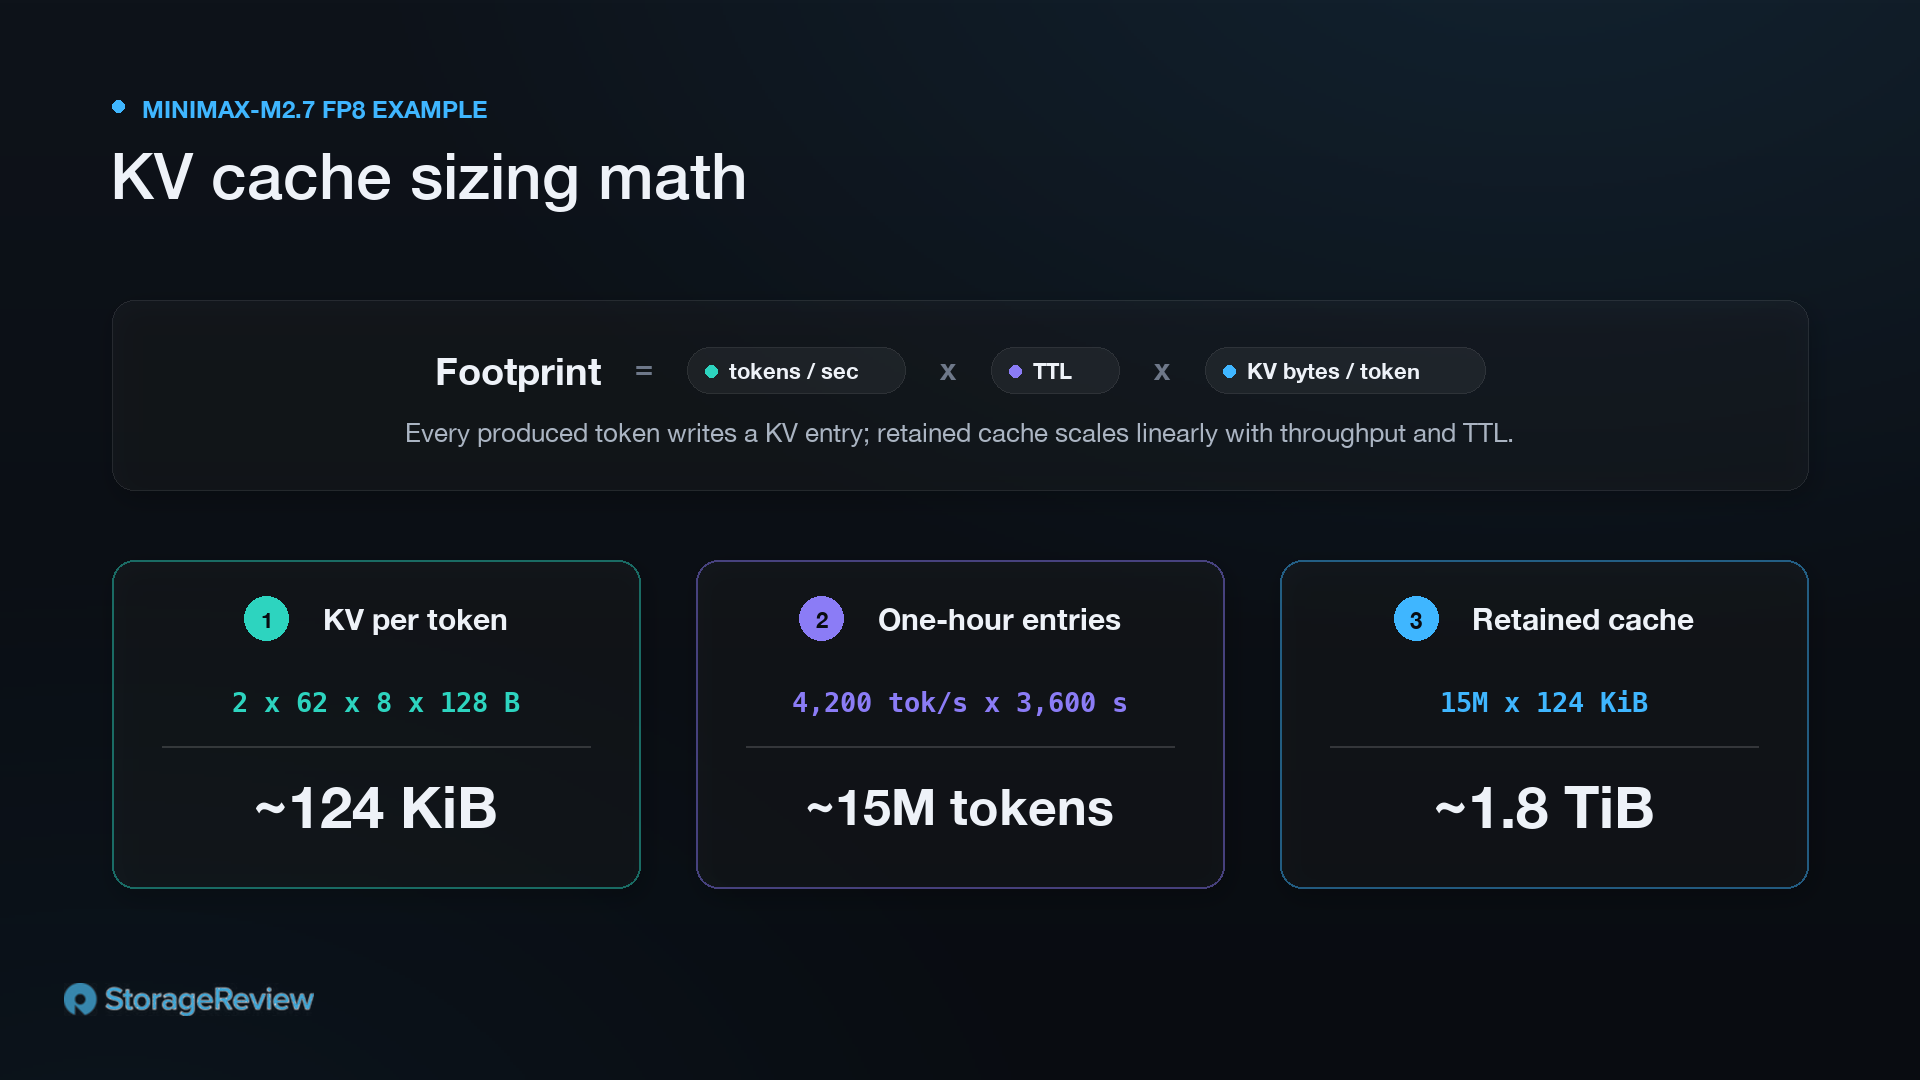
Obliczmy rozmiar pamięci podręcznej KV dla MiniMax-M2.7 w FP8, jak przetestowano tutaj. Przy jednym bajcie na element KV, wpis na token wynosi 2 × 62 × 8 × 128 bajtów, czyli około 124 KiB. Uogólnia się to do dowolnego transformatora uwagi grupowanego zapytania: KV na token to warstwy × głowice KV × rozmiar głowicy × 2 (dla K i V) × dtype-bajty, więc model z większą liczbą warstw lub głowic KV zapisuje proporcjonalnie więcej na token. W umiarkowanym punkcie pracy (około 4,200 tokenów na sekundę w warstwie RAM), godzina retencji generuje około 15 milionów tokenów pamięci podręcznej, co przy 124 KiB na token daje około 1.8 TB. To dużo pamięci DRAM i podnosi koszt kompilacji.
Mając to na uwadze, wymagania SLO i budżet determinują wybór warstwy. Jeśli SLO jest na tyle luźne, że opóźnienie ładowania warstwy SSD mieści się w jego granicach, druga warstwa pamięci podręcznej KV może opierać się wyłącznie na pamięci masowej, z jedynie cienkim buforem przejściowym RAM wymaganym przez złącza przed nią. Koszt pamięci masowej jest umiarkowany: szczytowy ruch KV podczas wszystkich naszych testów wynosił 4.1 GB/s zapisu w umiarkowanym punkcie pracy i 1.1 GB/s odczytu, w porównaniu z mierzonym przez FIO limitem około 114 GB/s. Używana przez nas macierz RAID10 miała około 28-krotnie większy zapas przepustowości, więc pamięć flash nie stanowi wąskiego gardła, nawet gdy XE7740 skaluje się do pełnych ośmiu procesorów graficznych i przyjmuje więcej współbieżnych obciążeń. Ten zapas pozwala operatorowi zapewnić warstwie pojemność, a nie szybkość. Każdy dodatkowy terabajt pamięci D7-PS1030 wydłuża czas TTL oraz zestaw roboczy, jaki system przechowuje, a większa pamięć podręczna oznacza mniej konieczności ponownego obliczania i obsługę większej liczby tokenów.
Wytrzymałość to ograniczenie definiujące tę warstwę. Pamięć podręczna KV Offload jest bardzo intensywna pod względem zapisu: każdy token generowany przez model zapisuje wpis KV, a rotacja TTL nieustannie nadpisuje warstwę, więc dyski praktycznie nigdy nie przestają zapisywać. W naszej macierzy ośmiodyskowej, ciągłe zapisy wyniosły 1.9 GB/s, a w testowanym układzie RAID10, dublowanie podwaja absorbcję nośnika, co daje około 3.2 zapisu dziennie na każdym dysku 12.8 TB, nieco powyżej wartości DWPD dla dysku D7-PS1030. W przypadku podstawowej pamięci masowej byłoby to dyskwalifikujące, jednak w tym przypadku jest to akceptowalne. Pamięć podręczna jest z założenia jednorazowa, a trybem awarii zużytego dysku jest ponowne obliczenie, a nie utrata danych. RAID0 jest prawdopodobnie lepszym wyborem dla tego poziomu, zdaniem niektórych, ponieważ rozkłada dane na wszystkie osiem dysków, dzięki czemu nic nie jest zapisywane dwukrotnie, a szybkość transmisji danych na nośniku spada do około 1.6 DWPD, co mieści się w granicach normy. Tak czy inaczej, wniosek jest trafny: to obciążenie zużywa zasoby szybciej niż jakiekolwiek inne dostępne rozwiązanie, a dedykowane dyski o wysokiej wytrzymałości mają ułamek pojemności potrzebnej dla tego poziomu, a to właśnie ta kombinacja sprawia, że dysk o dużej pojemności, skoncentrowany na zapisie, taki jak PS1030, jest właściwym wyborem.
Tokeny za dolara
Sekcja dotycząca wydajności wykazała, że pamięć flash zachowuje większość przepustowości i utrzymuje opóźnienie pierwszego tokena, czego nie jest w stanie zrobić pamięć DRAM, gdy zestaw roboczy przekroczy limit pamięci. Z komercyjnego punktu widzenia ma to znaczenie ze względu na koszt warstwy przechowującej dane. Prostym rozwiązaniem problemu przeliczania jest zakup większej ilości drogiej pamięci DRAM w systemie; argument o odciążeniu działa tylko wtedy, gdy warstwa pamięci masowej jest znacząco tańsza w przeliczeniu na jednostkę pojemności.
Najbardziej oczywistą różnicą jest pojemność, a nie cena. Warstwa pamięci DRAM o pojemności 512 GB z funkcją odciążania została zapełniona i zaczęła usuwać dane; warstwa pamięci flash, mierzona w terabajtach, nie została zapełniona. Żaden praktyczny budżet na pamięć DRAM nie pozwala na umieszczenie dziesiątek terabajtów pamięci podręcznej KV obok procesorów GPU, więc po przekroczeniu pewnej długości kontekstu decyzja nie dotyczy szybkiej pamięci DRAM czy pamięci flash, ale pamięci flash czy usuwania kontekstu, co w pierwszej kolejności wpływa na przepustowość i opóźnienia.
Jeśli chodzi o cenę, pamięci flash klasy korporacyjnej od dawna są sprzedawane za ułamek ceny pamięci DRAM w przeliczeniu na terabajt. Jest to luka strukturalna wynikająca z wielowarstwowych, trójwymiarowych komórek pamięci NAND w porównaniu z konstrukcją DRAM z jednym tranzystorem i jednym kondensatorem. Kryzys w 2026 roku spowodował gwałtowny wzrost cen obu tych pamięci, a ceny kontraktowe pamięci NAND rosły w tym roku co najmniej tak szybko, jak ceny pamięci DRAM. Nie jest to więc sytuacja, w której pamięć flash tanieje, podczas gdy DRAM gwałtownie rośnie. Jednak nawet przy obecnych zawyżonych cenach, luka w przeliczeniu na terabajt utrzymuje się, a pamięć flash pozostaje jedyną kategorią, w której pojemność pamięci podręcznej rzędu terabajtów jest dostępna w cenie mieszczącej się w budżecie.
Przepustowość i koszt są takie same. W momencie przełomu, gdy pamięć flash wyprzedzała konkurencję, utrzymywała ona więcej tokenów na sekundę niż DRAM, a nie mniej, więc nie chodzi o zamianę przepustowości na pojemność, ale o dostarczanie większej jej ilości na nośnikach, które kosztują mniej za terabajt. W przeliczeniu na tokeny na sekundę i dolara, jest to znaczna przewaga na korzyść pamięci flash, co poszerza perspektywę, ponieważ to właśnie tam pamięć DRAM się wyczerpuje, a pamięć flash nie.
Pamięć DRAM pozostaje właściwym poziomem, dopóki zestaw roboczy się do niego mieści, a cienki bufor przejściowy RAM, wymagany przez złącza, nadal znajduje się przed pamięcią flash. Jednak dodanie większej liczby procesorów GPU lub pamięci DRAM kosztuje najwięcej w przeliczeniu na terabajt, aby zapewnić maksymalną wydajność potrzebną obciążeniu, aż do zapełnienia pamięci podręcznej. Odciążenie lub warstwowanie pamięci do pamięci flash pozwala zachować większość tej wydajności, jednocześnie zachowując kontekst w nieskończoność, przy koszcie terabajta, który czyni to rozwiązanie przystępnym cenowo. Ostateczna decyzja sprowadza się jednak do wymagań SLO dla obciążenia optymalizowanego przez operatora.
Wniosek
W przypadku obciążeń wnioskowania tokenomika stanowi całą rozmowę. Token jest produktem, a ponowne obliczenie to marnotrawstwo: GPU już raz wygenerowało ten kontekst i jest zmuszane do jego odbudowy. Obsługa agentowa to obszar, w którym stawka jest najwyższa, ponieważ nasz tydzień zinstrumentowanego ruchu Claude Code wykazał, że 98.16% tokenów to odczyty z pamięci podręcznej, kontekst, który GPU już obliczył i w przeciwnym razie odbudowałby przy każdym usunięciu. Odciążenie pamięci podręcznej KV zamienia obliczenia wstępnego wypełniania, które zostałyby przeznaczone na odbudowę tej historii, na nowe tokeny. Na XE7740 okazało się to nawet 2.9-krotnie większą całkowitą przepustowością obsługi niż w przypadku bazowej pamięci VRAM przy dużym obciążeniu, przy stałym modelu, GPU i silniku. Tam, gdzie warstwa DRAM była zapełniana i zanikała, pamięć flash utrzymywała tę przepustowość, a pojemność DRAM nie była w stanie dorównać.
To jednak nie eliminuje potrzeby pamięci DRAM. W przypadku krótkich, dynamicznych obciążeń, gdzie sesja otwiera się, działa krótko i zamyka, zanim pamięć podręczna się wyczerpie, DRAM jest odpowiednią warstwą, a odciążenie pamięci podręcznej KV niewiele wnosi. Zestaw roboczy jest odpowiedni, opóźnienie jest najlepsze z możliwych i nie ma czego usuwać.
Ale postrzegamy ten profil jako wyjątek, gdzie wystarczająca jest tylko warstwa pamięci DRAM. Większość wnioskowania produkcyjnego działa obecnie długo i nieprzerwanie: agenci wieloobrotowi, duże konteksty, stała współbieżność, użytkownicy powracający do tej samej sesji. W tym przypadku zestaw roboczy przekracza każdą warstwę pamięci, na jaką operator może sobie pozwolić, pamięć podręczna jest usuwana, a procesor graficzny wraca do pracy, odbudowując kontekst, który już wygenerował. To jest kosztowny tryb awarii i jest on powszechny.
W przypadku tych obciążeń przeniesienie pamięci podręcznej KV do pamięci flash opłaca się z dwóch powodów. Pozwala to procesorom GPU na generowanie nowych tokenów zamiast ponownego obliczania starych, co jest mierzoną przez to całe ćwiczenie wydajnością tokenomiczną, a także przenosi pojemność, która to umożliwia, na najbardziej opłacalną, trwałą warstwę w systemie. Najważniejszą konsekwencją w arkuszu kompilacji jest to, co się z tego usuwa: serwer, który opiera się na pamięci flash jako pamięci podręcznej, można określić z dużo mniejszą ilością pamięci DRAM, a biorąc pod uwagę ceny pamięci w 2026 roku, jest to jedna z największych oszczędności dostępnych w ofercie. Token jest produktem, a dla obciążeń długokontekstowych, które obecnie dominują w obsłudze, ścieżka efektywnego tokenowania to ta, która przestaje płacić za dwukrotne generowanie tych samych tokenów i ta ścieżka przebiega przez pamięć flash.
Dysk SSD Solidigm dla sztucznej inteligencji
Niniejszy raport jest sponsorowany przez firmę Solidigm. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej ocenie rozpatrywanego produktu/produktów.


 Amazon