

Podczas tegorocznego projektu Open Compute Project firma Toshiba ogłosiła premierę nowego oprogramowania dla technologii NVMe over Fabrics (NVMe-oF) – KumoScale. KumoScale został zaprojektowany z myślą o maksymalizacji korzyści wydajnościowych wynikających z bezpośredniego podłączenia dysków NVMe w sieci centrum danych poprzez dezagregację, abstrakcję i integrację zarządzania. Oprogramowanie umożliwia dostęp do i tak już wysokowydajnych dysków SSD NVMe, umożliwiając bezdyskowym węzłom obliczeniowym (wyposażonym jedynie w dysk rozruchowy) dostęp do tej pamięci flash za pośrednictwem szybkiej sieci szkieletowej. Ten typ połączenia zapewni sieciowej pamięci masowej wydajność bliską szczytowej.
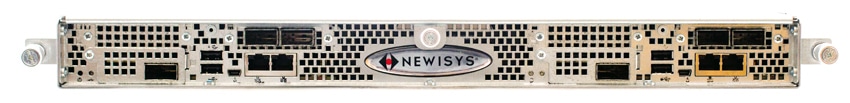
Chociaż to oprogramowanie może być używane na dowolnej standardowej platformie systemowej x86, do naszej recenzji wykorzystujemy dwuwęzłowy serwer Newisys NSS-1160G-2N. Platforma Newisys NSS-1160G-2N jest zoptymalizowana pod kątem modelu usług hiperskalowalnych z możliwością wymiany dysków NVMe podczas pracy, zrównoważoną przepustowością z sieci do dysków, serwisowaniem opartym na FRU w zimnym korytarzu, redundantnym zasilaniem i chłodzeniem, a także innymi kluczowymi wymaganiami skalowalnego centrum danych. Nasz serwer udostępnia pamięć masową za pośrednictwem dwóch kart Mellanox 100G z 8 dyskami SSD Toshiba NVMe na jednym węźle, a drugi węzeł służy do celów zarządzania. Generowanie obciążenia będzie realizowane przez pojedynczy serwer Dell PowerEdge R740xd, który jest bezpośrednio podłączony do serwera Newisys za pośrednictwem dwóch kart sieciowych Mellanox ConnectX-5 100G. Newisys może pomieścić do 16 płyt serwerowych NVMe i dual Xeon w kompaktowej obudowie 1U i jest zoptymalizowany pod kątem najniższych opóźnień i najwyższej wydajności z napędami podłączanymi bezpośrednio, chociaż serwer jest nieco dłuższy od tych, do których jesteśmy przyzwyczajeni w naszych szafach.
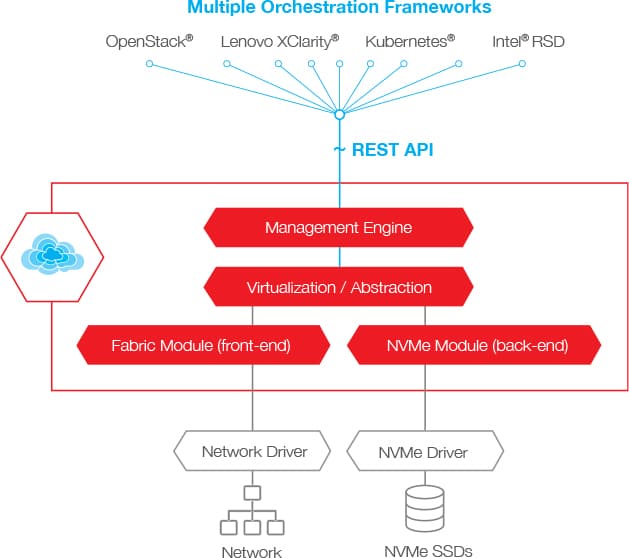
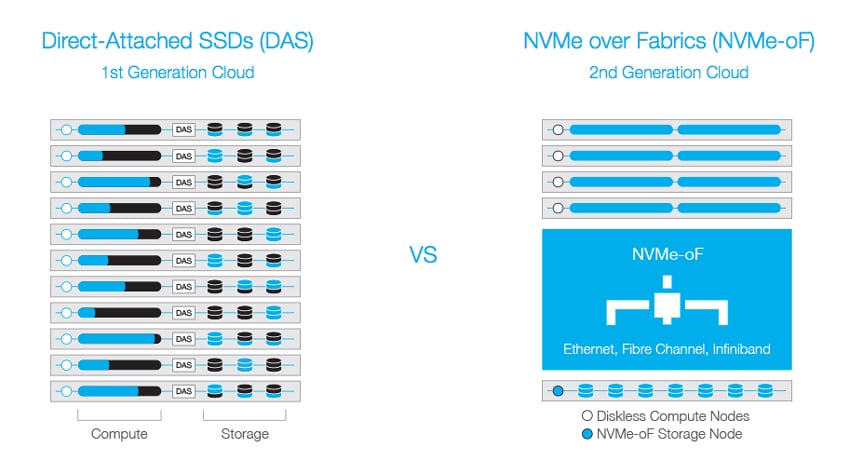
KumoScale oferuje szereg innych korzyści w porównaniu z tradycyjnymi dyskami SSD podłączanymi bezpośrednio. Wykorzystanie technologii NVMe-oF wymaga mniejszej liczby węzłów, aby osiągnąć jeszcze większą moc obliczeniową i pojemność. Mniejsza liczba węzłów oznacza lepsze zarządzanie nimi i niższe koszty. Częścią redukcji kosztów jest eliminacja nieaktywnej pamięci masowej i mocy obliczeniowej. KumoScale wykorzystuje interfejsy API RESTful do integracji z wieloma platformami orkiestracji; co najciekawsze, działa z platformą Kubernetes. Dzięki temu użytkownicy korzystający z platformy Kubernetes do przechowywania kontenerów będą mogli to robić z dużo wyższą wydajnością, dysponując jednocześnie odpowiednią ilością dostępnej pamięci masowej. Oprócz platformy Kubernetes, KumoScale współpracuje również z platformami OpenStack, Lenovo XClarity i Intel RSD.
Zarząd
KumoScale wyróżnia się na tle innych, oferując dość przejrzysty i intuicyjny interfejs graficzny. Zazwyczaj tego typu rozwiązanie jest kontrolowane za pomocą interfejsu wiersza poleceń (CLI) (i tak naprawdę, kilka aspektów nadal będzie kontrolowanych). Na karcie pulpitu użytkownicy mogą łatwo sprawdzić wydajność pamięci masowej, pojemność systemu i stan sprzętu, a także uzyskać szczegółowe informacje o stanie poszczególnych dysków SSD.
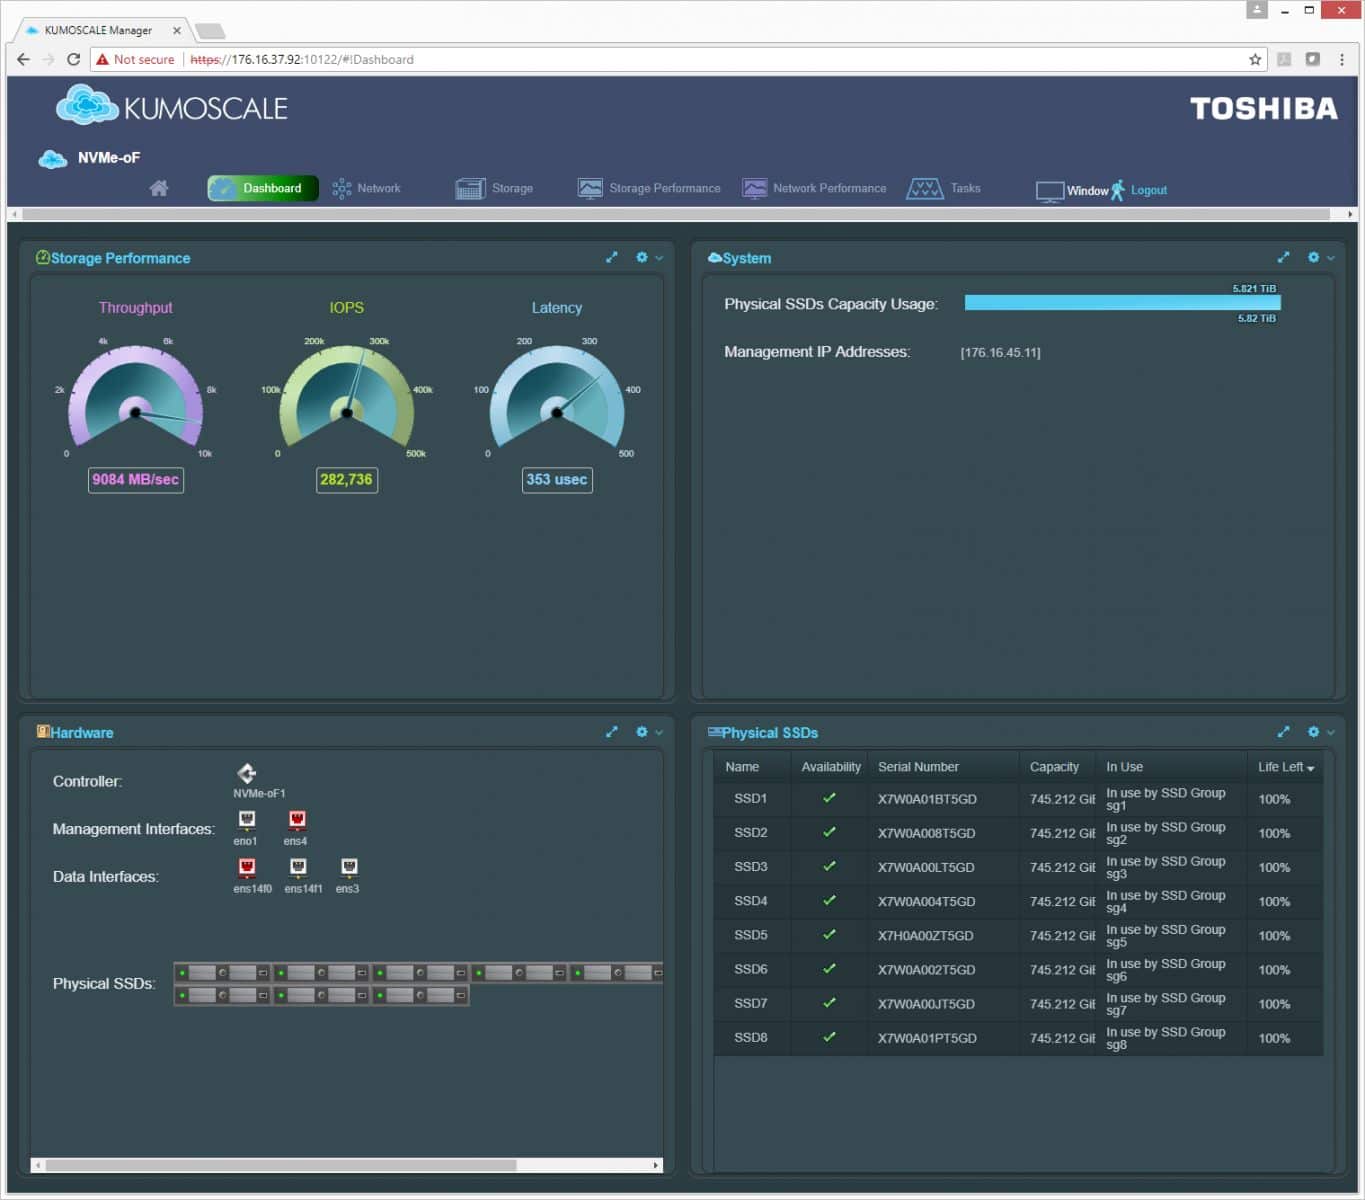
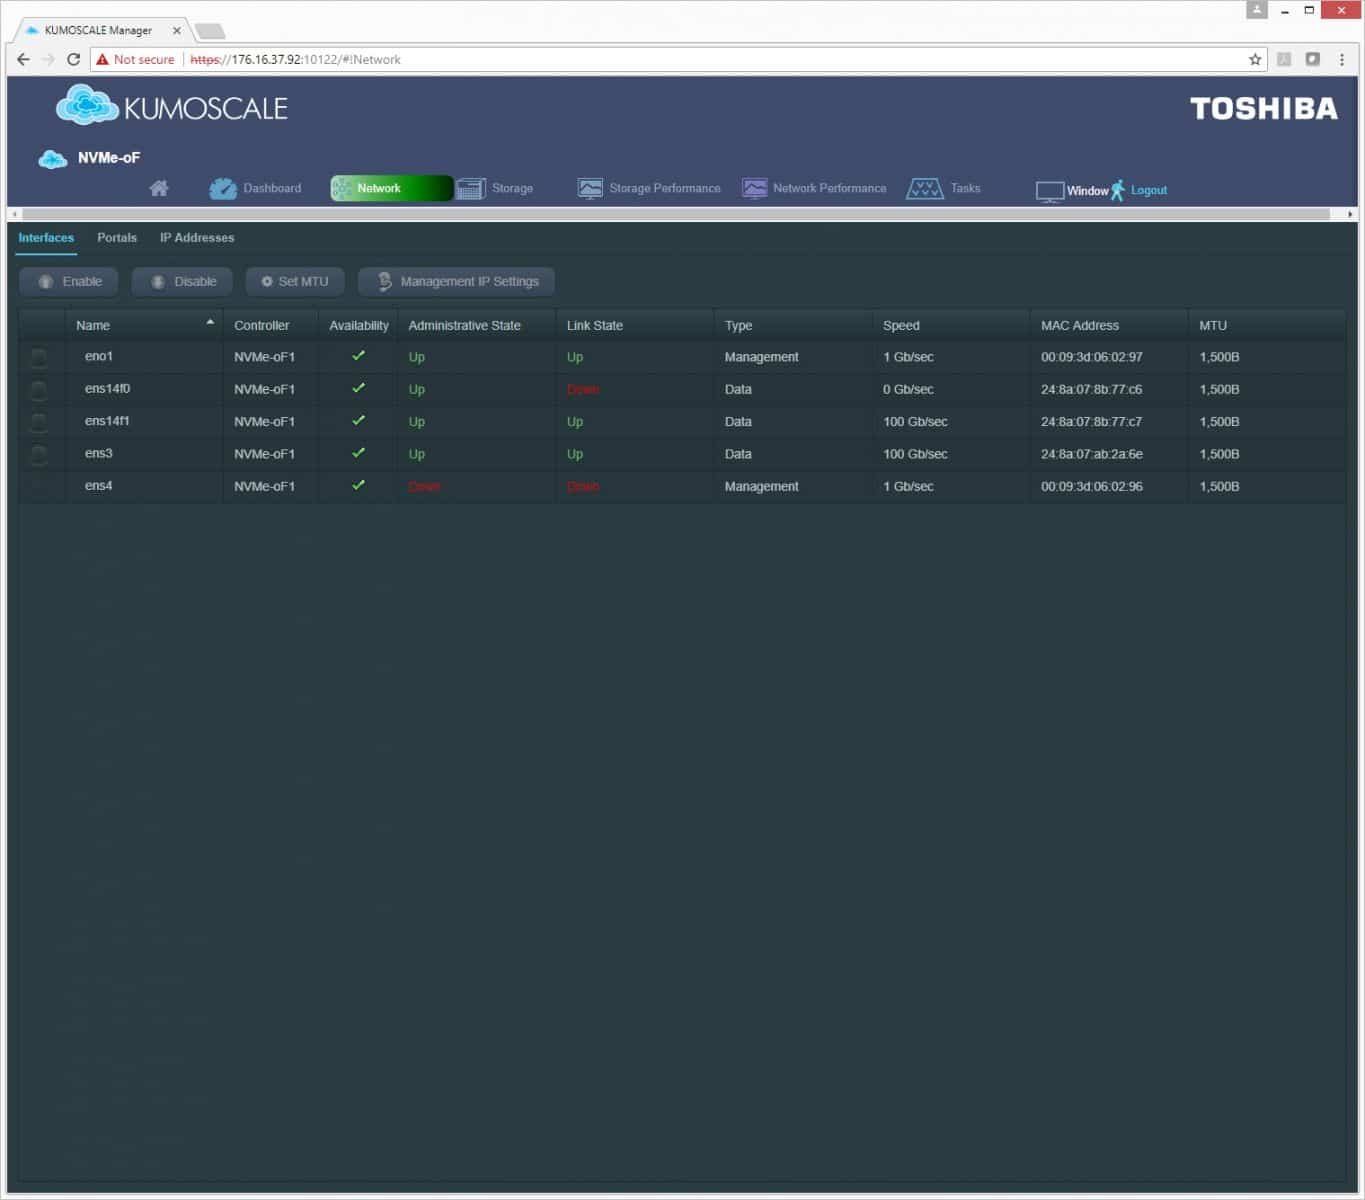
Następna karta to karta sieciowa, na której wyświetlane są informacje o dostępności i stanie łącza kontrolera(-ów), a także typ, prędkość, adres MAC i MTU.
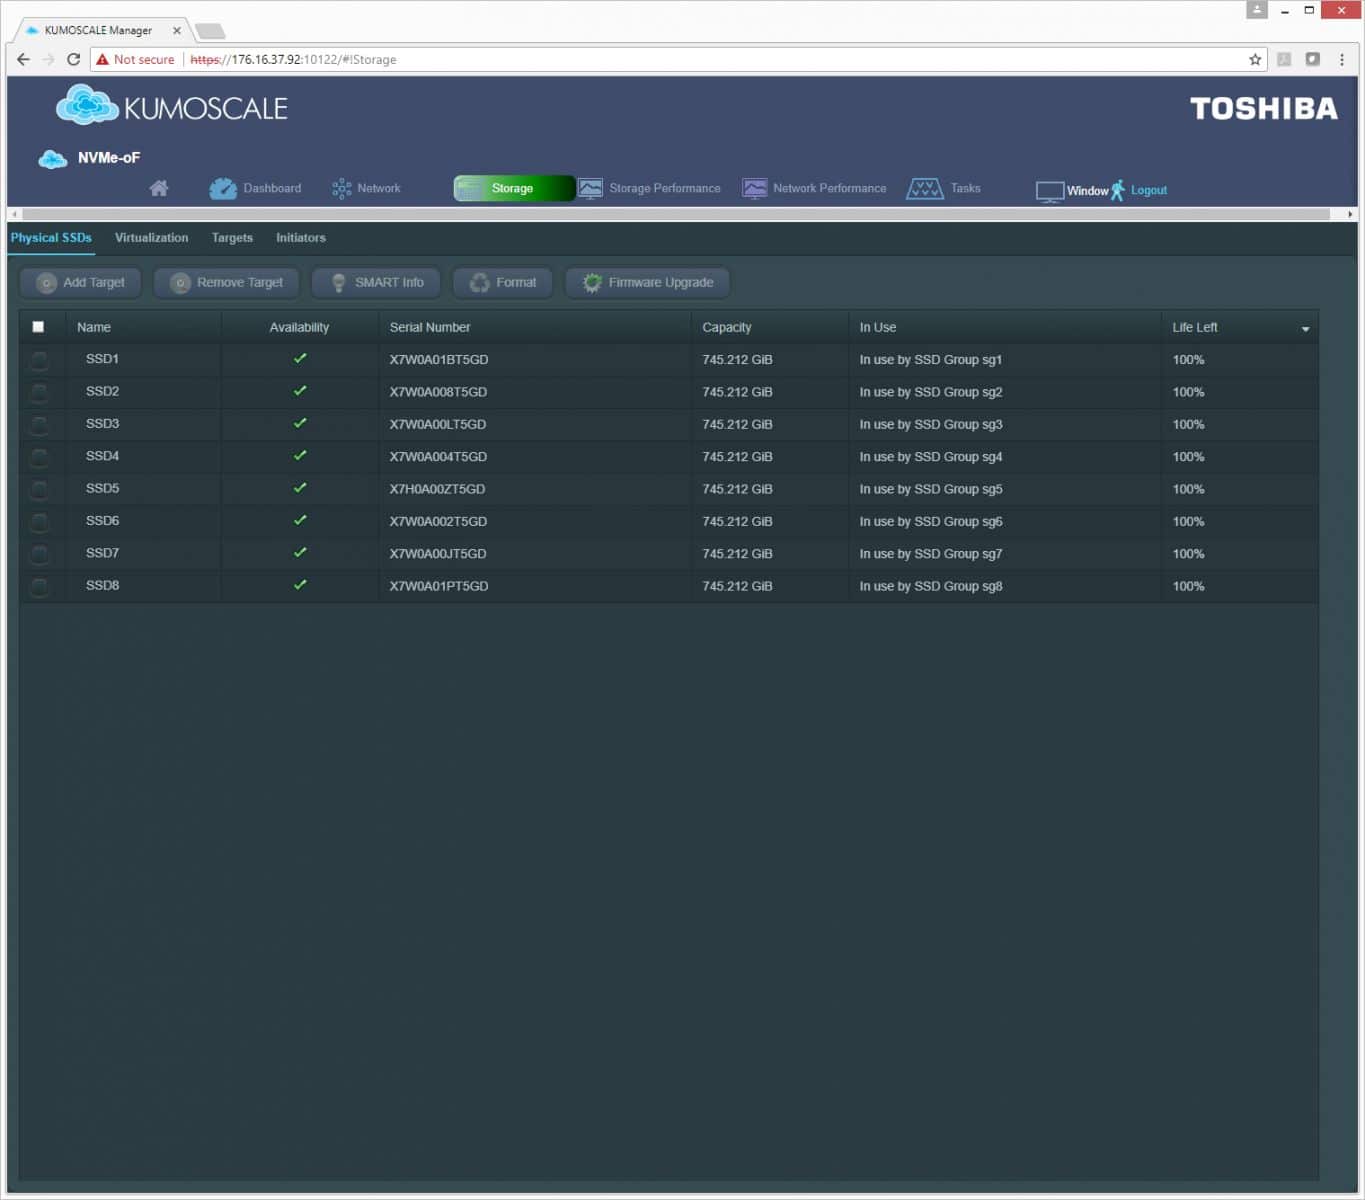
Karta pamięci masowej dzieli się na cztery podzakładki. Pierwsza podzakładka to fizyczne dyski SSD. Użytkownicy mogą tu zobaczyć dyski według nazwy, dostępności, numerów seryjnych, pojemności, wykorzystania grupowego oraz procentu pozostałego czasu pracy.
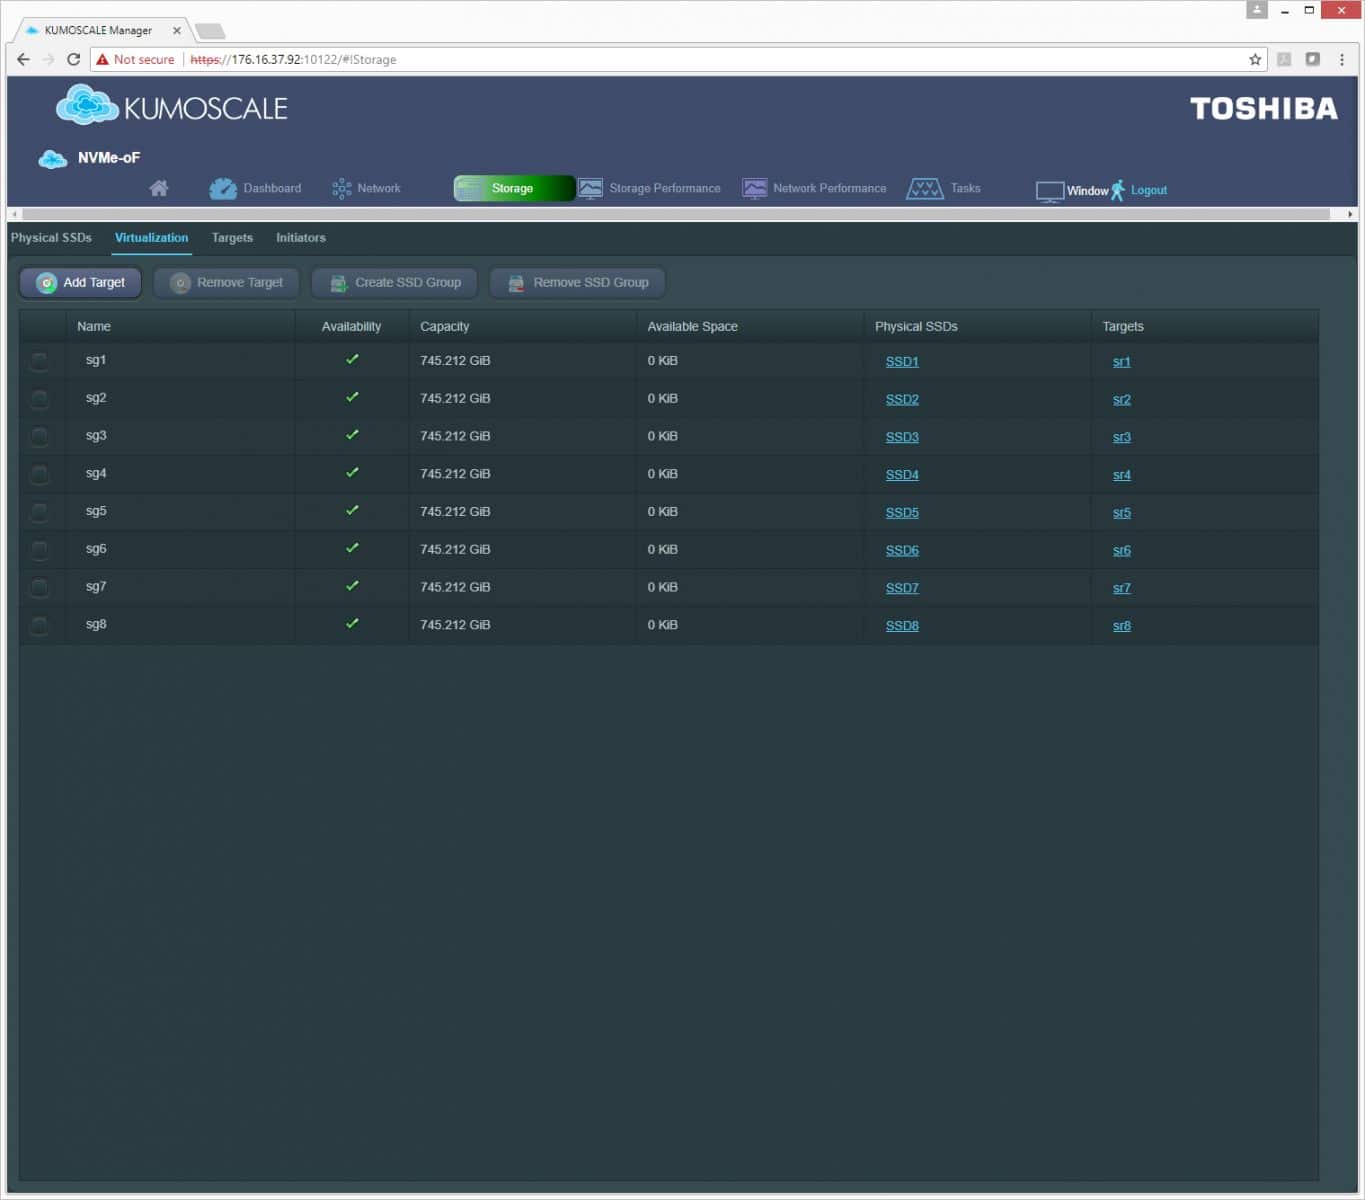
Kolejna podzakładka w grupach wirtualizowanych pamięci masowych. Ta podzakładka jest podobna do powyższej i zawiera nazwę, dostępność, pojemność, a także dostępne miejsce, fizyczny dysk SSD, z którego jest wirtualizowana, oraz jego miejsce docelowe.
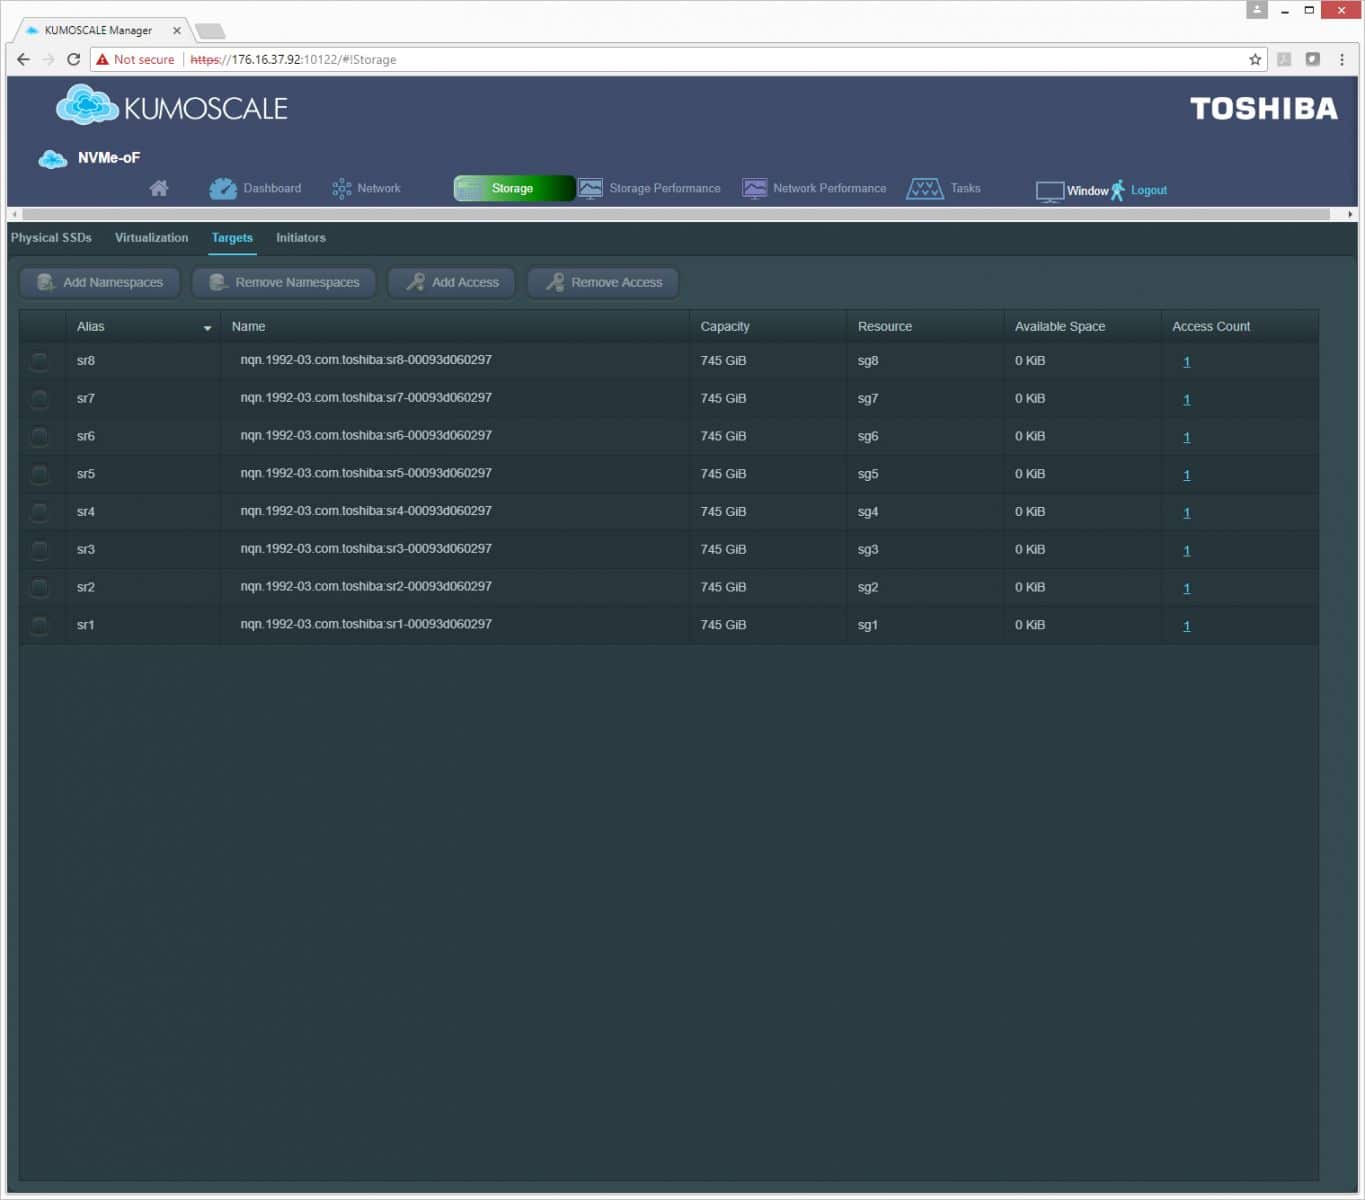
Następna podkarta, Cele, rozszerza powyższe cele i pokazuje wirtualizowaną pamięć masową udostępnioną hostowi, w tym woluminy grupowe.
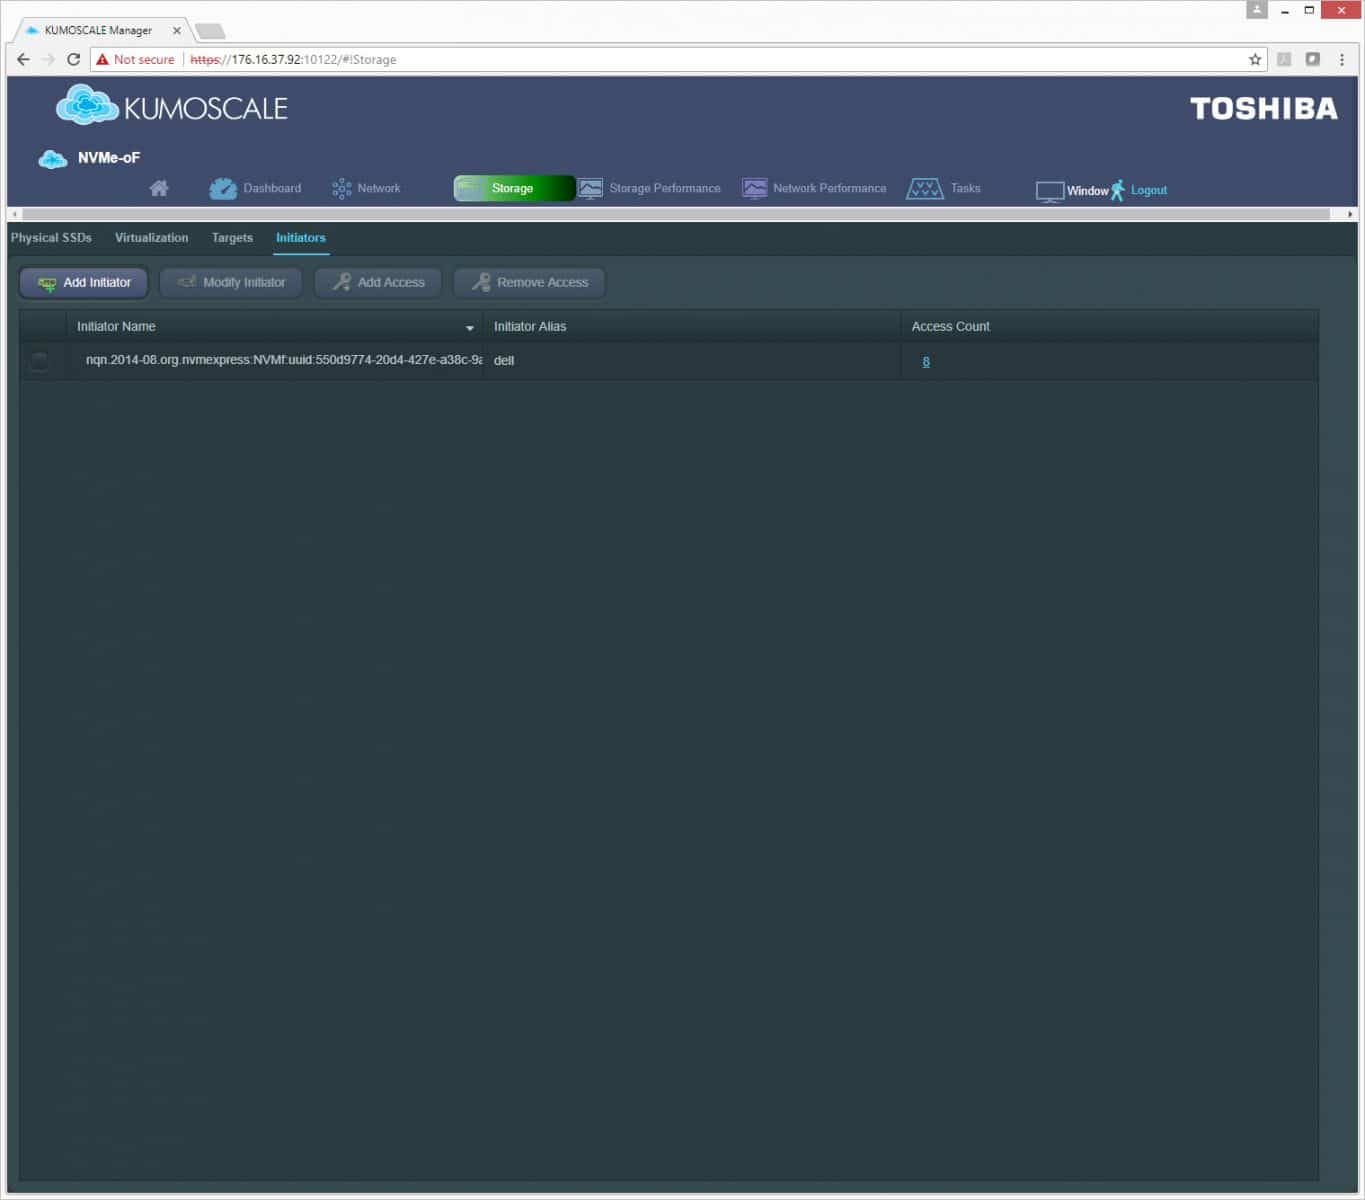
Ostatnia podzakładka w sekcji „Magazyn” to zakładka „Inicjatory”. Zawiera ona nazwę inicjatora, alias (w tym przypadku Dell) oraz liczbę dostępów. Użytkownik może przyznać kontrolę dostępu (ACL) dla pary cel-inicjator.
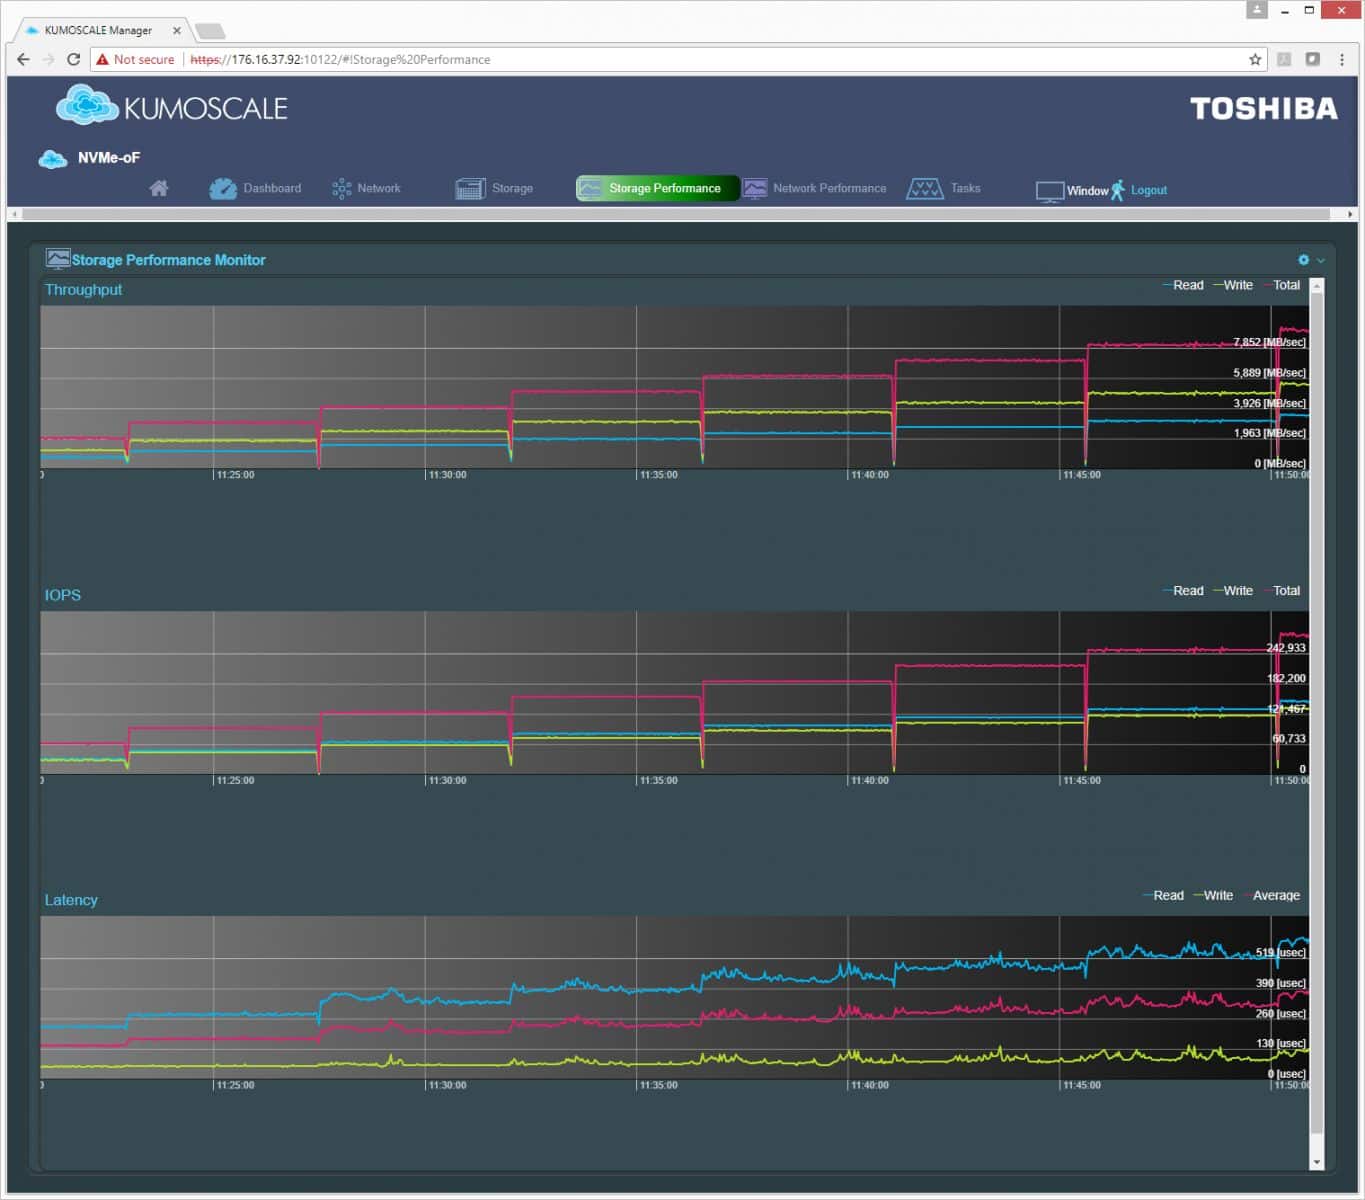
Następna główna zakładka to Wydajność pamięci masowej. Tutaj użytkownicy mogą zobaczyć odczyty przepustowości, operacji wejścia/wyjścia na sekundę (IOPS) i opóźnień w danym przedziale czasowym.
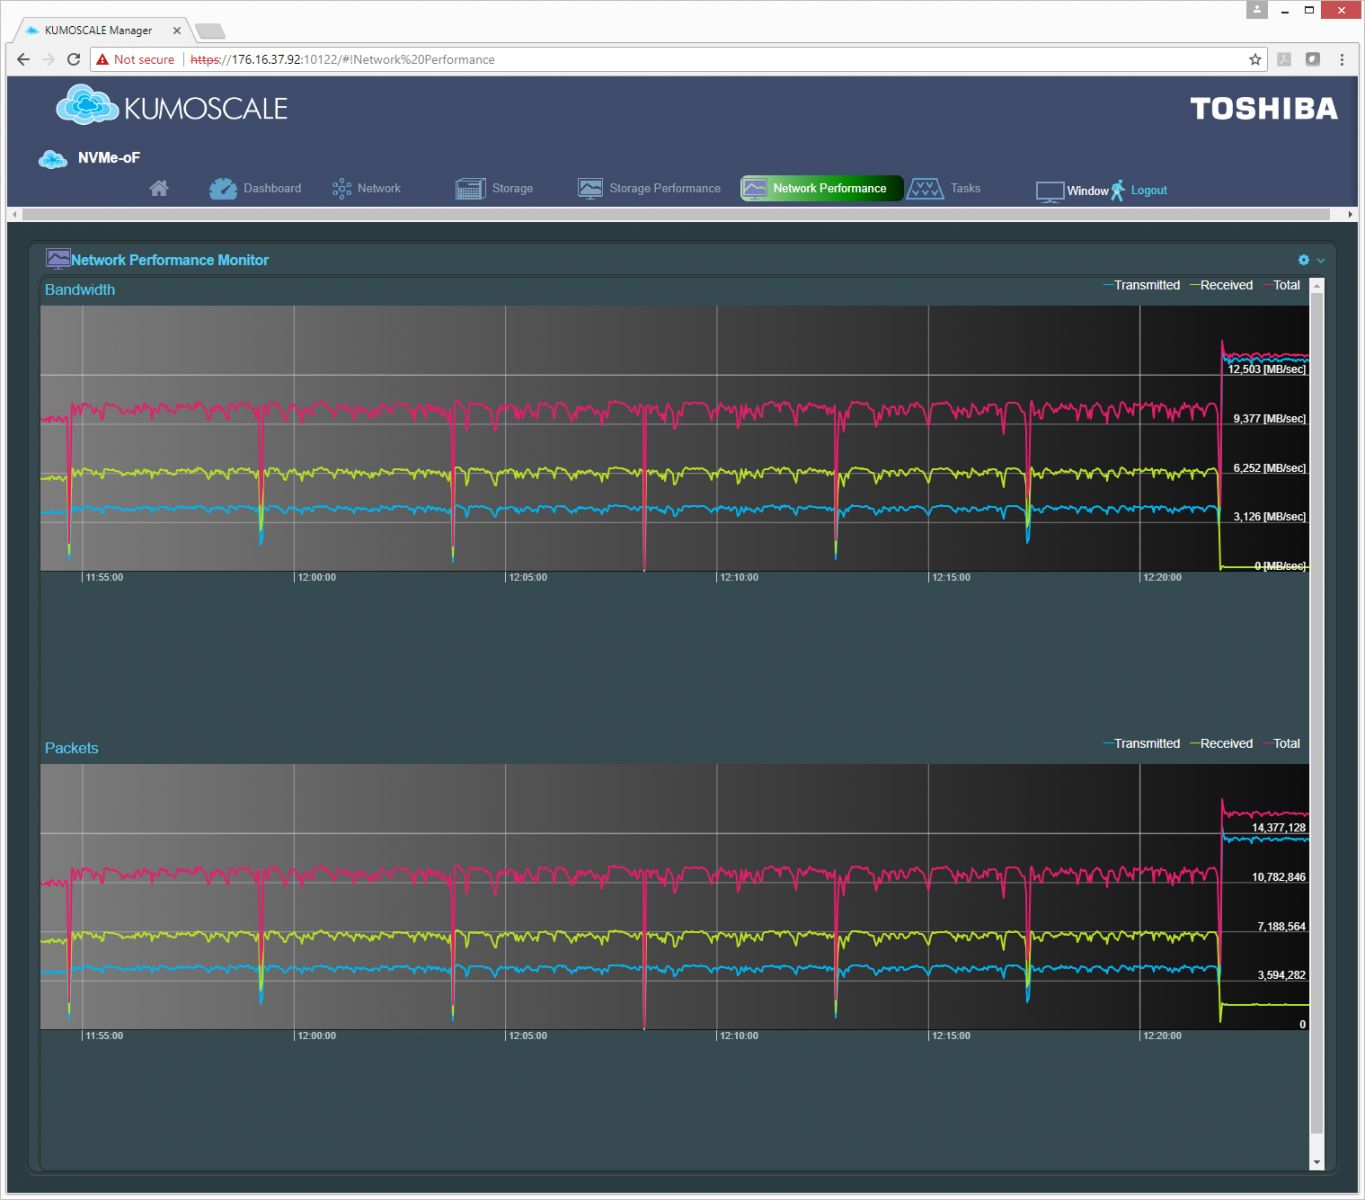
Na koniec przechodzimy do wydajności sieci, która także zapewnia użytkownikom zestawienie wskaźników wydajności, przepustowości i pakietów w danym momencie.
Wydajność
Analiza obciążenia VDBench
W przypadku testów porównawczych macierzy pamięci masowej, testy aplikacji są najlepsze, a testy syntetyczne plasują się na drugim miejscu. Chociaż nie odzwierciedlają one idealnie rzeczywistych obciążeń, testy syntetyczne pomagają w ustaleniu punktu odniesienia dla urządzeń pamięci masowej, zapewniając powtarzalność, która ułatwia porównywanie konkurencyjnych rozwiązań. Obciążenia te oferują szereg różnych profili testowych, od testów „czterech kątów”, przez testy rozmiaru transferu baz danych, po przechwytywanie śladów z różnych środowisk VDI. Wszystkie te testy wykorzystują generator obciążeń vdBench z silnikiem skryptowym do automatyzacji i przechwytywania wyników w dużym klastrze obliczeniowym. Pozwala to nam powtarzać te same obciążenia dla szerokiej gamy urządzeń pamięci masowej, w tym macierzy flash i pojedynczych urządzeń pamięci masowej. Po stronie macierzy wykorzystujemy klaster serwerów Dell PowerEdge R740xd:
Profile:
- Losowy odczyt 4K: 100% odczytu, 128 wątków, 0-120% ioratu
- 4K losowy zapis: 100% zapisu, 64 wątki, 0-120% ioracji
- 64K Sekwencyjny odczyt: 100% odczytu, 16 wątków, 0-120% ioracji
- 64K Sekwencyjny zapis: 100% zapisu, 8 wątków, 0-120% ioratu
- Syntetyczna baza danych: SQL i Oracle
- Ślady pełnego klonu VDI i klonów powiązanych
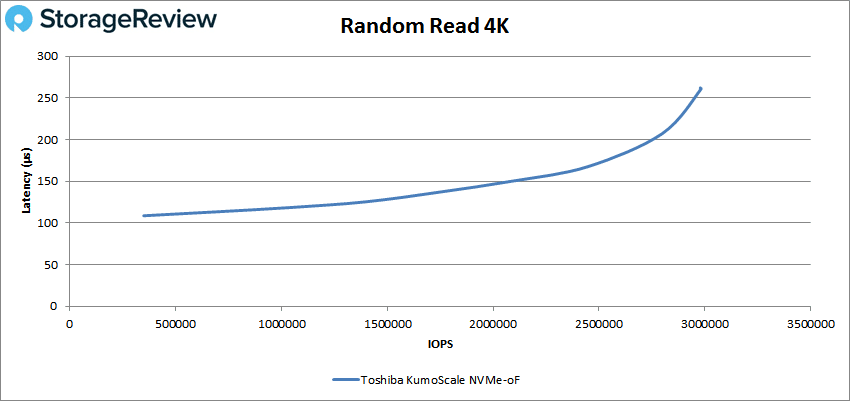
W przypadku szczytowej wydajności odczytu 4K, Newisys z KumoScale (nazywany w dalszej części recenzji „węzłem pamięci masowej”, ponieważ jest to jedyne analizowane urządzenie) osiągnął wydajność poniżej milisekundy w całym teście, osiągając szczytową wartość 2 981 084 IOPS przy opóźnieniu 260 μs.
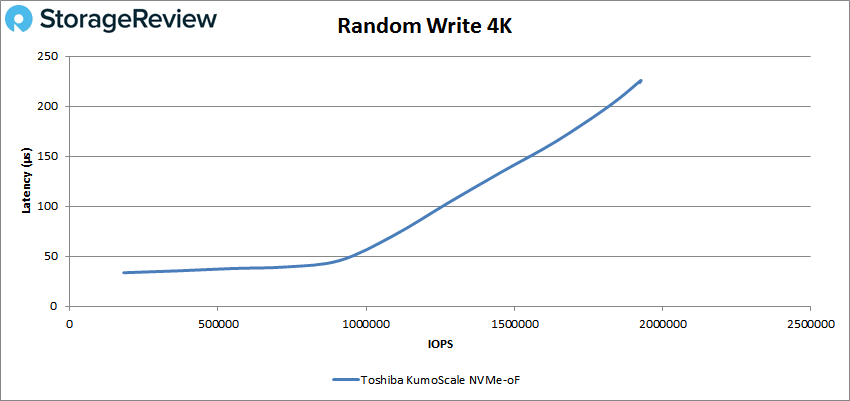
Podczas szczytowej wydajności zapisu 4K węzeł pamięci masowej osiągnął 1 926 637 IOPS przy opóźnieniu 226 μs.
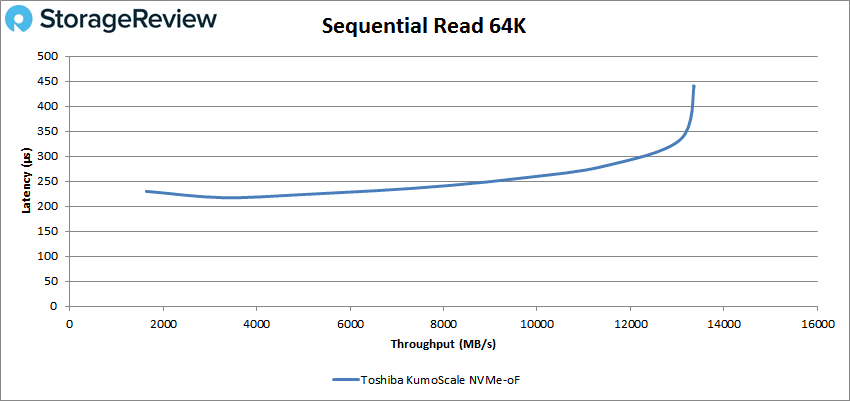
Po przełączeniu na szczytowy odczyt 64 KB węzeł pamięci masowej osiągnął szczytową wydajność 213 765 IOPS lub 13.36 GB/s przy opóźnieniu 441 μs.
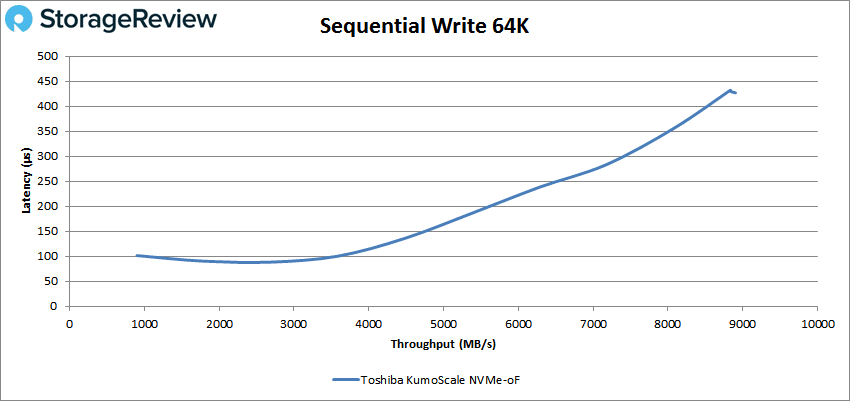
W przypadku sekwencyjnego szczytowego zapisu 64 KB węzeł pamięci masowej osiągnął 141 454 IOPS lub 8.83 GB/s przy opóźnieniu wynoszącym 432 μs.
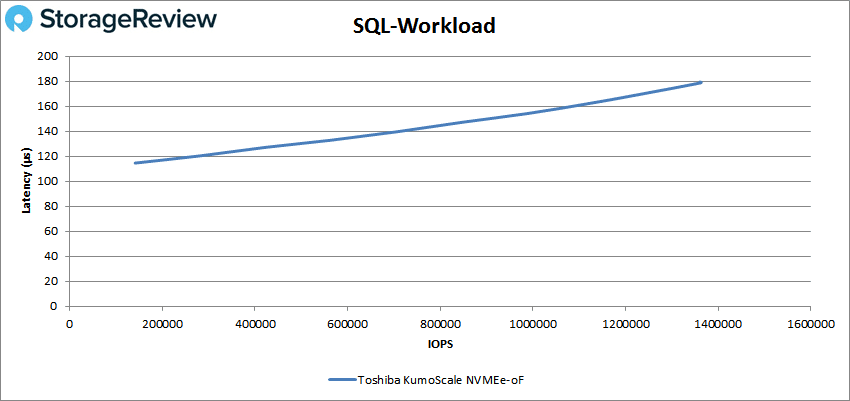
Podczas obciążenia SQL węzeł pamięci masowej osiągnął szczytową wydajność 1 361 815 IOPS przy opóźnieniu 179 μs.
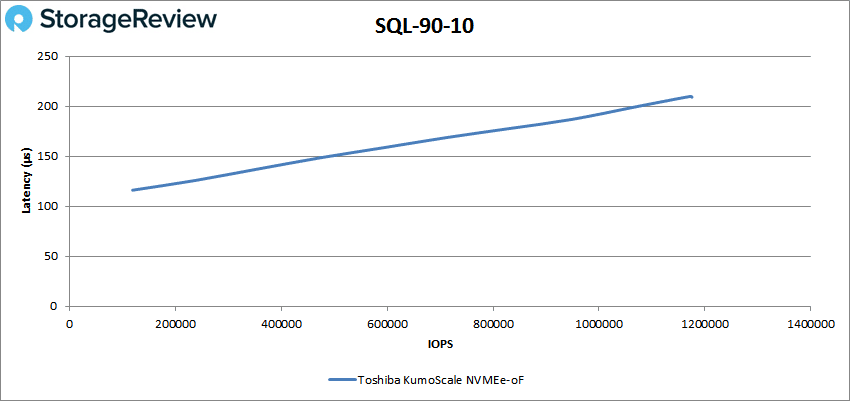
W teście porównawczym SQL 90-10 odnotowaliśmy maksymalną wydajność na poziomie 1 171 467 IOPS przy opóźnieniu wynoszącym zaledwie 210 μs.
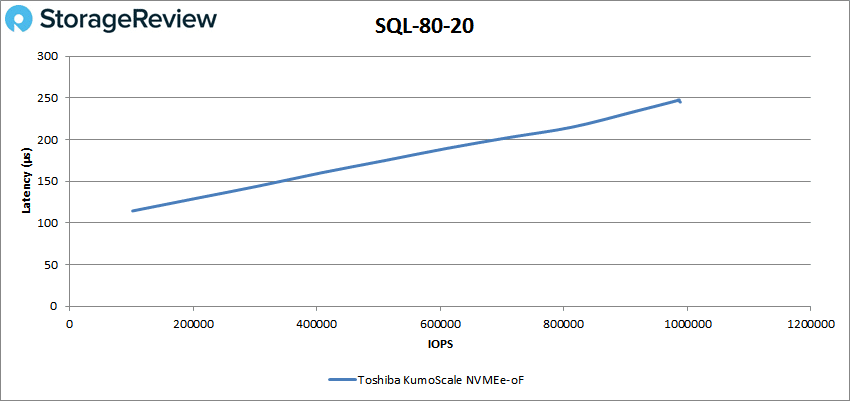
Test SQL 80-20 wykazał, że węzeł pamięci masowej osiągnął szczytową wydajność na poziomie 987 015 IOPS przy opóźnieniu 248 μs.
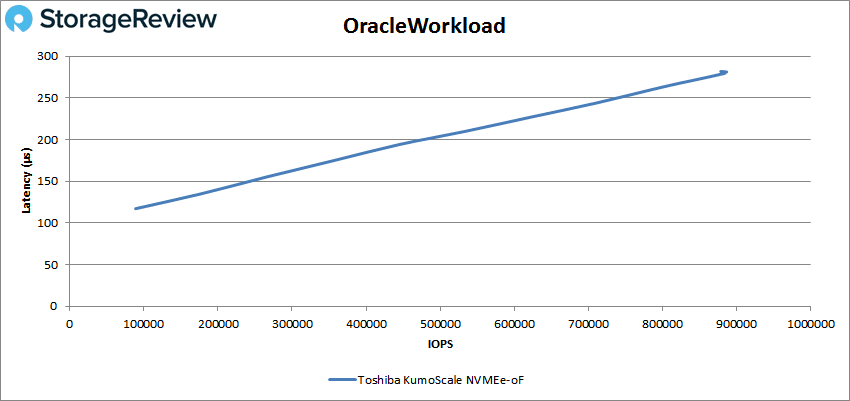
Dzięki obciążeniu Oracle węzeł pamięci masowej osiągnął szczytową wydajność na poziomie 883 894 IOPS przy opóźnieniu 280 μs.
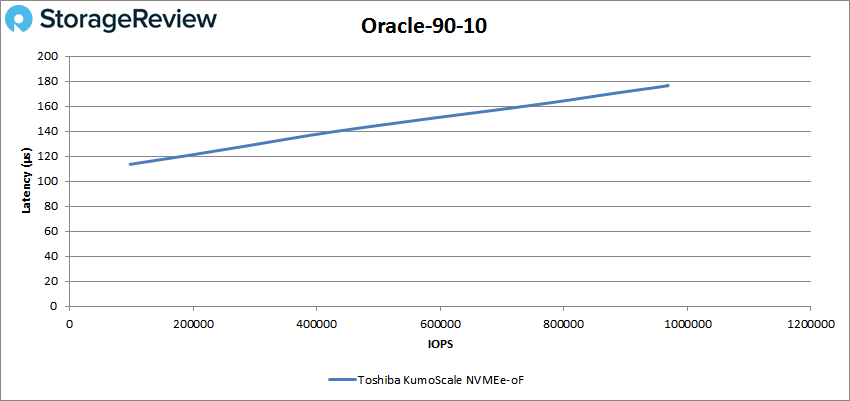
Oracle 90-10 osiągnął szczytową wydajność na poziomie 967 507 IOPS przy opóźnieniu 176 μs.
W systemie Oracle 80-20 węzeł pamięci masowej osiągnął 829 765 IOPS przy opóźnieniu 204 μs.
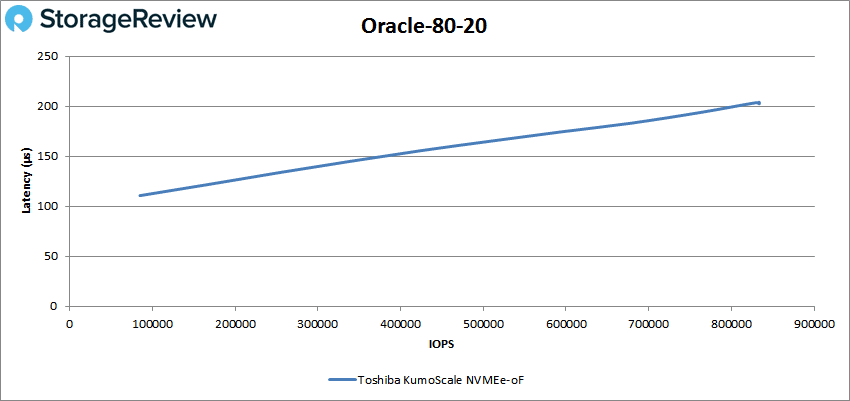
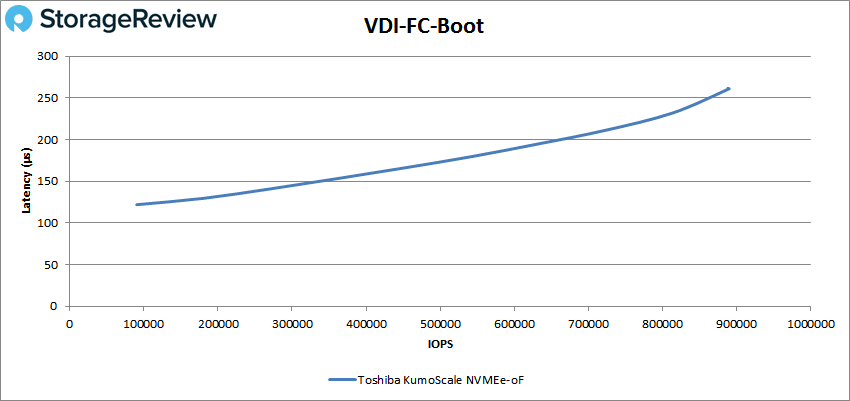
Następnie przeszliśmy do testu klonowania VDI, pełnego i połączonego. W przypadku rozruchu pełnego klonowania VDI węzeł pamięci masowej osiągnął szczytową wydajność 889 591 IOPS z opóźnieniem 261 μs.
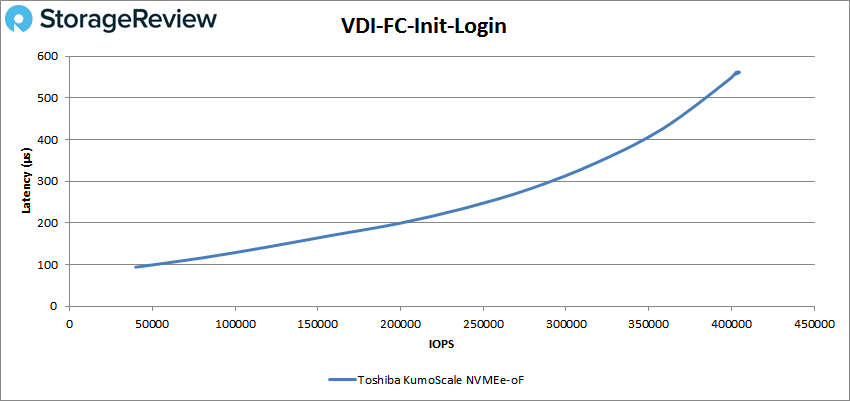
Podczas pierwszego logowania do VDI Full Clone węzeł pamięci masowej osiągnął szczytową wydajność 402 840 IOPS przy opóźnieniu 562 μs.
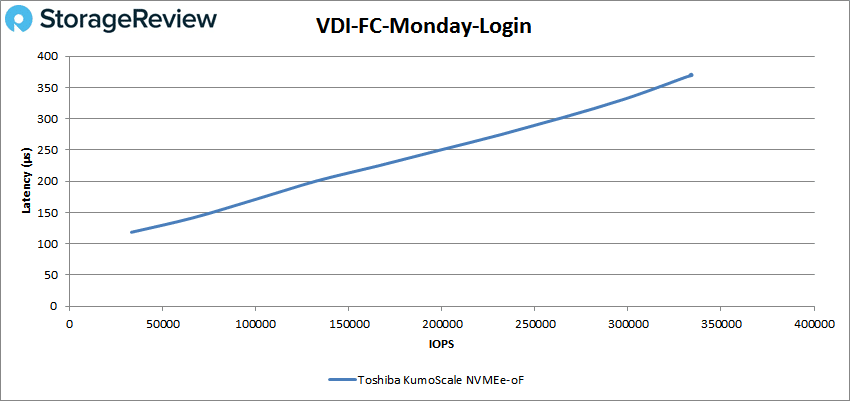
Poniedziałkowe logowanie do VDI Full Clone wykazało maksymalną wydajność 331 351 IOPS i opóźnienie 369 μs.
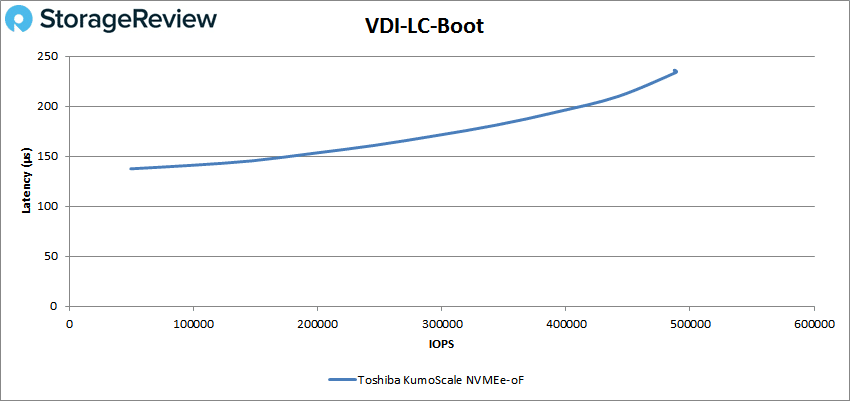
Przechodząc do VDI Linked Clone, test rozruchowy wykazał maksymalną wydajność 488 484 IOPS i opóźnienie 234 μs.
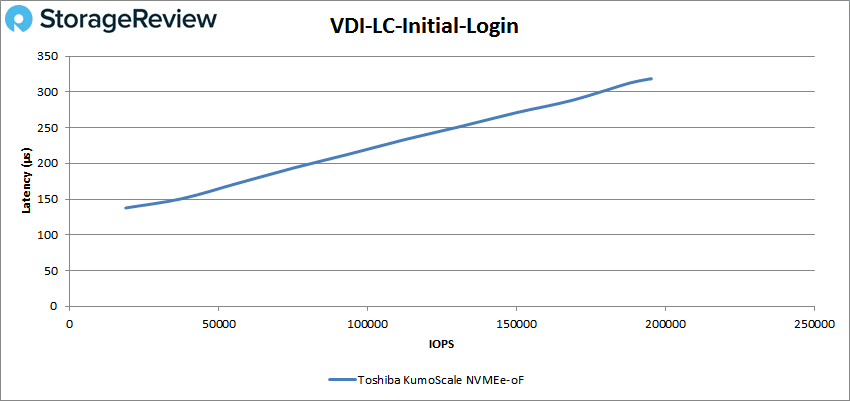
W profilu Linked Clone VDI mierzącym wydajność początkowego logowania węzeł pamięci masowej osiągnął szczyt na poziomie 194 781 IOPS przy opóźnieniu 318 μs.
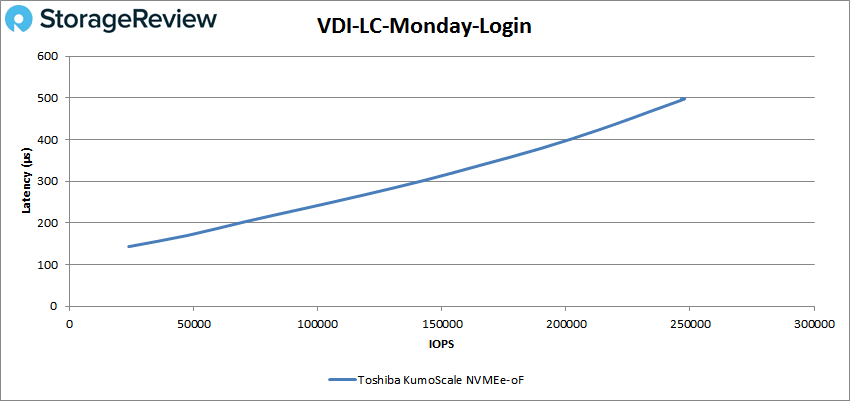
W naszym ostatnim profilu przyjrzeliśmy się wydajności logowania VDI Linked Clone Monday. Węzeł pamięci masowej osiągnął szczyt na poziomie 247 806 IOPS z opóźnieniem 498 μs.
Wniosek
Oprogramowanie KumoScale, zaprojektowane z myślą o maksymalizacji wydajności pamięci blokowej, łączy dyski SSD NVMe, aby zapewnić odpowiednią pojemność i liczbę operacji wejścia/wyjścia na sekundę (IOPS), które mogą być współużytkowane przez tysiące instancji zadań przez NVMe-oF. Zapewnia to użytkownikom chmury większą elastyczność, skalowalność i wydajność. Chociaż KumoScale można używać w kilku różnych konfiguracjach sprzętowych do tworzenia węzła pamięci masowej (Toshiba zaleca procesor Intel Xeon E5-2690 v4 o taktowaniu 2.30 GHz lub równoważny oraz 64 GB pamięci DRAM), my użyliśmy serwera dwuwęzłowego Newisys NSS-1160G-2N. NVMe-oF nie tylko zapewni pamięci masowej wydajność bliską szczytowej, ale KumoScale współpracuje również z wieloma platformami orkiestracji, takimi jak Kubernetes, OpenStack, Lenovo XClarity i Intel RSD.
System Newisys oparty na platformie Toshiba KumoScale z pewnością może poszczycić się imponującą wydajnością. Węzeł pamięci masowej ani razu nie zbliżył się do wartości 1 ms, a najwyższe opóźnienie wyniosło 562 μs podczas pierwszego logowania do VDI FC. Do najważniejszych osiągnięć należą: prawie 3 miliony IOPS w odczycie 4K, prawie 2 miliony w zapisie 4K, 1.3 miliona IOPS w obciążeniu SQL, 1.1 miliona IOPS w SQL 90-10 i prawie 1 milion w SQL 80-20. W przypadku wydajności sekwencyjnej 64K, węzeł pamięci masowej osiągnął 13.36 GB/s odczytu i 8.83 GB/s zapisu.
Chociaż nie ma wątpliwości, że wydajność jest astronomiczna, umieszczenie KumoScale w odpowiednim kontekście naprawdę go wyróżnia. Opóźnienia i wydajność są znacznie lepsze dzięki tej platformie niż na innych platformach bez NVMe-oF. Opóźnienia są bliższe wydajności lokalnej pamięci masowej, co jest dokładnie tym, do czego dąży protokół NVMe-oF i czego wymagają aplikacje, w których te systemy są pozycjonowane. Wydajność w skali tego systemu powinna jednak mieć największe znaczenie. Przeanalizowaliśmy wydajność 8 dysków SSD w jednym węźle pamięci masowej, podczas gdy systemy produkcyjne miałyby wiele węzłów pamięci masowej, każdy z własnymi pulami pamięci masowej. Wydajność w tym zamierzonym scenariuszu z łatwością bije na głowę tradycyjne wskaźniki macierzy pamięci masowej, co czyni KumoScale przełomem w przypadku macierzy NVMe-oF. Toshiba doskonale poradziła sobie z zapewnieniem efektywności wydajności dzięki KumoScale, a platforma oferuje nawet graficzny interfejs użytkownika do oceny i rozwoju. W połączeniu z obudową Newisys rozwiązanie to z pewnością sprawdzi się w dużych centrach danych, które potrafią wykorzystać zalety przepustowości i mniejszych opóźnień, jakie oferuje oprogramowanie Toshiba KumoScale.


 Amazon