

Atualizado em 28 de outubro de 2026: Ollama se torna a terceira opção com resultados de testes práticos (145.48 e 92.87 tokens por segundo no benchmark Ada da RTX 5000, o mais rápido dos três até o momento), o FAQ para iniciantes agora reflete a diferença de velocidade e a coluna Guia inclui um link para a análise prática do Ollama. Em 19 de outubro, o Open WebUI se tornou a segunda opção, com 115.32 e 75.06 tokens por segundo, contra 123 e 82 em janeiro. Publicado originalmente em 19 de agosto de 2026.
Existem quatro razões para executar um modelo de linguagem em seu próprio hardware, e apenas uma delas é ideológica. Privacidade: um documento que você entrega a um modelo local nunca sai da máquina, o que é essencial para proteger o código do cliente, contratos, dados de pacientes e produtos ainda não lançados.
Estrutura de custos: a IA na nuvem é tarifada por uso, e as cargas de trabalho automatizadas multiplicam a quantidade de tokens tão rapidamente que uma estação de trabalho adequada se paga; o hardware que você possui tem o custo da eletricidade. Disponibilidade: sem limites de taxa, sem interrupções, sem avisos de descontinuação alterando seu fluxo de trabalho numa terça-feira. E controle: o modelo que você validou é o modelo que você usa até decidir o contrário.
A contrapartida é que os modelos de nuvem de ponta continuam mais capazes e, para trabalhos de longo prazo com agentes, a diferença é real. Onde os modelos locais atingiram a paridade é em trabalhos com escopo limitado: bate-papo, sumarização, código em um único arquivo e perguntas e respostas em documentos. Isso, por acaso, representa a maior parte do que a maioria das pessoas faz o dia todo. Se sua prioridade é a capacidade máxima a qualquer custo, use a nuvem. Se sua prioridade é privacidade, custo ou controle, o modelo local é viável hoje, e esta página é o mapa.
Essa definição deve moldar seu orçamento de hardware, pois o investimento em IA local é, antes de qualquer outra coisa, uma decisão sobre memória. 16 GB de VRAM ou 32 GB de memória unificada cobrem a classe de 7 a 8 bilhões de bits, que lida com o trabalho limitado mencionado acima. De 24 a 32 GB de VRAM, ou 48 GB de memória unificada, alcançam a classe de 30 bilhões de bits, onde a programação agentiva deixa de ser uma demonstração. De 96 a 128 GB de memória unificada executam os modelos de mais de 100 bilhões de bits que se aproximam da qualidade de ponta. Investir em excesso significa obter uma velocidade que você pode não perceber; investir em falta significa que a classe de modelo desejada nunca será carregada.
Nossos guias "Melhores laptops para IA local" e "Melhores desktops para IA local" classificam as máquinas por nível. Esta página explica o que executar em cada uma delas.
O lado do software não amadureceu tão bem quanto o do hardware. Cerca de um terço das ferramentas recomendadas em uma busca hoje em dia estão obsoletas, e a maioria das páginas que as recomendam nem percebeu isso.
Esta página acompanha o que funciona e em qual hardware, até outubro de 2026. Por enquanto, classificamos por estrelas do GitHub, pois é um indicador neutro e verificável, e indicamos quando uma ferramenta é de código fechado e não possui classificação por estrelas. Cada nome de ferramenta nas tabelas contém um link para o download oficial. À medida que cada ferramenta selecionada passa pelos testes de laboratório, a coluna Guia é preenchida com um passo a passo prático de configuração e nossos próprios resultados, começando com janeiro.
Três regras regem esta página, começando pela distinção entre um modelo local e um agente local . Vários produtos são executados em sua máquina, enquanto todas as chamadas de inferência são direcionadas para a nuvem de um fornecedor; isso representa uma postura de privacidade, não uma capacidade offline, e essas ferramentas são listadas separadamente na parte inferior para que a distinção permaneça visível. Em segundo lugar, cada entrada apresenta uma especificação de hardware mínima realista, porque "funciona em um laptop" não significa nada sem uma informação sobre a memória. Em terceiro lugar, registramos o que deixou de ser relevante, com as respectivas datas, nas Perguntas Frequentes.
As Escolhas
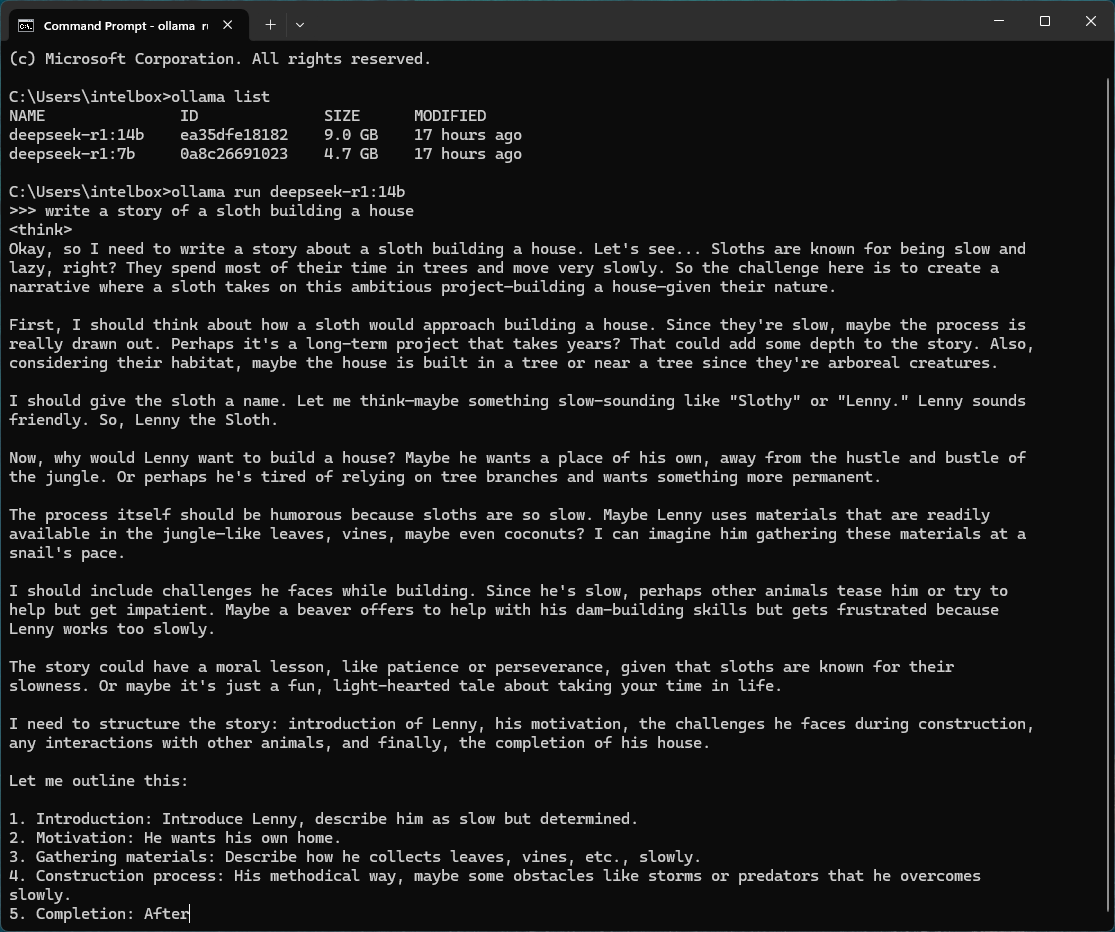
Melhor duração geral de um LLM local: Ollama
O Ollama é a resposta padrão e a ferramenta com a qual a maioria das outras ferramentas se comunica. Licenciado sob a licença MIT, com aproximadamente 179,000 estrelas no GitHub, agora inclui uma interface gráfica para desktop além da linha de comando. Ele baixa modelos com um único comando, expõe um endpoint compatível com OpenAI em localhost e, em janeiro de 2026, adicionou compatibilidade com a API de Mensagens Antropológicas, que é como as pessoas agora direcionam o Claude Code para um modelo local. Requisitos mínimos: 8 GB de RAM para um modelo de 3 bilhões de células, 16 GB para modelos de 7 a 8 bilhões de células e 24 GB de VRAM para a classe de 30 bilhões de células.
É também a plataforma mais rápida desta página, com nossos próprios números comprovando isso. Em nosso teste prático do Ollama , usando o mesmo benchmark Ada com RTX 5000 e os mesmos arquivos de modelo dos guias Jan e Open WebUI, o Ollama 0.40.11 decodificou Jan V3.5 4B com uma média de 145.48 tokens por segundo e Jan V2 VL High com 92.87, 18% e 13% à frente do Jan, respectivamente, com descarregamento total da GPU e sem configuração CUDA. As desvantagens estão no aplicativo para desktop: importar GGUFs existentes requer um arquivo de modelo e PowerShell, um modelo de visão importado perdeu o suporte a imagens sem o arquivo do projetor e a pesquisa na web exige uma conta e retornou um erro HTTP 402.
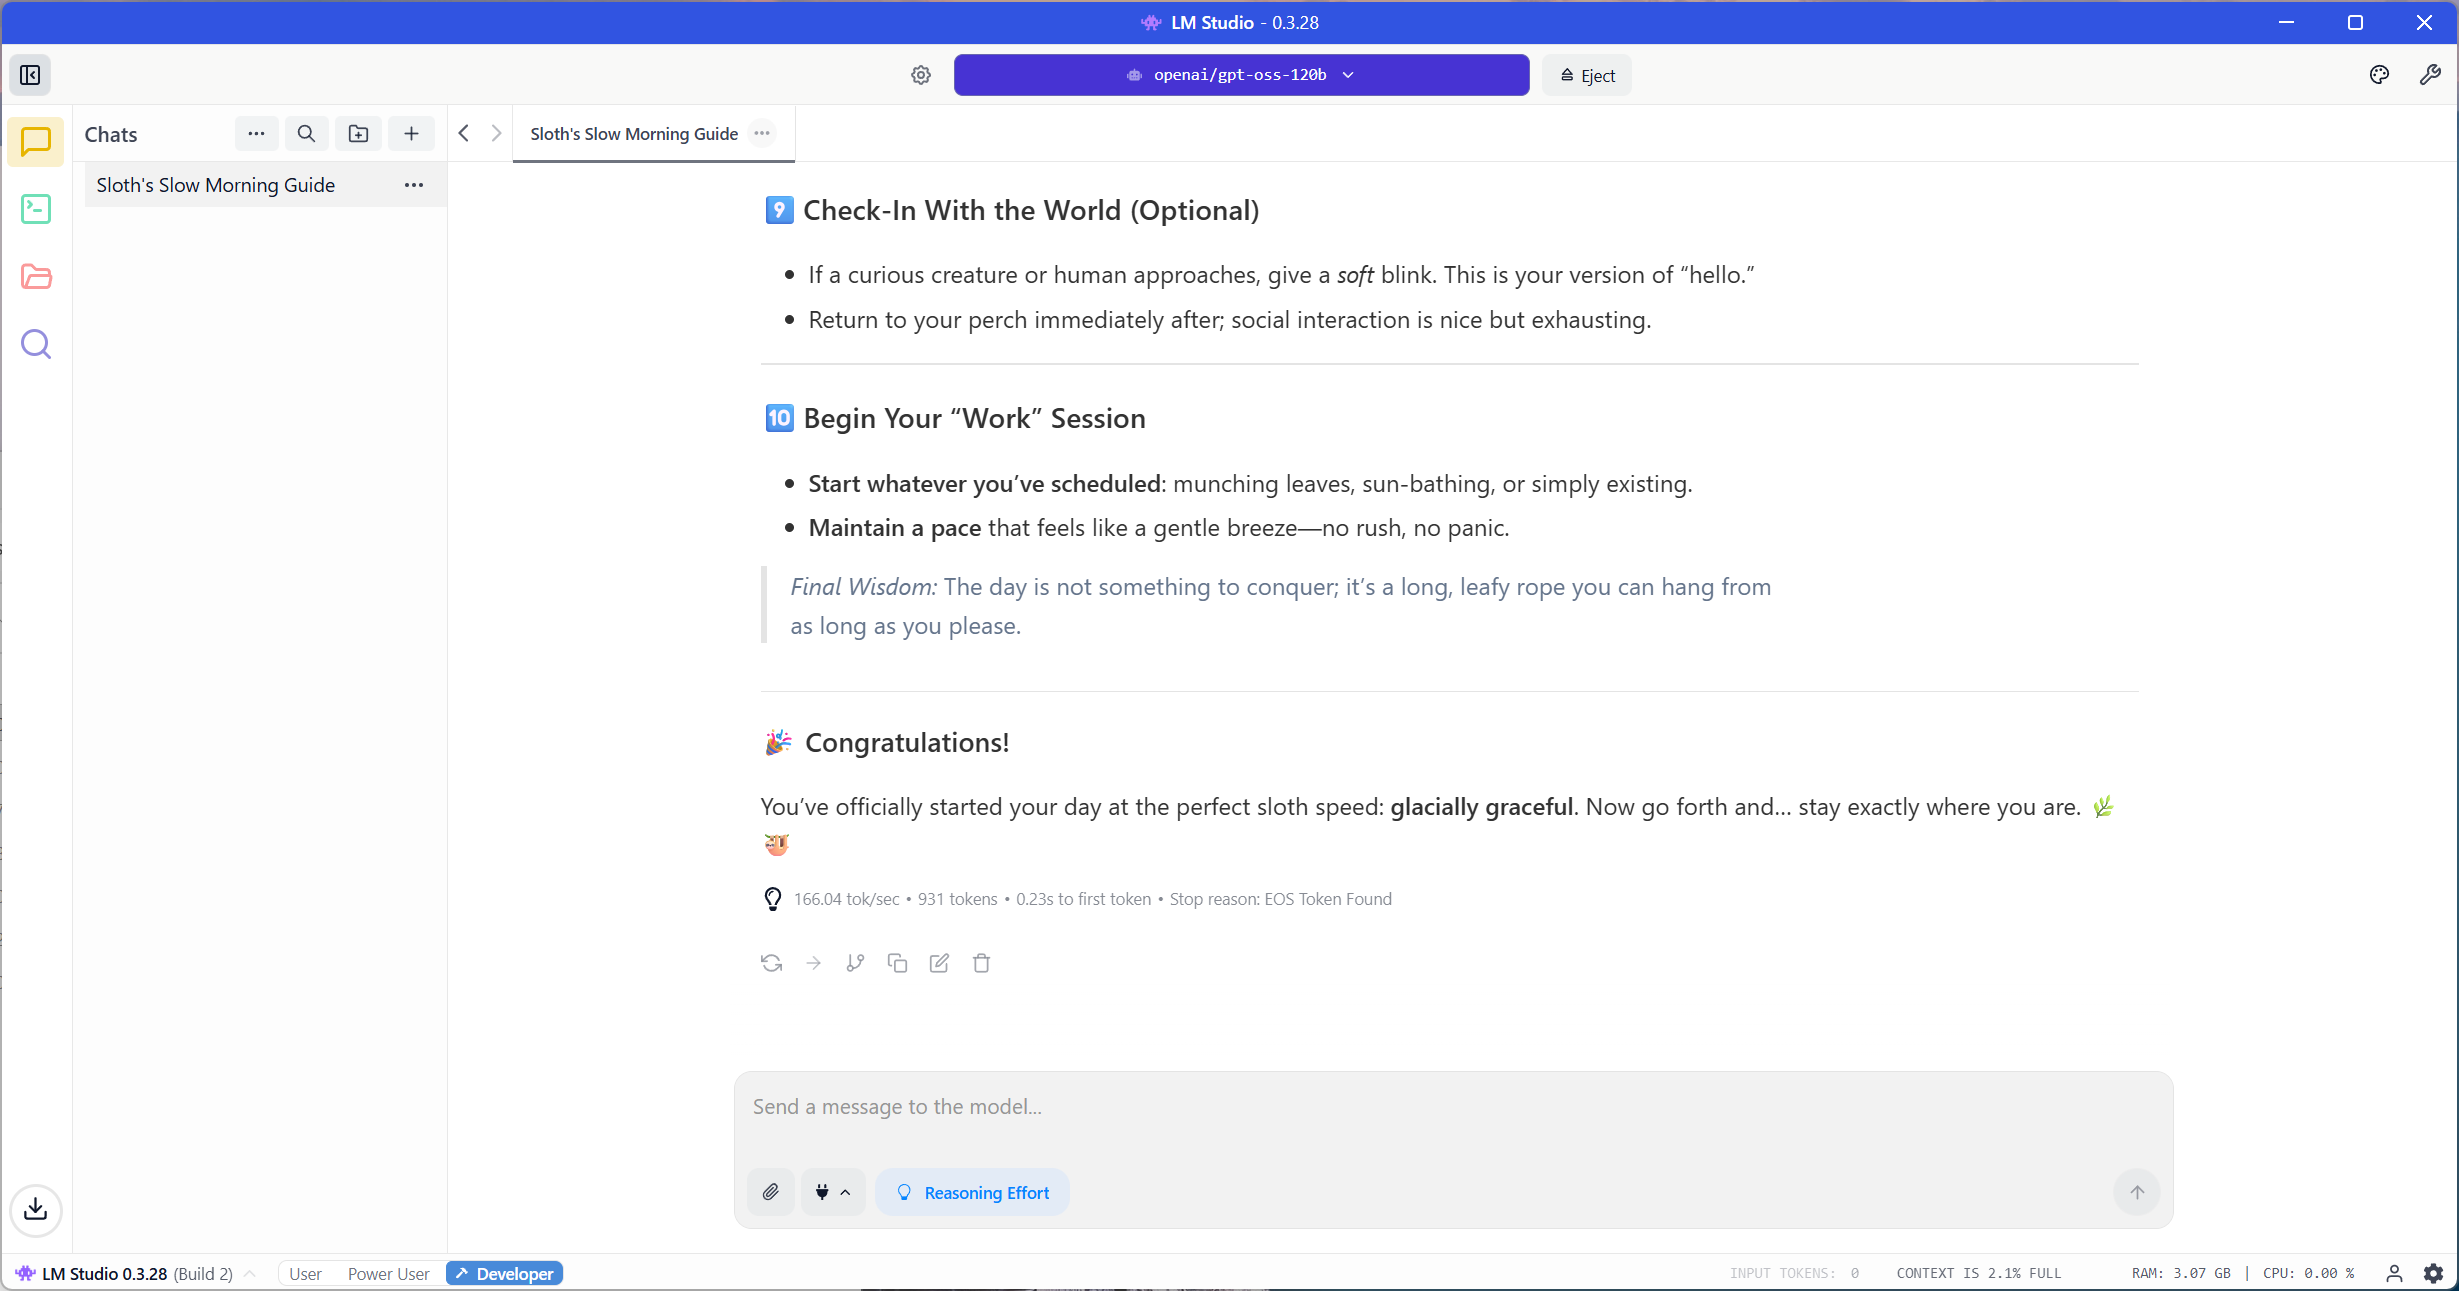
Melhor para avaliação comparativa de hardware: LM Studio
Por ser de código fechado, não possui classificação por estrelas, mas mesmo assim merece destaque. O LM Studio inclui tanto o llama.cpp quanto o MLX e expõe os controles que importam quando você está medindo o desempenho de uma máquina em vez de usá-la: camadas de descarregamento de GPU, escolha de quantização, comprimento do contexto e comportamento multi-GPU. É gratuito para uso comercial desde julho de 2025. Esta é a ferramenta por trás da maioria das medições de tokens por segundo em nossos painéis de estações de trabalho e laptops. Requisitos mínimos: 16 GB de RAM; 24 GB de VRAM ou 32 GB de memória unificada para um desempenho interessante.
Melhor motor subjacente: llama.cpp
Quase tudo o mais nesta página depende do llama.cpp. Licenciado sob a licença MIT, com aproximadamente 124,700 estrelas e várias versões com tags publicadas diariamente. É importante para o público de hardware por um motivo específico: a lista de backends é enorme, abrangendo CUDA, ROCm, Metal, Vulkan, SYCL, CANN e OpenCL, e os engenheiros dos fornecedores agora contribuem com otimizações diretamente para ele. Uma melhoria no pré-preenchimento do Intel Arc na versão 8688 representou um ganho de aproximadamente 5 vezes, e todos os usuários do Ollama e do LM Studio a receberam sem precisar instalar nada. Requisitos mínimos: funciona apenas com a CPU; 8 GB de RAM para ser utilizável.
Melhor aplicativo de desktop com foco em localização: janeiro
Apache 2.0, aproximadamente 44,100 estrelas, versão 0.8.6 em outubro de 2026. O Jan inclui o llama.cpp, então não há mais nada para instalar, e funciona mesmo com o cabo de rede desconectado. Isso parece pouco, até você verificar quantos aplicativos nesta categoria são clientes em nuvem com um campo Ollama. Este é o aplicativo ideal para entregar a um colega que nunca abre um terminal.
É também a primeira plataforma nesta página com nossos próprios números: em nosso benchmark Ada com RTX 5000, o Jan V3.5 4B decodificou a uma média de 123 tokens por segundo e o Jan V2 VL High a 82, usando 4.8 GB e 8.2 GB de memória da GPU, com aceleração por GPU habilitada na primeira execução e sem configuração CUDA. O passo a passo completo, da instalação à API compatível com OpenAI, está em nosso guia prático do Jan ; o documento RAG é a única parte do aplicativo que não foi abordada nele. Requisitos mínimos: 8 GB de RAM.
Melhor documento local RAG: AnythingLLM
MIT, aproximadamente 64,800 estrelas. Ele inclui um banco de dados vetorial e lida com fragmentação e incorporação sem configuração, o que o torna o chat de documentos mais fácil de usar da categoria desktop. Duas coisas que não vamos esconder: uma vulnerabilidade de março de 2026, classificada como CVSS 9.6, permitia a execução remota de código acionada pela própria resposta transmitida do modelo, corrigida na versão 1.11.2, então atualize antes de usar. E a telemetria vem ativada por padrão em um aplicativo comercializado como prioritariamente local, que você pode desativar nas Configurações. Requisitos mínimos: 16 GB de RAM para trabalho com documentos.
Melhor solução multiusuário autohospedada: Open WebUI
Com aproximadamente 149,000 estrelas e a mais profunda capacidade de configuração de recuperação de dados disponível, testamos o servidor v0.12.2. Inicialmente, era um servidor auto-hospedado com Docker como ponto de entrada, e agora um aplicativo para desktop Windows o instala com um ambiente Python integrado e seu próprio runtime llama.cpp. Um detalhe importante a saber antes de usar: a licença mudou em abril de 2025, de BSD-3 para uma licença personalizada não aprovada pela OSI, adicionando uma cláusula contra a remoção da marca Open WebUI, com uma exceção para usuários abaixo de cinquenta em qualquer período de trinta dias. Execute-o sem modificações em pequena escala e nada mudará para você.
Esta é a segunda plataforma nesta página com nossos próprios números. Em nossos arquivos de bancada e modelo Jan, o Open WebUI Desktop decodificou o Jan V3.5 4B com uma mediana de 115.32 tokens por segundo, enquanto o Jan V2 VL High apresentou desempenhos 75.06, 6.2 e 8.5% inferiores ao Jan em uma versão diferente do llama.cpp. A divergência reside na configuração: fixamos a versão b11612 do llama.cpp, adicionamos manualmente as DLLs de tempo de execução do CUDA e restauramos um contexto de 8,192 tokens após uma reinstalação que permitiu a alocação de até 169,984 tokens por slot.
As predefinições, a entrada de imagens, a pesquisa na web do DDGS e a API local funcionaram normalmente, conforme detalhado em nosso guia prático do Open WebUI . Requisitos mínimos: um ambiente de execução separado e 4 GB para o contêiner, ou o aplicativo de desktop com o arquivo llama.cpp incluído.
Melhor agente de codificação local: Cline
Apache 2.0, aproximadamente 63,900 estrelas. A Cline investiu mais em engenharia local do que qualquer concorrente, incluindo um prompt de sistema compacto criado especificamente para Ollama e LM Studio, além de chamadas de ferramentas nativas por família de modelos. A própria documentação da empresa é excepcionalmente franca sobre as vantagens que a nuvem ainda oferece. Requisitos mínimos: 24 GB de VRAM ou 36 GB de memória unificada e contexto configurado para 32K ou superior.
Melhor Programação de Terminal Offline: Aider
Apache 2.0, aproximadamente 48,300 estrelas, e arquiteturalmente a opção local mais confiável por um motivo que vale a pena entender. O Aider não usa chamadas de ferramentas JSON. Ele analisa formatos de diff e edição de arquivos inteiros a partir de texto simples, o que evita exatamente o modo de falha que quebra a maioria dos agentes em modelos locais. A ressalva é a manutenção: um único autor escreveu 96% dos commits, e a cadência de lançamentos caiu para aproximadamente uma versão estável em 2026. Requisitos mínimos: 24 GB de VRAM ou 36 GB de memória unificada.
Melhor plataforma de agentes autohospedados: OpenHands
Licenciado pelo MIT, com aproximadamente 84,500 estrelas. O OpenHands documenta os modelos locais adequadamente e, mais útil, indica quando o problema não está na sua configuração: a própria documentação afirma que, se o agente se comportar como um chatbot ou falhar constantemente com as ferramentas, o modelo é a limitação. Ele exige um mínimo de 22 mil contextos e recomenda 32 mil. Requisitos mínimos: 24 GB de VRAM para modelos quantizados ou 64 GB de memória unificada.
A melhor surpresa gratuita offline: GitHub Copilot CLI
Desde abril de 2026, a CLI do Copilot funciona com Ollama, vLLM e Foundry Local. A autenticação do GitHub é opcional e não é necessária uma assinatura do Copilot. Configurar COPILOT_OFFLINE interrompe toda a telemetria e comunicação de rede, e seus subagentes herdam seu provedor local. A maioria dos artigos comparativos ainda o lista como exclusivo para nuvem. Observe a diferença: a extensão para IDE ainda envia sugestões de conclusão embutidas para a nuvem, mesmo com a opção "traga sua própria chave". Requisitos mínimos: um modelo com uma janela de contexto de 128 KB, ou seja, 32 GB de VRAM ou 64 GB de memória unificada.
Melhor servidor com suporte do fornecedor: Lemonade
Apache 2.0, com aproximadamente 5,400 estrelas, é a única ferramenta de fornecedor que recomendamos com base apenas em seus méritos. É mantida por engenheiros da AMD e funciona com NVIDIA CUDA, Apple Metal, Vulkan e CPUs comuns, além de NPUs Radeon e Ryzen AI. É lançada aproximadamente a cada duas semanas e migrou seu aplicativo para desktop do Electron para o Tauri em abril de 2026. Requisitos mínimos: 16 GB de RAM; Ryzen AI série 300 ou posterior para uso com NPU.
Melhor RAG local para todo o sistema de arquivos: Nexa AI Hyperlink
O Nexa AI Hyperlink é de código fechado e gratuito, e indexa todo o seu sistema de arquivos no dispositivo, fornecendo respostas com citações embutidas. Ele está nesta lista por ser a única ferramenta RAG local nova com dados de aceleração publicados para hardware de consumo: indexação aproximadamente 3 vezes mais rápida e inferência 2 vezes mais rápida em uma RTX 5090, com uma pasta de 1 GB tendo seu tempo de indexação reduzido de cerca de quinze minutos para quatro ou cinco. Requisitos mínimos: uma GPU RTX moderna; 16 GB de RAM.
Tempos de execução: O que executa o modelo
Esses cinco são os mecanismos, e tudo nas duas tabelas seguintes é uma interface que se comunica com um deles; portanto, a tabela está ordenada por estrelas do GitHub, assim como o restante da página.
A coluna Guia aqui se sobrepõe aos aplicativos, portanto, seu escopo é definido de acordo: Ollama recebe um guia próprio por ser a escolha principal e o backend para o qual a maioria das outras ferramentas apontam; LM Studio aparece em ambas as tabelas e recebe um guia; llama.cpp é abordado por meio dos aplicativos que o incluem, começando com a análise prática de janeiro; e MLX é abordado por meio do LM Studio no Apple Silicon. vLLM é um mecanismo de servidor e seu teste já está presente em nossa análise do cluster GB300 de duas torres.
| Runtime | Estrelas | Licença | Hardware Mínimo | Aceleração | Guias |
|---|---|---|---|---|---|
| Ollama | ~ 179,000 | MIT | 8 GB de RAM (3B), 16 GB (7-8B), 24 GB de VRAM (classe 30B) | CUDA, ROCm, Metal, Vulkan | Guia prático da lhama |
| lhama.cpp | ~ 124,700 | MIT | 8 GB de RAM, somente CPU funciona | CUDA, ROCm, Metal, Vulkan, SYCL, CANN, OpenCL | Coberto por meio de Jan e Abrir WebUI prático |
| MLX / mlx-lm | ~ 27,500 | MIT | Apple Silicon, 16 GB unificado | Metal; Backend CUDA adicionado em 2026 | Através do guia do LM Studio (em breve) |
| Estúdio LM | Fonte fechada | Propriedade exclusiva, livre para uso comercial. | 16 GB de RAM; 24 GB de VRAM ou 32 GB unificados. | Pacotes llama.cpp e MLX | Em breve |
| vLLM | Serviço de produção | Apache 2.0 | 24 GB de VRAM, piso realista | CUDA, ROCm | Testado em nosso Análise do cluster GB300 |
Aplicativos de desktop e RAG local
Esses são os aplicativos que um leitor instala, e a coluna "Local-First" é a que deve ser lida com atenção: ela separa o software que executa um modelo em sua máquina do software que adicionou um campo para um URL do Ollama.
| App | Estrelas | Licença | Local-Primeiro | Hardware Mínimo | Guias |
|---|---|---|---|---|---|
| Abrir WebUI | ~ 149,000 | Personalizado, não aprovado pela OSI | Capaz; servidor, além de um aplicativo para desktop Windows que inclui o llama.cpp. | Ambiente de execução separado + 4 GB para o contêiner ou o aplicativo para desktop. | Guia prático do Open WebUI |
| Qualquer coisaLLM | ~ 64,800 | MIT | Compatível; telemetria ativada por padrão | RAM 16GB | Em breve |
| Jan | ~ 44,100 | Apache 2.0 | Sim, pacotes llama.cpp | RAM 8GB | Guia prático de Jan |
| Estúdio LM | Fonte fechada | Proprietário | Sim | 16 GB de RAM; 24 GB de VRAM para ser interessante. | Em breve |
| Msty | Fonte fechada | Proprietário, nível gratuito | Sim, pacotes Ollama, MLX, llama.cpp | RAM 8GB | Em breve |
| Hiperlink Nexa AI | Fonte fechada | Proprietário, gratuito | Sim, indexação no dispositivo. | GPU RTX moderna, 16 GB de RAM | Em breve |
Ferramentas de Codificação e Agentes
Essas são as entradas da página que mais exigem hardware, pois o trabalho com agentes requer uma grande janela de contexto e sessões longas. Considere 32 GB de VRAM ou 64 GB de memória unificada como o ponto em que isso deixa de ser uma demonstração.
| ferramenta | Estrelas | Licença | Caminho local | Hardware Mínimo | Guias |
|---|---|---|---|---|---|
| Mãos Abertas | ~ 84,500 | MIT | LM Studio, Ollama, vLLM, SGLang | 24 GB de VRAM ou 64 GB unificados; contexto de 32K | Em breve |
| Cline | ~ 63,900 | Apache 2.0 | Ollama, LM Studio, compatível com OpenAI | 24 GB de VRAM ou 36 GB unificados | Em breve |
| Ganso | ~ 52,900 | Apache 2.0 | Ollama de primeira classe; agora Linux Foundation | 24 GB de VRAM ou 36 GB unificados | Em breve |
| ajudar | ~ 48,300 | Apache 2.0 | Ollama, compatível com OpenAI; sem necessidade de chamada de ferramenta. | 24 GB de VRAM ou 36 GB unificados | Em breve |
| Zed | v1.0, abril de 2026 | Apache 2.0 | LM Studio, Ollama, llama.cpp | 24 GB de VRAM ou 36 GB unificados | Em breve |
| CLI do GitHub Copilot | Fonte fechada | Proprietário, sem necessidade de assinatura | Ollama, vLLM, Foundry Local | 32 GB de VRAM ou 64 GB unificados; contexto de 128K | Em breve |
Iniciativas de Fornecedores
Todos os fornecedores de silício e sistemas operacionais lançam algo para IA local, e a categoria merece um item próprio, pois a nomenclatura é confusa e a taxa de mortalidade é alta. O padrão ao longo de 2026 é consistente: os fornecedores pararam de competir com a pilha de terceiros e começaram a alimentá-la. A NVIDIA descontinuou seus dois produtos de IA local e agora publica otimizações para Ollama, llama.cpp e ComfyUI. A AMD faz parceria com a LM Studio. A Qualcomm lançou sua capacidade de NPU portando o aplicativo de outra empresa.
A única coisa que as ferramentas do fornecedor fazem que o Ollama e o LM Studio não conseguem: acessar a NPU . O llama.cpp não possui um backend para a NPU, então, em uma máquina de IA com Snapdragon ou Ryzen, essas ferramentas deixam o mecanismo neural com utilização zero. Se você pagou por 40 a 60 TOPS, somente um caminho do fornecedor os utiliza. Ajuste suas expectativas de acordo, porque as NPUs atualmente atingem um limite de cerca de 7 bilhões de modelos, e a vantagem é a duração da bateria em tarefas contínuas com modelos pequenos, não a taxa de transferência. Uma GPU dedicada supera a NPU em velocidade sempre.
| Vendedor | O que é | Formato | Hardware Necessário | Status | Guias |
|---|---|---|---|---|---|
| Limonada AMD | Servidor, GUI e SDK; ~5,400 estrelas, Apache 2.0 | Aplicativo + servidor | 16 GB de RAM; Ryzen AI 300+ para NPU. Também funciona em placas NVIDIA, Apple e CPUs. | Ativo, envios aproximadamente quinzenais. | Em breve |
| Intel OpenVINO GenAI | Runtime e SDK; ~10,700 estrelas | SDK | Core Ultra, série Arc A/B; 16 GB de RAM | Ativo, 2026.3 em agosto de 2026 | Rastreado, sem guia planejado |
| Modelos da Apple Foundation | Modelos no dispositivo expostos pelo sistema operacional | estrutura do SO | Apple Silicon; já instalado | Ativo; aberto a qualquer provedor na WWDC 2026. | Rastreado, sem guia planejado |
| Microsoft Foundry Local | SDK e CLI de inferência local; ~2,400 estrelas | SDK | Windows, macOS, Linux; NPU/GPU/CPU | GA abril de 2026; catálogo de modelos selecionados | Rastreado, sem guia planejado |
| AMD GAIA | Aplicativo LLM local para IA Ryzen; ~1,400 estrelas, MIT | Aplicativo + SDK | Processador Ryzen AI série 300 (mínimo); 16 GB de RAM, 64 GB recomendados. | Ativo, v0.20.0 Junho de 2026 | Rastreado, sem guia planejado |
| Parque de IA da Intel | Aplicativo para computador; ~900 estrelas | App | Arc série A 8GB+, Arc série B, Core Ultra | Ativo, mas ainda em versão beta após dois anos. | Rastreado, sem guia planejado |
| Qualcomm GenieX | Ambiente de execução GGUF integrado para NPU Snapdragon | Runtime | Snapdragon X / X Elite, 8 Elite | Prévia para desenvolvedores, julho de 2026 | Rastreado, sem guia planejado |
| Projeto NVIDIA G-Assist | Assistente 8B integrado para controle do sistema | App | RTX série 20 ou posterior, 6 GB de VRAM | Ativo, mas ainda classificado como pré-lançamento. | Rastreado, sem guia planejado |
A nomenclatura contribui para a confusão, pois o "RTX AI Garage" da NVIDIA soa como um produto, mas não é; trata-se de uma série de posts em um blog. A plataforma da Microsoft foi renomeada diversas vezes: as APIs do Copilot Runtime se tornaram APIs de IA do Windows, o Azure AI Foundry se tornou Microsoft Foundry e o DirectML agora está em modo de manutenção, recebendo apenas correções de segurança. O Qualcomm AI Hub é um serviço em nuvem que provisiona dispositivos físicos remotamente, não algo que você execute localmente.
O que geralmente quebra
A maioria dos relatos de que os modelos locais "não funcionam" são problemas de configuração, não problemas do modelo em si. Quatro deles, em particular, são responsáveis por uma grande parte desses casos, e todos os quatro são aspectos que o público interessado em hardware deve conhecer antes de culpar o silício.
1. O Ollama usa por padrão um contexto de 4,096 tokens. Ele não gera um erro quando você excede esse limite. Ele trunca silenciosamente e um loop agentivo é encerrado sem problemas. Qualquer harness sério precisa de mais: o OpenHands exige pelo menos 22 tokens e recomenda 32, o Codex precisa de 32, o Copilot CLI precisa de 128 e o Cline define 262,144. Essa configuração específica é provavelmente a causa mais comum dos relatos de falhas que você encontrará online.
2. A quantização do cache KV degrada especificamente as chamadas de ferramentas , e isso ocorre antes que a qualidade geral da saída seja visivelmente afetada. A documentação do llama.cpp alerta diretamente sobre isso. Se você estiver executando um agente, desative-a.
3. A quantidade de ferramentas é um precipício, não uma ladeira. Acima de aproximadamente cinco ou seis ferramentas em uso, alguns modelos silenciosamente param de emitir chamadas de ferramentas JSON válidas e começam a incorporar XML no corpo da resposta, o que o sistema interpreta como "nenhuma ferramenta usada". Um agente popular distribuía onze ferramentas por padrão e quebrou seu próprio modelo recomendado até o início de 2026. Encontramos uma versão disso em nossos testes com o Open WebUI, onde as instruções de ferramentas integradas levaram uma pequena solicitação de benchmark a ultrapassar um contexto de 8,192 tokens. A consequência prática é contra-intuitiva: sobrecarregar muitos servidores MCP é ativamente prejudicial em modelos locais, de uma forma que não ocorre em modelos de ponta.
4. Q4_K_M é o limite mínimo prático. Abaixo dele, a confiabilidade das chamadas de ferramentas cai mais rapidamente do que a qualidade geral, então o modelo ainda parece bom, mas silenciosamente falha em fazer qualquer coisa.
A memória é a limitação.
Em todas as ferramentas desta página, o fator determinante para a execução de seus programas é a quantidade de memória que o acelerador consegue acessar. Estas são as combinações mais citadas para trabalhos com agentes e as que pretendemos verificar em laboratório.
| Hardware | Modelo | Pegada | Taxa de transferência relatada |
|---|---|---|---|
| RTX 5090, 32 GB | Qwen3.6-35B-A3B Q4_K_M | ~ 21 GB | 160-180 tok/s, contexto de 262K |
| RTX 5090, 32 GB | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19 GB | 50-90 tok/s em classe de 24 GB |
| RTX 5090, 32 GB | Devstral Pequeno 24B Q4_K_M | ~ 14 GB | Projetado especificamente para chamadas de ferramentas. |
| RTX PRO 6000, 96 GB | GPT-OSS 120B MXFP4 | ~ 63 GB | A classe 100B em uma única placa de workstation; a GPU da nossa análise de laboratório. |
| Notebook RTX PRO 5000, 24GB GDDR7 | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19 GB | A maior GPU para laptop que testamos (ThinkPad P16 Gen 3); a classe 30B se encaixa perfeitamente, com folga. |
| 96-128 GB unificado, série M | gpt-oss-120b Q6_K | ~ 93 GB | 14-20 tok/s; JSON de chamada de ferramenta mais limpo de qualquer modelo open-weight |
Vale a pena dizer, pois o marketing não menciona: os maiores modelos de código aberto não são para estações de trabalho. O GLM-5.2 tem aproximadamente 744 bytes de parâmetros e precisa de cerca de 744 GB em um FP8, que é um nó de data center com oito GPUs. O Kimi K2 e o DeepSeek V4 estão na mesma categoria. Qualquer guia que diga para executar esses modelos em um desktop está errado.
Os dados de throughput acima são provenientes de testes de terceiros e materiais de fornecedores, e ainda não são resultados de laboratório da StorageReview, com exceção dos dados de Jan, Open WebUI e decodificação Ollama nas opções acima. Substituiremos esses dados pelos nossos próprios números à medida que cada opção passar pelo processo de avaliação do Guia.
Ferramentas Cloud-First e por que elas não estão classificadas aqui
Um agente local não é um modelo local , e as ferramentas abaixo mostram a diferença: cada uma delas é executada em sua máquina, enquanto envia todas as chamadas de inferência para a nuvem de um fornecedor.
| ferramenta | Suporte ao modelo local | Observação |
|---|---|---|
| Cursor | Não | A documentação oficial afirma que todas as solicitações são roteadas pelos servidores da Cursor; as teclas personalizadas funcionam apenas com os principais provedores de nuvem, e o recurso de autocompletar com a tecla Tab sempre utiliza os modelos da Cursor. Adquirida pela SpaceX em 2026. |
| Devin Desktop (antes Windsurf) | Não | Renomeado em junho de 2026. Todos os modelos são hospedados na nuvem. |
| Antigravidade do Google | Não | A documentação afirma explicitamente que não é possível usar Ollama, LM Studio ou um endpoint personalizado. |
| Gemini CLI | Não | O suporte local existe apenas em forks da comunidade. |
| Qodo | Não | "On-premise" refere-se à infraestrutura auto-hospedada que ainda utiliza modelos de nuvem. |
| GitHub Copilot no IDE | Parcial | O chat pode usar modelos locais; as conclusões embutidas permanecem na nuvem mesmo em ambientes BYOD (Bring Your Own Key). |
| ChatGPT | Não | Os aplicativos para desktop e dispositivos móveis são clientes para os modelos em nuvem da OpenAI. Os modelos gpt-oss de peso aberto da OpenAI podem ser executados localmente, mas por meio dos ambientes de execução mencionados acima, e não pelo aplicativo ChatGPT. |
| Claude | Não | Os aplicativos Claude e o Cowork são executados nos modelos de nuvem da Anthropic. O Claude Code pode ser direcionado para um modelo local por meio da API compatível com Anthropic do Ollama, o que funciona, mas é uma configuração não suportada. |
| assistentes gerais de agentes | Não | As ferramentas desta classe são executadas na sua máquina, mas dependem de um modelo em nuvem para raciocínio. |
Existe um gênero bastante difundido de guias sobre como "conectar o Cursor ao Ollama". A própria documentação do Cursor os contradiz. Se a operação offline for um requisito para você, essa distinção é crucial.
E quanto à geração de imagens e vídeos?
A geração local de imagens é uma das maiores comunidades em IA local. Só o ComfyUI supera a maioria das ferramentas classificadas acima por estrelas no GitHub, e a geração local de vídeos está se tornando a carga de trabalho de consumo que mais consome VRAM. Ela merece seu próprio ranking, e terá um; adicionar uma quarta categoria a esta página a enterraria. Até lá, a lógica de hardware desta página se aplica diretamente: o processamento de imagens e vídeos é ainda mais limitado pela memória do que os modelos de linguagem, e os mesmos níveis de exigência se aplicam.
Como funciona esta página
Três regras regem o ranking, e a primeira é que a ordenação é feita por estrelas do GitHub, por enquanto. Não é o ideal, mas é neutro, verificável e não nos obriga a fingir que testamos coisas que não testamos. Ferramentas de código fechado são marcadas como tal e não recebem uma pontuação inventada. À medida que nossos próprios testes identificarem favoritos claros, a ordenação mudará para refletir os resultados mensurados, e nós informaremos isso; Jan, Open WebUI e Ollama agora têm números de laboratório, então essa mudança já começou. Em segundo lugar, cada entrada possui um requisito mínimo de memória, porque esse é o número que determina se um modelo será carregado.
Em terceiro lugar, a coluna Guia representa um compromisso específico com as escolhas: cada escolha classificada recebe um passo a passo prático de configuração com nossos números em nosso hardware; o ambiente de execução que acompanha um aplicativo é abordado por meio do guia desse aplicativo; e as iniciativas dos fornecedores são acompanhadas em sua tabela, caso não haja um guia específico. O link aparece aqui quando cada guia é publicado.
Perguntas frequentes sobre ferramentas locais de mestrado em direito
Qual ferramenta local de LLM devo usar para começar?
Ollama é uma boa opção se você se sente confortável usando um terminal; LM Studio é ideal para quem prefere uma janela com controles; e Jan é perfeito para quem busca uma solução pronta para uso, sem necessidade de instalação adicional. Os três são gratuitos, funcionam totalmente offline e utilizam o arquivo llama.cpp internamente, garantindo o mesmo comportamento do modelo. A diferença está na velocidade: em nosso teste com RTX 5000 Ada, o Ollama decodificou os mesmos arquivos de modelo de 13 a 18% mais rápido que o Jan. Portanto, a principal diferença reside na interface e na versão compilada de cada um.
O que aconteceu com o NVIDIA ChatRTX, o GPT4All e o Continue.dev?
Eles desapareceram, juntamente com um número surpreendente de seus concorrentes, e esta é a informação mais importante a saber antes de seguir uma recomendação antiga. O NVIDIA ChatRTX foi descontinuado em 21 de janeiro de 2026, seu repositório foi arquivado e seu fórum de suporte foi bloqueado, sem que um substituto tenha sido anunciado.
O GPT4All é o caso mais complicado: não teve commits nos últimos doze meses e sua última versão foi lançada em fevereiro de 2025, mas o repositório não está arquivado e ainda exibe uma grande quantidade de estrelas, então parece estar ativo. Ele sempre suportou apenas um conjunto limitado de formatos de quantização e não consegue carregar a maioria das versões atuais do modelo.
Continue.dev , que durante dois anos foi a recomendação padrão para codificação de modelos locais, foi adquirido pela Cursor e encerrado em junho de 2026. O Roo Code foi desativado em maio de 2026, o Void foi arquivado em junho de 2026, o Twinny em novembro de 2025 e o Reor em março de 2026. O Khoj desativou seu serviço hospedado em abril de 2026, embora a versão auto-hospedada continue disponível. No lado dos fornecedores, o Intel IPEX-LLM foi arquivado em janeiro de 2026 e sinalizado por problemas de segurança conhecidos, sem um caminho de migração publicado, e o NVIDIA RTX AI Toolkit foi descontinuado em novembro de 2025.
De quanta VRAM eu preciso para executar um LLM local?
Para bate-papo, 8 GB de RAM do sistema executam um modelo de 3 bits, e 16 GB executam um modelo de 7 a 8 bits de forma aceitável apenas com a CPU. Para obter velocidade útil, você precisa do modelo em VRAM ou memória unificada: 16 GB suportam a classe de 7 a 14 bits, 24 GB alcançam a classe de 30 bits no quarto trimestre, e 32 GB ou mais é onde o trabalho de programação de agentes deixa de ser frustrante. Acima disso, a capacidade importa mais do que a largura de banda, e é por isso que máquinas com memória unificada de 96 a 128 GB executam modelos que nenhuma placa de vídeo para consumidor consegue suportar.
As ferramentas locais do LLM utilizam minha NPU?
Geralmente não, porque o arquivo llama.cpp não possui um backend para NPU, então o Ollama e o LM Studio deixarão o mecanismo neural em zero por cento em uma máquina de IA com Snapdragon ou Ryzen e executarão na CPU ou GPU. Acessar a NPU atualmente requer um caminho específico do fornecedor: Qualcomm GenieX, AMD Lemonade com seu runtime de NPU, Intel OpenVINO ou o Neural Engine da Apple por meio das estruturas do sistema operacional. A vantagem é a duração da bateria e a operação contínua de baixo consumo de energia, já que as NPUs também atingem o limite em torno de 7 bilhões de modelos hoje em dia e uma GPU dedicada sempre terá um desempenho superior em termos de throughput.
Devo executar IA localmente no Windows ou no Linux?
Para os aplicativos de desktop desta página, Windows e macOS oferecem uma experiência mais fluida. LM Studio, Jan, AnythingLLM e Ollama são instalados nativamente, os drivers de GPU vêm dos locais usuais e nada requer um terminal. O Linux se destaca um nível abaixo: os mecanismos de produção, vLLM e SGLang, são desenvolvidos prioritariamente para Linux, o suporte a múltiplas GPUs pressupõe isso e algumas das mais recentes tecnologias de aceleração chegam ao Linux antes de qualquer outra plataforma, incluindo o suporte a NPUs de IA do AMD Ryzen, que já está disponível para Linux e requer um kernel bastante recente.
A diferença é menor do que costumava ser. A AMD unificou suas versões do ROCm para Windows e Linux em 2026, e o WSL2 cobre a maior parte do restante, o que permite que ferramentas baseadas em Docker, como o Open WebUI, funcionem perfeitamente em uma máquina Windows. A regra prática é: se você estiver instalando a partir da tabela de aplicativos para desktop, mantenha o sistema operacional que você já possui; se estiver criando um servidor dedicado ou buscando todas as possibilidades de aceleração, compile em Linux.
Será que os modelos locais são suficientemente bons para substituir um modelo em nuvem na programação?
Depende inteiramente da tarefa, e a diferença é mais acentuada do que a maioria das análises admite. Em tarefas com escopo limitado, como geração de um único arquivo, testes unitários, código repetitivo e explicação de código, os modelos open-weight atuais em uma boa estação de trabalho estão praticamente em paridade com os modelos de ponta em nuvem. Em tarefas de longo prazo e com agentes, como refatorações de múltiplos arquivos em um grande repositório, eles perdem claramente, e os modos de falha são do tipo desagradável: operações nulas silenciosas e tarefas relatadas com confiança que nunca foram realizadas. Se o seu motivo para optar por uma infraestrutura local é privacidade, requisitos de isolamento da internet ou custo, é viável hoje. Se o seu motivo é capacidade, ainda não é.
Executar um modelo localmente é mais seguro do que usar um serviço em nuvem?
Para residência de dados, sim, e essa é a razão pela qual a maioria das pessoas opta por soluções locais. Para segurança de software, a resposta é não por padrão: um aplicativo de IA local com classificação CVSS 9.6 em março de 2026 poderia ser induzido a executar código no host pela própria saída transmitida do modelo, porque o aplicativo para desktop foi empacotado com configurações padrão inseguras. Local significa que seus dados permanecem no mesmo local, e não significa que o software seja reforçado, já que essa categoria inclui muitos códigos que são atualizados rapidamente.
O que é um ambiente de testes (sandbox) para agentes de IA e preciso de um para IA local?
Um sandbox é um ambiente isolado, geralmente um contêiner ou uma máquina virtual leve, onde um agente de IA executa os comandos e o código que gera, de modo que um erro ou uma instrução maliciosa não possa afetar o sistema hospedeiro. Ele existe porque os agentes fazem mais do que responder perguntas: eles executam comandos do shell, editam arquivos e navegam, e cada uma dessas ações é orientada pela saída do modelo, que pode ser manipulada. Executar o modelo localmente não altera essa lógica.
O objetivo do sandbox é isolar o que o agente faz, não onde o modelo reside, e a vulnerabilidade de execução de código descrita acima ilustrou exatamente esse ponto em um aplicativo que prioriza o ambiente local. Algumas ferramentas nesta página já vêm com sandbox integrado, e aquelas que executam agentes com acesso irrestrito ao host merecem uma análise mais cuidadosa antes de serem usadas em uma máquina importante. À medida que a adoção de agentes se expande para ambientes corporativos, espere que o sandbox se torne um recurso essencial e que passemos a considerá-lo em nossas avaliações dessas ferramentas.
É possível que o hardware local execute cargas de trabalho com agentes e dezenas de subagentes?
Esta é a fronteira, e a resposta curta é que uma única estação de trabalho fica sem espaço rapidamente. Cargas de trabalho multiagentes geram subagentes, cada um com seu próprio contexto, e no lado da inferência, cada contexto ativo significa seu próprio cache KV na memória, portanto, o espaço ocupado aumenta tanto com a concorrência quanto com o tamanho do modelo. Para onde esses caches vão quando a memória excede a capacidade é um problema de engenharia à parte; nosso estudo aprofundado sobre o descarregamento de cache KV para memória flash , baseado em hardware Dell e Solidigm, é a melhor abordagem que publicamos sobre esse assunto.
Uma máquina que atende confortavelmente uma sessão de agente de classe 30B geralmente consegue lidar com algumas sessões paralelas por meio de um servidor de processamento em lote antes que a latência se degrade; dezenas de subagentes simultâneos já exigem um servidor dedicado, com memória suficiente para armazenar muitos contextos ativos e um mecanismo de serviço como o vLLM, desenvolvido para processamento em lote contínuo. Existe também um limite de qualidade, pois os modelos locais já perdem confiabilidade à medida que o número de ferramentas aumenta, e a orquestração multiplica as ferramentas e as transferências de responsabilidade.
Nossa visão é que o trabalho com um único agente ou com poucos agentes é uma tarefa legítima para estações de trabalho atualmente, enquanto grandes frotas de subagentes são uma tarefa que exige infraestrutura. Essa fronteira, e o hardware necessário para ultrapassá-la, é algo que planejamos explorar com muito mais profundidade.


 Amazon