

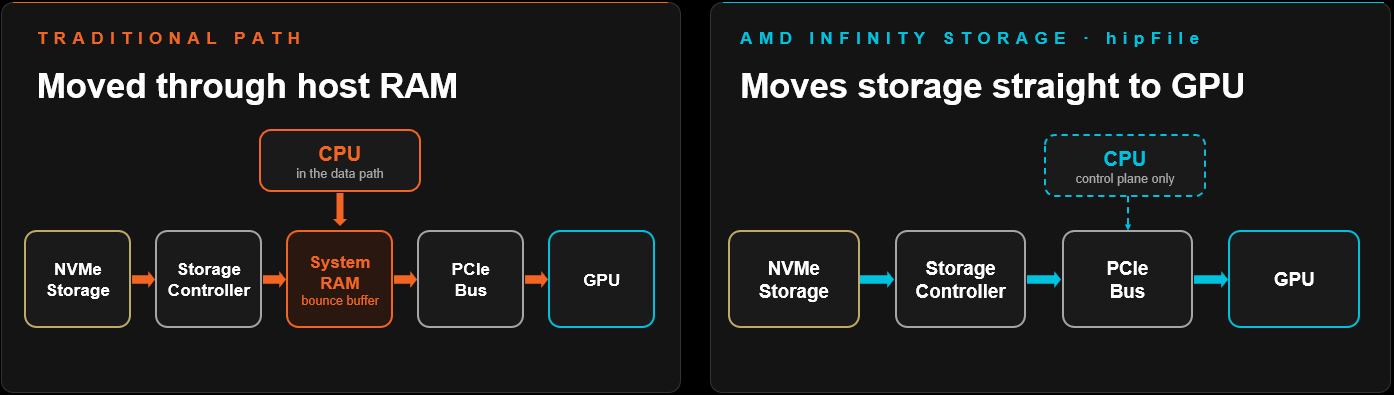
O AMD ROCm 10.1, lançado em 5 de outubro, prioriza o caminho entre o armazenamento e a GPU. Arquivos de checkpoint, caches de chave-valor e pesos de modelos agora rotineiramente ultrapassam a memória do acelerador e, quando isso acontece, o tempo gasto na movimentação de dados passa a influenciar o tempo de iteração mais do que os cálculos matemáticos. Esta versão aprimora o AMD Infinity Storage, a pilha de armazenamento direto introduzida no ROCm 7.14, integrando o acesso ao armazenamento ao runtime HIP e adicionando memória host compatível com NUMA, para que os dados cheguem à GPU sem passar pela memória da CPU.
Pipelines de armazenamento direto da GPU e memória compatível com NUMA
A biblioteca hipFILE dentro do AMD Infinity Storage agora conta com um backend assíncrono de caminho rápido. As solicitações de leitura e gravação são executadas diretamente em um fluxo HIP, ignorando a etapa de preparação na memória do host exigida pelo caminho tradicional. Segundo a AMD, o resultado é uma menor latência para os mecanismos de checkpoint e para o descarregamento do cache KV, mantendo a largura de banda sustentada. As notas de lançamento mencionam as chamadas: hipFileReadAsync() e hipFileWriteAsync() agora suportam o caminho rápido.
Uma API de E/S em lote envia várias solicitações de arquivos simultaneamente e as distribui por um conjunto interno de threads de trabalho, o que mantém as filas de armazenamento cheias quando uma tarefa de treinamento está processando um grande conjunto de dados. A telemetria acompanha o processo: hipFileGetStatsL1, L2 e L3 retornam estatísticas de E/S progressivamente mais detalhadas, e esses contadores alimentam os profilers do ROCm para que um operador possa determinar se um pipeline está limitado por computação, memória ou entrega de dados.
Em hosts com dois sockets, um buffer alocado no socket errado acarreta uma penalidade entre sockets em cada transferência. O ROCm 10.1 estende as APIs de gerenciamento de memória virtual do HIP com hipMemLocationTypeHostNuma e hipMemLocationTypeHostNumaCurrent, permitindo que a memória do host seja alocada em um nó NUMA específico durante todo o ciclo de vida de criação, reserva, mapeamento e desativação. Bibliotecas como o RCCL podem criar buffers de comunicação locais a NUMA e sem cópia, mantendo o tráfego entre host e dispositivo fora da interconexão de sockets.
ROCm CLI v1.0.0 e fluxos de trabalho do agente de IA
A CLI do ROCm chega à versão 1.0.0 como um único binário para Linux, Windows e WSL2 que instala, configura e executa cargas de trabalho de IA locais em GPUs AMD. Ela detecta os pacotes flash-attn e amd-aiter necessários para o vLLM, oferece suporte ao layout de pacote atualizado do ROCm 10 e adiciona uma opção para instalações totalmente não interativas em ambientes de script ou CI. Um painel de controle TUI em tela cheia exibe a telemetria da GPU ao vivo, além de uma janela de bate-papo local para verificar se um endpoint respondeu.
O AMD Skills, pacote de integrações para agentes de codificação como Claude Code e Codex, agora conta com mais duas funcionalidades. O quark-install instala o AMD Quark com uma versão compatível do PyTorch, e o quark-torch-llm-ptq executa a quantização pós-treinamento em LLMs do PyTorch e do Hugging Face com esquemas como FP8 e INT4.
Modernização de perfis e telemetria
O ROCprofiler-SDK adiciona a função de reprodução de kernel (kernel replay), em versão beta. O hardware da GPU expõe um número limitado de contadores de desempenho por despacho, portanto, coletar um conjunto completo de contadores costumava significar executar novamente toda a aplicação uma vez por grupo de contadores. A reprodução de kernel reexecuta cada despacho no local, reiniciando a memória da GPU entre as passagens e coletando o conjunto completo em uma única execução. O SDK também permite iniciar e parar a criação de perfis em qualquer ponto de uma execução para PyTorch Kineto e Triton Proton, e inclui uma habilidade de agente de amostragem de PC que guia um assistente de codificação pela amostragem de PC do rocprofv3 para encontrar paralisações de computação.
O relatório roofline do ROCm Compute Profiler agora é uma página HTML interativa, permitindo que um engenheiro isole um único kernel e alterne o eixo de intensidade aritmética entre os níveis de cache. Os relatórios de amostragem do PC são atualizados para cada kernel, detalhando as contagens de amostras e paralisações em instruções individuais, e um novo guia aborda a criação de perfis vLLM. O ROCm Systems Profiler adiciona rastreamento Linux para as APUs Gorgon Point 1, 2 e 3 (gfx1150, gfx1152 e gfx1153), e o ROCm Optiq agora visualiza perfis rocprofv3 juntamente com rastreamentos do Systems Profiler e análises do Compute Profiler.
O AMD SMI (amd-smi) substitui o ROCm SMI, que foi removido da versão padrão nesta versão. Ele abrange GPUs, CPUs e APUs da AMD em Linux e Windows, tanto em hardware físico quanto virtualizado, com uma interface de linha de comando (CLI), uma biblioteca em C (amd_smi_lib) e bindings para Python, Go e Rust. O reconhecimento de contêineres se estende a containerd, CRI-O, Podman, LXC e LXD, incluindo pods do Kubernetes, permitindo que um administrador de cluster associe os processos e a utilização da GPU ao contêiner que os executa.
Atualizações do compilador principal, bibliotecas e suporte de tempo de execução.
A cadeia de ferramentas migrou do LLVM 23 para o LLVM 24, e a macro clang_major agora reporta a versão 24. Quem utiliza versões fixas do compilador ou vincula à libLLVM deve verificar essa informação antes de atualizar. As compilações incrementais ficam mais rápidas graças ao cache das partições criadas pela otimização de tempo de vinculação do código do dispositivo, permitindo que as partições inalteradas sejam reutilizadas na próxima compilação.
O Composable Kernel acelera a atenção em GPUs Radeon e adiciona mais tipos de multiplicação de matrizes quantizadas ao seu dispatcher. O MIGraphX troca seu compilador de backend de rocMLIR para rocMLIRTriton, o que, segundo a AMD, melhora o desempenho da inferência e geralmente reduz os tempos de compilação do modelo, mantendo o compilador em sincronia com o Triton upstream. O rocSPARSE executa resoluções triangulares diretamente em matrizes armazenadas no formato ELLPACK (ELL), sem nenhuma etapa de conversão prévia.
O hipThreads, uma novidade nas bibliotecas de threading do ROCm Core SDK, traz os conceitos padrão de threading do C++ para GPUs AMD em Linux e Windows. O objetivo é acelerar o código existente que roda em threads de CPU na GPU sem a necessidade de reescrevê-lo completamente em kernels HIP e primitivas de sincronização.
O Subsistema Windows para Linux 2 (WSL2) entra em fase de pré-visualização técnica, com a instalação de pacotes Linux padrão no sistema operacional convidado e a paravirtualização da GPU delegando tarefas ao driver do Windows no host. A pré-visualização abrange pacotes .deb e wheels do Python, mas não RPMs, e as ferramentas de criação de perfil, depuração e dependentes do KFD ainda não funcionam no WSL2. No que diz respeito à virtualização, o KVM SR-IOV agora é suportado no Ubuntu 26.04 LTS, tanto como host quanto como convidado, em conjunto com a versão 9.3.0.K do driver de virtualização GIM da AMD.
A lista de hardware compatível adiciona a Radeon AI PRO R9600, juntamente com as Instinct MI355X, MI350X e MI350P, as séries MI300 e MI200, o restante da família Radeon AI PRO R9700 e os processadores Ryzen AI.


 Amazon