

A Cerebras Systems apresentou oficialmente o CS-4 , a quarta geração de sua plataforma de supercomputação de IA em escala de wafer, projetada para treinamento de ponta e cargas de trabalho de inferência de alta concorrência. O sistema é baseado em três processadores Turbo WSE-3 (Wafer Scale Engine 3) recém-desenvolvidos, alojados em uma plataforma totalmente redesenhada chamada Nexus, em escala de rack. A Cerebras afirma que o sistema oferece até 30 vezes o desempenho de inferência de soluções baseadas em GPUs, um número que a empresa baseia no GPT-OSS-120B , onde cita mais de 4,400 tokens por segundo por usuário, juntamente com um aumento de 10 vezes na taxa de transferência por watt em comparação com a geração anterior, o CS-3.
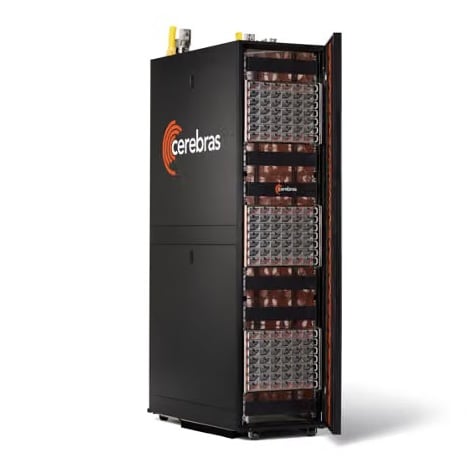
O CS-4 foi projetado para solucionar as limitações sistêmicas de escalabilidade inerentes a clusters de GPUs discretos com múltiplos nós, onde a comunicação entre chips, as perdas na conversão de energia e os limites térmicos frequentemente restringem a eficiência computacional sustentada. A Cerebras posiciona a plataforma para atender aos dois extremos do espectro de cargas de trabalho de inferência, oferecendo os tempos de resposta abaixo de um milissegundo necessários para fluxos de trabalho complexos baseados em agentes e raciocínio interativo, ao mesmo tempo que fornece a capacidade agregada que os hiperescaladores precisam para maximizar a densidade computacional por gigawatt.
Aprimoramentos na interconexão são essenciais para a capacidade de escalonamento multiprocessador da plataforma. O CS-4 reduz a latência de interconexão entre wafers para até 2 microssegundos, permitindo que estruturas multi-wafer operem com coesão quase monolítica. Essa interconexão de latência ultrabaixa permite que o CS-4 mantenha velocidades de geração superiores a 1,000 tokens por segundo em modelos com mais de 10 trilhões de parâmetros, eliminando a lacuna de desempenho histórica em que o aumento do número de parâmetros comprometia severamente as taxas de entrega de tokens interativos.

Arquitetura de rack Nexus e a mochila em escala de wafer
Uma grande transição de engenharia no CS-4 é a Arquitetura de Plataforma Cerebras Nexus, uma implementação modular em rack construída em torno de domínios independentes de computação, energia e E/S. A densidade de computação é ancorada por um novo módulo Wafer-Scale Backpack montado na parte traseira, que se conecta verticalmente ao conjunto de energia principal. Cada módulo é uma unidade autônoma que abriga coletores de resfriamento líquido direto no chip, estágios de conversão de energia no ponto de carga, caminhos de rede de alta velocidade e eletrônica de controle integrada, localizados diretamente atrás do wafer de silício. Ao isolar a camada central de computação da estrutura de distribuição de energia principal, a Cerebras reduziu a quantidade de componentes do sistema em 50%, aumentou a montagem automatizada em 60% e comprimiu os prazos de implantação do data center para meras horas.

A eficiência do fornecimento de energia foi aprimorada com a realocação dos módulos de regulação de tensão CC-CC 100 vezes mais próximos da borda do silício do que em implementações típicas de placas de servidor. Essa configuração no ponto de carga reduz as perdas resistivas na rede de distribuição de energia (PDN) e permite que o chassi Nexus forneça o dobro de energia para cada processador WSE-3 Turbo, possibilitando frequências de clock sustentadas mais altas sem limitação térmica.

O subsistema de E/S também foi expandido com um Módulo de E/S de Wafer programável que duplica a largura de banda de ponta a ponta da estrutura, reduzindo a latência de trânsito. A rede do sistema opera em dois modos: interfaces RoCE v2 padrão (RDMA sobre Ethernet Convergida) para conexão de baixa latência à estrutura com redes corporativas legadas e nós aceleradores de terceiros, e Links Diretos de Wafer proprietários que fornecem caminhos de interconexão diretos e sem switches entre sistemas adjacentes dentro e entre racks.
Especificações dos turbocompressores CS-4 e WSE-3
| SISTEMA CS-4 | |
| Plataforma | Rack de energia ativo com três módulos de computação. |
| Motores em escala de wafer | 3 turbos WSE-3 por sistema |
| Computação de IA | 750 PFLOPS* |
| Largura de banda de memória | 129.6 PB/s |
| Largura de banda do tecido integrado | 160.5 PB/s |
| Largura de banda de E/S | 7.2 Tbit / s |
| Latência de E/S | 2 microssegundos |
| WSE-3 TURBO (POR WAFER) | |
| Transistores / Silício | 4 trilhões de transistores; 46,225 mm², TSMC 5nm |
| Núcleos de IA / SRAM integrada | 900,000 núcleos; 44 GB de SRAM |
| Computação de IA | 250 PFLOPS* |
| Largura de banda de memória | 43.2 PB/s |
| Largura de banda do tecido integrado | 53.5 PB/s |
| Largura de banda de E/S | 2.4 Tbit / s |
| *Computação de IA mostrada como FP16 esparso | |
Inferência e disponibilidade desagregadas
Arquiteturalmente, o CS-4 foi projetado com suporte nativo para topologias de inferência desagregadas. Em ambientes corporativos e de nuvem, os operadores podem desacoplar as fases computacionais da inferência usando aceleradores de preenchimento externos especializados, como o AMD Helios ou o AWS Trainium, para ingerir contextos de prompts e construir estados do modelo. O cache KV, que exige alto poder computacional, é então roteado por meio de links de alta velocidade para a enorme rede SRAM do CS-4, para geração de tokens autorregressivos de latência ultrabaixa.
A Cerebras confirmou que as primeiras implantações e remessas da plataforma CS-4 estão programadas para começar neste trimestre.


 Amazon