

Na ISC 2026, a DDN anunciou uma ampla expansão de seu portfólio de plataformas de dados para IA e HPC, apresentando novos recursos de hardware, software e plataforma projetados para melhorar a utilização de GPUs, acelerar a inferência de IA e simplificar as implantações de infraestrutura de IA em larga escala.
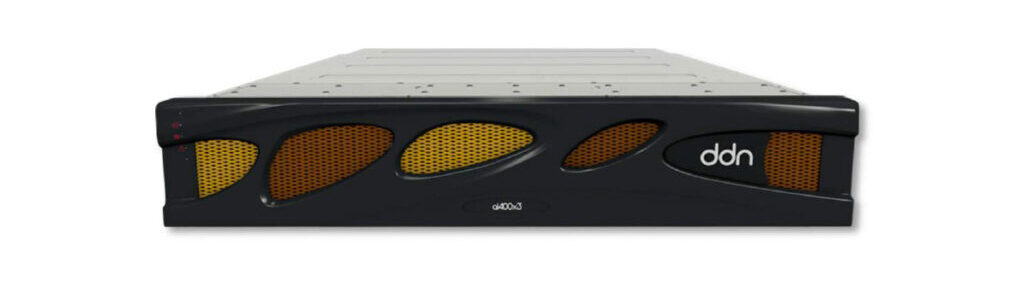
Os anúncios incluem o dispositivo de armazenamento AI400X3M, a disponibilidade geral da tecnologia de aceleração de cache KV distribuída da DDN integrada ao NVIDIA Dynamo e novos recursos de segurança, observabilidade e gerenciamento de infraestrutura em todas as plataformas de dados de IA da empresa.
A DDN afirmou que as atualizações visam solucionar gargalos em todo o pipeline de dados de IA, incluindo preparação de dados, treinamento de modelos, inferência, geração aumentada por recuperação (RAG), modelos de raciocínio e cargas de trabalho de IA ativa. A empresa está focada em melhorar a eficiência da infraestrutura, aumentando a utilização de GPUs e, ao mesmo tempo, reduzindo o consumo de energia e os custos de infraestrutura.
Alex Bouzari, CEO e cofundador da DDN, afirmou que a infraestrutura moderna de IA exige mais do que apenas recursos computacionais. Ele enfatizou que o gerenciamento eficiente de dados, a segurança e a visibilidade operacional se tornaram componentes críticos das implementações de IA em produção, e que os lançamentos mais recentes da empresa visam aprimorar a eficiência da GPU, reduzir os custos de inferência e acelerar o tempo até a primeira tokenização (TTF).
AI400X3M visa alta densidade de desempenho em IA e HPC
O destaque do anúncio é o AI400X3M, o mais recente dispositivo desenvolvido com base no sistema de arquivos paralelos EXAScaler da DDN.
Especificações do AI400X3M
| Desempenho | |
| Desempenho de leitura sequencial | Até 190 GB/s |
| Desempenho de Gravação Sequencial | Até 110 GB/s |
| IOPS de leitura aleatória | 8M |
| Recursos do sistema | |
| Plataforma | Dispositivo EXAScaler completo para sistema de arquivos paralelo compartilhado de IA com controladores de armazenamento ativo/ativo. |
| Portas do host por dispositivo | 4x XDR/400GbE OSFP ou 8x NDR200/200GbE QSFP112 |
| Suporte do Drive | 24 slots PCIe G5 NVMe de 2.5" com porta dupla e troca a quente |
| Opções de capacidade | 120/250/500 TB e 1 PB/2 PB utilizáveis |
| Recursos padrão do firmware | Mapeamento e mascaramento de LUNs, distribuição inteligente de escrita, QoS de leitura, verificação/correção de integridade de dados, opções de interface (CLI, GUI, API Python), syslog de saída incluindo suporte a RELP, mensagens de mudança de estado (via e-mail e traps SNMP) |
| Segurança e Conformidade | |
| Segurança (Safety) | IEC/EN/UL/CSA 62368-1, GB4943 |
| EMC | EN 55032 Classe A, EN 55035, EN 61000-3-2, EN 61000-3-3, FCC Parte 15 Classe A, VCCI Classe A, ICES-003 Classe A, GB/T9254 Classe A, BSMI Classe A |
| Responsabilidade | RoHS, REACH, WEEE, ERP Lot9X |
| Atributos físicos | |
| Fator de Forma | Montagem em rack 2U |
| Dimensões | Altura: 3.43 ″ (87mm) Largura: 17.56 ″ (446mm) Profundidade: 856 mm (33.7") sem a moldura; 895 mm (35.2") no total. Trilho de rack ajustável: 26.75″ a 34.0″ (680–860 mm) |
| Peso | 98 lbs (44 kg) vazio; 108 lbs (49 kg) máximo |
| Energia e refrigeração | |
| Tensão de entrada | 200–240 V 50/60 Hz |
| Fonte de alimentação do laboratório | 2 entradas IEC60320-C20 redundantes e hot-swappable |
| Ambiente de trabalho | |
| Faixa de temperatura | 5 ° C para 30 ° C (° F para 41 86 ° F) |
| Umidade Relativa | 8% –80% sem condensação |
| Altitude | 3,117 pés (950 m) a 30 °C — 10,000 pés (3,048 m) a 23 °C |
A plataforma oferece uma taxa de transferência de até 190 GB/s e um desempenho de leitura até 35% superior ao da geração anterior. A DDN também suporta configurações que escalam até 30 PB em um único rack, além de adicionar suporte a discos híbridos que combinam armazenamento flash e HDD para equilibrar desempenho, capacidade e custo.
O dispositivo foi projetado para treinamento de modelos de IA, inferência, checkpointing, simulação HPC e outras cargas de trabalho altamente paralelas, onde a taxa de transferência de armazenamento pode impactar diretamente a utilização da GPU. A disponibilidade geral está prevista para o final do terceiro trimestre de 2026.
Cache KV distribuída agora disponível para o público em geral.
Após uma prévia tecnológica apresentada na NVIDIA GTC 2026, a DDN lançou oficialmente sua arquitetura de aceleração de cache KV distribuída, integrando o NVIDIA Dynamo. Essa funcionalidade está disponível tanto na plataforma de armazenamento de objetos Infinia quanto no sistema de arquivos EXAScaler.
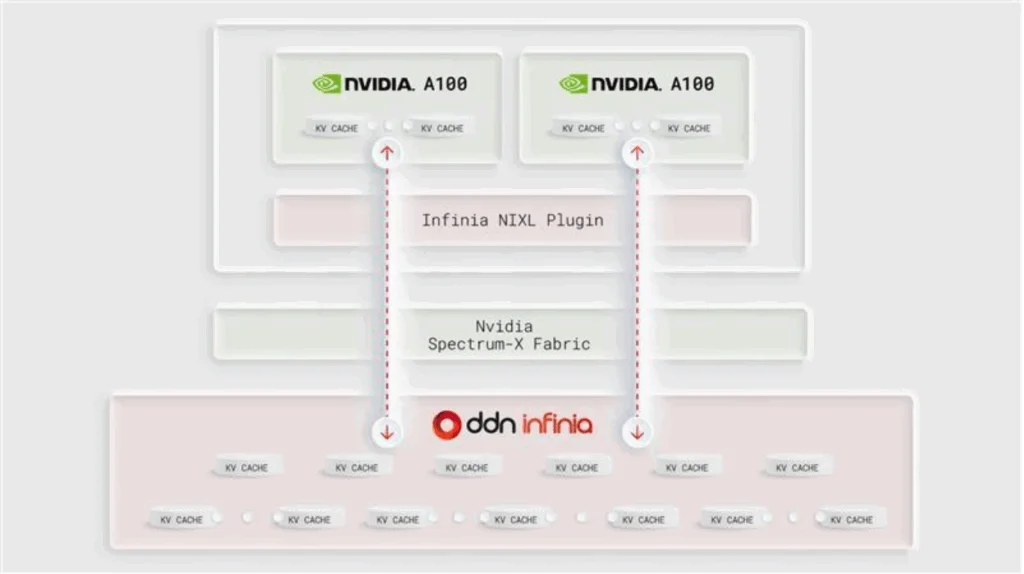
Em vez de depender da memória local da GPU para o contexto do modelo, a arquitetura distribuída armazena e recupera dados de cache KV da plataforma de dados da DDN, reduzindo os gargalos de memória durante a inferência.
A DDN afirmou que a plataforma suporta NVIDIA Dynamo, vLLM e outras estruturas de inferência modernas, permitindo o compartilhamento de cache KV distribuído em vários nós de inferência. A empresa alega carregamento de cache KV até 55 vezes mais rápido para cargas de trabalho de inferência em larga escala, juntamente com melhor utilização da GPU, geração de tokens mais rápida e custos de infraestrutura reduzidos para grandes implantações de modelos de linguagem.
A tecnologia tem como objetivo beneficiar a inferência de contexto extenso, a geração aumentada por recuperação, os modelos de raciocínio e os fluxos de trabalho de IA com agentes que acessam repetidamente grandes contextos de modelo.
Pipeline de dados de IA unificado
A DDN também delineou sua estratégia mais ampla de combinar o armazenamento de objetos Infinia para inferência com o EXAScaler para treinamento de modelos e checkpointing em uma única infraestrutura de dados de IA.
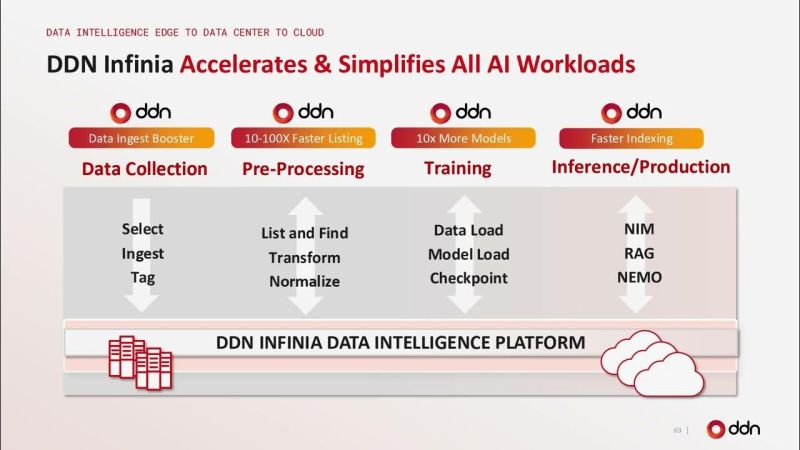
A empresa afirmou que o Infinia oferece operações de metadados de baixa latência, alta concorrência e desempenho de objetos otimizado para cargas de trabalho com uso intensivo de inferência, enquanto o EXAScaler continua atendendo ambientes de treinamento de alto desempenho. Juntas, as plataformas visam eliminar silos de dados e manter alta utilização da GPU ao longo de todo o ciclo de vida da IA.
Novos recursos de segurança e infraestrutura
Aprimoramentos adicionais da plataforma focam nos requisitos de implantação corporativa, incluindo multilocação em bare metal, criptografia e gerenciamento de chaves baseados em KMIP, integração com o VictoriaLogs para visibilidade operacional e APIs multilocatárias expandidas.

Na área de armazenamento, a DDN introduziu o recurso de fixação inteligente de arquivos e os Hot Pools acelerados por NAND, permitindo que os dados acessados com frequência permaneçam na memória flash enquanto os dados menos acessados são automaticamente transferidos para discos rígidos de menor custo. A empresa afirmou que esses recursos foram projetados para melhorar a eficiência do armazenamento e, ao mesmo tempo, reduzir os requisitos de capacidade da memória flash.
Expansão contínua da IA na nuvem
A DDN também destacou a contínua adoção de suas ofertas de infraestrutura de IA em nuvem, incluindo os desenvolvimentos do Managed Lustre anunciados com o Google Cloud e uma implementação do Salesforce que usa o Google Cloud Managed Luster com tecnologia EXAScaler.
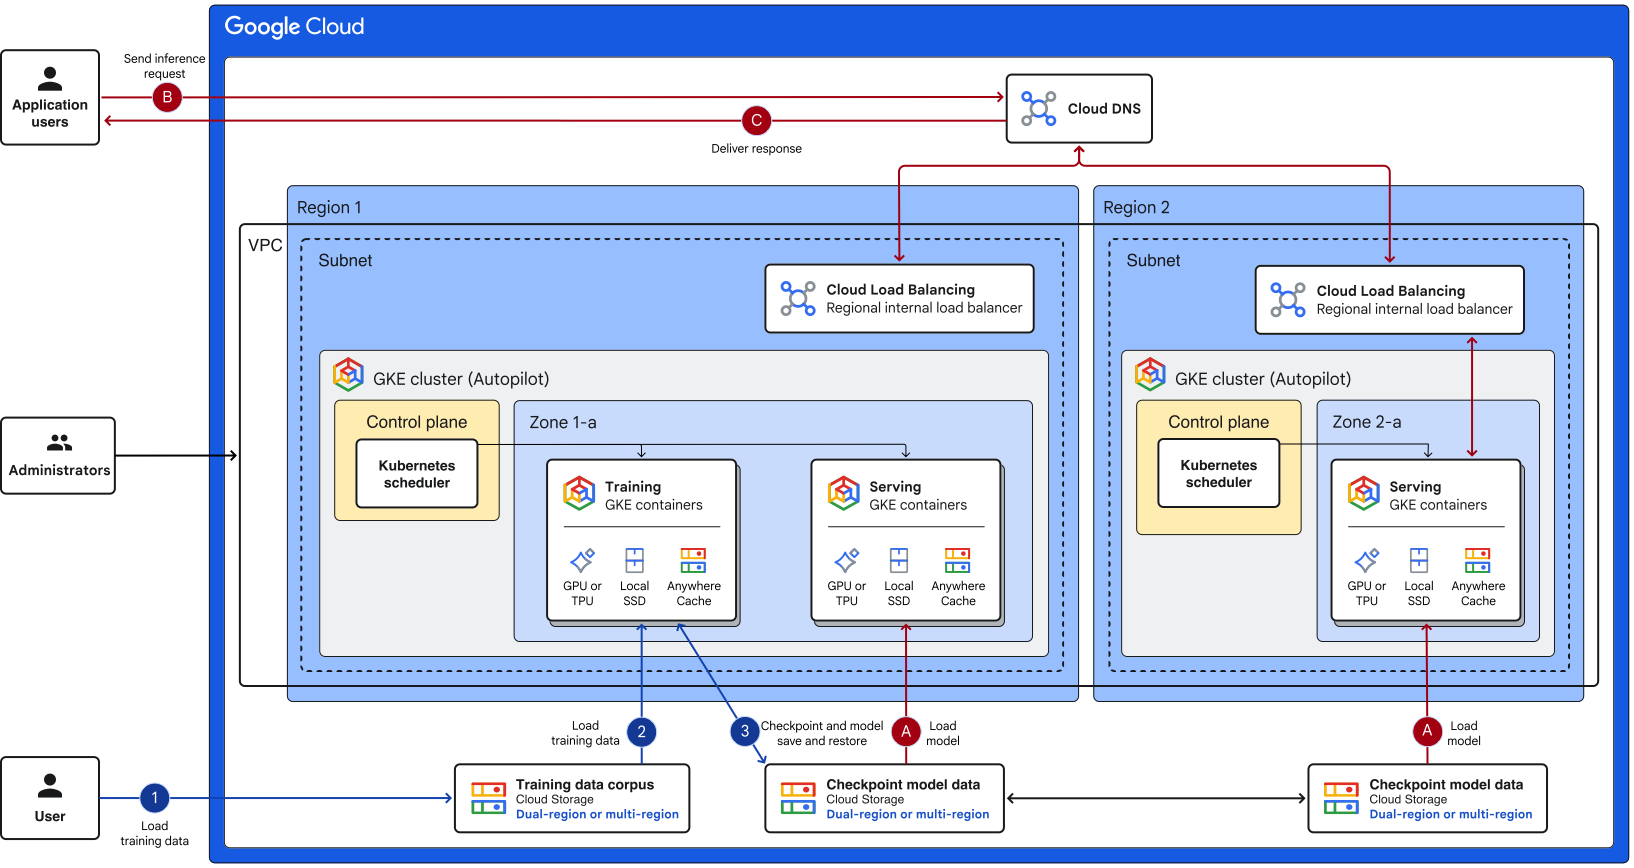
Segundo a DDN, a implementação no Salesforce alcançou um treinamento de modelos 1.5 vezes mais rápido, reduziu a latência de E/S em 75% e diminuiu os custos de treinamento em 42%, demonstrando o impacto da redução dos gargalos de armazenamento em ambientes de IA de grande escala.
Com os anúncios mais recentes, a DDN continua a expandir seu portfólio além do armazenamento paralelo, abrangendo orquestração de dados de IA, aceleração de inferência e gerenciamento de infraestrutura, posicionando suas plataformas para dar suporte a implantações de IA corporativas, em nuvem, de pesquisa e soberanas, operando em grande escala de GPUs.


 Amazon