

A MLCommons publicou hoje os resultados do MLPerf Storage v3.0, e esta rodada altera não apenas o benchmark em si, mas também quem o lidera. Pela primeira vez, o único benchmark de armazenamento para IA auditado abrange todo o pipeline: taxa de transferência de treinamento, checkpointing e duas novas cargas de trabalho de inferência, um teste de banco de dados vetorial e um teste de cache KV. Dezenove organizações submeteram 143 resultados, onze delas participando pela primeira vez, incluindo Microsoft Azure, NVIDIA, Everpure e uma onda de startups de armazenamento para IA que a maioria dos leitores provavelmente não reconhecerá. Vale destacar também que DDN, Huawei, Hammerspace e Lightbits, nomes que definiram o ranking da v2.0, não participaram desta rodada.
Uma observação importante sobre comparabilidade: a versão 3.0 alterou os aceleradores simulados de H100 para B200, o que aumenta a largura de banda mínima exigida por acelerador. Portanto, os resultados da versão 3.0 não podem ser comparados diretamente com os da versão 2.0. Esses dados foram submetidos por fornecedores e auditados pelo MLCommons; o StorageReview não realizou nem verificou esses testes de forma independente.
O evento principal é o checkpointing.
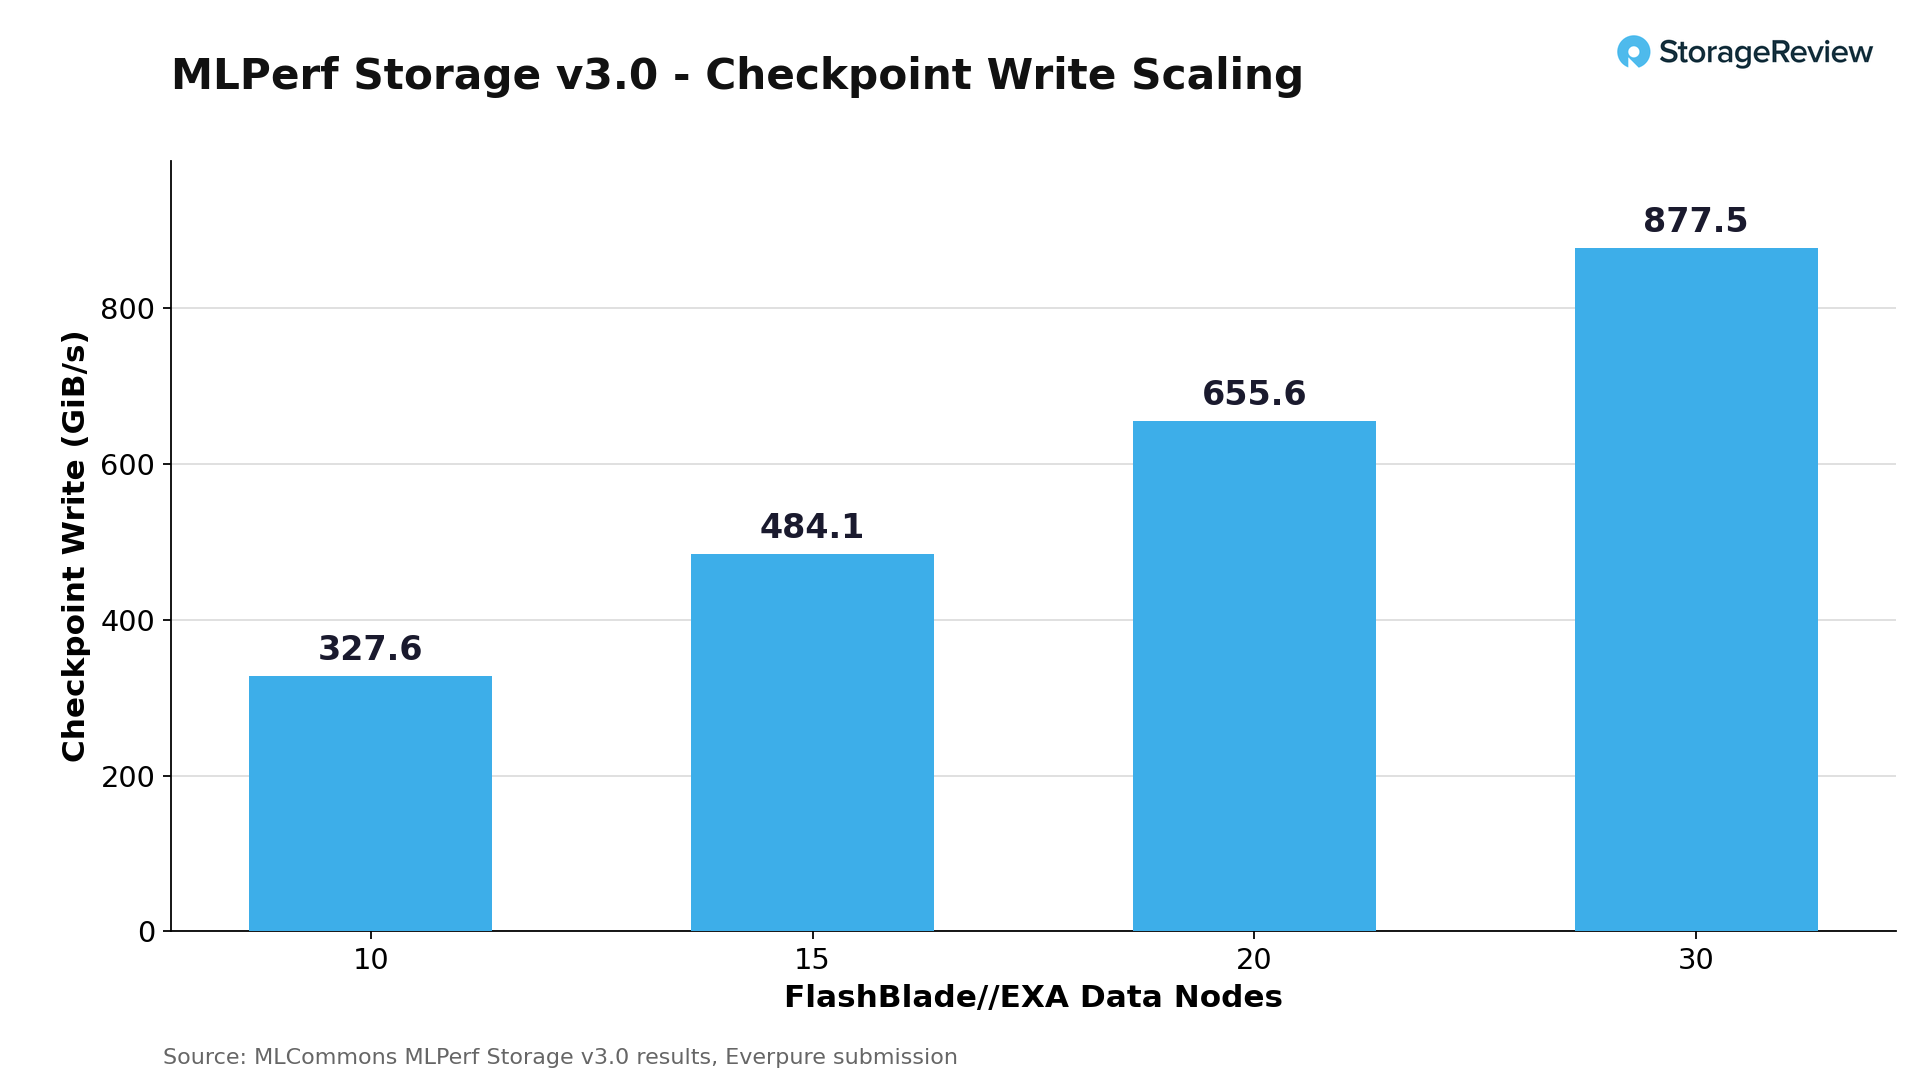
O MLCommons adicionou o checkpointing como uma carga de trabalho de primeira classe porque se tornou um gargalo comprovado: trabalhos de treinamento em escala de fronteira gravam enormes quantidades de estado em intervalos regulares, e cada segundo gasto gravando um checkpoint representa um segundo de tempo ocioso do acelerador. O maior número da rodada pertence a esta categoria. A Everpure (antiga Pure Storage), em sua primeira participação no MLPerf Storage, apresentou resultados do FlashBlade//EXA que escalam quase linearmente com a quantidade de nós de dados: 327.6 GiB/s de gravação de checkpoint com 10 nós de dados, 484.1 GiB/s com 15, 655.6 GiB/s com 20 e 877.5 GiB/s de gravação com 833.0 GiB/s de leitura com 30 nós de dados. A Everpure passou o último ano fazendo grandes afirmações de throughput para o //EXA; esta é a primeira vez que um resultado auditado corrobora essas afirmações.
O segundo maior número de checkpoints é, sem dúvida, a notícia mais importante do setor. O Azure Managed Lustre, o primeiro serviço de armazenamento em nuvem hiperescalável a ser submetido ao benchmark, registrou 642.2 GiB/s de gravação de checkpoints em uma implantação de 4,096 TiB com 128 clientes. Um serviço de arquivos em nuvem gerenciado apresentando números comparáveis aos de arrays de armazenamento de IA dedicados seria algo difícil de imaginar duas rodadas atrás.
| Pontos de verificação (Principais envios) | System | Escrever em preto e branco (GiB/s) |
|---|---|---|
| sempre puro | FlashBlade//EXA, 30 nós de dados | 877.5 |
| Azul | Lustre gerenciado, 4,096 TiB, 128 clientes | 642.2 |
| YanRongTech | F9000X, 8 clientes | 313.7 |
| Suzhou Zishan Longlin | Múltiplas configurações | 313.7 |
| Dados de Turing | F9200, 8 clientes | 307.1 |
| UBIX | UbiPower18000, 3 nós de armazenamento | 293.8 |
Treinamento: Nomes que você provavelmente não conhece
A tabela de classificação do treinamento 3D U-Net pertence a estreantes. O F9000X da YanRongTech manteve uma largura de banda de leitura de 543.9 GiB/s, alimentando 99 aceleradores B200 simulados, o maior rendimento de treinamento da rodada. A TuringData, uma empresa de infraestrutura de IA de Singapura que fez sua primeira submissão, ficou 4 GiB/s atrás, com 541.5 GiB/s, alimentando 96 B200s simulados a partir de apenas três nós de armazenamento. O mesmo cluster F9200 de três nós também submeteu o Checkpoint-70B com 539.9 GiB/s de leitura e 307.1 GiB/s de gravação. O UbiPower18000 da UBIX, com três nós de armazenamento, 16 unidades NVMe de 15.36 TB e rede quad NDR400, atingiu 454.1 GiB/s. A HPE foi a única fornecedora consolidada de arrays corporativos a enviar resultados de treinamento, com o K3000 atingindo 345.8 GiB/s.
| Treinamento 3D U-Net (Principais Submissões) | Leitura em preto e branco (GiB/s) | Aceleradores B200 simulados |
|---|---|---|
| YanRongTech F9000X | 543.9 | 99 |
| TuringData F9200 | 541.5 | 96 |
| UBIX UbiPower18000 | 454.1 | 80 |
| Suzhou Zishan Longlin | 433.4 | 80 |
| FarmGPU | 406.7 | 75 |
| Azure Managed Lustre | 379.1 | 70 |
A inferência entra para o padrão de referência.
As duas novas cargas de trabalho reconhecem onde a demanda por armazenamento está realmente crescendo. O teste de cache KV mede a rapidez com que um sistema de armazenamento consegue paginar o estado de atenção para o fornecimento de LLM de contexto longo, um padrão que examinamos detalhadamente em nosso trabalho de descarregamento de cache KV da Dell e da Solidigm . A Everpure novamente apresentou o maior número da rodada, 1,623.4 GiB/s de leitura de cache KV em uma configuração FlashBlade//EXA com 51 hosts, com a UBIX (443.7 GiB/s) e a FarmGPU (443.6 GiB/s) liderando as submissões de escala padrão. No lado do banco de dados vetorial, o sistema Seahorse da TTA liderou o ranking de taxa de transferência de consultas com 57,620 consultas por segundo.
A outra mudança estrutural é o protocolo. A versão 3.0 adicionou suporte ao armazenamento de objetos S3, e aproximadamente um sexto das submissões o utilizou. A NVIDIA foi responsável pela maior parte disso, com 20 submissões do AIStore abrangendo configurações bare-metal em OCI, AWS e GCP, atingindo um pico de 133.3 GiB/s de gravação de checkpoint. Os números absolutos ficam atrás dos sistemas de arquivos paralelos, mas o armazenamento de objetos executando cargas de trabalho de treinamento e checkpoint dentro do benchmark marca um território que os sistemas de arquivos POSIX dominavam há algum tempo.
Nesta rodada, a MLCommons também passou a monitorar a eficiência energética e o aproveitamento do espaço em rack como métricas de primeira linha.
Everpure FlashBlade//EXA
O sistema Everpure FlashBlade//EXA liderou as categorias de checkpoint de modelos de parâmetros de 405B e 1.25T, bem como os benchmarks de recuperação de cache Key-Value (KV), destacando a capacidade da plataforma de manter alto desempenho durante cargas de trabalho de treinamento e inferência de inteligência artificial com uso intensivo de dados.
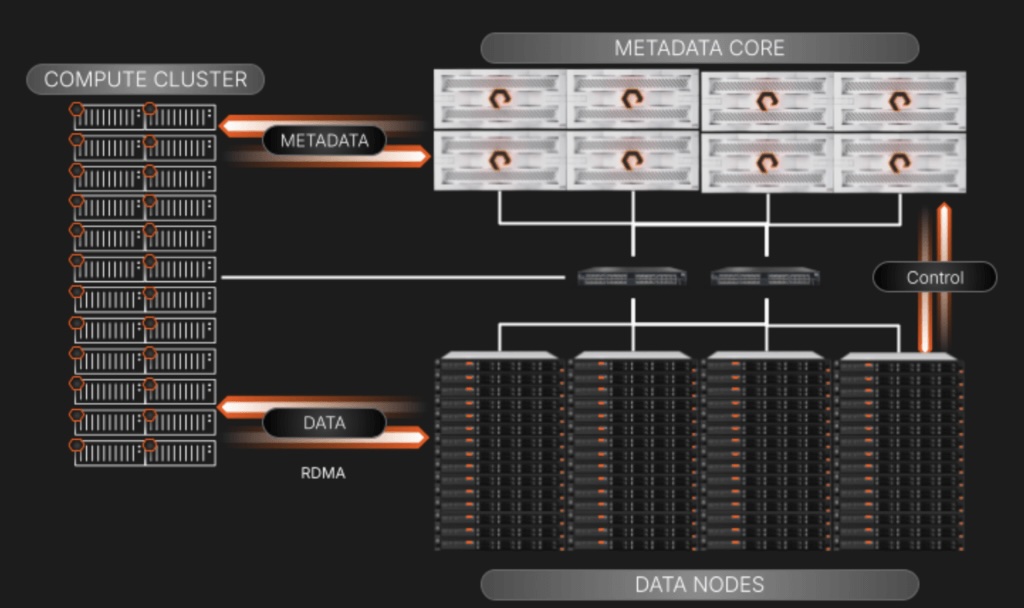
A configuração submetida pela Everpure combinou 30 blades FlashBlade//EXA (120 módulos DirectFlash para gerenciamento de metadados) com 30 nós de dados Linux/NVMe, totalizando aproximadamente 866 TB de capacidade utilizável em um único sistema de arquivos. Os metadados foram distribuídos via pNFS/TCP e os dados em massa via NFSv3 em RDMA. Na simulação de checkpoint de parâmetros 1.25T com 1,024 aceleradores de clientes, a configuração de 30 nós manteve uma largura de banda de gravação de 877.52 GiB/s durante uma operação de 17.74 segundos, além de uma largura de banda de leitura de 588.28 GiB/s, concluída em 28.99 segundos. No teste de inferência de cache KV, foram relatados 85,736 tokens/seg em uma execução de 8B usando apenas armazenamento no Llama 3.1, 67,642 tokens/seg em uma execução de 8B combinando armazenamento e memória do sistema e 33,403 tokens/seg em uma execução de 70B usando apenas armazenamento.
O que significam as faltas sem aviso prévio
Uma rodada de benchmarks demonstra duas coisas: o que os participantes conseguem fazer e o que os ausentes optaram por não mostrar. A VAST Data, a WEKA e a DDN, fornecedoras que conquistaram as maiores implantações em neocloud e fábricas de IA, não participaram da versão 3.0, assim como a Huawei, a Hammerspace e a Lightbits, que participaram da versão 2.0. Os fornecedores podem pular rodadas por motivos banais, como ciclos de engenharia, cronograma de lançamento e questões políticas relacionadas aos benchmarks; pular uma rodada não significa que um sistema seja lento. Mas significa que o histórico de auditoria e o histórico de implantação agora apontam para listas de fornecedores diferentes, e os compradores precisam ponderar ambos. Nossa página "Melhores Arrays de Armazenamento" acompanha exatamente essa divisão, indicando o que é auditado e o que é evidência de implantação, e foi atualizada com os resultados completos da versão 3.0.
Os resultados da versão 3.0 foram divulgados hoje na página de benchmarks de armazenamento do MLCommons.



 Amazon