

A LPU, ou Unidade de Processamento de Linguagem, é um acelerador de inferência de IA personalizado, projetado e construído pela Groq, Inc. Fundada em 2016 por Jonathan Ross, ex-engenheiro do Google creditado como um dos inventores originais da TPU, a Groq passou anos desenvolvendo uma arquitetura de processador determinística e definida por software desde o início. Ao contrário das GPUs, que dependem de agendamento dinâmico de hardware e hierarquias de cache multinível, a LPU adota uma abordagem radicalmente diferente: ela elimina todos os componentes de hardware reativos e coloca todo o plano de controle no compilador, permitindo uma execução totalmente previsível até o nível do ciclo de clock.
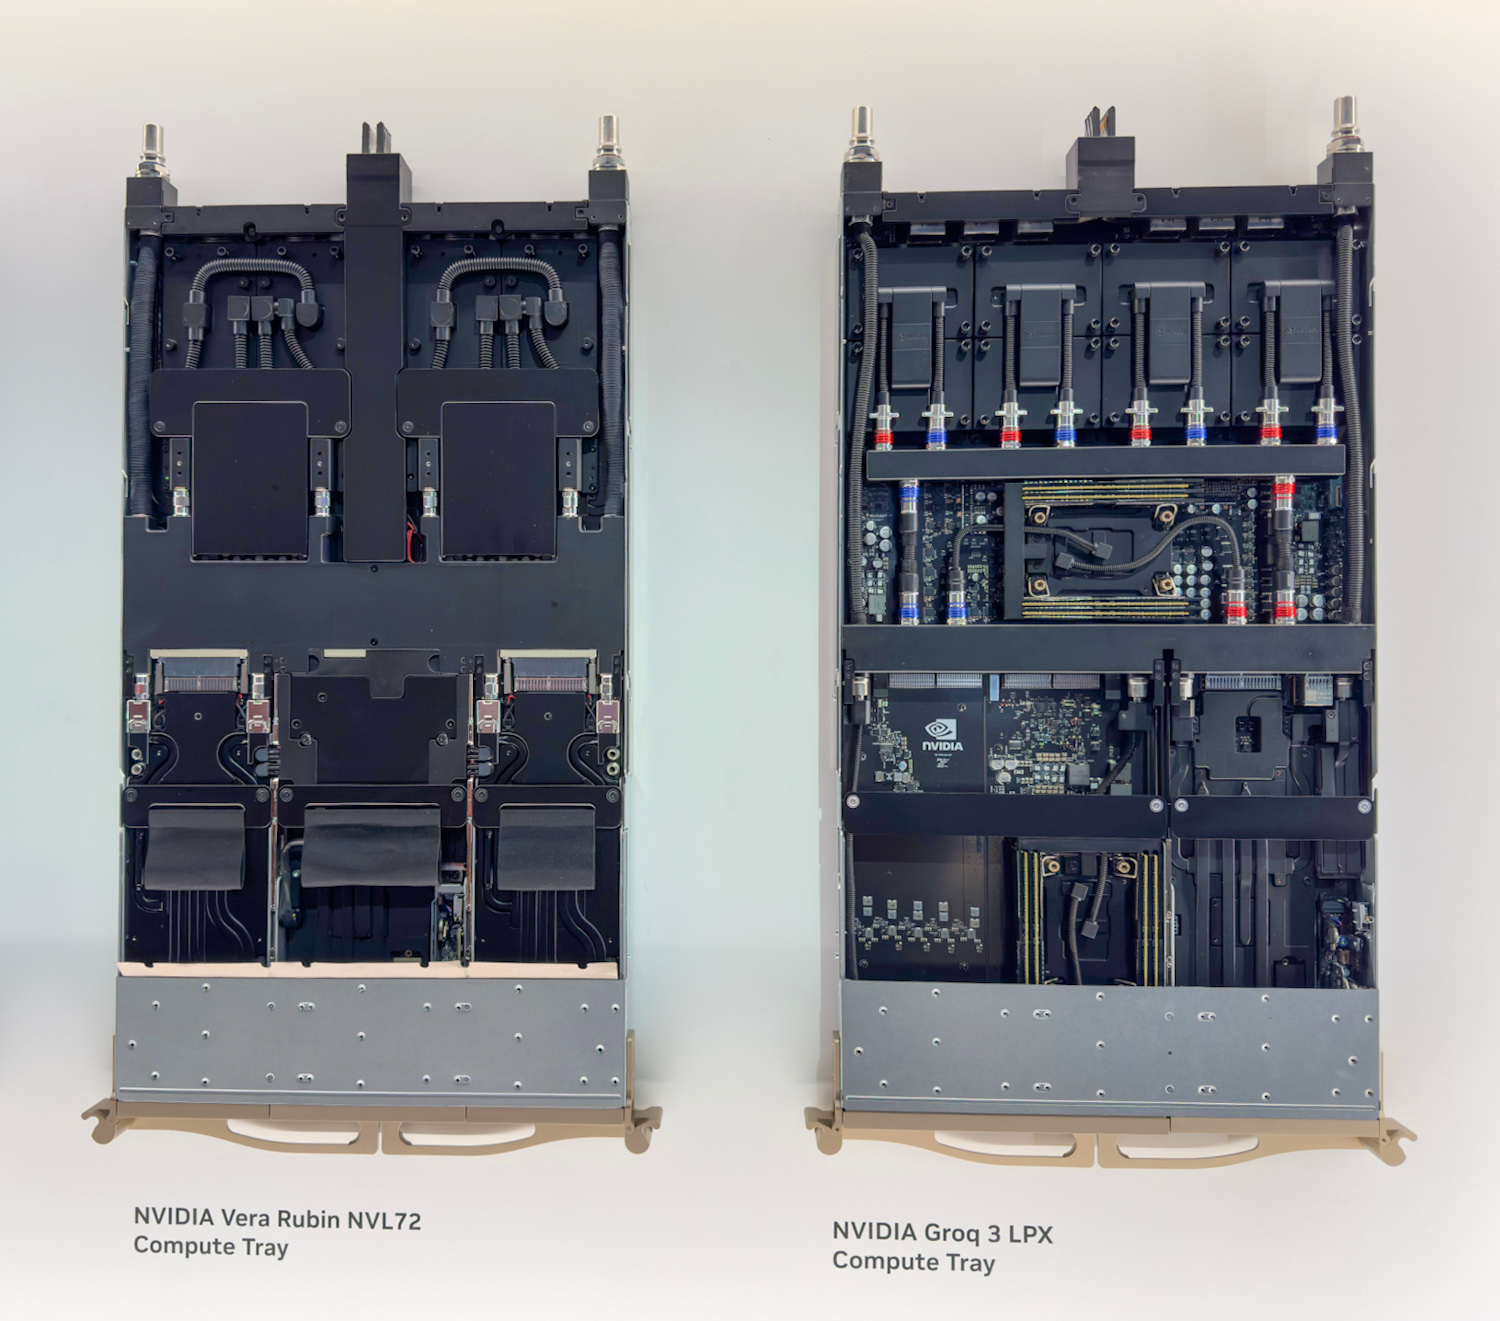
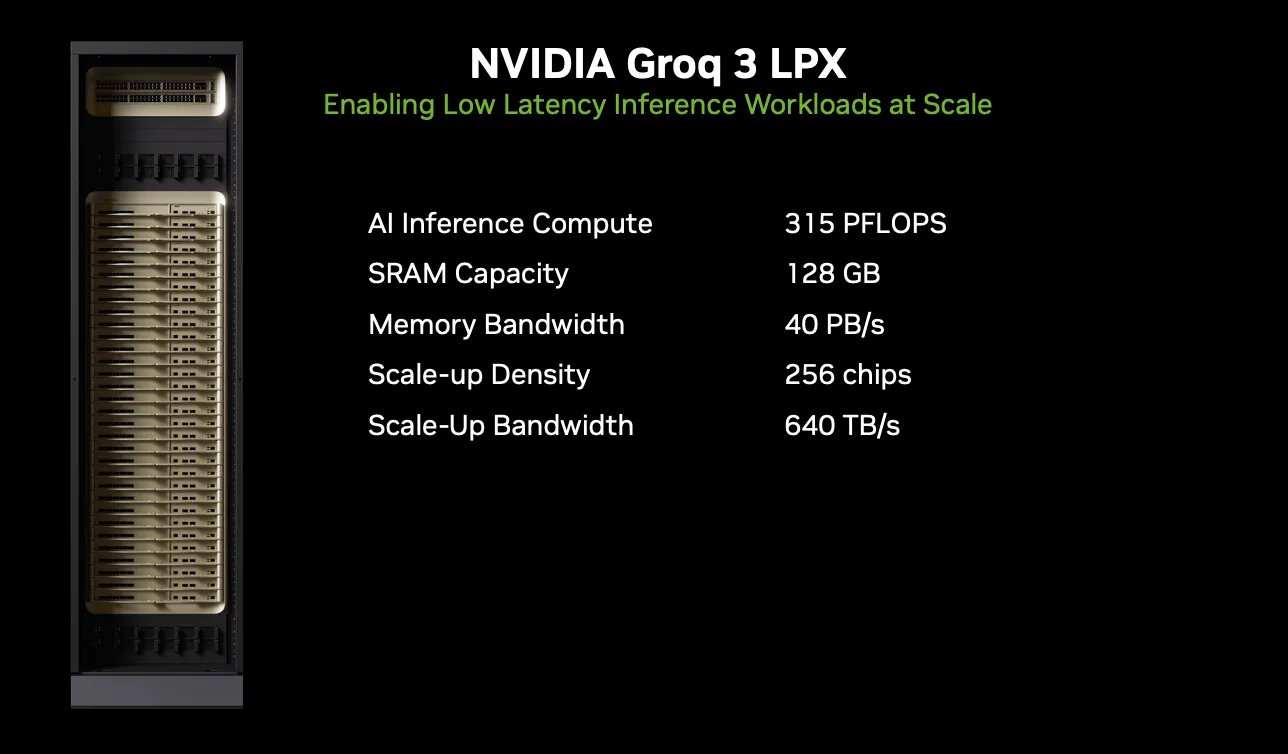
Em dezembro do ano passado, a NVIDIA adquiriu a Groq, incorporando a arquitetura LPU ao seu portfólio. A aquisição foi extremamente popular no setor e gerou especulações imediatas sobre como a NVIDIA integraria a tecnologia da Groq ao seu ecossistema de data centers. Essas questões foram finalmente respondidas na GTC 2026, onde a NVIDIA apresentou o Groq 3 LPX como o sétimo chip da plataforma Vera Rubin, combinando 256 aceleradores LPU em um sistema de escala de rack com o Vera Rubin NVL72.
O que aconteceu com a CPX?
No ano passado, durante o AI Infra Summit, a NVIDIA também anunciou o rack CPX em algumas configurações projetadas para acelerar consultas de inferência de contexto longo. Após nossa cobertura inicial desse anúncio, surgiram várias dúvidas sobre a função real do CPX. À primeira vista, embora fosse um conceito arquitetônico interessante, o CPX não parecia oferecer nada substancial além da própria GPU Rubin, exceto talvez uma aceleração adicional para operações de atenção. Então veio a aquisição da Groq, que gerou especulações sobre como a NVIDIA integraria a tecnologia LPU da Groq à plataforma Vera Rubin mais ampla.
Bem, a NVIDIA esclareceu tudo na GTC 2026 com o anúncio do LPX. Pelo que foi apresentado, parece que o conceito de rack CPX evoluiu para o Groq 3 LPX Rack, com o foco original do CPX no processamento de contexto dando lugar a uma arquitetura de aceleração de decodificação fundamentalmente diferente, construída em torno do silício Groq. O LPX Rack é totalmente refrigerado a líquido, construído sobre a infraestrutura MGX e estará disponível no segundo semestre de 2026, coincidindo com o lançamento mais amplo do Vera Rubin. A NVIDIA afirma que o novo rack oferece até 35 vezes mais throughput de inferência por megawatt e até 10 vezes mais oportunidades de receita para modelos com trilhões de parâmetros.
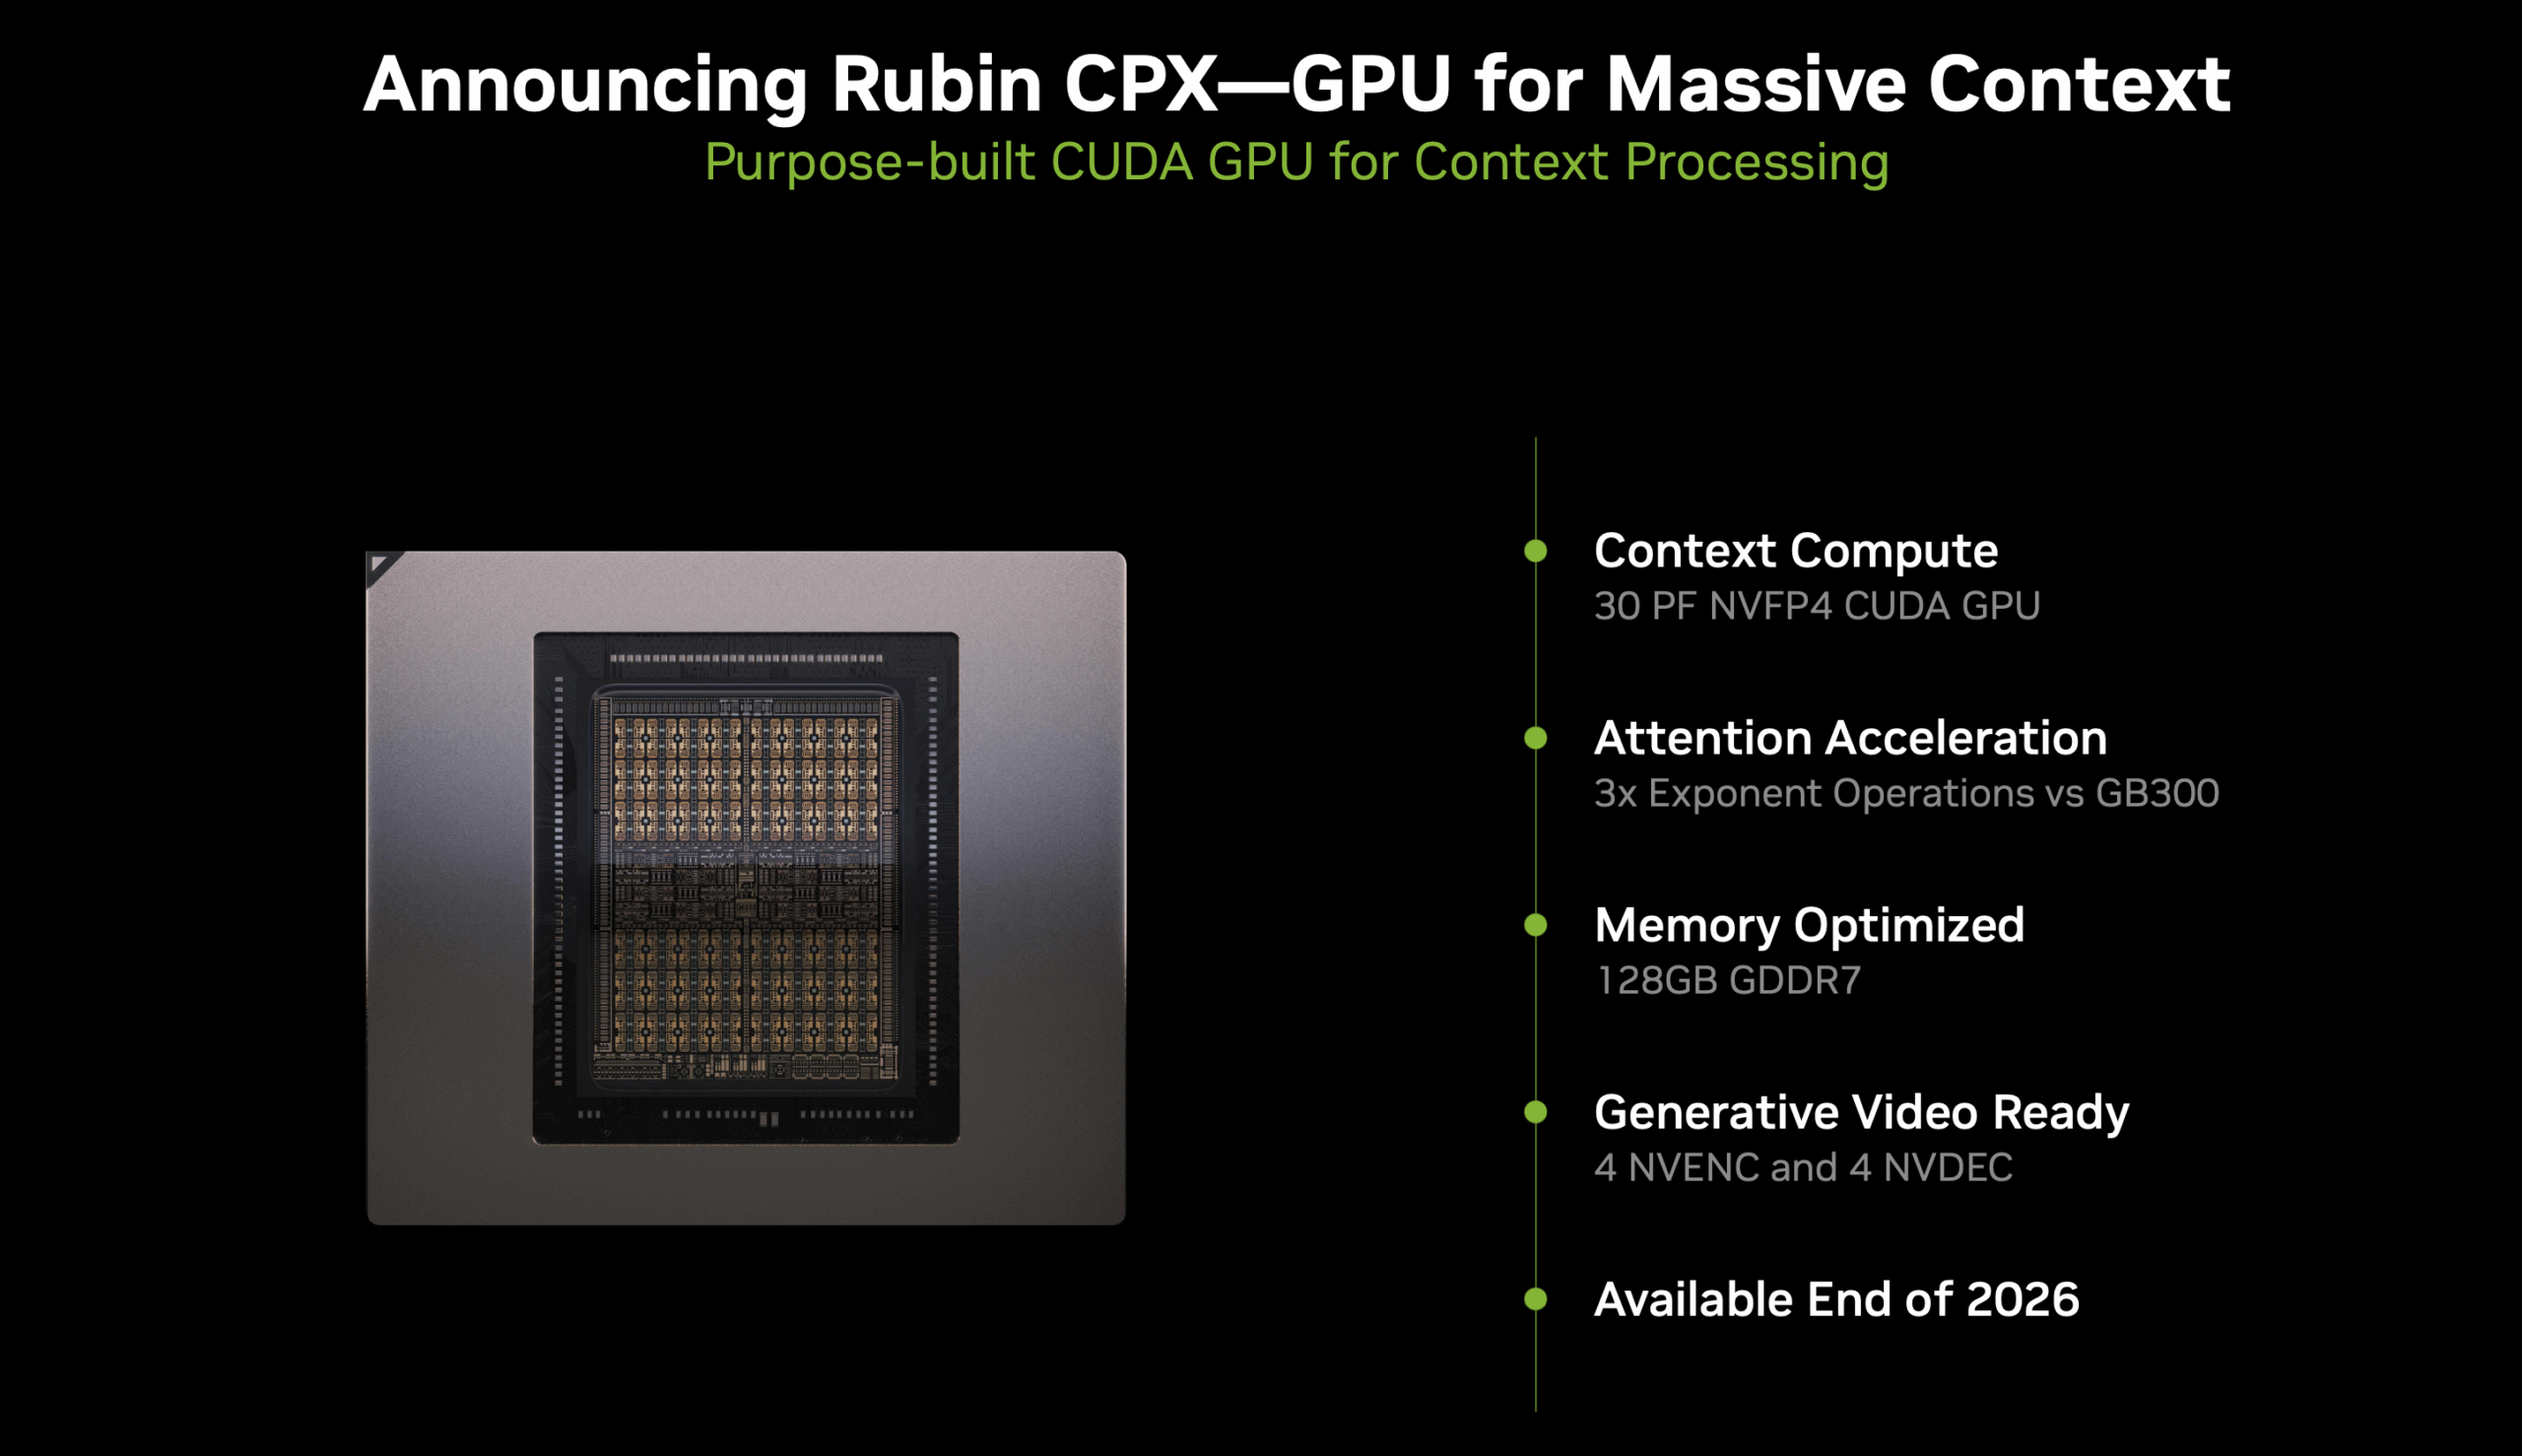
Mas, mais importante ainda, a NVIDIA confirmou que a LPU opera como um acelerador dentro da pilha CUDA existente, executada nas plataformas Vera e NVL72, com computação descarregada de forma transparente por token. Durante a sessão de perguntas e respostas da GTC, a NVIDIA descreveu a LPU como um "impulsionador de modelos de decodificação" e explicou que trabalhará em estreita colaboração com laboratórios de IA e desenvolvedores de modelos de ponta que implementam modelos com trilhões de parâmetros para viabilizar a próxima geração de serviços de modelos premium.
Com a questão do CPX resolvida, a pergunta seguinte natural é: o que exatamente é essa LPU em torno da qual a NVIDIA está construindo um sistema inteiro em escala de rack?
O que é uma LPU?
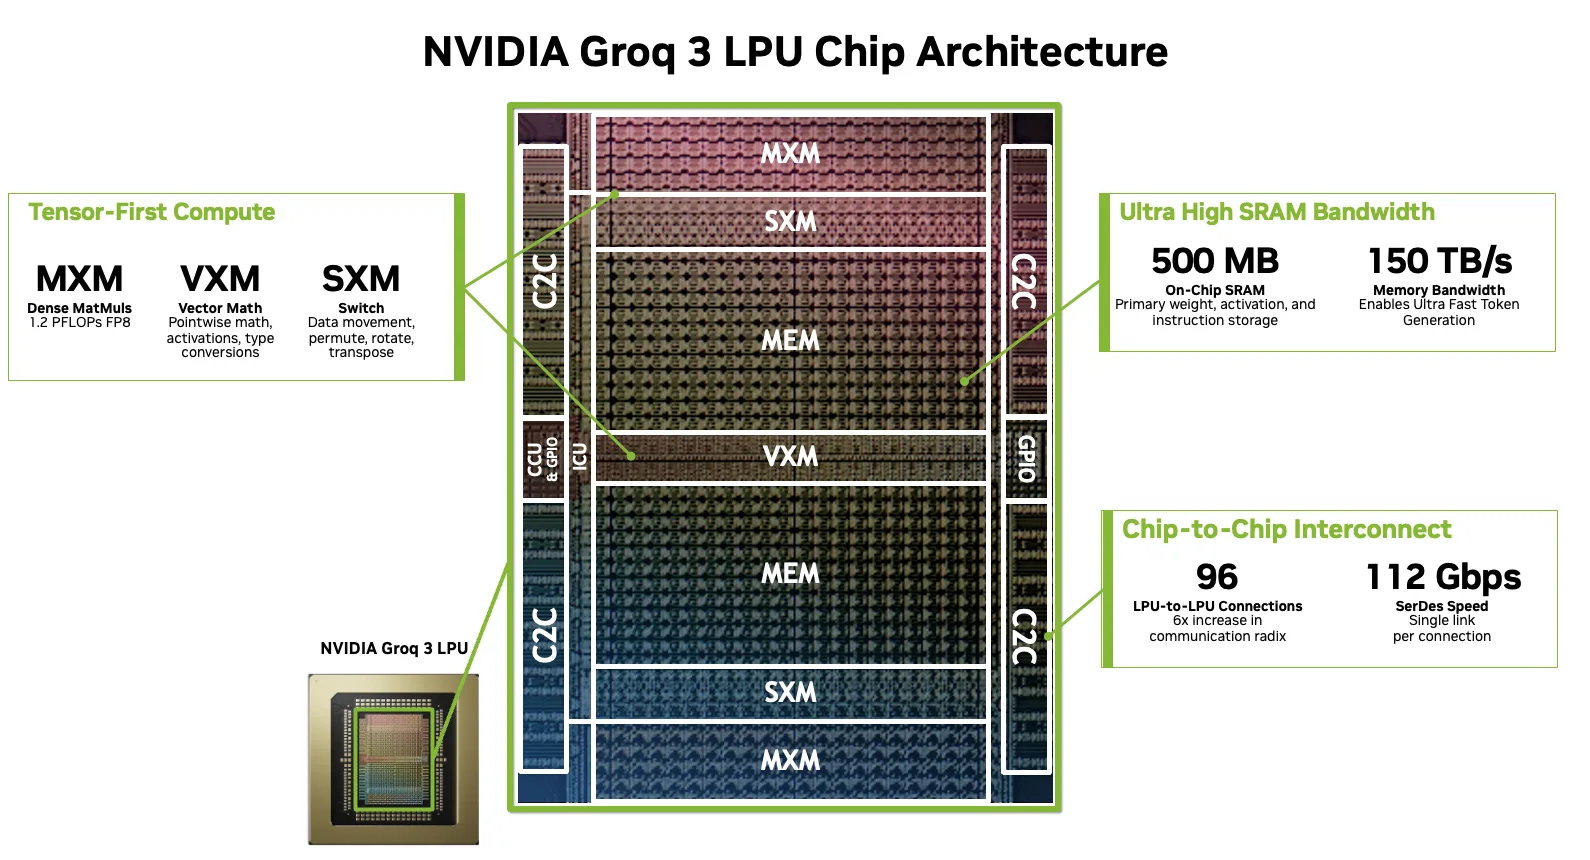
Em sua essência, a LPU é um processador vetorial de grande porte. A unidade fundamental tanto para computação quanto para comunicação é um vetor de 320 elementos, composto por 320 bytes em INT8 e 640 bytes em FP16. Todas as operações no chip, sejam aritméticas, de acesso à memória, de remodelação de dados ou de transferência entre chips, operam nesses vetores de tamanho fixo.
Fonte: Nvidia
A arquitetura é construída a partir de um único bloco fundamental: uma unidade funcional SIMD combinada com uma unidade de despacho de instruções leve. O Groq trata isso como uma classe base que se especializa em quatro tipos distintos, cada um otimizado para uma categoria específica de operações:
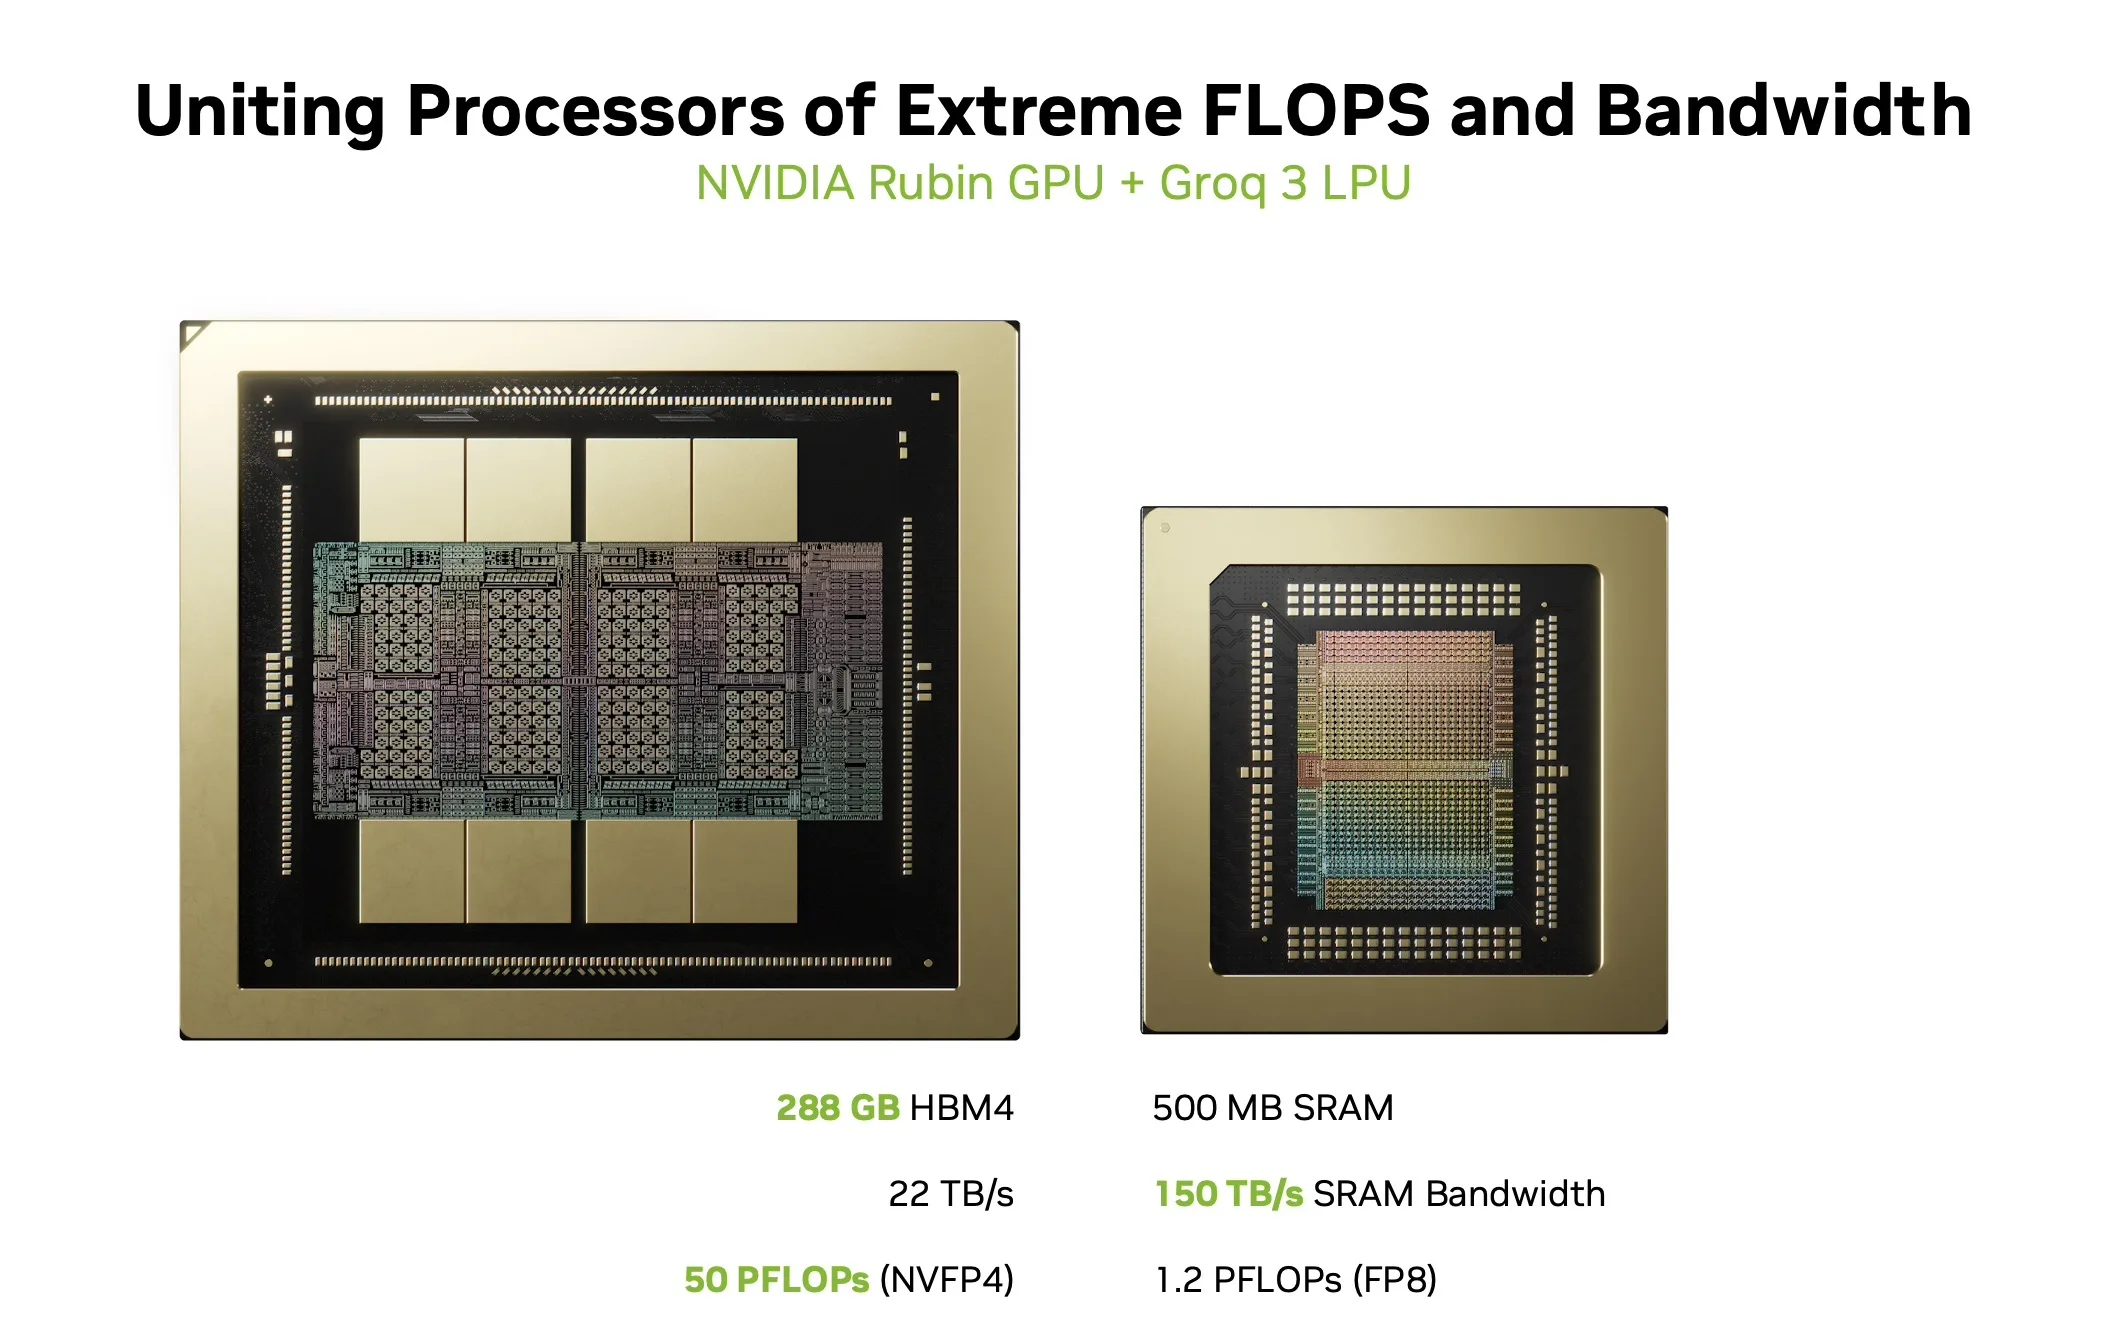
Módulos de Execução de Matrizes (MXM): O principal componente de computação, fornecendo capacidade de multiplicação e acumulação densas para operações de matriz-vetor e matriz-matriz. Cada um dos 8 chips Groq 3 LP30 no rack LPX da NVIDIA oferece 1.2 PFLOPS de computação FP8 por chip, totalizando 9.6 PLOPS de computação FP8 por bandeja LPX.
Módulos de Execução Vetorial (VXM): Lidam com aritmética pontual, operações lógicas, conversões de tipo e funções de ativação. O VXM contém um array de ALUs que o compilador encadeia automaticamente para formar operações compostas (por exemplo, redução seguida de adição com viés, seguida de ativação, seguida de conversão de tipo) em uma única passagem.
Módulos de Execução de Switches (SXM): Realizam movimentação de dados estruturados, incluindo permutação, rotação, distribuição e transposição de vetores.
Unidades de Memória (MEM): Uma arquitetura de memória plana, com prioridade para SRAM, sem caches, sem hierarquia e sem o conceito de falha de cache. O Groq 3 LP30 oferece 500 MB de SRAM integrada com largura de banda de 150 TB/s. O compilador endereça diretamente os bancos de memória físicos, conhecendo a posição exata de todos os dados durante a execução do programa.
Múltiplas cópias de cada tipo de unidade funcional são impressas ao longo da dimensão horizontal do chip. As instruções fluem de cima e de baixo para o meio, enquanto os fluxos de dados fluem de leste para oeste, cruzando as unidades funcionais para realizar operações.
Interconexão 1D, Registros de Fluxo e Determinismo
Registros de fluxo e a interconexão 1D
A comunicação entre as unidades funcionais na LPU ocorre por meio de registradores de fluxo, uma interconexão unidimensional deliberadamente simples. Existem dois caminhos de comunicação, um fluindo para leste e outro para oeste, com cada registrador de fluxo representando um único salto. Os dados se movem exatamente um salto por ciclo de clock, o que significa que o compilador pode calcular o tempo de percurso entre quaisquer duas unidades funcionais realizando uma simples adição ou subtração com base em suas posições físicas no layout do chip.
Não existem filas nem mecanismos de contenção na interconexão. Isso simplifica o problema de agendamento, transformando-o de um complexo problema de empacotamento bidimensional em um problema unidimensional muito mais tratável. Igor Arsovski, arquiteto-chefe da Groq, descreve isso da melhor forma: o compilador sabe exatamente onde um dado estará daqui a 10 ciclos, porque estará exatamente a 10 saltos de distância. Não há ambiguidade, especulação ou hardware tomando decisões de roteamento independentes.
Determinismo
A característica definidora da LPU é o determinismo. Ao contrário dos processadores convencionais, onde o escalonamento dinâmico, o comportamento do cache e a contenção de acesso à memória introduzem variação em tempo de execução, as LPUs executam com variação zero, e cada unidade funcional opera em sincronia.
Esse determinismo é alcançado removendo recursos como intertravamentos de hardware e transferindo toda a tomada de decisões para o compilador; o hardware simplesmente executa a programação resultante. Outros benefícios dessa abordagem são que tudo opera com a mesma latência exata e até mesmo o consumo de energia é previsível em todos os momentos.
O determinismo também se estende ao domínio numérico por meio da tecnologia TruePoint da Groq, onde a ordem de operações garantida da arquitetura permite precisão de nível FP32 a partir de entradas FP16, através de um produto escalar fundido de 320 elementos com uma única etapa de arredondamento. Os detalhes sobre por que o determinismo numérico é importante para a inferência LLM e por que o hardware não determinístico produz saídas sutilmente diferentes entre execuções são explorados em profundidade no white paper da Thinking Lab, "Defeating Nondeterminism in LLM Inference" (Derrotando o Não Determinismo na Inferência LLM) . Esse não é o foco deste artigo, mas os leitores interessados nas implicações para a precisão numérica podem encontrar a análise relevante na documentação técnica do TruePoint da Groq, cujo link está no final.
Como as LPUs se conectam: RealScale, a linha de montagem e a topologia de racks
A Linha de Montagem: Como os Dados se Movem
Em sua forma mais simples, a movimentação de dados entre LPUs funciona como uma linha de montagem. Quando um modelo é compilado para o sistema, o compilador o divide em estágios e mapeia espacialmente cada estágio em um grupo de chips LPU. Cada grupo armazena os parâmetros de peso necessários em uma SRAM local no chip. Durante a inferência, os únicos dados que trafegam entre os grupos de chips são os tensores de ativação intermediários do estágio anterior. Os dados fluem de chip para chip como um produto se movendo em uma esteira rolante, com cada estação realizando seu cálculo atribuído e passando o resultado para a próxima. Isso é fundamentalmente diferente das GPUs, onde cada estágio de computação requer a recuperação do conjunto completo de pesos da memória HBM externa e a gravação dos resultados de volta. Na LPU, os pesos já estão residentes na SRAM em cada estação; apenas os tensores de ativação são transferidos.
Nota sobre links C2C: RealScale, não NVIDIA C2C.
Antes de entrarmos nos detalhes da topologia, é importante esclarecer uma possível fonte de confusão. As conexões chip-a-chip (C2C) usadas em todo o sistema LPX são as interconexões RealScale C2C da Groq. Elas não são as mesmas da tecnologia C2C da NVIDIA, usada em outros locais do ecossistema NVIDIA. As duas tecnologias são arquiteturalmente distintas:
- NVIDIA C2C é uma interconexão coerente em cache projetada para conectar dois tipos diferentes de chips dentro de um módulo fortemente acoplado, como uma conexão CPU-GPU. Ela utiliza um protocolo coerente com SerDes de alta velocidade e foi projetada para comunicação heterogênea entre chips dentro de um único encapsulamento ou módulo.
- Groq RealScale C2C é uma interconexão ponto a ponto determinística e com agendamento por software. Os links de rede são explicitamente controlados pelo compilador e agendados como unidades funcionais de primeira classe, assim como as unidades de computação MXM ou VXM. Não há arbitragem de hardware nem roteamento adaptativo, e os pacotes não carregam cabeçalhos de origem ou destino. Os links são alinhados em fase e atuam como fios de alta largura de banda e latência fixa entre os chips. Um protocolo plesiócrono compensa deterministicamente a deriva natural do relógio entre os chips, expondo um único domínio de tempo comum ao compilador em toda a rede.
Todas as conexões C2C no rack LPX, seja dentro de uma bandeja, entre bandejas através da espinha dorsal ou entre racks através das portas do painel frontal, utilizam RealScale. Esta é a mesma tecnologia de interconexão fundamental que a Groq utiliza desde o GroqNode original, com velocidade de link aumentada (de 30 Gbps para 112 Gbps por canal), mas arquiteturalmente inalterada.
Nota: A próxima seção, que explica a conectividade, baseia-se em nossa compreensão da arquitetura, conforme a documentação da Groq (link no final), a postagem no blog da NVIDIA e a explicação do rack que nos foi fornecida no estande da GTC:
- As conexões C2C usadas nas unidades de rack LPX são tecnologia da Groq e não são as mesmas conexões C2C usadas em outros sistemas de rack da NVIDIA.
- Os 4 links C2C na parte frontal de cada unidade de rack LPX são usados para conectar unidades de rack adjacentes no mesmo nível.
- Dentro de um rack, existe comunicação completa entre as LPUs.
- O processador no rack LPX é x86.
Conectividade intra-bandeja
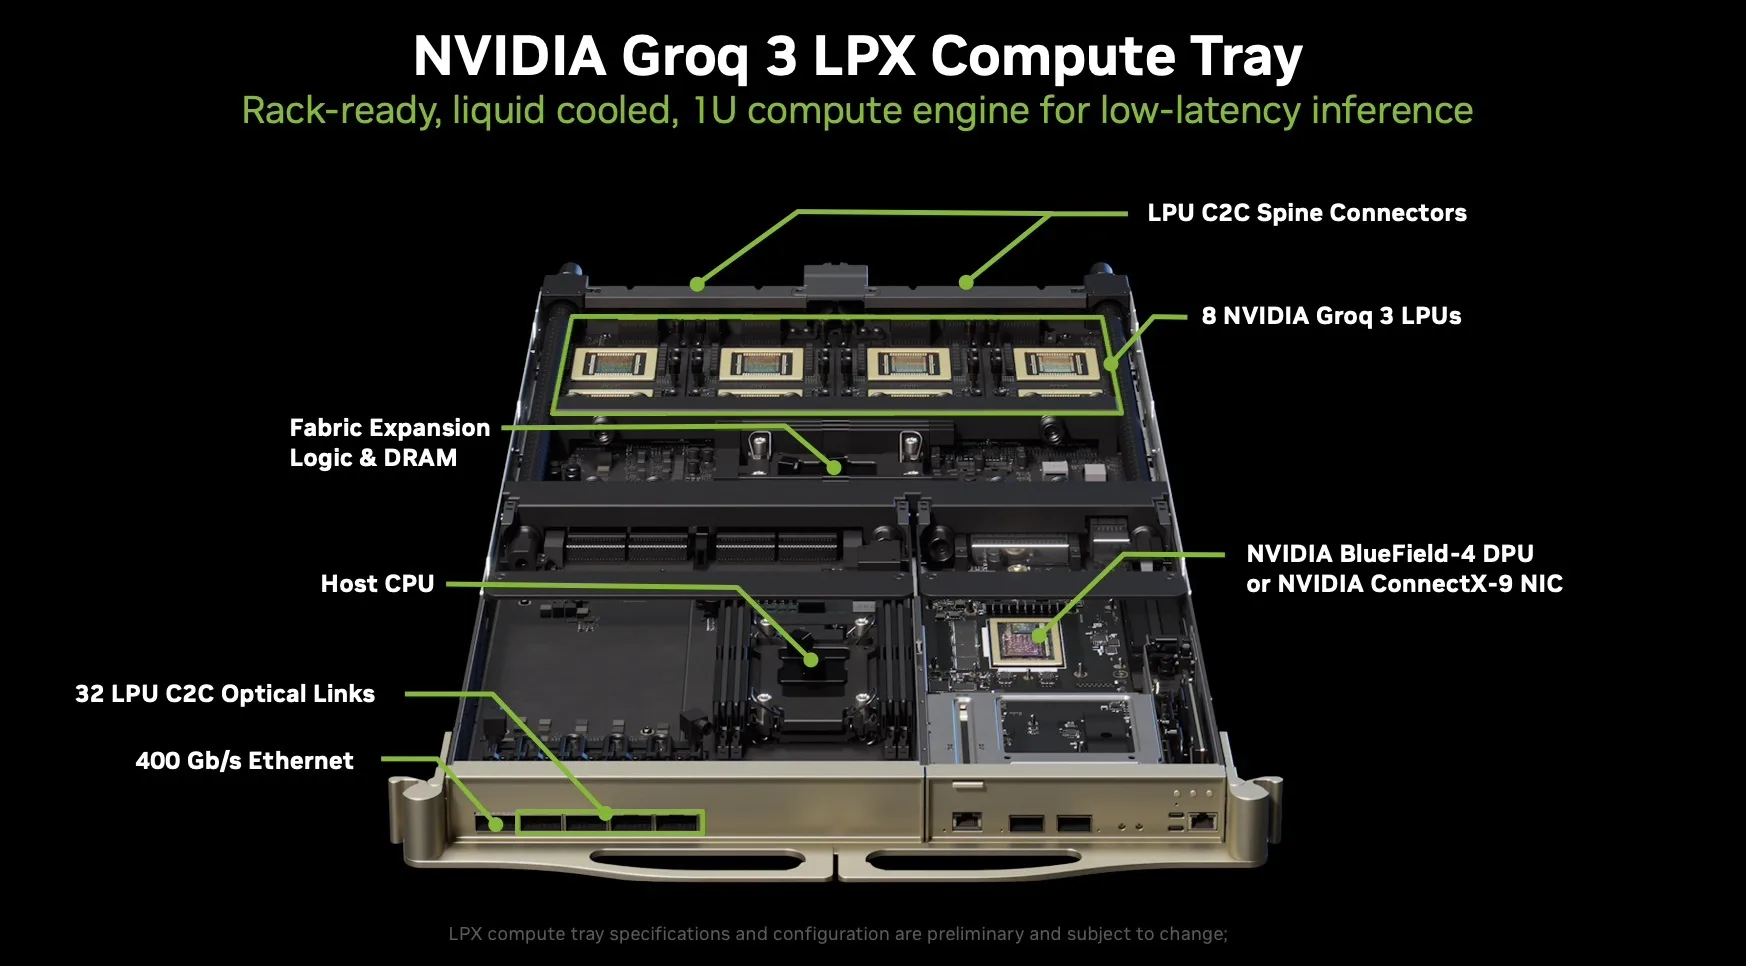
O princípio fundamental da topologia de rede do Groq não mudou do GroqNode original para o NVIDIA Groq 3 LPX. Cada bandeja de computação 1U contém exatamente oito chips LP30, densamente interconectados em um grafo completo (todos para todos), onde cada chip pode se comunicar diretamente com todos os outros chips na mesma taxa.
Fonte: Nvidia
Cada chip LP30 possui 96 links C2C, cada um operando a 112 Gbps, fornecendo 2.5 TB/s de largura de banda bidirecional por chip. Em um grafo completo de 8 chips, cada chip possui 7 vizinhos. O número de arestas únicas entre chips dentro de uma bandeja é C(8,2) = 28. Uma parte dos 96 links de cada chip é dedicada a essas conexões intra-bandeja (all-to-all), com os links restantes roteados para o backplane (para a espinha dorsal do rack) e para o painel frontal (para inter-rack). A especificação publicada pela NVIDIA lista 20 TB/s de largura de banda total de escalonamento por bandeja, o que representa a largura de banda combinada intra-bandeja e da espinha dorsal. Podemos verificar isso: cada bandeja possui 8 chips × 96 links = 768 links no total. Subtraindo as 32 vias inter-rack do painel frontal, restam 736 links para escalonamento. Com 112 Gbps por link, isso corresponde a 736 × 112 Gbps = 82,432 Gbps, ou aproximadamente 10.3 TB/s por direção, o que resulta em cerca de 20.6 TB/s bidirecional. Isso está em boa consonância com os 20 TB/s por bandeja declarados pela NVIDIA.
Este grupo de 8 chips com comunicação total entre si forma o “grupo local” de uma topologia de rede em formato de libélula. O GroqChip 1 original possuía 11 links C2C por placa, cada um com 30 Gbps por canal (quatro canais por link), totalizando 330 GB/s por placa. Os 96 links a 112 Gbps do Groq 3 LP30 representam um salto geracional significativo na largura de banda de E/S por chip, mantendo a mesma estrutura topológica.
Conectividade intra-rack
Em um único rack LPX, 32 bandejas de computação (totalizando 256 chips) interconectam-se por meio de quatro spines ETL no backplane. Esses spines transportam o tráfego RealScale C2C entre as bandejas, criando o domínio de escalonamento em escala de rack. A largura de banda agregada de escalonamento em todo o rack é de 640 TB/s (32 bandejas × 20 TB/s por bandeja). Dividida entre os quatro spines, cada spine transporta aproximadamente 160 TB/s de largura de banda bidirecional.
Conectividade entre racks
Cada bandeja de computação 1U expõe quatro portas QSFP C2C no painel frontal, fornecendo um total de 32 pistas (8 pistas por porta) para comunicação entre racks. Essas portas se conectam aos racks adjacentes em um padrão simétrico: duas portas (16 pistas) se conectam ao rack adjacente à esquerda e duas portas (16 pistas) se conectam ao rack adjacente à direita. Cada posição U se conecta à sua posição U correspondente no rack vizinho (a primeira posição U no rack A se conecta à primeira posição U no rack B, a segunda à segunda posição U e assim por diante).
Fonte: Nvidia
Com 112 Gbps por canal, cada bandeja com 32 canais inter-rack fornece 32 × 112 Gbps = 3,584 Gbps, ou aproximadamente 448 GB/s por direção por bandeja de largura de banda inter-rack. Em todo o rack, as 32 bandejas fornecem 32 × 32 = 1,024 canais inter-rack. Isso resulta em 1,024 × 112 Gbps = 114,688 Gbps, ou aproximadamente 14.3 TB/s por direção para cada rack adjacente (dividido igualmente: ~7.2 TB/s por direção para o vizinho da esquerda e ~7.2 TB/s por direção para o vizinho da direita).
Essa largura de banda entre racks é, por projeto, mais esparsa do que a largura de banda dentro do rack. Dentro do rack, o domínio de escalonamento de 640 TB/s proporciona conectividade densa e abrangente através da espinha dorsal. Entre racks, os links do painel frontal fornecem as conexões globais mais esparsas da topologia dragonfly. Esse é o mesmo padrão arquitetônico do GroqRack original, onde quatro links C2C externos por chip conectavam grupos locais (nós) para formar sistemas multi-rack com baixo diâmetro de rede (três saltos no máximo em uma implantação de 264 chips).
Em resumo: mesma arquitetura, 4 vezes mais densidade.
A implementação original do GroqRack, com quatro racks, continha 264 processadores GroqChip. Um único rack LPX agora comporta 256 chips LP30 em um rack MGX ETL, representando aproximadamente quatro vezes a densidade de chips em um único formato de rack com refrigeração líquida e um backplane sem cabos. O grupo local de comunicação total entre oito chips, a topologia dragonfly e o paradigma de roteamento com agendamento por software permanecem intactos. A tecnologia fundamental de rede Groq não mudou; ela foi apenas escalada.
Para modelos que excedem a capacidade de SRAM de um único rack (128 GB no total, distribuídos em 256 chips), vários racks LPX ou fileiras de racks podem ser interconectados através das portas C2C do painel frontal para expandir ainda mais a linha de montagem. Mais detalhes sobre o que isso significa para tamanhos de modelos reais serão apresentados na próxima seção.
Por que usar camadas FFN? Entendendo o que a NVIDIA está descarregando para outras camadas.
Por que o serviço Decode está ficando mais difícil de usar?
Antes de entrarmos nos detalhes do que a NVIDIA está transferindo para o LPX e por quê, é útil entender as tendências mais amplas, como a NVIDIA destaca, que tornam essa decisão arquitetônica necessária. A inferência de IA não é uma carga de trabalho única e uniforme. Dentro de uma única solicitação, a fase de preenchimento (ingerir o prompt e construir o cache KV) e a fase de decodificação (gerar tokens um de cada vez) impõem demandas muito diferentes ao hardware, e essas demandas variam com o tamanho do lote, o comprimento do contexto e a estrutura do modelo.
À medida que os modelos produzem resultados de raciocínio mais longos e cadeias de pensamento com várias etapas, uma parcela maior de cada solicitação passa a ser realizada na fase de decodificação sequencial. Ao mesmo tempo, técnicas como o cache de prefixos reduzem o custo do preenchimento prévio, reutilizando o estado de prompts compartilhados entre as solicitações, o que apenas torna o custo relativo da decodificação mais evidente. As janelas de contexto também estão crescendo para centenas de milhares de tokens, exercendo uma pressão crescente sobre a largura de banda da memória durante o cálculo da atenção. E em fluxos de trabalho com agentes, a latência se acumula em diversas chamadas de modelo, interações com ferramentas e loops de verificação. O efeito cumulativo é que a latência de decodificação se torna cada vez mais o gargalo percebido pelos usuários, e o hardware otimizado puramente para a taxa de transferência agregada máxima nem sempre é a melhor opção para cargas de trabalho que exigem geração rápida e previsível de tokens para cada solicitação individual.
Além disso, como demonstrado pelo lançamento do Modo Rápido da Anthropic , menor latência e maior taxa de transferência de tokens geram maiores receitas, sendo que a oferta de inferência rápida da Anthropic custa 6 vezes mais do que as solicitações regulares.
Com este anúncio do LPX, sabemos que a NVIDIA quer transferir o maior gargalo de decodificação para as LPUs: as camadas de rede feed-forward (FFN). Para entender por que a FFN é o alvo e para apreciar a enorme dimensão do que isso significa, analisamos a quantidade de parâmetros da FFN nos modelos de código aberto mais populares da atualidade.
O que são camadas FFN e por que elas dominam?
Cada camada do Transformer possui dois blocos principais: um bloco de atenção e um bloco de propagação direta (FFN). O bloco de atenção permite que os tokens observem e combinem informações de outros tokens na sequência. O bloco FFN opera em cada token de forma independente: ele projeta a representação do token em um espaço de dimensão superior, aplica uma não linearidade e a projeta de volta para baixo. Você pode considerá-lo como o repositório de conhecimento do modelo, onde residem as associações factuais e as transformações aprendidas.
A arquitetura MoE, ou Mixture of Experts (Mistura de Especialistas), emergiu como a arquitetura dominante entre os principais modelos de linguagem de código aberto da atualidade: DeepSeek R1, Kimi K2, Qwen3-235B, GLM-5, MiniMax M2.5 e GPT-OSS 120B da OpenAI.
Nesses modelos MoE, é especificamente o bloco FFN que é replicado em centenas de cópias independentes menores, chamadas de especialistas, enquanto a atenção permanece compartilhada. Uma função de roteamento aprendida e leve seleciona dinamicamente um pequeno subconjunto de especialistas para ativar a cada token. O resultado é um modelo que armazena uma enorme quantidade total de parâmetros, mas ativa apenas uma fração por token, obtendo os benefícios de qualidade da escala sem o custo computacional proporcional.
No entanto, como você já deve ter percebido, isso representa outro desafio: as camadas FFN são responsáveis pela maior parte dos pesos do modelo. Especificamente para modelos MoE, isso pode chegar a 90% dos pesos do modelo.
Por dentro do DeepSeek R1: um exemplo prático
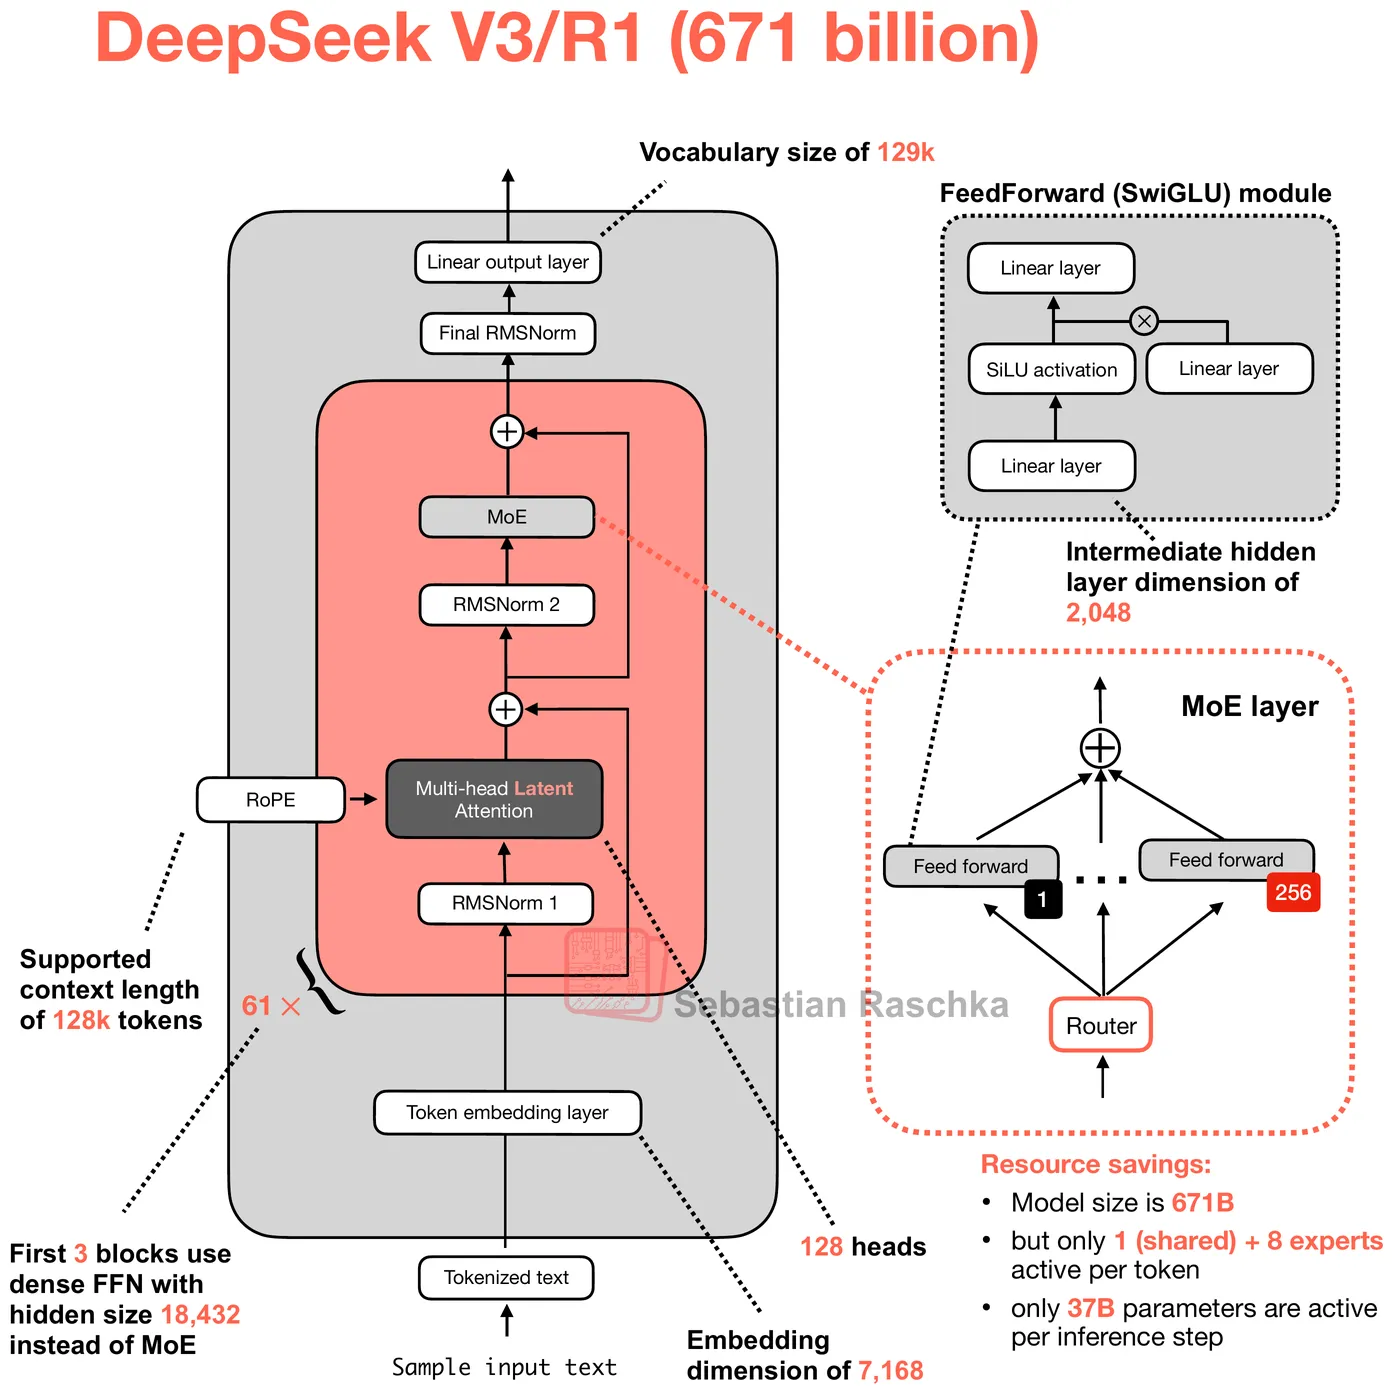
Para ilustrar, vamos analisar o DeepSeek R1 em detalhes. O modelo possui 61 camadas Transformer com uma dimensão oculta (H) de 7,168. As três primeiras camadas utilizam uma FFN densa padrão, enquanto as 58 restantes utilizam MoE (mais uma camada MTP adicional com seus próprios especialistas, totalizando 59 camadas MoE). Os LLMs modernos utilizam uma variante chamada SwiGLU, que possui três matrizes de pesos em vez de duas. A passagem direta calcula w2(SiLU(w1(x)) ⊙ w3(x)), onde w1 (a projeção do gate) e w3 (a projeção ascendente) expandem a dimensão oculta de H para um tamanho intermediário I, e w2 (a projeção descendente) a comprime de volta. O ⊙ representa a multiplicação elemento a elemento entre os caminhos com e sem gate. Nenhuma dessas matrizes possui termos de bias, portanto, cada bloco FFN SwiGLU contém exatamente 3 × H × I parâmetros.
Fonte: Sebastian Raschka
Para as camadas densas do DeepSeek R1 (as três primeiras), a dimensão intermediária é 18,432, resultando em 3 × 7,168 × 18,432 = 396.4 milhões de parâmetros por camada. Para as camadas MoE, cada um dos 256 especialistas roteados é um bloco SwiGLU completo com uma dimensão intermediária menor, de 2,048, portanto, cada especialista possui 3 × 7,168 × 2,048 = 44.0 milhões de parâmetros. Multiplicando por 256 especialistas, obtemos 11.27 bilhões de parâmetros apenas nos especialistas roteados, por camada. Além disso, cada camada MoE possui um especialista compartilhado (o mesmo bloco SwiGLU de 44 milhões de parâmetros, sempre ativado para cada token), um roteador (uma projeção linear de formato [256, 7168] = 1.8 milhão de parâmetros) e um pequeno vetor de bias de 256 valores FP32 usado para balanceamento de carga durante o roteamento.
A FFN completa possui aproximadamente 669.1 bilhões de parâmetros. No formato FP8 E4M3 (1 byte por peso), isso se traduz em cerca de 623.1 GB de dados FFN. Isso representa 97.7% do tamanho total estimado do modelo em disco. Os ~2.3% restantes correspondem a pesos de atenção, embeddings, cabeçalho de saída, normas de camada e metadados de escala FP8.
Decodificar Desagregação
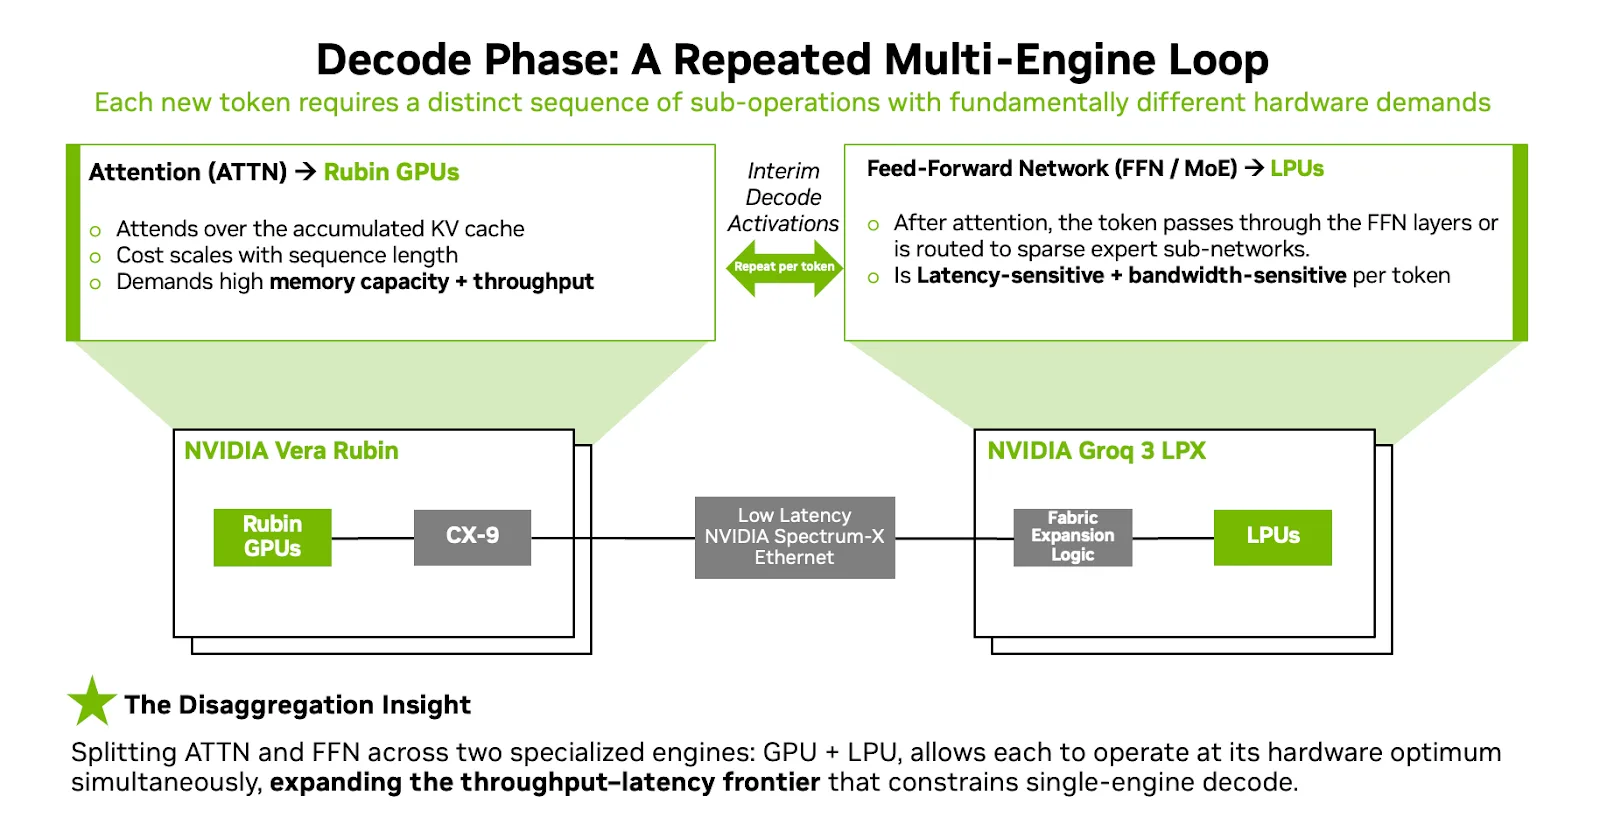
A NVIDIA agora define a fase de decodificação não como uma operação monolítica, mas como um loop repetido por token, onde diferentes partes sobrecarregam diferentes gargalos de hardware. A fase de pré-preenchimento é dominada pela ingestão de grandes entradas e pela construção do cache KV, uma carga de trabalho que se beneficia de computação paralela densa e grande capacidade de memória. O Vera Rubin NVL72 lida com isso de forma eficiente, especialmente para cargas de trabalho de contexto longo, onde o prompt pode ser enorme e altamente variável.
Fonte: Nvidia
A decodificação é diferente. Para cada novo token, o sistema deve executar a atenção sobre todo o cache KV acumulado e, em seguida, executar o cálculo FFN/MoE na saída da atenção. Na arquitetura de Desagregação de Atenção-FFN (AFD) da NVIDIA, essas duas etapas são divididas entre dois mecanismos. As GPUs Rubin lidam com a atenção de decodificação: lendo o cache KV da HBM, calculando as pontuações de atenção e produzindo a ativação intermediária. Esse tensor de ativação (o que a NVIDIA chama de "estado tensor provisório") é então entregue ao LPX, que executa o cálculo especializado FFN ou MoE com largura de banda extrema e latência determinística antes de retornar o resultado para a GPU para continuar a geração de tokens.
Essa transferência ocorre para cada token. Os tensores de ativação trocados entre a GPU e a LPU são pequenos em relação aos dados de peso, que é precisamente o regime em que a rede de sobrecarga quase nula da LPU se destaca. A divisão aproveita os pontos fortes fundamentais de cada processador: as GPUs fornecem a capacidade da HBM e a execução flexível necessárias para a atenção de comprimento variável em grandes caches KV, enquanto as LPUs fornecem a largura de banda da SRAM e o agendamento determinístico necessários para os pesos FFN com largura de banda limitada e agendamento estático.
Fonte: Nvidia
Há uma propriedade de escalabilidade sutil, porém importante, que vale a pena destacar aqui. À medida que o comprimento do contexto aumenta, os requisitos de computação e memória da operação de atenção também aumentam: o cache KV se expande linearmente com cada token adicional de contexto, e cada nova etapa de decodificação deve considerar todo o cache acumulado. A FFN, no entanto, não cresce com o contexto. As matrizes de peso da FFN (w1, w2, w3 no SwiGLU) são constantes fixas da arquitetura do modelo. Elas têm o mesmo tamanho, independentemente de o contexto ter 1,000 tokens ou 1,000,000 tokens, e cada token passa por elas independentemente. Isso significa que, na arquitetura AFD, à medida que as janelas de contexto continuam a crescer, o lado da GPU absorve o custo crescente (mais HBM para o cache KV, mais computação para a atenção), enquanto o lado LPX permanece completamente estático. O número de racks LPX necessários para atender à FFN de um modelo é determinado inteiramente pela arquitetura do modelo, e não pelo comprimento do contexto da configuração de serviço. Isso resolve de forma elegante o que historicamente era um dos maiores desafios para aceleradores baseados apenas em SRAM: o fato de que as crescentes demandas de contexto eventualmente ultrapassam a capacidade fixa de memória on-chip. Na divisão AFD, o trabalho dependente do contexto permanece no hardware com HBM expansível, e a LPU lida apenas com o trabalho independente do contexto que se encaixa naturalmente na SRAM fixa.
O NVIDIA Dynamo torna a decodificação heterogênea operacional.
Fazer com que esse ciclo de dois mecanismos funcione em produção exige mais do que apenas hardware. A camada de orquestração Dynamo da NVIDIA é o que torna a decodificação heterogênea viável. O Dynamo coordena o fornecimento desagregado entre os backends de GPU e LPU, lidando com a classificação, o roteamento e a transferência de ativação por token exigidos pelo AFD.
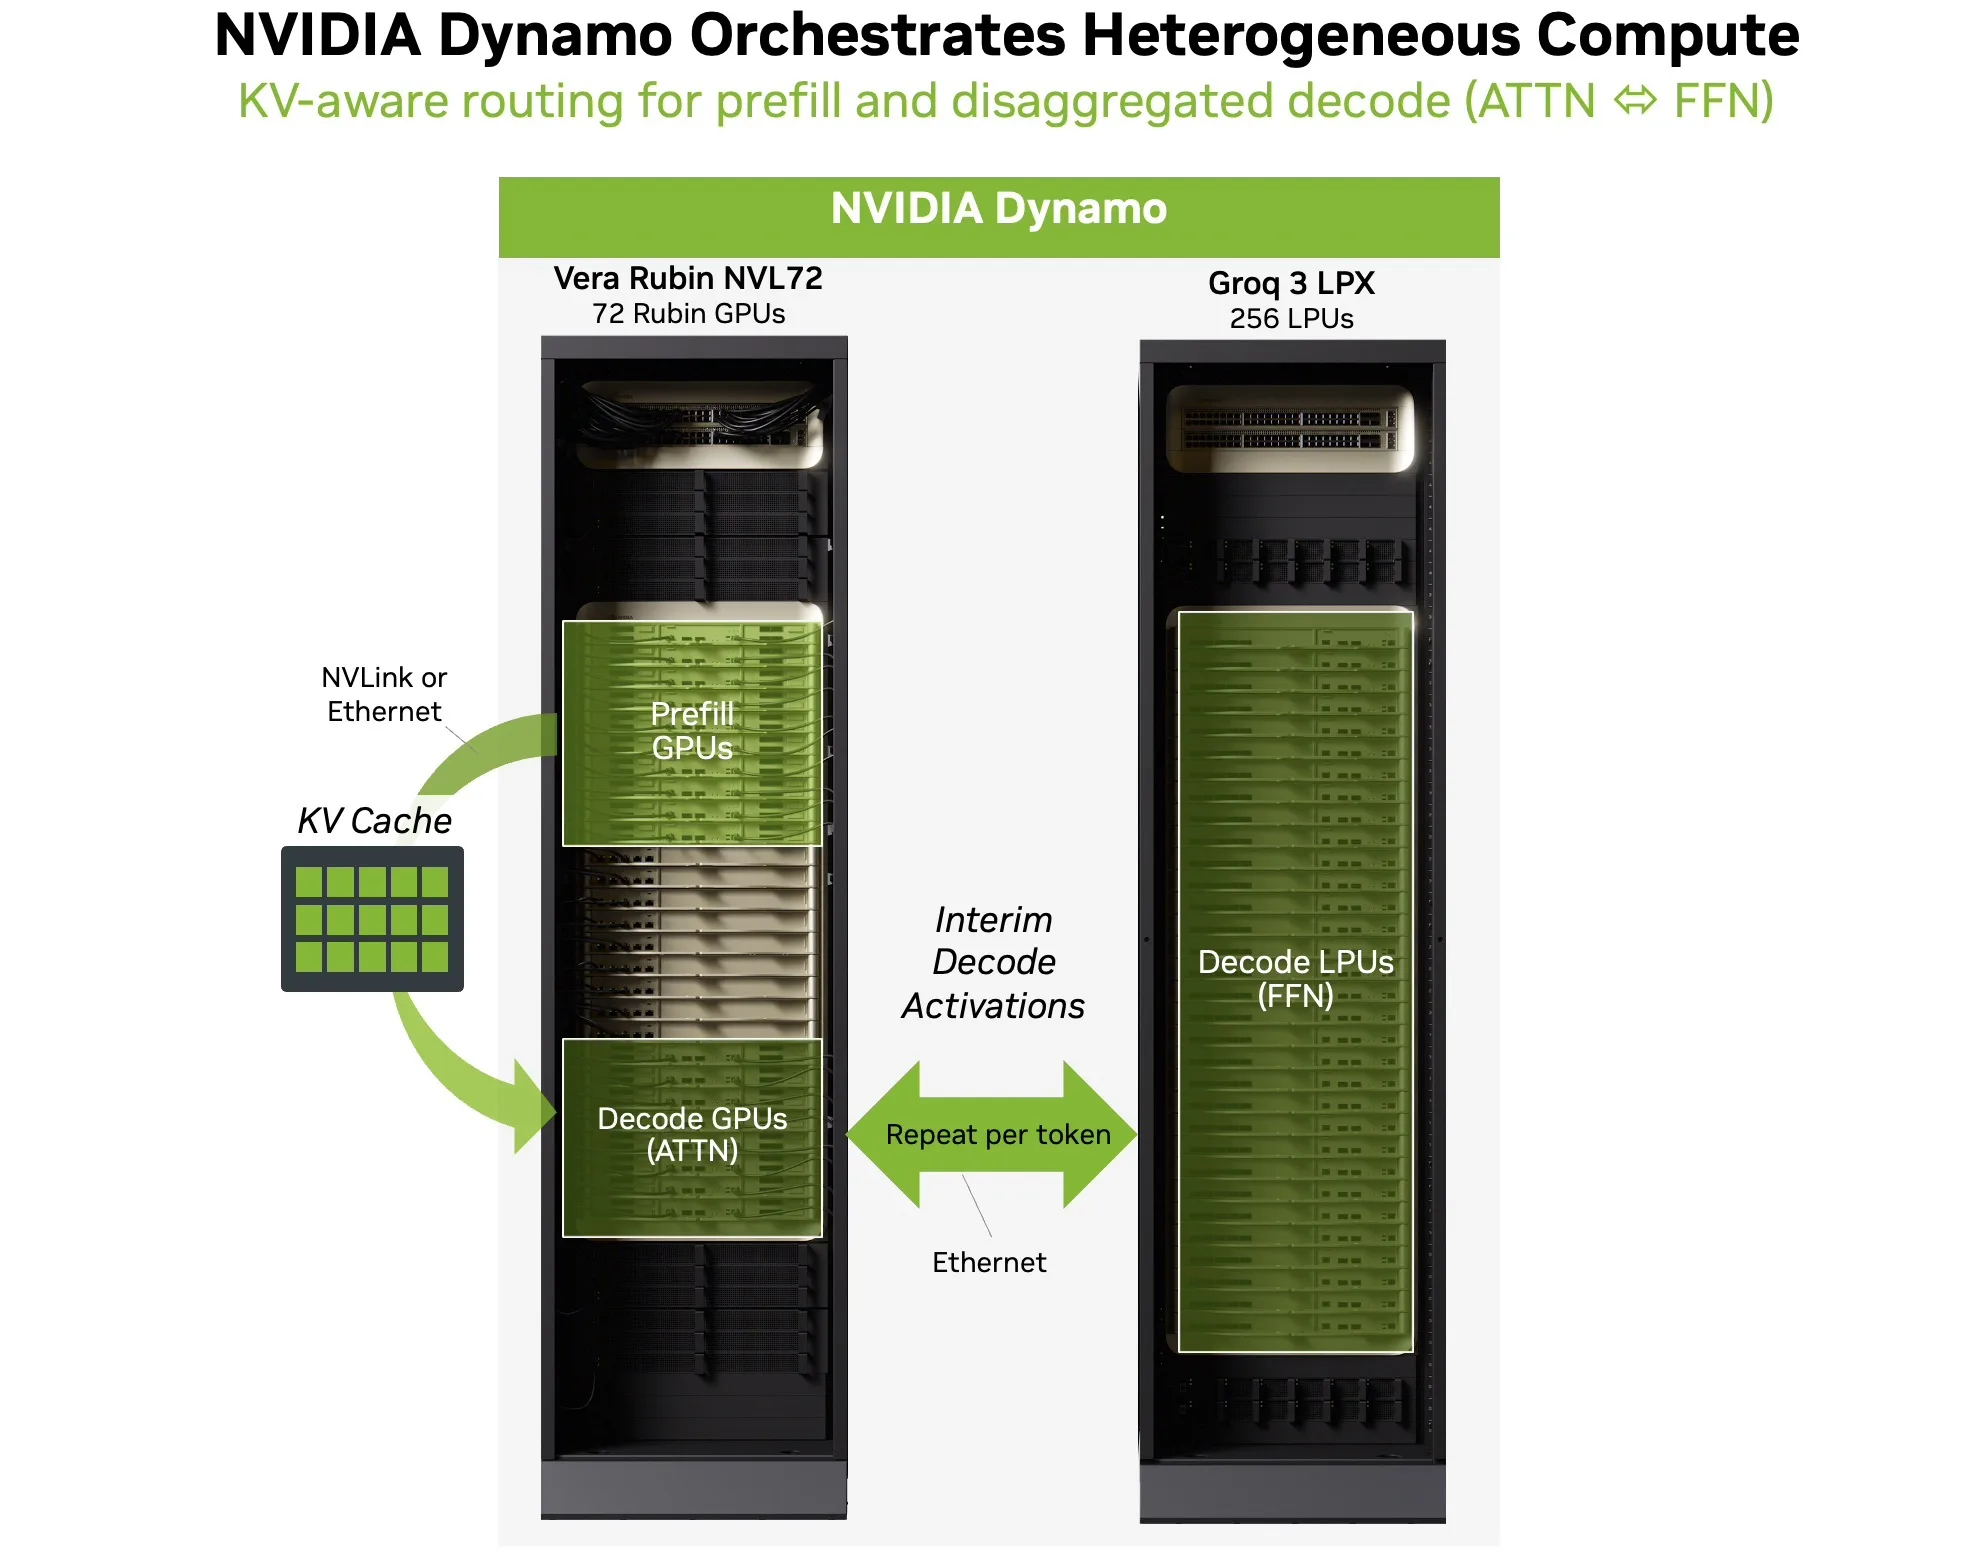
Fonte: Nvidia
Na prática, o Dynamo encaminha o preenchimento automático para os workers da GPU para processar a entrada e construir o cache KV. Durante a decodificação, o Dynamo orquestra o loop AFD: as GPUs executam a atenção sobre o cache KV acumulado, as ativações intermediárias são repassadas para as LPUs para execução de FFN/MoE e as saídas retornam às GPUs para continuar a geração de tokens. O resultado é um único caminho de serviço coerente, em vez de dois sistemas desconectados.
O Dynamo também oferece roteamento com reconhecimento de chave-valor (para que as solicitações sejam direcionadas aos nós de trabalho que já possuem o cache de chave-valor relevante), agendamento orientado por metas de latência (para que as sessões interativas não entrem em longas filas) e gerenciamento de transferência com baixa sobrecarga. Esses recursos são importantes porque, em condições reais de tráfego de produção com durações de contexto variáveis, tipos de solicitação mistos e concorrência intermitente, a camada de orquestração mantém a latência estável e evita que a variação entre tenants prejudique a experiência do usuário.
Tamanhos FFN em todos os principais modelos de código aberto e dimensionamento LPX
Agora que entendemos como o LPX funciona e o que ele tenta resolver, vamos analisar o que isso significa em termos de requisitos de hardware.
Calculamos o número de parâmetros e o tamanho da FFN em disco para modelos populares usando os arquivos config.json e model.safetensors.index.json disponíveis no Huggingface.
| Modelo | Parâmetros FFN | Tamanho FFN (em disco) | FFN % | Tipo D | Especialistas |
|---|---|---|---|---|---|
| DeepSeek R1 e DeepSeek V3.2 | 669.1B | 623.1 GB | 97.7% | FP8 | 256 |
| Kimi K2 | 1.02T | 948.0 GB | 98.9% | FP8 | 384 |
| Kimi K2.5 | 1.02T | 474.0 GB | 98.5% | INT4 | 384 |
| MiniMax M2.5 | 224.7B | 209.3 GB | 97.7% | FP8 | 256 |
| OpenAI GPT-OSS 120B | 114.7B | 53.4 GB | 95.4% | MXFP4 | 128 |
| GLM 5 | 738.1B | 1,374.8 GB | 98.0% | BF16 | 256 |
| Qwen3 235B-A22B | 227.2B | 423.1 GB | 96.6% | BF16 | 128 |
O padrão confirma o que exploramos anteriormente: em todos os modelos desta análise, os parâmetros FFN representam de 95% a 99% do tamanho total do modelo em disco. O Kimi K2 é o caso mais extremo, com 384 especialistas roteados por camada, elevando o FFN para mais de 1 trilhão de parâmetros e quase 99% do total. Mesmo o menor modelo do conjunto, o GPT-OSS 120B da OpenAI, com 128 especialistas armazenados em MXFP4, ainda apresenta FFN representando 95.4% do total. Os tamanhos em disco variam de modestos 53 GB para o GPT-OSS 120B (graças à quantização de 4 bits) até quase 1.4 TB para o GLM 5 (armazenado em BF16 sem quantização).
Esses números nos ajudam a entender o dimensionamento do LPX. Um único rack LPX fornece 128 GB de SRAM total em seus 256 chips. Para um modelo como o GPT-OSS 120B da OpenAI, com 53 GB de FFN, os pesos FFN cabem confortavelmente em um único rack, com espaço de sobra. O DeepSeek R1, com 623 GB, exigiria aproximadamente cinco racks LPX, enquanto o GLM 5, com 1.4 TB em BF16, precisaria de mais de dez (embora a quantização para FP8 reduza isso pela metade). É exatamente por isso que as portas C2C no painel frontal entre racks são necessárias: elas permitem que vários racks LPX sejam conectados em cadeia, estendendo a linha de montagem para acomodar modelos maiores.
Acelerando a decodificação especulativa com LPX
Além do loop de decodificação AFD, a NVIDIA identifica um segundo caso de uso principal para o LPX: servir como mecanismo de geração de rascunhos na decodificação especulativa.
A decodificação especulativa é uma técnica cada vez mais importante para reduzir a latência na inferência de modelos de lógica latente (LLM). A ideia é simples: um modelo preliminar menor e mais rápido gera vários tokens candidatos antecipadamente, enquanto um modelo alvo maior os verifica e os aceita em paralelo. Quando as previsões do modelo preliminar estão corretas (o que geralmente acontece com textos rotineiros), vários tokens podem ser confirmados de uma só vez em uma única etapa de verificação. O resultado é um número significativamente maior de tokens efetivos por segundo e uma latência percebida menor para o usuário final.
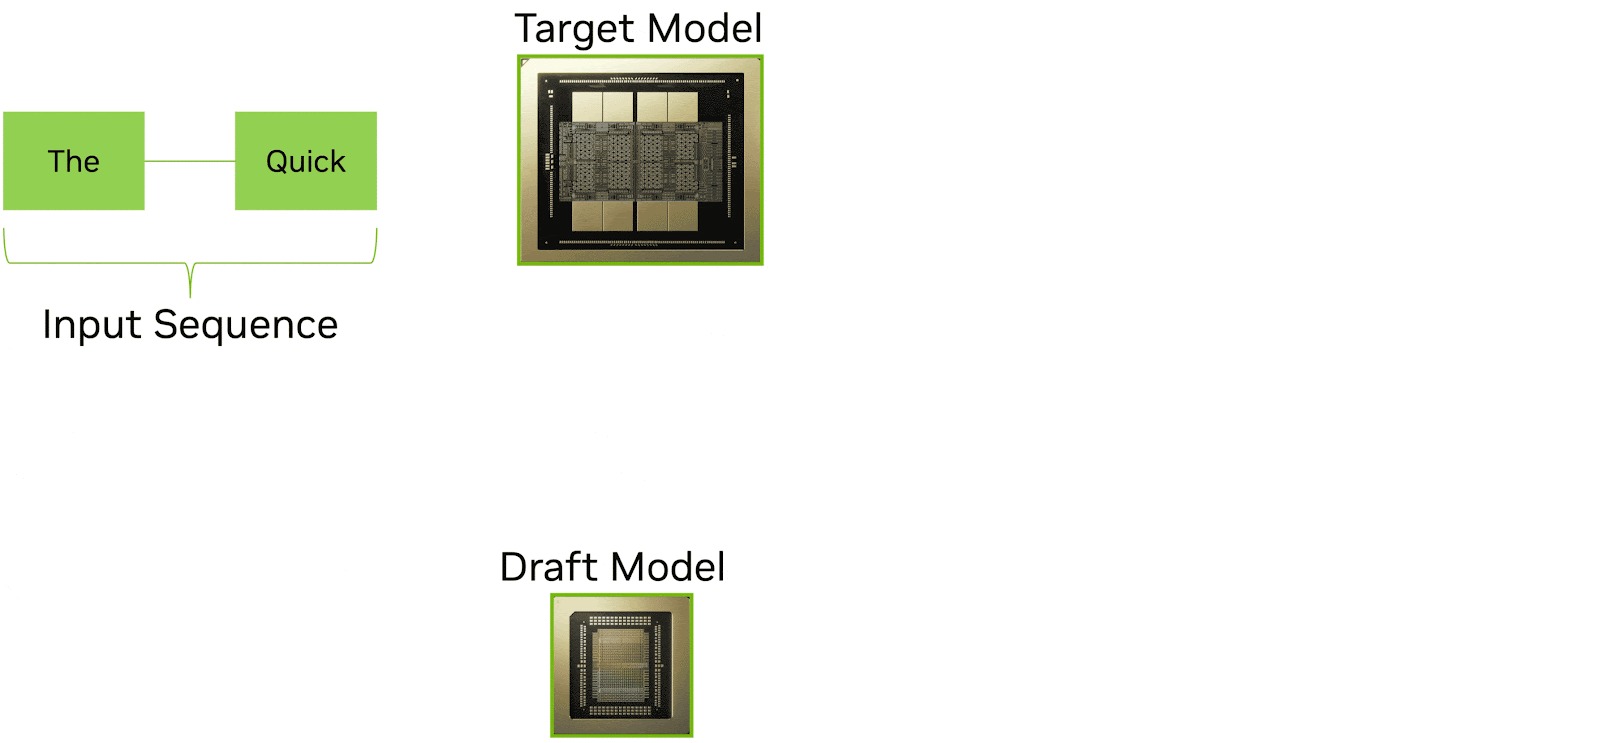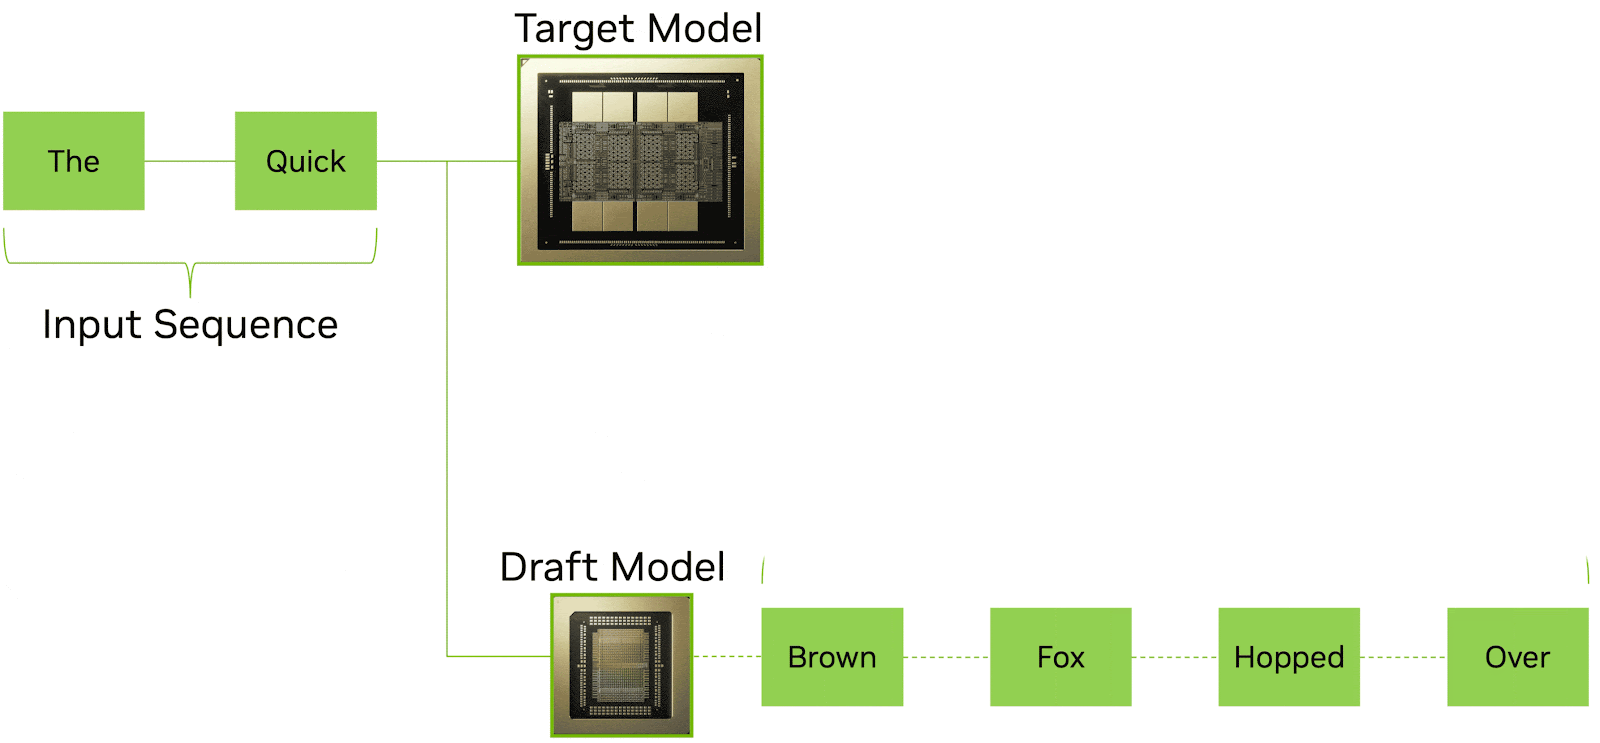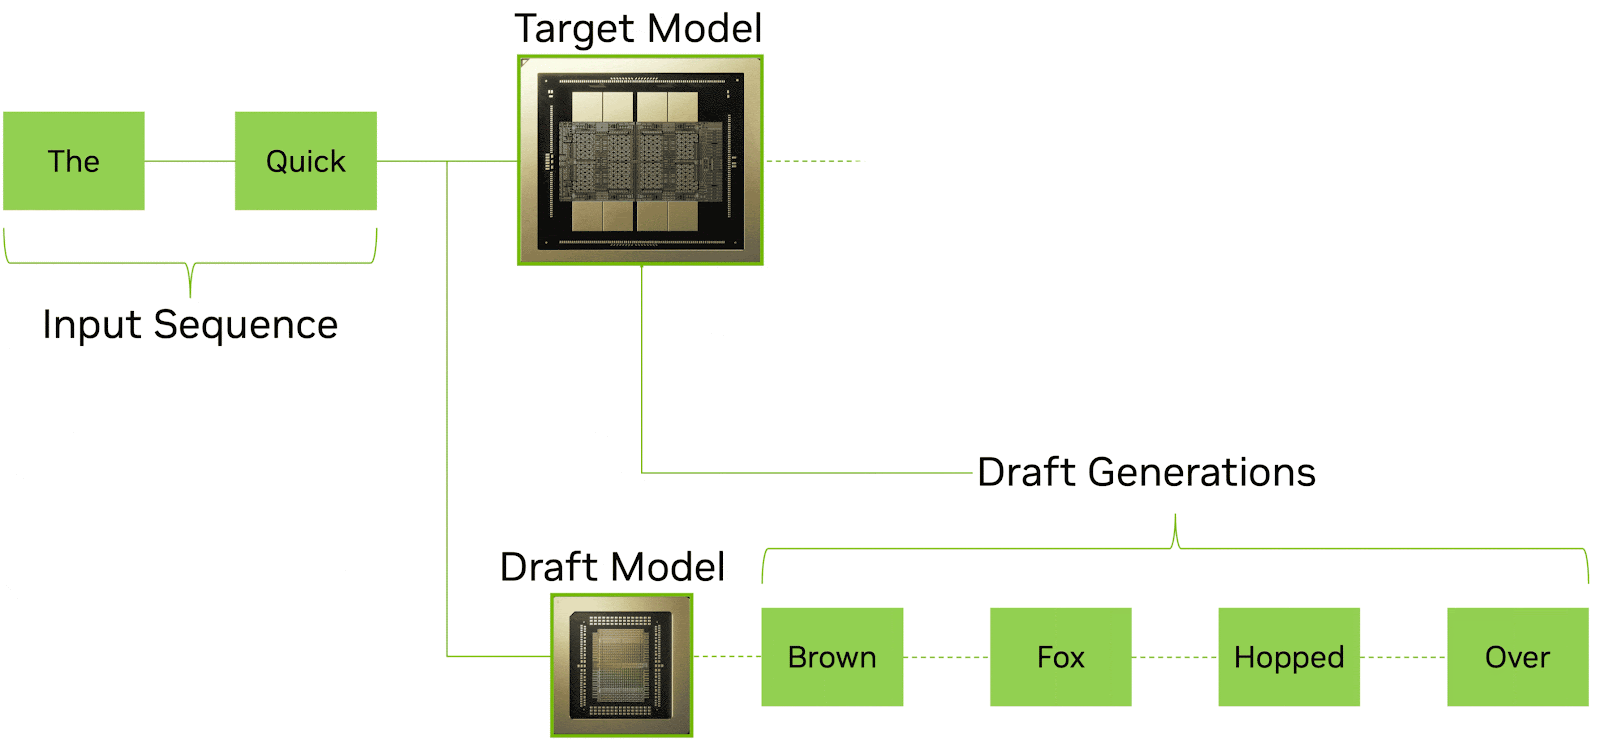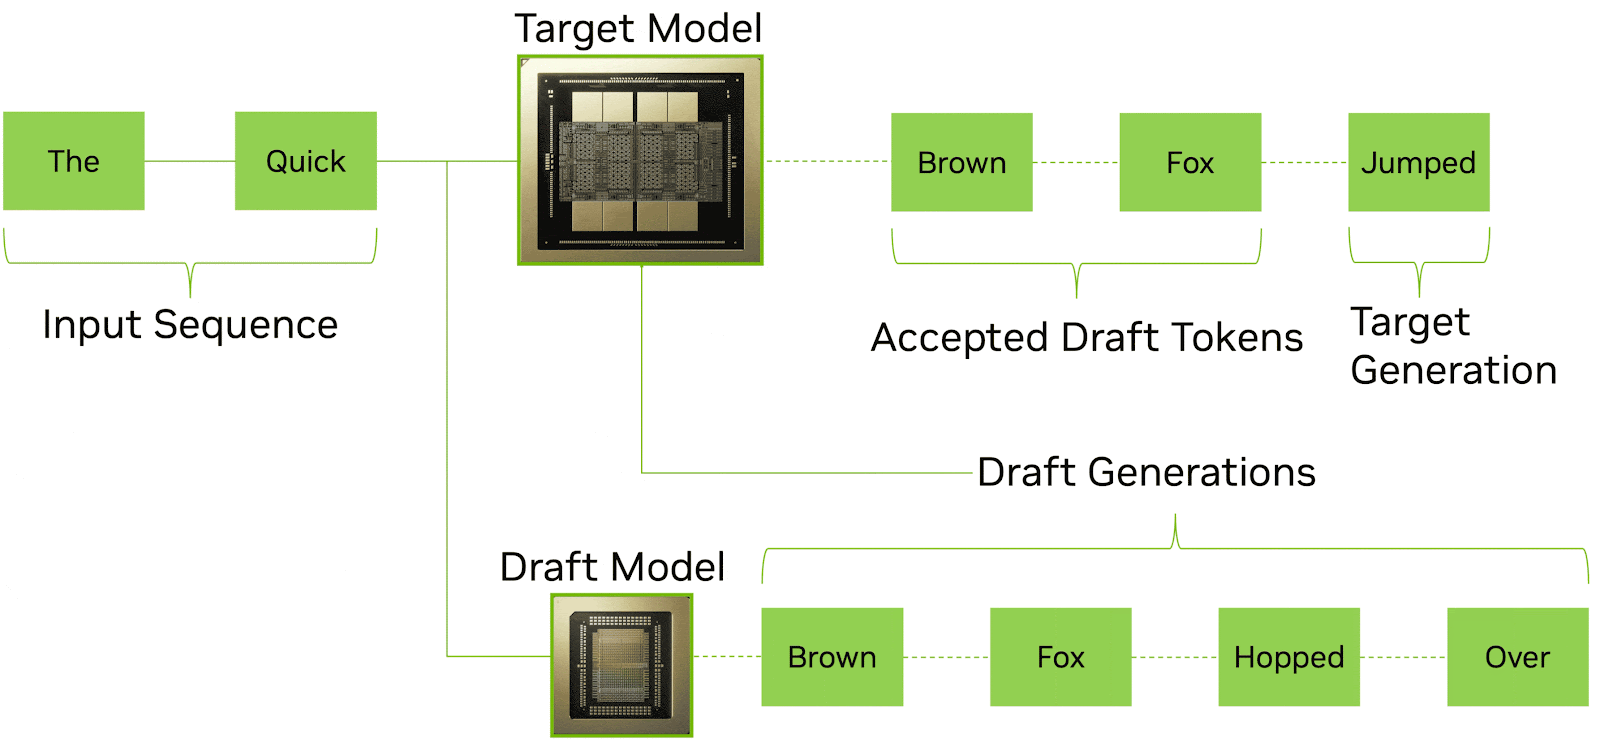
Fonte: Nvidia
O desafio reside no fato de que a decodificação especulativa exige que o modelo preliminar seja executado extremamente rápido. Cada milissegundo que o modelo preliminar gasta gerando candidatos é um milissegundo que o verificador está aguardando. Em uma configuração convencional com apenas GPUs, tanto o modelo preliminar quanto o modelo alvo competem pelos mesmos recursos de hardware, e a velocidade do modelo preliminar é limitada pelas mesmas restrições de largura de banda da HBM que afetam todo o resto.
O LPX é ideal para essa função. O modelo de execução determinístico e a largura de banda SRAM extremamente alta do LP30 permitem a geração de tokens de rascunho de forma muito rápida e previsível. Um modelo de rascunho menor cabe confortavelmente na SRAM de uma única bandeja LPX ou em um pequeno número de bandejas, e o agendamento determinístico garante que a geração de rascunhos seja executada em uma velocidade consistente e previsível, sem a variação que dificultaria o pipeline com o verificador.
Nessa configuração, o sistema emparelha os dois processadores para funções complementares: o LPX gera tokens de rascunho rapidamente usando sua arquitetura de baixa latência, enquanto as GPUs Rubin verificam e finalizam os tokens de forma eficiente, utilizando seu alto poder computacional e grande capacidade de memória HBM. Essa separação permite que a decodificação especulativa seja executada em processadores heterogêneos, em vez de exigir que ambos os modelos compartilhem uma única GPU, o que pode melhorar a velocidade de geração de rascunhos e o rendimento da verificação em comparação com uma configuração homogênea.
A NVIDIA destacou a decodificação especulativa, juntamente com a AFD (Application Functional Detection), como uma carga de trabalho fundamental para o LPX, sugerindo que considera isso uma parte significativa da proposta de valor do sistema. À medida que os modelos de vanguarda continuam a crescer e as cadeias de raciocínio se alongam, a capacidade de gerar e verificar tokens em paralelo em hardware especializado pode se tornar uma alavanca importante para manter a capacidade de resposta interativa.
Considerações finais: Codesign extremo de hardware e software
Um dos aspectos que mais se destaca na abordagem da NVIDIA com a plataforma Vera Rubin e o LPX é a precisão com que cada componente é direcionado. No mercado de consumo, encontramos com frequência produtos que tentam resolver problemas que ninguém realmente tem, de empresas que não compreendem profundamente as necessidades de seus clientes. A estratégia da NVIDIA aqui representa um contraste gritante. É extremamente óbvio que eles entendem os problemas do pipeline de inferência em um nível granular e estão otimizando cada segmento desse pipeline para ajudar seus clientes a maximizar o retorno sobre o investimento em hardware.
A separação entre atenção e FFN não é um conceito de marketing. É uma resposta direta ao perfil de gargalo observado no processamento de modelos MoE com trilhões de parâmetros. A decisão de descarregar especificamente o FFN (e não a atenção) e evoluir o rack CPX para o rack LPX reflete uma compreensão precisa de quais operações são limitadas por largura de banda versus capacidade, quais são escalonáveis estaticamente versus dinamicamente variáveis e qual arquitetura de processador é mais adequada para cada uma. A camada de orquestração Dynamo, a integração transparente com CUDA e o design do rack MGX sem cabos demonstram uma equipe de engenharia que considerou todo o ciclo de vida da implementação.
Ainda existem muitas incógnitas em relação ao LPX e aos novos produtos de ponta da NVIDIA. Uma das grandes questões que permanece é qual a finalidade da "Lógica de Expansão de Tecido e DRAM", que tipo de silício está sendo usado para isso e, como muitos já notaram o soquete x86, considerando o investimento na Intel no ano passado e o design de retenção do dissipador de calor, é provável que seja um processador Intel, mas qual componente ainda é uma grande incógnita.
A implementação do LPX terá como foco inicial os criadores de modelos e provedores de serviços, em vez da ampla disponibilidade. O desempenho em condições reais de tráfego de produção, com comprimentos de contexto variáveis, tipos de requisição mistos e concorrência intermitente, bem como a eficiência energética, ainda precisam ser validados de forma independente. Aguardamos ansiosamente o acesso a esses sistemas para testes independentes.
Fontes referenciadas:
Groq: O que é uma unidade de processamento de linguagem?
Groq: A tecnologia de inferência de IA Groq LPU proporciona maior eficiência energética…
Groq: Tecnologia de interconexão chip-a-chip RealScale
Groq: Baixa latência para IA em tempo real e HPC
Groq: Determinismo e o Processador de Fluxo de Tensores
Nvidia: Por dentro do Nvidia Groq 3 LPX…


 Amazon