

Grandes modelos de linguagem oferecem novos recursos incríveis, expandindo a fronteira do que é possível com IA. No entanto, seu grande tamanho e características de execução exclusivas podem torná-los difíceis de usar com boa relação custo-benefício. NVIDIA TensorRT-LLM foi de código aberto para acelerar o desenvolvimento de LLMs.
O que é NVIDIA TensorRT-LLM?
A NVIDIA tem trabalhado em estreita colaboração com empresas líderes, incluindo Meta, AnyScale, Cohere, Deci, Grammarly, Mistral AI, MosaicML, agora parte do Databricks, OctoML, Tabnine e Together AI para acelerar e otimizar a inferência LLM.
Essas inovações foram integradas ao software de código aberto NVIDIA TensorRT-LLM , com lançamento previsto para as próximas semanas. O TensorRT-LLM consiste no compilador de aprendizado profundo TensorRT e inclui kernels otimizados, etapas de pré e pós-processamento e primitivas de comunicação multi-GPU/multi-nó para desempenho inovador em GPUs NVIDIA. Ele permite que os desenvolvedores experimentem novos LLMs, oferecendo desempenho máximo e recursos de personalização rápida sem exigir conhecimento profundo de C++ ou NVIDIA CUDA.
O TensorRT-LLM melhora a facilidade de uso e a extensibilidade por meio de uma API Python modular de código aberto para definir, otimizar e executar novas arquiteturas e aprimoramentos à medida que os LLMs evoluem e podem ser facilmente personalizados.
Por exemplo, o MosaicML adicionou recursos específicos necessários ao TensorRT-LLM perfeitamente e os integrou à pilha de serviços existente. Naveen Rao, vice-presidente de engenharia da Databricks, observa que “tem sido muito fácil”.
Desempenho do NVIDIA TensorRT-LLM
Resumir artigos é apenas uma das muitas aplicações dos LLMs . Os benchmarks a seguir mostram as melhorias de desempenho proporcionadas pelo TensorRT-LLM na mais recente arquitetura NVIDIA Hopper.
As figuras a seguir refletem o resumo de artigos usando NVIDIA A100 e NVIDIA H100 com CNN/Daily Mail, um conjunto de dados bem conhecido para avaliar o desempenho de resumo.
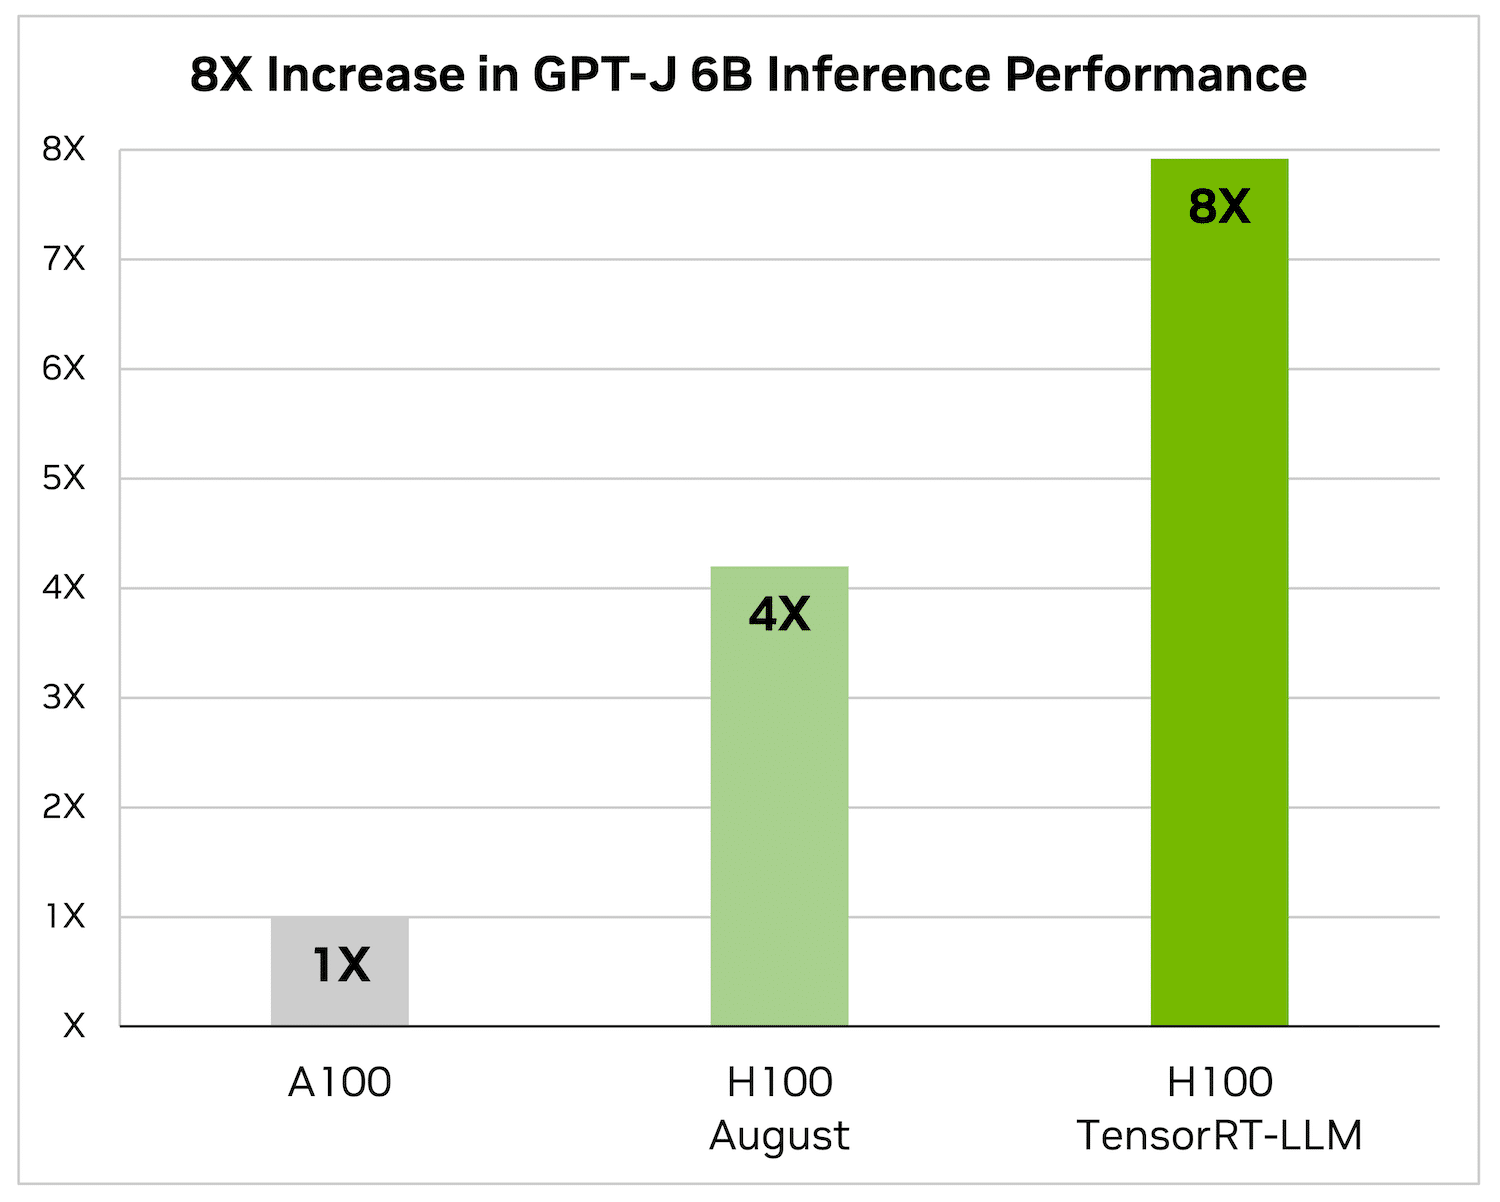
O H100 sozinho é 4x mais rápido que o A100. Adicionar o TensorRT-LLM e seus benefícios, incluindo lotes em andamento, resulta em um aumento de 8 vezes para fornecer o maior rendimento.
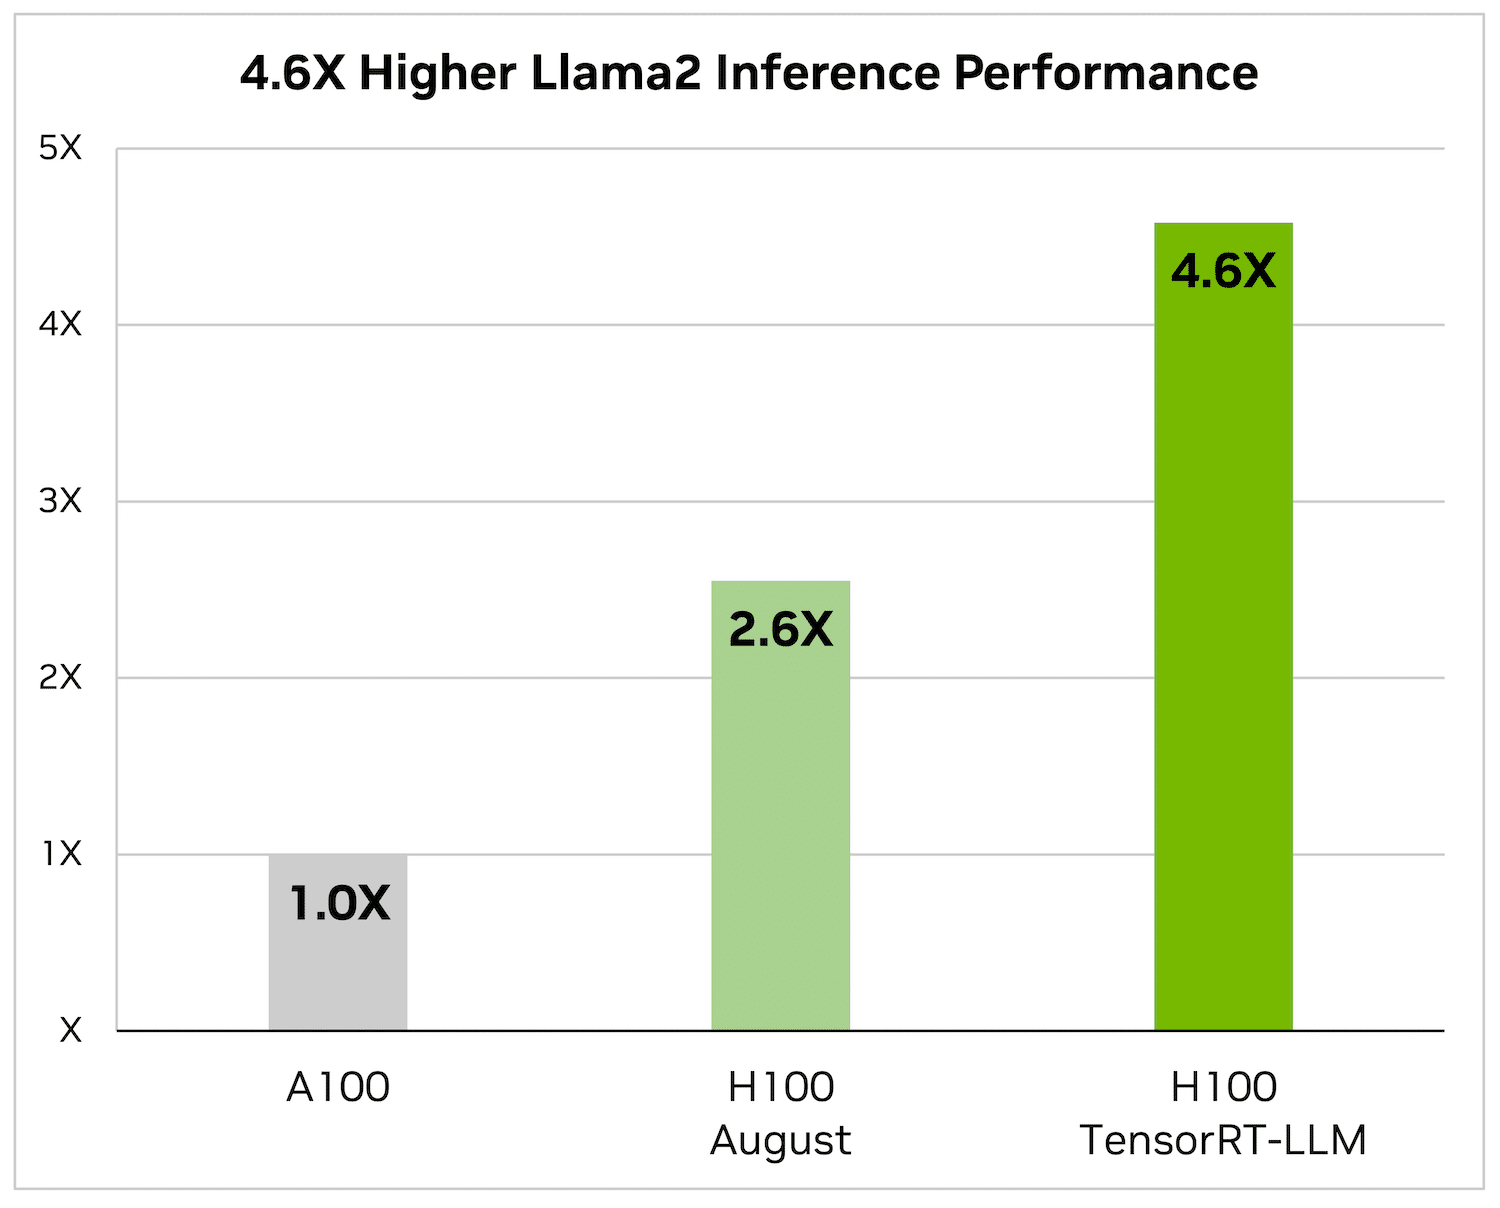
No Llama 2 – um modelo de linguagem popular lançado recentemente pela Meta e amplamente utilizado por organizações que buscam incorporar IA generativa – o TensorRT-LLM pode acelerar o desempenho de inferência em 4.6x em comparação com GPUs A100.
A inovação do ecossistema LLM evolui rapidamente
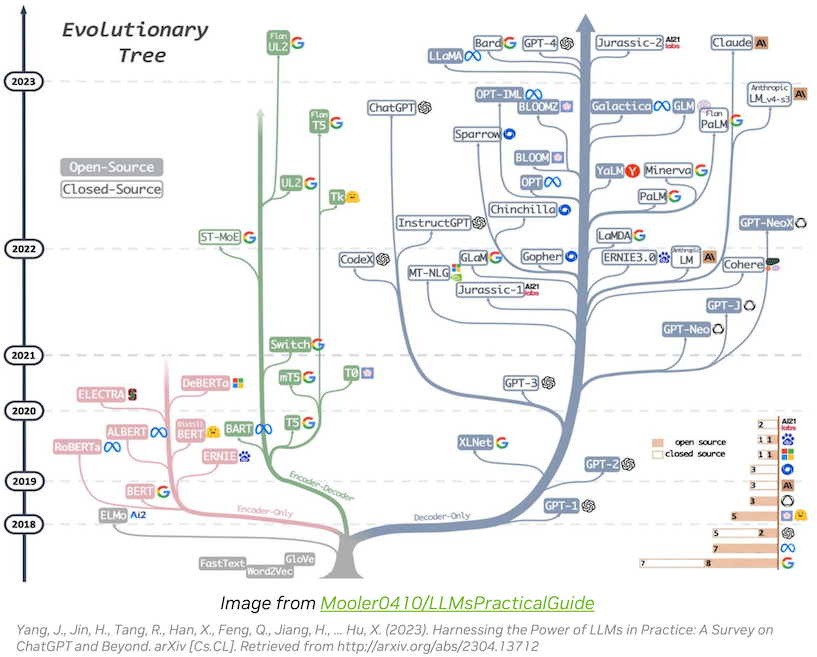
O ecossistema Large Language Model (LLM) está evoluindo rapidamente, dando origem a diversas arquiteturas de modelos com capacidades expandidas. Alguns dos maiores e mais avançados LLMs, como o Llama 70 de 2 bilhões de parâmetros da Meta, exigem múltiplas GPUs para fornecer respostas em tempo real. Anteriormente, otimizar a inferência LLM para desempenho máximo envolvia tarefas complexas, como dividir manualmente modelos de IA e coordenar a execução da GPU.
O TensorRT-LLM simplifica esse processo empregando paralelismo tensorial, uma forma de paralelismo de modelo que distribui matrizes de peso entre dispositivos. Essa abordagem permite inferência de expansão eficiente em várias GPUs interconectadas via NVLink e vários servidores sem intervenção do desenvolvedor ou modificações de modelo.
À medida que novos LLMs e arquiteturas de modelos surgem, os desenvolvedores podem otimizar seus modelos usando os mais recentes kernels de IA da NVIDIA disponíveis no TensorRT-LLM, que inclui implementações de ponta como FlashAttention e atenção mascarada de vários cabeçotes.
Além disso, o TensorRT-LLM inclui versões pré-otimizadas de LLMs amplamente utilizados, como Meta Llama 2, OpenAI GPT-2, GPT-3, Falcon, Mosaic MPT, BLOOM e outros. Eles podem ser facilmente implementados usando a API TensorRT-LLM Python de fácil utilização, capacitando os desenvolvedores a criar LLMs personalizados adaptados a vários setores.
Para lidar com a natureza dinâmica das cargas de trabalho LLM, o TensorRT-LLM introduz lotes em andamento, otimizando o agendamento de solicitações. Essa técnica melhora a utilização da GPU e quase dobra o rendimento em solicitações LLM do mundo real, reduzindo o custo total de propriedade (TCO).
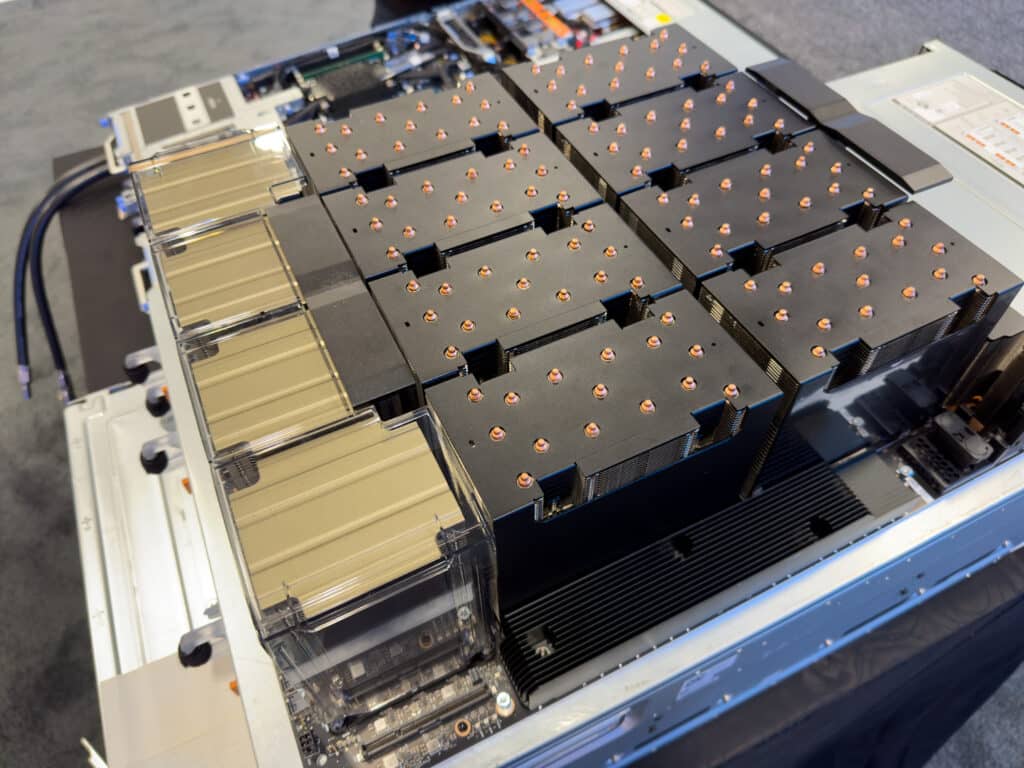
Bloco de GPU Dell XE9680
Além disso, o TensorRT-LLM usa técnicas de quantização para representar pesos e ativações de modelos com menor precisão (por exemplo, FP8). Isso reduz o consumo de memória, permitindo que modelos maiores sejam executados com eficiência no mesmo hardware e, ao mesmo tempo, minimizando a sobrecarga relacionada à memória durante a execução.
O ecossistema LLM está avançando rapidamente, oferecendo maiores capacidades e aplicações em todos os setores. O TensorRT-LLM simplifica a inferência do LLM, melhorando o desempenho e o TCO. Ele capacita os desenvolvedores a otimizar modelos de maneira fácil e eficiente. Para acessar o TensorRT-LLM, desenvolvedores e pesquisadores podem participar do programa de acesso antecipado por meio da estrutura NVIDIA NeMo ou GitHub, desde que estejam registrados no NVIDIA Developer Program com o endereço de e-mail de uma organização.
Pensamentos de Encerramento
Há muito tempo observamos no The Lab que há sobrecarga disponível que está sendo subutilizada pela pilha de software, e o TensorRT-LLM deixa claro que renovar o foco nas otimizações e não apenas na inovação pode ser extremamente valioso. À medida que continuamos a experimentar localmente várias estruturas e tecnologias de ponta, planejamos testar e validar de forma independente esses ganhos da biblioteca aprimorada e dos lançamentos do SDK.
A NVIDIA está claramente gastando tempo e recursos de desenvolvimento para extrair até a última gota de desempenho de seu hardware, solidificando ainda mais sua posição como líder do setor e continuando suas contribuições para a comunidade e democratização da IA, mantendo a natureza de código aberto das ferramentas. .


 Amazon