

A VAST Data expandiu sua colaboração com a AMD em infraestrutura de IA para provedores de nuvem e empresas que implementam serviços de treinamento, inferência, geração aumentada por recuperação e IA ativa. O projeto combina o Sistema Operacional de IA VAST com processadores AMD EPYC de 6ª geração , GPUs AMD Instinct, hardware de rede AMD e o software ROCm.
A colaboração reflete uma mudança mais ampla na infraestrutura, passando de clusters de IA focados em treinamento para ambientes que também devem suportar contexto persistente, inferência de alta concorrência e fluxos de trabalho de agentes com múltiplas etapas. Essas implementações enfatizam cada vez mais a movimentação de dados, o gerenciamento de cache chave-valor, a utilização de GPUs e a capacidade de fornecer acesso de baixa latência a grandes conjuntos de dados de modelos e contexto.
A VAST posiciona sua arquitetura Disaggregated Shared Everything (DASE ) como a camada de dados compartilhada para esses ambientes. A plataforma combina armazenamento de arquivos e objetos, bancos de dados, streaming de eventos e serviços de dados em um namespace global unificado. Ela também oferece recursos de multilocação e isolamento de cargas de trabalho para nuvens de IA que operam cargas de trabalho simultâneas de clientes e aplicativos.
Plataformas EPYC 9006 para sistemas VAST CBox e EBox
A VAST selecionou os processadores AMD EPYC de 6ª geração, anteriormente conhecidos pelo codinome Venice, para suas plataformas CBox e EBox de próxima geração. A empresa planeja usar os processadores em seus sistemas CBox de sexta geração e EBox de terceira geração, que são a base do Sistema Operacional de IA da VAST.
O suporte ao AMD EPYC 9006 introduz a conectividade PCIe Gen6 à plataforma de hardware VAST. A VAST afirma que a nova interface dobra a largura de banda de E/S da geração anterior, melhorando a taxa de transferência de armazenamento de arquivos e objetos, além de reduzir a latência para serviços de dados como bancos de dados, data warehouses e cargas de trabalho de streaming de eventos, fornecidos pelo VAST DataBase e DataEngine.
Para infraestrutura de IA, uma maior largura de banda de E/S pode ajudar a reduzir gargalos entre recursos de computação, rede e armazenamento NVMe. Isso é particularmente relevante para carregamento de modelos, pipelines de recuperação, acesso a checkpoints e fluxos de trabalho de cache KV externalizados, onde a capacidade de memória da GPU por si só é insuficiente para manter o contexto ativo.
A arquitetura de referência combina Helios, VAST e DriveNets.
A VAST, a AMD e a DriveNets também estão desenvolvendo uma arquitetura de referência de infraestrutura de IA construída em torno da infraestrutura de IA em escala de rack AMD Helios, do sistema operacional de IA da VAST e da rede DriveNets AI Fabric.

A arquitetura de referência tem como objetivo fornecer orientações de implementação para treinamento de modelos, inferência, aprendizado por reforço e cargas de trabalho de cache KV. Ela inclui considerações sobre dimensionamento e disponibilidade para organizações que constroem fábricas de IA que exigem infraestrutura de dados compartilhada e redes de alto desempenho, além de computação em GPU.
A VAST também mencionou a expansão da colaboração com os fornecedores de software de inferência TensorMesh e EmbeddedLLM. O esforço do ecossistema está focado em arquiteturas de inferência de produção para aplicações de IA com agentes, embora detalhes específicos sobre integrações de produtos e disponibilidade não tenham sido divulgados.
O descarregamento de cache KV visa a inferência de alta concorrência.
Um componente central do anúncio é o suporte expandido ao cache KV usando GPUs AMD Instinct , AMD Infinity Context, software ROCm e o sistema operacional VAST AI.
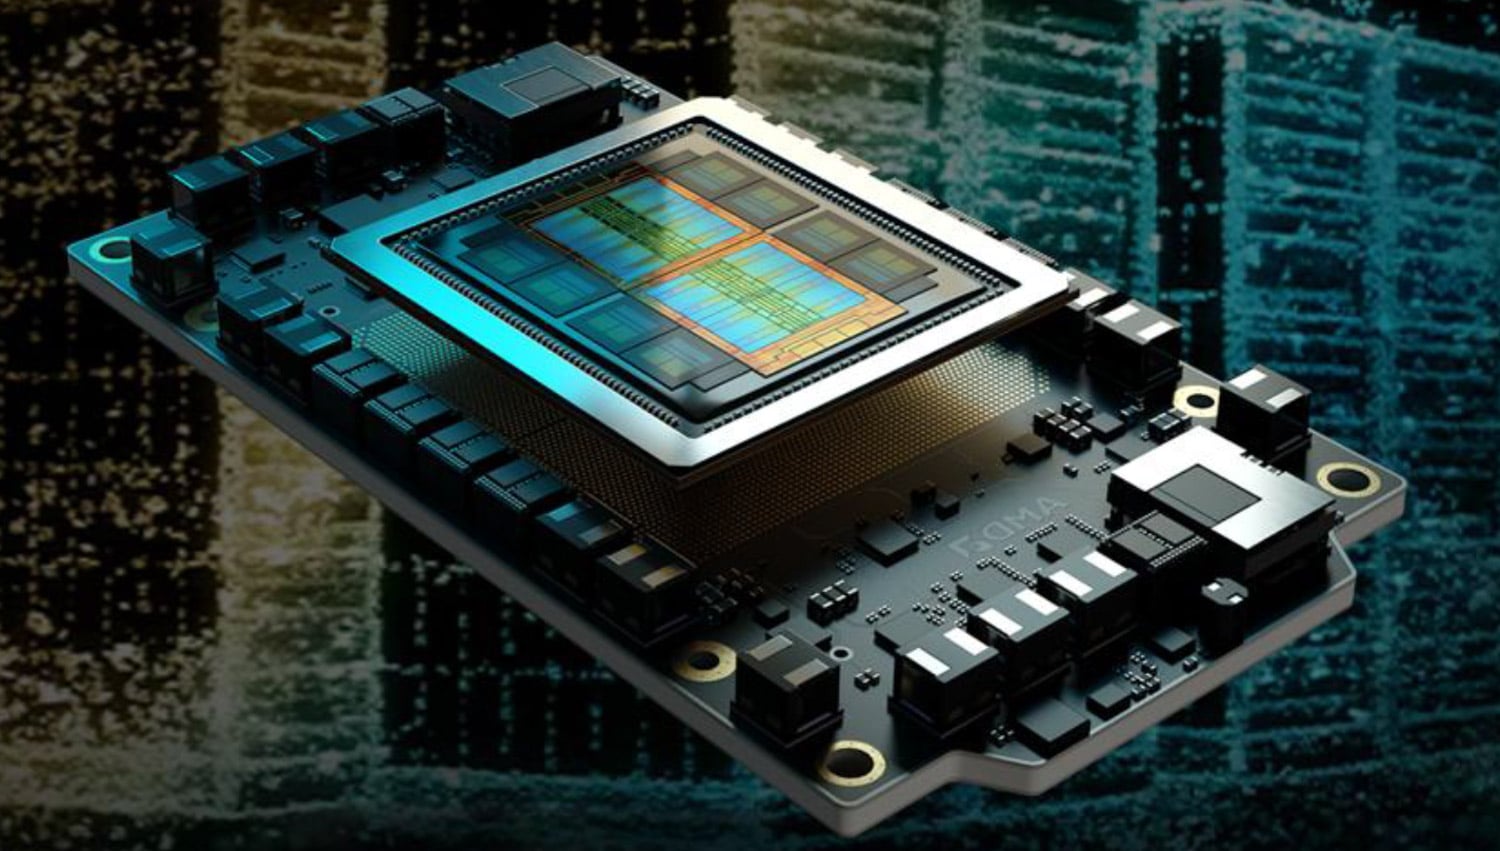
Os dados do cache KV armazenam informações intermediárias sobre o estado de atenção geradas durante a inferência. Reter esses dados melhora o desempenho para interações de múltiplas etapas e cargas de trabalho com contexto extenso, mas o grande tamanho do cache pode consumir uma quantidade significativa de memória da GPU. Externalizar ou hierarquizar o cache KV para uma plataforma de armazenamento de alto desempenho pode liberar memória da GPU para cargas de trabalho ativas, mantendo o contexto para solicitações de inferência subsequentes.
A VAST relatou testes preliminares com uma GPU AMD Instinct MI355X que mostraram uma melhoria de 9 vezes no tempo para o primeiro token e um aumento de 9.7 vezes na taxa de transferência de tokens ao usar o VAST para descarregar o cache KV em cargas de trabalho de IA com agentes de alta concorrência. A empresa observou que esses resultados dependem da configuração básica do hardware, das características da carga de trabalho e da configuração de armazenamento.
A integração também aplica políticas de ciclo de vida VAST aos dados de cache KV. Essa funcionalidade visa expirar e excluir automaticamente as informações em cache, o que é relevante quando o contexto de inferência contém dados sensíveis, pessoais ou regulamentados.
Pensando Pollara 400 conecta GPUs a armazenamento compartilhado
A arquitetura utiliza a placa de rede AMD Pensando Pollara 400 AI para conectar as GPUs AMD Instinct ao cluster de armazenamento VAST. De acordo com a VAST, a placa de rede suporta a movimentação de dados da GPU para o armazenamento por meio de NFS sobre TCP e RDMA, permitindo o acesso a clusters VAST baseados em SSDs NVMe para cache KV e requisitos mais amplos de dados de inferência.
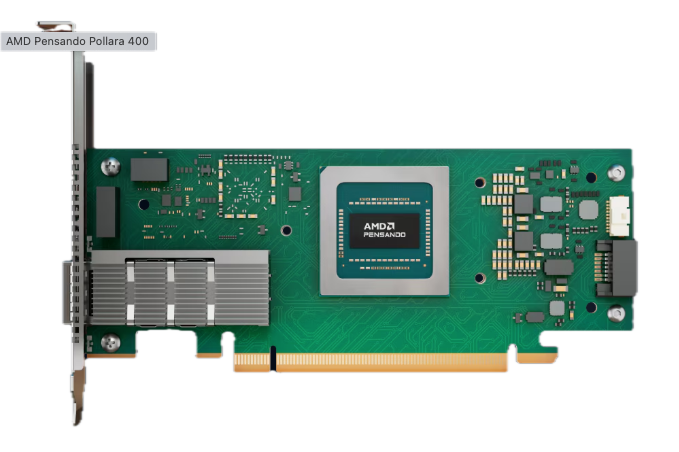
O projeto resultante visa suportar ambientes de IA que precisam escalar o gerenciamento de contexto independentemente da memória da GPU. Em vez de tratar o armazenamento como uma camada de persistência separada, a VAST posiciona a plataforma como uma camada de dados e execução capaz de gerenciar modelos, bancos de dados, dados de streaming, dados de arquivos e contexto de IA em infraestrutura distribuída.
Para provedores de nuvem de IA, a abordagem visa maior utilização de GPUs e melhoria da eficiência operacional, à medida que as implantações evoluem do aluguel de GPUs e do treinamento em lote para serviços de inferência persistente e IA orientada a agentes.


 Amazon