

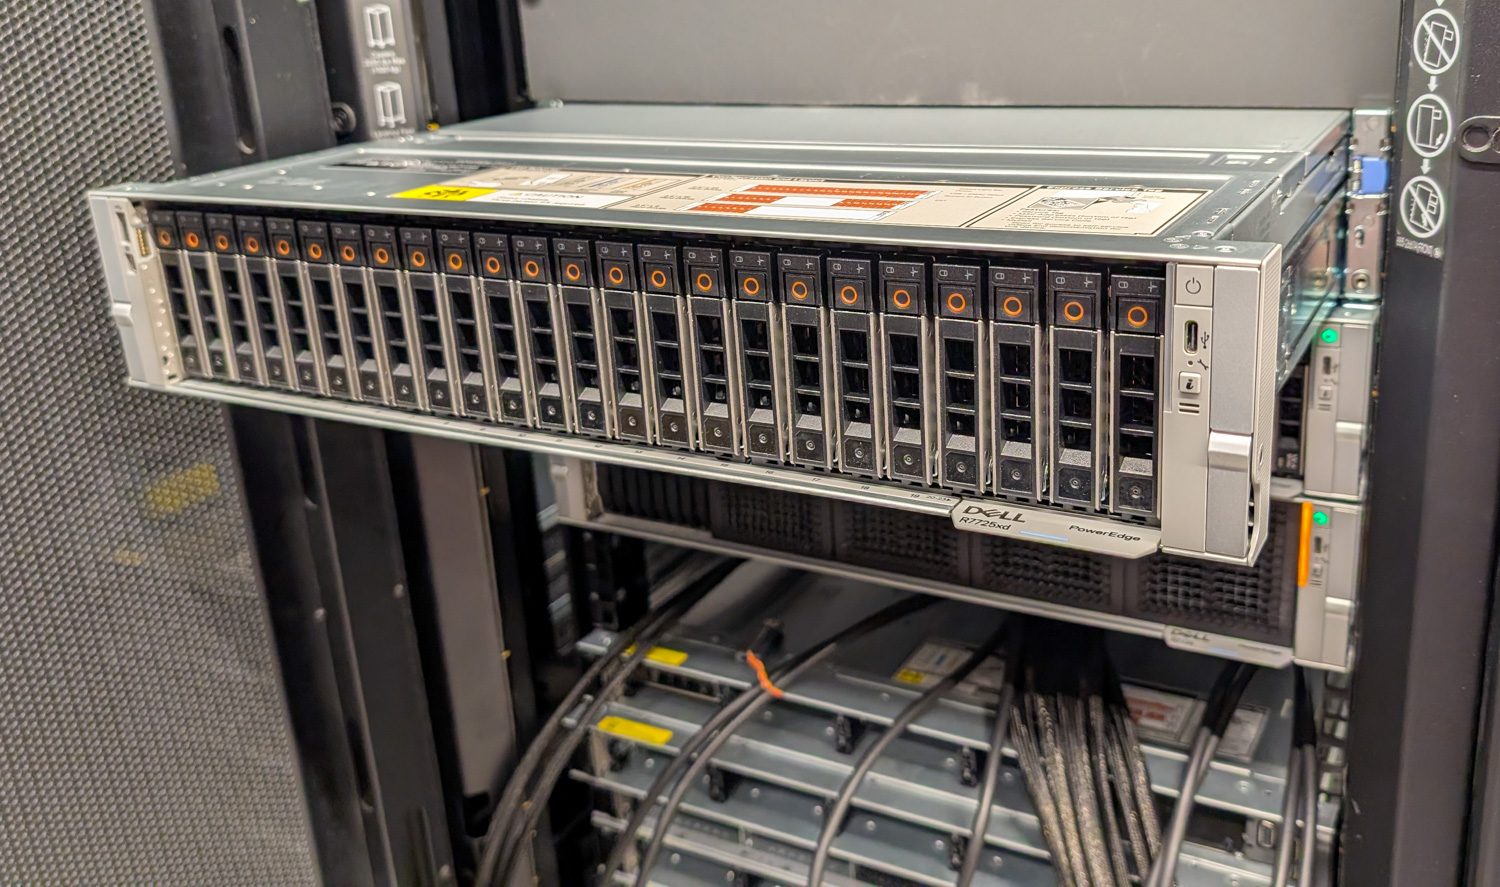
Alguns servidores ampliam o que já existe, enquanto outros redefinem as expectativas. O Dell PowerEdge R7725xd pertence à segunda categoria. Em nossos testes recentes, configurado com 24 SSDs Micron 9550 PRO PCIe Gen5 NVMe e quatro placas de rede 2x 200GbE, este servidor 2U alcançou uma taxa de transferência bruta de armazenamento superior a qualquer outro sistema que havíamos medido anteriormente. Internamente, a plataforma manteve mais de 300 GB/s no pool NVMe. Na rede, atingiu 160 GB/s usando RDMA padrão, sem qualquer complexidade adicional.
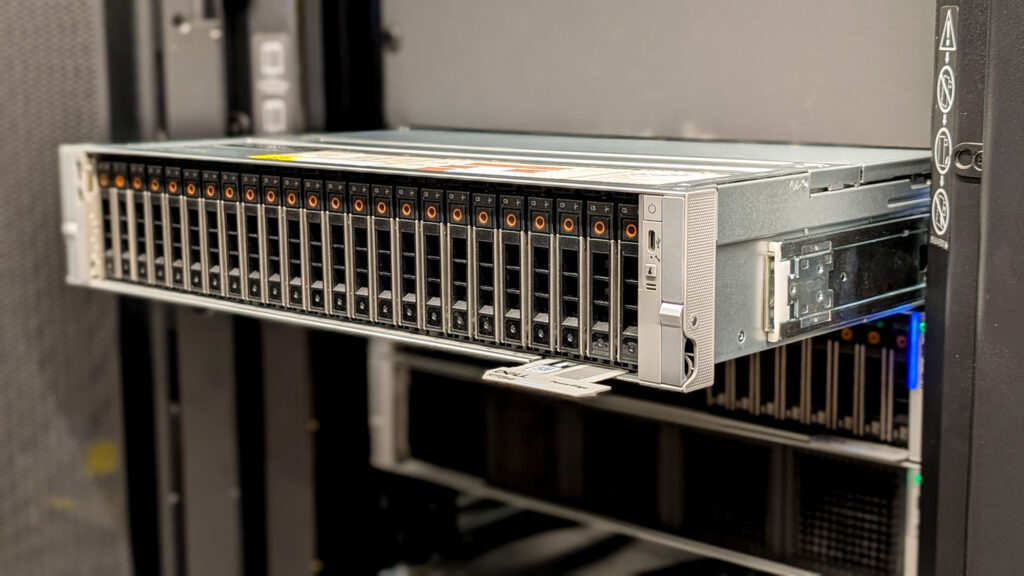
Este não é apenas um servidor de armazenamento mais rápido. É um sistema que muda a forma como a computação intensiva em dados é arquitetada. Os pipelines modernos de treinamento e inferência de IA são frequentemente limitados não pela potência da GPU, mas pela velocidade com que os dados podem ser preparados, transmitidos, reorganizados e salvos. Grandes nós de GPU ficarão ociosos se o armazenamento não conseguir acompanhar. As equipes resolvem essas limitações usando caches, superdimensionamento e camadas complexas para garantir que os aceleradores recebam dados com rapidez suficiente para justificar seus custos.
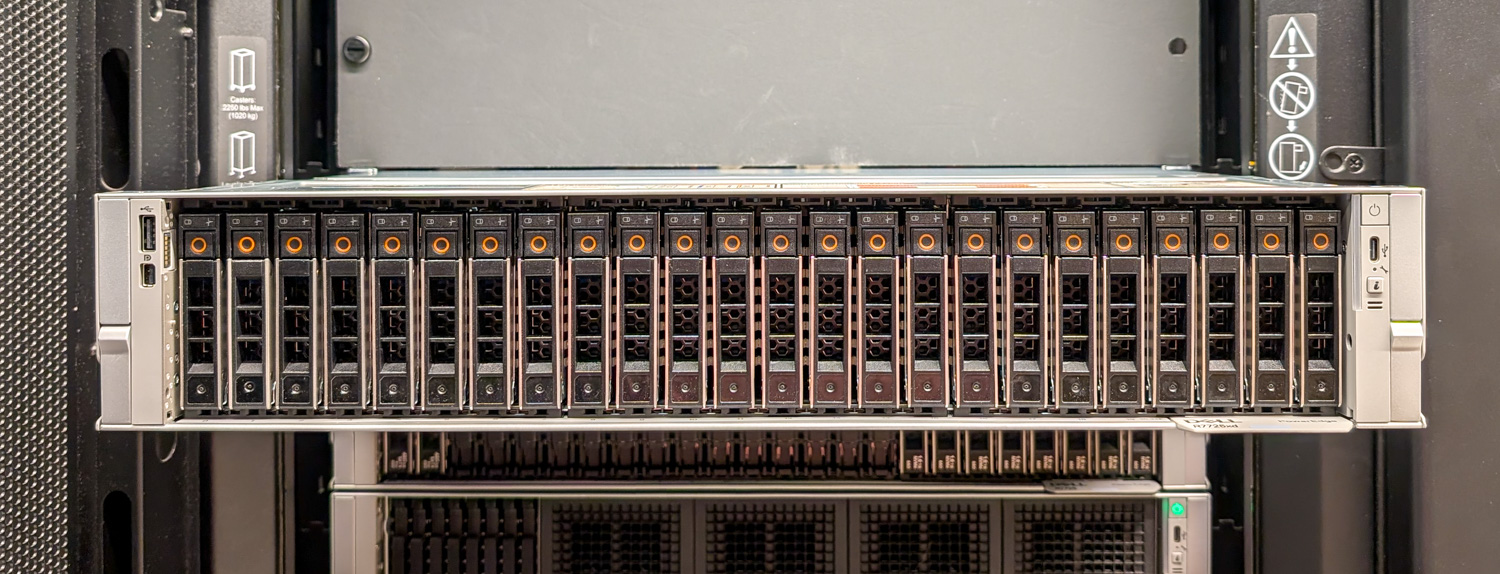
O Dell PowerEdge R7725xd resolve o gargalo na origem. O servidor é construído em torno de um backplane U.2 de 24 baias, com cada unidade recebendo um link PCIe Gen5 x4 dedicado diretamente para o complexo de CPUs AMD EPYC. Não há distribuição de largura de banda e nenhum expansor de plano intermediário é usado para reduzir a concorrência. O desempenho escala de forma limpa porque o hardware é projetado para agregar a taxa de transferência sem contenção. Em uma configuração tradicional de 2 soquetes, as CPUs são conectadas por 4 links XGMI para comunicação entre os soquetes. No R7725xd, um desses links é reaproveitado para 16 pistas adicionais de PCIe Gen5 por CPU, totalizando 160 pistas de PCIe Gen5 (96 para os SSDs frontais e 64 para os quatro slots PCIe traseiros). Quando combinado com os SSDs 9550 PRO da Micron, projetados para cargas de trabalho de gravação contínua e alta resistência, o sistema se torna um mecanismo de dados de alto desempenho capaz de suportar cargas de trabalho com uso intensivo de checkpoints e streaming contínuo.
Adicionamos a camada PEAK:AIO a essa arquitetura para aproveitar os caminhos de submissão paralelos e manter a eficiência à medida que a concorrência aumentava. O resultado foi não apenas um desempenho máximo, mas também um desempenho sustentado sob carga. A plataforma pode operar como um nó de execução local para pré-processamento, treinamento ou transformação, ou pode fornecer armazenamento de alta largura de banda em vários sistemas de GPU pela rede. Se você estiver se sentindo aventureiro, pode fazer os dois simultaneamente.
Principais lições
- Taxa de transferência sem precedentes em um único nó: O R7725xd suportou mais de 300 GB/s de largura de banda interna e 160 GB/s via NVMe-oF RDMA, rivalizando com clusters de armazenamento de múltiplos nós dentro de um chassi 2U.
- Arquitetura Gen5 verdadeira, sem switches, sem fan-out: Todos os 24 SSDs Micron 9550 PRO recebem 4 pistas PCIe Gen5 dedicadas diretamente do complexo da CPU, permitindo escalonamento em velocidade de linha sem disputa.
- Equipado com processador AMD EPYC Série 9005: Os processadores duplos AMD EPYC 9575F fornecem a quantidade de pistas, a largura de banda da memória e a topologia NUMA necessárias para E/S de alta concorrência sustentada.
- Projetado para cargas de trabalho com IA, análise de dados e grande volume de verificações: O sistema elimina os gargalos de E/S que paralisam os pipelines de GPU modernos, permitindo a entrega contínua de dados em alta largura de banda.
- PEAK:AIO Desbloqueia o Paralelismo Completo: A arquitetura de software da PEAK:AIO mantém as estruturas de filas saturadas sob carga, oferecendo desempenho empresarial com uma relação custo-benefício atraente por GB.
Projetado especificamente para o desempenho do NVMe.
Na mais recente geração de servidores, a Dell abandonou o uso de switches PCIe em configurações de servidores com alta densidade de armazenamento. Modelos como o PowerEdge R770 ou R7725 oferecem baias PCIe Gen5 x4, suportando configurações com até 16 SSDs, e alternam para baias x2 em configurações de backplane de armazenamento maiores. Servidores da geração anterior, como o PowerEdge R760, incluíam um switch PCIe em configurações NVMe com 24 baias. Para simplificar as configurações e eliminar a complexidade introduzida por um switch PCIe, os novos servidores adotaram uma estratégia de redução do número de pistas PCIe em configurações com alta densidade de armazenamento. Isso até o lançamento do R7725xd.
A diferença entre o R7725 padrão e o R7725xd reside na forma como as plataformas alocam recursos do complexo raiz PCIe. O R7725 base distribui as linhas PCIe entre armazenamento, expansão da GPU e E/S de uso geral. A variante 'xd' realoca esse orçamento para que o subsistema NVMe se torne o principal consumidor de largura de banda PCIe. Os 24 compartimentos U.2 são conectados diretamente às raízes PCIe Gen5 da CPU, com cada SSD recebendo seu próprio endpoint x4, e não um uplink compartilhado exposto por meio de um switch PCIe ou árvore de re-timers. Isso proporciona a cada unidade estruturas de fila independentes e caminhos DMA independentes de volta ao controlador de memória.
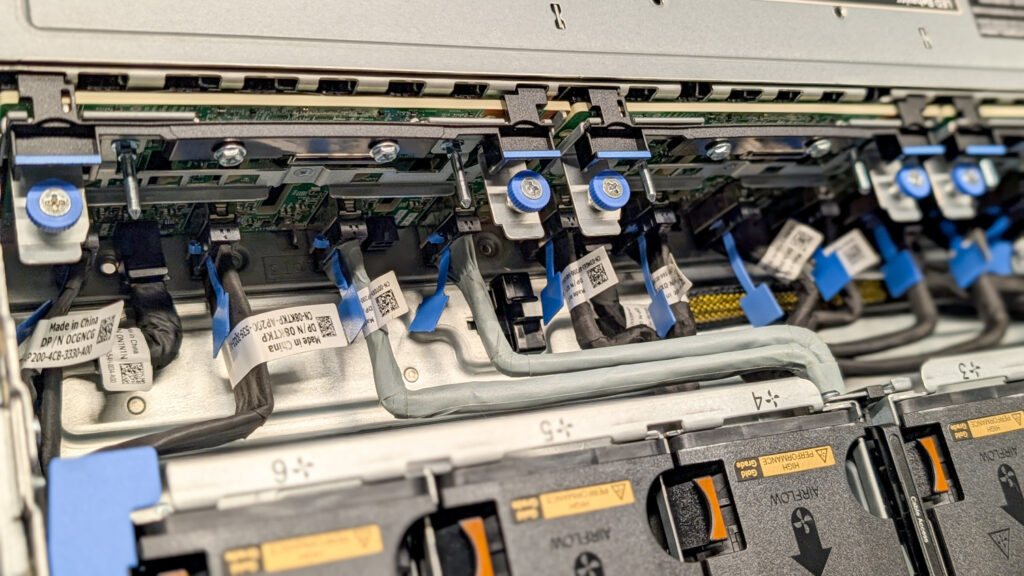
A topologia do backplane e do riser reflete esse compromisso. A Dell agrupa os conectores NVMe e os slots PCIe em ambos os sockets AMD EPYC, de modo que cada processador tenha controle direto de uma parte do conjunto de unidades. Na prática, isso cria dois domínios NVMe simétricos, cada um com características de latência local e total simultaneidade de leitura/gravação. Quando instalamos quatro placas de rede Broadcom de 200 GbE de porta dupla como placas adicionais, o posicionamento dos slots permitiu que cada placa de rede fosse integrada a um domínio PCIe alinhado ao grupo NVMe correspondente. Com NVMe sobre RDMA, isso significa que o tráfego de rede permaneceu local ao socket que processava a E/S da unidade associada, evitando o salto entre sockets da Infinity Fabric, que normalmente adiciona latência e consome largura de banda sob carga.
O comportamento térmico também suporta uma taxa de transferência sustentada. O padrão U.2 continua sendo vantajoso em configurações Gen5 densas, pois oferece um canal de fluxo de ar definido e uma área de dissipação de calor previsível para cada dispositivo. Os módulos de ventoinha de alta pressão estática e a canalização do chassi do R7725xd mantêm um fluxo de ar consistente em todas as 24 baias, permitindo que cargas de trabalho de gravação em unidades completas sejam executadas continuamente sem throttling. O design mecânico complementa o elétrico: cada unidade pode manter o desempenho em taxa máxima porque a plataforma foi projetada para resfriar 24 dispositivos Gen5 simultâneos sob carga.
Essa combinação de alinhamento do complexo raiz, layout de lanes NUMA (acesso não uniforme à memória) consistente, posicionamento de NICs com reconhecimento de socket e encapsulamento U.2 termicamente estável permite que o sistema alcance taxas de E/S de linha em grande escala. A arquitetura evita gargalos e otimiza o desempenho.
Visão geral do Dell PowerEdge R7725xd iDRAC 10
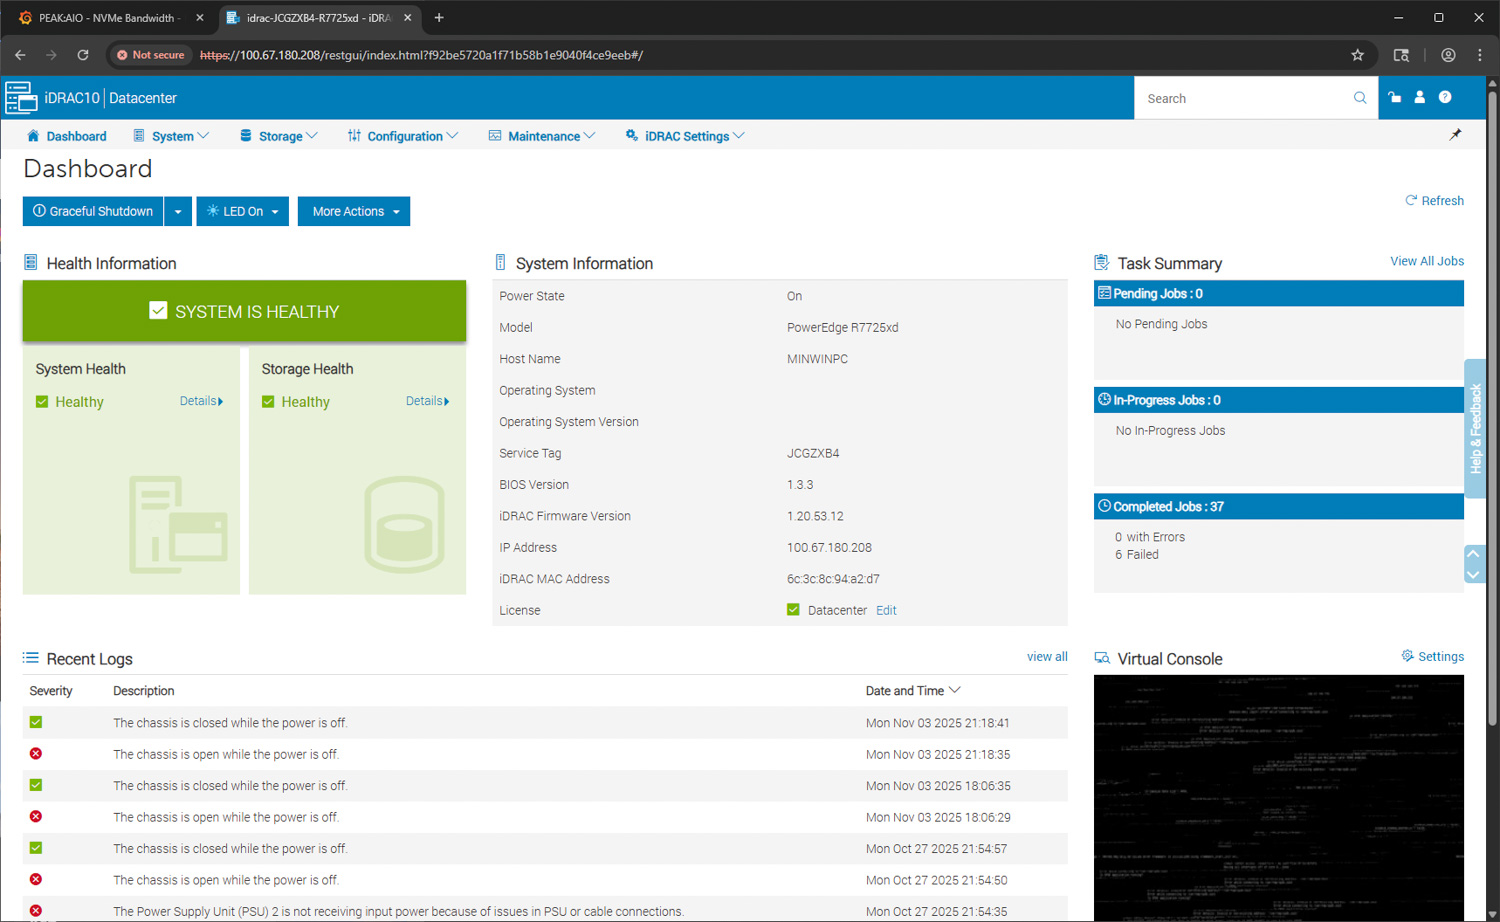
Assim como muitas outras plataformas de 17ª geração que avaliamos, esta geração do R7725xd apresenta a nova plataforma iDRAC 10 da Dell, que serve como ponto central para gerenciamento remoto, monitoramento de integridade e controle fora de banda. O painel de controle fornece um resumo imediato da integridade geral do sistema, do status do armazenamento e da atividade recente. Em nossa unidade de teste, o relatório de integridade do sistema e do armazenamento está verde, confirmando que o servidor está operando normalmente. Detalhes importantes do sistema, como modelo, nome do host, versão da BIOS, nível de firmware do iDRAC, endereço IP e informações de licenciamento, são exibidos no lado direito da interface.
O painel de controle também inclui um resumo de tarefas que exibe as operações concluídas, pendentes e em andamento. Abaixo, uma lista de registros recentes captura eventos de intrusão no chassi e mensagens da fonte de alimentação, fornecendo informações rápidas sobre as alterações no estado do hardware sem a necessidade de navegar por menus mais complexos. O painel do console virtual está disponível no canto inferior direito para controle remoto completo do KVM.
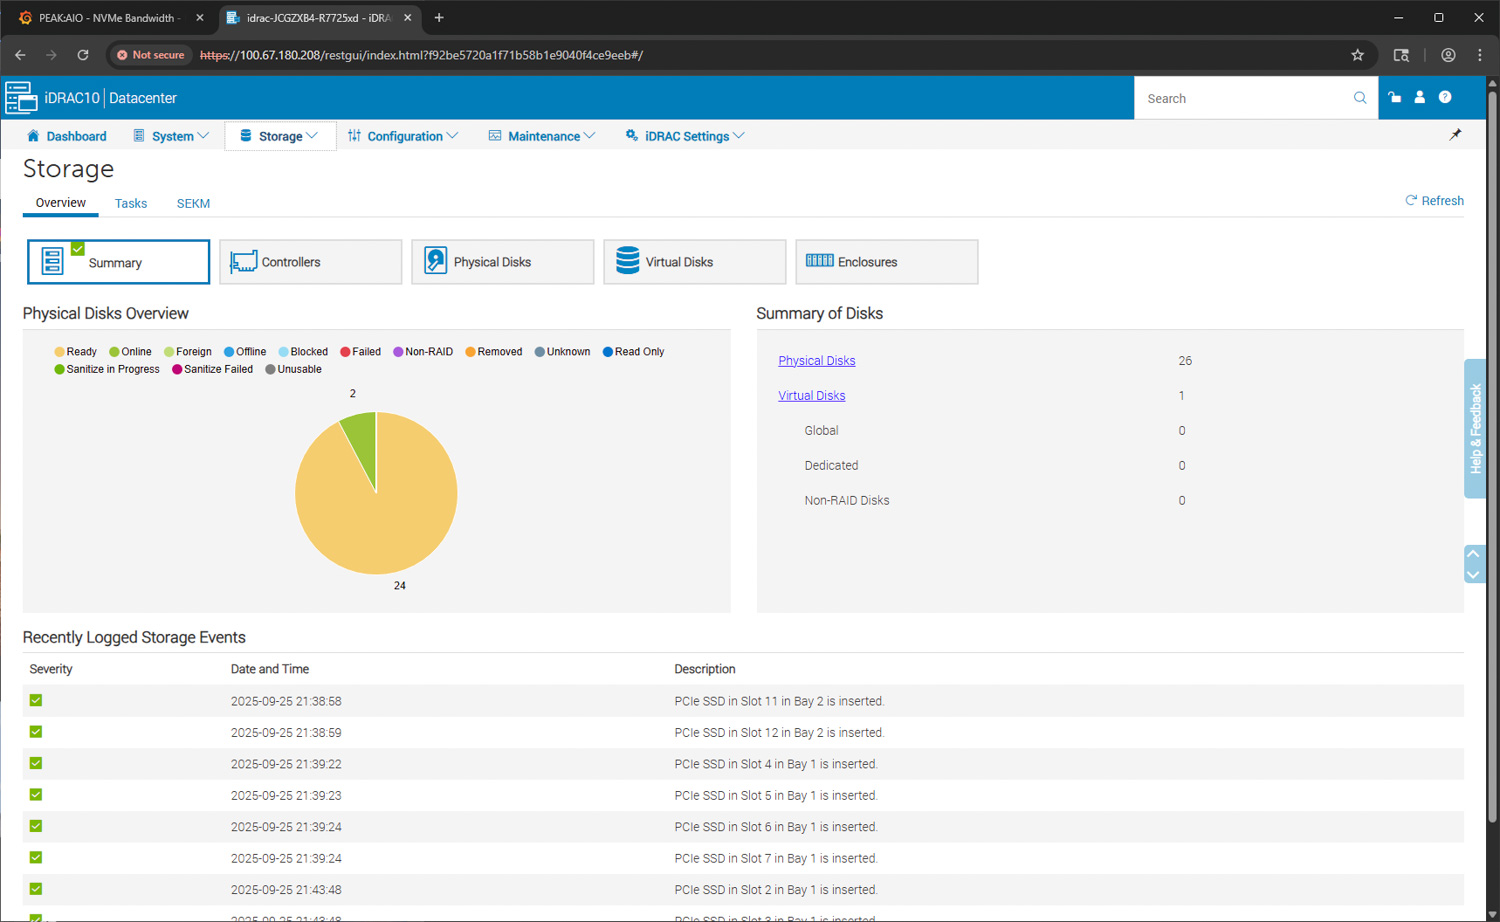
A seção de armazenamento do iDRAC 10 apresenta uma visão geral completa de todos os discos físicos instalados no R7725xd. O painel de resumo exibe uma contagem geral de todas as unidades conectadas, acompanhada por um gráfico de pizza que ilustra o estado de cada unidade. Nesta configuração, 24 SSDs NVMe estão ativos e reportando-se como prontos, com dois dispositivos de inicialização adicionais presentes no sistema, separados do banco NVMe frontal primário.
À direita, o painel Resumo de Discos divide os discos em discos físicos e quaisquer discos virtuais associados. Como o R7725xd usa uma arquitetura NVMe direta sem controladores RAID tradicionais, todas as unidades são relatadas como Não-RAID e endereçáveis individualmente, em conformidade com o projeto do sistema para grandes pools NVMe e plataformas SDS.
Abaixo do resumo de status, a área "Eventos de armazenamento registrados recentemente" lista os registros de inserção para cada SSD PCIe, organizados por baia e slot. Esse registro confirma a detecção correta em todas as baias de unidade e ajuda a identificar quaisquer problemas com encaixe, cabeamento ou atividade de troca a quente. Para grandes implantações, esses registros são úteis para rastrear o provisionamento de unidades ou verificar se a capacidade foi preenchida conforme o esperado.
A última captura de tela mostra a visualização detalhada do dispositivo NVMe no iDRAC10. Cada unidade NVMe instalada no sistema é listada com seu status, capacidade e localização no compartimento. Selecionar uma unidade individual abre uma descrição completa de suas características.
Neste exemplo, o painel de informações da unidade exibe a string completa do modelo, o protocolo do dispositivo, o formato e as configurações PCIe negociadas. Os dispositivos NVMe estão operando com velocidade de link de 32 GT/s e conexão x4 negociada, confirmando que as unidades estão utilizando toda a largura de banda disponível no backplane PCIe Gen5 do sistema. A seção de informações também exibe a porcentagem de resistência, o status de unidades sobressalentes disponíveis e o tipo de protocolo, auxiliando os administradores no monitoramento da integridade da unidade e nas expectativas de ciclo de vida.
Este relatório detalhado das unidades é valioso em configurações NVMe de alta densidade, onde a largura do link, a velocidade negociada e a integridade da mídia influenciam diretamente o comportamento da carga de trabalho e o desempenho do armazenamento.
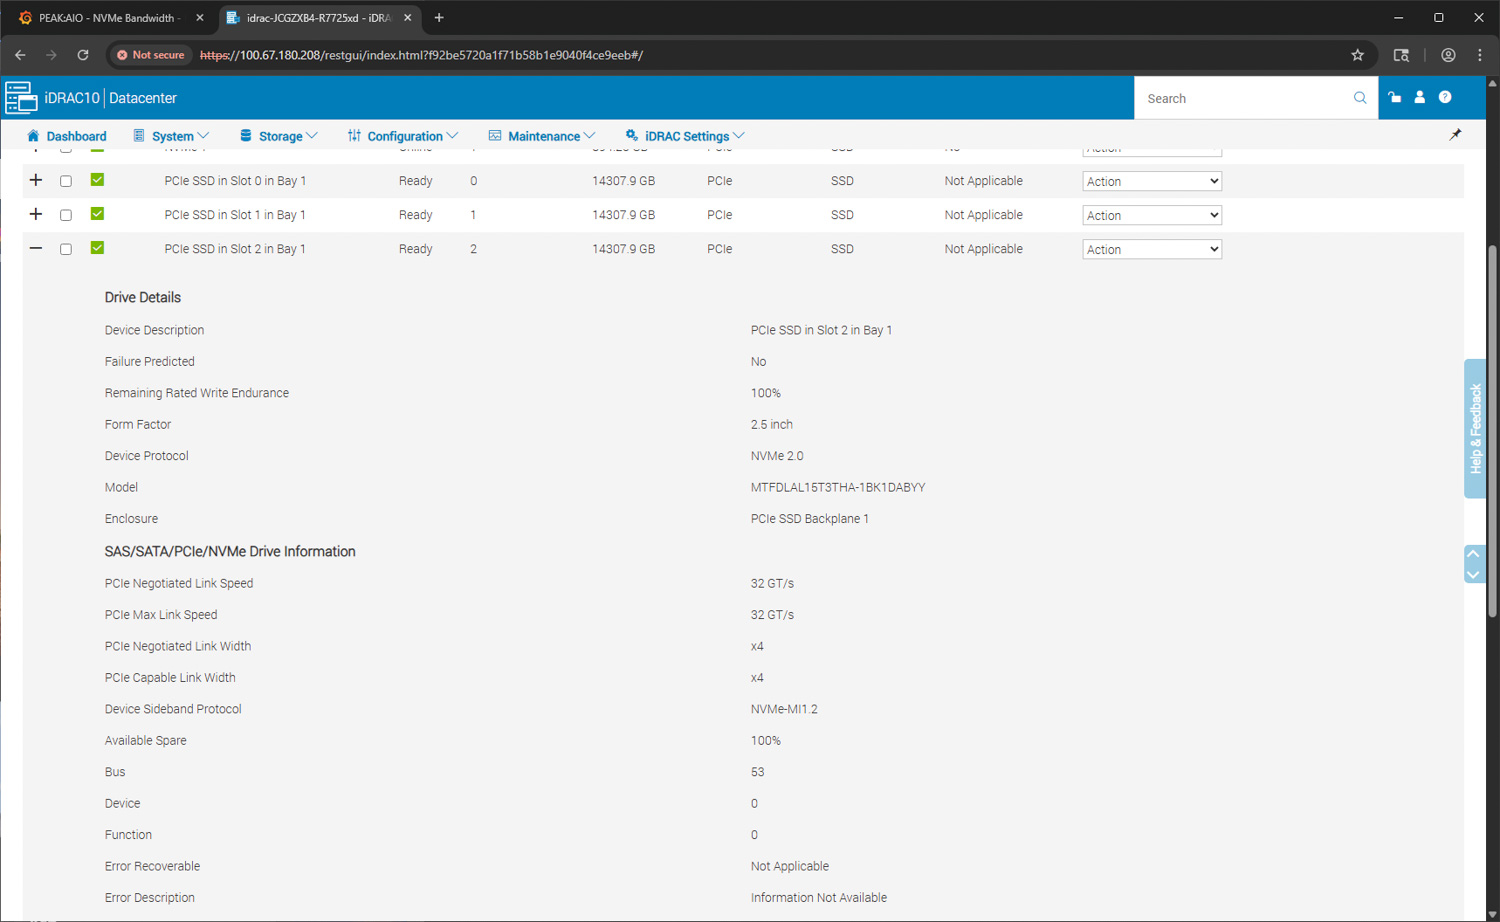
De forma geral, a interface iDRAC 10 oferece uma visão clara e centrada no hardware da arquitetura de armazenamento NVMe do R7725xd, permitindo a fácil validação da integridade do link, do status da unidade e da integridade do sistema em um relance.
Desempenho do Dell PowerEdge R7725xd
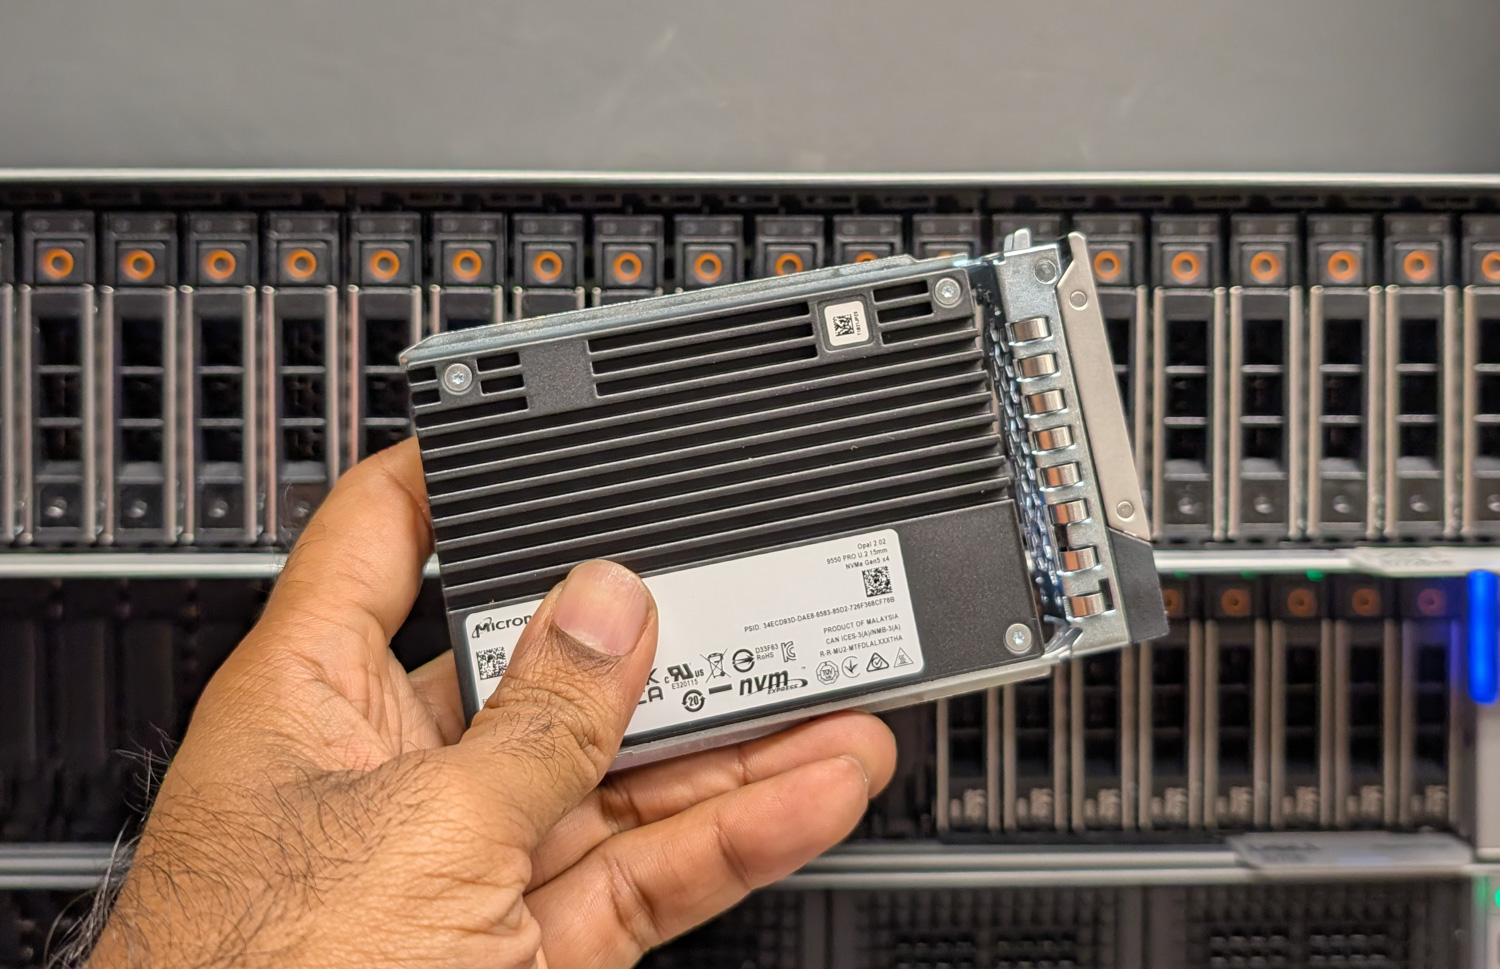
Antes dos testes, nosso sistema foi configurado com uma configuração equilibrada e de alto desempenho. O sistema é equipado com dois processadores AMD EPYC 9575F, cada um com 64 núcleos de alta frequência, e 24 módulos de memória DDR5 DIMM de 32 GB operando a 6400 MT/s. Para armazenamento, o chassi está totalmente preenchido com 24 SSDs Micron 9550 PRO U.2 NVMe de 15.36 TB, cada um conectado por meio de um link PCIe Gen5 x4 dedicado. Isso proporciona uma capacidade bruta total de 368.64 TB, e os drives Micron 9550 PRO oferecem velocidades de leitura sequencial de até 14,000 MB/s e velocidades de gravação sequencial de até 10,000 MB/s. A conectividade de rede é gerenciada por quatro adaptadores Broadcom BCM57608 que fornecem um total de oito portas de 200 Gb, juntamente com uma placa de rede OCP BCM57412 que oferece duas portas adicionais de 10 gigabits.
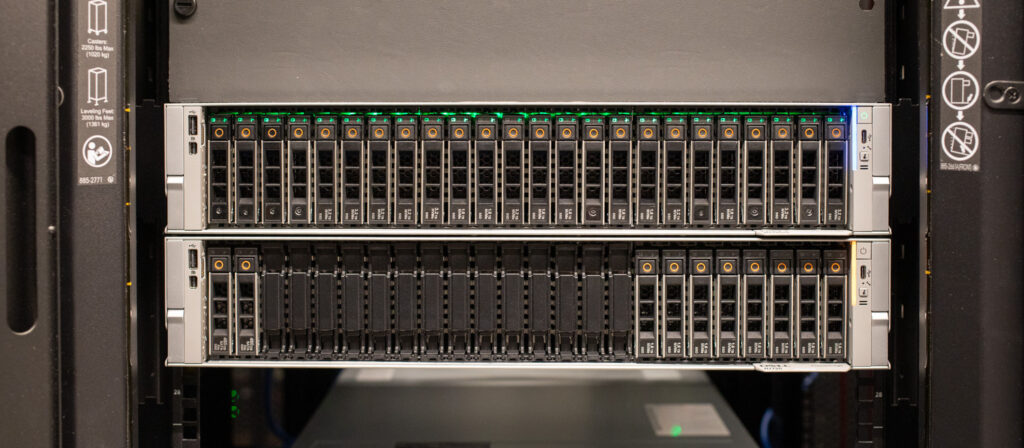
Especificações do sistema de teste
- CPU: 2 processadores AMD EPYC 9575F de 64 núcleos e alta frequência
- Memória: 24 módulos de 32 GB DDR5 a 6400 MT/s
- Armazenamento: 24 unidades Micron 9550 PRO U.2 de 15.36 TB (cada uma conectada em 4 pistas PCIe Gen5); suporta unidades de até 128 TB atualmente, com capacidades ainda maiores previstas para o futuro.
- Rede: 4 placas de rede Broadcom BCM57608 2x200G, 1 placa de rede BCM57412 2x10Gb OCP
- Interruptor: Dell PowerSwitch Z9664
Referência de desempenho da FIO
Para medir o desempenho de armazenamento do PowerEdge R7725xd, utilizamos métricas padrão do setor e a ferramenta FIO. Nesta seção, focamos nos seguintes benchmarks do FIO:
- 4K aleatório – 1M
- Sequencial 4K – 1M
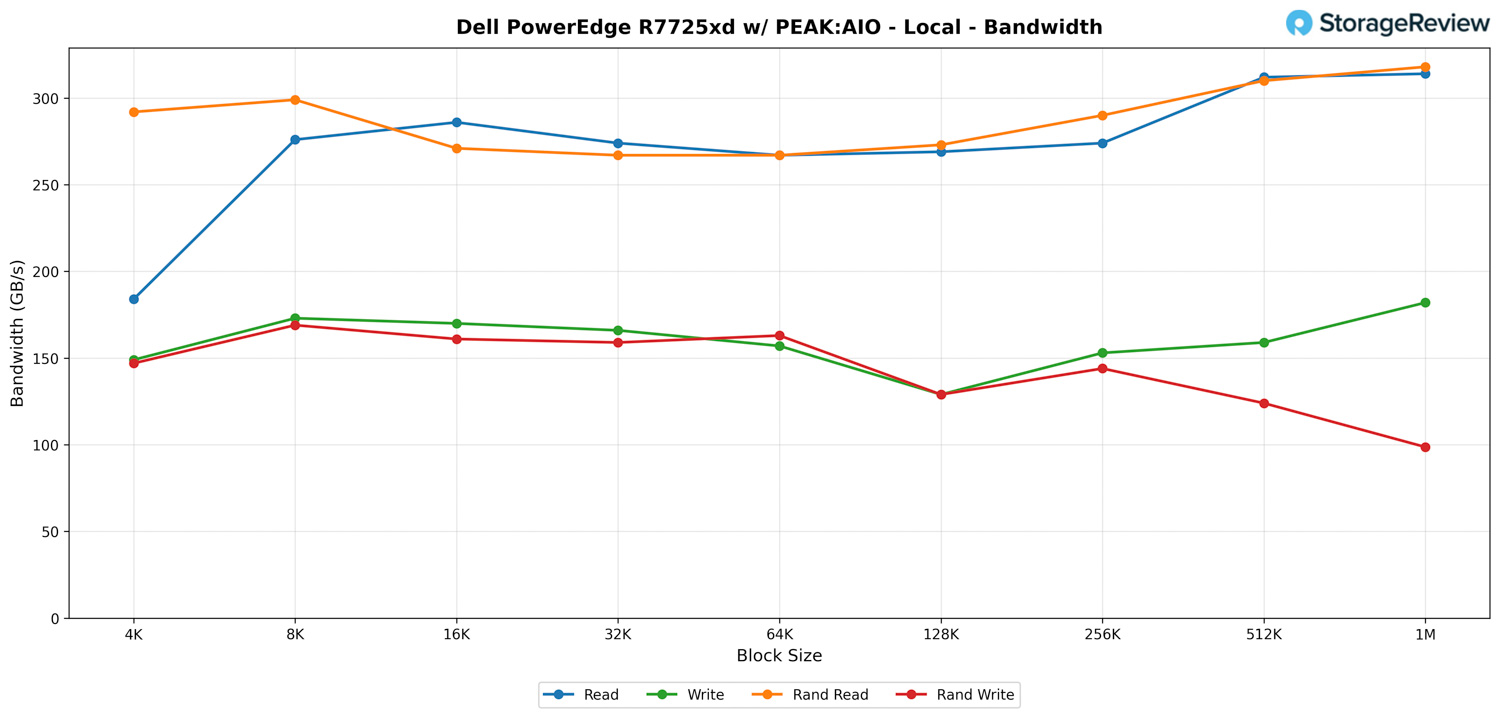
FIO – Local – Largura de banda
Ao testar o acesso local aos 24 SSDs NVMe PCIe Gen5 dentro do Dell PowerEdge R7725xd, o sistema demonstra exatamente o que se espera de uma plataforma onde cada unidade está conectada às CPUs usando uma conexão PCIe Gen5 de 4 vias. Sem nenhuma camada de rede envolvida, este é o desempenho puro e interno do layout de armazenamento Gen5 da Dell e a largura de banda PCIe da plataforma AMD EPYC funcionando sem restrições.
As leituras sequenciais começam em 184 GB/s com blocos de 4K e escalam rapidamente à medida que o tamanho do bloco aumenta. De 512K a 1M, o servidor mantém uma taxa consistente de 312 a 314 GB/s, o que indica claramente a capacidade do sistema de agregar todas as 24 × 4 pistas Gen5 em uma largura de banda de leitura sustentada, sem gargalos no controlador.
As gravações sequenciais seguem uma curva diferente, mas permanecem firmemente dentro da faixa esperada. Começando em 149 GB/s, os resultados sobem até meados dos 100 GB/s e atingem 182 GB/s em 1 milhão de gravações. Isso está de acordo com o comportamento de gravação dos SSDs Micron 9550 PRO e com a sobrecarga inerente às gravações NVMe altamente paralelas em tantos dispositivos independentes.
O desempenho de leitura aleatória é outro destaque. O sistema atinge velocidades de quase 300 GB/s nos menores tamanhos de bloco, apresenta uma leve queda na faixa intermediária e, em seguida, recupera para valores entre 200 e 300 GB/s em tamanhos de bloco maiores. Com 1M de tamanho de bloco, as leituras aleatórias atingem um máximo de 318 GB/s, demonstrando a capacidade da plataforma de distribuir operações mistas uniformemente entre todas as 24 unidades.
As gravações aleatórias ocorrem a uma taxa mais baixa, o que é típico para metadados dispersos e tarefas de alocação de gravação em um amplo conjunto de NVMe. Os resultados permanecem na faixa de 140 a 160 GB/s durante a maior parte do teste e diminuem para pouco menos de 100 GB/s em 1 M.
FIO – Local – IOPS
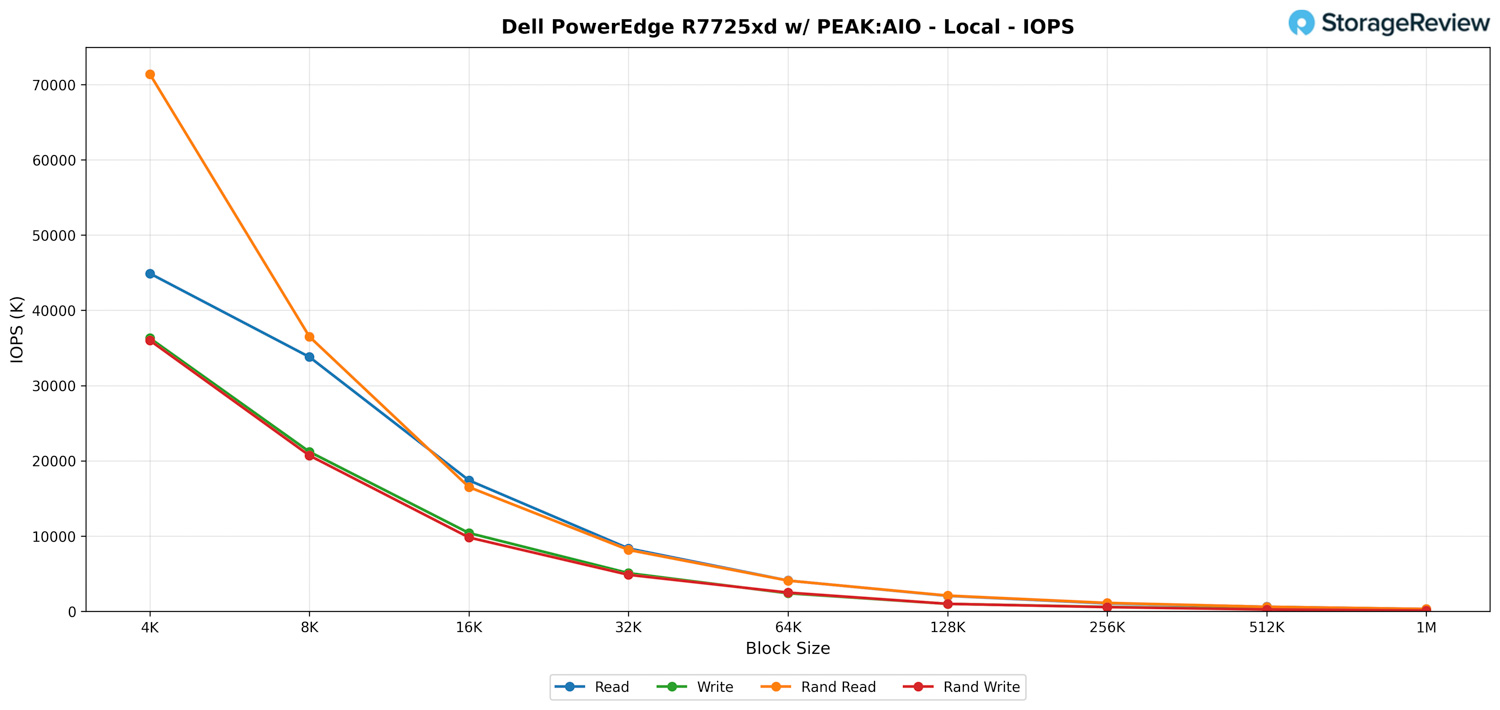
Ao analisar o desempenho de IOPS, o R7725xd demonstra um desempenho robusto em blocos pequenos, com taxas de requisição que chegam a dezenas de milhões antes que tamanhos de bloco maiores direcionem a carga de trabalho para um perfil orientado à largura de banda.
Em 4K, as leituras atingem 44.9 milhões de IOPS e as gravações, 36.3 milhões. As leituras aleatórias alcançam níveis ainda mais altos, com 71.4 milhões de IOPS, demonstrando a capacidade do sistema de distribuir com eficiência cargas de trabalho com alta demanda entre todas as unidades. Esses valores diminuem naturalmente à medida que os tamanhos dos blocos aumentam, mas a progressão permanece consistente nas faixas de 8K, 16K e 32K.
Em blocos de 16K e 32K, as taxas de leitura se estabilizam em 17.4 milhões e 8.35 milhões de IOPS, com leituras aleatórias apresentando valores muito próximos, de 16.5 milhões e 8.15 milhões. As taxas de escrita seguem o padrão esperado, apresentando valores mais baixos, porém permanecendo estáveis tanto em acessos sequenciais quanto aleatórios.
À medida que avançamos para tamanhos de bloco de 64 KB e superiores, o teste transita de um cenário puramente dependente de IOPS para um cenário mais limitado pela largura de banda. Os IOPS caem para a faixa dos milhões e, eventualmente, para as centenas de milhares. Com um tamanho de bloco de 1 MB, os IOPS de leitura ficam em torno de 300 mil, os de gravação em torno de 174 mil, e as operações aleatórias terminam em valores semelhantes.
De forma geral, os resultados de IOPS locais demonstram claramente a capacidade do sistema de suportar cargas de trabalho com filas de alta profundidade em pequenos blocos, com escalabilidade previsível à medida que as transferências aumentam e a largura de banda se torna o fator dominante.
PEAK:AIO: Por que o Dell PowerEdge R7725xd é ideal para esta carga de trabalho
O PEAK:AIO foi projetado para ambientes que exigem acesso extremamente rápido e de baixa latência a grandes conjuntos de dados, normalmente para treinamento de IA, pipelines de inferência, modelagem financeira e análises em tempo real. A plataforma se destaca com armazenamento NVMe denso, largura de banda PCIe balanceada e latência previsível em grande escala. Para atender a esses requisitos, o hardware subjacente deve fornecer taxa de transferência sustentada, mantendo desempenho consistente e repetível sob cargas pesadas simultâneas.
É aqui que o Dell PowerEdge R7725xd se alinha naturalmente com o PEAK:AIO. A arquitetura do sistema foi projetada para maximizar os recursos PCIe Gen5, expondo toda a largura de banda de seus 24 slots U.2 NVMe frontais diretamente às CPUs, sem depender de controladores RAID tradicionais. Esse layout proporciona ao PEAK:AIO o paralelismo e o perfil de latência esperados de pipelines de dados modernos baseados em NVMe. A configuração do sistema dividiu os SSDs NVMe em dois grupos RAID 0.
No cenário testado, utilizamos dois sistemas clientes conectados ao R7725xd, cada um equipado com duas placas de rede Broadcom BCM57608 de 200G. Isso criou um total de quatro uplinks de 200G alimentando cada cliente, levando o R7725xd a uma configuração realista de alto desempenho que espelha o que as implementações do PEAK:AIO observam em produção. Esse nível de largura de banda de rede nos deu a margem necessária para testar totalmente o subsistema NVMe, a topologia PCIe e as interconexões da CPU sem gargalos na camada de rede.
O resultado é uma plataforma que se alinha de forma eficaz com as cargas de trabalho do PEAK:AIO. O R7725xd oferece alta densidade de armazenamento NVMe, taxa de transferência PCIe Gen5, dois processadores AMD EPYC 9005 para paralelismo e capacidade de rede para suportar a ingestão de dados de múltiplos clientes a centenas de gigabits por cliente. Todas essas características são fundamentais para atingir as expectativas de desempenho do PEAK:AIO.
PEAK:AIO – NVMe-oF RDMA – Largura de banda
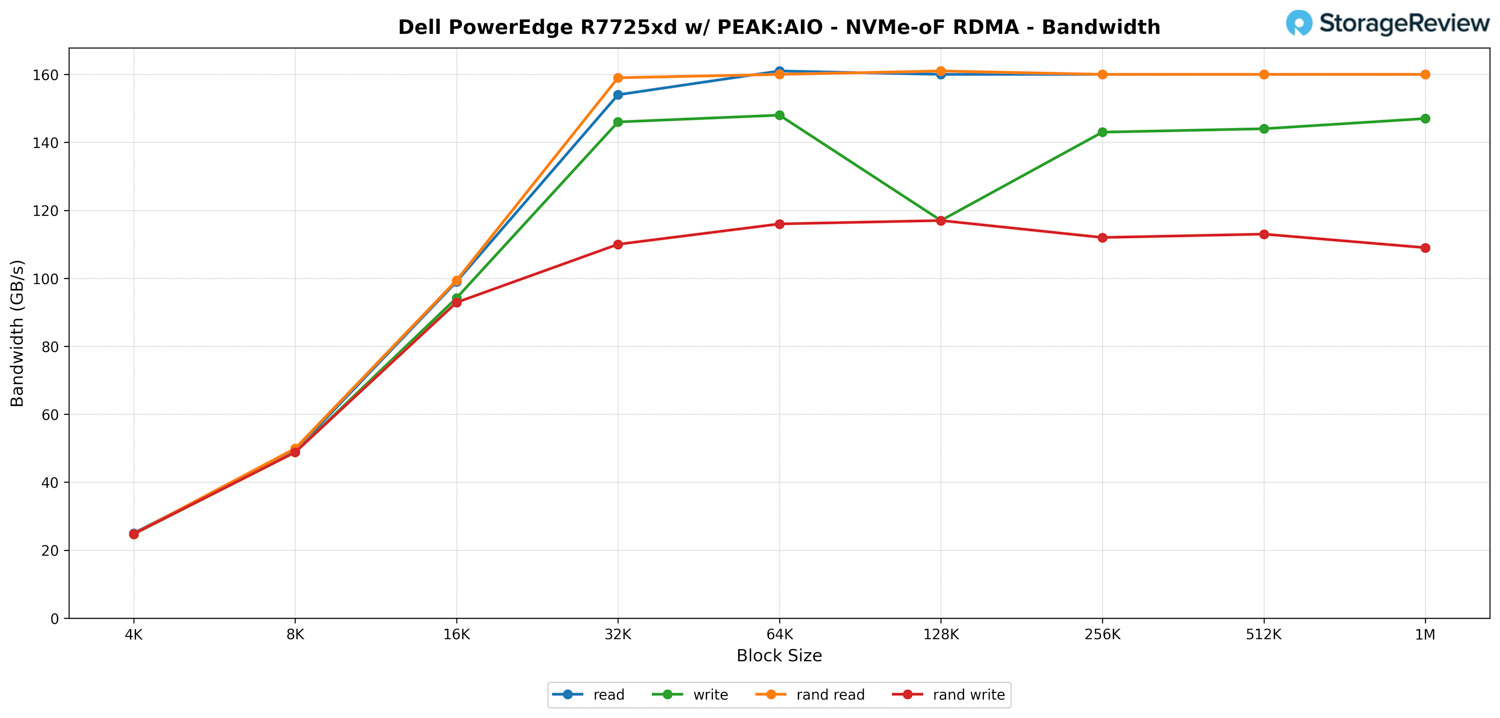
Ao analisar os resultados de largura de banda RDMA NVMe-oF no PowerEdge R7725xd com PEAK:AIO, a tendência geral é exatamente o que se espera de um sistema com essa quantidade de largura de banda PCIe e de rede. À medida que o tamanho do bloco aumenta, a taxa de transferência cresce rapidamente até se estabilizar próximo ao limite prático da plataforma.
Em blocos pequenos, o desempenho começa na faixa de 20 GB/s tanto para leitura quanto para gravação, o que é normal, pois as transferências de 4K e 8K exigem muito mais do caminho de IOPS do que do caminho de throughput. Ao chegarmos aos blocos de 16K e 32K, o pipeline se torna mais eficiente. As leituras saltam para cerca de 154 GB/s em blocos de 32K e continuam subindo até a faixa de 160 GB/s, que é exatamente o que esperaríamos de uma configuração com dois clientes em quatro links de 200 Gb/s.
O desempenho de leitura aleatória espelha o sequencial quase perfeitamente. O PEAK:AIO faz um excelente trabalho ao manter as filas de comandos alimentadas, de modo que a largura de banda de leitura aleatória essencialmente acompanha a largura de banda de leitura sequencial em toda a sua extensão, estabilizando-se em aproximadamente 159 a 161 GB/s de 32K a 1M. Isso indica que a pilha de armazenamento não está sofrendo gargalos sob padrões de acesso mistos e que a topologia PCIe do R7725xd está distribuindo a carga uniformemente entre os 24 SSDs NVMe Gen5.
O desempenho de escrita segue uma curva semelhante, embora atinja um pico ligeiramente inferior ao das leituras. As escritas sequenciais mantêm-se na faixa de 140 a 148 GB/s em blocos de tamanho médio, caindo para aproximadamente 117 GB/s em blocos de 128 KB, mas recuperando-se à medida que o tamanho do bloco aumenta. As escritas aleatórias comportam-se de forma diferente e estabilizam-se mais perto de 110-117 GB/s, o que é normal para cargas de trabalho com filas mistas que introduzem sobrecarga adicional.
A principal conclusão desta seção é que o R7725xd não tem dificuldade em manter uma largura de banda extremamente alta em NVMe-oF, mesmo com vários clientes levando o sistema ao limite. Quando os tamanhos dos blocos atingem 32 KB ou mais, o servidor satura consistentemente sua largura de banda de rede e armazenamento disponível. Este é exatamente o tipo de desempenho que o PEAK:AIO foi projetado para extrair, tornando esses resultados uma forte validação da capacidade da plataforma de escalar em condições reais.
PEAK AIO – IOPS RDMA NVMe-oF
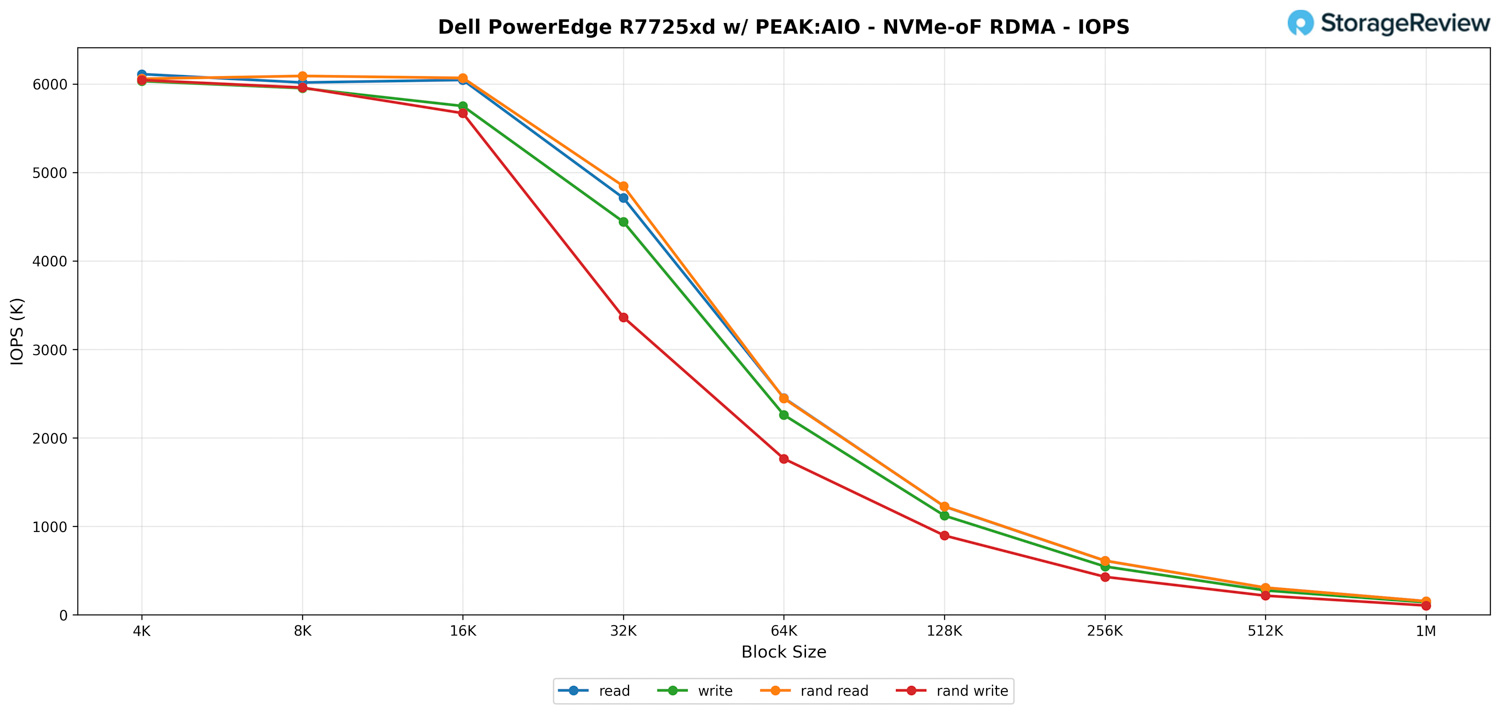
Em termos de IOPS, o PowerEdge R7725xd apresenta um desempenho robusto com blocos pequenos, embora inicialmente tenhamos observado números abaixo do esperado; espera-se que esse problema seja resolvido com o aprimoramento do suporte aos drivers de rede no futuro. Mesmo com essa melhoria, a tendência geral de escalonamento se mostra exatamente como o NVMe-oF RDMA normalmente se comporta quando o tamanho do bloco aumenta.
Com o menor tamanho de bloco, o sistema consegue fornecer mais de 6 milhões de IOPS em cargas de trabalho sequenciais e aleatórias. As taxas de leitura, gravação, leitura aleatória e gravação aleatória situam-se aproximadamente na mesma faixa em 4K e 8K, indicando que os clientes front-end, a infraestrutura PCIe e as próprias unidades NVMe não têm dificuldade em acompanhar a taxa de solicitações.
À medida que os tamanhos dos blocos aumentam, a queda esperada no IOPS começa. Com 32 KB, as leituras atingem cerca de 4.7 milhões de IOPS, enquanto as gravações ficam um pouco atrás, em torno de 4.4 milhões. As gravações aleatórias são as mais afetadas, caindo para aproximadamente 3.3 milhões de IOPS, o que está de acordo com a sobrecarga adicional de fila e CPU introduzida pelos padrões de acesso misto.
Ao passar para blocos maiores, o IOPS continua a diminuir de forma linear e previsível. Quando atingimos transferências de 256K e 512K, a taxa de transferência torna-se a métrica dominante e o IOPS cai naturalmente para a faixa das centenas de milhares. Com um tamanho de bloco de 1M, todas as cargas de trabalho convergem para 140K-153K IOPS, o que está de acordo com os valores de largura de banda observados na seção anterior.
Desempenho de armazenamento GPUDirect
Um dos testes que realizamos na R7725xd foi o teste Magnum IO GPUDirect Storage (GDS). O GDS é um recurso desenvolvido pela NVIDIA que permite que as GPUs ignorem a CPU ao acessar dados armazenados em unidades NVMe ou outros dispositivos de armazenamento de alta velocidade. Em vez de rotear os dados pela CPU e pela memória do sistema, o GDS possibilita a comunicação direta entre a GPU e o dispositivo de armazenamento, reduzindo significativamente a latência e melhorando a taxa de transferência de dados.
Como funciona o armazenamento GPUDirect
Tradicionalmente, quando uma GPU processa dados armazenados em uma unidade NVMe, os dados precisam primeiro passar pela CPU e pela memória do sistema antes de chegar à GPU. Esse processo introduz gargalos, pois a CPU se torna intermediária, adicionando latência e consumindo recursos valiosos do sistema. O GPUDirect Storage elimina essa ineficiência, permitindo que a GPU acesse os dados diretamente do dispositivo de armazenamento por meio do barramento PCIe. Esse caminho direto reduz a sobrecarga de movimentação de dados, possibilitando transferências de dados mais rápidas e eficientes.
Cargas de trabalho de IA, especialmente aquelas que envolvem aprendizado profundo, exigem um alto consumo de dados. O treinamento de grandes redes neurais requer o processamento de terabytes de dados, e qualquer atraso na transferência de dados pode levar à subutilização de GPUs e a tempos de treinamento mais longos. O GPUDirect Storage aborda esse desafio garantindo que os dados sejam entregues à GPU o mais rápido possível, minimizando o tempo ocioso e maximizando a eficiência computacional.
Além disso, o GDS é particularmente benéfico para cargas de trabalho que envolvem streaming de grandes conjuntos de dados, como processamento de vídeo, processamento de linguagem natural ou inferência em tempo real. Ao reduzir a dependência da CPU, o GDS acelera a movimentação de dados e libera recursos da CPU para outras tarefas, aprimorando ainda mais o desempenho geral do sistema.
Além da largura de banda bruta, o GPUDirect com NVMe-oF (TCP/RDMA) também oferece E/S de latência ultrabaixa. Isso garante que as GPUs nunca fiquem sem dados, tornando o sistema ideal para inferência de IA em tempo real, pipelines de análise e reprodução de vídeo.
Leitura sequencial de GDSIO
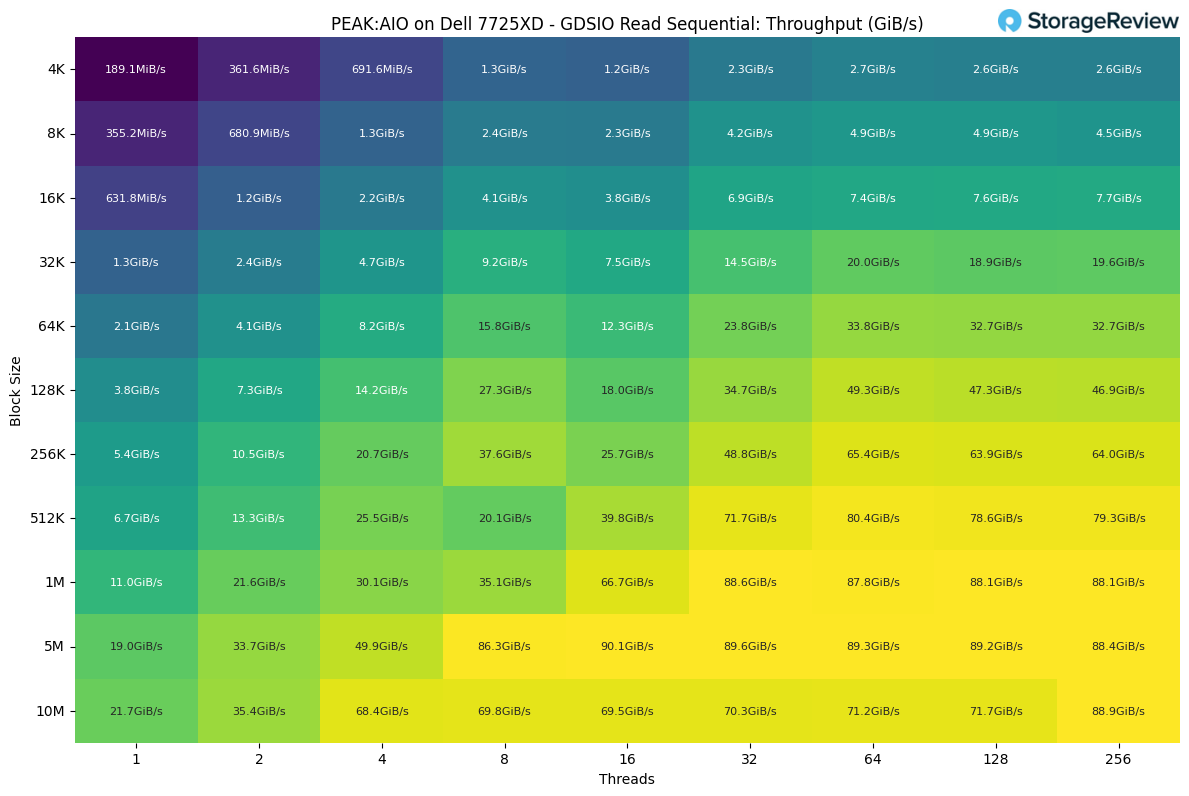
Ao analisar o PEAK:AIO com um cliente usando GDSIO, a taxa de transferência de leitura exibe um padrão de escalabilidade claro à medida que o tamanho do bloco e a contagem de threads aumentam. Este cliente único estava conectado por meio de dois links de 400G, limitando seu potencial total a 90 GB/s.
Com blocos de tamanho muito pequeno e um número reduzido de threads, o desempenho é modesto, com leituras de 4K a partir de cerca de 189 MiB/s em uma única thread. Assim que aumentamos o paralelismo de threads, o sistema responde imediatamente, atingindo 691 MiB/s em quatro threads e ultrapassando a marca de vários GiB/s à medida que trabalhamos com blocos maiores.
Os tamanhos de bloco intermediários mostram a maior sensibilidade à contagem de threads. Com 32K, a taxa de transferência aumenta de 1.3 GiB/s com uma única thread para quase 20 GiB/s com 64 threads, com apenas uma ligeira redução a partir desse ponto. Um padrão semelhante aparece com 64K e 128K, onde o sistema transita de taxas de transferência na casa de um dígito em GiB/s com baixo paralelismo para mais de 30 GiB/s à medida que a carga de trabalho aumenta.
Ao atingirmos tamanhos de bloco maiores, a taxa de transferência começa a estabilizar à medida que o sistema se aproxima do seu limite de desempenho para um único cliente. Com 1 MiB, o desempenho sobe de 11 GiB/s com uma única thread para cerca de 88 GiB/s com um grande número de threads. As transferências de 5 MiB e 10 MiB mostram o mesmo platô, atingindo um pico em torno de 89–90 GiB/s, independentemente de o teste estar sendo executado com 64, 128 ou 256 threads.
Gravação sequencial GDSIO
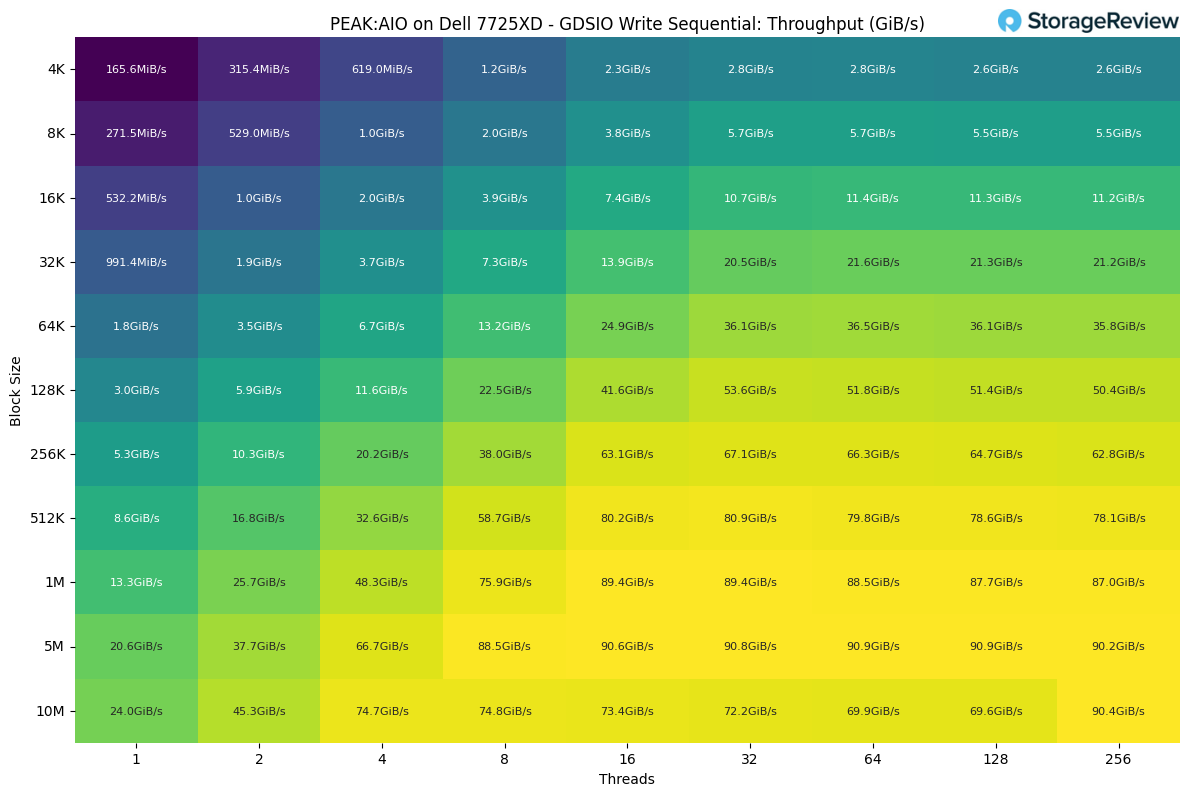
No lado da escrita, o comportamento de escalabilidade segue um padrão semelhante ao das leituras, mas com desempenho ligeiramente inferior na maioria dos tamanhos de bloco, o que é esperado para cargas de trabalho de escrita sequencial. Nos menores tamanhos de bloco, a taxa de transferência começa em 165 MiB/s para um único thread em 4K e aumenta constantemente à medida que o paralelismo aumenta. Com quatro threads, esse valor sobe para pouco mais de 619 MiB/s antes de ultrapassar 1 GiB/s com oito threads.
Os tamanhos de bloco intermediários apresentam ganhos mais expressivos à medida que o número de threads aumenta. Com 32K, a taxa de transferência começa em pouco menos de 1 GiB/s e escala para mais de 21 GiB/s em níveis mais altos de threads. As faixas de 64K e 128K continuam a tendência, passando de valores baixos de um dígito em GiB/s para valores entre 30 GiB/s e 50 GiB/s conforme a carga de trabalho se torna mais paralela.
Transferências maiores ocorrem quando o sistema atinge seu limite natural de taxa de transferência de gravação. Com 1 MiB, o desempenho sobe de 13.3 GiB/s em um único thread para pouco menos de 90 GiB/s com um grande número de threads. Os testes com 5 MiB e 10 MiB seguem um padrão semelhante, com resultados atingindo picos em torno de 90 GiB/s, independentemente de o sistema estar rodando com 64, 128 ou 256 threads.
Redefinindo o desempenho na era Gen5
O Dell PowerEdge R7725xd é mais do que um servidor de armazenamento; ele representa uma mudança na forma como a largura de banda é distribuída dentro do rack. Ao eliminar os switches PCIe e fornecer a cada unidade NVMe um caminho direto para a CPU, a Dell criou um sistema onde a taxa de transferência escala de forma eficiente, as temperaturas permanecem previsíveis e a simultaneidade se torna uma vantagem, em vez de um desafio.
Quando combinado com os SSDs 9550 PRO da Micron e o software de E/S paralela da PEAK:AIO, o R7725xd se transforma de um chassi NVMe compacto em um verdadeiro motor de dados. Ele pode saturar sua malha PCIe local, alimentar GPUs via RDMA na velocidade da linha ou funcionar simultaneamente como computação e armazenamento, tudo em um formato 2U.
Dell PowerEdge R7225xd
Na prática, essa configuração oferece mais de 300 GB/s de taxa de transferência local e 160 GB/s na rede, rivalizando com o desempenho de clusters de armazenamento com múltiplos nós, a uma fração da complexidade e do custo. É uma demonstração do que acontece quando todas as camadas da infraestrutura, do silício ao software, estão alinhadas em torno da eficiência e da largura de banda sustentada.
O R7725xd estabelece um novo padrão de desempenho para armazenamento em nó único na era Gen5. Para organizações que desenvolvem pipelines de IA de última geração, análises de alta velocidade ou ambientes de treinamento com grande volume de checkpoints, ele oferece uma visão do que é possível quando os gargalos são completamente eliminados do sistema.
Este relatório é patrocinado pela Dell Technologies. Todas as visões e opiniões expressas neste relatório são baseadas em nossa visão imparcial do(s) produto(s) em consideração.


 Amazon