

O ASUS ExpertCenter Pro ET900N G3 é a segunda estação GB300 DGX que testamos e a primeira que tivemos em mãos no laboratório; nossos testes com a MSI XpertStation WS300 foram realizados remotamente. Ele utiliza o mesmo chip NVIDIA que testamos na MSI XpertStation WS300: um Grace Blackwell Ultra Desktop Superchip com 72 núcleos Grace, uma GPU B300, 252 GB de HBM3e, 496 GB de LPDDR5X e uma placa de rede ConnectX-8 SuperNIC com duas portas 400GbE. A ASUS integra essa plataforma de núcleo fixo em uma torre compacta, projetada para IA em mesas de trabalho, adicionando alguns detalhes não encontrados na WS300: duas alças de transporte na parte superior, uma ventoinha dedicada direcionada para as gaiolas ópticas da ConnectX-8 e uma fonte de alimentação de 1,600 W com certificação 80 PLUS Titanium.
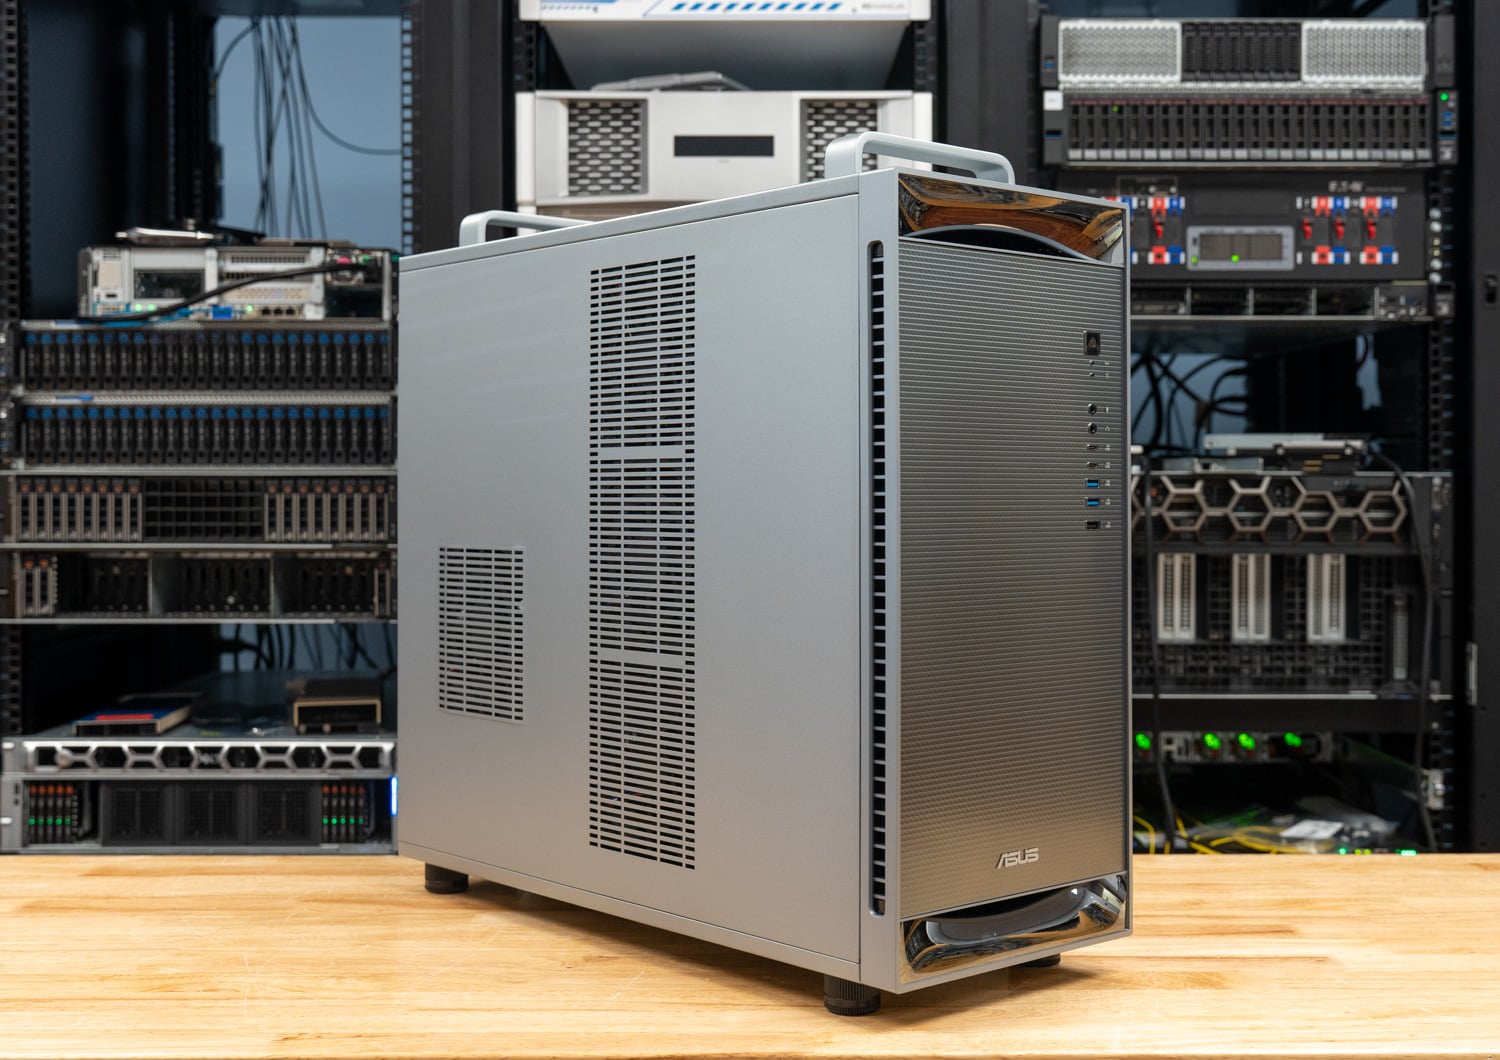
A ASUS enviou o ET900N G3 para o laboratório para cerca de uma semana de testes de benchmark, fotografia e verificações físicas, com uma RTX PRO 2000 instalada. Para informações sobre a plataforma em si, o chipset B300, Grace, NVLink-C2C, MIG e a função de uma DGX Station, a análise do WS300 aborda esses tópicos. Esta análise se concentra no que a ASUS construiu em torno do Superchip e se os números se comparam aos do primeiro gabinete torre GB300 que testamos.
Especificações do ASUS ExpertCenter Pro ET900N G3
| Especificação | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| Visão geral da plataforma | |
| superchip | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| CPU | NVIDIA Grace, 72 núcleos Arm Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra (B300), até 20 PFLOPS NVFP4 com esparsidade |
| Interconexão CPU-GPU | NVLink-C2C, bidirecional de 900 GB/s |
| Memória | |
| Memória coerente | 748GB |
| Memória GPU | 252 GB HBM3e, 7.1 TB/s |
| Memória CPU | 496 GB LPDDR5X, 396 GB/s, 4x SOCAMM |
| Armazenamento | |
| Unidades de Inicialização | 2 slots M.2 2280 PCIe 5.0 x4 (Key M), configurados com 2 SSDs NVMe de 2 TB em RAID 1. |
| Expansão impulsiona | 2 slots M.2 2280 (Key M), PCIe 6.0 x4 de acordo com a ASUS, abertos de fábrica. |
| Networking | |
| SuperNIC | NVIDIA ConnectX-8, 2x QSFP112 400GbE |
| Ethernet | 1x Marvell 10GbE 1x Realtek 1GbE (BMC) |
| Expansão | |
| Slots PCIe | 1x PCIe 5.0 x16 2x PCIe 5.0 x16 (sinais x8) |
| GPU adicional | Até uma placa NVIDIA RTX PRO Blackwell; a unidade de teste foi enviada com uma RTX PRO 2000 Blackwell. |
| I / O | |
| Frente | 2 portas USB 10Gbps Tipo-C 2 portas USB 10Gbps Tipo A 1x USB 2.0 Conectores para fone de ouvido e microfone |
| Traseiro | 4 portas USB 10Gbps Tipo A 1x Micro-USB COM (console serial BMC) 1x Mini DisplayPort (BMC) 3 conectores de áudio |
| Gerenciamento e Segurança | |
| BMC | ASPEED AST2600 com firmware AMI MegaRAC, IPMI e Redfish |
| Total | TPM 2.0 integrado |
| Potência e refrigeração | |
| Fonte de alimentação do laboratório | 1x ATX de 1,600 W, 80 PLUS Titanium |
| Resfriamento | Sistema de refrigeração líquida AIO de circuito fechado (segundo a ASUS) com placas frias no GB300, SOCAMM e ConnectX-8; radiadores frontais e superiores, ventoinha traseira do gabinete e ventoinha dedicada sobre os slots QSFP112. |
| Temperatura de Operação | 10C para 35C |
| Software e formato | |
| Sistema Operacional | Ubuntu com ferramentas de desenvolvimento de IA da NVIDIA; ASUS afirma que está planejado suporte para desenvolvimento de IA baseado em Windows. |
| Dimensões | 584 x 232 x 565 mm (23.0 x 9.1 x 22.3 polegadas), conforme especificado pela ASUS. |
| Peso | 27 kg líquido, 32 kg bruto |
Design e Construção
A ASUS apresenta o ET900N G3 como uma estação de trabalho empresarial, com um chassi prateado escovado, uma frente em malha escura, tampa e pés com acabamento cromado e o logotipo da ASUS na parte inferior frontal. As proporções são as que a plataforma dita: 584 x 232 x 565 mm, segundo a especificação da ASUS, o que o torna um pouco mais alto e ligeiramente mais estreito do que o WS300, com 529 mm de altura, 570 mm de profundidade e 246 mm de largura. Com 27 kg, não é um sistema que se mova casualmente, e é aí que entra a primeira decisão específica da ASUS. Duas alças de metal na borda superior, uma na frente e outra na parte traseira, permitem que duas pessoas levantem a torre para uma mesa ou para dentro de um carrinho sem precisar segurar os painéis. Elas parecem um pouco deslocadas em uma máquina de escritório até você ter que carregar uma torre GB300 por um laboratório.
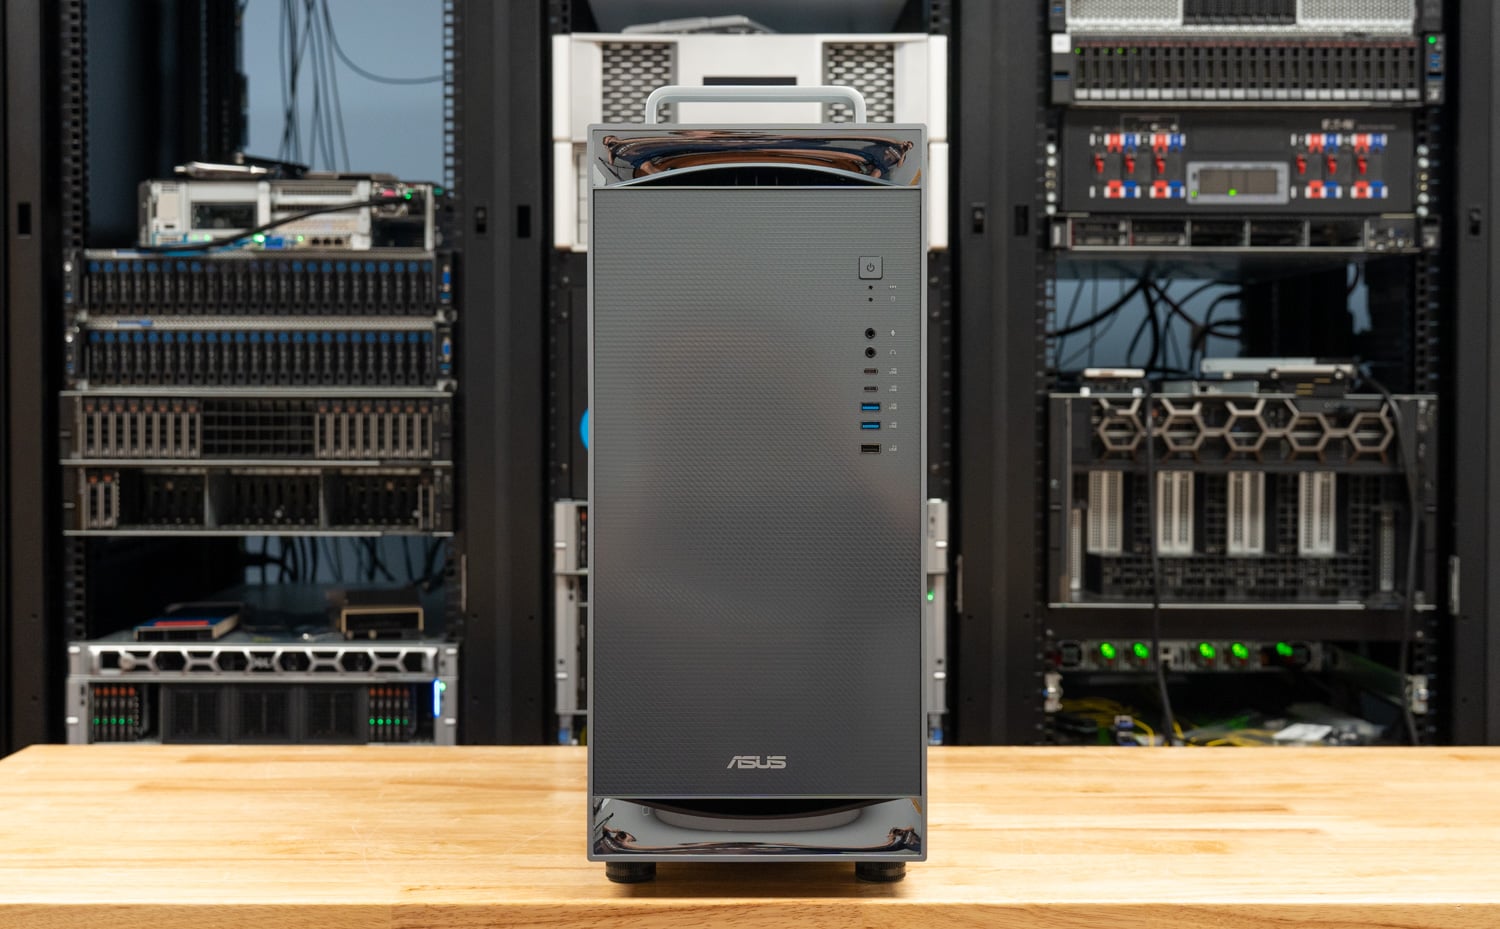
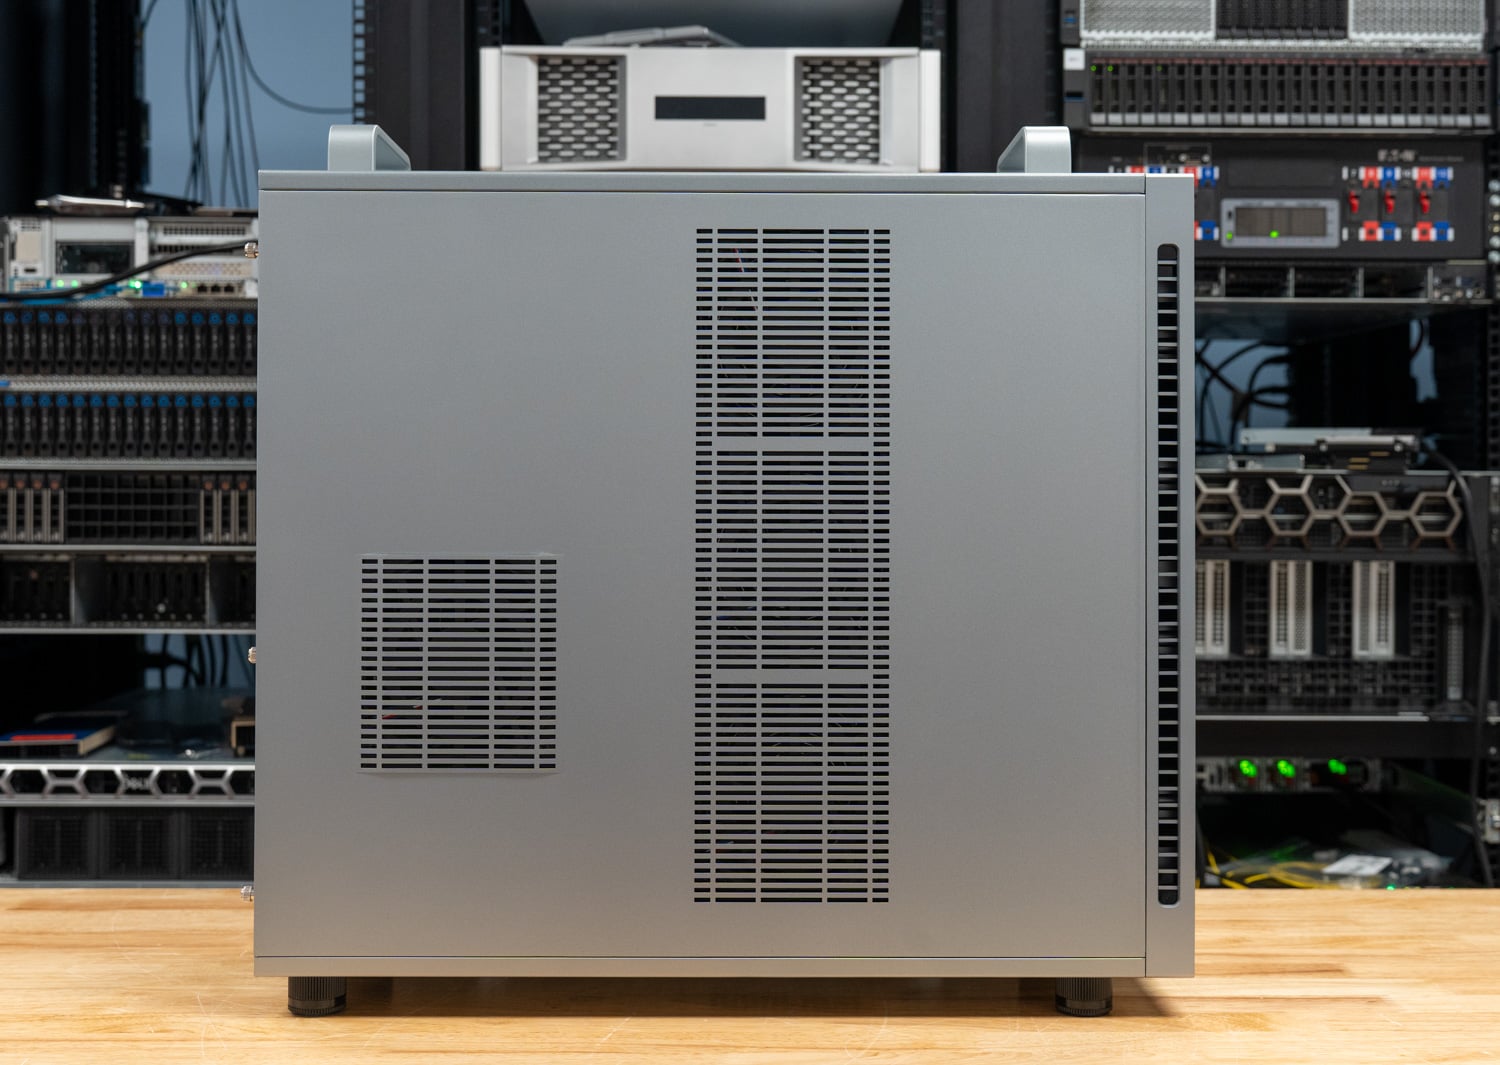
O painel frontal apresenta o botão liga/desliga, duas portas USB Tipo-A de 10 Gbps, duas portas USB Tipo-C de 10 Gbps, uma porta USB 2.0 e entradas separadas para fone de ouvido e microfone, todas dispostas em uma faixa vertical no canto superior direito da tela de malha. O painel lateral é uma grande placa ventilada, com uma longa coluna perfurada na parte frontal para a entrada de ar do radiador e uma grade quadrada menor na parte traseira, alinhada com as ventoinhas do sistema. Não há janela nem iluminação, o que atende ao perfil do público-alvo.
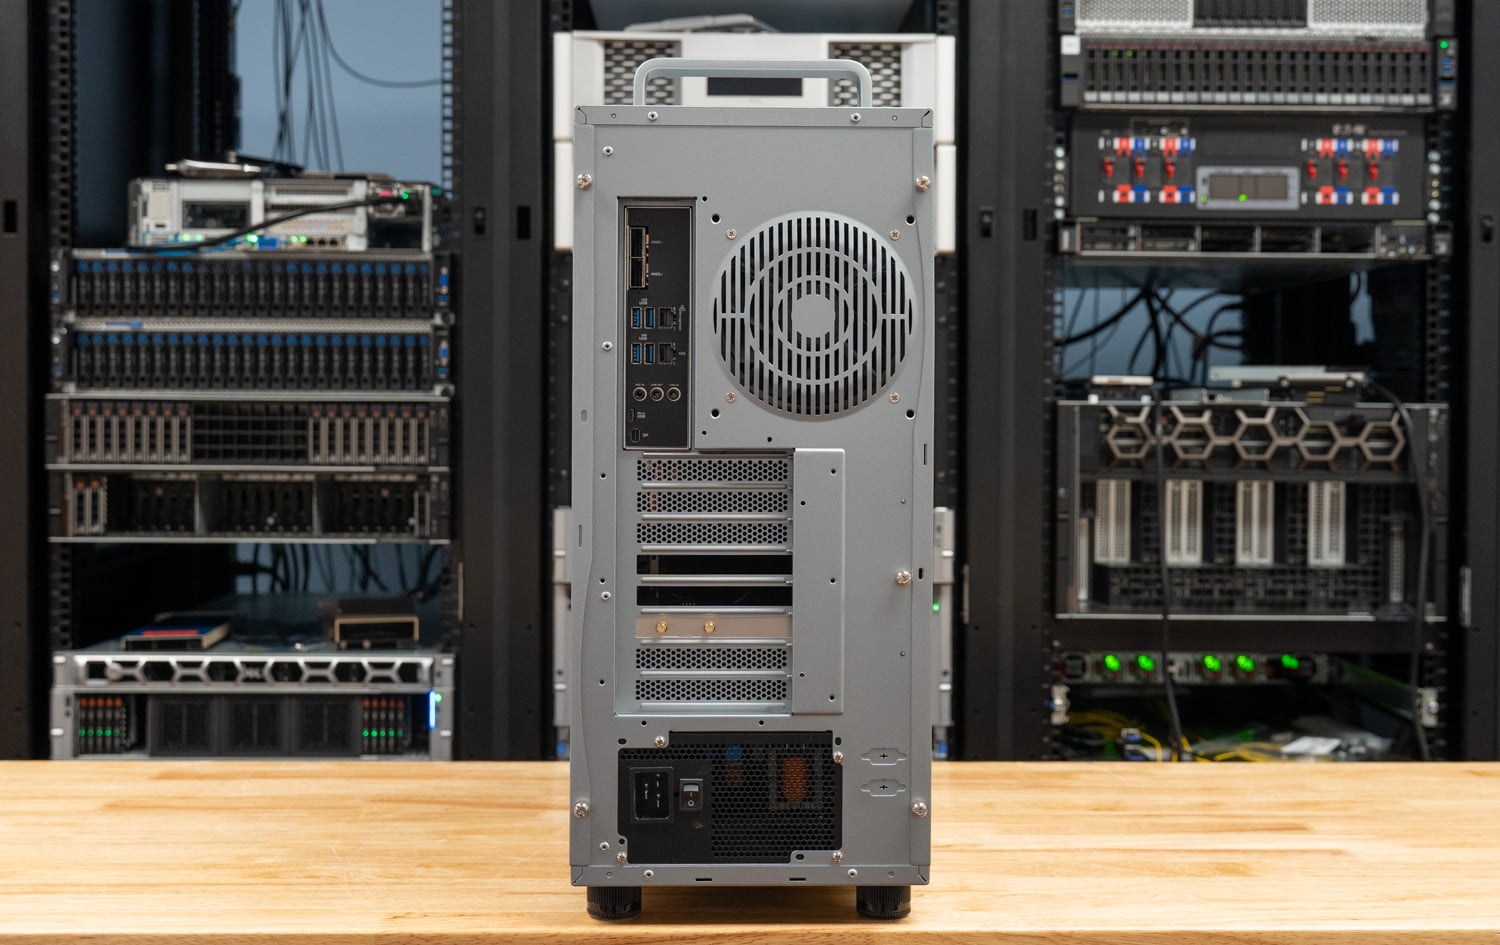
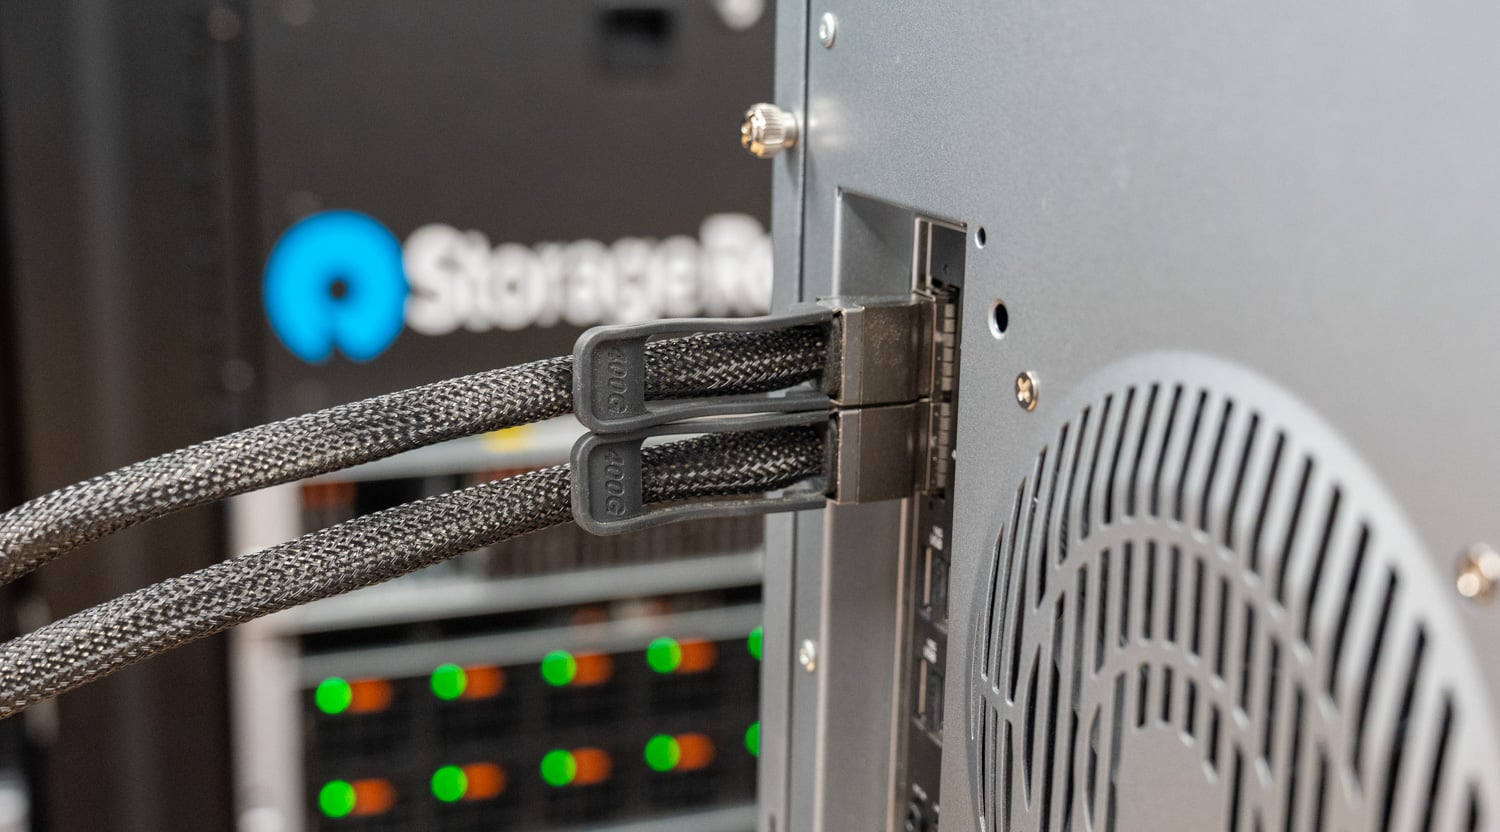
Na parte traseira, o layout separa as E/S da estação de trabalho do hardware do servidor abaixo. O cluster superior abriga as quatro portas USB Tipo A de 10 Gbps, os conectores RJ45 de 10 GbE e 1 GbE, os três conectores de áudio, a porta de console Micro-USB do BMC e a Mini DisplayPort que o BMC utiliza para configuração. Os dois slots QSFP112 para o ConnectX-8 ficam na parte superior do painel de E/S; um ventilador de exaustão fica ao lado; as três tampas dos slots de expansão percorrem o centro; e a fonte de alimentação com sua entrada C19 está na parte inferior. Assim como no WS300, a Mini DisplayPort é uma saída do BMC para configuração inicial e solução de problemas; quem quiser uma área de trabalho nesta máquina precisa da placa RTX PRO.
Por dentro do ET900N G3
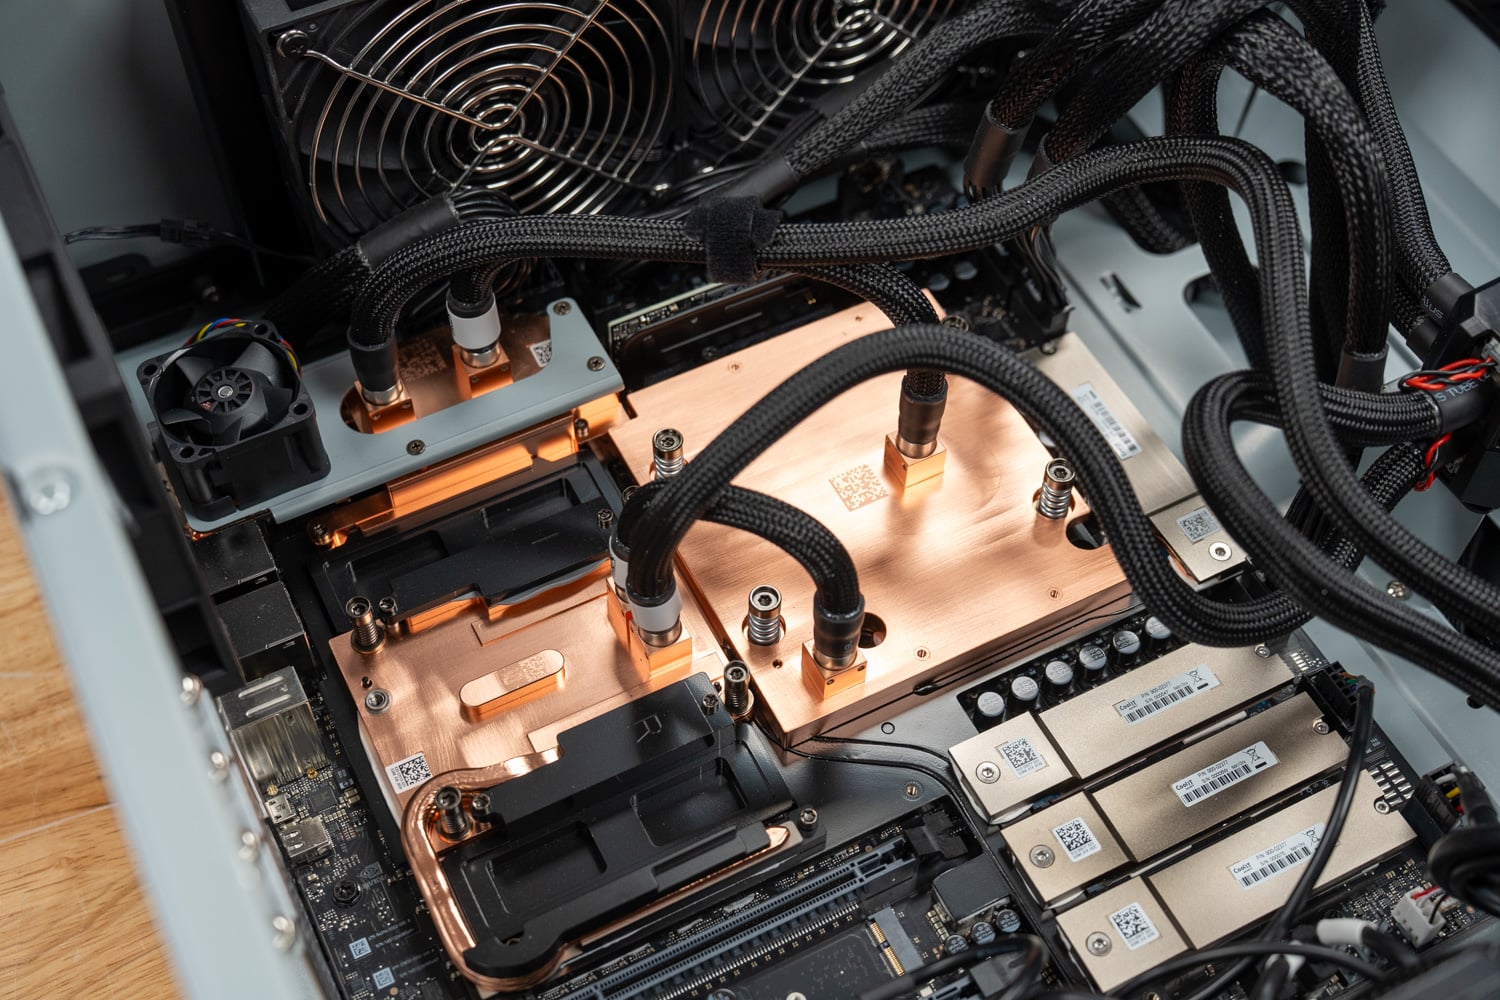
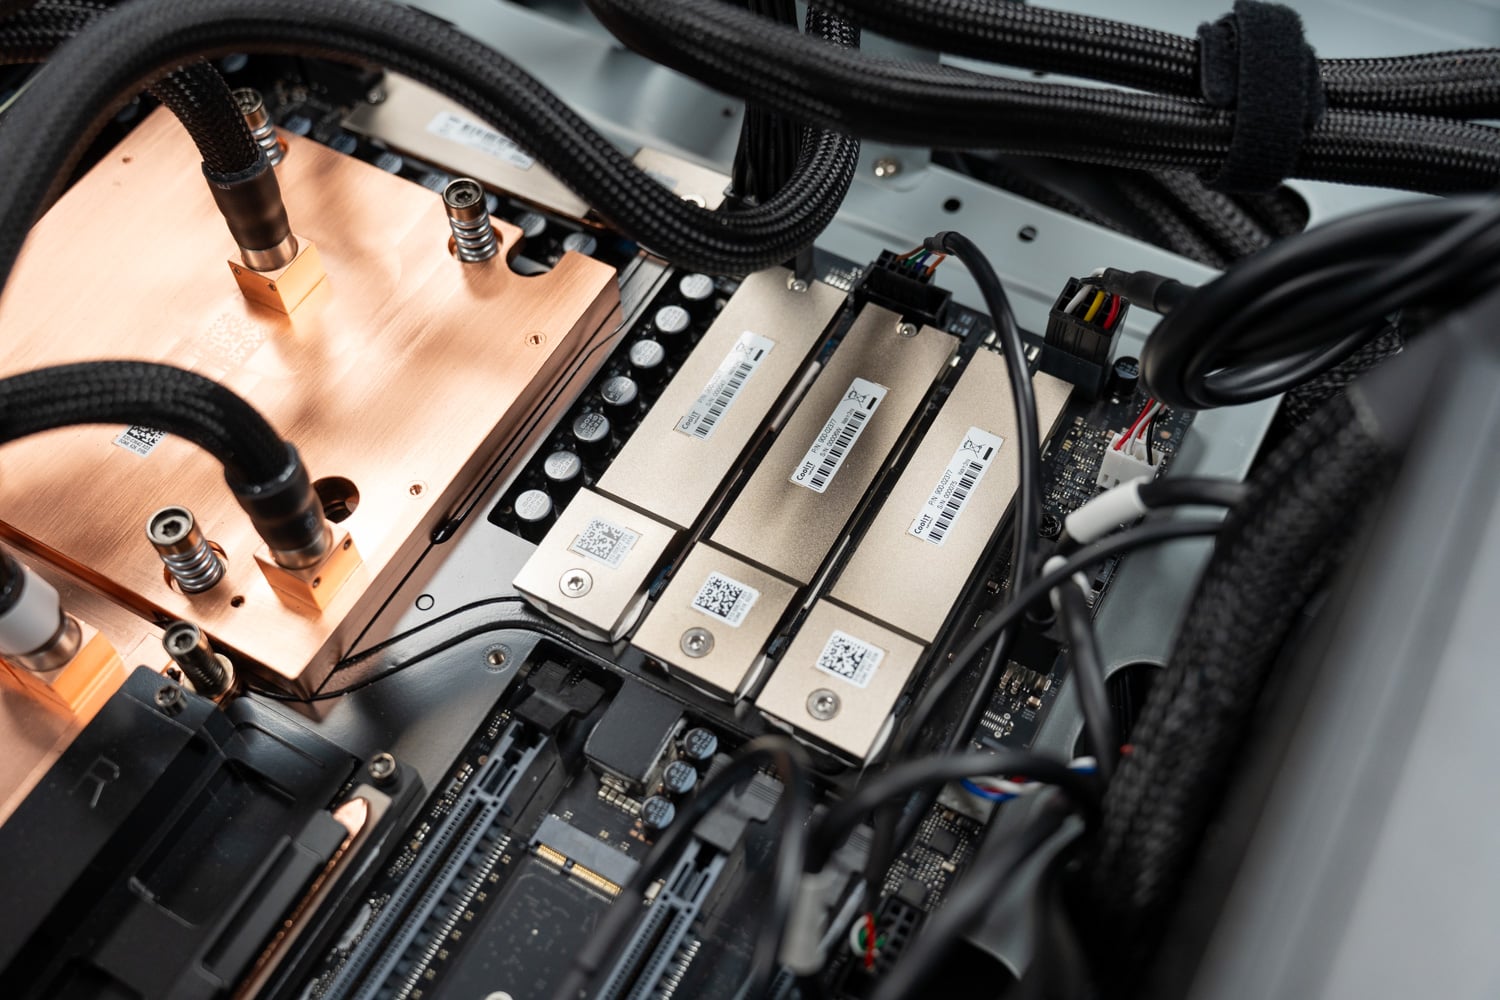
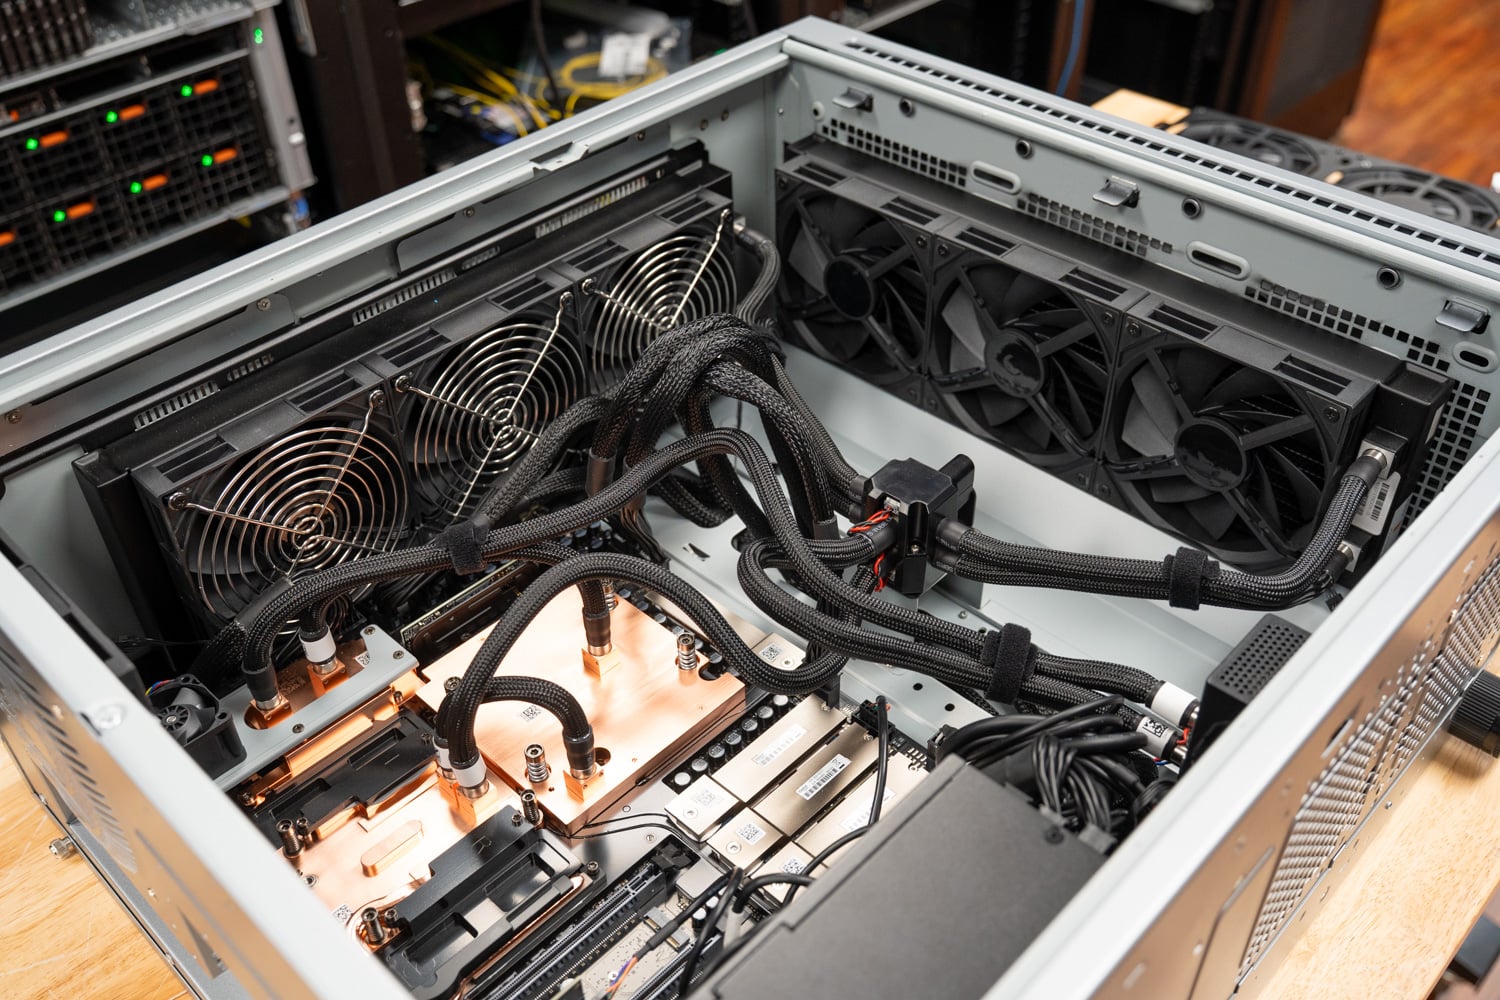
Com o painel lateral removido, o ET900N G3 parece ser um parente próximo do WS300, o que é esperado, visto que ambos compartilham a mesma placa-mãe NVIDIA. O Superchip GB300 fica sob um conjunto de placa fria de cobre à esquerda do chassi, com os módulos SOCAMM sob suas próprias placas de cobre ao lado e o ConnectX-8 sob um terceiro bloco próximo ao painel traseiro de E/S. Tubos trançados conectam os blocos a um coletor de distribuição montado na travessa do chassi e, deste, aos radiadores. Os três slots PCIe de tamanho normal ficam abaixo do Superchip, a fonte de alimentação ocupa o canto inferior frontal e uma cobertura metálica protege o caminho dos cabos na parte inferior.
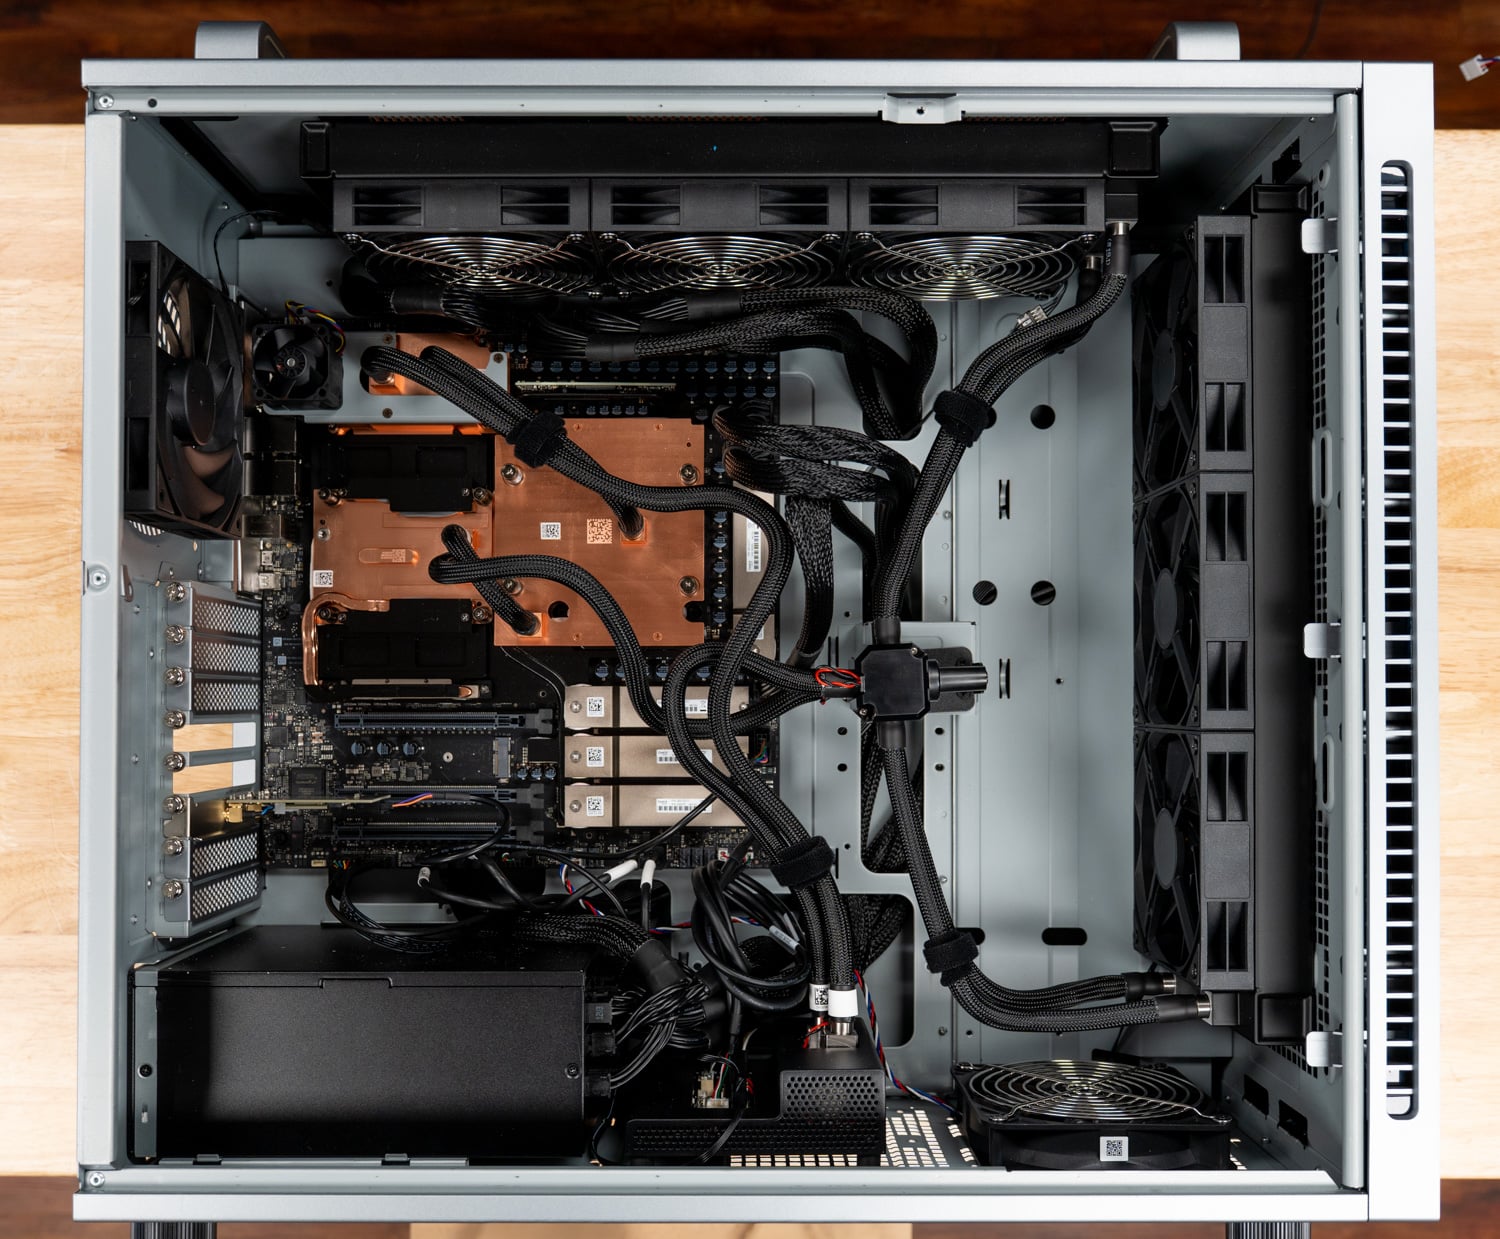
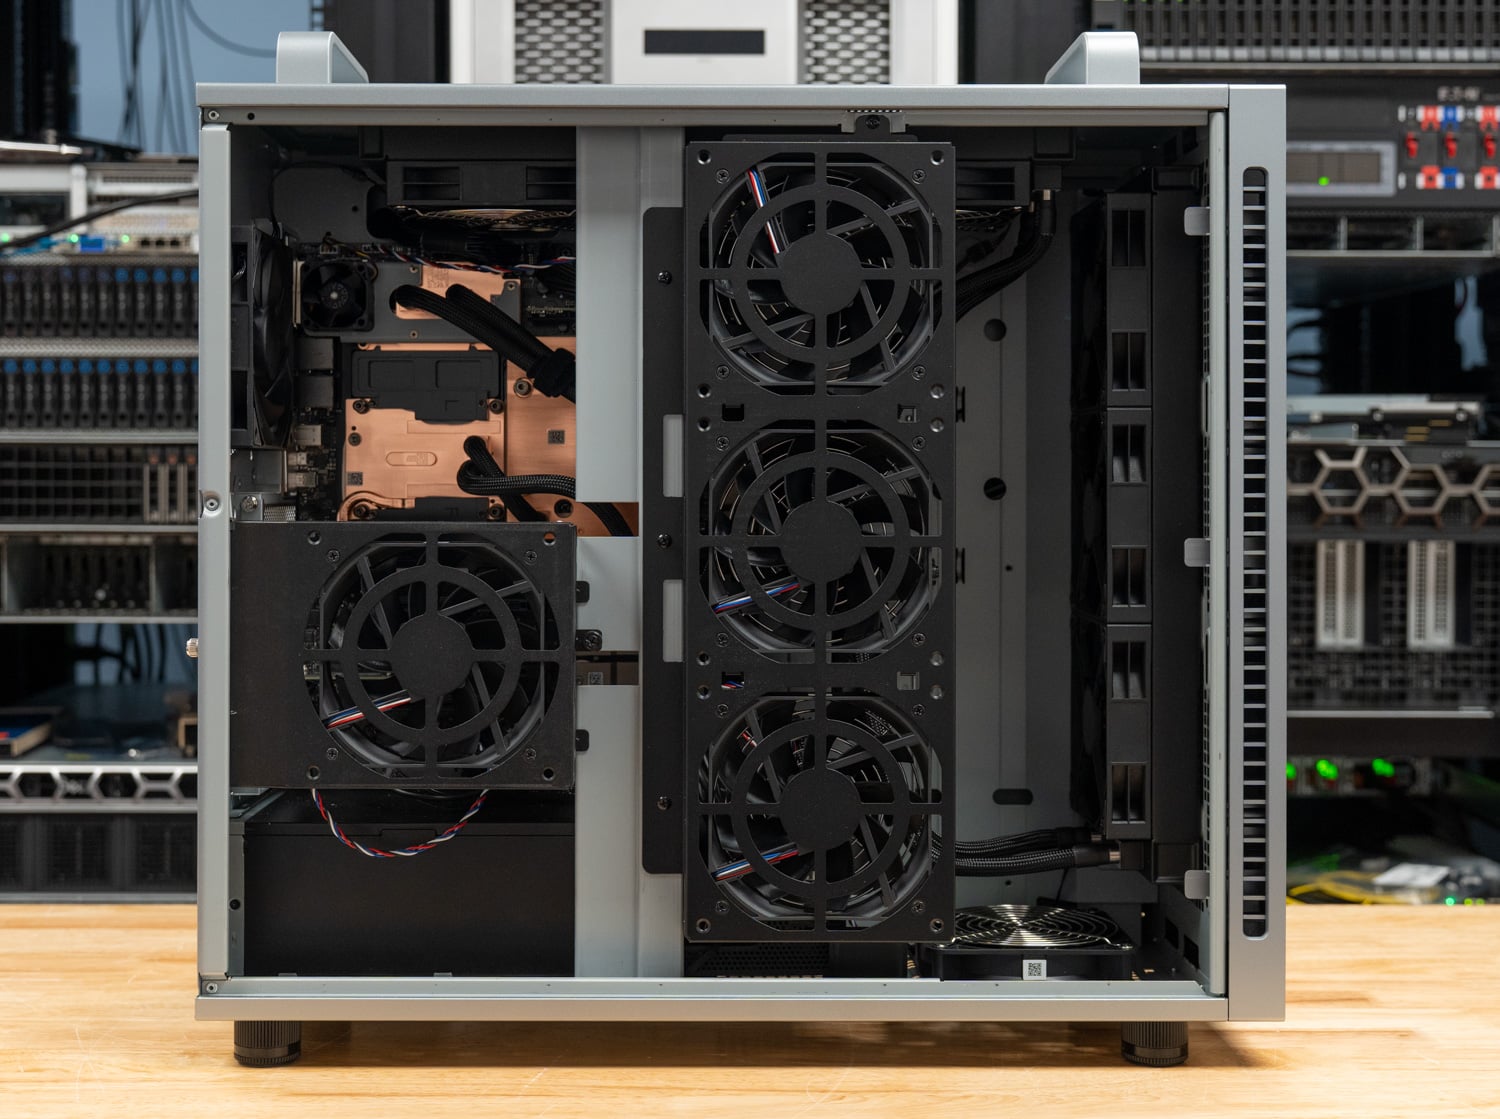
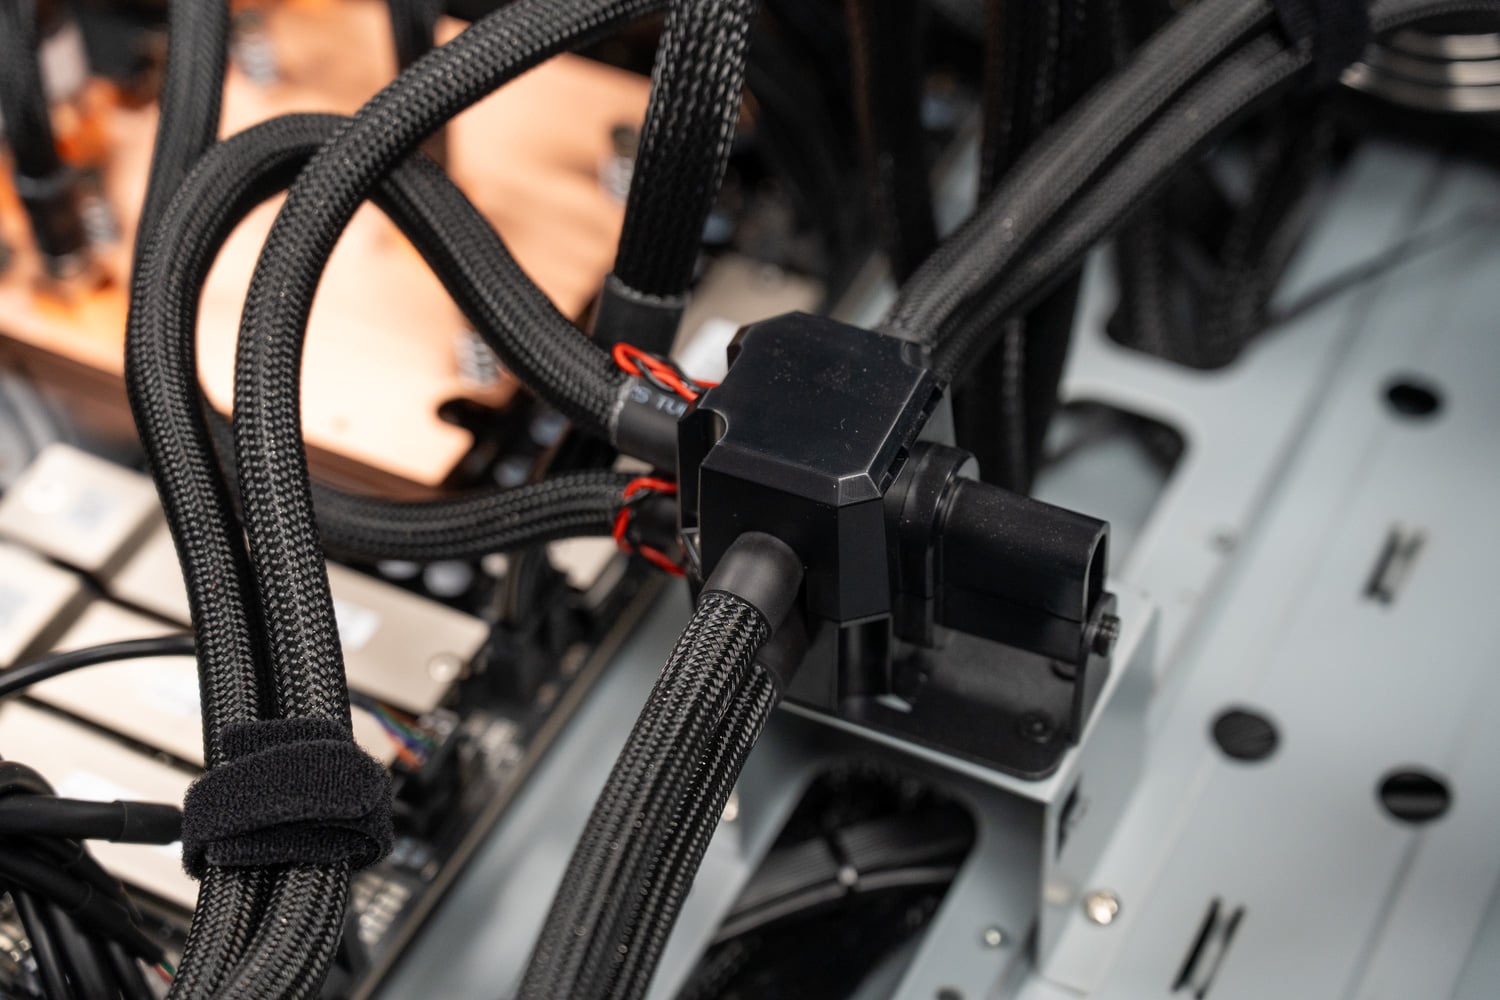
A disposição interna segue o mesmo padrão do WS300: um radiador montado verticalmente atrás da grade frontal e um segundo na parte superior, cada um com uma fileira de ventoinhas, além de uma ventoinha de chassi na parte traseira. As linhas de refrigeração são revestidas e fixadas à travessa com abraçadeiras de velcro, e o coletor consolida as conexões das quatro placas frias, de modo que apenas duas linhas cheguem a cada radiador.
O fã de óptica
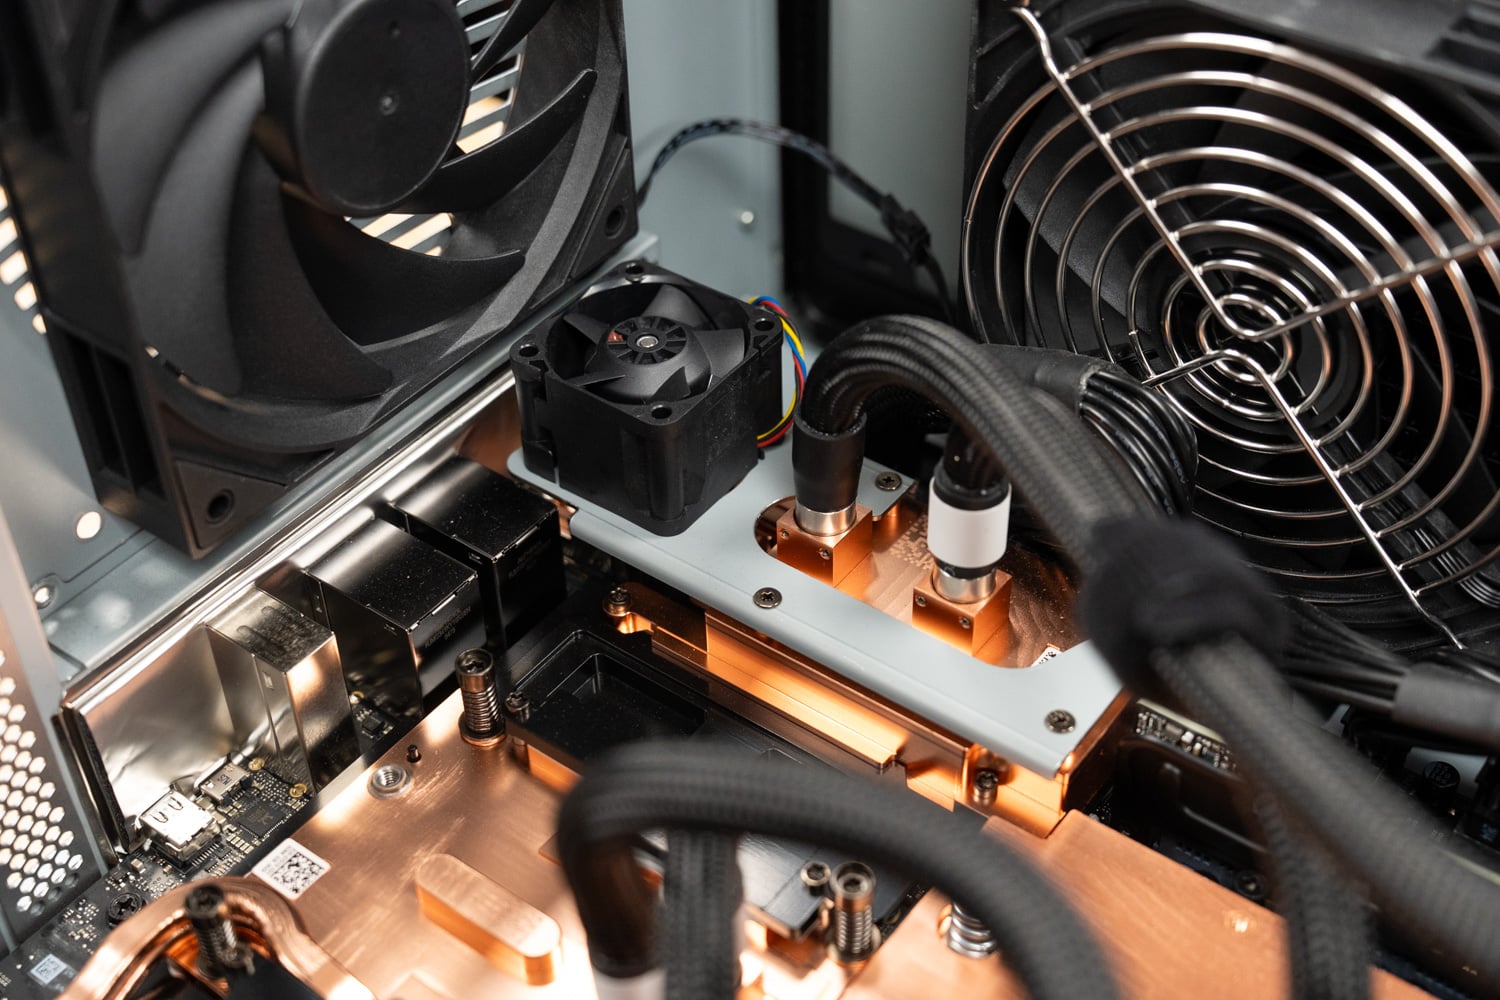
O único elemento de resfriamento que não tem equivalente no WS300 é um pequeno ventilador montado em um suporte acima da placa fria ConnectX-8, direcionado para os slots QSFP112. O circuito de refrigeração líquida lida com o próprio silício do SuperNIC, mas os transceptores ópticos de 400G geram seu próprio calor e ficam em slots de metal que a placa fria só alcança por condução. Em outros testes , observamos que o ConnectX-8 esquenta sob carga contínua e que os próprios componentes ópticos podem aquecer bastante, portanto, um caminho de fluxo de ar dedicado através dos slots é um ótimo recurso de design para quem planeja usar o ET900N G3 em fibra óptica por horas seguidas. Com DACs, que foi como o conectamos a uma segunda estação GB300 para um estudo aprofundado de inferência em cluster que ainda está em andamento, o ventilador tem menos trabalho a fazer.
Armazenamento, expansão e energia
A ASUS enviou o ET900N G3 com um único SSD NVMe de 2 TB para o sistema operacional e o pacote de software da NVIDIA, instalado nos dois slots M.2 2280 conectados à placa Grace via PCIe 5.0 x4. O segundo par de slots, conectado ao switch PCIe integrado do ConnectX-8, foi enviado vazio.
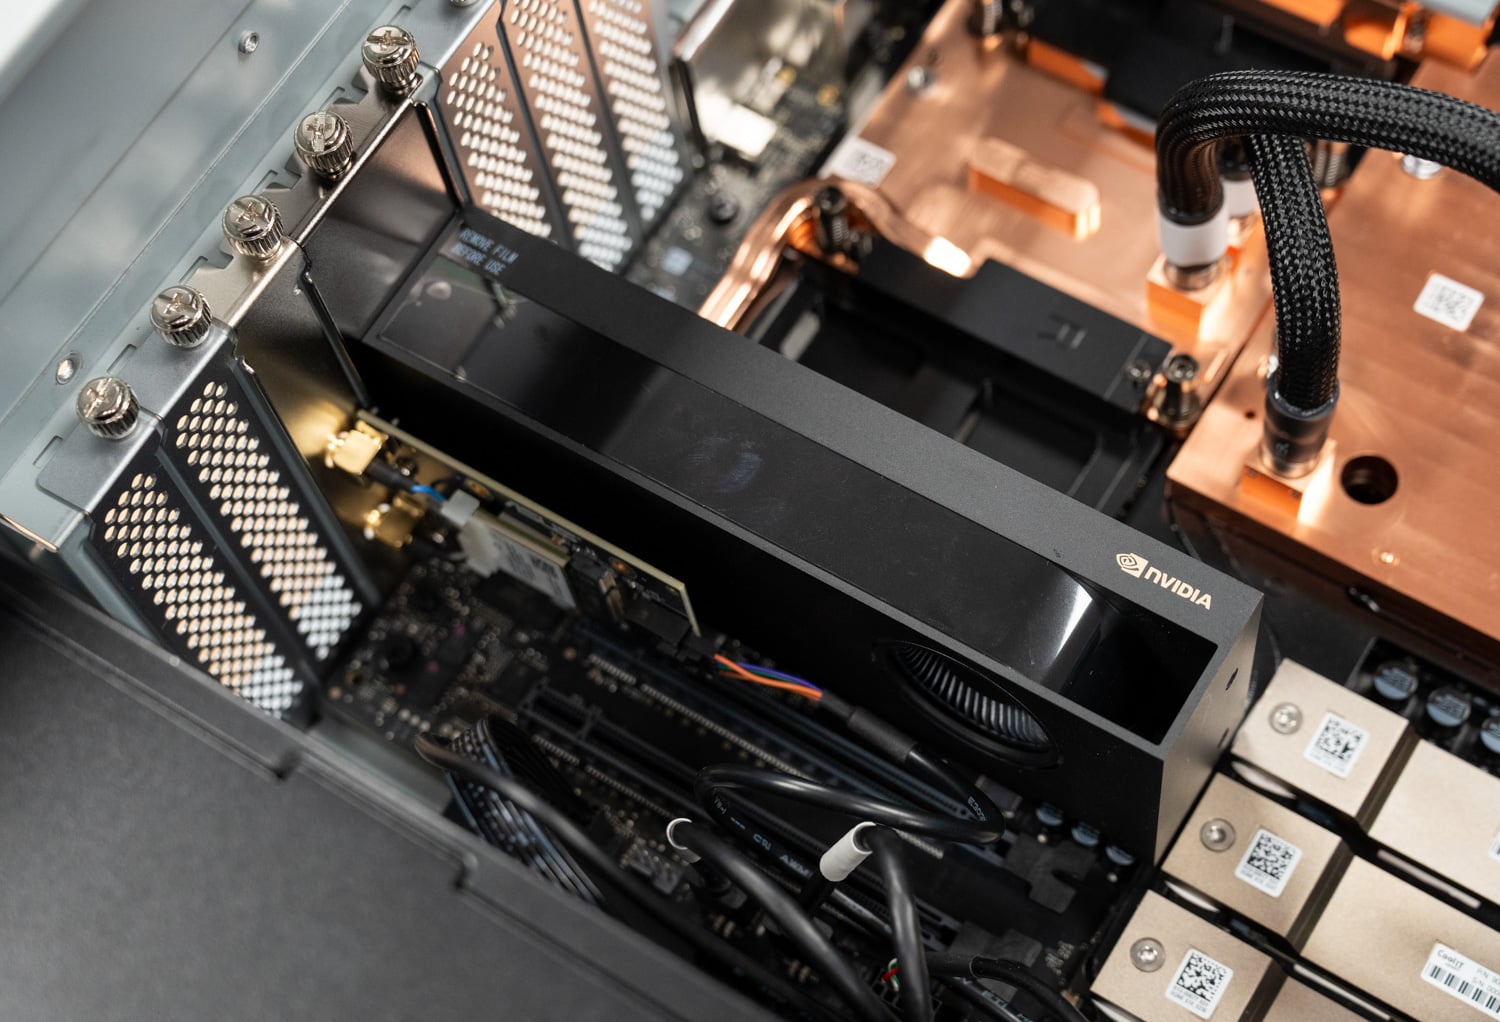
Nossa unidade de teste chegou com uma NVIDIA RTX PRO 2000 Blackwell no slot PCIe 5.0 x16, uma das configurações listadas pela ASUS. A placa fornece saída de vídeo sem consumir significativamente do orçamento de energia do GB300, e a ASUS afirma que o gabinete comporta até uma placa RTX PRO Blackwell. Removemos a RTX PRO 2000 antes dos testes de benchmark para que o Superchip tivesse o orçamento de aceleração total disponível, a mesma condição que usamos para o WS300, e não testamos uma placa RTX PRO de alto consumo neste gabinete; esse caminho, e seu impacto no orçamento de energia compartilhado, será abordado em uma futura análise do GB300 Station.
A fonte de alimentação é uma unidade ATX de 1,600 W com certificação 80 PLUS Titanium da ASUS, um nível acima da unidade Platinum presente no WS300. A certificação Titanium exige 94% de eficiência com 50% de carga em uma entrada de 115 V, em comparação com 92% para a Platinum, e é a única que estabelece um limite mínimo de 10% de carga. Portanto, a ET900N G3 deve desperdiçar algumas dezenas de watts a menos na tomada sob carga máxima da placa-mãe GB300. O consumo de energia continua sendo compartilhado: Grace, a placa-mãe B300, as bombas, as ventoinhas, o armazenamento e qualquer placa RTX PRO consomem os mesmos 1,600 W, e o serviço vsloshd da NVIDIA ajusta a margem de consumo entre o Superchip e uma GPU adicional conforme o consumo de cada um varia, sem um limite fixo para nenhum dos dois. A análise do WS300 detalha essa política, que permanece inalterada aqui. Um circuito dedicado de 20 A continua sendo o requisito para instalações na América do Norte.
Conectividade
As duas portas QSFP112 do ConnectX-8 são a ligação do ET900N G3 a todos os outros componentes: armazenamento, uma segunda Estação DGX ou uma malha de cluster. Essas portas já estão em uso no laboratório, com o ET900N G3 conectado a uma segunda Estação GB300 por meio de DACs de 400G para uma análise detalhada de inferência em cluster que publicaremos separadamente. A porta Marvell de 10GbE lida com o tráfego de host comum e a porta Realtek de 1GbE é dedicada ao BMC.
Anotações para teste
Todos os resultados desta análise são da unidade que a ASUS enviou para o nosso laboratório, na configuração de memória de fábrica com 252 GB de HBM3e e 496 GB de LPDDR5X. O sistema funcionou sem uma placa RTX PRO instalada, portanto o Superchip GB300 teve acesso a toda a sua capacidade de aceleração, correspondendo às condições dos nossos testes com o WS300. O conjunto de softwares, a configuração do vLLM, os perfis de carga de trabalho e a varredura de concorrência são os mesmos que usamos para o WS300, permitindo uma comparação direta entre os dois gabinetes. Esta análise foca apenas no desempenho; não medimos o consumo de energia nem a temperatura desta unidade.
As cargas de trabalho são os mesmos dois perfis de inferência ao vivo do vLLM que executamos em todos os sistemas de IA locais: uma carga de trabalho equilibrada com 512 tokens de entrada e 512 de saída, e uma carga de trabalho com preenchimento automático intensivo, com 8,192 tokens de entrada e 1,024 de saída, variando de um a 128 fluxos simultâneos. Para os modelos de escala de fronteira, comparamos com um servidor Dell PowerEdge XE7740 com GPU, equipado com duas ou quatro placas RTX PRO 6000 , a alternativa de caixa única mais próxima para esses pontos de verificação. Para os modelos menores, comparamos com uma única RTX PRO 6000 no mesmo XE7740, uma única H200 NVL em um Dell PowerEdge R770 e um Spark GB10 DGX representado pelo Acer Veriton GN100 , o mesmo Spark que usamos na análise do WS300. Os valores do ET900N G3 abaixo são os valores exatos dos registros de execução; Os dados do sistema de comparação são obtidos a partir de nossos gráficos de resultados.
Desempenho de inferência
Modelos de fronteira no pool de memória coerente
A razão de ser da GB300 é atender modelos que estejam em ambos os lados do limite de 252 GB de HBM3e da B300, então começamos com quatro pontos de verificação que abrangem essa faixa: DeepSeek V4 Flash e MiniMax M2.7 cabem na HBM com folga, MiniMax M3 cabe por pouco e transfere parte de seus recursos para a memória Grace, e GLM-5.2 descarrega aproximadamente metade de sua carga. Do outro lado de cada gráfico está a alternativa mais próxima em um único gabinete: placas RTX PRO 6000 juntas no PowerEdge XE7740, com transferência de recursos para a memória do host quando necessário.
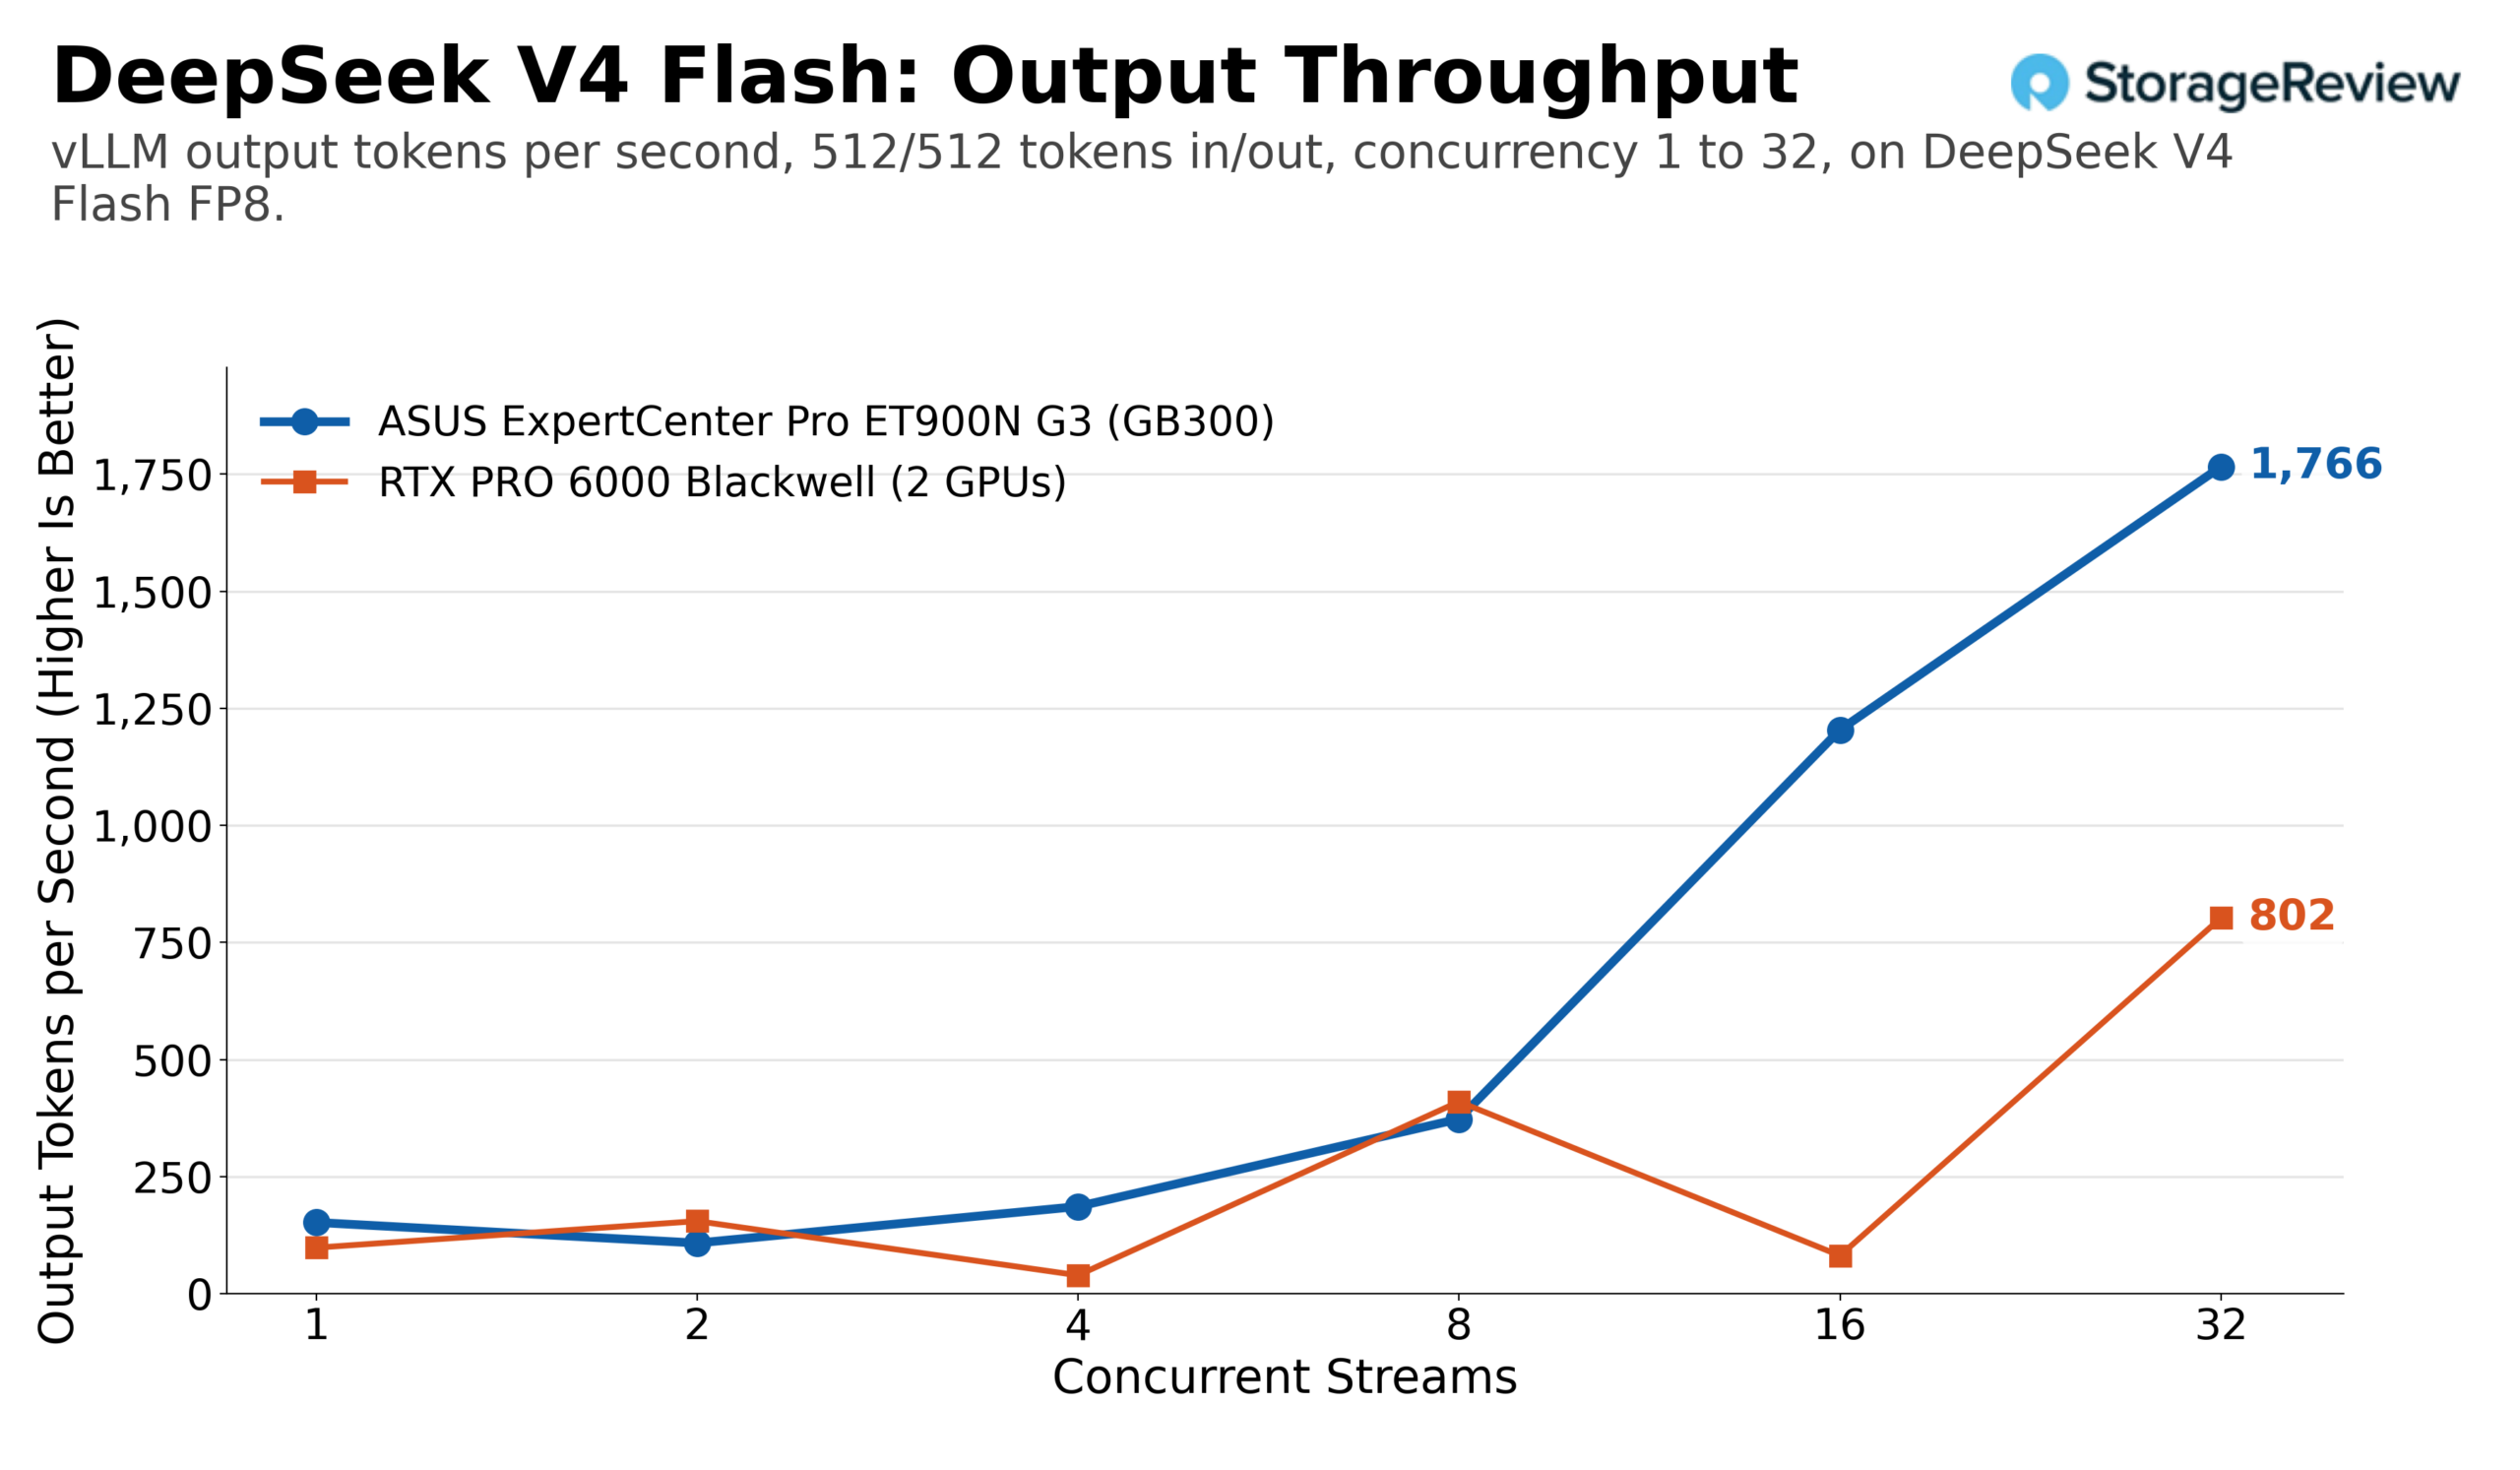
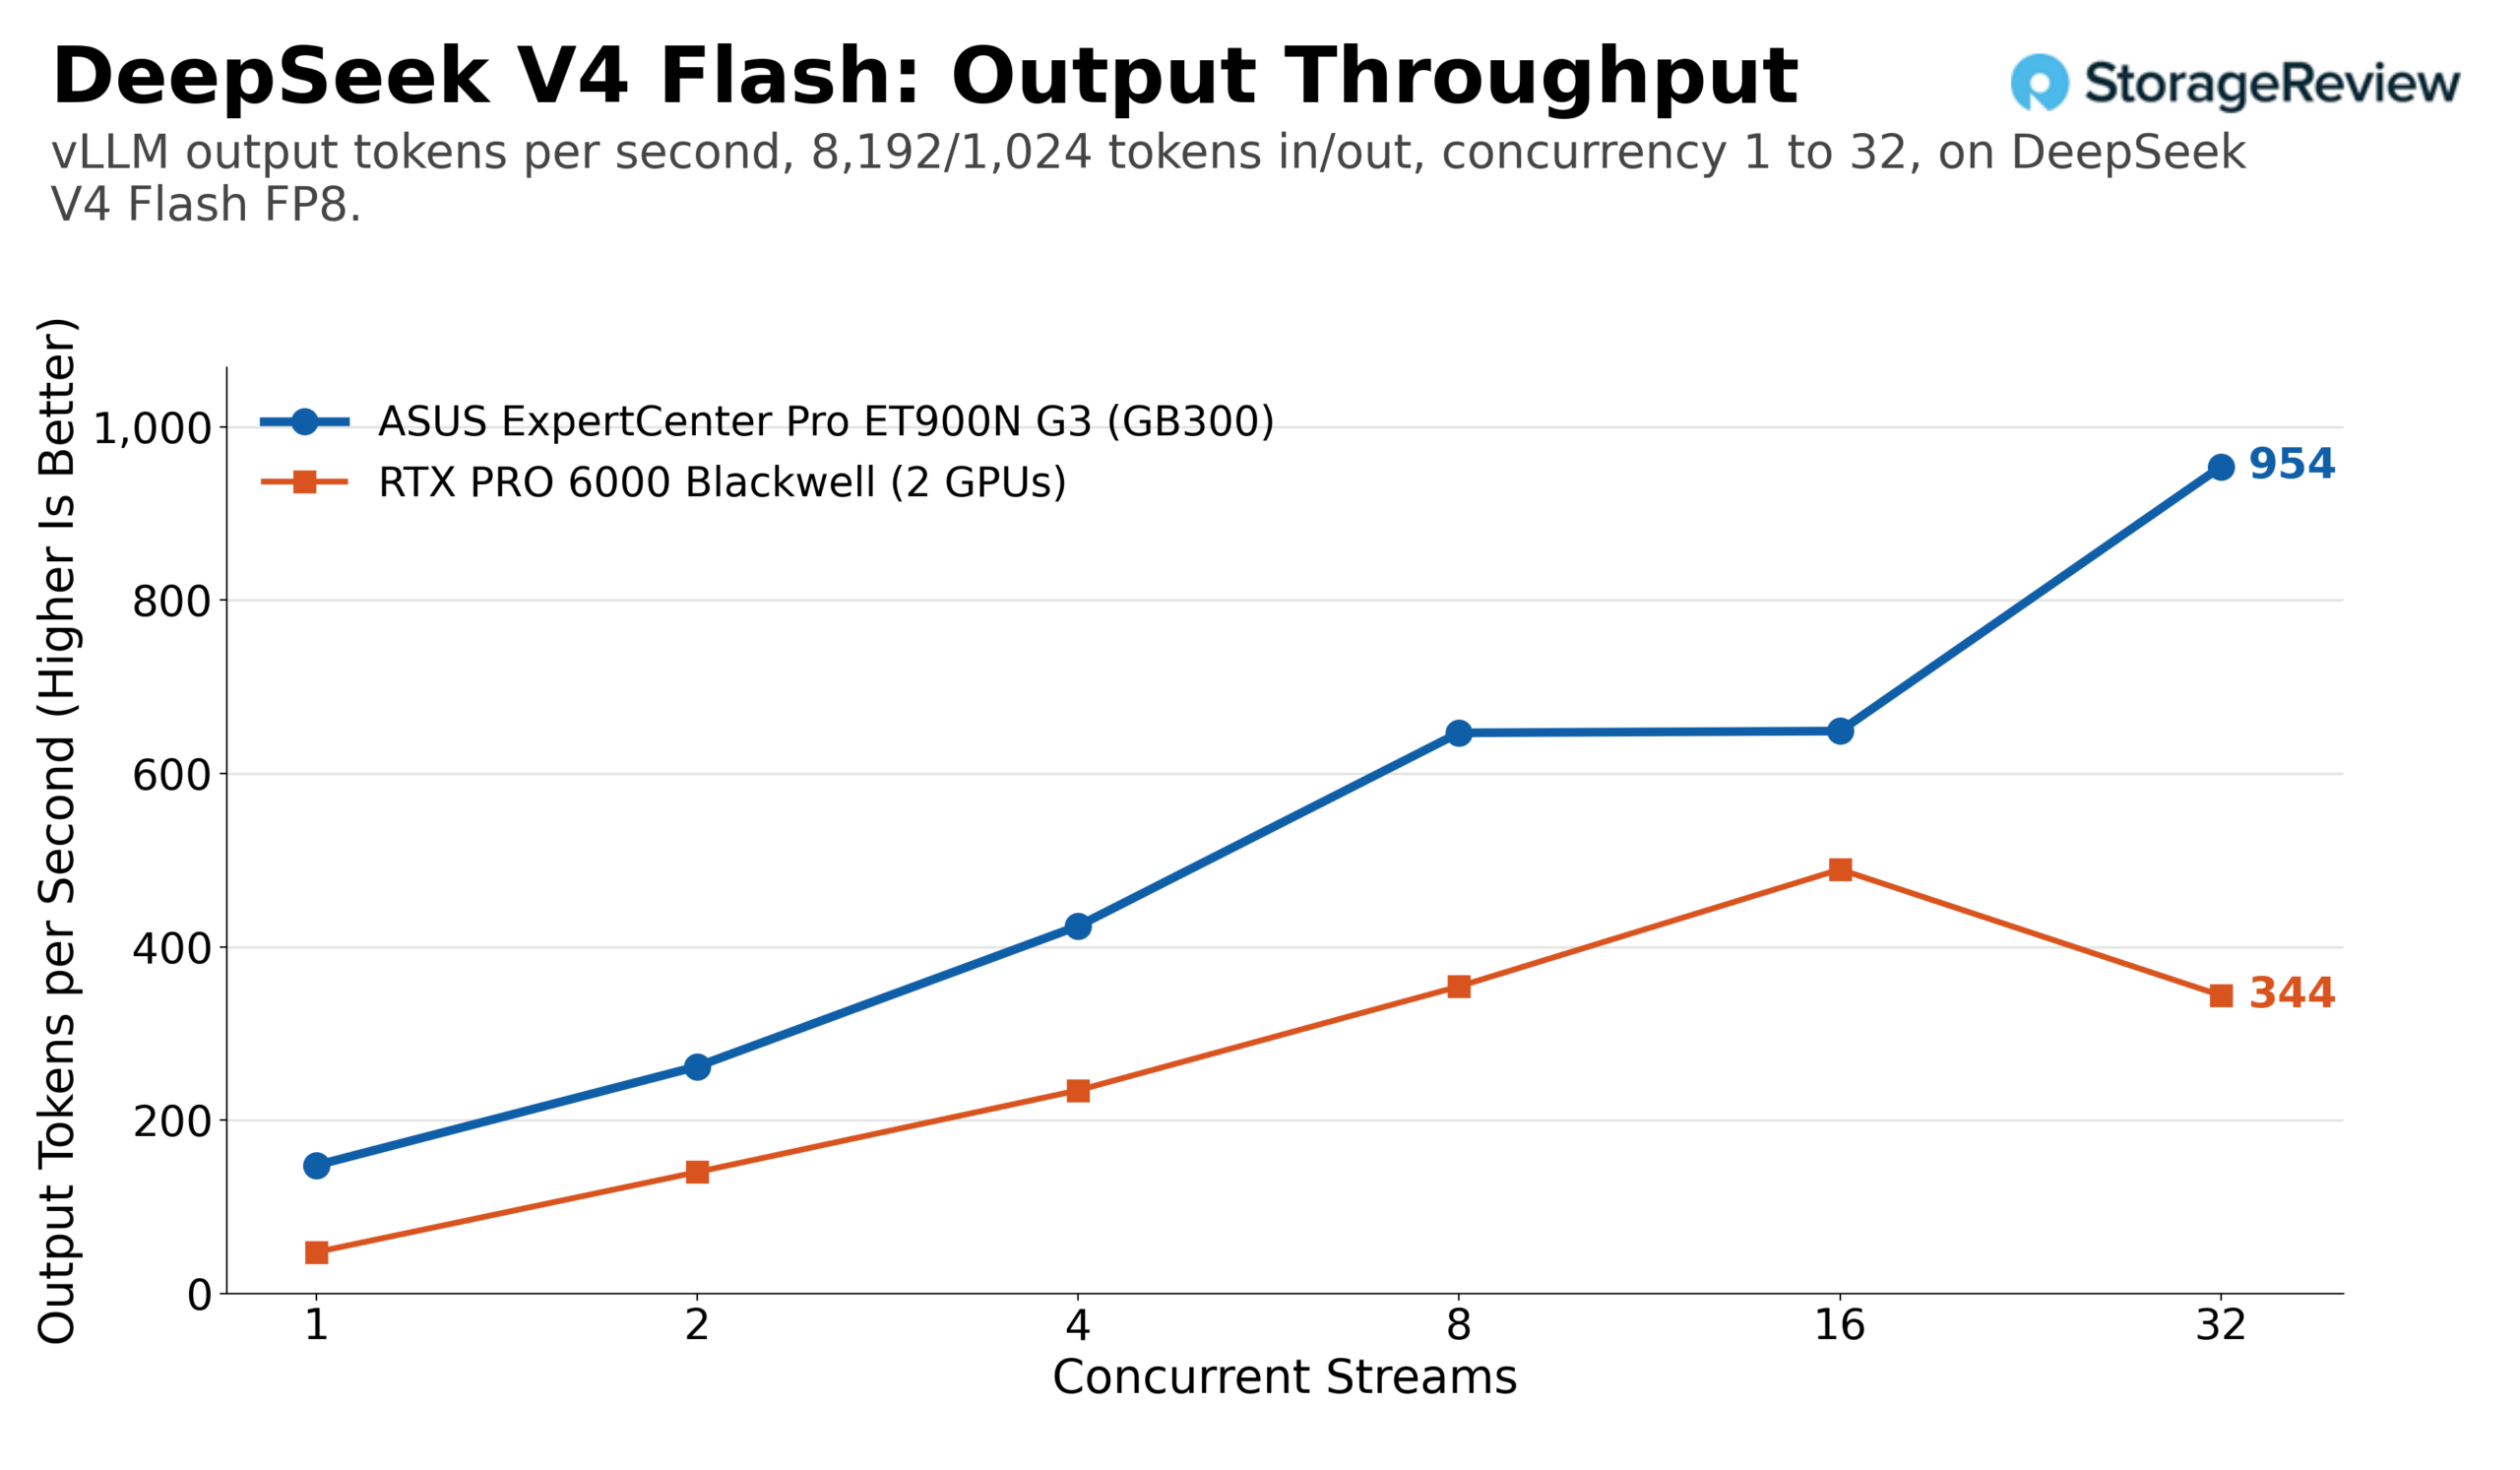
O DeepSeek V4 Flash é o caso mais simples: um checkpoint FP8 nativo de cerca de 20 GB que o B300 processa sem dificuldades. A taxa de transferência de saída na mesma carga de trabalho subiu de 152 tokens por segundo com 1 fluxo para 1,766 com 32 fluxos, elevando a taxa total de transferência de tokens para 3,532. No perfil com uso intensivo de pré-preenchimento, o ET900N G3 aumentou de 148 para 954 tokens de saída por segundo, com um total de 8,587 tokens. Um par de placas RTX PRO 6000 atingiu um pico próximo a 800 tokens de saída por segundo na mesma carga de trabalho e cerca de 490 nos prompts longos, com uma curva irregular em baixa concorrência.
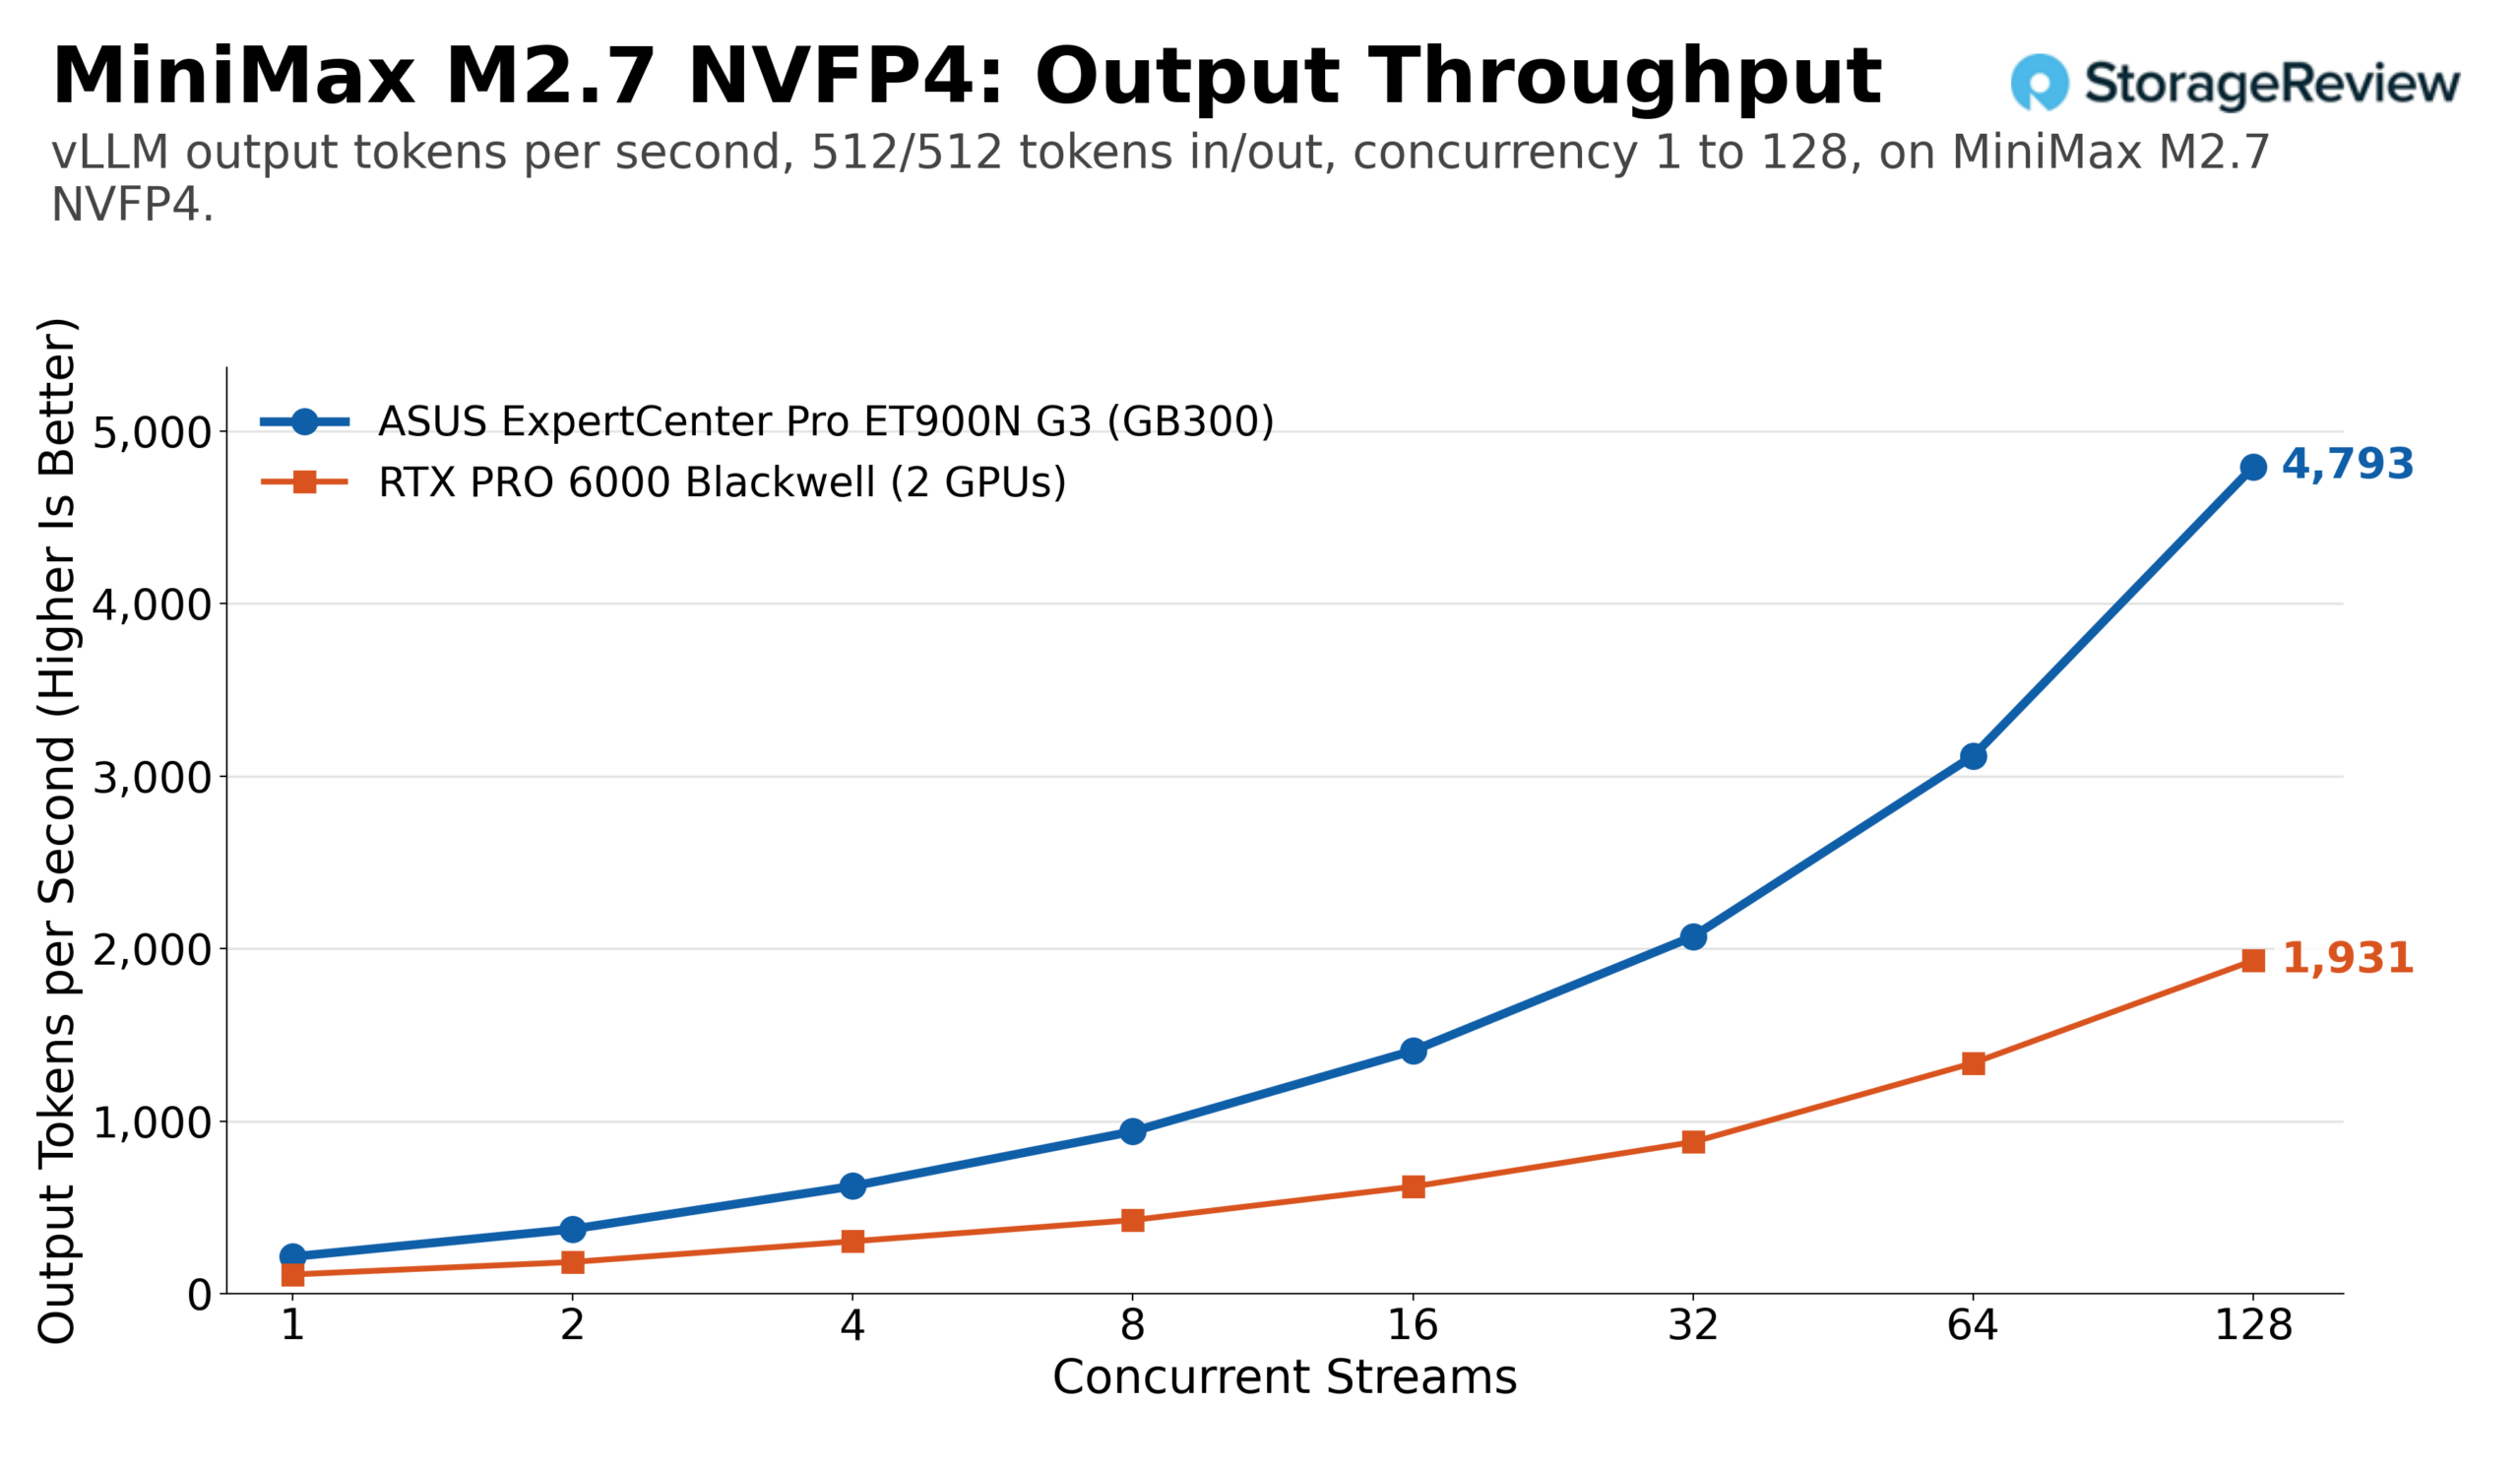
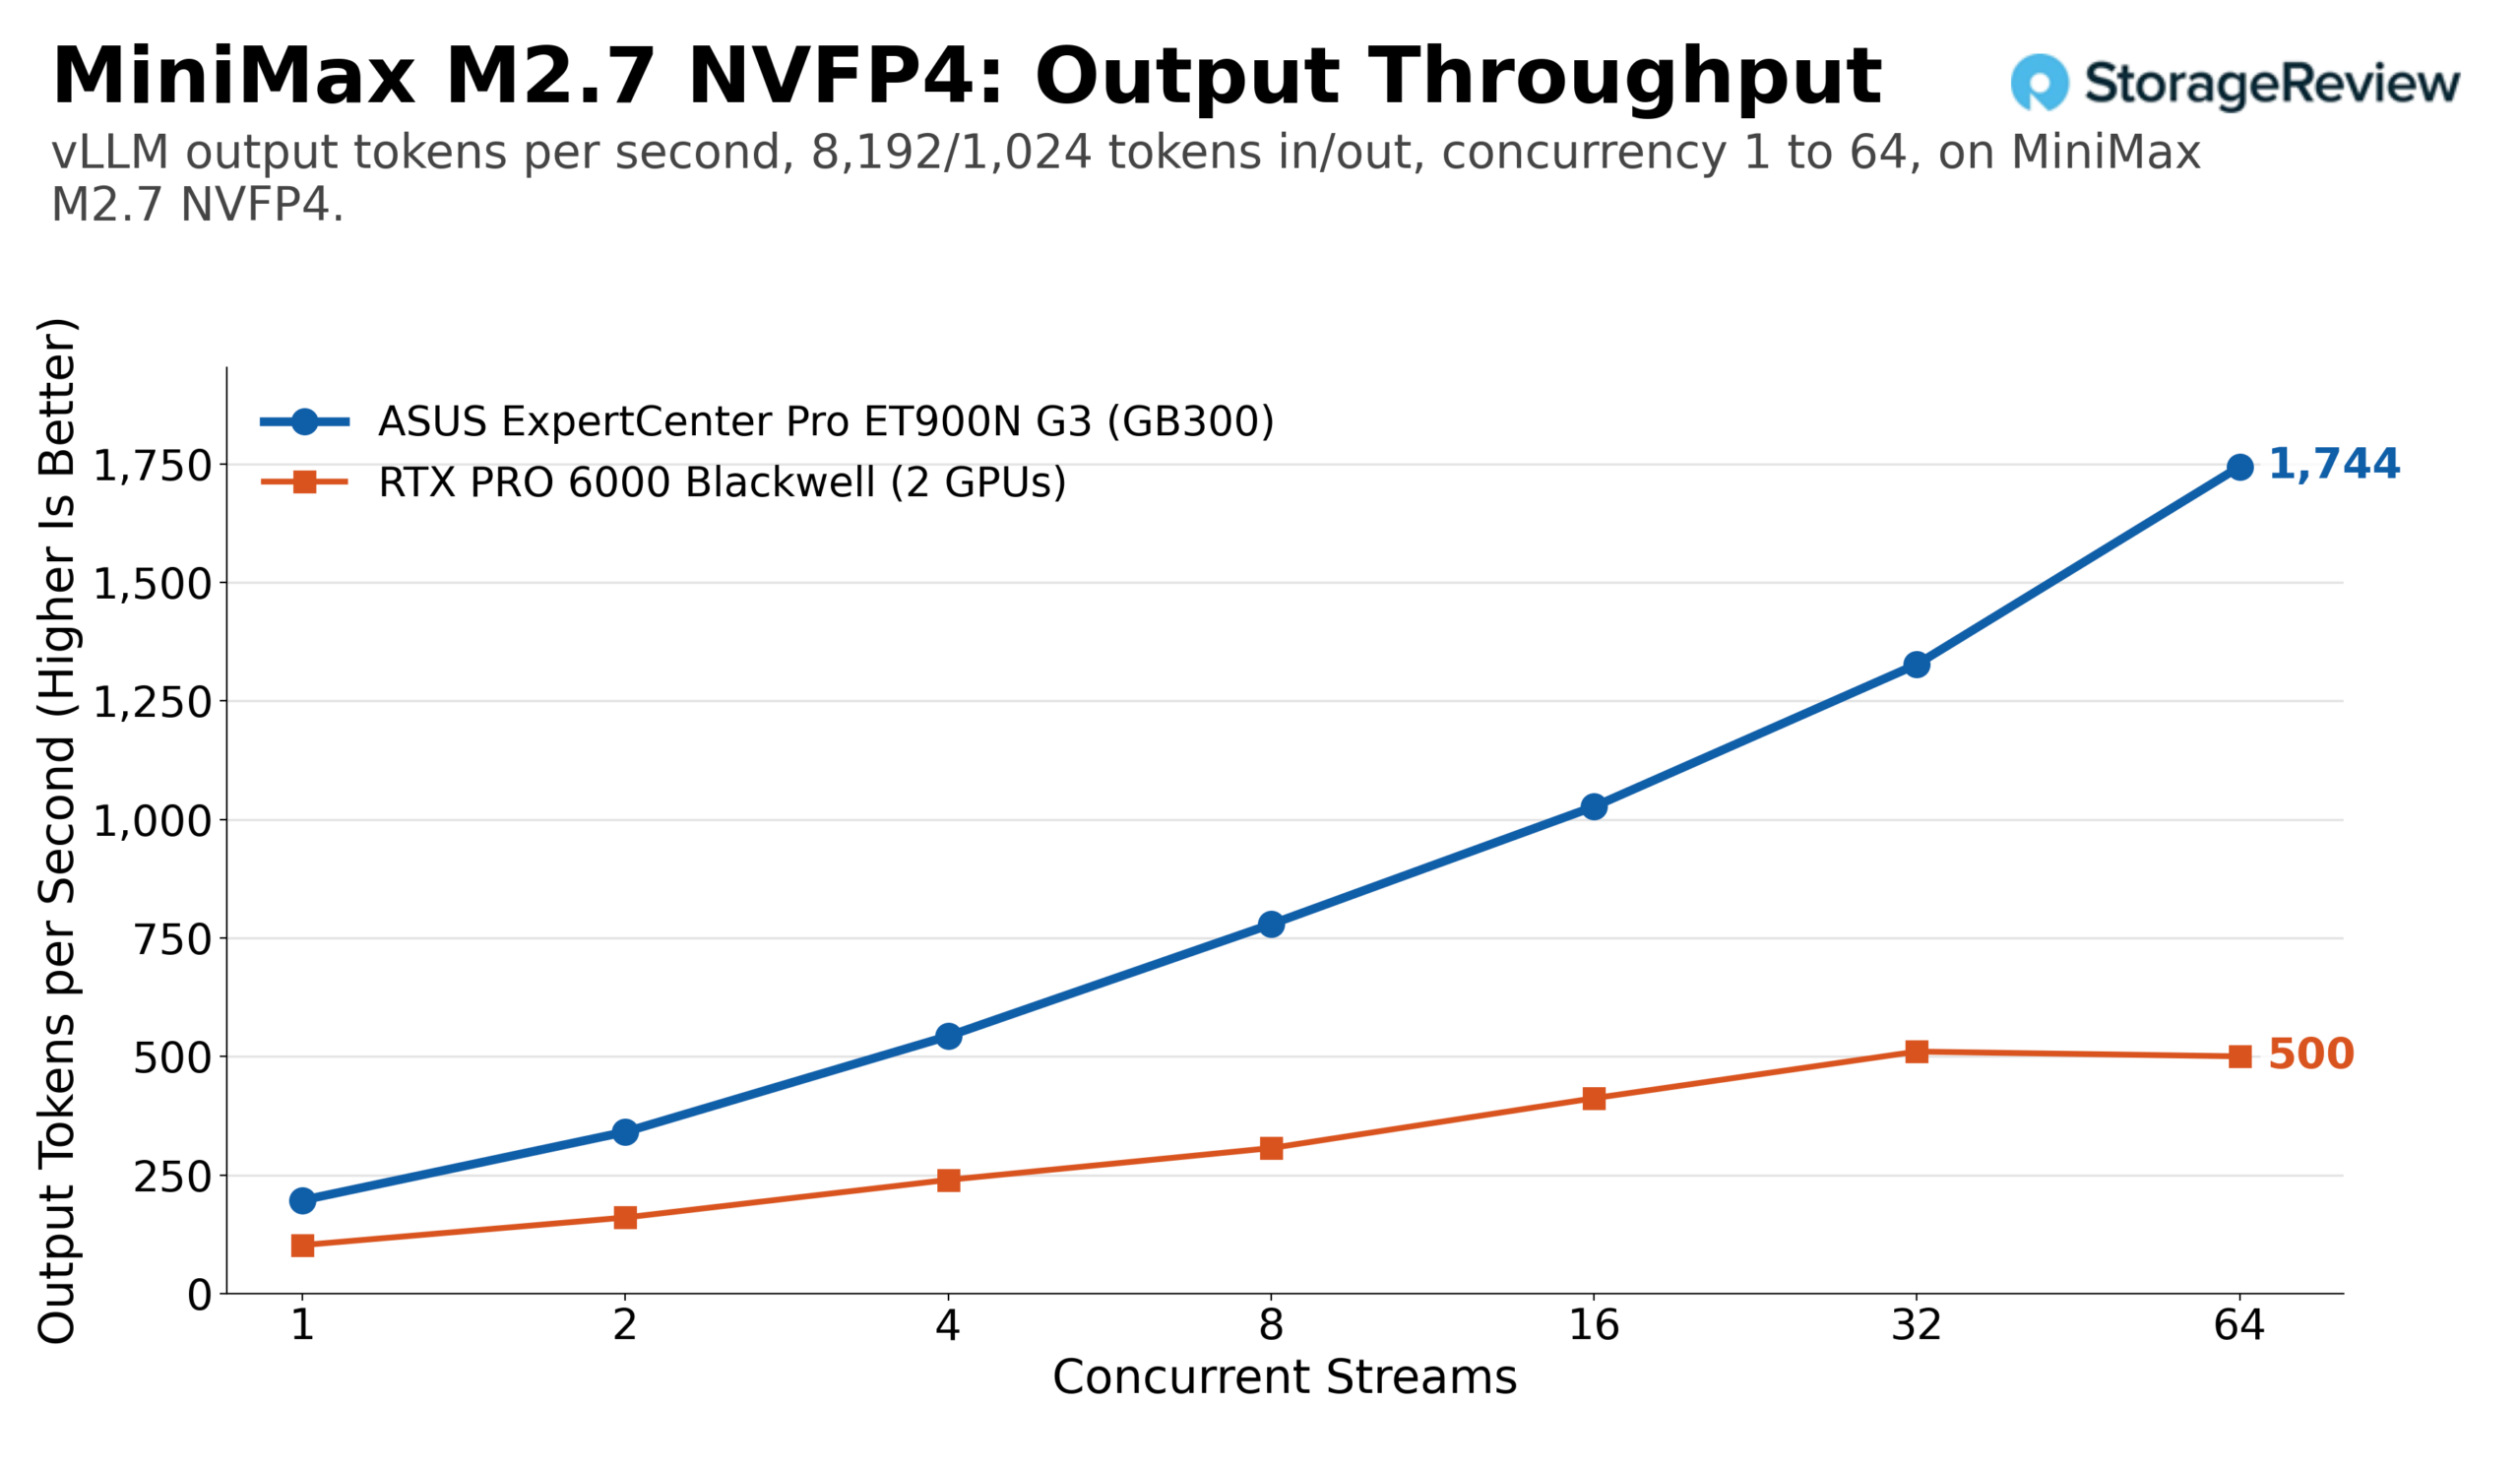
O MiniMax M2.7, com quantização NVFP4 da NVIDIA, ocupa cerca de 125 GB de HBM e apresentou o maior potencial de escalabilidade entre os quatro processadores. A carga de trabalho equivalente aumentou de 214 tokens de saída por segundo em um fluxo para 4,793 em 128 fluxos, e a taxa de transferência total atingiu 9,586. A execução com uso intensivo de pré-preenchimento alcançou 1,744 tokens de saída por segundo e 15,700 tokens totais por segundo em 64 fluxos. Duas placas RTX PRO 6000 seguiram o mesmo padrão, porém com menos da metade da altura, atingindo um pico próximo a 1,930 tokens de saída por segundo na carga de trabalho equivalente e cerca de 510 nos prompts longos.
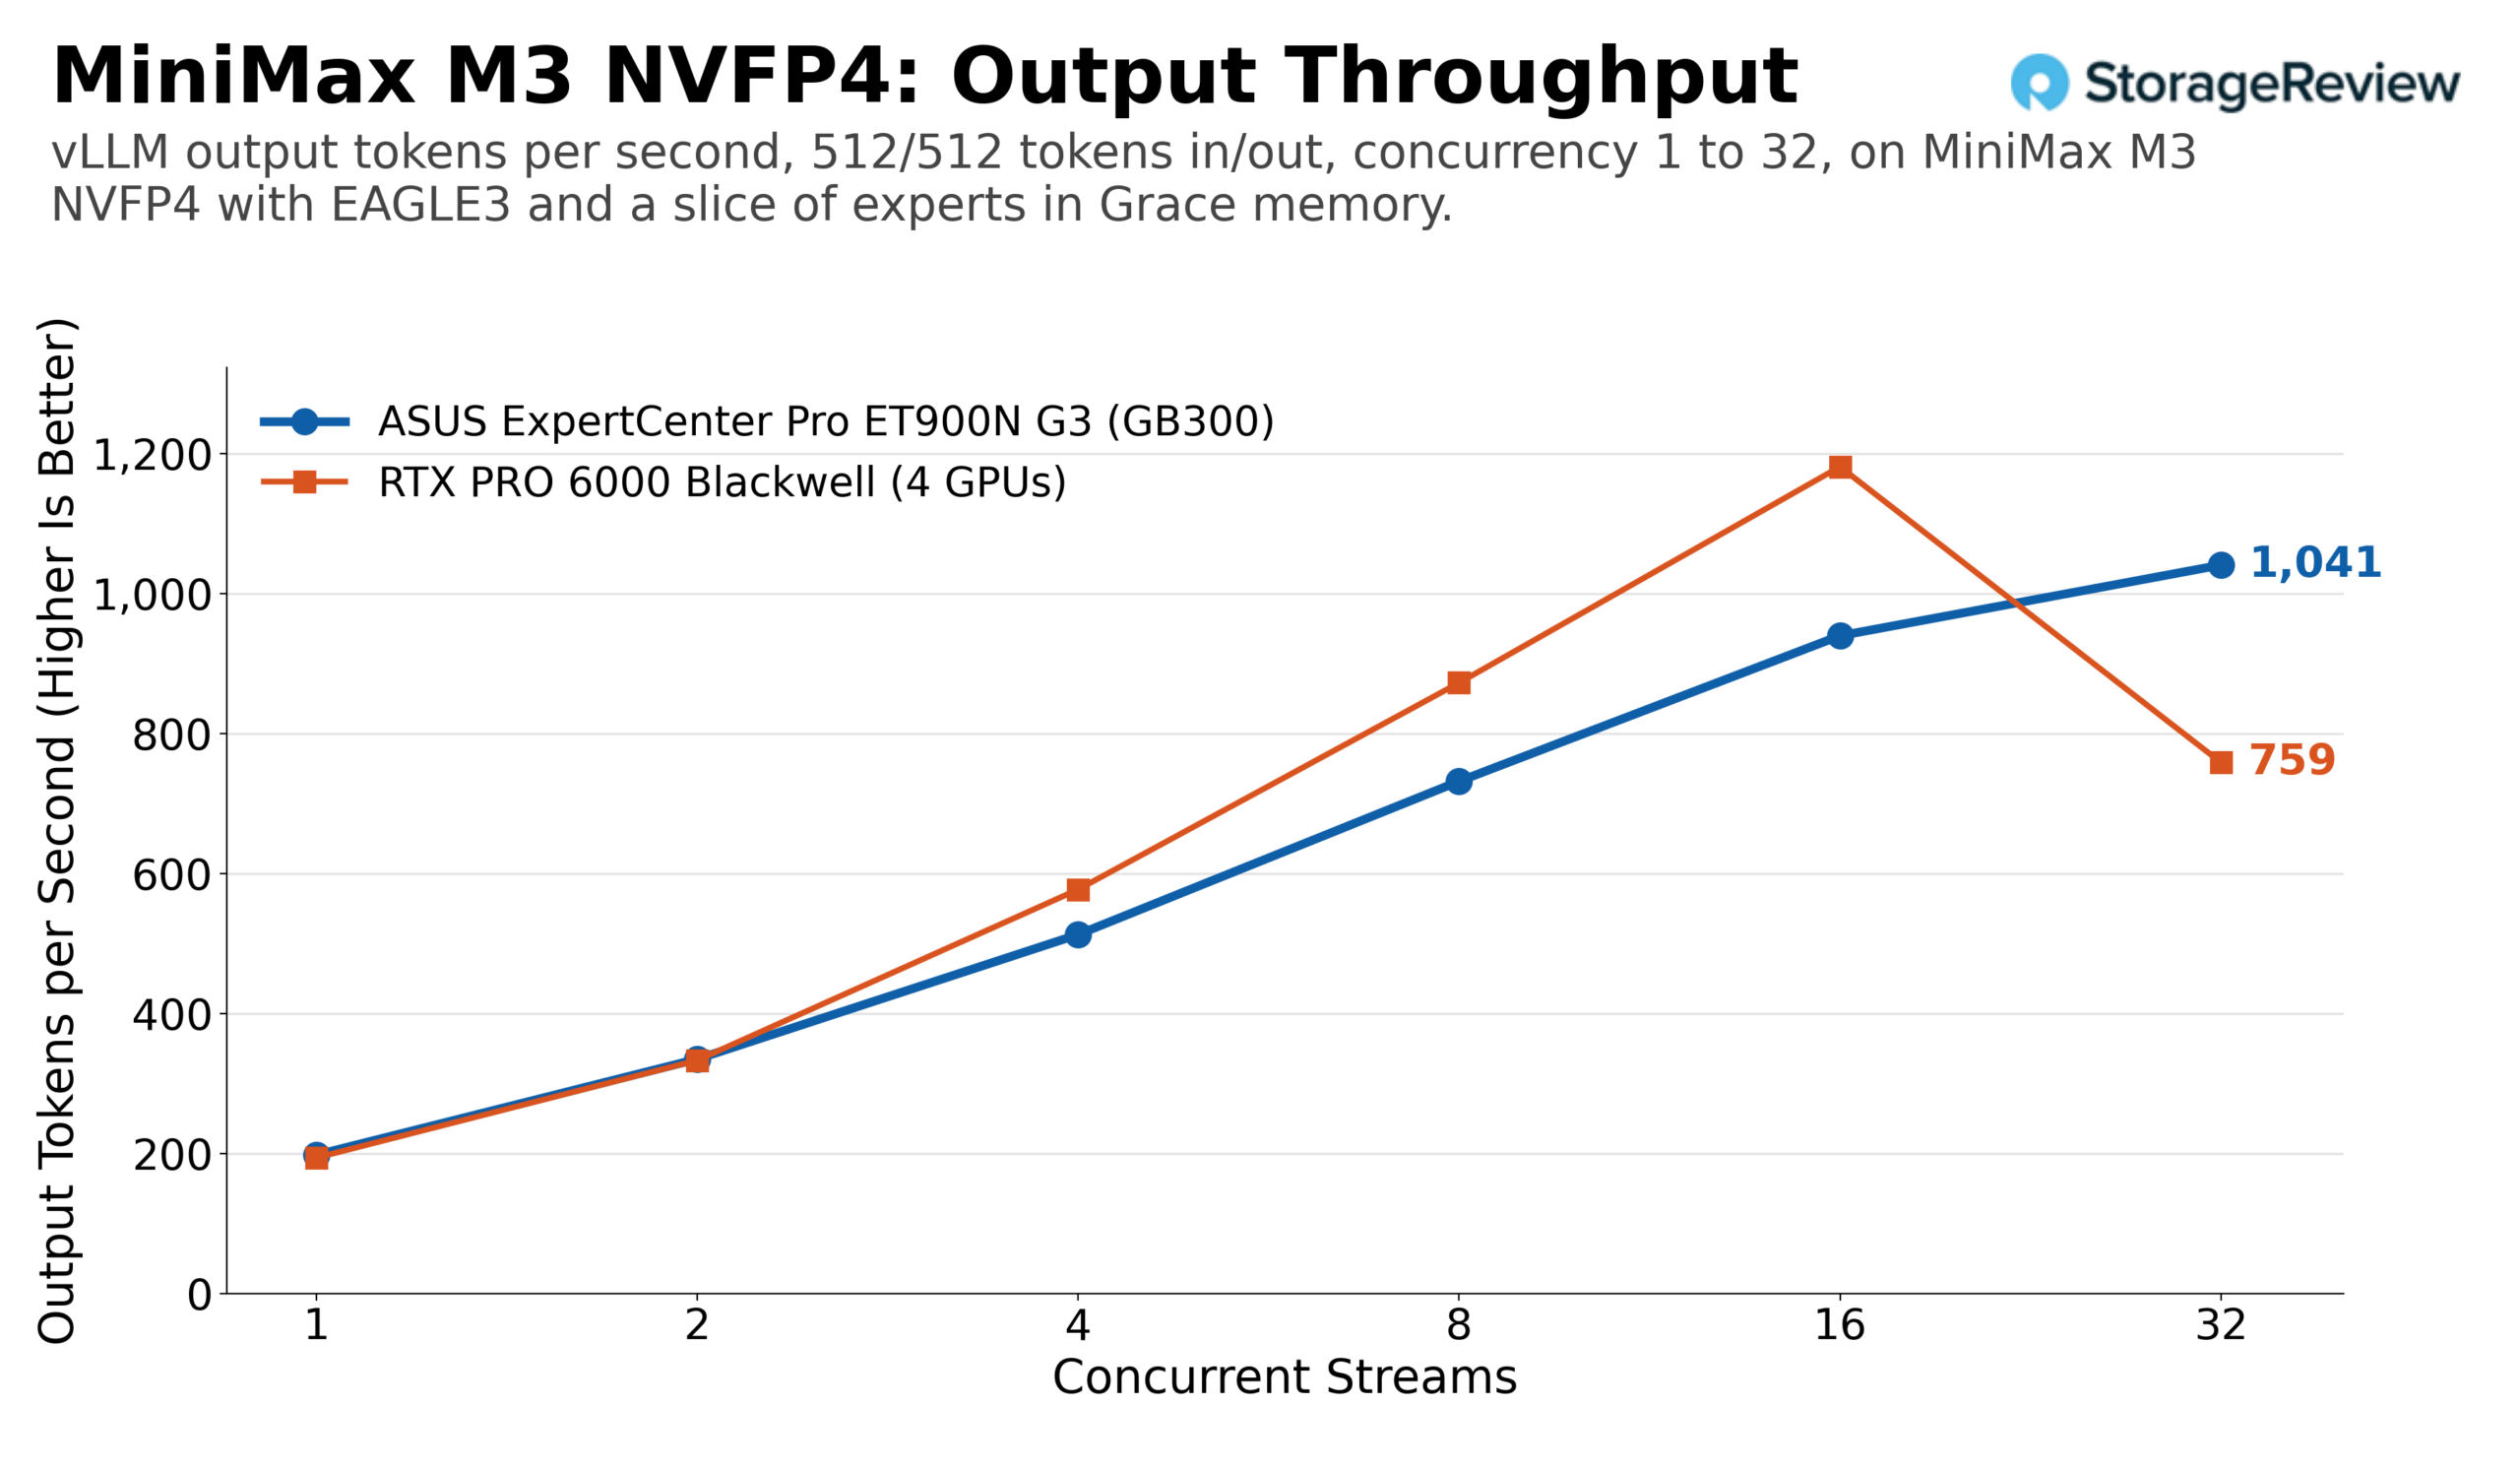
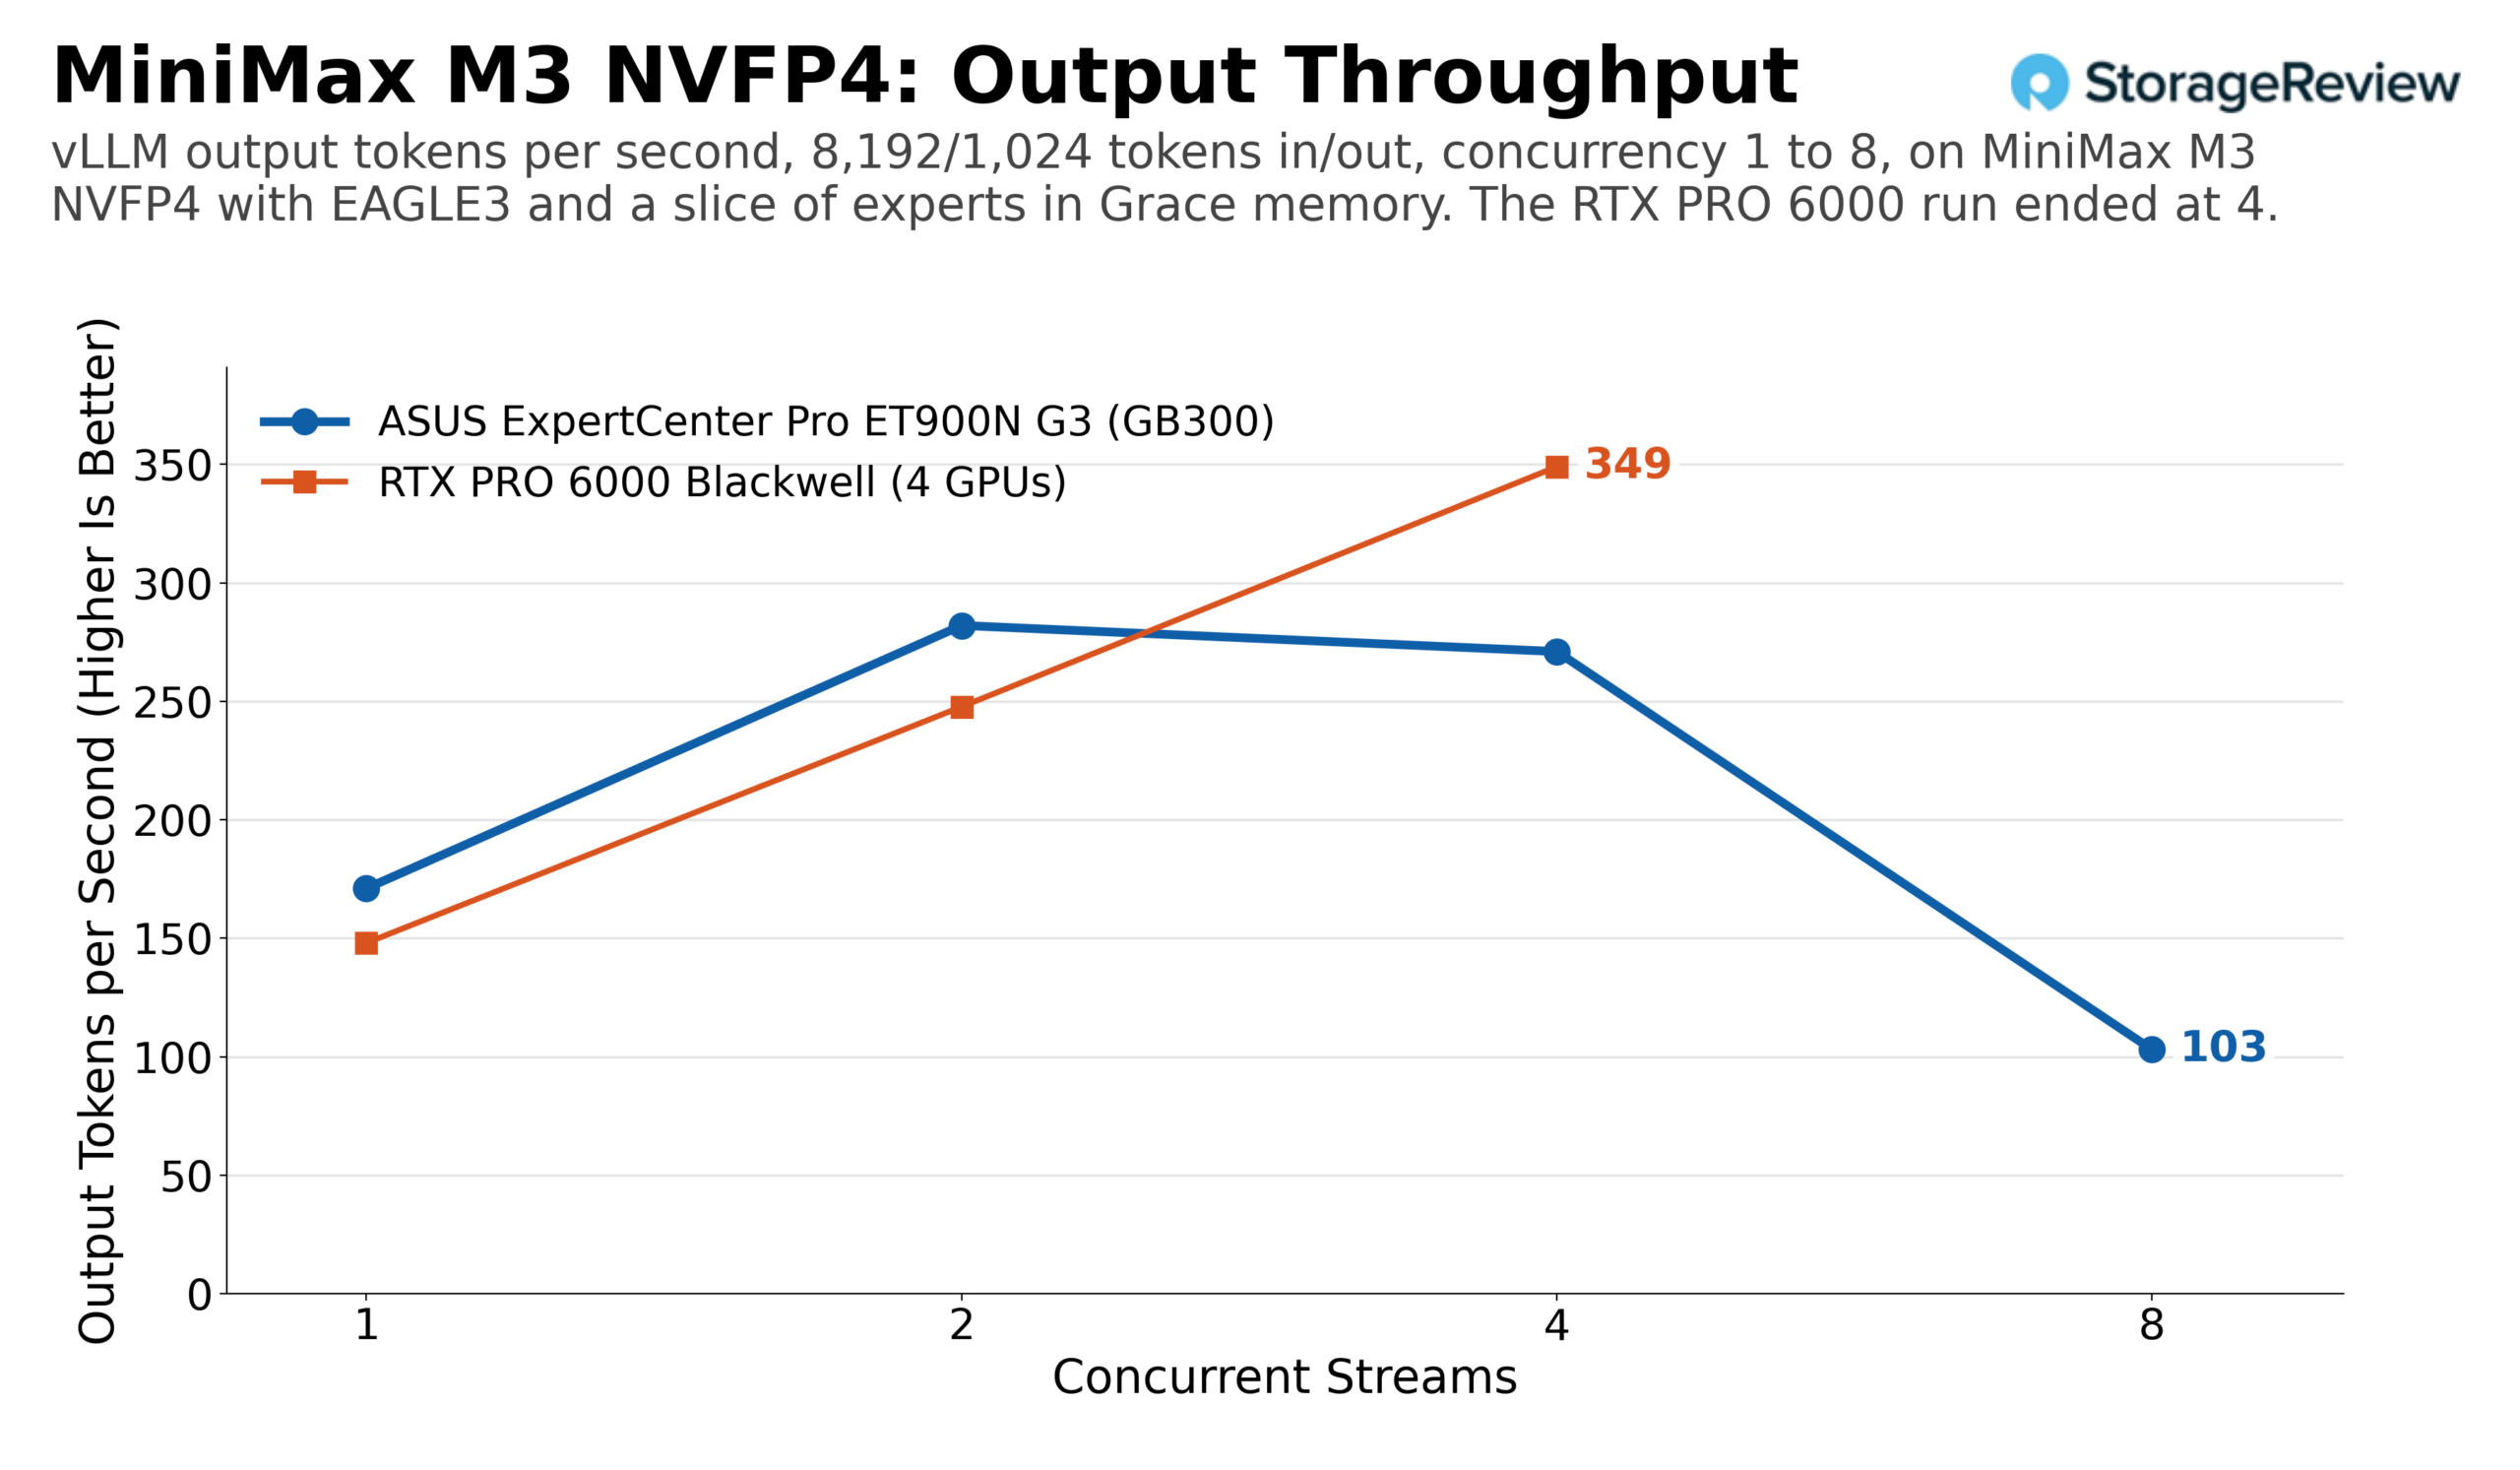
O MiniMax M3 demonstra o que significa ter espaço de sobra na memória. O ponto de verificação NVFP4 é menor que 252 GB, mas o cache de tempo de execução e o cache KV também precisam de espaço, então uma parte dos recursos reside na memória Grace, e cada etapa de decodificação que os utiliza passa pelo NVLink-C2C. Com a decodificação especulativa EAGLE3, o ET900N G3 atingiu 1,041 tokens de saída por segundo com 32 fluxos na mesma carga de trabalho, e o perfil com uso intensivo de pré-preenchimento atingiu um pico de 282 com dois fluxos, manteve-se em 271 com quatro e caiu para 103 com oito, à medida que os prompts longos consumiam o cache restante. Quatro placas RTX PRO 6000 com o mesmo decodificador especulativo acompanharam o ritmo com oito fluxos e ultrapassaram o ET900N G3 com 16 fluxos, atingindo cerca de 1,180 tokens de saída por segundo, antes de recuar para aproximadamente 760 com 32 fluxos. No perfil com uso intensivo de pré-carregamento, o conjunto de quatro placas comportava cerca de 349 tokens de saída por segundo, com quatro fluxos conectados aos 271 da Estação. Um modelo que se situa exatamente no limite da HBM é o único ponto neste conjunto onde 384 GB de VRAM distribuídos em quatro placas competem com 252 GB de HBM mais o recurso de descarregamento.
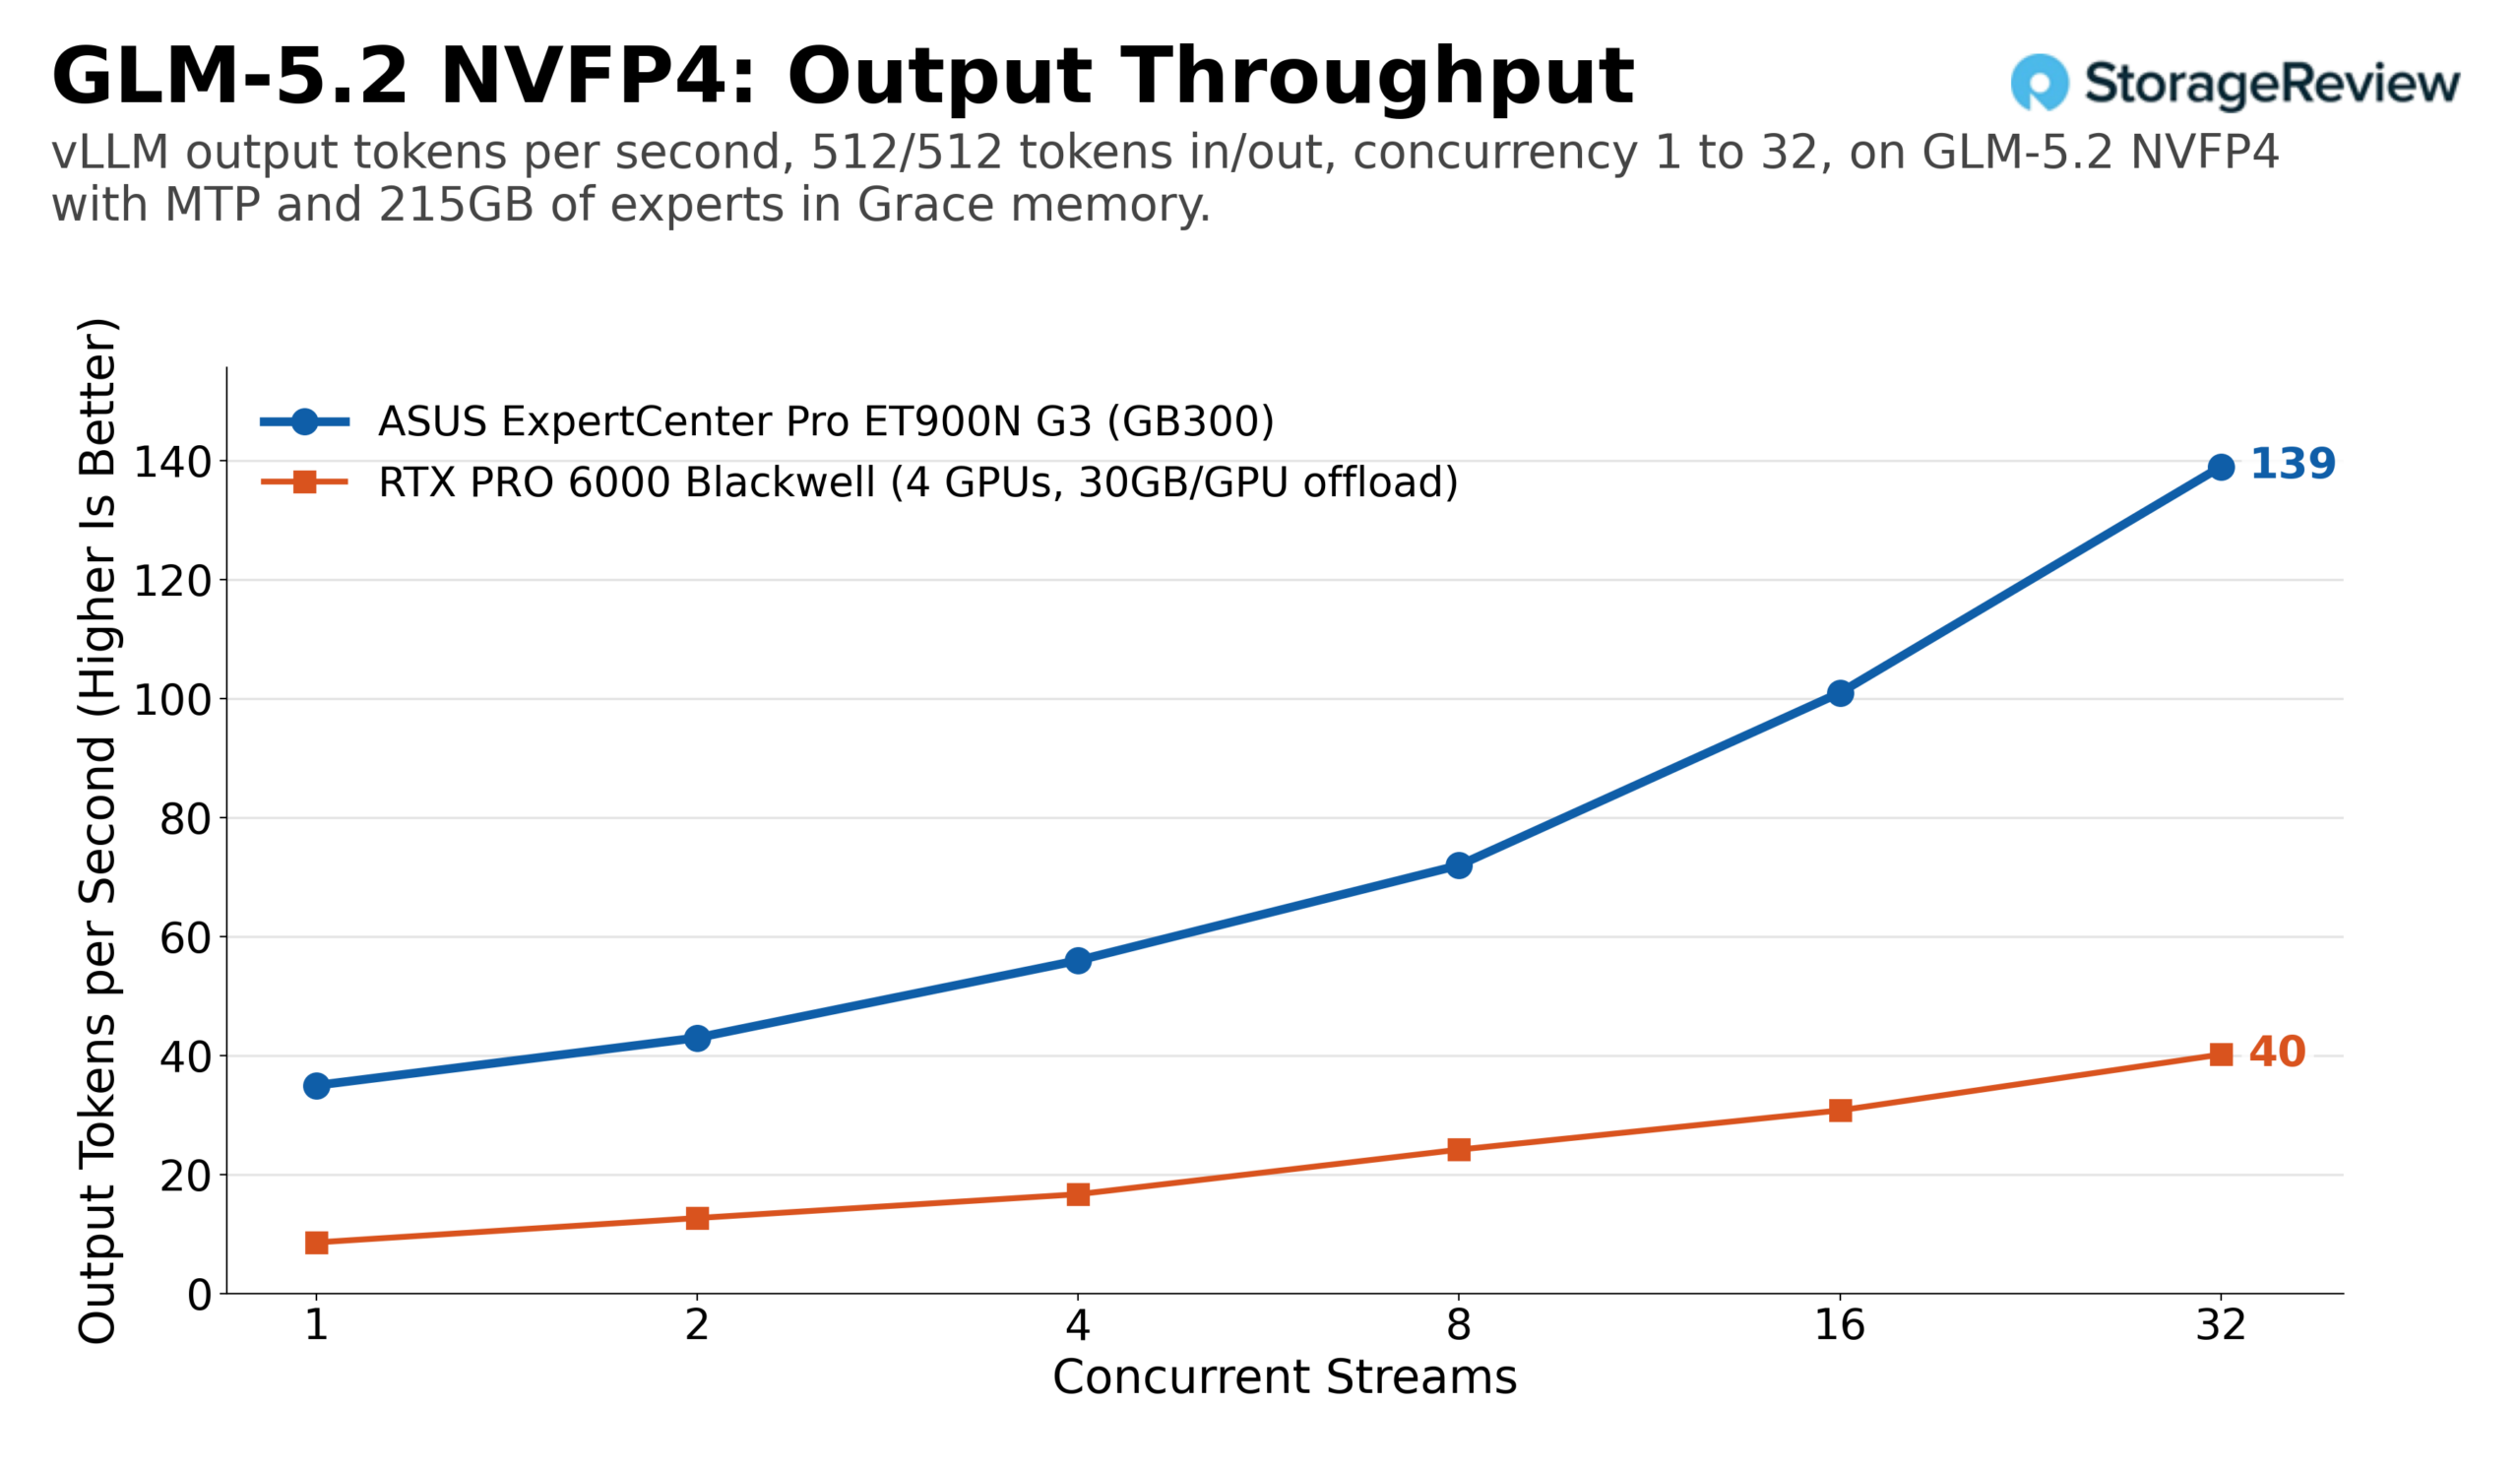
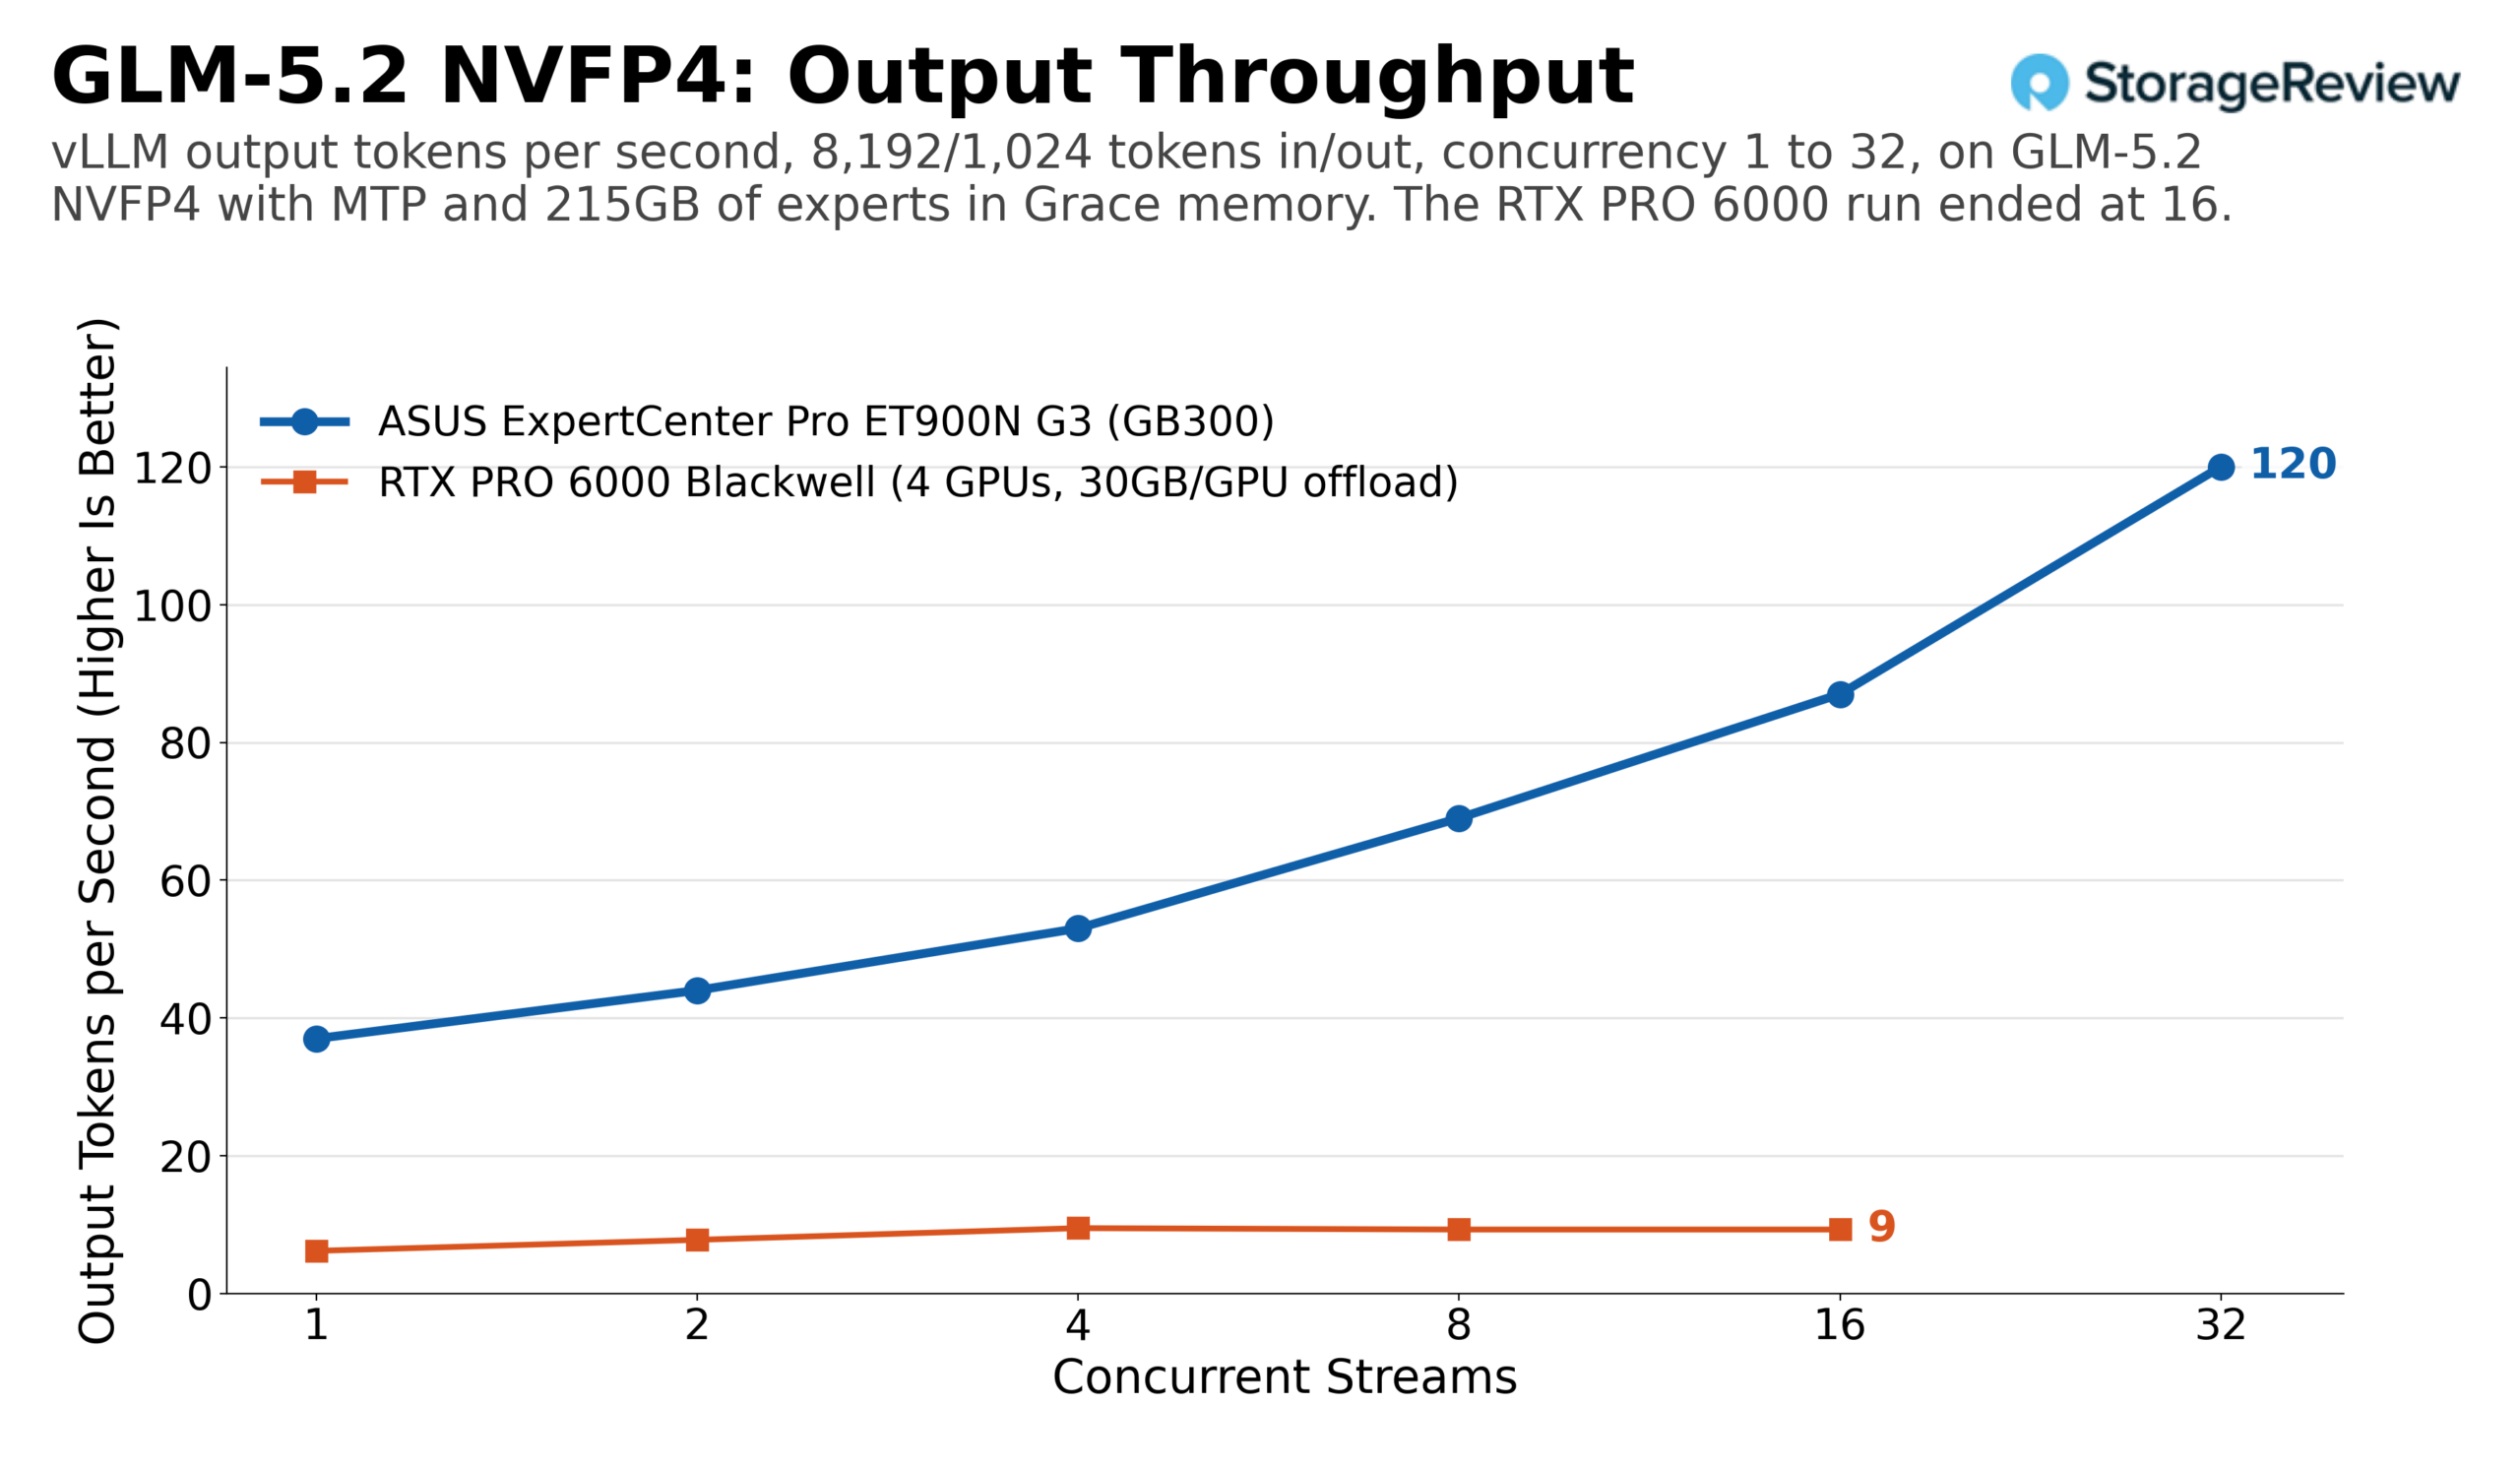
O GLM-5.2 é o caso de uso que somente o pool coerente torna possível. O checkpoint NVFP4 mantém cerca de 215 GB de pesos de especialistas na memória Grace com decodificação especulativa MTP, e o ET900N G3 o serviu a 35 tokens de saída por segundo para um fluxo e 139 para 32 fluxos em uma carga de trabalho equivalente, com taxa de transferência total atingindo 277. No perfil com uso intensivo de pré-preenchimento, a varredura foi executada em 32 fluxos, atingindo 120 tokens de saída por segundo e 1,079 tokens no total. Quatro placas RTX PRO 6000, cada uma descarregando cerca de 30 GB para a memória do host, conseguiram cerca de 40 tokens de saída por segundo em 32 fluxos, estabilizando em aproximadamente 9 a 10 em prompts longos a partir de quatro fluxos. Nenhum dos sistemas faz com que um modelo de 433 GB pareça rápido, mas a conexão LPDDR5X de 396 GB/s e o caminho NVLink-C2C de 900 GB/s do GB300 para aplicações com memória dedicada continuam a escalar onde a memória host conectada via PCIe em quatro placas para.
Em comparação com o MSI WS300, os resultados do modelo de ponta ET900N G3 ficam dentro de uma margem de aproximadamente 1% em todos os pontos que podemos comparar: 1,766 tokens de saída por segundo no DeepSeek V4 Flash com 32 fluxos em ambas as torres, 4,793 contra 4,801 no MiniMax M2.7 com 128 fluxos, 1,041 no MiniMax M3 com 32 fluxos em ambas as torres e 139 no GLM-5.2 com 32 fluxos em ambas as torres.
Modelos compartilhados com o RTX PRO 6000, H200 NVL e DGX Spark.
A segunda parte dos testes comparativos utiliza modelos suficientemente pequenos para serem executados em qualquer sistema: GPT-OSS-20B e 120B em MXFP4 nativo; Llama 3.1 8B em BF16 e FP8; Mistral Small 24B em BF16 e FP8; e Qwen3 Coder 30B em BF16 e FP8. A novidade desde a análise do WS300 é a inclusão de uma única H200 NVL, a placa Hopper de 141 GB da NVIDIA, que coloca na comparação um acelerador de data center de uma geração anterior.
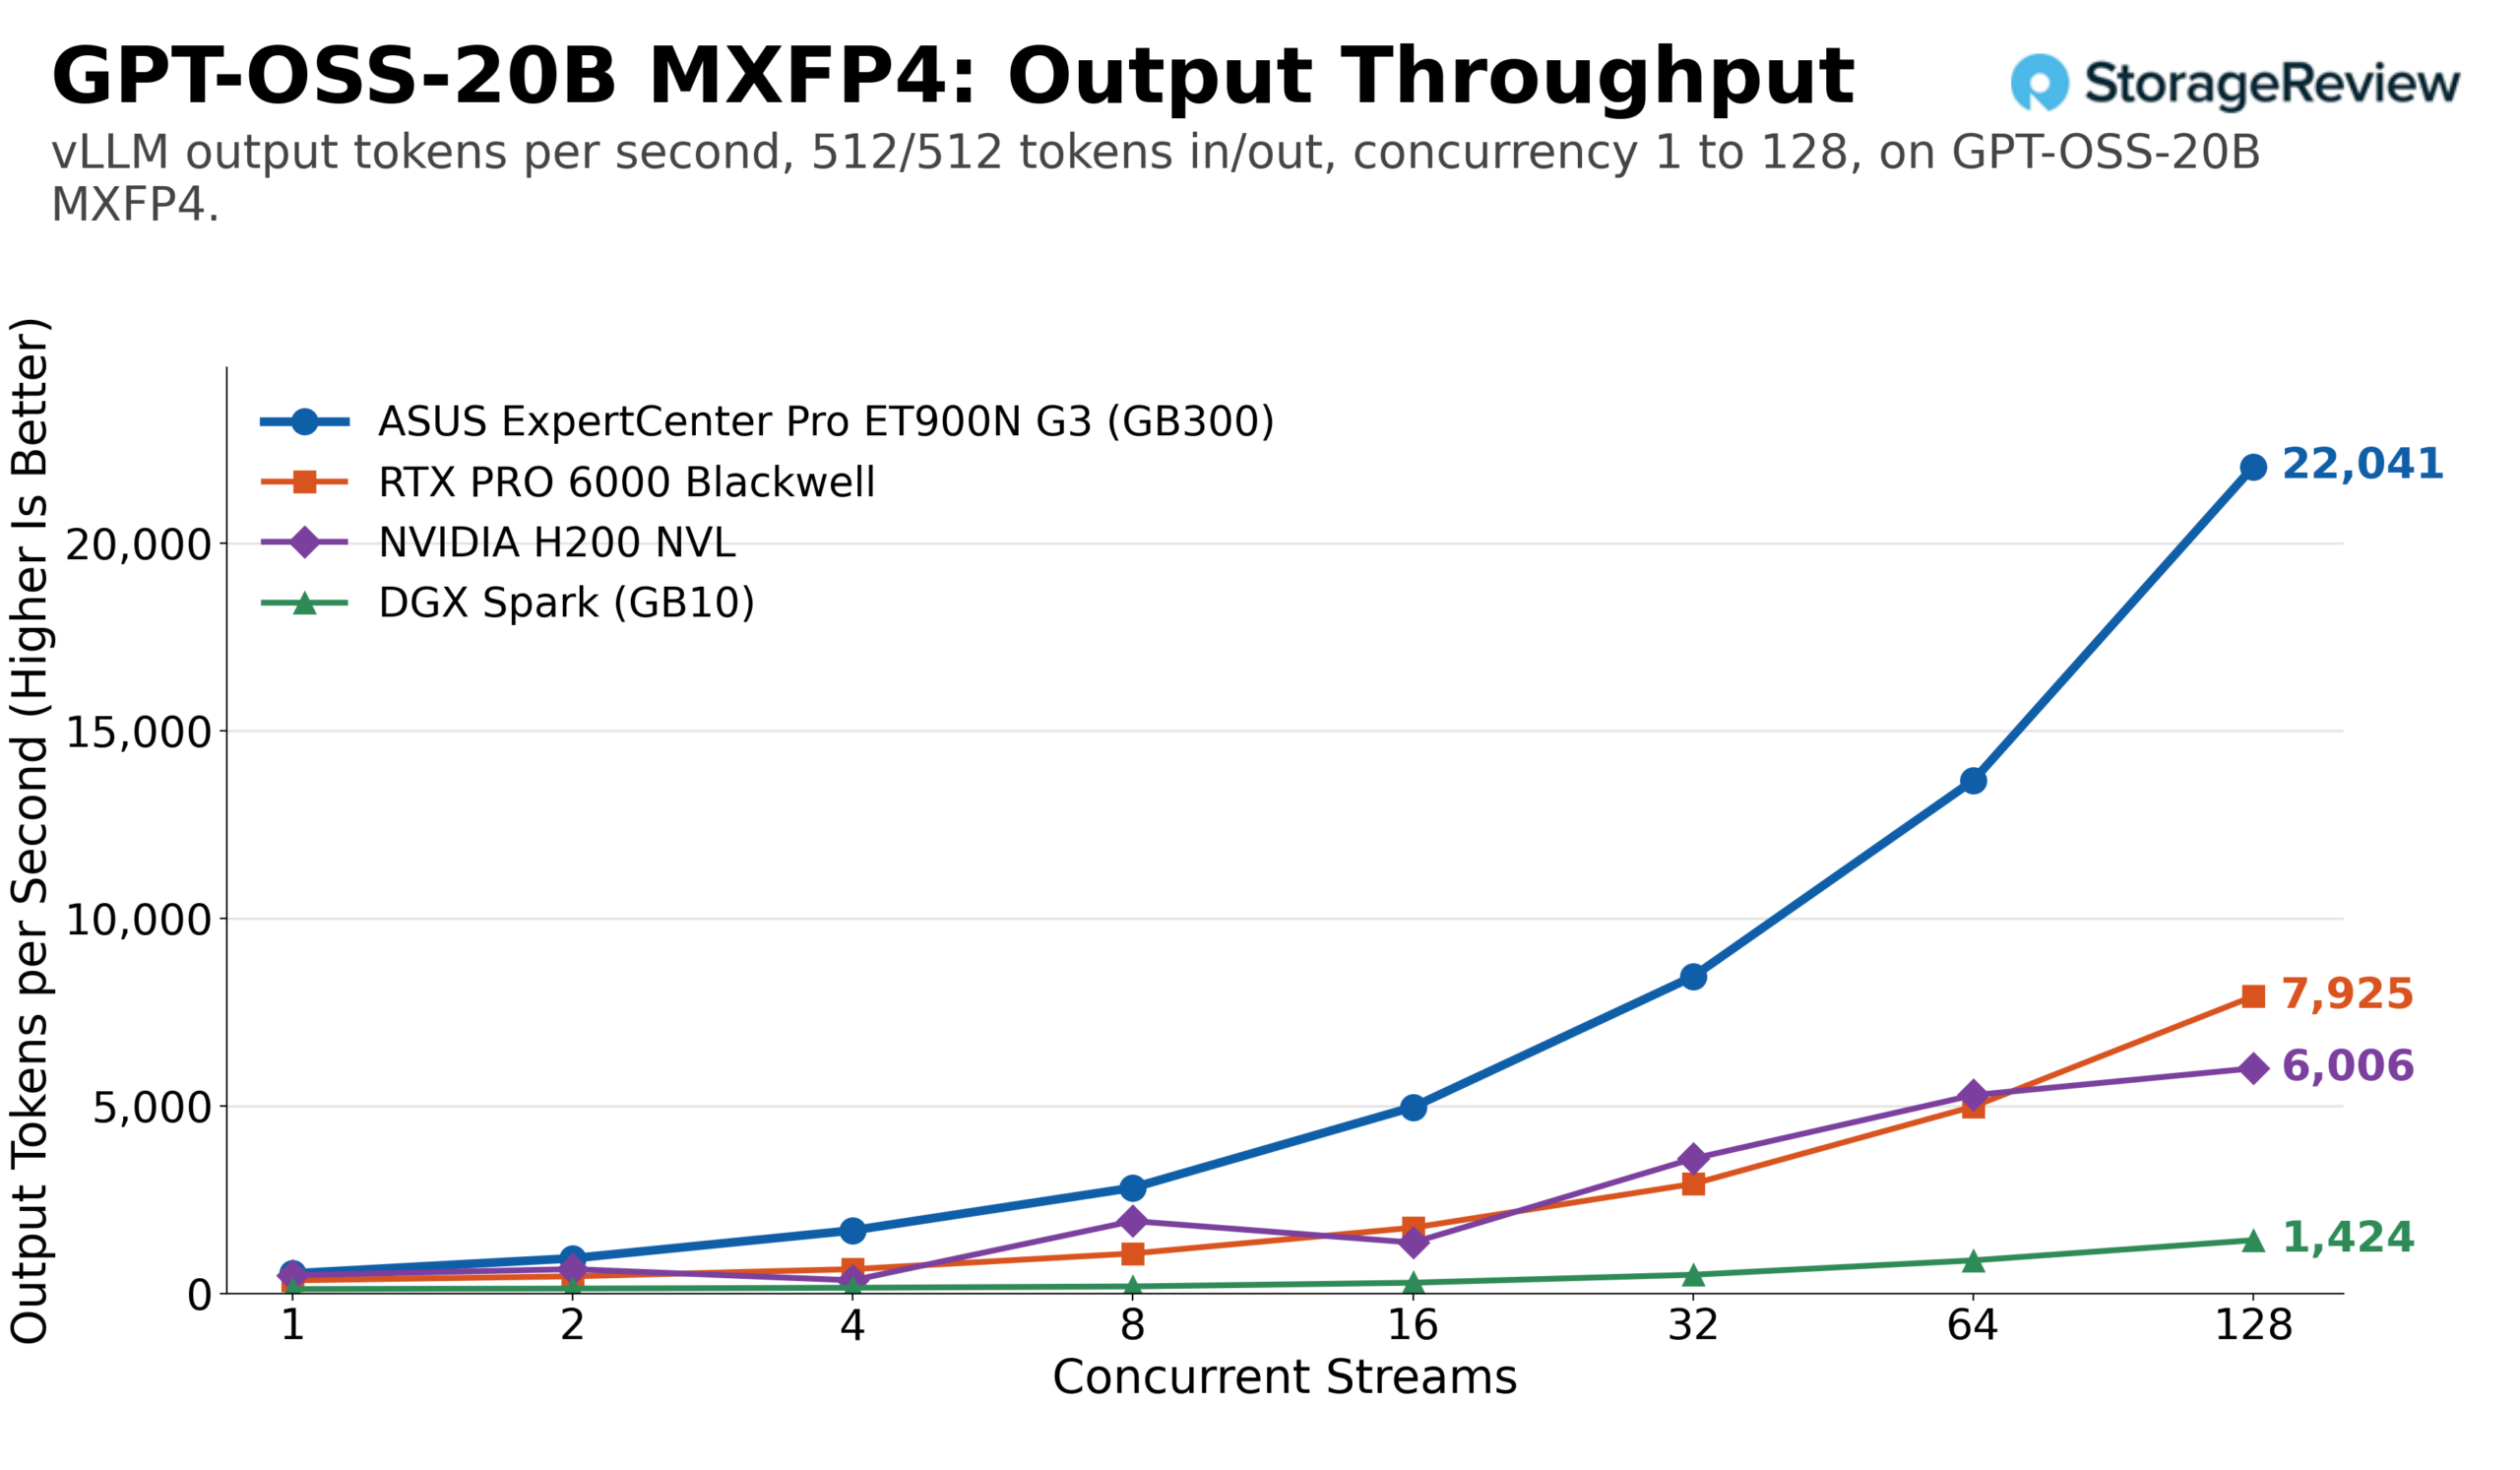
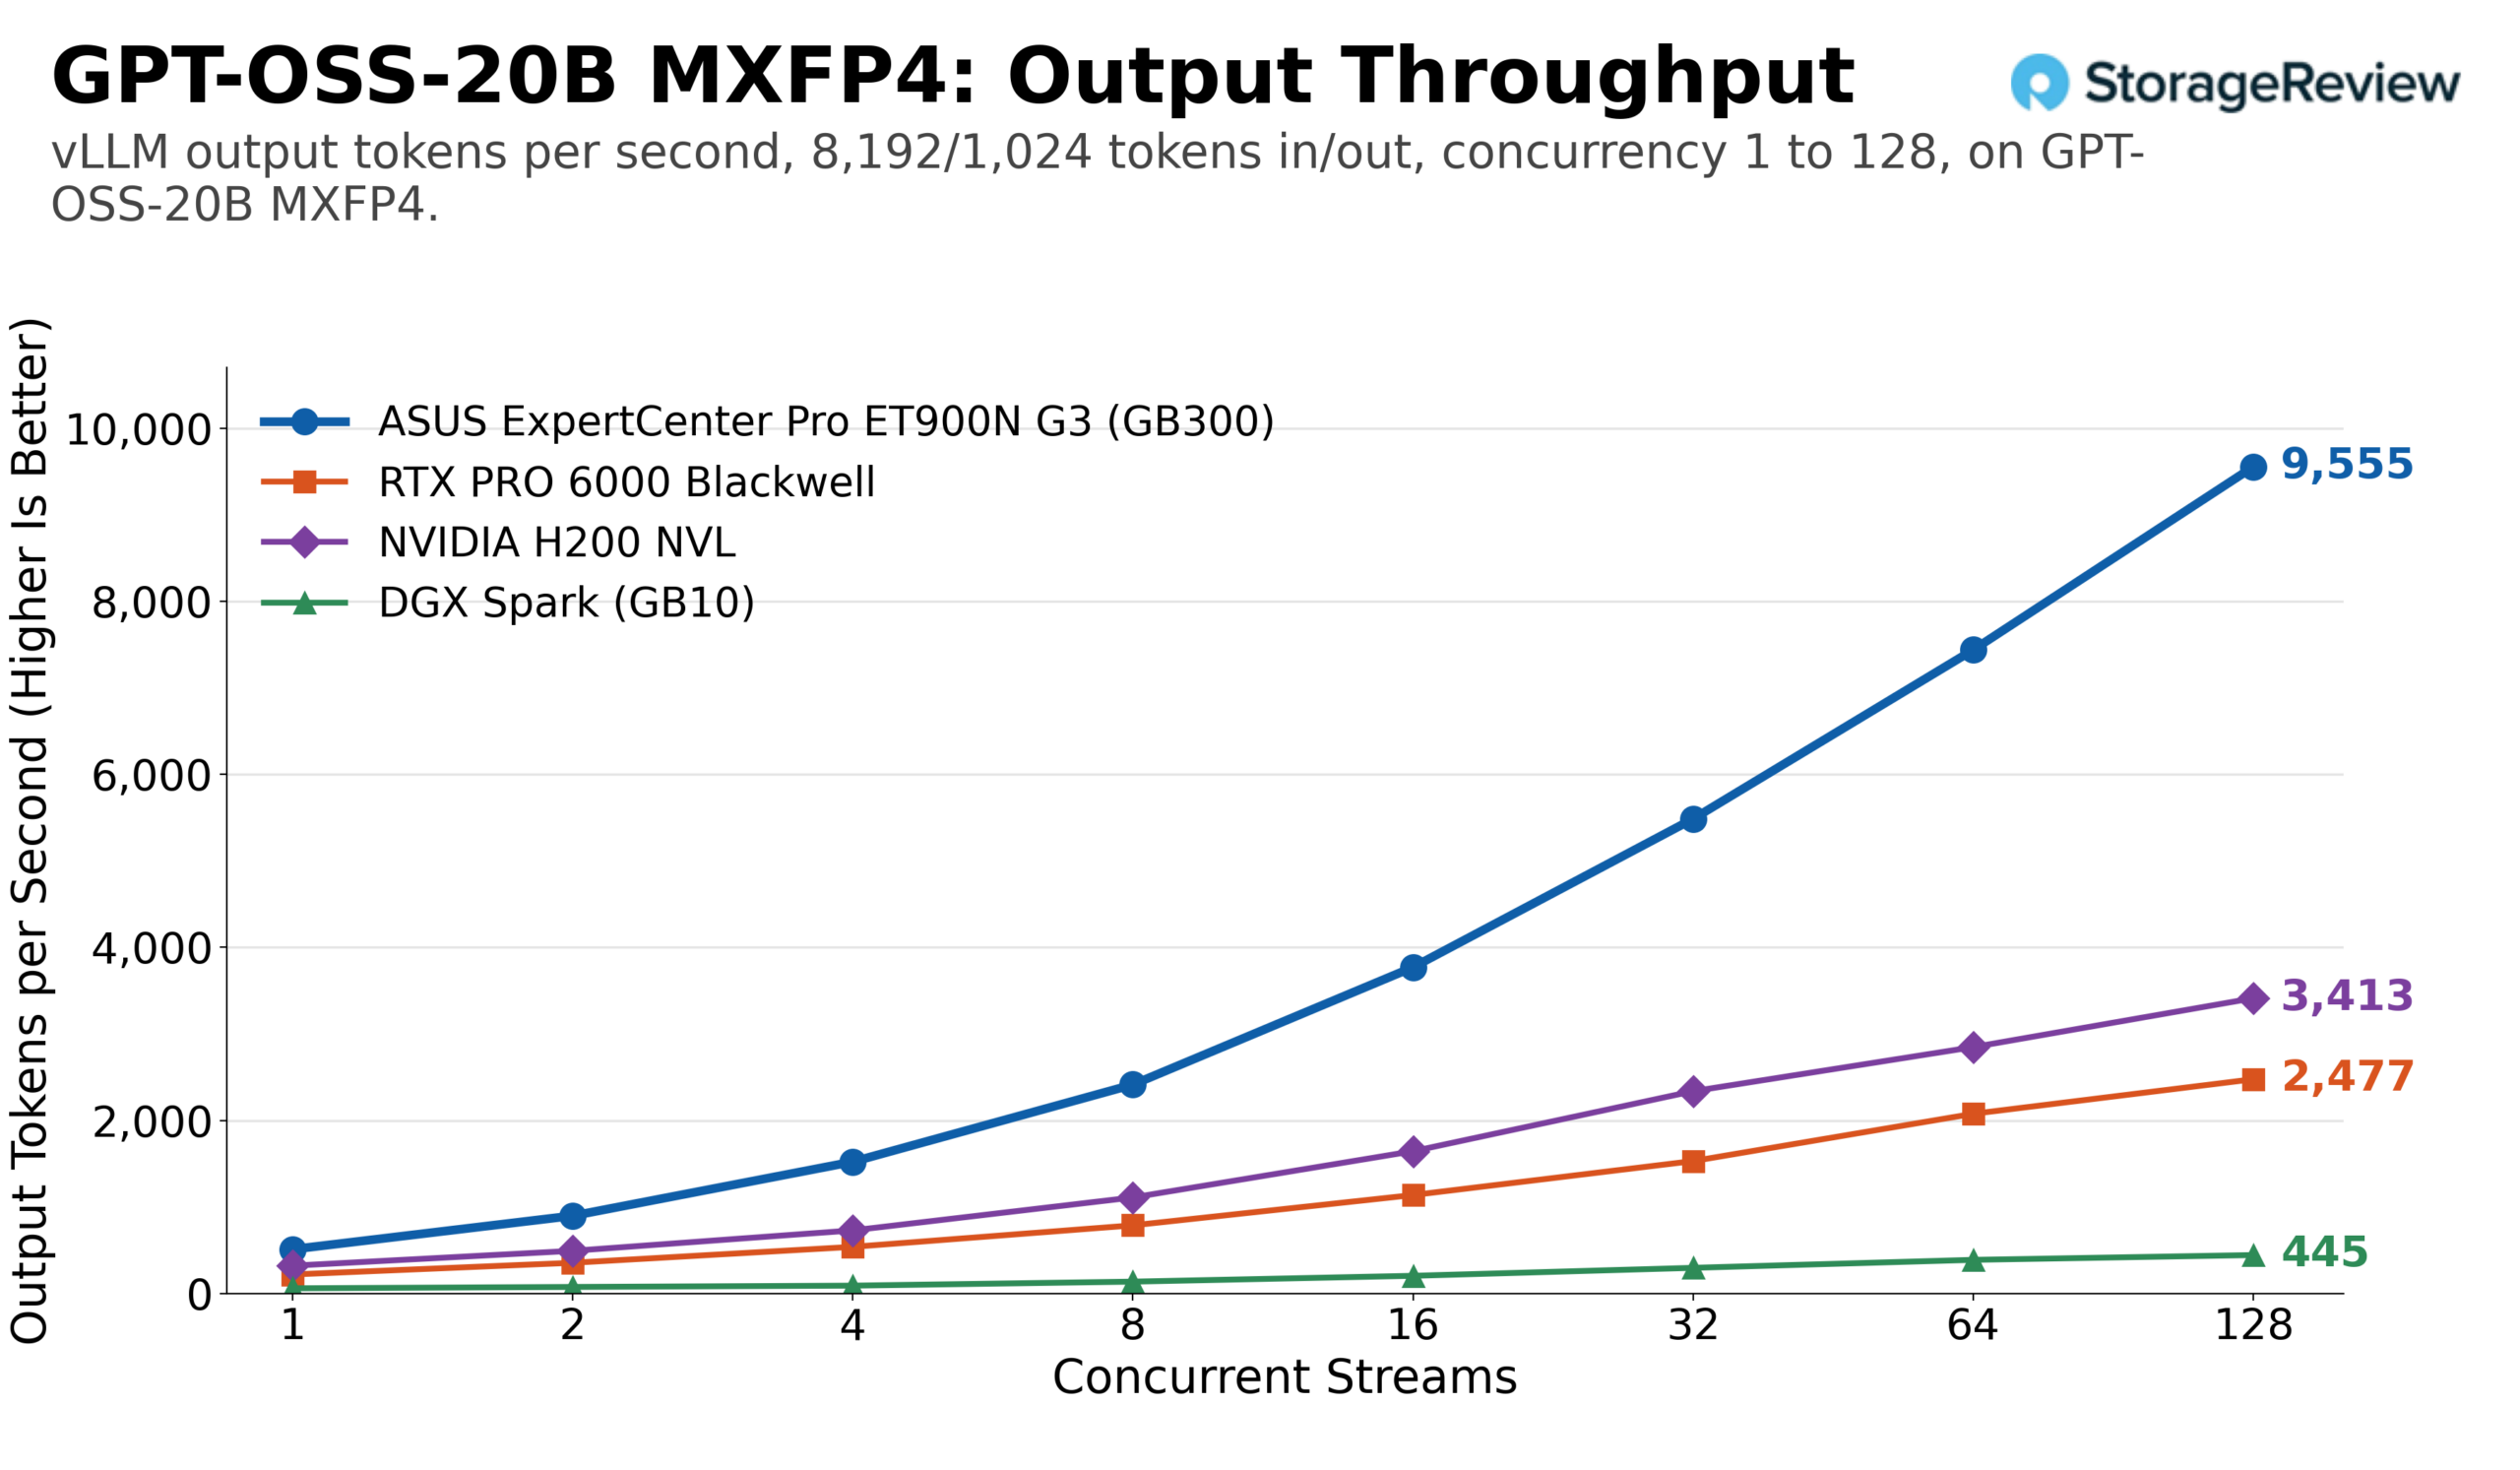
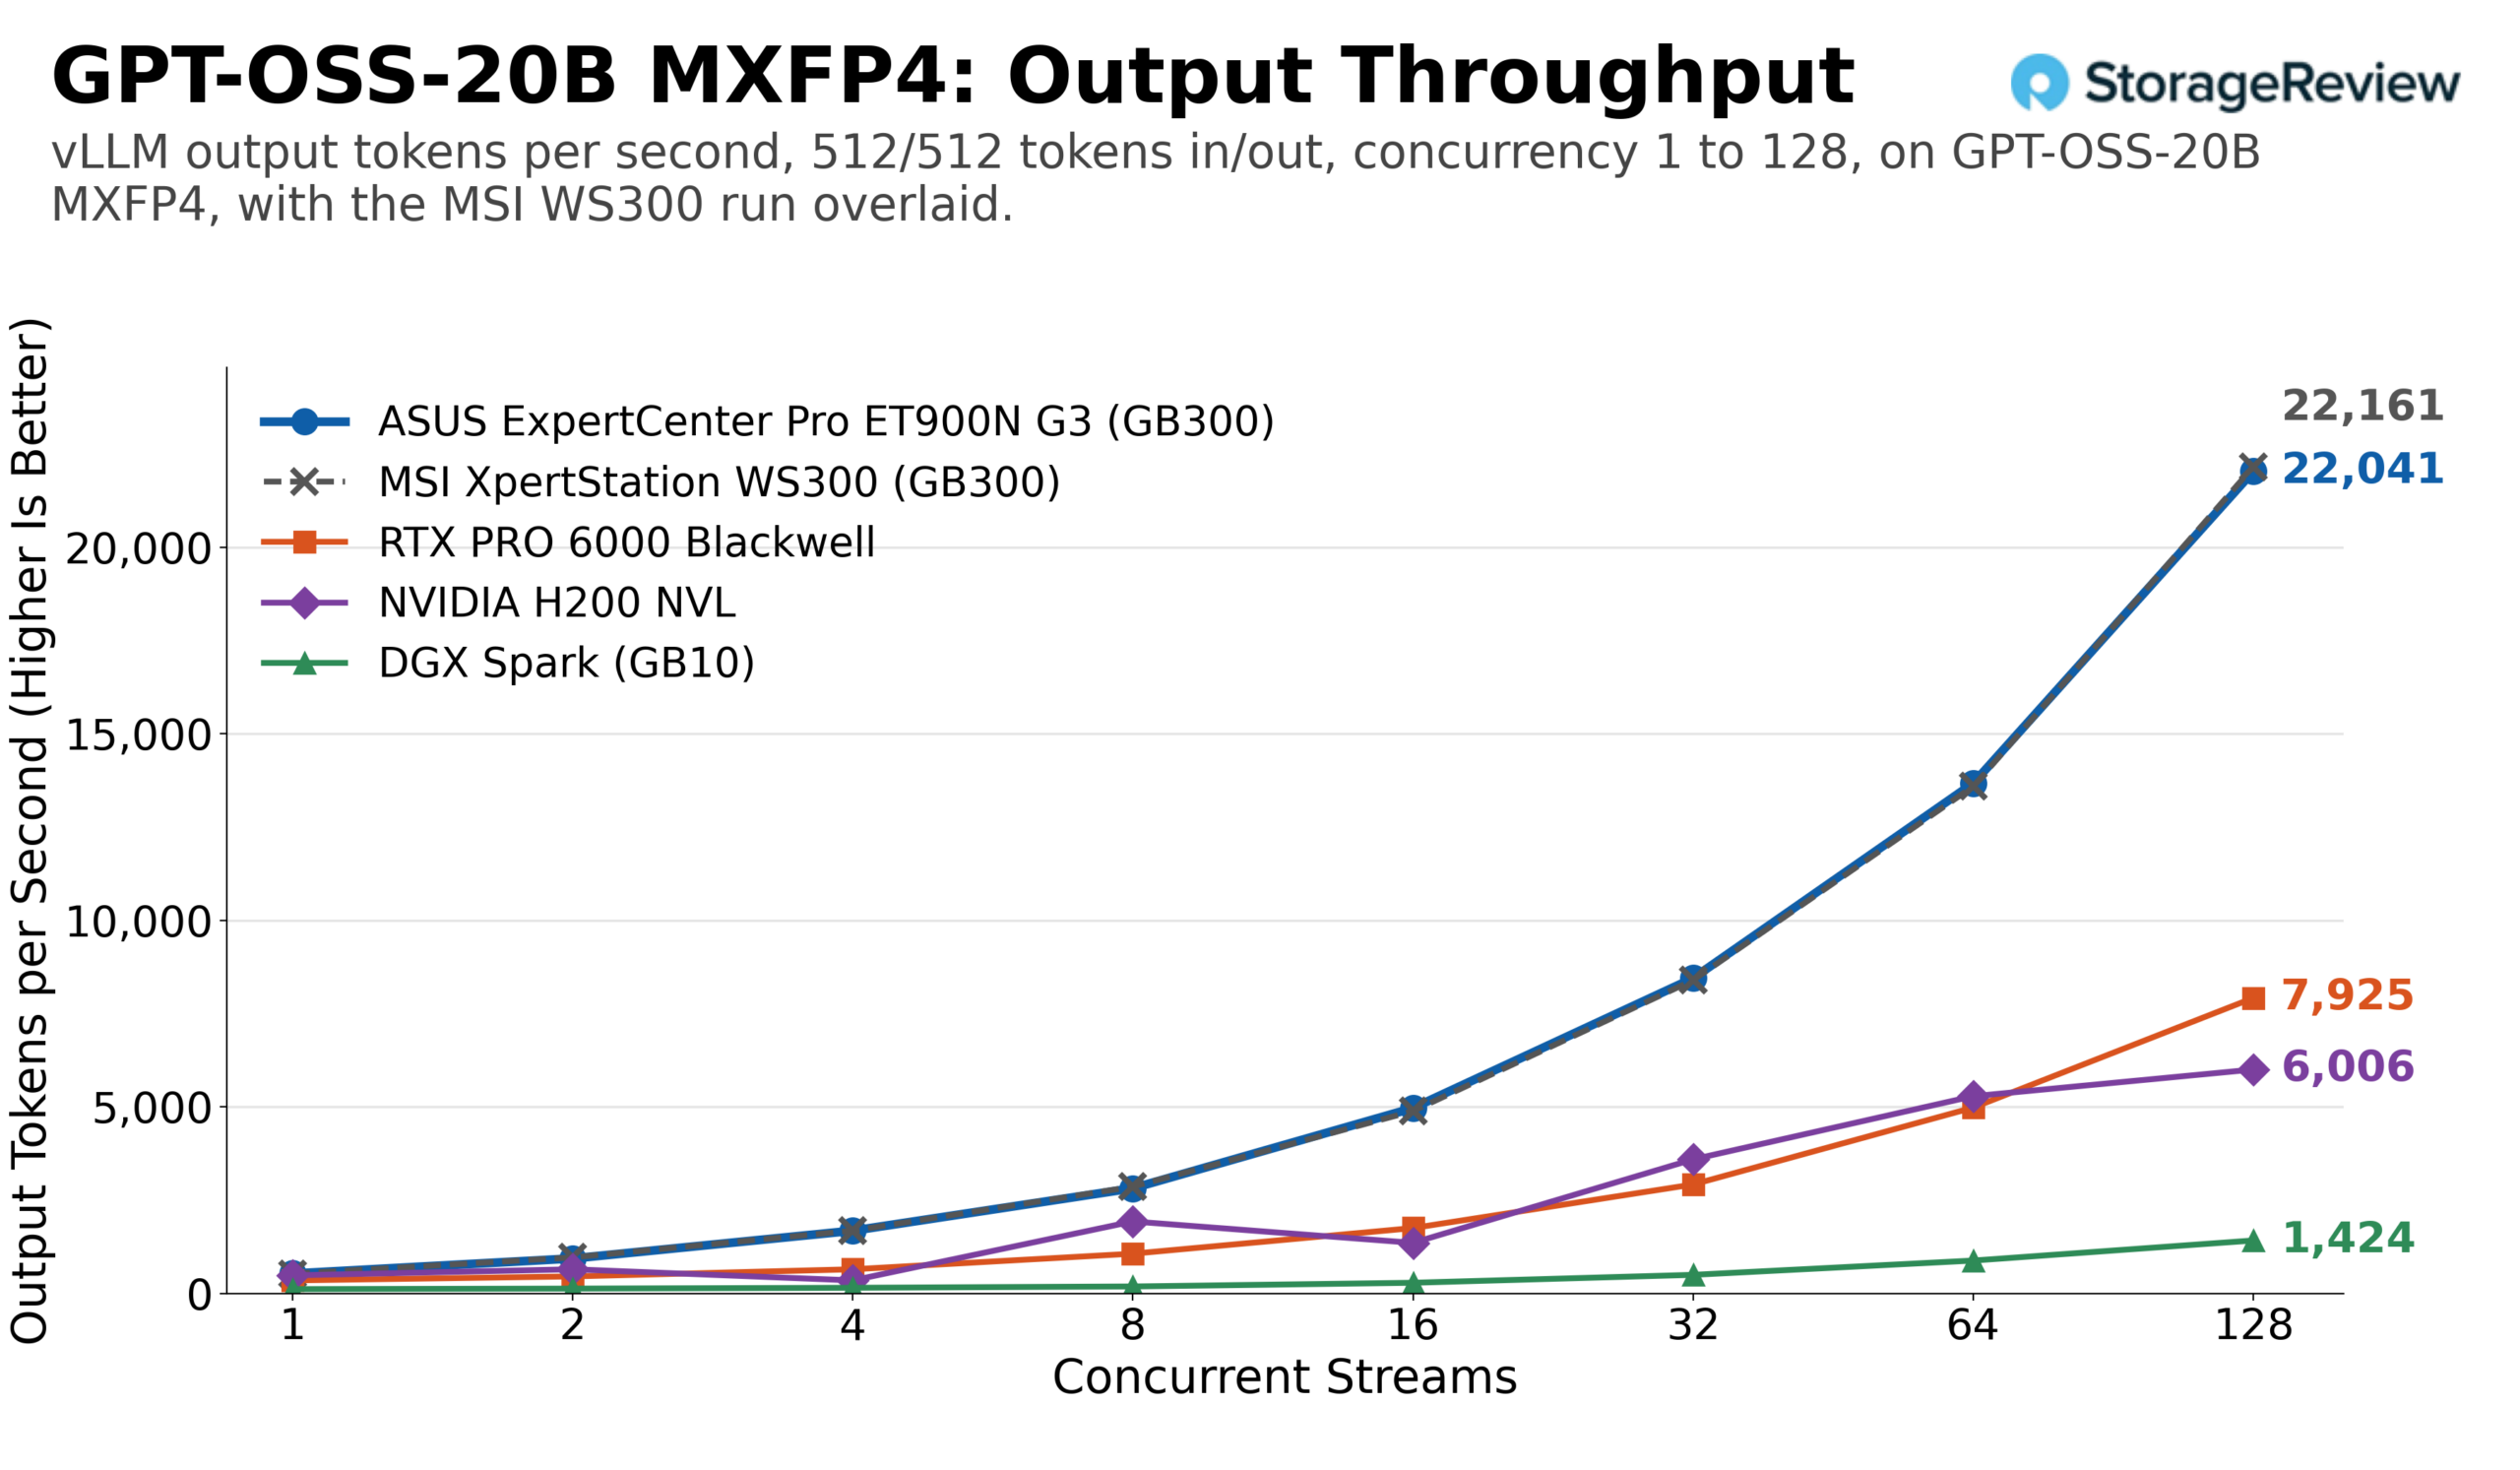
O GPT-OSS-20B é o teste mais amigável do conjunto, um ponto de verificação que todos os sistemas executam com facilidade, e com a mesma carga de trabalho, o ET900N G3 alcançou 22,041 tokens de saída por segundo a 128 fluxos, ou 44,082 no total, contra cerca de 7,920 para o RTX PRO 6000, 6,010 para o H200 NVL e 1,420 para o DGX Spark. No modo de fluxo único, a Station produziu 536 tokens de saída por segundo, em comparação com os 354 da placa, os 489 da H200 e os 120 da Spark. O perfil com uso intensivo de pré-carregamento ampliou a diferença: 9,555 tokens de saída por segundo e 85,994 no total com 128 fluxos para a Station, com a RTX PRO 6000 em torno de 2,480, a H200 NVL em 3,410 e a Spark em 445.
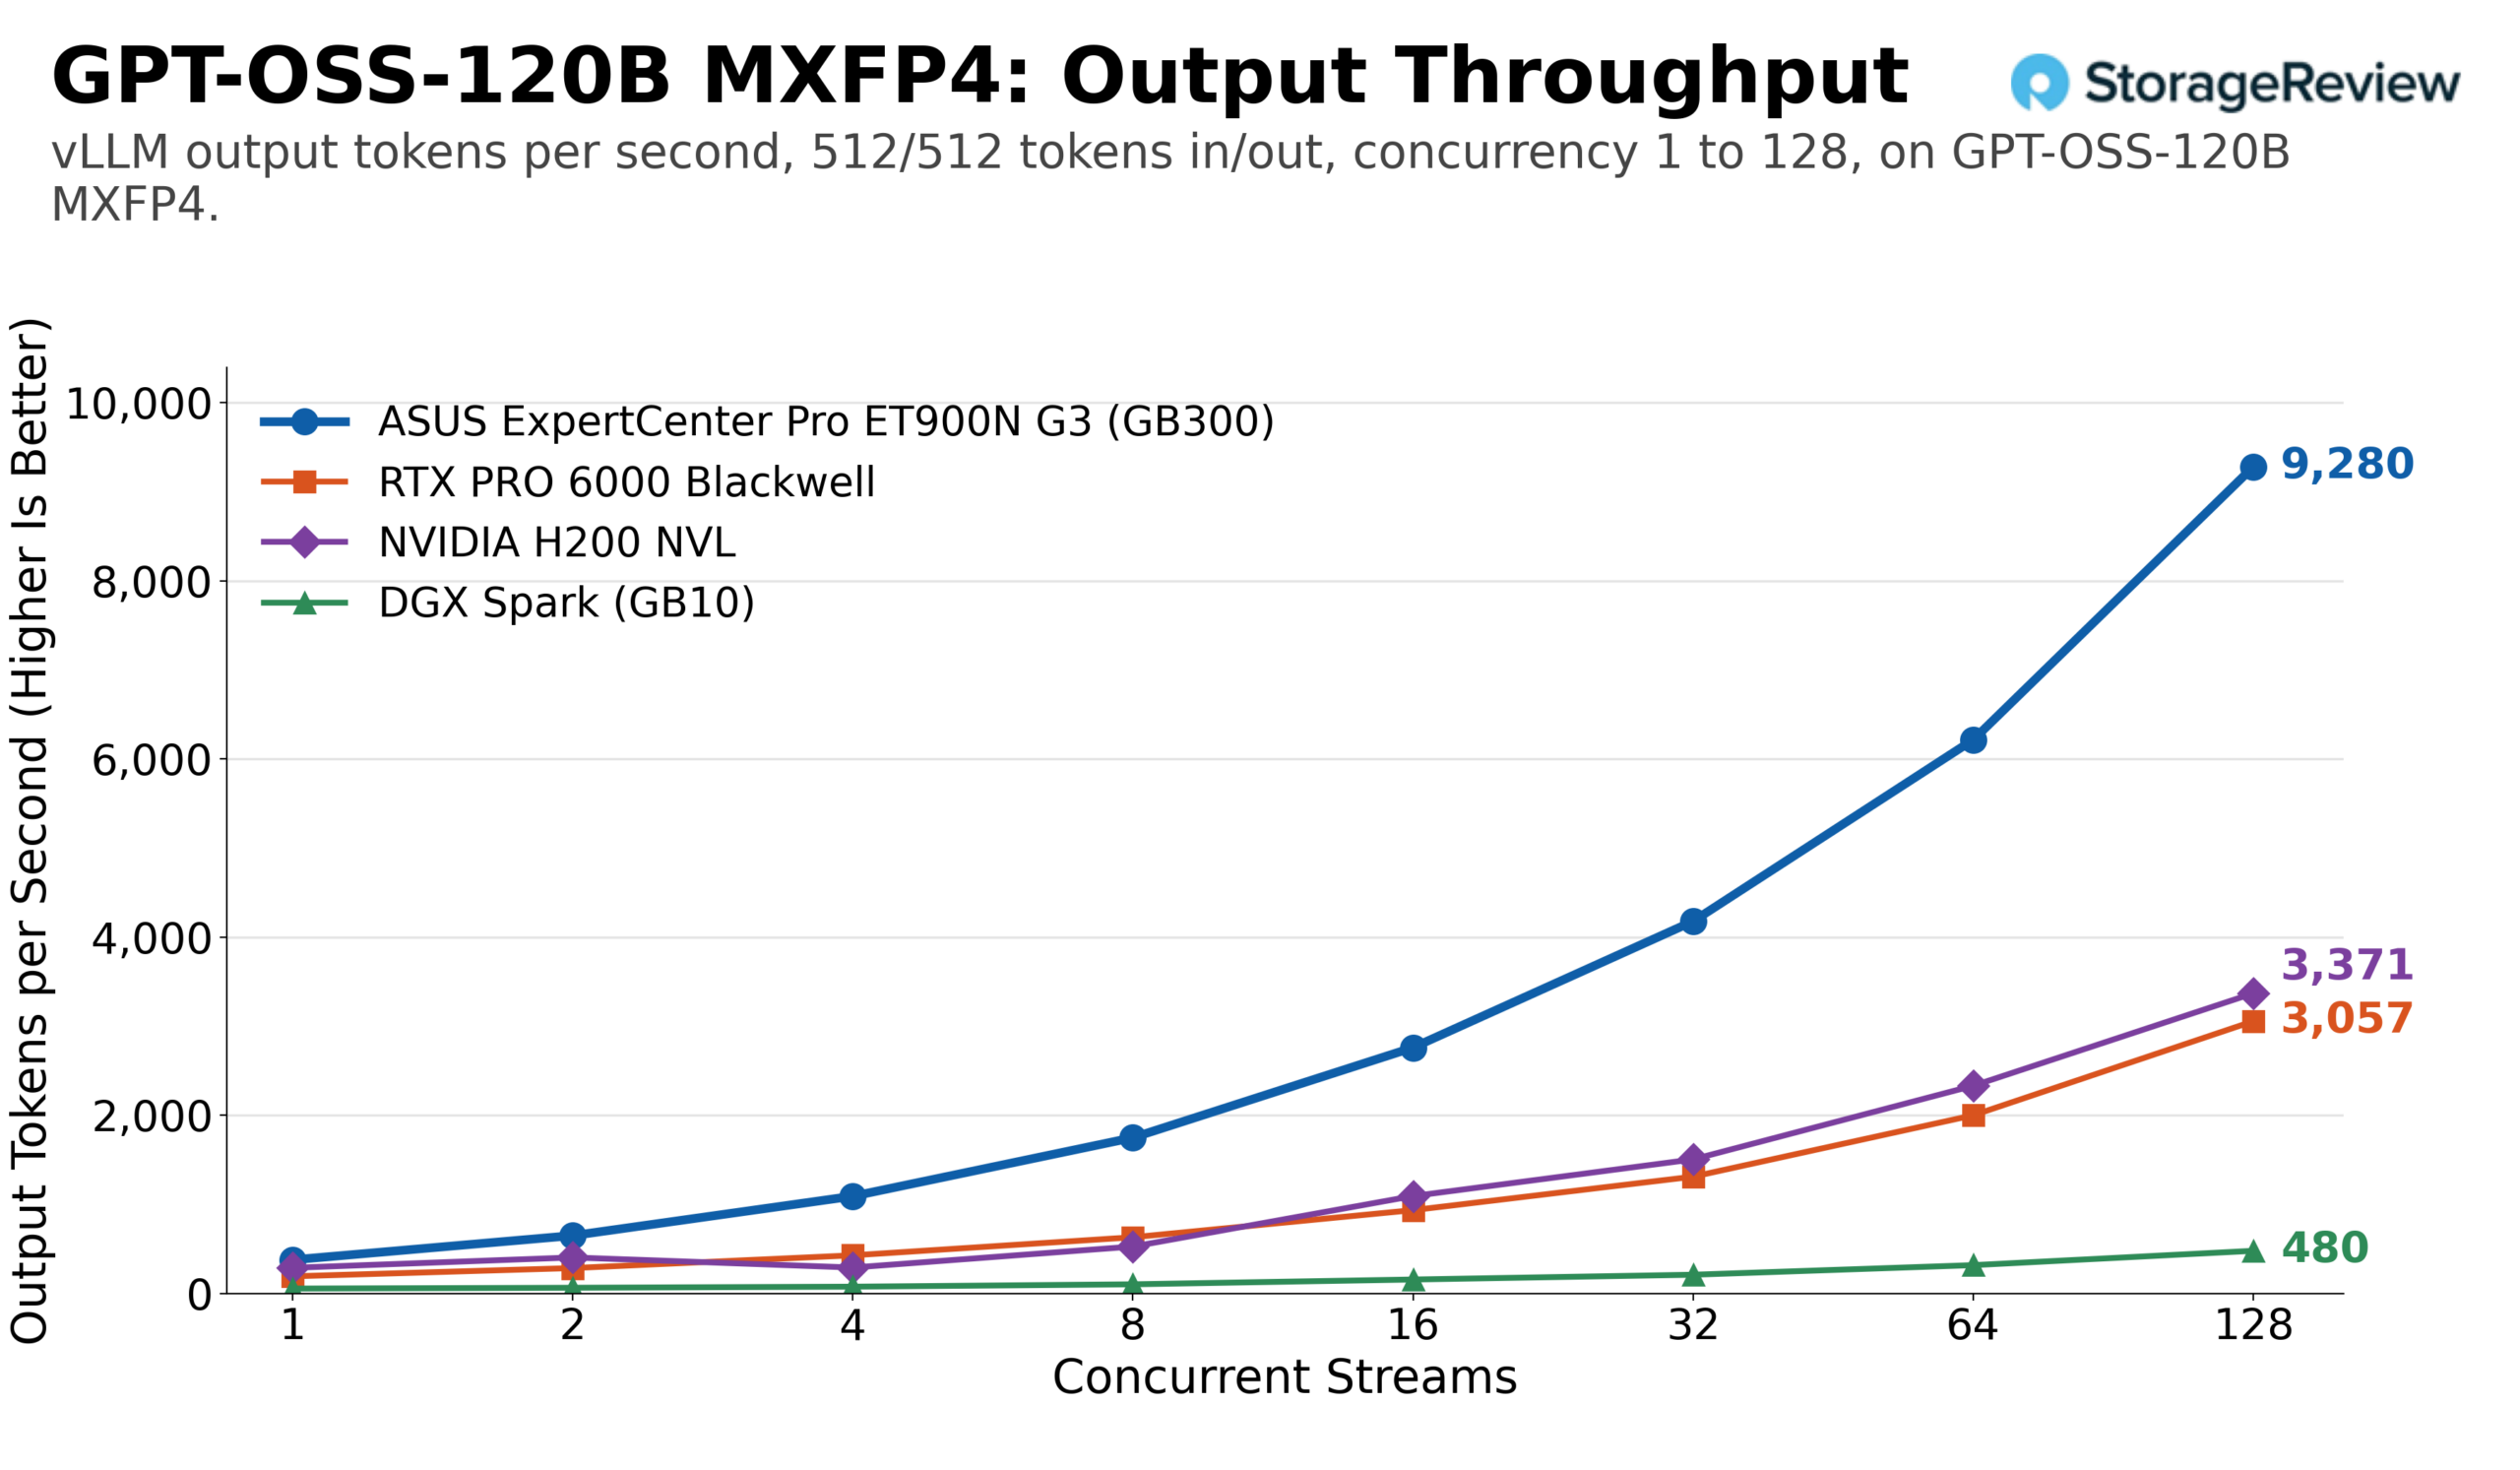
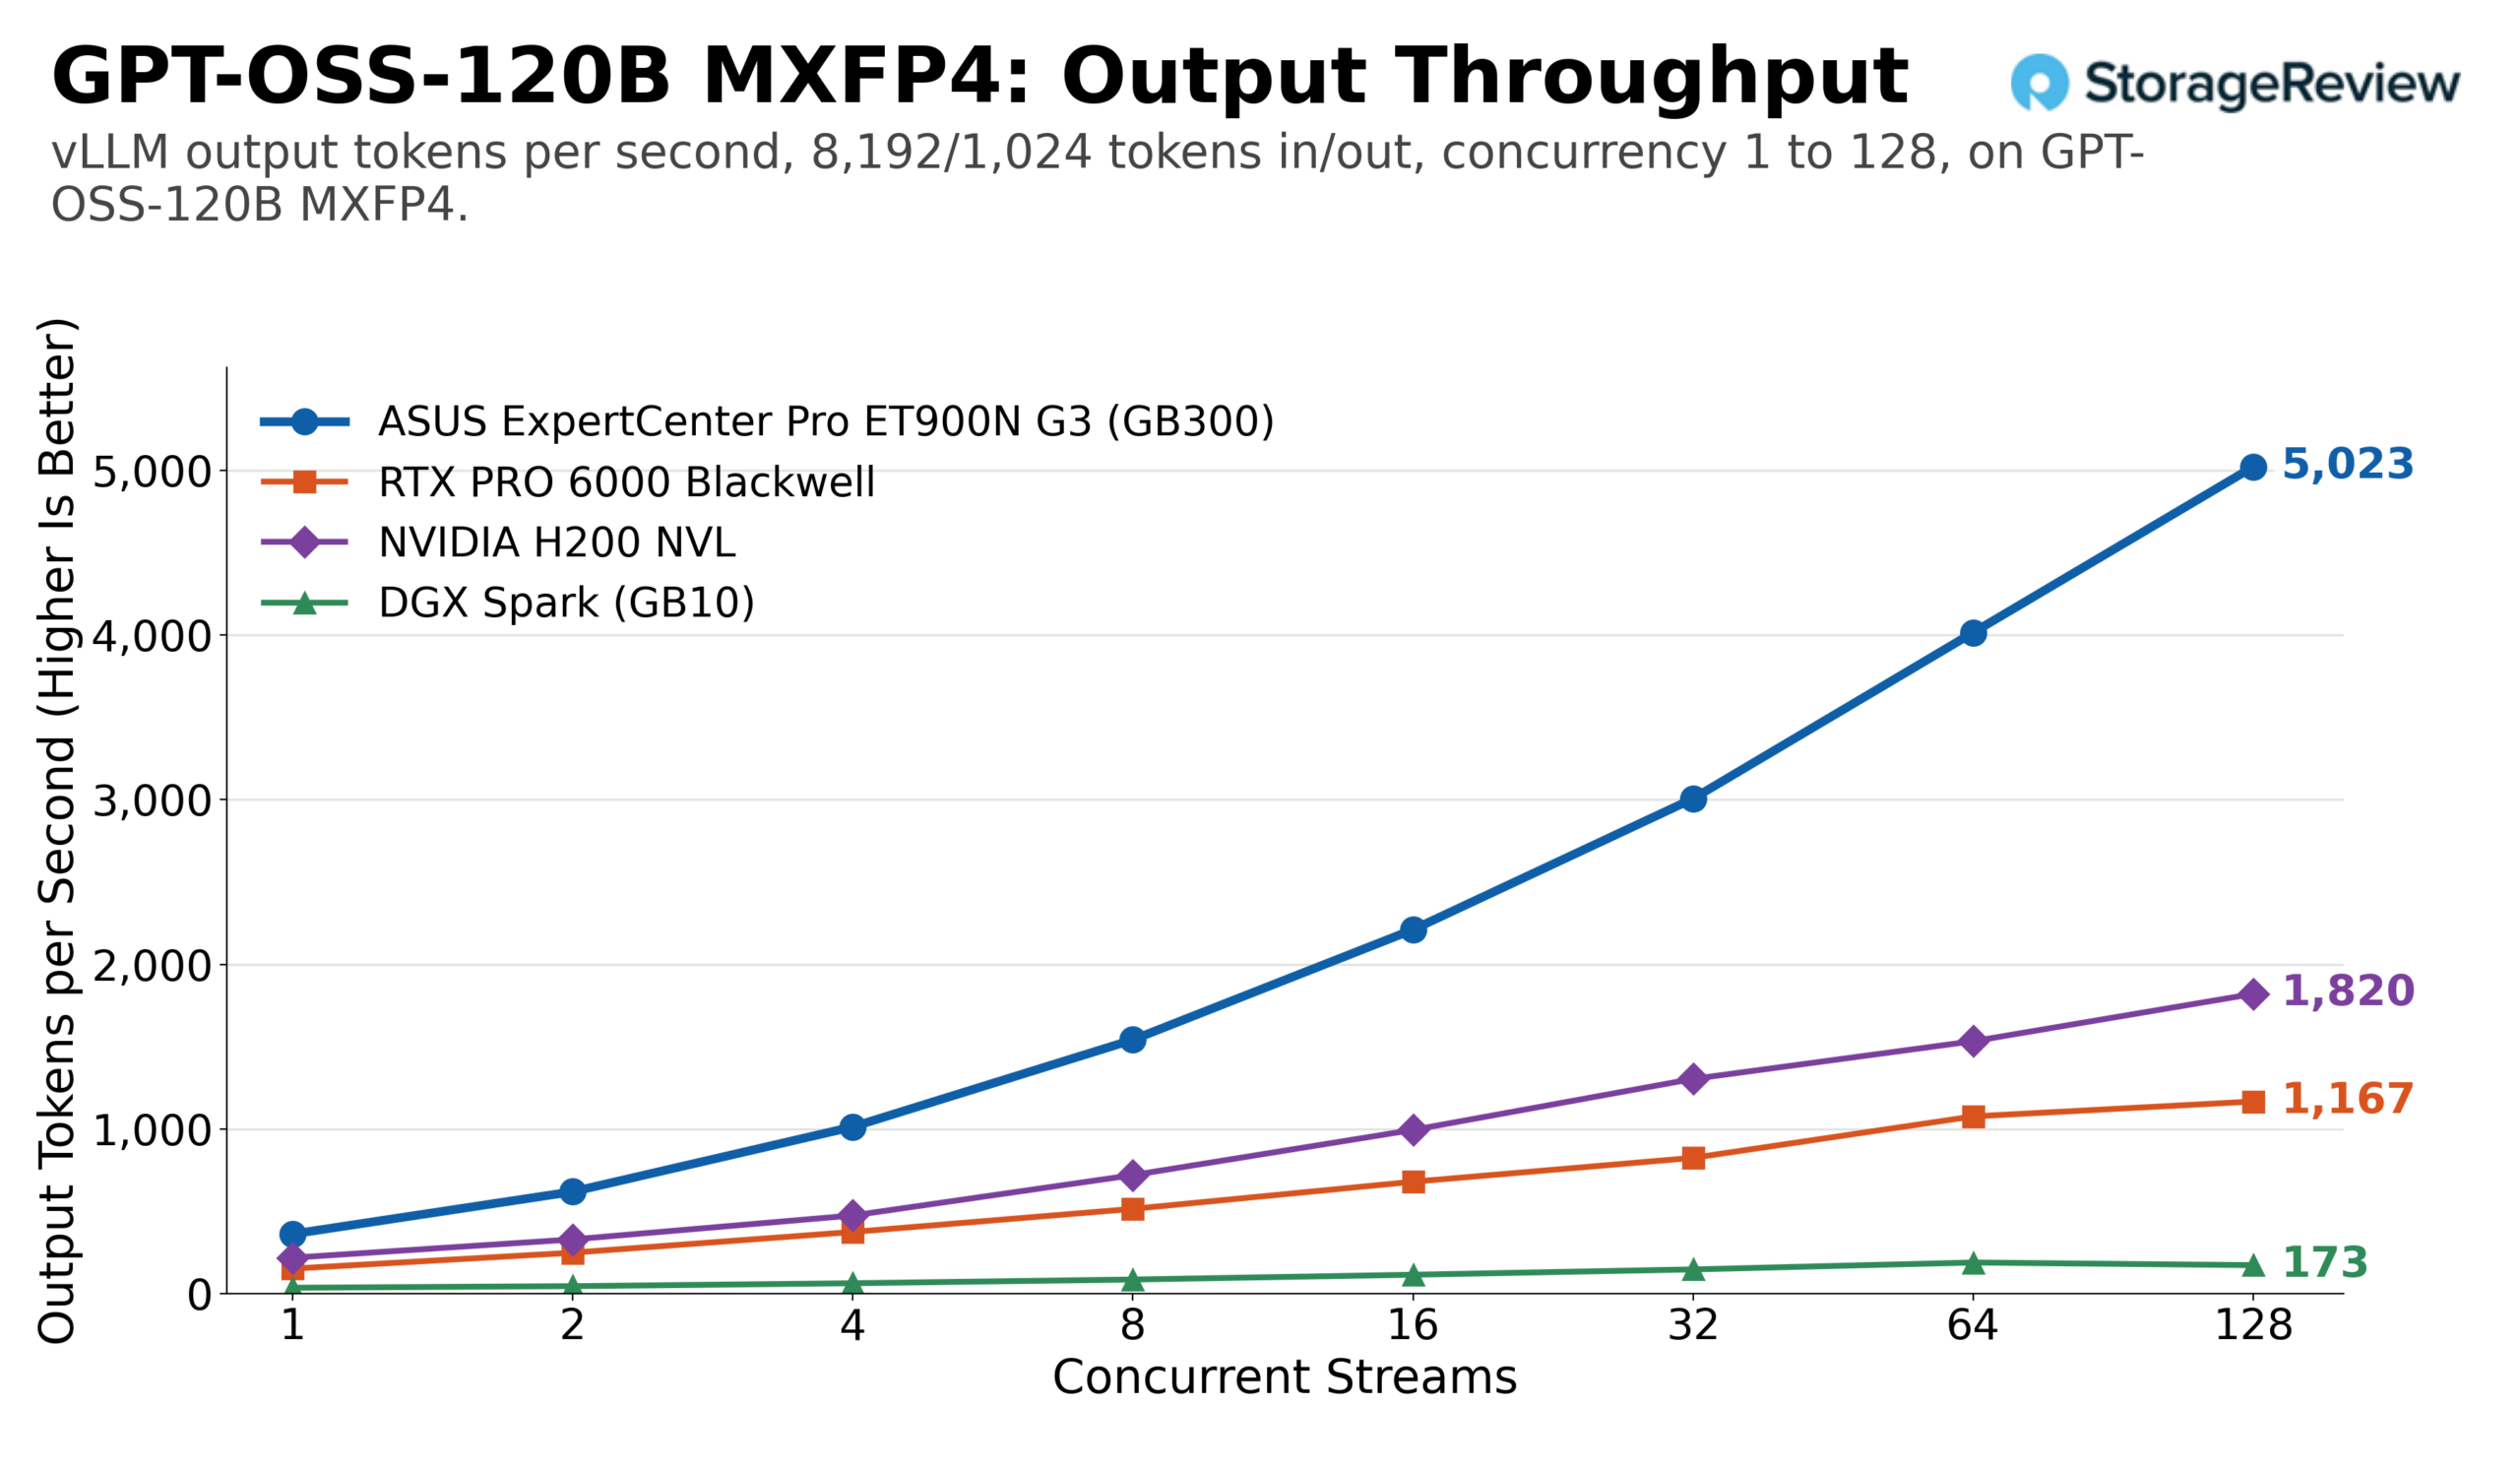
O GPT-OSS-120B é onde a memória começa a separar o jogo. O ET900N G3 atingiu 9,280 tokens de saída por segundo com a mesma carga de trabalho e 128 fluxos, aproximadamente três vezes mais que o RTX PRO 6000 (3,060), 2.8 vezes mais que o H200 NVL (3,370) e mais de 19 vezes mais que o Spark (480). Sob longas solicitações de dados, os sistemas menores esgotaram rapidamente a capacidade do cache KV: o RTX PRO 6000 atingiu um pico de cerca de 1,170 tokens de saída por segundo e o H200 NVL, quase 1,820, enquanto o Station, ainda em fase de crescimento com 128 fluxos, terminou com 5,023 tokens, totalizando uma taxa de transferência de 45,205 tokens por segundo.
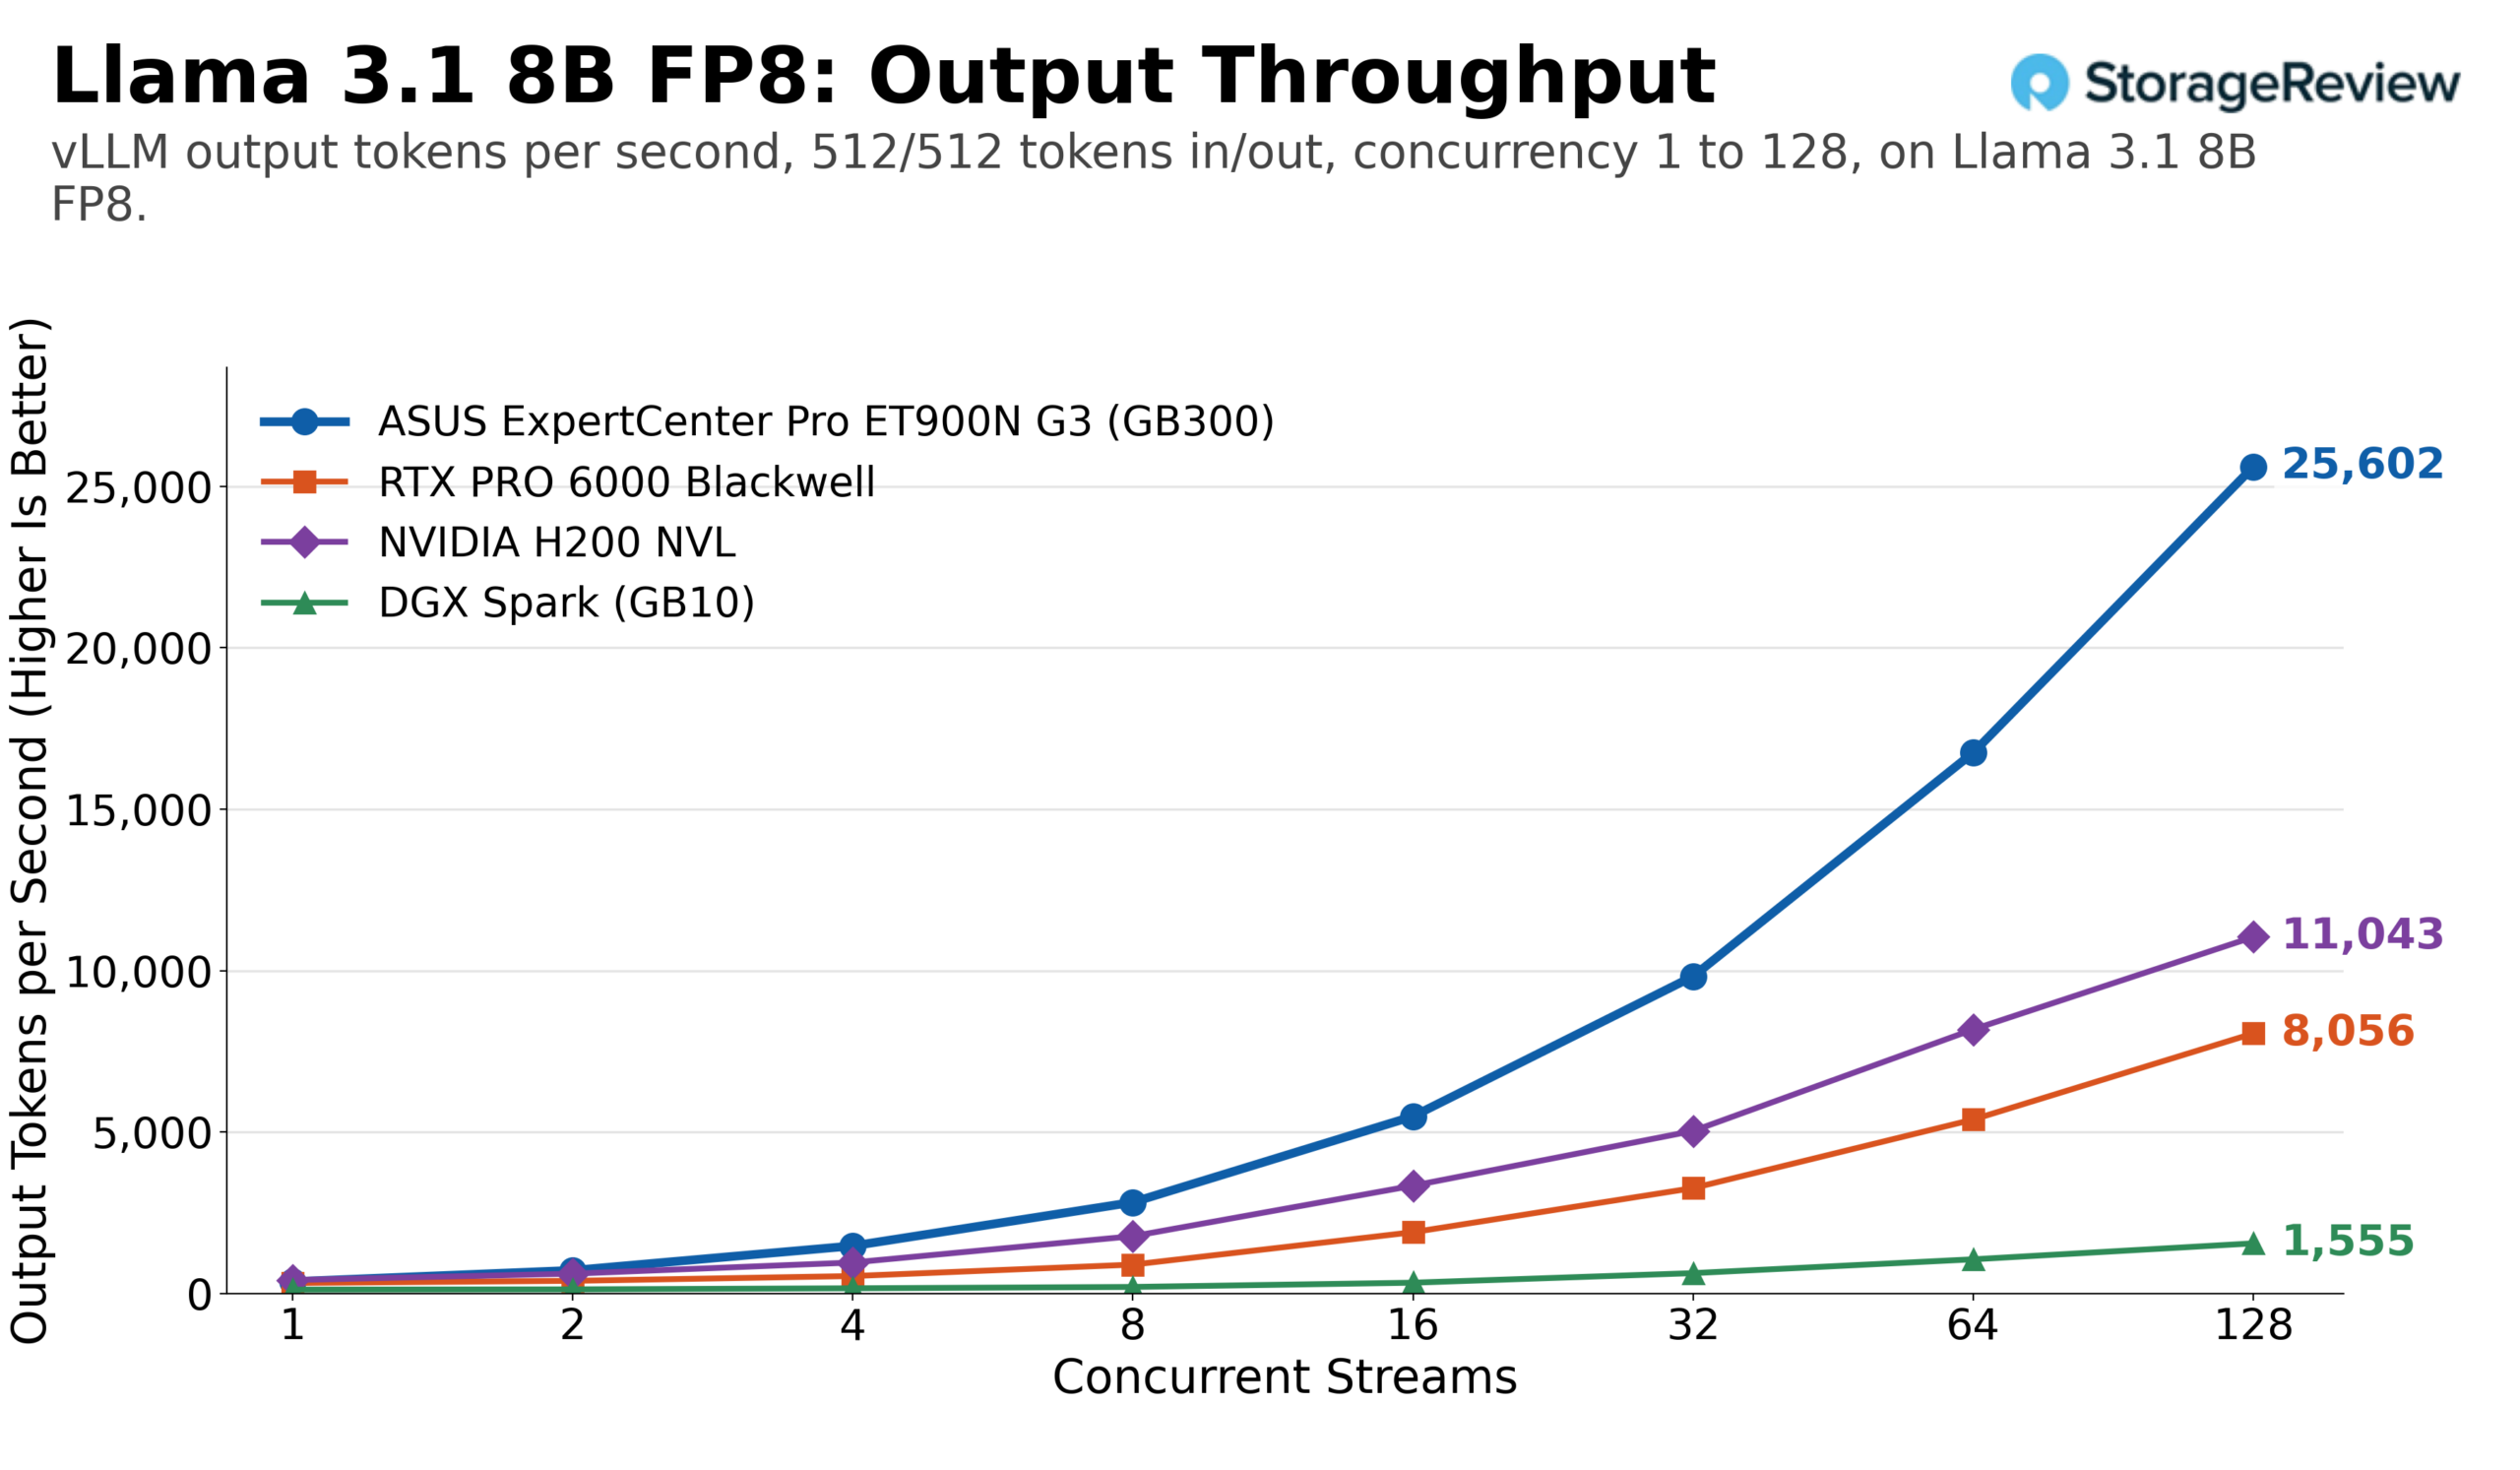
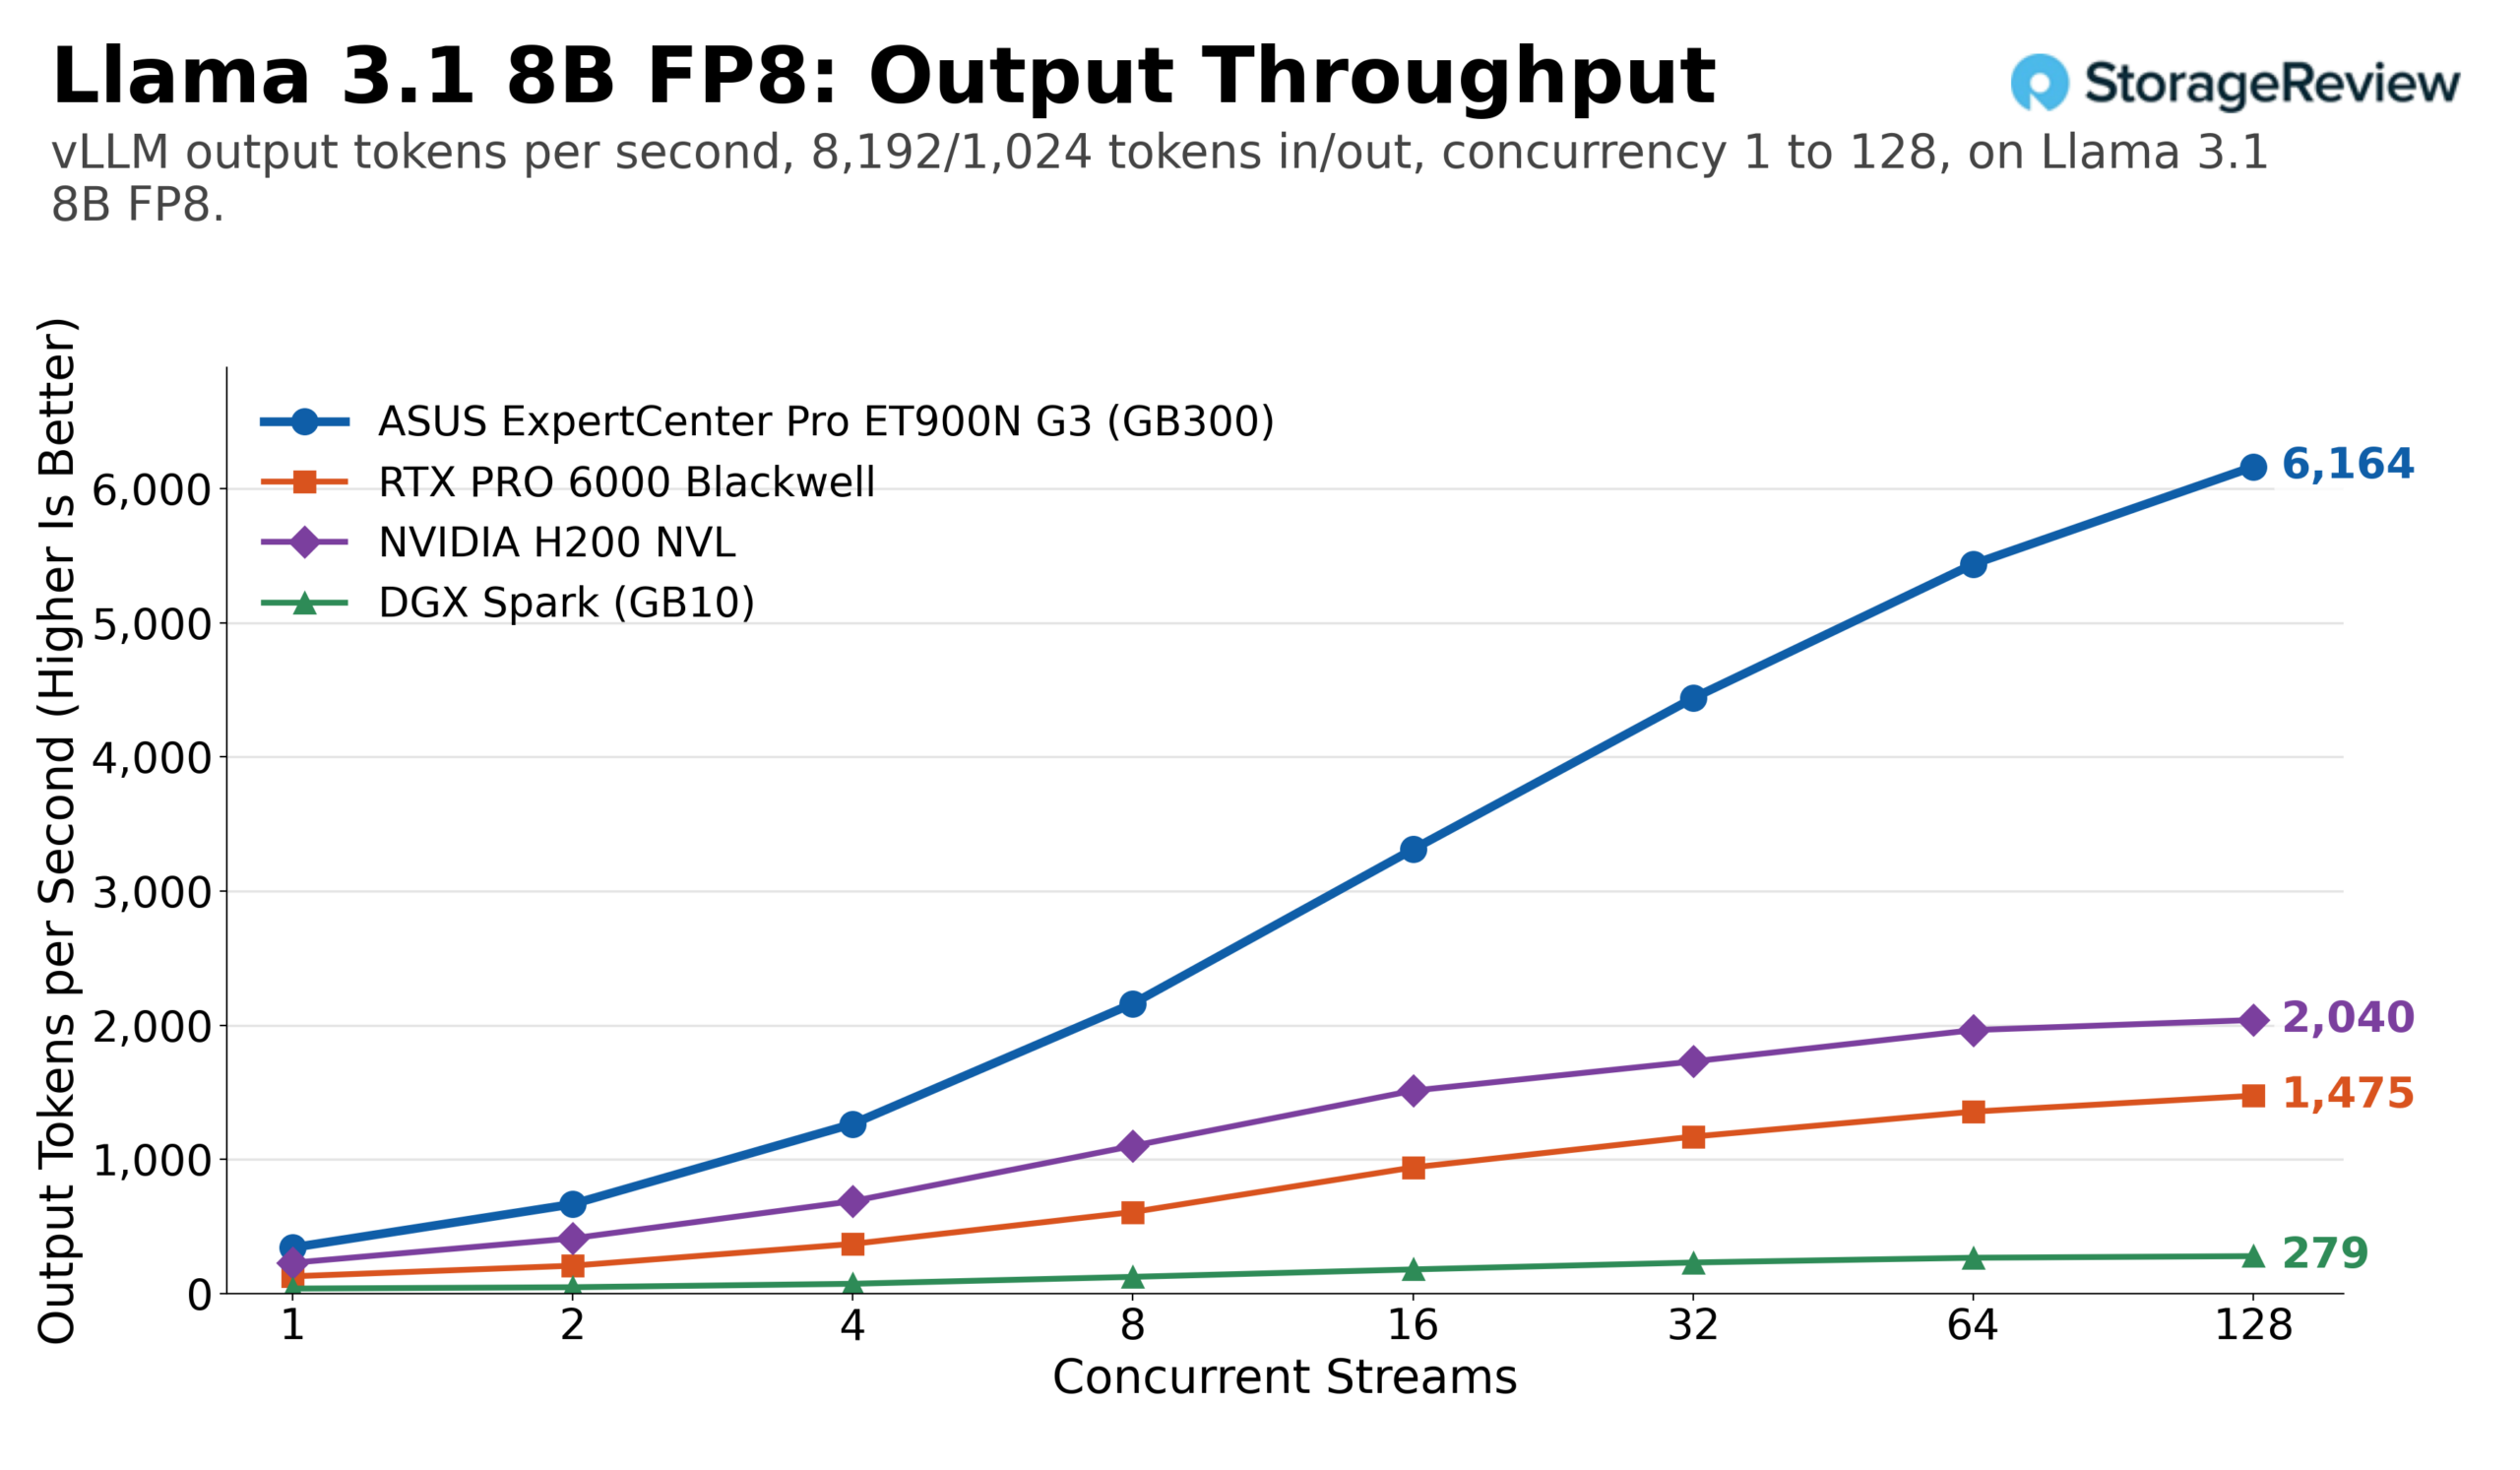
O perfil Llama 3.1 8B em FP8 apresentou o maior valor individual no conjunto de testes. A placa ET900N G3 gerou 25,602 tokens de saída por segundo em 128 fluxos com a mesma carga de trabalho, totalizando 51,205 tokens, em comparação com cerca de 8,060 para a RTX PRO 6000 e 11,040 para a H200 NVL. A mudança de BF16 para FP8 aumentou o desempenho da Station em cerca de 50% (de 17,074 para 25,602), enquanto a RTX PRO 6000 obteve um aumento de cerca de 70% e a H200 NVL de cerca de 37% com a mesma alteração. O perfil com uso intensivo de pré-preenchimento comprimiu tudo, resultando em 6,164 tokens de saída por segundo para a Station, 1,480 para a placa de vídeo e 2,040 para a H200.
O Mistral Small 24B em FP8 produziu as maiores taxas de variação. O ET900N G3 atingiu um pico de 11,075 tokens de saída por segundo com a mesma carga de trabalho, 3.4 vezes o RTX PRO 6000 com 3,240, 2.4 vezes o H200 NVL com 4,610 e quase 20 vezes o Spark com 559. Sob prompts longos, o RTX PRO 6000 atingiu um pico de 32 fluxos e cerca de 480 tokens de saída por segundo antes de diminuir a taxa; o H200 NVL atingiu um máximo de cerca de 854 e o Station alcançou 2,302 com 128 fluxos.


O modelo Qwen3 Coder 30B, que utiliza uma combinação de especialistas e possui um número reduzido de parâmetros ativos, é onde a diferença em fluxo único diminui. Com um fluxo único e carga de trabalho equivalente, a RTX PRO 6000 entregou cerca de 232 tokens de saída por segundo, contra 319 da Station e 308 da H200 NVL. O processamento em lote restaura a ordem: com 128 fluxos, a ET900N G3 atingiu 12,439 tokens de saída por segundo em FP8, 3.1 vezes mais que a placa (3,990) e 1.7 vezes mais que a H200 NVL (7,450). No perfil com uso intensivo de pré-preenchimento, a Station alcançou 3,837 tokens de saída por segundo, enquanto a RTX PRO 6000 atingiu um pico de cerca de 880 com 64 fluxos, e a H200 NVL, cerca de 1,820.


Nos modelos compartilhados, o ET900N G3 apresentou desempenho de 2.8 a 3.4 vezes superior ao de uma única RTX PRO 6000 e de 1.7 a 3.7 vezes superior ao de uma H200 NVL em concorrência máxima, com a margem sobre ambas aumentando sob prompts longos à medida que a capacidade do cache KV se esgotava. Em comparação com o WS300, esses quatro modelos novamente apresentam diferenças de menos de 1%: 22,041 contra 22,161 no GPT-OSS-20B, 9,280 contra 9,294 no GPT-OSS-120B, 11,075 contra 11,157 no Mistral Small FP8 e 12,439 contra 12,425 no Qwen3 Coder FP8. A comparação completa dos 14 modelos, incluindo os três modelos com maiores diferenças, está na próxima seção.
Duas torres, uma placa-mãe: ASUS ET900N G3 vs MSI WS300
O ET900N G3 e o MSI XpertStation WS300 utilizam a mesma placa-mãe NVIDIA GB300 DGX Station em dois chassis OEM diferentes. Ambos foram submetidos aos mesmos 14 modelos, às mesmas duas cargas de trabalho e à mesma varredura de concorrência na mesma compilação vLLM. O gráfico abaixo compara a taxa de transferência máxima do ET900N G3 em todos os modelos com a do WS300.
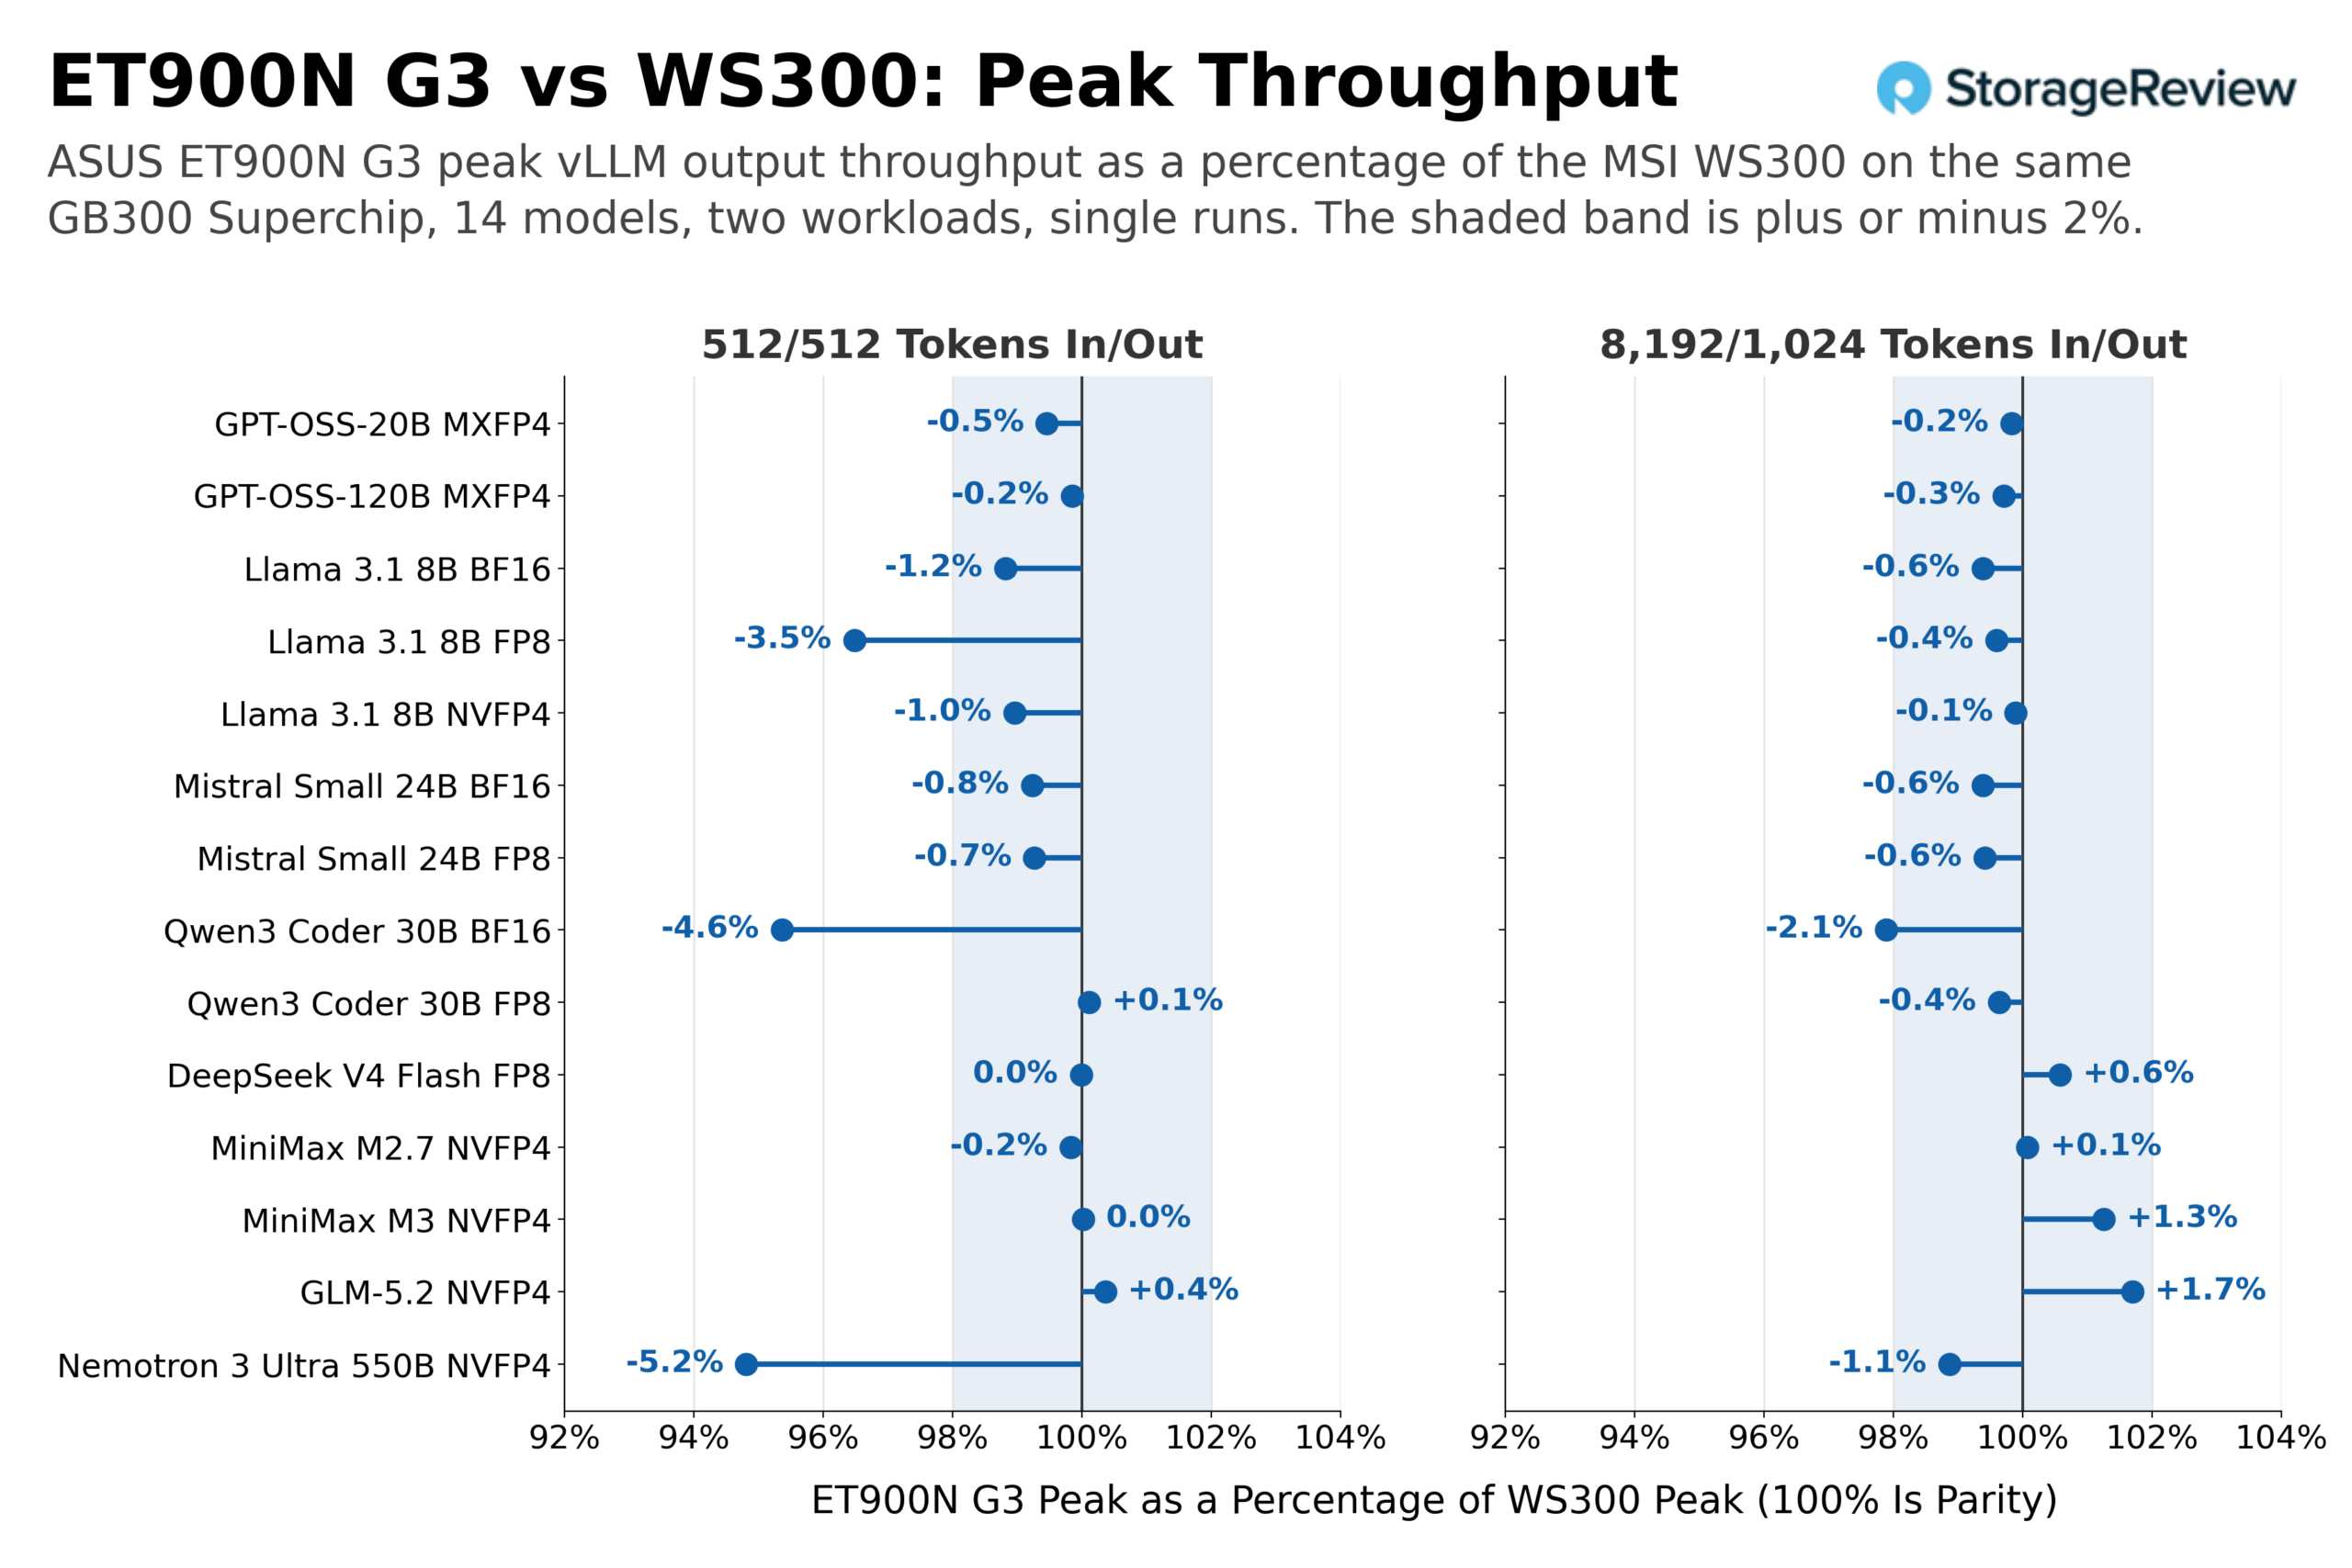
Entre os 28 pares modelo-carga de trabalho, 24 apresentam uma diferença de no máximo 2% entre si, e a maioria deles representa uma diferença de fração de um por cento a favor do WS300. Quatro estão fora dessa faixa, três deles com a mesma carga de trabalho: Llama 3.1 8B FP8 com 3.5% a menos que o WS300 (25,602 versus 26,536 tokens de saída por segundo), Qwen3 Coder 30B BF16 com 4.6% a menos (10,000 versus 10,486) e Nemotron 3 Ultra 550B com 5.2% a menos (159 versus 168), além do Qwen3 Coder 30B BF16 novamente com 2.1% a menos nos prompts longos. Cada valor aqui representa uma única execução em cada torre, portanto, uma diferença de 2 a 5% em três modelos de um total de 14 não é algo que atribuiremos ao chassi; Estamos apenas registrando os dados e a diferença entre os dois. Os modelos que dependem do pool de memória coerente, MiniMax M3 e GLM-5.2, atingem paridade ou desempenho superior em ambas as cargas de trabalho; esse é o resultado que consideramos mais importante para a plataforma: o caminho de descarregamento Grace tem o mesmo desempenho no chassi da ASUS e no da MSI.
| Modelo | WS300 512/512 | ET900N G3 512/512 | Delta | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| Lhama 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Lhama 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Lhama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| Mistral Pequeno 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| Mistral Pequeno 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Qwen3 Coder 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Qwen3 Coder 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 Flash FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
O GPT-OSS-20B, o caso denso de maior taxa de transferência no conjunto, e o GLM-5.2, o caso de descarregamento, mostram a sobreposição sem uma proporção: em ambos, a execução do WS300 segue o ET900N G3 ponto a ponto.
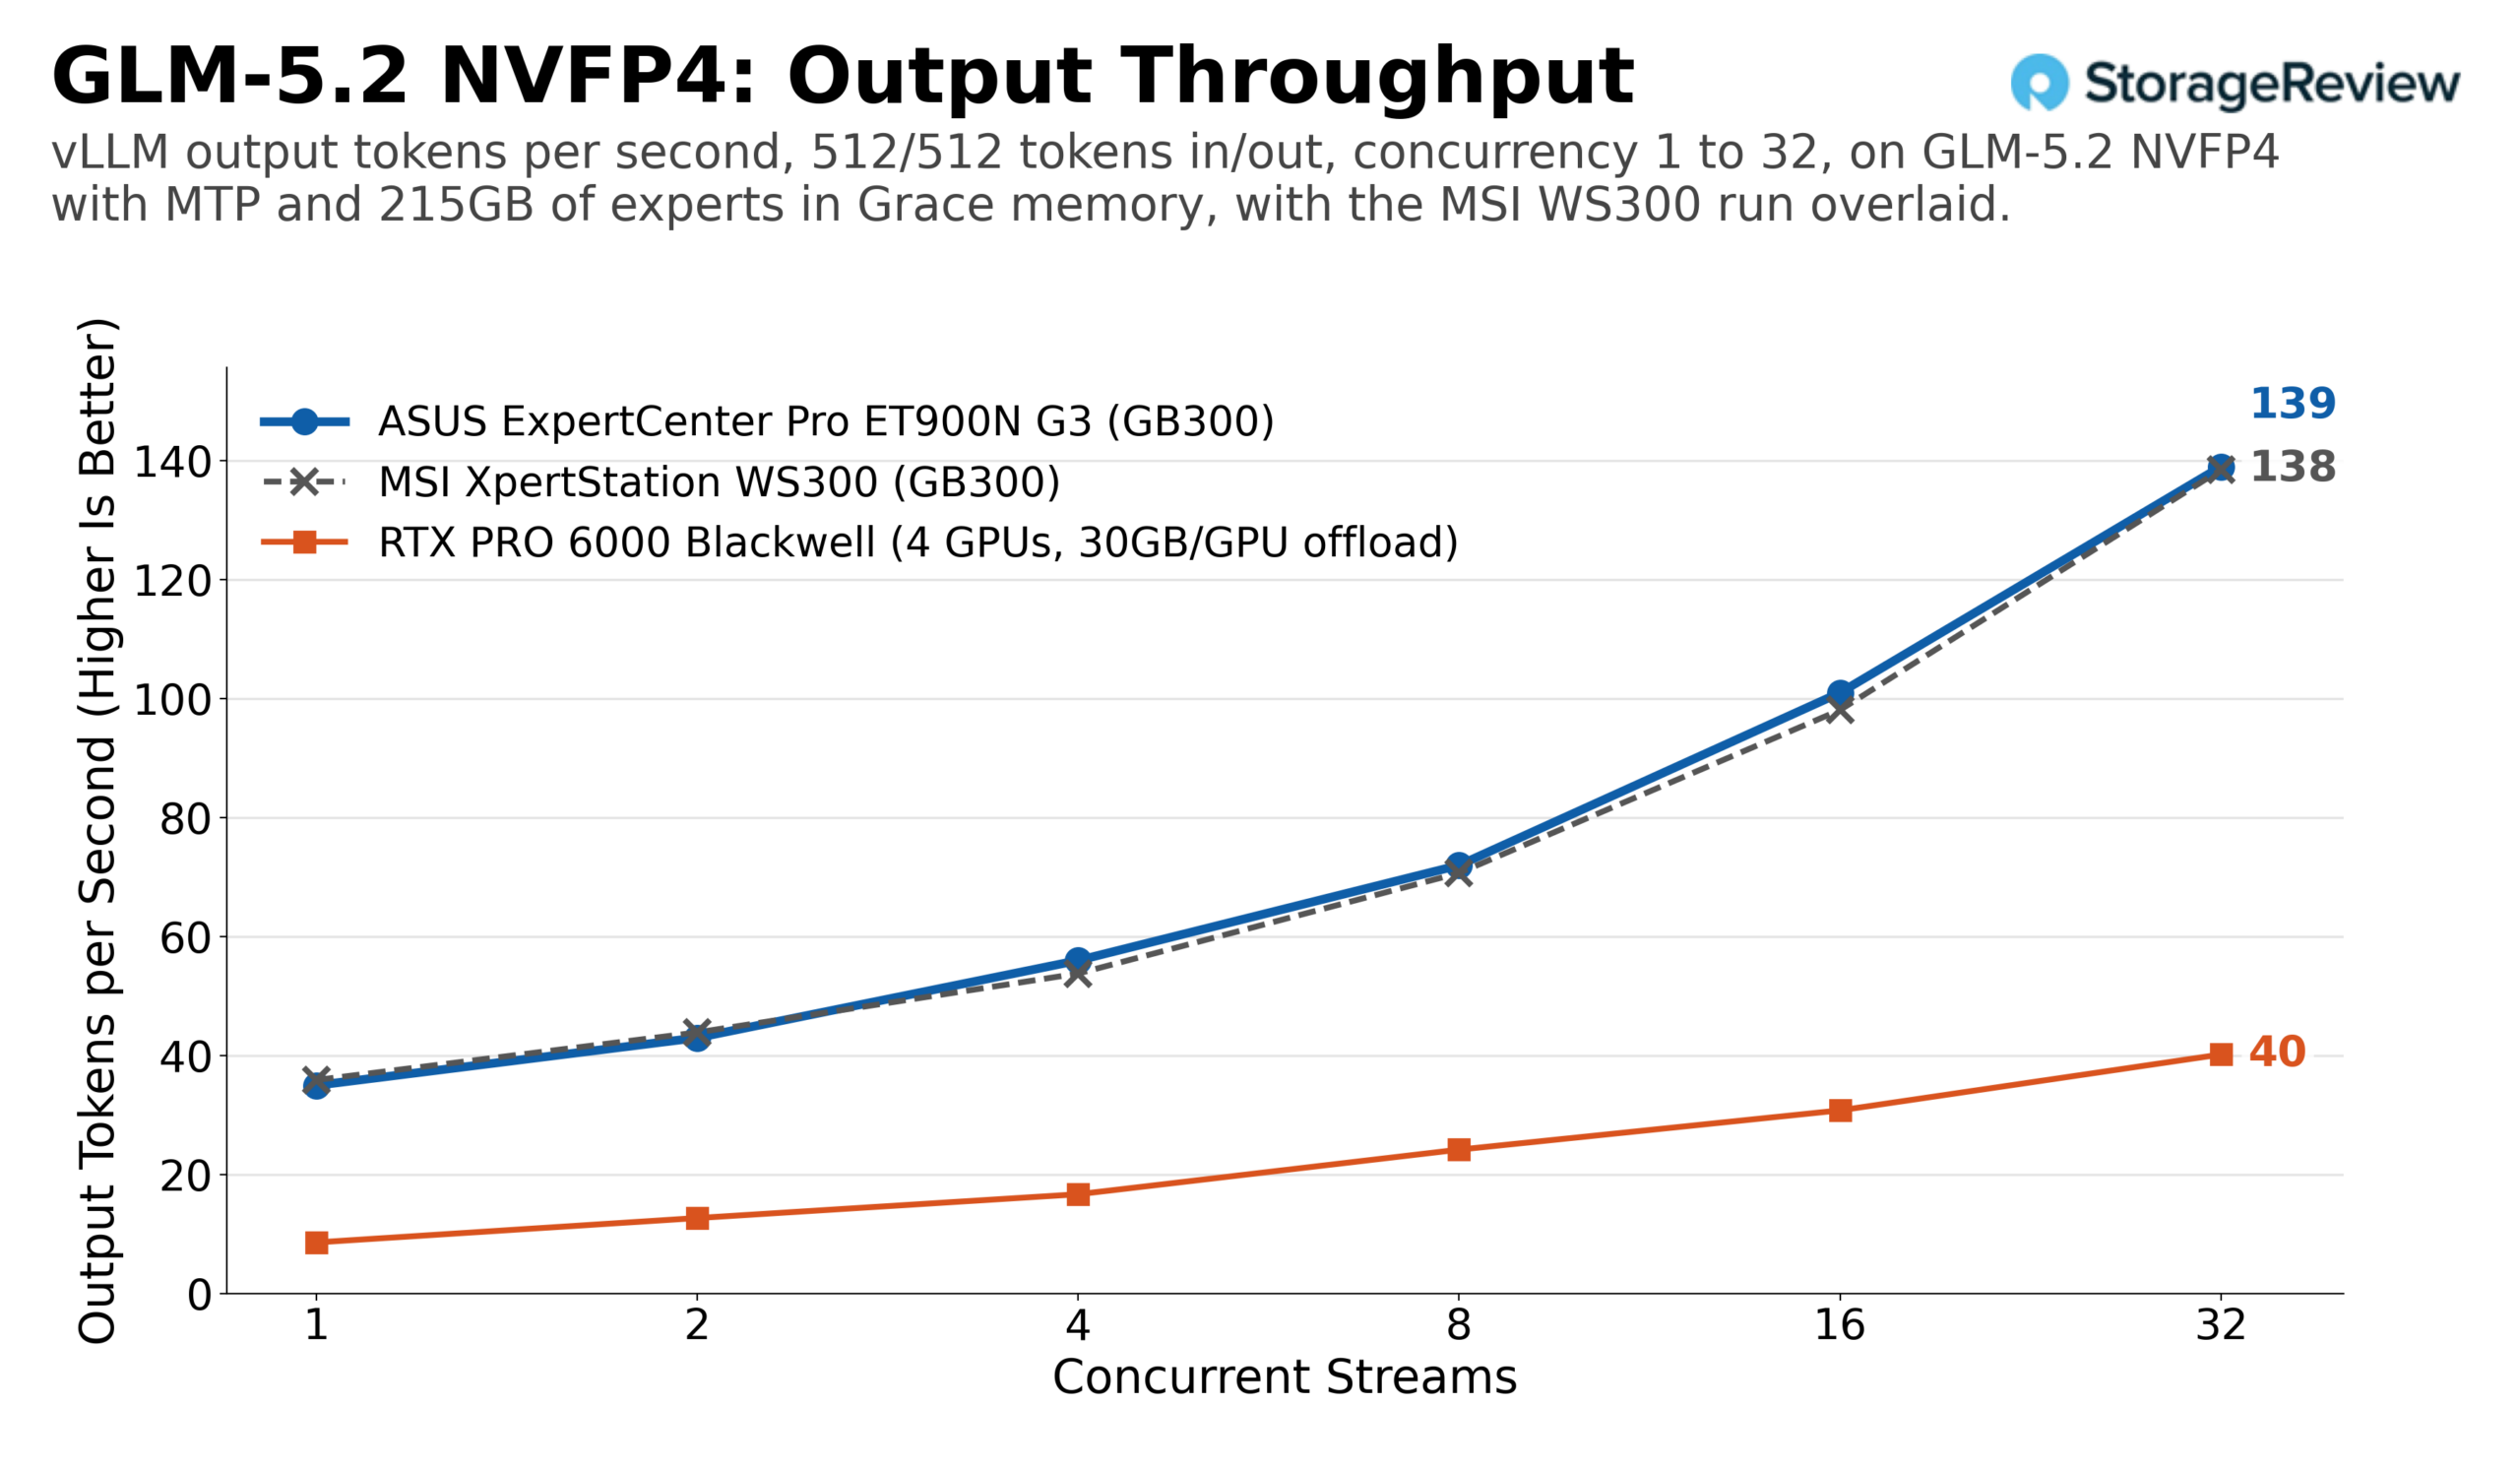
Esta é a comparação que aprimoraremos à medida que mais torres GB300 passarem pelo laboratório. A próxima é a ZGX da HP, e outras virão em seguida. Cada uma delas executa a mesma varredura, portanto, quaisquer diferenças entre as implementações dos fabricantes aparecerão aqui, em um gráfico por torre, com os gráficos dos modelos contendo as curvas brutas.
Conclusão
O ASUS ExpertCenter Pro ET900N G3 faz o que uma segunda implementação de uma plataforma de referência deve fazer: confirma a primeira. Em 14 modelos e duas cargas de trabalho, seu desempenho máximo no teste vLLM ficou dentro de 2% do MSI XpertStation WS300 em 24 das 28 comparações, variando de 1,766 tokens de saída por segundo no DeepSeek V4 Flash a 22,041 no GPT-OSS-20B, com quatro outliers pontuais entre 2% e 5% abaixo do esperado. Além disso, atendeu ao GLM-5.2 com 215 GB de especialistas na memória Grace em taxas que quatro placas RTX PRO 6000 não conseguiram alcançar. O Superchip GB300 define o limite, e a ASUS fez um excelente trabalho ao executá-lo.
O que a ASUS adiciona é prático: as alças transformam uma torre de 27 kg em algo que duas pessoas podem mover sem precisar segurar os painéis; a ventoinha sobre os slots QSFP112 resolve um problema potencial para quem usa ópticas de 400G por horas; e a fonte Titanium reduz o consumo de energia na tomada. O host Arm, o circuito de 20 A, a saída de vídeo exclusiva para BMC e o orçamento compartilhado de 1,600 W quando uma placa de vídeo grande está instalada são características da plataforma que se aplicam igualmente a ambas as torres.
A estação GB300 DGX continua sendo o dispositivo mais completo que já colocamos em uma mesa, e a ASUS tornou sua versão uma ótima opção para adquiri-la.
No nosso Melhores desktops para IA local leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon