

Os sistemas de IA de mesa baseados no NVIDIA GB10 têm uma única função, e a desempenham muito bem: colocar 128 GB de memória unificada e um petaflop de poder computacional em uma mesa próxima o suficiente do usuário para que a iteração seja instantânea. O que eles não têm é uma conexão com o armazenamento que a organização já utiliza. Cada DGX Spark e variante OEM é fornecida com um único slot M.2 curto, o que limita a capacidade local a cerca de 4 TB e coloca todos os conjuntos de dados, modelos e pontos de verificação dessa máquina fora da governança, dos controles de acesso, do backup e da trilha de auditoria que residem no data center. Multiplique isso por um laboratório, um departamento ou um campus, e o resultado são dezenas de ilhas isoladas de 4 TB, cada uma contendo sua própria cópia dos mesmos modelos e conjuntos de dados, cada uma tão segura quanto a mesa em que está instalada.
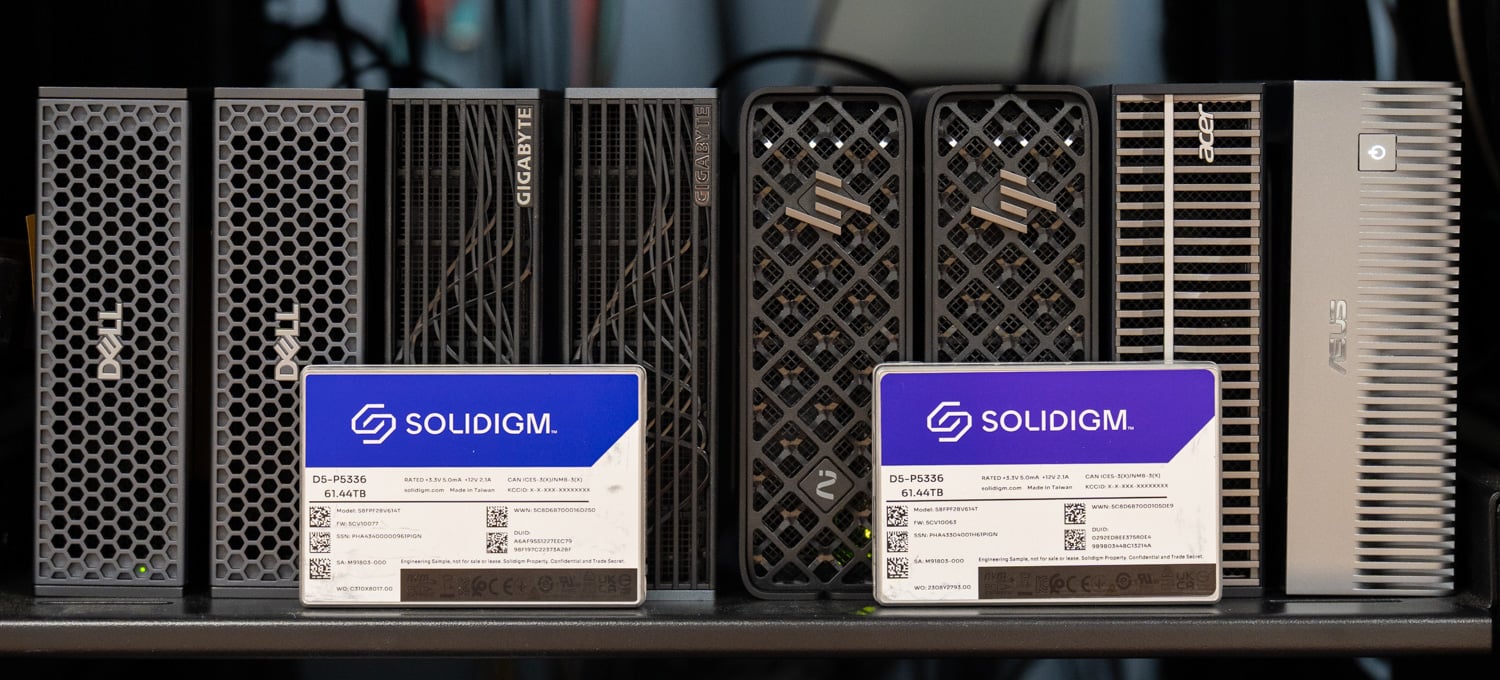
Este projeto leva o problema de armazenamento de volta para o data center. Construímos um host de armazenamento compartilhado DGX Spark a partir de um Dell PowerEdge R770AP, oito SSDs Solidigm D5-P5336 QLC em RAID 5 Graid SupremeRAID, rede Broadcom 400GbE e Tuxera Fusion servindo NFS sobre RDMA, e então conectamos oito Sparks às suas portas 100GbE. Cada Spark na malha utiliza o mesmo pool de armazenamento governado e protegido por paridade com uma única linha; uma única cópia de cada modelo e conjunto de dados atende a todos eles, nenhuma estação de trabalho precisa de mais armazenamento do que o fornecido e os próprios Sparks podem ficar no rack ao lado do array, onde são mais fáceis de proteger, refrigerar e compartilhar. O objetivo desta construção é armazenar os dados, e qualquer servidor NVMe com NICs rápidas pode desempenhar essa função. A Universidade Estadual do Oregon, que está explorando um laboratório Spark em grande escala para aprendizado de IA e deseja dar aos alunos acesso a conjuntos de dados de pesquisa medidos em dezenas de terabytes, compartilhou suas ideias conosco enquanto projetávamos a infraestrutura, e para dados nessa escala, o armazenamento compartilhado foi a abordagem que melhor se adequou a essa avaliação.
Principais lições
- Um conjunto de oito Sparks, sem software cliente: Oito DGX Sparks de cinco fabricantes diferentes montam compartilhamentos NFS/RDMA de um único array Solidigm D5-P5336 QLC atrás de Graid SupremeRAID e Tuxera Fusion, através das portas 100GbE que já possuem, com uma configuração de uma linha no Ubuntu padrão.
- Os modelos hospedados carregam da mesma forma que os modelos locais: Um modelo Qwen3.5-122B-A10B-NVFP4 de 78 GB foi carregado do array compartilhado em 269.6 segundos em um Spark, dentro de 13% dos 239.6 segundos que o mesmo Spark precisou de seu NVMe interno, e oito Sparks carregando a mesma cópia única simultaneamente terminaram entre 232.8 e 326.5 segundos.
- Uma única cópia substitui um silo em cada mesa: Modelos e conjuntos de dados em armazenamento de data center governado e protegido por paridade substituem cópias individuais em unidades M.2 de 4 TB, aumentando a utilização, reduzindo o volume de cópias e eliminando a necessidade de upgrade de armazenamento ou espaço físico para o Spark. Para um laboratório de aprendizado de IA em larga escala, como o que a Universidade Estadual do Oregon está explorando, onde os conjuntos de dados de pesquisa chegam a dezenas de terabytes, essa é a abordagem que melhor se adequa ao caso de uso em nossa avaliação.
- Os discos rígidos definem o limite máximo, e a rede tem margem de segurança: Com os oito dispositivos Spark lendo simultaneamente, o array RAID 5 de oito discos atingiu um pico próximo a 25 GiB/s, cerca de 214 Gb/s, o que representa 27% dos 800 Gb/s que as duas placas de rede Broadcom BCM57608 do host podem suportar. Uma leitura de um dos dispositivos Spark no array, a 10.8 GiB/s, corresponde à velocidade mais rápida já medida em um SSD M.2 interno em um sistema GB10.
- A governança vem com o protocolo: O NFS com RDMA coloca pastas por usuário, conjuntos de dados compartilhados e modelos hospedados em um único namespace com integrações com Active Directory, Kerberos e LDAP, o que permite que os dados permaneçam sob o controle do data center enquanto os Sparks são movidos para o rack.
O problema de ter uma ilha de IA em cada mesa
O DGX Spark e suas variantes OEM da Dell, GIGABYTE, HP, Acer e ASUS compartilham a plataforma GB10 e o mesmo limite de armazenamento. Em nossa análise original do DGX Spark , o armazenamento era a limitação mais evidente da plataforma. O slot interno aceita unidades M.2 curtas, portanto, os SSDs de 8 TB para clientes, que vêm no formato 2280, não cabem fisicamente. O Luisuantech GP Spark, que analisamos em agosto, resolve esse problema com um gabinete M.2 de quatro baias conectado a uma porta 100GbE, uma solução prática para um Spark em uma mesa e, em escala de laboratório, para um silo maior em cada mesa.
A capacidade é metade do problema; a outra metade é o que acontece com os dados depois que chegam a um computador de mesa. Um modelo de 78 GB baixado para um Spark é uma cópia que ninguém da TI consegue ver. Um conjunto de dados de pesquisa armazenado em flash local é uma cópia fora do cronograma de backup, fora da política de acesso e fora das auditorias institucionais. Dez Sparks em um laboratório significam dez cópias dos mesmos pesos consumindo 780 GB de flash que poderiam ser usados para outra coisa, e dez lugares diferentes onde um conjunto de dados pode sair pela porta com o computador. O problema piora à medida que os números aumentam, sejam sistemas GB10 ou qualquer infraestrutura de IA para desktops. Toda organização que já gerenciou uma frota de laptops conhece esse padrão, e a resposta era sempre a mesma: manter os dados em armazenamento compartilhado no data center e deixar o endpoint ser apenas um endpoint.
Felizmente, a NVIDIA projetou o Spark com portas que permitem isso. Cada unidade possui dois slots QSFP56 em um ConnectX-7 integrado, com um limite de plataforma de 200 Gb de largura de banda utilizável por trás de um par de links PCIe Gen5 x4. Em nossa análise do cluster DGX Spark , descrevemos a configuração de função dividida, na qual um slot se conecta a um Spark par e o outro ao armazenamento. Este projeto utiliza um slot por Spark para armazenamento em 100 GbE, deixando o segundo livre para clustering ou largura de banda adicional. Em 100 GbE, cada Spark tem cerca de 12.5 GB/s de largura de banda teórica para o host de armazenamento, o que excede a largura de banda fornecida pelo slot M.2 interno na maioria desses sistemas.
Uma vez que os dados estejam na outra extremidade da conexão, o papel do Spark muda. Ele se torna um ponto de acesso computacional com um disco de inicialização e um disco de cache local, e a capacidade deixa de ser uma compra por estação de trabalho. Um modelo ou conjunto de dados é gravado uma única vez e lido por todos os clientes, aumentando assim a utilização do armazenamento e diminuindo o número de cópias. A proteção de dados passa a ser feita por um array com proteção de paridade em um chassi de servidor, e o controle de acesso, a criptografia em repouso, o backup e a auditoria ocorrem onde já são realizados para todos os outros processos. E como o Spark agora só precisa de energia e uma conexão de 100 GbE, não há motivo para que ele fique em cima de uma mesa. Instalado em um rack ao lado do host de armazenamento, ele fica mais frio, mais silencioso, fisicamente seguro e disponível para quem precisar dele.
O Host de Armazenamento
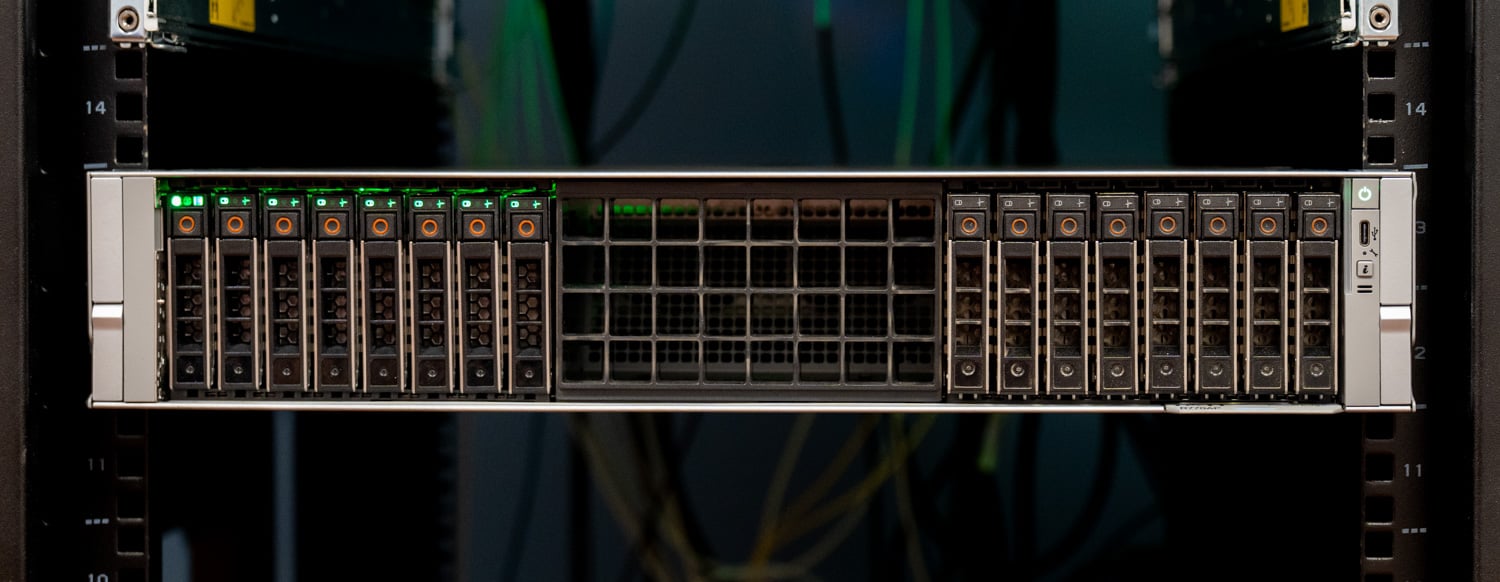
O servidor de armazenamento é um Dell PowerEdge R770AP , a mesma plataforma 2U com Xeon 6 que analisamos no início deste ano, e o utilizamos por estar disponível gratuitamente no laboratório quando o projeto começou. Qualquer servidor NVMe com espaço para placas de rede rápidas e uma pequena GPU poderia servir para essa função, e o R770AP é uma opção viável, mesmo que um pouco exagerada. O nosso utiliza dois processadores Xeon 6 6978P com 1.5 TB de memória DDR5 distribuída em 24 DIMMs, usa um dos seus dois bancos de oito baias NVMe Gen5 e conecta os drives e a GPU Graid à CPU 0, com os dois adaptadores 400GbE à CPU 1. O servidor roda Ubuntu 24.04.
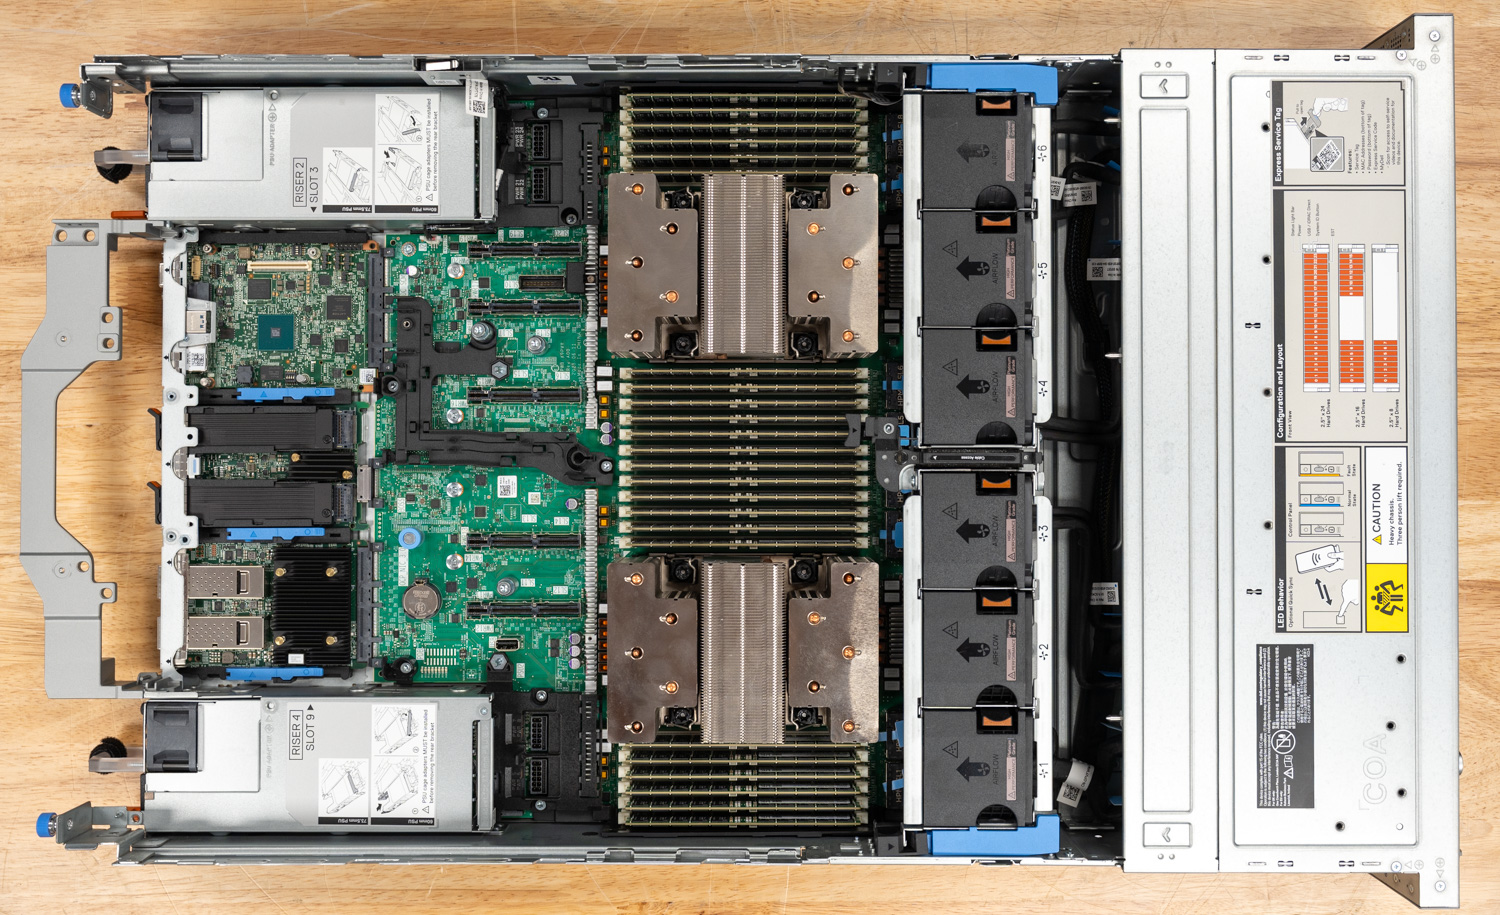
| Componente | Configuração do host de armazenamento |
|---|---|
| servidor | Dell PowerEdge R770AP, 2U, 16 baias NVMe Gen5 de 2.5 polegadas |
| CPU | 2x Intel Xeon 6 6978P |
| Memória | 1.5 TB DDR5 (24 x 64 GB) |
| Armazenamento | 8x Solidigm D5-P5336 61.44 TB U.2 PCIe 4.0 QLC (491.52 TB brutos) |
| RAID | Graid SupremeRAID, RAID 5 em todos os oito discos, GPU NVIDIA RTX A2000 na CPU 0 |
| Sistema de Arquivo | XFS na unidade virtual SupremeRAID |
| Servidor de arquivos | Tuxera Fusion (Fusion NFS, versão de pré-visualização privada), NFS 4.1 sobre RDMA (RPC-RDMA na porta 20049), modo de usuário |
| Networking | 2x Broadcom BCM57608 (Thor 2) porta única 400GbE, PCIe Gen5 x16 na CPU 1, RoCEv2 |
| Interruptor | Dell PowerSwitch Z9864F-ON, 64 portas 800GbE OSFP112, Enterprise SONiC |
| Links do cliente | Conexão óptica de 800G dividida em 8x100GbE, um link por Spark, quatro Sparks por placa de rede de armazenamento em VLANs separadas. |
| Clientes | 2x Dell Pro Max com GB10, 2x GIGABYTE AI TOP ATOM, 2x HP ZGX Nano G1n, Acer Veriton GN100, ASUS Ascent GX10 |
| OS | Ubuntu LTS 24.04 |
Por que QLC e por que o D5-P5336?
Em nossas conversas com a Oregon State sobre o conceito do laboratório Spark, a capacidade foi o primeiro requisito, pois os conjuntos de dados de pesquisa envolvidos são grandes. A função deste servidor é armazenar tudo o que uma sala cheia de Sparks possa precisar e fornecer esse conteúdo em um formato que possa ser lido por vários clientes simultaneamente. Trata-se de um perfil de alta capacidade, com foco em leitura e blocos grandes, e é para esse perfil que a tecnologia QLC foi criada. A família D5-P5336 oferece capacidades de 7.68 TB a 122.88 TB; os drives U.2 de 61.44 TB usados aqui são classificados pela Solidigm com velocidades de leitura sequencial de até 7,000 MB/s, gravação sequencial de 3,000 MB/s, 1.005 milhão de IOPS de leitura aleatória de 4K e 65.2 PBW de resistência, ou 0.58 gravações de drive por dia ao longo de cinco anos, em NAND QLC de 192 camadas com uma unidade de indireção de 16 KB.
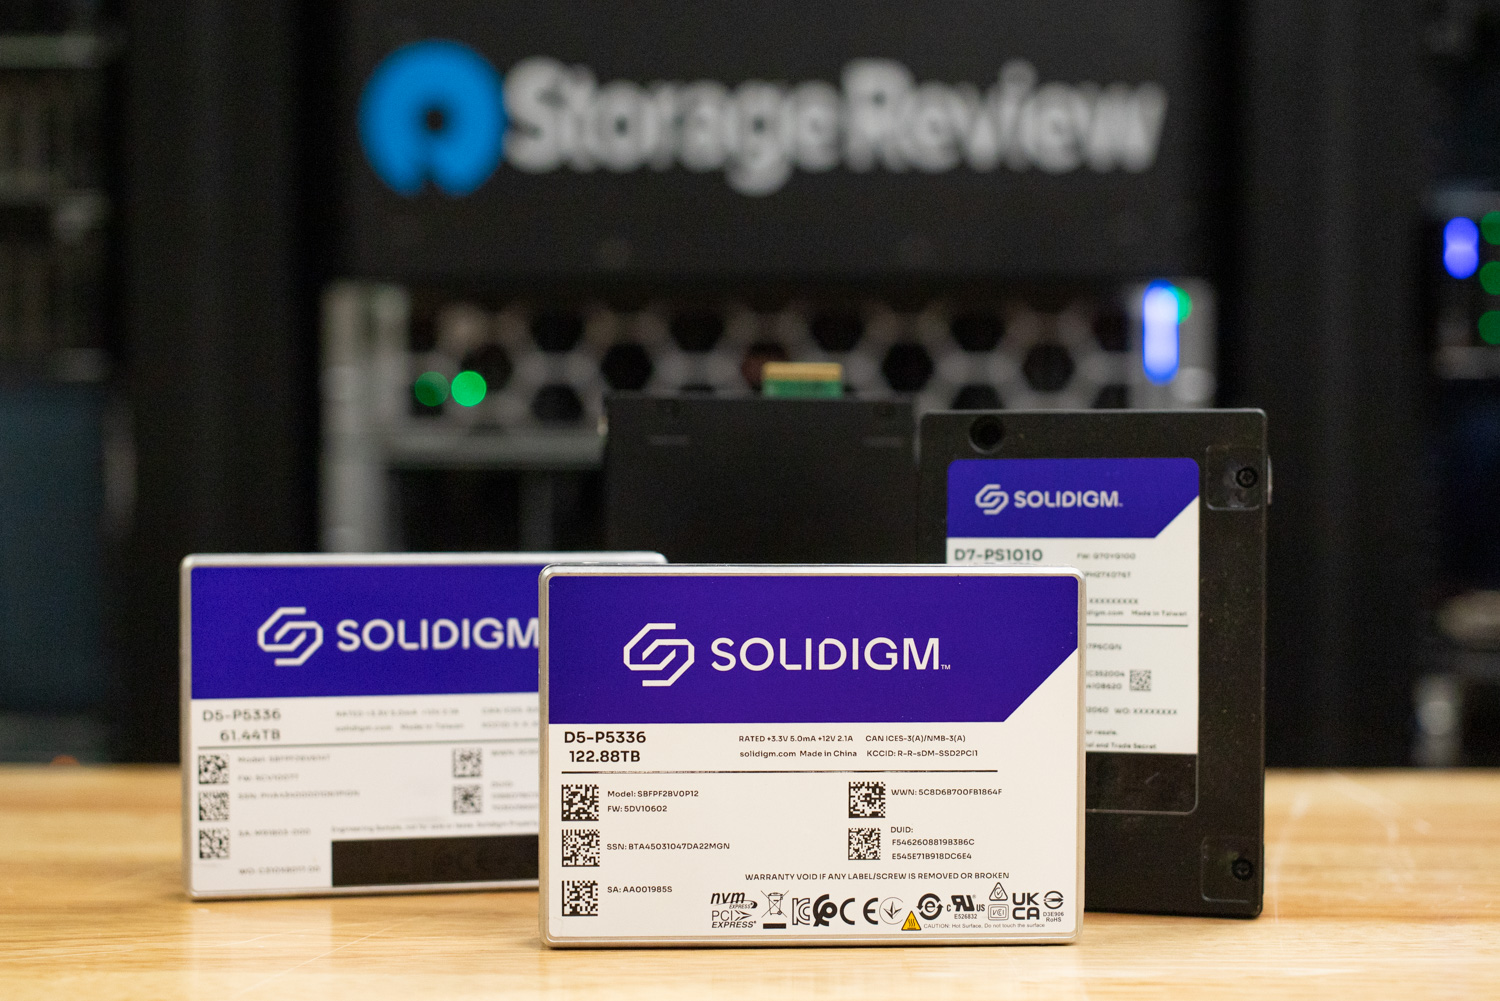
Os oito discos rígidos de 61.44 TB ocupam metade das baias frontais do R770AP, e uma configuração de produção poderia escolher qualquer capacidade da família e qualquer número de baias. Mesmo assim, oito discos em RAID 5 fornecem cerca de 430 TB de espaço utilizável com tolerância a falhas de um único disco. Isso é mais de 100 vezes a capacidade de um slot M.2 do Spark e suficiente para a biblioteca de modelos de um departamento, os conjuntos de dados compartilhados que os alunos utilizam e os diretórios pessoais de cada usuário. Preencher as outras oito baias dobra essa capacidade sem alterar o projeto de rede, e os dados de dimensionamento apresentados mais adiante nesta análise mostram por que os discos rígidos são o componente ideal para expansão.
A unidade de indireção de 16 KB é importante para essa carga de trabalho porque a IU maior da Solidigm sacrifica a eficiência de pequenas gravações aleatórias em prol de densidade e custo, e para um compartilhamento que atende modelos e conjuntos de dados, pequenas gravações aleatórias são a minoria. O carregamento de modelos envolve grandes leituras sequenciais. O streaming de conjuntos de dados também envolve grandes leituras sequenciais. Os checkpoints e os arquivos de alunos são gravados uma única vez e lidos com frequência. A divisão de trabalho resultante disso é a ideal para um laboratório Spark: o array QLC compartilhado armazena tudo o que é lido por vários usuários, e o próprio M.2 do Spark lida com o tráfego de memória temporária e de swap gravado por um único usuário.
RAID em uma GPU: Graid SupremeRAID
O RAID NVMe em oito unidades Gen4, cada uma capaz de leitura a 7,000 MB/s, é o ponto em que uma placa RAID de hardware convencional se torna o gargalo, pois cada byte precisa passar pelo slot PCIe da placa. O RAID por software enfrenta um conjunto diferente de desafios de recursos. O Graid SupremeRAID descarrega os cálculos de paridade para uma GPU e mantém o caminho de dados nas linhas PCIe do host, razão pela qual o vimos escalar para mais de 180 GB/s em nossos testes com o SupremeRAID AE com 16 unidades. Para este host, executamos o SupremeRAID em uma NVIDIA RTX A2000, uma GPU de workstation compacta.
Os oito discos D5-P5336 foram apagados com segurança e preenchidos sequencialmente antes de serem entregues à Graid, que os configurou como um único array RAID 5. O disco virtual resultante foi formatado com XFS e gerenciado pelo Tuxera. O RAID 5 é o nível ideal para um compartilhamento como este: a falha de um disco mantém o array online, as reconstruções ocorrem sem interromper o acesso dos dados do usuário e a penalidade de capacidade é de um disco para cada oito. RAID 6 ou RAID 10 seriam opções razoáveis para uma implementação em produção que prioriza a proteção da janela de reconstrução em detrimento da capacidade, e o SupremeRAID oferece suporte a ambos.
A rede: Broadcom 400GbE e um núcleo de 800G
O lado de armazenamento da malha consiste em dois adaptadores Broadcom BCM57608 Thor 2 no R770AP, cada um com uma única porta 400GbE em uma interface PCIe Gen5 x16. A Broadcom posiciona o BCM57608 como a placa de rede 400G de menor consumo de energia do mercado, e seu conjunto de recursos o torna uma ótima opção: RoCEv2 com controle de congestionamento DCQCN aprimorado, roteamento adaptativo, inicialização segura com raiz de confiança em silício e descarregamento de criptografia kTLS em linha. O RoCEv2 transporta NFS sobre RDMA neste projeto, e o controle de congestionamento impede que vários clientes interfiram uns nos outros quando todos começam a acessar simultaneamente. Durante a montagem, o driver bnxt_en relatou que os módulos ópticos nas portas 400G estavam atingindo o limite de aviso de 70°C sob carga sustentada. Resolvemos isso com um pequeno ajuste no perfil da ventoinha no R770AP, e as placas de rede funcionaram sem problemas depois disso.
Ambas as placas de rede (NICs) estão conectadas a um Dell PowerSwitch Z9864F-ON , o switch central de 800G do nosso laboratório, executando o Enterprise SONiC. O Z9864F-ON possui 64 portas OSFP112 a 800GbE e pode distribuí-las em 2x400G, 4x200G ou 8x100G. Uma fibra óptica de 800G, distribuída em 8x100G, conecta os oito servidores Spark, um link para cada um, ao mesmo switch que termina os dois links de armazenamento de 400G. Cada NIC de 400G está em sua própria VLAN e atende a quatro servidores Spark, portanto, o host de armazenamento apresenta dois alvos RDMA, e a carga é distribuída igualmente entre eles por projeto. Na prática, trata-se de uma topologia de taxa total: 8x100G de largura de banda para clientes de um lado, 2x400G de largura de banda para armazenamento do outro e um switch com capacidade de 102.4 Tbps no meio.
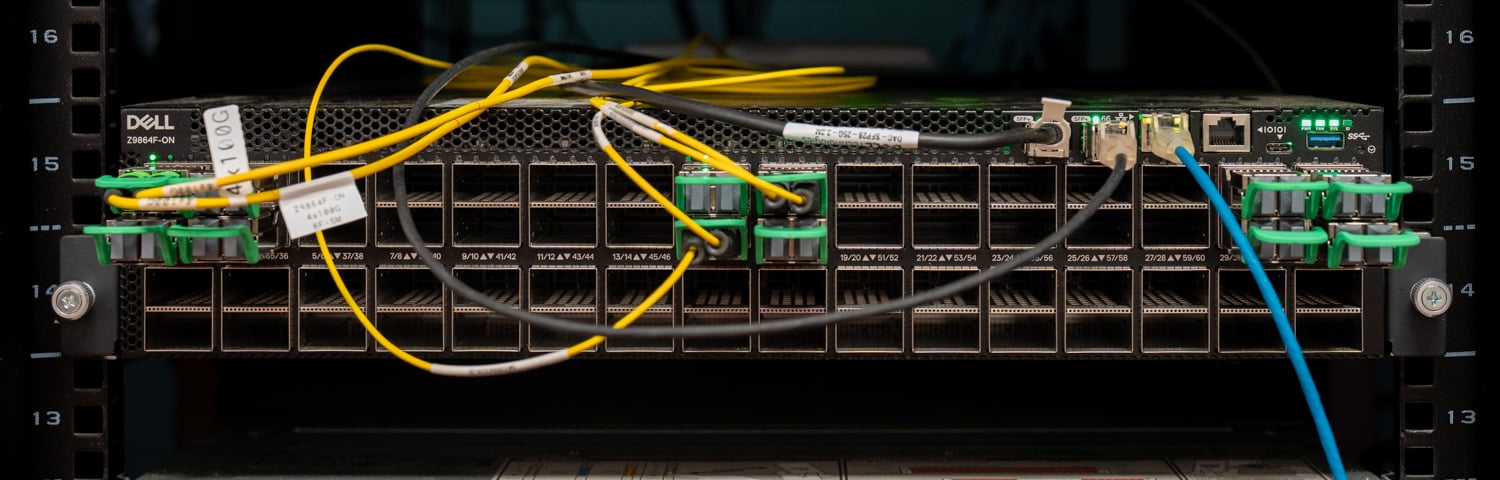
Validamos a estrutura antes de qualquer software de armazenamento a utilizar. Testes de servidor para servidor entre o R770AP e um segundo host através dos links de 400G foram executados na velocidade da linha em ambas as direções, e o tráfego RDMA dos Sparks confirmou que as portas breakout de 100G operavam em velocidade máxima. Assim que os engenheiros da Tuxera configuraram os compartilhamentos NFS, o iperf3 dos Sparks para suas respectivas NICs mostrou uma taxa de transferência estável de 99 Gbps com quatro fluxos paralelos e zero retransmissões.
Por que NFS e por que Tuxera?
Com o Graid apresentando um dispositivo de bloco rápido, o host de armazenamento poderia servir os Sparks como destinos de bloco NVMe-oF ou compartilhamentos de arquivos. Testamos o caminho de bloco na análise do GP Spark e ele funciona bem para um cliente. Para um laboratório com muitos Sparks, queríamos algo diferente. Os volumes de bloco são um-para-um; cada usuário precisaria de um LUN e, no momento em que dois usuários quisessem o mesmo conjunto de dados, seria necessário copiá-lo, que é o problema que todo esse design visa resolver. O NFS é o ponto central do diagrama de Venn: um único namespace contém conjuntos de dados compartilhados, modelos hospedados e pastas por usuário. Cada montagem do Spark usa o cliente NFS já presente no Ubuntu, e as ferramentas Kubernetes e Slurm que uma universidade implementaria em um laboratório Spark também são compatíveis com NFS.
O Fusion NFS é a parte NFS do Tuxera Fusion, o servidor de arquivos multiprotocolo que abrange SMB e NFS em um único núcleo multithread em modo de usuário. Analisamos o Fusion SMB pela primeira vez em um projeto de fluxo de trabalho de mídia da Solidigm e Tuxera em 2024. A Tuxera afirma atingir até 22.7 GB/s em uma única conexão 200GbE com RDMA, superando o kernel NFSD e o Ganesha em seus próprios testes. O produto também suporta NFS 4.1, clustering ativo-ativo com escalabilidade horizontal, failover transparente e integração com Active Directory, Kerberos e LDAP. Este último conjunto é o recurso de governança: o mesmo diretório que controla quem pode fazer login no Spark também controla o que essas pessoas podem ver no compartilhamento. Uma ressalva se aplica a todos os números da Tuxera mencionados neste artigo: a versão que utilizamos é uma prévia privada do Fusion NFS que, segundo a Tuxera, ainda não foi totalmente otimizada para desempenho, e o software ainda não está disponível para venda comercial. A disponibilidade geral está prevista para novembro, após a SC'26.
Tuxera instalou o Fusion no R770AP, formatou o volume Graid com XFS e configurou o servidor com NFS na porta padrão e RPC-RDMA na porta 20049, deixando os listeners SMB de fora, já que este projeto é exclusivo para NFS. A configuração inicial de threads consistia em quatro threads de protocolo, cada uma com oito threads para transmissão e recepção de transporte, dados VFS e metadados VFS, o que Tuxera descreve como um ponto de partida para ajustes. Os serviços de diretório foram deliberadamente omitidos da configuração de laboratório; uma implantação universitária adicionaria seus próprios serviços de identidade. No Spark, montar o compartilhamento é feito com um único comando:
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
Essa única linha de código representa toda a integração do cliente, sem driver, sem configuração de iniciador e sem software de fornecedor no Spark. Um usuário que fizer login em um Spark diferente amanhã executará a mesma linha de código e verá os mesmos arquivos.
Prova de Configuração: Oito Sparks em um Conjunto de Dados
Antes de qualquer trabalho de modelagem, realizamos um teste de sanidade em cada Spark individualmente: uma leitura sequencial de 1 milhão de operações com 16 jobs e uma profundidade de fila de 16, em sua própria pasta no array. As oito unidades retornaram entre 10.0 e 11.2 GiB/s, saturando o link de 100 GbE em cada uma. Em seguida, realizamos um teste de varredura para comprovar que todas as oito unidades conseguiam suportar sua parcela da carga. Cada execução mantém um número fixo de 16 threads com uma profundidade de fila agregada de 16 e as distribui entre um, dois, quatro e oito Sparks, em cargas de trabalho de 1 milhão de operações sequenciais, 64 mil operações aleatórias, 16 mil operações sequenciais e 4 mil operações aleatórias, com leitura e gravação, E/S direta, 60 segundos por teste. Cada Spark grava em sua própria pasta no array, quatro por NIC de armazenamento, e não há QoS em nenhum lugar da pilha. Com os oito switches carregados simultaneamente, as leituras sequenciais de 1M por unidade variaram de 3.09 a 3.13 GiB/s, as leituras aleatórias de 64K de 6,648 a 6,779 IOPS e as gravações aleatórias de 4K de 2,136 a 2,155 IOPS, em cinco OEMs em duas VLANs sem aplicação de fairness. Cada Spark alcançou o array, cada Spark recebeu uma parcela igual e a configuração estava pronta para a carga de trabalho que importa.
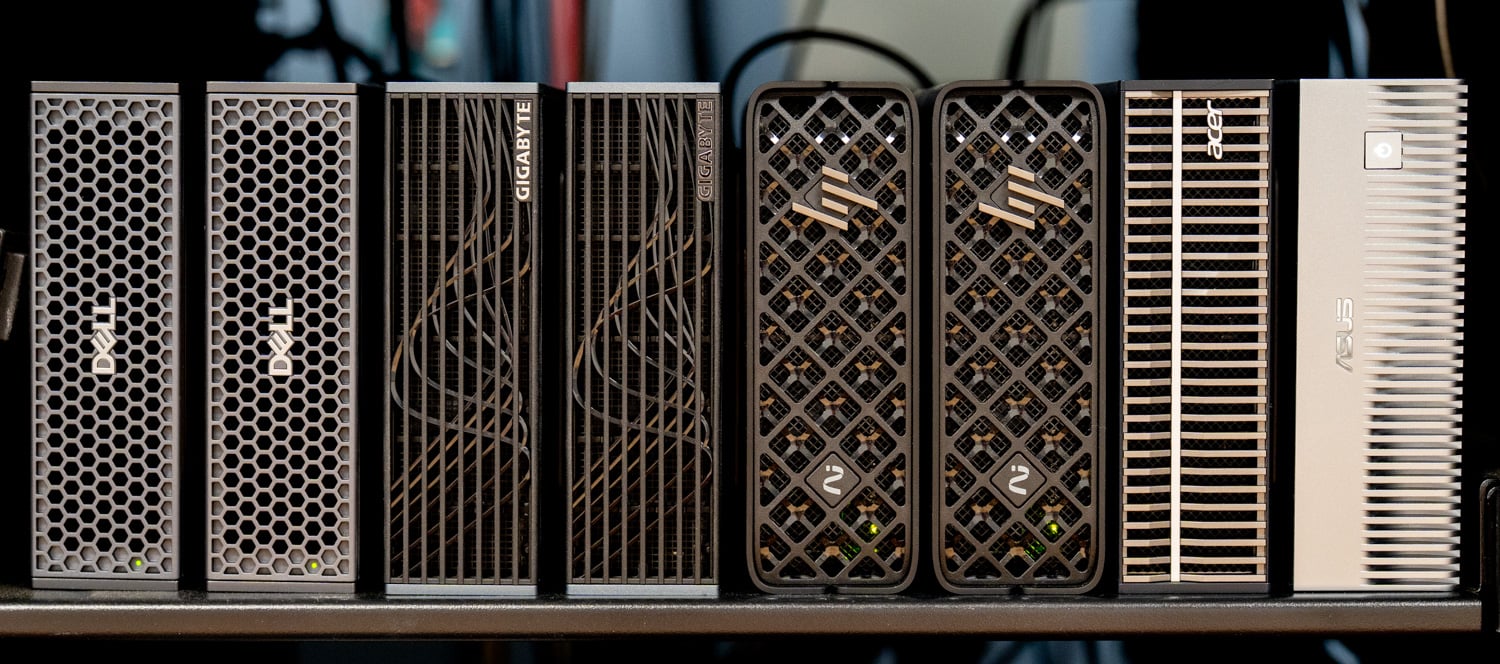
| Spark (oito clientes, 2 threads x QD16 cada) | NIC de armazenamento | 1 milhão de leitura sequencial | IOPS de leitura aleatória em 64K | IOPS de leitura aleatória em 4K | IOPS de gravação aleatória em 4K |
|---|---|---|---|---|---|
| Dell Pro Max com GB10 (1) | 1 | 3,176 MiB/s | 6,648 | 10,000 | 2,150 |
| GIGABYTE AI TOP ATOM (1) | 1 | 3,195 MiB/s | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201 MiB/s | 6,696 | 10,100 | 2,136 |
| Acer Veriton GN100 | 1 | 3,194 MiB/s | 6,670 | 10,100 | 2,149 |
| Dell Pro Max com GB10 (2) | 2 | 3,184 MiB/s | 6,694 | 10,200 | 2,155 |
| GIGABYTE AI TOP ATOM (2) | 2 | 3,187 MiB/s | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189 MiB/s | 6,678 | 10,100 | 2,151 |
| ASUS Ascent GX10 | 2 | 3,163 MiB/s | 6,734 | 10,300 | 2,145 |
Dimensionando o host: duas placas de rede e bastante espaço livre.
A mesma análise responde à pergunta que um laboratório ou uma empresa precisa responder antes de comprar: qual é o limite e qual parte do host o define? Os quatro painéis abaixo mostram a taxa de transferência de leitura em todas as quatro cargas de trabalho, à medida que a carga fixa aumenta de um Spark para oito; o lado da gravação é abordado no texto e na tabela mais abaixo.
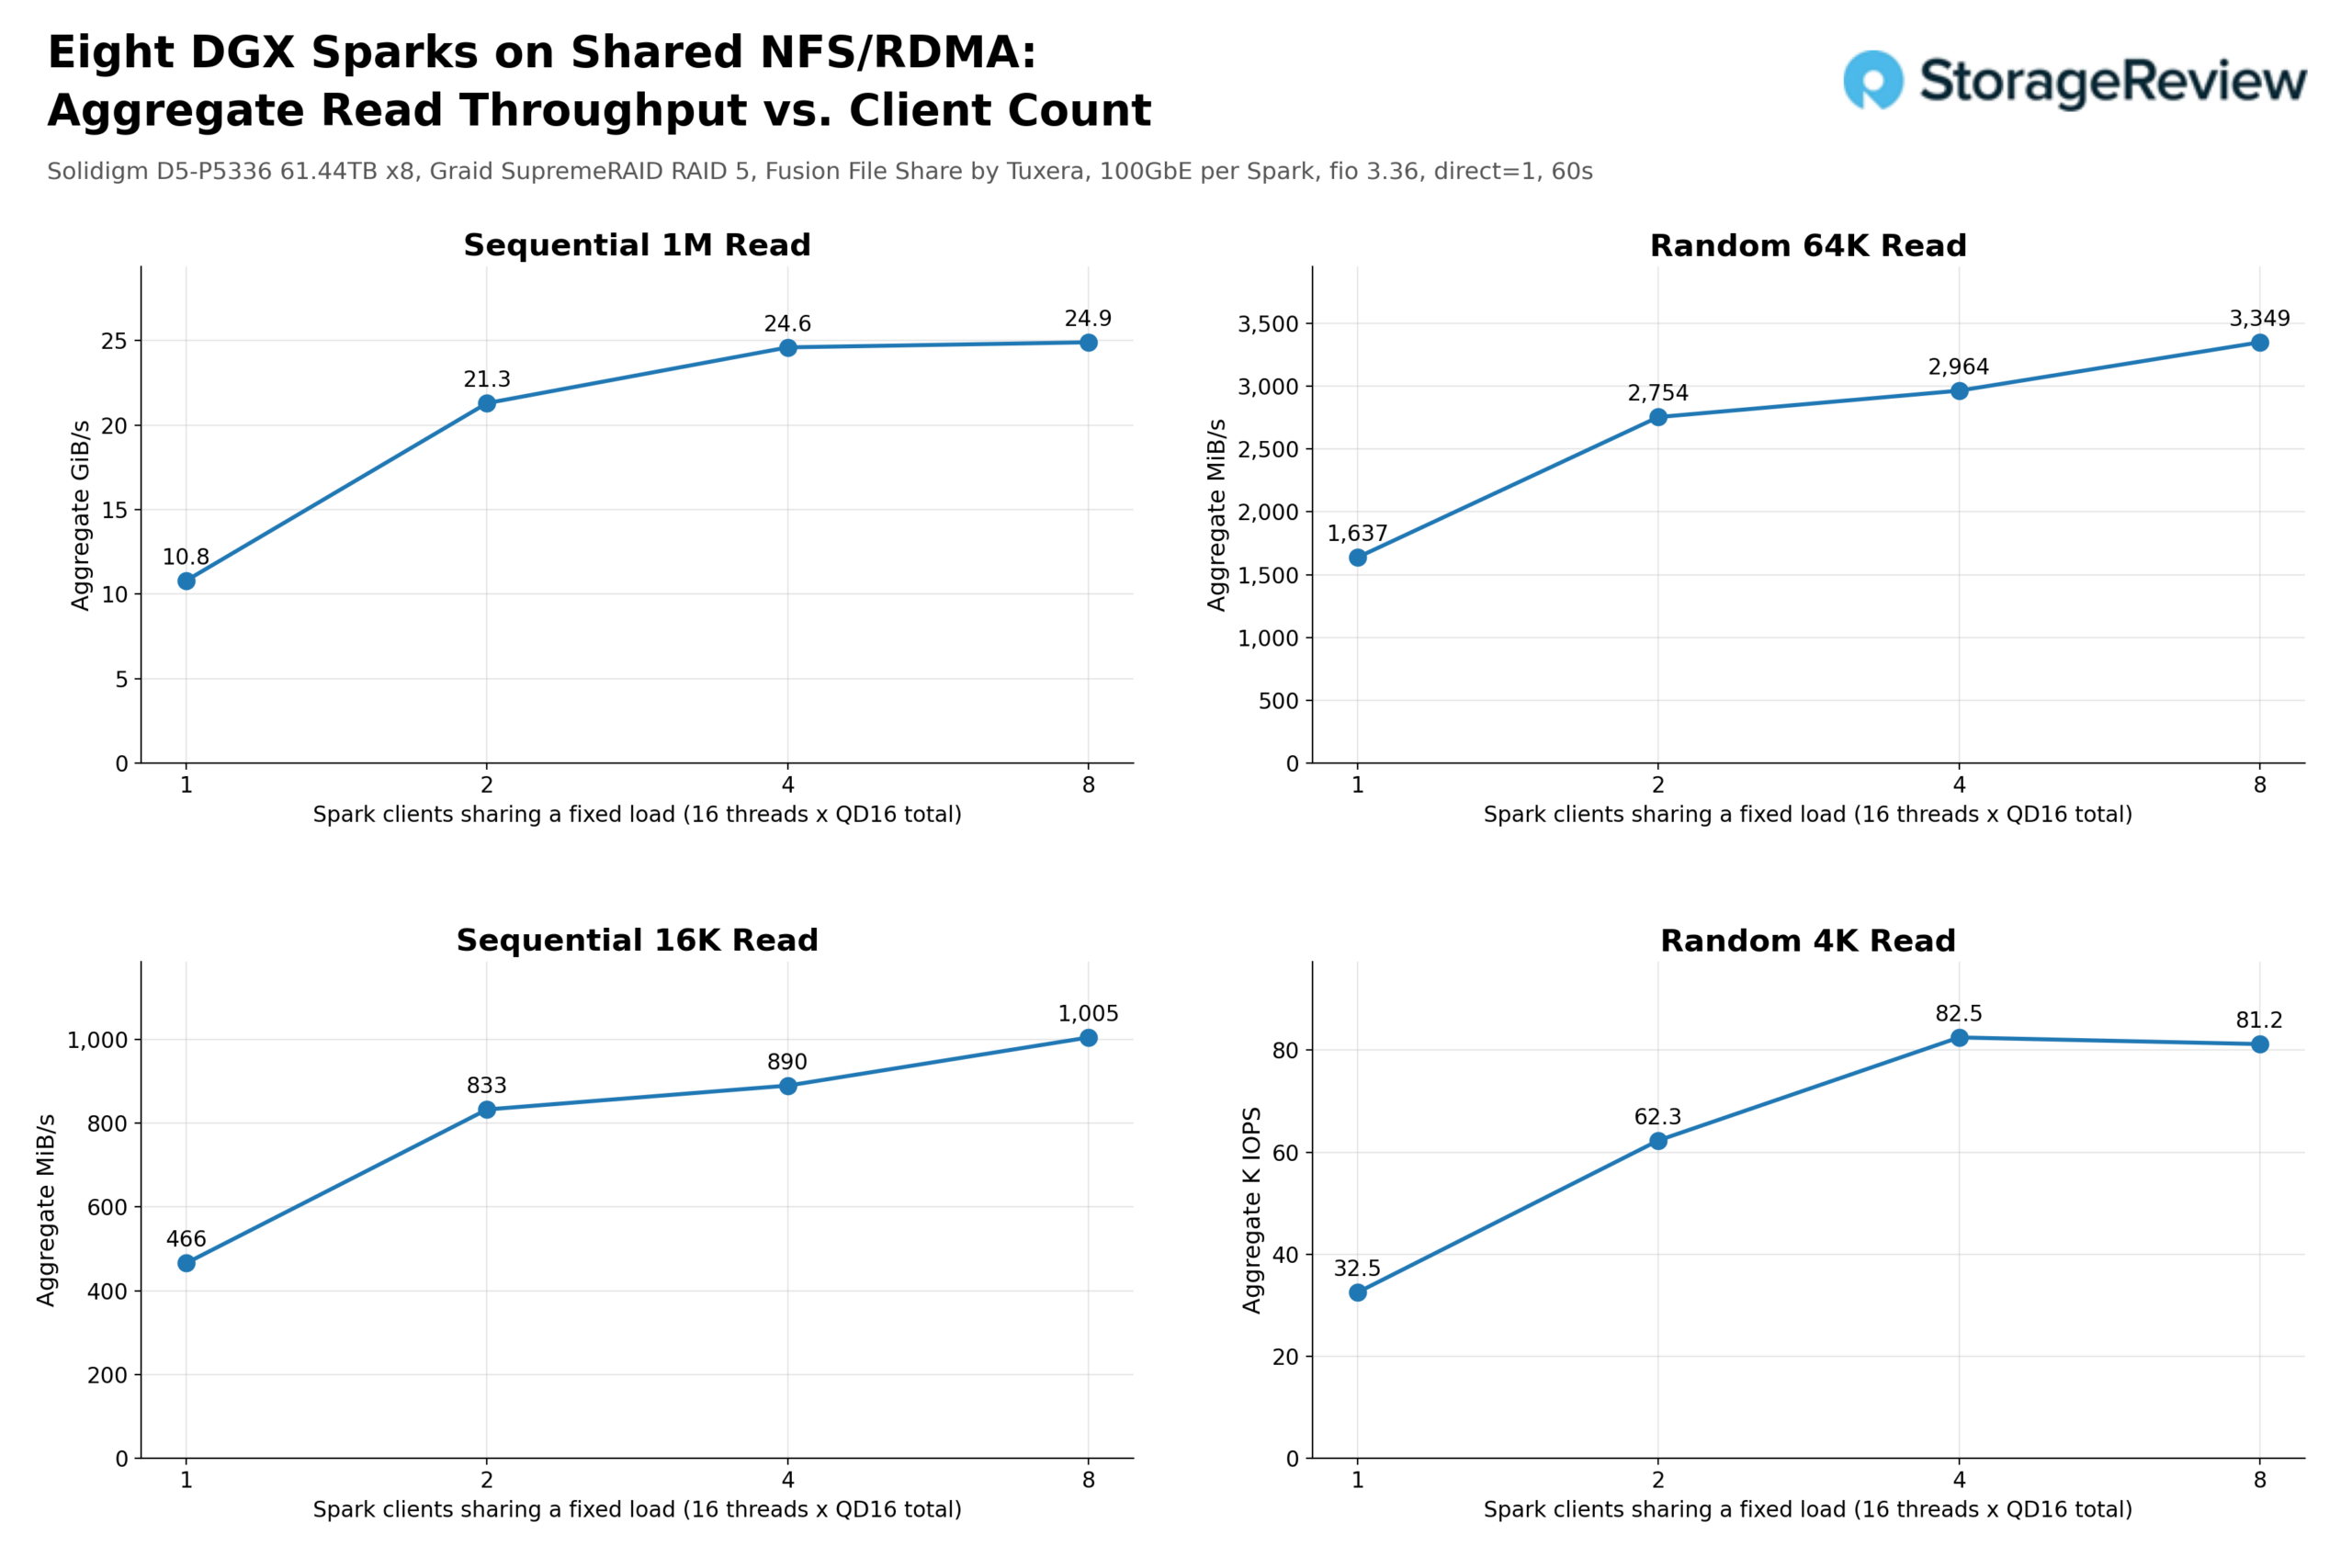
A taxa de leitura sequencial agregada de 1 milhão de dados subiu de 10.8 GiB/s em um Spark para 21.3 GiB/s em dois, 24.6 GiB/s em quatro e 24.9 GiB/s em oito. Em termos de rede, isso representa 93 Gb/s, 183 Gb/s, 212 Gb/s e 214 Gb/s, contra os 800 Gb/s que as duas placas de rede Broadcom 400GbE podem suportar. Assim, com a carga máxima de oito clientes, o array utilizou 27% da capacidade de rede do host. O patamar próximo a 25 GiB/s corresponde ao array RAID 5 QLC de oito discos; as placas de rede, o switch e os próprios links 100GbE dos Sparks nunca representaram o limite.
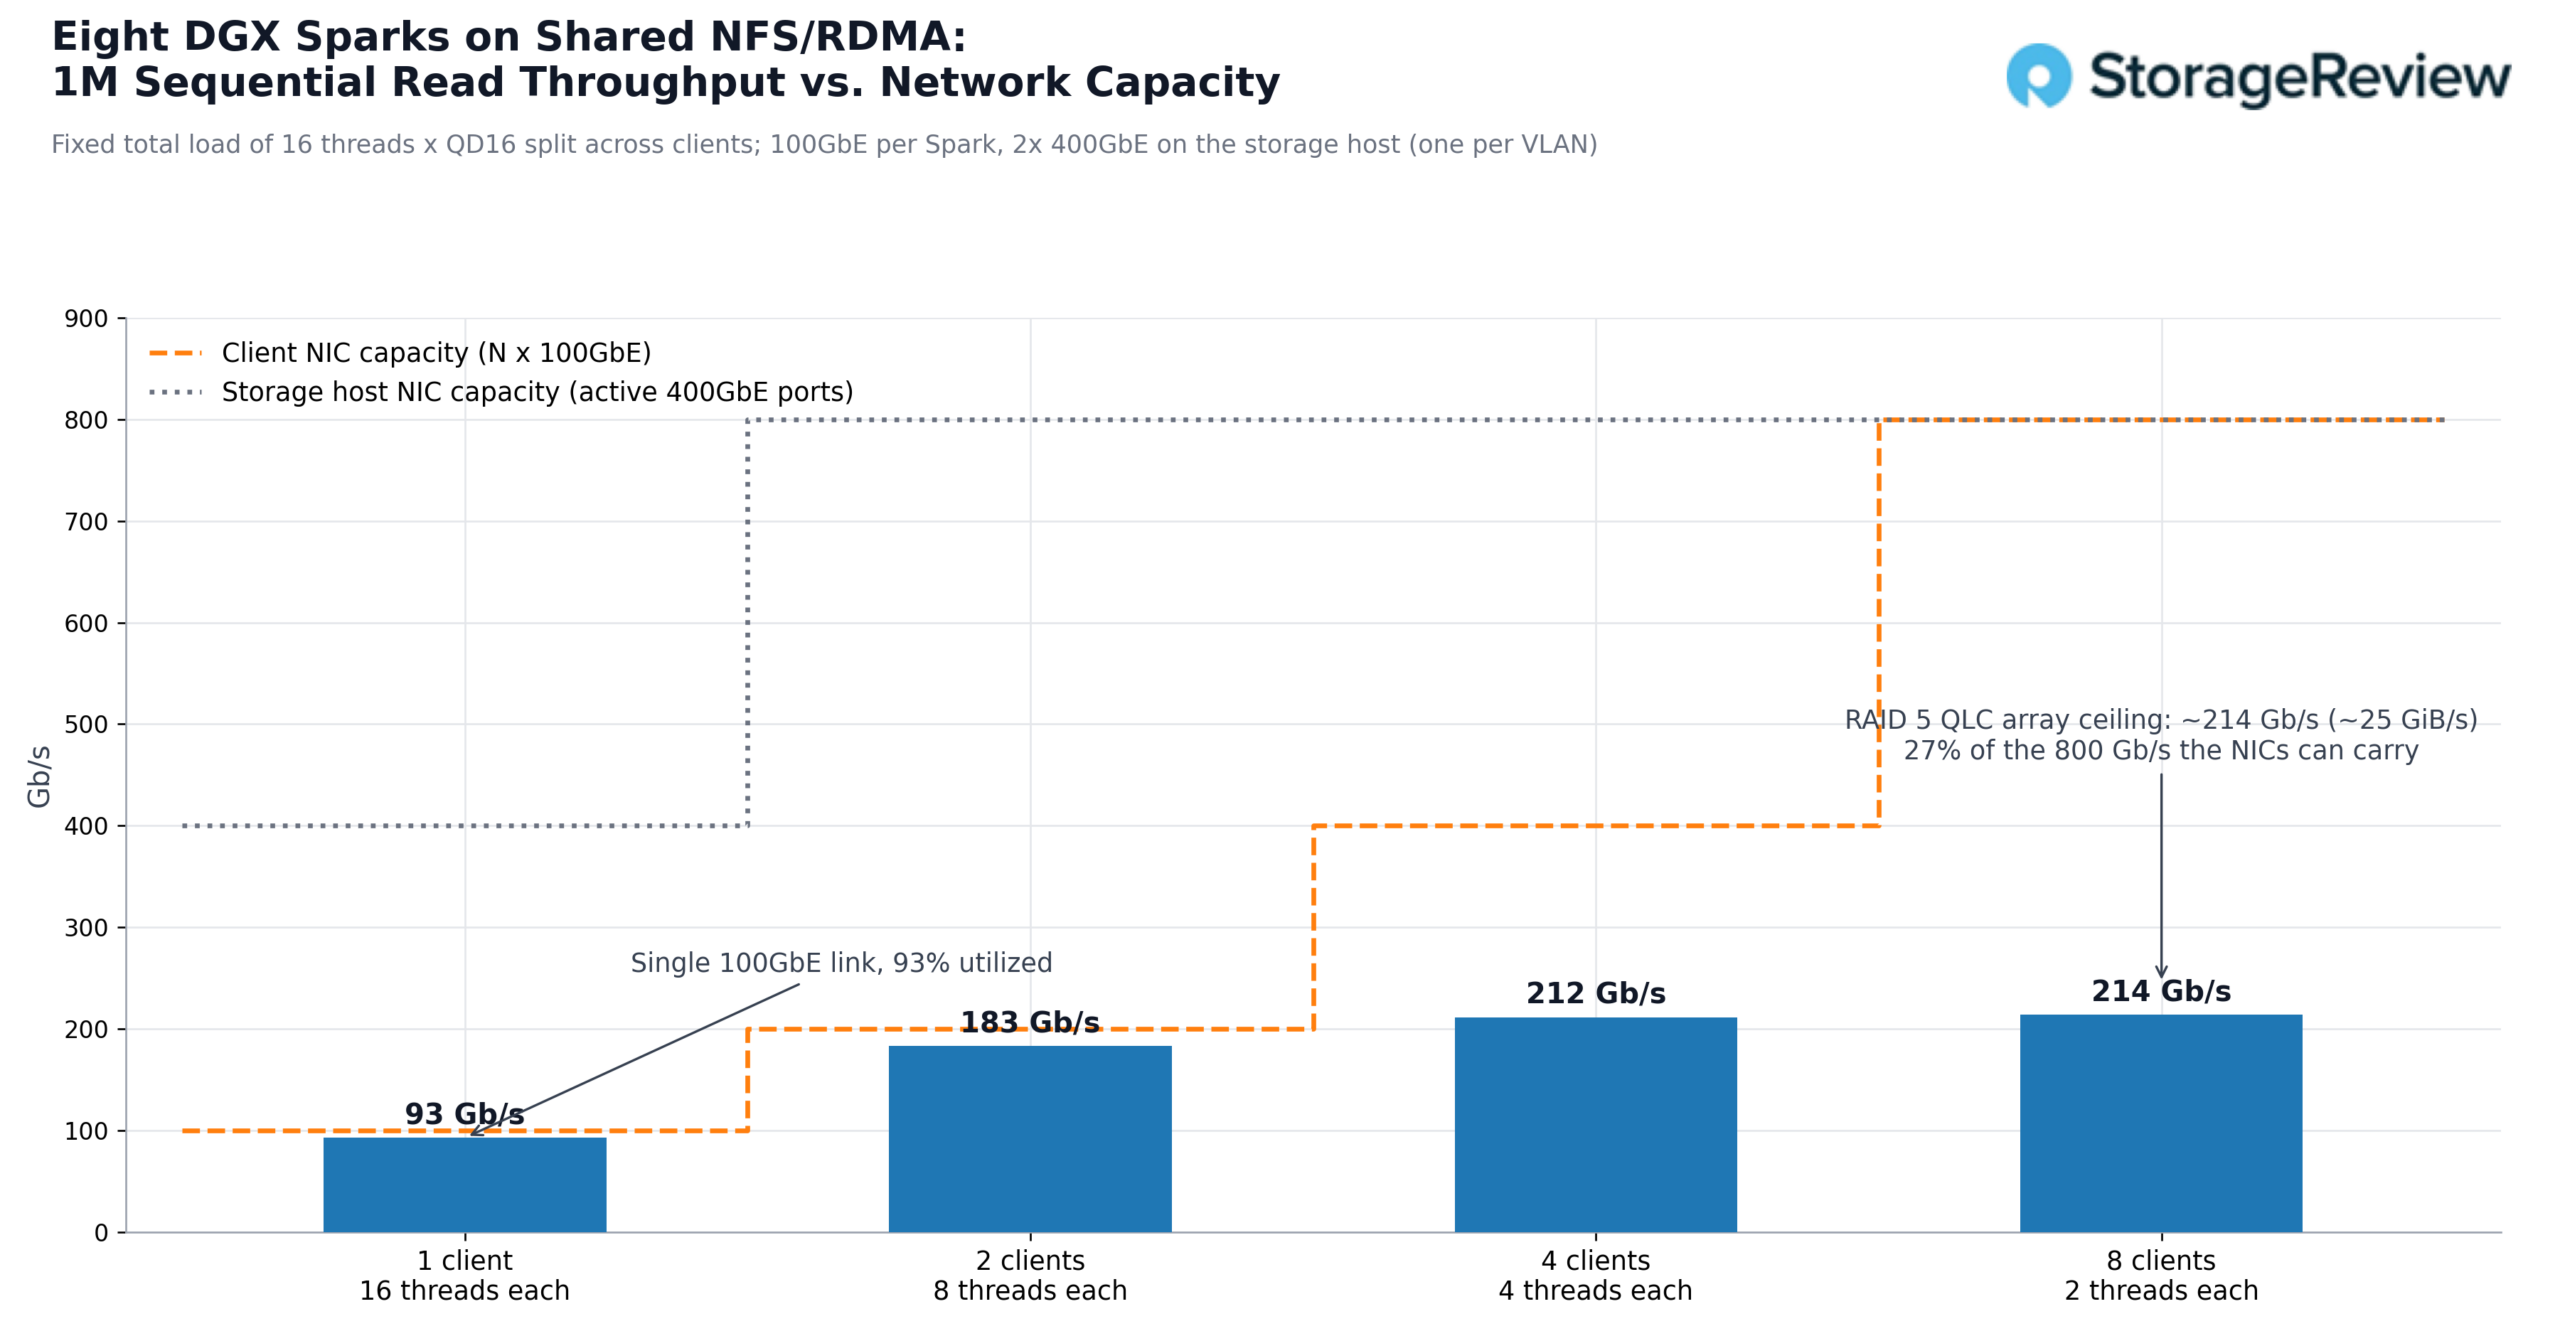
Duas placas de rede (NICs) do lado do servidor já cobrem oito discos Spark em velocidade de linha e também cobririam as outras oito baias do R770AP: dobrar o número de discos, seja como um segundo array ou um conjunto RAID mais amplo, coloca mais largura de banda de leitura nas mesmas duas portas, com folga. O mesmo vale para E/S. Leituras aleatórias de 4K escalaram de 32.5 mil IOPS em um cliente para um patamar de cerca de 81 mil IOPS em quatro clientes ou mais, com a latência por E/S caindo de 7.9 ms para 3.1 ms à medida que a fila de cada cliente ficava menor, e leituras aleatórias de 64K passaram de 1,637 para 3,349 MiB/s, com a rede bem abaixo de seu limite em ambos os casos.
Outra comparação importante é com o armazenamento que o Spark já possui. Em nossas análises individuais do GB10, as leituras GDSIO 1M do M.2 interno atingiram quase 11.2 GiB/s no Acer Veriton GN100 e no GIGABYTE AI TOP ATOM. O Dell Pro Max com GB10 e o HP ZGX Nano G1n alcançaram cerca de 5.5 GiB/s, enquanto o ASUS Ascent GX10 chegou perto de 5 GiB/s. Em comparação, o SSD NVMe-oF externo do Luisuantech GP Spark entregou 9.5 GB/s na mesma porta 100GbE. Uma única leitura do Spark a partir do array QLC compartilhado a 10.8 GiB/s iguala os drives internos mais rápidos desse grupo e praticamente dobra a velocidade do mais lento, em um único cabo, considerando que todos os outros Sparks também conseguem ler os dados. As ferramentas utilizadas são diferentes: GDSIO nos drives internos e fio via NFS neste caso, portanto, trata-se de uma comparação de faixa de valores.
A análise completa está abaixo, com os valores agregados para todas as quatro cargas de trabalho em cada número de clientes. O número de linhas lidas aumenta com o número de clientes até que o array atinja sua capacidade máxima, enquanto o número de linhas gravadas permanece constante de um a oito Sparks, porque o caminho de paridade do RAID 5 mantém o array em um limite máximo de gravação fixo, independentemente do número de clientes que o compartilham. Para um compartilhamento projetado para ser lido por muitos e gravado apenas uma vez na ingestão, esse é o perfil para o qual o projeto foi desenvolvido.
| Agregado (16 threads no total) | 1 Spark | 2 Faíscas | 4 Faíscas | 8 Faíscas |
|---|---|---|---|---|
| 1 milhão de leitura sequencial | 10.8 GiB/s | 21.3 GiB/s | 24.6 GiB/s | 24.9 GiB/s |
| Gravação sequencial de 1 milhão | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s |
| Leitura aleatória 64K | 1,637 MiB/s | 2,754 MiB/s | 2,964 MiB/s | 3,349 MiB/s |
| Gravação aleatória 64K | 722 MiB/s | 719 MiB/s | 723 MiB/s | 703 MiB/s |
| Leitura sequencial de 16K | 466 MiB/s | 833 MiB/s | 890 MiB/s | 1,005 MiB/s |
| Gravação sequencial de 16K | 57 MiB/s | 60 MiB/s | 62 MiB/s | 28 MiB/s |
| Leitura aleatória 4K | IOPS 32.5K | IOPS 62.3K | IOPS 82.5K | IOPS 81.2K |
| Gravação aleatória 4K | IOPS 17.8K | IOPS 17.7K | IOPS 17.5K | IOPS 17.2K |
Modelos de hospedagem em armazenamento compartilhado
O teste de varredura do fio comprova que o array e a rede são mais do que capazes. O próximo teste relevante para o caso de uso é verificar se um modelo hospedado no array compartilhado carrega tão bem quanto um modelo hospedado no NVMe do próprio Spark, pois esse é o fluxo de trabalho do qual todo o projeto depende: uma única cópia, hospedada centralmente, acessível a qualquer usuário. Selecionamos o modelo Qwen3.5-122B-A10B no NVFP4, um modelo de 122 bilhões de parâmetros com a colaboração de especialistas, que ocupa 78 GB em disco e cabe nos 128 GB de memória unificada de um único Spark. Medimos o tempo desde a inicialização do servidor de inferência até o servidor reportar funcionamento adequado, juntamente com a largura de banda média de armazenamento durante esse período, em três cenários: um Spark carregando dados de seu NVMe interno, o mesmo Spark carregando dados via NFS/RDMA do array compartilhado e todos os oito Sparks carregando a mesma cópia única do array simultaneamente.
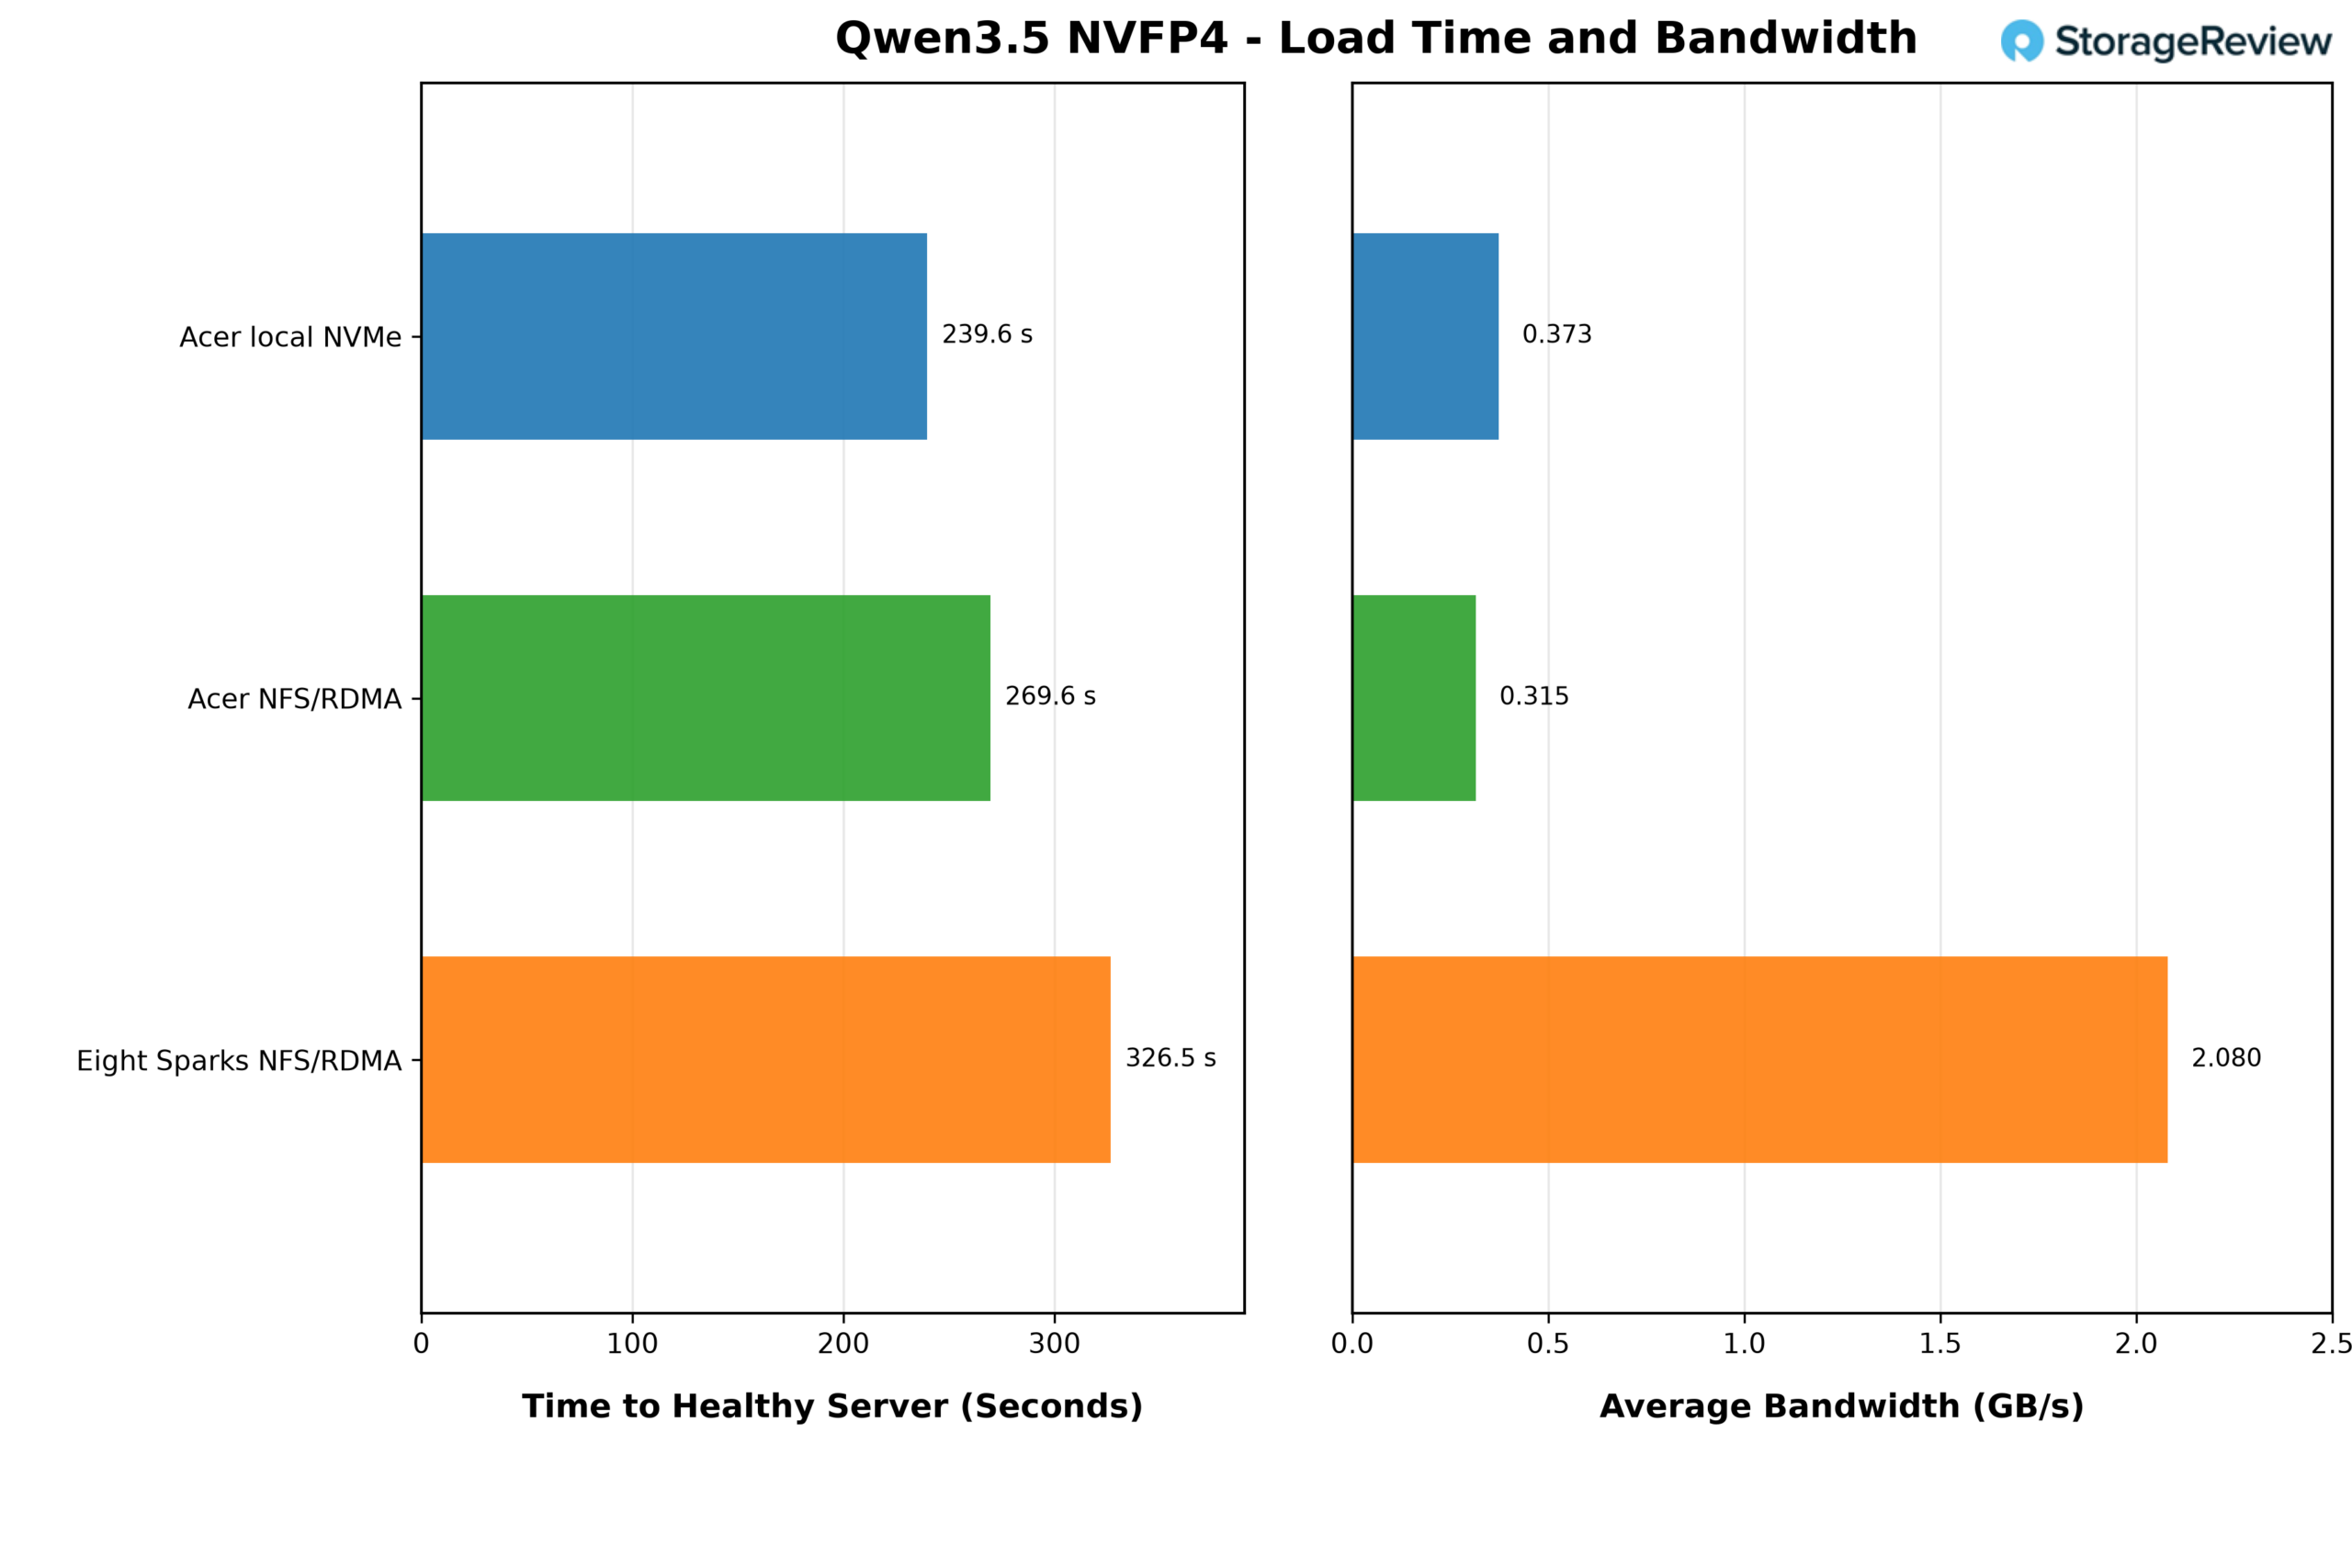
A partir do NVMe interno, o Acer Veriton GN100 atingiu um servidor íntegro em 239.6 segundos, com uma média de 0.373 GB/s. A partir do array compartilhado via NFS/RDMA, o mesmo Spark levou 269.6 segundos a 0.315 GB/s, cerca de 30 segundos, ou 13%, a mais. As médias mostram que, com 78 GB em quatro minutos, o carregamento do modelo em um Spark não é limitado pelo armazenamento em nenhum dos casos. O próprio processamento dos pesos pelo GB10 define o ritmo, e o armazenamento passa a maior parte do tempo aguardando.
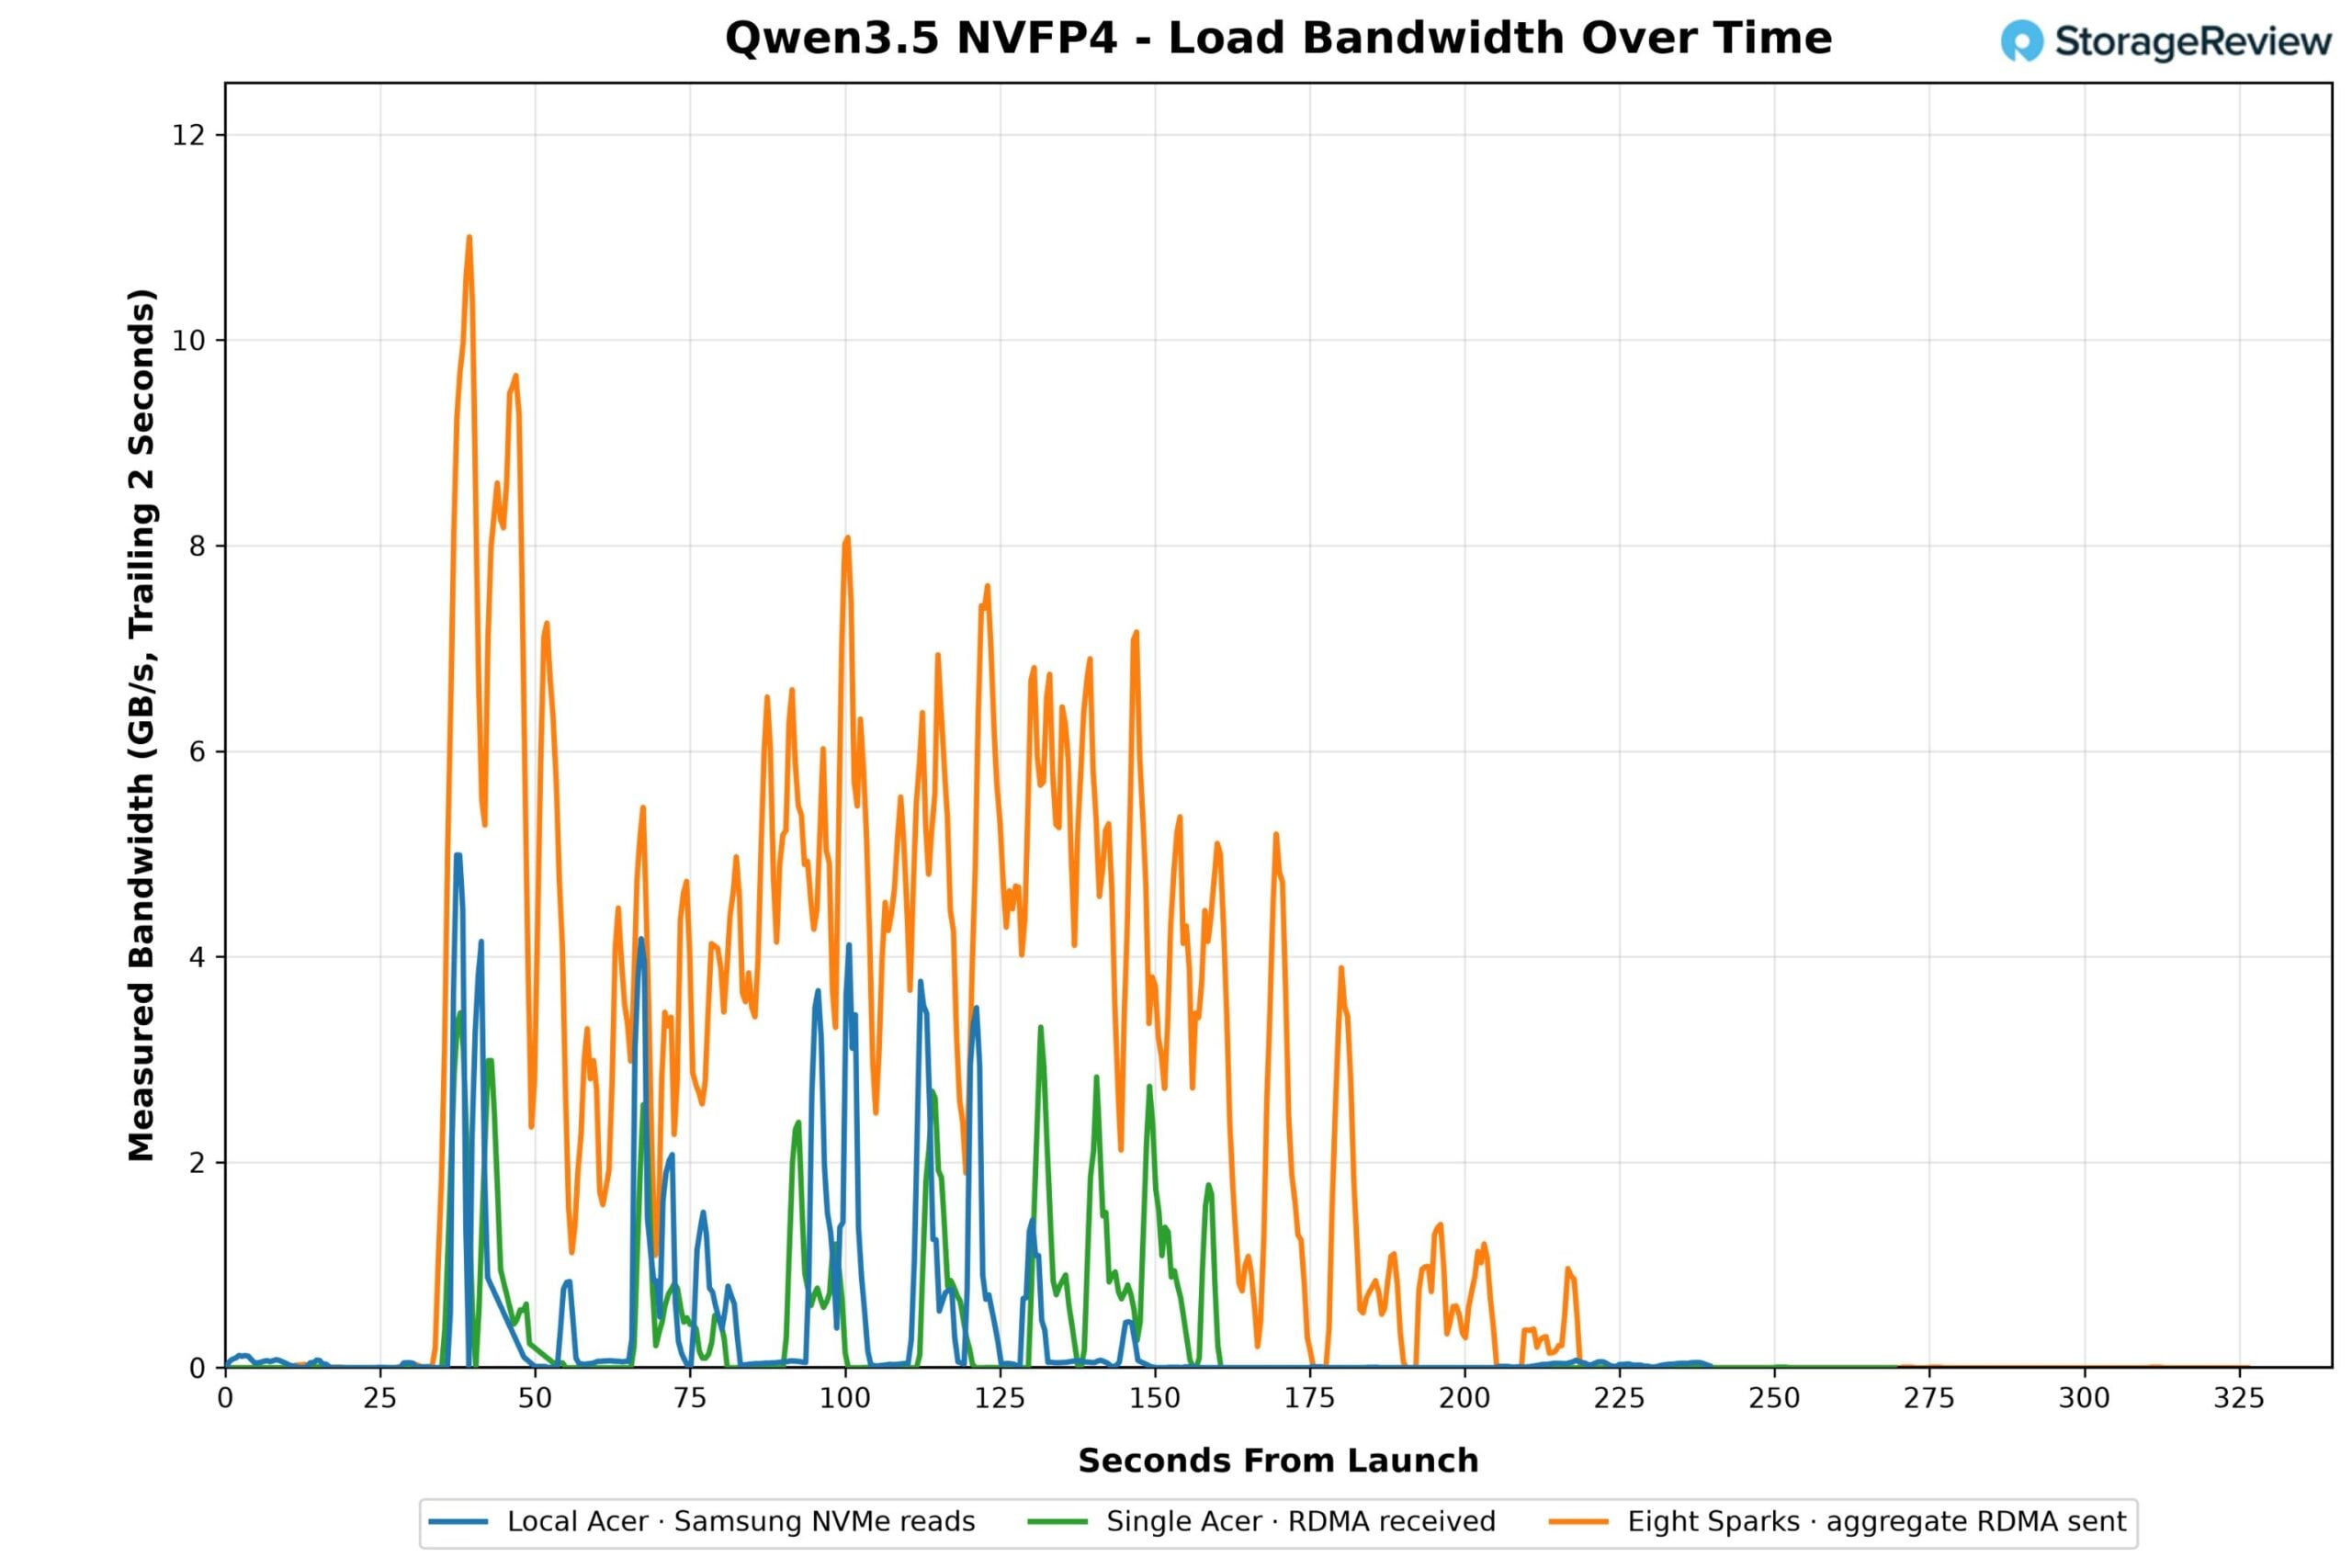
O gráfico de largura de banda mostra esse padrão: as leituras locais de NVMe chegam em rajadas que atingem picos próximos a 5 GB/s com longos intervalos entre elas; o cliente NFS único mostra o mesmo formato de rajada, porém com picos ligeiramente menores. A linha agregada de oito Sparks mostra o array sob demanda simultânea. Com todos os oito Sparks consumindo os mesmos 78 GB simultaneamente, o array apresentou um pico agregado de 11 GB/s no primeiro minuto, estabilizando-se entre aproximadamente 4 e 8 GB/s nos dois minutos seguintes, enquanto os Sparks processavam seus pesos, com uma média de 2.08 GB/s em todo o período. Considerando os 25 GiB/s que o teste com o fio mostrou que o array pode fornecer, oito Sparks carregando um modelo simultaneamente utilizaram apenas uma fração da capacidade disponível.
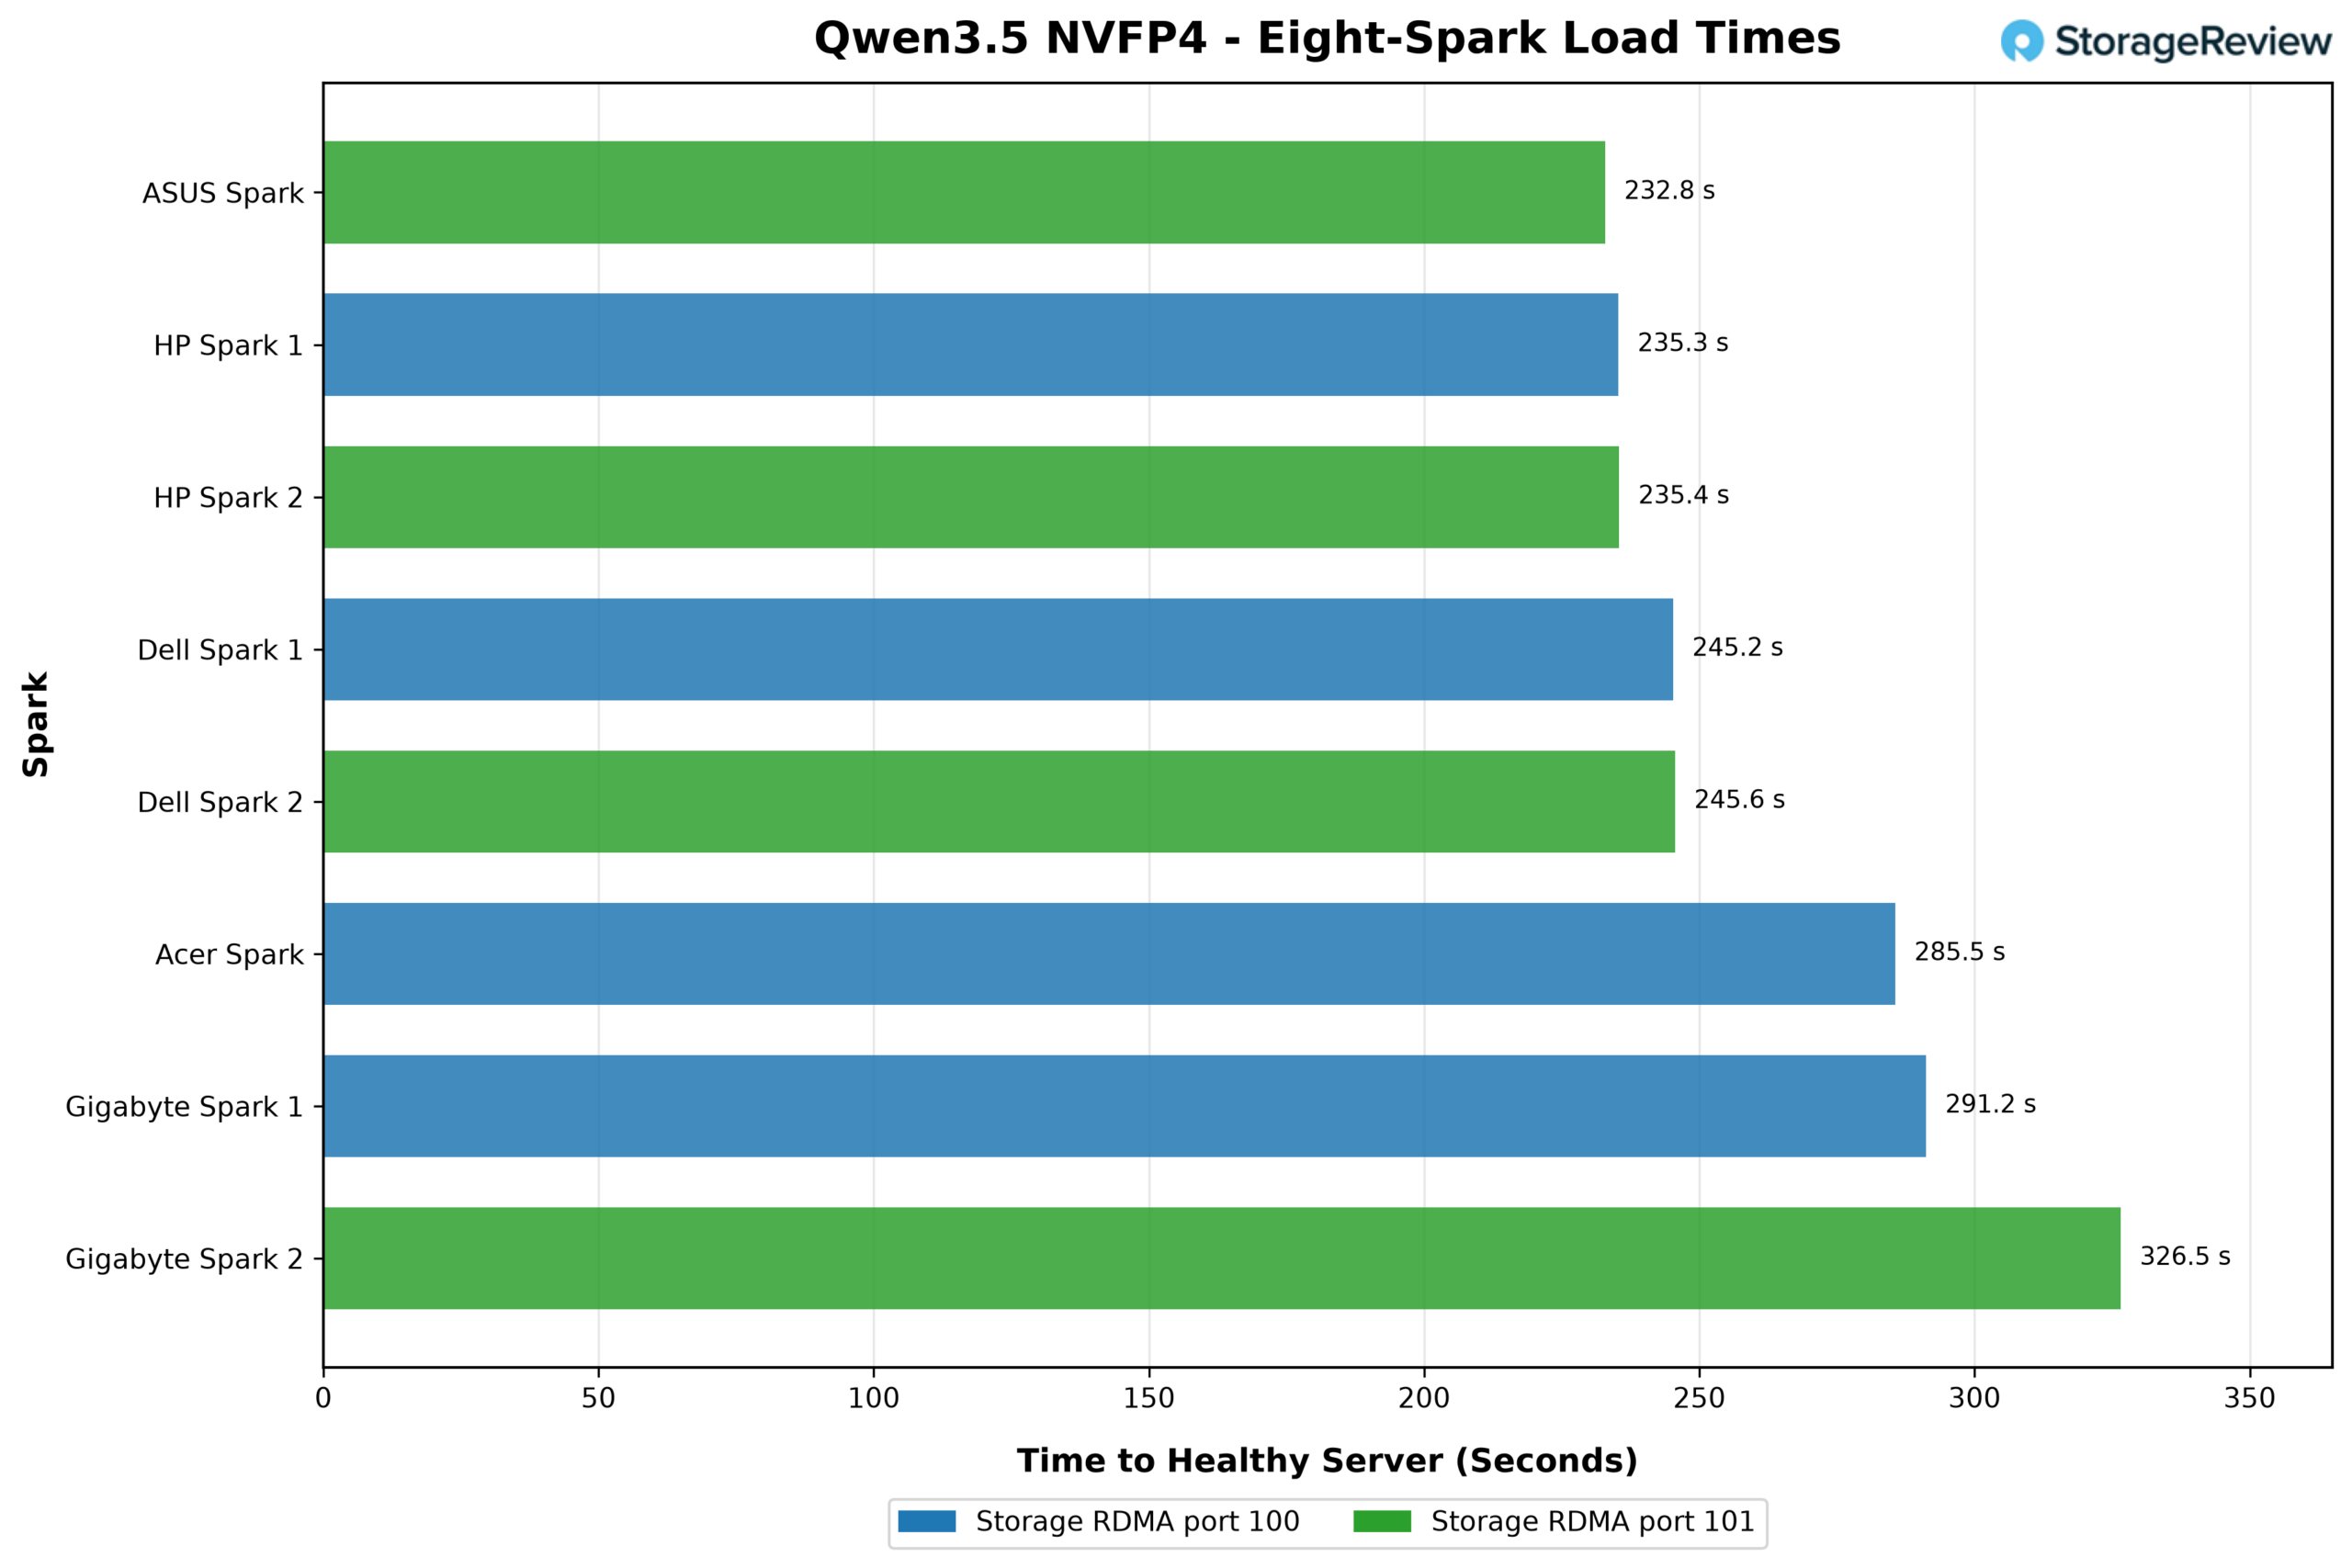
Os tempos de carregamento por unidade no teste com oito dispositivos variaram de 232.8 segundos no ASUS Ascent GX10 a 326.5 segundos em uma das unidades GIGABYTE AI TOP ATOM, com os dois sistemas HP ZGX Nano G1n registrando 235.3 e 235.4 segundos e as duas unidades Dell Pro Max com GB10 atingindo 245.2 e 245.6 segundos. Cinco dos oito dispositivos Spark carregando simultaneamente do array compartilhado superaram o carregamento de um único Spark via NFS/RDMA, e três deles superaram a execução local em NVMe. Essa variação não se deve a um problema específico do fornecedor; sem QoS na pilha, a unidade que acaba aguardando o array a cada momento varia de execução para execução, e as duas unidades em cada placa de rede de armazenamento se dividem igualmente entre as extremidades rápida e lenta do gráfico.
Para um laboratório, o resultado é que ele pode manter uma cópia de cada modelo no array, e qualquer Spark, ou todos os Sparks, carregam o modelo em aproximadamente o mesmo tempo que levaria para carregar uma cópia local, sem etapa de download, sem consumo de capacidade local e sem cópias dos pesos armazenadas em uma mesa.
O caso de uso do estado do Oregon
A Faculdade de Ciências da Terra, Oceano e Atmosfera da Universidade Estadual do Oregon tem sido uma colaboradora frequente em nosso trabalho de infraestrutura de IA, desde pesquisas oceânicas em tempo real a bordo de um navio de pesquisa até avaliações acadêmicas assistidas por IA com a Metrum AI . Chris Sullivan, Diretor de Pesquisa e Computação Acadêmica da OSU, e seu arquiteto, Thomas Olson, estão explorando um laboratório Spark em larga escala para aprendizado de IA que poderia ser dimensionado para até 100 unidades, e suas ideias sobre armazenamento influenciaram nosso projeto de duas maneiras específicas.
Primeiro, o armazenamento precisa ser independente dos Sparks. A OSU considerou um sistema de arquivos distribuído entre os próprios Sparks, mas o rejeitou para uma sala de aula porque adicionar ou remover um único nó interromperia o serviço de armazenamento para todos. Um array central que qualquer Spark monta significa que um Spark pode ser adicionado, removido, reinstalado ou entregue a um aluno diferente sem afetar os dados de ninguém. Segundo, o armazenamento precisa acompanhar o usuário. Descrevemos o requisito da OSU como uma versão aprimorada de compartilhamentos de arquivos para fins de IA, onde os alunos armazenam informações persistentes à medida que transitam entre os sistemas. Com NFS, isso significa uma pasta por aluno; basta fazer login em qualquer Spark, montar o compartilhamento e seu trabalho estará lá.
Os conjuntos de dados são o motivo pelo qual isso é mais importante para a OSU do que seria para um servidor de diretório pessoal. A Faculdade de Ciências da Terra, Oceano e Atmosfera deseja disponibilizar seus dados de pesquisa, coleções oceanográficas e atmosféricas medidas em dezenas de terabytes, para que os alunos realizem suas próprias pesquisas. Não existe uma versão disso em armazenamento de mesa: um slot M.2 de 4 TB não comporta nem mesmo uma única dessas coleções, e mesmo um laboratório cheio de gabinetes externos exigiria a compra e o preenchimento de uma cópia para cada mesa, além da manutenção de todas as cópias atualizadas, o que nenhum departamento teria condições de arcar. Hospedar os dados uma única vez no array e conectá-los via 100GbE é a abordagem que melhor atendeu a esse requisito em nossa avaliação. O mesmo array hospeda a biblioteca de modelos, permitindo que os alunos executem o Qwen, o Llama ou qualquer outro modelo durante suas sessões, sem a necessidade de download. O mesmo princípio se aplica a uma empresa que implementa sistemas de IA para desktops como estações de trabalho de desenvolvedores: disponibilize o conjunto de dados de produção em uma rede de alta velocidade e deixe o sistema processá-lo localmente, o que elimina a necessidade de criar um segundo data lake para que as máquinas desktop tenham algo para ler. Os dados permanecem no data center, sob os controles de acesso, criptografia e regime de backup já existentes, e o Spark não armazena nada relevante ao sair do data center.
Conclusão
O hardware de IA para desktops é bom em muitas coisas, mas não é ideal para integrar-se ao ambiente de dados de uma organização, e o único slot M.2 em cada sistema GB10 garante isso: tudo o que um usuário precisa acaba copiado para um arquivo flash local, invisível para a TI, desprotegido e duplicado em todas as outras mesas que precisam da mesma coisa. Para um único Spark, um dispositivo de armazenamento local externo é uma solução razoável. Para um laboratório, um departamento ou uma empresa que implanta dezenas desses dispositivos, cada mesa com seus próprios dados se torna um silo, e a solução é a mesma que os data centers descobriram anos atrás: colocar a capacidade atrás de uma rede rápida, governá-la uma única vez e compartilhá-la. Os Sparks já possuem rede de alta velocidade; este projeto mostra o que acontece quando se tem um lugar para essa capacidade se conectar e defende que os próprios Sparks devem estar no rack ao lado.
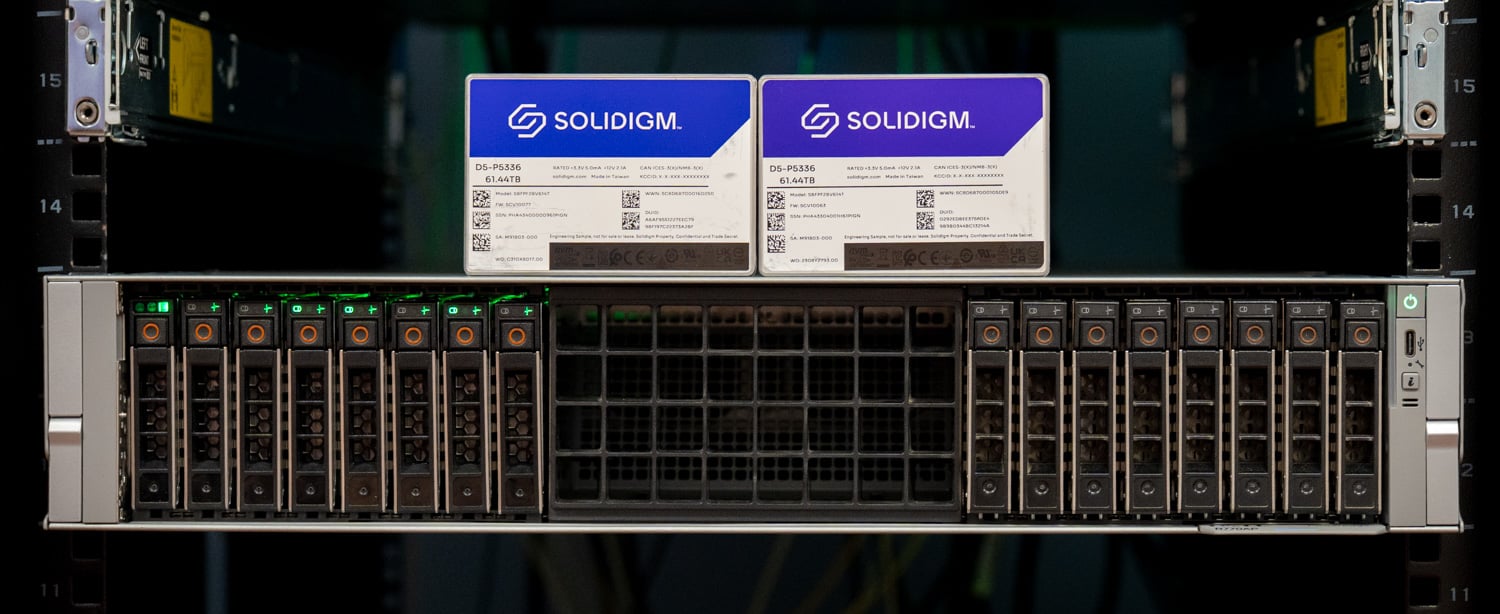
Oito discos Solidigm D5-P5336 QLC em RAID 5 em um servidor Dell forneceram a oito Sparks um único conjunto de dados com proteção de paridade. Duas placas de rede Broadcom 400GbE e uma placa Dell Z9864F-ON com uma conexão breakout 800G forneceram a oito Sparks 100GbE cada. O Fusion NFS sobre RDMA da Tuxera tornou essa capacidade acessível com uma única linha de código no Ubuntu padrão, com hooks de serviço de diretório para controle de acesso. Sob uma carga fixa distribuída entre os oito servidores, o array entregou 24.9 GiB/s de leitura sequencial agregada, dividida igualmente sem QoS, e um Spark sozinho saturou seu link a 10.8 GiB/s, tão rápido quanto o melhor disco interno em qualquer sistema GB10 que testamos; esse limite utilizou 27% da capacidade das duas placas de rede do servidor, portanto a rede está dimensionada para um servidor com maior capacidade. O teste do modelo confirmou o fluxo de trabalho: um modelo de 78 GB hospedado uma única vez no array compartilhado carrega em um Spark com uma diferença de 13% em relação ao NVMe local e em oito Sparks simultaneamente, com cinco dos oito concluindo mais rápido do que a execução NFS individual.
A memória flash QLC torna essa economia viável porque a carga de trabalho exige muita capacidade e leitura, o ponto forte do D5-P5336, e um único servidor pode armazenar o que cem servidores Spark jamais conseguiriam localmente, com uma única cópia de tudo e cada cópia sob o controle do data center. A Universidade Estadual do Oregon possui armazenamento de pesquisa de produção para o trabalho que não pode esperar. O conceito que Chris Sullivan e Thomas Olson estão explorando é um nível educacional que a universidade não possui atualmente: um pool compartilhado e governado, dimensionado para um rack ou mais de servidores Spark, construído a partir de um servidor e alguns discos rígidos de alta capacidade, que poderia disponibilizar dezenas de terabytes de dados oceanográficos e atmosféricos reais para um laboratório de aprendizado de IA em larga escala, na mesma infraestrutura que seus servidores Spark utilizam.
Este relatório é patrocinado pela Solidigm. Todas as visões e opiniões expressas neste relatório são baseadas em nossa visão imparcial do(s) produto(s) em consideração.
As referências a produtos comerciais neste artigo têm caráter meramente informativo e não constituem um endosso por parte da Universidade Estadual do Oregon.



 Amazon