

A L40S preenche uma lacuna crítica no ecossistema de GPUs para data centers. Enquanto GPUs de treinamento de IA focadas em computação, como a Nvidia H100, priorizam o desempenho bruto, mas omitem completamente a aceleração gráfica, as placas de visualização profissionais tradicionais normalmente não possuem os recursos computacionais de IA exigidos por cargas de trabalho de inferência modernas e aplicativos gráficos emergentes baseados em IA. Esse posicionamento a torna particularmente valiosa para geração de dados sintéticos, desenvolvimento de IA multimodal e aplicações Omniverse, onde tanto o desempenho computacional quanto o gráfico são essenciais.
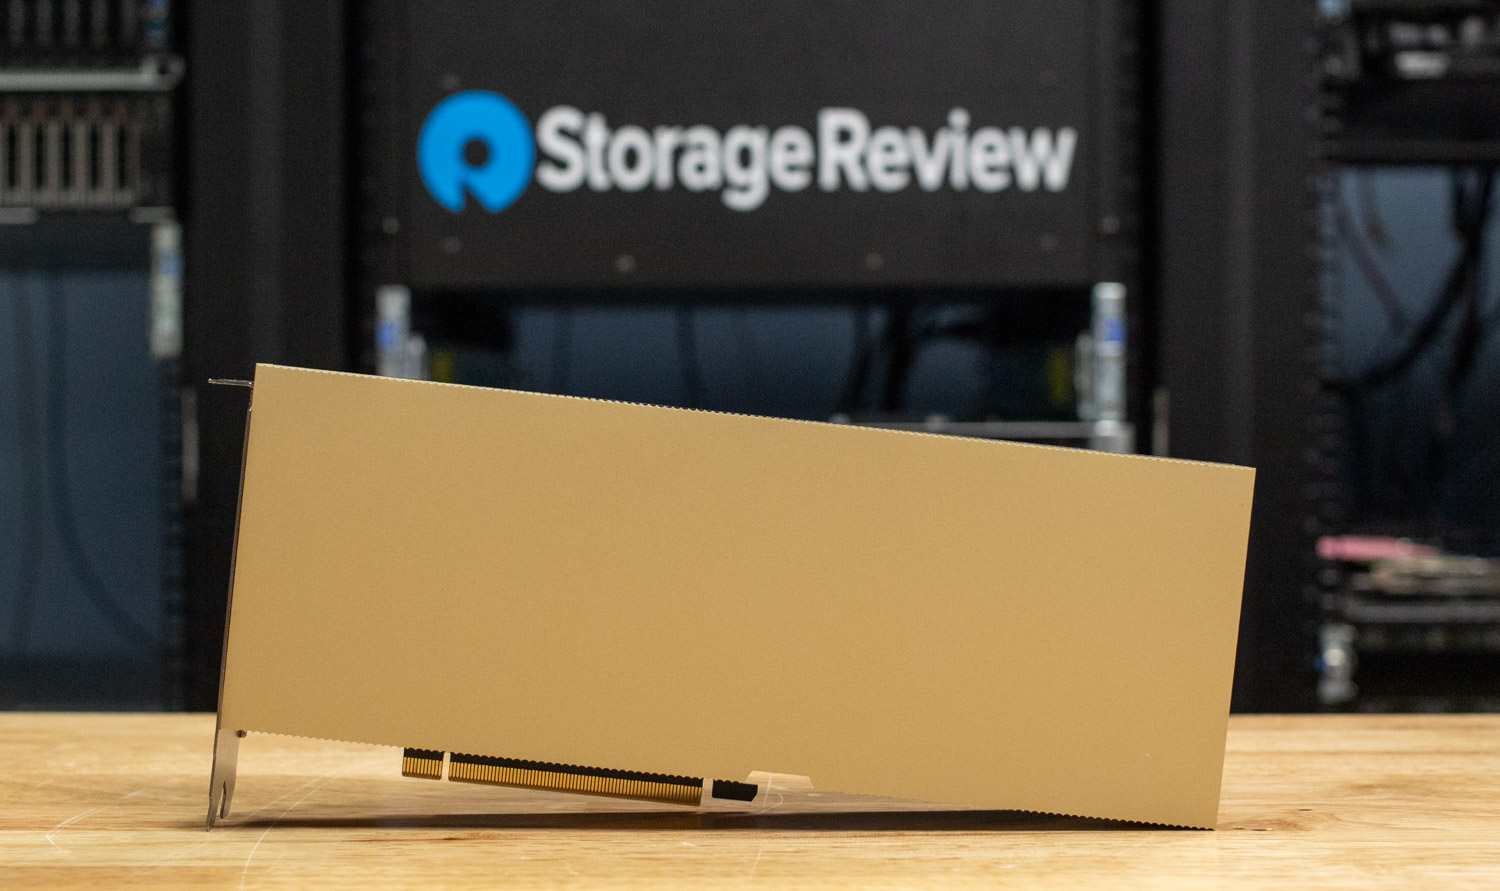
Especificações da NVIDIA L40S
| Especificação | L40 | L40S | H100 80G PCIe |
| Arquitetura GPU | Ada Lovelace | Ada Lovelace | saltador |
| Matriz GPU | AD102 | AD102 | GH100 |
| Cursos de CUDA | 18,176 | 18,176 | 14,592 |
| Núcleos Tensores | 568 (4ª geração) | 568 (4ª geração) | 456 |
| RT Núcleos | 142 (3ª Geração) | 142 (3ª Geração) | - |
| Memória GPU | 48 GB GDDR6 com ECC | 48 GB GDDR6 com ECC | 80GB HBM2e |
| Largura de banda de memória | 864 GB / s | 864 GB / s | 2 TB / s |
| Interface de Memória | 384-bit | 384-bit | 5120-bit |
| Consumo Máximo de Energia | 300W | 350W | 350W |
| Fator de Forma | 4.4″ A x 10.5″ C: Slot duplo | 4.4″ A x 10.5″ C: Slot duplo | 4.4″ A x 10.5″ C: Slot duplo |
| Solução Térmica | Renda | Renda | Renda |
| Conectores de tela | 4 portas DisplayPort 1.4a | 4 portas DisplayPort 1.4a | - |
| Interface PCIe | Ger4 x16 | Ger4 x16 | Ger5 x16 |
| Conector de força | 16-pin | 16-pin | 16-pin |
| Suporte vGPU | Sim | Sim | Não |
| GPU multi-instância (MiG) | Não | Não | Sim |
| Suporte NVLink | Não | Não | Não |
Especificações de performance
| métrico | Desempenho L40 | Desempenho do L40S | Desempenho H100 |
| Desempenho FP32 | 90.5 TFLOPS | 91.6 TFLOPS | 51.2 TFLOPS |
| Núcleo tensor TF32 | 362.1 TFLOPS | 366 TFLOPS | 756 TFLOPS |
| Núcleo Tensor FP16 | 724 TFLOPS | 733 TFLOPS | 1513 TFLOPS |
| Núcleo Tensor FP8 | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TFLOPS |
| Peak INT8 Tensor TOPS | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TOPS |
| Desempenho do núcleo RT | 209 TFLOPS | 212 TFLOPS | - |
(Os números de desempenho são escassos)
NVIDIA L40S vs. H100
Uma análise detalhada das especificações revela as distintas filosofias de design por trás da NVIDIA L40S e da H100. A L40S é construída sobre a arquitetura Ada Lovelace, utilizando o mesmo chip AD102 encontrado nas placas de vídeo de alta performance da NVIDIA para workstations. Essa herança lhe confere uma impressionante quantidade de 18,176 núcleos CUDA, resultando em excelente desempenho de FP32 de precisão única, um pilar fundamental da renderização gráfica tradicional e da computação científica. Em contraste, a arquitetura Hopper e o chip GH100 da H100 são projetados especificamente para cargas de trabalho de IA e HPC.
O diferencial mais revelador é a configuração dos núcleos. A L40S inclui 142 núcleos RT de terceira geração e 568 núcleos Tensor de quarta geração. Os núcleos RT são hardware especializado para acelerar o ray tracing, um recurso totalmente ausente na H100, tornando a L40S excepcionalmente capaz de renderização fotorrealista. Embora a H100 tenha menos núcleos Tensor, eles são mais rápidos e avançados, otimizados para novos formatos de dados de IA, como FP8, o que lhe confere uma liderança expressiva em desempenho bruto de IA.
Essa compensação também é evidente nos subsistemas de memória. O H100 utiliza 80 GB de memória HBM2e de alto custo, proporcionando impressionantes 2 TB/s de largura de banda. Isso é essencial para manter os SMs alimentados durante o treinamento e a inferência de modelos de IA em larga escala. O L40S utiliza 48 GB de memória GDDR6 mais convencional, fornecendo 864 GB/s de largura de banda. Embora seja menos da metade do H100, essa quantidade ainda é substancial, perfeitamente adequada para carregar grandes cenas 3D, texturas de alta resolução e modelos de IA de tamanho considerável para inferência.
Por fim, o conjunto de recursos descreve suas funções pretendidas. O L40S inclui quatro saídas DisplayPort 1.4a e suporte robusto a vGPU, tornando-o ideal para estações de trabalho virtualizadas, farms de renderização e implantações de jogos em nuvem. O H100, sem saídas de vídeo ou recursos de vGPU, oferece a tecnologia Multi-Instance GPU (MiG), que permite que ele seja particionado em várias instâncias de GPU menores e isoladas para atender a múltiplas cargas de trabalho com uso intensivo de computação simultaneamente. O design térmico passivo de dois slots compartilhados e o envelope de energia de 350 W do L40S e do PCIe H100 permitem flexibilidade de implantação em uma ampla gama de servidores padrão do setor.
Ao comparar a L40S com a H100, a principal placa de vídeo da NVIDIA, as diferenças em suas funções ficam claras. A H100 é a líder indiscutível em desempenho bruto de treinamento de IA daquela geração de GPUs, mas essa comparação conta apenas parte da história. Vale ressaltar que a L40 também faz parte da linha da NVIDIA, com um TDP de 300 W menor em comparação com o envelope de energia de 40 W da L350S, oferecendo recursos semelhantes com consumo de energia reduzido.
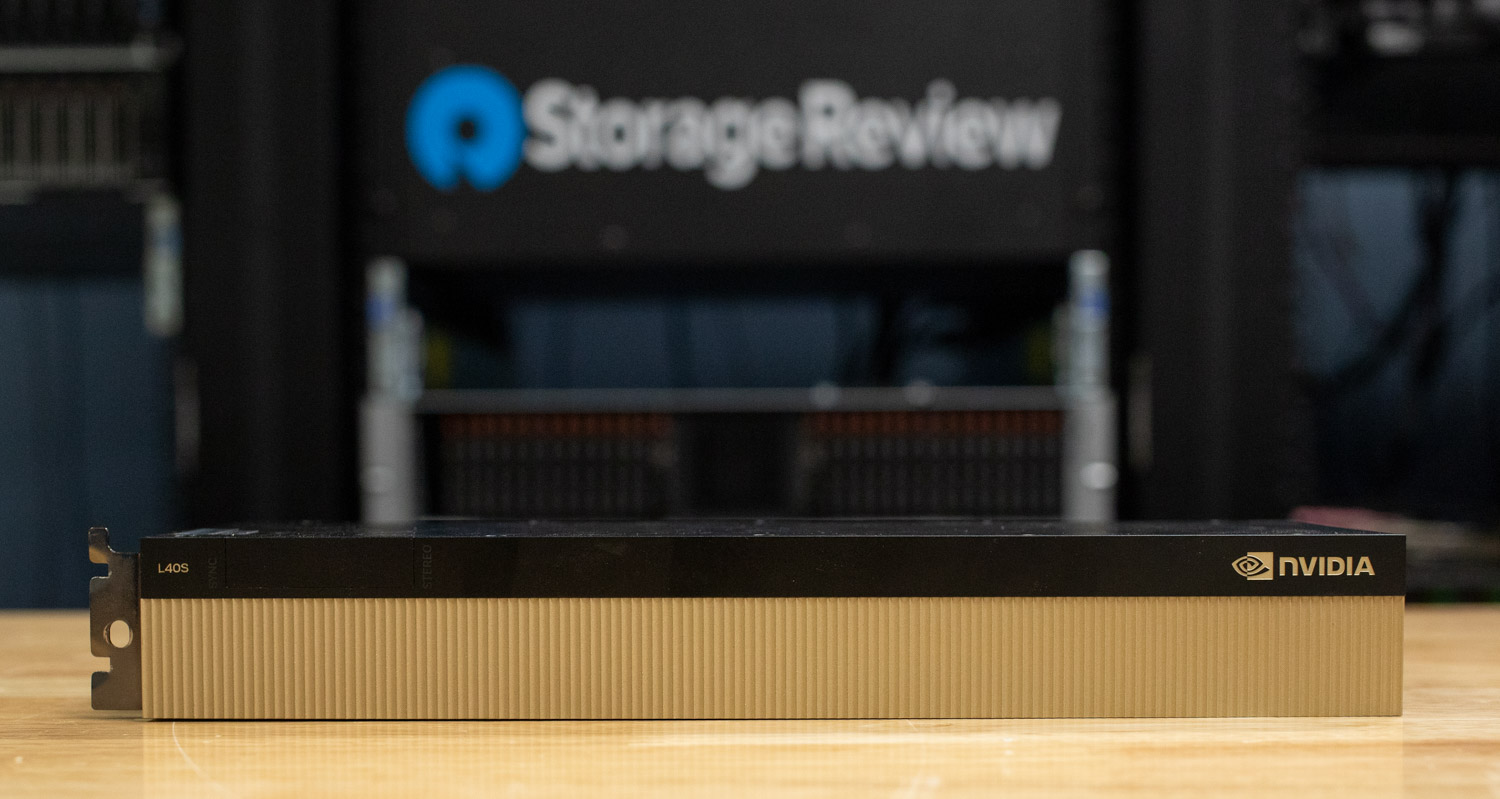
O H100 que estamos analisando aqui é a versão PCIe original de 80 GB com memória HBM2e. Desde então, a NVIDIA expandiu essa linha com variantes como o H100 NVL, que substitui o modelo PCIe original de 80 GB, oferecendo 94 GB de memória e um TDP de 400 W, além de adicionar suporte a NVLink para configurações de GPU dupla. A família H100 também se estende a configurações SXM de 8 GPUs e ao mais novo H200, que compartilha o mesmo chip de GPU, mas oferece desempenho aprimorado nos formatos PCIe e SXM.
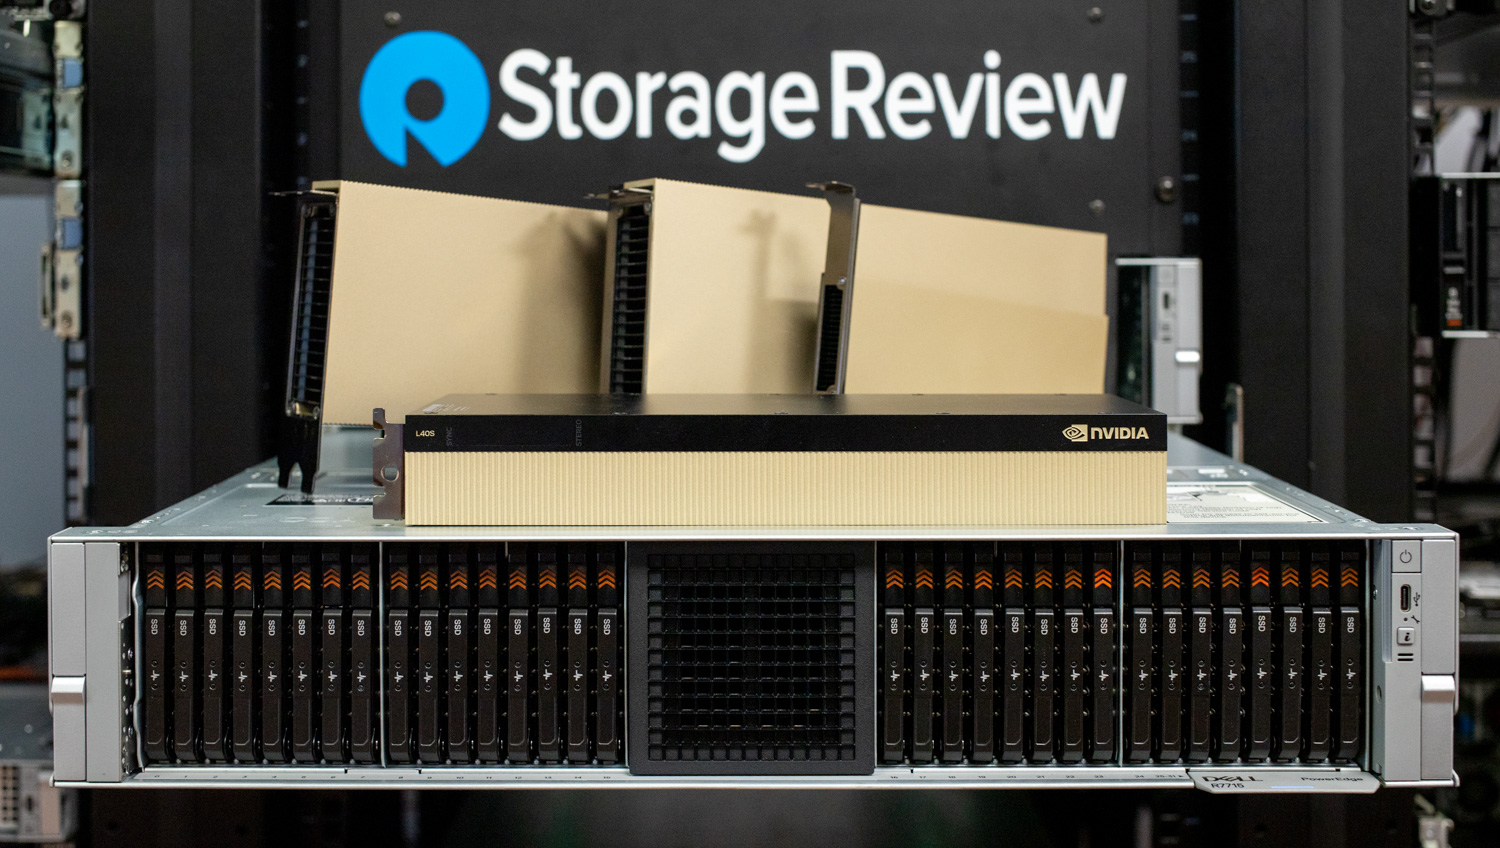
A distinção entre a L40S e a H100 destaca uma divergência estratégica no design de GPU para data centers. A H100 é uma placa focada exclusivamente em computação, otimizada exclusivamente para IA e cargas de trabalho de computação de alto desempenho. O objetivo é o treinamento de IA em larga escala, onde a máxima taxa de transferência computacional é o objetivo principal. Todos os aspectos de seu design, desde a enorme largura de banda de memória HBM2e até os núcleos Tensor especializados, foram projetados para os cenários de treinamento de redes neurais mais exigentes.
Em contraste, a L40S é uma GPU universal projetada para versatilidade, voltada para inferência de IA, além de cargas de trabalho com uso intensivo de gráficos e implantações de vGPU NVIDIA. Embora seja uma solução competente e econômica para inferência de IA, seu verdadeiro ponto forte reside no suporte a uma gama diversificada de aplicativos com uso intensivo de gráficos, para os quais a H100 simplesmente não foi projetada.
Cargas de trabalho com uso intensivo de gráficos e aplicativos profissionais
A L40S se destaca em diversos domínios com uso intensivo de gráficos que exigem poder computacional e recursos avançados de renderização. Em renderização e animação 3D, os estúdios contam com a L40S para renderização de cenas complexas, onde seus núcleos RT aceleram cálculos de ray tracing que seriam impossíveis em GPUs com processamento exclusivo. Produtoras de cinema e televisão utilizam esses recursos para pré-visualização em tempo real, permitindo que diretores e cinegrafistas vejam renderizações fotorrealistas de cenas CGI durante as filmagens, reduzindo drasticamente o tempo e os custos de pós-produção.
Escritórios de arquitetura e engenharia utilizam a L40S para visualização arquitetônica e design de produtos em tempo real, permitindo que os clientes percorram renderizações fotorrealistas de edifícios ou examinem protótipos detalhados de produtos antes do início da construção física. Os recursos gráficos profissionais da placa também a tornam ideal para estações de trabalho CAD, onde os engenheiros precisam tanto do poder computacional para simulações complexas quanto da aceleração gráfica para um desempenho suave e de alta fidelidade na viewport.
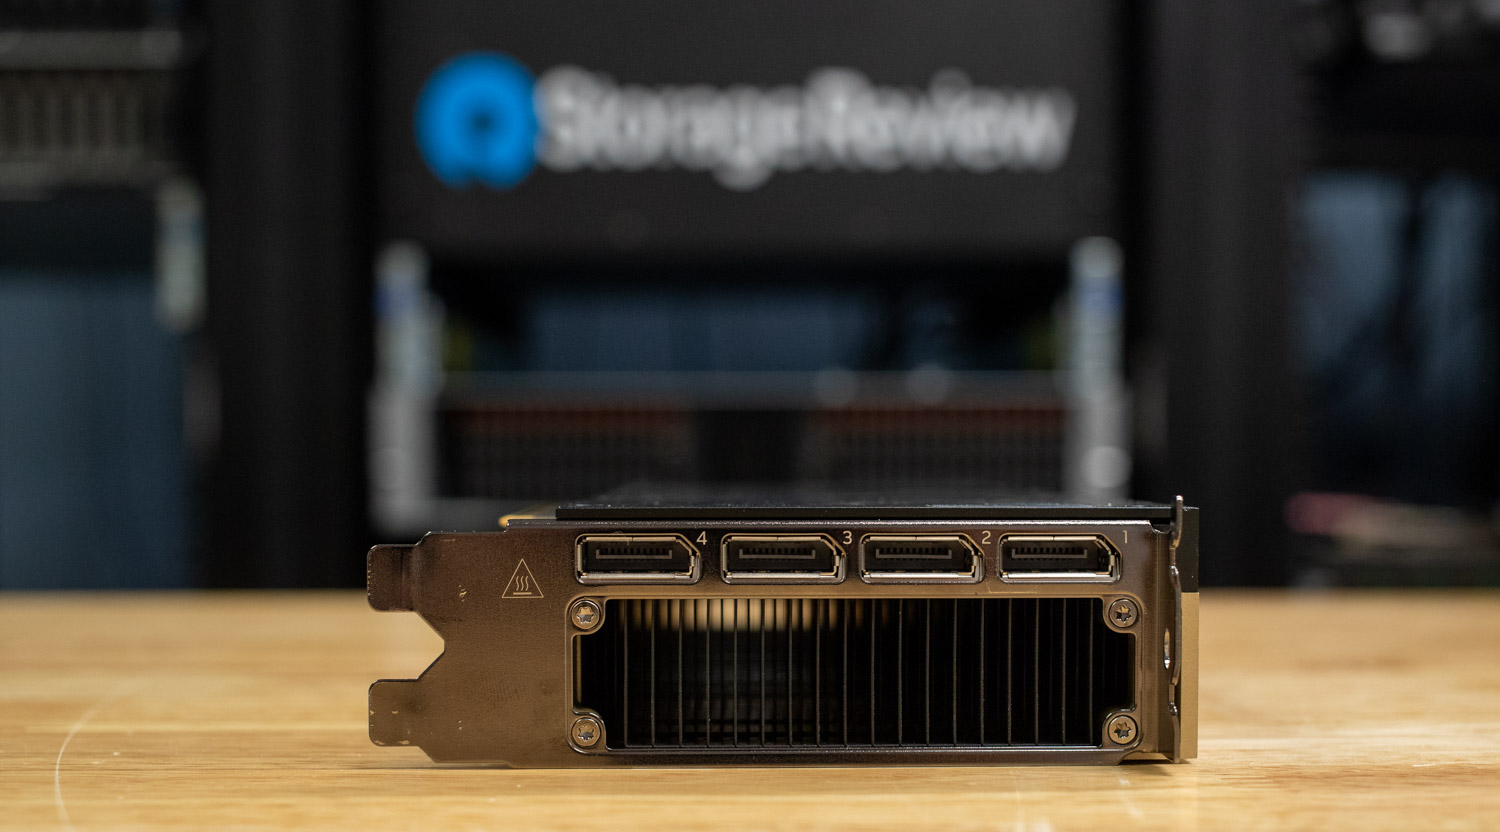
No setor de mídia e entretenimento, a L40S potencializa fazendas de renderização que processam quadros de animação com qualidade final. Ao mesmo tempo, seus recursos de vGPU permitem fluxos de trabalho criativos baseados em nuvem, onde os artistas podem acessar remotamente poderosas estações de trabalho gráficas. Instalações de edição e pós-produção de vídeo utilizam a L40S para processamento de efeitos em tempo real, correção de cores e fluxos de trabalho de composição que exigem aceleração gráfica e recursos computacionais substanciais.
O mercado de infraestrutura de desktop virtual (VDI) representa outra área de aplicação fundamental, onde a tecnologia vGPU do L40S permite que vários usuários compartilhem recursos de GPU para desktops virtuais com aceleração gráfica. Isso torna recursos gráficos profissionais acessíveis em ambientes corporativos sem a necessidade de GPUs individuais dedicadas a cada usuário.
A evolução em direção ao treinamento de IA baseado em física
Mais importante ainda, a L40S oferece recursos que a H100 não possui. O principal diferencial está nos 40 núcleos RT de terceira geração da L142S, que permitem ray tracing em tempo real e renderização fotorrealista. Embora a H100 não tenha núcleos RT e não possa realizar aceleração gráfica, os núcleos RT da L40S a tornam a escolha certa para aplicações que exigem computação de IA e gráficos avançados.
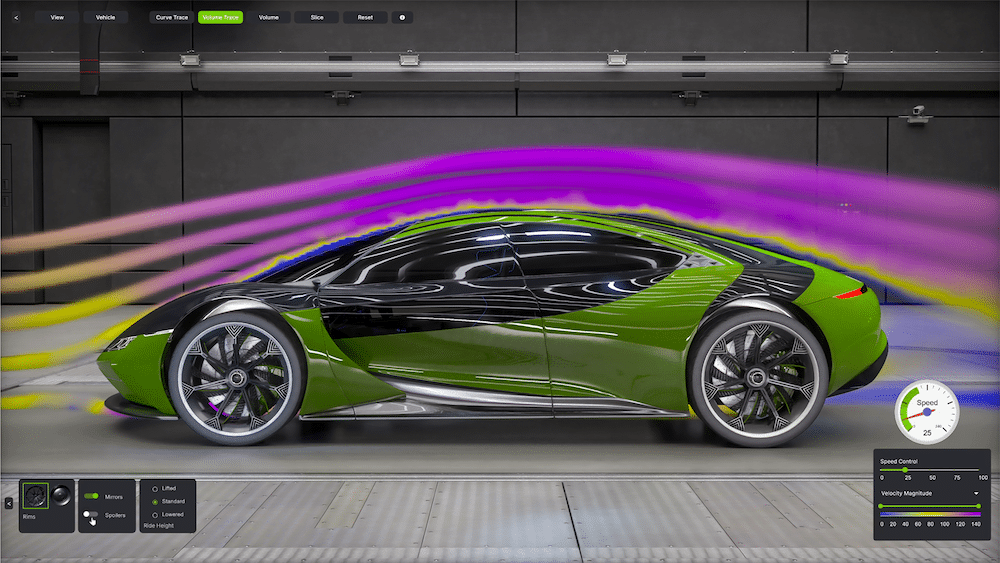
Fonte: Nvidia
Essa distinção torna-se cada vez mais crucial à medida que testemunhamos a crescente popularidade da modelagem 3D gerada por IA, simulações de gêmeos digitais e fluxos de trabalho de Descrição Universal de Cena (OpenUSD). A próxima fronteira da inteligência artificial não se resume apenas ao treinamento de modelos de linguagem maiores; trata-se de desenvolver modelos de mundo que compreendam física, relações espaciais e interações do mundo real. Essa evolução exige uma mudança fundamental na forma como abordamos a geração de dados de treinamento.
Embora o treinamento de modelos tradicionais de IA dependa fortemente das GPUs de computação topo de linha da NVIDIA, o treinamento da próxima geração de modelos de mundos fisicamente aterrados exige uma abordagem diferente. Esses sistemas avançados de IA precisam de grandes quantidades de dados de treinamento que capturem não apenas informações visuais, mas também propriedades físicas, comportamento da iluminação, interações de materiais e relações espaciais. GPUs como a L40S tornam-se essenciais para a geração de dados de treinamento em larga escala, onde seus núcleos RT permitem a criação de ambientes sintéticos fisicamente precisos que servem de base para o treinamento de modelos de IA mais sofisticados.
Essa capacidade de renderização gráfica avançada, alimentada pelos núcleos RT dedicados, é precisamente o que torna o L40S o mecanismo ideal para a plataforma Omniverse da NVIDIA e o ecossistema mais amplo de desenvolvimento de IA baseado em física.
Omniverse
O Omniverse é uma plataforma de desenvolvimento de APIs, SDKs e serviços que permite aos desenvolvedores criar aplicativos e fluxos de trabalho baseados na Descrição Universal de Cena (OpenUSD). Ele foi projetado para criar e conectar mundos virtuais 3D fisicamente precisos e em tempo real. Isso é possível graças à integração da tecnologia RTX da NVIDIA para renderização fotorrealista com traçado de raios diretamente em fluxos de trabalho de simulação industrial e robótica. O L40S, com seus poderosos núcleos RT, fornece a aceleração de hardware essencial para lidar com essas exigentes cargas de trabalho de renderização RTX, permitindo que os desenvolvedores simulem luz, materiais e física com um realismo impressionante.
Mais do que uma ferramenta de visualização, o Omniverse é uma plataforma para o desenvolvimento da próxima geração de IA física. Ao criar esses mundos virtuais realistas, ou "gêmeos digitais", os desenvolvedores podem simular instalações industriais complexas, testar frotas inteiras de robôs e validar veículos autônomos em um ambiente virtual seguro antes da implantação no mundo real. Essas simulações de alta fidelidade tornam-se a base para a geração de grandes quantidades de dados sintéticos baseados em física; um recurso essencial para o treinamento de poderosos modelos de IA executados em GPUs com foco em computação.
Geração de Movimento de Manipulação Sintética para Robótica
O projeto NVIDIA Isaac GR00T para geração de movimentos sintéticos de manipulação fornece uma estrutura para treinamento de robôs, demonstrando como os recursos do RT Core do L40S permitem a criação de grandes conjuntos de dados a partir de demonstrações humanas mínimas. Esse fluxo de trabalho aborda um dos principais desafios no desenvolvimento de robôs: o processo demorado e caro de coletar dados de treinamento de alta qualidade suficientes para tarefas de manipulação robótica.
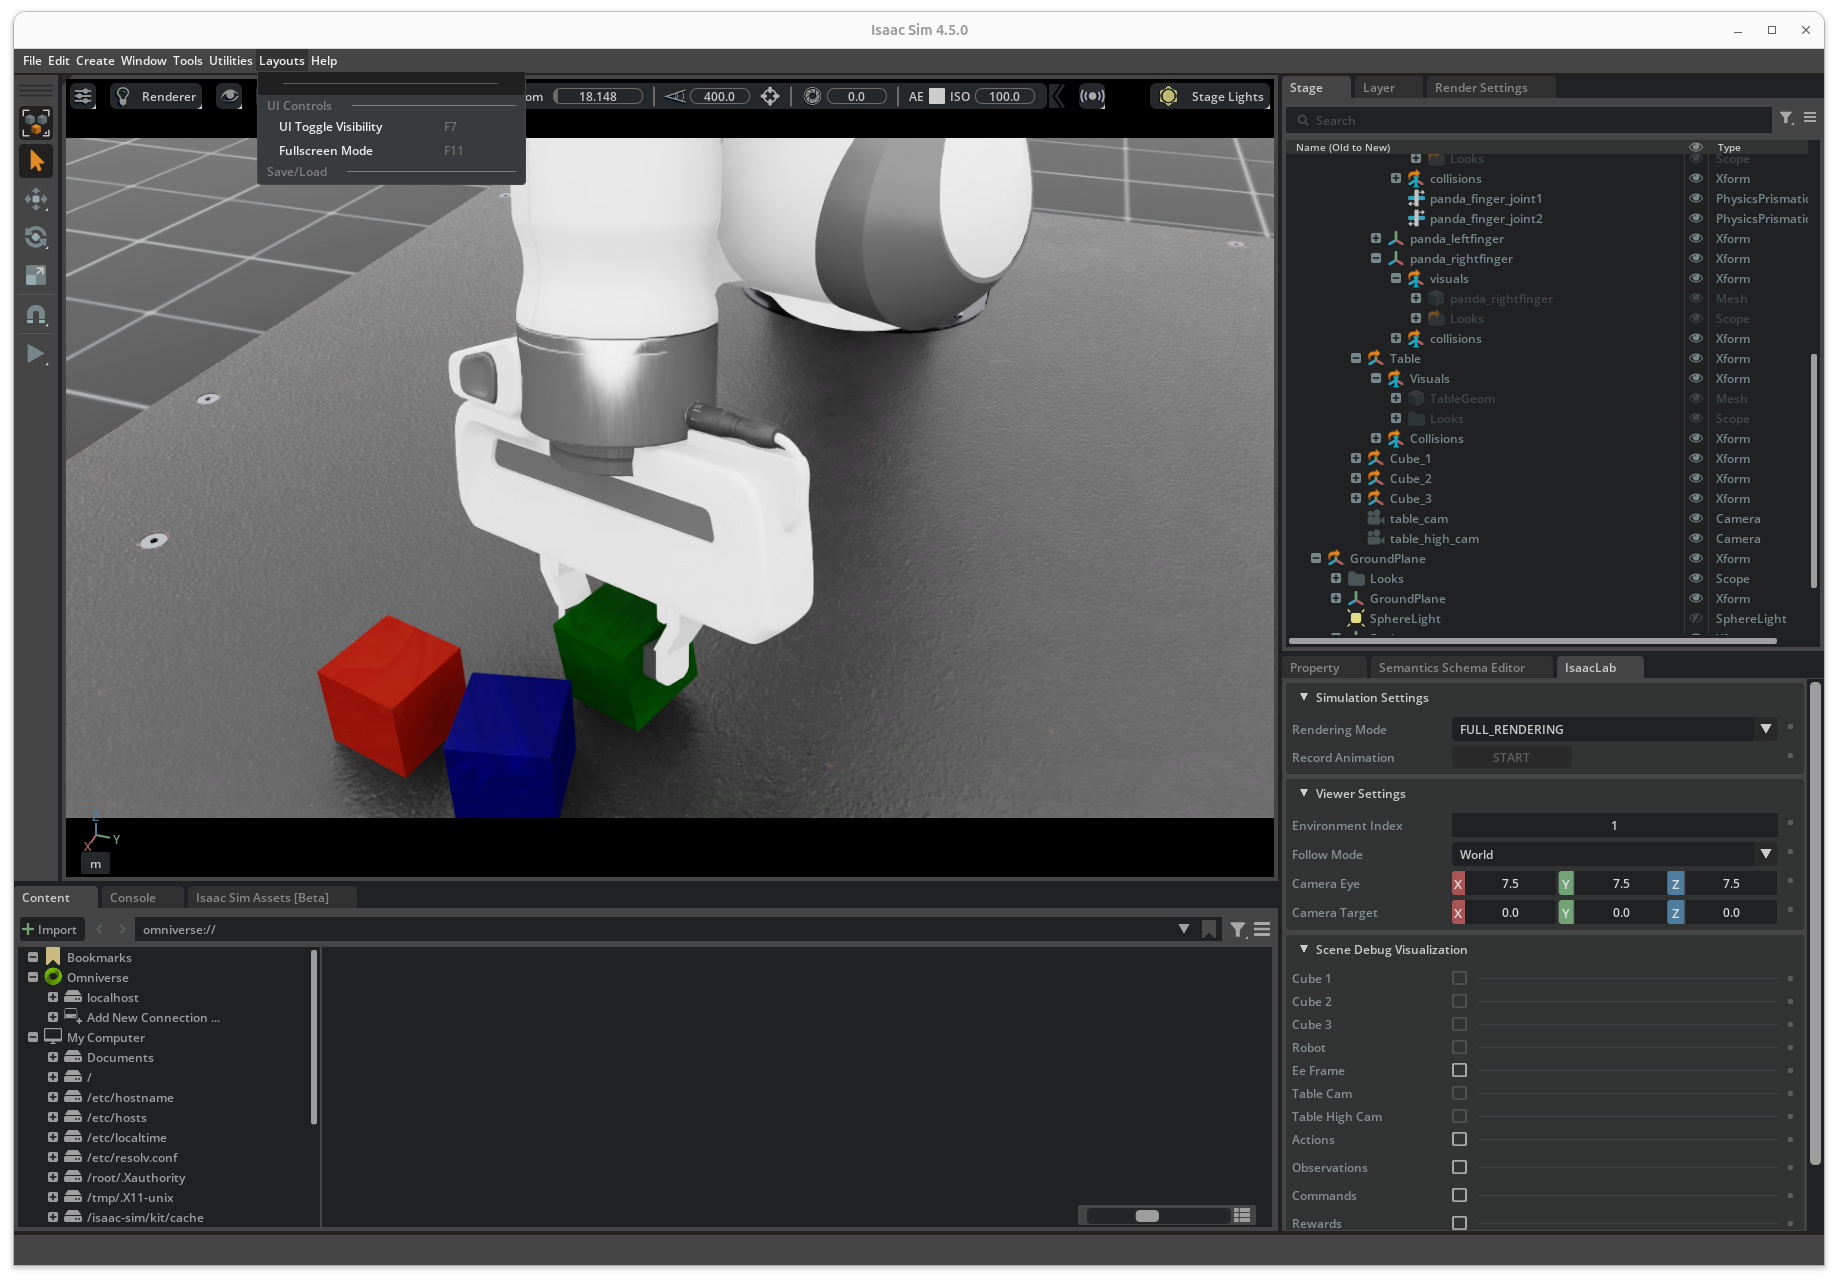
O treinamento tradicional em robótica depende fortemente do aprendizado supervisionado ou por imitação, no qual os robôs adquirem novas habilidades observando e imitando demonstrações humanas especializadas. No entanto, criar demonstrações perfeitas é desafiador, e coletar conjuntos de dados extensos e de alta qualidade no mundo real é tedioso, demorado e caro. Um operador humano devidamente treinado normalmente leva cerca de um minuto para gravar uma única demonstração de alta qualidade, o que é difícil de escalar devido ao esforço humano significativo necessário e ao potencial de erros.
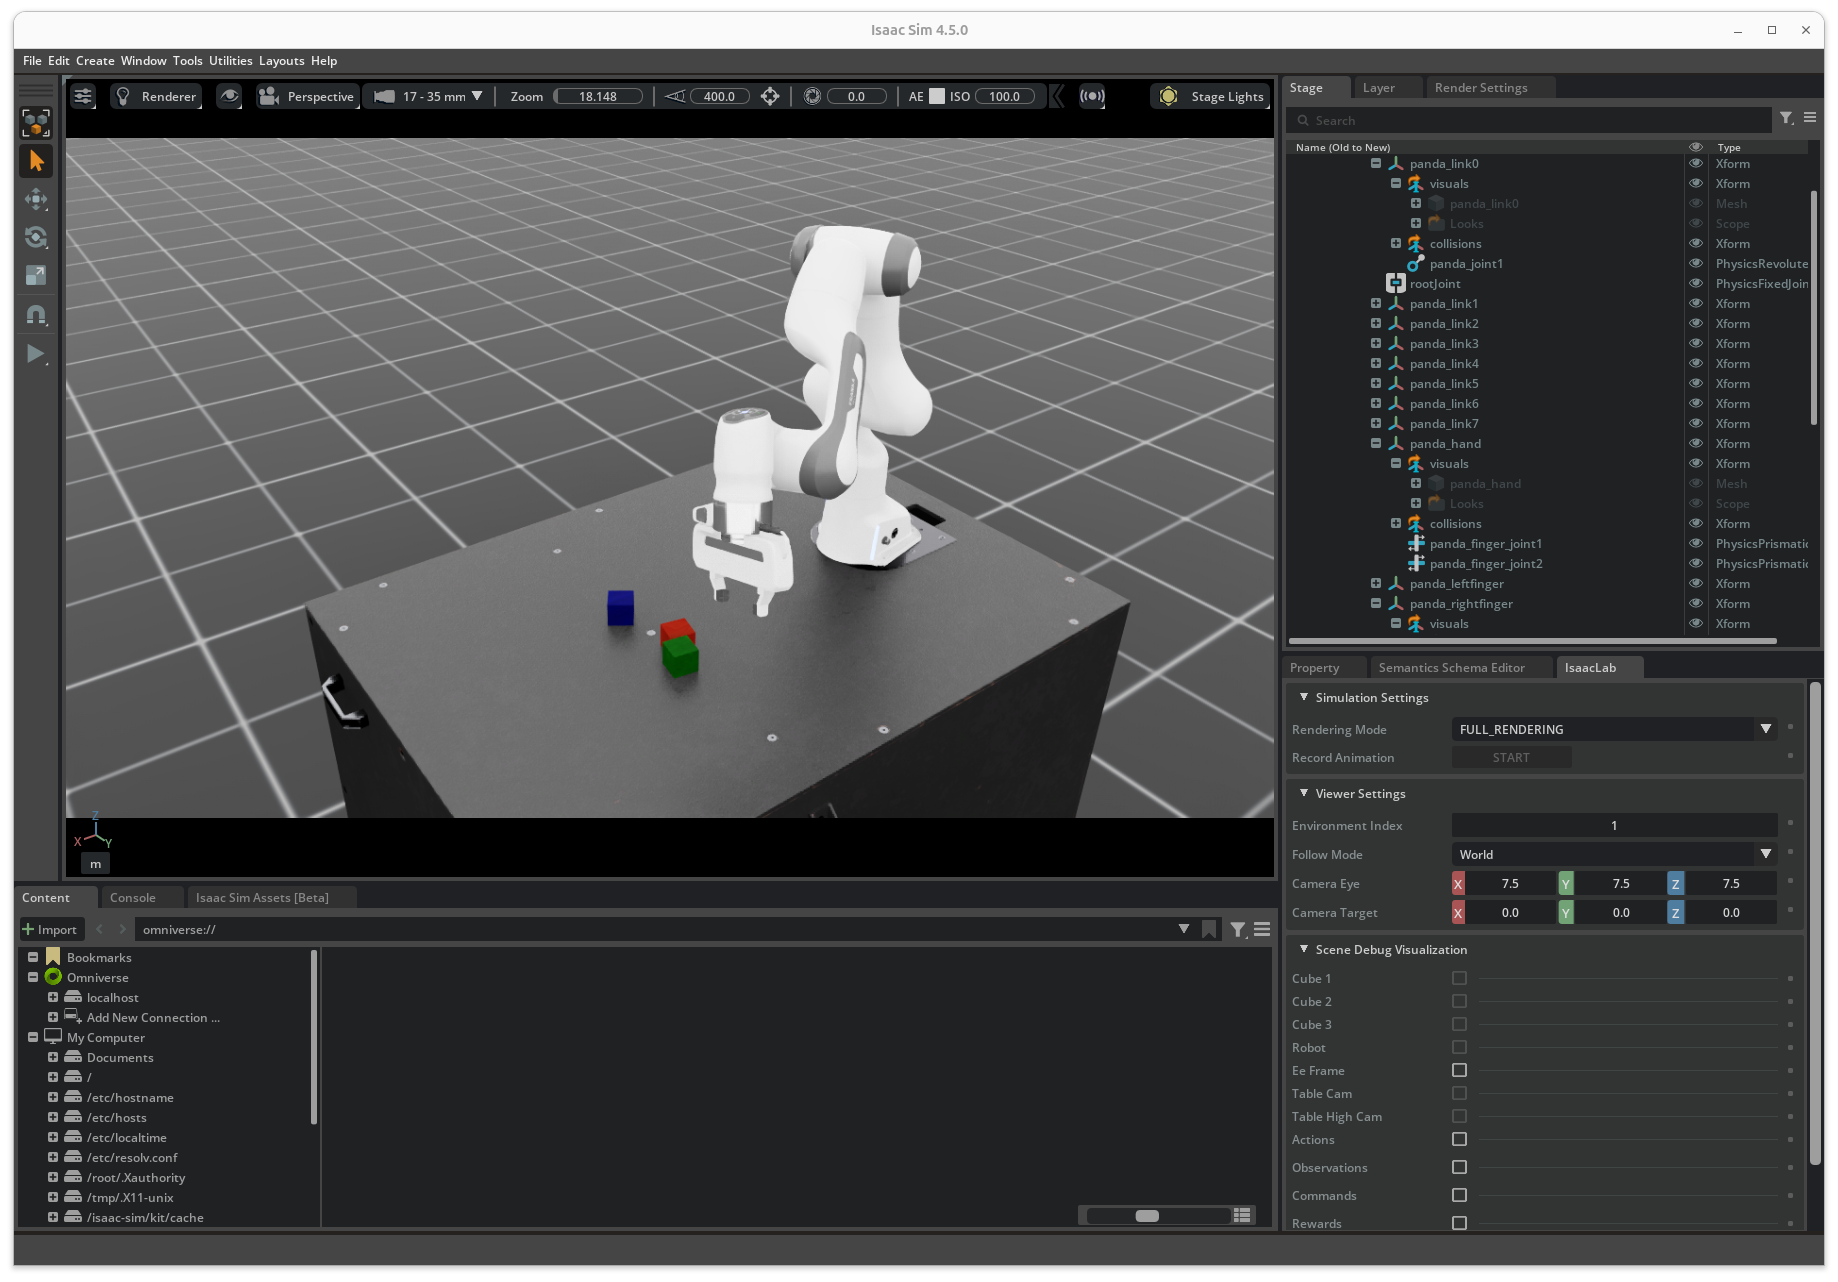
O projeto Isaac GR00T aborda esse desafio aproveitando dados sintéticos gerados a partir de simulações fisicamente precisas para acelerar o processo de coleta de dados. As organizações podem coletar exponencialmente mais dados com apenas algumas horas de demonstrações humanas.
O projeto Isaac GR00T consiste em três componentes principais que trabalham em conjunto para criar um pipeline abrangente de geração de dados sintéticos:
- GR00T-Teleop permite que operadores humanos qualificados controlem robôs virtuais usando dispositivos de computação espacial como o Apple Vision Pro. Este sistema permite que operadores demonstrem tarefas complexas de manipulação em ambientes virtuais fotorrealistas, capturando não apenas as trajetórias de movimento, mas também o contexto ambiental e as interações entre objetos. O Apple Vision Pro transmite dados de rastreamento manual para o Isaac Lab, que simultaneamente transmite uma visão imersiva do ambiente do robô de volta para o dispositivo, permitindo um controle intuitivo e interativo do robô.
- GR00T-Mimic pega as demonstrações gravadas e as multiplica em conjuntos de dados sintéticos maiores usando técnicas avançadas de simulação. Este componente usa as demonstrações gravadas como entrada para gerar trajetórias de movimento sintéticas adicionais no Isaac Lab, suportando a manipulação de robôs humanoides de braço único e bimanuais. O processo envolve anotar pontos-chave nas demonstrações e usar interpolação para garantir que as trajetórias sintéticas sejam suaves e contextualmente apropriadas.
- GR00T-Gen utiliza as plataformas NVIDIA Omniverse e Cosmos para expandir conjuntos de dados sintéticos por meio de upscaling 3D e randomização de domínio. Este componente adiciona diversidade adicional ao randomizar o fundo, a iluminação e outras variáveis na cena. Ele amplia as imagens geradas por meio do NVIDIA Cosmos Transfer, alcançando fotorrealismo que ajuda a reduzir a lacuna entre a simulação e a realidade.
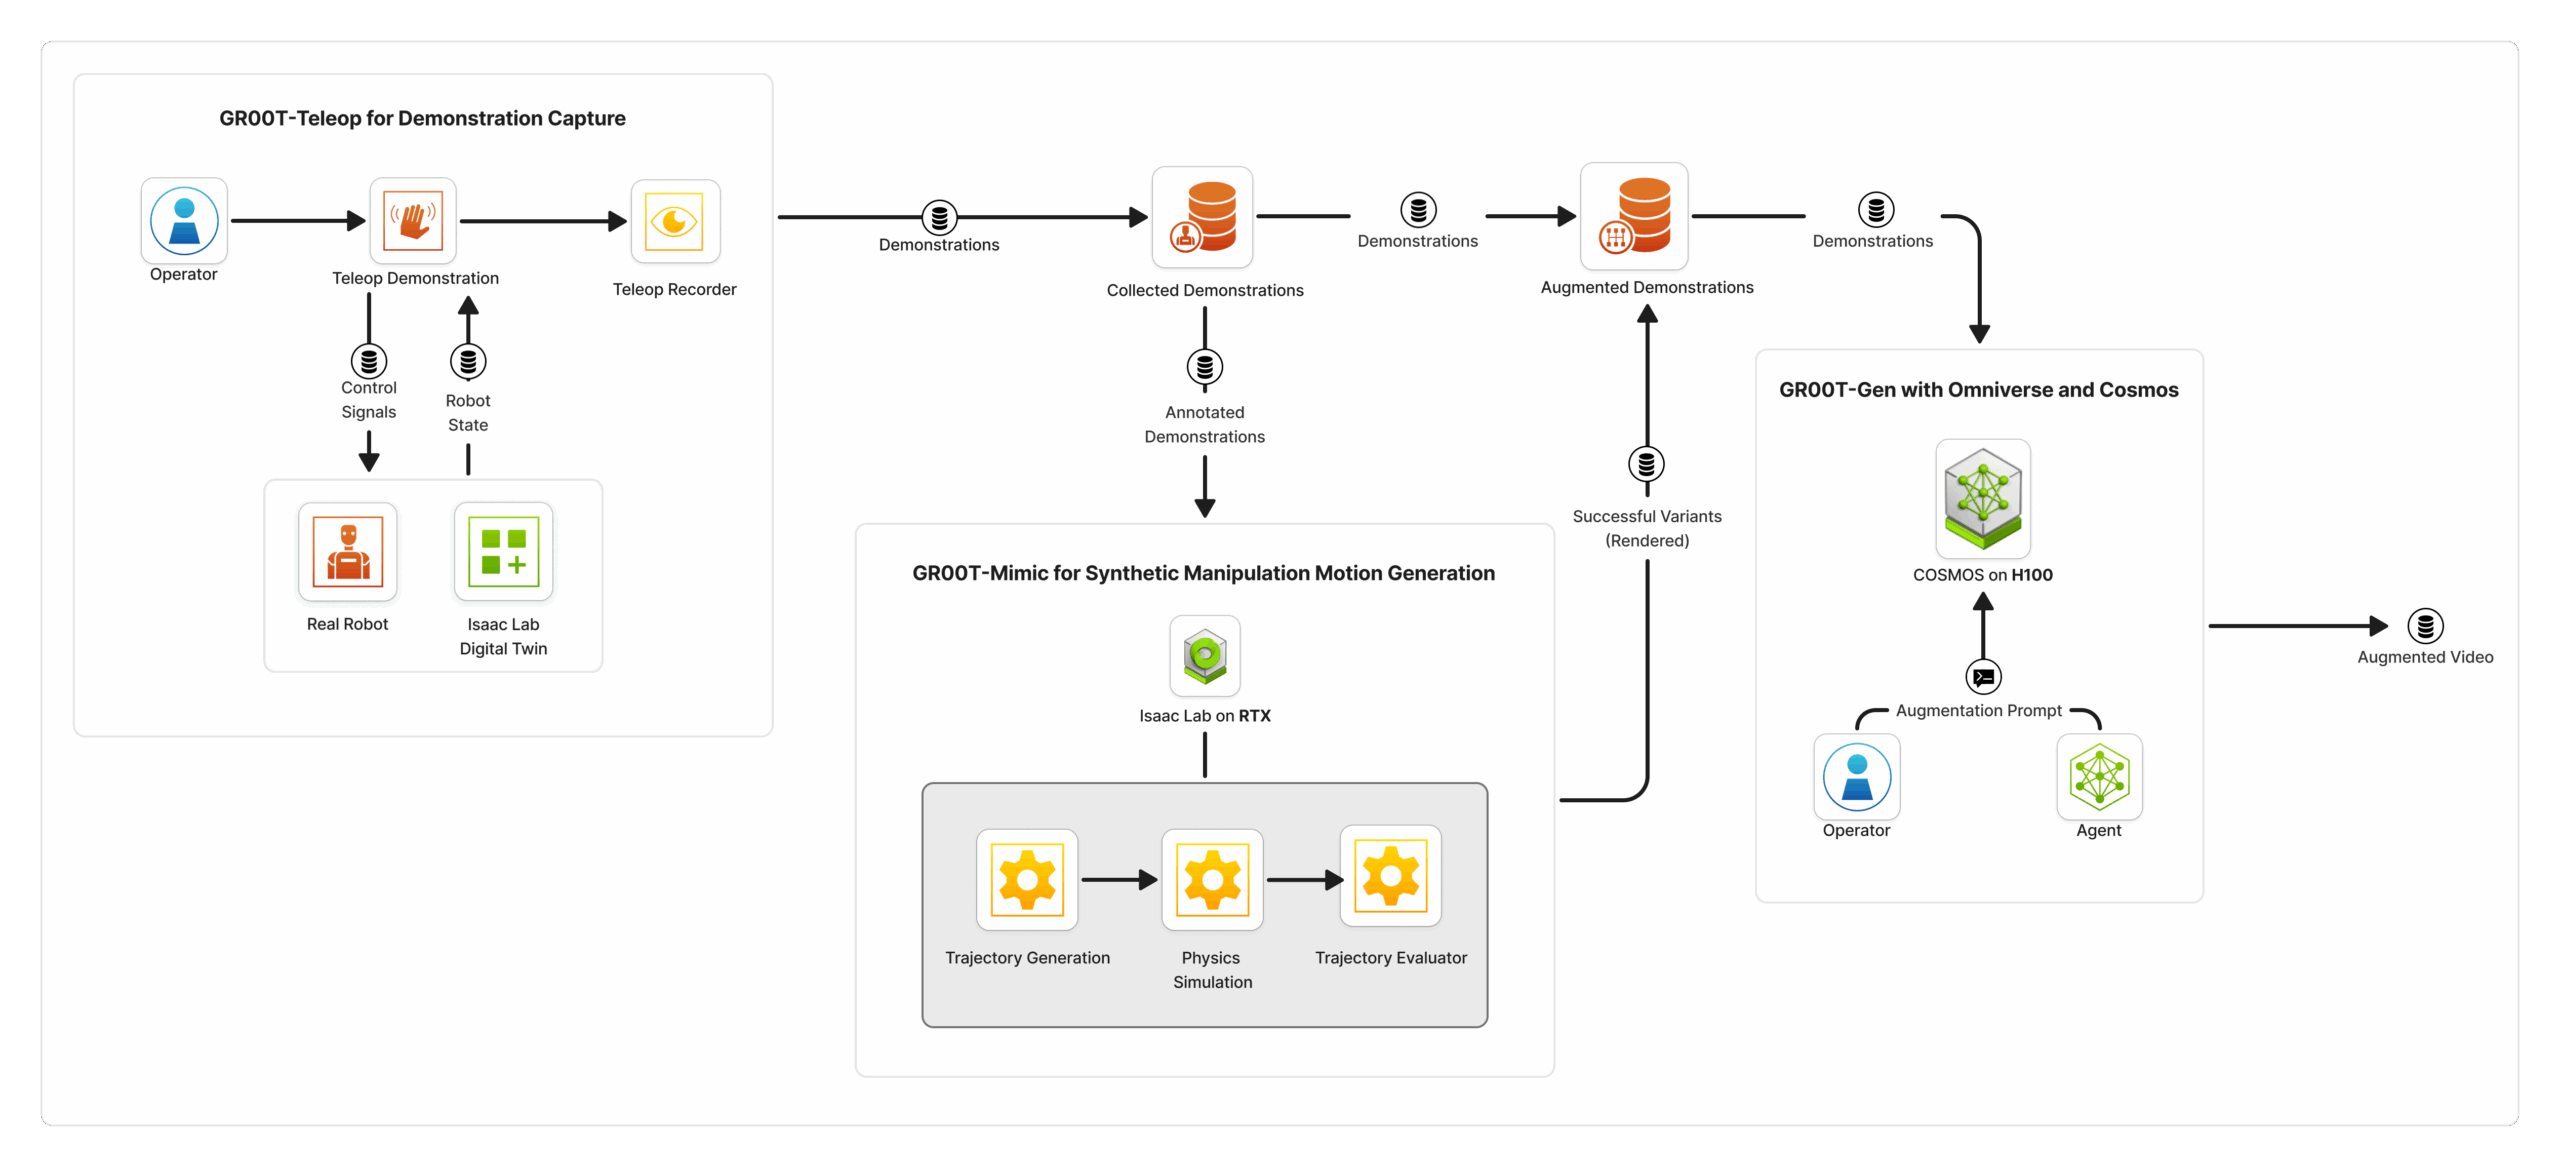
Este pipeline ilustra perfeitamente as funções especializadas e complementares das GPUs modernas para data centers. A L40S, com seus núcleos RT dedicados, atua como construtora de mundos. Ela é indispensável para os estágios iniciais da geração de dados, onde lida com a renderização baseada em física, o ray tracing em tempo real e a randomização de domínio necessários para criar um ambiente virtual fotorrealista e diverso.
Este mundo virtual de alta fidelidade torna-se então a tela para a próxima etapa de geração. Modelos de IA generativa, como os do NVIDIA Cosmos , são executados em GPUs com foco em computação, como a H100, para produzir os dados de treinamento finais. A H100 aproveita o ambiente realista criado pela L40S para gerar milhões de cenários dinâmicos e fisicamente compatíveis.
Benchmarks de desempenho de inferência de IA
Outro caso de uso em que placas como a L40S são populares é para inferência com boa relação custo-benefício. Para avaliar as capacidades de inferência de IA do mundo real da L40S em comparação com a H100, comparamos o desempenho do LLM usando o vLLM executando o modelo de parâmetros Open Reasoning Nemotron 14B da Nvidia em BF16 com comprimento máximo de token de 32K.
Resultados de benchmark do vLLM
O H100 demonstra clara liderança em desempenho, oferecendo uma taxa de transferência aproximadamente 4.2 vezes maior que a do L40S. Essa vantagem decorre diretamente do desempenho dobrado do Tensor Core do H100 e da largura de banda de memória mais que dobrada (2 TB/s vs. 864 GB/s).
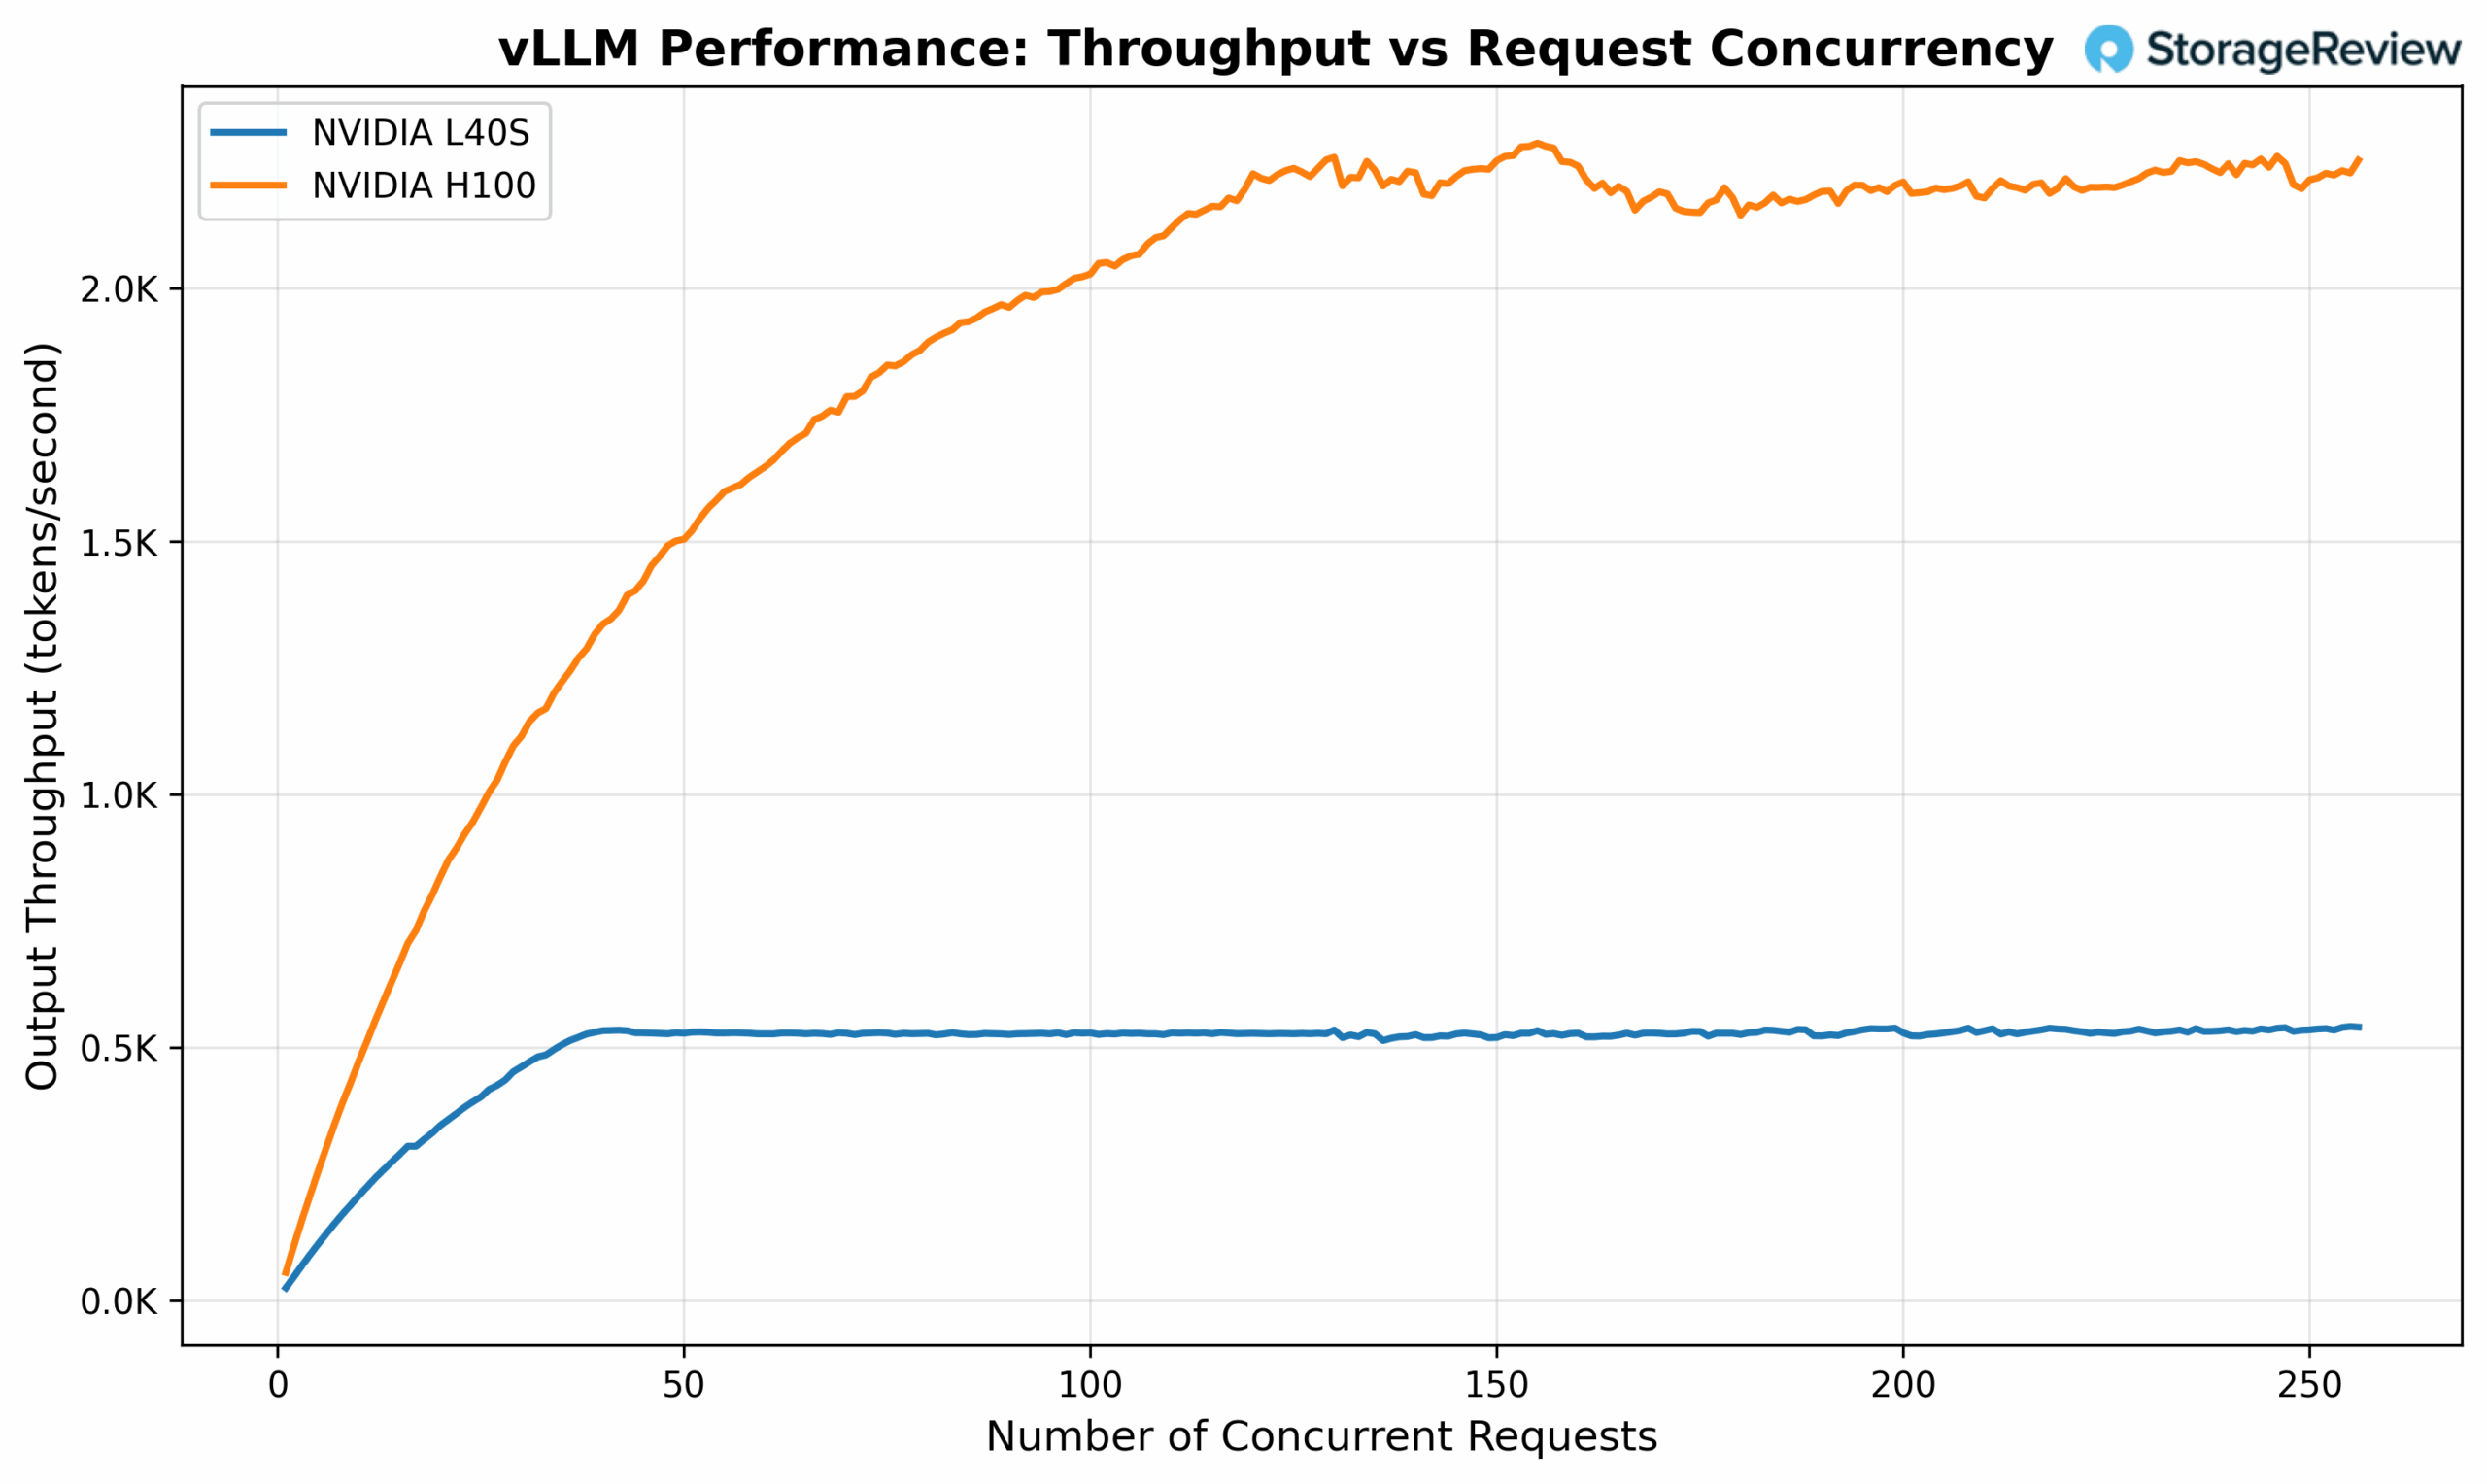
No entanto, o desempenho por dólar conta uma história diferente. O L40S normalmente custa menos de um terço do preço de um H100, tornando-o mais econômico para muitas cargas de trabalho de inferência. Organizações que operam serviços de inferência onde o desempenho máximo absoluto não é crítico geralmente descobrem que o L40S oferece um melhor custo total de propriedade.
Clicando duas vezes na seção com desempenho linear, vemos que o L40S oferece um nível de desempenho muito aceitável, sendo capaz de atender a 16 solicitações simultâneas com SLO de TPOT (Tempo por Token de Saída) de ~52 ms.
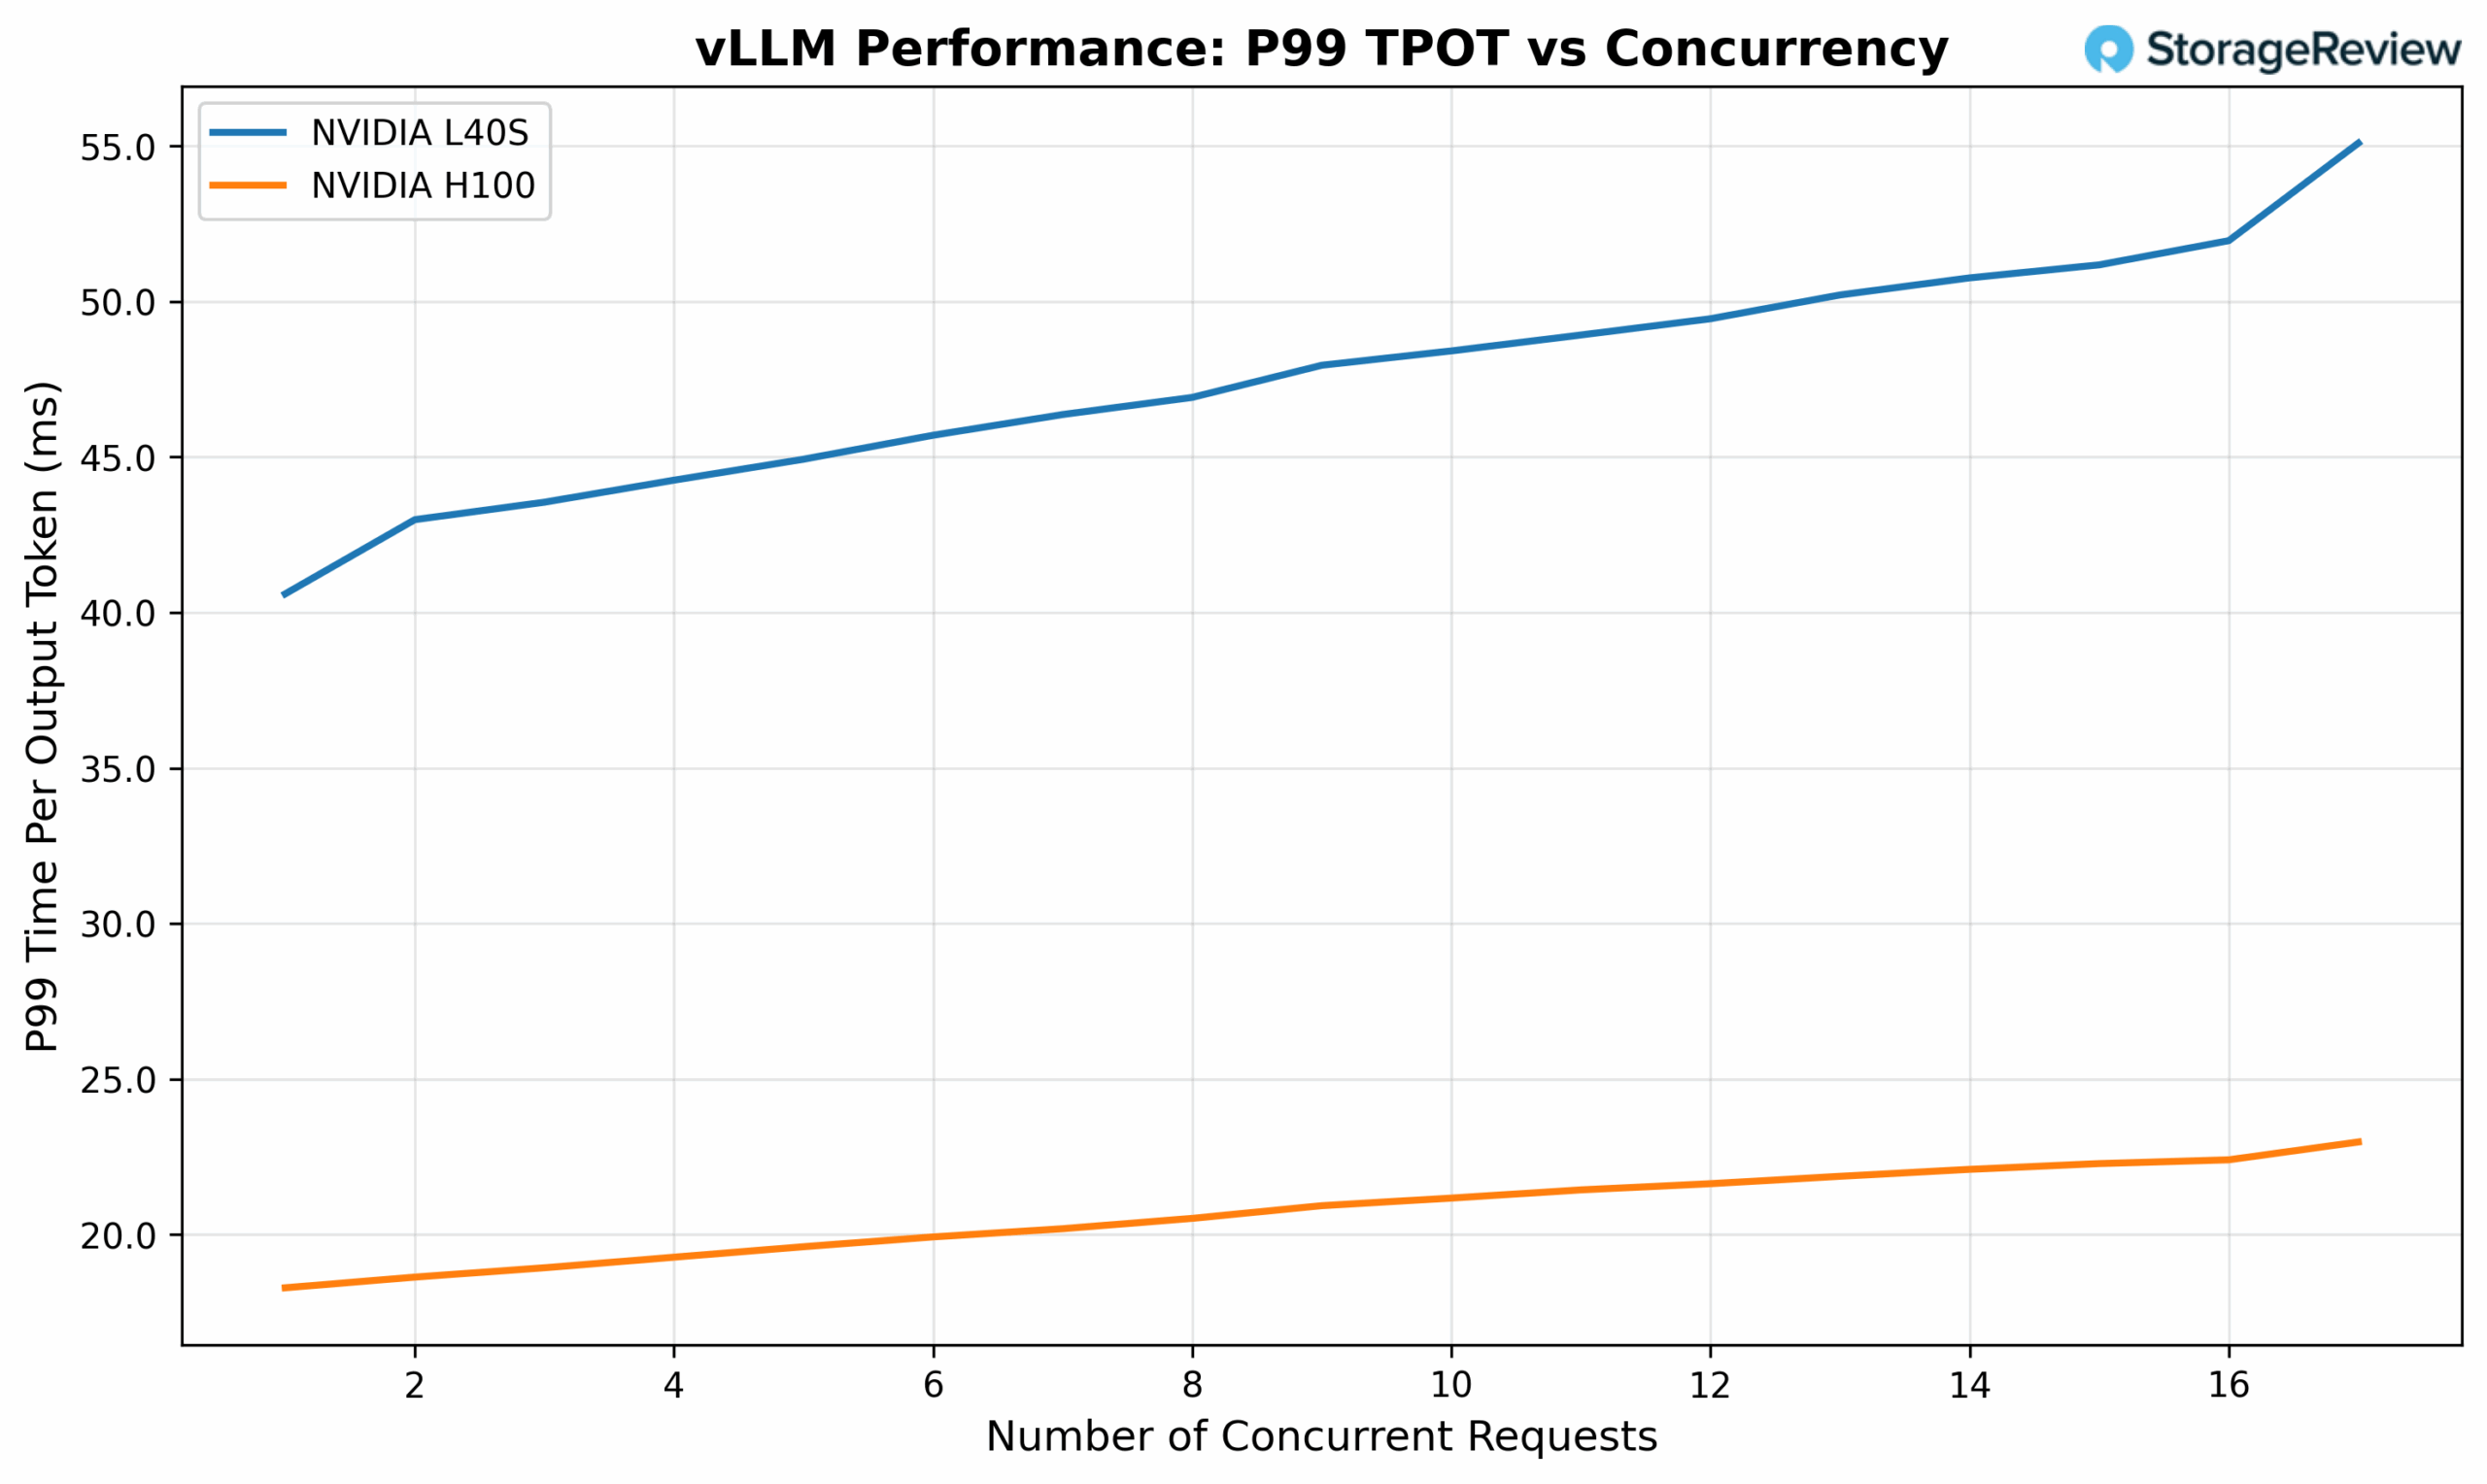
Um fator importante a ser observado é que a inferência de IA, particularmente a fase de decodificação da geração de texto, é fundamentalmente uma operação que consome muita largura de banda da memória. Durante a inferência, o modelo precisa acessar repetidamente os pesos armazenados na memória da GPU para gerar cada novo token, tornando a taxa de transferência de memória um gargalo crítico de desempenho. Essa característica explica por que o H100, com sua largura de banda de memória superior e desempenho aprimorado do Tensor Core, naturalmente atinge uma taxa de transferência de inferência mais alta.
No entanto, para cenários de implantação que exigem inferência de IA e aceleração gráfica, como renderização em tempo real com efeitos aprimorados por IA e aplicativos interativos com recursos baseados em IA, o L40S se torna a única opção viável.
Conclusão
A NVIDIA L40S e as mais recentes sucessoras da Blackwell RTX Pro 6000 surgem como uma GPU estrategicamente posicionada que atende às crescentes demandas dos data centers modernos, onde a computação de IA e os recursos gráficos avançados convergem cada vez mais. Enquanto as classes de GPU H100 e B200 permanecem as líderes indiscutíveis em cargas de trabalho de treinamento e inferência de IA pura, a L40S conquista um nicho distinto e valioso como uma GPU universal que preenche a lacuna entre placas de IA focadas em computação e soluções tradicionais de visualização profissional.
A proposta de valor exclusiva do L40S se torna mais evidente em cenários que exigem recursos de inferência de IA e aceleração gráfica. Seus 142 núcleos RT de terceira geração permitem aplicações que são simplesmente impossíveis em GPUs computacionais como a H100, desde ray tracing em tempo real em fluxos de trabalho profissionais até a geração de dados sintéticos fotorrealistas para treinamento de IA de última geração. Essa dupla capacidade o torna indispensável para aplicações emergentes em desenvolvimento de gêmeos digitais, treinamento de IA baseado em física e no crescente ecossistema Omniverse.
Do ponto de vista econômico, o L40S oferece um valor atraente para organizações que não exigem o desempenho de IA de pico absoluto do H100. Custando aproximadamente um terço do preço de um H100, o L40S oferece um desempenho de inferência respeitável, além de recursos gráficos que agregam enorme versatilidade às implantações em data centers. Para muitas organizações, essa combinação de custo-benefício e versatilidade torna o L40S uma opção mais prática do que investir em soluções separadas de IA e gráficos.
Classificação: A L40S ocupa o primeiro lugar como a melhor GPU de inferência convencional ainda disponível no mercado em nossa classificação de melhores GPUs corporativas , com base nos resultados de nossos testes vLLM.


 Amazon