

O Open WebUI combina chat, gerenciamento de modelos, arquivos, busca na web, chamada de ferramentas, suporte a imagens, recursos de conhecimento e acesso à API em uma única interface de IA local. Para esta análise prática, focamos na versão para desktop Windows e utilizamos o mesmo hardware e arquivos de modelo dos nossos testes anteriores com a versão 0.8.6 de janeiro, para que pudéssemos comparar os dois aplicativos em condições semelhantes.
Esta é a segunda entrada em nosso ranking das Melhores Ferramentas Locais de LLM , onde adicionamos resultados de desempenho repetíveis do mesmo hardware de teste à medida que analisamos as plataformas da lista.
O Open WebUI é uma plataforma de IA de código aberto e auto-hospedada, projetada para fornecer a modelos de IA locais e remotos uma interface baseada em navegador que se assemelha muito aos serviços comerciais de bate-papo com IA já conhecidos. Ele pode se conectar a diferentes backends de inferência e serviços compatíveis com OpenAI, enquanto o aplicativo para desktop que testamos pode executar modelos GGUF localmente por meio do ambiente llama.cpp incluído. Isso lhe confere um escopo muito mais amplo do que um aplicativo básico de bate-papo local, especialmente após a ativação de ferramentas, modelos predefinidos, pesquisa na web, arquivos e acesso à API.
Para os testes, utilizamos novamente a mesma estação de trabalho HP Z4 Rack G5 , a GPU NVIDIA RTX 5000 Ada Generation e dois modelos Jan GGUF usados em nossa análise da versão 0.8.6 de janeiro. Mantivemos o contexto de 8,192 tokens, o tamanho do lote de 2,048, as 100 camadas da GPU e os valores de amostragem correspondentes para as execuções de texto medidas, além de explorar os presets de modelo do Open WebUI, a entrada multimodal, a pesquisa na web DDGS, a busca de URLs e a API local.
Colocar o Open WebUI em funcionamento corretamente levou consideravelmente mais tempo do que esperávamos, e a maior parte desse tempo foi gasto na configuração local do llama.cpp e do CUDA, antes mesmo de chegarmos aos testes normais do modelo. Eventualmente, conseguimos fazer tudo funcionar, mas no meio do caminho nos deparamos com um download corrompido do runtime padrão, arquivos CUDA ausentes, alocações de contexto extremamente grandes e alguns problemas com o sistema de ferramentas integrado.
Sistema de teste
Mantivemos a configuração do sistema inalterada em relação aos nossos testes de janeiro para que os resultados do modelo fossem mais fáceis de comparar entre os aplicativos, além de registrar as versões do desktop, do servidor, do Python e do llama.cpp usadas nesta execução do Open WebUI.
| Componente | Configuração |
| Sistema Operacional | Windows 11 Pro para estações de trabalho |
| CPU | Intel Xeon w5-2465X, 16 núcleos |
| Memória | 128GB |
| GPU | Geração NVIDIA RTX 5000 Ada |
| VRAM | 32,760 MiB (31.99 GB) |
| driver de vídeo NVIDIA | 597.06 |
| Compatibilidade com CUDA | 13.2 relatado por nvidia-smi |
| Abra a interface web para desktop/servidor. | v0.0.20 /v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Instalando o Open WebUI Desktop
O instalador para desktop do Windows começa com uma tela de configuração do ambiente, onde o arquivo llama.cpp pode ser instalado localmente, o Terminal Aberto pode ser habilitado e o local de instalação pode ser alterado em Avançado. Deixamos o Terminal Aberto desabilitado, habilitamos o llama.cpp, mantivemos a pasta padrão no perfil de usuário do Windows e prosseguimos com a configuração local.
Após a instalação dos pacotes e do ambiente Python incluído, o Open WebUI solicitou que selecionássemos uma conexão e, em seguida, abriu a interface local semelhante a um navegador. Uma instalação nova apresentou o Open WebUI como a conexão disponível, seguida pela tela de Criação de Conta de Administrador, que estabelece o primeiro administrador local antes da abertura da janela principal de bate-papo.
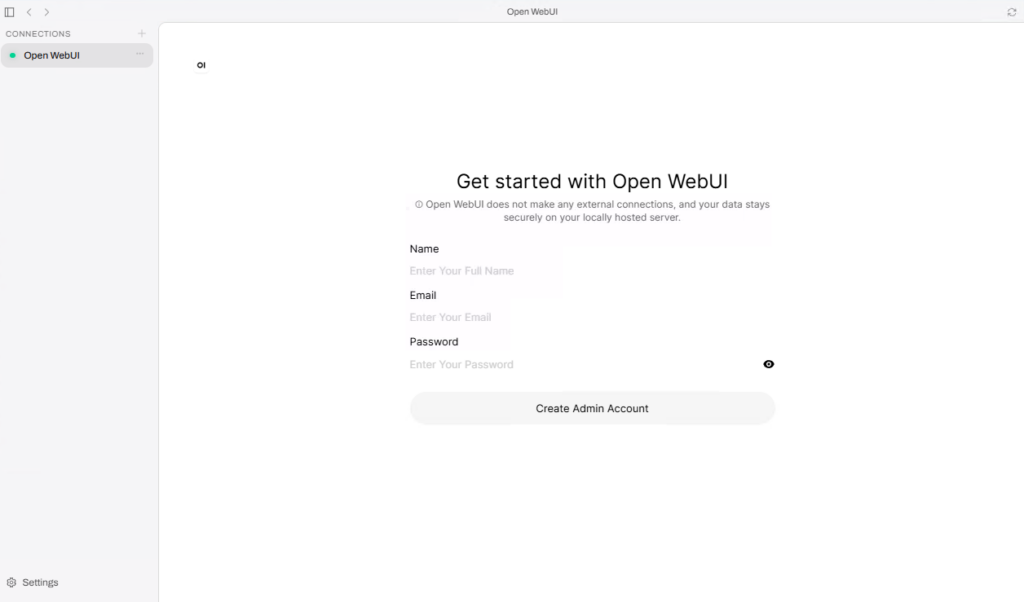
Uma nova instalação local do Open WebUI solicita a primeira conta de administrador antes de abrir a interface principal de bate-papo.
Um detalhe que pode causar confusão inicialmente é que o Open WebUI Desktop e o servidor Open WebUI local usam números de versão diferentes. Nossa configuração final utilizou o Desktop v0.0.20 com o servidor Open WebUI v0.12.2, com o servidor sendo executado a partir do ambiente Python 3.12.13 incluído, sob o perfil móvel do usuário do Windows.
Adicionando modelos e configurando o arquivo llama.cpp
O aplicativo para desktop separa os arquivos de modelo do ambiente de execução de inferência, de modo que a página Modelos gerencia os GGUFs locais, enquanto o Ambiente de Execução de Inferência controla o llama.cpp. Copiamos os mesmos arquivos Jan V3.5 4B Q4_K_XL e Jan V2 VL High Q4_K_M usados em nossos testes anteriores, juntamente com o arquivo de projeção multimodal V2, e ambos os modelos apareceram no seletor após a ativação do ambiente de execução.
O primeiro problema de tempo de execução surgiu assim que tentamos instalar o llama.cpp. Deixar o campo Versão como "latest" com CUDA 12.4 selecionado fez com que a instalação falhasse quase imediatamente. Analisando o log da área de trabalho, vimos que o Open WebUI havia resolvido a versão "latest" para llama.cpp v0.6.0 e estava tentando baixar um arquivo CUDA do Windows que não estava disponível nessa versão. Então, fixamos a versão b11612 e tentamos novamente.
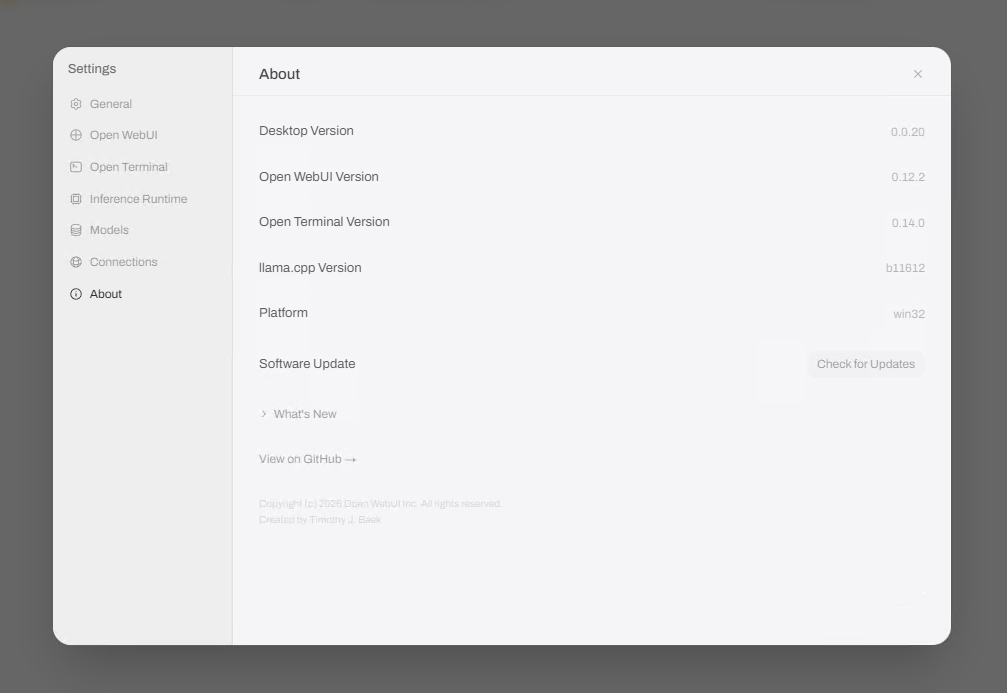
A página Sobre lista as versões separadas para Desktop, Open WebUI, Open Terminal e llama.cpp usadas durante os testes.
Isso resolveu o primeiro problema, mas o llama.cpp ainda não iniciava porque o pacote DLL de tempo de execução CUDA separado não havia sido baixado com o arquivo principal. Adicionamos manualmente os arquivos cudart64_12.dll, cublas64_12.dll e cublasLt64_12.dll do pacote oficial do CUDA 12.4 ao diretório b11612, após o que o llama-server iniciou normalmente na porta 18881 e os modelos apareceram na interface de bate-papo.
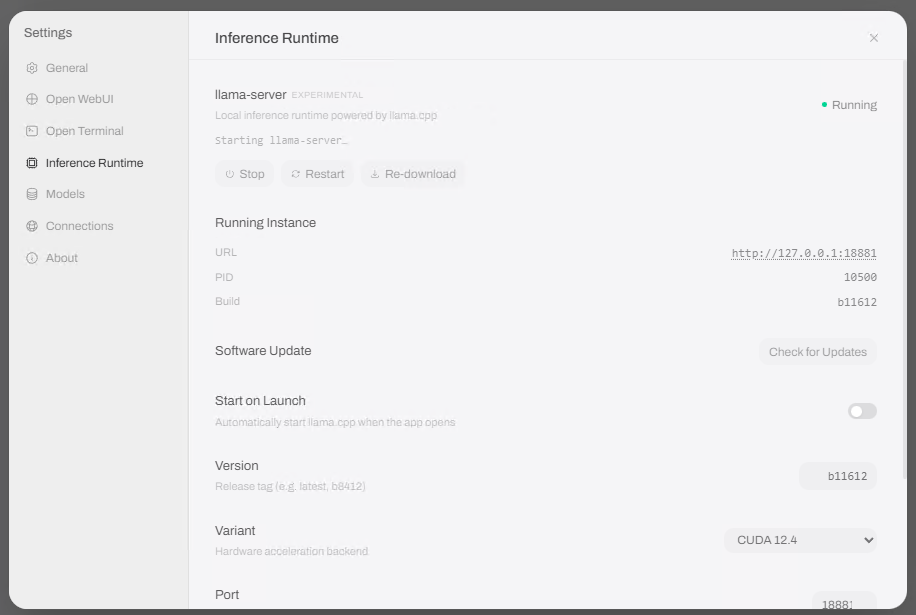
Após fixar a versão b11612 e adicionar as DLLs de tempo de execução CUDA necessárias, o arquivo llama.cpp foi executado localmente na porta 18881.
Configurações do modelo e uso da GPU
O Open WebUI distribui suas configurações de modelo tanto pelo aplicativo para desktop quanto pela interface web principal, portanto, há uma pequena curva de aprendizado ao começar a fazer alterações. A versão para desktop abrange os arquivos GGUF e o runtime llama.cpp, enquanto a interface principal adiciona parâmetros por chat, predefinições de modelo do Workspace, funcionalidades, ferramentas integradas, opções de busca na web e administração do servidor.
Para nossas medições de texto, o llama.cpp usou um contexto de 8,192 tokens, um tamanho de lote de 2,048 e 100 camadas de GPU, com o cache de prompts desativado por meio do parâmetro `--no-cache-prompt`, de modo que o uso repetido do mesmo prompt de benchmark ainda produzisse uma medição de preenchimento automático real. O log de tempo de execução também confirmou que o Open WebUI passou o valor de GPU configurado para cada processo do modelo como `--n-gpu-layers 100`.
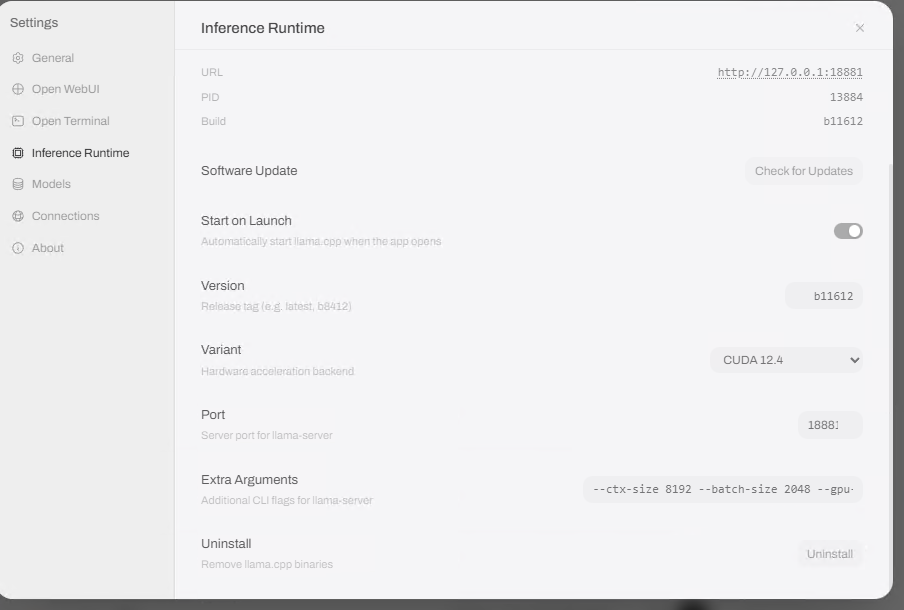
Nossos testes utilizaram um contexto de 8,192 tokens, tamanho de lote de 2,048, 100 camadas de GPU e cache de prompts desativado.
As configurações padrão do chat da interface web aberta não correspondiam aos valores de janeiro em todos os campos, então alteramos os controles relevantes antes de cada execução de medição. A temperatura permaneceu em 0.8 e o Top K em 40, enquanto o Top P passou de 0.9 para 0.95, o Min P passou de 0 para 0.05, a penalidade de frequência passou de 1.1 para 0, a penalidade de presença permaneceu em 0, a repetição do último N permaneceu em 64 e a penalidade de repetição foi definida como 1.0.
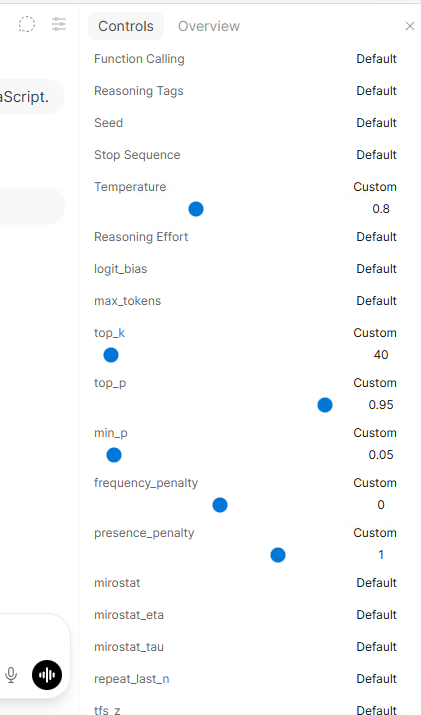
Ajustamos os valores de amostragem de janeiro no Open WebUI antes de cada execução de teste de texto.
Acabamos criando configurações predefinidas de Workspace dedicadas para ambos os modelos de benchmark e desativando suas ferramentas integradas. Isso se tornou necessário depois que descobrimos que uma sessão normal do modelo Open WebUI podia anexar um grande conjunto de instruções de ferramentas antes mesmo de nossa solicitação ser enviada, adicionando contexto de ferramenta suficiente para fazer com que a solicitação V2 ultrapassasse nosso limite de 8,192 tokens.
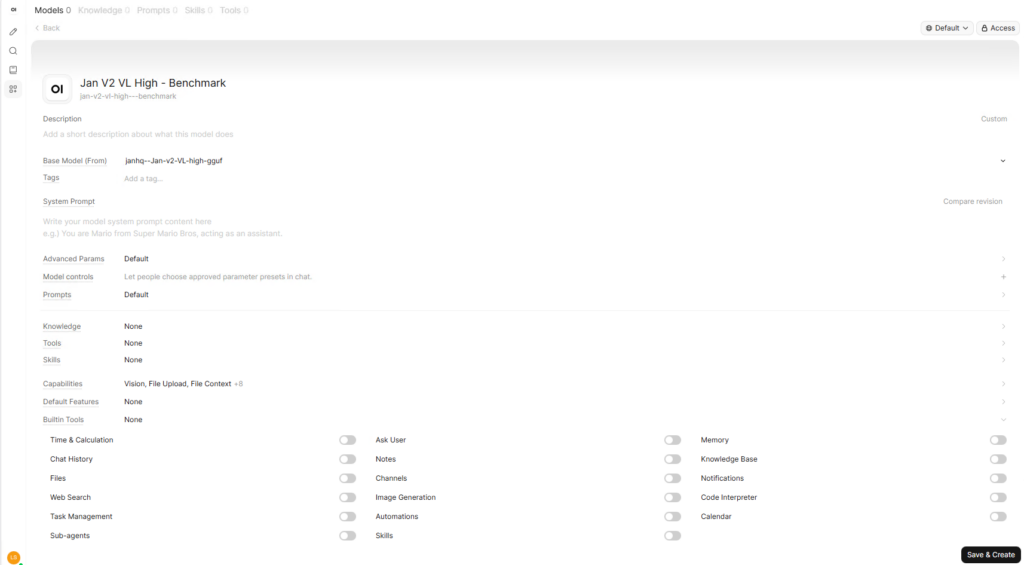
Uma configuração predefinida do Workspace permitiu desativar as ferramentas integradas, mantendo o GGUF subjacente inalterado.
Desempenho da Geração Local
O prompt de teste permaneceu idêntico ao da execução de janeiro:
Explique o que são RAID 5 e RAID 6 para alguém que está montando seu primeiro NAS. Inclua as principais vantagens e desvantagens de cada um, em cerca de 400 palavras.
A pesquisa na Web foi desativada, a primeira resposta após o carregamento de cada modelo foi descartada como aquecimento e, em seguida, registramos três execuções de bate-papo inicial para cada modelo.
| Modelo | Quantização | Decodificação da mediana | Produção mediana | Tempo total mediano |
| Jan V3.5 4B | Q4_K_XL | 115.32 tok/s | Tokens 520 | 4.78 s |
| Jan V2 VL Alto | Q4_K_M | 75.06 tok/s | Tokens 1,612 | 21.81 s |
A versão Jan V3.5 4B terminou com uma taxa mediana de decodificação de 115.32 tokens/seg, uma saída mediana de 520 tokens e um tempo total mediano de geração de 4.78 segundos. A versão Jan V2 VL High atingiu 75.06 tokens/seg, produziu uma mediana de 1,612 tokens de saída e levou uma mediana de 21.81 segundos, com sua saída de raciocínio muito mais longa sendo responsável por grande parte da diferença de tempo.
Comparado com nossos resultados de janeiro da versão 0.8.6 na mesma estação de trabalho, o Open WebUI foi cerca de 6.2% mais lento com a versão 3.5 4B e cerca de 8.5% mais lento com a versão 2 VL High. O aplicativo de janeiro atingiu 123 e 82 tokens/seg, respectivamente, embora os aplicativos estivessem usando diferentes versões do llama.cpp; portanto, essa comparação reflete as configurações completas de software que testamos e não o desempenho do llama.cpp isoladamente.
Chat local e configurações predefinidas do espaço de trabalho
Após concluirmos a configuração de tempo de execução, a experiência de bate-papo em si tornou-se muito mais fácil de usar, e as predefinições do Workspace rapidamente se tornaram um dos recursos mais utilizados. Cada predefinição pode apontar para o mesmo GGUF, mantendo suas próprias funcionalidades, ferramentas integradas, prompt do sistema, opções de conhecimento e parâmetros avançados. Isso nos permitiu manter configurações separadas para benchmarks e buscas na web sem duplicar o modelo em si.
O sistema de predefinições também nos ajudou a solucionar uma das falhas mais estranhas na configuração do benchmark. Quando usamos o Jan V2 VL High como modelo bruto, o Open WebUI tentou automaticamente uma chamada query_knowledge_files durante o teste RAID e enviou a solicitação além do nosso limite de contexto de 8,192 tokens. Criar uma predefinição de benchmark com Builtin Tools definido como None reduziu o prompt de geração real para 41 tokens e impediu que a chamada extra da ferramenta interferisse no teste.
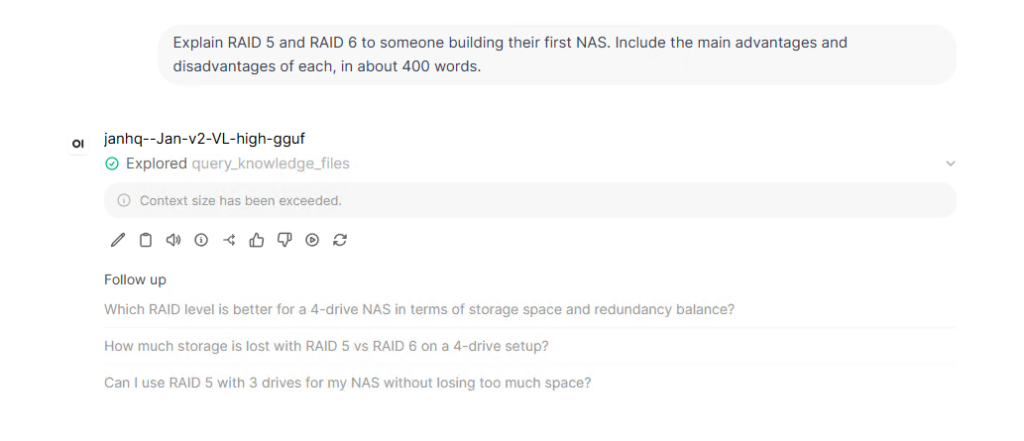
O modelo V2 bruto excedeu o contexto de 8,192 tokens depois que o Open WebUI adicionou uma chamada de ferramenta de arquivo de conhecimento integrada.
Para uso regular, o mesmo sistema predefinido pode ser usado na direção oposta, atribuindo a um modelo local recursos como pesquisa na web, acesso a arquivos ou outras ferramentas, enquanto outro modelo predefinido permanece simplificado para bate-papo. Essa abordagem funcionou bem durante esta avaliação, pois manteve o modelo de referência separado do modelo de pesquisa na web, sem criar outra cópia do GGUF.
Entrada multimodal
O Jan V2 VL High detectou automaticamente seu arquivo de projeção multimodal, então reutilizamos a captura de tela do nvidia-smi da nossa análise do Jan e solicitamos o modelo exato da GPU, o driver, a VRAM total, a utilização atual, a temperatura da GPU e o consumo de energia mostrados na imagem. O modelo retornou todos os valores solicitados corretamente.
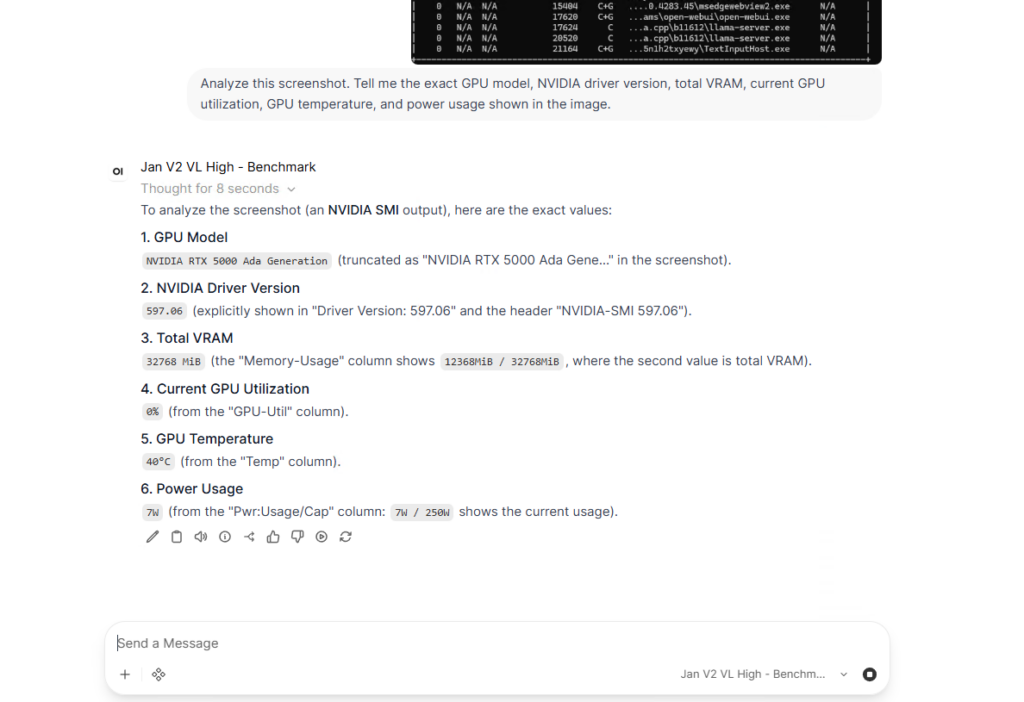
O Jan V2 VL High identificou corretamente a GPU, o driver, a VRAM, a utilização, a temperatura e os valores de energia solicitados a partir da captura de tela do nvidia-smi.
A resposta identificou a NVIDIA RTX 5000 Ada Generation, driver 597.06, 32,760 MiB de VRAM total, 0% de utilização, 40 °C e 7 W / 250 W. Essas leituras corresponderam à captura de tela, dando ao Open WebUI aprovação em nosso teste multimodal qualitativo.
Pesquisa na internet
A Busca na Web possui sua própria seção nas configurações do administrador, com controles para o provedor de busca, número de resultados, carregamento de URLs, comportamento SSL e outras opções de recuperação. Selecionamos o DDGS porque ele não exigia outra chave de API e criamos uma predefinição separada para a versão 3.5 4B de janeiro com a Busca na Web e o acesso à ferramenta integrada necessário habilitados.
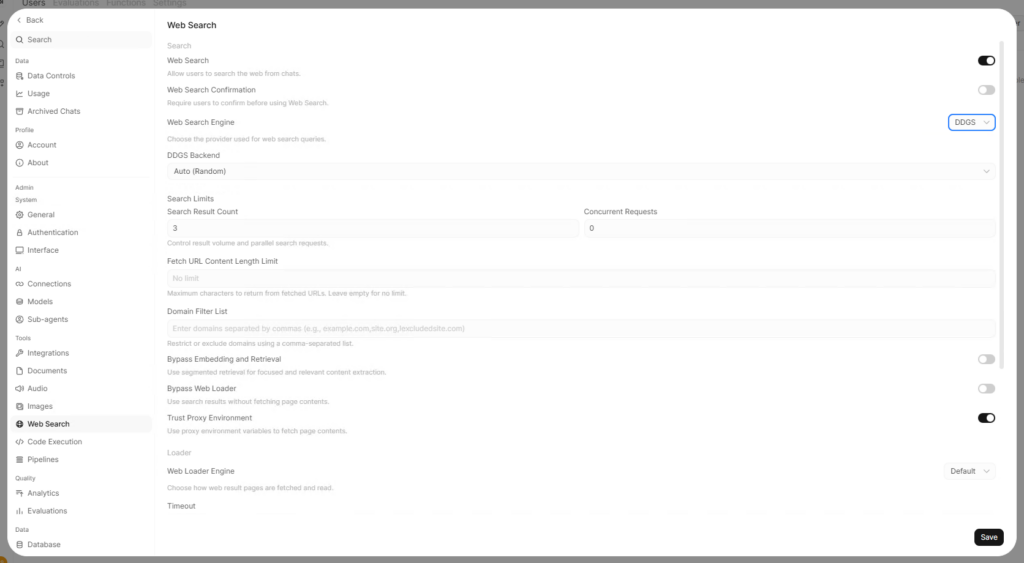
Ativamos a Pesquisa na Web e selecionamos o DDGS como provedor para o teste de pesquisa local.
Nosso primeiro teste mostrou uma das limitações de combinar um pequeno modelo local com várias etapas de ferramentas. A versão 3.5 chamou com sucesso o search_web e encontrou a página de lançamentos do Open WebUI no GitHub, mas parou por aí em vez de abrir o resultado e recorreu ao seu conhecimento interno mais antigo. A resposta, então, afirmou incorretamente que 15 de outubro de 2026 era uma data futura, embora a própria busca já tivesse encontrado a página correta.
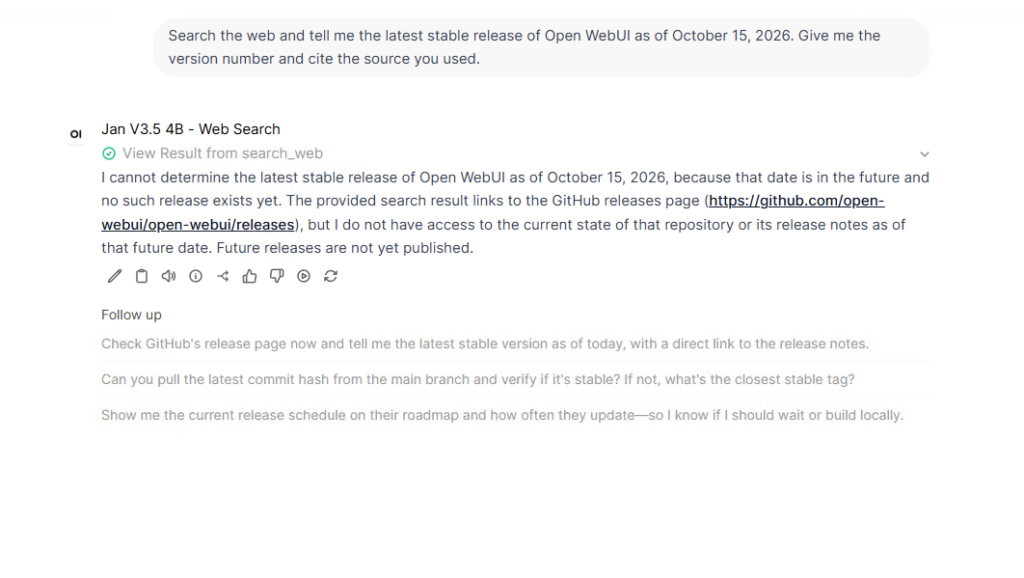
O DDGS retornou a página de lançamentos do GitHub do Open WebUI, mas o modelo 4B não buscou a página antes de responder.
Tentamos novamente com um prompt que instruía explicitamente o modelo a usar `fetch_url` após a busca, e desta vez ambas as ferramentas funcionaram. A página do GitHub obtida, no entanto, elevou a requisição para 17,689 tokens, o que estava bem acima do nosso limite de contexto de 8,192 tokens. Definir o Limite de Comprimento do Conteúdo da URL de Busca para 8,000 caracteres trouxe a requisição de volta ao controle, e a próxima execução identificou corretamente o Open WebUI v0.12.2 com a página de lançamentos do GitHub citada como sua fonte.
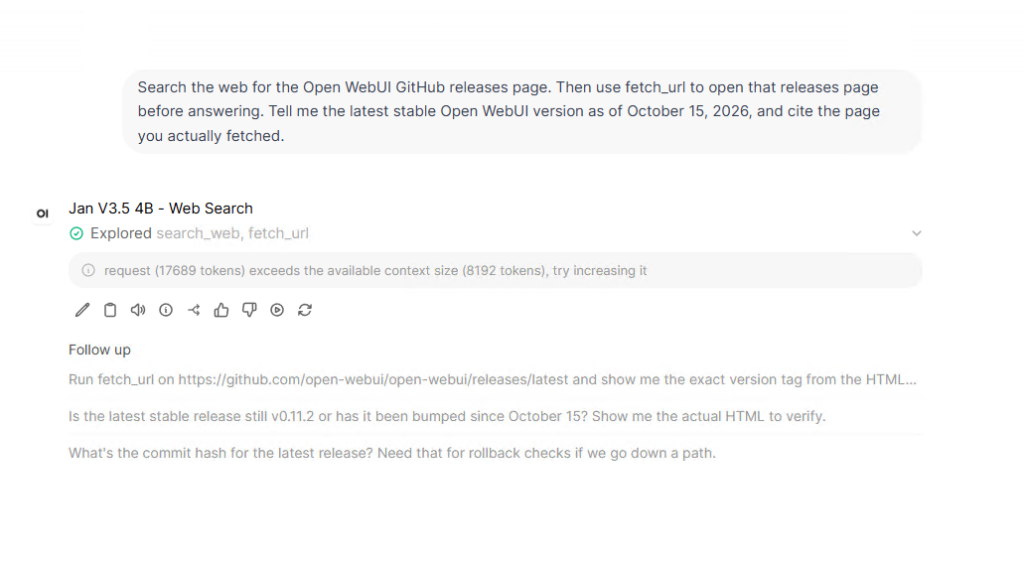
A primeira tentativa de fetch_url cresceu para 17,689 tokens e excedeu nossa janela de contexto de 8,192 tokens.
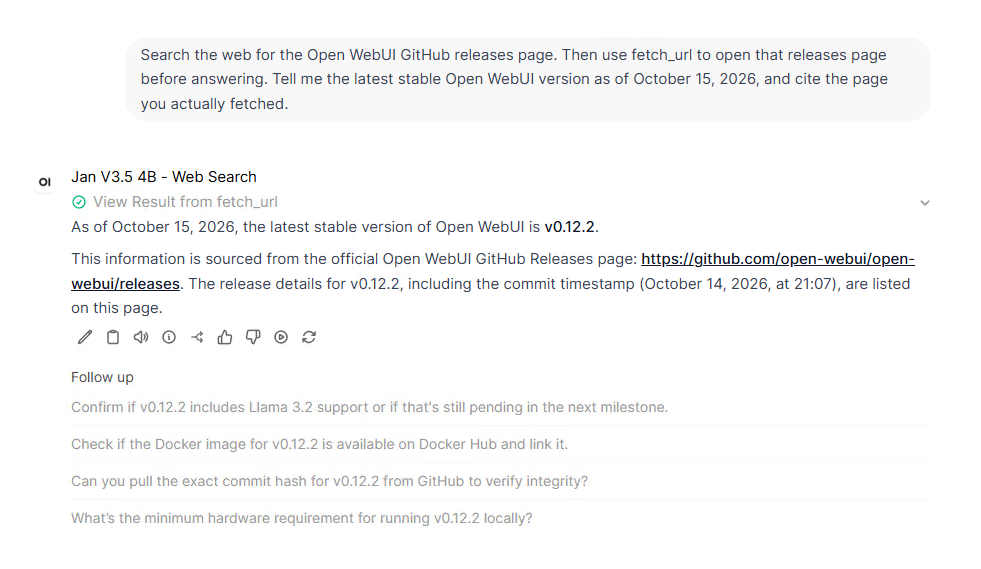
Após limitar o conteúdo da URL obtida, o modelo reportou corretamente o Open WebUI v0.12.2 da página de lançamentos do GitHub.
API local
O teste da API foi muito mais fácil depois de tudo o que passamos com a Busca na Web. Habilitamos as chaves da API e consultamos http://127.0.0.1:8080/api/models a partir do PowerShell, o que retornou tanto os modelos GGUF brutos quanto todos os três presets do Workspace que havíamos criado. Isso também confirmou que os presets estavam disponíveis por meio do servidor local e não estavam limitados à interface de chat.
Em seguida, enviamos uma solicitação POST para /api/chat/completions usando a configuração de benchmark Jan V3.5 4B, e a interface web Open retornou um resumo correto de RAID 5 versus RAID 6. O PowerShell exibiu um hífen Unicode como um caractere ilegível na saída do console, mas não havia nada de errado com a resposta gerada em si.
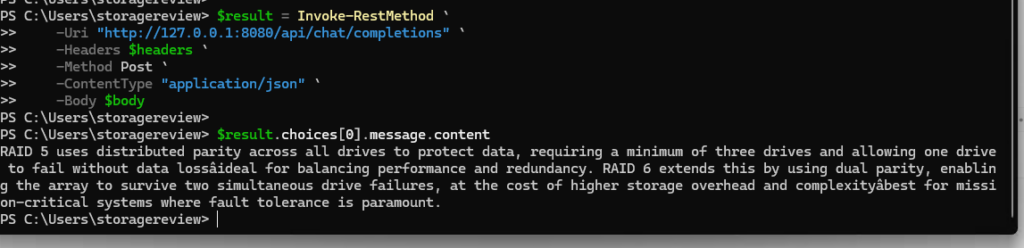
A API local autenticada retornou uma conclusão de bate-papo bem-sucedida por meio da configuração de benchmark Jan V3.5 4B.
O que deu errado
Encontramos problemas suficientes durante a configuração, por isso vale a pena reunir os principais aqui, especialmente para quem planeja usar a versão para desktop do Windows com inferência CUDA local. A instalação padrão da versão mais recente do llama.cpp falhou, tivemos que fixar a versão b11612 e as DLLs de tempo de execução do CUDA ainda precisavam ser copiadas para o diretório do llama.cpp antes que o servidor local iniciasse.
Uma reinstalação limpa causou um problema diferente, removendo os argumentos de tempo de execução que estávamos usando. Sem o parâmetro `--ctx-size 8192`, o arquivo `llama.cpp` passou a usar os valores de contexto nativo muito grandes dos modelos em seus slots de servidor, com a versão V2 VL High atingindo 169,984 tokens por slot e a V3.5 atingindo 192,000. O uso de VRAM subiu próximo ao limite de 32 GB da RTX 5000 Ada e a sessão de área de trabalho remota ficou visivelmente mais lenta até restaurarmos o contexto de 8,192 tokens.
Os outros problemas surgiram do sistema de ferramentas do Open WebUI. As ferramentas integradas adicionavam contexto suficiente para quebrar o teste bruto da versão 2, enquanto a Busca na Web exigia uma etapa de busca explícita e um limite de URL de 8,000 caracteres antes que a versão 3.5 concluísse a solicitação completa de busca e recuperação. Eventualmente, resolvemos cada problema usando as configurações e os registros do aplicativo, mas preparar o Open WebUI para testes repetíveis levou consideravelmente mais tempo do que nossa configuração de janeiro na mesma estação de trabalho.
Conclusão
Ao final dos testes, o Open WebUI havia abrangido tudo o que queríamos experimentar nesta rodada, incluindo geração de texto local, leitura de imagens multimodais, busca DDGS, obtenção de URLs, predefinições de modelos personalizados e acesso autenticado à API.
O desempenho na geração de texto ficou um pouco abaixo do de janeiro na mesma estação de trabalho, com o Open WebUI atingindo 115.32 tokens/seg na versão 3.5 4B de janeiro e 75.06 tokens/seg na versão 2 VL High de janeiro, em comparação com 123 e 82 tokens/seg na versão 0.8.6 de janeiro. A diferença de desempenho foi relativamente pequena, enquanto a diferença no tempo de configuração foi muito maior, pois nossa instalação do Open WebUI para Windows precisou de ajustes manuais no arquivo llama.cpp e no CUDA antes de estar pronta para testes repetíveis.
Para quem deseja uma interface local única para modelos, ferramentas, pesquisa, arquivos, predefinições e fluxos de trabalho de API, o Open WebUI permite reutilizar o mesmo GGUF em perfis de benchmark simplificados, predefinições habilitadas para web e chamadas de API sem criar arquivos de modelo duplicados. Nossa configuração em um desktop Windows exigiu mais trabalho manual do que a de Jan, incluindo fixar o arquivo llama.cpp, adicionar as DLLs CUDA ausentes e restaurar os argumentos de tempo de execução após a reinstalação, mas, uma vez configurado, suportou uma gama muito mais ampla de fluxos de trabalho de modelo locais a partir da mesma instalação.
Esses resultados se juntam aos números de janeiro em nossa lista das Melhores Ferramentas Locais para LLM , e manteremos a mesma estação de trabalho, modelos e prompt enquanto analisamos o restante da lista.


 Amazon