

Open WebUI объединяет чат, управление моделями, файлы, веб-поиск, вызов инструментов, поддержку изображений, функции управления знаниями и доступ к API в одном локальном интерфейсе ИИ. Для этого практического обзора мы сосредоточились на версии для настольных компьютеров под управлением Windows и использовали то же оборудование и файлы моделей, что и в нашем предыдущем тестировании версии 0.8.6 от января, чтобы сравнить два приложения в аналогичных условиях.
Это вторая запись в нашем рейтинге лучших локальных инструментов LLM , где мы добавляем результаты, воспроизводимые с помощью одного и того же тестового оборудования, по мере того, как мы тестируем платформы из списка.
Open WebUI — это платформа искусственного интеллекта с открытым исходным кодом, предназначенная для самостоятельного размещения и предоставления локальным и удаленным моделям ИИ браузерного интерфейса, который выглядит и работает во многом так же, как коммерческие сервисы чата для ИИ, уже знакомые пользователям. Она может подключаться к различным бэкэндам вывода и сервисам, совместимым с OpenAI, а протестированное нами настольное приложение может запускать модели GGUF локально через встроенную среду llama.cpp. Это значительно расширяет ее возможности по сравнению с базовым локальным приложением для чата, особенно после включения инструментов, предустановок моделей, веб-поиска, файлов и доступа к API.
Для тестирования мы вернулись к той же рабочей станции HP Z4 Rack G5 , графическому процессору NVIDIA RTX 5000 Ada Generation и двум моделям Jan GGUF, которые использовались в нашем обзоре Jan v0.8.6. Мы сохранили контекст из 8,192 токенов, размер пакета 2,048, 100 слоев GPU и соответствующие значения выборки для измеренных текстовых запусков, а также уделили время работе с предустановками моделей Open WebUI, многомодальным вводом, веб-поиском DDGS, получением URL-адресов и локальным API.
Наладка корректной работы Open WebUI заняла значительно больше времени, чем мы ожидали, и большая часть этого времени ушла на локальную настройку llama.cpp и CUDA, прежде чем мы даже дошли до обычного тестирования модели. В конце концов, нам удалось всё запустить, но по пути мы столкнулись с неисправной загрузкой среды выполнения по умолчанию, отсутствующими файлами CUDA, чрезвычайно большими выделениями контекста и несколькими проблемами со встроенной системой инструментов.
Испытательная система
Мы сохранили конфигурацию системы без изменений по сравнению с январским тестированием, чтобы упростить сравнение результатов модели между различными приложениями, а также зафиксировали версии для настольных компьютеров, серверов, Python и llama.cpp, использованные в этом запуске Open WebUI.
| Компонент | Конфигурация |
| Operating System | Windows 11 Pro для рабочих станций |
| ЦП | Процессор Intel Xeon w5-2465X, 16 ядер. |
| Память | 128GB |
| GPU : | NVIDIA RTX 5000 поколения Ada |
| VRAM | 32 760 МиБ (31.99 ГБ) |
| NVIDIA Драйвер | 597.06 |
| Совместимость с CUDA | 13.2 сообщает nvidia-smi |
| Открыть веб-интерфейс рабочего стола / сервера | v0.0.20/v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Установка Open WebUI Desktop
Установка Windows на рабочий стол начинается с экрана настройки среды, где можно установить llama.cpp локально, включить Open Terminal и изменить место установки в разделе «Дополнительно». Мы оставили Open Terminal отключенным, включили llama.cpp, сохранили папку по умолчанию в профиле пользователя Windows и продолжили локальную установку.
После установки пакетов и встроенной среды Python Open WebUI предложил выбрать подключение, а затем открыл локальный интерфейс в стиле браузера. После чистой установки Open WebUI был представлен как доступное подключение, после чего появился экран создания учетной записи администратора, который определяет первого локального администратора, прежде чем откроется главное окно чата.
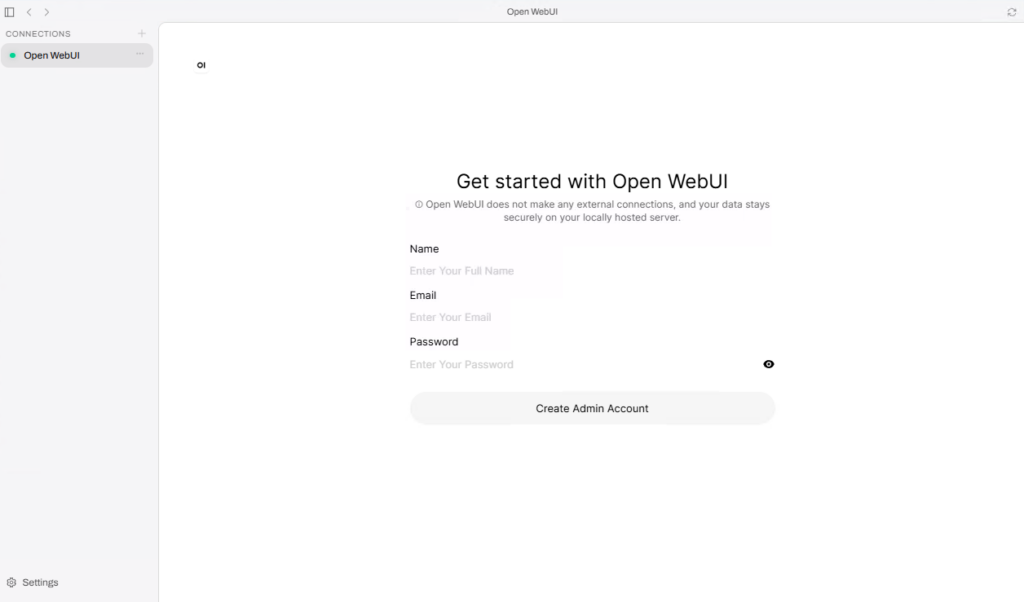
При чистой локальной установке Open WebUI перед открытием основного интерфейса чата запрашивается первая учетная запись администратора.
Одна деталь, которая может поначалу вызывать путаницу, заключается в том, что Open WebUI Desktop и локальный сервер Open WebUI используют разные номера версий. В нашей окончательной конфигурации использовалась версия Desktop v0.0.20 с сервером Open WebUI v0.12.2, при этом сервер работал из встроенной среды Python 3.12.13 под перемещаемым профилем пользователя Windows.
Добавление моделей и настройка файла llama.cpp
Настольное приложение отделяет файлы моделей от среды выполнения вывода, поэтому страница «Модели» управляет локальными файлами GGUF, а среда выполнения вывода — файлом llama.cpp. Мы скопировали те же файлы Jan V3.5 4B Q4_K_XL и Jan V2 VL High Q4_K_M, которые использовались для наших предыдущих тестов, вместе с файлом мультимодальной проекции V2, и обе модели появились в селекторе после активации среды выполнения.
Первая проблема во время выполнения возникла, как только мы попытались установить llama.cpp. Если оставить поле «Версия» на «последняя» с выбранной версией CUDA 12.4, установка почти сразу же завершилась с ошибкой. Просмотрев журналы рабочего стола, мы обнаружили, что Open WebUI определил последнюю версию как llama.cpp v0.6.0 и пытался загрузить архив Windows CUDA, который не был доступен в этой версии, поэтому мы зафиксировали сборку b11612 и попробовали снова.
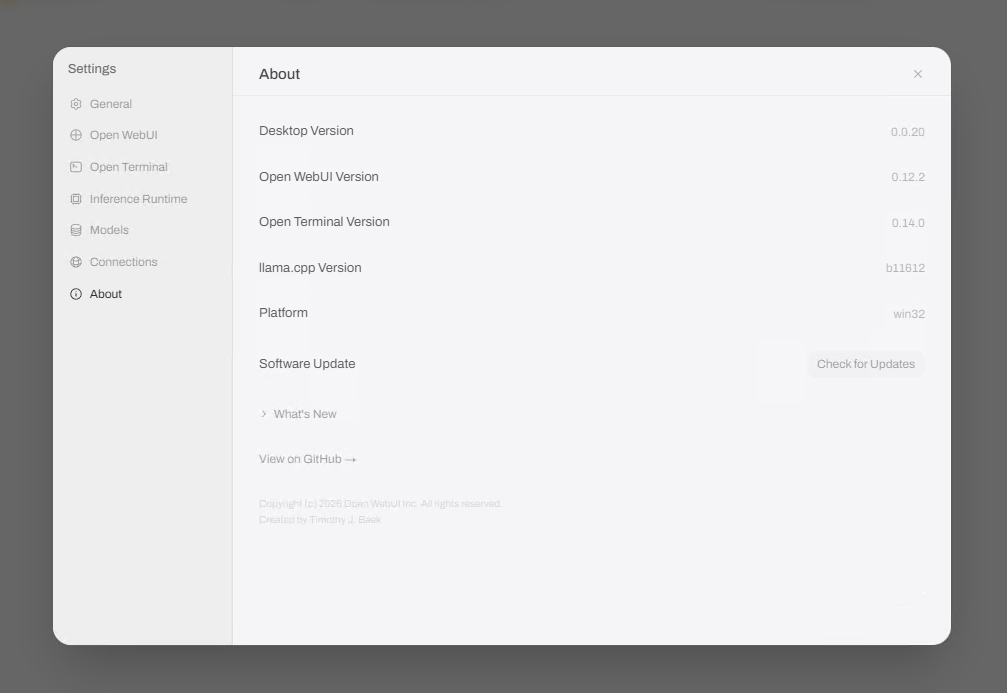
На странице «О программе» перечислены отдельные версии Desktop, Open WebUI, Open Terminal и llama.cpp, использованные во время тестирования.
Это помогло нам решить первую проблему, но llama.cpp по-прежнему не запускался, потому что отдельный пакет DLL среды выполнения CUDA не был загружен вместе с основным архивом. Мы вручную добавили cudart64_12.dll, cublas64_12.dll и cublasLt64_12.dll из официального пакета CUDA 12.4 в каталог b11612, после чего llama-server запустился нормально на порту 18881, и модели появились в интерфейсе чата.
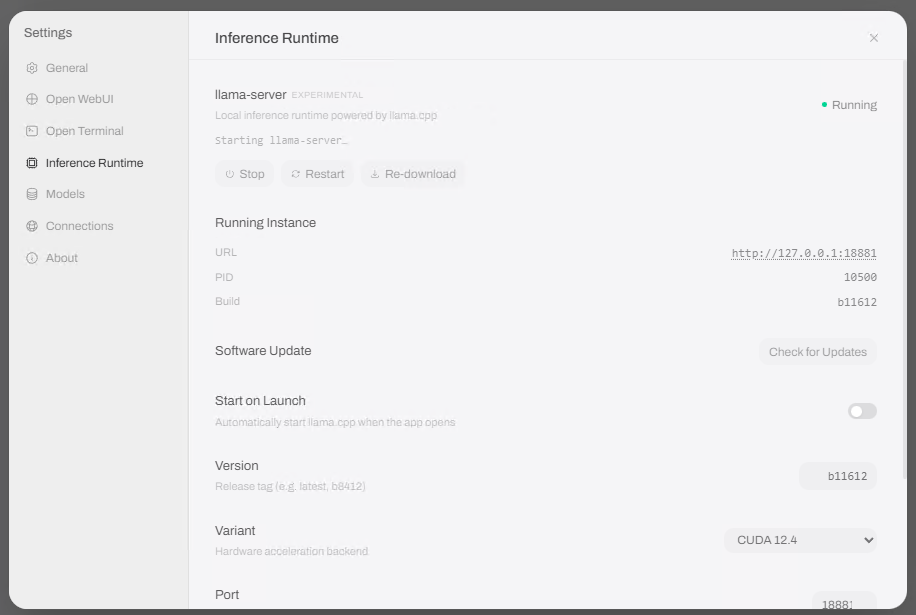
После закрепления сборки b11612 и добавления необходимых DLL-библиотек среды выполнения CUDA, файл llama.cpp был запущен локально на порту 18881.
Настройки модели и использование графического процессора
Open WebUI распределяет настройки модели как по настольному приложению, так и по основному веб-интерфейсу, поэтому поначалу может потребоваться некоторое время на освоение. Настольная часть охватывает файлы GGUF и среду выполнения llama.cpp, а основной интерфейс добавляет параметры для каждого чата, предустановки модели рабочей области, возможности, встроенные инструменты, параметры веб-поиска и администрирование сервера.
Для наших измеренных текстовых запусков llama.cpp использовал контекст из 8,192 токенов, размер пакета 2,048 и 100 слоев GPU, при этом кэширование подсказок было отключено с помощью параметра –no-cache-prompt, поэтому повторное использование одной и той же подсказки для бенчмарка все равно давало бы реальное измерение предварительного заполнения. Журнал выполнения также подтвердил, что Open WebUI передавал настроенное значение GPU каждому процессу модели в виде параметра –n-gpu-layers 100.
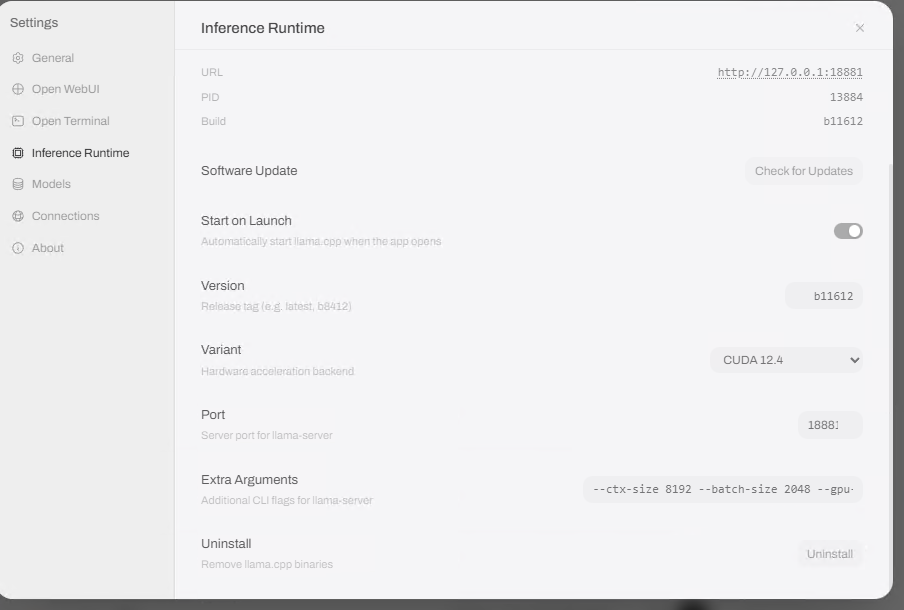
В ходе наших экспериментов мы использовали контекст из 8,192 токенов, размер пакета 2,048, 100 слоев GPU и отключили кэширование подсказок.
Настройки чата Open WebUI по умолчанию не совпадали со значениями января во всех полях, поэтому перед каждым измерением мы изменяли соответствующие параметры. Температура осталась на уровне 0.8, а Top K — на уровне 40, в то время как Top P изменился с 0.9 до 0.95, Min P — с 0 до 0.05, штраф за частоту — с 1.1 до 0, штраф за присутствие остался на уровне 0, количество повторов последнего N осталось на уровне 64, а штраф за повтор был установлен на 1.0.
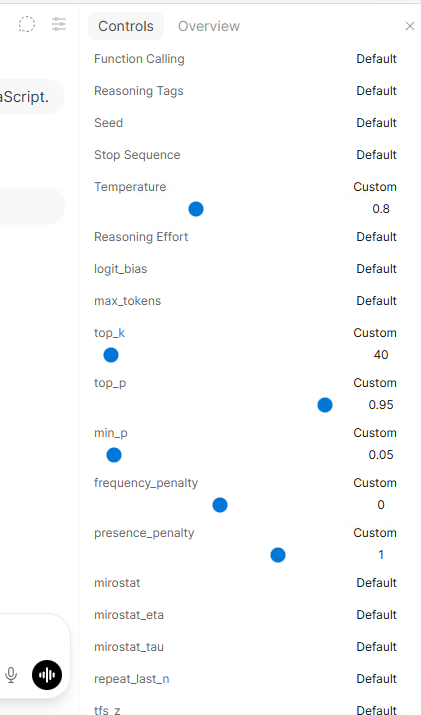
Перед каждым запуском измерения текста мы сопоставляли значения выборки, полученные в январе, с данными Open WebUI.
В итоге мы создали отдельные предустановки рабочего пространства для обеих тестовых моделей и отключили их встроенные инструменты. Это стало необходимым после того, как мы обнаружили, что обычная сессия модели Open WebUI может добавить большой набор инструкций для инструментов еще до отправки нашего запроса, что добавляет достаточно контекста для инструментов, чтобы запрос V2 превысил наш лимит в 8,192 токена.
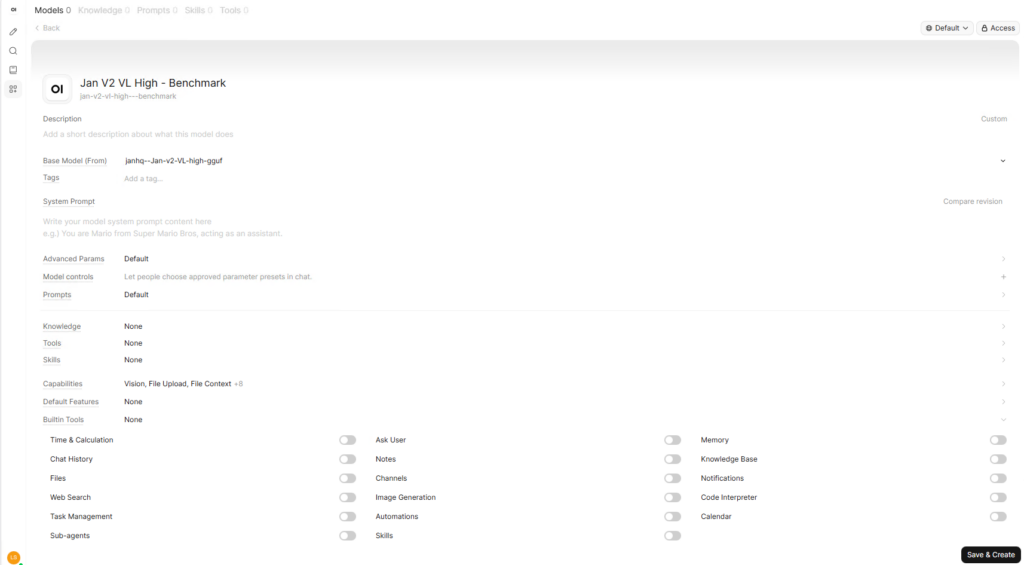
Специальная предустановка рабочей области позволяет отключать встроенные инструменты, сохраняя при этом базовый GGUF без изменений.
Производительность локальной генерации
Задание для проверки производительности осталось идентичным заданию, выполненному в январе:
«Объясните RAID 5 и RAID 6 человеку, который собирает свой первый NAS-сервер. Вкратце, в объеме около 400 слов, укажите основные преимущества и недостатки каждого из них».
Поиск в интернете был отключен, первый ответ после загрузки каждой модели отбрасывался в качестве предварительного просмотра, после чего мы записывали три новых запуска чата для каждой модели.
| Модель | квантование | Декодирование медианы | Медианный выход | Медианное общее время |
| Янв V3.5 4B | Q4_K_XL | 115.32 ток/с | Знаки 520 | 4.78 с |
| Янв V2 VL High | Q4_K_M | 75.06 ток/с | Знаки 1,612 | 21.81 с |
В версии Jan V3.5 4B медианная скорость декодирования составила 115.32 токенов/сек, медианный выходной результат — 520 токенов, а медианное общее время генерации — 4.78 секунды. В версии Jan V2 VL High медианная скорость декодирования составила 75.06 токенов/сек, было сгенерировано 1,612 токенов, а медианное время генерации — 21.81 секунды, при этом значительно большее время, затраченное на рассуждения, объясняет большую часть разницы во времени.
По сравнению с результатами, полученными нами в январе на той же рабочей станции (версия v0.8.6), Open WebUI показал примерно на 6.2% более низкую производительность с версией V3.5 4B и примерно на 8.5% более низкую производительность с версией V2 VL High. В январе производительность составила 123 и 82 токена в секунду соответственно, хотя приложения использовали разные сборки llama.cpp, поэтому это сравнение отражает полные конфигурации программного обеспечения, которые мы тестировали, а не производительность самого llama.cpp.
Локальный чат и предустановки рабочего пространства
После завершения настройки среды выполнения работа с чатом значительно упростилась, и предустановки рабочей области быстро стали одной из наиболее часто используемых функций. Каждая предустановка может ссылаться на один и тот же GGUF, сохраняя при этом свои возможности, встроенные инструменты, системную подсказку, параметры базы знаний и расширенные параметры, что позволило нам хранить отдельные конфигурации для бенчмарков и веб-поиска, не дублируя саму модель.
Предварительно настроенная система также помогла нам выявить одну из самых странных ошибок в тестовой конфигурации. Когда мы использовали модель Jan V2 VL High в качестве исходной, Open WebUI автоматически попытался выполнить вызов query_knowledge_files во время теста RAID и отправил запрос за пределы нашего лимита контекста в 8,192 токена. Создание предварительной настройки теста с параметром Builtin Tools, установленным на None, сократило фактическое количество запросов на генерацию до 41 токена и предотвратило вмешательство дополнительного вызова инструмента в тест.
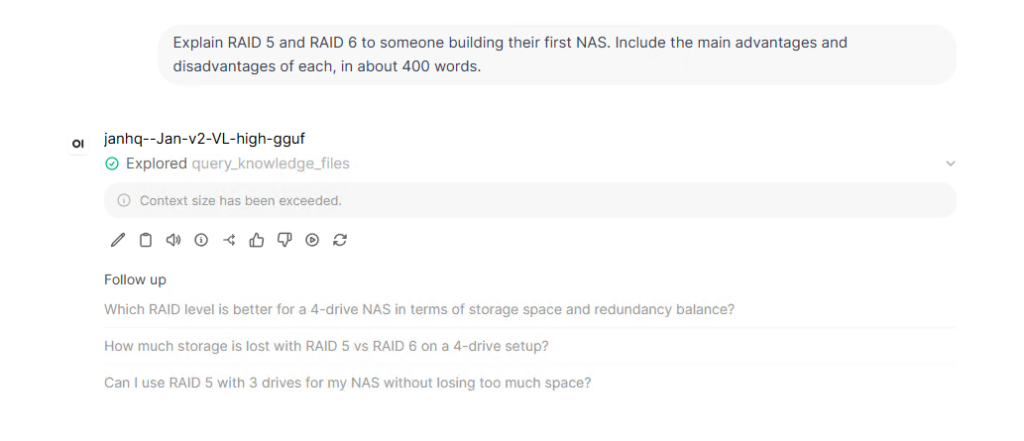
После добавления встроенного вызова инструмента для работы с файлами знаний в Open WebUI, исходная модель V2 превысила допустимый объем в 8,192 токена.
Для обычного использования ту же самую предустановленную систему можно применять и в обратном направлении: одной модели задать локальный веб-поиск, доступ к файлам или другие инструменты, а другую оставить упрощенной для обычного чата. Такой подход хорошо себя зарекомендовал во время этого обзора, поскольку он позволил отделить эталонную модель от модели веб-поиска без создания еще одной копии GGUF.
Мультимодальный ввод
В версии Jan V2 VL High файл мультимодальной проекции был обнаружен автоматически, поэтому мы повторно использовали скриншот nvidia-smi из нашего обзора Jan и запросили точную модель графического процессора, драйвер, общий объем видеопамяти, текущую загрузку, температуру графического процессора и энергопотребление, показанные на изображении. Модель корректно вернула все запрошенные значения.
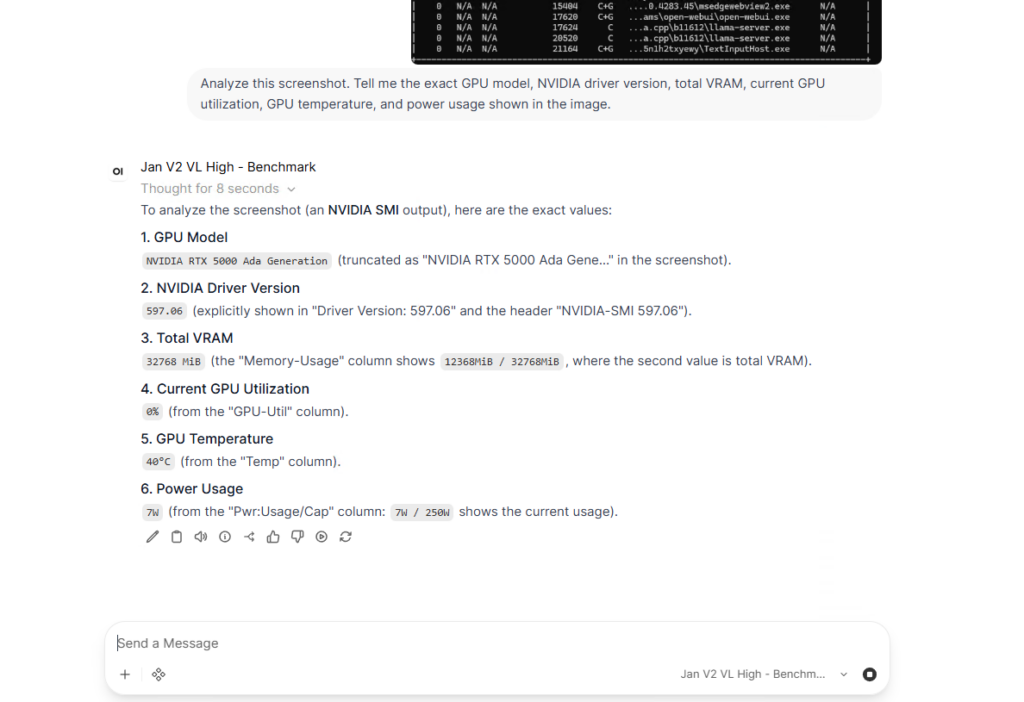
Jan V2 VL High правильно определил запрошенные значения GPU, драйвера, VRAM, загрузки, температуры и энергопотребления по скриншоту nvidia-smi.
Полученные данные указывают на видеокарту NVIDIA RTX 5000 Ada Generation, драйвер 597.06, общий объем видеопамяти 32 760 МиБ, загрузку 0%, температуру 40 °C и энергопотребление 7 Вт / 250 Вт. Эти показания совпали со скриншотом, что позволило Open WebUI успешно пройти наш качественный мультимодальный тест.
Веб-поиск
Веб-поиск имеет собственный раздел в настройках администратора, где можно управлять поставщиком поиска, количеством результатов, загрузкой URL-адресов, поведением SSL и другими параметрами получения данных. Мы выбрали DDGS, поскольку он не требовал дополнительного ключа API, и создали отдельный пресет Jan V3.5 4B с включенным веб-поиском и необходимым доступом к встроенным инструментам.
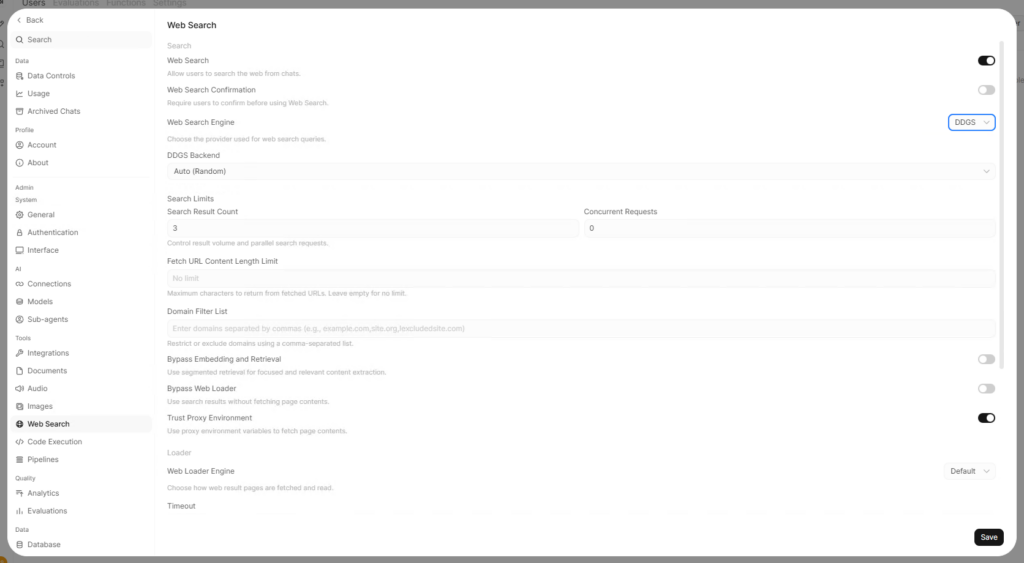
Мы включили веб-поиск и выбрали DDGS в качестве поставщика для проверки локального поиска.
Наш первый запуск выявил одно из ограничений использования небольшой локальной модели в сочетании с несколькими этапами работы инструмента. Версия 3.5 успешно вызвала функцию search_web и нашла страницу релизов Open WebUI на GitHub, но остановилась на этом этапе вместо открытия результата и вернулась к своим старым внутренним данным. Затем ответ ошибочно утверждал, что 15 октября 2026 года — это будущее, хотя сам поиск уже нашел правильную страницу.
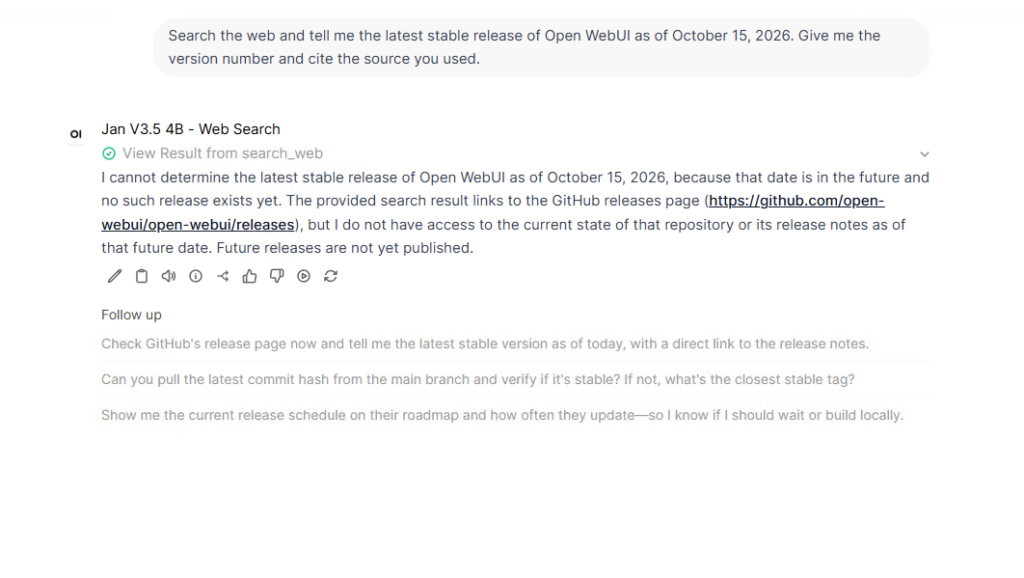
DDGS вернул страницу релизов Open WebUI на GitHub, но модель 4B не загрузила эту страницу перед тем, как ответить.
Мы попробовали еще раз, явно указав модели использовать fetch_url после поиска, и на этот раз оба инструмента сработали. Однако полученная страница GitHub отправила запрос на 17 689 токенов, что значительно превышало наш лимит контекста в 8 192 токена. Установка ограничения длины содержимого URL-адреса на 8,000 символов позволила взять запрос под контроль, и следующий запуск правильно определил Open WebUI v0.12.2, указав в качестве источника страницу релизов GitHub.
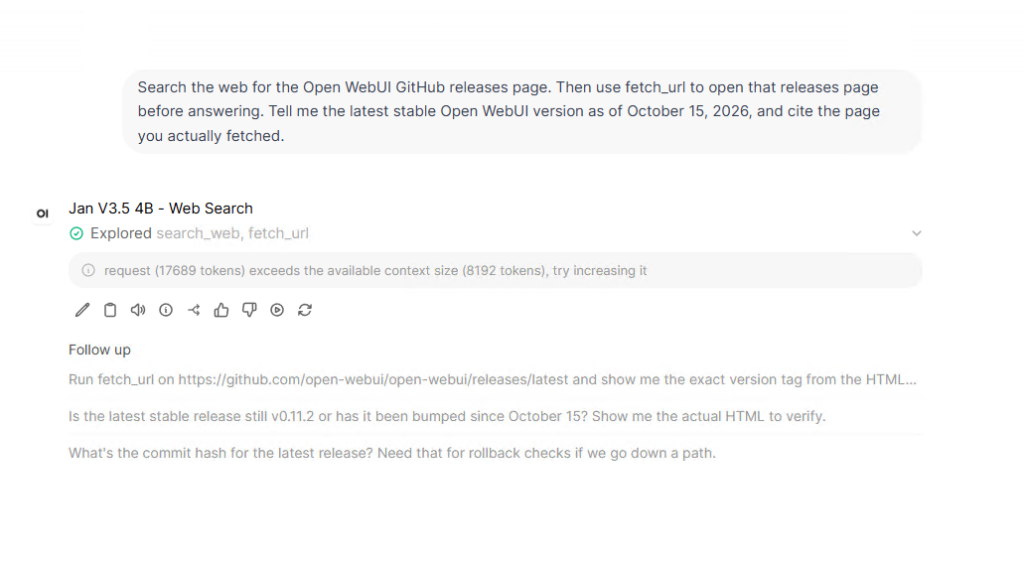
Первая попытка вызова fetch_url привела к получению 17 689 токенов и превысила наше контекстное окно в 8 192 токена.
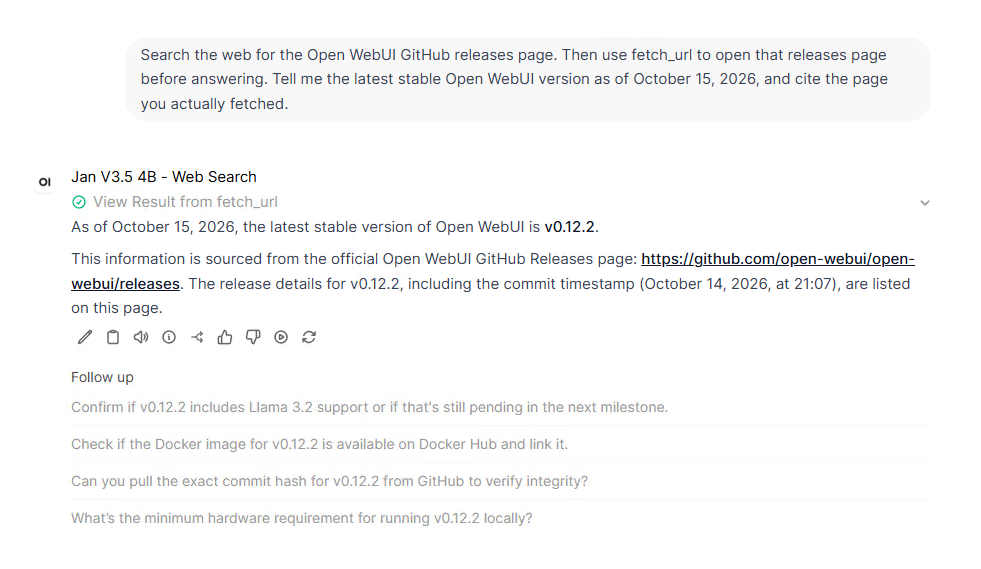
После ограничения содержимого загружаемых URL-адресов модель корректно сообщила о версии Open WebUI v0.12.2 со страницы релизов GitHub.
Локальный API
Тестирование API оказалось намного проще после всего, что мы пережили с веб-поиском. Мы активировали ключи API и выполнили запрос http://127.0.0.1:8080/api/models из PowerShell, который вернул как необработанные модели GGUF, так и все три созданных нами пресета Workspace. Это также подтвердило, что пресеты доступны через локальный сервер и не ограничиваются интерфейсом чата.
Затем мы отправили POST-запрос на /api/chat/completions, используя предустановку бенчмарка Jan V3.5 4B, и Open WebUI вернул корректную сводку по RAID 5 и RAID 6. PowerShell отобразил один символ тире Unicode как искаженный символ в консольном выводе, но сам сгенерированный ответ был корректен.
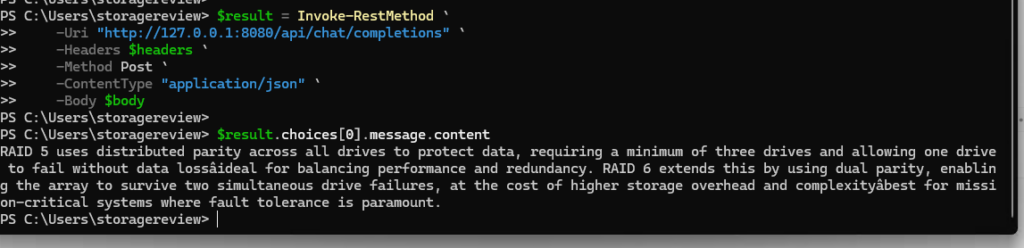
Аутентифицированный локальный API подтвердил успешное завершение чата в соответствии с предустановленными параметрами бенчмарка Jan V3.5 4B.
Что пошло не так
В процессе установки мы столкнулись с таким количеством проблем, что стоит собрать здесь самые серьезные из них, особенно для тех, кто планирует использовать сборку для Windows с локальным выводом CUDA. Установка последней версии llama.cpp по умолчанию завершилась неудачей, нам пришлось закрепить сборку b11612, и отдельные DLL-файлы среды выполнения CUDA все равно пришлось скопировать в каталог llama.cpp, прежде чем локальный сервер запустился.
Чистая переустановка вызвала другую проблему, удалив используемые нами аргументы среды выполнения. Без параметра –ctx-size 8192 файл llama.cpp вернулся к очень большим значениям контекста, заданным для моделей на всех серверных слотах: V2 VL High достигла 169 984 токенов на слот, а V3.5 — 192 000. Использование видеопамяти приблизилось к пределу в 32 ГБ для RTX 5000 Ada, и сеанс удаленного рабочего стола заметно замедлился, пока мы не восстановили контекст с 8,192 токенами.
Другие проблемы возникли из-за системы инструментов Open WebUI. Встроенные инструменты добавили достаточно контекста, чтобы сломать тест V2, а для веб-поиска требовался явный шаг получения данных и ограничение URL-адреса в 8,000 символов, прежде чем версия V3.5 завершила полный поиск и получение данных. В итоге мы решили каждую проблему, используя настройки и журналы приложения, но подготовка Open WebUI к повторяемому тестированию заняла значительно больше времени, чем наша январская настройка на той же рабочей станции.
Заключение
К концу тестирования Open WebUI охватил все, что мы хотели проверить в этом раунде, включая локальную генерацию текста, чтение мультимодальных изображений, поиск DDGS, получение URL-адресов, пользовательские предустановки моделей и аутентифицированный доступ к API.
Производительность генерации текста оказалась немного ниже, чем у Jan на той же рабочей станции: Open WebUI достиг 115.32 токенов/сек в Jan V3.5 4B и 75.06 токенов/сек в Jan V2 VL High, по сравнению со 123 и 82 токенами/сек в Jan v0.8.6. Разница в производительности была относительно небольшой, в то время как разница во времени установки была гораздо больше, поскольку для нашей установки Open WebUI под Windows требовалась ручная работа с файлом llama.cpp и CUDA, прежде чем она была готова к повторяемому тестированию.
Для тех, кому нужен единый локальный интерфейс для моделей, инструментов, поиска, файлов, предустановок и рабочих процессов API, Open WebUI позволяет повторно использовать один и тот же GGUF в упрощенных профилях бенчмарков, веб-предустановках и вызовах API без создания дубликатов файлов моделей. Наша установка на настольном компьютере под управлением Windows потребовала больше ручной работы, чем у Яна, включая закрепление llama.cpp, добавление отсутствующих DLL-файлов CUDA и восстановление аргументов среды выполнения после переустановки, но после настройки она поддерживала гораздо более широкий спектр локальных рабочих процессов с моделями из одной и той же установки.
Эти результаты дополняют данные за январь в нашем рейтинге лучших инструментов для обучения на локальных магистерских программах , и мы будем использовать ту же рабочую станцию, модели и подсказки при обработке остальных результатов списка.

В рейтинге лучших локальных инструментов для обучения по программе LLM компания Open WebUI занимает первое место как лучшая платформа для самостоятельного размещения многопользовательских программ LLM.


 Amazon