

Spoločnosť Comino nám nedávno poslala na recenziu najnovšiu verziu Comino Grando, nakonfigurovanú s ôsmimi grafickými kartami NVIDIA RTX PRO 6000 Blackwell, každá s 96 GB VRAM, čo predstavuje celkovo 768 GB GPU pamäte. Comino sme recenzovali už v roku 2024, nakonfigurovanú so šiestimi grafickými kartami RTX 4090 , ktoré ponúkali celkovú GPU pamätu 144 GB, ako aj verziu s grafickými kartami NVIDIA H100 . Táto najnovšia aktualizácia predstavuje podstatný generačný skok v kapacite pamäte aj v rozsahu pracovných záťaží, ktoré platforma dokáže zvládnuť.
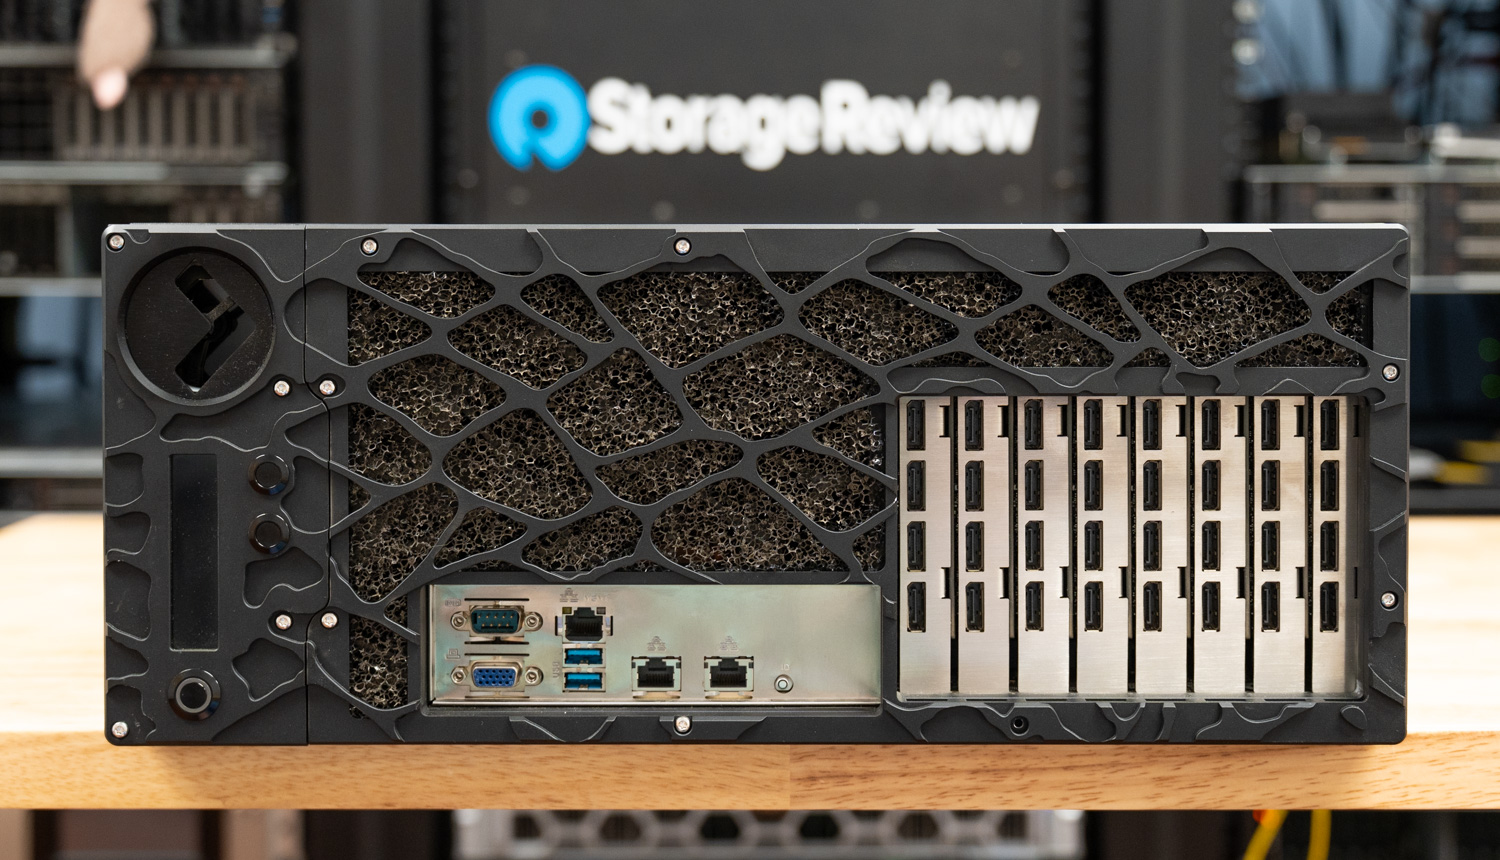
Grando je účelová 4U platforma navrhnutá tak, aby vyriešila kritický konflikt medzi výpočtovým výkonom GPU s vysokou hustotou a tepelným manažmentom. Zatiaľ čo štandardné vzduchom chladené šasi sa pod trvalými požiadavkami moderných profesionálnych grafických kariet na TDP vyšší ako 600 W rozpadá, Grando volí zásadne odlišný prístup, postavený od základov na kvapalinou chladenej architektúre schopnej odvádzať masívnych 6.5 kW nepretržitého tepla. Nejde o dodatočnú úpravu ani dodatočný nápad; celé šasi, od obráteného rozloženia základnej dosky až po farebne odnímateľný systém rozdeľovačov, bolo navrhnuté okolo chladiaceho okruhu.
Výsledkom je platforma, ktorá dokáže udržať osem profesionálnych grafických procesorov s plným TDP v jednom 4U šasi, ktoré bežia 24 hodín denne, 7 dní v týždni v prostredí s teplotou 3 – 38 °C, bez tepelného škrtenia, bez akustického náporu vysokorýchlostného vzduchového chladenia a bez kompromisov v prevádzkyschopnosti. Pre organizácie, ktoré nasadzujú inferenciu umelej inteligencie, trénovanie strojového učenia alebo vysokovýkonné simulačné úlohy vo veľkom meradle, Grando ponúka niečo skutočne vzácne: server, ktorý vás nežiada, aby ste si vybrali medzi hustotou, teplotou a spoľahlivosťou.
Špecifikácie Comino Grando
V nasledujúcej tabuľke sú uvedené fyzické špecifikácie a podporované hardvérové konfigurácie pre platformu Comino Grando.
| Špecifikácia / Funkcia | Comino Grande |
|---|---|
| Server a racková pracovná stanica Comino Grando | |
| Chladiaca kapacita | 6.5 kW (maximálne 6 500 W pri teplote nasávaného vzduchu 20 °C) |
| Základné dosky | Až do EATX a EBB |
| GPU (server) | Až 8; NVIDIA: RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200 |
| GPU (rackové pracovné stanice) | Až 6; NVIDIA: 3090, 4090, 5080, 5090, RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200; AMD: W7800, W7900 |
| procesory | Až 2; Jedna pätica: Intel Xeon W-2400/2500 a 3400/3500, Intel Xeon Scalable 4. generácie, 5. generácie, XEON 6, AMD Threadripper PRO 5000WX, 7000WX, 9000WX, AMD EPYC 9004/9005 Dvojitá pätica: Intel Xeon Scalable 4. generácie a 5. generácie, XEON 6, AMD EPYC 9004/9005 |
| RAM | Až 2TB |
| Jednotky M2 | Až 8x NVME |
| Uskladnenie | Konzoly na výmenu za chodu na zadnom paneli: až 4x SSD disky s výmenou za chodu (4x 7 mm alebo 2x 15 mm) a až 4 ďalšie (4x 7 mm alebo 2x 15 mm) namiesto 4. zdroja; Vnútorná 3.5″ klietka až pre 4x 3.5″ alebo 4x 2.5″ 15 mm alebo 12x 2.5″ 7 mm; Vnútorné 2.5″ sloty: až 4x 2.5″ SSD 7 mm |
| Napájanie a prevádzkové napätie | Až 4x 2000W Hot Swap CRPS pri 180-264V Až 4x 1000W Hot Swap CRPS pri 90-140V Redundantné režimy: 4+0, 3+1, 2+2 |
| Hladina hluku | 39 dB – 70 dB |
| Lan | Až 2x 10 Gb/s na MoBo a až 400 Gb/s v PCIe |
| OS | Ubuntu / Windows 11 (Pro/Home) / Windows Server |
| Fyzikálne a chladiace špecifikácie | |
| Chladenie kvapalinou | CPU s VRM a GPU s GDDR a VRM |
| nádrž | Comino Custom 450ml s integrovanými pumpičkami |
| fanúšikovia | 3x Ultra High Flow 6200 ot./min. (vysoká hladina hluku) alebo 3x vysoký prietok 3000 ot./min. (nízka hladina hluku) |
| inštalácia | Možnosť montáže do 19-palcového racku alebo samostatná pracovná stanica |
| Požadovaný priestor v regáli | 4U |
| Veľkosť | 439 x 681 x 177 mm (bez úchytiek a vyčnievajúcich častí) |
| Váha | 4 GPU: 49 kg (netto), 67 kg (hrubo) 6 GPU: 52 kg (netto), 70 kg (hrubo) 8 GPU: 55 kg (netto), 72 kg (hrubo) |
| Rozsah prevádzkovej a skladovacej teploty | Skladovanie: -5..50°C / 23..122°F Prevádzková teplota: 3..38 °C / 38..100 °F |
| Monitorovací systém Comino (CMS) | |
| Prehľad | Riadiaca doska so senzormi a softvérom pre monitorovanie v reálnom čase |
| Kľúčové výhody | Monitorovanie chladiaceho systému a CPU/GPU, webové rozhranie, protokol chladiaceho systému, centralizované monitorovanie pre pracovné skupiny |
| Senzory a pripojené zariadenia | Teplota (vzduch a chladiaca kvapalina), % vlhkosť, napätie, prietok chladiacej kvapaliny, hladina chladiacej kvapaliny v nádržke, ventilátory, čerpadlá, základná doska, displej a tlačidlá |
| Možnosti integrácie | Zaveďte monitorovanie prostredníctvom REST API a odosielajte dáta zo senzorov do monitorovacieho softvéru (napr. Zabbix, Grafana) alebo databáz (napr. InfluxDB). |
| Technické požiadavky na redakčný systém (CMS) | |
| OS | Windows 11 / 10 Ubuntu 22.04/20.4 (Závislosť pre Ubuntu: cieľový systém musí mať nainštalované nástroje nvidia-smi a sensors) |
| Webové prehliadače | Mozilla Firefox, Google Chrome, Chromium, Apple Safari, Microsoft Edge (Pozor: Internet Explorer 11 nie je podporovaný) |
| Pevný disk | 300MB |
| Verzia firmvéru ovládača | 1.0.6 alebo novší |
| Verzia s plošnými spojmi ovládača | 2.xx.xx |
Návrh, zostavenie a hustota grafických kariet
Usporiadanie a rozmiestnenie podvozku
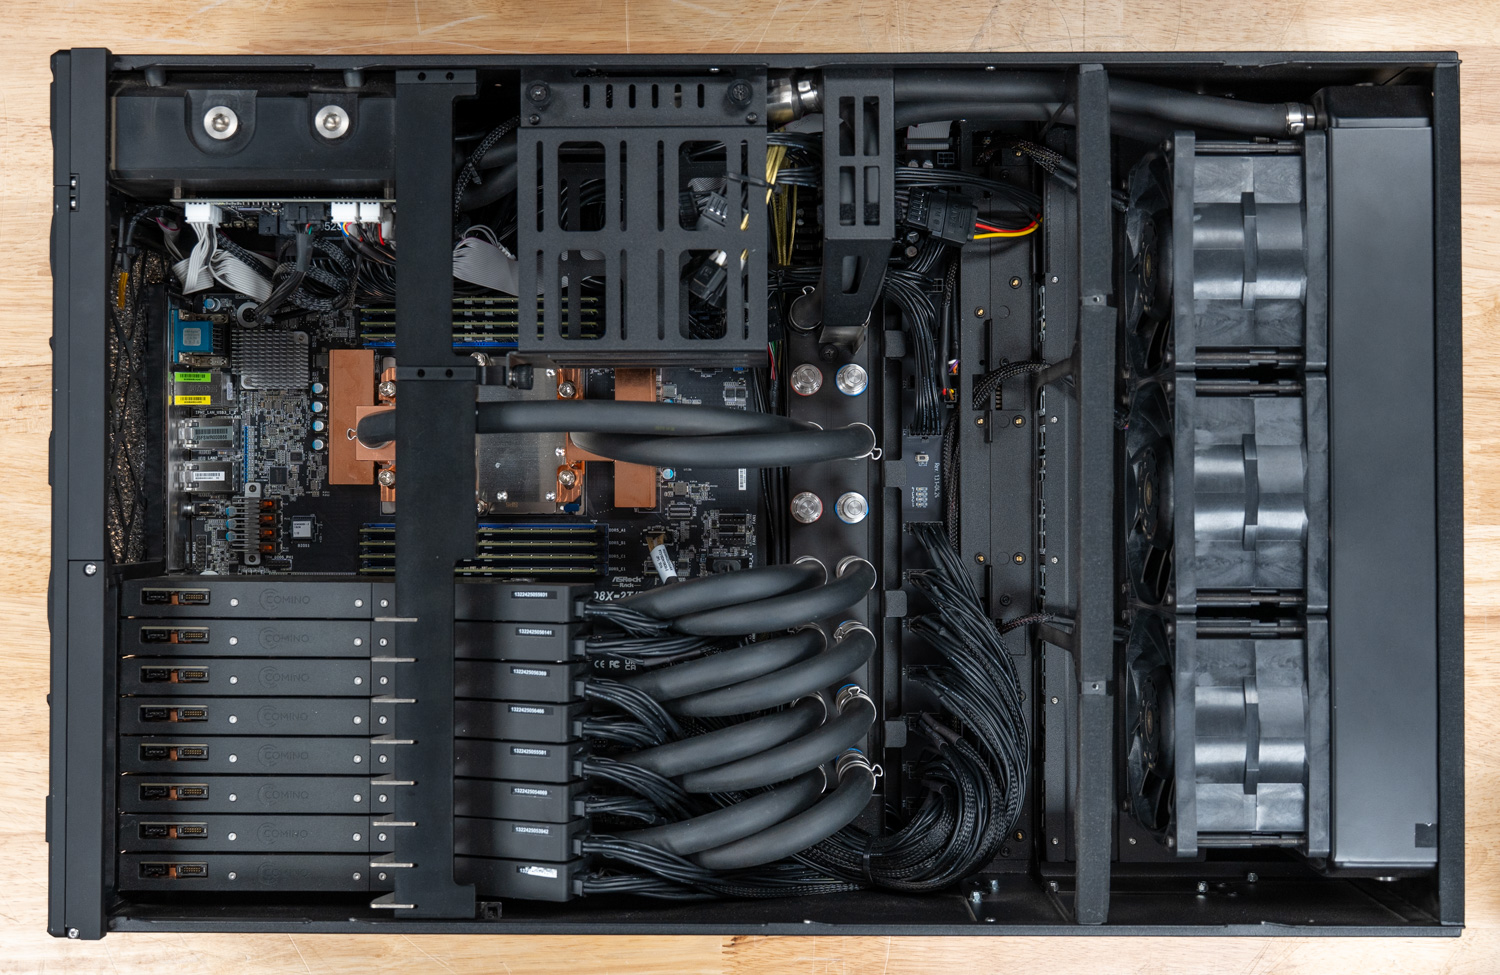
Grando Server je majstrovskou triedou v optimalizácii priestoru s rozmermi 17.3 x 26.8 x 6.97 palca (4U). Na rozdiel od tradičných serverov umiestňuje zadnú časť základnej dosky v prednej časti šasi, čím obracia konvenčné vnútorné usporiadanie. To zaisťuje, že vzduchom chladené komponenty, ako sú moduly RAM a VRM, dostávajú najchladnejší možný nasávaný vzduch predtým, ako sa dostane k kvapalinovému chladiču v zadnej časti.
Samotné šasi je vyrobené podľa rovnakých prísnych štandardov a vyznačuje sa pevnou oceľovou konštrukciou s matným čiernym práškovým nástrekom naneseným zvnútra aj zvonka. Táto zámerná voľba sa vzťahuje aj na trubice, káble, chladič a spájkovaciu masku dosky plošných spojov, čo odráža jasný zámer dosiahnuť čistú a profesionálnu estetiku. Systém navyše podporuje všestranné nasadenie a bezproblémovo funguje buď ako 19-palcová jednotka montovateľná do racku, alebo ako samostatná stolová jednotka. V závislosti od konfigurácie váži 148 až 159 libier.
Chladiace dosky a vodné bloky GPU
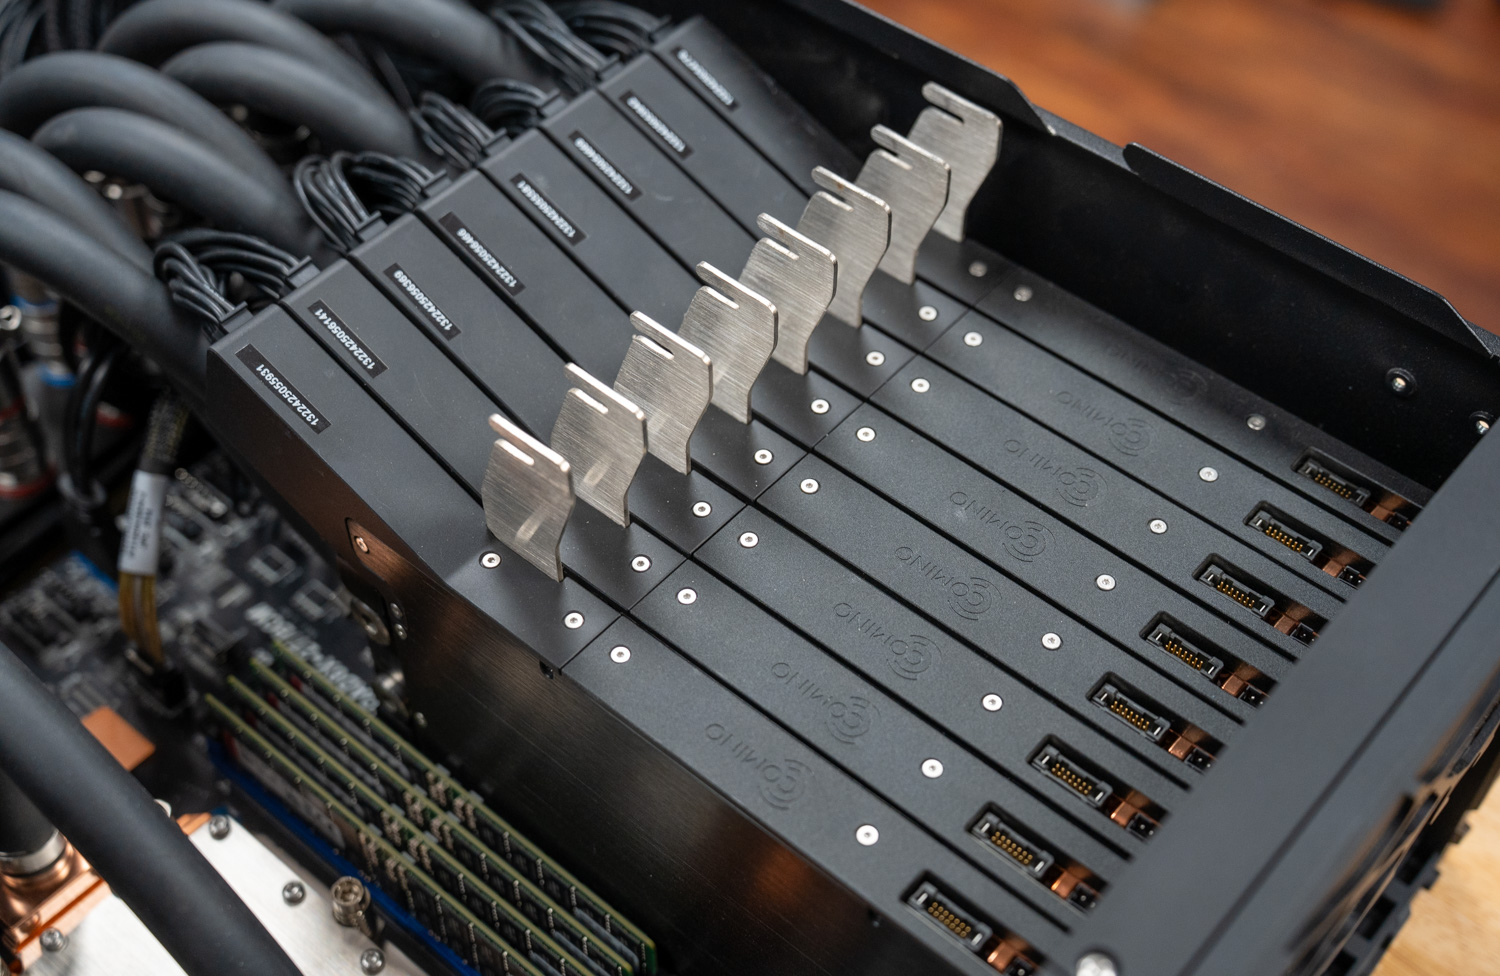
Patentované medené vodné bloky tvoria jadro hustoty Grando a chladia nielen grafickú kartu, ale aj ostatné komponenty, ako sú pamäť a regulátory napätia. Každá grafická karta sa dodáva ako štandardne vyrobená karta, na ktorú spoločnosť Comino montuje vlastnú zostavu chladiacej dosky. V praxi tento tenkoprofilový dizajn redukuje každú kartu na jeden slot, čo umožňuje umiestniť šesť alebo dokonca osem profesionálnych grafických kariet vedľa seba v jednom 4U šasi. Náš recenzovaný kus sa dodával s ôsmimi kartami NVIDIA RTX PRO 6000 Blackwell, každá s TDP 600 W, čo vedie k celkovej požiadavke na chladenie 4 800 W pri plnom zaťažení.
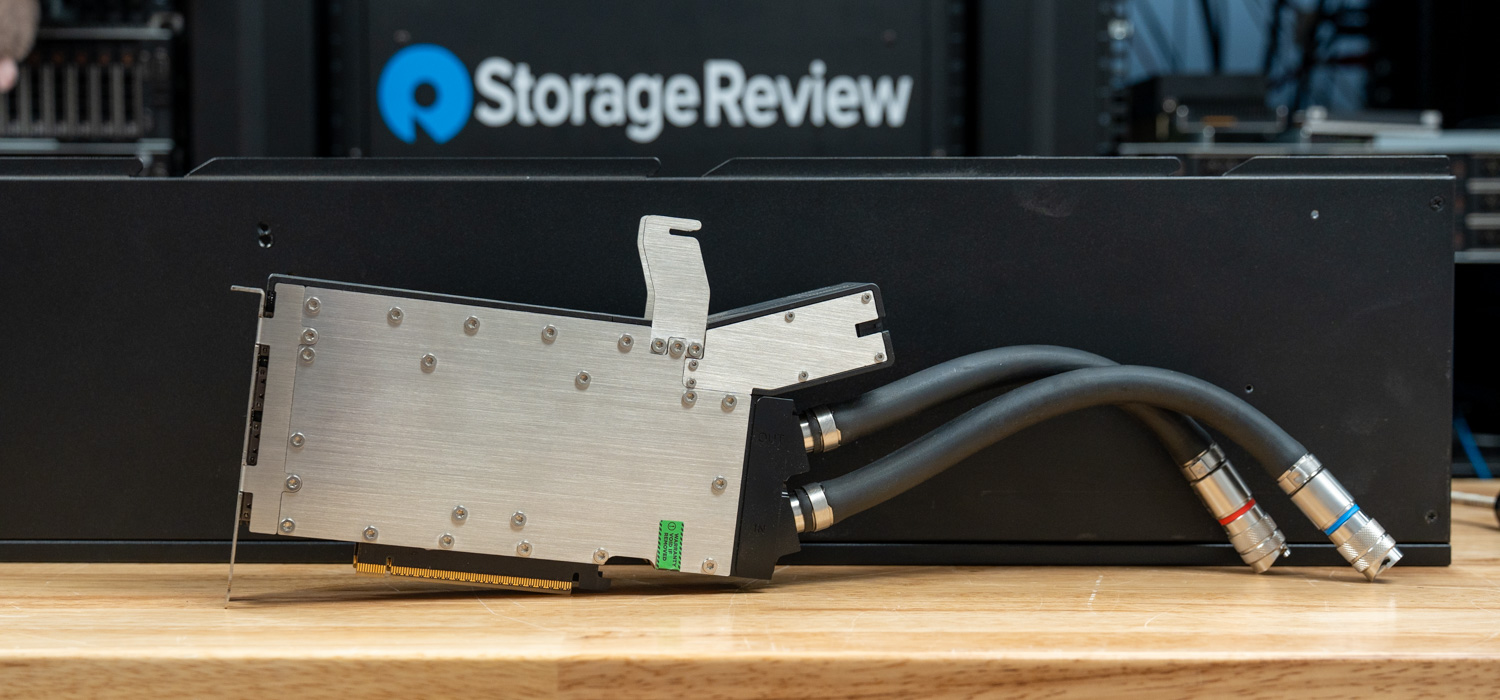
Dosiahnutie 8-slotovej hustoty grafických kariet GPU ako v Comine by bolo s chladením vzduchom takmer nemožné, pretože štandardné karty NVIDIA RTX PRO 6000 zaberajú dva sloty a vyžadujú si značné prúdenie vzduchu. Naproti tomu tieto karty s vlastným chladením zaberajú iba jeden slot. Chladiace platne sú pevne vyrobené, čo každej karte pridáva citeľnú hmotnosť, ale táto hmotnosť odráža kvalitu a chladiaci výkon požadovaný na tejto úrovni.
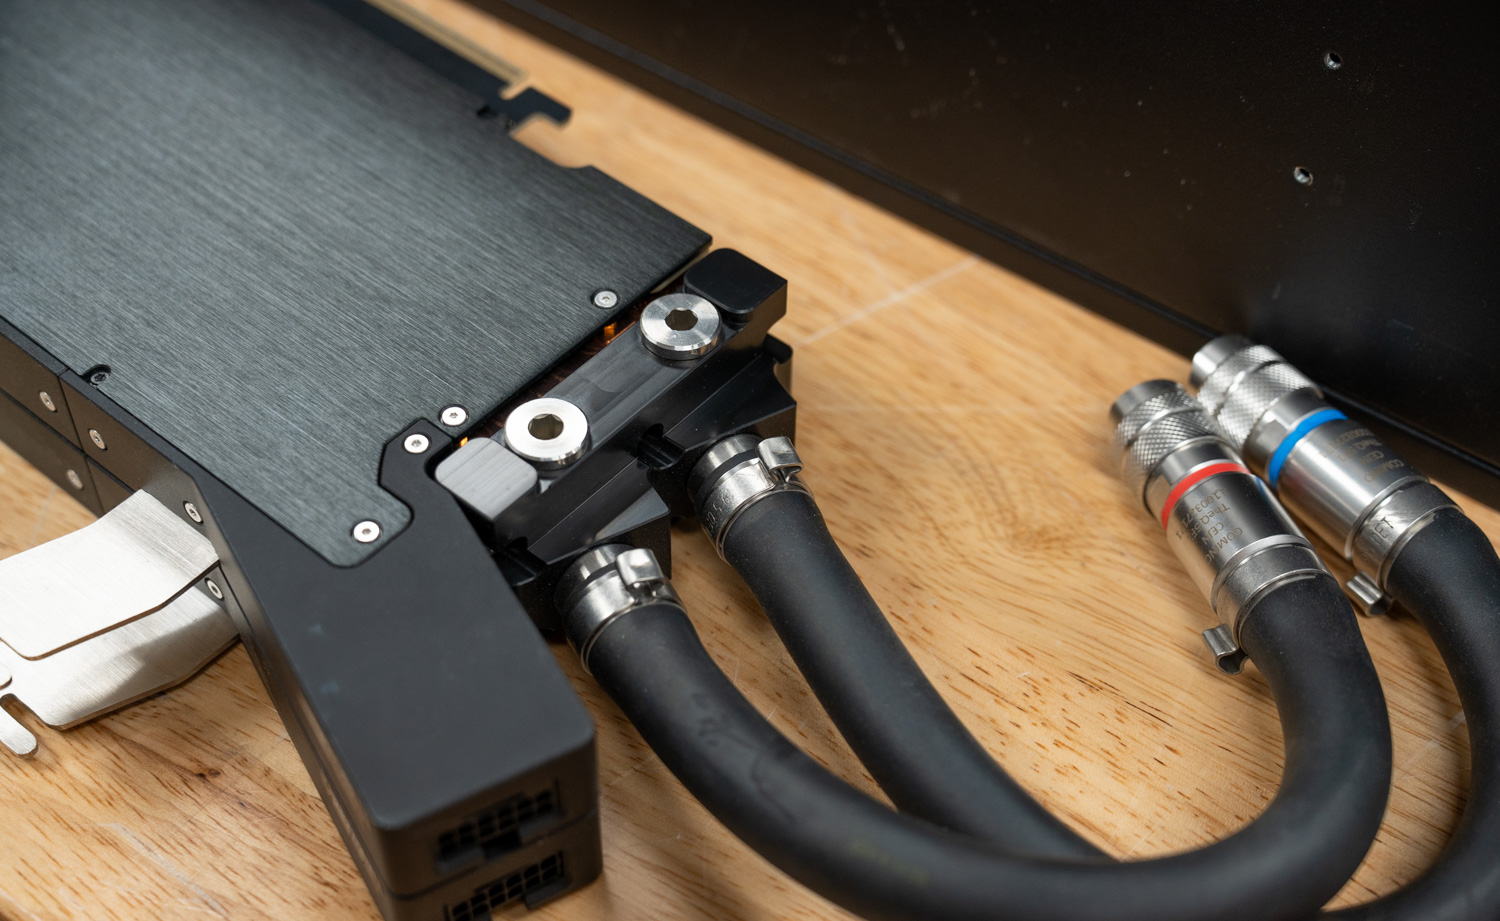
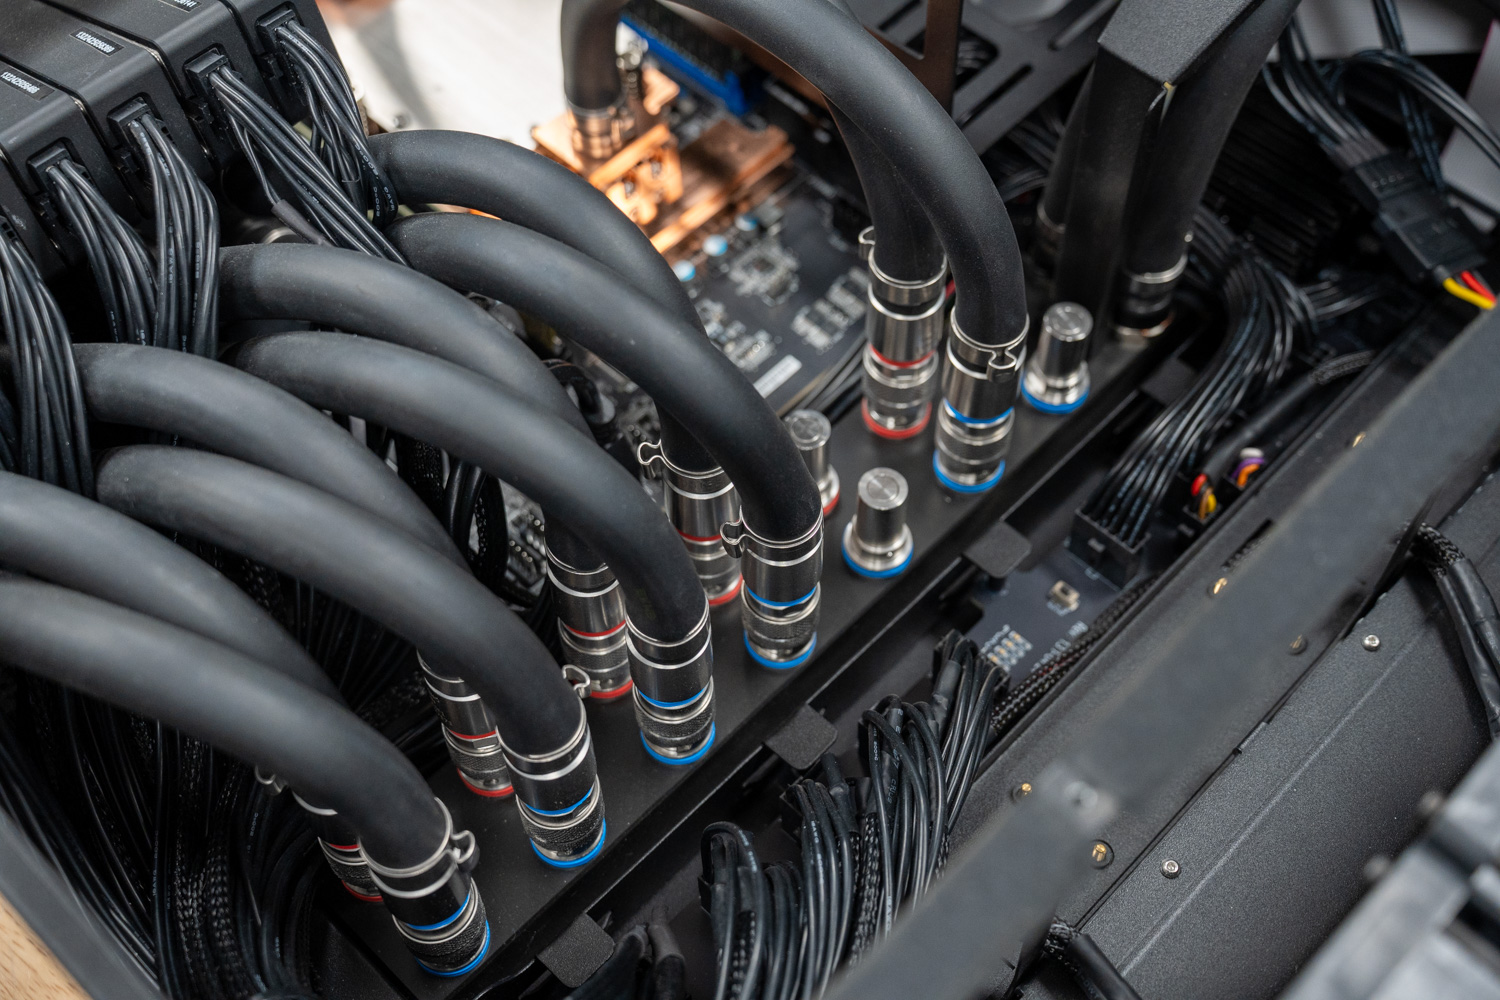
Každý pár grafických procesorov je prepojený cez vyhradený podrozdeľovač, ktorý spája obe karty do jedného vstupného a výstupného pripojenia k hlavnému rozdeľovaču chladiacej kvapaliny. Tento párový prístup zjednodušuje celkovú architektúru slučky, znižuje počet pripojení na hlavnom rozdeľovači a umožňuje technikovi odpojiť jeden pár rýchlospojok a vybrať tak dve karty naraz, čo ďalej zefektívňuje údržbu.
Rozvod vody a rozdeľovač
V strede systému sa nachádza veľké rozdeľovacie potrubie vody, ktoré dodáva chladnú kvapalinu do každej chladiacej dosky grafickej karty a procesora a zabezpečuje spätnú cestu k chladiču. Všetky pripojenia medzi potrubím a grafickou kartou a procesorom používajú rýchlospojky Comino „TheQ“. Tieto nerezové bezkvapkavé spoje sú farebne odlíšené červenými a modrými krúžkami, ktoré jasne identifikujú teplú a studenú stranu okruhu, čím sa eliminujú akékoľvek nejasnosti počas inštalácie alebo servisu.
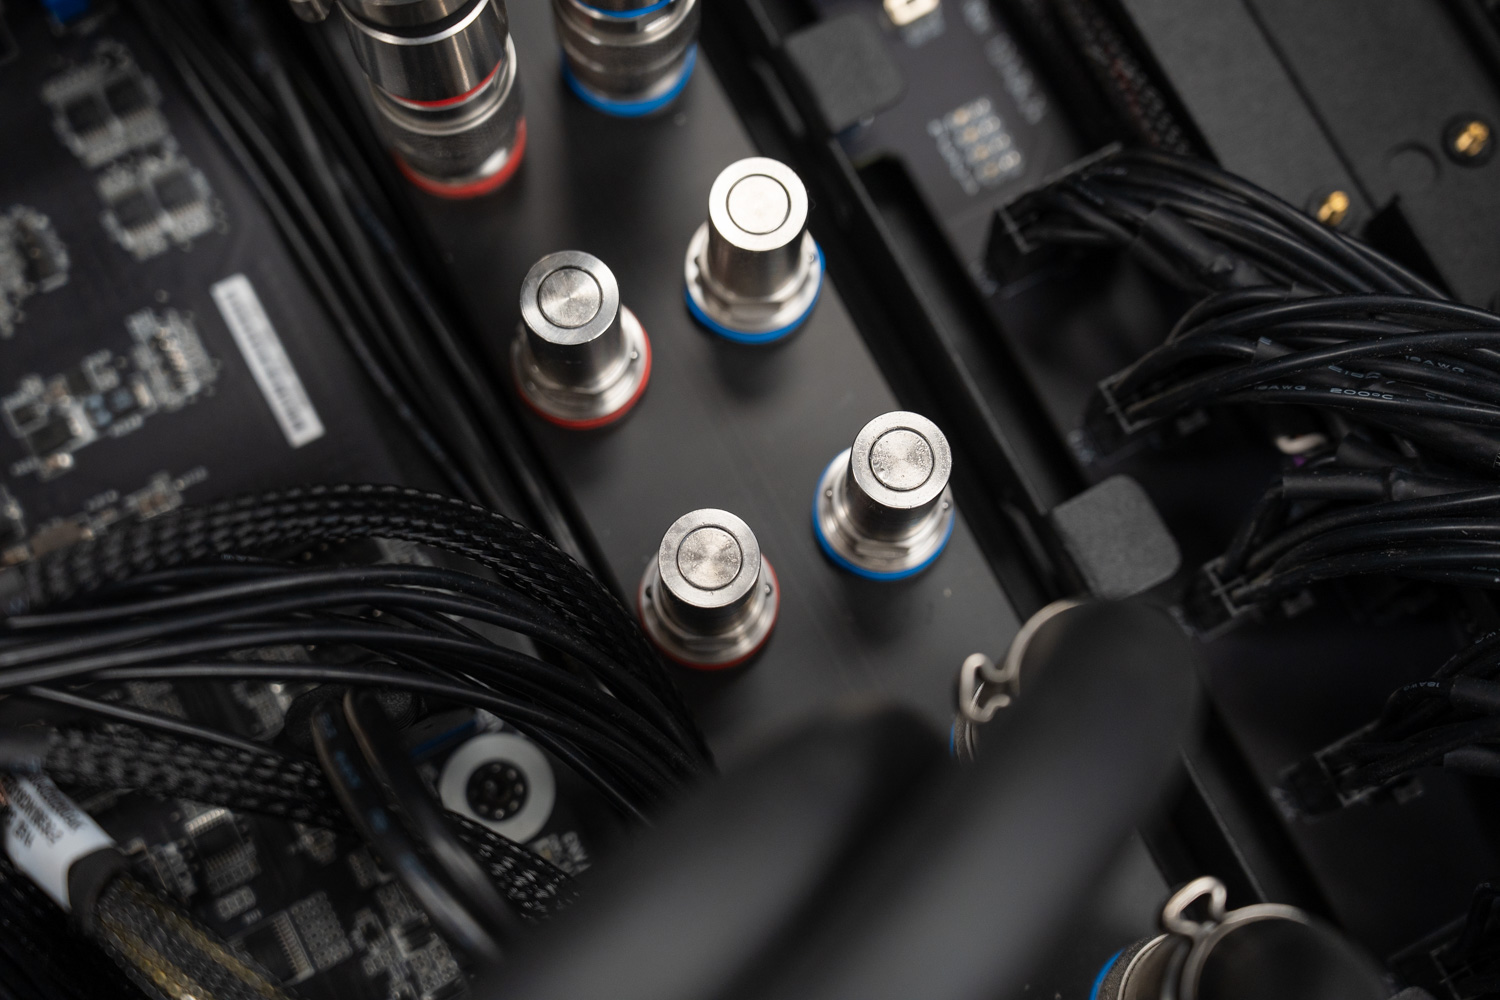
Po odpojení zanechávajú na spojovacom povrchu minimálne zvyšky, čo umožňuje technikom vybrať alebo vymeniť jednotlivé grafické karty alebo procesory bez vypustenia 450 ml nádržky alebo zvyšku slučky. Týmto spôsobom Grando prináša jednoduchú údržbu vzduchom chladených systémov na vysoko výkonnú kvapalinou chladenú platformu.
Chladenie CPU a pamäte
CPU a jeho regulátory napätia tiež využívajú špeciálnu chladiacu dosku pripojenú priamo k chladiacemu okruhu, čo zabraňuje tomu, aby sa procesor stal úzkym hrdlom počas intenzívneho zaťaženia viacerými GPU. Náš recenzovaný kus bol dodaný s doskou AMD Turin/Genoa s jedným 48-jadrovým procesorom AMD EPYC 9474F. Chladiaca doska odráža kvalitu chladiacich dosiek karty, je vyrobená z masívnej medi a zaistená nerezovými hardvérmi.
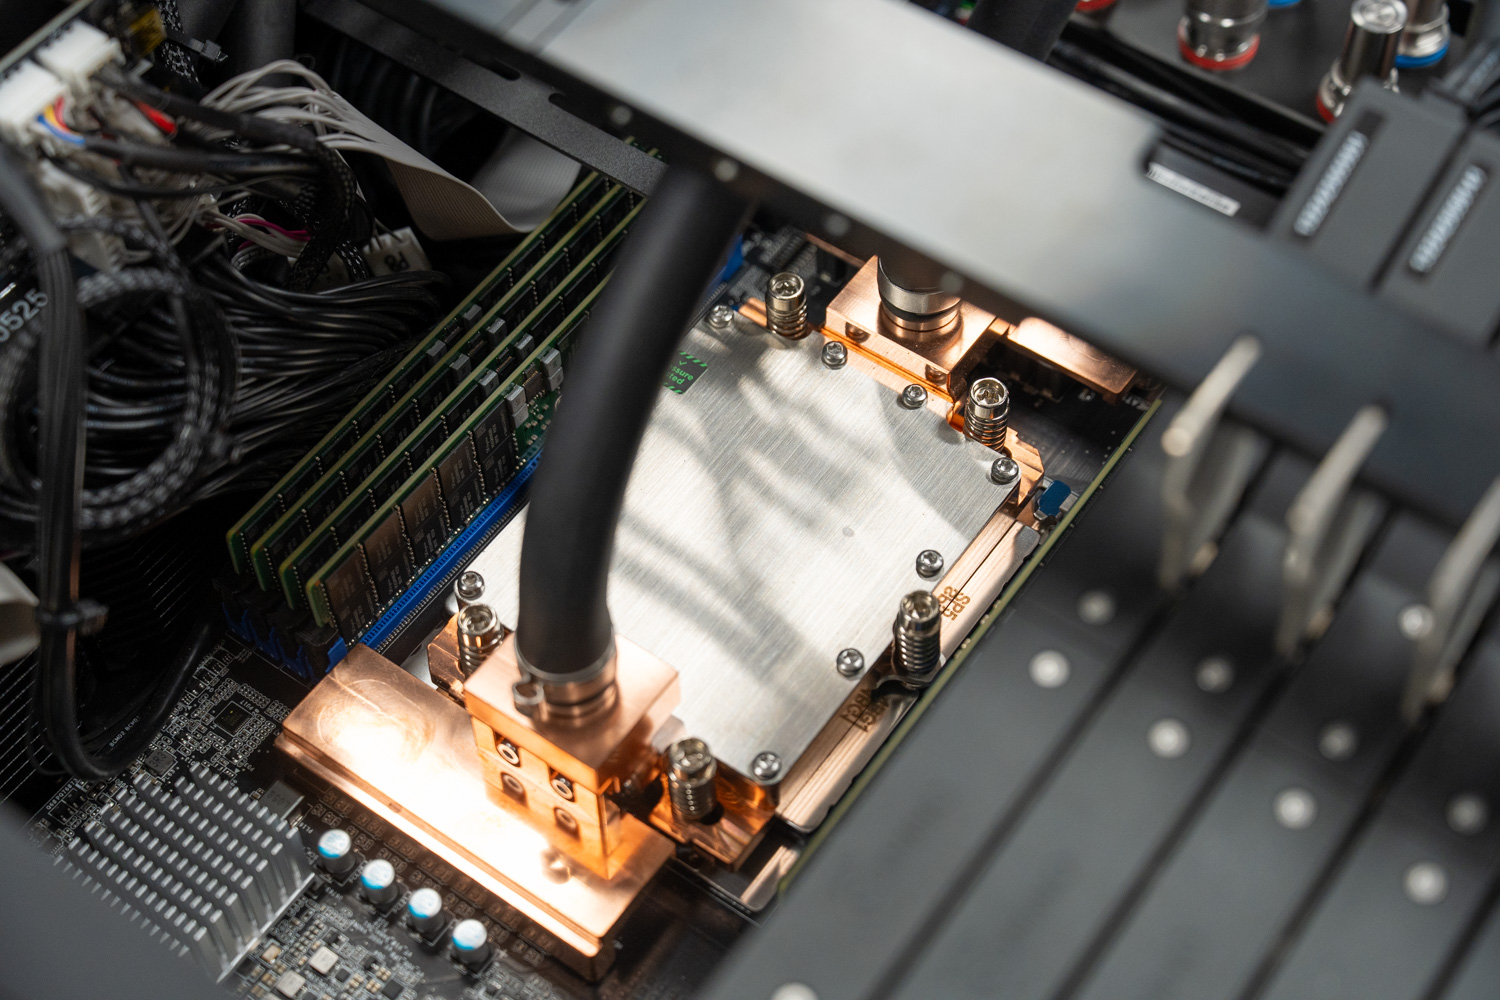
Po oboch stranách procesora sa nachádza osem plne obsadených slotov DRAM, ktoré podporujú konfigurácie až do 2 TB RAM. Náš testovaný kus bol vybavený 512 GB pamäte DDR5 RAM. Nad oblasťou grafického a procesorového procesora v šasi sa kolmo na ne rozprestiera podporná lišta, ktorá zaisťuje citlivé komponenty, ako sú grafické karty, a zachováva tuhosť šasi počas prepravy.
Chladič a ventilátory
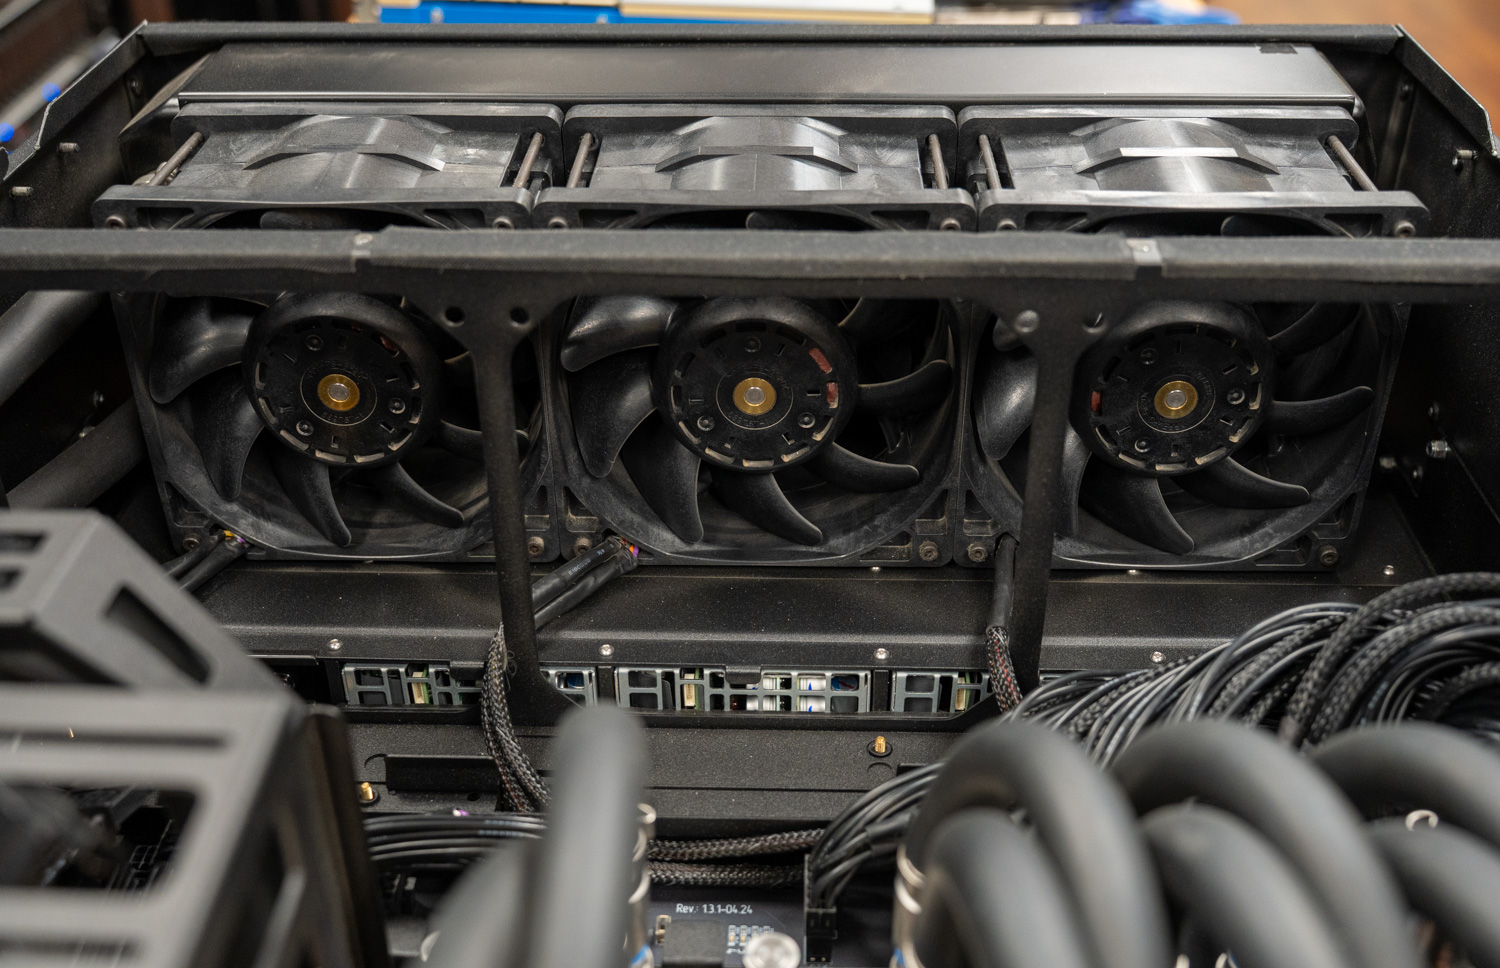
Chladenie zabezpečuje veľký trojitý 140 mm radiátor umiestnený v zadnej časti šasi, spárovaný s tromi vysokorýchlostnými 140 mm ventilátormi schopnými dosiahnuť 6 200 ot./min. a prietok vzduchu až 1 000 m³/h. Hustý rebrovaný systém, ktorý poskytuje hrubý radiátor, podčiarkuje tepelnú rezervu navrhnutú v platforme, ktorá je v našej konfigurácii skonštruovaná tak, aby odvádzala až 6.5 kW trvalého tepla.
Najprekvapujúcejšie je azda to, že napriek takémuto zaťaženiu a rýchlostiam ventilátorov sa jednotke darí udržiavať v prijateľnom rozsahu hluku, pričom hladina hluku dosahuje pri plnom výkone viac ako 70 dB. To je síce na štandardy pracovných staníc hlučné, ale na systém rozptyľujúci tepelný výkon malej elektrickej pece je to pozoruhodne nízke číslo, čo svedčí o tom, ako efektívne kvapalinový okruh zariadenia Comino odvádza teplo od komponentov.
Predný panel a telemetrický displej
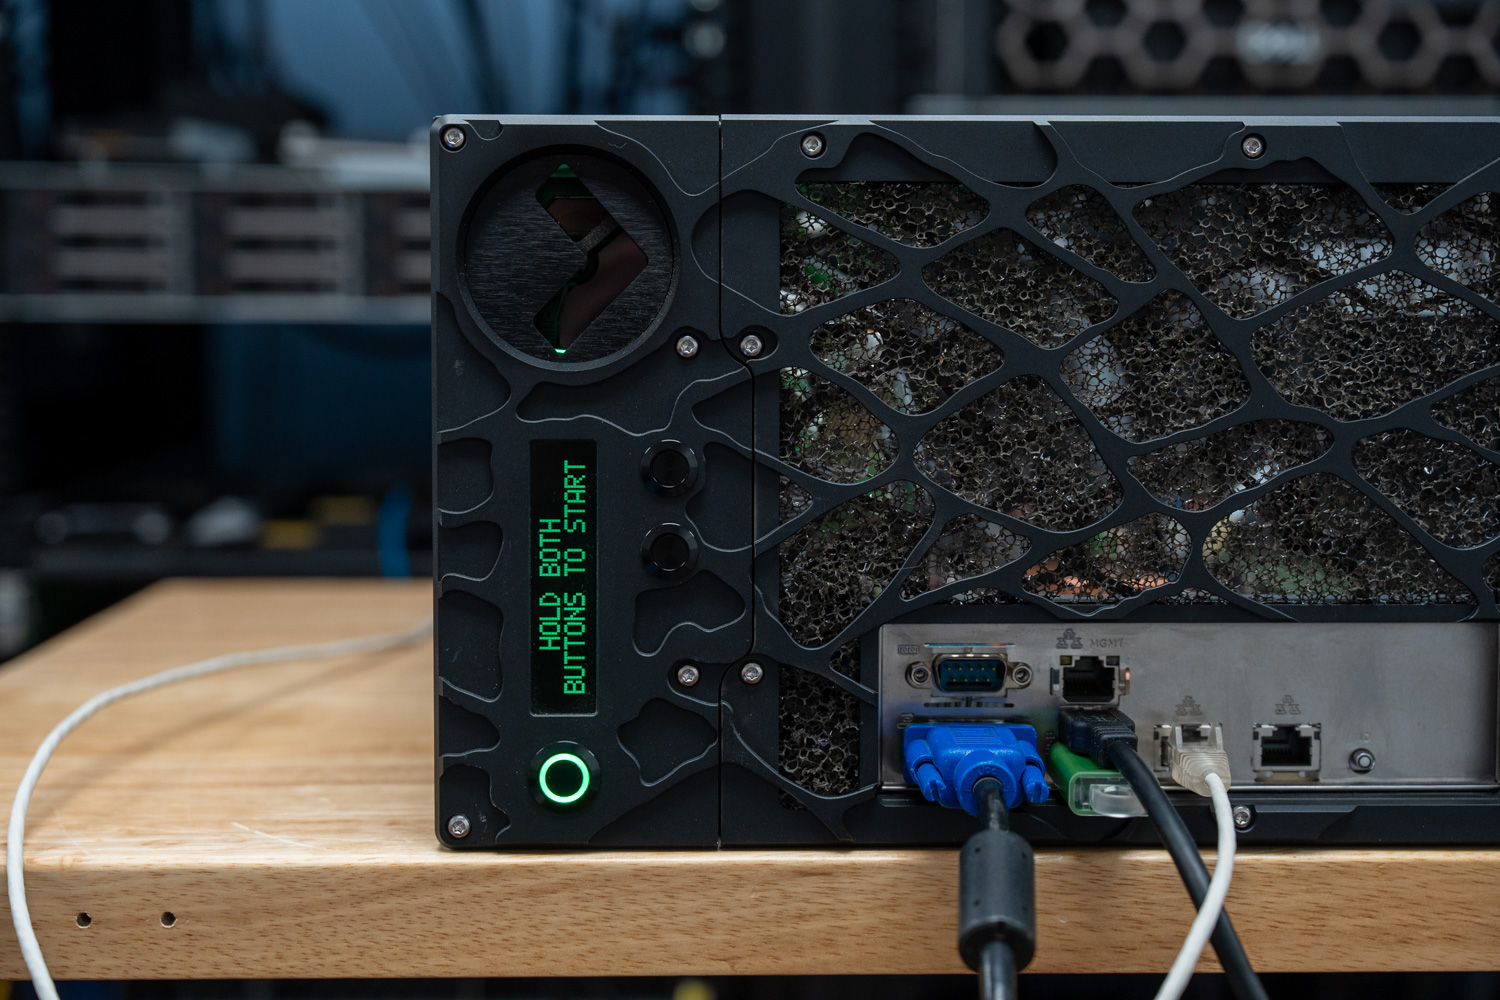
Na prednom paneli LED displej poskytuje živé zobrazenie kľúčových telemetrických údajov vrátane stavu čerpadla, teploty okolitého vzduchu, teploty chladiacej kvapaliny a otáčok ventilátora. Používatelia sa v ponuke pohybujú pomocou osvetlených tlačidiel na chladiacom module a krátkymi stlačeniami prechádzajte dostupnými údajmi. Dlhým stlačením tlačidla PB2 sa otvoria ďalšie vetvy ponuky vrátane Príkazov, Servisných nastavení a Denníka udalostí. Okrem toho predný vstupno-výstupný panel obsahuje port VGA pre výstup na displej, sériový port, viacero portov USB a sieťové pripojenia pre pripojenie periférnych zariadení a iných zariadení.
Architektúra napájania a úložiska
Dodávka energie a redundancia
Podpora tejto úrovne výpočtového výkonu si vyžaduje rovnako robustné napájanie. Grando podporuje až štyri hot-swap 1000W alebo 2000W CRPS moduly v redundantnej konfigurácii, ktoré poskytujú až 8.0 kW pri 180 – 264 V. Vďaka podpore redundantných režimov 4+0, 3+1 a 2+2 dokáže systém tolerovať poruchy zdroja a zároveň zachovať nepretržitú prevádzku pre úlohy umelej inteligencie a HPC 24 hodín denne, 7 dní v týždni.
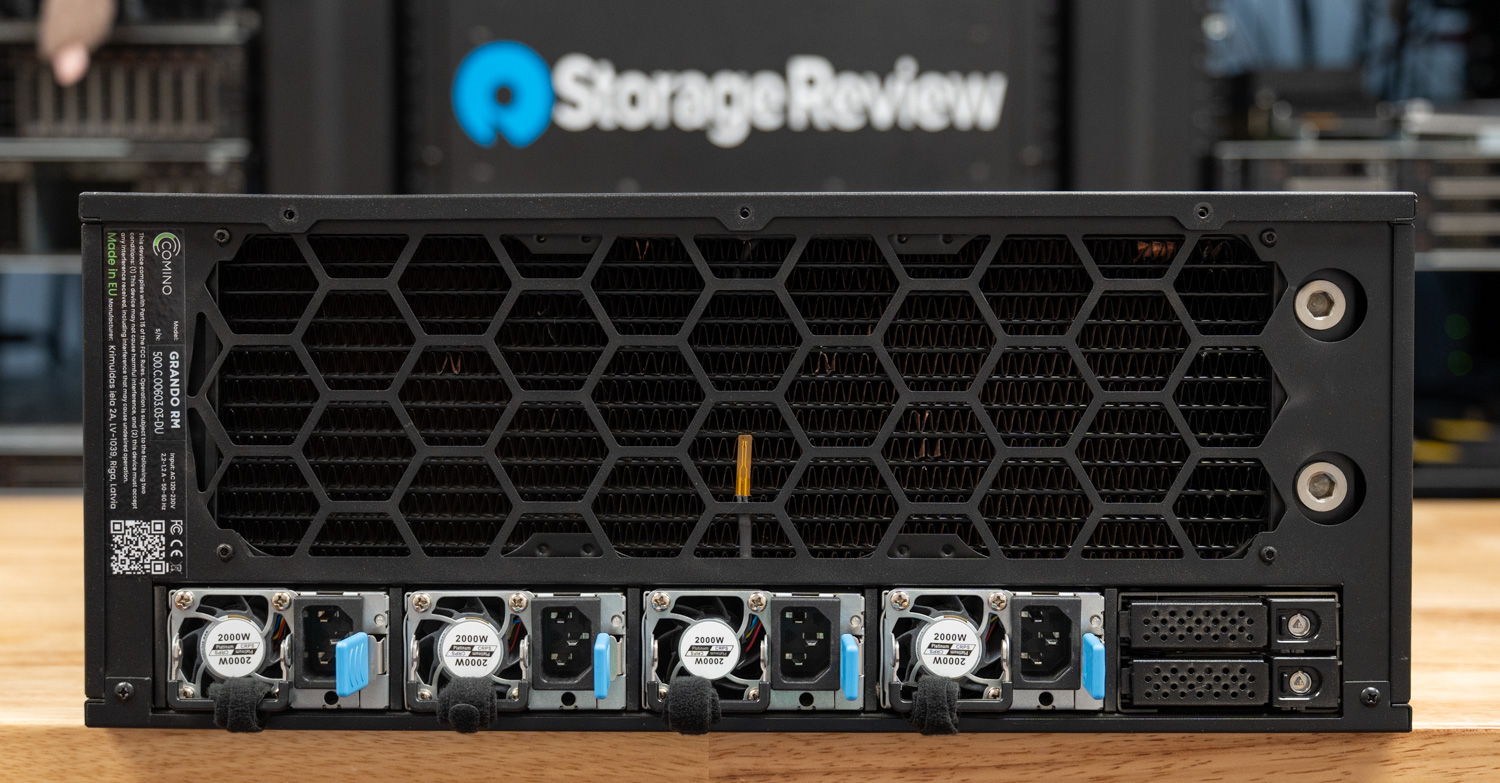
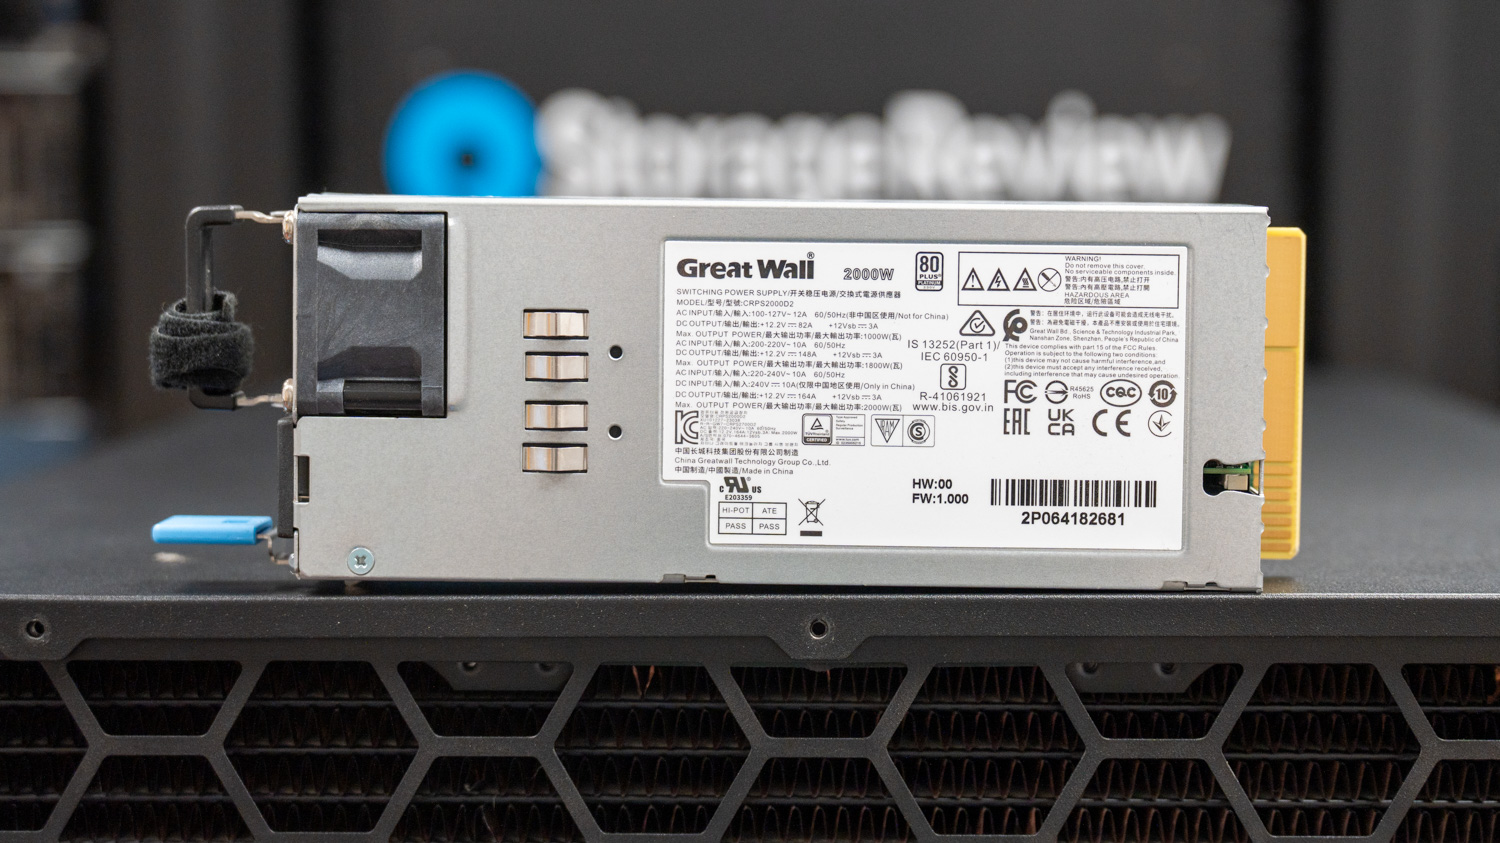
Náš recenzovaný kus bol dodaný so štyrmi hot-swap napájacími zdrojmi Great Wall 2000W 80 Plus Platinum, ktoré tvoria kompletnú konfiguráciu s výkonom 8.0 kW.
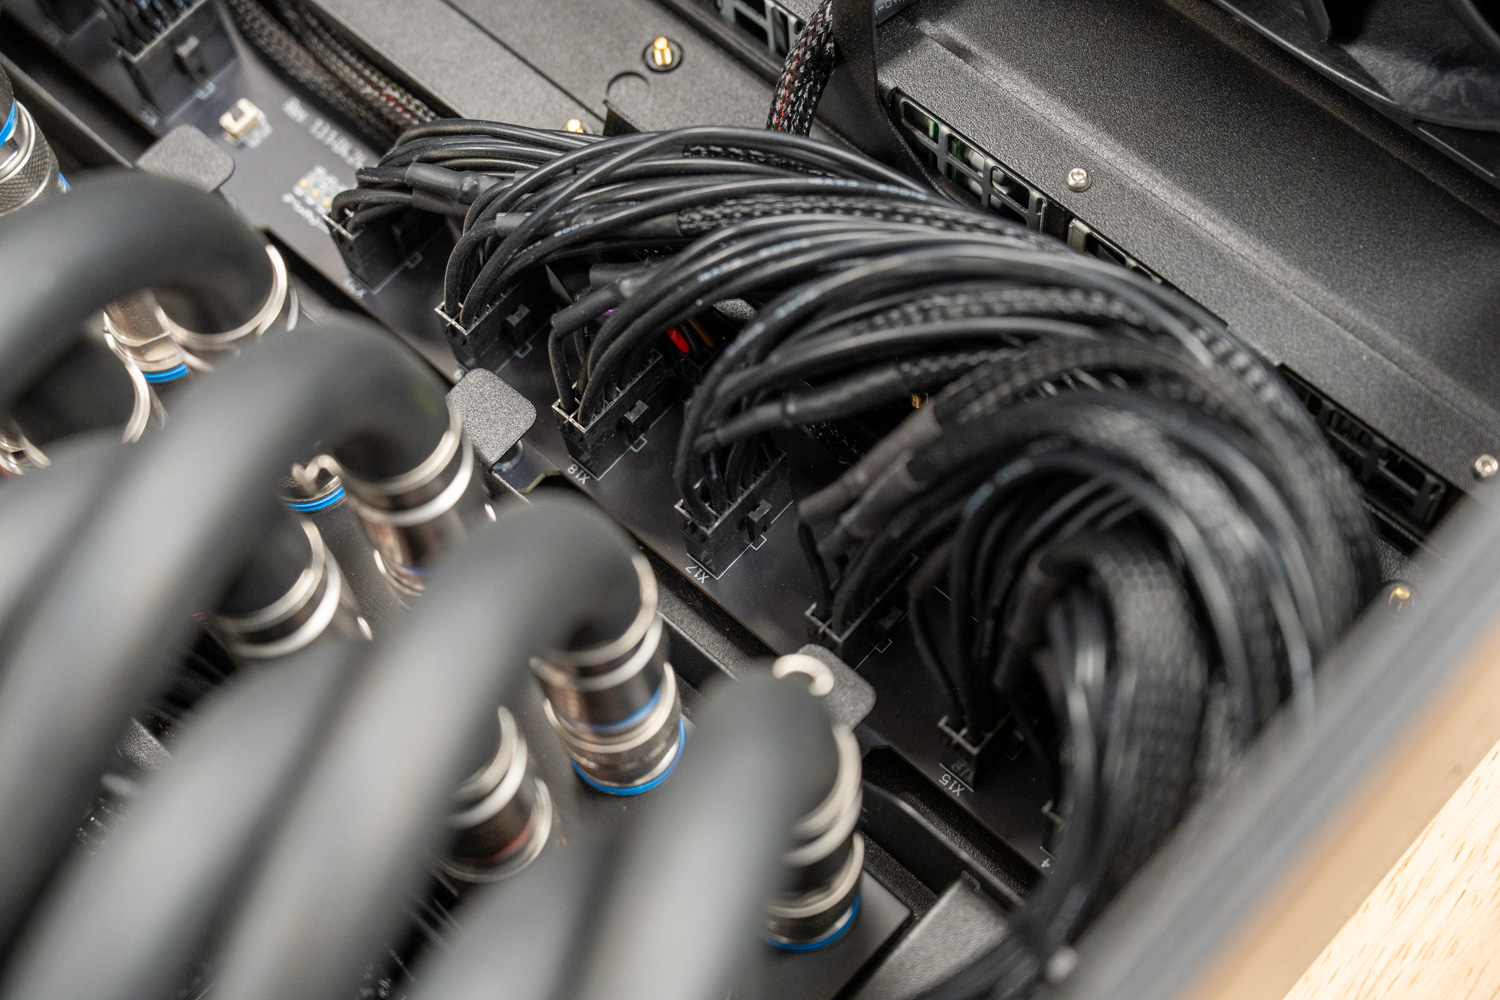
Napájanie každej grafickej karty (GPU) prebieha cez centralizovanú 12-pinovú rozvodnú dosku napájania, ktorá je namontovaná medzi poľom GPU a hlavným káblovým vedením. Grando používa túto rozvodnú dosku na konsolidáciu prichádzajúcich napájacích zdrojov a ich následné rozvetvenie do každej GPU organizovaným a priestorovo efektívnym spôsobom.
PCIe, úložisko a siete
Grando pohodlne podporuje šesť GPU bez kompromisov v šírke pásma slotov a šasi sa dá škálovať na plnú konfiguráciu s ôsmimi kartami pre maximálnu hustotu. Základná doska ASRock Rack GENOAD8X-2T/BCM od spoločnosti Comino ponúka sedem slotov x16 a jeden x8 PCIe Gen 5, čo znamená, že sedem z ôsmich GPU beží na plnej šírke pásma x16 a ôsma karta pracuje na x8. Ide o kompromis medzi počtom PCIe liniek, ktoré dokáže jedno-socketový procesor podporiť, a neochotou spoločnosti Comino pridať veľkosť, náklady a zložitosť prepínača PCIe. Prechod na dvojsocketovú základnú dosku by poskytol viac PCIe liniek, ale ponúkol by ešte menej slotov, pretože druhý socket by v priestorovo obmedzenom formáte zaberal miesto, ktoré by inak využívali sloty PCIe.
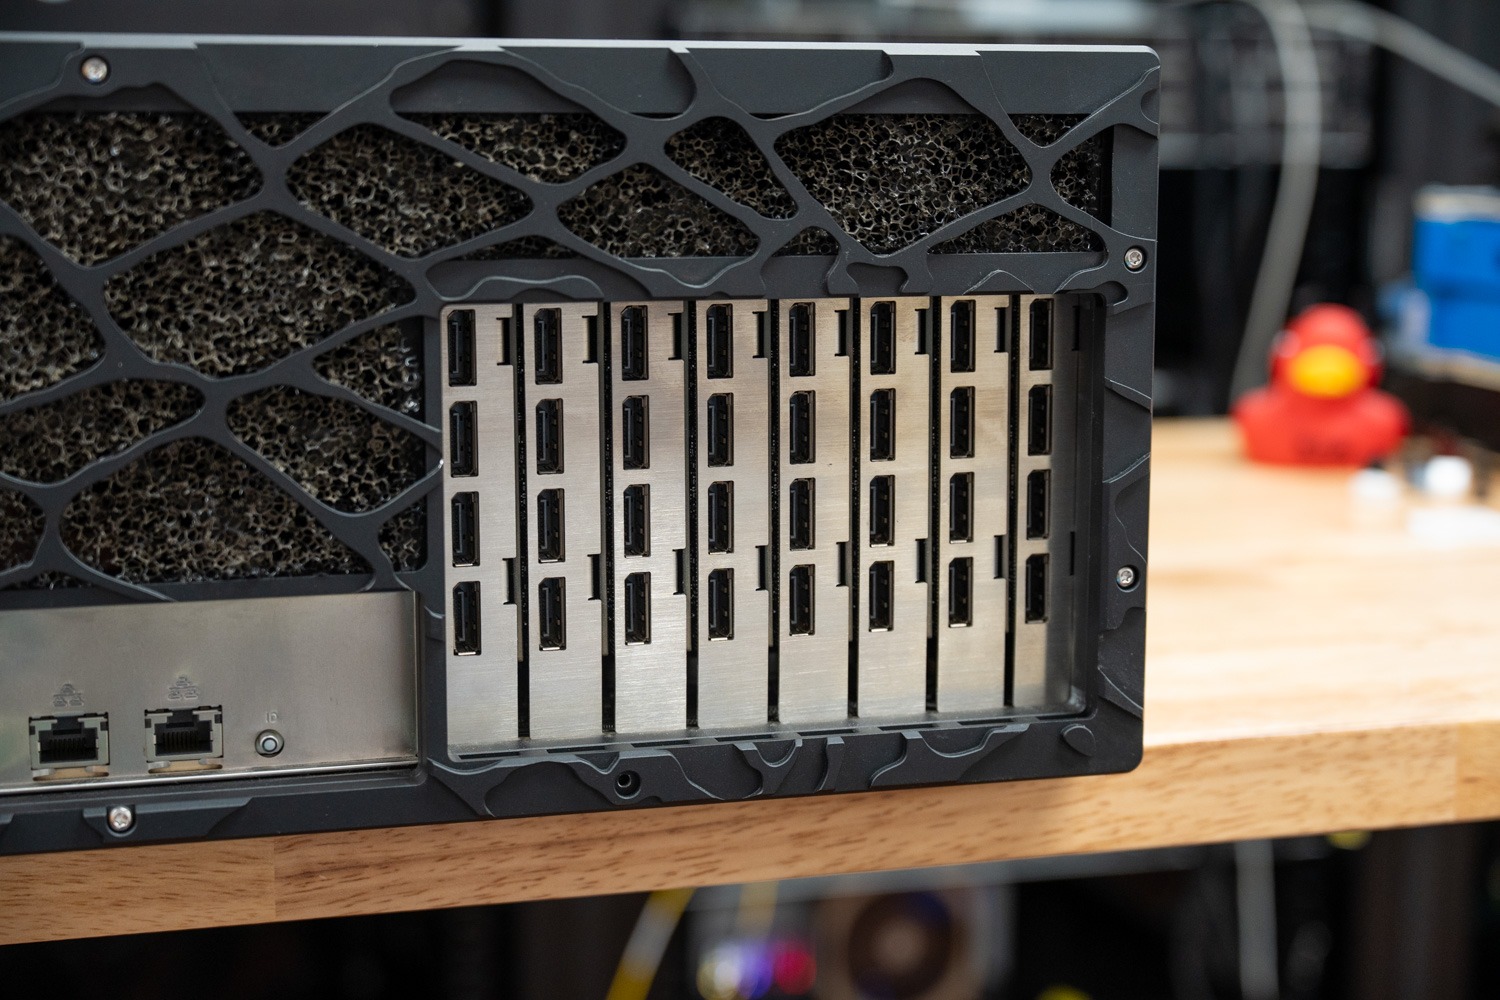
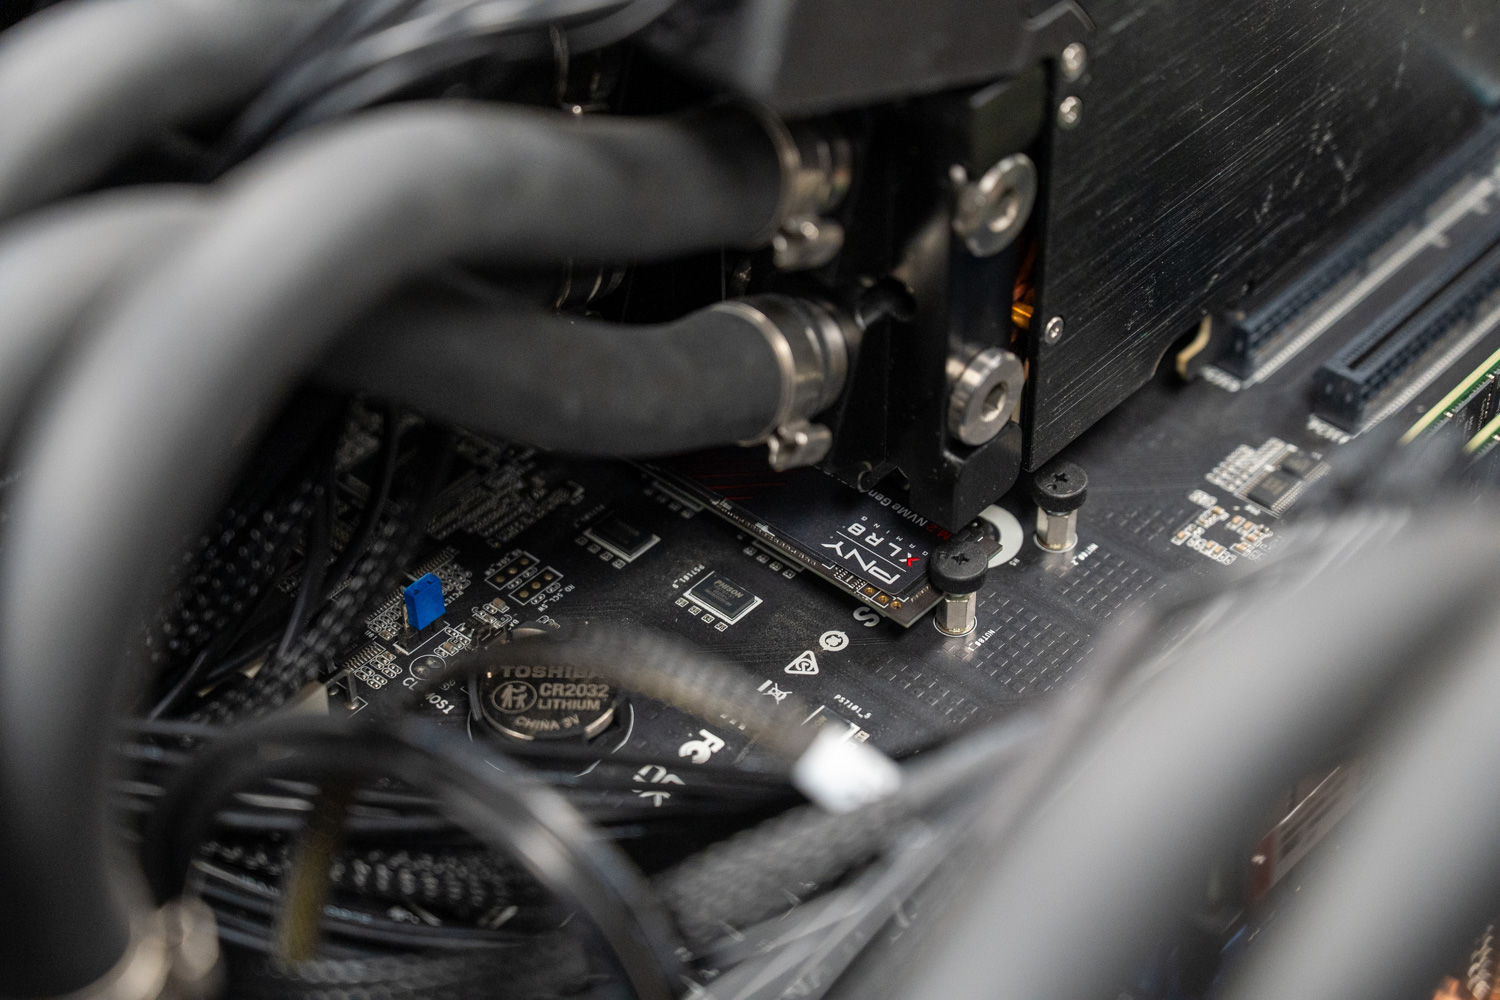
Prevádzkovanie ôsmich grafických kariet (GPU) v jednozásukovom systéme spotrebuje leví podiel dostupných liniek PCIe, čo so sebou prináša určité kompromisy. Náš recenzovaný kus, založený na procesore AMD Genoa, má k dispozícii celkovo 128 liniek PCIe Gen 5. Keďže osem GPU spotrebúva 120 z týchto liniek, zvyšných 8 liniek je rozdelených štyrikrát do každého slotu M.2 SSD, takže nie je možné súčasne prevádzkovať osem GPU a plný počet diskov NVMe v zadnej časti šasi pripojených cez dva konektory MCIO. V našej plnej konfigurácii s 8 GPU boli pre úložisko k dispozícii iba 2 sloty M.2. Správcovia, ktorí potrebujú dodatočnú kapacitu NVMe popri maximálnej hustote GPU, by si mali uvedomiť, že pridanie zadného hot-swap úložiska NVMe cez zadné panely spotrebuje ďalšie linky PCIe a deaktivuje časť kapacity GPU v ich systéme.
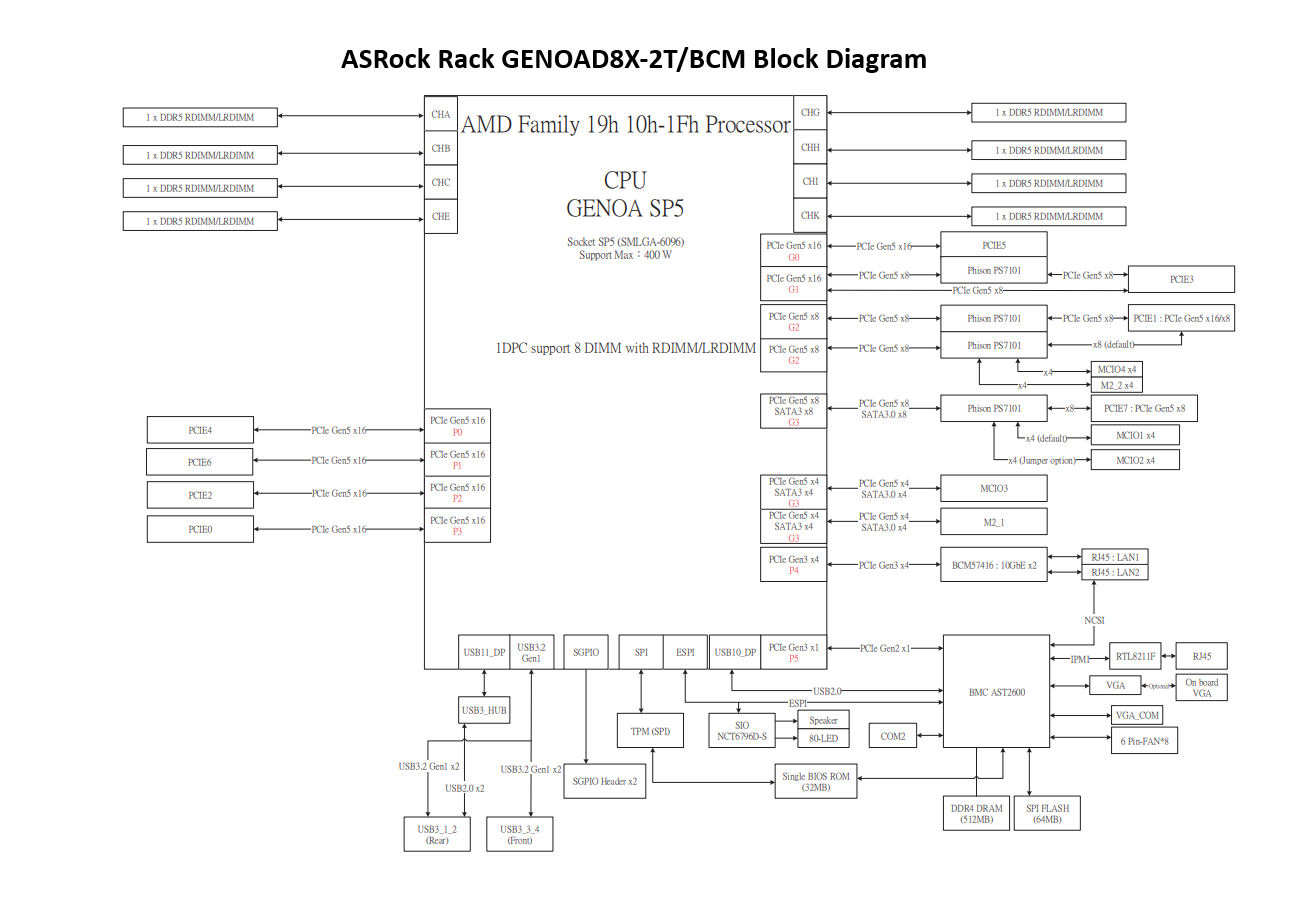
Bloková schéma základnej dosky ASRock Rack GENOAD8X-2T/BCM zobrazujúca CPU, sloty PCIe Gen 5, kanály DIMM, sloty M.2, BMC, USB, SATA a sieťové pripojenia.
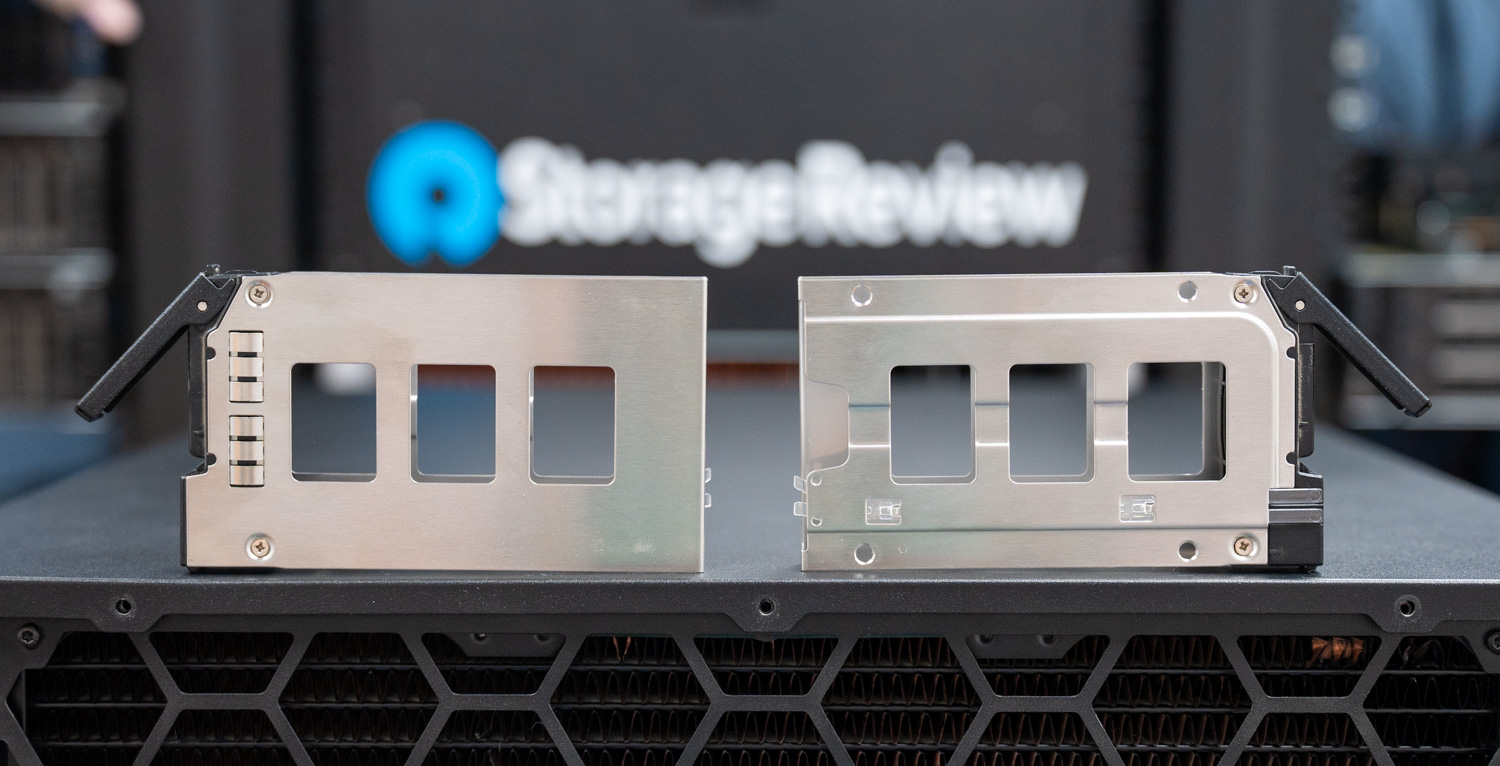
Napriek tomu je úložisko rovnako modulárne a rozsiahle, hoci konfigurácia ovplyvňuje rozpočet PCIe liniek pre GPU, čo sa oplatí zvážiť v závislosti od zamýšľaného použitia. Zadný panel našej recenzovanej jednotky obsahuje 2.5-palcovú klietku pre disky, ktorá podporuje až štyri 2.5-palcové SSD disky v konfigurácii 4x 7 mm alebo 2x 15 mm, s voliteľnou druhou sadou až štyroch diskov namiesto štvrtého slotu pre zdroj. Keďže naša recenzovaná jednotka vyžadovala všetky štyri pozície pre napájacie zdroje na podporu plnej konfigurácie s 8 GPU, mali sme prístup iba k prvej z dvoch pozícií pre výmenu za chodu. Vnútorne môže šasi podporovať 3.5-palcovú klietku, ktorá pojme až štyri 3.5-palcové disky, štyri 2.5-palcové 15 mm disky alebo až dvanásť 2.5-palcových 7 mm diskov a štyri ďalšie interné 2.5-palcové 7 mm SSD sloty, ak sú nakonfigurované.
Pre sieťové pripojenie sú na základnej doske štandardne k dispozícii dva integrované porty RJ45 10 Gb/s s čipovou sadou Broadcom BCM57416 a tiež vyhradený port pre správu Gigabit Ethernet IPMI. Správcovia môžu ďalej zvýšiť šírku pásma inštaláciou sieťových kariet PCIe, ktoré podporujú rýchlosť až 400 Gb/s pre vysokorýchlostné pripojenie fabric. Treba však poznamenať, že ďalšie sieťové karty PCIe obsadzujú sloty pre grafické karty, čím sa znižuje maximálny počet grafických kariet, ktoré systém môže hostiť.
Vzdialená správa a systémová inteligencia
Na ochranu hardvéru a optimalizáciu výkonu systém obsahuje monitorovací systém Comino (CMS). Samostatná autonómna riadiaca doska riadi CMS a slúži ako „mozog“ servera, nezávisle od hlavného operačného systému. V praxi táto riadiaca jednotka číta údaje z komplexného súboru senzorov, ktoré v reálnom čase sledujú teplotu vzduchu a chladiacej kvapaliny, hladinu vlhkosti, prietok chladiacej kvapaliny a hladiny v nádržiach. Dôležité je, že táto autonómna konštrukcia umožňuje CMS vykonávať samodiagnostiku a spúšťať núdzové vypnutia po zistení úniku alebo poruchy čerpadla, čím chráni drahý interný hardvér pred poškodením.
Webové grafické rozhranie zabezpečuje každodennú správu a poskytuje správcom jasný prehľad o výkone chladenia, dostupnosti a spotrebe energie CPU a GPU v reálnom čase. V prípade nasadení v podnikovom meradle sa CMS tiež pripája k centralizovaným monitorovacím nástrojom prostredníctvom rozhraní REST API, ako sú Zabbix, Grafana a InfluxDB. Tieto funkcie spoločne pomáhajú správcom udržiavať 3-ročné obdobie medzi servismi a udržiavať server v prevádzke s maximálnou účinnosťou bez tepelného obmedzenia, a to aj v prostrediach s vysokou teplotou okolia.
Viac než len umelá inteligencia: kreatívne a inžinierske aplikácie
Zatiaľ čo naše testovanie sa zameriavalo na pracovné zaťaženie založené na umelej inteligencii, Grando slúži rovnako praktickej úlohe pre kreatívnych profesionálov a inžinierov, ktorí potrebujú značné lokálne výpočty na GPU. 768 GB celkovej VRAM na ôsmich kartách RTX PRO 6000 odomyká možnosti, ktorým sa bežné konfigurácie pracovných staníc nedokážu porovnať.
FX umelci a profesionáli v oblasti pohyblivej grafiky môžu vykresľovať zložité scény s masívnymi sadami textúr výhradne vo VRAM, čím eliminujú úzke miesta s výmenou diskov, ktoré trápia produkcie s použitím 8K záberov alebo prostredí s vysokým počtom polygónov. CAD inžinieri, ktorí používajú výpočtovú dynamiku tekutín alebo štrukturálne simulácie, sa môžu zaoberať zostavami bezprecedentnej zložitosti bez toho, aby rozdeľovali svoje modely do viacerých cyklov. Z tejto hustoty pamäte a výpočtového výkonu GPU profitujú video editori pracujúci s viacnásobnými časovými líniami 8K RAW, koloristi aplikujúci redukciu šumu založenú na strojovom učení.
Grando nevyžaduje kompletnú konfiguráciu s ôsmimi grafickými procesormi. Spoločnosť Comino ponúka platformu v konfiguráciách so štyrmi, šiestimi a ôsmimi grafickými procesormi, pričom všetky varianty sú k dispozícii na okamžité odoslanie. Menšie štúdiá, nezávislí tvorcovia a inžinierske tímy si môžu prispôsobiť svoju investíciu aktuálnym potrebám a zároveň si zachovať jasnú cestu k aktualizácii s rastúcim pracovným zaťažením.
Kompromisy platformy: Hustota verzus rozšíriteľnosť
Kompaktný dizajn Grando poskytuje výnimočnú hustotu grafických kariet a tepelný manažment v rámci štandardného 4U priestoru, ale táto hustota zahŕňa architektonické kompromisy, ktoré je potrebné pochopiť pred nasadením.
Šasi je kompatibilné so základnými doskami s formátmi EATX a EEB, ale nie s rozšírenými serverovými doskami, ktoré sa nachádzajú v tradičných dvojzásuvných platformách. To obmedzuje celkový počet liniek PCIe dostupných pre periférie mimo poľa GPU. V našej konfigurácii s ôsmimi GPU je 128 liniek PCIe Gen 5 procesora AMD EPYC takmer úplne využívaných grafickými kartami, čím zostáva len malá šírka pásma pre ďalšie úložisko NVMe alebo vysokorýchlostné siete mimo integrovaných portov 10GbE.
To je v kontraste s platformami s ôsmimi grafickými procesormi, ktoré sme recenzovali od spoločností Dell, HPE a Supermicro. Tieto systémy používajú väčšie šasi, konfigurácie s dvoma soketmi a topológiu prepínačov PCIe na podporu výrazne väčšieho množstva periférnych konektivít. Zvyčajne obsahujú štyri až osem ďalších sieťových kariet alebo procesorov DPU popri plnom počte grafických kariet a osem alebo viac pozícií NVMe s možnosťou výmeny za chodu, vďaka čomu sú vhodné pre distribuované inferenčné úlohy, ktoré vyžadujú prepojenia s vysokou šírkou pásma.
Táto rozšírená kapacita však prináša značné náklady. Spotreba energie presahuje 8 kW. Tepelné zaťaženie si vyžaduje vyhradenú chladiacu infraštruktúru dátového centra. Minimálna hlučnosť bráni nasadeniu mimo účelových strojovní. A dodacie lehoty sa často predlžujú o šesť až osemnásť mesiacov kvôli pretrvávajúcim obmedzeniam dodávok na podnikových platformách GPU.
Grando zaujíma inú pozíciu. Pre organizácie, ktoré uprednostňujú rýchle nasadenie, zvládnuteľné operačné prostredia a inferenčné alebo kreatívne pracovné zaťaženie pred rozsiahlym distribuovaným školením, sú kompromisy často priaznivé. Tímy, ktoré potrebujú svoj hardvér teraz, v prostredí, s ktorým môžu skutočne pracovať, môžu považovať prístup Grando k hustote za praktickejší ako čakanie v rade na platformu, ktorú realisticky nemôžu nasadiť, keď dorazí.
Výsledky testovania výkonu Comino Grando
Konfigurácia systému
- Podvozok: Comino Grande
- Základná doska: ASRock Rack GENOAD8X-2T/BCM
- CPU: AMD EPYC 9474F 48C
- pamäť: 512 GB DDR5
- GPU: 8 x NVIDIA RTX PRO 6000
- Skladovanie: M.2 SSD
Claude Code Serving – MiniMax M2.5
Okrem tradičných benchmarkov inferencie LLM sme chceli vyhodnotiť, ako dobre si tento hardvér vedie v pracovnom postupe agentového kódovania, konkrétne obsluhovaním viacerých súbežných relácií Claude Code pomocou lokálne hostovaného modelu. Tento prípad použitia sa priamo vzťahuje na produktivitu vývojového tímu: koľko inžinierov môže súčasne používať asistenta kódovania s umelou inteligenciou poskytovaného z jedného uzla, kým sa skúsenosť s ním nezhorší?
Aby sme to otestovali, vytvorili sme benchmarkový systém, ktorý generuje súbor údajov o stredne náročných kódovacích problémoch (ako je implementácia vyrovnávacej pamäte LRU, vytvorenie aplikácie úloh CLI, napísanie prevodníka markdown a vytvorenie REST API) a spúšťa každú reláciu Claude Code v samostatnom kontajneri Docker na lokálnom serveri vLLM. Medzi reláciami a inferenčným koncovým bodom sa nachádza transparentný proxy server, ktorý zachytáva metriky pre každú inštanciu Claude Code pre jednotlivé požiadavky. Použitý model bol MiniMax M2.5, poskytovaný prostredníctvom vLLM na ôsmich grafických procesoroch NVIDIA RTX PRO 6000 systému. Hoci M2.5 nie je najvyššie hodnoteným kódovacím modelom vo verejných rebríčkoch, je schopný model, ktorý mnoho používateľov vrátane našich priateľov vývojárov používa lokálne.
Ako referenčný bod používame priemernú výstupnú priepustnosť Claude Opus 4.6 od spoločnosti Anthropic cez OpenRouter.ai, jednu z najpopulárnejších smerovacích služieb pre prístup k produkčnému API. Táto základná hodnota predstavuje približne 37 tokenov za sekundu na požiadavku API.
Merali sme dve kľúčové metriky: priemerný počet výstupných tokenov za sekundu na reláciu Claude Code (čo každý vývojár zažije) a súhrnný počet výstupných tokenov za sekundu vo všetkých reláciách (celková práca, ktorú server vyprodukuje).
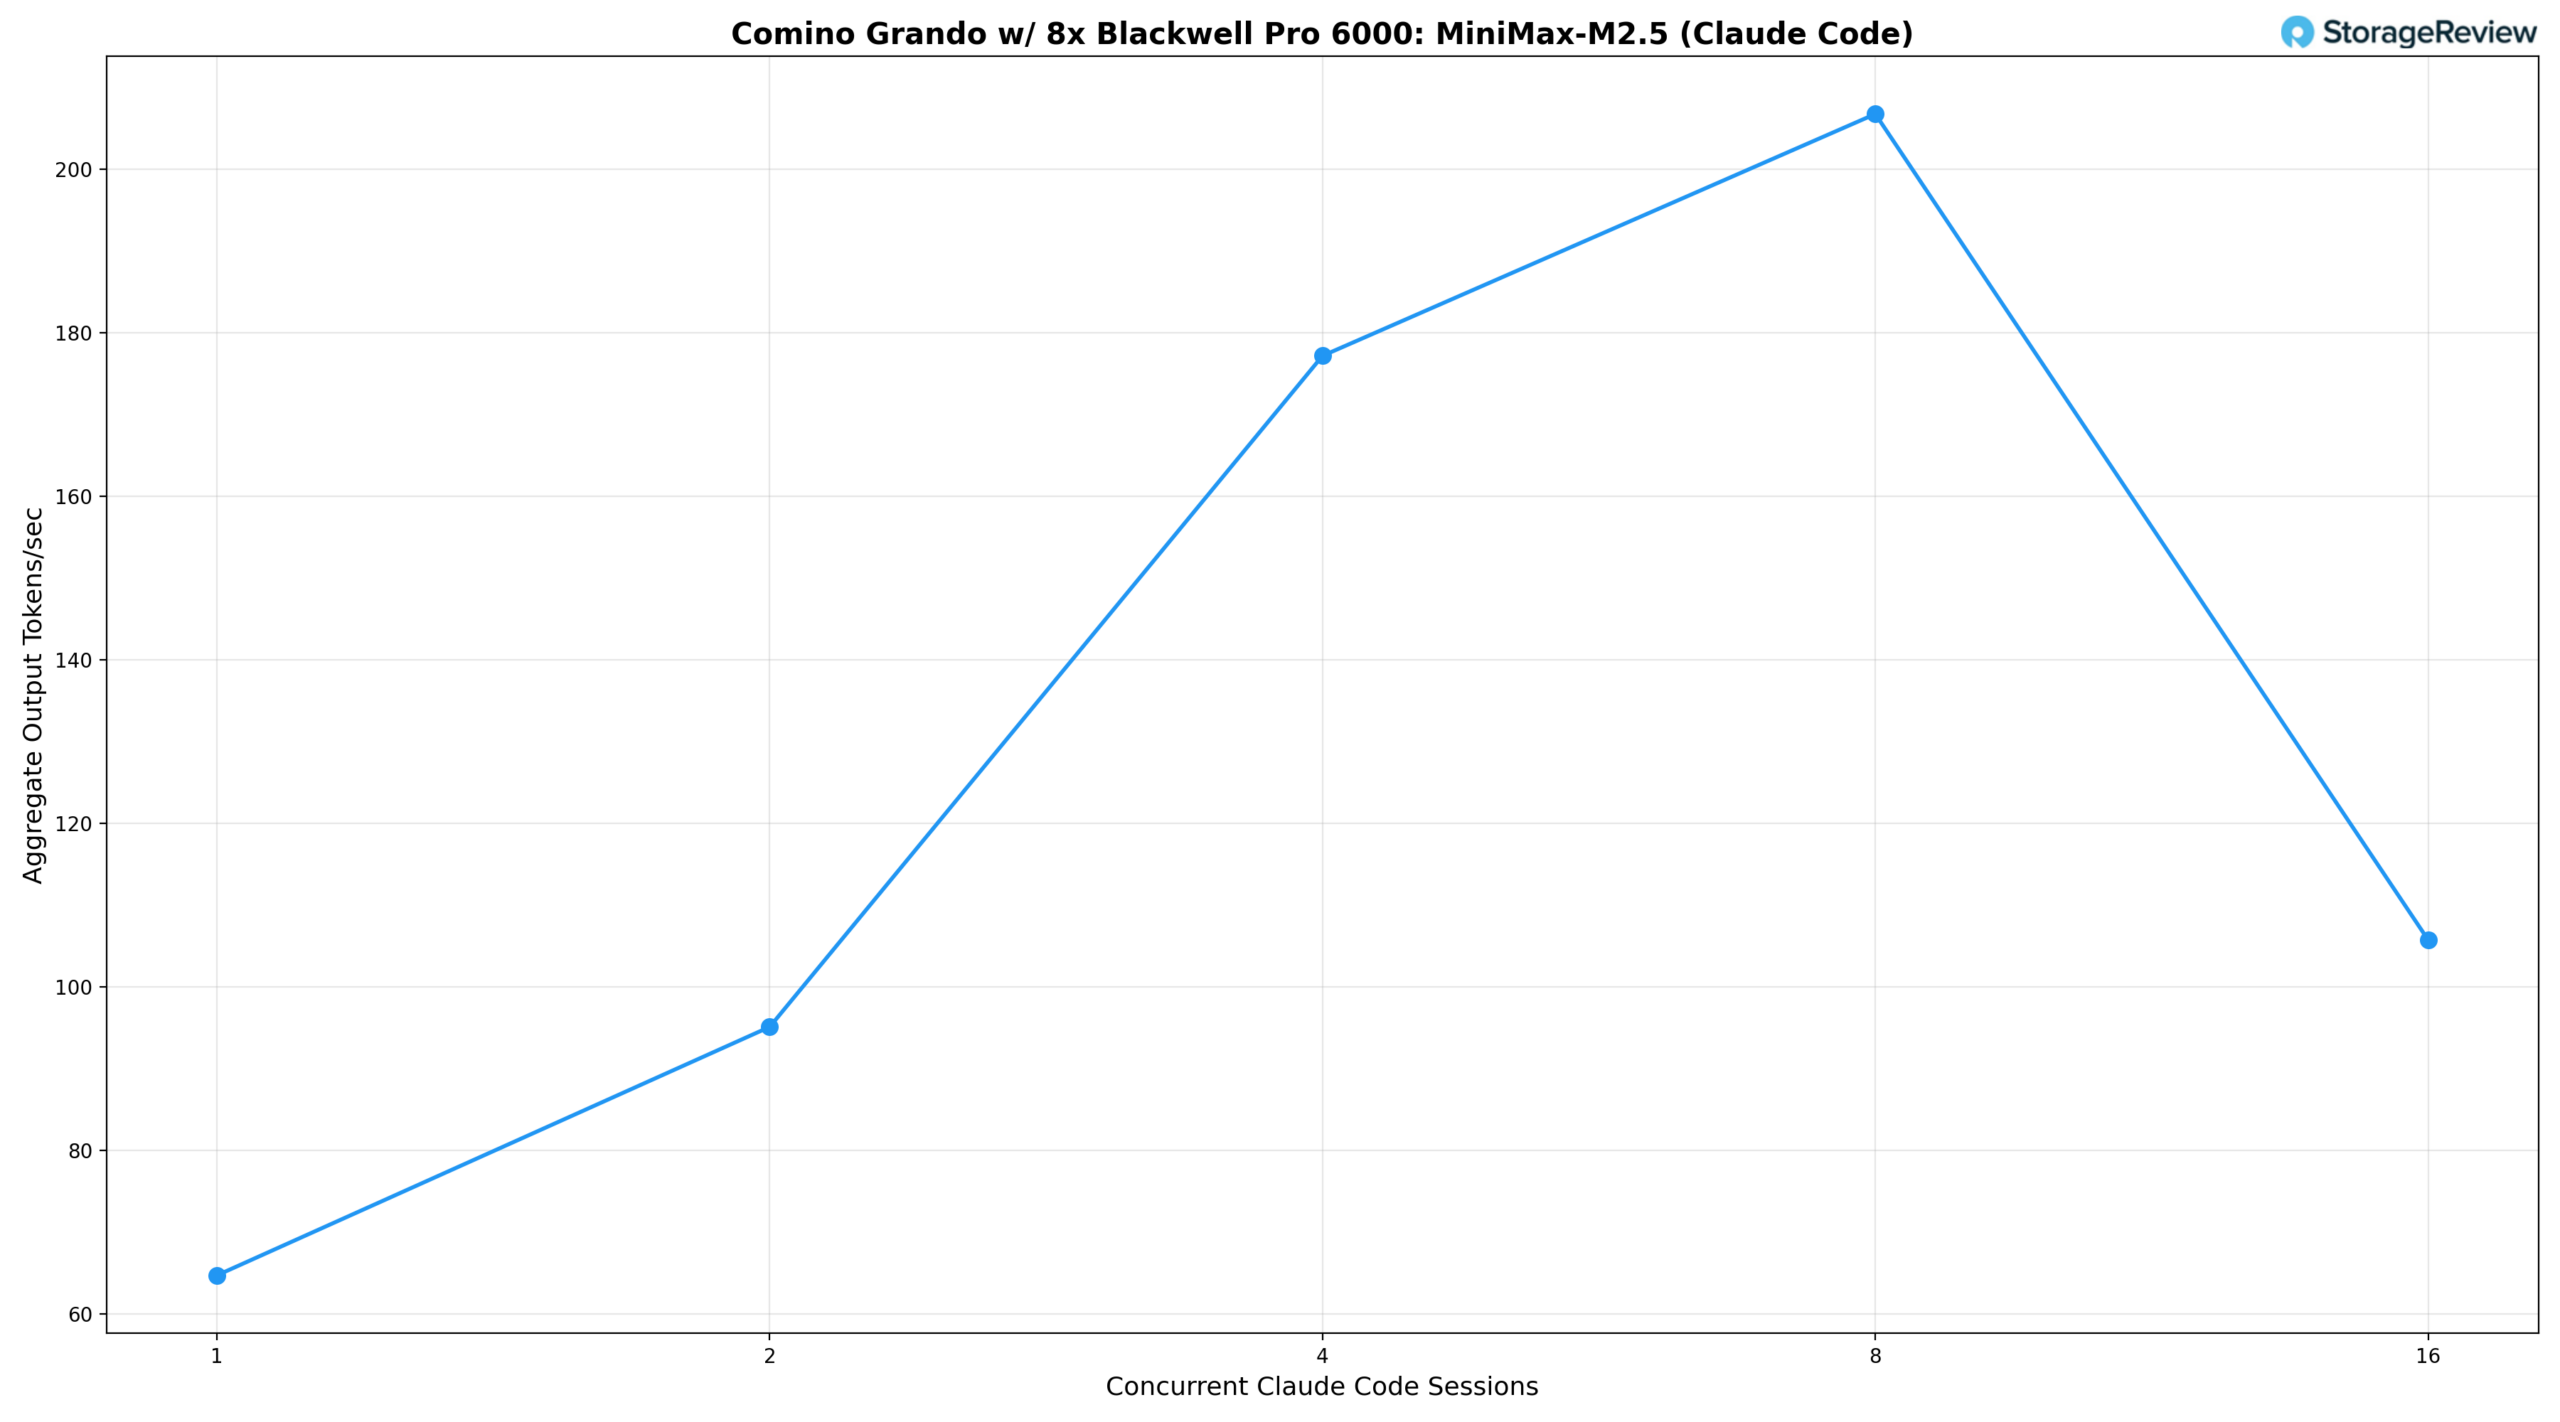
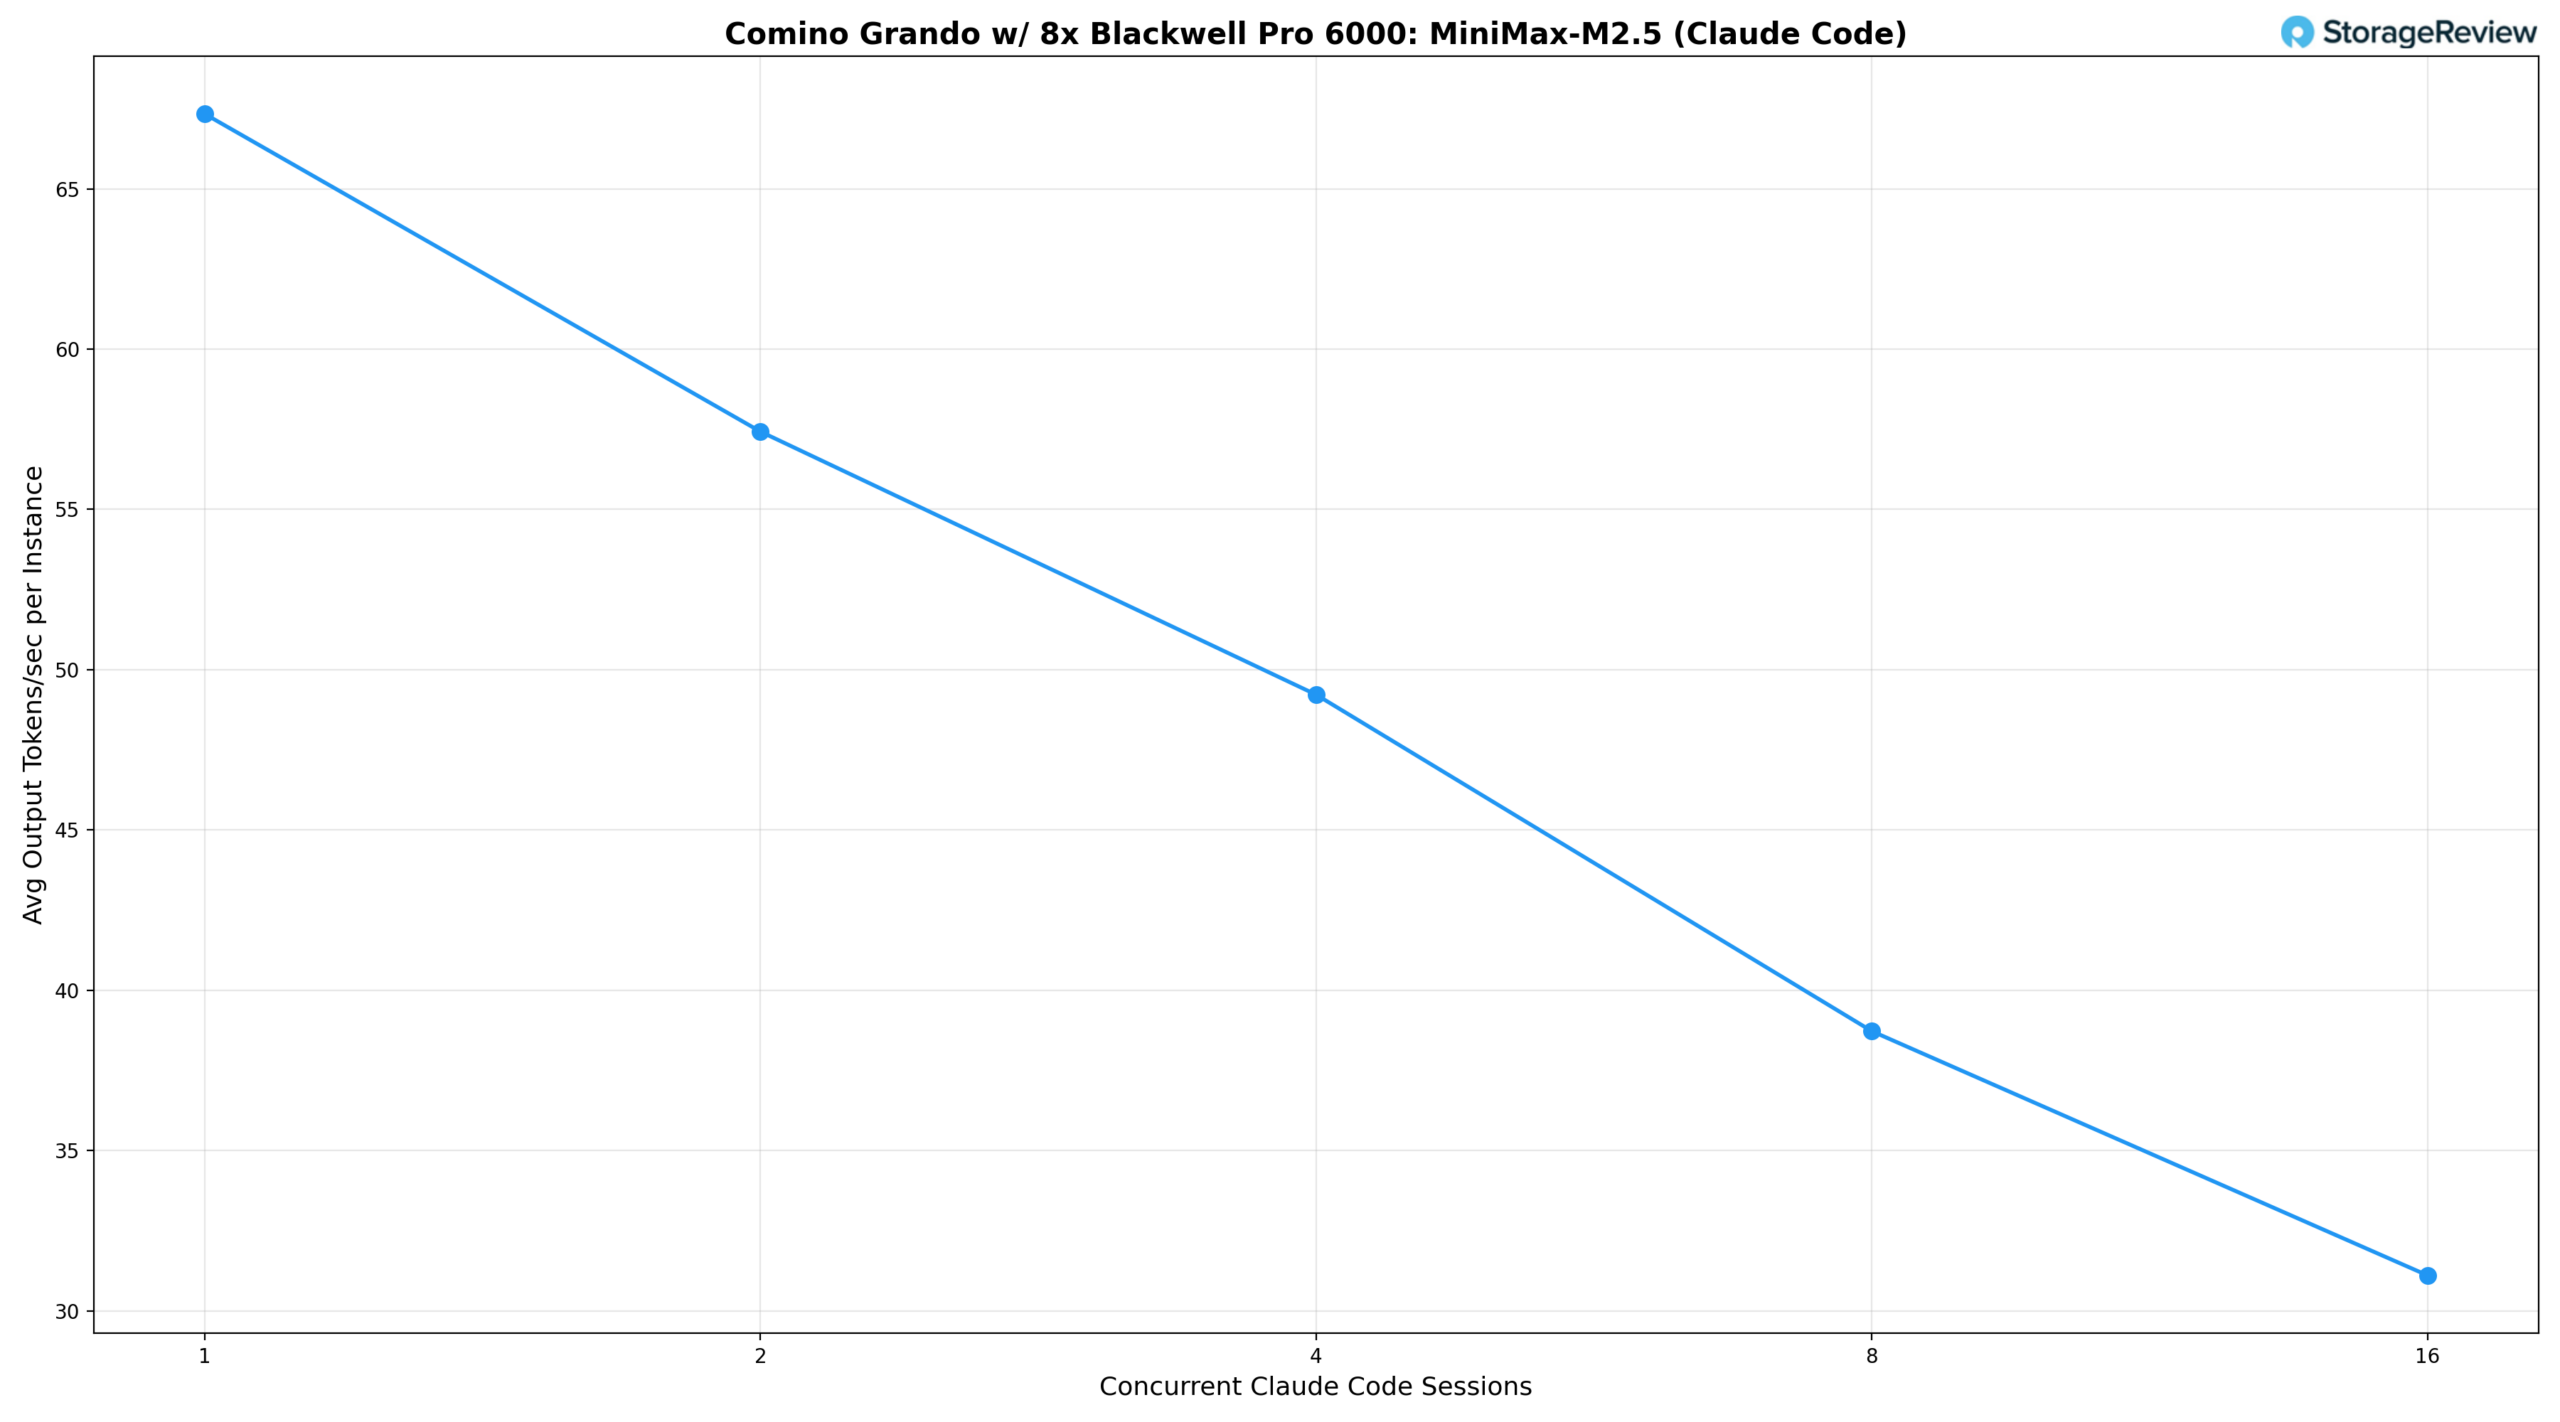
Na základe výsledkov jedna súbežná relácia Claude Code prináša 67.3 tokov/s na používateľa a celkový výstup 64.7 tokov/s. Pri dvoch reláciách priepustnosť na inštanciu mierne klesne na 57.4 tokov/s, zatiaľ čo celkový výstup stúpne na 95.1 tokov/s, keďže dávkovanie vLLM začína amortizovať réžiu. Štyri súbežné relácie si udržiavajú 49.2 tokov/s na používateľa, čo je stále vysoko responzívny zážitok pre interaktívne kódovacie pracovné postupy, zatiaľ čo celková priepustnosť dosahuje 177.2 tokov/s. Osem relácií predstavuje ideálnu hodnotu pre celkový výstup s maximom 206.7 tokov/s, zatiaľ čo priepustnosť na inštanciu sa ustáli na 38.7 tokov/s, čo je úroveň, ktorá zostáva pohodlná pre generovanie kódu v reálnom čase a iteráciu.
Pri 16 súbežných reláciách systém vykazuje klasický kompromis v dávkovom spracovaní: priepustnosť na inštanciu klesne na 31.1 tok/s a celkový výstup klesne na 105.8 tok/s. To naznačuje, že pri tejto úrovni súbežnosti model 230B MiniMax M2.5 posúva hranice toho, čo osem GPU dokáže udržať bez toho, aby to spôsobilo zmysluplnú latenciu pre každého používateľa. Celkový pokles z 8 na 16 relácií odráža skôr nároky na šírku pásma pamäte veľkej architektúry MoE pri veľkom zaťažení simultánneho dekódovania než neefektívnosť plánovania.
Pre organizácie, ktoré hodnotia samostatne hostovanú infraštruktúru umelej inteligencie pre vývojárske nástroje, je Grando silným argumentom. Vďaka modelu 230B na úrovni popredných technológií dokáže pohodlne obslúžiť až osem simultánnych relácií Claude Code s úrovňou priepustnosti, ktorá sa zdá byť skutočne interaktívna, s rýchlosťami na používateľa presahujúcimi 38 taktov/s pri špičkovom súhrnnom výkone. Tímy štyroch až ôsmich inžinierov môžu pracovať s takmer optimálnou priepustnosťou bez citeľného zníženia odozvy.
Architektúra chladená kvapalinou umožňuje praktickú prevádzku tejto úrovne výpočtového výkonu v prostrediach, kde tradičné GPU servery nemôžu fungovať. Systém beží dostatočne ticho na to, aby sa dal umiestniť do kancelárie startupu, malej strojovne alebo vyhradeného rohu otvoreného pracovného priestoru. Vzduchom chladené systémy s podobnou hustotou GPU zvyčajne dosahujú 90 dB alebo viac, čo je dostatočne hlučné na to, aby si vyžadovalo vyhradený priestor v dátovom centre alebo minimálne uzavretú serverovú skriňu s dôkladnou akustickou úpravou. Grando môže koexistovať s tímom, ktorý ho používa. V kombinácii s plnou lokalitou dát, žiadnymi nákladmi na API za token a úplnou kontrolou nad výberom modelu ponúka samostatne hostovanú cestu, ktorá sa škáluje s rastúcim vývojovým tímom bez nutnosti infraštruktúry dátového centra alebo zvyšovania nákladov na kľúčové prvky.
Online poskytovanie vLLM – výkon inferencie LLM
vLLM je jeden z najpopulárnejších vysokokapacitných inferenčných a obslužných nástrojov pre LLM. Online benchmark vLLM hodnotí reálny výkon obsluhy tohto inferenčného nástroja pri súbežných požiadavkách. Simuluje produkčné pracovné zaťaženie odosielaním požiadaviek na bežiaci server vLLM s konfigurovateľnými parametrami, ako je rýchlosť požiadaviek, dĺžka vstupných a výstupných požiadaviek a počet súbežných klientov. Benchmark meria kľúčové metriky vrátane priepustnosti (tokeny za sekundu), času do prvého tokenu a času na výstupný token (TPOT), čo pomáha používateľom pochopiť, ako vLLM funguje pri rôznych podmienkach zaťaženia.
Testovali sme výkon inferencie v rámci komplexnej sady modelov zahŕňajúcich rôzne architektúry, škály parametrov a stratégie kvantizácie, aby sme vyhodnotili priepustnosť v rámci rôznych profilov súbežnosti.
Súhrn výsledkov
| Modelka | Presnosť | Rovnaké (256/256) | Predfill-Hrubý (8k/1k) | Dekódovacie náročné (1k/8k) |
|---|---|---|---|---|
| Comino Grando s 8× RTX PRO 6000 Blackwell — výsledky inferencie vLLM (tok/s, vrchol pri BS=256) | ||||
| GPT-OSS 20B | ep_dp1 | 17,280 | 32,061 | 11,187 |
| GPT-OSS 120B | ep_dp1 | 11,726 | 21,636 | 7,570 |
| Lama 3.1 8B Inštrukt | FP8 | 12,109 | 20,137 | 7,353 |
| Lama 3.1 8B Inštrukt | FP4 | 11,954 | 20,206 | 7,239 |
| Lama 3.1 8B Inštrukt | BF16 | 11,752 | 17,346 | 6,155 |
| Kódovač Qwen3 30B A3B | FP8 | 10,985 | 16,659 | 4,907 |
| Kódovač Qwen3 30B A3B | BF16 | 10,588 | 16,680 | 4,829 |
| Mistral Malý 3.1 24B | BF16 | 8,925 | 11,846 | 4,975 |
| MiniMax M2.5 (230B) | ep_dp1 | 5,753 | 7,357 * | 2,555 |
| Všetky hodnoty sú v tok/s, maximálna priepustnosť pri BS=256. *MiniMax M2.5 s vysokým obsahom predplnenia dosiahol maximum pri BS=128 (7 357 tok/s); BS=256 predstavovalo 7 141 tok/s. | ||||
GPT-OSS 120B a 20B
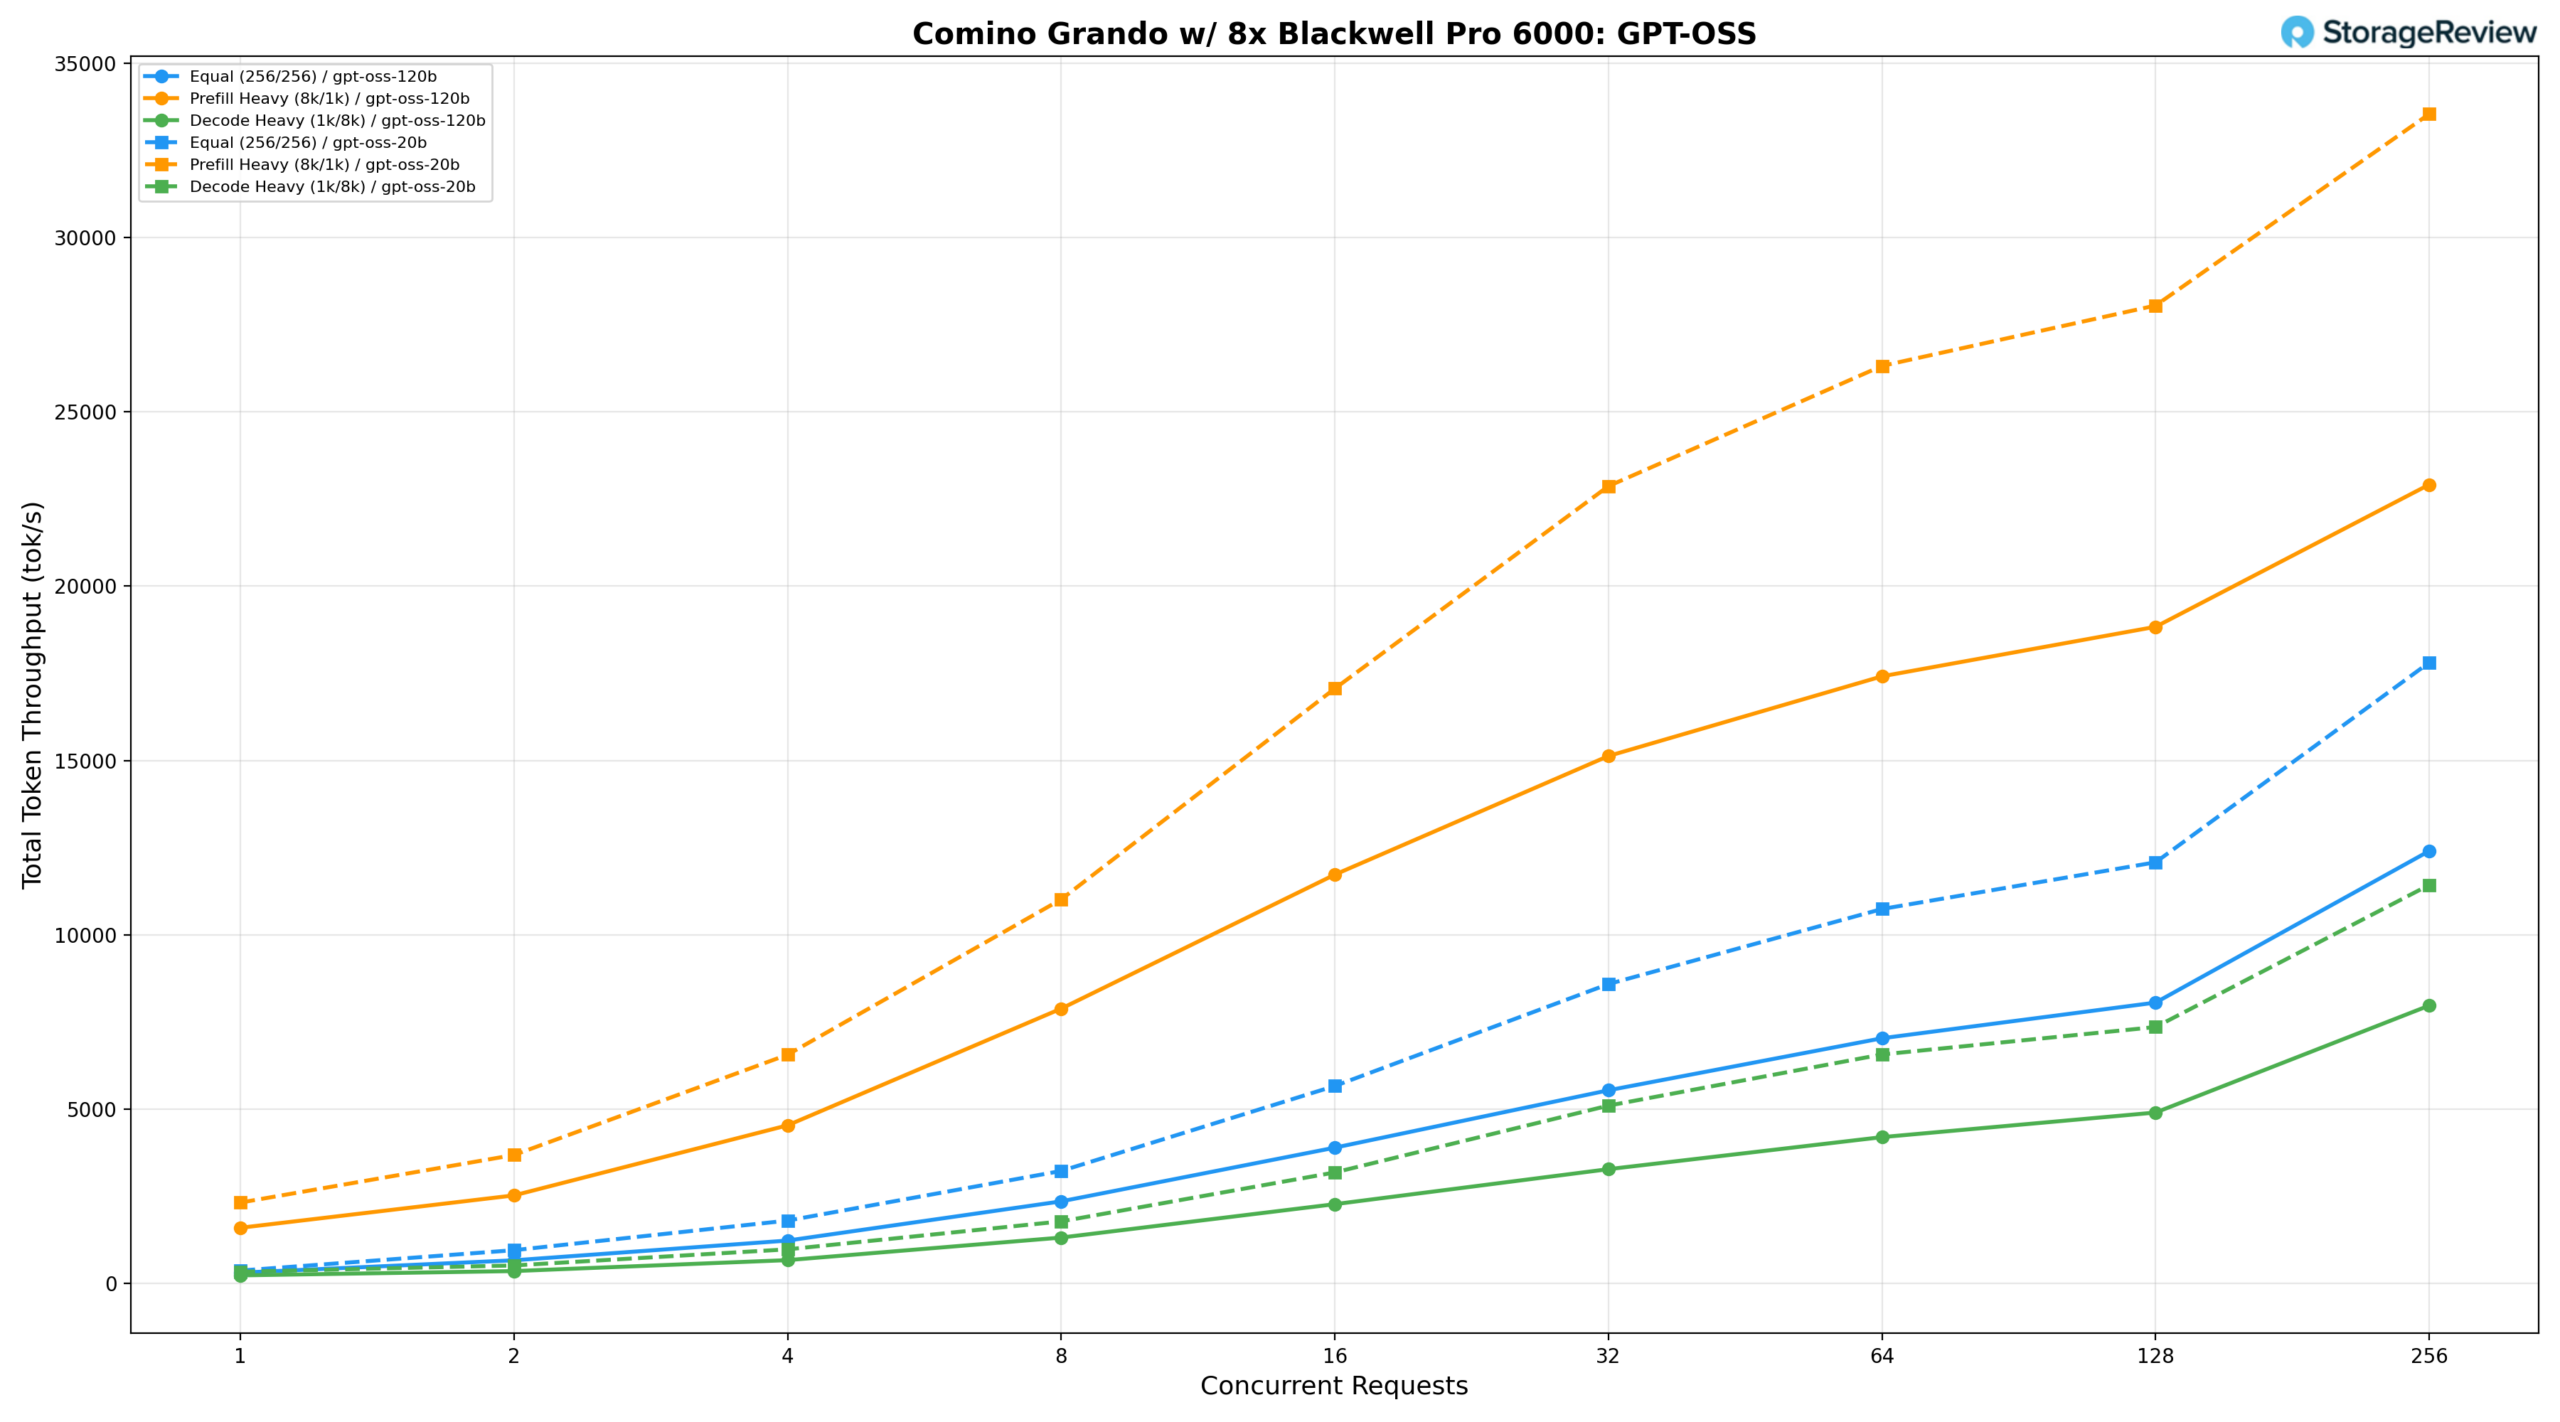
Modelová rada GPT-OSS bola testovaná v konfiguráciách 120B aj 20B na Comino Grando.
GPT-OSS 120B
Pri rovnakom zaťažení (256/256) dosahuje model 120B rýchlosť 268.85 tok/s pri BS=1, dosahuje 6 666,23 tok/s pri BS=64 a vrcholí pri 11 726,04 tok/s pri BS=256. Rýchlosť s vysokým zaťažením pred napĺňaním (8k/1k) začína na 1 375,69 tok/s, stúpa na 16 374,19 tok/s pri BS=64 a 17 944,55 tok/s pri BS=128 a vrcholí pri 21 636,41 tok/s pri BS=256. Rýchlosť s vysokým zaťažením dekódovaním (1k/8k) rastie zo 196.28 tok/s pri BS=1 na 7 569,97 tok/s pri BS=256 s dobre kontrolovanou latenciou pri nižších úrovniach súbežnosti.
GPT-OSS 20B
Model 20B dosahuje pri rovnakom zaťažení 334.80 tokov/s pri BS=1, dosahuje 10 303,56 tokov/s pri BS=64 a vrcholí pri 17 280,12 tokov/s pri BS=256. Pri vysokom predplnení začína na 2 007,90 tokoch/s, stúpa na 24 990,46 tokov/s pri BS=64 a 26 866,25 tokov/s pri BS=128, pričom vrcholí pri 32 060,72 tokov/s pri BS=256, čo je najvyššia absolútna priepustnosť predplnenia zaznamenaná v oboch veľkostiach modelu. Dekódovacia priepustnosť sa zvyšuje z 286.08 tok/s pri BS=1 na 11 187,36 tok/s pri BS=256, čo prináša približne 1.5-násobok dekódovacej priepustnosti 120B pri špičkovej súbežnosti a zároveň zachováva nižšiu latenciu.
Inštrukcie Qwen3 Coder 30B A3B a inštrukcie FP8
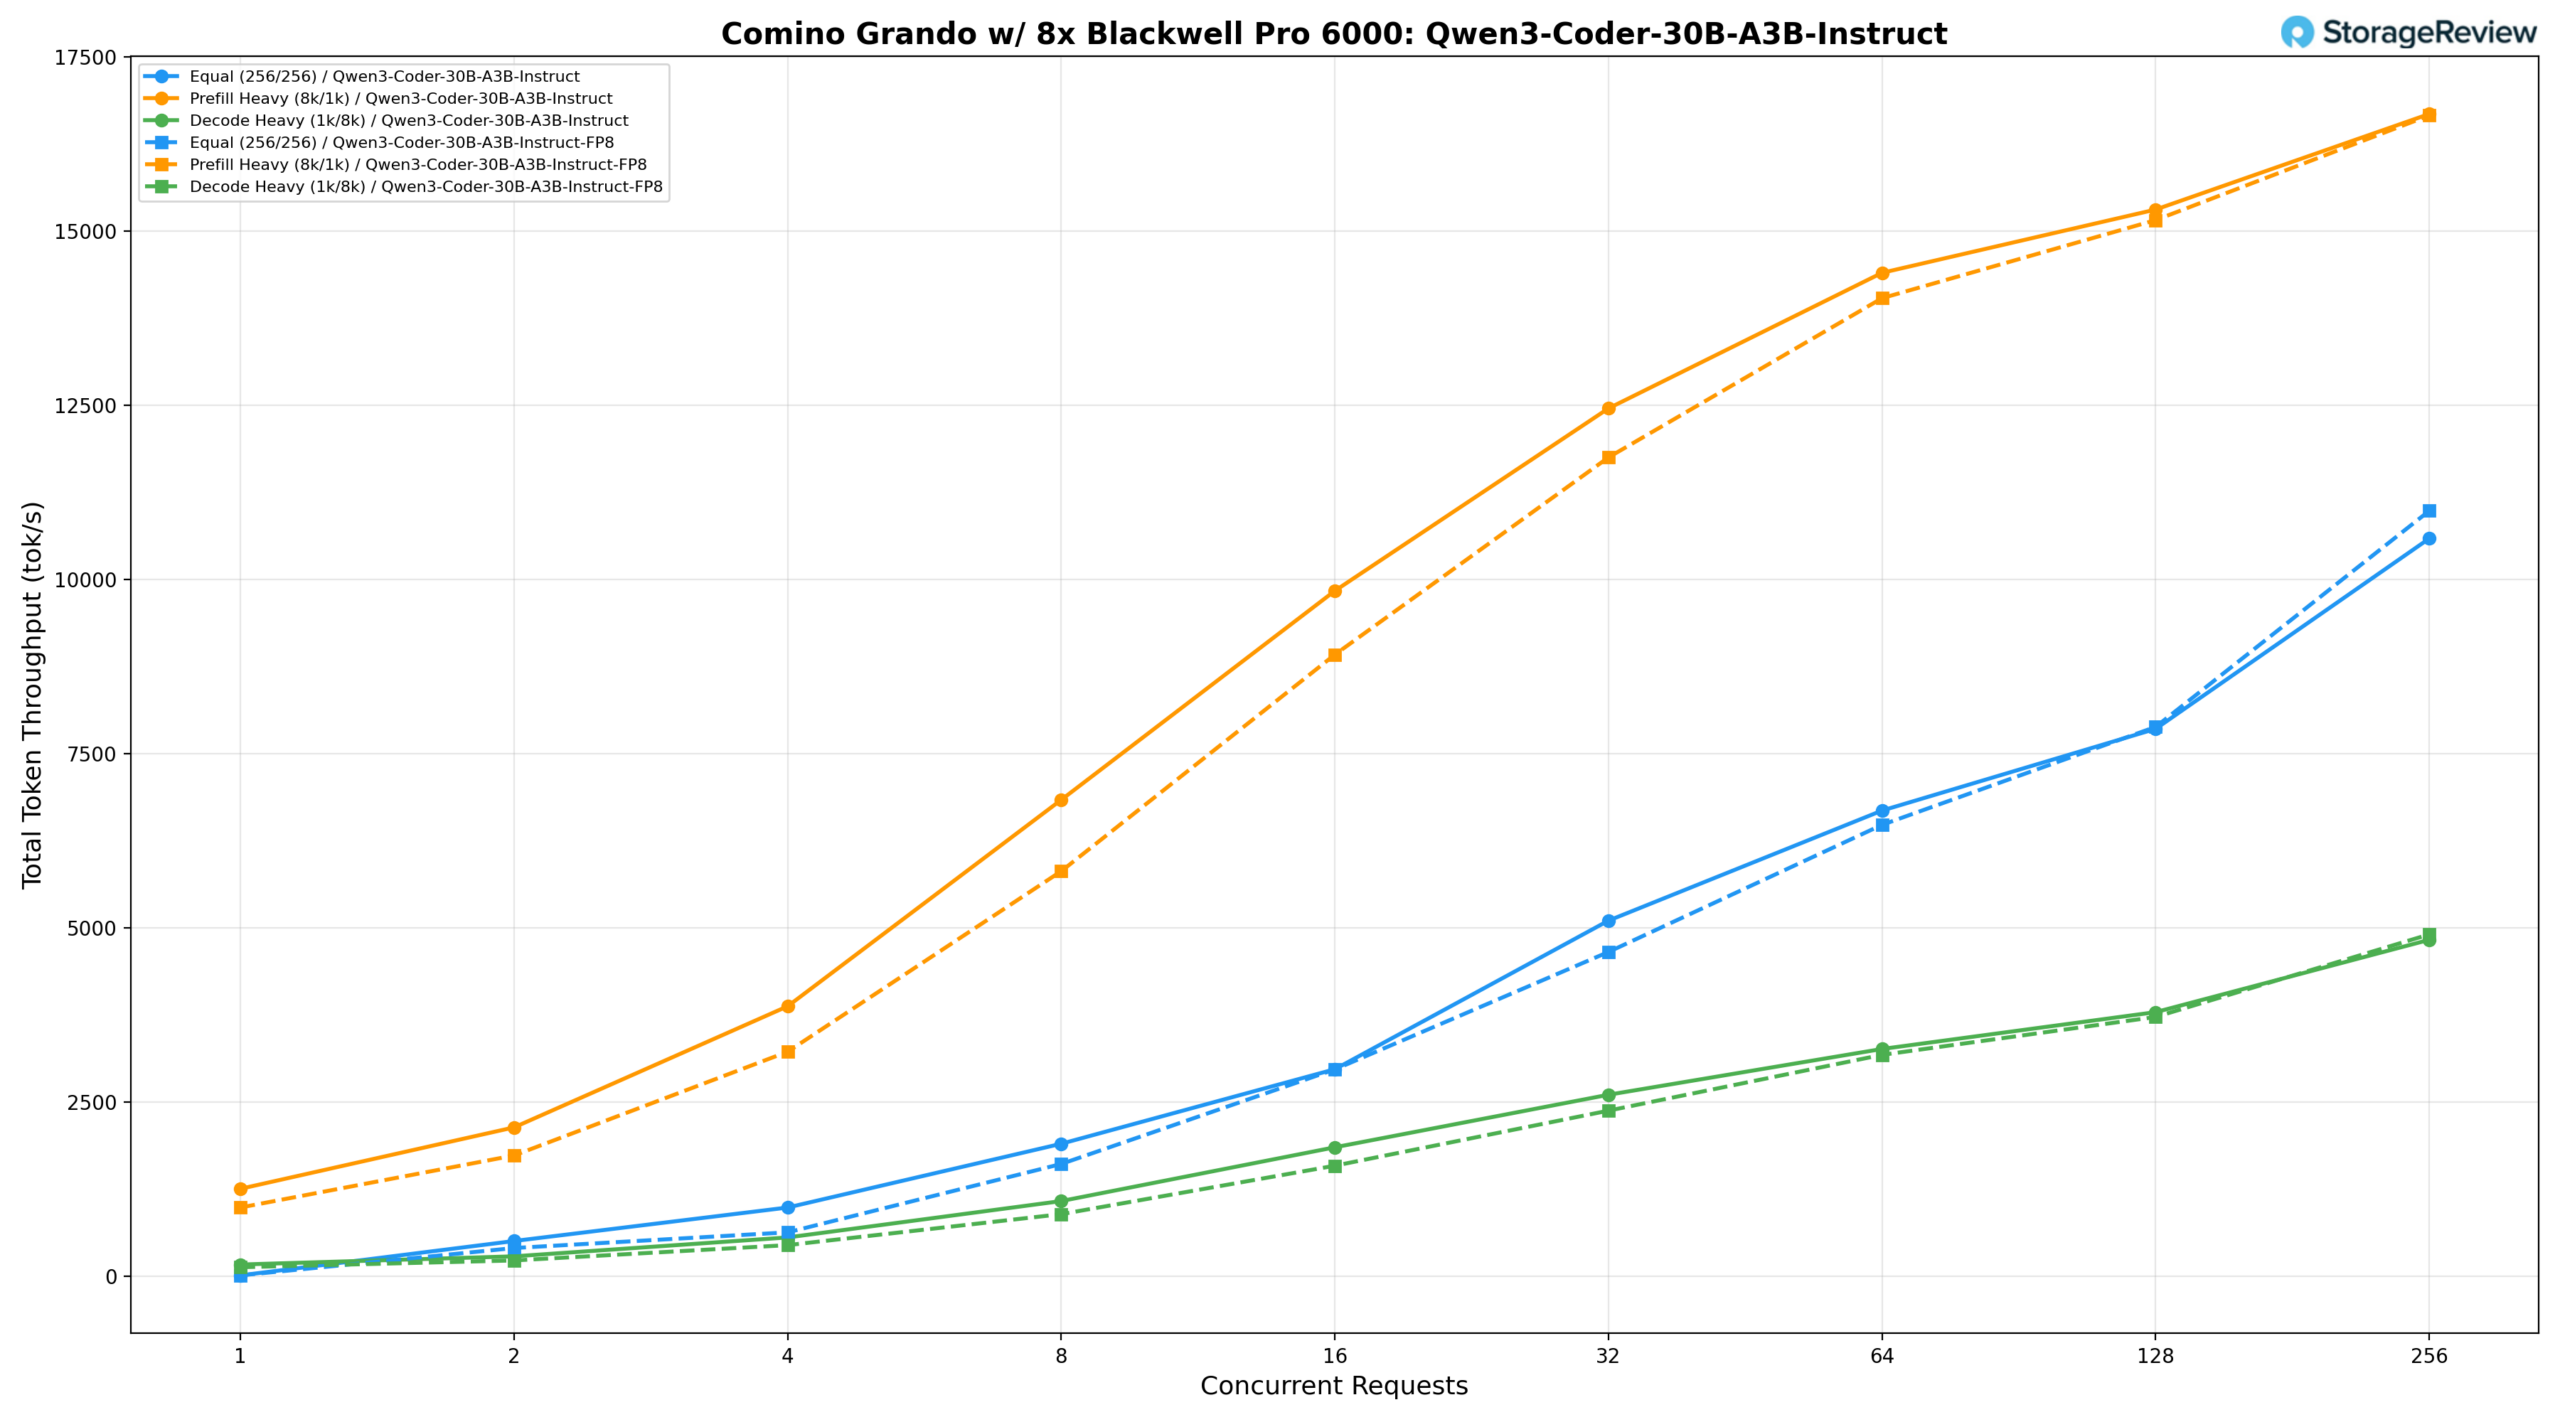
Model Qwen3-Coder-30B-A3B-Instruct bol testovaný s presnosťou BF16 aj FP8.
Inštrukcia Qwen3-Coder-30B-A3B (BF16)
Pri rovnakom zaťažení (256/256) dosahuje model BF16 rýchlosť 1 902,32 tokov/s pri BS=8, dosahuje 6 683,58 tokov/s pri BS=64 a vrcholí na 10 587,56 tokov/s pri BS=256. Rýchlosť s vysokým zaťažením pred naplnením (8k/1k) začína na 1 256,03 tokov/s pri BS=1, stúpa na 14 400,57 tokov/s pri BS=64 a 15 308,35 tokov/s pri BS=128 a vrcholí na 16 679,52 tokov/s pri BS=256. Dekódovacia rýchlosť (1k/8k) rastie zo 169.19 tok/s pri BS=1 na 4 828,82 tok/s pri BS=256, s dobre kontrolovanou latenciou pri nižších úrovniach súbežnosti.
Qwen3-Coder-30B-A3B-Instruct (FP8)
Model FP8 poskytuje priepustnosť porovnateľnú s BF16 vo väčšine scenárov, pričom rovnaké pracovné zaťaženie dosahuje 6 478,54 tokov/s pri BS=64 a vrcholí na 10 984,61 tokov/s pri BS=256, čo je mierne zlepšenie oproti BF16 pri maximálnej súbežnosti. Model s vysokým zaťažením pred napĺňaním začína na 987.48 tokov/s pri BS=1, stúpa na 14 036,46 tokov/s pri BS=64 a 15 156,69 tokov/s pri BS=128 a vrcholí na 16 658,98 tokov/s pri BS=256. Rýchlosť dekódovania sa zvyšuje zo 130.70 tok/s pri BS=1 na 4 906,51 tok/s pri BS=256, čím mierne prekonáva BF16 pri maximálnej súbežnosti, zatiaľ čo obe konfigurácie zostávajú v zvyšku rozsahu súbežnosti úzko zhodné.
Mistral Small 3.1 24B Inštrukt 2503
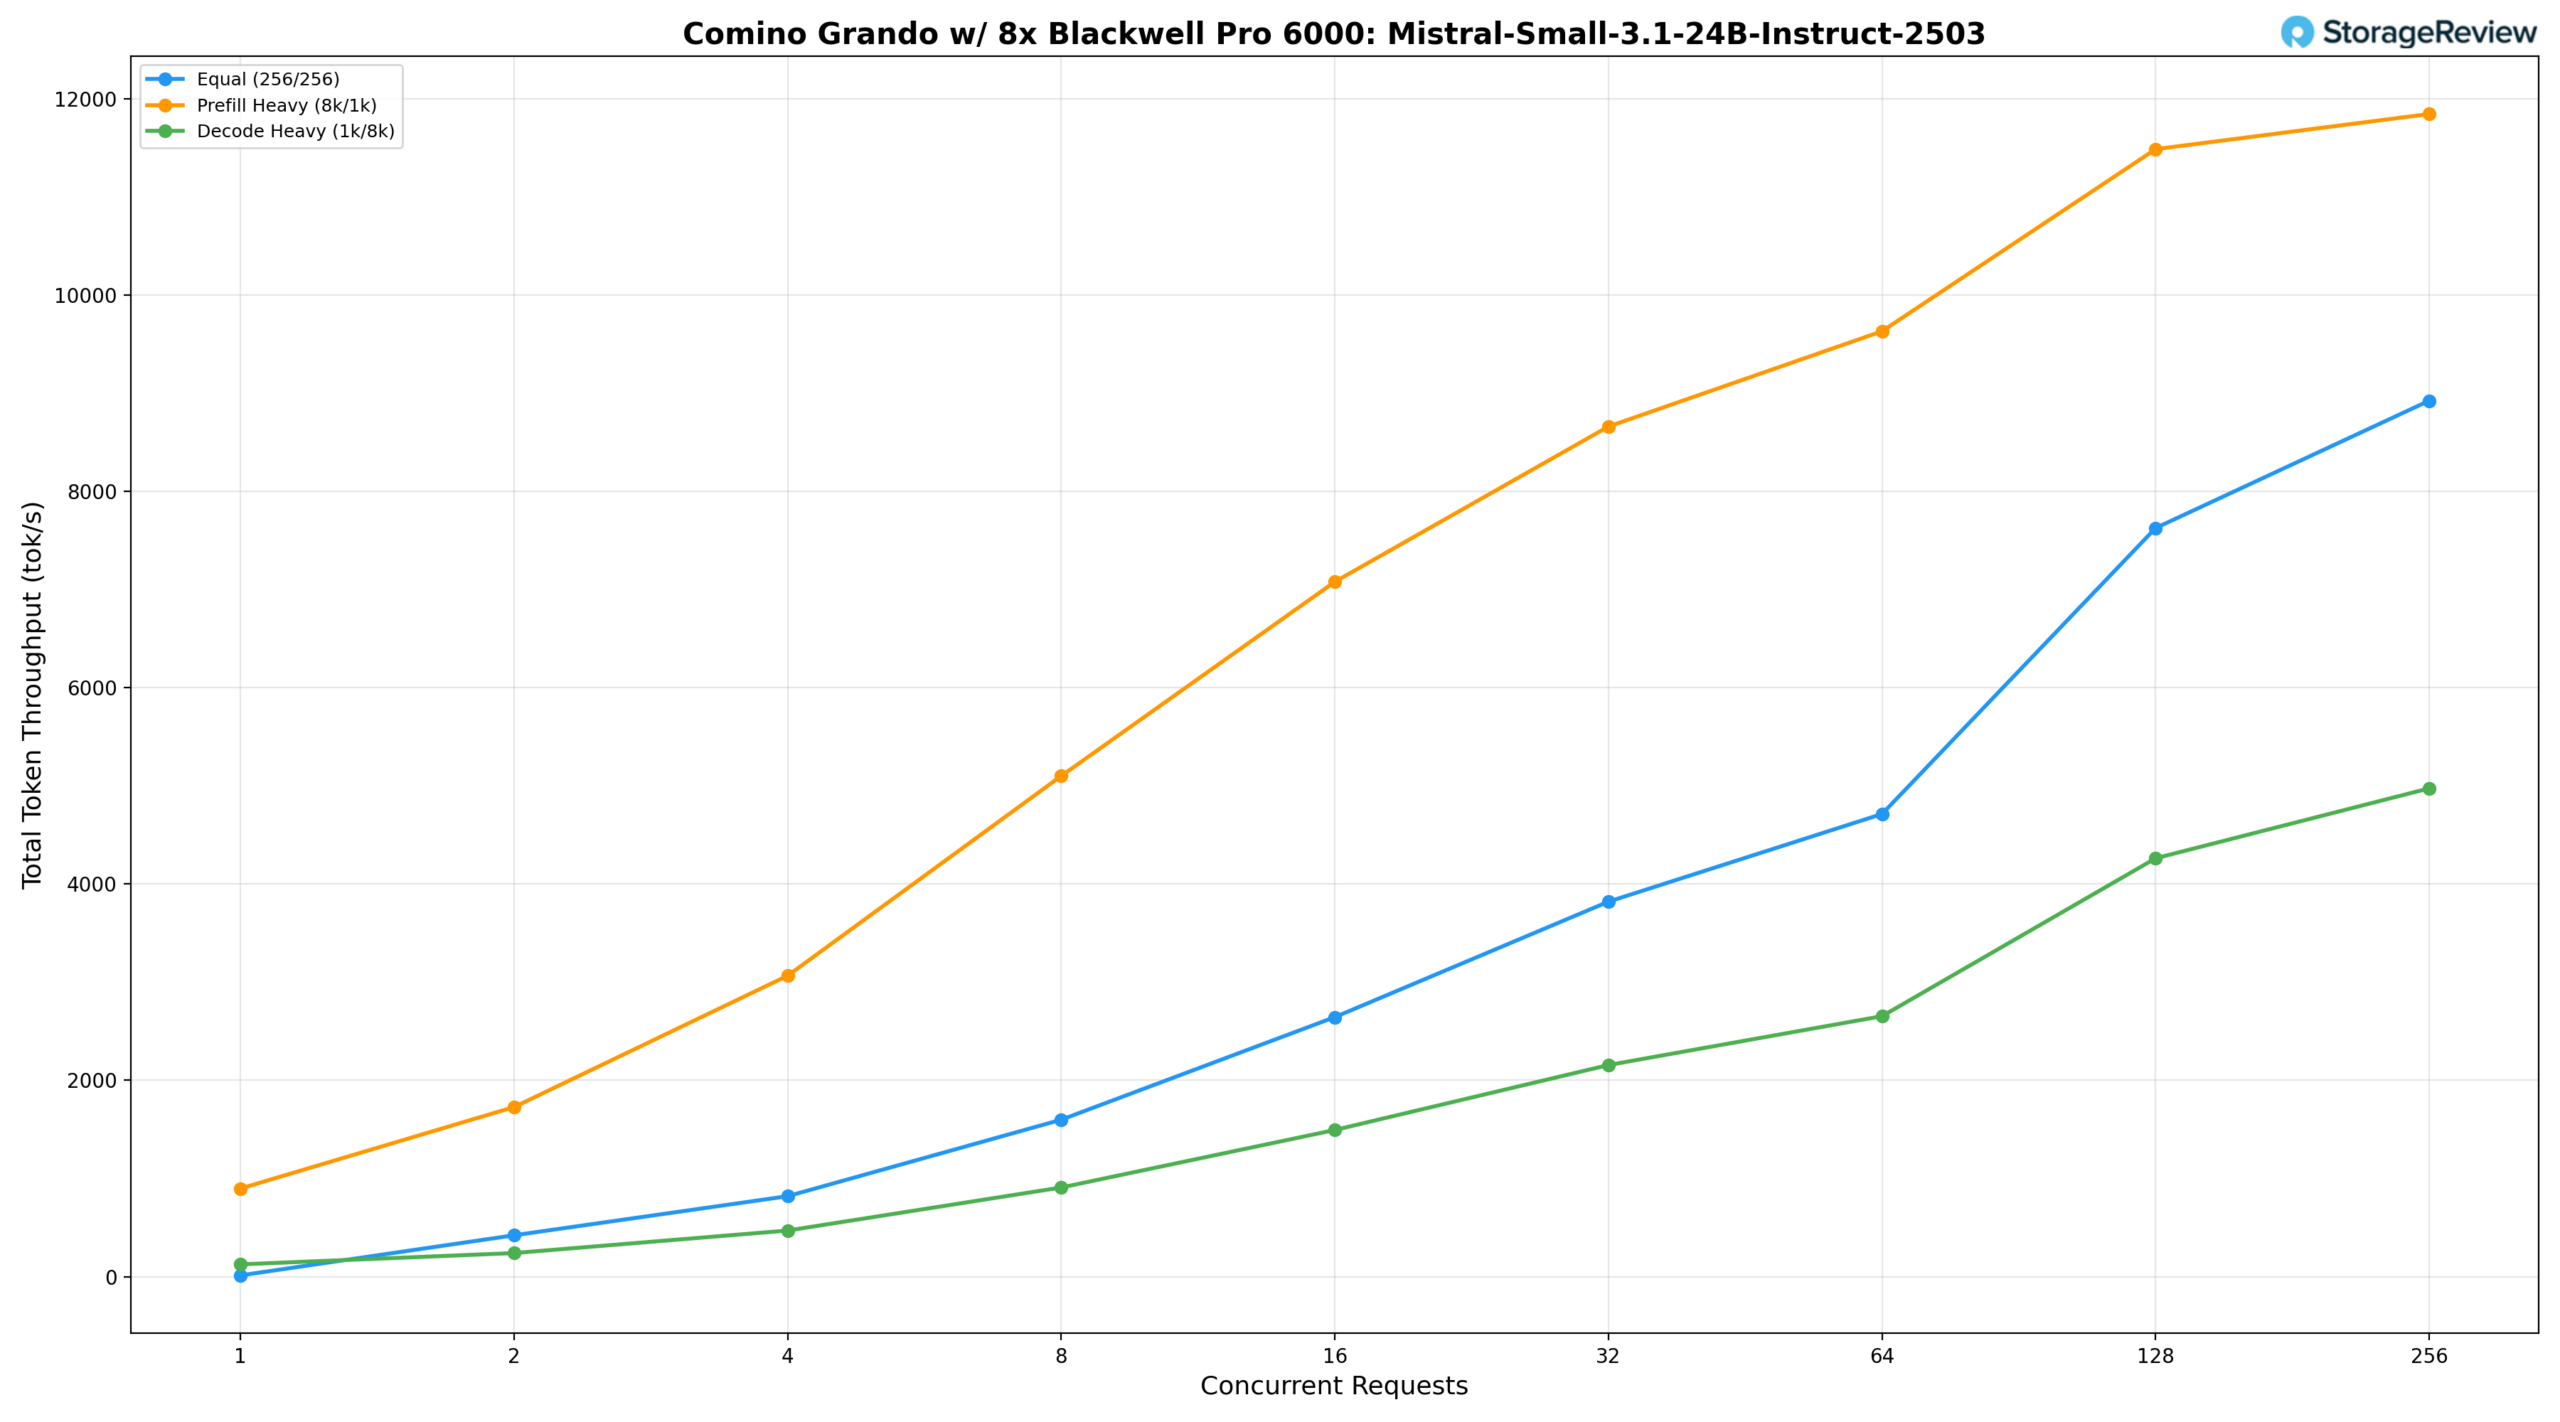
Pri rovnakom zaťažení (256/256) model poskytuje 1 598,79 tok/s pri BS=8, dosahuje 4 713,84 tok/s pri BS=64 a výrazne sa škáluje na 8 925,12 tok/s pri BS=256. Model s vysokým zaťažením pred naplnením (8k/1k) začína na 897.84 tok/s pri BS=1, stúpa na 9 632,58 tok/s pri BS=64 a 11 488,13 tok/s pri BS=128, pričom vrcholí na 11 846,15 tok/s pri BS=256. Dekódovacia rýchlosť (1k/8k) rastie zo 124.98 tok/s pri BS=1 na 2 653,82 tok/s pri BS=64, potom sa pri vyšších úrovniach súbežnosti citeľne zrýchľuje, dosahuje 4 262,53 tok/s pri BS=128 a vrcholí na 4 975,06 tok/s pri BS=256, čo odráža schopnosť modelu udržiavať vysokú dekódovaciu priepustnosť pri škálovaní súbežnosti.
Lama 3.1 8B Inštrukt
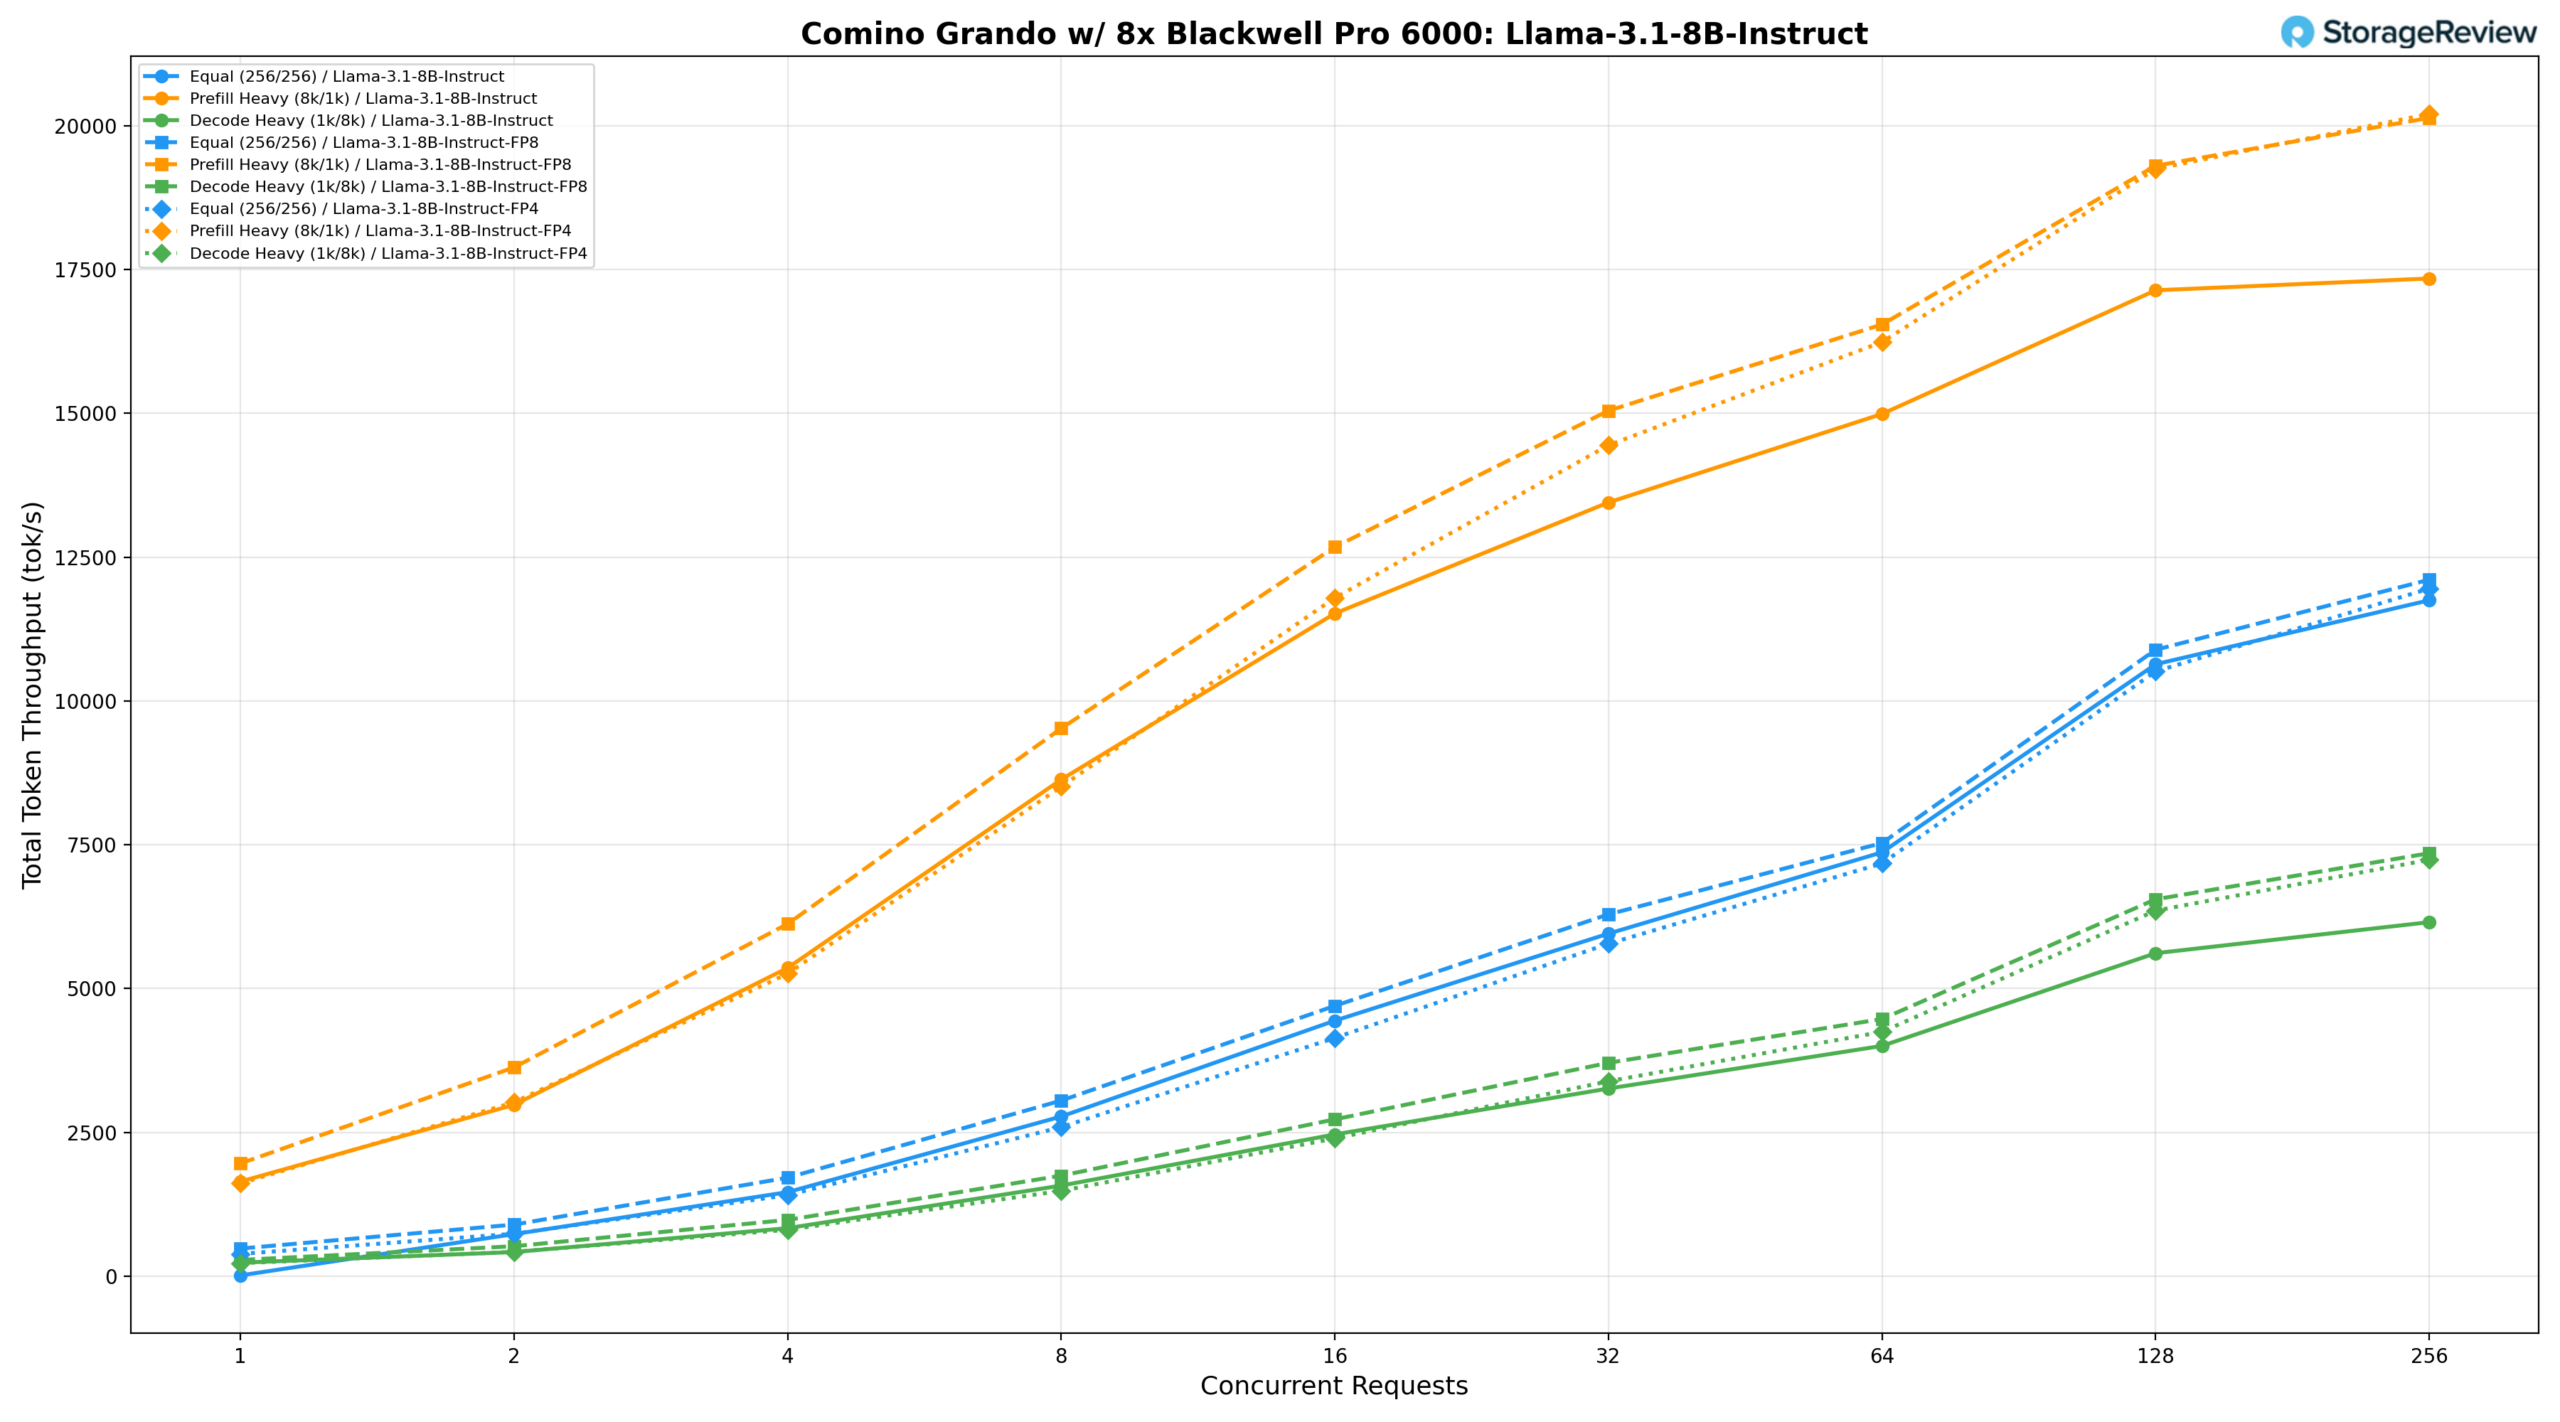
Model Llama-3.1-8B-Instruct bol testovaný v troch konfiguráciách presnosti na zariadení Comino, čo poskytuje jasný pohľad na to, ako kvantizácia ovplyvňuje priepustnosť pre túto veľkosť modelu.
Lama 3.1 8B Inštrukt BF16
Pri rovnakom zaťažení (256/256) dosahuje model BF16 rýchlosť 2 776,42 tokov/s pri BS=8, dosahuje 7 369,01 tokov/s pri BS=64 a vrcholí na 11 751,56 tokov/s pri BS=256. Rýchlosť s vysokým zaťažením pred napĺňaním (8k/1k) začína na 1 645,29 tokov/s pri BS=1, stúpa na 14 990,47 tokov/s pri BS=64 a 17 140,71 tokov/s pri BS=128 a vrcholí na 17 345,80 tokov/s pri BS=256. Rýchlosť s vysokým zaťažením dekódovaním (1k/8k) rastie z 234.78 tokov/s pri BS=1 na 6 154,73 tokov/s pri BS=256.
Lama 3.1 8B Inštruktáž FP8
Kvantizácia FP8 prináša zmysluplné zvýšenie vo všetkých scenároch. Rovnaké zaťaženie dosahuje 7 530,39 tokov/s pri BS=64 a vrcholí na 12 108,98 tokov/s pri BS=256. Zaťaženie s vysokým zaťažením pred naplnením stúpa na 16 546,53 tokov/s pri BS=64 a 19 306,49 tokov/s pri BS=128, vrcholí na 20 137,35 tokov/s pri BS=256, čo je zhruba 16 % nárast oproti BF16 pri maximálnej súbežnosti. Zaťaženie s vysokým zaťažením dekódovaním dosahuje vrchol na 7 353,40 tokov/s pri BS=256, približne o 19 % pred BF16.
Lama 3.1 8B Inštruktáž FP4
FP4 poskytuje priepustnosť, ktorá je pri vyšších úrovniach súbežnosti blízko konkurencieschopná s FP8, hoci pri nižších veľkostiach dávok mierne zaostáva. Rovnaká pracovná záťaž dosahuje vrchol 11 954,40 tak/s pri BS=256 a náročné predfillovanie dosahuje svoj najvyšší bod pri 20 205,57 tak/s pri BS=256, čím tesne predbieha FP8 pri maximálnej súbežnosti. Náročné dekódovanie dosahuje vrchol 7 239,29 tak/s pri BS=256 a zostáva v rámci niekoľkých percent FP8, čo robí z FP4 presvedčivú voľbu, keď je prioritou efektivita pamäte bez významnej straty priepustnosti.
MiniMax M2.5
MiniMax-M2.5 230B, testovaný na Comino Grando, bol najväčší a najnáročnejší model, ktorý sme použili.
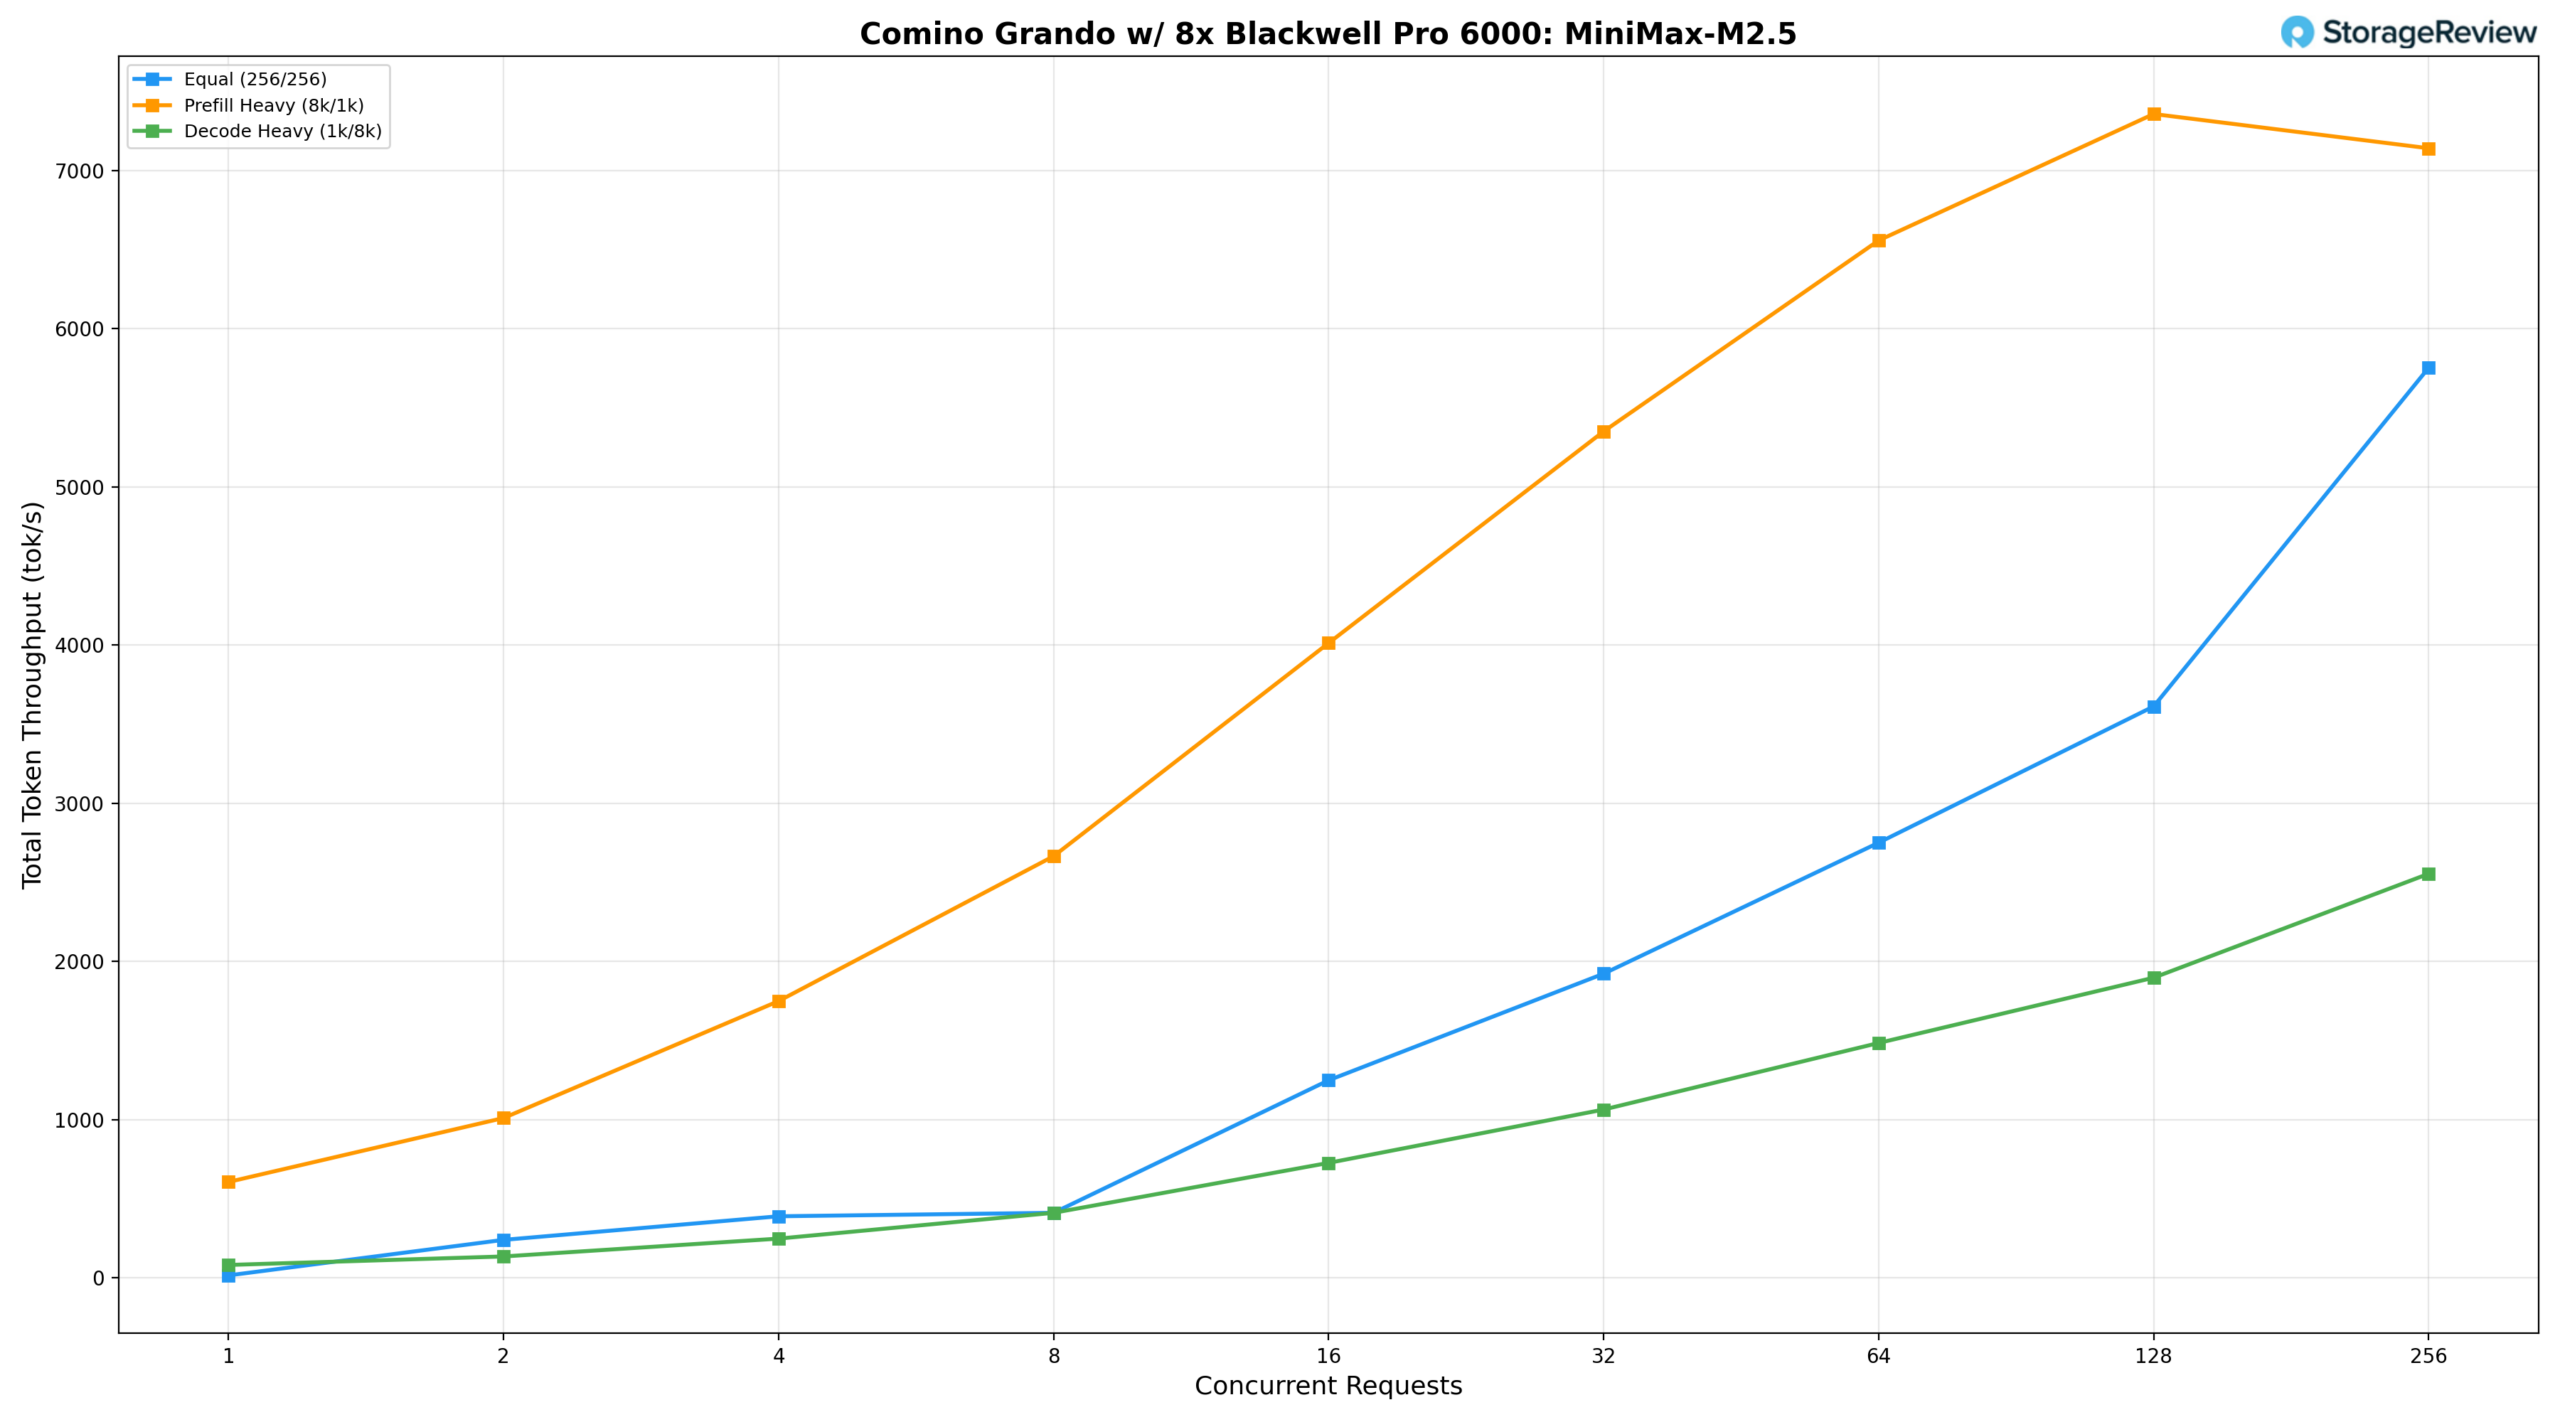
Pri rovnakom zaťažení (256/256) model začína na 16.35 tok/s pri BS=1, dosahuje 2 751,25 tok/s pri BS=64 a silne sa škáluje pri vyššej súbežnosti, pričom vrchol dosahuje na 5 753,24 tok/s pri BS=256. Model s vysokým zaťažením pred naplnením (8k/1k) začína na 606.97 tok/s pri BS=1, stabilne stúpa na 5 351,02 tok/s pri BS=32 a 6 557,92 tok/s pri BS=64, pričom svoj vrchol dosahuje na 7 357,26 tok/s pri BS=128, než mierne klesne na 7 140,74 tok/s pri BS=256, čo naznačuje, že model sa blíži k saturácii v priepustnosti pred naplnením za hranicou BS=128. Dekódovanie náročné (1k/8k) konzistentne rastie z 82.21 takt/s pri BS=1 na 1 485,28 takt/s pri BS=64, pričom vrchol dosahuje 2 554,87 takt/s pri BS=256, čo odráža očakávané nároky na šírku pásma pamäte architektúry 230B MoE pri trvalom dekódovacom zaťažení.
Záver
Comino Grando možno najlepšie chápať ako systém navrhnutý tak, aby odomkol plný potenciál ôsmich grafických kariet NVIDIA RTX PRO 6000. Každé dôležité konštrukčné rozhodnutie, od obráteného rozloženia základnej dosky až po chladiaci okruh a integrovaný monitorovací zásobník, má zabezpečiť, aby tieto grafické karty mohli nepretržite pracovať s plným TDP 600 W bez tepelných alebo energetických obmedzení.
To, čo robí Grando pútavým, nie je žiadna samostatná funkcia, ale spôsob, akým celý systém funguje. Chladenie kvapalinou nie je nejakým dodatočným doplnkom; je to architektúra. Napájanie je redundantné, hot-swappable a škálovateľné na záťaž 4 800 W ôsmich 600 W kariet s rezervou. Monitorovací systém ide nad rámec hlásenia teplôt; autonómne chráni hardvér, keď sa niečo pokazí. Nič tu nepôsobí ako dodatočná myšlienka.
Výkonnostné čísla túto súdržnosť posilňujú. V rámci rozmanitej sady modelov, od Llama 3.1 8B až po 230B MiniMax M2.5, Grando dosiahol hodnoty priepustnosti, ktoré sú pre platformu s vlastným hostingom dostatočne vysoké. Testovanie súbežnosti Claude Code zdôraznilo praktickú hodnotu: osem inžinierov môže spúšťať simultánne agentické kódovacie relácie na lokálne hostovanom modeli 230B pri interaktívnych rýchlostiach, pričom priepustnosť na používateľa presahuje 38 taktov/s pri špičkovom súhrnnom výkone. Tímy štyroch až ôsmich členov môžu pracovať s takmer optimálnou priepustnosťou bez badateľného zhoršenia výkonu.
Hodnota tejto konfigurácie presahuje rámec inferencie umelej inteligencie. Vďaka 96 GB VRAM na GPU a hustému škálovaniu viacerých GPU je platforma rovnako vhodná pre náročné kreatívne aj inžinierske pracovné úlohy vrátane renderovania VFX, rozsiahlych simulácií a komplexných CAD procesov. Systém sa dá škálovať na konfigurácie so štyrmi a dvoma GPU, čím sa táto úroveň výkonu sprístupňuje aj menším štúdiám a tímom, ktoré stále vyžadujú hustotu na úrovni pracovných staníc.
Grando sa od podnikových platforiem s ôsmimi grafickými procesormi, ktoré sme recenzovali, najviac líši v praktickosti nasadenia. Tieto systémy ponúkajú väčší priestor pre linky PCIe, viac slotov pre sieťové karty a hlbšiu konektivitu úložiska, ale vyžadujú si aj vyhradenú infraštruktúru dátového centra, spotrebúvajú viac ako 8 kW a majú dodacie lehoty, ktoré sa môžu predĺžiť na viac ako rok. Grando obetuje časť tejto rozšíriteľnosti periférií za systém, ktorý beží dostatočne ticho na to, aby sa s používateľmi delil o miestnosť, rozptyľuje menej tepla do okolitého prostredia a dodáva sa ihneď. Pre organizácie, ktoré uprednostňujú rýchle nasadenie a spravovateľné operačné prostredie pred maximálnou konektivitou siete Fabric, je tento kompromis priaznivý.
Stránka produktu – Comino Grando
Konfigurátor Comino – Strana
Rebríček: Comino Grando RTX PRO 6000 drží priečku Extreme Pick v našom rebríčku Najlepšie stolové počítače pre lokálnu umelú inteligenciu.


 Amazonka