

Trh s infraštruktúrou umelej inteligencie sa nepohybuje jedným smerom; rozdeľuje sa na dva odlišné svety. Na jednej strane sú klastre pre hraničné vzdelávanie, vybudované na vývoj základných modelov v masívnom meradle, úzko prepojené s proprietárnymi štruktúrami a úzkym súborom akcelerátorov. Na druhej strane je rýchlo sa rozširujúca realita podnikovej inferencie, kde organizácie nasadzujú modely na obsluhu používateľov, spracovanie aktuálnych údajov a generovanie merateľnej obchodnej hodnoty. Dell PowerEdge XE7740 je navrhnutý výslovne pre tento druhý svet.
Kľúčové poznatky
- PowerEdge XE7740 je navrhnutý pre podnikové inferencie, s dvojzónovým tepelným systémom, štruktúrovanou topológiou PCIe Gen5 a škálovateľnou sieťou prispôsobenou skutočným produkčným záťažiam.
- Rovnováha systému je zámerná, kombinácia hustoty jadier Xeon 6, vysokej šírky pásma pamäte a PCIe Gen 5 E3.S NVMe na podporu odľahčenia a orchestrácie vyrovnávacej pamäte KV.
- Flexibilita kremíka je základom, podpora širokej škály akcelerátorov PCIe Gen5 bez nútenej zmeny infraštruktúry.
- Platforma sa časom bez problémov škáluje, od čiastočného osadenia GPU v jednom šasi až po distribuovanú inferenciu naprieč rackmi s využitím ôsmich zadných vyhradených sieťových slotov Gen5 x16.
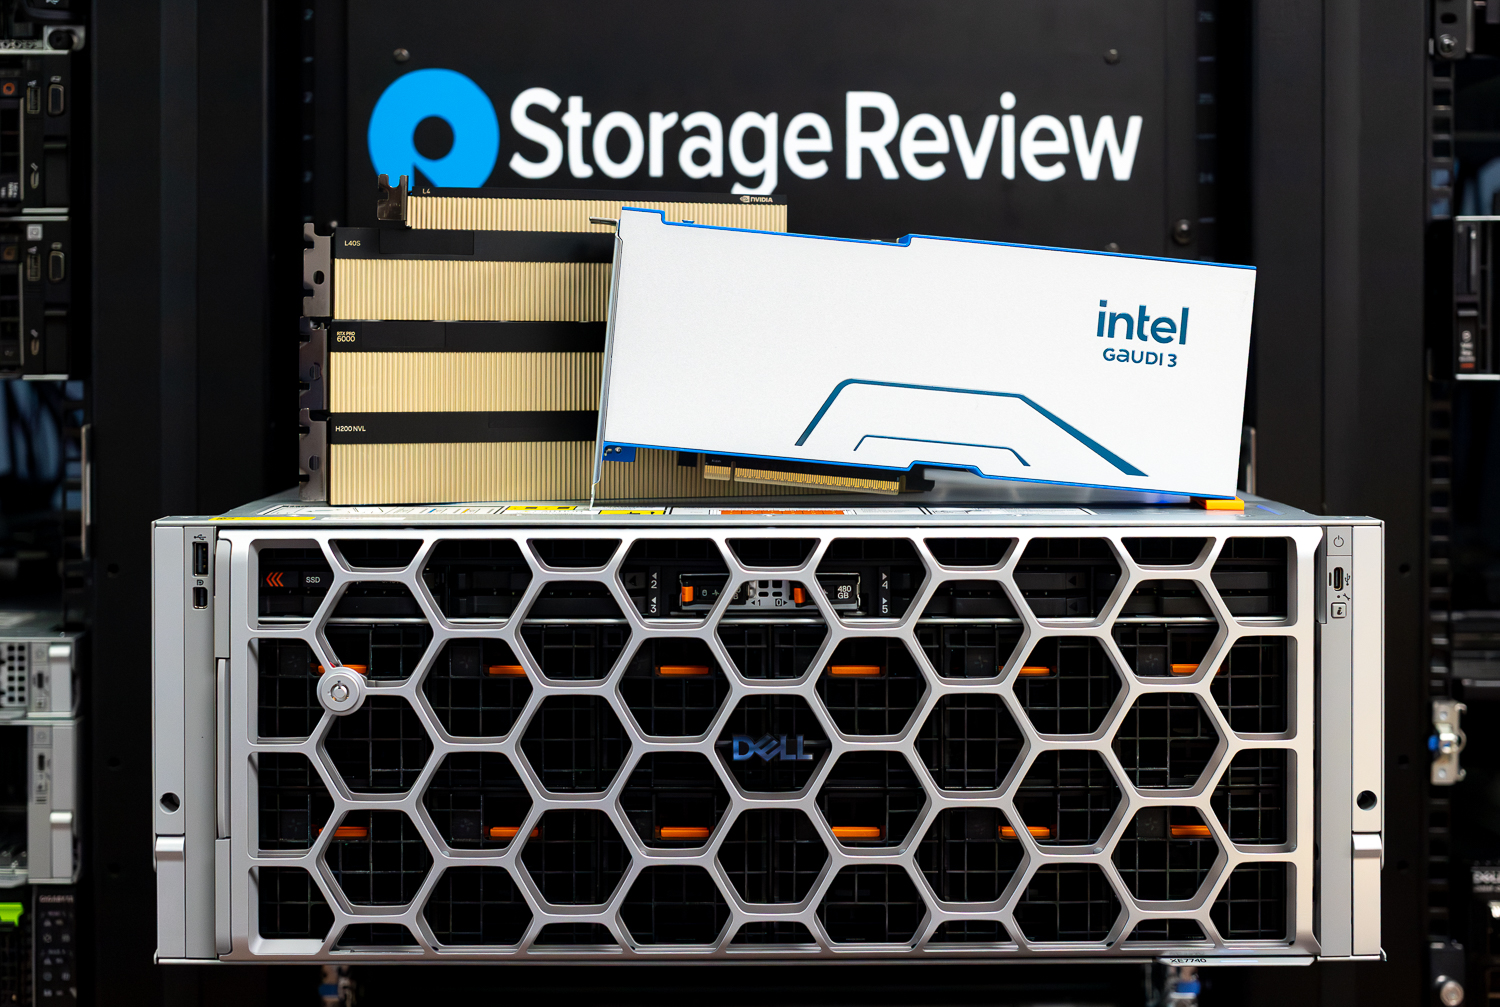
Jadrom XE7740 je záväzok k diverzite kremíkových technológií. Namiesto toho, aby spoločnosť Dell viazala platformu na jeden akcelerátor, vytvorila systém, ktorý sa prispôsobuje dostupnosti, nákladom a pripravenosti organizácie. XE7740 podporuje celý rad akcelerátorov PCIe Gen5 vrátane grafických kariet NVIDIA RTX PRO 6000, H100/200, L40S, L4 a A16 pre organizácie, ktoré si cenia kompatibilitu so širokým ekosystémom, a Intel Gaudi 3 pre tímy hľadajúce nákladovo efektívnejšiu a ľahko dostupnú cestu inferencie. Akcelerátory Gaudi 3 sú dostupné už dnes a umožňujú organizáciám prejsť od plánovania k nasadeniu bez oneskorení pri obstarávaní, ktoré často formujú stratégiu akcelerátorov.
Keďže sa inferencia stáva dominantnou pracovnou záťažou v oblasti umelej inteligencie, dôležitá je dostupnosť a nákladová štruktúra. Väčšina podnikov netrénuje modely na hraniciach možností. Prevádzkujú inferenčné kanály, obsluhujú stredne veľké jazykové modely, zabezpečujú pracovné postupy generovania s rozšíreným vyhľadávaním a nasadzujú počítačové videnie v produkčnom prostredí. V tomto kontexte je Gaudi 3 umiestnený ako jeden z najdostupnejších moderných inferenčných akcelerátorov na trhu a ponúka modernú architektúru s pamäťou s vysokou šírkou pásma a škálovateľnosťou založenou na Ethernete bez cenového profilu vlajkových trénovacích GPU. V rámci XE7740 sa Gaudi 3 menej zameriava na nahradenie a viac na umožnenie udržateľného nasadenia inferencie.
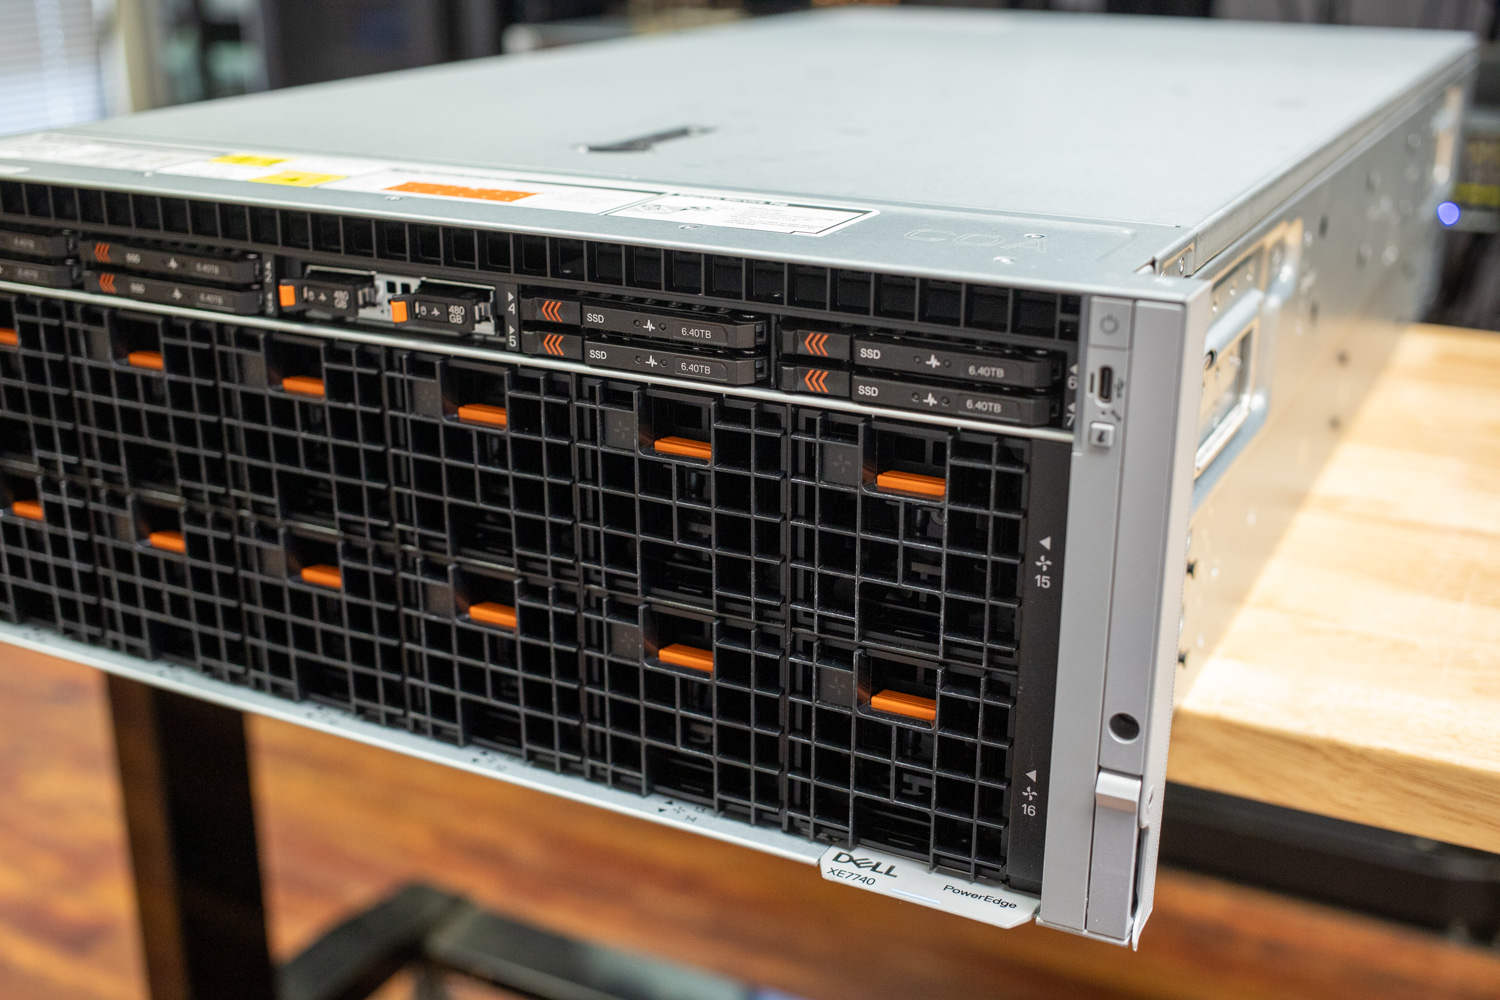
Platforma obklopujúca akcelerátory je rovnako premyslená. XE7740 je postavený na procesoroch Intel Xeon 6 a v systémoch zameraných na inferenciu zostáva CPU kritickou súčasťou. Vysoký počet jadier a zvýšená šírka pásma pamäte poskytujú potrebný priestor pre plánovače, tokenizáciu, predspracovanie a orchestráciu, ktoré sa nachádzajú priamo na kritickej ceste inferencie. Predné úložisko E3.S NVMe ďalej podporuje lokálne staging dát a odľahčenie vyrovnávacej pamäte KV, čím sa znižuje zaťaženie akcelerátora a zlepšuje celková efektivita systému. Tento vyvážený dizajn odráža pochopenie, že výkon inferencie je formovaný celým systémom, nie iba akcelerátormi.
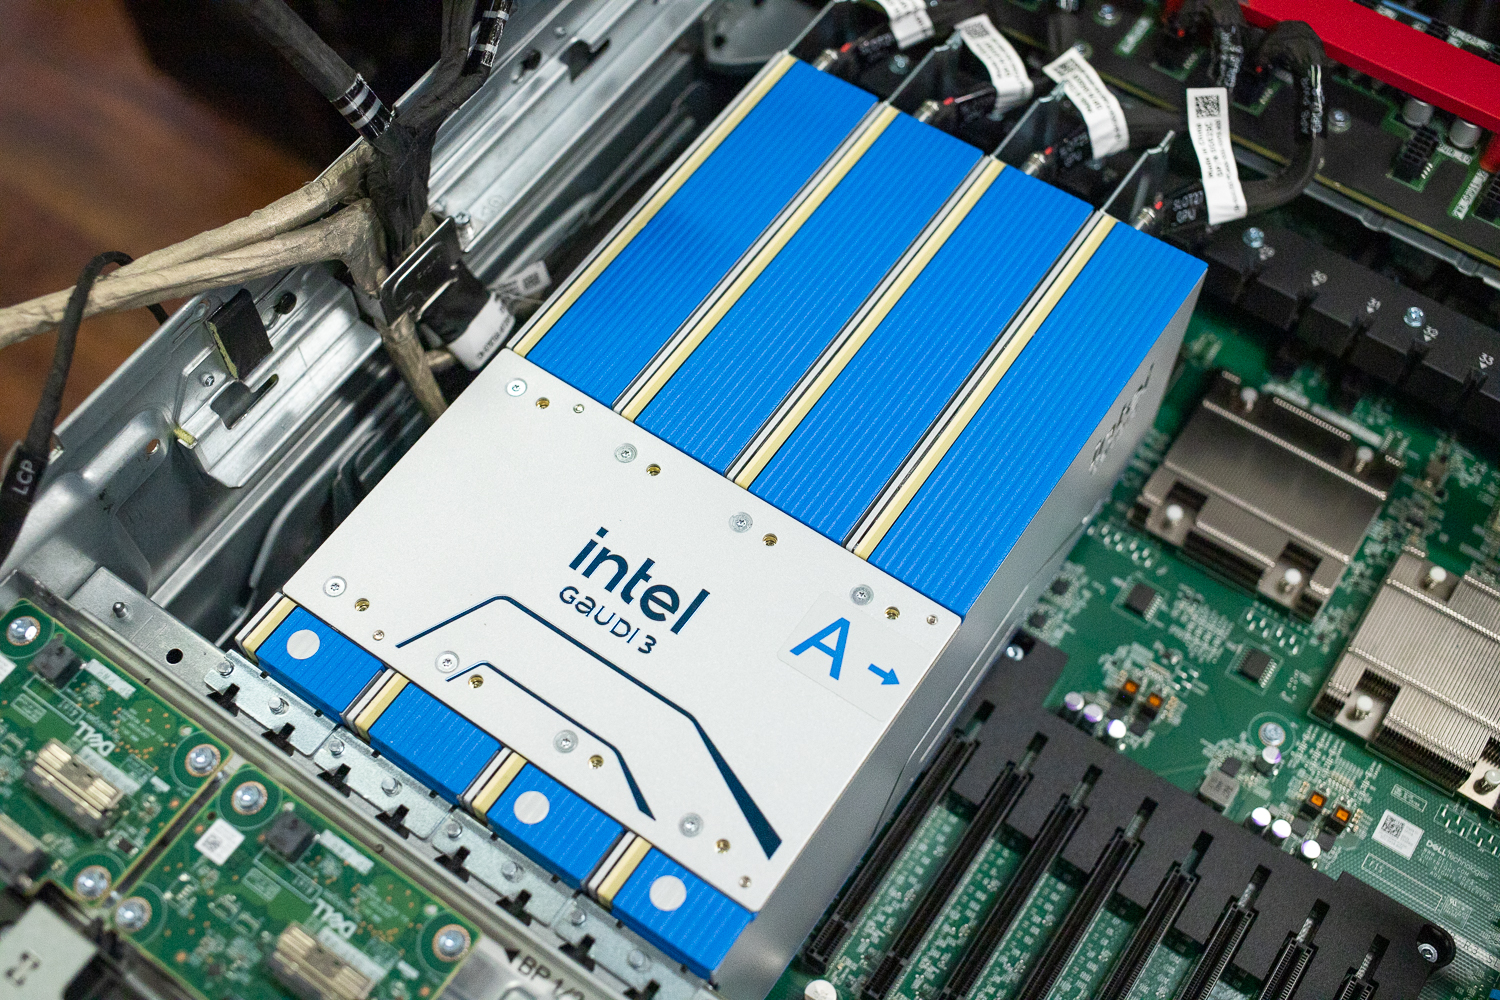
XE7740 je tiež navrhnutý tak, aby sa v priebehu času ľahko škáloval. Organizácie môžu začať s miernou konfiguráciou, ako sú dva alebo štyri akcelerátory, a získať okamžitú hodnotu bez toho, aby museli úplne osadiť šasi. S rastúcimi požiadavkami sa tá istá platforma môže škálovať vertikálne alebo prejsť na distribuovanú inferenciu. Osem zadných slotov PCIe Gen5 x16 poskytuje vyhradenú šírku pásma pre vysokorýchlostné siete, čo umožňuje XE7740 slúžiť ako stavebný kameň pre škálovateľné inferenciálne klastre. Voliteľná podpora DPU túto flexibilitu ďalej rozširuje odľahčením sieťových a komunikačných úloh počas vývoja nasadení.
Kľúčové špecifikácie servera Dell PowerEdge XE7740
| špecifikácia | PowerEdge XE7740 |
|---|---|
| Funkcie PowerEdge XE7740 | |
| procesor | Dva procesory Intel® Xeon® radu 6 s až 86 jadrami na procesor |
| Slots | |
| PCIe akcelerátory | 8x PCIe Gen 5 x16 DW-FHFL až do 600 W, alebo
16x PCIe Gen 5 x16 SW-FHFL až do 75 W |
| PCIe sieťové karty |
|
| Tvarový faktor | |
| Tvarový faktor | 4U rackový server |
| Memory Masážne stoly | |
| Rýchlosť DIMM, maximálna kapacita | Až 6400 MT/s, max. 4 TB |
| Sloty pre pamäťové moduly | 32 slotov DDR5 DIMM Podporuje iba registrované ECC DDR5 RDIMM. |
| Uskladnenie | |
| Predné pozície | Až 8 x EDSFF E3.S Gen5 NVMe (SSD) max. 122.88 TB |
| Regulátory úložiska | |
| Interné bootovanie | Úložný subsystém optimalizovaný pre bootovanie (BOSS-N1 DC-MHS): HWRAID 1, 2 x M.2
NVMe SSD |
| Zdroj | |
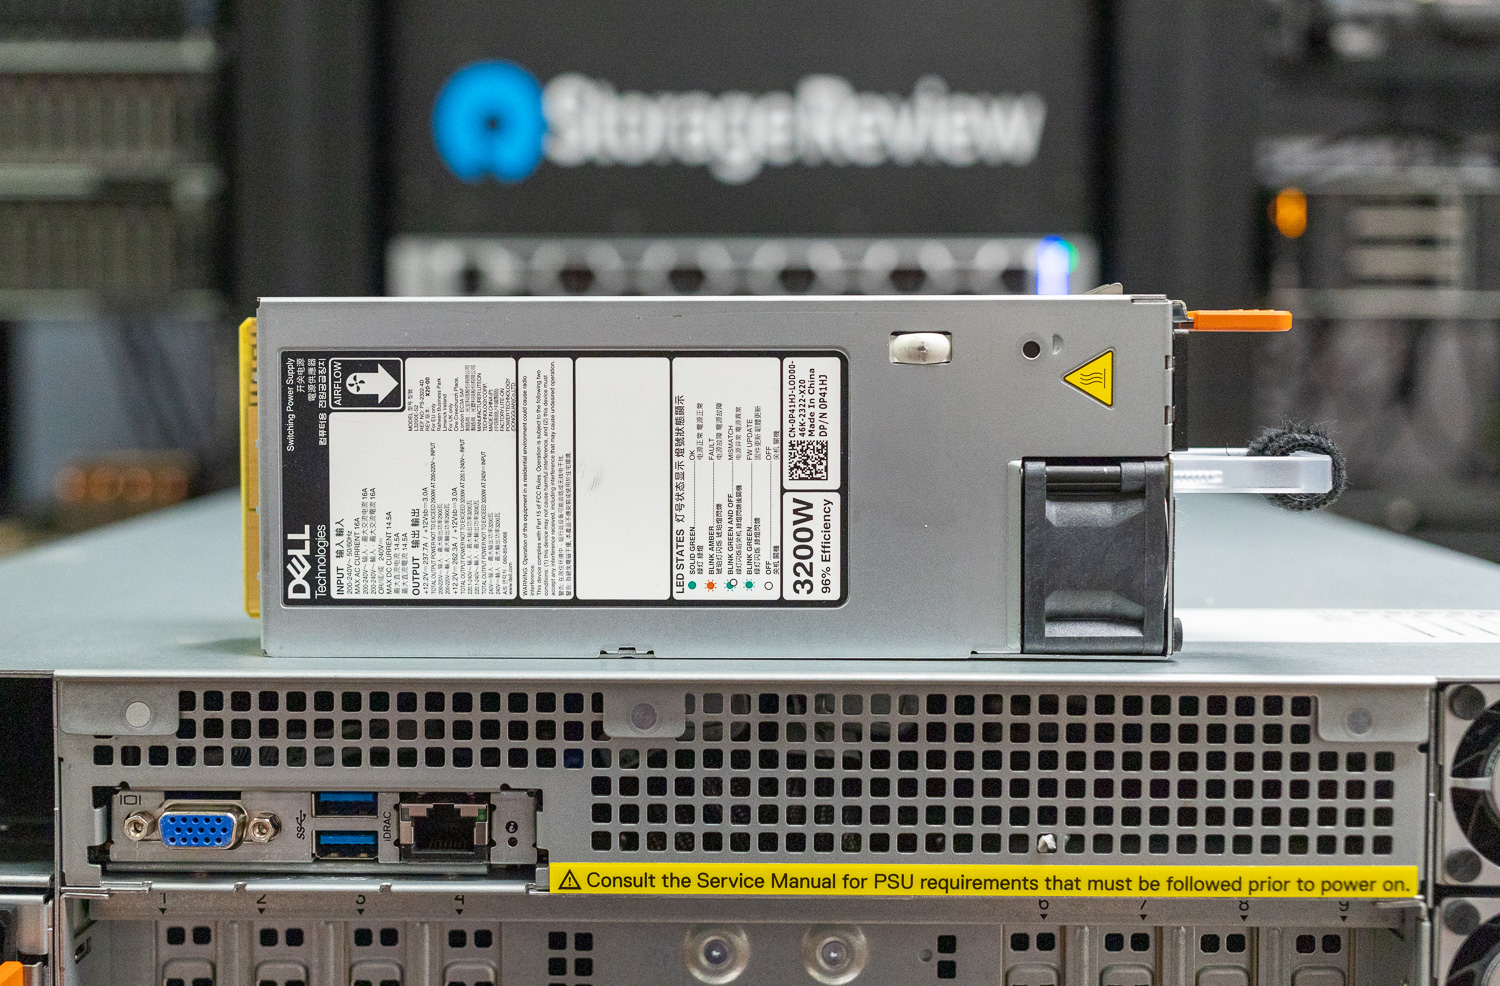
| Zdroj | 3200 W titánový 200 – 240 V AC alebo 240 V DC, redundantná výmena za chodu
Viackapacitný zdroj s výkonom 3200 W:
Viackapacitný zdroj s výkonom 2400 W:
UPOZORNENIE: Systém vyžaduje aspoň jeden zdroj napájania (PSU) v zóne CPU a jeden zdroj napájania (PSU) v zóne GPU na udržanie napájania BMC a v pohotovostnom režime. Ak v zóne GPU nie je nainštalovaný žiadny zdroj napájania, systém zostane v režime pozastavenia. Pre zabezpečenie úplnej redundancie nainštalujte do každej zóny N+N zdrojov napájania: 1+1 v zóne CPU a 3+3 v zóne GPU. Odstránenie všetkých zdrojov napájania zo zóny CPU, keď je systém zapnutý, spôsobí okamžité vypnutie a môže viesť k strate údajov. |
| Možnosti chladenia | |
| Možnosti chladenia | Chladenie vzduchom |
| fanúšikovia | Až štyri sady vysokovýkonných (HPR) ventilátorov platinovej triedy (duálny ventilátorový modul) nainštalované v strednom zásobníku
Až dvanásť vysokovýkonných (HPR) ventilátorov platinovej triedy nainštalovaných na prednej strane systému Všetky sú ventilátory s možnosťou výmeny za chodu |
| porty | |
| Možnosti siete | 1 PCIe Gen 5 kompatibilný OCP 3.0 I/O (podporovaný linkami x8 PCIe) |
| Predné porty | 1 x USB 2.0 typu A (voliteľné) 1 x Mini-DisplayPort (voliteľné) 1 x USB 2.0 typu C s duálnym režimom (port Host/iDRAC Direct) |
| Zadné porty | 1 x vyhradený port iDRAC/BMC Direct Ethernet 2 x port USB 3.1 typu A 1 x VGA |
| Interné porty | 1 x USB 3.1 typ A |
Návrh a výroba XE7740
Dvojzónová architektúra: Oddelenie CPU a GPU
Jednou z najvýraznejších dizajnových volieb v XE7740 je jej fyzické rozdelenie na dve odlišné tepelné a napájacie zóny. Horná 1U sekcia obsahuje zónu CPU, ktorá obsahuje oba procesory Xeon 6, všetkých 32 slotov DIMM, úložisko a modul správy DC-SCM. Zóna CPU využíva štyri sady vysokovýkonných modulov s dvoma ventilátormi (40 × 40 × 56 mm), ktoré poskytujú prúdenie vzduchu 47.4 CFM.
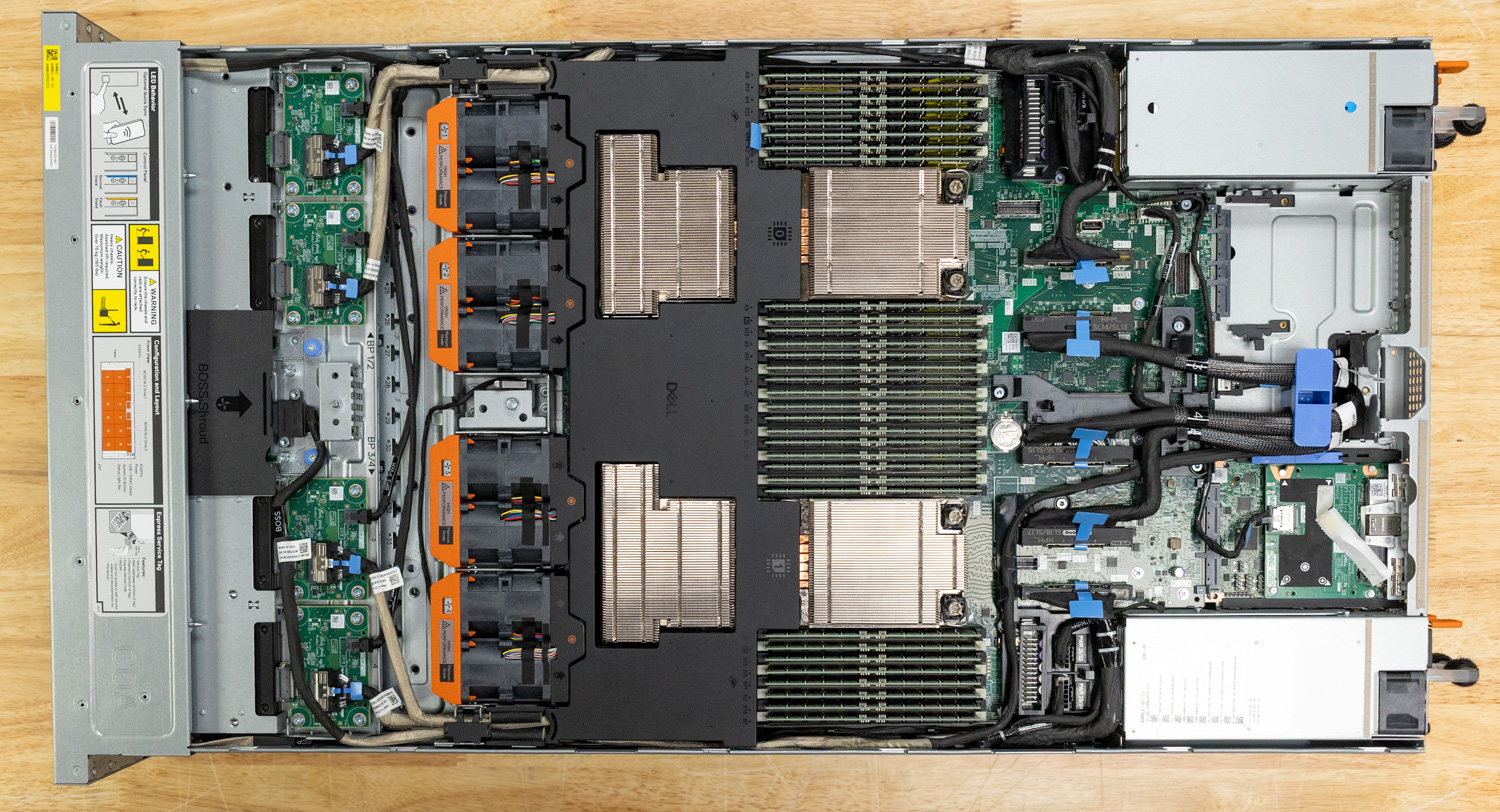
Spodná 3U sekcia je zóna GPU, ktorá obsahuje všetky sloty akcelerátorov s vlastnou chladiacou infraštruktúrou spolu so základnou doskou PCIe (PBB), rozširujúcimi slotmi PCIe smerujúcimi dozadu a pripojením OCP NIC. Zóna GPU využíva dvanásť väčších vysokovýkonných ventilátorov (60 × 60 × 56 mm) s výrazne vyššou kapacitou prúdenia vzduchu až do 122.2 CFM na ventilátor v porovnaní s ventilátormi CPU. Všetky ventilátory sú vymeniteľné za chodu. Tento dvojzónový prístup k chladeniu znamená, že tepelné nároky akcelerátorov s vysokým TDP (až 600 W na kartu) neohrozujú chladenie CPU a pamäte a naopak, v 19-palcovom štandardnom racku.
Spoločnosť Dell venovala v modeli XE7740 veľkú pozornosť optimalizácii prúdenia vzduchu. Systémy s vysokou hustotou akcelerátorov si prirodzene vyžadujú rozsiahlu internú kabeláž vrátane pomocných napájacích káblov GPU, signálnych káblov PCIe medzi doskou HPM a PBB a pripojení dosky ventilátorov. V modeli XE7740 sú tieto káble vedené pozdĺž bočných stien šasi pomocou špeciálnych držiakov káblov a krytov káblov. Každý kábel je vyrobený v presne požadovanej dĺžke; vo vnútri systému nie sú žiadne nadbytočné zväzky káblov. Vďaka tomu, že kabeláž nie je v centrálnom kanáli prúdenia vzduchu, dizajn zachováva voľnú cestu prúdenia vzduchu spredu dozadu a minimalizuje impedanciu v chladiacich zónach CPU aj GPU.
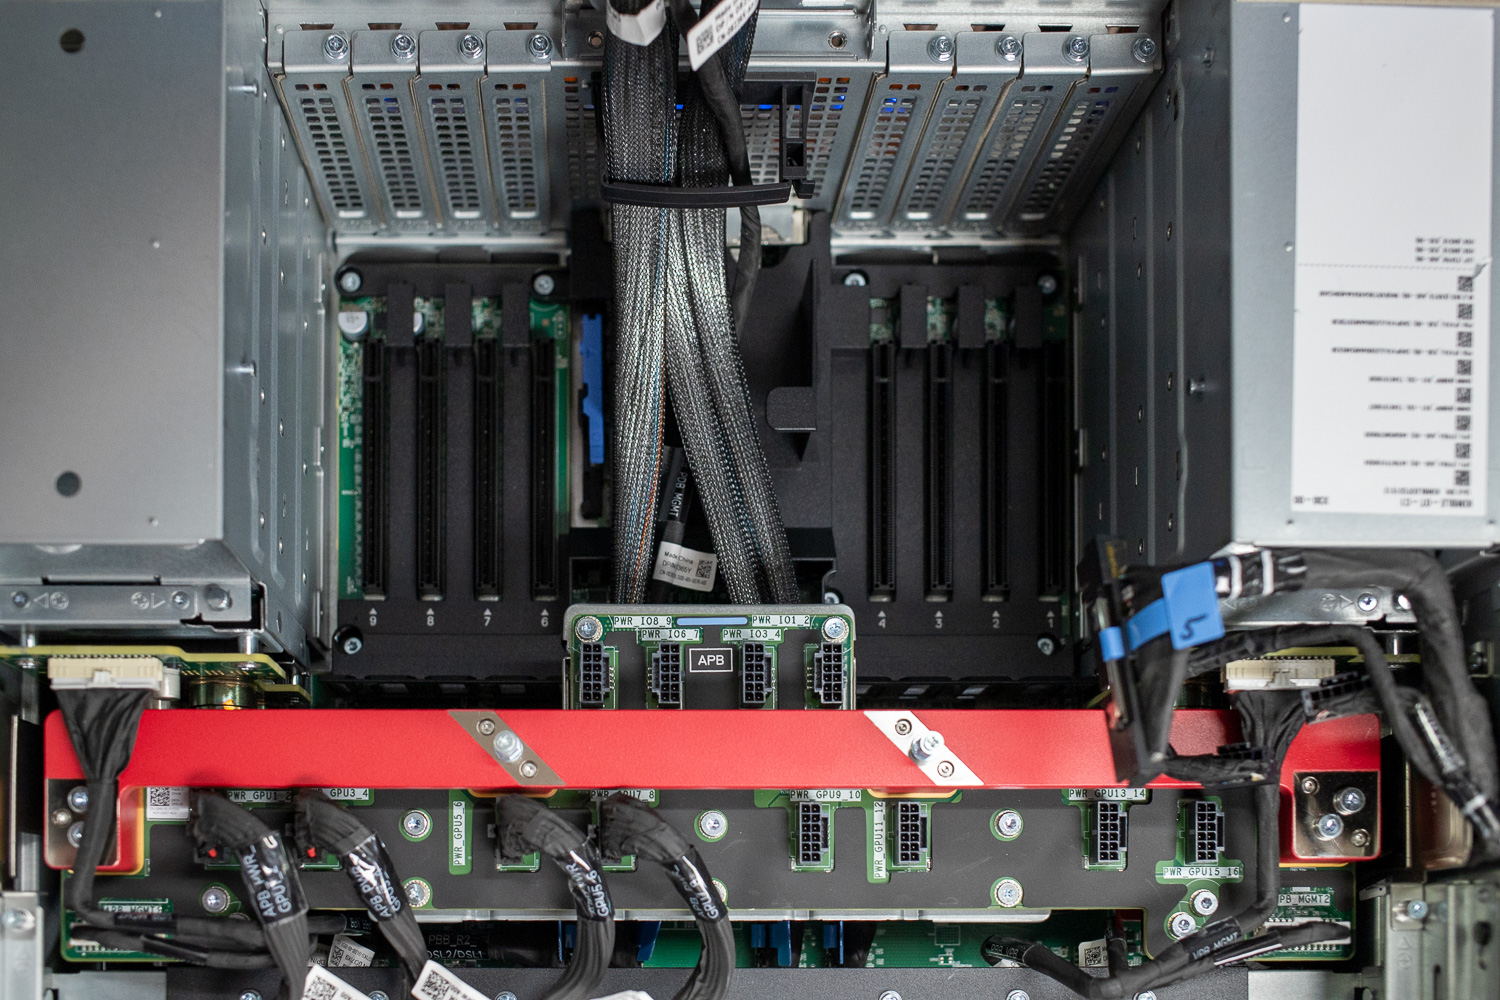
V šasi, ktoré obsahuje až osem 600W akcelerátorov, môžu aj malé prekážky v dráhe prúdenia vzduchu vytvárať lokálne horúce miesta a nútiť ventilátory bežať na vyššie rýchlosti, čím sa zvyšuje spotreba energie aj akustický výkon. Systém správy káblov od spoločnosti Dell udržiava stred šasi voľný pre priame a nerušené prúdenie vzduchu nad komponentmi, ktoré ho najviac potrebujú.
Topológia prepínačov PCIe a tok dát
Podsystém PCIe procesora XE7740 je postavený na štyroch prepínačoch PCIe Gen 5 na doske PBB (PCIe Base Board), označených ako SW1 až SW4. Tieto prepínače tvoria chrbticu architektúry I/O systému a pripájajú akcelerátory, siete a úložisko k dvom procesorom Xeon 6 v starostlivo organizovanej topológii.
16 interných slotov pre grafickú kartu (GPU) je rozdelených do dvoch bánk po ôsmich, pričom každá banka je obsluhovaná dvojicou prepínačov PCIe, pričom každý je pripojený k CPU. V rámci každej banky sa medzi dvoma prepínačmi prelínajú dvojice susedných slotov pre grafickú kartu s dvojitou šírkou. Na strane CPU0 obsluhuje SW1 sloty GPU 21 a 25, ako aj zadné sloty PCIe 8 a 9, zatiaľ čo SW2 obsluhuje sloty GPU 23 a 27, ako aj zadné sloty PCIe 6 a 7. Na strane CPU1 obsluhuje SW3 sloty GPU 29 a 33, ako aj zadné sloty PCIe 3 a 4, zatiaľ čo SW4 obsluhuje sloty GPU 31 a 35, ako aj zadné sloty PCIe 1 a 2.

Každá doména CPU preto vlastní štyri sloty akcelerátora s dvojitou šírkou, štyri sloty NIC/I/O smerujúce dozadu a štyri z ôsmich predných úložných pozícií E3.S NVMe. Táto topológia prepínača má významný vplyv na tok dát, najmä pre prevádzku založenú na RDMA. Keďže každý prepínač hostí sloty akcelerátora aj zadné sloty NIC, akcelerátor a sieťový adaptér na tom istom prepínači môžu vykonávať prenosy RDMA výlučne v rámci prepínačovej štruktúry. Dáta nikdy nemusia prechádzať koreňovým komplexom CPU, čím sa eliminuje vyrovnávacia pamäť CPU pre odskoky, ktorá by inak bola potrebná, keď zariadenie PCIe na jednom koreňovom porte komunikuje so zariadením na inom. To znižuje latenciu, zabraňuje spotrebe drahocennej šírky pásma pamäte CPU a uvoľňuje cykly CPU pre inú prácu.
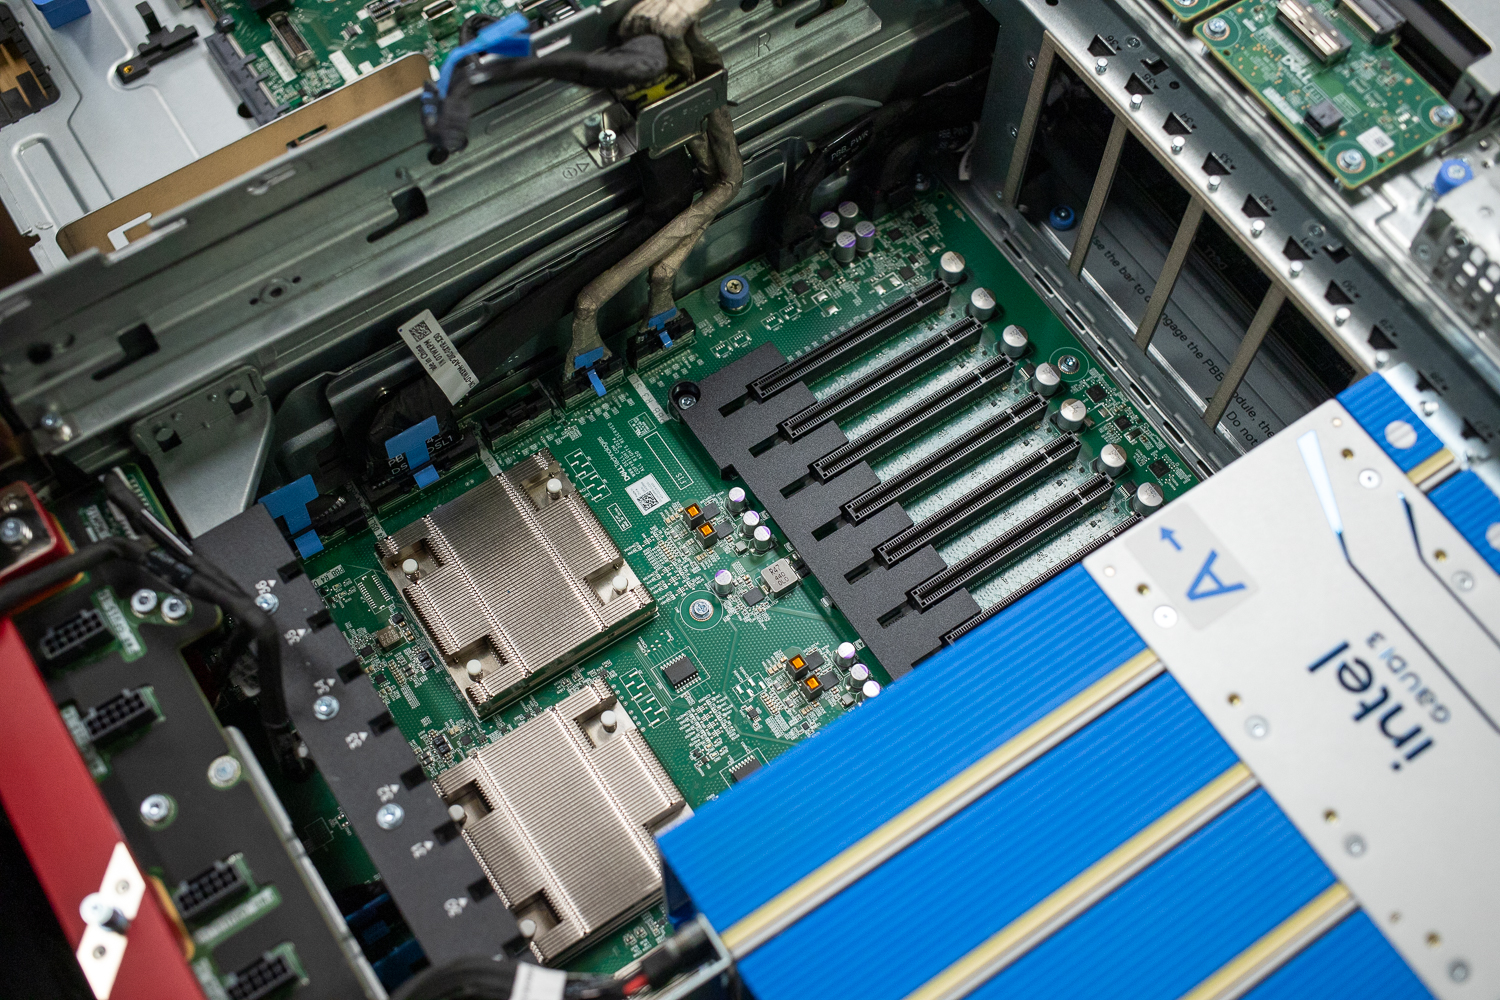
Komunikácia v rámci domény jedného CPU medzi jeho dvoma prepínačmi smeruje cez koreňový komplex CPU, ale zostáva lokálna pre daný socket. Komunikácia medzi CPU však musí prechádzať cez UPI linky medzi dvoma procesormi Xeon 6. 6787P poskytuje štyri UPI 2.0 linky s rýchlosťou 24 GT/s každá, čo ponúka značnú šírku pásma medzi soketmi. Prevádzka medzi akcelerátorom na prepínačovej banke CPU0 a sieťovou kartou na prepínačovej banke CPU1 však bude mať inherentne vyššiu latenciu ako prenosy lokálne na prepínači alebo v rámci rovnakého soketu.
Samotné prepínače nie sú priamo prepojené. Všetka prevádzka medzi prepínačmi prechádza cez koreňový komplex CPU, takže je dôležité pochopiť afinitu medzi slotmi GPU, slotmi sieťovej karty, úložiskom a soketmi CPU. Aby sa táto zložitosť pre organizácie zjednodušila, spoločnosť Dell ponúka overené a optimalizované konfigurácie pre populárne akcelerátory.
Dvojzónový zdroj napájania
Napájanie XE7740 odráža jeho tepelnú architektúru s trochu nezvyčajným dizajnom dvojzónového zdroja. Systém podporuje až osem hot-swappable napájacích zdrojov, rozdelených do dvoch zón: Zóna 1 (zóna CPU) obsahuje zdroje PSU 1 a 2, zatiaľ čo zóna 2 (zóna GPU) obsahuje zdroje PSU 3 až 8.
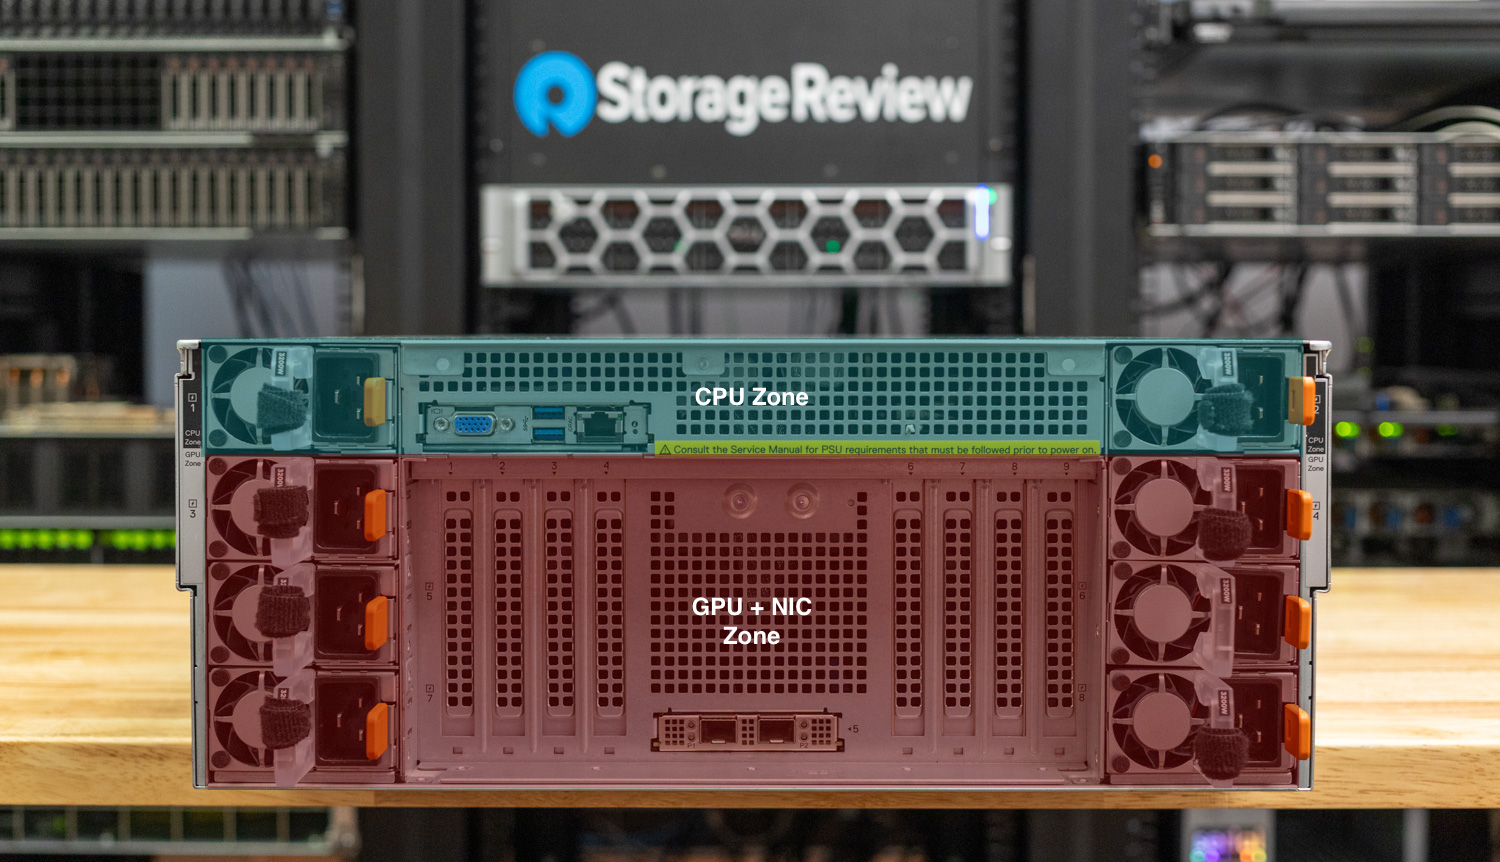
Systém vyžaduje v každej zóne aspoň jeden zdroj napájania (PSU) na udržanie napájania pre BMC a v pohotovostnom režime. Ak niektorá zo zón stratí striedavé napájanie počas prevádzky systému, systém sa okamžite vypne, aby sa predišlo strate údajov. Zóny sú navzájom závislé z hľadiska prevádzky, aj keď sú fyzicky a elektricky oddelené. Pre úplnú redundanciu spoločnosť Dell odporúča konfiguráciu 1+1 v zóne CPU a konfiguráciu 3+3 v zóne GPU, čo znamená, že pre plne redundantné nasadenie by malo byť obsadených všetkých osem pozícií pre zdroje napájania.
Riadenie, správa a spoľahlivosť podnikov spoločnosti Dell AIOps
Platforma PowerEdge od spoločnosti Dell si v odvetví získala reputáciu vďaka spoľahlivosti a jednoduchej údržbe. Podnikoví zákazníci neustále zdôrazňujú tie isté témy: systémy PowerEdge sú vyrobené tak, aby vydržali, organizácia podpory spoločnosti Dell rýchlo rieši problémy a nástroje správy sú vyspelé a dobre integrované. XE7740 pokračuje v tejto tradícii a spoločnosť Dell s touto generáciou dosiahla významný pokrok v oblasti správy hardvéru aj zabezpečenia.
iDRAC 10
Model XE7740 sa dodáva s radičom iDRAC 10 novej generácie od spoločnosti Dell, čo je výrazná zmena oproti už aj tak schopnému iDRAC 9, na ktorý sa zákazníci spoločnosti Dell spoliehajú už roky. Radič iDRAC 10, implementovaný ako modul zabezpečenej kontroly dátového centra (DC-SCM) v súlade so štandardom OCP DC-MHS, nie je len aktualizáciou firmvéru; predstavuje nový hardvér. Radič má štyri jadrá s frekvenciou 1 GHz so 64-bitovou architektúrou a 2 GB pamäte DDR4 (dvojnásobok oproti predchádzajúcej generácii), čo prináša výrazne lepší výkon a odozvu pri operáciách správy.
Z hľadiska bezpečnosti prináša iDRAC 10 niekoľko významných vylepšení. Platforma ponúka silnejšiu kryptografickú podporu naprieč všetkými oblasťami vrátane overovania SHA-384 a SHA-512 a kvantovo bezpečného šifrovania AES-256, keďže sa odvetvie pripravuje na postkvantové kryptografické hrozby. Vyhradená integrovaná bezpečnostná enkláva v rámci kremíka iDRAC 10 spravuje funkcie kybernetickej odolnosti vrátane atestácie na úrovni zariadenia a vlastnej technológie Root-of-Trust od spoločnosti Dell. Táto hardvérová technológia Root-of-Trust zabezpečuje, že všetok firmvér (BIOS, iDRAC a firmvér komponentov) je pred spustením kryptograficky overený, čím chráni pred útokmi dodávateľského reťazca a manipuláciou s firmvérom.
Zabezpečené overovanie komponentov overuje, či systémy dodané z továrne spoločnosti Dell prichádzajú s presnými komponentmi a konfiguráciami špecifikovanými zákazníkom, čím sa zachováva integrita od výroby až po nasadenie. Najnovší firmvér iDRAC 10 tiež prináša aktualizované, modulárne používateľské rozhranie, ktoré zlepšuje každodenné administratívne prostredie.
OpenManage Enterprise
Pre správu vozového parku vo veľkom rozsahu poskytuje Dell OpenManage Enterprise centralizované monitorovanie, aktualizácie firmvéru a správu konfigurácie v rámci celých nasadení PowerEdge. Pozoruhodným nedávnym prírastkom pre nasadenia zamerané na umelú inteligenciu je, že OME teraz podporuje priamy prehľad o štatistikách GPU a akcelerátora: spotreba energie, teplota, využitie, počet chýb a ďalšie, bez potreby samostatných nástrojov od špecifických dodávateľov. Pre organizácie spravujúce desiatky alebo stovky uzlov XE7740 v inferenčnom klastri predstavuje táto jednotná rovina správy významné zjednodušenie prevádzky.
Intel Xeon 6
Srdcom procesora XE7740 sú dva procesory Intel Xeon 6 6787P, vlajková loď série Xeon 6700P. Procesor 6787P, postavený na architektúre Granite Rapids s využitím 3 nm technológie Intel, ponúka 86 P-jadier (172 vlákien) na socket s TDP 350 W, so základným taktom 2.0 GHz a turbo taktom 3.8 GHz.
Granite Rapids je obzvlášť relevantný pre infraštruktúru umelej inteligencie vďaka kombinácii vysokého počtu jadier a pamäťového subsystému. Každý procesor 6787P poskytuje osem pamäťových kanálov DDR5 s rýchlosťou až 6400 MT/s. S dvojzásuvným procesorom XE7740 osadeným 32 modulmi DIMM je možné systém nakonfigurovať až na 4 TB celkovej systémovej pamäte.
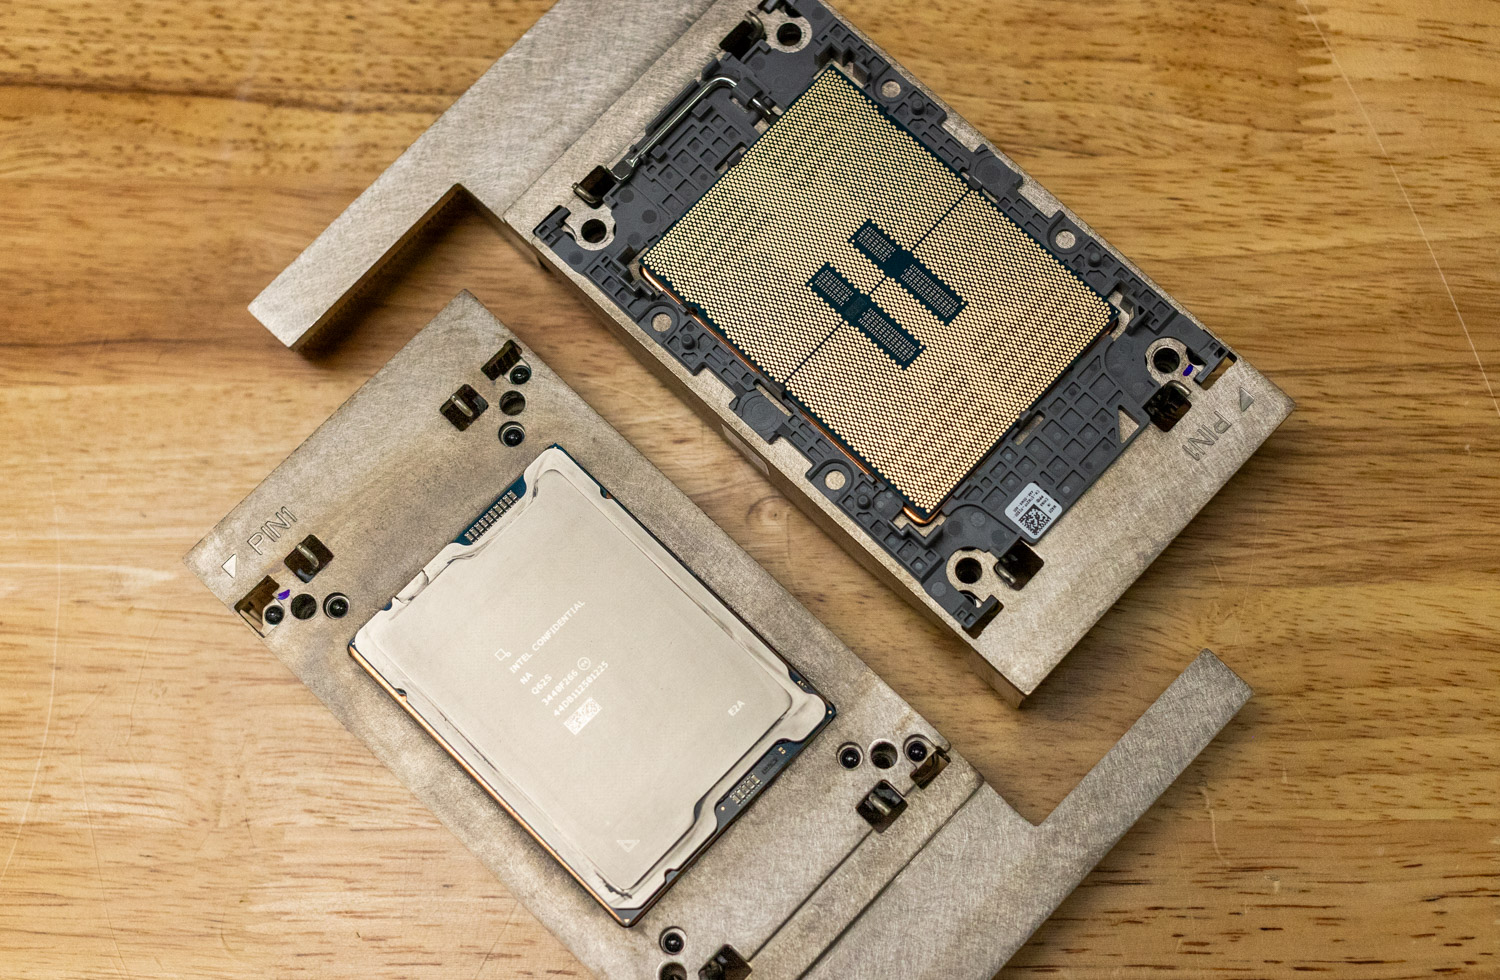
Kapacita pamäte a šírka pásma sú kritické pre pracovné zaťaženia umelej inteligencie, najmä pri použití odľahčenia vyrovnávacej pamäte KV. Keďže rozsiahle jazykové modely zväčšujú dĺžku kontextu, vyrovnávacia pamäť KV sa úmerne škáluje a môže spotrebovať značné množstvo pamäte akcelerátora. Odľahčenie častí vyrovnávacej pamäte KV do systémovej pamäte alebo rýchleho úložiska umožňuje efektívnejšie využívať HBM akcelerátora na aktívne výpočty, čím sa skracuje čas do prvého tokenu (TTFT) pre viacnásobné rozhovory.
Za zmienku tiež stojí tenzorové jednotky AMX v procesore Xeon 6, ktoré zvládajú značnú prácu na strane CPU. Patria sem úlohy predspracovania, tokenizácie a hybridnej inferencie, ktoré zahŕňajú maticové operácie. Toto sa stáva obzvlášť užitočným pri inferenčných rámcoch, ako je SGLang, ktoré využívajú CPU pre Radix Tree pre správu KV Cache a plánovanie s nulovou réžiou.
Doplnkové karty Intel Gaudi 3: Konkurenčná inferencia vo veľkom meradle
Gaudi 3 od spoločnosti Intel je vlajkovou loďou spoločnosti v oblasti akcelerátorov umelej inteligencie, ktorá bola uvedená na trh v 4. štvrťroku 2024. Intel tieto akcelerátory umiestňuje veľmi agresívne, namiesto toho, aby priamo konkuroval najkvalitnejším akcelerátorom tréningu pre dátové centrá. Gaudi 3 je zameraný priamo na segment inferencie.
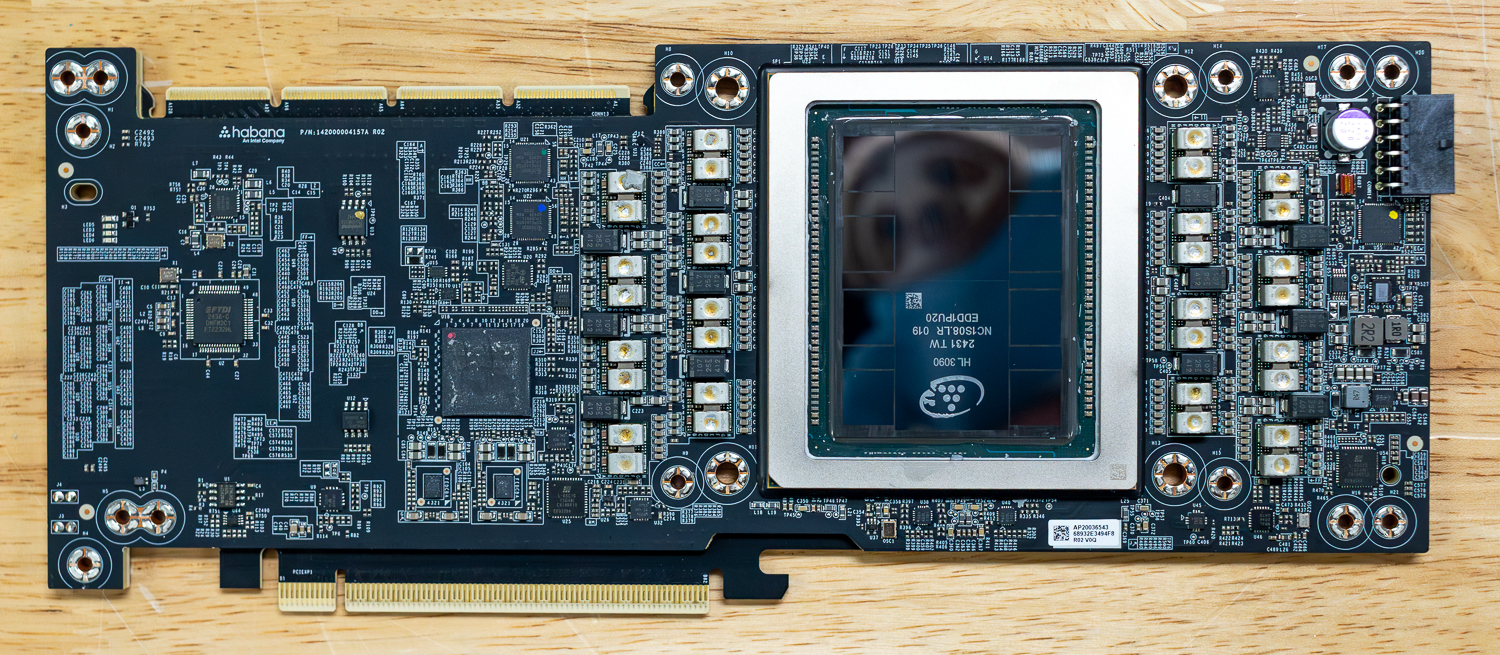
Inferencia modelu založená na transformátoroch vo všetkých populárnych LLM je dnes v podstate viazaná na pamäť. Počas dekódovacej fázy autoregresného generovania model generuje tokeny jeden po druhom a číta váhy modelu a položky vyrovnávacej pamäte KV pre každý vytvorený token. Úzkym hrdlom nie sú výpočtové schopnosti, ale šírka pásma pamäte, čo je rýchlosť, s akou dokáže akcelerátor streamovať dáta z HBM do výpočtových enginov.
Gaudi 3 disponuje 128 GB pamäte HBM2e s pamäťovou priepustnosťou 3.7 TB/s. Architektonicky je Gaudi 3 postavený na 5nm procese spoločnosti TSMC a využíva dizajn s dvoma čipmi: dva identické kremíkové čipy spojené vysokopásmovým prepojením, ktoré tvoria jedno jednotné zariadenie pre softvér. Výpočty sú organizované do štyroch jadier hlbokého učenia (DCORE), z ktorých každé obsahuje 2 MME, 16 TPC a 24 MB lokálnej vyrovnávacej pamäte SRAM. Celkových 96 MB pamäte SRAM na čipe poskytuje internú šírku pásma 12.8 TB/s. Akcelerátor tiež integruje 14 špecializovaných mediálnych dekodérov (H.265, H.264, JPEG, VP9), čo umožňuje rýchle predspracovanie obrazu pre multimodálne pracovné zaťaženia.
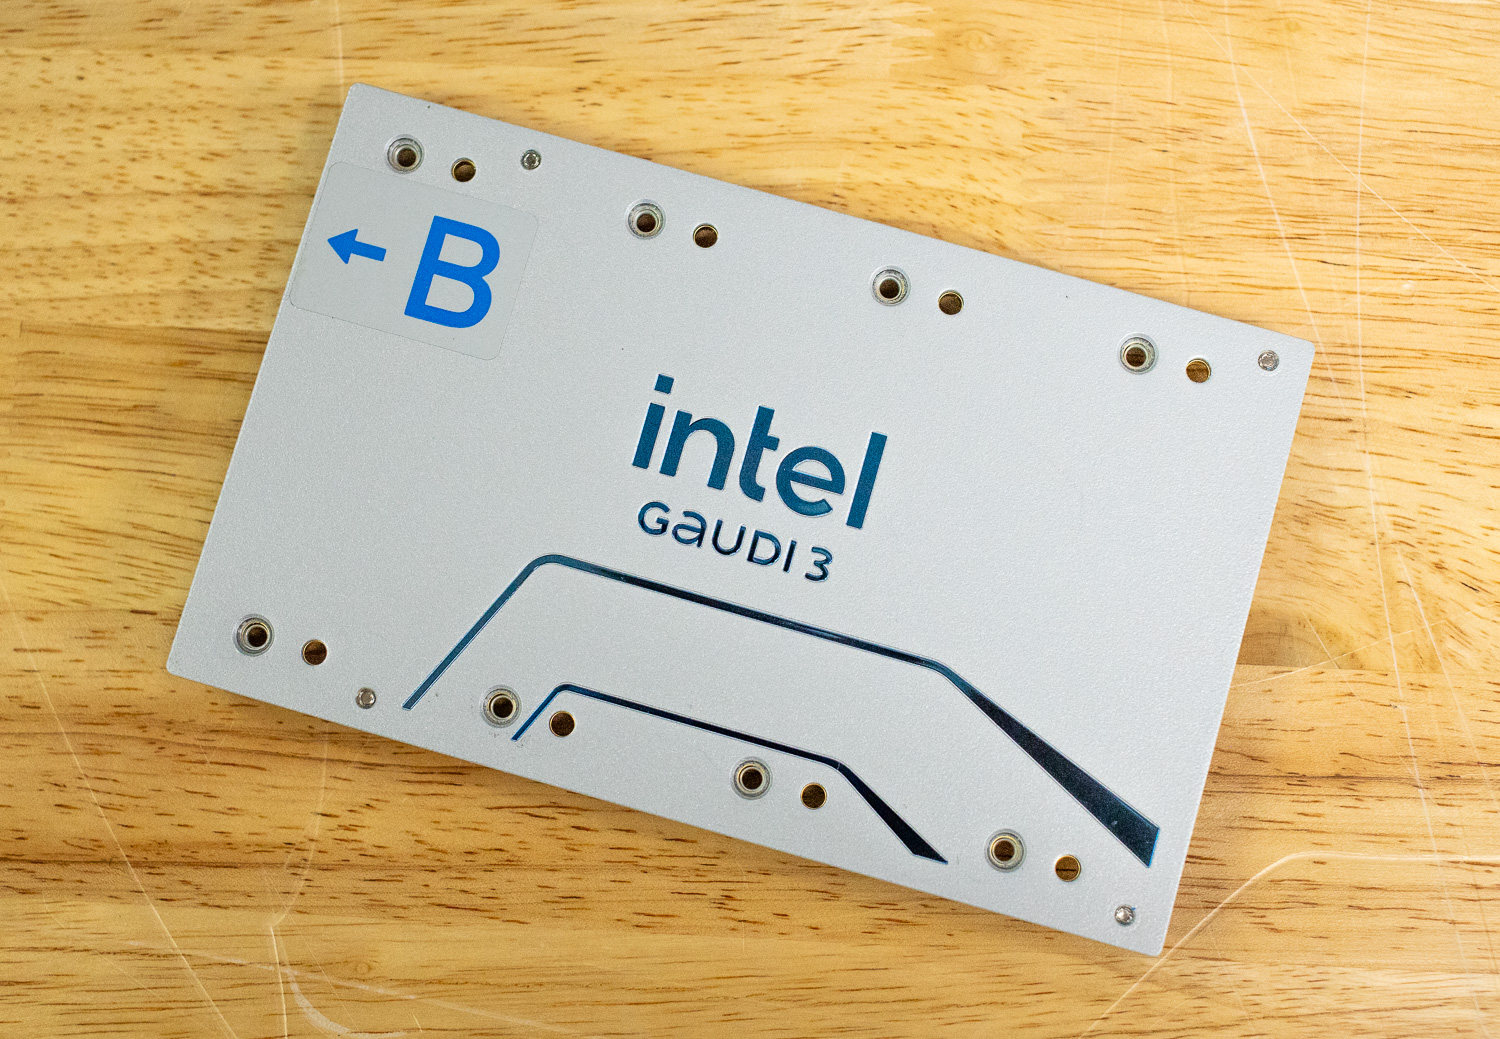
Veľká časť popredných modelov umelej inteligencie s otvoreným zdrojovým kódom, ktoré sa dnes vydávajú, sú buď natívne trénované v FP8, alebo hybridné modely, ktoré kombinujú váhy FP8 (E4M3) a BF16. Gaudi 3 poskytuje natívnu akceleráciu FP8 pre tieto modely prostredníctvom svojich 8 enginov na násobenie matíc a 64 jadier tenzorového procesora, čím dosahuje výpočtový výkon FP8 s výkonom 1.8 peflopov.
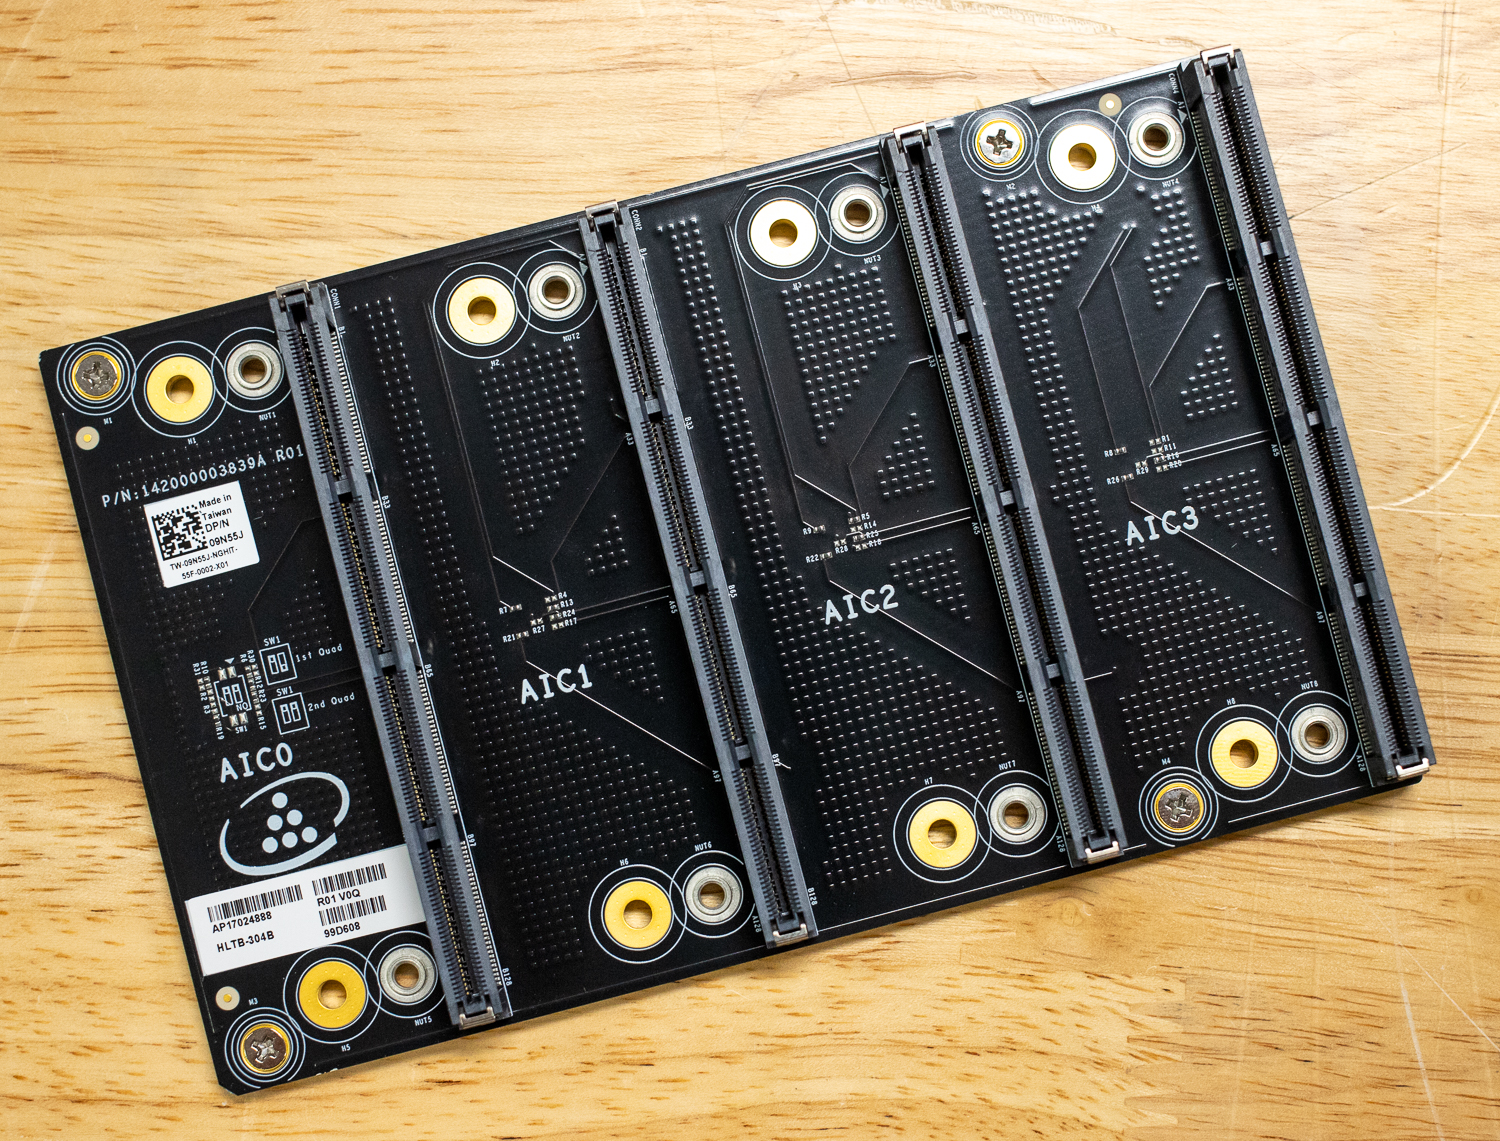
Gaudi 3 tiež integruje sieť RDMA over Converged Ethernet (RoCEv2) s 24×200 GbE portami vo verzii OAM, ktoré sú zabudované priamo do kremíka. Zatiaľ čo variant prídavnej karty PCIe použitý v XE7740 neposkytuje všetky tieto porty rovnakým spôsobom, varianty prídavných kariet podporujú premostenie 4 kariet pre rýchlejšiu komunikáciu medzi nimi.
Výkon a benchmarky
Podrobnosti o konfigurácii XE7740:
- 2 x procesor Intel Xeon 6787P (86 jadier, 2.00 GHz)
- 2TB DDR5 (32 x 64GB 5200MT/s DDR5
- 4 x akcelerátor Intel Gaudi 3 PCIe AI so 128 GB HBM
- Server Ubuntu 24.04.5
Výkon online poskytovania vLLM
Aby sme vyhodnotili inferenčné schopnosti servera Dell XE7740 s akcelerátormi Intel Gaudi 3, porovnali sme výkon online služieb vLLM v rôznych populárnych modeloch s rôznymi architektúrami, počtom parametrov a formátmi presnosti. Každý model bol testovaný v troch profiloch pracovného zaťaženia s počtom súbežných požiadaviek v rozmedzí od 1 do 128.
Inferencia LLM pozostáva z dvoch odlišných fáz. Fáza predbežného dopĺňania spracováva všetky vstupné tokeny paralelne predtým, ako je možné vygenerovať akýkoľvek výstupný token, čím sa jedná o operáciu viazanú na výpočty, ktorá sa lineárne škáluje s počtom vstupných tokenov. Fáza dekódovania potom generuje výstupné tokeny jeden po druhom (autoregresívne), pričom každý nový token vyžaduje načítanie všetkých váh modelu z pamäte, ale vykonáva relatívne málo výpočtov na token, čo ju robí viazanou na šírku pásma pamäte.
Tieto dve fázy zaťažujú zásadne odlišné časti akcelerátora, preto testujeme tri profily pracovnej záťaže, ktoré medzi nimi posúvajú rovnováhu:
- Rovnosť (1024 vstupných/1024 výstupných tokenov) predstavuje vyvážené interakcie v chate.
- Prefill Heavy (8192 vstup/1024 výstup) simuluje generovanie rozšírené o vyhľadávanie alebo sumarizáciu dlhého kontextu, pri ktorej musí systém spracovať rozsiahle vstupné kontexty.
- Decode Heavy (1024 vstupov/8192 výstupov) predstavuje generovanie dlhého obsahu, kde trvalá šírka pásma pamäte určuje priepustnosť.
V tejto časti sa zameriavame na dve hlavné metriky. Celková priepustnosť tokenov, meraná v tokenoch za sekundu, zachytáva celkovú obslužnú kapacitu systému pri zaťažení. Čas do prvého tokenu (TTFT) meria oneskorenie medzi odoslaním požiadavky a prijatím prvého vygenerovaného tokenu. Keďže model musí dokončiť celú fázu predbežného dopĺňania predtým, ako môže vygenerovať prvý token, TTFT je priamo prepojený s výpočtovou priepustnosťou akcelerátora. Vďaka tomu je scenár s vysokým obsahom predbežného dopĺňania (v kombinácii s TTFT) obzvlášť užitočným ukazovateľom na pochopenie hrubých výpočtových schopností akcelerátorov Gaudi 3, pretože systém musí spracovať všetkých 8 192 vstupných tokenov predtým, ako používateľ uvidí akúkoľvek odpoveď.
Naopak, scenár s vysokým dekódovaním testuje pamäťovú šírku pásma akcelerátorov, pretože systém musí udržiavať vysokú priepustnosť pre tisíce vygenerovaných tokenov. TTFT je kritický pre interaktívne aplikácie, v ktorých používatelia čakajú na odpoveď predtým, ako sa môže začať streamovanie. Systém môže dosiahnuť vynikajúcu priepustnosť pri intenzívnom dávkovaní, ale stále sa môže zdať pomalý, ak TTFT stúpne príliš vysoko, takže obe metriky sú dôležité pre produkčné nasadenia.
Poznámka k výsledkom presnosti FP8: hoci akcelerátory Intel Gaudi 3 zahŕňajú natívnu výpočtovú akceleráciu FP8 (a FP8 by teoreticky mal poskytovať vyššiu priepustnosť ako BF16), výkonnostné čísla FP8 v našich benchmarkoch sú nižšie ako ich náprotivky BF16. Nejde o hardvérové obmedzenie, ale skôr o problém so zrelosťou softvéru v rámci Intelovej fork verzie vLLM. Verzia, ktorú sme testovali (inštalátor vLLM 2.7.1 na Gaudi Docker 1.22.2), ešte úplne neoptimalizovala svoje kódové cesty FP8. Intel má v súčasnosti v beta verzii novú verziu vLLM založenú na pluginoch, ktorá môže vyriešiť mnohé z týchto výkonnostných problémov.
Lama 3.1 8B Inštrukt
Llama 3.1 8B Instruct je hustý transformačný model od spoločnosti Meta, čo znamená, že každý parameter je aktívny pre každý vygenerovaný token. S 8 miliardami parametrov patrí medzi modely s otvoreným zdrojovým kódom. Modely v tejto veľkostnej triede sú obľúbené pre každodenné úlohy, ako je sumarizovanie krátkych dokumentov, písanie e-mailov a správ, odpovedanie na jednoduché otázky a napájanie jednoduchých interakcií s chatbotmi, kde je rýchlosť a nákladová efektívnosť dôležitejšia ako hlboké uvažovanie.
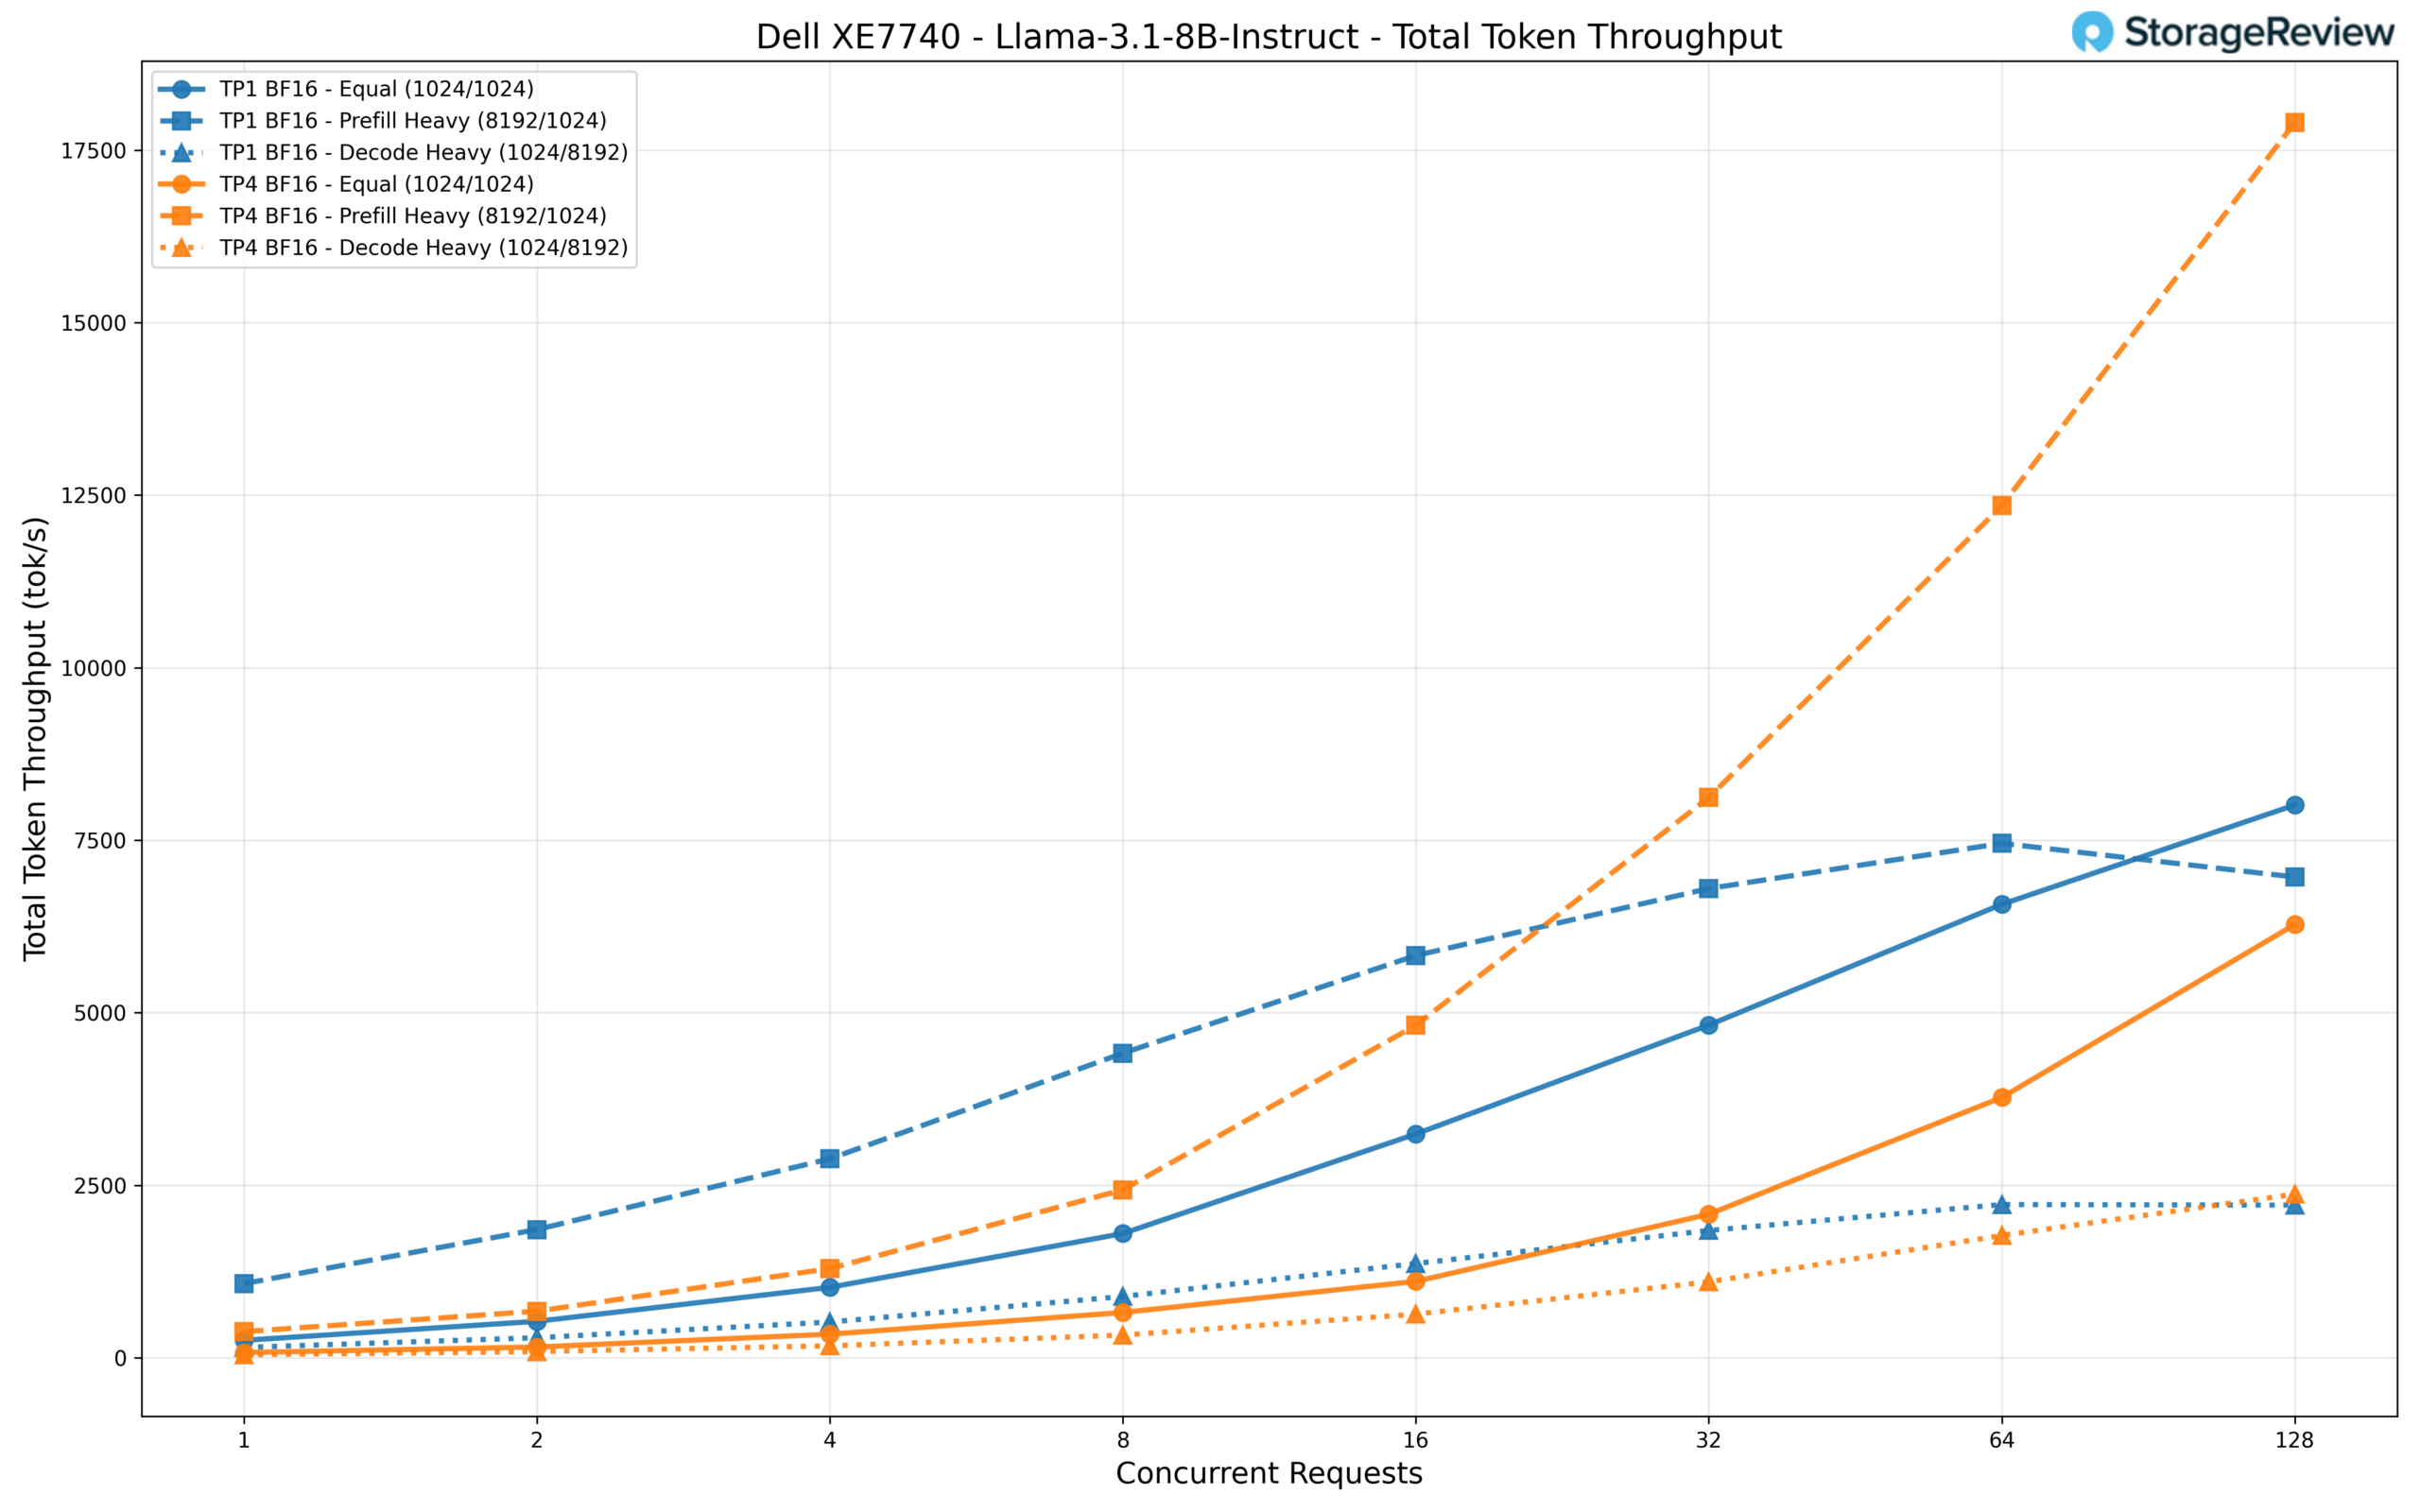
Tento model sme testovali v konfiguráciách TP1 (jeden akcelerátor) aj TP4 (všetky štyri akcelerátory Gaudi 3). Bežiaci na TP1 model dosahuje celkovú priepustnosť približne 8 000 tokov/s pri 128 súbežných požiadavkách pri rovnakom zaťažení, pričom sa čiste škáluje z približne 250 tokov/s pri jednej požiadavke. Scenár s vysokým počtom predfillov vykazuje zaujímavý vzorec: zatiaľ čo TP1 dosahuje vrchol okolo 7 000 tokov/s, TP4 prudko stúpa na viac ako 17 900 tokov/s pri 128 súbežných požiadavkách, čím využíva ďalšie akcelerátory na efektívnejšie spracovanie rozsiahleho vstupného kontextu.
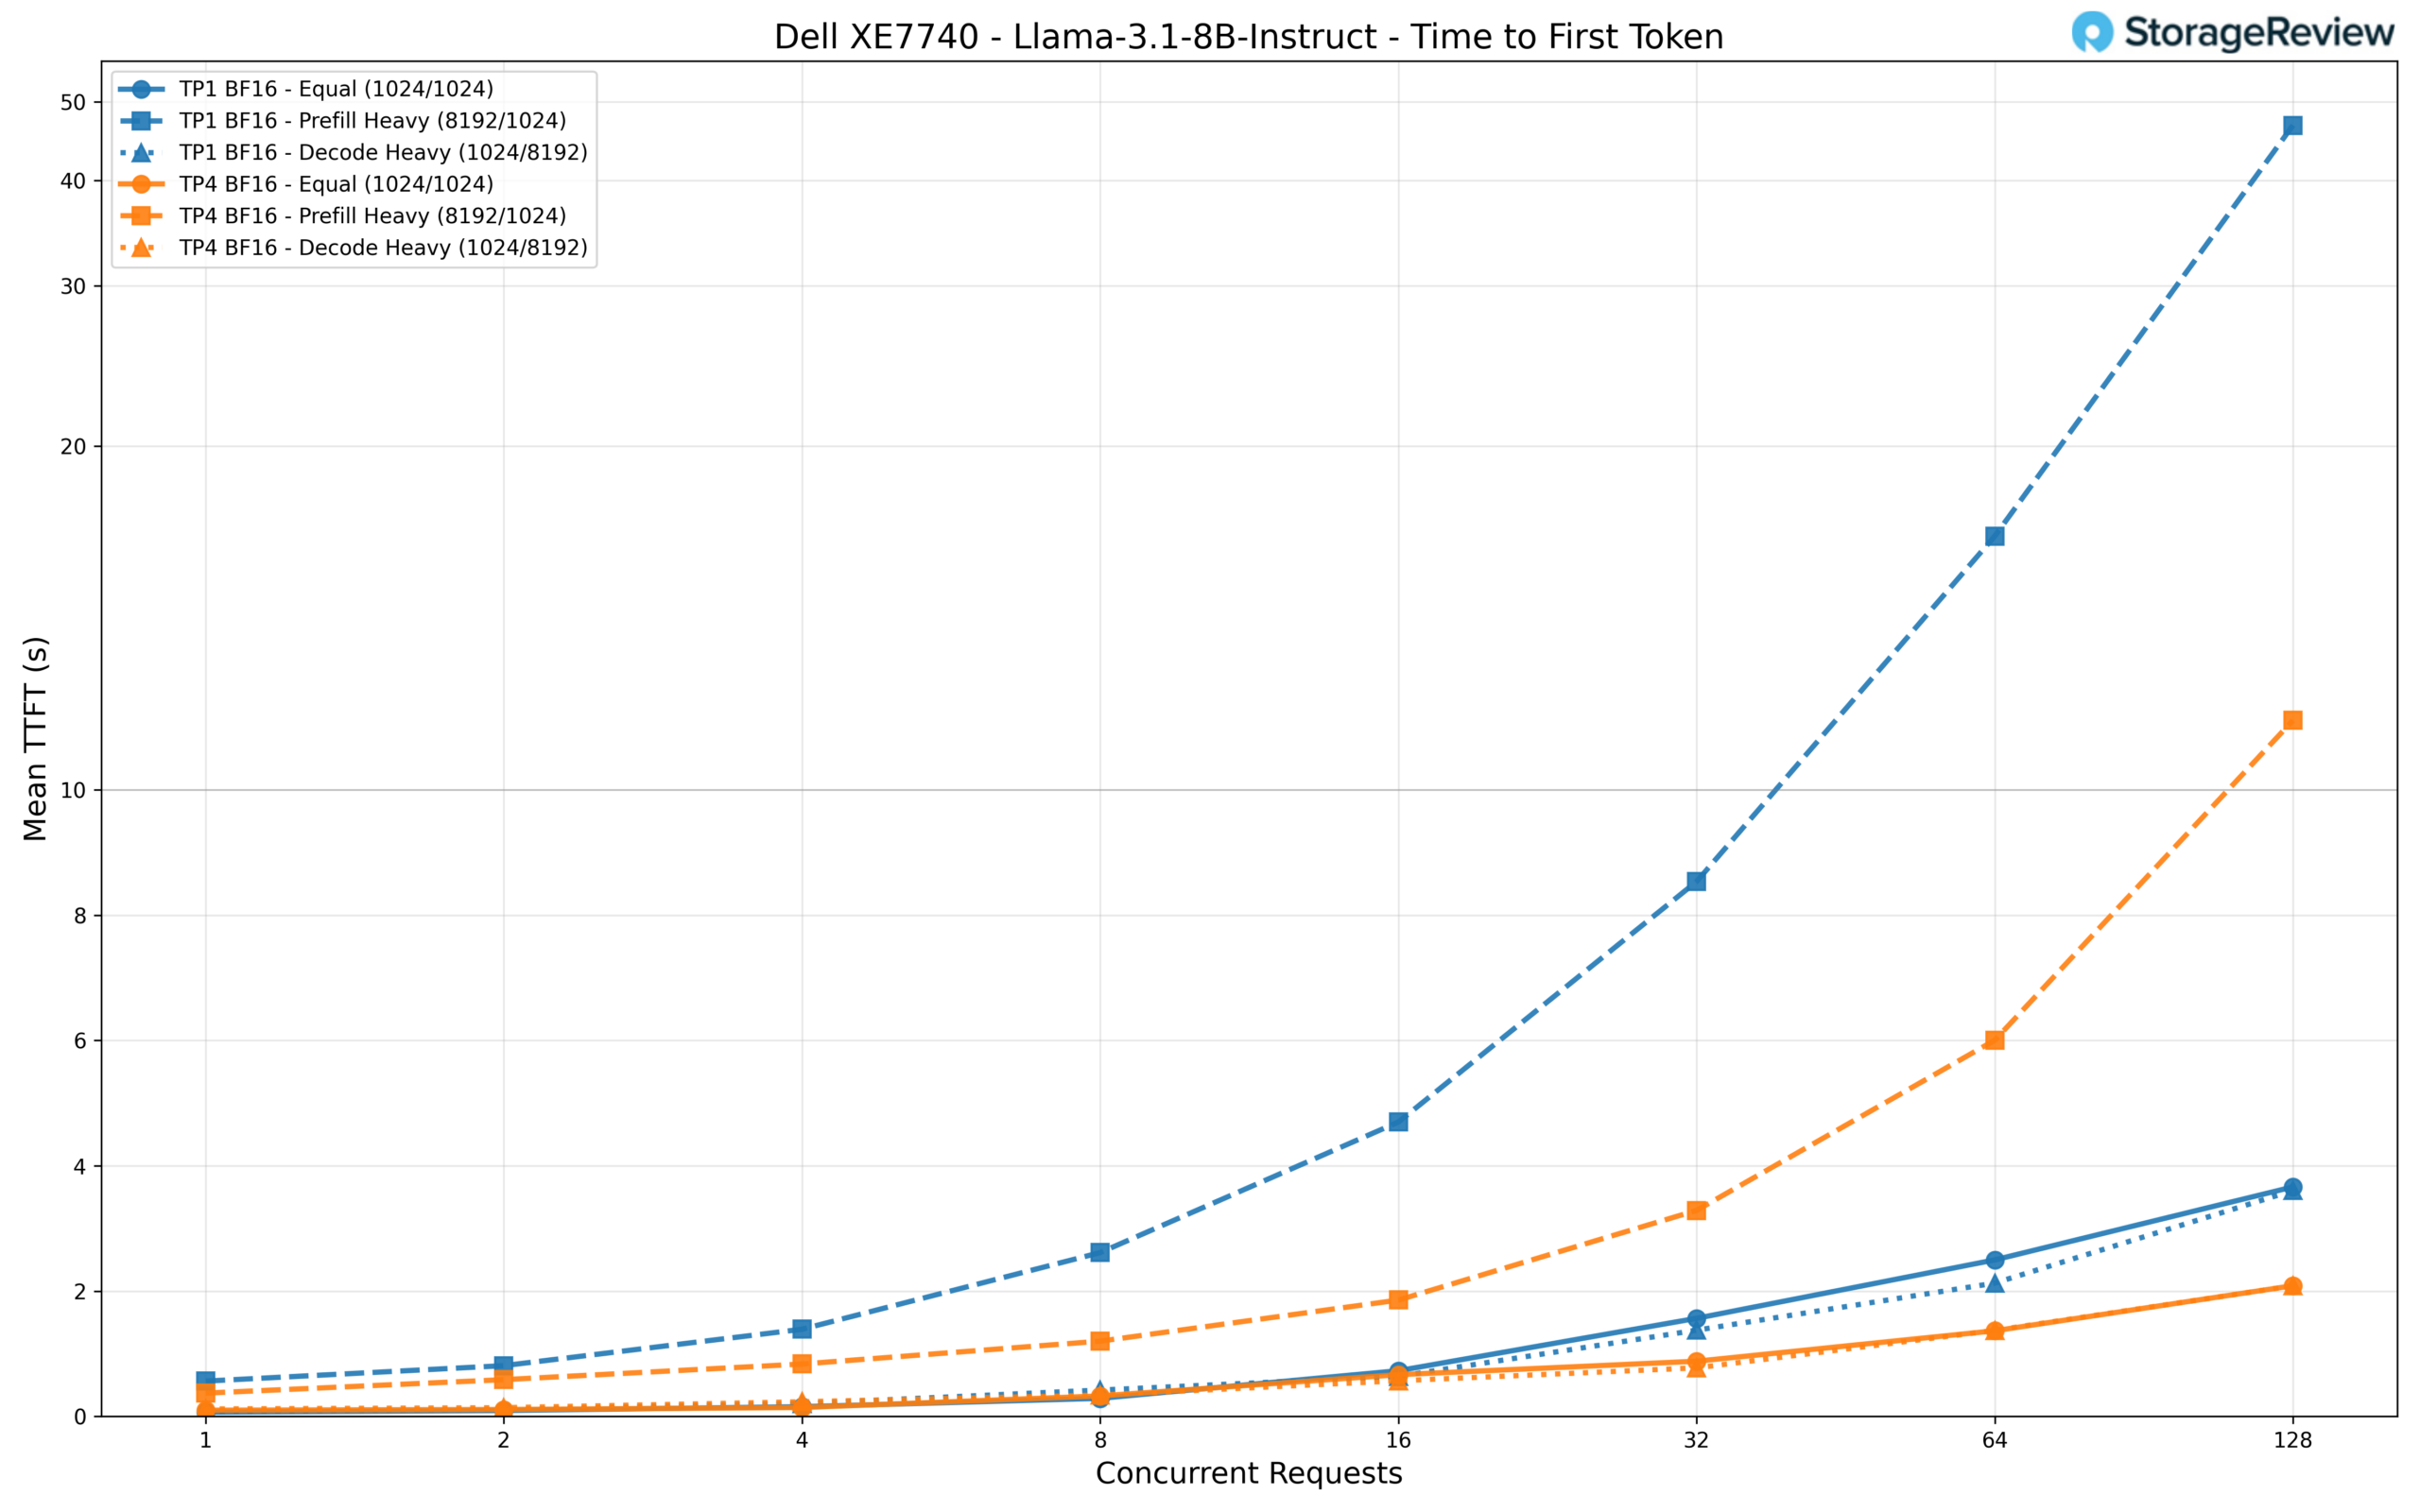
Pri latencii jedného používateľa TP1 v skutočnosti poskytuje nižšiu TTFT pri nízkej súbežnosti (67 ms oproti 98 ms pre TP4), čo odráža réžiu koordinácie medzi štyrmi akcelerátormi pre model, ktorý sa pohodlne zmestí na jeden. S rastúcou záťažou sa však TP4 rozhodne dostáva dopredu. Pri 128 súbežných požiadavkách drží TP4 TTFT na približne 2 sekundách pri rovnakých a dekódovacích pracovných zaťaženiach, zatiaľ čo TP1 stúpa na 3.7 sekundy, respektíve 6.6 sekundy. Scenár s vysokým počtom predfillov je miestom, kde je rozdiel najdramatickejší: TP1 dosahuje takmer 47 sekúnd TTFT pri 128 požiadavkách, zatiaľ čo TP4 si ho udržiava na približne 11 sekundách.
Lama 3.1 70B Inštrukt
Llama 3.1 70B Instruct je model s väčšou hustotou v rodine Meta Llama 3.1. S parametrami 70B poskytuje podstatne lepšie možnosti sledovania inštrukcií a viacjazyčnosti ako variant 8B. Modely v tejto mierke sú vhodné pre intenzívnejšie agentské pracovné zaťaženie, ako sú agenti zákazníckej podpory, viacstupňoví výskumní asistenti, komplexná analýza dokumentov a úlohy, ktoré vyžadujú udržiavanie koherentného kontextu počas dlhších interakcií.
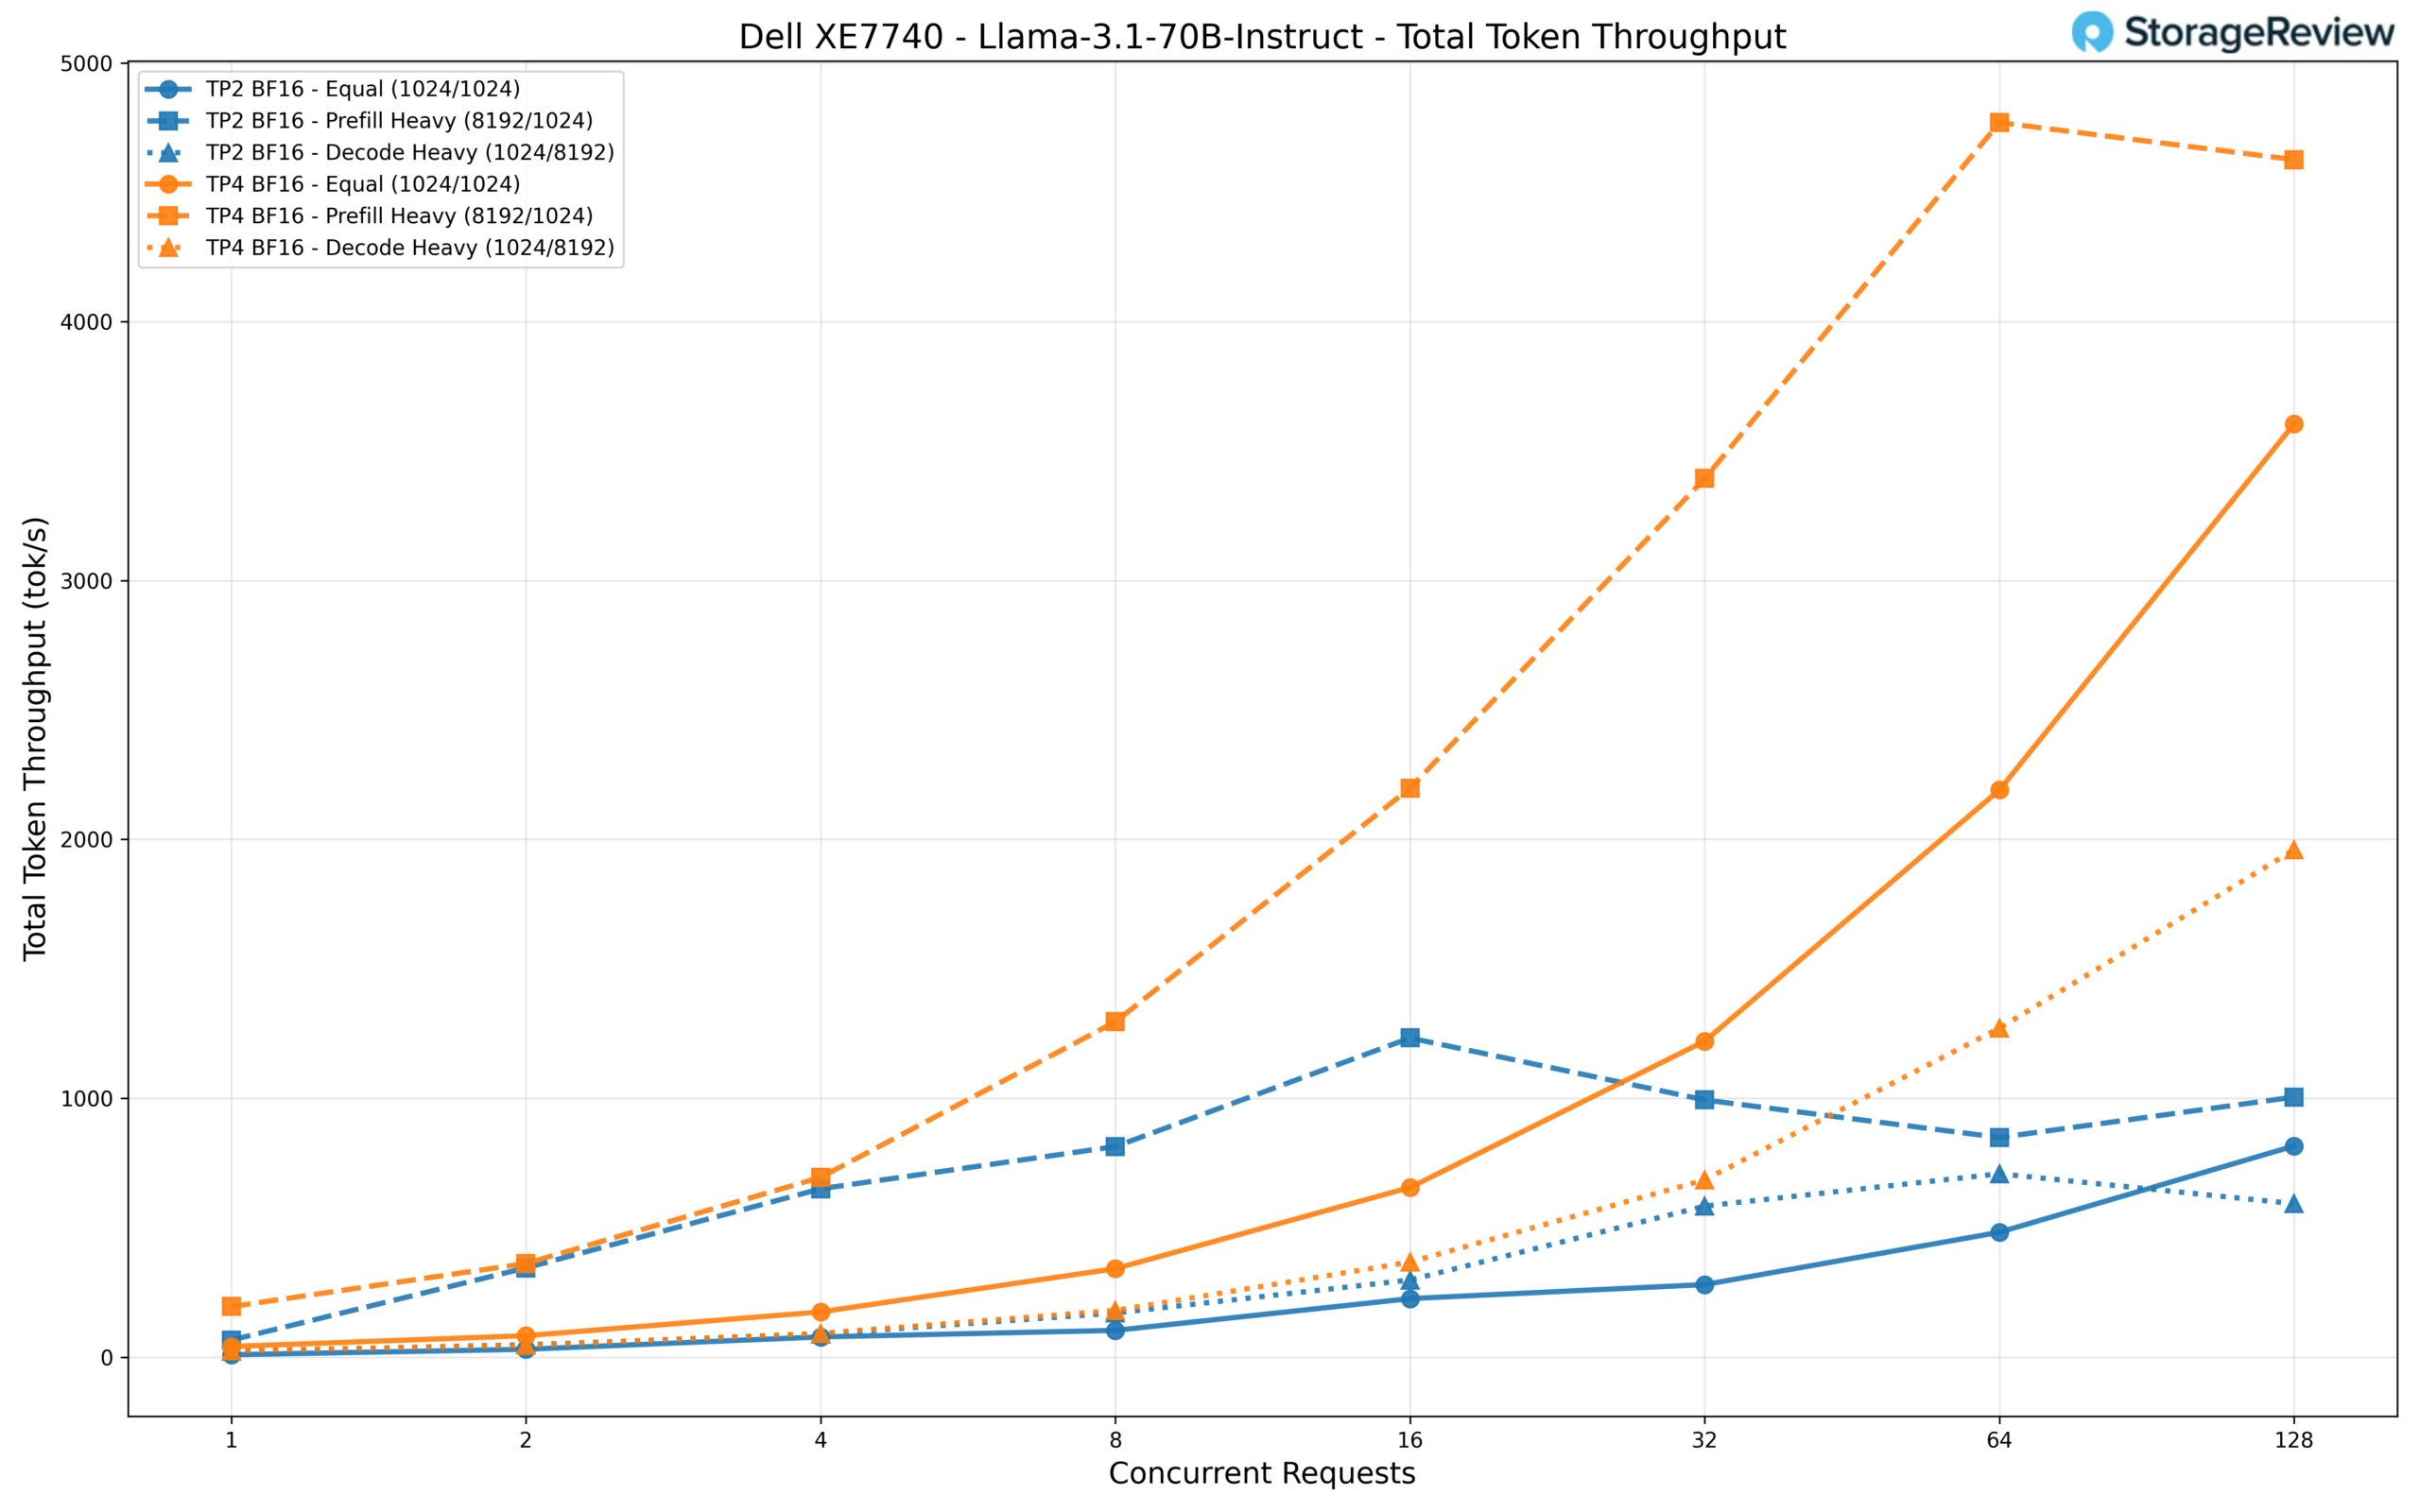
Tento model sme testovali s konfiguráciami TP2 a TP4. Rozdiel v priepustnosti medzi nimi je značný. Pri 128 súbežných požiadavkách poskytuje TP4 približne 3 600 tokov/s pri rovnakom zaťažení a dosahuje maximum okolo 4 600 tokov/s v scenári s vysokým zaťažením pred napĺňaním. To je približne 4.4-násobok a 4.6-násobok priepustnosti TP2, ktorá dosahuje maximálne hodnoty okolo 816 tokov/s a 1 005 tokov/s. Dokonca aj zaťaženie s vysokým zaťažením dekódovaním dosahuje na TP4 približne 1 960 tokov/s v porovnaní s 593 tokami/s na TP2.
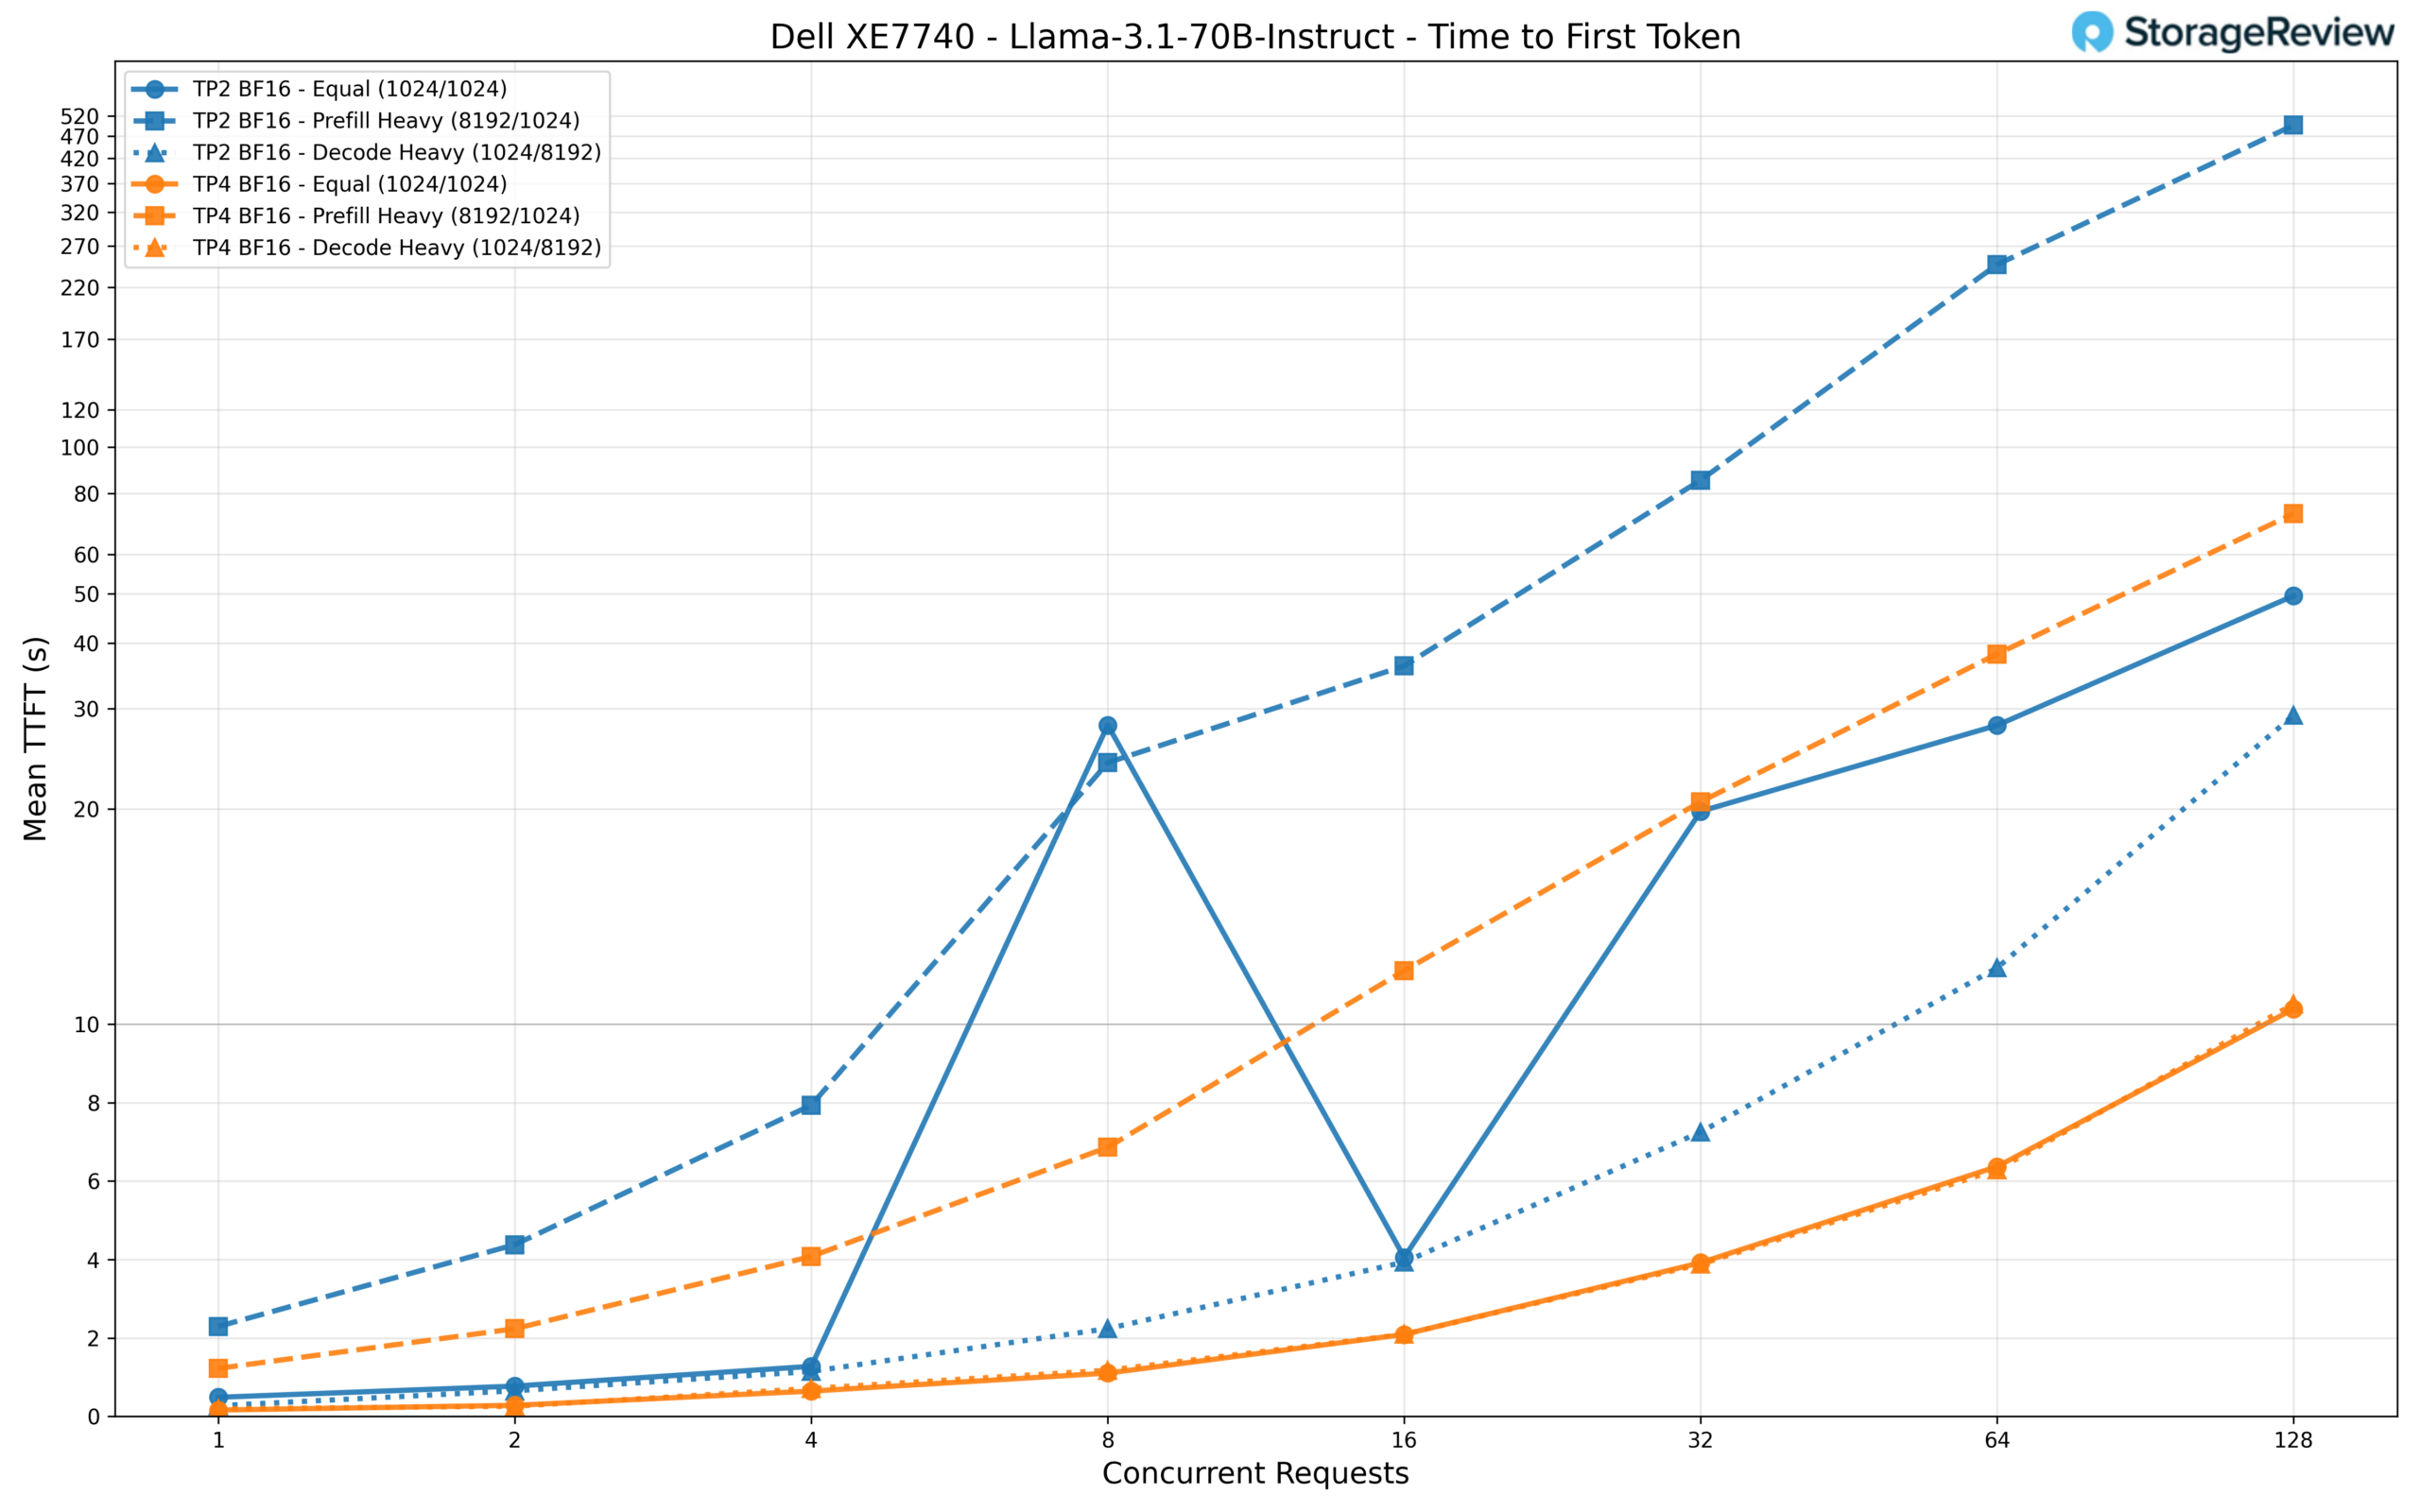
V prípade TTFT má TP2 problém s vysokou záťažou predfillov, pričom sa pri 128 súbežných požiadavkách vyšplhá na ohromujúcich 496 sekúnd, čo ho robí v podstate nepoužiteľným pre interaktívne aplikácie. TP4 to znižuje na približne 73 sekúnd. Pri rovnakých a dekódovacích úlohách TP4 drží TTFT na približne 10 sekundách pri 128 požiadavkách, zatiaľ čo TP2 dosahuje 50, respektíve 29 sekúnd. Pri nízkej súbežnosti TP4 doručí odpovede na prvý token za približne 160 ms pri rovnakom zaťažení v porovnaní so 486 ms v prípade TP2.
Inštrukcia Qwen3 Coder 30B-A3B
Qwen3 Coder 30B-A3B je jeden z najpopulárnejších kódovacích modelov pre lokálne inferenčné nasadenia a využíva architektúru Mixture-of-Experts (MoE). Na rozdiel od hustých modelov, kde každý parameter sa podieľa na každom prechode dopredu, modely MoE smerujú každý token cez malú podmnožinu špecializovaných expertných sietí. Qwen3 Coder udržiava plnú veľkosť modelu 30B parametrov s presnosťou BF16, pričom aktivuje iba 3B parametrov na vygenerovaný token. Tento riedky aktivačný vzor znamená, že model dokáže poskytnúť kvalitu oveľa väčšej siete a zároveň vyžaduje iba zlomok výpočtového výkonu na token, vďaka čomu je mimoriadne efektívny na hardvéri, ktorý podporuje réžiu smerovania. Pre koncových používateľov je tento model vhodný na každodennú pomoc s kódovaním, ako je generovanie štandardných vzorov, dokončovanie funkcií, vysvetľovanie kódu, písanie jednotkových testov a spracovanie rutinných vývojových úloh, ktoré profitujú z modelu špecializovaného na kód bez nutnosti náročného uvažovania.
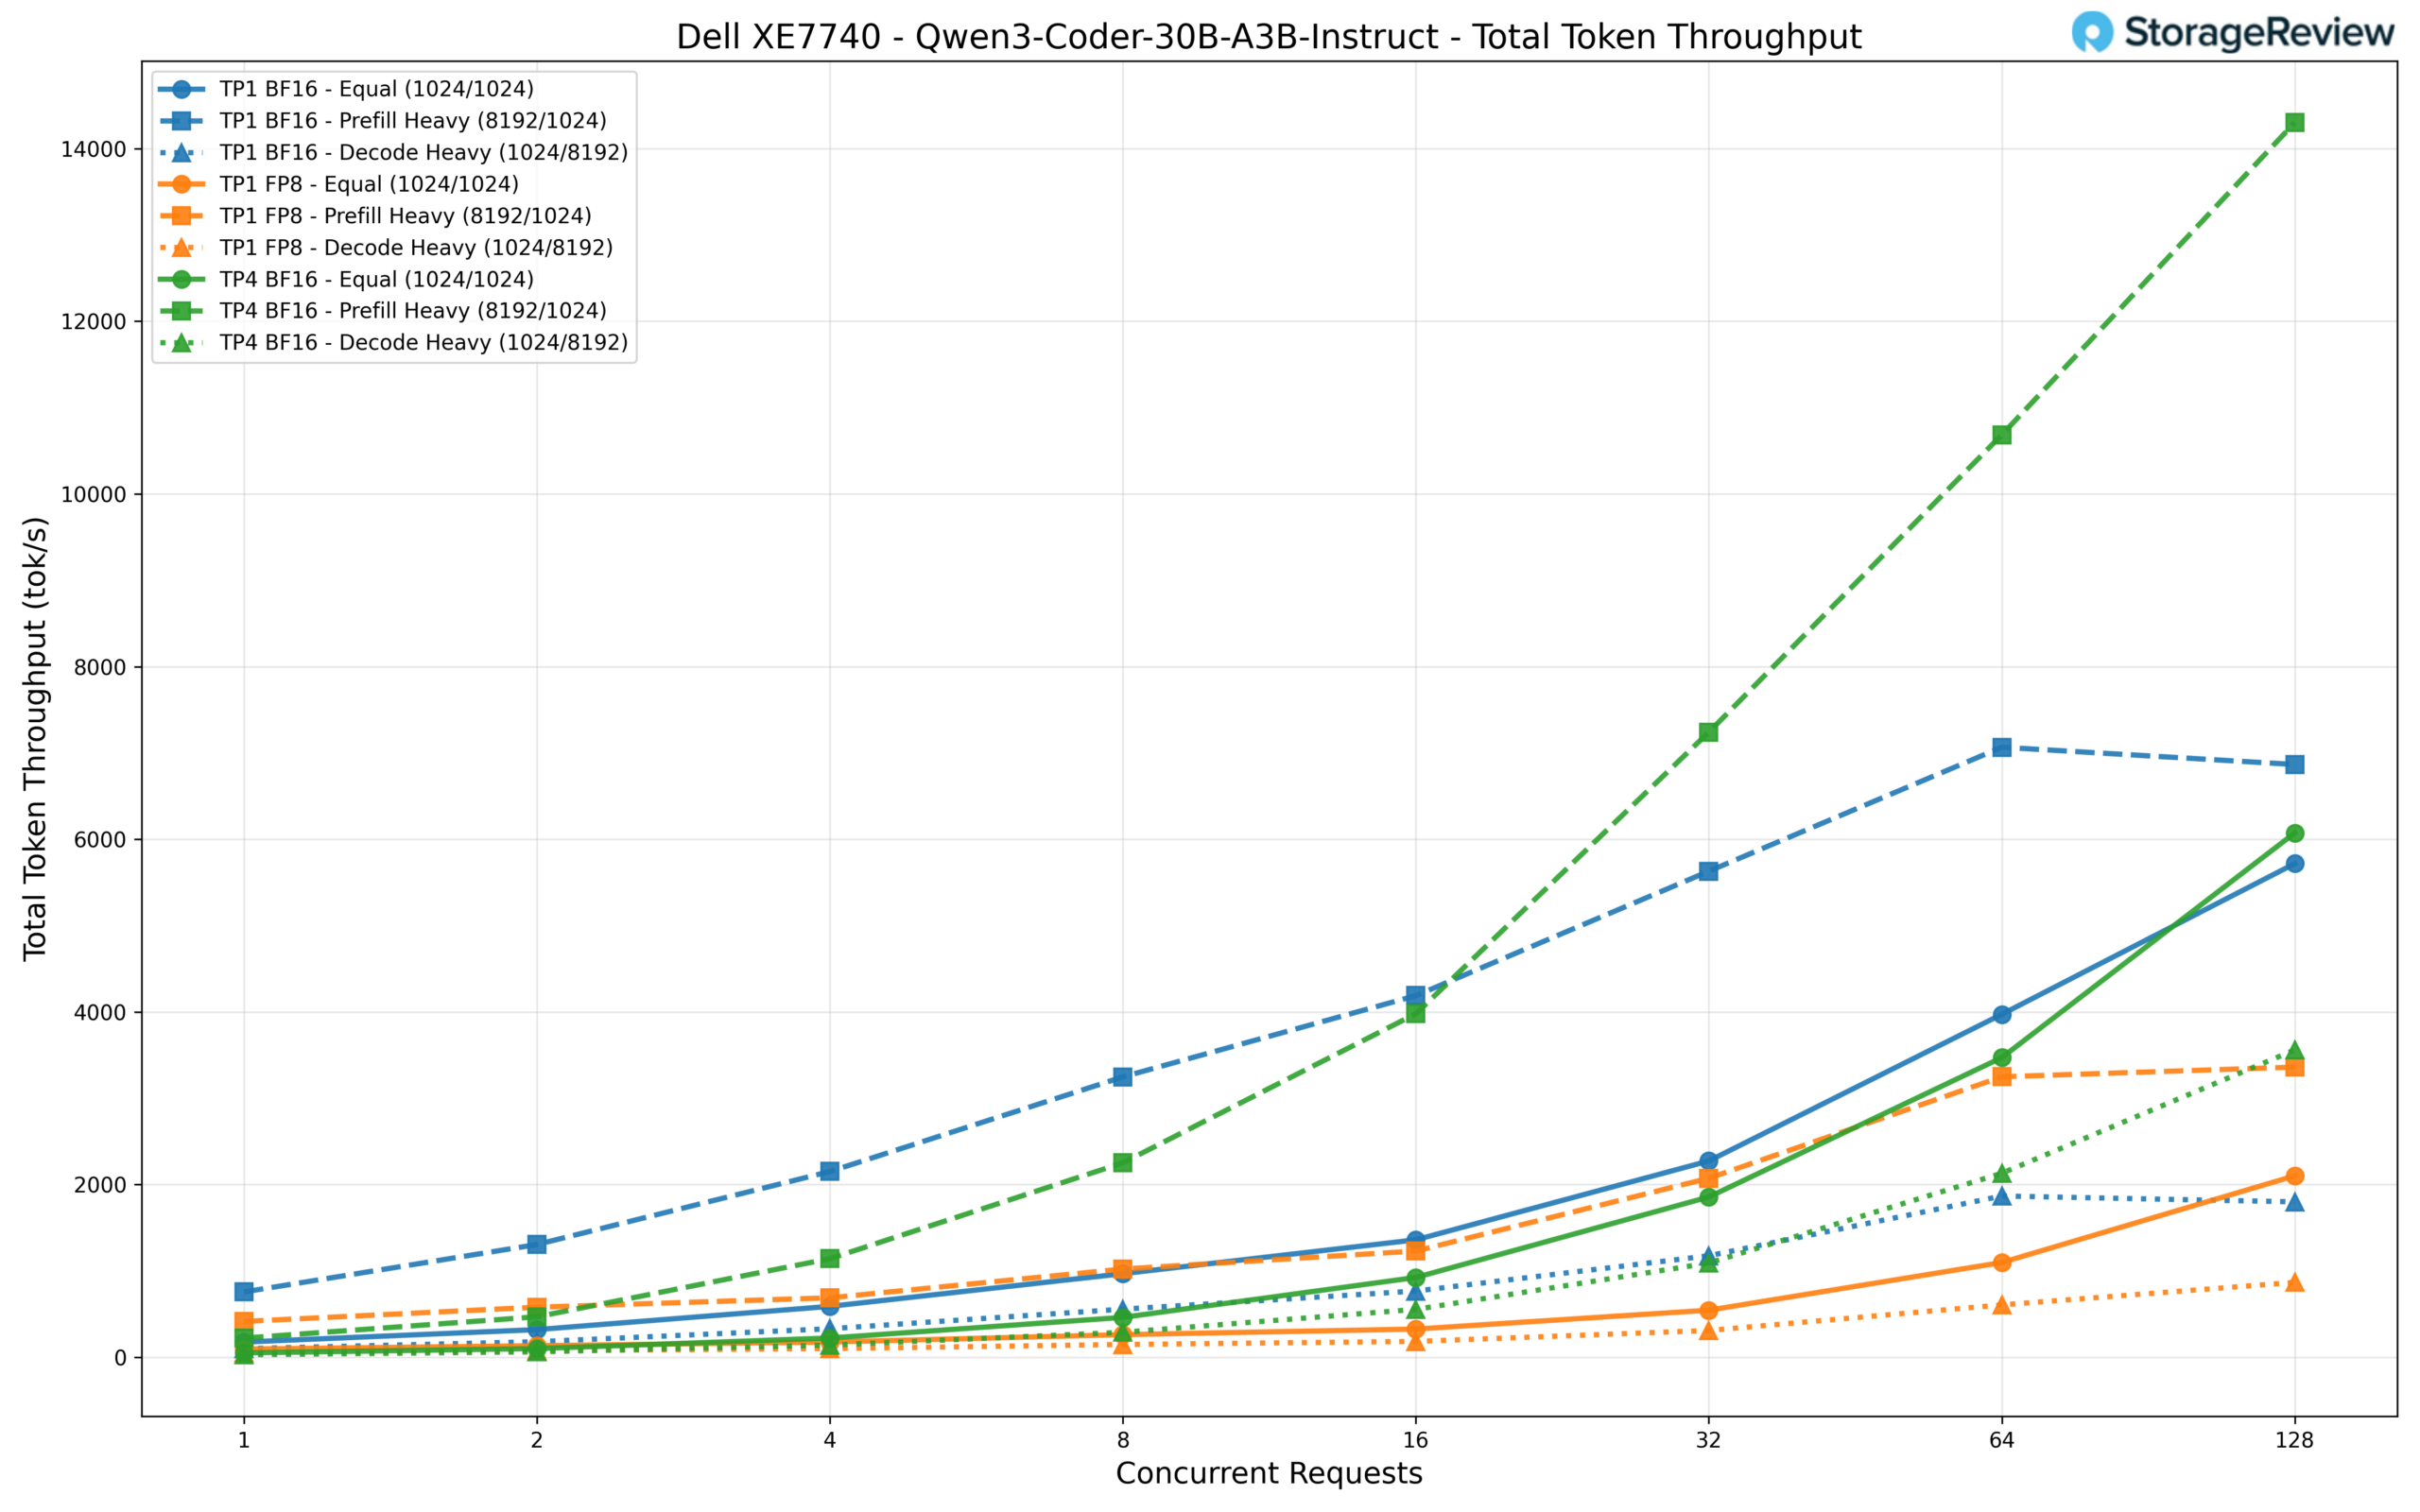
Testovali sme tri konfigurácie: TP1 BF16, TP1 FP8 a TP4 BF16. Pri 128 súbežných požiadavkách vedie TP4 BF16 s približne 14 300 tokami/s v scenári s vysokým zaťažením pred napĺňaním, čo je najvyššia hodnota priepustnosti, akú sme zaznamenali v rámci ktoréhokoľvek modelu v našej testovacej sade. TP1 BF16 nasleduje s približne 6 900 tokami/s v rovnakom scenári, zatiaľ čo TP1 FP8 zaostáva s približne 3 360 tokami/s. Pri rovnakom zaťažení sa rozdiel mierne zmenšuje, pričom TP4 dosahuje 6 073 tokov/s, TP1 BF16 5 718 tokov/s a TP1 FP8 2 101 tokov/s. Ako je uvedené v poznámke k FP8 vyššie, nižšie čísla FP8 odrážajú skôr aktuálny stav rozvetvenia vLLM od spoločnosti Intel než hardvérové úzke miesto.
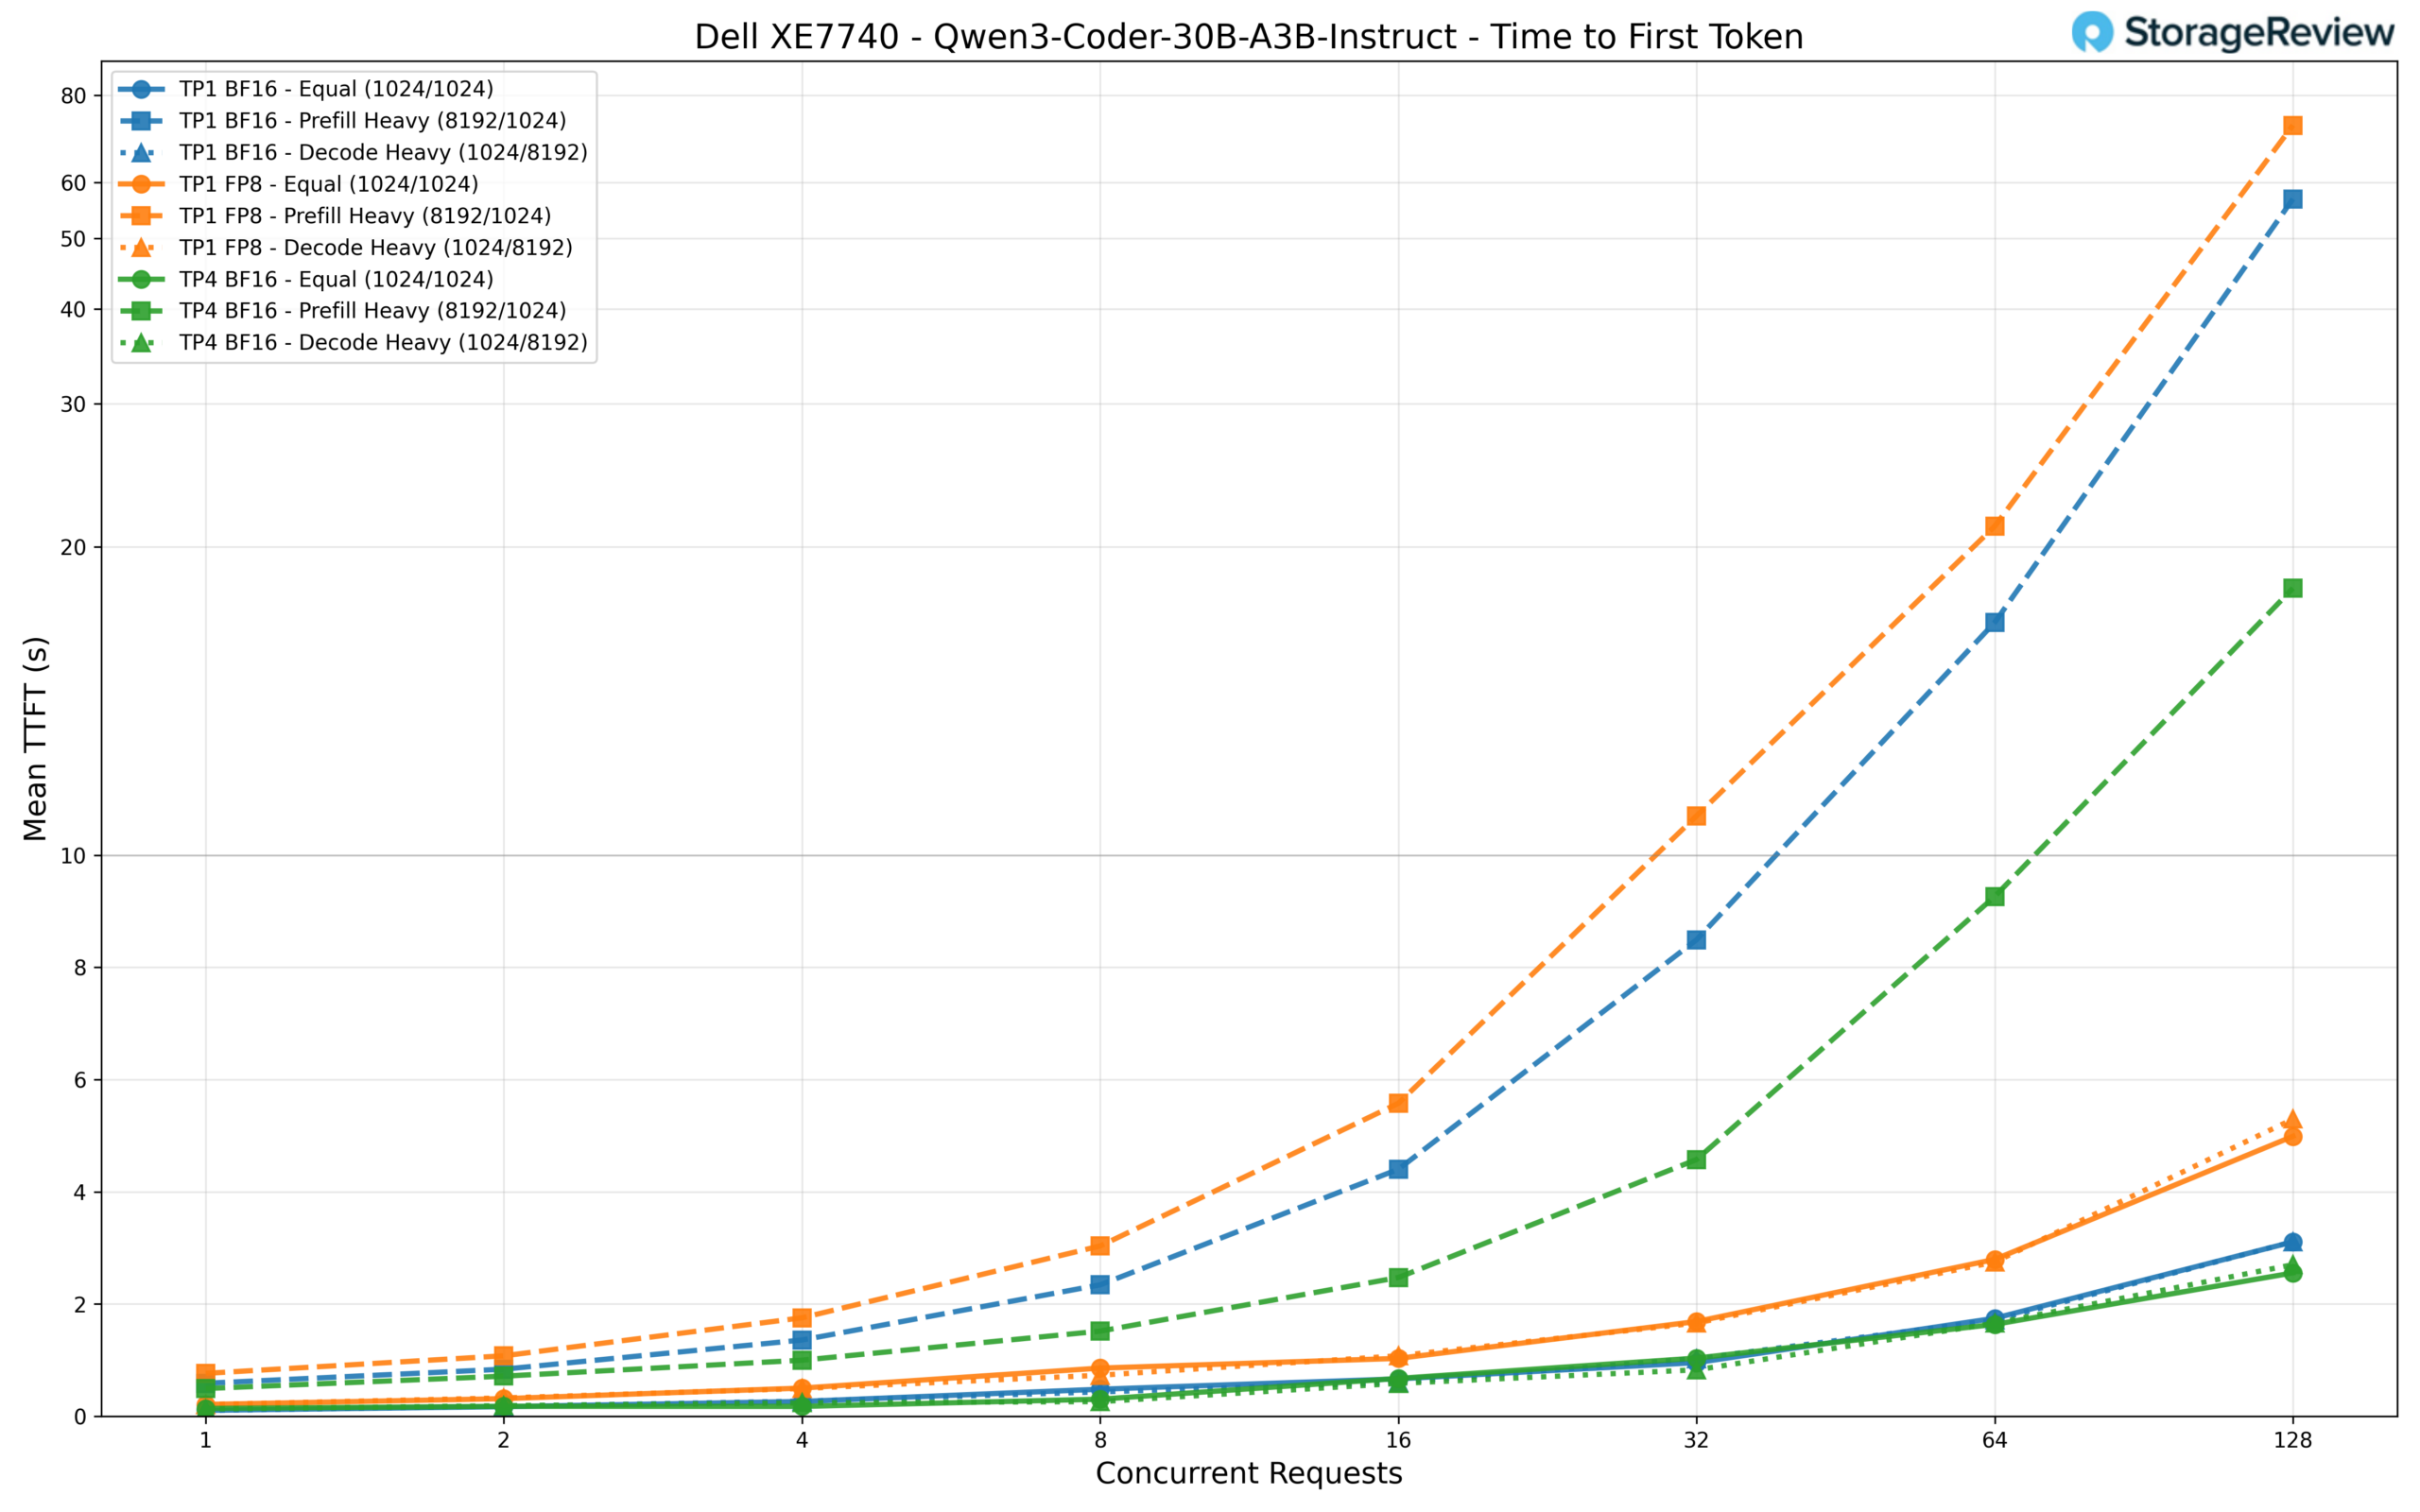
TTFT zostáva nízky vďaka riedkemu aktivačnému vzoru. TP4 BF16 poskytuje latenciu prvého tokenu približne 140 ms pri zaťažení jedným používateľom a drží sa približne 2.6 sekundy pri 128 súbežných požiadavkách v rovnakej pracovnej záťaži. TP1 BF16 je porovnateľný pri nízkej súbežnosti (106 ms), ale pri plnom zaťažení stúpa na 3.1 sekundy. Scenár s vysokým zaťažením preddopĺňania opäť jasne odlišuje konfigurácie: TP4 dosahuje približne 18 sekúnd pri 128 požiadavkách, TP1 BF16 dosahuje 57 sekúnd a TP1 FP8 sa predlžuje na 72 sekúnd.
Qwen3 235B-A22B Myslenie
Najväčší model v našom benchmarkovom balíku, Qwen3 235B-A22B Thinking, je rozsiahly model uvažovania MoE s celkovým počtom parametrov 235 miliardami a 22 miliardami aktívnych parametrov na token. Okrem svojej obrovskej veľkosti tento model obsahuje vstavané funkcie uvažovania v reťazci myšlienok, ktoré mu umožňujú krok za krokom rozobrať zložité problémy predtým, ako dospeje k odpovedi, a to za cenu väčšieho množstva dekódovacích tokenov. Vďaka tomu je obzvlášť vhodný pre najnáročnejšie úlohy: pokročilé generovanie a ladenie kódu, matematické riešenie problémov, viackrokové logické uvažovanie a zložité, agentické pracovné postupy, kde presnosť je dôležitejšia ako hrubá rýchlosť. Tento model vyžaduje na spustenie TP4 a testovali sme ho s presnosťou BF16 aj FP8.
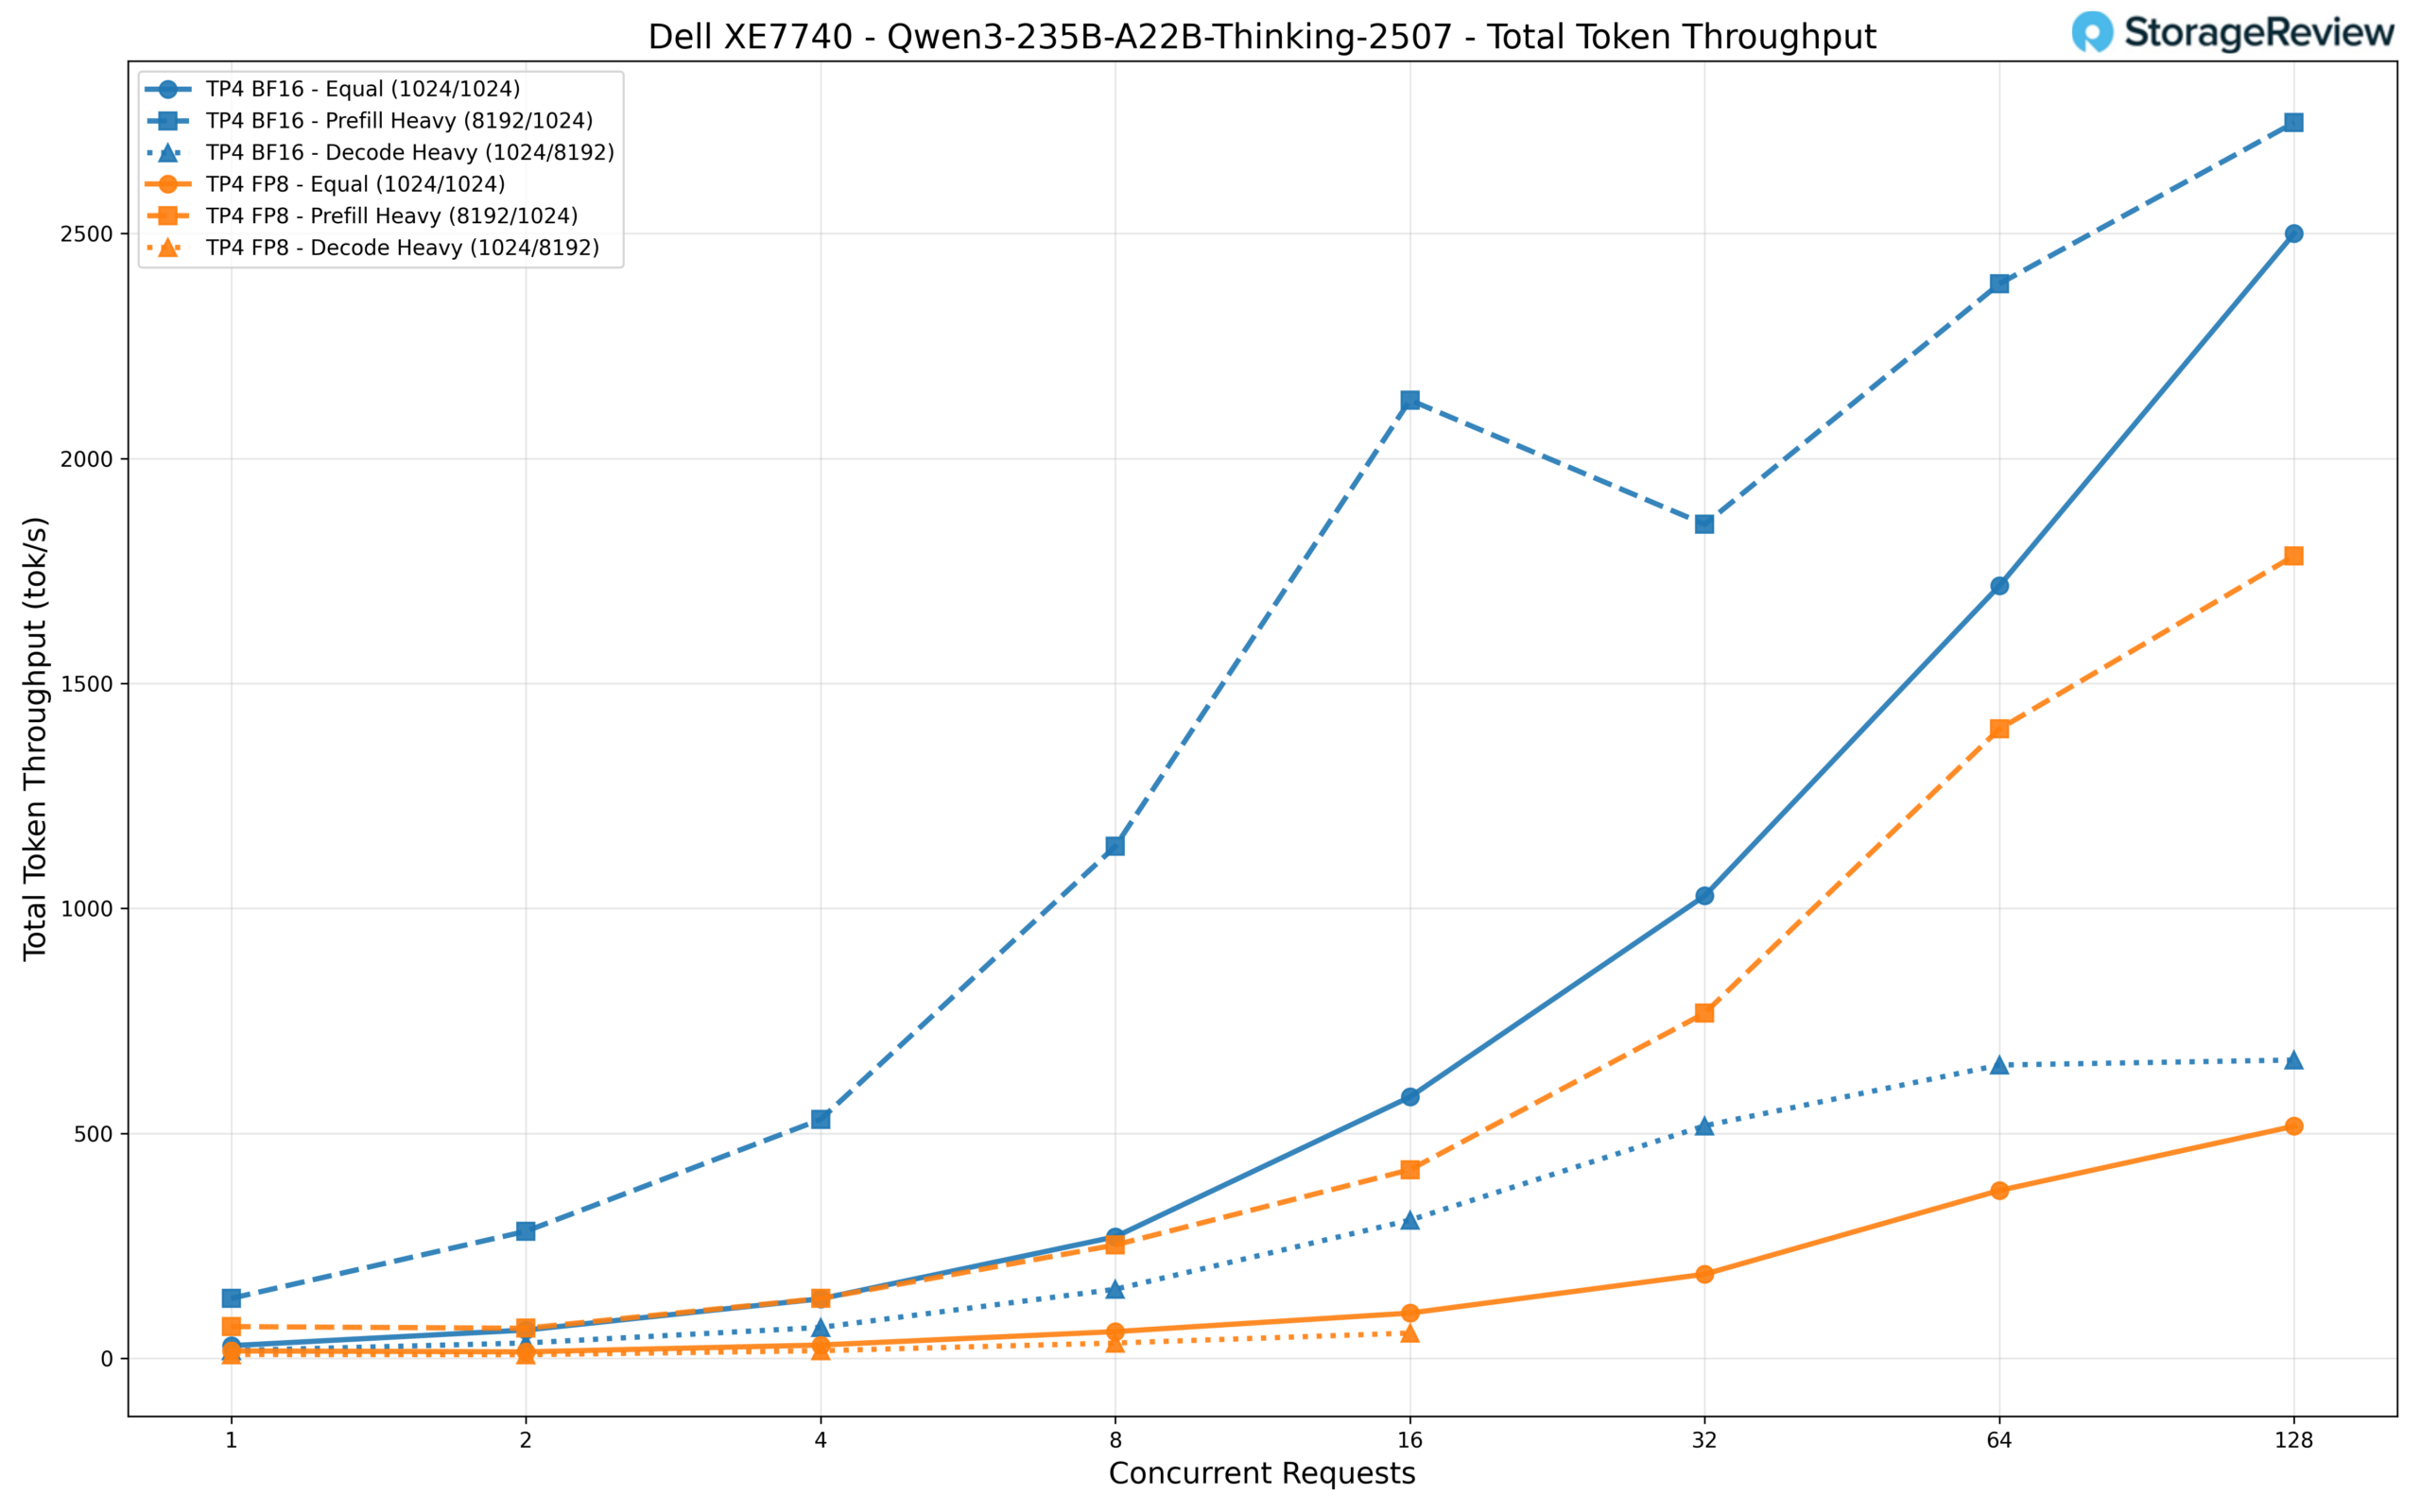
BF16 jednoznačne prekonáva FP8 vo všetkých ohľadoch. Pri 128 súbežných požiadavkách dosahuje BF16 približne 2 750 tokov/s v scenári s vysokou záťažou predfillu a 2 500 tokov/s v rovnakom scenári, zatiaľ čo FP8 zvláda približne 1 784 tokov/s a 516 tokov/s. Variant FP8 tiež zaznamenal časové limity v scenári s vysokou záťažou dekódovania pri vyšších úrovniach súbežnosti (32+ požiadaviek).
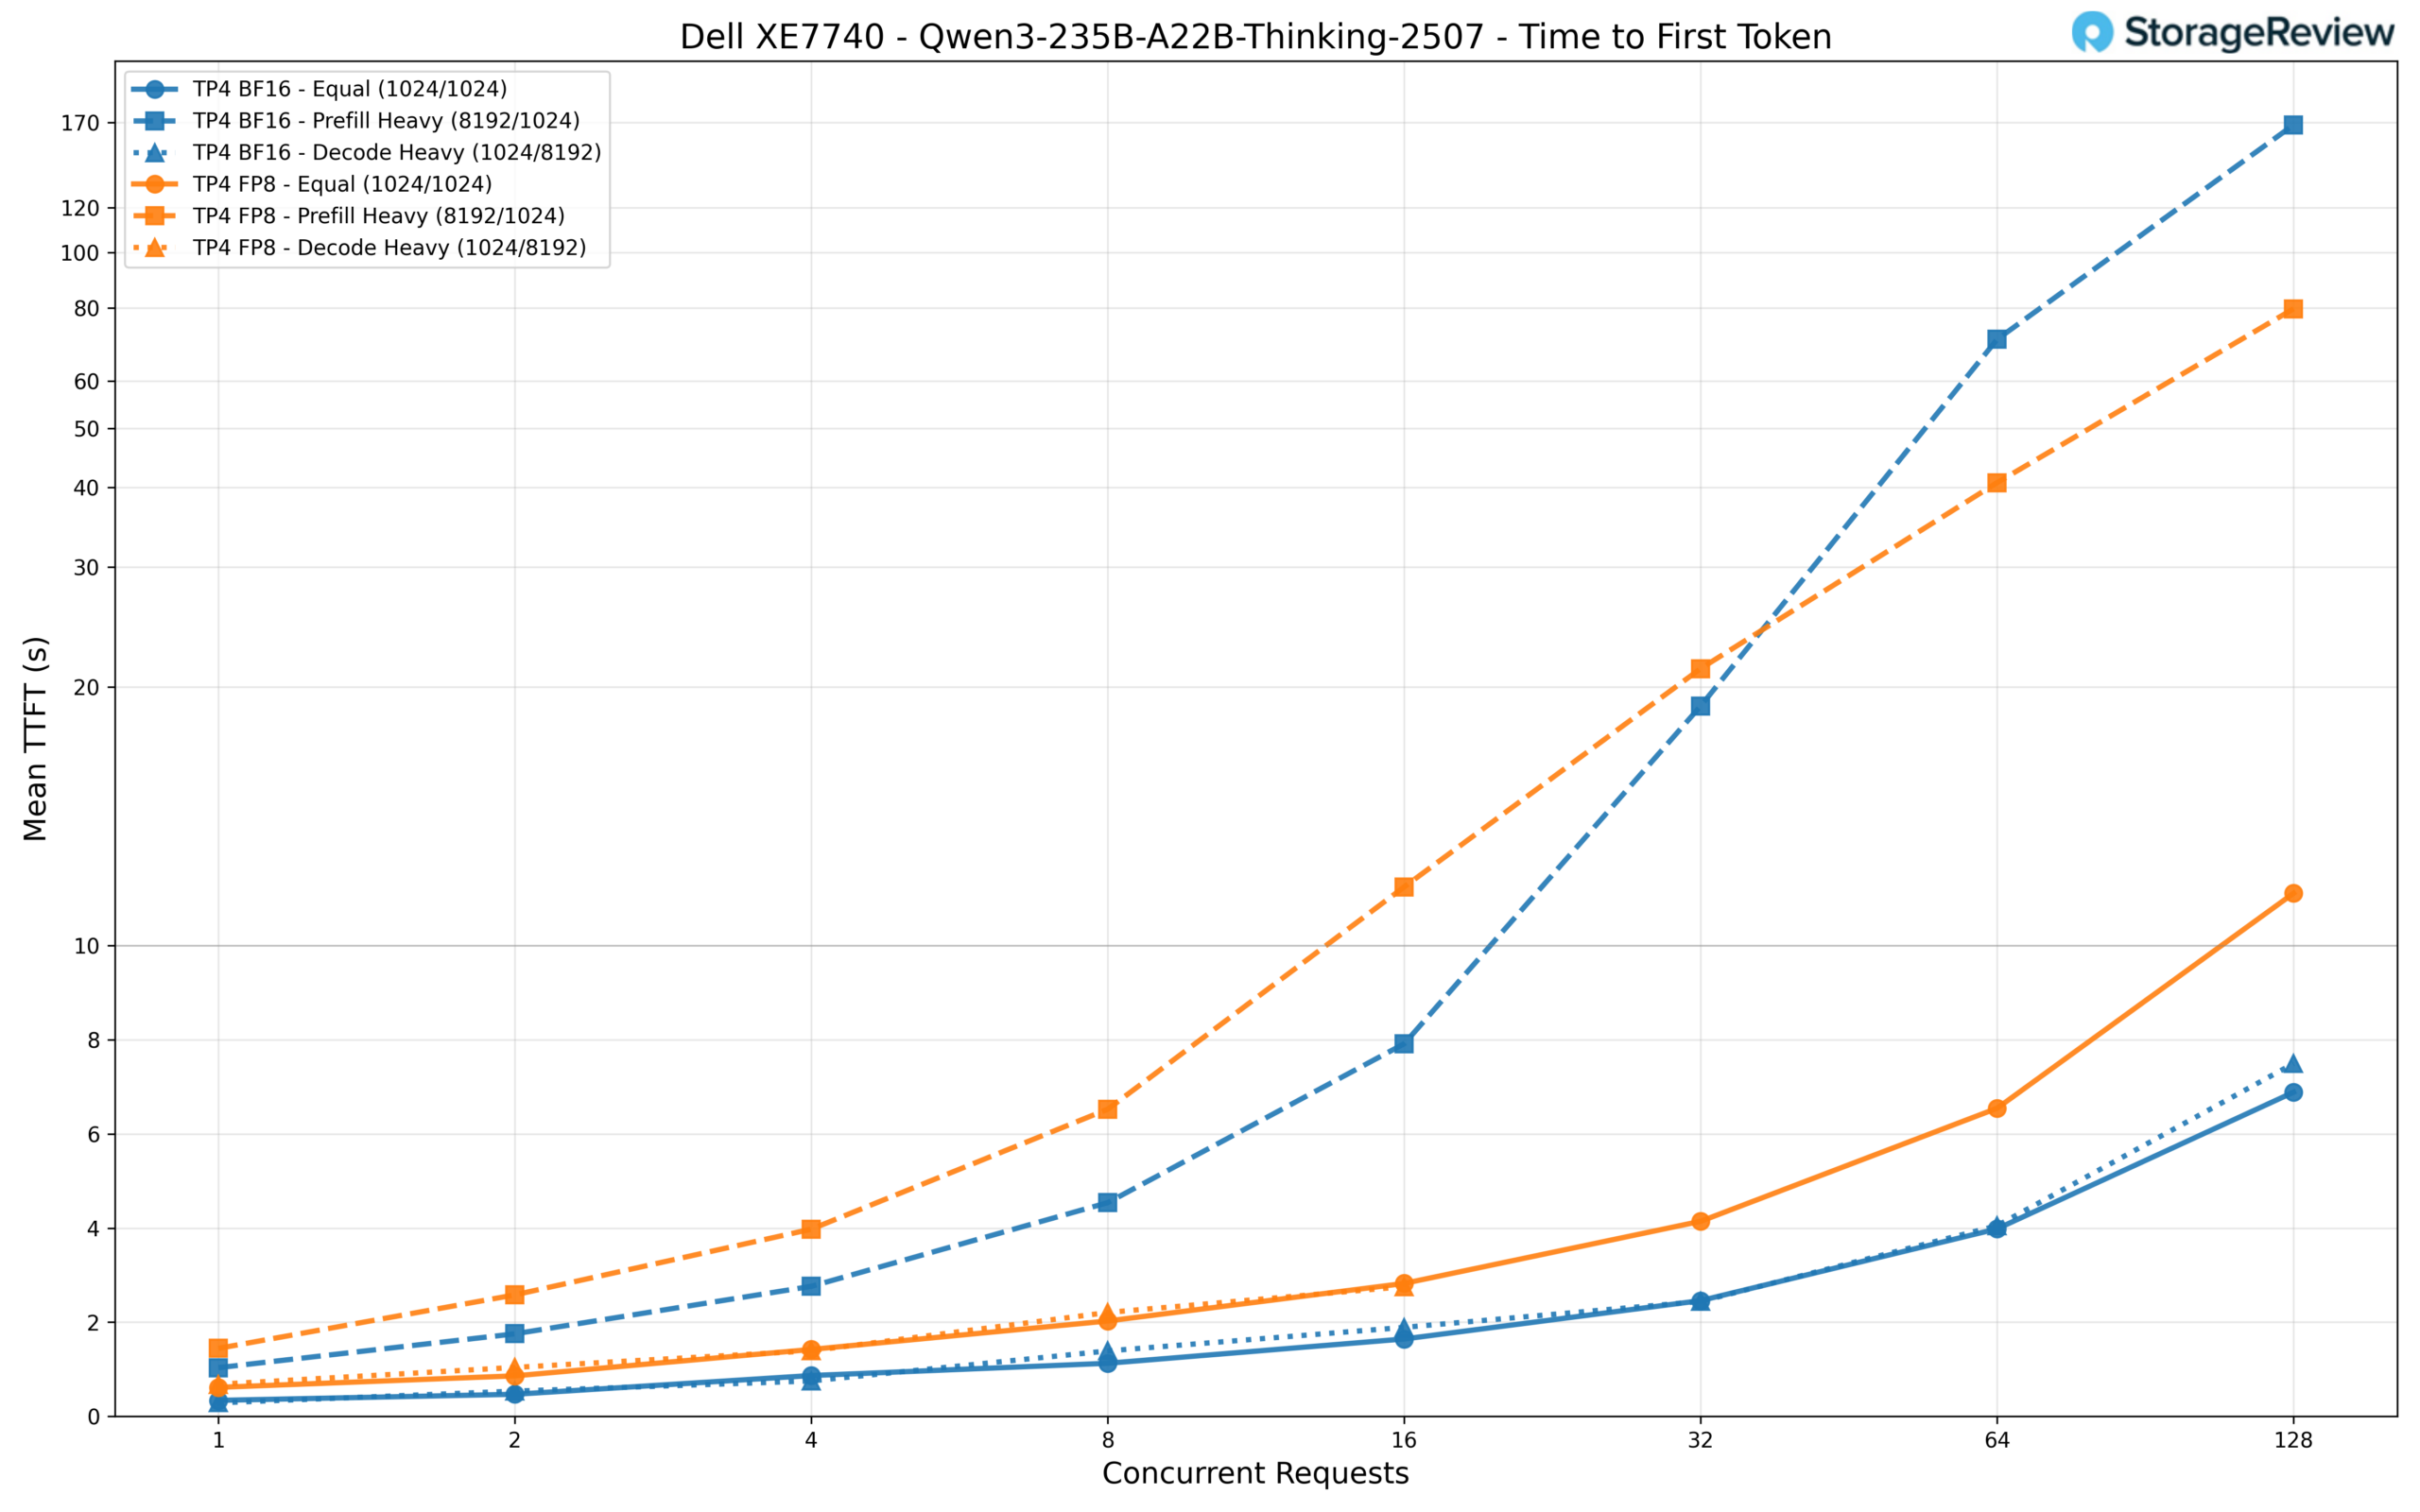
Pre TTFT začína BF16 na približne 340 ms pre jednu požiadavku rovnakej dĺžky a škáluje sa na približne 6.9 sekundy pri 128 súbežných požiadavkách. To je pre model tejto veľkosti celkom pohotová doba. FP8 je približne 2-krát pomalší, začína na 615 ms a dosahuje približne 11.2 sekundy pri plnom zaťažení. Najnáročnejším scenárom je pracovná záťaž s vysokým zaťažením predbežného dopĺňania, pričom BF16 sa pri 128 požiadavkách vyšplhá na 168 sekúnd a FP8 na 80 sekúnd.
Pre koho je to určené?
Dopyt po inferencii sa nespomaluje. Či už organizácie interne nasadzujú modely na urýchlenie vývojárskych tímov, vkladajú umelú inteligenciu do produktov orientovaných na zákazníka alebo budujú automatizované kanály, ktoré bežia nepretržite, požiadavky na výpočtový výkon neustále rastú. A s týmto dopytom prichádza známe úzke hrdlo: obstarávanie. Dodacie lehoty v populárnych akcelerátoroch sa môžu natiahnuť na mesiace, čo zastaví projekty, ktoré už boli financované a personálne obsadené.
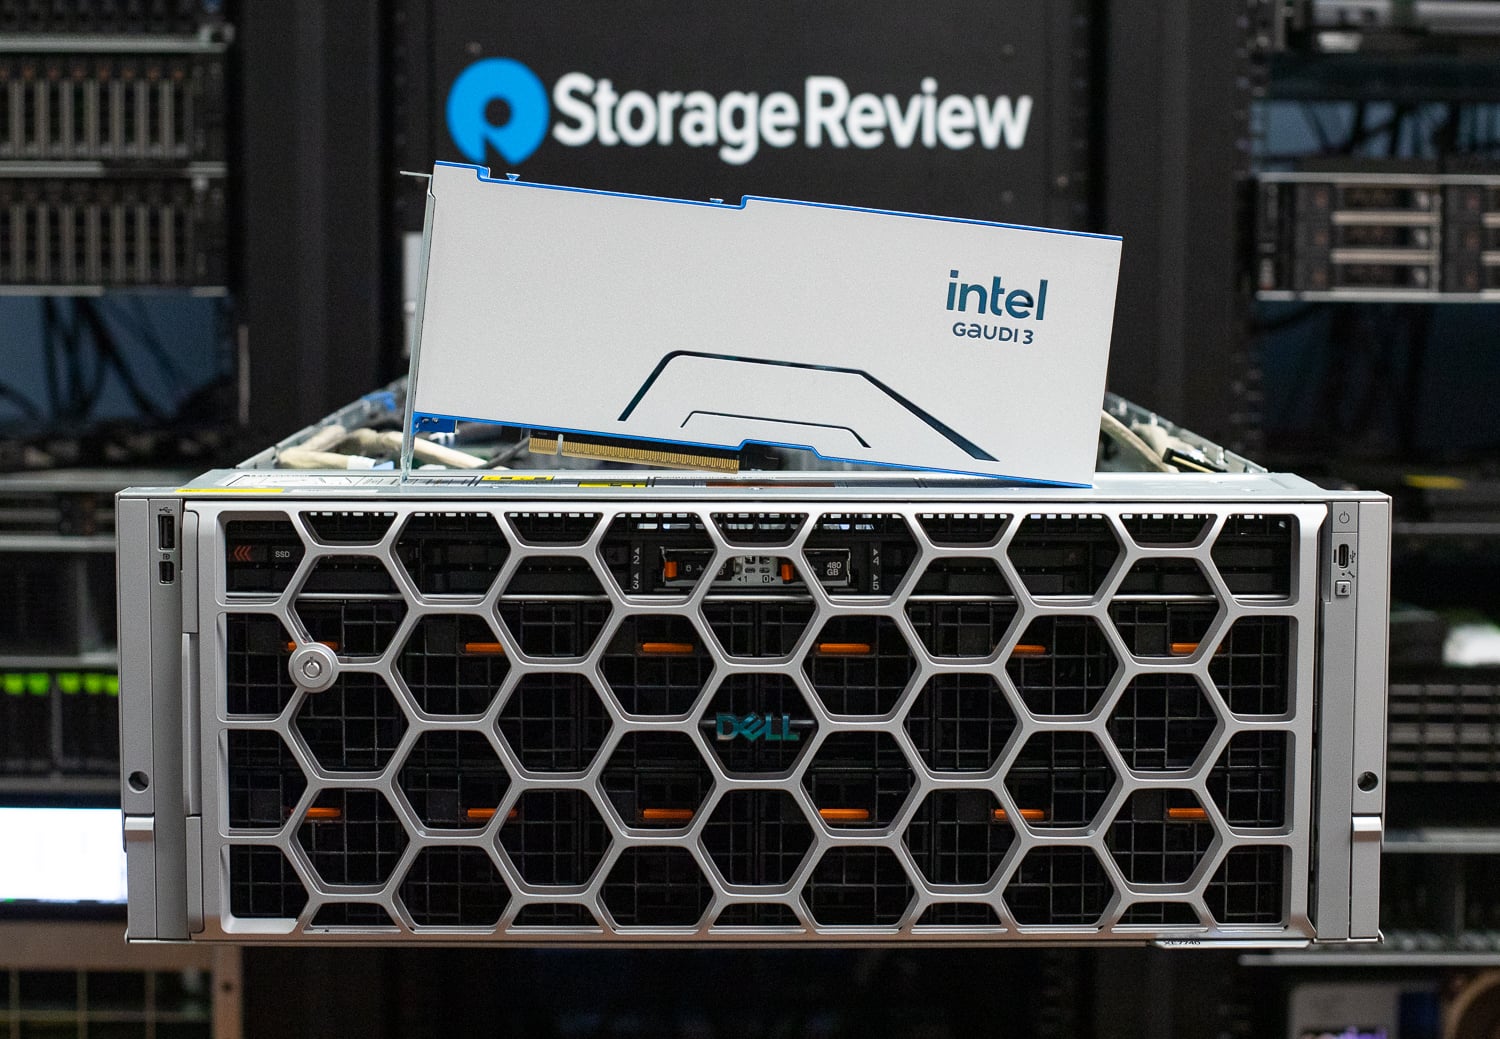
XE7740, nakonfigurovaný s Intel Gaudi 3, toto obmedzenie priamo rieši. Akcelerátory Gaudi 3 sú teraz k dispozícii a Intel poskytuje overené šablóny nasadenia, aby tímy mohli prejsť od rozbaľovania k poskytovaniu inferencie v priebehu niekoľkých hodín. Spoločnosť Dell ďalej znižuje bariéru pomocou programov „vyskúšaj a kúp“, ktoré umiestňujú systémy XE7740 priamo do vášho prostredia, čo vám umožňuje overiť výkon oproti skutočným pracovným zaťaženiam, údajom a infraštruktúre predtým, ako sa rozhodnete pre úplné nasadenie. Táto kombinácia okamžitej dostupnosti, rýchleho času a hodnoty a nízkorizikového hodnotenia robí konfiguráciu Gaudi 3 obzvlášť atraktívnou pre organizácie, ktoré dnes potrebujú inferenčnú kapacitu a nemôžu si dovoliť čakať v alokačných radoch.
Napriek tomu XE7740 nie je platforma s jedným akcelerátorom. Vďaka záväzku spoločnosti Dell k diverzite kremíkových čipov je možné mať rovnakú platformu s rôznymi možnosťami a každým populárnym akcelerátorom na trhu a správna voľba závisí výlučne od pracovného zaťaženia. Napríklad kanály na spracovanie videa sú prirodzenou súčasťou NVIDIA L4 a XE7740 môže byť vybavený 16 GPU L4 spolu s 8 slotmi PCIe Gen5 x16 NIC pre bezkompromisný systém streamovania a transkódovania. Organizácie, ktoré prevádzkujú zmiešané pracovné zaťaženia umelej inteligencie naprieč oddeleniami, môžu štandardizovať šasi XE7740 a jednoducho meniť konfiguráciu akcelerátora tak, aby zodpovedala každému nasadeniu, čím sa zjednoduší správa flotily a zároveň sa prispôsobia výpočty úlohe.
Záver
Server Dell PowerEdge XE7740 je navrhnutý pre realitu podnikovej inferencie. Jeho dvojzónový tepelný dizajn, štruktúrovaná topológia PCIe, architektúra pamäte s vysokou šírkou pásma a škálovateľná sieťová kapacita tvoria systém vytvorený pre trvalé produkčné pracovné zaťaženie. Nejde o náhodné voľby dizajnu; odrážajú model infraštruktúry, kde inferencia beží nepretržite, predvídateľne sa škáluje a čisto sa integruje do existujúcich operácií dátového centra. V tomto hodnotení Intel Gaudi 3 demonštruje, že XE7740 dnes poskytuje inferenciu naprieč hustými architektúrami a architektúrami MoE s predvídateľným správaním pri škálovaní a silnou pamäťovou priepustnosťou. Optimalizácia softvéru sa bude naďalej zlepšovať, ale architektonický základ platformy je už teraz pevný.
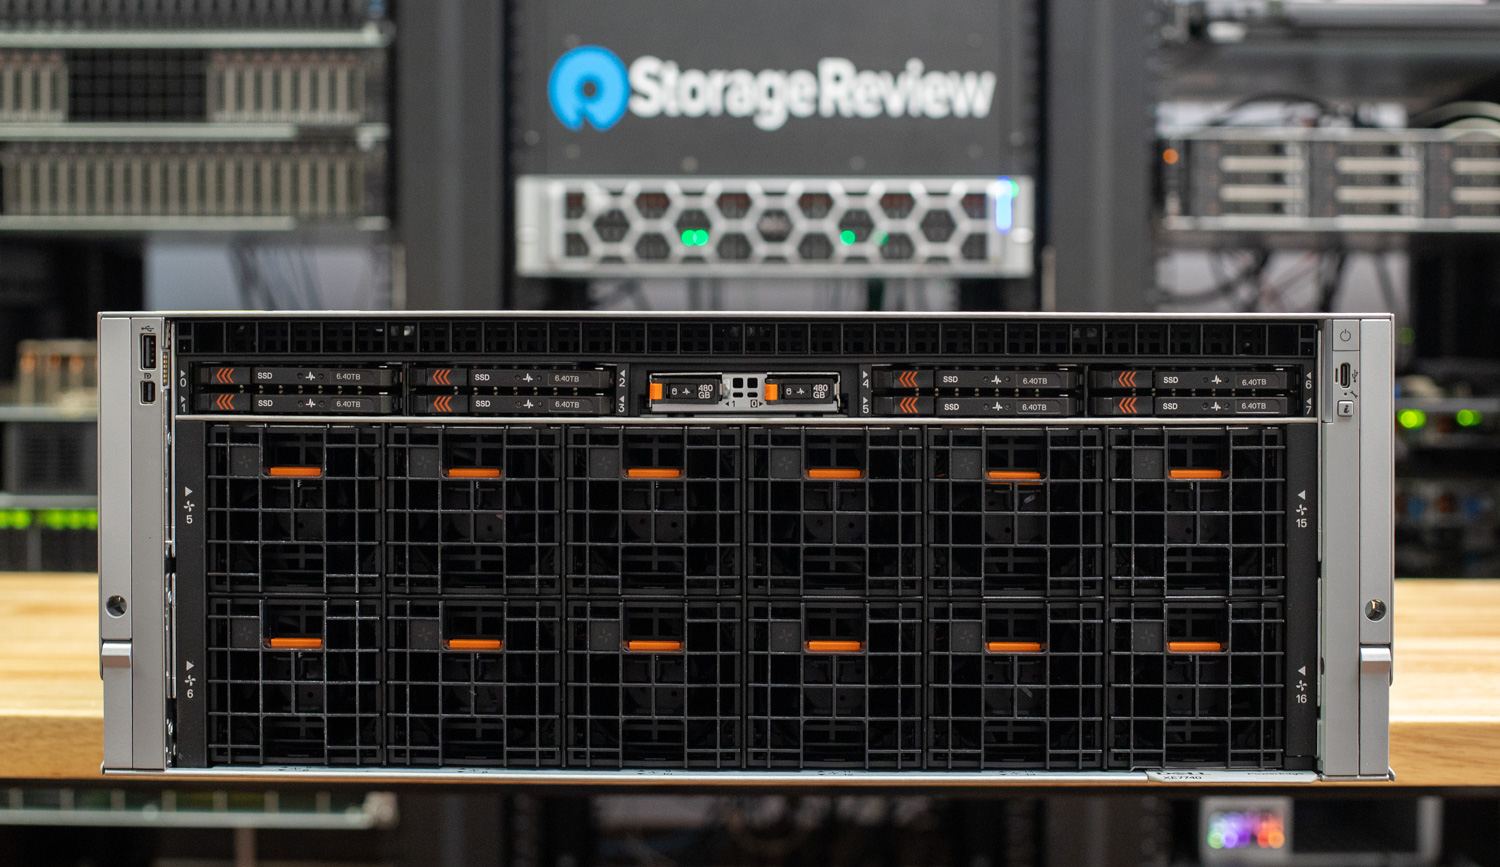
A čo je dôležitejšie, XE7740 vytvára odolný plán pre podnikovú infraštruktúru umelej inteligencie. Organizácie môžu štandardizovať konzistentné šasi, zásobník správy a model nasadenia a zároveň postupne vyvíjať stratégiu akcelerátora. S rastom modelov, diverzifikáciou pracovných zaťažení a hlbším začleňovaním inferencie do obchodných operácií sa bude len zvyšovať potreba stabilnej a prispôsobivej infraštruktúry. PowerEdge XE7740 je pripravený na splnenie tejto trajektórie. Poskytuje architektonickú rovnováhu, prevádzkovú zrelosť a priestor na rozširovanie, ktoré podniková umelá inteligencia potrebuje pri prechode od rýchleho prijatia k dlhodobej integrácii.
Túto správu sponzoruje spoločnosť Dell Technologies. Všetky názory a stanoviská vyjadrené v tejto správe vychádzajú z nášho nestranného pohľadu na posudzovaný(é) produkt(y).


 Amazonka