

NVIDIA DGX Spark predstavuje zlomový moment v prístupnej infraštruktúre umelej inteligencie. V roku 2017 bol publikovaný prelomový dokument „Attention is All You Need“ (Všetko, čo potrebujete, je len pozornosť), ktorý predstavil architektúru Transformer, založenú na konfigurácii servera P100 s ôsmimi grafickými procesormi, spotrebúvajúc desiatky kilowatthodín a zaberajúc značný priestor v dátových centrách. Dnes DGX Spark poskytuje vynikajúci výpočtový výkon v kompaktnom stolovom počítači s výkonom 240 wattov. Tento dramatický vývoj v energetickej účinnosti a kompresii tvarových faktorov sprístupňuje funkcie umelej inteligencie, ktoré boli predtým určené výhradne pre dátové centrá, jednotlivým výskumníkom, malým tímom a distribuovaným vývojovým organizáciám.
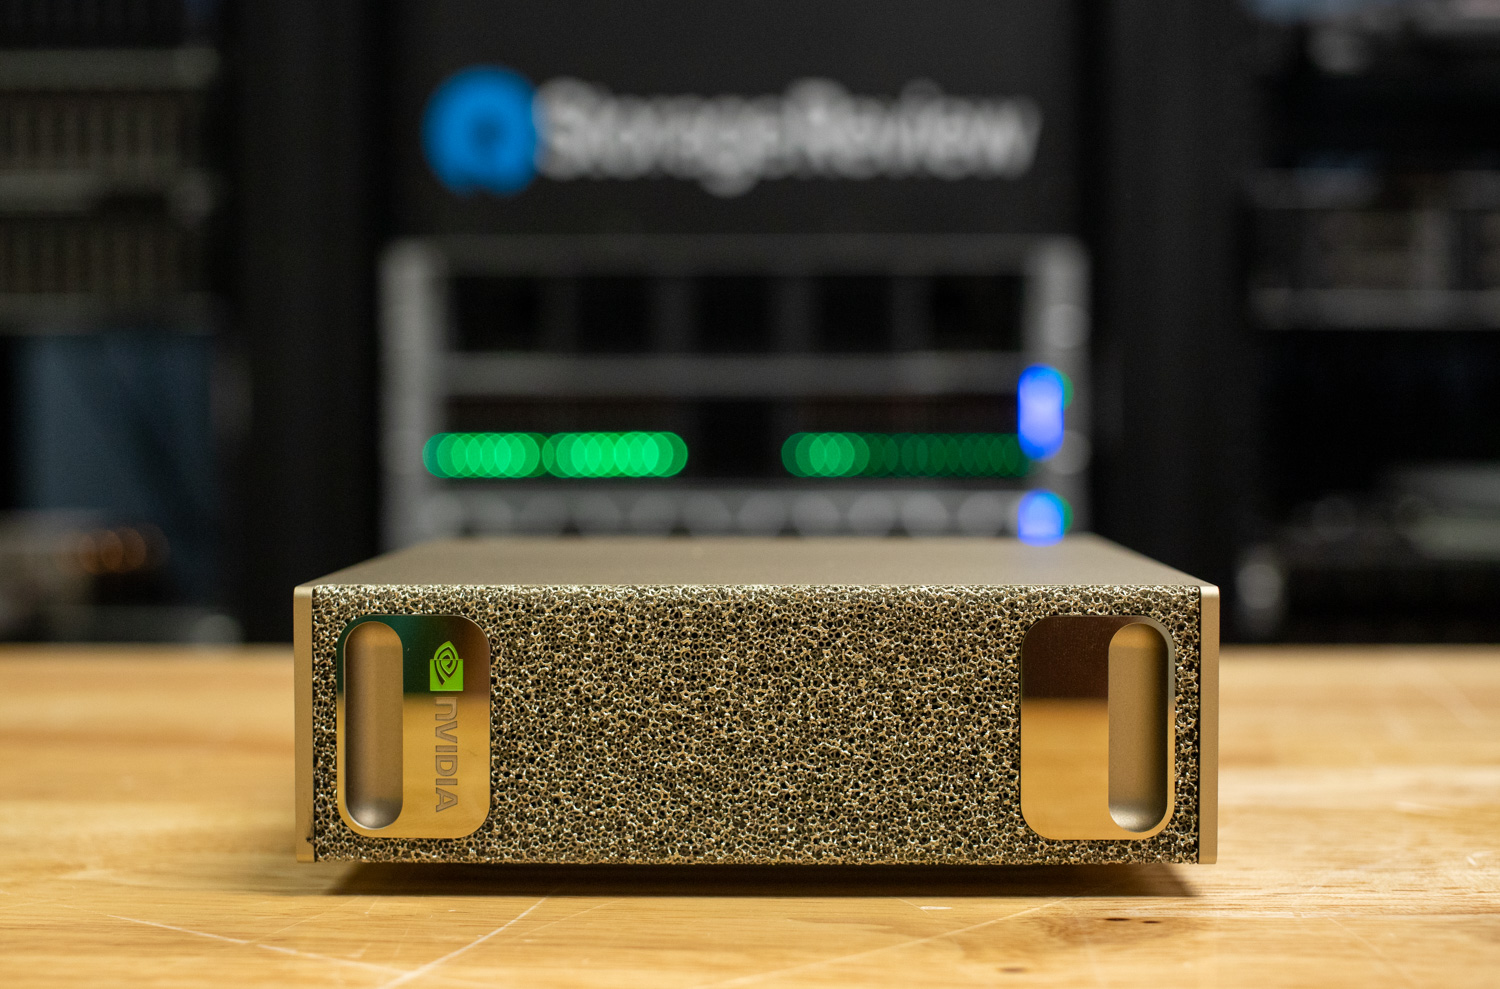
To, čo odlišuje Spark od predchádzajúcich riešení umelej inteligencie pre stolné počítače, je jeho komplexný prístup k celému životnému cyklu vývoja. Namiesto nútenia kompromisov medzi experimentovaním, jemným dolaďovaním a nasadením poskytuje Spark skutočné možnosti vo všetkých fázach. Architektúra unifikovanej pamäte s kapacitou 128 GB umožňuje úplné jemné doladenie parametrov modelov, ktoré by na konvenčných pracovných staniciach vyžadovali cloudové zdroje, a zároveň poskytuje priepustnosť stoviek tokenov za sekundu vhodnú pre dávkové inferenčné úlohy vrátane generovania syntetických údajov. Zahrnutie siete ConnectX-7 s kapacitou 200 GB fabric znamená, že organizácie môžu zoskupovať viacero systémov Spark pre ešte rozsiahlejší prieskum modelov, hoci, ako ukážeme, aj jedna jednotka sa ukazuje ako pozoruhodne výkonná.
Kľúčové poznatky
Výkon dátového centra v stolnom počítači : GB10 Grace Blackwell v 1.13-litrovom, 240W boxe, cena 3 999 dolárov, poskytuje výkon až 1 petaFLOP FP4 s nízkym výkonom.
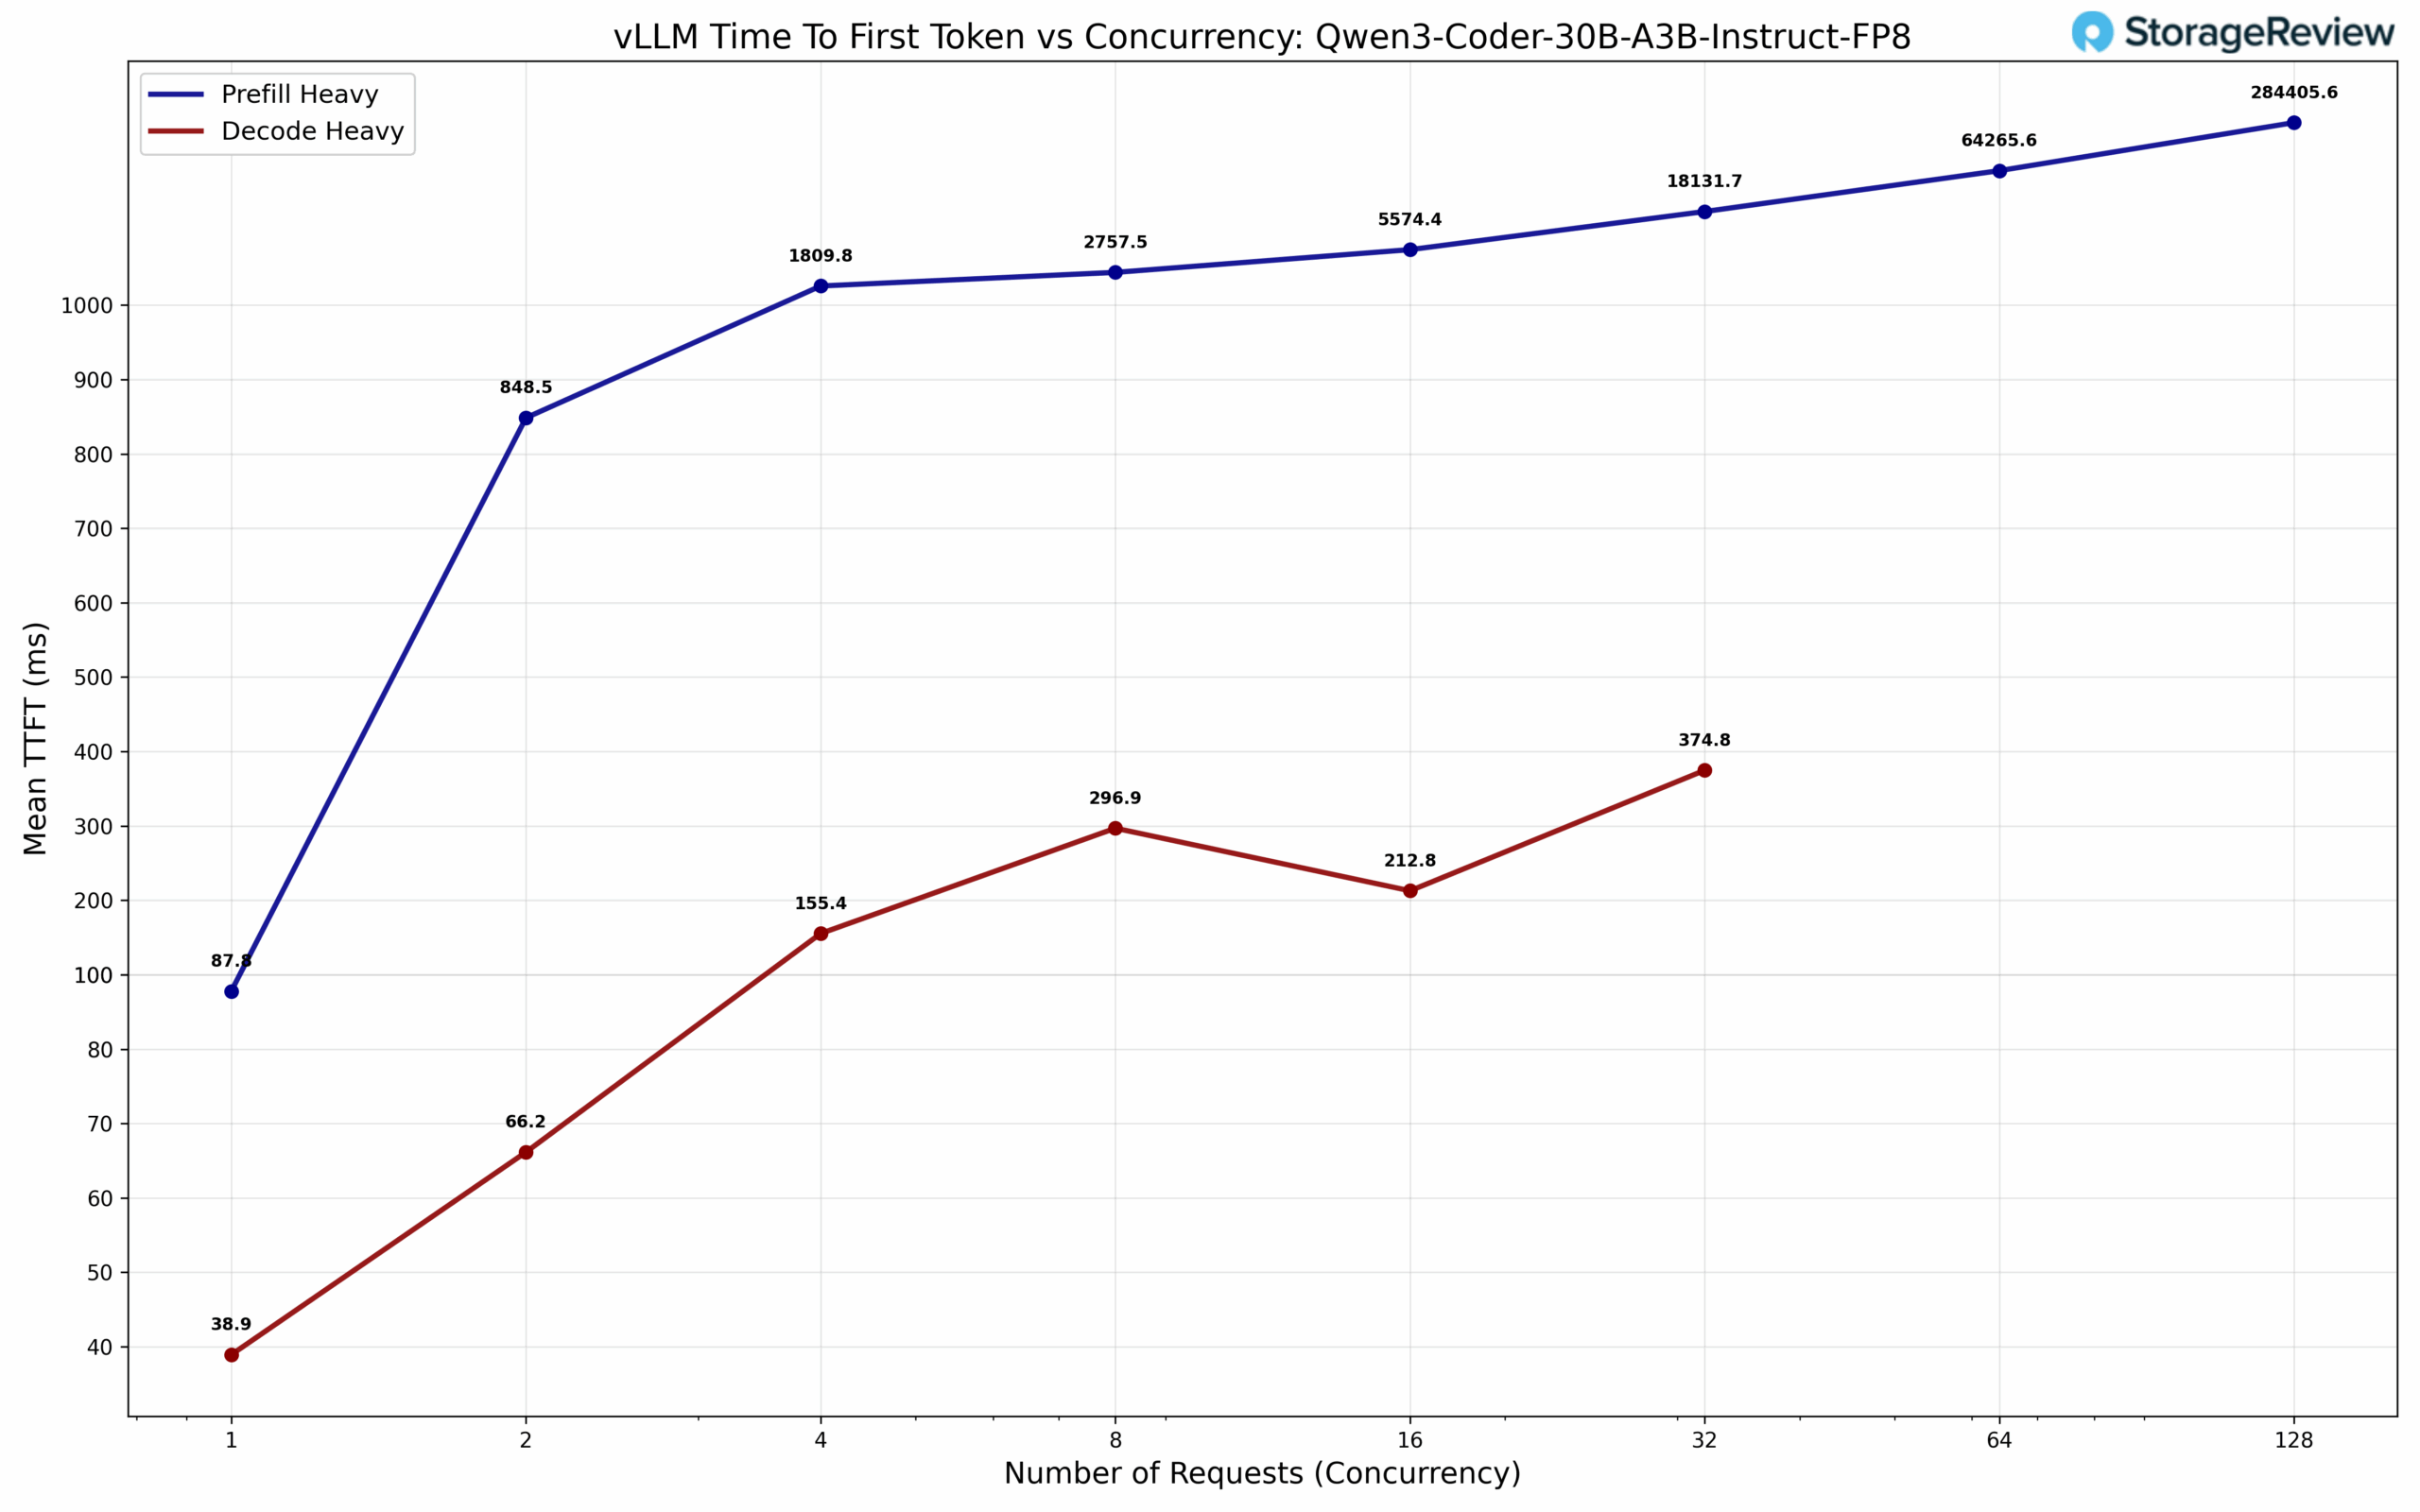
Pamäť, ktorá mení pracovné postupy : 128 GB unifikovaná pamäť umožňuje lokálne doladenie všetkých parametrov 8B modelov a vysokokapacitnú inferenciu. V testovaní sme videli, že Llama 3.1 8B FP4 dosiahol ~924 taktov/s pri 128 súbežnostiach a Qwen3 Coder 30B-A3B FP8 dosiahol ~483 taktov/s pri dávke 64.
Pripravené na škálovanie a pripojenie rýchleho úložiska : Integrovaný ConnectX-7 poskytuje 200G fabric pre klastrovanie alebo NVMe-oF. Interný 2242 Gen5 NVMe je pohodlný, ale obmedzený pre náročné I/O operácie, takže externý NVMe-oF cez RDMA je lepšou cestou pre trvalú priepustnosť.
Softvérová zrelosť od prvého dňa : Dodáva sa s DGX OS, CUDA, cuDNN, TensorRT, AI Workbench, kontajnermi a workbookmi, aby tímy mohli okamžite spúšťať skutočné pracovné záťaže.
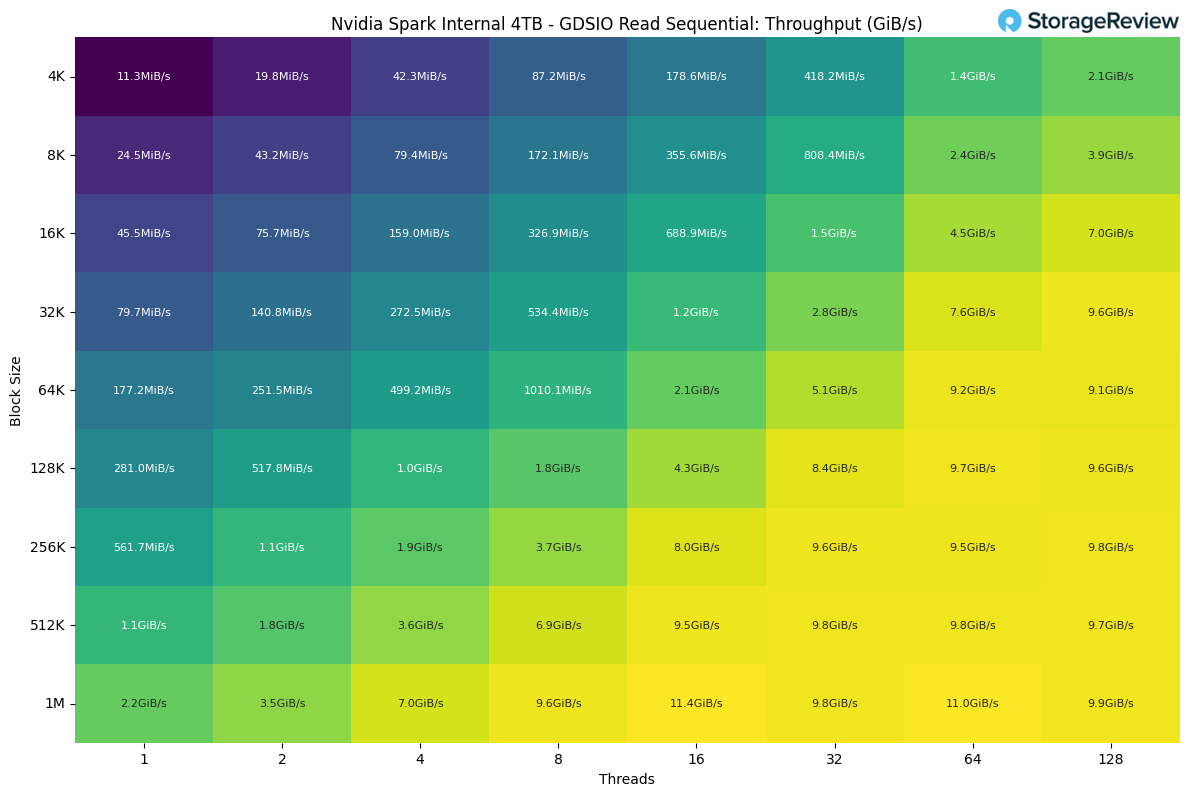
Osvedčený výkon v reálnom svete : MAMF namerala ~99.8 TFLOPs BF16 a ~207.7 TFLOPs FP8. Čítania GDSIO dosiahli maximum ~11.4 GiB/s interne, pričom sa očakával vyšší strop v porovnaní s 200G fabric.
Čo je DGX Spark a kto by ho mal zvážiť?
NVIDIA DGX Spark je v podstate kompletná platforma pre vývoj umelej inteligencie, a nie len komponent GPU. Jeho jadrom je superčip GB10 Grace Blackwell, ktorý integruje GPU s architektúrou Blackwell s jadrami Tensor piatej generácie s 20-jadrovým procesorom Arm (10× Cortex-X925 + 10× Cortex-A725) pripojeným cez NVLink-C2C. Táto koherentná architektúra prepojenia podľa spoločnosti NVIDIA umožňuje až 5× vyššiu šírku pásma v porovnaní s PCIe Gen 5, čím vytvára unifikovanú výpočtovú štruktúru namiesto diskrétnych procesných domén.
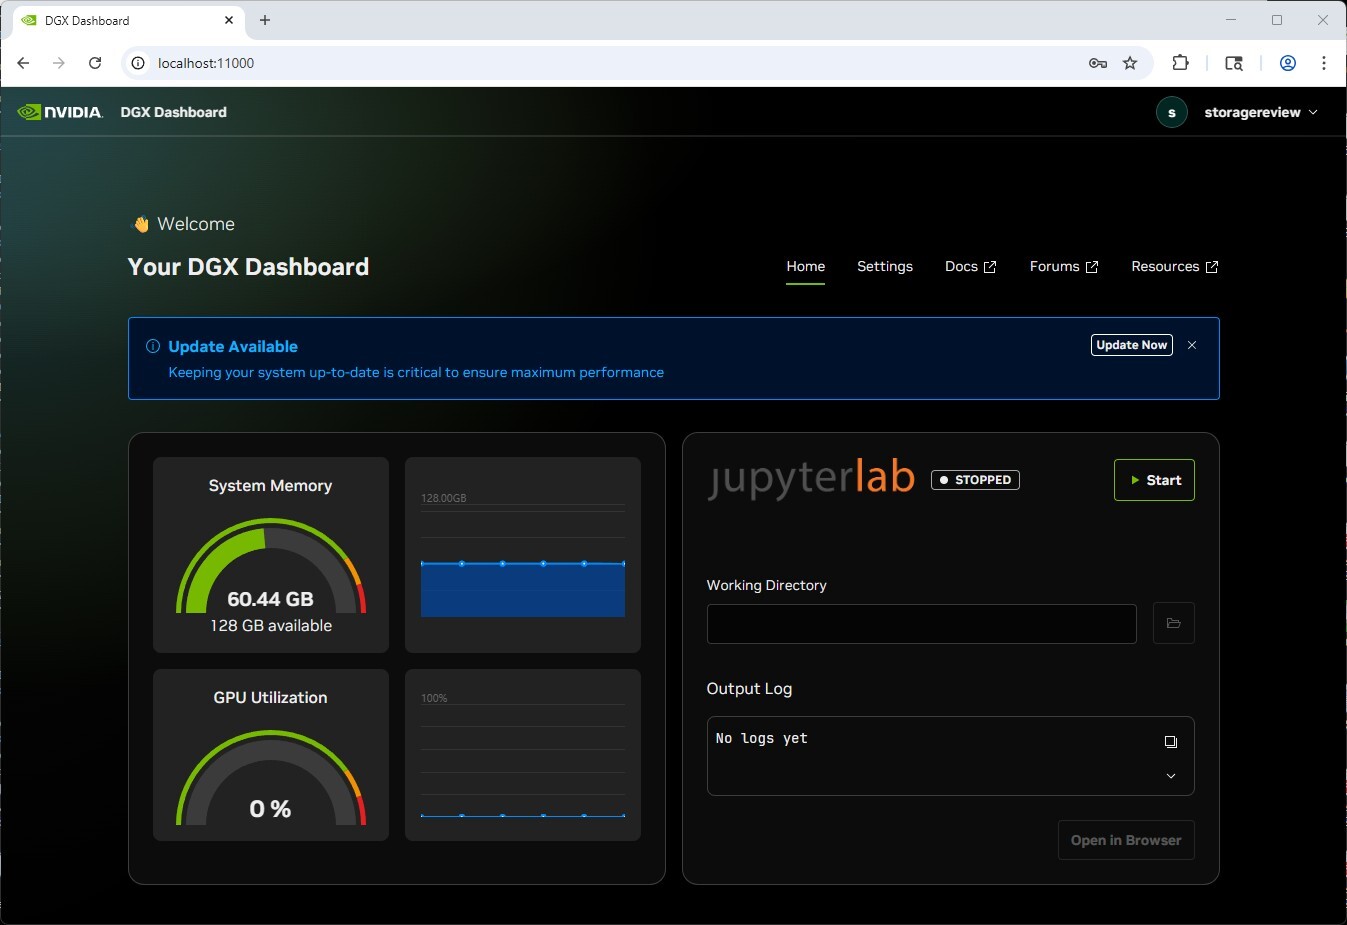
Aby používatelia mohli začať, NVIDIA dodáva operačný systém DGX postavený na Ubuntu Desktop s kompletným predkonfigurovaným softvérovým balíkom AI vrátane CUDA, cuDNN, TensorRT, NVIDIA Container Runtime a AI Workbench, čím eliminuje typické problémy s ovládačmi a réžiou konfigurácie prostredia, ktoré trápia zostavovanie vlastných pracovných staníc. Systém ponúka flexibilné paradigmy nasadenia: pripojte periférie a používajte ho ako kompaktnú pracovnú stanicu s plným zážitkom z Ubuntu alebo ho nasaďte ako sieťové zariadenie bez headless prístupné prostredníctvom NVIDIA Sync, ktoré poskytuje bezproblémovú integráciu s terminálmi JupyterLab, VS Code, Cursor IDE a SSH.
Ide o účelovo vybudovanú infraštruktúru pre odborníkov z oblasti umelej inteligencie, výskumníkov, ktorí dolaďujú jazykové modely, dátových vedcov, ktorí urýchľujú pracovné postupy RAPIDS, vývojárov implementujúcich agentické systémy alebo tímy experimentujúce s architektúrami s ablatívnymi modelmi v malom meradle. Spark je určený pre profesionálov, ktorí potrebujú seriózne výpočtové kapacity umelej inteligencie bez zložitosti dátového centra.
Technické špecifikácie NVIDIA DGX Spark
| špecifikácia | podrobnosti |
|---|---|
| architektúra | |
| GPU | Architektúra NVIDIA Blackwell |
| CPU | 20-jadrové rameno (10x Cortex-X925 + 10x Cortex-A725) |
| Tenzorové jadrá | 5th Generation |
| RT Cores | 4th Generation |
| NVENC / NVDEC | 1× / 1× |
| Memory Masážne stoly | |
| Systémová pamäť | 128 GB LPDDR5X (zjednotená systémová pamäť) |
| Pamäťové rozhranie | 256-bit |
| Šírka pamäte | 273 GB / s |
| výkon | |
| FP4 | až 1 petaFLOP (s riedkosťou) |
| Uskladnenie | |
| Uskladnenie | 1 TB alebo 4 TB NVMe M.2 (samostatne šifrovaný) |
| pripojenie | |
| USB | 4× USB 3.2 Gen 2×2 typu C (20 Gb/s) |
| Ethernet | 1× 10GbE RJ-45 |
| NIC | Inteligentná sieťová karta ConnectX-7 – 2x 200G QSFP (umožňuje maximálnu šírku pásma 200G) |
| Bezdrôtový | Wi-Fi 7, Bluetooth 5.3 |
| zvukový výstup | Viackanálový zvukový výstup HDMI |
| Konektory displeja | 1× HDMI 2.1a |
| Mechanický | |
| Rozmery | 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98 palca) |
| Váha | 1.2 kg |
| Spotreba energie | 240 W |
Návrh a zostavenie NVIDIA DGX Spark
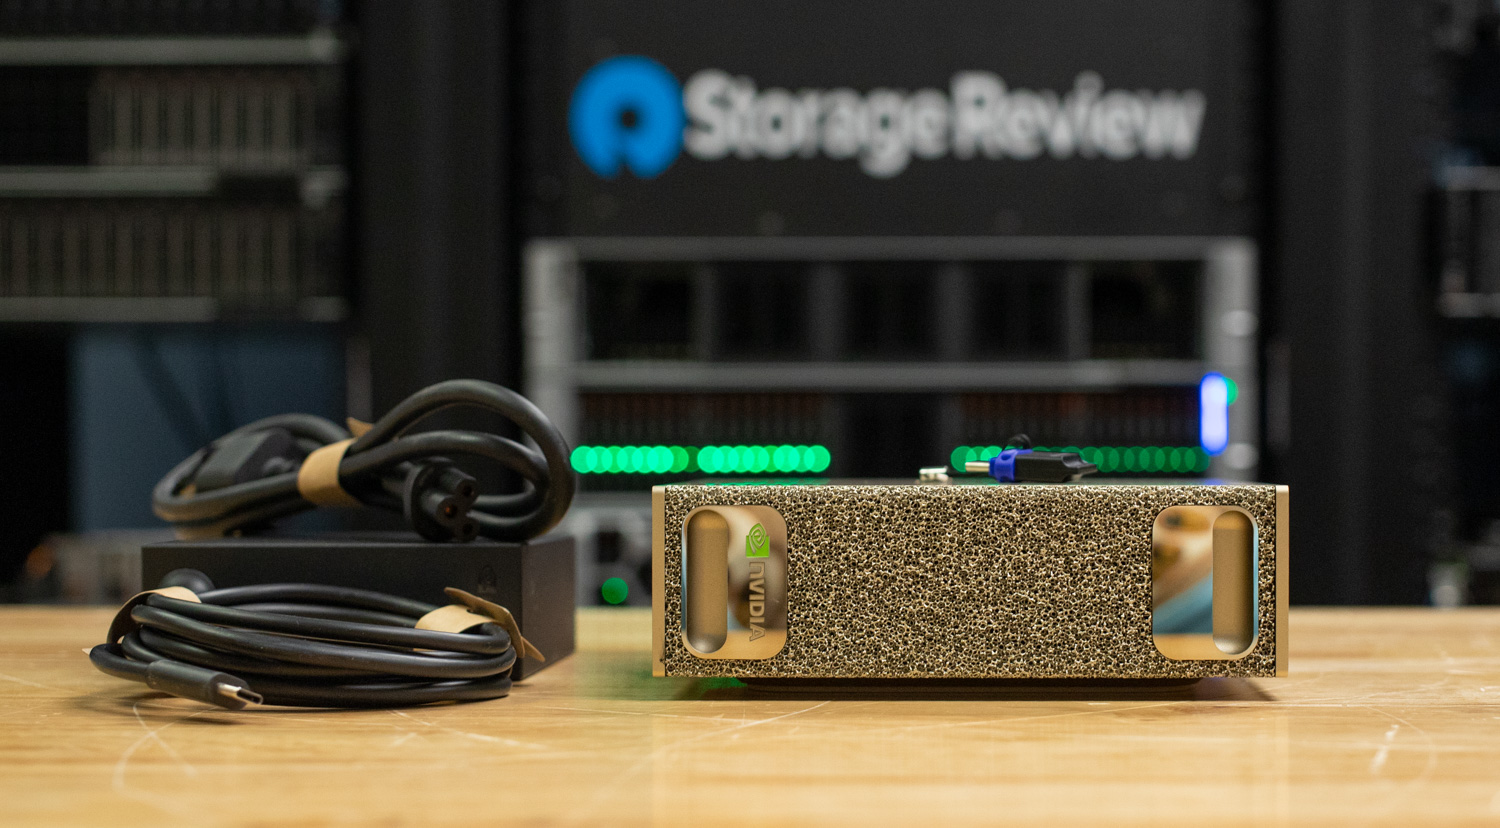
NVIDIA DGX Spark pokračuje v nezameniteľnom priemyselnom dizajnovom jazyku spoločnosti NVIDIA a vyznačuje sa kompaktným šasi, ktoré odráža vzhľad a dojem z jej väčších systémov DGX. Predný panel sa vyznačuje miniatúrnymi výrezmi na držanie, ktoré sú odkazom na pôvodné rukoväte plnohodnotných jednotiek DGX, a zlato-škvrnitým kovovým povrchom, ktorý dodáva rafinovanú, prémiovú textúru, zvýraznenú ikonickým zeleným logom NVIDIA.
Fyzické rozmery DGX Spark sú 5.9 × 5.9 × 1.98 palca (150 × 150 × 50.5 mm) a váži 2.6 libry (1.2 kg), čo mu dáva celkový vnútorný objem 1.13 litra. Vďaka tomu sa pevne radí do triedy malých počítačov s objemom 1 liter. Napriek minimálnym rozmerom pôsobí systém robustne a kompaktne vďaka celokovovému plášťu zo zliatiny, ktorý slúži aj ako pasívny rozvádzač tepla, pričom sa dôraz kladie na formu aj funkčnosť.
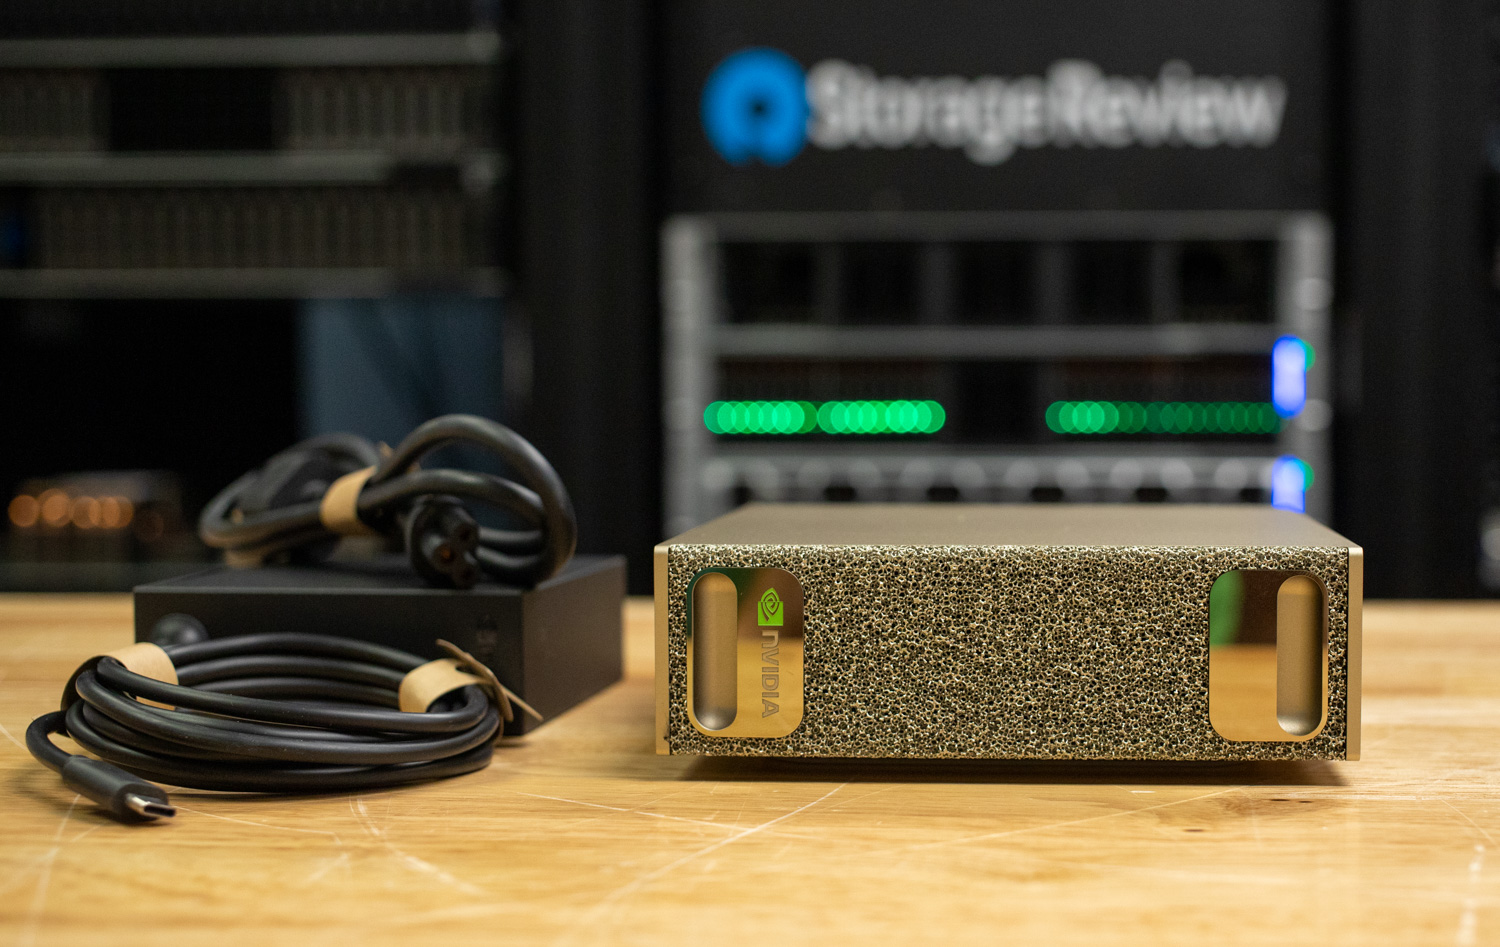
Napájanie zabezpečuje externý napájací adaptér s výkonom 240 W a rozhraním USB-C, ktorý je na obrázku umiestnený vedľa hlavnej jednotky. Napájací adaptér je kompaktný a dobre skonštruovaný, používa štandardný konektor C5 (cloverleaf) pre vstup striedavého prúdu a zodpovedá čistému a efektívnemu dizajnu DGX Spark.
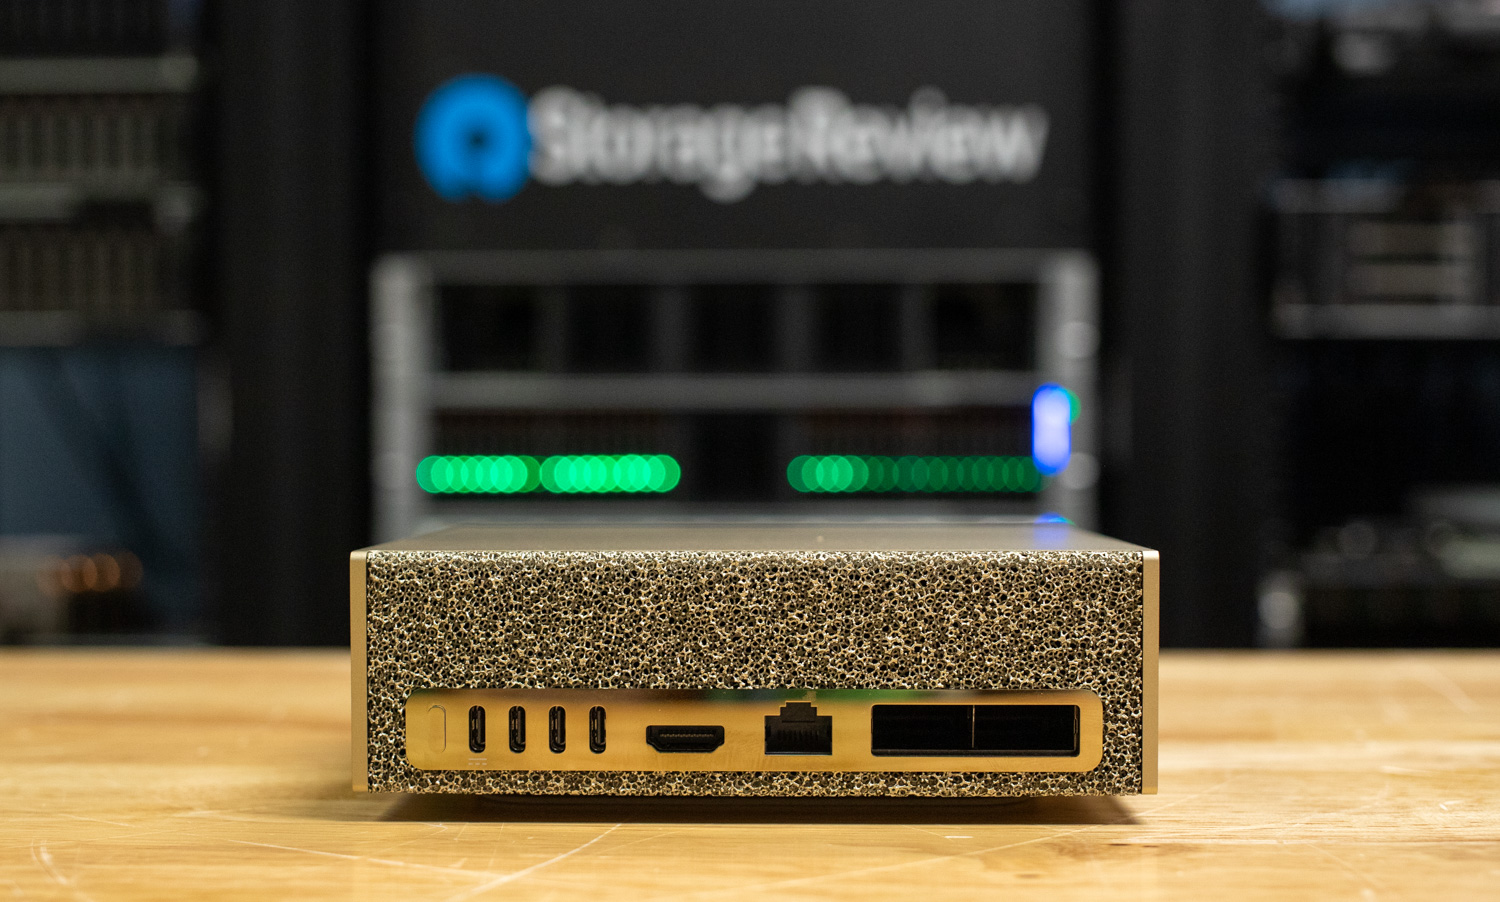
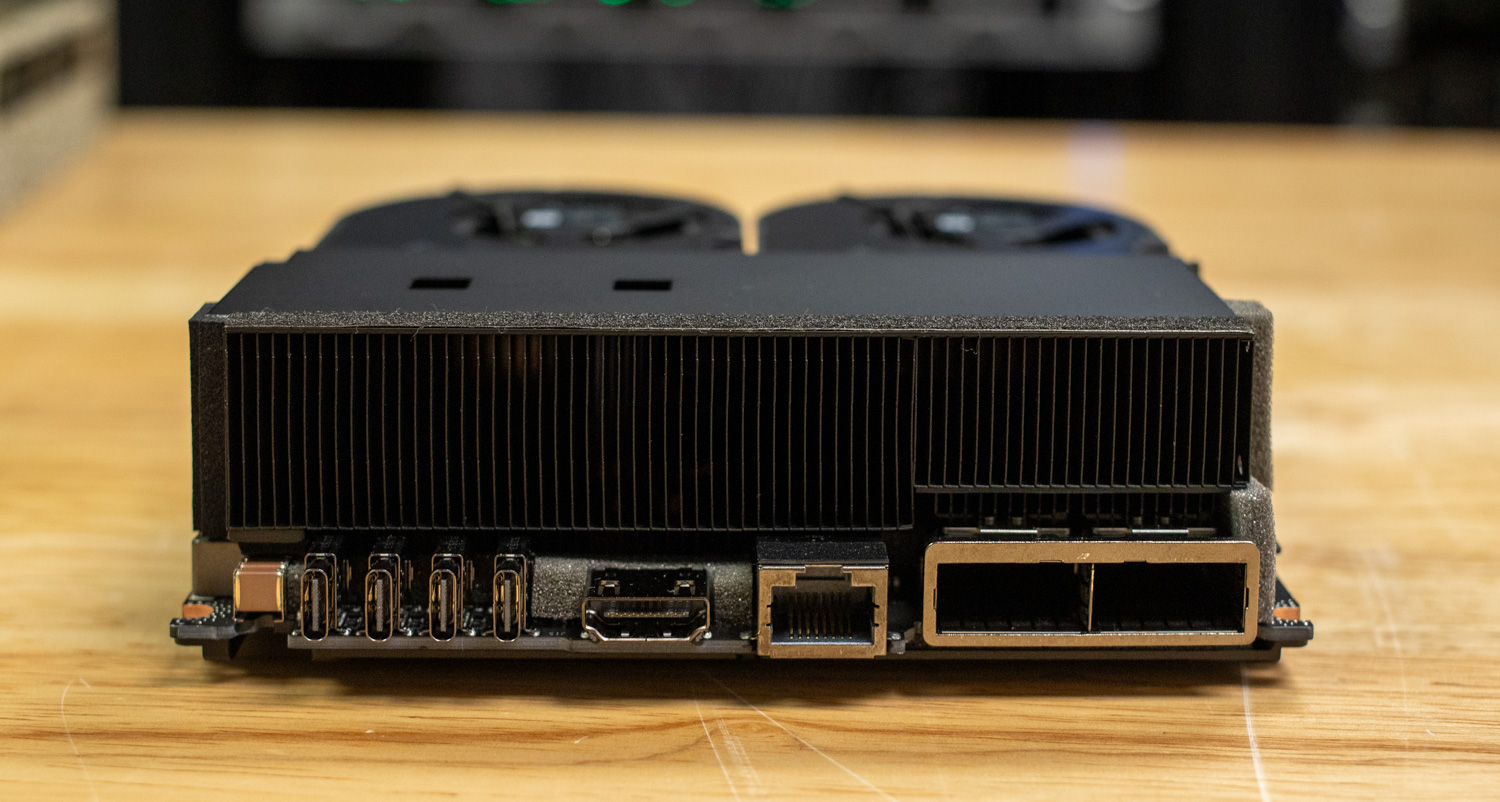
Pri pohľade na zadnú stranu si DGX Spark zachováva rovnaký zlato-škvrnitý textúrovaný povrch ako na prednej strane, čím si zachováva ucelený dizajn celého šasi. Zľava sa nachádza tlačidlo napájania vedľa štyroch portov USB-C, z ktorých jeden zabezpečuje napájanie zariadenia. Nasleduje jeden výstup HDMI 2.1a, 10 GbE port RJ-45 a zaujímavosťou tohto zariadenia sú dve rozhrania 200 GbE QSFP56, ktoré sú poháňané integrovanou sieťovou kartou NVIDIA ConnectX-7 SmartNIC.
Na prvý pohľad by sa dalo usudzovať, že Spark umožňuje 400G konektivitu; bohužiaľ, kvôli obmedzeniam PCIe dokáže Spark poskytnúť iba 200G konektivitu. Aby sme sa dozvedeli viac, preskúmali sme topológiu Sparka hlbšie:
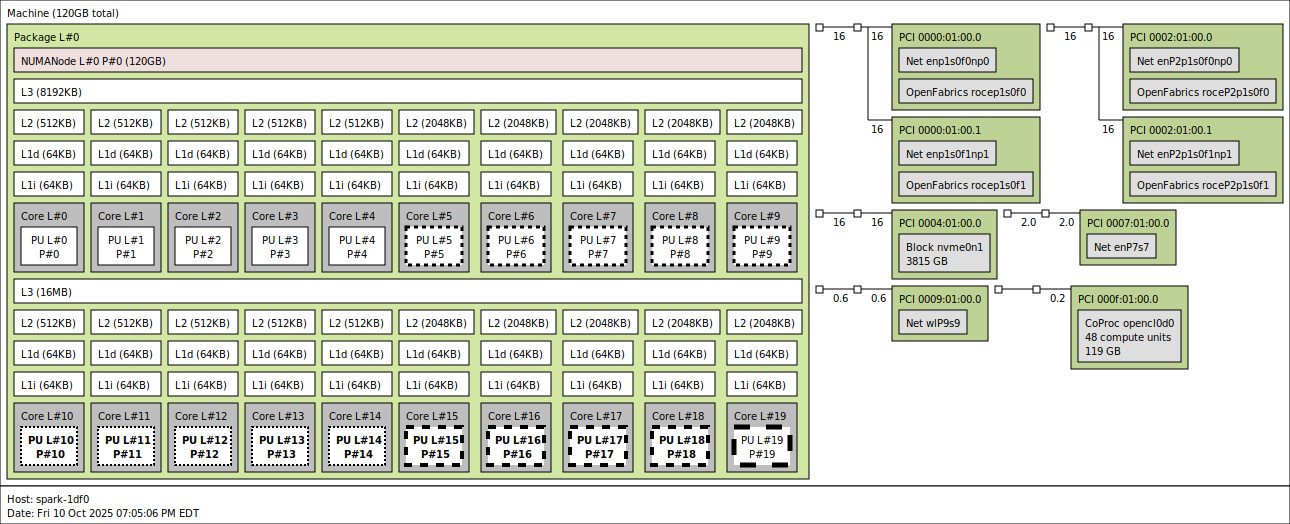
Pomocou nástroja lstopo pozorujeme dva prepojenia z CX7 NIC. Elektricky je CX7 pripojený cez dve linky Gen5 x4. V rámci operačného systému sa tieto pripojenia javia ako štyri rozhrania, z ktorých každé podporuje maximálnu šírku pásma 200G. Kvôli obmedzenému času testovania sme neboli schopní objaviť všetky sieťové zvláštnosti tejto platformy mimo našich testov NVMe-oF, ktoré sú podrobne opísané ďalej v článku. Plánujeme však túto platformu ďalej preskúmať a v budúcnosti vydáme články, ktoré sa hlbšie ponoria do jej možností, ako je napríklad zoskupovanie viacerých iskier do mini klastra.
Pri pohľade na ďalšie pripojené zariadenia je ďalším v poradí malý M.2 SSD disk s formátom 2242 pripojený k rozhraniu Gen5 x4, nasledovaný radičom Realtek RJ45 10GbE pripojeným k rozhraniu PCIe Gen4 x1 a radičom MediaTek Wi-Fi pripojeným k rozhraniu PCIe Gen3 x1.
Pokiaľ ide o CPU, Spark obsahuje 20-jadrový procesor Arm s heterogénnou architektúrou typu „veľká malá“, podobnou najnovším procesorom Intel. Pozostáva z 10 efektívnych jadier Cortex-A725 a 10 výkonnostných jadier Cortex-X925 rozdelených do dvoch klastrov vyrovnávacej pamäte L3. Prvý klaster (8 MB L3) obsahuje CPU 0-4 (Cortex-A725, max. 2808 MHz) a CPU 5-9 (Cortex-X925, max. 3900 MHz), zatiaľ čo druhý klaster (16 MB L3) obsahuje CPU 10-14 (Cortex-A725, max. 2860 MHz) a CPU 15-19 (Cortex-X925, max. 3978-4004 MHz). Každé jadro má súkromnú vyrovnávaciu pamäť L1 s kapacitou 64 KB a vyrovnávaciu pamäť L1 s kapacitou 64 KB, ale vyrovnávacia pamäť L2 sa výrazne líši podľa typu jadra: efektívne jadrá Cortex-A725 majú vyrovnávaciu pamäť L2 s kapacitou 512 KB, zatiaľ čo výkonné jadrá Cortex-X925 majú podstatne väčšie 2 MB vyrovnávacie pamäte L2 (4× väčšie). Najrýchlejšie jadrá sú CPU 15 – 19, ktoré profitujú z väčšej 16 MB vyrovnávacej pamäte L3 aj z vyšších frekvencií, pričom CPU 19 je jadro s najvyšším výkonom na 4004 MHz. Tieto rôzne úrovne výkonu/frekvencie sú znázornené prerušovanými čiarami na jadre v topológii zobrazenej vyššie.
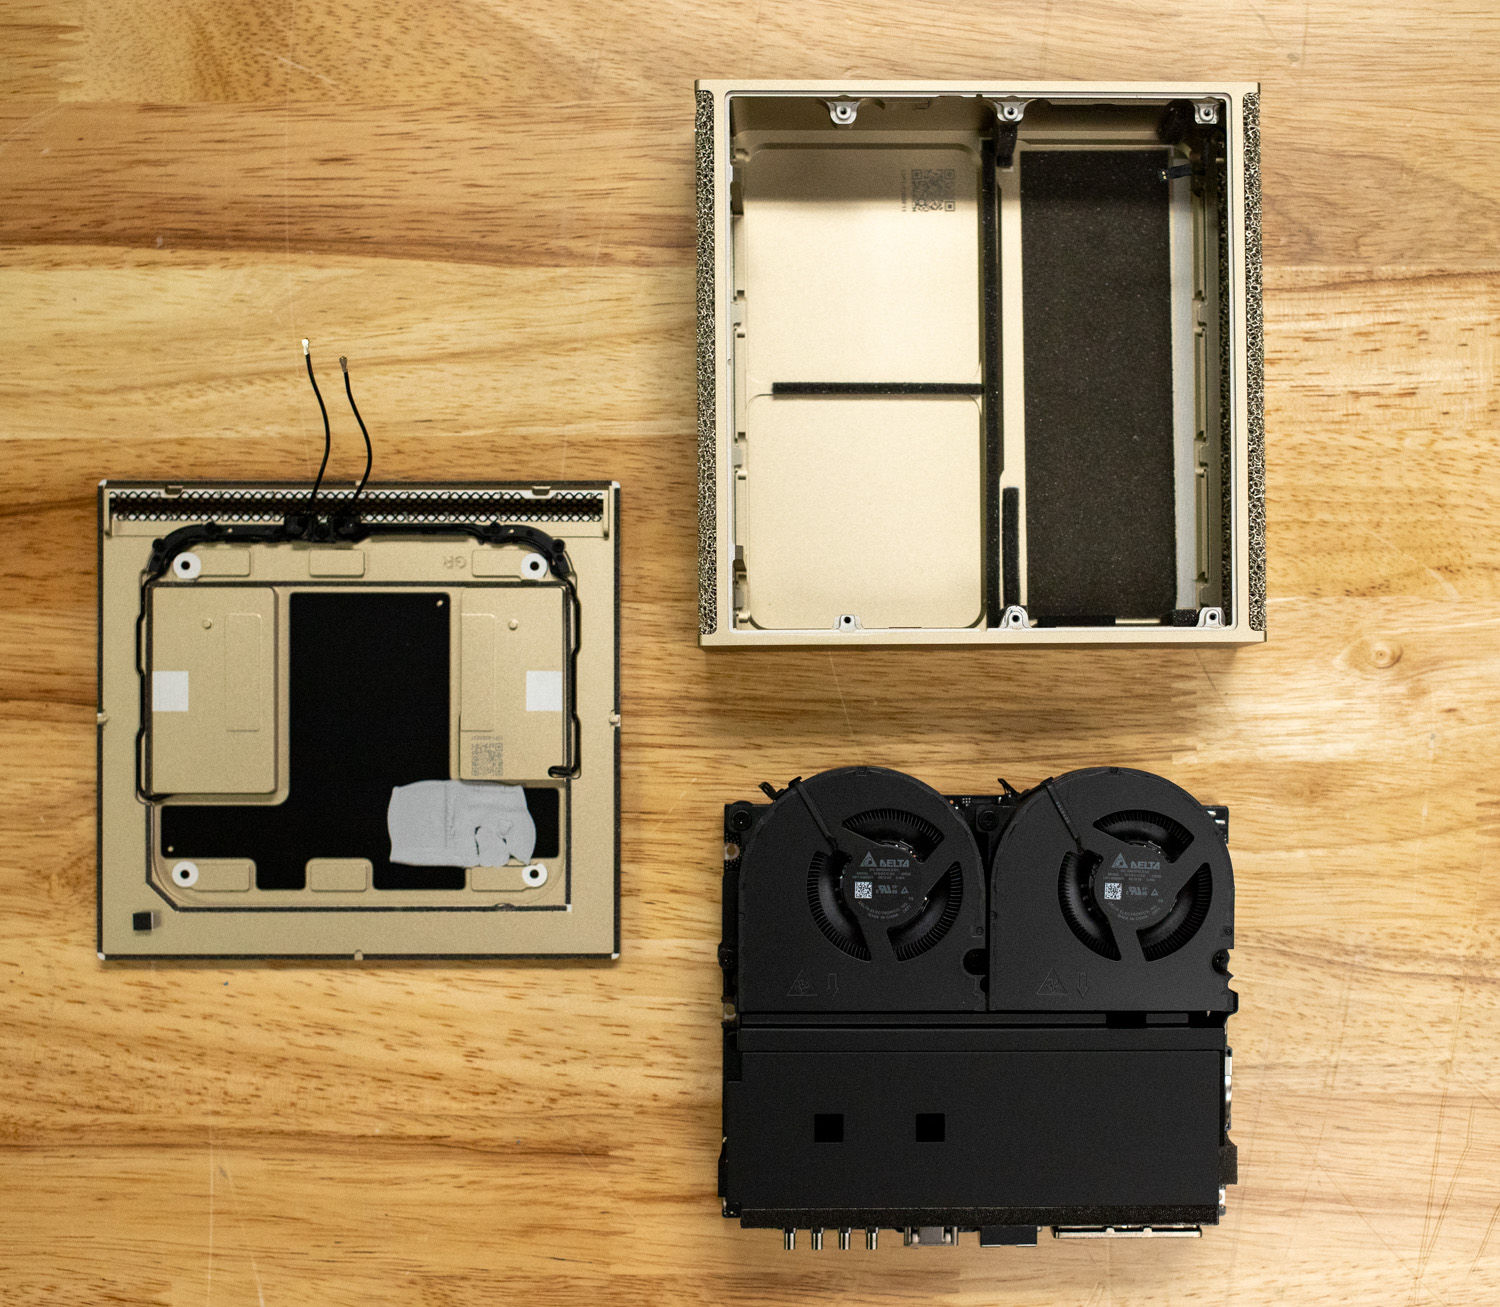
Pri opätovnom oddialení otočíme DGX Spark; jedinou viditeľnou plastovou súčasťou je spodný kryt, ktorý sa magneticky pripevňuje k spodnej časti šasi. Táto konštrukcia udržiava exteriér čistý a zároveň umožňuje rýchly prístup k vnútorným častiam. Po odstránení magnetickej základne sa odkryjú štyri skrutky, ktoré umožňujú prístup k hlavnému vnútornému priestoru.
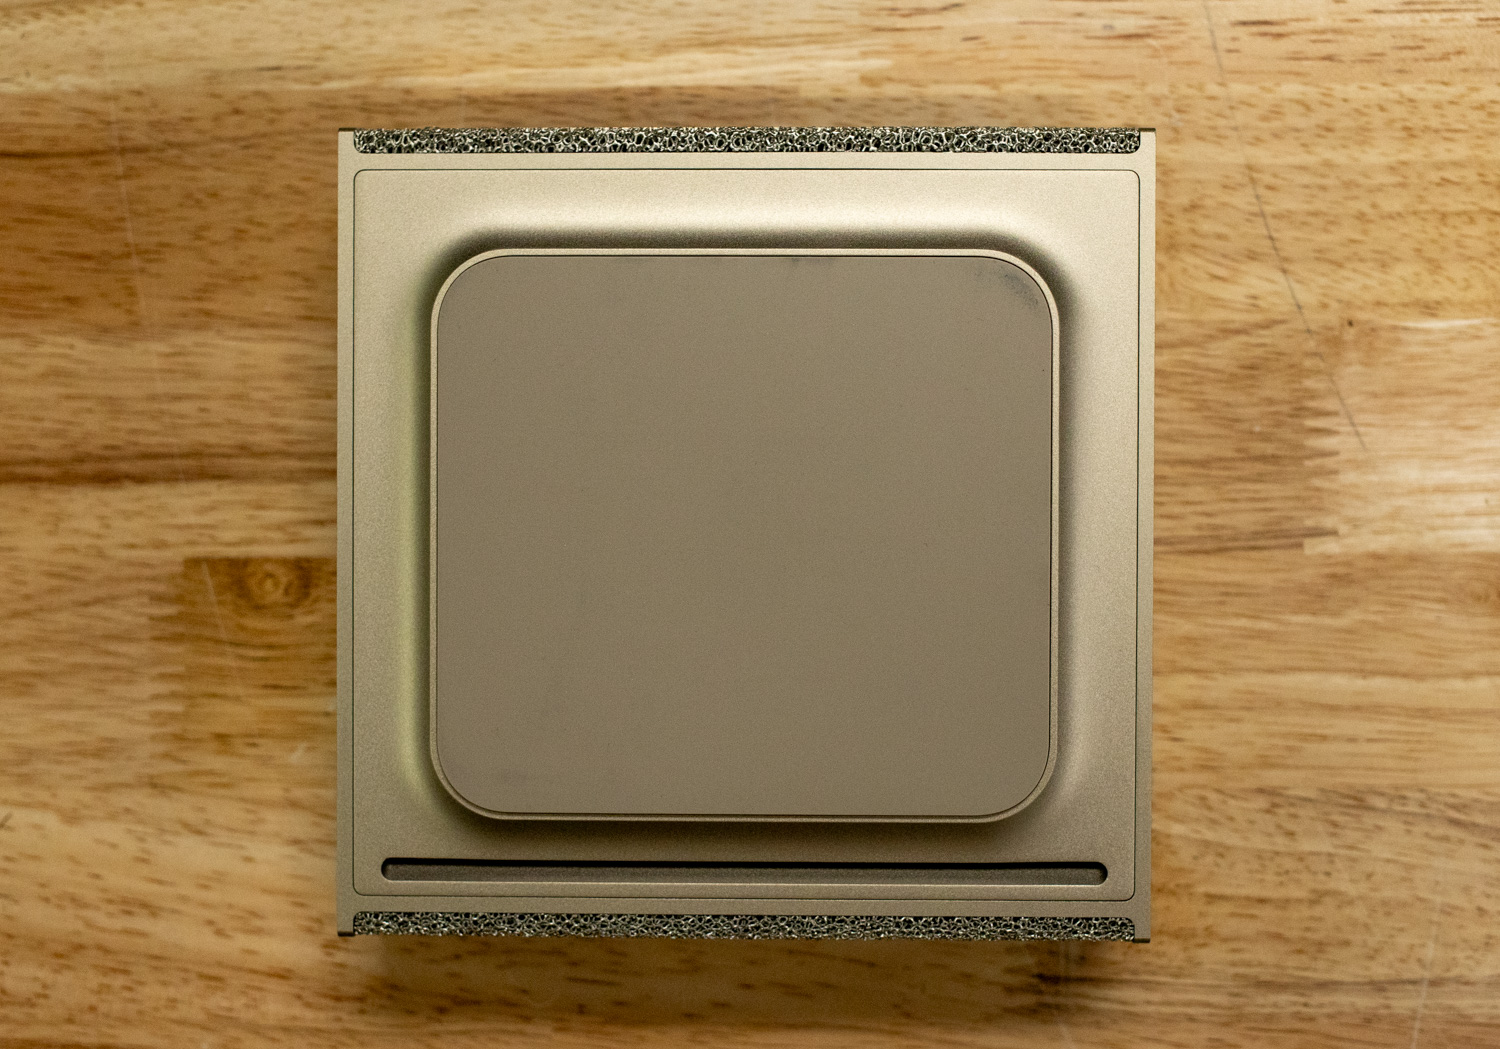
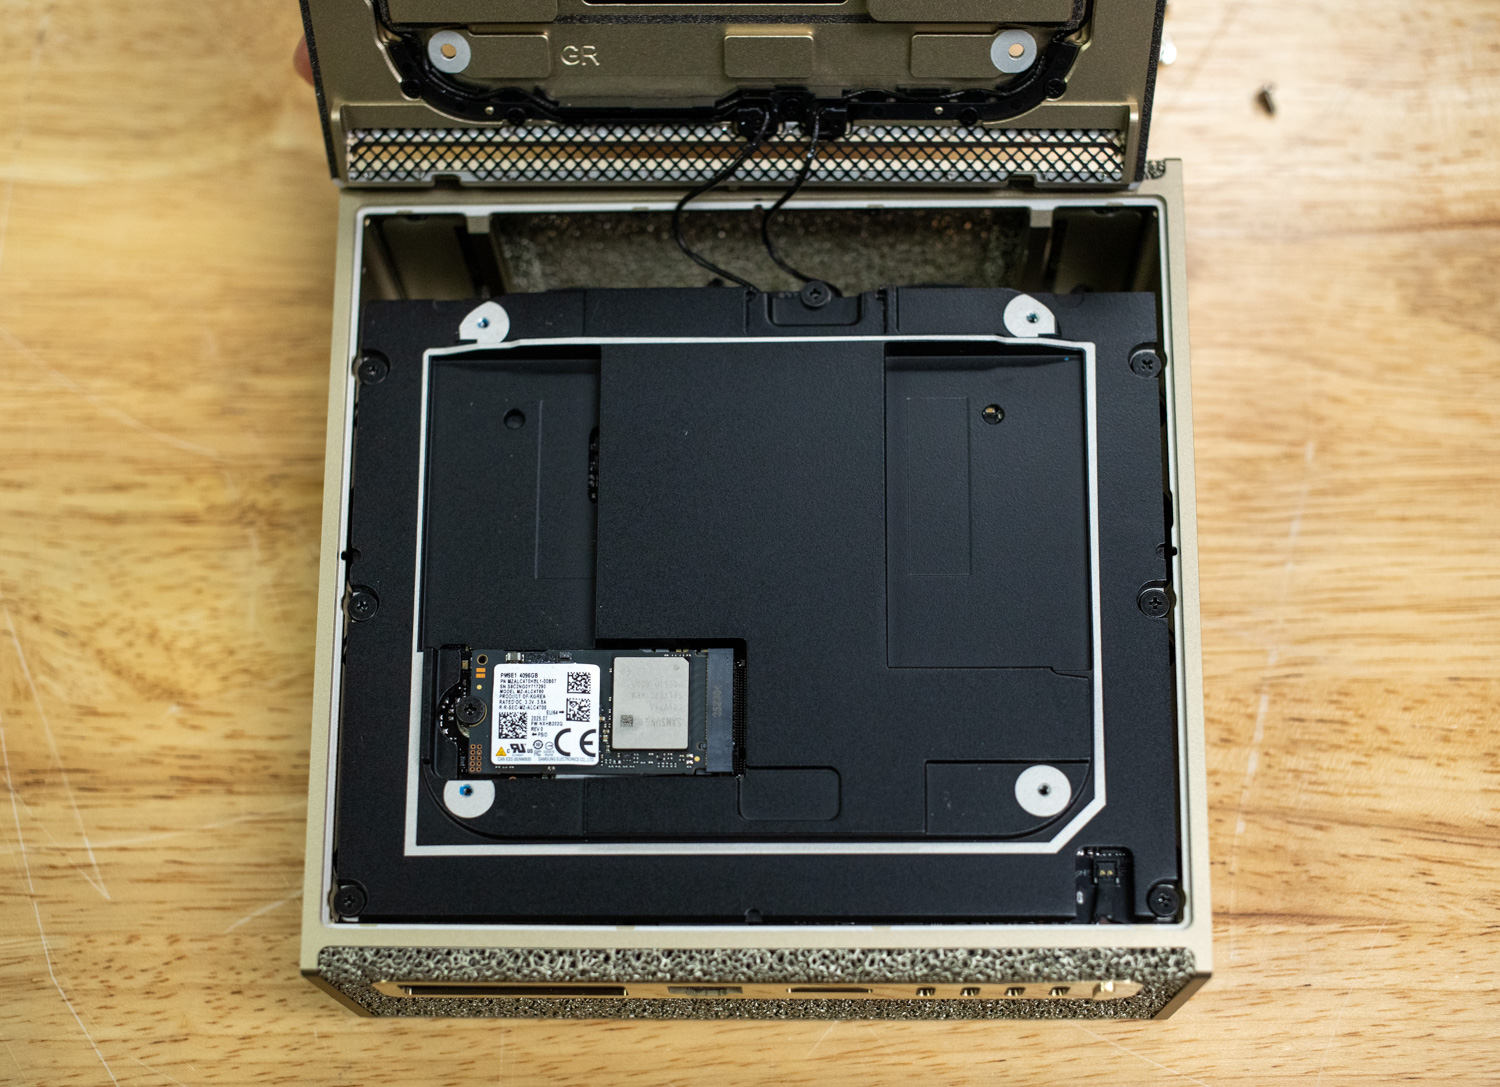
Vo vnútri vidíme anténne káble smerujúce do hornej časti jednotky, čo potvrdzuje prítomnosť Wi-Fi 7 a Bluetooth 5.3. To poskytuje flexibilné možnosti sieťového pripojenia, ktoré sú užitočné najmä pre mobilné alebo laboratórne nasadenia, kde nemusí byť k dispozícii káblový prístup.
Viditeľné je aj úložné riešenie jednotky, PCIe Gen5 2242 M.2 SSD, čo je menej bežný tvarový faktor pre takýto vysokovýkonný hardvér. Zobrazená konfigurácia obsahuje v našej konfigurácii 4TB disk Samsung NVMe.
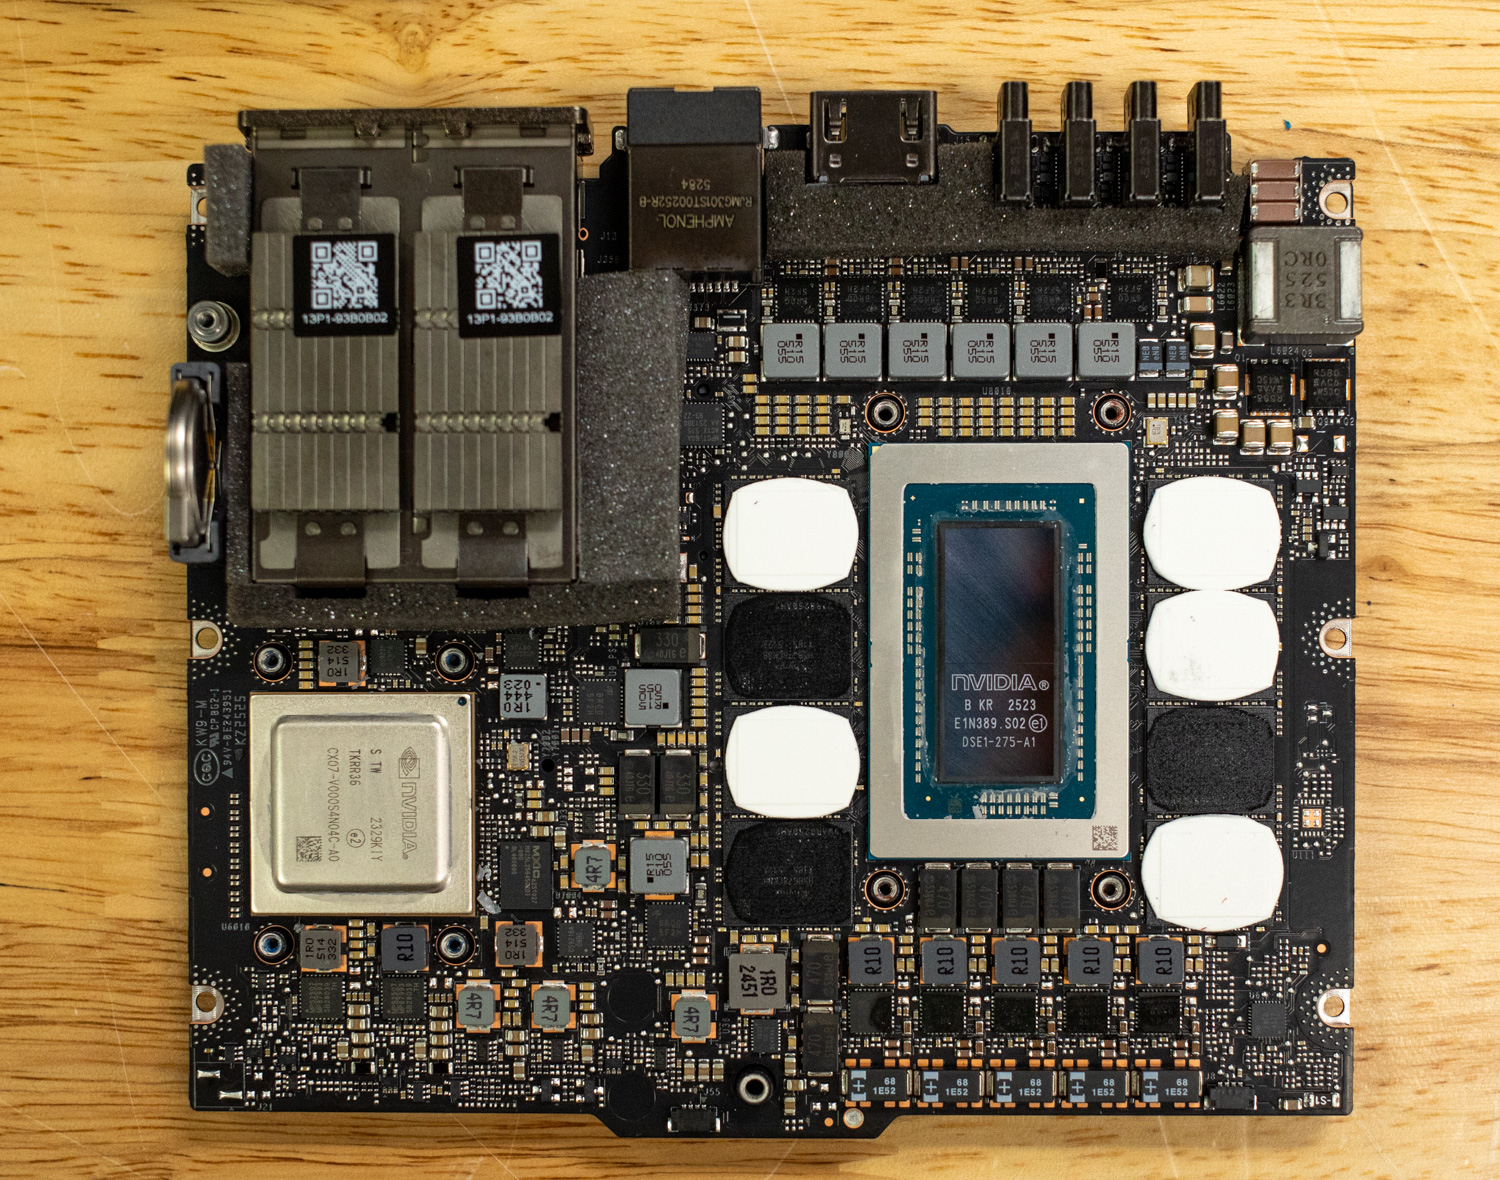
Hlbšie ponorenie sa do DGX Spark odhalí srdce systému, superčip GB10 od NVIDIA Grace Blackwell. Po bokoch superčipu GB10 sa nachádza 8 spájkovaných unifikovaných systémových pamätí LPDDR5X s priepustnosťou 273 GB/s, čo zaisťuje rýchly prístup k dátam v rámci operácií CPU aj GPU.
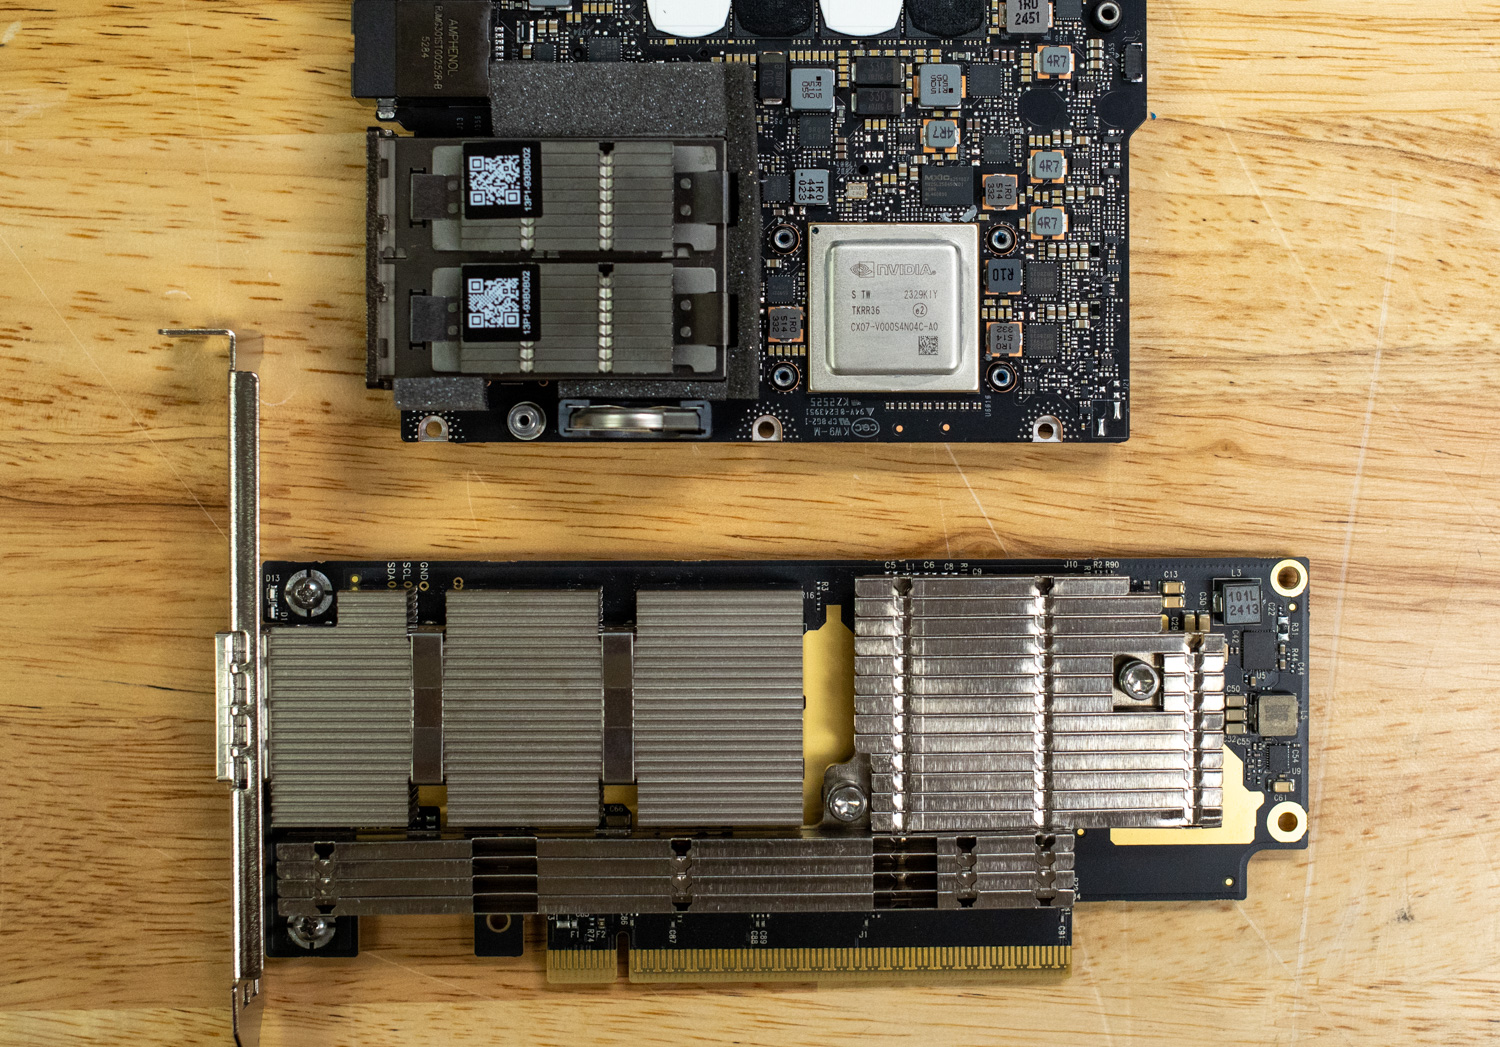
Hneď vedľa čipu sa nachádza sieťová karta CX7, ktorá, ako už bolo spomenuté, poskytuje 200G konektivitu. To umožňuje používateľom pripojiť Spark k vysokorýchlostnému úložisku alebo dokonca zoskupiť viacero inštancií Sparku. Spoločnosť NVIDIA overila a predáva klaster 2 Sparkov, ktoré je možné priamo pripojiť na podporu ešte väčších modelov umelej inteligencie.
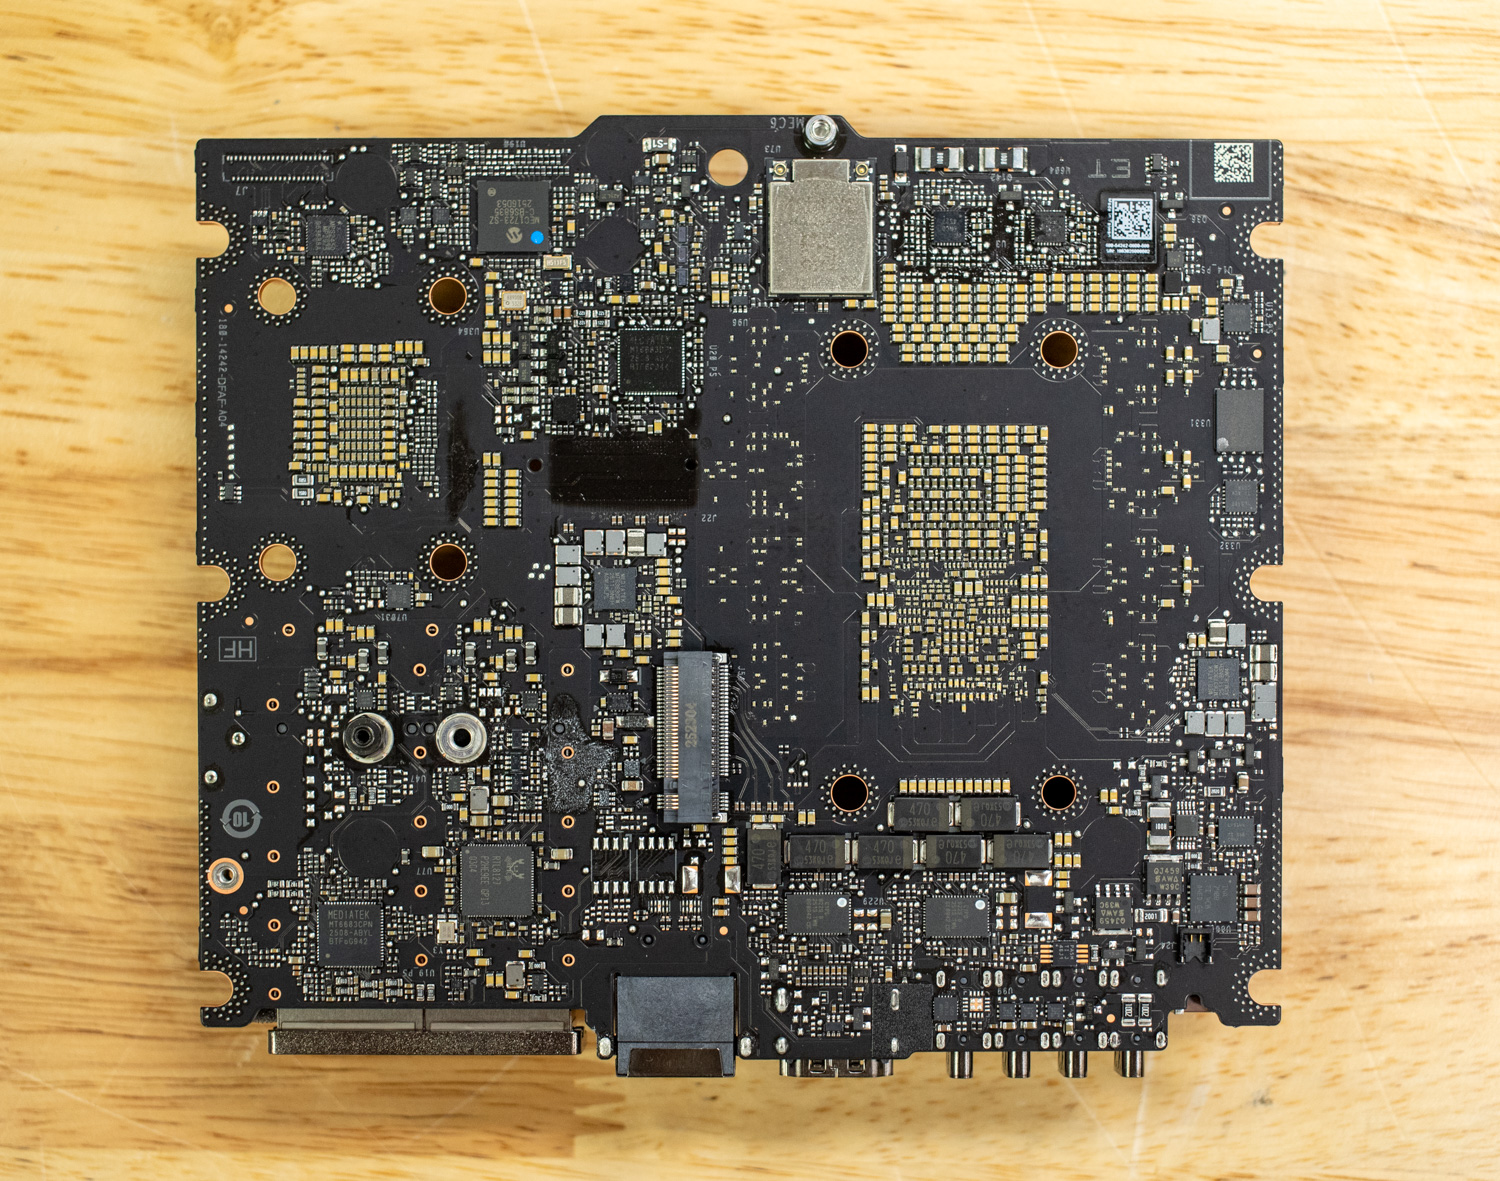
Nakoniec, otočením dosky sa odhalia všetky PCIe porty vrátane PCIe Gen5 x4 2242 M.2 SSD disku a PCIe Gen3x1 MediaTek Wi-Fi adaptéra.
Kde sa Spark stáva nevyhnutným: Moderné zariadenie pre vývoj umelej inteligencie
DGX Spark sa osvedčil najmä v niekoľkých rôznych profesionálnych kontextoch, pričom každý z nich ťaží z jedinečnej kombinácie unifikovanej pamäte, kompaktného tvaru a komplexnej softvérovej integrácie.
Akcelerácia dátovej vedy: Od Pandas po produkciu
Pre dátových vedcov predstavuje NVIDIA DGX Spark veľké zlepšenie v rýchlosti pracovných postupov a zážitku. Sieť ConnectX-7 poskytujúca šírku pásma 200 Gb/s v kombinácii s akcelerovanými knižnicami CUDA X transformuje predspracovanie dát. Umelá inteligencia a dátová veda sú postavené na princípe „dobré dáta dnu, dobré dáta von“. Tradične najnáročnejšou fázou každého konvenčného projektu strojového učenia je čistenie dát a extrakcia prvkov. Konvenčné pracovné postupy zvyčajne zahŕňajú načítanie súborov údajov do nástrojov, ako sú pandy, a vykonávanie transformácií na jadrách CPU, čo je vo všeobecnosti pomalé. Manuálne skúmanie a inžinierstvo prvkov môže byť tiež významnou prekážkou. Spark umožňuje komplexnú akceleráciu GPU prostredníctvom RAPIDS.
Typický scenár v oblasti podnikovej dátovej vedy zahŕňa inžinierstvo funkcií na súboroch údajov v rozsahu 40 – 80 GB: spájanie viacerých tabuliek, výpočet agregácií v časových oknách, spracovanie kategorického kódovania a normalizáciu distribúcií. Na infraštruktúre CPU môže toto predspracovanie trvať hodiny. Vďaka načítaniu celého súboru údajov do 128 GB unifikovanej pamäte Spark pomocou RAPIDS cuDF sa tieto operácie dokončia v priebehu niekoľkých minút s 10-násobným alebo vyšším zrýchlením. Následné trénovanie modelu má rovnaký úžitok, či už ide o klasické strojové učenie s cuML alebo hlboké učenie s PyTorch, čím sa eliminuje tradičné úzke hrdlo, kde dátoví vedci čakajú na infraštruktúru, namiesto toho, aby iterovali na hypotézach.
Generovanie syntetických dát: Robotika a simulácia
Zahrnutie RT jadier štvrtej generácie stavia Spark na jedinečnú pozíciu pre vznikajúci pracovný postup: generovanie syntetických dát pre trénovanie modelov sveta. Trénovanie robustných manipulačných politík tradične vyžaduje desiatky tisíc reálnych demonštrácií, čo je neúmerne drahé a časovo náročné. Fotorealistická simulácia na platformách ako Isaac Sim alebo Omniverse poskytuje alternatívu, ale vykresľovanie lúčovo sledovaných snímok s fyzikálne presným osvetlením, odrazmi a materiálmi si historicky vyžadovalo drahé grafické procesory pre pracovné stanice, ako sú NVIDIA L40S a RTX 6000 Ada.
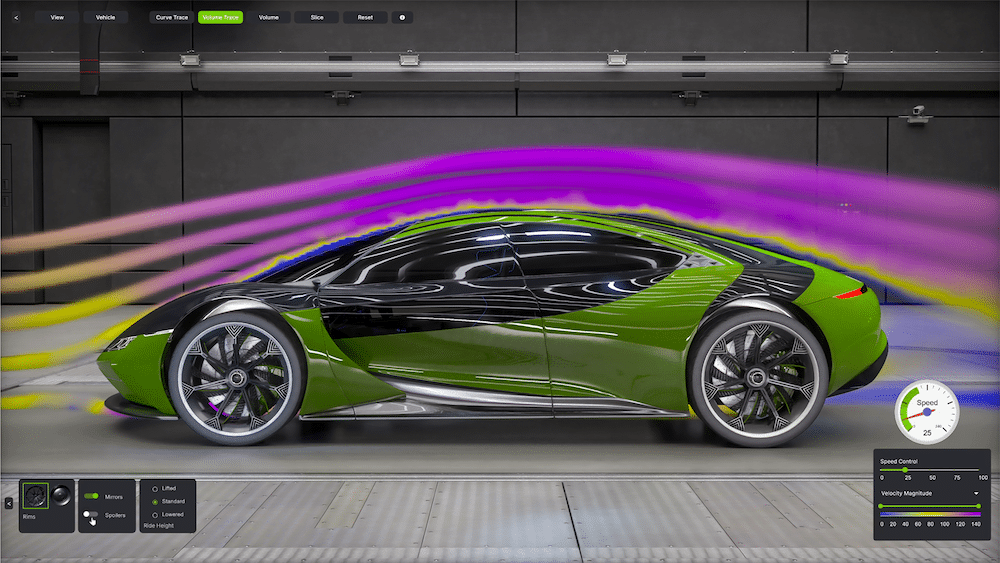
Zdroj: NVIDIA
Spark konsoliduje tento pracovný postup. RT jadrá umožňujú pracovným záťažiam OpenUSD spracovávať generovanie syntetických dát, zatiaľ čo Tensor jadrá sa používajú na inferenciu umelej inteligencie v rámci plánu/pracovného postupu. Predtým mohli organizácie nasadiť viacero počítačov na vykresľovanie a samostatný server optimalizovaný na inferenciu. Teraz je to možné dosiahnuť v jednom 240W zariadení. Pre robotické startupy, univerzitné laboratóriá alebo výrobcov automobilov, ktorí skúmajú autonómnu manipuláciu, táto integrácia výrazne skracuje časové rámce vývoja a kapitálové výdavky.
V našej predchádzajúcej analýze NVIDIA L40S sme už predtým skúmali podobné kanály generovania syntetických dát pomocou špecializovaných renderovacích systémov L40S spárovaných s H100 pre inferenciu . Architektonická konsolidácia týchto funkcií GB10 do jednotného vývojového zariadenia predstavuje presvedčivý vývoj tohto pracovného postupu. V nadchádzajúcej analýze plánujeme vykonať ďalšie testovanie výkonu RT Core od Sparku v porovnaní s týmito diskrétnymi konfiguráciami, pričom preskúmame renderovanie a ďalšie pracovné zaťaženia pre reprezentatívne scenáre robotickej manipulácie.
Revolúcia v kódovaní vibrácií
Andrej Karpathy, bývalý riaditeľ pre umelú inteligenciu v spoločnosti Tesla a zakladajúci člen OpenAI, zaviedol termín „vibe coding“ na opis nového prístupu k rýchlemu vývoju softvéru s pomocou umelej inteligencie. Namiesto dôkladného písania kódu riadok po riadku využíva vibe coding LLM ako interaktívnych párových programátorov: opisuje funkcionalitu v prirodzenom jazyku, generuje implementačné lešenie, iteruje cez konverzačné zdokonaľovanie a rýchlo prototypuje funkcie. Tento pracovný postup transformuje kódovanie zo zámernej konštrukcie na riadenú konverzáciu s umelou inteligenciou, ktorá rozumie kontextu, API a architektonickým vzorom, čo umožňuje jednotlivým vývojárom vytvárať pozoruhodne sofistikované systémy bezprecedentnou rýchlosťou.
Rozsah prijatia kódovania s pomocou umelej inteligencie dokazuje rebríček používania OpenRouteru , kde modely zamerané na kódovanie konzistentne dominujú v objeme inferencie. Technickí profesionáli, primárna demografická skupina Vibe kódovania, zvyčajne pracujú ako nároční používatelia a spúšťajú viacero kódovacích agentov paralelne v rôznych kontextoch. A keďže modely s otvorenou váhou sa čoraz viac zhodujú s proprietárnymi alternatívami v kľúčových benchmarkoch , vývojári skúmajú lokálne nasadenie inferencie, aby eliminovali obmedzovanie rýchlosti, zabezpečili dostupnosť počas kritických vývojových okien a zachovali dôvernosť kódu pre proprietárne projekty.
Komunita r/LocalLLaMA predstavuje skutočne pôsobivé vlastné zostavy, od pracovných staníc s viacerými grafickými procesormi až po servery spojené lepiacou páskou s lokálnymi modelmi, distribuovanú inferenciu naprieč spotrebiteľským hardvérom a prepracované riešenia chladenia, ktoré umožňujú trvalú vysokú priepustnosť. Tieto konfigurácie však predstavujú značné bariéry: kapitálové výdavky často presahujúce desiatky tisíc dolárov, značnú spotrebu energie, problémy s tepelným manažmentom vyžadujúce vyhradené priestory namiesto štandardných kancelárskych prostredí a značné technické znalosti v oblasti konfigurácie, optimalizácie a riešenia problémov.
Spark zásadne mení túto hodnotovú ponuku. Za cenu 3 999 dolárov a 128 GB unifikovanej pamäte poskytuje pôsobivý výkon inferencie modelov v tichom, kompaktnom a energeticky úspornom zariadení so spotrebou iba 240 W. Používatelia, ktorí chcú vytvoriť lokálnu infraštruktúru kódovacieho asistenta, už nepotrebujú zložité domáce laboratóriá, ktoré spotrebúvajú kilowatthodiny a generujú značný tepelný výkon. Overený prístup zariadenia s predkonfigurovaným operačným systémom DGX eliminuje zložitosť konfigurácie, ktorá predtým obmedzovala lokálne nasadenie LLM na používateľov s rozsiahlymi znalosťami Linuxu a CUDA.
Okrem eliminácie trenia v infraštruktúre rieši Spark kritické problémy týkajúce sa súkromia kódu a prispôsobenia modelu. Cloudoví programátori nevyhnutne prenášajú zdrojový kód na vzdialené servery, čo nie je vhodné pre organizácie pracujúce s proprietárnymi algoritmami, bezpečnostne kritickou infraštruktúrou alebo regulovanými údajmi. Lokálna inferencia v Sparku zabezpečuje, že kód nikdy neopustí vývojové prostredie. Okrem toho kapacita pamäte 128 GB umožňuje úplné doladenie parametrov kódovacích modelov, čo skúseným vývojárom umožňuje špecializovať sa na modely na interných kódových základniach. Táto funkcia je obzvlášť cenná pre organizácie s doménovo špecifickými jazykmi, vlastnými frameworkami alebo architektonickými vzormi, ktoré nie sú dostatočne zastúpené vo verejných tréningových dátach.
Jemné ladenie s NVIDIA NeMo na DGX Spark
Zjednotená pamäť DGX Spark s kapacitou 128 GB umožňuje úplné doladenie parametrov 8B modelov, ktoré tradične vyžadovali drahé cloudové konfigurácie s viacerými GPU. Úplné doladenie Qwen3 8B so štandardnou optimalizáciou Adam vyžaduje približne 132 GB (16 GB váhy modelu, 96 GB stavy optimalizátora, 16 GB gradienty plus aktivácie), čo prevyšuje duálne konfigurácie H100 80 GB. Použitie pamäťovo efektívneho 8-bitového Adamu znižuje požiadavky na približne 70 GB v závislosti od veľkosti dávky, čo sa pohodlne zmestí do pamäťového fondu Spark. To je dôležité, pretože úplné doladenie poskytuje o 4 – 6 % lepšiu presnosť ako LoRA pri úlohách komplexného uvažovania. Zatiaľ čo cloudové konfigurácie 2× H100 80 GB stoja približne 5 dolárov za hodinu s distribuovanou zložitosťou trénovania, Spark poskytuje trénovanie jedného systému s jednorazovou investíciou 3 999 dolárov.
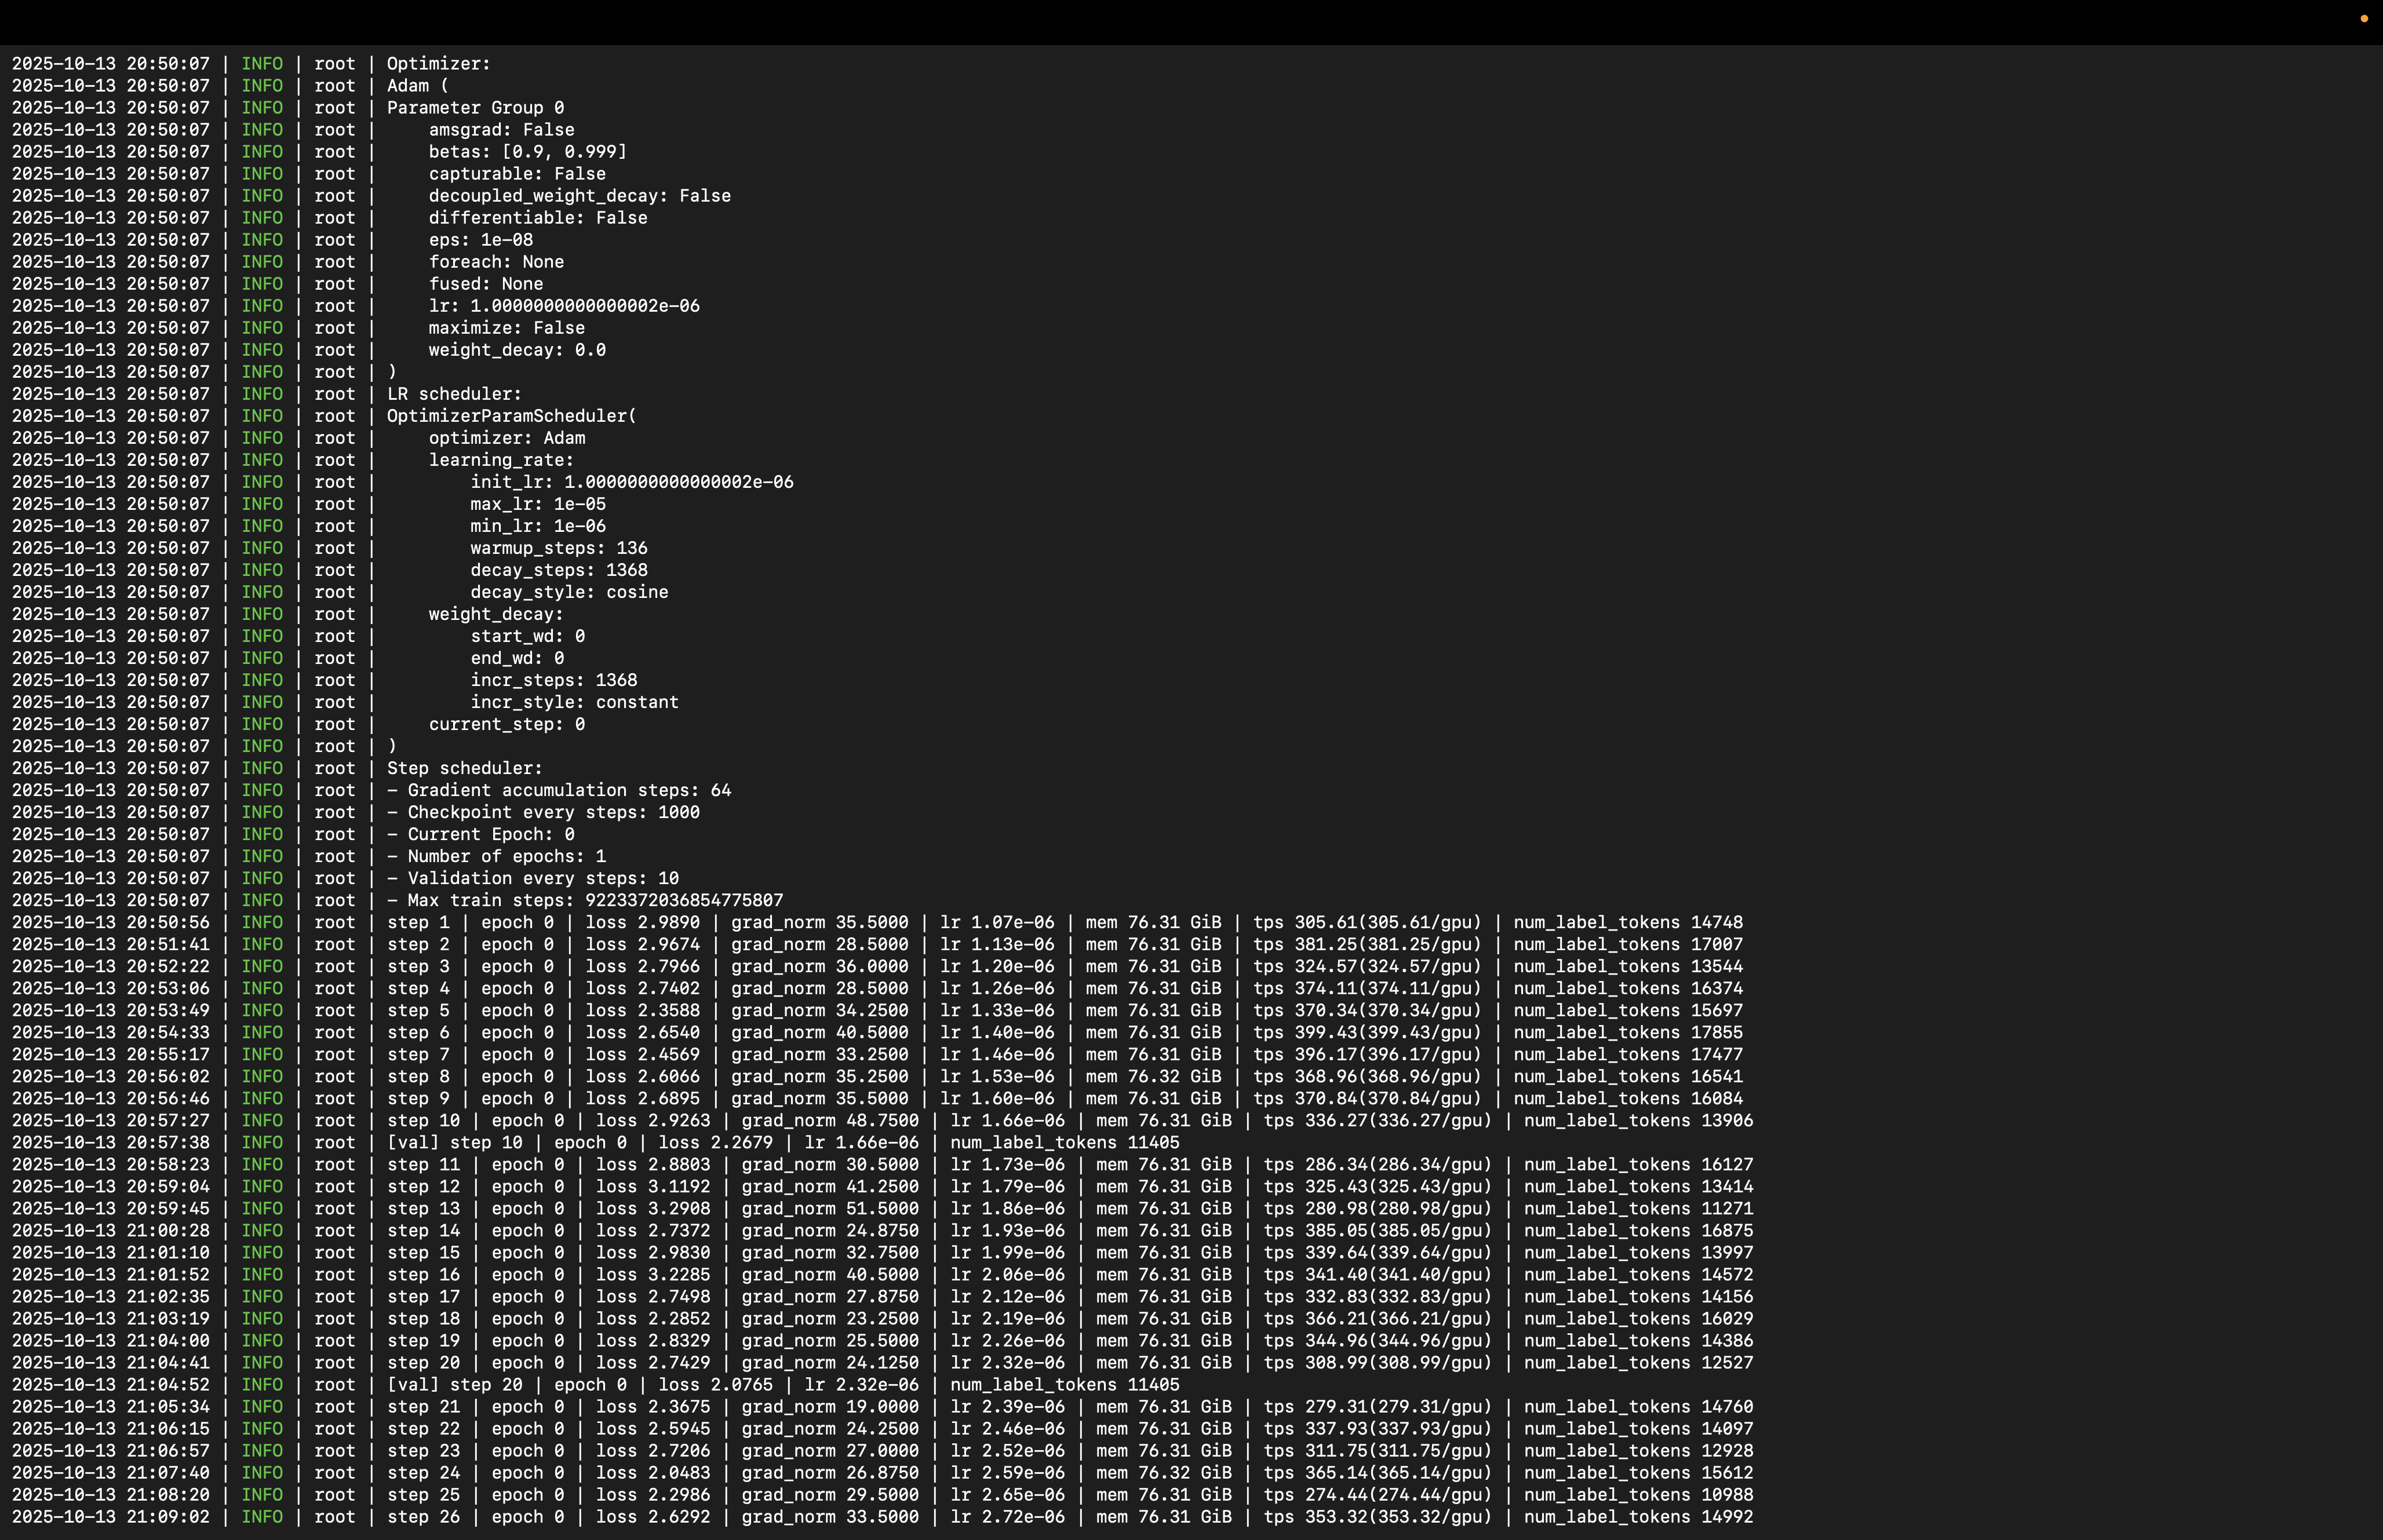
NVIDIA NeMo Automodel eliminuje prekážky v rámci podnikového tréningového rámca tým, že poskytuje podporu Day-0 pre akýkoľvek model Hugging Face bez konverzie kontrolných bodov. Načítajte Qwen3 8B priamo z HuggingFace Hub a nakonfigurujte jemné doladenie prostredníctvom súborov YAML s určením zdrojov dátových súborov, nastavení optimalizátora a cieľov LoRA. NeMo automatizuje distribuované kontrolné body s kompatibilitou safetensors, implementuje fúzované jadrá CUDA pre 2-5× zrýchlenie a spracováva akumuláciu gradientov.
Generovanie obrázkov s pohodlným používateľským rozhraním
ComfyUI poskytuje grafické rozhranie založené na uzloch, ktoré transformuje Stable Diffusion a súvisiace difúzne modely do vysoko prispôsobiteľných kreatívnych kanálov. Na rozdiel od tradičných webových rozhraní, ktoré abstrahujú zložitosť za zjednodušené posuvníky parametrov, ComfyUI využíva vizuálnu grafovú architektúru, kde používatelia vytvárajú pracovné postupy prepojením samostatných funkčných uzlov, z ktorých každý predstavuje špecifické operácie, ako je načítanie modelu, kódovanie promptov, vzorkovanie latentnej difúzie, dekódovanie VAE alebo transformácie na zvýšenie škálovania. Tento modulárny dizajn umožňuje granulárnu kontrolu nad celým generačným kanálom, vďaka čomu je každý výpočtový krok transparentný a nastaviteľný. Umožňuje tiež používateľom reťaziť viacero modelov, implementovať vlastné plány vzorkovania alebo integrovať pokročilé techniky, ako je navádzanie ControlNet, čo by v zjednodušených rozhraniach nebolo možné.
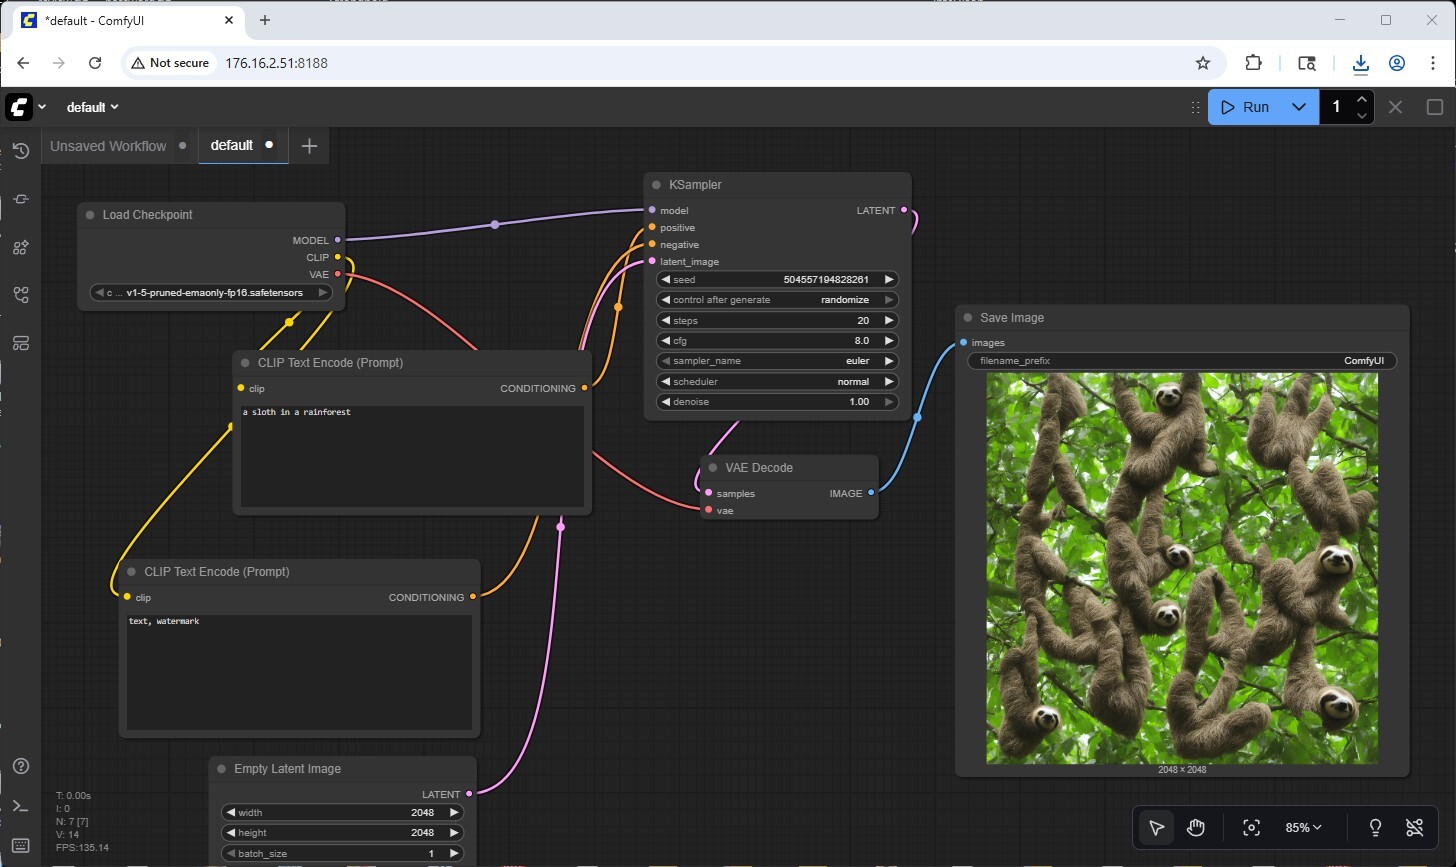
V systéme DGX Spark využíva ComfyUI tenzorové jadrá grafického procesora Blackwell na zrýchlené difúzne vzorkovanie, pričom generovanie sa zvyčajne dokončí za 15 – 30 sekúnd v závislosti od zložitosti vzorkovania. Architektúra unifikovanej pamäte so 128 GB sa ukazuje ako obzvlášť výhodná, pretože súčasne udržiava v pamäti viacero modelov kontrolných bodov, adaptérov LoRA a dekodérov VAE, čím eliminuje réžiu opätovného načítavania, ktorá trápi systémy s obmedzenou pamäťou VRAM. Používatelia môžu lokálne generovať neobmedzený počet umeleckých diel s umelou inteligenciou bez obmedzení rýchlosti API, nákladov na cloud na generáciu a obáv o súkromie spojených s proprietárnymi kreatívnymi pracovnými postupmi. Model perzistencie pracovného postupu pridáva prevádzkovú hodnotu: kompletné kanály sa serializujú do súborov JSON, ktoré je možné verzovane kontrolovať, zdieľať medzi tímami alebo vkladať priamo do generovaných obrázkov ako metadáta, čo umožňuje reprodukovateľnosť, ktorá je kritická pre organizácie, ktoré vytvárajú kanály syntetických dátových súborov alebo udržiavajú konzistentné umelecké štýly v rámci generovaných aktív.
Testovanie výkonu NVIDIA DGX Spark
Online poskytovanie vLLM – inferenčný test LLM
vLLM je najpopulárnejší vysokokapacitný inferenčný a obslužný engine pre LLM. Online serving benchmark vLLM je nástroj na hodnotenie výkonu určený na meranie reálnych obslužných schopností tohto inferenčného enginu pri spracovaní súbežných požiadaviek. Simuluje produkčné pracovné zaťaženie odosielaním požiadaviek na bežiaci server vLLM s konfigurovateľnými parametrami, ako je frekvencia požiadaviek, dĺžka vstupu/výstupu a počet súbežných klientov. Benchmark meria kľúčové metriky vrátane priepustnosti, t. j. tokenov za sekundu, času do prvého tokenu a času na výstupný token, čo pomáha používateľom pochopiť, ako vLLM funguje pri rôznych podmienkach zaťaženia.
Výkonnosť inferencie sme testovali v rámci komplexnej sady modelov predstavujúcich najpopulárnejšie architektúry a typy modelov v dnešných produkčných nasadeniach.
Zmes expertných modelov
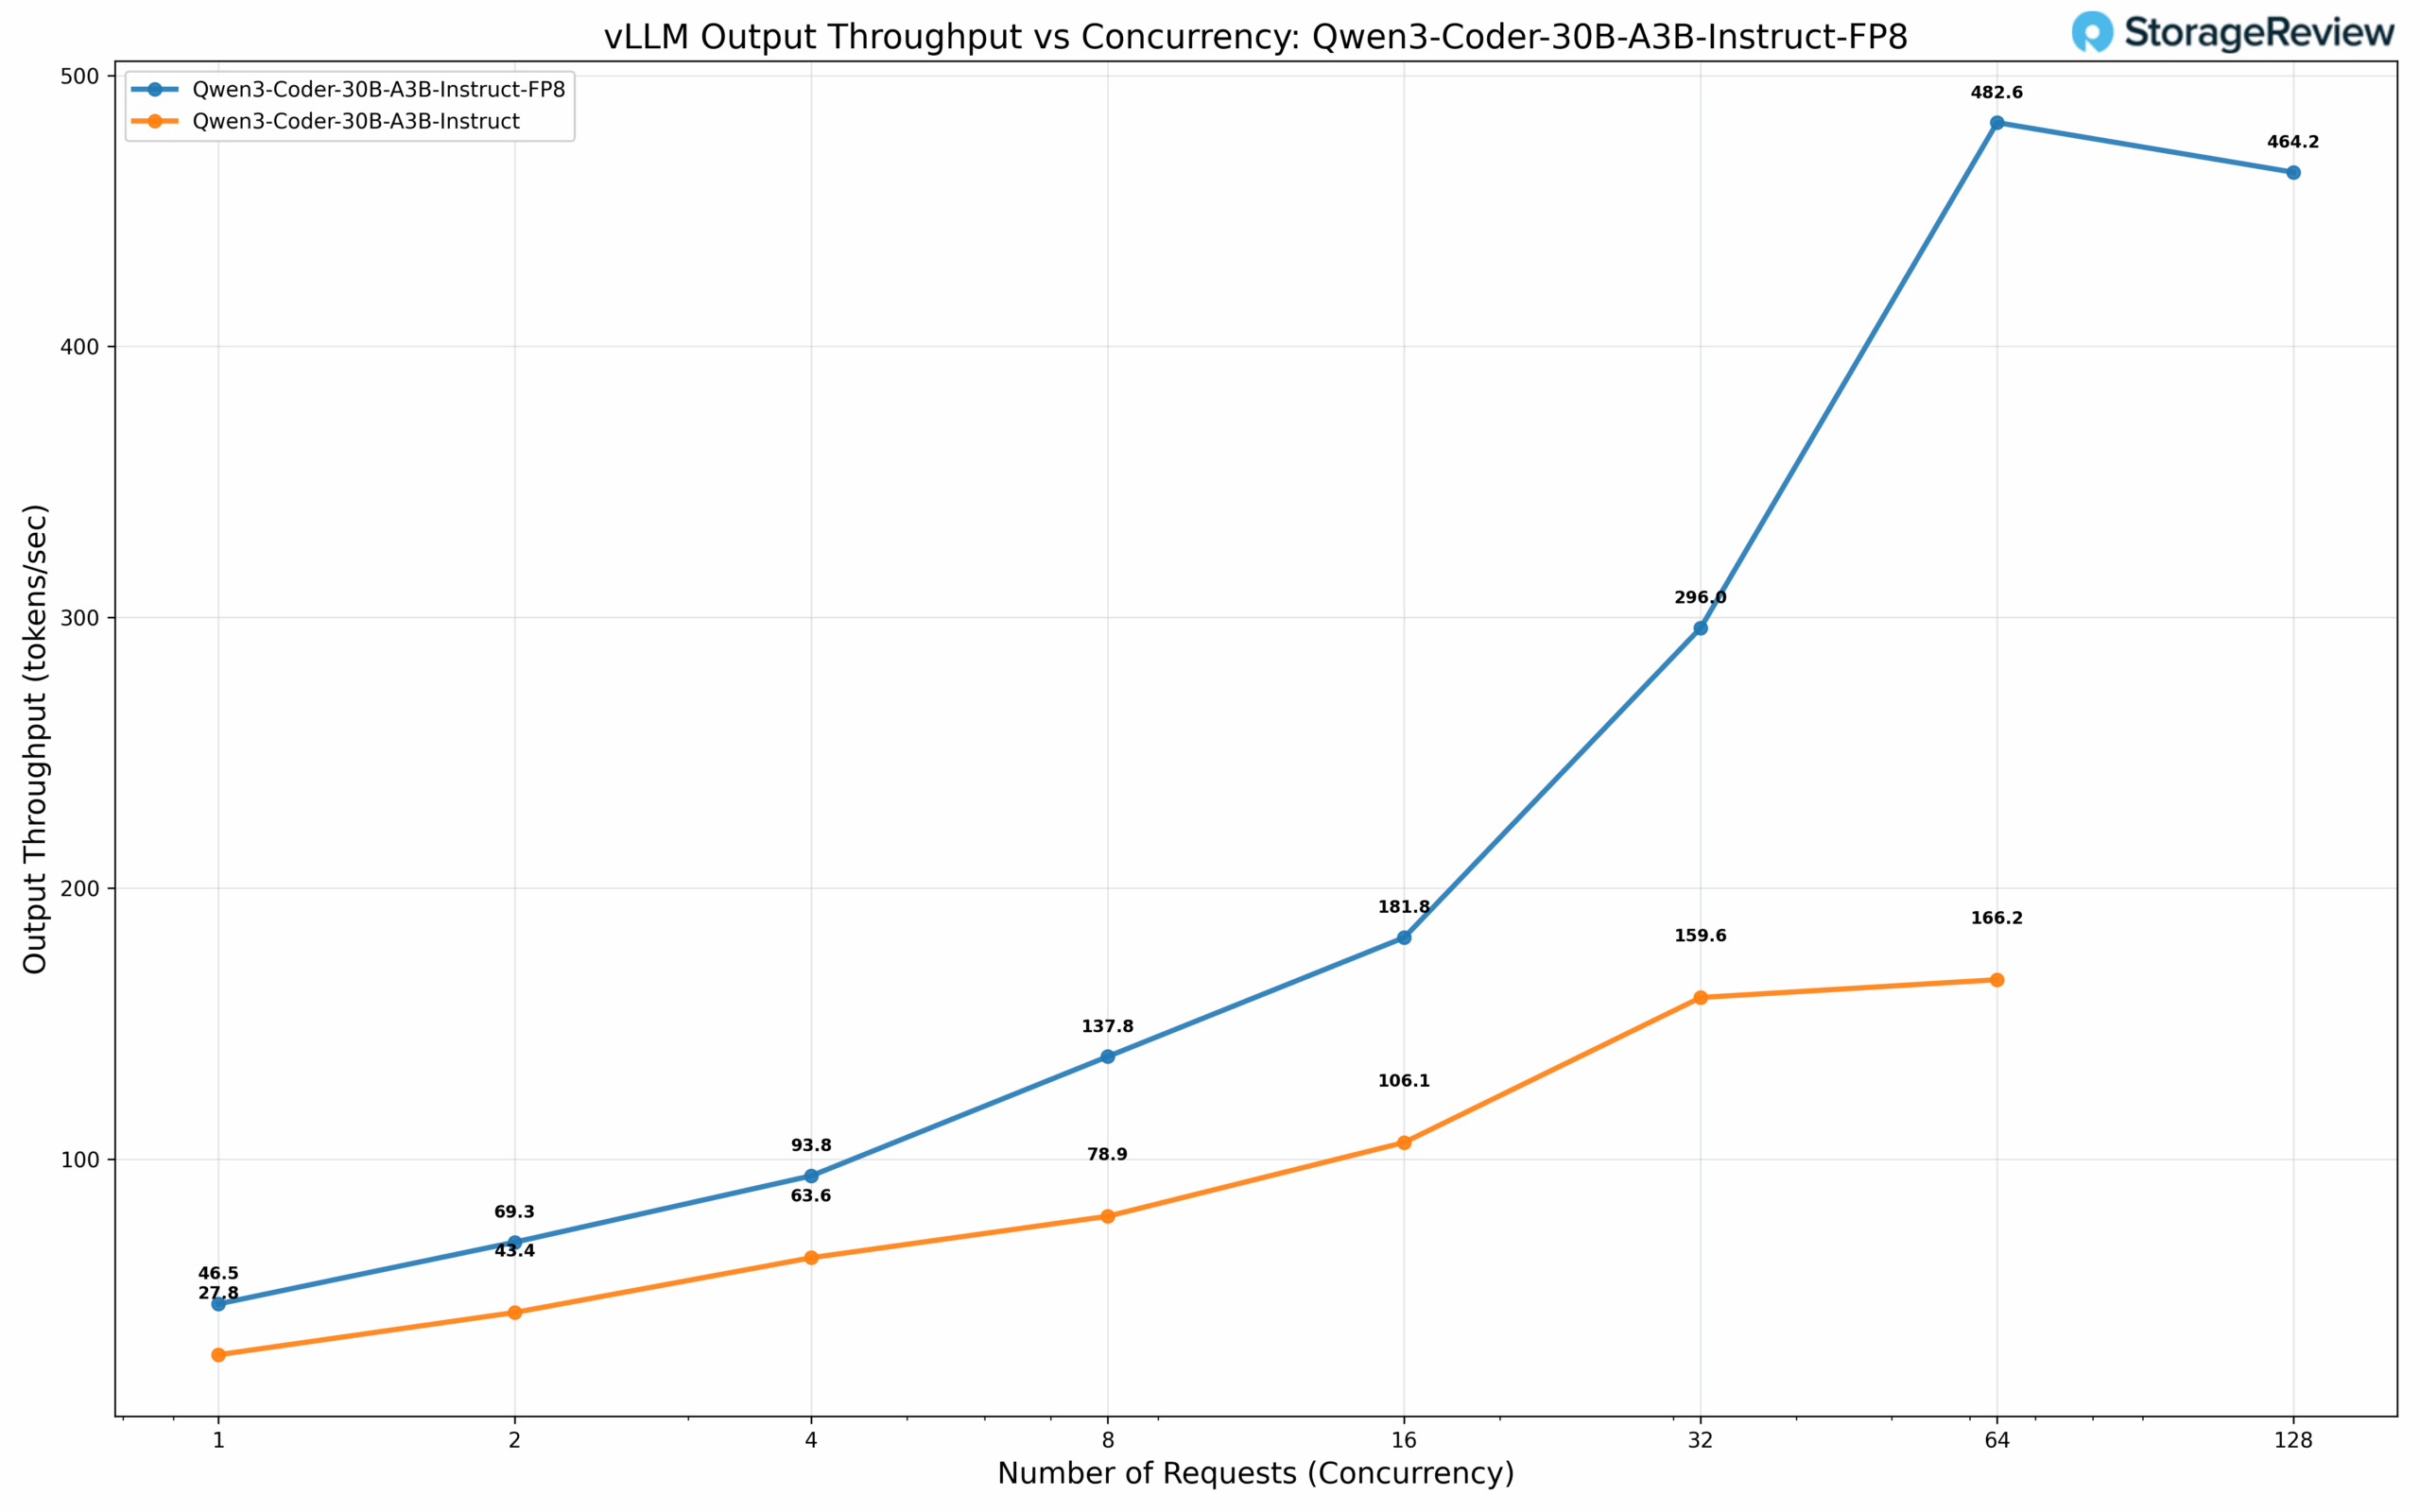
Vyhodnotili sme Qwen3 Coder 30B-A3B, jeden z najpopulárnejších kódovacích modelov pre lokálne inferenčné nasadenia. Táto riedka architektúra si zachováva plnú veľkosť modelu 30B parametrov s presnosťou BF16, pričom aktivuje iba 3B parametrov na vygenerovaný token. Porovnali sme štandardný model aj kvantizovaný variant FP8 od spoločnosti Qwen. Kvantovaný model FP8 vykazuje značné zvýšenie výkonu: dosahuje 46.5 tokov/s pri súbežnosti 1, pričom sa škáluje na pôsobivých 482.6 tokov/s pri veľkosti dávky 64. Štandardný model BF16 poskytuje 27.8 tokov/s pri súbežnosti 1, pričom dosahuje 166.2 tokov/s pri veľkosti dávky 64, čo je takmer 3-násobný rozdiel vo výkone.
Husté modely
Husté modely predstavujú konvenčnú architektúru LLM, kde sú všetky parametre a aktivácie zapojené počas inferencie, čo vedie k výpočtovo náročnejšiemu spracovaniu v porovnaní s ich riedkymi náprotivkami. Pre komplexné vyhodnotenie výkonnostných charakteristík naprieč škálami modelu a stratégiami kvantizácie sme porovnali päť konfigurácií hustého modelu.
Naša testovacia sada zahŕňala Mistral Small 3.1 24B od spoločnosti Mistral AI s presnosťou BF16, spolu s dynamicky kvantovanou variantou Mistral Small 3.1 24B FP8 od spoločnosti RedHat AI. Dynamická kvantizácia využíva techniky selektívnej váhovej kvantizácie na optimalizáciu kompromisu medzi výkonom a presnosťou, čím strategicky znižuje presnosť a zároveň minimalizuje degradáciu modelu. Tieto väčšie husté modely sme doplnili o vyhodnotenia Meta Llama 3.1 8B v troch formátoch presnosti: štandardná konfigurácia BF16 a kvantované verzie FP8 a FP4 od spoločnosti NVIDIA. Táto stratégia výberu modelu umožňuje priame porovnanie výkonu naprieč mierkami modelu a zároveň izoluje vplyv progresívnej kvantizácie na priepustnosť inferencie.
Analýza výkonnosti: Veľké husté modely
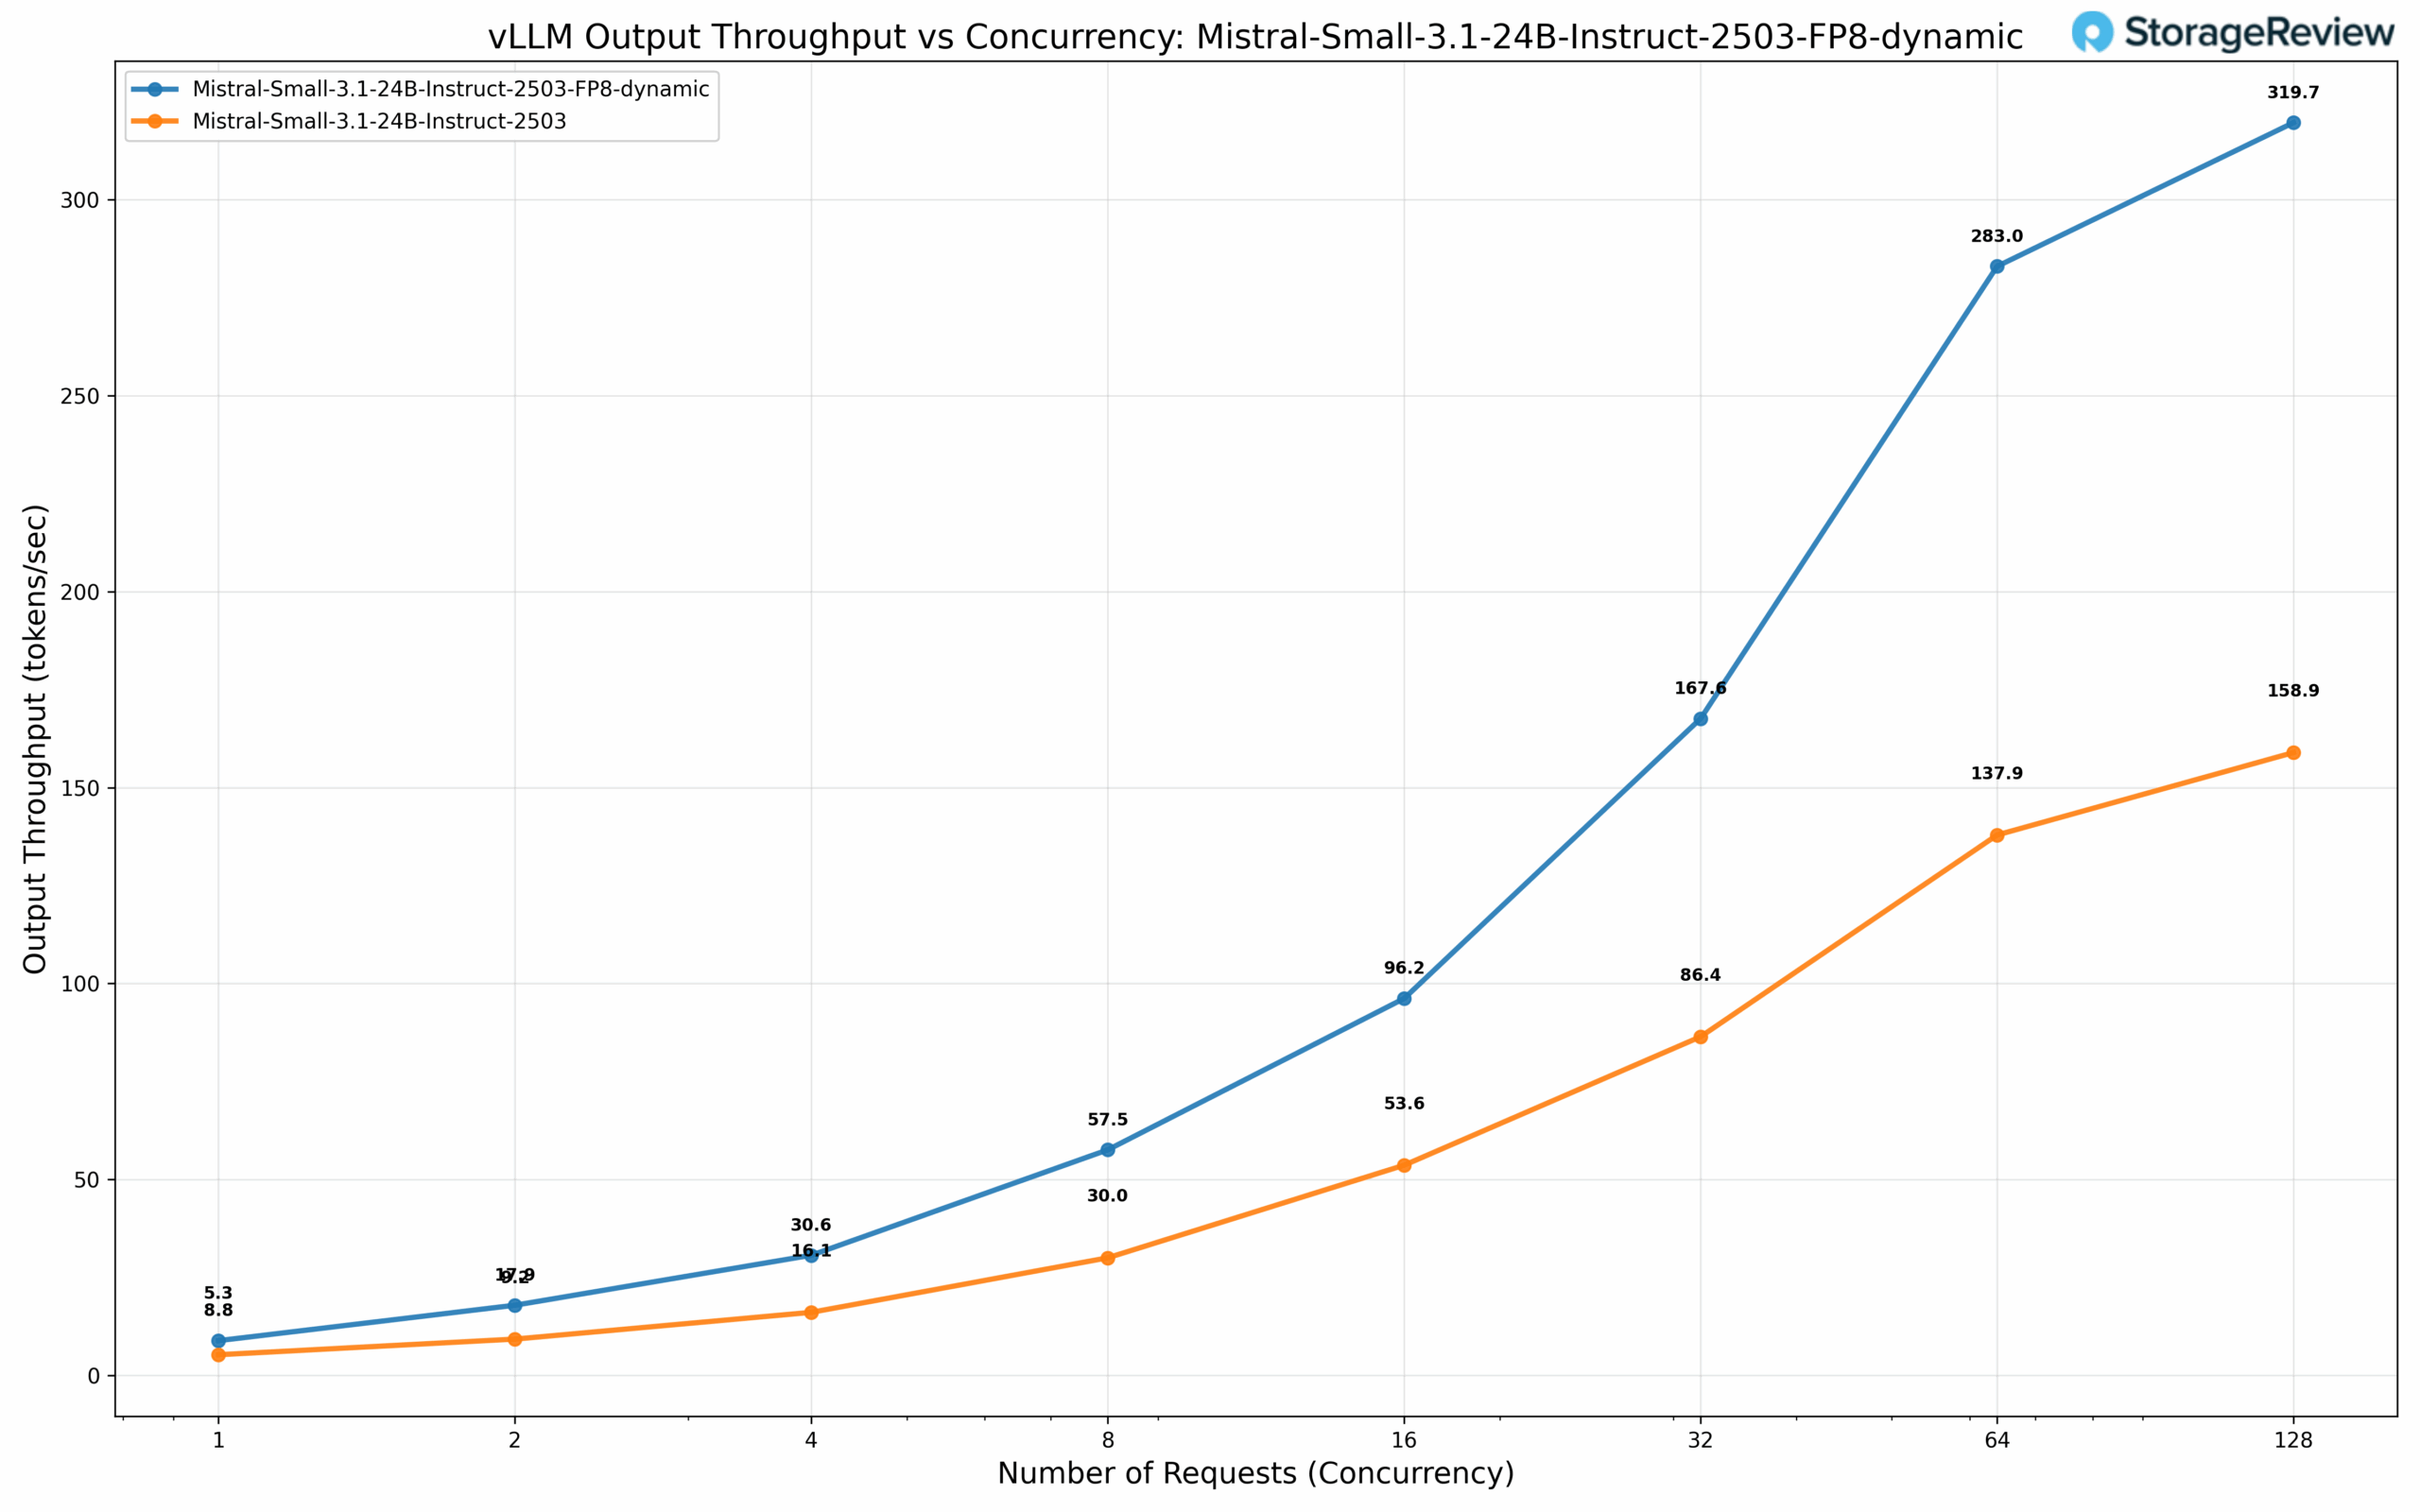
Mistral Small 3.1 24B s presnosťou BF16 vykazuje základnú priepustnosť 5.3 tok/s pri súbežnosti 1, ktorá sa škáluje na podstatných 158.9 tok/s pri 128 súbežných požiadavkách. Dynamicky kvantizovaný variant FP8 vykazuje mierne zisky pri nižšej súbežnosti s 8.8 tok/s, ale poskytuje presvedčivý 2-násobný multiplikátor výkonu pri škálovaní, dosahujúc 319.7 tok/s pri súbežnosti 128 – čo podčiarkuje účinnosť dynamickej kvantizácie pre scenáre s vysokou priepustnosťou.
Analýza výkonnosti: Kompaktné husté modely
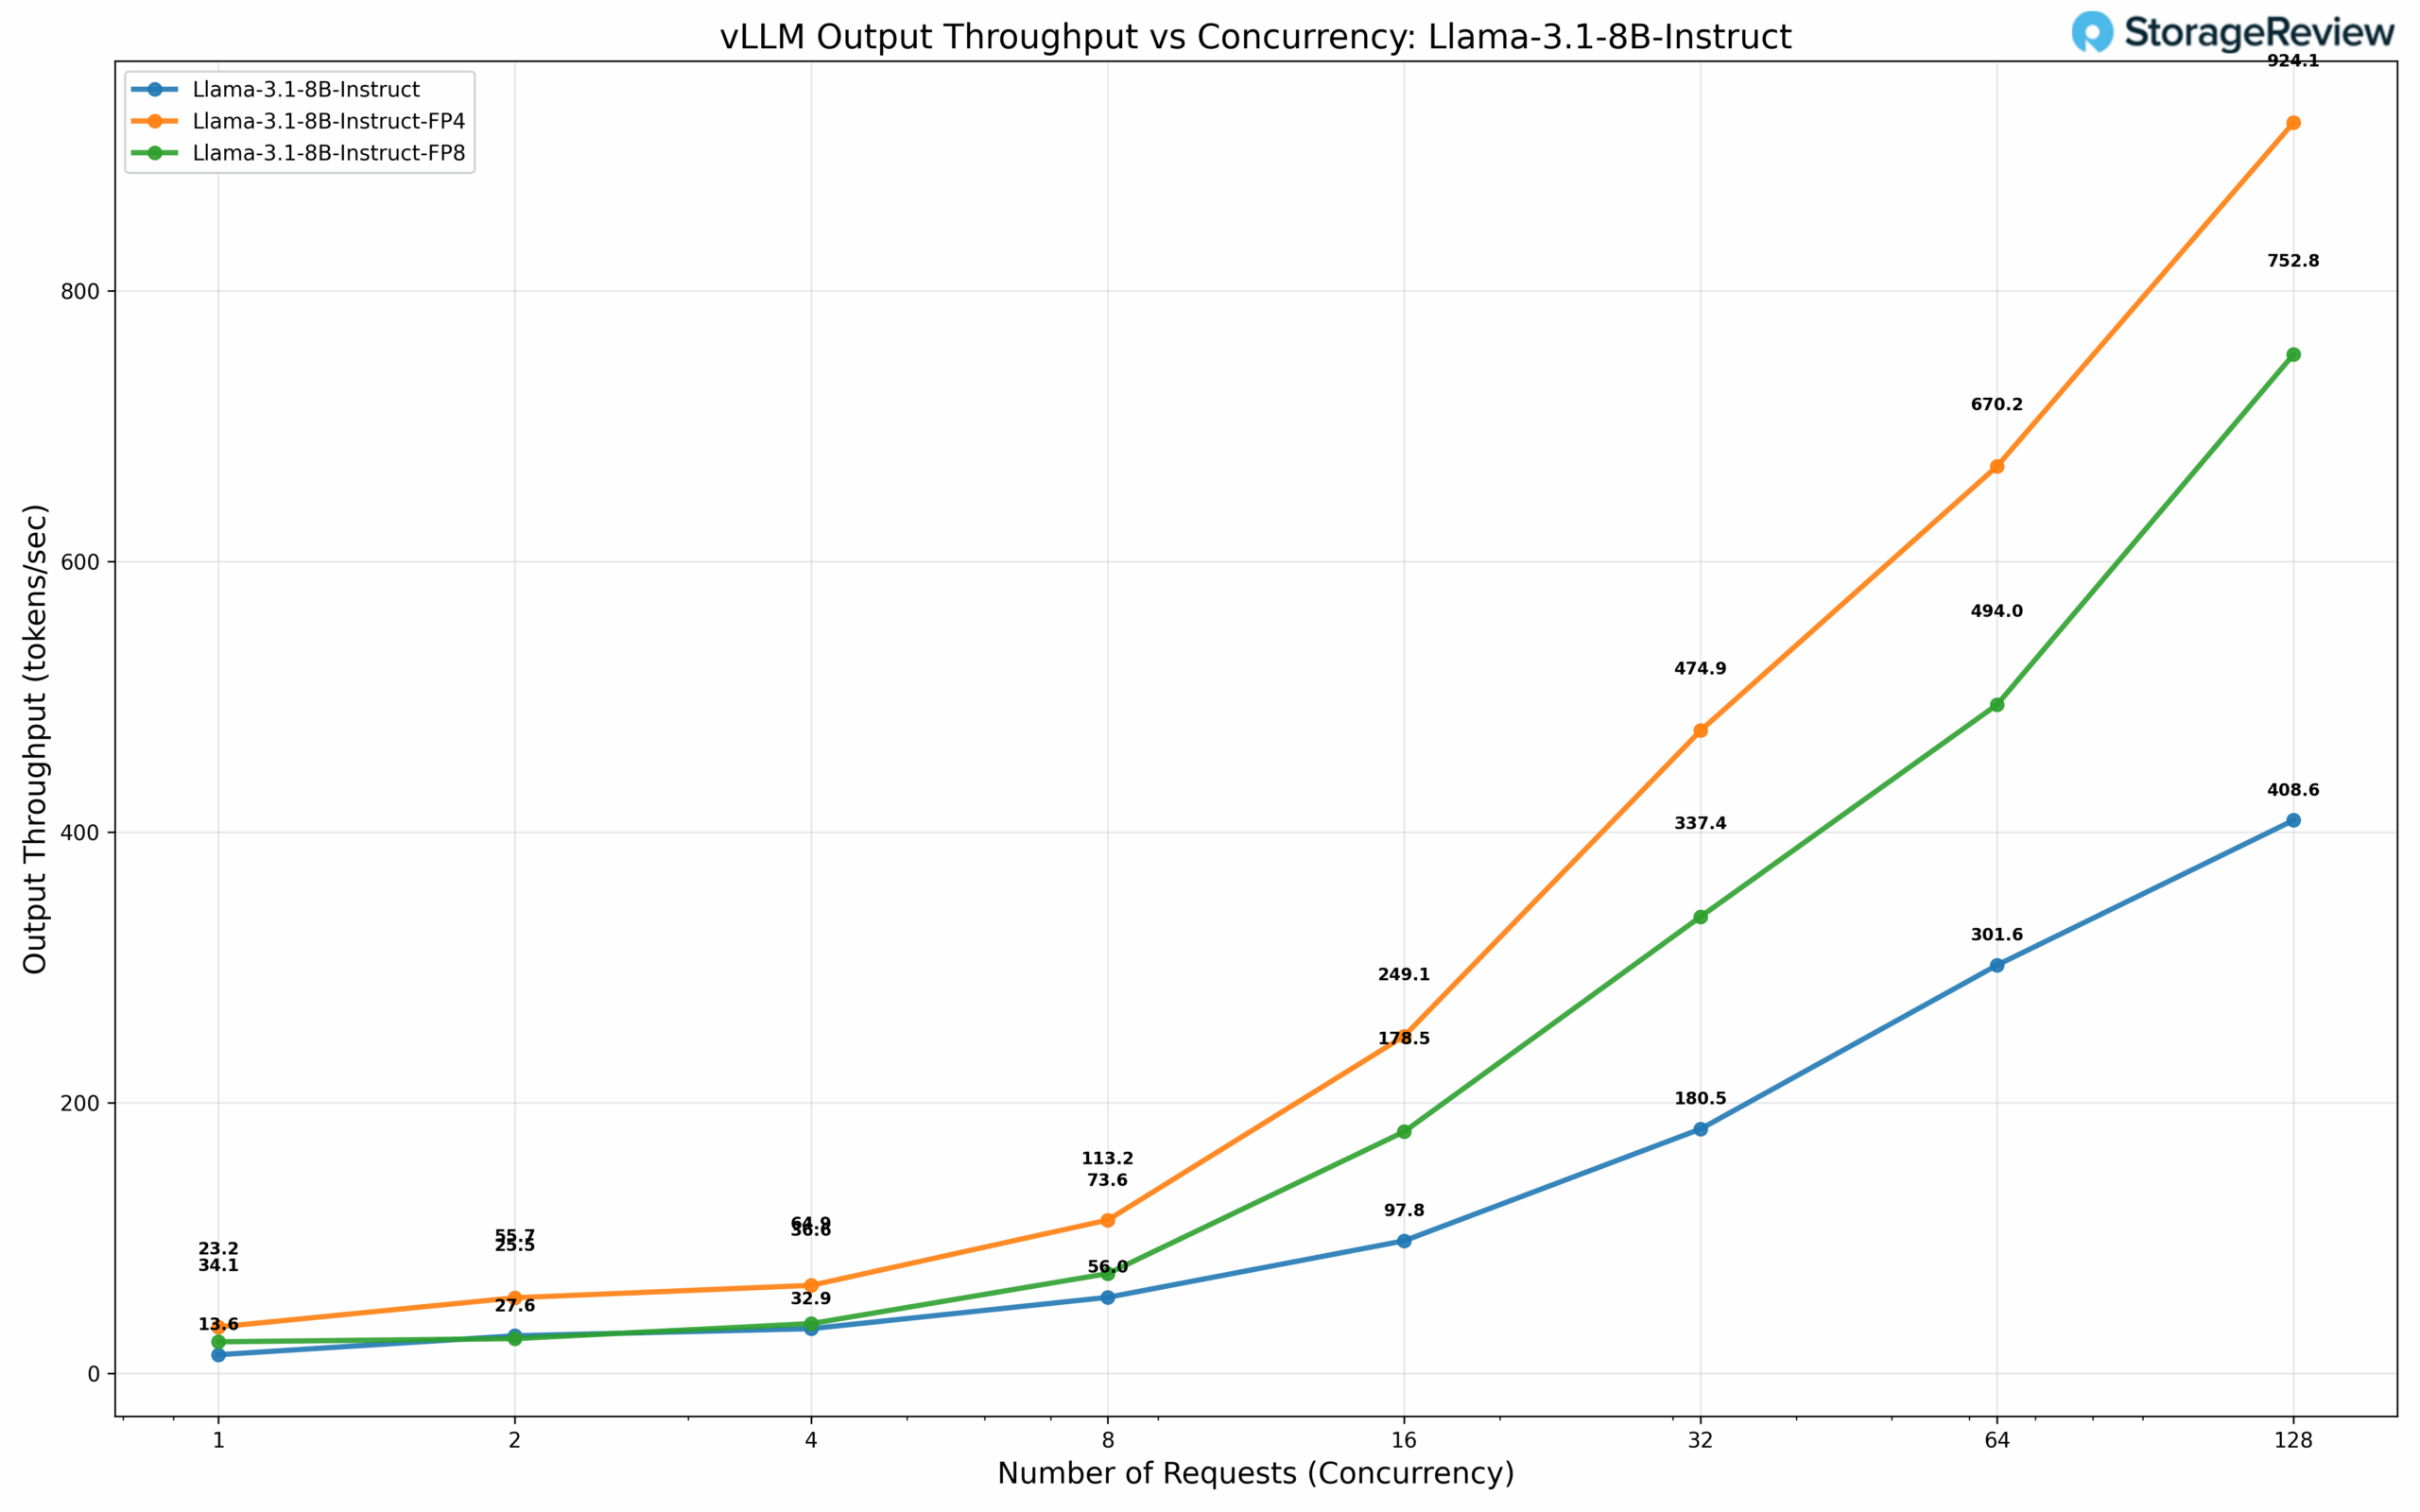
Architektúra Llama 3.1 8B vykazuje výrazne odlišné výkonnostné charakteristiky v rôznych stratégiách kvantizácie. Pri presnosti BF16 model dosahuje 13.6 tok/s pri súbežnosti 1 a pri 128 súbežných požiadavkách sa zvyšuje na 408.6 tok/s. Prechod na kvantizáciu FP8 prináša 23.2 tok/s a 752.8 tok/s pri úrovniach súbežnosti 1 a 128 – čo predstavuje 84 % zlepšenie priepustnosti vo veľkom meradle. Konfigurácia FP4 posúva výkon ešte ďalej a dosahuje 34.1 tok/s a 924.1 tok/s pri rovnakých úrovniach súbežnosti, čo dokazuje, že agresívne stratégie kvantizácie môžu priniesť 2.3-násobné zvýšenie výkonu oproti základnej presnosti a zároveň zachovať prijateľnú kvalitu modelu pre mnohé produkčné pracovné zaťaženia.
Dátový typ mikroškálovania
Mikroškálovanie predstavuje pokročilý prístup ku kvantizácii, ktorý aplikuje jemnozrnné škálovacie faktory na malé bloky váh namiesto rovnomernej kvantizácie naprieč veľkými skupinami parametrov. Formát NVFP4 od spoločnosti NVIDIA implementuje túto techniku prostredníctvom blokovanej reprezentácie s pohyblivou rádovou čiarkou, kde každý mikroškálový blok s 8 – 32 hodnotami zdieľa spoločný exponent ako škálovací faktor. Tento granulárny prístup zachováva numerickú presnosť a zároveň dosahuje 4-bitovú reprezentáciu, čím sa zachováva dynamický rozsah kritický pre transformátorové architektúry. Formát sa integruje s architektúrou Tensor Core od spoločnosti NVIDIA, čo umožňuje efektívny výpočet so zmiešanou presnosťou s dekompresiou za chodu počas maticových operácií.
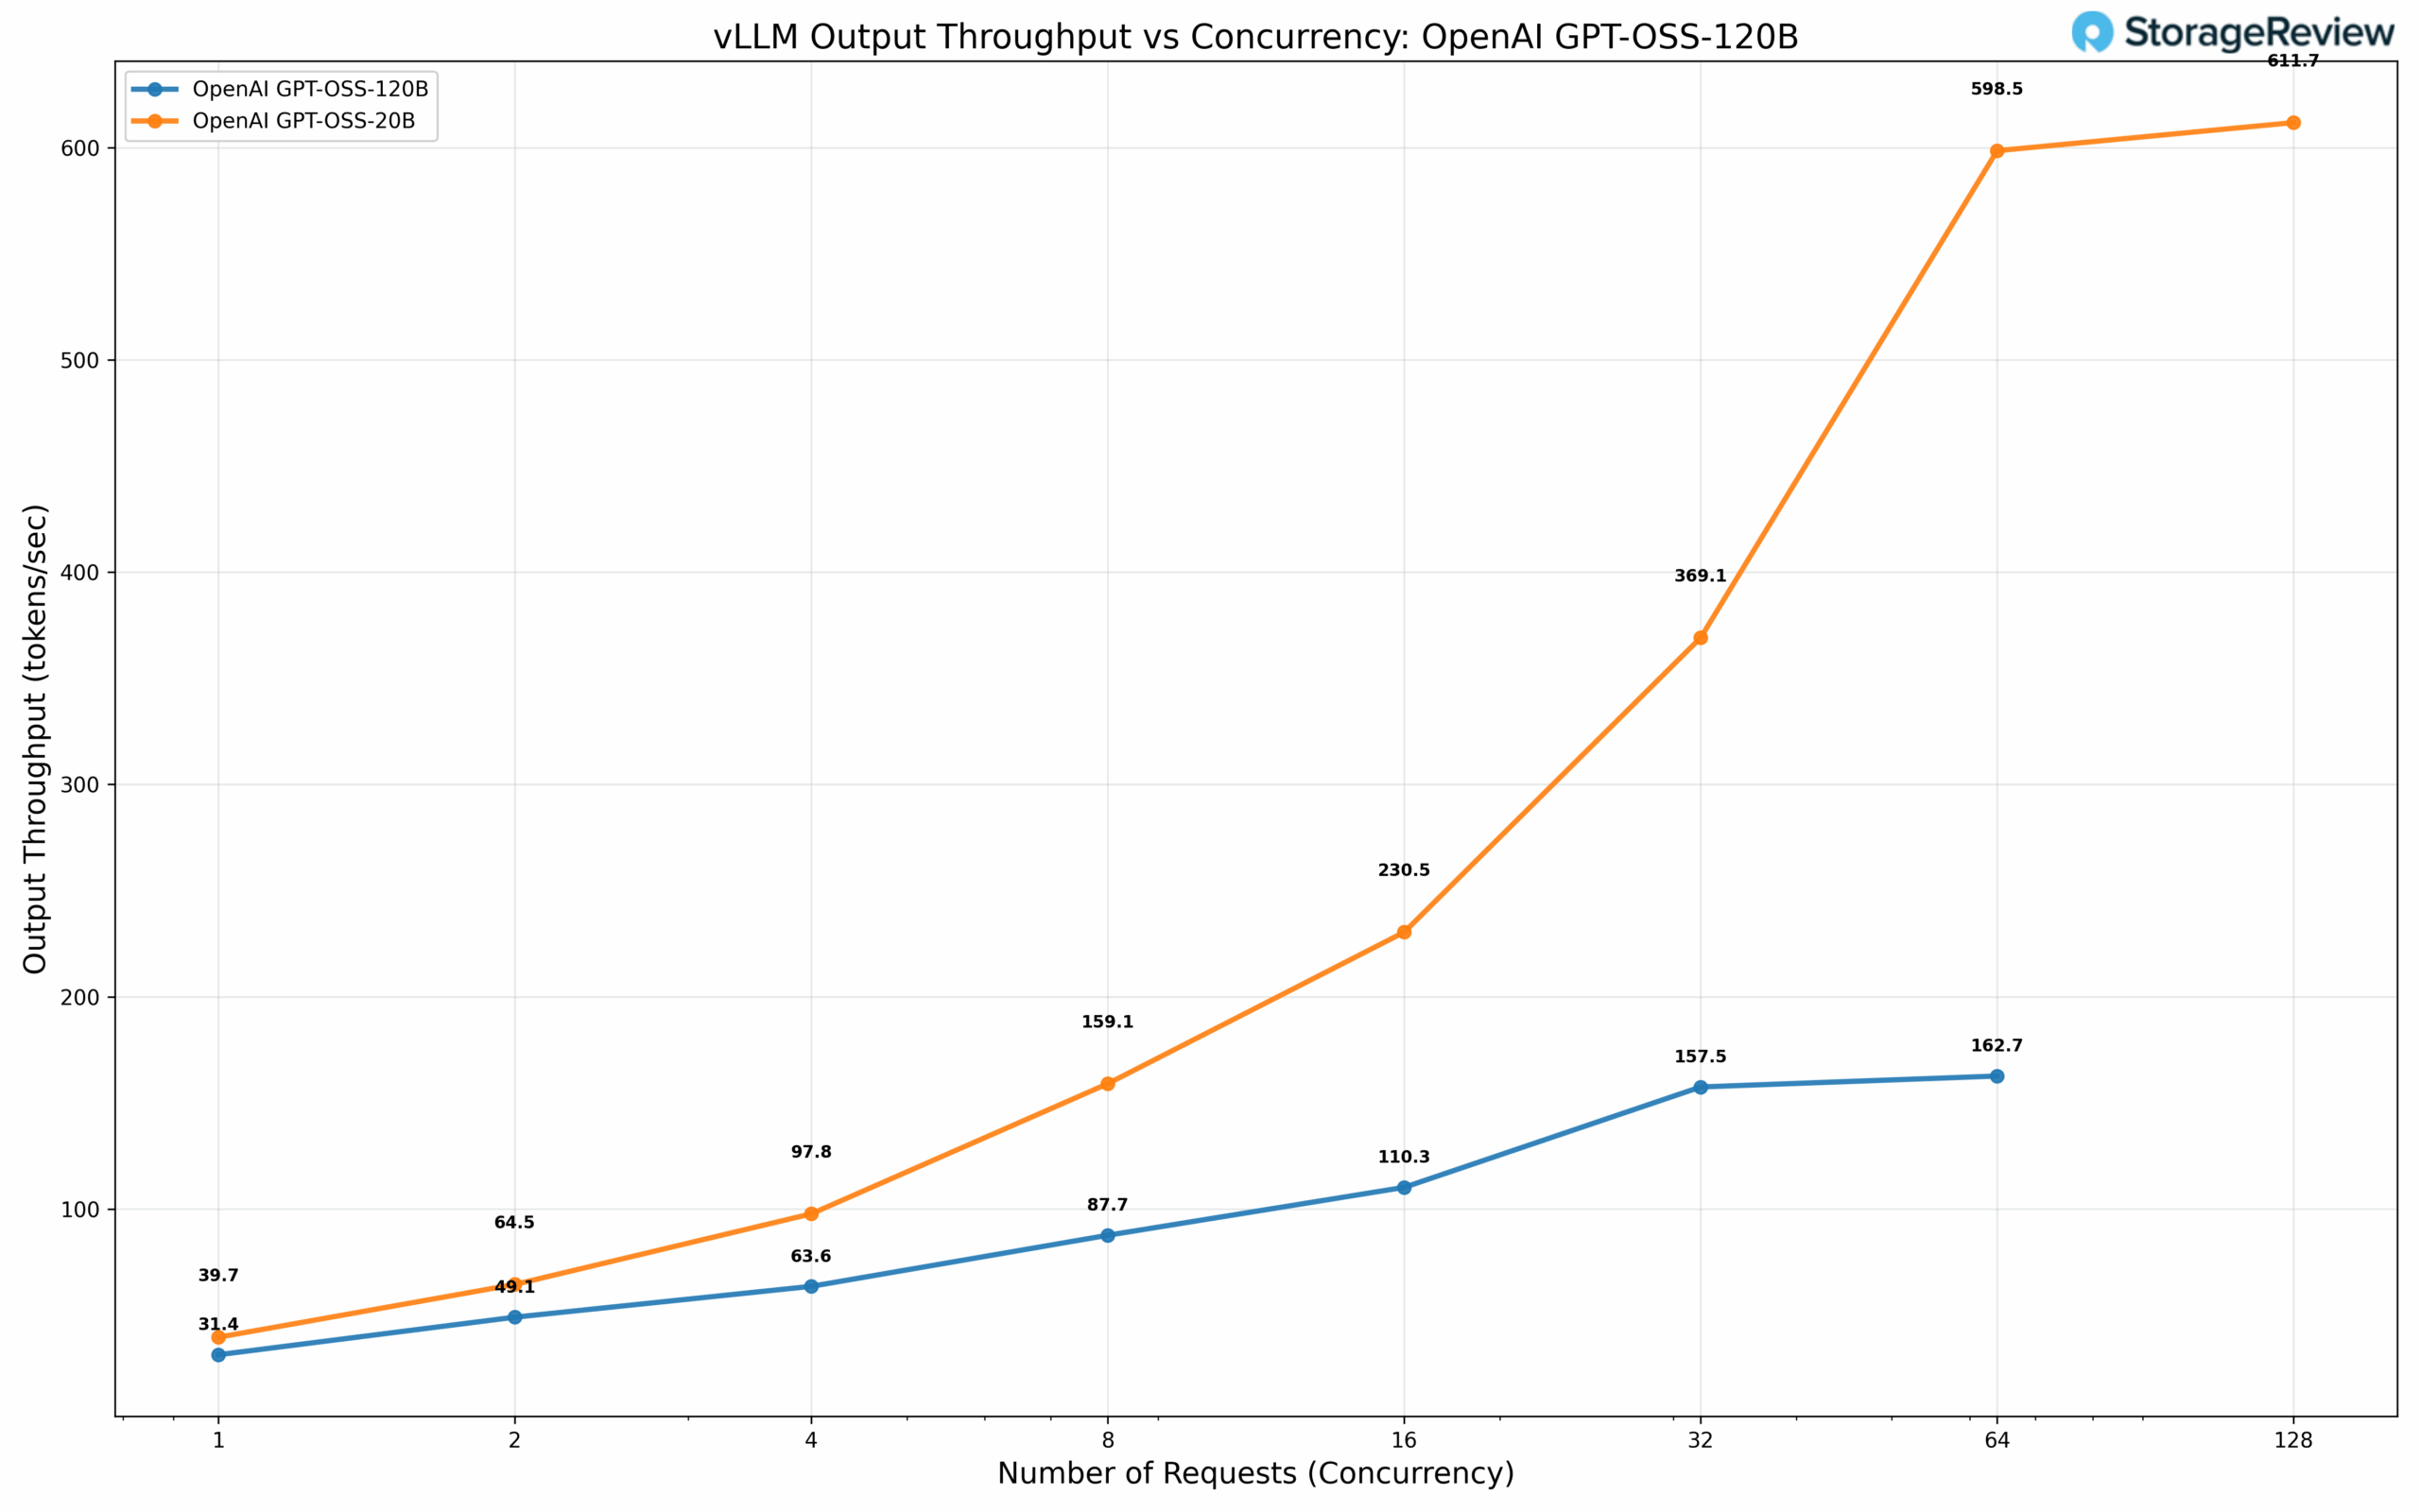
Modely GPT OSS od OpenAI sme vyhodnotili pri parametrických škálach 20B a 120B pomocou kvantizácie NVFP4. Model s parametrami 20B dosahuje 39.7 tok/s pri súbežnosti 1, pričom sa škáluje na 611.7 tok/s pri 128 súbežných požiadavkách. Variant s parametrami 120B poskytuje 31.4 tok/s pri súbežnosti 1 a 162.7 tok/s pri 64 súbežných požiadavkách.
Poznámka: Výstupná priepustnosť je priepustnosť naprieč požiadavkami a nie priepustnosť na požiadavku.
Kvôli obmedzenému času sme neboli schopní dokončiť naše testy TensorRT, sledujte ďalšie články v Spark, kde preskúmame výkon na ďalších inferenčných frameworkoch.
Preddoplnenie a dekódovanie náročnej inferencie
Inferenciu LLM možno zásadne rozdeliť na dve odlišné výpočtové fázy, z ktorých každá vykazuje výrazne odlišné výkonnostné charakteristiky a vzorce využitia zdrojov. Fáza predbežného dopĺňania spracováva celú vstupnú výzvu v jednej paralelnej operácii, pričom súčasne vypočítava mechanizmy pozornosti naprieč všetkými vstupnými tokenmi. Ide o výpočtovo náročnú operáciu, ktorá plne saturuje tenzorové jadrá a výpočtové jednotky. Naopak, fáza dekódovania generuje výstupné tokeny autoregresívne, pričom produkuje jeden token naraz prostredníctvom sekvenčných operácií, ktoré vykazujú nižšiu výpočtovú náročnosť, ale kladú značné nároky na šírku pásma pamäte, pretože model musí opakovane pristupovať k váham a rastúcej vyrovnávacej pamäti kľúč-hodnota. To vytvára zásadne odlišné profily úzkych miest: operácie predbežného dopĺňania sú zvyčajne viazané na výpočty, zatiaľ čo operácie dekódovania sa stávajú náročnými na šírku pásma pamäte, čo ich robí obzvlášť náchylnými na obmedzenia pamäťového subsystému.
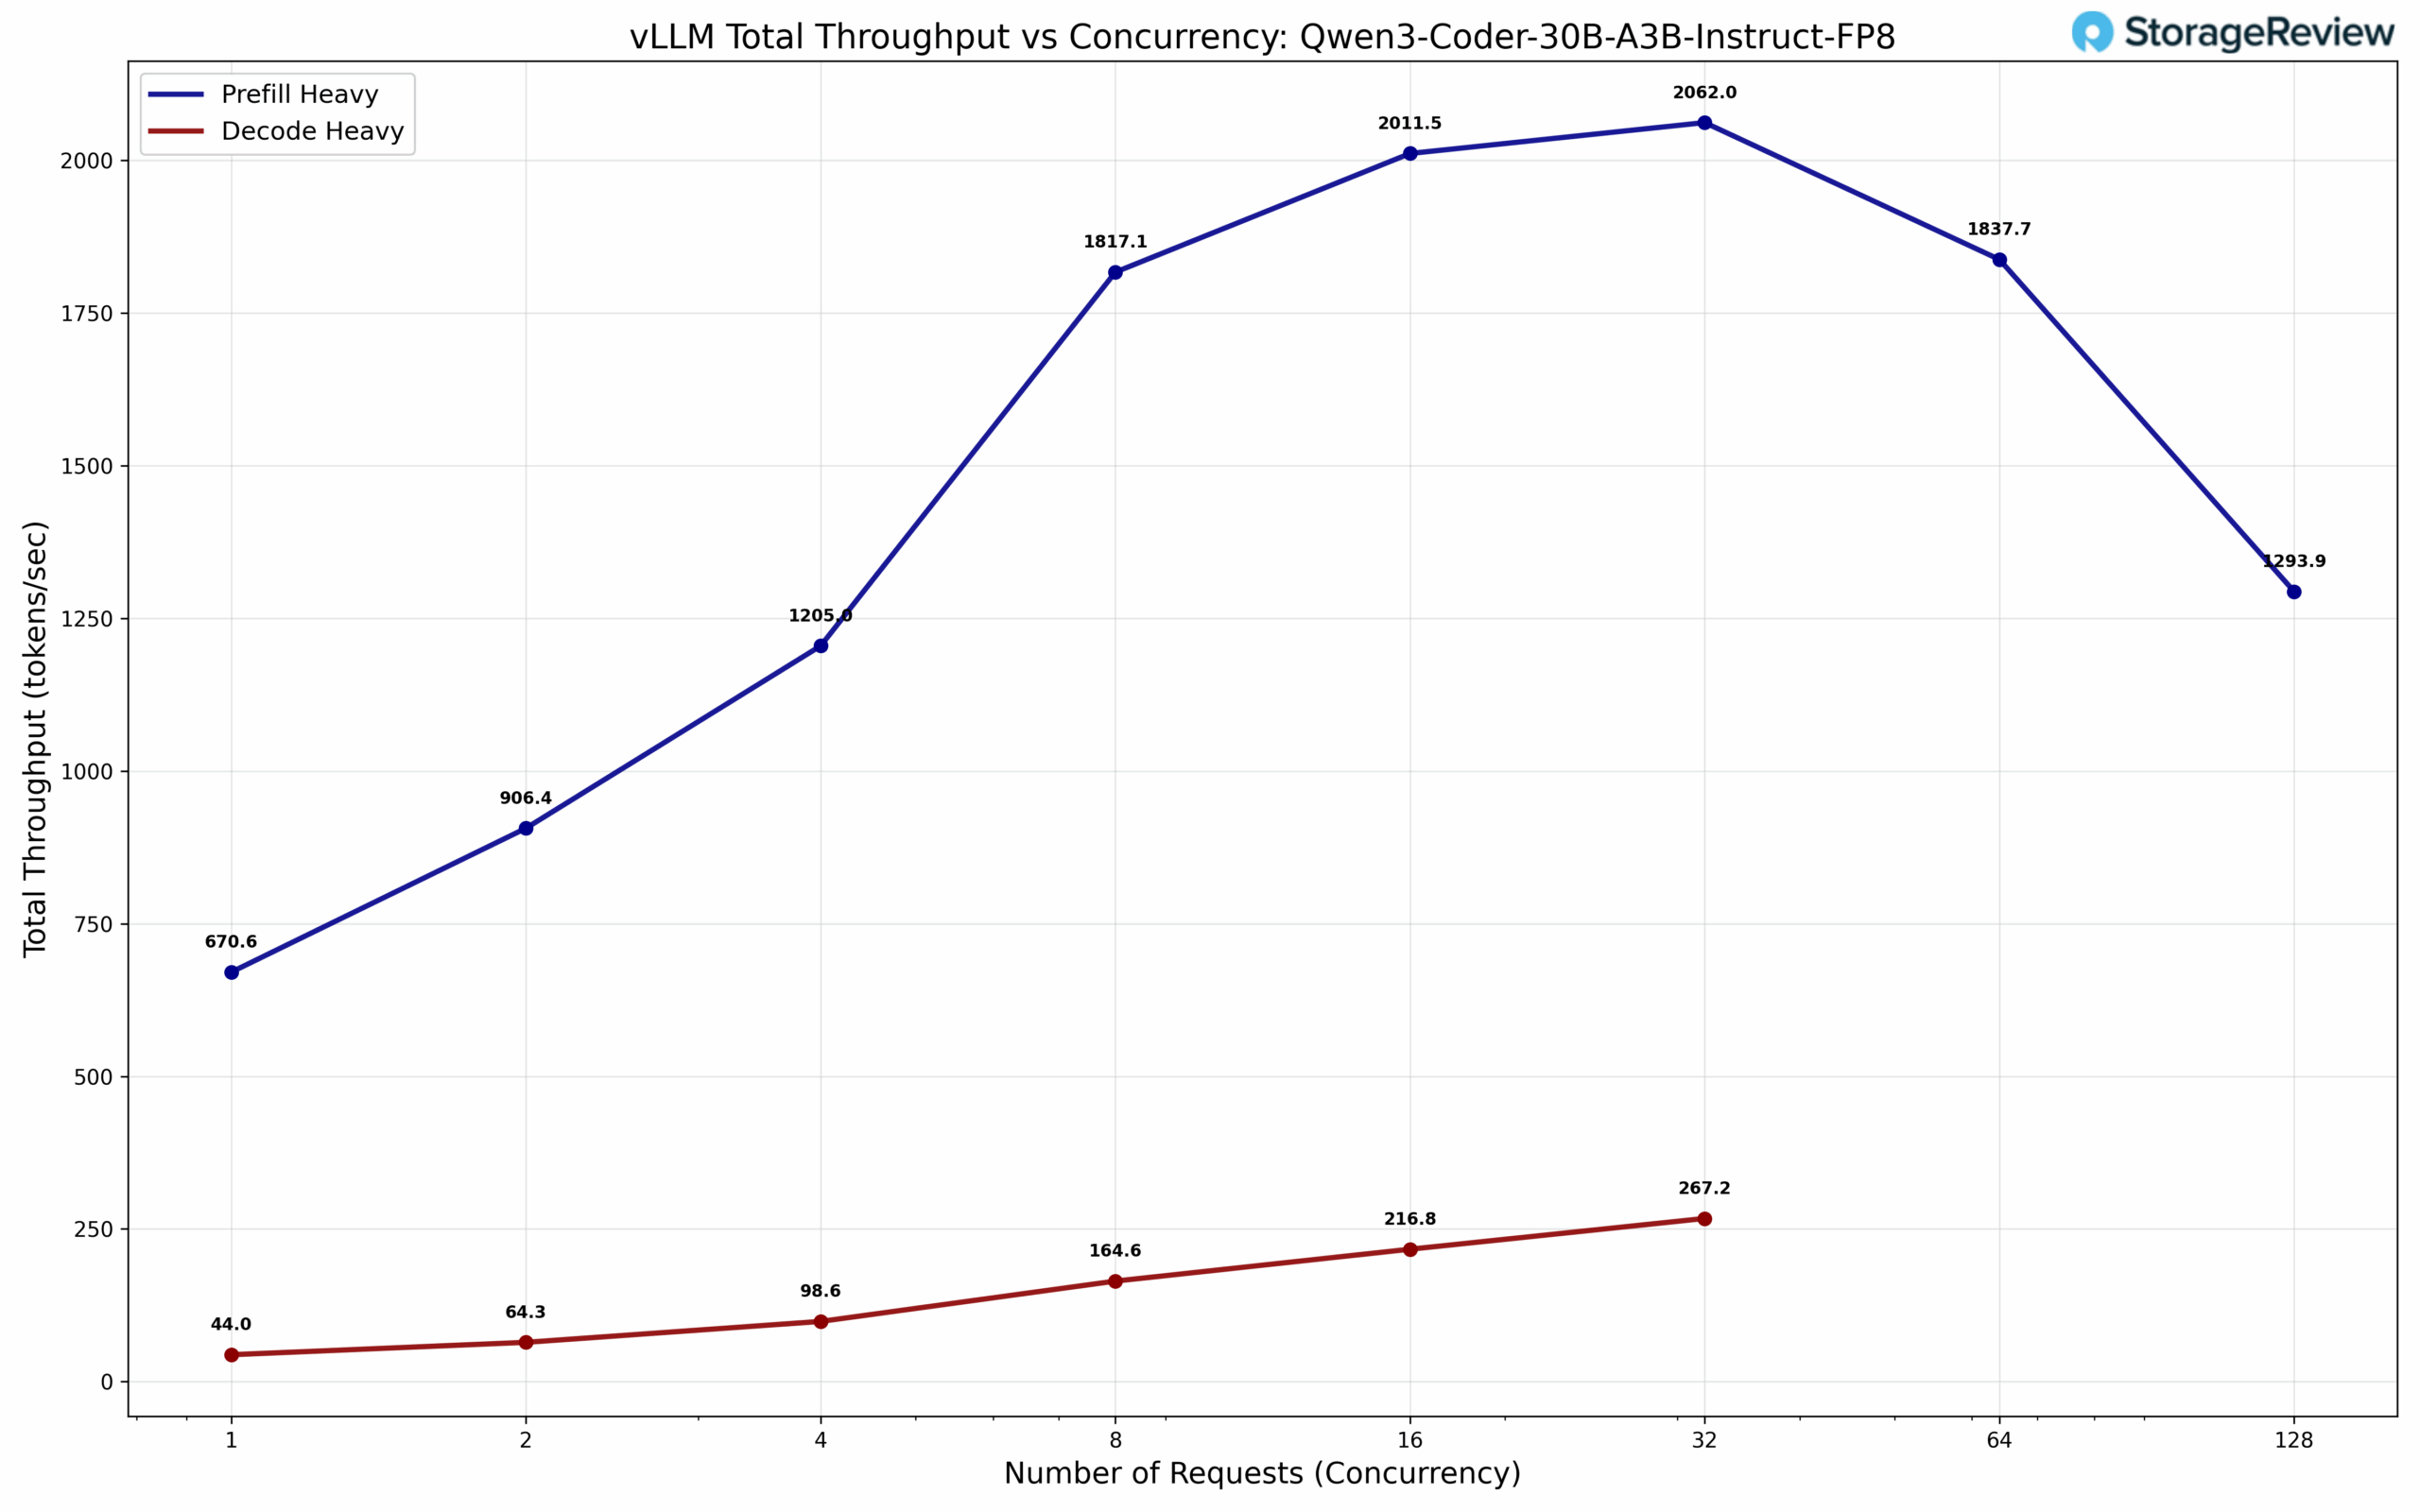
Vykonali sme komplexné testovanie v dvoch odlišných profiloch pracovnej záťaže: inferencia s vysokou mierou dekódovania s 512 vstupnými tokenmi a 8 192 výstupnými tokenmi a inferencia s vysokou mierou preddopĺňania s 8 192 vstupnými tokenmi a 512 výstupnými tokenmi. Charakterizácia výkonu odhaľuje očakávané architektonické kompromisy: Spark vykazuje konkurencieschopnú priepustnosť pri pracovných záťažiach s vysokou mierou preddopĺňania, kde výpočtové zdroje zostávajú hlavným úzkym hrdlom, ale vykazuje znížený výkon v scenároch s vysokou mierou dekódovania. Tento rozdiel vo výkone presne zodpovedá obmedzeniam šírky pásma pamäte. Sekvenčná povaha dekódovacích operácií a intenzívne vzory prístupu k pamäti priamo odhaľujú obmedzenia šírky pásma, ktoré sú vlastné architektúre Sparku. Tieto výsledky poskytujú kritický kontext pre interpretáciu meraní MAMF v ďalšej časti, pretože oba benchmarkové súbory konzistentne identifikujú šírku pásma pamäte ako základný faktor obmedzujúci výkon v reálnych nasadeniach inferencie.
Maximálne dosiahnuteľné Matmul FLOPS (MAMF)
MAMF (Maximum Achievable Matmul FLOPS) je praktická metrika výkonu určená na meranie realistického maximálneho počtu operácií s pohyblivou rádovou čiarkou za sekundu, ktorý je možné dosiahnuť na akcelerátoroch strojového učenia počas operácií násobenia matíc. Ponúka presnejší benchmark ako teoretický maximálny FLOPS často inzerovaný v hardvérových špecifikáciách. Používame benchmark mamf-finder od Stasa Beckmana.
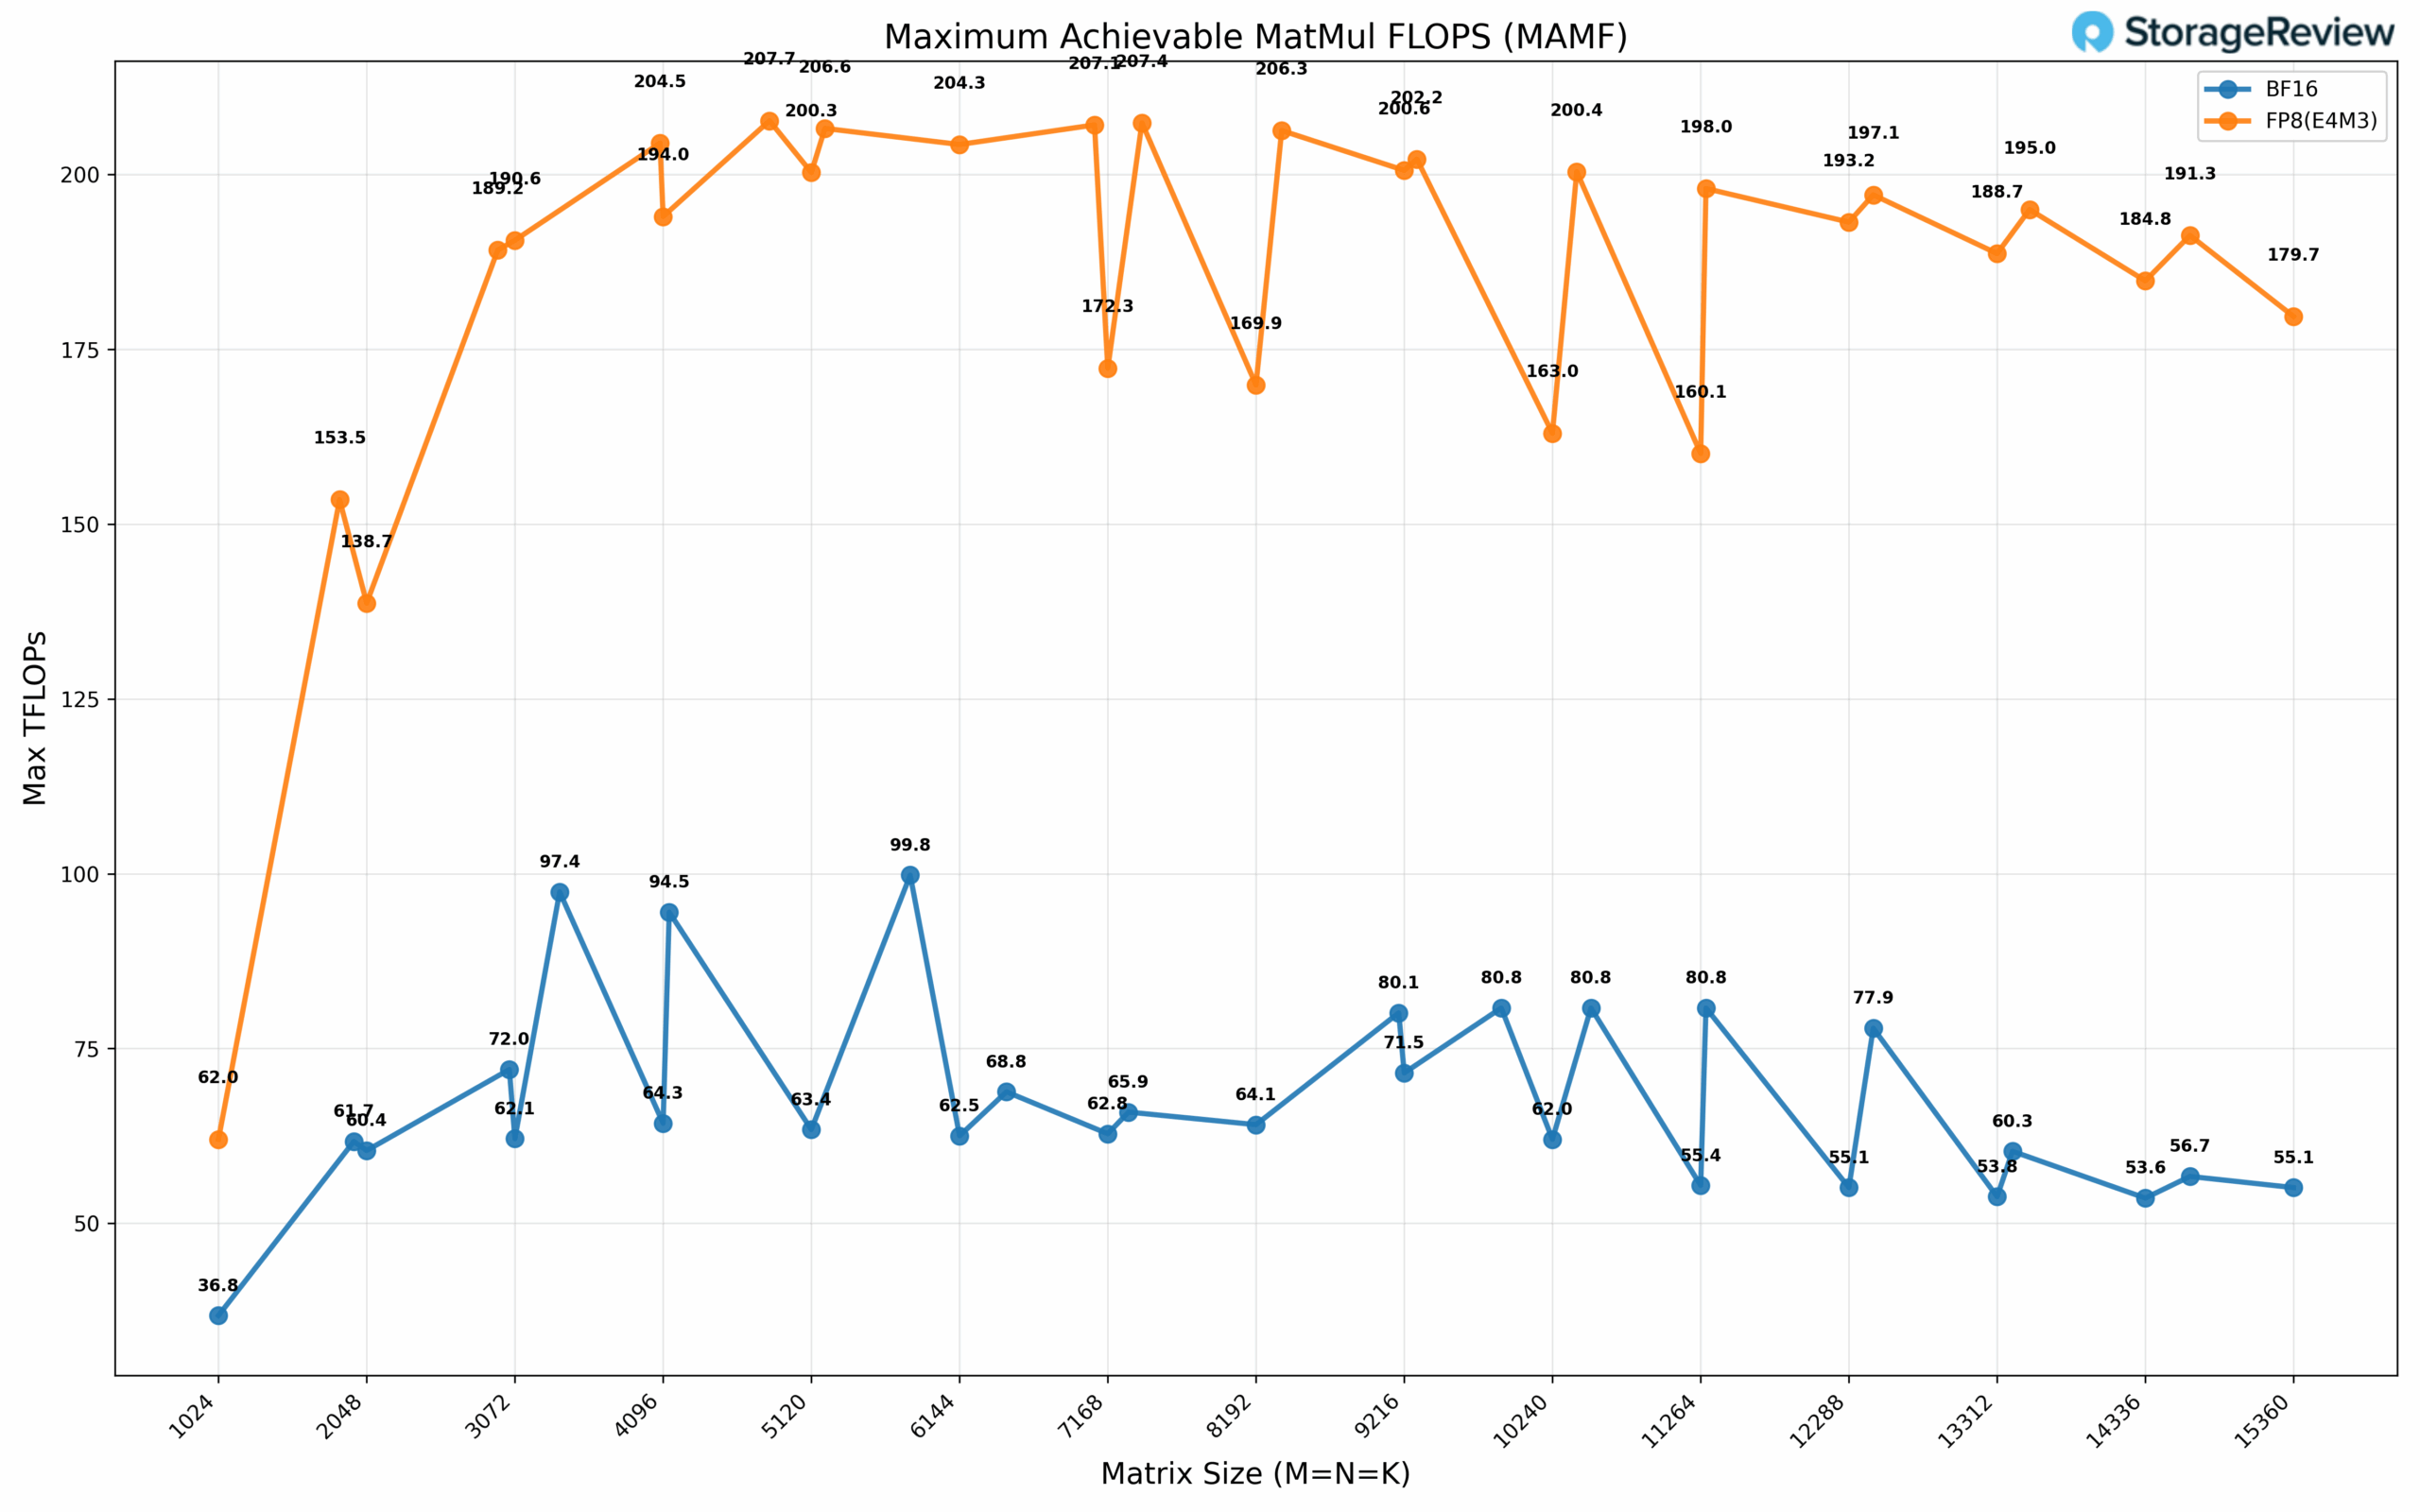
Pri presnosti BF16 pozorujeme MAMF 99.8 TFLOP, zatiaľ čo FP8 (E4M3) vykazuje MAMF 207.7 TFLOP. Kvôli časovým obmedzeniam sme neboli schopní vykonať komplexnú charakterizáciu MAMF FP4; extrapoláciou z pozorovaných vzorcov škálovania založených na presnosti však očakávame dodatočný 2-násobný nárast výkonu oproti FP8, čo prináša približne 400 TFLOP pre husté operácie FP4. Pri zohľadnení štruktúrovanej optimalizácie riedkosti 2:1 sa to premieta do zhruba 80 % teoretických výkonnostných možností FP4, pričom sa dosahuje približne 800 TFLOP pri riedkom výpočtovom zaťažení. Je dôležité poznamenať, že tieto merania MAMF môžu byť pod teoreticky inzerovanými špecifikáciami z mnohých dôvodov, ktorými sa v tejto recenzii nebudeme zaoberať.
Priame úložisko GPU
Jedným z testov, ktoré sme vykonali na Spark, bol test MagnumIO GPU Direct Storage (GDS). GDS je funkcia vyvinutá spoločnosťou NVIDIA, ktorá umožňuje grafickým procesorom obísť CPU pri prístupe k údajom uloženým na diskoch NVMe alebo iných vysokorýchlostných úložných zariadeniach. Namiesto smerovania údajov cez CPU a systémovú pamäť umožňuje GDS priamu komunikáciu medzi grafickým procesorom a úložným zariadením, čím sa výrazne znižuje latencia a zlepšuje priepustnosť dát.
Ako funguje priame úložisko GPU
Tradične, keď grafická karta (GPU) spracováva dáta uložené na disku NVMe, musia dáta najprv prejsť cez procesor (CPU) a systémovú pamäť, než sa dostanú k grafickej karte (GPU). Tento proces spôsobuje úzke miesta, pretože procesor sa stáva sprostredkovateľom, čo zvyšuje latenciu a spotrebúva cenné systémové zdroje. Priame úložisko (GPU Direct Storage) eliminuje túto neefektívnosť tým, že umožňuje grafickej karte pristupovať k dátam priamo z úložného zariadenia cez zbernicu PCIe. Táto priama cesta znižuje réžiu spojenú s pohybom dát, čo umožňuje rýchlejší a efektívnejší prenos dát.
Pracovné zaťaženie umelej inteligencie, najmä tie, ktoré zahŕňajú hlboké učenie, je vysoko dátovo náročné. Trénovanie veľkých neurónových sietí vyžaduje spracovanie terabajtov dát a akékoľvek oneskorenie v prenose dát môže viesť k nedostatočnému využitiu grafických procesorov (GPU) a dlhším časom trénovania. Priame úložisko GPU rieši túto výzvu tým, že zabezpečuje čo najrýchlejšie doručenie dát do GPU, minimalizuje čas nečinnosti a maximalizuje výpočtovú efektivitu.
Okrem toho je GDS obzvlášť výhodný pre pracovné zaťaženia, ktoré zahŕňajú streamovanie veľkých súborov údajov, ako je spracovanie videa, spracovanie prirodzeného jazyka alebo inferencia v reálnom čase. Znížením závislosti od CPU GDS zrýchľuje pohyb údajov a uvoľňuje zdroje CPU pre iné úlohy, čím ďalej zvyšuje celkový výkon systému.
GDSIO – Interný 4 TB M.2
NVIDIA DGX Spark má zaujímavú voľbu úložiska. Z hľadiska veľkosti vo vnútri malej skrinky sa NVIDIA rozhodla pre menej bežný SSD Gen5 2242 M.2. Pre čitateľov, ktorí nie sú s týmto typom SSD oboznámení, ide o kratšiu 42 mm verziu v porovnaní s 80 mm, ktorá je bežnejšia v oblasti stolových počítačov. Existuje menej možností diskov, pričom 4 TB je najvyššia kapacita v tejto veľkosti. Hlavným problémom je však výkon. Malé SSD disky, ako sú modely 2242 a 2230, uprednostňujú rozmery, pričom rýchlosť disku zohráva druhoradú úlohu. Sú bežné v prenosných herných konzolách, tabletoch a niektorých notebookoch.
Na doske plošných spojov SSD 2230 a 2242 nie je veľa miesta, čo má za následok menej miesta pre ovládače, DRAM a NAND puzdrá. Niektoré z týchto kompromisov sme pozorovali počas nášho testovania. Pri použití našej záťaže GDSIO v priestore s kapacitou 1 TB alebo 128 GB sa SSD zasekával a vyžadoval si preprogramovanie obrazu disku Spark. Zníženie testovacej kapacity na 64 GB, ako aj zníženie vyššieho počtu vlákien, tento problém vyriešilo. Tieto problémy sa vo všeobecnosti nevyskytujú pri bežnejších vysokovýkonných 80 mm SSD diskoch.
Pri pohľade na výkon sekvenčného čítania interného disku vidíme najvyššiu priepustnosť pri veľkosti bloku 1 MB so 16 vláknami, čo dosahuje 11.4 GiB/s.
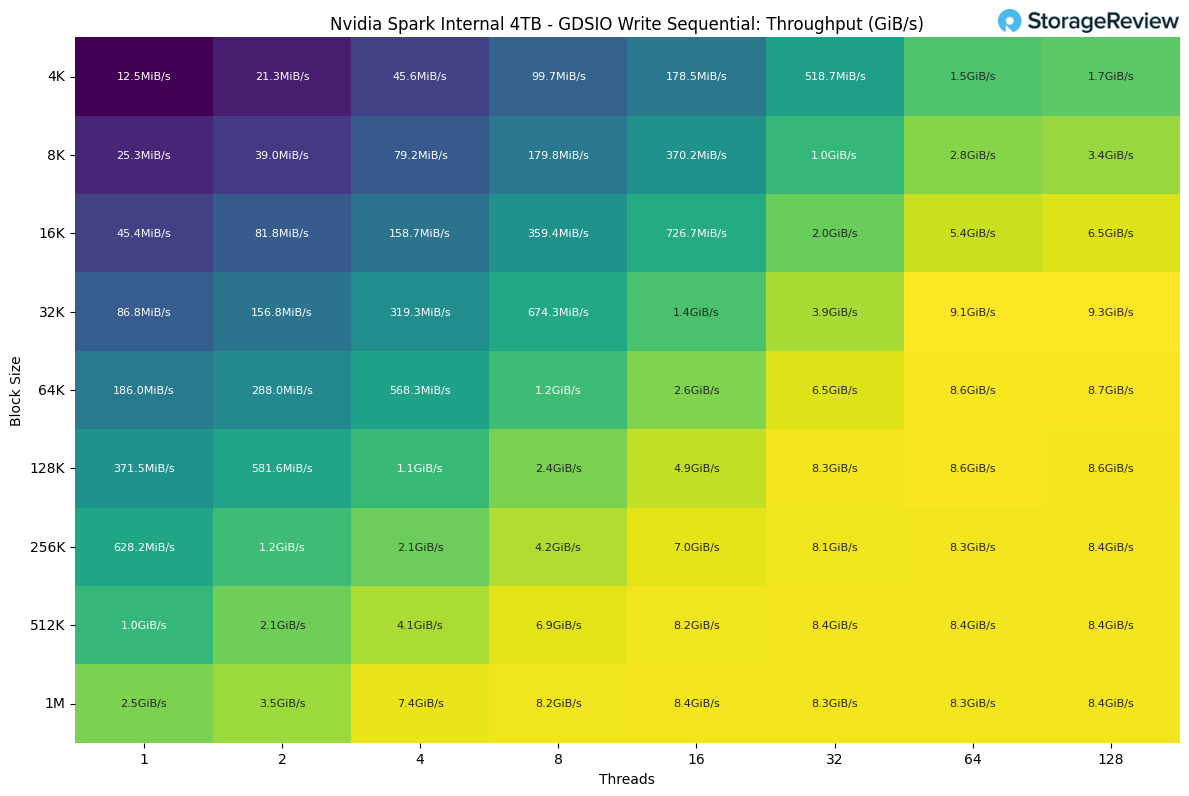
Pri pohľade na výkon sekvenčného zápisu dosahuje disk najvyššiu priepustnosť pri veľkosti bloku 32 kB so 128 vláknami. Pri väčších veľkostiach blokov sa výkon zdá byť stabilný, v priemere okolo 8.3 GiB/s.
Pre kupujúcich, ktorí chcú kúpiť NVIDIA DGX Spark na náročnejšie vývojové práce, najmä pre firmy, ktoré by z nich mohli vytvárať malé klastre, dôrazne odporúčame využiť integrovanú 200Gb sieťovú kartu NVIDIA ConnectX-7.
GDSIO – NVMe-oF cez RDMA
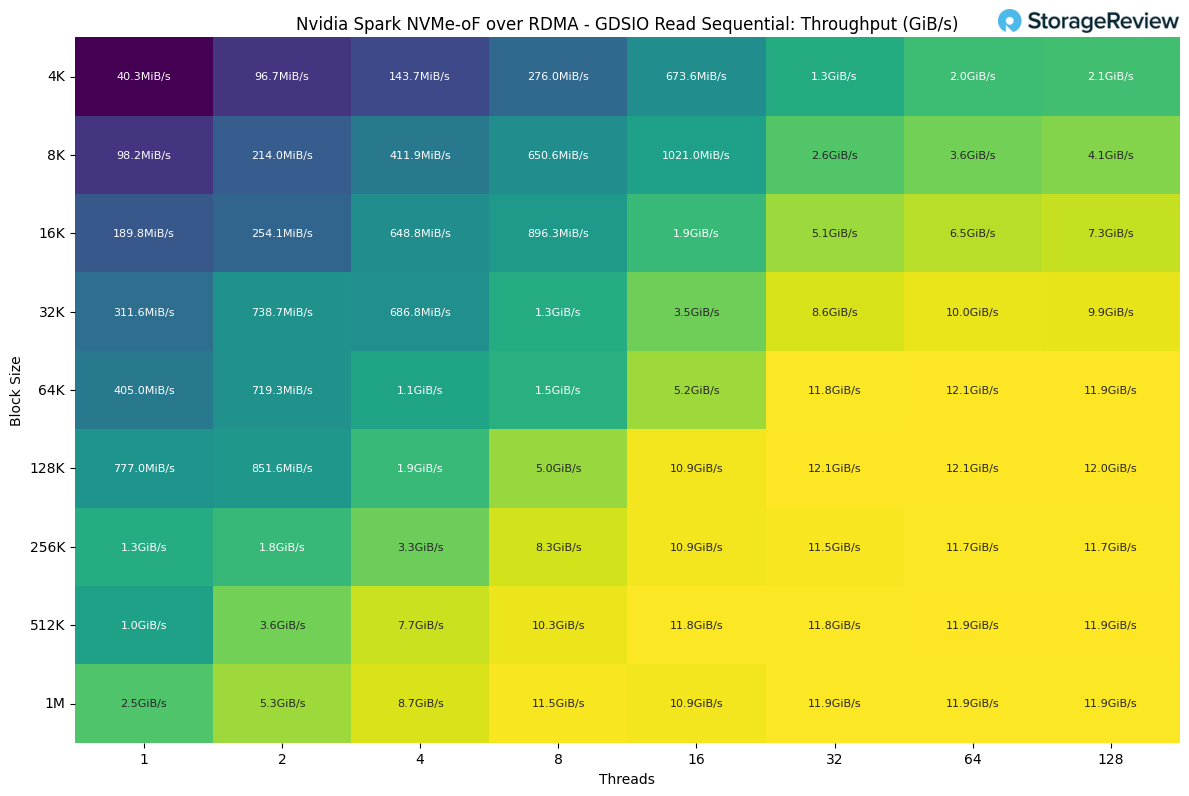
Na testovanie NVMe-oF RDMA s NVIDIA DGX Spark sme použili softvér PEAK:AIO na vytvorenie cieľa NVMe-oF na serveri Dell PowerEdge R770 so šiestimi SSD diskami Micron 9550 s kapacitou 3.84 TB a pripojením cez RDMA. Ako sme už spomenuli, sieťová karta CX7 v Spark má svoje zvláštnosti a kvôli časovým obmedzeniam sme mohli Spark testovať iba so 100G pripojením. Spark aj PEAK:AIO dokážu dosiahnuť výrazne vyššie čísla. V ďalších častiach vykonáme ďalšie testovanie úložiska a siete so Sparkom.
Pri pohľade na výkon sekvenčného čítania interného disku vidíme najvyššiu priepustnosť pri veľkosti bloku 128 kB s 32 vláknami, čo dosahuje 12.1 GiB/s.
Pri pohľade na výkon sekvenčného zápisu dosahuje disk najvyššiu priepustnosť pri veľkosti bloku 128 kB so 16 vláknami. Pri väčších veľkostiach blokov sa výkon zdá byť stabilný, v priemere okolo 11.3 GiB/s.
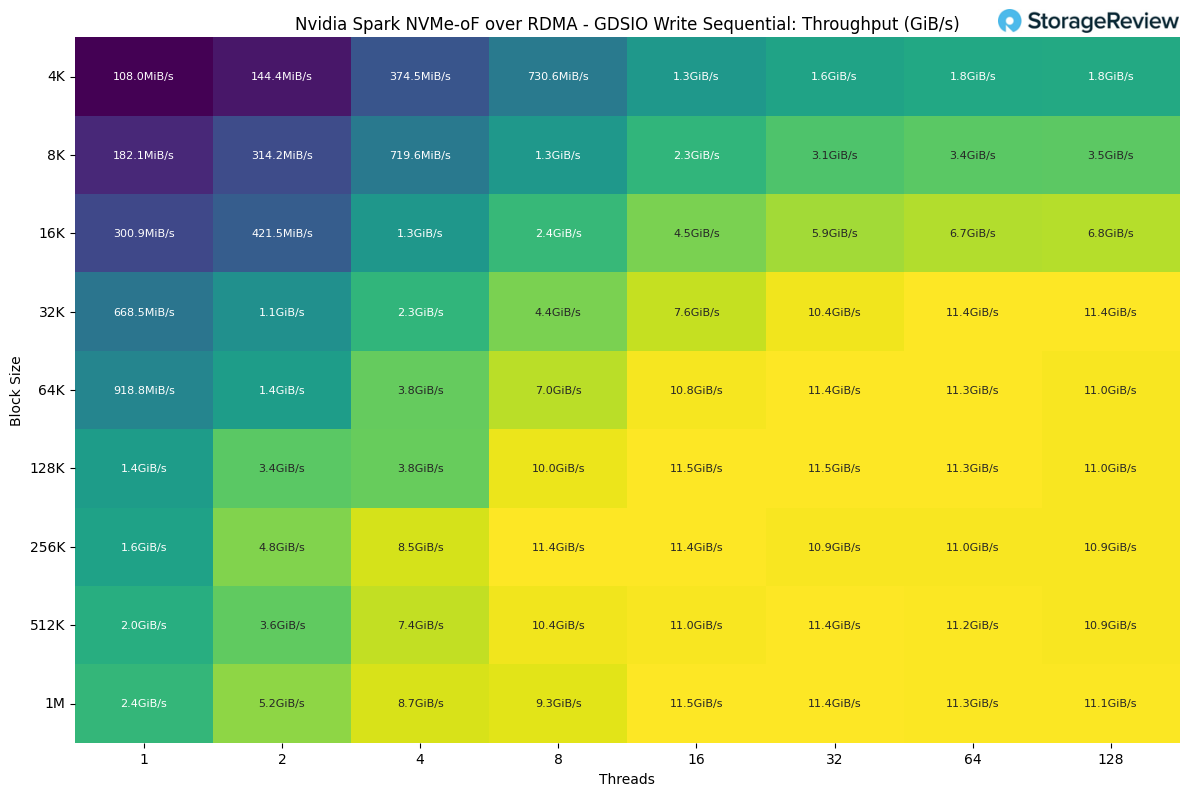
Tieto výsledky majú veľa odchýlok, vidíme iba polovicu teoretického maxima z už spomínaných dôvodov súvisiacich s časom a sieťou. Okrem toho je najvyššia priepustnosť pri veľkosti bloku 128 kB ovplyvnená viacerými faktormi, ako sú napríklad podnikové disky, ktoré sme použili, alebo ako PEAK:AIO spracováva tento vstup/výstup. Vaša priepustnosť sa môže líšiť a v budúcnosti plánujeme urobiť viac prostredníctvom testovania so Sparkom.
Softvérový ekosystém prvého dňa
NVIDIA a ďalší dodávatelia značne investovali do pripravenosti softvéru, čo je výrazný odklon od typických hardvérových spustení, kde sa prví používatelia stretávajú s neúplnou dokumentáciou a chýbajúcimi nástrojmi. Spark uvádza na trh komplexné príručky pokrývajúce bežné pracovné postupy: ComfyUI pre difúzne modely, TRT-LLM pre optimalizovanú inferenciu, Ollama s Open WebUI pre lokálne poskytovanie modelov, Unsloth pre jemné doladenie a multiagentové architektúry s LangGraph.
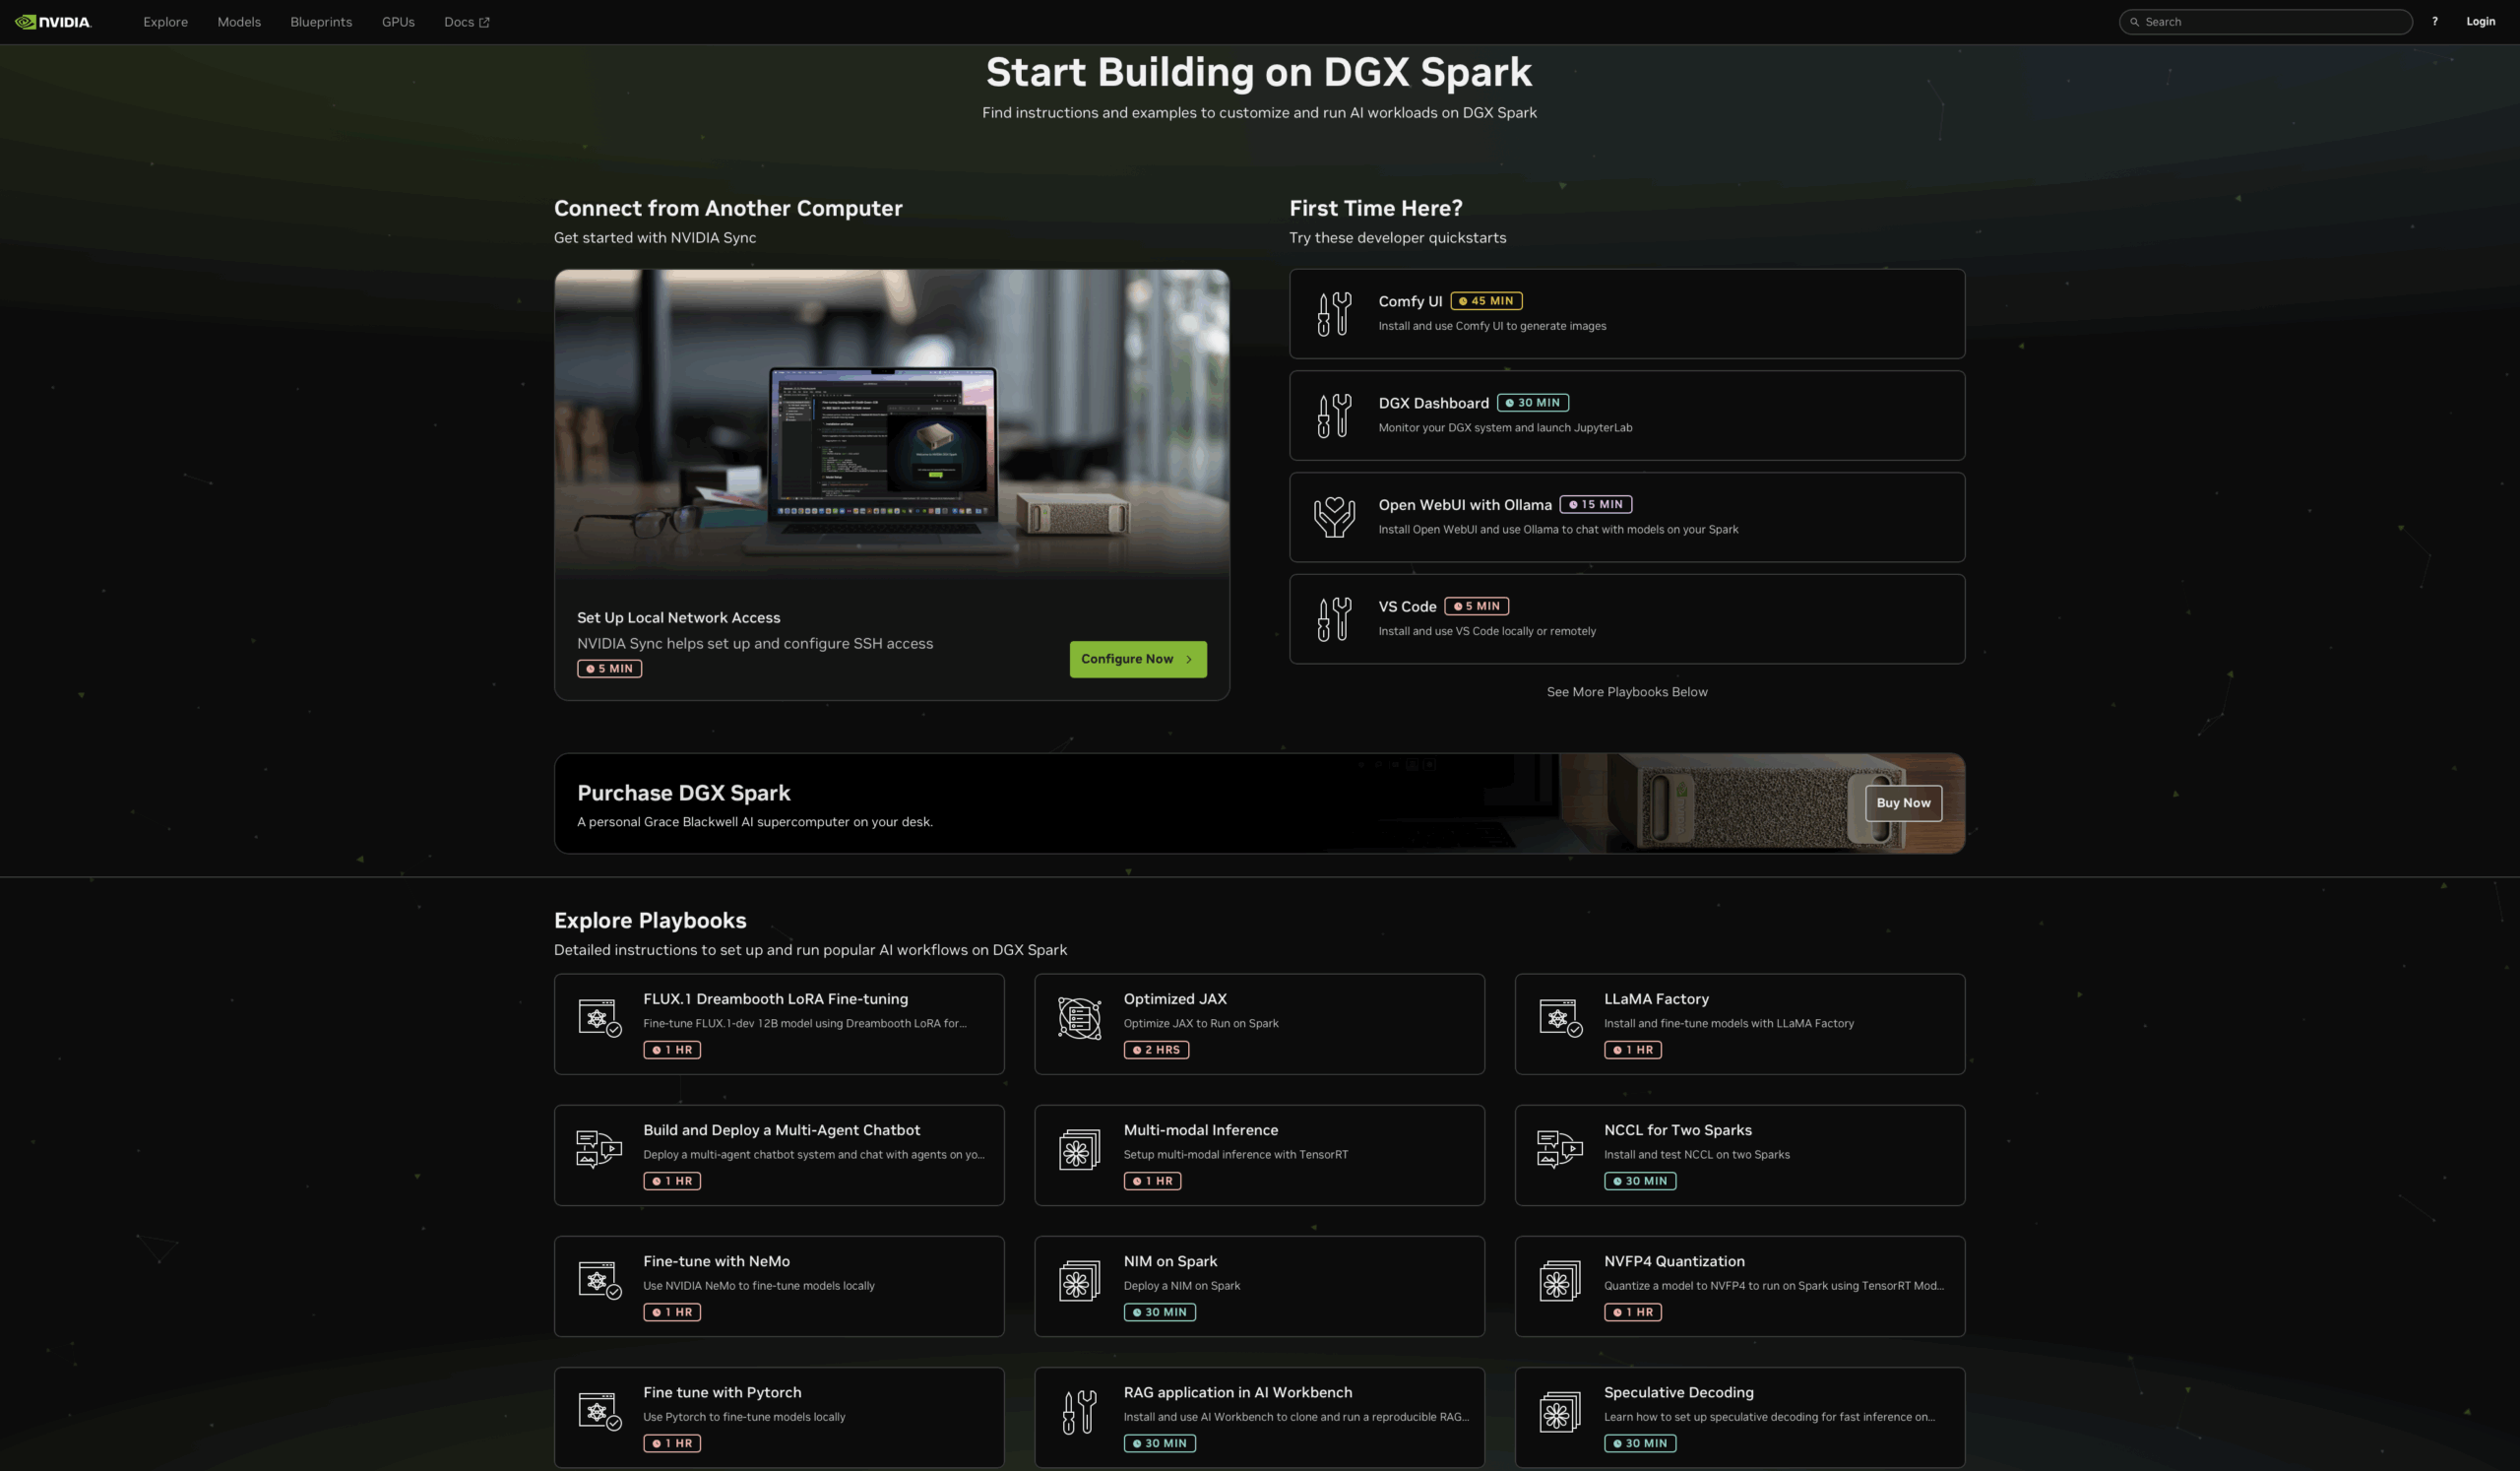
Táto vyspelosť softvéru transformuje proces hodnotenia. Namiesto toho, aby vývojári trávili dni konfiguráciou prostredí, môžu okamžite posúdiť, či Spark spĺňa ich požiadavky spustením reprezentatívnych pracovných záťaží. Playbooky poskytujú nielen inštrukcie, ale aj kontajnerizované prostredia, vzorové súbory údajov a očakávané metriky výkonu.
Dostupnosť a OEM systémy
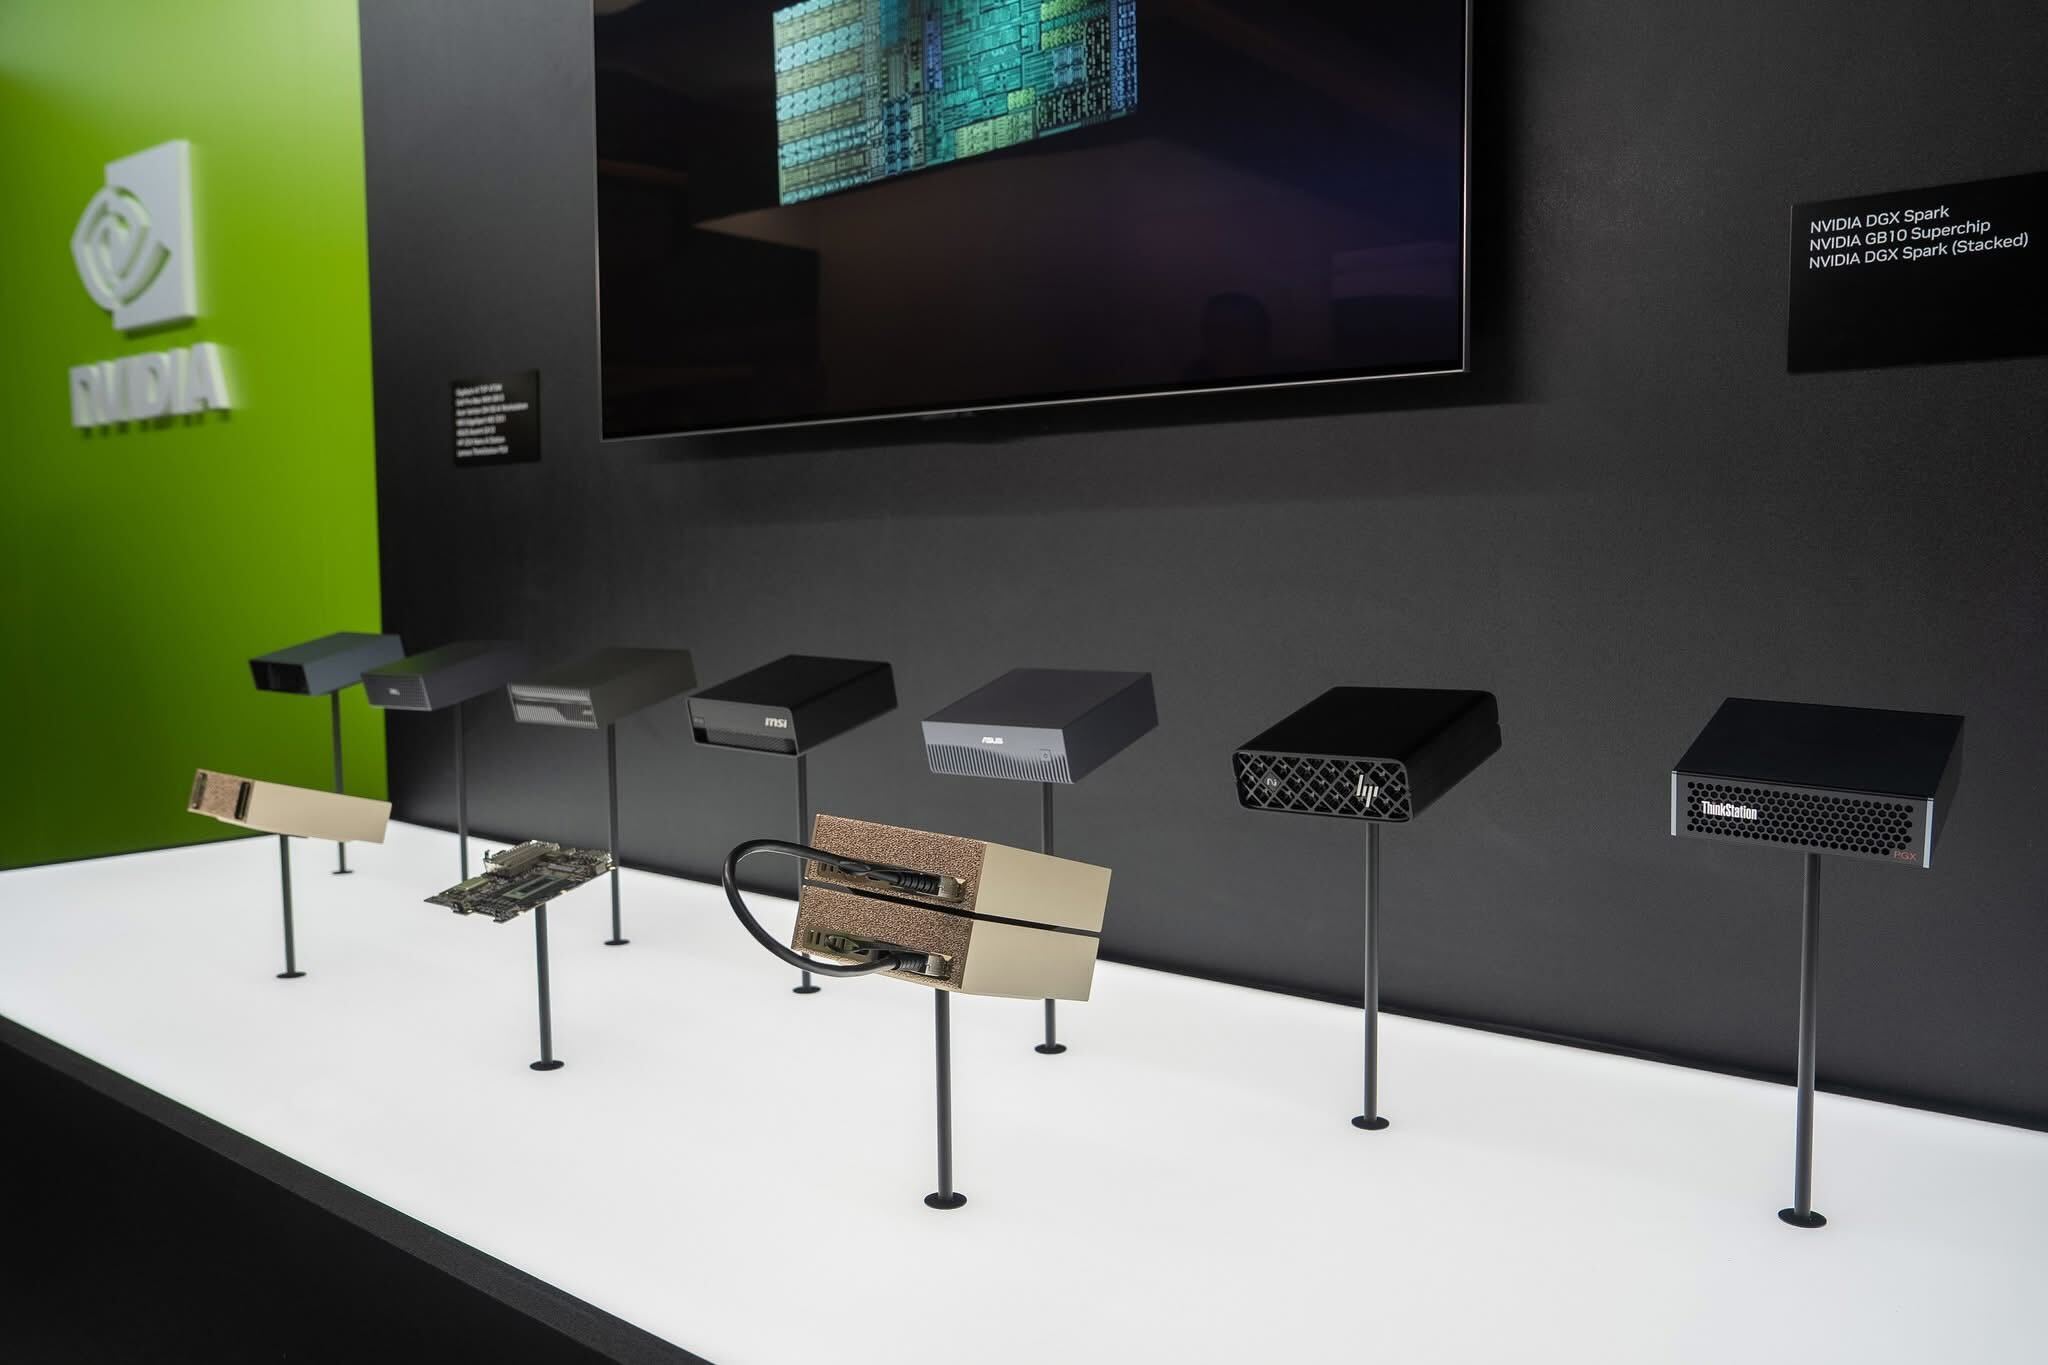
Edícia Founders od spoločnosti NVIDIA je k dispozícii na objednanie za 3 999 dolárov v konfigurácii 4 TB a všeobecná dostupnosť začína 15. októbra. Popri vlastnej jednotke od NVIDIA prichádza od veľkých výrobcov OEM aj niekoľko stolových počítačov s procesorom GB10. Základný hardvér bude u všetkých výrobcov OEM dosť podobný, ale môže existovať malý priestor na manévrovanie, aby sa od seba odlišovali, hoci väčšina cenových rozdielov bude pravdepodobne prameniť z výberu úložiska. Už sme videli mnoho oznámení, vrátane Dell Pro Max s procesorom GB 10, Lenovo ThinkStation PGX, Acer Veriton GN100 a ASUS Ascent GX10.
Zdroj: Nvidia
Záver
NVIDIA DGX Spark predstavuje zásadný inflexný bod v paradigme prístupnosti pokročilej infraštruktúry výpočtovej techniky s umelou inteligenciou. Konsolidáciou schopností superčipu GB10 Grace Blackwell: 128 GB unifikovanej pamäte, výkonu 1 petaFLOP FP4, jadier štvrtej generácie RT a siete ConnectX-7 do 240W zariadenia s objemom 1.13 litra za cenu 3 999 dolárov, spoločnosť NVIDIA efektívne zbúrala bariéry, ktoré historicky oddeľovali schopnosti umelej inteligencie na úrovni dátových centier od jednotlivých výskumníkov a malých vývojových tímov.
Validovaný prístup k zariadeniu rieši pretrvávajúci problém pri nasadzovaní infraštruktúry umelej inteligencie: prevádzkové náklady spojené s údržbou vlastných konfigurácií. Organizácie nasadzujúce jednotky Spark profitujú z komplexného testovania a validácie celého balíka spoločnosťou NVIDIA vrátane operačného systému DGX, sady nástrojov CUDA, kontajnerov frameworku a hardvérového firmvéru, čím eliminujú konfiguračný dlh, ktorý trápi zostavovanie vlastných pracovných staníc. Integrovaná správa aktualizácií, monitorovanie systému a poskytovanie JupyterLab v rámci dashboardu DGX ďalej znižujú prevádzkovú záťaž, zatiaľ čo automatická distribúcia kľúčov SSH a správa tunelov v rámci funkcie NVIDIA Sync robia vzdialený prístup skutočne bezproblémovým. Pre škálovateľné organizácie sa to premieta do merateľne rýchlejšieho nástupu: noví výskumníci dostanú štandardizovaný hardvér, pripoja sa k existujúcej infraštruktúre prostredníctvom validovanej konfigurácie klastrovania s dvoma uzlami a začnú produktívnu prácu v priebehu niekoľkých hodín namiesto dní od riešenia problémov s konfliktmi ovládačov alebo konfiguráciou sieťovej štruktúry.
DGX Spark už teraz poskytuje skutočný výkon umelej inteligencie v kompaktnom a tichom zariadení a naše prvé výsledky ukazujú, prečo je dôležitý pre tímy, ktoré chcú seriózne možnosti bez réžie dátového centra. Príbeh sa len začína. Plánujeme rozšíriť naše testovanie o 200G fabric, ciele NVMe-oF a viacuzlové klastrovanie, aby sme preskúmali efektívnosť škálovania, väčšie rozmery modelov a architektúry zdieľaného úložiska. S dozrievaním softvérového a partnerského ekosystému očakávame, že nasadenia Spark sa vyvinú z výkonných jednouzlových konfigurácií na úzko integrované, vysoko výkonné mini klastre, ktoré túto platformu ďalej vylepšia.
Rebríček: NVIDIA DGX Spark sa umiestnil v kategórii Najlepší celkový systém s umelou inteligenciou pre stolné počítače v našom rebríčku Najlepšie stolné počítače pre lokálnu umelú inteligenciu .
Rebríček: Pokyny na dimenzovanie pre túto triedu systémov nájdete v našom sprievodcovi RAM, GPU a úložiskom pre Agentic AI.


 Amazonka