

Amazon Web Services och NVIDIA har tillkännagivit en större utökning av sina gemensamma infrastrukturinitiativ och redogör för planer på att driftsätta ytterligare 2 miljoner NVIDIA GPU:er i AWS datacenter mellan 2027 och 2028. Det utökade samarbetet bygger på ett 16-årigt ingenjörssamarbete och riktar sig mot heltäckande skalning av AI-infrastruktur, vilket omfattar acceleratorkapacitet, värd-CPU-arkitekturer, sammankopplingar med hög bandbredd, statliga driftsättningar och accelererade databehandlingspipelines.
”Kunderna vill ha friheten att välja de bästa verktygen för sina AI-arbetsbelastningar, och de vill ha förtroende för att allt fungerar sömlöst tillsammans”, säger Matt Garman, VD för AWS. Jensen Huang, grundare och VD för NVIDIA, sa att de två företagen ”har byggt en av de stora tillväxtmotorerna i AI-eran, och efterfrågan överträffar alla prognoser”, vilket pekar på en expansion som omfattar GPU:er, processorer, nätverk, öppna modeller och programvara för att få agentisk och fysisk AI att fungera i stor skala.
Skalade GPU-distributioner och EC2 G7-instanser
Den fleråriga utrullningen kommer att integrera 2 miljoner NVIDIA Blackwell Ultra-, Rubin- och Rubin Ultra-grafikprocessorer i AWS Global Infrastructure, specifikt utformad för att driva stora AI-fabriker som hanterar distribuerad utbildning, vetenskaplig simulering, företagsautomation och agentiska arbetsflöden.
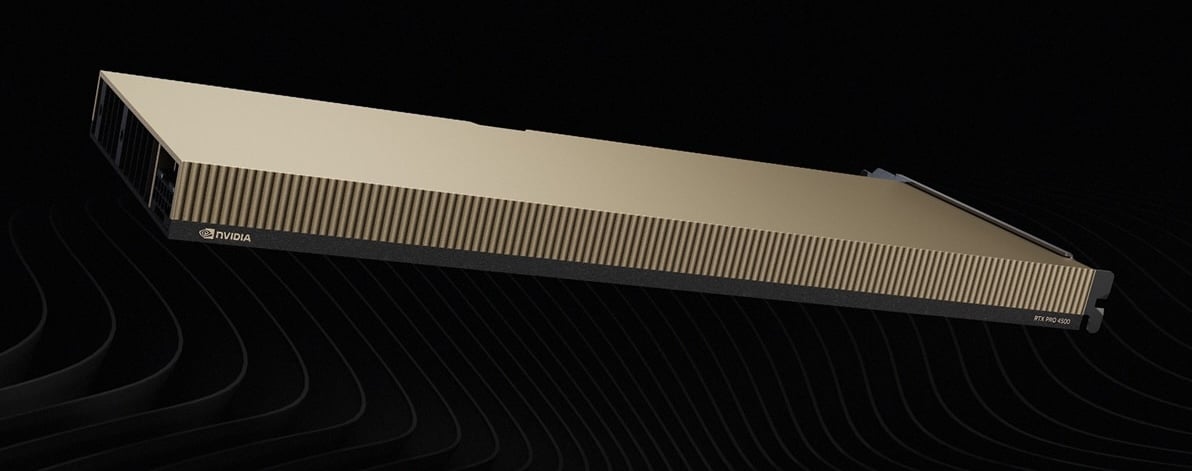
AWS utökar också sin nuvarande generations Blackwell-grafikkortsflotta genom att introducera NVIDIA RTX PRO 4500 Blackwell Server Edition-grafikkort i Amazon EC2 G7-instanser. AWS är den första stora molnleverantören som erbjuder instanser accelererade av RTX PRO 4500, vilket ger upp till 4.6 gånger högre AI-inferensprestanda och 2.1 gånger högre grafikgenomströmning jämfört med föregående generations EC2 G6-instanser. För att bibehålla klusteromfattande genomströmning och låg latens över dessa högdensitetsnoder samarbetar företagen kring NVIDIA Spectrum-nätverksoptimeringar skräddarsydda för stora GPU-träningskluster.
NVIDIA Vera-processorer och NVLink Fusion med anpassad HBM
För att möta beräkningskraven för agentbaserade AI-arbetsbelastningar med flera steg samarbetar AWS och NVIDIA för att erbjuda NVIDIA Vera CPU -baserad infrastruktur till AWS. NVIDIA beskriver Vera som specialbyggd för nästa generations AI, vilket ger AWS-kunder ett högpresterande CPU-alternativ tillsammans med accelererad infrastruktur och kompletterar AWS strategi att erbjuda det bredaste möjliga utbudet av beräkningar, från egenutvecklade kisel till partner-CPU:er och acceleratorer.
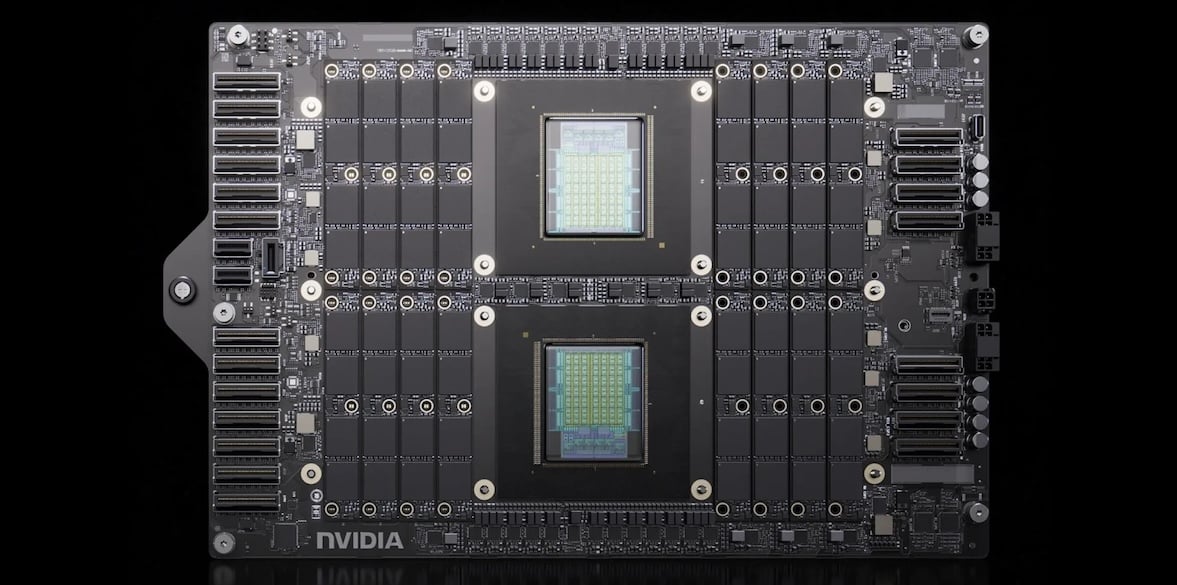
Inom området sammankoppling och minne utökar NVIDIA och Amazons Annapurna Labs sitt partnerskap kring NVIDIA NVLink Fusion. Ursprungligen introducerades NVLink Fusion för nästa generations AWS Trainium-processorer, men nu paras den ihop med NVIDIAs anpassade högbandbreddminnesteknik (NVHBM) i samarbete med minnesleverantörer. NVIDIA säger att kombinationen skulle ge Trainium tillgång till snabbare, mer energieffektivt minne, vilket gör det möjligt för Annapurna Labs att kombinera Trainium-kisel och NVIDIA-GPU:er i en delad, skalbar rackarkitektur.
Dedikerade AI-fabriker för federala och nationella säkerhetsarbetsbelastningar
För den statliga sektorns behov utvecklar AWS och NVIDIA tillsammans dedikerade AI-fabriker utrustade med 100 000 grafikkort, distribuerade över isolerad, säker AWS-infrastruktur. Miljön är konstruerad för att stödja känsliga arbetsbelastningar från federala myndigheter och försvar, och ger efterlevnad och driftssäkerhet för klassificeringar på Impact Level 6 (IL6) och högre.
Kärnplattformsintegrationer: Nitro, databehandling och robotik
Den utökade alliansen fortsätter att utnyttja befintliga tekniska kärnintegrationer i hela AWS-stacken:
- AWS Nitro-system och EFA: Alla NVIDIA GPU- och Trainium-baserade EC2-instanser förlitar sig på AWS Nitro System för avlastad virtualisering och hårdvarusäkerhet, i kombination med Elastic Fabric Adapter (EFA)-nätverk för att leverera skalbar sammankoppling med låg latens och linjehastighet.
- Hanterade öppna modeller: NVIDIA Nemotrons öppna modellfamilj är fortfarande integrerad i AWS och erbjuds som fullständigt hanterade, serverlösa slutpunkter på Amazon Bedrock och som anpassningsbara grundmodeller på Amazon SageMaker.
- Hårdvaruaccelererad analys och sökning: Amazon EMR använder Amazon EC2 G7-instanser och NVIDIA cuDF-biblioteket för att leverera upp till 3.7 gånger snabbare databehandlingshastighet och en 30-procentig förbättring av pris-prestanda jämfört med standard CPU-konfigurationer. Dessutom utnyttjar Amazon OpenSearch Service dedikerade GPU:er via NVIDIA CUDA-X cuVS-bibliotek för vektorindexering, vilket ger upp till 9 gånger snabbare indexbyggtider till ungefär 1/4 av infrastrukturkostnaden för hanterade och serverlösa distributioner.
- Fysisk AI och robotautomation: Amazon Robotics införlivar NVIDIAs fysiska AI-portfölj, som omfattar NVIDIA Jetson edge computing-moduler, Omniverse-simuleringsbibliotek och Isaac-robotplattformen. Denna pipeline, som körs på GPU-accelererade EC2-instanser, stöder storskalig syntetisk datagenerering, simulering, robotträning, ruttoptimering, funktionell säkerhet och real-to-sim-validering för automatiserade lagersystem.


 Amazon