

Cloudera har introducerat Cloudera Anywhere Cloud , en hybrid data- och AI-plattform konstruerad för att bygga, driftsätta och skala produktionsklassade arbetsbelastningar över publika moln, suveräna miljöer och privat lokal infrastruktur. Plattformen kan fungera som en fristående driftsättning eller integreras direkt i befintliga företagsdatasjöar. Den tillhandahåller ett centraliserat kontrollplan som levererar automatiserad hantering, modulär tjänsteleverans och enhetlig datastyrning utan att kräva datamigrering från lokala lagringsnivåer.
Arkitektonisk översikt och arbetsbelastningsmobilitet
Cloudera Anywhere Cloud använder en modulär, frikopplad arkitektur som separerar beräkningstjänster från underliggande lagringsinfrastruktur. Denna design gör det möjligt för tekniska team att distribuera oberoende analysmotorer, inklusive Apache Spark, Apache Kafka och Trino, tillsammans med anpassade motorer med öppen källkod eller tredjepartsmotorer via självbetjäningsritningar för marknadsplatser. Systemet kopplar samman dessa distribuerade beräkningsmotorer över heterogen infrastruktur med hjälp av standard-API:er, Apache Icebergs öppna tabellformat och Polaris-katalogen, vilket eliminerar proprietära dataformat och anpassade integrationskostnader.
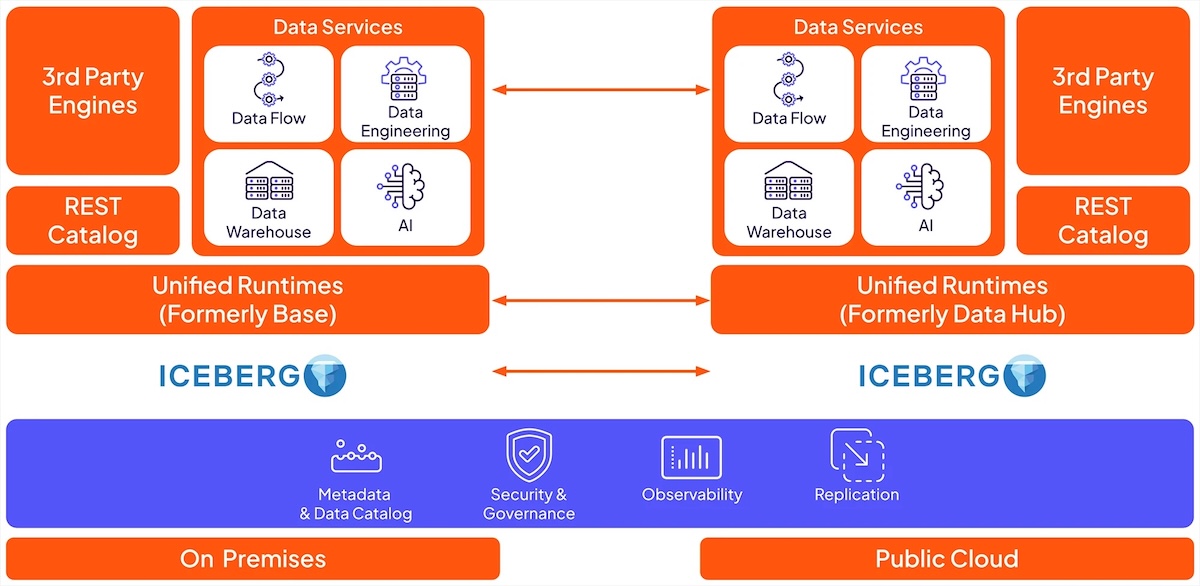
Flaskhalsar i infrastrukturprestanda och komplexa krav på datalagring stoppar ofta företags AI-pipelines när de övergår från pilotfaser till produktion. Cloudera hänvisar till färsk forskning som visar att 73 procent av IT-chefer anser att begränsningar i infrastrukturprestanda har hindrat operativa initiativ. Cloudera Anywhere Cloud åtgärdar denna operativa latens genom att underlätta lokaliserad arbetsbelastningsplacering. Applikationer körs där affärs-, regel- eller hårdvarukrav kräver det, vilket eliminerar behovet av att replikera eller överföra stora datamängder mellan olika miljöer.
Styrning, agentautomation och kontroll
Plattformen innehåller inbyggda säkerhetskontroller med noll förtroende över distribuerad lagring och beräkningsnoder. Detta ramverk upprätthåller datalinje, åtkomstgränser och kontinuerlig efterlevnad över suveräna, privata och publika molnnivåer. Distributioner ärver automatiskt befintliga företagsstyrningspolicyer för att bevara datasuveränitet och immateriella rättigheter.
För att förenkla den dagliga verksamheten har Cloudera integrerat en agentisk copilot i kontrollgränssnittet. Copiloten översätter instruktioner på naturligt språk till körbara operativa uppgifter, såsom att starta beräkningsmotorer, konfigurera infrastrukturresurser och orkestrera heltäckande datapipelines över anslutna miljöer.
”Företags-AI har vuxit ur den publika molnmodellen”, säger Leo Brunnick, produktchef på Cloudera. ”Organisationer borde inte behöva välja mellan innovation och kontroll. Cloudera Anywhere Cloud ger molnets hastighet och flexibilitet direkt till företagsdata. Detta gör det möjligt för företag att accelerera AI-initiativ samtidigt som de bibehåller fullständigt ägande av sina data och immateriella rättigheter, samtidigt som de optimerar kostnaden för sin infrastruktur, tokens och affärsmodeller.”
Lanseringen utökar Clouderas senaste satsning på infrastruktur, inklusive deras gemensamma AI-fabriksstack med VAST Data . Cloudera demonstrerar Cloudera Anywhere Cloud denna vecka på sitt EVOLVE-evenemang i Singapore.
GPU-accelererad Spark via NVIDIA cuDF
Parallellt med plattformslanseringen tillkännagav Cloudera native GPU-acceleration för Apache Spark 4.1 i Cloudera Data Engineering, byggt på NVIDIAs cuDF CUDA-X-bibliotek. cuDF-pluginet accelererar befintliga Spark-pipelines utan ändringar i PySpark- eller SQL-kod, vilket Cloudera positionerar som ett sätt att förbereda AI-klar data snabbare samtidigt som molnberäkningskostnaderna minskas, och det ingår i Cloudera Data Engineering som en del av Anywhere Cloud.


 Amazon