

På ISC 2026 tillkännagav DDN en bred expansion av sin portfölj av AI- och HPC-dataplattformar, genom att introducera nya hårdvaru-, mjukvaru- och plattformsfunktioner utformade för att förbättra GPU-utnyttjandet, accelerera AI-inferens och förenkla storskaliga implementeringar av AI-infrastruktur.
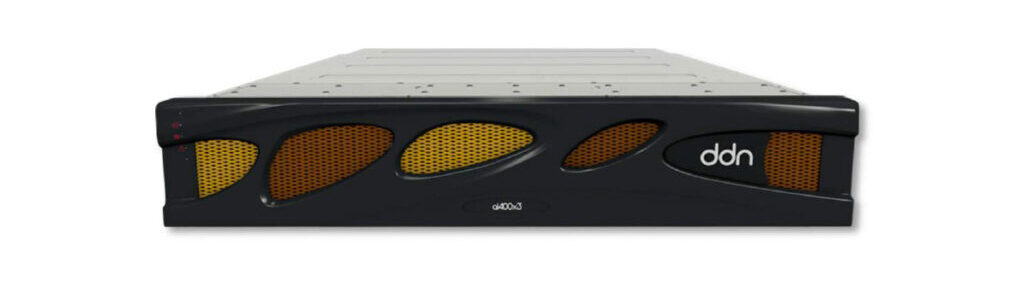
Tillkännagivandena inkluderar lagringsenheten AI400X3M, den allmänna tillgängligheten av DDN:s distribuerade KV Cache-accelerationsteknik integrerad med NVIDIA Dynamo , och nya säkerhets-, observerbarhets- och infrastrukturhanteringsfunktioner över företagets AI-dataplattformar.
DDN sa att uppdateringarna är avsedda att åtgärda flaskhalsar i hela AI-datapipelinen, inklusive dataförberedelse, modellträning, inferens, retrieval-augmented generation (RAG), resonemangsmodeller och agentbaserade AI-arbetsbelastningar. Företaget fokuserar på att förbättra infrastrukturens effektivitet genom att öka GPU-utnyttjandet samtidigt som strömförbrukningen och infrastrukturkostnaderna sänks.
DDN:s VD och medgrundare Alex Bouzari sa att modern AI-infrastruktur kräver mer än bara beräkningsresurser. Han betonade att effektiv datahantering, säkerhet och operativ insyn har blivit kritiska komponenter i AI-implementeringar i produktion, där företagets senaste utgåvor syftar till att förbättra GPU-effektiviteten, minska inferenskostnader och accelerera tiden till första token.
AI400X3M riktar sig mot AI- och HPC-prestandatäthet
I spetsen för tillkännagivandet står AI400X3M, den senaste apparaten byggd på DDN:s parallella filsystem EXAScaler.
AI400X3M Specifikationer
| Prestanda | |
| Sekventiell läsprestanda | Upp till 190 GB/s |
| Sekventiell skrivprestanda | Upp till 110 GB/s |
| Slumpmässig Läs IOPS | 8M |
| Systemegenskaper | |
| plattform | Nyckelfärdig EXAScaler delad parallell filsystemsenhet för AI med Active/Active-lagringskontroller |
| Värdportar per enhet | 4x XDR/400 GbE OSFP eller 8x NDR200/200GbE QSFP112 |
| Drive Support | 24x 2.5″ PCIe G5 NVMe med dubbla portar, kan bytas under drift |
| Kapacitetsalternativ | 120/250/500 TB och 1 PB/2 PB användbara |
| Standardfunktioner i den inbyggda programvaran | LUN-mappning och maskering, intelligent skrivstrimning, läs-QoS, kontroll/korrigering av dataintegritet, gränssnittsalternativ (CLI, GUI, Python API), utgående syslogg inklusive RELP-stöd, meddelanden om tillståndsändringar (via e-post och SNMP-fällor) |
| Säkerhet och efterlevnad | |
| Säkerhet | IEC/EN/UL/CSA 62368-1, GB4943 |
| EMC | EN 55032 Klass A, EN 55035, EN 61000-3-2, EN 61000-3-3, FCC Del 15 Klass A, VCCI Klass A, ICES-003 Klass A, GB/T9254 Klass A, BSMI Klass A |
| Miljö | RoHS, REACH, WEEE, ERP Lot9X |
| Fysiska attribut | |
| Formfaktor | 2U rackmontering |
| Mått | Höjd: 3.43 "(87mm) Bredd: 17.56 "(446mm) Djup: 856 mm utan ram; 895 mm totalt Justerbar rackskena: 26.75″ till 34.0″ (680–860 mm) |
| Vikt | 44 kg tom; max 49 kg |
| Kraft & Kyla | |
| Inspänning | 200–240V 50/60 Hz |
| Strömförsörjning | 2x redundanta, IEC60320-C20-ingångar, kan bytas under drift |
| Verksamhetsmiljö | |
| Temperaturintervall | 5 ° C till 30 ° C (41 ° F till 86 ° F) |
| Relativ fuktighet | 8% –80% icke-kondenserande |
| Höjd | 950 m vid 30 °C — 3,048 m vid 23 °C |
Plattformen levererar upp till 190 GB/s dataflöde och upp till 35 % högre läsprestanda än föregående generation. DDN stöder även konfigurationer som skalar upp till 30 PB inom ett enda rack, samtidigt som den lägger till hybriddiskstöd som kombinerar flash- och hårddisklagring för att balansera prestanda, kapacitet och kostnad.
Apparaten är utformad för AI-modellträning, inferens, kontrollpunkter, HPC-simulering och andra mycket parallella arbetsbelastningar där lagringskapaciteten direkt kan påverka GPU-utnyttjandet. Allmän tillgänglighet förväntas i slutet av tredje kvartalet 2026.
Distribuerad KV-cache nu allmänt tillgänglig
Efter en tidigare förhandsvisning av tekniken på NVIDIA GTC 2026 lanserade DDN officiellt sin distribuerade KV Cache-accelerationsarkitektur, som integrerar NVIDIA Dynamo. Funktionen är tillgänglig på både Infinias objektlagringsplattform och EXAScaler-filsystemet.
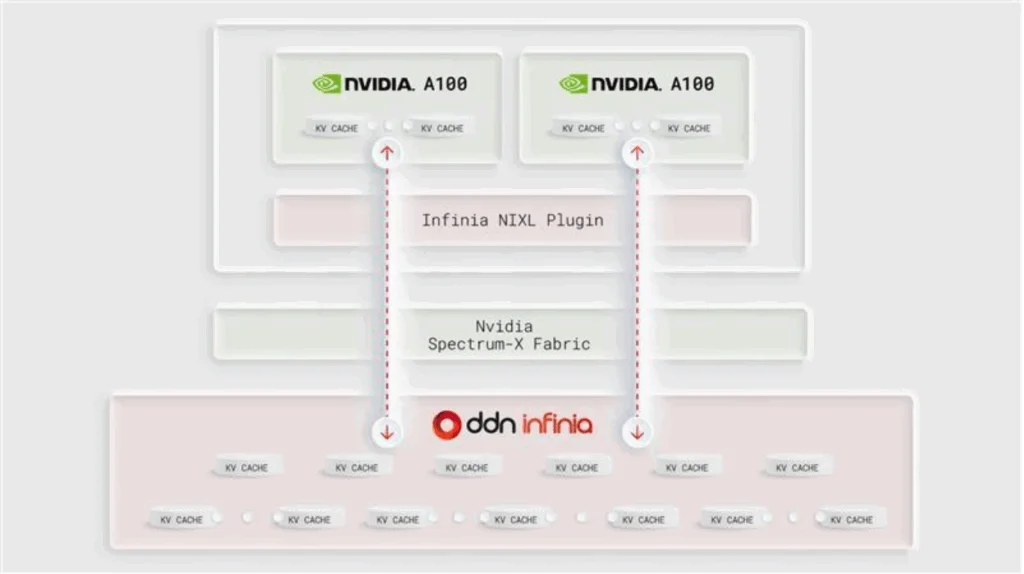
Istället för att förlita sig på lokalt GPU-minne för modellkontext lagrar och hämtar den distribuerade arkitekturen KV-cachedata från DDN:s dataplattform, vilket minskar minnesflaskhalsar under inferens.
DDN uppgav att plattformen stöder NVIDIA Dynamo, vLLM och andra moderna inferensramverk samtidigt som den möjliggör delad distribuerad KV-cache över flera inferensnoder. Företaget hävdar upp till 55 gånger snabbare KV-cacheladdning för storskaliga inferensarbetsbelastningar, tillsammans med förbättrad GPU-utnyttjande, snabbare tokengenerering och lägre infrastrukturkostnader för stora språkmodelldistributioner.
Tekniken är avsedd att gynna långkontextinferens, hämtningsutökad generering, resonemangsmodeller och agentiska AI-arbetsflöden som upprepade gånger får åtkomst till stora modellkontexter.
Enhetlig AI-datapipeline
DDN redogjorde också för sin bredare strategi att kombinera Infinia-objektlagring för inferens med EXAScaler för modellträning och kontrollpunkter under en enda AI-datainfrastruktur.
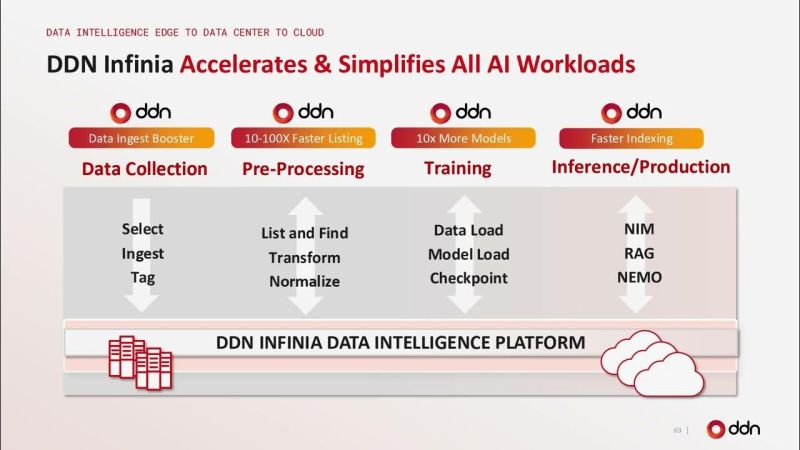
Företaget uppgav att Infinia tillhandahåller metadataoperationer med låg latens, hög samtidighet och objektprestanda optimerade för inferenstunga arbetsbelastningar, medan EXAScaler fortsätter att betjäna högpresterande träningsmiljöer. Tillsammans är plattformarna avsedda att eliminera datasilos och upprätthålla hög GPU-utnyttjandegrad under hela AI-livscykeln.
Nya säkerhets- och infrastrukturfunktioner
Ytterligare plattformsförbättringar fokuserar på krav på företagsimplementering, inklusive multitenancy på bare-metal-nivå, KMIP-baserad kryptering och nyckelhantering, VictoriaLogs-integration för operativ insyn och utökade API:er för flera hyresgäster.

På lagringssidan introducerade DDN intelligent filfäsning och NAND-accelererade Hot Pools, vilket gör att ofta åtkomna data kan finnas kvar på flashminnet samtidigt som kallare data automatiskt nivåeras till billigare hårddiskar. Företaget sa att dessa funktioner är utformade för att förbättra lagringseffektiviteten samtidigt som de minskar kraven på flashminneskapacitet.
Fortsatt expansion av molnbaserad AI
DDN lyfte också fram fortsatt användning av sina erbjudanden inom molnbaserad AI-infrastruktur, inklusive utvecklingen av Managed Lustre som aviserats med Google Cloud och en Salesforce-implementering som använder Google Cloud Managed Luster som drivs av EXAScaler.
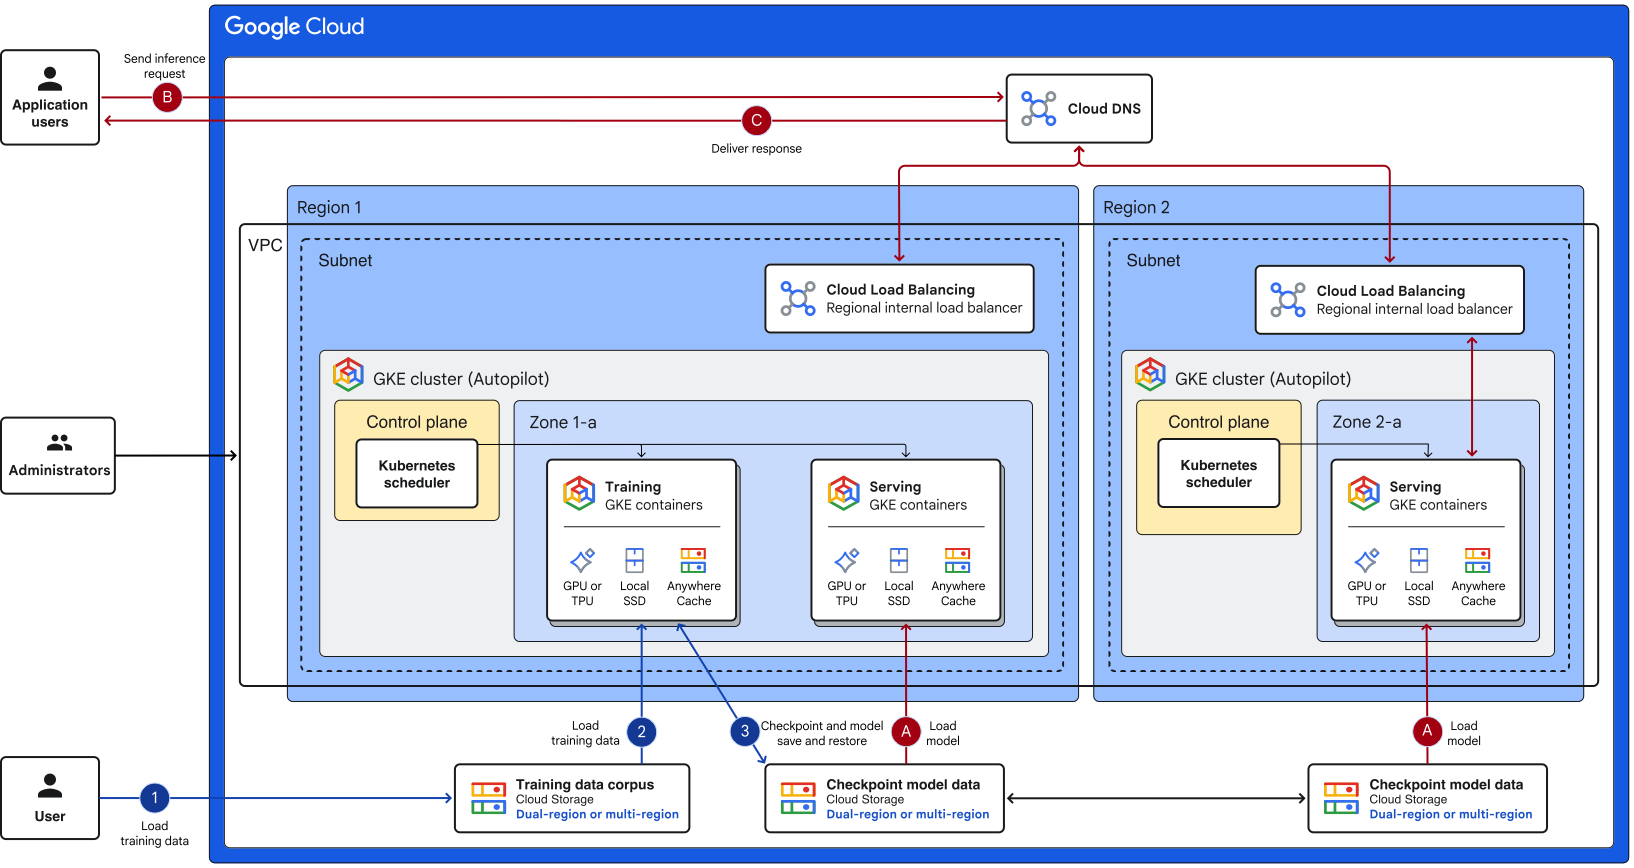
Enligt DDN uppnådde Salesforce-implementeringen 1.5 gånger snabbare modellträning, minskade I/O-latensen med 75 % och sänkte utbildningskostnaderna med 42 %, vilket visar effekten av att minska flaskhalsar i lagring i storskaliga AI-miljöer.
Med de senaste tillkännagivandena fortsätter DDN att utöka sin portfölj bortom parallell lagring till AI-dataorkestrering, inferensacceleration och infrastrukturhantering, och positionerar sina plattformar för att stödja företag, moln, forskning och suveräna AI-implementeringar som arbetar i stor GPU-skala.


 Amazon