

IBM introducerade en innehållsmedveten lagringsarkitektur (CAS) som integrerar AI-databehandling direkt i lagringslagret. Metoden riktar sig mot arbetsflöden för retrieval-augmented generation (RAG) genom att bädda in dokumentvektorisering i lagringssystemet, vilket minskar behovet av externa förbehandlingspipelines.
CAS flyttar en central RAG-funktion, dokumentinbäddning med hjälp av stora språkmodellbaserade tekniker, till lagringsinfrastrukturen. Detta gör det möjligt för företag att bearbeta och indexera data på plats, anpassa lagringssystem till AI-drivna arbetsbelastningar och minska dataförflyttningar mellan infrastrukturnivåer. IBM positionerar detta som ett sätt att förenkla distributionen samtidigt som prestanda och datalokalitet för AI-applikationer förbättras.
Vektordatabas i stor skala
I centrum för IBMs CAS-implementering finns en vektordatabas optimerad för semantisk sökning. Vektordatabaser stöder approximativ sökning efter närmaste granne, vilket gör det möjligt för AI-system att hämta relevanta datablock baserat på likhetsmått som cosinuslikhet eller L2-avstånd. Denna funktion är grundläggande för RAG, där användarfrågor konverteras till vektorer och matchas mot indexerad företagsdata för att ge kontextmedvetna svar.
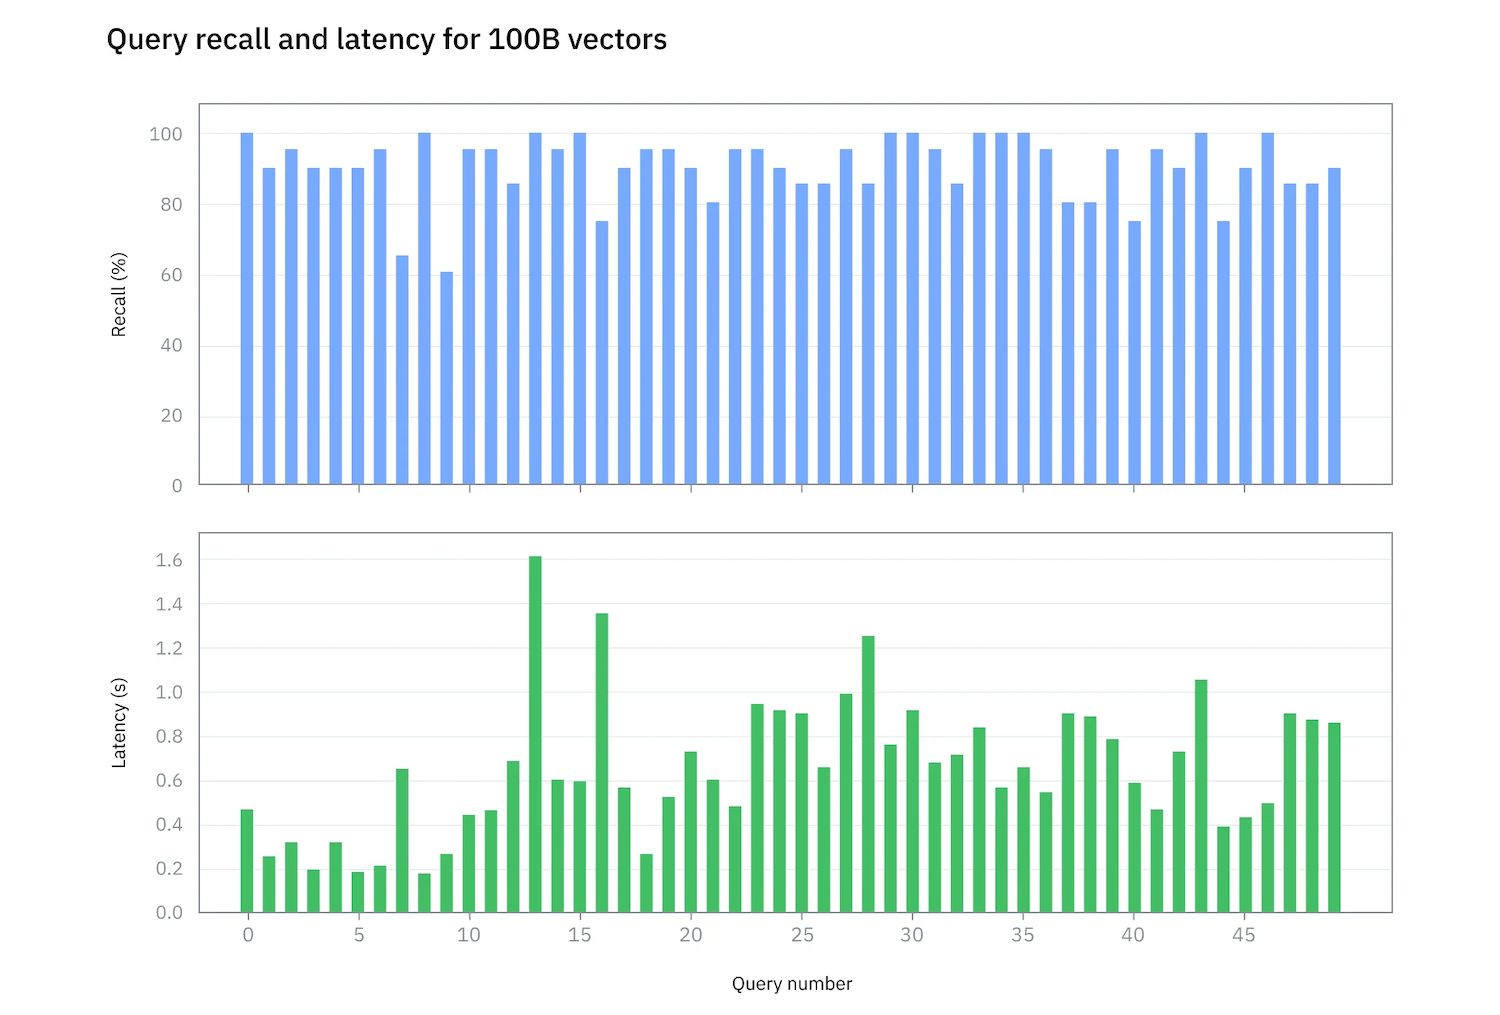
Källa: IBM
IBM Research, i samarbete med Samsung och NVIDIA, demonstrerade ett prototypsystem som kan skalas till 100 miljarder vektorer på en enda server. Systemet uppnådde över 90 procents återkallelse och precision, med en genomsnittlig frågetarens på under 700 millisekunder. Denna skala riktar sig till företagsmiljöer där datamängder kan omfatta miljarder filer och, när de väl är helt indexerade, nå hundratals miljarder vektorer.
RAG-rörledningsintegration
RAG framstår som en föredragen metod för AI för företag eftersom den förbättrar noggrannheten i utdata utan att kräva omskolning av modellen. Den fungerar genom att utöka prompter med företagsspecifik data som hämtas från en vektordatabas.
Pipelinen börjar med datainmatning, där dokument som PDF-filer och presentationer tolkas, delas upp i bitar och konverteras till inbäddningar. Dessa inbäddningar lagras i en vektordatabas som organiserar data för effektiv likhetssökning. Under frågetiden bäddas användarinmatning in och matchas mot lagrade vektorer, med relevant innehåll som skickas till språkmodellen som kontext. Denna grundmekanism minskar hallucinationer och förbättrar förtroendet för AI-genererade utdata.
IBMs CAS integrerar denna pipeline direkt i lagring, vilket konsoliderar inmatning, indexering och hämtning närmare data.
Att hantera skal- och kostnadsutmaningar
Företagslagringssystem fungerar redan i petabyte-skala. När de utökas till CAS kan varje fil generera hundratals vektorer, vilket snabbt ökar datamängden. Traditionella vektordatabaser skalas vanligtvis ut över flera servrar, vilket medför kostnader och driftskomplexitet. Indexering och omindexering av stora datamängder blir också tidskrävande.
IBMs tillvägagångssätt fokuserar på att förbättra vektordensiteten och minska indexeringskostnader för att begränsa infrastrukturspridning. Arkitekturen frikopplar vektor- och indexlagring från frågeberäkning, vilket möjliggör oberoende skalning av lagrings- och beräkningsresurser. Detta möjliggörs av IBM Storage Scale och dess högpresterande parallella filsystem.
Lagrings- och hårdvaruarkitektur
CAS-implementeringen utnyttjar IBM Storage Scale System 6000 (ESS 6000), en all-flash-plattform utformad för AI och högpresterande arbetsbelastningar. Systemet stöder upp till 48 NVMe-enheter per 4U-kabinett, med kapaciteter från 7 TB till 60 TB per enhet. Det integrerar PCIe Gen5, 400 Gb InfiniBand eller 200 Gb Ethernet-anslutning och levererar upp till 340 GB/s läs- och 175 GB/s skrivdata per nod, med upp till 7 miljoner IOPS.
Plattformen stöder även NVIDIA GPUDirect Storage, vilket möjliggör direkta datavägar mellan lagring och GPU:er, samt BlueField-3 DPU:er för avlastning av nätverk och databehandling.
Samsung PM9D3a PCIe Gen5 NVMe SSD-diskar ger hög datakapacitet och högdensitetslagring. Baserade på åttonde generationens TLC V-NAND, levererar dessa diskar upp till 30.72 TB per enhet, med sekventiella läshastigheter på upp till 12 GB/s och skrivhastigheter på upp till 6.8 GB/s. Användningen av kommersiellt tillgängliga företags-SSD-diskar gör att arkitekturen kan skalas med hjälp av standardkomponenter.
Hierarkisk indexering och GPU-acceleration
För att hantera indexering i stor skala utvecklade IBM en hierarkisk indexeringsmodell som består av flera delindex som kan optimeras oberoende av varandra. Denna struktur möjliggör stegvisa uppdateringar och lokaliserad omindexering utan att störa hela datamängden, vilket förbättrar både tillgänglighet och driftseffektivitet.
GPU-acceleration minskar indexeringstiden avsevärt jämfört med metoder med enbart CPU. Uppgifter som skulle ta timmar på processorer kan slutföras på minuter med NVIDIA GPU:er. I tester tog det 4 dagar att bygga index för 100 miljarder vektorer med 6 NVIDIA H200 GPU:er, jämfört med uppskattningsvis 120 dagar på ett system med dubbla processorsockel.
Hela datamängden, inklusive vektorer och index, förbrukade cirka 153 TiB lagringsutrymme. Initial datainläsning och partitionering tog nio dagar. Det resulterande systemet levererade en genomsnittlig frågetarens på 694 ms med 90 % återkallelse, validerat mot brute-force ground-truth-beräkningar.
färdplan
IBM och NVIDIA fortsätter att optimera plattformen med fokus på att minska indexering och frågetarens. Nuvarande mål inkluderar att indexera 100 miljarder eller fler vektorer inom en dag, minska datainmatningstiden från nio dagar till en dag och sänka frågetarensen till intervallet 50–100 millisekunder samtidigt som 90 procents återkallelse bibehålls.
Att integrera vektorindexering i standardfilsystem syftar till att förenkla driftsättning och minska hindren för AI-implementering i företag. Genom att bädda in RAG-funktioner direkt i lagring positionerar IBM CAS som ett grundläggande lager för AI-aktiverad infrastruktur.


 Amazon