

MLPerf Inference v5.1 erbjuder rigorösa riktmärken för AI-inferens för LLM, vision och multimodala uppgifter. Här är den tekniska analysen av NVIDIAs Blackwell Ultra-resultat och AMDs Instinct MI300X/MI325X/MI355X-inlämningar. Den innehåller detaljerade riktmärkesdata, programvaruoptimeringar, arkitekturstrategier och implikationer för hyperskalare och företag.
MLPerf Benchmarking Framework
MLPerf Inference-riktmärken fungerar som resultattavla för AI-acceleratorer och tillhandahåller en standardiserad, äpple-till-äpple-metod för att mäta prestanda inom bildklassificering, språkmodeller och rekommendationssystem. För företag som driftsätter GPU:er i stor skala vägleder dessa siffror ofta omfattande köpbeslut.
MLPerf-inferens styrs av MLCommons och definierar regler för stängd kontra öppen division. Scenarier inkluderar:
- Off-lineDataflödescentrerad (batchar så många frågor som möjligt).
- serverLatenskompatibel multiströmsinferens.
- InteractiveStrikt TTFT (Time-to-First-Token) och TPS (tokens per sekund @ 99:e percentilen).
Arbetsbelastningssviten v5.1 inkluderade:
- DeepSeek-R1: En 671B-expertmixmodell (stresstest för resonemangs-inferens).
- Llama-3.1-405B och 8BNyaste LLM:erna över flera inferensmetoder.
- ViskaASR ersätter RNN-T.
- Stabil diffusion XL (SD-XL)Text-till-bild-generativ AI.
- Mixtral, DLRMv2, plus äldre arbetsbelastningar som ResNet-50.
När diagram över dataflöde (tokens/sek eller samples/sek) visas, belyser de vanligtvis NVIDIAs fortsatta dominans i absoluta tal, särskilt per GPU. AMDs framsteg inom relativ effektivitet och skalningsjämnhet visar dock att de minskar gapet varv efter varv, särskilt i serverscenarier och distributioner med flera noder.
NVIDIA Blackwell Ultra-resultat
Blackwell Ultra-system uppnådde rekordhög dataflödeshastighet för alla nya arbetsbelastningar. Viktiga möjliggörare:
- NVFP4-precision: anpassad 4-bitars flyttal, accelererande DeepSeek och Llama.
- FP8 KV-cache: minnesbesparingar för uppmärksamhetslager.
- Disaggregerad servering: delad kontext kontra generationsfaser över 72 GPU:er via 1,800 XNUMX GB/s NVLink.
- Programvara: CUDA-grafer, TensorRT-LLM, ADP-balans.
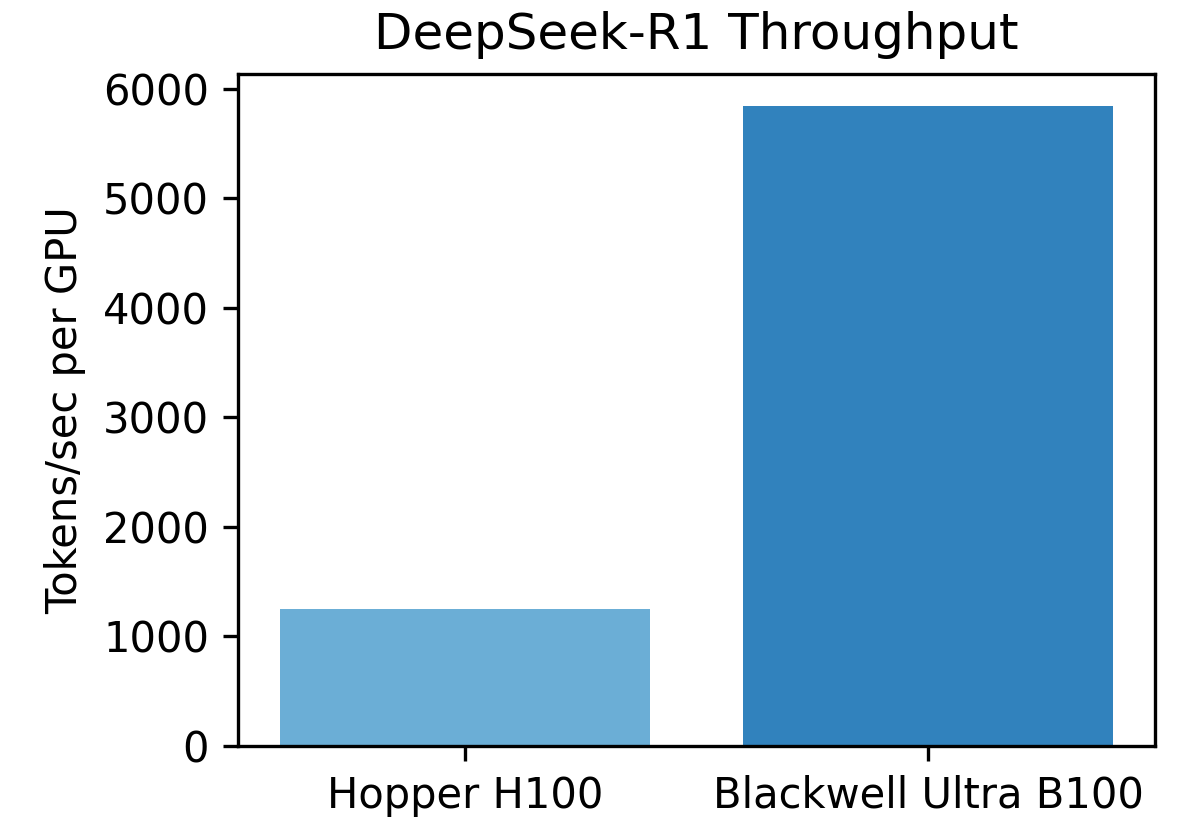
Stapeldiagrammet nedan, som jämför Hopper med Blackwell Ultra per GPU, visar en nästan 5× ökning av dataflödet på DeepSeek-R1, vilket validerar att finkorniga dataformat (NVFP4) och rackbred bandbredd skalas linjärt för massiva inferensarbetsbelastningar. En annan figur inramad kring rekordresultaten från interaktiva Llama-405B visar hur NVIDIA använder NVLink-struktur och disaggregerad servering för att bibehålla latens-SLA:er samtidigt som tidigare dataflödesgränser bryts. Slutsatsen: NVIDIA är fortfarande branschledande för ren rå hastighet och latenskänsliga arbetsbelastningar.
Resultat för AMD Instinct MI300X/MI325X/MI355X
AMD riktade in sig på effektivitet och flexibilitet:
- FP4 på MI355X: levererar 2.7× mer Llama-2-70B-genomströmning jämfört med MI325X FP8.
- Strukturerad beskärningPå Llama-405B minskade beskärningen med 21–33 % FLOP utan att påverka noggrannheten, vilket ökade genomströmningen med ~82–90 %.
- Förkalkning Jämn linjär skalning bevisad upp till 8 noder; det första heterogena klustret (4 × MI300X + 2 × MI325X) uppnådde 94 % skalningseffektivitet.
- Reproducerbarhet av ROCm-ekosystemetPartnerbidrag ligger konsekvent inom 1–3 % av AMD:s egna resultat.
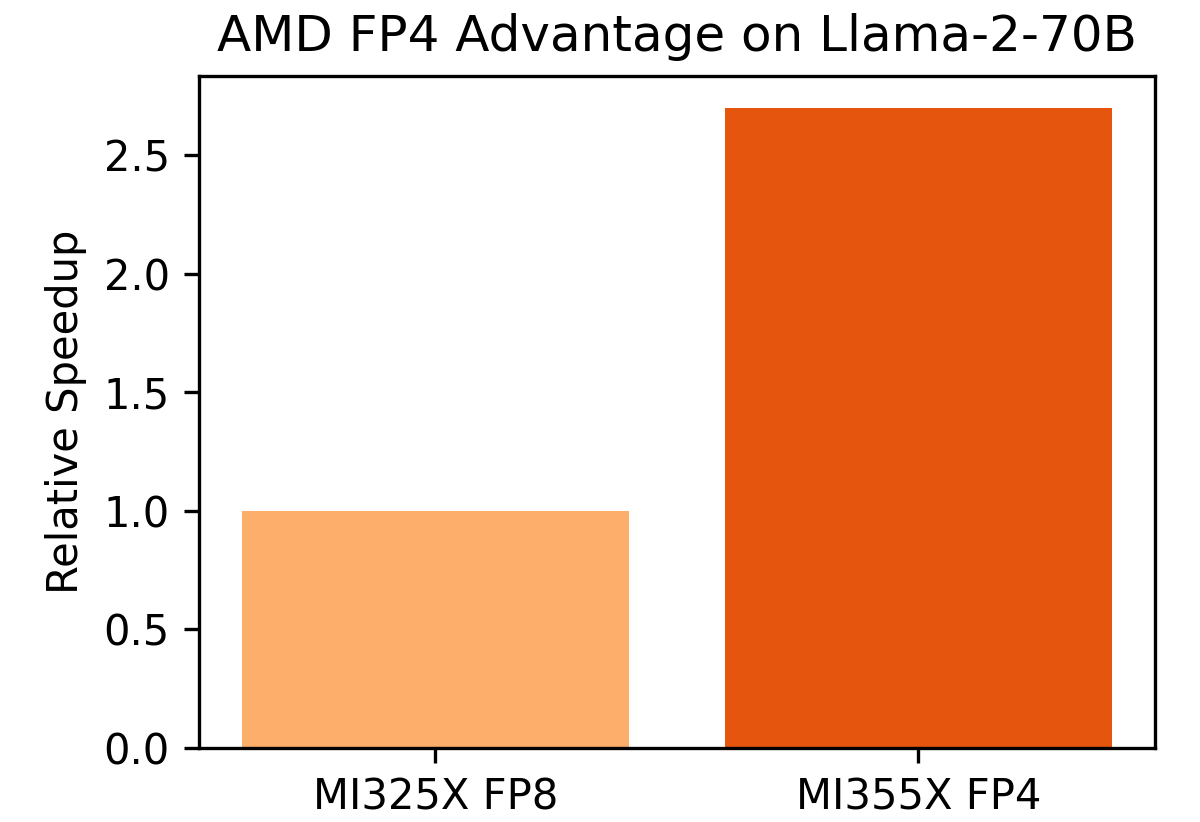
Diagrammet ovan som visar MI325X FP8 jämfört med MI355X FP4 illustrerar banbrytande FP4-fördelar, högre tokens/sekund med minimal noggrannhetsförlust, vilket bevisar att FP4 inte är experimentell utan redo för driftsättning.
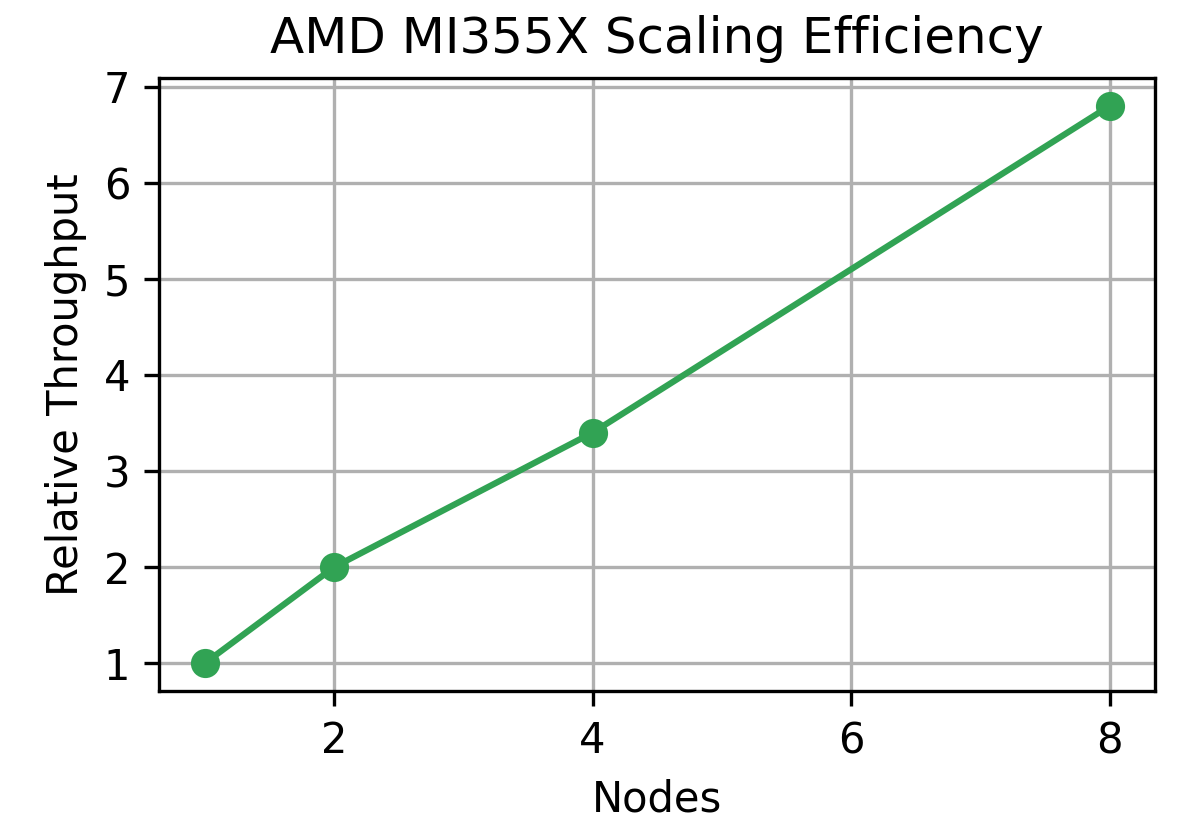
Detta diagram över skalningskurvan (1 → 8 noder) belyser nästan linjär skalning, något som hyperskalare värdesätter eftersom det leder till förutsägbara expansionskostnader. Samtidigt visar schemat för strukturerad beskärning att AMD:s fokus inte bara ligger på hårdvarubaserad brute force utan även på algoritmisk effektivitet, vilket är avgörande för verkliga inferenskluster begränsade av kraft och utrymme.
Jämförelse mellan AMD och NVIDIA
|
metrisk |
NVIDIA Blackwell Ultra |
AMD MI355X |
Anmärkningar |
Vinnare |
|
Tokens/sek per GPU |
5842 (DeepSeek-R1) |
~2200 (skalad FP4) |
Högre NVIDIA råprestanda |
NVIDIA |
|
Minne per GPU |
192 GB HBM3e |
288 GB HBM3e |
AMD passar 520B-modellen med en enda GPU |
AMD |
|
Precisionsstöd |
FP16, FP8, NVFP4 |
FP16, FP8, FP4 |
Båda 4-bitars ledningarna |
Binda fast |
|
Skalningstyg |
72 GPU NVLink |
Linjär nodskalning till 8 |
Olika skalningsstrategier |
Binda fast |
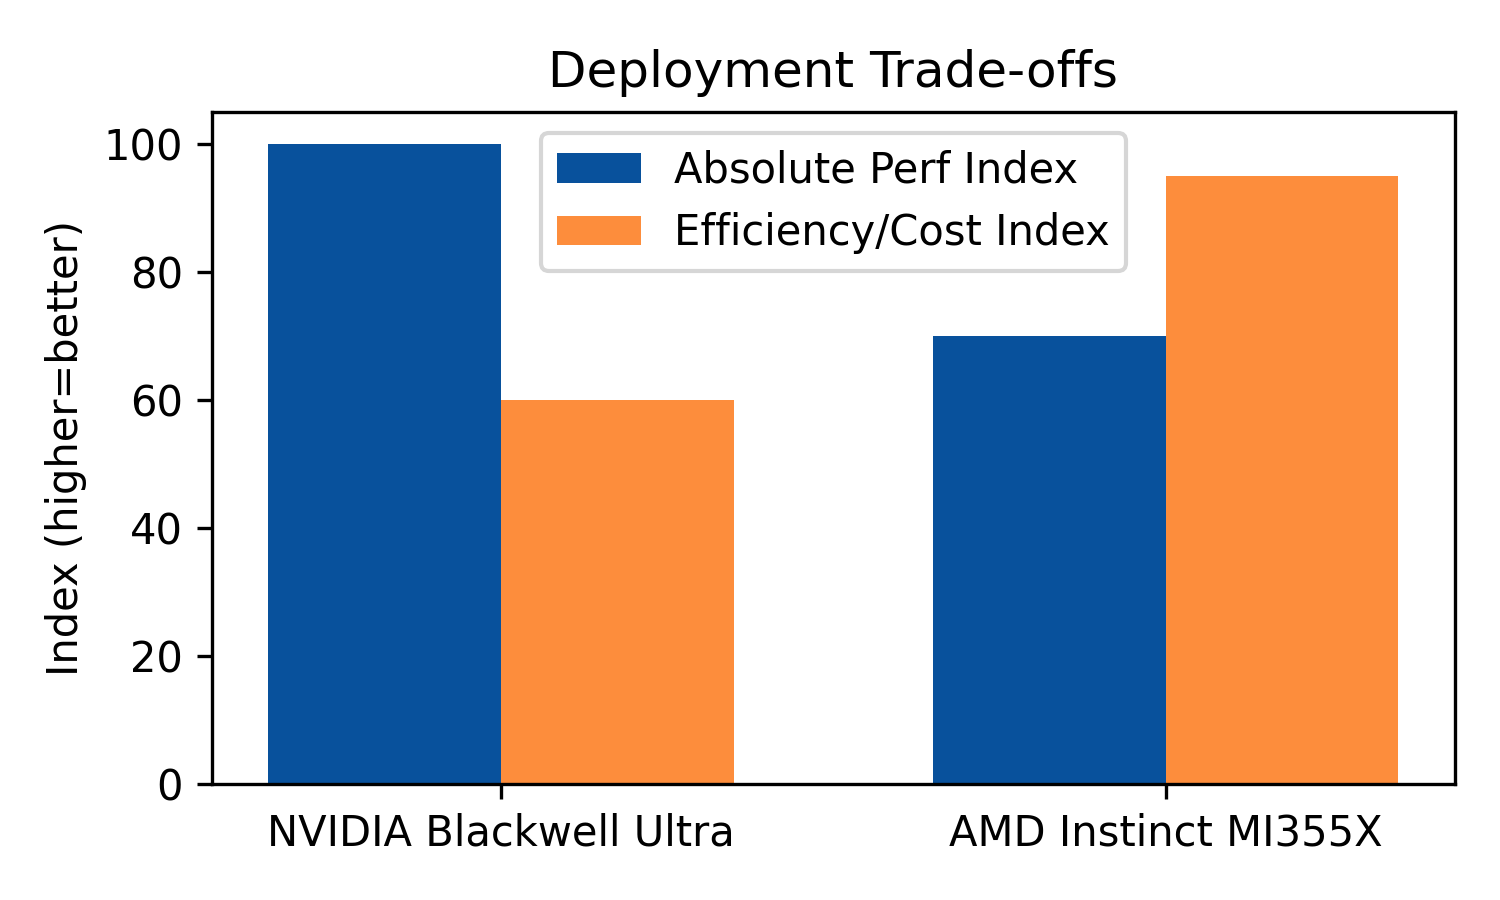
Sida-vid-sida-visualiseringar betonar avvägningarna.
- NVIDIA dominerar genomströmningen per GPU, vilket gör den idealisk för AI-fabriker där floptätheten är viktig.
- AMD, med större minne (288 GB) och FP4-beskärning, lyser där kostnad per token och distributionsflexibilitet är av största vikt.
Industrins konsekvenser
- HyperscalersNVIDIA är fortfarande det verktyg AI-fabriker väljer som jagar topprestanda. AMD:s växande effektivitetsinnovationer låser dock upp kostnadsoptimerad skalning, vilket är tilltalande för att balansera arbetsbelastningar över olika nivåer.
- MolnleverantörerFörvänta dig heterogena erbjudanden, högpresterande NVIDIA-nivåer kontra kostnadseffektiva AMD Kubernetes-podar.
- företagStrukturerad beskärning, FP4 och stöd för heterogena kluster gör det möjligt för AMD att leverera modellinferens på över 405 miljarder dollar till lägre total ägandekostnad. NVIDIAs innovationer (disaggregerad servering och Dynamo) är fortfarande fördelaktiga för latenskänsliga appar (t.ex. LLM-chattrobotar i realtid).
- FramtidsutsikterFörvänta dig universellt införande av 4-bitarsinferens som baslinje, bredare användning av heterogena GPU-pooler och nya systemdesigner inklusive NVIDIAs Rubin CPX för långa sekvenser och AMDs ROCm-expansion för att täcka fler ramverk.
NVIDIA fortsätter att sätta takten inom rå dataöverföring, med H200-GPU:er som leder inferens i ResNet-50 och BERT över stängda divisionstester. Med det sagt halkar AMDs MI300 inte långt efter, och visar konkurrenskraftiga siffror i server- och offline-scenarier samtidigt som de visar starka vinster i energieffektivitet. Den verkliga historien här är inte bara att NVIDIA ligger kvar i toppen, utan att AMD har minskat gapet avsevärt jämfört med bara en MLPerf-runda sedan. För köpare betyder det att dagarna då man bara tittade på gröna GPU:er kan vara över – ROCm mognar, och MI300 är gångbar i verkliga inferensimplementeringar.


 Amazon