

NVIDIA och Cisco tillkännagav idag planer på Ultra-Dense Small Form Factor Pluggable (USFP), ett optiskt modulformat byggt för 400 Gb/s-per-lane Ethernet i AI-strukturer. De första planerade transceivrarna placerar 16 fullduplexbanor i ett fotavtryck ungefär lika stort som en OSFP-modul, vilket motsvarar 6.4 TB/s per modul, och kontakten är utformad för att växa till 32 banor och 12.8 TB/s. NVIDIA och Cisco säger att USFP levererar 4 gånger bandbredd och frontpanelstäthet jämfört med 200 Gb/s-per-lane-pluggbara kort med cirka 1.3 gånger högre energieffektivitet.
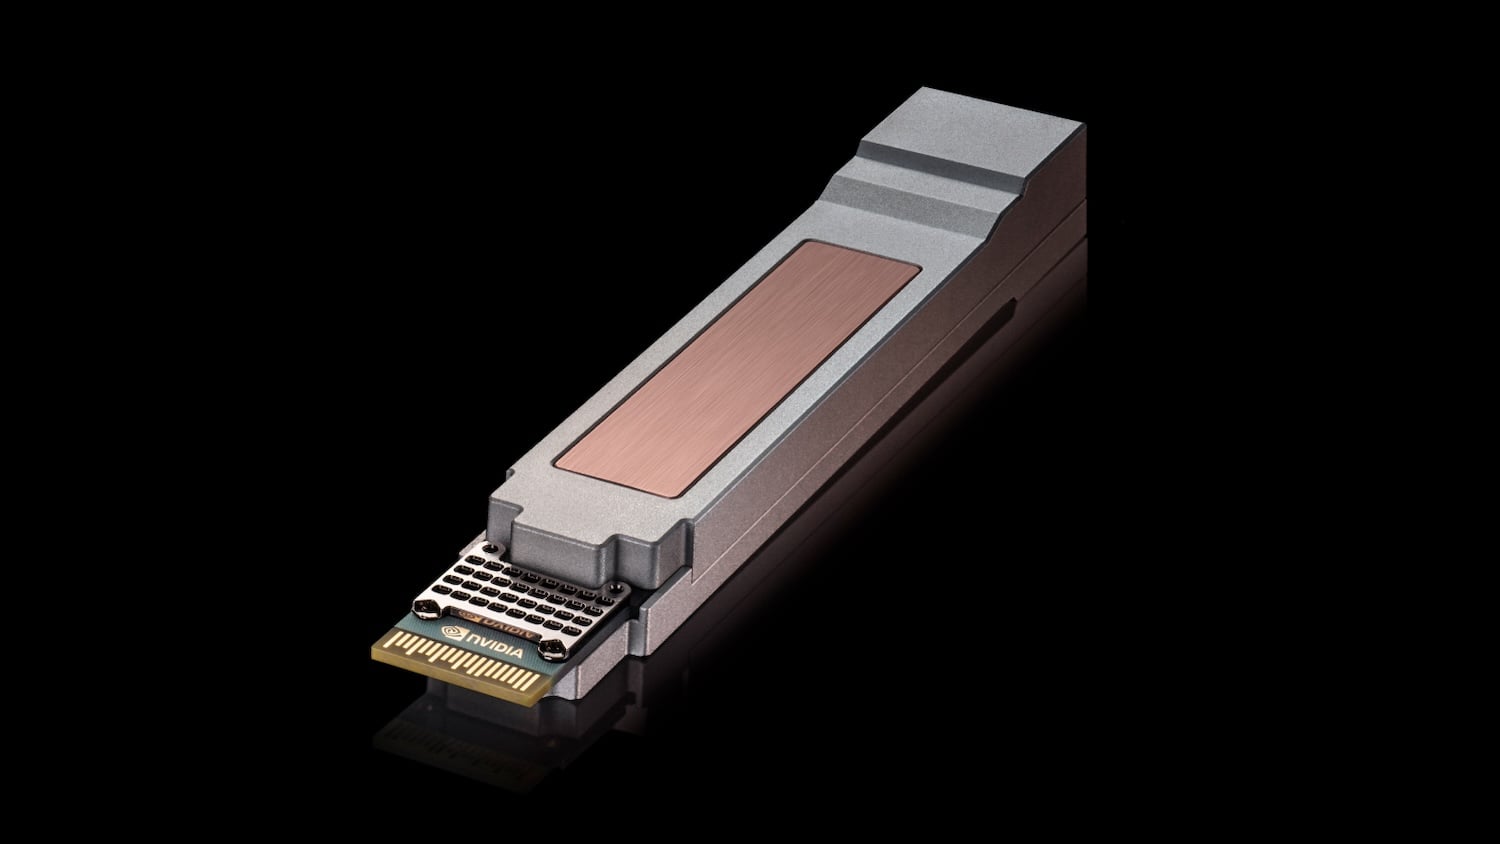
USFP är en plan utan provtagningsschema eller tillgänglighetsdatum, och NVIDIA och Cisco avser att omvandla designen till en öppen branschspecifikation genom ett samhällslett avtal med flera källor. Det är en del av en större uppsättning NVIDIA-bidrag vid OCP Global Summit som även täcker Vera Rubins rackdesigner, DSX AI-fabriksprogramvara, anläggnings- och nätspecifikationer, 800 VDC-ström och Ethernet-arbete med Meta och Google.
USFP ökar antalet banor och bandbreddsdensiteten på frontpanelen
USFP fördubblar både antalet banor och hastigheten per ban för dagens moduler, vilket NVIDIA och Cisco säger låter en switch ansluta fler 1.6 Tb/s-slutpunkter utan att lägga till en nätverksnivå. Modulerna är avsedda för både switchar och SuperNIC-kort. Företagen betraktar frontpanelstätheten som den begränsande faktorn i AI-strukturtillväxt: när en switch får slut på portar är nästa steg ytterligare ett switchlager med mer optik, vilket ökar latensen, strömförbrukningen och kostnaden. USFP behåller den inpluggbara modellen, så modulerna förblir utbytbara och servicebara i fält.
”Att bygga världens största AI-fabriker börjar med att ompröva även de minsta anslutningarna”, säger Gilad Shainer, Senior Vice President på NVIDIA. Bill Gartner, Senior Vice President och General Manager för optiska system och optik på Cisco, sa att det krävdes mer än en stegvis utökning av nuvarande moduldesigner för att kunna utöka den instickbara optiken till 400 Gb/s per fil.
En ny kontakt stöder 400 Gb/s signalering
Kontakten är en tvådimensionell kontaktmatris med en tvåstegs isättningssekvens, där höghastighetskontakterna först aktiveras efter att modulen är på plats. NVIDIA och Cisco säger att detta minskar kontaktslitage, förbättrar signalintegriteten och gör isättningskraften mer förutsägbar. Kontakten är konstruerad för 400 Gb/s per fil och förbättrar, enligt företagen, även prestandan vid 200 Gb/s per fil.
En USFP-modul kan förbruka upp till 100 W utan en dedikerad kylkrets inuti transceivern, vilket enligt företagen förenklar switchdesignen och förbättrar tillförlitligheten. Varje USFP-konfiguration stöder optiska designer som förenklar signalbehandling för att minska latens och effekt, och formatet tillgodoser en rad olika optiska tekniker och räckviddsklasser. NVIDIA och Cisco samarbetar med TE Connectivity och Amphenol kring burar, kontakter och moduler, och fler partners förväntas, och bygger vidare på deras befintliga interoperabilitetsarbete mellan NVIDIA Spectrum-X och Cisco Silicon One-baserade Ethernet-nätverk.
MGX 1.2 utökar Vera Rubins rackinfrastruktur
NVIDIA bidrog med sina Vera Rubin -rack- och datorfacksdesigner till OCP genom sin öppna MGX-arkitektur, som en del av tredje generationens MGX-referensdesign i OCP:s Open DC Initiative, tillsammans med de öppna vätskekylningsdesignerna MQD och MQDB. MGX 1.2-specifikationen lägger till rackskalig blind-mate-vätskekylning, interoperabel rackskalig sammankopplingsinfrastruktur och en vätskekyld 5 000 A samlingsskena, med inbyggt stöd för 19-tumsutrustning och rackinstallationer upp till 250 kW.
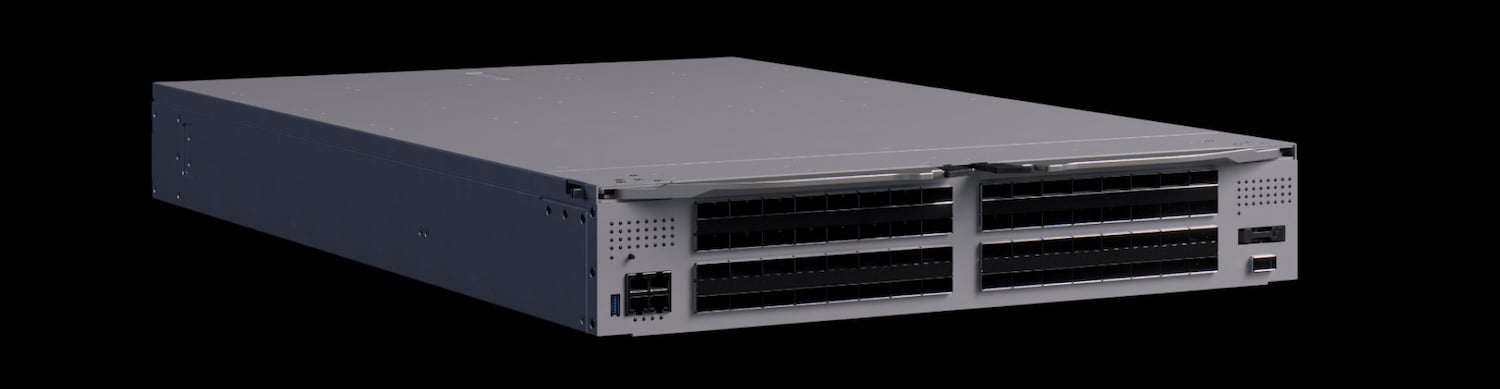
Konfigurerbara I/O-fack, fläktlösa vätskekylda datorbrickor och standardiserade gränssnitt för strömförsörjning och kylning kompletterar specifikationen, och NVIDIA säger att de gemensamma gränssnitten förkortar monterings-, test- och servicetider för partners. En separat Vera CPU- rackdesignspecifikation utökar MGX bortom accelererad databehandling. NVIDIA positionerar Vera Rubin NVL72 som plattformen för storskalig träning och inferens, och Vera CPU-racket för verktygsanrop, orkestrering och sandlådebaserad exekvering som agentiska arbetsbelastningar tillför.
DSX OS lägger till komponenter för nätverks-, rack- och klusterhantering
NVIDIA utökade DSX OS, det öppna operativa lagret i sin DSX AI-fabriksplattform, med fyra komponenter med öppen källkod. NVIDIA Config Manager automatiserar konfiguration, validering och underhåll av switchar över AI-strukturer. NVIDIA Cluster Readiness Engine stresstestar GPU-kluster med arbetsbelastningssimuleringar innan träningen startar, vilket enligt NVIDIA upptäcker hårdvaruproblem som annars skulle misslyckas med jobb.

NVIDIA Rack Management Service behandlar racket som en enhet för driften, med hårdvaruabstraktion och firmwarehantering på den nivån. Cluster API Provider för NVIDIA Infrastructure Controller hanterar driftsättning på bara metall och onboarding av hyresgäster, och NVIDIA hävdar att de omvandlar rå hårdvara till produktionsklara kluster på några timmar. Komponenterna kommer från NVIDIAs erfarenhet av att köra DGX Cloud, och de är avsedda att låta molnleverantörer och mjukvarupartners integrera AI-fabriksdrift i plattformar med flera hyresgäster.
Öppna specifikationer täcker anläggningsdesign och nätåterställning
NVIDIA, AMD, Google och Meta publicerade Open Data Center Specification v0.7, en gemensam anläggningsritning som täcker kraftarkitektur, kylning och fysisk layout som utrustningstillverkare, colocation-leverantörer och operatörer kan designa utifrån. Google, Meta, Microsoft och NVIDIA publicerade också OCP Grid Resilience Specification, som definierar hur stora AI-anläggningar ska klara av störningar i elnätet: förbli uppkopplade, svara automatiskt och återgå till nästan full belastning på under två sekunder. NVIDIA säger att båda specifikationerna överensstämmer med deras DSX-referensdesign.
Visionbay presenterade planer för K-1, en AI-fabriksplattform som parar ihop NVIDIAs 800 VDC -referensarkitektur med Vertivs kraft- och värmeutrustning för framtida Vera Rubin-distributioner. K-1 flyttar AC-till-DC-konvertering till kraftcenter på klusternivå och distribuerar 800 VDC närmare beräkningssystemet, med etappvis införande av 800 VDC, vätskekylning och modulär expansion, och Visionbay har inte angett något distributionsdatum.
Meta använder Spectrum-6 och flerplansnätverk
Meta kommer att använda NVIDIA Spectrum-6 102.4Tb/s Ethernet för sina Vera Rubin AI-fabriker. NVIDIA säger att Spectrum-6 fördubblar switchkapaciteten och bandbredden per fil jämfört med Spectrum-4, med en hastighet på 200G per fil med prestandaisolering mellan jobb. Metas Spectrum-6-baserade N-IceCube-switch monteras i deras vätskekylda rack IcePack 100T och kör FBOSS, Metas öppna switchprogramvara, som använder OCP Switch Abstraction Interface för leverantörsoberoende kontroll av hårdvaran.
Spectrum-X Multiplane parar ihop Spectrum-6-switchar med ConnectX-9 SuperNIC-kretsar och sprider GPU-trafik i hårdvara över upp till åtta oberoende nätverksplan. NVIDIA säger att designen skalar bortom 100 000 GPU:er med färre switchnivåer, och när en komponent går sönder flyttas trafiken till de återstående planen så att jobb fortsätter med reducerad bandbredd. Meta och NVIDIA säger att de har validerat förbättringarna i motståndskraft lokalt och i molnet, utan att publicera siffror.
Google Falcon Transport siktar på framtida NVIDIA-nätverkshårdvara
NVIDIA och Google tillkännagav Falcon Transport-stöd för framtida NVIDIA ConnectX-10 SuperNIC och BlueField DPU:er. Falcon levererar tillförlitlig data över Ethernet genom flervägsbelastningsbalansering, programmerbar överbelastningskontroll, hårdvarubaserad förluståterställning och säkerhet per anslutning. NVIDIA implementerar det med hårdvaruacceleration och DOCA-programvara, så att NVIDIA och Googles NIC använder en gemensam transportlösning medan applikationer behåller standard RDMA-gränssnitt. Företagen säger att detta förbättrar bandbreddsutnyttjandet och prestandaförutsägbarheten för AI- och lagringstrafik i takt med att Ethernet-strukturer skalas upp.
Cisco levererar Silicon One G300-system och lägger till en 51.2T Top-of-Rack-del
Cisco använde samma OCP-meddelande för att uppdatera sin egen kiselserie. 102.4 Tb/s Silicon One G300 testas nu och de första G300-baserade systemen levereras till kunder, och Cisco har lagt till G302, en 51.2 Tb/s switch-ASIC med 200G SerDes byggd för top-of-rack-system med 1.6 T optik och direkt-till-chip-vätskekylning, som beräknas levereras före slutet av 2026. Cisco säger också att deras 51.2 Tb/s P200 djupbuffertroutingkisel nu är i produktion hos hyperskalare: Microsoft har flyttat P200-system till produktion, och Alibaba Cloud har driftsatt sin egen Quantum Cat-router på P200 över sin eCORE-stamkedja, med SONiC.
Resten av Cisco-listan är i drift. Cisco 8001 är en hanteringsswitch på Silicon One A100 i 10G- och 1G-versioner som tar SONiC till out-of-band-nätverket, så att operatörer kan köra en uppsättning API:er och automatisering från fabric ner till racket. Cisco-validerade SONiC levereras med Nexus One-arkitekturen, och ett Live Protect-alternativ som korrigerar avslöjade sårbarheter vid körning innan den permanenta fixen är planerad till mitten av 2027. Cisco är medlem i ESUN och säger att de arbetar med 1.0-specifikationen för skalbara nätverk.


 Amazon